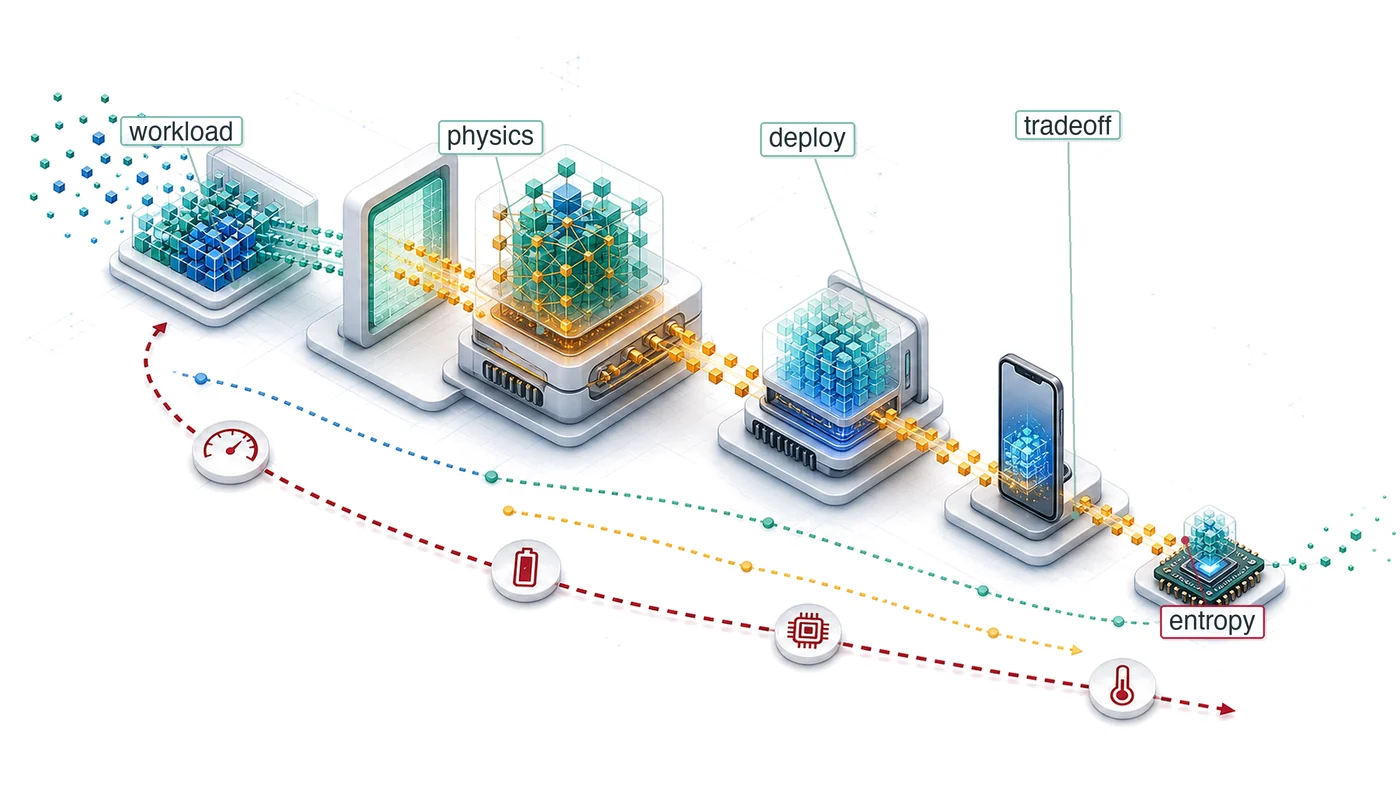
Framework về mô hình triển khai
Hệ thống ML
Mục đích
Tại sao việc triển khai cùng một mô hình lên điện thoại so với một trung tâm dữ liệu lại đòi hỏi kỹ thuật khác biệt về cơ bản?
Nhận thức cốt lõi của kỹ thuật hệ thống ML là: các ràng buộc quyết định kiến trúc. Tốc độ ánh sáng đặt ra giới hạn tuyệt đối cho tốc độ phản hồi của các máy chủ ở xa. Nhiệt động lực học giới hạn lượng tính toán có thể thực hiện trong một thể tích trước khi nhiệt trở nên không kiểm soát được. Vật lý bộ nhớ khiến việc di chuyển dữ liệu thường tốn kém hơn xử lý. Đây không phải những hạn chế kỹ thuật đang chờ công nghệ tốt hơn; chúng là các ranh giới vật lý vĩnh viễn, phân chia thế giới thành những chế độ vận hành khác biệt về bản chất. Một trung tâm dữ liệu có thể huấn luyện các mô hình hàng tỷ tham số nhưng không thể đảm bảo phản hồi với độ trễ thấp cho người dùng ở cách xa hàng nghìn dặm. Một điện thoại thông minh có thể phản hồi tức thì nhưng chỉ có một phần nhỏ ngân sách bộ nhớ. Một vi điều khiển có thể chạy bằng pin cúc áo trong nhiều năm nhưng gần như chỉ đủ tính toán cho một bộ phát hiện từ khóa đơn giản. Cùng một mô hình, cùng một thuật toán áp dụng trên cùng một dữ liệu vẫn đòi hỏi kỹ thuật hoàn toàn khác nhau ở mỗi chế độ — không phải vì các định luật vật lý thay đổi, mà vì những ràng buộc khác nhau lên ngôi chi phối. Những nhóm xem triển khai là chuyện tính sau — huấn luyện trong một môi trường rồi để dành ràng buộc mục tiêu tới sát ngày ra mắt — sẽ nhận ra quá muộn rằng môi trường mục tiêu khiến hàng tháng quyết định kiến trúc trở nên vô hiệu. Vì vậy, nhiệm vụ kỹ thuật không phải tìm ra một cách triển khai “tốt nhất cho mọi nơi”, mà là xác định ràng buộc đang chi phối trong chế độ vận hành dự kiến. Theo thuật ngữ D·A·M, hiểu các chế độ này biến triển khai từ một chi tiết vận hành thành một bài toán đồng thiết kế bậc nhất, nơi tính cục bộ của dữ liệu, cấu trúc thuật toán và các ràng buộc của máy cùng quyết định những gì khả thi.
Learning Objectives
- Giải thích cách các ràng buộc vật lý tạo ra các mô hình triển khai từ đám mây đến TinyML.
- Áp dụng quy luật sắt và nguyên tắc nút thắt cổ chai để phân loại các khối lượng công việc (workload) bị giới hạn bởi tính toán, bộ nhớ và I/O.
- Đối sánh các kiểu khối lượng công việc (workload) điển hình với các mô hình triển khai, qua các ví dụ mô hình tiêu biểu (lighthouse).
- So sánh đám mây, edge, di động và TinyML theo các ràng buộc vận hành và những đánh đổi định lượng.
- Áp dụng framework quyết định để chọn mô hình triển khai dựa trên các ràng buộc về quyền riêng tư, độ trễ, năng lực tính toán và chi phí.
- Phân tích các mẫu lai (hybrid patterns) kết hợp nhiều mô hình triển khai để đáp ứng các ràng buộc của hệ thống.
- Đánh giá các quyết định triển khai, những sai lầm thường gặp và các nguyên tắc chung có thể áp dụng ở nhiều quy mô khác nhau.
Hãy xem xét hai trường hợp cực đoan: một bộ phát hiện từ đánh thức trên đồng hồ thông minh và một công cụ đề xuất trong trung tâm dữ liệu. Bộ phát hiện từ đánh thức đại diện cho một khối lượng công việc (workload) TinyML hoạt động với mức công suất chỉ vài miliwatt và giới hạn bộ nhớ kilobyte; trong khi đó, công cụ đề xuất là ví dụ điển hình cho một khối lượng công việc (workload) ML trên đám mây, đòi hỏi hàng terabyte bảng embedding và hạ tầng quy mô megawatt. Các hệ thống này giải quyết những vấn đề khác nhau dưới các ràng buộc vật lý đối lập, và hạ tầng hỗ trợ của chúng cũng khác biệt rõ rệt về quy mô và thiết kế. Thực tế này biến việc triển khai từ một yếu tố thường bị xem nhẹ trong vận hành thành một quyết định kỹ thuật hàng đầu. Phân loại D·A·M, như được minh họa trong Bức tranh giao thoa D·A·M, giúp chúng ta lý giải điều này bằng cách đặt hạ tầng lên cùng hàng với dữ liệu và thuật toán.
Các ràng buộc vật lý quyết định nơi một mô hình ML có thể chạy và định hình khả năng thực hiện theo cách mà không lựa chọn thuật toán nào có thể thay đổi. Tuy nhiên, việc triển khai khó hơn nhiều so với vẻ ngoài, và lý do không nằm ở bản thân mô hình. Trong các hệ thống ML thực tế (production), mô hình thường chỉ là một phần nhỏ của toàn bộ hệ thống (Sculley et al. 2015). Hạ tầng xung quanh gồm thu thập dữ liệu, xử lý đặc trưng, hạ tầng phục vụ (serving), giám sát và quản lý tài nguyên. Tất cả những yếu tố này thay đổi đáng kể tùy nơi mô hình được thực thi.
Công suất sử dụng trải rộng trên các mô hình triển khai, từ mức megawatt (đám mây) đến miliwatt (TinyML).
Shi, Weisong, Jie Cao, Quan Zhang, Youhuizi Li, and Lanyu Xu. 2016. “Edge Computing: Vision and Challenges.” IEEE Internet of Things Journal 3 (5): 637–46. https://doi.org/10.1109/jiot.2016.2579198.
Các ràng buộc vật lý của từng môi trường (độ trễ, công suất và bộ nhớ) buộc ta phải triển khai ML theo bốn mô hình khác nhau, mỗi mô hình có những đánh đổi kỹ thuật và mẫu thiết kế hệ thống riêng. ML trên đám mây tập trung tài nguyên tính toán ở các trung tâm dữ liệu, cung cấp năng lực tính toán co giãn và lưu trữ quy mô lớn, nhưng phải đánh đổi bằng độ trễ mạng. ML ở Edge đưa việc tính toán đến gần nơi dữ liệu được tạo ra, giúp giảm độ trễ trên đường truyền từ xa và hạn chế truyền dữ liệu nhạy cảm (Shi et al. 2016). ML trên thiết bị di động mang trí tuệ trực tiếp lên điện thoại thông minh và máy tính bảng, cân bằng giữa khả năng tính toán với thời lượng pin và giới hạn tỏa nhiệt. TinyML đưa trí tuệ vào các vi điều khiển có giá vài đô la và tiêu thụ vài miliwatt (Janapa Reddi et al. 2022). Phạm vi công suất từ megawatt đến miliwatt trải dài chín bậc độ lớn, còn các hệ thống tiêu biểu ở figure 1 thì trải dài gần tám bậc. Hình này đặt năm tầng triển khai—từ các cảm biến siêu tiết kiệm năng lượng ở bên trái đến các trung tâm dữ liệu kiểu nhà kho ở bên phải—qua đó chỉ ra vùng giao nhau giữa các phạm vi hoạt động của TinyML, AI ở Edge và AI trên đám mây.

Trong khi figure 1 minh họa cấu trúc định tính của trí tuệ phân tán, table 1 định lượng các bao hoạt động theo vị trí xử lý, độ trễ khứ hồi, mức tiêu thụ công suất và dung lượng bộ nhớ. Phạm vi công suất chín bậc độ lớn này phản ánh ba giới hạn vật lý không thể tránh: tốc độ ánh sáng (ấn định ngưỡng độ trễ tối thiểu), giới hạn tản nhiệt theo nhiệt động học (giới hạn khả năng tính toán trên mỗi watt) và năng lượng tín hiệu bộ nhớ (bức tường bộ nhớ).
| Mô hình | Nơi | Độ trễ (ms) | Công suất | Bộ nhớ | Tốt nhất cho |
|---|---|---|---|---|---|
| Cloud ML | Trung tâm dữ liệu | 100-500 | MW | TB | Huấn luyện, suy luận phức tạp |
| Edge ML | Máy chủ cục bộ | 10-100 | 100 W | GB | Suy luận thời gian thực, quyền riêng tư |
| Mobile ML | Điện thoại thông minh | 5-50 | 3–5 W | GB | AI cá nhân, ngoại tuyến |
| TinyML | Vi điều khiển | 1-10 | mW | KB | Cảm biến luôn bật |
Nền tảng kiến trúc: Ngăn xếp một nút
Để điều hướng các chế độ vận hành này, chúng tôi đặt các quyết định kỹ thuật của mình dựa trên một mô hình bốn lớp của ngăn xếp một nút, mô hình này tinh chỉnh phía máy của phân loại D·A·M cho một máy chủ, trong khi dữ liệu và thuật toán đi vào qua các yêu cầu của khối lượng công việc (workload). Ở lớp trên cùng của ngăn xếp, ứng dụng xác định nhiệm vụ thông qua mục tiêu thông lượng huấn luyện hoặc độ trễ suy luận. Huấn luyện mô hình và Phục vụ mô hình phát triển các cơ chế để xác định liệu hệ thống có đáp ứng được mục tiêu đó hay không. ML framework chuyển mã mô hình thành các thao tác có thể thực thi (Các Framework ML). Hệ điều hành điều phối tài nguyên và luân chuyển dữ liệu giữa bộ nhớ máy chủ và bộ nhớ bộ tăng tốc. Bản thân phần cứng, được xác định bởi dung lượng bộ nhớ băng thông cao (HBM), băng thông bộ nhớ, các liên kết nội nút như NVLink và thông lượng tính toán, đặt ra các giới hạn vật lý, với “bức tường bộ nhớ” là một ràng buộc lặp đi lặp lại (Tăng tốc phần cứng).
Ngăn xếp này thiết lập hợp đồng silicon cho chương này: đó là một cam kết hiệu suất cố định mà một mảnh silicon cụ thể cung cấp cho một mô hình, được xác định bởi băng thông bộ nhớ, tốc độ tính toán đỉnh và chi phí cố định. Mỗi chương trong nửa đầu cuốn sách này xem xét một hoặc nhiều lớp, vì hiểu cách chúng tương tác trong một máy đơn là điều kiện tiên quyết về mặt kỹ thuật để làm chủ các hệ thống phân tán ở quy mô lớn hơn.
Những ràng buộc vật lý này tương tác với định luật sắt của các hệ thống ML (Định luật sắt của hệ thống ML), định luật tách độ trễ đầu-cuối thành di chuyển dữ liệu, tính toán và phần phụ trợ. Các môi trường triển khai khác nhau nhấn mạnh các ràng buộc khác nhau: huấn luyện trên đám mây có thể bị giới hạn bởi tính toán, hệ thống di động đối mặt với giới hạn về công suất, và thiết bị TinyML thường chạm trần dung lượng bộ nhớ. Khi ghép các ràng buộc vật lý với định luật sắt, chúng tôi xây dựng một vốn từ vựng định lượng để lý giải mô hình nào phù hợp với một khối lượng công việc (workload) cụ thể và tại sao. Để neo phân tích này vào các ví dụ cụ thể, chương giới thiệu năm mô hình hải đăng (ResNet-50, GPT-2, DLRM cho khuyến nghị sử dụng nhiều embedding, MobileNetV2, và một bộ phát hiện từ khóa cho nhận diện từ kích hoạt) bao phủ toàn bộ phổ triển khai và làm rõ các nút thắt hệ thống khác nhau. Các khối lượng công việc (workload) tham chiếu này sẽ xuất hiện xuyên suốt cuốn sách, tạo cơ sở nhất quán để so sánh các kỹ thuật tối ưu hóa giữa các chương, các khối lượng công việc (workload) và các tầng triển khai.
Trước hết là phần vật lý tạo nên các ranh giới giữa những mô hình này, tiếp theo là các công cụ phân tích (định luật sắt, nguyên tắc nút thắt, các nguyên mẫu khối lượng công việc (workload)) để ánh xạ các khối lượng công việc (workload) tới các mục tiêu triển khai. Mỗi mô hình sau đó sẽ được phân tích chuyên sâu về hạ tầng, các đánh đổi và các khối lượng công việc (workload) tiêu biểu, đồng thời chỉ ra cách lựa chọn giữa chúng khi một hệ thống có thể chạy trên hơn một mô hình. Chương kết lại bằng một khung quyết định so sánh và các kiến trúc lai kết hợp nhiều mô hình khi không có một mục tiêu triển khai đơn lẻ nào đáp ứng được tất cả yêu cầu.
Các ràng buộc vật lý: Vì sao các mô hình tồn tại
Một hệ thống an toàn với ngân sách phản hồi 10 ms không thể chờ một chuyến đi khứ hồi xuyên quốc gia. Tương tự, một mô hình hàng tỉ tham số không thể nhồi vào một vi điều khiển chỉ nhờ viết mã tốt hơn. Đây không phải lỗi triển khai; đó là hệ quả của các định luật vật lý về tốc độ ánh sáng, nhiệt động lực học liên quan đến công suất, và truyền tín hiệu bộ nhớ. Hệ thống chạy ở đâu sẽ định hình lại ‘hợp đồng silicon’ giữa mô hình và phần cứng. Ba ràng buộc sau chi phối các đánh đổi kỹ thuật phía trước: rào cản ánh sáng, bức tường công suất, và bức tường bộ nhớ.1
1 Mô hình triển khai: Một chế độ vận hành riêng, với ranh giới do các quy luật vật lý đặt ra chứ không phải tập quán. Phổ từ đám mây đến TinyML trải dài chín bậc độ lớn về công suất vì các ràng buộc nhiệt động lực học và điện từ tạo nên những bức tường cứng mà tối ưu hóa phần mềm không thể vượt qua, buộc mỗi tầng phải có kiến trúc hệ thống khác biệt rõ rệt. Xác định sai ranh giới mô hình triển khai sẽ lãng phí công sức kỹ thuật: tối ưu hóa một mô hình đám mây để tăng thông lượng thêm 5% là vô nghĩa nếu ứng dụng có ngân sách độ trễ 10 ms và đòi hỏi triển khai tại edge.
Rào cản ánh sáng
Rào cản ánh sáng đặt ra giới hạn dưới tuyệt đối cho độ trễ2. Gọi \(\text{Distance}\) là chiều dài quãng đường truyền một chiều và \(c_{\text{fiber}}\) là tốc độ truyền tín hiệu trong sợi quang. Equation 1 cho ta thời gian khứ hồi tối thiểu: \[L_{\text{lat,min}} = \frac{2 \times \text{Distance}}{c_{\text{fiber}}} \approx \frac{2 \times \text{Distance}}{200{,}000 \text{ km/s}} \tag{1}\] Đối với sợi quang, \(c_{\text{fiber}} \approx 200{,}000\) km/s, xấp xỉ hai phần ba giá trị của nó trong chân không, vì ánh sáng truyền qua thủy tinh chậm hơn so với trong chân không.
2 Độ trễ: Khoảng thời gian từ lúc gửi yêu cầu đến khi nhận được kết quả, tương ứng với \(T\) trong định luật sắt. Rào cản ánh sáng khiến mức sàn này không thể hạ thấp: tốc độ ánh sáng trong sợi quang tạo ra một tối thiểu khoảng 36 ms cho vòng khứ hồi xuyên lục địa Hoa Kỳ, và chỉ riêng quãng đường đã ăn hết toàn bộ ngân sách độ trễ 10 ms của một hệ thống an toàn tới hạn trước khi kịp thực hiện bất kỳ phép tính nào. Mỗi mili giây mất vì khoảng cách là một mili giây không còn dành cho suy luận mô hình, nên rào cản ánh sáng buộc phải lựa chọn cách tiếp cận triển khai phù hợp thay vì chỉ tối ưu hóa.
Từ California đến Virginia (khoảng ~3,600 km đường chim bay) mất ~36 ms round-trip trước khi kịp bắt đầu tính toán. Các dịch vụ thực tế còn cộng thêm độ trễ do định tuyến, giao thức, xếp hàng và xử lý. Các ứng dụng cần phản hồi dưới 10 ms không thể dùng hạ tầng đám mây đặt ở xa—vật lý không cho phép. Ràng buộc này tạo ra nhu cầu về edge ML và TinyML: khi ngân sách độ trễ rất chặt, việc tính toán phải được đưa lại gần nguồn dữ liệu.
Bức tường công suất
Bức tường công suất xuất hiện vì nhiệt động lực học giới hạn lượng tính toán có thể diễn ra trong một thể tích nhất định. Công suất CMOS động tuân theo equation 2, trong đó \(C\) là điện dung hiệu dụng, \(V\) là điện áp và \(f\) là tần số xung nhịp. Nếu giữ điện dung hiệu dụng \(C\) không đổi trong một phạm vi hoạt động cục bộ nơi điện áp tăng tỷ lệ thuận với tần số \((V \propto f)\), thì công suất động sẽ tăng theo \(f^3\). Mối quan hệ bậc ba này xuất hiện khi đẩy tần số xung nhịp vượt quá ngưỡng danh định, buộc phải tăng điện áp cung cấp để duy trì tốc độ chuyển mạch của transistor. Khi việc tỉ lệ hóa điện áp dừng lại ở ngưỡng danh định, công suất động tỷ lệ tuyến tính với tần số, nhưng các ràng buộc tản nhiệt vẫn ngăn cản việc tăng liên tục tần số xung nhịp. \[\text{Power} \propto C \times V^2 \times f \quad \text{where } V \propto f \implies \text{Power} \propto f^3 \tag{2}\]
Theo giả định minh họa này, tăng gấp đôi tần số xung nhịp đòi hỏi công suất động lớn hơn khoảng 8\(\times\). Sự đổ vỡ của tỉ lệ hóa điện áp trên diện rộng3 đã chấm dứt các mức tăng tốc độ xung nhịp “miễn phí” và buộc ngành công nghiệp chuyển sang song song hóa (đa lõi) và chuyên môn hóa (GPU, Tensor Processing Units (TPU)). Các thiết bị di động chạm tới giới hạn nhiệt nghiêm ngặt ở 3–5 W; vượt quá mức này dẫn đến “tiết lưu” (throttling), khi thiết bị giảm hiệu suất để tránh quá nhiệt. Trên thực tế, điều này nghĩa là một mô hình di động chạy ở 60 FPS trong 1 minute có thể bị tiết lưu xuống 15 FPS khi thiết bị nóng lên. Giới hạn vật lý này làm nảy sinh ML trên thiết bị di động: các thiết bị chạy bằng pin không thể đơn giản chạy cục bộ các mô hình ở quy mô đám mây.
3 Dennard scaling: Được đặt theo tên Dennard et al. (1974) tại IBM, người đã mô tả các quan hệ tỉ lệ của MOSFET, theo đó khi thu nhỏ thiết bị có thể giảm điện áp và dòng điện trong khi vẫn giữ mật độ công suất ở mức xấp xỉ kiểm soát. Khi tỉ lệ hóa điện áp chậm lại và năng lượng trở thành một ràng buộc kiến trúc quan trọng hàng đầu, tăng trưởng hiệu suất chuyển dịch sang song song hóa và chuyên môn hóa: bộ xử lý đa lõi, GPU và TPU (Hennessy and Patterson 2019; Esmaeilzadeh et al. 2011).
Dennard, Robert H., Frank H. Gaensslen, Hwa-Nien Yu, Victor L. Rideout, Elias Bassous, and Antoine R. LeBlanc. 1974. “Design of Ion-Implanted MOSFET’s with Very Small Physical Dimensions.” IEEE J. Solid-State Circuits 9 (5): 256–68. https://doi.org/10.1109/jssc.1974.1050511.
Hennessy, John L., and David A. Patterson. 2019. “A New Golden Age for Computer Architecture.” Communications of the ACM 62 (2): 48–60. https://doi.org/10.1145/3282307.
Esmaeilzadeh, Hadi, Emily Blem, Renee St. Amant, Karthikeyan Sankaralingam, and Doug Burger. 2011. “Dark Silicon and the End of Multicore Scaling.” Proceedings of the 38th Annual International Symposium on Computer Architecture, 365–76. https://doi.org/10.1145/2000064.2000108.
Bức tường bộ nhớ
Bức tường bộ nhớ (Wulf and McKee 1995) phản ánh khoảng cách băng thông4 ngày càng rộng. Một minh họa đơn giản ở mức sách giáo khoa, dùng các hệ số tăng trưởng hàng năm đại diện, cho thấy vì sao khoảng cách này tích lũy theo thời gian: \[\frac{\text{Compute Growth Rate}}{\text{Memory Bandwidth Growth Rate}} \approx \frac{1.6}{1.2} \approx 1.33 \tag{3}\]
Wulf, Wm. A., and Sally A. McKee. 1995. “Hitting the Memory Wall: Implications of the Obvious.” ACM SIGARCH Computer Architecture News 23 (1): 20–24. https://doi.org/10.1145/216585.216588.
4 Băng thông bộ nhớ (bức tường bộ nhớ): Thuật ngữ “bức tường bộ nhớ” được Wulf và McKee đặt ra vào năm 1995. Họ dự đoán rằng khoảng cách hiệu suất giữa bộ xử lý và bộ nhớ cuối cùng sẽ chi phối hiệu suất hệ thống — một dự đoán đã trở nên chính xác với các khối lượng công việc (workload) ML, nơi việc di chuyển trọng số hoặc activation có thể giới hạn hiệu suất. Trong định luật sắt, băng thông \((\text{BW})\) nằm ở mẫu số của thành phần dữ liệu \(D_{\text{vol}}/\text{BW}\), nên nếu số byte cần di chuyển tăng gấp đôi mà băng thông không tăng tương ứng, thời gian di chuyển dữ liệu sẽ tăng. Nút cổ chai này phụ thuộc vào cường độ số học, kích thước batch, mức tái sử dụng dữ liệu, kiểu truy cập và cân bằng phần cứng, chứ không chỉ riêng kích thước mô hình.
Trong equation 3, tử số và mẫu số là các hệ số tăng trưởng hàng năm không thứ nguyên. Một tỉ số lớn hơn 1 nghĩa là khả năng tính toán đang kéo xa băng thông bộ nhớ, nên mỗi thế hệ phần cứng mới làm phần chi phí do di chuyển dữ liệu chiếm tỷ trọng lớn hơn trong vấn đề hiệu năng, trừ khi khối lượng công việc (workload) tăng tính cục bộ hoặc cường độ số học.
Các xu hướng đại diện đằng sau tỉ số này là: khả năng tính toán của bộ xử lý tăng gấp đôi cứ mỗi 18 months, còn băng thông bộ nhớ chỉ tăng ~20 percent mỗi năm. Khoảng cách ngày càng rộng này khiến việc luân chuyển dữ liệu thường trở thành nút thắt cổ chai và chi phí năng lượng trong các khối lượng công việc (workload) ML. Ràng buộc này tác động tới mọi mô hình, nhưng đặc biệt nghiêm trọng với TinyML, nơi thiết bị chỉ có vài kilobyte bộ nhớ để làm việc. Hiểu về bức tường bộ nhớ AI trình bày các phản ứng kiến trúc trước bức tường bộ nhớ, bao gồm HBM và các phân cấp SRAM trên chip.
Checkpoint 1.1: Các ràng buộc vật lý và triển khai
Các lựa chọn triển khai được chi phối bởi các quy luật vật lý, không chỉ bởi sở thích. Hãy kiểm tra sự hiểu biết của bạn:
Những định luật vật lý này giải thích tại sao bốn mô hình tồn tại. Vật lý tạo ra các ranh giới; quy định về quyền riêng tư, ưu đãi kinh tế và yêu cầu về chủ quyền dữ liệu củng cố và làm sắc nét chúng chứ không tạo ra chúng. Không có quy định nào làm tốc độ ánh sáng nhanh hơn, và không mô hình kinh tế nào bãi bỏ được nhiệt động lực học.
Năng lực tính toán vượt xa băng thông bộ nhớ; khoảng cách ngày càng nới rộng này chính là bức tường bộ nhớ.
Biết được sự tồn tại của những rào cản này là cần thiết nhưng chưa đủ. Với một khối lượng công việc ML cụ thể (chẳng hạn như công cụ gợi ý hoặc bộ nhận diện từ kích hoạt), chúng ta cần xác định cách tiếp cận nào phù hợp và khối lượng công việc đó sẽ gặp rào cản nào trước tiên. Để trả lời, chúng ta cần các công cụ phân tích có thể kết nối đặc điểm của khối lượng công việc với các ràng buộc vật lý này: định luật sắt để phân tách độ trễ, nguyên tắc nút thắt cổ chai để xác định ràng buộc chi phối, và một tập hợp các kiểu khối lượng công việc điển hình để phân loại vị trí của mỗi mô hình trên phổ.
Self-Check: Question
A safety-critical autonomous braking system requires an end-to-end decision latency budget of 10 ms. A cloud data center is located 1,500 km away. Given that light travels through optical fiber at approximately \(200{,}000\text{ km/s}\), why is offloading inference to this cloud data center physically impossible?
- The cloud server queue latency always adds at least 25 ms regardless of server load.
- The speed of light in fiber allows a round trip in 5 ms, but serialization of model weights requires 15 ms.
- The minimum speed-of-light round-trip propagation time alone is 15 ms, consuming the entire 10 ms budget before compute begins.
- Wireless transmission protocols require a minimum 50 ms handshake before transmitting sensor packets.
Under dynamic CMOS power scaling where supply voltage scales proportionally with clock frequency (\(V \propto f\)), doubling the processor clock frequency increases dynamic power dissipation by a factor of 8 (\(f^3\)).
How does the memory wall manifest in modern computing hardware according to the historical growth rates of compute capacity versus memory bandwidth?
- Memory bandwidth doubles every 18 months while compute throughput increases by only 20% annually, causing compute starvation.
- Both compute throughput and memory bandwidth grow at identical 60% annual rates, but memory capacity limits model size.
- Processors have reached absolute thermal limits while memory signaling energy has dropped to near-zero levels.
- Compute capacity historically doubles roughly every 18 months (~60% annually), whereas memory bandwidth grows by only ~20% annually, causing the compute-to-bandwidth gap to widen compounding over time.
What causes thermal throttling on passively cooled mobile devices running sustained ML inference, and how does it affect continuous model execution?
The historical scaling relationship under which shrinking MOSFET transistor dimensions allowed reducing voltage and current while keeping power density constant is known as ____ scaling.
Phân tích khối lượng công việc
Với một công cụ gợi ý hoặc bộ nhận diện từ kích hoạt, câu hỏi về khối lượng công việc là yếu tố nào sẽ ràng buộc trước tiên trên phần cứng mục tiêu. Công cụ phân tích trung tâm để trả lời câu hỏi về hợp đồng silicon đó là định luật sắt của các hệ thống ML, được thiết lập trong Định luật sắt của hệ thống ML. Ở đây, \(T\) là tổng thời gian, \(D_{\text{vol}}\) là số byte di chuyển, \(\text{BW}\) là băng thông, \(O\) là tổng số phép toán, \(R_{\text{peak}}\) là tốc độ tính toán đỉnh, \(\eta_{\text{hw}}\) là hiệu suất phần cứng, và \(L_{\text{lat}}\) là chi phí cố định; equation 4 cộng các chi phí này cho một đường thực thi được tuần tự hóa: \[T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}} \tag{4}\]
Equation 4 phân tách tổng độ trễ thành ba yếu tố: di chuyển dữ liệu \((D_{\text{vol}}/\text{BW})\), tính toán \((O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\), và chi phí cố định \((L_{\text{lat}})\). Đối với một suy luận đơn lẻ, các chi phí này chỉ đơn giản là cộng lại—mỗi chi phí được tính lần lượt. Tuy nhiên, trong các hệ thống sản xuất, các tác vụ được xử lý liên tục dưới dạng luồng, và phân tích chuyển từ độ trễ của tác vụ đơn lẻ sang việc xác định yếu tố nào giới hạn hệ thống. Câu trả lời hoàn toàn phụ thuộc vào môi trường triển khai: một mô hình ràng buộc bởi tính toán trong quá trình huấn luyện có thể trở thành ràng buộc bởi bộ nhớ trong quá trình suy luận; một hệ thống chạy hiệu quả trên đám mây có thể chạm giới hạn công suất trên các thiết bị di động. Để xác định yếu tố nào chi phối, chúng ta cần một nguyên lý bổ trợ.
Nguyên lý nút thắt cổ chai
Định luật sắt cho ta biết chi phí của từng thành phần. Nguyên lý nút thắt cổ chai cho ta biết thành phần nào quyết định. Trong một pipeline ML, việc xác định nút thắt cổ chai của hệ thống là then chốt, vì tối ưu các thao tác vốn đã nhanh sẽ không mang lại lợi ích nếu giai đoạn chậm nhất vẫn giữ nguyên. Các bộ tăng tốc hiện đại dùng thực thi dạng pipeline để chồng lấp việc di chuyển dữ liệu với tính toán: khi bộ tăng tốc đang tính trên batch \(n\), hệ thống bộ nhớ nạp trước batch \(n+1\). Khi việc di chuyển dữ liệu, tính toán và I/O được chồng lấp hoàn toàn ở trạng thái ổn định, đặt \(T_{\text{network}}\) là thời gian truyền từ xa và \(T_{\text{bottleneck}}\) là thời gian cho mỗi tác vụ, bao gồm cả chi phí cố định. Các giai đoạn nhanh hơn sẽ bị che khuất bởi giai đoạn chậm nhất trong chuỗi chồng lấp, nên tổng trong định luật sắt trở thành giá trị lớn nhất, như equation 5 nêu rõ: \[ T_{\text{bottleneck}} = \max\left(\frac{D_{\text{vol}}}{\text{BW}}, \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}, T_{\text{network}}\right) + L_{\text{lat}} \tag{5}\]
- \(\frac{D_{\text{vol}}}{\text{BW}}\) (Bộ nhớ): Thời gian di chuyển dữ liệu giữa bộ nhớ và bộ xử lý.
- \(\frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\) (Tính toán): Thời gian thực hiện các phép tính.
- \(T_{\text{network}}\): Thời gian cho giao tiếp mạng (nếu có offloading).
- \(L_{\text{lat}}\) (Overhead): Độ trễ cố định (khởi chạy kernel, overhead của runtime).
Khi một hệ thống bị ràng buộc bởi bộ nhớ \((D_{\text{vol}}/\text{BW} > O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\), các bộ xử lý nhanh hơn \((R_{\text{peak}})\) sẽ không giúp tăng tốc, cũng như việc mở rộng đường cao tốc không giải được tắc nghẽn nếu nút thắt là một cây cầu hẹp. Kỹ sư phải xác định thành phần chi phối trước khi tối ưu hóa. Khi truyền qua mạng là một thành phần ứng viên, việc offloading bổ sung yếu tố năng lượng vào phân tích dựa trên thời gian. Vì vậy, quyết định xử lý cục bộ hay offload phải cân nhắc cả joule lẫn mili giây.
Napkin Math 1.1: Năng lượng truyền tải
Bài toán: Một cảm biến chạy bằng pin nên xử lý dữ liệu cục bộ (suy luận NPU trên thiết bị) hay gửi lên đám mây, khi năng lượng truyền tải va vào giới hạn năng lượng do pin áp đặt?
Cho biết:
- Dữ liệu \((D_{\text{vol}})\): 1 MB (dung lượng dữ liệu minh họa).
- Năng lượng truyền tải \((E_{\text{tx}})\): 100 mJ/MB (Wi‑Fi/LTE).
- Năng lượng tính toán \((E_{\text{op}})\): 0.1 mJ/inference (mốc tham chiếu minh họa cho NPU MobileNetV2).
Công thức:
- Phương pháp đám mây: \(E_{\text{cloud}} \approx D_{\text{vol}} \times E_{\text{tx}}\) = 1 MB \(\times\) 100 mJ/MB = 100 mJ.
- Phương pháp cục bộ: \(E_{\text{local}} \approx\) suy luận = 0.1 mJ.
Hiểu biết về hệ thống: Truyền dữ liệu thô tốn kém hơn 1,000× lần so với xử lý cục bộ. Ngay cả khi đám mây có tốc độ vô hạn \((T \approx 0)\), với ngân sách pin đã cho thì nên ưu tiên suy luận cục bộ thay vì truyền dữ liệu thô. Ràng buộc của máy (pin) quyết định cách lựa chọn triển khai.
Các biến của định luật sắt tương tác khác nhau theo từng kịch bản triển khai. Trước khi xem xét các mẫu hình khối lượng công việc (workload) cụ thể, chúng ta cần định nghĩa ngắn gọn các yếu tố cốt lõi quyết định hiệu suất.
Systems Perspective 1.1: Định luật sắt như một công cụ chẩn đoán triển khai
Định luật sắt được giới thiệu trong Định luật sắt của hệ thống ML là công cụ chẩn đoán triển khai dùng xuyên suốt chương này: nó biểu diễn tổng thời gian \(T\) cần thiết cho một khối lượng công việc là tổng thời gian di chuyển dữ liệu, tính toán số học và độ trễ: \[T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\] Sự phân tách này mang tính chẩn đoán: nó định lượng cách khối lượng dữ liệu \((D_{\text{vol}})\), khả năng tính toán \((R_{\text{peak}})\) và độ trễ cố định \((L_{\text{lat}})\) cùng nhau xác định ngân sách thời gian cho một khối lượng công việc. Khác với Định luật Amdahl, vốn tập trung vào tăng tốc nhờ song song hóa, định luật sắt ràng buộc công việc của mô hình với việc di chuyển dữ liệu và độ trễ cố định tại ranh giới triển khai. Một hiểu lầm phổ biến là các thành phần này độc lập; thực tế, chúng là các trục đánh đổi. Tăng kích thước batch có thể cải thiện chu kỳ hoạt động và khả năng tái sử dụng dữ liệu, dịch một kernel bị giới hạn bởi bộ nhớ sang thiên về bị giới hạn bởi tính toán, đồng thời cũng làm tăng tập làm việc và thời gian phục vụ batch.

Trục máy đặt ra giới hạn triển khai.
Định luật sắt định lượng chi phí của từng thành phần; còn nguyên tắc nút cổ chai xác định tốc độ của dây chuyền lắp ráp. Ghi nhớ quy tắc sau: khi phân tích độ trễ của một tác vụ đơn lẻ, dùng dạng cộng ở equation 4; khi phân tích thông lượng của một luồng tác vụ liên tục, dùng dạng max ở equation 5.
Các nguyên mẫu khối lượng công việc (workload)
Nguyên tắc nút cổ chai giúp đơn giản hóa việc tối ưu hóa, quy về việc xác định ràng buộc chính cho một khối lượng công việc (workload) cụ thể. Câu trả lời dựa trên phân loại D·A·M trong Bức tranh giao thoa D·A·M, phân tách mọi hệ thống ML thành Dữ liệu (Data), Thuật toán (Algorithm) và Máy (Machine). Các môi trường triển khai khác nhau sẽ tạo ra các nút cổ chai khác nhau dọc theo các trục này, nên cùng một họ mô hình có thể cần kỹ thuật khác nhau khi chuyển từ máy chủ đám mây với bộ nhớ terabyte sang vi điều khiển với bộ nhớ kilobyte. Định luật sắt biến việc chẩn đoán đó thành bốn nguyên mẫu khối lượng công việc (workload).5 Đây không phải là các loại mô hình, mà là các nút cổ chai vật lý lặp lại, quyết định những hướng kỹ thuật nào có thể hữu ích.
5 Nguyên mẫu khối lượng công việc (workload): Cách phân loại các khối lượng công việc (workload) ML dựa trên nút thắt cổ chai chi phối theo định luật sắt, thay vì theo họ mô hình. Sự phân biệt này quan trọng vì chiến lược tối ưu hóa khác nhau về căn bản: một khối lượng công việc (workload) bị giới hạn bởi tính toán sẽ hưởng lợi từ số học nhanh hơn \((R_{\text{peak}})\), còn khối lượng công việc (workload) bị giới hạn bởi băng thông lại hưởng lợi từ bus bộ nhớ rộng hơn, hoặc giảm số byte cần di chuyển nhờ tái sử dụng, hợp nhất, nén, hoặc dùng độ chính xác thấp hơn. Xác định sai nguyên mẫu sẽ lãng phí công sức tối ưu hóa vào sai thành phần trong định luật sắt, như khi các nhóm thêm FLOP/s của bộ tăng tốc vào một pipeline suy luận bị giới hạn bởi bộ nhớ nhưng vẫn không thấy tăng tốc độ.
Sự phân tách đầu tiên phân biệt các hệ thống bị giới hạn bởi phép tính số học (arithmetic-bound) và các hệ thống bị giới hạn bởi di chuyển dữ liệu (data-movement-bound). Một compute beast thực hiện rất nhiều phép tính trên mỗi byte dữ liệu được tải, nên muốn tiến bộ thì cần tăng thông lượng tính toán, tận dụng tài nguyên tốt hơn và đẩy mạnh thực thi song song; huấn luyện các mạng nơ-ron lớn là ví dụ kinh điển. Ngược lại, một bandwidth hog phải chờ việc di chuyển các trọng số hoặc activation dày đặc, nên bus bộ nhớ rộng hơn và tái sử dụng dữ liệu tốt hơn quan trọng hơn là chỉ tăng thêm FLOP/s đỉnh; tạo văn bản tự hồi quy là một ví dụ điển hình cho chế độ này.
Phân loại thứ hai đề cập đến các khối lượng công việc (workload) mà ràng buộc chính không nằm ở các phép tính số học dày đặc. Các khối lượng công việc (workload) sparse scatter bị chi phối bởi các phép tra cứu bảng không đều và khả năng tận dụng cache kém; vì vậy dung lượng bộ nhớ, độ trễ truy cập và truyền dữ liệu sẽ định hình hiệu năng trong các hệ thống khuyến nghị với các bảng embedding khổng lồ. Ngược lại, các khối lượng công việc (workload) tiny constraint lại ở đầu kia: năng lượng cho mỗi lần suy luận và mức chiếm dụng bộ nhớ, chứ không phải tốc độ xử lý thô, mới quyết định liệu các cảm biến luôn hoạt động có chạy được hay không.
Lighthouse 1.1: Năm khối lượng công việc (workload) tham chiếu
Năm mô hình hải đăng, được tóm tắt trong table 2, sẽ được nhắc lại nhiều lần trong cuốn sách này như những khối lượng công việc (workload) cụ thể. Chúng trải dọc phổ triển khai và giúp chúng ta nhận diện các nút cổ chai hệ thống riêng biệt. Kiến trúc mạng cung cấp đầy đủ chi tiết kiến trúc và “tiểu sử” của các mô hình này.
| Hải đăng | Nguyên mẫu | Mô hình triển khai |
|---|---|---|
| ResNet-50 | Quái vật tính toán | Huấn luyện trên đám mây, suy luận biên (edge) |
| GPT-2/Llama | Kẻ ngốn băng thông | Suy luận trên đám mây |
| DLRM | Phân tán thưa thớt | Chỉ trên đám mây (phân tán) |
| MobileNetV2 | Quái vật tính toán (hiệu quả) | Di động, biên (edge) |
| Keyword Spotting (KWS) | Ràng buộc nhỏ | TinyML, always-on |
Các nguyên mẫu này tương ứng tự nhiên với các kiểu triển khai. Các khối lượng công việc (workload) đòi hỏi tính toán khổng lồ và phân tán thưa thớt thường hướng tới ML trên đám mây, nơi tài nguyên dồi dào. Các khối lượng công việc (workload) ngốn băng thông có thể trải rộng giữa đám mây và edge, tùy thuộc vào yêu cầu độ trễ. Còn các khối lượng công việc (workload) có ràng buộc nhỏ thì thuộc về TinyML. Vì vậy, mỗi nguyên mẫu gắn với một mô hình cụ thể và được nhắc lại xuyên suốt cuốn sách này như một trong năm khối lượng công việc (workload) tham chiếu.
Năm mô hình hải đăng này neo các mối phụ thuộc lẫn nhau trừu tượng của định luật sắt vào thực hành cụ thể. Các phần tóm tắt này sẽ liên hệ từng khối lượng công việc (workload) với nút thắt cổ chai cụ thể của định luật sắt mà nó minh họa.
Mô hình hải đăng đầu tiên, ResNet-50, phân loại hình ảnh thành 1.000 danh mục, xử lý mỗi hình ảnh với khoảng 8.2 GFLOP và sử dụng 25.6 million parameters tham số (102.4 MB ở FP32) (He et al. 2016). Được dùng trong chẩn đoán hình ảnh y tế, các pipeline nhận thức của xe tự hành và làm xương sống cho các hệ thống kiểm duyệt nội dung, cấu trúc đều đặn và đậm đặc tính toán của nó khiến ResNet-50 trở thành một benchmark tiêu chuẩn để đánh giá hiệu suất của bộ tăng tốc phần cứng.
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2016. “Deep Residual Learning for Image Recognition.” 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 770–78. https://doi.org/10.1109/cvpr.2016.90.
Radford, Alec, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. 2019. Language Models Are Unsupervised Multitask Learners. OpenAI.
Touvron, Hugo, Thibaut Lavril, Gautier Izacard, Xavier Martinet, Marie-Anne Lachaux, Timothée Lacroix, Baptiste Rozière, et al. 2023. “LLaMA: Open and Efficient Foundation Language Models.” arXiv Preprint arXiv:2302.13971.
Pope, Reiner, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. 2023. “Efficiently Scaling Transformer Inference.” Proceedings of Machine Learning and Systems (MLSys) 5: 606–24.
Các mô hình ngôn ngữ GPT-2/Llama là ví dụ điển hình cho việc tạo văn bản tự hồi quy (Radford et al. 2019; Touvron et al. 2023). Các mô hình này tạo văn bản từng token một. Khi giải mã với batch nhỏ, để tạo ra mỗi token, có thể cần di chuyển hầu hết hoặc toàn bộ tham số mô hình (1.5 billion parameters cho GPT-2, 7 billion–70 billion parameters cho Llama) qua bộ nhớ. Kiểu truy cập tuần tự này tạo ra một nút thắt cổ chai tự hồi quy, định hình chi phí phục vụ (serving) (Pope et al. 2023).
Mô hình hải đăng khuyến nghị, DLRM, đại diện cho khối lượng công việc (workload) khuyến nghị sử dụng nhiều embedding, thường thấy trong các hệ thống “Bạn cũng có thể thích” quy mô lớn (Naumov et al. 2019). Nó ánh xạ người dùng và các mục thành các vector embedding, được lưu trữ trong các bảng có thể vượt 100 GB embedding. Điều này khiến dung lượng bộ nhớ, chứ không phải khả năng tính toán, trở thành yếu tố ràng buộc chính.
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, et al. 2019. “Deep Learning Recommendation Model for Personalization and Recommendation Systems.” arXiv Preprint arXiv:1906.00091.
Sandler, Mark, Andrew Howard, Menglong Zhu, Andrey Zhmoginov, and Liang-Chieh Chen. 2018. “MobileNetV2: Inverted Residuals and Linear Bottlenecks.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 4510–20. https://doi.org/10.1109/cvpr.2018.00474.
Ngọn hải đăng di động, MobileNetV2, được thiết kế để xử lý hiệu quả các tác vụ thị giác trên thiết bị di động như phân loại, phát hiện và phân đoạn (Sandler et al. 2018). Cũng như ResNet, nó thực hiện tác vụ phân loại ảnh, nhưng dùng các tích chập tách sâu, tách riêng bước lọc theo không gian khỏi bước trộn kênh, để giảm lượng tính toán đi 13.7×, nhờ đó có thể suy luận thời gian thực trên điện thoại thông minh với mức tiêu thụ điện 3–5 W.
Ngọn hải đăng TinyML, phát hiện từ khóa (KWS), đại diện cho kiểu ứng dụng cảm biến luôn bật. Hệ thống KWS dùng các mô hình nhỏ gọn, thiết kế cho vi điều khiển hạn chế tài nguyên, để phát hiện các cụm từ kích hoạt ngắn (Zhang et al. 2017). Trong kịch bản Chuông cửa thông minh, cùng khuôn mẫu đó trở thành một kích hoạt cục bộ như “Ding Dong” hoặc “Hello”. Khối lượng công việc (workload) của ngọn hải đăng này có khoảng 200K parameters tham số và chiếm khoảng 800 KB bộ nhớ, đặt nó vào phân khúc TinyML với bộ nhớ tính bằng kilobyte và ngân sách năng lượng tính bằng milliwatt.
Zhang, Yundong, Naveen Suda, Liangzhen Lai, and Vikas Chandra. 2017. Hello Edge: Keyword Spotting on Microcontrollers.
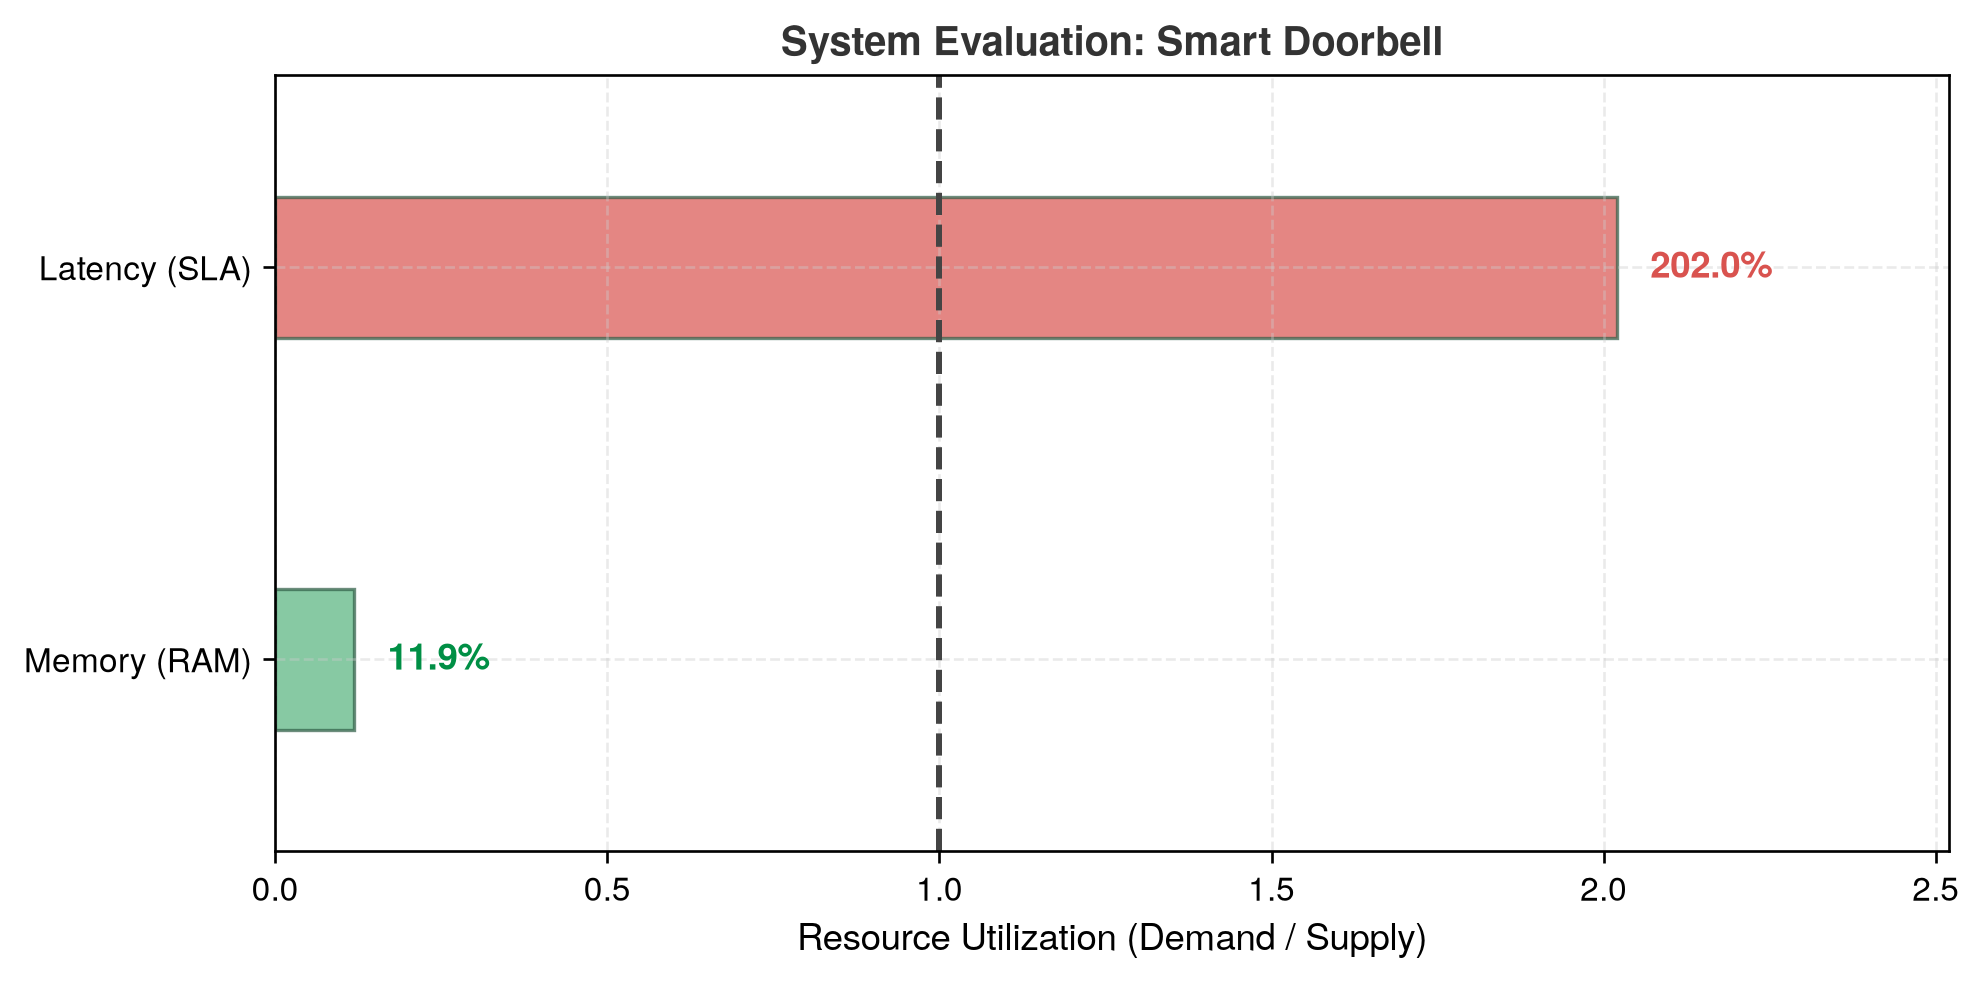
Tính khả thi của việc triển khai được đánh giá theo thứ tự: trước tiên kiểm tra xem có vừa bộ nhớ vật lý hay không, rồi mới đến độ trễ khi thực thi. Trong figure 2, các thanh ngang biểu diễn nhu cầu tài nguyên dưới dạng phần trăm so với nguồn cung và so với ngưỡng bão hòa 100% (đường thẳng đứng) của vi điều khiển ESP32-S3, so sánh dung lượng bộ nhớ ở Cấp 1 với độ trễ ở Cấp 2 theo thỏa thuận mức dịch vụ (SLA).
Khoảng biến thiên lớn về yêu cầu tính toán và bộ nhớ giải thích vì sao không có một mô hình triển khai nào phù hợp cho mọi khối lượng công việc (workload). Một bộ phát hiện từ khóa có thể chạy với khoảng 20 MFLOP và 800 KB, trong khi ResNet-50 cần khoảng 8.2 GFLOP và chừng 102.4 MB cho mỗi ảnh. Ví dụ DLRM tham chiếu đã đạt tới 100 GB, và các hệ thống khuyến nghị kiểu DLRM ngoài thực tế có thể vượt 100 TB. Mô hình ngôn ngữ bổ sung một chế độ do băng thông chi phối: hàng tỷ tham số được nạp lặp đi lặp lại từ bộ nhớ trong quá trình suy luận tự hồi quy. Năm mô hình “hải đăng” này đóng vai trò là các điểm tựa cụ thể xuyên suốt cuốn sách, mỗi mô hình cô lập một nút thắt cổ chai của hệ thống, và chúng sẽ được nhắc lại ở mỗi chương.
Các công cụ phân tích vẫn chỉ là khái quát cho đến khi được kiểm chứng trên silicon thực. Bước tiếp theo là chuyển định luật sắt, nguyên tắc nút thắt cổ chai và các kiểu khối lượng công việc (workload) thành những quyết định kỹ thuật định lượng bằng cách xem hệ cân bằng của hệ thống (sự tương tác giữa tính toán, bộ nhớ và I/O) thay đổi ra sao trên các nền tảng phần cứng thực tế.
Self-Check: Question
When analyzing ML system performance, when should an engineer apply the additive form of the iron law (\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\)) versus the bottleneck principle’s max form (\(T = \max\left(\frac{D_{\text{vol}}}{\text{BW}}, \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}, T_{\text{network}}\right) + L_{\text{lat}}\))?
- Use the additive form for single-task, serialized latency, and the max form for pipelined, steady-state throughput where computation and data prefetching overlap.
- Use the additive form exclusively for cloud workloads, and the max form exclusively for microcontroller TinyML workloads.
- Use the additive form when batch size is greater than 128, and the max form when batch size equals 1.
- Use the additive form during model training only, and the max form during on-device model quantization.
Which pairing correctly matches a workload archetype to its dominant physical bottleneck and canonical lighthouse model?
- Compute Beast \(\rightarrow\) dominated by irregular table lookups and cache misses \(\rightarrow\) DLRM
- Bandwidth Hog \(\rightarrow\) dominated by dense parameter streaming during autoregressive token decode \(\rightarrow\) GPT-2/Llama
- Sparse Scatter \(\rightarrow\) dominated by dense FLOP throughput at high arithmetic intensity \(\rightarrow\) ResNet-50
- Tiny Constraint \(\rightarrow\) dominated by petabyte-scale distributed training \(\rightarrow\) Keyword Spotting (KWS)
In a battery-powered IoT sensor, why does sending raw sensor data (e.g., 1 MB audio) over a cellular or Wi-Fi radio often consume significantly more energy than running local neural network inference (e.g., MobileNetV2)?
Order the steps of the hierarchical deployment feasibility evaluation for the Smart Doorbell scenario from initial resource check to latency verification:
- Verify Level 1 resource capacity fit (confirm model weights and activations fit in microcontroller SRAM/Flash)
- Define application mission targets (specify model task, accuracy target, and real-time SLA budget)
- Verify Level 2 timing constraints (evaluate per-inference execution latency against the strict interaction SLA)
- Select deployment candidate platform and model archetype (match keyword spotter to ESP32-S3 microcontroller)
- An ML workload characterized by high arithmetic intensity where throughput is bounded by peak FLOP/s (\(R_{\text{peak}}\)) rather than memory bandwidth, such as dense convolutional neural network training, belongs to the ____ archetype.
Cân bằng hệ thống và phần cứng
Các ràng buộc vật lý chuyển những đánh đổi giữa độ trễ và thông lượng thành các quyết định kỹ thuật thông qua những con số cụ thể. Table 3 cung cấp các mức độ trễ theo bậc độ lớn mà chúng ta nên dùng để cân nhắc mọi quyết định triển khai—trải dài tám bậc, từ các phép toán tính toán mất vài nanogiây đến hàng trăm mili giây cho các cuộc gọi mạng liên vùng. Chi tiết về độ trễ phần cứng và các ràng buộc băng thông được trình bày ở Tăng tốc phần cứng. Một phép toán có độ trễ \(> X\) không thể xuất hiện trên đường găng của một hệ thống có ngân sách độ trễ \(X\) ms.6
6 Đường găng: Chuỗi tuần tự dài nhất của các phép toán phụ thuộc trong một pipeline. Quy tắc được nêu ở câu trước rất nghiêm ngặt: nếu ở bất kỳ đâu trên đường găng có một cuộc gọi mạng liên vùng mất 200 ms, thì một hệ thống với tổng ngân sách độ trễ 100 ms chắc chắn sẽ thất bại, bất kể các giai đoạn khác chạy nhanh đến mức nào. Quá trình suy luận mô hình không nhất thiết là giai đoạn dài nhất; các bước tiền xử lý và hậu xử lý có thể chiếm ưu thế, khiến đường găng dài hơn so với chỉ thời gian chạy mô hình.
| Hoạt động | Độ trễ | Ý nghĩa triển khai |
|---|---|---|
| Tính toán | ||
| Nhân ma trận trên GPU (mỗi phép toán) | ~1 ns | Độ trễ mỗi phép toán nhỏ |
| Suy luận NPU (MobileNetV2) | 5–20 ms | Di động có thể thực hiện thị giác thời gian thực |
| Tạo token LLM | 20–100 ms | Được cảm nhận như “tốc độ gõ phím” |
| Bộ nhớ | ||
| L1 cache hit | ~1 ns | Giữ dữ liệu nóng trong thanh ghi |
| Đọc bộ nhớ GPU không được cache | ~200–500 ns | Ẩn độ trễ; gom các truy cập lại |
| Đọc DRAM (di động) | 50–100 ns | Các lần đọc lặp lại có thể hạn chế khối lượng công việc (workload) |
| Mạng | ||
| Cùng trung tâm dữ liệu | 0.5 ms | Microservices khả thi |
| Cùng khu vực | 1–5 ms | Máy chủ edge khả thi |
| Liên khu vực | 50–150 ms | Không phù hợp với ngân sách độ trễ chặt chẽ |
| Vận hành ML | ||
| Phát hiện từ đánh thức (TinyML) | ~1–10 ms | Always-on khả thi ở mức \(<1\text{ mW}\) |
| Phát hiện khuôn mặt (di động) | 10–30 ms | Thời gian thực ở 30 FPS |
| Token đầu tiên của GPT-4 | 200–500 ms | Người dùng nhận thấy độ trễ |
| Bước huấn luyện ResNet-50 | 200–400 ms | Tối ưu hóa thông lượng |
Bốn mô hình triển khai sẽ trở nên rõ ràng và chính xác hơn khi chúng ta đặt chúng trên nền tảng phần cứng cụ thể. Trong khi table 1 định nghĩa các mô hình này ở mức khái niệm, thì table 6 cung cấp các thiết bị, bộ xử lý cụ thể cùng các ngưỡng định lượng để lựa chọn mục tiêu triển khai.7 Dải công suất trải dài chín bậc độ lớn, kết hợp với các chỉ số PUE (hiệu quả sử dụng công suất) của trung tâm dữ liệu,8 và khoảng chi phí từ hàng triệu đô la đến 10 đô la, cùng xác định mô hình nào phục vụ một khối lượng công việc (workload) nhất định một cách kinh tế.
7 Phổ chi phí phần cứng ML: Cơ sở hạ tầng AI có dải chi phí trải rộng sáu bậc độ lớn, từ các vi điều khiển $10 cho đến các cụm bộ tăng tốc trị giá hàng triệu đô la. Với dải chi phí rộng tới hàng triệu lần như vậy, việc lựa chọn mô hình triển khai đồng thời là quyết định về vật lý và kinh tế. Ngay cả khi chọn từng thiết bị riêng lẻ, cùng một mục tiêu độ chính xác có thể đạt được trên một vi điều khiển chi phí thấp (chỉ sau khi giảm mô hình đáng kể) hoặc trên một bộ tăng tốc trung tâm dữ liệu đắt tiền với ngân sách tài nguyên lớn hơn nhiều, nhưng sẽ có các đặc tính về độ trễ, công suất và chi phí vận hành khác biệt căn bản.
8 Hiệu quả sử dụng công suất (PUE): Chỉ số này tách phần năng lượng cho cơ sở hạ tầng (như làm mát, phân phối điện) khỏi phần năng lượng cấp cho thiết bị tính toán. Ngay cả với PUE là 1.06, vẫn còn một phần công suất đáng kể không dùng cho tính toán ở quy mô trung tâm dữ liệu. TinyML không yêu cầu hệ thống làm mát cơ sở chuyên dụng, dù cảm biến, truyền thông, tổn thất chuyển đổi và công suất khi ngủ vẫn góp vào tổng ngân sách năng lượng của hệ thống. Các chi phí ở cấp độ thiết bị này nằm ngoài phạm vi PUE.
Những khác biệt về phần cứng này trực tiếp tạo ra các nút thắt hiệu suất. Để hiểu ràng buộc nào chi phối trong từng mô hình, chúng ta áp dụng nguyên tắc nút thắt cổ chai (section 1.2.1).
Systems Perspective 1.2: Cân bằng hệ thống giữa các mô hình
Dạng pipeline của định luật sắt trong các hệ thống ML từ Định luật sắt của hệ thống ML bổ sung thêm \(\text{BW}_{\text{IO}}\) (băng thông I/O của lưu trữ hoặc mạng) vào các thành phần tính toán và bộ nhớ cơ bản. Equation 6 chính thức hóa cận dưới của tổng thời gian thực thi \(T\): \[T \geq \max\left( \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}, \frac{D_{\text{vol}}}{\text{BW}}, \frac{D_{\text{vol}}}{\text{BW}_{\text{IO}}} \right) + L_{\text{lat}} \tag{6}\]
Ở đây, \(O\) là tổng số phép toán, \(R_{\text{peak}}\) là tốc độ tính toán tối đa, \(\eta_{\text{hw}}\) là hiệu suất sử dụng phần cứng, \(D_{\text{vol}}\) là lượng dữ liệu, \(\text{BW}\) là băng thông bộ nhớ, \(\text{BW}_{\text{IO}}\) là băng thông I/O (lưu trữ hoặc mạng), và \(L_{\text{lat}}\) là chi phí cố định. Giới hạn dưới này cho biết tài nguyên nào (tính toán, bộ nhớ hay I/O) đang giới hạn hiệu suất; để đạt dấu bằng, cần chồng chéo lý tưởng giữa các tác vụ mà không có thêm dừng trệ. Yếu tố chi phối thay đổi theo khối lượng công việc (workload) và chế độ triển khai. Bộ tăng tốc nhanh hơn giúp huấn luyện trên đám mây khi bị giới hạn bởi tính toán; còn giải mã mô hình ngôn ngữ lớn (LLM) bị giới hạn bởi bộ nhớ và các khối lượng công việc (workload) ở edge được lợi hơn khi giảm số byte phải chuyển hoặc tăng băng thông. Table 4 phân tích cả bốn mô hình, trong đó tách đám mây thành huấn luyện và suy luận LLM, và Chẩn đoán nút thắt cổ chai ánh xạ từng yếu tố chi phối tới các tối ưu hóa hiệu quả cũng như các tối ưu hóa lãng phí, biến chẩn đoán này thành một kế hoạch hành động.
| Mô hình | Ràng buộc chi phối | Tại sao | Trọng tâm tối ưu hóa |
|---|---|---|---|
| Huấn luyện trên đám mây | \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\) (Compute) | Bộ nhớ/mạng dồi dào; FLOP/s giới hạn thông lượng | Tối đa hóa việc sử dụng bộ tăng tốc, kích thước batch |
| Suy luận LLM trên đám mây | \(D_{\text{vol}}/\text{BW}\) (memory bandwidth) | Tạo tuần tự liên tục di chuyển trạng thái mô hình | Tăng khả năng tái sử dụng; giảm số byte di chuyển |
| Suy luận tại edge | \(D_{\text{vol}}/\text{BW}\) (memory bandwidth) | Băng thông cục bộ hạn chế; các mô hình thường bị giới hạn bởi bộ nhớ | Các mô hình nhỏ hơn; ít truyền bộ nhớ hơn |
| Di động | Năng lượng (ngầm định) | Battery = \(\int \text{Power} \cdot dt\); thermal throttling | Độ chính xác thấp hơn; chu kỳ hoạt động (duty cycling) |
| TinyML | Dấu chân mô hình phải vừa trên chip (dung lượng) | Bộ nhớ quy mô kilobyte; mô hình phải vừa trên chip | Các mô hình nhỏ và số học dấu chấm cố định |
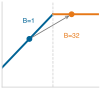
Suy luận batch-1 nằm ở phía bị giới hạn bởi bộ nhớ của biểu đồ roofline.
Williams, Samuel, Andrew Waterman, and David Patterson. 2009. “Roofline: An Insightful Visual Performance Model for Multicore Architectures.” Communications of the ACM 52 (4): 65–76. https://doi.org/10.1145/1498765.1498785.
Phân tích Roofline phân loại các nút thắt cổ chai bằng cách so sánh cường độ số học—tỷ lệ số phép toán dấu phẩy động trên mỗi byte bộ nhớ được di chuyển (\(\text{FLOPs/byte}\))—với điểm cân bằng của phần cứng (\(R_{\text{peak}} / \text{BW}\)) (Williams et al. 2009). Cách trình bày ở đây mang tính giới thiệu; Mô hình Roofline trình bày đầy đủ mô hình, định nghĩa chính thức cường độ số học và suy ra điểm ranh giới phân tách các vùng bị giới hạn bởi bộ nhớ (memory-bound) và bị giới hạn bởi tính toán (compute-bound). Theo cách nhìn đó, cùng một mô hình ResNet-50 có thể chuyển từ hành vi huấn luyện bị giới hạn bởi tính toán ở kích thước batch lớn sang suy luận một ảnh đơn (batch=1) nhạy hơn với bộ nhớ. Việc lựa chọn phương án triển khai phải tính đến sự thay đổi này.
Sự chuyển dịch giữa huấn luyện và suy luận này rất quan trọng để nắm rõ. Nhớ lại phân loại D·A·M từ Bức tranh giao thoa D·A·M: mọi hệ thống ML gồm Dữ liệu, Thuật toán và Máy. Table 5 cho thấy mỗi thành phần ứng xử khác nhau tùy thuộc vào việc hệ thống đang huấn luyện (học các mẫu) hay phục vụ (serving, áp dụng chúng).
| Thành phần | Huấn luyện (Có thể thay đổi) | Suy luận (Bất biến) |
|---|---|---|
| Dữ liệu | Thông lượng lớn: các batch lớn, xáo trộn, tăng cường dữ liệu | Độ trễ thấp: các mẫu đơn lẻ, tính mới, tốc độ |
| Thuật toán | Giai đoạn học: cập nhật các tham số mô hình từ các ví dụ | Giai đoạn dự đoán: áp dụng các trọng số cố định cho các đầu vào mới |
| Máy | Tối ưu hóa thông lượng: các cụm băng thông cao, bộ nhớ lớn | Tối ưu hóa độ trễ: thiết bị edge, bộ tăng tốc suy luận |
Một so sánh định lượng áp dụng phân tích này cho suy luận ResNet-50 trên một bộ tăng tốc trung tâm dữ liệu cao cấp và một NPU di động. Hãy xem đây là những mốc phần cứng tại một thời điểm cụ thể: các phép tính liên quan đến tốc độ tính toán, băng thông bộ nhớ và kích thước batch, còn Tăng tốc phần cứng giải thích kiến trúc bộ tăng tốc đằng sau các con số này.
Napkin Math 1.2: ResNet-50 trên đám mây so với di động
Vấn đề: Suy luận ResNet-50 bị giới hạn bởi tính toán hay bởi bộ nhớ trên (a) một bộ tăng tốc trung tâm dữ liệu cao cấp và (b) một NPU di động hàng đầu?
Đã cho (từ các mô hình tham chiếu):
- ResNet-50: 8.2 GFLOP mỗi suy luận, 25.6 million parameters (102.4 MB FP32, 51.2 MB FP16)
Phân tích:
(a) Bộ tăng tốc cho trung tâm dữ liệu đám mây (batch=1, FP16)
- Tính toán đỉnh: 312 TFLOP/s (FP16)
- Băng thông bộ nhớ: 2.04 TB/s
- Thời gian tính toán: \(T_{\text{comp}}\) = \(\frac{8.20 \times 10^{9}}{3.12 \times 10^{14}}\) = 0.026 ms
- Thời gian truy cập bộ nhớ (trọng số và activation): \(T_{\text{mem}}\) = \(\frac{5.63 \times 10^{7}}{2.04 \times 10^{12}}\) = 0.028 ms
- Kết quả: Nút thắt cổ chai = Memory (chậm hơn tính toán 1.1× lần)
- Phân tích: Tính toán trên mỗi byte được chuyển = \(\frac{8.20 \times 10^{9}}{5.63 \times 10^{7}}\) = 146 FLOP/byte. Tỷ lệ này đo lường số phép tính mà khối lượng công việc (workload) thực hiện trên mỗi byte dữ liệu được tải. Khi tỷ lệ này vượt quá tỷ lệ tính toán trên băng thông của phần cứng \((R_{\text{peak}}/\text{BW})\), khối lượng công việc sẽ bị giới hạn bởi tính toán; ngược lại, sẽ bị giới hạn bởi bộ nhớ. Với suy luận ảnh đơn, batch nhỏ làm hạn chế khả năng tái sử dụng dữ liệu, nên ngay cả các bộ tăng tốc mạnh cũng có thể bị giới hạn bởi bộ nhớ khi batch = 1.
(b) Di động: NPU hàng đầu (batch=1, INT8)
- Tính toán đỉnh: ~35 TOPS (INT8)—đại diện cho các NPU di động hiện đại
- Băng thông bộ nhớ: ~51.2 GB/s (LPDDR5)
- Kích thước mô hình: 25.6 MB (INT8 được lượng hoá)
- Thời gian tính toán: \(T_{\text{comp}}\) = \(\frac{8.20 \times 10^{9} \text{ INT8 ops}}{3.50 \times 10^{13} \text{ INT8 ops/s}}\) = 0.23 ms
- Thời gian truy cập bộ nhớ (trọng số và activation): \(T_{\text{mem}}\) = \(\frac{2.82 \times 10^{7}}{5.12 \times 10^{10}}\) = 0.55 ms
- Kết quả: Nút thắt cổ chai = Memory (chậm hơn tính toán 2.3× lần)
Nhận định hệ thống: Cả hai nền tảng đều bị giới hạn bởi bộ nhớ với suy luận ảnh đơn. Băng thông bộ nhớ nhanh hơn của A100 (2.04 TB/s so với 51.2 GB/s = 39.8×) giúp suy luận nhanh hơn khoảng 19.9× lần; chỉ riêng hiệu năng tính toán đỉnh không phải là yếu tố quyết định khi so sánh. Điều này giải thích vì sao các kỹ thuật giảm số byte và dùng độ chính xác thấp hơn có thể hiệu quả hơn việc chỉ tăng FLOP/s đỉnh cho triển khai.
ResNet-50 sẽ bị giới hạn bởi tính toán khi việc gộp batch và tái sử dụng dữ liệu làm tăng lượng tính toán trên mỗi byte dữ liệu phải di chuyển, vượt quá điểm cân bằng phần cứng, tức \(I > R_{\text{peak}}/\text{BW}\), với \(I = O/D_{\text{vol}}\). Điểm giao cắt này phụ thuộc vào kiến trúc và cách triển khai, vì lưu lượng activation, việc di chuyển dữ liệu vào/ra, khả năng tái sử dụng cache và các chi tiết thực thi runtime đều làm thay đổi số byte hiệu dụng được di chuyển cho mỗi lần suy luận.
Khi ngân sách phần cứng bị thắt chặt, việc nén càng trở nên quan trọng hơn. Khi các hệ thống chuyển từ đám mây sang Edge rồi đến TinyML, tài nguyên sẵn có giảm mạnh. Table 6 định lượng sự chuyển dịch này bằng các ví dụ phần cứng cụ thể: bộ nhớ giảm từ 128 TB (đám mây) xuống 512 KB (TinyML), tức giảm 250 triệu lần, đồng thời dải công suất cũng trải từ megawatt xuống milliwatt. Sự chênh lệch tài nguyên này rõ nhất trên các vi điều khiển – nền tảng phần cứng chính cho TinyML – nơi bộ nhớ và lưu trữ không đủ cho các mô hình ML thông thường.
| Danh mục | Thiết bị ví dụ | Bộ xử lý | Bộ nhớ | Lưu trữ | Công suất | Phạm vi giá |
|---|---|---|---|---|---|---|
| Cloud ML | Google TPU v4 Pod | 4,096 TPU v4 chips, 1.1 EFLOP/s BF16 | 128 TB HBM2 | Quy mô đám mây (PB) | ~3 MW | Dịch vụ đám mây (thuê) |
| Edge ML | NVIDIA DGX Spark | GB10 Grace Blackwell, 1 PFLOP/s thưa thớt FP4 | 128 GB LPDDR5x | 4 TB NVMe | ~200 W | ~$3,000–$5,000 |
| Mobile ML | Điện thoại thông minh cao cấp | SoC di động (CPU + GPU + NPU) | 8–16 GB | 128 GB-1 TB | 3–5 W | $999+ |
| TinyML | ESP32-S3 | Lõi kép @ 240 MHz | 512 KB SRAM | 4 MB Flash | 0.05 W–1.2 W công suất bảng mạch hoạt động | $10 |
Phổ phần cứng biến việc chẩn đoán nút thắt thành một bài kiểm tra độ phù hợp. Các nền tảng trong table 6 là kết quả của hàng thập kỷ tiến hóa phần cứng, từ bộ đồng xử lý số thực vào những năm 1980, qua bộ xử lý đồ họa vào những năm 2000, đến các bộ tăng tốc AI chuyên biệt theo lĩnh vực ngày nay. Tăng tốc phần cứng sẽ lần theo tiến trình lịch sử này và các nguyên tắc kiến trúc đã thúc đẩy nó. Ở đây, hệ quả mới là điều quan trọng: phần cứng khác biệt về bản chất xuất hiện ở các điểm khác nhau trong hạ tầng, nên mỗi khối lượng công việc (workload) phải được ghép với khu vực có thể đáp ứng các yêu cầu về tính toán, bộ nhớ, công suất và chi phí của nó.
Mỗi mô hình triển khai chiếm một khu vực riêng trong phổ triển khai, được chi phối bởi các ràng buộc vật lý (rào cản ánh sáng, rào cản công suất, rào cản bộ nhớ) và được định lượng bằng các công cụ phân tích (định luật sắt, nguyên tắc nút thắt) đã giới thiệu trong section 1.2. Các ngưỡng định lượng trong table 7 giúp người làm nghề xác định liệu một khối lượng công việc (workload) có phù hợp với phạm vi tính toán, băng thông, công suất và độ trễ của mục tiêu hay không.
| Mô hình | Tính toán | Băng thông bộ nhớ | Công suất | Độ trễ (ms) |
|---|---|---|---|---|
| Cloud ML | > 1000 TFLOP/s | > 1000 GB/s | Loại MW (PUE 1.1–1.3) | 100-500 |
| Edge ML | ~1 PFLOP/s | > 270 GB/s | Loại 100 W | 10-100 |
| Mobile ML | 15–45 TOPS | 51.2–77 GB/s | 3–5 W | 5-50 |
| TinyML | < 1 TOPS | — | < 1 mW mục tiêu trung bình luôn bật | 1-10 |
Table 7 hoàn tất bài kiểm tra độ phù hợp: mỗi mô hình trong bảng là một phạm vi hoạt động với một tài nguyên ràng buộc khác nhau. Bốn phần tiếp theo đi từ đám mây đến TinyML, lần theo trục chuyển từ mức tài nguyên tính toán tối đa đến các ràng buộc hiệu quả khắt khe nhất, đồng thời luôn giữ cùng các câu hỏi: yếu tố nào ràng buộc, tối ưu hóa nào hữu ích, và những đánh đổi nào kéo theo.
Self-Check: Question
Why is single-image (batch=1) ResNet-50 inference memory-bound on both a high-end cloud accelerator (NVIDIA A100) and a mobile NPU (iPhone 15 Pro)?
- ResNet-50 contains dynamic control flow that causes branching stalls on SIMD execution units.
- Both platforms lack matrix multiplication coprocessors, forcing scalar CPU execution.
- At batch=1, model weights must be loaded from memory once per single image without weight reuse across batch items, keeping arithmetic intensity below each platform’s hardware balance point (\(R_{\text{peak}}/\text{BW}\)).
- The activations at batch=1 exceed the total high-bandwidth memory (HBM) and SRAM capacities of both devices.
Why does a convolutional neural network (e.g., ResNet-50) shift from a compute-bound regime during cloud training to a memory-bound regime during single-sample (\(\text{batch}=1\)) edge inference?
An ML service SLA guarantees a total end-to-end response time of 100 ms. The pipeline involves client preprocessing, a cross-region network RPC, model inference, and postprocessing. According to critical path latency principles, why will this system fail if a cross-region network call taking 120 ms is placed on the synchronous critical path?
- The ML framework compiler will refuse to lower the graph if network RPC operations are detected.
- Cross-region RPCs corrupt the numerical precision of FP16 tensors during serialization.
- A cross-region network call reduces the accelerator compute throughput (\(R_{\text{peak}}\)) by half.
- The critical path is the longest sequential chain of dependent operations; any single stage exceeding 100 ms guarantees the end-to-end SLA will be breached regardless of how fast all other stages execute.
What is the hardware balance point (or roofline ridge point) of an accelerator, and what does it tell an ML systems engineer about whether a workload will be compute-bound or memory-bound?
In ML accelerator memory hierarchies, an L1 cache hit requires approximately 1 ns, whereas an uncached global DRAM read requires approximately 200–____ ns.
ML trên đám mây: Sức mạnh tính toán
Hãy xem cần gì để huấn luyện GPT-3:9 3,634.3 PFLOP-days tính toán, 10,000 V100 GPUs chạy trong khoảng 15 days, tiêu thụ công suất ở mức megawatt (Patterson et al. 2021). Không có điện thoại thông minh, máy chủ edge hay một máy đơn lẻ nào có thể hoàn tất lần huấn luyện này trong một khung thời gian thực tế. Nó đòi hỏi một cụm máy chủ quy mô trung tâm dữ liệu với tổng tài nguyên tính toán, bộ nhớ và lưu trữ đủ lớn. Đây là luận điểm cốt lõi của ML trên đám mây: khi có thể chịu được độ trễ, nó mang lại quy mô tính toán mà không mô hình nào khác sánh kịp.
9 Quy mô huấn luyện mô hình ngôn ngữ lớn (LLM): GPT-3 cần xấp xỉ 3,634.3 PFLOP-days (Patterson et al. 2021). Quy mô này cho thấy sự đánh đổi cốt lõi trong Cloud ML: chỉ hạ tầng tập trung mới có thể tập hợp đủ \(R_{\text{peak}}\) cho các đợt huấn luyện lớn, nhưng suy luận từ xa làm tăng độ trễ mạng và không phù hợp khi tổng độ trễ đầu-cuối vượt ngân sách độ trễ của ứng dụng.
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. 2021. “Carbon Emissions and Large Neural Network Training.” arXiv Preprint arXiv:2104.10350.
10 Đám mây như điện toán tiện ích: Mô hình tiện ích cho phép nhà cung cấp đưa ra danh mục phần cứng chuyên biệt mà một tổ chức đơn lẻ khó có thể duy trì về mặt kinh tế. Nhờ đó, người dùng có thể truy cập trực tiếp, theo yêu cầu, vào các kiến trúc cụ thể mà mỗi kiểu workload cần: các cụm bộ tăng tốc dày đặc cho Compute Beasts, các nút được trang bị HBM cho Bandwidth Hogs, và các hệ thống bộ nhớ lớn với kết nối nhanh cho Sparse Scatter. Vì vậy, một nhóm có thể thuê một cụm siêu máy tính chuyên dụng trị giá $10M+ trong vài giờ thay vì phải sở hữu.
ML trên đám mây tập hợp các tài nguyên tính toán trong các trung tâm dữ liệu10 để xử lý các tác vụ đòi hỏi nhiều tính toán: xử lý dữ liệu quy mô lớn, phát triển mô hình mang tính hợp tác và phân tích nâng cao. Hạ tầng này là nơi tự nhiên cho ba trong bốn kiểu khối lượng công việc (workload): các workload dạng Compute Beast (ví dụ: huấn luyện ResNet) cần TFLOP/s duy trì trên hàng nghìn bộ tăng tốc; các workload dạng Bandwidth Hog (ví dụ: suy luận mô hình ngôn ngữ lớn) hưởng lợi từ băng thông HBM ở mức TB/s; và các workload dạng Sparse Scatter (ví dụ: hệ thống khuyến nghị) cần hàng terabyte bảng embedding và các kết nối băng thông cao cho các mô hình giao tiếp tất cả-đến-tất cả.
Các triển khai đám mây rất đa dạng, từ các máy đơn (máy trạm, máy chủ nhiều GPU, hệ thống DGX) đến các hệ thống phân tán quy mô lớn trải rộng qua nhiều trung tâm dữ liệu. Cuốn sách này tập trung vào các hệ thống đám mây trên một máy đơn, giúp người đọc học cách xây dựng và tối ưu hóa hệ thống ML trên từng máy mạnh. Các nghiên cứu sau có thể đi sâu vào hạ tầng đám mây phân tán, nơi hệ thống phối hợp tính toán trên nhiều máy kết nối mạng. Cách tiếp cận này tuân theo nguyên tắc xây nền tảng trước khi tăng thêm độ phức tạp.
Triển khai trên đám mây mang lại khả năng tính toán linh hoạt, đồng thời làm tăng khoảng cách trên các đường đi từ xa.
Definition 1.1: Cloud ML
machine learning trên đám mây là mô hình triển khai chấp nhận đánh đổi độ trễ để lấy khả năng tính toán linh hoạt. Cách làm là đặt các khối lượng công việc (workload) machine learning tại các trung tâm dữ liệu tập trung, qua đó tách rời năng lực tính toán khỏi vị trí vật lý của nguồn dữ liệu và người dùng.
- Ý nghĩa: Triển khai trên đám mây vượt trội ở \(R_{\text{peak}}\): một vùng đám mây có thể cấp phát hàng nghìn bộ tăng tốc theo yêu cầu, mang lại tổng thông lượng mà không hệ thống tại chỗ thông thường nào có thể sánh kịp về mặt kinh tế. Tuy nhiên, sự đánh đổi nằm ở \(L_{\text{lat}}\): độ trễ khứ hồi tối thiểu 10–100 ms (do tốc độ ánh sáng trên khoảng cách lục địa) khiến đám mây không khả thi cho bất kỳ khối lượng công việc (workload) nào đòi hỏi phản hồi dưới 10 ms.
- Điểm khác biệt: Không giống như machine learning trên edge, vốn ưu tiên độ trễ ổn định và dữ liệu cục bộ với \(R_{\text{peak}}\) cố định, machine learning trên đám mây ưu tiên \(R_{\text{peak}}\) linh hoạt, đổi lại \(L_{\text{lat}}\) biến thiên.
- Sai lầm phổ biến: Một quan niệm sai lầm thường gặp là machine learning trên đám mây có “khả năng tính toán không giới hạn.” Trên thực tế, hình phạt khoảng cách \((L_{\text{lat}})\) và nút thắt cổ chai khi nạp dữ liệu \((D_{\text{vol}}/\text{BW})\) là những ràng buộc vật lý mà không tối ưu hóa phần mềm nào có thể loại bỏ. Chúng đặt ra một giới hạn cứng về thời gian phản hồi cho bất kỳ khối lượng công việc (workload) nào có dữ liệu bắt nguồn từ bên ngoài trung tâm dữ liệu.
Sự tập trung hóa định hình thỏa hiệp của đám mây: gộp khả năng tính toán linh hoạt trên các cụm máy chủ quy mô lớn giúp loại bỏ giới hạn năng lực cục bộ, nhưng lại phát sinh khoảng cách và độ trễ mạng. Sơ đồ cây bốn cột trong figure 3 minh họa sự đánh đổi này từ trái sang phải, liên kết ràng buộc về quy mô với phản hồi hệ thống, ranh giới lỗi và các khối lượng công việc (workload) phù hợp. Những ví dụ thành công trong môi trường này, như trợ lý ảo, hệ thống đề xuất và phát hiện gian lận, đều chấp nhận thỏa hiệp đó vì quy mô quan trọng hơn tính tức thời. Thách thức căn bản nhất, độ trễ mạng, không phải là hạn chế kỹ thuật mà là một ràng buộc vật lý. Một phép tính nhanh về hình phạt khoảng cách sẽ làm rõ điều này.
Napkin Math 1.3: Hình phạt khoảng cách
Bài toán: Hãy xem xét một hệ thống giám sát an toàn thời gian thực cho cánh tay robot. Logic an toàn yêu cầu thời gian phản hồi đầu-cuối là 10 ms để ngăn ngừa thương tích, nên tác động của khoảng cách do rào cản tốc độ ánh sáng gây ra là rất quan trọng. Mô hình đang chạy tại một trung tâm dữ liệu đám mây hiệu suất cao cách đó 1,500 km. Liệu ngân sách an toàn này có đáp ứng được không?
Vật lý:
- Ánh sáng trong sợi quang: ~200,000 km/s.
- Thời gian truyền khứ hồi: (1,500 km \(\times\) 2)/200,000 km/s = 15 ms.
- Kết quả: Chỉ riêng thời gian truyền khứ hồi đã tốn 15 ms, vượt quá ngân sách đầu-cuối 10 ms (thâm hụt -5 ms) ngay cả trước khi mô hình thực hiện bất kỳ suy luận nào.
Góc nhìn hệ thống: Vật lý đã khiến machine learning trên đám mây không thể thực hiện được cho ứng dụng này. Mô hình bắt buộc phải chuyển lên Edge.

Cơ sở hạ tầng đám mây và quy mô
ML trên đám mây tập hợp các tài nguyên tính toán trong các trung tâm dữ liệu với quy mô chưa từng có. Figure 4 minh họa quy mô vật lý đằng sau lớp trừu tượng này: một sàn trung tâm dữ liệu TPU trong đám mây11. Các thiết kế siêu máy tính TPU sắp xếp hàng nghìn chip bộ tăng tốc chuyên dụng thành các hệ thống ở quy mô trung tâm dữ liệu, cung cấp thông lượng ở độ chính xác thấp từ PFLOP/s đến EFLOP/s (Jouppi et al. 2023). Table 6 cho thấy các hệ thống đám mây cung cấp năng lực tính toán và băng thông bộ nhớ cao hơn nhiều bậc so với thiết bị di động, đồng thời đi kèm mức công suất và chi phí vận hành cao hơn tương ứng. Những cơ sở này cho phép thực hiện các khối lượng công việc (workload) mà thiết bị bị hạn chế tài nguyên không thể đảm đương. Tuy nhiên, vị trí đặt từ xa kéo theo các đánh đổi quan trọng, sẽ được phân tích ngay sau đây: độ trễ khứ hồi của mạng loại trừ các ứng dụng thời gian thực, và chi phí vận hành tăng tuyến tính theo mức sử dụng.
11 Bộ xử lý tensor (TPU): Là một mạch tích hợp chuyên dụng (ASIC) cung cấp thông lượng ở cấp độ PFLOP/s bằng cách cố định kiến trúc để tối ưu cho các phép nhân ma trận, vốn chiếm ưu thế trong các khối lượng công việc (workload) ML. Sự chuyên biệt hóa cao độ này đánh đổi tính linh hoạt đa năng để đạt hiệu suất trên mỗi watt cao hơn hơn \(>10\times\) so với một bộ tăng tốc đa năng khi thực hiện cùng tác vụ ML. Do đó, chi phí cao để triển khai các bộ tăng tốc này ở quy mô trung tâm dữ liệu chỉ kinh tế khi phục vụ các phép tính ML quy mô lớn và duy trì liên tục.
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
Thực tế vật lý của năng lực tính toán ở quy mô PFLOP/s thể hiện ngay trong hạ tầng: một sàn của một cơ sở có thể chứa hàng nghìn chip bộ tăng tốc, được sắp xếp thành các dãy tủ rack làm mát bằng chất lỏng. Mỗi tủ rack tiêu thụ hàng kilowatt công suất để duy trì thông lượng tổng hợp mà không thiết bị đơn lẻ nào có thể chạm tới.
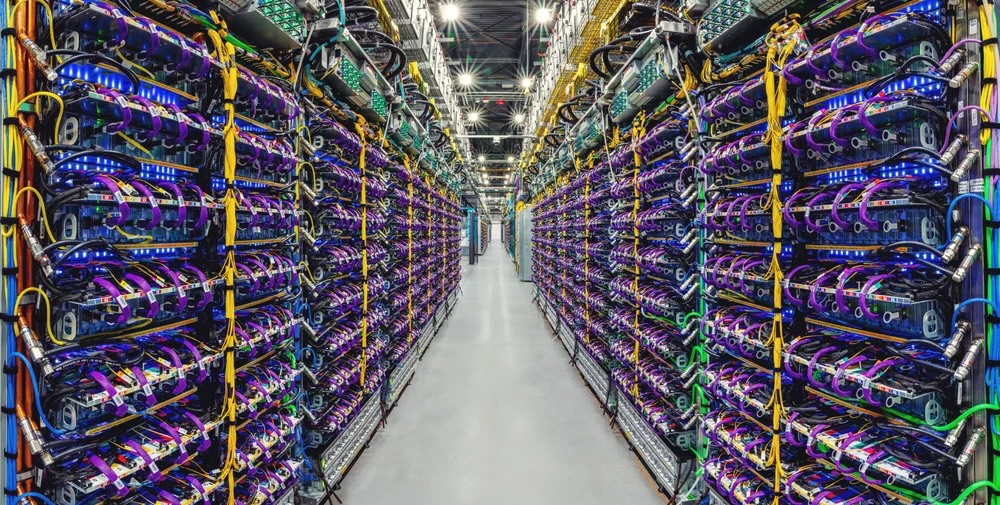
Pichai, Sundar. 2023. Introducing Gemini: Our Largest and Most Capable AI Model.
ML trên đám mây vượt trội trong việc xử lý khối lượng dữ liệu khổng lồ nhờ kiến trúc song song, cho phép huấn luyện trên những tập dữ liệu cần tới hàng trăm terabyte lưu trữ và PFLOPs tính toán—các yêu cầu vốn không thực tế trên những thiết bị bị giới hạn. Các kỹ thuật huấn luyện trong Huấn luyện mô hình và phân tích phần cứng ở Tăng tốc phần cứng giải thích cách người làm nghề đạt được quy mô này.
Chính sự tập trung hóa này cũng thay đổi cách chia sẻ và vận hành mô hình. API đám mây giúp các mô hình đã huấn luyện có thể được truy cập trên toàn cầu qua các nền tảng di động, web và IoT. Hạ tầng dùng chung cho phép các nhóm cộng tác với kiểm soát phiên bản tích hợp, trong khi mô hình định giá trả theo mức sử dụng (pay-as-you-go)12 thay thế phần lớn chi phí mua sắm hạ tầng bằng chi phí vận hành dựa trên mức sử dụng và mở rộng theo nhu cầu.
12 Định giá trả theo mức sử dụng: Một mô hình kinh tế đám mây trong đó người dùng thanh toán theo số giờ bộ tăng tốc đã dùng thay vì sở hữu phần cứng. Cơ chế định giá linh hoạt này chuyển chi phí cố định của \(R_{\text{peak}}\) khi nhàn rỗi thành chi phí biến đổi tỷ lệ với mức sử dụng thực tế. Tuy nhiên, các khối lượng công việc (workload) chạy liên tục 24/7 có thể tốn kém hơn trên đám mây so với phần cứng tại chỗ tương đương được khấu hao trong ba năm. Mốc giao cắt này là yếu tố dẫn dắt phân tích tổng chi phí sở hữu (TCO) trong table 8.
Một hiểu lầm phổ biến là cho rằng nguồn lực tính toán khổng lồ của ML trên đám mây khiến nó luôn vượt trội. Sức mạnh tính toán và lưu trữ lớn không tự động mang lại giải pháp tối ưu cho mọi ứng dụng. Quy luật data gravity invariant trong Tính nhẩm: Vật lý của trọng lực dữ liệu giải thích vì sao: khi khối lượng dữ liệu tăng, chi phí đưa dữ liệu tới nơi tính toán \((C_{\text{move}}(D_{\text{vol}}) \gg C_{\text{move}}(\text{Compute}))\) sẽ dần chiếm ưu thế. Những đánh đổi trong figure 3 trở nên cụ thể khi xét các khu vực mà triển khai edge và nhúng vượt trội: phản hồi thời gian thực với quyết định dưới 10 ms trong các vòng điều khiển tự động; đảm bảo quyền riêng tư dữ liệu nghiêm ngặt cho thiết bị y tế xử lý dữ liệu bệnh nhân; chi phí dự đoán được nhờ đầu tư phần cứng một lần thay vì phí đám mây định kỳ; hoặc vận hành trong môi trường không kết nối như thiết bị công nghiệp ở khu vực xa xôi. Mô hình triển khai tối ưu phụ thuộc vào yêu cầu cụ thể của ứng dụng, chứ không chỉ vào sức mạnh tính toán thuần.
Đánh đổi và hạn chế của ML trên đám mây
Những lợi thế của ML trên đám mây đi kèm các đánh đổi cố hữu, định hình quyết định triển khai. Độ trễ là hệ quả lớn nhất: độ trễ mạng do kết nối từ xa khiến xử lý trên đám mây không phù hợp khi đường dẫn đầu cuối vượt quá ngân sách phản hồi của ứng dụng. Thời gian phản hồi khó dự đoán còn làm phức tạp việc giám sát hiệu năng và gỡ lỗi trên hạ tầng phân tán theo địa lý.
Quyền riêng tư và bảo mật là những thách thức nghiêm trọng khi triển khai trên đám mây. Việc truyền dữ liệu nhạy cảm đến các trung tâm dữ liệu từ xa làm tăng bề mặt lộ lọt và làm phức tạp việc tuân thủ quy định. Các tổ chức xử lý dữ liệu chịu điều chỉnh bởi các quy định như Quy định chung về bảo vệ dữ liệu (GDPR)13 hoặc Đạo luật về khả năng chuyển đổi và trách nhiệm giải trình bảo hiểm y tế (HIPAA)14 phải lựa chọn, lập tài liệu và duy trì các biện pháp bảo vệ phù hợp với dữ liệu, hệ thống và các nghĩa vụ pháp lý áp dụng. Các phương pháp bảo vệ quyền riêng tư có thể giảm lượng dữ liệu nhạy cảm phải rời khỏi môi trường ban đầu, nhưng chúng bổ trợ chứ không thay thế các kiểm soát này.
13 GDPR (Quy định chung về bảo vệ dữ liệu): Điều 17 quy định quyền được xóa khi có các căn cứ cụ thể (European Parliament and Council of the European Union 2016). Với một hệ thống ML, yêu cầu xóa đòi hỏi truy vết nơi dữ liệu của cá nhân còn tồn tại trong các kho nguồn, các đặc trưng suy dẫn, nhật ký, cache và các tạo phẩm mô hình. Huấn luyện lại có thể là một biện pháp khắc phục, nhưng quy định không yêu cầu phải huấn luyện lại mọi mô hình đã từng gặp dữ liệu đó.
European Parliament, and Council of the European Union. 2016. Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016. Official Journal of the European Union.
14 HIPAA: Quy tắc An toàn yêu cầu các tổ chức chịu sự quản lý phải áp dụng các biện pháp bảo vệ hành chính, vật lý và kỹ thuật một cách hợp lý và phù hợp cho thông tin sức khỏe điện tử được bảo vệ, bao gồm kiểm soát truy cập và kiểm toán (U.S. Department of Health and Human Services 2005). Quy tắc này trung lập về công nghệ và không bắt buộc sử dụng các enclave tính toán bí mật (confidential-computing enclaves); các biện pháp kiểm soát cụ thể và phần chi phí hiệu năng phát sinh của chúng phụ thuộc vào phân tích rủi ro và cách triển khai hệ thống.
U.S. Department of Health and Human Services. 2005. “Summary of the HIPAA Security Rule.”
15 Tổng chi phí sở hữu (TCO): Định lượng khoảng cách giữa giá niêm yết và chi phí thực tế của hệ thống bằng cách tính mọi chi phí trực tiếp và gián tiếp (công suất, làm mát, nhân công) trong suốt vòng đời hệ thống, đồng thời cân đối chi phí vốn ban đầu (CapEx) với chi phí vận hành định kỳ (OpEx). Ví dụ, với một GPU triển khai tại chỗ (on-premise), giá mua chỉ là một phần của TCO trong 3 năm, bên cạnh các chi phí vận hành.
Quản lý chi phí làm tăng độ phức tạp vận hành, nên cần phân tích TCO15 thay vì so sánh đơn giá một cách ngây thơ. Một phép so sánh TCO giữa đám mây và edge sẽ minh họa khoảng cách giữa giá niêm yết và chi phí thực tế của hệ thống.
Để thực hiện phép so sánh này, bảng table 8 liệt kê chi phí hàng năm cho GPU, mạng, bộ cân bằng tải và giám sát của một triển khai đám mây minh họa, dựa trên giá niêm yết công khai. Còn bảng table 9 liệt kê các chi phí tương ứng về phần cứng, công suất, làm mát, mạng và nhân công DevOps cho một triển khai máy chủ edge đặt tại chỗ.
| Thành phần chi phí | Tính toán | Chi phí hàng năm |
|---|---|---|
| Suy luận GPU (A10G) | 4 phiên bản \(\times\) 8760 h/year \(\times\) $0.75/hr | ~$26,280 |
| Thoát mạng | 100 GB/day \(\times\) 365 d/year \(\times\) $0.09/GB | ~$3,285 |
| Bộ cân bằng tải | $0.025/hr + phí LCU | ~$3,723 |
| CloudWatch/ghi nhật ký | Giám sát, cảnh báo | ~$2,000 |
| Tổng cộng đám mây | ~$35,288/year |
Các triển khai trên đám mây cũng có những ràng buộc vận hành. Các đợt tăng sử dụng khó lường làm phức tạp việc lập ngân sách, đòi hỏi các framework giám sát và quản trị chi phí toàn diện. Sự phụ thuộc vào mạng còn tạo thêm hạn chế: bất kỳ gián đoạn kết nối nào cũng tác động trực tiếp đến tính sẵn sàng của hệ thống, đặc biệt ở những nơi truy cập mạng hạn chế hoặc không ổn định. Tình trạng vendor lock-in càng làm vấn đề trầm trọng hơn, vì phụ thuộc vào các công cụ và API riêng của một nhà cung cấp dẫn tới khó khăn về khả năng mang chuyển khi đổi nhà cung cấp. Các tổ chức cần cân đối những hạn chế này với lợi ích của đám mây, dựa trên yêu cầu cụ thể của ứng dụng và mức chấp nhận rủi ro của họ. Dù vậy, ML trên đám mây vẫn rất phù hợp với các ứng dụng tiêu dùng cần năng lực co giãn ở quy mô toàn cầu.
| Thành phần chi phí | Tính toán | Chi phí hàng năm |
|---|---|---|
| CapEx phần cứng | $15,000 ÷ 3 years tuổi thọ | ~$5,000 |
| Công suất (24/7) | 300 W \(\times\) 8760 h/year \(\times\) $0.12/kWh | ~$315.4 |
| Chi phí làm mát phụ trội | ~30% của công suất | ~$94.6 |
| Mạng (cáp quang) | Đường dây cố định để quản lý từ xa | ~$1,200 |
| Lao động DevOps | Lương 0.1 FTE \(\times\) $150,000 | ~$15,000 |
| Tổng Edge | ~$21,610/year |
Napkin Math 1.4: So sánh TCO giữa đám mây và edge
Bài toán: Một hệ thống thị giác thực hiện 1M lượt suy luận mỗi ngày với mô hình ResNet-50 (độ trễ 10 ms, kích thước phản hồi 100 KB). Khi tính đầy đủ mọi chi phí (giờ GPU, egress mạng, công suất, làm mát và nhân công, được liệt kê trong table 8 và table 9), việc triển khai trên đám mây hay trên edge tại chỗ sẽ rẻ hơn trong 3 years?
Phân tích: Kịch bản này cấp sẵn một nhóm cố định gồm 4 instance GPU trên đám mây và một máy chủ tại chỗ cố định. Phần lớn chi phí là cố định, trong khi egress của đám mây thay đổi theo lưu lượng. Vì vậy, lấy tỷ lệ giữa hai tổng chi phí hàng năm không cho ta một mức sử dụng hòa vốn hợp lệ. Tại điểm vận hành đã nêu, phép so sánh hợp lệ trong equation 7 là chênh lệch chi phí hàng năm: \[\text{Annual cost gap} = \text{Cloud annual TCO} - \text{Edge annual TCO} \tag{7}\]
Tại điểm vận hành 1M lượt suy luận/ngày đã nêu, chênh lệch chi phí là ~$35,288/year − ~$21,610/year = ~$13,678/year. Nhân lưu lượng này với tỷ lệ tổng chi phí hàng năm là không đúng, vì cách đó coi dung lượng đã cấp phát như chi phí trên mỗi lượt suy luận.
Kết quả: Chi phí edge thấp hơn khoảng 38.8 percent tại điểm vận hành này. Vì cấu hình đám mây cố định đã đắt hơn tổng chi phí edge ngay cả trước khi tính phần egress phụ thuộc lưu lượng, nên các giả định này không cho ra một điểm hòa vốn theo lưu lượng. Để có điểm hòa vốn hợp lý, cần tài nguyên đám mây co giãn theo nhu cầu, một “thang” dung lượng rõ ràng, hoặc mức giá theo mỗi truy vấn có thể bảo vệ được.
Thông tin chuyên sâu về hệ thống: Tổng chi phí sở hữu (TCO) của edge chủ yếu do chi phí nhân công (~$15,000 ÷ ~$21,610/year ≈ 69.4 percent) chi phối, không phải phần cứng. Các tổ chức không có sẵn năng lực DevOps cần tính đủ chi phí vận hành và duy trì hạ tầng tại chỗ.
Huấn luyện và suy luận quy mô lớn
Những lợi thế tính toán của ML trên đám mây thể hiện rõ nhất trong các ứng dụng hướng người dùng cần quy mô lớn. Các trợ lý ảo như Siri và Alexa minh họa các kiến trúc lai tiêu biểu của hệ thống ML hiện đại: phát hiện từ khóa kích hoạt (wake-word detection) có thể chạy trên phần cứng chuyên dụng công suất từ dưới miliwatt đến miliwatt ngay trên thiết bị, cho phép luôn bật chế độ lắng nghe mà không phải kích hoạt liên tục bộ xử lý chính; nhận dạng giọng nói bước đầu có thể chạy trên thiết bị để đảm bảo quyền riêng tư và độ phản hồi; còn phần hiểu và tạo ngôn ngữ tự nhiên phức tạp có thể dùng hạ tầng đám mây để truy cập các mô hình lớn hơn và kho kiến thức rộng hơn.
Yếu tố kinh tế quan trọng không kém độ trễ trong việc định hình kiến trúc này. Cố gắng xử lý mọi tương tác giọng nói cho hàng tỷ thiết bị hoàn toàn trên đám mây sẽ chạm trần cả về kinh tế lẫn hạ tầng. Khi lượng hóa “bức tường” của trợ lý giọng nói, ta thấy rõ cả hai giới hạn cùng lúc.
Napkin Math 1.5: Bức tường trợ lý giọng nói
Bài toán: Trong kịch bản dung lượng minh họa này, 1B thiết bị trợ lý giọng nói (điện thoại thông minh, loa thông minh, tai nghe) mỗi thiết bị phát ra 20 queries/day dưới dạng lưu lượng từ khóa kích hoạt. Chi phí mở rộng hạ tầng sẽ là bao nhiêu nếu tất cả truy vấn đều được phục vụ từ ML trên đám mây, và tải đỉnh sẽ cần tương đương bao nhiêu trung tâm dữ liệu chuyên dụng?
Rào cản kinh tế: Đầu tiên là chi phí để phục vụ (serving) lưu lượng từ khóa kích hoạt từ đám mây.
- Chi phí đám mây: Khoảng $0.50/device/year cho 1B thiết bị, tổng cộng $500,000,000/year. Với các giả định này, chi phí này quá cao về mặt kinh tế cho một đặc trưng miễn phí.
- Giải pháp thay thế TinyML: Phát hiện từ khóa kích hoạt cục bộ chỉ tiêu tốn 0.1–1 mW và có chi phí dưới $0.01/device/year. Khả thi ở quy mô đã mô hình hóa.
Rào cản hạ tầng: Thứ hai là số lượng trung tâm dữ liệu cần thiết để đáp ứng tải đỉnh.
Lập luận kinh tế rất thuyết phục, và phép tính dung lượng sau đây cũng đáng tham khảo:
- Khối lượng truy vấn: 1 tỷ thiết bị \(\times\) 20 queries/day = 20B queries/day.
- Nhu cầu GPU: Mỗi truy vấn yêu cầu ~200 ms thời gian GPU. Tổng cộng: 1,111,111 giờ GPU/ngày.
- Dung lượng ước tính: Một trung tâm dữ liệu tương đương, nếu được trang bị 10,000 GPUs GPU, sẽ cung cấp 240,000 giờ GPU mỗi ngày.
- Yêu cầu trung bình: ~4.6 trung tâm dữ liệu chuyên dụng chỉ để suy luận giọng nói.
- Thực tế khi tải đạt đỉnh: Các truy vấn thường tập trung vào giờ mọi người thức (~gấp 4.5× lần so với mức trung bình), nên tại đỉnh cần khoảng 20.8 trung tâm dữ liệu.
Giới hạn trên về băng thông: Thứ ba, hãy xét một kịch bản giả định khác: nếu đưa chính âm thanh lên đám mây. Nếu mỗi thiết bị truyền phát âm thanh liên tục (16 kHz, 16-bit), mỗi thiết bị sẽ truyền khoảng 32 KB/s. Với 1 tỷ thiết bị, tổng lưu lượng đạt 32 TB/s. Đây là một giới hạn trên mang tính minh họa, khác với mô hình yêu cầu dựa trên truy vấn.
Hiểu biết về hệ thống: Xử lý giọng nói chỉ trên đám mây không chỉ tốn kém; với các giả định này, còn đòi hỏi vận hành rất lớn ở quy mô toàn cầu. Phát hiện từ khóa kích hoạt cục bộ là một kiến trúc có khả năng mở rộng, chứ không phải là một yêu cầu vật lý bắt buộc.
pipeline trợ lý giọng nói minh họa một nguyên tắc cốt lõi của hệ thống: các quyết định triển khai chịu ràng buộc bởi yêu cầu hiệu năng, thực tế kinh tế và các yếu tố vật lý của hạ tầng. Cách tiếp cận lai này giúp giảm độ trễ đầu cuối so với xử lý thuần trên đám mây, đồng thời vẫn duy trì khả năng truy cập vào năng lực tính toán cần thiết cho việc hiểu ngôn ngữ phức tạp.
Các hệ thống đề xuất quy mô lớn cũng cho thấy sự đánh đổi tương tự với đám mây, nhưng ở dạng bị giới hạn bởi dung lượng bộ nhớ. Các hệ thống này xử lý các tập dữ liệu lớn bằng lọc cộng tác và các kiến trúc dùng nhiều embedding như DLRM16 để khám phá các mẫu trong sở thích người dùng. DLRM là một ví dụ điển hình về khối lượng công việc (workload) bị giới hạn bởi dung lượng bộ nhớ: các bảng embedding của nó, đại diện cho hàng triệu người dùng và mục, có thể có kích thước lên tới hàng terabyte, đòi hỏi bộ nhớ phân tán trên nhiều máy chủ chỉ để lưu các tham số của mô hình. Tài nguyên tính toán trên đám mây cho phép cập nhật và tinh chỉnh liên tục khi dữ liệu người dùng tăng lên.
16 Mô hình đề xuất deep learning (DLRM): Kiến trúc của Meta ra đời năm 2019, minh họa cho nguyên mẫu “Sparse Scatter”. Các bảng embedding trong các hệ thống đề xuất thực tế có thể vượt quá 100 TB, khiến DLRM bị giới hạn bởi dung lượng bộ nhớ và băng thông truyền thông \(\text{BW}\), thay vì bởi hiệu năng tính toán thô \(R_{\text{peak}}\). Sự đảo ngược so với giả định thường gặp rằng bài toán bị giới hạn bởi tính toán buộc phải thiết kế các cụm chuyên biệt, nơi bộ nhớ, chứ không phải các phép tính số học, mới là tài nguyên khan hiếm.
Các ứng dụng này có một điểm chung: họ chấp nhận đánh đổi độ trễ để đạt được quy mô, tức là chấp nhận độ trễ trên đường đi từ xa để đổi lấy các tài nguyên tính toán khó có thể cung cấp tại chỗ. Các hệ thống phát hiện gian lận phân tích hàng triệu giao dịch, các hệ thống đề xuất xử lý hàng terabyte bảng embedding, và các mô hình ngôn ngữ tạo văn bản từng token một đều có thể dựa vào sự đánh đổi này. Tuy nhiên, như ví dụ về trợ lý giọng nói đã cho thấy, có những ứng dụng mà dù có bao nhiêu tài nguyên tính toán trên đám mây cũng không thể bù đắp được các giới hạn vật lý của khoảng cách. Khi ngân sách độ trễ (latency budget) giảm xuống dưới mức mà đường đi từ xa cho phép, hoặc khi khối lượng dữ liệu vượt quá khả năng truyền tải của mạng, việc tính toán phải tiến gần hơn tới nguồn dữ liệu.
Self-Check: Question
Why does serving always-on voice assistant traffic (e.g., 1 billion devices issuing continuous audio queries) entirely in the cloud create an ‘infrastructure and economic wall’?
- The cloud approach would cost hundreds of millions of dollars annually and require dozens of dedicated data centers at peak hours, whereas on-device TinyML wake-word detection filters idle traffic for pennies per device.
- Cloud servers cannot execute transformer models with audio spectrogram inputs due to floating-point representation limits.
- Data privacy regulations in all jurisdictions make transmitting any encrypted audio to cloud servers illegal under all circumstances.
- Cloud network switches drop all audio packets exceeding 1 kHz sampling rates due to MTU size limits.
In a 3-year Total Cost of Ownership (TCO) comparison for an on-premises edge server deployment serving 1 million inferences per day, what is typically the largest component of the edge system’s annual cost?
- GPU hardware silicon purchase price amortized over 3 years
- DevOps engineering labor required to maintain, update, and manage on-premises edge infrastructure
- Electricity costs for running the server 24/7
- Dedicated server room air-conditioning and cooling overhead
What is the data gravity invariant in cloud ML, and why does it make moving multi-terabyte raw sensor datasets to the cloud economically and physically problematic?
Under GDPR Article 17 (Right to Erasure), when a user requests deletion of their data, an organization is legally mandated to retrain from scratch every ML model that ever encountered that user’s training samples.
Order the steps of a hybrid voice assistant query pipeline from the initial acoustic trigger to user response:
- Run on-device speech-to-text (ASR) on a mobile NPU to convert speech to text tokens locally
- Transmit text tokens to cloud infrastructure for large language model reasoning and broad knowledge retrieval
- Always-on TinyML wake-word detector listens continuously on a sub-milliwatt dedicated core
- Send synthetic audio/text response back to the client device to render the answer to the user
- Detect trigger phrase (“Hey Assistant”) and wake the main application processor from sleep
Edge ML: Độ trễ và quyền riêng tư
Khi một đường dẫn từ xa vượt quá ngân sách độ trễ của khối lượng công việc (workload), suy luận trên đám mây trở nên bất khả thi. Hình phạt khoảng cách đồng nghĩa với việc các yêu cầu liên vùng sẽ cộng thêm độ trễ mạng ngay cả trước khi bất kỳ tính toán nào bắt đầu. Ví dụ, với hệ thống phanh của xe tự hành hay vòng lặp an toàn trong công nghiệp, độ trễ mạng 100 ms có thể chiếm hết toàn bộ ngân sách phản hồi. Phản ứng kỹ thuật hợp lý là đưa tính toán lại gần nguồn dữ liệu.
Edge ML ra đời từ chính ràng buộc này, đánh đổi khả năng co giãn của đám mây để đạt độ trễ dưới 100 ms và giữ dữ liệu cục bộ. Ở mức mô hình tổng quát, triển khai edge làm thay đổi mục tiêu tối ưu hóa: một khối lượng công việc (workload) ngốn băng thông như suy luận LLM, vốn bị giới hạn bởi bộ nhớ khi chạy trên đám mây, có thể lại bị chi phối bởi độ trễ đường dẫn từ xa nếu không xử lý cục bộ tại edge. Phần cứng edge có đủ bộ nhớ cục bộ sẽ loại bỏ hình phạt đường dẫn từ xa đó, đưa trọng tâm trở lại băng thông bộ nhớ cục bộ và năng lực tính toán. Hãy nhớ lại quy luật sắt từ equation 6: xử lý cục bộ loại bỏ số hạng chuyển tải \(D_{\text{vol}}/\text{BW}_{\text{IO}}\) khỏi đường dẫn yêu cầu, để lại bài toán đánh đổi giữa bộ nhớ và tính toán nhưng không còn hình phạt mạng từ xa.
Sự chuyển đổi mô hình này rất cần thiết cho những ứng dụng không chấp nhận được độ trễ khứ hồi lên đám mây. Các hệ thống tự hành cần quyết định trong tích tắc và các ứng dụng IoT công nghiệp17 đòi hỏi phản hồi thời gian thực không thể chịu được một đường dẫn từ xa bỏ lỡ hạn chót điều khiển. Các ứng dụng chịu ràng buộc về chủ quyền dữ liệu hoặc quyền riêng tư cũng có thể yêu cầu xử lý cục bộ thay vì truyền tới một trung tâm dữ liệu từ xa. Các thiết bị edge, bao gồm cổng (gateway) và bộ tập trung IoT (IoT hub), nằm ở vị trí trung gian trong phổ triển khai, duy trì hiệu suất chấp nhận được trong khi vận hành dưới các ràng buộc tài nguyên ở mức vừa phải.
17 IoT công nghiệp (IIoT): Một lĩnh vực mà các ràng buộc về độ trễ được quyết định bởi an toàn vật lý, chứ không phải bởi cảm nhận của người dùng. Một vòng lặp an toàn với ngân sách dừng 5 ms không thể chấp nhận một chuyến khứ hồi từ xa mất 100 ms, vì vậy cảm biến và quyết định dừng phải diễn ra cục bộ. Lựa chọn này loại bỏ yếu tố mạng đường dài, nhưng hệ thống edge vẫn bị giới hạn bởi năng lực tính toán cục bộ \((R_{\text{peak}})\).
Sự đánh đổi ưu tiên tính cục bộ này chính là đặc trưng của mô hình edge.
Definition 1.2: Edge ML
Edge machine learning là một mô hình triển khai được tối ưu cho tính xác định về độ trễ và tính cục bộ của dữ liệu, bằng cách đặt các hoạt động tính toán ngay cạnh nguồn dữ liệu.
- Ý nghĩa: Mô hình này giúp khắc phục hạn chế do khoảng cách \((L_{\text{lat}})\) khi dùng đám mây. Đổi lại, chúng ta phải chấp nhận năng lực tính toán cục bộ cố định \((R_{\text{peak}})\) thay vì khả năng mở rộng linh hoạt.
- Điểm khác biệt: Khác với Cloud ML ưu tiên thông lượng, edge ML ưu tiên tính xác định và quyền riêng tư. Hơn nữa, không như TinyML, edge ML vẫn có thể dùng các bộ tăng tốc mạnh như GPU đa năng (GPGPU) thường thấy trên máy trạm.
- Sai lầm phổ biến: Nhiều người nhầm rằng edge ML là một loại phần cứng cụ thể. Thực chất, đây là một mô hình triển khai theo vị trí: nó trải từ các cổng IoT đến máy chủ đặt tại chỗ, với điểm chung là đều nằm gần nguồn dữ liệu về mặt vật lý.
Việc chuyển các hoạt động tính toán đến máy chủ cục bộ giúp loại bỏ truyền dữ liệu đường dài khỏi luồng xử lý yêu cầu, nhưng đổi lại, chúng ta phải quản lý một hạ tầng phân tán. Trong figure 5, cây ràng buộc cho thấy sự gần gũi vật lý với các cảm biến sẽ quyết định việc lọc dữ liệu tại chỗ và sử dụng phần cứng bộ tăng tốc chuyên dụng, đồng thời cũng bộc lộ những giới hạn về dung lượng cố định.
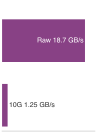
Dữ liệu edge thô có thể quá lớn so với khả năng của đường truyền mạng.

Lợi ích của việc dùng ít băng thông hơn và giảm độ trễ hiện lên rõ ràng khi xét đến tốc độ dữ liệu thực tế. Đặc trưng của triển khai edge không nằm ở nơi xử lý diễn ra, mà ở lượng dữ liệu mà nơi đó phải xử lý. Khi tốc độ dữ liệu vượt quá năng lực mạng sẵn có, nút thắt băng thông sẽ buộc việc xử lý phải đưa ra edge, bất kể các yếu tố khác.
Napkin Math 1.6: Nút thắt băng thông
Bài toán: Hãy xem xét một hệ thống kiểm soát chất lượng cho xưởng sản xuất với 100 camera, chạy ở tốc độ 30 FPS với độ phân giải 1080p. Liệu việc truyền video có trở thành nút thắt băng thông không, và liệu ML trên edge có giảm đủ băng thông để xử lý tại chỗ không?
Vật lý:
- Tốc độ dữ liệu thô mỗi camera: 1920 \(\times\) 1080 \(\times\) 3 byte \(\times\) 30 FPS ≈ 186.6 MB/s.
- Tổng tốc độ dữ liệu: 100 camera \(\times\) 186.6 MB/s = 18.7 GB/s.
- Vấn đề khi truyền dữ liệu lên đám mây: Việc tải các luồng dữ liệu thô từ camera lên đám mây chủ yếu là bài toán về băng thông, nhập liệu, lưu trữ và xử lý; phí xuất dữ liệu (egress charges) tính theo GB sẽ áp dụng khi dữ liệu được chuyển ra khỏi đám mây. Nếu luồng dữ liệu thô này sau đó được truy xuất với mức giá $0.09/GB cho việc chuyển dữ liệu ra ngoài, riêng chi phí chuyển dữ liệu đã lên tới $4.4M/month.
- Thực tế mạng: Ngay cả một đường truyền 10 Gbps chuyên dụng (1.25 GB/s) cũng không gánh nổi. Khối lượng công việc (workload) này đòi hỏi băng thông nhiều hơn 14.9× lần so với mức hiện có.
Nhận định về hệ thống: Do giới hạn vật lý, streaming lên đám mây là bất khả thi cho ứng dụng này. Xử lý tại edge không phải tùy chọn, mà là bắt buộc. Nếu máy chủ edge chỉ gửi siêu dữ liệu về lỗi (1 KB cho mỗi lần phát hiện, khoảng 20 events/s sự kiện trên toàn bộ khu vực sản xuất), băng thông giảm khoảng 933,120× lần.
Phép tính băng thông trong phần tính toán sơ bộ 1.6 cho thấy vì sao xử lý tại edge được ưu tiên trong kịch bản cảm biến tạo ra lượng dữ liệu lớn. Với các thiết bị edge chạy pin (camera không dây, drone, thiết bị đeo), ràng buộc còn khắt khe hơn: theo giả định về tải trọng và vô tuyến trong phần tính toán sơ bộ 1.1, truyền vô tuyến tốn năng lượng gấp 1,000× lần so với suy luận cục bộ. Điều này có thể khiến việc đẩy lên đám mây trở nên không thực tế, dù kết quả còn phụ thuộc vào kích thước tải, loại vô tuyến, chu kỳ hoạt động và khả năng tính toán cục bộ. Figure 6 mở rộng phép so sánh này với năm điểm neo năng lượng minh họa cho các khối lượng công việc và cách triển khai khác nhau.
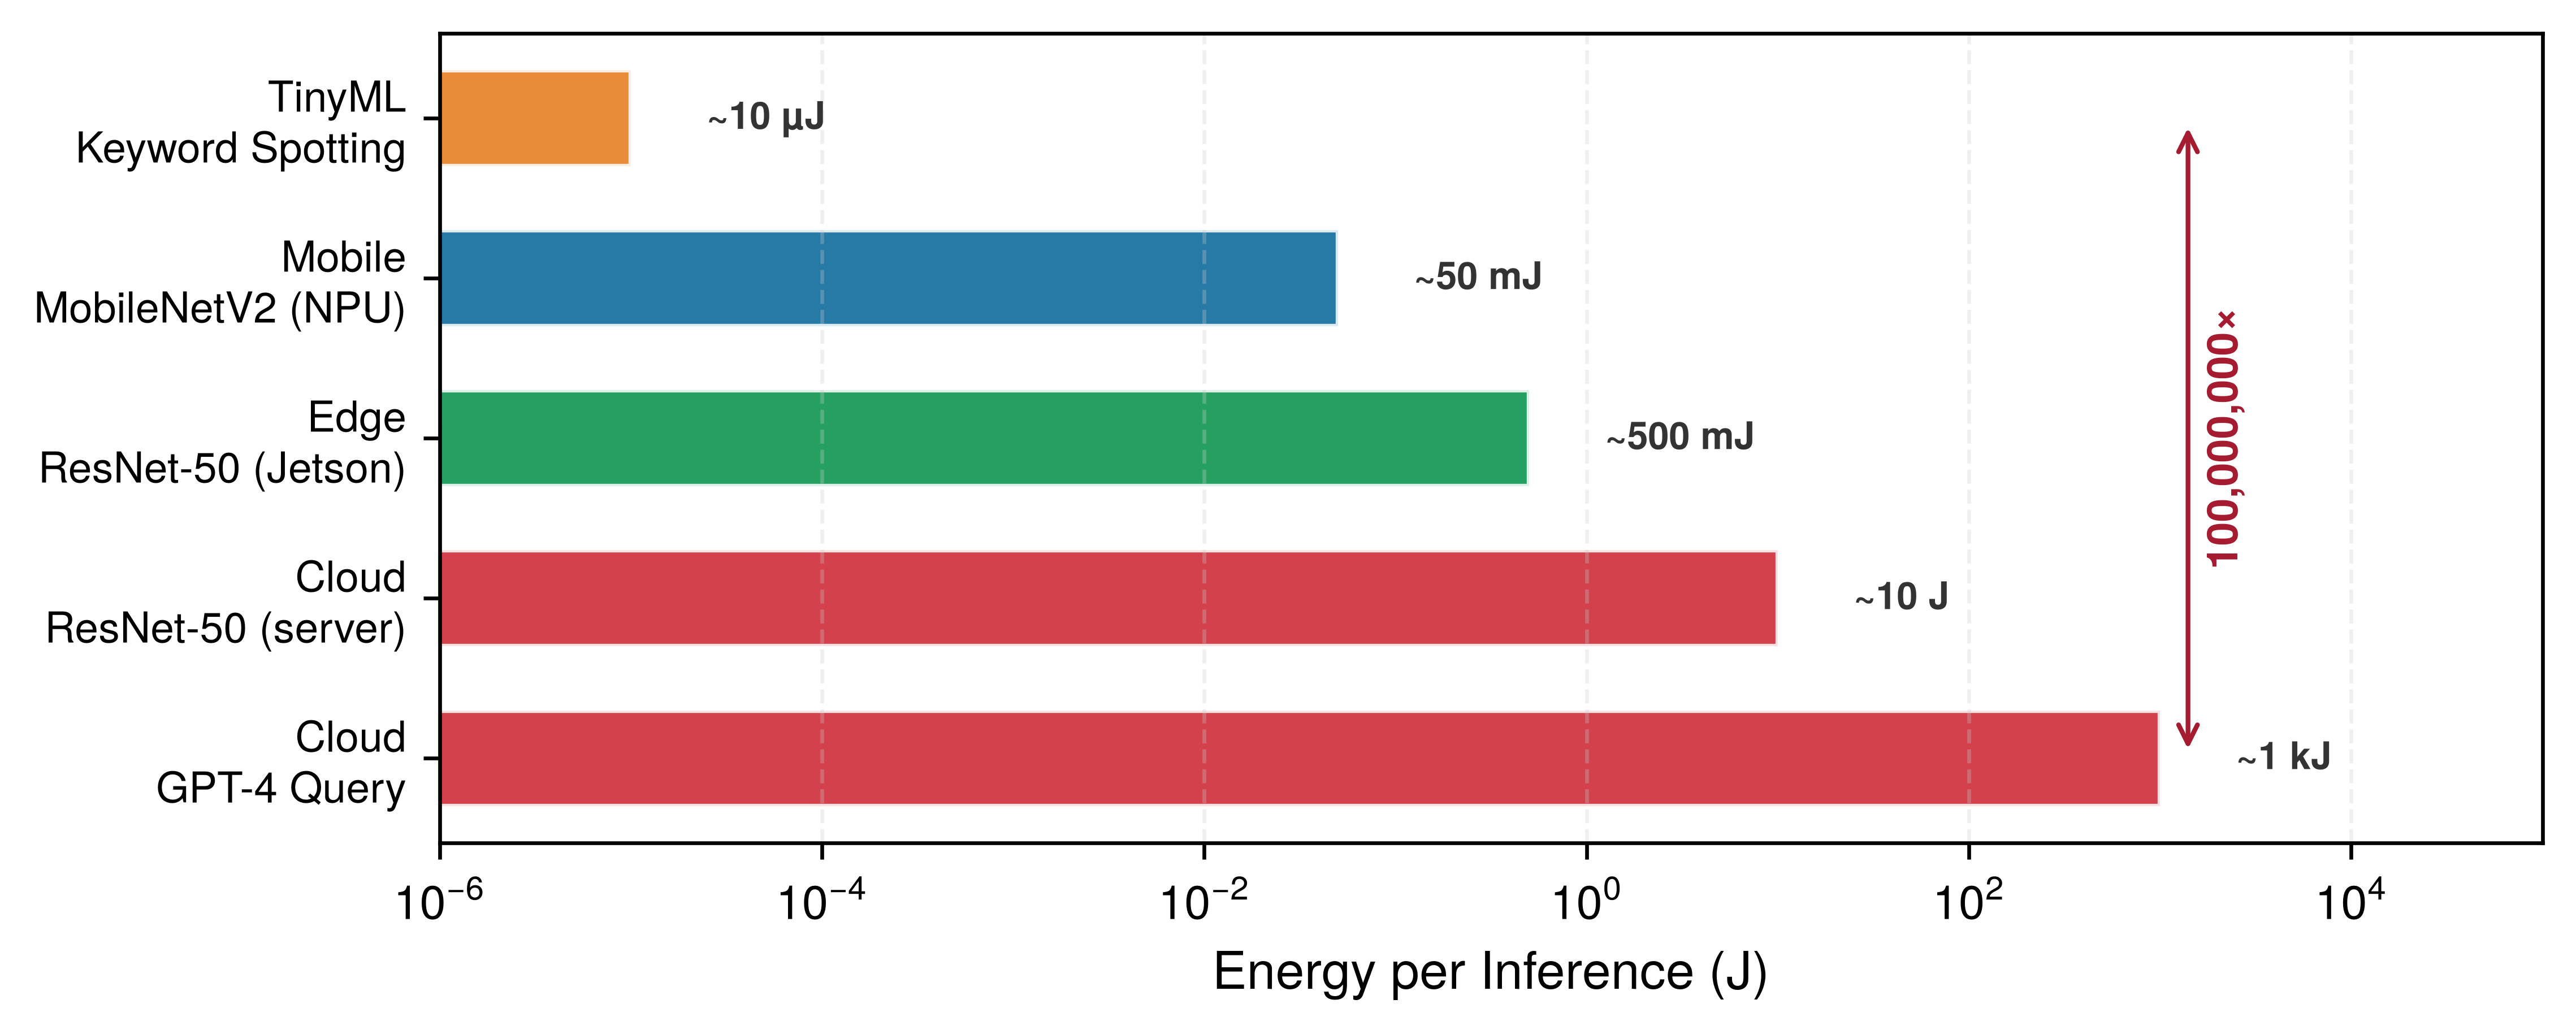
Lợi ích và thách thức khi triển khai Edge ML
Edge ML hiện diện trong các thiết bị đeo, cảm biến công nghiệp và thiết bị gia dụng thông minh, nơi dữ liệu được xử lý cục bộ18 mà không phụ thuộc vào máy chủ trung tâm. Khoảng chênh lệch tám bậc độ lớn được minh họa trong figure 6 phản ánh sự khác biệt về các khối lượng công việc (workload) và ranh giới phạm vi tính toán, chứ không phải là một hằng số bất biến của các cấp độ triển khai.
18 Bức tường dữ liệu của Internet vạn vật (IoT): McKinsey ước tính rằng việc triển khai IoT có thể tạo ra giá trị kinh tế lên đến hàng nghìn tỷ đô la vào năm 2030, nhưng những triển khai này phụ thuộc vào các luồng dữ liệu cảm biến liên tục từ các thiết bị phân tán khắp nhà ở, nhà máy, trang trại, phương tiện và cơ sở hạ tầng (McKinsey Global Institute 2021). Ở nhiều bối cảnh như vậy, tổng \(D_{\text{vol}}\) từ các luồng dữ liệu thô vượt quá ngân sách băng thông uplink hoặc ngân sách độ trễ cho việc thu thập tập trung, khiến xử lý cục bộ tại edge trở thành một yêu cầu kiến trúc chứ không chỉ là một tối ưu chi phí.
McKinsey Global Institute. 2021. The Internet of Things: Catching up to an Accelerating Opportunity. McKinsey & Company.
Cùng một giới hạn năng lượng cũng trở thành giới hạn về kích thước mô hình. Vì các thiết bị edge hoạt động trong giới hạn công suất nghiêm ngặt, dung lượng bộ nhớ giới hạn những gì có thể chứa, còn băng thông giới hạn tốc độ di chuyển của các trọng số và activation. Những ràng buộc này thúc đẩy các kỹ thuật tối ưu hóa được đề cập trong Nén mô hình, nhằm giảm số byte của mô hình và số phép toán để phù hợp với giới hạn phần cứng. Lợi ích không chỉ ở phần tính toán: xử lý luồng camera thô ngay trên thiết bị có thể tránh yêu cầu uplink ở mức terabit, vì dữ liệu thô không bao giờ rời khỏi thiết bị, qua đó giảm các chi phí định kỳ cho truyền tải, lưu trữ và xử lý trên đám mây.
Tính bất biến của dữ liệu cục bộ
Quyết định giữa xử lý cục bộ trên edge và xử lý từ xa trên đám mây được chi phối bởi sự đánh đổi giữa băng thông và độ trễ. Thực thi từ xa là không khả thi nếu toàn bộ đường đi của nó vi phạm thời hạn dịch vụ; ngược lại, đường đi khả thi nhanh hơn được chọn bằng cách so sánh tổng thời gian xử lý cục bộ và từ xa.
Definition 1.3: Tính bất biến của dữ liệu cục bộ
Bất biến về cục bộ dữ liệu trước hết kiểm tra xem một đường đi từ xa hoàn chỉnh có đáp ứng thời hạn dịch vụ hay không. Gọi \(T_{\text{remote}}\) là tổng thời gian của đường đi từ xa, \(T_{\text{deadline}}\) là thời hạn, \(\text{BW}_{\text{network}}\) là băng thông mạng, \(L_{\text{lat,network}}\) là độ trễ mạng, còn \(R_{\text{peak,remote}}\) và \(\eta_{\text{hw,remote}}\) lần lượt là tốc độ tính toán và hiệu suất phần cứng phía xa: \[T_{\text{remote}} = \frac{D_{\text{vol}}}{\text{BW}_{\text{network}}} + L_{\text{lat,network}} + \frac{O}{R_{\text{peak,remote}} \cdot \eta_{\text{hw,remote}}}, \quad \text{remote feasible} \iff T_{\text{remote}} \le T_{\text{deadline}}\]
\(T_{\text{local}}\) tương ứng là tổng thời gian của đường đi cục bộ. Nếu cả hai đường dẫn đều khả thi, ta so sánh \(T_{\text{local}}\) và \(T_{\text{remote}}\); bất kỳ đường dẫn nào cũng có thể bị loại nếu không kịp thời hạn.
- Ý nghĩa: Bất biến này xác định một điểm giao cắt mà sau đó, việc bổ sung năng lực tính toán từ xa \((R_{\text{peak}})\) hầu như không còn tác dụng vì thời gian truyền qua mạng chi phối \(T_{\text{remote}}\). Đường dẫn cục bộ chỉ được ưu tiên sau khi đã kiểm tra đầy đủ tổng thời gian thực thi và các giới hạn tài nguyên của chính nó.
- Điểm khác biệt: Khác với iron law, vốn phân tích một đường dẫn thực thi duy nhất, bất biến về cục bộ dữ liệu so sánh hai đường dẫn hoàn chỉnh với nhau và với một thời hạn dịch vụ rõ ràng.
- Cạm bẫy thường gặp: Một hiểu lầm phổ biến là 5G/6G sẽ “giải quyết” vấn đề cục bộ. Dù các công nghệ này cải thiện \(\text{BW}_{\text{network}}\), chúng không loại bỏ độ trễ lan truyền và độ trễ giao thức, nên một đường đi từ xa vẫn có thể không kịp một thời hạn dịch vụ nghiêm ngặt.
Điểm giao cắt về cục bộ dễ thấy nhất khi so sánh một khung dữ liệu cảm biến tốc độ cao với ngân sách thời gian khứ hồi dành cho xử lý từ xa.
Vật lý định hình lựa chọn kiến trúc; các đánh đổi kỹ thuật theo sau đó. Lợi ích thấy ngay là giảm độ trễ: tránh các lượt khứ hồi lên đám mây có thể rút ngắn thời gian phản hồi, cho phép các ứng dụng an toàn trọng yếu khi toàn bộ đường xử lý cục bộ đáp ứng được deadline thời gian thực. Tiết kiệm băng thông càng củng cố lợi thế này; chẳng hạn, một cửa hàng bán lẻ có 50 camera có thể giảm mạnh lưu lượng truyền bằng cách xử lý tại chỗ và chỉ gửi siêu dữ liệu, dù mức giảm và chi phí cụ thể còn tùy codec, lưu lượng và giá dịch vụ. Quyền riêng tư cũng được tăng cường, vì giữ dữ liệu thô tại chỗ làm giảm rủi ro lộ lọt trong truyền dẫn, dù không loại trừ các nghĩa vụ riêng tư khác. Với các triển khai công nghiệp, khả năng vận hành bền bỉ có thể mang tính quyết định: hệ thống vẫn tiếp tục hoạt động khi mất liên kết với đám mây, miễn là điện và mạng cục bộ còn sẵn sàng — một thuộc tính thiết yếu ở nơi thời gian ngừng hoạt động gây chi phí ngay lập tức.
Những lợi ích này đi kèm các hạn chế tương ứng, và các hạn chế đó sẽ chồng chất khi quy mô triển khai tăng. Trong kịch bản edge của chương này, phần cứng chỉ có 1–8 GB bộ nhớ và 5–50 W công suất, thấp hơn nhiều so với máy chủ đám mây tham chiếu.19 Những ràng buộc đó khiến kích thước mô hình, activations, trạng thái runtime và chu kỳ làm việc bền vững trở thành các giới hạn hạng nhất. Quản lý mạng phân tán làm phát sinh độ phức tạp tăng phi tuyến theo quy mô, vì việc phối hợp quản lý phiên bản và cập nhật trên hàng nghìn thiết bị đòi hỏi các hệ thống điều phối tinh vi,20 và sự khác biệt phần cứng giữa nhiều nền tảng buộc phải có chiến lược tối ưu hóa riêng cho từng đích.
19 Ràng buộc máy chủ edge: Trong phạm vi đại diện của chương này, 1–8 GB có thể chứa khoảng 1–8 tỷ trọng số INT8 trước activations, trạng thái runtime và các bộ đệm khác, nên số tham số tự thân không xác lập một trần phổ quát ở mức chỉ vài triệu. Khả năng tính toán bền vững còn bị giới hạn bởi công suất, làm mát và chu kỳ hoạt động.
20 Điều phối đội thiết bị edge: Quản lý hàng nghìn thiết bị edge phân tán tạo ra những kiểu lỗi không có trong đám mây tập trung: kết nối chập chờn dẫn đến trôi phiên bản mô hình, phần cứng không đồng nhất đòi hỏi tối ưu hóa theo từng thiết bị, và việc tiếp cận vật lý hạn chế khiến rollback firmware trở nên tốn kém. Các mẫu vận hành này được phân tích trong Vận hành machine learning.
Napkin Math 1.7: Điểm giao thoa cục bộ
Bài toán: Hệ thống tránh vật cản của máy bay không người lái (4K, 60 FPS) có nên chuyển xử lý lên đám mây, hay đây là một điểm giao thoa cục bộ?
Cho trước:
- Dữ liệu \((D_{\text{vol}})\): Một khung 4K có kích thước xấp xỉ 24.9 MB.
- Băng thông \((\text{BW}_{\text{network}})\): 100 Mb/s (băng thông rộng gia đình, chiều tải lên).
- Thời gian phản hồi mạng và tính toán từ xa: 110 ms (bao gồm thời gian khứ hồi và thời gian tính toán từ xa).
Tính toán:
- Thời gian truyền: 24.9 MB \(\times\) 8 bit/100 Mb/s = 1,990.7 ms.
- Tổng đường dẫn từ xa: Thời gian truyền + 110 ms = 2100.7 ms, so với khoảng thời gian giữa hai khung là 16.7 ms.
Nhận định về hệ thống: Đường dẫn từ xa đã không kịp khung hình ngay cả trước khi tính phần dư của vòng lặp điều khiển, và tăng tốc tính toán từ xa cũng không loại bỏ được thời gian truyền. Vì vậy, với các giả định này, offload lên đám mây là không khả thi; vẫn cần đo lường đường dẫn cục bộ để xác nhận đáp ứng thời hạn.
Một ví dụ triển khai bán lẻ thực tế cho thấy những ràng buộc này chuyển thành các yêu cầu về thông lượng, phần cứng và chi phí đội thiết bị như thế nào. Hãy xét một chuỗi bán lẻ thông minh triển khai phát hiện người tại 500 cửa hàng, mỗi cửa hàng có 20 cameras/store camera chạy ở 15 FPS. Bảng Table 10 dẫn suất tốc độ suy luận mỗi cửa hàng qua số FLOP trên mỗi khung hình của YOLOv8-nano, để ra thông lượng mà mỗi cửa hàng phải duy trì.
| Chỉ số | Tính toán | Kết quả |
|---|---|---|
| Số suy luận mỗi cửa hàng | 20 cameras/store \(\times\) 15 FPS | 300 inferences/s |
| Tính toán mô hình | YOLOv8-nano: 8.7 GFLOP/inference | 2610 GFLOP/s |
| Thông lượng yêu cầu | 2610 GFLOP/s \(\times\) 2 (headroom) | ~5.22 TOPS tương đương |
Table 11 so sánh thông lượng, công suất, chi phí đơn vị và chi phí đội thiết bị của ba bộ tăng tốc edge tiềm năng, bao gồm cả các bộ tăng tốc GPU nhúng.
| Thiết bị Edge | INT8 TOPS | Công suất | Chi phí đơn vị | Chi phí đội thiết bị |
|---|---|---|---|---|
| NVIDIA Jetson Orin NX | 100 TOPS | 10–25 W | $600 | $300,000 |
| Intel NUC + Movidius | 1 TOPS | 15 W | $400 | $200,000 |
| Google Coral Dev (3 boards/store) | đỉnh 12 TOPS, giảm định mức 6 TOPS | 6 W | $450 | $225,000 |
Napkin Math 1.8: Định cỡ suy luận edge
Bài toán: Với mục tiêu thông lượng đã nêu trong bảng table 10 và các lựa chọn bộ tăng tốc được trình bày trong bảng table 11, bộ tăng tốc edge nào (TPU kích thước USB, GPU nhúng cấp máy trạm, hay mini-PC đa năng) sẽ cung cấp thông lượng cần thiết với chi phí đội thiết bị thấp nhất trong ba năm?
Tính toán: Chúng ta định cỡ dựa trên khả năng duy trì của một bo mạch, không dựa vào mức đỉnh trên bảng dữ liệu của nó. Một Coral Dev Board được đánh giá ở mức đỉnh 4 TOPS nhưng duy trì khoảng 2 TOPS sau khi áp dụng mức giảm 50 percent, nên số lượng cho mỗi cửa hàng là 5.22 TOPS yêu cầu ÷ 2 TOPS mỗi bo mạch = 2.6 bo mạch, làm tròn lên thành 3 boards/store.
Trong 3 years trên 500 cửa hàng, TCO cho cấu hình đó gồm Phần cứng $225,000 + chi phí điện (công suất 0.006 kW \(\times\) 500 \(\times\) 8760 h/year \(\times\) 3 years \(\times\) $0.12/kWh = $9,460.8) = $234,460.8 tổng cộng, so với mức cơ bản “mỗi cửa hàng một GPU đám mây chuyên dụng” khoảng ~$9,855,000.
Kết quả: Một Coral đơn lẻ là thiếu công suất, nhưng cấu hình phân mảnh với 3 boards/store là lựa chọn edge chi phí thấp, cung cấp 6 TOPS và CapEx phần cứng trên mỗi cửa hàng thấp hơn khoảng 1.3× so với Jetson. Jetson vẫn là phương án triển khai một thiết bị đơn giản hơn khi độ phức tạp tích hợp quan trọng hơn chi phí phần cứng.
Góc nhìn hệ thống: Định cỡ edge là bài toán dung lượng và chi phí, không phải chuyện tên thiết bị. Phương án rẻ nhất khả thi có thể là dùng vài bộ tăng tốc nhỏ cho mỗi địa điểm thay vì một bo lớn, nhưng khoản tiết kiệm phần cứng đó phải cân đối với gánh nặng điều phối và bảo trì một đội thiết bị edge phân mảnh.
Các thách thức bảo mật trở nên gay gắt hơn vì thiết bị edge có thể bị tiếp cận trực tiếp: thiết bị triển khai ở cửa hàng bán lẻ hoặc hạ tầng công cộng đối mặt nguy cơ bị can thiệp, điều mà các trung tâm dữ liệu tập trung không gặp, nên cần các cơ chế bảo vệ dựa trên phần cứng như khởi động an toàn, lưu trữ được mã hóa và vỏ chống giả mạo. Trong một ví dụ triển khai, với phần cứng edge trị giá $500–2.000 cho mỗi địa điểm, trang bị 1.000 địa điểm cần $500.000–2.000.000 vốn ban đầu trước khi lắp đặt và vận hành. Việc khoản vốn đó có lợi hơn chi tiêu đám mây hay không phụ thuộc vào mức độ sử dụng, nhân công, bảo trì và giá dịch vụ.
Hệ thống công nghiệp và IoT thời gian thực
Các ứng dụng edge khác nhau tùy lĩnh vực, nhưng đều cụ thể hóa cùng một lập luận về tính cục bộ: hệ thống không thể chờ mạng, không thể chuyển dữ liệu đi, không thể lộ tín hiệu thô, hoặc không thể dừng khi xảy ra sự cố mạng. Xe tự hành là một ứng dụng đòi hỏi rất cao, vì các quyết định về nhận thức và điều khiển liên quan trực tiếp đến an toàn phải đáp ứng ngân sách thời gian ở mức mili giây. Các hệ thống trên xe xử lý dữ liệu từ nhiều camera và cảm biến khác bằng phần cứng cục bộ; một kết nối đến đám mây từ xa không thể đáp ứng vòng điều khiển chặt chẽ đó, vì chỉ riêng độ trễ mạng đã vượt quá thời hạn cho phép.
Môi trường bán lẻ thông minh cho thấy lợi ích thực tế của ML trên edge đối với các ứng dụng nhạy cảm về quyền riêng tư và tiêu tốn nhiều băng thông. Một cửa hàng không quầy thanh toán21 có thể xử lý tín hiệu từ nhiều camera trên các máy chủ edge cục bộ, theo dõi chuyển động của khách hàng và lựa chọn mặt hàng mà không phải liên tục truyền video thô qua liên kết diện rộng. Kiến trúc này giúp giảm nhu cầu băng thông và giảm rủi ro phơi lộ trong quá trình truyền, nhưng tự nó không đảm bảo quyền riêng tư: việc lưu trữ, truy cập, sử dụng thứ cấp và các cơ chế kiểm soát quản trị vẫn quyết định mức độ tuân thủ và rủi ro của hệ thống.
21 Bán lẻ không cần thanh toán: Một cửa hàng có thể kết hợp dữ liệu quan sát từ camera với các sự kiện trên kệ và trạng thái giao dịch ngay tại chỗ, rồi chỉ truyền đi những sự kiện hoặc số liệu tổng hợp đã chọn. Tuy vậy, ranh giới quyền riêng tư vẫn phải bao gồm cả những bản ghi suy ra này, vì giảm truyền tải video thô không quyết định việc lưu giữ, truy cập hay sử dụng dữ liệu cho mục đích khác.
22 Công nghiệp 4.0: Cuộc cách mạng công nghiệp lần thứ tư tích hợp ML vào vòng phản hồi cảm biến–chấp hành ngay trên sàn nhà máy. Hệ quả là độ trễ của vòng điều khiển \((L_{\text{lat}})\) phải ngắn hơn quá trình vật lý mà nó kiểm soát: một robot hàn phát hiện lỗi ở 60 Hz có khoảng thời gian lấy mẫu 16.7 ms, đòi hỏi triển khai với toàn bộ đường dẫn phản hồi phải kịp trong thời hạn đó.
23 Bảo trì dự đoán: Các mô hình phân tích dữ liệu cảm biến như độ rung và nhiệt độ để ước tính tình trạng thiết bị và rủi ro hỏng hóc. Giám sát liên tục biến nhịp lấy mẫu, chu kỳ hoạt động, công suất và lưu trữ cục bộ thành các ràng buộc chính. Các nút chạy pin có thể cần mức công suất trung bình dưới 1 watt, trong khi các cổng công nghiệp dùng điện lưới có không gian công suất lớn hơn nhiều.
IoT công nghiệp22 sử dụng ML trên edge cho các ứng dụng mà khả năng phản hồi ở mức mili giây ảnh hưởng trực tiếp đến hiệu quả sản xuất và an toàn của người lao động. Các cơ sở sản xuất triển khai hệ thống ML trên edge để kiểm soát chất lượng thời gian thực và bảo trì dự đoán.23
Các tòa nhà thông minh dùng ML tại edge để tối ưu hóa tiêu thụ năng lượng, đồng thời duy trì hoạt động liên tục ngay cả khi mất mạng. Các tòa nhà thương mại được trang bị hệ thống quản lý tòa nhà dựa trên edge xử lý dữ liệu từ hàng nghìn cảm biến theo dõi nhiệt độ, mức độ có người, chất lượng không khí và mức tiêu thụ năng lượng. Cách làm này giúp giảm yêu cầu truyền lên đám mây ít nhất 10 lần, đồng thời cho phép thời gian phản hồi dưới một giây. Tương tự, các ứng dụng chăm sóc sức khỏe cũng dùng ML tại edge để theo dõi bệnh nhân và hỗ trợ phẫu thuật, vừa giảm truyền dữ liệu vừa hỗ trợ các quy trình làm việc có độ trễ thấp cho hướng dẫn theo thời gian thực.
Nhiều hệ thống edge trong công nghiệp và bán lẻ là cố định và được nối với nguồn điện tại chỗ. Hãy nhớ lại định luật sắt trong equation 6: triển khai cục bộ loại bỏ thành phần mạng từ xa, còn điện lưới khiến ngân sách năng lượng bớt bị ràng buộc hơn so với dùng pin. Một máy chủ edge trong nhà máy tiêu thụ hàng trăm watt liên tục có thể chấp nhận được khi dùng điện tại chỗ. Ngược lại, thiết bị di động theo chân người dùng và chạy trên ngân sách pin cố định. Khi ta chuyển từ hạ tầng edge cố định sang chiếc smartphone trong túi người dùng, một hạng mục tối ưu hóa mới xuất hiện: \(\text{Energy} = \text{Power} \times T\). Ràng buộc chính có thể chuyển từ độ trễ sang năng lượng trên mỗi suy luận, và theo đó, cách tính toán kỹ thuật cũng đổi khác.
Self-Check: Question
A manufacturing facility deploys 100 cameras recording uncompressed 1080p video (\(1920 \times 1080 \times 3\text{ bytes/pixel}\)) at 30 FPS. The factory has a dedicated 10 Gbps (~1.25 GB/s) fiber uplink. Why is streaming all raw video to a cloud ML server physically impossible?
- 1080p video frames contain interlaced scanlines that cloud GPUs cannot decompress.
- Fiber optic cables can only carry voice data, requiring microwave radio relays for video.
- The aggregate raw video data rate is approximately 18.7 GB/s, which exceeds the 1.25 GB/s uplink capacity by roughly 15-fold.
- Cloud object detection models require uncompressed video to be transmitted in 10-minute batched tar archives.
An autonomous drone navigates at 60 FPS (16.7 ms per-frame budget) capturing uncompressed 4K frames (~24.9 MB per frame). The drone connects via a 100 Mbps uplink to a cloud server whose round-trip latency plus inference time is 110 ms. Applying the data locality invariant, what is the feasibility of offloading this obstacle avoidance system to the cloud?
- Feasible, because the cloud GPU computes inference in under 10 ms.
- Feasible, provided 5G network slicing is enabled on the drone modem.
- Infeasible, solely because cloud servers do not support drone telemetry protocols.
- Infeasible, because transmitting a 24.9 MB frame over a 100 Mbps link requires ~2,000 ms, causing the complete remote path (~2,110 ms) to violate the 16.7 ms frame deadline by over two orders of magnitude.
Why cannot high-bandwidth wireless networking technologies (such as 5G or 6G) eliminate the need for edge ML in tight real-time control loops (\(<10\text{ ms}\))?
When sizing edge accelerators for a retail store deployment requiring 7.2 TOPS of sustained INT8 throughput, why is it inadequate to select a single accelerator rated at 8 TOPS peak datasheet throughput?
In industrial IoT manufacturing systems (Industry 4.0), the complete ML control loop latency (\(L_{\text{lat}}\)) must be strictly shorter than the ____ of the physical machinery it governs (such as a 16.7 ms window for a 60 Hz welding robot).
ML di động: Trí tuệ ngoại tuyến
Edge ML giải quyết bài toán khoảng cách vốn hạn chế các triển khai trên đám mây bằng cách đưa tính toán lại gần dữ liệu. Nhiều hệ thống edge là các gateway cố định, máy chủ trong nhà máy và thiết bị bán lẻ, trong khi người dùng mang điện thoại và máy tính bảng di chuyển qua nhiều môi trường. Đưa cùng mức độ gần dữ liệu đó lên một thiết bị di động lại kéo theo một ràng buộc khác: pin. Khác với các máy chủ edge cắm điện có thể liên tục tiêu thụ hàng trăm watt, thiết bị di động phải hoạt động nhiều giờ hoặc nhiều ngày với ngân sách năng lượng cố định.
Mobile ML giải quyết thách thức này bằng cách tích hợp machine learning trực tiếp vào các thiết bị di động như điện thoại thông minh và máy tính bảng, mang lại khả năng phản hồi nhanh và cá nhân hóa. Cách tiếp cận này đặc biệt hiệu quả khi tính cục bộ của dữ liệu, khả năng hoạt động ngoại tuyến và phản hồi tức thì quan trọng hơn quy mô tính toán, hỗ trợ các ứng dụng như nhận dạng giọng nói, nhiếp ảnh tính toán,24 và giám sát sức khỏe. Xử lý tại chỗ giúp giảm phơi lộ khi truyền dữ liệu nhưng tự thân nó không bảo đảm quyền riêng tư. Các thiết bị chạy pin này phải cân bằng giữa hiệu năng, hiệu quả sử dụng công suất và quản lý nhiệt, nên phù hợp với các tác vụ AI thường xuyên, thời lượng ngắn.
24 Nhiếp ảnh tính toán: Sử dụng các thuật toán ML (ví dụ: ghép nhiều khung hình, khử nhiễu bằng mạng nơ-ron) để vượt qua giới hạn vật lý của cảm biến camera di động nhỏ. Đây là một ví dụ điển hình về sự đánh đổi trong điện toán di động: một pipeline nhiều giai đoạn phải chạy trong khoảng độ trễ màn trập mà người dùng cảm nhận, đồng thời tuân thủ ngân sách nhiệt chung 3–5 W.
25 Thu gọn mô hình thị giác di động: Các kiến trúc kiểu MobileNet giảm lượng tính toán ở các lớp thị giác phổ biến mà vẫn giữ được độ chính xác cần thiết cho các tác vụ di động. Các chi tiết kiến trúc sẽ được trình bày trong Kiến trúc mạng; điều quan trọng về mặt hệ thống là triển khai di động thường đòi hỏi thay đổi cả họ mô hình, chứ không chỉ đơn giản là đem nguyên mô hình đó lên điện thoại.
Môi trường di động đặt ra một hạn chế quan trọng mà các hệ thống cố định không có: năng lượng cho mỗi lần suy luận trở thành tham số thiết kế hàng đầu. Theo định luật sắt trong equation 6, các hệ thống đám mây và edge tối ưu để giảm \(T\), tức tổng độ trễ. Còn hệ thống di động có thêm ràng buộc: \(\text{Energy} = \text{Power} \times T\), và “power wall” được mô tả bởi equation 2 giới hạn công suất duy trì ở 3–5 W. Ở góc nhìn nguyên mẫu, một khối lượng công việc (workload) kiểu Compute Beast như phân loại ảnh phải được thu gọn thành một mô hình thị giác nhỏ hơn,25 giảm FLOPS đi 13.7× mà vẫn đủ chính xác cho ứng dụng. Đây không chỉ là tối ưu hóa; mà còn là một chuyển dịch về chất trong đánh đổi compute-per-byte, chấp nhận thông lượng đỉnh thấp hơn để vận hành bền vững trong “giới hạn nhiệt” 3–5 W.
Chính giới hạn về pin và nhiệt này đã định hình nên mô hình di động.
Definition 1.4: Mobile ML
Mobile machine learning là mô hình triển khai bị ràng buộc bởi công suất thiết kế nhiệt (TDP) và năng lượng từ pin.
- Ý nghĩa: Nó bị giới hạn bởi khả năng tản nhiệt chỉ vài watt của hệ thống làm mát thụ động, nên các kiến trúc cần ưu tiên duy trì hiệu quả năng lượng hơn là đạt thông lượng đỉnh \((R_{\text{peak}})\).
- Điểm khác biệt: Khác với edge ML có thể dùng làm mát chủ động, mobile ML phải hoạt động trong ngân sách năng lượng cá nhân. So với TinyML, mobile ML vẫn cung cấp hệ điều hành đầy đủ và khả năng tính toán ở mức vài watt.
- Hiểu lầm phổ biến: Nhiều người nghĩ hiệu suất của mobile ML là một giá trị cố định. Thực tế, đây là một ràng buộc thay đổi theo thời gian: hiệu suất thường giảm khi thiết bị chạm ngưỡng nhiệt, kích hoạt cơ chế điều tiết (throttling) làm giảm chu kỳ hoạt động \((\eta_{\text{hw}})\).
Xử lý trực tiếp trên thiết bị mang lại phản hồi tức thì và tính cục bộ của dữ liệu, nhưng phải hoạt động trong các ranh giới điện hóa và nhiệt động học nghiêm ngặt. Sơ đồ phân loại bốn nhánh trong figure 7 liên kết pin dùng chung và khung máy làm mát thụ động của điện thoại với yêu cầu hợp nhất kernel NPU và các giới hạn điều tiết nhiệt.
Thời lượng pin và các ràng buộc tài nguyên trong mobile ML trực tiếp trở thành yêu cầu kỹ thuật. Các tính năng ML luôn bật phải chịu thuế pin, vì suy luận liên tục tiêu tốn ngân sách năng lượng hữu hạn của điện thoại, ngay cả trước khi các phần khác của hệ thống chạy.
Ràng buộc về pin giới hạn tổng năng lượng tiêu thụ theo thời gian. Ngay cả khi ta có thể tạm bỏ qua thời lượng pin với một máy tính bảng cắm điện hay một bản demo ngắn, nhiệt động lực học vẫn áp một giới hạn thứ hai. Công suất điện rốt cuộc biến thành nhiệt mà thiết bị phải tản. Một trung tâm dữ liệu dùng làm mát chủ động để loại bỏ nhiệt này. Ngược lại, một thiết bị di động mỏng chủ yếu dựa vào truyền nhiệt thụ động qua khung và bề mặt. Điều đó tạo ra giới hạn nhiệt – một trần cứng cho mức công suất duy trì, tồn tại độc lập với dung lượng pin.

Napkin Math 1.9: Thuế pin
Vấn đề: Hãy triển khai một tính năng phát hiện đối tượng chạy nền “thời gian thực” trên điện thoại thông minh. Mô hình này tiêu thụ 2 W công suất liên tục khi hoạt động. Điện thoại có pin tiêu chuẩn 15 Wh. Liệu tính năng này có thể luôn bật cả ngày không? Đây chính là thuế pin – yếu tố biến thời lượng pin thành một ràng buộc về ngân sách năng lượng cho ML trên thiết bị di động.
Vật lý:
- Thời gian runtime lý tưởng: \(\frac{15 Wh}{2 W}\) = 7.5 hours
- Thực tế: Người dùng kỳ vọng điện thoại của họ dùng được 24 hours. Chạy liên tục tính năng này trong một ngày sẽ cần 320 percent ngân sách năng lượng hằng ngày của điện thoại.
Góc nhìn hệ thống: Không thể cứ thế “triển khai” mô hình. Các kỹ thuật trong Nén mô hình phải đồng thời giảm khối lượng tính toán của mô hình và chu kỳ hoạt động, để đặc trưng này có thể duy trì hoạt động cả ngày.

Hiệu năng nhiệt duy trì thấp hơn nhiều so với các đỉnh bùng nổ.
Việc phân biệt hai yếu tố này rất quan trọng cho quyết định kỹ thuật: “thuế pin” là một bài toán ngân sách, về nguyên tắc có thể giải bằng cách giảm tần suất chạy mô hình hoặc tăng dung lượng pin. Ngược lại, bức tường nhiệt là một trần vật lý. Một viên pin lớn hơn không thể nâng công suất duy trì tối đa mà một khung máy thụ động có thể tản; thay đổi chu kỳ hoạt động và phần mềm chỉ có thể giảm sinh nhiệt. Vận hành liên tục vượt quá giới hạn nhiệt sẽ kích hoạt điều tiết phần cứng, bất kể năng lượng pin còn lại là bao nhiêu. Do đó, hai ràng buộc này tác động vào những điểm khác nhau của định luật sắt: pin giới hạn tổng số hoạt động trên mỗi lần sạc (\(O\) tích phân theo thời gian), còn bức tường nhiệt chặn trần tốc độ tức thời (\(R_{\text{peak}} \cdot \eta_{\text{hw}}\)) mà silicon có thể duy trì.
Napkin Math 1.10: Bức tường nhiệt
Vấn đề: Một mô hình thị giác chưa được tối ưu hóa đòi hỏi 12 W công suất tính toán đỉnh. Liệu mô hình này có thể triển khai trên thiết bị di động không, hay nó sẽ gặp phải bức tường nhiệt và bức tường công suất di động?
Kịch bản: Một hệ thống trên chip (SoC) di động cho phép khoảng 3 W cho làm mát thụ động. Giả sử mô hình chưa tối ưu vẫn được triển khai; một vệt điều tiết điển hình trên thiết bị làm mát thụ động như vậy diễn ra theo ba bước:
- Tăng nhiệt độ: Khi hoạt động ở mức 12 W, nhiệt độ thiết bị tăng khoảng 1 °C/s.
- Ngắt nhiệt: Trong khoảng 60 s, phần cứng đạt đến điểm ngắt nhiệt (80 °C), kích hoạt cơ chế điều tiết của hệ điều hành.
- Thông lượng bị điều tiết: Thông lượng của mô hình đột ngột từ 100 FPS xuống 30 FPS để duy trì trong giới hạn nhiệt.
Toán học: Giả sử mức giảm công suất hoạt động minh hoạ là 4× sau khi thiết kế lại từ FP32 sang INT8 (xem Nén mô hình): 12 W ÷ 4 = 3 W, và kết quả chạm đúng trần làm mát thụ động 3 W, không còn dư địa. Hệ số này là tham số đầu vào cho kịch bản, không phải bảo chứng chung cho toàn hệ thống chỉ nhờ lượng tử hoá.
Góc nhìn hệ thống: Ngay cả khi giảm công suất tới 4× cũng không tạo thêm khoảng trống nhiệt; nó chỉ vừa đủ chạm tới giới hạn bền vững. Các định luật vật lý đặt ra một trần cứng mà không tối ưu hoá nào có thể vượt qua.
Lợi ích và ràng buộc tài nguyên của ML di động
Thiết bị di động là ví dụ điển hình về những ràng buộc ở mức trung gian: 8–16 GB RAM (tuỳ phân khúc, từ tầm trung đến cao cấp), 128 GB-1 TB bộ nhớ trong, và khả năng tính toán AI 15–45 TOPS thông qua các đơn vị xử lý thần kinh26 với mức tiêu thụ công suất 3–5 W. Kiến trúc hệ thống trên chip (SoC)27 tích hợp chặt chẽ tính toán và bộ nhớ để giảm chi phí năng lượng. Dung lượng bộ nhớ giới hạn kích thước mô hình, còn băng thông 51.2–77 GB/s giới hạn tốc độ di chuyển của trọng số và activation. Hạn chế về pin (dung lượng 15 Wh–22 Wh) khiến tối ưu hoá năng lượng trở nên tối quan trọng: nếu thêm 1 W xử lý ML liên tục vào một điện thoại vốn dùng được 24 giờ, thời gian runtime sẽ giảm còn khoảng 9.2 hours–11.5 hours, tuỳ dung lượng pin. Các framework ML chuyên dụng trên thiết bị cung cấp suy luận được tối ưu hoá theo phần cứng, giúp đạt độ trễ UI trong khoảng 5–50 ms.
26 Đơn vị xử lý thần kinh (NPU): Là một khối phần cứng chuyên dụng trên hệ thống trên chip di động, với các mạch được thiết kế cho các phép toán tensor độ chính xác thấp. Sự chuyên biệt này giúp cải thiện hiệu quả năng lượng so với khi thực thi trên CPU, nhờ đó các khối lượng công việc (workload) AI có thể hoạt động trong giới hạn công suất của thiết bị di động.
27 Hệ thống trên chip (SoC): Các SoC di động tích hợp các lõi CPU, GPU và NPU cùng với các cache và bộ điều khiển bộ nhớ để giảm chi phí di chuyển dữ liệu. DRAM trên thiết bị di động thường nằm ngoài chip, và kích thước mô hình khả thi sẽ phụ thuộc vào dung lượng, độ chính xác, bộ nhớ làm việc, băng thông và độ trễ.
28 Face ID: Apple thực hiện đối sánh khuôn mặt trong Secure Enclave và mã hóa các biểu diễn toán học được lưu trữ, đảm bảo chúng chỉ có thể truy cập bởi hệ thống con đó và không rời khỏi thiết bị (Apple 2024a, 2024b). Apple báo cáo xác suất khớp sai ngẫu nhiên dưới 1 trên 1.000.000 cho một lần đăng ký khuôn mặt, với xác suất cao hơn đối với một số nhóm người dùng và cấu hình cụ thể. Ví dụ này cho thấy suy luận cục bộ và cách ly phần cứng có thể giảm thiểu rủi ro lộ dữ liệu khi truyền tải, đồng thời hỗ trợ xác thực với độ trễ thấp.
Apple. 2024a. Facial Matching Security. Apple Platform Security.
Apple. 2024b. The Secure Enclave. Apple Platform Security.
ML trên thiết bị di động nổi trội trong việc mang lại trải nghiệm phản hồi nhanh với độ cục bộ dữ liệu cao hơn. Xử lý thời gian thực có thể đạt độ trễ dưới 10 mili giây cho một số tác vụ, giúp các ứng dụng tương tác có thời gian phản hồi giao diện người dùng (UI) ở mức 5–50 ms. Việc xử lý các dữ liệu đầu vào nhạy cảm ngay trên thiết bị giúp giảm truyền dữ liệu và giảm lưu trữ tập trung. Các khu vực bảo mật trên thiết bị như Secure Enclave của Apple có thể bảo vệ tốt hơn dữ liệu sinh trắc học,28 mặc dù mức độ đảm bảo quyền riêng tư cuối cùng phụ thuộc vào thiết kế hệ thống tổng thể và mô hình mối đe dọa. Các đặc trưng như điều hướng, dịch thuật và xử lý phương tiện cũng có thể hoạt động mà không cần mạng khi mô hình và dữ liệu hỗ trợ của chúng phù hợp với giới hạn tài nguyên trên thiết bị di động. Khả năng cá nhân hóa cũng là một lợi thế, vì các mô hình có thể tận dụng tín hiệu và ngữ cảnh người dùng ngay trên thiết bị trong khi vẫn giữ dữ liệu thô cục bộ.
Để có được các lợi ích này, phải chấp nhận những ràng buộc tài nguyên rất chặt. So với triển khai trên đám mây, ứng dụng di động thường bị siết chặt hơn về bộ nhớ, lưu trữ và độ trễ, nên bị giới hạn kích thước mô hình và hành vi batch. Thời lượng pin tác động trực tiếp đến người dùng, và giới hạn nhiệt có thể kìm hãm đáng kể hiệu năng duy trì: thông lượng NPU đỉnh có thể cao hơn nhiều so với mức thiết bị giữ được dưới các khối lượng công việc (workload) kéo dài. Độ phức tạp phát triển tăng lên khi phải hỗ trợ nhiều nền tảng, đòi hỏi triển khai riêng và tinh chỉnh hiệu năng cẩn thận; đồng thời sự đa dạng thiết bị buộc phải có nhiều biến thể mô hình. Quy trình duyệt của cửa hàng ứng dụng và phát hành theo giai đoạn cũng có thể làm chậm tốc độ lặp so với một dịch vụ do nhà vận hành kiểm soát hoàn toàn.
Trợ lý cá nhân và xử lý đa phương tiện
Trong các ứng dụng di động, vấn đề cốt lõi của hệ thống là nhiều pipeline ngắn phải cùng chia sẻ ngân sách pin và giới hạn nhiệt. Nhiếp ảnh tính toán là một ví dụ điển hình cho thách thức khi chạy nhiều pipeline ML trong một giới hạn nhiệt cho phép. Các dòng điện thoại flagship hiện đại xử lý mỗi bức ảnh qua nhiều giai đoạn ML: chế độ chân dung29 sử dụng ước tính độ sâu và phân đoạn, chế độ ban đêm thì căn chỉnh nhiều khung hình và khử nhiễu bằng ML, còn ghép ảnh HDR, siêu phân giải và tối ưu hóa cảnh được chạy tuần tự. Thách thức kỹ thuật ở đây không nằm ở từng mô hình riêng lẻ, mà là ở toàn bộ pipeline: các mô hình này phải chia sẻ một ngân sách công suất 3–5 W và hoàn thành trong độ trễ màn trập mà người dùng cảm nhận được. Điều này đòi hỏi phải lập lịch cẩn thận trên CPU, GPU và NPU để tránh giảm xung do nhiệt.
29 Pipeline Chế độ chân dung: Đây không phải là một mô hình duy nhất mà là một chuỗi mô hình chạy thời gian thực để ước tính độ sâu, phân đoạn và kết xuất. Vấn đề kỹ thuật cốt lõi là quản lý tổng độ trễ và công suất của toàn bộ pipeline, chứ không phải hiệu suất của từng mô hình riêng lẻ. Toàn bộ pipeline phải thực thi trong độ trễ màn trập mà người dùng cảm nhận và chia sẻ ngân sách nhiệt 3–5 W của điện thoại, buộc phải chấp nhận các đánh đổi khi lập lịch giữa CPU, GPU và NPU để tránh bị giảm hiệu năng.
Các tương tác điều khiển bằng giọng nói cho thấy kiến trúc nhiều lớp của ML di động. Tính năng phát hiện từ đánh thức chạy liên tục trên một lõi chuyên dụng tiêu thụ ít công suất, trong khi nhận dạng giọng nói và dự đoán bàn phím sử dụng các lớp xử lý thần kinh tiêu thụ nhiều công suất hơn. Mỗi lớp hoạt động ở một mức công suất khác nhau, cho thấy ML di động phân chia khối lượng công việc (workload) trên các đơn vị xử lý không đồng nhất trong cùng một SoC.
Giám sát sức khỏe và thực tế tăng cường đẩy ML trên di động tới giới hạn về hiệu năng duy trì. Các thiết bị đeo như Apple Watch xử lý dữ liệu ECG và gia tốc kế ngay trên thiết bị để giảm truyền dữ liệu, trong khi các framework AR yêu cầu tổng thời gian cho mỗi khung hình là 16.7 ms ở 60 FPS cho các tác vụ như định vị đồng thời, theo dõi bàn tay và hiểu môi trường xung quanh. Những ứng dụng này đại diện cho mức trần của hiệu năng mà các thiết bị chạy pin, làm mát thụ động có thể duy trì, và chúng xác định ranh giới mà khi vượt qua, chỉ tối ưu hóa trên thiết bị di động là không còn đủ.
Những thành công này dễ tạo cảm giác mọi thứ đơn giản. Một sai lầm phổ biến là cố gắng triển khai các mô hình được huấn luyện trên máy bàn trực tiếp lên thiết bị di động hoặc edge mà không chỉnh sửa kiến trúc. Các mô hình phát triển trên máy trạm mạnh thường thất bại khi đưa lên thiết bị hạn chế tài nguyên. Một pipeline ResNet-50 trên máy bàn có thể cần đến vài gigabyte bộ nhớ khi tính cả activation, batch, bộ đệm tiền xử lý và overhead của runtime, dù riêng các trọng số FP32 chỉ khoảng 102.4 MB. Một pipeline như vậy, đòi hỏi 8.2 GFLOP cho mỗi lần suy luận, không thể chạy nguyên trạng trên một thiết bị edge cấp thấp điển hình với 512 MB RAM và bộ xử lý 1 GFLOP/s. Không chỉ vi phạm giới hạn tài nguyên, các mô hình tối ưu cho máy bàn còn có thể dùng phép toán phần cứng di động không hỗ trợ, giả định định dạng số không có trên hệ thống nhúng, hoặc yêu cầu xử lý theo batch không tương thích với suy luận từng mẫu. Để triển khai thành công, cần thiết kế có ý thức về kiến trúc ngay từ đầu: họ mô hình, định dạng số học và các lựa chọn hiện thực phải phù hợp với thiết bị mục tiêu.
Mobile ML cho thấy trí tuệ hữu ích có thể vận hành trong giới hạn nhiệt 3–5 W khi chạy bằng pin. Tuy vậy, điện thoại thông minh vẫn có giá hàng trăm đô la, cần gigabyte bộ nhớ, và đòi hỏi người dùng sạc mỗi ngày. Những yêu cầu này khiến chúng không phù hợp với một loạt ứng dụng: giám sát độ ẩm đất trên trang trại hàng nghìn mẫu Anh, phát hiện ứng suất cấu trúc trong cáp cầu, hay lắng nghe các loài có nguy cơ tuyệt chủng trong rừng sâu. Các bài toán này không chỉ cần công suất thấp hơn, mà còn đòi hỏi một chế độ kỹ thuật khác hẳn: thiết bị chỉ vài đô la thay vì hàng trăm, bộ nhớ tính bằng kilobyte thay vì gigabyte, và hệ thống chạy không cần giám sát trong nhiều tháng hoặc nhiều năm. Các phương pháp tối ưu hóa di động có ích, nhưng không thể bắc cầu một khoảng cách bộ nhớ tới 10.000 lần. Cần không phải một chiếc smartphone thu nhỏ, mà là một lớp phần cứng và thuật toán hoàn toàn khác.
Self-Check: Question
How do the battery tax and the thermal wall differ as physical constraints on mobile ML systems?
- The battery tax is an energy budget problem bounding total operations over time (\(\int \text{Power} \cdot dt\)), whereas the thermal wall is a heat dissipation ceiling bounding instantaneous sustained power (\(\text{Power} \le 2\text{--}5\text{ W}\)) regardless of battery size.
- The battery tax applies only to iOS devices, while the thermal wall applies only to Android devices.
- The battery tax can be resolved by lowering clock frequency, but the thermal wall requires increasing the clock frequency to finish calculations faster.
- The battery tax represents static memory leakage in SRAM, while the thermal wall represents network transmission power in 5G modems.
Why does deploying a mobile computational photography feature (such as Portrait Mode or Night Mode) present a pipeline scheduling challenge rather than a single-model optimization problem?
- Mobile cameras can only run one neural network per battery charge cycle.
- The feature executes a multi-stage pipeline (depth estimation, semantic segmentation, alignment, and HDR tone mapping) that must all complete within a perceived shutter delay while sharing a 2–5 W thermal budget across CPU, GPU, and NPU.
- Computational photography models cannot use quantized INT8 representations due to mathematical rounding artifacts in lens optics.
- Camera image signal processors (ISPs) operate asynchronously from the operating system and reject all external ML tensor inputs.
Why does deploying an unoptimized desktop-trained vision model (such as an FP32 ResNet-50 pipeline) directly onto a mobile device frequently fail, even when the model’s FP32 weights (~98 MB) appear smaller than the phone’s total RAM?
Running biometric matching (such as Face ID) inside a dedicated on-device Secure Enclave reduces data disclosure risks by keeping mathematical representations isolated in encrypted hardware, but it does not automatically eliminate all security or privacy risks without rigorous end-to-end system design.
Order the sequence of events that occurs when an unoptimized 12 W deep learning model runs continuously on a passively cooled 3 W smartphone SoC:
- The device temperature rises rapidly (e.g., at ~1 °C per second) as power dissipation exceeds passive cooling capacity
- The unoptimized model launches at full burst performance (e.g., 100 FPS) drawing 12 W of active compute power
- Operating system and hardware thermal controllers engage thermal throttling, reducing clock frequencies and duty cycles
- The internal SoC junction temperature reaches the critical thermal trip point (e.g., 80 °C)
- Sustained inference throughput drops precipitously (e.g., from 100 FPS to 30 FPS) to stabilize power within the 3 W TDP envelope
TinyML: Cảm biến mọi nơi
Hãy hình dung việc gắn cảm biến cho mọi pallet trong kho, mọi sợi cáp trên cầu treo, hay mọi tổ ong trong một trại nuôi ong. Để đặt “mắt và tai” lên hàng chục nghìn đến hàng triệu vật thể như vậy, thiết bị phải có giá chỉ vài đô la, không phải hàng trăm, và kích thước tính bằng milimét, không phải centimét. Điện thoại thông minh quá đắt và quá lớn; điều chúng ta cần là công nghệ cảm biến phổ biến ở kích thước như một con tem bưu chính và mức giá bằng một tách cà phê.
TinyML hoàn thiện dải triển khai bằng cách đẩy trí tuệ tới giới hạn vật lý: ML chi phí thấp, công suất thấp trên các thiết bị nhúng bị hạn chế sâu (Janapa Reddi et al. 2022). Trong phạm vi vận hành của cuốn sách này, các thiết bị có giá dưới $10 và tiêu thụ công suất dưới 1 milliwatt30 giúp cảm biến phổ biến31 trở nên khả thi về mặt kinh tế ở quy mô rất lớn; MLPerf Tiny và MCUNet cho thấy cách đánh giá và tối ưu hóa các ràng buộc này trong thực tế (Banbury et al. 2021; Lin et al. 2020). Đây là phạm vi riêng của kiểu Tiny Constraint, nơi mục tiêu tối ưu hóa chuyển từ tối đa hóa thông lượng sang tối thiểu hóa năng lượng trên mỗi suy luận. Với các giả định về chu kỳ hoạt động trong chương này, một mô hình phát hiện từ khóa tiêu thụ 10 µJ trên mỗi suy luận có thể chạy nhiều năm chỉ với một viên pin cúc áo, đạt mức cải thiện hiệu quả năng lượng gấp hàng triệu lần bằng cách đánh đổi dung lượng mô hình lấy tuổi thọ vận hành.
30 Ngưỡng 1 mW: Thu hoạch năng lượng môi trường có thể cấp nguồn cho thiết bị vô thời hạn chỉ khi công suất thu được trong dài hạn vượt quá tải trung bình của toàn bộ hệ thống. Công suất sẵn có thay đổi theo nguồn và môi trường — pin mặt trời cỡ bằng móng tay có thể tạo ra ~10 mW ngoài trời nhưng ~10 µW trong nhà, máy phát điện nhiệt điện trên ống dẫn ấm ~100 µW, và năng lượng RF từ các bộ phát gần đó ~10 µW. Sự chuyển đổi này có thể biến mô hình triển khai từ “tuổi thọ bị giới hạn bởi pin” thành “triển khai rồi quên,” nhưng còn tùy thuộc vào nguồn, môi trường và khối lượng công việc (workload).
31 Điện toán phổ biến: Tầm nhìn về điện toán phổ biến của Mark Weiser hình dung việc điện toán đan xen vào môi trường hàng ngày đến mức dần rời khỏi sự chú ý trực tiếp (Weiser 1991). TinyML là một con đường hiện đại để hiện thực hóa tầm nhìn đó: khi chi phí và công suất của cảm biến thông minh đủ thấp để triển khai hàng loạt, mục tiêu tối ưu hóa sẽ chuyển từ hiệu suất (thông lượng) sang công suất (năng lượng trên mỗi suy luận), đây là sự đánh đổi cốt lõi của nguyên mẫu Ràng buộc Nhỏ.
Weiser, Mark. 1991. “The Computer for the 21st Century.” Scientific American 265 (3): 94–104. https://doi.org/10.1038/scientificamerican0991-94.
Trong khi machine learning di động cần phần cứng tinh vi với bộ nhớ gigabyte và bộ xử lý đa lõi, TinyML chạy trên các vi điều khiển32 với RAM ở mức kilobyte và giá chỉ vài đô la (Banbury et al. 2021; Lin et al. 2020; Janapa Reddi et al. 2022). Ràng buộc khắc nghiệt này đòi hỏi một cách tiếp cận hoàn toàn khác đối với việc triển khai machine learning, ưu tiên tiêu thụ công suất cực thấp và chi phí tối thiểu thay vì mức độ tinh vi về tính toán. Hệ thống TinyML được dùng cho các ứng dụng như bảo trì dự đoán, giám sát môi trường và nhận dạng cử chỉ đơn giản. Khoảng cách về năng lượng giữa TinyML và suy luận đám mây (figure 6) chênh lệch ít nhất sáu bậc độ lớn33 và lên tới tám bậc độ lớn đối với các truy vấn LLM trên đám mây, dẫn đến các kiến trúc hệ thống và mô hình triển khai hoàn toàn khác biệt. Hiệu quả phi thường này cho phép hoạt động trong nhiều tháng hoặc nhiều năm chỉ với pin cúc áo.34 Trong figure 8, các bo mạch phát triển có chú thích minh họa quy mô vật lý này, với các chip vi điều khiển tích hợp, mảng cảm biến và hàng chân cắm, được thiết kế để chạy các mô hình nhỏ gọn trong môi trường không kết nối.
32 Vi điều khiển (MCU): Đây là một máy tính đơn chip, được thiết kế ưu tiên giảm chi phí và công suất thay vì hiệu năng, tạo ra “ràng buộc nghiêm ngặt” đã đề cập. Nhiều thiết bị TinyML chỉ có vài chục đến vài trăm kilobyte SRAM tích hợp và không có bộ nhớ ảo; một số vi điều khiển cao cấp hơn có thể gắn thêm bộ nhớ ngoài. Vì vậy, toàn bộ mô hình, activation và trạng thái runtime phải nằm gọn trong phần bộ nhớ thực sự có sẵn trên thiết bị đích, thường nhỏ hơn nhiều bậc so với một chiếc điện thoại thông minh.
Banbury, Colby, Vijay Janapa Reddi, Peter Torelli, Jeremy Holleman, Nat Jeffries, Csaba Kiraly, Pietro Montino, et al. 2021. “MLPerf Tiny Benchmark.” arXiv Preprint.
Lin, Ji, Wei-Ming Chen, Yujun Lin, John Cohn, Chuang Gan, and Song Han. 2020. “MCUNet: Tiny Deep Learning on IoT Devices.” In Advances in Neural Information Processing Systems 33: Annual Conference on Neural Information Processing Systems 2020, NeurIPS 2020, December 6-12, 2020, Virtual, edited by Hugo Larochelle, Marc’Aurelio Ranzato, Raia Hadsell, Maria-Florina Balcan, and Hsuan-Tien Lin. Curran Associates.
Janapa Reddi, Vijay, Brian Plancher, Susan Kennedy, Laurence Moroney, Pete Warden, Lara Suzuki, Anant Agarwal, et al. 2022. “Widening Access to Applied Machine Learning with TinyML.” Harvard Data Science Review 4 (1). https://doi.org/10.1162/99608f92.762d171a.
33 Khoảng cách năng lượng của TinyML: Sự khác biệt này bắt nguồn từ triết lý thiết kế phần cứng; GPU đám mây được tối ưu cho thông lượng thô và tiêu thụ hàng trăm watt, còn vi điều khiển TinyML được thiết kế để có trạng thái ngủ với công suất gần như bằng không. Với suy luận trên đám mây thông thường, một yêu cầu có thể tiêu thụ khoảng 10 joule, trong khi thiết bị TinyML chuyên dụng chỉ dùng khoảng 10 microjoule, tương ứng chênh lệch \(1{,}000{,}000\times\). Các truy vấn LLM trên đám mây còn có thể đẩy chênh lệch này lên nữa, như được định lượng trong table 12.
34 Triển khai bằng pin cúc áo: Một viên pin CR2032 (225 mAh ở 3 V, ~675 mWh) trong điều kiện lý tưởng có thể cấp nguồn cho một hệ thống tiêu thụ 10–50 µW trong khoảng 1,5–7,7 năm. Mô hình vận hành “triển khai và quên” này thúc đẩy đổi mới trong tính toán không liên tục, nơi thiết bị chuyển sang trạng thái ngủ giữa các lần suy luận để kéo dài ngân sách năng lượng, giúp thiết bị hoạt động trong nhiều năm mà không cần giám sát.
Để tích hợp toàn bộ pipeline suy luận—từ thu nhận tín hiệu cảm biến đến đầu ra phân loại—vào những gói phần cứng nhỏ gọn này, chúng ta cần thiết kế lại cách lưu trữ trọng số mô hình và activation trên silicon.
Definition 1.5: TinyML
TinyML là lĩnh vực machine learning dành cho các hệ thống cảm biến luôn hoạt động, với những ràng buộc chặt chẽ về bộ nhớ (chỉ vài kilobyte) và công suất tiêu thụ (chỉ vài milliwatt).
- Ý nghĩa: Để hoạt động được, các mô hình TinyML cần có trọng số và mã chương trình vừa vặn trong bộ nhớ flash, còn các activation và trạng thái runtime phải nằm gọn trong SRAM tích hợp trên chip. Điều này giúp chúng có thể thực hiện suy luận liên tục chỉ với vài milliwatt công suất.
- Điểm khác biệt: Khác với ML di động (vốn dùng bộ xử lý công suất vài watt và hệ điều hành đầy đủ), TinyML chạy trên các vi điều khiển, sử dụng firmware bare-metal hoặc một hệ điều hành thời gian thực.
- Cạm bẫy thường gặp: Một lầm tưởng phổ biến là TinyML chỉ đơn thuần là “các mô hình nhỏ”. Thực tế, đây là một mô hình bị giới hạn bởi năng lượng: chỉ số quan trọng nhất là năng lượng tiêu thụ cho mỗi lần suy luận (tính bằng microjoule), chứ không chỉ là số lượng tham số của mô hình.
Mức tiêu thụ công suất chỉ vài milliwatt của TinyML tạo ra một khoảng cách năng lượng lớn hơn nhiều bậc độ lớn so với suy luận trên đám mây, điều này có tác động sâu sắc đến thiết kế hệ thống. Theo equation 6, TinyML thường gặp một ràng buộc về khả năng vừa vặn bộ nhớ mà phương trình độ trễ không nêu rõ: kích thước mô hình \(M_{\text{model}}\) và kích thước activation phải nằm trong dung lượng bộ nhớ \(C_{\text{mem}}\). Khi tổng bộ nhớ chỉ tính bằng kilobyte, cấu trúc mô hình và cách cấp phát runtime sẽ quyết định tính khả thi trước khi bắt đầu tối ưu hóa độ trễ, và mỗi lần di chuyển dữ liệu tránh được đều tiết kiệm một phần ngân sách năng lượng. Do đó, mục tiêu chuyển từ thông lượng thuần sang năng lượng trên mỗi lần suy luận và mức phù hợp bộ nhớ.
Systems Perspective 1.3: Đọc các chỉ số năng lượng trên mỗi lần suy luận
Các giá trị năng lượng trong table 12 là sự kết hợp giữa ước tính năng lượng thiết bị suy ra bằng bộ giải và các mốc chuẩn về quy mô riêng; chúng không phải là các phép đo full-system có kiểm soát. Chẳng hạn, giới hạn của một mô hình ResNet-50 chỉ chạy trên A100 là dưới 1 ms và khoảng ~0.3 J, trong khi một máy chủ hoàn chỉnh có thể tiêu thụ khoảng ~1 kW khi tính cả CPU, bộ nhớ và chi phí phụ trợ. Các con số ở cột cuối cùng cho biết số lượng suy luận mà năng lượng danh định của một viên pin có thể cung cấp; chúng không phải là thời lượng pin thực tế và không tính đến cảm biến, chế độ ngủ và giao tiếp.
Khoảng cách về hiệu quả năng lượng của TinyML giúp giải thích vì sao các mô hình cục bộ tiết kiệm năng lượng lại hấp dẫn cho các ứng dụng cảm biến luôn bật. Tuy nhiên, runtime thực tế còn phụ thuộc vào nhịp suy luận, công suất ở chế độ ngủ, cảm biến, giao tiếp và các phần còn lại của thiết bị.
Khoảng cách về năng lượng giữa các phương pháp không chỉ là vấn đề về mức độ mà là về quy mô, trải rộng tám bậc độ lớn như được minh họa trong figure 6. Bảng Table 12 đặt khoảng cách đó trên các con số cụ thể, bằng cách quy đổi chi phí năng lượng của từng phương pháp thành số lượng suy luận mà một viên pin điện thoại thông minh có thể duy trì.
| Mô hình | Khối lượng công việc (workload) ví dụ | Năng lượng/Suy luận | Số suy luận mỗi Pin (3.7 V, 3000 mAh) |
|---|---|---|---|
| Đám mây | Truy vấn GPT-4 | ~1 kJ | 40 queries |
| Đám mây | ResNet-50 (máy chủ bộ tăng tốc) | 75.5 mJ | 529,505 queries |
| Edge | ResNet-50 (Jetson) | 15.9 mJ | 2,511,628 queries |
| Di động | MobileNet (NPU) | 2.60 mJ | 15,393,505 queries |
| TinyML | Phát hiện từ khóa | 10 μJ | 3996 million queries |
Vận hành với ngân sách công suất dưới milliwatt cho phép cảm biến liên tục mà không cần điện lưới, nhưng buộc toàn bộ trạng thái suy luận phải nằm trong SRAM trên chip. Sơ đồ phân loại bốn cột trong figure 9 cho thấy cách bộ nhớ tính bằng kilobyte và các trạng thái ngủ theo chu kỳ giúp thực hiện các khối lượng công việc (workload) luôn bật, đồng thời hạn chế việc cập nhật mô hình.

Ưu điểm và các đánh đổi vận hành của TinyML
TinyML hoạt động ở những cực hạn phần cứng. So với các hệ thống đám mây, các triển khai TinyML thường có ít bộ nhớ hơn khoảng \(10^6\) đến \(10^9\) lần, tùy vào bộ nhớ vi điều khiển chỉ ở mức megabyte thấp hay kilobyte, với ngân sách công suất ở dải miliwatt. Những giới hạn nghiêm ngặt này cho phép thiết bị vận hành tự chủ trong nhiều tháng đến nhiều năm35 nhưng đòi hỏi thuật toán chuyên biệt, nén mô hình và đồng thiết kế hệ thống một cách cẩn trọng. Thiết bị trải rộng từ bộ kit phát triển cỡ lòng bàn tay đến các chip cỡ milimet,36 mở đường cho cảm biến phổ biến ở những nơi mà kết nối mạng, cung cấp điện hoặc bảo trì đều tốn kém. Các bộ kit phát triển tiêu biểu gồm Arduino Nano 33 BLE Sense (256 KB RAM, 1 MB flash, 20–40 mW) và ESP32-CAM (520 KB RAM, 4 MB flash, 50–250 mW).
35 Các ràng buộc khi huấn luyện trên thiết bị: Để huấn luyện đầy đủ trên thiết bị, hệ thống phải lưu giữ các đầu ra của các lớp trung gian để các bước cập nhật trọng số sau này có thể tái sử dụng chúng; điều này tiêu tốn bộ nhớ tỉ lệ thuận với độ sâu của mô hình. Trong quá trình suy luận, các giá trị tạm thời của mỗi lớp thường có thể được loại bỏ ngay sau khi lớp tiếp theo sử dụng xong; còn trong quá trình huấn luyện, nhiều giá trị đó phải luôn sẵn có để bước cập nhật quyết định cách thay đổi các trọng số. Với chỉ 256 KB đến 2 MB RAM, huấn luyện đầy đủ thường vượt quá giới hạn bộ nhớ này; TinyTL đóng băng các trọng số và chỉ cập nhật độ chệch (bias) để giảm bộ nhớ cần cho activation (Cai et al. 2020). Chính ràng buộc về bộ nhớ này là lý do tại sao các thiết bị TinyML chủ yếu chỉ thực hiện suy luận, với các cập nhật mô hình được đẩy qua firmware thay vì học trực tiếp trên thiết bị.
Cai, Han, Chuang Gan, Ligeng Zhu, and Song Han. 2020. “TinyTL: Reduce Activations, Not Trainable Parameters for Efficient on-Device Learning.” Advances in Neural Information Processing Systems 33: 11285–97.
36 Phạm vi thiết bị TinyML: Sự khác biệt về kích thước vật lý của các thiết bị TinyML phản ánh sự đánh đổi trực tiếp giữa ngữ cảnh triển khai và khả năng tính toán. Các hệ thống kích thước milimet ưu tiên công suất tối thiểu (~140 µW) cho các tác vụ đơn chức năng, hoạt động dài hạn, trong khi các bo mạch cỡ lòng bàn tay chấp nhận kích thước lớn hơn và công suất cao hơn để có thể xử lý nhiều luồng dữ liệu cảm biến phức tạp. Cách đồng thiết kế này tạo ra chênh lệch về công suất hơn \(10.000\times\) và về diện tích khoảng \(100\times\) trên toàn phổ hoạt động của các thiết bị TinyML.
Những hạn chế tài nguyên cực kỳ nghiêm ngặt của TinyML lại mang đến những lợi thế độc đáo. Khi không cần truyền dữ liệu qua mạng, các thiết bị TinyML tránh được độ trễ do truyền qua mạng, cho phép phản hồi nhanh tại chỗ cho các vòng lặp cảm biến và điều khiển mà không tốn chi phí truyền thông. Khả năng tự chủ này cũng thay đổi đáng kể bài toán kinh tế của các triển khai quy mô lớn: khi chi phí mỗi nút giảm xuống mức vài đô la, việc gắn cảm biến cho toàn bộ nhà máy, trang trại hay tòa nhà trở nên khả thi về mặt tài chính theo cách mà các giải pháp edge hoặc đám mây khó sánh kịp. Hiệu quả năng lượng còn củng cố thêm luận điểm kinh tế, cho phép thiết bị hoạt động nhiều năm với pin nhỏ, hoặc thậm chí hoạt động liên tục nhờ thu hoạch năng lượng. Lợi ích về quyền riêng tư cũng xuất phát tự nhiên từ tính cục bộ, vì dữ liệu thô không bao giờ rời khỏi thiết bị, giúp giảm rủi ro truyền dữ liệu và đơn giản hóa việc tuân thủ. Tuy nhiên, chỉ xử lý trên thiết bị thôi thì không tự động mang lại các bảo đảm quyền riêng tư chính thức nếu không có thêm các cơ chế bảo mật.
Để có được những khả năng này, chúng ta phải chấp nhận những đánh đổi đáng kể. Các hạn chế về tính toán đặt ra giới hạn rất nghiêm ngặt: bộ vi điều khiển thường chỉ có \(10^5\) đến \(10^6\) byte RAM, buộc mô hình và các activation trung gian phải nằm trong khoảng từ vài chục kilobyte đến mức megabyte nhỏ, tùy thuộc vào khối lượng công việc (workload). Sự phức tạp trong quá trình phát triển đòi hỏi chuyên môn trải rộng, bao gồm tối ưu hóa mạng nơ-ron, quản lý bộ nhớ ở cấp phần cứng, chuỗi công cụ nhúng và gỡ lỗi chuyên biệt trên nhiều kiến trúc bộ vi điều khiển khác nhau.
Ngoài các hạn chế về kỹ thuật, những thách thức trong vận hành còn làm mọi thứ khó khăn hơn. Một thiết bị thu hoạch năng lượng có thể đáp ứng được ngân sách công suất trung bình dài hạn, nhưng vẫn có thể gặp sự cố nếu năng lượng dự trữ cạn trước lần thu hoạch tiếp theo. Vì vậy, chu kỳ hoạt động của thiết bị phải tính đến cả năng lượng cho mỗi lần suy luận và thời điểm công suất sẵn có. Chất lượng mô hình có thể bị giảm do nén quá mức và giảm độ chính xác, hạn chế khả năng dùng cho các ứng dụng đòi hỏi độ chính xác hoặc độ bền cao. Việc triển khai cũng có thể thiếu linh hoạt: các thiết bị có thể chỉ chạy một tập nhỏ các mô hình cố định, và việc cập nhật có thể đòi hỏi quy trình firmware chậm hơn, rủi ro hơn so với triển khai trên đám mây. Sự phân mảnh hệ sinh thái37 giữa các nhà cung cấp bộ vi điều khiển và các framework ML cũng làm tăng chi phí và gây thêm thách thức về tính di động.
37 Sự phân mảnh hệ sinh thái TinyML: TinyML bao trùm nhiều họ vi điều khiển như Arm Cortex-M, RISC-V và Xtensa. Mỗi họ có tập lệnh, bố cục bộ nhớ, nhân và chuỗi công cụ riêng. Các stack đám mây và di động cũng khác nhau, nhưng các runtime của chúng thường che đi phần lớn sự đa dạng phần cứng này. Vì vậy, một mô hình được tối ưu hóa cho một mục tiêu vi điều khiển có thể cần phải điều chỉnh và xác thực lại khi dùng cho mục tiêu khác. Điều này làm tăng đáng kể chi phí kỹ thuật khi triển khai mô hình trên nhiều thiết bị.
Giám sát môi trường và sức khỏe
Các ứng dụng TinyML thuộc nhóm này khi yêu cầu công suất cực thấp, chi phí mỗi nút thấp và xử lý tại chỗ giúp việc triển khai khả thi theo cách mà các cách tiếp cận khác không thể duy trì. Tính năng phát hiện từ đánh thức là ví dụ tiêu dùng quen thuộc: một thành phần công suất thấp chuyên dụng liên tục lắng nghe, xử lý âm thanh tại chỗ, và chỉ kích hoạt các thành phần công suất cao hơn khi phát hiện cụm từ đánh thức, từ đó giảm công suất trung bình.38 Nông nghiệp chính xác cũng tận dụng áp lực xử lý tại chỗ theo một hướng khác: dự án FarmBeats dùng cảm biến, camera, máy bay không người lái và xử lý tại cổng cục bộ để giảm luân chuyển dữ liệu thô ở những nơi kết nối trang trại đắt đỏ (Vasisht et al. 2017). TinyML còn đẩy xa hơn logic xử lý cục bộ này khi chính nút cảm biến phải hoạt động trong ngân sách công suất chỉ vài milliwatt.
38 Phát hiện từ đánh thức luôn bật: Một mô hình nhỏ, chuyên biệt lắng nghe tín hiệu âm thanh của một cụm từ đánh thức và đóng vai trò như một cổng cấp nguồn cho bộ xử lý ứng dụng tiêu thụ nhiều công suất hơn. Ngân sách công suất chấp nhận được cho bộ phát hiện này phụ thuộc vào nền tảng, nhưng ngay cả việc tiêu tốn thêm vài milliwatt liên tục cũng có thể rút ngắn đáng kể thời lượng pin. Kiến trúc này chỉ thành công khi đường dẫn luôn bật tiêu thụ công suất trung bình ít hơn nhiều so với các thành phần mà nó ngăn không cho kích hoạt.
Vasisht, Deepak, Zerina Kapetanovic, Jongho Won, Xinxin Jin, Ranveer Chandra, Sudipta N. Sinha, Ashish Kapoor, Madhusudhan Sudarshan, and Sean Stratman. 2017. “FarmBeats: An IoT Platform for Data-Driven Agriculture.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 515–29.
Trong lĩnh vực bảo tồn động vật hoang dã, TinyML được dùng để giám sát môi trường từ xa. Các cảm biến âm thanh dùng năng lượng mặt trời có thể xử lý tại chỗ các luồng âm thanh liên tục để nhận dạng loài. Theo các giả định về tải dữ liệu minh họa trong chương này, phân tích cục bộ giúp giảm lượng truyền từ 4.3 GB/day âm thanh thô xuống 400 KB/day các bản tóm tắt phát hiện, tức là giảm 10,750× lần. Thiết bị đeo y tế cũng áp dụng cùng logic xử lý cục bộ này cho chăm sóc sức khỏe. Độ nhạy, tốc độ lấy mẫu, công suất và thời lượng pin là các mục tiêu xác thực đặc thù cho từng thiết bị, không phải thuộc tính phổ quát của phần cứng TinyML. Xử lý cục bộ có thể giảm truyền liên tục và hỗ trợ quyền riêng tư, còn tổng runtime vẫn phụ thuộc vào cảm biến, radio, chu kỳ hoạt động và công suất khi ngủ.
Bốn mô hình triển khai hiện nay bao phủ toàn bộ dải từ các trung tâm dữ liệu công suất megawatt đến các vi điều khiển công suất milliwatt. Mỗi mô hình xuất hiện để đáp ứng các ràng buộc vật lý cụ thể và phát huy tốt nhất trong phạm vi vận hành của mình. Câu hỏi kỹ sư nên chọn mô hình nào, và làm gì khi không có mô hình nào đáp ứng hết mọi yêu cầu, là động lực cho phần phân tích so sánh dưới đây.
Self-Check: Question
Comparing a dedicated TinyML keyword spotting model (~\(10\ \mu\text{J}\) per inference) to a cloud foundation model query (~\(1\text{ kJ}\) per inference), by approximately what factor does energy consumption per inference differ?
- Approximately \(100\times\) (2 orders of magnitude)
- Approximately \(10{,}000\times\) (4 orders of magnitude)
- Approximately \(100{,}000{,}000\times\) (\(10^8\), 8 orders of magnitude)
- Approximately \(10^{14}\times\) (14 orders of magnitude)
Why are microcontroller TinyML devices predominantly restricted to inference-only execution rather than full in-situ backpropagation training?
- Microcontrollers use flash memory which permanently locks all transistor gates against state changes.
- Backpropagation requires double-precision FP64 floating-point arithmetic which is mathematically impossible on 32-bit cores.
- The speed of light inside microcontroller silicon is too slow to support backward gradient propagation.
- Standard backpropagation requires storing intermediate activation tensors from every forward layer until the backward pass executes, which quickly exceeds the microcontroller’s 256 KB–2 MB on-chip SRAM capacity.
Why is the 1 mW average power threshold considered a transformative milestone in TinyML system deployment?
Why is it a fallacy to treat TinyML as merely ‘scaled-down mobile ML’ that can be addressed simply by applying standard INT8 post-training quantization?
The power management paradigm in which a battery-less or energy-harvesting microcontroller sleeps in ultra-low-power states and wakes periodically to perform inference before energy reserves deplete is called ____ computing.
Lựa chọn mô hình triển khai
Khi chọn nơi chạy một đặc trưng ML, kiến trúc sư hiếm khi chỉ tối ưu một chiều duy nhất. Chẳng hạn, quy tắc về quyền riêng tư có thể cấm xử lý trên đám mây; ngân sách độ trễ có thể không cho phép suy luận từ xa; dấu chân bộ nhớ có thể vượt quá khả năng của thiết bị di động; còn mục tiêu chi phí có thể loại trừ phần cứng edge luôn bật. Đám mây, edge, di động và TinyML là các phạm vi vận hành cho những xung đột đó, nên để chọn giữa chúng cần một framework so sánh thống nhất và một quy trình ra quyết định có cấu trúc.
Phân tích đánh đổi so sánh
Các quyết định triển khai đòi hỏi đặt các đánh đổi độ trễ so với thông lượng cạnh nhau trên các khía cạnh quan trọng. Một kiến trúc sư hệ thống khi cân nhắc giữa triển khai edge và di động phải đồng thời so sánh độ trễ, công suất, chi phí, quyền riêng tư và độ phức tạp phát triển. Table 13 cung cấp so sánh này trên mười bốn khía cạnh, từ năng lực tính toán và độ trễ đến chi phí và tốc độ triển khai.
| Khía cạnh | Cloud ML | Edge ML | Mobile ML | TinyML |
|---|---|---|---|---|
| Vị trí xử lý | Máy chủ đám mây tập trung (Trung tâm dữ liệu) | Thiết bị edge cục bộ (cổng, máy chủ) | Điện thoại thông minh và máy tính bảng | Vi điều khiển công suất cực thấp và hệ thống nhúng |
| Độ trễ | 100–500 ms | 10–100 ms | 5–50 ms | 1–10 ms |
| Công suất tính toán | Rất cao (Nhiều GPUs/TPUs) | Cao (Edge GPUs) | Trung bình (NPUs/GPUs di động) | Rất thấp (MCU/bộ xử lý siêu nhỏ) |
| Dung lượng lưu trữ | Quy mô đám mây (petabytes+) | Lớn (terabytes) | Vừa phải (gigabytes) | Rất hạn chế (kilobytes–megabytes) |
| Mức tiêu thụ năng lượng | Rất cao (phạm vi kW–MW) | Cao (hàng trăm watt) | Vừa phải (3–5 W) | Rất thấp (phạm vi mW) |
| Khả năng mở rộng | Cao (giới hạn bởi năng lực nhà cung cấp) | Tốt (giới hạn bởi phần cứng edge) | Vừa phải (mở rộng theo từng thiết bị) | Hạn chế (phần cứng cố định) |
| Tiếp xúc dữ liệu | Xử lý từ xa làm tăng bề mặt tiếp xúc | Xử lý cục bộ giảm việc truyền tải | Xử lý trên thiết bị giảm việc truyền tải | Dữ liệu thô có thể giữ nguyên cục bộ |
| Yêu cầu kết nối | Băng thông cao liên tục | Không liên tục | Tùy chọn | Không |
| Khả năng ngoại tuyến | Không | Tốt | Xuất sắc | Hoàn toàn |
| Xử lý thời gian thực | Phụ thuộc vào mạng | Tốt | Rất tốt | Xuất sắc |
| Chi phí | Cao ($1000s+/tháng) | Vừa phải ($100s–$1000s) | Mua thiết bị ($200–$1000+; thường thuộc sở hữu người dùng) | Rất thấp ($1–$10) |
| Yêu cầu phần cứng | Cơ sở hạ tầng đám mây | Máy chủ edge/cổng (gateways) | Điện thoại thông minh hiện đại | MCUs/hệ thống nhúng |
| Độ phức tạp phát triển | Cao (cần chuyên môn về đám mây) | Trung bình-Cao (edge + mạng) | Trung bình (SDK di động) | Cao (chuyên môn về hệ thống nhúng) |
| Tốc độ triển khai | Nhanh | Trung bình | Nhanh | Chậm |
Sự đối chiếu này cho thấy một đánh đổi phổ biến giữa tính cục bộ của dữ liệu và quy mô tính toán. Xử lý từ xa làm tăng bề mặt lộ thông tin và cần thêm biện pháp bảo vệ; xử lý cục bộ giúp giảm truyền tải dữ liệu và rủi ro từ lưu trữ tập trung, nhưng tự nó không đảm bảo quyền riêng tư. Sơ đồ ánh xạ nguyên mẫu–mô hình được trình bày trong section 1.2 liên kết các đặc điểm này với yêu cầu cụ thể của khối lượng công việc (workload), trong đó mỗi nguyên mẫu có xu hướng chọn các mô hình giải quyết được ràng buộc chính của nó.
Không có mô hình nào vượt trội trên mọi trục kỹ thuật. Trong figure 10, các biểu đồ radar cực bốn trục đánh giá các mô hình theo thang điểm thứ tự 0–10: biểu đồ con (a) đối chiếu công suất tính toán thô và khả năng mở rộng với độ trễ và hiệu quả năng lượng, còn biểu đồ con (b) đánh giá mức độ tự chủ vận hành theo các tiêu chí kết nối, tính cục bộ, khả năng phản hồi thời gian thực và thực thi ngoại tuyến.

Các biểu đồ radar giúp làm rõ quyết định triển khai: không có mô hình nào thống trị tất cả các trục. Mỗi mô hình tập trung độ phức tạp ở một chỗ khác nhau: đám mây đòi hỏi chuyên môn về hạ tầng phân tán và quản trị chi phí; edge và TinyML bổ sung bài toán quản lý đội thiết bị, đa dạng phần cứng và các ràng buộc hệ thống nhúng; di động cần tích hợp theo từng nền tảng và quy trình phát hành riêng. Cấu trúc chi phí cũng khác nhau, không theo một thứ tự xếp hạng cố định: đám mây nhấn mạnh chi phí dịch vụ định kỳ, edge nhấn mạnh phần cứng và vận hành tại chỗ, di động thường tận dụng thiết bị của người dùng, còn TinyML có chi phí mỗi thiết bị thấp nhưng cần phát triển chuyên biệt và bảo trì đội thiết bị lớn.
Một sai lầm nghiêm trọng khi chọn phương án triển khai là chỉ dựa vào độ chính xác của mô hình mà bỏ qua các ràng buộc ở cấp hệ thống. Ví dụ, một mô hình triển khai trên đám mây đạt độ chính xác 99% sẽ trở nên vô dụng cho hệ thống phanh khẩn cấp tự động nếu độ trễ mạng vượt quá thời gian phản ứng yêu cầu; tương tự, một mô hình edge có độ chính xác cao nhưng khiến pin thiết bị di động cạn chỉ trong vài phút cũng thất bại dù độ chính xác vượt trội. Để triển khai thành công, cần đánh giá đồng thời yêu cầu về độ trễ, ngân sách công suất, độ tin cậy của mạng, các quy định về quyền riêng tư dữ liệu và tổng chi phí sở hữu. Những ràng buộc này nên được xác lập trước khi phát triển mô hình để tránh những thay đổi kiến trúc tốn kém ở giai đoạn cuối của dự án.
Decision framework
Để chọn được phương án triển khai phù hợp, chúng ta cần một framework quyết định dựa trên các ràng buộc của ứng dụng, không dựa vào độ chệch (bias) của tổ chức hay các xu hướng công nghệ. Các tiêu chí được sắp xếp theo thứ tự dựa trên tốc độ loại trừ một kiến trúc: quyền riêng tư có thể khiến xử lý từ xa không được phép; độ trễ có thể khiến việc đó bất khả thi về mặt vật lý; nhu cầu tính toán có thể làm cho mục tiêu xử lý cục bộ không khả thi; và chi phí dùng để so sánh các phương án còn lại nhằm chọn kiến trúc vận hành. Hãy dùng figure 11 như một công cụ sàng lọc để tổ chức các câu hỏi về quyền riêng tư, độ trễ, nhu cầu tính toán và chi phí trước khi chọn kiến trúc cuối cùng.

Framework này nhóm bốn lớp quyết định quan trọng, chứ không tính ra một đáp án duy nhất. Quyền riêng tư xác định liệu xử lý từ xa có được phép hay không. Độ trễ loại bỏ các phương án không đáp ứng ngân sách thời gian phản hồi. Nhu cầu tính toán loại bỏ các mục tiêu không thể chạy được khối lượng công việc (workload). Cuối cùng, chi phí so sánh các lựa chọn khả thi còn lại. Vì các nhánh trong sơ đồ hội tụ lại và nhánh chi phí thấp vẫn giữ cả ML trên thiết bị di động và TinyML, nên figure 11 chỉ thu hẹp không gian thiết kế chứ không chọn một cách tiếp cận duy nhất.
Một ví dụ về hệ thống phanh an toàn tới hạn giúp làm rõ trình tự này, vì độ trễ có thể loại bỏ phương án triển khai trên đám mây ngay từ đầu trước khi xét đến tính toán hay chi phí.
Example 1.1: Phanh khẩn cấp của xe tự hành
Tình huống: Hệ thống thị giác của xe tự hành thực hiện phát hiện người đi bộ theo thời gian thực để phanh khẩn cấp, với giới hạn độ trễ đầu cuối nghiêm ngặt 100 ms.
Chẩn đoán: Tình huống này giả định độ trễ khứ hồi mạng là 50–150 ms khi chuyển xử lý lên đám mây và 10–30 ms khi phát hiện đối tượng cục bộ trên một bộ tăng tốc edge dành cho ô tô (hiệu năng 300 GFLOP/s). Với các giả định đó, chỉ riêng đường xử lý từ xa đã khiến xe di chuyển thêm 2.8 m trước khi phanh.
Bài học về hệ thống: Các ràng buộc an toàn thời gian thực nghiêm ngặt loại bỏ việc chuyển xử lý lên đám mây, bất kể năng lực tính toán. Giới hạn độ trễ buộc phải dùng kiến trúc triển khai Edge ML, và dành kết nối đám mây cho huấn luyện mô hình ngoại tuyến và tổng hợp telemetry.
Framework này giúp xác định các lựa chọn khả thi về mặt kỹ thuật, nhưng khả thi không đồng nghĩa với thành công. Triển khai sản xuất còn phụ thuộc vào năng lực tổ chức, quyết định xem một lựa chọn kỹ thuật hợp lý có được triển khai và vận hành hiệu quả hay không.
Để triển khai thành công, chúng ta cần xem xét nhiều yếu tố, không chỉ các ràng buộc kỹ thuật. Chuyên môn của đội ngũ phải phù hợp với yêu cầu của từng cách tiếp cận: machine learning trên đám mây đòi hỏi kiến thức về hệ thống phân tán; machine learning trên edge cần khả năng quản lý thiết bị; machine learning trên thiết bị di động cần kỹ năng tối ưu hóa theo từng nền tảng; còn TinyML đòi hỏi chuyên môn về hệ thống nhúng. Tổ chức thiếu kỹ năng phù hợp sẽ phải kéo dài thời gian phát triển, có thể làm suy giảm ngay cả những lợi thế kỹ thuật mạnh nhất. Tương tự, khả năng giám sát và bảo trì cũng quyết định tính khả thi ở quy mô lớn: triển khai trên edge đòi hỏi điều phối các thiết bị phân tán, còn TinyML yêu cầu quản lý firmware chuyên biệt mà nhiều tổ chức chưa có. Cấu trúc chi phí cũng là một khía cạnh quan trọng, vì mô hình chi tiêu theo thời gian khác nhau đáng kể giữa các cách tiếp cận. Triển khai trên đám mây phát sinh chi phí vận hành định kỳ, phù hợp với khối lượng công việc (workload) khó đoán; triển khai trên edge cần đầu tư ban đầu lớn nhưng được bù lại bằng chi phí vận hành thấp hơn; triển khai trên thiết bị di động tận dụng thiết bị của người dùng để giảm chi phí hạ tầng; còn TinyML giảm chi phí phần cứng nhưng đòi hỏi đầu tư phát triển đáng kể.
Những thực tế này nêu bật một vấn đề rộng hơn: machine learning không phải lúc nào cũng là lựa chọn đúng. Mọi triển khai ML đều đi kèm chi phí vận hành (bao gồm pipeline dữ liệu, giám sát và hạ tầng huấn luyện lại) mà các hệ thống heuristic đơn giản tránh được, và chi phí đó phải được biện minh bằng các kết quả tốt hơn có thể đo lường.
Systems Perspective 1.4: Cái giá của độ phức tạp
Trước khi cam kết triển khai bất kỳ hệ thống machine learning nào, chúng ta phải cân nhắc gánh nặng vận hành so với các phương án đơn giản hơn.
Hãy xét một bài toán phân loại có thể giải bằng heuristic (các luật if-then) hoặc một pipeline deep learning. Giải pháp heuristic có thể chỉ khoảng năm mươi dòng mã, chi phí tính toán gần như bằng không, mất khoảng một giờ mỗi tháng để cập nhật luật và không có trôi mô hình. Hệ thống ML có thể cũng chỉ có năm mươi dòng mã cho phần mô hình, nhưng kéo theo khoảng 2.000 dòng mã hạ tầng cho pipeline dữ liệu, giám sát và trình điều khiển GPU, cùng khoảng 40 giờ mỗi tháng để gỡ lỗi hiện tượng trôi và quản lý hạ tầng.
Một hệ thống ML dù nâng độ chính xác từ 90% lên 95% vẫn có thể là một lựa chọn kỹ thuật không tốt nếu kéo theo độ phức tạp tăng gấp 40 lần. Kỹ thuật hệ thống ML là nghệ thuật giảm thiểu khoản “thuế” này bằng một kiến trúc vững chắc. Nếu chi phí vận hành để duy trì chất lượng mô hình theo thời gian vượt quá khả năng chi trả, thì phương pháp heuristic đơn giản hơn có thể là lựa chọn hệ thống tối ưu hơn.
So sánh đó biến việc chọn mô hình thành một quyết định thiết kế hệ thống, bao trùm các yếu tố về vật lý, chi phí hạ tầng và gánh nặng liên tục để duy trì độ chính xác. Khi thuế phức tạp vượt quá lợi ích về độ chính xác, phương pháp heuristic đơn giản hơn là lựa chọn hệ thống tối ưu hơn.
Checkpoint 1.2: Thiết kế hệ thống
Sự đánh đổi chính thường là giữa độ chính xác và độ phức tạp.
Các điểm quyết định
Việc triển khai thành công đòi hỏi cân bằng giữa tối ưu hóa kỹ thuật và năng lực tổ chức. Việc chọn cách tiếp cận vượt xa yêu cầu kỹ thuật để bao gồm cả kỹ năng của đội ngũ, năng lực vận hành và các ràng buộc kinh tế, tất cả đều bị giới hạn bởi các quy luật mở rộng vật lý được trình bày trong chương này. Vận hành machine learning và Benchmarking phát triển các hệ quả về vận hành và đo lường. Tuy nhiên, trong thực tế, khung quyết định hiếm khi chỉ ra một lựa chọn duy nhất. Hầu hết các hệ thống sản xuất kết hợp nhiều cách tiếp cận, chẳng hạn như huấn luyện trên đám mây, phục vụ (serving) tại edge và tiền xử lý trên thiết bị di động, để đáp ứng các ràng buộc mà không một mục tiêu triển khai đơn lẻ nào có thể đáp ứng được.
Self-Check: Question
In the four-layer deployment screening decision framework, why is the Privacy layer evaluated first, followed by Latency, Compute Demand, and Cost?
- The layers are ordered by how rapidly a hard constraint can completely invalidate an architecture: legal/privacy rules may forbid remote transmission entirely, physical latency limits can make cloud offload impossible, compute demands eliminate undersized devices, and cost compares the remaining feasible survivors.
- Privacy is the easiest parameter to optimize in software using compiler flags, whereas cost cannot be calculated until after deployment.
- Cloud providers require privacy agreements before allowing access to GPU instances.
- The framework is ordered purely alphabetically based on traditional software engineering conventions.
An autonomous vehicle travels at 100 km/h (~27.8 m/s). An emergency pedestrian detection system evaluates two architectures: (1) an automotive Edge ML accelerator with a 15 ms local detection latency, and (2) a Cloud ML server with 115 ms total latency (100 ms network RTT + 15 ms compute). How much additional distance does the vehicle travel before braking begins if the cloud architecture is used?
- 0.28 meters
- Approximately 2.8 meters
- Approximately 28 meters
- Exactly 100 meters
What is the complexity tax in ML systems engineering, and when is a simple heuristic (e.g., rule-based logic or regular expressions) superior to a deep learning pipeline?
In ML systems engineering, selecting a deployment paradigm based solely on benchmark model accuracy is a sound practice because hardware infrastructure can always be scaled to meet application constraints later.
What is the Total Cost of Ownership (TCO) calculation, and why must ML architects evaluate TCO rather than hardware purchase price or cloud VM hourly rates alone when selecting a deployment paradigm?
Kiến trúc lai
Khung quyết định (figure 11) giúp thu hẹp phạm vi các cách tiếp cận khả thi cho một ứng dụng cụ thể. Trên thực tế, các hệ thống triển khai hiếm khi chỉ dùng một cách tiếp cận duy nhất. Ví dụ, trợ lý giọng nói kết hợp phát hiện từ khóa đánh thức bằng TinyML với nhận dạng giọng nói trên di động và hiểu ngôn ngữ tự nhiên trên đám mây. Xe tự hành ghép suy luận tại edge cho nhận thức theo thời gian thực với huấn luyện trên đám mây để cập nhật mô hình. Những kiến trúc lai này tận dụng điểm mạnh của nhiều cách tiếp cận, đồng thời khắc phục những hạn chế riêng của từng cách. Ba chiến lược tích hợp dưới đây chuẩn hoá cách những kết hợp này vận hành trong thực tế.
Các mẫu tích hợp
Ba mẫu Hybrid ML cơ bản khác nhau ở chỗ ranh giới nào tạo ra ràng buộc: phân tách huấn luyện-phục vụ, xử lý phân cấp, hoặc triển khai từng bước. Việc lựa chọn tuân theo một quy tắc bất di bất dịch: mỗi giai đoạn nên chạy ở nơi mà yếu tố ràng buộc của nó (như tài nguyên tính toán cho huấn luyện, độ trễ cục bộ hay kích thước mô hình) có chi phí thấp nhất để đáp ứng.
Phân tách huấn luyện-phục vụ đặt quá trình huấn luyện trên đám mây, trong khi suy luận diễn ra trên các thiết bị edge, di động hoặc thiết bị nhỏ. Mẫu này tận dụng quy mô của đám mây cho việc huấn luyện, đồng thời hưởng lợi từ độ trễ suy luận tại chỗ thấp và tính cục bộ của dữ liệu. Khi một mô hình đã được huấn luyện phục vụ nhiều yêu cầu, chi phí huấn luyện cố định của nó có thể được phân bổ trên nhiều lần suy luận lặp lại.39
39 Bất đối xứng chi phí huấn luyện-phục vụ: Huấn luyện thường cần nhiều lượt truyền xuôi và truyền ngược, trong khi một yêu cầu suy luận dùng artifact đã huấn luyện cho một hoặc vài lượt truyền xuôi. Huấn luyện không hẳn chỉ diễn ra một lần vì mô hình có thể được huấn luyện lại, và chi phí suy luận thay đổi mạnh theo kích thước mô hình, độ dài chuỗi, batching, và overhead của phục vụ (serving). Lý do kinh tế cho sự tách đôi này là khấu hao: dùng lặp lại sẽ phân bổ chi phí cố định của mỗi chu kỳ huấn luyện cho nhiều dự đoán được phục vụ.
Definition 1.6: Hybrid ML
Hybrid machine learning là một chiến lược triển khai phân tán một pipeline machine learning trên hai hoặc nhiều tầng triển khai, trong đó mỗi giai đoạn được gán theo các ràng buộc về độ trễ, tài nguyên tính toán, dữ liệu và vận hành.
- Ý nghĩa: Các kiến trúc lai tận dụng cấu trúc cộng tính của định luật sắt: tầng edge có thể giảm \(L_{\text{lat}}\) cho các tác vụ tiền xử lý và suy luận nhạy thời gian, trong khi tầng đám mây có thể cung cấp \(R_{\text{peak}}\) cần thiết cho huấn luyện, huấn luyện lại và suy luận batch nặng. Việc chia tách này tuân theo bất biến về tính cục bộ của dữ liệu: so sánh đầy đủ các đường dẫn cục bộ và từ xa của từng giai đoạn, loại bỏ những đường dẫn không đáp ứng được hạn dịch vụ, rồi chọn trong số các phương án khả thi.
- Điểm khác biệt: Khác với triển khai hoàn toàn trên đám mây (chấp nhận độ trễ do khoảng cách cho mọi giai đoạn) hay triển khai hoàn toàn trên edge (chấp nhận giới hạn về \(R_{\text{peak}}\) cho mọi giai đoạn), hybrid ML phân bổ động từng giai đoạn của pipeline vào tầng nơi hạng mục ràng buộc theo định luật sắt của nó được tối thiểu hóa.
- Cạm bẫy thường gặp: Một quan niệm sai lầm phổ biến là hybrid ML chỉ đơn giản là “chạy hai mô hình.” Thực tế, các tầng tham gia phải chia sẻ trạng thái đồng bộ—bao gồm định nghĩa đặc trưng, phiên bản mô hình và logic tiền xử lý—để các đường xử lý của chúng cho ra kết quả nhất quán. Nếu thiếu sự đồng bộ này, sai lệch giữa huấn luyện và phục vụ (serving) sẽ xuất hiện tại ranh giới giữa các tầng.
Trong xử lý phân cấp, dữ liệu và năng lực xử lý luân chuyển giữa các tầng tính toán. Cảm biến TinyML thực hiện phát hiện bất thường cơ bản; thiết bị edge tổng hợp và phân tích dữ liệu từ nhiều cảm biến; còn hệ thống đám mây xử lý các phân tích phức tạp và cập nhật mô hình. Mỗi tầng đảm nhiệm các tác vụ phù hợp với năng lực của mình.
Mẫu thứ ba là triển khai lũy tiến, trong đó các mô hình được nén có hệ thống để triển khai trên nhiều tầng. Một mô hình đám mây lớn sẽ được tối ưu dần thành các phiên bản phù hợp cho máy chủ edge, thiết bị di động và cảm biến rất nhỏ. Trợ lý giọng nói là ví dụ điển hình: phát hiện từ đánh thức dùng các mô hình nhỏ, luôn bật, thường chỉ vài chục kilobyte đối với các mạng nơ-ron TinyML benchmark và tiêu thụ công suất ở mức dưới miliwatt đến miliwatt trên phần cứng chuyên dụng, công suất thấp; trong khi hiểu ngôn ngữ tự nhiên phức tạp đòi hỏi các mô hình lớn hơn nhiều trong hạ tầng đám mây.
Khi có ba mẫu tích hợp để lựa chọn, việc quyết định trở thành bài toán ghép ràng buộc: chọn mẫu có đặc điểm đánh đổi phù hợp với điểm nghẽn chính của hệ thống. Table 14 tóm tắt các yếu tố đánh đổi, các điều kiện nên dùng và các điều kiện không nên dùng.
| Mô hình | Sự đánh đổi | Chọn khi | Tránh khi |
|---|---|---|---|
| Phân tách huấn luyện-phục vụ | Chi phí huấn luyện so với độ trễ suy luận | Huấn luyện yêu cầu quy mô mà suy luận không cần; quyền riêng tư quan trọng đối với suy luận nhưng không quan trọng đối với huấn luyện | Mô hình cần học liên tục từ dữ liệu đã triển khai |
| Xử lý phân cấp | Quyền tự chủ cục bộ so với tối ưu hóa toàn cầu | Khối lượng dữ liệu vượt quá khả năng truyền tải; cần đưa ra quyết định ở nhiều khung thời gian | Tất cả quá trình xử lý có thể diễn ra ở một cấp; mạng đáng tin cậy và nhanh chóng |
| Triển khai lũy tiến | Chất lượng mô hình so với phạm vi triển khai | Cần cùng một mô hình ở nhiều cấp độ khả năng; yêu cầu suy giảm hiệu suất một cách duyên dáng | Mô hình không thể được nén một cách có ý nghĩa; mục tiêu triển khai đơn lẻ |
Trợ lý giọng nói kết hợp tách đôi huấn luyện-phục vụ, triển khai tăng dần và xử lý phân cấp; xe tự hành kết hợp xử lý phân cấp với triển khai tăng dần để chạy các mô hình tối ưu ở mỗi tầng. Các phương pháp huấn luyện phân tán bảo vệ quyền riêng tư còn mở rộng thêm các lựa chọn này khi dữ liệu cần được giữ gần với thiết bị tạo ra nó.
Tích hợp hệ thống vào sản xuất
Các hệ thống lai trong môi trường sản xuất phối hợp nhiều tầng thông qua các kênh tương tác có cấu trúc. Trong figure 12, các vector kết nối có nhãn minh họa kiến trúc đa tầng này, cho thấy cách các mô hình đã huấn luyện được triển khai xuống các tầng dưới, trong khi các luồng dữ liệu cảm biến và kết quả suy luận trung gian truyền lên các hệ thống phân tích tập trung.

Các hệ thống sản xuất thể hiện các mẫu tích hợp này bằng cách đặt ranh giới mỗi tầng tại một điểm giới hạn khác nhau. Ví dụ, phát hiện lỗi trong công nghiệp minh họa mô hình Tách Huấn luyện-Phục vụ (serving): cơ sở hạ tầng đám mây huấn luyện các mô hình thị giác trên các tập dữ liệu từ nhiều cơ sở, rồi phân phối các phiên bản đã tối ưu đến máy chủ edge quản lý khu vực sản xuất, máy tính bảng cho thanh tra chất lượng và camera nhúng trên dây chuyền. Giám sát nông nghiệp minh họa Xử lý phân cấp: cảm biến đất phát hiện bất thường cục bộ ở tầng TinyML, bộ xử lý edge tổng hợp dữ liệu từ hàng chục cảm biến và nhận diện các mẫu ở cấp độ cánh đồng, trong khi cơ sở hạ tầng đám mây xử lý phân tích toàn trang trại và lập kế hoạch theo mùa. Theo dõi thể chất minh họa Triển khai từng bước với mẫu gateway: thiết bị đeo liên tục theo dõi hoạt động bằng các thuật toán tối ưu cho vi điều khiển tiêu thụ \(<1\text{ mW}\), đồng bộ các bản tóm tắt đã xử lý với điện thoại thông minh để tổng hợp chỉ số từ nhiều nguồn, rồi truyền các cập nhật định kỳ lên cơ sở hạ tầng đám mây để phân tích sức khỏe theo thời gian.
Vì sao các cách tiếp cận lai hoạt động hiệu quả
Bốn mô hình triển khai khác nhau về ngân sách tài nguyên vật lý nhưng cùng dựa trên nền tảng kỹ thuật hệ thống. Trong figure 13, một hệ phân cấp dọc ba tầng cho thấy các mục tiêu triển khai cấp cao phụ thuộc vào dữ liệu chung, năng lực tính toán và các nguyên tắc kiến trúc chung, và những yếu tố này lại nâng đỡ các cân nhắc về hiệu quả và độ tin cậy xuyên suốt hệ thống.
Sự hội tụ này giải thích vì sao các kỹ thuật có thể chuyển giao giữa các quy mô khi chúng cùng giải quyết một nút thắt chung. Các mô hình huấn luyện trên đám mây có thể triển khai tới edge vì có thể tái sử dụng các trọng số đã học và đồ thị toán tử, nhưng thiết bị đích sẽ thay đổi ngân sách bộ nhớ, độ chính xác, độ trễ và công suất. Các biểu diễn độ chính xác thấp hơn phát triển cho triển khai edge giúp giảm chi phí phục vụ (serving) trên đám mây; Nén mô hình chính thức hóa các phương pháp này dưới dạng lượng tử hoá. Các chiến lược chia nhỏ công việc giữa thiết bị cũng định hướng cho triển khai edge khi phân tách một mô hình trên nhiều bộ xử lý; Huấn luyện mô hình chính thức hóa họ kỹ thuật này là song song mô hình.
Những kinh nghiệm tối ưu hóa trên di động giúp nâng cao hiệu quả trên đám mây, vì các hạn chế về băng thông bộ nhớ xuất hiện ở mọi quy mô. Các phương pháp giảm lưu lượng truy cập bộ nhớ trên điện thoại cũng có thể giảm chi phí suy luận trên đám mây khi áp dụng cho việc phục vụ theo batch. Tương tự, các ràng buộc khắc nghiệt của TinyML thúc đẩy các biểu diễn nhỏ gọn và kỹ thuật quản lý bộ nhớ, những kỹ thuật này có thể áp dụng cho các hệ thống lớn hơn khi chúng chịu áp lực bộ nhớ tương tự.

Mô hình phân lớp tương tự tiếp tục được áp dụng trong Kỹ thuật dữ liệu cho các pipeline dữ liệu, Nén mô hình cho việc nén mô hình, và Vận hành machine learning cho các khía cạnh vận hành. Tất cả những điều này đều đúng dù mục tiêu là một TPU Pod hay một ESP32. Các nguyên tắc chung cũng đồng nghĩa với các lỗ hổng chung: trôi dữ liệu, suy giảm mô hình và giám sát đều tái diễn ở mọi tầng, vì vậy các bài học còn lại phải tính đến chúng.
Checkpoint 1.3: Các mẫu ML lai
Các kiến trúc lai hoạt động hiệu quả khi phân chia công việc giữa các tầng, chứ không phải khi sao chép cùng một pipeline ở mọi nơi.
Các mẫu tích hợp
Kiểm tra tính hợp lý của thiết kế
Self-Check: Question
A smart agriculture system deploys soil moisture sensors on microcontrollers performing local anomaly detection, local gateway edge servers that aggregate sensor feeds across crop fields to trigger automated irrigation valves, and a central cloud system that aggregates regional data for seasonal crop yield forecasting. Which hybrid ML integration pattern does this architecture exemplify?
- Pure Train-Serve Split
- Monolithic Cloud Offload
- Hierarchical Processing
- Linear Single-Node Pipelining
What is the primary operational failure risk in a hybrid ML system where preprocessing and feature extraction are split between client devices (mobile/edge) and centralized cloud servers?
- Transistors in edge devices reverse polarity when receiving cloud RPC payloads.
- The speed of light in optical fiber decreases proportionally with the number of connected edge clients.
- Edge devices become unable to allocate floating-point registers during network handshakes.
- Training-serving skew, where slight discrepancies in feature extraction logic, library versions, or numerical precision between the edge client and cloud server cause silent model degradation.
What is the economic rationale behind the Train-Serve Split pattern in hybrid ML architectures?
Optimization techniques such as quantization and memory traffic reduction are mutually exclusive between tiers, meaning methods developed for TinyML microcontrollers have no applicability to cloud data center serving.
Order the steps of the Progressive Deployment pattern where a single foundation model architecture is adapted for deployment across multiple tiers:
- Quantize and prune the model into an ultra-low-power integer representation for microcontroller TinyML deployment
- Train a large, high-capacity baseline model on a centralized cloud accelerator cluster
- Apply structured compression and distillation to generate an optimized intermediate model for edge servers
- Further compress the architecture with depthwise separable layers and INT8 quantization for mobile NPU deployment
Entropy hệ thống: Tại sao triển khai không phải là kết thúc
Các nền tảng chung được trình bày trong figure 13 cũng có một điểm yếu chung. Triển khai không phải là dấu chấm hết cho thách thức kỹ thuật; đó là khởi đầu của một thách thức mới. Một thuật toán sắp xếp vẫn giữ đúng hành vi đã được xác định miễn là mã, môi trường thực thi và hợp đồng đầu vào vẫn còn hợp lệ. Các hệ thống ML còn phải đối mặt với một dạng entropy hệ thống: sự suy giảm về mặt thống kê do khoảng cách giữa điều kiện huấn luyện và điều kiện vận hành thực tế.
Độ chính xác của một mô hình ML có thể thay đổi khi thế giới lệch khỏi phân phối huấn luyện của nó, ngay cả khi mã và các trọng số vẫn giữ nguyên. Equation 8 đưa ra một xấp xỉ chẩn đoán cục bộ: chất lượng hệ thống có thể suy giảm khi khoảng cách giữa phân phối huấn luyện và phân phối dữ liệu thực tế tăng lên, với tốc độ tỷ lệ thuận với độ nhạy của mô hình trước sự dịch chuyển phân phối: \[ \Delta \text{Quality} \approx - S_{\text{shift}} \cdot \mathcal{D}(P_{\text{train}}, P_{\text{live}}) \tag{8}\] Vì vậy, để đảm bảo độ tin cậy, cần giám sát để xác định khi nào nên cập nhật. Các khía cạnh vận hành được đề cập trong Vận hành machine learning giải quyết đúng thách thức này.
War Story 1.1: Sự sụp đổ của Zillow Offers (2021)
Bối cảnh: Zillow, một thị trường bất động sản, đã ra mắt “Zillow Offers” để mua nhà trực tiếp thông qua mô hình iBuying, phụ thuộc vào việc dự báo giá nhà và hiệu quả kinh tế khi bán lại (Zillow Group 2021).
Cơ chế: Zillow báo cáo rằng họ đã mua nhà với giá cao hơn so với các ước tính đã điều chỉnh về giá bán trong tương lai, trong khi các hạn chế về năng lực bán lại khiến một số thương vụ bị chậm đóng giao dịch (Zillow Group 2021). Sự không chắc chắn trong dự báo đã trở thành rủi ro tồn kho vì hệ thống đã gắn các ước tính giá với các cam kết mua.
Tác động: Zillow đã ghi giảm $304 triệu hàng tồn kho nhà ở, sa thải 25% lực lượng lao động (2.000 nhân viên) và đóng cửa vĩnh viễn bộ phận Offers.
Phản hồi: Một thiết kế an toàn hơn sẽ đặt trần mức tồn kho rủi ro, giữ quyền can thiệp thủ công, và lắp cơ chế ngắt mạch giữa sự không chắc chắn trong dự báo và các quyết định mua hàng.
Bài học về hệ thống: Sự dịch chuyển phân phối không chỉ là việc các chỉ số bị giảm sút; đó còn là một rủi ro lớn cho doanh nghiệp. Các hệ thống ra quyết định tự động khi tương tác với thị trường luôn thay đổi cần có các vòng phản hồi nhanh và cơ chế ngắt mạch, chứ không chỉ đơn thuần là mô hình ngoại tuyến chính xác.
Sự sụp đổ của Zillow không chỉ là một câu chuyện cảnh báo. Thất bại này liên quan đến sự không chắc chắn trong dự báo và cả hệ thống hành động dựa trên đó: việc mua tự động đã nối các ước tính không chắc chắn với tồn kho và các cam kết trên bảng cân đối kế toán. Kỹ thuật hệ thống ML giúp nhìn rõ đường lan truyền đó trước khi tổn thất chồng chất.
Self-Check: Question
In the 2021 collapse of Zillow Offers ($304M inventory write-down and division closure), what was the fundamental systems engineering failure in how the ML model was integrated into production operations?
- The system directly coupled algorithmic forecast uncertainty to high-stakes real-world purchase commitments without human overrides, circuit breakers, or rapid feedback loops to absorb distribution shift.
- The model weights were corrupted because the hosting cloud server ran out of physical SSD storage space.
- The real estate forecasting model was written in an interpreted language rather than compiled C++.
- The system failed because it attempted to run real estate valuation algorithms on microcontrollers.
Explain the variables in the quality degradation diagnostic equation \(\Delta \text{Quality} \approx - S_{\text{shift}} \cdot \mathcal{D}(P_{\text{train}}, P_{\text{live}})\), and describe why traditional software testing cannot prevent system entropy.
System entropy in deployed ML systems can occur even when the underlying software code, dependencies, and model weights remain completely unmodified.
Những ngụy biện và cạm bẫy
Ngoài sự suy giảm về thống kê, các kỹ sư còn dễ mắc những quan niệm sai lầm phổ biến khi triển khai ML. Các ràng buộc vật lý được phân tích trong chương này tạo ra các hành vi trái trực giác, thách thức trực giác vốn có từ kỹ thuật phần mềm truyền thống. Những ngụy biện và cạm bẫy này khái quát các sai lầm về kiến trúc, dẫn đến lãng phí tài nguyên phát triển, không đạt mục tiêu hiệu suất, hoặc triển khai các hệ thống lệch hẳn so với ràng buộc vận hành của chúng.
Ngụy biện: Một mô hình triển khai duy nhất giải quyết mọi vấn đề ML.
Các ràng buộc vật lý tạo ra ranh giới cứng mà không một mô hình triển khai nào có thể bao trùm. Phần thảo luận về giới hạn bộ nhớ trong section 1.3 cho thấy băng thông, dung lượng bộ nhớ và độ trễ mở rộng theo cách khác với năng lực tính toán thuần túy, từ đó tạo ra những nút thắt cổ chai khác nhau giữa các mô hình. Table 13 liệt kê các phạm vi triển khai minh họa, chứ không chỉ là các giới hạn độ trễ thuần vật lý. Một hệ thống robot thời gian thực cần phản hồi dưới 10 ms không thể dùng đường truyền từ xa nếu độ trễ đầu cuối vượt ngân sách đó, và một mô hình ngôn ngữ với hàng tỷ tham số không thể đặt trên vi điều khiển 256 KB RAM, bất kể đã giảm kích thước mô hình tới đâu. Kiến trúc tối ưu thường kết hợp nhiều mô hình, như huấn luyện trên đám mây với suy luận trên edge, hoặc tiền xử lý trên thiết bị di động với phân tích trên đám mây.
Một ngộ nhận liên quan cho rằng đưa việc tính toán lại gần người dùng luôn giúp giảm độ trễ, mà bỏ qua phần chi phí xử lý do phần cứng edge kém mạnh hơn. Sự đánh đổi này đã được phân tích trong các benchmark suy luận (Benchmark suy luận).
Cạm bẫy: Dựa vào tối ưu hoá mô hình để vượt qua giới hạn công suất và nhiệt của thiết bị di động.
Các kỹ thuật nén không thể mở rộng vô hạn trước những giới hạn vật lý. Hãy xét một điện thoại thông minh có pin 15 Wh. Một khối lượng công việc (workload) suy luận nhẹ, tiêu thụ 1 W, có thể chạy trong \(\frac{15 Wh}{1 W}\) = 15 h. Nhưng một khối lượng công việc (workload) nặng, tiêu thụ 5 W (thường gặp với các mô hình lớn chạy trên thiết bị), sẽ làm cạn viên pin đó chỉ trong \(\frac{15 Wh}{5 W}\) = 3 h.
Khối lượng công việc (workload) 5 W cũng có thể gây ra hiện tượng điều tiết nhiệt (thermal throttling). Trong kịch bản này, khoảng 3 W được dành cho làm mát thụ động kéo dài. Mức giảm 4× là một mục tiêu thiết kế lại mang tính minh hoạ, không phải là hệ quả phổ quát của lượng tử hoá. Nếu một khối lượng công việc (workload) liên tục vẫn vượt quá giới hạn nhiệt đo được, cần giảm chu kỳ hoạt động, dùng mô hình khác, hoặc đổi phần cứng.
Ngụy biện: TinyML là ML trên di động thu nhỏ.
Sự khác biệt mang tính định tính, không chỉ là về mặt định lượng. Như section 1.7.1 đã chỉ ra, vi điều khiển TinyML cung cấp bộ nhớ từ 256 KB đến 1 MB, so với các thiết bị di động có 8–16 GB. Đây là chênh lệch 10.000\(\times\), đòi hỏi các thuật toán hoàn toàn khác. Cả ML di động và TinyML đều sử dụng số học độ chính xác rút gọn; tác động tới độ chính xác phụ thuộc vào mô hình, tập dữ liệu, phương pháp và phần cứng. Các thiết bị di động chạy các mô hình với hàng triệu tham số; còn các mô hình TinyML thường chỉ chứa từ vài chục đến vài trăm nghìn tham số, nên cần những lựa chọn kiến trúc khác biệt, chẳng hạn các phép toán nhẹ chuyên biệt được thiết kế để giảm tối đa số phép nhân-tích lũy. Ngân sách công suất cũng cho thấy những khác biệt gián đoạn tương tự: suy luận di động tiêu thụ 3–5 W, trong khi TinyML nhắm đến 1–10 mW cho thu hoạch năng lượng không dùng pin. Những khoảng cách hàng nghìn lần này khiến TinyML trở thành một lớp bài toán riêng, không phải một phiên bản nhỏ hơn của ML di động. Các nhóm áp dụng trực tiếp các kỹ thuật tối ưu hóa di động vào các dự án TinyML nhận ra rằng lượng tử hoá từ FP32 sang INT8 là không đủ khi mô hình phải vừa trong 64 KB, buộc họ phải thiết kế lại kiến trúc hoàn toàn.
Cạm bẫy: Giảm thiểu tài nguyên tính toán sẽ giảm thiểu tổng chi phí.
Các nhóm tối ưu hóa mức tiêu thụ tài nguyên trên mỗi đơn vị nhưng lại bỏ qua chi phí vận hành và tốc độ phát triển. Như decision framework trong section 1.8.2 nhấn mạnh, việc chọn cách tiếp cận cần đánh giá tổng chi phí sở hữu, không chỉ chi phí tính toán. Trong kịch bản minh họa này, một dịch vụ suy luận trên đám mây có chi phí tính toán $2,000/month trông có vẻ đắt hơn so với $500/month cho khấu hao phần cứng edge. Nhưng triển khai trên edge còn cộng thêm chi phí kỹ thuật mạng ($3,000/month), bảo trì phần cứng ($500/month) và kỹ thuật đảm bảo độ tin cậy ($2,000/month), tổng cộng $6,000/month—chênh lệch 3× lần. Nếu phiên bản trên đám mây đưa vào sản xuất trong hai tháng, còn hạ tầng edge tùy chỉnh mất sáu tháng, thì bốn tháng chậm trễ là chi phí riêng của kịch bản này chứ không phải lịch trình chung. Giải pháp chi phí tối ưu đòi hỏi phân tích tổng chi phí sở hữu, bao gồm thời gian phát triển, độ phức tạp vận hành và chi phí cơ hội, chứ không chỉ cố giảm chi phí tính toán.
Một giai đoạn mô hình nhanh hơn không làm tăng tốc pipeline camera một cách tuyến tính.
Ngụy biện: Việc tối ưu hóa mô hình sẽ dẫn đến tăng tốc hệ thống một cách tuyến tính.
Định luật Amdahl40 đặt ra những giới hạn cứng, và nguyên tắc nút thắt cổ chai (section 1.2.1) giúp hiện thực hóa chúng; Mở rộng mạnh (Định luật Amdahl) suy dẫn dạng strong-scaling và minh họa một ví dụ tăng tốc với tám bộ xử lý: \(\text{Speedup}_{\text{overall}} = \frac{1}{(1-p) + \frac{p}{s}}\), với \(p\) là phần công việc có thể được cải thiện và \(s\) là mức tăng tốc của phần đó. Hãy xem việc nhấn nút chụp trên camera điện thoại thông minh. Ảnh đi qua 100 ms xử lý tín hiệu (tự động phơi sáng, cân bằng trắng), 60 ms phân loại cảnh ML, và 40 ms xử lý hậu kỳ (ánh xạ tông màu, ghép HDR)—tổng cộng 200 ms. Nếu tối ưu hóa bộ phân loại ML để chạy nhanh hơn 10× lần (tức còn 6 ms thay vì 60 ms), tổng thời gian giảm từ 200 ms xuống —tăng tốc tổng thể chỉ 1.37× lần, chứ không phải 10× lần. Ngay cả khi loại bỏ hoàn toàn ML \((s = \infty)\) thì cũng chỉ đạt mức tăng tốc 1.43× lần, vì 70 percent còn lại của pipeline không đổi. Để tối ưu hóa hiệu quả, cần phân tích hiệu năng toàn bộ pipeline và xử lý các nút thắt cổ chai một cách có hệ thống, vì hiệu năng hệ thống bị chi phối bởi giai đoạn chưa được tối ưu hóa chậm nhất.
40 Định luật Amdahl: Được Amdahl (1967) phát biểu cho mở rộng hệ thống đa bộ xử lý, nguyên tắc này áp dụng trực tiếp cho các pipeline triển khai ML, nơi mô hình chỉ là một trong nhiều giai đoạn. Trong ví dụ về pipeline camera này, phần suy luận ML là 60 ms trên tổng thời gian 200 ms của pipeline; ngay cả khi mô hình tăng tốc 100\(\times\), cải thiện end-to-end cũng chỉ khoảng 1.4–2× vì các phần còn lại của pipeline không đổi. Các nhóm chỉ đo/đánh giá độ trễ của mô hình một cách riêng lẻ thường đánh giá quá cao mức cải thiện khi triển khai.
Amdahl, Gene M. 1967. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” Proceedings of the April 18-20, 1967, Spring Joint Computer Conference on - AFIPS ’67 (Spring), AFIPS ’67 (spring), 483–85. https://doi.org/10.1145/1465482.1465560.
Cạm bẫy: Cho rằng nhiều dữ liệu huấn luyện hơn luôn cải thiện hiệu suất của mô hình đã triển khai.
Ba yếu tố giới hạn lợi ích khi mở rộng dữ liệu, như các kiểu khối lượng công việc (workload) minh họa trong section 1.2. Thứ nhất, khả năng của mô hình có thể giới hạn lợi ích từ dữ liệu bổ sung. Thứ hai, chất lượng dữ liệu có thể quan trọng hơn số lượng, vì ví dụ gán nhãn sai và các mẫu gây hiểu lầm làm giảm hiệu suất. Thứ ba, phân phối trong môi trường triển khai rất quan trọng: dữ liệu trong miền (in-domain) có thể vượt trội so với các tập dữ liệu ngoài miền (out-of-domain) lớn hơn nhiều.
Ngụy biện: Một tệp nhị phân của mô hình có thể phục vụ mọi mục tiêu phần cứng edge một cách hiệu quả.
Các nhóm thường xây dựng một gói mô hình duy nhất và triển khai y hệt lên mọi thiết bị đích, coi triển khai chỉ là bước đóng gói thay vì một cơ hội tối ưu hóa. Thực tế cho thấy, các tối ưu hóa đặc thù phần cứng có thể mang lại mức hiệu quả đáng kể mà các tệp nhị phân chung không đạt được. Ví dụ, một mô hình INT8 chạy trên thiết bị có NPU chuyên dụng có thể đạt thông lượng trên mỗi watt cao hơn cùng mô hình chạy FP32 trên CPU đa năng, vì các đường dẫn INT8 chuyên dụng của NPU tránh được chi phí năng lượng của số học dấu phẩy động. Tương tự, hợp nhất toán tử (kết hợp các phép toán liền kề để không phải ghi các tensor trung gian về bộ nhớ) và tinh chỉnh bố cục bộ nhớ cho hệ thống phân cấp bộ nhớ cache của một bộ tăng tốc cụ thể có thể giảm độ trễ suy luận mà không thay đổi trọng số mô hình. Như phân tích về mô hình triển khai trong Framework về mô hình triển khai đã chỉ ra, mỗi mô hình triển khai áp đặt các ràng buộc phần cứng khác nhau; một bản nhị phân mô hình được tối ưu cho Arm Cortex-A78 sẽ không khai thác hết các đơn vị tăng tốc ma trận trên thiết bị có NPU Arm Ethos-U. Bỏ qua tối ưu hóa theo từng thiết bị đích sẽ dẫn đến lãng phí pin trên thiết bị di động hoặc không đáp ứng SLA về độ trễ trên phần cứng edge, buộc phải khắc phục tốn kém sau khi triển khai. Một gói mô hình chung vẫn có thể làm mốc cho tính di động, nhưng cần profiling trên runtime sản xuất, delegate, hệ thống phân cấp bộ nhớ và giới hạn nhiệt để xác định xem nó chấp nhận được, kém hiệu quả, hay về bản chất là không phù hợp.
Self-Check: Question
A smartphone camera pipeline takes 200 ms total: 100 ms for the image signal processor (ISP), 60 ms for ML scene classification, and 40 ms for postprocessing. If an engineering team optimizes the ML model to run \(10\times\) faster (reducing ML time from 60 ms to 6 ms), what is the overall system-level speedup?
- \(10.00\times\) speedup
- \(1.37\times\) speedup
- \(5.50\times\) speedup
- \(0.73\times\) speedup (system becomes slower)
Why does deploying a single generic FP32 model binary across diverse edge devices (e.g., Arm CPU, Apple Neural Engine, and Google Coral Edge TPU) result in suboptimal efficiency compared to per-target compilation?
- Generic model binaries violate cryptographic signatures required by PCI Express buses.
- Floating-point operations are mathematically undefined on mobile CPUs.
- Generic binaries cannot exploit hardware-specific operator fusion, dedicated fixed-point INT8 matrix datapaths, or accelerator-specific on-chip SRAM memory tiling.
- The operating system automatically deletes untuned model weights to prevent memory fragmentation.
Why does choosing an on-premises edge deployment solely because its hardware amortizes to a lower monthly compute cost than a cloud VM often result in a higher Total Cost of Ownership (TCO)?
Increasing the quantity of training data is guaranteed to continuously improve deployed model performance regardless of model capacity, label noise, or domain distribution shift.
What is operator fusion in ML compilers, and how does it optimize memory-bound inference pipelines?
Tóm tắt
Kỹ thuật hệ thống ML bị chi phối bởi thực tế vật lý: mỗi đích triển khai đều áp đặt những ràng buộc phần cứng riêng. Định luật sắt của hệ thống ML (\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\)) hợp nhất các giới hạn này vào một mô hình thực thi duy nhất: độ trễ lan truyền đóng góp một thành phần độ trễ cố định (\(L_{\text{lat}}\)), bức tường bộ nhớ đặt trần cho việc di chuyển dữ liệu (\(D_{\text{vol}}/\text{BW}\)), và ngân sách công suất nhiệt giới hạn khả năng tính toán duy trì. Trên các tầng đám mây, edge, di động và TinyML, dải công suất theo hạng mục trải từ megawatt xuống milliwatt, tức chín bậc độ lớn; trong đó các hệ thống tiêu biểu chỉ nằm trong những khoảng hẹp hơn.
Bằng cách áp dụng nguyên tắc nút thắt cổ chai cho các nguyên mẫu khối lượng công việc (workload), các kỹ sư xác định xem độ trễ của một mô hình chủ yếu do hiệu quả tính toán, băng thông bộ nhớ hay thời gian truyền qua mạng, trước khi quyết định dùng kiến trúc một nút hay kiến trúc lai. Các đánh đổi định lượng (table 13) và framework ra quyết định có hệ thống (figure 11) được trình bày trong chương này thiết lập các đường chuẩn vật lý, chi phối mọi quyết định về sau trong nén mô hình, thiết kế pipeline dữ liệu và phục vụ (serving) hiệu suất cao.
Key Takeaways: Cùng mô hình, cách làm kỹ thuật khác
- Các ràng buộc vật lý xác định tính khả thi: Tốc độ ánh sáng (khoảng 36 ms cho chuyến khứ hồi xuyên quốc gia), giới hạn công suất, giới hạn bộ nhớ và ngân sách độ trễ tạo ra những ranh giới cứng mà kỹ thuật không thể vượt qua, chỉ có thể tìm cách điều hướng trong các ranh giới đó.
- Xác định nút thắt cổ chai trước khi tối ưu hóa: Cùng một mô hình có thể bị giới hạn bởi năng lực tính toán trong huấn luyện, nhưng lại bị giới hạn bởi bộ nhớ trong suy luận. Định luật sắt và nguyên tắc nút thắt cổ chai giúp xác định ràng buộc nào chi phối; tối ưu hóa nhầm yếu tố sẽ không mang lại bất kỳ tăng tốc nào.
- Các nguyên mẫu khối lượng công việc (workload) xác định tính khả thi của việc triển khai: Một Compute Beast, chẳng hạn như huấn luyện mô hình hình ảnh quy mô lớn, thường cần tài nguyên quy mô đám mây; trong khi một Tiny Constraint, như phát hiện từ khóa, đòi hỏi hiệu quả ở mức vi điều khiển. Cùng một chiến lược tối ưu hóa không thể phục vụ (serving) cho cả hai; các kỹ sư phải ghép nguyên mẫu khối lượng công việc (workload) với kiểu triển khai phù hợp.
- Công suất triển khai trải rộng chín bậc độ lớn: Cơ sở hạ tầng trung tâm dữ liệu đám mây hoạt động ở quy mô megawatt, trong khi các hệ thống TinyML hướng đến mức milliwatt. Khoảng cách lớn này cho phép hình thành các lớp ứng dụng hoàn toàn khác nhau, chứ không phải là một giới hạn.
- Kiến trúc lai phổ biến trong các hệ thống sản xuất: Các trợ lý giọng nói trải dài từ TinyML (phát hiện từ đánh thức), di động (chuyển giọng nói thành văn bản) đến đám mây (hiểu ngôn ngữ). Khi một cách tiếp cận không đủ, các mẫu tích hợp (phân tách huấn luyện-phục vụ (serving), xử lý phân cấp, triển khai lũy tiến) sẽ chuẩn hóa cách các cách tiếp cận này kết hợp với nhau.
- Tăng tốc ở cấp hệ thống tuân theo Định luật Amdahl, không phải mức tăng ở cấp mô hình: Trong pipeline camera minh họa, một mô hình nhanh hơn 10\(\times\) chỉ đem lại tăng tốc hệ thống 1.37\(\times\) khi ML chiếm 30% của pipeline. Hãy đo đạc và phân tích toàn bộ hệ thống trước khi tối ưu hóa bất kỳ thành phần nào.
- Triển khai bắt đầu một vòng lặp phản hồi: Dữ liệu thực tế có thể lệch khỏi điều kiện huấn luyện trong khi mã và trọng số vẫn giữ nguyên, nên giám sát và giới hạn phạm vi vận hành là một phần của kiến trúc hệ thống.
Các phương thức triển khai không phải là lựa chọn thiết kế tùy hứng; chúng là các miền vận hành liên tục bị chi phối bởi các định luật vật lý. Việc chọn mục tiêu triển khai quyết định điều khoản nào của “định luật sắt” có khả năng trở thành ràng buộc chính: huấn luyện trong trung tâm dữ liệu có thể chạm trần năng lực tính toán đỉnh (\(O/R_{\text{peak}}\)), suy luận trên thiết bị di động có thể va vào băng thông bộ nhớ (\(D_{\text{vol}}/\text{BW}\)), và suy luận thời gian thực từ xa có thể bị giới hạn bởi độ trễ lan truyền (\(L_{\text{lat}}\)). Kỹ thuật hệ thống bắt đầu bằng việc đo lường ràng buộc đang “trói” hệ thống. Tối ưu hóa kiến trúc mô hình hoặc runtime/phần mềm mà không tôn trọng “hợp đồng” phần cứng nền tảng sẽ tạo ra các hệ thống mong manh, dễ thất bại dưới áp lực vận hành thực tế.
What’s Next: Từ lý thuyết đến quy trình
Mặc dù các ràng buộc vật lý và decision framework được thiết lập trong section 1.8.2 xác định nơi một hệ thống ML có thể thực thi về mặt vật lý, chỉ riêng tính khả thi về mặt vật lý vẫn chưa đủ để đảm bảo thành công vận hành theo thời gian. Như khoản ghi giảm 304 triệu đô la của Zillow (Zillow Group 2021) cho thấy, triển khai mô hình vào môi trường sản xuất đòi hỏi phải kiềm chế độ bất định của dự báo và quản lý rủi ro vận hành xuyên suốt vòng đời phần mềm. Quy trình ML giới thiệu vòng đời phát triển ML, một quy trình kỹ thuật có hệ thống dẫn dắt một hệ thống từ khâu xác định vấn đề đến triển khai, giám sát và bảo trì.
Zillow Group. 2021. Zillow Group Reports Third-Quarter 2021 Financial Results and Shares Plan to Wind down Zillow Offers Operations. Investor Relations Press Release.
Self-Check: Question
Which summary statement best captures the core thesis of ML systems engineering regarding deployment paradigms?
- Software compilers have eliminated hardware differences, making any model executable on any hardware platform with identical efficiency.
- Model accuracy on standard benchmark datasets is the sole determinant of whether a system succeeds in production.
- Cloud computing is always the optimal deployment target because network bandwidth expands faster than processor compute capacity.
- Constraints drive architecture: permanent physical boundaries (the speed of light, thermodynamics, and memory signaling) partition deployment into distinct operating regimes, making deployment a first-order co-design problem across Data, Algorithm, and Machine.
Summarize how the iron law of ML systems helps engineers avoid wasted optimization effort during model development and deployment.
In ML systems engineering, successful deployment of a trained model represents the completion of the engineering task, because verified model weights maintain static accuracy indefinitely.
Self-Check Answers
Self-Check: Answer
A safety-critical autonomous braking system requires an end-to-end decision latency budget of 10 ms. A cloud data center is located 1,500 km away. Given that light travels through optical fiber at approximately \(200{,}000\text{ km/s}\), why is offloading inference to this cloud data center physically impossible?
- The cloud server queue latency always adds at least 25 ms regardless of server load.
- The speed of light in fiber allows a round trip in 5 ms, but serialization of model weights requires 15 ms.
- The minimum speed-of-light round-trip propagation time alone is 15 ms, consuming the entire 10 ms budget before compute begins.
- Wireless transmission protocols require a minimum 50 ms handshake before transmitting sensor packets.
Answer: The correct answer is C. The minimum round-trip propagation time over optical fiber is \(\frac{2 \times 1{,}500\text{ km}}{200{,}000\text{ km/s}} = 0.015\text{ s} = 15\text{ ms}\). This propagation delay alone exceeds the 10 ms budget by 5 ms before accounting for network routing, packet queuing, or model inference. The option citing a fixed 25 ms server queue latency confuses operational queuing with an invariant physical floor. The option claiming a 5 ms round trip miscalculates the distance-speed formula. The option attributing the failure to wireless handshakes references protocol overhead rather than the primary speed-of-light constraint.
Learning Objective: Calculate the physical latency floor imposed by the speed of light in optical fiber for distributed ML workloads.
Under dynamic CMOS power scaling where supply voltage scales proportionally with clock frequency (\(V \propto f\)), doubling the processor clock frequency increases dynamic power dissipation by a factor of 8 (\(f^3\)).
Answer: True. Dynamic CMOS power follows \(\text{Power} \propto C \cdot V^2 \cdot f\). When supply voltage \(V\) must scale proportionally with frequency \(f\) to support faster switching, substituting \(V \propto f\) yields \(\text{Power} \propto C \cdot f^3\). Consequently, doubling clock frequency (\(2\times\)) results in an \(8\times\) (\(2^3\)) increase in dynamic power, which explains why frequency scaling stalled when Dennard scaling broke down.
Learning Objective: Explain the cubic relationship between clock frequency and dynamic power in CMOS circuits and its impact on hardware scaling.
How does the memory wall manifest in modern computing hardware according to the historical growth rates of compute capacity versus memory bandwidth?
- Memory bandwidth doubles every 18 months while compute throughput increases by only 20% annually, causing compute starvation.
- Both compute throughput and memory bandwidth grow at identical 60% annual rates, but memory capacity limits model size.
- Processors have reached absolute thermal limits while memory signaling energy has dropped to near-zero levels.
- Compute capacity historically doubles roughly every 18 months (~60% annually), whereas memory bandwidth grows by only ~20% annually, causing the compute-to-bandwidth gap to widen compounding over time.
Answer: The correct answer is D. The memory wall is defined by the widening gap between compute growth (doubling roughly every 18 months, ~60% annual growth) and memory bandwidth growth (~20% annual growth), yielding a growth factor ratio of approximately \(\frac{1.6}{1.2} \approx 1.33\). This divergence makes data movement an increasingly dominant bottleneck across successive hardware generations. The option reversing compute and memory bandwidth growth contradicts historical scaling trends. The option claiming identical growth rates ignores the core definition of the memory wall. The option claiming memory signaling energy has dropped to near zero contradicts the physics of memory bus signaling.
Learning Objective: Analyze the quantitative divergence between processor compute growth and memory bandwidth growth that creates the memory wall.
What causes thermal throttling on passively cooled mobile devices running sustained ML inference, and how does it affect continuous model execution?
Answer: Passively cooled mobile devices have a limited thermal dissipation capacity (typically 2–5 W TDP). When sustained ML computation generates heat faster than the chassis can dissipate it, the internal temperature rises until it reaches the hardware thermal trip point (e.g., 80 °C). The operating system then throttles clock frequencies and duty cycles to protect the hardware, which can cause frame rates and inference throughput to drop precipitously (e.g., from 60 FPS down to 15 FPS).
Learning Objective: Evaluate the thermal throttling mechanism on mobile devices and its operational impact on sustained inference throughput.
The historical scaling relationship under which shrinking MOSFET transistor dimensions allowed reducing voltage and current while keeping power density constant is known as ____ scaling.
Answer: Dennard. Dennard scaling (formulated by Robert Dennard in 1974) held that as transistors shrank, power density remained constant because operating voltage and current scaled downward proportionally. Its breakdown in the mid-2000s ended free clock frequency scaling and forced the computing industry toward multicore parallelism and domain-specific accelerators.
Learning Objective: Explain the transistor power-scaling law whose breakdown led to domain-specific ML accelerators.
Self-Check: Answer
When analyzing ML system performance, when should an engineer apply the additive form of the iron law (\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\)) versus the bottleneck principle’s max form (\(T = \max\left(\frac{D_{\text{vol}}}{\text{BW}}, \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}, T_{\text{network}}\right) + L_{\text{lat}}\))?
- Use the additive form for single-task, serialized latency, and the max form for pipelined, steady-state throughput where computation and data prefetching overlap.
- Use the additive form exclusively for cloud workloads, and the max form exclusively for microcontroller TinyML workloads.
- Use the additive form when batch size is greater than 128, and the max form when batch size equals 1.
- Use the additive form during model training only, and the max form during on-device model quantization.
Answer: The correct answer is A. The additive form models isolated single-task execution where data movement, computation, and overhead occur sequentially and their latencies sum up directly. The max form applies to pipelined, steady-state execution where modern hardware overlaps data movement (prefetching batch \(n+1\)) with computation (processing batch \(n\)), making the slowest pipelined stage the bounding throughput bottleneck. The option dividing the formulas by deployment tier (cloud vs. TinyML) incorrectly couples execution flow with device location. The choice associating the additive form with large batch sizes reverses the intuition: batching often enables pipelined overlap. The option restricting the formulas to training versus quantization confuses performance modeling with workflow stages.
Learning Objective: Apply the iron law and bottleneck principle to distinguish between serialized task latency and pipelined throughput bounds.
Which pairing correctly matches a workload archetype to its dominant physical bottleneck and canonical lighthouse model?
- Compute Beast \(\rightarrow\) dominated by irregular table lookups and cache misses \(\rightarrow\) DLRM
- Bandwidth Hog \(\rightarrow\) dominated by dense parameter streaming during autoregressive token decode \(\rightarrow\) GPT-2/Llama
- Sparse Scatter \(\rightarrow\) dominated by dense FLOP throughput at high arithmetic intensity \(\rightarrow\) ResNet-50
- Tiny Constraint \(\rightarrow\) dominated by petabyte-scale distributed training \(\rightarrow\) Keyword Spotting (KWS)
Answer: The correct answer is B. Bandwidth Hog workloads, exemplified by autoregressive language models such as GPT-2 and Llama, perform sequential token decoding where generating each token requires streaming large parameter matrices through memory, making memory bandwidth (\(\text{BW}\)) the primary bottleneck. The option pairing Compute Beast with DLRM confuses dense arithmetic with sparse embedding lookups. The option pairing Sparse Scatter with ResNet-50 misclassifies a dense convolution model as an irregular lookup table. The option pairing Tiny Constraint with petabyte-scale distributed training contradicts the kilobyte memory and milliwatt power constraints of TinyML.
Learning Objective: Classify ML workloads into archetypes based on their dominant iron law bottlenecks and reference lighthouse models.
In a battery-powered IoT sensor, why does sending raw sensor data (e.g., 1 MB audio) over a cellular or Wi-Fi radio often consume significantly more energy than running local neural network inference (e.g., MobileNetV2)?
Answer: Radio transmission of raw data typically requires 500–1000 mJ per megabyte over wireless links (e.g., 5G/Wi-Fi), whereas running a compact quantized model like MobileNetV2 on an energy-efficient on-device processor requires only tens of millijoules (e.g., ~50 mJ) per inference. Because transmission energy is hundreds of times higher than local compute energy for the same payload, battery-constrained sensors achieve much longer battery life by processing data locally and transmitting only compact detection summaries.
Learning Objective: Calculate and compare the energy trade-off between wireless data transmission and local neural processing.
**Order the steps of the hierarchical deployment feasibility evaluation for the Smart Doorbell scenario from initial resource check to latency verification:
- Verify Level 1 resource capacity fit (confirm model weights and activations fit in microcontroller SRAM/Flash)
- Define application mission targets (specify model task, accuracy target, and real-time SLA budget)
- Verify Level 2 timing constraints (evaluate per-inference execution latency against the strict interaction SLA)
- Select deployment candidate platform and model archetype (match keyword spotter to ESP32-S3 microcontroller)**
Answer: The correct order is (2) Define application mission targets, (4) Select deployment candidate platform and model archetype, (1) Verify Level 1 resource capacity fit, and (3) Verify Level 2 timing constraints. Deployment feasibility must be evaluated hierarchically: first define the application SLA and task, then select candidate hardware and archetype, next confirm physical memory fit (Level 1 capacity check), and finally evaluate execution latency against the SLA budget (Level 2 timing check).
Learning Objective: Design a hierarchical constraint scorecard evaluation to determine deployment feasibility on embedded hardware.
An ML workload characterized by high arithmetic intensity where throughput is bounded by peak FLOP/s (\(R_{\text{peak}}\)) rather than memory bandwidth, such as dense convolutional neural network training, belongs to the ____ archetype.
Answer: Compute Beast. Compute Beast workloads perform many floating-point operations per byte of memory loaded (\(I = \text{FLOPs/byte}\)), ensuring that processor arithmetic units remain saturated and execution time is dominated by the compute term (\(O / (R_{\text{peak}} \cdot \eta_{\text{hw}})\)) of the iron law.
Learning Objective: Classify ML workloads exhibiting high arithmetic intensity into the Compute Beast archetype.
Self-Check: Answer
Why is single-image (batch=1) ResNet-50 inference memory-bound on both a high-end cloud accelerator (NVIDIA A100) and a mobile NPU (iPhone 15 Pro)?
- ResNet-50 contains dynamic control flow that causes branching stalls on SIMD execution units.
- Both platforms lack matrix multiplication coprocessors, forcing scalar CPU execution.
- At batch=1, model weights must be loaded from memory once per single image without weight reuse across batch items, keeping arithmetic intensity below each platform’s hardware balance point (\(R_{\text{peak}}/\text{BW}\)).
- The activations at batch=1 exceed the total high-bandwidth memory (HBM) and SRAM capacities of both devices.
Answer: The correct answer is C. For single-image inference (\(\text{batch}=1\)), the full model weight parameters must be fetched from memory to process a single sample. Because weights cannot be amortized across multiple samples in parallel, the effective arithmetic intensity (\(I = \text{FLOPs/byte}\)) is low and falls to the left of the roofline ridge point (\(R_{\text{peak}}/\text{BW}\)) on both the A100 and the mobile NPU, making memory bandwidth the limiting constraint on both chips. The option citing dynamic control flow is incorrect because ResNet-50 consists of regular static feedforward convolutions. The claim that both platforms lack matrix acceleration is false, as both feature specialized tensor cores / NPUs. The option claiming activations exceed memory capacity is false, as ResNet-50 activations at batch=1 require only a few megabytes.
Learning Objective: Analyze why single-batch inference is memory-bound across heterogeneous hardware platforms using the roofline model.
Why does a convolutional neural network (e.g., ResNet-50) shift from a compute-bound regime during cloud training to a memory-bound regime during single-sample (\(\text{batch}=1\)) edge inference?
Answer: During cloud training with large batch sizes (e.g., \(\text{batch}=256\)), loaded model weights are reused across hundreds of input samples in parallel, raising arithmetic intensity (\(I = \text{FLOPs/byte}\)) above the hardware balance point into the compute-bound regime. During single-sample inference (\(\text{batch}=1\)), the full set of model weights must be streamed from memory to process just one input without reuse, causing arithmetic intensity to plummet onto the memory-bandwidth-bound slope of the roofline.
Learning Objective: Explain how the dominant bottleneck shifts between compute-bound and memory-bound regimes across training and inference phases.
An ML service SLA guarantees a total end-to-end response time of 100 ms. The pipeline involves client preprocessing, a cross-region network RPC, model inference, and postprocessing. According to critical path latency principles, why will this system fail if a cross-region network call taking 120 ms is placed on the synchronous critical path?
- The ML framework compiler will refuse to lower the graph if network RPC operations are detected.
- Cross-region RPCs corrupt the numerical precision of FP16 tensors during serialization.
- A cross-region network call reduces the accelerator compute throughput (\(R_{\text{peak}}\)) by half.
- The critical path is the longest sequential chain of dependent operations; any single stage exceeding 100 ms guarantees the end-to-end SLA will be breached regardless of how fast all other stages execute.
Answer: The correct answer is D. In a synchronous pipeline, end-to-end latency is bounded below by the sum of sequential operations on the critical path. If an individual operation on the critical path requires 120 ms, the system latency is guaranteed to be at least 120 ms, violating the 100 ms budget before accounting for inference, preprocessing, or postprocessing. The options citing compiler lowering errors, tensor precision corruption, or halved accelerator throughput invent non-existent technical failures instead of applying critical-path analysis.
Learning Objective: Apply the critical path latency rule to evaluate end-to-end ML service level agreements.
What is the hardware balance point (or roofline ridge point) of an accelerator, and what does it tell an ML systems engineer about whether a workload will be compute-bound or memory-bound?
Answer: The hardware balance point is the ratio of peak arithmetic throughput to memory bandwidth (\(R_{\text{peak}} / \text{BW}\)), expressed in \(\text{FLOPs/byte}\). If a workload’s arithmetic intensity (\(I = \text{operations} / \text{bytes moved}\)) is greater than this balance point (\(I > R_{\text{peak}}/\text{BW}\)), the workload is compute-bound and limited by processor arithmetic capacity. If \(I < R_{\text{peak}}/\text{BW}\), the workload is memory-bound and limited by memory bandwidth, meaning buying more peak FLOP/s will provide zero speedup unless data movement is reduced.
Learning Objective: Calculate the hardware balance point and use it to classify workloads into compute-bound and memory-bound regimes.
In ML accelerator memory hierarchies, an L1 cache hit requires approximately 1 ns, whereas an uncached global DRAM read requires approximately 200–____ ns.
Answer: 500. Global memory access latency on GPUs and accelerators is roughly 200–500 ns, which is over two orders of magnitude slower than an L1 cache hit (~1 ns). This latency penalty is why accelerator kernels rely on memory coalescing, shared memory tiling, and massive thread parallelism to hide DRAM access latencies.
Learning Objective: Compare order-of-magnitude latencies across the memory hierarchy in modern ML accelerators.
Self-Check: Answer
Why does serving always-on voice assistant traffic (e.g., 1 billion devices issuing continuous audio queries) entirely in the cloud create an ‘infrastructure and economic wall’?
- The cloud approach would cost hundreds of millions of dollars annually and require dozens of dedicated data centers at peak hours, whereas on-device TinyML wake-word detection filters idle traffic for pennies per device.
- Cloud servers cannot execute transformer models with audio spectrogram inputs due to floating-point representation limits.
- Data privacy regulations in all jurisdictions make transmitting any encrypted audio to cloud servers illegal under all circumstances.
- Cloud network switches drop all audio packets exceeding 1 kHz sampling rates due to MTU size limits.
Answer: The correct answer is A. Continuous cloud-only voice processing for 1 billion devices would require tens of millions of daily GPU hours (~20+ dedicated data centers at peak waking hours) and hundreds of millions of dollars in annual cloud infrastructure costs. Layering a TinyML wake-word detector directly on the device enables always-on listening at sub-milliwatt power (<$0.01/device/year) and only engages higher-power speech recognition and cloud reasoning when a wake word is detected. The option claiming transformers cannot process audio spectrograms is factually false. The option asserting that transmitting encrypted audio is globally illegal misrepresents privacy regulations, which permit transmission with appropriate user consent and legal safeguards. The option alleging that network switches drop packets above 1 kHz fabricates an impossible networking rule.
Learning Objective: Analyze the infrastructure and economic scaling limits that prevent cloud-only processing for global-scale always-on voice assistants.
In a 3-year Total Cost of Ownership (TCO) comparison for an on-premises edge server deployment serving 1 million inferences per day, what is typically the largest component of the edge system’s annual cost?
- GPU hardware silicon purchase price amortized over 3 years
- DevOps engineering labor required to maintain, update, and manage on-premises edge infrastructure
- Electricity costs for running the server 24/7
- Dedicated server room air-conditioning and cooling overhead
Answer: The correct answer is B. In realistic edge server TCO modeling, engineering labor (e.g., 0.1 FTE DevOps support per server/site, totaling ~$15,000/year) accounts for roughly 60% of total annual edge expenses, far exceeding hardware CapEx (~$5,000/year), power (~$500/year), or cooling (~$150/year). Teams that focus solely on minimizing hardware purchase costs systematically underestimate the total cost of ownership. The choices identifying hardware amortization, electricity, or cooling as the dominant cost ignore the reality that personnel and operational maintenance dominate distributed on-premise infrastructure.
Learning Objective: Evaluate the cost components of edge vs. cloud TCO to identify the dominant role of operational labor.
What is the data gravity invariant in cloud ML, and why does it make moving multi-terabyte raw sensor datasets to the cloud economically and physically problematic?
Answer: The data gravity invariant states that as data volume (\(D_{\text{vol}}\)) grows, the cost and latency of moving data to compute (\(C_{\text{move}}(D_{\text{vol}})\)) eventually dominates the cost of moving compute to data (\(C_{\text{move}}(\text{Compute})\)). For massive sensor streams (such as hundreds of raw video feeds generating tens of gigabytes per second), the required network bandwidth exceeds uplink capacities and incurs exorbitant cloud ingest/egress costs, forcing computation to move to the edge.
Learning Objective: Explain the data gravity invariant and its implications for data-movement costs in cloud systems.
Under GDPR Article 17 (Right to Erasure), when a user requests deletion of their data, an organization is legally mandated to retrain from scratch every ML model that ever encountered that user’s training samples.
Answer: False. GDPR Article 17 provides a right to erasure across source data stores, derived feature pipelines, caches, and logs where specified grounds apply, but it is technology-neutral and does not prescribe retraining every trained model as the sole mandatory remediation. Organizations evaluate risk, data persistence, and technical measures appropriate to the system.
Learning Objective: Classify the operational and legal boundaries of data erasure regulations (GDPR) on deployed ML models.
**Order the steps of a hybrid voice assistant query pipeline from the initial acoustic trigger to user response:
- Run on-device speech-to-text (ASR) on a mobile NPU to convert speech to text tokens locally
- Transmit text tokens to cloud infrastructure for large language model reasoning and broad knowledge retrieval
- Always-on TinyML wake-word detector listens continuously on a sub-milliwatt dedicated core
- Send synthetic audio/text response back to the client device to render the answer to the user
- Detect trigger phrase (“Hey Assistant”) and wake the main application processor from sleep**
Answer: The correct order is (3) Always-on TinyML wake-word detector listens continuously on a sub-milliwatt dedicated core, (5) Detect trigger phrase and wake the main application processor, (1) Run on-device speech-to-text on mobile NPU, (2) Transmit text tokens to cloud infrastructure for reasoning, and (4) Send response back to the client device. This tiered architecture minimizes power by keeping the main processor asleep until a wake word is detected, protects privacy and latency with local ASR, and leverages cloud scale only for complex natural language queries.
Learning Objective: Design a tiered hybrid pipeline spanning TinyML, mobile NPU, and cloud infrastructure for voice assistant processing.
Self-Check: Answer
A manufacturing facility deploys 100 cameras recording uncompressed 1080p video (\(1920 \times 1080 \times 3\text{ bytes/pixel}\)) at 30 FPS. The factory has a dedicated 10 Gbps (~1.25 GB/s) fiber uplink. Why is streaming all raw video to a cloud ML server physically impossible?
- 1080p video frames contain interlaced scanlines that cloud GPUs cannot decompress.
- Fiber optic cables can only carry voice data, requiring microwave radio relays for video.
- The aggregate raw video data rate is approximately 18.7 GB/s, which exceeds the 1.25 GB/s uplink capacity by roughly 15-fold.
- Cloud object detection models require uncompressed video to be transmitted in 10-minute batched tar archives.
Answer: The correct answer is C. Each camera generates \(1920 \times 1080 \times 3 \times 30 \approx 186.6\text{ MB/s}\). Across 100 cameras, the aggregate data rate is \(18.66\text{ GB/s}\) (~18.7 GB/s). A 10 Gbps network provides a maximum theoretical bandwidth of \(\frac{10\text{ Gbps}}{8\text{ bits/byte}} = 1.25\text{ GB/s}\). The required traffic exceeds the network capacity by roughly \(15\times\), making cloud streaming physically impossible. Edge processing resolves this by detecting defects locally and transmitting only compact metadata events (~1 KB per event). The options alleging interlaced scanline incompatibilities, fiber cable restrictions to voice, or mandatory 10-minute tar archiving fabricate false technical constraints.
Learning Objective: Calculate aggregate sensor bandwidth demand and compare it against uplink limits to diagnose edge bandwidth bottlenecks.
An autonomous drone navigates at 60 FPS (16.7 ms per-frame budget) capturing uncompressed 4K frames (~24.9 MB per frame). The drone connects via a 100 Mbps uplink to a cloud server whose round-trip latency plus inference time is 110 ms. Applying the data locality invariant, what is the feasibility of offloading this obstacle avoidance system to the cloud?
- Feasible, because the cloud GPU computes inference in under 10 ms.
- Feasible, provided 5G network slicing is enabled on the drone modem.
- Infeasible, solely because cloud servers do not support drone telemetry protocols.
- Infeasible, because transmitting a 24.9 MB frame over a 100 Mbps link requires ~2,000 ms, causing the complete remote path (~2,110 ms) to violate the 16.7 ms frame deadline by over two orders of magnitude.
Answer: The correct answer is D. Under the data locality invariant, the complete remote path time is \(T_{\text{remote}} = \frac{D_{\text{vol}}}{\text{BW}_{\text{network}}} + L_{\text{lat,network}} + T_{\text{compute,remote}}\). Transmitting \(24.9\text{ MB} = 199.2\text{ Mbits}\) over a \(100\text{ Mbps}\) uplink requires \(\frac{199.2}{100} \approx 1.992\text{ s} \approx 2{,}000\text{ ms}\). Adding the 110 ms network/compute delay yields \(T_{\text{remote}} \approx 2{,}110\text{ ms}\), vastly exceeding the 16.7 ms per-frame budget. Because transmission time alone dominates, cloud offloading is completely infeasible. The options claiming feasibility ignore the two-second transmission bottleneck. The option blaming telemetry protocols misses the fundamental bandwidth-latency physics.
Learning Objective: Apply the data locality invariant equation to determine whether an application must run locally at the edge.
Why cannot high-bandwidth wireless networking technologies (such as 5G or 6G) eliminate the need for edge ML in tight real-time control loops (\(<10\text{ ms}\))?
Answer: While 5G and 6G technologies dramatically increase network bandwidth (\(\text{BW}_{\text{network}}\)) and reduce data transmission serialization time, they cannot alter the speed of light in optical fiber or eliminate physical geographic routing delays and protocol overhead (\(L_{\text{lat,network}}\)). For tight real-time control loops (\(<10\text{ ms}\)), physical round-trip propagation over geographic distances alone can consume the entire latency budget before any computation begins, making local edge execution physically mandatory.
Learning Objective: Evaluate why high-bandwidth cellular networks (5G/6G) cannot eliminate the need for edge ML in sub-10 ms control loops.
When sizing edge accelerators for a retail store deployment requiring 7.2 TOPS of sustained INT8 throughput, why is it inadequate to select a single accelerator rated at 8 TOPS peak datasheet throughput?
Answer: Hardware datasheets publish peak theoretical throughput (\(R_{\text{peak}}\)), but real-world sustained workloads encounter thermal limits, memory bandwidth bottlenecks, and software overhead, typically achieving only a derated fraction (e.g., 50% derating, yielding ~4 TOPS sustained from an 8 TOPS peak chip). To reliably deliver 7.2 TOPS sustained throughput with sufficient headroom, sizing must be based on sustained performance, requiring multiple sharded boards (e.g., two 8 TOPS peak boards delivering 8 TOPS sustained) or a higher-tier accelerator.
Learning Objective: Calculate sustained accelerator requirements for edge deployments using hardware derating factors.
In industrial IoT manufacturing systems (Industry 4.0), the complete ML control loop latency (\(L_{\text{lat}}\)) must be strictly shorter than the ____ of the physical machinery it governs (such as a 16.7 ms window for a 60 Hz welding robot).
Answer: sampling interval (or control cycle time / sampling period). In real-time cyber-physical systems, sensor-actuator feedback loops require that sensing, model inference, and actuation complete within the physical process’s sampling interval (e.g., 16.7 ms for a 60 Hz process), otherwise the system fails to prevent defects or safety violations.
Learning Objective: Evaluate the control loop timing constraints governing real-time industrial IoT ML deployments.
Self-Check: Answer
How do the battery tax** and the thermal wall differ as physical constraints on mobile ML systems?**
- The battery tax is an energy budget problem bounding total operations over time (\(\int \text{Power} \cdot dt\)), whereas the thermal wall is a heat dissipation ceiling bounding instantaneous sustained power (\(\text{Power} \le 2\text{--}5\text{ W}\)) regardless of battery size.
- The battery tax applies only to iOS devices, while the thermal wall applies only to Android devices.
- The battery tax can be resolved by lowering clock frequency, but the thermal wall requires increasing the clock frequency to finish calculations faster.
- The battery tax represents static memory leakage in SRAM, while the thermal wall represents network transmission power in 5G modems.
Answer: The correct answer is A. The battery tax represents the depletion of finite electrochemical energy (\(E = P \cdot t\)) over a full day, meaning a model running continuously draws down the daily battery budget. The thermal wall represents the maximum rate of heat that a phone’s passive chassis can continuously dissipate (typically 2–5 W TDP). Adding a larger battery extends runtime but cannot prevent thermal throttling if the workload exceeds the thermal dissipation ceiling. The option dividing the constraints by mobile operating system is factually baseless. The option suggesting higher clock frequencies to beat the thermal wall violates the cubic power law (\(\text{Power} \propto f^3\)). The option conflating the terms with SRAM leakage and modem power misdefines both concepts.
Learning Objective: Compare the battery tax and the thermal wall as distinct energy and thermodynamic constraints in mobile ML.
Why does deploying a mobile computational photography feature (such as Portrait Mode or Night Mode) present a pipeline scheduling challenge rather than a single-model optimization problem?
- Mobile cameras can only run one neural network per battery charge cycle.
- The feature executes a multi-stage pipeline (depth estimation, semantic segmentation, alignment, and HDR tone mapping) that must all complete within a perceived shutter delay while sharing a 2–5 W thermal budget across CPU, GPU, and NPU.
- Computational photography models cannot use quantized INT8 representations due to mathematical rounding artifacts in lens optics.
- Camera image signal processors (ISPs) operate asynchronously from the operating system and reject all external ML tensor inputs.
Answer: The correct answer is B. Mobile computational photography does not rely on a single isolated model; it executes a sequence of specialized real-time models (such as depth estimation, segmentation, and denoising) alongside the ISP. All stages must execute within the user’s perceived shutter delay (tens to hundreds of milliseconds) while sharing the phone’s tight 2–5 W thermal envelope across heterogeneous SoC cores (CPU, GPU, NPU) without triggering thermal throttling. The option claiming one network per charge cycle is absurd. The option claiming optics prevent INT8 quantization is false, as mobile vision pipelines routinely use quantized models. The option claiming ISPs reject ML tensor inputs misrepresents modern mobile SoC architectures where ISPs and NPUs share memory.
Learning Objective: Analyze the system scheduling and thermal constraints of multi-stage computational photography pipelines on mobile SoCs.
Why does deploying an unoptimized desktop-trained vision model (such as an FP32 ResNet-50 pipeline) directly onto a mobile device frequently fail, even when the model’s FP32 weights (~98 MB) appear smaller than the phone’s total RAM?
Answer: While the raw FP32 weights are ~98 MB, a complete desktop pipeline requires gigabytes of memory once intermediate activation tensors, input/output preprocessing buffers, runtime framework overhead, and batch buffers are allocated. Furthermore, unoptimized desktop models execute billions of FLOPs (e.g., 4.1 GFLOPs per image) using unsupported float operations or desktop-specific layers, exceeding the mobile device’s 2–5 W thermal envelope and causing thermal throttling or out-of-memory crashes.
Learning Objective: Analyze why desktop-trained models fail on mobile devices due to activation memory, thermal budgets, and unsupported operations.
Running biometric matching (such as Face ID) inside a dedicated on-device Secure Enclave reduces data disclosure risks by keeping mathematical representations isolated in encrypted hardware, but it does not automatically eliminate all security or privacy risks without rigorous end-to-end system design.
Answer: True. Hardware isolation mechanisms like the Secure Enclave restrict biometric mathematical representations to dedicated encrypted memory on-device, preventing remote transmission and unauthorized operating system access. However, overall system security and privacy still depend on the complete threat model, authentication policies, and software implementation.
Learning Objective: Evaluate how dedicated hardware enclaves (e.g., Secure Enclave) provide biometric privacy while recognizing holistic system threat models.
**Order the sequence of events that occurs when an unoptimized 12 W deep learning model runs continuously on a passively cooled 3 W smartphone SoC:
- The device temperature rises rapidly (e.g., at ~1 °C per second) as power dissipation exceeds passive cooling capacity
- The unoptimized model launches at full burst performance (e.g., 100 FPS) drawing 12 W of active compute power
- Operating system and hardware thermal controllers engage thermal throttling, reducing clock frequencies and duty cycles
- The internal SoC junction temperature reaches the critical thermal trip point (e.g., 80 °C)
- Sustained inference throughput drops precipitously (e.g., from 100 FPS to 30 FPS) to stabilize power within the 3 W TDP envelope**
Answer: The correct order is (2) The unoptimized model launches at full burst performance drawing 12 W, (1) The device temperature rises rapidly as power exceeds passive cooling capacity, (4) The internal SoC temperature reaches the critical thermal trip point, (3) OS and hardware engage thermal throttling, and (5) Sustained inference throughput drops precipitously to stabilize within the 3 W TDP envelope. This sequence illustrates why peak burst benchmarks on mobile devices do not reflect sustained real-world performance.
Learning Objective: Explain the physical sequence of events during mobile thermal throttling under unoptimized compute workloads.
Self-Check: Answer
Comparing a dedicated TinyML keyword spotting model (~\(10\ \mu\text{J}\) per inference) to a cloud foundation model query (~\(1\text{ kJ}\) per inference), by approximately what factor does energy consumption per inference differ?
- Approximately \(100\times\) (2 orders of magnitude)
- Approximately \(10{,}000\times\) (4 orders of magnitude)
- Approximately \(100{,}000{,}000\times\) (\(10^8\), 8 orders of magnitude)
- Approximately \(10^{14}\times\) (14 orders of magnitude)
Answer: The correct answer is C. The energy ratio between a cloud LLM query (\(1\text{ kJ} = 10^3\text{ J}\)) and an always-on TinyML keyword spotting inference (\(10\ \mu\text{J} = 10^{-5}\text{ J}\)) is \(\frac{10^3\text{ J}}{10^{-5}\text{ J}} = 10^8 = 100{,}000{,}000\times\) (eight orders of magnitude). This vast efficiency gap enables TinyML sensors to operate for years on a coin-cell battery or milliwatt energy harvesters. The options citing 2 orders (\(100\times\)) or 4 orders (\(10{,}000\times\)) severely underestimate the energy gap between cloud data centers and microcontrollers. The option citing 14 orders (\(10^{14}\)) overstates the ratio.
Learning Objective: Calculate the multi-order-of-magnitude energy efficiency gap between TinyML sensing and cloud LLM queries.
Why are microcontroller TinyML devices predominantly restricted to inference-only execution rather than full in-situ backpropagation training?
- Microcontrollers use flash memory which permanently locks all transistor gates against state changes.
- Backpropagation requires double-precision FP64 floating-point arithmetic which is mathematically impossible on 32-bit cores.
- The speed of light inside microcontroller silicon is too slow to support backward gradient propagation.
- Standard backpropagation requires storing intermediate activation tensors from every forward layer until the backward pass executes, which quickly exceeds the microcontroller’s 256 KB–2 MB on-chip SRAM capacity.
Answer: The correct answer is D. During inference, intermediate activation buffers can be discarded and overwritten as soon as the subsequent layer completes execution. In contrast, standard backpropagation training requires retaining intermediate activations from all layers in memory throughout the forward pass to compute weight gradients during the backward pass, scaling memory linearly with model depth. With only 256 KB to 2 MB of on-chip SRAM and no virtual memory, microcontrollers cannot hold these training activations unless specialized parameter-efficient techniques (such as TinyTL, which freezes weights and updates only bias vectors) are applied. The choices claiming flash memory locks transistors, FP64 is mathematically impossible on 32-bit cores, or speed of light prevents gradient calculation are all scientifically absurd.
Learning Objective: Explain why activation memory retention during the backward pass prevents full on-device training on microcontrollers.
Why is the 1 mW average power threshold considered a transformative milestone in TinyML system deployment?
Answer: Operating at or below an average power draw of 1 mW allows embedded devices to be powered indefinitely by ambient energy harvesting (such as small thumbnail-sized solar cells, thermoelectric generators on warm pipes, or RF energy harvesters). This shifts the deployment model from a battery-limited lifespan requiring periodic manual battery replacement to a ‘deploy and forget’ paradigm, enabling ubiquitous sensing across millions of unattended physical assets.
Learning Objective: Justify how achieving a sub-1 mW power envelope enables perpetual operation via ambient energy harvesting.
Why is it a fallacy to treat TinyML as merely ‘scaled-down mobile ML’ that can be addressed simply by applying standard INT8 post-training quantization?
Answer: TinyML operates under qualitative discontinuities rather than minor quantitative scale-downs: microcontrollers possess a 10,000-fold smaller memory budget (kilobytes of on-chip SRAM vs. gigabytes of DRAM) and a 1,000-fold lower power envelope (milliwatts vs. watts). Quantizing a standard mobile model from FP32 to INT8 yields only a \(4\times\) size reduction, which fails to fit multi-megabyte models into a 64–256 KB microcontroller SRAM budget, requiring entirely different lightweight architectures, fixed-point operations, and bare-metal runtime execution.
Learning Objective: Explain the qualitative architectural discontinuities in memory and power that differentiate TinyML from mobile ML.
The power management paradigm in which a battery-less or energy-harvesting microcontroller sleeps in ultra-low-power states and wakes periodically to perform inference before energy reserves deplete is called ____ computing.
Answer: intermittent (or duty-cycled). Intermittent computing enables microcontrollers powered by tiny batteries (like CR2032 coin cells) or ambient energy harvesters to achieve multi-year lifespans by keeping average active power consumption in the microwatt to milliwatt regime.
Learning Objective: Explain the operational role of intermittent computing in energy-harvesting TinyML deployments.
Self-Check: Answer
In the four-layer deployment screening decision framework, why is the Privacy** layer evaluated first, followed by Latency, Compute Demand, and Cost?**
- The layers are ordered by how rapidly a hard constraint can completely invalidate an architecture: legal/privacy rules may forbid remote transmission entirely, physical latency limits can make cloud offload impossible, compute demands eliminate undersized devices, and cost compares the remaining feasible survivors.
- Privacy is the easiest parameter to optimize in software using compiler flags, whereas cost cannot be calculated until after deployment.
- Cloud providers require privacy agreements before allowing access to GPU instances.
- The framework is ordered purely alphabetically based on traditional software engineering conventions.
Answer: The correct answer is A. The decision framework sequences evaluation gates by their ability to disqualify candidates immediately: privacy and regulatory mandates can strictly prohibit sending raw data off-premises; physical latency constraints (e.g., speed of light) can make remote execution physically incapable of meeting real-time SLAs; compute/memory capacity determines whether candidate hardware can fit the workload; and finally, cost and operational complexity compare the feasible options. The option claiming privacy is a compiler flag trivializes regulatory compliance. The option alleging cloud GPU access requires upfront privacy agreements confuses commercial terms with architectural screening. The choice claiming alphabetical ordering is factually false.
Learning Objective: Apply the sequential screening logic of the four-layer deployment decision framework.
An autonomous vehicle travels at 100 km/h (~27.8 m/s). An emergency pedestrian detection system evaluates two architectures: (1) an automotive Edge ML accelerator with a 15 ms local detection latency, and (2) a Cloud ML server with 115 ms total latency (100 ms network RTT + 15 ms compute). How much additional distance does the vehicle travel before braking begins if the cloud architecture is used?
- 0.28 meters
- Approximately 2.8 meters
- Approximately 28 meters
- Exactly 100 meters
Answer: The correct answer is B. At \(100\text{ km/h}\), the vehicle travels at \(\frac{100}{3.6} \approx 27.78\text{ m/s}\). The cloud architecture adds $100 = 0.1 of network round-trip delay. The additional distance traveled during this delay is \(27.78\text{ m/s} \times 0.1\text{ s} \approx 2.78\text{ m}\) (~2.8 meters). In safety-critical emergency braking, a 2.8-meter delay can be the difference between stopping safely and a catastrophic collision, demonstrating why hard real-time latency budgets eliminate cloud offload. The options calculating 0.28 m, 28 m, or 100 m represent arithmetic scaling errors.
Learning Objective: Calculate the physical displacement and safety consequences of network latency in autonomous vehicle braking systems.
What is the complexity tax** in ML systems engineering, and when is a simple heuristic (e.g., rule-based logic or regular expressions) superior to a deep learning pipeline?**
Answer: The complexity tax refers to the extensive hidden operational overhead that an ML system introduces beyond its core model code, including data validation pipelines, continuous monitoring, retraining infrastructure, GPU dependencies, and model drift management. When an ML model provides only marginal accuracy gains (e.g., 95% vs. 90%) over a simple heuristic, but demands a massive increase in code maintenance and operational debugging (e.g., 40 hours/month vs. 1 hour/month), the simpler heuristic is the superior systems engineering choice.
Learning Objective: Evaluate the complexity tax of deploying machine learning systems compared to traditional software heuristics.
In ML systems engineering, selecting a deployment paradigm based solely on benchmark model accuracy is a sound practice because hardware infrastructure can always be scaled to meet application constraints later.
Answer: False. Selecting a deployment paradigm based solely on accuracy without evaluating physical constraints (latency floors, battery life, thermal ceilings, memory budgets, network availability) leads to deployment failures. A high-accuracy cloud model is useless if network delay violates an emergency response SLA, and an edge model that drains a mobile battery in minutes fails regardless of benchmark accuracy. Systems constraints must be co-designed upfront.
Learning Objective: Evaluate the critical pitfall of selecting deployment paradigms based on model accuracy alone.
What is the Total Cost of Ownership (TCO) calculation, and why must ML architects evaluate TCO rather than hardware purchase price or cloud VM hourly rates alone when selecting a deployment paradigm?
Answer: Total Cost of Ownership (TCO) encompasses all direct and indirect expenses over a system’s multi-year operational lifetime, including hardware CapEx, recurring energy and cooling costs, network bandwidth/egress, reliability engineering, software maintenance, and DevOps labor. Focusing solely on hardware purchase price or cloud VM rental rates leads to false economies, because operational overhead and engineering labor often constitute the vast majority (e.g., ~60%) of total system costs.
Learning Objective: Evaluate how Total Cost of Ownership (TCO) analysis prevents misleading paradigm selection based on compute list prices alone.
Self-Check: Answer
A smart agriculture system deploys soil moisture sensors on microcontrollers performing local anomaly detection, local gateway edge servers that aggregate sensor feeds across crop fields to trigger automated irrigation valves, and a central cloud system that aggregates regional data for seasonal crop yield forecasting. Which hybrid ML integration pattern does this architecture exemplify?
- Pure Train-Serve Split
- Monolithic Cloud Offload
- Hierarchical Processing
- Linear Single-Node Pipelining
Answer: The correct answer is C. Hierarchical Processing organizes data and decision-making across computational tiers based on timescale and capability: TinyML nodes perform millisecond-level local anomaly detection, edge gateways aggregate multi-sensor data for sub-second local irrigation actuation, and cloud infrastructure handles macro-scale long-term analytics. Train-Serve Split focuses specifically on separating centralized training from distributed serving. Monolithic Cloud Offload routes all raw sensor telemetry directly to the cloud without intermediate edge intelligence. Linear Single-Node Pipelining refers to overlapping compute within a single host.
Learning Objective: Classify real-world multi-tier deployments into canonical hybrid ML integration patterns.
What is the primary operational failure risk in a hybrid ML system where preprocessing and feature extraction are split between client devices (mobile/edge) and centralized cloud servers?
- Transistors in edge devices reverse polarity when receiving cloud RPC payloads.
- The speed of light in optical fiber decreases proportionally with the number of connected edge clients.
- Edge devices become unable to allocate floating-point registers during network handshakes.
- Training-serving skew, where slight discrepancies in feature extraction logic, library versions, or numerical precision between the edge client and cloud server cause silent model degradation.
Answer: The correct answer is D. In hybrid systems spanning multiple tiers, participating platforms must maintain strict synchronization of feature extraction logic, tokenizers, normalization parameters, and model versions. Discrepancies between how features are computed on edge devices versus cloud training environments produce training-serving skew, leading to silent prediction errors. The options claiming reversed transistor polarity, reduced speed of light, or register allocation failures during handshakes describe fabricated physical absurdities.
Learning Objective: Analyze the risk of training-serving skew in hybrid architectures with distributed feature pipelines.
What is the economic rationale behind the Train-Serve Split** pattern in hybrid ML architectures?**
Answer: Training deep learning models requires massive computational scale (\(R_{\text{peak}}\)), extensive memory capacity, and large clusters of accelerators to execute millions of forward and backward passes. In contrast, individual inference requests require only a single forward pass. The Train-Serve Split leverages centralized cloud infrastructure to pay the heavy fixed training cost once, and amortizes that investment across millions of efficient, low-latency forward-pass inferences executed locally on edge or mobile devices.
Learning Objective: Explain the economic and computational rationale behind the Train-Serve Split hybrid pattern.
Optimization techniques such as quantization and memory traffic reduction are mutually exclusive between tiers, meaning methods developed for TinyML microcontrollers have no applicability to cloud data center serving.
Answer: False. Because memory bandwidth bottlenecks and the memory wall exist across all computing scales, core systems principles transfer across tiers. Techniques such as integer quantization, operator fusion, and memory layout tuning originally developed to fit models into microcontrollers or mobile NPUs are routinely applied to cloud LLM serving to reduce HBM traffic and lower inference serving costs.
Learning Objective: Explain how systems optimization techniques (e.g., quantization, operator fusion) transfer across deployment scales.
**Order the steps of the Progressive Deployment pattern where a single foundation model architecture is adapted for deployment across multiple tiers:
- Quantize and prune the model into an ultra-low-power integer representation for microcontroller TinyML deployment
- Train a large, high-capacity baseline model on a centralized cloud accelerator cluster
- Apply structured compression and distillation to generate an optimized intermediate model for edge servers
- Further compress the architecture with depthwise separable layers and INT8 quantization for mobile NPU deployment**
Answer: The correct order is (2) Train a large high-capacity baseline model on cloud accelerators, (3) Apply structured compression and distillation for edge servers, (4) Further compress with depthwise separable layers and INT8 quantization for mobile NPUs, and (1) Quantize and prune into an ultra-low-power integer representation for microcontrollers. Progressive deployment systematically derives smaller, specialized artifacts from a parent model family to match the shrinking resource envelopes of each tier.
Learning Objective: Design a progressive deployment pipeline that adapts a single model family across cloud, edge, mobile, and TinyML tiers.
Self-Check: Answer
In the 2021 collapse of Zillow Offers ($304M inventory write-down and division closure), what was the fundamental systems engineering failure in how the ML model was integrated into production operations?
- The system directly coupled algorithmic forecast uncertainty to high-stakes real-world purchase commitments without human overrides, circuit breakers, or rapid feedback loops to absorb distribution shift.
- The model weights were corrupted because the hosting cloud server ran out of physical SSD storage space.
- The real estate forecasting model was written in an interpreted language rather than compiled C++.
- The system failed because it attempted to run real estate valuation algorithms on microcontrollers.
Answer: The correct answer is A. Zillow Offers failed because the automated iBuying system coupled uncertain home price forecasts directly to irreversible, capital-intensive real estate purchase commitments. When live housing market dynamics diverged from historical training distributions (\(\mathcal{D}(P_{\text{train}}, P_{\text{live}}) > 0\)), the model overpaid for inventory. The lack of operational circuit breakers, inventory caps, and feedback mechanisms allowed forecast errors to compound into catastrophic financial loss. The options attributing the collapse to corrupted SSD weights, interpreted language execution, or microcontroller execution fabricate irrelevant technical excuses.
Learning Objective: Analyze the systems engineering failure modes in the Zillow Offers collapse, focusing on automated decision coupling and lack of circuit breakers.
Explain the variables in the quality degradation diagnostic equation \(\Delta \text{Quality} \approx - S_{\text{shift}} \cdot \mathcal{D}(P_{\text{train}}, P_{\text{live}})\), and describe why traditional software testing cannot prevent system entropy.
Answer: In the equation, \(\mathcal{D}(P_{\text{train}}, P_{\text{live}})\) represents the statistical distance between the training data distribution and the live operational data distribution, and \(S_{\text{shift}}\) represents the model’s sensitivity to distributional drift. Unlike traditional software whose deterministic logic remains correct as long as code and environment are unchanged, an ML model suffers quality degradation solely because the external world drifts away from \(P_{\text{train}}\), even when its code, weights, and hardware execute with zero software bugs.
Learning Objective: Apply the degradation equation to explain how distribution shift causes system entropy in deployed ML models.
System entropy in deployed ML systems can occur even when the underlying software code, dependencies, and model weights remain completely unmodified.
Answer: True. System entropy refers to the statistical decay of model accuracy over time caused by the divergence between the static training distribution (\(P_{\text{train}}\)) and changing real-world live data (\(P_{\text{live}}\)). Because data distributions evolve in dynamic environments, a model’s operational performance can degrade significantly without any change to its code or weight parameters.
Learning Objective: Explain why system entropy occurs independently of software code or configuration changes.
Self-Check: Answer
A smartphone camera pipeline takes 200 ms total: 100 ms for the image signal processor (ISP), 60 ms for ML scene classification, and 40 ms for postprocessing. If an engineering team optimizes the ML model to run \(10\times\) faster (reducing ML time from 60 ms to 6 ms), what is the overall system-level speedup?
- \(10.00\times\) speedup
- \(1.37\times\) speedup
- \(5.50\times\) speedup
- \(0.73\times\) speedup (system becomes slower)
Answer: The correct answer is B. Prior to optimization, total latency is \(100\text{ ms} + 60\text{ ms} + 40\text{ ms} = 200\text{ ms}\). The ML model represents \(p = \frac{60}{200} = 0.30\) (30%) of total pipeline execution time. Optimizing the ML stage by \(s = 10\times\) reduces its latency to \(\frac{60}{10} = 6\text{ ms}\), resulting in a new total latency of \(100\text{ ms} + 6\text{ ms} + 40\text{ ms} = 146\text{ ms}\). The overall system speedup is \(\frac{200\text{ ms}}{146\text{ ms}} \approx 1.37\times\). Even an infinite ML speedup (\(s = \infty\)) would yield at most \(\frac{200}{140} \approx 1.43\times\) speedup because the remaining 70% of the pipeline is unoptimized. The option claiming a \(10.00\times\) system speedup commits the classic fallacy of assuming model-level speedup translates linearly to end-to-end system speedup. The options claiming \(5.50\times\) or \(0.73\times\) represent calculation errors.
Learning Objective: Calculate end-to-end pipeline speedup using Amdahl’s law when optimizing an isolated ML component.
Why does deploying a single generic FP32 model binary across diverse edge devices (e.g., Arm CPU, Apple Neural Engine, and Google Coral Edge TPU) result in suboptimal efficiency compared to per-target compilation?
- Generic model binaries violate cryptographic signatures required by PCI Express buses.
- Floating-point operations are mathematically undefined on mobile CPUs.
- Generic binaries cannot exploit hardware-specific operator fusion, dedicated fixed-point INT8 matrix datapaths, or accelerator-specific on-chip SRAM memory tiling.
- The operating system automatically deletes untuned model weights to prevent memory fragmentation.
Answer: The correct answer is C. Different edge accelerators feature unique hardware architectures, such as specialized INT8 tensor systolic arrays, proprietary NPU delegates, and distinct on-chip memory hierarchies. A generic model binary fails to utilize operator fusion (which avoids round-trip memory traffic between layers), cannot map operations to dedicated low-precision datapaths, and fails to align tensor dimensions with on-chip cache lines. The options claiming PCI Express signature violations, undefined mobile float math, or automatic OS weight deletion are entirely fabricated.
Learning Objective: Explain why hardware-aware compilation and operator fusion are essential for efficient edge deployment.
Why does choosing an on-premises edge deployment solely because its hardware amortizes to a lower monthly compute cost than a cloud VM often result in a higher Total Cost of Ownership (TCO)?
Answer: Hardware compute cost is only one fraction of the total cost of ownership. Deploying on-premise edge fleets introduces substantial recurring operational expenses (OpEx), including distributed network engineering, on-site hardware maintenance, security patching, and DevOps reliability engineering, alongside extended development timelines. When these operational and labor costs are accounted for, an edge deployment can cost several times more per month than a managed cloud service.
Learning Objective: Evaluate the pitfall of ignoring operational expenses and DevOps labor when calculating edge ML deployment costs.
Increasing the quantity of training data is guaranteed to continuously improve deployed model performance regardless of model capacity, label noise, or domain distribution shift.
Answer: False. Data scaling benefits are bounded by three critical constraints: model capacity (a small model saturates and cannot absorb more information), data quality (noisy, mislabeled, or redundant data harms accuracy), and distribution alignment (adding massive out-of-domain data does not improve, and can degrade, performance on target deployment distributions).
Learning Objective: Explain the physical and statistical limits that prevent data quantity from guaranteeing deployment accuracy gains.
What is operator fusion in ML compilers, and how does it optimize memory-bound inference pipelines?
Answer: Operator fusion is an optimization technique where a compiler merges multiple adjacent operations in a neural network graph (such as Conv2D, BatchNorm, and ReLU) into a single executed kernel. By computing intermediate values directly in high-speed processor registers or on-chip SRAM rather than writing them back to off-chip DRAM and reading them again for the next layer, operator fusion drastically reduces off-chip memory traffic (\(D_{\text{vol}}/\text{BW}\)) and kernel launch overhead (\(L_{\text{lat}}\)).
Learning Objective: Explain how operator fusion reduces memory traffic and kernel launch overhead in inference pipelines.
Self-Check: Answer
Which summary statement best captures the core thesis of ML systems engineering regarding deployment paradigms?
- Software compilers have eliminated hardware differences, making any model executable on any hardware platform with identical efficiency.
- Model accuracy on standard benchmark datasets is the sole determinant of whether a system succeeds in production.
- Cloud computing is always the optimal deployment target because network bandwidth expands faster than processor compute capacity.
- Constraints drive architecture: permanent physical boundaries (the speed of light, thermodynamics, and memory signaling) partition deployment into distinct operating regimes, making deployment a first-order co-design problem across Data, Algorithm, and Machine.
Answer: The correct answer is D. ML systems engineering is governed by the physical reality that immutable physical boundaries—the light barrier (latency floor), the power wall (thermal dissipation limits), and the memory wall (bandwidth divergence)—create distinct operating regimes spanning from megawatt cloud data centers to milliwatt microcontrollers. System architects must identify the binding constraint and co-design data representations, algorithm structures, and machine hardware accordingly. The option claiming compilers eliminate hardware differences ignores physical resource limits. The choice claiming accuracy is the sole determinant ignores latency, power, and cost constraints. The option claiming cloud computing is universally optimal ignores speed-of-light propagation latency and data locality requirements.
Learning Objective: Evaluate the overarching thesis of ML systems engineering regarding physical constraints and deployment co-design.
Summarize how the iron law of ML systems helps engineers avoid wasted optimization effort during model development and deployment.
Answer: The iron law (\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\)) decomposes execution time into data movement, arithmetic computation, and fixed latency. By identifying which term binds on the target hardware before optimizing, engineers avoid futile efforts—such as adding peak FLOP/s to a memory-bandwidth-bound inference pipeline or optimizing compute when speed-of-light network latency dominates the critical path.
Learning Objective: Explain how the iron law serves as a diagnostic framework to prevent misdirected optimization effort.
In ML systems engineering, successful deployment of a trained model represents the completion of the engineering task, because verified model weights maintain static accuracy indefinitely.
Answer: False. Deployment is the beginning of a continuous operational feedback loop rather than the end of the engineering lifecycle. Because real-world environments evolve, live data distributions inevitably diverge from training data (\(P_{\text{live}} \neq P_{\text{train}}\)), inducing system entropy (model decay) that requires continuous monitoring, data collection, retraining pipelines, and operational safeguards.
Learning Objective: Justify why deployment initiates a continuous operational monitoring and feedback lifecycle rather than concluding it.