Biên soạn tập dữ liệu
Kỹ thuật dữ liệu
Mục đích
Tại sao dữ liệu huấn luyện lại hoạt động như mã nguồn trong một hệ thống machine learning?
Trong phần mềm truyền thống, lập trình viên viết ra logic để máy tính thực thi. Trong machine learning, lập trình viên viết các quy trình tối ưu hóa để trích xuất logic vận hành từ dữ liệu. Sự đảo chiều này khiến dữ liệu huấn luyện giống mã nguồn: thay đổi dữ liệu có thể làm thay đổi hệ thống đã học khi mô hình được huấn luyện lại, ngay cả khi không có thay đổi mã theo nghĩa truyền thống. Những bất nhất nhỏ trong nhãn có thể dẫn đến hành vi bất nhất; thiếu các edge case có thể khiến các lỗi tương ứng không được đo lường; các độ chệch (bias) lịch sử có thể lan vào hành vi đã học. Một mô hình chỉ được huấn luyện trên tập dữ liệu đó không thể suy ra bằng chứng liên quan đến tác vụ nếu chúng không có trong dữ liệu, và các lỗi nhãn có hệ thống có thể định hình những gì nó học. Khác với mã nguồn truyền thống vốn nằm im cho đến khi lập trình viên sửa đổi, phân phối vận hành có thể dịch chuyển khi thế giới thay đổi, từ đó làm thay đổi hiệu suất khi vận hành ngay cả khi không hề đụng tới cơ sở mã. Kỹ thuật dữ liệu có thể tiêu tốn đáng kể công sức của dự án vì hệ quả rất lớn. Mọi quyết định trong pipeline dữ liệu (thu thập gì, gán nhãn ra sao, khi nào lọc, chia tách thế nào) đều tác động về sau, ràng buộc kiến trúc mô hình, động lực học huấn luyện và khả năng triển khai. Do đó, kỹ thuật dữ liệu không phải là tiền xử lý mà là lập trình bằng một ngôn ngữ khác, nơi kiểm soát chất lượng, quản lý phiên bản và giám sát quyết định liệu hệ thống đã biên dịch có hoạt động hôm nay và tiếp tục hoạt động vào ngày mai hay không. Theo thuật ngữ D·A·M, bản thân pipeline là một vấn đề đồng thiết kế dữ liệu-máy: dù dữ liệu được quản lý tốt đến đâu, thuật toán cũng chỉ có thể học nhanh bằng đúng tốc độ mà máy có thể cung cấp dữ liệu.
Learning Objectives
- Giải thích vì sao dữ liệu giống mã nguồn và lần theo cách các hiệu ứng dây chuyền của dữ liệu lan truyền qua các hệ thống machine learning
- Tính toán lực hấp dẫn dữ liệu, thuế cấp dữ liệu và chi phí băng thông lưu trữ để di chuyển hoặc phục vụ (serving) các tập dữ liệu
- Đánh giá chiến lược thu thập theo các tiêu chí: phạm vi bao phủ, chất lượng, chi phí gán nhãn, quản trị và các ràng buộc khi triển khai.
- Thiết kế các pipeline nhập liệu và xác thực cho các khối lượng công việc (workload) dạng batch, streaming, ETL và ELT.
- Triển khai các phép biến đổi idempotent, truy xuất nguồn gốc và kiểm tra độ trôi để giữ nhất quán giữa huấn luyện và phục vụ (serving).
- Chọn thiết kế cho gán nhãn, lưu trữ, định dạng tệp, quản lý phiên bản và feature-store để đáp ứng nhu cầu của vòng đời ML.
- Chẩn đoán các vấn đề về nợ dữ liệu và lỗi trong pipeline sản xuất dựa trên bằng chứng về chất lượng, độ tin cậy, khả năng mở rộng và quản trị.
Quy trình làm việc trở nên cụ thể trong pipeline dữ liệu: đầu vào thô đi qua các bước thu thập, nhập liệu, phân tích, gán nhãn, xác thực và chuẩn bị trước khi trở thành các tập dữ liệu sẵn sàng cho ML. Báo cáo phân tích công việc từ khảo sát Crowdflower năm 2016 (CrowdFlower 2016) giải thích vì sao pipeline này cần một cách tiếp cận ở cấp hệ thống: 60% người trả lời cho rằng làm sạch và tổ chức dữ liệu là nhiệm vụ tốn thời gian nhất, và 19% chọn thu thập tập dữ liệu. Trục dữ liệu trong phân loại D·A·M chỉ thực sự hiện hữu dưới dạng cơ sở hạ tầng: các hệ thống thu thập, kiểm tra xác thực, quy trình gán nhãn, bố cục lưu trữ và quản trị.
CrowdFlower. 2016. Data Science Report 2016.
Definition 1.1: Kỹ thuật dữ liệu
Kỹ thuật dữ liệu là lớp cơ sở hạ tầng chịu trách nhiệm quản lý vòng đời của dữ liệu, từ nguồn đến mô hình, bao gồm các công đoạn thu thập, chuyển đổi, lưu trữ và quản trị.
- Ý nghĩa: Chức năng cốt lõi của kỹ thuật dữ liệu là đảm bảo tính nhất quán giữa huấn luyện và phục vụ (serving), đồng thời ngăn chặn sự suy giảm hiệu suất ngầm bằng cách tách rời mô hình khỏi sự biến động của dữ liệu thô. Theo quy luật sắt, nó quản lý số byte dữ liệu được di chuyển \((D_{\text{vol}})\), trong khi thành phần và chất lượng của tập dữ liệu quyết định liệu tập dữ liệu \((D)\) có còn đại diện cho phân phối mục tiêu hay không.
- Điểm khác biệt: Không như khoa học dữ liệu, vốn tập trung vào suy luận và khám phá insight, kỹ thuật dữ liệu tập trung vào khả năng mở rộng và độ tin cậy của pipeline dữ liệu.
- Cạm bẫy thường gặp: Một quan niệm phổ biến là kỹ thuật dữ liệu chỉ là “làm sạch dữ liệu.” Thực tế, đó là biên soạn tập dữ liệu: chuyển đổi các quan sát thô, nhiễu thành một tệp nhị phân đã được tối ưu hóa để mô hình sử dụng.
Phép so sánh với biên dịch tập dữ liệu giúp làm rõ hạ tầng kỹ thuật. Giống như một trình biên dịch phần mềm biến đổi mã nguồn qua một chuỗi biểu diễn ngày càng tinh gọn (token, cây cú pháp trừu tượng, biểu diễn trung gian, mã máy), một pipeline biến các quan sát thô và nhiễu thành các tensor số sẵn sàng cho huấn luyện qua những giai đoạn tương tự. Việc lọc bỏ các bản ghi bị hỏng, các giá trị ngoại lai và các đặc trưng không liên quan tương ứng với loại bỏ mã chết: loại bỏ những phần không đóng góp gì cho biểu diễn đã học. Tăng cường dữ liệu (augmentation), tức mở rộng tổng hợp các ví dụ hạn chế bằng cách xoay hình ảnh, dịch cao độ âm thanh hoặc thêm nhiễu, giống như khai triển vòng lặp, giúp mô hình tiếp xúc với nhiều biến thể hơn của mẫu nền mà không cần thu thập dữ liệu mới. Khử trùng lặp đóng vai trò loại bỏ biểu thức con chung, xác định và gộp các bản ghi trùng lặp; nếu không, chúng sẽ gây độ chệch (bias) cho ước lượng gradient và lãng phí tài nguyên tính toán. Xác thực lược đồ, áp các kiểu và khoảng giá trị nghiêm ngặt cho từng bản ghi, chính là bộ kiểm tra kiểu của pipeline, từ chối các đầu vào sai định dạng trước khi chúng làm sập “runtime” của quá trình huấn luyện mô hình.
Về mặt kỹ thuật, điều này có nghĩa là các tập dữ liệu phải được quản lý phiên bản (như git), được kiểm thử đơn vị (kiểm tra chất lượng dữ liệu) và được gỡ lỗi. Xóa một hàng dữ liệu huấn luyện có thể làm thay đổi kết quả đã học, giống như xóa một dòng mã có thể làm thay đổi tệp nhị phân đã biên dịch; huấn luyện lại chính là bước biên dịch lại tương ứng. Việc “biên dịch” cũng đặt ra ranh giới tin cậy giữa các phần của tập dữ liệu. Tập huấn luyện được phép định hình tham số; tập xác thực được phép định hình các lựa chọn về mô hình và pipeline; còn tập kiểm thử được dành để ước lượng khả năng tổng quát hóa sau khi các lựa chọn đó đã chốt. Rò rỉ xảy ra khi thông tin vượt qua các ranh giới này: ví dụ các ví dụ trùng lặp xuất hiện ở nhiều phần, các biến thể đã tăng cường của cùng một bản ghi gốc nằm ở cả hai phía của phần chia, các bản ghi người dùng từ cùng một hộ gia đình xuất hiện ở cả huấn luyện và kiểm thử, hoặc các đặc trưng theo thời gian được tính bằng các quan sát trong tương lai. Với nghiên cứu điển hình về nhận diện từ khóa xuyên suốt chương này, điều đó có nghĩa là các phần chia độc lập theo người nói và có ý thức về thời gian không phải chuyện thủ tục; chúng quyết định giữa việc đo khả năng ghi nhớ giọng quen và đo hiệu suất trên quần thể người dùng khi triển khai.
Phép ẩn dụ biên dịch này định hình tư duy kỹ thuật xuyên suốt chương. Trình biên dịch có các pha riêng (phân tích từ vựng, phân tích cú pháp, tối ưu hóa, sinh mã), và “trình biên dịch” tập dữ liệu của chúng ta cũng vậy: thu thập, nạp, xử lý, gán nhãn, lưu trữ và bảo trì liên tục. Một framework bốn trụ cột gồm Chất lượng, Độ tin cậy, Khả năng mở rộng và Quản trị giúp sắp xếp các quyết định thiết kế trong mọi giai đoạn. Nghiên cứu điển hình về keyword spotting (KWS) minh họa từng giai đoạn trong điều kiện tài nguyên bị bó chặt, nơi mỗi byte và mỗi thao tác đều đáng kể.

Lợi ích lựa chọn đạt đỉnh khi mật độ tín hiệu (entropy) cao và chi phí di chuyển (trọng lực) thấp.
Để thiết kế một pipeline hiệu quả, chúng ta phải bắt đầu từ các thuộc tính vật lý ràng buộc từng giai đoạn. Cũng giống như một kỹ sư xây dựng cần nắm vững cơ học đất trước khi thiết kế móng, một kỹ sư dữ liệu phải hiểu rõ các yếu tố vật lý chi phối việc di chuyển dữ liệu và mật độ thông tin trước khi đưa ra bất kỳ quyết định nào về pipeline. Những ràng buộc vật lý này tạo ra các giới hạn cứng mà dù phần mềm có thông minh đến mấy cũng không thể vượt qua.
Vật lý của dữ liệu
Phép ẩn dụ “dữ liệu như mã” mô tả dữ liệu làm gì (quyết định hành vi của hệ thống) nhưng không giải thích được vì sao việc di chuyển dữ liệu lại đắt đỏ như vậy. Vật lý của dữ liệu cho thấy vì sao các hệ thống dữ liệu phải xem dữ liệu như một chất vật lý với các thuộc tính có thể đo lường. Tương tự như việc các vật liệu khác nhau có mật độ và độ nhớt, các tập dữ liệu cũng có tín hiệu liên quan đến tác vụ và trọng lực dữ liệu.
Trọng lực dữ liệu
Trọng lực dữ liệu là chi phí di chuyển. Nó là hàm của khối lượng dữ liệu \((D_{\text{vol}})\) và băng thông mạng \((\text{BW})\). Thời gian để chuyển một tập dữ liệu cỡ petabyte qua một đường truyền 10 Gbps là cố định theo vật lý (\(T = D_{\text{vol}}/\text{BW} \approx 9.3 \text{ days}\)); ngay cả với một đường truyền chuyên dụng 100 Gbps, thời gian truyền và chi phí egress vẫn đủ lớn để định hình kiến trúc. Trọng lực này quyết định kiến trúc: vì việc đưa 1 PB tới nơi tính toán là chậm và tốn kém, nên thường phải đưa nơi tính toán tới gần dữ liệu. Điều này lý giải sự trỗi dậy của các kiến trúc “Data Lakehouse”1 (Zaharia et al. 2021), nơi các công cụ xử lý như Spark và Presto hoạt động trên lưu trữ đối tượng dùng chung. Ngược lại, data mesh (Dehghani 2022) đề xuất phân tán quyền sở hữu để quản lý quy mô này ở cấp tổ chức, coi dữ liệu là một sản phẩm do các nhóm miền sở hữu.
1 Data lakehouse: Đây là kiến trúc kết hợp lưu trữ kiểu data lake (rẻ, không cần schema) với ngữ nghĩa truy vấn của kho dữ liệu (giao dịch ACID, cưỡng chế schema) thông qua các lớp bảng giao dịch như Delta Lake. Với các khối lượng công việc (workload) ML, lakehouse giúp giảm việc sao chép dữ liệu trong quy trình trích xuất, chuyển đổi, tải (ETL) giữa lake và kho dữ liệu, cho phép tính toán các đặc trưng trực tiếp trên lớp lưu trữ nơi dữ liệu đang nằm. Đây là phản ứng trực diện với “trọng lực dữ liệu”, vì việc lặp lại các bản sao ở quy mô petabyte sẽ làm tăng chi phí \(D_{\text{vol}}/\text{BW}\) (Armbrust et al. 2020; Zaharia et al. 2021).
Armbrust, Michael, Tathagata Das, Liwen Sun, Burak Yavuz, Shixiong Zhu, Mukul Murthy, Joseph Torres, et al. 2020. “Delta Lake: High-Performance ACID Table Storage over Cloud Object Stores.” Proceedings of the VLDB Endowment 13 (12): 3411–24. https://doi.org/10.14778/3415478.3415560.
Zaharia, Matei, Ali Ghodsi, Reynold Xin, and Michael Armbrust. 2021. “Lakehouse: A New Generation of Open Platforms That Unify Data Warehousing and Advanced Analytics.” Proceedings of CIDR 8.
Dehghani, Zhamak. 2022. Data Mesh: Delivering Data-Driven Value at Scale. O’Reilly Media.
Tín hiệu liên quan đến tác vụ
Tín hiệu liên quan đến tác vụ là một heuristic về lượng thông tin hữu ích mà một tập dữ liệu đóng góp cho một tác vụ cụ thể, chứ không phải entropy Shannon tính từ các byte thô. Một tập dữ liệu gồm 1 triệu ảnh giống hệt nhau có “trọng lực dữ liệu” cao nhưng gần như không thêm thông tin liên quan đến tác vụ ngoài ảnh lặp lại. Ngược lại, một tập dữ liệu gồm 10.000 edge case đa dạng có thể có trọng lực dữ liệu thấp hơn nhưng tín hiệu liên quan đến tác vụ lớn hơn. Heuristic này đo tín hiệu hữu ích trên mỗi byte, còn trọng lực dữ liệu phản ánh chi phí di chuyển. Tỷ lệ của chúng biểu diễn lợi tức trên chi phí di chuyển của tập dữ liệu: \[ \text{Data Selection Gain} \propto \frac{\text{Task-Relevant Signal}}{\text{Data Gravity}} \tag{1}\] Heuristic này ưu tiên các tập dữ liệu có tín hiệu gia tăng cho tác vụ đủ để bù đắp chi phí di chuyển. Vì thế, loại bỏ trùng lặp và học chủ động sẽ cải thiện quyết định lựa chọn khi chúng loại bỏ các byte dư thừa hoặc ưu tiên các ví dụ giàu thông tin.
Vấn đề cấp liệu: Tốc độ dòng chảy và “thuế cấp liệu”
Trọng lực dữ liệu xác định chi phí để di chuyển toàn bộ khối lượng; vấn đề cấp liệu xác định chi phí để đưa nó vào hệ thống. Ta phân tích điều này như một bài toán tốc độ dòng chảy: thách thức bão hòa một máy có thông lượng cao từ một nguồn dữ liệu có băng thông thấp.
Theo định luật sắt, hiệu năng hệ thống chỉ nhanh bằng thành phần chậm nhất. Nếu một bộ tăng tốc có thông lượng cao chạy một mô hình xử lý ảnh có thể xử lý 1,843 img/s, nhưng pipeline lưu trữ chỉ cung cấp 250 MB/s, thì silicon đắt tiền sẽ bị nhàn rỗi. Chúng ta định lượng điều này như thuế cấp dữ liệu: thời gian đồng hồ thực bị mất do phải chờ I/O, điều này trực tiếp làm giảm hiệu suất hệ thống \((\eta_{\text{hw}})\). Với một volume tiêu chuẩn trên đám mây, thuế cấp dữ liệu có thể vượt quá 77.5 percent, nghĩa là bộ tăng tốc dành phần lớn thời gian chỉ để chờ bit. Khoản thuế này biến pipeline dữ liệu từ một mối quan tâm về lưu trữ đơn thuần thành yếu tố chính điều tiết chu kỳ hoạt động của hệ thống. Để cấp dữ liệu cho bộ tăng tốc tham chiếu trong ví dụ này, thường cần tốc độ truyền 1.1 GB/s, buộc chúng ta chuyển từ các hệ thống tệp truyền thống sang các kiến trúc lưu trữ chuyên biệt được phát triển trong section 1.7.1. Những thuộc tính vật lý này cũng kéo theo chi phí năng lượng: dữ liệu càng đi xa bộ xử lý, chi phí cho việc di chuyển càng chiếm phần lớn ngân sách.
Systems Perspective 1.1: Bất biến năng lượng-di chuyển
Định luật sắt trong Định luật sắt của hệ thống ML và phân tích ‘memory-wall’ trong Cân bằng hệ thống và phần cứng gợi ý một nguyên lý kỹ thuật dữ liệu: di chuyển một giá trị 32-bit tốn năng lượng gấp khoảng 173× đến 10,810.8× lần so với phép nhân FP32 trong bảng, và hệ số này tăng lên khi dữ liệu rời khỏi chip. Các chương tối ưu hóa sau này sẽ khai thác cùng một độ dốc chi phí này trong thiết kế mô hình và phần cứng; còn ở đây, câu hỏi là luồng thông tin từ thế giới bên ngoài đã tiêu thụ bao nhiêu năng lượng trước khi mô hình bắt đầu tính toán. Table 1 cho thấy rõ độ dốc chi phí này trên toàn bộ hệ thống phân cấp bộ nhớ.
Table 1: Chi phí năng lượng khi di chuyển so với tính toán trên giá trị 32-bit: Năng lượng ước tính cho mỗi sự kiện ở từng cấp trong hệ thống di chuyển dữ liệu, với các hệ số được chuẩn hóa theo một phép nhân FP32 32-bit. Tất cả các hàng đều dùng cùng độ rộng 32-bit, nên các tỷ lệ này so sánh những sự kiện có kích thước tương đương. Bản thân các tỷ lệ này không đủ để kết luận yếu tố nào chi phối một khối lượng công việc hoàn chỉnh; tổng năng lượng còn phụ thuộc vào số lượng phép toán số học và số lần truyền dữ liệu.
| Thao tác | Năng lượng (pJ) | Chi phí tương đối |
|---|---|---|
| Phép nhân FP 32-bit | 3.7 pJ/FLOP | 1\(\times\) |
| Truy cập bộ nhớ DRAM (32-bit) | 640 pJ | 173× |
| Truy cập SSD cục bộ (32-bit) | 4,000 pJ | 1,081.1× |
| Truyền qua mạng (32-bit) | 40,000 pJ | 10,810.8× |
Mức chênh lệch chi phí được định lượng trong table 1 giải thích vì sao tính cục bộ (locality) có thể là một tối ưu hóa hệ thống có đòn bẩy lớn. Mỗi lượt truyền dữ liệu tránh được sẽ loại bỏ phần năng lượng di chuyển tương ứng, dù tổng lợi ích còn phụ thuộc vào số lần truy cập và mức độ tái sử dụng.
Dữ liệu có khối lượng vật lý. Việc tỉa (pruning) 50 percent dữ liệu huấn luyện bằng cách loại bỏ trùng lặp không chỉ tiết kiệm dung lượng đĩa; nó còn giảm khối lượng công việc ở các giai đoạn chuyên sâu về dữ liệu trong vòng đời huấn luyện. Vì vậy, lựa chọn dữ liệu là một công cụ có đòn bẩy lớn khi việc di chuyển và xử lý dữ liệu chi phối khối lượng công việc (workload).
Lập luận về năng lượng và heuristic mật độ tín hiệu cùng chỉ ra một đòn bẩy từ hai hướng: kỹ thuật dữ liệu hiệu quả giúp tối đa hóa Lợi ích Lựa chọn Dữ liệu được định nghĩa trong equation 1. “Làm sạch dữ liệu” không chỉ là vệ sinh cơ bản; đó là kỹ thuật tín hiệu trên nhiễu. Loại bỏ trùng lặp có thể giảm phần dữ liệu dư thừa nhưng vẫn giữ được tín hiệu liên quan đến tác vụ, từ đó trực tiếp tăng tỷ lệ này. Học chủ động (active learning) có thể ưu tiên các ví dụ giàu thông tin hơn so với các ví dụ dư thừa, nhờ đó tăng lượng thông tin hữu ích trên mỗi byte. Chúng tôi tối ưu tỷ lệ này để đảm bảo ngân sách lưu trữ và tính toán được chi cho tín hiệu, không phải nhiễu.
Những nguyên tắc này vận hành ở cấp độ tệp và các batch riêng lẻ. Ở quy mô trung tâm dữ liệu, chi phí di chuyển dữ liệu tích tụ thành một ràng buộc, khiến việc truyền các tập dữ liệu lớn trở nên quá tốn kém đến mức các tác vụ tính toán phải di chuyển đến gần dữ liệu thay vì ngược lại. Việc truyền một tập dữ liệu petabyte giữa các trung tâm dữ liệu sẽ gắn cho ràng buộc này một con số chi phí cụ thể bằng tiền.
Napkin Math 1.1: Vật lý của trọng lực dữ liệu
Bài toán: Một tập dữ liệu huấn luyện 1 PB đang ở một trung tâm dữ liệu tại US East, trong khi một pod bộ tăng tốc từ xa có sẵn ở US West. Vậy, chuyển dữ liệu hay chuyển phần tính toán sẽ nhanh hơn?
Tính toán:
- Băng thông mạng: 100 Gb/s \(\div 8 =\) 12.5 GB/s.
- Thời gian truyền tải: 1,000,000 GB \(\div\) 12.5 GB/s = 80,000 seconds, xấp xỉ
- Chi phí: 1,000,000 GB \(\times\) $0.02/GB = $20,000. (Mức cơ sở: giá chuyển dữ liệu ra của AWS, 2024.)
Góc nhìn hệ thống: Nếu huấn luyện mất ít hơn 22 h, thì truyền dữ liệu sẽ lâu hơn huấn luyện. Nếu huấn luyện tốn ít hơn $20,000 (xấp xỉ 5,000 TPUv4-hours), thì chi phí băng thông còn đắt hơn chi phí tính toán. Với dữ liệu quy mô petabyte, code di chuyển đến dữ liệu; với dữ liệu quy mô gigabyte, dữ liệu di chuyển đến code.
Những ràng buộc vật lý này chi phối mọi quyết định trong các pipeline dữ liệu sản xuất. Trước khi tiếp tục, hãy rà soát lại những trực giác cốt lõi sẽ lặp lại xuyên suốt pipeline.
Checkpoint 1.1: Vật lý của dữ liệu
Kỹ thuật dữ liệu chịu sự chi phối của các chi phí vật lý. Hãy kiểm tra trực giác của bạn:
Những thuộc tính vật lý này đặt ra các ràng buộc cứng cho mọi quyết định trong pipeline: lưu dữ liệu ở đâu, biến đổi dữ liệu thế nào, và khi nào nên chuyển tính toán thay vì chuyển byte. Tuy nhiên, chỉ riêng vật lý không thể ngăn lỗi; nó chỉ xác định các giới hạn trong đó ta phải đưa ra quyết định kỹ thuật. Ngay cả khi hiểu rất rõ về “trọng lực dữ liệu”, một nhóm vẫn có thể xây dựng một pipeline mong manh nếu kiểm tra chất lượng làm kiểu chắp vá, không có xử lý lỗi, hoặc coi quản trị là chuyện nghĩ sau. Biến các ràng buộc vật lý thành thực hành đáng tin cậy đòi hỏi một framework có hệ thống để tổ chức các quyết định thiết kế ở mọi giai đoạn của pipeline.
Self-Check: Question
A machine learning team maintains a \(1\text{ PB}\) raw training corpus in a US East cloud storage bucket and provisions a dedicated compute cluster in US West. The regions are connected by a dedicated \(100\text{ Gbps}\) network fabric. Cloud egress pricing is $0.02/, and the model training run takes \(20\text{ hours}\). Under the principles of data gravity and transfer economics (\(T = D_{\text{vol}}/\text{BW}\)), which architecture should the team select?
- Stream the dataset remotely across the link during training, because a 100 Gbps network provides sufficient throughput to prevent GPU I/O stalls.
- Partition the dataset equally across both cloud regions so that each region trains half the model asynchronously without transfer fees.
- Apply standard gzip compression to eliminate data gravity, enabling real-time remote streaming at zero net cost.
- Provision or relocate compute in US East near the data, because transferring 1 PB requires ~22.2 hours and incurs ~$20,000 in egress fees, exceeding the training run’s time and budget.
A computer vision model training on an accelerator cluster consumes images at \(3{,}119\text{ img/s}\), demanding \(1.9\text{ GB/s}\) of sustained input streaming bandwidth. However, the host DataLoader reads from a standard cloud block storage volume delivering only \(125\text{ MB/s}\). According to the chapter’s feeding tax analysis, what is the resulting operational state of the system?
- The accelerator suffers a feeding tax of >90% (spending over 90% of its wall-clock time idle waiting for I/O), severely degrading hardware efficiency _{}.
- The accelerator remains 100% compute-bound because internal GPU tensor execution is mathematically decoupled from storage I/O.
- Increasing the per-device batch size by 8x will completely eliminate the I/O bottleneck without requiring storage upgrades.
- Host memory caches automatically compensate for the throughput gap after the first epoch without any CPU overhead.
Using the data selection gain formula ( ) and the energy-movement invariant, explain why pruning 50% of redundant samples via deduplication provides high systems leverage even when per-batch model execution is compute-bound.
According to the chapter’s energy-movement hierarchy, arrange the following operations in ascending order of energy consumed per 32-bit value (from lowest energy to highest energy):
- Local NVMe SSD access
- On-chip 32-bit FP multiply
- Wide-area network transfer
- Off-chip DRAM memory access
- The wall-clock time lost by high-throughput accelerators while waiting for input batches from slow storage pipelines is formally termed the ____.
Framework Bốn Trụ Cột
Một mô hình chấm điểm tín dụng từ chối mọi ứng viên từ một vùng vì nhóm ở công đoạn trước đã đổi trường mã ZIP từ số nguyên sang chuỗi. Một mô hình ảnh y tế suy giảm âm thầm suốt nhiều tháng vì phần cứng camera thay đổi tại một bệnh viện đối tác. Một hệ thống phát hiện gian lận bỏ lỡ một vector tấn công mới vì dữ liệu huấn luyện đã cũ sáu tháng. Mỗi lỗi có một nguyên nhân gốc khác nhau (trôi lược đồ, dịch chuyển phân phối, dữ liệu cũ), nhưng đều có chung một mẫu số: các quyết định kỹ thuật về dữ liệu được làm kiểu tùy tiện, tương tác với nhau theo những cách không ai lường trước cho đến lúc hệ thống được triển khai. Những lỗi dây chuyền này là động lực cho một framework bốn trụ cột xoay quanh chất lượng, độ tin cậy, khả năng mở rộng, và quản trị.
Thác dữ liệu
Các hệ thống machine learning thường gặp một kiểu lỗi đặc trưng gọi là thác dữ liệu, nơi chất lượng dữ liệu kém ở các giai đoạn đầu bị khuếch đại xuyên suốt toàn bộ pipeline (Sambasivan et al. 2021). Một số đầu vào không hợp lệ gây lỗi phần mềm ngay, nhưng dữ liệu cũng có thể vẫn vượt qua schema và kiểm thử trong khi âm thầm làm suy giảm hành vi đã học2 cho đến khi các vấn đề chất lượng trở nên đủ nghiêm trọng, buộc phải điều tra, làm lại, hoặc huấn luyện lại tốn kém.
2 Thác dữ liệu: Lỗi là “âm thầm” vì nó làm suy giảm đầu vào của mô hình, chứ không phải mã của mô hình—dữ liệu hỏng có thể vượt qua các kiểm thử đơn vị và trông bình thường trong giám sát hệ thống thông thường. Sambasivan et al. (2021) mô tả thác dữ liệu là thường vô hình và xuất hiện muộn: các thực hành dữ liệu sai có thể chỉ lộ ra sau khi đánh giá ở các bước sau, triển khai, hoặc khi các lỗi phía người dùng cho thấy mô hình đã học từ tín hiệu sai. Để khắc phục, cần lần theo vấn đề ngược trở lại qua các quyết định thu thập dữ liệu, gán nhãn, kỹ thuật đặc trưng và đánh giá, thậm chí một số nhóm phải khởi động lại hoặc từ bỏ phần công việc bị ảnh hưởng.
Sambasivan, Nithya, Shivani Kapania, Hannah Highfill, Diana Akrong, Praveen Paritosh, and Lora M Aroyo. 2021. “‘Everyone Wants to Do the Model Work, Not the Data Work’: Data Cascades in High-Stakes AI.” Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–15. https://doi.org/10.1145/3411764.3445518.
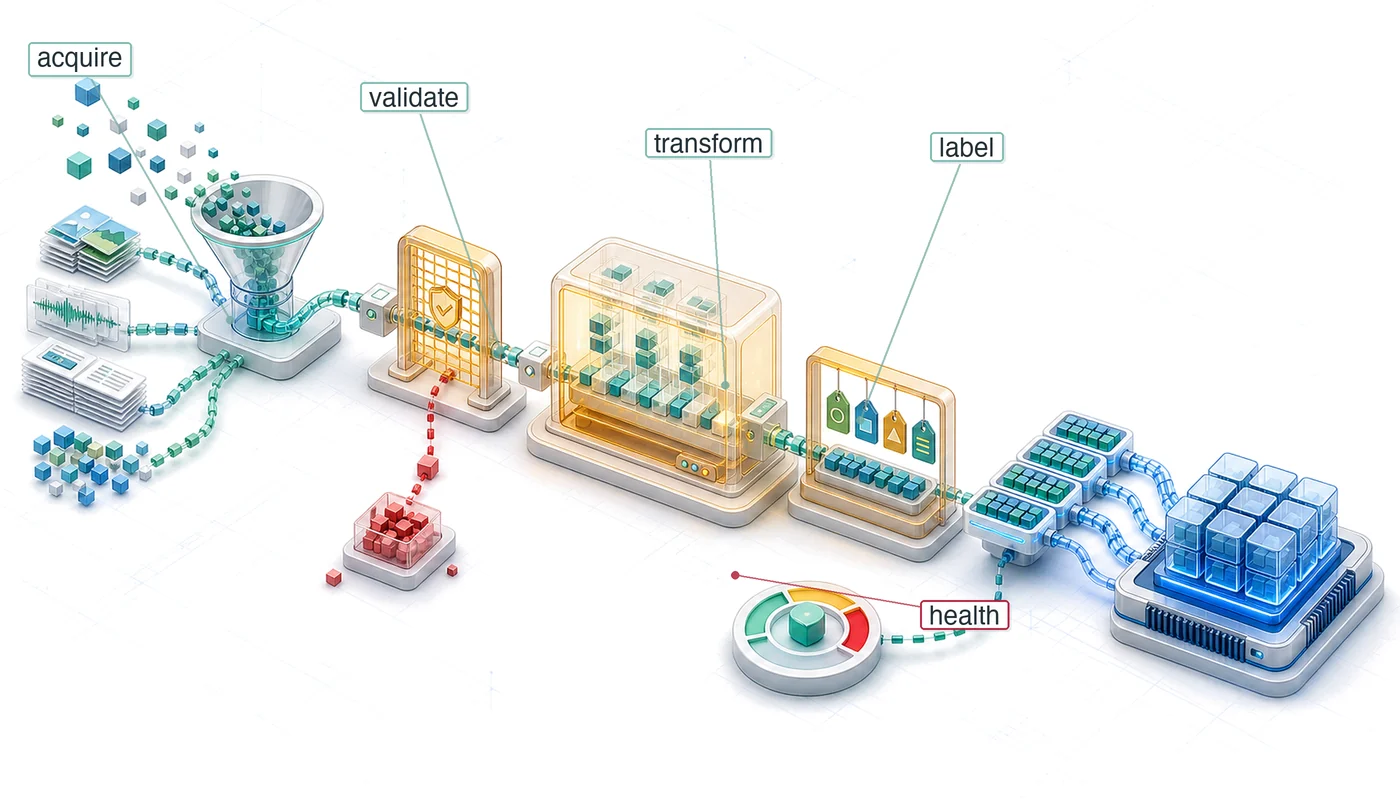
Các lỗi dữ liệu hiếm khi chỉ giới hạn ở nơi chúng phát sinh; chúng tích lũy dần qua các giai đoạn của pipeline. Để thấy một khiếm khuyết dữ liệu ban đầu lan truyền như thế nào vào các quyết định trích xuất đặc trưng, tối ưu hóa mô hình và triển khai, hãy theo dõi chuỗi các giai đoạn được kết nối trong figure 1 từ trái sang phải.

Definition 1.2: Thác dữ liệu
Thác dữ liệu là một dạng lỗi trong hệ thống ML, xảy ra khi các vấn đề về chất lượng dữ liệu ở giai đoạn đầu (thượng nguồn) lan truyền qua các bước thu thập, gán nhãn, kỹ thuật đặc trưng, huấn luyện, đánh giá và triển khai, rồi khuếch đại thành lỗi mô hình ở các giai đoạn sau hoặc gây hại cho người dùng.
- Ý nghĩa: Chi phí khắc phục tăng theo số lượng thành phần hạ nguồn đã tiêu thụ dữ liệu bị hỏng: các bảng đặc trưng phải được tạo lại, mô hình phải được huấn luyện lại, các chỉ số đánh giá phải được tính lại, và các hệ thống đã triển khai phải được rollback hoặc vá. Chỉ một lỗi về lược đồ hoặc nhãn cũng có thể làm mất hiệu lực toàn bộ một lần huấn luyện và mọi thí nghiệm phát sinh từ đó, biến một lỗi dữ liệu cục bộ thành sự cố phải làm lại toàn bộ pipeline.
- Điểm khác biệt: Khác với một lỗi chất lượng dữ liệu đơn lẻ, thác dữ liệu được đặc trưng bởi sự lan truyền và khuếch đại. Lỗi ban đầu có thể rất nhỏ, nhưng mỗi giai đoạn trong pipeline coi đầu vào là đáng tin và biến lỗi đó thành trạng thái dẫn xuất mới, khiến nguyên nhân gốc ngày càng khó quan sát khi hệ thống đi xa dần khỏi khâu thu thập.
- Cạm bẫy phổ biến: Một hiểu lầm thường gặp là thác dữ liệu sẽ bị bắt bởi các kiểm thử phần mềm thông thường. Thực tế, dữ liệu bị hỏng vẫn có thể đáp ứng lược đồ, vượt qua kiểm thử đơn vị và hoàn tất huấn luyện, nhưng lại “dạy” cho mô hình tín hiệu sai. Để ngăn thác dữ liệu, cần có lineage, cơ chế xác thực, contracts, và giám sát gắn với hành vi của mô hình.
Vòng lặp phản hồi này tạo ra một kiểu lỗi vận hành ngấm ngầm: suy giảm âm thầm. Khác với các sự cố phần mềm thông thường gây ra stack trace và trang cảnh báo, lỗi mô hình do dữ liệu gây ra vẫn cho ra đầu ra hợp lệ về mặt cú pháp nhưng độ chính xác ngữ nghĩa bị suy giảm. Đến khi các chỉ số hạ nguồn phản ánh sự cố, các dự đoán sai lệch đã làm nhiễm bẩn các kho dữ liệu lịch sử, buộc phải khôi phục và nạp lại dữ liệu, rất tốn kém.
Example 1.1: Rừng pipeline
Tình huống: Một mô hình chấm điểm tín dụng đang vận hành đột nhiên bắt đầu từ chối tất cả ứng viên từ một khu vực địa lý cụ thể.
Chẩn đoán: Nhóm cơ sở dữ liệu thượng nguồn đã đổi lược đồ trường zip_code từ integer sang string (“02139”) để hỗ trợ mã quốc tế mà không cập nhật hợp đồng dữ liệu hạ nguồn. Một bước biến đổi cũ ở hạ nguồn vẫn ép chuỗi đó về số nguyên trước khi tuần tự hóa, làm mất số 0 ở đầu (“2139”), khiến mô hình coi một mã bưu chính quen thuộc như một danh mục rủi ro cao, chưa từng quan sát.
Bài học về hệ thống: Khi ranh giới của các đặc trưng không được thực thi, pipeline sẽ trở thành “rừng rậm”, nơi các thay đổi lược đồ ở thượng nguồn âm thầm làm hỏng mô hình ở hạ nguồn. Các hợp đồng dữ liệu có phiên bản, kèm xác thực lược đồ và phạm vi nghiêm ngặt, sẽ ngăn hỏng dữ liệu xuyên hệ thống.
Bốn trụ cột nền tảng
Để ngăn các lỗi âm thầm tích tụ dọc theo pipeline, hạ tầng dữ liệu phải cân bằng bốn ưu tiên vận hành cạnh tranh. Hãy quan sát cách figure 2 sắp xếp các ưu tiên này thành các cột nền tảng, bao gồm tính toàn vẹn đầu vào, ổn định triển khai, hiệu suất thực thi và quản trị dữ liệu.

Bốn nền tảng vận hành này xác định không gian đánh đổi cho mọi quyết định kiến trúc trong chương này. Chẳng hạn, ưu tiên khả năng mở rộng mà bỏ qua xác thực chất lượng hoặc các hợp đồng đảm bảo độ tin cậy có thể làm tăng thông lượng nhưng cho phép dữ liệu kém chất lượng hoặc không nhất quán lan truyền. Ngược lại, các biện pháp kiểm soát quản trị toàn diện có thể làm tăng chi phí lưu trữ và tính toán, từ đó hạn chế tốc độ lặp huấn luyện.
Độ tin cậy đặt câu hỏi liệu cùng một pipeline đăng ký có tiếp tục hoạt động khi thiết bị, mạng hoặc hành vi người dùng không hoàn hảo. Một pipeline tạo ra các ví dụ về từ khóa đánh thức tuyệt vời trong phòng thí nghiệm nhưng lại thất bại khi kết nối chập chờn, pin bị áp lực hoặc micrô trục trặc thì không mang lại giá trị trong nhà của người dùng. Các cơ chế như xử lý lỗi, thử lại, bộ đệm cục bộ và suy giảm có kiểm soát biến quy tắc chất lượng thành một hệ thống hữu dụng: thiết bị có thể yêu cầu người dùng phát âm lại, hoãn tải lên cho đến khi có lại kết nối, hoặc giữ nguyên một bản đăng ký đã biết là tốt thay vì âm thầm chấp nhận âm thanh bị lỗi.
Khả năng mở rộng đặt câu hỏi liệu quyết định đó còn phù hợp khi quy mô tăng. Một chính sách rà soát thủ công có thể hoạt động tốt với 1.000 bản ghi âm, nhưng sẽ sụp đổ khi sản phẩm mở rộng lên hàng triệu người dùng, hàng chục ngôn ngữ và các điều kiện âm thanh thuộc đuôi dài. Hệ thống phải mở rộng các khâu xác thực, lưu trữ, nhãn và huấn luyện lại, đồng thời không để chi phí hạ tầng tăng nhanh hơn giá trị từ phạm vi bao phủ tốt hơn. Vì vậy, tài nguyên giới hạn sẽ phụ thuộc vào khối lượng công việc (workload).
Lighthouse 1.1 cho thấy nơi trụ cột khả năng mở rộng chịu áp lực lớn nhất: điểm nghẽn là dung lượng bộ nhớ, và việc phân chia các bảng embedding trên nhiều máy trở thành một mối quan tâm thiết kế hàng đầu chứ không còn là chuyện tính sau. Tiếp đó, quản trị xác định các ranh giới trong đó chất lượng, độ tin cậy và khả năng mở rộng được vận hành. Với ví dụ KWS, quản trị quyết định liệu các bản ghi âm thô có được phép rời thiết bị, thời gian lưu giữ âm thanh đăng ký, hồ sơ đồng ý nào cho phép sử dụng, và tài liệu nào chứng minh rằng tập dữ liệu bao phủ các giọng liên quan mà không làm lộ lời nói riêng tư. Một pipeline hoàn hảo về khả năng mở rộng, độ tin cậy và chất lượng nhưng vi phạm GDPR hoặc duy trì các độ chệch (bias) nhân khẩu học sẽ tạo ra trách nhiệm pháp lý thay vì giá trị. Các thực hành tài liệu hóa tập dữ liệu, như các tuyên bố về dữ liệu, giúp làm rõ một phần công tác quản trị bằng cách ghi lại nguồn gốc, mục đích sử dụng, điều kiện thu thập và phạm vi bao phủ cần thiết cho phân tích độ chệch (bias) và so sánh khoa học (Bender and Friedman 2018).
Bender, Emily M., and Batya Friedman. 2018. “Data Statements for Natural Language Processing: Toward Mitigating System Bias and Enabling Better Science.” Transactions of the Association for Computational Linguistics 6: 587–604. https://doi.org/10.1162/tacl_a_00041.
Khi các hệ thống ML gặp lỗi, bốn trụ cột này cung cấp một lăng kính chẩn đoán để tìm nguyên nhân gốc. Độ chính xác suy giảm dần cho thấy vấn đề về chất lượng: dữ liệu bị trôi (data drift) làm phân phối khi phục vụ (serving) lệch so với lúc huấn luyện, hoặc chất lượng nhãn giảm do nhóm gán nhãn thay đổi. Các lỗi pipeline xuất hiện ngắt quãng cho thấy vấn đề về độ tin cậy: thiếu cơ chế xử lý lỗi, logic thử lại, hoặc kiểm soát tài nguyên khi hệ thống chịu tải cao điểm. Việc huấn luyện mất quá nhiều thời gian dù phần cứng đủ mạnh cho thấy vấn đề về khả năng mở rộng: có thể do một phép biến đổi đơn luồng, xáo trộn không được phân vùng, hoặc tầng lưu trữ chậm khiến tài nguyên song song không được tận dụng. Các khoảng trống tuân thủ được phát hiện trong quá trình kiểm toán cho thấy “nợ quản trị” (governance debt): theo dõi nguồn gốc dữ liệu chưa đầy đủ, kiểm soát truy cập đã lỗi thời, hoặc chính sách lưu giữ chưa theo kịp thay đổi quy định.
Lighthouse 1.1: Lighthouse về hệ thống khuyến nghị DLRM
Các hệ thống đề xuất được xây dựng theo kiểu DLRM là ví dụ điển hình cho thách thức về khả năng mở rộng trong kỹ thuật dữ liệu hiện đại. Các khối lượng công việc (workload) đề xuất ngày nay chia nhu cầu tài nguyên của pipeline thành hai nhánh: các tín hiệu liên tục đi qua các pipeline ma trận dày đặc, còn các ID phân loại đòi hỏi hạ tầng tra cứu phân tán ở quy mô terabyte. Table 2 mô tả các điểm gây áp lực vận hành này qua các giai đoạn: nhập dữ liệu, tổng hợp bảng embedding và tương tác đặc trưng.
Table 2: Hồ sơ khả năng mở rộng của DLRM: Các mô hình đề xuất gây áp lực lên kỹ thuật dữ liệu ở khía cạnh dung lượng bộ nhớ và băng thông truy cập thưa thớt, hơn là ở khía cạnh tính toán.
| Thuộc tính | Giá trị | Ảnh hưởng đến hệ thống |
|---|---|---|
| Quy mô dữ liệu | ID người dùng/mặt hàng có số lượng lớn | Embedding và bảng tra cứu có thể vượt quá bộ nhớ của một máy. |
| Ràng buộc | Dung lượng bộ nhớ | Các bảng không còn vừa trên một máy và phải được phân vùng. |
| Nút thắt cổ chai | Truy cập thưa thớt | Các tra cứu ngẫu nhiên gây áp lực lên băng thông bộ nhớ nhiều hơn là tính toán. |
Ở giai đoạn nhập dữ liệu, các ID phân loại có cardinality cao vẫn là các bản ghi gọn trong một luồng bị giới hạn thông lượng. Nút thắt về băng thông mạng và dung lượng bộ nhớ xuất hiện muộn hơn, khi huấn luyện hoặc phục vụ (serving) phải tìm nạp các embedding thưa thớt từ các bảng trạng thái được phân vùng có kích thước hàng terabyte. Để giảm bất đối xứng này, cần áp dụng các chiến lược caching cho feature-store và phân vùng bảng, được xây dựng ở các giai đoạn sau trong vòng đời của pipeline.
Những lỗi khó nhận biết nhất thường bắc qua nhiều trụ cột. Các đặc trưng khác nhau giữa giai đoạn huấn luyện và phục vụ (serving) sẽ ảnh hưởng đến cả chất lượng (giá trị sai) và độ tin cậy (tính toán không nhất quán). Một chính sách xóa dữ liệu vì lý do bảo mật cũng có thể tạo ra khoảng trống chất lượng nếu phần dữ liệu còn lại không còn bao phủ nhóm người dùng trong môi trường triển khai. Để chẩn đoán các lỗi giao thoa nhiều trụ cột như vậy, chúng ta cần kiểm tra các ràng buộc nhất quán, so sánh phân phối đặc trưng giữa các môi trường và truy vết nguồn gốc của các phép biến đổi. Những kỹ thuật này sẽ được trình bày chi tiết trong chương này. Vì vậy, chẩn đoán trong môi trường sản xuất cần kiểm tra cả hạ tầng dữ liệu lẫn hành vi của mô hình.
Nghiên cứu điển hình về KWS
Các hệ thống KWS là một nghiên cứu điển hình lý tưởng để áp dụng framework bốn trụ cột của chúng ta vào các thách thức kỹ thuật dữ liệu thực tế. Các hệ thống này cung cấp năng lực cho các thiết bị kích hoạt bằng giọng nói như điện thoại thông minh và loa thông minh, phát hiện các từ đánh thức cụ thể như “OK, Google” hoặc “Alexa” trong các luồng âm thanh liên tục, đồng thời phải hoạt động dưới các ràng buộc tài nguyên nghiêm ngặt.3
3 Đăng ký Voice Match: Việc lặp lại “OK Google” tạo ra một pipeline dữ liệu quy mô nhỏ: bộ lọc chất lượng loại bỏ các mẫu nhiễu, độ tin cậy đảm bảo quá trình đăng ký được hoàn tất, khả năng mở rộng giúp mô hình vừa vặn trong bộ nhớ hệ thống trên chip (SoC) luôn hoạt động, và quản trị kiểm soát việc lưu trữ, xử lý và lưu giữ. Kỹ thuật dữ liệu được áp dụng ở bất cứ đâu dữ liệu quyết định hành vi của hệ thống.
Các mục tiêu vận hành rộng của kỹ thuật dữ liệu được cụ thể hóa thành các kỹ thuật, công cụ và kiểm tra xác thực. Với cuộc trao đổi của trợ lý giọng nói minh họa trong figure 3, các cơ chế này gồm loại bỏ trùng lặp, hợp đồng lược đồ, tìm nạp trước và theo dõi nguồn gốc, được ánh xạ tới các trụ cột kiến trúc tương ứng.
Bốn trụ cột này chuyển thẳng thành các ràng buộc kỹ thuật cho hệ thống KWS.
Vấn đề cốt lõi nghe thì đơn giản: phát hiện các từ khóa cụ thể giữa âm thanh môi trường và lời nói khác, với độ chính xác cao, độ trễ thấp, số lần kích hoạt sai tối thiểu, trên các thiết bị có tài nguyên tính toán cực kỳ hạn chế. Một định nghĩa vấn đề được đặc tả rõ sẽ chỉ ra các từ khóa cần phát hiện, ứng dụng dự kiến và kịch bản triển khai. Các mục tiêu tiếp theo phải cân bằng các yêu cầu đối nghịch: mục tiêu hiệu suất như độ chính xác phát hiện từ khóa đạt 98 percent với độ trễ dưới 200 ms, đồng thời đáp ứng các ràng buộc tài nguyên đòi hỏi mức tiêu thụ công suất tối thiểu và kích thước mô hình tối ưu cho bộ nhớ sẵn có trên thiết bị.
Tỷ lệ dương tính giả nhỏ trên mỗi cửa sổ tích lũy thành lỗi vận hành.
Napkin Math 1.2: Mục tiêu dương tính giả
Vấn đề: Một hệ thống KWS luôn hoạt động cần đảm bảo không quá một lần kích hoạt sai mỗi tháng. Với các cửa sổ phân loại một giây chạy liên tục 24/7, tỷ lệ dương tính giả trên mỗi cửa sổ cần chặt chẽ đến mức nào?
Các biến:
- Chu kỳ hoạt động: Luôn hoạt động (24 hours/day).
- Kích thước cửa sổ: Các cửa sổ phân loại một giây.
- Số cửa sổ mỗi tháng: Với một cửa sổ mỗi giây, 24 hours/day trong suốt 30 days, ta có tổng cộng 2,592,000 windows/month cửa sổ.
Tính toán:
- Tỷ lệ dương tính giả (FPR): 1 lần kích hoạt sai được chấp nhận, chia cho tổng số cửa sổ trong tháng, xấp xỉ \(3.9 \times 10^{-7}\).
- Yêu cầu từ chối không phải từ khóa: Hệ thống cần từ chối 99.99996 percent các cửa sổ không chứa từ khóa.
Thông tin chuyên sâu về hệ thống: Độ chính xác tổng thể (ví dụ: “99 phần trăm”) là chưa đủ trong trường hợp này. Việc đánh giá phải báo cáo số lần chấp nhận sai mỗi giờ (FA/Hr) cùng với hành vi từ chối sai tương ứng.
Các chỉ số thành công của KWS không chỉ dừng lại ở độ chính xác đơn thuần, mà còn bao gồm tỷ lệ dương tính thật (số từ khóa được nhận diện chính xác so với tổng số từ khóa được nói), tỷ lệ dương tính giả (số từ không phải từ khóa bị nhận diện nhầm thành từ khóa), và các đường cong đánh đổi giữa phát hiện và lỗi. Các đường cong này so sánh số lần chấp nhận sai mỗi giờ với tỷ lệ từ chối sai trên luồng âm thanh đại diện cho môi trường triển khai thực tế, như Nayak et al. (2022) đã chứng minh. Trong số các chỉ số này, tỷ lệ dương tính giả đặc biệt quan trọng đối với các hệ thống luôn hoạt động. Bởi vì KWS liên tục lắng nghe, từng giây, từng ngày, nên ngay cả một tỷ lệ dương tính giả tưởng chừng không đáng kể cũng sẽ tích lũy qua hàng triệu cửa sổ đánh giá. Một phép tính nhanh sẽ cho thấy yêu cầu này chặt chẽ đến mức nào.
Nayak, Prateeth, Takuya Higuchi, Anmol Gupta, Shivesh Ranjan, Stephen Shum, Siddharth Sigtia, Erik Marchi, et al. 2022. “Improving Voice Trigger Detection with Metric Learning.” Interspeech 2022, 1896–900. https://doi.org/10.21437/interspeech.2022-11160.
Các chỉ số vận hành còn theo dõi thời gian phản hồi (từ lúc người dùng nói từ khóa đến khi hệ thống phản hồi) và mức tiêu thụ công suất (công suất trung bình sử dụng trong quá trình phát hiện từ khóa), đồng thời các ưu tiên của các bên liên quan tạo thêm áp lực xoay quanh các chỉ số này. Cụ thể, các nhà sản xuất thiết bị ưu tiên mức tiêu thụ công suất thấp, các nhà phát triển phần mềm đề cao tính dễ tích hợp, còn người dùng cuối yêu cầu độ chính xác và khả năng phản hồi cao. Việc cân bằng những yêu cầu cạnh tranh này sẽ định hình các quyết định về kiến trúc hệ thống trong suốt quá trình phát triển.
Các ràng buộc của thiết bị nhúng đặt ra những giới hạn cứng cho các lựa chọn kiến trúc này. Hạn chế về bộ nhớ đòi hỏi các mô hình phải cực kỳ nhẹ, thường chỉ khoảng vài chục kilobyte, để vừa vặn trong vùng ‘always-on’ của SoC;4 vùng nhớ này thường chỉ đủ cho trọng số của mô hình, và mã tiền xử lý cũng phải nằm gọn trong giới hạn bộ nhớ rất chặt chẽ. Khả năng tính toán hạn chế (thường chỉ vài trăm MHz tốc độ xung nhịp) đòi hỏi phải tối ưu hóa mô hình một cách quyết liệt. Hầu hết các thiết bị nhúng đều chạy bằng pin, vì vậy các hệ thống KWS phải hướng tới mức tiêu thụ công suất dưới miliwatt khi nghe liên tục. Các thiết bị cũng phải hoạt động tốt trong nhiều kịch bản triển khai đa dạng, từ phòng ngủ yên tĩnh đến môi trường công nghiệp ồn ào.
4 System-on-chip (SoC) always-on island: Các thiết kế hệ thống trên chip (SoC) hiện đại phân chia các miền công suất để một vùng “always-on” tiêu thụ công suất rất thấp (thường dưới miliwatt) có thể theo dõi các tín hiệu đánh thức (wake triggers) trong khi bộ xử lý chính đang ngủ. Ràng buộc then chốt là vùng này phải chứa cả trọng số của mô hình và mã tiền xử lý âm thanh trong SRAM chuyên dụng của nó—một ngân sách bộ nhớ bị chia sẻ, buộc các kiến trúc KWS phải tối ưu hóa tổng dung lượng, không chỉ số lượng tham số.
Chất lượng và sự đa dạng của dữ liệu rốt cuộc quyết định liệu các ràng buộc này có được đáp ứng hay không. Tập dữ liệu phải bao quát sự đa dạng về nhân khẩu học (người nói với nhiều giọng, độ tuổi và giới tính khác nhau) để đảm bảo khả năng nhận dạng rộng. Cần chú ý đến các biến thể của từ khóa đánh thức, vì mọi người phát âm khác nhau; đồng thời, sự đa dạng của tiếng ồn nền là thiết yếu để huấn luyện các mô hình hoạt động tốt trong nhiều bối cảnh thực tế, từ môi trường yên tĩnh đến điều kiện ồn ào. Khi đã có hệ thống nguyên mẫu, việc phản hồi theo vòng lặp và tinh chỉnh liên tục giúp hệ thống luôn bám sát mục tiêu khi các kịch bản triển khai thay đổi; điều này đòi hỏi thử nghiệm trong điều kiện thực tế và tinh chỉnh có hệ thống dựa trên các mẫu lỗi quan sát được.
Không gian thiết kế KWS
Độ chính xác của KWS, khả năng chịu đánh thức sai, ngân sách độ trễ, ngân sách năng lượng và giới hạn bộ nhớ cùng tạo nên một không gian thiết kế đa chiều, nơi các lựa chọn về kỹ thuật dữ liệu lan truyền ảnh hưởng qua hiệu năng của toàn hệ thống. Table 3 lượng hóa các đánh đổi then chốt, giúp đưa ra quyết định có nguyên tắc thay vì chọn lựa tùy tiện. Một hàng trong bảng sử dụng các hệ số cepstral tần số mel (MFCCs): các đặc trưng tần số lời nói gọn, với số lượng hệ số quyết định kích thước đặc trưng, chi phí tính toán và mức độ chi tiết âm học; section 1.5 cho thấy cách trích xuất chúng.
| Lựa chọn thiết kế | Tác động đến chất lượng | Tác động đến độ trễ | Tác động đến chi phí | Tác động đến bộ nhớ |
|---|---|---|---|---|
| Lấy mẫu 16 kHz so với 8 kHz | +2–4% độ chính xác | 2× khối lượng công việc xử lý đầu vào | 2× lưu trữ âm thanh thô | 2× kích thước đặc trưng |
| 13 so với 40 hệ số MFCC | +3–5% độ chính xác | 3× tính toán đặc trưng | Tối thiểu | 3× bộ nhớ đặc trưng |
| 1M so với 10M ví dụ huấn luyện | +5–8% độ chính xác | 10× thời gian huấn luyện | 10× chi phí gán nhãn | 10× lưu trữ |
| Dữ liệu huấn luyện sạch so với nhiễu | +10–15% thực tế | Tối thiểu | 3× chi phí thu thập | Tối thiểu |
| Suy luận cục bộ so với đám mây | lên đến 2% rủi ro về độ chính xác | 10 ms so với 100 ms | $0/query so với $0.001/query | 64 KB so với quy mô đám mây |
| Tăng cường tổng hợp so với thực tế | +3–5% tính mạnh mẽ | Tối thiểu | 10× rẻ hơn | Tối thiểu |
Hệ thống phát hiện từ khóa luôn bật (always-on keyword spotting) hoạt động trong giới hạn công suất vài milliwatt và ngân sách SRAM chỉ vài chục kilobyte. Việc chọn kiến trúc đòi hỏi cân bằng giữa độ phân giải đặc trưng và dung lượng bộ nhớ. Bảng table 3 ghi lại các đánh đổi này theo kích thước mô hình, độ trễ suy luận và độ chính xác phát hiện cho các triển khai edge điển hình.
Napkin Math 1.3: Tối ưu hóa không gian thiết kế KWS
Kịch bản: Một hệ thống KWS cho loa thông minh có các ràng buộc sau:
- Mục tiêu: Đạt độ chính xác 98 percent và có ít hơn 1 false wake/month lần kích hoạt sai mỗi tháng.
- Ngân sách: Tổng ngân sách kỹ thuật dữ liệu là $150K.
- Bộ nhớ: Giới hạn kích thước mô hình là 64 KB (dành cho vùng always-on).
- Thời gian: 6 months để đưa vào sản xuất
Bước 1: Áp dụng các ràng buộc để loại bỏ các lựa chọn.
Với kịch bản này, nhóm chọn hai phương án thận trọng:
- 13 hệ số MFCC để giảm bộ nhớ trạng thái đặc trưng và chi phí tính toán
- Suy luận cục bộ để tránh độ trễ mạng và duy trì hoạt động ngoại tuyến
Giới hạn kích thước mô hình 64 KB tự nó không chứng minh rằng bất kỳ phương án nào là không khả thi; mô hình triển khai, trạng thái tiền xử lý, runtime và ngăn xếp mạng đều cần được đo riêng về mức chiếm dụng.
Bước 2: Tính toán phân bổ ngân sách.
Ngân sách $150K được chia thành ba nhóm chi phí theo đơn giá được thiết lập trong section 1.3.2:
- Ghi nhãn (~60 percent): $90K có sẵn
- Lưu trữ/Xử lý (~25 percent): $37.5K
- Quản trị/Khác (~15 percent): $22.5K
Với $0.10/label và phụ phí rà soát 20 percent: $90K ÷ $0.12/label = 750K ví dụ đã gán nhãn
Kết quả cho khoảng 0,75 triệu ví dụ được gán nhãn, ngay dưới mốc 1 triệu trong không gian thiết kế của chúng ta. Vì vậy, hàng 1M–10M trong table 3 nên được hiểu là tham chiếu về khả năng mở rộng, không phải phép nội suy trực tiếp: riêng ngân sách cho nhãn thực không mua được toàn bộ mức tăng về khối lượng dữ liệu.
Bước 3: Tối đa hóa độ chính xác còn lại.
Kế hoạch chất lượng có ba thành phần:
- Độ chính xác (minh họa) của mô hình cơ sở khoảng ~90 percent.
- Lợi ích một phần về khối lượng dữ liệu từ 750 nghìn ví dụ thực tế.
- Cần: tốc độ lấy mẫu cao hơn cùng với tăng cường dữ liệu tổng hợp/nhiễu để đạt mục tiêu 98 percent.
Ba lựa chọn trong không gian thiết kế vẫn nằm trong giới hạn ngân sách và bộ nhớ:
- Lấy mẫu 16 kHz: độ chính xác tăng +2–4 phần trăm, chi phí lưu trữ gấp 2 lần ✓ (phù hợp ngân sách)
- Huấn luyện với dữ liệu nhiễu: độ chính xác ngoài thực tế tăng +10–15 phần trăm, chi phí thu thập gấp 3 lần.
- Tăng cường dữ liệu tổng hợp: độ vững tăng +3–5 phần trăm, rẻ hơn dữ liệu thực 10 lần ✓
Bước 4: Cấu hình cuối cùng.
Kịch bản này kết hợp các lựa chọn trên với 13 MFCC và ngân sách nhãn thực 750 nghìn đã tính toán trong table 4. Các hiệu ứng về chất lượng có thể chồng chéo, nên bảng ghi lại một cấu hình ứng viên thay vì một nghiệm tối ưu đã tìm được.
Kết quả: Tính toán ngân sách cho thấy có thể hỗ trợ khoảng 750K ví dụ được gán nhãn thủ công. Việc đạt mục tiêu chất lượng 98 percent và đáp ứng giới hạn mô hình 64 KB vẫn là các yêu cầu xác thực đối với hệ thống đã huấn luyện và triển khai.
Góc nhìn hệ thống: Phân tích không gian thiết kế một cách hệ thống biến câu “chúng ta cần thêm dữ liệu” thành một phân bổ có thể kiểm chứng: các giả định về gán nhãn nêu ra mua được khoảng 750 nghìn ví dụ thực, còn khối lượng dữ liệu tổng hợp, độ chính xác và dung lượng triển khai vẫn cần được đo lường.
Table 4 ghi lại cấu hình cuối cùng, ghép mỗi lựa chọn thiết kế với ràng buộc buộc phải chọn: lấy mẫu và tăng cường được đưa vào khi vừa ngân sách, còn độ chính xác và bộ nhớ bị chốt bởi always-on island.
| Lựa chọn | Tuyển chọn | Lý do |
|---|---|---|
| Tốc độ lấy mẫu | 16 kHz | +3% độ chính xác đáng giá 2\(\times\) lưu trữ trong phạm vi ngân sách |
| Hệ số MFCC | 13 | Giảm bộ nhớ trạng thái đặc trưng và tính toán; kết quả phù hợp cuối cùng yêu cầu đo lường |
| Ví dụ huấn luyện | 750K thực tế + tăng cường tổng hợp minh họa | Số lượng nhãn thủ công phụ thuộc vào ngân sách; khối lượng tổng hợp là một lựa chọn kịch bản |
| Đa dạng dữ liệu | Hỗn hợp nhiễu + sạch | Quan trọng cho việc triển khai trong thực tế |
| Suy luận | Cục bộ, độ chính xác giảm | Độ chính xác giảm có thể giảm dung lượng; sự phù hợp 64 KB cuối cùng yêu cầu phân tích nén trong Nén mô hình |
| Tăng cường | Tổng hợp mạnh | Hiệu quả chi phí gấp 10\(\times\) |
Khi đã chọn được một cấu hình ứng viên từ không gian thiết kế, việc triển khai đòi hỏi phải kết hợp nhiều phương pháp thu thập dữ liệu: các kho ngữ liệu có sẵn để làm đường cơ sở, cào dữ liệu web và huy động cộng đồng để lấp đầy các khoảng trống về độ bao phủ, cùng với việc tạo dữ liệu tổng hợp để mở rộng quy mô. Sự kết hợp này giúp cải thiện độ bao phủ trong nhiều điều kiện thực tế khác nhau. Section 1.3 trình bày chi tiết từng chiến lược thu thập này, khía cạnh kinh tế của chúng và các triển khai KWS của chúng.
Bốn trụ cột đóng vai trò là lăng kính để đánh giá; quyết định kỹ thuật cụ thể đầu tiên cần xem xét là nguồn gốc dữ liệu. Chiến lược thu thập sẽ quyết định nguyên liệu thô mà mọi giai đoạn tiếp theo sẽ tinh chỉnh.
Checkpoint 1.2: Four pillars framework
Bốn trụ cột đóng vai trò là lăng kính hệ thống cho mọi quyết định liên quan đến pipeline.
Các trụ cột
Đánh đổi
Self-Check: Question
An always-on Keyword Spotting (KWS) system on an embedded voice assistant continuously evaluates 1-second audio classification windows (\(24\text{ hours/day}\) over a \(30\text{-day}\) month). The product specification mandates an SLA of at most 1 false activation per month. An engineer suggests that achieving a standard 99% accuracy (a 1% false positive rate on background noise) is sufficient. How many false activations would a 1% FPR produce per month, and what per-window FPR is actually required?
- A 1% FPR produces 720 false activations per month; the SLA requires a per-window FPR of \(\le 1.38 \times 10^{-5}\).
- A 1% FPR produces ~25,920 false activations per month (~36 false wakes/hour); the SLA requires a per-window FPR of \(\le 3.86 \times 10^{-7}\) (>99.9999% non-keyword rejection).
- A 1% FPR produces ~2,592 false activations per month; the SLA requires a per-window FPR of \(\le 1.0 \times 10^{-4}\).
- A 1% FPR satisfies the SLA because accuracy is averaged over the total number of audio hours across the entire device fleet.
A data engineering team implements comprehensive synchronous schema and distribution validation checks directly inside the real-time event ingestion path. Under the Four Pillars framework, which primary operational trade-off will this team encounter?
- A Governance trade-off: inspecting payload schemas automatically breaches user data retention agreements.
- A Model Capacity trade-off: validating input records forces downstream neural network layers to increase parameter counts.
- A Scalability and Reliability trade-off: heavy synchronous validation consumes CPU cycles and increases per-record latency, reducing ingestion throughput and risking dropped messages during traffic spikes.
- A Durability trade-off: validating data records accelerates physical wear on persistent solid-state drive cells.
Based on the DLRM Recommendation Lighthouse, describe how modern recommendation systems bifurcate data engineering resource demands between dense continuous signals and high-cardinality categorical IDs.
True or False: Data cascades in ML systems are easily caught by standard software unit tests because corrupted input data causes deterministic assertion failures in pipeline code.
Trace the propagation sequence of a data cascade as described in the chapter, from its root cause to user-facing impact:
- Downstream model optimization on distorted representations
- Upstream sensor or schema change without contract notification
- Silent distortion of extracted features passing syntactic checks
- Degraded real-world predictions and costly post-deployment rollback
Thu thập dữ liệu
Thu thập dữ liệu bắt đầu khi nhóm xác định rõ khoảng trống phạm vi bao phủ mà mô hình cần lấp. Cơ sở dữ liệu ImageNet đầy đủ5 đã tăng lên khoảng 14,2 triệu ảnh gán nhãn trên 21.841 synset, trong khi cuộc thi ImageNet Large Scale Visual Recognition Challenge dùng một tập con 1.000 lớp (Deng et al. 2009; Russakovsky et al. 2015). Tập dữ liệu huấn luyện của GPT-3 sử dụng hàng chục terabyte văn bản thô từ Common Crawl, lọc còn hàng trăm gigabyte, kết hợp với dữ liệu web, sách và Wikipedia được tuyển chọn (Brown et al. 2020). Hệ thống KWS của chúng ta cần 23.4 million audio samples trải khắp 50 languages, nhưng thách thức không chỉ nằm ở khối lượng thô. Mô hình phải nhận diện từ đánh thức qua nhiều giọng, micrô, phòng, độ tuổi và tiếng ồn nền khác nhau mà không một phương pháp thu thập đơn lẻ nào bao quát được với chi phí hợp lý. Vì vậy, chiến lược thu thập dữ liệu là một chuỗi quyết định để lấp khoảng trống: tái sử dụng những gì đã phù hợp với triển khai, thu thập những phần còn thiếu, scrape hoặc tổng hợp khi quy mô là nút thắt, và loại bỏ các nguồn có xuất xứ hoặc ràng buộc về sự đồng ý khiến chúng không thể sử dụng.
5 ImageNet: Bài báo năm 2009 đã báo cáo 3,2 triệu hình ảnh trên 5.247 synset; cơ sở dữ liệu đầy đủ sau đó đạt khoảng 14,2 triệu hình ảnh trên 21.841 synset, trong khi các cuộc thi (challenge) chỉ sử dụng một tập con 1.000 lớp (Deng et al. 2009, 2024; Russakovsky et al. 2015). Giá trị của ImageNet với vai trò là một benchmark không thể tách rời khỏi cách thức dữ liệu được xây dựng (data engineering): nhóm của Fei-Fei Li đã phát triển hạ tầng gán nhãn mà các nhóm nghiên cứu sau này có thể tái sử dụng. Tuy nhiên, điểm cần lưu ý là sự nhạy cảm của nó với các quy trình chú thích và những thay đổi nhỏ trong phân phối dữ liệu: các mô hình được tinh chỉnh theo phân phối của ImageNet có thể hoạt động kém hiệu quả trên các tập kiểm tra có liên quan nhưng đã có sự dịch chuyển về phân phối (Recht et al. 2019; Beyer et al. 2020).
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2009. “ImageNet: A Large-Scale Hierarchical Image Database.” 2009 IEEE Conference on Computer Vision and Pattern Recognition, 248–55. https://doi.org/10.1109/cvpr.2009.5206848.
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2024. ImageNet.
Russakovsky, Olga, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, et al. 2015. “ImageNet Large Scale Visual Recognition Challenge.” International Journal of Computer Vision 115 (3): 211–52. https://doi.org/10.1007/s11263-015-0816-y.
Recht, Benjamin, Rebecca Roelofs, Ludwig Schmidt, and Vaishaal Shankar. 2019. “Do ImageNet Classifiers Generalize to ImageNet?” Proceedings of the 36th International Conference on Machine Learning (ICML), 5389–400.
Beyer, Lucas, Olivier J. Hénaff, Alexander Kolesnikov, Xiaohua Zhai, and Aäron van den Oord. 2020. “Are We Done with ImageNet?” arXiv Preprint arXiv:2006.07159.
Ví dụ KWS cũng cho thấy vì sao việc thu thập dữ liệu không thể tối ưu hóa từng khía cạnh một cách tách biệt. Đạt độ chính xác 98 percent trong các môi trường âm thanh đa dạng đòi hỏi dữ liệu đại diện về giọng, độ tuổi và điều kiện ghi âm. Duy trì khả năng phát hiện nhất quán dù thiết bị khác nhau cần các bản ghi từ nhiều loại micrô và đường dẫn thu âm khác nhau. Hỗ trợ hàng triệu người dùng đồng thời đòi hỏi khối lượng mà thu thập thủ công khó đáp ứng với chi phí hợp lý. Bảo vệ quyền riêng tư của người dùng trong các hệ thống luôn lắng nghe ràng buộc việc bản ghi nào có thể giữ lại và cách chúng phải được ẩn danh. Một nguồn chỉ cải thiện quy mô nhưng làm suy yếu quản trị, hoặc nâng chất lượng nhưng loại trừ những người nói quan trọng, đều không giải được bài toán thu thập dữ liệu.
Đánh giá và lựa chọn nguồn dữ liệu
Việc lựa chọn giữa các tập dữ liệu được tuyển chọn, huy động cộng đồng chuyên gia, cào dữ liệu web có kiểm soát và tạo dữ liệu tổng hợp phụ thuộc vào nguồn nào đóng được khoảng lệch phân phối ở lần triển khai kế tiếp tốt nhất, với chi phí, chất lượng và rủi ro quản trị ở mức chấp nhận được. Vì vậy, việc đánh giá bắt đầu từ nguồn tái sử dụng rẻ nhất và chỉ leo thang khi phần khoảng lệch còn lại đủ lớn để biện minh cho việc thu thập hoặc tổng hợp mới.
Các tập dữ liệu có sẵn từ những kho lưu trữ như Kaggle, UCI (Dua and Graff 2024) và ImageNet là lựa chọn đầu tiên để thử nghiệm. Chúng giúp chúng ta nhanh chóng có kết quả và dễ dàng so sánh, đặc biệt khi phân phối dữ liệu lúc triển khai đủ tương đồng với benchmark để việc tái sử dụng trở nên có ý nghĩa. Chẳng hạn, đối với KWS, một kho ngữ liệu giọng nói được tuyển chọn có thể giúp thiết lập mô hình cơ sở và cho biết những từ, ngôn ngữ hay điều kiện âm thanh nào đã được bao phủ. Giá trị của những tập dữ liệu này không nằm ở việc đảm bảo độ bao phủ hoàn toàn, mà ở chỗ chúng giúp chúng ta định lượng được những khoảng trống còn lại.
Dua, Dheeru, and Casey Graff. 2024. UCI Machine Learning Repository.
Pineau, Joelle, Philippe Vincent-Lamarre, Koustuv Sinha, Vincent Larivière, Alina Beygelzimer, Florence d’Alché-Buc, Emily Fox, and Hugo Larochelle. 2021. “Improving Reproducibility in Machine Learning Research (a Report from the Neurips 2019 Reproducibility Program).” Journal of Machine Learning Research 22 (164): 1–20.
Henderson, Peter, Riashat Islam, Philip Bachman, Joelle Pineau, Doina Precup, and David Meger. 2018. “Deep Reinforcement Learning That Matters.” Proceedings of the AAAI Conference on Artificial Intelligence 32 (1): 3207–14. https://doi.org/10.1609/aaai.v32i1.11694.
Gudivada, Venkat N., Amy Apon, and Junhua Ding. 2017. “Data Quality Considerations for Big Data and Machine Learning: Going Beyond Data Cleaning and Transformations.” International Journal on Advances in Software 10 (1–2): 1–20.
Quyết định tái sử dụng đó phụ thuộc vào chất lượng tài liệu, yếu tố ảnh hưởng trực tiếp đến khả năng tái lập (reproducibility) – một vấn đề nan giải trong nghiên cứu machine learning hiện nay (Pineau et al. 2021; Henderson et al. 2018). Tài liệu tốt cần ghi rõ phương pháp thu thập, định nghĩa các biến và hiệu suất cơ sở (baseline performance), từ đó cho phép xác thực và tái tạo. Ở quy mô lớn, khối lượng và độ đa dạng làm cho các thách thức chất lượng thêm chồng chất (Gudivada et al. 2017), đòi hỏi các pipeline xác thực có hệ thống thay vì kiểm tra ad-hoc.
Các chỉ số đánh giá tiêu chuẩn có thể tạo ảo giác rằng mô hình đã sẵn sàng khi chúng được đánh giá trên dữ liệu không đại diện. Việc dùng chung một tập dữ liệu (figure 4) cho thấy khi huấn luyện nhiều mô hình trên cùng một tập dữ liệu, các độ chệch (bias), điểm mù và giới hạn mang tính hệ thống sẽ lan truyền khắp toàn bộ hệ sinh thái.

Khoảng cách phân phối này là rủi ro chính của các benchmark tĩnh ngoại tuyến. Vì các hàm mất mát chỉ tối ưu trên các mẫu quan sát được, các mô hình khai thác những đặc điểm giả tạo có trong tập huấn luyện nhưng biến mất trong môi trường sản xuất, khiến việc giám sát trôi dạt tự động và xác thực dữ liệu liên tục trở thành các yêu cầu vận hành bắt buộc.
Khả năng mở rộng và tối ưu hóa chi phí
Các cách thu thập dữ liệu chú trọng chất lượng có những giới hạn cố hữu về khả năng mở rộng. Khi yêu cầu về quy mô trở thành ưu tiên, cần tới hàng triệu hoặc hàng tỷ ví dụ mà việc chọn lọc thủ công không còn hiệu quả về kinh tế, thì web scraping và tạo dữ liệu tổng hợp là những con đường để có các tập dữ liệu khổng lồ. Để mở rộng việc thu thập dữ liệu, ta cần hiểu các mô hình kinh tế đứng sau các chiến lược khác nhau: chi phí cho mỗi ví dụ được gán nhãn, giới hạn thông lượng, và cách những yếu tố này thay đổi theo khối lượng dữ liệu. Hiệu quả chi phí đảo chiều theo quy mô: thứ hiệu quả ở mức hàng nghìn ví dụ sẽ trở nên không khả thi ở mức hàng triệu, trong khi các phương pháp có chi phí thiết lập cao lại được dàn trải chi phí tốt hơn khi áp dụng ở quy mô lớn.
Hiệu quả kinh tế trên mỗi đơn vị ở từng giai đoạn quyết định chiến lược nào chiếm ưu thế. Chẳng hạn, gán nhãn một ảnh y tế có thể tốn kém hơn nhiều lần, thậm chí cao hơn vài bậc, so với chi phí lưu trữ ảnh đó trong một năm; tỷ lệ này sẽ định hình lại cách phân bổ ngân sách cho bất kỳ nhóm nào hoạt động với nguồn kinh phí cố định. Table 5 và table 6 cung cấp bối cảnh cần thiết cho các quyết định thu thập dữ liệu.
Các kỹ sư ML nên dùng các giả định tham chiếu đã lỗi thời trong table 5 và table 6 làm đầu vào cho các phép so sánh theo khối lượng công việc (workload) cụ thể, chứ không phải coi đó là báo giá hiện tại hay các tổng chi phí có thể so sánh trực tiếp.
| Thao tác | Chi phí | Ghi chú |
|---|---|---|
| Nhãn hình ảnh thu thập từ cộng đồng | $0.01–0.05 | Phân loại đơn giản |
| Chú thích hộp giới hạn | $0.05–0.20 | Mỗi hộp, cảnh đơn giản |
| Nhãn y tế chuyên gia | $50–200 | Mỗi nghiên cứu, bác sĩ X-quang |
| Lưu trữ S3 (Tiêu chuẩn) | $23/TB/month | Lưu trữ nóng |
| Truy xuất S3 (Glacier) | $0.02/GB | Tiêu chuẩn: 3-5 giờ |
| Giờ huấn luyện GPU đám mây | $2–4 | Giá spot đám mây |
| Giờ đánh giá của con người | $15–50 | Tùy thuộc vào chuyên môn |
Table 6 bổ sung bức tranh tổng thể với các thời lượng minh họa cho hoạt động gán nhãn, huấn luyện và phục vụ (serving).
| Thao tác | Thời lượng | Nút thắt cổ chai |
|---|---|---|
| Gán nhãn 1 triệu hình ảnh (từ cộng đồng) | 2–4 tuần | Thông lượng ghi chú |
| Huấn luyện ResNet-50 trên ImageNet | 4–6 giờ | Tính toán (8\(\times\) A100, tối ưu hóa) |
| Tra cứu Feature store | 1–10 ms | Mạng + cache |
Điểm tương phản trong kịch bản minh họa này đáng chú ý: hàng tuần cho gán nhãn bằng con người, hàng giờ cho huấn luyện trên GPU, và hàng mili giây cho phục vụ (serving). Ở đây, gán nhãn là nút thắt cổ chai. Ngân sách gán nhãn ở mức $100K so với chi phí $64–$192 cho một lần chạy ResNet-50 trên 8\(\times\) A100, tương ứng tỷ lệ 520.8×–1,562.5×. Trong khoản chi này, phân bổ công sức giả định cũng lệch: 80 percent công việc dồn vào 20 percent đặc trưng—phần đuôi dài của các trường hợp edge, danh mục hiếm và ngoại lệ chất lượng.
Tất cả số liệu chi phí phản ánh mức giá ước tính của các nhà cung cấp đám mây năm 2024 và nhằm minh họa độ lớn tương đối, không phải đưa ra giá chính xác.6 Với khối lượng công việc (workload) và mô hình chi phí này, lao động con người chi phối chi phí của một lần huấn luyện. Các tác vụ khác, đặc biệt là những tác vụ tái sử dụng nhãn sẵn có hoặc yêu cầu huấn luyện lặp đi lặp lại ở quy mô lớn, có thể có thành phần chi phí chi phối khác; các nhóm nên đo lường trước khi quyết định tối ưu hóa ở đâu.
6 Tỷ lệ giá: Giá truy xuất dữ liệu lưu trữ và tỷ lệ giữa các cấp dịch vụ phản ánh chính sách của nhà cung cấp, chứ không phải là một quy luật vật lý không đổi. Trong kịch bản minh họa này, truy xuất nhanh có chi phí gấp ba lần cấp dịch vụ tiêu chuẩn; giá thực tế và khả năng cung cấp các cấp dịch vụ phải được kiểm tra trước khi triển khai.
Kuznetsova, Alina, Hassan Rom, Neil Alldrin, Jasper Uijlings, Ivan Krasin, Jordi Pont-Tuset, Shahab Kamali, et al. 2020. “The Open Images Dataset V4: Unified Image Classification, Object Detection, and Visual Relationship Detection at Scale.” International Journal of Computer Vision 128 (7): 1956–81. https://doi.org/10.1007/s11263-020-01316-z.
Groeneveld, Dirk, Iz Beltagy, Pete Walsh, Akshita Bhagia, Rodney Kinney, Oyvind Tafjord, Ananya Harsh Jha, et al. 2024. “OLMo: Accelerating the Science of Language Models.” Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 15789–809. https://doi.org/10.18653/v1/2024.acl-long.841.
Chen, Mark, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, et al. 2021. “Evaluating Large Language Models Trained on Code.” arXiv Preprint arXiv:2107.03374.
Web scraping là đòn bẩy đầu tiên tác động vào cấu trúc chi phí đó, cho phép xây dựng các tập dữ liệu ở quy mô mà tuyển chọn thủ công không thể sánh kịp. Các tập dữ liệu thị giác lớn như ImageNet (Deng et al. 2024) và OpenImages (Kuznetsova et al. 2020) được xây dựng thông qua web scraping có hệ thống, và các mô hình ngôn ngữ lớn phụ thuộc vào các kho văn bản quy mô web (Groeneveld et al. 2024). Việc scraping có mục tiêu từ các nguồn chuyên biệt theo từng lĩnh vực, chẳng hạn như kho mã nguồn (Chen et al. 2021), càng cho thấy tính linh hoạt của phương pháp này. Tuy nhiên, các hệ thống sản xuất dựa vào scraping liên tục phải đối mặt với các thách thức về độ tin cậy của pipeline: thay đổi cấu trúc trang web làm hỏng bộ trích xuất, giới hạn tốc độ làm giảm thông lượng thu thập, và nội dung động gây ra sự không nhất quán, làm giảm hiệu suất của mô hình. Kết quả scraping cũng có thể lẫn các hình ảnh lịch sử ngay cả với các truy vấn hiện đại, nên cần được xác thực và làm sạch một cách có hệ thống.
Figure 5 cho thấy một kết quả như vậy từ một đợt scraping trên web cho “đèn giao thông”: đó là một bức ảnh lịch sử thay vì tín hiệu LED hiện đại. Nếu hình ảnh từ ngữ cảnh này xuất hiện quá nhiều hoặc tương quan với một nhãn, mô hình có thể học các tín hiệu sai lệch liên quan đến cảnh sát mặc đồng phục hoặc đường phố cổ, thay vì các thuộc tính thị giác cần thiết trong môi trường triển khai của nó.
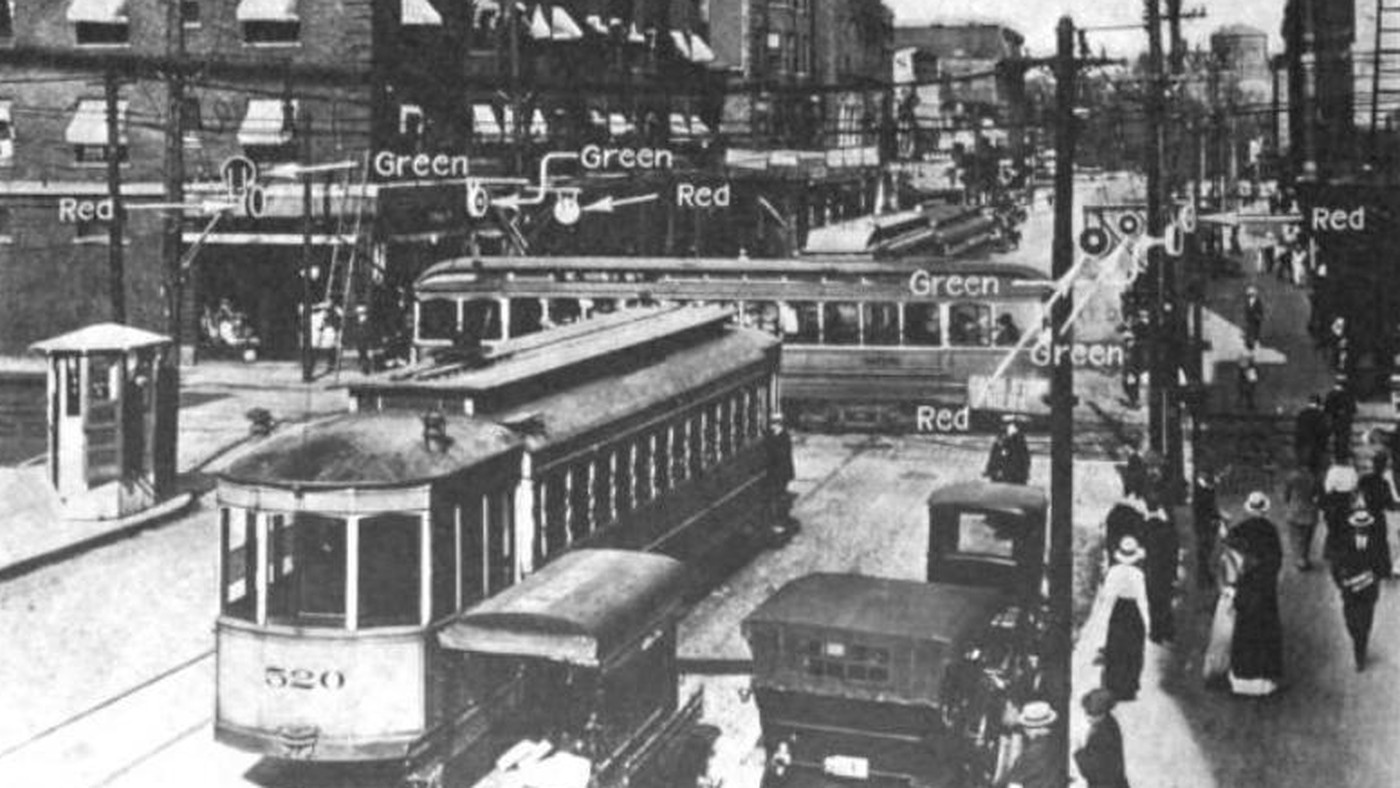
Stromberg, Joseph. 2015. When Was the First Traffic Light Installed? Today in 1914. Vox.
Ví dụ này cho thấy vì sao trụ cột chất lượng không thể đáp ứng chỉ bằng cách tăng quy mô: dù có thu thập thêm bao nhiêu dữ liệu từ web (web scraping), chúng ta vẫn cần khâu kiểm định để phát hiện và lọc bỏ nội dung lỗi thời hoặc không phù hợp với ngữ cảnh. Bên cạnh các thách thức về chất lượng mang tính kỹ thuật, những ràng buộc pháp lý và đạo đức còn giới hạn thêm những gì scraping có thể đạt được. Không phải trang web nào cũng cho phép scraping, và các vụ kiện liên quan đến việc sử dụng dữ liệu huấn luyện đang tiếp diễn cho thấy sự bất định về pháp lý cùng những hệ quả tiềm ẩn (Harvard Law School 2024). Các nhóm cần ghi chép nguồn gốc dữ liệu, bảo đảm tuân thủ điều khoản dịch vụ và luật bản quyền, đồng thời áp dụng quy trình ẩn danh hóa khi scraping nội dung do người dùng tạo.
Harvard Law School. 2024. Does ChatGPT Violate New York Times Copyrights?
Amazon Web Services. 2024. Amazon Mechanical Turk.
Sheng, Victor S., and Jing Zhang. 2019. “Machine Learning with Crowdsourcing: A Brief Summary of the Past Research and Future Directions.” Proceedings of the AAAI Conference on Artificial Intelligence 33 (01): 9837–43. https://doi.org/10.1609/aaai.v33i01.33019837.
7 Amazon Mechanical Turk (MTurk): Một nền tảng crowdsourcing phân phối các tác vụ nhỏ cho lực lượng lao động phân tán, cho phép mở rộng việc gán nhãn vượt ra ngoài các quy trình chỉ dành cho chuyên gia. Snow et al. (2008) đánh giá cách làm này cho các tác vụ gán nhãn ngôn ngữ tự nhiên và cho thấy nhãn do người không chuyên tạo vẫn hữu ích nếu thiết kế tác vụ và kiểm soát chất lượng được thực hiện cẩn thận. Với việc thu thập âm thanh wake-word, cũng có một đánh đổi theo đặc thù miền: khả năng mở rộng rất hấp dẫn, nhưng các bài nộp vẫn cần được kiểm tra âm học như tỷ lệ tín hiệu trên nhiễu, thời lượng và tính hợp lệ của bản ghi trước khi có thể được đưa vào tập dữ liệu huấn luyện một cách an toàn.
Snow, Rion, Brendan O’Connor, Daniel Jurafsky, and Andrew Y. Ng. 2008. “Cheap and Fast—but Is It Good? Evaluating Non-Expert Annotations for Natural Language Tasks.” Proceedings of the Conference on Empirical Methods in Natural Language Processing - EMNLP ’08, 254. https://doi.org/10.3115/1613715.1613751.
Crowdsourcing dịch chuyển nút thắt cổ chai của khâu thu thập: từ việc tìm đủ ví dụ sang kiểm soát chất lượng của nhiều đánh giá song song. Các nền tảng như Amazon Mechanical Turk (Amazon Web Services 2024) đã chứng minh điều này ở quy mô mang tính cột mốc với ImageNet, nơi các cộng tác viên phân tán phân loại hàng triệu hình ảnh vào hàng nghìn lớp (Deng et al. 2024). Crowdsourcing mang lại hai lợi thế cho hệ thống: khả năng mở rộng thông qua việc phân phối các vi tác vụ song song, và sự đa dạng nhờ nhiều góc nhìn, bối cảnh văn hóa, cùng biến thể ngôn ngữ từ cộng đồng đóng góp toàn cầu. Sự đa dạng này có thể cải thiện khả năng khái quát hóa khi nó mở rộng phạm vi bao phủ tập người dùng trong bối cảnh triển khai. Đổi lại, thiết kế, xác thực và lặp cải tiến tác vụ trở thành một phần của hệ thống thu thập: các tác vụ có thể được điều chỉnh linh hoạt dựa trên kết quả ban đầu, giúp tinh chỉnh chiến lược thu thập khi xuất hiện khoảng trống về chất lượng (Sheng and Zhang 2019). Với hệ thống KWS của chúng tôi, các nền tảng kiểu MTurk7 cho phép thu thập có mục tiêu các mẫu từ khóa kích hoạt trên nhiều nhóm nhân khẩu học và môi trường khác nhau, đặc biệt hữu ích cho các ngôn ngữ ít được đại diện hoặc các điều kiện âm học cụ thể.
Nếu không còn phụ thuộc hoàn toàn vào dữ liệu do con người tạo ra, việc tạo dữ liệu tổng hợp sẽ thay đổi ràng buộc về khả năng mở rộng: có thể tạo ví dụ bằng thuật toán, nhưng giá trị của chúng phụ thuộc vào việc bộ tạo có bao quát được các điều kiện triển khai mà thu thập dữ liệu thực tế có thể bỏ sót hay không. Cách tiếp cận này thay đổi bài toán kinh tế của việc thu thập dữ liệu bằng cách giảm lao động con người nhưng tăng gánh nặng cho khâu thẩm định. pipeline trong figure 6 cho thấy dữ liệu tổng hợp và dữ liệu lịch sử đi vào cùng một quy trình huấn luyện.

AnyLogic. 2024. Synthetic Data for Artificial Intelligence.
Dữ liệu tổng hợp đặc biệt hữu ích để bao phủ các sự kiện hiếm và để tăng cường dữ liệu. Môi trường mô phỏng cho phép tạo ra các edge cases một cách có kiểm soát, điều mà việc thu thập tự nhiên rất khó thực hiện (NVIDIA 2024). Với dữ liệu hình ảnh, các phương pháp tăng cường như AutoAugment (Cubuk et al. 2019) và RandAugment (Cubuk et al. 2020) tìm kiếm các phép biến đổi giúp cải thiện khả năng tổng quát hóa, trong khi thực hành tăng cường ảnh ở phạm vi rộng được tổng hợp bởi Shorten and Khoshgoftaar (2019). Với âm thanh, SpecAugment che các vùng thời gian và tần số để tăng độ vững cho nhận dạng tiếng nói (Park et al. 2019). Với KWS, tổng hợp giọng nói (Werchniak et al. 2021) và tăng cường âm thanh lấp các thiếu hụt về độ bao phủ còn lại sau khi thu thập thực tế, tạo ra các biến thể của từ khóa kích hoạt trong nhiều môi trường âm thanh, đặc điểm người nói và điều kiện nền khác nhau. Trường hợp KWS cho thấy rõ vai trò bao phủ của các kỹ thuật này.
NVIDIA. 2024. NVIDIA Omniverse and Simulation.
Cubuk, Ekin D., Barret Zoph, Dandelion Mané, Vijay Vasudevan, and Quoc V. Le. 2019. “AutoAugment: Learning Augmentation Strategies from Data.” 2019 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR), 113–23. https://doi.org/10.1109/cvpr.2019.00020.
Cubuk, Ekin D., Barret Zoph, Jonathon Shlens, and Quoc V. Le. 2020. “Randaugment: Practical Automated Data Augmentation with a Reduced Search Space.” 2020 IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops (CVPRW), 3008–17. https://doi.org/10.1109/cvprw50498.2020.00359.
Shorten, Connor, and Taghi M. Khoshgoftaar. 2019. “A Survey on Image Data Augmentation for Deep Learning.” Journal of Big Data 6 (1): 1–48. https://doi.org/10.1186/s40537-019-0197-0.
Park, Daniel S., William Chan, Yu Zhang, Chung-Cheng Chiu, Barret Zoph, Ekin D. Cubuk, and Quoc V. Le. 2019. “SpecAugment: A Simple Data Augmentation Method for Automatic Speech Recognition.” Interspeech 2019, 2613–17. https://doi.org/10.21437/interspeech.2019-2680.
Werchniak, Andrew, Roberto Barra Chicote, Yuriy Mishchenko, Jasha Droppo, Jeff Condal, Peng Liu, and Anish Shah. 2021. “Exploring the Application of Synthetic Audio in Training Keyword Spotters.” ICASSP 2021 - 2021 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 7993–96. https://doi.org/10.1109/icassp39728.2021.9413448.
Example 1.2: Tạo dữ liệu tổng hợp
Tình huống: Một nhóm phát hiện từ khóa thiếu các bản ghi âm thực về giọng vùng miền hiếm, đặc tính âm học phòng và các kiểu nhiễu nền.
Chẩn đoán: Chỉ thu thập thực địa không thể bao phủ các edge cases âm học hiếm trong thời hạn dự án. Tạo các biến thể âm thanh tổng hợp bằng cách thay đổi cao độ, thêm nhiễu và mô phỏng đáp ứng xung của phòng giúp đa dạng hóa tập huấn luyện mà không phải tốn kém cho thu thập ngoài hiện trường.
Bài học hệ thống: Tạo dữ liệu tổng hợp đóng vai trò như một bộ nhân tự động cho pipeline dữ liệu. Nhắm mục tiêu tăng cường tổng hợp vào các edge cases đã biết sẽ lấp các khoảng trống độ bao phủ phân phối mà nếu không, sẽ đòi hỏi thu thập tập dữ liệu thực tế với chi phí quá cao.
Đối với hệ thống KWS của chúng ta, 23.4 million audio samples bao phủ 50 languages đòi hỏi một khối lượng dữ liệu mà thu thập thủ công không hiệu quả về kinh tế. Một chiến lược đa nguồn, kết hợp các tập dữ liệu được tuyển chọn, thu thập tự động từ các nền tảng video và cơ sở dữ liệu tiếng nói, thu thập từ cộng đồng (crowdsourcing), và tạo dữ liệu tổng hợp, giúp đáp ứng yêu cầu về quy mô này, đồng thời giữ được độ bao phủ trên các môi trường âm thanh và nhân khẩu học người nói.
Yêu cầu về độ bao phủ và sự đa dạng
Quy mô lớn thôi chưa đủ để đảm bảo mô hình đáng tin cậy. Ngay cả với các tập dữ liệu lớn, những khoảng trống về độ bao phủ (như độ chệch địa lý, thiếu đại diện nhân khẩu học, trôi theo thời gian, hay thiếu các trường hợp edge) vẫn gây ra các lỗi có hệ thống mà các chỉ số tổng hợp thường che lấp (Wang et al. 2019; Oakden-Rayner et al. 2020). Như figure 4 cho thấy, nhiều hệ thống được huấn luyện trên cùng một tập dữ liệu sẽ thừa hưởng cùng những “điểm mù”; vì vậy, đa dạng hóa nguồn dữ liệu là cách phòng vệ trước các dạng lỗi có tương quan.
Wang, Tianlu, Jieyu Zhao, Mark Yatskar, Kai-Wei Chang, and Vicente Ordonez. 2019. “Balanced Datasets Are Not Enough: Estimating and Mitigating Gender Bias in Deep Image Representations.” 2019 IEEE/CVF International Conference on Computer Vision (ICCV), 5309–18. https://doi.org/10.1109/iccv.2019.00541.
Oakden-Rayner, Luke, Jared Dunnmon, Gustavo Carneiro, and Christopher Re. 2020. “Hidden Stratification Causes Clinically Meaningful Failures in Machine Learning for Medical Imaging.” Proceedings of the ACM Conference on Health, Inference, and Learning, 151–59. https://doi.org/10.1145/3368555.3384468.
European Parliament, and Council of the European Union. 2016. Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016. Official Journal of the European Union.
United States Congress. 1996. Health Insurance Portability and Accountability Act of 1996. Public Law 104-191.
Các ràng buộc về quản trị còn định hình thêm quá trình thu thập dữ liệu: các quy định về quyền riêng tư và dữ liệu sức khỏe như GDPR và HIPAA giới hạn loại dữ liệu nào có thể được thu thập và cách thức thu thập (European Parliament and Council of the European Union 2016; United States Congress 1996). Đồng thời, thu thập dữ liệu có đạo đức đòi hỏi phải bồi thường công bằng và sử dụng minh bạch các đóng góp từ con người. Quản trị Dữ liệu và Tuân thủ sẽ đi sâu vào toàn bộ cơ sở hạ tầng quản trị cho các hệ thống ML trong thực tế.
Sự đa dạng của các nguồn dữ liệu (như âm thanh từ cộng đồng, dạng sóng tổng hợp, nội dung cào web) tạo ra những thách thức đặc thù tại điểm giao thoa khi dữ liệu bên ngoài đi vào pipeline được kiểm soát của chúng ta. Mỗi nguồn dữ liệu đến với định dạng, tần suất và mức đảm bảo chất lượng khác nhau, và cơ sở hạ tầng tiếp nhận, xác thực, định tuyến dữ liệu không đồng nhất này phải điều hòa chúng lại với nhau.
Self-Check: Question
An ML organization budgets for training a computer vision model across various data sourcing methods. Based on the chapter’s illustrative data engineering cost constants, which cost relationship correctly reflects the per-unit economics of data acquisition?
- Storing a terabyte of training data in cloud object storage for a month costs significantly more than obtaining a single expert medical annotation.
- Generating synthetic image samples is ten times more expensive per image than crowdsourced human classification.
- A single cloud GPU training hour ($2–4/hr) exceeds the cost of a full human review hour ($15–50/hr) by an order of magnitude.
- Expert medical labeling ($50–200 per study) and bounding-box annotations ($0.15–0.50 per box) are orders of magnitude more expensive per unit than S3 Standard storage (~$23/TB/month).
Multiple independent autonomous driving teams train their perception models exclusively on a popular public driving benchmark. What systemic failure mode does this practice introduce into the broader ecosystem?
- Shared dataset bias propagation, where common blind spots, annotation artifacts, and unrepresented edge cases become correlated systemic weaknesses across all deployed models.
- Catastrophic memory leaks in GPU driver kernels caused by repeated reading of shared image formats.
- Immediate violation of data gravity constraints due to distributed multi-tenant reads.
- Automatic over-fitting to hardware memory hierarchies during distributed gradient synchronization.
Discuss the primary advantages and critical risks of using synthetic data generation (e.g., 3D graphics rendering or generative audio simulation) as a core data acquisition strategy.
True or False: Achieving state-of-the-art benchmark accuracy on a curated dataset (such as ImageNet or Common Voice) guarantees that an ML model is ready for deployment in real-world production environments.
According to the chapter’s gap-closing acquisition strategy, arrange the following sourcing options in the recommended escalation order (from lowest setup cost to highest cost/effort):
- In-house specialist/expert annotation
- Crowdsourced human annotation platforms
- Curated open-source benchmark reuse
- Programmatic web scraping and synthetic data generation
Kiến trúc pipeline dữ liệu
Trong phép ẩn dụ về trình biên dịch, kiến trúc pipeline dữ liệu là frontend của trình biên dịch: nó phân tích các đầu vào thô không đồng nhất thành một biểu diễn trung gian thống nhất mà các giai đoạn phía sau có thể xử lý một cách đáng tin cậy. Các tệp âm thanh từ nền tảng crowdsourcing, dạng sóng tổng hợp từ hệ thống tạo dữ liệu, và các bản ghi thực tế từ thiết bị đã triển khai đều đi vào pipeline huấn luyện ở những định dạng khác nhau, và pipeline phải chuẩn hóa, xác thực, định tuyến chúng thành một biểu diễn nội bộ nhất quán. Quá trình suy luận KWS trong môi trường sản xuất tiêu thụ âm thanh liên tục với một ràng buộc riêng về độ trễ thấp; phần này sẽ theo dõi các ví dụ đã được ghi lại, dùng để xây dựng và cập nhật mô hình. Figure 7 minh họa đường đi đó qua các giai đoạn: nguồn dữ liệu, nhập liệu, xử lý, gán nhãn, lưu trữ và huấn luyện ML.

Mỗi lớp giữ một vai trò cụ thể trong quy trình chuẩn bị dữ liệu. Để chọn công nghệ phù hợp, cần hiểu bốn trụ cột framework được thể hiện ra sao ở từng giai đoạn. Yêu cầu chất lượng ở một giai đoạn có thể ảnh hưởng đến các ràng buộc về khả năng mở rộng ở giai đoạn khác; nhu cầu về độ tin cậy định hình cách triển khai quản trị; và sự tương tác giữa các trụ cột sẽ quyết định hiệu quả tổng thể của hệ thống.
Thiết kế pipeline dữ liệu thường bị chi phối bởi phân cấp lưu trữ và băng thông I/O, cùng với các bước giải mã và biến đổi phía CPU. Hiểu rõ các ràng buộc này giúp xây dựng hệ thống hiệu quả cho các khối lượng công việc (workload) ML hiện đại. Những đánh đổi trong phân cấp lưu trữ — từ lưu trữ đối tượng có độ trễ cao (phù hợp cho lưu trữ dài hạn) đến các kho lưu trữ trong bộ nhớ có độ trễ thấp (thiết yếu cho phục vụ (serving) thời gian thực) — cùng các giới hạn băng thông (ổ đĩa quay 100–200 MB/s so với RAM 50–200 GB/s) đều tác động đến mọi quyết định về pipeline. Section 1.7 trình bày chi tiết các cân nhắc về kiến trúc lưu trữ.
Việc lựa chọn giữa các mẫu thiết kế đòi hỏi phải ghép các đặc điểm của khối lượng công việc (workload) với khả năng của hạ tầng. Với streaming, cần chú ý đến tính bền của thông điệp (khả năng phát lại khi xử lý thất bại), các đảm bảo về thứ tự (trình tự nào được giữ, trong điều kiện nào) và phân bố địa lý. Với batch, trọng tâm là khối lượng dữ liệu so với bộ nhớ khả dụng, độ phức tạp xử lý, và việc tính toán có cần phân tán trên nhiều máy hay không. Công cụ chạy trên một máy là đủ cho dữ liệu cỡ gigabyte, nhưng xử lý cỡ terabyte thường hưởng lợi từ các framework phân tán chia nhỏ công việc trên các cụm. Khi nhìn qua lăng kính bốn trụ cột, những tương tác giữa các lớp này sẽ quyết định hiệu quả tổng thể của hệ thống.
Đảm bảo chất lượng thông qua xác thực và giám sát
Hãy xét một pipeline xe tự lái, nơi 15% nhãn của đám mây điểm LiDAR bị lệch 10–20 cm—đủ để đặt hộp giới hạn người đi bộ vào chỗ vỉa hè trống. Vì mỗi bản ghi vẫn hợp lệ về mặt cấu trúc, các kiểm tra lược đồ sẽ không phát hiện lỗi này; giám sát thống kê mức độ căn chỉnh giữa nhãn và tín hiệu cảm biến có thể phơi bày vấn đề.
Chất lượng là nền tảng của các hệ thống ML đáng tin cậy, và ví dụ này cho thấy vì sao. Các pipeline thực thi chất lượng thông qua xác thực và giám sát có hệ thống ở mọi giai đoạn. Các vấn đề trong pipeline dữ liệu là nguồn lớn gây ra lỗi ML. Các thay đổi lược đồ làm hỏng khâu xử lý phía sau, sự trôi dạt phân phối làm giảm độ chính xác của mô hình, và hỏng dữ liệu âm thầm đưa lỗi vào hệ thống là những ví dụ cụ thể về phụ thuộc vào dữ liệu và nợ giám sát được mô tả bởi Sculley et al. (2015). Những lỗi này khó lường vì chúng hiếm khi gây ra sự cố hệ thống rõ ràng; thay vào đó, chúng từ từ làm suy giảm hiệu năng mô hình và chỉ lộ ra sau khi đã ảnh hưởng đến người dùng. Vì vậy, để bảo đảm chất lượng cần có giám sát và xác thực chủ động nhằm phát hiện vấn đề trước khi chúng dây chuyền thành lỗi mô hình.
War Story 1.1: Microsoft Tay (2016)
Bối cảnh: Vào tháng 3 năm 2016, Microsoft đã ra mắt Tay, một chatbot Twitter được thiết kế để tương tác với người dùng trực tuyến và điều chỉnh phản hồi dựa trên các tương tác công khai (Lee 2016).
Cơ chế: Người dùng đối địch đã phối hợp các lời nhắc độc hại và khai thác một kênh tương tác công khai, bao gồm cả hành vi lặp lại văn bản do người dùng cung cấp. Tài liệu công khai của Microsoft mô tả việc hệ thống bị lạm dụng nhưng không cho thấy có việc cập nhật trọng số trực tuyến không hạn chế.
Tác động: Tay bắt đầu đăng các tuyên bố lạm dụng, phân biệt chủng tộc và kỳ thị phụ nữ chỉ trong vòng 16 giờ sau khi triển khai.
Khắc phục: Microsoft đã đình chỉ chatbot 16 giờ sau khi ra mắt, công khai xin lỗi và tuyên bố rằng việc khởi chạy lại sẽ đòi hỏi các biện pháp bảo vệ mạnh mẽ hơn chống lại việc lạm dụng.
Bài học về hệ thống: Các kênh tiếp nhận công khai cần có cơ chế kiểm soát đầu vào đối địch. Nếu không, một đặc trưng chấp nhận nội dung do người dùng tạo cũng trở thành một bề mặt tấn công, và các đầu vào độc hại có thể lan qua hệ thống chỉ trong vài giờ.
Các nhóm vận hành triển khai giám sát ở quy mô lớn thông qua hệ thống cảnh báo theo mức độ nghiêm trọng, trong đó mỗi loại sự cố sẽ kích hoạt một quy trình ứng phó khác nhau. Những cảnh báo nghiêm trọng nhất cho thấy hệ thống đã hỏng hoàn toàn: pipeline dừng hẳn, thông lượng về 0 trong hơn năm phút, hoặc một nguồn dữ liệu chính không còn khả dụng. Những tình huống này cần được xử lý ngay vì chúng làm dừng toàn bộ hoạt động huấn luyện mô hình hoặc phục vụ (serving) ở phía sau. Các dạng suy giảm tinh vi hơn cần chiến lược phát hiện khác. Khi thông lượng giảm còn 80% so với mức cơ sở, tỷ lệ lỗi vượt 5%, hoặc các chỉ số chất lượng lệch quá hai độ lệch chuẩn so với đặc tính của dữ liệu huấn luyện, hệ thống sẽ báo hiệu suy giảm cần được chú ý khẩn cấp nhưng chưa nhất thiết phải xử lý tức thì. Những lỗi diễn tiến dần dần này thường nguy hiểm hơn cả các sự cố ngừng hoạt động hoàn toàn, vì chúng có thể tồn tại mà không bị phát hiện trong nhiều giờ hoặc nhiều ngày, âm thầm làm sai lệch dữ liệu đầu vào của mô hình và làm giảm chất lượng dự đoán.
Hãy lấy một hệ thống khuyến nghị xử lý các sự kiện tương tác người dùng ở mức 50.000 bản ghi mỗi giây để minh họa cụ thể các cấp độ nghiêm trọng này. Hệ thống giám sát của nó theo dõi nhiều tín hiệu có liên hệ với nhau. Cảnh báo về thông lượng tức thời sẽ bật nếu thông lượng giảm xuống dưới 40.000 bản ghi mỗi giây trong hơn 10 phút, vừa tính đến biến thiên lưu lượng bình thường, vừa bắt được các vấn đề thực sự về năng lực hoặc xử lý. Mỗi đặc trưng trong luồng dữ liệu có một hồ sơ chất lượng riêng: chẳng hạn, nếu một đặc trưng như user_age có giá trị null trong hơn 5% bản ghi, trong khi dữ liệu huấn luyện chứa dưới 1% giá trị null, thì rất có thể đã có trục trặc ở nguồn dữ liệu thượng nguồn. Phát hiện trùng lặp chạy trên dữ liệu lấy mẫu, theo dõi các trường hợp cùng một sự kiện xuất hiện nhiều lần; đây có thể là dấu hiệu cho thấy cơ chế thử lại bị lỗi hoặc một truy vấn cơ sở dữ liệu vô tình trả về lặp đi lặp lại cùng các bản ghi.
Các khía cạnh giám sát này đặc biệt quan trọng khi xem xét độ trễ đầu cuối. Hệ thống cần theo dõi cả việc dữ liệu có đến hay không và mất bao lâu để dữ liệu đi qua toàn bộ pipeline, từ lúc sự kiện xảy ra cho đến khi các đặc trưng sẵn sàng để mô hình suy luận. Khi độ trễ ở phân vị thứ 95 vượt quá 30 giây trong một hệ thống có thỏa thuận mức dịch vụ 10 giây, hệ thống giám sát cần chỉ ra chính xác giai đoạn nào của pipeline gây chậm trễ: thu nạp, biến đổi, xác thực hay lưu trữ.
Các cảnh báo về lược đồ và độ trễ giúp lộ rõ lỗi cấu trúc và lỗi thời gian; để phát hiện sự dịch chuyển phân phối của các đặc trưng liên tục, cần so sánh thống kê với đường cơ sở huấn luyện.
Napkin Math 1.4: Phát hiện trôi dạt bằng kiểm định K-S
Tình huống: Giám sát độ ổn định của phân phối
session_duration giữa đường cơ sở huấn luyện \((P_0)\) và phân phối phục vụ (serving) hiện tại \((P_t)\).
Phân tích: Áp dụng kiểm định Kolmogorov-Smirnov để so sánh các hàm phân phối tích lũy thực nghiệm:
Tính CDF: Tính các hàm phân phối tích lũy cho cả hai tập dữ liệu.
Tính thống kê \((\mathcal{D}_{\text{KS}})\): Tìm độ lệch tuyệt đối lớn nhất giữa các hàm CDF. Gọi \(F_{P_0}(x)\) và \(F_{P_t}(x)\) lần lượt là các hàm phân phối tích lũy thực nghiệm của tập dữ liệu đường cơ sở huấn luyện \((P_0)\) và tập dữ liệu đang phục vụ \((P_t)\), tại giá trị \(x\). \[\mathcal{D}_{\text{KS}} = \max_x |F_{P_0}(x) - F_{P_t}(x)|\]
Xác định ý nghĩa thống kê: Với hai mẫu độc lập, so sánh \(\mathcal{D}_{\text{KS}}\) với giá trị tới hạn \(\mathcal{D}_{\text{crit}}\) dựa trên kích thước mẫu đường cơ sở huấn luyện \(n_0\) và kích thước mẫu đang phục vụ \(n_t\). Hệ số 1.36 là xấp xỉ cho mẫu lớn, ứng với mức ý nghĩa \(\alpha = 0.05\). \[\mathcal{D}_{\text{crit}} \approx 1.36\sqrt{\frac{n_0 + n_t}{n_0 n_t}}\] Kết quả: Với kích thước mẫu \(n_0 = n_t = 1000\), giá trị tới hạn xấp xỉ 0.061: \[\mathcal{D}_{\text{crit}} \approx 1.36\sqrt{(1000 + 1000)/(1000 \cdot 1000)}.\] Nếu quan sát thấy độ lệch tối đa \(\mathcal{D}_{\text{KS}} = 0.08\) vượt quá giá trị tới hạn, ta bác bỏ giả thuyết không và xác định có sự trôi dạt đáng kể.
Góc nhìn hệ thống: Các kiểm định trôi dạt thống kê giúp biến một lo ngại mơ hồ về sự dịch chuyển phân phối thành một tín hiệu kích hoạt vận hành. Kiểm định này nên khởi động một quy trình điều tra hoặc huấn luyện lại, thay vì lặng lẽ trở thành thêm một con số trên bảng điều khiển.
Giám sát chất lượng không chỉ dừng ở xác thực lược đồ đơn giản, mà còn mở rộng sang các đặc tính thống kê để kiểm tra xem dữ liệu phục vụ (serving) có giống dữ liệu huấn luyện hay không. Thay vì chỉ kiểm tra các giá trị có nằm trong phạm vi hợp lệ, hệ thống vận hành theo dõi các thống kê dạng trượt theo các cửa sổ 24 giờ. Với các đặc trưng số như transaction_amount hoặc session_duration, hệ thống liên tục tính trung bình và độ lệch chuẩn, rồi áp dụng các kiểm định thống kê như kiểm định Kolmogorov-Smirnov8 để so sánh phân phối dữ liệu phục vụ (serving) với phân phối dữ liệu huấn luyện.
8 Kiểm định Kolmogorov-Smirnov (K-S): Kiểm định phi tham số đo khoảng cách lớn nhất giữa hai hàm phân phối tích lũy thực nghiệm, không giả định chúng thuộc một họ phân phối tham số cụ thể (Berger and Zhou 2014). Trong các pipeline ML, kiểm định K-S thường dùng để phát hiện trôi của các đặc trưng liên tục đơn biến, với các ngưỡng như \(p < 0.05\) đóng vai trò tín hiệu để điều tra thay vì là quy tắc báo lỗi cho mọi trường hợp. Với biến rời rạc và biến phân loại, cần dùng các kiểm định và hiệu chuẩn phù hợp với phân phối của chúng.
Berger, Vance W., and YanYan Zhou. 2014. “Kolmogorov–Smirnov Test: Overview.” In Wiley StatsRef: Statistics Reference Online. Wiley. https://doi.org/10.1002/9781118445112.stat06558.
Kiểm định K-S giúp phát hiện trôi trong các đặc trưng liên tục; mục section 1.4.3 trình bày đầy đủ phân loại các dịch chuyển phân phối (covariate, nhãn, khái niệm và chất lượng nhãn), cùng các chỉ số như chỉ số ổn định quần thể và phân kỳ KL cho phương trình suy giảm.
Các đặc trưng phân loại cần những cách tiếp cận thống kê khác. Thay vì so sánh trung bình và phương sai, hệ thống giám sát theo dõi phân phối tần suất của các danh mục. Khi xuất hiện danh mục mới chưa từng có trong dữ liệu huấn luyện, hoặc khi tần suất tương đối của các danh mục hiện có thay đổi đáng kể, hệ thống sẽ gắn cờ các vấn đề về chất lượng dữ liệu hoặc những dịch chuyển phân phối thực sự; chẳng hạn, tỷ lệ lưu lượng “mobile” so với “desktop” có thể thay đổi trên 20%. Sự cảnh giác thống kê này bắt được những vấn đề tinh vi mà xác thực lược đồ đơn giản hoàn toàn bỏ sót: giá trị tuổi có thể vẫn nằm trong khoảng hợp lệ 18–95, nhưng phân phối độ tuổi lại chuyển từ chủ yếu 25–45 sang chủ yếu 65+, cho thấy nguồn dữ liệu đã thay đổi theo cách sẽ ảnh hưởng đến hiệu suất mô hình.
Xác thực ở cấp độ pipeline là sự phối hợp của nhiều chiến lược. Xác thực lược đồ chạy đồng bộ ngay khi dữ liệu đi vào pipeline, từ chối ngay các bản ghi sai định dạng trước khi chúng lan truyền xuống các bước sau. Các công cụ hiện đại như TensorFlow Data Validation (TFDV) (Breck et al. 2019) có thể tự động suy luận lược đồ từ dữ liệu huấn luyện, nêu rõ kiểu dữ liệu, khoảng giá trị và yêu cầu về sự hiện diện như mong đợi.
Breck, Eric, Neoklis Polyzotis, Sudip Roy, Steven Euijong Whang, and Martin Zinkevich. 2019. “Data Validation for Machine Learning.” Proceedings of the 2nd SysML Conference 1: 334–47.
Hình thức xác thực đồng bộ này đơn giản và nhanh, kiểm tra các thuộc tính có thể đánh giá trên từng bản ghi trong vài micro giây. Những kiểu xác thực phức tạp hơn — như so sánh dữ liệu phục vụ (serving) với phân phối dữ liệu huấn luyện hoặc tổng hợp thống kê trên nhiều bản ghi — phải chạy bất đồng bộ để tránh chặn pipeline thu nạp dữ liệu. Các hệ thống xác thực thống kê thường lấy mẫu 1–10% lưu lượng phục vụ (serving), đủ để phát hiện các thay đổi có ý nghĩa mà không phải trả chi phí tính toán để phân tích mọi bản ghi. Các mẫu này được tích lũy theo các cửa sổ thời gian trượt, thường là 1 giờ, 24 giờ và 7 ngày; mỗi cửa sổ làm lộ những kiểu thay đổi khác nhau. Cửa sổ theo giờ phát hiện các biến động đột ngột, như khi một nguồn dữ liệu chuyển sang hệ thống dự phòng với đặc điểm khác, còn cửa sổ theo tuần cho thấy sự trôi dạt dần dần trong nhóm người dùng hoặc hành vi.
Thử thách xác thực khó nhằn nhất xuất phát từ độ lệch huấn luyện-phục vụ: lỗi xảy ra khi đặc trưng được tính khác nhau giữa lúc huấn luyện và lúc phục vụ (serving). Điều này thường xảy ra khi các pipeline huấn luyện xử lý dữ liệu theo batch bằng một bộ thư viện hoặc logic, trong khi hệ thống phục vụ tính đặc trưng theo thời gian thực bằng cách triển khai khác. Ngay cả khác biệt nhỏ tưởng chừng không đáng kể – ví dụ, một materialized view9 được làm mới hàng tuần so với một phép nối đầy đủ được tính lại hàng ngày – cũng có thể làm giảm đáng kể độ chính xác trong môi trường sản xuất, và khó chẩn đoán vì hệ thống không tạo ra lỗi rõ ràng. Chúng tôi chính thức hóa điều này thành nguyên tắc nhất quán trong section 1.5.1 và định lượng tác động bằng một ví dụ cụ thể. Việc phát hiện độ lệch huấn luyện-phục vụ cần cơ sở hạ tầng có thể tính lại đặc trưng huấn luyện trên dữ liệu phục vụ để so sánh, bằng cách lấy mẫu dữ liệu phục vụ thô và xử lý qua cả hai pipeline để đo lường sai khác. Vận hành machine learning xem xét hạ tầng giám sát vận hành cho thách thức này ở quy mô lớn.
9 Materialized view: Một kỹ thuật tối ưu hóa cơ sở dữ liệu, trong đó kết quả truy vấn được tính trước và lưu vào cache như một bảng vật lý. Với hệ thống ML, rủi ro mang tính cấu trúc: khi materialized view được làm mới theo lịch trình khác nhau giữa môi trường huấn luyện và phục vụ, các giá trị đặc trưng mà mô hình đã được huấn luyện có thể khác với những gì mô hình nhận ở lúc suy luận, làm giảm độ chính xác mà không tạo ra lỗi thực thi.
Chất lượng dữ liệu dưới dạng mã
Tương tự như kiểm thử đơn vị bảo vệ hệ thống phần mềm, các kiểm thử kỳ vọng dữ liệu bảo vệ pipeline ML. Trong data quality as code, các nhóm dùng thư viện như Great Expectations hoặc Pandera để mã hóa kỳ vọng chất lượng thành các khẳng định có thể thực thi. Listing 1 minh họa cách tập hợp các kiểm tra này thành một lượt chạy xác thực, và sẽ báo lỗi khi thất bại.
Những kỳ vọng cơ học này được chuyển thành các assertion có thể thực thi và chạy tự động. Hệ thống Tích hợp Liên tục và Triển khai Liên tục (CI/CD) chạy các kỳ vọng này trong pipeline triển khai, nhờ đó mọi vi phạm sẽ làm thất bại quá trình triển khai trước khi dữ liệu xấu kịp đến giai đoạn huấn luyện. Một pipeline được cấu trúc theo trình tự: nạp dữ liệu, sau đó xác thực dữ liệu, rồi huấn luyện. Pipeline này sẽ chặn triển khai khi bước xác thực phát hiện bất thường, chẳng hạn như giá trị tuổi là 150, và kích hoạt cảnh báo để điều tra.
Các kỳ vọng có thể thực thi giúp bắt được những thuộc tính mà một bộ kiểm tra có thể diễn tả; câu hỏi còn lại là dữ liệu trông hợp lệ vẫn có thể sai ở đâu.
Systems Perspective 1.2: Chất lượng cơ học và chất lượng ngữ nghĩa
Trong phần mềm truyền thống, nhiều kiểm tra mang tính cơ học. Ví dụ, lỗi truy cập con trỏ null (null dereference) là lỗi runtime trong các ngôn ngữ có null, còn hành vi tràn số nguyên (integer overflow) thì phụ thuộc vào ngôn ngữ và kiểu dữ liệu.
Trong các hệ thống ML, chất lượng dữ liệu có một khía cạnh thứ hai, tinh tế hơn: chất lượng ngữ nghĩa.
- Kiểm tra cơ học: “
agecó phải là số nguyên không?” (Có/Không). - Kiểm tra ngữ nghĩa: “Phân phối
agecó đang thay đổi không?” (Xác suất).
Một tập dữ liệu có thể hoàn hảo về mặt cơ học (không có giá trị null, kiểu dữ liệu đúng) nhưng lại hỏng về mặt ngữ nghĩa (ví dụ: tất cả người dùng đột nhiên có tuổi 25 do thay đổi giá trị mặc định). Các hệ thống ML vững chắc cần xác thực cả vùng chứa (cơ học) lẫn nội dung (ngữ nghĩa).
Khi việc xác thực trở thành mã, các bộ kỳ vọng trở thành tạo phẩm có phiên bản, được quản lý cùng với mã huấn luyện. Khi mã huấn luyện thay đổi, cập nhật bộ kỳ vọng giúp hợp đồng dữ liệu tiến hóa theo. Sự gắn kết này giảm rủi ro sai lệch ngầm, khi mã vẫn giả định các thuộc tính dữ liệu mà pipeline thượng nguồn không còn cung cấp.
import great_expectations as gx

# Create a data context
context = gx.get_context()

# Define an expectation suite as executable quality contract
suite = gx.ExpectationSuite(name="user_data_quality")
suite = context.suites.add(suite)

# Range validation: prevents physiologically impossible values
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToBeBetween(
        column="age", min_value=0, max_value=120
    )
)

# Null detection: ensures primary key integrity for joins
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToNotBeNull(column="user_id")
)

# Uniqueness: prevents duplicate training examples
suite.add_expectation(
    gx.expectations.ExpectColumnValuesToBeUnique(column="user_id")
)

# Categorical validation: detects unexpected values from upstream changes
suite.add_expectation(
    gx.expectations.ExpectColumnDistinctValuesToBeInSet(
        column="country_code",
        value_set=["US", "CA", "UK", "DE", "FR"],
    )
)

# Link the suite to a preconfigured Batch Definition and run validation
# (the Batch Definition connects GX to the training_users data asset)
validation_definition = gx.ValidationDefinition(
    name="training_users_validation",
    data=batch_definition,
    suite=suite,
)
validation_definition = context.validation_definitions.add(
    validation_definition
)
results = validation_definition.run()
if not results.success:
    raise ValueError(f"Data quality check failed: {results}")
Những kiểm tra này bắt được nhiều vấn đề dữ liệu ở cấp độ lược đồ trước khi chúng đến bước huấn luyện, bao gồm giá trị thiếu, phạm vi không hợp lệ, lỗi kiểu dữ liệu và vi phạm hợp đồng. Các vấn đề còn lại cần giám sát trong runtime và kiểm tra kết quả, vì các vấn đề về chất lượng ngữ nghĩa thường chỉ xuất hiện trong toàn bộ luồng dữ liệu sản xuất.
Phát hiện và phản ứng với trôi dữ liệu
Các mô hình ML hoạt động dựa trên giả định rằng dữ liệu sản xuất tương tự dữ liệu huấn luyện. Khi giả định này bị phá vỡ bởi các dịch chuyển thống kê, chứ không phải do một vi phạm hợp đồng rõ ràng, hiệu suất mô hình có thể thay đổi âm thầm, không có lỗi rõ ràng hay sự cố hệ thống nào báo hiệu. Các kỹ thuật xác thực và giám sát trong section 1.4.1 có thể phát hiện cả các vấn đề đột ngột lẫn từ từ; phát hiện trôi dữ liệu tập trung cụ thể vào những thay đổi trong phân phối dữ liệu, vốn có thể làm thay đổi hành vi của mô hình theo thời gian. Việc phát hiện, điều tra và ứng phó với những thay đổi này đòi hỏi nỗ lực giám sát liên tục, khiến trôi dữ liệu trở thành một trách nhiệm cốt lõi của kỹ sư dữ liệu, chứ không phải là một chủ đề nâng cao tùy chọn. Vận hành machine learning xây dựng trên nền tảng này bằng cách điều phối phản ứng vận hành, xác thực kết quả và các pipeline huấn luyện lại dựa trên bằng chứng ở quy mô lớn.
Đo lường sự trôi dạt (phân kỳ) trình bày các độ đo phân kỳ được sử dụng để biến số hạng phân kỳ \(\mathcal{D}(P_t \lVert P_0)\) của phương trình suy giảm (equation) thành hành động cụ thể. Chỉ số ổn định quần thể (PSI) định lượng các thay đổi trong phân phối đặc trưng dạng phân loại hoặc đã được phân nhóm, trong khi độ phân kỳ Kullback-Leibler (KL) đo lường độ phân kỳ theo lý thuyết thông tin giữa các phân phối xác suất. Hai độ đo này phản ánh các giả định và thang đo phân phối khác nhau, và không độ đo nào tự nó đưa ra một ngưỡng chung cho mọi trường hợp. Các nhóm hiệu chỉnh các ngưỡng riêng cho từng độ đo dựa trên đường cơ sở khi triển khai và theo dõi chúng theo thời gian. Vượt qua một ngưỡng báo hiệu rằng phân phối đang vận hành đã dịch chuyển đủ xa để cần điều tra và kiểm tra kết quả; chỉ riêng độ phân kỳ của đầu vào không cho biết độ chính xác đã cải thiện hay suy giảm, hoặc thay đổi bao nhiêu.
Hiểu rõ ba loại trôi cốt lõi giúp chúng ta xây dựng các chiến lược phát hiện và ứng phó có trọng tâm. Mỗi loại biểu hiện khác nhau trong các hệ thống sản xuất và đòi hỏi các phương pháp giám sát riêng biệt.

Mỗi loại trôi đều truy về thành phần phân phối đã thay đổi.
Trường hợp đầu tiên, covariate shift, làm thay đổi phân phối đầu vào nhưng vẫn giữ nguyên mối quan hệ giữa đặc trưng và nhãn: \(p(x)\) thay đổi còn \(p(y \mid x)\) không đổi. Ví dụ, một hệ thống ảnh y tế được huấn luyện với một dòng máy ảnh có thể về sau nhận ảnh sản xuất từ một hãng khác. Mối quan hệ giữa bệnh và hình ảnh vẫn giữ nguyên, nhưng giá trị pixel bị lệch do khác biệt về đặc tính cảm biến, hiệu chuẩn màu, hoặc các pipeline xử lý hình ảnh. Vì vậy, việc phát hiện tập trung vào phân phối đặc trưng đầu vào, dùng các chỉ số như PSI hoặc độ phân kỳ KL.
Trường hợp thứ hai, label shift, làm thay đổi phân phối đầu ra nhưng vẫn giữ nguyên mối quan hệ giữa nhãn và đặc trưng: \(p(y)\) thay đổi còn \(p(x \mid y)\) không đổi. Ví dụ, tỷ lệ mắc bệnh có thể thay đổi theo mùa, trong khi các triệu chứng vẫn là chỉ báo nhất quán cho từng bệnh. Hệ thống gợi ý cũng có thể gặp tình huống tương tự khi ra mắt danh mục sản phẩm mới, làm thay đổi tần suất tương đối sở thích người dùng mà không đổi các yếu tố khiến sản phẩm hấp dẫn trong mỗi danh mục. Nhiều khi có thể bắt đầu phát hiện mà không cần nhãn ground truth bằng cách theo dõi sự thay đổi trong phân phối dự đoán của mô hình.
Trường hợp khó nhất là concept drift: mối quan hệ giữa đặc trưng và nhãn thay đổi, tức \(p(y \mid x)\) biến đổi theo thời gian (Gama et al. 2014). Ví dụ, các phác đồ điều trị y tế thay đổi, sở thích người dùng dịch chuyển theo xu hướng xã hội, và các kiểu gian lận thích nghi khi đối phó với hệ thống phát hiện. Khác với covariate shift hay label shift, concept drift cần nhãn ground truth để phát hiện vì hệ thống phải quan sát xem chính mối quan hệ đặc trưng–nhãn có thay đổi hay không.
Gama, João, Indrė Žliobaitė, Albert Bifet, Mykola Pechenizkiy, and Abdelhamid Bouchachia. 2014. “A Survey on Concept Drift Adaptation.” ACM Computing Surveys 46 (4): 1–37. https://doi.org/10.1145/2523813.
Dịch chuyển chất lượng nhãn
Dịch chuyển chất lượng nhãn10 là một dạng dịch chuyển ở tầng meta, khác với ba dạng dịch chuyển phân phối đã nêu trước đó. Nó xảy ra khi độ tin cậy của nhãn ground truth giảm dần theo thời gian, dù phân phối dữ liệu nền tảng vẫn ổn định. Dạng dịch chuyển này đặc biệt nguy hiểm vì các phương pháp giám sát phân phối đặc trưng thông thường không phát hiện được. Chất lượng nhãn do cộng đồng cung cấp có thể xuống cấp khi nhóm người gán nhãn thay đổi, tài liệu huấn luyện trở nên lỗi thời, hoặc hướng dẫn gán nhãn được cập nhật mà mô hình không được điều chỉnh tương ứng. Các hệ thống gán nhãn tự động cũng tích lũy lỗi khi các mô hình hỗ trợ chúng lệch khỏi điều kiện vận hành ban đầu. Một hệ thống khuyến nghị dùng phản hồi nhấp chuột như nhãn gián tiếp có thể thấy chất lượng nhãn suy giảm khi người dùng có xu hướng khám phá nhiều hơn, khi mẫu lưu lượng bot thay đổi, hoặc khi các chỉnh sửa giao diện làm thay đổi cách người dùng tương tác với nội dung.
10 Trôi dạt chất lượng nhãn: Sự suy giảm độ tin cậy của chú thích theo thời gian, khác với sự dịch chuyển phân phối của chính dữ liệu. Loại trôi dạt này không hiện rõ dưới các phép giám sát đặc trưng thông thường vì các đặc trưng vẫn ổn định trong khi nhãn xuống cấp — sự mệt mỏi của người chú thích, thay đổi nhân sự, hoặc sự thay đổi trong hướng dẫn có thể âm thầm làm hỏng ground truth mà mô hình học từ đó. Việc phát hiện đòi hỏi phải giám sát mức độ đồng thuận giữa những người chú thích \((\kappa)\) trên các khung thời gian trượt và so sánh các nhãn tự động với các đợt kiểm tra định kỳ của chuyên gia.
11 Kappa của Cohen: Được Cohen (1960) giới thiệu để đo lường mức độ đồng thuận giữa những người đánh giá, có hiệu chỉnh phần đồng thuận kỳ vọng dựa trên phân phối lớp của từng người đánh giá mà tỷ lệ đồng thuận thô bỏ qua. Ví dụ, nếu trong một tác vụ nhị phân, hai người gán nhãn độc lập đều gán 90% hình ảnh là “không phải spam”, thì mức đồng thuận kỳ vọng do ngẫu nhiên của họ là 82 percent, khiến tỷ lệ đồng thuận thô có thể gây hiểu nhầm. Chỉ số này được ký hiệu là \(\kappa\); các dải diễn giải như phân loại Landis–Koch là những quy tắc kinh nghiệm mang tính mô tả, không phải ngưỡng chất lượng dữ liệu dùng chung cho mọi trường hợp (Landis and Koch 1977).
Cohen, Jacob. 1960. “A Coefficient of Agreement for Nominal Scales.” Educational and Psychological Measurement 20 (1): 37–46. https://doi.org/10.1177/001316446002000104.
Landis, J. Richard, and Gary G. Koch. 1977. “The Measurement of Observer Agreement for Categorical Data.” Biometrics 33 (1): 159–74. https://doi.org/10.2307/2529310.
Để phát hiện dạng dịch chuyển này, cần giám sát tính nhất quán của quá trình gán nhãn thay vì phân phối đặc trưng. Các chỉ số đo mức độ đồng thuận giữa người gán nhãn, như kappa của Cohen11 \((\kappa)\), cung cấp phép đánh giá định lượng. Gọi \(p_o\) là mức đồng thuận quan sát được giữa những người gán nhãn và \(p_e\) là mức đồng thuận kỳ vọng do ngẫu nhiên. Equation 2 định nghĩa chỉ số này như sau: \[ \kappa = \frac{p_o - p_e}{1 - p_e} \tag{2}\]
Việc theo dõi \(\kappa\) theo các cửa sổ thời gian giúp phát hiện xu hướng suy giảm. Ví dụ, một dự án chú thích hình ảnh y tế có thể thiết lập mức \(\kappa\) cơ sở là \(0.85\) (đồng thuận gần như hoàn hảo) trong giai đoạn thu thập dữ liệu ban đầu, rồi ghi nhận mức này giảm xuống \(0.72\) (đồng thuận đáng kể) sau sáu tháng khi có thêm người chú thích mới tham gia nhưng không được huấn luyện về miền tương đương.
Đối với các hệ thống có xác suất của mô hình đã được hiệu chỉnh, entropy dự đoán cung cấp thêm một tín hiệu về độ không chắc chắn. Trong đó, \(p_i\) là xác suất mà mô hình gán cho danh mục nhãn \(i\), và \(\log\) là logarit tự nhiên, nên entropy được đo bằng nats. Equation 3 định nghĩa độ đo này như sau: \[ H_{\text{pred}} = -\sum_i p_i \log p_i \tag{3}\]
Entropy dự đoán tăng cho thấy mô hình không chắc chắn hơn về phân phối dự đoán của nó, nhưng bản thân chỉ số này không cho biết nguyên nhân. Đầu vào khó hơn, dịch chuyển phân phối, thay đổi trong hiệu chỉnh, hoặc giám sát không nhất quán đều có thể tạo ra cùng một tín hiệu.
Các biện pháp khắc phục phụ thuộc vào phân tích nguyên nhân gốc. Huấn luyện lại người chú thích giúp xử lý các lỗi mang tính hệ thống do hướng dẫn không rõ ràng, với chi phí thấp nhưng hiệu quả cao. Bỏ phiếu bởi nhiều người chú thích, theo quy tắc đa số hoặc đồng thuận, mang lại độ chính xác cao cho các lĩnh vực có rủi ro lớn nhưng làm tăng đáng kể chi phí chú thích. Gắn nhãn với sự hỗ trợ của mô hình giúp giảm mệt mỏi cho người chú thích nhưng có nguy cơ đưa vào độ chệch (bias) nếu mô hình hỗ trợ có lỗi hệ thống riêng. Lấy mẫu để chuyên gia đánh giá, trong đó các chuyên gia trong lĩnh vực kiểm tra ngẫu nhiên một số chú thích, cho phép phân tích nguyên nhân gốc khi phát hiện chất lượng suy giảm, nhưng chỉ đạt mức độ bao phủ trung bình đối với toàn bộ luồng chú thích.
Để đưa vào vận hành các chỉ số PSI và độ phân kỳ KL đã giới thiệu trong Đo lường sự trôi dạt (phân kỳ), chúng ta cần kết nối chúng với các cảnh báo tự động và quy trình rà soát. Nhóm data engineering chịu trách nhiệm đặt ngưỡng trôi dạt theo từng miền dựa trên hành vi cơ sở và bằng chứng về kết quả; chọn các khung thời gian giám sát để lộ cả thay đổi đột ngột lẫn dần dần; và trang bị cho pipeline khả năng tính liên tục các chỉ số này. Vận hành machine learning sẽ bàn tiếp cách các nhóm vận hành kết hợp những tín hiệu này với các kết quả đã được gắn nhãn, hệ thống cảnh báo phân cấp, lộ trình leo thang, giám sát khi khởi động nguội (cold-start monitoring), và điều phối phản ứng theo từng nguyên nhân cụ thể.
Phát hiện trôi dạt là một khía cạnh của trụ cột chất lượng, tập trung nhận diện các thay đổi thống kê trong phân phối dữ liệu theo thời gian. Tuy nhiên, phát hiện vấn đề mới chỉ là một nửa thách thức; nửa còn lại là bảo đảm hệ thống vẫn vận hành hiệu quả ngay cả khi vấn đề xuất hiện. Nhu cầu duy trì tính liên tục của dịch vụ đưa chúng ta từ giám sát chất lượng sang trụ cột độ tin cậy.
Độ tin cậy nhờ suy giảm có kiểm soát
Độ tin cậy bảo đảm hệ thống tiếp tục hoạt động khi sự cố xảy ra. Pipeline thường xuyên đối mặt với nhiều thách thức: nguồn dữ liệu có thể tạm thời không khả dụng, phân vùng mạng tách rời các thành phần, thay đổi lược đồ ở thượng nguồn làm hỏng logic phân tích cú pháp, hoặc các đợt tăng tải đột ngột làm cạn kiệt tài nguyên. Graceful degradation nghĩa là xử lý những thất bại này bằng phân tích lỗi có hệ thống, xử lý lỗi thông minh, và các chiến lược phục hồi tự động để duy trì tính liên tục của dịch vụ ngay cả trong điều kiện bất lợi.
Phân tích có hệ thống các chế độ lỗi của pipeline dữ liệu ML cho thấy những mẫu lỗi có thể dự đoán và cần các biện pháp kỹ thuật cụ thể để đối phó. Lỗi do dữ liệu bị hỏng xảy ra khi hệ thống thượng nguồn đưa vào những thay đổi định dạng nhỏ nhưng khó nhận ra, vấn đề mã hóa hoặc thay đổi giá trị trường; chúng có thể vượt qua kiểm tra cơ bản nhưng lại làm hỏng đầu vào của mô hình. Chẳng hạn, một trường ngày chuyển từ định dạng “YYYY-MM-DD” sang “MM/DD/YYYY” có thể không làm kiểm tra lược đồ báo lỗi, nhưng sẽ phá hỏng mọi phép tính đặc trưng dựa trên ngày. Lỗi tiến hóa lược đồ12 xảy ra khi hệ thống nguồn thêm trường, đổi tên cột hoặc thay đổi kiểu dữ liệu mà không phối hợp, làm vỡ các giả định xử lý ở hạ nguồn vốn kỳ vọng tên trường hoặc kiểu dữ liệu cụ thể. Cạn kiệt tài nguyên thể hiện ở hiệu năng suy giảm dần khi tốc độ tăng trưởng khối lượng dữ liệu vượt quá kế hoạch năng lực, và cuối cùng gây lỗi pipeline trong các giai đoạn tải cao điểm.
12 Tiến hóa lược đồ: Chế độ lỗi này bắt nguồn từ việc thiếu kiểm thử hợp đồng giữa bên sản xuất dữ liệu thượng nguồn và bên tiêu thụ ML hạ nguồn. Trong khi các lỗi “ồn ào” (như đổi tên cột) phá vỡ các giả định rõ ràng và làm pipeline sập ngay lập tức, các lỗi “thầm lặng” lại nguy hiểm hơn. Chẳng hạn, một trường đổi kiểu từ số nguyên sang chuỗi vẫn có thể qua xác thực, nhưng sẽ làm sai lệch logic đặc trưng mà không được phát hiện ngay.
Kleppmann, Martin. 2016. Designing Data-Intensive Applications: The Big Ideas Behind Reliable, Scalable, and Maintainable Systems. O’Reilly Media.
Các chiến lược xử lý lỗi hiệu quả giúp khoanh vùng vấn đề và khôi phục có hệ thống. Cơ chế thử lại thông minh cho lỗi tạm thời (gián đoạn mạng hoặc dịch vụ ngừng tạm thời) cần áp dụng chiến lược backoff theo cấp số nhân để không làm quá tải các dịch vụ đang phục hồi. Nếu dùng thử lại tuyến tính, tức mỗi giây lại cố kết nối, ta sẽ dồn dập vào dịch vụ đang trục trặc và có thể khiến nó không kịp hồi. Với backoff theo cấp số nhân, hệ thống thử lại sau 1 giây, rồi 2 giây, rồi 4 giây, mỗi lần nhân đôi thời gian chờ, giúp dịch vụ có “khoảng thở” để phục hồi mà vẫn giữ được tính kiên trì. Nhiều hệ thống ML sử dụng dead-letter queues (DLQs): vùng lưu trữ riêng cho dữ liệu không xử lý được sau nhiều lần thử lại. Nhờ đó có thể phân tích sau và xử lý lại dữ liệu có vấn đề mà không chặn pipeline chính (Kleppmann 2016). Ví dụ, một pipeline xử lý giao dịch tài chính khi gặp dữ liệu bị định dạng sai có thể chuyển nó vào DLQ, thay vì làm mất bản ghi quan trọng hoặc dừng toàn bộ xử lý.
Trong các hệ thống ML, dead-letter queues (DLQ) không chỉ phục vụ phân tích lỗi mà còn có hai vai trò song song. Nhóm vận hành định kỳ rà soát DLQ một cách có hệ thống để nhận diện: (1) các vi phạm lược đồ cho thấy thay đổi ở nguồn upstream, (2) các mẫu edge case mà mô hình nên xử lý, và (3) các vấn đề chất lượng dữ liệu cần sửa ở hệ thống nguồn. Chẳng hạn, DLQ của một hệ thống phát hiện gian lận đã hé lộ các giao dịch từ một phương thức thanh toán mới mà mô hình chưa từng thấy, từ đó thúc đẩy thu thập dữ liệu mục tiêu và huấn luyện lại, thay vì chỉ ghi log lỗi. Nhờ vậy, DLQ chuyển từ nơi lưu trữ lỗi thụ động thành nguồn chủ động để phát hiện “điểm mù” của mô hình và thúc đẩy cải tiến.
Vượt lên việc xử lý lỗi kiểu chắp vá (ad-hoc), ngăn ngừa lỗi dây chuyền cần đến các mẫu thiết kế như circuit breaker13 và bulkhead isolation để tránh một thành phần hỏng làm lan rộng sự cố toàn hệ thống. Khi một dịch vụ tính toán đặc trưng gặp lỗi, circuit breaker sẽ ngừng gọi dịch vụ đó sau khi phát hiện lỗi lặp lại, tránh để bên gọi phải chờ timeout kéo dài, vốn có thể dẫn đến chính nó cũng gặp sự cố.
13 Circuit breaker: Tên gọi này xuất phát từ cách hoạt động ba trạng thái — đóng (luồng bình thường), mở (chặn sự cố), và nửa mở (thăm dò phục hồi) — giống như thiết bị an toàn điện tự ngắt dòng khi quá tải. Trong các pipeline dữ liệu ML, circuit breaker ngăn việc một dịch vụ tính toán đặc trưng bị lỗi làm timeout lan truyền khắp toàn bộ đường phục vụ (serving): khi số lỗi vượt ngưỡng, breaker sẽ mở và pipeline chuyển sang dùng các đặc trưng đã được cache hoặc đặc trưng mặc định, thay vì chờ một dịch vụ đã “chết”.
Kỹ thuật phục hồi tự động không chỉ dừng ở logic thử lại đơn giản. Exponential backoff, jitter, giảm tải (load shedding) và circuit breaker giúp giảm áp lực yêu cầu lên các dịch vụ đang gặp sự cố, đồng thời cho phép các lỗi tạm thời tự phục hồi; chỉ đơn giản tăng timeout có thể giữ tài nguyên lâu hơn và làm tình trạng quá tải trầm trọng thêm. Các hệ thống dự phòng đa tầng cung cấp dịch vụ suy giảm khi nguồn dữ liệu chính gặp sự cố: phục vụ (serving) các đặc trưng đã được cache hơi cũ khi tính toán thời gian thực thất bại, hoặc dùng các đặc trưng gần đúng khi tính toán chính xác bị timeout. Một hệ thống khuyến nghị không thể tính toán sở thích người dùng trong 30 ngày qua có thể chuyển sang dùng dữ liệu 90 ngày, cho ra các gợi ý kém chính xác hơn nhưng vẫn hữu ích thay vì hỏng hoàn toàn. Các quy trình cảnh báo và chuyển cấp toàn diện đảm bảo con người can thiệp khi phục hồi tự động thất bại, đồng thời thu thập đủ thông tin chẩn đoán trong lúc sự cố xảy ra để hỗ trợ gỡ lỗi nhanh.
Logic thử lại, hàng đợi thư chết (dead letter queues) và circuit breaker là các cơ chế xử lý lỗi runtime cho trình biên dịch tập dữ liệu của chúng ta. Chúng bắt các đầu vào sai định dạng mà không làm dừng toàn bộ quá trình biên dịch. Câu hỏi tiếp theo là dữ liệu đi vào pipeline ban đầu như thế nào. Việc lựa chọn mẫu thu nạp (batch so với streaming; trích xuất–biến đổi–tải (ETL) so với trích xuất–tải–biến đổi (ELT)) quyết định tốc độ dữ liệu mới đến mô hình, lượng hạ tầng hệ thống cần có, và cách các mẫu độ tin cậy này được triển khai cụ thể.
Thu nạp dữ liệu
Tiếp nối phép so sánh với quá trình biên dịch, nạp dữ liệu giống như lexer: nó đọc nguồn thô (các luồng dữ liệu), tách thành các token và ghép thành các bản ghi chuẩn để phần còn lại của pipeline xử lý. Một ràng buộc quan trọng nhưng hay bị bỏ qua trong thiết kế nạp dữ liệu là nút thắt cổ chai I/O (đầu vào/đầu ra). Nhiều nhóm đầu tư lớn vào các GPU đắt tiền, nhưng mức tận dụng của chúng hoàn toàn phụ thuộc vào việc dữ liệu có đến đủ nhanh để giữ chúng luôn bận rộn hay không. Trong một mô hình hai giai đoạn lý tưởng, thời gian của mỗi bước nằm trong khoảng từ \(\max(T_{\text{compute}}, T_{\text{io}})\) (khi chồng lấp hoàn toàn) đến \(T_{\text{compute}} + T_{\text{io}}\) (khi không chồng lấp). Những cận này diễn lại vấn đề cấp dữ liệu từ section 1.1.3 dưới một lăng kính tài nguyên khác: khi đó yếu tố bị thiếu là băng thông lưu trữ; còn trong nạp dữ liệu, thường là khâu giải mã phía CPU.
Nếu pipeline dữ liệu không giải mã ảnh đủ nhanh để giữ GPU luôn bận rộn, bộ tăng tốc đắt tiền sẽ bị nhàn rỗi. Hiện tượng này tạo ra một “Choke Point” (điểm nghẽn), nơi việc thêm GPU không mang lại tăng tốc cho đến khi pipeline đầu vào được cải thiện — một kết quả trái với kỳ vọng tăng tốc tuyến tính từ đầu tư phần cứng. Nút thắt này xảy ra thường xuyên trong thị giác máy tính, nơi việc giải mã và tăng cường JPEG độ phân giải cao trên CPU có thể chi phối toàn bộ đường vào. Ví dụ minh họa: mỗi worker cung cấp 375 ảnh/giây và bộ tăng tốc tiêu thụ 3.000 ảnh/giây, vậy cần 8 worker để đạt điểm giao. Đây là một phép “khớp công suất”, không phải hằng số phần cứng: dưới điểm giao, pipeline đầu vào là nút thắt; trên điểm đó, thêm worker cũng không tăng thông lượng vì trần của bộ tăng tốc đã chi phối. Yêu cầu thực tế của ResNet-50 và A100 phụ thuộc vào các phép biến đổi ảnh, lưu trữ, kích thước batch, CPU máy chủ và cấu hình framework.
Tăng thông lượng huấn luyện không chỉ đơn giản là nâng cấp phần cứng GPU; pipeline tiền xử lý trên máy chủ phải cung cấp các tensor đủ nhanh để bộ tăng tốc không bị đói dữ liệu. Trong figure 8, hãy quan sát giao điểm giữa trần tiêu thụ GPU phẳng và đường cong thông lượng CPU tăng dưới tuyến tính khi kích thước batch tăng.
Khi thông lượng của dataloader thấp hơn tốc độ tiêu thụ của GPU, mức sử dụng bộ tăng tốc sẽ sụt mạnh, biến các cụm tính toán đắt tiền thành những bộ đệm bộ nhớ nhàn rỗi. Để gỡ nút thắt này, cần dùng các nhóm worker đa tiến trình, cơ chế prefetch không đồng bộ, và các pipeline giải nén tăng tốc bằng phần cứng để bỏ qua hoàn toàn các nút thắt trên CPU máy chủ.
Các mô hình tiếp nhận dữ liệu theo batch và theo luồng
Việc lựa chọn giữa batch và streaming không phải là chọn kiến trúc này thay cho kiến trúc khác; đó là đánh giá về tốc độ dữ liệu mất giá trị và mức chi phí hạ tầng có thể chấp nhận để giữ độ tươi đó. Hệ thống batch đạt hiệu quả bằng cách chấp nhận dữ liệu cũ hơn, còn hệ thống streaming đổi lấy độ tươi bằng việc chấp nhận độ phức tạp vận hành liên tục.
Tiếp nhận dữ liệu theo batch là quá trình thu thập dữ liệu theo nhóm (batch) trong một khoảng thời gian xác định rồi mới xử lý. Phương pháp này phù hợp khi không cần xử lý thời gian thực và dữ liệu có thể xử lý theo các mốc thời gian đã định. Cách tiếp cận theo batch giúp dùng tài nguyên tính toán hiệu quả bằng cách phân bổ chi phí khởi động trên khối lượng dữ liệu lớn và xử lý khi tài nguyên sẵn có hoặc rẻ nhất. Ví dụ, một công ty bán lẻ có thể dùng tiếp nhận dữ liệu theo batch để xử lý dữ liệu bán hàng hằng ngày vào ban đêm, cập nhật các mô hình ML cho dự đoán tồn kho mỗi sáng (Akidau et al. 2015). Một tác vụ batch có thể xử lý hàng gigabyte dữ liệu giao dịch bằng hàng chục máy trong 30 phút, rồi giải phóng các tài nguyên đó cho các khối lượng công việc (workload) khác. Việc xử lý theo lịch này tiết kiệm chi phí hơn nhiều so với duy trì hạ tầng luôn bật, đặc biệt khi dự đoán hơi cũ một chút không ảnh hưởng đến kết quả kinh doanh.
Akidau, Tyler, Robert Bradshaw, Craig Chambers, Slava Chernyak, Rafael J. Fernández-Moctezuma, Reuven Lax, Sam McVeety, et al. 2015. “The Dataflow Model: A Practical Approach to Balancing Correctness, Latency, and Cost in Massive-Scale, Unbounded, Out-of-Order Data Processing.” Proceedings of the VLDB Endowment 8 (12): 1792–803. https://doi.org/10.14778/2824032.2824076.
Xử lý batch cũng đơn giản hóa việc xử lý lỗi và khôi phục. Khi một công việc batch lỗi giữa chừng, hệ thống có thể chạy lại toàn bộ batch hoặc tiếp tục từ các checkpoint mà không cần quản lý trạng thái phức tạp. Nhà khoa học dữ liệu có thể kiểm tra các batch lỗi, hiểu nguyên nhân và xử lý lại sau khi sửa. Công việc batch có thể tái lập khi kiểm soát được đầu vào, mã, cấu hình, tính ngẫu nhiên, các thao tác nhạy với thứ tự và trạng thái bên ngoài, từ đó đơn giản hóa gỡ lỗi và xác thực. Những đặc điểm này khiến tiếp nhận theo batch hấp dẫn cho các quy trình ML, ngay cả khi xử lý thời gian thực khả thi về mặt kỹ thuật nhưng không bắt buộc.
Ngược với cách làm theo lịch này, tiếp nhận dữ liệu dạng luồng xử lý dữ liệu theo thời gian thực ngay khi nó đến, liên tục xử lý các sự kiện thay vì chờ tích lũy thành các batch. Mô hình này rất cần thiết cho các ứng dụng đòi hỏi xử lý tức thì, các trường hợp dữ liệu nhanh chóng mất giá trị và các hệ thống cần phản ứng ngay khi sự kiện xảy ra. Ví dụ, một tổ chức tài chính có thể dùng tiếp nhận dữ liệu dạng luồng để phát hiện gian lận thời gian thực, xử lý từng giao dịch ngay khi nó diễn ra để gắn cờ hoạt động đáng ngờ ngay lập tức trước khi giao dịch hoàn tất. Giá trị của phát hiện gian lận sẽ giảm đáng kể nếu việc phát hiện diễn ra hàng giờ sau khi giao dịch gian lận hoàn tất—khi đó tiền đã được chuyển và tài khoản đã bị xâm phạm.
Tuy nhiên, xử lý theo luồng kéo theo những phức tạp mà xử lý batch không có. Hệ thống phải xử lý áp lực ngược, tức là khi các hệ thống hạ nguồn không theo kịp tốc độ dữ liệu vào. Khi lưu lượng tăng đột biến và dữ liệu được tạo ra nhanh hơn khả năng xử lý, hệ thống buộc phải chọn: đệm dữ liệu (tốn bộ nhớ và tăng độ trễ), lấy mẫu (mất một phần dữ liệu), hoặc đẩy ngược về phía bên sản xuất (có thể khiến chúng lỗi). Các thỏa thuận mức dịch vụ (SLA) về tính cập nhật của dữ liệu quy định độ trễ tối đa chấp nhận được giữa thời điểm dữ liệu được tạo và thời điểm dữ liệu được xử lý. Đáp ứng SLA 100 mili giây đòi hỏi hạ tầng khác hẳn so với SLA một giờ, ảnh hưởng đến kiến trúc mạng, lưu trữ và xử lý.
Nhận thấy mỗi cách tiếp cận đều có hạn chế, nhiều hệ thống ML thực tế dùng phương án lai, kết hợp tiếp nhận dữ liệu theo batch và theo luồng. Ví dụ, một hệ thống đề xuất có thể dùng tiếp nhận theo luồng cho các tương tác người dùng thời gian thực để cập nhật ngay các đề xuất theo phiên, trong khi dùng tiếp nhận theo batch để xử lý qua đêm hồ sơ người dùng và các đặc trưng của mặt hàng.
Napkin Math 1.5: Chi phí của thời gian thực
Bài toán: Một pipeline tiếp nhận 1M events/s. Cách nào rẻ hơn: tiếp nhận theo batch (hàng giờ) hay theo luồng (dưới một giây)?
Các đặc tính vật lý:
- Thông lượng: Với 1M events/s sự kiện mỗi giây và 1 KB cho mỗi sự kiện, pipeline mang 1 GB/s.
- Yêu cầu cho xử lý theo luồng: Để duy trì thông lượng 1 GB/s với độ trễ dưới 100 ms, hệ thống cần khoảng 50 lõi chính và khoảng 50 lõi dự phòng, tức tổng cộng 100 lõi luôn bật. Chạy các lõi này trong 24 hours/day với chi phí $0.05/hr mỗi giờ sẽ tốn $120/day.
- Yêu cầu batch: Xử lý 3.6 TB dữ liệu (cửa sổ 1-hour) trong 10 minutes. Thông lượng cao (I/O tuần tự) là hiệu quả. Thiết kế batch này cần 200 lõi để hoàn thành 10 minutes trong mỗi giờ lịch, tích lũy 800 core-hours giờ lõi mỗi ngày. Với chi phí $0.05/hr, tổng chi là $40/day.
Nhận định hệ thống: Thời gian thực đắt hơn khoảng 3× lần cho cùng một khối lượng dữ liệu. Khoản chi phí tăng thêm này chỉ hợp lý khi giá trị của độ trễ dưới một giây lớn hơn chi phí bỏ ra.
Cách thức nạp dữ liệu cũng buộc phải lựa chọn ở phía huấn luyện mô hình. Nạp dữ liệu theo batch thường đi cùng huấn luyện lại định kỳ: dữ liệu được tích lũy trong một kho lưu trữ, một tác vụ chạy hằng đêm hoặc hằng tuần sẽ huấn luyện lại mô hình trên tập dữ liệu đã cập nhật, và một checkpoint mới được triển khai. Nạp dữ liệu theo luồng khiến ranh giới batch kém tự nhiên hơn và đặt ra câu hỏi liệu mô hình có nên cập nhật dần dần khi mỗi sự kiện đến hay không — một cách tiếp cận học liên tục, nơi trọng số thay đổi theo luồng dữ liệu thay vì được đặt lại theo một lịch cố định. Việc cập nhật trọng số liên tục từ một luồng dữ liệu trực tiếp tiềm ẩn những rủi ro mà huấn luyện lại theo batch tránh được: một sự chuyển dịch phân phối đột ngột, một hành vi chèn dữ liệu độc hại, hoặc một loạt sự kiện chất lượng thấp có thể làm hỏng trọng số mô hình trước khi bất kỳ cơ chế kiểm định nào kịp can thiệp. Báo cáo công khai của Microsoft về Tay minh họa nguy cơ khi một hệ thống đang hoạt động tiếp xúc với các đầu vào trực tiếp không đáng tin cậy, nhưng không khẳng định rằng Tay đã thực hiện các cập nhật trọng số trực tuyến không hạn chế (Lee 2016). Vì vậy, hầu hết các hệ thống sản xuất tách biệt hai vấn đề này: luồng dữ liệu vào một bộ đệm trong khi vẫn huấn luyện trên các batch đã tích lũy, và chỉ dành cập nhật trực tuyến liên tục cho các mô hình có phân phối hẹp, được giám sát chặt chẽ.
Lee, Peter. 2016. Learning from Tay’s Introduction. The Official Microsoft Blog.
Khi lựa chọn các phương pháp xử lý, các hệ thống sản xuất cần cân bằng giữa chi phí và độ trễ. Xử lý thời gian thực thường đắt đáng kể so với xử lý theo batch, thường gấp vài lần và đôi khi tới cả chục lần về tổng chi phí trên mỗi byte dữ liệu được xử lý. Chênh lệch chi phí này đến từ nhiều yếu tố: hệ thống xử lý luồng cần hạ tầng luôn bật thay vì tài nguyên có thể lập lịch; phải duy trì xử lý dự phòng để đảm bảo khả năng chịu lỗi, không mất sự kiện; cần mạng và lưu trữ có độ trễ thấp để đáp ứng SLA ở mức mili giây; và không tận dụng được lợi thế theo quy mô như xử lý theo batch, vốn phân bổ chi phí khởi động trên khối lượng dữ liệu lớn. Ví dụ, một job batch xử lý một terabyte có thể dùng 100 máy trong 10 phút, trong khi một hệ thống xử lý luồng xử lý cùng lượng dữ liệu đó trong 24 giờ cần tài nguyên chuyên dụng luôn sẵn sàng. Khác biệt này định hình nhiều quyết định kiến trúc về việc dữ liệu nào thật sự cần xử lý thời gian thực. Ước tính chi phí sẽ làm rõ phần chi phí phụ trội này.
So sánh ETL và ELT
Kiến trúc pipeline quyết định thời điểm và nơi áp dụng tài nguyên tính toán cho các bản ghi thô đầu vào. Hãy so sánh hai luồng xử lý trong figure 9 để xem giai đoạn biến đổi được thực thi ở đâu trong các pipeline ETL truyền thống14 so với ELT hiện đại15.
14 Trích xuất, biến đổi, tải (ETL): ETL truyền thống kiểm tra schema và kiểu dữ liệu—các kiểm tra mang tính xác định, chỉ có thể đạt hoặc không đạt. ETL cho machine learning cần xác thực thêm tính chất phân phối: tức là phân phối giá trị không bị thay đổi theo cách làm giảm hiệu suất mô hình. Điều này đòi hỏi các kiểm định thống kê (như kiểm định K-S, PSI) thay vì chỉ kiểm tra schema, và ngưỡng đạt/không đạt là một quyết định kinh doanh, không phải kỹ thuật. Một đánh đổi khác là sự cứng nhắc: khi thay đổi logic tính toán đặc trưng, phải xử lý lại toàn bộ tập dữ liệu từ nguồn thô. Chi phí này tăng tuyến tính theo khối lượng dữ liệu.
15 Trích xuất, tải, biến đổi (ELT): Cách tiếp cận này lưu trữ dữ liệu thô trước khi biến đổi, cho phép các nhóm chỉnh sửa truy vấn biến đổi và chạy lại trên đầu vào đã lưu mà không cần nạp lại từ các hệ thống nguồn. Thời gian lặp vẫn phụ thuộc vào khối lượng dữ liệu, độ phức tạp của truy vấn, năng lực kho dữ liệu và chiến lược materialization.

Đối với các hệ thống machine learning, ELT giúp tách rời việc nạp dữ liệu khỏi kỹ thuật đặc trưng. Việc lưu trữ các sự kiện thô không thay đổi trong lakehouse cho phép các nhà khoa học dữ liệu trích xuất lại các đặc trưng mới từ các tập dữ liệu lịch sử mà không cần nạp lại từ các nguồn bên ngoài, trong khi các biến đổi ETL cứng nhắc có thể vĩnh viễn loại bỏ các trường chưa được phân tích, vốn có thể hữu ích cho dự đoán về sau.
Mô hình ELT đảo ngược thứ tự này: tải dữ liệu thô trước, sau đó áp dụng các biến đổi trong hệ thống đích. Đối với phát triển machine learning, cách này cho phép thử nghiệm đặc trưng linh hoạt trên cùng một dữ liệu thô. Nhiều nhóm có thể tính toán các cửa sổ tổng hợp khác nhau. Khi phát hiện lỗi trong logic biến đổi, các nhóm có thể xử lý lại bằng cách chạy lại các truy vấn, thay vì phải nạp lại từ các nguồn. Sự linh hoạt này giúp tăng tốc thử nghiệm machine learning, đặc biệt khi yêu cầu về kỹ thuật đặc trưng thay đổi nhanh. Đổi lại, chi phí là nhu cầu lưu trữ cao hơn (vì dữ liệu thô lớn hơn dữ liệu đã biến đổi), việc tính toán lặp lại khi nhiều mô hình cùng biến đổi một dữ liệu nguồn, và độ phức tạp lớn hơn trong việc đảm bảo tuân thủ quyền riêng tư khi dữ liệu nhạy cảm thô vẫn được lưu trữ.
Napkin Math 1.6: Chi phí của vị trí đặt bước biến đổi
Vấn đề: Một nhóm xử lý 10 TB dữ liệu clickstream thô mỗi ngày và cần tính các đặc trưng phiên người dùng cho 3 mô hình ML, mỗi mô hình yêu cầu các cửa sổ tổng hợp khác nhau (1 giờ, 24 giờ, 7 ngày). Phương án nào rẻ hơn: ETL hay ELT?
Toán học:
- Cách tiếp cận ETL: Biến đổi trước khi tải. Tính cả ba cửa sổ tổng hợp trong cụm Spark trước khi tải vào kho dữ liệu.
- Chi phí tính toán trên Spark: 10 TB với mức $5/TB = $50/day
- Lưu trữ: 3 tập dữ liệu đã biến đổi, mỗi tập khoảng ~2 TB = tổng cộng 6 TB, với giá $23/TB/month = $138/month
- Chi phí thay đổi lược đồ: Chạy lại toàn bộ pipeline (~4 hours) cho mỗi lần thay đổi
- Cách tiếp cận ELT: Tải dữ liệu thô trước, rồi biến đổi trong kho dữ liệu.
- Lưu trữ: 10 TB dữ liệu thô mỗi ngày, lưu trong 30 days ngày = 300 TB, với giá $23/TB/month = $6,900/month
- Chi phí tính toán truy vấn: 3 mô hình, mỗi mô hình có chi phí truy vấn hằng ngày $5/query trong 30 days ngày, tổng cộng $450/month
- Chi phí thay đổi lược đồ: Viết lại truy vấn SQL (~30 minutes) cho mỗi lần thay đổi
Góc nhìn chuyên sâu về hệ thống: ETL tiết kiệm $6,762/month chi phí lưu trữ. Sau khi quy đổi chi phí tính toán Spark về chi phí hàng tháng, tổng chi phí ETL là $1,638/month ($1,500/month cho tính toán và $138/month cho lưu trữ), trong khi tổng chi phí ELT là $7,350/month ($6,900/month cho lưu trữ và $450/month cho tính toán truy vấn), mang lại lợi thế chi phí đám mây $5,712/month trước khi tính đến chi phí nhân công kỹ thuật. Tuy vậy, ETL vẫn tốn thêm 8× thời gian kỹ thuật cho mỗi lần thay đổi lược đồ. Điểm hòa vốn cụ thể phụ thuộc vào chi phí nhân công kỹ thuật và tần suất thay đổi lược đồ: lược đồ ổn định nghiêng về ETL nhờ chi phí đám mây thấp hơn, còn thay đổi định nghĩa đặc trưng thường xuyên thì nghiêng về ELT nhờ khả năng lặp nhanh hơn.
Trong môi trường sản xuất, các hệ thống ML hiếm khi chỉ dùng một cách làm duy nhất. Dữ liệu có cấu trúc với lược đồ ổn định thường đi qua ETL để đạt hiệu quả và tuân thủ, còn dữ liệu phi cấu trúc hoặc các pipeline đặc trưng thay đổi nhanh thì hưởng lợi từ sự linh hoạt của ELT. Với các khối lượng công việc (workload) deep learning xử lý hình ảnh, âm thanh hoặc văn bản, xu hướng thiên về ELT còn rõ hơn: bước “Transform” cho dữ liệu phi cấu trúc thường chạy ngay trong bộ nạp dữ liệu của framework ML thay vì trong kho dữ liệu, áp dụng các thao tác như cắt ngẫu nhiên, tạo phổ tần hoặc tokenization văn bản ngay trong mỗi epoch huấn luyện. Nếu lưu sẵn mười biến thể tăng cường ở bước trước, một tập dữ liệu 50.000 hình ảnh sẽ tăng lên 500.000 bản sao lưu trữ, nên nguyên tắc “tải dữ liệu thô, chuyển đổi sau” của ELT tự nhiên được mở rộng vào chính vòng lặp huấn luyện. Phần so sánh chi phí ETL/ELT đi kèm giúp cụ thể hóa chi phí do vị trí đặt bước chuyển đổi.
Khi đưa các thành phần xử lý dữ liệu streaming vào kiến trúc ETL/ELT, việc chọn công cụ thực chất là chọn cách hệ thống sẽ hành xử khi xảy ra sự cố. Định lý CAP16 nêu rằng khi mạng bị phân vùng, một dịch vụ đọc/ghi phân tán không thể đồng thời đảm bảo cả tính nhất quán tuyến tính (linearizable consistency) và tính khả dụng (availability) cho mọi yêu cầu. Apache Kafka17 đảm bảo thứ tự trong từng phân vùng; tính khả dụng và độ bền khi có sự cố phụ thuộc vào các thiết lập về xác nhận, sao chép và bầu chọn leader. Apache Pulsar tách các broker không trạng thái khỏi lớp lưu trữ thông điệp bền vững trong các sổ cái (ledger) của Apache BookKeeper được sao chép. Tính năng sao chép địa lý (geo-replication) tích hợp của nó là không đồng bộ, nên khi có sự cố hoặc phân vùng mạng, cụm ở xa có thể bị trễ so với cụm gốc, thay vì vừa đảm bảo nhất quán mạnh giữa các vùng vừa duy trì khả dụng. Amazon Kinesis thể hiện các đánh đổi vận hành thông qua dung lượng shard, thời gian lưu giữ và cấu hình của bên sản xuất (producer) và bên tiêu thụ (consumer), nhưng theo định lý CAP, trong tình huống mạng phân vùng, nó vẫn không thể đồng thời đảm bảo tính nhất quán chặt chẽ và tính khả dụng.
16 Định lý CAP (consistency, availability, partition tolerance): Do Brewer (2000) đưa ra và Gilbert and Lynch (2002) chứng minh chính thức. Khi mạng bị phân vùng, để giữ tính nhất quán tuyến tính có thể phải từ chối yêu cầu, trong khi một hệ thống ưu tiên khả dụng có thể trả về các giá trị cũ hoặc lệch nhau. Định lý CAP không đảm bảo sự đồng nhất trong biến đổi các đặc trưng hoặc tính chính xác tại một thời điểm cụ thể.
Brewer, Eric A. 2000. “Towards Robust Distributed Systems (Abstract).” Proceedings of the Nineteenth Annual ACM Symposium on Principles of Distributed Computing, 7. https://doi.org/10.1145/343477.343502.
Gilbert, Seth, and Nancy Lynch. 2002. “Brewer’s Conjecture and the Feasibility of Consistent, Available, Partition-Tolerant Web Services.” ACM SIGACT News 33 (2): 51–59. https://doi.org/10.1145/564585.564601.
17 Apache Kafka: Kafka sử dụng một log dựa trên leader, được phân vùng, và sắp xếp các bản ghi trong từng phân vùng, không phải trên toàn bộ topic. Độ bền và khả năng ghi khi có sự cố phụ thuộc vào chế độ xác nhận, sao chép, yêu cầu về các bản sao đồng bộ và cách bầu chọn leader.
Việc chọn giữa biến đổi trước (upfront transformation) và biến đổi tại lúc tải (load-time transformation) phụ thuộc vào mức độ tái sử dụng truy vấn: dữ liệu đã biến đổi mà được truy vấn hàng trăm lần sẽ giúp trải đều chi phí tính toán ETL, trong khi các truy vấn khám phá chỉ chạy một lần thì nên tận dụng tính co giãn của kho ELT. Mô hình chi phí có tham số trong listing 2 đánh giá ngưỡng hòa vốn này theo các mức khối lượng dữ liệu (\(V\)) và tần suất truy vấn (\(Q\)) khác nhau.
# ETL vs ELT cost comparison
daily_raw_tb = 10
s3_per_tb_mo = 23
spark_per_tb = 5
n_models = 3
retention_days = 30
query_cost_per = 5

# ETL
etl_spark_daily = daily_raw_tb * spark_per_tb
etl_datasets = 3
etl_tb_each = 2
etl_storage_tb = etl_datasets * etl_tb_each
etl_storage_mo = etl_storage_tb * s3_per_tb_mo

# ELT
elt_storage_tb = daily_raw_tb * retention_days
elt_storage_mo = elt_storage_tb * s3_per_tb_mo
elt_query_mo = n_models * query_cost_per * retention_days

# Savings
storage_savings_mo = elt_storage_mo - etl_storage_mo
Trong kịch bản này, về lưu trữ, ETL có lợi thế hơn. Tuy nhiên, bảng kê không tính chi phí nhân công cho việc thay đổi lược đồ; phép tính minh họa ở trên coi chi phí đó là một yếu tố quyết định riêng.
Vị trí tính toán đặc trưng
Với các pipeline ML, vị trí tính toán đặc trưng quyết định tài nguyên nào gánh chi phí cho một đặc trưng: lưu trữ gánh khi đặc trưng được lưu sẵn, còn tính toán và độ trễ gánh khi đặc trưng được tạo theo yêu cầu. Lựa chọn này ảnh hưởng đáng kể đến tốc độ huấn luyện, chi phí lưu trữ và khả năng tái lập.
Một cách là tính trước các đặc trưng trong ETL và lưu kết quả. Các đặc trưng do pipeline tính mang lại tốc độ lặp huấn luyện nhanh (vì đặc trưng đã sẵn sàng trên đĩa), khả năng tái lập (dùng nhất quán cùng đặc trưng), và giảm tính toán khi huấn luyện. Nhược điểm là chi phí lưu trữ (đặc trưng lưu riêng so với dữ liệu thô), rủi ro lỗi thời (đặc trưng tính sẵn có thể lệch khi logic thay đổi), và kém linh hoạt (bất kỳ thay đổi nào cũng cần tính lại toàn bộ).
Cách khác là tính đặc trưng tức thời trong lúc huấn luyện. Đặc trưng do loader tính đảm bảo kết quả luôn mới (thay đổi logic được phản ánh ngay), thử nghiệm linh hoạt (dễ chỉnh sửa đặc trưng), và giảm lưu trữ (chỉ lưu dữ liệu thô). Đổi lại là huấn luyện chậm hơn (tính toán lặp lại mỗi epoch), chi phí tính toán cao hơn (GPU thường rỗi vì phải chờ đặc trưng), và có thể không xác định nếu không triển khai cẩn thận.
Trong thực tế, các mẫu lai là phổ biến nhất. Những đặc trưng đắt đỏ, ổn định (như embedding người dùng cần phân rã ma trận, hoặc các phép tổng hợp lịch sử trên nhiều tháng dữ liệu) được tính trước và lưu sẵn. Ngược lại, các đặc trưng rẻ và nhạy theo thời gian như tín hiệu gần đây, ngữ cảnh phiên và các biến đổi theo thời gian sẽ được tính trong data loader.
Ví dụ, một hệ thống khuyến nghị sẽ tính trước các đặc trưng biểu diễn người dùng ổn định (đắt đỏ, ổn định trong nhiều ngày), đồng thời tính các đặc trưng như thời gian kể từ lần tương tác gần nhất (rẻ, nhạy theo thời gian) ngay trong data loader. Cách làm này cân bằng chi phí lưu trữ, thời gian tính toán và độ tươi của đặc trưng theo đúng đặc tính của từng đặc trưng.
Chiến lược tích hợp và nghiên cứu điển hình KWS
Dù theo cách ETL hay ELT, tích hợp các nguồn dữ liệu đa dạng vẫn là một thách thức cốt lõi ở bước tiếp nhận. Dữ liệu có thể đến từ cơ sở dữ liệu, API, hệ thống tệp và thiết bị IoT, mỗi nguồn có định dạng riêng (hàng quan hệ, tài liệu JavaScript Object Notation (JSON)18, luồng nhị phân), giao thức truy cập và tần suất cập nhật khác nhau. Nguyên tắc hệ thống là chuẩn hóa ngay tại ranh giới tiếp nhận: chuẩn hóa định dạng, xác thực lược đồ và cung cấp một giao diện nhất quán cho các bước xử lý phía sau, bất kể nguồn dữ liệu. Chuẩn hóa ở ranh giới này tách biệt sự phức tạp do đa dạng nguồn khỏi sự phức tạp của kỹ thuật đặc trưng, cho phép mỗi phần tiến hóa độc lập.
18 JSON (JavaScript object notation): Tính linh hoạt về lược đồ khiến JSON trở thành định dạng phổ biến cho các API, nhưng đồng thời tạo ra điểm nghẽn xác thực tại ranh giới tiếp nhận dữ liệu. Không giống các định dạng nhị phân có lược đồ định nghĩa sẵn, mỗi tài liệu JSON phải được phân tích cú pháp và xác thực lược đồ trước khi chuẩn hóa cho các bước xử lý phía sau. Chi phí phát sinh trên mỗi bản ghi này có thể làm quá trình tiếp nhận chậm hơn so với các định dạng nhị phân như Protobuf; mức chênh lệch phụ thuộc vào lược đồ, trình phân tích cú pháp, tải trọng và khối lượng công việc (workload).
Các hệ thống KWS trong sản xuất thường chạy phát hiện từ khóa kích hoạt (wake-word detection) luôn bật ngay trên thiết bị. Các pipeline streaming và batch ở backend có thể tiếp nhận các yêu cầu đã kích hoạt, dữ liệu chẩn đoán đã được chấp thuận, bản ghi do cộng đồng đóng góp, dữ liệu tổng hợp và các tương tác đã được xác thực để phục vụ (serving) và huấn luyện. Xử lý batch thường theo quy trình ETL: âm thanh được chuẩn hóa, lọc nhiễu và cắt đoạn thành các khoảng thời gian đồng nhất trước khi lưu trữ dưới các định dạng tối ưu cho huấn luyện.
Việc xử lý lỗi trong các hệ thống tương tác giọng nói cần được chú ý đặc biệt. Hàng đợi dead letter (dead letter queues) lưu các lần nhận dạng thất bại để phân tích sau, qua đó lộ ra các edge case cần được bao phủ trong các lần lặp mô hình tiếp theo. Mỗi mẫu âm thanh đầu vào phải qua kiểm tra chất lượng (tỷ lệ tín hiệu trên nhiễu, tốc độ lấy mẫu, giới hạn thời lượng, khoảng cách người nói) trước khi đi vào pipeline xử lý. Các mẫu không hợp lệ được chuyển đến hàng đợi phân tích thay vì bị loại bỏ, vì những lỗi này thường cho thấy các điều kiện âm thanh còn thiếu trong dữ liệu huấn luyện. Các mẫu hợp lệ tiếp tục sang phát hiện theo thời gian thực, đồng thời được ghi lại để có thể đưa vào dữ liệu huấn luyện sau này.
Kiến trúc nhập liệu này hoàn thiện lớp biên nơi dữ liệu bên ngoài đi vào pipeline được kiểm soát của chúng ta. Dù được chuyển giao đáng tin cậy đến đâu, dữ liệu đã nhập vẫn là thô: âm thanh có tốc độ lấy mẫu không nhất quán, văn bản với nhiều kiểu mã hóa, các đặc trưng số trên các thang đo không tương thích. Thách thức tiếp theo là biến các bản ghi không đồng nhất này thành một biểu diễn đồng nhất, sẵn sàng cho mô hình, đồng thời đảm bảo các phép biến đổi y hệt được áp dụng trong cả huấn luyện và phục vụ (serving).
Self-Check: Question
A production monitoring system tracks feature distributions over time using the Population Stability Index (PSI). The incoming feature distribution for a key credit feature yields a PSI value of \(0.28\) compared to the baseline training distribution. According to standard operational drift bands, how should the data pipeline respond?
- No action is required because PSI values below 0.50 indicate negligible distribution change.
- Trigger a critical alert and initiate root-cause investigation or automated model retraining, because a PSI > 0.25 indicates significant distribution drift.
- Immediately drop all incoming records and halt the ingestion cluster with a fatal error.
- Switch the database storage format from Parquet to CSV to improve float precision.
An ML engineering team is architecting an ingestion pipeline for tabular transaction data. They evaluate Extract-Transform-Load (ETL) versus Extract-Load-Transform (ELT). Which architectural trade-off correctly characterizes ELT in modern data lakehouses?
- ELT executes all transformations in memory on the edge device before transmitting bytes to cloud storage.
- ELT requires rigid upfront schema definitions (schema-on-write) and rejects any semi-structured data formats.
- ELT loads raw data directly into scalable lakehouse storage first and transforms it downstream using scalable query engines, preserving raw data history and decoupling ingestion from evolving feature logic.
- ELT eliminates the need for data governance and quality validation because transformations occur after storage.
Explain how combining a Circuit Breaker pattern with a Dead Letter Queue (DLQ) prevents cascading failures and data loss in streaming ML data ingestion pipelines.
Using the 2016 Microsoft Tay chatbot incident, explain why public data ingestion surfaces require strict input validation, rate limiting, and adversarial filtering before data shapes model behavior.
An explicit, machine-enforceable agreement between data producers and data consumers that defines column types, value bounds, nullability, and distribution constraints is called a ____.
Xử lý dữ liệu có hệ thống
Giai đoạn nhập liệu đã phân tích các luồng dữ liệu thô thành các bản ghi có cấu trúc chuẩn; giai đoạn biên dịch tiếp theo là lượt tối ưu hóa: xử lý dữ liệu có hệ thống. Tương tự như tối ưu hóa trình biên dịch phải giữ nguyên ngữ nghĩa chương trình trong khi cải thiện hiệu suất, các phép biến đổi dữ liệu cũng phải giữ nguyên tín hiệu trong khi nâng cao mức sẵn sàng cho mô hình. Ràng buộc quan trọng nhất là tính nhất quán: các phép biến đổi dùng chung cho huấn luyện và phục vụ (serving) phải giữ ngữ nghĩa tương đương, các thao tác lặp lại phải an toàn khi chạy lại, và quá trình xử lý phải mở rộng mà không làm mất nguồn gốc dữ liệu.
Sculley et al. (2015) chỉ ra các phụ thuộc dữ liệu, biến động từ thế giới bên ngoài, nợ cấu hình và thiếu giám sát là những rủi ro nợ kỹ thuật ẩn trong các hệ thống ML trong sản xuất. Sự không nhất quán giữa huấn luyện và phục vụ (serving) là một dạng cụ thể của rủi ro này. Ví dụ, hãy xem xét việc chuẩn hóa số tiền giao dịch trong huấn luyện bằng cách bỏ ký hiệu tiền tệ và chuyển về số thực, nhưng lại quên áp dụng đúng y như vậy trong phục vụ (serving). Sự không nhất quán tưởng nhỏ này có thể làm giảm đáng kể độ chính xác của mô hình. Với hệ thống KWS của chúng ta, mâu thuẫn rất cụ thể: các phép biến đổi phải chuẩn hóa giữa nhiều điều kiện ghi âm khác nhau (micrô, mức nhiễu, tốc độ lấy mẫu) nhưng vẫn giữ được những đặc tính âm thanh giúp phân biệt từ khóa kích hoạt (wake words) với tiếng nói nền — và việc chuẩn hóa đó phải giống hệt nhau ở cả đường huấn luyện lẫn phục vụ (serving).
Tính nhất quán giữa huấn luyện và phục vụ (serving)
Thách thức về tính nhất quán giữa huấn luyện và phục vụ (serving) không chỉ là dùng chung một đoạn mã—mà còn đòi hỏi các tham số được tính trên dữ liệu huấn luyện (hằng số chuẩn hóa, từ điển mã hóa, ánh xạ từ vựng) phải được lưu và dùng lại trong phục vụ (serving). Đây chính là nguyên tắc nhất quán.
Definition 1.3: Nguyên tắc nhất quán
Nguyên tắc nhất quán yêu cầu hành vi biến đổi và trạng thái phải như nhau giữa các môi trường huấn luyện và phục vụ (serving).
- Ý nghĩa: Độ phân kỳ KL \((\mathcal{D}_{\text{KL}}(p_{g_{\text{serve}}} \lVert p_{g_{\text{train}}}))\) giữa các phân bố đặc trưng do phép biến đổi phục vụ (serving) \(g_{\text{serve}}\) (hiện tại) và phép biến đổi huấn luyện \(g_{\text{train}}\) (chuẩn) tạo ra có thể báo hiệu sự lệch nhau. Mức độ liên hệ của nó với suy giảm hiệu suất phụ thuộc vào mô hình, tác vụ và các đặc trưng bị dịch chuyển, và cần được kiểm chứng bằng bằng chứng từ kết quả.
- Điểm khác biệt: Khác với chất lượng dữ liệu, vốn tập trung vào sự sạch sẽ của từng bản ghi đơn lẻ, nguyên tắc nhất quán tập trung vào sự căn chỉnh của toàn bộ pipeline biến đổi.
- Lỗi thường gặp: Một hiểu lầm phổ biến là có thể “cố định” tính nhất quán chỉ bằng cách chia sẻ mã. Thực ra đây là vấn đề đồng bộ trạng thái: các tham số được tính trên dữ liệu huấn luyện (ví dụ: giá trị trung bình, độ lệch chuẩn) phải được lưu và dùng lại trong phục vụ (serving).
Mức độ rủi ro rất cao: vi phạm nguyên tắc nhất quán sẽ âm thầm làm giảm độ chính xác của mô hình trong sản xuất. Trước khi bàn đến các kỹ thuật làm sạch và biến đổi dữ liệu, hãy xác minh yêu cầu này, bắt đầu từ nhánh phục vụ (serving) rồi lần ngược trở lại.
Checkpoint 1.3: Xử lý phòng thủ
Độ lệch giữa huấn luyện và phục vụ (serving) là một nguyên nhân phổ biến khiến chất lượng trong sản xuất suy giảm âm thầm.
Làm sạch dữ liệu là nơi đầu tiên có thể đảm bảo hoặc làm vỡ tính nhất quán. Dữ liệu thô thường có giá trị thiếu, bản ghi trùng lặp, hoặc ngoại lai, tất cả đều làm giảm hiệu suất mô hình. Điều cốt lõi là các thao tác làm sạch phải có tính xác định và có thể tái tạo: cùng một đầu vào thì phải cho ra cùng một đầu ra, bất kể môi trường. Yêu cầu này quyết định những kỹ thuật làm sạch nào an toàn để dùng trong sản xuất.
Việc làm sạch dữ liệu có thể bao gồm loại bỏ bản ghi trùng lặp dựa trên khóa có tính xác định, xử lý giá trị thiếu bằng điền khuyết hoặc xóa theo các quy tắc áp dụng nhất quán, và sửa các bất nhất định dạng một cách có hệ thống. Chẳng hạn, một cơ sở dữ liệu khách hàng có thể chuẩn hóa “John Doe,” “john doe,” và “DOE, John” về cùng một định dạng hiển thị. Tuy nhiên, chỉ chuẩn hóa thôi chưa đủ để khẳng định các bản ghi nói về cùng một người; phân giải định danh đòi hỏi một mã định danh ổn định hoặc một quy tắc ghép khớp được xác thực riêng. Cả quy tắc định dạng và quy tắc ghép khớp đều phải được mã hóa và thực thi tương đương trong huấn luyện và phục vụ (serving).
Phát hiện và xử lý ngoại lai là một mảng quan trọng khác của làm sạch dữ liệu, song lại kéo theo thách thức về tính nhất quán. Giá trị ngoại lai đôi khi phản ánh thông tin quý giá về các sự kiện hiếm, nhưng cũng có thể xuất phát từ lỗi đo lường hoặc dữ liệu bị hỏng. Người làm ML cần cân nhắc kỹ bản chất dữ liệu và yêu cầu của mô hình khi quyết định cách xử lý ngoại lai. Cách loại bỏ ngoại lai theo ngưỡng đơn giản (loại các giá trị cách trung bình hơn ba độ lệch chuẩn) vẫn giữ được tính nhất quán giữa huấn luyện và phục vụ (serving) nếu trung bình và độ lệch chuẩn được tính trên dữ liệu huấn luyện và tái sử dụng khi phục vụ (serving). Tuy nhiên, các phương pháp phát hiện ngoại lai tinh vi hơn, có xét đến quan hệ giữa các đặc trưng hoặc các mẫu theo thời gian, đòi hỏi thiết kế và triển khai cẩn thận để đảm bảo áp dụng nhất quán.
Đánh giá chất lượng bổ trợ cho làm sạch dữ liệu bằng cách đánh giá có hệ thống độ tin cậy và tính hữu dụng của dữ liệu theo nhiều khía cạnh: độ chính xác, tính đầy đủ, tính nhất quán và tính kịp thời. Trong các hệ thống sản xuất, chất lượng dữ liệu có thể suy giảm theo những cách tinh vi mà các chỉ số cơ bản không bắt được: các trường vốn không bao giờ có null bỗng xuất hiện các mẫu thưa, các phân bố số liệu trôi khỏi phạm vi đã thấy khi huấn luyện, hoặc xuất hiện các giá trị phân loại chưa từng có trong giai đoạn phát triển mô hình.
Để xử lý những mẫu suy giảm tinh vi này, giám sát chất lượng trong sản xuất cần các chỉ số chuyên biệt vượt ra ngoài việc đếm số giá trị thiếu đơn giản (section 1.4.1). Các chỉ báo then chốt gồm: các mẫu giá trị null theo từng đặc trưng (sự gia tăng đột ngột gợi ý lỗi ở các khâu phía trước), các bất thường về số đếm (tăng 10\(\times\) thường cho thấy dữ liệu bị trùng lặp hoặc lỗi trong pipeline), vi phạm phạm vi giá trị (giá chuyển thành số âm, tuổi vượt quá giới hạn thực tế), và tỷ lệ lỗi nối giữa các nguồn dữ liệu. Phát hiện trôi dạt thống kê19 trở nên thiết yếu bằng cách theo dõi trung bình, phương sai và các phân vị của đặc trưng theo thời gian để kịp thời phát hiện sự suy giảm dần dần trước khi ảnh hưởng đến hiệu suất của mô hình. Ví dụ, trong một hệ thống gợi ý thương mại điện tử, thời lượng phiên trung bình của người dùng có thể tăng dần từ tám phút lên 12 phút trong sáu tháng nhờ thiết kế trang web được cải thiện, nhưng nếu đột ngột giảm xuống còn ba phút, điều đó gợi ý có lỗi trong quá trình thu thập dữ liệu.
19 Phát hiện trôi dữ liệu thống kê: Các giá trị trung bình, phương sai và phân vị được theo dõi trong giám sát chất lượng là tín hiệu cảnh báo sớm cho số hạng phân kỳ \(\mathcal{D}(P_t \lVert P_0)\) của phương trình suy giảm. Ví dụ, nếu thời lượng phiên trung bình tăng từ 8 lên 12 phút trong sáu tháng, đó có thể là dấu hiệu trôi dữ liệu; còn nếu đột ngột giảm xuống 3 phút, có thể là lỗi thu thập. Cần kiểm tra kết quả và điều tra nguồn trước khi quyết định huấn luyện lại hay sửa hệ thống nguồn.
Mức độ tinh vi của công cụ không quan trọng bằng việc các tiêu chuẩn chất lượng có được giữ giống hệt nhau giữa các môi trường hay không. Các công cụ lập hồ sơ dữ liệu cung cấp thống kê tóm tắt và trực quan hóa, giúp nhận diện các vấn đề chất lượng tiềm ẩn; trong khi đó, các kỹ thuật nâng cao dùng thuật toán học không giám sát để phát hiện bất thường hoặc điểm không nhất quán trong các tập dữ liệu lớn. Điều mấu chốt là duy trì tiêu chuẩn chất lượng và logic xác thực giống hệt nhau giữa huấn luyện và phục vụ (serving) để tránh các vấn đề chất lượng gây ra sai lệch huấn luyện–phục vụ.
Các kỹ thuật biến đổi chuyển dữ liệu từ dạng thô sang dạng sẵn sàng cho mô hình, nhưng rủi ro hệ thống nằm ở các tham số mà những biến đổi này học được. Các tác vụ biến đổi phổ biến gồm chuẩn hóa và tiêu chuẩn hóa, nhằm đưa các đặc trưng số về cùng phạm vi hoặc phân phối. Chẳng hạn, diện tích sàn và số phòng có thể có thang đo rất khác nhau; chuẩn hóa sẽ đưa chúng về các khoảng giá trị có thể so sánh, dù mức ảnh hưởng vẫn phụ thuộc vào mô hình và các tham số đã học (Bishop 2006). Để giữ nhất quán giữa huấn luyện và phục vụ (serving), các tham số chuẩn hóa tính trên dữ liệu huấn luyện phải được lưu trữ và áp dụng giống hệt trong giai đoạn phục vụ. Về vận hành, các tham số này cần được lưu cùng với mô hình và được nạp khi khởi tạo phục vụ (serving).
Bishop, Christopher M. 2006. Pattern Recognition and Machine Learning. Springer.
Ngoài việc chuẩn hóa dữ liệu số, các phép biến đổi khác có thể bao gồm mã hóa các biến phân loại, xử lý dữ liệu ngày giờ, hoặc tạo ra các đặc trưng suy ra. Ví dụ, one-hot encoding thường được dùng để chuyển các biến phân loại sang định dạng mà nhiều thuật toán machine learning có thể dễ dàng hiểu và xử lý. Việc mã hóa phân loại phải xử lý được cả các danh mục có trong quá trình huấn luyện và các danh mục chưa biết xuất hiện khi phục vụ (serving). Một cách tiếp cận đáng tin cậy là xây dựng bộ từ vựng các danh mục trong quá trình huấn luyện (tức là tập hợp tất cả các danh mục đã quan sát), lưu trữ nó cùng với mô hình, và khi phục vụ, hoặc ánh xạ các danh mục chưa biết sang một token “unknown” đặc biệt, hoặc dùng giá trị mặc định. Nếu không tuân thủ cách làm này, quá trình phục vụ có thể gặp các danh mục mà mô hình chưa từng thấy trong quá trình huấn luyện, dẫn đến lỗi hoặc suy giảm hiệu suất.
Một mô hình dự đoán sức khỏe có thể nhận tọa độ GPS gốc cho mỗi lượt khám của bệnh nhân, nhưng riêng vĩ độ và kinh độ không trực tiếp thể hiện khả năng tiếp cận dịch vụ chăm sóc y tế. Một kỹ sư có thể suy ra khoảng cách đến bệnh viện gần nhất như một chỉ báo thay thế tiềm năng cho khả năng tiếp cận theo địa lý. Việc đặc trưng đó có dự đoán được kết quả, cải thiện mô hình, hay vô tình đưa vào các chỉ báo về vị trí nhạy cảm và yếu tố kinh tế - xã hội phải được xác định bằng dữ liệu và đánh giá chuyên môn, chứ không thể chỉ suy ra từ bản thân phép biến đổi.
Kỹ thuật đặc trưng là việc sử dụng kiến thức chuyên môn để tạo ra các đặc trưng mới, giúp thuật toán machine learning hoạt động hiệu quả hơn (Kuhn and Johnson 2013). Bước này thường được xem là thiên về nghệ thuật hơn là khoa học, đòi hỏi sự sáng tạo và hiểu biết sâu về cả dữ liệu lẫn vấn đề cần giải quyết. Kỹ thuật đặc trưng có thể bao gồm việc kết hợp các đặc trưng hiện có, trích xuất thông tin từ các kiểu dữ liệu phức tạp, hoặc tạo ra các đặc trưng hoàn toàn mới dựa trên hiểu biết chuyên môn. Ví dụ, trong một hệ thống gợi ý bán lẻ, các kỹ sư có thể tạo các đặc trưng thể hiện độ mới, tần suất và giá trị tiền tệ (RFM) của các giao dịch mua hàng của khách hàng, được gọi là phân tích RFM.
Kuhn, Max, and Kjell Johnson. 2013. Applied Predictive Modeling. Springer New York. https://doi.org/10.1007/978-1-4614-6849-3.
20 Kho đặc trưng: Một vấn đề lớn thường gặp là sự sai lệch giữa huấn luyện và phục vụ (serving) (training-serving skew): các đặc trưng dùng cho huấn luyện có thể được tính toán theo batch (ví dụ: trung bình động bảy ngày trên dữ liệu lịch sử), trong khi các đặc trưng dùng cho phục vụ (serving) lại được tính theo thời gian thực từ một nguồn streaming. Ngay cả khi logic được chia sẻ trên danh nghĩa, khác biệt về thời gian và trạng thái vẫn có thể tạo ra các sai lệch có hệ thống. Một kho đặc trưng có thể giảm rủi ro này bằng cách phối hợp các định nghĩa, nguồn dữ liệu, cách xử lý dấu thời gian, cũng như việc tạo ra các đặc trưng (materialization) ở chế độ ngoại tuyến và trực tuyến. Tuy nhiên, tính đúng đắn vẫn phụ thuộc vào cách triển khai, độ tươi mới của dữ liệu và khả năng đồng bộ hóa. Hệ thống Michelangelo của Uber đã góp phần định hình mẫu giao diện kép này cho huấn luyện theo batch và phục vụ (serving) với độ trễ thấp (Hermann and Del Balso 2017).
Hermann, Jeremy, and Mike Del Balso. 2017. Meet Michelangelo: Uber’s Machine Learning Platform. Uber Engineering Blog.
Kỹ thuật đặc trưng có thể là một hoạt động mang lại tác động lớn vì nó thay đổi tín hiệu mà mô hình có thể quan sát. Trong một số khối lượng công việc (workload), các đặc trưng được thiết kế tốt cải thiện hiệu suất nhiều hơn so với thử thêm một vòng chọn thuật toán hay tinh chỉnh siêu tham số. Tác động đó cần được cân bằng với yêu cầu về tính nhất quán của hệ thống sản xuất. Mọi đặc trưng được thiết kế và chia sẻ giữa quá trình huấn luyện và phục vụ (serving) phải có hành vi tương đương trong cả hai môi trường. Do đó, các hệ thống sản xuất thường triển khai logic kỹ thuật đặc trưng trong các thư viện dùng chung hoặc các pipeline được phối hợp, thay vì tự triển khai lại độc lập. Nhiều tổ chức sử dụng kho đặc trưng,20 được thảo luận trong section 1.7.5, để giảm thiểu sự không nhất quán giữa các môi trường.
Áp dụng các khái niệm xử lý này vào hệ thống KWS của chúng ta: các bản ghi âm thanh đi qua pipeline thu nhận, dù đến từ đóng góp cộng đồng, dữ liệu tổng hợp, hay ghi âm thực tế, đều cần được làm sạch kỹ để đảm bảo phát hiện từ đánh thức đáng tin cậy. Dữ liệu âm thanh thô thường có những khiếm khuyết mà chúng ta đã lường trước ngay từ bước định nghĩa vấn đề: nhiễu nền từ nhiều môi trường khác nhau (từ phòng ngủ yên tĩnh đến nhà xưởng ồn ào), tín hiệu bị cắt đỉnh (do thiết lập mức ghi âm), âm lượng không đồng đều giữa các micrô và loa, và tốc độ lấy mẫu không nhất quán do dùng nhiều thiết bị thu khác nhau. Pipeline làm sạch phải chuẩn hóa những khác biệt này, đồng thời giữ được các đặc tính âm học giúp phân biệt từ đánh thức với lời nói nền. Đây là yêu cầu bảo toàn chất lượng quan trọng, ảnh hưởng trực tiếp đến mục tiêu độ chính xác 98% mà chúng ta đặt ra.
Đánh giá chất lượng cho KWS mở rộng các nguyên tắc chung bằng những chỉ số riêng cho âm thanh. Ngoài việc kiểm tra giá trị null hoặc mức độ phù hợp với lược đồ, hệ thống của chúng ta còn theo dõi mức nhiễu nền (tỷ lệ tín hiệu trên nhiễu phải trên 20 dB), điểm độ rõ âm thanh (dựa trên phân tích phổ tần số), và độ nhất quán về tốc độ nói (thời lượng từ đánh thức nằm trong 500 ms–800 ms). Pipeline sẽ đánh dấu những bản ghi có nhiễu, thời lượng, cắt đỉnh hoặc méo tiếng vượt ngoài các quy tắc chấp nhận của bối cảnh. Các bước sàng lọc này không chứng minh rằng một mẫu là hữu ích, nhưng chúng giúp giảm khả năng các lỗi đã biết lọt vào giai đoạn phát triển mô hình. Hãy nhớ figure 1 đã cho thấy các lỗi chất lượng dữ liệu sớm có thể gây hiệu ứng cộng dồn; kiểm tra ở nguồn sẽ giảm rủi ro đó trước khi các kết quả dẫn xuất làm vấn đề trầm trọng hơn.
Để chuyển đổi dữ liệu âm thanh cho KWS, chúng ta cần biến dạng sóng thô thành các định dạng phù hợp cho mô hình ML, đồng thời duy trì tính nhất quán giữa huấn luyện và phục vụ (serving). Dạng sóng âm thanh thô (chuỗi các giá trị biên độ được lấy mẫu hàng nghìn lần mỗi giây) có số chiều rất lớn. Các pipeline KWS thường biến chúng thành những biểu diễn gọn nhẹ hơn, nhấn mạnh các tần số và mẫu thời gian quan trọng nhất đối với lời nói. Figure 10 so sánh ba cách biểu diễn minh họa dùng trong pipeline này: dạng sóng gốc, spectrogram thời gian–tần số của nó, và một biểu diễn MFCC gọn nhẹ. Các biểu diễn đặc trưng chuẩn hóa này, thường là các hệ số cepstral tần số Mel (MFCC)21 hoặc spectrogram22, làm nổi bật các đặc tính quan trọng cho lời nói đồng thời giảm nhiễu và độ biến thiên giữa các điều kiện ghi âm khác nhau.
21 MFCC (hệ số cepstral tần số Mel): Phép biến đổi này đạt được độ gọn nhẹ và khả năng chống nhiễu nhờ áp dụng bộ lọc theo thang Mel, chọn lọc nhấn mạnh các tần số mà con người dùng để phân biệt lời nói. Quá trình này có thể giảm hàng nghìn mẫu âm thanh thô trong một cửa sổ thời gian nhỏ (ví dụ, 25 ms) xuống chỉ còn 13–39 hệ số, mức giảm chiều mạnh mẽ cần cho phần cứng luôn bật ở quy mô kilobyte. Nếu các tham số giữa huấn luyện và phục vụ (serving) không khớp, sẽ tạo ra độ lệch đặc trưng và có thể làm giảm độ chính xác.
22 Spectrogram: Biến đổi Fourier thời gian ngắn (STFT) tạo ra biểu diễn 2D này bằng cách chuyển dạng sóng một chiều thành ảnh thời gian–tần số. Nhờ đó, có thể áp dụng các mô hình ML kiểu xử lý ảnh để xử lý âm thanh. Tuy nhiên, điều này cũng tạo ra sự phụ thuộc cứng: chỉ cần tham số STFT lệch nhau (ví dụ, cửa sổ 25 ms so với 30 ms) là biểu diễn đặc trưng giữa huấn luyện và phục vụ (serving) sẽ khác nhau, làm giảm hiệu năng.
Các phép biến đổi idempotent
Độ tin cậy bổ sung khả năng thử lại an toàn cho các nền tảng về chất lượng này. Chất lượng tập trung vào thứ mà các phép biến đổi tạo ra, còn độ tin cậy điều chỉnh mức độ an toàn khi lặp lại chúng. Idempotency23 nghĩa là áp dụng một thao tác lặp đi lặp lại nhiều lần cũng có hiệu ứng như khi chỉ áp dụng một lần. Thuộc tính này đặc biệt quan trọng trong các hệ thống ML vận hành sản xuất, nơi xử lý có thể được thử lại sau lỗi, dữ liệu có thể được xử lý lại để sửa lỗi, hoặc cùng một dữ liệu có thể đi qua nhiều nhánh xử lý. Tính xác định là một yêu cầu liên quan nhưng khác biệt: cùng đầu vào và trạng thái đã được lưu lại phải tạo ra cùng đầu ra.
23 Idempotency: Từ tiếng Latin idem (“giống nhau”) + potens (“có công suất”) – theo nghĩa đen là “có cùng công suất khi áp dụng lại.” Trong các pipeline ML, idempotency cho phép thử lại an toàn sau các lỗi một phần: một thao tác không idempotent (ví dụ, thêm vào nhật ký) sẽ tạo ra bản trùng khi thử lại. Một thao tác idempotent để lại trạng thái kết quả như nhau dù áp dụng một lần hay nhiều lần.
Hãy hình dung với một công tắc đèn để tạo trực giác. Gạt công tắc sang vị trí “bật” thì đèn sáng. Gạt sang “bật” lần nữa, đèn vẫn sáng; thao tác này có thể lặp lại mà không đổi kết quả. Đây là hành vi idempotent. Ngược lại, một công tắc bật tắt (toggle switch) đổi trạng thái sau mỗi lần nhấn thì không idempotent: nhấn liên tục sẽ làm đèn luân phiên bật rồi tắt. Trong xử lý dữ liệu, ta muốn hành vi như công tắc đèn, tức là áp dụng lại cùng một phép biến đổi cho cùng một kết quả, chứ không phải kiểu công tắc bật tắt, nơi áp dụng lặp lại làm kết quả thay đổi khó lường.
Các phép biến đổi idempotent giúp phục hồi lỗi một cách đáng tin cậy. Khi một công việc xử lý bị lỗi giữa chừng, hệ thống có thể an toàn xử lý lại cùng dữ liệu mà không lo biến đổi trùng lặp hay trạng thái không nhất quán. Một phép biến đổi không idempotent có thể thêm dữ liệu vào các bản ghi hiện có, nên khi thử lại sẽ tạo trùng lặp. Ngược lại, một phép biến đổi idempotent sẽ upsert dữ liệu (tức là chèn nếu chưa tồn tại, cập nhật nếu đã tồn tại), nhờ đó thử lại vẫn cho ra cùng một trạng thái cuối. Sự khác biệt này trở nên cực kỳ quan trọng trong các hệ thống phân tán, nơi lỗi một phần xảy ra thường xuyên và thử lại là cơ chế phục hồi chính.
Xử lý các lỗi một phần trong quá trình xử lý dữ liệu đòi hỏi quản lý trạng thái thật cẩn thận. Các pipeline xử lý nên được thiết kế để mỗi giai đoạn có thể được thử lại độc lập mà không ảnh hưởng đến các giai đoạn khác. Các cơ chế checkpoint và khởi động lại cho phép phục hồi từ trạng thái xử lý thành công gần nhất thay vì phải bắt đầu lại từ đầu. Với các công việc xử lý dữ liệu chạy lâu trên tập dữ liệu quy mô terabyte, checkpoint tiến độ mỗi vài phút giúp, nếu lỗi xảy ra gần cuối, ta chỉ cần xử lý lại dữ liệu gần đây thay vì toàn bộ tập dữ liệu. Logic checkpoint phải theo dõi cẩn thận dữ liệu nào đã được xử lý và dữ liệu nào còn lại, đảm bảo không dữ liệu nào bị mất hoặc được xử lý hai lần.
Các phép biến đổi xác định là những phép biến đổi luôn tạo ra cùng một đầu ra cho cùng một đầu vào, không phụ thuộc vào các yếu tố bên ngoài như thời gian, số ngẫu nhiên hoặc trạng thái toàn cục có thể bị thay đổi. Các phép biến đổi phụ thuộc vào thời gian hiện tại (ví dụ: tính “số ngày kể từ sự kiện” dựa trên ngày hiện tại) sẽ phá vỡ tính xác định, vì việc xử lý lại dữ liệu lịch sử sẽ tạo ra kết quả khác nhau. Giải pháp là xác định rõ các điểm tham chiếu thời gian: thay vì tính “số ngày kể từ sự kiện”, hãy tính “số ngày từ sự kiện đến ngày tham chiếu”, trong đó ngày tham chiếu được cố định và lưu lại. Các phép toán ngẫu nhiên nên dùng bộ tạo số ngẫu nhiên có hạt giống (seed), trong đó hạt giống được suy ra một cách xác định từ dữ liệu đầu vào, nhằm đảm bảo khả năng tái tạo.
Để đảm bảo độ tin cậy trong pipeline KWS, việc trích xuất đặc trưng phải tái lập được. Quá trình tiền xử lý âm thanh phải có tính xác định: với cùng một tệp âm thanh thô, luôn tính ra cùng một bộ đặc trưng MFCC, bất kể thời điểm xử lý hay máy chủ nào thực hiện. Điều này cho phép gỡ lỗi hành vi của mô hình (luôn có thể tái tạo chính xác đặc trưng cho ví dụ có vấn đề), xử lý lại dữ liệu khi lỗi được sửa (kết quả vẫn nhất quán), và xử lý phân tán (các worker khác nhau tạo ra đặc trưng giống hệt từ cùng một đầu vào). Mã xử lý ghi lại toàn bộ tham số (kích thước cửa sổ biến đổi Fourier nhanh (FFT), độ dài bước nhảy, số lượng hệ số MFCC) trong cấu hình được quản lý phiên bản cùng với mã, đảm bảo khả năng tái lập theo thời gian và trên các môi trường thực thi. Dù thiết kế chặt chẽ, hệ thống sản xuất vẫn phải triển khai giám sát runtime để phát hiện sai lệch khi phát sinh; Vận hành machine learning trình bày so sánh trong vận hành và giám sát phân bố ở quy mô lớn.
Xử lý phân tán
Khi chất lượng và độ tin cậy đã được đảm bảo, ràng buộc tiếp theo là khả năng mở rộng. Chất lượng đảm bảo các phép biến đổi tạo ra đầu ra chính xác; độ tin cậy đảm bảo chúng tạo ra đầu ra nhất quán. Nhưng cả hai trở nên vô nghĩa nếu quá trình xử lý không theo kịp khối lượng dữ liệu hoặc hạn chót. Khi tập dữ liệu và số lượng thử nghiệm chạy đồng thời tăng, việc xử lý dữ liệu có thể vượt quá khả năng của một máy đơn, ngay cả khi dữ liệu thô vẫn còn nằm gọn trên bộ nhớ cục bộ. Khi đó, các kỹ thuật làm sạch dữ liệu vốn hoạt động tốt với gigabyte trong bộ nhớ phải trở nên nhận biết phân vùng, xử lý ngoài bộ nhớ chính (out-of-core) hoặc phân tán, mà không thay đổi ngữ nghĩa.
Những thách thức này xuất hiện khi việc đánh giá chất lượng phải theo kịp dữ liệu đầu vào, khi kỹ thuật đặc trưng đòi hỏi tính toán thống kê trên toàn bộ tập dữ liệu trước khi biến đổi từng bản ghi, và khi các pipeline biến đổi tạo ra nút thắt cổ chai ở quy mô rất lớn. Quá trình xử lý phải mở rộng từ giai đoạn phát triển (gigabyte dữ liệu trên máy tính xách tay) đến giai đoạn sản xuất (terabyte dữ liệu trên các cụm máy chủ) mà vẫn duy trì hành vi nhất quán.
Để gỡ các nút thắt khi mở rộng, dữ liệu phải được phân chia trên nhiều tài nguyên tính toán, kéo theo các thách thức về phối hợp. Phối hợp phân tán bị giới hạn bởi thời gian khứ hồi của mạng: thao tác cục bộ hoàn tất trong micro giây, còn phối hợp qua mạng mất mili giây, tạo ra chênh lệch độ trễ tới 1.000\(\times\). Đây là lý do vì sao các thao tác cần phối hợp toàn cục (như tính thống kê chuẩn hóa trên 100 máy) lại trở thành nút thắt. Mỗi phân vùng tính thống kê cục bộ rất nhanh, nhưng để gộp lại thì phải lấy thông tin từ tất cả phân vùng.
Tính cục bộ của dữ liệu trở nên cực kỳ quan trọng ở quy mô này. Với thông lượng đỉnh 10 GB/s, truyền một terabyte dữ liệu huấn luyện qua mạng mất khoảng 100 giây; đọc cùng lượng đó từ SSD 5 GB/s mất khoảng 200 giây. Hai con số này cùng bậc độ lớn, nên thiết kế hệ thống ML có xu hướng theo kiến trúc ‘tính toán theo dữ liệu’ (compute-follows-data).24 Khi các nút xử lý truy cập dữ liệu cục bộ ở tốc độ RAM (50–200 GB/s) nhưng phải phối hợp qua mạng chỉ 1–10 GB/s, chênh lệch băng thông sẽ tạo ra các nút thắt nghiêm trọng. Phân tán theo địa lý còn khuếch đại thách thức: phối hợp giữa các trung tâm dữ liệu phải xử lý độ trễ mạng (50–200 ms giữa các khu vực), các lỗi một phần (partial failures), và các ràng buộc pháp lý ngăn dữ liệu vượt biên giới. Hiểu rõ thao tác nào dễ song song hóa và thao tác nào cần phối hợp tốn kém sẽ quyết định kiến trúc hệ thống và đặc tính hiệu suất. Phụ phí này tạo thành một thuế phối hợp giới hạn xử lý dữ liệu phân tán. Mức thuế này, và việc tập trung hóa hay tổng hợp cái nào nhanh hơn, phụ thuộc vào tỷ lệ giữa thời gian khứ hồi mạng và thời gian tính toán cục bộ—suy ra trong phép tính nháp 1.7.
24 MapReduce: Được Dean and Ghemawat (2004) thiết kế tại Google để xử lý chỉ mục web nhiều petabyte của công ty trên hàng nghìn máy tính phổ thông. Bộ lập lịch của nó ưu tiên gán tác vụ map cho các nút đang giữ dữ liệu đầu vào, giảm lưu lượng mạng đầu vào. Mẫu nhận biết tính cục bộ này đã ảnh hưởng đến Hadoop và các hệ thống xử lý dữ liệu phân tán sau này.
Dean, Jeffrey, and Sanjay Ghemawat. 2004. “MapReduce: Simplified Data Processing on Large Clusters.” Proceedings of the 6th Symposium on Operating Systems Design and Implementation (OSDI), 137–50.
Tổng hợp cục bộ hiệu quả hơn gom-tất-cả khi độ trễ mạng chi phối.
25 Parquet: Một định dạng lưu trữ theo cột (columnar storage format) tổ chức dữ liệu theo cột, không theo hàng. Điều này rất quan trọng cho các tối ưu hóa trên một máy đã nêu; thay vì lãng phí đọc toàn bộ một hàng CSV chỉ để truy cập vài cột, trình đọc Parquet chỉ tải các cột cần cho phép tính. Mức giảm I/O đạt được phụ thuộc vào các cột được chọn, mã hóa, nén và khối lượng công việc (workload).
Xử lý trên một máy có thể đáp ứng những khối lượng công việc (workload) lớn đáng ngạc nhiên nếu được thiết kế cẩn thận. Các máy chủ hiện đại với 256 gigabyte RAM có thể xử lý các tập dữ liệu vài terabyte bằng xử lý ngoài bộ nhớ (out-of-core processing) để truyền dữ liệu từ đĩa theo luồng. Các thư viện như Dask hoặc Vaex cung cấp API kiểu pandas, tự động xử lý theo luồng và song song hóa phép tính trên nhiều lõi. Trước khi đầu tư vào hạ tầng xử lý phân tán, các nhóm nên khai thác tối đa tối ưu hóa trên một máy: dùng định dạng dữ liệu hiệu quả (Parquet25 thay vì CSV), giảm cấp phát bộ nhớ, dùng phép toán vector hóa và tận dụng song song đa lõi. Sự đơn giản trong vận hành của xử lý trên một máy (không cần điều phối mạng, không có lỗi từng phần, gỡ lỗi đơn giản) khiến nó đáng ưu tiên khi hiệu suất là đủ.
Napkin Math 1.7: Chi phí phối hợp
Vấn đề: Cần tính chuẩn hóa trung bình cho 1 TB đặc trưng phân tán trên 100 nút. Cách nào nhanh hơn: (A) gom tất cả dữ liệu về một nút và tính tập trung, hay (B) tính trung bình cục bộ rồi tổng hợp?
Tùy chọn A (tập trung):
- Truyền 1 TB qua mạng 10 GB/s: 100 giây
- Tính trung bình trên một nút: ~5–20 giây ở băng thông RAM
- Tổng cộng: ~105–120 giây
Tùy chọn B (phân tán):
- Mỗi nút tính trung bình cục bộ: ~0,05–0,2 giây (10 GB ở băng thông RAM)
- Gửi 100 giá trị trung bình cục bộ (mỗi giá trị 8 byte): \(<1\text{ ms}\)
- Tổng hợp: không đáng kể
- Tổng cộng: ~0,05–0,2 giây (nhanh hơn hàng trăm đến vài nghìn lần)
Hiểu biết về hệ thống: Các phép rút gọn có thể tách theo đại số thường cho phép tổng hợp từng phần ngay gần nơi lưu trữ dữ liệu; ví dụ, tính trung bình phân tán sẽ mang theo các tổng và số đếm cục bộ. Các phép nối (join) và tích Descartes (cross-product) có thể cần xáo trộn (shuffling) dữ liệu, dù việc phân vùng và đặt cùng vị trí (colocation) có thể giảm chi phí này. Thiết kế pipeline nên giảm thiểu việc di chuyển dữ liệu không cần thiết bằng cách đẩy những phần tính toán phù hợp về phía dữ liệu — nguyên tắc compute-follows-data vốn là trọng tâm của các hệ thống như MapReduce (Dean and Ghemawat 2004), Spark (Zaharia et al. 2010) và các framework ML hiện đại.
Zaharia, Matei, Mosharaf Chowdhury, Michael J. Franklin, Scott Shenker, and Ion Stoica. 2010. “Spark: Cluster Computing with Working Sets.” HotCloud 10: 10–10.
26 Định luật Amdahl: Amdahl (1967) đã trình bày lập luận về phần tuần tự tại Hội nghị Máy tính Liên hợp Mùa xuân AFIPS năm 1967 để giải thích vì sao các thiết kế đa bộ xử lý cho lợi ích giảm dần. Luận điểm cốt lõi—rằng phần tuần tự của một khối lượng công việc (workload) áp đặt một trần cứng lên mức độ song song—áp dụng trực tiếp cho các pipeline dữ liệu: các thao tác như tính thống kê chuẩn hóa toàn cục buộc phải có các giai đoạn tổng hợp tuần tự, từ đó giới hạn tốc độ tăng tốc bất kể có bao nhiêu worker xử lý các bản ghi riêng lẻ song song.
Amdahl, Gene M. 1967. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” Proceedings of the April 18-20, 1967, Spring Joint Computer Conference on - AFIPS ’67 (Spring), AFIPS ’67 (spring), 483–85. https://doi.org/10.1145/1465482.1465560.
Việc song song hóa quá trình nạp dữ liệu trên các worker phân tán mang lại lợi ích thông lượng giảm dần bất cứ khi nào các nút thắt cổ chai không thể phân vùng—như giải nén tuần tự hoặc việc lấy khóa ở cơ sở dữ liệu trung tâm—giới hạn mức độ đồng thời. Định luật Amdahl26 chính thức hóa trần khả năng mở rộng này trong equation 4:
\[\text{Speedup} \leq \frac{1}{f_{\text{serial}} + \frac{f_{\text{parallel}}}{N_{\text{workers}}}} \tag{4}\] trong đó \(f_{\text{serial}}\) biểu thị phần thời gian thực thi nằm ở các giai đoạn vốn dĩ tuần tự, \(f_{\text{parallel}}\) là phần có thể song song hóa (\(f_{\text{serial}} + f_{\text{parallel}} = 1\)), và \(N_{\text{workers}}\) là số tiến trình worker đang hoạt động. Ngay cả khi 90 phần trăm của một pipeline trích xuất đặc trưng được song song hóa trên hàng trăm nút (\(f_{\text{serial}} = 0.10\)), tốc độ tăng tốc tối đa về lý thuyết cũng không thể vượt quá \(10\times\), cho thấy loại bỏ các nút thắt cổ chai I/O tuần tự cần được ưu tiên hơn việc chỉ thêm các nút tính toán.
Việc lựa chọn framework cũng đặt ra câu hỏi phối hợp tương tự phân tích Amdahl: phụ thuộc vào những phần của phép biến đổi có thể chạy độc lập và những phần cần trạng thái chung hoặc phải giữ thứ tự. Apache Spark song song hóa các phép biến đổi trên cụm máy, tự động quản lý phân vùng dữ liệu, lập lịch tác vụ và chịu lỗi. Beam cung cấp một API thống nhất cho cả xử lý theo batch và xử lý luồng, cho phép cùng một logic biến đổi chạy trên nhiều công cụ thực thi khác nhau (Spark, Flink, Dataflow). API tf.data của TensorFlow tối ưu hóa các pipeline nạp dữ liệu cho huấn luyện ML, hỗ trợ đọc phân tán, tìm nạp trước (prefetching) và biến đổi. Việc lựa chọn framework phụ thuộc vào xử lý là batch hay streaming, cách các phép biến đổi có thể được song song hóa, và môi trường thực thi sẵn có.
Sự đánh đổi về nơi đặt tính toán đặc trưng được giới thiệu trong section 1.4.5.3 càng trở nên quan trọng khi mở rộng quy mô. Khi xử lý phân tán làm tăng thông lượng, cần cân nhắc kỹ chi phí tính lại các đặc trưng trên hàng trăm worker mỗi epoch so với chi phí lưu trữ khi vật hóa các đặc trưng đó một lần. Ở quy mô terabyte, ngay cả những chi phí tính toán nhỏ cho mỗi ví dụ cũng có thể nhân lên thành tổng chi phí đáng kể, càng khẳng định vì sao các hệ thống sản xuất thường áp dụng mẫu hình lai: tính trước các đặc trưng ổn định, tốn kém; đồng thời tính các đặc trưng rẻ, nhạy thời gian một cách tức thì (on-the-fly).
Khả năng mở rộng trong pipeline KWS xuất hiện ở nhiều giai đoạn. Ở giai đoạn phát triển, ta thường xử lý trên một máy với các tập dữ liệu mẫu để có thể lặp thử nhanh. Khi huấn luyện ở quy mô lớn, có thể cần xử lý phân tán nếu tập dữ liệu (23.4 million examples) vượt quá khả năng của một máy đơn, hoặc khi cần chạy nhiều thí nghiệm đồng thời. Việc trích xuất đặc trưng theo từng tệp rất dễ song song hóa, nhưng tốc độ end-to-end bị giới hạn bởi băng thông lưu trữ dùng chung, các thao tác trên siêu dữ liệu, lập lịch, và tắc nghẽn khi ghi đầu ra. Khi triển khai vào môi trường sản xuất, bên cạnh giới hạn kích thước mô hình (64 KB), còn có ngân sách trạng thái tiền xử lý trên edge nghiêm ngặt hơn (16 KB), đòi hỏi phải tối ưu hóa cẩn trọng mức sử dụng tài nguyên để toàn bộ xử lý nằm trong khả năng của thiết bị.
Dòng dõi biến đổi
Quản trị là trụ cột cuối cùng, hoàn thiện bức tranh bốn trụ cột về xử lý dữ liệu bằng cách đảm bảo trách nhiệm và khả năng tái lập. Trụ cột quản trị yêu cầu theo dõi những biến đổi nào đã áp dụng, khi nào chúng chạy, phiên bản mã xử lý nào chạy, và các tham số đã dùng. Dòng dõi biến đổi27 này hỗ trợ khả năng tái lập, gỡ lỗi, kiểm toán và cải tiến lặp khi phát hiện lỗi trong quá trình biến đổi. Nó có thể cung cấp bằng chứng cho việc lập tài liệu hoặc các quy trình tuân thủ, nhưng chỉ riêng dòng dõi không thể giải thích quyết định của mô hình hay thiết lập sự tuân thủ theo quy định.
27 Dòng dõi dữ liệu: Khi một mô hình đưa ra dự đoán sai hoặc mang tính phân biệt đối xử, dòng dõi giúp các kỹ sư xác định vấn đề bắt nguồn từ đâu: dữ liệu thô, tính toán đặc trưng, huấn luyện hay phục vụ (serving). Dấu vết này có thể hỗ trợ điều tra sự cố và các yêu cầu về tài liệu theo từng khu vực pháp lý, nhưng mức độ hữu ích của nó phụ thuộc vào việc ghi nhận đầy đủ và lịch sử được lưu trữ; nó không đảm bảo có thể giải thích được hành vi của mô hình.
Phiên bản hóa các biến đổi ghi nhận phiên bản mã xử lý đã tạo ra mỗi tập dữ liệu. Khi logic biến đổi thay đổi (sửa lỗi, thêm đặc trưng hoặc cải thiện chất lượng), số phiên bản được tăng. Các tập dữ liệu được gắn nhãn bằng phiên bản biến đổi đã tạo ra chúng, nhờ đó có thể xác định tất cả dữ liệu cần xử lý lại khi sửa lỗi. Việc phiên bản hóa này không chỉ dừng ở phiên bản mã, mà còn mở rộng để ghi lại toàn bộ môi trường xử lý: phiên bản thư viện (ví dụ, các phiên bản NumPy khác nhau có thể cho kết quả số hơi khác), cấu hình runtime (các biến môi trường ảnh hưởng đến hành vi), và hạ tầng thực thi (kiến trúc CPU ảnh hưởng đến độ chính xác số học dấu phẩy động).
Theo dõi tham số lưu giữ các giá trị cụ thể đã dùng trong quá trình biến đổi. Với chuẩn hóa, điều này nghĩa là lưu giá trị trung bình và độ lệch chuẩn tính từ dữ liệu huấn luyện. Với mã hóa phân loại, ta lưu từ vựng (tập tất cả danh mục đã quan sát). Với kỹ thuật tạo đặc trưng, ta lưu mọi hằng số, ngưỡng, hoặc tham số dùng trong quá trình tính đặc trưng. Các tham số này thường được tuần tự hóa cùng với các tạo phẩm mô hình, để quá trình phục vụ (serving) dùng đúng các tham số như lúc huấn luyện. Các framework ML hiện đại như TensorFlow và PyTorch cung cấp cơ chế đóng gói các tham số tiền xử lý cùng với mô hình, giúp đơn giản hóa triển khai và đảm bảo tính nhất quán.
Dòng dõi xử lý phục vụ mục tiêu tái lập theo dõi toàn bộ lịch sử biến đổi từ dữ liệu thô đến các đặc trưng cuối cùng. Nó ghi lại những tệp dữ liệu thô nào được đọc, áp dụng các biến đổi gì theo thứ tự nào, dùng tham số nào, và thời điểm xử lý diễn ra. Các hệ thống dòng dõi như Apache Atlas, Amundsen, hoặc các giải pháp thương mại được tích hợp vào pipeline để tự động ghi nhận luồng này. Khi mô hình dự đoán sai, kỹ sư có thể truy vết ngược theo dòng dõi để xác định dữ liệu huấn luyện góp phần tạo ra hành vi đó, các điểm chất lượng gắn với dữ liệu ấy, các biến đổi đã áp dụng, và liệu có thể tái lập chính xác kịch bản đó để điều tra hay không.
Phiên bản mã giúp gắn kết kết quả xử lý với đúng đoạn mã đã tạo ra chúng. Khi mã xử lý được quản lý trong hệ thống kiểm soát phiên bản (Git), mỗi tập dữ liệu nên ghi lại hash của commit đã tạo ra nó. Nhờ vậy, ta có thể tái lập chính xác môi trường xử lý: checkout đúng phiên bản mã, cài đặt các phụ thuộc được liệt kê tại phiên bản đó, và chạy xử lý với các tham số y hệt. Các công nghệ container như Docker đơn giản hóa việc này bằng cách đóng gói toàn bộ môi trường xử lý (mã, phụ thuộc, thư viện hệ thống) vào một image bất biến, có thể chạy lại sau nhiều tháng hoặc nhiều năm và cho ra kết quả giống hệt.
Trong pipeline KWS, trụ cột quản trị theo dõi các tham số xử lý âm thanh ảnh hưởng trực tiếp đến cách mô hình hoạt động. Chẳng hạn, khi âm thanh được chuẩn hóa về mức âm lượng tiêu chuẩn, mức âm lượng tham chiếu sẽ được lưu lại. Khi FFT đưa âm thanh sang miền tần số, kích thước cửa sổ, độ dài bước nhảy (hop length) và hàm cửa sổ (Hamming, Hanning, v.v.) đều được ghi nhận. Khi tính MFCC, số lượng hệ số, dải tần số và các tham số bộ lọc mel cũng được lưu. Việc theo dõi toàn diện các tham số này mang lại nhiều lợi ích quan trọng: tái tạo chính xác dữ liệu huấn luyện khi gỡ lỗi mô hình, xác thực rằng phục vụ (serving) dùng đúng tiền xử lý như khi huấn luyện, và nghiên cứu có hệ thống cách các lựa chọn tiền xử lý ảnh hưởng đến độ chính xác của mô hình. Nếu thiếu hạ tầng quản trị này, các nhóm sẽ phải dựa vào tài liệu thủ công vốn dễ lỗi thời hoặc sai, dẫn đến lệch giữa huấn luyện và phục vụ (serving), làm giảm hiệu suất trong môi trường sản xuất.
Dữ liệu sạch, đã chuẩn hóa và sẵn sàng để tạo đặc trưng vẫn vô nghĩa nếu không được gán ý nghĩa. Điều này rất quan trọng về mặt vận hành, vì một phép biến đổi có thể hoàn toàn tái lập nhưng lại gán sai nhãn đích, và ngay cả tính xác định của pipeline cũng không thể sửa một ví dụ bị gán nhãn sai. Câu hỏi còn lại là gán ý nghĩa thế nào: nhãn cho biết đoạn âm thanh nào chứa từ đánh thức và đoạn nào là tiếng ồn nền, qua đó đưa phán đoán của con người vào một pipeline vốn đã tự động.
Self-Check: Question
An engineer normalizes a numerical feature by computing standard \(z\)-scores: \(x' = (x - \mu)/\sigma\). During production serving, how must the parameters \(\mu\) and \(\sigma\) be handled to satisfy the Consistency Imperative and prevent training-serving skew?
- Persist the exact \(\mu\) and \(\sigma\) computed on the training dataset alongside the model artifact, loading and applying those fixed constants to live serving inputs.
- Recompute \(\mu\) and \(\sigma\) dynamically over each incoming serving batch to ensure the live data is always centered at zero.
- Discard \(\mu\) and \(\sigma\) entirely at inference time and rely on batch normalization layers inside the neural network.
- Compute \(\mu\) and \(\sigma\) independently over a rolling 1-hour window of serving traffic to track seasonal shifts.
A distributed preprocessing job must compute global mean normalization across \(1\text{ TB}\) of feature data distributed evenly over 100 worker nodes. Architecture 1 gathers all \(1\text{ TB}\) of raw data to a central coordinator node over a \(1\text{ Gbps}\) network to compute the global mean. Architecture 2 computes a local sum and record count on each node (transferring only 16 bytes per node to the coordinator) and calculates the exact global mean locally. What is the systems trade-off and coordination tax difference?
- Centralized gathering is faster because centralizing all data eliminates worker-level floating-point rounding errors.
- Local aggregation produces only an approximation of the mean, whereas centralized gathering computes the true mathematical value.
- Both approaches take identical execution time because the total number of arithmetic additions is preserved.
- Centralized gathering incurs a massive coordination tax, taking ~8,000 seconds to transfer 1 TB over 1 Gbps, whereas local aggregation transfers under 2 KB of aggregated statistics in sub-seconds while computing the exact same mathematical mean.
Define idempotency in the context of data transformation pipelines and explain why idempotent operations (such as upserts) are essential for fault recovery in distributed ML pipelines.
True or False: Using the identical Python preprocessing function in both training and serving code repositories is sufficient to eliminate training-serving skew.
Arrange the sequential signal processing stages used in Keyword Spotting (KWS) pipelines to extract Mel-Frequency Cepstral Coefficients (MFCCs) from raw audio waveforms:
- Mel-filterbank application (emphasizing human speech frequency bands)
- Discrete Cosine Transform (DCT) for decorrelation and dimensionality reduction
- Short-Time Fourier Transform (STFT) to produce time-frequency power spectrum
- Raw audio framing and windowing (e.g., 25 ms frames)
- Pre-emphasis filtering to amplify high frequencies
Gán nhãn dữ liệu
Các pipeline xử lý trong section 1.5 biến đổi dữ liệu thô thành các đặc trưng có cấu trúc. Tuy nhiên, học có giám sát vẫn cần các nhãn để cho mô hình biết mẫu nào tương ứng với mỗi mục tiêu. Lấy ví dụ hệ thống KWS của chúng ta: các giai đoạn thu nạp và xử lý đã tạo ra hàng triệu phổ âm thanh (spectrogram) sạch, được chuẩn hóa. Nhưng để huấn luyện mô hình, cần có người hoặc một hệ thống nào đó xác định rõ ràng đoạn âm thanh nào chứa từ đánh thức và đoạn nào là tiếng ồn nền. Thông tin xác định này chính là ground truth,28 và việc tạo ra nó ở quy mô lớn thường là giai đoạn phụ thuộc nhiều vào con người và dễ xảy ra lỗi nhất trong toàn bộ pipeline.
28 Ground truth: Thuật ngữ này xuất phát từ viễn thám, nơi các phép đo từ quỹ đạo được kiểm chứng bằng cách cử một nhóm đến vị trí thực tế – tức là ‘mặt đất’ – để xác định ‘sự thật’. Nguồn gốc này hàm ý một cảnh báo ở góc độ hệ thống: các nhãn trong học máy chỉ là đại diện (proxy) cho thực tế, chứ không phải bản thân thực tế. Chẳng hạn, khi một người gán nhãn thuê ngoài (crowdsourced annotator) gán nhãn ‘mèo’ cho một bức ảnh, nhãn đó phản ánh đánh giá của người gán nhãn, chứ không phải một sự thật khách quan. Mọi chỉ số đánh giá sau đó – như độ chính xác (accuracy), độ chính xác từng phần (precision), độ thu hồi (recall) – đều được đo lường dựa trên đại diện này. Điều đó có nghĩa là các lỗi về chất lượng nhãn sẽ âm thầm lan truyền vào mọi đánh giá của mô hình.
Không như các phép biến đổi tự động có thể chạy song song trên nhiều máy, việc gán nhãn đưa phán đoán của con người vào pipeline, từ đó tạo ra những thách thức kỹ thuật đặc thù. Ví dụ, một người gán nhãn thuê ngoài có thể gán nhãn sai một câu nói thì thầm ‘Alexa’ thành tiếng ồn nền. Một bác sĩ X-quang chuyên gia có thể không đồng ý với đồng nghiệp về một chẩn đoán giáp ranh. Những bất đồng như vậy có thể xuất phát từ sự mơ hồ thực sự, hướng dẫn không rõ ràng, lỗi của người gán nhãn, hoặc sự khác biệt về chuyên môn; hệ thống gán nhãn cần phân biệt và quản lý các nguyên nhân này, thay vì coi mọi bất đồng là không thể làm rõ. Do đó, hạ tầng cần phải xử lý được thông lượng, kiểm soát chất lượng, quản lý chi phí và quản trị.
Các loại nhãn và yêu cầu hệ thống
Xây dựng hệ thống gán nhãn hiệu quả đòi hỏi hiểu rõ cách các loại nhãn khác nhau ảnh hưởng đến kiến trúc hệ thống và nhu cầu tài nguyên. Hãy xét một ví dụ thực tế: xây dựng một hệ thống thành phố thông minh cần phát hiện và theo dõi các đối tượng như phương tiện, người đi bộ và biển báo giao thông từ luồng video. Nhãn ghi lại thông tin về các tác vụ hoặc khái niệm chính, và mỗi loại nhãn đặt ra những yêu cầu riêng về lưu trữ, tính toán và xác thực.
Nhãn phân loại là dạng đơn giản nhất, dùng để phân loại hình ảnh bằng một nhãn cụ thể hoặc nhiều nhãn (trong phân loại đa nhãn), chẳng hạn gán một ảnh là “ô tô” hay “người đi bộ”. Dù khái niệm đơn giản, một hệ thống sản xuất xử lý hàng triệu khung hình video vẫn phải lưu trữ và truy xuất các nhãn này một cách hiệu quả. Yêu cầu lưu trữ khá nhỏ (chỉ một số nguyên hoặc chuỗi cho mỗi ảnh), nhưng cách truy xuất lại rất quan trọng: quá trình huấn luyện thường lấy mẫu ngẫu nhiên các tập con, trong khi xác thực cần truy cập tuần tự toàn bộ nhãn, dẫn đến các chiến lược lập chỉ mục khác nhau.
Hộp giới hạn mở rộng so với phân loại đơn thuần bằng cách xác định vị trí đối tượng, vẽ một hộp bao quanh mỗi đối tượng quan tâm. Hệ thống phải theo dõi cả danh tính đối tượng và vị trí trong không gian ở từng khung hình. Thông tin không gian này đưa ra những thách thức mới về lưu trữ và xử lý, đặc biệt khi theo dõi các đối tượng di chuyển qua các khung hình video. Mỗi hộp giới hạn lưu bốn tọa độ (x, y, chiều rộng, chiều cao) cùng lớp đối tượng, nên dung lượng lưu trữ tăng theo số lượng đối tượng được chú thích trên mỗi ảnh thay vì một nhãn kích thước cố định cho mỗi ảnh. Việc chú thích hộp giới hạn đòi hỏi định vị chính xác đến từng pixel, tốn thời gian gấp 10–20\(\times\) so với phân loại, làm ảnh hưởng đáng kể đến thông lượng và chi phí gán nhãn.
Độ chi tiết chú thích càng cao thì quy mô lưu trữ và xử lý càng tăng.
Bản đồ phân đoạn cung cấp thông tin toàn diện nhất bằng cách phân loại đối tượng ở cấp độ pixel, làm nổi bật từng đối tượng bằng một màu riêng. Với hệ thống giám sát giao thông của chúng ta, điều này có thể là vẽ đường viền chính xác cho từng phương tiện, người đi bộ và biển báo. Những chú thích chi tiết này làm tăng đáng kể nhu cầu lưu trữ và xử lý. Một mặt nạ phân đoạn cho hình ảnh \(1920{\times}1080\) cần khoảng 2.1M nhãn (mỗi pixel một nhãn), so với khoảng 10 hộp giới hạn hoặc chỉ một nhãn phân loại. Nếu mỗi hộp lưu 4 tọa độ, thì số mục nhãn vô hướng sẽ nhiều hơn khoảng 51,840× lần so với 10 hộp, chưa tính đến việc mã hóa cho từng giá trị. Thêm nữa, số giờ cần cho việc phân đoạn thủ công mỗi hình ảnh khiến cách làm này chỉ phù hợp khi thật sự cần độ chính xác đến từng pixel.
Figure 11 so sánh năm kiểu chú thích, và lựa chọn phụ thuộc vào dữ liệu đầu vào, nhiệm vụ và ngân sách chú thích. Phân loại có thể gán nhãn cho toàn bộ khung cảnh, còn hộp giới hạn và bản đồ phân đoạn giúp định vị đối tượng hoặc vùng. Các tập dữ liệu dùng trong thực tế có thể kết hợp nhiều kiểu: một khung hình từ camera có thể có nhãn cho toàn cảnh, các hộp chướng ngại vật và mặt nạ vùng đường đi, với mỗi loại nhãn phục vụ một nhiệm vụ xuống dòng riêng.
Ngoài các nhãn hình học này, các hệ thống vận hành cũng phải quản lý siêu dữ liệu phong phú, thiết yếu cho kiểm soát chất lượng và gỡ lỗi. Tập dữ liệu Common Voice (Ardila et al. 2020) là một ví dụ điển hình trong nhận dạng giọng nói: theo dõi thông tin nhân khẩu học của người nói để đảm bảo công bằng, ghi nhận các chỉ số chất lượng để lọc, và thông tin ngôn ngữ để hỗ trợ đa ngôn ngữ. Nếu hệ thống giám sát giao thông của chúng ta trục trặc khi trời mưa, siêu dữ liệu về thời tiết được ghi lại lúc thu thập sẽ giúp xác định đúng khoảng trống vùng phủ. Yêu cầu về siêu dữ liệu này cho thấy lựa chọn loại nhãn tạo ra tác động dây chuyền lên toàn bộ thiết kế hệ thống: cơ sở hạ tầng phải tối ưu hóa lưu trữ cho định dạng đã chọn, triển khai các mẫu truy xuất phù hợp, và theo dõi phiên bản mô hình nào dùng phiên bản nhãn nào để đối chiếu cải thiện chất lượng với mức tăng hiệu suất.
Ardila, Rosana, Megan Branson, Kelly Davis, Michael Kohler, Josh Meyer, Michael Henretty, Reuben Morais, Lindsay Saunders, Francis Tyers, and Gregor Weber. 2020. “Common Voice: A Massively-Multilingual Speech Corpus.” Proceedings of the Twelfth Language Resources and Evaluation Conference, 4218–22.
Độ chính xác và sự đồng thuận của nhãn
Trong lĩnh vực gán nhãn, chất lượng nhãn tập trung vào việc đảm bảo nhãn chính xác, dù nhiều nhiệm vụ gán nhãn vốn mang tính chủ quan và mơ hồ. Ngay cả khi có hướng dẫn rõ ràng và hệ thống được thiết kế cẩn thận, một phần nhãn vẫn sẽ không chính xác (Northcutt et al. 2021; Thyagarajan et al. 2022). Thách thức không phải là loại bỏ hoàn toàn lỗi gán nhãn (điều này là không thể) mà là đo lường một cách có hệ thống mức độ đồng thuận giữa người chú thích và quản lý tỷ lệ lỗi để giữ chúng trong giới hạn không làm giảm hiệu suất của mô hình.
Thyagarajan, Aditya, Elı́as Snorrason, Curtis G. Northcutt, and Jonas Mueller. 2022. “Identifying Incorrect Annotations in Multi-Label Classification Data.” CoRR abs/2211.13895. https://doi.org/10.48550/ARXIV.2211.13895.
Lỗi gán nhãn phát sinh từ hai nguồn riêng biệt, mỗi nguồn đòi hỏi phản ứng kỹ thuật khác nhau. Figure 12 đưa ra các ví dụ cụ thể cho cả hai kiểu lỗi. Một số trường hợp đến từ đầu vào suy giảm hoặc mơ hồ, khiến khó suy ra nhãn đúng chỉ từ dữ liệu; số khác nhìn thì rõ ràng nhưng để gán nhãn chính xác lại cần kiến thức lĩnh vực, ngữ nghĩa đặc thù của tập dữ liệu, hoặc đánh giá của chuyên gia. Những kiểu lỗi này định hướng các quyết định kiến trúc về tiêu chuẩn người gán nhãn, cách định tuyến tác vụ và cơ chế đồng thuận: lỗi do chất lượng dữ liệu kém thì cần lọc từ đầu nguồn, còn lỗi do thiếu chuyên môn thì cần định tuyến người gán nhãn theo tầng.
Northcutt, Curtis G., Anish Athalye, and Jonas Mueller. 2021. “Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks.” arXiv Preprint arXiv:2103.14749 34: 19075–90. https://doi.org/10.48550/arxiv.2103.14749.
Với những thách thức về chất lượng vốn có này, các hệ thống ML sản xuất áp dụng nhiều lớp kiểm soát chất lượng. Các kiểm tra chất lượng có hệ thống liên tục giám sát pipeline gán nhãn bằng cách lấy mẫu ngẫu nhiên dữ liệu đã gán nhãn để chuyên gia xem xét, đồng thời dùng các phương pháp thống kê để gắn cờ lỗi tiềm ẩn. Cơ sở hạ tầng phải xử lý hiệu quả các kiểm tra này trên hàng triệu ví dụ mà không tạo nút thắt cổ chai. Các chiến lược lấy mẫu thường xác thực 1-10% số nhãn, cân bằng giữa khả năng phát hiện và chi phí đánh giá. Với các ứng dụng rủi ro cao như chẩn đoán y tế hoặc xe tự lái, có thể xác thực 100% số nhãn thông qua nhiều đánh giá độc lập; ngược lại, các ứng dụng ít rủi ro hơn như đề xuất sản phẩm có thể chỉ xác thực 1% qua kiểm tra ngẫu nhiên.
Ngoài các phương pháp lấy mẫu ngẫu nhiên, thu thập nhiều nhãn cho mỗi điểm dữ liệu, thường gọi là “gán nhãn đồng thuận”, có thể giúp nhận diện các trường hợp gây tranh cãi hoặc mơ hồ. Các nền tảng gán nhãn thương mại như Labelbox và Scale AI cung cấp các quy trình kiểm soát chất lượng theo tầng và dựa trên đồng thuận (Labelbox, Inc. 2024; Scale AI, Inc. 2024), nhưng lõi thống kê vẫn là mức độ đồng thuận giữa những người gán nhãn. Hạ tầng đồng thuận thường thu thập nhiều nhãn cho mỗi ví dụ, rồi tính các chỉ số như Fleiss’ kappa, một tổng quát hóa của thống kê Cohen’s kappa (được giới thiệu trong section 1.4.3) từ hai người đánh giá lên bất kỳ số lượng người gán nhãn nào (Fleiss 1971). Các ví dụ có mức đồng thuận thấp, dựa trên các ngưỡng như dải Landis–Koch dùng như một quy tắc thực nghiệm, sẽ được chuyển cho chuyên gia xem xét thay vì cố ép đạt đồng thuận ở những trường hợp thực sự mơ hồ (Landis and Koch 1977).
Labelbox, Inc. 2024. Labelbox Consensus Documentation.
Scale AI, Inc. 2024. Scale AI Advanced Settings.
Fleiss, Joseph L. 1971. “Measuring Nominal Scale Agreement Among Many Raters.” Psychological Bulletin 76 (5): 378–82. https://doi.org/10.1037/h0031619.
Cách tiếp cận đồng thuận phản ánh một sự đánh đổi kinh tế, điều cốt yếu để hệ thống có thể mở rộng. Việc chuyên gia xem xét tốn kém hơn cho mỗi ví dụ so với gán nhãn cộng đồng, nhưng ép buộc đồng thuận cho các ví dụ mơ hồ bằng bỏ phiếu đa số của người không chuyên có thể tạo ra nhãn có độ chệch (bias) một cách hệ thống. Bằng cách chỉ chuyển những trường hợp thực sự mơ hồ—được phát hiện qua mức đồng thuận thấp giữa những người gán nhãn hoặc không vượt qua các kiểm tra tiêu chuẩn vàng—đến chuyên gia, hệ thống cân bằng được chi phí và chất lượng. Cách tiếp cận theo tầng này cho phép xử lý hàng triệu ví dụ với chi phí hợp lý, đồng thời duy trì chuẩn chất lượng nhờ các can thiệp có trọng tâm của chuyên gia.
Trong khi hạ tầng kỹ thuật là nền tảng cho kiểm soát chất lượng, các hệ thống gán nhãn hiệu quả cũng phải tính đến yếu tố con người. Khi làm việc với người gán nhãn, tổ chức cần các hệ thống đáng tin cậy để huấn luyện và hướng dẫn. Điều này bao gồm: tài liệu rõ ràng với các ví dụ về cách gán nhãn chính xác; minh họa trực quan các trường hợp edge và cách xử lý; cơ chế phản hồi định kỳ cho biết độ chính xác của người gán nhãn trên các ví dụ chuẩn vàng; và các buổi hiệu chuẩn nơi họ cùng thảo luận các trường hợp mơ hồ để xây dựng hiểu biết chung. Với các tác vụ phức tạp hoặc chuyên biệt theo miền, hệ thống có thể phân tầng quyền truy cập, định tuyến các trường hợp khó tới những người gán nhãn có chuyên môn phù hợp, dựa trên độ chính xác đã được chứng minh của họ trên các ví dụ tương tự.
Giám sát chất lượng tạo ra một lượng lớn dữ liệu cần được xử lý và theo dõi hiệu quả. Những tín hiệu hữu ích nhất trải rộng trên nhiều khía cạnh. Tỷ lệ đồng thuận giữa người gán nhãn cho biết liệu nhiều người có cùng gán một nhãn cho một ví dụ hay không, trong khi điểm tin cậy của nhãn phản ánh mức độ chắc chắn của họ về quyết định. Thời gian cho mỗi lượt gán nhãn là một chỉ báo hai mặt: quá nhanh có thể cho thấy cẩu thả, còn quá lâu gợi ý bối rối hoặc hướng dẫn chưa rõ. Mẫu lỗi phơi bày các độ chệch (bias) có hệ thống hoặc những hiểu lầm trong nhóm người gán nhãn, và hiệu suất của họ trên các ví dụ chuẩn vàng cung cấp cơ sở để hiệu chuẩn theo chuẩn vàng. Cuối cùng, phân tích nhân khẩu học về hành vi của người gán nhãn giúp phát hiện liệu có nhóm nào gán nhãn khác biệt một cách có hệ thống hay không, điều này có thể vô tình đưa độ chệch (bias) không mong muốn vào dữ liệu huấn luyện. Các chỉ số này cần được tính toán và cập nhật hiệu quả trên hàng triệu ví dụ, thường đòi hỏi các pipeline phân tích chuyên dụng xử lý dữ liệu gán nhãn gần như theo thời gian thực, nhằm phát hiện vấn đề chất lượng trước khi chúng ảnh hưởng đến khối lượng lớn dữ liệu.
Mở rộng quy mô với gán nhãn có hỗ trợ AI
Trụ cột về khả năng mở rộng định vị AI như công cụ tăng lực cho việc gán nhãn của con người, không phải để thay thế. Việc gán nhãn thủ công khó theo kịp nhu cầu dữ liệu của hệ thống, còn gán nhãn hoàn toàn tự động thì không thể đưa ra phán đoán đáng tin cậy cho mọi trường hợp mơ hồ hoặc rủi ro cao. Gán nhãn có hỗ trợ AI đi giữa hai thái cực này: dùng tự động hóa để xử lý các trường hợp rõ ràng và tăng tốc gán nhãn, đồng thời vẫn giữ phần rà soát của con người ở những chỗ quan trọng. Figure 13 minh họa bốn con đường phổ biến. Giám sát truyền thống sử dụng nhãn trực tiếp từ con người. Học bán giám sát khai thác cấu trúc trong dữ liệu chưa được gán nhãn cùng với một tập con đã gán nhãn. Giám sát yếu thay thế một số nhãn đơn lẻ bằng các hàm gán nhãn có lập trình. Học chuyển giao tái sử dụng các biểu diễn đã học từ một tác vụ khác, thường giúp giảm nhưng không loại bỏ hẳn các nhãn đặc thù của tác vụ hiện tại. Mỗi con đường thay đổi chỗ phải trả chi phí giám sát, cũng như những giả định, cấu trúc dữ liệu chưa gán nhãn, hoặc các tạo phẩm đã huấn luyện sẵn mà pipeline cần kiểm chứng.

Ratner, Alex, Paroma Varma, Braden Hancock, and Christopher Ré. 2019. Weak Supervision: A New Programming Paradigm for Machine Learning. Stanford AI Lab Blog.
Những con đường này đánh đổi các giả định khác nhau, không chỉ là số lượng nhãn. Tùy con đường, pipeline có thể cần cấu trúc trong dữ liệu chưa gán nhãn phù hợp với tác vụ, một biểu diễn có thể chuyển giao, các lỗi của hàm gán nhãn đo được, hoặc một vòng lặp đánh giá với chi phí hợp lý. Hệ thống vận hành nên ghi lại từng giả định và kiểm tra chúng trên dữ liệu giữ lại đã được con người rà soát. Sơ đồ này là một bản đồ quyết định, không phải bảng xếp hạng chất lượng.
Ghi nhãn có AI hỗ trợ phân chia công việc theo thế mạnh của từng bên. Con người xử lý các trường hợp mơ hồ, phát hiện lỗi tinh vi và áp dụng kiến thức chuyên môn; mô hình đảm nhận các trường hợp thường gặp ở quy mô lớn, kèm theo bước xác thực. Các hệ thống vận hành thực tế kết hợp những năng lực này bằng nhiều cách tiếp cận bổ trợ.
Ghi nhãn trước sử dụng các mô hình AI để tạo nhãn sơ bộ, sau đó con người xem xét và chỉnh sửa — biến nhiệm vụ từ “ghi nhãn từ đầu” thành “xác minh và sửa chữa.” Các framework ghi nhãn theo lập trình như Snorkel (Ratner et al. 2018; Ratner et al. 2017) mở rộng hơn nữa thông qua giám sát yếu,29 tự động tạo nhãn ban đầu ở quy mô lớn bằng các quy tắc dựa trên heuristic, cơ sở tri thức và đầu ra của các mô hình hiện có. Trong lái xe tự hành, các mô hình phát hiện đối tượng đã được huấn luyện trước có thể gán nhãn phương tiện và người đi bộ để người gán nhãn xác minh và tinh chỉnh, qua đó tự động xử lý nhiều trường hợp rõ ràng.
Ratner, Alex, Braden Hancock, Jared Dunnmon, Roger Goldman, and Christopher Ré. 2018. “Snorkel MeTaL: Weak Supervision for Multi-Task Learning.” Proceedings of the Second Workshop on Data Management for End-to-End Machine Learning, 1–4. https://doi.org/10.1145/3209889.3209898.
Ratner, A., S. H. Bach, H. Ehrenberg, J. Fries, S. Wu, and C. Ré. 2017. “Snorkel: Rapid Training Data Creation with Weak Supervision.” Proceedings of the VLDB Endowment 11 (3): 269–82. https://doi.org/10.14778/3157794.3157797.
29 Giám sát yếu: Một cách tiếp cận “lập trình dữ liệu” đánh đổi một phần công sức chú thích thủ công để đầu tư vào việc viết và xác thực các hàm ghi nhãn có lập trình. Khi đã có, hàm này có thể được áp dụng ở quy mô lớn với chi phí thấp, nhưng việc chạy, giải quyết xung đột, giám sát chất lượng và bảo trì vẫn tốn chi phí; vì vậy, so sánh hiệu quả nên dựa trên khối lượng công việc (workload) cụ thể chứ không phải giả định chi phí biên bằng không.
Các mô hình ngôn ngữ lớn (LLM) hiện hỗ trợ các pipeline ghi nhãn bằng cách tạo mô tả, soạn thảo hướng dẫn ghi nhãn từ ví dụ và giải thích lý do cho việc gán nhãn. Chẳng hạn, các hệ thống kiểm duyệt nội dung dùng LLM để phân loại ban đầu, kèm theo giải thích để người đánh giá xác thực. Tuy nhiên, tích hợp LLM nảy sinh nhiều thách thức hệ thống: chi phí suy luận và hạn mức tốc độ phụ thuộc vào nhà cung cấp và từng mô hình, cùng nhu cầu xác thực đầu ra một cách có hệ thống vì LLM có thể đưa ra nhãn rất tự tin nhưng sai. Nhiều tổ chức áp dụng cách tiếp cận theo tầng, dùng các mô hình chuyên biệt nhỏ hơn cho trường hợp thường gặp, và dành các LLM lớn hơn cho kịch bản phức tạp đòi hỏi đánh giá tinh tế.
Học chủ động chọn một đánh đổi bổ sung: dùng suy luận của mô hình để giảm công gán nhãn thủ công. Vì vậy, câu hỏi then chốt là phần tính toán đó có nằm trong cùng một ngân sách hay không.
Các phương pháp như học chủ động30 bổ trợ cho các cách tiếp cận này bằng cách ưu tiên thông minh những ví dụ cần con người xem xét (Settles 2009; Coleman et al. 2022). Các hệ thống này liên tục phân tích độ không chắc chắn của mô hình để xác định các ứng viên gán nhãn có giá trị. Thay vì gán nhãn ngẫu nhiên dữ liệu chưa gán nhãn, học chủ động chọn những ví dụ mà mô hình hiện tại không chắc chắn nhất, hoặc nơi việc gán nhãn sẽ cải thiện hiệu suất mô hình nhiều nhất. Hạ tầng cần tính toán hiệu quả các chỉ số độ không chắc chắn (thường là entropy của dự đoán hoặc mức độ bất đồng giữa các mô hình ensemble), duy trì các hàng đợi công việc được sắp xếp theo mức độ hữu ích của thông tin, và điều chỉnh chiến lược ưu tiên dựa trên các nhãn mới nhận được. Ví dụ, trong một hệ thống chẩn đoán hình ảnh y tế: học chủ động có thể xác định các bệnh lý bất thường để chuyên gia xem xét, trong khi các ca thường lệ được tiền gán nhãn và chuyên gia chỉ cần xác minh. Cách tiếp cận này có thể giảm đáng kể số lượng nhãn cần thiết trong bối cảnh thuận lợi, nhưng đòi hỏi kỹ thuật cẩn thận để tránh các vòng lặp phản hồi, nơi độ không chắc chắn của mô hình chi phối việc dữ liệu nào được gán nhãn. Việc tính toán ngân sách sẽ giúp lượng hóa cụ thể mức đòn bẩy này.
30 Học chủ động: Đảo ngược cách gán nhãn truyền thống: thay vì chọn ngẫu nhiên các ví dụ để gán nhãn, mô hình sẽ truy vấn những ví dụ nó cần nhất, thường là nơi độ không chắc chắn của dự đoán cao nhất (Settles 2009). Cách này có thể giảm số lượng nhãn cần để đạt độ chính xác mục tiêu. Tuy nhiên, đánh đổi về hạ tầng là dùng chi phí tính toán để đổi lấy nhãn: tại $0.01/image, chạy suy luận cho toàn bộ tập dữ liệu 10M sẽ tốn $100K trước khi có bất kỳ nhãn thủ công nào. Học chủ động chỉ thực sự trở thành đòn bẩy ngân sách khi tập ứng viên được lọc trước, suy luận rẻ hơn nhiều, hoặc ngân sách tính toán tách biệt với ngân sách gán nhãn.
Settles, Burr. 2009. Active Learning Literature Survey. Computer Sciences Technical Report 1648. University of Wisconsin-Madison.
Coleman, Cody, Edward Chou, Julian Katz-Samuels, Sean Culatana, Peter Bailis, Alexander C. Berg, Robert Nowak, Roshan Sumbaly, Matei Zaharia, and I. Zeki Yalniz. 2022. “Similarity Search for Efficient Active Learning and Search of Rare Concepts.” Proceedings of the AAAI Conference on Artificial Intelligence 36 (6): 6402–10. https://doi.org/10.1609/aaai.v36i6.20591.
Napkin Math 1.8: Hệ số nhân của học chủ động
Vấn đề: Chúng ta có một tập dữ liệu 10M với ngân sách gán nhãn là $50K. Khi lấy mẫu ngẫu nhiên, ta đạt độ chính xác 85 percent với 100K mẫu đã gán nhãn, trong khi mục tiêu là đạt độ chính xác 95 percent.
Nguyên lý:
- Hiệu quả lấy mẫu: Học chủ động có thể đạt độ chính xác mong muốn với số mẫu ít hơn so với chọn ngẫu nhiên, trong những điều kiện thuận lợi.
- Chi phí trên mỗi điểm: Với lấy mẫu ngẫu nhiên, chi phí là $0.50/label cho mỗi điểm. Học chủ động phát sinh thêm chi phí tính toán (khoảng $0.01/image cho mỗi lần suy luận) để tìm các ví dụ khó.
- Hệ số nhân:
- Ngẫu nhiên: Để đạt độ chính xác 95 percent, có thể cần tới 1M nhãn (tổng chi phí $500K). Như vậy là vượt quá ngân sách.
- Chỉ tính nhãn từ học chủ động: Hệ thống có thể chỉ cần khoảng 100K–200K ví dụ khó (chi phí tương ứng $50K–$100K).
- Đánh giá toàn bộ tập ứng viên: Đánh giá tất cả 10M ảnh ứng viên sẽ tốn thêm $100K, nên tổng chi phí cho học chủ động sẽ là $150K–$200K. Điều này vượt quá ngân sách.
Hiểu biết về hệ thống: Lựa chọn thuật toán là đòn bẩy lớn đối với số lượng nhãn cần gán, nhưng chi phí tính toán phải nằm trong ngân sách. Nếu dành 10 percent của ngân sách này cho suy luận (tức $5K), thì chỉ chấm được 500K ảnh ứng viên với mức giá suy luận hiện tại, và chỉ còn đủ cho khoảng 90K nhãn. Học chủ động chỉ khả thi nếu tập ứng viên được thu hẹp trước khi chấm, chi phí suy luận giảm đáng kể, hoặc chi phí tính toán được cấp riêng, không gộp với chi phí gán nhãn.

Đánh giá toàn bộ tập có thể vượt quá ngân sách nhãn ngay cả trước khi bắt đầu gán nhãn.
Kiểm soát chất lượng càng trở nên quan trọng khi các thành phần AI này tương tác. Hệ thống phải giám sát hiệu suất của cả AI và con người bằng các chỉ số có hệ thống. Hiệu chỉnh độ tin cậy của mô hình rất quan trọng: nếu AI báo cáo độ tin cậy 95% nhưng chỉ đạt độ chính xác 75% ở mức độ tin cậy đó, các tiền chú thích sẽ gây hiểu lầm cho người rà soát. Tỷ lệ đồng thuận giữa con người và AI cho thấy AI đang giúp hay đang cản: khi con người thường xuyên ghi đè các đề xuất của AI, các tiền chú thích có thể đang gây ra độ chệch (bias) thay vì tăng tốc công việc. Các chỉ số này đòi hỏi phải thiết lập đo lường cẩn thận xuyên suốt pipeline gán nhãn, theo dõi cả nhãn cuối cùng và tương tác giữa người chú thích và AI ở từng giai đoạn.
Những nguyên tắc này thể hiện rõ ở quy mô lớn trong các lĩnh vực an toàn then chốt. Hạ tầng gán nhãn cho xe tự hành có thể xử lý khối lượng lớn khung hình cảm biến, dùng tiền chú thích AI cho các đối tượng phổ biến, đồng thời chuyển các kịch bản bất thường (khu vực xây dựng, xe cấp cứu) cho chuyên gia con người — một kiến trúc phân tán: tiền chú thích chạy trên các cụm GPU, còn phần rà soát của con người được mở rộng qua các nhóm chú thích. Các hệ thống hình ảnh y tế đối mặt với bài toán khan hiếm nhãn tương tự: các kho dữ liệu lâm sàng chưa gán nhãn rất lớn khiến chú thích của chuyên gia trở thành nút thắt cổ chai và thúc đẩy các quy trình làm việc hiệu quả về dữ liệu, học các biểu diễn hữu ích từ cấu trúc chưa gán nhãn trước khi áp dụng nhãn của chuyên gia (Krishnan et al. 2022). Ở những lĩnh vực như vậy, mẫu hình kỹ thuật dữ liệu phổ biến là leo thang theo tầng: tự động hóa xử lý các trường hợp rõ ràng, con người xử lý các trường hợp mơ hồ, và giám sát đảm bảo ranh giới giữa “rõ ràng” và “mơ hồ” được điều chỉnh theo sự thay đổi của cả khả năng AI lẫn điều kiện triển khai.
Krishnan, Rayan, Pranav Rajpurkar, and Eric J. Topol. 2022. “Self-Supervised Learning in Medicine and Healthcare.” Nature Biomedical Engineering 6 (12): 1346–52. https://doi.org/10.1038/s41551-022-00914-1.
Gán nhãn tự động trong KWS
Việc gán nhãn dữ liệu KWS ở quy mô lớn tạo ra một thách thức riêng trong bài toán tiếng nói. Để có được hàng triệu mẫu từ kích hoạt đã gán nhãn mà chi phí nhân công không tăng tương ứng, chúng ta phải vượt ra ngoài các cách thủ công và crowdsourcing đã nêu trước đó. Multilingual Spoken Words Corpus (MSWC) (Mazumder et al. 2021) cho thấy gán nhãn tự động giải quyết thách thức này bằng một cách tiếp cận sáng tạo để tạo ra dữ liệu từ kích hoạt đã gán nhãn; bộ ngữ liệu này chứa hơn 23.4 million examples đoạn tiếng nói dài một giây, bao phủ 340,000 keywords từ khóa trong 50 languages ngôn ngữ.
Mazumder, Mark, Sharad Chitlangia, Colby Banbury, Yiping Kang, Juan Manuel Ciro, Keith Achorn, Daniel Galvez, et al. 2021. “Multilingual Spoken Words Corpus.” Advances in Neural Information Processing Systems 35 (NeurIPS 2021) Datasets and Benchmarks Track.
31 Căn chỉnh bắt buộc: Với một bản chép lời đã biết, công cụ căn chỉnh ước tính vị trí xuất hiện của các từ trong âm thanh, thường dựa vào các điểm số âm học theo khung và giải mã chuỗi. Độ phân giải thời gian và độ chính xác phụ thuộc vào mô hình, đặc trưng, ngôn ngữ và chất lượng ghi âm, nên các ước tính ranh giới vẫn cần được kiểm tra chất lượng. Nhờ có bản chép lời, việc phân đoạn ở mức từ rẻ hơn nhiều so với gán nhãn thủ công từng đoạn, dù vẫn cần công sức cho tính toán, rà soát và sửa lỗi.
Với quy mô này, gán nhãn thủ công là không khả thi: Để gán nhãn 23.4 million examples mẫu, dù mỗi nhãn chỉ mất 10 giây, cũng cần khoảng 65,000 hours, xấp xỉ 32.5 person-years công việc toàn thời gian. Thu thập có phạm vi rộng, có tài liệu minh bạch trên 50 languages ngôn ngữ có thể cải thiện độ bao phủ, nhưng chỉ tăng số lượng ngôn ngữ thì chưa đảm bảo đại diện cho người nói, giọng vùng miền, thiết bị hay môi trường âm thanh. Hệ thống tự động trong figure 14 giải quyết bài toán quy mô bằng cách bắt đầu từ các cặp âm thanh câu và bản phiên âm, rồi dùng căn chỉnh bắt buộc31 để ước lượng ranh giới từ trong lời nói liên tục.
Ở quy mô này, kiểm soát chất lượng trở thành bài toán lấy mẫu và nguồn gốc dữ liệu, chứ không biến mất. Pipeline nên báo cáo độ bao phủ theo ngôn ngữ, người nói, giọng, thiết bị và môi trường âm thanh; lưu trữ bản thu gốc, phiên bản bản phiên âm, phiên bản bộ căn chỉnh và độ tin cậy ranh giới cho mỗi đoạn cắt; và chuyển các căn chỉnh có độ tin cậy thấp cùng các lát cắt ít đại diện cho con người duyệt. Tiếp đó, đánh giá trên tập giữ lại phải đo lường các từ kích hoạt mục tiêu trên những lát cắt đó. Những kiểm soát này giúp phân biệt một tập dữ liệu lớn với một tập dữ liệu có tính đại diện, đồng thời giúp truy vết lỗi trích xuất khi một mô hình KWS ở hạ nguồn gặp lỗi.
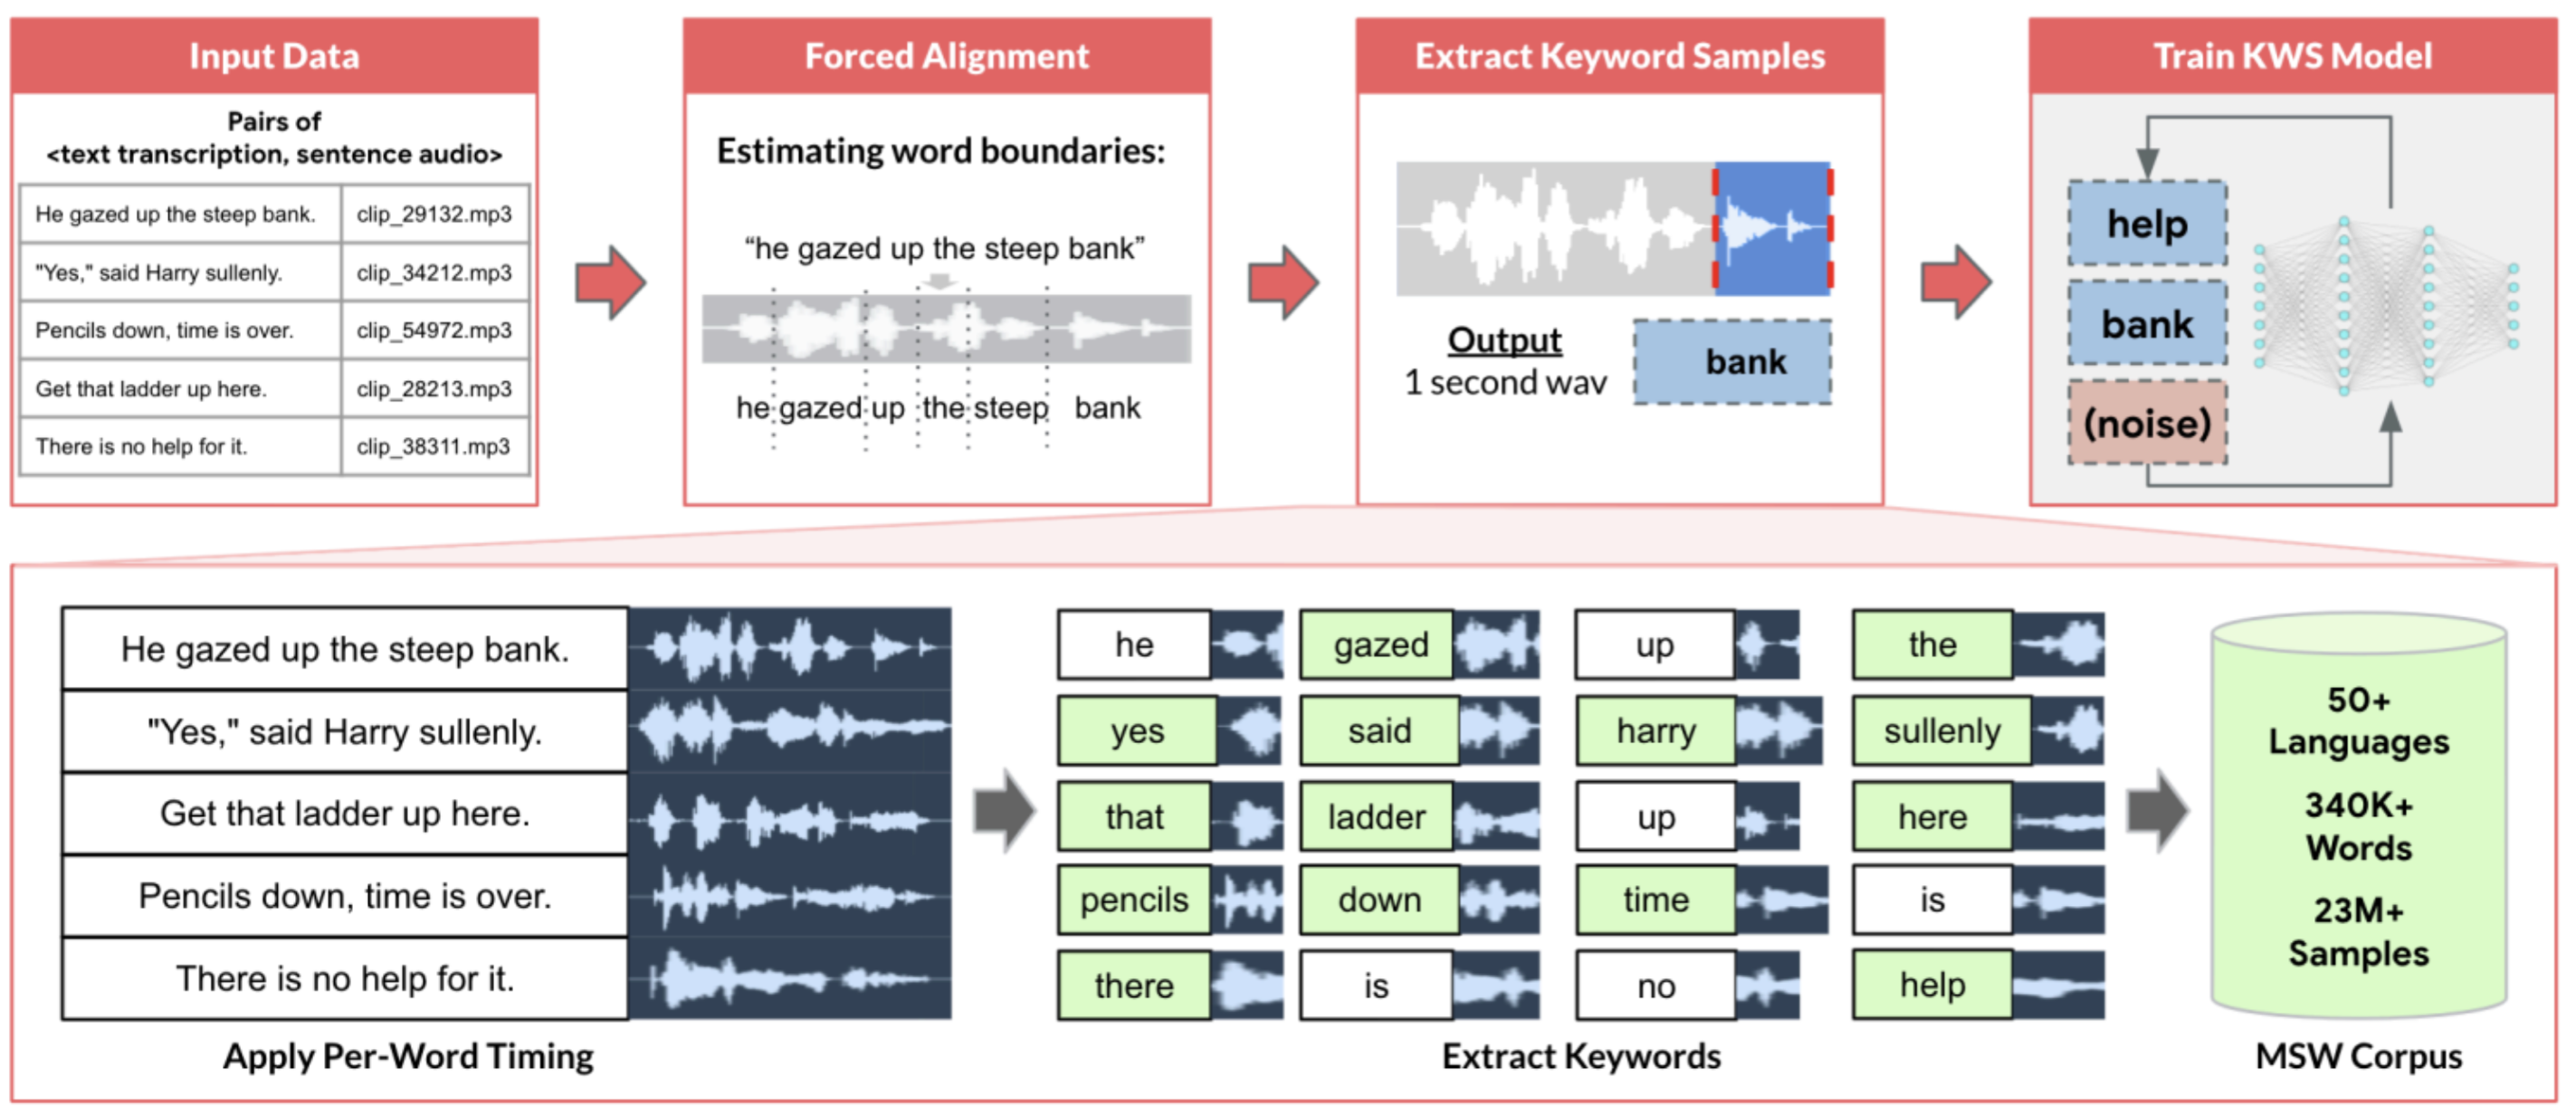
Mazumder, Mark. 2021. TinyML: Multilingual Spoken Words Corpus. tinyML Talks.
Hệ thống trích xuất dùng các mốc thời gian chính xác này để tạo các mẫu từ khóa sạch, đồng thời xử lý các thách thức kỹ thuật đã được dự liệu trong định nghĩa bài toán: nhiễu nền làm lệch ranh giới từ; người nói kéo dài hoặc nén từ bất ngờ vượt quá thời lượng mục tiêu 500 ms–800 ms; và các từ dài hơn vượt quá giới hạn một giây. MSWC cung cấp đánh giá chất lượng tự động, phân tích đặc tính âm thanh để phát hiện các vấn đề tiềm ẩn về chất lượng ghi âm, độ rõ của giọng nói hoặc nhiễu nền. Điều này rất cần thiết để duy trì tiêu chuẩn nhất quán trên 23.4 million samples mà không phải chịu chi phí rà soát thủ công vốn khiến quy mô này trở nên bất khả thi.
Các nhà phát triển trợ lý giọng nói hiện đại thường xây dựng dựa trên nền tảng gán nhãn tự động này. Dù các kho ngữ liệu tự động có thể không chứa các từ đánh thức cụ thể mà một sản phẩm cần, chúng vẫn là điểm khởi đầu tốt để tạo mẫu KWS, đặc biệt với các ngôn ngữ ít được hỗ trợ, nơi chưa có các tập dữ liệu thương mại. Các hệ thống sản xuất thường bổ sung ghi âm có mục tiêu và xác minh thủ công cho các trường hợp khó (như giọng khác thường, từ hiếm hoặc môi trường âm thanh phức tạp), phối hợp chặt chẽ giữa xử lý tự động và chuyên môn của con người.
pipeline hiện đã tạo ra các kết quả biên dịch: hàng triệu vector đặc trưng được ghép với các nhãn ground truth. Câu hỏi lúc này không còn là dữ liệu gì đã được thu thập, mà là dữ liệu đó nằm ở đâu và nó tới các bộ tăng tốc nhanh đến đâu. Kiến trúc lưu trữ sẽ quyết định liệu các GPU đắt tiền dành thời gian tính toán hay chờ đợi dữ liệu.
Self-Check: Question
A smart city perception system evaluates annotation formats for a \(1920 \times 1080\) video stream. The team compares bounding box annotations (10 boxes per frame, each with 4 spatial coordinates) against pixel-level semantic segmentation masks. What is the ratio of scalar label entries generated between a full segmentation mask and the 10 bounding boxes?
- Roughly 10x more entries for segmentation, matching the ratio of bounding box coordinates.
- Roughly 50,000x more scalar entries for segmentation (~2.07 million pixel labels vs. 40 bounding box coordinates).
- Both formats require identical scalar entries because both represent 1080p resolution.
- Bounding boxes require 50,000x more entries because floating-point coordinates consume more bytes than integer masks.
An ML team implements weak supervision (e.g., using Snorkel) to label a million unlabeled text documents. Domain experts write 20 programmatic labeling functions (LFs) based on regex patterns and keyword heuristics. How does weak supervision combine these noisy heuristics into high-quality training labels?
- It forces all 20 LFs to execute synchronously in a database trigger, throwing an exception if any two LFs disagree.
- It simply computes an unweighted majority vote across all LFs and discards any record where LFs disagree.
- It uses a generative label model to estimate the unknown accuracies and correlations of the LFs without ground truth, producing probabilistic training labels for downstream model learning.
- It converts the regex heuristics into neural network weights using automatic differentiation.
Describe how a tiered consensus labeling system uses inter-annotator agreement metrics (such as Fleiss’ kappa) and ‘gold standard’ honeypot examples to balance labeling cost against annotation quality.
True or False: In Active Learning, uncertainty sampling selects the unlabeled examples for which the current model has the highest prediction confidence to ensure the training set contains only clean data.
A statistical metric that measures the degree of agreement among three or more annotators classifying items into discrete categories, adjusting for chance agreement, is called ____.
Kiến trúc lưu trữ
Các tập dữ liệu đã được gán nhãn từ pipeline của chúng ta (23.4 million samples bao quát 50 languages cho KWS) giờ cần những quyết định lưu trữ mang tính chiến lược, quyết định hiệu quả huấn luyện, độ trễ phục vụ (serving) và khả năng bảo trì lâu dài. Kiến trúc lưu trữ giải quyết một mâu thuẫn cốt lõi: huấn luyện theo batch cần quét tuần tự qua hàng triệu ví dụ, trong khi phục vụ (serving) theo thời gian thực đòi hỏi tra cứu từng vector đặc trưng trong vài mili giây. Những kiểu truy cập đối lập này định hình mọi quyết định về lưu trữ.
Yêu cầu lưu trữ của ML khác với các hệ thống giao dịch. Thay vì tối ưu cho các ghi nhỏ thường xuyên và các tra cứu theo điểm vốn đặc trưng cho thương mại điện tử hoặc ngân hàng, các khối lượng công việc (workload) trong ML ưu tiên đọc tuần tự với thông lượng cao, quét quy mô lớn và tính linh hoạt về lược đồ. Một cơ sở dữ liệu phục vụ ứng dụng thương mại điện tử có thể vận hành tốt với hàng triệu lượt tra cứu sản phẩm riêng lẻ mỗi giây, nhưng một tác vụ huấn luyện ML quét đi quét lại toàn bộ danh mục đó qua nhiều epoch lại cần một cách tối ưu hóa lưu trữ hoàn toàn khác.
Các tùy chọn hệ thống lưu trữ
Huấn luyện theo batch quét tuần tự hàng triệu ví dụ; còn phục vụ (serving) thời gian thực thì lấy từng vector đặc trưng một. Hai kiểu truy cập trái ngược này kéo hệ thống lưu trữ theo hai hướng khác nhau, và khi chọn hệ thống, ta cần tối thiểu hóa số hạng dữ liệu \((\frac{D_{\text{vol}}}{\text{BW}})\) trong định luật sắt của các hệ thống ML, tùy kiểu truy cập nào chiếm ưu thế. Mọi phương tiện lưu trữ đều có ràng buộc vật lý về băng thông, qua đó quyết định tốc độ tối đa của các pipeline huấn luyện và phục vụ (serving).
Hai chỉ số hiệu suất lưu trữ chi phối việc tối ưu hóa này. IOPS (input/output operations per second) đếm số yêu cầu đọc/ghi riêng biệt mà một thiết bị có thể xử lý mỗi giây, nên nó là giới hạn cho các khối lượng công việc (workload) truy cập ngẫu nhiên, như lấy các batch ảnh nhỏ hoặc hồ sơ người dùng riêng lẻ. Thông lượng (băng thông) đo lượng dữ liệu được truyền mỗi giây, thường là \(\text{IOPS} \times \text{Block Size}\), nên nó là giới hạn cho các khối lượng công việc (workload) truy cập tuần tự, như quét tệp Parquet để huấn luyện.
Việc lựa chọn giữa cơ sở dữ liệu, kho dữ liệu (data warehouse) và hồ dữ liệu (data lake) về cốt lõi là chọn tối ưu hóa chỉ số nào trong hai chỉ số này. Cơ sở dữ liệu (hệ thống xử lý giao dịch trực tuyến [OLTP]) tối ưu hóa cho IOPS cao với kích thước khối nhỏ, nên phù hợp để phục vụ (serving) từng vector đặc trưng trong thời gian thực, nơi độ trễ trên mỗi yêu cầu chi phối. Kho dữ liệu (hệ thống xử lý phân tích trực tuyến [OLAP]) tối ưu hóa cho thông lượng cao với kích thước khối lớn và truy cập tuần tự, nên rất phù hợp cho kỹ thuật đặc trưng và phân tích theo batch. Hồ dữ liệu (data lake) ưu tiên dung lượng và thông lượng cho dữ liệu phi cấu trúc, điều cốt yếu cho các tác vụ huấn luyện nơi tử số \(D_{\text{vol}}\) đo bằng petabyte và băng thông tổng hợp phải mở rộng tới hàng nghìn GPU.
Quyết định về kiểu truy cập trở nên cụ thể khi gắn với các giai đoạn của quy trình ML. Đối với phục vụ (serving) đặc trưng trực tuyến, các đặc tính IOPS cao của cơ sở dữ liệu cho phép tra cứu từng bản ghi trong vài mili giây. Các hệ thống đề xuất lớn là ví dụ điển hình ở mức độ cực đoan: dữ liệu tra cứu quy mô terabyte có thể phải phục vụ hàng tỷ lượt đọc thưa thớt mỗi giây, đòi hỏi các kiến trúc lưu trữ ưu tiên IOPS hơn thông lượng tuần tự. Tổng quát hơn, một hệ thống đề xuất khi tra cứu hồ sơ người dùng trong suy luận (inference) thời gian thực cần truy cập ngẫu nhiên được tối ưu cho độ trễ mỗi yêu cầu.
Khi huấn luyện mô hình có cấu trúc, quyết định đi theo hướng ngược lại: thông lượng quan trọng hơn độ trễ ở mức yêu cầu. Thiết kế kho dữ liệu tối ưu cho thông lượng cho phép quét tuần tự tốc độ cao trên các bảng lớn, sạch. Việc huấn luyện một mô hình phát hiện gian lận xử lý hàng triệu giao dịch, mỗi giao dịch có hàng trăm đặc trưng, sẽ hưởng lợi từ lưu trữ theo cột, vì chỉ đọc hiệu quả các đặc trưng liên quan, qua đó trực tiếp giảm lượng dữ liệu cần xử lý bằng cách giảm thiểu số byte được truyền.
Phân tích khám phá và dữ liệu huấn luyện phi cấu trúc đặt thêm một ràng buộc thứ ba: lược đồ có thể chưa được biết khi dữ liệu được thu thập. Với hình ảnh, âm thanh và văn bản, hồ dữ liệu (data lake) cung cấp tính linh hoạt và khả năng lưu trữ chi phí thấp cho các khối lượng khổng lồ. Một hệ thống thị giác máy tính lưu trữ hàng terabyte hình ảnh thô cùng siêu dữ liệu, chú thích và kết quả xử lý trung gian sẽ hưởng lợi từ tính linh hoạt về lược đồ và hiệu quả chi phí mà hồ dữ liệu thường mang lại, trong khi quy mô của tử số \(D_{\text{vol}}\) đòi hỏi băng thông tổng hợp cao.
Cơ sở dữ liệu có đất dụng võ khi tính nhất quán giao dịch và độ trễ của các tra cứu từng điểm là yếu tố quyết định. Chúng duy trì danh mục sản phẩm, hồ sơ người dùng hoặc lịch sử giao dịch với các đảm bảo nhất quán mạnh và tra cứu độ trễ thấp. Trong các quy trình làm việc ML, cơ sở dữ liệu phù hợp với những vai trò cụ thể: lưu trữ siêu dữ liệu đặc trưng thường xuyên thay đổi, quản lý theo dõi thử nghiệm nơi tính nhất quán giao dịch là then chốt, hoặc duy trì sổ đăng ký mô hình cần các cập nhật nguyên tử. Một cơ sở dữ liệu PostgreSQL xử lý các thuộc tính người dùng có cấu trúc (user_id, age, country, preferences) có thể cung cấp tra cứu ở mức mili giây cho các hệ thống phục vụ (serving) cần các đặc trưng người dùng riêng lẻ theo thời gian thực. Tuy nhiên, cơ sở dữ liệu gặp khó khi huấn luyện ML yêu cầu quét hàng triệu bản ghi lặp lại qua nhiều epoch. Kiểu lưu trữ theo hàng, vốn tối ưu cho tra cứu giao dịch, trở nên kém hiệu quả khi quá trình huấn luyện chỉ cần 20 trong 100 cột của mỗi bản ghi nhưng vẫn phải đọc toàn bộ hàng để lấy các cột đó.
Kho dữ liệu phát huy tác dụng khi việc quét lặp đi lặp lại trên các đặc trưng có cấu trúc chiếm ưu thế. Định dạng lưu trữ cột (Stonebraker et al. 2018) cho phép đọc các đặc trưng cụ thể mà không cần tải toàn bộ bản ghi, điều này rất quan trọng khi bảng có hàng trăm cột nhưng quá trình huấn luyện chỉ cần một tập con. Mức giảm I/O tỷ lệ với phần cột được chọn: đọc 20 trong 100 cột tương ứng chuyển khoảng một phần năm tải dữ liệu của hàng ở dạng chưa nén, chưa kể nén hoặc overhead siêu dữ liệu. Phần tính toán hiệu quả định dạng trong section 1.7.2 định lượng lợi ích này với một ví dụ phát hiện gian lận. Nhiều hệ thống ML thành công lấy dữ liệu huấn luyện từ kho dữ liệu vì môi trường có cấu trúc giúp đơn giản hóa phân tích khám phá và phát triển lặp. Các nhà phân tích dữ liệu có thể nhanh chóng tính các thống kê tổng hợp, tìm các tương quan giữa đặc trưng và kiểm định chất lượng dữ liệu bằng các giao diện SQL quen thuộc.
Stonebraker, Mike, Daniel J. Abadi, Adam Batkin, Xuedong Chen, Mitch Cherniack, Miguel Ferreira, Edmond Lau, et al. 2018. “C-Store: A Column-Oriented DBMS.” In Making Databases Work: The Pragmatic Wisdom of Michael Stonebraker. Association for Computing Machinery. https://doi.org/10.1145/3226595.3226638.
Tuy nhiên, kho dữ liệu giả định lược đồ tương đối ổn định và gặp khó với dữ liệu thật sự phi cấu trúc (hình ảnh, âm thanh, văn bản tự do) hoặc các định dạng thay đổi nhanh, vốn phổ biến trong các pipeline ML mang tính thử nghiệm. Khi một nhóm thị giác máy tính muốn lưu trữ hình ảnh thô cùng với các đặc trưng đã trích xuất, nhiều định dạng chú thích từ các nhà cung cấp gán nhãn khác nhau, các dự đoán trung gian của mô hình và vector biểu diễn đã học, ép tất cả những thứ này vào các lược đồ cứng nhắc của kho dữ liệu sẽ gây nhiều ma sát hơn là giá trị. Việc tiến hoá lược đồ trở nên nhọc nhằn: thêm loại đặc trưng mới đòi hỏi thao tác ALTER TABLE, có thể mất hàng giờ trên các tập dữ liệu lớn, chặn các hoạt động khác và làm chậm nhịp độ lặp.
Hồ dữ liệu đặc biệt hữu ích khi tính linh hoạt của lược đồ và chi phí lưu trữ thấp là ưu tiên. Chúng khắc phục hạn chế của kho dữ liệu bằng cách lưu trữ dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc ở định dạng nguyên bản, và trì hoãn việc định nghĩa lược đồ đến lúc đọc dữ liệu, một cách làm gọi là schema-on-read.32
32 Schema-on-read: Áp dụng định nghĩa cấu trúc dữ liệu tại thời điểm truy vấn thay vì lúc nạp dữ liệu, trái ngược với schema-on-write (các cơ sở dữ liệu truyền thống), nơi dữ liệu phải tuân thủ cấu trúc định sẵn trước khi lưu trữ. Với các pipeline ML ở giai đoạn đầu, schema-on-read cho phép thử nghiệm nhanh — nhóm có thể lưu trữ dữ liệu cảm biến thô, hình ảnh và nhật ký mà không cần cam kết lược đồ đặc trưng ngay từ đầu. Đổi lại là bài toán quản trị: nếu không có lược đồ được thực thi, hồ dữ liệu dễ biến thành “đầm lầy dữ liệu”, khiến việc tìm và xác thực dữ liệu huấn luyện lại trở thành nút thắt cổ chai.
Tính linh hoạt này đặc biệt hữu ích ở giai đoạn đầu phát triển ML, khi các nhóm thử nghiệm với nhiều nguồn dữ liệu và vẫn chưa chắc đặc trưng nào sẽ hữu ích. Ví dụ, một hệ thống khuyến nghị có thể lưu cùng trong một hồ dữ liệu: nhật ký giao dịch dạng JSON, ảnh sản phẩm dạng JPEG, đánh giá người dùng dưới dạng tệp văn bản, clickstream dạng Parquet, và embedding của mô hình dưới dạng mảng NumPy. Thay vì ép các loại dữ liệu dị thể này vào một lược đồ chung ngay từ đầu, hồ dữ liệu giữ nguyên chúng ở định dạng gốc. Ứng dụng chỉ áp dụng lược đồ khi đọc, nhờ đó các bên tiêu thụ khác nhau có thể diễn giải cùng một dữ liệu theo các cách khác nhau: một nhóm trích xuất số tiền mua hàng từ nhật ký giao dịch, trong khi nhóm khác phân tích các mẫu theo thời gian, mỗi nhóm áp dụng lược đồ phù hợp với phân tích của mình.
Tính linh hoạt đó chỉ hữu ích khi công tác quản trị ngăn hồ dữ liệu trở nên mù mờ. Thiếu quản lý siêu dữ liệu và lập danh mục có kỷ luật, hồ dữ liệu sẽ biến thành “đầm lầy dữ liệu” — những kho lưu trữ lộn xộn, nơi việc tìm dữ liệu liên quan gần như bất khả thi, làm suy giảm chính lợi ích năng suất từng thúc đẩy việc áp dụng chúng. Một hồ dữ liệu có thể chứa hàng nghìn tập dữ liệu trong hàng trăm thư mục với các tên như userdata_v2_final và userdata_v2_final_ACTUALLY_FINAL, mà chỉ những tác giả ban đầu (đã rời công ty) mới hiểu chúng khác nhau ở điểm nào. Các triển khai hồ dữ liệu thành công duy trì siêu dữ liệu có thể tìm kiếm về nguồn gốc dữ liệu, chỉ số chất lượng, tần suất cập nhật, quyền sở hữu và mẫu truy cập, về cơ bản mang lại khả năng khám phá kiểu kho dữ liệu trên quy mô của hồ. Các công cụ như AWS Glue Data Catalog, Apache Atlas, hoặc Databricks Unity Catalog cung cấp lớp siêu dữ liệu này, giúp các nhóm khám phá và hiểu dữ liệu trước khi đầu tư công sức xử lý.
Mỗi kiến trúc lưu trữ ưu tiên một mẫu truy cập và một giai đoạn khác nhau của quy trình ML, như table 7 nêu rõ. Một sự kết hợp không phù hợp có thể khiến hiệu năng giảm đáng kể.
| Thuộc tính | Cơ sở dữ liệu truyền thống | Kho dữ liệu | Hồ dữ liệu |
|---|---|---|---|
| Mục đích | Vận hành và giao dịch | Phân tích và báo cáo | Lưu trữ dữ liệu thô và đa dạng để xử lý trong tương lai |
| Loại dữ liệu | Có cấu trúc | Có cấu trúc | Có cấu trúc, bán cấu trúc và phi cấu trúc |
| Quy mô | Khối lượng nhỏ đến trung bình | Khối lượng trung bình đến lớn | Khối lượng lớn dữ liệu đa dạng |
| Tối ưu hóa hiệu suất | Tối ưu hóa cho truy vấn giao dịch (OLTP) | Tối ưu hóa cho truy vấn phân tích (OLAP) | Tối ưu hóa cho lưu trữ và truy xuất có khả năng mở rộng |
| Ví dụ | MySQL, PostgreSQL, Oracle DB | Google BigQuery, Amazon Redshift, Microsoft Azure Synapse | Google Cloud Storage, AWS S3, Azure Data Lake Storage |
Việc chọn hệ thống lưu trữ phù hợp cần dựa trên yêu cầu của khối lượng công việc (workload), không nên chạy theo xu hướng công nghệ. Quyết định này thường đi theo một lộ trình trưởng thành: giai đoạn đầu thường dùng cơ sở dữ liệu (quen SQL, tận dụng hạ tầng sẵn có), rồi chuyển sang kho dữ liệu khi truy vấn phân tích bắt đầu làm suy giảm hiệu năng giao dịch, và áp dụng hồ dữ liệu khi cần xử lý dữ liệu phi cấu trúc (hình ảnh, âm thanh, văn bản) hoặc tối ưu chi phí ở quy mô petabyte. Các tổ chức ML trưởng thành thường dùng cả ba, được điều phối qua các danh mục dữ liệu hợp nhất: cơ sở dữ liệu cho dữ liệu vận hành và phục vụ (serving) theo thời gian thực; kho dữ liệu cho dữ liệu phân tích đã được quản lý và cho kỹ thuật đặc trưng (feature engineering); và hồ dữ liệu cho dữ liệu thô, không đồng nhất và cho huấn luyện (training) quy mô lớn. Ví dụ hệ thống xe tự lái: dữ liệu đo từ xa của xe nằm trong cơ sở dữ liệu để giám sát theo thời gian thực; số liệu lái xe tổng hợp nằm trong kho dữ liệu để phân tích batch; còn hàng terabyte ảnh camera thô và đám mây điểm lidar nằm trong hồ dữ liệu để huấn luyện mô hình—mỗi tầng lưu trữ đều được tối ưu cho kiểu truy cập tương ứng.
Hiệu suất và chi phí lưu trữ
Bên cạnh khác biệt về chức năng, các đặc tính chi phí và hiệu suất tác động trực tiếp đến hiệu quả kinh tế của hệ thống ML và tốc độ lặp lại (iteration speed). Hiểu rõ các đánh đổi định lượng này giúp đưa ra quyết định kiến trúc sáng suốt dựa trên yêu cầu của khối lượng công việc (workload).
Table 8 cho thấy vì sao các hệ thống ML dùng lưu trữ phân tầng. Với các giả định năm 2024, lưu tập dữ liệu huấn luyện KWS (748.8 GB) trên object storage tốn $17.2/month, cho phép giữ âm thanh thô với chi phí phải chăng. Trong khi đó, các tập dữ liệu làm việc trên Non-Volatile Memory Express (NVMe)33 có chi phí từ $74.9/month đến $224.6/month cho giai đoạn huấn luyện tích cực, nhưng tải nhanh hơn 50× lần.
33 NVMe (non-volatile memory express): Một giao thức lưu trữ kết nối trực tiếp với bus PCIe với 64K hàng đợi lệnh, cung cấp thông lượng tuần tự 5–7 GB/s và độ trễ ở mức micro giây. Trái lại, SATA SSD (500 MB/s, chỉ một hàng đợi) có băng thông thấp hơn 10× lần, có thể gây tắc nghẽn pipeline huấn luyện nếu thời gian phục vụ của hệ thống lưu trữ vượt quá thời gian tính toán.
| Tầng lưu trữ | Chi phí ($/TB/tháng) | Thông lượng đọc tuần tự | Độ trễ đọc ngẫu nhiên | Trường hợp sử dụng machine learning điển hình |
|---|---|---|---|---|
| NVMe SSD (cục bộ) | $100–300 | 5–7 GB/s | 10–100 μs | Tải dữ liệu huấn luyện, phục vụ (serving) đặc trưng hoạt động |
| Lưu trữ đối tượng (S3, GCS) | $20–25 | 100–500 MB/s (mỗi kết nối) | 10–50 ms | Lưu trữ thô data lake, tạo phẩm mô hình |
| Kho dữ liệu (BigQuery, Redshift) | $20–40 | 1–5 GB/s (quét cột) | 100–500 ms (khởi động truy vấn) | Truy vấn dữ liệu huấn luyện, kỹ thuật đặc trưng |
| Cache trong bộ nhớ (Redis, Memcached) | $500–1000 | 20–50 GB/s | 1–10 μs | Phục vụ (serving) đặc trưng trực tuyến, suy luận thời gian thực |
| Lưu trữ hồ sơ (Glacier, Nearline) | $1–4 | 10–50 MB/s (sau khi truy xuất) | Giờ (truy xuất) | Lưu giữ lịch sử, kho lưu trữ tuân thủ |
Sự khác biệt hiệu suất này tác động trực tiếp đến tốc độ lặp. Nếu tải dữ liệu ở 5 GB/s, quá trình sẽ nạp xong tập dữ liệu trong 149.8 s, so với 7,488 s ở tốc độ object storage điển hình. Mức chênh lệch 50× này quyết định liệu các nhóm có thể lặp nhiều lần mỗi ngày hay phải chờ hàng giờ giữa các thử nghiệm.
Độ trễ truy cập trải dài tám bậc độ lớn, từ cache đến internet.
Khoảng cách độ trễ giữa các thanh ghi trên chip và hệ lưu trữ từ xa trải dài hơn tám bậc độ lớn, khiến các yêu cầu I/O không đệm gây tổn thất lớn cho mức độ tận dụng bộ tăng tốc GPU. Khi quy đổi những độ trễ ở mức micro giây này sang khung thời gian trực quan của con người (table 9), cái giá của việc tìm nạp không qua cache trở nên thấy rõ ngay lập tức.
Những con số về độ trễ này được phổ biến nhờ bài phát biểu quan trọng của Jeff Dean tại LADIS năm 2009.34 Chúng cho thấy vì sao một kiến trúc lưu trữ thiết kế kém có thể khiến một bộ tăng tốc đắt tiền bị bỏ không, và vì sao huấn luyện phân tán cần đặc biệt chú ý đến tính cục bộ của dữ liệu.
34 Jeff Dean: Nghiên cứu viên cao cấp của Google, kiến trúc sư của MapReduce, BigTable, Spanner và TensorFlow. Bài phát biểu quan trọng của ông tại LADIS năm 2009 đã đúc kết các con số trong table 9 thành một nguyên tắc kinh nghiệm trong kỹ thuật: một truy cập cache L1 (0.5 ns) và một chuyến đi khứ hồi giữa các trung tâm dữ liệu (150 ms) có tỉ lệ chênh lệch là \(3 \times 10^{8}\) – tức là tám bậc độ lớn. Điều này giải thích tại sao một pipeline huấn luyện đọc các đặc trưng từ lưu trữ từ xa thay vì NVMe cục bộ lại khiến bộ tăng tốc không được cấp dữ liệu kịp thời.
| Thao tác | Độ trễ (ns) | Thang đo con người | Tác động hệ thống machine learning |
|---|---|---|---|
| Tham chiếu Cache L1 | 0.5 | 1 giây | Tức thì |
| Tham chiếu Cache L2 | 7 | 14 giây | Tính toán nhanh |
| Bộ nhớ chính (DRAM) | 100 | 3 phút | Ngưỡng “memory wall” |
| SSD (NVMe cục bộ) | 100,000 | 2 ngày | Nút thắt cổ chai tải dữ liệu |
| Mạng (cùng trung tâm dữ liệu) | 500,000 | 11.57 ngày | Độ trễ phối hợp phân tán |
| SSD (mạng từ xa) | 2,000,000 | 46.30 ngày | Nguồn lệch giữa huấn luyện và phục vụ (serving) |
| Kho lưu trữ đối tượng (S3) | 20,000,000 | 1 năm | Truy cập lưu trữ |
| Internet (CA đến VA) | 100,000,000 | 6 năm | Trải nghiệm người dùng toàn cầu |
Chỉ riêng kiểu truy cập thôi thì chưa đủ để bao quát vấn đề lưu trữ. Các khối lượng công việc (workload) ML còn lưu trữ những tạo phẩm mà các cơ sở dữ liệu và kho dữ liệu truyền thống không được thiết kế xoay quanh, và chính những tạo phẩm này định hình các quyết định về hạ tầng trong suốt vòng đời phát triển, từ notebook thử nghiệm đến các hệ thống phục vụ (serving) sản xuất xử lý hàng triệu yêu cầu mỗi giây.
Các mô hình ML hiện đại có từ hàng triệu đến hàng nghìn tỷ tham số, nên chúng cần cách lưu trữ và truy xuất rất khác so với dữ liệu truyền thống. Chẳng hạn, GPT-3 (Brown et al. 2020) cần khoảng 700 GB để lưu các trọng số ở định dạng FP32 (với 175B tham số, mỗi tham số chiếm 4 byte). Trong triển khai thực tế, người ta thường dùng các định dạng số nhỏ hơn như FP16 (350 GB) để giảm chi phí lưu trữ và truy cập. Ngay cả ở độ chính xác FP16, dung lượng này vẫn lớn hơn cả toàn bộ cơ sở dữ liệu vận hành của nhiều tổ chức. Xu hướng phát triển cho thấy quy mô mô hình tăng rất nhanh: từ 60M tham số của AlexNet (Krizhevsky et al. 2012) đến 175B tham số của GPT-3 (Brown et al. 2020), kích thước mô hình đã tăng khoảng 2916× lần chỉ trong tám năm. Vì vậy, các hệ thống lưu trữ phải xử lý hiệu quả các mảng số dày đặc này, đáp ứng cả dung lượng và tốc độ truy cập. Khác với tệp thông thường, nơi tổ chức tuần tự quan trọng cho việc đọc, trọng số mô hình lại hưởng lợi từ lưu trữ căn chỉnh theo khối, cho phép đọc song song theo nhóm tham số. Khi nhiều bộ tăng tốc cần đọc dữ liệu mô hình từ kho lưu trữ dùng chung, dù lúc khởi tạo huấn luyện hay khi tải checkpoint, hệ thống lưu trữ phải cung cấp tổng băng thông tiệm cận giới hạn của giao diện mạng (thường 25 Gbps hoặc cao hơn), tránh tạo nút thắt cổ chai khiến tài nguyên tính toán đắt tiền bị rỗi. Nén mô hình sẽ giải thích các kỹ thuật phía mô hình giúp giảm thêm dung lượng này.
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
Tính lặp trong phát triển ML kéo theo các yêu cầu quản lý phiên bản khác hẳn về chất so với phần mềm truyền thống. Git rất giỏi theo dõi thay đổi mã nguồn (đa số là tệp văn bản) với các chỉnh sửa nhỏ, tăng dần, nhưng lại không phù hợp với các tệp nhị phân lớn, nơi chỉ một thay đổi nhỏ trong mô hình cũng tạo ra một checkpoint hoàn toàn mới. Nếu lưu mười phiên bản của một mô hình 10 GB theo cách ngây thơ, bạn sẽ tốn 100 GB dung lượng. Vì vậy, các hệ thống versioning cho ML thường chỉ giữ các con trỏ siêu dữ liệu nhẹ trong Git hoặc một registry, còn artifact được lưu ở kho lưu trữ bên ngoài theo địa chỉ nội dung. Các tệp giống hệt nhau có thể được khử trùng lặp; còn các checkpoint nhị phân đã thay đổi thường được lưu thành các đối tượng riêng biệt, trừ khi backend tự hỗ trợ nén delta. Các công cụ như DVC (Data Version Control) và MLflow duy trì con trỏ tới các artifact của mô hình thay vì lưu các bản sao, nhờ đó phiên bản hoá hiệu quả mà vẫn đảm bảo có thể tái tạo bất kỳ mô hình lịch sử nào.
Trong một dự án ML điển hình, tinh chỉnh siêu tham số có thể tạo ra hàng trăm phiên bản mô hình—mỗi lần chạy huấn luyện tương ứng một phiên bản—khi kỹ sư thử các tốc độ học, kích thước batch, kiến trúc, và chiến lược regularization khác nhau. Nếu không có hệ thống phiên bản hoá ghi lại có hệ thống cấu hình huấn luyện, các chỉ số độ chính xác, phiên bản dữ liệu huấn luyện và trọng số mô hình, việc tái tạo kết quả sẽ bất khả thi. Ví dụ, hôm qua mô hình chạy tốt hơn hôm nay nhưng nhóm không thể xác định cấu hình nào đã tạo ra nó. Thách thức tái tạo này gắn trực tiếp với các yêu cầu quản trị được nêu tại section 1.7.4: để tuân thủ quy định, thường phải chứng minh chính xác dữ liệu và quy trình nào đã tạo ra các dự đoán cụ thể của mô hình.
Huấn luyện ở quy mô lớn tạo ra nhiều dữ liệu trung gian, nên hệ thống lưu trữ phải xử lý đọc/ghi đồng thời một cách hiệu quả. Khi các tác vụ huấn luyện dùng nhiều bộ tăng tốc, mỗi đơn vị xử lý làm việc trên các phần dữ liệu khác nhau, khiến hệ thống lưu trữ phải đáp ứng rất nhiều thao tác đọc và ghi cùng lúc. Mẫu truy cập cụ thể phụ thuộc vào chiến lược song song hóa, sẽ được Huấn luyện mô hình phân tích chi tiết. Ở góc độ lưu trữ, hệ thống phải chịu tải I/O đồng thời với tốc độ tỉ lệ với số lượng đơn vị xử lý; mỗi đơn vị có thể ghi hàng chục đến hàng trăm megabyte kết quả trung gian trong các bước cập nhật mô hình. Tạm thời, hãy coi các tệp checkpoint, bản chụp trạng thái của optimizer và các đường dẫn offload tường minh là những tệp nhị phân lớn sinh ra trong quá trình huấn luyện. Hệ thống lưu trữ phải cung cấp truy cập có độ trễ thấp để phối hợp hiệu quả. Nếu các worker tốn nhiều thời gian chờ lưu trữ hơn là tính toán, thì xử lý song song sẽ phản tác dụng, bất kể phương pháp huấn luyện nào được dùng.
Thứ bậc băng thông, yếu tố gây ra chi phí phối hợp ở section 1.5.3, hạn chế thiết kế hệ thống ML ở mọi tầng, tạo ra các nút thắt cổ chai mà dù tối ưu hóa tính toán thế nào cũng không vượt qua được. RAM trên máy chủ hiện đại cung cấp băng thông khoảng 50–200 gigabyte/giây, trong khi hệ thống lưu trữ qua mạng thường chỉ 1–10 gigabyte/giây, và ngay cả SSD NVMe cao cấp cũng chỉ đạt thông lượng tuần tự 1–7 gigabyte/giây. GPU hiện đại xử lý dữ liệu nhanh hơn khả năng cung cấp của lưu trữ, dẫn tới việc các bộ tăng tốc đắt tiền phải chờ dữ liệu. Ví dụ với một mô hình phân loại ảnh: tải 1.000 ảnh mỗi giây, mỗi ảnh 150 KB, đòi hỏi thông lượng bền vững 150 MB/s từ lưu trữ. Khi GPU xử lý ảnh nhanh hơn tốc độ lưu trữ cung cấp, thì data pipeline, không phải mô hình, trở thành nút thắt cổ chai. Chênh lệch gấp 10 lần giữa tốc độ xử lý của GPU và băng thông lưu trữ đồng nghĩa các bộ tăng tốc sẽ nhàn rỗi 90% thời gian để chờ dữ liệu. Không mức tối ưu hóa GPU nào có thể vượt qua ràng buộc I/O này.
Việc hiểu rõ các mối quan hệ định lượng này giúp chúng ta đưa ra quyết định kiến trúc có căn cứ khi chọn hệ thống lưu trữ và tối ưu hóa pipeline dữ liệu. Điều này còn quan trọng hơn trong huấn luyện phân tán. Thông lượng huấn luyện bị giới hạn bởi giá trị nhỏ nhất giữa năng lực tính toán và tốc độ cung cấp dữ liệu: khi lưu trữ không kịp cung cấp dữ liệu cho bộ tăng tốc, nút thắt cổ chai sẽ chuyển từ silicon sang I/O.
Napkin Math 1.9: Ngân sách băng thông lưu trữ
Vấn đề: Cấu hình lưu trữ nào có thể đảm bảo một bộ tăng tốc tham chiếu không bị thiếu dữ liệu khi huấn luyện ResNet-50? Tăng tốc phần cứng sẽ giải thích về dòng thiết bị này sau; ở đây, mục tiêu là cho thấy cách trần tính toán trở thành ngân sách cho đường dẫn dữ liệu.
Hãy bắt đầu với trần tính toán. Bộ tăng tốc tham chiếu có thể đạt 312 TFLOP/s trên các phép toán FP16 dày đặc. ResNet-50 tốn khoảng tám GFLOP cho mỗi lượt truyền xuôi, và khi tính cả truyền ngược trong huấn luyện, chi phí mỗi bước huấn luyện là khoảng 24.6 GFLOP cho mỗi hình ảnh. Chương về huấn luyện sẽ suy ra phần truyền ngược đó; còn ở đây, tổng chi phí trên mỗi hình ảnh là đầu vào cho ngân sách lưu trữ. Khi chia hiệu suất đỉnh của bộ tăng tốc cho chi phí của mô hình, phép tính cho ta một giới hạn trên là 12,682 img/s.
Trần tính toán đó trở thành yêu cầu lưu trữ khi mỗi hình ảnh phải được lấy từ đĩa hoặc lưu trữ đối tượng. Với ảnh nén JPEG kích thước 150 KB, đường dẫn dữ liệu phải cung cấp số ảnh mỗi giây (ứng với giới hạn trên đã tính) nhân với 150 KB mỗi ảnh, xấp xỉ 1.9 GB/s.
Giờ đây, các lựa chọn lưu trữ đã có mục tiêu cụ thể: để bộ tăng tốc này chạy hết công suất, cần 1.9 GB/s băng thông duy trì.
- S3 Standard cung cấp khoảng 100 MB/s mỗi luồng, nên pipeline cần 19 concurrent worker threads luồng trước khi tính đến overhead phần mềm.
- SSD SATA cung cấp khoảng 500 MB/s theo tuần tự, khiến chúng trở thành nút thắt cổ chai cho bộ tăng tốc này.
- Các SSD NVMe cung cấp xấp xỉ 5–7 GB/s, đúng với lớp lưu trữ cục bộ cần cho mục tiêu này.
Thông tin chuyên sâu về hệ thống: Với SSD SATA, thông lượng tối đa bị giới hạn bởi 500 MB/s; khi chia cho kích thước mỗi ảnh 150 KB, ta được xấp xỉ 3,333 img/s. GPU trị giá $15.000 sẽ chạy ở mức sử dụng 26 percent vì hệ lưu trữ chỉ cung cấp một phần nhỏ so với trần xử lý ảnh của bộ tăng tốc. Vật lý lưu trữ quyết định tốc độ huấn luyện.
Thiết kế cho huấn luyện thông lượng cao bắt đầu bằng việc khớp thông lượng lưu trữ với nhu cầu của bộ tăng tốc. Đây là lập luận về tình trạng “đói” tài nguyên của chương, được xoay sang góc nhìn thứ ba và cũng là cuối cùng: section 1.1.3 đã định giá bộ tăng tốc nhàn rỗi như một khoản thuế cấp liệu, section 1.4.5 đã truy nguyên cùng một điểm nghẽn đến các worker giải mã trên CPU, và ở đây câu hỏi là tầng lưu trữ nào có thể duy trì tốc độ cung cấp cần thiết.
Con số 500 MB/s đại diện cho thông lượng đọc tuần tự hiệu quả của SATA III (trần giao diện là 550 MB/s), và hiệu suất đọc ngẫu nhiên trong thực tế với các tệp nhỏ có thể thấp hơn đáng kể. Lưu ý đó củng cố nguyên tắc chung chi phối các pipeline dữ liệu: equation 5 giới hạn thông lượng huấn luyện bởi năng lực tính toán và tốc độ cung cấp dữ liệu được định nghĩa trong equation 6. Gọi \(R_{\text{train}}\), \(R_{\text{compute}}\), và \(R_{\text{data}}\) là các tốc độ tính bằng mẫu mỗi giây; gọi \(B_{\text{storage}}\) là băng thông lưu trữ tính bằng byte mỗi giây, \(\eta_{\text{overhead}}\) là tỷ lệ không thứ nguyên mất đi do overhead, và \(S_{\text{sample}}\) là số byte trên mỗi mẫu. Trong trường hợp chồng lấp hoàn toàn, dạng min-of-rates tương ứng với cận dưới \(T_{\text{step}} = \max(T_{\text{compute}}, T_{\text{io}})\) từ section 1.4.5; với chồng lấp không hoàn toàn, thời gian mỗi bước thực tế sẽ cao hơn. \[R_{\text{train}} \leq \min(R_{\text{compute}}, R_{\text{data}}) \tag{5}\] \[R_{\text{data}} = \frac{B_{\text{storage}}(1-\eta_{\text{overhead}})}{S_{\text{sample}}} \tag{6}\]
Khi \(R_{\text{data}}\) là tốc độ nhỏ hơn, tăng thêm năng lực tính toán của bộ tăng tốc cũng không thể nâng thông lượng huấn luyện; biện pháp khắc phục phải là tăng băng thông lưu trữ khả dụng hoặc giảm số byte trên mỗi mẫu.
Khi băng thông lưu trữ trở thành nút thắt, các nhóm phải hoặc nâng hiệu năng lưu trữ bằng phương tiện nhanh hơn, song song hóa, hoặc caching; hoặc giảm lượng dữ liệu phải di chuyển. Huấn luyện mô hình ngôn ngữ lớn có thể cần xử lý hàng trăm gigabyte văn bản mỗi giờ, còn các mô hình thị giác máy tính với ảnh độ phân giải cao có thể đòi hỏi tốc độ dữ liệu duy trì trên 50 gigabyte mỗi giây trên các cụm phân tán. Những yêu cầu này biến việc tải dữ liệu thành một quyết định bố trí trong hệ thống: các data loader của framework song song hóa I/O qua các tiến trình worker bất đồng bộ, dùng double-buffering prefetch queues để chồng lấp giai đoạn lấy dữ liệu \(D_{\text{vol}}/\text{BW}_{\text{IO}}\) cho batch \(k+1\) vào RAM máy chủ trong khi bộ tăng tốc đang thực hiện lượt \(O/R_{\text{peak}}\) của batch \(k\) trên bộ nhớ GPU, tránh tình trạng tính toán bị đói dữ liệu (\(L_{\text{lat}}\)). Các loader của framework cũng có thể đưa phần tăng cường dữ liệu tốn kém lại gần bộ tăng tốc hơn, thay vì lưu mọi biến thể đã tăng cường.
Việc lựa chọn định dạng tệp ảnh hưởng đáng kể đến thành phần dữ liệu \(\left(\frac{D_{\text{vol}}}{\text{BW}}\right)\) của Iron Law. Các định dạng cột như Parquet rất hiệu quả cho các đặc trưng dạng bảng vì cho phép chiếu cột và lọc đẩy xuống, trong khi các định dạng tuần tự dựa trên chia mảnh (sharding) như WebDataset hoặc TFRecord đóng gói hàng triệu đối tượng nhị phân nhỏ (ví dụ: ảnh hoặc âm thanh) vào các luồng tuần tự liên tục. Cách chia mảnh này loại bỏ chi phí tìm kiếm đĩa ngẫu nhiên (\(L_{\text{lat}}\)), biến I/O ngẫu nhiên chậm chạp thành thông lượng lưu trữ tuần tự ổn định (\(\text{BW}_{\text{IO}}\)). Ta có thể định lượng tác động này bằng hiệu quả định dạng \((\eta_{\text{format}})\), đóng vai trò hệ số nhân cho băng thông hiệu dụng.
Napkin Math 1.10: Hiệu quả định dạng
Định dạng lưu trữ quyết định lượng dữ liệu “lãng phí” phải di chuyển để lấy được tín hiệu cần cho huấn luyện. Gọi \(\eta_{\text{format}}\) là tỷ lệ không thứ nguyên (từ 0 đến 1) của số byte đọc vào thực sự chứa các đặc trưng được chọn. Equation 7 cho thấy tỷ lệ này biến băng thông vật lý thành băng thông pipeline hữu ích như thế nào: \[ \text{Effective Bandwidth} = \text{Physical Bandwidth} \times \eta_{\text{format}} \tag{7}\] Các giá trị dưới 1 có nghĩa là định dạng đang dùng một phần đường dẫn dữ liệu vật lý cho các byte không liên quan; vì vậy, cải thiện cách bố trí có thể tăng thông lượng khả dụng mà không cần thay đổi thiết bị lưu trữ.
Kịch bản: Huấn luyện một mô hình phát hiện gian lận sử dụng 20 đặc trưng từ một bảng có 100 cột.
Lưu trữ hướng hàng (CSV) phải đọc tất cả 100 cột để lấy 20 cột cần dùng, dẫn đến tỷ lệ byte hữu ích chỉ là 0.2 và lãng phí 80 percent băng thông ổ đĩa. Ngược lại, lưu trữ hướng cột (Parquet) chỉ đọc các cột cần thiết, nhờ đó \(\eta_{\text{format}} \approx\) 1 (bỏ qua phần chi phí siêu dữ liệu), và pipeline đạt thông lượng hiệu dụng cao hơn 5× lần.
Hiểu biết về hệ thống: Trong kịch bản chỉ thực hiện phép chiếu, chuyển từ CSV sang Parquet mang lại mức tăng thông lượng đọc hiệu dụng tương đương với một đường dẫn dữ liệu nhanh hơn 5× lần. Định dạng theo hàng và theo cột trình bày chi tiết về bố trí lưu trữ hướng hàng so với hướng cột và đại số các phép toán dữ liệu (chọn, chiếu, nối).
Việc lựa chọn định dạng phụ thuộc vào mẫu truy cập của khối lượng công việc (workload). Khi một tập dữ liệu dạng bảng lớn không thể di chuyển rẻ và quá trình huấn luyện chỉ đọc các cột được chọn, định dạng hướng cột giúp giảm số byte cần đọc ở mỗi bước.
Các định dạng lưu trữ theo cột như Parquet hoặc Optimized Row Columnar (ORC) hiện thực hóa mức giảm này, thường từ năm đến mười lần với các khối lượng công việc (workload) ML điển hình, thông qua hai cơ chế: phép chiếu cột (như đã định lượng trong tính toán hiệu quả định dạng ở trên), và nén ở cấp cột bằng cách tận dụng các mẫu giá trị trong từng cột. Nén cột đặc biệt hiệu quả đối với các đặc trưng phân loại có số lượng giá trị khác nhau hạn chế: ví dụ, một cột mã quốc gia với 200 giá trị duy nhất trong 100 triệu bản ghi có thể được nén từ 20 đến 50 lần nhờ mã hóa từ điển (dictionary encoding), trong khi mã hóa độ dài chạy (run-length encoding) nén các cột đã sắp xếp bằng cách chỉ lưu các lần thay đổi giá trị. Kết hợp hai phương pháp này có thể đạt tổng mức giảm I/O từ 20 đến 100 lần so với các định dạng hàng không nén, trực tiếp rút ngắn vòng lặp huấn luyện và giảm chi phí hạ tầng.
Việc lựa chọn thuật toán nén là sự đánh đổi giữa tỷ lệ nén và tốc độ giải nén. Trong khi gzip đạt tỷ lệ nén cao hơn, từ sáu đến tám lần, Snappy chỉ đạt từ hai đến ba lần nhưng giải nén ở tốc độ 500 MB/s, nhanh hơn khoảng 4.2× so với 120 MB/s của gzip. Với huấn luyện ML, nơi thông lượng quan trọng hơn chi phí lưu trữ, lợi thế tốc độ của Snappy thường đáng giá hơn mức tiết kiệm dung lượng của gzip. Huấn luyện trên một tập dữ liệu 100 GB được nén bằng gzip cần 13.9 minutes thời gian giải nén, trong khi Snappy chỉ cần 3.3 minutes. Khi huấn luyện duyệt dữ liệu trong 50 epochs epoch, chênh lệch 10.6 minutes này mỗi epoch sẽ cộng dồn thành tổng 9 hours, có thể là khác biệt giữa việc chạy thí nghiệm qua đêm và phải chờ thêm nhiều ngày mới có kết quả. Sự lựa chọn này còn lan tỏa trong toàn hệ thống: giải nén nhanh hơn cho phép thông lượng đầu vào cao hơn, giảm nhu cầu đệm (ít dữ liệu đã giải nén cần được chuẩn bị), và tận dụng GPU tốt hơn (ít thời gian nhàn rỗi chờ dữ liệu).
Việc tối ưu hóa hiệu suất lưu trữ không chỉ dừng lại ở định dạng và nén, mà còn bao gồm cả cách bố trí dữ liệu. Phân vùng dữ liệu dựa trên các tham số truy vấn thường dùng có thể cải thiện đáng kể hiệu quả truy xuất. Ví dụ, một hệ thống khuyến nghị xử lý tương tác người dùng có thể phân vùng theo ngày và theo các thuộc tính nhân khẩu học; như vậy có thể huấn luyện trên dữ liệu mới nhất hoặc trên những phân khúc người dùng cụ thể mà không phải quét toàn bộ tập dữ liệu. Các chiến lược phân vùng gắn chặt với các kiểu huấn luyện phân tán: phân vùng theo khoảng ID người dùng cho phép huấn luyện song song theo dữ liệu, trong đó mỗi worker xử lý một tập con người dùng ổn định; ngược lại, phân vùng ngẫu nhiên giúp các worker nhìn thấy phân phối dữ liệu đa dạng. Độ chi tiết của phân vùng rất quan trọng: quá ít phân vùng sẽ hạn chế mức độ song song, trong khi quá nhiều phân vùng làm tăng chi phí siêu dữ liệu và giảm hiệu quả đọc tuần tự trong từng phân vùng. Phân vùng kém còn làm trầm trọng vấn đề trong huấn luyện trên nhiều bộ tăng tốc: khi một bài toán huấn luyện song song theo dữ liệu phân tán gán các shard (phân đoạn) cho các worker, kích thước phân vùng không cân bằng sẽ gây ra hiệu ứng straggler, nơi worker chậm nhất kéo chậm toàn bộ bước đồng bộ gradient. Nếu tất cả worker trong một job với tám bộ tăng tốc đều tải xong batch trong 12 ms, nhưng một worker phải đọc từ phân vùng quá lớn và mất tới 180 ms, thì chính straggler đó sẽ quyết định thời gian batch hiệu quả. Vì vậy, cần các tập dữ liệu được phân vùng tốt, sao cho mỗi shard phù hợp với ngân sách đọc cục bộ của worker và có thể được lấy mà không tranh chấp trên một handle tệp dùng chung, để duy trì mức sử dụng bộ tăng tốc phân tán cao. Vấn đề này sẽ được xem xét kỹ hơn trong Huấn luyện mô hình.
Lưu trữ trong suốt vòng đời machine learning
Các yêu cầu về lưu trữ thay đổi theo thời gian vì mỗi giai đoạn trong vòng đời machine learning cần truy cập cùng một tập dữ liệu theo những kiểu khác nhau. Cùng một tập dữ liệu có thể được truy cập bằng cách lấy mẫu ngẫu nhiên trong phân tích khám phá, quét tuần tự trong huấn luyện mô hình, và truy cập ngẫu nhiên trong quá trình phục vụ (serving). Những kiểu truy cập đa dạng này đòi hỏi các kiến trúc lưu trữ phải đáp ứng được cả ba chế độ.
Trong giai đoạn phát triển, tính linh hoạt quan trọng hơn hiệu năng thuần. Thách thức then chốt là quản lý các phiên bản tập dữ liệu mà không làm quá tải dung lượng lưu trữ: mười thử nghiệm trên một tập dữ liệu 100 GB, nếu làm theo cách đơn giản, sẽ cần tới 1 TB bản sao. Cơ chế con trỏ siêu dữ liệu đã được giới thiệu cho checkpoint mô hình trong section 1.7.2 áp dụng nguyên vẹn: các công cụ như DVC theo dõi phiên bản bằng con trỏ và lưu trữ artifact theo địa chỉ nội dung, khử trùng lặp các nội dung giống hệt nhau khi có thể. Ở khía cạnh quản trị, cần kiểm soát truy cập theo tầng: các tập dữ liệu tổng hợp hoặc ẩn danh có thể được cung cấp rộng rãi cho thử nghiệm, trong khi dữ liệu sản xuất chứa thông tin nhạy cảm phải có phê duyệt và có dấu vết kiểm toán.
Ở giai đoạn huấn luyện, yêu cầu chuyển mạnh sang thông lượng. deep learning hiện đại xử lý các tập dữ liệu khổng lồ lặp đi lặp lại qua hàng chục hoặc hàng trăm epoch, khiến hiệu quả I/O trở nên cực kỳ quan trọng. Huấn luyện ResNet-50 trên ImageNet với tám GPU ở 40,000 img/s sẽ cần khoảng 6 GB/s cho các hình ảnh nén 150 KB, và còn nhiều hơn đáng kể nếu các tensor FP32 đã giải mã được đưa vào bộ đệm. Hệ thống lưu trữ không duy trì được thông lượng này sẽ khiến các GPU nhàn rỗi, trực tiếp làm tăng chi phí cơ sở hạ tầng. Sự đánh đổi về vị trí tính toán đặc trưng (section 1.4.5.3) đặc biệt gay gắt ở đây: tính trước đặc trưng giúp giảm 30× dung lượng lưu trữ (từ 150 KB xuống các vector 5 KB), nhưng lại tiềm ẩn rủi ro lỗi thời khi logic trích xuất thay đổi.
Yêu cầu triển khai và suy luận thời gian thực ưu tiên truy cập ngẫu nhiên với độ trễ thấp. Một hệ thống khuyến nghị phục vụ 10,000 req/s với ngân sách độ trễ 10 ms và 10 feature reads/request sẽ cần 100,000 IOPS. Để đạt mục tiêu minh họa đó, có thể cần một cơ sở dữ liệu trong bộ nhớ như Redis, cache tích cực, hoặc một dịch vụ key-value phân tán chuyên dụng. Triển khai edge đặt ra thêm nhiều ràng buộc: bộ nhớ thiết bị hạn chế, kết nối không ổn định, và cần cập nhật mô hình mà không làm gián đoạn suy luận. Thông thường, điều này được giải quyết bằng lưu trữ theo tầng, nơi mô hình được cache cục bộ, còn dữ liệu tham chiếu lấy từ đám mây. Việc quản lý phiên bản mô hình phải hỗ trợ chuyển đổi trơn tru giữa các phiên bản, khôi phục nhanh, và phục vụ đồng thời nhiều phiên bản cho thử nghiệm A/B; các mẫu vận hành này được xem xét trong Vận hành machine learning. Những đảm bảo về phục vụ (serving) và khôi phục này phụ thuộc vào provenance: hệ thống phải biết chính xác phiên bản tập dữ liệu đứng sau mỗi phiên bản mô hình.
Phiên bản hóa dữ liệu để đảm bảo khả năng tái lập trong ML
Giả sử tỷ lệ nhấp (CTR) của một mô hình khuyến nghị giảm sau một đợt huấn luyện lại hằng tuần theo lịch, dù mã không thay đổi. Nhóm phải phân biệt giữa dữ liệu thay đổi, nhãn bị dịch chuyển, và một bảng upstream bị lỗi. Nếu không có bản ghi liên kết mô hình với đúng tập dữ liệu đã sinh ra nó, nhóm có thể mất nhiều ngày để khoanh vùng nguyên nhân. Với phiên bản hóa dữ liệu, họ có thể so sánh các bản chụp huấn luyện và xác định một thao tác backfill từ upstream đã làm dịch chuyển phân phối nhãn. Listing 3 minh họa cơ chế này: Git ghi lại tệp con trỏ nhỏ, DVC chuyển dữ liệu lớn lên lưu trữ từ xa, và một lần checkout sau đó sẽ khôi phục chính xác bản chụp huấn luyện đi kèm với commit mã đó (Iterative 2024).
git checkout and dvc checkout commands.
# Add data to version control
dvc add data/training.csv
git add data/training.csv.dvc
git commit -m "Add training data v1"
dvc push  # Upload to remote storage

# Later: retrieve exact data for any historical commit
git checkout abc123
dvc checkout  # Restores exact data from that commit
Quản lý phiên bản dữ liệu là đối ứng ở lớp lưu trữ của tính truy nguyên trong hệ thống kiểm soát phiên bản mã. Nó kết nối các phiên bản mô hình với đúng dữ liệu huấn luyện, nhờ đó hỗ trợ gỡ lỗi và đảm bảo khả năng tái tạo. Thiếu cơ chế này, các nhóm sẽ không thể xác định chính xác bộ dữ liệu đã dùng để huấn luyện mô hình hiện đang gặp lỗi trong môi trường sản xuất.
DVC (Data Version Control) cung cấp ngữ nghĩa kiểu Git cho các ảnh chụp tệp (Iterative 2024), còn listing 4 minh họa truy vấn lịch sử của Delta Lake dựa trên nhật ký giao dịch (Armbrust et al. 2020).
Iterative. 2024. Data Version Control (DVC).
-- Query data as it existed on a specific date
SELECT * FROM training_data TIMESTAMP AS OF '2024-01-15'

-- Or by version number for programmatic access
SELECT * FROM training_data VERSION AS OF 47
Hai khả năng bổ trợ này giúp hoàn thiện hạ tầng quản lý phiên bản. Thứ nhất, tính năng truy xuất đặc trưng theo thời điểm của feature store duy trì các giá trị đặc trưng lịch sử. Điều này cho phép huấn luyện mô hình với các đặc trưng “như chúng đã tồn tại” tại thời điểm dự đoán, đồng thời ngăn rò rỉ nhãn – tức là vô tình dùng thông tin vốn không có sẵn khi đưa ra dự đoán. Thứ hai, tích hợp Model registry liên kết mỗi mục trong model registry (một bản ghi danh mục về một tạo phẩm mô hình và siêu dữ liệu của nó) với nguồn gốc của nó: mã hash commit Git, phiên bản dữ liệu, dấu thời gian bản chụp đặc trưng và cấu hình huấn luyện. Quay lại ví dụ về sụt giảm tỷ lệ nhấp ở đầu phần, bộ bản ghi đầy đủ có thể biến một cuộc tìm kiếm mở thành phép so sánh trực tiếp các bản chụp, từ đó lộ ra phần backfill ở hệ thống nguồn.
Bảo trì dài hạn đưa ra một cân nhắc lưu trữ cuối cùng: giữ đủ dữ liệu để gỡ lỗi, đồng thời tôn trọng quyền riêng tư, chi phí và các yêu cầu lưu trữ hồ sơ áp dụng. Một hệ thống khuyến nghị có lưu lượng lớn có thể dùng chiến lược lưu trữ phân cấp: lưu trữ nóng cho phân tích nhanh, lưu trữ ấm cho việc rà soát định kỳ, và lưu trữ lạnh để lưu trữ dài hạn phục vụ điều tra hoặc lưu hồ sơ đã được phê duyệt. Thời hạn lưu giữ và yêu cầu về tính bất biến phụ thuộc vào dữ liệu, khu vực pháp lý, sản phẩm và rủi ro; giữ mọi thứ vô thời hạn không phải là quy tắc tuân thủ chung, cũng không phải mặc định hợp lý.
Kiến trúc lưu trữ quyết định dữ liệu được đặt ở đâu và truy xuất như thế nào, nhưng chỉ dựa vào bố cục lưu trữ vật lý thì không thể đảm bảo các đặc trưng tính trong huấn luyện batch sẽ khớp với các đặc trưng được phục vụ trong thời gian thực. Để bắc cầu giữa môi trường huấn luyện batch và hệ thống phục vụ có độ trễ thấp, cần một hạ tầng chuyên biệt bảo đảm tính nhất quán khi truy cập kép.
Feature stores
Thách thức cốt lõi trong quản lý đặc trưng ở môi trường sản xuất là duy trì tính nhất quán ngữ nghĩa giữa các môi trường: phục vụ các giá trị đặc trưng lịch sử cho huấn luyện và các giá trị đặc trưng hiện tại cho suy luận. Tính đúng đắn tại một thời điểm là một lý do các nhóm áp dụng feature store, giúp giảm training-serving skew và cho phép tái sử dụng đặc trưng giữa các mô hình và nhóm. Tuy nhiên, feature store không tự loại bỏ skew; việc xử lý dấu thời gian, backfills, độ tươi và đồng bộ hóa offline-online vẫn phải chính xác.
Vấn đề cốt lõi mà feature store giải quyết sẽ rõ khi nhìn vào quy trình phát triển ML điển hình. Trong giai đoạn phát triển mô hình, nhà khoa học dữ liệu viết logic tạo đặc trưng trong notebook hoặc script, thường dùng thư viện và ngôn ngữ khác với hệ thống phục vụ sản xuất. Chẳng hạn, ở bước huấn luyện, có thể dùng SQL để tổng hợp dữ liệu lịch sử và tính “tổng số lần mua trong 30 ngày qua” của một người dùng; còn khi phục vụ, một microservice sẽ tính cùng đặc trưng đó bằng cách cập nhật dần các giá trị trong cache. Hai cách triển khai này lẽ ra phải cho kết quả giống nhau, nhưng những khác biệt nhỏ trong xử lý múi giờ, dữ liệu thiếu, hoặc cách làm tròn số có thể khiến đặc trưng ở huấn luyện và phục vụ lệch nhau. Mô tả về nền tảng Michelangelo của Uber xem training-serving skew và khả năng tái sử dụng pipeline đặc trưng là các vấn đề trọng tâm trong sản xuất, từ đó đề xuất cách tiếp cận nền tảng tích hợp cho quản lý đặc trưng (Hermann and Del Balso 2017).
Definition 1.4: Feature store
Feature store là lớp kiến trúc tập trung quản lý các đặc trưng của machine learning, tách rời quá trình tính toán đặc trưng khỏi quá trình tiêu thụ.
- Ý nghĩa: Nó hỗ trợ truy xuất lịch sử chính xác theo thời điểm cho huấn luyện \((x_{t-\Delta})\) và phối hợp định nghĩa đặc trưng cho suy luận thời gian thực \((x_t)\), giúp giảm training-serving skew khi dấu thời gian, backfills, độ tươi và đồng bộ hóa được xử lý đúng cách.
- Điểm khác biệt: Không giống một cơ sở dữ liệu mục đích chung, feature store được thiết kế cho hai chế độ lưu trữ: offline store (dạng cột/batch) phục vụ huấn luyện và online store (key-value/độ trễ thấp) cho phục vụ (serving).
- Lỗi thường gặp: Một hiểu nhầm phổ biến là feature store chỉ là “chỗ để lưu dữ liệu”. Thực tế, nó quản lý định nghĩa đặc trưng, giá trị và cách truy xuất; các phép biến đổi có thể chạy ngay trong feature store, trong một kho ngoại tuyến (offline store), hoặc trên một hệ tính toán riêng theo batch hoặc stream.
Feature stores (được thảo luận về kiến trúc trong Kho đặc trưng) cung cấp một nguồn chuẩn chung cho các định nghĩa đặc trưng, giúp đảm bảo tính nhất quán xuyên suốt vòng đời ML. Khi các nhà khoa học dữ liệu định nghĩa một đặc trưng như user_purchase_count_30d, feature store có thể lưu giữ định nghĩa đó (truy vấn SQL, logic biến đổi, hoặc đồ thị tính toán) và cung cấp các giá trị lịch sử cho huấn luyện, cùng các giá trị hiện tại cho phục vụ (serving). Mẫu kiến trúc này giúp giảm một nhóm lỗi tinh vi, khó lần ra nguyên nhân: mô hình huấn luyện thành công nhưng hoạt động kém trong môi trường sản xuất dù không có lỗi hiển nhiên. Cách tiếp cận tập trung tương tự cũng cho phép tái sử dụng đặc trưng giữa các mô hình và các nhóm: khi nhiều nhóm xây dựng mô hình cần các đặc trưng tương tự, feature store có thể tránh việc mỗi nhóm tự triển khai lại cùng phép tính với những khác biệt nhỏ khó kiểm soát. Chẳng hạn, một hệ thống khuyến nghị có thể tính các vector embedding người dùng với hàng trăm chiều, tổng hợp lịch sử tương tác trong nhiều tháng. Thay vì mỗi nhóm mô hình phải tự tính lại các embedding tốn kém này, feature store có thể tính một lần và phục vụ cho nhiều bên tiêu thụ.
Mẫu kiến trúc này thường triển khai hai chế độ lưu trữ được tối ưu cho các kiểu truy cập khác nhau. Offline store dùng các định dạng dạng cột như Parquet trên lưu trữ đối tượng (object storage), tối ưu cho truy cập batch trong giai đoạn huấn luyện, nơi việc quét tuần tự hàng triệu ví dụ là chuyện phổ biến. Ngược lại, online store dùng các hệ thống key-value như Redis, tối ưu cho truy cập ngẫu nhiên khi phục vụ (serving), nơi cần truy xuất từng vector đặc trưng trong vài mili giây. Vì vậy, đồng bộ giữa hai kho lưu trữ trở nên hết sức quan trọng. Khi huấn luyện tạo ra các mô hình mới dựa trên các giá trị đặc trưng hiện tại, các mô hình đó khi được đưa vào sản xuất kỳ vọng online store cung cấp đặc trưng một cách nhất quán. Các feature store thường triển khai các bản cập nhật batch theo lịch, đẩy các giá trị đặc trưng mới từ offline store sang online store, với tần suất cập nhật phụ thuộc vào yêu cầu về độ tươi của đặc trưng.
Khả năng du hành thời gian là điểm khác biệt giữa các feature store tinh vi và các lớp bộ nhớ đệm đơn giản. Khi huấn luyện, chúng ta cần truy cập các giá trị đặc trưng đúng như chúng tồn tại tại những thời điểm cụ thể, chứ không phải các giá trị hiện tại. Ví dụ, khi huấn luyện một mô hình dự đoán churn: với những người dùng đã churn vào ngày 15 tháng 1, mô hình phải dùng các đặc trưng được tính vào ngày 14 tháng 1, không phải các đặc trưng hiện tại phản ánh trạng thái đã churn. Tính chính xác theo thời điểm bảo đảm dữ liệu huấn luyện phù hợp với điều kiện sản xuất, nơi các đặc trưng hiện có được dùng để dự báo kết quả tương lai. Để triển khai du hành thời gian, chúng ta cần lưu trữ lịch sử của các đặc trưng, không chỉ các giá trị hiện tại; điều này làm tăng đáng kể nhu cầu lưu trữ nhưng cho phép huấn luyện đúng trên dữ liệu lịch sử.
Các đặc tính hiệu suất của feature store ảnh hưởng trực tiếp đến cả thông lượng huấn luyện và độ trễ phục vụ (serving). Offline store phải hỗ trợ đọc batch với thông lượng cao (hàng triệu vector đặc trưng mỗi phút), sử dụng định dạng cột để đọc hiệu quả các đặc trưng cụ thể từ các bảng rộng. Online store phải hỗ trợ hàng nghìn đến hàng triệu lượt đọc mỗi giây với độ trễ chỉ vài mili giây. Trong môi trường sản xuất, tính cập nhật của đặc trưng gây thêm áp lực: khi người dùng thêm sản phẩm vào giỏ hàng, hệ thống khuyến nghị cần các đặc trưng được cập nhật trong vài giây, chứ không phải vài giờ. Các pipeline tính toán đặc trưng kiểu streaming giải quyết vấn đề này bằng cách cập nhật online store liên tục thay vì dùng các job batch định kỳ. Tuy nhiên, streaming cũng làm tăng độ phức tạp liên quan đến ngữ nghĩa xử lý chính xác một lần (exactly-once semantics)—đảm bảo mỗi sự kiện chỉ cập nhật trạng thái một lần dù có thử lại—và việc xử lý các sự kiện đến muộn.
Một pipeline hoàn chỉnh bao gồm thu thập, nạp dữ liệu, xử lý, gán nhãn và lưu trữ có thể khiến ta nghĩ rằng công việc kỹ thuật dữ liệu đã “hoàn thành.” Tuy nhiên, các hệ thống sản xuất không đứng yên. Hành vi người dùng thay đổi, schema upstream tiến hóa, hướng dẫn gán nhãn thay đổi, và phần kỹ thuật pipeline được mô tả ở các phần trước sẽ dần bị xói mòn nếu không được bảo trì chủ động.
Self-Check: Question
An ML systems architect must select storage backends for three distinct workloads: (1) Millisecond point lookups of user feature vectors during real-time online serving; (2) High-throughput sequential scans over tabular fraud features during batch training; (3) Storing petabytes of raw, unstructured multi-modal audio and video recordings. Which mapping of storage architectures to workloads is optimal?
- Low-latency transactional database / key-value store; (2) Columnar data warehouse; (3) Scalable cloud data lake (object storage).
- Cloud object storage (S3); (2) Key-value database; (3) Columnar data warehouse.
- Columnar data warehouse; (2) Cloud data lake; (3) Low-latency transactional database.
- Scalable cloud data lake; (2) Low-latency transactional database; (3) Columnar data warehouse.
How does a feature store’s point-in-time correctness (time-travel join) prevent data leakage during offline training dataset generation?
- It encrypts historical feature values so that model weights cannot memorize training labels.
- It forces all features to be computed strictly in real time on the client device during model inference.
- It converts all timestamps into UTC strings to prevent database indexing errors.
- It reconstructs feature values exactly as they existed at the observation timestamp of each training event, preventing future feature values from leaking into historical training records.
Explain the storage-bandwidth bottleneck when feeding accelerators directly from cloud object storage versus local NVMe SSDs, and describe the common architectural caching pattern used to resolve it.
True or False: In a columnar storage format like Apache Parquet, reading 10 columns out of a 100-column table requires scanning the entire uncompressed row payload from disk.
Arrange the storage tiers across the ML lifecycle in their natural operational progression, from raw data capture to online inference serving:
- Online feature store (low-latency key-value store for inference)
- Offline feature store (point-in-time historical feature registry)
- Fast local NVMe cache on accelerator compute nodes
- Raw data lake (immutable object storage staging)
- Curated transactional table layer (lakehouse / warehouse)


Ngộ nhận và cạm bẫy
Từ khâu thu thập đến lưu trữ, mỗi giai đoạn của pipeline đều mở ra cả cơ hội lẫn nguy cơ thất bại. Các ngụy biện và cạm bẫy dưới đây tóm lược những quan niệm sai lầm đáng kể nhất, dễ khiến các nhóm đi chệch hướng.
Ngụy biện: Nhiều dữ liệu hơn luôn cải thiện hiệu suất mô hình.
Khi vượt một ngưỡng nhất định, thêm dữ liệu sẽ cho lợi ích giảm dần. Các nghiên cứu thực nghiệm trong phân loại ảnh, dịch thuật và mô hình ngôn ngữ xác nhận rằng test loss thường tuân theo quy luật lũy thừa theo kích thước tập dữ liệu, nên mỗi đợt dữ liệu bổ sung chỉ mang lại cải thiện nhỏ dần (Hestness et al. 2017). Heuristic về tín hiệu liên quan tác vụ từ section 1.1 cũng phản ánh bài toán đánh đổi tương tự ở cấp hệ thống: các ví dụ dư thừa làm tăng chi phí xử lý dữ liệu nhưng bổ sung rất ít thông tin mới có ích cho tác vụ.
Hestness, Joel, Sharan Narang, Newsha Ardalani, Gregory Diamos, Heewoo Jun, Hassan Kianinejad, Md. Mostofa Ali Patwary, Yang Yang, and Yanqi Zhou. 2017. “Deep Learning Scaling Is Predictable, Empirically.” arXiv Preprint arXiv:1712.00409.
Cạm bẫy: Lập kế hoạch di chuyển petabyte chỉ như một bài toán băng thông.
Các kỹ sư có thể ước tính thời gian di chuyển bằng cách chia kích thước tập dữ liệu cho băng thông mạng, nhưng trọng lực dữ liệu (data gravity) (section 1.1) còn kéo theo việc tái thiết kế pipeline, xác thực lại chất lượng dữ liệu, di chuyển lược đồ (schema), cập nhật lineage và đồng bộ các dịch vụ phụ thuộc. Vì vậy, các đợt di chuyển quy mô petabyte thường đòi hỏi thời gian kỹ thuật lớn hơn rất nhiều so với thời gian truyền trên dây.
Ngụy biện: Tiền xử lý dữ liệu có thể hoàn thành một lần và không cần động đến nữa.
Phân phối dữ liệu có thể trôi khi hành vi người dùng, điều kiện thị trường và các hệ thống thượng nguồn thay đổi. Một pipeline tiền xử lý được xác thực lúc ra mắt có thể nhanh chóng lỗi thời khi bối cảnh xung quanh biến chuyển. Hệ thống sản xuất cần được giám sát và phản ứng dựa trên bằng chứng, không phải chỉ xác thực một lần rồi thôi.
Cạm bẫy: Bỏ qua chi phí tuần tự hóa dữ liệu.
Các nhóm có thể tỉ mỉ tối ưu hóa các nhân trên bộ tăng tốc nhưng lại để tải dữ liệu ở định dạng như JSON hoặc CSV. Các định dạng văn bản này làm tăng chi phí phân tích cú pháp và truyền byte so với định dạng nhị phân, trong khi định dạng cột như Parquet giúp giảm I/O khi các khối lượng công việc (workload) dạng bảng chỉ đọc một phần cột. Hãy benchmark các định dạng theo mẫu truy cập thực tế và chỉ chuyển đổi khi mức tiết kiệm đo được đủ lớn để đáng công di chuyển.
Ngụy biện: Độ chính xác huấn luyện cao cho thấy hệ thống đã sẵn sàng sản xuất.
Độ chính xác khi huấn luyện (training accuracy) đo mức độ mô hình khớp với dữ liệu lịch sử. Đánh giá trên tập giữ lại (held-out evaluation) ước tính khả năng tổng quát hóa trong những điều kiện đã được lấy mẫu, còn hiệu suất vận hành (production performance) phụ thuộc vào môi trường live. Độ lệch huấn luyện-phục vụ (training-serving skew), dịch chuyển phân phối (distribution shift) và khoảng trống bao phủ (coverage gaps) có thể khiến một mô hình dù có kết quả đánh giá tốt vẫn hoạt động kém sau khi triển khai. Sơ đồ gỡ lỗi trong figure 15 tồn tại vì để chẩn đoán khoảng cách đó, cần lần theo dữ liệu và các điều kiện hệ thống, thay vì tin vào một điểm số tổng hợp duy nhất.
Cạm bẫy: Bỏ qua độ lệch huấn luyện-phục vụ cho đến khi triển khai.
Sự khác biệt trong cách tính toán đặc trưng giữa môi trường huấn luyện và phục vụ (serving) là một nguyên nhân quan trọng gây ra lỗi khi triển khai hệ thống học máy. Khi độ lệch này đã hiện rõ trong các chỉ số vận hành, việc gỡ lỗi có thể trở nên khó khăn. Vì vậy, các kho đặc trưng (feature stores) và hợp đồng nhất quán (consistency contracts) cần được cân nhắc ngay từ đầu, thay vì chỉ tính đến sau khi xảy ra sự cố triển khai.
Ngụy biện: Dữ liệu tổng hợp có thể thay thế hoàn toàn việc thu thập dữ liệu thực tế.
Dữ liệu tổng hợp có thể bổ trợ cho các quan sát thực, bằng cách nhắm tới các trường hợp hiếm, các biến thể được kiểm soát, hoặc những kịch bản nhạy cảm về quyền riêng tư; nhưng giá trị của nó phụ thuộc vào mức độ sát với tác vụ triển khai. Quá trình sinh dữ liệu kế thừa các thiếu sót và tạo tác (artifacts) từ mô hình và các giả định của nó. Một hệ thống KWS (Keyword Spotting) chỉ được huấn luyện bằng giọng nói tổng hợp có thể bỏ sót giọng vùng miền, tiếng ồn nền và các biến thể phát âm mà bộ sinh không có. Nhóm phát triển nên xác thực sự pha trộn giữa dữ liệu thực và dữ liệu tổng hợp trên dữ liệu đại diện cho môi trường triển khai, thay vì giả định có một công thức tối ưu cho mọi trường hợp.
Cạm bẫy: Bỏ qua việc quản lý phiên bản dữ liệu cho đến khi cần gỡ lỗi mô hình.
Nhiều nhóm trì hoãn việc phiên bản hóa dữ liệu cho đến khi mô hình đã triển khai cho ra kết quả bất thường. Nếu không có phiên bản, để tái hiện một lần huấn luyện, bạn phải tái dựng chính xác đầu vào hoặc chạy lại toàn bộ pipeline. Hãy xét một mô hình ba tháng trước còn hoạt động tốt nhưng sau đó kém đi khi huấn luyện lại trên dữ liệu cập nhật. Thiếu các snapshot có phiên bản, nhóm không thể biết sự suy giảm đến từ thay đổi chính sách gán nhãn, lỗi migration lược đồ, hay một dịch chuyển phân phối thực sự. Các nguyên tắc về dòng dữ liệu (data lineage) được nêu trong section 1.5.4 chính thức hóa yêu cầu này: mọi tạo tác huấn luyện phải truy ngược về một phiên bản tập dữ liệu cụ thể, bất biến. Việc trì hoãn phiên bản hóa làm dài thời gian gỡ lỗi vì mỗi lần điều tra phải bắt đầu bằng việc xác định chính xác dữ liệu đã dùng để huấn luyện mô hình.
Self-Check: Question
An engineering team assumes that doubling their raw dataset volume by web scraping uncurated text and generating synthetic speech samples will automatically improve downstream model accuracy. According to the chapter’s fallacies and pitfalls, why is this assumption flawed?
- Because scaling laws exhibit diminishing returns (power-law test loss flattening), and adding uncurated or synthetic data can increase data gravity and transport energy while introducing generator domain gaps and noise.
- Because neural networks cannot mathematically process more than one million training records without floating-point overflow.
- Because synthetic data is legally prohibited from being combined with real-world sensor captures.
- Because web scraping always converts binary audio files into plain text formats, corrupting feature representations.
Explain why planning a petabyte-scale dataset migration solely as a network wire transfer (\(T = D_{\text{vol}}/\text{BW}\)) is a major systems pitfall.
True or False: Achieving high accuracy on a randomly split validation set during model development proves that the system will perform reliably after deployment.
Tóm tắt
Kỹ thuật dữ liệu cung cấp hạ tầng nền để biến dữ liệu thô thành nền tảng cho các hệ thống machine learning, qua đó quyết định hiệu suất mô hình, độ tin cậy hệ thống, sự tuân thủ đạo đức và khả năng bảo trì lâu dài. Framework bốn trụ cột (Chất lượng, Độ tin cậy, Khả năng mở rộng, Quản trị) định hình các lựa chọn thiết kế trong các khâu thu thập, nhập liệu, xác thực và lưu trữ, trong khi tính chất lan truyền của lỗi chất lượng dữ liệu cho thấy vì sao mọi giai đoạn của pipeline đều đòi hỏi các quyết định kỹ thuật cẩn trọng. Nhiệm vụ “chuẩn bị dữ liệu” bao gồm nhiều đánh đổi phức tạp đã được lượng hóa xuyên suốt chương này: các hằng số chi phí của kỹ thuật dữ liệu phục vụ lập ngân sách, thứ bậc hiệu năng lưu trữ, và các ngưỡng phát hiện trôi dạt giúp hiện thực hóa phương trình suy giảm vào hạ tầng giám sát sản xuất.
Key Takeaways: Dữ liệu là mã nguồn
- Data cascades khiến chất lượng dữ liệu ở thượng nguồn là khoản đầu tư mang lại hiệu quả cao nhất: Các lỗi thu thập dữ liệu sẽ khuếch đại qua mọi giai đoạn của pipeline (figure 1). Bốn trụ cột (Chất lượng, Độ tin cậy, Khả năng mở rộng, Quản trị) giúp tổ chức việc phòng ngừa, trong khi các khoản nợ về tài liệu, lược đồ, chất lượng và độ tươi mới đòi hỏi được khắc phục liên tục.
- Dữ liệu là mã nguồn; hãy phiên bản hóa, kiểm thử và xem xét nó: Một tập dữ liệu chính là mã nguồn của một hệ thống machine learning. Hãy áp dụng mức độ chặt chẽ tương tự như với mã nguồn, thông qua kiểm soát phiên bản, kiểm thử xác thực và xem xét dữ liệu.
- Tính nhất quán giữa huấn luyện và phục vụ (serving) là điều không thể thỏa hiệp: Các phép biến đổi đặc trưng dùng chung cho cả huấn luyện và phục vụ phải có ngữ nghĩa tương đương và tái sử dụng cùng một trạng thái đã học, ví dụ như các hằng số chuẩn hóa và ánh xạ từ vựng.
- Các lựa chọn kiến trúc pipeline có ảnh hưởng lớn đến chi phí: Vận hành streaming tốn kém hơn batch, còn ETL thì đổi lấy việc tiết kiệm lưu trữ bằng chi phí cao hơn khi thay đổi lược đồ. Hãy chọn mẫu nhập liệu dựa trên giá trị của độ trễ, không phải vì sức hấp dẫn của thời gian thực.
- Chi phí gán nhãn chiếm phần lớn và đòi hỏi phân bổ tài nguyên đáng kể: Việc gán nhãn có thể tốn kém gấp hàng trăm đến hơn một nghìn lần so với một lần chạy huấn luyện đã được tối ưu hóa. Trong phép tính tham chiếu tại section 1.3.2, tỷ lệ này là 521×–1,562×. Gán nhãn vẫn có thể là một nút thắt cổ chai tốn kém trong khâu lập lịch, ngay cả khi công việc gán nhãn được thực hiện song song.
- Hệ thống phân cấp lưu trữ quyết định nhịp độ lặp: Sự chênh lệch thông lượng 50× giữa ổ NVMe cục bộ (5 GB/s) và bộ nhớ đối tượng trên đám mây (100 MB/s) sẽ quyết định liệu các lần lặp diễn ra hàng ngày hay hàng tuần.
- Phương trình suy giảm trở nên hữu ích khi gắn với giám sát độ trôi và kết quả: Các chỉ số phân kỳ như KL đo lường sự thay đổi giữa \(P_t\) và \(P_0\), trong khi các kết quả có nhãn hoặc các proxy đã được xác thực sẽ xác định liệu những thay đổi đó có tương ứng với sự suy giảm của mô hình hay không.
Nghiên cứu điển hình KWS kết hợp thu thập dữ liệu được tuyển chọn, từ cộng đồng và tổng hợp; xác thực tính nhất quán; lưu trữ phân cấp cho 23.4 million audio samples mẫu trên 748.8 GB dữ liệu thô; và theo dõi nguồn gốc cho các thiết bị luôn lắng nghe. Kỹ thuật dữ liệu không phải chỉ là bước tiền xử lý trước công việc ML “thực sự”; nó là nền tảng cho hiệu suất mô hình, sự tin cậy của người dùng và tuân thủ quy định.
What’s Next: Từ mã nguồn đến tệp thực thi
Pipeline dữ liệu đã tạo ra một tập huấn luyện sạch, có phiên bản, nhưng một tập dữ liệu tự nó thì không dạy được gì. Tính toán nơ-ron sẽ mở hộp đen đó để xem xét trục thuật toán: các phép toán học biến các ví dụ đã chuẩn bị thành hành vi đã học, và khiến các mạng nơ-ron có thể dự đoán, gỡ lỗi và tối ưu hóa.
Self-Check: Question
Reflecting on the chapter’s quantitative summaries, which two systems constants highlight the dominant economic and performance bottlenecks in modern ML data engineering?
- GPU arithmetic execution is \(1{,}000\times\) more expensive than data labeling, and object storage is \(50\times\) faster than local NVMe SSDs.
- Data labeling costs dominate compute by \(500\times\text{--}1{,}000\times\) the cost of an optimized training run, and local NVMe SSDs provide a \(50\times\) bandwidth advantage over cloud object storage.
- Network egress costs are always zero, and database row scans are faster than columnar Parquet reads.
- Feature stores eliminate 100% of memory requirements, and audio preprocessing requires more memory than model weights.
Summarize why training data must be treated as the ‘source code’ of an ML system, and describe the core responsibilities of data engineering in managing this source code across its lifecycle.
Arrange the primary operational phases of the end-to-end ML data engineering lifecycle in their canonical order:
- Strategic data acquisition and gap closing
- Ingestion, schema validation, and defensive quality checks
- Idempotent transformation and feature engineering
- Labeled dataset compilation and consensus verification
- Strategic storage tiering and feature store materialization
- Continuous operational health monitoring and data debt remediation
Self-Check Answers
Self-Check: Answer
A machine learning team maintains a \(1\text{ PB}\) raw training corpus in a US East cloud storage bucket and provisions a dedicated compute cluster in US West. The regions are connected by a dedicated \(100\text{ Gbps}\) network fabric. Cloud egress pricing is $0.02/, and the model training run takes \(20\text{ hours}\). Under the principles of data gravity and transfer economics (\(T = D_{\text{vol}}/\text{BW}\)), which architecture should the team select?
- Stream the dataset remotely across the link during training, because a 100 Gbps network provides sufficient throughput to prevent GPU I/O stalls.
- Partition the dataset equally across both cloud regions so that each region trains half the model asynchronously without transfer fees.
- Apply standard gzip compression to eliminate data gravity, enabling real-time remote streaming at zero net cost.
- Provision or relocate compute in US East near the data, because transferring 1 PB requires ~22.2 hours and incurs ~$20,000 in egress fees, exceeding the training run’s time and budget.
Answer: The correct answer is D. Provision or relocate compute in US East near the data, because transferring 1 PB requires ~22.2 hours and incurs ~$20,000 in egress fees, exceeding the training run’s time and budget. Transferring \(1\text{ PB}\) (\(1\text{ PB} = 10^6\text{ GB} = 8 \times 10^6\text{ Gb}\)) over a \(100\text{ Gbps}\) link requires \((8 \times 10^6) / 100 = 80{,}000\text{ s} \approx 22.2\text{ hours}\), which exceeds the \(20\text{ hour}\) training job itself, while incurring \(10^6\text{ GB} \times \$0.02/\text{GB} = \$20{,}000\) in network egress costs. When dataset mass makes \(D_{\text{vol}}/\text{BW}\) dominate compute duration and cost, data gravity dictates that compute must move to data. Streaming over the wide-area link stalls training because wire time exceeds compute time; splitting across regions still requires synchronization or cross-region transfers; and gzip cannot deliver the orders-of-magnitude reduction needed to overcome the physical bottleneck.
Learning Objective: Calculate transfer time (\(D_{\text{vol}}/\text{BW}\)) and network egress costs to evaluate compute placement under data gravity constraints.
A computer vision model training on an accelerator cluster consumes images at \(3{,}119\text{ img/s}\), demanding \(1.9\text{ GB/s}\) of sustained input streaming bandwidth. However, the host DataLoader reads from a standard cloud block storage volume delivering only \(125\text{ MB/s}\). According to the chapter’s feeding tax analysis, what is the resulting operational state of the system?
- The accelerator suffers a feeding tax of >90% (spending over 90% of its wall-clock time idle waiting for I/O), severely degrading hardware efficiency _{}.
- The accelerator remains 100% compute-bound because internal GPU tensor execution is mathematically decoupled from storage I/O.
- Increasing the per-device batch size by 8x will completely eliminate the I/O bottleneck without requiring storage upgrades.
- Host memory caches automatically compensate for the throughput gap after the first epoch without any CPU overhead.
Answer: The correct answer is A. The accelerator suffers a feeding tax of >90% (spending over 90% of its wall-clock time idle waiting for I/O), severely degrading hardware efficiency {}. The feeding tax measures the fraction of wall-clock time an accelerator spends stalled on I/O: delivering \(125\text{ MB/s}\) (\(0.125\text{ GB/s}\)) when \(1.9\text{ GB/s}\) is demanded yields an effective feeding efficiency {} / 1.9 %, meaning the accelerator experiences a feeding tax of $(1 - 0.066) % %. The claim that tensor execution is decoupled from storage ignores pipeline starvation; scaling batch size increases per-step data volume without resolving the sustained transfer deficit; and host caching cannot overcome baseline disk bandwidth during cold or out-of-core scans.
Learning Objective: Calculate the feeding tax and analyze how I/O bandwidth deficits degrade accelerator hardware efficiency.
Using the data selection gain formula ( ) and the energy-movement invariant, explain why pruning 50% of redundant samples via deduplication provides high systems leverage even when per-batch model execution is compute-bound.
Answer: Selection gain is the ratio of useful task signal to data mass (\(D_{\text{vol}}\)). Pruning \(50\%\) redundant data doubles the selection gain by halving total bytes moved and stored without sacrificing learned accuracy. Furthermore, by the energy-movement invariant, moving a 32-bit value across DRAM (\(100\text{--}200\text{ pJ}\)) or network (\(100{,}000\text{ pJ}\)) costs \(100\times\) to \(100{,}000\times\) more energy than an on-chip FP32 multiply (~\(1\text{ pJ}\)). Halving dataset volume eliminates massive off-chip data transport energy, DataLoader decompression load, and persistent storage fees across every training epoch.
Learning Objective: Analyze the systems benefits of dataset deduplication using the data selection gain ratio and the energy-movement hierarchy.
**According to the chapter’s energy-movement hierarchy, arrange the following operations in ascending order of energy consumed per 32-bit value (from lowest energy to highest energy):
- Local NVMe SSD access
- On-chip 32-bit FP multiply
- Wide-area network transfer
- Off-chip DRAM memory access**
Answer: The correct order is: (2) On-chip 32-bit FP multiply -> (4) Off-chip DRAM memory access -> (1) Local NVMe SSD access -> (3) Wide-area network transfer. An on-chip 32-bit floating-point multiply costs ~\(1\text{ pJ}\) (baseline \(1\times\)). Moving a 32-bit value from off-chip DRAM costs ~\(100\text{--}200\text{ pJ}\) (~\(100\times\)). Reading a 32-bit value from a local NVMe SSD costs ~\(1{,}000\text{--}2{,}000\text{ pJ}\) (~\(1{,}000\times\)). Transferring a 32-bit value across a data-center network costs ~\(100{,}000\text{ pJ}\) (~\(100{,}000\times\)).
Learning Objective: Compare storage and compute operations across the memory hierarchy by their relative energy cost per bit.
The wall-clock time lost by high-throughput accelerators while waiting for input batches from slow storage pipelines is formally termed the ____.
Answer: The correct answer is feeding tax (or the feeding tax). The feeding tax quantifies the reduction in hardware efficiency (_{}) caused by I/O bottlenecks where storage and data-loading flow rates cannot keep pace with accelerator consumption.
Learning Objective: Explain the technical definition and systems impact of the feeding tax in ML data pipelines.
Self-Check: Answer
An always-on Keyword Spotting (KWS) system on an embedded voice assistant continuously evaluates 1-second audio classification windows (\(24\text{ hours/day}\) over a \(30\text{-day}\) month). The product specification mandates an SLA of at most 1 false activation per month. An engineer suggests that achieving a standard 99% accuracy (a 1% false positive rate on background noise) is sufficient. How many false activations would a 1% FPR produce per month, and what per-window FPR is actually required?
- A 1% FPR produces 720 false activations per month; the SLA requires a per-window FPR of \(\le 1.38 \times 10^{-5}\).
- A 1% FPR produces ~25,920 false activations per month (~36 false wakes/hour); the SLA requires a per-window FPR of \(\le 3.86 \times 10^{-7}\) (>99.9999% non-keyword rejection).
- A 1% FPR produces ~2,592 false activations per month; the SLA requires a per-window FPR of \(\le 1.0 \times 10^{-4}\).
- A 1% FPR satisfies the SLA because accuracy is averaged over the total number of audio hours across the entire device fleet.
Answer: The correct answer is B. A 1% FPR produces ~25,920 false activations per month (~36 false wakes/hour); the SLA requires a per-window FPR of \(\le 3.86 \times 10^{-7}\) (>99.9999% non-keyword rejection). Over a 30-day month with continuous 1-second windows, there are \(30 \times 24 \times 3600 = 2{,}592{,}000\) evaluation windows. A 1% false-positive rate yields \(0.01 \times 2{,}592{,}000 = 25{,}920\) false wake-ups per month (roughly 36 false activations every hour, rendering the device unusable). To meet the SLA of \(\le 1\) false activation per month, the per-window FPR must satisfy \(\text{FPR} \le 1 / 2{,}592{,}000 \approx 3.86 \times 10^{-7}\), requiring \(>99.9999\%\) non-keyword rejection. The other options miscalculate the monthly window count or incorrectly assume standard aggregate classification metrics apply directly to streaming continuous inference.
Learning Objective: Calculate the required per-window false positive rate for always-on streaming ML systems and explain why aggregate accuracy fails for streaming workloads.
A data engineering team implements comprehensive synchronous schema and distribution validation checks directly inside the real-time event ingestion path. Under the Four Pillars framework, which primary operational trade-off will this team encounter?
- A Governance trade-off: inspecting payload schemas automatically breaches user data retention agreements.
- A Model Capacity trade-off: validating input records forces downstream neural network layers to increase parameter counts.
- A Scalability and Reliability trade-off: heavy synchronous validation consumes CPU cycles and increases per-record latency, reducing ingestion throughput and risking dropped messages during traffic spikes.
- A Durability trade-off: validating data records accelerates physical wear on persistent solid-state drive cells.
Answer: The correct answer is C. A Scalability and Reliability trade-off: heavy synchronous validation consumes CPU cycles and increases per-record latency, reducing ingestion throughput and risking dropped messages during traffic spikes. The Four Pillars framework highlights tension between Quality and Scalability/Reliability: performing exhaustive synchronous validation in the hot ingestion path adds CPU latency and backpressure, reducing peak throughput and creating potential availability failures under load surges. Production pipelines balance this by executing lightweight structural checks synchronously at ingestion while offloading deep statistical and semantic validation to asynchronous processing or dead-letter queues. The remaining choices misattribute the trade-off to privacy violations, neural parameter expansion, or SSD wear.
Learning Objective: Analyze the cross-pillar trade-offs between validation rigor (Quality) and processing throughput/latency (Scalability and Reliability).
Based on the DLRM Recommendation Lighthouse, describe how modern recommendation systems bifurcate data engineering resource demands between dense continuous signals and high-cardinality categorical IDs.
Answer: DLRM architectures split data demands into two divergent pipelines: (1) Dense continuous features require high-throughput streaming compute and dense matrix multiplications on accelerators; (2) High-cardinality categorical IDs (e.g., billions of user and item IDs) require terabyte-scale distributed embedding tables constrained by memory capacity and sparse memory-bandwidth lookups. Because these large embedding tables cannot fit on a single accelerator’s memory, data engineering must implement distributed table partitioning and caching strategies to mitigate sparse lookup bottlenecks.
Learning Objective: Explain the bifurcated scalability profile (memory capacity and sparse lookup bandwidth vs. dense compute) of modern recommendation system architectures.
True or False: Data cascades in ML systems are easily caught by standard software unit tests because corrupted input data causes deterministic assertion failures in pipeline code.
Answer: False. Data cascades are characterized as ‘silent’ failures precisely because corrupted or drifted data often remains syntactically valid (e.g., non-null strings or valid numeric ranges) and passes traditional code unit tests. The defect cascades downstream, subtly biasing feature distributions, distorting learned model representations, and degrading real-world accuracy without throwing software exceptions.
Learning Objective: Compare silent data cascade failure modes with traditional software bugs caught by unit tests.
**Trace the propagation sequence of a data cascade as described in the chapter, from its root cause to user-facing impact:
- Downstream model optimization on distorted representations
- Upstream sensor or schema change without contract notification
- Silent distortion of extracted features passing syntactic checks
- Degraded real-world predictions and costly post-deployment rollback**
Answer: The correct order is: (2) Upstream sensor or schema change without contract notification -> (3) Silent distortion of extracted features passing syntactic checks -> (1) Downstream model optimization on distorted representations -> (4) Degraded real-world predictions and costly post-deployment rollback. A data cascade begins with an uncoordinated upstream source or schema change. Because the data passes basic syntactic tests, it enters feature extraction and silently distorts intermediate representations. Downstream model training optimizes over these corrupted features, ultimately manifesting as degraded production predictions and requiring expensive system rollback.
Learning Objective: Analyze the multi-stage propagation of data cascades from upstream defects to production degradation.
Self-Check: Answer
An ML organization budgets for training a computer vision model across various data sourcing methods. Based on the chapter’s illustrative data engineering cost constants, which cost relationship correctly reflects the per-unit economics of data acquisition?
- Storing a terabyte of training data in cloud object storage for a month costs significantly more than obtaining a single expert medical annotation.
- Generating synthetic image samples is ten times more expensive per image than crowdsourced human classification.
- A single cloud GPU training hour ($2–4/hr) exceeds the cost of a full human review hour ($15–50/hr) by an order of magnitude.
- Expert medical labeling ($50–200 per study) and bounding-box annotations ($0.15–0.50 per box) are orders of magnitude more expensive per unit than S3 Standard storage (~$23/TB/month).
Answer: The correct answer is D. Expert medical labeling ($50–200 per study) and bounding-box annotations ($0.15–0.50 per box) are orders of magnitude more expensive per unit than S3 Standard storage (~$23/TB/month). Per-unit data engineering costs show that human annotation—especially domain expert labeling ($50–200/study) and dense spatial annotations ($0.15–0.50/box)—dominates project budgets, whereas raw object storage (~$23/TB/month) is cheap. Storing 1 TB in S3 is comparable to or cheaper than a single medical study label; synthetic generation is typically an order of magnitude cheaper (not more expensive) than manual collection; and human review hours ($15–50/hr) cost substantially more than spot GPU training hours ($2–4/hr).
Learning Objective: Compare per-unit data engineering cost constants across human labeling tiers, cloud storage, and compute resources.
Multiple independent autonomous driving teams train their perception models exclusively on a popular public driving benchmark. What systemic failure mode does this practice introduce into the broader ecosystem?
- Shared dataset bias propagation, where common blind spots, annotation artifacts, and unrepresented edge cases become correlated systemic weaknesses across all deployed models.
- Catastrophic memory leaks in GPU driver kernels caused by repeated reading of shared image formats.
- Immediate violation of data gravity constraints due to distributed multi-tenant reads.
- Automatic over-fitting to hardware memory hierarchies during distributed gradient synchronization.
Answer: The correct answer is A. Shared dataset bias propagation, where common blind spots, annotation artifacts, and unrepresented edge cases become correlated systemic weaknesses across all deployed models. When multiple models across an industry rely on a single common benchmark dataset, any systemic flaws (e.g., geographic bias, missing weather conditions, or consistent label errors) propagate across the entire ecosystem. Rather than producing independent models with diverse failure modes, the ecosystem develops correlated blind spots. The other options describe unrelated GPU memory bugs, network gravity violations, or hardware synchronization issues.
Learning Objective: Evaluate the ecosystem-wide risks of shared dataset bias propagation and benchmark over-reliance.
Discuss the primary advantages and critical risks of using synthetic data generation (e.g., 3D graphics rendering or generative audio simulation) as a core data acquisition strategy.
Answer: Advantages: Synthetic data provides scalable, low-cost training examples with perfectly accurate, automated ground-truth labels (e.g., exact 3D bounding boxes, depth maps, or audio SNR) and enables targeted generation of rare safety-critical edge cases. Risks: Synthetic generators inherit domain gaps and omissions from their underlying models; models trained purely on synthetic data often fail on real-world distributions due to missing acoustic reverberations, lighting variations, or demographic accents absent from the generator.
Learning Objective: Analyze the trade-offs between synthetic data scalability and real-world domain gaps in acquisition strategy.
True or False: Achieving state-of-the-art benchmark accuracy on a curated dataset (such as ImageNet or Common Voice) guarantees that an ML model is ready for deployment in real-world production environments.
Answer: False. Curated benchmarks provide standardized baselines for research comparison, but their distributions rarely capture the full variety of real-world deployment conditions (e.g., microphone hardware variations, regional acoustic noise, adversarial inputs, or demographic shifts). Models tuned specifically to benchmark distributions frequently suffer severe performance drops when exposed to uncurated production data.
Learning Objective: Explain why benchmark performance fails to guarantee real-world generalization across deployment distributions.
**According to the chapter’s gap-closing acquisition strategy, arrange the following sourcing options in the recommended escalation order (from lowest setup cost to highest cost/effort):
- In-house specialist/expert annotation
- Crowdsourced human annotation platforms
- Curated open-source benchmark reuse
- Programmatic web scraping and synthetic data generation**
Answer: The correct order is: (3) Curated open-source benchmark reuse -> (4) Programmatic web scraping and synthetic data generation -> (2) Crowdsourced human annotation platforms -> (1) In-house specialist/expert annotation. Data acquisition begins by evaluating preexisting curated datasets to establish a baseline and identify specific coverage gaps. If scale is the binding constraint, teams escalate to programmatic web scraping or synthetic data. When human judgment is required, crowdsourced platforms offer moderate cost, escalating finally to expensive in-house domain experts for high-stakes or ambiguous edge cases.
Learning Objective: Design an escalated data acquisition workflow that balances cost, scale, and annotation expertise.
Self-Check: Answer
A production monitoring system tracks feature distributions over time using the Population Stability Index (PSI). The incoming feature distribution for a key credit feature yields a PSI value of \(0.28\) compared to the baseline training distribution. According to standard operational drift bands, how should the data pipeline respond?
- No action is required because PSI values below 0.50 indicate negligible distribution change.
- Trigger a critical alert and initiate root-cause investigation or automated model retraining, because a PSI > 0.25 indicates significant distribution drift.
- Immediately drop all incoming records and halt the ingestion cluster with a fatal error.
- Switch the database storage format from Parquet to CSV to improve float precision.
Answer: The correct answer is B. Trigger a critical alert and initiate root-cause investigation or automated model retraining, because a PSI > 0.25 indicates significant distribution drift. Standard operational PSI thresholds establish three monitoring bands: < 0.10 indicates stability (no action); \(0.10 \le \text{PSI} \le 0.25\) indicates moderate drift (warning, monitor closely); and > 0.25 indicates significant distribution drift requiring urgent investigation, retraining, or pipeline remediation. Halting the ingestion cluster is inappropriate for statistical drift, and changing file formats has no bearing on feature distributions.
Learning Objective: Apply Population Stability Index (PSI) thresholds to detect feature drift and determine appropriate pipeline response protocols.
An ML engineering team is architecting an ingestion pipeline for tabular transaction data. They evaluate Extract-Transform-Load (ETL) versus Extract-Load-Transform (ELT). Which architectural trade-off correctly characterizes ELT in modern data lakehouses?
- ELT executes all transformations in memory on the edge device before transmitting bytes to cloud storage.
- ELT requires rigid upfront schema definitions (schema-on-write) and rejects any semi-structured data formats.
- ELT loads raw data directly into scalable lakehouse storage first and transforms it downstream using scalable query engines, preserving raw data history and decoupling ingestion from evolving feature logic.
- ELT eliminates the need for data governance and quality validation because transformations occur after storage.
Answer: The correct answer is C. ELT loads raw data directly into scalable lakehouse storage first and transforms it downstream using scalable query engines, preserving raw data history and decoupling ingestion from evolving feature logic. ELT decouples raw ingestion from transformation: raw events land directly in cheap, scalable storage (schema-on-read), allowing downstream engines (Spark, Presto) to execute feature transformations iteratively. This preserves historical raw inputs for future reprocessing and prevents upstream schema updates from blocking ingestion. In contrast, ETL transforms data before loading, which enforces schema-on-write but loses raw unstructured details and requires pipeline redeployments when feature definitions change. The remaining options mischaracterize edge compute, schema requirements, or governance needs.
Learning Objective: Compare ETL and ELT architectures regarding storage decoupled ingestion, schema evolution, and historical data retention.
Explain how combining a Circuit Breaker pattern with a Dead Letter Queue (DLQ) prevents cascading failures and data loss in streaming ML data ingestion pipelines.
Answer: A Circuit Breaker monitors failure rates (e.g., malformed payloads, timeout surges) and automatically trips to halt downstream processing when error thresholds are exceeded, preventing crashing downstream model services or overwhelming databases. A Dead Letter Queue (DLQ) captures and isolates unparsable or rejected records alongside error metadata without dropping them, allowing the primary pipeline to maintain throughput for valid traffic while engineers inspect and reprocess bad records asynchronously.
Learning Objective: Design reliable streaming data pipelines using Circuit Breaker and Dead Letter Queue (DLQ) patterns for fault isolation.
Using the 2016 Microsoft Tay chatbot incident, explain why public data ingestion surfaces require strict input validation, rate limiting, and adversarial filtering before data shapes model behavior.
Answer: Microsoft Tay ingested uncurated public user interactions from Twitter to adapt its responses. Adversarial users exploited this unfiltered public surface with coordinated toxic prompts, causing the bot to tweet abusive statements within 16 hours. The incident demonstrates that any public ingestion path directly influencing model behavior acts as a security attack surface, requiring robust content filtering, anomaly detection, adversarial input controls, and rate limits to prevent malicious data from corrupting the system.
Learning Objective: Analyze the security and safety implications of unvalidated public data ingestion using the Microsoft Tay war story.
An explicit, machine-enforceable agreement between data producers and data consumers that defines column types, value bounds, nullability, and distribution constraints is called a ____.
Answer: The correct answer is schema contract (or data contract). Schema contracts prevent upstream data drift from silently breaking downstream ML processing by enforcing type and semantic guarantees at integration boundaries.
Learning Objective: Explain schema contracts and their role in preventing breaking changes across ML data pipelines.
Self-Check: Answer
An engineer normalizes a numerical feature by computing standard \(z\)-scores: \(x' = (x - \mu)/\sigma\). During production serving, how must the parameters \(\mu\) and \(\sigma\) be handled to satisfy the Consistency Imperative and prevent training-serving skew?
- Persist the exact \(\mu\) and \(\sigma\) computed on the training dataset alongside the model artifact, loading and applying those fixed constants to live serving inputs.
- Recompute \(\mu\) and \(\sigma\) dynamically over each incoming serving batch to ensure the live data is always centered at zero.
- Discard \(\mu\) and \(\sigma\) entirely at inference time and rely on batch normalization layers inside the neural network.
- Compute \(\mu\) and \(\sigma\) independently over a rolling 1-hour window of serving traffic to track seasonal shifts.
Answer: The correct answer is A. Persist the exact \(\mu\) and \(\sigma\) computed on the training dataset alongside the model artifact, loading and applying those fixed constants to live serving inputs. The Consistency Imperative requires state synchronization across training and serving: transformation parameters computed during training (means, standard deviations, one-hot vocabularies, embedding lookups) must be persisted and reused during serving. Recomputing statistics dynamically over live batches or rolling windows alters the feature scale relative to what the model learned, creating training-serving skew and causing silent prediction degradation. Relying on neural batch normalization does not resolve pre-network input feature scaling.
Learning Objective: Apply the Consistency Imperative by synchronizing stateful transformation parameters between training and serving.
A distributed preprocessing job must compute global mean normalization across \(1\text{ TB}\) of feature data distributed evenly over 100 worker nodes. Architecture 1 gathers all \(1\text{ TB}\) of raw data to a central coordinator node over a \(1\text{ Gbps}\) network to compute the global mean. Architecture 2 computes a local sum and record count on each node (transferring only 16 bytes per node to the coordinator) and calculates the exact global mean locally. What is the systems trade-off and coordination tax difference?
- Centralized gathering is faster because centralizing all data eliminates worker-level floating-point rounding errors.
- Local aggregation produces only an approximation of the mean, whereas centralized gathering computes the true mathematical value.
- Both approaches take identical execution time because the total number of arithmetic additions is preserved.
- Centralized gathering incurs a massive coordination tax, taking ~8,000 seconds to transfer 1 TB over 1 Gbps, whereas local aggregation transfers under 2 KB of aggregated statistics in sub-seconds while computing the exact same mathematical mean.
Answer: The correct answer is D. Centralized gathering incurs a massive coordination tax, taking ~8,000 seconds to transfer 1 TB over 1 Gbps, whereas local aggregation transfers under 2 KB of aggregated statistics in sub-seconds while computing the exact same mathematical mean. Transferring \(1\text{ TB}\) (\(8{,}000\text{ Gb}\)) across a \(1\text{ Gbps}\) link takes \((8{,}000 / 1) = 8{,}000\text{ s} \approx 2.2\text{ hours}\) purely in network coordination tax. In contrast, local aggregation computes local partial sums \(\sum x_i\) and counts \(N_k\) on each node in parallel, transferring only 16 bytes per worker (\(100 \times 16\text{ B} = 1.6\text{ KB}\)), allowing the coordinator to compute the exact global mean \(\mu = (\sum \text{sum}_k) / (\sum N_k)\) in milliseconds. Local aggregation is mathematically exact (not an approximation) and exploits data locality.
Learning Objective: Calculate the coordination tax of distributed data processing and compare centralized gathering against local aggregation.
Define idempotency in the context of data transformation pipelines and explain why idempotent operations (such as upserts) are essential for fault recovery in distributed ML pipelines.
Answer: Idempotency means applying an operation multiple times produces the exact same system state as applying it once (\(f(f(x)) = f(x)\)). In distributed pipelines subject to network timeouts and worker crashes, retry mechanisms can execute the same task repeatedly; non-idempotent operations (such as appending rows) create duplicate records and corrupt gradient updates, whereas idempotent operations (such as database upserts or deterministic partition overwrites) allow safe retries without duplicating data.
Learning Objective: Explain the importance of idempotent transformations and deterministic pipelines for safe fault recovery.
True or False: Using the identical Python preprocessing function in both training and serving code repositories is sufficient to eliminate training-serving skew.
Answer: False. Sharing code logic is necessary but insufficient. Training-serving skew also arises from state desynchronization (using different normalization constants or vocabulary encodings), temporal dependencies (using current clock time rather than fixed reference timestamps), timing differences (batch aggregations over historical tables vs. live event streams), and environmental library version mismatches.
Learning Objective: Analyze the root causes of training-serving skew beyond shared source code.
**Arrange the sequential signal processing stages used in Keyword Spotting (KWS) pipelines to extract Mel-Frequency Cepstral Coefficients (MFCCs) from raw audio waveforms:
- Mel-filterbank application (emphasizing human speech frequency bands)
- Discrete Cosine Transform (DCT) for decorrelation and dimensionality reduction
- Short-Time Fourier Transform (STFT) to produce time-frequency power spectrum
- Raw audio framing and windowing (e.g., 25 ms frames)
- Pre-emphasis filtering to amplify high frequencies**
Answer: The correct order is: (5) Pre-emphasis filtering to amplify high frequencies -> (4) Raw audio framing and windowing (e.g., 25 ms frames) -> (3) Short-Time Fourier Transform (STFT) to produce time-frequency power spectrum -> (1) Mel-filterbank application (emphasizing human speech frequency bands) -> (2) Discrete Cosine Transform (DCT) for decorrelation and dimensionality reduction. Feature extraction begins with pre-emphasis to balance high-frequency speech spectrums, followed by framing the continuous waveform into short windows (e.g., 25 ms). An STFT computes the frequency power spectrum, which is mapped onto the non-linear Mel scale via filterbanks, and finally a DCT reduces dimensionality to 13–39 compact MFCC coefficients.
Learning Objective: Design the acoustic feature extraction pipeline required to transform raw audio waveforms into compact MFCC representations.
Self-Check: Answer
A smart city perception system evaluates annotation formats for a \(1920 \times 1080\) video stream. The team compares bounding box annotations (10 boxes per frame, each with 4 spatial coordinates) against pixel-level semantic segmentation masks. What is the ratio of scalar label entries generated between a full segmentation mask and the 10 bounding boxes?
- Roughly 10x more entries for segmentation, matching the ratio of bounding box coordinates.
- Roughly 50,000x more scalar entries for segmentation (~2.07 million pixel labels vs. 40 bounding box coordinates).
- Both formats require identical scalar entries because both represent 1080p resolution.
- Bounding boxes require 50,000x more entries because floating-point coordinates consume more bytes than integer masks.
Answer: The correct answer is B. Roughly 50,000x more scalar entries for segmentation (~2.07 million pixel labels vs. 40 bounding box coordinates). A \(1920 \times 1080\) image contains \(2{,}073{,}600\) pixels, requiring ~2.07 million discrete pixel class labels for semantic segmentation. In contrast, 10 bounding boxes with 4 coordinates each store \(10 \times 4 = 40\) scalar entries. The ratio is \(2{,}073{,}600 / 40 \approx 51{,}840 \approx 50{,}000\times\). This massive scalar expansion explains why segmentation labeling costs 10–50x more human annotation time and storage bandwidth than bounding box annotations.
Learning Objective: Calculate the storage and annotation scale differences between classification, bounding boxes, and pixel-level semantic segmentation.
An ML team implements weak supervision (e.g., using Snorkel) to label a million unlabeled text documents. Domain experts write 20 programmatic labeling functions (LFs) based on regex patterns and keyword heuristics. How does weak supervision combine these noisy heuristics into high-quality training labels?
- It forces all 20 LFs to execute synchronously in a database trigger, throwing an exception if any two LFs disagree.
- It simply computes an unweighted majority vote across all LFs and discards any record where LFs disagree.
- It uses a generative label model to estimate the unknown accuracies and correlations of the LFs without ground truth, producing probabilistic training labels for downstream model learning.
- It converts the regex heuristics into neural network weights using automatic differentiation.
Answer: The correct answer is C. It uses a generative label model to estimate the unknown accuracies and correlations of the LFs without ground truth, producing probabilistic training labels for downstream model learning. Weak supervision replaces individual hand-labeling with programmatic Labeling Functions (LFs). Because LFs are noisy, overlap, and conflict, a generative label model observes agreements and disagreements across unlabeled data to learn the latent accuracy and correlation of each LF without requiring ground truth. It then outputs calibrated probabilistic training labels that supervise a downstream deep neural network. An unweighted majority vote fails to account for varying LF accuracy, database triggers cannot resolve statistical ambiguity, and heuristics cannot be directly differentiated into weights.
Learning Objective: Explain the mechanics of weak supervision and how generative label models synthesize noisy labeling functions into probabilistic training labels.
Describe how a tiered consensus labeling system uses inter-annotator agreement metrics (such as Fleiss’ kappa) and ‘gold standard’ honeypot examples to balance labeling cost against annotation quality.
Answer: A tiered consensus system routes data through escalating quality tiers: inexpensive crowdsourced workers label all instances, with agreement statistics (e.g., Fleiss’ kappa) and embedded ‘gold standard’ honeypots (pre-labeled ground-truth items) continuously measuring annotator accuracy. High-agreement, clear instances are approved automatically at low cost, while low-agreement ambiguous samples or failed gold-standard checks are selectively escalated to expensive domain experts, maximizing overall dataset accuracy while controlling budget.
Learning Objective: Design a tiered consensus labeling workflow using inter-annotator agreement metrics and gold-standard benchmarks.
True or False: In Active Learning, uncertainty sampling selects the unlabeled examples for which the current model has the highest prediction confidence to ensure the training set contains only clean data.
Answer: False. Uncertainty sampling selects the examples where the model is least confident (e.g., smallest difference between top two predicted class probabilities or highest prediction entropy). Labeling high-confidence examples adds little new task-relevant signal, whereas querying high-uncertainty instances maximally informs the model’s decision boundaries.
Learning Objective: Evaluate active learning query strategies (uncertainty, margin, and entropy sampling) for sample efficiency.
A statistical metric that measures the degree of agreement among three or more annotators classifying items into discrete categories, adjusting for chance agreement, is called ____.
Answer: The correct answer is Fleiss’ kappa (or Fleiss’ kappa statistic). Fleiss’ kappa generalizes Cohen’s kappa to multi-annotator workflows, providing a formal inter-annotator agreement metric to identify ambiguous samples.
Learning Objective: Apply Fleiss’ kappa as the standard inter-annotator agreement metric in multi-annotator labeling workflows.
Self-Check: Answer
An ML systems architect must select storage backends for three distinct workloads: (1) Millisecond point lookups of user feature vectors during real-time online serving; (2) High-throughput sequential scans over tabular fraud features during batch training; (3) Storing petabytes of raw, unstructured multi-modal audio and video recordings. Which mapping of storage architectures to workloads is optimal?
- Low-latency transactional database / key-value store; (2) Columnar data warehouse; (3) Scalable cloud data lake (object storage).
- Cloud object storage (S3); (2) Key-value database; (3) Columnar data warehouse.
- Columnar data warehouse; (2) Cloud data lake; (3) Low-latency transactional database.
- Scalable cloud data lake; (2) Low-latency transactional database; (3) Columnar data warehouse.
Answer: The correct answer is A. (1) Low-latency transactional database / key-value store; (2) Columnar data warehouse; (3) Scalable cloud data lake (object storage). Storage architectures optimize for specific access patterns: online serving requires high IOPS and millisecond random access provided by transactional key-value databases; batch training over structured tables requires high sequential read throughput and column projection provided by columnar data warehouses; and petabyte-scale multi-modal raw data requires the cheap capacity and schema-on-read flexibility of cloud data lakes (object storage). The other mappings mismatch access patterns to storage strengths, causing high latency or extreme costs.
Learning Objective: Evaluate storage systems (databases, data warehouses, data lakes) based on IOPS, sequential throughput, and schema flexibility requirements.
How does a feature store’s point-in-time correctness (time-travel join) prevent data leakage during offline training dataset generation?
- It encrypts historical feature values so that model weights cannot memorize training labels.
- It forces all features to be computed strictly in real time on the client device during model inference.
- It converts all timestamps into UTC strings to prevent database indexing errors.
- It reconstructs feature values exactly as they existed at the observation timestamp of each training event, preventing future feature values from leaking into historical training records.
Answer: The correct answer is D. It reconstructs feature values exactly as they existed at the observation timestamp of each training event, preventing future feature values from leaking into historical training records. When generating training datasets from historical logs, naive table joins risk using feature values computed after the prediction event occurred (e.g., joining an event at \(t=10:00\) with an aggregate feature updated at \(t=12:00\)). A feature store’s point-in-time join ensures that each training example receives features valid precisely as of its event timestamp, eliminating future-data leakage. Encryption, client-side inference, and UTC string conversion do not prevent temporal leakage.
Learning Objective: Explain how feature store point-in-time correctness prevents temporal data leakage during training dataset compilation.
Explain the storage-bandwidth bottleneck when feeding accelerators directly from cloud object storage versus local NVMe SSDs, and describe the common architectural caching pattern used to resolve it.
Answer: A single cloud object storage stream delivers ~\(100\text{ MB/s}\), which is \(50\times\) slower than a local NVMe SSD (~\(5\text{ GB/s}\)). Streaming directly from object storage severely starves high-throughput accelerators, creating massive feeding taxes. To resolve this, ML architectures use a tiered caching pattern: petabyte-scale training corpora reside cheaply in cloud object storage (~\(\$23/\text{TB/month}\)), and active training tranches are prefetched and staged onto fast local NVMe SSDs (~\(\$200\text{--}400/\text{TB/month}\)) on the compute node for high-throughput multi-epoch training.
Learning Objective: Analyze the bandwidth and cost trade-offs between cloud object storage and local NVMe SSD caching in ML training pipelines.
True or False: In a columnar storage format like Apache Parquet, reading 10 columns out of a 100-column table requires scanning the entire uncompressed row payload from disk.
Answer: False. Parquet is a columnar storage format that organizes data on disk by column rather than by row. When a query or DataLoader requests 10 out of 100 columns, the reader performs column projection and dictionary filter pushdown, reading only the byte ranges corresponding to those 10 columns and eliminating up to ~90% of disk I/O compared to row-oriented formats.
Learning Objective: Explain the I/O reduction mechanisms (column projection and filter pushdown) of columnar storage formats.
**Arrange the storage tiers across the ML lifecycle in their natural operational progression, from raw data capture to online inference serving:
- Online feature store (low-latency key-value store for inference)
- Offline feature store (point-in-time historical feature registry)
- Fast local NVMe cache on accelerator compute nodes
- Raw data lake (immutable object storage staging)
- Curated transactional table layer (lakehouse / warehouse)**
Answer: The correct order is: (4) Raw data lake (immutable object storage staging) -> (5) Curated transactional table layer (lakehouse / warehouse) -> (2) Offline feature store (point-in-time historical feature registry) -> (3) Fast local NVMe cache on accelerator compute nodes -> (1) Online feature store (low-latency key-value store for inference). Raw multi-modal data lands first in object storage (data lake), is cleaned and structured into transactional lakehouse tables, and is registered in the offline feature store for training set compilation. Training jobs cache active splits onto fast local NVMe SSDs, while production features are materialized into the online feature store for low-latency serving.
Learning Objective: Design storage tiers across the end-to-end ML lifecycle from raw ingestion to model training and online serving.
Self-Check: Answer
An engineering team assumes that doubling their raw dataset volume by web scraping uncurated text and generating synthetic speech samples will automatically improve downstream model accuracy. According to the chapter’s fallacies and pitfalls, why is this assumption flawed?
- Because scaling laws exhibit diminishing returns (power-law test loss flattening), and adding uncurated or synthetic data can increase data gravity and transport energy while introducing generator domain gaps and noise.
- Because neural networks cannot mathematically process more than one million training records without floating-point overflow.
- Because synthetic data is legally prohibited from being combined with real-world sensor captures.
- Because web scraping always converts binary audio files into plain text formats, corrupting feature representations.
Answer: The correct answer is A. Because scaling laws exhibit diminishing returns (power-law test loss flattening), and adding uncurated or synthetic data can increase data gravity and transport energy while introducing generator domain gaps and noise. The chapter highlights the fallacy that ‘more data always improves performance’: empirical loss follows power-law curves where marginal gains diminish, and redundant or uncurated data increases data gravity (\(D_{\text{vol}}\)) and processing costs without adding task-relevant signal. Furthermore, synthetic data inherits generator domain gaps that fail to represent real deployment conditions. The other options invent false mathematical limits, legal bans, or automatic file format conversions.
Learning Objective: Evaluate the fallacy of monotonic scaling with uncurated or synthetic data using diminishing returns and domain gaps.
Explain why planning a petabyte-scale dataset migration solely as a network wire transfer (\(T = D_{\text{vol}}/\text{BW}\)) is a major systems pitfall.
Answer: Treating a petabyte-scale migration as a simple network transfer overlooks the massive systemic overhead of data gravity: updating transformation pipelines, re-engineering feature stores, revalidating data quality and schema contracts across environments, re-establishing lineage tracking, and synchronizing dependent downstream training jobs. The non-network engineering and validation time often exceeds the raw wire transfer time by weeks or months.
Learning Objective: Analyze the hidden engineering and validation overheads in large-scale dataset migration beyond raw network wire transfer time.
True or False: Achieving high accuracy on a randomly split validation set during model development proves that the system will perform reliably after deployment.
Answer: False. High validation accuracy only measures performance on data sampled from the historical distribution under development conditions. It does not account for production distribution shifts, training-serving skew, adversarial inputs, unrepresented deployment subgroups, or leakage across train/validation splits.
Learning Objective: Evaluate why high validation accuracy is insufficient to guarantee production reliability without drift and skew monitoring.
Self-Check: Answer
Reflecting on the chapter’s quantitative summaries, which two systems constants highlight the dominant economic and performance bottlenecks in modern ML data engineering?
- GPU arithmetic execution is \(1{,}000\times\) more expensive than data labeling, and object storage is \(50\times\) faster than local NVMe SSDs.
- Data labeling costs dominate compute by \(500\times\text{--}1{,}000\times\) the cost of an optimized training run, and local NVMe SSDs provide a \(50\times\) bandwidth advantage over cloud object storage.
- Network egress costs are always zero, and database row scans are faster than columnar Parquet reads.
- Feature stores eliminate 100% of memory requirements, and audio preprocessing requires more memory than model weights.
Answer: The correct answer is B. Data labeling costs dominate compute by \(500\times\text{--}1{,}000\times\) the cost of an optimized training run, and local NVMe SSDs provide a \(50\times\) bandwidth advantage over cloud object storage. The chapter’s quantitative synthesis highlights two critical constants: (1) Human data labeling can cost hundreds to over a thousand times (\(500\times\text{--}1{,}000\times\)) the cost of a single GPU training run; and (2) The storage hierarchy creates a \(50\times\) throughput gap between local NVMe SSDs (~\(5\text{ GB/s}\)) and single-stream cloud object storage (~\(100\text{ MB/s}\)), making data staging critical to eliminate accelerator idle time. The other options reverse the economic and bandwidth ratios or make false claims about network costs and feature stores.
Learning Objective: Compare the dominant economic (labeling-to-compute ratio) and physical (storage bandwidth hierarchy) bottlenecks of ML data systems.
Summarize why training data must be treated as the ‘source code’ of an ML system, and describe the core responsibilities of data engineering in managing this source code across its lifecycle.
Answer: Training data functions as source code because model behavior is compiled directly from data via optimization; any change, noise, or bias in data alters the compiled model weights. Data engineering serves as the compiler and runtime infrastructure: it manages the entire lifecycle through acquisition, validation, deterministic idempotent transformations, versioned lineage, storage staging, and continuous drift monitoring to ensure reliable training-serving parity.
Learning Objective: Justify the data-as-source-code paradigm and articulate data engineering’s end-to-end lifecycle responsibilities.
**Arrange the primary operational phases of the end-to-end ML data engineering lifecycle in their canonical order:
- Strategic data acquisition and gap closing
- Ingestion, schema validation, and defensive quality checks
- Idempotent transformation and feature engineering
- Labeled dataset compilation and consensus verification
- Strategic storage tiering and feature store materialization
- Continuous operational health monitoring and data debt remediation**
Answer: The correct order is: (1) Strategic data acquisition and gap closing -> (2) Ingestion, schema validation, and defensive quality checks -> (3) Idempotent transformation and feature engineering -> (4) Labeled dataset compilation and consensus verification -> (5) Strategic storage tiering and feature store materialization -> (6) Continuous operational health monitoring and data debt remediation. The lifecycle begins with strategic acquisition to close coverage gaps, followed by ingestion with defensive schema checks. Data is transformed through deterministic, idempotent operations, annotated via consensus labeling, staged across storage tiers and feature stores, and continuously maintained through drift monitoring and debt remediation.
Learning Objective: Design the end-to-end operational workflow of the ML data engineering lifecycle.