Các nguyên tắc cơ bản của hệ thống huấn luyện
Huấn luyện mô hình
Mục đích
Tại sao việc huấn luyện một mô hình lại có thể tốn kém gấp nhiều lần so với một lần suy luận?
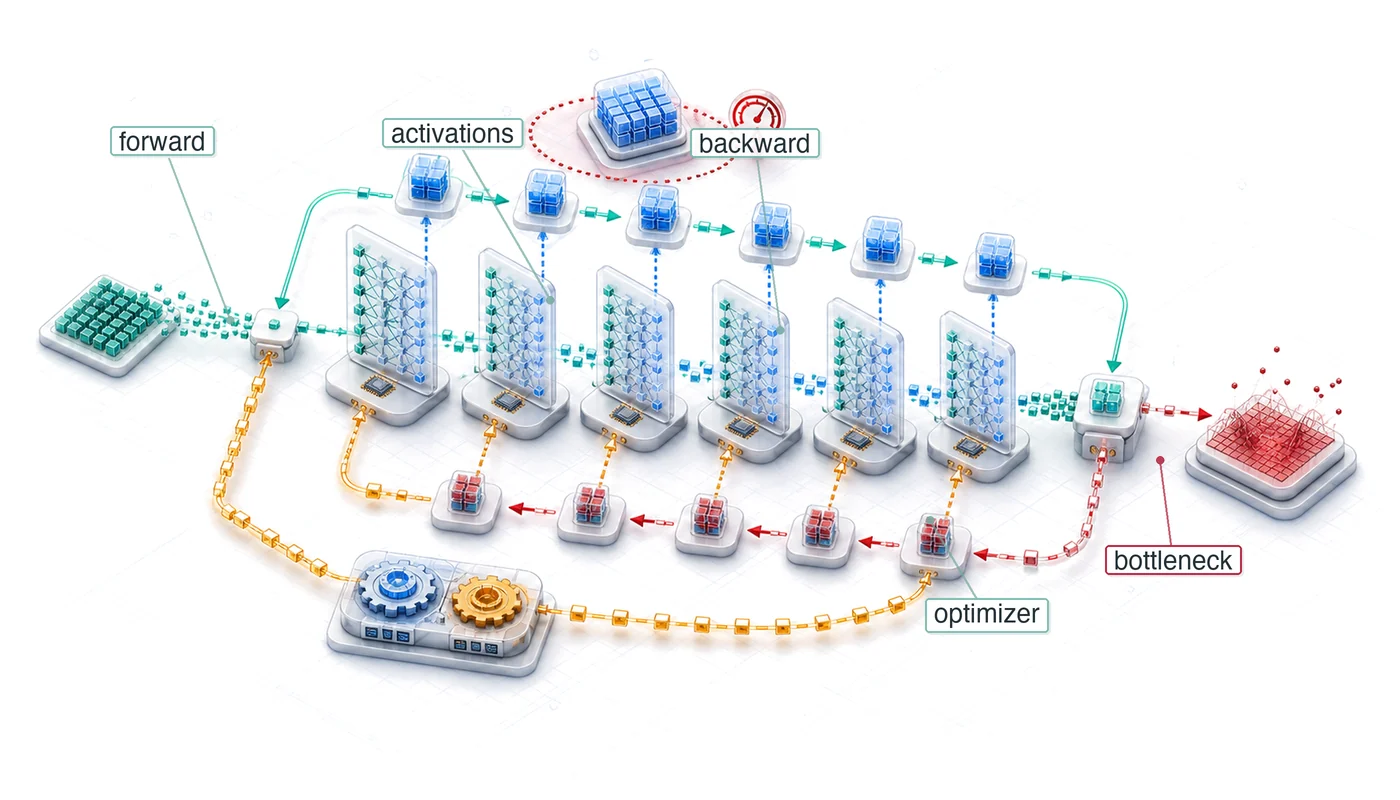
Suy luận thực hiện một lượt truyền xuôi (forward pass) khi dữ liệu đi qua mạng nơ-ron, và đưa ra dự đoán. Huấn luyện thêm lượt truyền ngược (backward pass) và bước optimizer, giữ trạng thái trung gian, rồi lặp lại quy trình này trên nhiều ví dụ và các bước tối ưu. Các optimizer cũng có thể duy trì ước tính động lượng (momentum) và phương sai (variance) với yêu cầu lưu trữ thậm chí lớn hơn cả trọng số mô hình. Tỷ lệ chi phí phụ thuộc vào mô hình, khối lượng công việc (workload), thời lượng huấn luyện và khối lượng suy luận, nhưng một lần chạy huấn luyện thường đắt hơn nhiều bậc so với một lần suy luận. Phòng thí nghiệm huấn luyện trong ba ngày có thể khám phá nhiều thiết kế hơn phòng mất một tháng. Một bước nhanh hơn không làm huấn luyện nhanh hơn nếu nó làm chậm hội tụ, nên thông lượng chỉ có ý nghĩa khi gắn với thời gian đạt chất lượng mục tiêu. Qua các thí nghiệm lặp lại, những thay đổi nhỏ về hội tụ hoặc mức sử dụng cũng có thể tích lũy thành khác biệt lớn về lịch trình và chi phí. Thách thức hệ thống cốt lõi là giữ cho các bộ tăng tốc luôn có dữ liệu và phép tính hữu ích, mà không cạn bộ nhớ hay mất thời gian đồng bộ. Can thiệp nào hữu ích còn tùy vào nút thắt ở tính toán, bộ nhớ, dữ liệu hay truyền thông, nên phải phân tích hiệu năng (profiling) trước khi mở rộng (scaling) hay tối ưu. Kích thước batch, độ chính xác số, checkpointing, tải dữ liệu và mức song song cần được xem là các quyết định gắn kết với nhau, không phải các nút chỉnh độc lập. Với kỹ sư hệ thống, huấn luyện là nơi phần cứng và song song quyết định một lần chạy có khớp với giới hạn bộ nhớ, lịch và ngân sách hay không, và liệu vòng lặp tối ưu lặp lại sẽ tăng tốc hay khựng lại. Theo thuật ngữ D·A·M, mỗi quyết định về độ chính xác và mức song song là sự thương lượng giữa toán học của tối ưu hóa và vật lý của thực thi.
Learning Objectives
- Giải thích tính bất đối xứng trong chi phí huấn luyện qua các hạng mục: chi phí forward, backward, trạng thái optimizer, dữ liệu và chi phí theo vòng lặp.
- Tính toán FLOPS, bộ nhớ activation, trạng thái optimizer và chi phí đô la cho quá trình huấn luyện mạng nơ-ron.
- So sánh SGD, Adam và AdamW theo hành vi hội tụ (convergence behavior), phụ trội bộ nhớ và chi phí tính toán.
- Chẩn đoán các điểm nghẽn trong quá trình huấn luyện (do giới hạn về tính toán, bộ nhớ hoặc dữ liệu) bằng cách sử dụng phân tích roofline và các bằng chứng từ việc phân tích hiệu năng.
- Áp dụng độ chính xác hỗn hợp, checkpointing, tích lũy gradient và FlashAttention để đáp ứng các giới hạn về bộ nhớ và thông lượng của bộ tăng tốc.
- Thiết kế các pipeline huấn luyện trên một máy, áp dụng các kỹ thuật như tìm nạp trước, chồng lấn, tạo batch và phân tích hiệu năng lại một cách có hệ thống.
- Đánh giá khi nào cần mở rộng hệ thống ra nhiều máy, dựa trên các ràng buộc về bộ nhớ, thời gian chạy, giao tiếp, năng lượng và chi phí.
Việc chạy một mô hình một lần và huấn luyện nó từ đầu đại diện cho hai thái cực về chi phí trên đường cong chi phí hệ thống. Các framework cung cấp nền tảng để thực thi: các đồ thị tính toán sẽ lên lịch các phép toán, vi phân tự động giúp tính toán gradient, và các lớp trừu tượng phần cứng hỗ trợ nhiều loại bộ tăng tốc khác nhau. Những cơ chế này giúp thực hiện một bước huấn luyện đơn lẻ; còn các hệ thống huấn luyện sẽ giúp quá trình này lặp lại được ở quy mô lớn. Cùng một vòng lặp truyền xuôi/truyền ngược/cập nhật có thể chạy hàng nghìn hoặc hàng triệu lần, đồng thời vẫn giữ lại các activations, cấp dữ liệu cho các bộ tăng tốc và đảm bảo nằm trong các giới hạn thực tế về bộ nhớ, thời gian và ngân sách.
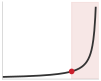 {width=“100%” fig-alt=“Đường cong gần như phẳng, uốn lên tại một điểm gối (knee) được đánh dấu, rồi tăng rất dốc qua vùng tô bóng ở phía bên phải.”khuỷu” rõ rệt, rồi tăng vọt qua một vùng tô bóng ở phía bên phải.”}
Chi phí huấn luyện duy trì ổn định trên các quy mô, sau đó bùng nổ vượt qua điểm uốn quy mô lớn.
1 Quy mô chi phí huấn luyện: Tỷ lệ khoảng 2.000\(\times\) giữa hai mốc chi phí trong chương này minh họa cách số lượng tham số, ngân sách token huấn luyện, thế hệ phần cứng và các cụm bộ tăng tốc có thể nhân lên; đây không phải là một phép so sánh có kiểm soát giữa các khoản chi huấn luyện đã công bố. Báo cáo GPT-2 của OpenAI mô tả mô hình và thiết lập huấn luyện nhưng không công bố chi phí huấn luyện (Radford et al. 2019). Chi tiết huấn luyện GPT-4 cũng không được công bố, nên con số cho lớp GPT-4 được nêu rõ là một ước tính trong ngành, dựa trên các báo cáo công khai và phân tích cơ sở hạ tầng độc lập (Knight 2023; Patel and Wong 2023).
Radford, Alec, Jeffrey Wu, Rewon Child, David Luan, Dario Amodei, and Ilya Sutskever. 2019. Language Models Are Unsupervised Multitask Learners. OpenAI.
Knight, Will. 2023. OpenAI’s CEO Says the Age of Giant AI Models Is Already over. WIRED.
Patel, Dylan, and Gerald Wong. 2023. GPT-4 Architecture, Infrastructure, Training Dataset, Costs, Vision, MoE. SemiAnalysis Blog.
Chương này sử dụng một ước tính sơ bộ từ nguồn bên ngoài, khoảng $50,000 cho việc huấn luyện mô hình quy mô GPT-2, và một ước tính công khai gần $100M cho một lần chạy huấn luyện thuộc lớp GPT-4.1 Cả hai con số này đều không được công bố là hóa đơn huấn luyện đã kiểm toán. Sự bất đối xứng về chi phí huấn luyện này phản ánh sự khác biệt giữa việc đánh giá một mô hình đã huấn luyện cho một yêu cầu cụ thể và việc thực hiện lặp đi lặp lại các phép tính truyền xuôi, truyền ngược và cập nhật trên toàn bộ tập dữ liệu huấn luyện.
Đối với GPT-2, chương này sử dụng khoảng 3.00 × 10⁹ phép toán dấu phẩy động trên mỗi token cho một lượt truyền xuôi, theo cách hạch toán dựa trên tham số gắn với kiến trúc trong báo cáo kỹ thuật GPT-2 (Radford et al. 2019). Tổng ngân sách 1.50 × 10²¹ FLOPs tương đương khoảng 167 tỷ vị trí token, khi tổng công việc truyền xuôi và truyền ngược được xấp xỉ bằng ba lần chi phí của lượt truyền xuôi. Ước tính hạch toán này không ngụ ý rằng GPT-2 đã thực hiện từng ấy yêu cầu suy luận hoàn chỉnh. Quy mô đó khiến kỹ thuật hệ thống huấn luyện trở thành một lĩnh vực riêng, và cho thấy việc tiếp cận cơ sở hạ tầng huấn luyện có thể hạn chế mức độ tham gia vào phát triển AI như thế nào.
Definition 1.1: Hệ thống huấn luyện
Hệ thống huấn luyện machine learning là các hệ thống phần mềm-phần cứng thực hiện vòng lặp tối ưu hóa lặp đi lặp lại (gồm lượt truyền xuôi, tính toán hàm mất mát, lượt truyền ngược và cập nhật tham số) nhằm tối thiểu hóa một hàm mất mát trên một tập dữ liệu huấn luyện.
- Ý nghĩa: Trong thiết lập Adam (Adaptive Moment Estimation) tiêu chuẩn với độ chính xác hỗn hợp, chi phí bộ nhớ cho huấn luyện là 8× lần chi phí bộ nhớ cho suy luận trên mỗi tham số. Cụ thể, một mô hình có 7B tham số cần ít nhất 14 GB (trọng số FP16) + 14 GB (gradient FP16) + 28 GB (trọng số master FP32) + 56 GB (các moment thứ nhất và thứ hai của Adam ở FP32) = 112 GB, chưa tính phần lưu trữ activation. Chính hệ số này khiến một mô hình chạy suy luận trên một GPU lại cần nhiều GPU để huấn luyện.
- Điểm khác biệt: Khác với các hệ thống suy luận chỉ thực hiện một lần truyền xuôi rồi bỏ các activation trung gian, lan truyền ngược tiêu chuẩn phải lưu trữ các tensor cần cho lượt truyền ngược, tạo ra nhu cầu bộ nhớ tăng theo chiều sâu của mô hình và kích thước batch.
- Cạm bẫy thường gặp: Một hiểu lầm phổ biến là thất bại khi huấn luyện là vấn đề tính toán. Trên thực tế, lỗi thường gặp là hết bộ nhớ (OOM), tức vấn đề quản lý bộ nhớ: các tensor được lưu cho lan truyền ngược tích lũy trong lượt truyền xuôi và có thể làm cạn kiệt bộ nhớ trước khi tính được gradient đầu tiên.
Ba đặc điểm sau đây phân biệt khối lượng công việc (workload) huấn luyện với tính toán mục đích chung:
- Cường độ tính toán: Ngân sách 1.50 × 10²¹ FLOPs trải qua nhiều ngày thời gian thực đòi hỏi phần cứng phải duy trì thông lượng ở mức PFLOP/s, trong khi thông lượng thực tế với mô hình lớn thường thấp hơn nhiều so với mức đỉnh lý thuyết (Narayanan et al. 2021; Chowdhery et al. 2022).
- Áp lực bộ nhớ: Để lưu trữ 1.5B trọng số, cần 6 GB bộ nhớ ở dạng FP32; optimizer Adam thêm hai tensor trạng thái cho mỗi tham số, tiêu tốn thêm 12 GB. Bộ nhớ cho activation còn phụ thuộc vào khối lượng công việc (workload), kiến trúc, độ dài chuỗi, kích thước batch, độ chính xác và checkpointing; tổng trạng thái kết hợp có thể vượt quá dung lượng của một bộ tăng tốc duy nhất.
- Phụ thuộc dữ liệu: Mỗi lần cập nhật gradient phụ thuộc vào kết quả của lần trước, tạo ra các nút thắt cổ chai tuần tự và hạn chế mức độ song song mà hệ thống có thể khai thác.
2 Gradient checkpointing (activation checkpointing): Trong lan truyền ngược, các giá trị forward cần cho mỗi quy tắc backward được giữ lại. Checkpointing sẽ lưu một số giá trị đã chọn và tính lại các giá trị khác trong quá trình lan truyền ngược, đổi thêm lượng tính toán để giảm bộ nhớ activation. Cách đặt checkpoint theo \(\sqrt{N_L}\) cùng với chi phí tính toán lại tương ứng mô tả lịch trình cổ điển do Chen et al. (2016) phân tích, không phải mọi cách triển khai checkpointing. Section 1.5.5.2 sẽ đi qua lịch trình này cho số lượng lớp của GPT-2.
Chen, Tianqi, Bing Xu, Chiyuan Zhang, and Carlos Guestrin. 2016. “Training Deep Nets with Sublinear Memory Cost.” arXiv Preprint arXiv:1604.06174.
3 Huấn luyện độ chính xác hỗn hợp: Kỹ thuật này dùng độ chính xác thấp hơn cho một số phép tính và lưu trữ, nhưng vẫn giữ độ chính xác cao hơn ở những chỗ cần tích lũy hoặc khi phạm vi số bắt buộc. Một công thức phổ biến với FP16 là duy trì FP32 master weights và áp dụng loss scaling để giảm hiện tượng tràn dưới của gradient (Micikevicius et al. 2017). BF16 (“Brain Floating Point,” từ Google Brain (Wang and Kanwar 2019)) có dải số mũ 8 bit giống FP32 nên thường không cần loss scaling động, dù độ chính xác của trạng thái và phép tích lũy còn phụ thuộc vào optimizer và cách triển khai.
Micikevicius, Paulius, Sharan Narang, Jonah Alben, Gregory Diamos, Erich Elsen, David Garcia, Boris Ginsburg, et al. 2017. “Mixed Precision Training.” arXiv Preprint arXiv:1710.03740.
Wang, Shibo, and Pankaj Kanwar. 2019. BFloat16: The Secret to High Performance on Cloud TPUs.
Mỗi thách thức dẫn đến một hướng khắc phục khác nhau. Cường độ tính toán thúc đẩy hệ thống hướng tới việc tận dụng bộ tăng tốc tốt hơn và dùng số học với độ chính xác thấp hơn. Áp lực bộ nhớ kêu gọi các kỹ thuật như gradient checkpointing,2 một ứng dụng cụ thể của rematerialization (bỏ và tính lại các giá trị trung gian để tiết kiệm bộ nhớ, từ Các Framework ML) nhằm đánh đổi việc tính toán lại để giảm lưu trữ activation, và huấn luyện độ chính xác hỗn hợp,3 giúp giảm bộ nhớ cho trọng số và activation. Phụ thuộc dữ liệu thúc đẩy thiết kế các pipeline chồng chéo tính toán với di chuyển dữ liệu, xây trên thông lượng tải dữ liệu đã được tối ưu trong Kỹ thuật dữ liệu để bộ tăng tốc không phải chờ batch tiếp theo. Chương này tập trung vào huấn luyện trên máy đơn và một nút đa GPU; mở rộng lên hàng trăm máy qua ranh giới mạng sẽ phát sinh các thách thức về giao tiếp và chịu lỗi nằm ngoài phạm vi của chương.
Pipeline hệ thống theo giai đoạn: Xác định “bong bóng bộ tăng tốc”
Một hệ thống huấn luyện không chỉ là một vòng lặp; đó là một pipeline hệ thống theo giai đoạn. Để tận dụng bộ tăng tốc ở mức cao, ta cần phân tích huấn luyện như một dây chuyền sản xuất, nơi bốn giai đoạn riêng biệt phối hợp để giữ các ALU luôn bận rộn:
- Tải & Tiền xử lý dữ liệu (CPU/Lưu trữ): Lấy các bit thô từ Non-Volatile Memory Express (NVMe), giải mã, và tăng cường dữ liệu trên các lõi CPU.
- Truyền từ host sang thiết bị (PCIe): Di chuyển batch đã xử lý qua bus PCIe vào bộ nhớ GPU bằng truy cập bộ nhớ trực tiếp.
- Lượt truyền xuôi/ngược (bộ tăng tốc): Lan truyền activation và gradient qua các lớp trên GPU.
- Đồng bộ tham số (liên kết): Trao đổi gradient giữa các bộ tăng tốc qua fabric hiện có. NVLink cung cấp lên đến 900 GB/s trong cấu hình H100 được dùng về sau, trong khi các hệ thống khác có thể dùng PCIe hoặc kết nối mạng.
Bất kỳ chênh lệch thông lượng nào giữa các giai đoạn này đều tạo ra các bong bóng bộ tăng tốc — những khoảng thời gian một số tài nguyên của bộ tăng tốc bị nhàn rỗi hoặc không được tận dụng hết vì phải chờ giai đoạn khác. Kỹ sư hệ thống giảm các bong bóng này bằng các kỹ thuật như tìm nạp trước không đồng bộ và chồng chéo pipeline, với mục tiêu có sẵn batch kế tiếp trước khi bước hiện tại cần đến. Section 1.4 phát triển các công cụ định lượng để đo và giảm các bong bóng này.
Chương này đi theo chuỗi phụ thuộc đó. Trước hết là quy luật sắt về hiệu suất huấn luyện, một ứng dụng chuyên biệt của quy luật sắt chung (Định luật sắt của hệ thống ML), tách bạch tổng số phép toán, thông lượng đỉnh và mức sử dụng. Phương trình này đóng vai trò như hệ thống tính toán cho phần nền tảng toán học tiếp theo: coi tính toán mạng nơ-ron như một khối lượng công việc (workload), hành vi của optimizer, cơ chế lan truyền ngược và cường độ số học. Khi các chi phí đã hiện rõ, chương chuyển sang chính pipeline huấn luyện, nơi tải dữ liệu, lan truyền xuôi, lan truyền ngược và cập nhật tham số lần lượt ràng buộc nhau. Các phần tối ưu hóa sau đó nhắm vào các hạng mục đã lộ ra qua phép “hạch toán”: huấn luyện độ chính xác hỗn hợp, FlashAttention, tích lũy gradient, checkpointing và prefetch dữ liệu. Việc mở rộng vượt quá một bộ tăng tốc được trình bày sau cùng, khi các đòn bẩy trên một máy đơn đã cho thấy chi phí giao tiếp là nút thắt cổ chai kế tiếp.
Trước khi chính thức hóa quy luật sắt, hãy xem các ràng buộc này tương tác ra sao trong thực tế. Framework lý thuyết rất quan trọng vì thất bại rất tốn kém: chỉ một lần bùng nổ gradient cũng có thể xóa sạch kết quả của nhiều ngày tính toán, trị giá hàng nghìn đô la.
War Story 1.1: Các đỉnh tổn thất của PaLM (2022)
Bối cảnh: Quá trình huấn luyện PaLM với 540 tỷ tham số sử dụng 6.144 chip Tensor Processing Unit (TPU) v4 trên hai Pod, mỗi Pod 3.072 chip, kết nối qua mạng trung tâm dữ liệu của Google, và gặp các đợt tăng đột biến mất ổn định huấn luyện nghiêm trọng, điều không xuất hiện ở các lần chạy nhỏ hơn (Chowdhery et al. 2022).
Kiểu lỗi: Tổn thất huấn luyện tăng đột biến khoảng 20 lần dù đã cắt gradient. Các đỉnh này xuất hiện rất thất thường, đôi khi xảy ra muộn trong quá trình huấn luyện, không thấy ở các mô hình nhỏ hơn, và chưa xác định được biện pháp giảm thiểu có cơ sở.
Tác động: Mỗi lần khôi phục đều làm mất tiến độ gần đây của một lần chạy 6.144 chip rất tốn kém. Do đó, checkpoint có thể tái lập và thứ tự dữ liệu có thể lặp lại là các điều kiện tiên quyết để chạy lại.
Phản ứng: Các kỹ sư khởi động lại huấn luyện từ một checkpoint không bị hỏng khoảng 100 bước trước mỗi đỉnh và bỏ qua khoảng 200–500 batch dữ liệu quanh khoảng thời gian xảy ra lỗi.
Bài học hệ thống: Khả năng chịu lỗi trong vận hành trực tiếp chi phối hệ số sử dụng \(\eta_{\text{hw}}\) trong quy luật sắt về hiệu suất huấn luyện (equation 1). Cơ chế tự động phát hiện đỉnh tổn thất, tần suất checkpoint và bỏ qua batch là các thành phần hệ thống cốt lõi để bảo vệ hiệu suất tính toán của cụm.
Quy luật sắt về hiệu suất huấn luyện
Các đợt tăng đột biến của loss trong PaLM cho thấy một vấn đề lớn hơn: sự mất ổn định ở quy mô tiên phong không phải chuyện hiếm, mà là hệ quả có thể dự đoán khi đồng thời đẩy mạnh cường độ tính toán, áp lực bộ nhớ và phụ thuộc vào dữ liệu. Mỗi yếu tố trong ba yếu tố này có thể quản lý riêng, nhưng sự tương tác giữa chúng tạo ra các kiểu lỗi mà chỉ khôi phục vận hành thôi thì không ngăn được. Để chẩn đoán yếu tố nào chi phối một lỗi cụ thể, và định lượng chi phí của từng yếu tố, cần phân tích chính thức thời gian huấn luyện thành các thành phần vật lý của nó.
Quy luật sắt chính là framework tổ chức đó: nó phân tích thời gian huấn luyện sao cho mỗi kỹ thuật tối ưu hóa tương ứng với một hạng mục cụ thể trong phương trình. Đây là một ứng dụng chuyên biệt của quy luật sắt chung cho các hệ thống ML đã được giới thiệu trong Định luật sắt của hệ thống ML, tập trung vào việc tối đa hóa thông lượng tính toán.
Definition 1.2: Quy luật sắt về hiệu suất huấn luyện
Quy luật sắt về hiệu suất huấn luyện biểu diễn thời gian huấn luyện dựa trên số lượng phép toán trong khối lượng công việc (workload) và thông lượng hiệu quả đạt được: \[T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}} \tag{1}\]
Ở đây \(\eta_{\text{hw}}\) là hệ số sử dụng hiệu quả tổng thể, bằng tỉ lệ giữa tốc độ vận hành mô hình đạt được và mức đỉnh phần cứng liên quan. Đình trệ dữ liệu, giao tiếp, đồng bộ hóa, chi phí khởi chạy và các kernel kém hiệu quả đều làm giảm hệ số này. Tìm nạp trước (prefetching) và chồng lấp (overlap) có thể che bớt một phần các chi phí đó nhưng không đảm bảo loại bỏ được chúng.
- Ý nghĩa: Ba yếu tố này chỉ ra ba đòn bẩy tối ưu hóa riêng biệt: \(O\) (có thể giảm bằng thay đổi thuật toán, dùng ít token huấn luyện hơn, hoặc áp dụng các phương pháp nén mô hình như tỉa (pruning) và chưng cất), \(R_{\text{peak}}\) (thay đổi theo phần cứng và độ chính xác được chọn), và \(\eta_{\text{hw}}\) (hệ số sử dụng hiệu quả và mục tiêu chính của hệ thống; Narayanan et al. (2021) đo được 44 đến 52 phần trăm thông lượng đỉnh lý thuyết trên các mô hình GPT huấn luyện trên các cụm A100). Nén mô hình định nghĩa các kỹ thuật nén; ở đây, chúng chỉ nhằm chỉ ra những phương pháp đó được hạch toán ở đâu.
- Điểm khác biệt: Định luật sắt tổng quát tách riêng di chuyển dữ liệu, tính toán và độ trễ. Phiên bản áp dụng cho huấn luyện này lại gộp mọi nguồn gây mất thông lượng vào \(\eta_{\text{hw}}\), nên hữu ích cho việc lập ngân sách nhưng không đủ để chẩn đoán xem thành phần gốc nào là nguyên nhân.
- Lỗi thường gặp: Một hiểu lầm phổ biến là \(\eta_{\text{hw}}\) cố định theo phần cứng. Thực tế, hiệu quả hệ thống là thuộc tính của pipeline: bão hòa băng thông bộ nhớ, chi phí khởi chạy kernel và các rào cản đồng bộ hóa đều độc lập làm giảm \(\eta_{\text{hw}}\). Muốn biết yếu tố nào chi phối, cần profiling thay vì chỉ đọc thông số phần cứng.
Equation 1 nêu ra ba đòn bẩy để cải thiện: giảm tổng số phép toán bằng đổi mới thuật toán, tăng thông lượng đỉnh bằng cách tận dụng phần cứng tốt hơn, hoặc cải thiện mức sử dụng bằng cách điều phối pipeline hiệu quả hơn. Mỗi kỹ thuật tối ưu hóa trong chương này kéo một hoặc nhiều đòn bẩy đó, như được tóm tắt trong table 1.
| Kỹ thuật | Thuật ngữ bị ảnh hưởng | Cơ chế |
|---|---|---|
| Độ chính xác hỗn hợp (FP16/BF16) | Thông lượng đỉnh ↑ | Sử dụng các đường dẫn phần cứng độ chính xác thấp hơn được hỗ trợ |
| Tìm nạp trước dữ liệu | Tỷ lệ sử dụng ↑ | Giảm thời gian nhàn rỗi của bộ tăng tốc khi chờ dữ liệu |
| Kiểm tra gradient | Bộ nhớ ↓, Thao tác ↑ | Giảm các activation đã lưu bằng cách tính toán lại các giá trị được chọn |
| Tích lũy gradient | Bộ nhớ ↓, Đồng bộ hóa ↓ | Xây dựng một batch hiệu quả từ các micro-batch được tuần tự hóa |
| Hợp nhất toán tử | Lưu lượng bộ nhớ ↓, Chi phí phụ trội ↓ | Tránh các lần truyền trung gian và giảm số lần khởi chạy kernel |
| FlashAttention | Lưu lượng bộ nhớ ↓, Tỷ lệ sử dụng ↑ | Cùng FLOPs tiệm cận, HBM IO thấp hơn nhiều; tính toán lại ngược có thể thêm FLOPs |
Một lưu ý: định luật sắt tập trung vào hiệu quả thực thi—tức phần cứng xử lý một khối lượng công việc (workload) nhất định nhanh đến mức nào. Nó không phản ánh các yếu tố phía dữ liệu như chất lượng dữ liệu, kích thước tập dữ liệu, hay thiết kế chương trình huấn luyện (curriculum design), vốn quyết định tổng số phép toán \(O\) cần để đạt độ chính xác mục tiêu. Một tập dữ liệu sạch hơn hoặc phối trộn dữ liệu tốt hơn có thể giảm số epoch cần thiết, làm giảm \(O\) mà không phải đụng gì đến phần cứng. Khi giữ nguyên khối lượng công việc (workload), câu hỏi là làm sao thực thi nó nhanh nhất có thể.
Thông lượng huấn luyện thực tế luôn thấp hơn đỉnh số học mỗi khi các kernel, việc phân phối dữ liệu hoặc giao tiếp khiến tài nguyên bị nhàn rỗi. Mở rộng sang nhiều bộ tăng tốc sẽ phát sinh thêm chi phí giao tiếp—một sự đánh đổi được định lượng trong section 1.6.
Checkpoint 1.1: Vật lý của quá trình huấn luyện
Tốc độ huấn luyện được quyết định bởi mức độ tận dụng hiệu năng đỉnh của phần cứng.
Khoảng cách tận dụng
Định luật sắt cung cấp một framework tĩnh để suy luận về hiệu suất huấn luyện, nhưng lịch sử của deep learning cho thấy ràng buộc then chốt đã dịch chuyển theo thời gian khi phần cứng và thuật toán cùng tiến hóa. Năm 1986, Rumelhart và cộng sự phổ biến lan truyền ngược cho các mạng nơ-ron nhiều lớp (Rumelhart et al. 1986). Năm 2012, AlexNet huấn luyện một bộ phân loại ImageNet trong năm đến sáu ngày trên hai GPU (Krizhevsky et al. 2012), cho thấy khả năng song song của mạng nơ-ron rất phù hợp với phần cứng đồ họa. Đến năm 2017, các transformer (Vaswani et al. 2017) chuyển trọng tâm sang mô hình hóa chuỗi quy mô lớn và các kernel trên bộ tăng tốc có thông lượng cao. GPT-3 năm 2020 tiêu thụ khoảng \(3.14 \times 10^{23}\) FLOPs (Brown et al. 2020), khiến mức tận dụng \((\eta_{\text{hw}})\) trở nên cực kỳ quan trọng. Đến năm 2023, hiệu quả huấn luyện được cải thiện nhờ các kỹ thuật được xem xét trong chương này: FlashAttention giảm lưu lượng bộ nhớ đồng thời cải thiện \(\eta_{\text{hw}}\); gradient checkpointing đánh đổi thêm \(O\) để đổi lấy dung lượng bộ nhớ; mixed precision tăng \(R_{\text{peak}}\). Mỗi cải tiến giải quyết một nút thắt cụ thể theo định luật sắt.
Vaswani, Ashish, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. 2017. “Attention Is All You Need.” Advances in Neural Information Processing Systems (NeurIPS) 30: 5998–6008.
Ví dụ chạy xuyên suốt: Huấn luyện GPT-2
Trong suy luận, GPT-2 đóng vai trò “lighthouse” cho Bandwidth Hog. Ở đây, nó tiếp tục là khối lượng công việc (workload) ổn định của chương để kiểm tra từng chi phí và tối ưu hóa huấn luyện.
Lighthouse 1.1: Ví dụ lighthouse: Huấn luyện GPT-2
Bối cảnh: GPT-2 (1.5 tỷ tham số) được chọn làm nghiên cứu tình huống chính vì đủ lớn để bộc lộ rõ các ràng buộc đáng kể về tính toán, activation và trạng thái của optimizer, đồng thời vẫn dễ phân tích hơn so với các mô hình ở quy mô tiên phong. Việc có cần huấn luyện phân tán hay không phụ thuộc vào độ chính xác, trạng thái của optimizer, bộ nhớ activation, khả năng phần cứng và thời gian huấn luyện mục tiêu. Table 2 ánh xạ từng thuộc tính của mô hình tới ràng buộc hệ thống mà nó tạo ra:
Table 2: Thông số kỹ thuật của mô hình GPT-2 (1.5 tỷ tham số) làm ví dụ điển hình: Bảng này trình bày số lượng tham số, độ sâu kiến trúc, kích thước tập dữ liệu và tổng lượng tính toán cần cho huấn luyện, cùng với những tác động của chúng lên hệ thống. Mỗi hàng ghép một thuộc tính của mô hình với ràng buộc kỹ thuật tương ứng—như bộ nhớ cho trọng số, áp lực lên bộ nhớ activation do pipeline sâu, yêu cầu về thông lượng I/O và nhu cầu song song hoá.
| Thuộc tính | Thông số kỹ thuật | Hàm ý hệ thống |
|---|---|---|
| Tham số | 1.5B (XL) | Yêu cầu ~3 GB (FP16) hoặc ~6 GB (FP32) chỉ riêng cho các trọng số. |
| Kiến trúc | 48 Lớp, 1600 Chiều | Áp lực bộ nhớ activation lớn do pipeline sâu tạo ra. |
| Tập dữ liệu | WebText (40 GB) | Tiền xử lý, xáo trộn và phân phối phải duy trì cấu hình huấn luyện đã chọn. |
| Tính toán | ~ 1.50 × 10²¹ FLOPs | Thời lượng huấn luyện phụ thuộc vào thông lượng đạt được và số lượng bộ tăng tốc. |
Cơ chế: Huấn luyện GPT-2 gắn với tổng số phép toán \(O \approx 6 \cdot P \cdot D_{\text{tokens}}\), hay 1.50 × 10²¹ FLOPs, cùng với một yêu cầu bộ nhớ trạng thái nghiêm ngặt \(M_{\text{state}} = M_{\text{weights}} + M_{\text{grads}} + M_{\text{opt}} + M_{\text{act}}\). Để cân bằng thời gian thực thi \(T_{\text{train}} = \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\), ta cần phối hợp việc nạp dữ liệu, bộ nhớ cho activation và thông lượng tính toán sao cho phù hợp với dung lượng bộ nhớ băng thông cao (HBM) của bộ tăng tốc.
Không phải mọi khối lượng công việc huấn luyện đều bị giới hạn bởi khả năng tính toán. Các mô hình khuyến nghị như DLRM chủ yếu dùng các bảng embedding khổng lồ (từ 100B đến 10T tham số, phần lớn là embedding), khiến chúng bị giới hạn bởi băng thông bộ nhớ thay vì bởi khả năng tính toán. Với những khối lượng công việc như vậy, bài toán mở rộng đầu tiên thường là dung lượng: phải chia các bảng embedding qua nhiều thiết bị để mô hình có thể chứa vừa. Phần còn lại của chương này tập trung vào huấn luyện các mô hình dày đặc, chuyên sâu về tính toán, lấy GPT-2 làm ví dụ chính.
Hệ thống huấn luyện giữ vai trò then chốt trong pipeline machine learning: chúng nhận dữ liệu đã được chuẩn bị từ các công đoạn kỹ thuật thượng nguồn (Kỹ thuật dữ liệu) và tạo ra các mô hình đã huấn luyện để các hệ thống tiếp theo triển khai và giám sát. Chất lượng dữ liệu ảnh hưởng trực tiếp đến độ ổn định huấn luyện, còn hiệu quả huấn luyện quyết định tốc độ lặp trong quá trình phát triển mô hình. Áp lực này xuất hiện ở ba quy mô. Ở quy mô dữ liệu, các tập dữ liệu cỡ petabyte đòi hỏi pipeline I/O hiệu quả và lưu trữ phân tán. Ở quy mô mô hình, các mô hình hàng tỷ tham số buộc hệ thống phải quyết định: nhân bản mô hình trên các batch theo song song dữ liệu4, hay chia mô hình ra nhiều thiết bị theo song song mô hình.5 Ở quy mô hạ tầng, điều phối hàng nghìn bộ tăng tốc làm phát sinh chi phí giao tiếp có thể lấn át thời gian huấn luyện. Chính vì vậy, các hợp đồng quy trình làm việc từ Quy trình ML rất quan trọng trong giai đoạn huấn luyện: các quyết định điều phối sẽ định hình cả tốc độ lặp của nghiên cứu lẫn chi phí hệ thống.
4 Song song dữ liệu: Phương pháp này nhân bản toàn bộ mô hình trên mọi thiết bị và chỉ chia nhỏ dữ liệu. Mỗi thiết bị tính gradient độc lập, sau đó phép toán AllReduce đồng bộ hóa chúng—tăng khối lượng giao tiếp tỉ lệ thuận với kích thước mô hình ở mỗi bước. Thuế đồng bộ hóa này giới hạn hiệu quả mở rộng: khi giao tiếp trở thành nút thắt cổ chai, tăng gấp đôi số bộ tăng tốc hiếm khi rút ngắn một nửa thời gian huấn luyện.
5 Song song mô hình: Phương pháp này phân chia các lớp của mô hình qua nhiều thiết bị khi mô hình vượt quá bộ nhớ của một thiết bị. Các activation phải được truyền giữa các thiết bị tại mỗi ranh giới phân chia, và cách chia đơn giản tạo ra các “bong bóng pipeline”, khiến các thiết bị phía sau phải chờ và nhàn rỗi. Kỹ thuật pipelining microbatch, như trong GPipe và PipeDream, giúp khôi phục phần lớn hiệu quả bị mất này (Huang et al. 2019; Narayanan et al. 2019).
Narayanan, Deepak, Aaron Harlap, Amar Phanishayee, Vivek Seshadri, Nikhil R. Devanur, Gregory R. Ganger, Phillip B. Gibbons, and Matei Zaharia. 2019. “PipeDream: Generalized Pipeline Parallelism for DNN Training.” Proceedings of the 27th ACM Symposium on Operating Systems Principles, 1–15. https://doi.org/10.1145/3341301.3359646.
Corpus WebText 40 GB của GPT-2 nằm ở phía thấp của phổ quy mô dữ liệu này. Những corpus lớn hơn có thể làm thay đổi bản chất của đường dữ liệu.
Systems Perspective 1.1: Hệ số tỷ lệ từ 10 GB đến 10 TB
Trong chế độ thường trú trong bộ nhớ, toàn bộ tập dữ liệu có thể nằm gọn trong RAM hệ thống. Nhờ đó, hệ thống tránh phải đọc lặp lại từ lưu trữ sau khi đã đưa vào cache, dù chi phí tiền xử lý và truyền tải vẫn còn. Ngược lại, trong chế độ streaming, tập dữ liệu vượt quá bộ nhớ cục bộ. Khi đó, hệ thống phải điều phối việc đọc từ lưu trữ, tiền xử lý, cache và phân phối dữ liệu xuyên suốt quá trình huấn luyện. Tùy giai đoạn nào đang giới hạn thông lượng, thiết kế phù hợp có thể gồm nhiều worker, cơ chế tìm nạp trước (prefetching), cache cục bộ hoặc lưu trữ phân tán.
Vì vậy, việc mở rộng quy mô không chỉ làm thay đổi lượng dữ liệu; nó còn biến đổi cả nguyên lý hoạt động của hệ thống.
Những thách thức về mở rộng quy mô này dẫn đến các yêu cầu cụ thể cho quy trình làm việc. Các quy trình huấn luyện gồm nhiều giai đoạn phụ thuộc lẫn nhau—như tiền xử lý dữ liệu, các lượt truyền xuôi (forward pass) và truyền ngược (backward pass), cùng cập nhật tham số—mở rộng các khái niệm về mạng nơ-ron đã trình bày trong Tính toán nơ-ron. Các ràng buộc của hệ thống thường đặt ra giới hạn hiệu suất: các bộ tăng tốc có tỷ lệ tính toán trên băng thông cao thường bị nghẽn bởi băng thông bộ nhớ, vì việc di chuyển dữ liệu giữa các tầng bộ nhớ chậm hơn chính các phép tính (Hennessy and Patterson 2017). Trong các hệ thống phân tán, việc đồng bộ giữa các thiết bị gây thêm độ trễ, và hiệu suất liên kết (NVLink, InfiniBand) ảnh hưởng then chốt đến thông lượng.6
Hennessy, John L., and David A. Patterson. 2017. Computer Architecture: A Quantitative Approach. 6th ed. Morgan Kaufmann.
6 Độ nhạy của kết nối nội bộ trong huấn luyện Transformer: Do self-attention có độ phức tạp bộ nhớ và tính toán \(\mathcal{O}(S^2)\), kích thước activation tăng theo độ dài chuỗi. Với song song pipeline, activation phải đi qua các thiết bị tại ranh giới phân vùng mô hình; còn song song dữ liệu phải đồng bộ gradient với khối lượng tỉ lệ theo số tham số. Vì vậy, chi phí giao tiếp phụ thuộc vào chiến lược song song, cấu trúc liên kết, kích thước thông điệp và mức độ chồng chéo, khiến việc chọn kết nối nội bộ trở thành một quyết định hàng đầu trong hệ thống huấn luyện.
Ranh giới giữa phần cứng và phần mềm, điều mà các framework đã nêu trong Các Framework ML, là trọng tâm ở đây. Kỹ thuật huấn luyện độ chính xác hỗn hợp (mixed-precision training) xuất hiện khi người ta nhận ra phần cứng Tensor Core có thể tăng tốc các phép toán với độ chính xác thấp hơn. Kỹ thuật gradient checkpointing ra đời từ các hạn chế về dung lượng bộ nhớ. Kỹ sư hệ thống huấn luyện cần ghép các lựa chọn thuật toán đó với những giới hạn vật lý của máy.
Những thách thức mở rộng này có một điểm chung: mọi nút thắt đều quy về chi phí của các phép toán cụ thể. Phép nhân ma trận dày đặc là một kernel hệ thống đã được nghiên cứu kỹ (Goto and Geijn 2008), trong khi hàm activation tiêu tốn băng thông bộ nhớ và trạng thái của optimizer làm tăng dung lượng bộ nhớ thường trú. Thiết kế hệ thống để thực thi các phép toán này ở quy mô lớn bắt đầu từ việc hạch toán riêng từng loại chi phí.
Goto, Kazushige, and Robert A. van de Geijn. 2008. “Anatomy of High-Performance Matrix Multiplication.” ACM Transactions on Mathematical Software 34 (3): 1–25. https://doi.org/10.1145/1356052.1356053.
Self-Check: Question
A 1,024-GPU training run has its prefetching pipeline well staged: PCIe is saturated overlapping with compute and gradient AllReduce is hidden behind the next forward pass. Profiling reports 38 percent MFU. Under the simplified iron law of training performance (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)), which lever is the most actionable target for the next engineering investment, and why?
- Hardware utilization \(\eta_{\text{hw}}\), because with external data movement and communication already overlapped, the remaining gap to peak throughput consists of kernel-level memory stalls, launch latency, and small tile overheads that profiling can isolate.
- Peak hardware throughput \(R_{\text{peak}}\), because purchasing next-generation accelerators is the only mechanism that directly changes realized MFU.
- Total operations \(O\), because reducing model operations is the only permissible systems modification when communication is hidden.
- Dataset size \(D_{\text{tokens}}\), because shrinking training tokens mathematically raises the hardware utilization factor \(\eta_{\text{hw}}\).
When a team transitions a model from FP32 training to mixed-precision (FP16/BF16) on Tensor Core accelerators without changing the model architecture, batch size, or dataset, which term of the Iron Law of Training Performance (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)) is most directly improved?
- Total operations \(O\), because lower numerical precision halves the number of multiplications required in each matrix multiplication.
- Hardware utilization \(\eta_{\text{hw}}\), because mixed precision automatically eliminates all GPU pipeline bubbles and CPU data stalls.
- Peak throughput \(R_{\text{peak}}\), because Tensor Cores provide a substantially higher theoretical FLOP/s ceiling for reduced-precision matrix operations compared to standard FP32 execution units.
- Data volume \(D_{\text{tokens}}\), because lower precision requires fewer training tokens for the loss to converge.
Explain the scope conditions under which the simplified Iron Law of Training Performance (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)) accurately models training duration, and identify why it fails for a small-batch debugging session.
All large-scale deep learning models, including recommendation models with multi-terabyte embedding tables (such as DLRM), are primarily compute-bound workloads where training speed is strictly governed by Tensor Core TFLOP/s.
Place the following milestones in the historical evolution of deep learning training systems in chronological order, reflecting how the binding constraint shifted:
- Transformers shift sequence modeling toward high-throughput dense matrix multiplication and large activation footprints.
- Backpropagation is popularized for multilayer neural networks, establishing the algorithmic foundations of gradient descent.
- Large-scale foundation models (such as GPT-3 requiring \(\approx 3.14 \times 10^{23}\) FLOPs) make hardware utilization \(\eta_{\text{hw}}\) and multi-accelerator scaling critical.
- AlexNet demonstrates that neural network training parallelism maps effectively to GPUs, training ImageNet in under a week.
- IO-aware algorithms (such as FlashAttention) and memory-compute trade-offs (gradient checkpointing) co-evolve to overcome memory bandwidth and capacity walls.
Nền tảng toán học
Phép nhân ma trận chỉ là \(\mathbf{C} = \mathbf{A}\mathbf{B}\) về mặt ký hiệu, nhưng khi huấn luyện GPT-2, phép toán này được lặp đi lặp lại trên các ma trận quá lớn để có thể nằm trọn trong lớp bộ nhớ nhanh nhất. Tensor Cores tăng tốc các phép toán ma trận phù hợp, còn các lựa chọn như rectified linear unit (ReLU) hay sigmoid ảnh hưởng đến chi phí, cơ hội hợp nhất (fusion), và hành vi bộ nhớ của các kernel xử lý từng phần tử xung quanh. Tính toán nơ-ron đã chỉ ra những gì các phép toán mạng nơ-ron thực hiện và vì sao chúng cho phép học; câu hỏi ở góc độ hệ thống là chúng tốn bao nhiêu về FLOPs, bộ nhớ và băng thông khi các phép toán đó chạy ở quy mô lớn.
Bốn khía cạnh sau định hình phân tích chi phí này:
- Số lượng FLOPs của các phép toán ma trận chi phối quá trình huấn luyện mạng nơ-ron dày đặc.
- Yêu cầu bộ nhớ để đồng thời lưu trữ activation và trạng thái optimizer.
- Nhu cầu băng thông quyết định liệu các phép toán bị giới hạn bởi tính toán hay bởi bộ nhớ.
- Phân loại cường độ số học để định hướng lựa chọn chiến lược tối ưu hóa.
Tổng hợp lại, những khía cạnh này cung cấp ngôn ngữ chung để phân tích cường độ tính toán, áp lực bộ nhớ và các phụ thuộc dữ liệu đã được giới thiệu trong Các nguyên tắc cơ bản của hệ thống huấn luyện.
Tính toán mạng nơ-ron
Huấn luyện mạng nơ-ron gồm các phép toán ma trận lặp đi lặp lại và các biến đổi phi tuyến. Những phép toán này đơn giản về mặt ý niệm nhưng lại kéo theo các thách thức ở cấp hệ thống, vốn chi phối hạ tầng huấn luyện hiện đại. Sự ra đời của lan truyền ngược7 bởi Rumelhart et al. (1986) và sự phát triển của các thư viện tính toán ma trận hiệu quả như Basic Linear Algebra Subprograms (BLAS)8 (Dongarra et al. 1988) đã đặt nền móng cho các kiến trúc huấn luyện hiện đại.
7 Nguồn gốc của lan truyền ngược: Thuật toán này được Linnainmaa (1970) phát triển độc lập cho vi phân tự động của các chương trình máy tính và bởi Werbos (1974) trong một luận án tiến sĩ của Harvard về mô hình hóa kinh tế—hơn một thập kỷ trước khi Rumelhart et al. (1986) phổ biến nó cho mạng nơ-ron. Sự chậm trễ giữa việc phát triển và áp dụng rộng rãi lại tái diễn trong lịch sử hệ thống ML: cơ chế attention đã có trước transformer hàng thập kỷ, nhưng Transformer năm 2017 cho thấy các mô hình dùng nhiều attention có thể huấn luyện hiệu quả trên các hệ thống GPU đương đại; về sau, các cụm TPU và GPU cho phép triển khai ở quy mô lớn hơn nhiều. Pha lan truyền ngược của một framework duyệt đồ thị tính toán theo thứ tự topo ngược và áp dụng quy tắc chuỗi; các đồ thị con độc lập có thể bộc lộ công việc song song trong quá trình duyệt đó.
Linnainmaa, Seppo. 1970. “The Representation of the Cumulative Rounding Error of an Algorithm as a Taylor Expansion of the Local Rounding Errors.” Master's thesis, University of Helsinki.
Werbos, Paul. 1974. “Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences.” PhD thesis, Harvard University.
Rumelhart, David E., Geoffrey E. Hinton, and Ronald J. Williams. 1986. “Learning Representations by Back-Propagating Errors.” Nature 323 (6088): 533–36. https://doi.org/10.1038/323533a0.
8 BLAS (các chương trình con đại số tuyến tính cơ bản): Đặc tả BLAS ban đầu chuẩn hóa các phép toán vector có thể gọi từ Fortran và có thể tái sử dụng (Lawson et al. 1979); các phần mở rộng BLAS sau đó bổ sung các thủ tục ma trận–vector và ma trận–ma trận, hình thành hệ thống phân cấp Level 1, Level 2 và Level 3 quen thuộc (Dongarra et al. 1988). Trong huấn luyện, các phép toán Level 3 chiếm ưu thế chính vì cường độ tính toán cao của chúng—\(\mathcal{O}(n)\) FLOP/byte—giúp duy trì mức sử dụng tài nguyên tính toán cao. Các framework thường chuyển các phép nhân ma trận dày đặc sang các thư viện tối ưu như cuBLAS và oneDNN, hoặc dùng các kernel do trình biên dịch tạo ra.
Lawson, Charles L., Richard J. Hanson, David R. Kincaid, and Fred T. Krogh. 1979. “Basic Linear Algebra Subprograms for Fortran Usage.” ACM Transactions on Mathematical Software 5 (3): 308–23. https://doi.org/10.1145/355841.355847.
Dongarra, Jack J., Jeremy Du Croz, Sven Hammarling, and Richard J. Hanson. 1988. “An Extended Set of FORTRAN Basic Linear Algebra Subprograms.” ACM Transactions on Mathematical Software 14 (1): 1–17. https://doi.org/10.1145/42288.42291.
Các phép toán trong mạng nơ-ron
Lan truyền tiến, trong trường hợp đơn giản nhất, gồm hai thao tác: nhân ma trận và áp dụng hàm activation. Phép nhân ma trận thực hiện biến đổi tuyến tính tại mỗi lớp. Ở lớp \(\ell\), phép tính có thể được mô tả như sau (theo quy ước vector hàng được thiết lập trong Tính toán nơ-ron): \[ \mathbf{A}^{(\ell)} = f\left(\mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)}\right) \] trong đó:
- \(\mathbf{A}^{(\ell-1)}\) biểu thị các activation từ lớp trước (hoặc lớp đầu vào đối với lớp đầu tiên), với mỗi hàng là một mẫu trong batch,
- \(\mathbf{W}^{(\ell)} \in \mathbb{R}^{n_{\ell-1} \times n_\ell}\) là ma trận trọng số tại lớp \(\ell\), chứa các tham số mà mạng học được,
- \(\mathbf{b}^{(\ell)}\) là vector độ chệch (bias) cho lớp \(\ell\),
- \(f(\cdot)\) là hàm activation được áp dụng theo từng phần tử (ví dụ: ReLU, sigmoid) để đưa tính phi tuyến vào mô hình.
Các phép toán ma trận
Biểu diễn bằng phép nhân ma trận đã chỉ ra rằng quá trình lan truyền tiến thực chất rút gọn thành chuỗi các phép nhân ma trận, và Các nguyên thủy tính toán cốt lõi đã liệt kê các phép toán cơ bản mà mọi kiến trúc đều dùng, bao gồm: nhân ma trận tổng quát, tích chập và attention động. Khi huấn luyện, các mẫu hình này được phóng đại: mỗi phép toán không chỉ chạy một lần mà hàng tỷ lần, và mỗi lượt truyền tiến đi kèm một lượt truyền ngược, làm chi phí tính toán tăng gần gấp đôi. Hiểu rõ phép toán ma trận nào chiếm ưu thế — và kích thước của chúng thay đổi ra sao giữa lượt truyền tiến và truyền ngược — sẽ cho thấy vì sao các thiết kế hệ thống và tối ưu hóa cụ thể đã xuất hiện cho quá trình huấn luyện.
Sự thống trị của phép nhân ma trận đã thúc đẩy cả đổi mới về thuật toán lẫn phần cứng. Ban đầu, các hệ thống mạng nơ-ron dựa vào các thư viện đại số tuyến tính tiêu chuẩn chạy trên CPU, nhưng quy mô huấn luyện hiện đại đòi hỏi các tối ưu hóa chuyên biệt. Thuật toán Strassen9 đã giảm độ phức tạp \(\mathcal{O}(n^3)\) của phương pháp trực tiếp xuống xấp xỉ \(\mathcal{O}(n^{2.807})\) (Strassen 1969), và các thư viện tăng tốc phần cứng hiện đại như cuBLAS (NVIDIA 2024) tiếp tục đẩy giới hạn hiệu quả tính toán.
9 Thuật toán Strassen: Thuật toán này đạt độ phức tạp \(\mathcal{O}(n^{2.807})\) bằng cách thay một trong tám phép nhân con bằng các phép cộng, nhưng các hệ thống huấn luyện hiếm khi tận dụng được. Đệ quy làm gián đoạn các mẫu truy cập bộ nhớ đều đặn mà Tensor Cores khai thác, và các lỗi làm tròn tích lũy qua hàng tỷ vòng lặp huấn luyện có thể khiến quá trình hội tụ trở nên bất ổn. Trên thực tế, các thư viện nhân ma trận tổng quát phổ biến như cuBLAS thường để các phép nhân ma trận chủ đạo trong huấn luyện cho các kernel \(\mathcal{O}(n^3)\) dạng khối được tối ưu hóa cao, tận dụng phần cứng tốt hơn so với các biến thể Strassen đệ quy.
Strassen, Volker. 1969. “Gaussian Elimination Is Not Optimal.” Numerische Mathematik 13 (4): 354–56. https://doi.org/10.1007/bf02165411.
NVIDIA. 2024. cuBLAS: CUDA Basic Linear Algebra Subprograms.
Nhu cầu tính toán lớn này đã dẫn đến các tối ưu hóa ở cấp hệ thống: các phép tính ma trận dạng khối được song song hóa trên nhiều đơn vị, và các tầng phân cấp bộ nhớ được thiết kế phù hợp với cách truy cập dữ liệu ở cả truyền xuôi lẫn truyền ngược. Khi kiến trúc mạng nơ-ron phát triển, cả ma trận trọng số và activation đều phải luôn sẵn sàng cho lan truyền ngược, và phần cứng cũng tiến hóa để phục vụ các phép nhân dày đặc này trong giới hạn ngân sách bộ nhớ ngày càng tăng. Để minh họa cụ thể quy mô của các phép toán này, hãy xem xét các phép tính của lớp attention trong mô hình GPT-2 lighthouse của chúng ta.
Chỉ một lớp GPT-2 cũng đủ để minh họa rõ ràng quy mô của các phép tính này.
Napkin Math 1.1: Phép tính của lớp attention trong GPT-2
Mỗi lớp GPT-2 thực hiện các phép tính attention, qua đó cho thấy rõ nhu cầu về phép nhân ma trận dày đặc. Ví dụ, với một lớp transformer của GPT-2 (khi gộp tất cả các head) có kích thước batch \(B\) = 32, độ dài chuỗi \(S\) = 1024, và chiều ẩn \(d\) = 1600:
Phép chiếu Query, Key, Value (ba phép biến đổi tuyến tính tạo đầu vào cho attention—gồm 3 phép nhân ma trận riêng biệt): \[\begin{gather*} \text{FLOPs} = 2 \times 3 \times (B \times S \times d \times d) \\ = 2 \times 3 \times (32 \times 1024 \times 1600 \times 1600) \approx 503 \text{ billion FLOPs} \end{gather*}\] Các phép nhân ma trận trong Attention (\(\mathbf{Q}\mathbf{K}^\top\) và \(\mathbf{A}_{\text{attn}}\mathbf{V}\)): \[\begin{gather*} \text{FLOPs}_{QK} = 2 \times B \times N_{\text{heads}} \times S \times S \times d_{\text{head}} = 107.4 \text{ billion FLOPs} \\ \text{FLOPs}_{\text{Attn}\times V} = \text{FLOPs}_{QK};\quad \text{pair total} \approx 214.8 \text{ billion FLOPs} \end{gather*}\] Phép chiếu đầu ra (từ đầu ra attention \(\rightarrow\) chiều ẩn): \[ \text{FLOPs} = 2 \times B \times S \times d \times d \approx 168 \text{ billion FLOPs} \] Mạng truyền thẳng (hai phép biến đổi tuyến tính với hệ số mở rộng 4): \[ \text{FLOPs} \approx 16 \times B \times S \times d^2 \] Quy mô tính toán
- Tổng số phép tính truyền xuôi trên mỗi lớp (QKV 503 + attention 214.8 + phép chiếu đầu ra 168 + FFN): ~2228.01 GFLOP
- Với 48 lớp trong GPT-2: ~320.8 TFLOP cho mỗi bước huấn luyện
- Trong kịch bản minh họa với 50,000 steps bước huấn luyện: ~16041.7 PFLOP
Góc nhìn hệ thống: Một GPU V100 (đạt 125 TFLOP/s khi dùng Tensor Cores, và 15.7 TFLOP/s khi không dùng) sẽ cần 2.6 s để hoàn thành một bước huấn luyện attention cộng FFN theo ước tính mô hình, ở mức sử dụng 100% (đỉnh lý thuyết; thông lượng thực tế sẽ thấp hơn). Vì vậy, để đạt một bước huấn luyện 180 đến 220 ms, đây đã là một bài toán giới hạn dưới cần nhiều bộ tăng tốc: chỉ tính toán lý thuyết thôi đã cần khoảng 12 đến 15 V100, và các hệ thống thực tế còn cần thêm khoảng đệm cho tổn thất mức sử dụng, truyền thông và overhead của pipeline.
Việc đếm FLOP này không phải chuyện lý thuyết suông. Đây là phần tính toán cụ thể của “định luật sắt”, và chúng giải thích vì sao chi phí huấn luyện tăng theo một hàm có thể dự đoán dựa trên kiến trúc mô hình và độ dài chuỗi, chứ không phải một đặc tính ngẫu nhiên, khó lường.
Các phép toán ma trận-vector và theo batch
Không phải mọi phép toán trong mạng nơ-ron đều là nhân ma trận-ma trận lớn. Các lớp chuẩn hóa, phép cộng độ chệch (bias), và một số phép tính lặp nhất định lại là các phép toán ma trận-vector. Dù đơn giản hơn về mặt tính toán so với nhân ma trận-ma trận, những phép toán này đặt ra thách thức riêng cho hệ thống: chúng tận dụng phần cứng kém hiệu quả do khả năng song song hóa hạn chế. Một vector đơn lẻ không tạo đủ việc để giữ hàng nghìn lõi của bộ tăng tốc bận rộn cùng lúc. Đặc điểm này ảnh hưởng đến cả thiết kế phần cứng lẫn quyết định về kiến trúc mô hình, đặc biệt trong các mạng xử lý đầu vào tuần tự hoặc tính thống kê của lớp.
Nhận ra những hạn chế của các phép toán ma trận-vector, việc giới thiệu batching đã thay đổi cách tính toán ma trận trong mạng nơ-ron. Bằng cách xử lý nhiều đầu vào cùng lúc, các hệ thống huấn luyện chuyển các phép toán ma trận-vector thành các phép toán ma trận-ma trận hiệu quả hơn. Cách tiếp cận này cải thiện mức tận dụng phần cứng nhưng làm tăng nhu cầu bộ nhớ để lưu trữ kết quả trung gian. Các triển khai hiện đại phải cân bằng kích thước batch với bộ nhớ khả dụng, từ đó dẫn đến các tối ưu hóa cụ thể trong quản lý bộ nhớ và lập lịch tính toán.
Việc chuyển từ các phép toán ma trận-vector sang các phép toán ma trận-ma trận theo batch giúp giải thích các lựa chọn thiết kế phần cứng trong các bộ tăng tốc hiện đại. TPU đầu tiên của Google, vốn được thiết kế cho suy luận, đã tích hợp một đơn vị ma trận chuyên biệt cùng hệ thống phân cấp bộ nhớ để xử lý các phép toán ma trận dày đặc (Jouppi et al. 2017). Ở một quy mô lớn hơn, quá trình huấn luyện GPT-3 đã dùng các bộ tăng tốc phân tán để thực thi các mẫu nhân ma trận-ma trận xuất hiện khi sử dụng các batch lớn (Brown et al. 2020).
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Systems Perspective 1.2: Tại sao GPU thống trị huấn luyện
Các phép toán ma trận được mô tả trong section 1.2.1.2 giải thích trực tiếp kiến trúc phần cứng dùng để huấn luyện tại các trung tâm dữ liệu. GPU đã trở thành trung tâm của huấn luyện quy mô lớn vì ba lý do sau:
- Các phép tính độc lập của từng phần tử trong phép nhân ma trận rất phù hợp để tận dụng hàng nghìn lõi GPU (ví dụ, NVIDIA A100 có 6,912 lõi CUDA).
- Các đơn vị phần cứng chuyên biệt như Tensor Cores mang lại thông lượng đỉnh cao hơn đáng kể cho các phép toán ma trận độ chính xác thấp mà chúng hỗ trợ.
- Các mẫu tính toán ma trận theo khối giúp tận dụng hiệu quả hệ thống phân cấp bộ nhớ của GPU (gồm cache L1/L2, bộ nhớ chia sẻ và bộ nhớ toàn cục).
Khi một kịch bản GPT-2 minh họa sau này giả định mức tăng tốc 2.4\(\times\) trên V100 với độ chính xác hỗn hợp, thì việc Tensor Cores tăng tốc các phép nhân ma trận đủ điều kiện là một nguồn đóng góp. Tỷ lệ đầu-cuối đạt được còn phụ thuộc vào các phép toán không phải ma trận, lưu lượng bộ nhớ, cũng như chi phí nhập liệu và giao tiếp.
Các phép nhân ma trận chiếm phần lớn chi phí tính toán khi huấn luyện, nhưng mạng nơ-ron cần nhiều hơn các biến đổi tuyến tính. Xen giữa các phép toán ma trận của mỗi lớp, các hàm activation đưa vào tính phi tuyến, giúp mạng học được các mẫu phức tạp. Dù trông đơn giản hơn so với phép nhân ma trận, cách triển khai của các hàm này vẫn có thể ảnh hưởng đáng kể đến hiệu quả huấn luyện khi mở rộng quy mô.
Các hàm activation
Các hàm activation như sigmoid, tanh, ReLU và softmax đưa vào tính phi tuyến, đồng thời đặc tính triển khai của chúng cũng định hình hiệu năng hệ thống huấn luyện. Từ góc độ hệ thống, lựa chọn hàm activation quyết định chi phí tính toán, mức tận dụng phần cứng và mẫu truy cập bộ nhớ trong quá trình lan truyền ngược.
Câu hỏi cốt lõi với kỹ sư hệ thống ML không phải là các hàm này làm gì về mặt toán học, mà là chi phí của chúng thay đổi thế nào khi mở rộng. Các benchmark và đánh đổi dưới đây hướng đến một luận điểm hệ thống. Vì các activation theo từng phần tử di chuyển nhiều byte dữ liệu hơn là thực hiện phép tính, kernel của chúng thường bị giới hạn bởi băng thông bộ nhớ hơn là bởi năng lực tính toán số học. Do đó, những khác biệt theo từng phép dưới đây ít quan trọng hơn so với mức độ mà các con số ban đầu gợi ra.
Chi phí của các activation có thể tích lũy qua nhiều phần tử và lớp, nhưng mức đóng góp của chúng vào tổng thời gian phụ thuộc vào hình dạng tensor, việc hợp nhất (fusion), cách triển khai, độ chính xác và phần cứng. Figure 1 lưu lại một ảnh chụp thời gian minh họa trên Apple M2 trong quá trình phát triển chương này. Cấu hình benchmark khi đo không được ghi lại, nên các giá trị đó không nên coi là bằng chứng có thể tái lập hay áp dụng sang hệ thống khác. Trên các bộ tăng tốc, kernel của activation thường bị giới hạn bởi lưu lượng truy cập bộ nhớ, ranh giới hợp nhất và thông lượng của các hàm chuyên biệt hơn là bởi độ trễ lệnh CPU vô hướng. Cùng một activation có thể chạy như một kernel độc lập, được hợp nhất với toán tử kế cận, hoặc dùng một phép xấp xỉ do trình biên dịch chọn. Vì vậy, thời gian đo theo từng phép riêng lẻ không thể dự đoán chi phí của nó bên trong một bước huấn luyện đã biên dịch.

Các bộ tăng tốc hiện đại có thể triển khai các hàm này bằng lệnh gốc, xấp xỉ đa thức, tra cứu hoặc các kernel hợp nhất. ReLU chỉ cần một phép so ngưỡng đơn giản, trong khi các biểu thức chính xác của sigmoid, tanh và Gaussian Error Linear Unit (GELU) đòi hỏi nhiều phép toán số học hơn hoặc hỗ trợ hàm đặc biệt. Khác biệt về độ trễ thực tế còn tùy yếu tố đang giới hạn: tính toán số học, lưu lượng bộ nhớ hay chi phí khởi chạy. ReLU có thể tạo ra các giá trị 0 để hệ thống phía sau tận dụng, nhưng mức độ thưa phụ thuộc vào phân phối activation và mô hình đã huấn luyện. Softmax10 thêm bước gộp giảm và chuẩn hóa theo trục được chọn. Những phụ thuộc này cần sự phối hợp, dù các triển khai tối ưu hóa vẫn có tính song song cao.
10 Softmax: Để tính toán softmax ổn định về số học, cần thực hiện lấy giá trị lớn nhất, lũy thừa, gộp tổng và chuẩn hóa theo trục đã chọn. Các kernel song song hiện thực hóa các giai đoạn này bằng các phép giảm được phối hợp. FlashAttention tái cấu trúc phép tính attention lớn hơn để duy trì thống kê softmax trong khi các tile vẫn nằm gần các đơn vị tính toán.
Table 3 tóm tắt cách các hành vi này chuyển thành các ràng buộc hệ thống.
| Chức năng | Ưu điểm chính | Nhược điểm chính | Hàm ý hệ thống |
|---|---|---|---|
| Sigmoid | Mượt mà; đầu ra bị chặn trong \((0, 1)\). | Độ dốc bão hòa ở các độ lớn lớn; đầu ra không tập trung vào 0. | Sử dụng các kernel hàm mũ hoặc xấp xỉ mà chi phí của chúng phụ thuộc vào mục tiêu. |
| Tanh | Mượt mà; đầu ra tập trung vào 0 trong \((-1, 1)\). | Độ dốc bão hòa ở các độ lớn lớn. | Sử dụng các kernel hàm đặc biệt hoặc xấp xỉ có cấu trúc tương tự sigmoid. |
| ReLU | Thao tác ngưỡng đơn giản; không bão hòa đối với đầu vào dương. | Có thể tạo ra các đơn vị không hoạt động liên tục. | Thường không tốn kém và có thể kết hợp; độ thưa thớt có thể khai thác phụ thuộc vào hỗ trợ hạ nguồn. |
| Softmax | Tạo ra một phân phối được chuẩn hóa trên một trục. | Yêu cầu các phép giảm và phối hợp giữa các phần tử. | Các triển khai song song phối hợp các giai đoạn tìm giá trị lớn nhất, tổng và chuẩn hóa. |
ReLU vẫn phổ biến vì đơn giản và hiệu quả, trong khi softmax rất cần thiết khi một mô hình phải chuẩn hóa điểm thành xác suất. GPT-2 minh họa một lựa chọn khác qua GELU, tức Gaussian Error Linear Unit.
Systems Perspective 1.3: Lựa chọn activation GELU
Ngoài các hàm activation nền tảng đã được đề cập trong Tính toán nơ-ron (Sigmoid, Tanh, ReLU), các kiến trúc hiện đại ngày càng dùng những lựa chọn mượt hơn. GPT-2 sử dụng activation GELU (Radford et al. 2019), Gaussian Error Linear Unit do Hendrycks and Gimpel (2016) giới thiệu và thường được triển khai bằng phép xấp xỉ dựa trên tanh phổ biến trong công thức đó. Định nghĩa chính xác của nó là: \[
\text{GELU}(x) = x \cdot \Phi(x) = x \cdot \frac{1}{2}\left[1 + \text{erf}\left(\frac{x}{\sqrt{2}}\right)\right]
\] trong đó \(\Phi(x)\) là hàm phân phối tích lũy của phân phối chuẩn tắc.
GELU áp dụng cơ chế scaling mượt và phụ thuộc vào đầu vào, thay vì ngưỡng cứng như ReLU. Nó là hàm xác định, dù được biểu diễn thông qua hàm phân phối tích lũy Gaussian. Việc GELU có cải thiện chất lượng mô hình so với một activation khác hay không là đặc tính thực nghiệm của kiến trúc và quy trình huấn luyện, không phải là một đảm bảo chung.
GELU chính xác dùng erf, còn các triển khai phổ biến dùng phép xấp xỉ dựa trên tanh như listing 1. Phép xấp xỉ này làm thay đổi chi phí tính toán và tạo ra một sai khác số học nhỏ so với hàm chính xác. Tác động tổng thể phụ thuộc vào việc hợp nhất (fusion), kích thước tensor, độ chính xác, cách triển khai kernel và tỷ lệ thời gian runtime dành cho các kernel activation, nên không có tỷ lệ GELU-to-ReLU cố định nào áp dụng cho mọi hệ thống.
Hendrycks, Dan, and Kevin Gimpel. 2016. “Gaussian Error Linear Units (GELUs).” arXiv Preprint arXiv:1606.08415.
# Fast GELU approximation used in production systems
# Avoids expensive erf() computation while
# preserving activation properties
gelu_approx = (
    0.5 * x * (1 + tanh(sqrt(2 / pi) * (x + 0.044715 * x**3)))
)
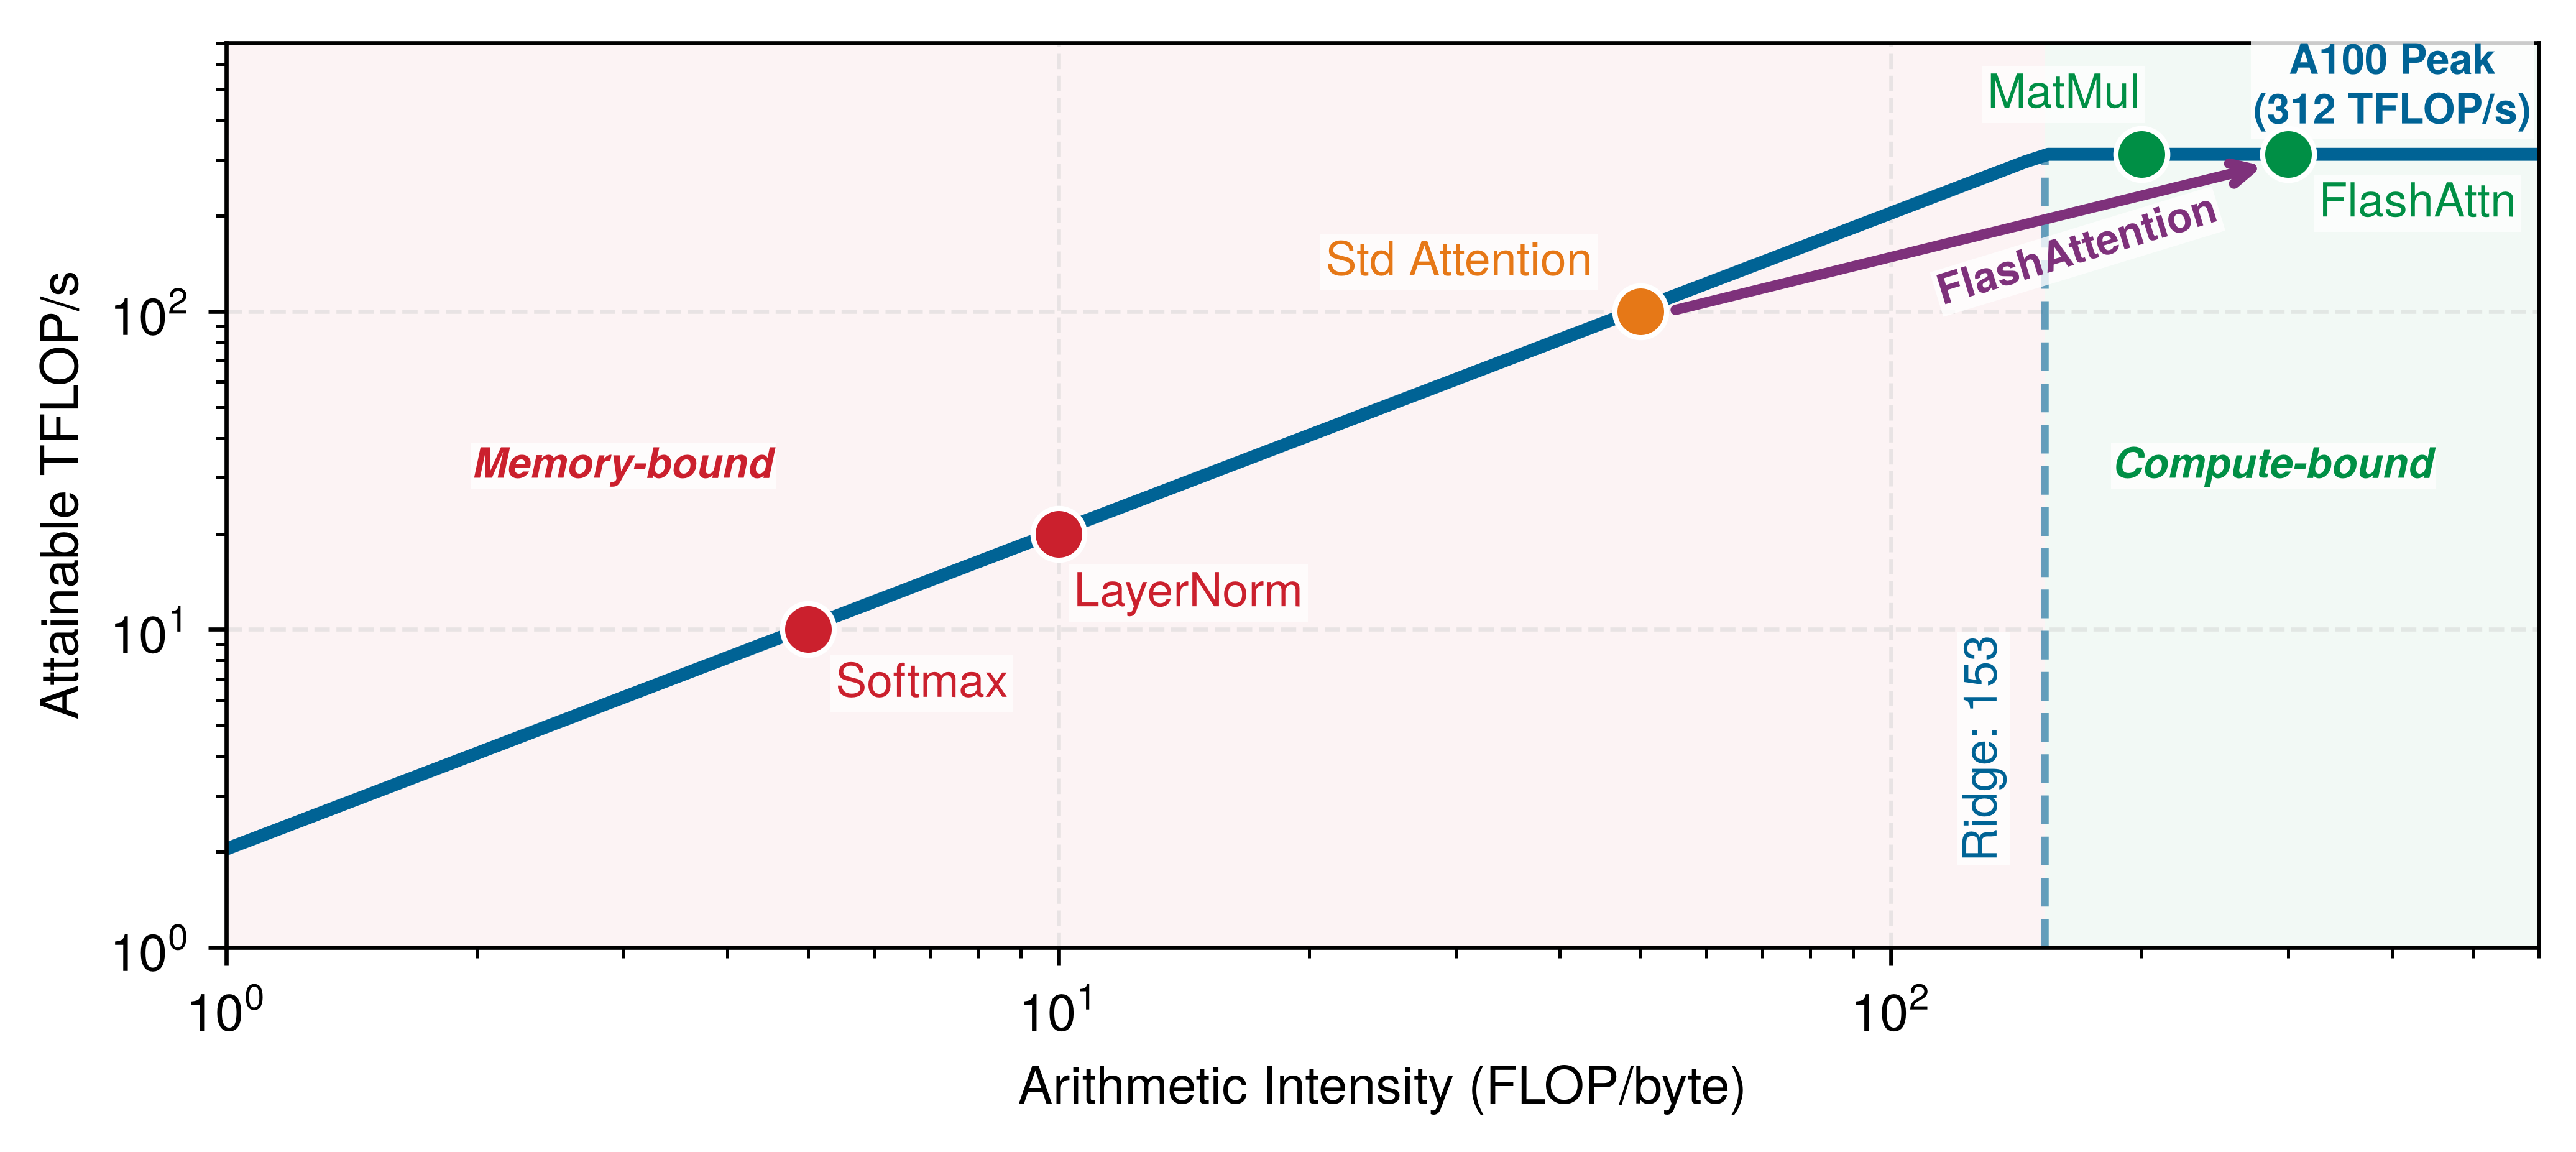
Phép xấp xỉ GELU cho thấy một bức tranh rộng hơn: chi phí tính toán không phải lúc nào cũng là mối quan tâm hàng đầu. Với các hàm activation, nút thắt cổ chai thực sự thường là băng thông bộ nhớ chứ không phải các phép toán. Sự phân biệt giữa phép toán bị giới hạn bởi tính toán (compute-bound) và bị giới hạn bởi bộ nhớ (memory-bound) ảnh hưởng trực tiếp đến ưu tiên tối ưu hóa và sẽ lặp lại xuyên suốt phần phân tích các nút thắt cổ chai khi huấn luyện.
Nhân ma trận dày đặc có thể tái sử dụng các toán hạng qua nhiều phép nhân-tích lũy, trong khi một activation elementwise không được hợp nhất (unfused) thường làm rất ít việc cho mỗi giá trị đọc và ghi. Khoảng cách về cường độ tính toán này thường khiến các kernel activation đơn lẻ nhạy với băng thông bộ nhớ. Hợp nhất (fusion) có thể loại bỏ lưu lượng bộ nhớ trung gian, và thông lượng của các hàm đặc biệt vẫn quan trọng đối với những kernel mà phép toán của chúng không được che giấu hoàn toàn. Vì vậy, thay một activation bằng activation khác không tạo ra tác động cố định lên thời gian thực (wall-clock time).
Systems Perspective 1.4: Nút thắt cổ chai về băng thông bộ nhớ
Các activation function cho thấy một nguyên lý hệ thống quan trọng: không phải mọi phép toán đều bị ràng buộc bởi tính toán. Trong khi phép nhân ma trận có thể làm bão hòa các đơn vị tính toán của bộ tăng tốc, activation function thường trở nên bị giới hạn bởi băng thông bộ nhớ vì ba lý do:
- Các phép toán elementwise thực hiện rất ít phép tính cho mỗi lần truy cập bộ nhớ; ví dụ, ReLU chỉ thực hiện một phép trên mỗi lần tải dữ liệu.
- Các phép toán đơn giản thường hoàn thành nhanh hơn thời gian truyền dữ liệu từ bộ nhớ, nên lợi ích của xử lý song song bị hạn chế.
- Khả năng tính toán của bộ tăng tốc đã tăng nhanh hơn băng thông bộ nhớ ngoài, làm tăng áp lực phải tái sử dụng dữ liệu gần các đơn vị tính toán.
Đó là lý do tại sao chỉ riêng số phép toán vô hướng không thể dự đoán được độ trễ của kernel của activation. Khi xác định liệu băng thông bộ nhớ có giới hạn thông lượng hay không, lượt truyền xuôi phải tính đến cả việc hợp nhất, lưu trữ activation, cũng như chi phí đánh giá hàm.
Các phép toán trong lượt truyền xuôi cùng với đặc điểm tính toán của chúng tạo nên khối lượng công việc (workload) mà các hệ thống huấn luyện cần xử lý: phép nhân ma trận chiếm phần lớn FLOPS, còn các activation function bị giới hạn bởi băng thông bộ nhớ. Tuy nhiên, một mạng nơ-ron chỉ thực hiện dự đoán thì không học được gì cả. Quá trình huấn luyện đòi hỏi cập nhật các tham số của mô hình để các dự đoán sau này chính xác hơn. Lượt truyền xuôi tạo ra một giá trị mất mát (loss value) cho biết mức độ sai lệch của các dự đoán hiện tại; câu hỏi lúc này chuyển từ bao nhiêu chi phí tính toán sang cách sử dụng kết quả đó để cải thiện.
Các thuật toán tối ưu hóa
Các thuật toán tối ưu hóa, dựa trên giá trị mất mát và thông tin gradient mà nó tạo ra, xác định mỗi tham số cần thay đổi thế nào để giảm lỗi trong tương lai. Các thuật toán này điều khiển quỹ đạo học tập, biến gradient thành cập nhật tham số để đưa mô hình tới hiệu suất tốt hơn, và lựa chọn chúng có tác động trực tiếp tới hiệu quả tính toán, yêu cầu bộ nhớ và khả năng mở rộng ở cấp hệ thống. Trọng tâm ở đây là bản thân các thuật toán trong quá trình huấn luyện: chúng dùng gradient ra sao, giữ lại bao nhiêu trạng thái, và cách các quy tắc cập nhật tương tác với ngân sách phần cứng (hardware budget).
Các phương pháp tối ưu hóa dựa trên gradient
Các thuật toán cập nhật tham số giới thiệu gradient descent như thuật toán tối ưu cơ bản: lặp dần điều chỉnh các tham số theo hướng dốc nhất. Nền tảng khái niệm này giả định các mạng nơ-ron nhỏ gọn chạy trên một thiết bị duy nhất. Ở quy mô phần cứng lớn, gradient descent và các biến thể của nó phải tương tác với những ràng buộc vật lý thực tế. Phép toán tưởng chừng gọn gàng để chỉnh các trọng số lại trở thành một bài toán hệ thống đáng kể khi mô hình có hàng tỷ tham số và dữ liệu huấn luyện đạt tới hàng terabyte.
Gradient descent
Gradient descent là nền tảng toán học của việc huấn luyện mạng nơ-ron, lặp dần điều chỉnh tham số để tối thiểu hóa một hàm mất mát. Trong các hệ thống huấn luyện, phép toán này được chuyển thành những mẫu tính toán cụ thể. Mỗi vòng lặp, hệ thống phải thực hiện bốn thao tác phụ thuộc:
- Tính các activation ở lượt truyền xuôi
- Tính giá trị hàm mất mát
- Tính gradient thông qua lan truyền ngược
- Cập nhật tham số bằng các giá trị gradient
Nhu cầu tính toán của gradient descent tăng theo cả kích thước mô hình và kích thước tập dữ liệu. Để tính gradient, hệ thống phải lưu các activation trung gian trong lượt truyền xuôi để phục vụ lan truyền ngược. Lượng bộ nhớ các activation này tiêu thụ tỉ lệ thuận với độ sâu của mạng và số lượng ví dụ đang được xử lý.
Phương pháp gradient descent truyền thống xử lý toàn bộ tập dữ liệu trước mỗi lần cập nhật tham số. Chẳng hạn, với một tập huấn luyện có một triệu ví dụ, hệ thống phải tính gradient tổng hợp trên tất cả các ví dụ đó rồi mới thực hiện một bước. Gọi \(D\) là số lượng ví dụ trong tập dữ liệu huấn luyện, \(B_{\text{micro}}\) là số ví dụ cư trú trong một lượt truyền xuôi/ngược, và \(T_{\text{forward+backward per example}}\) là thời gian bình quân cho lượt truyền xuôi/ngược trên mỗi ví dụ dưới chế độ thực thi micro-batch đã chọn. Kỹ thuật tích lũy gradient (gradient accumulation) kết hợp nhiều micro-batch thành một batch hiệu quả lớn hơn. Mối quan hệ về bộ nhớ đỉnh trong equation 2 và mối quan hệ về thời gian mỗi bước trong equation 3 thể hiện rõ khác biệt về cách triển khai: \[ \text{Peak Activation Memory} \propto B_{\text{micro}} \times \text{Activation Memory per Example} \tag{2}\] \[ T_{\text{step}} \propto D \times T_{\text{forward+backward per example}} \tag{3}\]
Chi phí bộ nhớ thực sự của huấn luyện trình bày chi tiết phân tích này bằng cách dẫn xuất phương trình đầy đủ cho bộ nhớ huấn luyện, bao gồm cả chi phí cho trạng thái của optimizer. Huấn luyện full-batch không nhất thiết phải lưu đồng thời activation của mọi ví dụ nếu tập dữ liệu được truyền theo luồng hoặc chia thành các micro-batch; bộ nhớ đỉnh do số ví dụ đồng thời giữ trong bộ nhớ quyết định. Bài toán hệ thống vẫn rất nghiêm trọng: xử lý \(D=1{,}000{,}000\) ví dụ trước mỗi lần cập nhật tạo ra các vòng lặp phải xử lý đến hàng triệu ví dụ, làm giảm tốc độ mô hình học từ dữ liệu.
Các biến thể thân thiện với phần cứng nới lỏng yêu cầu phải có gradient chính xác trên toàn bộ tập dữ liệu ở mỗi lần cập nhật. Cụ thể, stochastic gradient descent (SGD)11 ước tính gradient từ các ví dụ được lấy mẫu hoặc các mini-batch thay vì từ toàn bộ tập dữ liệu. Cách làm này làm thay đổi tần suất cập nhật và phương sai của gradient, đồng thời cho phép mỗi lần cập nhật chỉ hoạt động trên một tập làm việc có kích thước giới hạn.
11 Stochastic gradient descent: “Stochastic” từ tiếng Hy Lạp stochastikos (“có thể đoán”); thay vì chờ gradient chính xác trên toàn bộ tập dữ liệu, SGD cập nhật từ các ví dụ được lấy mẫu hoặc các mini-batch. Cả phương pháp full-batch và stochastic đều có thể truyền dữ liệu qua các micro-batch có kích thước giới hạn, nên bộ nhớ activation đỉnh của chúng do micro-batch đang cư trú quyết định, không chỉ phụ thuộc vào kích thước tập dữ liệu. Khác biệt trung tâm giữa chúng là có bao nhiêu gradient được lấy mẫu đóng góp vào mỗi lần cập nhật tham số.
Tuy nhiên, xử lý từng ví dụ đơn lẻ tạo ra những thách thức hệ thống mới. Các bộ tăng tốc hiện đại đạt hiệu năng cao nhờ tính toán song song, xử lý đồng thời nhiều phần tử dữ liệu. Cập nhật theo từng ví dụ khiến phần lớn tài nguyên tính toán nhàn rỗi, dẫn đến hiệu quả sử dụng phần cứng thấp. Việc cập nhật tham số thường xuyên cũng làm tăng yêu cầu băng thông bộ nhớ, vì các trọng số phải được đọc và ghi cho từng ví dụ thay vì dàn đều các thao tác này trên nhiều ví dụ.
Xử lý mini-batch
Mini-batch gradient descent là một thỏa hiệp thực tế giữa full-batch và stochastic, một kiểu đồng thiết kế thuật toán-phần cứng tính gradient trên các batch nhỏ gồm nhiều ví dụ, phù hợp với kiến trúc của các bộ tăng tốc hiện đại (Dean et al. 2012). Kích thước batch \(B\) là một tham số hệ thống then chốt, ảnh hưởng đến cả hiệu quả tính toán và yêu cầu bộ nhớ.
Dean, Jeffrey, Greg Corrado, Rajat Monga, Kai Chen, Matthieu Devin, Quoc V. Le, Mark Z. Mao, et al. 2012. “Large Scale Distributed Deep Networks.” In Advances in Neural Information Processing Systems (NeurIPS), edited by Peter L. Bartlett, Fernando C. N. Pereira, Christopher J. C. Burges, Léon Bottou, and Kilian Q. Weinberger, vol. 25. Curran Associates.
Definition 1.3: Xử lý batch
Xử lý batch gom nhiều ví dụ huấn luyện vào các phép toán tensor, giúp phân bổ chi phí cố định cho mỗi bước trên \(B\) ví dụ và có thể bộc lộ nhiều công việc song song hơn. Tăng \(B\) có thể cải thiện occupancy và arithmetic intensity, nhưng không đảm bảo mọi phép toán đều trở thành compute bound.
- Ý nghĩa: Thông lượng thường tăng theo kích thước batch cho đến khi phần cứng được sử dụng đủ mức mục tiêu, trong khi số lượng và chất lượng các cập nhật cần để hội tụ lại đi theo một đường cong khác, phụ thuộc vào khối lượng công việc (workload). Goyal và cộng sự đã trình diễn một công thức huấn luyện ResNet-50 trên ImageNet với \(B=8{,}192\) bằng cách dùng quy tắc điều chỉnh tốc độ học tuyến tính và warmup (Goyal et al. 2017). Kết quả đó chỉ là một minh họa cho cấu hình cụ thể, không phải một kích thước batch tới hạn áp dụng cho mọi trường hợp.
- Điểm khác biệt: Một cập nhật mini-batch lấy trung bình gradient trên \(B\) ví dụ. Với các mẫu độc lập và có phân phối tương tự, độ lệch chuẩn của trung bình này giảm xấp xỉ theo \(1/\sqrt{B}\). Cập nhật này xử lý nhiều dữ liệu hơn so với cập nhật từng ví dụ, nên lượng dữ liệu di chuyển và thời gian của nó phụ thuộc vào mức độ tái sử dụng, cách triển khai, và việc kích thước batch thay đổi số lượng cập nhật cần thiết như thế nào.
- Sai lầm phổ biến: Nhiều người cho rằng quy tắc điều chỉnh tốc độ học tuyến tính (nhân \(\eta\) với \(B/B_0\)) luôn hiệu quả ở mọi kích thước batch. Thực tế, đây là một công thức huấn luyện thường cần warmup và xác thực thực nghiệm, và phạm vi hữu ích của nó phụ thuộc vào mô hình, dữ liệu, optimizer, và độ chính xác mục tiêu.
Mối quan hệ giữa kích thước batch và hiệu suất hệ thống cho thấy các đánh đổi giữa phần cứng và phần mềm. Phân rã trong equation 4 tách phần bộ nhớ cố định cho tham số và gradient khỏi một thành phần activation phụ thuộc vào batch: \[ \text{Memory Required} = \text{Parameter Memory} + \text{Gradient Memory} + B \times \text{Activation Memory} \tag{4}\]
Vì thành phần activation tỷ lệ theo \(B\) trong khi bộ nhớ dành cho tham số và gradient giữ nguyên, nên nếu tăng gấp đôi kích thước batch thì tập làm việc của activation cũng tăng gấp đôi. Do đó, một mô hình chạy thoải mái với batch nhỏ có thể làm cạn 40–80 GB HBM trên một bộ tăng tốc huấn luyện cao cấp khi tăng kích thước batch. Section 1.3.3.2 phân tích ngân sách bộ nhớ này theo từng lớp cho
Các batch lớn hơn có thể giúp tính toán hiệu quả hơn nhờ tăng mức độ song song và cải thiện mẫu truy cập bộ nhớ. Hiệu quả sử dụng bộ tăng tốc thể hiện rõ sự đánh đổi này: các batch lớn hơn thường phơi bày nhiều công việc song song hơn cho bộ tăng tốc, trong khi các batch rất nhỏ có thể khiến các đơn vị tính toán không được lấp đầy. Các quy tắc điều chỉnh tuyến tính cho huấn luyện batch lớn (điều chỉnh tốc độ học tỷ lệ thuận với mức tăng kích thước batch) có thể giúp duy trì tốc độ hội tụ trong một phạm vi đã được kiểm chứng thực nghiệm (Goyal et al. 2017).
Điều này cho thấy một chủ đề trung tâm trong các hệ thống huấn luyện: sự đánh đổi giữa giới hạn bộ nhớ và hiệu suất tính toán trên trục phần cứng-phần mềm. Các hệ thống huấn luyện phải chọn kích thước batch để tối đa hóa việc sử dụng phần cứng nhưng vẫn nằm trong giới hạn bộ nhớ. Lựa chọn tối ưu thường đòi hỏi tích lũy gradient khi giới hạn bộ nhớ không cho phép dùng các batch lớn một cách hiệu quả, chấp nhận xử lý tuần tự các micro-batch và một phần chi phí bổ sung để đạt cùng kích thước batch hiệu quả.
Các optimizer thích nghi và dựa trên động lượng
SGD cơ bản áp dụng một tốc độ học cho mọi tham số, điều này có thể làm việc tối ưu hóa trở nên khó khăn khi thang của gradient khác nhau đáng kể giữa các chiều. Momentum làm mượt các cập nhật bằng lịch sử gradient, RMSprop điều chỉnh kích thước bước theo từng tham số, và Adam kết hợp theo dõi moment thứ nhất với điều chỉnh tỷ lệ thích nghi (Kingma and Ba 2015). Các phương pháp này tiêu thụ gradient do lan truyền ngược tính ra; chúng không quyết định các gradient đó có đúng hay không. Hành vi hội tụ của chúng phụ thuộc vào mô hình và công thức huấn luyện, trong khi trạng thái bổ sung mà chúng duy trì tạo ra chi phí bộ nhớ và tính toán cụ thể.
Kingma, Diederik P., and Jimmy Ba. 2015. “Adam: A Method for Stochastic Optimization.” 3rd International Conference on Learning Representations (ICLR).
Các phương pháp dựa trên động lượng
Các phương pháp Momentum12 giải quyết vấn đề dao động của SGD bằng cách tích lũy một vector vận tốc qua nhiều vòng lặp, làm mượt các hướng gradient nhiễu. Từ góc độ hệ thống, việc làm mượt này có giá: hệ thống huấn luyện phải duy trì một vector vận tốc có cùng số chiều với vector tham số. Vì vậy, tổng dung lượng lưu trữ cho tham số cộng với trạng thái phụ trợ này sẽ gấp đôi dung lượng dành cho tham số, chưa kể đến gradient và activation.
12 Momentum: Thuật ngữ này được mượn từ vật lý, nơi động lượng (khối lượng \(\times\) vận tốc) mô tả xu hướng một vật thể tiếp tục chuyển động. Sự tương đồng này giải thích cho thiết kế này, vì vận tốc tích lũy giúp làm mượt các gradient nhiễu và có thể giảm số vòng lặp cần để hội tụ. Về mặt hệ thống, chi phí là một giá trị vận tốc bổ sung cho mỗi tham số, trong khi Adam duy trì hai giá trị moment cho mỗi tham số.
Các phương pháp tốc độ học thích nghi
Trong khi momentum làm mượt hướng của gradient, nó không xử lý được sự khác nhau về độ lớn gradient giữa các tham số. RMSprop13 khắc phục điều này bằng cách duy trì trung bình động của bình phương gradient cho từng tham số, nhờ đó tự động giảm kích thước bước cho các tham số có lịch sử gradient lớn. Việc thích nghi theo từng tham số này đòi hỏi lưu trữ trung bình động \(s_t\), tạo ra chi phí bộ nhớ tương tự như các phương pháp dùng momentum. Các phép toán theo phần tử trong RMSprop cũng bổ sung thêm bước tính toán so với gradient descent cơ bản.
13 RMSprop: Được Geoffrey Hinton đề xuất trong Bài giảng 6e của khóa Coursera năm 2012 của ông—chưa từng được công bố trên một bài báo bình duyệt—khiến nó có lẽ là optimizer có ảnh hưởng nhất được phổ biến qua một bộ slide. RMSprop chia tốc độ học cho trung bình động của độ lớn gradient gần đây, từ đó điều chỉnh kích thước bước theo từng tham số. Cơ chế thích nghi theo từng tham số này được Adam kế thừa thành moment thứ hai \(v_t\), góp phần trực tiếp vào chi phí bộ nhớ 3\(\times\) của Adam được mô tả trong section 1.2.2.3.
Tối ưu hóa Adam
Adam14 kết hợp lợi ích của cả momentum và RMSprop: momentum làm mượt gradient để giảm nhiễu trong cập nhật, còn RMSprop tự điều chỉnh bước theo từng tham số. Khi dùng Adam, ta duy trì hai giá trị trung bình động cho mỗi tham số. Cụ thể, \(m_t\) và \(v_t\) là các bộ đệm moment thứ nhất và thứ hai; \(\beta_1\) và \(\beta_2\) là các hệ số suy giảm tương ứng; và \(\epsilon\) là hằng số ổn định số học ở mẫu số: \[\begin{gather*} m_t = \beta_1 m_{t-1} + (1-\beta_1)\nabla \mathcal{L}(\theta_t) \\[0.5ex] v_t = \beta_2 v_{t-1} + (1-\beta_2)\big(\nabla \mathcal{L}(\theta_t)\big)^2 \\[0.5ex] \hat{m}_t = \frac{m_t}{1-\beta_1^t}, \qquad \hat{v}_t = \frac{v_t}{1-\beta_2^t} \\[0.5ex] \theta_{t+1} = \theta_t - \eta \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon} \end{gather*}\]
14 Adam (adaptive moment estimation): Hai trung bình động này là moment thứ nhất (momentum) và moment thứ hai (phương sai không chuẩn hóa) của các gradient, được lưu cho từng tham số của mô hình. Với một mô hình 7B, chỉ riêng các tensor moment FP32 của Adam đã tốn 56 GB. Toàn bộ trạng thái huấn luyện mixed-precision chuẩn (trước khi tính toán các activation) là 112 GB nếu tính cả các trọng số FP16, gradient FP16, trọng số chính FP32 và các moment Adam.
Adam có tác động đến hệ thống lớn hơn các phương pháp trước. optimizer phải lưu thêm hai vector (\(m_t\) và \(v_t\)) cho mỗi tham số, khiến tổng dung lượng tham số cộng trạng thái của optimizer tăng gấp ba. Ví dụ, với một mô hình có 100 triệu tham số, chỉ riêng các vector phụ trợ này đã tiêu tốn thêm 800 MB bộ nhớ, chưa kể dung lượng lưu trữ trọng số.
Tác động hệ thống của thuật toán tối ưu hóa
Việc lựa chọn thuật toán tối ưu hóa tạo ra các kiểu tính toán và truy cập bộ nhớ đặc thù, ảnh hưởng đến hiệu quả huấn luyện. Bộ nhớ phụ trợ mà optimizer cần dùng tăng dần từ SGD (không có trạng thái phụ trợ) qua Momentum (một vector vận tốc) đến Adam (hai vector moment), như được định lượng trong table 4. Những chi phí bộ nhớ này cần được cân nhắc với lợi ích về khả năng hội tụ15. Adam có thể cần ít vòng lặp hơn cho một số khối lượng công việc (workload), nhưng chi phí bộ nhớ và tính toán trên mỗi vòng lặp có thể làm giảm tốc độ huấn luyện trên các hệ thống hạn chế bộ nhớ. Ở quy mô GPT-2, chi phí này trở thành một ràng buộc bộ nhớ bậc nhất.
15 Hội tụ: Một lần chạy đạt tiêu chí dừng khi chỉ số huấn luyện hoặc kiểm định không còn cải thiện đủ để biện minh cho việc tiếp tục. Số bước cần thiết phụ thuộc vào mô hình, dữ liệu, optimizer, lịch, kích thước batch và chất lượng mục tiêu. Ít bước hơn có thể giảm thời gian thực tế và chi phí, nhưng các optimizer thích nghi bổ sung trạng thái; bộ nhớ và lưu lượng dữ liệu của trạng thái này phải được tính vào ngân sách hệ thống.
| Thuộc tính | SGD | Momentum | RMSprop | Adam |
|---|---|---|---|---|
| Chi phí bộ nhớ | Không có | Các số hạng vận tốc | Độ dốc bình phương | Cả vận tốc và độ dốc bình phương |
| Tham số + trạng thái optimizer | 1\(\times\) | 2\(\times\) | 2\(\times\) | 3\(\times\) |
| Truy cập trạng thái dày đặc | Tham số và độ dốc | Thêm vận tốc | Thêm trạng thái độ dốc bình phương | Thêm trạng thái mô men bậc nhất và bậc hai |
| Công việc cập nhật | Công việc phụ trợ thấp nhất | Thêm cập nhật momentum | Thêm tỷ lệ thích ứng | Thêm cập nhật mô men và hiệu chỉnh độ chệch (bias). |
| Hiệu suất phần cứng | Thay đổi | Thay đổi | Thay đổi | Thay đổi |
| Hành vi hội tụ | Thay đổi | Thay đổi | Thay đổi | Thay đổi |
Các chi phí được định lượng trong table 4 tạo ra một cân nhắc trong thiết kế. Hai bộ đệm moment của Adam có thể cải thiện tối ưu hóa cho một khối lượng công việc (workload) nhất định, nhưng bộ nhớ chúng tiêu tốn có thể làm giảm kích thước mô hình hoặc kích thước batch có thể chạy trên một bộ tăng tốc. AdamW16 (Loshchilov and Hutter 2019) tách weight decay khỏi cập nhật gradient thích nghi của Adam, mà không cần thêm một tensor trạng thái riêng cho từng tham số.
16 AdamW (Adam với weight decay tách rời): Regularization \(L_2\) chuẩn đi vào gradient và do đó bị Adam tái tỷ lệ theo cập nhật thích nghi. AdamW áp dụng weight decay như một bước cập nhật tham số riêng biệt, khôi phục sự phân biệt dự định giữa việc điều chỉnh tỷ lệ gradient thích nghi và suy giảm trọng số (Loshchilov and Hutter 2019). Nó dùng cấu trúc bộ đệm moment giống Adam, dù hiệu quả lên chất lượng mô hình vẫn phụ thuộc vào khối lượng công việc (workload).
Loshchilov, Ilya, and Frank Hutter. 2019. “Decoupled Weight Decay Regularization.” Proceedings of the International Conference on Learning Representations (ICLR).
Napkin Math 1.2: Yêu cầu bộ nhớ của optimizer GPT-2
Một cấu hình huấn luyện GPT-2 XL tiêu biểu dùng Adam optimizer với năm siêu tham số:
- β₁ = 0.9 (suy giảm động lượng)
- β₂ = 0.999 (suy giảm moment thứ hai)
- Tốc độ học: Tăng dần từ 0 lên 2.5e-4 trong 500 bước đầu, sau đó suy giảm cosine
- Suy giảm trọng số: 0.01
- Cắt gradient: cắt theo chuẩn toàn cục 1.0
Toán học:
Đối với 1.5B tham số của GPT-2 ở FP32 (mỗi tham số 4 byte), bộ nhớ được chia thành bốn thành phần:
- Tham số: 1.5B \(\times\) 4 byte = 6 GB
- Gradient: 1.5B \(\times\) 4 byte = 6 GB
- Trạng thái Adam (m, v): 1.5B \(\times\) 8 byte = 12 GB
- Tổng bộ nhớ tĩnh: 24 GB
Điều này giải thích vì sao chỉ riêng trạng thái huấn luyện tĩnh 24 GB của GPT-2 đã gần chạm ngưỡng dung lượng 32 GB của một V100, ngay cả trước khi tính phần lưu activation.
Các quyết định hệ thống do optimizer chi phối
- Huấn luyện với độ chính xác hỗn hợp (FP16) làm giảm độ chính xác tính toán, nhưng vẫn phải giữ các trọng số gốc (master weights) ở FP32, nên bộ nhớ tĩnh vẫn khoảng ~24 GB.
- Kỹ thuật tích lũy gradient (chia batch hiệu quả thành nhiều micro-batch nhỏ hơn) cho phép dùng kích thước batch hiệu quả \(B=512\) dù bộ nhớ bị giới hạn.
Góc nhìn hệ thống: Cấu hình minh họa này cho thấy các bộ đệm moment của Adam là yếu tố giới hạn dung lượng. Mọi lợi ích về khả năng hội tụ so với SGD hoặc momentum cần được đo trong điều kiện khớp về mô hình, dữ liệu, lịch trình, kích thước batch và tiêu chí dừng.
Giao diện optimizer của framework và lập lịch
Sau khi định lượng bộ nhớ của optimizer, giao diện framework trở nên quan trọng vì nó quyết định khi nào trạng thái đó được đọc, ghi, xoá và giữ lại qua các bước. Vòng lặp huấn luyện tách tính toán gradient khỏi cập nhật tham số, để hệ thống có thể tích luỹ gradient, đồng bộ chúng hoặc hoãn cập nhật mà không thay đổi các phương trình của optimizer. Listing 2 minh họa Adam optimization tham gia vào chu trình này ở đâu.
import torch
import torch.nn as nn
import torch.optim as optim

# Initialize Adam optimizer with model parameters and learning rate
optimizer = optim.Adam(
    model.parameters(), lr=0.001, betas=(0.9, 0.999)
)
loss_function = nn.CrossEntropyLoss()

# Standard training loop implementing the four-step optimization cycle
for epoch in range(num_epochs):
    for batch_idx, (data, targets) in enumerate(dataloader):
        # Step 1: Clear accumulated gradients from previous iteration
        optimizer.zero_grad()

        # Step 2: Forward pass - compute model predictions
        predictions = model(data)
        loss = loss_function(predictions, targets)

        # Step 3: Backward pass - compute gradients via autodiff
        loss.backward()

        # Step 4: Parameter update - apply Adam optimization equations
        optimizer.step()
Lời gọi optimizer.zero_grad() đánh dấu ranh giới giữa một lần cập nhật và lần tiếp theo. Gradient được tích lũy qua các lời gọi backward(), nên việc xóa chúng rõ ràng sẽ tránh để gradient cũ lẫn vào batch tiếp theo. Hành vi tích lũy này về sau hữu ích khi cần kích thước batch hiệu quả lớn, nhưng chỉ khi vòng lặp huấn luyện chủ động kiểm soát ranh giới.
Phương thức optimizer.step() là ranh giới còn lại: nó tiêu thụ các gradient hiện tại và thay đổi trạng thái bền (persistent) của optimizer. Đối với Adam optimization, lời gọi này thực hiện ước tính động lượng, theo dõi bình phương gradient, hiệu chỉnh độ chệch (bias), và cập nhật tham số. Algorithm 1 làm cho trạng thái ẩn trở nên rõ ràng để chi phí bộ nhớ vẫn hiển thị thay vì biến mất sau một lời gọi API.
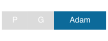
Trong cách nhìn đơn giản hóa về trạng thái tĩnh này, hai bộ đệm moment của Adam chiếm gấp đôi dung lượng lưu trữ tham số.
\begin{algorithm} \caption{Adam parameter update (one optimizer step)} \begin{algorithmic} \Require gradient $g_t = \nabla\mathcal{L}(\theta_t)$; step $t$; rate $\eta$; decays $\beta_1,\beta_2$; constant $\epsilon$ \Ensure updated parameter $\theta_{t+1}$; moment buffers $m_t, v_t$ carried to the next step \State $m_t \gets \beta_1 m_{t-1} + (1-\beta_1)\, g_t$ \Comment{first moment (momentum)} \State $v_t \gets \beta_2 v_{t-1} + (1-\beta_2)\, g_t^2$ \Comment{uncentered second moment} \State $\hat{m}_t \gets m_t / (1-\beta_1^{t})$; $\hat{v}_t \gets v_t / (1-\beta_2^{t})$ \Comment{bias correction} \State $\theta_{t+1} \gets \theta_t - \eta\, \hat{m}_t / (\sqrt{\hat{v}_t} + \epsilon)$ \Comment{parameter update} \end{algorithmic} \end{algorithm}
Bước 1 và 2 duy trì hai bộ đệm moment cho mỗi tham số, nên tổng dung lượng của tham số cộng với trạng thái optimizer đạt khoảng 3\(\times\) dung lượng tham số trước khi tính đến gradient, activations và trọng số chính FP32. Các framework quản lý bộ cấp phát và cách truy cập các trạng thái optimizer này, nhưng không loại bỏ được chi phí. Mỗi bước Adam đọc gradient, tham số, moment thứ nhất và moment thứ hai, rồi ghi lại các moment và tham số đã cập nhật. Lớp trừu tượng giúp giảm gánh nặng triển khai; tuy vậy, ngân sách hệ thống vẫn phải chi cho hai tensor bổ sung này, vốn phải chiếm bộ nhớ và di chuyển qua hệ thống phân cấp ở mỗi bước.
Tích hợp lập lịch tốc độ học
Hook lập lịch tốc độ học của framework thay đổi quỹ đạo của optimizer mà không thêm trạng thái theo từng tham số. Nó điều chỉnh tốc độ học \(\eta\) trong quá trình huấn luyện, cho phép hệ thống định hình hành vi hội tụ trong khi vẫn giữ nguyên các phương trình nền của optimizer.
Các lịch như cosine annealing, suy giảm hàm mũ hoặc giảm theo từng bước thực hiện quỹ đạo đó bằng cách thay đổi kích thước bước theo thời gian. Một bộ lập lịch có thể theo dõi bước hiện tại, epoch, giai đoạn warmup, hoặc các trạng thái khác cần được khôi phục từ một checkpoint. Nó thay đổi \(\eta\) mà không làm thay đổi các phương trình cập nhật cơ bản của optimizer; Các Framework ML trình bày giao diện bộ lập lịch để tích hợp phần này. Sự tách biệt này cho phép kỹ sư hệ thống kết hợp các thuật toán tối ưu hóa cơ bản (SGD, Adam) với các chiến lược lập lịch (cosine annealing, linear warmup) mà không phải viết lại quy tắc cập nhật.
Các thuật toán tối ưu hóa ở phần trước chỉ ra cách cập nhật tham số khi đã có gradient, và chúng coi các gradient đó như đã được cung cấp sẵn. SGD, momentum và Adam đều giả định các véc-tơ gradient đã sẵn sàng. Trên thực tế, tính toán gradient cho một mạng nơ-ron với hàng tỷ tham số tự nó đã là một thách thức lớn về tính toán và bộ nhớ. Chính chi phí tính gradient, chứ không phải chi phí của một bước optimizer, mới là nguyên nhân khiến huấn luyện đắt đỏ hơn suy luận rất nhiều.
Cơ chế lan truyền ngược
Lan truyền ngược giải quyết bài toán tính gradient bằng cách lần ngược các tín hiệu lỗi qua mạng, quy trách nhiệm một cách có hệ thống cho từng tham số đối với lỗi dự đoán cuối cùng. Yêu cầu về bộ nhớ và tính toán của phương pháp này cho thấy vì sao các hệ thống huấn luyện phải đối mặt với những giới hạn tài nguyên lớn như vậy.
Thuật toán lan truyền ngược tính gradient bằng cách di chuyển ngược một cách có hệ thống qua đồ thị tính toán của một mạng nơ-ron. Tính toán gradient và lan truyền ngược thiết lập nền tảng toán học: quy tắc chuỗi phân rã phép tính gradient thành các phép toán theo từng lớp, với mỗi lớp nhận tín hiệu điều chỉnh tỷ lệ với đóng góp của nó vào lỗi cuối cùng. Nếu các khái niệm như “đồ thị tính toán” hay “luồng gradient” còn lạ lẫm, bạn nên xem lại phép tương tự dây chuyền lắp ráp trong nhà máy ở phần đó.
Ở quy mô hệ thống, câu hỏi chuyển từ lan truyền ngược tính toán cái gì sang nó tốn kém bao nhiêu. Các phép tính ở mỗi lớp (từ section 1.2.1.1) tạo ra các activation cần được giữ lại cho bước lan truyền ngược. Để tính \(\frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(\ell)}}\), ta phải truy cập các activation đã lưu này. Điều đó dẫn đến phương trình bộ nhớ huấn luyện mà kỹ thuật gradient checkpointing sẽ khai thác sau này.
Một mạng ba lớp đơn giản xử lý MNIST cần vài kilobyte để lưu activation. GPT-2 khi xử lý một batch duy nhất cần hơn 35.9 GB, vượt quá sức chứa của hầu hết các bộ tăng tốc. Khoảng cách đó chính là thách thức kỹ thuật mà chương này sẽ giải quyết. Chi phí bộ nhớ thực sự của huấn luyện trình bày cách lan truyền ngược làm phát sinh các chi phí bộ nhớ này, cùng với phương trình bộ nhớ huấn luyện đầy đủ (\(M_{\text{total}} = M_{\text{weights}} + M_{\text{gradients}} + M_{\text{optimizer}} + M_{\text{activations}}\)). Các hệ thống huấn luyện hiện đại dùng tự động vi phân (xem Các Framework ML) để tự động xử lý việc tính gradient, nhưng các mẫu bộ nhớ và tính toán cơ bản vẫn do kỹ sư hệ thống chịu trách nhiệm quản lý.
Bộ nhớ activation trải từ các bài toán MNIST nhỏ đến huấn luyện ở quy mô GPT.
Yêu cầu bộ nhớ activation
Các hệ thống huấn luyện giữ lại các giá trị trung gian mà các quy tắc lan truyền ngược yêu cầu. Bộ giá trị cần lưu chính xác tùy thuộc vào phép toán, chiến lược hợp nhất (fusion) và tính toán lại (recomputation). Trạng thái huấn luyện gồm một số nhóm riêng biệt:
- các giá trị từ lượt truyền xuôi được lưu lại, cần thiết cho các quy tắc lan truyền ngược,
- các tham số mô hình,
- các gradient tham số, và
- trạng thái optimizer và các bản sao tham số có độ chính xác cao hơn (nếu có).
Xét một batch các ví dụ huấn luyện đi qua một mạng. Lượt truyền xuôi sẽ tính toán và lưu trữ: \[\begin{gather*} \mathbf{Z}^{(\ell)} = \mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)} \\ \mathbf{A}^{(\ell)} = f(\mathbf{Z}^{(\ell)}) \end{gather*}\]
Một cách triển khai thông thường có thể giữ lại \(\mathbf{Z}^{(\ell)}\), \(\mathbf{A}^{(\ell)}\), hoặc các đầu vào và đầu ra khác theo quy tắc đạo hàm. Fused kernels và recomputation cho phép chỉ lưu một tập nhỏ hơn. Các activation phụ thuộc vào kích thước batch vẫn tạo áp lực nhân bội lên bộ nhớ, trong khi chi phí của optimizer tăng theo số lượng tham số. Phép tính cho GPT-2 phân tách áp lực này thành các chi phí theo từng lớp cho attention, feed-forward và trạng thái huấn luyện.
Napkin Math 1.3: Phân tích bộ nhớ activation của GPT-2
Đối với GPT-2 với kích thước batch \(B\) = 4, độ dài chuỗi \(S\) = 1024, chiều ẩn \(d\) = 1600, và 48 layers:
Toán học:
- Activation của attention: \(B \times S \times d \times 4\) (Q, K, V, đầu ra) = 4 \(\times\) 1024 \(\times\) 1600 \(\times\) \(4 \times 2\) byte (FP16) = 52.4 MB
- Activation của FFN: \(B \times S \times (4d)\) (mở rộng trung gian) = 4 \(\times\) 1024 \(\times\) 6400 \(\times\) 2 byte = 52.4 MB
- Điểm attention: \(5 \times N_{\text{heads}} \times S^2 \times B\) byte cho các bộ đệm điểm \(S{\times}S\), softmax và dropout. Với 25 head, hạng mục này đạt 524.3 MB trên mỗi lớp—thành phần chiếm ưu thế, tăng theo bậc hai theo độ dài chuỗi, và chính là phần mà selective recomputation loại bỏ.
- Trạng thái chuẩn hóa lớp: Tối thiểu (~10 MB trên mỗi lớp).
- Tổng cộng trên mỗi lớp: ~639.1 MB (attention + FFN + điểm attention + trạng thái chuẩn hóa lớp).
Kết quả:
- Tổng bộ nhớ activation (ước tính của thư viện, bao gồm các bộ đệm residual-stream và framework ngoài các mục đã liệt kê ở trên): 35.9 GB
- Tham số (FP16): 3 GB
- Gradient: 3 GB
- Trọng số chính (FP32): 6 GB
- Trạng thái moment Adam (FP32): 12 GB
- Mức sử dụng bộ nhớ đỉnh khi huấn luyện: ~59.9 GB
Điều này vượt quá dung lượng 32 GB của một V100 đơn lẻ.
Giải pháp:
- Tính toán lại activation có chọn lọc: Bỏ các giá trị trung gian của attention và tính lại chúng khi lan truyền ngược, giảm thành phần activation được mô hình hóa này đi 70.2 percent còn ~10.7 GB; phần việc bổ sung phụ thuộc vào cách triển khai.
- Offload activation sang CPU: Lưu một số activation trong RAM của CPU và chuyển lại trong pha lan truyền ngược.
- Độ chính xác hỗn hợp: activation FP16 (đã áp dụng) so với FP32 (sẽ là 71.7 GB).
- Giảm kích thước micro-batch và tích lũy gradient: Ghép nhiều lượt truyền tiến/lùi phù hợp bộ nhớ để tạo thành một batch hiệu quả lớn hơn.
Systems insight: Ngay cả sau khi tính lại có chọn lọc, tổng activation được mô hình hóa cộng với trạng thái tĩnh vẫn khoảng 34.7 GB, hơi vượt quá dung lượng thô 32 GB của V100, trước khi tính không gian làm việc và chi phí bộ cấp phát. Vì vậy, với biểu diễn này, vẫn cần tính toán lại hoàn toàn, sharding, offload, hoặc dùng micro-batch nhỏ hơn.
Phần phân tích này cho thấy các quyết định kỹ thuật thực tế phải cân nhắc khi bộ nhớ của bộ tăng tốc không đủ. Nguyên tắc đánh đổi giữa việc lưu activation, tính lại, và kích thước batch cũng là nền tảng cho phân tích bộ nhớ–tính toán ở phần tiếp theo.
Checkpoint 1.2: Sự đánh đổi giữa bộ nhớ và tính toán
Để huấn luyện các mô hình lớn, chúng ta cần quản lý “bức tường bộ nhớ” (tức nút cổ chai băng thông đã được giới thiệu ở Tính toán nơ-ron và nhắc lại ở Tại sao chiến lược thực thi lại quan trọng: Bức tường bộ nhớ).
Nút cổ chai
Giới hạn khi mở rộng
Sự đánh đổi giữa bộ nhớ và tính toán
Các hệ thống huấn luyện cần cân bằng giữa việc sử dụng bộ nhớ và hiệu quả tính toán. Mỗi lượt truyền xuôi (forward) tạo ra các giá trị mà lượt truyền ngược có thể cần. Với một mô hình mạng đơn giản gồm \(N_L\) lớp, ký hiệu \(s_\ell\) là số byte trạng thái trung gian được lưu trên mỗi ví dụ ở lớp \(\ell\), và \(a_\ell\) là số byte đầu ra activation được lưu trên mỗi ví dụ. Theo quy ước tính theo mỗi ví dụ này, dung lượng lưu trữ của chúng tỷ lệ tuyến tính với kích thước batch và được xấp xỉ bằng equation 5:
\[ \text{Memory per batch} = B \times \sum_{\ell=1}^{N_L} (s_\ell + a_\ell) \tag{5}\]
Yêu cầu bộ nhớ này còn cộng dồn với bộ nhớ dành cho trọng số, gradient và optimizer đã thảo luận trong section 1.2.2.3. Equation 6 đưa ra cách phân rã trạng thái huấn luyện về mặt khái niệm: \[ \text{Total Memory} = \text{Memory}_{\text{weights}} + \text{Memory}_{\text{gradients}} + \text{Memory}_{\text{optimizer}} + \text{Memory per batch} \tag{6}\]
Đỉnh bộ nhớ runtime có thể vượt quá tổng này vì các không gian làm việc tạm, bộ đệm giao tiếp, hành vi của bộ cấp phát và phần sổ sách của framework cũng chiếm bộ nhớ. Để giảm phần activation, các hệ thống huấn luyện có thể chủ động tính lại các giá trị trung gian trong lượt truyền ngược thay vì lưu trữ chúng. Cách này tăng khối lượng tính toán nhưng cho phép huấn luyện các mạng sâu hơn hoặc dùng batch lớn hơn trên phần cứng hạn chế bộ nhớ (Chen et al. 2016). Algorithm 2 làm rõ sự đánh đổi này: lượt truyền xuôi chỉ giữ activation tại một tập lớp checkpoint thưa, còn lượt truyền ngược sẽ tính lại phần còn lại khi cần.
\begin{algorithm} \caption{Gradient checkpointing (activation recomputation)} \begin{algorithmic} \Require $N_L$-layer network; checkpoint set $\mathcal{C} \subseteq \{1,\dots,N_L\}$ (e.g., every $\sqrt{N_L}$ layers) \Ensure parameter gradients, at reduced peak activation memory \For{$\ell = 1$ to $N_L$} \State forward layer $\ell$; store its activation only if $\ell \in \mathcal{C}$ \Comment{drop the rest} \EndFor \For{$\ell = N_L$ down to $1$} \If{the activation of layer $\ell$ was dropped} \State recompute the forward segment from the nearest stored checkpoint through layer $\ell$ \EndIf \State compute the layer's gradient; free the activation \EndFor \State \Return the accumulated gradients \end{algorithmic} \end{algorithm}
Nếu đặt các checkpoint cách nhau mỗi \(\sqrt{N_L}\) lớp, ta có thể giảm đỉnh bộ nhớ activation từ \(\mathcal{O}(N_L)\) xuống \(\mathcal{O}(\sqrt{N_L})\) bằng cách làm thêm phần truyền xuôi trên các đoạn giữa checkpoint trong pha lan truyền ngược. Đây là đòn bẩy giúp huấn luyện một mạng quá lớn so với bộ nhớ của bộ tăng tốc, đánh đổi thành phần phép tính trong định luật sắt để lấy dung lượng activation.
Hiệu quả của các chiến lược quản lý bộ nhớ này phụ thuộc nhiều vào kiến trúc phần cứng nền tảng. Các hệ thống bộ tăng tốc, với thông lượng tính toán cao nhưng băng thông bộ nhớ hạn chế, thường đối mặt với các điểm nghẽn khác so với hệ thống CPU. Hạn chế về băng thông bộ nhớ trên các bộ tăng tốc đồng nghĩa rằng, ngay cả khi có đủ dung lượng lưu trữ, việc di chuyển dữ liệu giữa bộ nhớ và các đơn vị tính toán có thể trở thành yếu tố hạn chế hiệu suất chính (Jouppi et al. 2017).
Jouppi, Norman P., Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, et al. 2017. “In-Datacenter Performance Analysis of a Tensor Processing Unit.” Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ’17, 1–12. https://doi.org/10.1145/3079856.3080246.
Paszke, Adam, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, et al. 2019. “PyTorch: An Imperative Style, High-Performance Deep Learning Library.” Advances in Neural Information Processing Systems (NeurIPS) 32: 8024–35.
Những cân nhắc phần cứng này định hướng cách triển khai lan truyền ngược trong các hệ thống huấn luyện hiện đại. Các thuật toán chuyên biệt, tiết kiệm bộ nhớ cho các phép toán như tích chập, tính gradient theo từng ô (tiles) hoặc từng đoạn (chunks), thích ứng với băng thông bộ nhớ sẵn có. Quản lý bộ nhớ động theo dõi vòng đời của các giá trị trung gian trong toàn bộ đồ thị tính toán, giải phóng bộ nhớ ngay khi các tensor không còn cần thiết cho các phép tính tiếp theo (Paszke et al. 2019).
Truyền xuôi, tính toán gradient và cập nhật tham số xác định những gì các hệ thống huấn luyện phải tính. Tuy nhiên, chỉ tên của một phép toán thôi không cho biết nơi hệ thống bị tắc nghẽn. Kích thước ma trận, fusion, độ chính xác, cách triển khai và phần cứng quyết định liệu tính toán hay di chuyển dữ liệu là nút thắt. Cường độ số học là công cụ phân tích tiếp theo.
Cường độ số học
Cường độ số học là tỉ lệ giữa khối lượng tính toán và lượng dữ liệu phải di chuyển, cho thấy một phép toán bị giới hạn bởi thông lượng tính toán hay băng thông bộ nhớ: \[ \text{Arithmetic Intensity} = \frac{\text{FLOPs}}{\text{bytes moved}} \]
Các phép toán có cường độ số học cao là các phép toán bị giới hạn bởi tính toán: hiệu năng của chúng bị chi phối bởi thông lượng tính toán của bộ xử lý. Ngược lại, các phép toán có cường độ số học thấp bị giới hạn bởi bộ nhớ: chúng tốn nhiều thời gian di chuyển dữ liệu hơn là tính toán. Mô hình Roofline trình bày định nghĩa chính thức của Mô hình Roofline và cách tính điểm đỉnh của phần cứng.17
17 Điểm đỉnh và độ chính xác: Điểm đỉnh của Mô hình Roofline – ngưỡng cường độ số học phân tách các phép toán bị giới hạn bởi bộ nhớ và các phép toán bị giới hạn bởi tính toán – sẽ thay đổi theo độ chính xác số học. Trên cùng một bộ tăng tốc, dùng đường Tensor Core với độ chính xác thấp hơn có thể phơi bày thông lượng số học cao hơn nhiều trong khi băng thông bộ nhớ gần như không đổi, từ đó đẩy điểm đỉnh lên đáng kể. Vì vậy, chuyển từ thực thi kiểu TF32 sang BF16 kiểu hỗn hợp có thể làm thay đổi kỹ thuật tối ưu hóa nào mang lại hiệu quả, khiến lựa chọn độ chính xác gắn liền với phân tích Roofline.
Table 5 tóm tắt các xu hướng chung, không phải các phép đo cố định. Phép nhân ma trận dày đặc có thể tái sử dụng toán hạng đủ nhiều để đạt cường độ số học cao, trong khi các kernel xử lý từng phần tử (elementwise) và kernel rút gọn (reduction) độc lập thường thực hiện ít công việc hơn trên mỗi byte dữ liệu di chuyển. Điểm đỉnh của phần cứng mục tiêu sẽ quyết định chế độ hoạt động tương ứng.
| Thao tác | Xu hướng cường độ số học | Điều kiện phân loại |
|---|---|---|
| Phép nhân ma trận đặc (lớn) | Cao khi hình dạng và phân ô cung cấp khả năng tái sử dụng toán hạng đáng kể | Giới hạn bởi tính toán chỉ khi cường độ vượt quá ngưỡng |
| Các hàm activation | Thường thấp dưới dạng các kernel theo từng phần tử độc lập | Thường nhạy cảm với bộ nhớ trừ khi hợp nhất loại bỏ lưu lượng |
| LayerNorm/BatchNorm | Tác vụ giảm và theo từng phần tử với nhiều lượt tensor | Phụ thuộc vào hợp nhất, hình dạng và điểm ngưỡng mục tiêu |
| Attention softmax | Giảm và chuẩn hóa trên trục attention | Phụ thuộc vào hiện thực hóa, phân ô và hợp nhất |
Hiệu suất phần cứng trong huấn luyện mô hình phụ thuộc trực tiếp vào cường độ số học của kernel. Xác định các điểm vận hành trong Roofline huấn luyện minh họa dọc theo trục cường độ số học theo thang logarit, rồi so sánh các toán tử bị giới hạn bởi băng thông bộ nhớ (nằm trên phần trần dốc) với các toán tử bị giới hạn bởi tính toán (nằm trên phần đỉnh phẳng).
::: {#fig-training-roofline fig-env=“figure” fig-pos=“htb” fig-cap=“Roofline huấn luyện minh họa: Một sơ đồ roofline của A100, với các tọa độ tác vụ giả định, cho thấy cường độ số học làm thay đổi mức trần hiệu năng có thể đạt đến thế nào. Các điểm này không phải là hồ sơ của một lần chạy GPT-2 cụ thể. FlashAttention được vẽ dịch sang phải vì nó giảm lưu lượng truy cập HBM; việc một kernel attention thực tế có vượt qua điểm ridge hay không còn phụ thuộc vào shape, độ chính xác, phần cứng và cách triển khai.”đỉnh” (ridge) hay không còn tùy thuộc vào hình dạng dữ liệu, độ chính xác, phần cứng và cách triển khai.” fig-alt=“Đường roofline dạng log-log trên A100 với các điểm giả định cho Softmax, LayerNorm, attention tiêu chuẩn, MatMul và FlashAttention; một mũi tên chỉ từ attention tiêu chuẩn sang FlashAttention ở mức cường độ số học cao hơn.”}
:::
Để hình dung rõ các mối quan hệ này, hãy xem sơ đồ roofline trong Roofline huấn luyện minh họa. Điểm “ridge” đánh dấu “khớp gối” nơi vùng bị giới hạn bởi bộ nhớ (có độ dốc) gặp vùng bị giới hạn bởi tính toán (nằm ngang). Một triển khai nằm bên trái điểm này được xem là bị giới hạn bởi băng thông theo các giả định của roofline; còn nếu nằm bên phải thì bị giới hạn bởi tính toán. Các điểm tác vụ trong sơ đồ này chỉ mang tính minh họa cách diễn giải mô hình, không phải là tọa độ đo lường thực tế của GPT-2.
Hãy xem xét một lớp attention GPT-2 hiện thực hóa ma trận điểm attention \(S{\times}S\). Với mỗi head, tích \(\mathbf{Q}\mathbf{K}^\top\) tốn xấp xỉ \(2S^2d_{\text{head}}\) FLOPs, còn ghi ma trận điểm FP16 rồi đọc lại sẽ di chuyển khoảng \(4S^2\) byte. Chỉ tính lưu lượng của ma trận điểm đó cho ra xấp xỉ \(d_{\text{head}}/2\). Với GPT-2 Small (\(d_{\text{model}}=\) 768 trên 12 head, nên \(d_{\text{head}}=\) 64), cách tính rút gọn này cho ra 32 FLOP/byte. Một phân tích kernel đầy đủ còn phải tính cả lưu lượng Q và K, công việc softmax, các lần đọc/ghi bổ sung, tái sử dụng cache và fusion. Lưu lượng dữ liệu của ma trận điểm được hiện thực hóa, có độ phức tạp \(\mathcal{O}(S^2)\), vẫn là thành phần mà FlashAttention nhắm tối ưu.
Các bộ tăng tốc có những điểm ridge đặc trưng trên phần cứng, nơi các phép toán chuyển từ bị giới hạn bởi bộ nhớ sang bị giới hạn bởi tính toán. Một bộ tăng tốc điển hình trong trung tâm dữ liệu có điểm ridge đủ cao, đến mức các phép toán cường độ thấp như softmax trong attention được hiện thực hóa vẫn bị giới hạn bởi bộ nhớ, ngay cả khi các phép nhân ma trận lớn đã bị giới hạn bởi tính toán. Các phép toán dưới điểm ridge bị giới hạn bởi bộ nhớ; trên điểm ridge, chúng bị giới hạn bởi tính toán.
Systems Perspective 1.5: FLOP/s đỉnh và hiệu suất duy trì
Giá trị TFLOP/s cao nhất (peak TFLOP/s) là giới hạn trên về mặt tính toán, chứ không phải là dự đoán về hiệu suất thực tế mà ứng dụng có thể duy trì. Với một bản triển khai bị giới hạn hoàn toàn bởi băng thông, việc chỉ tăng giới hạn tính toán sẽ không cải thiện được giới hạn roofline. Huấn luyện độ chính xác hỗn hợp có thể vừa cho phép các đường tính toán nhanh hơn, vừa giảm lượng dữ liệu truyền tải cho các tensor được lưu trữ và truyền ở độ chính xác thấp hơn. Lợi ích thực tế phụ thuộc vào việc kernel có hỗ trợ hay không, chi phí chuyển đổi, các yêu cầu về mặt số học và tài nguyên nào đang là nút thắt. Vì vậy, tối ưu hóa theo hướng roofline cần đo lường bản triển khai trước khi quyết định hợp nhất các phép toán, thay đổi độ chính xác hay bổ sung tính toán.
Kích thước batch có thể ảnh hưởng đến cường độ tính toán và mức độ sử dụng tài nguyên bằng cách thay đổi hình dạng ma trận cũng như khả năng tái sử dụng dữ liệu của một kernel. Không có một ngưỡng chung nào, chẳng hạn batch 32, để phân biệt rõ ràng giữa việc thực thi bị giới hạn bởi bộ nhớ hay bởi tính toán. Sự chuyển đổi này phụ thuộc vào loại phép toán, kích thước, cách triển khai, độ chính xác và phần cứng.
Phân tích này giúp lựa chọn chiến lược tối ưu hóa phù hợp. Với các phép toán bị giới hạn bởi bộ nhớ (memory-bound), giảm lượng dữ liệu di chuyển bằng cách hợp nhất các toán tử (operator fusion), giảm độ chính xác (reduced precision) hoặc cải tiến thuật toán như FlashAttention sẽ đem lại lợi ích lớn nhất. Còn với các phép toán bị giới hạn bởi tính toán (compute-bound), tăng thông lượng thông qua Tensor Cores và thực thi song song lại quan trọng hơn. Sự phân biệt này mang tính thực dụng: trường hợp đầu tiên hỏi làm sao di chuyển ít byte dữ liệu hơn, còn trường hợp thứ hai hỏi làm sao giữ cho nhiều đơn vị tính toán luôn bận rộn.
Trong Roofline huấn luyện minh họa, FlashAttention18 nêu bật ý tưởng cốt lõi của thiết kế thuật toán nhận biết IO. Thay vì tạo và lưu toàn bộ ma trận attention \(S{\times}S\) trong HBM, FlashAttention xử lý theo các ô (tile) vừa với SRAM tốc độ cao. Nhờ vậy, FlashAttention giảm bộ nhớ phụ trợ cho attention từ \(\mathcal{O}(S^2)\) xuống \(\mathcal{O}(S)\) và cắt giảm mạnh lưu lượng truy cập HBM. Công trình gốc báo cáo mức tăng tốc lên tới 3\(\times\) trên các khối lượng công việc (workload) đã được đánh giá (Dao et al. 2022), với mức lợi còn phụ thuộc vào hình dạng tensor, phần cứng và baseline. Thuật toán và các điều kiện áp dụng sẽ được phân tích chi tiết trong section 1.5.4.
18 FlashAttention: Cơ chế chính là xử lý attention theo các ô nhỏ đủ để nằm gọn trong SRAM nhanh trên chip của bộ tăng tốc, tránh phải ghi toàn bộ ma trận trung gian \(S{\times}S\) vào HBM chậm hơn. Giới hạn IO của HBM chính xác phụ thuộc vào kích thước ô và dung lượng SRAM, nhưng hiệu ứng thực tế là giảm mạnh lưu lượng truy cập bộ nhớ và nhu cầu lưu trữ các activation phụ trợ. Công trình gốc báo cáo mức tăng tốc lên tới 3\(\times\) tùy thuộc vào khối lượng công việc (workload).
Phân tích cường độ số học trong phần này cho thấy cách xác định tài nguyên nào đang giới hạn một triển khai cụ thể. Phép nhân ma trận dày đặc thường rơi vào vùng bị giới hạn bởi tính toán khi kích thước cho phép tái sử dụng đủ nhiều, trong khi các kernel chuẩn hóa và activation độc lập thường nhạy với bộ nhớ. FlashAttention minh họa cách một thuật toán có thể giảm luân chuyển dữ liệu và tăng cường độ số học, dù chế độ cuối cùng vẫn phụ thuộc vào khối lượng công việc (workload).
Tối ưu từng phép toán riêng lẻ là cần thiết nhưng chưa đủ. Một phép nhân ma trận được tinh chỉnh hoàn hảo cũng vô ích nếu bộ tăng tốc phải rảnh rỗi chờ batch dữ liệu tiếp theo. Cơ sở toán học đã xây dựng trước đó trong chương này đã định lượng chi phí của từng phần—phép nhân ma trận tiêu tốn hàng nghìn tỷ FLOPs, các hàm activation bị nghẽn bởi băng thông bộ nhớ, và trạng thái của optimizer làm tăng gấp ba lần yêu cầu bộ nhớ. Câu hỏi tiếp theo là làm thế nào để phối hợp các phần này thành một pipeline sao cho không giai đoạn nào bỏ đói các giai đoạn khác.
Self-Check: Question
Why do batched matrix-matrix multiplications (GEMM, BLAS Level 3) dominate accelerator-based neural network training workloads, whereas matrix-vector operations (GEMV, BLAS Level 2) struggle to achieve high hardware utilization?
- Matrix-matrix operations avoid computing gradients during backpropagation, halving the memory footprint.
- Batched matrix-matrix operations exhibit \(\mathcal{O}(N)\) arithmetic intensity, allowing high operand reuse in on-chip SRAM/registers to saturate compute units, whereas matrix-vector operations have \(\mathcal{O}(1)\) arithmetic intensity and are strictly memory-bandwidth bound.
- Matrix-vector operations cannot be executed on GPUs without constant CPU synchronization barriers at every layer.
- Batched matrix-matrix operations reduce total model parameters, fitting larger architectures into accelerator HBM.
A team trains a 7-billion-parameter model on accelerators with 80 GB of HBM each. Weights, gradients, and activations together occupy 64 GB per accelerator at the planned batch size. Using the section’s optimizer-memory accounting, explain the systems trade-off between choosing standard SGD and Adam for this run.
The point on a roofline model curve where the memory-bandwidth-bound diagonal ceiling intersects the flat peak-compute ceiling, defined mathematically as \(\text{Peak FLOP/s} / \text{Memory Bandwidth}\), is known as the ____ point.
Order the following events in a standard backpropagation training step to reflect their strict causal and data dependencies:
- Compute scalar objective loss by evaluating predictions against ground-truth labels.
- Update model parameters using gradient-based optimization rules (such as Adam or SGD).
- Execute forward propagation through successive layers while caching intermediate activations.
- Evaluate the chain rule backward from the loss through layers to compute parameter and activation gradients.
- Fetch and preprocess the training mini-batch on the host and transfer it to device memory.
For a transformer with hidden dimension \(d_{\text{model}} = 768\) and 12 heads (\(d_{\text{head}} = 64\)), the arithmetic intensity of materialized attention score computation (\(\mathbf{Q}\mathbf{K}^\top\) and score matrix I/O) is approximately \(d_{\text{head}}/2 = 32\text{ FLOP/byte}\). If executed on an accelerator with a ridge point of \(153\text{ FLOP/byte}\), how does this kernel behave, and what optimization strategy is appropriate?
- The kernel is compute-bound; upgrade to an accelerator with higher peak TFLOP/s to accelerate execution.
- The kernel is latency-bound; reduce the batch size to 1 so the matrix fits in registers.
- The kernel is network-bound; upgrade the inter-node InfiniBand fabric to prevent AllReduce stalls.
- The kernel is memory-bandwidth bound because \(32 < 153\text{ FLOP/byte}\); apply IO-aware tiling (such as FlashAttention) to avoid writing and reading intermediate score matrices from HBM, increasing arithmetic intensity.
Kiến trúc Pipeline
Một bước huấn luyện không phải là một thao tác đơn lẻ mà là một chuỗi giai đoạn phụ thuộc nhau. Cụ thể, dữ liệu phải được tải trước khi bắt đầu tính toán; các lượt truyền xuôi (forward pass) phải hoàn tất trước khi các lượt truyền ngược (backward pass) bắt đầu; và các gradient phải được tính xong trước khi tham số có thể cập nhật. Tốc độ của giai đoạn chậm nhất quyết định tốc độ của toàn bộ hệ thống.
Pipeline cấp hệ thống điều phối các giai đoạn này trên phần cứng thực với các ràng buộc về bộ nhớ và băng thông có hạn. Các Framework ML đã giới thiệu cách các framework như PyTorch và TensorFlow cung cấp API để định nghĩa mô hình và thực hiện các lượt truyền xuôi; tại đây, các lời gọi API đó trở thành một phần của kiến trúc lớn hơn, gồm tải dữ liệu, tiền xử lý, truyền sang bộ tăng tốc và cập nhật tham số—tạo thành một pipeline thống nhất thay vì các thao tác rời rạc.
Việc điều phối này không phải một quy trình khối đơn, mà là ba hệ thống con liên kết, mỗi hệ thống có trách nhiệm và nhu cầu tài nguyên riêng. Figure 2 minh họa cách chúng kết nối: pipeline dữ liệu phụ trách nạp và tiền xử lý, vòng lặp huấn luyện chạy các lượt truyền xuôi, truyền ngược và cập nhật tham số, còn pipeline đánh giá định kỳ đo chất lượng mô hình. Luồng giữa các thành phần này là nơi xuất hiện nút thắt cổ chai—các điểm kết nối phơi bày những ràng buộc then chốt.

Tổng quan kiến trúc
Mỗi lần lặp huấn luyện gồm ba hệ thống con chạy tuần tự: một pipeline dữ liệu nạp, biến đổi và gom batch từ dữ liệu thô; một vòng lặp huấn luyện thực hiện pha truyền xuôi, tính gradient và cập nhật tham số; và một pipeline đánh giá đo chất lượng mô hình trên dữ liệu được giữ lại. Chuỗi hệ thống con này định hình pipeline huấn luyện của chương. Hiểu rõ vai trò từng hệ thống con giúp xác định nơi xuất hiện nút thắt hiệu suất và nơi các tối ưu hóa ở cấp hệ thống tạo ra tác động lớn nhất.
Để hiểu một hệ thống huấn luyện, cách dễ nhất là xem xét từ các ranh giới của nó vào bên trong. Pipeline dữ liệu nạp các bản ghi thô từ bộ lưu trữ, áp dụng các biến đổi như thay đổi kích thước, tăng cường dữ liệu (augmentation) và chuẩn hóa, rồi ghép các ví dụ kết quả thành các batch; chuẩn hóa đầu vào là một trợ giúp huấn luyện lâu đời (LeCun et al. 2012). Pipeline đánh giá nằm ở ranh giới còn lại. Theo các khoảng thời gian có thể cấu hình, nó đưa dữ liệu xác thực được giữ lại qua mô hình hiện tại, tính các số đo như độ chính xác hoặc hàm mất mát, và bộc lộ các vấn đề hội tụ như overfitting, tức là khi hàm mất mát huấn luyện giảm nhưng hàm mất mát xác thực lại tăng. Vì việc đánh giá tiêu tốn thời gian của bộ tăng tốc, nên tần suất đánh giá là một sự đánh đổi giữa phản hồi chi tiết hơn và thông lượng huấn luyện.
LeCun, Yann, Leon Bottou, Genevieve B. Orr, and Klaus-Robert Müller. 2012. “Efficient BackProp.” In Neural Networks: Tricks of the Trade, vol. 7700. Lecture Notes in Computer Science. Springer Berlin Heidelberg. https://doi.org/10.1007/978-3-642-35289-8_3.
Cơ chế cốt lõi của quá trình học trong mạng nơ-ron là xâu chuỗi dự đoán truyền xuôi, lan truyền ngược sai số và tối ưu hóa tham số trong một vòng lặp kín. Hãy theo dõi luồng dữ liệu tuần hoàn trong figure 3 qua ba giai đoạn liên tiếp: pha truyền xuôi, tính toán gradient và cập nhật trọng số.

Mỗi lần lặp sẽ thực hiện pha truyền xuôi, tính toán hàm mất mát, pha truyền ngược và cập nhật tham số, như đã trình bày trong section 1.2. Câu hỏi về hệ thống ở đây không phải là các phép toán này tính gì (đã nói trước đó), mà là cách chúng phối hợp như một pipeline, trong đó nút thắt ở bất kỳ giai đoạn nào cũng sẽ giới hạn thông lượng tổng thể.
Quá trình này lặp lại qua các batch và epoch, dần dần tinh chỉnh mô hình để cải thiện độ chính xác dự đoán. Vòng lặp này gắn chặt với các giai đoạn xung quanh: việc chuẩn bị dữ liệu có thể chồng lắp với tính toán bằng cách tiền xử lý batch tiếp theo trong khi batch hiện tại đang huấn luyện, còn bước đánh giá sẽ tạm thời dừng cập nhật gradient để đo chất lượng trên tập xác thực. Sự tích hợp này giúp giảm tối đa thời gian nhàn rỗi của tài nguyên hệ thống, nhưng bất kỳ mất cân bằng nào, như pipeline dữ liệu chậm hoặc lịch đánh giá quá dày, cũng sẽ kéo giảm thông lượng tổng thể.
Pipeline dữ liệu
Trong tổng quan kiến trúc, pipeline dữ liệu được xác định là thành phần đầu tiên của hệ thống huấn luyện. Hiệu quả của pipeline này trực tiếp quyết định liệu các tài nguyên bộ tăng tốc đắt tiền được khai thác tối đa hay phải nhàn rỗi chờ dữ liệu. Ở đây, chúng ta tập trung vào các khía cạnh hệ thống của việc di chuyển và tiền xử lý dữ liệu; còn công việc kỹ thuật dữ liệu ở phía trước được trình bày trong Kỹ thuật dữ liệu.
Pipeline dữ liệu chạy trên CPU đóng vai trò cầu nối giữa nơi lưu trữ dữ liệu thô và quá trình tính toán của bộ tăng tốc. Figure 4 phân tách kiến trúc này thành ba vùng riêng biệt.

Các vùng này quan trọng vì mỗi vùng đều có thể trở thành giai đoạn chậm nhất. Lưu trữ cung cấp các ví dụ thô từ đĩa, thường là tệp hình ảnh cho thị giác máy tính hoặc tệp văn bản cho xử lý ngôn ngữ tự nhiên. Tiền xử lý trên CPU sau đó chuyển đổi định dạng, áp dụng thay đổi kích thước, chuẩn hóa hoặc tăng cường dữ liệu, và gom các ví dụ thành batch dưới dạng các tensor mà bộ tăng tốc có thể tiêu thụ.
Vùng huấn luyện GPU tiêu thụ các batch đã tiền xử lý này trên nhiều bộ tăng tốc để thực hiện tính toán song song. Vì vậy, việc chuyển đổi định dạng, xử lý và tạo batch không phải là các bước phụ trợ; chúng là các điểm nghẽn thông lượng. Nếu bất kỳ bước nào trong số này chạy chậm hơn vòng lặp huấn luyện, các tài nguyên bộ tăng tốc đắt tiền sẽ nhàn rỗi trong khi pipeline dữ liệu cố gắng bắt kịp.
Các thành phần cốt lõi
Thông lượng của pipeline dữ liệu cuối cùng bị giới hạn bởi tốc độ truy xuất dữ liệu huấn luyện từ hệ thống lưu trữ. Các phương pháp kỹ thuật dữ liệu từ Kỹ thuật dữ liệu, bao gồm việc lựa chọn định dạng dữ liệu (Parquet, TFRecord, Arrow), các chiến lược phân vùng và tối ưu hóa tính cục bộ của dữ liệu, đều ảnh hưởng trực tiếp đến các đặc tính lưu trữ này. Những ràng buộc về lưu trữ này sẽ lan truyền khắp hệ thống huấn luyện.
Thông lượng lưu trữ bị giới hạn bởi yếu tố chậm hơn trong hai ràng buộc phần cứng, được thể hiện trong equation 7: \[R_{\text{storage}} =\min(\text{BW}_{\text{disk}}, \text{BW}_{\text{network}}) \tag{7}\] trong đó \(\text{BW}_{\text{disk}}\) là băng thông đĩa vật lý, còn \(\text{BW}_{\text{network}}\) là băng thông mạng cho các hệ thống lưu trữ phân tán. Trong thực tế, khối lượng công việc (workload) huấn luyện hiếm khi đạt được mức tối đa lý thuyết này vì việc xáo trộn dữ liệu có thể biến các thao tác đọc tuần tự lớn thành các truy cập nhỏ hơn, kém hiệu quả hơn. Thông lượng lưu trữ hiệu quả có thể được mô tả bằng công thức \(R_{\text{storage,eff}} = R_{\text{storage}} \times F_{\text{access}}\), trong đó \(F_{\text{access}}\) phụ thuộc vào kích thước bản ghi, cách bố trí tệp, cơ chế bộ nhớ đệm và phần cứng lưu trữ. Chính sự hao hụt này giải thích tại sao kỹ thuật thiết kế pipeline dữ liệu lại quan trọng: nếu không có cách bố trí dữ liệu cẩn thận, cơ chế tìm nạp trước (prefetching) và bộ đệm (buffering) phù hợp, các bộ tăng tốc có thể phải ngồi chờ lưu trữ.
Tiền xử lý
Sau khi lưu trữ, bước tiền xử lý chuyển các đầu vào thô thành các tensor sẵn sàng cho mô hình. Các pipeline dữ liệu trong Kỹ thuật dữ liệu thường trích xuất và nạp dữ liệu thô, rồi biến đổi theo yêu cầu trong quá trình huấn luyện. Trong điều kiện lý tưởng khi các worker hoạt động độc lập và có thể mở rộng tuyến tính, thông lượng tiền xử lý tăng theo số lượng worker, như trong equation 8: \[R_{\text{preprocessing}} = \frac{N_{\text{workers}}}{T_{\text{transform}}} \tag{8}\] trong đó \(N_{\text{workers}}\) là số luồng xử lý song song, mỗi luồng thực hiện các biến đổi mất \(T_{\text{transform}}\) giây. Các kiến trúc huấn luyện thường dùng nhiều worker để đảm bảo tiền xử lý theo kịp tốc độ tiêu thụ của bộ tăng tốc. Ví dụ, một luồng đơn lẻ mất 30 ms để tăng cường hình ảnh cho mỗi batch sẽ không thể cung cấp đủ dữ liệu cho một bộ tăng tốc chỉ mất 10 ms để tính một lượt truyền xuôi (forward pass).
Dữ liệu đã tiền xử lý sau đó phải được chuyển sang bộ tăng tốc trước khi bắt đầu tính toán. Vì vậy, thông lượng huấn luyện tổng thể bị giới hạn bởi giai đoạn chậm nhất trong ba giai đoạn, như equation 9 nêu rõ: \[R_{\text{training}} =\min\left(R_{\text{preprocessing}}, \frac{\text{BW}_{\text{GPU transfer}}}{D_{\text{vol}}^{(\text{batch})}}, \frac{R_{\text{compute}}}{O_{\text{batch}}}\right) \tag{9}\] trong đó \(D_{\text{vol}}^{(\text{batch})}\) là số byte đầu vào trên mỗi batch và \(O_{\text{batch}}\) là khối lượng công việc truyền xuôi–truyền ngược cho mỗi batch, tính bằng FLOPs. Vì vậy, mỗi thành phần đều được biểu diễn theo số batch mỗi giây trước khi lấy giá trị nhỏ nhất.
Example 1.1: Pipeline dữ liệu của mô hình ngôn ngữ GPT-2
Kịch bản: Định lượng truy cập bộ nhớ lưu trữ, tokenization trên CPU, và truyền PCIe từ host sang device để cung cấp dữ liệu cho một cụm GPU V100 32 đang huấn luyện GPT-2.
Trình tự các giai đoạn:
- Lưu trữ văn bản thô: WebText đóng góp khoảng 40 GB văn bản thô. Tốc độ đọc tuần tự từ NVMe SSD đạt 7 GB/s. Khi lấy mẫu tài liệu với hệ số truy cập 0.1, băng thông lưu trữ khi truy cập ngẫu nhiên giảm còn 0.70 GB/s, dẫn đến \(T_{\text{read}} = D_{\text{vol}} / \text{BW}_{\text{storage}} \approx 0.1\text{ ms}\).
- Tokenization: Bộ tokenizer BPE (bộ từ vựng 50,257) chuyển văn bản thành ID token. Với kích thước batch \(B =\) \(B=32\) và độ dài chuỗi \(S =\) \(S=1024\) (tổng 32.8K tokens), một nhân CPU xử lý 500K tokens/s sẽ mất \(T_{\text{tokenize}} \approx\) 65.5 ms cho mỗi batch.
- Batching và padding: Quá trình padding và packing tạo một tensor int64 có kích thước 32 sequences \(\times\) 1,024 tokens, tương đương 262.1 KB cho mỗi batch.
- Truyền PCIe: Truyền tensor qua bus PCIe Gen3 x16 (băng thông 15.75 GB/s) mất \(T_{\text{transfer}} =\) 0.017 ms, nên chi phí truyền qua bus là không đáng kể.
Thông tin chuyên sâu về hệ thống: Khâu chuẩn bị trên CPU một nhân (\(T_{\text{prep}} \approx\) 65.6 ms) chiếm phần lớn ngân sách mỗi bước của bộ tăng tốc (\(T_{\text{step}} \approx\) 84.4 ms), nên một pipeline nối tiếp phải trả cả hai chi phí ở mỗi bước và \(\eta_{\text{hw}}\) giảm xuống khoảng 56 percent. Nếu chuẩn bị còn chậm hơn, bộ tăng tốc sẽ không có dữ liệu để chạy. Mở rộng lên 8 tiến trình worker song song giúp giảm độ trễ tokenization xuống \(T_{\text{tokenize}} / N_{\text{worker}} \approx\) 8.2 ms, đồng thời prefetching chồng chéo \(T_{\text{prep}}\) với \(T_{\text{step}}\) để khôi phục mức sử dụng phần cứng về 95 percent, đạt thông lượng 379 mẫu toàn cục mỗi giây trên 32 GPU V100.
Mối quan hệ min-of-three này chi phối thiết kế pipeline huấn luyện, vì thông lượng của hệ thống bằng với thông lượng của nút thắt cổ chai. Một bộ tăng tốc với năng lực tính toán 312 TFLOP/s vẫn không tạo ra công việc hữu ích khi phải chờ dữ liệu. Ngược lại, một pipeline dữ liệu tối ưu hoàn hảo cũng không giúp gì nếu bộ tăng tốc đã bão hòa tính toán. Thiết kế pipeline cân bằng là điều chỉnh năng lực tiền xử lý, băng thông truyền và thông lượng tính toán sao cho không giai đoạn nào chi phối thời gian mỗi vòng lặp. Áp dụng phân tích thông lượng này cho mô hình GPT-2 lighthouse cho thấy nút thắt của pipeline dữ liệu nằm ở đâu trong huấn luyện mô hình ngôn ngữ.
Thông lượng của pipeline dữ liệu không phải là dòng chảy duy nhất có thể khiến bộ tăng tốc bị “đói”. Huấn luyện đa GPU còn thêm một luồng lưu lượng thứ hai: đồng bộ hóa gradient sau mỗi bước, và khi thời gian đồng bộ vượt quá thời gian tính toán, giao tiếp trở thành rào cản giới hạn. Section 1.6.2 định lượng bức tường mạng này tại thời điểm quá trình huấn luyện vượt qua ranh giới nút.
Hệ quả đối với hệ thống
Pipeline dữ liệu và bộ máy tính toán tạo thành một hệ thống ghép nối, trong đó thông lượng bằng với thành phần chậm hơn, như equation 10 nêu: \[R_{\text{system}} =\min(R_{\text{pipeline}}, R_{\text{compute}}) \tag{10}\]
Mối quan hệ này kéo theo hệ quả trực tiếp. Khi \(R_{\text{pipeline}} < R_{\text{compute}}\), bộ tăng tốc sẽ nhàn rỗi vì phải chờ dữ liệu, và mức sử dụng bộ tăng tốc giảm theo tỷ lệ, như equation 11 cho thấy: \[\text{Accelerator Utilization} = \min\left(1, \frac{R_{\text{pipeline}}}{R_{\text{compute}}}\right) \times 100\% \tag{11}\]
Một mô hình ResNet-50 chạy trên phần cứng bộ tăng tốc hiện đại có thể xử lý 1.000 hình ảnh mỗi giây, nhưng nếu pipeline dữ liệu chỉ cung cấp 200 hình ảnh mỗi giây, mức sử dụng bộ tăng tốc sẽ giảm xuống 20%—tức là bộ tăng tốc nhàn rỗi 80% thời gian. Nâng cấp lên phần cứng nhanh hơn cũng không giúp gì trong trường hợp này; một bộ tăng tốc có thể xử lý 2.000 hình ảnh mỗi giây cũng chỉ đạt 10% mức sử dụng với cùng pipeline. Thiết kế hệ thống cân bằng nhằm đảm bảo bộ tăng tốc luôn được cung cấp dữ liệu, thay vì phải chờ các giai đoạn phía trước.
Luồng dữ liệu
Dữ liệu huấn luyện đi qua ba tầng của hệ thống phân cấp bộ nhớ trên đường từ đĩa đến bộ tăng tốc. Sự chênh lệch băng thông giữa các tầng này, lên tới ba bậc độ lớn, là thách thức cốt lõi trong thiết kế pipeline dữ liệu. Tốc độ truyền dữ liệu hiệu quả qua hệ thống phân cấp bộ nhớ bị giới hạn bởi liên kết chậm nhất, như equation 12 cho thấy: \[R_{\text{memory}} =\min(\text{BW}_{\text{storage}}, \text{BW}_{\text{system}}, \text{BW}_{\text{accelerator}}) \tag{12}\]
Băng thông tăng dần theo thứ tự lưu trữ → DRAM → HBM trong hệ thống phân cấp bộ nhớ.
Lưu trữ NVMe cục bộ cung cấp 7 GB/s, bộ nhớ hệ thống đạt 50 GB/s, và HBM của bộ tăng tốc đạt 900 GB/s hoặc cao hơn. Mỗi tầng nhanh hơn tầng bên dưới nó khoảng một bậc độ lớn. Điều đó có nghĩa là dữ liệu di chuyển thoải mái trong bộ nhớ của bộ tăng tốc nhưng sẽ gặp nút thắt cổ chai nghiêm trọng khi phải lấy từ đĩa. Hệ thống phân cấp băng thông xếp tầng này giải thích tại sao thời gian lặp của một hệ thống được pipeline tốt được chi phối bởi giá trị lớn nhất của độ trễ các thành phần thay vì tổng của chúng, như equation 13 chỉ ra: \[T_{\text{iteration}} =\max(T_{\text{fetch}}, T_{\text{process}}, T_{\text{transfer}}) \tag{13}\]
Khi các giai đoạn pipeline chồng lấp đúng cách (tức là lấy batch tiếp theo từ lưu trữ trong khi tiền xử lý batch hiện tại và chuyển batch trước đó đến bộ tăng tốc), thời gian lặp sẽ bằng thời gian của giai đoạn chậm nhất, thay vì tổng thời gian của tất cả các giai đoạn. Sự chồng lấp này chính là điều mà prefetching đạt được, biến một nút thắt cổ chai nối tiếp thành một pipeline song song, nơi mỗi tầng hoạt động đồng thời trên các batch khác nhau.
Các kiến trúc thực tế
Một thiết bị NVMe với băng thông danh định 7 GB/s có thể duy trì 3.50 GB/s nếu khối lượng công việc (workload) đạt một nửa mức đỉnh. Các lệnh đọc ngẫu nhiên nhỏ và việc xáo trộn dữ liệu có thể làm giảm thông lượng hơn nữa; mức phạt này phụ thuộc vào kích thước truy cập, độ sâu hàng đợi, bố cục tệp và bộ nhớ đệm.
Để các bộ tăng tốc luôn được cấp đủ dữ liệu dù băng thông bị giảm, kiến trúc pipeline duy trì đồng thời nhiều bộ đệm dữ liệu: bộ đệm prefetch (tải các batch tiếp theo), bộ đệm xử lý (giữ dữ liệu đang biến đổi), và bộ đệm truyền tải (chuẩn bị dữ liệu cho bộ tăng tốc tiêu thụ). Tổng bộ nhớ phía máy chủ cần thiết sẽ tỷ lệ với dung lượng bộ nhớ trên mỗi batch \(M_{\text{batch}}\) theo equation 14: \[M_{\text{required}} = (N_{\text{prefetch}} + N_{\text{processing}} + N_{\text{transfer}}) \times M_{\text{batch}} \tag{14}\]
Để tránh làm bộ tăng tốc bị đói dữ liệu, thời gian phục vụ tiền xử lý trung bình trên mỗi batch phải thỏa mãn equation 15. \[T_{\text{preprocessing}} \leq T_{\text{compute}} \tag{15}\]
Nếu tiền xử lý mất 40 ms mỗi batch trên một worker, trong khi bộ tăng tốc tiêu thụ một batch mỗi 10 ms, thì để đạt scaling lý tưởng cần tối thiểu bốn worker. Yêu cầu thực tế còn phụ thuộc vào bộ lưu trữ, mức độ tranh chấp CPU và chi phí biến đổi; section 1.5.2 phân tích prefetching và các worker song song.
Lượt truyền xuôi
Các batch đã chuẩn bị đi vào vòng lặp huấn luyện qua lượt truyền xuôi, nơi dữ liệu đầu vào lan truyền qua mô hình để tạo ra dự đoán. Về mặt khái niệm, luồng xử lý tuân theo phép biến đổi từng lớp \(\mathbf{A}^{(\ell)} = f\left(\mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)}\right)\) đã trình bày trước đó, nhưng khi triển khai ở cấp hệ thống, cần lên lịch các kernel, di chuyển các activation và lưu giữ đủ trạng thái cho lan truyền ngược.
Các thao tác tính toán
Lượt truyền xuôi điều phối các mẫu tính toán đã giới thiệu ở section 1.2.1.2 và tối ưu chúng cho các phép toán mạng nơ-ron cụ thể. Dựa trên nền tảng phép nhân ma trận, hệ thống phải thực thi hiệu quả các phép nhân-tích lũy với độ phức tạp \(N \times M \times B\) cho mỗi lớp. Cụ thể, các lớp điển hình có kích thước \(512 \times 1024\), khi xử lý các batch gồm 64 mẫu, sẽ thực hiện khoảng 33.6 million MACs phép nhân-tích lũy, tương đương khoảng 67.1 MFLOP theo quy ước mỗi MAC bằng hai FLOPs.
Systems Perspective 1.6: Hiện tượng lượng tử hoá theo sóng và hiệu ứng đuôi
Một lỗi phổ biến trong các hệ thống ML là bỏ qua đơn vị thực thi cố định của các kernel GPU. Việc thực thi trên GPU được lượng tử hoá thành các “sóng” công việc. Tuy nhiên, đơn vị liên quan ở đây là cách kernel ánh xạ luồng (thread) hoặc tile, chứ không nhất thiết là một mẫu (sample) trên mỗi luồng.
Table 6: Minh hoạ phép tính phần đuôi của warp: Với cách ánh xạ mỗi luồng xử lý một tác vụ, số lượng tác vụ chỉ vừa vượt ngưỡng 32 luồng sẽ khởi chạy một warp không được lấp đầy hoàn toàn. Ví dụ, 33 tác vụ sẽ cần hai warp, trong khi 64 tác vụ cũng chỉ cần hai warp đó nhưng được lấp đầy hoàn toàn. Trong thực tế, các kernel huấn luyện sẽ ánh xạ các tensor tới các luồng và tile tuỳ theo cách triển khai cụ thể, thường gán nhiều luồng cho mỗi mẫu dữ liệu, nên không thể suy ra các giá trị này chỉ dựa vào kích thước batch. Do đó, việc phân tích hiệu năng (profiling) là cần thiết để xác định ánh xạ thực tế và các ranh giới sóng của kernel.
Hiệu ứng sóng: Một GPU NVIDIA thực thi công việc theo các warp gồm 32 luồng. Trong trường hợp đặc biệt minh hoạ, nếu một tác vụ độc lập được gán cho một luồng, thì 32 tác vụ sẽ lấp đầy một warp. Ngược lại, 33 tác vụ sẽ cần đến một warp thứ hai, nhưng warp này sẽ gần như trống. Các kernel mạng nơ-ron thường ánh xạ mỗi mẫu tới nhiều luồng, vì vậy kích thước batch đơn thuần không quyết định mức độ tận dụng này.
Hiệu ứng đuôi ở quy mô lớn: Trên một GPU lớn như H100 với 132 Bộ xử lý luồng (SM - Streaming Multiprocessors), nơi mỗi SM lập lịch cho các nhóm warp, phần cứng có thể xử lý hàng nghìn luồng trong một “sóng”. Nếu tổng khối lượng công việc (workload) chỉ hơi vượt quá một ranh giới sóng (ví dụ: 1.01 sóng), phần cứng sẽ phải đợi một sóng gần như trống hoàn thành trước khi tác vụ tiếp theo bắt đầu.
Table 6 định lượng cho ví dụ minh hoạ về một tác vụ trên mỗi luồng. Tuy nhiên, đây không phải là một mô hình hiệu suất tổng quát cho kích thước batch.
| Các mục công việc độc lập | Số lượng Warps cần thiết | Mức sử dụng Lane | Thời gian tương đối |
|---|---|---|---|
| 32 | 1 | 100% | 1\(\times\) |
| 33 | 2 | 51.6% | ~2× |
| 64 | 2 | 100% | 1\(\times\) |
| 65 | 3 | 67.7% | ~1.5× |
Quy tắc kỹ thuật: Hãy căn chỉnh kích thước tensor và tile sao cho phù hợp với cách kernel được ánh xạ lên phần cứng, sau đó benchmark các kích thước batch tiềm năng. Một công cụ phân tích hiệu năng (profiler) có thể phát hiện các warp hoặc sóng bị lấp đầy một phần; riêng kích thước batch thì không thể.
Hiểu rõ các hiệu ứng đuôi này là khác biệt giữa người thực hành chỉ chỉnh bằng thử-sai và kỹ sư thiết kế theo phần cứng.
Các kiến trúc mạng nơ-ron hiện đại không chỉ dừng lại ở các phép toán ma trận cơ bản mà còn mở rộng sang các mẫu tính toán chuyên biệt. Chẳng hạn, mạng tích chập thực hiện các phép toán với kernel một cách có hệ thống trên các tensor đầu vào. Hãy xem xét một tensor đầu vào điển hình có kích thước \(64 \times 224 \times 224 \times 3\) (kích thước batch \(\times\) chiều cao \(\times\) chiều rộng \(\times\) kênh) được xử lý bởi \(7 \times 7\) kernel. Mỗi vị trí yêu cầu 147 multiply-accumulate operations, và với 64 bộ lọc hoạt động trên \(218 \times 218\) chiều không gian, khối lượng tính toán trở nên rất lớn.
Các kiến trúc Transformer giới thiệu cơ chế attention (xem Kiến trúc mạng) để tính toán điểm tương đồng giữa các chuỗi. Các phép toán này kết hợp phép nhân ma trận với chuẩn hóa softmax, đòi hỏi các phép toán broadcasting và reduction hiệu quả trên các độ dài chuỗi khác nhau. Mẫu tính toán ở đây khác biệt đáng kể so với phép tích chập, do đó yêu cầu các bộ tăng tốc phần cứng phải có chiến lược thực thi linh hoạt.
Trong các mạng này, các phép toán theo phần tử đóng vai trò hỗ trợ. Các hàm activation như ReLU và sigmoid khi được triển khai riêng lẻ sẽ biến đổi các giá trị một cách độc lập và thường bị giới hạn bởi băng thông bộ nhớ hơn là khả năng tính toán (xem section 1.2.4). Chuẩn hóa batch cũng gặp những thách thức tương tự: nó tính toán thống kê và chuẩn hóa các giá trị theo các chiều của batch, đồng thời tạo ra các điểm đồng bộ trong pipeline tính toán.
Các bộ tăng tốc phần cứng hiện đại, đặc biệt là GPU, tối ưu hóa các phép tính đa dạng này thông qua song song hóa quy mô lớn. Để đạt hiệu suất cao nhất, cần chú ý kỹ đến kiến trúc phần cứng. GPU xử lý dữ liệu theo các nhóm luồng có kích thước cố định, gọi là warps19 trên kiến trúc NVIDIA hoặc wavefronts trên kiến trúc AMD. Kích thước ma trận hiệu quả phụ thuộc vào cách ánh xạ thread-block và tile của kernel, bao gồm cả các yêu cầu căn chỉnh do các lệnh Tensor Core đặt ra.
19 Warp: Thuật ngữ này xuất phát từ ngành dệt may, trong đó “warp” là tập hợp các sợi chỉ được căng chặt trên khung dệt, còn con thoi dệt ngang qua chúng. NVIDIA đã dùng thuật ngữ này vì các luồng GPU trong một warp thực hiện cùng một lệnh một cách đồng bộ, tương tự như các sợi chỉ song song di chuyển cùng nhau trên khung dệt. Một warp của NVIDIA chứa 32 luồng.
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
NVIDIA Corporation. 2023. NVIDIA cuDNN Developer Guide, Version 8.9.6.
Các thư viện như cuDNN (Chetlur et al. 2014) giải quyết những thách thức này bằng cách cung cấp các triển khai tối ưu cho từng loại phép toán. Những hệ thống này tự động chọn thuật toán dựa trên kích thước đầu vào, khả năng phần cứng và các ràng buộc bộ nhớ. Quá trình lựa chọn cân bằng giữa hiệu quả tính toán và mức sử dụng bộ nhớ, thường cần đo lường thực nghiệm để xác định cấu hình tối ưu cho từng thiết lập phần cứng cụ thể (NVIDIA Corporation 2023). Những cách thức tận dụng phần cứng này củng cố mối quan hệ giữa kích thước batch và mức độ sử dụng tài nguyên đã được đề cập trong section 1.2.2.1: sự giằng co giữa kích thước batch lớn hơn (tận dụng tài nguyên tốt hơn) và các ràng buộc bộ nhớ (buộc phải dùng batch nhỏ hơn) xuyên suốt mọi tầng thiết kế hệ thống huấn luyện.
Quản lý bộ nhớ
Quản lý bộ nhớ trở nên then chốt ở pha truyền xuôi, vì các activation trung gian cần được lưu lại để phục vụ bước lan truyền ngược sau đó. Trước khi xem cách các framework quản lý bộ nhớ trong truyền xuôi, hữu ích là ước tính tổng VRAM cần cho huấn luyện. Một ví dụ cụ thể với mô hình 7 tỷ tham số trên GPU 24 GB cho thấy cách trọng số, gradient, trạng thái optimizer và các activation cộng dồn.
Napkin Math 1.4: Ước tính dung lượng VRAM cần thiết
Bài toán: Liệu một mô hình có 7B tham số có thể được huấn luyện trên một GPU 24 GB không?
Cho trước: 7B tham số, trọng số và gradient ở định dạng FP16, trọng số chính và trạng thái Adam ở định dạng FP32, cùng với bộ nhớ GPU 24 GB.
Phép tính:
- Trọng số (FP16): 7B \(\times\) 2 byte = 14 GB.
- Gradients (FP16): Có cùng kích thước với trọng số = 14 GB.
- Trạng thái huấn luyện FP32: Trọng số gốc cần 28 GB; động lượng và phương sai của Adam cần thêm 56 GB.
- Tổng phụ (trước khi tính đến các activation): 14 GB + 14 GB + 28 GB + 56 GB = 112 GB, con số này đã vượt quá dung lượng VRAM của một GPU 24 GB.
- Các activation: Một ước tính đơn giản cho transformer là Batch \(\times\) SeqLen \(\times\) Hidden \(\times\) Layers \(\times\) Bytes \(\times\) một hệ số activation để tính phần attention, multilayer perceptron và các giá trị trung gian của chuẩn hóa được giữ lại. Với Batch = 1, Seq = 2048, Hidden = 4096, 32 layers, và một hệ số activation khoảng 57×, các activation được giữ lại sẽ chiếm thêm 30.6 GB.
Góc nhìn hệ thống: Để huấn luyện toàn bộ tham số, ta cần phân vùng hoặc chuyển trạng thái qua các hệ thống như song song dữ liệu phân mảnh hoàn toàn (FSDP) hoặc ZeRO. Trọng số cơ sở đã lượng tử hóa giúp giảm bộ nhớ cho tinh chỉnh (fine-tuning) hiệu quả tham số, nhưng không thể tái tạo công thức mixed-precision cho huấn luyện toàn bộ tham số này.
Chỉ bộ nhớ activation tăng xấp xỉ tuyến tính theo kích thước batch (equation 5); còn trạng thái mô hình và optimizer thì cố định. Điểm phức tạp thực tế nằm ở cách các chi phí này tương tác với nhau qua các lớp.
Hãy xét một mô hình lớn tiêu biểu như ResNet-50 (kiến trúc phân loại ảnh phổ biến), xử lý ảnh ở độ phân giải 224 \(\times\) 224 với kích thước batch 32. Lớp tích chập đầu tiên tạo ra các bản đồ activation kích thước 112 \(\times\) 112 \(\times\) 64; với mỗi ảnh ở độ chính xác đơn (4 byte), cần khoảng 3.2 MB bộ nhớ. Khi mạng đi qua 50 layers lớp, nhu cầu bộ nhớ tích lũy tăng đáng kể: tổng activation của toàn bộ truyền xuôi khoảng 8 GB; truyền ngược cần thêm 4 GB bộ nhớ làm việc cho activation (tổng theo thực nghiệm, không bao gồm gradient tham số được lưu trữ); và tham số mô hình tiêu tốn 102.4 MB. Tổng cộng, 12.1 GB này chiếm khoảng 15.1 percent dung lượng bộ nhớ 80 GB của một GPU A100 cho một batch duy nhất.
Các quy luật mở rộng bộ nhớ cho thấy những đánh đổi quan trọng trong việc tận dụng phần cứng. Tăng gấp đôi kích thước batch lên 64 làm tăng bộ nhớ activation cho truyền xuôi lên 16 GB và bộ nhớ làm việc cho activation của truyền ngược lên 8 GB, tổng cộng 24.1 GB, khiến khoảng trống bộ nhớ còn lại cho các mô hình sâu hơn, đầu vào lớn hơn và trạng thái optimizer bị thu hẹp. Huấn luyện các mô hình lớn ở quy mô GPT-3 (175B tham số, đại diện cho các mô hình ngôn ngữ lớn hiện nay) cần khoảng 700 GB chỉ riêng cho tham số ở FP32 (350 GB ở FP16), nên phải dùng các chiến lược bộ nhớ phân tán trên nhiều nút có bộ nhớ lớn.
Các GPU cao cấp dùng cho huấn luyện thường có bộ nhớ từ 40 GB đến 80 GB. Bộ nhớ này phải đủ chỗ cho activation, tham số mô hình, gradient và trạng thái của optimizer. Có hai kỹ thuật trực tiếp giải quyết ràng buộc này: activation checkpointing đánh đổi việc tính toán lại để giảm lượng activation cần lưu, và huấn luyện hỗn hợp độ chính xác (mixed-precision training) giảm một nửa bộ nhớ cho mỗi giá trị bằng cách dùng FP16 thay vì FP32. Cả hai kỹ thuật này sẽ được xem xét chi tiết trong section 1.5; ở đây, điểm mấu chốt là dung lượng bộ nhớ, chứ không phải thông lượng, thường quyết định kích thước batch tối đa khả thi và độ sâu của mô hình. Trong thực tế, người làm thường bắt đầu với kích thước batch lớn khi phát triển ban đầu trên các mạng nhỏ hơn, rồi giảm dần khi chuyển sang các kiến trúc sâu hơn hoặc khi phần cứng bị hạn chế bộ nhớ.
Pha lan truyền ngược đảo ngược luồng này, tính gradient với chi phí xấp xỉ gấp đôi pha truyền xuôi (section 1.2.3). Chi phí bộ nhớ theo từng lớp tăng nhanh trên toàn mạng: ở các phần sâu hơn của ResNet-50, các lớp tích chập giữa mạng dùng 256 bộ lọc thay vì 64 ở phần đầu, nhưng kích thước bản đồ không gian nhỏ hơn giúp bù bớt bộ nhớ activation, trong khi lượng tính toán tích chập phụ thuộc vào kích thước kernel cùng số kênh vào và ra. Trên 50 layers, tập làm việc của pha lan truyền ngược minh họa đạt khoảng 3.2 GB trước khi tính đến trạng thái của optimizer và các cập nhật tham số. Các quan hệ phụ thuộc quyết định thứ tự tính gradient theo từng lớp, dù các runtime có thể chồng lấp các kernel độc lập và việc truyền gradient. Đỉnh bộ nhớ phản ánh các activation giữ lại từ pha truyền xuôi, các gradient, không gian làm việc tạm thời và lịch cấp phát của framework, chứ không chỉ do độ rộng của một lớp đơn lẻ.
Cập nhật tham số và các optimizer
Sau khi pha lan truyền ngược tính xong gradient, hệ thống phải cấp phát và quản lý bộ nhớ cho cả tham số và gradient, rồi thực hiện tính toán cập nhật. Việc chọn optimizer quyết định quy tắc cập nhật toán học và tài nguyên hệ thống cần cho quá trình huấn luyện. Listing 3 minh họa phần lan truyền ngược/cập nhật trong chu trình cập nhật tham số của PyTorch: sau khi pha truyền xuôi tính toán dự đoán và hàm mất mát đo lường sai số, loss.backward() sẽ điền gradient vào các tensor tương ứng và optimizer.step() áp dụng quy tắc cập nhật cho tất cả tham số dựa trên optimizer đã cấu hình (Adam, SGD, v.v.).
loss.backward()  # Compute gradients
optimizer.step()  # Update parameters
Các thao tác này kích hoạt một chuỗi truy cập bộ nhớ và phép tính. Hệ thống phải nạp tham số từ bộ nhớ, tính toán cập nhật bằng các gradient đã lưu, rồi ghi các tham số đã chỉnh sửa trở lại bộ nhớ. Các optimizer khác nhau có yêu cầu bộ nhớ và kiểu tính toán khác nhau, ảnh hưởng trực tiếp đến hiệu suất hệ thống và mức dùng tài nguyên.
Bộ nhớ của optimizer trong vòng lặp huấn luyện
Hệ thống phân cấp bộ nhớ của optimizer được thiết lập trong table 4 thể hiện rõ trong mỗi vòng lặp huấn luyện. Mỗi lần cập nhật tham số bao gồm việc đọc giá trị hiện tại của tham số, truy cập gradient, tính toán quy tắc cập nhật, và ghi các tham số đã thay đổi trở lại bộ nhớ. Với Adam, còn phải cập nhật và truy cập các bộ đệm momentum và variance, gây ra lưu lượng truy cập bộ nhớ đáng kể cho các mô hình lớn.
Ở quy mô hàng tỷ tham số, trạng thái optimizer chiếm phần lớn ngân sách bộ nhớ. Như được định lượng trong ví dụ GPT-2 (section 1.2.2.3), một mô hình 1.5B cần 12 GB chỉ riêng cho trạng thái của Adam ở FP32, ngoài các tham số và gradient, và còn chưa tính activation. Thách thức này đã thúc đẩy các biến thể optimizer tiết kiệm bộ nhớ. Adafactor phân rã trạng thái moment bậc hai (Shazeer and Stern 2018), các optimizer 8-bit lượng tử hóa các thống kê của optimizer (Dettmers et al. 2022), và GaLore tính toán cập nhật trong một không gian hạng thấp. Hãy so sánh các thanh bộ nhớ trong figure 5 để thấy GaLore giải quyết hạn chế này thế nào: bằng cách tính toán cập nhật trong không gian nén (Zhao et al. 2024), kỹ thuật này giảm phần bộ nhớ vốn bị trạng thái optimizer chi phối xuống chỉ còn một phần nhỏ so với ban đầu, cho phép huấn luyện các mô hình lớn hơn trên phần cứng cố định.
Shazeer, Noam, and Mitchell Stern. 2018. “Adafactor: Adaptive Learning Rates with Sublinear Memory Cost.” International Conference on Machine Learning (ICML), Proceedings of machine learning research, vol. 80: 4596–604.
Dettmers, Tim, Mike Lewis, Sam Shleifer, and Luke Zettlemoyer. 2022. “8-Bit Optimizers via Block-Wise Quantization.” International Conference on Learning Representations (ICLR).
Zhao, Jiawei, Zhenyu Zhang, Beidi Chen, Zhangyang Wang, Anima Anandkumar, and Yuandong Tian. 2024. “GaLore: Memory-Efficient LLM Training by Gradient Low-Rank Projection.” arXiv Preprint.

Các thanh biểu đồ làm rõ thứ hạng: BF16 Adam vượt xa nhất so với ngưỡng ngân sách của một GPU, còn Adafactor, 8-bit Adam và 8-bit GaLore lần lượt giảm dần phần vượt mức. Ngay cả tổng nhỏ nhất được minh họa vẫn trên 24 GB, nên ta vẫn cần thêm một kỹ thuật tiết kiệm bộ nhớ khác.
Kích thước batch và cập nhật tham số
Nếu tăng kích thước batch mà không điều chỉnh lại lịch tốc độ học, quá trình hội tụ có thể kém hiệu quả. Hãy so sánh các đường biểu diễn loss minh họa trong figure 6, bạn sẽ thấy tốc độ học cố định làm chậm hội tụ so với lần chạy có tốc độ học được điều chỉnh trong kịch bản này.
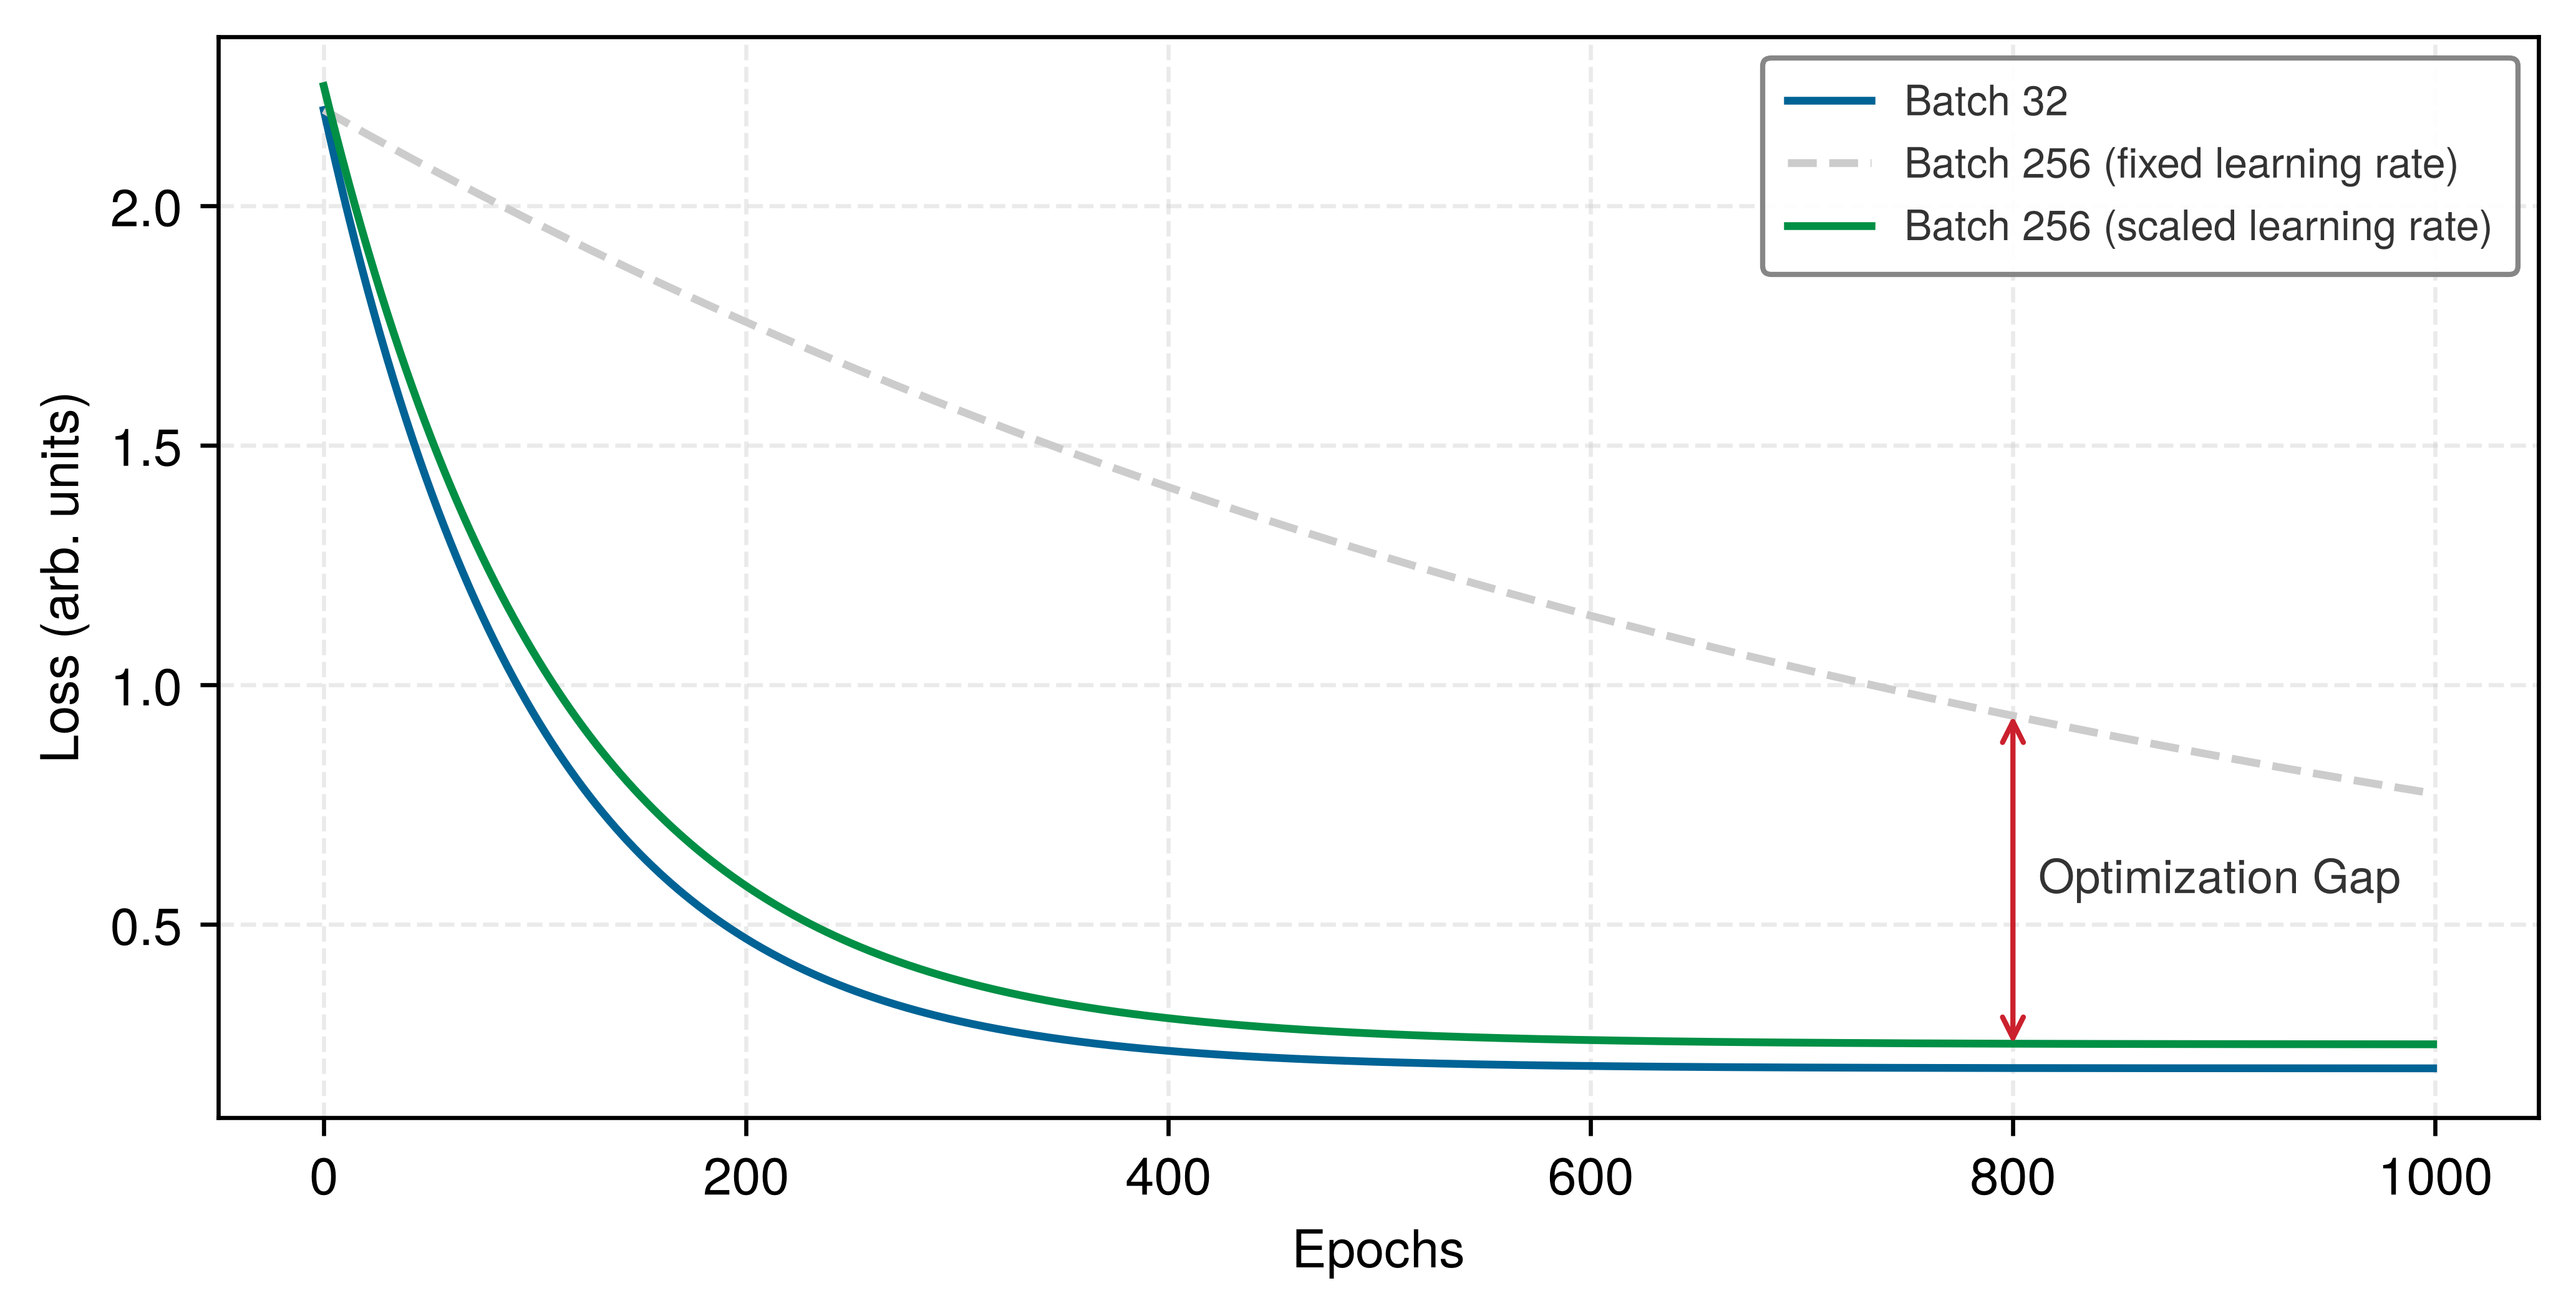
Với một tập dữ liệu cố định, nếu tăng gấp đôi kích thước batch toàn cục, số lần cập nhật trong mỗi epoch sẽ giảm một nửa. Quy tắc mở rộng tuyến tính (\(\eta_{\text{new}} = k \times \eta_{\text{base}}\)) là một công thức thực nghiệm hữu ích trong một số khoảng kích thước batch, thường được kết hợp với warmup tốc độ học, nhưng không đảm bảo hội tụ hay khả năng khái quát hóa tương đương. Figure 6 dùng các đường cong tổng hợp đã được chuẩn hóa để minh họa hiệu ứng mong muốn.
Ngoài các tác động đến hội tụ, kích thước batch còn tương tác với các chiến lược huấn luyện phân tán. Batch toàn cục lớn hơn làm giảm số bước optimizer và số lần đồng bộ hóa gradient trong mỗi epoch, trong khi khối lượng truyền tải của mỗi lần đồng bộ hóa đầy đủ chủ yếu do kích thước gradient của tham số mô hình quyết định, chứ không phải kích thước batch. Trong môi trường phân tán, kích thước batch cục bộ và toàn cục sẽ ràng buộc mức độ song song dữ liệu và tần suất cập nhật tham số. Kỹ thuật tích lũy gradient (section 1.5.5) tách kích thước batch hiệu quả khỏi số mẫu trong một micro-batch, nhưng vẫn cần tinh chỉnh kích thước batch hiệu quả.
Napkin Math 1.5: Chi phí vận hành
Bài toán: Với các giả định đơn giản hóa dưới đây, giữa việc thuê và mua một cụm 1.024 H100 để huấn luyện mô hình Llama 2 70 tỷ tham số trong một lần chạy, phương án nào rẻ hơn?
Tính toán:
- Khối lượng công việc (workload): Mô hình Llama 2 70B (70B tham số, 2T token).
- Tính toán cần thiết: \(6 \times 70 \times 10^9 \times 2 \times 10^{12} \approx 8.4 \times 10^{23}\) FLOPs. Hệ số dẫn 6 xuất phát từ cách hạch toán của chương: khoảng 2 FLOPs trên mỗi tham số và mỗi token trong lượt truyền xuôi (hai FLOPs cho mỗi phép nhân-tích lũy). Khi tính cả lượt truyền ngược, vốn tốn khoảng gấp đôi lượt truyền xuôi, tổng chi phí được nhân ba.
- Phần cứng: NVIDIA H100 (Đỉnh: 989 TFLOP/s FP16). Tỷ lệ sử dụng giả định: 50 percent (494.5 TFLOP/s).
- Thời gian: \(8.4 \times 10^{23} / (494.5 \times 10^{12}) \approx 1.70 \times 10^{9}\) giây ≈ 53.8 years (trên một GPU).
- Cụm: Với 1,024 GPUs GPU, thời gian sẽ là 19.2 days.
Phân tích kinh tế:
- Thuê ($3/hr): 1,024 GPUs \(\times\) 24 giờ \(\times\) 19.2 days \(\times\) $3/hr ≈ $1.42M.
- Mua ($30,000 mỗi GPU): 1,024 GPUs \(\times\) $30,000 = $30.7M.
Thông tin chuyên sâu về hệ thống: Trong kịch bản đơn giản hóa về mức độ sử dụng và giá cả này, chi phí mua tương đương khoảng 21.7 lần thuê. So sánh chi phí sở hữu thực tế còn phải tính đến mạng cho cụm, hệ thống máy chủ, cơ sở vật chất, công suất, nhân sự, khấu hao, tài chính và mức độ sử dụng đạt được giữa các lần chạy.
Mọi quyết định về kích thước batch và độ chính xác cho đến nay đều nhằm tối ưu thời gian thực; ở quy mô lớn, thời gian đó được tính bằng đô la. Chi phí tính toán trở thành một ràng buộc then chốt, định hình mọi quyết định huấn luyện, từ chọn phần cứng đến quy mô cụm. Phép tính ở đây chuyển chi phí đó thành bài toán thuê hay mua cho một lần huấn luyện thực tế.
Phần này đã trình bày những gì về cấu trúc của các hệ thống huấn luyện, và các nền tảng toán học trong section 1.2 đã định lượng FLOPs, bộ nhớ và băng thông mà mỗi giai đoạn cần. Tuy nhiên, biết những gì phải diễn ra không cho ta biết đâu là chỗ hệ thống đang yếu. Một pipeline huấn luyện chỉ nhanh bằng giai đoạn chậm nhất của nó: nếu tải dữ liệu mất 50 ms và tính toán mất 100 ms, tối ưu hóa tính toán 20% chỉ tiết kiệm 20 ms; nhưng nếu nút thắt cổ chai lại là khâu tải dữ liệu, cùng từng ấy công sức kỹ thuật sẽ không tiết kiệm được gì. Trước khi áp dụng các kỹ thuật tối ưu hóa, cần dùng các công cụ chẩn đoán để xác định chính xác yếu tố nào thực sự giới hạn hiệu suất.
Self-Check: Question
Which set of subsystems defines the chapter’s high-level training system architecture, and what systems engineering advantage does this decomposition provide?
- Storage controller, compiler intermediate representation, and runtime execution engine; this separates hardware target code generation from storage layout.
- Data pipeline, training loop, and evaluation pipeline; this separates distinct resource profiles (CPU/storage I/O, accelerator compute/memory, and periodic validation) so bottlenecks can be isolated at subsystem interfaces.
- Tokenizer, hyperparameter optimizer, and model registry; this organizes the model deployment lifecycle around developer interfaces.
- Gradient aggregator, parameter server, and checkpoint restorer; this decomposes cloud service microservices.
In a profiled training pipeline, CPU data preprocessing delivers batches at \(4\text{ GB/s}\), host-to-device PCIe transfer operates at \(32\text{ GB/s}\), and GPU compute consumes data at an equivalent rate of \(12\text{ GB/s}\). According to the pipeline bottleneck model, what determines end-to-end throughput, and what is the optimal first engineering action?
- The average rate of the three stages (\((4+32+12)/3 = 16\text{ GB/s}\)); apply incremental tuning across all stages simultaneously.
- The PCIe transfer rate (\(32\text{ GB/s}\)), because every batch must physically cross the bus; upgrade from PCIe Gen4 to Gen5.
- The minimum rate (\(4\text{ GB/s}\) at preprocessing); parallelize CPU preprocessing (e.g., via multi-worker DataLoader and prefetching) because the slowest stage caps total system throughput.
- The GPU compute rate (\(12\text{ GB/s}\)), because accelerator computation is always the primary cost driver in deep learning.
Explain why CPU-side tokenization and data augmentation can severely bottleneck GPU training even when the resulting tensor transfer across PCIe takes less than one millisecond.
Scaling the training batch size by \(8\times\) (e.g., from 512 to 4,096) while keeping the learning rate and schedule constant guarantees identical validation convergence in \(8\times\) less wall-clock time.
To enable fast, asynchronous Direct Memory Access (DMA) transfers from host RAM to GPU memory without intermediate CPU staging copies, host memory buffers must be allocated as page-locked or ____ memory.
Xác định nút thắt cổ chai
Biết sơ đồ tổng thể không đồng nghĩa với chẩn đoán. Việc biết rằng các phép toán attention tiêu thụ 50% FLOPs và việc tải dữ liệu chiếm 25% thời gian thực tế vẫn không cho biết nên xử lý ràng buộc nào trước; điều đó còn tùy vào tài nguyên nào thực sự bị bão hòa trong lúc chạy.
Để biến hiểu biết từ sơ đồ tổng thể thành các quyết định tối ưu hóa khả thi, phương pháp chẩn đoán cần bắt đầu bằng một thước đo có ý nghĩa về hiệu suất huấn luyện. Tỷ lệ sử dụng bộ tăng tốc thô có thể gây hiểu lầm, vì bộ tăng tốc vẫn có thể hoạt động khi thực hiện tính toán lại, đệm, hoặc các công việc khác nằm ngoài phần tính FLOPs của mô hình. Tỷ lệ sử dụng FLOPs của mô hình (MFU)20 cung cấp phép so sánh đó.
20 Tỷ lệ sử dụng FLOPs của mô hình (MFU): Bài báo PaLM (Chowdhery et al. 2022) định nghĩa MFU là thông lượng quan sát được chia cho thông lượng tối đa lý thuyết ở FLOPs đỉnh. Lần chạy với 540 tỷ tham số của họ báo cáo MFU đạt 46.2% trên 6,144 chip TPU v4. Phần còn lại không được tính vào tử số dựa trên FLOPs của mô hình; bản thân MFU cũng không chỉ ra bao nhiêu đến từ lưu lượng bộ nhớ, giao tiếp, các khoảng chờ trong pipeline, tính toán lại, hay các công việc khác.
Chowdhery, Aakanksha, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, et al. 2022. “PaLM: Scaling Language Modeling with Pathways.” arXiv Preprint arXiv:2204.02311.
Definition 1.4: Tỷ lệ sử dụng FLOPs của mô hình (MFU)
Tỷ lệ sử dụng FLOPs của mô hình (MFU) là một chỉ số hiệu suất, được tính bằng công thức \(\text{MFU} = O_{\text{model}} / (R_{\text{peak}} \cdot T_{\text{step}})\). Ở đây, \(O_{\text{model}}\) là số FLOPs hữu ích mỗi bước của mô hình (gồm forward và backward, không tính phần tái tính (rematerialization)), còn \(T_{\text{step}}\) là thời gian đo thực tế cho mỗi bước huấn luyện. MFU cho biết phần thông lượng đỉnh của phần cứng thực sự dành cho các phép tính hữu ích của mô hình.
- Ý nghĩa: MFU giúp cụ thể hóa khái niệm “thông lượng hiệu quả” trong định luật sắt. Ví dụ, với một mô hình transformer có 7B tham số, xử lý 1,024 tokens token mỗi bước trên A100 (đạt đỉnh 312 TFLOP/s trên Tensor Core FP16/BF16), nếu thời gian một bước là 1.2-second, thì MFU sẽ là tỷ lệ giữa FLOPs của mô hình và ngân sách FLOPs ở tốc độ đỉnh khả dụng, xấp xỉ 0.11 (11.5 percent). Phần 88.5 percent còn lại không được ghi nhận vào FLOPs của mô hình, và có thể do lưu lượng bộ nhớ, giao tiếp, các khoảng chờ (bubbles), các thao tác ngoài mô hình, hoặc thời gian nhàn rỗi. Việc một giá trị MFU có tốt hay không phụ thuộc vào mô hình, phần cứng, độ chính xác và chiến lược song song hóa; để chẩn đoán cần có hồ sơ hiệu năng (profile) cụ thể thay vì một ngưỡng chung.
- Sự khác biệt: Báo cáo mức sử dụng phần cứng cho biết các khối xử lý của thiết bị có đang hoạt động hay không, trong khi MFU ghi nhận theo ước tính phân tích về FLOPs của mô hình dùng ở tử số. Vì vậy, MFU có thể loại trừ việc tính toán lại và padding, ngay cả khi các thao tác này vẫn khiến thiết bị bận rộn. So sánh giữa các bộ tăng tốc vẫn nhạy với thông số thông lượng đỉnh được chọn và quy ước đếm FLOPs.
- Sai lầm phổ biến: Nhiều người nghĩ rằng đạt 100% MFU là mục tiêu thực tế và có thể duy trì. Lưu lượng bộ nhớ, giao tiếp và các công việc không phải phép toán ma trận khiến chạy end-to-end luôn thấp hơn mức đỉnh, nhưng không tồn tại trần chung 55–65% cho mọi trường hợp. Giá trị báo cáo còn tùy vào mô hình, độ chính xác, batch, phần cứng và cách định nghĩa MFU, và có thể cải thiện nhờ FlashAttention cùng việc tinh chỉnh cẩn thận.
Các nút thắt cổ chai trong quá trình huấn luyện có thể được phân tích theo ba nhóm, tương ứng với phân loại D·A·M (Dữ liệu, Thuật toán, Máy). Phần Khung phân loại D·A·M cung cấp framework chẩn đoán đầy đủ, ma trận khắc phục sự cố và Thẻ điểm D·A·M. Bảng Table 7 liên kết từng trục với một nút thắt cổ chai phổ biến trong huấn luyện, các triệu chứng dễ nhận biết và các kỹ thuật tối ưu hóa liên quan. Đây là điểm khởi đầu để chẩn đoán, không phải ánh xạ cố định.
| Trục D·A·M | Nút thắt cổ chai | Triệu chứng | Các giải pháp chính |
|---|---|---|---|
| Thuật toán | Giới hạn bởi tính toán | Hoạt động của đơn vị số học cao; băng thông bổ sung không cải thiện thông lượng; thông lượng số học là yếu tố giới hạn | Độ chính xác giảm, thuật toán hiệu quả hơn, phần cứng tính toán nhanh hơn |
| Máy | Giới hạn bởi bộ nhớ | Mức sử dụng băng thông bộ nhớ cao so với thông lượng số học; các kernel bị đình trệ do di chuyển dữ liệu | Hợp nhất toán tử, attention hiệu quả bộ nhớ, định dạng độ chính xác giảm |
| Dữ liệu | Giới hạn bởi dữ liệu | Mức sử dụng bộ tăng tốc định kỳ giảm xuống gần bằng 0; CPU bận hoàn toàn trong các khoảng trống; pipeline không thể cung cấp dữ liệu cho GPU đủ nhanh | Tìm nạp trước, chồng chéo pipeline, lưu trữ nhanh hơn, song song hóa DataLoader |
Trong thực tế, nhóm nút thắt data-bound (liên quan đến dữ liệu) thường bị chẩn đoán sai.
Example 1.2: GPU bị khóa GIL
Tình huống: Một nhóm kỹ sư xây dựng một pipeline tải dữ liệu PyTorch, dùng
threading Python tiêu chuẩn cho khâu tiền xử lý hình ảnh bị giới hạn bởi CPU (CPU-bound), và giữ khóa trình thông dịch toàn cục (GIL).
Chẩn đoán: GIL tuần tự hóa các luồng tiền xử lý ở cấp độ Python này, khiến thời gian chuẩn bị trên máy chủ (\(T_{\text{prep}} \approx 250 \text{ ms}\)) vượt xa thời gian thực thi của GPU (\(T_{\text{step}} \approx 12 \text{ ms}\)), làm mức sử dụng phần cứng giảm mạnh xuống \(\eta_{\text{hw}} \approx 4.6\%\).
Bài học về hệ thống: Các tác vụ CPU của Python giữ GIL có thể tuần tự hóa luồng và làm GPU bị đói; các thao tác native có thể giải phóng GIL. Dùng tiến trình worker (num_workers > 0) để tránh bị trình thông dịch tuần tự hóa, còn NVIDIA DALI có thể chuyển các tác vụ phù hợp ra khỏi máy chủ.
Các công cụ profiling cho biết nút thắt cổ chai nào đang chi phối một khối lượng công việc (workload) cụ thể. Hình Figure 7 minh họa tình trạng data-bound được nêu trong phần chú thích: các khoảng trắng giữa những khối tính toán lặp lại cho thấy các đoạn thời gian không có kernel GPU trên dòng thời gian của thiết bị.
Bốn công cụ được tích hợp trong các framework machine learning cung cấp phân tích chi tiết các nút thắt cổ chai. Table 8 tách riêng các công cụ dòng thời gian ở cấp framework khỏi các công cụ thực thi ở cấp GPU, vì mỗi loại để lộ những dấu hiệu sự cố khác nhau.
| Công cụ | Phạm vi | Tín hiệu tốt nhất |
|---|---|---|
PyTorch Profiler (torch.profiler) |
Dấu vết hoạt động cấp framework | Thời gian dành cho mỗi hoạt động, các mẫu cấp phát bộ nhớ và thực thi kernel GPU |
| TensorFlow Profiler | Dòng thời gian huấn luyện cấp framework | Các nút thắt cổ chai của pipeline đầu vào và bố trí thiết bị |
| NVIDIA Nsight Systems | Dấu vết GPU cấp hệ thống | Thực thi kernel, truyền bộ nhớ và các điểm đồng bộ hóa |
| NVIDIA Nsight Compute | Phân tích GPU cấp kernel | Cường độ số học, thông lượng bộ nhớ và mức độ chiếm dụng |
Quy trình profiling tuân theo một khuôn mẫu có hệ thống: chạy một vòng lặp huấn luyện đại diện khi bật profiling, xem timeline để tìm các khoảng trống (nghẽn do dữ liệu), kiểm tra mức sử dụng băng thông bộ nhớ (nghẽn do bộ nhớ hay do tính toán), rồi xác định nút thắt chính trước khi chọn kỹ thuật tối ưu hóa.
Trong thực tế, các dấu hiệu đặc trưng từ table 7 hiện rõ trong dấu vết của profiler: mức độ sử dụng bộ tăng tốc, mức bão hòa băng thông bộ nhớ, và tỷ lệ hoạt động CPU so với GPU đều chỉ ra một lớp nút thắt cổ chai cụ thể. Những dấu hiệu này tương ứng với các kỹ thuật tối ưu hóa cụ thể: prefetching cho nút thắt do dữ liệu, mixed precision và operator fusion cho nút thắt do bộ nhớ, và cải tiến thuật toán hoặc nâng cấp phần cứng cho nút thắt do tính toán. Khi đã có một framework chẩn đoán trong tay, bước tiếp theo là xem xét chi tiết từng kỹ thuật tối ưu hóa: nó làm gì, nhắm vào thành phần nào trong luật sắt, và khi nào kết quả profiling cho thấy nên áp dụng.
Self-Check: Question
Why is Model FLOPs Utilization (MFU) a more reliable metric than raw GPU busy percentage (reported by tools like
nvidia-smi) when evaluating training systems efficiency?- MFU is measured directly from host CPU clock cycles, eliminating GPU driver instrumentation overhead.
- MFU is mathematically fixed to 100% on any healthy accelerator cluster regardless of software overhead.
- MFU counts only the theoretical forward and backward FLOPs required by the model architecture divided by peak hardware throughput, whereas raw GPU busy percentage also credits uncredited recomputation, padding tokens, and memory stalls that do not advance model training.
- MFU measures training loss convergence speed per dollar rather than floating-point operations.
An engineer profiles two training workloads. Workload A exhibits 92 percent GPU utilization, near-saturated HBM bandwidth, low CPU activity, and continuous kernel timelines. Workload B exhibits 20 percent GPU utilization with regular 50 ms idle gaps on the GPU timeline, low HBM bandwidth, and 100 percent CPU utilization. Apply the D·A·M taxonomy to classify each workload’s bottleneck and state the primary optimization category for each.
Order the steps of the systematic training optimization workflow recommended in the chapter:
- Classify the primary performance constraint (Data-, Memory-, or Compute-bound) using the D·A·M taxonomy.
- Run a representative training run with framework and system profilers enabled to capture CPU, PCIe, and GPU timeline traces.
- Re-profile the system to evaluate MFU improvement and identify whether the bottleneck has shifted to a new pipeline stage.
- Apply a targeted optimization technique specifically addressing the identified binding constraint.
An engineering team suspects that an individual custom LayerNorm kernel has poor arithmetic intensity and low register occupancy, while another team suspects their DataLoader is causing host-to-device PCIe transfer stalls. Which combination of profiling tools from the chapter is best suited to investigate each respective issue?
- NVIDIA Nsight Compute for the kernel-level arithmetic intensity and occupancy analysis; NVIDIA Nsight Systems (or PyTorch Profiler) for system-level timeline visualization of DataLoader and PCIe transfers.
nvidia-smifor kernel-level arithmetic intensity; TensorBoard loss curves for DataLoader PCIe transfer stalls.- NVIDIA Nsight Compute for cluster-wide inter-node network bandwidth; PyTorch Profiler for register allocation analysis.
- Linux
topcommand for GPU kernel instruction analysis; NVIDIA Nsight Systems for CPU register spill tracking.
Tối ưu hóa pipeline
Profiling cho biết chỗ nào trong hệ thống huấn luyện hoạt động chưa hiệu quả; phân loại D·A·M (Khung phân loại D·A·M) cho thấy loại nút thắt cổ chai nào đang giới hạn thông lượng. Câu hỏi còn lại là làm thế nào để khắc phục. Bốn kỹ thuật tối ưu hóa, mỗi kỹ thuật nhắm vào một loại nút thắt cổ chai cụ thể, cùng với một framework có tính hệ thống để phối hợp chúng, là lời giải.
Ngay cả các kiến trúc pipeline được thiết kế tốt cũng hiếm khi đạt thông lượng đỉnh phần cứng nếu không có tối ưu hóa chuyên biệt. Để minh họa quy mô của khoảng cách này, áp dụng mức sử dụng model-FLOP 30 percent đến 50 percent lên thông lượng đỉnh 312 TFLOP/s của A100 sẽ cho ra thông lượng model-FLOP thực tế chỉ 93.6 TFLOP/s–156 TFLOP/s. Đây là các giá trị kịch bản được suy ra, không phải các phép đo được báo cáo cho một khối lượng công việc (workload) trên A100. Các hệ thống mô hình lớn đã công bố cũng ghi nhận khoảng cách tương tự giữa thông lượng đỉnh và thông lượng thực tế (Narayanan et al. 2021; Chowdhery et al. 2022). Các hệ thống như SuperNeurons minh họa một khía cạnh của vấn đề này: các nút thắt cổ chai ở quản lý bộ nhớ có thể khiến các mạng lớn không huấn luyện hiệu quả, trừ khi runtime chủ động tối ưu hóa lưu trữ và truyền activation (Wang et al. 2018). Table 9 mở rộng phân loại nút thắt cổ chai dựa trên D·A·M từ table 7 bằng cách ánh xạ mỗi nút thắt cổ chai tới kỹ thuật tối ưu hóa cụ thể để xử lý nó.
Narayanan, Deepak, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Korthikanti, Dmitri Vainbrand, et al. 2021. “Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM.” Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis, 1–15. https://doi.org/10.1145/3458817.3476209.
Wang, Linnan, Jinmian Ye, Yiyang Zhao, Wei Wu, Ang Li, Shuaiwen Leon Song, Zenglin Xu, and Tim Kraska. 2018. “SuperNeurons: Dynamic GPU Memory Management for Training Deep Neural Networks.” Proceedings of the 23rd ACM SIGPLAN Symposium on Principles and Practice of Parallel Programming, 41–53. https://doi.org/10.1145/3178487.3178491.
| Nút thắt cổ chai | Giải pháp chính |
|---|---|
| Độ trễ di chuyển dữ liệu | Tìm nạp trước & Chồng chéo Pipeline |
| Thông lượng tính toán | Huấn luyện độ chính xác hỗn hợp |
| Dung lượng bộ nhớ | Tích lũy Gradient & Checkpointing Activation |
| Băng thông bộ nhớ (Attn.) | FlashAttention (xếp lát nhận biết IO) |
Những nút thắt cổ chai này thể hiện khác nhau theo quy mô hệ thống (một mô hình 100 GB sẽ chịu các ràng buộc khác so với một mô hình 1 GB), nhưng cách nhận diện và khắc phục thì dựa trên các nguyên tắc nhất quán. Độ trễ luân chuyển dữ liệu xuất hiện khi các batch huấn luyện không kịp đi từ hệ lưu trữ, qua tiền xử lý, đến các đơn vị tính toán đủ nhanh để giữ các bộ tăng tốc luôn hoạt động. Giới hạn về thông lượng tính toán xảy ra khi các phép toán chạy dưới mức hiệu năng đỉnh của phần cứng do lựa chọn độ chính xác chưa tối ưu hoặc kernel kém hiệu quả. Hạn chế về dung lượng bộ nhớ giới hạn cả kích thước mô hình và kích thước batch mà hệ thống có thể xử lý, trực tiếp giới hạn độ phức tạp của mô hình và hiệu quả huấn luyện.
Những nút thắt này tương tác với nhau, minh họa nguyên lý bảo toàn độ phức tạp từ Phần I: gỡ một ràng buộc có thể làm lộ ra ràng buộc khác. Khi tải dữ liệu trở thành nút thắt cổ chai, GPU phải ngồi chờ batch. Khi dung lượng bộ nhớ eo hẹp, phải giảm kích thước batch, từ đó có thể làm giảm hiệu suất GPU. Với một hồ sơ GPT-2 giả định, giả sử attention chiếm 50 percent thời gian, tải dữ liệu chiếm 25 percent, và các phép toán nặng tính toán khác chiếm 25 percent. Hồ sơ này gợi ý nên đánh giá attention tiết kiệm bộ nhớ, prefetching, và giảm độ chính xác; sau đó đo lại để xem thay đổi nào quan trọng nhất. Bài toán tối ưu hóa là xác định nút thắt hiện tại và chọn kỹ thuật xử lý nó mà không tạo ra một ràng buộc còn tệ hơn ở chỗ khác.
Framework tối ưu hóa có hệ thống
Ví dụ về profile cho thấy tối ưu hóa phải bắt đầu từ bằng chứng, không phải sở thích. Tối ưu hóa hiệu quả cần một cách làm có hệ thống, áp dụng cho mọi quy mô hệ thống và kiến trúc mô hình: profile để xác định nút thắt; chọn kỹ thuật phù hợp với các ràng buộc đã tìm ra; và phối hợp các giải pháp để xử lý nhiều nút thắt cùng lúc mà không gây xung đột.
Giai đoạn phân tích hiệu năng sử dụng các công cụ như PyTorch Profiler, TensorFlow Profiler hoặc NVIDIA Nsight Systems để cho thấy thời gian được dùng vào đâu trong các vòng lặp huấn luyện. Đây là các cách phân tích hiệu năng đã được giới thiệu ở phần tổng quan, nay được áp dụng có hệ thống để định lượng nút thắt nào chiếm ưu thế. Kết quả có thể cho thấy 40 percent thời gian dành cho tải dữ liệu, 35 percent cho tính toán và 25 percent cho các thao tác bộ nhớ, từ đó chỉ ra tải dữ liệu là mục tiêu tối ưu hóa chính.
Giai đoạn lựa chọn ghép các kỹ thuật tối ưu hóa với các nút thắt đã xác định. Mỗi kỹ thuật nhắm vào những ràng buộc cụ thể. Ví dụ, tìm nạp trước giúp giảm độ trễ khi di chuyển dữ liệu; huấn luyện độ chính xác hỗn hợp vừa cải thiện thông lượng tính toán vừa giảm áp lực bộ nhớ; còn tích lũy gradient thì quản lý các giới hạn về bộ nhớ. Để lựa chọn đúng, cần hiểu loại nút thắt cùng với đặc điểm phần cứng, kiến trúc mô hình và cấu hình huấn luyện, vì các yếu tố này ảnh hưởng đến hiệu quả của từng kỹ thuật.
Giai đoạn kết hợp phối nhiều kỹ thuật để cộng hưởng lợi ích. Tìm nạp trước và huấn luyện độ chính xác hỗn hợp bổ trợ cho nhau (một kỹ thuật xử lý tải dữ liệu, kỹ thuật kia xử lý tính toán và bộ nhớ) nên có thể áp dụng đồng thời. Tuy nhiên, một số tổ hợp có thể xung đột: tìm nạp trước quá mạnh làm tăng áp lực bộ nhớ, dễ mâu thuẫn với các cấu hình bị giới hạn bộ nhớ. Muốn kết hợp thành công, cần hiểu rõ các tương tác và phụ thuộc giữa các kỹ thuật.
Framework có hệ thống này (phân tích hiệu năng, lựa chọn, kết hợp) được áp dụng cho bốn kỹ thuật tối ưu hóa cốt lõi sẽ trình bày tiếp theo. Tìm nạp trước nhắm vào độ trễ khi di chuyển dữ liệu. Huấn luyện độ chính xác hỗn hợp giải quyết cả thông lượng và các ràng buộc về bộ nhớ. FlashAttention giảm lưu lượng bộ nhớ cho attention. Tích lũy gradient quản lý giới hạn bộ nhớ của batch bằng cách tuần tự hóa các micro-batch, trong khi checkpointing đánh đổi tính toán lại để giảm dung lượng lưu trữ activation. Kết quả phân tích hiệu năng nên quyết định thứ tự đánh giá các kỹ thuật này, và mỗi kỹ thuật đều cần phân tích chi phí-lợi ích, bao gồm cả công sức triển khai và gỡ lỗi.
Figure 8 cung cấp một cây quyết định giúp triển khai framework có hệ thống này. Các nhánh dẫn từ kết quả profiling, qua bước xác định nút thắt cổ chai, đến lựa chọn kỹ thuật, bảo đảm nỗ lực tối ưu hóa nhắm đúng ràng buộc thực sự thay vì những vấn đề mang tính chủ quan.

Lưu đồ này cho thấy một nhận định then chốt: tối ưu hóa là một quá trình lặp. Sau khi áp dụng một kỹ thuật, việc profiling lại thường cho thấy một nút thắt khác trở nên chiếm ưu thế. Một hệ thống bị giới hạn bởi dữ liệu, sau khi thêm tìm nạp trước, có thể chuyển thành bị giới hạn bởi bộ nhớ, khi đó cần áp dụng kỹ thuật tiếp theo trong cây quyết định. Việc tinh chỉnh lặp đi lặp lại sẽ tiếp tục cho đến khi profiling cho thấy tài nguyên được sử dụng cân bằng hoặc đạt thông lượng huấn luyện ở mức chấp nhận được.
Tìm nạp dữ liệu trước và chồng chéo
Các kỹ thuật prefetching và overlapping minh họa cách framework có hệ thống này vận hành trong thực tế, nhằm vào các nút thắt do độ trễ di chuyển dữ liệu bằng cách phối hợp truyền dữ liệu với tính toán. Tối ưu hóa này hiệu quả nhất khi profiling cho thấy các đơn vị tính toán vẫn nhàn rỗi trong lúc chờ truyền dữ liệu hoàn tất.
Huấn luyện các mô hình machine learning kéo theo việc di chuyển nhiều dữ liệu giữa hệ lưu trữ, bộ nhớ và các đơn vị tính toán. Data pipeline hoạt động theo chuỗi truyền tuần tự: từ ổ đĩa vào bộ nhớ CPU, từ bộ nhớ CPU sang bộ nhớ GPU, rồi qua các đơn vị xử lý của GPU. Trong huấn luyện machine learning, thao tác “Đọc” hiếm khi chỉ là lấy tệp từ đĩa: với workload xử lý ảnh, nó bao gồm giải mã JPEG, cắt ngẫu nhiên (random crops) và điều chỉnh màu sắc (color jitter) trên các lõi CPU trước khi tensor sẵn sàng để truyền; với workload ngôn ngữ, nó bao gồm tokenization, subword encoding và sequence padding. Figure 9 cho thấy sự kém hiệu quả của truyền dữ liệu tuần tự: GPU nhàn rỗi trong lúc thao tác tệp (Open 1, Open 2), và các bước huấn luyện chỉ bắt đầu sau khi xong đọc và tiền xử lý, khiến tài nguyên tính toán đắt tiền bị bỏ phí trong một phần đáng kể của mỗi epoch.
Prefetching khắc phục những điểm kém hiệu quả này bằng cách tải dữ liệu vào bộ nhớ trước thời điểm nó được lên lịch tính toán. Trong khi batch hiện tại đang được xử lý, data pipeline của các framework như tf.data sẽ đồng thời tải và chuẩn bị các batch kế tiếp, duy trì nguồn dữ liệu sẵn sàng cung cấp liên tục (Murray et al. 2021).
Murray, Derek G., Jiřı́ Šimša, Ana Klimovic, and Ihor Indyk. 2021. “Tf.data: A Machine Learning Data Processing Framework.” Proceedings of the VLDB Endowment 14 (12): 2945–58. https://doi.org/10.14778/3476311.3476374.

Kỹ thuật chồng chéo (overlapping) mở rộng tìm nạp trước bằng cách phối hợp nhiều giai đoạn của pipeline để chạy đồng thời. Hệ thống xử lý batch hiện tại trong khi đồng thời chuẩn bị các batch kế tiếp qua các bước tải và tiền xử lý dữ liệu. Hãy so sánh các lịch minh họa trong figure 9 và figure 10. Với các thời lượng giai đoạn giả định, chồng chéo giúp rút thời gian hoàn thành từ khoảng 95 min xuống 65 min, tức giảm 31.6 percent. Lợi ích thực tế tùy thuộc độ cân bằng giữa các giai đoạn và mức độ đồng thời sẵn có.

Cơ chế tìm nạp trước
Tìm nạp trước chỉ phát huy khi profile cho thấy việc di chuyển dữ liệu nằm trên critical path. Dữ liệu huấn luyện vẫn phải qua các bước truy xuất, biến đổi và thực thi mô hình; tối ưu hóa chỉ thay đổi thời điểm các giai đoạn đó chạy. Một pipeline chưa tối ưu sẽ xếp chúng tuần tự, khiến GPU rảnh trong lúc tải và tiền xử lý dữ liệu. Các data loader tránh điểm nghẽn này bằng cách chuẩn bị batch kế tiếp trong các luồng hoặc tiến trình riêng, trong khi batch hiện tại đang huấn luyện.
Kỹ thuật chồng chéo mở rộng cùng ý tưởng này cho toàn bộ pipeline. Khi GPU xử lý một batch, tiền xử lý bắt đầu cho batch kế tiếp, đồng thời việc tải dữ liệu khởi động cho batch sau nữa. Mục tiêu là giữ mỗi giai đoạn luôn bận, để giai đoạn chậm nhất không còn bắt các giai đoạn khác phải chờ.
Các framework machine learning (được giới thiệu trong Các Framework ML) cung cấp các biến điều khiển cho phép cân chỉnh sự đánh đổi này. Listing 4 minh họa cách cấu hình DataLoader của PyTorch, trong đó num_workers = 4 thiết lập mức độ song song của tiền xử lý, còn prefetch_factor = 2 duy trì một bộ đệm với 8 batch sẵn sàng để bộ tăng tốc sử dụng.
loader = DataLoader(
    dataset, batch_size=32, num_workers=4, prefetch_factor=2
)
Các tham số num_workers và prefetch_factor không phải là các tuỳ chọn hiệu năng chung. Chúng quyết định mức độ song song của CPU và độ sâu bộ đệm, tức là chuyển áp lực từ thời gian nhàn rỗi của bộ tăng tốc sang bộ nhớ phía host và việc lập lịch CPU.
Quản lý bộ đệm là trọng tâm của sự đánh đổi. Bộ đệm quá nhỏ sẽ khiến GPU phải chờ khâu chuẩn bị dữ liệu, làm tái xuất hiện thời gian nhàn rỗi mà prefetching nhắm tới để loại bỏ. Ngược lại, bộ đệm quá lớn tiêu tốn bộ nhớ lẽ ra có thể dùng cho tham số mô hình hoặc batch lớn hơn. Cấu hình hợp lý cần phối hợp việc chuẩn bị trên CPU, I/O lưu trữ và tính toán trên GPU sao cho mỗi tài nguyên đều có công việc sẵn sàng ngay khi nó có thể sử dụng. Các kỹ thuật này phát huy hiệu quả lớn nhất khi truy cập lưu trữ chậm, tiền xử lý phức tạp, hoặc tập dữ liệu lớn.
Các cân nhắc thực tế
Các bộ đệm prefetch và độ sâu chồng chéo đều có thể điều chỉnh, nên cùng một cơ chế có thể thích ứng với bất kỳ giai đoạn nào đang là nút thắt cổ chai, dù đó là lưu trữ chậm, băng thông mạng hạn chế hay thông lượng tính toán. Prefetching và chồng chéo mang lại lợi ích lớn nhất khi tiền xử lý nằm trên đường găng nhưng vẫn có thể chạy đồng thời với tính toán của mô hình. Ví dụ, trong một pipeline xử lý ảnh, cắt ngẫu nhiên (10 ms), nhiễu màu (15 ms) và chuẩn hóa (5 ms) tổng cộng mất 30 ms cho mỗi batch. Chồng chéo có thể che khuất tối đa phần thời gian tính toán của bộ tăng tốc chạy đồng thời; phần vượt quá vẫn nằm trên đường găng. Các khối lượng công việc (workload) NLP cũng hưởng lợi tương tự khi tokenization và xử lý subword nếu không sẽ chặn vòng lặp huấn luyện.
Đánh đổi chính là bộ nhớ: các bộ đệm prefetch tiêu tốn bộ nhớ máy chủ, hoặc bộ nhớ thiết bị (khi dùng hàng đợi riêng trên thiết bị), tỷ lệ thuận với độ sâu bộ đệm và kích thước batch. Với kích thước batch 256 và ảnh độ phân giải cao (\(1024\times 1024\) pixels), một batch được đệm sẽ cần khoảng 3.2 GB. Với num_workers = 4 và prefetch_factor = 2, cửa sổ prefetch gồm 8 batch có thể giữ khoảng 25.8 GB. Việc chỉnh các tham số này cần thử nghiệm thực tế: quá nhiều worker sẽ tranh chấp tài nguyên CPU, lưu trữ và bộ nhớ; còn đệm không đủ sẽ làm dữ liệu bị khựng. Hãy bắt đầu với số worker vừa phải, tăng dần trong khi đo thông lượng và bộ nhớ, và dừng khi thêm worker không còn giúp giảm thời gian bộ tăng tốc rảnh. Khi pipeline đầu vào đã vượt nhu cầu tính toán, prefetch sâu hơn chỉ làm phức tạp thêm mà không cải thiện thông lượng.
Huấn luyện độ chính xác hỗn hợp
Trong khi prefetch tối ưu hóa luân chuyển dữ liệu, huấn luyện độ chính xác hỗn hợp xử lý cả các giới hạn về thông lượng tính toán lẫn dung lượng bộ nhớ. Cách làm là dùng định dạng độ chính xác thấp hơn khi phù hợp, đồng thời giữ độ chính xác cao hơn cho một số phép tích lũy hoặc cập nhật. Biểu diễn số so sánh các đánh đổi giữa độ chính xác và dải biểu diễn của FP32, FP16, BF16, FP8 và INT8. Một công thức huấn luyện thường kết hợp FP32 với FP16 hoặc BF16; thường không dùng FP16 và BF16 thay thế nhau trong cùng một luồng. Tác động lên tốc độ, bộ nhớ và độ chính xác sẽ phụ thuộc vào khối lượng công việc (workload) và phần cứng (Micikevicius et al. 2017; Wang and Kanwar 2019; Kalamkar et al. 2019).
Trọng số FP32 lưu trong một mạng nơ-ron dùng 4 byte cho mỗi tham số, còn trọng số FP16 và BF16 dùng 2 byte. Với một mô hình có \(10^9\) tham số, tensor trọng số giảm từ 4 GB xuống 2 GB. Tổng bộ nhớ huấn luyện giảm ít hơn nếu quy trình vẫn giữ FP32 master weights, trạng thái của optimizer, hoặc một số activation được chọn.
Những khác biệt số học giữa các định dạng này quyết định cách dùng của chúng. Table 10 cho thấy số mũ 8-bit của BF16 cho phạm vi số mũ bình thường gần tương đương FP32, trong khi số mũ 5-bit của FP16 cho giá trị bình thường dương tối thiểu khoảng \(6.1 \times 10^{-5}\) và giá trị hữu hạn tối đa \(65{,}504\). Các giá trị dưới chuẩn của FP16 kéo dài đến \(6 \times 10^{-8}\), dù cách xử lý tùy phép toán và chế độ phần cứng. Về độ chính xác, FP32 khoảng bảy chữ số thập phân, FP16 khoảng ba, còn BF16 khoảng hai đến ba. Vì vậy, BF16 đánh đổi độ chính xác phần định trị để lấy phạm vi số mũ rộng hơn, thường giúp đơn giản hóa huấn luyện học sâu.
| Thuộc tính | FP32 | FP16 | BF16 |
|---|---|---|---|
| Bit số mũ | 8 | 5 | 8 |
| Bit phần định trị | 23 | 10 | 7 |
| Giá trị chuẩn nhỏ nhất | \(10^{-38}\) | \(6.1 \times 10^{-5}\) | \(10^{-38}\) |
| Tỷ lệ thông lượng đỉnh của A100 | 1\(\times\) | 16× | 16× |
Việc chọn định dạng phụ thuộc vào đặc điểm mô hình và hỗ trợ phần cứng. Phạm vi số mũ rộng hơn của BF16 giúp giảm lo ngại tràn và dưới tràn, còn FP16 có nhiều bit phần định trị hơn nhưng thường cần loss scaling. Các chính sách autocast của framework và các kernel hợp nhất sẽ chọn tích lũy ở độ chính xác cao hơn cho những phép toán nhạy cảm về số học khi cần; các phép toán thường gặp gồm giảm loss, softmax, chuẩn hóa và cập nhật optimizer, nhưng kiểu dữ liệu thực thi chính xác phụ thuộc vào từng triển khai.
Figure 11 minh họa một quy trình FP16 độ chính xác hỗn hợp thông thường. Theo đó, các trọng số chính FP32 được ép kiểu để tính toán ở độ chính xác thấp hơn. Loss được điều chỉnh tỷ lệ trước khi lan truyền ngược, và các gradient được khôi phục tỷ lệ trước khi cập nhật FP32. Các triển khai framework hiện đại có thể lưu trữ hoặc tích lũy một số tensor theo những cách khác nhau, và với BF16, quy trình thường bỏ qua bước điều chỉnh tỷ lệ loss do định dạng này có phạm vi số mũ rộng hơn.

Các kiến trúc phần cứng hiện đại được thiết kế đặc biệt để tăng tốc các phép tính với độ chính xác giảm. NVIDIA Tensor Cores được giới thiệu cho các phép toán FP16 độ chính xác hỗn hợp (NVIDIA 2017), và sau đó Tensor Cores dòng A100 bổ sung hỗ trợ BF16 (NVIDIA Corporation 2020). TPU của Google hỗ trợ sẵn BF16, vì định dạng này được thiết kế đặc biệt cho khối lượng công việc (workload) machine learning (Wang and Kanwar 2019). Những tối ưu hóa kiến trúc này thường mang lại thông lượng tính toán cao hơn đáng kể cho các phép toán độ chính xác giảm so với FP32, giúp huấn luyện độ chính xác hỗn hợp đặc biệt hiệu quả trên phần cứng hiện đại.
NVIDIA. 2017. Training with Mixed Precision.
NVIDIA Corporation. 2020. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
Huấn luyện độ chính xác hỗn hợp biến những khả năng phần cứng đó thành một cơ chế chia tách độ chính xác số học. Các phép nhân ma trận và tích chập đủ điều kiện sẽ dùng đầu vào FP16 hoặc BF16 trên các Tensor Core, trong khi các phép giảm, tích lũy và cập nhật tham số được chọn vẫn giữ độ chính xác cao hơn. Hiệu suất tăng nhờ cả tính toán số học lẫn di chuyển dữ liệu. Các kernel dùng độ chính xác thấp hơn có thể chạy với thông lượng cao hơn, và activation hoặc gradient nhỏ hơn giúp giảm lưu lượng bộ nhớ khi được lưu hoặc truyền ở định dạng đó. Tuy vậy, độ chính xác cao hơn vẫn cần thiết ở các trường hợp như phép giảm rộng, cập nhật tham số nhỏ, hoặc chuẩn hóa nhạy cảm, vì các phép này dễ tích lũy lỗi làm tròn. Sự phân chia này không mang tính phổ quát. Các framework chọn dtype cho từng phép; các kernel có thể tích lũy ở FP32; BF16 thường không cần loss scaling; và các optimizer có thể giữ các trọng số và trạng thái “master” ở FP32. Vì vậy, huấn luyện độ chính xác hỗn hợp sẽ điều phối định dạng xuyên suốt bước huấn luyện, thay vì chạy mọi phép toán bằng một độ chính xác thấp duy nhất.
Loss scaling
Một trong những thách thức chính với FP16 là dải động bị thu hẹp,21 làm tăng khả năng các giá trị gradient trở nên quá nhỏ để biểu diễn chính xác. Loss scaling giải quyết vấn đề này bằng cách tạm thời phóng đại các giá trị gradient trong quá trình lan truyền ngược. Cụ thể, giá trị loss được nhân với một hệ số lớn (ví dụ: \(2^{10}\)) trước khi tính gradient, giúp chúng nằm trong phạm vi FP16 có thể biểu diễn.
21 FP16 (số thực dấu phẩy động bán chính xác): Dải giá trị bình thường bị thu hẹp của nó là do dùng 5 bit cho phần mũ, so với 8 bit trong FP32; giá trị dương nhỏ nhất trong dải bình thường là khoảng \(6.1 \times 10^{-5}\), nhưng các giá trị dưới chuẩn có thể xuống đến khoảng \(6 \times 10^{-8}\). Cách xử lý tràn dưới (underflow) phụ thuộc vào phép toán và chế độ phần cứng. Loss scaling giúp giảm khả năng các gradient nhỏ bị làm tròn hoặc bị đặt về 0.
Các framework machine learning cung cấp sẵn hỗ trợ cho huấn luyện với độ chính xác hỗn hợp. Thư viện torch.amp (automatic mixed precision) của PyTorch tự động chọn độ chính xác cho từng phép toán và có thể áp dụng loss scaling khi cần.
Lợi ích của độ chính xác hỗn hợp
Lợi ích của độ chính xác hỗn hợp thể hiện trên ba khía cạnh và trong thực tế các lợi ích này thường cộng dồn:
- Bộ nhớ trọng số: Giảm 50 percent. Cụ thể, trọng số của một mô hình transformer có một tỷ tham số sẽ cần 4 GB khi dùng FP32, nhưng chỉ cần 2 GB khi dùng FP16 hoặc BF16. Tổng lượng bộ nhớ tiết kiệm được khi huấn luyện còn phụ thuộc vào việc giữ lại các trạng thái có độ chính xác cao hơn.
- Thông lượng tính toán: Có thể tăng khi các phép toán phù hợp sử dụng các đường dẫn Tensor Core có thông lượng cao hơn (section 1.5.3.3).
- Băng thông giao tiếp: Có thể giảm khi chiến lược phân tán truyền các tensor ở độ chính xác thấp hơn; tuy vậy, một số chiến lược vẫn thực hiện reduce hoặc truyền gradient ở FP32.
Những lợi ích này cộng dồn: người thực hành có thể đồng thời tăng gấp đôi kích thước batch (nhờ tiết kiệm bộ nhớ), tăng tốc mỗi lần lặp (nhờ thông lượng Tensor Core cao hơn), và giảm thời gian đồng bộ gradient (do tensor nhỏ hơn). Trên GPT-2, hiệu ứng tổng hợp này thể hiện rõ ở cả ngân sách bộ nhớ và thông lượng huấn luyện.
Napkin Math 1.6: Tiết kiệm bộ nhớ khi dùng độ chính xác hỗn hợp cho GPT-2
Vấn đề: Liệu GPT-2 XL (1.5B parameters) có thể huấn luyện trên một GPU V100 duy nhất không? Và độ chính xác hỗn hợp kết hợp với gradient checkpointing giúp tiết kiệm bao nhiêu bộ nhớ?
Cấu hình cơ sở FP32:
- Tham số và gradient (FP32): 12 GB (6 GB tham số + 6 GB gradient)
- Activations (batch = 4): ~71.7 GB
- Trạng thái optimizer (Adam m, v ở định dạng FP32): 12 GB
- Tổng cộng: ~95.7 GB (vượt quá dung lượng của bất kỳ GPU đơn lẻ nào)
Độ chính xác hỗn hợp FP16:
- Tham số (FP16): 1.5B tham số, mỗi tham số 2 byte = 3 GB
- Activations (FP16): ~35.9 GB
- Gradients (FP16): 3 GB
- Trọng số master FP32: 6 GB (dùng để các cập nhật của optimizer chính xác hơn)
- Trạng thái optimizer (Adam m, v ở FP32): 12 GB
- Tổng: ~59.9 GB (vẫn chặt, nhưng có thể xoay xở với các tối ưu)
Độ chính xác hỗn hợp + giảm activation bốn lần (minh họa):
- Activations giảm còn ~9 GB nhờ tái tính toán có chọn lọc
- Tổng dung lượng tensor ước tính: ~33 GB, so với dung lượng V100 32 GB, trước khi tính không gian làm việc tạm và chi phí của bộ cấp phát
Góc nhìn hệ thống: Mixed precision giảm một nửa các tensor tham số và gradient trong công thức này; checkpointing thì đánh đổi việc tái tính toán để giảm lưu trữ activation. Với kích thước batch 4, ước tính tensor đơn giản hóa gần chạm dung lượng V100, nên khi chạy thực tế có thể vẫn phải giảm thêm bộ nhớ sau khi tính đến không gian làm việc và cách bộ cấp phát hoạt động. Với batch 32, ước tính tương tự cần ~95.7 GB, là động lực cho các kỹ thuật mở rộng quy mô ở phần sau của chương.
Chỉ tiết kiệm bộ nhớ thôi không đảm bảo huấn luyện đúng hoặc ổn định. Dải động hạn chế của FP16 đòi hỏi các lựa chọn triển khai cụ thể để gradient vẫn biểu diễn được và các cập nhật trọng số không bị thành 0.
Có ba chi tiết triển khai hỗ trợ mixed precision FP16 truyền thống:
- Loss scaling: Nhân loss trước bước lan truyền ngược để giảm khả năng các gradient nhỏ bị underflow. Bộ điều chỉnh tỷ lệ động sẽ thay đổi hệ số dựa trên việc phát hiện gradient không hữu hạn, thay vì dựa vào một giá trị hoặc dải khởi tạo chung.
- FP32 master weights: Trong các công thức dùng chúng, các cập nhật được bảo toàn thay vì bị làm tròn mất nếu áp trực tiếp lên trọng số FP16.
- Chính sách Autocast: Cho phép chọn độ chính xác thấp hoặc cao cho từng phép toán. Thông thường, reductions, normalization và softmax dùng tích lũy ở độ chính xác cao hơn, nhưng chính sách cụ thể còn tùy framework và kernel.
Khi đã có các cơ chế ổn định này, lợi ích của mixed precision có thể đo được rõ ràng qua thông lượng và chi phí.
Mixed precision không tự động. Dải số mũ hạn chế của FP16 có thể gây overflow hoặc underflow, và cách xử lý số dưới chuẩn (subnormal) khác nhau theo phép toán và phần cứng. Dynamic loss scaling xử lý các lỗi do dải gradient, trong khi việc theo dõi các loss, gradient và activation không hữu hạn vẫn là điều thiết yếu. BF16 giữ nguyên dải số mũ của FP32 và thường tránh được loss scaling, nhưng mantissa ngắn hơn vẫn làm thay đổi hành vi làm tròn. Với các khối lượng công việc (workload) nhỏ hoặc không do Tensor Core chi phối, chi phí chuyển đổi và scaling có thể lớn hơn lợi ích hiệu suất; khi đó, profiling—chứ không phải một ngưỡng số lượng tham số—sẽ quyết định kết quả.
Napkin Math 1.7: Thông lượng và chi phí của GPT-2 với độ chính xác hỗn hợp
Bài toán: Với các giả định minh họa về thông lượng và chi phí sau đây cho một tác vụ GPT-2 XL, sự khác biệt về tốc độ và chi phí khi dùng mixed precision FP16 là gì?
Thông lượng V100 giả định:
- Thông lượng FP32: ~90 samples/s
- Thông lượng FP16: ~220 samples/s
- Tăng tốc: 220 samples/s ÷ 90 samples/s ≈ 2.4× huấn luyện nhanh hơn
Tác động chi phí trên một cụm gồm 32 GPUs:
- Chi phí FP32 giả định: $50,000 trong 2 weeks
- Chi phí FP16 giả định: $28,000 trong 1.2 weeks
- Lợi ích thời gian thực (wall-clock gain): 2 weeks ÷ 1.2 weeks ≈ 1.7×, thấp hơn mức tăng tốc thông lượng 2.4×, vì lịch trình giả định có phần công việc mà các kernel FP16 không tăng tốc.
- Thời gian tiết kiệm: 2 weeks − 1.2 weeks = 0.8 weeks (5.6 days)
- Chi phí tiết kiệm được: $50,000 − $28,000 = $22,000
Kiểm định chất lượng: Việc so sánh chi phí chỉ hợp lệ nếu một lần chạy kiểm định có kiểm soát cho thấy công thức FP16 đáp ứng cùng tiêu chí chấp nhận như đường cơ sở FP32. Kịch bản này không giả định một mức chênh lệch perplexity cụ thể.
Thông tin chuyên sâu về hệ thống: Theo các giả định này, cùng một cụm gồm 32 GPUs thay đổi từ 2 weeks và $50,000 sang 1.2 weeks và $28,000. Đây là phép tính theo kịch bản, không phải tuyên bố benchmark; một quyết định thực tế đòi hỏi phải đo lường thông lượng, chi phí tính cước, và kiểm định chất lượng cho khối lượng công việc (workload) mục tiêu.
Hỗ trợ phần cứng cho độ chính xác hỗn hợp
Hiểu cách phần cứng hiện đại triển khai số học giảm độ chính xác giúp giải thích vì sao độ chính xác hỗn hợp không chỉ thay đổi dung lượng bộ nhớ mà còn cả thời gian thực (wall-clock time). Lợi ích hiệu năng từ phép tính FP16 và BF16 đến từ các đơn vị phần cứng chuyên dụng, thiết kế cho các phép toán tensor độ chính xác thấp.22 Các đơn vị này đánh đổi phạm vi số hoặc độ chính xác để đạt thông lượng ma trận cao hơn nhiều, trong khi công thức huấn luyện vẫn giữ các phép tích lũy nhạy cảm về mặt số học ở các định dạng an toàn hơn.
22 Tensor Core: Một đơn vị nhân–tích lũy ma trận chuyên dụng hỗ trợ đầu vào giảm độ chính xác và tích lũy ở độ chính xác cao hơn. Các hình dạng ô (tile shapes), ràng buộc căn chỉnh (alignment constraints) và tỷ lệ thông lượng đỉnh (peak-throughput ratios) được hỗ trợ khác nhau tùy kiến trúc, kiểu dữ liệu (dtype), chế độ thưa (sparsity mode) và kernel của thư viện.
NVIDIA giới thiệu Tensor Cores trong kiến trúc Volta (2017) như các đơn vị nhân ma trận được tối ưu cho khối lượng công việc (workload) dùng độ chính xác hỗn hợp. Khác với các nhân CUDA tiêu chuẩn xử lý phép toán vô hướng hoặc vector nhỏ, Tensor Cores thực hiện phép nhân–tích lũy ma trận \(4{\times}4\) chỉ trong một chu kỳ xung nhịp. Với đầu vào FP16, một Tensor Core duy nhất thực hiện: \[ \mathbf{D}_{\text{tc}} = \mathbf{A}_{\text{tc}} \times \mathbf{B}_{\text{tc}} + \mathbf{C}_{\text{acc}} \] trong đó \(\mathbf{A}_{\text{tc}}\) và \(\mathbf{B}_{\text{tc}}\) là đầu vào FP16, còn \(\mathbf{C}_{\text{acc}}\) và \(\mathbf{D}_{\text{tc}}\) có thể dùng tích lũy FP32. Tích lũy với độ chính xác cao hơn giúp giảm lỗi làm tròn, nhưng không loại bỏ hoàn toàn lỗi số hay hiện tượng triệt tiêu.
Các con số đỉnh giúp ta hình dung rõ ràng giới hạn trên. GPU NVIDIA A100 đạt thông lượng FP32 là 19.5 TFLOP/s trên các nhân CUDA tiêu chuẩn, và thông lượng Tensor Core FP16 hoặc BF16 là 312 TFLOP/s, cho tỉ lệ tốc độ đỉnh 16×. Các bộ tăng tốc dòng H100 bổ sung Tensor Cores FP8 ở mức 1,979 TFLOP/s (không dùng sparsity), khoảng 2× so với tốc độ Tensor Core FP16/BF16 của H100. Đây là các trần phần cứng, không phải cam kết hiệu năng huấn luyện end-to-end: phép nhân ma trận vốn phù hợp để ánh xạ lên Tensor Cores, nhưng vẫn còn chi phí di chuyển dữ liệu, các kernel không phải Tensor Core, giao tiếp, loss scaling và phần việc của optimizer. Cơ chế attention của một transformer khi tính \(\mathbf{Q}\mathbf{K}^T\) cho một tensor có kích thước batch \(B\), số head \(N_{\text{heads}}\), độ dài chuỗi \(S\), và chiều head \(d_{\text{head}}\) cần \(2 \times B \times N_{\text{heads}} \times S^2 \times d_{\text{head}}\) FLOPs; phần này có thể tăng tốc mạnh, còn mức tăng tốc thực tế của cả bước phụ thuộc vào các phần còn lại.
Brain Float 16 (BF16) giữ nguyên phần số mũ 8 bit như FP32, nhưng giảm phần trị xuống còn 7 bit. Thiết kế này ưu tiên giữ dải động hơn là độ chính xác, điều này quan trọng với học dựa trên gradient, nơi các giá trị có thể trải rộng qua nhiều bậc độ lớn. TPU của Google hỗ trợ BF16 trực tiếp, còn kiến trúc Ampere (A100) của NVIDIA và các thế hệ mới hơn hỗ trợ đầy đủ ở mức phần cứng.
Lợi thế về dải động của BF16 so với FP16 xuất hiện khi gradient hoặc giá trị trung gian vượt ra ngoài dải giá trị bình thường của FP16. Giá trị dương bình thường nhỏ nhất của FP16 là \(6.1 \times 10^{-5}\), còn mức dưới chuẩn nhỏ nhất của nó xấp xỉ \(6 \times 10^{-8}\).23 Giá trị dương bình thường nhỏ nhất của BF16 xấp xỉ \(10^{-38}\), bằng với dải số mũ của FP32. Nhờ vậy, BF16 thường không cần đến loss scaling như FP16, dù độ chính xác khi tích lũy và làm tròn vẫn rất quan trọng.
23 Xử lý số dưới chuẩn FP16: Chuẩn IEEE FP16 có thể biểu diễn các số dưới chuẩn (subnormal) từ dưới \(6.1 \times 10^{-5}\) xuống đến khoảng \(6 \times 10^{-8}\). Tuy nhiên, một số thao tác hoặc chế độ của bộ tăng tốc sẽ đưa các giá trị đầu vào hoặc kết quả dưới chuẩn về 0. Cần kiểm tra kỹ hành vi này đối với phần cứng và kernel mục tiêu.
Kiến trúc Hopper (H100) của NVIDIA hỗ trợ FP8 với hai định dạng. E4M3 dùng bốn bit số mũ và ba bit phần trị (ưu tiên độ chính xác cho trọng số và activations trong lượt truyền xuôi), trong khi E5M2 dùng năm bit số mũ và hai bit phần trị (ưu tiên dải động cho gradient trong lượt truyền ngược).
Huấn luyện với FP8 giúp tăng gấp đôi thông lượng của Tensor Core một lần nữa (1.98 PFLOP/s trên H100 ở chế độ dense so với 0.99 PFLOP/s cho FP16 ở chế độ dense, không có sparsity). Tuy nhiên, độ chính xác rất hạn chế của FP8 đòi hỏi các hệ số tỉ lệ theo từng tensor phải được duy trì ở độ chính xác cao hơn, làm tăng độ phức tạp thuật toán. Table 11 tóm tắt khi nào mỗi độ chính xác phù hợp:
| Độ chính xác | Khi nào sử dụng | Yêu cầu phần cứng |
|---|---|---|
| FP8 | Huấn luyện hướng thông lượng với khả năng mở rộng đã được xác thực | Phần cứng FP8 được hỗ trợ |
| BF16 | Dải số mũ rộng không cần điều chỉnh tỷ lệ mất mát FP16 | Bộ tăng tốc BF16 được hỗ trợ |
| FP16 | Độ chính xác phần định trị cao hơn với điều chỉnh tỷ lệ mất mát được quản lý | Bộ tăng tốc FP16 được hỗ trợ |
| FP32 | Độ chính xác cao hơn hoặc đường dẫn độ chính xác thấp hơn không được hỗ trợ | GPU |
Quyết định bắt đầu từ yêu cầu của khối lượng công việc (workload) và phần cứng sẵn có, và kết thúc bằng xác thực thực nghiệm. Không có định dạng nào đúng cho mọi lớp kiến trúc.
Giảm độ chính xác giúp tăng tốc tính toán và giảm nút thắt băng thông bộ nhớ. Các GPU hiện đại ngày càng bị giới hạn bởi năng lực tính toán hơn là băng thông ở các phép toán ma trận lớn, nhưng việc di chuyển dữ liệu vẫn giới hạn hiệu năng với các phép toán nhỏ. Thông số của A100 minh họa điều này:
- Băng thông HBM2e: 2,039 GB/s
- Thông lượng FP32 (19.5 TFLOP/s): nhu cầu băng thông ở kịch bản xấu nhất là 78 TB/s nếu mỗi FLOP cần dữ liệu mới
- Yêu cầu thực tế (khi có tái sử dụng dữ liệu): Thấp hơn nhiều, nhưng bị giới hạn bởi băng thông đối với các phép toán có cường độ số học thấp
Sử dụng FP16 hoặc BF16 giúp giảm một nửa số byte lưu cho mỗi giá trị so với FP32, nhưng lưu lượng bộ nhớ thực tế còn phụ thuộc vào caching, fusion, định dạng bộ tích lũy và các chuyển đổi bổ sung. Vì vậy, các phép toán bị giới hạn bởi băng thông có thể tăng tốc ngay cả khi không dùng phép tính trên Tensor Core, dù mức tăng còn tùy khối lượng công việc (workload) chứ không đồng nghĩa với việc tự động tăng gấp đôi.
Các framework hiện đại ẩn bớt độ phức tạp phần cứng bằng cách tự động định tuyến phép toán (Các Framework ML). Framework runtime quyết định phép toán nào hưởng lợi từ việc giảm độ chính xác và phép toán nào cần FP32 để đảm bảo ổn định số học. Automatic mixed precision của PyTorch quản lý việc lựa chọn độ chính xác và loss scaling một cách minh bạch (listing 5).
Ngữ cảnh autocast áp dụng một chính sách dtype do framework quy định cho các phép toán đủ điều kiện; điều đó không có nghĩa mọi phép toán ma trận đều ở độ chính xác thấp, hay mọi phép chuẩn hóa và hàm mất mát đều chạy ở FP32. Ví dụ này dùng FP16 cùng bộ điều chỉnh tỉ lệ gradient. Với BF16, công thức thường bỏ bước điều chỉnh tỉ lệ gradient. Table 12 tóm tắt các tùy chọn phổ biến trên các thế hệ GPU, nhưng lựa chọn cuối cùng cần được kiểm chứng trên khối lượng công việc (workload).
import torch

model = TransformerModel().cuda()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-4)
amp_dtype = (
    torch.float16
)  # torch.bfloat16 usually does not need loss scaling
scaler = torch.amp.GradScaler(
    "cuda", enabled=(amp_dtype == torch.float16)
)

for inputs, targets in dataloader:
    optimizer.zero_grad()

    # Automatic precision selection per operation
    with torch.amp.autocast("cuda", dtype=amp_dtype):
        output = model(inputs)
        loss = criterion(output, targets)

    # Scale loss to prevent gradient underflow
    scaler.scale(loss).backward()

    # Unscale gradients before optimizer step
    scaler.step(optimizer)
scaler.update() # Adjust scaling factor dynamically| Kiến trúc | Độ chính xác khuyến nghị | Các cân nhắc chính |
|---|---|---|
| V100 (Volta) | FP16 với điều chỉnh tỷ lệ mất mát | Không có đường dẫn Tensor Core BF16 gốc; cắt xén phụ thuộc vào công thức huấn luyện. |
| A100 (Ampere) | BF16 hoặc FP16 | BF16 tránh được việc mở rộng thang đo mất mát của FP16; TF32 có thể tăng tốc các phép toán ma trận FP32 đủ điều kiện. |
| H100 (Hopper) | BF16, FP16, hoặc FP8 đã được xác thực | FP8 yêu cầu một công thức nhận biết FP8; 1,979 TFLOP/s là mức trần cao nhất. |
Một kịch bản GPT-2 minh họa trên một GPU (1.5B) cho thấy thông lượng giả định có thể thay đổi theo phần cứng và độ chính xác: 18 samples/s cho V100 FP32, 45 samples/s cho V100 FP16, 165 samples/s cho A100 BF16, và 380 samples/s cho H100 FP8. Các giá trị này là đầu vào của kịch bản, chứ không phải một benchmark đa thế hệ được kiểm soát, vì các phiên bản phần mềm, kernel, kích thước batch và công thức FP8 cũng thay đổi. Bài học về hệ thống là các thuật toán độ chính xác thấp và phần cứng chuyên dụng phải được đánh giá cùng nhau.
FlashAttention: Tối ưu hóa attention nhận biết I/O
Huấn luyện độ chính xác hỗn hợp xử lý hai nút thắt: thông lượng tính toán, vì Tensor Cores chạy nhanh hơn với FP16, và dung lượng bộ nhớ, vì mỗi giá trị dùng ít byte hơn. Tuy nhiên, với các mô hình transformer trong quá trình huấn luyện, một nút thắt thứ ba thường chi phối: băng thông bộ nhớ. Các ma trận trung gian của attention tăng theo bình phương kích thước phải liên tục được tải và lưu trong lượt truyền xuôi và được truy cập lại trong lan truyền ngược. Ngay cả khi giảm độ chính xác, khối lượng truy cập bộ nhớ quá lớn có thể khiến các đơn vị tính toán nhàn rỗi trong khi bộ xử lý chờ dữ liệu.
FlashAttention24 (Dao et al. 2022) giải quyết nút thắt băng thông này bằng cách tối ưu hóa cách dữ liệu luân chuyển giữa các tầng bộ nhớ. Xử lý attention theo các ô có kích thước cỡ SRAM giúp tránh phải tạo toàn bộ ma trận \(S{\times}S\) trong HBM và giảm lưu lượng truyền tải mà không làm thay đổi kết quả toán học. Nghiên cứu ban đầu báo cáo tốc độ tăng tới 3\(\times\) trên các khối lượng công việc (workload) được đánh giá; mức tăng phụ thuộc vào hình dạng tensor, phần cứng và bản triển khai baseline.
24 FlashAttention: Được giới thiệu bởi Dao et al. (2022), phương pháp này giữ nguyên chính xác attention trong khi giảm lưu lượng HBM bằng cách chia ô theo kích thước phù hợp với SRAM. Điểm mấu chốt là coi attention như một bài toán I/O: tránh phải tạo toàn bộ ma trận điểm \(S{\times}S\) trong HBM, đồng thời vẫn giữ phép tính điểm dày đặc \(\mathcal{O}(S^2)\). Hiệu suất của FlashAttention phụ thuộc vào hình dạng tensor, phần cứng và bản triển khai baseline. FlashAttention-2 (Dao 2023) tiếp tục cải thiện khả năng song song và phân chia công việc, báo cáo đạt 50–73% mức đỉnh lý thuyết trên A100.
Dao, T., D. Y. Fu, S. Ermon, A. Rudra, and C. Ré. 2022. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” Advances in Neural Information Processing Systems (NeurIPS) 35: 16344–59. https://doi.org/10.52202/068431-1189.
Dao, Tri. 2023. “FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning.” arXiv Preprint arXiv:2307.08691.
Nút thắt bộ nhớ của cơ chế attention tiêu chuẩn
Cơ chế self-attention tiêu chuẩn (Kiến trúc mạng) tính toán mối quan hệ giữa tất cả các vị trí trong một chuỗi. Với một chuỗi đầu vào dài \(S\), cơ chế này tính một ma trận attention \(S{\times}S\) theo equation 16:
\[ \text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{softmax}\left(\frac{\mathbf{Q}\mathbf{K}^T}{\sqrt{d_k}}\right)\mathbf{V} \tag{16}\]
Ở đây, \(\mathbf{Q}\), \(\mathbf{K}\), và \(\mathbf{V}\) là các ma trận query, key, và value cho chuỗi, còn \(d_k\) là chiều vector key dùng để chia tỷ lệ các tích vô hướng trước softmax. Số hạng \(\mathbf{Q}\mathbf{K}^T\) tạo ra ma trận điểm \(S{\times}S\), đó là lý do attention trở thành một bài toán I/O ngay cả khi các phép toán số học có thể ánh xạ tốt lên Tensor Cores.
Nút thắt bộ nhớ xuất phát từ việc tạo và lưu trữ các ma trận trung gian \(S{\times}S\) cho điểm số và xác suất. Với độ dài chuỗi 4,096 và chiều embedding 64 (điển hình cho một head attention), riêng ma trận điểm số attention đã cần \(4,096^2 \times 4\) bytes = 67.1 MB trong FP32. Với 16 heads, lượng này tăng thành 1.1 GB chỉ cho các ma trận attention trung gian, chưa tính keys, queries, values hay các tensor đầu ra.
Hệ thống phân cấp bộ nhớ GPU mở ra cơ hội cho attention nhận biết I/O. HBM cung cấp dung lượng lớn ngoài chip, trong khi SRAM trên chip tuy nhỏ hơn nhiều nhưng có băng thông cao hơn đáng kể và độ trễ thấp hơn. Các triển khai attention tạo và lưu trữ các giá trị trung gian bậc hai trong HBM sẽ phải ghi và sau đó đọc lại chúng trong quá trình lan truyền ngược. Phần thời gian dành cho các lần truyền này phụ thuộc vào độ dài chuỗi, kích thước head, dtype, phần cứng và cách triển khai kernel; đây không phải là thuộc tính cố định của các mô hình ở quy mô GPT-2.
Quá trình lan truyền ngược cần thông tin từ các xác suất attention, nhưng một triển khai có thể chọn lưu các giá trị trung gian đó hoặc tính toán lại chúng. Đối với \(\mathbf{A}_{\text{attn}} = \text{softmax}(\mathbf{Z}_{\text{attn}})\) và \(\mathbf{Z}_{\text{attn}} = \mathbf{Q}\mathbf{K}^T/\sqrt{d_k}\), một biểu thức gradient là: \[ \frac{\partial \mathcal{L}}{\partial \mathbf{Q}} = \frac{1}{\sqrt{d_k}} \cdot \text{dsoftmax}\!\left(\frac{\partial \mathcal{L}}{\partial \mathbf{A}_{\text{attn}}},\, \mathbf{A}_{\text{attn}}\right) \cdot \mathbf{K} \] trong đó \(\text{dsoftmax}\) biểu thị tích Jacobian-vector của softmax. Một triển khai thông thường có thể lưu ma trận xác suất cho phép tính này; việc lưu cả xác suất và điểm thô không phải là yêu cầu về mặt toán học. Thay vào đó, FlashAttention lưu các thống kê chuẩn hóa nhỏ gọn và tính toán lại các khối điểm số và xác suất đã được chia ô trong quá trình lan truyền ngược, từ đó tránh phải lưu trữ đầy đủ các giá trị trung gian bậc hai trong HBM.
Attention nhận biết I/O thông qua chia ô
FlashAttention loại bỏ nhu cầu tạo toàn bộ ma trận attention \(S{\times}S\) trong HBM bằng cách tính attention theo từng phần với kỹ thuật chia ô. Cụ thể, thay vì tính cả ma trận attention cùng lúc, thuật toán chia các tensor \(\mathbf{Q}\), \(\mathbf{K}\) và \(\mathbf{V}\) thành các ô (tile) đủ nhỏ để vừa trong SRAM tốc độ cao, tính điểm attention cho từng ô, rồi tích lũy kết quả dần dần.
Ý tưởng thuật toán chính dựa trên cấu trúc toán học của cơ chế softmax attention. Cụ thể, attention tiêu chuẩn tính như sau: \[ \text{Attention}(\mathbf{Q}, \mathbf{K}, \mathbf{V}) = \text{softmax}\left(\frac{\mathbf{Q}\mathbf{K}^T}{\sqrt{d_k}}\right)\mathbf{V} \]
Algorithm 3 phân rã phép tính này bằng cách chia các truy vấn (query) và khóa/giá trị (key/value) thành những ô đủ nhỏ để vừa trong SRAM, rồi xử lý tuần tự các ô khóa/giá trị trong khi duy trì các thống kê softmax đang chạy, cần để ghép từng ô đầu ra, mà không bao giờ hình thành toàn bộ ma trận điểm số.
FlashAttention thay ma trận attention đầy đủ bằng các ô SRAM nhỏ.
Không có ma trận điểm số hoặc xác suất \(S{\times}S\) đầy đủ nào được ghi vào HBM. Ví dụ, một ô điểm số FP32 kích thước \(128{\times}128\) chiếm 65.5 KB, trong khi một ma trận \(4096{\times}4096\) chiếm 67.1 MB. Các đầu vào, đầu ra và các thống kê đang chạy khác vẫn tồn tại, nên ô (tile) không nhất thiết là tensor lớn nhất trong toàn bộ kernel.
\begin{algorithm} \caption{FlashAttention: tiled attention with online softmax} \begin{algorithmic} \Require queries $\mathbf{Q}$, keys $\mathbf{K}$, values $\mathbf{V}$ for a length-$S$ sequence; tile size $b$ \Ensure attention output $\mathbf{Y}$, without materializing the $S\times S$ score matrix \For{each query tile $\mathbf{Q}_i$} \State in SRAM: $\mathbf{Y}_i^{\text{acc}} \gets \mathbf{0}$, $m_i \gets -\infty$, $l_i \gets 0$ \For{each key/value tile $(\mathbf{K}_j, \mathbf{V}_j)$} \State load $\mathbf{Q}_i, \mathbf{K}_j, \mathbf{V}_j$ into SRAM; $\mathbf{Z}_{ij} \gets \mathbf{Q}_i \mathbf{K}_j^\top / \sqrt{d_k}$ \State $m_i' \gets \max(m_i,\operatorname{rowmax}(\mathbf{Z}_{ij}))$ \Comment{new stable max} \State $\mathbf{Y}_i^{\text{acc}} \gets \mathbf{Y}_i^{\text{acc}}\odot e^{m_i-m_i'} + e^{\mathbf{Z}_{ij}-m_i'}\mathbf{V}_j$ \State $l_i \gets l_i\odot e^{m_i-m_i'} + \operatorname{rowsum}(e^{\mathbf{Z}_{ij}-m_i'})$; $m_i \gets m_i'$ \State discard $\mathbf{Z}_{ij}$ \Comment{never written to HBM} \EndFor \State $\mathbf{Y}_i \gets \mathbf{Y}_i^{\text{acc}} / l_i$; write $\mathbf{Y}_i$ to HBM \EndFor \end{algorithmic} \end{algorithm}
Thuật toán softmax trực tuyến cho phép thực hiện cách chia nhỏ này. Softmax truyền thống yêu cầu biết mọi đầu vào trước khi tính bất kỳ đầu ra nào: \(\text{softmax}(x)_i = e^{x_i} / \sum_j e^{x_j}\). FlashAttention dùng một công thức tính tăng dần, cập nhật các thống kê softmax khi có khối mới đến: theo dõi giá trị lớn nhất đang chạy \(m\) (để ổn định số học) và mẫu số \(l\) khi xử lý từng khối, rồi chuẩn hóa lại các kết quả đã tích lũy tương ứng.
Phân tích độ phức tạp về bộ nhớ và IO
FlashAttention cải thiện cả bộ nhớ activation và IO bộ nhớ, vốn là các chi phí bị giới hạn bởi băng thông trong attention. Cơ chế attention tiêu chuẩn cần bộ nhớ \(\mathcal{O}(S^2)\) để lưu các ma trận điểm số \(\mathbf{Z}_{\text{attn}}\) và ma trận xác suất attention \(\mathbf{A}_{\text{attn}}\) cho toàn bộ vị trí trong chuỗi. FlashAttention giảm lượng activation phải lưu xuống \(\mathcal{O}(S)\) bằng cách chỉ giữ các tensor đầu vào và đầu ra \((\mathbf{Q}, \mathbf{K}, \mathbf{V}, \mathbf{Y})\) cùng một bộ đệm SRAM nhỏ cho khối hiện tại.
Với \(S = 4096\), \(d_{\text{head}} = 64\): Cơ chế attention tiêu chuẩn yêu cầu \(4096^2 \times 4\) byte = 67.1 MB cho mỗi head. FlashAttention chỉ yêu cầu \((3 \times 4096{\times}64) \times 4\) byte ≈ 3.1 MB cho mỗi head, tức là giảm đi 21.3× lần.
Mẫu IO cũng thay đổi vì cùng lý do. Cơ chế attention tiêu chuẩn đọc \(\mathbf{Q}\), \(\mathbf{K}\) và \(\mathbf{V}\) từ HBM, ghi các ma trận điểm số, xác suất và đầu ra trong lượt truyền xuôi, rồi đọc lại các ma trận đã lưu đó trong lượt truyền ngược trước khi ghi \(d\mathbf{Q}\), \(d\mathbf{K}\) và \(d\mathbf{V}\). Lưu lượng HBM phát sinh cũng chứa cùng số hạng \(\mathcal{O}(S^2)\) vốn làm lượng activation phải lưu trở nên lớn. FlashAttention tạo các khối điểm số và xác suất trong SRAM và không bao giờ ghi toàn bộ các tensor \(S \times S\) xuống HBM. Trong lượt truyền ngược, nó tính lại các khối cần thiết thay vì đọc các ma trận đầy đủ đã lưu. Độ phức tạp IO HBM chính xác phụ thuộc vào kích thước khối và lượng SRAM sẵn có, vì các khối key và value được truyền lặp lại qua các khối query, nên cận này không chỉ đơn thuần là \(\mathcal{O}(S \cdot d)\).
Với độ dài chuỗi lớn, FlashAttention giảm lưu lượng HBM bằng cách tránh ghi và đọc lại các ma trận điểm số và xác suất \(S \times S\). Với \(S = 4096\) và \(d_{\text{head}} = 64\), dung lượng bộ nhớ activation giảm từ hàng trăm MB cho mỗi head (khi lưu trữ các ma trận attention) xuống còn vài MB (khi xử lý đầu vào và đầu ra theo từng khối), còn mức giảm băng thông chính xác phụ thuộc vào phần cứng và cách chia khối của kernel.
Cả hai cách đều cần số FLOPS tiệm cận \(\mathcal{O}(S^2 d)\) cho attention dày đặc. Ở lượt truyền ngược, FlashAttention tính lại các trung gian attention theo từng ô (tiled) từ các đầu vào đã lưu và các thống kê chuẩn hóa, thay vì lưu toàn bộ ma trận điểm số và ma trận xác suất. Nhờ giảm lưu lượng HBM, kernel có thể trở nên giới hạn bởi tính toán (compute-bound) và đạt tăng tốc ròng; tuy vậy, nút thắt cuối cùng vẫn phụ thuộc vào hình dạng dữ liệu và phần cứng.
Triển khai và khai thác phần cứng
FlashAttention đạt hiệu năng bằng cách khai thác hiệu quả hệ thống phân cấp bộ nhớ của GPU. Các framework hiện đại có thể điều phối các phép toán attention phù hợp giữa các triển khai fused và fallback, tùy theo phần cứng, đầu vào và bố trí dữ liệu; profiling xác thực đường chạy nào đã được dùng và liệu nó có hữu ích hay không. Listing 6 đối chiếu các triển khai attention tiêu chuẩn và tối ưu hóa.
import torch
import torch.nn.functional as F


# Standard attention (materializes n-by-n matrix)
def standard_attention(q, k, v):
    # q, k, v: [batch, heads, seq_len, head_dim]
    scores = torch.matmul(q, k.transpose(-2, -1)) / (
        q.size(-1) ** 0.5
    )
    attn = F.softmax(scores, dim=-1)  # n-by-n matrix in HBM
    output = torch.matmul(attn, v)
    return output


# FlashAttention (no n-by-n materialization)
def flash_attention(q, k, v):
    # Can use FlashAttention when inputs and hardware are eligible
    output = F.scaled_dot_product_attention(q, k, v)
    return output


# Explicit FlashAttention 2 (flash-attn library)
from flash_attn import flash_attn_func


def flash_attn_2(q, k, v):
    # q, k, v: [batch, seq_len, heads, head_dim]
    # Different layout for optimized memory access
    output = flash_attn_func(q, k, v)
    return output
Kết quả benchmark
Lợi ích của FlashAttention trở nên rõ ràng khi đo trên phần cứng thực. Dao et al. (2022) báo cáo tăng tốc huấn luyện end-to-end cho các mô hình kiểu GPT và các benchmark riêng cho kernel attention, cho thấy IO-aware attention giúp giảm lưu lượng bộ nhớ và cải thiện runtime. Table 13 dùng một kịch bản minh họa kiểu A100 để cho thấy cùng một mô hình hệ thống; các số về thời gian và bộ nhớ ở đây chỉ là giá trị đại diện dùng trong chương, không phải giá trị Dao et al. (2022) báo cáo nguyên văn.
| Độ dài chuỗi | Chuyển tiếp tiêu chuẩn | Chuyển tiếp Flash | Lan truyền ngược tiêu chuẩn | Lan truyền ngược Flash | Bộ nhớ (Tiêu chuẩn) | Bộ nhớ (Flash) |
|---|---|---|---|---|---|---|
| 512 | 12 ms | 8 ms | 35 ms | 18 ms | 4.2 GB | 2.8 GB |
| 2048 | 45 ms | 15 ms | 120 ms | 35 ms | 18 GB | 6 GB |
| 4096 | OOM | 32 ms | OOM | 85 ms | \(>40\) GB | 12 GB |
| 8192 | OOM | 68 ms | OOM | 180 ms | \(>80\) GB | 24 GB |
Trong kịch bản minh họa cấu hình kiểu A100 40 GB này, attention tiêu chuẩn sẽ hết bộ nhớ khi vượt quá 2048 token, trong khi FlashAttention xử lý được chuỗi dài tới 8192 token. Ngay cả ở 2048 token, khi cả hai đều chạy được, FlashAttention vẫn đạt tăng tốc lượt truyền xuôi 3× và tăng tốc lượt truyền ngược 3.4×.
Các phiên bản tiếp theo tiếp tục cải thiện hiệu suất: FlashAttention-2 (Dao 2023) đạt tăng tốc thêm 1.5–2\(\times\) nhờ khả năng song song tốt hơn và phân bổ thanh ghi hiệu quả hơn, trong khi FlashAttention-3 (Shah et al. 2024) tận dụng các lõi tensor FP8 và các thao tác bộ nhớ bất đồng bộ trên GPU dòng Hopper, báo cáo đạt khoảng 740 TFLOP/s trên H100, tức khoảng 75% mức đỉnh lý thuyết.
Shah, Jay, Ganesh Bikshandi, Ying Zhang, Vijay Thakkar, Pradeep Ramani, and Tri Dao. 2024. “FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-Precision.” Advances in Neural Information Processing Systems 37 (NeurIPS), 68658–85. https://doi.org/10.52202/079017-2193.
Khi nào nên sử dụng FlashAttention
Đối với huấn luyện transformer với các chuỗi dài, FlashAttention thường là cách triển khai attention đầu tiên nên thử. Nó thường trở nên thiết yếu khi độ dài chuỗi khiến attention tiêu chuẩn gặp nút thắt cổ chai về dung lượng hoặc băng thông HBM, đặc biệt quanh ngưỡng vài nghìn token khi các ma trận attention \(S{\times}S\) chiếm ưu thế về bộ nhớ. Các GPU dòng A100 và H100 với SRAM trên chip tốc độ cao sẽ hưởng lợi nhiều nhất. Hiệu quả của FlashAttention giảm đối với chuỗi ngắn, khi chi phí tiling không bù được lợi ích; trên các kiến trúc GPU cũ hơn không có băng thông SRAM tương đương; và đối với các kiến trúc không dùng attention, như mạng nơ-ron tích chập và perceptron đa lớp.
Trong thực tế, các framework deep learning xử lý phần lớn việc tích hợp FlashAttention, nhưng quyết định sử dụng vẫn phụ thuộc vào bố cục (layout), độ chính xác (precision) và ngân sách bộ nhớ. Hàm scaled_dot_product_attention của PyTorch có thể tự động gọi FlashAttention khi phần cứng, đầu vào và các ràng buộc backend cho phép; còn attention tự viết tay phải dùng một primitive tương thích. Có ba kiểm tra thực tế để xác định FlashAttention có phù hợp hay không:
- Đảm bảo bố cục tensor khớp với kỳ vọng của thư viện (bộ nhớ liền kề, thứ tự chiều chính xác)
- Sử dụng FP16 hoặc BF16 để đạt tăng tốc tối đa (FlashAttention được tối ưu hóa cho mixed precision)
- Kết hợp với gradient checkpointing khi cần tiết kiệm thêm bộ nhớ activation.
Việc tích hợp thường chỉ là thay đổi một dòng mã duy nhất—thay thế lời gọi attention thủ công bằng F.scaled_dot_product_attention (xem listing 6). Quyết định kỹ thuật vẫn dựa trên nguyên tắc đã được thiết lập từ phân tích roofline: sử dụng primitive được tối ưu hóa khi nút thắt cổ chai là lưu lượng HBM, và để thư viện quản lý việc tiling và lập lịch SRAM cần thiết để loại bỏ nút thắt đó.
Hệ quả ở cấp hệ thống và các nguyên tắc rộng hơn
FlashAttention minh họa một nguyên tắc kỹ thuật hệ thống cơ bản: thiết kế thuật toán nhận biết IO. Nhiều bộ tăng tốc có dư dả năng lực tính toán so với băng thông bộ nhớ. Với một kernel bị giới hạn bởi băng thông, lưu lượng dữ liệu có thể chi phối runtime ngay cả khi FLOPS không đổi.
Nguyên tắc này không chỉ áp dụng cho attention. Trong phép nhân ma trận nhận biết IO, các thuật toán tiling như trong CUTLASS giảm lưu lượng DRAM bằng cách tối đa hóa tái sử dụng dữ liệu trong các cache nhanh. Một phép nhân ma trận \(m{\times}m\) ngây thơ thực hiện \(\mathcal{O}(m^3)\) FLOPS với lưu lượng bộ nhớ \(\mathcal{O}(m^2)\), trong khi các thuật toán chia khối vẫn duy trì \(\mathcal{O}(m^3)\) FLOPS nhưng giảm lỗi cache nhờ tận dụng tính cục bộ của dữ liệu.
Nguyên tắc di chuyển byte tương tự cũng xuất hiện trong huấn luyện phân tán hiệu quả về truyền thông, nơi nén gradient đánh đổi tính toán bổ sung (nén/giải nén) để giảm mức tiêu thụ băng thông mạng. Các thiết bị edge công suất thấp với băng thông bộ nhớ hạn chế còn hưởng lợi nhiều hơn từ các thuật toán nhận biết IO. Việc chấp nhận tăng thêm 10% phép tính để giảm một nửa lưu lượng bộ nhớ có thể tiệm cận mức giảm năng lượng 2\(\times\) trong giới hạn khi việc di chuyển dữ liệu chiếm toàn bộ ngân sách; và sẽ thấp hơn mức đó bất cứ khi nào phần tính toán chiếm tỷ trọng đáng kể, vì giảm một nửa một hạng cộng trong tổng không thể làm tổng đó giảm quá một nửa. Phần này thiết lập heuristic nhận biết IO; các thiết lập triển khai phân tán và edge đều áp dụng cùng một logic di chuyển byte.
FlashAttention đã thay đổi đáng kể khả năng huấn luyện mô hình trong thực tế. Bằng cách tránh tạo tường minh các ma trận attention \(\mathcal{O}(S^2)\), nó mang lại ba khả năng sau:
- Chuỗi dài hơn: Trong cấu hình minh họa này, cho phép tăng độ dài ngữ cảnh lên 4 lần trên cùng phần cứng, ví dụ chuyển GPT-2 trên A100 từ ngữ cảnh 2K lên 8K.
- Kích thước batch lớn hơn: Trong cùng cấu hình, tăng gấp đôi kích thước batch nhờ bộ nhớ được giải phóng, có thể cải thiện mức độ tận dụng; tác động đến hội tụ vẫn cần được kiểm chứng.
- Mô hình sâu hơn: Giảm bộ nhớ activation, nhờ đó nhiều lớp hơn có thể nằm trong cùng ngân sách bộ nhớ.
Trong kịch bản attention-only của chương này, kernel được tối ưu hóa đã đẩy ranh giới ngữ cảnh từ 2K lên 8K token; việc huấn luyện đầy đủ mô hình 7 tỷ tham số vẫn phụ thuộc vào trạng thái, sharding, kích thước batch và các activation khác.
Kỹ thuật này cho thấy các thuật toán cấp hệ thống có thể tận dụng hệ thống phân cấp bộ nhớ để giảm mạnh bộ nhớ dành cho activation và tăng tốc tùy theo khối lượng công việc (workload), vượt xa việc chỉ mở rộng phần cứng. Việc coi băng thông bộ nhớ là ràng buộc chính, còn năng lực tính toán thì dồi dào, là một khuynh hướng lặp lại trong tối ưu hóa hiệu suất ML.
FlashAttention xử lý nút thắt băng thông bộ nhớ trong lúc tính toán, nhưng còn một loại ràng buộc bộ nhớ khác: dung lượng lớn cần để lưu đồng thời activation và trạng thái optimizer. Khi mô hình hoặc kích thước batch vượt quá dung lượng bộ nhớ GPU, hai kỹ thuật bổ trợ sẽ đánh đổi giữa tính toán và bộ nhớ.
Tích lũy gradient và checkpointing
Huấn luyện các mô hình lớn đòi hỏi nhiều bộ nhớ cho activation, gradient và tham số. Khi bộ nhớ hạn chế kích thước batch hoặc độ phức tạp của mô hình, tích lũy gradient25 tạo ra một batch hiệu dụng lớn hơn từ các micro-batch tuần tự, còn checkpointing thì loại bỏ và tính toán lại các activation được chọn. Những kỹ thuật này trở thành công cụ tiêu chuẩn khi bộ nhớ là ràng buộc chính.
25 Tích lũy gradient: Kỹ thuật này cộng hoặc tính trung bình các gradient từ \(k\) micro-batch trước khi thực hiện một bước optimizer. Nó giúp giảm bộ nhớ activation cần thiết so với việc xử lý cùng một batch hiệu quả đó trong một lần, đồng thời vẫn giữ nguyên tổng số phép tính ở cấp độ từng mẫu dữ liệu. Runtime và tính tương đương số học phụ thuộc vào hiệu quả của micro-batch, việc đồng bộ hóa, các lớp có trạng thái, các phép toán ngẫu nhiên, độ chính xác và chuẩn hóa hàm mất mát.
Cơ chế tích lũy gradient và checkpointing
Tích lũy gradient và activation checkpointing dựa trên các nguyên tắc khác nhau, nhưng cả hai đều nhằm tối ưu hóa việc dùng bộ nhớ trong huấn luyện bằng cách điều chỉnh cách xử lý truyền xuôi và truyền ngược. Tích lũy gradient thay đổi số lượng ví dụ góp vào một lần cập nhật; còn checkpointing thì thay đổi những activation nào được giữ lại trong bộ nhớ giữa lượt truyền xuôi và truyền ngược.
Tích lũy gradient
Để huấn luyện batch lớn trên các bộ tăng tốc bị giới hạn bộ nhớ, hệ thống chia batch hiệu dụng thành các micro-batch tuần tự nhỏ hơn. Trong figure 12, hãy theo dõi cách các vector gradient của micro-batch \(\delta_1, \delta_2, \delta_3\) tích lũy thành một tensor gradient hợp nhất trước khi kích hoạt một lần cập nhật optimizer.

Trong PyTorch, tích lũy gradient thường được thực hiện bằng cách chia loss của mỗi micro-batch cho số bước tích lũy, và chỉ gọi optimizer.step() sau khi xử lý xong toàn bộ batch hiệu quả. Với quy ước lấy trung bình này, không cần điều chỉnh learning rate chỉ vì tích lũy. Triển khai gồm năm bước:
- Thực hiện forward pass cho một micro-batch.
- Tính gradient trong backward pass.
- Tích lũy gradient vào bộ đệm (buffer) mà chưa cập nhật tham số mô hình.
- Lặp lại bước 1–3 cho tất cả micro-batch trong batch hiệu quả.
- Sau khi xử lý xong mọi micro-batch, dùng gradient đã tích lũy để cập nhật tham số mô hình.
Tích lũy gradient có thể tái tạo gradient của một batch lớn hơn dưới các giả định được kiểm soát. Với kích thước batch hiệu quả \(B = k \times b\), trong đó \(k\) là số bước tích lũy và \(b\) là kích thước micro-batch, equation 17 xác nhận rằng gradient tích lũy bằng gradient của batch thực tế: \[ \nabla \mathcal{L}_B = \frac{1}{B}\sum_{i=1}^{B} \nabla \mathcal{L}_i = \frac{1}{k}\sum_{j=1}^{k}\left(\frac{1}{b}\sum_{i \in \mathcal{B}_j} \nabla \mathcal{L}_i\right) \tag{17}\]
Sự tương đương này đúng khi việc tính toán cho từng ví dụ là như nhau và loss được lấy trung bình nhất quán. Vế phải cho thấy lấy trung bình \(k\) gradient của các micro-batch (mỗi cái tính trên \(b\) ví dụ) cho kết quả như khi tính gradient trên toàn bộ \(B = kb\) ví dụ cùng lúc. Tuy nhiên, các lớp có trạng thái như BatchNorm, các phép toán ngẫu nhiên như dropout và data augmentation, thứ tự cộng dồn với độ chính xác hữu hạn, và các lịch trình phụ thuộc vào bước có thể làm mất tính tương đương tuyệt đối. Vì vậy, tích lũy batch lớn vẫn cần được kiểm chứng.
Tích lũy gradient là đánh đổi bộ nhớ lấy thời gian tính toán. Table 14 tách lợi ích về bộ nhớ khỏi các chi phí tính toán và lập lịch còn lại.
| Chiều | Hiệu ứng |
|---|---|
| Bộ nhớ | \(\mathcal{O}(b)\) thay vì \(\mathcal{O}(B)\), mang lại sự giảm \(k\times\) trong bộ nhớ activation. |
| Tính toán | Tổng FLOPs không thay đổi, vì tất cả \(B\) ví dụ vẫn được xử lý. |
| Thời gian | \(k\) lượt chuyển tiếp và lan truyền ngược micro-batch diễn ra trước mỗi bước optimizer; các micro-batch nhỏ hơn có thể làm giảm mức sử dụng và tăng thêm chi phí khởi chạy. |
Tích lũy giữ nguyên tổng lượng tính toán ở cấp độ ví dụ, nhưng có thể làm thay đổi hiệu quả vì micro-batch nhỏ sử dụng bộ tăng tốc khác đi và phải khởi chạy kernel thường xuyên hơn. Với tích lũy no_sync() phân tán, chỉ đồng bộ gradient một lần sau \(k\) micro-batch cục bộ, thay vì sau mỗi micro-batch. Mô hình trong equation 18 cho thời gian cho mỗi lần cập nhật: \[
T_{\text{effective}} = \sum_{j=1}^{k} T_{\text{micro},j} + T_{\text{sync}} + T_{\text{update}}
\tag{18}\]
Ở đây, \(T_{\text{micro},j}\) là thời gian truyền xuôi/truyền ngược đo được cho micro-batch \(j\), \(T_{\text{sync}}\) là thời gian đồng bộ hóa phải trả cho bản cập nhật tích lũy, và \(T_{\text{update}}\) là thời gian thực hiện một bước của optimizer.
Độ trễ thời gian thực so với việc xử lý toàn bộ effective batch một lần là phụ thuộc vào khối lượng công việc (workload). Cần đo đạc thực tế, không thể suy ra chỉ từ hệ số giảm bộ nhớ.
Khi tích lũy gradient được kết hợp với song song dữ liệu phân tán trên nhiều máy, sẽ phát sinh thêm các cân nhắc về thời điểm đồng bộ gradient và cách tính kích thước batch hiệu quả trên toàn cụm. Các tài liệu chuyên sâu về hệ thống phân tán bàn kỹ hơn về các mẫu này.
Activation checkpointing
Activation checkpointing giảm sử dụng bộ nhớ trong lượt truyền ngược bằng cách loại bỏ và tính toán lại có chọn lọc các activations. Trong huấn luyện tiêu chuẩn, các activations từ lượt truyền xuôi được lưu trong bộ nhớ để dùng khi tính gradient trong quá trình lan truyền ngược. Tuy nhiên, những activations này có thể tiêu tốn hàng gigabyte bộ nhớ, đặc biệt trong các mạng sâu.
Bộ nhớ cho activations có thể được giảm bằng cách đánh đổi FLOPS lấy băng thông bộ nhớ trong quá trình lan truyền ngược. Hãy so sánh lượt truyền xuôi ở hàng trên cùng của figure 13 với lượt truyền ngược ở hàng dưới cùng, bạn sẽ thấy các activation trung gian bị loại bỏ và được tính toán lại khi cần từ các tensor checkpoint màu xanh lá cây đặc.

Triển khai này giữ rõ ràng phép đánh đổi về dung lượng. Hệ thống chia mô hình thành các phân đoạn, chỉ giữ activation tại ranh giới phân đoạn trong lượt truyền xuôi và tính lại các activation trung gian trong lượt truyền ngược khi cần.
Các framework như PyTorch cung cấp công cụ như torch.utils.checkpoint để đơn giản hóa quy trình này, nhưng chi phí tính lại vẫn còn. Checkpointing hiệu quả nhất với các kiến trúc sâu gồm hàng chục hoặc hàng trăm lớp, như transformer hoặc các mạng tích chập lớn, khi lưu trữ activation vượt quá khả năng của GPU trước khi thông lượng tính toán bị bão hòa.
Sự kết hợp giữa tích lũy gradient và checkpointing cho phép huấn luyện các mô hình lớn hơn, phức tạp hơn. Tích lũy gradient xử lý các ràng buộc bộ nhớ liên quan đến kích thước batch, còn checkpointing tối ưu hóa bộ nhớ cho các activation trung gian. Cùng nhau, chúng mở rộng phạm vi mô hình có thể huấn luyện trên phần cứng hiện có.
Chiến lược đặt checkpoint tối ưu
Với một mạng có \(N_L\) lớp, mỗi lớp lưu \(A\) byte activation, table 15 định lượng cách số lượng và vị trí checkpoint quyết định sự đánh đổi giữa bộ nhớ và tính toán. Các chiến lược checkpointing dưới tuyến tính có thể giảm mức tiêu thụ bộ nhớ từ \(\mathcal{O}(N_L)\) xuống \(\mathcal{O}(\sqrt{N_L})\) trong khi chỉ tăng một phần nhỏ tổng thời gian tính toán, giúp huấn luyện các mô hình sâu hơn nhiều trên phần cứng hiện có.
| Chiến lược | Chi phí bộ nhớ | Chi phí tính toán lại |
|---|---|---|
| Không checkpoint | \(N_L \times A\) | 0 phép toán forward |
| Giữ lại một ranh giới | \(A\) | \((N_L-1)\) phép toán forward |
| k checkpoint | \(k\times A + (N_L/k)\times A\) | \((N_L-k)\) phép toán forward |
Nếu ta đặt đạo hàm của tổng chi phí bộ nhớ \((k \times A + (N_L/k) \times A)\) bằng 0, điểm tối ưu nằm tại \(k_{\text{optimal}} = \sqrt{N_L}\). Trong sơ đồ checkpointing \(\sqrt{N_L}\) phổ biến, cách này đánh đổi khoảng một phần ba chi phí tính toán forward để đạt mức sử dụng bộ nhớ tối thiểu theo mô hình đơn giản hóa này. Với GPT-2 có 48 lớp transformer, sự khác biệt rất rõ: không checkpointing thì bộ nhớ bằng \(48 \times A\) (lưu trữ activation đầy đủ). Checkpointing tối ưu (\(\sqrt{48}\) xấp xỉ bảy checkpoint) cần bộ nhớ khoảng \(7 \times A + (48/7) \times A \approx 14 \times A\), tiết kiệm 71% bộ nhớ với khoảng 33% chi phí tính toán bổ sung.
Không phải tất cả phép toán đều tốn kém như nhau khi tính lại, nên checkpointing có chọn lọc là hợp lý. Table 16 so sánh các trường hợp mà bộ nhớ activation đủ lớn để việc tính lại trở nên đáng làm.
| Loại lớp | Chi phí bộ nhớ | Chi phí tính toán lại | Chiến lược checkpointing |
|---|---|---|---|
| Các khối Attention | Phụ thuộc vào hình dạng; attention được hiện thực hóa có thể thêm các giá trị trung gian bậc hai | Cao và phụ thuộc vào độ dài chuỗi | Checkpoint các ranh giới khối khi trạng thái đã lưu biện minh cho việc tính toán lại |
| Các khối Feed-forward | Thường bị chi phối bởi các activation ẩn được mở rộng | Cao và phụ thuộc vào chiều rộng | Checkpoint khi các activation được mở rộng chiếm ưu thế bộ nhớ |
| Chuẩn hóa | Các đầu ra độc lập nhỏ | Thấp | Thường được xử lý trong một khối checkpointed lớn hơn |
Nguyên tắc thực tế là nên dành việc tính lại cho các lớp tiêu tốn nhiều bộ nhớ, thay vì cho các phép toán có activation vốn rẻ để giữ lại.
Lợi ích về bộ nhớ và tính toán
Tích lũy gradient tạo ra một batch hiệu quả lớn hơn so với micro-batch đang ở trong bộ nhớ mà không cần lưu đồng thời tất cả activation của nó. Một batch hiệu quả lớn hơn giúp giảm phương sai lấy mẫu nhưng không đảm bảo hội tụ nhanh hơn hay khả năng tổng quát hóa tốt hơn. Kỹ thuật này đặc biệt hữu ích khi batch hiệu quả mong muốn không thể vừa trong bộ nhớ cùng một lúc.
Kỹ thuật activation checkpointing giúp giảm đáng kể bộ nhớ dành cho các activation trung gian trong forward pass, nhờ đó cho phép huấn luyện các mô hình sâu hơn. Bằng cách loại bỏ và tính toán lại activation khi cần, checkpointing giải phóng bộ nhớ cho các mô hình lớn hơn, thêm lớp, hoặc xử lý dữ liệu độ phân giải cao hơn. Sự đánh đổi này đặc biệt quan trọng trong các kiến trúc như transformers, vốn đòi hỏi rất nhiều bộ nhớ cho các phép tính trung gian.
Cả hai kỹ thuật này đều cải thiện khả năng mở rộng bằng cách giảm nhu cầu bộ nhớ trước khi phải bổ sung phần cứng. Trở lại với ví dụ lighthouse 1.1, tích lũy gradient là tối quan trọng để đạt kích thước batch mục tiêu trong giới hạn bộ nhớ của V100.
Napkin Math 1.8: Chiến lược tích lũy gradient cho GPT-2
Kịch bản minh họa ở quy mô GPT-2 này sử dụng giá và thời lượng giả định để cho thấy cách tích lũy gradient; nó không nhằm tái hiện chi phí huấn luyện thực tế trong quá khứ của GPT-2.
Giới hạn bộ nhớ
- Theo công thức tính bộ nhớ đơn giản hóa của chương này, một GPU V100 với 32 GB có thể chứa một micro-batch \(B=4\).
- Do đó, một batch hiệu quả \(B=512\) sẽ cần 512 ÷ 4 = 128 GPUs.
Cấu hình tích lũy
- Dùng 8 GPUs và tích lũy 16 micro-batch, mỗi micro-batch chứa 4 mẫu.
- Mỗi bộ tăng tốc xử lý 4 \(\times\) 16 = 64 mẫu cho mỗi lần cập nhật, tạo ra một batch hiệu quả toàn cục là 8 GPUs \(\times\) 64 = 512.
Trong thiết lập phân tán, có thể dùng ngữ cảnh no_sync() để hoãn AllReduce đến micro-batch cuối cùng.
Phân tích đánh đổi
- Thời gian wall-clock (lý tưởng): 16× dài hơn vì ít bộ tăng tốc hơn đang thực hiện cùng một khối lượng tính toán
- Chi phí bộ nhớ: tích lũy thường tái sử dụng các bộ đệm gradient tham số, dù vẫn cần dung lượng cho việc quản lý và lưu trữ tạm thời
- Giao tiếp: cả hai cấu hình đều đồng bộ một lần cho mỗi lần cập nhật 512 mẫu, nhưng số lượng thiết bị tham gia và cấu trúc liên kết khác nhau
- Chi phí cho cùng khối lượng công việc: $688K theo cả hai phương án, trước khi tính đến tác động của mức sử dụng và giao tiếp
Vì sao cách này hiệu quả: Với các điều kiện tương đương nêu ở trên, các gradient trung bình theo từng ví dụ có thể cộng dồn. Mỗi bộ tăng tốc trước tiên tích lũy gradient cục bộ trên 64 ví dụ của nó: \[ \frac{1}{16}\sum_{j=1}^{16} \left[\frac{1}{4}\sum_{k=1}^{4} \nabla \mathcal{L}(x_{jk})\right] \]
AllReduce sau đó tính trung bình các gradient cục bộ đó trên 8 GPUs, tạo ra batch hiệu quả toàn cục: \[ \frac{1}{8}\sum_{g=1}^{8} \nabla \mathcal{L}_{\text{local}}^{(g)}, \qquad B_{\text{global}} = 8 \times 64 = 512 \]
So sánh vận hành
Cấu hình resident:
- 128 GPUs \(\times\) 4 examples = 512 ví dụ resident mỗi lần cập nhật
- Đồng bộ hóa gradient diễn ra trên 128 GPUs
- Chi phí hàng giờ: 128 GPUs \(\times\) $16/hour = $2,048/hour
Cấu hình tích lũy:
- 8 GPUs \(\times\) (4 examples \(\times\) 16 micro-batches) = 512 ví dụ mỗi lần cập nhật
- Đồng bộ hóa gradient diễn ra một lần mỗi lần cập nhật trên 8 GPUs
- Chi phí hàng giờ: 8 GPUs \(\times\) $16/hour = $128/hour
- Mức giảm theo giờ: $1,920/hour, hoặc 93.8 percent
Ngưỡng chất lượng
- Phải khớp bộ ví dụ và thứ tự của chúng, cách chuẩn hóa loss, trạng thái của optimizer và lịch bước, cùng hành vi của các lớp ngẫu nhiên.
- Hãy so sánh hàm mất mát hoặc perplexity trên tập giữ lại và quỹ đạo tối ưu hóa qua nhiều lần chạy, thay vì cho rằng chỉ riêng batch hiệu quả đã đảm bảo chất lượng tương đương.
- Hãy chờ đợi những sai khác làm tròn nhỏ do thay đổi thứ tự cộng; yêu cầu hội tụ trong một ngưỡng dung sai đã công bố, thay vì trùng khớp từng bit. Ở đây không giả định bất kỳ kết quả perplexity nào.
Góc nhìn hệ thống: Tích lũy giúp giảm số lượng bộ tăng tốc và mức tiêu tốn theo giờ, nhưng với mở rộng lý tưởng thì tổng giờ sử dụng bộ tăng tốc được giữ nguyên; chi phí thực tế còn phụ thuộc vào mức sử dụng và giao tiếp.
Listing 7 đặt một AllReduce sau mười sáu micro-batch cục bộ, qua đó làm rõ ranh giới đồng bộ.
optimizer.zero_grad()
for step in range(16):  # Accumulation steps
    micro_batch = next(dataloader)  # 4 samples
    loss = model(micro_batch) / 16  # Average effective-batch loss
    loss.backward()  # Accumulate gradients
# Now gradients represent 64 local samples
all_reduce(gradients, op=SUM)  # Sum across 8 GPUs
gradients /= 8  # Convert the sum to the global mean
optimizer.step()  # Update with effective batch=512
Những lưu ý thực tiễn
Tích lũy gradient đặc biệt hữu ích khi kích thước batch tối ưu vượt quá dung lượng bộ nhớ GPU. Các mô hình ngôn ngữ Transformer thường dùng batch hiệu dụng lên đến hàng trăm nghìn đến hàng triệu token; nếu bộ nhớ chỉ cho phép ít chuỗi hơn trên mỗi thiết bị, tích lũy sẽ giúp thu hẹp khoảng cách mà không cần thêm phần cứng. Activation checkpointing bổ trợ cho điều này bằng cách cho phép xây dựng các kiến trúc sâu hơn, và thường được dùng trong huấn luyện ở quy mô Transformer, cũng như trong các cấu hình hai mạng tiêu tốn nhiều activation như mạng đối kháng tạo sinh.
Cả hai kỹ thuật đều có những đánh đổi rõ ràng. Activation checkpointing sẽ tính toán lại các activation đã loại bỏ trong quá trình lan truyền ngược; với segment checkpointing thông thường, mỗi activation bị loại bỏ thường được tái tạo một lần, trong khi các lịch đệ quy có thể ứng xử khác. Gradient accumulation làm giảm tần suất cập nhật tham số vì mỗi lần cập nhật diễn ra sau \(k\) micro-batch. Khi chia loss của mỗi micro-batch cho \(k\), gradient tích lũy tuân theo quy ước lấy trung bình theo batch hiệu dụng. Nếu cộng dồn loss thay vì chia, cần hiệu chỉnh lại gradient trước bước optimizer, hoặc điều chỉnh tương ứng quy ước về tốc độ học. Các framework và mã nguồn có thể dùng những quy ước khác nhau, khiến việc chuẩn hóa trở thành nguồn gây ra nhiều lỗi khó phát hiện.
So sánh các kỹ thuật tối ưu hóa
Table 17 tổng hợp ba trong bốn chiến lược tối ưu hóa cốt lõi, đồng thời đối chiếu mục tiêu chính, cơ chế và các đánh đổi của chúng. FlashAttention bổ sung cho các chiến lược này bằng cách giải quyết nút thắt băng thông bộ nhớ của attention thông qua tiling nhận biết IO, giảm bộ nhớ phụ trợ cho attention từ \(\mathcal{O}(S^2)\) xuống \(\mathcal{O}(S)\) và báo cáo mức tăng tốc tới 3\(\times\) trên các khối lượng công việc (workload) đã được đánh giá. Việc chọn chiến lược phù hợp phụ thuộc vào nút thắt được phát hiện qua profiling.
Các kỹ thuật này nhắm vào những ràng buộc khác nhau. Prefetching giúp xử lý tình trạng thiếu dữ liệu, mixed precision có thể tăng tốc các phép tính phù hợp và giảm nhu cầu lưu trữ tensor, FlashAttention giảm lưu lượng truy cập bộ nhớ của attention, còn gradient accumulation cho phép dùng các batch hiệu dụng mà nếu không sẽ vượt quá bộ nhớ activation. Lợi ích của từng kỹ thuật phụ thuộc vào nút thắt được đo đạc, và áp dụng một kỹ thuật không đảm bảo sẽ loại bỏ ràng buộc đầu-cuối.
| Khía cạnh | Prefetching và Overlapping | Huấn luyện độ chính xác hỗn hợp | Tích lũy Gradient và Checkpointing |
|---|---|---|---|
| Mục tiêu chính | Giảm thiểu độ trễ truyền dữ liệu và tối đa hóa việc sử dụng bộ tăng tốc | Giảm lưu trữ tensor và tăng tốc các phép toán độ chính xác thấp đủ điều kiện | Khắc phục các giới hạn bộ nhớ trong quá trình lan truyền ngược và cập nhật tham số |
| Cơ chế chính | Tải dữ liệu không đồng bộ và xử lý song song | Kết hợp tính toán độ chính xác thấp và cao hơn | Mô phỏng kích thước batch lớn hơn và lưu trữ activation có chọn lọc |
| Tác động bộ nhớ | Tăng mức sử dụng bộ nhớ cho bộ đệm prefetch | Có thể giảm trọng số, activation và các tensor được truyền | Giảm các activation thường trú; kích thước gradient tham số không thay đổi |
| Tốc độ tính toán | Cải thiện bằng cách giảm thời gian nhàn rỗi | Có thể tăng tốc các phép toán FP16/BF16 đủ điều kiện trên phần cứng được hỗ trợ | Có thể làm chậm do tính toán lại trong checkpointing |
| Khả năng mở rộng | Có khả năng mở rộng cao, đặc biệt đối với các tập dữ liệu lớn | Cho phép huấn luyện các mô hình lớn hơn | Cho phép huấn luyện các mô hình sâu hơn trên phần cứng hạn chế |
| Yêu cầu phần cứng | Hưởng lợi từ bộ nhớ nhanh và CPU đa nhân | Các đường dẫn bộ tăng tốc độ chính xác thấp hơn được hỗ trợ | Hoạt động trên phần cứng tiêu chuẩn |
| Độ phức tạp triển khai | Trung bình (yêu cầu tinh chỉnh các tham số prefetch) | Thấp đến trung bình (với sự hỗ trợ của framework) | Trung bình (yêu cầu phân đoạn và tích lũy cẩn thận) |
| Lợi ích chính | Giảm thời gian huấn luyện, cải thiện việc sử dụng phần cứng | Huấn luyện nhanh hơn, các mô hình lớn hơn, giảm mức sử dụng bộ nhớ | Cho phép kích thước batch lớn hơn và các mô hình sâu hơn |
| Thách thức chính | Tinh chỉnh kích thước bộ đệm, tăng mức sử dụng bộ nhớ | Khả năng mất ổn định số; FP16 có thể yêu cầu loss scaling | Tăng chi phí tính toán, cập nhật tham số chậm hơn |
| Các trường hợp sử dụng lý tưởng | Tập dữ liệu lớn, tiền xử lý phức tạp | Các mô hình quy mô lớn, đặc biệt trong NLP và thị giác máy tính | Các batch bị giới hạn bộ nhớ hoặc các mô hình nặng về activation |
Bảng này so sánh các kỹ thuật một cách riêng lẻ; phần hướng dẫn về GPT-2 sẽ minh họa cách các kỹ thuật đó kết hợp với nhau khi một mô hình cần vừa với bộ nhớ, chạy đủ nhanh và nằm trong một giới hạn chi phí thực tế.
Hướng dẫn tối ưu hóa GPT-2
Lộ trình kiểm tra tính khả thi về bộ nhớ khi huấn luyện GPT-2 (1,5 tỷ tham số) trên một GPU V100 duy nhất cho thấy các tối ưu hóa này phối hợp ra sao, trước khi chúng ta mở rộng phân tích thời gian, năng lượng và chi phí cho một lần huấn luyện trên 32 GPU V100.
Napkin Math 1.9: Tối ưu hóa GPT-2 trên V100
Bước 1: Xác định mức sử dụng bộ nhớ cơ sở.
Table 18: Hồ sơ tối ưu hóa GPT-2 minh họa: Các số liệu bộ nhớ cho batch-4 được tính trong phần hướng dẫn; mức sử dụng, thông lượng và thời gian epoch là các giá trị giả định theo kịch bản, không phải kết quả benchmark. Table 19 báo cáo tổng số liệu cho kịch bản batch-32.
Phân tích bắt đầu với GPT-2 XL có 1,5 tỷ tham số, kích thước batch 4, độ dài chuỗi 1024, dùng tensor FP32 toàn bộ, và một bộ nạp dữ liệu đồng bộ một luồng. Đây là cấu hình cố ý giới hạn: đủ nhỏ để bàn trên một V100, nhưng đủ lớn để lỗi đầu tiên xảy ra ngay và rất rõ ràng. Hướng dẫn này dùng kích thước batch 4, cùng cấu hình với phần mixed precision (tính toán sơ bộ 1.6). Bảng table 19 báo cáo các giá trị tương đương ở batch 32 (597.8 GB cho FP32 cơ sở, 95.7 GB sau tối ưu), vốn vượt quá một GPU duy nhất ngay cả sau tối ưu. Ở kích thước batch 4, cấu hình FP32 cơ sở cần 95.7 GB, nên lần chạy sẽ vượt giới hạn máy trên V100 32 GB trước khi thông lượng trở thành vấn đề.
Bước 2: Áp dụng mixed precision.
Biện pháp đầu tiên tập trung vào khả năng phù hợp bộ nhớ, không phải tốc độ. Mixed precision thay đổi hạng mục đầu tiên trong ngân sách bộ nhớ và giảm mức chiếm dụng xuống 59.9 GB, tức giảm 37.5 percent, nhưng vẫn chưa vừa.
Bước 3: Thêm gradient checkpointing.
Gradient checkpointing tác động vào một hạng mục khác bằng cách lưu ít activation hơn và tính lại chúng trong quá trình lan truyền ngược. Kịch bản này giả định giảm 4× lần bộ nhớ dành cho activation, đưa tổng tensor (bản đơn giản hóa) xuống 33 GB. Phần chi phí tính toán tăng thêm 33 percent tuân theo mô hình đơn giản hóa với các lớp có kích thước bằng nhau; khi chạy thực tế, phải đo cả bộ nhớ và thời gian, kể cả các không gian làm việc tạm thời.
Bước 4: Xem xét một hồ sơ thông lượng minh họa.
Làm cho mô hình vừa bộ nhớ chỉ là bước chẩn đoán đầu tiên. Giả sử một hồ sơ tiếp theo báo cáo các giá trị kịch bản sau:
- Mức sử dụng bộ tăng tốc: 45 percent
- Tải dữ liệu: chiếm 40 percent thời gian của mỗi vòng lặp
- Tính toán: chiếm 35 percent thời gian của mỗi vòng lặp.
- Truyền dữ liệu giữa các bộ nhớ: chiếm 25 percent thời gian của mỗi vòng lặp.
Những phép đo giả định này sẽ chuyển hướng điều tra tiếp theo từ khía cạnh dung lượng máy sang khía cạnh dữ liệu (theo D·A·M), nên tối ưu hóa bộ nhớ thêm sẽ không phải là can thiệp đầu tiên theo thời gian thực.
Bước 5: Áp dụng prefetching và tối ưu hóa pipeline dữ liệu.
Giải pháp đề xuất là chồng chéo việc chuẩn bị đầu vào với quá trình thực thi trên bộ tăng tốc. Ở đây, cấu hình data loader với tám worker, pinned memory và prefetch factor = 2 được giả định sẽ tăng mức sử dụng bộ tăng tốc lên 85 percent. Một hồ sơ thực tế phải xác nhận mức cải thiện và chỉ ra phần overhead còn lại.
Table 18 so sánh cấu hình cơ bản (chưa tối ưu) với cấu hình đã được tối ưu hóa:
| Chỉ số | Cơ bản | Tối ưu hóa | Cải thiện |
|---|---|---|---|
| Bộ nhớ | 95.7 GB | 33 GB | 2.9× giảm |
| Sử dụng bộ tăng tốc | N/A | 85% | Có thể huấn luyện |
| Thông lượng | N/A | 1,200 tokens/s | — |
| Thời gian mỗi epoch | N/A | 8.3 hours | — |
Thông tin chuyên sâu về hệ thống: Nếu việc phân tích lại hiệu năng xác nhận rằng dung lượng và tắc nghẽn đầu vào không còn là yếu tố hạn chế, thì quyết định tối ưu hóa tiếp theo nên dựa trên nút thắt cổ chai mới được quan sát, thay vì mặc định rằng quá trình chạy bị giới hạn bởi tính toán.
Nghiên cứu điển hình này minh họa vì sao tối ưu hóa huấn luyện là một quy trình chẩn đoán lặp, chứ không phải một tập hợp mẹo vặt. Mỗi can thiệp đều giải quyết nút thắt cổ chai lộ ra từ phép đo trước đó: kỹ thuật mixed precision giúp giảm bộ nhớ lưu trữ tensor nhưng không tự nó giải quyết được vấn đề dung lượng; checkpointing chấp nhận thêm 33 percent chi phí tính toán để đạt được 2.9× mức giảm bộ nhớ; và prefetching chỉ thực sự có ý nghĩa sau khi mô hình có thể chạy và việc phân tích hiệu năng cho thấy tình trạng thiếu dữ liệu. Vòng lặp có hệ thống gồm các bước: phân tích hiệu năng, xác định nút thắt cổ chai, áp dụng kỹ thuật phù hợp và phân tích lại hiệu năng, đã biến tối ưu hóa từ thử-sai thành một quy trình kỹ thuật bài bản.
Tóm tắt tác động của tối ưu hóa
Nghiên cứu điển hình về GPT-2 cho thấy các kỹ thuật nhắm mục tiêu có thể phối hợp với nhau như thế nào. Các giá trị bộ nhớ của nó tuân theo mô hình tensor của chương, trong khi các đầu vào về thời gian, công suất, giá điện và cường độ carbon của lưới điện chỉ xác định một kịch bản vận hành mang tính minh họa, chứ không phải kết quả đo lường của một lần chạy GPT-2.
Table 19 tổng hợp các kết quả được suy ra từ những giả định ở cấp cụm đó.
| Chỉ số | Đường cơ sở FP32 | Tối ưu hóa | Kỹ thuật được áp dụng |
|---|---|---|---|
| Tham số | 6 GB | 3 GB | Độ chính xác hỗn hợp (FP16) |
| Gradient | 6 GB | 3 GB | Độ chính xác hỗn hợp (FP16) |
| Trọng số chính | 0 GB | 6 GB | Chi phí AMP |
| Trạng thái Optimizer (Adam) | 12 GB | 12 GB | Không thay đổi (mô men FP32) |
| Activations (batch=32) | 573.8 GB | 71.7 GB | Gradient checkpointing + FP16 |
| Tổng bộ nhớ | 597.8 GB | 95.7 GB | — |
| Thời gian huấn luyện (32 V100s) | 14 days | 8.4 days | Tìm nạp trước dữ liệu + sử dụng |
| Mức tiêu thụ năng lượng | 3,914 kWh | 2,348 kWh | Giả định công suất cluster không đổi trong mỗi khoảng thời gian |
| Chi phí điện ($0.10/kWh) | $391.4 | $234.8 | — |
| Dấu chân carbon | 1.7 t | 1.0 t | Mức trung bình lưới điện khu vực (0.43 kg/kWh) |
Như table 19 cho thấy, các đầu vào giả định tạo ra tỷ lệ giảm bộ nhớ 6×, tỷ lệ thời gian thực (wall-clock) 1.7×, và mức giảm năng lượng 40 percent khi giả định công suất được mô hình hóa không đổi. Trong thực tế, năng lượng và chi phí phải được tính từ runtime và công suất đo được, vì mức sử dụng cao hơn có thể làm thay đổi lượng điện năng tiêu thụ của cụm.
Các công cụ tối ưu hóa trên một máy cần cho chương này đến đây là hết. Độ chính xác hỗn hợp tăng thông lượng Tensor Core có thể đạt được. FlashAttention giảm lưu lượng bộ nhớ HBM. Gradient checkpointing đánh đổi tính toán lấy bộ nhớ. Prefetching có thể che giấu độ trễ tải dữ liệu. Kết hợp lại, các phương pháp này có thể huấn luyện các mô hình quy mô GPT-2 nhanh hơn đáng kể so với một hệ thống cơ bản chưa được tối ưu, nhưng với ngân sách tính toán đã nêu trong chương, việc huấn luyện vẫn không thể hoàn thành trên một GPU hiện đại chỉ trong vài ngày.
Một số mô hình sẽ không vừa trên một thiết bị, và một số lần huấn luyện vẫn kéo dài không thực tế ngay cả sau khi đã tối ưu hóa trên một máy. Khi quá trình huấn luyện vẫn vượt quá ngân sách thời gian hoặc bộ nhớ cho phép, lựa chọn tiếp theo là phân tán tính toán trên nhiều thiết bị. Bước chuyển này tạo ra các nút thắt cổ chai mới, gồm chi phí giao tiếp, chi phí đồng bộ và yêu cầu về khả năng chịu lỗi.
Self-Check: Question
A training step consists of three stages executed sequentially: data preprocessing (\(T_{\text{prep}} = 30\text{ ms}\)), PCIe host-to-device transfer (\(T_{\text{xfer}} = 10\text{ ms}\)), and GPU compute (\(T_{\text{comp}} = 50\text{ ms}\)). If the team implements multi-worker asynchronous prefetching with double buffering over dedicated CUDA streams, what is the theoretical iteration time and speedup?
- Iteration time becomes \(T_{\text{prep}} + T_{\text{xfer}} = 40\text{ ms}\) (a \(2.25\times\) speedup), because compute runs completely for free in background streams.
- Iteration time drops from the serial sum (\(30 + 10 + 50 = 90\text{ ms}\)) to \(\max(T_{\text{prep}}, T_{\text{xfer}}, T_{\text{comp}}) = 50\text{ ms}\) (a \(44.4\%\) latency reduction or \(1.8\times\) throughput speedup), bounded by the slowest stage.
- Iteration time drops to \(\min(T_{\text{prep}}, T_{\text{xfer}}, T_{\text{comp}}) = 10\text{ ms}\), because all three stages execute in lockstep at the fastest rate.
- Iteration time remains \(90\text{ ms}\), because CUDA streams cannot execute DMA transfers concurrently with kernel computations.
Explain how FlashAttention computes exact self-attention with substantially lower memory footprint and higher speed than standard attention, and describe how its backward pass handles the attention score matrix.
Why does standard mixed-precision training (FP16 or BF16) maintain a master copy of model weights and execute LayerNorm/Softmax reductions in FP32, rather than keeping the entire training state exclusively in 16-bit precision?
- Tensor Cores cannot execute backpropagation without storing gradients in 64-bit double precision.
- FP16 memory allocations cause hardware bus lockups if master weights are not stored in CPU host RAM.
- Automatic differentiation graphs require FP32 weights to compute symbolic derivatives in PyTorch.
- Small gradient updates (\(\eta \cdot \nabla \mathcal{L}\)) can underflow or become zero when added directly to 16-bit weights due to limited precision/mantissa bits, and normalization reductions are prone to overflow/underflow; FP32 master weights preserve small accumulated updates across steps.
Gradient accumulation increases the memory footprint on the accelerator linearly with the accumulation factor \(K\) because all \(K\) micro-batches’ intermediate activations must remain in GPU memory simultaneously until the optimizer step.
In FP16 mixed-precision training, to prevent small gradient values from underflowing to zero before backpropagation, gradients are multiplied by a scale factor during the forward/loss pass and unscaled before the optimizer update using a technique known as loss ____.
A team enables mixed precision on a transformer model and observes compute time drop by 45 percent, but total step time decreases by only 10 percent because the GPU now exhibits large idle gaps. Explain what occurred in the system pipeline and what the team must do next.
Mở rộng quy mô hệ thống huấn luyện
Phân tích GPT-2 mô phỏng cách độ chính xác hỗn hợp và checkpointing giảm ngân sách bộ nhớ cho tensor ở batch 4 xuống 33 GB, gần với dung lượng 32 GB của V100, trước khi tính vùng làm việc và chi phí bộ cấp phát. Ở batch 32, tổng dung lượng mô phỏng giảm từ 597.8 GB xuống 95.7 GB nhưng vẫn vượt quá V100. Các bộ tăng tốc có bộ nhớ lớn hơn có thể nới rộng ranh giới này. Tuy nhiên, một mô hình 70 tỷ tham số cần khoảng 140 GB chỉ riêng cho các trọng số FP16 và còn nhiều hơn đáng kể cho trạng thái huấn luyện đầy đủ tham số, nên cần chia mảnh (sharding), offload hoặc dùng nhiều thiết bị.
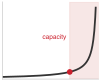
Một số mô hình đã vượt quá bộ nhớ của một GPU trước khi các yếu tố khác kịp ảnh hưởng.
Khi khối lượng công việc (workload) đã chọn vẫn vượt quá bộ nhớ hoặc lịch thực thi của một thiết bị, phân tán nó lên nhiều thiết bị sẽ cộng dồn bộ nhớ và năng lực tính toán. Các cách ứng phó khác gồm giảm kích thước mô hình, batch, độ dài chuỗi hoặc phạm vi huấn luyện; offloading state (chuyển bớt trạng thái); và dùng các phương pháp thích ứng hiệu quả về tham số. Việc mở rộng vượt khỏi một thiết bị thường bắt đầu với cấu hình đa GPU trong một máy, và có thể mở rộng ra nhiều nút (node). Các chiến lược song song hóa chính đòi hỏi những đánh đổi khác nhau về giao tiếp; phần triển khai huấn luyện phân tán chi tiết nằm ngoài phạm vi chương này.
Không phải mọi khối lượng công việc (workload) đều hưởng lợi như nhau khi thêm GPU. Mối quan hệ giữa phần tính toán hữu ích, giao tiếp, mất cân bằng và đồng bộ hóa quyết định hiệu quả mở rộng. Figure 14 mô hình hóa sự đánh đổi này theo kiểu Amdahl, trong đó phần chi phí không mở rộng tạo ra trần thông lượng. Khoảng cách ngày càng lớn giữa tăng tốc tuyến tính lý tưởng và tăng tốc thực tế đạt được trực quan hóa thuế giao tiếp phải trả khi mở rộng quy mô.
Khoảng cách ngày càng rộng giữa đường cong màu đỏ và đường lý tưởng nét đứt chính là thuế giao tiếp; mục tiêu của các chiến lược phân tán trong section 1.6.1 là thu hẹp khoảng cách này.
Huấn luyện đa GPU trên một nút
Huấn luyện đa GPU trên một nút — phạm vi của cuốn sách này — có trước các hệ thống phân tán quy mô lớn. AlexNet26 (Krizhevsky et al. 2012) nổi tiếng vì tách mô hình trên hai GPU GTX 580 do giới hạn bộ nhớ 3 GB khiến mạng quá lớn để huấn luyện trên một GPU. Việc tách này cũng biến kết nối giữa các GPU thành một quyết định kiến trúc. Cấu hình đa GPU trên một nút vẫn là điểm khởi đầu hữu ích vì nó giới thiệu các chiến lược song song hóa cốt lõi mà không phải gánh độ phức tạp của giao tiếp mạng.
26 AlexNet (2012): Bài báo báo cáo 60 triệu tham số và mức trần 3 GB cho một GPU, nhưng không quy giới hạn này cho một thành phần bộ nhớ cụ thể. Thiết kế song song hóa mô hình của AlexNet phân bổ khoảng một nửa số kernel cho mỗi GPU và chỉ cho phép giao tiếp ở các lớp được chọn, thể hiện sự đánh đổi giữa dung lượng bộ nhớ và giao tiếp.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
Hai chiến lược nền tảng, song song hóa dữ liệu và song song hóa mô hình, tương ứng với hai cách phân chia khác nhau về bản chất: song song hóa dữ liệu sao chép mô hình và phân chia dữ liệu, còn song song hóa mô hình phân chia trạng thái hoặc phép tính của mô hình. Sự khác biệt này quyết định yêu cầu bộ nhớ, kiểu giao tiếp và hành vi mở rộng.
Song song hóa dữ liệu
Song song hóa dữ liệu sao chép toàn bộ mô hình trên mỗi GPU, trong đó mỗi GPU sẽ xử lý các batch dữ liệu khác nhau. Sau khi tính toán gradient cục bộ, các GPU đồng bộ hóa bằng cách lấy trung bình các gradient. Figure 15 cho thấy luồng dữ liệu: dữ liệu đầu vào được chia thành các batch không trùng lặp, mỗi bộ tăng tốc tính toán truyền xuôi và truyền ngược một cách độc lập, rồi các gradient được gộp lại trước khi cập nhật mô hình dùng chung.

Sự hấp dẫn của song song dữ liệu nằm ở tính đơn giản và hiệu quả. Mỗi GPU chạy cùng một phép tính forward-backward trên các phần dữ liệu khác nhau, và các bản sao thống nhất gradient trước khi cập nhật tham số. Các triển khai hiện đại thường gom các phép reduce thành từng bucket và chồng lấp chúng với quá trình lan truyền ngược. Nhờ vậy, song song dữ liệu là lựa chọn ưu tiên đầu tiên khi mô hình vừa với bộ nhớ GPU. DistributedDataParallel của PyTorch và MirroredStrategy của TensorFlow tự động hóa đồng bộ hóa, giúp mô hình lập trình gần như giống với huấn luyện trên một GPU, dù vẫn có giao tiếp ở mỗi vòng lặp.
Song song dữ liệu không phân mảnh có một ràng buộc cứng: mỗi GPU phải giữ một bản sao mô hình hoàn chỉnh và thường kèm trạng thái optimizer cục bộ. Ví dụ, một mô hình 7 tỷ tham số đã cần 14 GB chỉ riêng cho trọng số FP16, chưa tính gradient, trạng thái optimizer hay activation. Song song dữ liệu phân mảnh (như Zero Redundancy Optimizer, hay ZeRO) phân tán các trạng thái đó lên nhiều thiết bị: ZeRO-1 phân mảnh trạng thái optimizer, ZeRO-2 phân mảnh gradient, và ZeRO-3 (hoặc FSDP) phân mảnh tham số mô hình. Nếu không, mô hình vượt quá bộ nhớ cục bộ sẽ cần đến phân vùng pipeline hoặc tensor.
Song song mô hình
Song song mô hình là kỹ thuật phân chia bản thân mô hình ra nhiều GPU, cần thiết khi mô hình vượt quá bộ nhớ của một GPU. AlexNet dùng một dạng đơn giản: một số lớp nằm trên GPU 1, các lớp khác trên GPU 2, với activation được truyền qua lại giữa chúng. Figure 16 minh họa đường đi forward và backward: dữ liệu di chuyển qua các phân vùng mô hình trên các thiết bị khác nhau, còn gradient đi ngược lại trong quá trình huấn luyện.

Systems Perspective 1.7: Song song dữ liệu và song song mô hình
Khi phân chia một khối lượng công việc (workload) trên \(N_{\text{GPU}}\) thiết bị, ta có thể chia theo các ví dụ, trạng thái mô hình, các lớp, hoặc các phép toán tensor. Với một mô hình có \(P\) tham số và kích thước batch \(B\), song song dữ liệu và song song mô hình là hai điểm xuất phát.
Song song dữ liệu (chia batch): Với một batch toàn cục cố định, mỗi worker trong số \(N_{\text{GPU}}\) xử lý khoảng \(1/N_{\text{GPU}}\) số ví dụ, nhưng mỗi worker vẫn giữ một bản sao mô hình và thường cả trạng thái huấn luyện đi kèm. Trao đổi gradient dày đặc có chi phí tỷ lệ với \(P\) cho mỗi lần cập nhật. Khả năng mở rộng sẽ kém lý tưởng khi kích thước batch cục bộ nhỏ dần hoặc chi phí đồng bộ và đầu vào tăng.
Song song mô hình (chia tính toán mô hình): Mỗi bộ tăng tốc lưu trữ và tính một phần của mô hình. Nếu chia đều, mỗi worker có thể gần khoảng \(P/N_{\text{GPU}}\) tham số, nhưng các embedding, bộ đệm, mất cân bằng và trạng thái nhân bản sẽ làm sai khác ước tính này. Truyền thông phụ thuộc vào cách chia: pipeline song song theo lớp trao đổi activation tại ranh giới các giai đoạn, còn song song tensor thực hiện các phép tập thể bên trong các lớp đã phân chia.
Góc nhìn hệ thống: Song song dữ liệu là lựa chọn đơn giản nhất khi mỗi worker đủ chứa toàn bộ trạng thái huấn luyện và cần tăng thông lượng. Khi không còn đủ chỗ, cần phân vùng trạng thái mô hình, pipeline hoặc tensor, và thường kết hợp cùng song song dữ liệu.
Khi một mô hình vượt quá dung lượng bộ nhớ của một bộ tăng tốc duy nhất, độ sâu của mô hình có thể được phân chia trên nhiều thiết bị nối tiếp. Hãy xem xét cách gán các giai đoạn pipeline trong figure 17, và quan sát cách các nhóm khối transformer liền kề được ánh xạ lên các thiết bị riêng biệt dọc theo chuỗi thực thi.

Thách thức của song song mô hình là thời gian nhàn rỗi. Khi Thiết bị 1 tính các lớp 1–6, các Thiết bị 2–4 phải chờ activations. Trong backward pass, tình thế đảo ngược: Thiết bị 4 chạy trước còn các thiết bị khác đợi. Hiện tượng “pipeline bubble” này cho thấy, ngay cả khi phân chia cẩn thận, cách song song mô hình đơn giản vẫn có thể lãng phí nhiều thời gian của bộ tăng tốc. Pipeline parallelism được dùng để khắc phục sự kém hiệu quả này, như phần thảo luận về các chiến lược phân tán sẽ trình bày.
Trong một node, các GPU có thể giao tiếp qua các liên kết băng thông cao như NVLink27 (đạt tới 900 GB/s băng thông hai chiều tổng hợp cho cấu hình H100 minh họa). Băng thông tập thể hiệu quả còn phụ thuộc vào cấu trúc liên kết và mức độ tranh chấp, nên thường thấp hơn thông số băng thông cộng dồn trên giấy. Song song dữ liệu truyền các gradient, còn song song mô hình theo lớp truyền các activations tại ranh giới phân vùng. Việc chọn chiến lược cần so sánh chi phí tính toán, bộ nhớ và truyền thông của nó trên cấu trúc liên kết thực tế.
27 NVLink: Công nghệ kết nối GPU băng thông cao của NVIDIA. Cấu trúc liên kết và thế hệ của NVLink quyết định băng thông giữa một cặp GPU cụ thể và cho các phép toán tập thể. Một chiến lược song song chỉ hữu ích khi chi phí truyền thông và đồng bộ hóa của nó nhỏ hơn thời gian hữu ích mà nó giúp tiết kiệm.
Mở rộng vượt khỏi một node đơn
Khi huấn luyện đa GPU trong một node vẫn chưa đủ, huấn luyện phân tán sẽ mở rộng sang nhiều máy. Điều này thêm một tầng giao tiếp chậm hơn hoặc dễ tranh chấp hơn, và khiến máy chủ, bộ chuyển mạch, định tuyến và xử lý lỗi trở thành một phần ảnh hưởng đến hiệu suất huấn luyện. Khoảng cách băng thông trở nên quan trọng vì cập nhật song song dữ liệu đồng bộ biến việc giảm gradient thành một bài toán di chuyển dữ liệu lặp lại.
Systems Perspective 1.8: Vật lý của đồng bộ hóa
Hãy nhớ lại bất biến năng lượng-di chuyển ở Kỹ thuật dữ liệu: di chuyển dữ liệu có thể tốn nhiều năng lượng và thời gian hơn đáng kể so với tính toán cục bộ. Trong huấn luyện phân tán, sự bất đối xứng này góp phần vào chi phí giao tiếp.
Việc đồng bộ hóa gradient giữa các GPU đòi hỏi truyền hàng megabyte dữ liệu qua mạng hoặc PCIe chỉ trong vài mili giây. Phần giao tiếp không được ẩn đi sẽ làm giảm mức sử dụng tài nguyên, còn năng lượng tiêu thụ cho giao tiếp làm tăng ngân sách năng lượng của lần chạy; đây là hai loại chi phí khác nhau. Các kỹ thuật như độ chính xác hỗn hợp (section 1.5.3) và nén gradient giúp giảm lượng dữ liệu nhờ dùng định dạng ít bit hơn, tận dụng tính thưa, lượng tử hoá hoặc mã hóa, từ đó giải quyết cả hai áp lực trên.
Trong một nút (node), các liên kết nhanh có thể cho phép chồng lấp một phần đồng bộ hóa gradient với tính toán lan truyền ngược. Khi vượt ra ngoài ranh giới giữa các nút, ta phải đi qua một lớp liên kết khác mà băng thông và độ trễ hiệu dụng phụ thuộc vào cấu trúc liên kết và cách triển khai các phép toán tập thể. Trong song song dữ liệu đồng bộ, AllReduce28 tổng hợp gradient từ các worker; ở quy mô đủ lớn, thời gian giao tiếp không được ẩn đi của nó có thể chi phối cả bước.
28 AllReduce: Một primitive giao tiếp tập thể dùng để cộng dữ liệu từ tất cả thiết bị rồi phân phối kết quả trở lại cho từng thiết bị. Ring AllReduce là một cách triển khai phổ biến: các thiết bị truyền các mảnh gradient quanh một vòng logic, nhờ vậy mỗi bên chỉ gửi và nhận các phần dữ liệu (chunks) có kích thước giới hạn thay vì phải gửi/nhận toàn bộ mọi tensor gradient cùng lúc. Đây là primitive giao tiếp giúp huấn luyện song song theo dữ liệu ở quy mô lớn trở nên khả thi, nhưng mô hình chi phí chi tiết sẽ để dành ở phần huấn luyện phân tán.
Một phép tính ngắn cho thấy kiến trúc mạng liên nút nhanh chóng trở thành ràng buộc chính như thế nào.
Napkin Math 1.10: Bức tường mạng
Vấn đề: Một nhóm mở rộng huấn luyện lên 8 GPUs GPU, mỗi GPU trên một nút riêng, được kết nối bằng liên kết 100 Gbps. Liệu mạng có trở thành nút thắt cổ chai không?
Cơ chế: Với một mô hình 7B tham số và gradient FP16:
- Kích thước gradient (FP16): 14 GB mỗi bước.
- Chi phí AllReduce: Ring AllReduce chuyền các mảnh gradient quanh một vòng logic, nên mỗi worker rốt cuộc phải gửi đi lượng dữ liệu gần bằng hai bản sao đầy đủ của gradient: \(2(N_{\text{GPU}}-1)/N_{\text{GPU}}\). Con số này bằng 1.75× khi có 8 GPUs GPU. Như vậy, tổng dữ liệu cần truyền là 1.75 \(\times\) 14 GB = 24.5 GB.
- Giới hạn dưới (chỉ xét băng thông): Với băng thông hiệu dụng 12.5 GB/s cho mỗi worker trên kết nối 100 Gbps, độ trễ đồng bộ là \(T_{\text{comm}} = D_{\text{comm}} / \text{BW}_{\text{net}} =\) 24.5 GB / 12.5 GB/s \(=\) 1.96 s.
- So sánh với thời gian tính toán: Nếu phần tính toán forward và backward không được chồng lấp mất khoảng \(T_{\text{compute}} \approx\) 1 s, thì độ trễ truyền thông \(T_{\text{comm}} \approx\) 1.96 s sẽ chiếm ưu thế.
Bài học về hệ thống: Mạng trở thành một “bức tường” khi \(T_{\text{comm}} > T_{\text{compute}}\), làm hiệu suất của bộ tăng tốc \(\eta_{\text{hw}} = \frac{T_{\text{compute}}}{T_{\text{compute}} + T_{\text{comm}}}\) tụt mạnh, chỉ còn khoảng 33.8 percent. Các cách giảm thiểu gồm nén gradient (giảm \(D_{\text{comm}}\)), các primitive AllReduce dạng vòng (ring AllReduce) (Sergeev and Balso 2018), và các cấu trúc liên kết phân cấp để giữ những lần truyền dữ liệu tần suất cao trong liên kết nội nút tốc độ cao (NVLink ở 900 GB/s so với 12.5 GB/s giữa các nút).
Sergeev, Alexander, and Mike Del Balso. 2018. “Horovod: Fast and Easy Distributed Deep Learning in TensorFlow.” CoRR abs/1802.05799.
29 GPipe (2019): GPipe áp dụng chiến lược micro-batching đã mô tả, sắp xếp thực thi so le để lấp đầy các “khoảng trống” nhàn rỗi trong song song mô hình kiểu đơn giản, qua đó tăng mức sử dụng (Huang et al. 2019). Sự đánh đổi chính mà GPipe quản lý là thêm bộ nhớ để lưu các activation của nhiều micro-batch đang trong pipeline. Nó giữ nguyên hành vi huấn luyện với batch lớn bằng cách tích lũy gradient trước khi cập nhật trọng số; bài báo báo cáo rằng thông lượng của Transformer mở rộng gần như tuyến tính khi số micro-batch ít nhất gấp bốn lần số phân vùng.
Huang, Y., Y. Cheng, A. Bapna, O. Firat, D. Chen, M. X. Chen, H. Lee, et al. 2019. “GPipe: Efficient Training of Giant Neural Networks Using Pipeline Parallelism.” Advances in Neural Information Processing Systems (NeurIPS) 32: 103–12.
Khi huấn luyện vượt qua ranh giới giữa các nút, chiến lược phải điều chỉnh tần suất giao tiếp cho phù hợp với băng thông sẵn có. Pipeline parallelism xử lý thời gian nhàn rỗi trong cách phân chia theo lớp bằng micro-batching. Khi một giai đoạn đang xử lý một micro-batch về sau, giai đoạn tiếp theo có thể xử lý một micro-batch trước đó. Lịch thực thi quyết định mỗi giai đoạn phải giữ lại bao nhiêu activation của micro-batch cho tới khi thực hiện lan truyền ngược; điều này có thể làm tăng nhu cầu bộ nhớ, nhưng không phải thiết bị nào cũng lưu toàn bộ activation của mô hình cho mọi micro-batch đang trong pipeline. GPipe29 và PipeDream đã đưa ra các lịch thực thi có ảnh hưởng cho sự đánh đổi này (Huang et al. 2019; Narayanan et al. 2019).
Song song hóa tensor tiếp cận ở mức hạt mịn hơn: thay vì gán cả lớp cho từng thiết bị, nó chia nhỏ từng phép toán ra nhiều thiết bị. (Song song hóa chuỗi mở rộng nguyên tắc này bằng cách chia nhỏ các tensor activation theo chiều chuỗi và phân mảnh chúng trên nhiều thiết bị trong quá trình huấn luyện transformer chuỗi dài.) Xét một lớp feed-forward của transformer với phép nhân ma trận lớn \(\mathbf{Y} = \mathbf{X}\mathbf{W}\). Song song hóa tensor chia ma trận trọng số \(\mathbf{W}\) theo cột trên các GPU, để mỗi bộ tăng tốc tính một phần của đầu ra. Sau đó, các phần này được gom lại để tạo thành đầu ra hoàn chỉnh. Chiến lược này đặc biệt hiệu quả với các lớp attention và feed-forward rất lớn trong các transformer lớn, khi một phép toán đơn lẻ có thể liên quan đến các ma trận quá lớn so với bộ nhớ của một GPU. Megatron-LM cho thấy song song hóa tensor cho phép huấn luyện các mô hình với hàng tỷ tham số bằng cách phân phối từng đầu attention và các khối feed-forward trên nhiều thiết bị (Shoeybi et al. 2019).
Shoeybi, Mohammad, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. 2019. “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism.” arXiv Preprint arXiv:1909.08053.
Các chiến lược lai kết hợp những cách tiếp cận này vì mỗi cách có đặc tính mở rộng khác nhau. Table 20 đưa ra một quy tắc kinh nghiệm phụ thuộc cấu trúc liên kết: đặt các trao đổi giao tiếp thường xuyên nhất lên các liên kết nhanh nhất, còn các đồng bộ ít thường xuyên hơn thì đặt lên các tầng chậm hơn.
Quy tắc sắp xếp này không tùy tiện; nó ánh xạ tần suất giao tiếp tới tầng băng thông nhanh nhất hiện có.
| Chiến lược | Vị trí điển hình | Mô hình giao tiếp |
|---|---|---|
| Song song hóa tensor | Trong một node | Giao tiếp thường xuyên tận dụng băng thông cao của NVLink |
| Song song hóa pipeline | Giữa các node trong một rack | Giao tiếp vừa phải tại ranh giới lớp |
| Song song hóa dữ liệu | Giữa các rack | Đồng bộ hóa gradient một lần mỗi lần lặp |
Các hệ thống song song dữ liệu cũng dựa vào các phép toán tập thể như AllReduce để gộp gradient từ nhiều thiết bị. Chi tiết triển khai các thuật toán tập thể, các mẫu hình giao tiếp kiểu máy chủ tham số và ngang hàng, cơ chế chịu lỗi, cùng phân tích hiệu quả mở rộng cho các phiên huấn luyện chạy trên hàng nghìn GPU là một lĩnh vực chuyên biệt, xây dựng trên những nền tảng đã trình bày ở đây.
Sự tiến hóa của hạ tầng huấn luyện
Các chiến lược song song hóa trong section 1.6.1 và section 1.6.2 là một đầu mút của một tiến trình tiến hóa hạ tầng dài hơn. Các hệ thống huấn luyện có hình hài như hiện nay vì hạ tầng tính toán đã trải qua bốn kỷ nguyên riêng biệt, mỗi kỷ nguyên được định hình bởi các khối lượng công việc (workload) chủ đạo. Hình Figure 18 đặt các kỷ nguyên đó trên một trục thời gian, còn Bảng table 21 so sánh các khối lượng công việc (workload), mẫu sử dụng bộ nhớ và mô hình xử lý của chúng.
Huấn luyện mạng nơ-ron kết hợp các yêu cầu từ nhiều lĩnh vực tiền nhiệm. Giống HPC, nó cần thông lượng dấu phẩy động lớn; và giống điện toán quy mô kho dữ liệu, các chạy lớn đòi hỏi phối hợp và xử lý lỗi giữa nhiều máy. Nhiều công việc quy mô lớn hiện nay dùng các phép tập hợp đồng bộ ở mỗi bước của optimizer, nhưng cũng có các máy chủ tham số bất đồng bộ, phương pháp cập nhật cục bộ và những sơ đồ đồng bộ hóa khác. Việc trao đổi dữ liệu khối lượng lớn lặp đi lặp lại trong các công thức huấn luyện đồng bộ phổ biến đã thúc đẩy sự ra đời của các cụm bộ tăng tốc với kết nối băng thông cao và các ngăn xếp phần mềm được tối ưu cho giao tiếp tập thể.

Sự phát triển kiến trúc này cho thấy các hệ thống huấn luyện đã kế thừa từ những mô hình tính toán trước đó như thế nào. Như table 21 chỉ ra, các hệ thống HPC đặt nền tảng cho tính toán số song song, còn các hệ thống ở quy mô kho dữ liệu chứng minh khả năng xử lý phân tán ở quy mô lớn. Các mạng nơ-ron hiện đại kết hợp cập nhật tham số cường độ cao, các kiểu truy cập bộ nhớ phức tạp và tính toán phân tán có phối hợp, nên kiến trúc phải hòa trộn các yếu tố của cả hai truyền thống.
Trong thực tế, khi cấu hình một job huấn luyện đa-GPU, chúng ta cần chọn giữa các chiến lược song song hóa được phát triển để xử lý các kiểu tính toán khác nhau. Hiểu rõ các chiến lược này, những đánh đổi, chi phí giao tiếp và các tình huống lỗi sẽ giúp quyết định khi nào thêm phần cứng thật sự hữu ích và khi nào nó chỉ làm mọi thứ phức tạp hơn.
| Kỷ nguyên | Khối lượng công việc (workload) chính | Các mẫu bộ nhớ | Mô hình xử lý |
|---|---|---|---|
| Mainframe | Xử lý batch tuần tự | Hệ thống phân cấp bộ nhớ đơn giản | Luồng lệnh đơn |
| HPC | Mô phỏng khoa học | Truy cập mảng đều đặn | Song song đồng bộ |
| Quy mô kho hàng | Dịch vụ Internet | Truy cập thưa thớt, không đều | Các tác vụ song song độc lập |
| AI Hypercomputing | Huấn luyện mạng nơ-ron | Nhiều tham số, truy cập hỗn hợp | Song song lai, phân tán |
Khi nào nên mở rộng: Giới hạn vật lý
Với vốn từ về các chiến lược song song hóa (dữ liệu, mô hình, pipeline, tensor và lai), biết cách mở rộng khác với biết khi nào nên mở rộng. Huấn luyện phân tán làm tăng đáng kể độ phức tạp. Trước khi chấp nhận điều đó, người thực hành nên đánh giá các kỹ thuật khả dụng trên một máy đơn, gắn với ràng buộc đã đo được:
- Huấn luyện độ chính xác hỗn hợp: Hãy sử dụng các chế độ độ chính xác thấp hơn được hỗ trợ (section 1.5.3) khi việc xác thực cho thấy hành vi số học vẫn chấp nhận được.
- Tích lũy gradient: Sử dụng kỹ thuật tích lũy (section 1.5.5) để mô phỏng kích thước batch lớn hơn.
- Activation checkpointing: Thực hiện checkpointing (section 1.5.5.1) để đánh đổi tài nguyên tính toán lấy bộ nhớ.
- Tối ưu hóa pipeline dữ liệu: Tối ưu hóa pipeline dữ liệu (section 1.5.2) khi khối lượng công việc đầu vào nằm trên đường găng.
Table 22 biến nguyên tắc này thành một bảng tra cứu, sử dụng các giới hạn tài nguyên đã đo lường làm khóa, thay vì các ngưỡng số tham số chung.
| Ràng buộc quan sát được | Phương án tiếp cận tiềm năng | Lý do |
|---|---|---|
| Trạng thái huấn luyện vừa với một thiết bị và thời gian chấp nhận được | Một GPU | Giảm thiểu giao tiếp và độ phức tạp vận hành |
| Trạng thái hoặc thông lượng vượt quá một thiết bị nhưng vừa với một node | Một node đa GPU | Sử dụng các kết nối nội bộ nhanh trước khi vượt qua mạng |
| Trạng thái hoặc lịch trình yêu cầu vượt quá một node | Cụm đa node | Thêm bộ nhớ tổng hợp hoặc tính toán với chi phí giao tiếp |
| Tốc độ phục vụ đầu vào thấp hơn nhu cầu của bộ tăng tốc | Pipeline đầu vào song song hoặc phân tán | Tăng thông lượng đầu vào khi profiling cho thấy cần thiết |
Chỉ khi profiling cho thấy các nút thắt cổ chai vẫn tồn tại dù đã tối ưu hóa, chúng ta mới nên cân nhắc các cách tiếp cận đa thiết bị. Mọi thiết bị phần cứng đều có một giới hạn vật lý: một khối lượng công việc yêu cầu \(10^{24}\) FLOPs không thể hoàn thành trên một bộ tăng tốc duy nhất trong một lịch trình huấn luyện hợp lý, cho dù bộ tăng tốc đó được tinh chỉnh kỹ lưỡng đến đâu. Việc chuyển sang huấn luyện đa thiết bị trở nên cần thiết khi một trong ba giới hạn cứng sau đây bị chạm tới:
- Cạn kiệt bộ nhớ: Các trọng số mô hình, gradient, trạng thái optimizer và activation vượt quá VRAM của một GPU đơn lẻ. Một mô hình 70 tỷ tham số yêu cầu khoảng 140 GB ở FP16 chỉ tính riêng trọng số, vượt quá cấu hình 80 GB của các bộ tăng tốc A100 và H100 SXM và để lại rất ít hoặc không còn dung lượng trống trên các biến thể dung lượng cao hơn như H100 NVL (94 GB) và H200 (141 GB) khi tính cả trạng thái huấn luyện.
- Thời gian thực tế huấn luyện: Thời gian ước tính trên một thiết bị vượt quá thời hạn thực tế của dự án. Với \(10^{15}\) FLOP/s duy trì, một khối lượng công việc yêu cầu \(10^{24}\) FLOPs sẽ mất khoảng 32 năm.
- Thông lượng đầu vào: Pipeline đầu vào không thể duy trì tốc độ tiêu thụ tổng hợp của bộ tăng tốc. Kích thước tập dữ liệu một mình không quyết định giới hạn này; việc tái sử dụng, nén, tính cục bộ, chi phí biến đổi và băng thông lưu trữ đều quan trọng.
Ba giới hạn này mang tính kỹ thuật, nhưng việc mở rộng hệ thống còn đi kèm với chi phí lớn hơn cả sự phức tạp và dung lượng. Việc thêm thiết bị làm tăng mức tiêu thụ năng lượng và tác động môi trường của quá trình huấn luyện, do đó, tối ưu hóa hiệu quả không chỉ là vấn đề về hiệu suất mà còn là mối quan tâm về môi trường.
Napkin Math 1.11: Dấu chân carbon của quá trình huấn luyện
Bối cảnh: Huấn luyện các mô hình lớn cần rất nhiều năng lượng và tài nguyên tính toán. Giới hạn vật lý xuất hiện trong hệ quả năng lượng của định luật sắt (\(E_{\text{total}} = P_{\text{fleet}} \cdot T_{\text{train}}\)), cho thấy quy mô tác động môi trường:
- Khối lượng công việc (workload): Huấn luyện một mô hình có 7 billion tham số với 1 trillion token.
- Tính toán: \(O \approx\) \(4.2 \times 10^{22}\).
- Hiệu suất: 156 TFLOP/s duy trì trên A100 (thermal design power 400 W).
- Thời gian thực thi: \(T_{\text{train}} \approx\) 3.04 days trên 1,024 GPUs.
- Dấu chân năng lượng: \(E_{\text{total}} = P_{\text{cluster}} \cdot T_{\text{train}} = (N_{\text{GPU}} \cdot P_{\text{GPU}} + N_{\text{host}} \cdot P_{\text{host}}) \cdot T_{\text{train}}\) được tính thành (1,024 GPUs \(\times\) 400 W + 128 hosts \(\times\) 200 W) \(\times\) 73 hours \(\approx\) 31,784.2 kWh.
Tác động: Năng lượng tiêu thụ tương đương 35.3 months mức dùng điện trung bình của một hộ gia đình.
Bài học về hệ thống: Tăng gấp đôi thông lượng phần cứng \(\eta_{\text{hw}}\) với công suất cluster \(P_{\text{cluster}}\) không đổi sẽ giảm một nửa thời gian thực thi \(T_{\text{train}}\) và tổng năng lượng \(E_{\text{total}}\). Với cường độ carbon trung bình của lưới điện, tăng gấp đôi hiệu suất giúp tiết kiệm ~15,892.1 kWh điện và tránh phát thải 6.8 t. Các cuộc kiểm toán môi trường phải đo \(E_{\text{total}} = \int P(t) dt\) thay vì chỉ dựa vào các chỉ số sử dụng GPU.
Mở rộng không xóa bỏ ràng buộc đang chi phối mà chỉ chuyển nó sang dạng khác: song song dữ liệu mang lại thông lượng, song song mô hình mang lại dung lượng bộ nhớ, song song pipeline cải thiện mức độ tận dụng, và song song tensor giúp khả thi ở cấp độ lớp; đổi lại, mỗi cách đều làm tăng chi phí giao tiếp và phối hợp. Các chi tiết triển khai của huấn luyện phân tán nhiều nút — bao gồm các phép giao tiếp tập thể, cơ chế chịu lỗi và lập lịch co giãn — dựa trực tiếp trên các nguyên tắc cho máy đơn đã trình bày xuyên suốt chương này, và được bàn sâu trong các tài liệu về hệ thống phân tán nâng cao.
Checkpoint 1.3: Các quyết định mở rộng
Khi mở rộng, bạn thường đổi tắc nghẽn tính toán lấy tắc nghẽn giao tiếp.
Self-Check: Question
A team trains a 1.5-billion-parameter model that fits comfortably in the 80 GB memory of a single GPU with batch size 16 and Adam optimizer state, but training takes 12 days per epoch. The team has an 8-GPU node. Which parallelism strategy should be adopted first, and why?
- Tensor parallelism; split each weight matrix across the 8 GPUs to maximize matrix multiplication speed.
- Pipeline parallelism; split the 48 transformer layers across the 8 GPUs (6 layers per GPU) to reduce per-device parameter storage.
- Data parallelism (such as PyTorch DDP); replicate the model across all 8 GPUs, assign each GPU a micro-batch of 16, and overlap gradient AllReduce with the backward pass, because the model already fits in single-GPU memory and data parallelism avoids pipeline bubble overhead.
- ZeRO-3 parameter sharding; shard weights, gradients, and optimizer states across all GPUs to minimize communication volume.
In a Distributed Data Parallel training setup with \(N\) GPUs and a model of \(P\) parameters (where each parameter gradient is \(B_{\text{bytes}}\) bytes), what is the total data volume transferred by each individual GPU during a Ring AllReduce gradient synchronization?
- \(2 \times \frac{N-1}{N} \times P \times B_{\text{bytes}}\), which approaches \(2 P B_{\text{bytes}}\) as \(N\) becomes large and is independent of the number of GPUs \(N\).
- \(N \times P \times B_{\text{bytes}}\), scaling linearly with the total number of GPUs in the cluster.
- \(\frac{P \times B_{\text{bytes}}}{N^2}\), decreasing quadratically as more GPUs are added.
- Zero bytes, because GPUs synchronize gradients directly through CPU shared memory without network transfers.
Explain what the “communication tax” is in distributed training, and analyze why adding more GPUs to a distributed run can lead to diminishing returns in throughput.
In pipeline model parallelism, partitioning a network linearly across \(K\) stages without micro-batching (naive pipeline parallelism) achieves 100 percent GPU utilization because downstream devices can compute backward gradients while upstream devices run forward passes.
Arrange the following engineering steps in the order prescribed by the chapter’s “single-machine-first” scaling discipline:
- Evaluate whether the workload still hits a physical hard limit (memory capacity exhaustion, wall-clock deadline, or dataset scale).
- Implement distributed data parallelism or model sharding across multiple accelerator nodes.
- Benchmark and optimize single-accelerator execution using mixed precision (FP16/BF16), FlashAttention, and data prefetching.
- Apply single-device memory reduction techniques such as gradient accumulation and activation checkpointing.
Những ngụy biện và cạm bẫy
Tiến trình từ tối ưu trên một GPU đến song song đa thiết bị cho thấy mỗi kỹ thuật đều có đánh đổi và ràng buộc mới. Cách tiếp cận trong chương này định lượng chi phí bằng “định luật sắt”, chẩn đoán tắc nghẽn bằng cách lập hồ sơ hiệu năng, áp dụng các tối ưu hóa có mục tiêu, và chỉ mở rộng khi cần. Những ngụy biện và cạm bẫy dưới đây tổng hợp các lỗi thường gặp, gây lãng phí tài nguyên tính toán, làm chậm tiến độ nghiên cứu, hoặc dẫn đến thất bại trong huấn luyện ở môi trường sản xuất.
Ngụy biện: Mô hình lớn hơn luôn mang lại hiệu suất tốt hơn.
Đôi khi các nhóm coi việc tăng quy mô như một đòn bẩy luôn mang lại kết quả tốt hơn: nếu một mô hình 7 tỷ tham số chạy tốt, thì mô hình 20 tỷ tham số chắc chắn sẽ tốt hơn. Một mô hình 20B cần khoảng 320 GB dung lượng cho trạng thái huấn luyện (không tính activation) theo công thức Mixed-precision Adam đã nêu (40 GB tham số FP16 + 40 GB gradient FP16 + 80 GB trọng số chính FP32 + 160 GB trạng thái của Adam). Việc nó có vượt trội hơn mô hình 7B hay không còn phụ thuộc vào số lượng và chất lượng dữ liệu, tài nguyên tính toán dành cho huấn luyện, cách tối ưu hóa và đánh giá. Không có ngưỡng chung về số lượng ví dụ hay hình phạt độ chính xác nào chỉ dựa trên số lượng tham số.
Cạm bẫy: Giả định rằng huấn luyện phân tán tự động tăng tốc phát triển.
Nhiều bộ tăng tốc hơn không đảm bảo huấn luyện nhanh hơn, vì giao tiếp, batch cục bộ nhỏ hơn, các hạn chế ở đầu vào và mất cân bằng có thể làm tiêu hao lợi ích. Trong một kịch bản minh họa với 8 GPUs bộ tăng tốc, đồng bộ hóa chiếm 30–50 percent thời gian mỗi bước, và mức tăng tốc chỉ đạt 4–6× thay vì mức lý tưởng 8×. Đây là các giá trị giả định; quyết định cần dựa trên thời gian thực tế từ đầu đến cuối và hiệu quả mở rộng đo được.
Ngụy biện: Siêu tham số có thể áp dụng trực tiếp từ thí nghiệm quy mô nhỏ sang huấn luyện quy mô lớn.
Tốc độ học phù hợp với kích thước batch 512 có thể không còn phù hợp với kích thước batch 4,096. Theo quy tắc mở rộng tuyến tính (Goyal et al. 2017), tốc độ học sẽ tăng từ 0.1 lên 0.8 cho sự thay đổi gấp tám lần này, thường đi kèm với giai đoạn khởi động (warmup). Tuy nhiên, đây chỉ là một phương pháp thực nghiệm, không phải yêu cầu bắt buộc hay đảm bảo hội tụ. Khi chạy ở quy mô lớn, cần xác thực đồng thời tốc độ học, lịch trình, trạng thái của optimizer và kích thước batch hiệu quả.
Goyal, Priya, Piotr Dollár, Ross Girshick, Pieter Noordhuis, Lukasz Wesolowski, Aapo Kyrola, Andrew Tulloch, Yangqing Jia, and Kaiming He. 2017. “Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour.” arXiv Preprint arXiv:1706.02677 abs/1706.02677.
Cạm bẫy: Coi huấn luyện độ chính xác hỗn hợp như một tùy chọn bật/tắt đơn thuần mà không cần xác thực.
Các đầu vào V100 minh họa của chương cho thấy mức tăng tốc 2.4×, nhưng đây không phải là một benchmark. FP16 thường yêu cầu loss scaling (Micikevicius et al. 2017), trong khi BF16 thường không cần (Wang and Kanwar 2019; Kalamkar et al. 2019) (xem section 1.5.3). Cả hai cách làm này đều có thể thay đổi hành vi số, vì vậy cần phải xác thực thông lượng và khả năng hội tụ trên khối lượng công việc (workload) mục tiêu.
Kalamkar, Dhiraj, Dheevatsa Mudigere, Naveen Mellempudi, Dipankar Das, Kunal Banerjee, Sasikanth Avancha, Dharma Teja Vooturi, et al. 2019. A Study of BFLOAT16 for Deep Learning Training.
Ngụy biện: Bộ nhớ và tính toán có thể được tối ưu hóa độc lập.
Bộ nhớ và tính toán có mối liên hệ chặt chẽ: trong profile minh họa này, mức sử dụng bộ tăng tốc giảm từ 90 percent ở batch 256 xuống 60–70 percent ở batch 16. Tích lũy gradient (effective batch 512, physical batch 64) đánh đổi 5 percent hiệu suất để lấy mức giảm bộ nhớ 8×. Điều chỉnh các tham số này một cách độc lập sẽ kéo dài thời gian huấn luyện thêm 20–40 percent (xem section 1.5.5).
Cạm bẫy: Lập ngân sách bộ nhớ huấn luyện như thể nó chỉ chứa trọng số mô hình.
Chỉ ước tính bộ nhớ huấn luyện dựa trên trọng số sẽ bỏ qua gradient, trạng thái của optimizer, master weights (nếu dùng), activations, vùng làm việc tạm và overhead của bộ phân bổ bộ nhớ. Trong công thức Adam độ chính xác hỗn hợp ở chương này, trọng số FP16 (2 byte), gradient FP16 (2), master weights FP32 (4) và hai moment FP32 (8) cộng lại thành 16 byte cho mỗi tham số, trước khi tính activations. Các optimizer khác và chiến lược sharding sẽ làm thay đổi ngân sách này. Bộ nhớ cho activations còn phụ thuộc vào kích thước batch, độ dài chuỗi, kiến trúc, kernel và checkpointing; vì vậy không có hệ số nhân phổ quát nào so với bộ nhớ của trọng số.
Ngụy biện: Bộ tăng tốc luôn là nút thắt cổ chai của quá trình huấn luyện.
Tải dữ liệu thường tạo ra thời gian nhàn rỗi, nhưng nhiều nhóm lại ưu tiên tối ưu phần tính toán trước. Trong ví dụ minh họa này, prefetching kết hợp chồng chéo pipeline giúp giảm wall-clock time đi 47.6 percent (từ 105 min xuống 55 min) bằng cách chồng lấn việc tải dữ liệu với tính toán (xem section 1.5.2). Hãy profile trước khi mặc định cho rằng GPU là nút thắt cổ chai.
Cạm bẫy: Tối ưu hóa kernel trước khi phân tích hiệu năng của pipeline đầu vào.
Việc tinh chỉnh ở mức kernel rất hấp dẫn vì mức sử dụng GPU dễ quan sát, nhưng một bộ tăng tốc bị “đói” dữ liệu có thể trông giống như đang hoạt động kém hiệu quả. Trước khi đổi độ chính xác, viết lại kernel, hoặc thêm GPU, hãy đo thông lượng của dataloader, thời gian tiền xử lý trên host, thời gian chờ lưu trữ, và mức độ chồng lấn khi truyền dữ liệu từ host sang thiết bị. Nếu bộ tăng tốc đang phải chờ các batch, cách tối ưu hóa nhanh nhất là cấp dữ liệu ổn định và liên tục cho nó, thay vì chỉ làm các kernel nhanh hơn đôi chút.
Self-Check: Question
A team scales an existing 7-billion-parameter model to a 20-billion-parameter model on the same 100-million-token dataset, expecting improved validation accuracy. Under the chapter’s discussion of training fallacies, what is the guaranteed systems consequence versus the scientific outcome?
- Validation accuracy improves by exactly \(2.85\times\), while memory footprint remains unchanged.
- Training automatically switches to CPU execution because 20B parameters cannot fit on GPU clusters.
- Validation accuracy is guaranteed to degrade to zero due to catastrophic parameter interference.
- The team is guaranteed to pay roughly \(3\times\) the memory footprint for weights, gradients, and optimizer state and \(\approx 3\times\) the compute FLOPs, while validation performance depends on data quality, optimization, and dataset size and is not guaranteed to improve.
Explain why directly transferring hyperparameters (such as learning rate and weight decay) from a batch-size 512 baseline to a batch-size 4,096 distributed run can cause training to fail or underperform, even when GPU utilization remains above 90 percent.
Which engineering mistake exemplifies “pipeline neglect” as described in the chapter’s pitfalls?
- Using BF16 mixed precision instead of FP16 on NVIDIA Ampere GPUs.
- Spending weeks hand-tuning custom CUDA attention kernels to achieve 95% peak arithmetic throughput, only to discover in production that the GPU sits idle 50% of the time waiting for single-threaded Python CPU tokenization.
- Setting
pin_memory=Trueandnum_workers=8in a PyTorch DataLoader. - Checkpointing activations every \(\sqrt{N_L}\) layers to reduce peak memory.
A team proposes moving a single-GPU training job to a 16-GPU cluster to achieve a \(16\times\) reduction in development cycle time. Explain two reasons why distributed training rarely delivers a linear \(16\times\) speedup in developer velocity.
Tóm tắt
Huấn luyện kết hợp thuật toán, quản lý bộ nhớ và bộ tăng tốc phần cứng để biến dữ liệu thành tham số mô hình. Ở quy mô lớn, lan truyền tiến và lan truyền ngược phải phối hợp chặt chẽ các phép toán ma trận, cấp phát bộ nhớ và gradient, trong các ràng buộc về phần cứng và hiệu suất.
Các kỹ thuật như prefetching, mixed precision, FlashAttention, gradient accumulation và checkpointing giải quyết các ràng buộc khác nhau về thông lượng, bộ nhớ và độ chính xác số. Hãy ghép đúng kỹ thuật với ràng buộc chi phối; khi một máy đã hết dư địa, song song dữ liệu, song song mô hình, song song pipeline và song song tensor sẽ đổi lấy quy mô lớn hơn bằng cái giá là độ phức tạp tăng lên.
Sự đồng thiết kế này định hình huấn luyện quy mô lớn: các mẫu ma trận đã thúc đẩy GPU Tensor Cores; các framework phơi bày chúng qua các API mixed precision; và các kỹ thuật như huấn luyện FP16 tiếp tục ảnh hưởng đến phần cứng về sau. Việc hạch toán FLOP và bộ nhớ hỗ trợ so sánh các optimizer, ước tính chi phí, và quyết định liệu thêm phần cứng có giúp ích hay chỉ đơn giản là dời nút thắt cổ chai sang chỗ khác.
Key Takeaways: Vì sao huấn luyện tốn hàng triệu đô la
- Chi phí huấn luyện là một quy luật bất biến: \(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\) khiến mọi tối ưu hóa đều phải được hạch toán rõ ràng: giảm khối lượng công việc (workload), tăng thông lượng hiệu quả, hoặc cải thiện mức độ sử dụng. Nếu thay đổi không tác động vào thành phần chi phối, nó chỉ chuyển chi phí sang chỗ khác trong vòng lặp huấn luyện.
- Bộ nhớ quyết định liệu optimizer có thể chạy được hay không: Adam mixed precision tiêu chuẩn cần bộ nhớ gấp 8 lần bộ nhớ trọng số suy luận FP16 trong cách biểu diễn đã nêu, chưa tính đến các activation. Trạng thái của optimizer và các activation phụ thuộc batch—chứ không chỉ riêng trọng số—mới quyết định việc huấn luyện có “vừa” bộ nhớ hay không.
- Profile để chọn đúng giải pháp: Lập profile, chẩn đoán, khắc phục, rồi lập profile lại. Tác vụ bị giới hạn bởi tính toán (compute-bound) cần cải thiện phép toán hoặc thuật toán; tác vụ bị giới hạn bởi bộ nhớ (memory-bound) cần ít trạng thái hơn hoặc giảm lưu lượng truy cập; tác vụ bị giới hạn bởi dữ liệu hoặc truyền thông (data- và communication-bound) cần thay đổi pipeline hoặc cách song song hóa.
- Các kernel nhận thức về độ chính xác và IO giúp dịch chuyển nút thắt cổ chai: FP16 với tích lũy FP32 có thể cải thiện thông lượng và sử dụng bộ nhớ, trong khi FlashAttention tránh phải vật hóa toàn bộ ma trận \(S{\times}S\) trong HBM; mức lợi ích thực tế còn tùy khối lượng công việc (workload) và phần cứng.
- Checkpointing đổi bộ nhớ lấy tính toán lại: Bằng cách lưu ít activation hơn và tính lại chúng trong quá trình lan truyền ngược, kỹ thuật này cắt bộ nhớ dành cho activation 3–4× trong phần walkthrough, cụ thể từ 35.9 GB xuống 9 GB ở batch 4. Hãy dùng checkpointing khi nút thắt là bộ nhớ, không phải tính toán.
- Các tối ưu hóa kết hợp có thể giúp trì hoãn việc mở rộng quy mô: Với GPT-2 batch 4, việc kết hợp độ chính xác hỗn hợp và checkpointing có thể chuyển tổng bộ nhớ 95.7 GB thành giá trị mô hình hóa 33 GB (chưa tính các không gian làm việc tạm thời). Hãy ưu tiên các đòn bẩy cục bộ phù hợp trước khi chấp nhận chi phí truyền thông phân tán và vận hành.
Theo quy luật sắt, một tác vụ chậm sẽ được phân loại là bị giới hạn bởi tính toán (cần cải thiện các phép toán hoặc thuật toán), bị giới hạn bởi bộ nhớ (cần giảm trạng thái hoặc lưu lượng), bị giới hạn bởi dữ liệu (cần sửa pipeline đầu vào), hoặc bị giới hạn bởi truyền thông (cần điều chỉnh tích lũy hoặc song song hóa). Chỉ nên tăng batch khi phần cứng chưa được lấp đầy. Việc tuân thủ kỷ luật này giúp tránh chữa triệu chứng bằng cách thêm phần cứng, và giữ cho việc lặp vẫn thực tế khi chi phí tăng.
Trong huấn luyện, quy luật sắt trở thành công cụ dùng hằng ngày. Độ chính xác hỗn hợp làm thay đổi thông lượng và lưu lượng bộ nhớ; checkpointing đổi bộ nhớ lấy tính toán lại; mở rộng quy mô làm tăng truyền thông. Nhiệm vụ của kỹ sư là xác định thành phần chi phối và áp dụng can thiệp ít tốn kém nhất để thay đổi nó.
What’s Next: Từ huấn luyện đến lựa chọn dữ liệu
Huấn luyện tạo ra các tham số đã học bằng cách tiêu tốn tính toán cho mọi ví dụ; ngay cả lần chạy đã tối ưu trong chương này vẫn cần 33 GB bộ nhớ. Khi vòng lặp huấn luyện đã hiệu quả, câu hỏi tiếp theo là liệu mỗi ví dụ có xứng với chi phí đó hay không. Các mẫu lặp lại hoặc ít thông tin vẫn tiêu tốn cùng một forward pass, lan truyền ngược, cập nhật optimizer và truyền thông như những ví dụ giúp tăng độ bao phủ hoặc sửa điểm yếu.
Lựa chọn dữ liệu vì vậy chuyển hướng từ khâu thực thi sang khâu thiết kế khối lượng công việc (workload). Phần này xem xét cách mức độ dư thừa, tính đại diện, độ bất định và độ bao phủ lớp quyết định những ví dụ nào nên đưa vào một ngân sách huấn luyện hữu hạn. Một tập con hữu ích phải giảm khối lượng công việc mà không loại bỏ các trường hợp hiếm hoặc làm lệch phân phối huấn luyện. Khi giữ được cân bằng đó, một tập con được chọn lọc kỹ có thể tiệm cận độ chính xác khi dùng toàn bộ tập dữ liệu, đồng thời giảm chi phí cho mỗi epoch và giúp có thể tiến hành thêm các thí nghiệm với chi phí chấp nhận được. Mục tiêu tối ưu hóa không còn chỉ là hệ thống xử lý một ví dụ hiệu quả đến mức nào, mà còn là hệ thống nên xử lý những ví dụ nào.
Self-Check: Question
Which statement best summarizes the chapter’s core methodology for optimizing machine learning training systems?
- Deconstruct training performance via the Iron Law (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)), profile end-to-end to classify bottlenecks via the D·A·M taxonomy, exhaust single-machine optimizations (mixed precision, prefetching, FlashAttention, checkpointing), and only scale out when hitting physical memory or time limits.
- Scale out to multi-node clusters immediately, because distributed hardware automatically compensates for pipeline inefficiencies.
- Replace Adam with SGD on all workloads to minimize memory usage, and disable gradient checkpointing to avoid recomputation FLOPs.
- Maximize raw GPU busy percentage using synthetic benchmarks rather than measuring Model FLOPs Utilization (MFU).
A cloud training run on 1,024 GPUs improves its MFU from 25 percent to 50 percent through pipeline prefetching, mixed precision, and FlashAttention. Explain how this utilization improvement propagates through wall-clock time, energy consumption, and infrastructure cost.
Why does the chapter emphasize exhausting single-machine optimization techniques before scaling training workloads across distributed multi-node clusters?
- Distributed training algorithms cannot execute mixed precision or FlashAttention.
- Multi-node clusters are legally restricted to inference workloads and cannot run backpropagation.
- Single-machine optimizations eliminate pipeline bubbles and reduce memory footprints without adding network communication overhead, synchronization latency, or distributed fault management complexity.
- Single-machine training always trains faster in absolute wall-clock time than a 1,000-GPU cluster.
Self-Check Answers
Self-Check: Answer
A 1,024-GPU training run has its prefetching pipeline well staged: PCIe is saturated overlapping with compute and gradient AllReduce is hidden behind the next forward pass. Profiling reports 38 percent MFU. Under the simplified iron law of training performance (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)), which lever is the most actionable target for the next engineering investment, and why?
- Hardware utilization \(\eta_{\text{hw}}\), because with external data movement and communication already overlapped, the remaining gap to peak throughput consists of kernel-level memory stalls, launch latency, and small tile overheads that profiling can isolate.
- Peak hardware throughput \(R_{\text{peak}}\), because purchasing next-generation accelerators is the only mechanism that directly changes realized MFU.
- Total operations \(O\), because reducing model operations is the only permissible systems modification when communication is hidden.
- Dataset size \(D_{\text{tokens}}\), because shrinking training tokens mathematically raises the hardware utilization factor \(\eta_{\text{hw}}\).
Answer: The correct answer is A. In the Iron Law of Training Performance (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)), once external communication and data loading are overlapped behind compute, the actionable lever for systems engineers is \(\eta_{\text{hw}}\) (effective hardware utilization). Profiling can identify kernel-level memory bandwidth bottlenecks, suboptimal tile shapes, and kernel launch overheads that keep utilization at 38%. The proposal to upgrade \(R_{\text{peak}}\) raises the theoretical ceiling without addressing why the current hardware achieves only 38% efficiency. Modifying \(O\) changes the mathematical model rather than systems efficiency. Shrinking the dataset reduces total time by lowering \(O\), not by increasing \(\eta_{\text{hw}}\).
Learning Objective: Apply the iron law of training performance to select the actionable engineering lever given measured MFU and overlapped pipeline stages.
When a team transitions a model from FP32 training to mixed-precision (FP16/BF16) on Tensor Core accelerators without changing the model architecture, batch size, or dataset, which term of the Iron Law of Training Performance (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)) is most directly improved?
- Total operations \(O\), because lower numerical precision halves the number of multiplications required in each matrix multiplication.
- Hardware utilization \(\eta_{\text{hw}}\), because mixed precision automatically eliminates all GPU pipeline bubbles and CPU data stalls.
- Peak throughput \(R_{\text{peak}}\), because Tensor Cores provide a substantially higher theoretical FLOP/s ceiling for reduced-precision matrix operations compared to standard FP32 execution units.
- Data volume \(D_{\text{tokens}}\), because lower precision requires fewer training tokens for the loss to converge.
Answer: The correct answer is C. The chapter’s iron-law mapping table explicitly assigns mixed precision (FP16/BF16) to peak throughput (\(R_{\text{peak}}\)). Tensor Cores execute reduced-precision matrix multiplications at several times the theoretical FLOP/s ceiling of FP32 ALUs. The claim regarding total operations \(O\) is incorrect because the algorithmic graph and number of multiply-accumulate operations remain identical. The utilization claim is incorrect because \(\eta_{\text{hw}}\) measures efficiency relative to the available peak, and precision changes do not inherently eliminate data loader bubbles. The data volume claim is false because precision does not reduce sample requirements.
Learning Objective: Classify mixed-precision training by its direct target term (\(R_{\text{peak}}\)) in the Iron Law of Training Performance.
Explain the scope conditions under which the simplified Iron Law of Training Performance (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)) accurately models training duration, and identify why it fails for a small-batch debugging session.
Answer: The simplified Iron Law models training time purely as compute throughput by assuming that non-compute stages (data loading, PCIe transfers, host-side preprocessing, and communication) are fully overlapped behind accelerator compute. This assumption holds during large-scale pretraining where large batch sizes yield long compute times per kernel that completely hide pipeline latencies. In a small-batch debugging session (e.g., batch size 1 or 2), compute time collapses below the serialized overheads of kernel launches, host transfers, and framework dispatch. The overlap assumption breaks down, causing serialized non-compute latencies to dominate execution time and rendering the compute-only formula inaccurate.
Learning Objective: Explain the overlap assumptions underlying the simplified iron law of training performance and identify when they break down.
All large-scale deep learning models, including recommendation models with multi-terabyte embedding tables (such as DLRM), are primarily compute-bound workloads where training speed is strictly governed by Tensor Core TFLOP/s.
Answer: False. As highlighted in the comparison between GPT-2 and DLRM, recommendation architectures are dominated by massive embedding tables (\(10^9\) to \(10^{12}\) parameters) that exhibit low arithmetic intensity. Consequently, DLRM training is memory capacity and memory bandwidth bound rather than compute bound, requiring devices to shard embedding tables across memory hierarchies rather than maximizing Tensor Core arithmetic utilization.
Learning Objective: Distinguish compute-bound dense transformer workloads from memory-capacity-bound recommendation workloads.
**Place the following milestones in the historical evolution of deep learning training systems in chronological order, reflecting how the binding constraint shifted:
- Transformers shift sequence modeling toward high-throughput dense matrix multiplication and large activation footprints.
- Backpropagation is popularized for multilayer neural networks, establishing the algorithmic foundations of gradient descent.
- Large-scale foundation models (such as GPT-3 requiring \(\approx 3.14 \times 10^{23}\) FLOPs) make hardware utilization \(\eta_{\text{hw}}\) and multi-accelerator scaling critical.
- AlexNet demonstrates that neural network training parallelism maps effectively to GPUs, training ImageNet in under a week.
- IO-aware algorithms (such as FlashAttention) and memory-compute trade-offs (gradient checkpointing) co-evolve to overcome memory bandwidth and capacity walls.**
Answer: The correct answer is 2, 4, 1, 3, 5: (2) Backpropagation is popularized for multilayer neural networks (1986). (4) AlexNet demonstrates GPU acceleration for deep networks (2012). (1) Transformers shift sequence modeling toward dense matrix multiplication (2017). (3) Large-scale foundation models (GPT-3) make hardware utilization and scaling critical (2020). (5) IO-aware algorithms (FlashAttention) and gradient checkpointing co-evolve to bypass memory walls (2022-2023).
Learning Objective: Trace the chronological evolution of deep learning training bottlenecks and system solutions from backpropagation to IO-aware attention.
Self-Check: Answer
Why do batched matrix-matrix multiplications (GEMM, BLAS Level 3) dominate accelerator-based neural network training workloads, whereas matrix-vector operations (GEMV, BLAS Level 2) struggle to achieve high hardware utilization?
- Matrix-matrix operations avoid computing gradients during backpropagation, halving the memory footprint.
- Batched matrix-matrix operations exhibit \(\mathcal{O}(N)\) arithmetic intensity, allowing high operand reuse in on-chip SRAM/registers to saturate compute units, whereas matrix-vector operations have \(\mathcal{O}(1)\) arithmetic intensity and are strictly memory-bandwidth bound.
- Matrix-vector operations cannot be executed on GPUs without constant CPU synchronization barriers at every layer.
- Batched matrix-matrix operations reduce total model parameters, fitting larger architectures into accelerator HBM.
Answer: The correct answer is B. Matrix-matrix multiplications (GEMM) perform \(\mathcal{O}(N^3)\) operations on \(\mathcal{O}(N^2)\) data, yielding an arithmetic intensity that scales as \(\mathcal{O}(N)\). This enables accelerators to load tiles into fast on-chip SRAM and reuse operands across thousands of parallel ALUs. In contrast, matrix-vector multiplications (GEMV) perform \(\mathcal{O}(N^2)\) operations on \(\mathcal{O}(N^2)\) data, giving \(\mathcal{O}(1)\) arithmetic intensity. GEMV spends more time moving weights across HBM than computing, leaving the vast majority of accelerator compute units starved for data. The claim that GEMM avoids gradients is false because backpropagation requires GEMM for weight and activation gradients. The CPU synchronization claim is incorrect because GPUs natively execute GEMV kernels. The parameter reduction claim confuses computational batching with model architecture.
Learning Objective: Compare batched matrix-matrix and matrix-vector operations in terms of arithmetic intensity and accelerator hardware utilization.
A team trains a 7-billion-parameter model on accelerators with 80 GB of HBM each. Weights, gradients, and activations together occupy 64 GB per accelerator at the planned batch size. Using the section’s optimizer-memory accounting, explain the systems trade-off between choosing standard SGD and Adam for this run.
Answer: Adam maintains two FP32 state vectors per parameter (first moment \(m_t\) and second moment \(v_t\)), requiring \(2 \times 4\text{ bytes} = 8\text{ bytes/parameter}\). For a 7B model, Adam’s optimizer state alone occupies \(7 \times 10^9 \times 8\text{ bytes} = 56\text{ GB}\). Adding this to the 64 GB of weights, gradients, and activations gives \(120\text{ GB}\), exceeding the 80 GB physical HBM capacity and causing an immediate Out-of-Memory (OOM) crash. In contrast, standard SGD without momentum maintains zero optimizer state (\(0\text{ bytes/parameter}\)), allowing the total footprint (\(64\text{ GB}\)) to fit within the 80 GB limit. The systems trade-off is convergence speed versus memory feasibility: Adam converges in fewer training steps but is infeasible on a single 80 GB GPU without activation checkpointing, CPU offload, or multi-GPU sharding, whereas SGD fits directly but requires more steps and careful learning rate tuning.
Learning Objective: Calculate the memory footprint of Adam vs SGD optimizer states and evaluate the systems feasibility trade-off on a fixed accelerator memory budget.
The point on a roofline model curve where the memory-bandwidth-bound diagonal ceiling intersects the flat peak-compute ceiling, defined mathematically as \(\text{Peak FLOP/s} / \text{Memory Bandwidth}\), is known as the ____ point.
Answer: The correct answer is ridge (or roofline ridge). The ridge point represents the minimum arithmetic intensity required for an operation to reach the accelerator’s maximum computational throughput.
Learning Objective: Identify the definition and significance of the ridge point in roofline model analysis.
**Order the following events in a standard backpropagation training step to reflect their strict causal and data dependencies:
- Compute scalar objective loss by evaluating predictions against ground-truth labels.
- Update model parameters using gradient-based optimization rules (such as Adam or SGD).
- Execute forward propagation through successive layers while caching intermediate activations.
- Evaluate the chain rule backward from the loss through layers to compute parameter and activation gradients.
- Fetch and preprocess the training mini-batch on the host and transfer it to device memory.**
Answer: The correct answer is 5, 3, 1, 4, 2: (5) Fetch and preprocess the training mini-batch on the host and transfer it to device memory. (3) Execute forward propagation through successive layers while caching intermediate activations. (1) Compute scalar objective loss by evaluating predictions against ground-truth labels. (4) Evaluate the chain rule backward from the loss through layers to compute parameter and activation gradients. (2) Update model parameters using gradient-based optimization rules.
Learning Objective: Order the operations of a training iteration based on their mathematical and data dependencies.
For a transformer with hidden dimension \(d_{\text{model}} = 768\) and 12 heads (\(d_{\text{head}} = 64\)), the arithmetic intensity of materialized attention score computation (\(\mathbf{Q}\mathbf{K}^\top\) and score matrix I/O) is approximately \(d_{\text{head}}/2 = 32\text{ FLOP/byte}\). If executed on an accelerator with a ridge point of \(153\text{ FLOP/byte}\), how does this kernel behave, and what optimization strategy is appropriate?
- The kernel is compute-bound; upgrade to an accelerator with higher peak TFLOP/s to accelerate execution.
- The kernel is latency-bound; reduce the batch size to 1 so the matrix fits in registers.
- The kernel is network-bound; upgrade the inter-node InfiniBand fabric to prevent AllReduce stalls.
- The kernel is memory-bandwidth bound because \(32 < 153\text{ FLOP/byte}\); apply IO-aware tiling (such as FlashAttention) to avoid writing and reading intermediate score matrices from HBM, increasing arithmetic intensity.
Answer: The correct answer is D. Because the operation’s arithmetic intensity (\(32\text{ FLOP/byte}\)) sits well below the hardware ridge point (\(153\text{ FLOP/byte}\)), the kernel is memory-bandwidth bound on the sloped ceiling of the roofline. Increasing peak compute TFLOP/s provides zero speedup because compute ALUs are stalled waiting for HBM data transfers. The correct optimization is IO-aware tiling (FlashAttention), which computes attention in SRAM tiles and avoids materializing the intermediate \(S \times S\) score matrix in HBM, sharply reducing bytes moved and increasing effective arithmetic intensity. The latency-bound choice is incorrect because reducing batch size lowers arithmetic intensity further. The network-bound choice is irrelevant because attention score computation is a local intra-GPU operation.
Learning Objective: Apply roofline model analysis and ridge-point comparison to classify a transformer attention kernel as memory-bound and identify IO-aware tiling as the solution.
Self-Check: Answer
Which set of subsystems defines the chapter’s high-level training system architecture, and what systems engineering advantage does this decomposition provide?
- Storage controller, compiler intermediate representation, and runtime execution engine; this separates hardware target code generation from storage layout.
- Data pipeline, training loop, and evaluation pipeline; this separates distinct resource profiles (CPU/storage I/O, accelerator compute/memory, and periodic validation) so bottlenecks can be isolated at subsystem interfaces.
- Tokenizer, hyperparameter optimizer, and model registry; this organizes the model deployment lifecycle around developer interfaces.
- Gradient aggregator, parameter server, and checkpoint restorer; this decomposes cloud service microservices.
Answer: The correct answer is B. The training architecture decomposes the system into three interconnected subsystems: the data pipeline (ingestion, transformation, batching), the training loop (forward pass, loss, backward pass, optimizer update), and the evaluation pipeline (validation metrics on held-out data). This separation enables engineers to diagnose bottlenecks by subsystem resource demands (host CPU/disk for data, accelerator compute/HBM for training loop, and periodic synchronization pauses for evaluation). The storage controller and compiler option describes compiler infrastructure rather than runtime training systems. The tokenizer and registry option describes MLOps lifecycle tools. The gradient aggregator option lists distributed implementation components rather than end-to-end training subsystems.
Learning Objective: Identify the three major subsystems of a training pipeline architecture and explain the systems rationale for this decomposition.
In a profiled training pipeline, CPU data preprocessing delivers batches at \(4\text{ GB/s}\), host-to-device PCIe transfer operates at \(32\text{ GB/s}\), and GPU compute consumes data at an equivalent rate of \(12\text{ GB/s}\). According to the pipeline bottleneck model, what determines end-to-end throughput, and what is the optimal first engineering action?
- The average rate of the three stages (\((4+32+12)/3 = 16\text{ GB/s}\)); apply incremental tuning across all stages simultaneously.
- The PCIe transfer rate (\(32\text{ GB/s}\)), because every batch must physically cross the bus; upgrade from PCIe Gen4 to Gen5.
- The minimum rate (\(4\text{ GB/s}\) at preprocessing); parallelize CPU preprocessing (e.g., via multi-worker DataLoader and prefetching) because the slowest stage caps total system throughput.
- The GPU compute rate (\(12\text{ GB/s}\)), because accelerator computation is always the primary cost driver in deep learning.
Answer: The correct answer is C. In a staged pipeline, total throughput is strictly bounded by the slowest stage (\(\min(R_{\text{prep}}, R_{\text{transfer}}, R_{\text{compute}})\)). Here, CPU preprocessing at \(4\text{ GB/s}\) starves the rest of the pipeline, capping system throughput regardless of PCIe bandwidth (\(32\text{ GB/s}\)) or GPU compute capability (\(12\text{ GB/s}\)). Upgrading the GPU or PCIe bus will yield zero speedup because the accelerator will spend more time idling. The correct intervention is to parallelize CPU preprocessing (using multi-process data loaders and asynchronous prefetching) to lift the binding \(4\text{ GB/s}\) constraint. Averaging stage rates misrepresents pipeline physics.
Learning Objective: Apply the pipeline throughput model to determine end-to-end throughput and identify the binding constraint.
Explain why CPU-side tokenization and data augmentation can severely bottleneck GPU training even when the resulting tensor transfer across PCIe takes less than one millisecond.
Answer: While the physical DMA transfer of processed integer tensors across PCIe is fast (often \(< 1\text{ ms}\) for a mini-batch), CPU tokenization and augmentation can take tens or hundreds of milliseconds per batch (e.g., \(65\text{ ms}\) on a single Python thread). If data preprocessing runs serially with training or if Python threads are serialized by the Global Interpreter Lock (GIL), the GPU must wait completely idle until the CPU finishes constructing the batch. Because training throughput is bounded by the slowest stage, a \(65\text{ ms}\) CPU preprocessing stage paired with an \(80\text{ ms}\) GPU step reduces utilization to \(\approx 55\%\) unless multiple CPU worker processes (
num_workers > 0) pre-compute and buffer batches asynchronously into pinned host memory.Learning Objective: Analyze how CPU-side preprocessing latency creates accelerator starvation despite low PCIe transfer times.
Scaling the training batch size by \(8\times\) (e.g., from 512 to 4,096) while keeping the learning rate and schedule constant guarantees identical validation convergence in \(8\times\) less wall-clock time.
Answer: False. An \(8\times\) larger batch size reduces the number of parameter updates per epoch by \(8\times\). Holding the learning rate constant results in an optimization-starved regime where the model takes too few gradient steps to navigate the loss landscape effectively. To maintain convergence dynamics when scaling batch sizes, practitioners typically must scale the learning rate (such as via the linear scaling rule \(\eta \propto B\) up to the critical batch size) and adjust warmup schedules, rather than leaving hyperparameters unchanged.
Learning Objective: Evaluate how scaling batch size alters optimization update frequency and requires corresponding learning rate adjustments.
To enable fast, asynchronous Direct Memory Access (DMA) transfers from host RAM to GPU memory without intermediate CPU staging copies, host memory buffers must be allocated as page-locked or ____ memory.
Answer: The correct answer is pinned (or page-locked). Pinned memory prevents the operating system from paging memory to disk, enabling the GPU DMA controller to read tensors asynchronously concurrently with compute.
Learning Objective: Identify the systems mechanism (pinned memory) used for asynchronous host-to-device transfers.
Self-Check: Answer
Why is Model FLOPs Utilization (MFU) a more reliable metric than raw GPU busy percentage (reported by tools like
nvidia-smi) when evaluating training systems efficiency?- MFU is measured directly from host CPU clock cycles, eliminating GPU driver instrumentation overhead.
- MFU is mathematically fixed to 100% on any healthy accelerator cluster regardless of software overhead.
- MFU counts only the theoretical forward and backward FLOPs required by the model architecture divided by peak hardware throughput, whereas raw GPU busy percentage also credits uncredited recomputation, padding tokens, and memory stalls that do not advance model training.
- MFU measures training loss convergence speed per dollar rather than floating-point operations.
Answer: The correct answer is C. Raw GPU utilization measures the percentage of time GPU execution units or kernels are active. A GPU can show 95% utilization while spending half its time stalling on memory bandwidth or recomputing activations during gradient checkpointing. In contrast, MFU (\(\text{MFU} = \frac{O_{\text{model}}}{R_{\text{peak}} \times T_{\text{step}}}\)) includes only the useful forward and backward model FLOPs in the numerator, explicitly penalizing recomputation, padding FLOPs, memory stalls, and pipeline bubbles. MFU is an accelerator metric, not a CPU metric. MFU is not fixed to 100% (real-world large model training typically achieves 35–55% MFU). MFU measures hardware efficiency, not loss convergence per dollar.
Learning Objective: Differentiate Model FLOPs Utilization (MFU) from raw GPU busy utilization and explain which overheads MFU exposes.
An engineer profiles two training workloads. Workload A exhibits 92 percent GPU utilization, near-saturated HBM bandwidth, low CPU activity, and continuous kernel timelines. Workload B exhibits 20 percent GPU utilization with regular 50 ms idle gaps on the GPU timeline, low HBM bandwidth, and 100 percent CPU utilization. Apply the D·A·M taxonomy to classify each workload’s bottleneck and state the primary optimization category for each.
Answer: Workload A is classified under the Machine axis as Memory-bound (or Algorithm axis depending on arithmetic intensity): the GPU is continuously active with saturated HBM bandwidth, meaning kernels are bottlenecked by data movement between HBM and on-chip SRAM. The primary optimization category is memory traffic reduction and fusion (e.g., FlashAttention, operator fusion, or reduced precision formats like BF16/FP8). Workload B is classified under the Data axis as Data-bound: periodic white gaps on the GPU timeline paired with pinned CPU utilization indicate the GPU is starving while waiting for host-side batch preparation. The primary optimization category is data pipeline parallelism and prefetching (e.g., multi-process DataLoader
num_workers, asynchronous prefetching, or moving preprocessing to GPU/DALI).Learning Objective: Apply the D·A·M taxonomy to classify profile signatures into memory-bound vs data-bound bottlenecks and match them to target optimizations.
**Order the steps of the systematic training optimization workflow recommended in the chapter:
- Classify the primary performance constraint (Data-, Memory-, or Compute-bound) using the D·A·M taxonomy.
- Run a representative training run with framework and system profilers enabled to capture CPU, PCIe, and GPU timeline traces.
- Re-profile the system to evaluate MFU improvement and identify whether the bottleneck has shifted to a new pipeline stage.
- Apply a targeted optimization technique specifically addressing the identified binding constraint.**
Answer: The correct answer is 2, 1, 4, 3: (2) Run a representative training run with framework and system profilers enabled to capture CPU, PCIe, and GPU timeline traces. (1) Classify the primary performance constraint (Data-, Memory-, or Compute-bound) using the D·A·M taxonomy. (4) Apply a targeted optimization technique specifically addressing the identified binding constraint. (3) Re-profile the system to evaluate MFU improvement and identify whether the bottleneck has shifted to a new pipeline stage.
Learning Objective: Order the systematic profile-diagnose-fix-reprofile optimization cycle.
An engineering team suspects that an individual custom LayerNorm kernel has poor arithmetic intensity and low register occupancy, while another team suspects their DataLoader is causing host-to-device PCIe transfer stalls. Which combination of profiling tools from the chapter is best suited to investigate each respective issue?
- NVIDIA Nsight Compute for the kernel-level arithmetic intensity and occupancy analysis; NVIDIA Nsight Systems (or PyTorch Profiler) for system-level timeline visualization of DataLoader and PCIe transfers.
nvidia-smifor kernel-level arithmetic intensity; TensorBoard loss curves for DataLoader PCIe transfer stalls.- NVIDIA Nsight Compute for cluster-wide inter-node network bandwidth; PyTorch Profiler for register allocation analysis.
- Linux
topcommand for GPU kernel instruction analysis; NVIDIA Nsight Systems for CPU register spill tracking.
Answer: The correct answer is A. The chapter distinguishes profiler scopes: NVIDIA Nsight Compute provides deep, low-level analysis of individual GPU kernels (arithmetic intensity, memory hierarchy throughput, warp occupancy, register pressure), making it ideal for the custom LayerNorm kernel. In contrast, NVIDIA Nsight Systems and PyTorch Profiler provide system-level timeline traces capturing CPU thread execution, CUDA API dispatches, PCIe memory copies, and GPU stream synchronization, making them ideal for diagnosing DataLoader and PCIe stalls.
nvidia-smiprovides coarse device-wide polling rather than kernel-level roofline analysis. Linuxtopmonitors host OS processes, not GPU internal instruction pipelines.Learning Objective: Select appropriate profiling tools (Nsight Compute vs Nsight Systems/PyTorch Profiler) based on the granularity of the performance investigation.
Self-Check: Answer
A training step consists of three stages executed sequentially: data preprocessing (\(T_{\text{prep}} = 30\text{ ms}\)), PCIe host-to-device transfer (\(T_{\text{xfer}} = 10\text{ ms}\)), and GPU compute (\(T_{\text{comp}} = 50\text{ ms}\)). If the team implements multi-worker asynchronous prefetching with double buffering over dedicated CUDA streams, what is the theoretical iteration time and speedup?
- Iteration time becomes \(T_{\text{prep}} + T_{\text{xfer}} = 40\text{ ms}\) (a \(2.25\times\) speedup), because compute runs completely for free in background streams.
- Iteration time drops from the serial sum (\(30 + 10 + 50 = 90\text{ ms}\)) to \(\max(T_{\text{prep}}, T_{\text{xfer}}, T_{\text{comp}}) = 50\text{ ms}\) (a \(44.4\%\) latency reduction or \(1.8\times\) throughput speedup), bounded by the slowest stage.
- Iteration time drops to \(\min(T_{\text{prep}}, T_{\text{xfer}}, T_{\text{comp}}) = 10\text{ ms}\), because all three stages execute in lockstep at the fastest rate.
- Iteration time remains \(90\text{ ms}\), because CUDA streams cannot execute DMA transfers concurrently with kernel computations.
Answer: The correct answer is B. Without overlapping, each iteration pays the sequential sum of all stages (\(T_{\text{iter}} = T_{\text{prep}} + T_{\text{xfer}} + T_{\text{comp}} = 30 + 10 + 50 = 90\text{ ms}\)). With asynchronous prefetching, double buffering, and dedicated CUDA copy streams, batch \(N+1\) is preprocessed on CPU and transferred over PCIe concurrently while batch \(N\) computes on the GPU. The iteration duration is governed by the maximum of the overlapped stages (\(\max(30, 10, 50) = 50\text{ ms}\)). This reduces iteration time from \(90\text{ ms}\) to \(50\text{ ms}\) (\(44.4\%\) time reduction, or \(90/50 = 1.8\times\) throughput). Compute does not run for free. Iteration time is bounded by the slowest stage (\(\max\)), not the fastest (\(\min\)). Modern GPUs natively support concurrent compute and copy streams.
Learning Objective: Calculate iteration time and throughput gains resulting from asynchronous prefetching and stage overlapping.
Explain how FlashAttention computes exact self-attention with substantially lower memory footprint and higher speed than standard attention, and describe how its backward pass handles the attention score matrix.
Answer: Standard attention materializes the full \(S \times S\) attention score matrix in GPU High-Bandwidth Memory (HBM) for softmax and masking, generating \(\mathcal{O}(S^2)\) memory traffic and storage. FlashAttention uses an IO-aware tiling algorithm: it loads blocks of Query, Key, and Value tensors into fast on-chip SRAM, computes local attention scores, and evaluates softmax incrementally using an online softmax algorithm (tracking running max \(m\) and sum \(\ell\)). This keeps intermediate scores entirely in SRAM, writing only the final output to HBM and reducing HBM access from \(\mathcal{O}(S^2)\) to \(\mathcal{O}(S)\). During the backward pass, rather than reading a massive \(S \times S\) matrix from HBM, FlashAttention recomputes the score blocks on-the-fly in SRAM from the saved Q, K, V blocks, trading a small amount of fast SRAM arithmetic for a massive reduction in slow HBM memory traffic.
Learning Objective: Explain the IO-aware SRAM tiling, online softmax, and backward recomputation mechanisms of FlashAttention.
Why does standard mixed-precision training (FP16 or BF16) maintain a master copy of model weights and execute LayerNorm/Softmax reductions in FP32, rather than keeping the entire training state exclusively in 16-bit precision?
- Tensor Cores cannot execute backpropagation without storing gradients in 64-bit double precision.
- FP16 memory allocations cause hardware bus lockups if master weights are not stored in CPU host RAM.
- Automatic differentiation graphs require FP32 weights to compute symbolic derivatives in PyTorch.
- Small gradient updates (\(\eta \cdot \nabla \mathcal{L}\)) can underflow or become zero when added directly to 16-bit weights due to limited precision/mantissa bits, and normalization reductions are prone to overflow/underflow; FP32 master weights preserve small accumulated updates across steps.
Answer: The correct answer is D. In mixed-precision training, weight updates calculated by the optimizer (\(\Delta W = -\eta g\)) are often orders of magnitude smaller than the weight values themselves (\(| \Delta W | \ll | W |\)). If added directly in FP16 (which has only 10 mantissa bits), the update underflows and rounds to zero, halting learning. Maintaining FP32 master weights (23 mantissa bits) ensures small updates accumulate accurately before being cast back to FP16 for the next forward pass. Furthermore, reductions in LayerNorm and Softmax sum many values and can easily overflow FP16’s narrow dynamic range (\([-65504, 65504]\)), requiring FP32 accumulation for numerical stability. Tensor Cores do not require FP64. Master weights are stored in GPU memory, not forced to host RAM. Autodiff does not require FP32 graphs.
Learning Objective: Justify the role of FP32 master weights and selective FP32 operations in maintaining numerical stability during mixed-precision training.
Gradient accumulation increases the memory footprint on the accelerator linearly with the accumulation factor \(K\) because all \(K\) micro-batches’ intermediate activations must remain in GPU memory simultaneously until the optimizer step.
Answer: False. Gradient accumulation executes forward and backward passes sequentially across \(K\) micro-batches, accumulating (summing) only the parameter gradients in a single fixed-size gradient buffer. Activations for each micro-batch are discarded immediately after its backward pass completes. Consequently, activation memory is bounded by the size of a single micro-batch (\(B_{\text{micro}}\)), allowing systems to emulate an effective batch size of \(K \times B_{\text{micro}}\) without increasing activation memory.
Learning Objective: Analyze the memory behavior of gradient accumulation across multiple micro-batches.
In FP16 mixed-precision training, to prevent small gradient values from underflowing to zero before backpropagation, gradients are multiplied by a scale factor during the forward/loss pass and unscaled before the optimizer update using a technique known as loss ____.
Answer: The correct answer is scaling (or dynamic loss scaling). Loss scaling shifts gradient magnitudes into the representable dynamic range of FP16.
Learning Objective: Identify the technique (loss scaling) used to prevent gradient underflow in FP16 training.
A team enables mixed precision on a transformer model and observes compute time drop by 45 percent, but total step time decreases by only 10 percent because the GPU now exhibits large idle gaps. Explain what occurred in the system pipeline and what the team must do next.
Answer: This scenario illustrates the iterative nature of pipeline optimization and Amdahl’s Law: removing or accelerating one stage exposes the next slowest stage as the new binding bottleneck. When compute time was \(100\text{ ms}\), it easily hid a \(55\text{ ms}\) CPU data loading stage. Once mixed precision accelerated compute to \(55\text{ ms}\), data preprocessing became the binding constraint. The GPU began experiencing idle bubbles waiting for batches, preventing further throughput gains. The team must re-profile the pipeline, recognize that the bottleneck has shifted from compute to data, and apply data-side optimizations—such as increasing DataLoader
num_workers, enabling pinned memory prefetching, or using GPU-accelerated decoding.Learning Objective: Explain why optimizing a compute bottleneck can expose a data-loading bottleneck and formulate the re-profiling response.
Self-Check: Answer
A team trains a 1.5-billion-parameter model that fits comfortably in the 80 GB memory of a single GPU with batch size 16 and Adam optimizer state, but training takes 12 days per epoch. The team has an 8-GPU node. Which parallelism strategy should be adopted first, and why?
- Tensor parallelism; split each weight matrix across the 8 GPUs to maximize matrix multiplication speed.
- Pipeline parallelism; split the 48 transformer layers across the 8 GPUs (6 layers per GPU) to reduce per-device parameter storage.
- Data parallelism (such as PyTorch DDP); replicate the model across all 8 GPUs, assign each GPU a micro-batch of 16, and overlap gradient AllReduce with the backward pass, because the model already fits in single-GPU memory and data parallelism avoids pipeline bubble overhead.
- ZeRO-3 parameter sharding; shard weights, gradients, and optimizer states across all GPUs to minimize communication volume.
Answer: The correct answer is C. When a model fits entirely within single-GPU memory, Data Parallelism (DistributedDataParallel) is the preferred strategy because it requires minimal code modification, achieves near-linear throughput scaling by processing independent micro-batches in parallel, and hides gradient synchronization (AllReduce) behind backward pass computation. Model parallelism (tensor or pipeline) is designed for memory-overflow regimes where models cannot fit on a single device; applying naive pipeline or tensor parallelism when memory is not constrained introduces unnecessary pipeline bubbles, communication synchronizations at every layer, and implementation complexity. ZeRO-3 increases per-step communication overhead and is unnecessary when memory capacity is ample.
Learning Objective: Select between Data Parallelism and Model Parallelism based on model size, memory capacity, and throughput requirements.
In a Distributed Data Parallel training setup with \(N\) GPUs and a model of \(P\) parameters (where each parameter gradient is \(B_{\text{bytes}}\) bytes), what is the total data volume transferred by each individual GPU during a Ring AllReduce gradient synchronization?
- \(2 \times \frac{N-1}{N} \times P \times B_{\text{bytes}}\), which approaches \(2 P B_{\text{bytes}}\) as \(N\) becomes large and is independent of the number of GPUs \(N\).
- \(N \times P \times B_{\text{bytes}}\), scaling linearly with the total number of GPUs in the cluster.
- \(\frac{P \times B_{\text{bytes}}}{N^2}\), decreasing quadratically as more GPUs are added.
- Zero bytes, because GPUs synchronize gradients directly through CPU shared memory without network transfers.
Answer: The correct answer is A. In the Ring AllReduce algorithm, synchronization proceeds in two phases: scatter-reduce and allgather. In each phase, every GPU sends and receives \(\frac{N-1}{N} \times (\text{data size})\) bytes. For a gradient buffer of size \(P \times B_{\text{bytes}}\), the total volume transferred per GPU is \(2 \times \frac{N-1}{N} \times P \times B_{\text{bytes}}\). As \(N \to \infty\), this value asymptotically approaches \(2 \times P \times B_{\text{bytes}}\), meaning the per-GPU communication volume remains bounded regardless of cluster size. The linear scaling claim describes a naive parameter server architecture. The quadratic reduction claim is mathematically incorrect. The zero bytes claim ignores physical communication requirements.
Learning Objective: Calculate per-GPU communication volume in Ring AllReduce and explain its asymptotic scaling behavior.
Explain what the “communication tax” is in distributed training, and analyze why adding more GPUs to a distributed run can lead to diminishing returns in throughput.
Answer: The communication tax is the time and bandwidth overhead required to synchronize gradients (in Data Parallelism) or exchange intermediate activations/tensors (in Model/Tensor Parallelism) across devices over PCIe, NVLink, or network fabrics. In Ring AllReduce data parallelism, while per-device compute time decreases as \(1/N\) (for a fixed total batch size), the per-device communication volume remains roughly constant at \(2P\) bytes. Consequently, communication occupies an increasing percentage of total step time as \(N\) grows. Once per-step compute time shrinks below communication latency and transfer time, communication becomes the binding bottleneck, causing parallel scaling efficiency to drop significantly below \(100\%\) (diminishing returns).
Learning Objective: Analyze the communication tax in distributed scaling and explain why scaling efficiency degrades as accelerator count increases.
In pipeline model parallelism, partitioning a network linearly across \(K\) stages without micro-batching (naive pipeline parallelism) achieves 100 percent GPU utilization because downstream devices can compute backward gradients while upstream devices run forward passes.
Answer: False. In naive pipeline parallelism without micro-batching, downstream devices must wait idle until upstream devices complete their forward passes, and upstream devices must wait idle until downstream devices compute backward loss gradients. This introduces massive idle pipeline bubbles where device utilization collapses to \(\approx 1/K\). Practical pipeline parallelism systems (like GPipe and 1F1B in PipeDream) mitigate this by splitting batches into multiple small micro-batches and interleaving forward and backward passes to fill the pipeline.
Learning Objective: Identify the pipeline bubble pathology of naive pipeline parallelism and explain how micro-batch schedules mitigate it.
**Arrange the following engineering steps in the order prescribed by the chapter’s “single-machine-first” scaling discipline:
- Evaluate whether the workload still hits a physical hard limit (memory capacity exhaustion, wall-clock deadline, or dataset scale).
- Implement distributed data parallelism or model sharding across multiple accelerator nodes.
- Benchmark and optimize single-accelerator execution using mixed precision (FP16/BF16), FlashAttention, and data prefetching.
- Apply single-device memory reduction techniques such as gradient accumulation and activation checkpointing.**
Answer: The correct answer is 3, 4, 1, 2: (3) Benchmark and optimize single-accelerator execution using mixed precision (FP16/BF16), FlashAttention, and data prefetching. (4) Apply single-device memory reduction techniques such as gradient accumulation and activation checkpointing. (1) Evaluate whether the workload still hits a physical hard limit (memory capacity exhaustion, wall-clock deadline, or dataset scale). (2) Implement distributed data parallelism or model sharding across multiple accelerator nodes.
Learning Objective: Order the single-machine-first optimization progression before adopting distributed multi-node scaling.
Self-Check: Answer
A team scales an existing 7-billion-parameter model to a 20-billion-parameter model on the same 100-million-token dataset, expecting improved validation accuracy. Under the chapter’s discussion of training fallacies, what is the guaranteed systems consequence versus the scientific outcome?
- Validation accuracy improves by exactly \(2.85\times\), while memory footprint remains unchanged.
- Training automatically switches to CPU execution because 20B parameters cannot fit on GPU clusters.
- Validation accuracy is guaranteed to degrade to zero due to catastrophic parameter interference.
- The team is guaranteed to pay roughly \(3\times\) the memory footprint for weights, gradients, and optimizer state and \(\approx 3\times\) the compute FLOPs, while validation performance depends on data quality, optimization, and dataset size and is not guaranteed to improve.
Answer: The correct answer is D. The first fallacy discussed in the chapter is that model scale is a monotonic lever for performance. Scaling parameter count from 7B to 20B on a fixed dataset guarantees a \(\approx 3\times\) increase in non-activation training memory (weights, gradients, and Adam moments) and an equivalent increase in FLOPs and cloud bills. However, validation accuracy depends heavily on data volume and quality; without increasing training tokens, a larger model may overfit or fail to realize quality gains. Validation gain does not scale linearly. 20B models run on multi-GPU clusters, not CPUs. Degradation to zero is not guaranteed.
Learning Objective: Analyze the cost guarantees versus validation performance uncertainty when scaling model parameters on a fixed dataset.
Explain why directly transferring hyperparameters (such as learning rate and weight decay) from a batch-size 512 baseline to a batch-size 4,096 distributed run can cause training to fail or underperform, even when GPU utilization remains above 90 percent.
Answer: Scaling batch size from 512 to 4,096 reduces the number of optimizer parameter updates per epoch by \(8\times\) for the same dataset. When hyperparameters are left unchanged, the optimizer takes too few steps, leaving the model optimization-starved and unable to match the convergence trajectory of the small-batch run. Furthermore, the gradient noise floor drops at larger batch sizes, which alters the optimal step size. High GPU utilization (\(\eta_{\text{hw}} > 90\%\)) only measures hardware execution efficiency, not optimization progress. To avoid this pitfall, teams must adjust the learning rate (such as applying linear scaling \(\eta \propto B\) or square-root scaling) and retune warmup schedules when scaling batch sizes.
Learning Objective: Explain the mathematical and optimization reasons why hyperparameter transfer fails when scaling batch sizes.
Which engineering mistake exemplifies “pipeline neglect” as described in the chapter’s pitfalls?
- Using BF16 mixed precision instead of FP16 on NVIDIA Ampere GPUs.
- Spending weeks hand-tuning custom CUDA attention kernels to achieve 95% peak arithmetic throughput, only to discover in production that the GPU sits idle 50% of the time waiting for single-threaded Python CPU tokenization.
- Setting
pin_memory=Trueandnum_workers=8in a PyTorch DataLoader. - Checkpointing activations every \(\sqrt{N_L}\) layers to reduce peak memory.
Answer: The correct answer is B. Pipeline neglect occurs when engineers focus exclusively on accelerator-side compute optimizations (such as custom CUDA kernels, mixed precision, or Tensor Core utilization) while neglecting end-to-end profiling. If the upstream data pipeline (CPU tokenization, disk I/O, or augmentation) is bottlenecked, the GPU will starve, rendering kernel-level speedups useless at the system level. Using BF16, tuning DataLoader workers/pin_memory, and activation checkpointing are recommended best practices, not pitfalls.
Learning Objective: Distinguish pipeline neglect and the data-side blind spot as a major operational pitfall in training optimization.
A team proposes moving a single-GPU training job to a 16-GPU cluster to achieve a \(16\times\) reduction in development cycle time. Explain two reasons why distributed training rarely delivers a linear \(16\times\) speedup in developer velocity.
Answer: First, distributed training incurs a communication tax (gradient AllReduce and synchronization overhead) that prevents linear hardware scaling, often yielding only a \(10\text{–}12\times\) throughput speedup on 16 GPUs rather than \(16\times\). Second, distributed systems dramatically increase operational and debugging complexity: multi-node jobs introduce network stragglers, hardware fault probabilities that scale with node count, non-deterministic race conditions, checkpointing coordination overheads, and complex distributed environment configurations. The additional engineering time spent diagnosing cluster failures and tuning communication often exceeds the wall-clock time saved on individual training runs.
Learning Objective: Evaluate why distributed training introduces communication and operational overheads that prevent linear speedups in development velocity.
Self-Check: Answer
Which statement best summarizes the chapter’s core methodology for optimizing machine learning training systems?
- Deconstruct training performance via the Iron Law (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)), profile end-to-end to classify bottlenecks via the D·A·M taxonomy, exhaust single-machine optimizations (mixed precision, prefetching, FlashAttention, checkpointing), and only scale out when hitting physical memory or time limits.
- Scale out to multi-node clusters immediately, because distributed hardware automatically compensates for pipeline inefficiencies.
- Replace Adam with SGD on all workloads to minimize memory usage, and disable gradient checkpointing to avoid recomputation FLOPs.
- Maximize raw GPU busy percentage using synthetic benchmarks rather than measuring Model FLOPs Utilization (MFU).
Answer: The correct answer is A. The chapter’s central methodology consists of: (1) using the Iron Law of Training Performance to isolate total operations, peak hardware throughput, and utilization; (2) using profiling and the D·A·M taxonomy to diagnose whether bottlenecks lie in Data, Algorithm, or Machine stages; (3) applying single-node optimizations (prefetching, mixed precision, FlashAttention, gradient accumulation/checkpointing); and (4) scaling to distributed architectures only when physical hard limits (memory exhaustion, wall-clock time, dataset scale) require it. Premature distributed scaling introduces communication overhead without fixing pipeline stalls. Replacing Adam with SGD can compromise model convergence. Raw GPU busy time conflates unproductive stalls with useful model computation.
Learning Objective: Synthesize the chapter’s end-to-end training optimization methodology from the Iron Law to single-node and distributed scaling.
A cloud training run on 1,024 GPUs improves its MFU from 25 percent to 50 percent through pipeline prefetching, mixed precision, and FlashAttention. Explain how this utilization improvement propagates through wall-clock time, energy consumption, and infrastructure cost.
Answer: In the Iron Law (\(T_{\text{train}} = \frac{O}{R_{\text{peak}} \times \eta_{\text{hw}}}\)), doubling \(\eta_{\text{hw}}\) (MFU from 25% to 50%) at fixed model FLOPs (\(O\)) and hardware peak (\(R_{\text{peak}}\)) cuts total training wall-clock time in half (\(T_{\text{train}} \to T_{\text{train}} / 2\)). Because the 1,024 GPUs run for half as many hours while drawing comparable instantaneous power, total energy consumption (kWh) and associated carbon emissions are roughly halved. Cloud infrastructure rental costs—billed per GPU-hour—are likewise reduced by 50%, saving hundreds of thousands of dollars on large-scale foundation model runs.
Learning Objective: Analyze how MFU improvements propagate through training wall-clock time, energy consumption, and financial cost.
Why does the chapter emphasize exhausting single-machine optimization techniques before scaling training workloads across distributed multi-node clusters?
- Distributed training algorithms cannot execute mixed precision or FlashAttention.
- Multi-node clusters are legally restricted to inference workloads and cannot run backpropagation.
- Single-machine optimizations eliminate pipeline bubbles and reduce memory footprints without adding network communication overhead, synchronization latency, or distributed fault management complexity.
- Single-machine training always trains faster in absolute wall-clock time than a 1,000-GPU cluster.
Answer: The correct answer is C. Single-machine optimizations (such as asynchronous prefetching, mixed precision, FlashAttention, gradient accumulation, and activation checkpointing) frequently resolve binding memory and throughput bottlenecks at zero communication penalty. Scaling to multi-node clusters prematurely introduces distributed communication taxes (AllReduce latency), networking bottlenecks, straggler effects, and fault-tolerance overheads that can erase expected gains. Distributed clusters do support mixed precision and FlashAttention. Multi-node clusters are standard for training. A properly scaled cluster can train faster than a single machine once single-machine limits are reached, but single-machine efficiency must be maximized first.
Learning Objective: Justify the single-machine-first engineering principle over premature distributed scaling.