Các nguyên tắc cơ bản của tăng tốc
Tăng tốc phần cứng
Mục đích
Tại sao việc di chuyển dữ liệu lại tốn kém hơn việc tính toán?
So với việc truy cập bộ nhớ nhiều lần, tính toán là rẻ. Trong thời gian chỉ để lấy một giá trị từ bộ nhớ chính, bộ xử lý có thể thực hiện nhiều phép tính. Sự lệch này, gọi là “bức tường bộ nhớ”, phản ánh độ trễ, băng thông và chi phí năng lượng của việc di chuyển dữ liệu trong hệ thống. Điều đó giải thích vì sao các bộ tăng tốc chuyên dụng không chỉ làm toán nhanh hơn, mà còn được kiến trúc để che giấu, phân bổ và giảm chi phí di chuyển dữ liệu nhờ phân cấp bộ nhớ sâu, song song hóa lớn và các đường dẫn dữ liệu chuyên biệt. Tăng tốc phần cứng giúp nhiều khối lượng công việc (workload) AI lớn tiếp tục mở rộng khi việc tăng quy mô bộ xử lý đa năng là không đủ. Nó cũng lý giải vì sao một số tối ưu hóa giảm số phép tính lý thuyết vẫn không cải thiện runtime. Nếu một phép toán bị giới hạn bởi bộ nhớ (memory bound), tính ít hơn có thể không giúp gì vì tính toán không phải nút thắt. Do đó, chọn phần cứng không thể chỉ so sánh FLOP/s đỉnh. Quan trọng là mô hình di chuyển dữ liệu của khối lượng công việc (workload) có phù hợp với những gì phần cứng được thiết kế để tăng tốc hay không. Một mô hình với các bảng embedding lớn và các truy vấn không đều cần một bộ tăng tốc khác với mô hình thực hiện nhân ma trận dày đặc trên các tensor trọng số nhỏ gọn. Phần mềm phải bộc lộ và lên lịch cho việc tái sử dụng dữ liệu; nếu không, các đơn vị chuyên dụng sẽ phải chờ dữ liệu di chuyển và thông lượng công bố vẫn chỉ là lý thuyết. Khớp đúng khối lượng công việc (workload) và phần cứng sẽ quyết định việc thực thi chỉ đạt một phần nhỏ so với đỉnh lý thuyết hay tiến gần trần hiệu năng thực tế của phần cứng. Theo thuật ngữ D·A·M, bộ tăng tốc làm ràng buộc của máy trở nên cụ thể và định hình những thuật toán nào còn khả thi trong sản xuất.
Learning Objectives
- Giải thích tăng tốc phần cứng như một dạng chuyên môn hóa theo trục máy (machine-axis) dành cho các khối lượng công việc (workload) dựa trên tensor, tái sử dụng dữ liệu và hiệu suất trên mỗi watt.
- Tính cường độ số học và các trần roofline để phân loại các kernel là bị giới hạn bởi tính toán (compute bound) hay bị giới hạn bởi bộ nhớ (memory bound).
- Chẩn đoán các nút thắt do giới hạn bộ nhớ (memory wall) dựa trên băng thông, phân cấp cache, truyền giữa host và thiết bị, cùng chi phí năng lượng cho việc di chuyển dữ liệu.
- So sánh Tensor Cores, mảng systolic, các đơn vị SIMD/SIMT và thực thi thưa (sparse execution) cho các phép toán cơ bản trong ML.
- Chọn các chiến lược về luồng dữ liệu (dataflow), phân ô (tiling) và ánh xạ (mapping) nhằm tối đa hóa việc tái sử dụng dữ liệu dưới các ràng buộc dung lượng bộ nhớ.
- Phân tích các tối ưu hóa của trình biên dịch và runtime, bao gồm việc hợp nhất các kernel, lập kế hoạch bộ nhớ và lên lịch cho các bộ tăng tốc.
- Đánh giá lựa chọn bộ tăng tốc theo các tiêu chí thông lượng, độ trễ, công suất, chi phí và các ràng buộc của ngữ cảnh triển khai.

Tăng tốc phần cứng kích hoạt trục Machine.
Việc giảm tham số, độ chính xác hay số phép toán chỉ thực sự có ý nghĩa khi máy có thể thực thi biểu diễn kết quả một cách hiệu quả. Lựa chọn dữ liệu giúp giảm thành phần dữ liệu (data term), còn nén giúp giảm khối lượng công việc của thuật toán. Tăng tốc phần cứng đặt ra câu hỏi về khả năng thực sự của máy. Câu trả lời bắt đầu từ giới hạn bộ nhớ (memory wall): các phép tính số học thường rẻ hơn nhiều so với việc di chuyển dữ liệu. Một lần truy cập bộ nhớ ngoài chip có thể tốn nhiều chu kỳ bộ xử lý và tiêu thụ năng lượng lớn hơn nhiều bậc độ lớn so với một phép toán số học độ chính xác thấp, với tỉ lệ chính xác phụ thuộc vào thiết bị và cấp độ bộ nhớ. Phần cứng chuyên dụng trở nên quan trọng vì nó không chỉ tăng thông lượng tính toán mà còn tổ chức bộ nhớ, luồng dữ liệu và mức độ song song để các đơn vị số học luôn có đủ dữ liệu để xử lý.
Definition 1.1: Tăng tốc phần cứng
Tăng tốc phần cứng là việc chuyển đổi công việc từ thực thi trên các bộ xử lý đa năng sang các bộ xử lý hoặc đơn vị chức năng chuyên dụng, được tối ưu hóa cho một nhóm tác vụ hẹp hơn. Đối với các khối lượng công việc (workload) trong ML, sự chuyên biệt hóa này thường đánh đổi một phần khả năng lập trình để đạt được mật độ tính toán \((R_{\text{peak}})\) và hiệu suất trên mỗi watt cao hơn, những lợi ích mà các phép toán tensor thông thường có thể tận dụng.
- Ý nghĩa: Một GPU A100 đạt 312 TFLOP/s khi thực hiện phép nhân ma trận FP16/BF16. So với CPU tham chiếu 1–2 TFLOP/s mà chương này dùng làm ví dụ, đây là một chênh lệch đạt 156–312×. 54,2 tỷ bóng bán dẫn của GPU này dành nhiều silicon hơn cho số học song song thay vì cho dự đoán nhánh, lập lịch ngoài thứ tự và các cache lớn (NVIDIA Corporation 2020a; Choquette et al. 2021).
- Phân biệt: Một CPU đa năng được thiết kế để thực thi linh hoạt, điều khiển với độ trễ thấp và xử lý các khối lượng công việc (workload) đa dạng. Ngược lại, một bộ tăng tốc tập trung tài nguyên vào một lớp thao tác hẹp hơn, nên nó chỉ đạt được lợi ích khi khối lượng công việc (workload) bộc lộ các thao tác được hỗ trợ và đủ mức song song để giữ cho các đơn vị số học luôn bận rộn.
- Lỗi thường gặp: Một quan niệm sai là thông lượng đỉnh mà nhà sản xuất quảng cáo cho bộ tăng tốc chính là thông lượng mà khối lượng công việc (workload) thực sự nhận được. Hiệu suất thực tế là mức thấp hơn giữa trần tính toán và những gì băng thông bộ nhớ có thể cấp — ràng buộc roofline. Cụ thể, một kernel có cường độ tính toán số học thấp có thể chỉ đạt một phần nhỏ FLOP/s đỉnh, bất kể silicon được đánh giá nhanh đến mức nào, vì nó thiếu dữ liệu để xử lý hơn là thiếu khả năng tính toán số học.
Định nghĩa này đặt khung cho sự đánh đổi kỹ thuật cốt lõi của chương. Các bộ xử lý đa năng hỗ trợ nhiều loại luồng điều khiển, bộ nhớ và mô hình thực thi. Ngược lại, một bộ tăng tốc có thể dành nhiều ngân sách thiết kế hơn cho số học, lưu trữ và các đường dẫn dữ liệu của một lớp khối lượng công việc (workload) hẹp hơn. Kết quả có thể là cải thiện thông lượng trên mỗi watt theo bậc độ lớn khi khối lượng công việc (workload) và đường đi phần mềm khớp với sự chuyên biệt đó.
Tuy nhiên, chỉ riêng phần cứng thì không thể đạt được những lợi ích này. Thuật toán phải được thiết kế để khai thác những gì phần cứng cung cấp, và phần cứng phải được xây dựng để tăng tốc các thao tác mà thuật toán thực sự dùng. Mối quan hệ cộng sinh này dẫn đến một nguyên tắc bổ sung: đồng thiết kế phần cứng-phần mềm.
Definition 1.2: Đồng thiết kế phần cứng-phần mềm
Đồng thiết kế phần cứng-phần mềm là một phương pháp phát triển bộ tăng tốc ML vượt qua các ranh giới trừu tượng truyền thống, cho phép các ràng buộc của thuật toán định hướng thiết kế silicon và khả năng của phần cứng định hình cách xây dựng thuật toán.
- Ý nghĩa: Trên các đường dẫn có hỗ trợ tensor core, lượng tử hoá số nguyên 8-bit (INT8) có thể mang lại mức tăng thông lượng gấp nhiều lần, vì phần cứng thực thi các phép toán độ chính xác thấp dày đặc hơn và phải di chuyển ít byte hơn so với đường dẫn FP32; mức tăng cụ thể phụ thuộc vào kiến trúc và khối lượng công việc (workload) (NVIDIA Corporation 2020a; Dally et al. 2021; Dally 2023).
- Điểm khác biệt: Khác với trừu tượng hoá theo lớp (layered abstraction), nơi phần mềm gọi API phần cứng mà không cần biết chi tiết về silicon, đồng thiết kế phơi bày trực tiếp các ràng buộc phần cứng cho tác giả thuật toán và trình biên dịch: yêu cầu căn chỉnh dữ liệu, định dạng độ chính xác và mẫu truy cập bộ nhớ đều trở thành đầu vào hiển thị cho tối ưu hoá xuyên lớp ở phạm vi toàn cục.
- Cạm bẫy thường gặp: Một quan niệm sai lầm phổ biến là đồng thiết kế chỉ là một quyết định thiết kế phần cứng một lần. Trên thực tế, các đặc trưng được hỗ trợ vẫn tiếp tục phát triển: NVIDIA Tensor Cores ban đầu chỉ hỗ trợ phép nhân ma trận FP16, các thế hệ sau bổ sung TF32 và hỗ trợ số nguyên rộng hơn, và kiến trúc Ampere thêm tăng tốc cho thưa thớt có cấu trúc 2:4 (NVIDIA 2017; NVIDIA Corporation 2020a).
Đồng thiết kế giải thích tại sao các kỹ thuật nén được giới thiệu trong Nén mô hình mang lại tăng tốc thực sự. Các kỹ thuật lượng tử hoá trong Lượng tử hoá và Độ chính xác cho thấy vì sao chuyển FP32 sang INT8 có thể tăng tốc một đường dẫn phần cứng được hỗ trợ: ít byte hơn làm giảm lưu lượng, và bộ tăng tốc có thể thực hiện nhiều phép toán độ chính xác thấp mỗi chu kỳ hơn so với các phép toán FP32 (NVIDIA Corporation 2020a). Tỉa (pruning) có cấu trúc có thể cải thiện hiệu suất khi nó tạo ra các khối dày đặc nhỏ hơn hoặc một mẫu thưa thớt được phần cứng hỗ trợ, trong khi độ thưa thớt không cấu trúc tuỳ ý cần các kernel thưa thớt tương ứng và cơ chế xử lý siêu dữ liệu. Đánh giá hiệu suất của bộ tăng tốc đòi hỏi lần theo đường đi từ khối lượng công việc (workload) đến silicon: các phép toán cơ bản, hệ thống bộ nhớ, phân tích roofline, ánh xạ và luồng dữ liệu, rồi đến hỗ trợ từ trình biên dịch và runtime. Câu hỏi lặp lại là vì sao một số tối ưu hoá thuật toán đầy hứa hẹn có thể “sống” trên phần cứng, trong khi số khác chỉ là tiết kiệm trên giấy.
Theorem 1.1: Giới hạn cơ bản của tăng tốc (Định luật Amdahl)
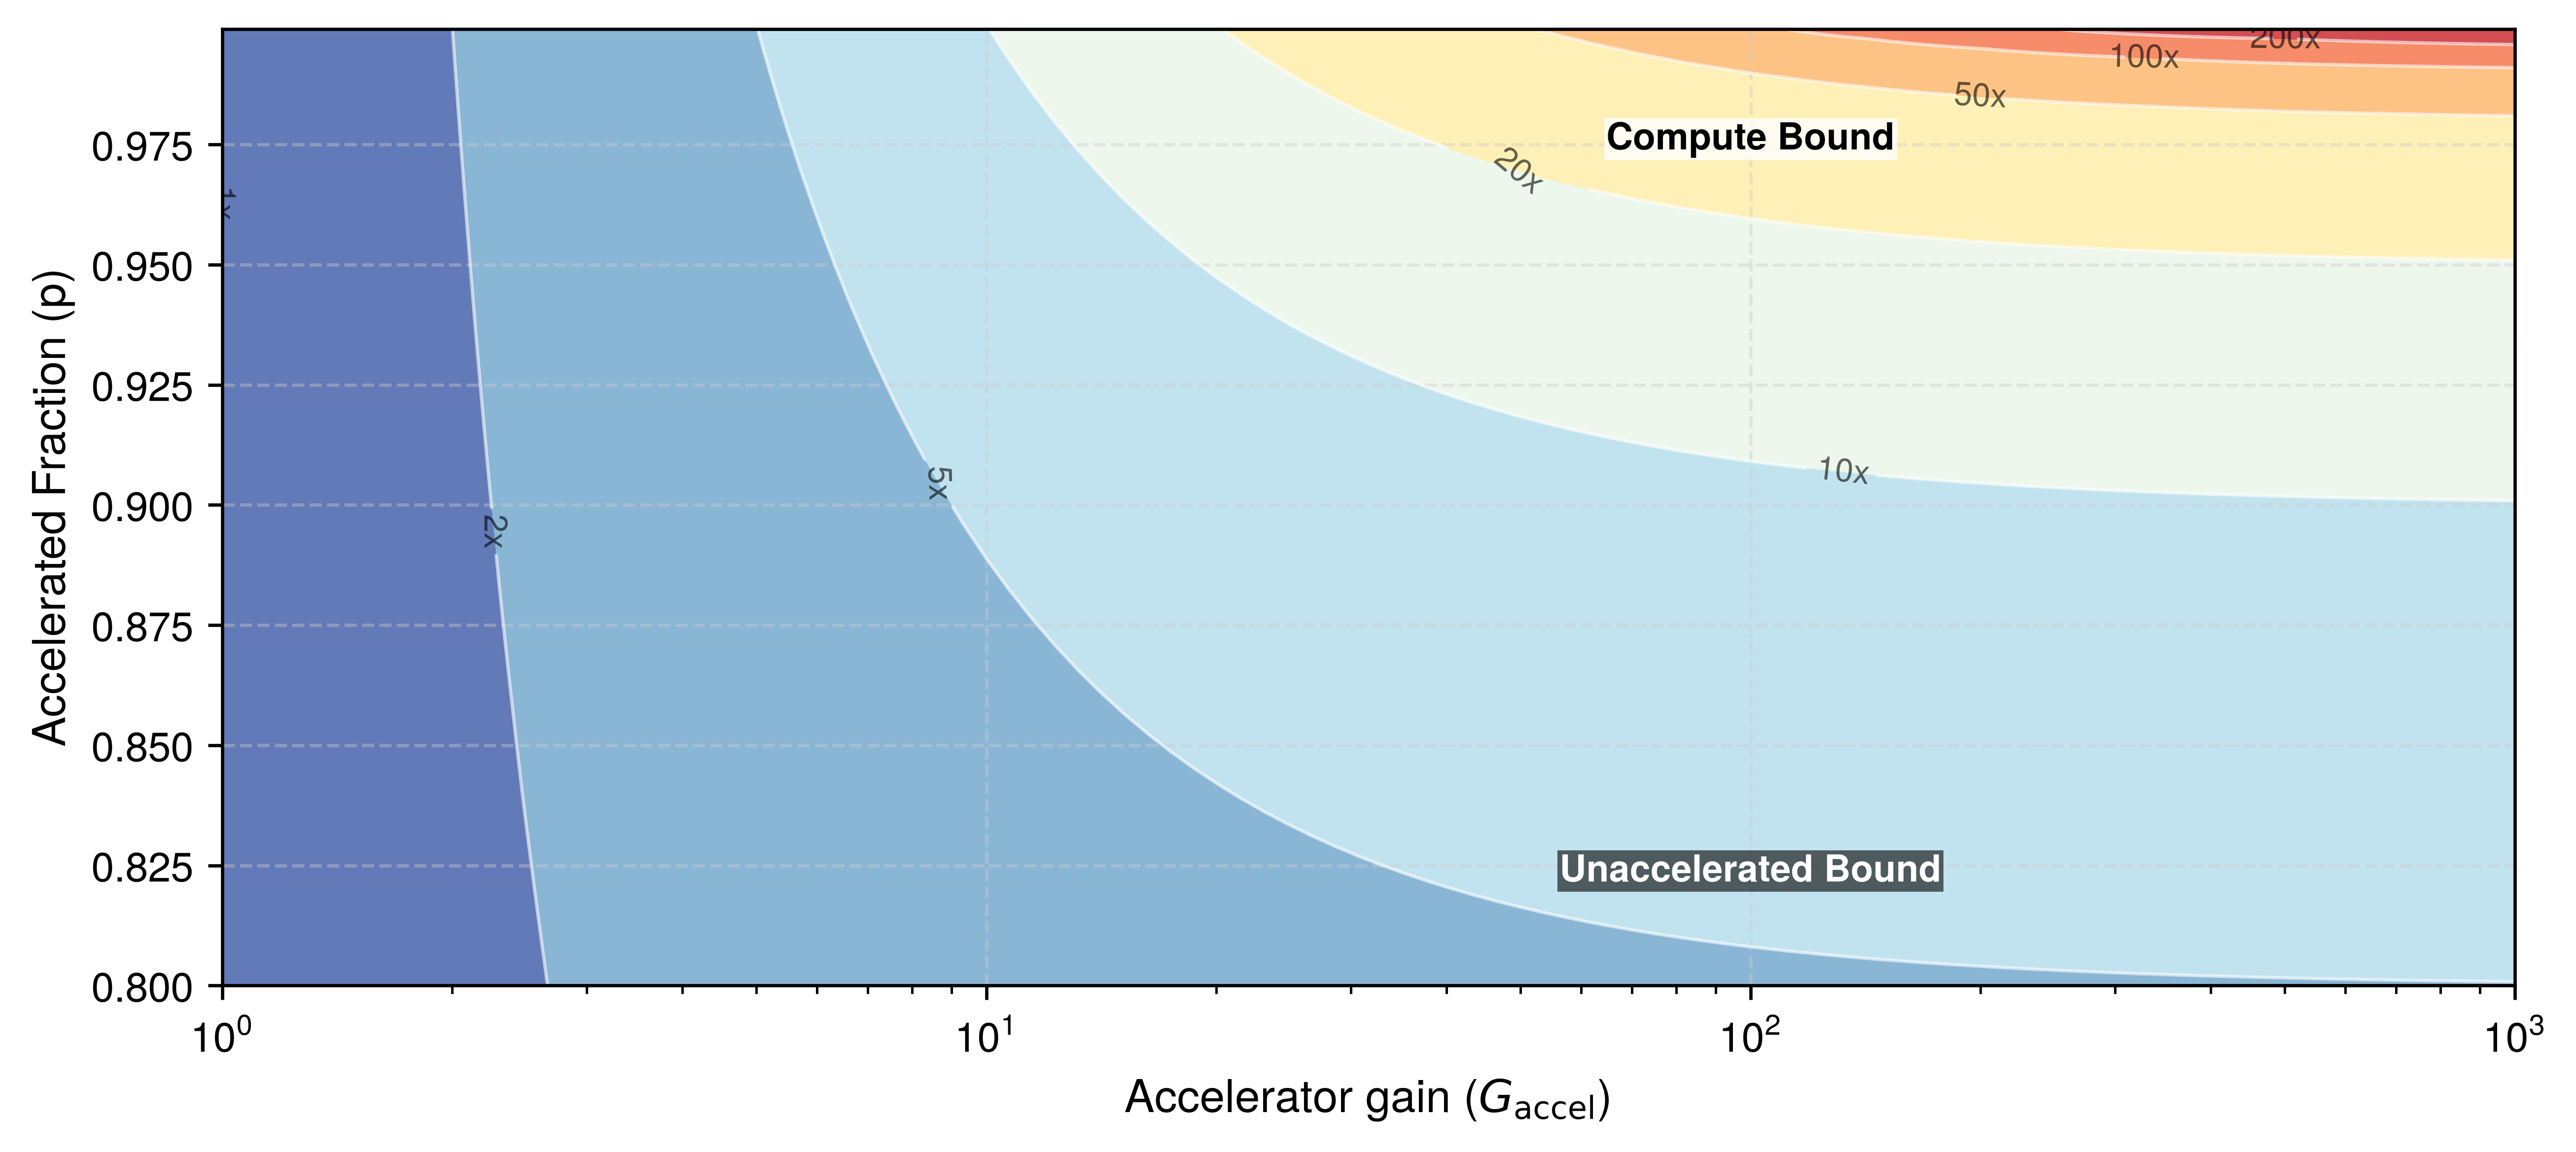
Tăng tốc phần cứng không làm tăng tốc toàn bộ hệ thống; nó chỉ tăng tốc phần thời gian cơ sở đi qua đường dẫn được tăng tốc. Với phần \(p\) đó và mức tăng \(G_{\text{accel}}\) trên đường dẫn, định luật Amdahl cho AI (Amdahl 1967) đưa ra giới hạn như trong equation 1. \[ \text{Speedup} = \frac{1}{(1 - p) + \frac{p}{G_{\text{accel}}}} \tag{1}\]
- Phần được tăng tốc (\(p\)): Tỷ lệ thời gian cơ sở nhận được mức tăng đã nêu, thường là trong phép nhân ma trận hoặc một kernel được hỗ trợ khác.
- Mức tăng của bộ tăng tốc (\(G_{\text{accel}}\)): Lợi thế tốc độ thô của GPU hoặc Đơn vị xử lý Tensor (TPU) so với CPU cho phần khối lượng công việc (workload) được tăng tốc.
- Phần không được tăng tốc (\(1-p\)): Công việc nằm ngoài đường dẫn đã chọn, chẳng hạn như tải dữ liệu, chi phí trên host, các toán tử không được hỗ trợ và độ trễ khởi chạy kernel.
Cạm bẫy: Công việc không được tăng tốc sẽ giới hạn mức tăng tốc tổng thể. Nếu 10% thời gian cơ sở không bị ảnh hưởng (\(p=0.9\)), ngay cả mức tăng trên đường dẫn là vô hạn (\(G_{\text{accel}}=\infty\)) cũng chỉ mang lại tối đa 10\(\times\) tổng thể. Khi thành phần được tăng tốc đủ nhanh, phần công việc không bị ảnh hưởng sẽ trở thành thành phần chi phối.
Amdahl, Gene M. 1967. “Validity of the Single Processor Approach to Achieving Large Scale Computing Capabilities.” Proceedings of the April 18-20, 1967, Spring Joint Computer Conference on - AFIPS ’67 (Spring), AFIPS ’67 (spring), 483–85. https://doi.org/10.1145/1465482.1465560.
1 Định luật Amdahl: Chỉ ánh xạ vào Định luật Sắt sau khi thay đổi đề xuất được xác định rõ. Nếu một đơn vị tensor nhanh hơn làm giảm thành phần tính toán \((O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\) nhưng giữ nguyên việc truyền dữ liệu và độ trễ cố định, thì các thành phần không bị tác động đó sẽ giới hạn tổng tốc độ tăng. Một bộ tăng tốc khác hoặc hệ thống bộ nhớ khác cũng có thể cải thiện băng thông. Vì vậy, phần không được tăng tốc được xác định bởi chính biện pháp can thiệp, không phải bởi một phân loại vĩnh viễn rằng mỗi thành phần là nối tiếp.
Tăng tốc phần cứng tác động đến các thành phần cụ thể trong định luật sắt của hệ thống ML (Định luật sắt của hệ thống ML), vốn phân tách thời gian từ đầu đến cuối thành khối lượng dữ liệu \((D_{\text{vol}}/\text{BW})\), tính toán \((O/(R_{\text{peak}} \cdot \eta_{\text{hw}}))\) và độ trễ cố định \((L_{\text{lat}})\). Trong khi lựa chọn dữ liệu giúp giảm tổng lượng dữ liệu và nén mô hình giúp giảm \(O\) trên mỗi mẫu, thì tăng tốc phần cứng làm tăng tốc độ thực thi các phép toán này bằng cách cải thiện \(R_{\text{peak}}\), \(\eta_{\text{hw}}\) và \(\text{BW}\). Vật lý của tính toán cung cấp các mô hình hiệu suất phân tích để chẩn đoán thành phần nào trong số này chiếm ưu thế đối với một khối lượng công việc (workload) nhất định, bao gồm cả phân tích thứ nguyên xác nhận rằng mỗi thành phần của định luật sắt đều quy về đơn vị giây. Tuy vậy, tăng tốc có một giới hạn cứng, được thiết lập bởi Định luật Amdahl.1
Định luật Amdahl cũng giải thích tại sao nhiều nâng cấp GPU gây thất vọng. Figure 1 trực quan hóa bức tường tăng tốc: khi một phần đáng kể thời gian thực thi ban đầu vẫn không được tăng tốc, giới hạn \(1/(1-p)\) khiến cho việc tăng tốc thêm trở nên kém hiệu quả dần, trừ khi \(p\) tiến gần đến 1. Các đường đồng mức chỉ mang tính minh họa.
Trực giác then chốt khi đi vào các kiến trúc phần cứng cụ thể là tốc độ tăng thô chỉ có ý nghĩa sau khi phần chưa được tăng tốc đã được giảm bớt. Phần được tăng tốc \(p\) có thể khác nhau đáng kể giữa các kiểu khối lượng công việc (workload) chạy trên cùng phần cứng, và ở quy mô toàn đội máy, những khác biệt này quyết định liệu khoản đầu tư vào bộ tăng tốc có mang lại hiệu quả hay bị dừng lại ở nút thắt cổ chai còn lại.
Checkpoint 1.1: Ngưỡng song song hóa
Những kiểm tra này biến giới hạn của Amdahl thành một bài kiểm tra lựa chọn phần cứng.
Thực tế của Amdahl
Nút thắt nối tiếp trở nên cụ thể trên phần cứng thực: cùng một bộ tăng tốc có thể gần chạm trần song song của nó ở một khối lượng công việc (workload), nhưng lại bị khựng ở một workload khác. Các con số cần biết thu thập các số liệu tham chiếu \(R_{\text{peak}}\) qua nhiều thế hệ bộ tăng tốc và thứ bậc độ trễ, để đặt các so sánh phần cứng này trong khung bậc độ lớn.
Lighthouse 1.1: Một ví dụ phân tích Amdahl trên H100
Ví dụ suy luận ResNet-50 trên NVIDIA H100:
- Giả sử H100 cung cấp \(G_{\text{accel}}\) = 247× cho phép nhân ma trận so với một CPU tham chiếu không có phần mở rộng ma trận (1979 TOPS INT8 so với ~8 TOPS) (Choquette 2023).
- Giả sử \(p\) = 0.95: 95 percent thời gian gốc được hưởng lợi từ mức tăng tốc đó, trong khi 5 percent còn lại dành cho việc tải dữ liệu, tiền xử lý, hậu xử lý và các công việc khác. \[ \text{$\text{Speedup} = \frac{1}{(1-0.95) + \frac{0.95}{247}} = \frac{1}{0.05 + 0.0038} \approx 18.6\times$} \] Mức tăng tốc 247× chỉ mang lại tổng độ tăng tốc đầu cuối 18.6×, vì phần 5 percent không bị ảnh hưởng đã đặt trần.
Đối chiếu với GPT-2 (tự hồi quy):
- Với việc tạo token của GPT-2, giả sử \(p\) = 0.80; phần 20 percent còn lại gồm chi phí phía host, lấy mẫu và công việc giải mã nằm ngoài đường dẫn ma trận được tăng tốc. \[ \text{$\text{Speedup} = \frac{1}{(1-0.80) + \frac{0.80}{247}} = \frac{1}{0.20 + 0.0032} \approx 4.9\times$} \] Do thời gian tạo token nhận được mức tăng giả định ít hơn, nên ngay cả khi mức tăng trên đường dẫn là vô hạn thì tổng độ tăng tốc cũng chỉ đạt tối đa \(1/(1-p)\) = 5×. Các tối ưu hóa phục vụ (serving) xử lý giới hạn này theo những cách khác nhau: batching cải thiện mức sử dụng tài nguyên giữa các yêu cầu, còn giải mã suy đoán dùng một mô hình nháp để giảm số bước tuần tự của mô hình đích.
2 Cường độ số học: Tỷ lệ giữa số phép toán và số byte dữ liệu được truyền qua giao diện bộ nhớ đang được mô hình hóa (FLOP/byte). Các khối lượng công việc nằm trên điểm đỉnh (ridge point) của cấp độ phần cứng đó, ví dụ các phép nhân ma trận được chia ô (tiled) tốt với tái sử dụng dữ liệu đáng kể, là bị giới hạn bởi tính toán và sẽ hưởng lợi khi có nhiều TFLOP/s hơn. Các phép toán cường độ thấp, bao gồm một số kernel attention và giải mã với batch thấp, bị giới hạn bởi băng thông ở cấp độ đó và cần nhiều băng thông hoặc tái sử dụng hơn, thay vì chỉ thêm thông lượng tính toán.
Những ví dụ này cho thấy tối ưu hóa phần cứng phụ thuộc vào việc một khối lượng công việc (workload) bị giới hạn bởi tốc độ tính toán hay bởi việc di chuyển dữ liệu. Sự phân biệt này quyết định chọn bộ tăng tốc nào, tối ưu nào là trọng yếu, và liệu một con chip mạnh hơn 10\(\times\) có thực sự giúp ích. Mô hình Roofline cung cấp một framework phân tích để đưa ra chẩn đoán này (Williams et al. 2009); mô hình được giới thiệu chính thức trong Mô hình Roofline và section 1.5 áp dụng nó cho các khối lượng công việc AI. Mô hình vẽ cường độ số học của một phép toán,2 được định nghĩa là tỷ lệ giữa số phép toán dấu phẩy động và số byte lưu thông qua bộ nhớ (FLOP/byte), trên nền khả năng phần cứng, từ đó cho thấy hiệu suất bị giới hạn bởi tính toán hay băng thông. Phép nhân ma trận dày đặc với cường độ số học cao sẽ hưởng lợi khi có nhiều TFLOP/s hơn; còn LayerNorm với cường độ số học thấp sẽ hưởng lợi từ băng thông bộ nhớ lớn hơn. Các tích chập ResNet-50 có khả năng tái sử dụng dữ liệu cao có thể chuyển sang vùng bị giới hạn bởi tính toán, trong khi attention tự hồi quy (autoregressive attention) với batch thấp có thể bị giới hạn bởi băng thông bộ nhớ. Chính sự phân biệt này là lý do tại sao các khối lượng công việc này cần những chiến lược tối ưu hóa khác nhau.
Chương này phát triển các ý tưởng ấy, đi từ lịch sử phần cứng, các nguyên thủy tính toán, hệ thống phân cấp bộ nhớ, phân tích roofline, ánh xạ, luồng dữ liệu và hỗ trợ runtime. Phần phân tích chính tập trung vào hệ thống chỉ có một bộ tăng tốc và một nút đơn; phần cuối dùng ví dụ đa thiết bị chỉ để cho thấy cách các chẩn đoán nút thắt cổ chai đó mở rộng theo quy mô. Lịch sử phần cứng chuyên dụng được đặt lên trước vì nó cho thấy những mẫu thiết kế lặp lại đằng sau các bộ tăng tốc hiện đại.
Chuyên môn hóa phần cứng
Cú sốc hiệu quả của TPUv1/K80 là một ví dụ hiện đại cho một quy luật quen thuộc trong phát triển phần cứng: khi một khối lượng công việc (workload) trở nên đủ quan trọng và ổn định, phần cứng chuyên dụng có thể vượt trội so với các nền tảng đa năng hơn. Việc tăng tốc machine learning đi theo quỹ đạo từng thấy ở số học dấu phẩy động, xử lý đồ họa và xử lý tín hiệu số. Ở mỗi giai đoạn, người ta chuyên biệt hóa thao tác hoặc đường dẫn dữ liệu đang giới hạn khối lượng công việc (workload) đó; trong machine learning hiện đại, chi phí cấp dữ liệu cho các phép toán số học dày đặc khiến việc di chuyển dữ liệu trở thành mục tiêu thiết kế trung tâm.
Các bộ tăng tốc machine learning hiện đại (bộ tăng tốc mạng nơ-ron dòng DianNao (Chen et al. 2014), GPU với Tensor Cores, TPU của Google,3 Neural Engine của Apple) ra đời từ những nguyên tắc kiến trúc đã được xác lập. Quá trình tiến hóa này trải qua bốn giai đoạn: khởi nguồn từ điện toán chuyên dụng, xử lý đồ họa song song, kiến trúc dành riêng cho miền, và sự xuất hiện của phần cứng chuyên biệt cho machine learning. Mỗi giai đoạn nêu bật các nguyên tắc thiết kế vẫn còn phù hợp để hiểu và tối ưu hóa các hệ thống AI đương đại.
Chen, Tianshi, Zidong Du, Ninghui Sun, Jia Wang, Chengyong Wu, Yunji Chen, and Olivier Temam. 2014. “DianNao: A Small-Footprint High-Throughput Accelerator for Ubiquitous Machine-Learning.” Proceedings of the 19th International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS ’14), 269–84. https://doi.org/10.1145/2541940.2541967.
3 TPU (đơn vị xử lý tensor): TPU đầu tiên đặt một “cược” hẹp có chủ đích, tập trung thiết kế quanh một mảng systolic \(256{\times}256\) duy nhất để nhân ma trận 8-bit, đồng thời lược bỏ nhiều cơ chế điều khiển mà một lõi đa năng cần có (Jouppi et al. 2017). Sự đánh đổi này giúp đạt mật độ tính toán cao cho các phép nhân ma trận dày đặc, nhưng phải hy sinh tính linh hoạt. Mã không đều (irregular) hoặc nhiều nhánh (branch-heavy) vẫn không phù hợp. Mức độ tận dụng mảng phụ thuộc vào cách trình biên dịch lát gạch (tiling), đệm (padding), và kích thước các lớp (layer dimensions).
Example 1.1: Cú sốc hiệu quả của TPUv1 so với K80
Tình huống: Năm 2015, Google triển khai Tensor Processing Unit (TPUv1) đầu tiên của mình vào các trung tâm dữ liệu trong môi trường sản xuất, và so sánh thông lượng cùng hiệu quả năng lượng của nó với các GPU NVIDIA K80 đa năng (Jouppi et al. 2017).
Chẩn đoán: K80 là một GPU có thể lập trình, được thiết kế để hỗ trợ phổ rộng hơn các khối lượng công việc (workload) đồ họa và tính toán. Kiến trúc dành riêng cho miền (DSA) của TPUv1 chọn tập trung hẹp vào suy luận, kết hợp một đơn vị ma trận systolic 8-bit lớn với bộ nhớ do phần mềm quản lý và cơ chế điều khiển đơn giản hơn.
Bài học về hệ thống: Trên sáu khối lượng công việc (workload) suy luận của Google và các mốc tham chiếu CPU/GPU cùng thời được đánh giá trong bài báo về TPU, việc tùy chỉnh silicon cho các phép toán ma trận chủ đạo đã mang lại thông lượng cao hơn 15–30\(\times\) và hiệu suất trên mỗi watt tốt hơn 30–80\(\times\) (Jouppi et al. 2017). Những tỷ lệ đó mô tả các hệ thống đã được đánh giá, không áp dụng cho mọi khối lượng công việc (workload).
Chuyên môn hóa phần cứng cải thiện hiệu suất bằng cách hiện thực các mẫu tính toán thường gặp trong các mạch chuyên dụng, nhưng cũng kéo theo những đánh đổi về tính linh hoạt, diện tích silicon và độ phức tạp lập trình. Những nguyên tắc từng định hình các bộ tăng tốc dấu phẩy động và đồ họa đời đầu nay đang dẫn dắt thiết kế phần cứng AI.
Điện toán chuyên dụng
Chuyên môn hóa phần cứng xuất hiện khi các mẫu tính toán cụ thể trở thành nút thắt cổ chai chính của hệ thống, khiến các bộ xử lý đa năng không thể mở rộng hiệu quả. Lịch sử này cho thấy ba giới hạn lặp đi lặp lại: thực thi chậm các phép toán dấu phẩy động vô hướng, thông lượng không đủ cho đồ họa song song, và tích hợp kém giữa bộ nhớ với tính toán song song.
Giai đoạn đầu tiên, nút thắt cổ chai về độ chính xác, xuất hiện khi các ứng dụng khoa học và kỹ thuật cần số học dấu phẩy động mà CPU mục đích chung xử lý kém. Cuối thập niên 1970, CPU thường mô phỏng các phép dấu phẩy động bằng phần mềm, cần rất nhiều lệnh cho một phép nhân. Sự kém hiệu quả vô hướng này đã dẫn đến ví dụ lớn đầu tiên của chuyên môn hóa phần cứng: bộ đồng xử lý toán học.
Intel 8087 (1980)4 giải quyết nút thắt này bằng cách chuyển các phép tính nặng về số học sang một đơn vị chuyên biệt. Việc hiện thực logic dấu phẩy động trực tiếp trong phần cứng đã tăng tốc đáng kể những phép toán vốn phải mô phỏng bằng phần mềm (Palmer 1980). Từ đây hình thành một nguyên tắc cốt lõi: đưa một phép tính chiếm ưu thế sang silicon chuyên dụng có thể mang lại mức tăng tốc lớn.
4 Intel 8087: Bộ đồng xử lý này tích hợp trực tiếp logic dấu phẩy động vào silicon, tránh cho CPU phải mô phỏng bằng phần mềm chậm chạp và tốn nhiều lệnh cho mỗi phép tính. Lợi ích của nó phụ thuộc vào mức thời gian ứng dụng dành cho các phép toán dấu phẩy động được hỗ trợ. Điều này cho thấy chuyên môn hóa hiệu quả nhất khi phần việc được tăng tốc chiếm phần lớn thời gian thực thi.
Khi các chức năng chuyên dụng như tính toán dấu phẩy động chứng tỏ giá trị, chúng đi theo một khuôn mẫu tích hợp lặp lại. Cụ thể, Intel 486DX (1989) đưa FPU trực tiếp lên khuôn chip CPU, loại bỏ độ trễ giao tiếp ngoài chip và biến tính toán độ chính xác cao thành một tính năng tiêu chuẩn thay vì một bộ tăng tốc tùy chọn (Hennessy and Patterson 2017). Chu trình này — chuyên môn hóa để giải quyết nút thắt, rồi tích hợp vào ngăn xếp đa dụng — đã lặp lại qua nhiều kỷ nguyên phát triển phần cứng.
Sự dịch chuyển từ chuyên môn hóa sang tích hợp đã định hình máy tính hiện đại. Mỗi lĩnh vực (đồ họa, xử lý tín hiệu, machine learning) đều đưa ra các kiến trúc chuyên dụng, rồi sau đó được hấp thụ vào các nền tảng đa dụng.
Figure 2 mô tả chu trình lặp lại của chuyên môn hóa và tích hợp qua năm kỷ nguyên, mỗi kỷ nguyên giải quyết nút thắt tính toán chủ đạo của thời kỳ đó: các đơn vị dấu phẩy động và xử lý tín hiệu thập niên 1980 (Intel 8087, TI TMS32010 DSP), đồ họa 3D thập niên 1990 (NVIDIA GeForce 256), xử lý đa phương tiện và mạng thập niên 2000 (codec H.264, Intel IXP2800), các phép toán tensor trong học sâu thập niên 2010 (Google TPU v1, NVIDIA Tensor Cores), và các bộ tăng tốc chuyên dụng theo ứng dụng thập niên 2020 (AI engines, chip ML quy mô wafer). Các khả năng như dịch thời gian thực, hệ thống gợi ý và suy luận trên thiết bị trực tiếp dựa vào những nguyên tắc đã hình thành từ các làn sóng chuyên môn hóa trước đó.

Điện toán song song và xử lý đồ họa
Những nguyên tắc đúc kết từ việc tăng tốc phép tính dấu phẩy động đã đặt ra một khuôn mẫu để giải quyết các thách thức tính toán về sau. Khi các ứng dụng điện toán ngày càng đa dạng, các mô hình tính toán mới xuất hiện, vượt quá khả năng của các bộ xử lý đa năng. Mỗi lĩnh vực đã đóng góp những hiểu biết độc đáo vào các chiến lược tăng tốc phần cứng.
Vào những năm 1990, xử lý đồ họa trở thành động lực chính thúc đẩy chuyên môn hóa phần cứng. Các bộ tăng tốc đồ họa ban đầu tập trung vào những thao tác cụ thể như truyền tải bitmap và tô đa giác. Năm 1999, GeForce 256 của NVIDIA đánh dấu một cột mốc quan trọng trong điện toán chuyên biệt. GeForce 256 đã tích hợp biến đổi và chiếu sáng (T&L) được tăng tốc bằng phần cứng, chuyển các phép tính này từ CPU sang silicon chuyên dụng. Mặc dù khi đó chưa thể lập trình, những Graphics Processing Units (GPUs) này cho thấy các kiến trúc song song chức năng cố định có thể xử lý hiệu quả các khối lượng công việc (workload) song song dữ liệu như ánh xạ kết cấu và biến đổi đỉnh. Việc chuyển sang các bộ đổ bóng (shader) có thể lập trình với GeForce 3 (2001) và các kiến trúc đổ bóng hợp nhất với GeForce 8 (2006) cuối cùng đã mở đường cho GPU tính toán các khối lượng công việc (workload) đa năng. Đến năm 2004, các GPU cao cấp có thể xử lý hơn 100 triệu đa giác mỗi giây (Owens et al. 2008).
Lyons, Richard G. 2011. Understanding Digital Signal Processing. 3rd ed. Prentice Hall.
Cùng thời điểm đó, các bộ xử lý DSP (Digital Signal Processing) xây dựng kiến trúc đường dẫn dữ liệu song song, với các đơn vị nhân-tích lũy chuyên dụng và bộ đệm vòng, tối ưu cho thao tác lọc và biến đổi. TMS32010 (1983) của Texas Instruments cho thấy các tập lệnh chuyên biệt theo miền có thể cải thiện mạnh mẽ hiệu năng cho ứng dụng xử lý tín hiệu (Lyons 2011).
Xử lý mạng đưa thêm những kiểu chuyên biệt hóa mới. Các bộ xử lý mạng phát triển kiến trúc riêng để xử lý gói ở tốc độ đường truyền, tích hợp nhiều lõi xử lý, các đơn vị thao tác gói chuyên dụng và hệ thống quản lý bộ nhớ nhiều cấp. Bộ xử lý mạng IXP2800 của Intel minh họa hệ quả của một ràng buộc cứng: phải đáp ứng hạn chót ở tốc độ đường truyền nên không có dư địa cho cache miss; vì vậy, thiết kế bố trí nhiều lõi song song xung quanh bộ nhớ trên chip theo nhiều tầng để giữ dữ liệu sát với nơi tính toán. Tổ chức tính toán gần bộ nhớ này, dù ở đây bị ép bởi yêu cầu thời gian của gói, chính là cách mà các bộ tăng tốc ML sau này áp dụng để bảo đảm lưới các phần tử xử lý luôn được cấp dữ liệu.
Trong các lĩnh vực này, một khuôn mẫu chung dần lộ rõ: xác định các kiểu tính toán chủ đạo, xây các phần tử xử lý chuyên biệt và các tầng bộ nhớ xoay quanh chúng, tạo mô hình lập trình phù hợp, rồi từng bước tiến hóa sang kiến trúc linh hoạt hơn. Kiểu đồng tiến hóa về kiến trúc này đặt nền cho thiết kế phần cứng AI hiện đại. Các đổi mới của DSP trong xử lý tín hiệu công suất thấp đã cho phép suy luận thời gian thực trên thiết bị edge, như trợ lý giọng nói và thiết bị đeo. Cùng nhau, các lĩnh vực này định hướng thiết kế phần cứng ML và cho thấy các bộ tăng tốc có thể triển khai cả trên đám mây lẫn trong môi trường nhúng.
Chỉ một kết quả đã khiến vai trò của GPU đối với AI trở nên không thể nhầm lẫn. AlexNet5 (Krizhevsky et al. 2012) thắng cuộc thi ImageNet 2012 với cách biệt hơn mười điểm phần trăm, chỉ với hai card đồ họa NVIDIA GTX 580 dành cho người dùng phổ thông, mỗi card có 3 GB VRAM. Bài học ở góc độ hệ thống là: khi song song dữ liệu của một khối lượng công việc (workload) khớp với phần cứng GPU, những bài huấn luyện trước đây vốn không khả thi trở nên khả thi. Kỷ nguyên deep learning lấy GPU làm trung tâm đã bắt đầu.
5 AlexNet: Mạng nơ-ron tích chập (CNN) 60 triệu tham số của Krizhevsky, Sutskever và Hinton đã giành chiến thắng ImageNet 2012 với cách biệt hơn 10 điểm phần trăm trên hai GPU GTX 580 dân dụng, mỗi GPU chỉ có 3 GB VRAM. Vì mô hình vượt quá bộ nhớ của một GPU, các tác giả đã chia mạng chạy trên hai card và hạn chế giao tiếp giữa chúng. Đây là một dạng song song mô hình (model parallelism) sơ khai, báo trước sự phát triển có hệ thống của song song hóa tensor và pipeline. Theo báo cáo, quá trình huấn luyện này mất từ năm đến sáu ngày (Krizhevsky et al. 2012).
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
Sự xuất hiện của các kiến trúc chuyên biệt theo miền
Những kiểu tăng tốc đa dạng này đã hội tụ thành một chuyển dịch kiến trúc rộng hơn. Sự xuất hiện của kiến trúc chuyên biệt theo miền (DSA)6 đánh dấu một bước chuyển trong thiết kế hệ thống máy tính, được thúc đẩy bởi lợi ích từ mở rộng quy mô truyền thống đang chậm lại (Esmaeilzadeh et al. 2011) và nhu cầu tính toán ngày càng tăng của các khối lượng công việc (workload) chuyên biệt. Định luật Moore7 mô tả sự gia tăng kéo dài về mật độ bóng bán dẫn (Moore 1998). Định luật Dennard scaling8 (Dennard et al. 1974) cho phép điện áp giảm khi bóng bán dẫn thu nhỏ; khi quy luật này không còn đúng, con đường đạt được mức tăng tần số đều đặn ở mật độ công suất không đổi cũng biến mất. Những thay đổi này cùng nhau đã kìm hãm hiệu năng và hiệu quả của các hệ thống đa dụng. Như Hennessy and Patterson (2019) lập luận trong Bài giảng Turing năm 2017, phản ứng là một kỷ nguyên mới của các giải pháp chuyên biệt theo miền, được tối ưu hóa cho các khối lượng công việc (workload) quan trọng.
6 DSA (kiến trúc chuyên biệt theo miền): Phần cứng được tối ưu cho một miền ứng dụng cụ thể, chấp nhận hy sinh một phần khả năng lập trình tổng quát để đổi lấy hiệu quả. Ví dụ, TPUv1 của Google đạt hiệu suất cao hơn 15–30\(\times\) và hiệu suất trên mỗi watt cao hơn 30–80\(\times\) so với các hệ thống CPU và GPU cùng thời, khi được đánh giá trên các khối lượng công việc (workload) suy luận của Google, nhờ thiết kế xoay quanh một mảng systolic và bộ nhớ do phần mềm quản lý (Jouppi et al. 2017). Một DSA xuất sắc trong phép nhân ma trận dày đặc có thể kém hơn CPU trên các khối lượng công việc (workload) bất quy tắc như duyệt đồ thị; vì vậy, các giới hạn của khối lượng công việc (workload) và mức tăng hiệu quả phải đủ để biện minh cho chi phí phần mềm, trình biên dịch và hệ sinh thái (Hennessy and Patterson 2019, 2017).
Hennessy, John L., and David A. Patterson. 2019. “A New Golden Age for Computer Architecture.” Communications of the ACM 62 (2): 48–60. https://doi.org/10.1145/3282307.
Hennessy, John L., and David A. Patterson. 2017. Computer Architecture: A Quantitative Approach. 6th ed. Morgan Kaufmann.
7 Định luật Moore: Theo các giả định minh hoạ trong figure 3, nhu cầu tính toán của mô hình tăng khoảng 6.1× mỗi năm. Trong khi đó, nguồn cung đỉnh của bộ tăng tốc tăng khoảng 1.7× mỗi năm, làm khoảng cách nhu cầu/cung trong mô hình rộng ra khoảng 3.5× mỗi năm. Các xu hướng tính toán đã công bố là động lực cho sự phân kỳ này, nhưng các tốc độ được vẽ chỉ là giả định chứ không phải dự báo. Do đó, hình này cho thấy khoảng cách hệ thống nhạy cảm thế nào với sự khác biệt kéo dài về tốc độ tăng trưởng, chứ không mô tả một quỹ đạo tương lai cố định. Khi tồn tại khoảng cách như vậy, các kỹ thuật nâng cao hiệu quả thuật toán như nén, lượng tử hoá và thưa hoá ngày càng trở nên quan trọng (Amodei and Hernandez 2018; Epoch AI 2024).
Moore, G. E. 1998. “Cramming More Components onto Integrated Circuits.” Proceedings of the IEEE 86 (1): 82–85. https://doi.org/10.1109/jproc.1998.658762.
8 Dennard scaling: Mô hình scaling năm 1974 cho rằng điện áp hoạt động có thể giảm khi kích thước bóng bán dẫn thu nhỏ, nhờ đó giữ mật độ công suất xấp xỉ không đổi (Dennard et al. 1974). Sau khoảng năm 2005, khuynh hướng này bị phá vỡ, làm hạn chế việc tăng tần số xung nhịp trong giới hạn công suất thiết kế nhiệt của chip. Các nghiên cứu về dark silicon ước tính rằng, với các nút công nghệ tiên tiến trong mô hình và giả định thiết kế, giới hạn nhiệt có thể ngăn cản một phần lớn số bóng bán dẫn hoạt động đồng thời. Tỷ lệ này không phải là một hằng số chung, nhưng ràng buộc về công suất thì bền bỉ: các đơn vị chuyên biệt giúp sử dụng hiệu quả hơn ngân sách silicon hoạt động bằng cách dành nó cho các lớp thao tác giá trị cao (Esmaeilzadeh et al. 2011).
Dennard, Robert H., Frank H. Gaensslen, Hwa-Nien Yu, Victor L. Rideout, Elias Bassous, and Antoine R. LeBlanc. 1974. “Design of Ion-Implanted MOSFET’s with Very Small Physical Dimensions.” IEEE J. Solid-State Circuits 9 (5): 256–68. https://doi.org/10.1109/jssc.1974.1050511.
Esmaeilzadeh, Hadi, Emily Blem, Renee St. Amant, Karthikeyan Sankaralingam, and Doug Burger. 2011. “Dark Silicon and the End of Multicore Scaling.” Proceedings of the 38th Annual International Symposium on Computer Architecture, 365–76. https://doi.org/10.1145/2000064.2000108.
9 Định luật Huang: Quan sát rằng hiệu suất GPU cho các khối lượng công việc (workload) AI đã được cải thiện nhờ các đổi mới kiến trúc như Tensor Cores cũng như nhờ thu nhỏ bóng bán dẫn. Biểu đồ đã chuẩn hóa sử dụng các đường cong minh họa về nguồn cung GPU và nhu cầu mô hình để cho thấy tốc độ tăng trưởng không đồng đều dẫn đến khoảng cách hệ thống ngày càng lớn như thế nào; đây không phải là dự báo về bất kỳ tốc độ nào trong số đó (Amodei and Hernandez 2018; Epoch AI 2024; NVIDIA Corporation 2020a; Choquette 2023).
Amodei, Dario, and Danny Hernandez. 2018. “AI and Compute.” OpenAI Blog 2.
Epoch AI. 2024. Machine Learning Trends. Epoch AI Research Database.
Mức độ nghiêm trọng của thách thức này trở nên rõ rệt trong figure 3, nơi biểu đồ minh họa khoảng cách giữa nhu cầu về mô hình và nguồn cung phần cứng, đôi khi được gọi không chính thức là Định luật Huang.9 Theo kịch bản chuẩn hóa, nguồn cung GPU tăng khoảng 1.7\(\times\) mỗi năm, trong khi nhu cầu mô hình tăng khoảng 6\(\times\) mỗi năm, tạo ra khoảng cách rộng thêm khoảng 3–4\(\times\) mỗi năm. Các xu hướng tính toán đã công bố hỗ trợ cho sự phân kỳ về mặt định tính, còn các tỷ lệ được vẽ chỉ là giả định cho kịch bản, không phải dự báo (Amodei and Hernandez 2018; Epoch AI 2024).
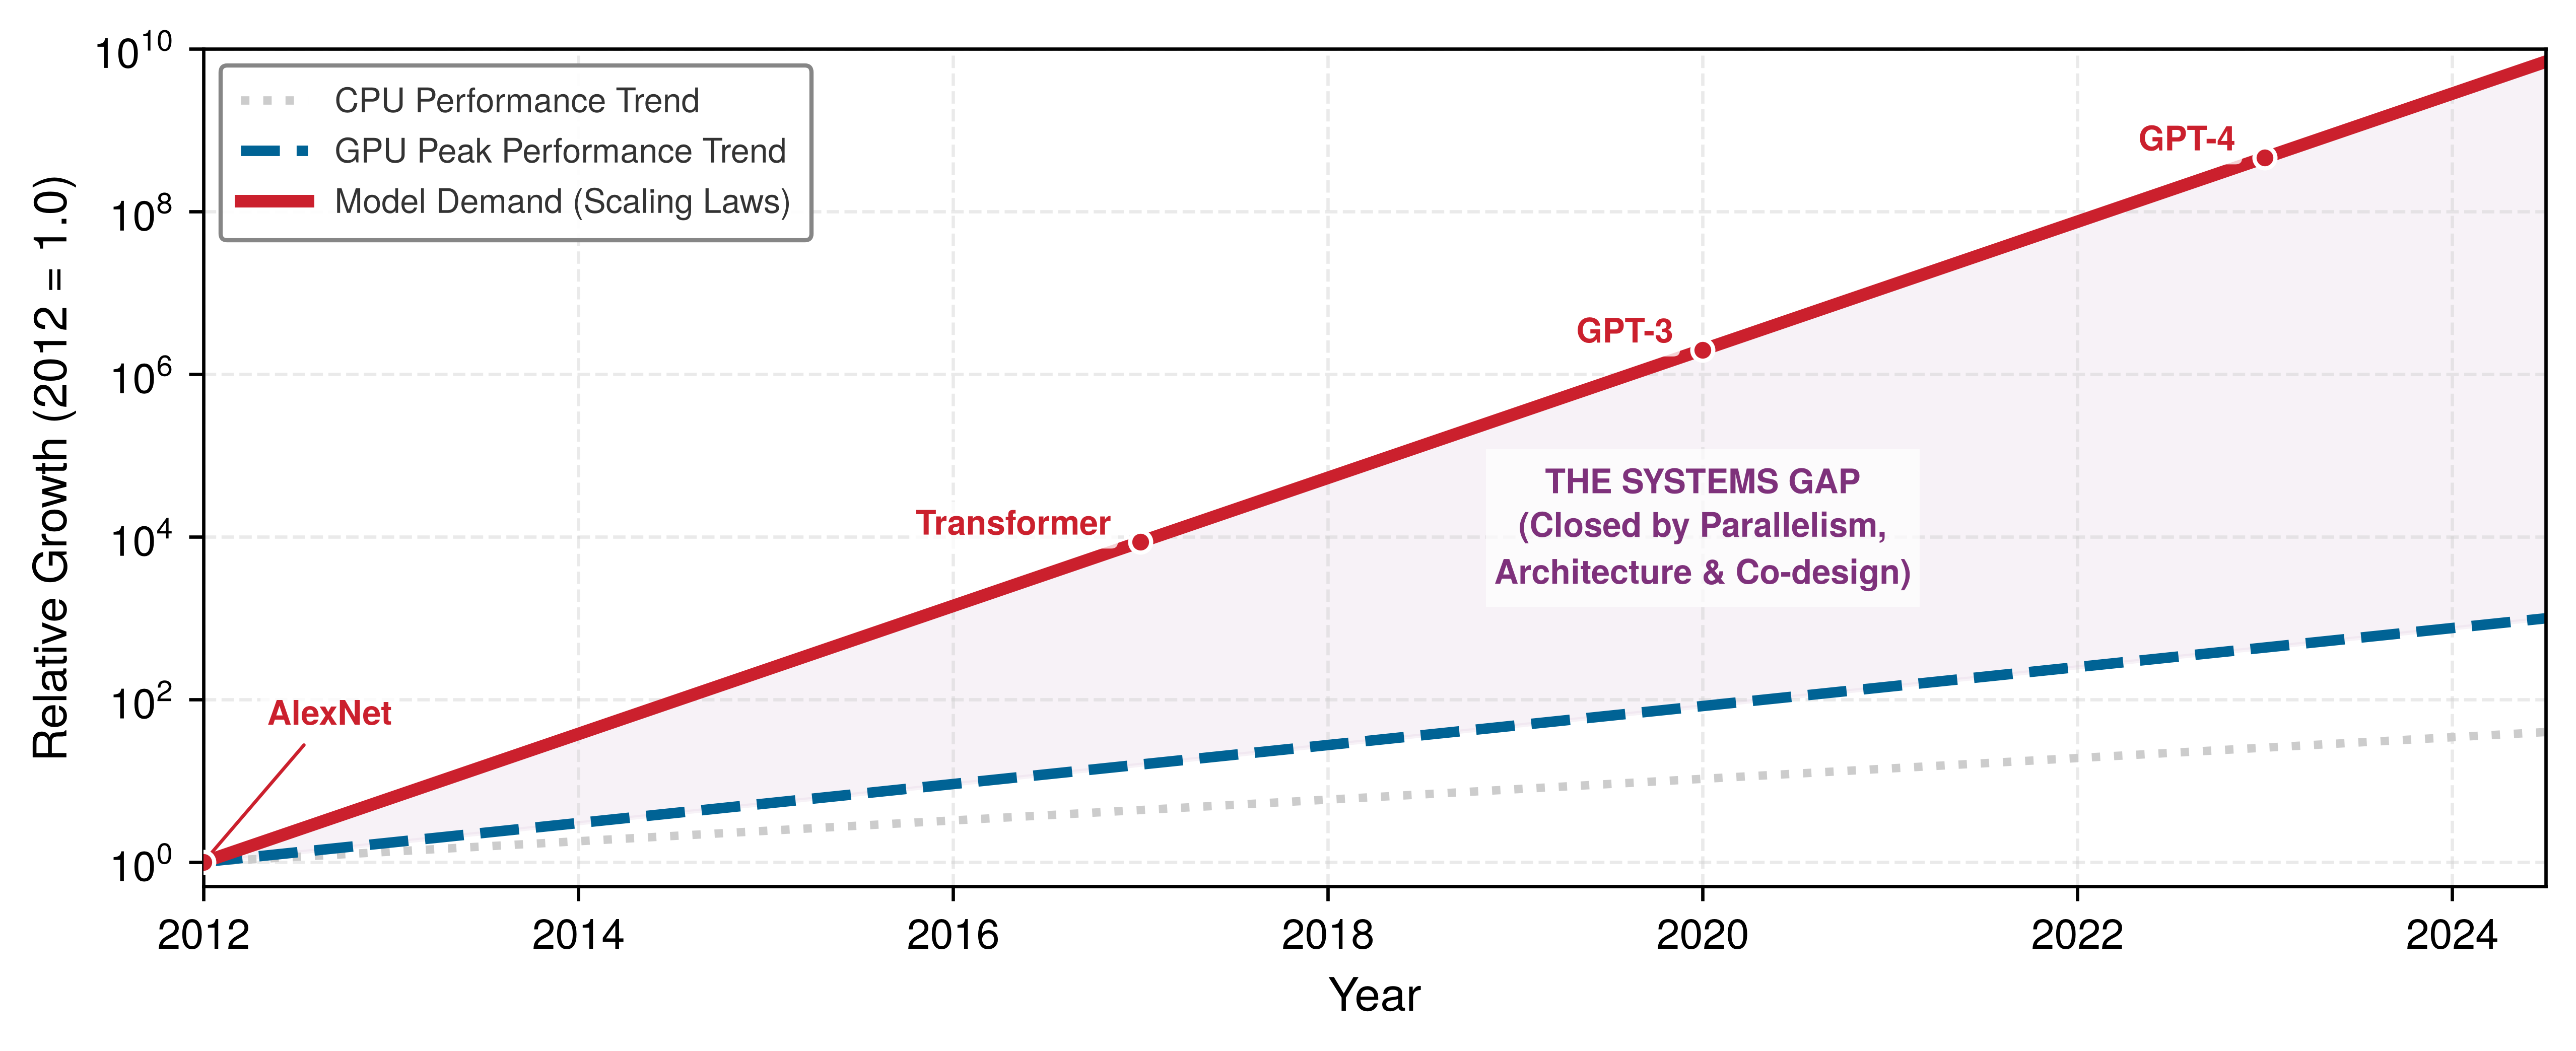
Biểu đồ được chuẩn hóa theo mức cơ sở năm 2012 để làm nổi bật tốc độ tăng trưởng tương đối. Hãy chú ý vùng tô màu tím giữa các đường cong ngày càng rộng ra—khoảng cách này không thể khép lại chỉ bằng cách chờ chip nhanh hơn; nó đòi hỏi đổi mới kiến trúc.
Đường cong S trong công nghệ: Tại sao chúng ta phải chuyển hướng
Nhiều công nghệ tính toán được mô tả theo một vòng đời gồm ba giai đoạn: ủ (tiến bộ chậm ban đầu), cất cánh (tăng trưởng nhanh), và bão hòa (hiệu quả giảm dần khi tiệm cận giới hạn vật lý hoặc kinh tế). Figure 4 dùng hai đường cong S mang tính khái niệm để minh họa quy luật này: khi lợi ích từ một phương pháp thiết kế dần chững lại, các kiến trúc chuyên biệt theo miền có thể mở ra một đường cong hiệu quả mới cho các khối lượng công việc (workload) có cấu trúc tính toán ổn định.
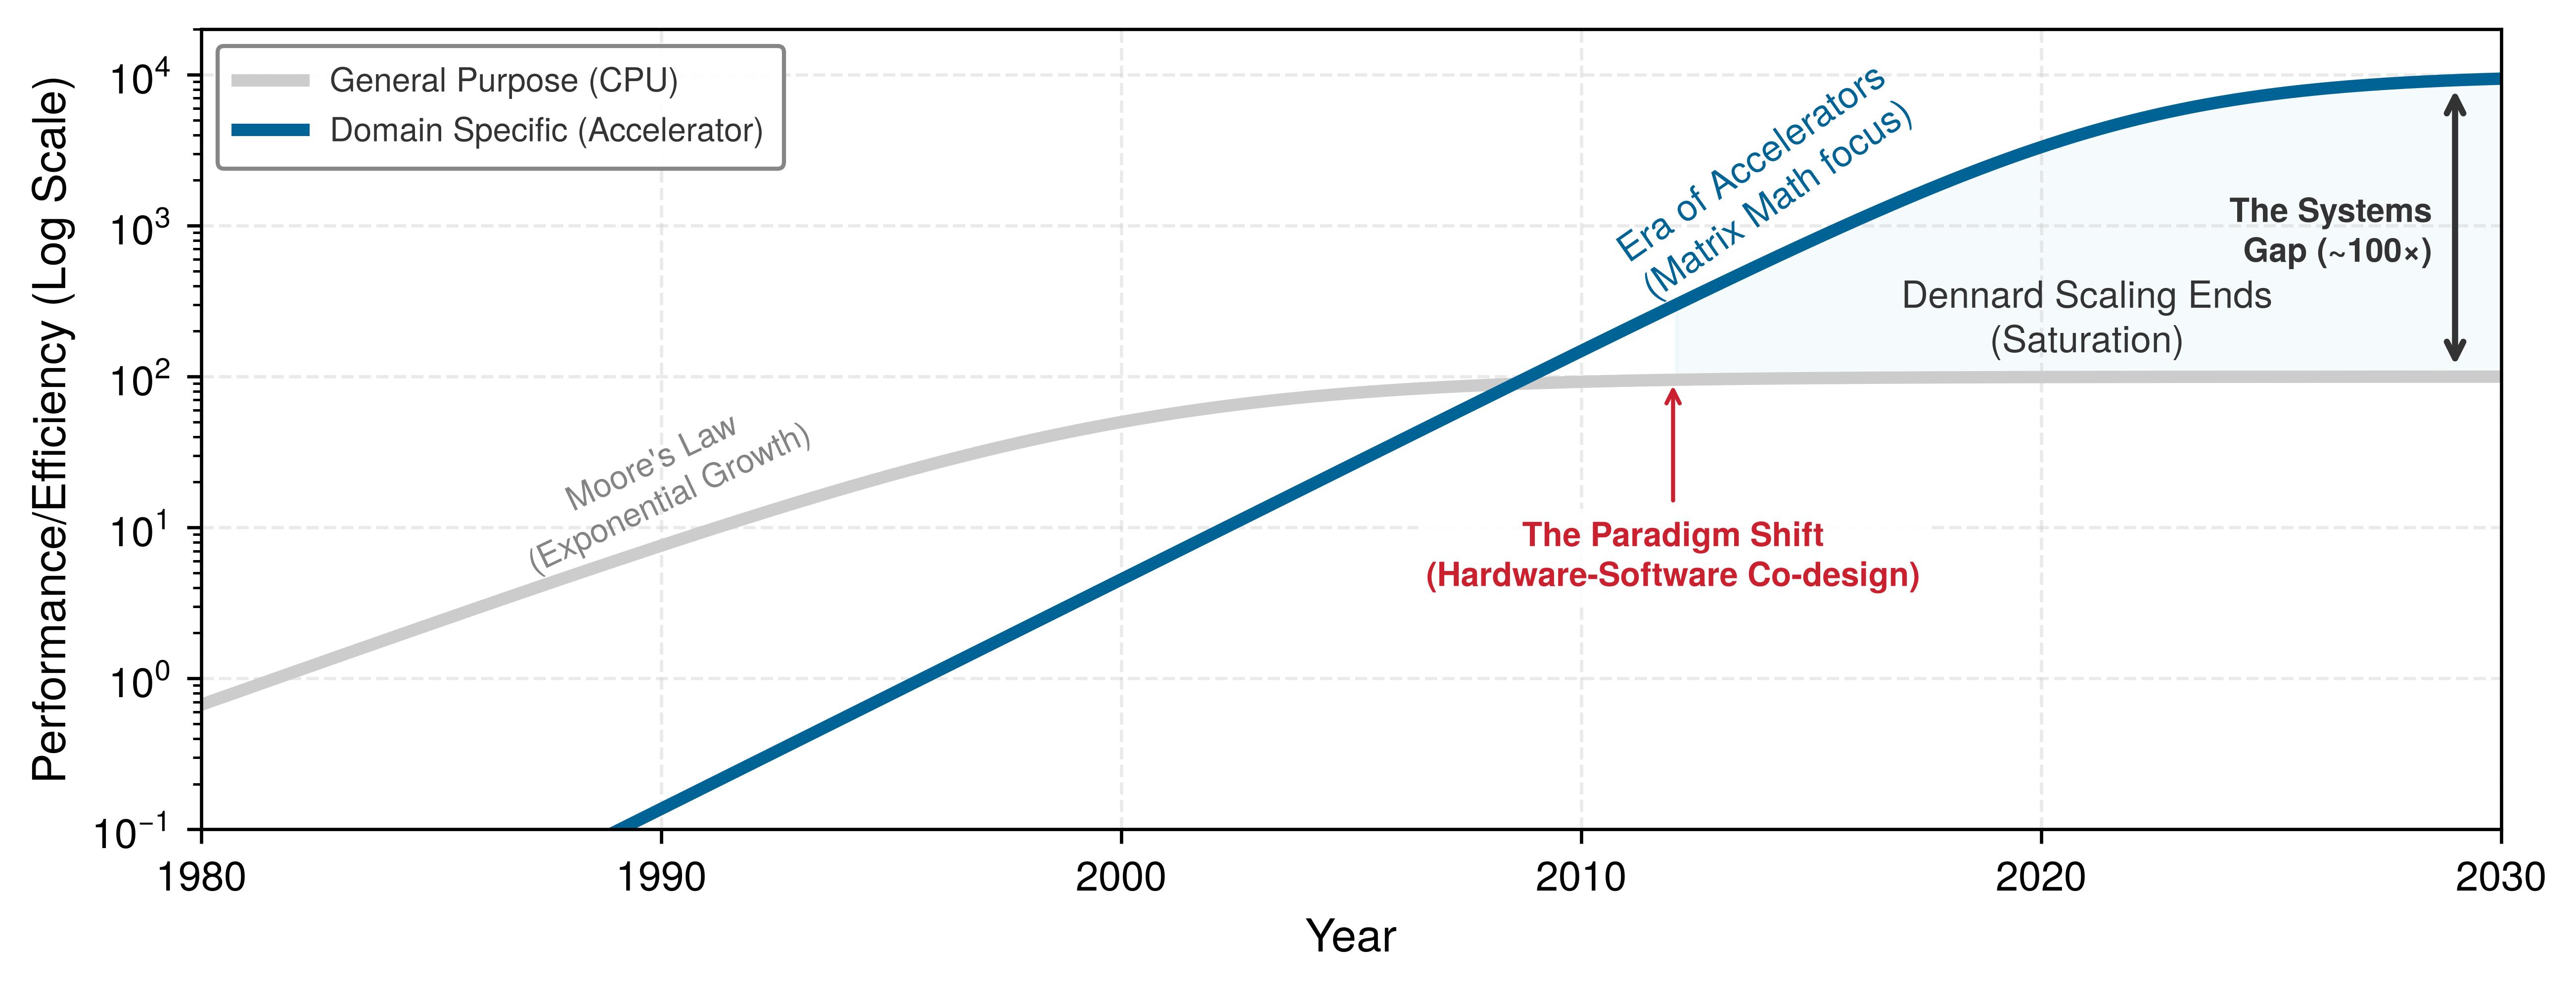
Những lợi ích tăng đều đặn nhờ thu nhỏ bóng bán dẫn đã chậm lại, trong khi nhu cầu ở một số thước đo của các mô hình AI tăng nhanh hơn nhiều so với khả năng cung ứng phần cứng. Không thể chỉ ngồi đợi thế hệ CPU tiếp theo; cần những thay đổi kiến trúc để cải thiện cách các khối lượng công việc (workload) quan trọng sử dụng bóng bán dẫn, băng thông bộ nhớ và năng lượng. Để hiểu giai đoạn chuyển tiếp này, ta cần xem lại các quy luật mở rộng quy mô từng thúc đẩy kỷ nguyên tính toán đa năng.
Trước đây, hiệu năng bộ xử lý tăng chủ yếu nhờ thu nhỏ quy trình bán dẫn và nâng tốc độ xung nhịp. Khi các giới hạn về mật độ công suất kìm hãm khả năng tăng tần số, và việc thu nhỏ bóng bán dẫn vấp phải các rào cản vật lý lẫn kinh tế, các kiến trúc sư phải tìm con đường khác để duy trì đà tăng tính toán. Hệ quả là sự chuyển dịch sang các kiến trúc chuyên biệt theo miền, nơi tài nguyên silicon được dồn cho việc tối ưu tính toán trong các lĩnh vực ứng dụng cụ thể, chấp nhận đánh đổi tính linh hoạt để lấy hiệu quả.
Các kiến trúc chuyên biệt đạt hiệu năng và hiệu quả năng lượng vượt trội khi phần cứng không còn xem khối lượng công việc (workload) là mã tùy ý. Bước đầu tiên là tùy chỉnh đường dẫn dữ liệu: chẳng hạn, các đơn vị nhân ma trận trong các bộ tăng tốc AI dùng mảng systolic, tức mạng các phần tử xử lý dạng lưới thực hiện tính toán và nhịp nhàng truyền dữ liệu qua các phần tử lân cận. Khi đường dẫn dữ liệu đã cố định, hệ thống phân cấp bộ nhớ có thể được tinh chỉnh theo mẫu tái sử dụng mà khối lượng công việc (workload) thực sự cần, với các cấu hình cache, logic tìm nạp trước và bộ điều khiển bộ nhớ được thiết kế cho luồng tensor dự kiến.
Sự chuyên biệt hóa này cũng giúp giảm chi phí điều khiển. Các tập lệnh chuyên dụng mã hóa những chuỗi thao tác phổ biến thành các lệnh đơn, nhờ đó giảm độ phức tạp khi giải mã và điều phối; đồng thời, các khối mạch chức năng cố định bỏ qua bước diễn giải phần mềm cho các thao tác xuất hiện thường xuyên. Kết quả không phải một mẹo đơn lẻ, mà là một chuỗi quyết định ăn khớp: di chuyển dữ liệu, tính cục bộ của bộ nhớ, chi phí lệnh và cách triển khai mạch đều được căn chỉnh quanh cùng một mẫu tính toán.
Điện thoại thông minh hiện đại minh họa rất thuyết phục các nguyên tắc này. Chúng có thể giải mã video độ phân giải cao trong các giới hạn công suất và nhiệt nghiêm ngặt, dù xử lý video đòi hỏi hàng tỷ phép toán mỗi giây. Hiệu quả này đến từ các codec video phần cứng chuyên dụng10 triển khai các tiêu chuẩn công nghiệp như H.264/AVC và H.265/HEVC (Sullivan et al. 2012). Các mạch chuyên dụng này có thể mang lại mức cải thiện hiệu suất trên mỗi watt theo bậc độ lớn so với giải mã bằng phần mềm trên các bộ xử lý đa năng; mức cải thiện cụ thể phụ thuộc vào codec, độ phân giải, process node và mức cơ sở của CPU.
10 Codec: Là từ ghép của “coder-decoder” (bộ mã hóa-giải mã), phản ánh chức năng kép của phần cứng này. Quá trình mã hóa (nén) đòi hỏi nhiều tính toán vì phải tìm kiếm các biểu diễn tối ưu, trong khi giải mã (giải nén) đòi hỏi nhiều băng thông vì cần tái tạo các khung hình độ phân giải đầy đủ từ các luồng đã nén. Silicon codec chuyên dụng triển khai cả hai đường dẫn này bằng phần cứng chức năng cố định, nên không đường dẫn nào lãng phí bóng bán dẫn cho logic điều khiển đa năng không liên quan.
Sullivan, Gary J., Jens-Rainer Ohm, Woo-Jin Han, and Thomas Wiegand. 2012. “Overview of the High Efficiency Video Coding (HEVC) Standard.” IEEE Transactions on Circuits and Systems for Video Technology 22 (12): 1649–68. https://doi.org/10.1109/tcsvt.2012.2221191.
Turakhia, Yatish, Gill Bejerano, and William J. Dally. 2018. “Darwin: A Genomics Co-Processor Provides up to 15,000X Acceleration on Long Read Assembly.” Proceedings of the Twenty-Third International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS), 199–213. https://doi.org/10.1145/3173162.3173193.
11 ASIC (mạch tích hợp chuyên dụng): Các mạch này đạt hiệu quả cực cao bằng cách triển khai trực tiếp một thuật toán duy nhất vào silicon, thường cải thiện hiệu suất trên mỗi watt từ \(10^3\times\) đến \(10^5\times\). Ví dụ gồm băm mật mã cho khai thác blockchain và căn chỉnh chuỗi trong xử lý bộ gen. Sự đánh đổi là hoàn toàn không linh hoạt: nếu thuật toán lõi thay đổi, ASIC không thể lập trình lại và sẽ trở nên lỗi thời, khóa thiết kế phần cứng vào đúng phiên bản bài toán mà nó được tạo ra để giải.
Bedford Taylor, Michael. 2017. “The Evolution of Bitcoin Hardware.” Computer 50 (9): 58–66. https://doi.org/10.1109/mc.2017.3571056.
Những lĩnh vực sau không phải các ví dụ rời rạc; chúng đều lặp lại cùng một cách ứng phó với nút thắt cổ chai. Xử lý bộ gen hưởng lợi từ các bộ tăng tốc tùy chỉnh vì lắp ráp chuỗi đọc dài có các nhân căn chỉnh ổn định mà phần cứng chuyên dụng có thể tăng tốc (Turakhia et al. 2018). Tính toán blockchain cũng tạo ra các mạch tích hợp chuyên dụng (ASIC)11 vì cùng lý do: băm mật mã đủ ổn định để việc dùng silicon đánh đổi bớt tính linh hoạt lấy hiệu quả là hợp lý (Bedford Taylor 2017).
Xu hướng này dẫn đến một quy tắc kỹ thuật: kỷ nguyên nhận “miễn phí” hiệu năng từ việc mở rộng tổng quát đã kết thúc. Suốt nhiều thập kỷ, kỹ sư phần mềm có thể dựa vào Định luật Moore để tăng tốc mã hiện có mà không phải đổi kiến trúc. Sự đổ vỡ của Dennard scaling đã buộc phải thay đổi dứt khoát: không thể ngồi chờ CPU nhanh hơn để gỡ các nút thắt tính toán, mà phải thiết kế phần cứng khớp với thuật toán. Nhu cầu đồng thiết kế phần cứng-phần mềm này là lý do kỹ thuật AI hiện đại đòi hỏi hiểu sâu về silicon nền tảng. Hiệu năng nay phụ thuộc vào việc các mẫu truy cập bộ nhớ và mức độ song song của thuật toán khớp thế nào với các cấu trúc vật lý chuyên dụng của những kiến trúc chuyên biệt theo miền.
Chuyên biệt hóa phần cứng cho machine learning
Nhiều khối lượng công việc (workload) quan trọng của mạng nơ-ron có các phép toán tensor đều đặn, song song dữ liệu lớn và cơ hội dùng độ chính xác thấp hơn. Phép nhân ma trận dày đặc (dense matrix multiplication) và tích chập (convolution) là ví dụ điển hình vì cấu trúc vòng lặp của chúng bộc lộ các phép lặp lại và khả năng tái sử dụng có thể dự đoán. Những đặc tính này đã thúc đẩy các kiến trúc phần cứng chuyên biệt; tuy không hiệu quả với mã tùy ý, nhưng chúng mang lại lợi ích lớn cho các kernel ML phù hợp. Ngược lại, các phép toán ML khác có thể không đều đặn, bị giới hạn bởi băng thông, mang tính tuần tự, hoặc quá nhỏ để tận dụng hết một khối xử lý rộng, nên cùng một thiết bị không nhất thiết phải tăng tốc mọi phần của một mô hình. Phần cứng được xây để khai thác phần đều đặn này tạo thành một lớp thiết bị gọi là bộ tăng tốc ML, và điểm kích hoạt kinh tế cho chuyên biệt hóa xuất hiện khi khối lượng công việc (workload) được hỗ trợ trở nên quan trọng ở quy mô đội máy (fleet scale), chứ không chỉ trong một benchmark.
Example 1.2: Ngưỡng giới hạn dung lượng của TPU
Tình huống: Năm 2013, Google dự báo rằng nếu người dùng áp dụng tính năng nhận dạng giọng nói trong tìm kiếm (voice-search speech recognition) với mức sử dụng 3 phút/ngày/người dùng, thì công ty sẽ cần tăng gấp đôi dung lượng trung tâm dữ liệu toàn cầu để thực hiện suy luận mạng nơ-ron trên CPU (Jouppi et al. 2017).
Chẩn đoán: Về mặt kinh tế, năng lực của các máy chủ CPU đa năng không đủ để hấp thụ mức tăng theo cấp số nhân của FLOPs cho suy luận, đe dọa tạo ra nút thắt cổ chai về vốn đầu tư hạ tầng.
Bài học hệ thống: Việc dùng bộ tăng tốc phần cứng tùy chỉnh trở thành bắt buộc khi khối lượng công việc (workload) vượt ngưỡng kinh tế ở cấp độ đội máy (fleet-level). Cường độ tính toán tổng hợp và tổng chi phí sở hữu (total cost of ownership) của máy chủ là hai yếu tố chính chi phối quyết định triển khai ASIC tùy chỉnh.
Các yêu cầu tính toán của machine learning bộc lộ hạn chế của các bộ xử lý truyền thống. Trong một ví dụ minh họa, một CPU tham chiếu chỉ tận dụng được 5 percent–10 percent so với mức đỉnh của nó trên một khối lượng công việc (workload) mạng nơ-ron, với mức cao nhất đạt khoảng 0 GFLOP/s (tỷ phép toán dấu phẩy động mỗi giây). Sự kém hiệu quả này bắt nguồn từ kiến trúc không phù hợp: CPU được tối ưu cho hiệu năng đơn luồng và truy cập bộ nhớ không tuần tự, trong khi mạng nơ-ron cần khả năng song song cực lớn và luồng dữ liệu dễ dự đoán. Hạn chế về băng thông bộ nhớ càng làm vấn đề trầm trọng: chỉ một lớp mạng nơ-ron cũng có thể cần truy cập hàng gigabyte tham số, vượt quá hệ thống phân cấp cache của CPU vốn được thiết kế cho các khối dữ liệu hoạt động nhỏ hơn.
Bài toán năng lượng khi di chuyển dữ liệu ảnh hưởng mạnh đến thiết kế bộ tăng tốc. Mỗi lần truy cập, lấy một giá trị 32-bit từ DRAM có thể tiêu tốn năng lượng cỡ \(10^2\times\) so với một phép nhân FP32 (giá trị chính xác thay đổi theo nút công nghệ và thiết kế), khiến di chuyển dữ liệu trở thành mục tiêu tối ưu hóa hàng đầu (Horowitz 2014; Sze et al. 2017). Sự chênh lệch này giúp giải thích quá trình chuyển từ việc tái sử dụng bộ xử lý đồ họa sang các bộ tăng tốc mạng nơ-ron chuyên dụng. TPU và các bộ tăng tốc tùy chỉnh khác có thể duy trì mức sử dụng cao trên các kernel dày đặc bằng cách triển khai mảng systolic và các kiến trúc khác, tối đa hóa tái sử dụng dữ liệu đồng thời giảm di chuyển.
IEEE Standards Association. 2019. IEEE 754-2019: Standard for Floating-Point Arithmetic. https://doi.org/10.1109/IEEESTD.2019.8766229.
12 Độ trễ so với thông lượng trong thiết kế bộ tăng tốc: Huấn luyện thường ưu tiên thực thi theo hướng thông lượng và dùng các batch lớn hơn để trải đều chi phí công việc. Trong khi đó, suy luận nhạy cảm với độ trễ thì cần kiểm soát độ trễ của từng yêu cầu và độ trễ đuôi. Đây là một mục tiêu dịch vụ, không phải là sự phân chia phổ quát giữa huấn luyện và suy luận: suy luận theo batch cũng có thể định hướng thông lượng, và các vòng lặp huấn luyện nhỏ hoặc tương tác có thể quan tâm đến độ trễ mỗi bước. Độ sâu của pipeline, độ trễ do batching, thời gian thiết lập kernel và việc xếp hàng có thể khiến một đường dẫn được tối ưu cho huấn luyện trở nên kém phù hợp hơn cho một yêu cầu tương tác, ngay cả khi hiệu suất FLOP/s đỉnh của nó cao hơn. Vì vậy, thiết kế phải khớp với mẫu hình lưu lượng đến thực tế, cơ hội batch và mục tiêu của khối lượng công việc (workload).
Huấn luyện và suy luận có những đặc điểm tính toán khác nhau, ảnh hưởng đến thiết kế bộ tăng tốc. Huấn luyện tính toán gradient và cập nhật trọng số: các định dạng dấu phẩy động nhị phân FP32 và FP16 là tiêu chuẩn (IEEE Standards Association 2019). Huấn luyện mixed-precision dùng các phép toán trên tensor ở độ chính xác thấp hơn nhưng tích lũy ở độ chính xác cao hơn khi độ chính xác cho phép (Micikevicius et al. 2017). Lan truyền ngược cũng cần giữ lại hoặc tính toán lại các activation (xem Yêu cầu bộ nhớ activation), làm tăng nhu cầu bộ nhớ. Suy luận chỉ cần thực hiện đường truyền xuôi và có thể dùng INT8 hoặc INT4 nếu mô hình và các kernel hỗ trợ. Suy luận tương tác có thể ưu tiên độ trễ đuôi, trong khi suy luận ngoại tuyến hoặc theo batch có thể ưu tiên thông lượng, chi phí hoặc năng lượng; việc lựa chọn bộ tăng tốc phải phù hợp với mục tiêu dịch vụ thực tế. Những đặc điểm này thường thiên về các hệ thống huấn luyện dung lượng lớn, định hướng thông lượng và các đường suy luận tiết kiệm năng lượng, nhưng kích thước batch và chính sách dịch vụ có thể đảo ngược lựa chọn tưởng như hiển nhiên này.12
Definition 1.3: Bộ tăng tốc ML
Bộ tăng tốc Machine Learning là các bộ xử lý hoặc đơn vị chuyên biệt, chủ yếu phục vụ các phép toán tensor và luồng dữ liệu phổ biến trong mạng nơ-ron. Chúng hướng tới \(R_{\text{peak}}\) cao và khả năng tái sử dụng dữ liệu trên các khối lượng công việc (workload) phù hợp, bằng cách dành nhiều tài nguyên hơn cho tính toán số học và di chuyển dữ liệu cục bộ so với một đường thực thi đa năng.
- Ý nghĩa: Đặc điểm cốt lõi của một bộ tăng tốc ML không chỉ là năng lực tính toán thô, mà là một đường dữ liệu cân bằng, cung cấp toán hạng và giữ các giá trị có thể tái sử dụng ngay gần đó. A100 cung cấp 2.04 TB/s băng thông bộ nhớ thiết bị, khoảng 10.2× lần so với đường host-DRAM minh họa 200 GB/s dùng ở đây (NVIDIA Corporation 2020a; Choquette et al. 2021). Đây chỉ là so sánh ở mức trần, không phải đảm bảo: vẫn cần đủ cường độ tính toán, mức độ song song và tái sử dụng để tiến gần đỉnh FP16/BF16 312 TFLOP/s của nó.
- Điểm khác biệt: Lợi ích còn tùy thuộc vào mức hỗ trợ phép toán, lượng công việc song song, truy cập dữ liệu đều đặn và một chồng phần mềm chọn đúng đường thực thi. Một bộ tăng tốc ML có thể nhanh hơn nhiều bậc so với CPU tham chiếu ở phép nhân ma trận dày đặc cỡ lớn, nhưng mất nhiều lợi thế đó với khối lượng công việc nhỏ, bất quy tắc, nặng đồng bộ hoặc nhiều nhánh điều khiển. Ngay cả khi kernel tăng tốc chạy nhanh, truyền dữ liệu và các toán tử không được hỗ trợ vẫn có thể chiếm ưu thế về thời gian.
- Cạm bẫy thường gặp: Một hiểu lầm hay gặp là bộ tăng tốc ML luôn tăng tốc mọi tác vụ ML. Để chạm gần thông lượng đỉnh, cần độ chính xác, hình dạng phép toán, bố cục, cách triển khai phù hợp và đủ công việc song song để các đơn vị liên quan luôn bận. Mức độ tận dụng còn phụ thuộc vào việc các đường bộ nhớ và liên kết có duy trì được khối lượng đó hay không. Vì vậy, một yêu cầu tự hồi quy batch-1 có thể chỉ dùng một phần nhỏ năng lực tính toán của một bộ tăng tốc huấn luyện lớn, dù cùng thiết bị đó chạy tốt với prefill theo batch hoặc huấn luyện.
Choquette, Jack, Wishwesh Gandhi, Olivier Giroux, Nick Stam, and Ronny Krashinsky. 2021. “NVIDIA A100 Tensor Core GPU: Performance and Innovation.” IEEE Micro 41 (2): 29–35. https://doi.org/10.1109/mm.2021.3061394.
Một lần truy cập DRAM tốn năng lượng gấp hơn 100 lần một phép nhân FP32 cho mỗi sự kiện.
Bối cảnh triển khai định hình lựa chọn kiến trúc bằng cách chỉ ra ràng buộc then chốt. Trong các trung tâm dữ liệu, ràng buộc thường là thời gian ra kết quả khi huấn luyện các mô hình lớn. NVIDIA H100 chấp nhận đổi lấy thông lượng cao bằng cách tiêu thụ hàng trăm watt công suất (Choquette 2023); việc đánh đổi này có giúp giảm tổng chi phí hay không còn tùy thuộc vào mức sử dụng, giá thuê, khả năng mở rộng khối lượng công việc (workload) và giá điện. TPUv4 của Google cũng có lựa chọn kiến trúc tương tự, ưu tiên thông lượng thông qua các mảng systolic và bộ nhớ băng thông cao (Jouppi et al. 2023).
Checkpoint 1.2: Ngưỡng bộ tăng tốc
Dùng thứ bậc năng lượng để quyết định khi nào chuyên biệt hóa mang lại lợi ích.
Đảo ngược năng lượng
Logic lựa chọn
Ở edge, ưu tiên thường chuyển sang năng lượng mỗi lần suy luận và các giới hạn nghiêm ngặt về độ trễ hoặc công suất, dù thông lượng vẫn quan trọng với các luồng camera, âm thanh hoặc cảm biến liên tục. Một camera trên điện thoại thông minh hoặc đường dẫn âm thanh luôn bật hoạt động trong ngân sách vài watt không thể đơn giản áp dụng hệ thống bộ nhớ công suất cao của bộ tăng tốc trong trung tâm dữ liệu. Thay vào đó, kiến trúc edge giảm di chuyển dữ liệu bằng các scratchpad cục bộ, bộ tăng tốc tích hợp chặt, điều chỉnh điện áp và tần số động, và xử lý theo sự kiện khi khối lượng công việc (workload) cho phép. Nguyên lý ‘bức tường bộ nhớ’ (memory-wall) vẫn giống nhau trong cả hai bối cảnh: chip cho trung tâm dữ liệu đầu tư vào dung lượng và băng thông của bộ nhớ băng thông cao (HBM), còn chip edge dựa nhiều vào độ gần và khả năng tái sử dụng dữ liệu.
Không có một kiến trúc nào phù hợp với mọi khối lượng công việc (workload) machine learning. Các thiết bị edge ưu tiên hiệu quả năng lượng và độ trễ được giới hạn, trong khi huấn luyện trên quy mô đám mây chú trọng thông lượng, dung lượng và hiệu năng kết nối. Suy luận trên đám mây có thể ưu tiên chi phí trên mỗi yêu cầu hoặc độ trễ đuôi, còn một thiết bị edge vẫn có thể cần thông lượng duy trì ổn định cho luồng dữ liệu thời gian thực. Do đó, các kiến trúc chuyên biệt được thiết kế để phù hợp với bối cảnh triển khai của chúng, nhưng tất cả đều phải đối mặt với chi phí năng lượng và độ trễ khi di chuyển dữ liệu.
Table 1 tóm tắt các cột mốc quan trọng trong chuyên biệt hóa phần cứng. Các bộ đồng xử lý dấu phẩy động đã tăng tốc các phép toán số học vốn trước đây được thực hiện bằng phần mềm, các GPU đời đầu đã tăng thông lượng đồ họa, và các bộ xử lý đa phương tiện cho thấy các pipeline ổn định có thể biện minh cho các khối chức năng cố định. Các bộ tăng tốc AI kết hợp các đơn vị tensor mật độ cao với hệ thống phân cấp bộ nhớ và hỗ trợ phần mềm, khiến việc tích hợp giữa di chuyển dữ liệu và thực thi song song trở thành một thách thức cốt lõi.
Vì vậy, việc tăng tốc AI hiện đại không chỉ nằm ở bản thân con chip. Để một bộ tăng tốc thực sự hữu ích, nó cần có sự hỗ trợ từ framework, trình biên dịch, thư viện, trình điều khiển và runtime cho các tác vụ như biến đổi đồ thị, chọn kernel, hợp nhất, lập lịch bộ nhớ và triển khai trên nhiều môi trường khác nhau, từ trung tâm dữ liệu đến thiết bị edge. Các thao tác không được hỗ trợ hoặc các lần truyền dữ liệu xung quanh có thể làm mất đi lợi ích đạt được ở cấp độ kernel.
| Kỷ nguyên | Mô hình tính toán | Ví dụ kiến trúc | Đặc điểm |
|---|---|---|---|
| Những năm 1980 | Xử lý dấu phẩy động & tín hiệu | FPU, DSP | • Các bộ máy chuyên dụng • Tập lệnh tập trung • Giao diện bộ đồng xử lý |
| Những năm 1990 | Đồ họa 3D & Đa phương tiện | GPU, Đơn vị SIMD | • Nhiều đơn vị tính toán giống hệt nhau • Các mô hình dữ liệu thông thường • Giao diện bộ nhớ rộng |
| Những năm 2000 | Mã hóa phương tiện thời gian thực | Bộ giải mã phương tiện, Bộ xử lý mạng | • Các pipeline chức năng cố định • Xử lý thông lượng cao • Tối ưu hóa công suất-hiệu năng |
| Những năm 2010 | Các phép toán Tensor của deep learning | TPU, GPU Tensor Cores | • Các đơn vị nhân ma trận • Song song hóa lớn • Tối ưu hóa băng thông bộ nhớ |
| Những năm 2020 | Tăng tốc chuyên biệt theo ứng dụng | Các bộ máy ML, Smart NIC, Bộ tăng tốc miền | • Các đường dẫn dữ liệu chuyên biệt theo khối lượng công việc • Hệ thống phân cấp bộ nhớ tùy chỉnh • Các thiết kế tối ưu hóa ứng dụng |
Nút thắt tích hợp
Đối với nhiều khối lượng công việc (workload) trên bộ tăng tốc, việc thêm các đơn vị tính toán số học thường dễ hơn so với việc cung cấp dữ liệu cho chúng một cách hiệu quả. Các bộ đồng xử lý ban đầu đã tăng tốc các phép toán dấu phẩy động vốn được thực hiện bằng phần mềm, và GPU đã tăng thông lượng cho đồ họa rồi sau đó cho tính toán tổng quát. Các hệ thống AI hiện đại cũng phải giải quyết một nút thắt tích hợp: di chuyển các toán hạng và kết quả qua hệ thống phân cấp bộ nhớ đủ nhanh và hiệu quả để duy trì nhiều đơn vị tính toán song song.
Ba đặc tính của nhiều kernel mạng nơ-ron giúp việc tích hợp này trở nên khả thi. Các phép nhân ma trận lớn và tích chập bộc lộ tính song song dữ liệu mà các mảng phần tử xử lý dày đặc có thể tận dụng. Các đồ thị tensor tĩnh hoặc đã biên dịch thường có luồng dữ liệu dễ phân tích, cho phép trình biên dịch chia nhỏ và chuyển dữ liệu vào các vùng nhớ tạm cục bộ (scratchpad)13 thay vì chỉ dựa vào cache do phần cứng quản lý. Nhờ đó, phần mềm có thể kiểm soát rõ ràng các tập dữ liệu làm việc được chọn, có cấu trúc đều đặn, mà không loại bỏ cache hay truy cập không đều. Ngoài ra, một số phép toán có thể chấp nhận độ chính xác thấp hơn, cho phép các đường dẫn 8-bit hoặc 4-bit tăng mật độ tính toán và giảm số byte trên mỗi giá trị (Dally et al. 2021; Dally 2023). Ngược lại, luồng điều khiển động, embeddings, các tensor nhỏ, hình dạng biến đổi và các toán tử nhạy cảm với độ chính xác ít phù hợp với các giả định này và có thể vẫn là điểm nghẽn.
13 Bộ nhớ scratchpad: Khi trình biên dịch xác định được mẫu truy cập của một kernel tensor, nó có thể chủ động sắp xếp các ô dữ liệu vào bộ nhớ cục bộ nhanh do phần mềm kiểm soát. Cách này tránh được một số cơ chế như tag, thay thế và duy trì tính nhất quán, nhưng việc truyền tải, đồng bộ hóa, phân chia ngân hàng (banking) và dung lượng phải được lập lịch chính xác. Scratchpad bổ sung cho cache chứ không thay thế hoàn toàn, vì dữ liệu không đều hoặc dữ liệu chia sẻ vẫn có thể hưởng lợi từ quản lý bằng phần cứng. Ví dụ, TPU v1 của Google dùng một Bộ đệm hợp nhất (Unified Buffer) 24 MB do phần mềm quản lý cho các activations trung gian, còn trọng số và lệnh đi theo các đường dẫn khác (Jouppi et al. 2017).
Jouppi, Norman P., Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, et al. 2017. “In-Datacenter Performance Analysis of a Tensor Processing Unit.” Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ’17, 1–12. https://doi.org/10.1145/3079856.3080246.
14 HBM: Các thế hệ A100 và H100 cung cấp 2.0–3.4 TB/s băng thông bộ nhớ thiết bị thông qua bộ nhớ xếp chồng và giao diện rộng, so với 760 GB/s của GDDR6X (tham chiếu dùng ở đây) (NVIDIA Corporation 2020a; Choquette 2023). Tăng trần băng thông có thể đẩy một số kernel về phía giới hạn tính toán trên biểu đồ roofline, nhưng chỉ khi mẫu truy cập và cường độ số học của chúng tận dụng được băng thông đó. HBM cũng làm tăng chi phí đóng gói và chi phí hệ thống, nên giá trị của nó phụ thuộc vào nhu cầu băng thông của khối lượng công việc (workload).
Khi khả năng tính toán đã dồi dào, thách thức kỹ thuật là giữ dữ liệu đủ gần để khai thác hiệu quả. Một lần truy cập DRAM có thể tiêu tốn năng lượng hơn 100\(\times\) so với một phép toán số học độ chính xác thấp, dựa trên các giả định công nghệ do Horowitz (2014) tổng hợp. Phân cấp này giúp giải thích vì sao các thiết kế bộ tăng tốc đầu tư vào HBM, SRAM trên chip và các scratchpad do phần mềm quản lý, thay vì chỉ thêm đơn vị tính toán.14
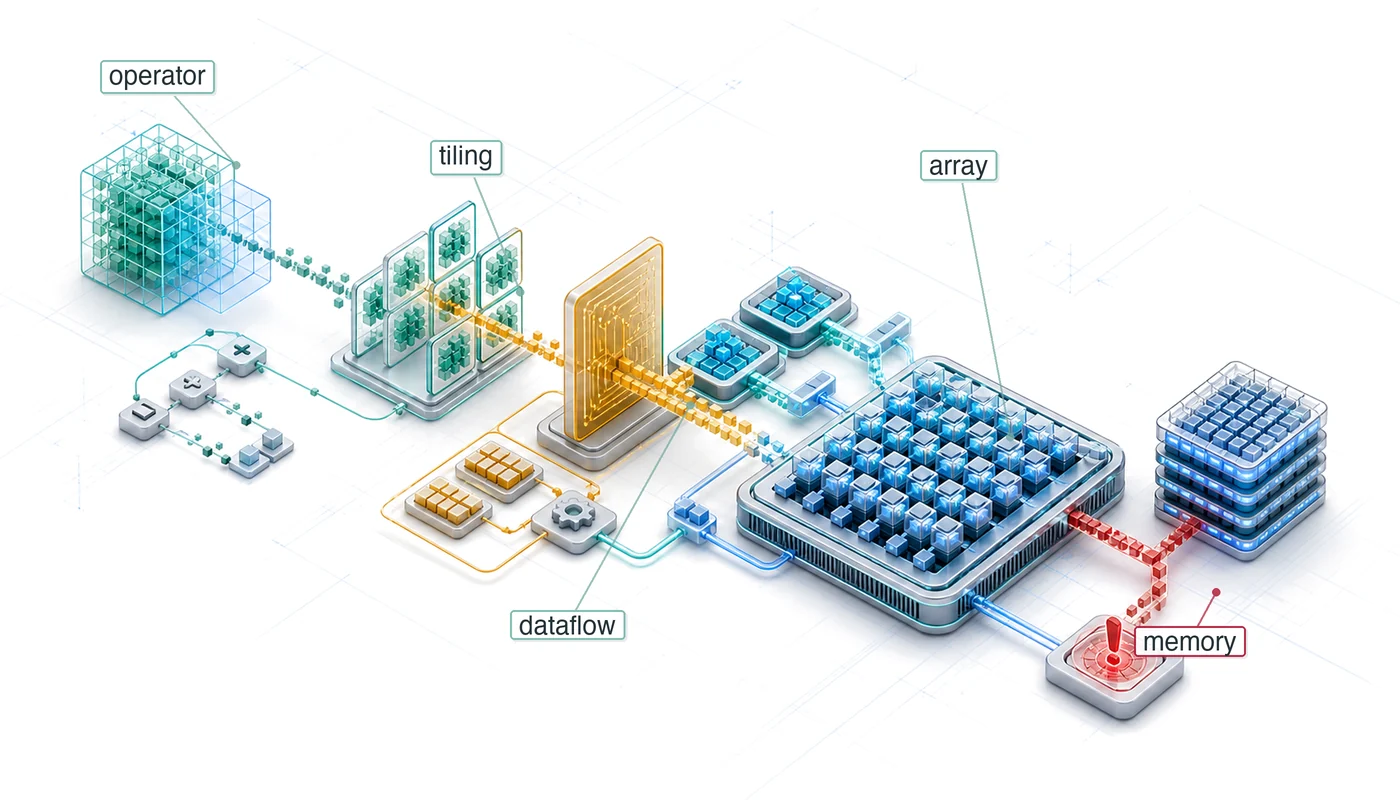
Tăng tốc phần cứng giải quyết nút thắt cổ chai về bộ nhớ bằng bố trí không gian chuyên biệt và lưu trữ nhiều tầng. Hãy xem sơ đồ kiến trúc trong figure 5, và chú ý cách bộ nhớ băng thông cao cấp dữ liệu cho các scratchpad cục bộ bao quanh lưới phần tử xử lý.

Sự tiến hóa từ Intel 8087 đến TPU của Google cho thấy một quy luật nhất quán: phần cứng được phát triển để phù hợp với nút thắt chính của thuật toán. 8087 giải quyết các phép toán dấu phẩy động vốn chi phối nhiều khối lượng công việc (workload) khoa học; còn các bộ tăng tốc AI hiện đại tập trung vào phép nhân ma trận dày đặc và tích chập, những phép toán chiếm phần lớn trong huấn luyện và suy luận của mạng nơ-ron (Palmer 1980; Goodfellow et al. 2016; Sze et al. 2017; Jouppi et al. 2017). Điều này lý giải vì sao AI silicon chuyên dụng có thể mang lại hiệu suất trên mỗi watt vượt trội so với các bộ xử lý đa năng khi chạy các khối lượng công việc (workload) phù hợp.
Ba cơ hội này—khả năng xử lý song song, luồng dữ liệu dễ phân tích, và hỗ trợ độ chính xác thấp—định hình nhiều quyết định thiết kế bộ tăng tốc. Giá trị của chúng phụ thuộc vào cấu trúc vật lý của bộ tăng tốc và việc phần mềm ánh xạ khối lượng công việc (workload) lên đó tốt đến đâu.
Trong thiết kế chung minh họa ở figure 5, một mảng phần tử xử lý chứa các đơn vị cho các lớp phép toán khác nhau: đơn vị ma trận thực hiện phép nhân ma trận, đơn vị vector thực hiện các phép toán trên từng phần tử, và các đơn vị chức năng đặc biệt xấp xỉ các hàm như hàm mũ. Số lượng, cách tổ chức và tên gọi của các đơn vị này thay đổi theo kiến trúc, nhưng tất cả đều nhằm khai thác tính song song cấp dữ liệu trên các khối tensor. Một số thiết kế để lộ rõ lưới systolic; số khác phân phối các đơn vị ma trận vào các lõi song song rộng hơn. Vì vậy, sơ đồ này mô tả các vai trò chức năng, không phải một sơ đồ cấu trúc vật lý áp dụng cho mọi kiến trúc.
Hệ thống phân cấp bộ nhớ cũng quan trọng không kém. Bộ nhớ băng thông cao cung cấp dung lượng ngoài chip và thông lượng tổng hợp, trong khi bộ nhớ chia sẻ trên chip cùng với các cache hoặc scratchpad theo từng phần tử giúp giảm lưu lượng dữ liệu và tiết kiệm năng lượng. Cách tổ chức phân cấp cụ thể khác nhau giữa các sản phẩm: một số thiết kế dựa nhiều hơn vào các cache do phần cứng quản lý, số khác cung cấp SRAM do phần mềm quản lý, và nhiều thiết kế kết hợp cả hai. Việc di chuyển một ô (tile) tensor xuống các cấp thấp hơn trong hệ thống phân cấp này tốn thời gian và năng lượng, vì vậy trình biên dịch và kernel cần phối hợp dung lượng, mức tái sử dụng, tìm nạp trước và đệm kép. Băng thông HBM cao hơn nâng trần hiệu năng ngoài chip nhưng không loại bỏ nhu cầu tái sử dụng cục bộ. Mục đích chung là giữ các trọng số, activation và kết quả trung gian có thể tái sử dụng ở gần các đơn vị tiêu thụ chúng. Phụ lục về nền tảng máy sẽ tổng hợp các thông số kỹ thuật tham chiếu cho các bộ tăng tốc hiện đại, bao gồm H100 và TPU v5, đồng thời tóm tắt hệ thống phân cấp độ trễ.
Giao diện máy chủ kết nối bộ tăng tốc với hệ thống tổng thể. Một CPU thường điều phối việc chạy chương trình, I/O và các tác vụ mà bộ tăng tốc không hỗ trợ, trong khi bộ tăng tốc thực thi các kernel được giao. Sự phân chia này không tuyệt đối: các bộ tăng tốc có thể tự lên lịch công việc, và CPU cũng có thể thực hiện các phép toán trên tensor. Điều quan trọng là mỗi toán tử sẽ chạy ở đâu, và những thao tác truyền dữ liệu, khởi chạy và đồng bộ hóa nào diễn ra xung quanh nó. Các cơ chế truy cập bộ nhớ trực tiếp (DMA) và hàng đợi công việc phía thiết bị có thể chồng lấp một phần chi phí này với tính toán, nhưng các toán tử không được hỗ trợ vẫn có thể buộc phải chuyển giao tốn kém. Do đó, đường đi từ máy chủ, qua bộ nhớ thiết bị, rồi đến bộ nhớ trên chip và cuối cùng là các phần tử xử lý, sẽ xác định ranh giới hữu ích của việc tăng tốc. Một kernel chạy nhanh chưa chắc giúp ứng dụng nhanh nếu chi phí giao tiếp qua ranh giới này chiếm ưu thế trong tổng thời gian từ đầu đến cuối.
Sau khi đã xác định kiến trúc vật lý của bộ tăng tốc, bước tiếp theo là giải thích vì sao những thành phần này lại chiếm ưu thế. Tensor Cores, các đơn vị vector và bộ nhớ phân cấp không phải tự nhiên mà có; chúng tồn tại vì các phép tính trong mạng nơ-ron lặp đi lặp lại một số ít thao tác. Hiểu rõ các mẫu này là chìa khóa để biết thay đổi thuật toán nào thật sự mang lại tăng tốc (những thay đổi ăn khớp với các primitive phần cứng) và thay đổi nào chỉ nằm trên lý thuyết.
Self-Check: Question
What primary physical limitation brought about the end of Dennard scaling in the mid-2000s, necessitating the transition from increasing CPU clock frequencies to domain-specific hardware accelerators?
- Lithography light diffraction preventing further reduction of transistor gate length below \(1\,\mu\text{m}\)
- Inability to lower operating voltage proportionally with transistor size, leading to unsustainable power density and heat dissipation limits
- Quantum tunneling in copper interconnect lines preventing data transmission between arithmetic units
- Depletion of global silicon substrate supplies requiring migration to gallium nitride semiconductors
Contrast the architectural trade-offs of software-managed scratchpad memory (such as Google TPUv1’s Unified Buffer) with hardware-managed cache hierarchies when executing large-scale tensor workloads.
Place the following computing milestones in chronological order (from earliest to most recent) as hardware evolved toward modern AI accelerators:
- Introduction of dedicated Tensor Cores and TPUs for deep learning matrix operations
- Emergence of fixed-function media codecs and network processors for video/packet streaming
- Integration of floating-point units (FPUs) and digital signal processors (DSPs) as discrete coprocessors
- General-purpose programmable GPUs and SIMD instruction set extensions for 3D graphics and multimedia
True or False: Google’s TPUv1 achieved substantial performance-per-watt improvements over contemporary general-purpose CPUs primarily by operating at significantly higher clock frequencies.
In the context of hardware scaling, what phenomenon does the ‘Systems Gap’ describe since the 2012 deep learning breakthrough?
- The difference in memory bandwidth between high-end datacenter GPUs and consumer-grade mobile SoCs
- The latency discrepancy between on-chip SRAM access times and host DRAM access times over PCIe
- The exponential divergence between model compute demand (growing \(\approx 6\times\)/year) and single-device hardware supply (growing \(\approx 1.7\times\)/year)
- The mismatch between Python framework dispatch overhead and raw GPU kernel execution duration
Các primitive tính toán AI
Ở các lớp fully connected, tích chập và attention, các biến đổi tuyến tính đã học quy về các phép nhân-tích lũy (MAC) lặp lại. Một lớp lớn có thể thực hiện hàng triệu hoặc hàng tỷ phép MAC, và cấu trúc tensor đều đặn của nó bộc lộ cơ hội song song và tái sử dụng, khiến nó trở thành mục tiêu tự nhiên để chuyên biệt hóa. MAC không chiếm ưu thế trong mọi mô hình hay mọi giai đoạn—các thao tác như chuẩn hóa, định tuyến, lập chỉ mục, giao tiếp và các phép toán theo từng phần tử có thể trở thành nút thắt—nhưng chúng chiếm phần lớn công suất tính toán số học đỉnh của các bộ tăng tốc ML hiện đại. Việc chúng có chi phối thời gian chạy hay không vẫn còn tùy vào hình dạng tensor, cách dữ liệu di chuyển và các toán tử xung quanh.
Các đơn vị phần cứng được thiết kế để khai thác các mẫu này là AI compute primitives: các khối chức năng chuyên dụng, mỗi khối được tối ưu cho một lớp phép toán cụ thể. Có ba primitive đặc biệt phổ biến trong các bộ tăng tốc, mỗi primitive nhắm tới một mẫu tính toán riêng biệt trong mạng nơ-ron.
Listing 1 minh họa cách một lớp dense được phân rã ở cấp độ framework, gói gọn hàng nghìn phép nhân-tích lũy chỉ trong một lời gọi cấp cao duy nhất.
# Framework abstracts compute-intensive operations
dense = Dense(512)(input_tensor)  # 256x512 MACs per sample
Chỉ một dòng mã này đã che giấu độ phức tạp tính toán mà các bộ tăng tốc phải xử lý. Listing 2 cho thấy framework mở rộng lời gọi cấp cao này thành các phép toán như thế nào.
# Linear transformation work scales with input_dim x output_dim x
# batch.
output = (
    matmul(input, weights) + bias
)  # Matrix multiply dominates cost
output = activation(
    output
)  # Element-wise: proportional to output_dim x batch
Phép nhân ma trận chiếm phần lớn thời gian tính toán, nhưng mức trừu tượng này vẫn che đi cấu trúc vòng lặp bên dưới. Ở cấp độ bộ xử lý, listing 3 cho thấy các vòng lặp lồng nhau nhân đầu vào với trọng số, cộng dồn kết quả, rồi áp dụng một hàm phi tuyến tính, qua đó bộc lộ độ phức tạp \(\mathcal{O}(B \times d_{\text{in}} \times d_{\text{out}})\) mà các bộ tăng tốc phải xử lý hiệu quả.
# Total operations: batch_size × output_size × input_size MACs
for n in range(batch_size):  # Batch dimension: parallelizable
    for m in range(output_size):  # Output neurons: parallelizable
        sum = bias[m]  # Initialize accumulator
        for k in range(input_size):  # Reduction dimension: sequential
            sum += input[n, k] * weights[k, m]  # MAC operation
        output[n, m] = activation(sum)  # Nonlinear transformation
# Example work scales as batch_size × output_size ×
# input_size multiply-accumulate operations
Cấu trúc vòng lặp này cho thấy ba mẫu tính toán lặp lại trong nhiều kiến trúc mạng nơ-ron: các phép toán theo từng phần tử dọc theo vector, các phép rút gọn ở cấp ma trận, và các biến đổi phi tuyến. Tần suất xuất hiện của chúng là lý do để có các đường dẫn thực thi chuyên biệt, dù mức lợi ích còn phụ thuộc vào hình dạng tensor, sự di chuyển của dữ liệu và mức hỗ trợ của các phép toán. Các mẫu này được hiện thực hóa thành các khối phần cứng: các đơn vị vector xử lý các phần tử độc lập và các phép rút gọn; các engine ma trận tổ chức công việc nhân-tích lũy theo từng tile; và các đường dẫn chức năng đặc biệt để xấp xỉ toán phi tuyến. Các ranh giới này mang tính kiến trúc hơn là toán học; một kernel hợp nhất có thể dùng nhiều đường dẫn mà không lộ các chuyển đổi đó với framework.
Các phép toán vector
Các phép toán vector mang lại một mức tăng tốc bằng cách xử lý nhiều phần tử dữ liệu trong mỗi lệnh. Hãy nhớ lại cấu trúc vòng lặp lồng nhau trong listing 3: một batch gồm 32 mẫu đi qua một lớp dense 256-to-512 sẽ cần 4.2M MACs phép tính. Ở phiên bản vô hướng, bộ xử lý tải từng cặp đầu vào–trọng số, nhân lên và cập nhật từng bộ tích lũy. Thực thi vector thực hiện công việc đó trên nhiều lane cùng lúc, giúp dàn trải chi phí giải mã lệnh, điều khiển vòng lặp và tạo địa chỉ. Lợi thế của cách này phụ thuộc vào độ rộng vector, căn chỉnh, cách xử lý phần đuôi, và đủ băng thông bộ nhớ để cung cấp dữ liệu cho các lane.
fmv.w.x fa0, zero          # Scalar dot-product accumulator
fmv.w.x ft1, zero          # Zero seed for vector reduction
loop_feature:
    vsetvli t0, feature_cnt, e32, m1, ta, ma
    vle32.v v1, (in_ptr)
    vle32.v v2, (wt_ptr)
    vfmul.vv v3, v1, v2
    vfmv.v.f v0, ft1
    vfredusum.vs v4, v3, v0
    vfmv.f.s ft0, v4
    fadd.s fa0, fa0, ft0
    slli t1, t0, 2         # Four bytes per FP32 element
    add in_ptr, in_ptr, t1
    add wt_ptr, wt_ptr, t1
    sub feature_cnt, feature_cnt, t0
    bnez feature_cnt, loop_feature
Các đơn vị xử lý vector giải quyết vấn đề này bằng cách xử lý nhiều phần tử dữ liệu cùng lúc. RISC-V,15 một kiến trúc tập lệnh (ISA) mở với phần mở rộng vector đã được tiêu chuẩn hóa (Waterman et al. 2013), là bối cảnh hữu ích để minh họa ý tưởng này. Listing 4 sử dụng mã hợp ngữ kiểu vector, trong đó một lệnh duy nhất xử lý nhiều phần tử dữ liệu. Vòng lặp này có năm giai đoạn hiển thị ở mức phần cứng:
15 RISC-V (reduced instruction set computer V): ISA mở cho phép các nhóm phần cứng thêm các lệnh ML tùy chỉnh, bao gồm tích vô hướng vector, các hàm activation và các phép toán tensor thưa, mà không cần thay đổi ISA cơ sở. Tuy nhiên, điểm cần cân nhắc là mức độ trưởng thành của hệ sinh thái phần mềm: các phần mở rộng tùy chỉnh đòi hỏi sự hỗ trợ tương ứng từ trình biên dịch, thư viện và runtime, điều này có thể hạn chế tính di động và làm tăng công sức tích hợp.
Waterman, Andrew, Yunsup Lee, Rimas Avizienis, Henry Cook, David Patterson, and Krste Asanovic. 2013. “The RISC-V Instruction Set.” 2013 IEEE Hot Chips 25 Symposium (HCS), 1–1. https://doi.org/10.1109/hotchips.2013.7478332.
- Cấu hình độ dài vector: Cấu hình các đơn vị vector để xử lý các phần tử 32-bit, đồng thời tự động xác định số lượng phép toán diễn ra song song dựa trên độ rộng phần cứng (VLEN).
- Khởi tạo vector: Xóa bộ tích lũy vô hướng sẽ giữ kết quả tích vô hướng hoàn chỉnh.
- Tải vector: Tải các giá trị 32-bit liền kề vào
v1vàv2, mỗi nguồn dùng một lệnh tải vector. - Nhân và rút gọn vector: Thực hiện nhân các phần tử tương ứng, sau đó rút gọn các tích thành một tổng vô hướng cục bộ.
- Số học con trỏ: Tăng các con trỏ và giảm số lượng phần tử còn lại một lượng bằng độ dài vector runtime.
Trong chuỗi hợp ngữ này, lệnh nhân vector xử lý nhiều cặp phần tử cùng lúc, trong khi phép rút gọn hoàn thành từng tích vô hướng cục bộ, và các lệnh tải vector giúp chia đều chi phí lệnh trên nhiều phần tử dữ liệu. Độ dài vector runtime quyết định số lượng giá trị mà mỗi lần lặp chuyển và xử lý, nhờ đó cùng một vòng lặp có thể hoạt động trên các triển khai với độ rộng vector khác nhau. Khối lượng công việc (workload) minh họa được chia thành khoảng 524,288 khối vector, mỗi khối được thực thi bởi một số lệnh vector và vô hướng.
Các phép toán vector chủ chốt có mối liên hệ trực tiếp với các mẫu deep learning phổ biến. Table 2 liệt kê cách các phép toán như rút gọn, gather, scatter và các phép toán có mặt nạ thường xuyên xuất hiện trong pooling, tra cứu embedding và các cơ chế attention, làm rõ sự ánh xạ trực tiếp giữa phần cứng vector cấp thấp và các khối lượng công việc (workload) machine learning cấp cao.
| Phép toán vector | Mô tả | Ứng dụng mạng nơ-ron |
|---|---|---|
| Phép rút gọn (Reduction) | Kết hợp các phần tử trong một vector (ví dụ: tổng, giá trị lớn nhất) | Các lớp Pooling, tính toán điểm attention |
| Phép thu thập (Gather) | Tải nhiều phần tử bộ nhớ không liên tiếp | Tra cứu embedding, các phép toán thưa |
| Phép phân tán (Scatter) | Ghi vào nhiều vị trí bộ nhớ không liên tiếp | Cập nhật gradient cho các embedding |
| Các phép toán có mặt nạ (Masked operations) | Thao tác chọn lọc trên các phần tử vector | Mặt nạ attention, xử lý phần đệm (padding) |
| Phép broadcast vector-vô hướng | Áp dụng scalar cho tất cả các phần tử vector | Cộng độ chệch (bias), các phép toán chia tỷ lệ |
Lợi ích không chỉ dừng lại ở việc giảm số lượng lệnh. Các thao tác tải vector liền kề có thể tận dụng hiệu quả giao diện bộ nhớ, và chi phí điều khiển được phân tán trên nhiều phần tử dữ liệu. Các thao tác gather, scatter, masking và các đuôi ngắn có thể dùng ít làn hơn hoặc cần thêm các giao dịch bộ nhớ, nên chỉ riêng độ rộng vector không đảm bảo tăng tốc tương ứng. Mẫu kiến trúc này không phải mới. Cray-116 đã sử dụng các thanh ghi vector và các đơn vị chức năng được thiết kế theo kiểu pipeline cho tính toán khoa học vào những năm 1970 (Jordan 1982); các bộ xử lý machine learning hiện đại áp dụng các nguyên tắc tương tự ở quy mô thương mại lớn hơn nhiều.
16 Di sản vector của Cray-1: Cray-1 (1975) đã sử dụng các thanh ghi vector 64 phần tử với các đơn vị chức năng được thiết kế theo kiểu pipeline, cho phép một luồng các phần tử xử lý qua các phép toán số học mà không cần phải phát ra từng lệnh vô hướng riêng lẻ cho mỗi phần tử. Các bộ tăng tốc hiện đại mở rộng các nguyên tắc tương tự về thanh ghi rộng, thực thi theo kiểu pipeline và tái sử dụng dữ liệu cho các khối (tiles) vector và ma trận.
Jordan, T. L. 1982. “A Guide to Parallel Computation and Some Cray-1 Experiences.” In Parallel Computations. Elsevier. https://doi.org/10.1016/b978-0-12-592101-5.50006-3.
Các phép toán vector rất hiệu quả với các biến đổi từng phần tử như các hàm activation, trong đó mỗi đầu ra chỉ phụ thuộc vào đầu vào tương ứng của nó. Tuy nhiên, mạng nơ-ron cũng cần các phép tính có cấu trúc, trong đó mỗi đầu ra phụ thuộc vào tất cả các đầu vào—chính là các tổng có trọng số dùng để định nghĩa các biến đổi của lớp. Các phép toán nhiều-đến-nhiều này tự nhiên được biểu diễn dưới dạng phép nhân ma trận, đây là phép toán cơ bản thứ hai của chúng ta.
Các phép toán ma trận
Phép nhân ma trận chiếm phần lớn khối lượng tính toán số học trong nhiều mạng nơ-ron dày đặc, biến đổi dữ liệu nhiều chiều thông qua các mẫu cấu trúc của trọng số, activation và gradient (Goodfellow et al. 2016). Trong khi các phép toán vector xử lý độc lập từng phần tử hoặc rút gọn chúng, các phép toán ma trận tổ chức công việc trên nhiều chiều. Phần cứng và các thư viện sẽ “tile” các chiều này để có thể tái sử dụng các khối trọng số và activation, đồng thời các tổng cục bộ được cộng dồn tại chỗ. Cấu trúc đều đặn này dẫn dắt nhiều chiến lược phần cứng quan trọng, nhưng các ma trận nhỏ hoặc không đều có thể khiến dung lượng tile không được tận dụng hết.
Các phép toán ma trận trong mạng nơ-ron
Các phép tính trong mạng nơ-ron có thể được phân rã thành các phép toán ma trận theo dạng phân cấp. Listing 5 minh họa phân cấp này thông qua một lớp tuyến tính, biến đổi các đặc trưng đầu vào thành các nơ-ron đầu ra trên một batch.
layer = nn.Linear(256, 512)  # Layer transforms 256 inputs to 512 outputs
output = layer(input_batch)  # Process a batch of 32 samples

# Framework Internal: Core operations (column-batch convention)
Z = matmul(weights, input)  # Matrix: transforms [256×32]
# input to [512×32] output
Z = Z + bias  # Vector: adds bias to each
# output independently
output = relu(Z)  # Vector: applies activation to
# each element independently
Ví dụ tính toán này cho thấy quy mô của các phép toán ma trận trong mạng nơ-ron. Mỗi nơ-ron đầu ra (tổng cộng 512) phải xử lý tất cả các đặc trưng đầu vào (tổng cộng 256) cho từng mẫu trong batch (32 mẫu). Riêng ma trận trọng số đã chứa 256 \(\times\) 512 = 131,072 parameters phần tử, chúng là các tham số xác định các phép biến đổi này. Điều đó cho thấy vì sao phép nhân ma trận hiệu quả lại chi phối các cân nhắc về hiệu suất.
Mạng nơ-ron sử dụng các phép toán ma trận trong nhiều mẫu kiến trúc khác nhau, không chỉ ở các lớp tuyến tính đơn giản. Các phép tích chập có thể được biến đổi thành phép nhân ma trận thông qua kỹ thuật im2col,17 giúp thực thi hiệu quả trên phần cứng tối ưu cho ma trận. Listing 6 minh họa các ứng dụng này.
17 Im2col (ảnh sang cột): Chuyển phép tích chập thành phép nhân ma trận bằng cách sắp xếp các giá trị trong vùng tiếp nhận thành các cột. Nếu tạo ma trận mở rộng một cách tường minh, các giá trị chồng lấn sẽ bị lặp lại và dung lượng lưu trữ có thể tăng lên tới xấp xỉ diện tích kernel, chưa tính đến các hiệu ứng biên, bước nhảy và kênh. Các thư viện dùng trong sản phẩm thường sử dụng các kernel implicit-GEMM hoặc tích chập trực tiếp để có cách thực thi thân thiện với ma trận mà không phải tạo ra toàn bộ ma trận đã mở rộng.
hidden = matmul(weights, inputs)
# weights: [out_dim x in_dim], inputs: [in_dim x batch]
# Result combines all inputs for each output

# Attention Mechanisms - Multiple matrix operations
Q = matmul(Wq, inputs)
# Project inputs to query space [query_dim x batch]
K = matmul(Wk, inputs)
# Project inputs to key space [key_dim x batch]
attention = matmul(Q.T, K)
# Compare all query tokens with all key tokens [batch x batch]

# Convolutions - Matrix multiply after reshaping
patches = im2col(input)
# Convert [H x W x C] image to matrix of patches
output = matmul(kernel, patches)
# Apply kernels to all patches simultaneously
Các ví dụ này khác nhau về hình dạng tensor và cách tái sử dụng, điều này quyết định mức độ mỗi phép nhân tận dụng hiệu quả một đơn vị ma trận. Lớp tuyến tính tái sử dụng cùng một ma trận trọng số cho cả một batch; attention tạo các phép chiếu rồi tạo ma trận điểm số token-to-token; tích chập tái sử dụng mỗi kernel trên nhiều mảnh ảnh. Biểu diễn cả ba dưới dạng phép nhân ma trận giúp lộ ra một giao diện chung cho phần cứng, nhưng chi phí thực thi của chúng không vì thế mà giống hệt nhau. Kích thước batch, độ dài chuỗi, số kênh và cách chia ô (tiling) quyết định liệu các toán hạng được tái sử dụng tại chỗ hay phải nạp lại từ bộ nhớ.
Tăng tốc phần cứng cho các phép toán ma trận
Kiểu phép nhân ma trận phổ biến này có ý nghĩa trực tiếp đối với thiết kế phần cứng: các bộ tăng tốc cần các đơn vị chuyên biệt có thể xử lý các phép tính này ở quy mô lớn. Listing 7 minh họa một đơn vị ma trận chuyên dụng tiêu biểu xử lý toàn bộ khối \(16{\times}16\) cùng một lúc, cho thấy lý do tại sao các lệnh ma trận và Tensor Cores có thể mang lại thông lượng cao hơn nhiều so với các đường thực thi chỉ dùng vô hướng hoặc chỉ dùng vector (NVIDIA 2017; Intel Corporation 2021a).
mload mr1, (weight_ptr)     # Load e.g., 16x16 block of
                            # weight matrix
mload mr2, (input_ptr)      # Load corresponding input block
matmul.mm mr3, mr1, mr2     # Multiply and accumulate entire
                            # blocks at once
mstore (output_ptr), mr3    # Store computed output block
Đơn vị minh họa này thao tác trên các ô ma trận thay vì từng phần tử đơn lẻ. Một phép nhân khối \(16{\times}16{\times}16\) đầy đủ chứa \(16^3=4{,}096\) phép toán nhân-tích lũy, nhưng số chu kỳ cần thiết còn phụ thuộc vào lệnh cụ thể và kiến trúc. Thông lượng duy trì cũng phụ thuộc vào số lượng đơn vị ma trận, độ chính xác của toán hạng, tốc độ phát lệnh, hành vi pipeline, và việc bộ nhớ có đủ khả năng cung cấp dữ liệu liên tục cho các đơn vị hay không. Các đơn vị ma trận bổ sung cho thực thi vector bằng cách tăng tốc các biến đổi có cấu trúc nhiều-sang-nhiều.
Tương tự xử lý vector, tăng tốc ma trận có lịch sử lâu đời—các DSP và GPU đã được tối ưu hóa cho các phép tính ma trận từ những năm 1980–1990, phục vụ xử lý ảnh, tính toán khoa học và kết xuất 3D (Owens et al. 2008; Hwu 2011). Các mạng nơ-ron đã khiến phép nhân ma trận trở thành phép toán chủ đạo về mặt thương mại, thúc đẩy sự phát triển của các Tensor Cores và TPU chuyên dụng, có khả năng xử lý các phép toán này ở quy mô chưa từng thấy.
Owens, John D., Mike Houston, David Luebke, Simon Green, John E. Stone, and James C. Phillips. 2008. “GPU Computing.” Proceedings of the IEEE 96 (5): 879–99. https://doi.org/10.1109/jproc.2008.917757.
Hwu, Wen-mei W. 2011. “Introduction.” In GPU Computing Gems Emerald Edition. Elsevier. https://doi.org/10.1016/b978-0-12-384988-5.00064-4.
Các phép toán ma trận và vector cùng nhau xử lý phần đại số tuyến tính của các mạng nơ-ron. Tuy nhiên, giữa mỗi phép biến đổi tuyến tính lại có một hàm activation phi tuyến tính—và các phép toán siêu việt này (như hàm mũ, căn bậc hai, hàm lượng giác) không thể được biểu diễn hiệu quả chỉ bằng các phép nhân-tích lũy. Table 3 tóm tắt ba vai trò thực thi này, đồng thời làm rõ những phép toán mạng nơ-ron nào tương ứng với từng vai trò.
| Loại thao tác | Tốt nhất cho | Ví dụ | Đặc điểm chính |
|---|---|---|---|
| Các phép toán ma trận | Các phép biến đổi nhiều-tới-nhiều | Các phép biến đổi lớp, attention, tích chập | Mỗi đầu ra phụ thuộc vào nhiều đầu vào |
| Các phép toán vector | Công việc vector và giảm chiều | Các hàm activation, chuẩn hóa lớp, gradient theo từng phần tử | Sử dụng các phép toán theo từng phần tử và giảm chiều vector |
| Các đường dẫn hàm đặc biệt | Số học siêu việt | Hàm mũ, logarit, nghịch đảo căn bậc hai | Sử dụng xấp xỉ dành riêng cho kiến trúc hoặc logic chuyên dụng |
Các đơn vị hàm đặc biệt
Các Đơn vị Hàm Đặc biệt (SFU) hoặc các đường dẫn lệnh chuyên biệt giúp tăng tốc các hàm phi tuyến tính và các phép toán liên quan, hoàn thiện bộ ba nguyên thủy xử lý của chương này. Nhu cầu này không mới: các bộ đồng xử lý dấu phẩy động đã giải quyết các nút thắt cổ chai trong số học vô hướng (Palmer 1980), và các bộ xử lý tín hiệu số đã bổ sung số học chuyên biệt cho các khối lượng công việc (workload) xử lý tín hiệu (Smith 1997). Một triển khai có thể dùng một đơn vị độc lập, các lệnh xấp xỉ vector, hoặc một trình tự trong thư viện, với các đánh đổi giữa độ chính xác, độ trễ và thông lượng. Trong các mạng nơ-ron, các phép toán activation, chuẩn hóa và softmax có thể trở nên quan trọng giữa các kernel ma trận, đặc biệt khi các lần truy cập bộ nhớ lặp lại hoặc các hàm siêu việt giới hạn thông lượng.
Palmer, John F. 1980. “The Intel 8087 Numeric Data Processor.” Proceedings of the 1980 National Computer Conference (AFIPS), 887–93. https://doi.org/10.1145/1500518.1500674.
Smith, Steven W. 1997. “Digital Signal Processing.” In Digital Signal Processing Demystified. Elsevier. https://doi.org/10.1016/b978-187870716-1/50004-4.
Các hàm phi tuyến tính
Để hiểu vì sao phần cứng chuyên dụng quan trọng, hãy xem xét một chuỗi các lớp điển hình (Goodfellow et al. 2016). Listing 8 kết hợp các biến đổi tuyến tính với các activation phi tuyến tính—những phép toán trông có vẻ đơn giản trong Python nhưng lại bộc lộ độ phức tạp tính toán đáng kể ở cấp phần cứng.
Goodfellow, Ian, Yoshua Bengio, and Aaron Courville. 2016. Deep Learning. MIT Press.
layer = nn.Sequential(
    nn.Linear(256, 512), nn.ReLU(), nn.BatchNorm1d(512)
)
output = layer(input_tensor)
Chuỗi này giới thiệu nhiều phép biến đổi phi tuyến vượt ra ngoài các phép toán ma trận đơn giản. Listing 9 sẽ phân tích các phép toán này thành các thành phần toán học, từ đó cho thấy rõ độ phức tạp tính toán mà phần cứng cần xử lý.
Z = matmul(weights, input) + bias  # Linear transformation
H = max(0, Z)  # ReLU activation
mean = reduce_mean(H, axis=0)  # BatchNorm statistics
var = reduce_mean((H - mean) ** 2)  # Variance computation
output = gamma * (H - mean) / sqrt(var + eps) + beta  # Normalization
Triển khai các hàm phi tuyến trên phần cứng
Độ phức tạp tính toán của các phép toán này trở nên rõ ràng khi xem xét cách triển khai chúng trên các bộ xử lý truyền thống. Những phép toán tưởng chừng đơn giản về mặt toán học lại được chuyển thành các chuỗi lệnh phức tạp. Ví dụ, với batch normalization (Ioffe and Szegedy 2015): việc chuẩn hóa đòi hỏi các phép rút gọn, tính phương sai và căn bậc hai; trong khi đó, các phép toán như softmax cần đến hàm mũ, mà chi phí của chúng phụ thuộc vào cách bộ xử lý hiện thực. Một rectified linear unit (ReLU) thì đơn giản về mặt toán học, nhưng một triển khai dạng scalar thông thường vẫn phải so sánh và chọn cho từng phần tử; các kernel ML được tối ưu hóa thường biến bước này thành không rẽ nhánh (branchless). Do đó, Listing 10 dùng ReLU và batch normalization để minh họa hai nguồn hao phí khác nhau: các lượt duyệt bộ nhớ theo từng phần tử và công việc chuẩn hóa nhiều lượt.
Ioffe, Sergey, and Christian Szegedy. 2015. “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift.” Proceedings of the 32nd International Conference on Machine Learning (ICML) 37: 448–56.
Cái tên phi tuyến thực ra ẩn ba dạng ràng buộc thực thi khác nhau. Các hàm theo điểm (pointwise) như ReLU giữ cho các phần tử độc lập, nên tự nhiên ánh xạ lên các làn vector hoặc các luồng song song. Các phép rút gọn như trung bình và phương sai trong batch normalization tạo ra phụ thuộc chéo giữa các phần tử: các kết quả trung gian phải được gộp lại trước khi các bước sau có thể tiếp tục. Các hàm siêu việt như hàm mũ, logarit và căn bậc hai nghịch đảo bổ sung ràng buộc số học, vì cách hiện thực chúng luôn đánh đổi giữa độ trễ, độ chính xác và phạm vi đầu vào hợp lệ. Mẫu phụ thuộc, chứ không chỉ nhãn toán học, quyết định nên dùng số học vector, cây rút gọn hay một đường dẫn xấp xỉ chuyên biệt. Một đường dẫn hàm đặc biệt nhanh hơn chỉ tăng tốc phép toán mà nó thực hiện; nó không loại bỏ lưu lượng tensor xung quanh hay yêu cầu đồng bộ.
Listing 10 cố ý làm rõ các phụ thuộc, thay vì mô phỏng một kernel đã được tối ưu. Các vòng lặp bộc lộ ba khoảng thời gian tồn tại của trạng thái: activation theo từng phần tử, các bộ tích lũy theo từng đặc trưng, và các đầu ra cuối cùng đã được chuẩn hóa. Các tham số chuẩn hóa chỉ áp dụng được khi có đủ thống kê, nên các triển khai phải hoặc giữ lại activation trung gian, hoặc tính lại chúng. Trong huấn luyện, các thống kê được lấy từ batch hiện tại, còn trong suy luận, có thể dùng các thống kê đã lưu và rút gọn chuẩn hóa thành một phép biến đổi affine theo từng phần tử. Trình biên dịch có thể gộp các giai đoạn hợp lệ, nhưng các phụ thuộc dữ liệu sẽ quyết định những biến đổi nào giữ nguyên được phép tính. Đọc phần liệt kê này như một đồ thị phụ thuộc sẽ lộ ra những câu hỏi phần cứng mang tính lâu dài: mỗi tensor đi qua giao diện bộ nhớ bao nhiêu lần, những giá trị trung gian nào được giữ cục bộ, và các phép rút gọn cần đồng bộ ở đâu.
for batch in range(32):
    for feature in range(512):
        # ReLU: Naive scalar compare/select; optimized kernels
        # usually implement this branchlessly.
        z = matmul_output[batch, feature]
        h = max(0.0, z)  # Conditional operation

        # BatchNorm: Multiple passes over data
        mean_sum[feature] += h  # First pass for mean
        var_sum[feature] += h * h  # Additional pass for variance

        temp[batch, feature] = h  # Extra memory storage needed


# Normalization requires complex arithmetic
for feature in range(512):
    mean = mean_sum[feature] / batch_size
    var = (var_sum[feature] / batch_size) - mean * mean

    # Square root computation: Multiple iterations
    scale = gamma[feature] / sqrt(var + eps)  # Iterative
    # approximation
    shift = beta[feature] - mean * scale

    # Additional pass over data for final computation
    for batch in range(32):
        output[batch, feature] = temp[batch, feature] * scale + shift
Mỗi phép toán phi tuyến đặt ra những thách thức phần cứng riêng trong các lớp mạng sâu. Batch normalization đòi hỏi nhiều lượt quét dữ liệu: một lượt để tính giá trị trung bình, một lượt khác để tính phương sai, và lượt cuối để biến đổi đầu ra. Mỗi lượt đều phải tải và lưu trữ dữ liệu qua hệ thống phân cấp bộ nhớ. Các phép toán trông có vẻ đơn giản trong ký hiệu toán học thực ra mở rộng thành nhiều lệnh, đặc biệt là căn bậc hai và hàm mũ trên những bộ xử lý không có đường dẫn phần cứng chuyên dụng. ReLU thường được ánh xạ thành phép so sánh-chọn hoặc phép cực đại, nên chi phí riêng của nó ít bị chi phối bởi số phép toán hơn là bởi việc đọc và ghi bổ sung nếu không được gộp với tác vụ lân cận. Việc triển khai cần bộ nhớ tạm cho các giá trị trung gian, làm tăng mức sử dụng bộ nhớ và tiêu thụ băng thông. Dù các đơn vị vector rất hiệu quả với các phép tính đều đặn, các hàm như hàm mũ và căn bậc hai thường cần các triển khai chuyên dụng có thể không tận dụng hết khả năng xử lý vector.
Triển khai phần cứng SFU
Các SFU khắc phục những kém hiệu quả này bằng phần cứng chuyên dụng. Các bộ tăng tốc ML hiện đại có các mạch chuyên dụng biến những phép toán phức tạp này thành các phép tính cố định với độ trễ thấp. Listing 11 minh họa cách ánh xạ: sau một lần tải vector, các đường dẫn ReLU, sigmoid, tanh và nghịch đảo căn bậc hai phụ thuộc kiến trúc sẽ cùng sử dụng chung vector đầu vào đó.
vld.v v1, (input_ptr)    # Load vector of values (pseudocode)
vrelu.v v2, v1           # Vector ReLU path
vsigm.v v3, v1           # Vector sigmoid path
vtanh.v v4, v1           # Vector tanh path
vrsqrt.v v5, v1          # Vector reciprocal-square-root path
Các đường chức năng chuyên biệt thực hiện các phép toán cơ bản (nguyên thủy) phi tuyến và rút gọn bằng mạch điện được thiết kế theo từng kiến trúc. Một ReLU có thể dùng logic so sánh–chọn; còn căn bậc hai, hàm mũ và logarit có thể dùng xấp xỉ lặp, bảng tra cứu hoặc nội suy. Table 4 tóm tắt các cơ chế tiêu biểu và đặc tính độ trễ định tính của chúng.
| Đơn vị hàm | Thao tác | Chiến lược triển khai | Độ trễ minh họa |
|---|---|---|---|
| Đơn vị activation | ReLU | So sánh và chọn hoặc cực đại | Thấp; phụ thuộc vào kiến trúc |
| Đơn vị thống kê | Trung bình, phương sai | Cây giảm chiều song song | Tăng theo độ sâu giảm chiều |
| Đơn vị hàm mũ | exp, log, sigmoid, tanh | Xấp xỉ, tra cứu bảng và nội suy | Phụ thuộc vào kiến trúc |
| Đơn vị căn/lũy thừa | sqrt, rsqrt | Phần cứng lặp hoặc xấp xỉ | Phụ thuộc vào kiến trúc |
Các phép toán vector, phép toán ma trận và các đường chức năng đặc biệt bao phủ ba mẫu tính toán quan trọng, nhưng bản thân các phép toán cơ bản không quyết định toàn bộ thông lượng. Chúng cho chúng ta biết bộ tăng tốc có thể thực hiện những gì một cách hiệu quả; còn mô hình thực thi và hệ thống bộ nhớ quyết định cách khối lượng công việc được ánh xạ lên phần cứng song song. Vì vậy, cùng một phép nhân ma trận có thể đạt các mức phần trăm hiệu suất đỉnh rất khác nhau khi hình dạng tensor, căn chỉnh tile, tổ chức luồng, mức độ chiếm dụng, cách truy cập bộ nhớ và cơ chế đồng bộ thay đổi. Các thông số hiệu suất đỉnh mô tả một phép toán được hỗ trợ trong điều kiện thuận lợi; các mô hình thực thi giải thích một khối lượng công việc thực tế có thể duy trì bao nhiêu phần trăm công suất đó.
Self-Check: Question
When executing a Transformer layer containing attention projection (\(Q = X W_q\)), Softmax (\(\text{Softmax}(S)\)), Layer Normalization (\(\text{LayerNorm}(X)\)), and GeLU activation (\(\text{GeLU}(Z)\)), which execution unit is specifically responsible for computing transcendental functions (exponential and error function approximations)?
- Systolic 2D Matrix Multiply Units
- Dense Tensor Cores
- Vector Load-Store Memory Controllers
- Special Function Units (SFUs)
Explain how the \(\text{im2col}\) (image-to-column) transformation allows standard 2D convolution operations to execute on high-throughput matrix multiplication hardware (GEMM engines), and describe the primary memory overhead associated with this approach.
True or False: In modern AI accelerators, element-wise vector operations such as residual additions (\(Y = X_1 + X_2\)) achieve higher arithmetic intensity than large matrix-matrix multiplications (\(C = A \cdot B\)).
The hardware transformation technique that enables convolutional layers to execute as matrix multiplications without physically duplicating overlapping patch data in memory is known as ____ GEMM.
Which of the following operations in a modern deep learning architecture exhibits the highest operational arithmetic reuse, making it most suitable for dense 2D systolic arrays and Tensor Cores?
- Batched linear layer matrix multiplication (\(Y = X W\))
- Element-wise ReLU activation (\(\max(0, x)\))
- Channel-wise Batch Normalization mean computation
- Token-wise embedding table lookup
Các Đơn vị Tính toán và Mô hình Thực thi
Áp dụng ReLU lên một vector 512 phần tử cho thấy vì sao mô hình thực thi quan trọng: thao tác thì đơn giản, nhưng thông lượng phụ thuộc vào việc phần cứng xem 512 phép so sánh đó là lệnh vô hướng, làn SIMD, luồng GPU, hay các đoạn chương trình tensor. Các bộ xử lý AI hiện đại gom ba phép toán cơ bản này vào các đơn vị thực thi riêng: các đơn vị SIMD (lệnh đơn, dữ liệu đa), Tensor Cores, và các phần tử xử lý, qua đó định nghĩa cách cấu trúc phép tính và cách chúng được đưa ra cho lập trình viên. Hiểu tổ chức này giúp thấy rõ cả năng lực lý thuyết lẫn đặc tính hiệu suất thực tế quyết định thông lượng trong môi trường thực.
Phân bổ các phép toán cơ bản vào các đơn vị thực thi
Quá trình đi từ các phép toán cơ bản sang các đơn vị thực thi tuân theo một hệ phân cấp có cấu trúc, phản ánh mức độ phức tạp và chuyên biệt hóa ngày càng cao của các bộ tăng tốc AI:
- Các phép toán vector → Các đơn vị SIMD và SIMT (lệnh đơn, đa luồng) cho phép xử lý song song các phần tử dữ liệu độc lập
- Các phép toán ma trận → Tensor Cores18 và các mảng systolic hỗ trợ nhân ma trận có cấu trúc
- Các chức năng chuyên biệt → Các đơn vị phần cứng chuyên dụng được tích hợp trong các phần tử xử lý
18 ML với độ chính xác giảm: Giảm một nửa độ rộng toán hạng sẽ giảm một nửa số byte cho mỗi phần tử được lưu trữ, và có thể cho phép mật độ tính toán cao hơn, dù thông lượng thực tế còn phụ thuộc vào đường dẫn dữ liệu và kernel có sẵn (Dally et al. 2021; Dally 2023). Việc NVIDIA chuyển từ các phép toán vector của Pascal P100 sang Tensor Cores với độ chính xác hỗn hợp trong Volta V100 đã giúp tăng thông lượng FP16 cực đại (được công bố) từ khoảng 21.2 lên 125 TFLOP/s, tức là tăng xấp xỉ 6\(\times\) trên các sản phẩm đó (NVIDIA 2017). Khi lựa chọn độ chính xác, cần giữ nguyên hành vi số học và sử dụng một đường dẫn được hỗ trợ hiệu quả; định dạng nhỏ nhất không phải lúc nào cũng là tốt nhất.
Dally, William J., Stephen W. Keckler, and David B. Kirk. 2021. “Evolution of the Graphics Processing Unit (GPU).” IEEE Micro 41 (6): 42–51. https://doi.org/10.1109/mm.2021.3113475.
Dally, Bill. 2023. “Hardware for Deep Learning.” 2023 IEEE Hot Chips 35 Symposium (HCS), 1–58. https://doi.org/10.1109/hcs59251.2023.10254716.
Mỗi đơn vị thực thi kết hợp các nguyên thủy tính toán này với các cơ chế bộ nhớ và điều khiển chuyên biệt, từ đó tối ưu hóa cả hiệu suất và hiệu quả năng lượng. Cách đóng gói có cấu trúc này cho phép các nhà cung cấp phần cứng cung cấp các giao diện lập trình chuẩn hóa, đồng thời triển khai các kiến trúc nền tảng đa dạng, được điều chỉnh theo yêu cầu của từng khối lượng công việc (workload) cụ thể. Việc lựa chọn đơn vị thực thi ảnh hưởng đáng kể đến hiệu quả tổng thể của hệ thống, bởi nó quyết định tính cục bộ của dữ liệu, mật độ tính toán, chi phí đồng bộ hóa và mức độ mà khối lượng công việc (workload) có thể tận dụng hiệu suất đỉnh lý thuyết.
Sự phát triển từ kiến trúc SIMD sang SIMT
Hãy tưởng tượng áp dụng hàm ReLU cho một vector 512 phần tử. Với cách tiếp cận vô hướng, cần 512 phép so sánh và chọn. Một lệnh SIMD có thể xử lý 8 hoặc 16 phần tử mỗi lần, trong khi một GPU SIMT có thể biểu diễn một luồng nhẹ cho mỗi phần tử và lên lịch các luồng đó theo warps hoặc waves. Số lượng lệnh thực tế và thông lượng phụ thuộc vào bộ xử lý, trình biên dịch, đường dẫn bộ nhớ và các hợp nhất liên quan. Sự tiến triển này minh họa hai ý tưởng liên quan: phân loại SIMD của Flynn đã chính thức hóa thực thi song song theo dữ liệu (Flynn 1966), và các kiến trúc SIMT của GPU phơi bày nhiều luồng logic được thực thi theo nhóm phần cứng (Lindholm et al. 2008; Nickolls et al. 2008).
Flynn, M. J. 1966. “Very High-Speed Computing Systems.” Proceedings of the IEEE 54 (12): 1901–9. https://doi.org/10.1109/proc.1966.5273.
Thực thi SIMD áp dụng cùng một phép toán cho nhiều phần tử dữ liệu một cách song song, giúp giảm thiểu chi phí lệnh và tối đa hóa thông lượng dữ liệu. Mô hình thực thi này được sử dụng rộng rãi để tăng tốc các khối lượng công việc (workload) có tính song song dữ liệu độc lập và có cấu trúc, ví dụ như các phép tính trong mạng nơ-ron. Arm Scalable Vector Extension (SVE) là một ví dụ điển hình về cách các kiến trúc hiện đại triển khai hiệu quả các phép toán SIMD có khả năng mở rộng (Stephens et al. 2017). Listing 12 minh họa cách tiếp cận này.
ptrue p0.s              # Create predicate for vector length
ld1w z0.s, p0/z, [x0]   # Load vector of inputs
fmul z1.s, z0.s, z0.s   # Multiply elements
fadd z2.s, z1.s, z0.s   # Add elements
st1w z2.s, p0, [x1]     # Store results
Lệnh ptrue kích hoạt tất cả các lane vị từ (predicate lanes) có sẵn mà không mã hóa độ dài vector cố định. Mô hình lập trình không phụ thuộc độ dài vector này cho phép cùng một mã nhị phân SVE chạy trên các triển khai có độ rộng từ 128 đến 2048 bit mà không cần biên dịch lại (Stephens et al. 2017). Intel Advanced Matrix Extensions (AMX) là một kiểu chuyên biệt hóa khác: các thanh ghi tile và các lệnh ma trận cho phép phần mềm thực hiện trực tiếp các phép toán ma trận hai chiều, thay vì chỉ mở rộng một lane vector (Intel Corporation 2021a). Tóm lại, SVE và AMX cho thấy hai hướng tiếp cận phần cứng cho các kernel ML: SIMD linh hoạt theo độ dài vector và tăng tốc ma trận dựa trên tile cố định.
Stephens, Nigel, Stuart Biles, Matthias Boettcher, Jacob Eapen, Mbou Eyole, Giacomo Gabrielli, Matt Horsnell, et al. 2017. “The ARM Scalable Vector Extension.” IEEE Micro 37 (2): 26–39. https://doi.org/10.1109/mm.2017.35.
Lindholm, Erik, John Nickolls, Stuart Oberman, and John Montrym. 2008. “NVIDIA Tesla: A Unified Graphics and Computing Architecture.” IEEE Micro 28 (2): 39–55. https://doi.org/10.1109/mm.2008.31.
Nickolls, John, Ian Buck, Michael Garland, and Kevin Skadron. 2008. “Scalable Parallel Programming with CUDA: Is CUDA the Parallel Programming Model That Application Developers Have Been Waiting For?” Queue 6 (2): 40–53. https://doi.org/10.1145/1365490.1365500.
19 SM (Streaming Multiprocessor): SM là một thành phần phần cứng vật lý, triển khai mô hình SIMT bằng cách dùng bộ lập lịch warp để điều phối nhiều luồng chạy song song. Việc duy trì đủ số warp đang hoạt động có thể giúp ẩn bớt độ trễ của lệnh và bộ nhớ, nhưng chỉ số chiếm dụng (occupancy) tự thân không chỉ ra nút thắt cổ chai. Chỉ số chiếm dụng thấp có thể do mức dùng thanh ghi, mức dùng bộ nhớ chia sẻ, kích thước khối, hoặc do không đủ khối lượng công việc song song; trong khi đó, một kernel bị giới hạn bởi bộ nhớ (memory-bound) vẫn có thể đạt chiếm dụng cao.
20 Warp: Trên các GPU của NVIDIA, một warp là nhóm lập lịch phần cứng gồm 32 luồng, thực thi cùng một lệnh khi đường điều khiển của chúng trùng nhau. Nếu các luồng đi theo các nhánh khác nhau, phần cứng sẽ thực thi các nhánh cần thiết dưới các mặt nạ (masks) khác nhau, làm giảm mức sử dụng hiệu quả các làn (lanes). Mức phạt phụ thuộc vào độ dài từng nhánh và số làn đi theo mỗi nhánh, đó là lý do các kernel ML thường ưu tiên luồng điều khiển đồng nhất (uniform) hoặc dạng predicated.
Để khắc phục những hạn chế này, SIMT mở rộng nguyên tắc của SIMD bằng cách cho phép thực thi song song trên nhiều luồng độc lập. Mỗi luồng đều có bộ đếm chương trình và trạng thái kiến trúc riêng (Lindholm et al. 2008; Nickolls et al. 2008). Mô hình này rất phù hợp với các phép tính ma trận, nơi mỗi luồng xử lý các phần khác nhau của một khối lượng công việc (workload) nhưng vẫn được hưởng lợi từ việc chia sẻ việc thực thi cùng một lệnh. Trong các kiến trúc GPU của NVIDIA, mỗi Streaming Multiprocessor (SM)19 điều phối hàng nghìn luồng chạy song song, giúp mở rộng hiệu quả các phép tính mạng nơ-ron. Các luồng được tổ chức thành các warp,20 là các đơn vị thực thi cơ bản giúp SIMT đạt hiệu quả cao. Listing 13 minh họa mô hình xử lý song song này trong thực tế.
__global__ void matrix_multiply(float* C, float* A, float*
                                B, int N) {  // CUDA kernel
    // Each thread processes one output element
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    float sum = 0.0f;
    for (int k = 0; k < N; k++) {
        // Threads in a warp execute in parallel
        sum += A[row * N + k] * B[k * N + col];
    }
    C[row * N + col] = sum;
}
Kernel CUDA21 gán mỗi phần tử đầu ra cho một luồng, nhờ đó tạo ra các đơn vị công việc độc lập mà GPU có thể lập lịch chạy trên nhiều warp. Các mô hình thực thi tương tự cũng xuất hiện trong kiến trúc RDNA của AMD và Xe của Intel, củng cố SIMT như một cơ chế cốt lõi để tăng tốc AI.
21 CUDA (compute unified device architecture): Được NVIDIA phát hành vào năm 2006, CUDA đã loại bỏ nhu cầu phải “ngụy trang” các tính toán đa năng thành tác vụ đồ họa, mở đường cho GPU phục vụ các khối lượng công việc khoa học và ML thông qua một mô hình lập trình giống C. Hệ sinh thái mà CUDA tạo ra—cuBLAS, cuDNN, TensorRT—hình thành một “rào” phần mềm (software moat) có thể “khóa chặt” ngăn xếp (stack) huấn luyện ML vào phần cứng của NVIDIA: việc chuyển sang nền tảng khác đòi hỏi viết lại hoặc thay thế hàng nghìn kernel đã tối ưu cho GPU, một chi phí thường vượt cả khoản tiết kiệm phần cứng của các nền tảng cạnh tranh. Chính sự “khóa chặt” phần mềm này, chứ không chỉ hiệu suất silicon thô, giúp lý giải vì sao nhiều ngăn xếp huấn luyện ML lớn vẫn xoay quanh CUDA.
Tensor Cores
Hãy xét một đầu chú ý transformer duy nhất tính tích \(\mathbf{Q} \times \mathbf{K}^T\) cho một chuỗi gồm 2,048 token, với embedding có 64 chiều. Phép toán này cần nhân một ma trận \(2048{\times}64\) với một ma trận \(64{\times}2048\): xấp xỉ 268.4M MACs phép nhân-tích lũy (MACs), hay khoảng 536.9 MFLOP FLOPs nếu tách riêng phép nhân và phép cộng. Trên một bộ xử lý vô hướng (scalar processor) thực hiện 1 FLOP mỗi chu kỳ ở 2 GHz, riêng đầu chú ý này sẽ mất khoảng 268.4 ms. Kiến trúc SIMT của GPU có thể phân phối khối lượng công việc này cho nhiều luồng, nhưng Tensor Cores còn tiến xa hơn khi xử lý trọn các ô khối (tile) ma trận trong mỗi lệnh; theo giả định minh họa ở đây, đường xử lý theo khối (tiled path) hoàn thành cùng phép toán trong 0.5 mili giây, nhanh hơn khoảng 536.9× lần so với thực thi vô hướng. Mức tăng tốc lớn này không đến từ xung nhịp cao hơn, mà từ cách tổ chức tính toán hoàn toàn khác: xoay quanh các khối ma trận thay vì từng phần tử riêng lẻ.
Các đơn vị SIMD và SIMT xử lý hiệu quả công việc dạng vector, nhưng các phép tính ma trận lớn lại hưởng lợi khi dùng các đơn vị xoay quanh các khối (tile) đa chiều. Các động cơ ma trận chuyên dụng có thể giảm chi phí nạp toán hạng cho nhiều phép nhân-tích lũy bằng cách tái sử dụng các tile ngay trên chip. GPU của NVIDIA cung cấp Tensor Cores, còn TPU của Google dùng các đơn vị ma trận xây dựng trên mảng systolic. Cả hai đều thực hiện phép nhân và tích lũy ma trận theo khối.22 Lợi ích đạt được phụ thuộc vào mức tái sử dụng tile, hình dạng, độ chính xác và hành vi bộ nhớ.
22 Căn chỉnh chiều Tensor Core: Tensor Cores của NVIDIA đạt hiệu quả cao nhất khi các chiều ma trận được căn theo các bội số phụ thuộc vào độ chính xác và kiến trúc, chẳng hạn bội số 8 hoặc 16 cho các đường FP16/BF16/INT8 phổ biến. Các thư viện cuBLAS và cuDNN hiện đại vẫn có thể dùng Tensor Cores cho nhiều kích thước không khớp chuẩn, nhưng các shape kém phù hợp có thể kích hoạt các kernel kém hiệu quả, cần thêm padding, hoặc làm giảm thông lượng thực tế (NVIDIA 2024a; NVIDIA Corporation 2021). Đây là lý do tại sao các kiến trúc sư mô hình thường chọn chiều embedding và kênh là 512 thay vì 500, và vì sao suy luận với batch-size-1 có thể không đạt mức sử dụng Tensor Core tối đa: việc căn chỉnh và cường độ tính toán cùng quyết định liệu các khối tính ma trận của phần cứng có được tận dụng hết công suất hay không.
NVIDIA Corporation. 2021. NVIDIA cuDNN Developer Guide.
23 Tensor Core: Một lệnh Tensor Core duy nhất thực hiện trọn vẹn phép nhân-tích lũy ma trận trên một ô dữ liệu nhỏ bằng một khối phần cứng chuyên dụng (NVIDIA 2017; NVIDIA Corporation 2020a). Cách tiếp cận này bỏ qua chi phí khi phải tìm nạp và lập lịch hàng chục lệnh số học riêng lẻ trên các CUDA cores đa năng. Vì các khối này chiếm một phần lớn thông lượng tensor được công bố của một bộ tăng tốc hiện đại, không sử dụng chúng có thể khiến phần lớn đỉnh hiệu năng lý thuyết của chip không phục vụ được cho khối lượng công việc (workload).
NVIDIA. 2017. Training with Mixed Precision.
Tensor Cores23 là một ví dụ điển hình cho cách tiếp cận này. Listing 14 cung cấp khả năng tính toán ma trận thông qua các lệnh chuyên biệt, sử dụng các khối phần cứng chuyên dụng.
Tensor Core Operation (example GPU PTX):
mma.sync.aligned.m16n8k16.row.col.f32.f16.f16.f32
  {d0,d1,d2,d3},     // Destination registers
  {a0,a1,a2,a3},     // Source matrix A
  {b0,b1},           // Source matrix B
  {c0,c1,c2,c3};     // Accumulator
Một lệnh Tensor Core duy nhất xử lý trọn một khối ma trận và giữ các kết quả trung gian trong các thanh ghi cục bộ, nhờ đó hiệu quả tính toán cao hơn so với các cách triển khai dựa trên phép toán vô hướng hoặc vector. Cách tiếp cận có cấu trúc này giúp phần cứng đạt thông lượng cao, đồng thời giảm gánh nặng của việc mở cuộn vòng lặp (loop unrolling) và quản lý dữ liệu ở tầng phần mềm.
Các ưu tiên thiết kế quyết định cách các khối ma trận xuất hiện trong các họ bộ xử lý khác nhau. Tensor Cores trên GPU giữ được tính lập trình, đồng thời tăng tốc các kernel deep learning mục đích chung. Các thiết kế kiểu TPU dùng các đơn vị ma trận cỡ lớn, sắp xếp theo mảng systolic, để tối đa hóa thông lượng huấn luyện duy trì trên các kernel tensor dày đặc. NPU di động24 thu nhỏ cùng ý tưởng thành các khối suy luận công suất thấp, còn CPU máy chủ thì bổ sung các phần mở rộng lệnh cho ma trận (các ô lớp AMX) để phục vụ suy luận và các khối lượng công việc (workload) hỗn hợp. Mỗi biến thể đều đặt lại cùng một ràng buộc: phần cứng giữ lại bao nhiêu linh hoạt trong khi giảm việc di chuyển dữ liệu quanh các phép toán ma trận dày đặc.
24 NPU (đơn vị xử lý nơ-ron): NPU di động đạt suy luận công suất thấp bằng cách thực thi các phép toán tensor phổ biến bằng phần cứng chức năng cố định hoặc phần cứng lập trình hạn chế, thay vì các kernel GPU hoàn toàn tổng quát. Cam kết kiến trúc này có thể mang lại mức tăng lớn về hiệu quả năng lượng cho các kernel được hỗ trợ, nhưng khiến việc triển khai phụ thuộc vào mức độ bao phủ toán tử: các toán tử không được hỗ trợ sẽ phải quay về chạy trên CPU hoặc GPU, mà điều này thường kém hiệu quả hơn nhiều cho khối lượng công việc (workload) đó (Sze et al. 2017).
Sze, Vivienne, Yu-Hsin Chen, Tien-Ju Yang, and Joel S. Emer. 2017. “Efficient Processing of Deep Neural Networks: A Tutorial and Survey.” Proceedings of the IEEE 105 (12): 2295–329. https://doi.org/10.1109/jproc.2017.2761740.
Hình Figure 6 cho thấy việc chuyên biệt hóa, giảm độ chính xác và hỗ trợ tính thưa thớt đã làm thay đổi khả năng đỉnh được quảng cáo như thế nào. Từ K20X FP32 đến H100 FP8 với độ thưa thớt có cấu trúc, các giá trị hiển thị tăng lên khoảng ba bậc độ lớn (NVIDIA Corporation 2017, 2020a, 2024; Choquette 2023). Các điểm này không đo lường một đại lượng nhất quán: chúng kết hợp nhiều định dạng độ chính xác khác nhau, và gộp cả FLOP/s với số phép toán INT8 mỗi giây. Vì vậy, đường cong này so sánh hiệu năng được quảng cáo nổi bật nhất của mỗi thế hệ, chứ không phải hiệu suất ứng dụng khi dùng cùng một độ chính xác. Bảng Ma trận thông số kỹ thuật bộ tăng tốc tổng hợp cung cấp các thông số kỹ thuật cụ thể cho từng độ chính xác, cùng với băng thông và giới hạn công suất tương ứng.

Các phần tử xử lý
Ở cấp tổ chức cao nhất của các đơn vị thực thi, nhiều Tensor Core cùng với bộ nhớ cục bộ được tích hợp thành các phần tử xử lý (PE). Một phần tử xử lý là khối xây dựng chính trong nhiều bộ tăng tốc AI, kết hợp các đơn vị tính toán khác nhau để thực thi hiệu quả các phép toán của mạng nơ-ron. Mỗi PE thường bao gồm các đơn vị vector cho phép toán theo phần tử, Tensor Core cho tính toán ma trận, các đơn vị chức năng đặc biệt cho biến đổi phi tuyến tính, và tài nguyên bộ nhớ chuyên dụng để tối ưu hóa tính cục bộ của dữ liệu và giảm chi phí di chuyển dữ liệu.
Thiết kế phần tử xử lý khác nhau vì mỗi kiến trúc chọn một cân bằng khác giữa mật độ tính toán, bộ nhớ cục bộ và khoảng cách liên kết. Đơn vị xử lý thông minh (IPU) của Graphcore phân phối tính toán trên 1.472 ô (tile), mỗi ô chứa các phần tử xử lý độc lập được tối ưu cho song song hạt mịn (Graphcore 2020). Cerebras mở rộng cùng nguyên lý tính toán cục bộ trong hệ thống CS-2, tích hợp khoảng 850.000 lõi tối ưu cho AI trên một thiết bị quy mô wafer để tăng tốc deep learning (Systems 2021). Trong khi đó, bộ xử lý D1 của Tesla nhấn mạnh bộ nhớ cục bộ lớn bên trong các phần tử xử lý, nhằm tối ưu hóa thông lượng và độ trễ cho các khối lượng công việc (workload) xe tự hành thời gian thực (Tesla, Inc. 2021).
Graphcore. 2020. The Colossus MK2 IPU Processor.
Tesla, Inc. 2021. Tesla Dojo Technology: A Guide to Tesla’s Configurable Floating Point Formats & Arithmetic. Tesla AI Day, Whitepaper.
Trong tất cả các thiết kế này, sự đánh đổi then chốt được thể hiện rõ là giữa mật độ tính toán và tính cục bộ của dữ liệu. Việc tích hợp nhiều lõi hơn chỉ giúp tăng thông lượng tối đa nếu mỗi lõi đều được cung cấp dữ liệu liên tục. Do đó, hiệu suất thực tế của một phần tử xử lý không chỉ phụ thuộc vào khả năng tính toán số học thô, mà còn phụ thuộc rất nhiều vào chiến lược kết nối và tính cục bộ của bộ nhớ.
Chính sự phụ thuộc vào tính cục bộ này cũng quyết định những tối ưu hóa thuật toán nào mà phần cứng có thể thực sự tận dụng. Một lưới các phần tử xử lý được sắp xếp đều đặn chỉ có thể tăng tốc độ thưa thớt khi các giá trị khác 0 còn lại vẫn giữ được các mẫu truy cập có thể dự đoán mà lưới đó dựa vào, và đó chính là ràng buộc mà độ thưa thớt có cấu trúc N:M được thiết kế để đáp ứng.
Cơ chế độ thưa thớt có cấu trúc N:M
Mặc dù tỉa (pruning) không cấu trúc giúp giảm kích thước mô hình, nhưng nó hiếm khi mang lại tốc độ xử lý nhanh hơn trên phần cứng vì việc truy cập bộ nhớ trở nên không đều. Các bộ tăng tốc phần cứng giải quyết vấn đề này bằng cách sử dụng độ thưa thớt có cấu trúc N:M,25 một cách tiếp cận dựa trên mẫu nhằm đảm bảo tính đều đặn. Ký hiệu “\(N{:}M\)” chỉ ra rằng trong mỗi khối \(M\) giá trị liên tiếp, chính xác \(N\) giá trị phải khác 0, tạo nên một mẫu có thể dự đoán để phần cứng khai thác.
25 Độ thưa thớt có cấu trúc N:M: Tỷ lệ 2:4 (mật độ 50 phần trăm) được sử dụng bởi Ampere Sparse Tensor Cores của NVIDIA là một thỏa hiệp thân thiện với phần cứng: mỗi nhóm bốn giá trị liên tiếp giữ lại hai giá trị khác 0, duy trì chỉ mục đều đặn trong khi giảm một nửa lượng giá trị dạng dense (NVIDIA Corporation 2020a). Ở tỷ lệ 2:4, chi phí siêu dữ liệu đủ nhỏ gọn để lưu kèm với các trọng số mà không làm mất đi lợi ích tiết kiệm lưu lượng bộ nhớ; đây là ràng buộc khiến đường dẫn thông lượng phép toán tensor 2\(\times\) trở nên khả thi khi các kernel và trọng số mô hình tuân thủ mẫu này.
NVIDIA Corporation. 2020a. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
NVIDIA. 2020a. Accelerating Matrix Multiplication with Block Sparse Format and NVIDIA Tensor Cores.
Sparse Tensor Core của NVIDIA triển khai một trường hợp cụ thể của mẫu này: ràng buộc 2:4, yêu cầu chính xác hai giá trị khác không trong mỗi khối bốn phần tử liên tiếp (tương đương, hai giá trị bằng 0) (NVIDIA Corporation 2020a; NVIDIA 2020a). Ràng buộc này cho phép phần cứng nén ma trận xuống còn 50% dung lượng lưu trong bộ nhớ (kể cả siêu dữ liệu). Quá trình thực thi gồm ba giai đoạn: thứ nhất, phần cứng chỉ lưu hai giá trị khác không và siêu dữ liệu gọn cho mỗi khối bốn phần tử (nén); thứ hai, trong quá trình nhân ma trận, Sparse Tensor Core đọc siêu dữ liệu để chọn các activation tương ứng và chỉ thực hiện phép toán trên các trọng số khác không (tính toán); thứ ba, điều này làm tăng tỷ lệ FLOP/byte hiệu quả, mang lại một đường dẫn thông lượng phép toán tensor nhanh hơn tối đa 2\(\times\) so với phép nhân ma trận dày đặc khi mô hình được tinh chỉnh để tuân thủ ràng buộc 2:4.
Để hiểu tại sao các mẫu “Structured” cần thiết cho việc tăng tốc phần cứng, hãy xem xét cách ma trận thưa thớt thực sự được lưu trong bộ nhớ. Các phương pháp lưu trữ CSR và block sparse được trình bày chính thức trong Các định dạng ma trận thưa. Figure 7 so sánh kiểu chiếm dụng của chúng và cho thấy rõ phần phụ trội do chỉ mục khối. Nếu tính thưa là ngẫu nhiên, chi phí lập chỉ mục và truy cập bất quy tắc sẽ làm sụt hiệu năng. Structured sparsity, dù ở cấp độ khối lớn hay N:M hạt mịn, khiến việc lập chỉ mục trở nên dễ dự đoán và gọn, cho phép phần cứng truy xuất dữ liệu hiệu quả.

Mẫu 2:4 minh họa một nguyên tắc rộng hơn: phần cứng không đạt hiệu quả bằng cách tính các số 0 nhanh hơn, mà bằng cách ngay từ đầu không tải chúng. Nhận định này nối độ thưa với bức tường bộ nhớ, vì các mẫu có cấu trúc giúp giảm lưu lượng truy cập vào bộ nhớ, nơi chi phí thực sự nằm.
Ngoài các tối ưu hóa thưa có cấu trúc, các kiến trúc phần cứng khác nhau còn triển khai phép toán ma trận bằng những cấu trúc tính toán riêng. Mảng systolic là một cách tiếp cận như vậy và đã chứng tỏ đặc biệt hiệu quả cho các khối lượng công việc (workload) AI.
Mảng systolic
Trong khi Tensor Cores đóng gói các phép toán ma trận vào các khối lệnh nhỏ, chuyên biệt, mảng systolic sắp xếp các phần tử xử lý thành các lưới hai chiều lớn, tối ưu cho luồng dữ liệu liên tục và tái sử dụng toán hạng. Bằng cách đưa các đầu vào theo chiều ngang và các tổng từng phần theo chiều dọc qua mảng, kiến trúc systolic giảm thiểu các lần truy xuất DRAM đắt đỏ, cho phép các trọng số lượng tử hóa, độ chính xác thấp đạt mật độ tính toán tối đa. Động lực cốt lõi của kiến trúc systolic xuất phát từ cùng ràng buộc năng lượng dẫn dắt thiết kế bộ tăng tốc: giảm chi phí truy cập bộ nhớ thông qua tái sử dụng toán hạng ở mức vật lý. Một so sánh năng lượng đơn giản trên toàn mảng cho thấy vì sao kiến trúc này trở thành trung tâm của các bộ tăng tốc AI hiện đại.
Napkin Math 1.1: Lợi thế năng lượng khi truyền dữ liệu theo nhịp
Kịch bản: Kiến trúc systolic cải thiện hiệu quả năng lượng bằng cách giữ các toán hạng cục bộ khi công việc “đập nhịp” qua mảng; phép ẩn dụ “Systolic” (nhịp tim) phản ánh lợi ích của việc tái sử dụng toán hạng cục bộ này. Mô hình minh họa này so sánh luồng dữ liệu systolic với một cách triển khai đơn giản (naive) là truyền mọi toán hạng qua DRAM:
- Đường cơ sở truyền qua DRAM: Tải \(\mathbf{A}\), tải \(\mathbf{B}\), tính \(\mathbf{A} \times \mathbf{B} + \mathbf{C}\), và ghi \(\mathbf{C}\) mà không tái sử dụng cache hoặc thanh ghi.
- Di chuyển dữ liệu: 3 lần tải + 1 lần ghi = 4 truy cập DRAM (mỗi phép toán).
- Năng lượng: ≈ 4 \(\times\) 640 pJ + 1 pJ (tính toán) = 2561 pJ/op.
- Mảng systolic (kích thước 128 \(\times\) 128): Tải A và B một lần tại các edge. Dữ liệu được đẩy theo nhịp qua 128 phần tử xử lý.
- Di chuyển dữ liệu: 2 lần tải cho mỗi 128 phép toán, tức 0.016 truy cập DRAM (mỗi phép toán).
- Năng lượng: ≈ 0.016 \(\times\) 640 pJ + 1 pJ (tính toán) ≈ 11 pJ/op.
Góc nhìn hệ thống: Với đường cơ sở truyền dữ liệu từ DRAM theo cách “ngây thơ” có chủ đích này, mô hình cho thấy mảng systolic có lợi thế năng lượng gấp 232.8× lần. Tỷ lệ này đo lường mức độ cục bộ của dữ liệu, chứ không phải khoảng cách cố hữu giữa phép toán vector và phép toán systolic.
- Cụ thể, một mảng \(128{\times}128\) có thể duy trì 16,384 MACs/cycle đồng thời mang lại lợi ích năng lượng đáng kể, bằng cách đẩy dữ liệu theo nhịp qua các phần tử xử lý thay vì phải tải đi tải lại từ DRAM (Horowitz 2014; Jouppi et al. 2023).
- Tính cục bộ này cho phép các mảng dày đặc duy trì nhiều phép toán MAC đồng thời mà không phải tốn chi phí truy cập DRAM cho mỗi phép toán.
- Hạn chế: Phép so sánh này giả định không có tái sử dụng hiệu quả ở đường cơ sở và có tái sử dụng hoàn toàn trên toàn bộ mảng. Các yếu tố như cache, chặn thanh ghi, việc sử dụng mảng không tối ưu và các luồng dữ liệu khác có thể làm thay đổi đáng kể tỷ lệ này.
Một mảng systolic sắp xếp các phần tử xử lý theo cấu trúc lưới, nơi dữ liệu luân chuyển nhịp nhàng giữa các đơn vị lân cận một cách đồng bộ, cho phép mỗi toán hạng tham gia vào nhiều phép tính khi nó đi qua mảng. Cách di chuyển có cấu trúc này giúp giảm truy cập bộ nhớ ngoài bằng cách tối đa hóa tái sử dụng dữ liệu cục bộ. Một giá trị trọng số duy nhất có thể tham gia vào hàng chục phép toán khi nó di chuyển qua các phần tử xử lý, từ đó chuyển đặc tính năng lượng từ bị giới hạn bởi bộ nhớ sang thực thi hiệu quả tính toán.
Kung và Leiserson26 (Kung and Leiserson 1979) là những người đầu tiên giới thiệu mảng systolic, và chính thức hóa cách dùng chúng trong các kiến trúc tính toán song song để xử lý ma trận hiệu quả (Kung 1982). Khác với các đơn vị xử lý đa dụng, mảng systolic tận dụng tính cục bộ theo không gian và thời gian bằng cách tái sử dụng các toán hạng khi chúng đi qua lưới. TPU của Google là ví dụ tiêu biểu cho cách tiếp cận này: trong TPUv4, một mảng systolic \(128{\times}128\) gồm các đơn vị nhân-tích lũy xử lý phép toán ma trận bằng cách cho dữ liệu luân chuyển qua mảng theo cơ chế pipeline (Jouppi et al. 2023). Figure 8 bám theo các đường đi của dữ liệu: một đơn vị điều khiển cấp dữ liệu vào các bộ đệm đầu vào, rồi dữ liệu được đưa theo chiều ngang vào mảng; đồng thời các tổng riêng phần do mỗi ô tạo ra chảy xuống theo chiều dọc tới chuỗi bộ tích lũy ở phía dưới để thu gom kết quả cuối cùng. Mỗi phần tử xử lý thực hiện một phép nhân-tích lũy mỗi chu kỳ và chuyển tiếp toán hạng cho các láng giềng, nhờ đó một giá trị nạp một lần có thể được tái sử dụng suốt cả một hàng hoặc cột thay vì phải nạp lại từ bộ nhớ.
26 Mảng systolic: Từ gốc Hy Lạp sustole (“co bóp”), mượn từ tim mạch để gợi hình ảnh bơm nhịp nhàng. Kung và Leiserson dùng thuật ngữ này cho các mảng mà dữ liệu tiến qua các phần tử xử lý lân cận theo lịch trình đều đặn (Kung and Leiserson 1979). Việc lấp đầy pipeline cho phép các mặt sóng đồng thời và tái sử dụng dữ liệu cục bộ. Lợi ích phụ thuộc vào toán hạng cố định, tile, bộ đệm và mức độ sử dụng; nó không đảm bảo mức tiết kiệm DRAM cố định. Các khối lượng công việc (workload) không đều và các hình dạng căn chỉnh kém vẫn kém phù hợp, vì chi phí lấp đầy, xả và các phần tử nhàn rỗi tiêu tốn năng lực.
Kung, Hsiang Tsung, and Charles E Leiserson. 1979. “Systolic Arrays (for VLSI).” Sparse Matrix Proceedings 1978 1: 256–82.
Kung, H. T. 1982. “Why Systolic Architectures?” Computer 15 (1): 37–46. https://doi.org/10.1109/mc.1982.1653825.

Nguyên lý lát gạch: Cầu nối giữa đồ thị tính toán và silicon
Tồn tại một sự không tương thích cơ bản giữa đồ thị tính toán (vốn coi một phép nhân ma trận 4,096 \(\times\) 4,096 là duy nhất) và silicon vật lý (vốn có một mảng systolic cố định 128 \(\times\) 128). Để khắc phục khác biệt này, cần áp dụng nguyên lý lát gạch: quá trình chia nhỏ các phép toán tensor lớn thành các “ô” (tiles) sao cho chúng vừa khít bộ nhớ cục bộ tốc độ cao của phần cứng (SRAM hoặc Scratchpad).
Để xử lý lớp ví dụ có bề rộng 4,096 của chúng ta trên một mảng systolic có bề rộng 128, trình biên dịch phân rã kết quả thành 1,024 ô đầu ra. Mỗi ô đầu ra tích lũy trên 32 ô theo chiều giảm, nên phép nhân ma trận hoàn chỉnh thực hiện 32,768 tích giữa các ô \(\mathbf{A}\) và \(\mathbf{B}\). Đây không chỉ là sự tiện lợi của phần mềm; đó là một yêu cầu vật lý. Các ô toán hạng được lấy từ HBM chậm, đệm trong SRAM nhanh, rồi được đưa qua mảng systolic. Algorithm 1 nêu cấu trúc vòng lặp lồng nhau mà trình biên dịch sinh ra cho phép phân rã này: đưa luồng ô của \(\mathbf{A}\) và \(\mathbf{B}\) lên chip và tích lũy tích của chúng vào một ô của \(\mathbf{C}\) trước khi ghi trả về.
Chỉ cần thêm một đơn vị vượt quá chiều rộng ô là hiệu suất sử dụng tụt dốc.
Kích thước ô là đòn bẩy. Ô lớn hơn giúp tái sử dụng mỗi byte dữ liệu đã nạp trong nhiều phép nhân-tích lũy hơn, làm tăng cường độ tính toán của kernel và đẩy kernel về phía miền bị giới hạn bởi tính toán trên biểu đồ roofline. Giới hạn trên ở đây là lượng dữ liệu của \(\mathbf{A}\), \(\mathbf{B}\) và \(\mathbf{C}\) có thể nằm gọn trong bộ nhớ trên chip tốc độ cao cùng lúc. Mẫu lát ô này là cơ chế trung tâm đứng sau các hệ thống ML hiệu suất cao. Nó giúp phần cứng duy trì hiệu suất hệ thống cao \((\eta_{\text{hw}})\) bằng cách đảm bảo rằng, với mỗi byte dữ liệu nạp từ bộ nhớ chính, dữ liệu đó được tái sử dụng 128× lần trong lưới systolic. Kỹ sư hiểu rõ về kỹ thuật lát ô sẽ nắm được “silicon contract”: nếu kích thước của một lớp không phải là bội số của kích thước ô (ví dụ, chiều rộng là 129 trên một mảng 128), hệ thống sẽ phải chịu một thuế rìa (fringe tax) do silicon không được sử dụng hết. Cụ thể, 127 đơn vị bị bỏ không trong khi một đơn vị khác hoàn thành ô “phần dư”.
\begin{algorithm} \caption{Tiled (blocked) matrix multiply} \begin{algorithmic} \Require $\mathbf{A} \in \mathbb{R}^{M\times K}$, $\mathbf{B} \in \mathbb{R}^{K\times N}$; tile sizes $T_M, T_N, T_K$ \Ensure $\mathbf{C} = \mathbf{A}\mathbf{B}$ \For{each row tile $i_0$ (size $T_M$)} \For{each column tile $j_0$ (size $T_N$)} \State initialize the $\mathbf{C}$-tile accumulator to zero on chip \For{each $k_0$ over $K$ in steps of $T_K$} \State load $\mathbf{A}$-tile $[i_0,k_0]$ and $\mathbf{B}$-tile $[k_0,j_0]$ on chip \State accumulate the tile product on chip \Comment{reuse $T_N$/$T_M$ per byte} \EndFor \State write the $\mathbf{C}$-tile back to memory \EndFor \EndFor \end{algorithmic} \end{algorithm}
Kiến trúc mảng systolic đạt hiệu quả tính toán nhờ di chuyển dữ liệu đồng bộ qua một lưới có cấu trúc gồm các phần tử xử lý. Mảng systolic tổ chức tính toán xoay quanh bốn thành phần:
- Đơn vị điều khiển: Phối hợp thời gian và phân phối dữ liệu trên toàn mảng, đảm bảo hoạt động đồng bộ xuyên suốt lưới tính toán.
- Luồng dữ liệu: Các ma trận đầu vào được dẫn qua các đường đi được phối hợp, trong đó các phần tử của ma trận A di chuyển ngang, còn các phần tử của ma trận B đi dọc qua lưới xử lý.
- Lưới phần tử xử lý: Các phần tử xử lý riêng lẻ thực hiện các phép nhân-tích lũy trên luồng dữ liệu, tạo ra các kết quả trung gian được tích lũy dần để cho ra kết quả cuối cùng.
- Thu thập đầu ra: Các kết quả được tập hợp tại các ranh giới đầu ra đã định, nơi các tổng trung gian đã tích lũy sẽ tạo thành các phần tử ma trận hoàn chỉnh.
Luồng dữ liệu đồng bộ đảm bảo rằng phần tử ma trận \(A_{ik}\) sẽ gặp các phần tử \(B_{kj}\) tương ứng vào đúng các khoảng thời gian đã định, từ đó thực hiện các phép nhân-tích lũy cần thiết cho phép nhân ma trận \(C_{ij} = \sum_k A_{ik}\times B_{kj}\). Việc tái sử dụng các toán hạng một cách có hệ thống trên nhiều phần tử xử lý giúp giảm đáng kể yêu cầu về băng thông bộ nhớ, vì nó loại bỏ các lần nạp dữ liệu lặp lại từ các hệ thống con bộ nhớ ngoài.
Với phép nhân \(2{\times}2\), mỗi đầu ra \(C_{ij}=A_{i0}B_{0j}+A_{i1}B_{1j}\) cần hai phép nhân và một phép cộng dồn. Một ánh xạ kiểu weight-stationary giữ các phần tử đã chọn của \(\mathbf{B}\) trong bộ nhớ cục bộ của PE, phát các phần tử \(\mathbf{A}\) theo dòng qua mảng, và định tuyến hoặc giữ lại các tổng trung gian cho đến khi cả hai hạng \(k\) cần thiết đều tới. Chẳng hạn, \(C_{00}\) kết hợp \(A_{00}B_{00}\) với \(A_{01}B_{10}\), còn \(C_{01}\) kết hợp \(A_{00}B_{01}\) với \(A_{01}B_{11}\). Các giá trị được đưa vào với độ lệch thời gian để các toán hạng của cùng một phép nhân gặp nhau tại đúng PE. Lộ trình theo từng chu kỳ phụ thuộc vào hình học mảng, cách đặt toán hạng, và việc giữ cố định trọng số, đầu vào hay đầu ra. Bài học là tận dụng tái sử dụng cục bộ: một ô dữ liệu đã nạp nên phục vụ nhiều phép MAC trước khi bị thay thế, đồng thời chi phí cho các chu kỳ nạp và xả vẫn phải được tính vào tổng chi phí.
Mỗi phần tử xử lý trong một mảng 2D thực hiện một phép nhân-tích lũy ở mỗi chu kỳ. Trong một cấu hình weight-stationary điển hình:
- Giữ một trọng số cố định (\(B_{k,j}\)) trong thanh ghi cục bộ
- Nhận một activation đầu vào dạng luồng (\(A_{i,k}\)) từ PE lân cận bên trái.
- Tính toán tích trung gian \(A_{i,k} \times B_{k,j}\) và cộng vào bộ tích lũy cục bộ.
- Chuyển tiếp giá trị activation sang phải đến PE lân cận để dùng cho chu kỳ tiếp theo.
Mô hình tính toán có cấu trúc này giúp giảm thiểu việc di chuyển dữ liệu giữa bộ nhớ toàn cục và các phần tử xử lý, từ đó nâng cao cả hiệu quả và khả năng mở rộng. Các phép nhân ma trận 2D được ánh xạ tự nhiên lên các mảng xử lý systolic dạng lưới: hãy theo dõi luồng dữ liệu đồng bộ trong figure 8, nơi các activation đầu vào đi ngang còn các trọng số cố định tích lũy các tích trung gian theo phương dọc. Vì mảng systolic hoạt động theo kiểu phát theo dòng, chúng đặc biệt hiệu quả cho các khối lượng công việc (workload) có thông lượng cao như huấn luyện và suy luận trong deep learning. Tuy nhiên, như trình bày chi tiết trong section 1.4.1, hiệu quả thực tế cuối cùng vẫn bị giới hạn bởi các nút thắt băng thông bộ nhớ.
Một mảng systolic 128 \(\times\) 128 có khả năng thực hiện 16,384 operations mỗi chu kỳ cần một luồng toán hạng liên tục để duy trì mức sử dụng. Các bộ đệm trên chip đưa activation và trọng số tới các cạnh của mảng và được nạp lại từ bộ nhớ ngoài chip khi cần; tái sử dụng ngay trong mảng giúp tránh phải nạp từng toán hạng từ HBM ở mỗi chu kỳ. Băng thông HBM2 1,200 GB/s của TPU v4 giúp duy trì luồng này, nhưng băng thông ngoài chip vẫn có thể là giới hạn đối với các mô hình có working set và mẫu tái sử dụng dữ liệu vượt quá sức chứa trên chip.
Các kỹ thuật lượng tử hoá trong Lượng tử hoá và Độ chính xác giúp giảm dung lượng bộ nhớ của mô hình bằng cách chuyển trọng số FP32 sang biểu diễn INT8. Tối ưu hoá này trực tiếp nhắm tới các hạn chế về băng thông bộ nhớ đã nêu ở đây. Chuyển trọng số dấu phẩy động 32-bit sang số nguyên 8-bit có thể giảm lưu lượng trọng số 4\(\times\); việc điều này có biến một kernel từ bị giới hạn bởi băng thông thành bị giới hạn bởi tính toán hay không còn tùy vào cường độ số học ban đầu của phép toán, điểm INT8 ridge của bộ tăng tốc (ngưỡng cường độ mà tại đó năng lực tính toán INT8 đạt bão hoà), và chi phí lượng tử hoá/giải lượng tử hoá. Tương tự, tỉa (pruning) có cấu trúc loại bỏ cả hàng hoặc cột của ma trận trọng số, giúp giảm cả lượng dữ liệu phải đi qua các tầng bộ nhớ lẫn khối lượng tính toán cần thiết. Những tối ưu hoá ở mức thuật toán này có giá trị chính vì chúng nhắm đúng nút thắt băng thông bộ nhớ đang giới hạn hiệu năng bộ tăng tốc trong thực tế.
Systems Perspective 1.1: Ghép kiến trúc với khối lượng công việc (workload)
Thử thách: Mảng systolic phải chọn dữ liệu nào giữ cố định (trong thanh ghi) để giảm di chuyển. Lựa chọn này sẽ ‘hard-code’ sở thích của phần cứng đối với một số loại mô hình. Table 5 giới thiệu ba chiến lược dữ liệu cố định (stationary-operand) và các khối lượng công việc (workload) mà mỗi chiến lược phù hợp; section 1.7 phát triển chi tiết từng chiến lược như một quyết định ánh xạ tổng quát.
Table 5: Chiến lược luồng dữ liệu của mảng systolic: Ba lựa chọn toán hạng cố định (stationary-operand) cho mảng systolic, kiểu tái sử dụng mà mỗi lựa chọn tối đa hóa, và nhóm khối lượng công việc (workload) được hưởng lợi; qua đó cho thấy một lựa chọn luồng dữ liệu cố định sẽ cố định sẵn sự ưu tiên của bộ tăng tốc đối với các mô hình cụ thể như thế nào.
| Chiến lược | Mục cố định | Tối ưu hóa cho | Khối lượng công việc (workload) ví dụ |
|---|---|---|---|
| Weight-stationary | Trọng số (\(\mathbf{W}\)) | Tái sử dụng trọng số cao | CNNs (Conv2D): Các bộ lọc nhỏ và được tái sử dụng trên toàn bộ hình ảnh. |
| Output-stationary | Tổng riêng phần (\(\mathbf{C}\)) | Tái sử dụng bộ tích lũy cao | Large Batch MatMul: Tích lũy kết quả cho nhiều đầu vào đối với một ma trận trọng số lớn. |
| Input-stationary | Đầu vào (\(\mathbf{A}\)) | Tái sử dụng activation cao | Transformers: Cùng một activation cấp cho nhiều ma trận trọng số trên các attention head. |
Không có bộ tăng tốc nào là “hoàn hảo”. Một chip được tối ưu cho luồng Weight-Stationary (như các TPU đời đầu) hoạt động rất tốt với CNN, nơi bộ lọc nhỏ và được tái sử dụng nhiều, nhưng gặp khó với suy luận mô hình ngôn ngữ lớn (LLM) ở kích thước batch nhỏ. Trong trường hợp này, ma trận trọng số chỉ được đọc một lần cho mỗi token với mức tái sử dụng tối thiểu, khiến kiến trúc phải nghiêng về các kiểu luồng dữ liệu output-stationary hoặc lai.
Số học trong tăng tốc AI
Các mảng systolic và Tensor Cores thường hỗ trợ số học độ chính xác giảm. FP16 giảm một nửa số byte mỗi giá trị so với FP32, và một hệ mục tiêu có thể bố trí thêm năng lực nhân-tích lũy ở độ chính xác thấp. Tăng tốc 2\(\times\) không tự động có được: cần một kernel được hỗ trợ và đủ khối lượng công việc song song mà không vướng nút thắt cổ chai khác. Dựa trên Nén mô hình, độ chính xác giảm là một quyết định giữa phần cứng và phần mềm. Định dạng đầu vào và tích lũy có thể khác nhau, ảnh hưởng đến độ chính xác, thông lượng, năng lượng và việc di chuyển dữ liệu.
Đánh đổi về độ chính xác
Độ chính xác thấp hơn không phải miễn phí. FP16 có số mũ 5 bit và 10 bit phần định trị được lưu trữ, cho độ chính xác phần định trị cao hơn BF16 nhưng dải động nhỏ hơn nhiều so với FP32. Giá trị chuẩn nhỏ nhất của nó khoảng \(6.1\times10^{-5}\) và giá trị hữu hạn lớn nhất là 65,504; các số dưới chuẩn mở rộng xuống thấp hơn với độ chính xác giảm. BF16 giữ lại số mũ 8 bit của FP32 và dùng 7 bit phần định trị, bảo toàn dải động tương tự ở độ chính xác thấp hơn. INT8 không có số mũ dấu phẩy động và phụ thuộc vào lựa chọn tỷ lệ, điểm 0 và cắt ngưỡng. Phần cứng và phần mềm phải cân bằng các thuộc tính này với thông lượng và băng thông.
Sự phát triển của phần cứng AI phản ánh sự đồng thiết kế giữa các phương pháp số và khả năng phần cứng. Các thế hệ GPU trước đây chưa có các đường xử lý ma trận mixed-precision chuyên dụng như hiện nay cho deep learning, dù những đơn vị khác đã hỗ trợ nhiều định dạng. Khi các phương pháp huấn luyện và suy luận cho thấy độ chính xác chấp nhận được với một số phép toán độ chính xác thấp hơn, các nhà cung cấp đã bổ sung các đường xử lý tensor gốc cho FP16, BF16 và số nguyên. Các frameworks và thư viện đưa chúng vào qua các kernel tương thích, autocasting, lượng tử hoá và hiệu chuẩn. Lợi ích phần mềm chỉ xuất hiện khi mô hình chọn đúng đường thực thi hiệu quả; chỉ thay đổi cách lưu trữ có thể giảm số byte nhưng không mang lại tốc độ tính toán như quảng cáo.
Hỗ trợ độ chính xác được tích hợp trong các đơn vị thực thi và các đường dữ liệu bộ nhớ. Các làn SIMD và SIMT có thể hỗ trợ nhiều định dạng vô hướng, trong khi Tensor Cores (section 1.3.3) và các đơn vị systolic (section 1.3.6) cung cấp các tổ hợp đầu vào và tích luỹ đặc thù theo kiến trúc. Độ chính xác thấp hơn giúp giảm số byte trên mỗi toán hạng và có thể tăng số phép toán mỗi chu kỳ. Khả năng tái sử dụng được quyết định bởi việc tiling và dataflow, không phải bởi bản thân độ chính xác. Đồng thời, chi phí chuyển đổi, scaling hoặc cơ chế fallback có thể bào mòn một phần lợi ích. Một định dạng chỉ hữu ích khi kernel và chính sách số học có thể dùng nó một cách an toàn.
Dù độ chính xác thấp hơn mang lại nhiều lợi ích, các mô hình deep learning không phải lúc nào cũng có thể chỉ dựa vào các biểu diễn ít bit. Để xử lý bài toán này, các bộ tăng tốc AI hiện đại triển khai mixed-precision computing, tức dùng các định dạng số khác nhau ở các giai đoạn thực thi khác nhau. Các lựa chọn độ chính xác này ảnh hưởng đến độ tin cậy số học: phép nhân ma trận có thể chạy bằng FP16 hoặc BF16, trong khi phép tích luỹ được giữ ở FP32 để tránh mất độ chính xác. Tương tự, các engine suy luận dùng số học INT8 nhưng vẫn giữ các activation quan trọng ở độ chính xác cao hơn khi cần.
Tính toán độ chính xác hỗn hợp
Các bộ tăng tốc AI hiện đại ngày càng hỗ trợ thực thi với độ chính xác hỗn hợp, cho phép dùng các định dạng số khác nhau ở nhiều giai đoạn tính toán. Trong quá trình huấn luyện, các khối lượng công việc (workload) thường dùng FP16 hoặc BF16 cho các phép nhân ma trận, đồng thời duy trì tích lũy ở FP32 để bảo toàn độ chính xác (Micikevicius et al. 2017; Mellempudi et al. 2019). Việc triển khai phần mềm cho huấn luyện với độ chính xác hỗn hợp, bao gồm kỹ thuật điều chỉnh tỷ lệ hàm mất mát (loss scaling) và hỗ trợ từ framework, được trình bày trong Huấn luyện độ chính xác hỗn hợp. Ngược lại, các khối lượng công việc suy luận thường được tối ưu hóa cho INT8, thậm chí INT4, đạt hiệu quả cao mà vẫn giữ được độ chính xác chấp nhận được.
Micikevicius, Paulius, Sharan Narang, Jonah Alben, Gregory Diamos, Erich Elsen, David Garcia, Boris Ginsburg, et al. 2017. “Mixed Precision Training.” arXiv Preprint arXiv:1710.03740.
Mellempudi, Naveen, Sudarshan Srinivasan, Dipankar Das, and Bharat Kaul. 2019. “Mixed Precision Training with 8-Bit Floating Point.” arXiv Preprint arXiv:1905.12334.
NVIDIA. 2020b. TensorFloat-32 in the A100 GPU Accelerates AI Training, HPC up to 20x.
NVIDIA Corporation. 2018. NVIDIA Tesla T4 Tensor Core GPU. NVIDIA product documentation.
Xu hướng đa dạng hóa độ chính xác thể hiện rõ trong tiến trình phát triển của phần cứng AI. Các kiến trúc ban đầu như NVIDIA Volta chỉ hỗ trợ hạn chế các định dạng có độ chính xác thấp hơn FP16, trong khi các kiến trúc sau này như Turing và Ampere đã mở rộng đáng kể dải định dạng được hỗ trợ. Table 6 minh họa quá trình này: GPU Ampere giới thiệu TF32, một định dạng lai giữa FP32 và FP16 (NVIDIA 2020b), đồng thời mở rộng hỗ trợ cho BF16, INT8 và INT4 (NVIDIA Corporation 2017, 2018, 2020a).
| Kiến trúc | Năm | Độ chính xác Tensor Core được hỗ trợ | Độ chính xác CUDA Core được hỗ trợ |
|---|---|---|---|
| Volta | 2017 | FP16 | FP64, FP32, FP16 |
| Turing | 2018 | FP16, INT8, INT4, INT1 | FP64, FP32, FP16, INT8 |
| Ampere | 2020 | FP64, TF32, BF16, FP16, INT8, INT4 | FP64, FP32, FP16, BF16, INT8 |
Các kiến trúc mới hơn tích hợp ngày càng nhiều định dạng số vì mỗi khối lượng công việc gắn với một điểm khác nhau trên đường đánh đổi giữa độ chính xác, thông lượng và năng lượng. Vì vậy, hỗ trợ độ chính xác là một hình thức “ghép” theo khối lượng công việc, không phải một danh sách đặc trưng chung.
Định dạng độ chính xác dùng trong thiết kế phần cứng kéo theo tác động dây chuyền lên toàn bộ hệ thống. Giảm từ FP32 xuống FP16 cắt một nửa lưu lượng truy cập bộ nhớ, và điều này quan trọng hơn bạn tưởng: vì truy cập bộ nhớ chiếm phần lớn năng lượng, việc giảm một nửa lưu lượng bộ nhớ có thể hạ đáng kể năng lượng cho mỗi lần suy luận khi di chuyển dữ liệu là nút thắt cổ chai (Horowitz 2014). Đồng thời, Tensor Cores và các mảng systolic có thể nhồi được nhiều đơn vị nhân-tích lũy độ chính xác thấp hơn vào cùng một diện tích silicon, nhờ đó tăng thông lượng đỉnh (Dally et al. 2021; Dally 2023). Các phép toán số nguyên ở độ chính xác thấp cũng tiêu thụ ít năng lượng hơn so với FP32 theo các nghiên cứu công nghệ điển hình (Horowitz 2014), và TPUv1 tập trung vào suy luận được xây dựng xoay quanh các đơn vị nhân 8-bit (Jouppi et al. 2017). Nhận định ở tầm hệ thống là: giảm độ chính xác không chỉ “tiết kiệm bit”, mà còn đồng thời giảm bớt nút thắt băng thông bộ nhớ và tăng mật độ tính toán, tức là đánh vào cả hai phía của biểu đồ roofline cùng lúc.
Khi các mô hình AI tiếp tục mở rộng, hỗ trợ độ chính xác kết nối cuộc bàn luận về phép tính cơ bản trở lại “bức tường bộ nhớ” (memory wall): các định dạng ít bit có ý nghĩa khi chúng giảm số byte phải di chuyển và giữ cho các nhân ma trận của phần cứng luôn được cấp dữ liệu. Câu hỏi kiến trúc còn lại là các đơn vị thực thi, các định dạng độ chính xác và các đường dẫn bộ nhớ sẽ được tích hợp thế nào vào một hệ thống bộ tăng tốc hoàn chỉnh. Việc tích hợp kiến trúc quyết định mức độ hiệu quả mà các phép tính cơ bản được chuyển hóa thành thông lượng hữu ích của bộ tăng tốc. Các làn SIMD, Tensor Cores và mảng systolic là những khối xây dựng, nhưng cách tổ chức chúng trên toàn chip khác nhau rất nhiều giữa các bộ xử lý AI; lựa chọn đơn vị thực thi, hỗ trợ độ chính xác số học, và cách kết nối của chúng sẽ định hình mức độ hiệu quả mà phần cứng có thể mở rộng cho các khối lượng công việc deep learning.
Kết nối nội nút: Mở rộng ngăn xếp
Để nắm vững ngăn xếp trên một máy, ta cần hiểu cách các bit di chuyển giữa GPU và CPU. Trong dải 1–8 GPU, việc mở rộng đạt được nhờ các kết nối nội nút tốc độ cao như NVLink và các đường truyền PCIe từ máy chủ đến thiết bị, giúp giảm bớt rào cản do bộ nhớ. Các liên kết này tạo thành một thang băng thông: tốc độ di chuyển dữ liệu giảm ở mỗi nấc khi đi xa dần khỏi khối tính toán, từ HBM tích hợp trong gói, qua cầu nối NVLink giữa các GPU, rồi xuống liên kết PCIe với máy chủ. Tầng PCIe chậm hơn nhiều so với bộ nhớ cục bộ của bộ tăng tốc và kết nối liên-GPU, nên bất kỳ đường dữ liệu nào đi qua CPU đều có thể trở thành điểm nghẽn hiệu suất, tạo nên “Bức tường PCIe” mà NVLink ra đời để tránh (NVIDIA Corporation 2020b). Section 1.4.5.1 sẽ lượng hóa hệ phân cấp này, với trọng tâm là giao tiếp giữa máy chủ và bộ tăng tốc.
Intel Corporation. 2021a. “Intel Advanced Matrix Extensions (Intel AMX).” Intel Architecture Instruction Set Extensions Programming Reference.
Các bộ xử lý AI hiện đại thể hiện nhiều đánh đổi trong thiết kế, tùy theo ứng dụng mục tiêu. So sánh các cấu hình cho thấy các ràng buộc khi triển khai đã dẫn tới những khác biệt kiến trúc. Một bộ tăng tốc tối ưu cho huấn luyện như NVIDIA A100 tích hợp nhiều Streaming Multiprocessor với các đơn vị SIMD rộng và FP16 Tensor Cores, vì thông lượng huấn luyện tăng theo tổng năng lực nhân-tích lũy (NVIDIA Corporation 2020a). TPUv4 của Google chọn hướng hoàn toàn khác: chỉ hai lõi trên mỗi chip, mỗi lõi chứa các mảng systolic BF16 rất lớn; thiết kế này đánh đổi sự linh hoạt của lập trình viên để lấy hiệu quả trên các phép nhân ma trận dày đặc (Jouppi et al. 2023). Ở phía suy luận, Intel Sapphire Rapids dành các engine ô Advanced Matrix Extensions (AMX) cho INT8 và BF16, phản ánh nhận định từ Nén mô hình rằng các mô hình suy luận chịu được độ chính xác thấp hơn (Intel Corporation 2021a). Các neural engine trên thiết bị di động còn đi xa hơn bằng cách thu nhỏ các engine ma trận thành các khối hệ thống trên chip (SoC) công suất thấp, ưu tiên hiệu quả năng lượng trên mỗi phép toán hơn là thông lượng cực đại. Table 7 so sánh các cấu hình kiến trúc này.
| Bộ xử lý | Thực thi vector | Engine ma trận | Các phần tử xử lý | Các khối lượng công việc (workload) chính |
|---|---|---|---|---|
| NVIDIA A100 | Làn CUDA FP/INT | Các tile lệnh Tensor Core | 108 SMs | Huấn luyện, HPC |
| Google TPUv4 | Đơn vị vector | \(128{\times}128\) mảng systolic BF16 | 2 core/chip | Huấn luyện |
| Intel Sapphire | 512-bit AVX-512 | AMX tiles (tối đa 16 hàng, mỗi hàng 64 bytes) | Lên đến 60 lõi | Suy luận |
| NPU di động | Các vector CPU/GPU/DSP | Các công cụ ma trận nhỏ | Các khối NPU tích hợp | Suy luận di động |
Nhìn vào các cấu hình này cho thấy một nguyên tắc kỹ thuật nhất quán: mỗi thiết kế chấp nhận hy sinh tính tổng quát để tối ưu cho phép toán chủ đạo và độ chính xác của khối lượng công việc mục tiêu. Chip huấn luyện đầu tư silicon vào các đường dữ liệu dấu phẩy động rộng; chip suy luận đánh đổi độ chính xác để tăng thông lượng; chip di động đánh đổi thông lượng để đạt hiệu quả năng lượng cao hơn. Không có thiết kế nào vượt trội cho mọi khối lượng công việc, và đó là lý do việc chọn phần cứng phải dựa trên phân tích khối lượng công việc thay vì chỉ nhìn vào các thông số kỹ thuật nổi bật.
Phân tích chi phí-hiệu suất
Thông số kiến trúc xác định tiềm năng tính toán, nhưng các quyết định triển khai cần phân tích chi phí-hiệu suất. Năng lực tính toán thuần túy chỉ là một đầu vào; hiệu suất thực tế có thể bị giới hạn bởi phép toán, bộ nhớ, giao tiếp, hỗ trợ phần mềm, hoặc mức độ sử dụng.
Sự chênh lệch năng lượng được nêu trong section 1.1.5 (nơi chi phí truy cập bộ nhớ chiếm ưu thế so với chi phí tính toán) là động lực cho cả cuộc cách mạng phần cứng chuyên dụng. Chênh lệch này cũng giải thích vì sao nhiều bộ tăng tốc chỉ đạt một phần nhỏ hiệu năng tính toán tối đa trên các khối lượng công việc bị giới hạn bởi bộ nhớ, trong khi các kiến trúc tối đa hóa tái sử dụng dữ liệu (ví dụ, mảng systolic cho các nhân ma trận dày đặc) có thể duy trì mức độ sử dụng cao hơn đáng kể trong điều kiện thuận lợi.
Hãy hình dung một tổ chức đang cân nhắc giữa việc dùng nhiều bộ tăng tốc đời cũ hay ít bộ tăng tốc đời mới. FLOP/s đỉnh có thể gây hiểu lầm bất cứ khi nào các kernel quan trọng bị giới hạn bởi băng thông hoặc giao tiếp. Các phép nhân ma trận lớn trong huấn luyện có thể bị giới hạn bởi năng lực tính toán, trong khi các bước optimizer, embeddings, chuẩn hóa và một số đường suy luận thì có thể không. So sánh phù hợp là thông lượng khối lượng công việc (workload) thực tế trên mỗi đô la, xét đến mức độ sử dụng, dung lượng bộ nhớ, băng thông và hiệu quả mở rộng dự kiến.
Những động lực này giúp giải thích vì sao các bộ tăng tốc mới hơn lại được áp dụng nhanh, dù giá thành đơn vị cao hơn. Với các khối lượng công việc (workload) bị giới hạn bởi bộ nhớ, những cải thiện về băng thông hiệu quả (và khả năng của ngăn xếp phần mềm trong việc tận dụng băng thông đó) có thể chi phối hiệu suất thực tế. Việc triển khai trên đám mây càng làm phân tích phức tạp hơn, vì giá thuê, mức độ sử dụng và chi phí vận hành có thể làm dịch chuyển điểm hòa vốn giữa mua và thuê phần cứng.
Table 8 đưa ra một bảng tính chi phí minh họa cho các bộ tăng tốc phổ biến. Giá cả khác nhau theo nhà cung cấp, khu vực, hợp đồng và khối lượng mua. Quan trọng hơn, các hàng về thông lượng dùng các chế độ độ chính xác khác nhau, nên giá trên mỗi phép toán đỉnh chỉ có ý nghĩa trong cùng một hàng, chứ không phải là một benchmark được kiểm soát giữa các thiết bị. Bảng này nhằm gợi ý để làm rõ các giả định, chứ không phải là một bảng xếp hạng.
| Bộ tăng tốc | Giá niêm yết | Thông lượng đỉnh đại diện (độ chính xác được hiển thị) | Băng thông bộ nhớ | Giá/hiệu năng |
|---|---|---|---|---|
| NVIDIA V100 | ~$10,000 | 125 TFLOP/s | 900 GB/s | $80/(TFLOP/s) |
| NVIDIA A100 | ~$15,000 | 312 TFLOP/s | 2,039 GB/s | $48.1/(TFLOP/s) |
| NVIDIA H100 | ~$25,000–30,000 | 494 TFLOP/s (TF32) | 3,350 GB/s | ~$50.6/(TFLOP/s) |
| Google TPUv4 | ~$8,000* | 275 TFLOP/s (BF16) | 1,200 GB/s | ~$29.1/(TFLOP/s) |
| Intel Gaudi 2 | ~$12,000 | 865 TFLOP/s (FP8) | 2,450 GB/s | $13.9/(TFLOP/s) |
Bảng tính cho thấy vì sao không thể rút gọn một quyết định phần cứng vào chỉ một cột. Một kernel bị giới hạn băng thông có thể coi trọng đường dẫn bộ nhớ 3,350 GB/s của H100 hơn là thêm đỉnh tính toán, trong khi một kernel bị giới hạn tính toán có thể ngược lại. Dung lượng có thể quyết định liệu một mô hình có nhét vừa hay không, và hỗ trợ phần mềm có thể quyết định liệu đường dẫn được quảng cáo có sử dụng được hay không. Phần tiếp theo tách riêng và xem xét khía cạnh bộ nhớ của quyết định đó.
Việc lựa chọn framework tác động đáng kể đến các quyết định kinh tế này. Các chiến lược tối ưu hóa framework-phần cứng chi tiết được đề cập trong Các Framework ML, trong khi các phương pháp đánh giá hiệu suất được thảo luận trong Benchmarking.
Các phần trước đã giới thiệu các lệnh vector, các phép toán trên ô ma trận và Tensor Cores có khả năng đạt thông lượng đỉnh rất cao. NVIDIA A100 quảng cáo 312 TFLOP/s cho đường dẫn tensor FP16 của nó, và các bộ tăng tốc mới hơn bổ sung thêm các đường dẫn FP8 (NVIDIA Corporation 2020a; Kuzmin et al. 2022; Micikevicius et al. 2022). Lấy số phép toán của ResNet-50 chia cho mức đỉnh đó chỉ cho ra một cận dưới về số học ở mức micro giây, chứ không phải dự đoán thời gian suy luận.
Kuzmin, Andrey, Mart Van Baalen, Yuwei Ren, Markus Nagel, Jorn Peters, and Tijmen Blankevoort. 2022. “FP8 Quantization: The Power of the Exponent.” Advances in Neural Information Processing Systems (NeurIPS), 14651–62. https://doi.org/10.52202/068431-1065.
Micikevicius, Paulius, Dusan Stosic, Neil Burgess, Marius Cornea, Pradeep Dubey, Richard Grisenthwaite, Sangwon Ha, et al. 2022. “FP8 Formats for Deep Learning.” arXiv Preprint arXiv:2209.05433.
Kiến trúc Blackwell (B200) của NVIDIA nối dài xu hướng này với đường dẫn tensor FP4, được quảng cáo đạt tới 9 PFLOP/s thông lượng đỉnh dày đặc hoặc 18 PFLOP/s thông lượng đỉnh thưa trên mỗi chip (NVIDIA Corporation 2024). Để chạm tới các mức đỉnh đó cần một mô hình, phương pháp số, kernel và mẫu thưa sử dụng đúng đường dẫn tương ứng. Phần cứng ít bit hơn mở rộng không gian thiết kế; nó không khiến mọi khối lượng công việc (workload) đều có thể giảm an toàn xuống FP4.
Tuy vậy, suy luận ResNet-50 thực tế mất mili giây, không phải micro giây. Khoảng cách giữa khả năng lý thuyết và hiệu suất thực tế nêu bật mâu thuẫn trung tâm của chương, như đã nêu trong phần Purpose: năng lực tính toán đã vượt trước khả năng cung cấp dữ liệu cho bộ xử lý. Việc di chuyển dữ liệu từ bộ nhớ tốn năng lượng lớn hơn nhiều so với phép tính số học, và băng thông bộ nhớ cải thiện chậm hơn thông lượng số học tensor. Sự chênh lệch này quyết định liệu 312 TFLOP/s sẽ chuyển thành mức sử dụng duy trì thấp hay cao trên một khối lượng công việc (workload) cụ thể (Horowitz 2014; Gholami et al. 2024).
Để hiểu khoảng cách này, cần xem xét các hệ thống bộ nhớ cung cấp dữ liệu cho các phép toán nguyên thủy. Hệ thống phân cấp bộ nhớ không chỉ là hạ tầng hỗ trợ; cùng với cường độ số học và cách ánh xạ, nó quyết định mức thông lượng đỉnh mà một khối lượng công việc (workload) có thể khai thác.
Self-Check: Question
In NVIDIA’s Ampere and Hopper architectures, how does 2:4 structured sparsity achieve an up to \(2\times\) theoretical speedup in Tensor Core matrix multiplication?
- Exactly two non-zero values are preserved in every contiguous four-element block, allowing weights to be stored in half the memory with 2-bit index metadata while sparse Tensor Cores perform math only on non-zeros
- Every alternate row of the weight matrix is dropped completely, allowing the GPU to halve the grid launch dimensions
- Four separate threads simultaneously execute one scalar multiply-accumulate instruction in a single clock cycle
- Floating-point numbers are converted to 2-bit integers, quadrupling register file capacity
Contrast the data movement mechanics and primary use cases of Weight-Stationary (WS) and Output-Stationary (OS) systolic array dataflows.
Place the following steps in the correct execution sequence for processing a matrix multiplication on an accelerator with Sparse Tensor Cores using 2:4 structured sparsity:
- Fine-tune or prune the weight matrix to ensure exactly two non-zero values exist in every four-element contiguous group
- Sparse Tensor Cores load compressed weights and decode metadata to gather matching input activation elements
- Multiply non-zero weights by gathered activations and accumulate into output partial sums at \(2\times\) dense throughput
- Compress the sparse weight matrix by storing only the non-zero values alongside 2-bit per-value selection metadata
What is the primary difference between the FP8 E4M3 and FP8 E5M2 numerical formats used in modern AI accelerators (such as NVIDIA Hopper and Ada Lovelace)?
- E4M3 uses 4 sign bits and 3 exponent bits, whereas E5M2 uses 5 sign bits and 2 exponent bits
- E4M3 has 4 exponent bits and 3 mantissa bits providing higher precision for forward-pass activations/weights, whereas E5M2 has 5 exponent bits and 2 mantissa bits providing wider dynamic range for gradients
- E4M3 is exclusively an integer fixed-point format, whereas E5M2 is a standard IEEE floating-point format
- E4M3 requires twice as many memory bytes per element as E5M2
True or False: In NVIDIA’s SIMT (Single Instruction, Multiple Threads) execution model, when threads within the same 32-thread warp execute divergent branches of an
if-elsecondition, both paths are executed concurrently in parallel at full hardware throughput.Describe the Tiling Principle in deep learning hardware mapping and explain why multi-level hierarchical tiling (from global memory down to registers) is necessary for high-throughput GEMM kernels.
Hệ thống bộ nhớ AI
ResNet-50 có thể phơi bày khoảng cách giữa khả năng tính toán của bộ tăng tốc và bộ nhớ: các trọng số tích chập, activations và kết quả trung gian vẫn phải đến kịp thời. Các bộ tăng tốc hiện đại đạt hàng trăm TFLOP/s hoặc hơn trên các đường xử lý độ chính xác thấp được chọn (NVIDIA Corporation 2020a, 2024; Choquette 2023), nhưng một kernel không thể sử dụng năng lực đó nếu lưu lượng yêu cầu vượt quá băng thông bộ nhớ tương ứng. Bức tường bộ nhớ AI là tên gọi cho sự lệch giữa nhu cầu tính toán số học và hệ thống bộ nhớ cấp dữ liệu cho nó ngày càng tăng.
Không giống các khối lượng công việc (workload) thông thường, các mô hình ML cần truy cập thường xuyên vào một lượng lớn tham số, activations và kết quả trung gian, dẫn đến nhu cầu băng thông bộ nhớ đáng kể. Thách thức này giao thoa với các chiến lược quản lý dữ liệu được trình bày trong Kỹ thuật dữ liệu. Phần cứng AI hiện đại đáp ứng các nhu cầu đó thông qua các hệ thống phân cấp bộ nhớ tiên tiến, kỹ thuật di chuyển dữ liệu hiệu quả và các chiến lược nén để thực thi hiệu quả.
Hiểu về bức tường bộ nhớ AI
Definition 1.4: Bức tường bộ nhớ AI
Bức tường bộ nhớ AI là giới hạn về hiệu suất của bộ tăng tốc ML, xảy ra khi thông lượng tính toán số học \((R_{\text{peak}})\) vượt quá băng thông bộ nhớ \((\text{BW})\). Vấn đề cốt lõi ở đây là liệu hệ thống bộ nhớ có thể cung cấp các toán hạng và nhận kết quả đủ nhanh để duy trì các phép toán nguyên thủy chuyên biệt đã được giới thiệu trong section 1.3.
- Ý nghĩa: Một khối lượng công việc (workload) được coi là đã chạm bức tường bộ nhớ khi việc chỉ tăng FLOP/s không còn cải thiện hiệu năng, vì số hạng \(\frac{D_{\text{vol}}}{\text{BW}}\) chi phối thời gian thực thi liên quan.
- Điểm khác biệt: Khác với bức tường bộ nhớ tổng quát ảnh hưởng đến mọi hệ thống tính toán, bức tường bộ nhớ AI được thúc đẩy bởi nhu cầu lưu trữ trạng thái mô hình và activation rất lớn mà deep learning đòi hỏi.
- Sai lầm phổ biến: Một hiểu lầm hay gặp là memory wall có thể được “khắc phục” chỉ bằng cách thêm bộ nhớ. Thực ra, đây là khoảng cách giữa băng thông và độ trễ: ngay cả khi dung lượng bộ nhớ là vô hạn, tốc độ di chuyển dữ liệu giữa bộ nhớ và khối tính toán vẫn là nút thắt vật lý cốt lõi.
Việc truy cập dữ liệu có thể chiếm phần lớn ngân sách năng lượng của một kernel chuyên sâu về bộ nhớ.27 Figure 9 so sánh chi phí hoạt động tiêu biểu từ một nghiên cứu công nghệ, cho thấy mức chênh lệch nhiều bậc giữa phép toán số học cục bộ đơn giản và việc truy cập DRAM ngoài chip.
27 Nút thắt cổ chai Von Neumann: Việc tách bộ nhớ khỏi khối tính toán buộc lệnh và dữ liệu phải đi qua các giao diện, thay vì nằm trong các thanh ghi cục bộ. Theo các ước tính tiêu biểu ở 45 nm từ Horowitz (2014), một lần truy cập DRAM tiêu thụ năng lượng gấp hơn 20.000\(\times\) so với một phép cộng INT8. Tỷ lệ chính xác thay đổi theo công nghệ và loại thao tác, nhưng tính cục bộ vẫn là một ưu tiên thiết kế hàng đầu.
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
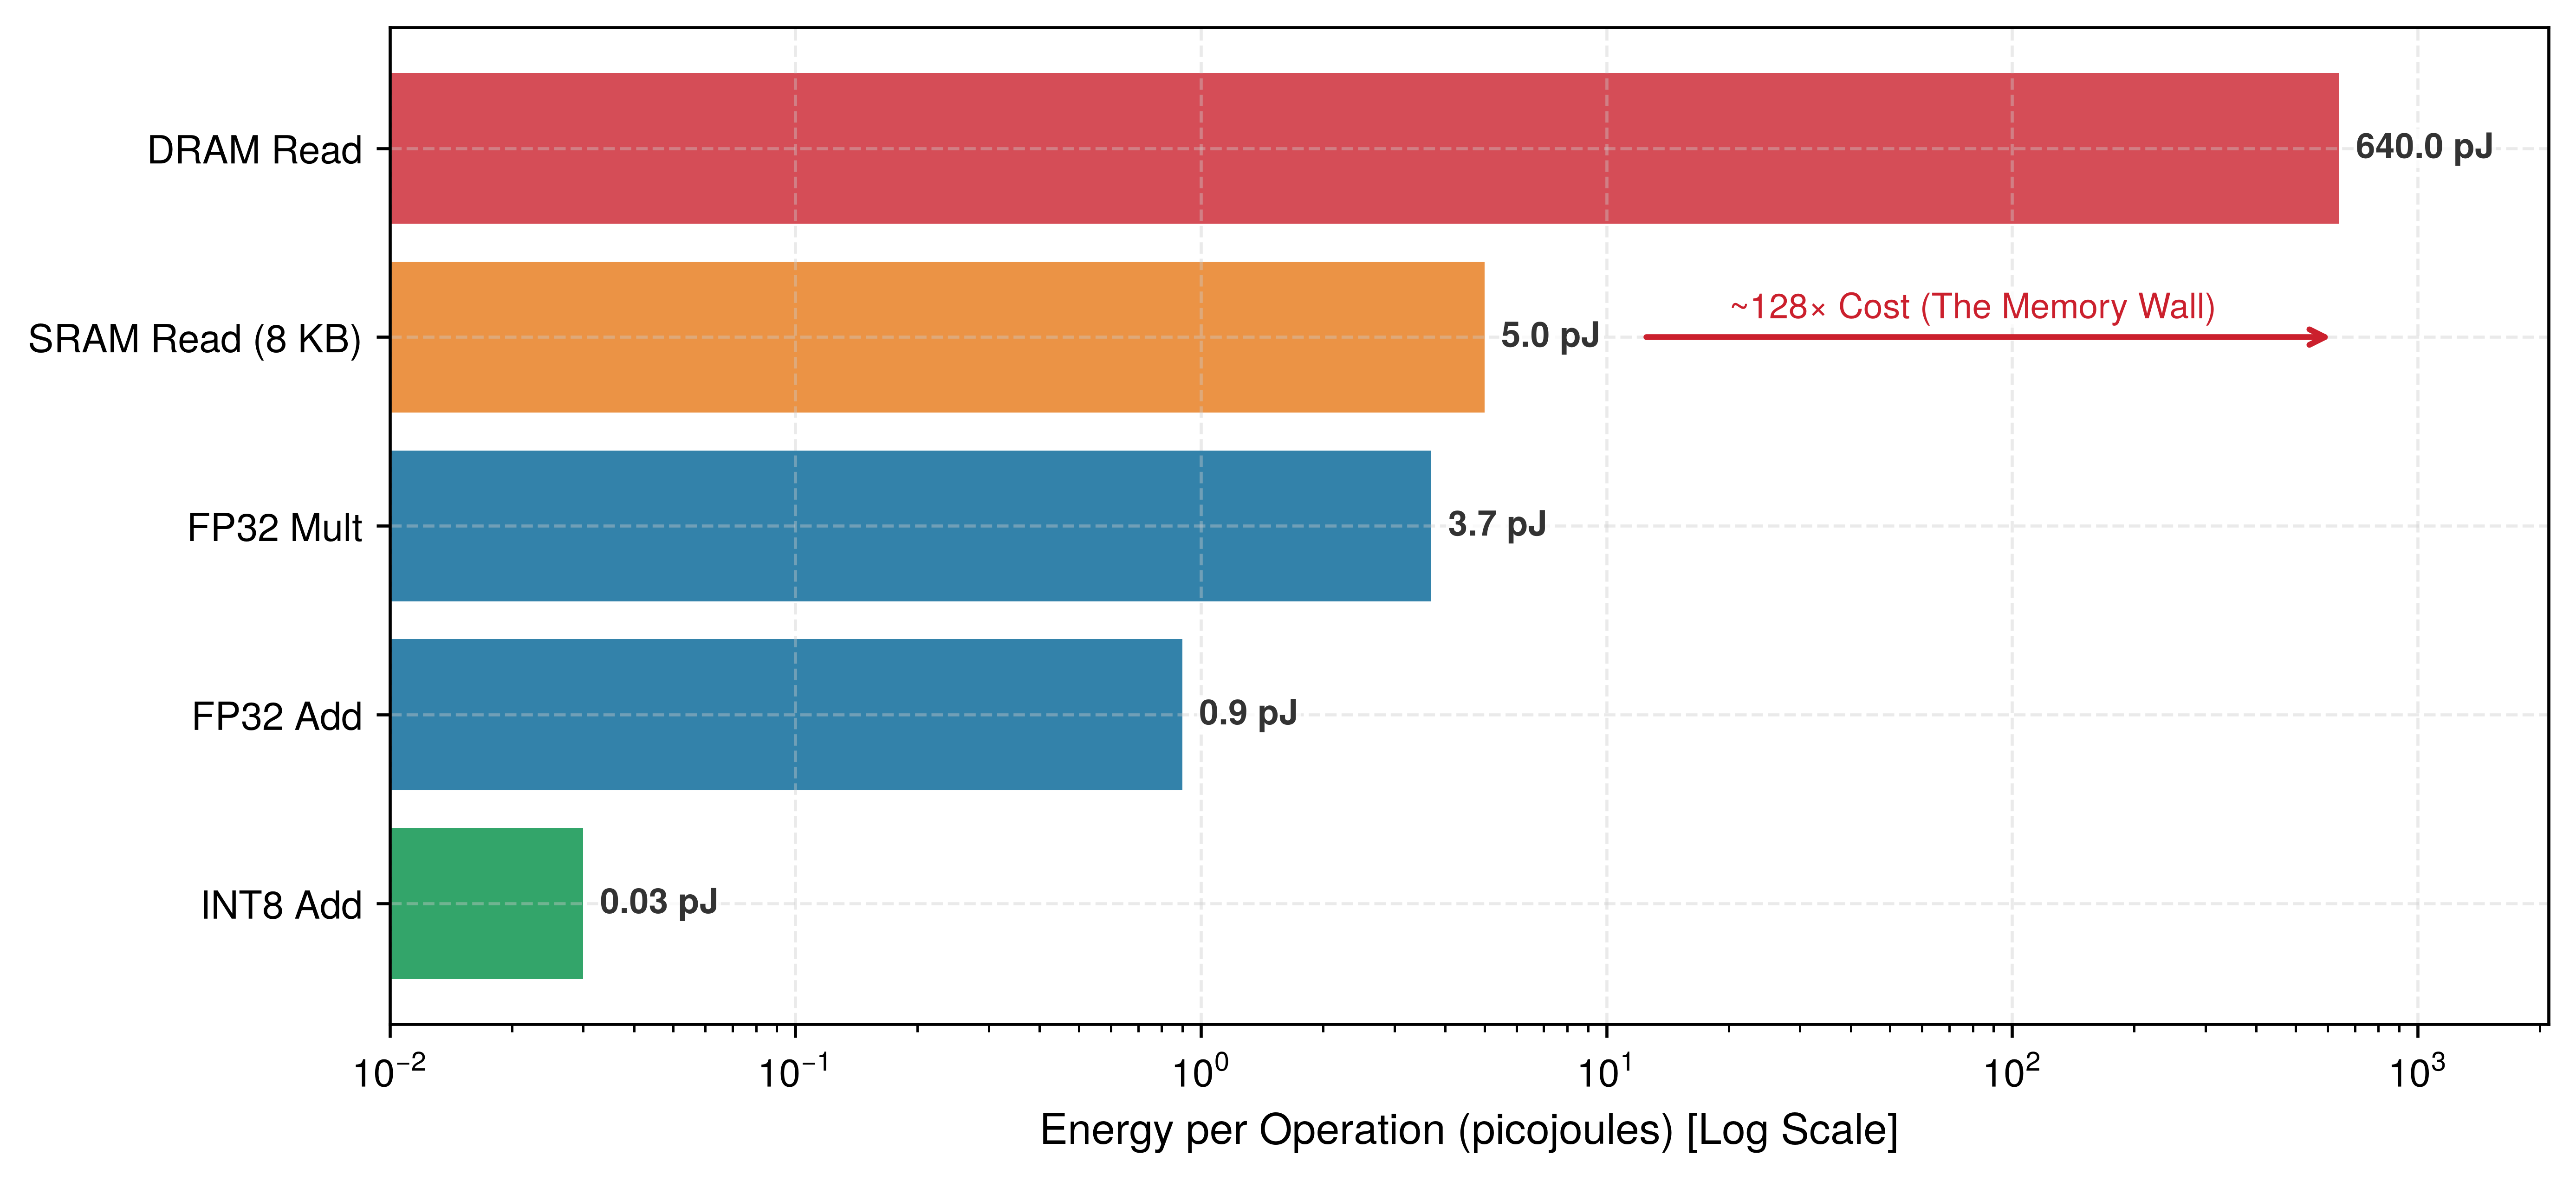
Định lượng khoảng cách hiệu năng giữa tính toán và bộ nhớ
Sự chênh lệch năng lượng mà figure 9 minh họa ngày càng nghiêm trọng hơn qua mỗi thế hệ phần cứng. Trong hai thập kỷ qua, khả năng tính toán đỉnh đã tăng nhanh đáng kể so với băng thông DRAM (Gholami et al. 2024). Sự phân kỳ này tạo ra một khoảng cách ngày càng lớn: các bộ tăng tốc có công suất tính toán khổng lồ nhưng không thể truy cập dữ liệu đủ nhanh để tận dụng hết công suất đó. Các bộ tăng tốc cao cấp điển hình có thể đạt thông lượng tensor đỉnh ở khoảng \(10^3\) TFLOP/s (ví dụ, NVIDIA H100 đạt 989 TFLOP/s với FP16, hoặc gần 2.000 TFLOP/s với FP8 dense) trong khi chỉ có băng thông bộ nhớ khoảng 3.35 TB/s (Choquette 2023). Điều này có nghĩa là cần khoảng \(10^2\) FLOP công việc trên mỗi byte dữ liệu được di chuyển để tận dụng hết khả năng tính toán, mức này có thể vượt quá cường độ số học của nhiều khối lượng công việc (workload) mạng nơ-ron trong thực tế.
Gholami, Amir, Zhewei Yao, Sehoon Kim, Coleman Hooper, Michael W. Mahoney, and Kurt Keutzer. 2024. “AI and Memory Wall.” IEEE Micro 44 (3): 33–39. https://doi.org/10.1109/mm.2024.3373763.
Memory wall biểu hiện qua ba ràng buộc quan trọng. Thứ nhất là sự chênh lệch năng lượng: truy cập DRAM có thể tiêu thụ năng lượng lớn hơn nhiều bậc độ lớn so với một phép toán nhân-tích lũy (Horowitz 2014; Sze et al. 2017), khiến nút thắt cổ chai thường chuyển từ tính toán thuần túy sang công suất và việc di chuyển dữ liệu. Thứ hai là giới hạn băng thông: ngay cả các hệ thống bộ nhớ có băng thông mức TB/s cũng có thể không cung cấp đủ dữ liệu liên tục cho các mảng tính toán song song lớn trên những khối lượng công việc (workload) bị giới hạn bởi bộ nhớ, làm cho khả năng tính toán bị bỏ phí. Thứ ba là hệ cấp bậc độ trễ: truy cập bộ nhớ ngoài chip có thể mất hàng trăm chu kỳ, gây ra các lần dừng pipeline lan truyền qua các đơn vị thực thi song song.
Cân bằng phần cứng (\(I_{\text{ridge}}\)): Ngưỡng phân chia
Các thiết bị khác nhau đặt ranh giới giữa tính toán và băng thông ở các cường độ khác nhau. Cân bằng phần cứng \((I_{\text{ridge}})\) là tỷ lệ giữa thông lượng số học đỉnh và băng thông bộ nhớ đỉnh. Trong mô hình roofline, đó là điểm ridge nơi trần tính toán và trần băng thông giao nhau: \[ I_{\text{ridge}} = \frac{R_{\text{peak}}}{\text{BW}} \]
Tỷ lệ này đặt ra một giới hạn riêng cho từng thiết bị. Tùy theo độ chính xác được chọn, một bộ tăng tốc cao cấp như H100 có thể cần khoảng \(150\)–\(300\) FLOP/byte để đạt tới trần tính toán, trong khi một vi điều khiển có thể có điểm ridge thấp hơn nhiều. Vì vậy, cùng một kernel có thể bị giới hạn bởi băng thông trên một bộ tăng tốc thiên về tính toán, nhưng lại bị giới hạn bởi tính toán trên một bộ xử lý edge. Sự cân bằng phần cứng không gán nhãn thiết bị nào là hiệu quả trong mọi trường hợp; nó cho biết khối lượng tái sử dụng dữ liệu mà một khối lượng công việc (workload) cần trên thiết bị đó.
Khả năng tính toán đỉnh đã tăng nhanh hơn hiệu năng bus bộ nhớ qua các thế hệ bộ tăng tốc, và độ chênh lệch đó quyết định một kernel cần tái sử dụng dữ liệu đến mức nào để luôn được nuôi dữ liệu đầy đủ. Figure 10 tách hai tốc độ tăng trưởng tạo nên điểm ridge, mỗi tốc độ được chuẩn hóa theo đường cơ sở V100, nên có thể trực quan đọc được khoảng cách giữa chúng ngày càng nới rộng.
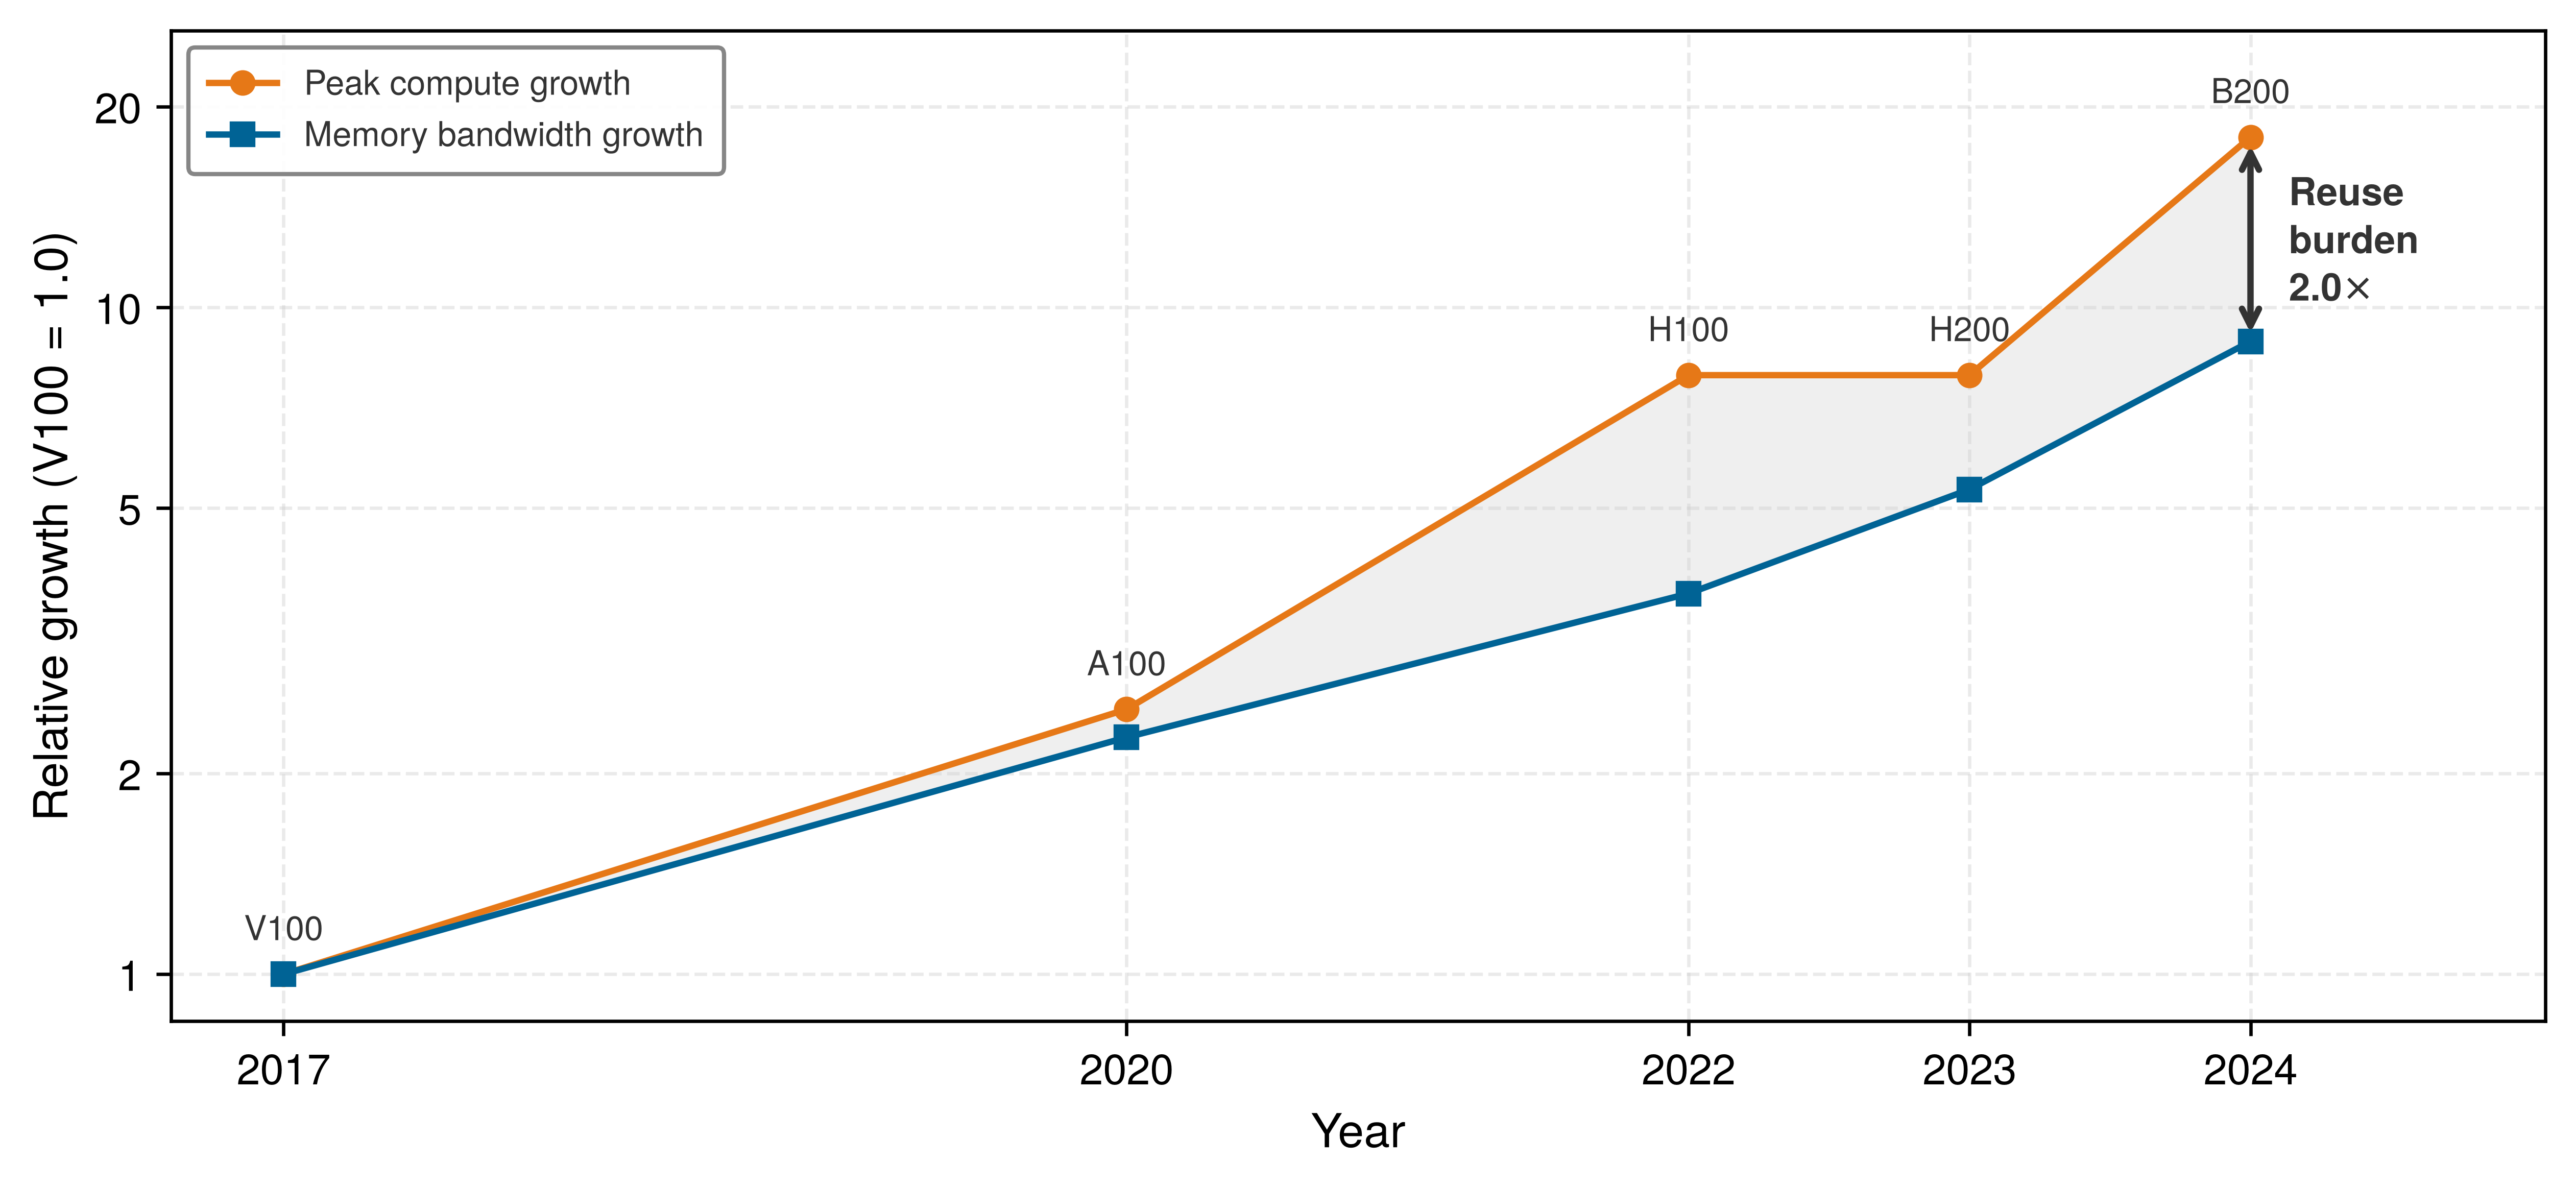
Ngưỡng để một kernel trở nên giới hạn bởi tính toán đã dịch chuyển theo các thế hệ phần cứng bộ tăng tốc. Hãy theo dõi quỹ đạo đi lên của các điểm ridge phần cứng trong figure 11 từ V100 đến B200 để thấy yêu cầu về cường độ số học tăng dần theo thời gian.
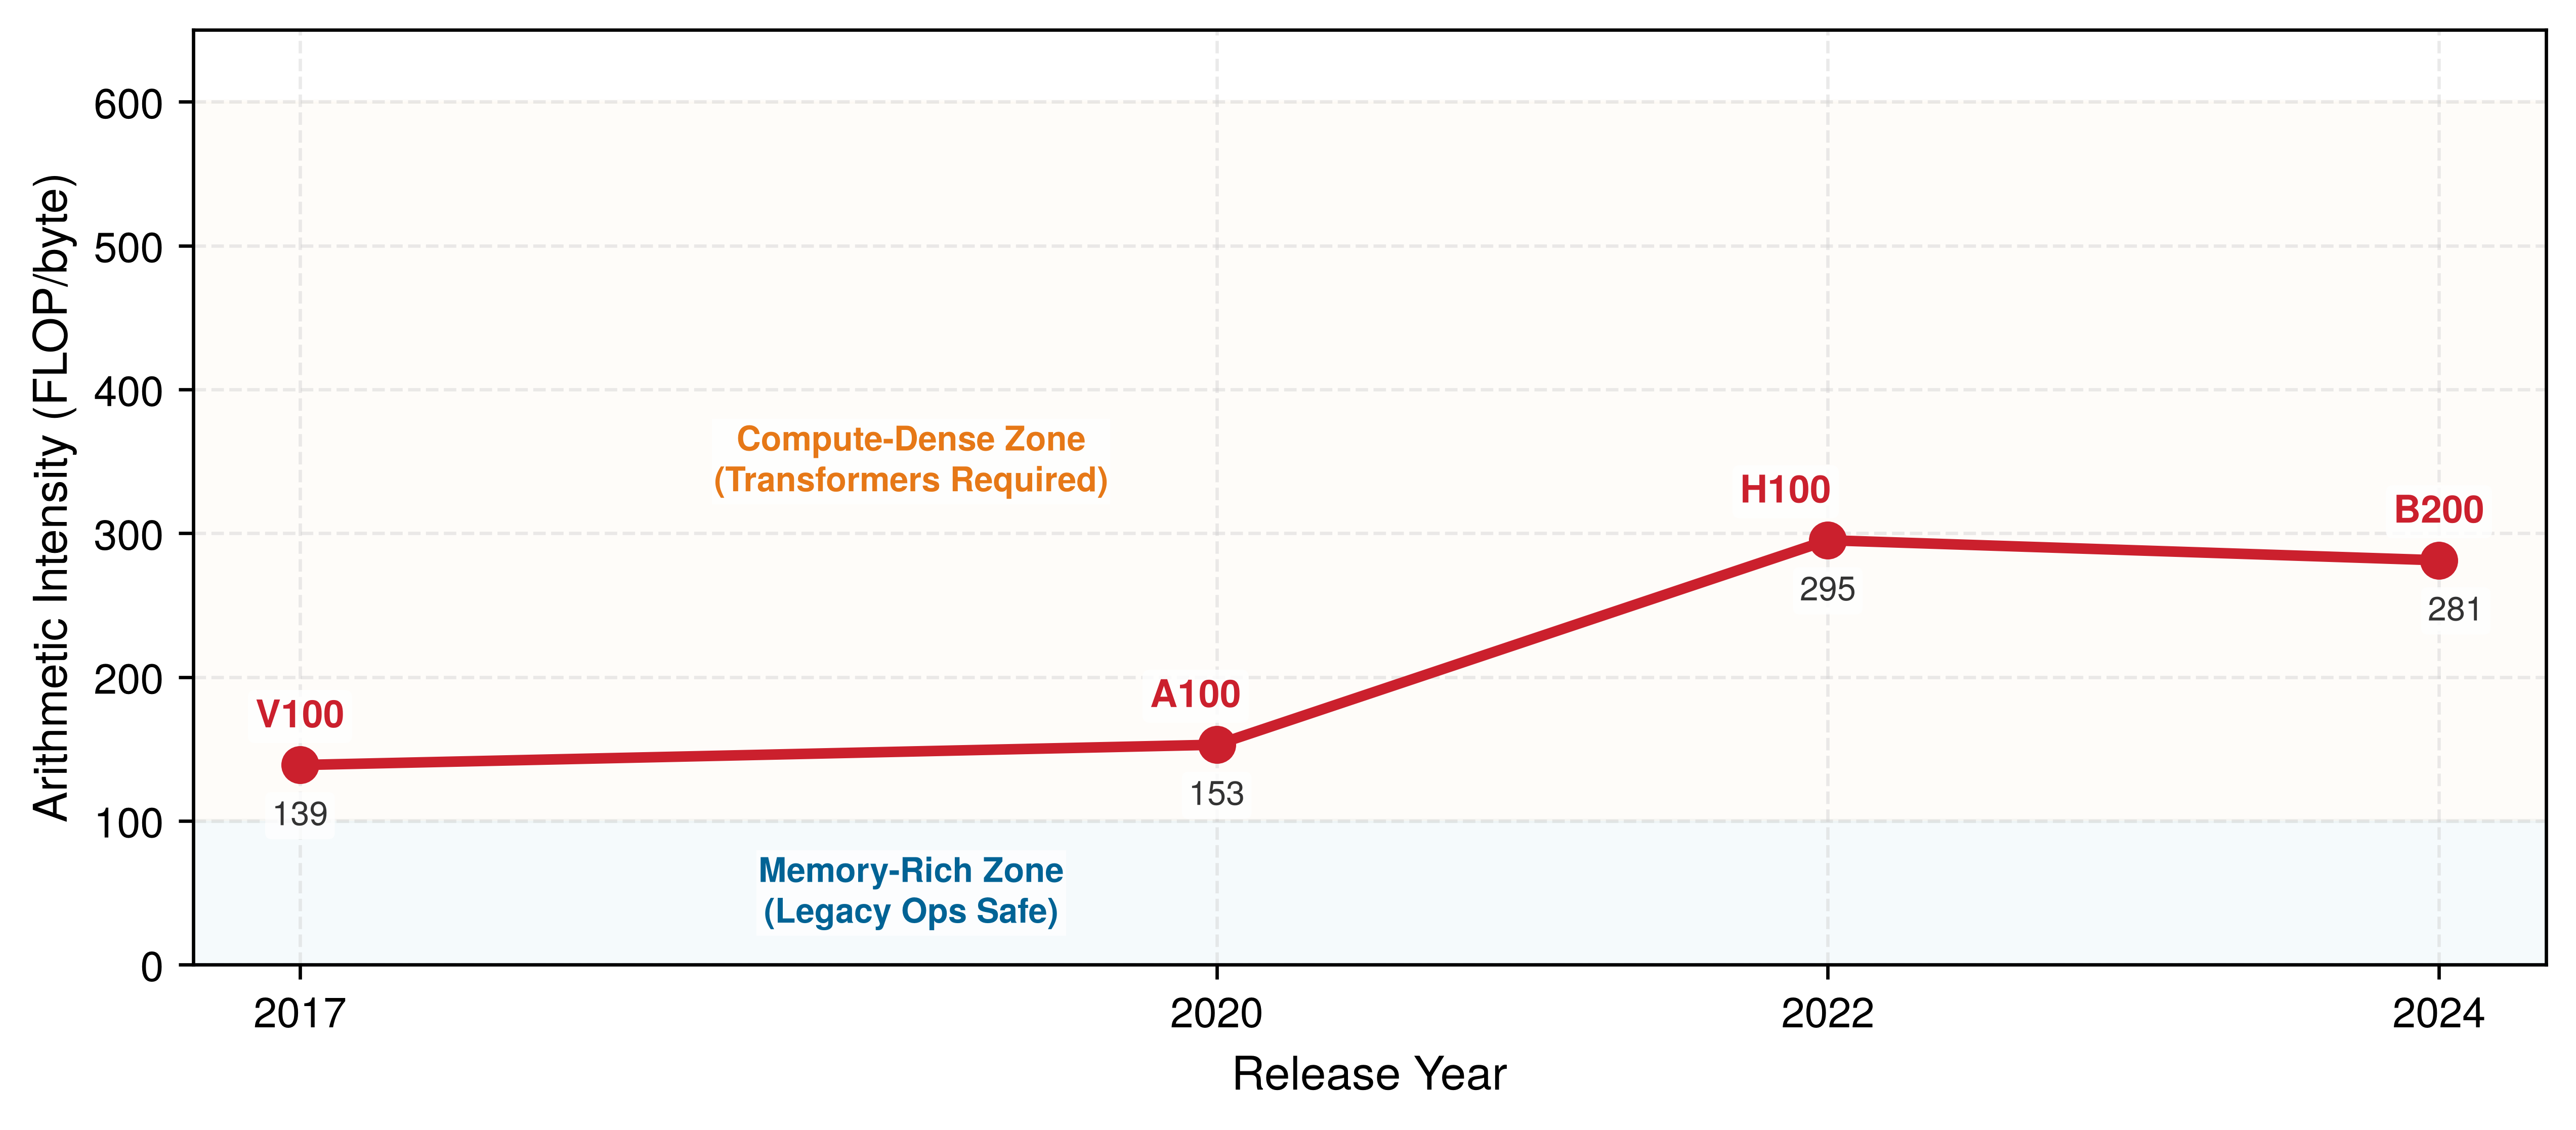
Ngoài các giới hạn về hiệu suất, truy cập bộ nhớ còn kéo theo chi phí năng lượng rất lớn. Việc lấy dữ liệu từ DRAM ngoài chip tiêu tốn năng lượng nhiều hơn đáng kể so với thực hiện các phép toán số học (Horowitz 2014). Sự kém hiệu quả này đặc biệt rõ trong các mô hình machine learning, nơi kích thước tham số lớn, truy cập bộ nhớ thường xuyên và các kiểu di chuyển dữ liệu không đồng đều làm trầm trọng thêm các nút thắt cổ chai ở bộ nhớ. Chính chênh lệch năng lượng này định hình các quyết định kiến trúc: TPUv1 của Google đạt hiệu suất trên mỗi watt cao hơn 30–80\(\times\) so với các CPU và GPU cùng thời trên các benchmark suy luận của Google bằng cách giảm thiểu di chuyển dữ liệu thông qua các mảng systolic và bộ nhớ trên chip lớn (Jouppi et al. 2017). Những lựa chọn thiết kế đó cho thấy các ràng buộc về năng lượng, chứ không phải giới hạn tính toán, thường quyết định tính khả thi khi triển khai trong thực tế. Việc lần theo một tensor duy nhất qua mọi tầng của hệ thống phân cấp bộ nhớ trong một lượt suy luận thực làm cho những chi phí năng lượng này trở nên cụ thể.
Các mẫu truy cập bộ nhớ trong khối lượng công việc (workload) machine learning
Ngoài thông lượng tính toán thô, hiệu suất của một bộ tăng tốc còn phụ thuộc vào khả năng liên tục cung cấp dữ liệu cho các đơn vị xử lý mà không bị gián đoạn. Mạng nơ-ron đặt ra ba yêu cầu đồng thời đối với việc cung cấp dữ liệu này. Các tham số mô hình (trọng số và độ chệch (bias)) có thể lên đến hàng tỷ, đòi hỏi lưu trữ và phát luồng hiệu quả để duy trì thông lượng. Các activation trung gian được tạo ra ở mỗi lớp phải được giữ tạm thời cho các bước xử lý tiếp theo, làm tăng chi phí bộ nhớ trong các kiến trúc sâu. Trong quá trình huấn luyện, lan truyền ngược bổ sung yêu cầu thứ ba: lưu trữ và truy cập gradient cho mọi tham số, làm tăng thêm khối lượng dữ liệu cần di chuyển giữa các đơn vị tính toán và bộ nhớ.
Khi các mô hình tăng về kích thước và độ phức tạp, những cải thiện về dung lượng bộ nhớ và băng thông ngày càng trở nên quan trọng. Mặc dù các đơn vị tính toán chuyên biệt giúp tăng tốc các phép toán như nhân ma trận, hiệu suất tổng thể của chúng phụ thuộc vào việc cung cấp dữ liệu liên tục và hiệu quả cho các phần tử xử lý. Trong các ứng dụng quy mô lớn như xử lý ngôn ngữ tự nhiên và thị giác máy tính, các mô hình thường có hàng triệu đến hàng tỷ tham số (Brown et al. 2020). Để đạt hiệu suất cao, cần giảm thiểu độ trễ và nghẽn do việc di chuyển dữ liệu không hiệu quả giữa bộ nhớ và các đơn vị tính toán (Narayanan et al. 2021; Kwon and Rhu 2018).
Kwon, Youngeun, and Minsoo Rhu. 2018. “TensorDIMM: A Practical Near-Memory Processing Architecture for Embeddings and Tensor Operations in Deep Learning.” Proceedings of the 52nd Annual IEEE/ACM International Symposium on Microarchitecture, 740–53. https://doi.org/10.1145/3352460.3358284.
Lighthouse 1.2: Vòng đời của một tensor: KWS chạy trên GPU
Nhắc lại đèn hiệu Phát hiện Từ khóa được tóm tắt trong Năm Mô hình Hải đăng. Nếu cùng một đoạn âm thanh dài một giây được xử lý theo batch trên đường suy luận chạy trên GPU, hành trình vật lý của nó qua hệ thống phân cấp bộ nhớ trông như sau:
- DRAM (HBM): Tensor bắt đầu ở đây.
- Kích thước: 16,000 mẫu \(\times\) 2 byte (FP16) = 32 KB.
- Độ trễ: Lấy dữ liệu này từ bộ nhớ ngoài chip mất khoảng ~300 ns (cộng với độ trễ xếp hàng).
- Năng lượng: Chi phí khoảng ~20 pJ/bit. Chi phí cao.
- L2 cache: Các yêu cầu bộ nhớ thiết bị có thể được phục vụ tại đây khi các dòng cache tương ứng đang hiện diện.
- Độ trễ: ~4 ns.
- Truy cập: Được chia sẻ giữa nhiều Streaming Multiprocessor (SM).
- L1 cache/bộ nhớ chia sẻ: Một SM cụ thể xử lý một phần (tile) của âm thanh, sử dụng cache do phần cứng quản lý hoặc bộ nhớ chia sẻ được cấp phát rõ ràng.
- Độ trễ: ~1 ns.
- Tính cục bộ: Nếu truy cập L1 bị trượt, L2 vẫn có thể đáp ứng trước khi phải truy cập HBM.
- Thanh ghi: Tensor Core hoạt động tại đây.
- Độ trễ: Thường chỉ vài chu kỳ, tùy thuộc vào lệnh và kiến trúc.
- Thông lượng: 312 TFLOP/s.
- Năng lượng: Chi phí ~0.1 pJ/bit.
Góc nhìn hệ thống: Hiệu suất bị giới hạn bởi giá trị nhỏ hơn giữa thông lượng tính toán đỉnh và tích của băng thông với cường độ số học. Liên kết bộ nhớ nào cung cấp băng thông phù hợp tùy thuộc vào nơi tập làm việc đang cư trú; đường từ HBM tới L2 là một khả năng gây nghẽn, chứ không phải yếu tố duy nhất quyết định roofline.
Một cách để định lượng thách thức này là so sánh thời gian truyền dữ liệu với thời gian tính toán. Để làm điều đó, ta định nghĩa năm biến chính: \(D_{\text{vol}}\) là tổng khối lượng dữ liệu (byte), \(\text{BW}\) là băng thông bộ nhớ khả dụng (byte/s), \(O\) là số lượng phép toán dấu phẩy động, \(R_{\text{peak}}\) là thông lượng phần cứng đỉnh (FLOP/s), và \(\eta_{\text{hw}}\) là mức sử dụng phần cứng thực tế.
Thời gian truyền qua bộ nhớ \(T_{\text{mem}}\) và thời gian tính toán \(T_{\text{compute}}\) được biểu diễn bằng: \[\begin{gather*} T_{\text{mem}} = \frac{D_{\text{vol}}}{\text{BW}} \\ T_{\text{compute}} = \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} \end{gather*}\]
Trong mô hình không chồng lấp, \(T_{\text{mem}} > T_{\text{compute}}\) cho thấy việc thực thi bị giới hạn bởi bộ nhớ. Khi có chồng lấp, thành phần có thời gian lớn hơn thường chi phối tổng thời gian, nhưng các phụ thuộc, xếp hàng và chồng lấp không hoàn toàn sẽ quyết định bao nhiêu tính toán bị nhàn rỗi và tối ưu hóa dịch chuyển dữ liệu nào có thể cải thiện hiệu suất.
Figure 12 định lượng sự chênh lệch này cho các mô hình có số lượng tham số công khai cụ thể và các thế hệ phần cứng. Khoảng cách giữa các đường cong này đại diện cho thách thức kỹ thuật thúc đẩy thiết kế hệ thống bộ nhớ của bộ tăng tốc (Krizhevsky et al. 2012; Brown et al. 2020; Chowdhery et al. 2022; Dubey et al. 2024). Ngay cả các bộ tăng tốc có băng thông cao như B200 của NVIDIA và các thiết bị thuộc lớp MI300X/MI325X của AMD cũng không thể thu hẹp khoảng cách tốc độ tăng trưởng này chỉ bằng băng thông (NVIDIA Corporation 2024; AMD 2023). Số lượng tham số cho các hệ thống độc quyền như GPT-4 và Gemini không được công bố chính thức, nên không được đưa vào đồ thị dưới dạng các điểm dữ liệu thực tế.
Chowdhery, Aakanksha, Sharan Narang, Jacob Devlin, Maarten Bosma, Gaurav Mishra, Adam Roberts, Paul Barham, et al. 2022. “PaLM: Scaling Language Modeling with Pathways.” arXiv Preprint arXiv:2204.02311.
Dubey, Abhimanyu, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, et al. 2024. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783.
NVIDIA Corporation. 2024. NVIDIA Blackwell Architecture. NVIDIA product documentation.
AMD. 2023. AMD Instinct MI300X Accelerators. AMD product documentation.
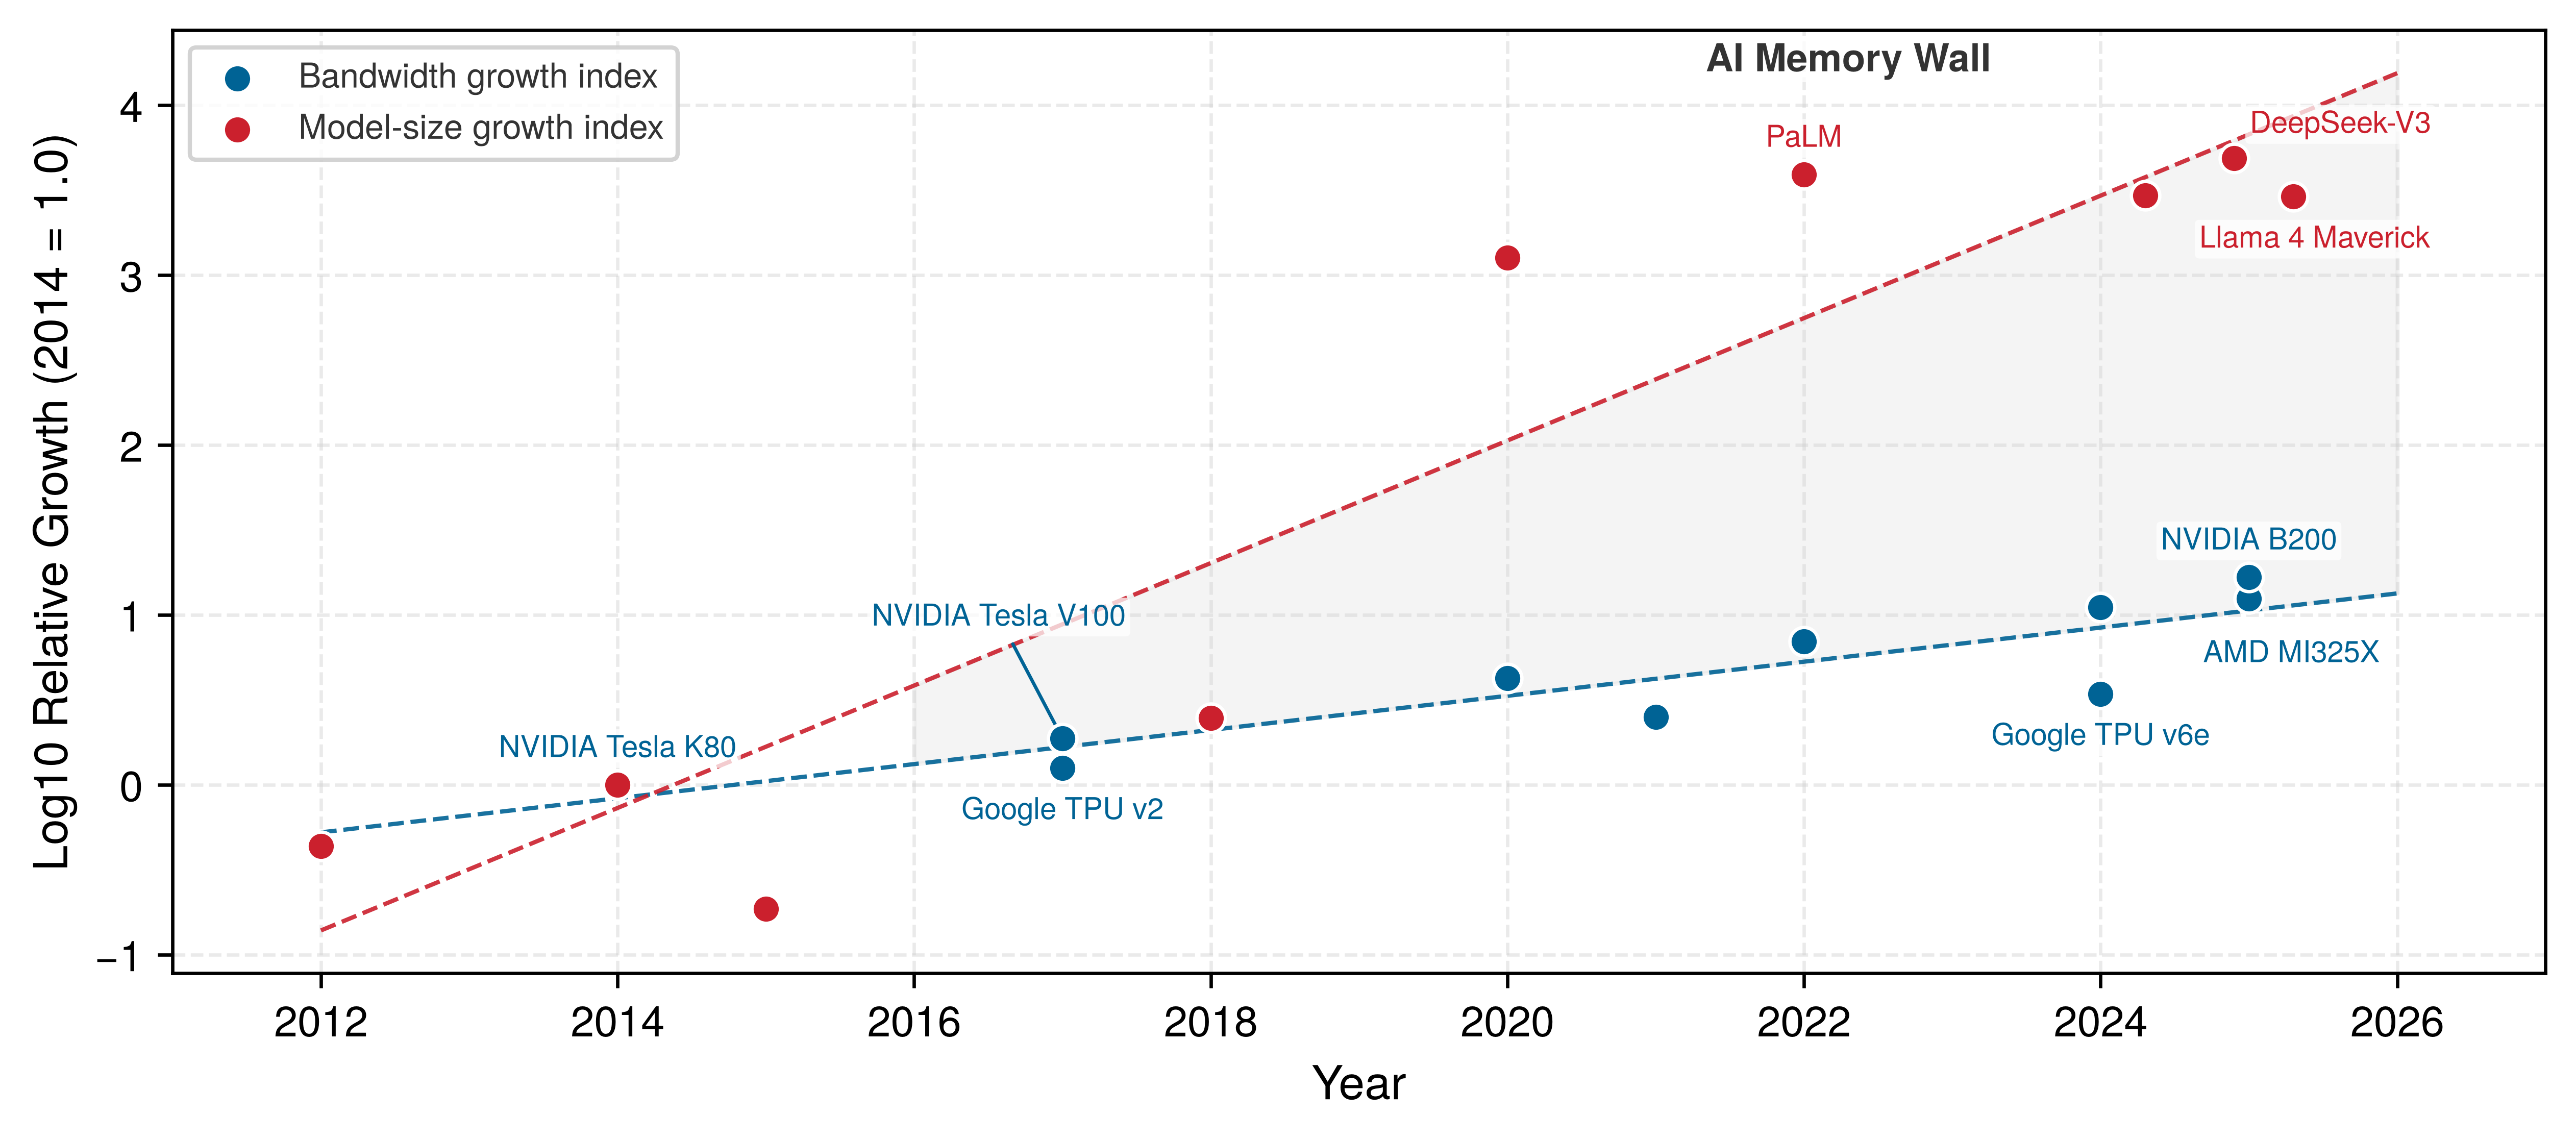
Truy cập bộ nhớ không đều
Nhiều khối lượng công việc (workload) ML kết hợp các kernel dày đặc có tính đều đặn với áp lực bộ nhớ không đều do tính thưa, tra cứu embedding, độ dài chuỗi thay đổi, lưu lượng attention/KV-cache và các batch nhỏ. Các phần dày đặc chính là lý do các bộ tăng tốc hoạt động rất hiệu quả; còn các phần không đều là nơi các cơ chế cache tiêu chuẩn và hệ thống phân cấp bộ nhớ gặp khó, dẫn tới tăng độ trễ bộ nhớ và sử dụng băng thông kém hiệu quả.
Nhiều hệ thống ML chứa cả hai chế độ truy cập này. Table 9 so sánh các kernel dày đặc có tính đều đặn với các thành phần không đều như embeddings, các toán tử thưa và cơ chế định tuyến phụ thuộc vào đầu vào.
Một nguồn gây không đều quan trọng trong các khối lượng công việc (workload) ML xuất phát từ kích thước batch và thứ tự thực thi. Cách dữ liệu đầu vào được xử lý theo batch ảnh hưởng trực tiếp đến khả năng tái sử dụng bộ nhớ, tạo ra một bài toán tối ưu hóa phức tạp. Kích thước batch nhỏ làm giảm khả năng tái sử dụng các activations và trọng số đã được cache, dẫn đến việc phải thường xuyên lấy dữ liệu từ bộ nhớ ngoài chip chậm hơn. Kích thước batch lớn hơn có thể cải thiện tái sử dụng và phân bổ chi phí truy cập bộ nhớ, nhưng đồng thời đòi hỏi băng thông bộ nhớ khả dụng cao hơn, có thể gây tắc nghẽn ở các cấp khác nhau trong hệ thống phân cấp bộ nhớ. Sự cân bằng tinh tế này đòi hỏi phải cân nhắc kỹ kiến trúc mô hình và các tài nguyên phần cứng sẵn có.
| Đặc trưng | Các kernel dày đặc thông thường | Các thành phần ML không đều |
|---|---|---|
| Mẫu truy cập | Liên tục hoặc xếp lát (tiled) | Gián tiếp, phân tán, hoặc phụ thuộc vào đầu vào |
| Tính cục bộ của cache | Thường cao sau khi xếp lát (tiling) | Thường thấp hơn và phụ thuộc vào khối lượng công việc (workload) |
| Tái sử dụng dữ liệu | Có cấu trúc trên các lát (tiles) hoặc các batch | Thưa thớt hoặc động, tùy thuộc vào toán tử |
| Các phụ thuộc | Các vòng lặp lồng nhau tĩnh | Định tuyến phụ thuộc vào đầu vào hoặc các hình dạng biến đổi |
| Ví dụ | GEMM, tích chập, attention dày đặc | Tra cứu embedding, độ thưa thớt không cấu trúc, định tuyến MoE |
| Áp lực chính | Tính toán hoặc băng thông, tùy thuộc vào cường độ số học | Độ trễ, băng thông, metadata và mất cân bằng tải |
| Hệ quả năng lượng | Phụ thuộc vào việc tái sử dụng và cấp bộ nhớ | Di chuyển thêm và metadata có thể làm tăng năng lượng |
Các lớp mạng nơ-ron khác nhau tương tác với bộ nhớ theo những cách riêng, không chỉ phụ thuộc vào kích thước batch. Các lớp tích chập tận dụng tốt tính cục bộ theo không gian, vì các pixel lân cận được xử lý cùng nhau và các kernel trọng số nhỏ được tái sử dụng. Các lớp kết nối đầy đủ và attention dày đặc sử dụng truy cập ma trận đều đặn, nhưng các trọng số lớn hoặc các tensor key-value của chúng có thể vượt quá dung lượng cache và bị giới hạn bởi băng thông khi mức độ tái sử dụng thấp. Độ dài chuỗi thay đổi làm phức tạp việc lập kế hoạch bộ nhớ, nhưng không làm cho các truy cập attention dày đặc trở nên ngẫu nhiên một cách nội tại.
Truy cập không đều có thể xuất phát từ độ thưa thớt không cấu trúc,28 embedding và định tuyến phụ thuộc vào đầu vào. Độ thưa thớt có cấu trúc giữ lại các khối đều đặn mà phần cứng chuyên dụng có thể xử lý hiệu quả, trong khi các định dạng không cấu trúc nén thường yêu cầu truy cập gián tiếp hoặc phân tán. Định tuyến Mixture-of-Experts là xác định đối với một đầu vào cho trước, nhưng thay đổi giữa các đầu vào khác nhau, làm phức tạp việc phân batch, prefetching và cân bằng tải.
28 Độ thưa thớt và sự không đều của bộ nhớ: Các định dạng thưa thớt không cấu trúc thường thu thập các phần tử khác 0 thông qua địa chỉ gián tiếp, có thể làm suy yếu tính tuần tự của truy cập và khiến chi phí metadata trở nên đáng kể. Độ thưa thớt có cấu trúc giữ lại các khối thân thiện với phần cứng, nên hành vi truy cập của nó khác với tỉa (pruning) tùy ý. Nếu không có các kernel hoặc hỗ trợ phần cứng phù hợp, một mô hình thưa thớt không cấu trúc có thể chạy chậm hơn phiên bản dày đặc của nó, dù thực hiện ít phép toán số học hơn.
Tính không đều làm giảm hiệu suất qua nhiều cơ chế khác nhau, và gom tất cả lại thành một “vấn đề bộ nhớ” có thể dẫn tới tối ưu sai. Các địa chỉ rải rác có thể biến một lần truy cập logic thành nhiều giao dịch bộ nhớ, khiến mỗi dòng cache nạp về chỉ chứa ít byte dữ liệu hữu ích. Truy cập gián tiếp cũng có thể làm tuần tự hóa việc tạo địa chỉ: hệ thống phải nạp một chỉ mục hoặc con trỏ trước khi biết cần yêu cầu dữ liệu nào, từ đó hạn chế mức song song ở cấp độ bộ nhớ ngay cả khi băng thông tổng vẫn còn dư. Định tuyến phụ thuộc dữ liệu đầu vào tạo ra một kiểu lỗi thứ ba khi một số phần tử xử lý nhận hàng đợi dài hơn phần tử khác; thời gian hoàn thành bị chi phối bởi hàng đợi chậm nhất, trong khi các đơn vị lân cận lại nhàn rỗi. Cấp phát kích thước biến thiên có thể làm phân mảnh dung lượng, nhưng phân mảnh không phải điều kiện bắt buộc, cũng không đủ để gây ra truy cập không đều. Một luồng dữ liệu tuần tự có thể bão hòa băng thông mà không hề không đều, trong khi một chuỗi tra cứu phụ thuộc có thể bị tắc nghẽn ở mức thấp hơn nhiều so với đỉnh băng thông.
Vì vậy, chẩn đoán nên bắt đầu từ cơ chế đang cản trở tiến triển. Tỷ lệ thấp giữa số byte dữ liệu hữu ích và tổng số byte truyền đi cho thấy hiệu quả sử dụng không gian hoặc mức độ gom/coalesce truy cập kém. Các khoảng chờ bộ nhớ kéo dài kèm với băng thông còn dư cho thấy có các miss phụ thuộc, hoặc quá ít yêu cầu đồng thời để che giấu độ trễ. Độ sâu hàng đợi không đồng đều hoặc lượng việc theo từng tuyến cho thấy mất cân bằng tải, chứ không phải vấn đề dung lượng cache. Chỉ số hit cache đơn lẻ không phân biệt được các trường hợp này, vì một miss có thể lãng phí băng thông, phơi bày độ trễ, hoặc cả hai. Mỗi chẩn đoán gợi ý một biện pháp khác nhau: đóng gói hoặc chia khối giúp cải thiện sử dụng không gian, sắp xếp lại và nạp trước giúp tạo ra nhiều yêu cầu đồng thời, các định dạng thưa có cấu trúc giúp giảm chi phí lập chỉ mục, còn định tuyến hoặc phân vùng giúp cân bằng khối lượng công việc. Hệ thống phân cấp bộ nhớ quyết định chi phí cho các lần truy cập còn lại, trong khi lựa chọn về luồng dữ liệu và bố cục tensor quyết định phần mềm có thể loại bỏ bao nhiêu mức độ không đều trước khi thực thi chạm tới phần cứng.
Thứ tự tối ưu hóa đi theo chẩn đoán đó. Khi định dạng nằm trong tầm kiểm soát của hệ thống, bước đầu tiên là cách biểu diễn: một định dạng thưa dạng khối hoặc định tuyến theo nhóm có thể loại bỏ truy cập gián tiếp trước khi kernel chạy. Tiếp theo là tổ chức yêu cầu: các truy cập phát ra cùng lúc nên nhắm tới các địa chỉ liền kề, và cần duy trì đủ yêu cầu độc lập đang ở trạng thái chờ để che lấp độ trễ không thể tránh khỏi. Tăng thêm dung lượng cache hoặc băng thông chỉ hữu ích khi phân tích hiệu năng cho thấy luồng yêu cầu đã được chuẩn hóa vẫn dùng hết tài nguyên đó. Băng thông nhiều hơn không thể giải quyết phụ thuộc con trỏ tuần tự, và dung lượng lớn hơn không thể cân bằng lại khối lượng công việc (workload) bị lệch. Mục tiêu là phơi bày càng nhiều cấu trúc đều đặn càng tốt, đồng thời khoanh gọn phần bất quy tắc không thể tránh khỏi vào phần nhỏ nhất của quá trình thực thi.
Các mẫu truy cập không đều và những hạn chế của bức tường bộ nhớ được xem xét trong section 1.4.1 đặt ra nhiều thách thức lớn, nhưng cũng hé lộ các cơ hội tối ưu hóa. Dù các truy cập bộ nhớ đơn lẻ có vẻ khó đoán, các khối lượng công việc (workload) ML lại có các mẫu tái sử dụng có cấu trúc ở cấp độ cao hơn: cùng các trọng số được áp dụng cho các phần tử batch, cùng các kernel trượt theo các chiều không gian, và các mẫu attention lặp lại tại các vị trí trong chuỗi. Các nhà thiết kế phần cứng tận dụng những tính đều đặn này thông qua các hệ thống phân cấp bộ nhớ được tổ chức cẩn thận, giữ dữ liệu được truy cập thường xuyên gần các đơn vị tính toán, ngay cả khi chuỗi truy cập cụ thể thay đổi.
Hệ thống phân cấp bộ nhớ
Các bộ tăng tốc AI hiện đại tận dụng các mẫu tái sử dụng có cấu trúc này thông qua các hệ thống phân cấp bộ nhớ đa cấp: thay vì coi bộ nhớ là một tài nguyên đơn khối, chúng tổ chức lưu trữ thành các tầng riêng biệt, được tối ưu cho những mẫu truy cập, khoảng cách tái sử dụng và chi phí năng lượng khác nhau. Trong khi tính toán đa năng phải đối phó với các truy cập bộ nhớ khó đoán, các khối lượng công việc (workload) ML thể hiện sự tái sử dụng có cấu trúc có thể được tối ưu hóa thông qua việc tổ chức dữ liệu cẩn thận qua nhiều cấp bộ nhớ.
Ở cấp cao nhất, các thiết bị lưu trữ dung lượng lớn nhưng chậm được dùng để lưu trữ mô hình lâu dài. Ở cấp thấp nhất, các thanh ghi tốc độ cao và cache đảm bảo các đơn vị tính toán có thể truy cập toán hạng với độ trễ tối thiểu. Giữa hai cực này, bộ nhớ scratchpad cung cấp không gian lưu trữ trên chip do phần mềm quản lý, trong khi các bộ tăng tốc dùng DRAM cục bộ thiết bị, như HBM hoặc GDDR, cho các tập làm việc lớn hơn.
Điểm mấu chốt trong table 10 là bộ lưu trữ càng lớn và càng xa thì thường có dung lượng lớn hơn nhưng đi kèm độ trễ và chi phí năng lượng cao hơn. Các tỷ lệ này không đồng đều giữa các cấp liền kề, và việc truy cập thanh ghi hoặc SRAM ở gần không nhất thiết đắt hơn từng phép toán số học.
| Cấp độ bộ nhớ | Độ trễ tương đối | Băng thông | Dung lượng tương đối | Ví dụ sử dụng trong deep learning |
|---|---|---|---|---|
| Thanh ghi | Thấp nhất | Cao nhất | Rất nhỏ | Lưu trữ toán hạng cho tính toán tức thì |
| Cache L1/L2 (SRAM) | Rất thấp | Cao | Nhỏ | Lưu vào cache các activation được truy cập thường xuyên và các khối trọng số nhỏ |
| Bộ nhớ scratchpad | Rất thấp | Cao | Nhỏ đến trung bình | Bộ nhớ được quản lý bằng phần mềm cho các tính toán trung gian |
| DRAM thiết bị (HBM, GDDR hoặc LPDDR) | Cao | Trung bình–Rất cao | Lớn | Lưu trữ các tham số mô hình và activation không vừa trên chip |
| DRAM máy chủ (thường là DDR) | Cao cục bộ; truyền tải làm tăng độ trễ | Trung bình | Lớn đến rất lớn | Chuẩn bị hoặc dỡ tải dữ liệu bên ngoài bộ nhớ bộ tăng tốc |
| Bộ nhớ Flash (SSD/NVMe) | Rất cao | Thấp | Rất lớn | Lưu trữ các mô hình đã huấn luyện trước và checkpoint để tải sau |
Hệ thống phân cấp này gợi ý một giải pháp có vẻ đơn giản: xây dựng bộ nhớ ngoài chip lớn hơn, nhanh hơn và loại bỏ hoàn toàn nhu cầu về SRAM trên chip. Tuy nhiên, câu trả lời nằm ở vật lý: sự lan truyền tín hiệu trong và giữa các chip đặt ra một ngưỡng độ trễ cứng.
Napkin Math 1.2: Giới hạn tốc độ ánh sáng
Vấn đề: Tại sao SRAM trên chip lại cần thiết thay vì lấy tất cả dữ liệu từ HBM?
Tính toán:
- Khoảng cách: Trên một chip (die) H100-class 814 mm², tín hiệu truyền khoảng 20 mm.
- Độ trễ lan truyền: Với tốc độ \(\approx 0.5c\) trong silicon, \(20\text{ mm}/(0.5c) \approx 130\text{ ps}\).
- Chu kỳ xung nhịp: Ở tần số 2 GHz, \(1/(2\text{ GHz}) = 500\text{ ps}\).
- DRAM: HBM ngoài chip nằm cách die vài milimét trên package, nhưng độ trễ truy cập DRAM cộng với phần phụ trội của giao thức lên tới hơn 100 chu kỳ.
Hiểu biết về hệ thống: Ước tính thời gian lan truyền 20 mm vào khoảng 130 ps, nhỏ hơn một chu kỳ xung nhịp 500 ps, nên chỉ riêng khoảng cách không đủ để kết luận truy cập trong một chu kỳ là bất khả thi. Một truy cập HBM thực tế còn gồm độ trễ mảng DRAM, tuần tự hóa, đi qua giao thức, độ trễ liên kết và chờ đợi trong hàng, tạo thành đường dẫn truy cập hơn 100 chu kỳ. Vì vậy, các thanh ghi cục bộ và SRAM là cần thiết để cung cấp dữ liệu cho các khối tính toán ở 2 GHz. Với các mô hình transformer, chính đường dẫn truy cập đầy đủ này giải thích vì sao trọng số phải được dàn sẵn trong SRAM theo từng khối thay vì đọc theo yêu cầu từ HBM, và vì sao việc liên tục streaming toàn bộ KV cache có thể làm sụt thông lượng suy luận khi lưu lượng bộ nhớ không thể ẩn sau các phép tính số học.
Bộ nhớ trên chip
Bộ nhớ trên chip bao gồm các thanh ghi, cache Static Random-Access Memory (SRAM) và các vùng nhớ tạm (scratchpad) do phần mềm quản lý trên khuôn bộ tăng tốc. Mỗi cấp bộ nhớ có sự đánh đổi giữa dung lượng, độ trễ, băng thông và chính sách quản lý. Băng thông trên chip tổng hợp có thể đạt nhiều TB/s, nhưng mức đạt được phụ thuộc vào độ rộng truy cập và mức độ đồng thời; dung lượng thì hạn chế và được phân vùng giữa các lõi hoặc khối. DRAM của thiết bị như HBM cung cấp dung lượng lớn hơn nhiều với băng thông thấp hơn và độ trễ cao hơn; tốc độ thực tế của nó cũng phụ thuộc vào mẫu truy cập. Các thanh ghi là nơi lưu trữ tức thời nhất cho toán hạng và bộ tích lũy, và không chỉ giới hạn ở vài toán hạng trên toàn chip. Một tập thanh ghi hữu hạn được chia cho các luồng hoặc lệnh đang hoạt động, nên mức cấp phát theo từng luồng ảnh hưởng đến mức độ chiếm dụng và kích thước khối. Các nhân hiệu quả giữ các giá trị sống ngắn trong thanh ghi, đồng thời luân chuyển các khối có thể tái sử dụng qua cache hoặc vùng nhớ tạm, tránh spill và các lần truyền xuống tầng thấp hơn khi dung lượng cho phép.
Để giảm nhu cầu di chuyển dữ liệu liên tục giữa các thanh ghi và bộ nhớ ngoài, các cache nhỏ nhưng nhanh đóng vai trò là bộ đệm trung gian. Các cache này lưu các activation, trọng số và giá trị trung gian vừa được truy cập, đảm bảo dữ liệu thường dùng luôn sẵn với độ trễ tối thiểu. Tuy nhiên, kích thước cache bị hạn chế, nên không đủ để chứa toàn bộ bản đồ đặc trưng hoặc các tensor trọng số lớn trong các mô hình machine learning. Vì vậy, tại mỗi thời điểm chỉ các phần tham số hoặc activation được dùng thường xuyên nhất mới có thể nằm ở đây.
Example 1.3: Hợp đồng Tensor Core
Tình huống: Một nhóm kỹ sư chuyển một khối lượng công việc transformer sang GPU NVIDIA A100, kỳ vọng Tensor Cores sẽ tự động được kích hoạt để tăng tốc. Tuy nhiên, phân tích hiệu năng cho thấy các Tensor Cores vẫn nhàn rỗi (NVIDIA Corporation 2020a).
Chẩn đoán: Khối lượng công việc đã dùng các hình dạng và kiểu dữ liệu khiến hệ thống chọn các nhân kém hiệu quả hơn, thay vì đi theo đường Tensor Core như dự định.
Bài học về hệ thống: Các đường chuyên biệt có yêu cầu cụ thể về toán tử, độ chính xác, bố cục và hình dạng. Thư viện thường có thể xử lý các kích thước không khớp bằng cách đệm hoặc dùng các nhân thay thế, nhưng để đạt mức sử dụng cao, cần xác minh đường nào thực sự đã được chọn.
Đối với các tập dữ liệu làm việc lớn hơn, nhiều bộ tăng tốc AI bao gồm bộ nhớ scratchpad. Bộ nhớ này cung cấp dung lượng lớn hơn cache, nhưng có một điểm khác biệt quan trọng: nó cho phép phần mềm kiểm soát rõ ràng dữ liệu nào được lưu trữ và khi nào bị loại khỏi bộ nhớ. Không giống cache dựa vào các chính sách loại bỏ do phần cứng quản lý, bộ nhớ scratchpad cho phép các khối lượng công việc machine learning giữ lại các giá trị quan trọng như activation và trọng số bộ lọc cho nhiều lớp tính toán. Khả năng này rất hữu ích trong các mô hình như mạng nơ-ron tích chập, nơi cùng một bản đồ đặc trưng đầu vào và trọng số bộ lọc được tái sử dụng qua nhiều phép tính. Bằng cách giữ dữ liệu này trong bộ nhớ scratchpad thay vì tải lại từ bộ nhớ ngoài, các bộ tăng tốc có thể giảm đáng kể các lần truyền dữ liệu không cần thiết và cải thiện hiệu quả tổng thể (Chen et al. 2017). Trên GPU NVIDIA, phần cứng cung cấp bộ nhớ scratchpad cho lập trình viên dưới dạng bộ nhớ chia sẻ: một vùng SRAM nhanh, do phần mềm quản lý, nơi tất cả các luồng trong một khối luồng có thể đọc và ghi, tách biệt với cache L1/L2 do phần cứng quản lý. Các nhân ML tùy chỉnh được viết bằng CUDA hoặc Triton điều khiển vùng nhớ này một cách tường minh. FlashAttention đạt được mức tăng thông lượng đáng kể cho các lớp attention của transformer chính xác nhờ khai thác cơ chế này: thay vì vật liệu hóa toàn bộ ma trận điểm attention \(S{\times}S\) trong HBM, nó chia nhỏ các truy vấn, khóa và giá trị qua SRAM/bộ nhớ chia sẻ và chỉ ghi kết quả cuối cùng trở lại HBM (Dao et al. 2022). Việc giảm các lượt truy cập HBM—chứ không phải giảm số phép toán số học—là nguồn chính của sự tăng tốc.
Bộ nhớ ngoài chip
Khi tập làm việc của một mô hình lớn hơn SRAM trên chip, câu hỏi thiết kế là liệu nó có vừa trong DRAM cục bộ của bộ tăng tốc hay không. Một bộ tăng tốc có thể dùng HBM, GDDR hoặc LPDDR; đây là các công nghệ bộ nhớ thay thế, không phải các tầng tuần tự. Dữ liệu không đủ chỗ phải được dàn sẵn hoặc chuyển bớt qua bộ nhớ máy chủ hoặc bộ lưu trữ, làm phát sinh thêm các lần truyền qua liên kết trước khi bộ tăng tốc có thể sử dụng.
Ngoài bộ nhớ trên chip, HBM cung cấp khả năng truy cập nhanh vào các tham số mô hình và activation lớn hơn không vừa trong cache hoặc bộ đệm scratchpad. HBM xếp chồng nhiều khuôn nhớ (die) và dùng các giao diện rộng để cung cấp băng thông tổng hợp cao hơn nhiều so với các giao diện DRAM ngoài chip thông thường. HBM thường được dùng cho tham số mô hình và activation trên các bộ tăng tốc hiệu năng cao, trong khi chi phí, độ phức tạp đóng gói và yêu cầu công suất khiến nó ít phổ biến hơn trên các thiết bị edge bị hạn chế.
Các bộ tăng tốc không có HBM có thể dùng GDDR hoặc LPDDR cục bộ của thiết bị. Khi một mô hình vượt quá dung lượng bộ nhớ thiết bị, hệ thống có thể chuyển dữ liệu sang DRAM của máy chủ, nhưng bộ tăng tốc phải chuyển dữ liệu đó qua một liên kết như PCIe trước khi tính toán. Vì vậy, chuyển tải hiệu quả sẽ chỉ dàn sẵn các phần cần cho mỗi phép tính và chồng lấn các lần truyền khi có thể.
Ở cấp cao nhất của hệ thống phân cấp bộ nhớ, bộ nhớ flash và ổ đĩa thể rắn (SSD) lưu trữ các mô hình đã huấn luyện sẵn lớn, các tập dữ liệu và các trọng số được checkpoint. Các thiết bị lưu trữ này có dung lượng lớn nhưng quá chậm cho thực thi thời gian thực, nên mô hình phải được nạp vào các tầng bộ nhớ nhanh hơn trước khi bắt đầu tính toán. Ví dụ, trong kịch bản huấn luyện, các mô hình được checkpoint lưu trong SSD phải được nạp vào DRAM hoặc HBM trước khi tiếp tục tính toán, vì thực thi trực tiếp từ SSD sẽ quá chậm để duy trì mức sử dụng bộ tăng tốc hiệu quả (Narayanan et al. 2021).
Hệ thống phân cấp bộ nhớ cân bằng các mục tiêu cạnh tranh giữa tốc độ, dung lượng và hiệu quả năng lượng. Di chuyển dữ liệu qua nhiều cấp làm tăng độ trễ và chi phí băng thông, còn dung lượng hạn chế buộc phải di chuyển thêm khi tập làm việc vượt quá bộ nhớ cục bộ. Vì vậy, băng thông bộ nhớ là yếu tố then chốt đối với các khối lượng công việc (workload) bị giới hạn bởi băng thông, bên cạnh thông lượng tính toán và chi phí phần mềm.
Băng thông bộ nhớ và các đánh đổi trong kiến trúc
Băng thông bộ nhớ được quảng cáo chỉ là trần trên; băng thông có thể đạt phụ thuộc vào kiểu truy cập, batching, tính cục bộ và giao diện máy chủ cấp dữ liệu cho bộ tăng tốc. Các bộ tăng tốc hiện đại thể hiện các đánh đổi rõ rệt giữa băng thông và dung lượng, trực tiếp quyết định những khối lượng công việc (workload) nào chúng phục vụ hiệu quả. Các bộ tăng tốc điển hình trong trung tâm dữ liệu cung cấp băng thông bộ nhớ ở mức vài TB/s, thường đi kèm hàng chục GB bộ nhớ băng thông cao. Tuy vậy, chỉ nhìn vào băng thông thô có thể gây hiểu lầm: điều quan trọng là băng thông đạt được với một kiểu truy cập cụ thể. Transformer attention, tích chập và các lớp fully connected có thể tận dụng những phần khác nhau của băng thông đỉnh vì mức tái sử dụng, cách chia ô (tiling) và tính đều đặn của truy cập khác nhau. Các lớp fully connected chỉ tiến gần băng thông đỉnh khi kích thước batch đủ lớn để phân bổ đều chi phí nạp các ma trận trọng số—điều này liên hệ trực tiếp tới độ nhạy theo kích thước batch được bàn trong phân tích roofline tại section 1.5. Hệ quả thực tế là băng thông hiệu quả của một bộ tăng tốc cho một khối lượng công việc cụ thể có thể thấp hơn nhiều so với mức đỉnh được quảng cáo; vì thế, băng thông trên mỗi đô la là thước đo mua sắm đáng tin cậy hơn so với chỉ băng thông đỉnh.
Như đã nêu ở section 1.4.1, truy cập bộ nhớ trên chip thường tiêu tốn từ vài đến vài chục picojoule mỗi lần, trong khi DRAM ngoài chip có thể ở mức hàng trăm picojoule mỗi lần—một mức phạt năng lượng chênh lệch nhiều bậc. Các bộ tăng tốc AI giảm truy cập DRAM bằng ba chiến lược chính: weight stationarity (giữ trọng số/tham số mô hình trong bộ nhớ trên chip), input stationarity (đệm activation đầu vào tại chỗ), và output stationarity (tích lũy các tổng riêng phần trên chip).
Khả năng mở rộng băng thông bộ nhớ khác nhau giữa các thiết kế bộ tăng tốc. Kiến trúc GPU tăng băng thông bằng cách thêm các kênh bộ nhớ, đạt khoảng 1 TB/s ở sản phẩm phổ thông và vài TB/s ở hệ thống cao cấp. Các thiết kế TPU đạt hiệu quả băng thông nhờ dataflow mảng systolic và tái sử dụng dữ liệu trên chip mạnh, thường đánh đổi tính linh hoạt để lấy hiệu quả trên các kernel tensor dày đặc. Các thiết kế SoC di động chịu ràng buộc chặt nhất, cung cấp băng thông bộ nhớ hợp nhất ở mức hàng trăm GB/s trong mức công suất chỉ vài watt, nên cần lập lịch khối lượng công việc (workload) và quản lý nhiệt cẩn thận.
HBM cung cấp băng thông cao hơn nhiều so với bộ nhớ DDR thông thường, nhưng đổi lại chi phí và độ phức tạp đóng gói cao hơn đáng kể. Vì vậy, các bộ tăng tốc băng thông cao chấp nhận chi phí hệ thống bộ nhớ lớn hơn để đổi lấy hiệu suất duy trì cao hơn trên các khối lượng công việc (workload) bị giới hạn bởi băng thông. Các bộ tăng tốc edge thường hy sinh băng thông để đáp ứng mục tiêu chi phí và công suất nghiêm ngặt, đồng thời vẫn duy trì hiệu suất đủ cho các khối lượng công việc (workload) suy luận.
Những đặc tính băng thông này ảnh hưởng trực tiếp đến quyết định triển khai: huấn luyện trên đám mây ưu tiên băng thông thô để đạt dung lượng mô hình tối đa, suy luận edge tối ưu hóa hiệu quả băng thông theo ràng buộc năng lượng, còn triển khai di động cân bằng giữa băng thông và giới hạn chi phí. Ngoài hệ thống bộ nhớ bên trong của bộ tăng tốc, lưu lượng giữa máy chủ và thiết bị có thể tạo thêm nút thắt cổ chai. Khi một đầu vào phải đi qua liên kết PCIe 64 GB/s trước khi tới bộ tăng tốc có băng thông HBM 2 TB/s, giao diện đó có băng thông thấp hơn khoảng 30\(\times\) và có thể chi phối các lượt truyền nhỏ, thường xuyên (NVIDIA Corporation 2020a, 2020b). Dữ liệu thường trú (resident data) và các đường dẫn lưu trữ hoặc mạng trực tiếp không cần đi qua liên kết máy chủ đó trước.
Giao tiếp giữa máy chủ và bộ tăng tốc
Các bộ tăng tốc machine learning như GPU và TPU đạt thông lượng tính toán cao nhờ thực thi song song. Tuy nhiên, hiệu quả của chúng thường bị giới hạn bởi việc di chuyển dữ liệu giữa máy chủ và bộ tăng tốc, cụ thể là giữa CPU và bộ nhớ của bộ tăng tốc. So với nhiều khối lượng công việc (workload) truyền thống vốn giữ phần lớn dữ liệu trong một miền bộ nhớ duy nhất, các khối lượng công việc (workload) AI thường cần truyền dữ liệu thường xuyên giữa bộ nhớ CPU và bộ nhớ của bộ tăng tốc, kéo theo độ trễ, tiêu tốn băng thông và ảnh hưởng đến hiệu suất tổng thể.
Figure 13 minh họa trình tự giữa máy chủ và bộ tăng tốc, cụ thể ở đây là GPU (đường “Memory for GPU” thể hiện bộ nhớ của bộ tăng tốc). Trước khi tính toán, dữ liệu được sao chép từ bộ nhớ CPU sang bộ nhớ của bộ tăng tốc (bước 1). Sau đó, CPU gửi lệnh thực thi (bước 2), và bộ tăng tốc xử lý dữ liệu song song (bước 3). Khi tính toán xong, bộ tăng tốc ghi kết quả vào bộ nhớ của nó (mũi tên “Store results”), và kết quả này được sao chép trở lại CPU (bước 4). Hãy chú ý đến chi phí độ trễ ở mỗi mũi tên: mỗi lần truyền là một điểm nghẽn tiềm ẩn cần được quản lý để tối ưu hóa hiệu suất đầu-cuối.

Những thách thức chính trong việc di chuyển dữ liệu giữa máy chủ và bộ tăng tốc gồm độ trễ, giới hạn băng thông và chi phí đồng bộ. Hiệu quả của các bộ tăng tốc machine learning phụ thuộc không chỉ vào sức mạnh tính toán thô mà còn vào khả năng cung cấp dữ liệu liên tục. Ngay cả các GPU và TPU hiệu năng cao cũng có thể bị bỏ trống nếu việc truyền dữ liệu kém hiệu quả. Bộ nhớ của máy chủ và bộ tăng tốc là các miền tách biệt, cần truyền tường minh qua các liên kết như PCIe, NVLink hoặc các liên kết riêng. Di chuyển dữ liệu kém hiệu quả gây đứng chờ khi thực thi, nên tối ưu hóa truyền dữ liệu là ưu tiên hàng đầu.
Cấu trúc liên kết ở cấp nút
Để tối ưu hóa luân chuyển dữ liệu, chúng ta cần hiểu cấu trúc liên kết vật lý của nút tính toán. Một máy chủ AI điển hình không phải là một mạng phẳng các thiết bị kết nối với nhau, mà là một phân cấp băng thông, thu hẹp dần khi dữ liệu đi xa khỏi chip.
Băng thông giảm mạnh khi dữ liệu di chuyển càng xa bộ tăng tốc.
Ở cấp độ nút, ba liên kết xác định xu hướng băng thông thu hẹp dần:
- Kết nối giữa các bộ tăng tốc (NVLink/Infinity Fabric): Các hệ thống đa GPU hiện đại dùng các kết nối tốc độ cao chuyên dụng như NVLink29 để nối trực tiếp các bộ tăng tốc, bỏ qua CPU máy chủ. Băng thông của mỗi GPU dao động từ 600 GB/s đến 900 GB/s (NVIDIA Corporation 2020b; Choquette 2023). Kết nối này rất quan trọng khi các tensor cần di chuyển giữa các bộ tăng tốc trong cùng một máy chủ, chẳng hạn như phân vùng mô hình, trao đổi activation, và đồng bộ hóa gradient trong quá trình huấn luyện. Bài học phần cứng ở đây là ranh giới: lưu lượng giữ trên mạng liên kết của bộ tăng tốc rẻ hơn nhiều so với lưu lượng phải quay về qua host.
- Kết nối giữa máy chủ và bộ tăng tốc (PCIe): Đây là liên kết giữa CPU và bộ tăng tốc. Băng thông của liên kết này dao động từ 32 đến 64 GB/s (PCIe Gen4/Gen5). Dữ liệu huấn luyện tạm thời trên máy chủ có thể bị nghẽn tại đây. Tuy nhiên, dữ liệu thường trú, I/O trực tiếp từ lưu trữ hoặc mạng, và các liên kết bộ tăng tốc có coherence có thể đi theo các đường khác. Các máy chủ đa GPU cũng có thể cung cấp nhiều liên kết PCIe, thay vì chỉ một đường truyền 64 GB/s dùng chung.
- Card mạng: Cầu nối từ máy chủ ra thế giới bên ngoài, để kết nối với các nút khác. Băng thông thường ở mức 25 đến 50 GB/s (200 Gb/s đến 400 Gb/s Ethernet/InfiniBand30). Đây là điểm chuyển đầu tiên khi ta rời phạm vi phần cứng một nút để tiến tới bài toán mở rộng quy mô. Cần lưu ý: khi rời khỏi nút, lưu lượng sẽ đi vào một đường truyền hẹp hơn và có độ trễ cao hơn.
29 NVLink (Liên kết NVIDIA): Đây là kết nối trực tiếp giữa các GPU, được thiết kế để giữ cho lưu lượng giữa các bộ tăng tốc không phải đi qua PCIe khi các tensor cần di chuyển trong cùng một máy chủ. Tổng băng thông hai chiều đạt 600–900 GB/s, tương đương khoảng 300–450 GB/s mỗi chiều khi lưu lượng song công cân bằng; con số này cao hơn nhiều lần so với băng thông một chiều của một liên kết PCIe tiêu chuẩn. Nhờ vậy, các khối lượng công việc (workload) có tần suất di chuyển tensor giữa các thiết bị cao vẫn có thể ở trong vùng băng thông cao của dải băng thông (NVIDIA Corporation 2020b; Choquette 2023). Các thuật toán huấn luyện (training) quyết định lượng tensor phải đi qua liên kết này sẽ được trình bày sau; điều cần ghi nhớ ở đây về phần cứng là khoảng cách băng thông.
NVIDIA Corporation. 2020b. “NVLink: Scalable High-Performance Interconnect.” NVIDIA Technical Report 2020.
Choquette, Jack. 2023. “NVIDIA Hopper H100 GPU: Scaling Performance.” IEEE Micro 43 (3): 9–17. https://doi.org/10.1109/mm.2023.3256796.
30 InfiniBand: Điểm then chốt của InfiniBand để mở rộng trên nhiều nút là RDMA (Truy cập bộ nhớ trực tiếp từ xa). Với đường dẫn nhận biết GPU như GPUDirect RDMA và vùng nhớ GPU đã được đăng ký, bộ điều hợp mạng có thể truyền dữ liệu trực tiếp giữa các GPU trên các nút mà không cần đi qua bộ nhớ máy chủ. Nhờ vậy, giảm sự tham gia của máy chủ và chi phí giao thức; khi đó, khả năng mở rộng thường bị chi phối bởi băng thông vật lý, cấu trúc liên kết và cách triển khai các phép toán tập thể hơn là bởi việc CPU xử lý gói tin.
Ba cấp độ này tạo ra một mẫu giảm dần băng thông đặc trưng:
\[\begin{aligned} \text{HBM (3350 GB/s)} &\gg \text{NVLink (900 GB/s)} \\ &\gg \text{PCIe (64 GB/s)} \gg \text{Network (50 GB/s)} \end{aligned}\]
Hiệu suất hệ thống phụ thuộc vào việc giữ dữ liệu trên đường đi nhanh nhất phù hợp. Các liên kết PCIe và mạng có băng thông thấp hơn đáng kể và độ trễ cao hơn so với bộ nhớ on-package, nên việc đặt dữ liệu và lập lịch cần tránh các lần đi qua máy chủ và mạng không cần thiết.
Khi chuyển bớt tính toán sang phần cứng chuyên dụng, sẽ phát sinh chi phí truyền qua bus giữa bộ nhớ máy chủ và VRAM của bộ tăng tốc.31 Hãy theo dõi các bước được đánh số trong figure 13, theo trình tự từ thao tác sao chép bộ nhớ qua PCIe ban đầu đến khởi chạy lệnh, thực thi kernel và truy xuất kết quả.
31 DMA (truy cập bộ nhớ trực tiếp): Một đơn vị phần cứng chuyên biệt quản lý việc sao chép dữ liệu (bước 1) mà không cần CPU quản lý trực tiếp, nhờ đó CPU có thể ngay lập tức phát lệnh tính toán (bước 2). Tính đồng thời này là tối quan trọng: nếu không có, bộ tăng tốc có thể bị nhàn rỗi giữa các batch tính toán, đặc biệt khi việc chuyển dữ liệu từ máy chủ sang thiết bị nằm trên đường găng.
Các giới hạn về độ trễ và băng thông tác động trực tiếp đến khối lượng công việc (workload) AI. Các liên kết máy chủ kiểu PCIe thường chậm hơn nhiều so với bộ nhớ băng thông cao on-package của bộ tăng tốc, nên các lần truyền lớn có thể trở thành nút thắt cổ chai, đặc biệt trong các tác vụ deep learning. Chi phí đồng bộ càng làm vấn đề trầm trọng khi tính toán phải chờ truyền dữ liệu hoàn tất. Cần lập lịch hiệu quả và chồng chéo truyền dữ liệu với thực thi để giảm các bất lợi này.
Tối ưu hóa truyền dữ liệu
Độ suy giảm băng thông được mô tả trong phần này tạo ra một trật tự ưu tiên tối ưu hóa rõ ràng. Người thực hành có hai chiến lược bổ trợ để giảm chi phí truyền tải: di chuyển dữ liệu không đồng bộ và trừu tượng hóa bộ nhớ hợp nhất.
Các engine DMA thực hiện truyền dữ liệu hàng loạt sau khi được phần mềm cấu hình, nhờ đó tránh việc CPU phải sao chép từng byte. Khi có các engine và vùng đệm riêng, batch tiếp theo có thể được chuyển trong khi bộ tăng tốc đang tính toán trên batch hiện tại. Sự chồng lấp này chỉ hữu ích khi các phụ thuộc cho phép chạy đồng thời và không bên nào tranh chấp cùng một tài nguyên giới hạn.
Bộ nhớ hợp nhất (Unified Memory) là chiến lược thứ hai, cung cấp một không gian địa chỉ duy nhất mà cả CPU và bộ tăng tốc đều có thể truy cập. Thay vì phải sao chép dữ liệu tường minh, runtime sẽ di chuyển các trang bộ nhớ theo nhu cầu khi bất kỳ bộ xử lý nào truy cập. Mô hình lập trình nhờ đó đơn giản đi đáng kể (một lệnh malloc thay cho các bước dàn dựng phức tạp), nhưng lại làm hiệu suất khó dự đoán. Việc di chuyển trang do mẫu truy cập kích hoạt có thể gây những đợt tăng độ trễ, và các truy cập nhỏ lẻ hoặc phân tán có thể khiến trang bị kéo qua lại trên đường liên kết. Vì vậy, trong môi trường sản xuất, các khối lượng công việc (workload) huấn luyện thường dùng truyền dữ liệu tường minh dựa trên DMA để có hiệu suất ổn định, dễ dự đoán; còn Bộ nhớ hợp nhất phù hợp với giai đoạn tạo mẫu và các khối lượng công việc (workload) ưu tiên tốc độ phát triển hơn thông lượng tuyệt đối.
Những chi phí này định hình cách các phép toán của mô hình được ánh xạ lên phần cứng. Phép tích chập thường bộc lộ khả năng tái sử dụng theo không gian, rất hợp với kỹ thuật phân ô (tiling). Attention dày đặc cũng có cấu trúc ma trận đều đặn, nhưng trạng thái trung gian và việc mở rộng theo độ dài chuỗi lại tạo ra áp lực khác nhau về dung lượng và băng thông. Ngoài ra, các embedding, các chuyên gia thưa thớt (sparse experts) và việc đọc từ KV-cache còn mang đến các mẫu truy cập khác nữa.
Áp lực bộ nhớ mô hình
Kiến trúc mô hình quyết định yếu tố bộ nhớ nào trở thành nút thắt cổ chai. Mặc dù mạng perceptron đa lớp (MLP), mạng nơ-ron tích chập (CNN) và mạng transformer đều cần tập tham số lớn, nhưng các mẫu truy cập khác nhau của chúng tạo ra áp lực khác nhau lên trọng số, activations, băng thông và các lần truyền dữ liệu với máy chủ, nên mỗi loại mô hình cần một chiến lược tối ưu hóa bộ tăng tốc khác nhau.
Các mô hình tiêu biểu (lighthouse models) trong Mô hình Hải đăng – Các khối lượng công việc (workload) tham chiếu là nền tảng cho phân tích này: ResNet-50 đại diện cho các khối lượng công việc (workload) CNN có mức tái sử dụng dữ liệu theo không gian cao; GPT-2/Llama cho thấy áp lực bộ nhớ trong các mô hình transformer; DLRM minh họa các truy vấn embedding thưa, gây áp lực lên hệ thống bộ nhớ theo cách khác với các phép toán dày đặc; còn MobileNetV2 thể hiện các kiến trúc tối ưu hóa hiệu quả với tích chập theo chiều sâu (depthwise convolutions). Những đặc tính bộ nhớ khác nhau này cho thấy cấu trúc của khối lượng công việc (workload) được chuyển hóa thành mức độ sử dụng phần cứng như thế nào.
Perceptron đa lớp
Một lớp MLP là phép nhân ma trận dày đặc, tiếp theo có thể là thêm độ chệch (bias), activation và chuẩn hóa. Ở các kích thước batch nhỏ, chi phí truy xuất trọng số rất cao. Khi batch lớn hơn, mỗi trọng số được tái sử dụng cho nhiều ví dụ hơn, khiến phép nhân ma trận có thể trở nên bị giới hạn bởi tính toán (compute-bound).
Về mặt bộ nhớ, MLP sử dụng các ma trận trọng số lớn, dày đặc, thường vượt quá dung lượng SRAM trên chip, nên phải truy cập DRAM cục bộ của thiết bị. PCIe hoặc các liên kết máy chủ–thiết bị khác chỉ trở thành nút thắt trên đường tới hạn khi đầu vào được cấp từ máy chủ, hoặc khi trọng số và activations bị đẩy ra ngoài bộ nhớ của thiết bị.
MLP có kiểu truy cập đều đặn, phù hợp với tìm nạp trước theo ô (tiled prefetching) và truyền liên tục (streaming). Các bộ tăng tốc sẽ đệm các ô trọng số và activation trong SRAM trên chip và, khi phụ thuộc cho phép, chồng chéo việc di chuyển dữ liệu với phép toán số học. Hiệu suất đạt được phụ thuộc vào kích thước batch, hình dạng tensor, độ chính xác, và liệu tập làm việc có nằm gọn trong bộ nhớ thiết bị hay không (Chen et al. 2017).
Mạng nơ-ron tích chập
Các CNN được dùng rộng rãi trong xử lý ảnh và thị giác máy tính. Khác với MLP vốn đòi hỏi nhân ma trận dày đặc, CNN xử lý các bản đồ đặc trưng đầu vào bằng các kernel lọc nhỏ trượt trên ảnh. Cấu trúc tính toán cục bộ này tạo ra mức tái sử dụng dữ liệu theo không gian rất cao, khi cùng một pixel đầu vào đóng góp vào nhiều phép tích chập.
Các bộ tăng tốc CNN hưởng lợi từ tối ưu hóa bộ nhớ trên chip, vì các bộ lọc tích chập được tái sử dụng nhiều, cho phép lưu trọng số trong SRAM cục bộ tốc độ cao thay vì liên tục truy cập DRAM của thiết bị. Các bản đồ activation có kích thước lớn nên cần quản lý chặt; vì vậy các bộ tăng tốc CNN chia chúng thành các ô (tile) vừa với bộ đệm trên chip. Cách này giảm lưu lượng truy cập bộ nhớ thiết bị và nâng cao hiệu quả (Chen et al. 2017).
Chen, Yu-Hsin, Joel Emer, and Vivienne Sze. 2017. “Using Dataflow to Optimize Energy Efficiency of Deep Neural Network Accelerators.” IEEE Micro 37 (3): 12–21. https://doi.org/10.1109/mm.2017.54.
Mạng CNN có thể tận dụng tái sử dụng trọng số và activation rất lớn, nhưng các bản đồ đặc trưng trung gian vẫn có thể chi phối lưu lượng dữ liệu. Phân ô (tiling) và đệm trên chip giúp giảm việc di chuyển dữ liệu giữa các bộ nhớ trong thiết bị; còn truyền giữa host và thiết bị là vấn đề riêng, quan trọng khi đầu vào hoặc đầu ra không sẵn trong bộ nhớ thiết bị. Eyeriss giới thiệu một luồng dữ liệu cố định theo hàng (row-stationary dataflow) để khai thác tái sử dụng trong phép tích chập (Chen et al. 2016). Trong phân loại rộng hơn của section 1.7, đây là một dạng lai, giữ cục bộ một số hàng và các tổng riêng phần (partial sums).
Các mạng Transformer
Các kiến trúc transformer được giới thiệu trong Transformers: Xử lý chuỗi song song đã trở thành kiến trúc chủ đạo trong xử lý ngôn ngữ tự nhiên và ngày càng được dùng nhiều hơn ở các lĩnh vực khác như thị giác và nhận dạng giọng nói. Không giống CNNs vốn dựa trên tính toán cục bộ, transformer sử dụng cơ chế attention toàn cục32, nơi mỗi token trong chuỗi đầu vào có thể tương tác với mọi token còn lại.
32 Cơ chế Attention: Bahdanau, Cho, và Bengio đã giới thiệu attention cho các mô hình tuần tự-sang-tuần tự (sequence-to-sequence); self-attention của Transformer sau đó cho phép mỗi token chú ý đến mọi token trong chuỗi (Bahdanau et al. 2015; Vaswani et al. 2017). Việc lưu đầy đủ điểm attention cho một chuỗi độ dài \(S\) đòi hỏi một ma trận \(S{\times}S\), dẫn tới lưu trữ trung gian bậc hai. FlashAttention phân ô (tiling) việc tính toán để tránh phải lưu toàn bộ ma trận này trong HBM (Dao et al. 2022). Cache KV cho suy luận là một phần riêng: dung lượng của nó tăng tuyến tính theo độ dài chuỗi trên mỗi lớp, dù mỗi bước giải mã sẽ đọc lượng cache ngày càng lớn (xem Bộ nhớ và KV cache).
Bahdanau, Dzmitry, Kyunghyun Cho, and Yoshua Bengio. 2015. “Neural Machine Translation by Jointly Learning to Align and Translate.” International Conference on Learning Representations (ICLR).
Vaswani, Ashish, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polosukhin. 2017. “Attention Is All You Need.” Advances in Neural Information Processing Systems (NeurIPS) 30: 5998–6008.
Dao, T., D. Y. Fu, S. Ermon, A. Rudra, and C. Ré. 2022. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” Advances in Neural Information Processing Systems (NeurIPS) 35: 16344–59. https://doi.org/10.52202/068431-1189.
Những mô hình này đặc biệt thách thức đối với các bộ tăng tốc vì tương tác token toàn cục tạo ra trạng thái attention lớn, còn các mô hình ngôn ngữ cỡ GPT-3 (Brown et al. 2020) có thể vượt quá dung lượng bộ nhớ trên chip do số lượng tham số quá lớn. Hệ quả là, việc di chuyển thường xuyên giữa HBM, cache và các đơn vị tính toán gây áp lực đáng kể lên độ trễ và băng thông. Nếu mô hình vượt quá bộ nhớ của bộ tăng tốc hoặc sử dụng host offload, các truyền qua PCIe hoặc NVLink sẽ trở thành nút thắt cổ chai khác. Kiến trúc Unified Memory có thể giảm bớt một số phức tạp trong lập trình bằng cách tự xử lý việc di chuyển dữ liệu giữa bộ nhớ host và thiết bị trong runtime, nhưng sẽ thêm độ trễ khi các trang dữ liệu di chuyển khó lường. Những áp lực này khiến bộ nhớ băng thông cao, phân ô tensor và phân vùng bộ nhớ trở thành những mối quan tâm trung tâm trong thiết kế bộ tăng tốc cho các khối lượng công việc transformer.
Các kỹ thuật như phân ô attention, cache KV và bố cục tensor giúp giảm hoặc tổ chức lại lưu lượng bộ nhớ. Khi huấn luyện transformer, nếu các tensor được phân vùng trên nhiều GPU trong một nút, NVLink có thể cung cấp băng thông lớn hơn PCIe cho các trao đổi cần thiết; nhưng sẽ không mang lại lợi ích nếu khối lượng công việc không đi qua liên kết đó. Các truyền không đồng bộ có thể chồng lấn việc di chuyển dữ liệu với tính toán khi lịch và tài nguyên cho phép (Narayanan et al. 2021).
Narayanan, Deepak, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Korthikanti, Dmitri Vainbrand, et al. 2021. “Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM.” Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis, 1–15. https://doi.org/10.1145/3458817.3476209.
Hệ quả đối với thiết kế bộ tăng tốc
Các yêu cầu bộ nhớ đa dạng của MLPs, CNNs và transformer nhấn mạnh nhu cầu thiết kế bộ tăng tốc chuyên biệt cho từng khối lượng công việc. Table 11 cho thấy các mẫu truy cập bộ nhớ khác nhau đáng kể giữa các loại mô hình.
| Loại mô hình | Kích thước trọng số | Tái sử dụng activation | Mẫu truy cập bộ nhớ | Nút thắt cổ chai chính |
|---|---|---|---|---|
| MLP (Đặc) | Lớn, đặc | Thấp | Đều đặn, tuần tự (dạng luồng) | Băng thông (ngoài chip) |
| CNN | Nhỏ, được tái sử dụng | Cao | Tính cục bộ không gian | Di chuyển feature map |
| Transformer | Lớn, thường đặc; thưa thớt trong các biến thể MoE/được tỉa (pruning) | Thấp đến trung bình | Chủ yếu là GEMM đều đặn cộng với lưu lượng KV-cache/attention | Dung lượng bộ nhớ + băng thông |
Mỗi loại mô hình tạo ra áp lực khác nhau. Với suy luận MLP có batch nhỏ, hệ thống có thể phải đọc tuần tự các ma trận trọng số lớn đang nằm trong bộ nhớ thiết bị; còn các batch lớn hơn thì tăng mức tái sử dụng. CNN có thể tận dụng chia ô không gian (spatial tiling) và tái sử dụng bộ lọc. Với Transformer, áp lực bộ nhớ phụ thuộc vào pha: khi huấn luyện, nó giữ lại các activation và trao đổi các tensor đã được phân vùng; còn khi suy luận tự hồi quy, nó đọc lặp lại các trọng số và một cache KV đang mở rộng dần.
Để giải quyết những thách thức này, các bộ tăng tốc AI hiện đại tích hợp kiến trúc bộ nhớ phân cấp nhiều tầng, giúp cân bằng giữa tốc độ, dung lượng và hiệu quả năng lượng. Các cache SRAM và bộ nhớ scratchpad trên chip lưu trữ dữ liệu được truy cập thường xuyên, trong khi bộ nhớ ngoài với băng thông cao cung cấp khả năng mở rộng cho các mô hình lớn. Các kết nối hiệu quả, chẳng hạn như NVLink, giúp giảm thiểu nút thắt khi truyền dữ liệu giữa host và bộ tăng tốc, đặc biệt trong các khối lượng công việc (workload) của Transformer, nơi các ràng buộc về di chuyển bộ nhớ có thể chi phối phần lớn thời gian thực thi.
Hiệu quả bộ nhớ có thể quan trọng ngang với năng lực tính toán thô. Các nghiên cứu về năng lượng cho thấy truy cập DRAM tốn năng lượng hơn nhiều so với các phép toán số học đơn giản trên chip, trong khi các kiến trúc mô hình khác nhau về mức tái sử dụng, dung lượng và nhu cầu giao tiếp. Câu hỏi còn lại mang tính định lượng: trên một bộ tăng tốc nhất định, liệu một kernel cụ thể bị giới hạn bởi khả năng tính toán hay bởi đường dẫn bộ nhớ liên quan? Mô hình Roofline trả lời câu hỏi đó, giúp các kỹ sư tránh tối ưu hóa nhầm tài nguyên.
Self-Check: Question
An accelerator delivers \(R_{\text{peak}} = 1{,}000\text{ TFLOP/s}\) (\(10^{15}\text{ FLOP/s}\)) in FP16 and has a High-Bandwidth Memory (HBM) subsystem delivering \(\text{BW} = 2.0\text{ TB/s}\) (\(2\times 10^{12}\text{ bytes/s}\)). What is the hardware balance point (ridge point \(I_{\text{ridge}}\)) of this system?
- \(50\text{ FLOP/byte}\)
- \(200\text{ FLOP/byte}\)
- \(500\text{ FLOP/byte}\)
- \(2{,}000\text{ FLOP/byte}\)
When training a 7-billion parameter model using standard mixed-precision (FP16/BF16) with the Adam optimizer, calculate the minimum memory required purely for model states (weights, gradients, and optimizer states) and explain why optimizer states dominate this footprint.
Arrange the following levels of a modern GPU memory hierarchy in order of access latency, from lowest latency (fastest) to highest latency (slowest):
- High-Bandwidth Memory (HBM3)
- Register File
- Pinned Host System Memory (DDR5 via PCIe)
- Shared Memory / L1 Cache
- On-Chip L2 Cache
Why does High-Bandwidth Memory (HBM) achieve significantly higher bandwidth (e.g., \(>2\text{ TB/s}\)) than traditional GDDR6X memory (e.g., \(\approx 760\text{ GB/s}\)) while maintaining comparable or lower power per bit?
- HBM operates at a \(10\times\) higher clock frequency than GDDR6X on standard PCB traces
- HBM uses optical photonic signaling to transmit data across the motherboard
- HBM eliminates all error correction codes and row buffer precharge cycles
- HBM vertically stacks DRAM dies using Through-Silicon Vias (TSVs) and connects to the GPU via a wide 1024-bit per stack silicon interposer bus at lower clock speeds
Memory allocated on the host CPU that is locked into physical RAM and prevents operating system paging, enabling direct DMA transfers over PCIe to the GPU, is called ____ host memory.
True or False: The AI Memory Wall refers solely to the limited physical capacity (GBs) of GPU DRAM, meaning that if an accelerator has sufficient gigabytes to store model weights, memory bandwidth will never bottleneck execution.
Mô hình Roofline
Cường độ tính toán thấp khiến khối lượng công việc (workload) nằm trong vùng bị giới hạn bởi bộ nhớ.
Mô hình Roofline trả lời câu hỏi này bằng cách vẽ cường độ tính toán so với hiệu năng có thể đạt, cho thấy liệu một phép toán gặp trần tính toán hay trần băng thông bộ nhớ. Mặc dù FLOP/s đỉnh là một đầu vào, mô hình này kết hợp nó với lưu lượng dữ liệu của khối lượng công việc (workload) và băng thông của nền tảng để đưa ra một giới hạn hữu ích hơn.
Mô hình Roofline33 (Williams et al. 2009) cung cấp một framework tiêu chuẩn để xác định liệu các khối lượng công việc (workload) bị giới hạn bởi tính toán hay bởi bộ nhớ, qua đó kết nối trực tiếp chủ đề “rào cản bộ nhớ” với phân tích hiệu năng thực tế. Mô hình này cho phép lập luận định lượng về mức độ tận dụng bộ tăng tốc và định hướng các quyết định tối ưu hóa.
33 Mô hình Roofline: Được giới thiệu bởi Williams et al. (2009) tại UC Berkeley, dựa trên các nghiên cứu trước đó về độ phức tạp I/O từ những năm 1980. Đóng góp cụ thể của họ là biến sự đánh đổi giữa tính toán và băng thông thành thứ trực quan và có thể hành động: biểu đồ Roofline đặc trưng ngay lập tức cho thấy một kernel bị giới hạn bởi tính toán (khi chạm trần phẳng) hay bởi bộ nhớ (khi chạm đường băng thông dốc), đồng thời định lượng khoảng cách so với giới hạn phần cứng. Nếu một kernel chỉ đạt 50% trần của nó, thì còn thiếu 2\(\times\) để chạm trần, khiến đây trở thành công cụ chẩn đoán tiêu chuẩn cho tối ưu hóa bộ tăng tốc.
Williams, Samuel, Andrew Waterman, and David Patterson. 2009. “Roofline: An Insightful Visual Performance Model for Multicore Architectures.” Communications of the ACM 52 (4): 65–76. https://doi.org/10.1145/1498765.1498785.
Hiệu năng bị giới hạn bởi hai trần, như equation 2 mô tả. Ở đây, hiệu năng đạt được \(R_{\text{attain}}\) và hiệu năng tính toán đỉnh \(R_{\text{peak}}\) tính bằng FLOP/s (thường báo cáo là TFLOP/s); băng thông đỉnh \(\text{BW}\) tính bằng byte/s (thường là TB/s); và cường độ tính toán \(I\) tính bằng FLOP/byte: \[R_{\text{attain}} = \min(R_{\text{peak}}, \text{BW} \times I) \tag{2}\]
Definition 1.5: Cường độ tính toán
Cường độ tính toán là tỷ lệ giữa số phép toán và số byte được truyền qua giao diện bộ nhớ đang mô hình hóa (\(\text{FLOP}/\text{byte}\)). Kết hợp với băng thông ở cấp độ đó và đỉnh tính toán tương ứng, nó quyết định trần roofline lý tưởng nào thấp hơn.
- Ý nghĩa: Ranh giới giữa hai đường trần là điểm gãy \(R_{\text{peak}} / \text{BW}\). Với A100 (312 TFLOP/s FP16/BF16, 2.04 TB/s), giá trị này vào khoảng 153 FLOP/byte. Theo các mô hình lưu lượng đã nêu, một phép nhân ma trận lớn, xếp lát (tiling) hiệu quả 1024 \(\times\) 1024 đạt cường độ tính toán khoảng 341.3 FLOP/byte, trong khi ReLU chạy độc lập khoảng 0.125. Vì vậy, trên cùng phần cứng, chúng chạm các trần khác nhau.
- Điểm khác biệt: Không giống tổng số FLOPS (chỉ là số lượng phép toán), cường độ tính toán là một tỉ lệ mô tả hình dạng nhu cầu phần cứng của một khối lượng công việc (workload). Hai kernel có cùng số FLOPS nhưng mẫu truy cập bộ nhớ khác nhau sẽ có cường độ tính toán khác nhau, và vì thế bị giới hạn bởi các tài nguyên phần cứng khác nhau.
- Lỗi thường gặp: Một hiểu lầm phổ biến là cường độ tính toán là thuộc tính cố định của một phép toán. Thực tế, nó phụ thuộc vào chi tiết triển khai: ví dụ, một phép nhân ma trận đơn giản phải tải lại các toán hạng từ DRAM cho mỗi phần tử kết quả sẽ có cường độ tính toán thấp; còn một cách triển khai theo khối (tiled) tái sử dụng dữ liệu từ SRAM nhanh sẽ đạt cường độ tính toán cao. Cùng một phép toán, nhưng hiệu quả phần cứng có thể khác nhau tới nhiều bậc.
Với \(O\) là số lượng phép toán không thứ nguyên và \(D_{\text{vol}}\) là khối lượng dữ liệu tính bằng byte, equation 3 giúp định nghĩa trở nên rõ ràng và có thể áp dụng được. \[I = \frac{O}{D_{\text{vol}}} \tag{3}\]
Biểu đồ roofline thể hiện hiệu năng (TFLOP/s) trên trục dọc và cường độ tính toán (FLOP/byte) trên trục ngang. Ở cường độ tính toán thấp, hiệu năng tăng tuyến tính theo cường độ (vùng bị giới hạn bởi bộ nhớ). Vượt qua điểm gãy (ridge point), hiệu năng bão hòa ở mức tính toán đỉnh (vùng bị giới hạn bởi tính toán). Chẩn đoán nút thắt cổ chai ánh xạ mỗi vùng với các tối ưu hóa đáng công và những tối ưu hóa lãng phí, nhờ đó khi phân loại một khối lượng công việc (workload) là bị giới hạn bởi bộ nhớ hay bởi tính toán, kỹ sư sẽ biết ngay nên đầu tư vào bộ tăng tốc nhanh hơn hay băng thông lớn hơn.
Các điểm gãy phần cứng
Điểm gãy, hay điểm cân bằng phần cứng \(I_{\text{ridge}}\) được thiết lập trong section 1.4.2, là ngưỡng cường độ tính toán tại đó một bộ tăng tốc chuyển từ bị giới hạn bởi bộ nhớ sang bị giới hạn bởi tính toán. Table 12 định lượng cách các bộ tăng tốc khác nhau thể hiện những đặc tính riêng dựa trên tỷ lệ giữa khả năng tính toán và băng thông:
| Bộ tăng tốc NVIDIA | Đỉnh FP16 | Băng thông | Ridge Point |
|---|---|---|---|
| V100 (2017) | 125 TFLOP/s | 0.9 TB/s | 138.9 FLOP/byte |
| A100 (2020) | 312 TFLOP/s | 2.04 TB/s | 153 FLOP/byte |
| H100 (2022) | 989 TFLOP/s | 3.35 TB/s | 295.2 FLOP/byte |
Các điểm gãy này cho thấy các tuyến tensor đời sau cần tái sử dụng dữ liệu nhiều hơn để chạm tới trần tính toán. So sánh các điểm gãy sẽ làm xu hướng này trở nên cụ thể.
Napkin Math 1.3: Khoảng hụt mức sử dụng
Vấn đề: Tại sao việc đạt mức sử dụng 100 percent trên H100 lại khó hơn so với trên V100?
Chỉ số: Điểm gãy \(I_{\text{ridge}} = R_{\text{peak}} / \text{BW}\) (FLOP/byte) từ section 1.4.2: phần cứng phải thực hiện bao nhiêu phép toán cho mỗi byte dữ liệu được tải để giữ cho các đơn vị tính toán luôn bận rộn.
Sự phát triển:
- V100 (2017): 125 TFLOP/s / 0.9 TB/s ≈ 138.9 FLOP/byte.
- A100 (2020): 312 TFLOP/s / 2.04 TB/s ≈ 153 FLOP/byte.
- H100 (2022): 989 TFLOP/s / 3.35 TB/s ≈ 295.2 FLOP/byte.
Kết quả: Cường độ cần thiết để đạt mức đỉnh tensor đã tăng. Theo mô hình roofline HBM đơn giản này, một kernel với \(I\) = 200 FLOP/byte nằm trên điểm gãy của A100 nhưng dưới điểm gãy của H100. Nếu cường độ và cách triển khai không đổi, mức tăng hiệu năng lý tưởng của nó sẽ gần với tỷ lệ băng thông 1.6× hơn là tỷ lệ tính toán đỉnh 3.2×.
Góc nhìn hệ thống: Một ReLU độc lập, trong mô hình lưu lượng FP32 một lần đọc và một lần ghi, chỉ đạt khoảng 1 phép toán trên 8 byte, thấp hơn nhiều so với ngưỡng hiệu năng tensor của H100. Một phép nhân ma trận dày đặc 1024 \(\times\) 1024 được chia ô (tiling) hợp lý đạt khoảng 341.3 FLOP/byte theo mô hình lưu lượng lý tưởng của nó. Hợp nhất (fusion) hữu ích với các chuỗi có cường độ thấp vì có thể loại bỏ các lượt đọc/ghi trung gian; nhưng nó không đương nhiên là tối ưu hóa tốt nhất cho mọi kernel.
Tích chập depthwise, tra cứu embedding, LayerNorm và softmax là những mốc tham chiếu cường độ thấp hữu ích, vì chúng tốn nhiều thời gian để di chuyển byte hơn là thực hiện phép tính. Table 13 ánh xạ các phép toán mạng nơ-ron phổ biến vào Mô hình Roofline.
| Thao tác | Arithmetic Intensity | Phân loại | Ví dụ điển hình |
|---|---|---|---|
| Conv2D (Đặc) | 50–200 FLOP/byte | Nằm vắt ngang ranh giới; các trường hợp tái sử dụng cao bị giới hạn bởi tính toán | ResNet-50 |
| MatMul đặc (batch lớn, được lát gạch tốt) | 64–256+ FLOP/byte | Thường bị giới hạn bởi tính toán ở batch lớn | GPT-2 (các phép chiếu theo batch) |
| Depthwise conv | 10–20 FLOP/byte | Giới hạn bởi bộ nhớ | MobileNet |
| Attention Softmax | Phụ thuộc vào quy ước | Giới hạn bởi bộ nhớ | GPT-2 (Tạo sinh) |
| LayerNorm | 1–2 FLOP/byte | Giới hạn bởi bộ nhớ | GPT-2/Llama |
| Embedding lookup | \(<1\) FLOP/byte | Giới hạn bởi bộ nhớ | DLRM |
Napkin Math 1.4: Phân tích lớp Transformer
Đối với một transformer với hidden_dim = 768, batch = 32, seq = 512:
Phép chiếu QKV của Attention:
- FLOPs: 2 \(\times\) 3 \(\times\) 32 \(\times\) 512 \(\times\) 768 \(\times\) 768 = 58 GFLOP
- Bytes: (đầu vào + trọng số + đầu ra) = (32 \(\times\) 512 \(\times\) 768 + 3 \(\times\) 768 \(\times\) 768 + 32 \(\times\) 512 \(\times\) 768 \(\times\) 3) \(\times\) 2 ≈ 104.2 MB
- AI = 58 GFLOP / 104.2 MB = 556.4 FLOP/byte, thuộc loại bị giới hạn bởi tính toán trên A100 (vượt ngưỡng 153 FLOP/byte)
Softmax:
- FLOPs: 32 \(\times\) 12 \(\times\) 512 \(\times\) 512 \(\times\) 3 ≈ 302 MFLOP (exp, sum, div)
- Bytes: 32 \(\times\) 12 \(\times\) 512 \(\times\) 512 \(\times 2 \times 2\) = 402.7 MB
- AI = 302 MFLOP / 402.7 MB = 0.75 FLOP/byte theo phép đếm thao tác đơn giản này, và đây là phép toán bị giới hạn bởi bộ nhớ. Nếu tính phép lũy thừa và phép chia là nhiều thao tác, cường độ số học sẽ lớn hơn nhưng vẫn không đổi phân loại nút thắt.
Góc nhìn hệ thống: Phân tích này giải thích vì sao FlashAttention tập trung giảm lưu lượng bộ nhớ trong attention thay vì giảm FLOPs.
Các phân loại này trực tiếp định hướng chiến lược tối ưu hóa. Với các phép toán bị giới hạn bởi bộ nhớ, ta nên giảm lượng dữ liệu phải di chuyển bằng hợp nhất operator (operator fusion), dùng độ chính xác thấp hơn (FP16, INT8), và tăng mật độ phép tính thông qua thay đổi thuật toán như FlashAttention. Ngược lại, với các phép toán bị giới hạn bởi tính toán, nên tối đa hóa mức sử dụng phần cứng bằng batching và song song hóa, khai thác Tensor Cores và các đơn vị tính toán chuyên dụng, và cải thiện hiệu quả tính toán bằng tiling và lập lịch.
Tính toán giới hạn do băng thông bộ nhớ
Miền bị giới hạn bởi bộ nhớ của Mô hình Roofline được xác định bởi băng thông bộ nhớ đỉnh. Để một phép toán đạt thông lượng \(R_{\text{ops}}\) (FLOP/s, thường biểu thị bằng TFLOP/s) trong miền bị giới hạn bởi bộ nhớ, equation 4 cho biết băng thông cần thiết: \[\text{BW}_{\text{req}} = \frac{R_{\text{ops}}}{I} \text{ bytes/s} \tag{4}\]
Khi băng thông cần thiết vượt quá băng thông đỉnh, hiệu suất sẽ bị giới hạn theo equation 5. Ở đây \(R_{\text{ops}}\) và \(R_{\text{attain}}\) tính bằng FLOP/s, còn \(I\) tính bằng FLOP/byte. \[R_{\text{attain}} = \text{BW} \times I \tag{5}\]
Một lớp tích chập là ví dụ đối lập thuộc loại bị giới hạn bởi tính toán.
Napkin Math 1.5: Phân tích lớp tích chập
Xét một lớp Conv2D với đầu vào có kích thước (batch = 32, channels = 128, height = 56, width = 56), số kênh đầu ra 256, kernel kích thước \(3{\times}3\), chạy trên GPU A100; đây là trường hợp đối lập thuộc loại bị giới hạn bởi tính toán:
Yêu cầu tính toán:
- Kích thước đầu ra: \(32 \times 256 \times 56 \times 56\) = 25.7M phần tử
- Số FLOPs trên mỗi đầu ra: \(128 \times 3 \times 3 \times 2\) = 2,304 (nhân-cộng)
- Tổng số FLOPs: 25.7M \(\times\) 2,304 = 59.2 GFLOP
Phân tích lưu lượng bộ nhớ:
- Đầu vào: \(32 \times 128 \times 56 \times 56 \times 2\) = 25.7 MB (FP16)
- Trọng số: \(256 \times 128 \times 3 \times 3 \times 2\) ≈ 0.6 MB (FP16)
- Đầu ra: \(32 \times 256 \times 56 \times 56 \times 2\) = 51.4 MB (FP16)
- Tổng cộng: 77.7 MB
Cường độ số học: \(I\) = 59.2 GFLOP / 77.7 MB = 762.2 FLOP/byte
Thông tin chuyên sâu về hệ thống: Giá trị này cao hơn nhiều so với điểm ridge của A100 là 153 FLOP/byte, nên mô hình Roofline đơn giản xếp phép toán này vào vùng bị giới hạn bởi tính toán. Thông lượng đỉnh khoảng ~312 TFLOP/s (FP16 với Tensor Cores) là mức trần, nhưng hiệu suất thực tế vẫn phụ thuộc vào các yếu tố như tiling, mức độ chiếm dụng, tổ hợp lệnh và hiệu quả của thư viện.
Cường độ số học cao của lớp tích chập đến từ khả năng tái sử dụng trọng số: cùng một kernel \(3{\times}3\) được áp dụng cho mọi vị trí không gian, nhờ đó chi phí tải trọng số được phân bổ cho hàng triệu phép tính đầu ra. Đây là mô hình kiến trúc giúp các mạng CNN hoạt động rất hiệu quả trên các bộ tăng tốc hiện đại.
Napkin Math 1.6: Phân tích lớp kết nối đầy đủ
Hãy xem xét một lớp kết nối đầy đủ với đầu vào (batch = 32, đặc trưng = 2048) → đầu ra (batch = 32, đặc trưng = 2048), cũng trên A100:
Yêu cầu tính toán:
- Phép nhân ma trận: \((32 \times 2048) \times (2048 \times 2048)\)
- Tổng số FLOPs: \(2 \times 32 \times 2048 \times 2048\) = 268.4 MFLOP
Phân tích lưu lượng bộ nhớ:
- Đầu vào: \(32 \times 2048 \times 2\) = 131.1 KB (FP16)
- Trọng số: \(2048 \times 2048 \times 2\) = 8.4 MB (FP16)
- Đầu ra: \(32 \times 2048 \times 2\) = 131.1 KB (FP16)
- Tổng cộng: 8.7 MB
Cường độ số học: \(I\) = 268.4 MFLOP / 8.7 MB = 31 FLOP/byte
Cường độ này thấp hơn điểm ridge của A100 là 153 FLOP/byte, cho thấy hoạt động này bị giới hạn bởi bộ nhớ. Hiệu suất có thể đạt được: \(R_{\text{attain}}\) = 2,039 GB/s \(\times\) 31 FLOP/byte = 63.3 TFLOP/s
Nhận định hệ thống: Thông lượng thực tế chỉ đạt 20.3 percent so với khả năng tính toán đỉnh, cho thấy hiệu ứng “tường bộ nhớ” (memory wall) khi kích thước batch nhỏ.
Tuy nhiên, không phải tất cả các lớp trong mạng nơ-ron đều có đặc điểm thuận lợi như vậy. Các lớp kết nối đầy đủ (dense) thường nằm ở cuối các mạng phân loại, hoặc là các lớp chiếu (projection layers) trong các mô hình transformer, có cường độ số học khác biệt. Một lớp dense tạo ra tương phản theo hướng bị giới hạn bởi bộ nhớ, giúp ta dự đoán các nút thắt cổ chai sẽ xuất hiện ở đâu trong quá trình thực thi mô hình end-to-end.
Cường độ số học thấp hơn của lớp dense bắt nguồn từ việc tái sử dụng trọng số hạn chế: mỗi trọng số được tái sử dụng trong toàn bộ batch, nhưng thiếu khả năng tái sử dụng theo không gian như các bộ lọc tích chập. Do đó, các lớp dense với kích thước batch nhỏ có cường độ số học thấp hơn nhiều so với tích chập. Sự khác biệt này lý giải tại sao quá trình suy luận của transformer (vốn bị chi phối bởi các lớp chiếu dense) thường bị giới hạn bởi bộ nhớ, trong khi suy luận của CNN có thể bị giới hạn bởi tính toán.
Napkin Math 1.7: Phân tích LayerNorm
LayerNorm với hình dạng đầu vào (batch = 32, seq = 512, hidden = 768):
Yêu cầu tính toán:
- Phần tử: \(32 \times 512 \times 768\) = 12.6M
- Số phép toán ước tính trên mỗi phần tử: tính trung bình (1 phép cộng), phương sai (2 phép cộng, 1 phép nhân), chuẩn hóa và biến đổi affine (2 phép cộng, 2 phép nhân) ≈ 8; chi phí tính nghịch đảo căn bậc hai được chia đều cho mỗi vector ẩn.
- Tổng số FLOPs: 12.6M \(\times\) 8 = 100.7 MFLOP
Lưu lượng bộ nhớ:
- Đầu vào: 12.6M \(\times\) 2 = 25.2 MB
- Tham số (hệ số tỉ lệ, độ chệch (bias)): \(768 \times 2 \times 2\) = 3.1 KB (không đáng kể)
- Đầu ra: 12.6M \(\times\) 2 = 25.2 MB
- Tổng cộng: 50.3 MB
Cường độ số học: \(I\) = 100.7 MFLOP / 50.3 MB = 2.0 FLOP/byte
Cường độ số học này thấp hơn đáng kể so với điểm ridge của A100 (77× bên dưới). Hiệu suất bị giới hạn ở: \(R_{\text{attain}}\) = 2039 GB/s \(\times\) 2.0 FLOP/byte = 4.1 TFLOP/s
Góc nhìn hệ thống: Đường giới hạn HBM đơn giản này đặt trần LayerNorm độc lập ở khoảng 1 phần trăm đỉnh tensor của A100. Độ trễ thực tế còn phụ thuộc vào hợp nhất, chiến lược giảm, chi phí khởi chạy và cấp bộ nhớ nào cung cấp dữ liệu.
Chuẩn hóa độc lập thực hiện rất ít phép toán so với số byte nó chạm tới, như ví dụ LayerNorm cho thấy. Trong lượt xử lý tách biệt đó, mỗi phần tử được đọc và ghi với rất ít tái sử dụng; hợp nhất với các toán tử liền kề có thể loại bỏ bớt những lượt đi-về bộ nhớ đó.
Tối ưu hóa theo chế độ cường độ
Phân tích đường giới hạn trực tiếp định hướng các ưu tiên tối ưu hóa, được tóm tắt trong table 14.
| Intensity regime | Typical operations | Optimization priority | Common techniques | Expected impact |
|---|---|---|---|---|
| AI cao (\(>200\) FLOP/byte) | Các tích chập lớn | Tối đa hóa tận dụng khả năng tính toán. | Tensor Cores, thread-block tuning, và high occupancy. | Nâng cao khả năng tận dụng tính toán bền vững khi kernel đã vượt qua ngưỡng. |
| AI trung bình (20–200 FLOP/byte) | Các lớp dày đặc kích thước trung bình | Cân bằng tối ưu hóa tính toán và bộ nhớ. | Các batch lớn hơn, register tiling, và kết hợp với các phép toán liền kề. | Có thể di chuyển nút thắt ràng buộc giữa bộ nhớ và tính toán. |
| AI thấp (\(<20\) FLOP/byte) | Các lớp dày đặc nhỏ và các phép toán từng phần tử | Giảm lưu lượng bộ nhớ. | Kết hợp toán tử mạnh mẽ, độ chính xác giảm (FP16 → INT8), và thay đổi thuật toán. | Giảm lưu lượng bộ nhớ ngoài khi việc kết hợp hoặc thay đổi bố cục là hợp lệ. |
| AI rất thấp (\(<2\) FLOP/byte) | Các lớp chuẩn hóa và hàm activation | Loại bỏ các chuyến đi khứ hồi của bộ nhớ. | Kết hợp với các phép toán liền kề và sử dụng tính toán tại chỗ khi hợp lệ. | Loại bỏ các chuyến đi khứ hồi trung gian khi các phép toán liền kề có thể được kết hợp. |
Với các phép toán có cường độ số học thấp, hợp nhất toán tử thường là tối ưu then chốt: ví dụ, LayerNorm kết hợp với Gaussian Error Linear Unit (GELU) có thể trở thành một kernel hợp nhất duy nhất. Một trong những đòn bẩy dễ tiếp cận nhất để đẩy một phép toán lên trên và sang phải trên biểu đồ Roofline là batching.
Napkin Math 1.8: Kích thước batch và cường độ số học
Tăng kích thước batch giúp cải thiện cường độ tính toán cho các phép toán ma trận bằng cách dàn đều chi phí tải trọng số. Equation 6 mô tả mối quan hệ này cho một lớp dense FP16/BF16 lý tưởng có kích thước \((B{\times}M){\times}(M{\times}N)\), trong đó tính mỗi lần đọc đầu vào và trọng số một lần, và một lần ghi đầu ra. Ở đây, \(B\) là kích thước batch, còn \(M\) và \(N\) là các chiều đầu vào và đầu ra: \[I = \frac{2BMN}{2BM + 2MN + 2BN} \approx \frac{2BMN}{2MN} = B \quad (\text{when } 2MN \gg 2B(M+N)) \tag{6}\]
Ví dụ: Lớp dense với M=N=2048 (FP16)
- Batch = 1: AI ≈ 1 FLOP/byte (bị giới hạn bởi bộ nhớ)
- Batch = 32: AI ≈ 31 FLOP/byte (bị giới hạn bởi bộ nhớ)
- Batch = 256: AI ≈ 204.8 FLOP/byte (bị giới hạn bởi tính toán trên A100)
Thông tin chuyên sâu về hệ thống: Điều này giải thích vì sao batching có thể mang lại cải thiện lớn về thông lượng trong các hệ thống suy luận trong môi trường sản xuất. MLPerf Inference — bộ benchmark tiêu chuẩn được đề cập trong Benchmarking — minh chứng điều đó bằng cách tách các lượt chạy thông lượng lớn (bulk-throughput runs) khỏi các lượt chạy phục vụ (serving) bị giới hạn độ trễ (latency-constrained serving runs) (Reddi et al. 2019).
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
Phân tích kích thước batch cho thấy vì sao các hệ thống phục vụ (serving) suy luận được thiết kế xoay quanh batching: nó làm thay đổi chế độ cường độ tính toán của các workload bị giới hạn bởi bộ nhớ. Tuy nhiên, batching cũng đem lại đánh đổi về độ trễ, vì yêu cầu phải đợi trong hàng đợi cho đến khi hình thành một batch. Sự giằng co giữa thông lượng (ưu tiên batch lớn) và độ trễ (ưu tiên batch nhỏ) là một thách thức cốt lõi trong các hệ thống phục vụ (serving) ML, sẽ được phân tích sâu hơn trong Đánh đổi độ trễ-thông lượng của gom batch động.
Khi độ trễ của dịch vụ giới hạn batching, quá trình giải mã LLM với batch-1 hoặc batch nhỏ thường có mức tái sử dụng trọng số thấp và cường độ tính toán thấp. Mô hình phân tích tiếp theo sẽ định lượng riêng chế độ này, thay vì coi mọi suy luận LLM là giống nhau.
Napkin Math 1.9: Mức trần thông lượng
Bài toán: Một phép tính với GPT-2 batch-1 làm rõ mức trần băng thông này: mức sử dụng tối đa có thể của một NVIDIA A100 khi chạy suy luận GPT-2 (kích thước batch 1) là bao nhiêu?
Các hạn chế phần cứng (các mẫu số)
Hiệu năng tính toán đỉnh: 312 TFLOP/s (FP16 Tensor Core).
Băng thông đỉnh: 2.04 TB/s (HBM2e).
Điểm đỉnh \((R_{\text{peak}}/\text{BW})\): 312 TFLOP/s / 2.04 TB/s = 153 FLOP/byte (cho FP16 Tensor Core).
Giải thích: Để bão hòa chip này ở độ chính xác FP16, cần 153 FLOP/byte phép toán cho mỗi byte được nạp. Điểm đỉnh thay đổi theo độ chính xác: các phép toán FP32 (đỉnh 19.5 TFLOP/s) chỉ có điểm đỉnh khoảng ~9.6 FLOP/byte.
Các đặc điểm khối lượng công việc (workload) (tử số)
- Mô hình: GPT-2 XL (1.5 tỷ tham số).
- Tác vụ: Sinh tự hồi quy (tạo 1 token mỗi lần).
- Di chuyển dữ liệu: Phải nạp toàn bộ trọng số (3 GB @ FP16) cho mỗi token.
- Tính toán: Phép nhân vector-ma trận. 2 \(\times\) Params ≈ 3 GFLOP.
- Cường độ số học: 3 GFLOP / 3 GB = 1 FLOP/byte
Dự đoán (quy luật sắt)
Vì cường độ thực tế (1) \(\ll\) điểm đỉnh (153 FLOP/byte), hệ thống này bị giới hạn bởi băng thông.
- Thông lượng tối đa: 1 FLOP/byte \(\times\) 2.04 TB/s = 2.04 TFLOP/s.
- Mức trần sử dụng: 2.04 TFLOP/s (thực tế) / 312 TFLOP/s (đỉnh) ≈ \(0.7\%\)
Nhận định về hệ thống: Không có batching, một GPU $15,000 chỉ đạt mức sử dụng tính toán dưới 1 percent trong mô hình giải mã truyền trọng số. Batching và lượng tử hoá trọng số giúp lấp khoảng trống đó; còn bộ đệm key-value thì tránh phải tính lại các trạng thái attention trước đó.
Từ suy diễn này, Mô hình Roofline đưa ra một framework chẩn đoán để xác định các phép toán bị giới hạn bởi tính toán hay bởi bộ nhớ. Việc biết rằng một khối lượng công việc (workload) bị giới hạn bởi bộ nhớ ở mức sử dụng 0.7 percent chỉ là bước đầu; thách thức tiếp theo là chuyển chẩn đoán đó thành các kế hoạch thực thi hiệu quả tận dụng kiến trúc bộ tăng tốc.
Self-Check: Question
A developer runs a LayerNorm kernel on an accelerator with \(R_{\text{peak}} = 312\text{ TFLOP/s}\) and \(\text{BW} = 1.5\text{ TB/s}\) (\(I_{\text{ridge}} = 208\text{ FLOP/byte}\)). The LayerNorm has an arithmetic intensity of \(I = 4\text{ FLOP/byte}\). What is the maximum attainable performance of this kernel, and what is the binding bottleneck?
- \(6.0\text{ TFLOP/s}\), bound by memory bandwidth
- \(312\text{ TFLOP/s}\), bound by peak compute capacity
- \(78\text{ TFLOP/s}\), bound by warp scheduler instruction issue rate
- \(1.5\text{ TFLOP/s}\), bound by PCIe bus transfer limits
Why has the hardware ridge point (\(I_{\text{ridge}}\)) increased dramatically across successive GPU generations (e.g., from Volta to Ampere to Hopper), and what pressure does this trend place on compiler and kernel developers?
True or False: When a kernel operates in the memory-bound regime of the Roofline model (\(I < I_{\text{ridge}}\)), doubling the accelerator’s peak tensor compute capability (\(R_{\text{peak}}\)) without changing memory bandwidth will double the kernel’s execution speed.
In the Roofline model, the transition point on the horizontal axis where the memory-bandwidth ceiling intersects the peak-compute ceiling is known as the hardware ____ point.
An engineer profiles a transformer inference workload and discovers that the attention Softmax kernel is heavily memory bandwidth bound. Which of the following optimization techniques directly increases arithmetic intensity to move the kernel closer to the compute-bound regime?
- Upgrading host CPU RAM to DDR5 to decrease kernel enqueue latency
- Fusing the scale, mask, Softmax, and dropout operations into a single kernel to keep intermediate activations in registers/SRAM
- Increasing the clock frequency of the GPU Tensor Cores by \(15\%\)
- Disabling warp scheduler out-of-order instruction issue
Ánh xạ phần cứng
Hãy xét một phép tích chập \(3{\times}3\) chạy trên một ô của bộ tăng tốc. Phép toán là cố định, nhưng kế hoạch thực thi thì không. Một lịch có thể giữ bộ lọc trong các thanh ghi cục bộ trong khi nhiều pixel đầu ra đi qua; một lịch khác có thể tiến từng pixel và liên tục nạp lại cùng các giá trị bộ lọc từ một tầng bộ nhớ chậm hơn. Cả hai lịch đều tính toán cùng một tensor. Chỉ có một cách biến khả năng tái sử dụng trong phép tích chập thành tiết kiệm băng thông thực sự.
Definition 1.6: Ánh xạ trong tăng tốc AI
Ánh xạ trong tăng tốc AI là quá trình trong chuỗi bộ tăng tốc–trình biên dịch, gắn Đồ thị tính toán logic với cấu trúc phần cứng vật lý bằng cách quyết định phép toán nào thực thi trên phần tử xử lý nào, dữ liệu nằm ở tầng bộ nhớ nào, và theo thứ tự thời gian nào.
- Ý nghĩa: Trong phân loại D·A·M, ánh xạ là một quyết định theo trục máy, giúp xác định mức độ một phép toán tiệm cận giới hạn roofline \(\min(R_{\text{peak}},\; \text{BW} \times I)\). Một lựa chọn tiling kém, buộc phải truy cập DRAM không cần thiết, có thể làm giảm cường độ số học hiệu quả đủ để đẩy một phép toán vốn dĩ bị giới hạn bởi tính toán sang vùng bị giới hạn bởi băng thông.
- Điểm khác biệt: Biên dịch truyền thống thường nhấn mạnh chọn lệnh, cấp phát thanh ghi và lập lịch cho các bộ xử lý đa năng. Ánh xạ cho bộ tăng tốc coi trọng ngang bằng việc bố trí không gian và di chuyển dữ liệu tường minh trong Kiến trúc Luồng dữ liệu (Dataflow Architecture). Lý do mang tính vật lý: trong so sánh 45 nm đã nêu trước đó, truy cập DRAM ngoài chip tiêu thụ năng lượng khoảng gấp 200 lần một phép nhân-tích lũy số nguyên cục bộ, dù tỷ lệ này còn phụ thuộc vào công nghệ và phép toán.
- Cạm bẫy thường gặp: Một hiểu lầm phổ biến là việc ánh xạ được framework tự động xử lý. Với các khối lượng công việc (workload) GPU nói chung, các trình biên dịch như Accelerated Linear Algebra (XLA) có thể tìm ra các ánh xạ tốt cho những kernel phổ biến. Còn với các bộ tăng tốc chuyên dụng (mảng systolic, ASIC tùy chỉnh), các ánh xạ do trình biên dịch tạo có thể vẫn thua các lịch do con người tinh chỉnh, vì không gian tìm kiếm của trình biên dịch bị giới hạn bởi ngân sách thời gian biên dịch.
Ví dụ về tích chập nêu bật ba quyết định lặp lại xuyên suốt quá trình biên dịch cho bộ tăng tốc. Placement gán công việc nhân-cộng dồn cho các phần tử xử lý để song song hóa không biến thành thời gian nhàn rỗi hay tắc nghẽn liên kết. Allocation giữ trọng số, activations và các tổng trung gian ở tầng bộ nhớ nơi chúng sẽ được dùng tiếp theo, thay vì để việc tái sử dụng phải quay về DRAM. Scheduling sắp xếp thứ tự các vòng lặp và kernel để việc bố trí và cấp phát đã chọn luôn hợp lệ theo thời gian. Chỉ cần chọn sai ở một khía cạnh cũng có thể biến một phép toán có cường độ số học cao thành một thực thi bị giới hạn bởi băng thông. Trên thực tế, các quyết định này gắn kết với nhau đến mức nhà phát triển khó quản lý thủ công ở quy mô mô hình, nên các hệ thống như XLA, TVM và TensorRT sẽ hạ các mô hình cấp cao xuống và tìm kiếm hoặc chọn kế hoạch thực thi trong giới hạn thời gian biên dịch và ngân sách phần cứng. Section 1.8 xem xét chi tiết hỗ trợ trình biên dịch đó.
Bố trí và cấp phát
Để chuyển đổi đồ thị tính toán của một mô hình thành thực thi hiệu quả trên phần cứng, chúng ta cần giải quyết hai vấn đề liên kết chặt chẽ. Bố trí tính toán (Computation placement) xác định phép toán nào chạy trên phần tử xử lý nào, đồng thời cân bằng giữa mức độ song song và chi phí giao tiếp. Cấp phát bộ nhớ (Memory allocation) xác định dữ liệu nằm ở đâu trong hệ thống phân cấp bộ nhớ, cân nhắc giữa dung lượng và độ trễ truy cập. Hai quyết định này tương tác với nhau: đặt các phép toán trên những phần tử xử lý ở xa nhau sẽ làm tăng băng thông bộ nhớ cần thiết để chuyển dữ liệu giữa chúng, trong khi cấp phát dữ liệu vào bộ nhớ on-chip nhanh nhưng nhỏ sẽ giới hạn số phép toán có thể chạy đồng thời. Chỉ cần sai ở một trong hai quyết định này cũng có thể khiến hàng nghìn phần tử xử lý bị nhàn rỗi hoặc thiếu dữ liệu.
Bố trí tính toán
Bố trí tính toán là quá trình gán các phép toán cho các phần tử xử lý (PE) của một bộ tăng tốc nhằm khai thác tính song song, giảm thời gian nhàn rỗi và hạn chế việc di chuyển dữ liệu không cần thiết. Các bộ tăng tốc hiện đại có rất nhiều tài nguyên như vậy: NVIDIA H100 có hơn 16.000 lõi CUDA và hơn 500 Tensor Cores (Choquette 2023); các TPU tổ chức hàng nghìn đơn vị nhân-tích lũy thành các mảng systolic (Jouppi et al. 2017); còn các bộ xử lý quy mô wafer như CS-2 của Cerebras tích hợp hơn 850.000 lõi (Systems 2021). Ở những quy mô này, các bất hiệu quả trong bố trí trở nên đáng kể vì lõi nhàn rỗi và truyền dữ liệu dư thừa đều lãng phí cả thời gian lẫn năng lượng.
Độ khó của việc bố trí phụ thuộc vào tính đều đặn của khối lượng công việc (workload). Các phép toán CNN và transformer dày đặc có cấu trúc rõ ràng và dễ chia tile, dù transformers kết hợp các kernel có hình dạng và mẫu tái sử dụng khác nhau. Mạng nơ-ron đồ thị (GNNs) khó phân vùng hơn vì các vùng lân cận thưa thớt, phụ thuộc vào đầu vào có thể gây mất cân bằng tải và giao tiếp phân tán. Bảng Table 15 liệt kê những thách thức cốt lõi mà việc bố trí cần giải quyết trên các loại khối lượng công việc (workload) này. Lịch trình tĩnh hoạt động tốt cho nhiều kernel dày đặc có hình dạng cố định; còn bố trí nhận biết runtime hữu ích khi hình dạng, độ thưa thớt, định tuyến hoặc mức sẵn có của tài nguyên thay đổi.
| Thách thức | Tác động đến thực thi | Các cân nhắc chính cho việc đặt vị trí |
|---|---|---|
| Mất cân bằng khối lượng công việc | Một số phần tử xử lý kết thúc sớm trong khi những phần tử khác vẫn bị quá tải, dẫn đến tài nguyên tính toán nhàn rỗi. | Phân phối các phép toán đều đặn để ngăn chặn tắc nghẽn và đảm bảo tận dụng tối đa các PE. |
| Các mẫu tính toán không đều | Đồ thị thưa thớt, định tuyến và hình dạng biến đổi có thể tạo ra công việc không đồng đều làm phức tạp việc đặt vị trí tĩnh. | Sử dụng việc đặt vị trí thích ứng khi các đặc điểm của khối lượng công việc thay đổi trong thời gian runtime. |
| Di chuyển dữ liệu quá mức | Việc truyền bộ nhớ thường xuyên gây ra độ trễ và tăng mức tiêu thụ công suất. | Giữ dữ liệu thường xuyên sử dụng gần các đơn vị tính toán và giảm thiểu truy cập bộ nhớ ngoài chip. |
| Băng thông kết nối hạn chế | Các phép toán được đặt không tối ưu có thể gây tắc nghẽn, làm chậm quá trình di chuyển dữ liệu giữa các PE. | Tối ưu hóa vị trí không gian và thời gian để giảm chi phí giao tiếp. |
| Nhu cầu thực thi cụ thể của mô hình | CNN, transformer và GNN yêu cầu các mẫu thực thi khác nhau, khiến một chiến lược đặt vị trí duy nhất trở nên không hiệu quả. | Điều chỉnh các chiến lược đặt vị trí để phù hợp với cấu trúc tính toán của từng loại mô hình. |
Việc bố trí tốt có thể giảm đáng kể độ trễ, còn bố trí kém sẽ khiến các phần tử xử lý bị nhàn rỗi hoặc làm tăng chi phí truyền dữ liệu. Vì vậy, các bộ tăng tốc kết hợp ánh xạ tĩnh cho các kernel quy củ với lập lịch nhận biết runtime khi hành vi của khối lượng công việc (workload) thay đổi. Các quyết định bố trí cũng gắn trực tiếp với mối quan tâm tiếp theo: dữ liệu mà các phần tử xử lý đó cần đang nằm ở đâu trong hệ thống phân cấp bộ nhớ.
Cấp phát bộ nhớ
Trong khi bố trí tính toán quyết định thao tác chạy ở đâu, thì cấp phát bộ nhớ xác định dữ liệu nằm ở đâu và cách chúng luân chuyển qua hệ thống phân cấp bộ nhớ. Mục tiêu là giữ dữ liệu được tái sử dụng gần các phần tử xử lý mà không vượt quá dung lượng của các tầng nhanh hơn. GPU cung cấp bộ nhớ toàn cục, bộ nhớ chia sẻ, cache và thanh ghi; các kernel phối hợp chúng thông qua kỹ thuật tiling (NVIDIA Corporation 2020a). TPU dùng các bộ đệm trên chip để dàn sẵn activation và trọng số cho thực thi trên systolic-array (figure 8) (Jouppi et al. 2017), trong khi các bộ xử lý quy mô wafer phân vùng bộ nhớ và tính toán để kiểm soát lưu lượng trên liên kết (Systems 2021). Cả bộ xử lý đa năng và bộ tăng tốc đều dùng hệ thống phân cấp bộ nhớ, nhưng nhiều bộ tăng tốc trao cho trình biên dịch và kernel nhiều quyền quyết định hơn về vị trí dữ liệu. Vì vậy, cấp phát bộ nhớ kém có thể gây ra ba hệ quả liên quan: tăng độ trễ, tốn nhiều năng lượng hơn do phải truy cập các tầng cao hơn, và giảm thông lượng khi các phần tử xử lý phải chờ dữ liệu.
Systems, Cerebras. 2021. “Wafer-Scale Deep Learning Acceleration with the Cerebras CS-2.” Cerebras Technical Paper 2021.
Mức độ nghiêm trọng của các hệ quả này khác nhau theo khối lượng công việc (workload). CNN dựa vào các mẫu truy cập có cấu trúc, cục bộ và được hưởng lợi từ các bố cục bộ nhớ rõ ràng, giúp việc tái sử dụng dữ liệu trở nên dễ dự đoán (Chen et al. 2016). Các mô hình Transformer cần truy cập các tập tham số lớn và activation trung gian, nên rất nhạy với dung lượng và băng thông. GNN còn thêm các cấu trúc thưa, không đều, khiến việc cấp phát và nạp trước trở nên phức tạp.
Dung lượng chỉ là bài kiểm tra đầu tiên khi cấp phát bộ nhớ. Một tensor có thể vừa trong bộ nhớ của bộ tăng tốc nhưng vẫn chi phối thời gian thực thi nếu mỗi kernel phải đọc lại nó từ một tầng bộ nhớ xa; ngược lại, kỹ thuật tiling có thể giúp một tập làm việc lớn hơn vẫn hiệu quả bằng cách giữ tái sử dụng cục bộ. Vì vậy, chẩn đoán cấp phát phải nhìn vào lưu lượng, không chỉ chuyện “vừa hay không”: các nhà thiết kế cần đếm xem các giá trị băng qua mỗi ranh giới bộ nhớ bao nhiêu lần và giữ những giá trị được tái sử dụng thường xuyên ở tầng nhanh nhất có thể. Table 16 tóm tắt những thách thức này. Hệ thống thường kết hợp kế hoạch bộ nhớ tĩnh cho các hình dạng đã biết với quản lý bộ đệm động khi hình dạng thay đổi, trong khi dung lượng thiết bị giới hạn những mô hình nào có thể chạy mà không phải phân vùng hoặc đưa bớt dữ liệu ra ngoài.
| Thách thức | Tác động đến việc thực thi | Các cân nhắc chính cho việc cấp phát |
|---|---|---|
| Độ trễ bộ nhớ cao | Truy cập dữ liệu chậm làm trì hoãn quá trình thực thi và giảm thông lượng. | Ưu tiên đặt dữ liệu được truy cập thường xuyên vào các vị trí bộ nhớ nhanh hơn. |
| Bộ nhớ lưu trữ trên chip hạn chế | Bộ nhớ cục bộ nhỏ hạn chế lượng dữ liệu có sẵn gần các đơn vị tính toán. | Cấp phát bộ nhớ hiệu quả để tối đa hóa khả năng sẵn có của dữ liệu mà không vượt quá giới hạn phần cứng. |
| Nhu cầu băng thông ngoài chip cao | Truy cập thường xuyên vào bộ nhớ ngoài làm tăng độ trễ và tiêu thụ công suất. | Giảm các lần truyền bộ nhớ không cần thiết bằng cách quản lý cẩn thận thời điểm và cách thức di chuyển dữ liệu. |
| Các mẫu truy cập bộ nhớ không đều | Một số mô hình yêu cầu truy cập dữ liệu không thể đoán trước, dẫn đến việc sử dụng bộ nhớ không hiệu quả. | Sắp xếp bố cục bộ nhớ để phù hợp với các mẫu truy cập và giảm thiểu di chuyển dữ liệu không cần thiết. |
| Nhu cầu bộ nhớ cụ thể của mô hình | Các mô hình khác nhau yêu cầu các chiến lược cấp phát khác nhau để tối ưu hóa hiệu suất. | Điều chỉnh các quyết định cấp phát dựa trên cấu trúc và đặc điểm thực thi của khối lượng công việc. |
Độ phức tạp tổ hợp
Ví dụ tích chập nhỏ cũng giải thích vì sao ánh xạ phần cứng trở thành một bài toán tìm kiếm tổ hợp. Giữ một bộ lọc ở cục bộ chỉ giúp tái sử dụng tốt hơn nếu các phần tử xử lý được chọn có đủ bộ nhớ lân cận và nếu thứ tự vòng lặp quay lại bộ lọc đó trước khi nó bị đẩy ra. Song song hóa trên nhiều phần tử xử lý hơn chỉ tăng thông lượng cho đến khi chi phí đồng bộ và lưu lượng liên kết tiêu hao hết lợi ích. Table 17 liệt kê những căng thẳng lặp đi lặp lại giữa đặt vị trí, cấp phát và lập lịch. Vì thay đổi một quyết định sẽ làm thay đổi các lựa chọn khả thi và hữu ích của những quyết định khác, nên các bộ ánh xạ thực tế tìm kiếm hoặc tối ưu chúng đồng thời, thay vì tách riêng từng chiều để chọn độc lập.
Các yếu tố tương tác này tạo nên một không gian thiết kế mang tính tổ hợp rất lớn, nơi chỉ một thay đổi nhỏ trong quyết định ánh xạ cũng có thể dẫn đến khác biệt lớn về hiệu suất và hiệu quả năng lượng. Khác với các khối lượng công việc (workload) truyền thống có kiểu thực thi dễ đoán, các mô hình machine learning có cấu trúc tính toán đa dạng, đòi hỏi ánh xạ phải được điều chỉnh để tận dụng tái sử dụng dữ liệu, cơ hội song song hóa và đáp ứng các ràng buộc bộ nhớ. Không gian tìm kiếm tăng theo tổ hợp, khiến việc tìm kiếm toàn diện trở nên bất khả thi. Ba nguồn biến thiên góp phần vào độ phức tạp này:
| Chiều | Các cân nhắc về vị trí | Các cân nhắc về cấp phát và lập lịch |
|---|---|---|
| Độ hạt tính toán | Đặt vị trí hạt mịn cho phép song song hóa lớn hơn nhưng làm tăng chi phí đồng bộ hóa. | Lập lịch hạt thô giảm chi phí đồng bộ hóa nhưng có thể hạn chế tính linh hoạt. |
| Ánh xạ không gian so với thời gian | Đặt vị trí không gian tăng cường thực thi song song nhưng có thể dẫn đến tranh chấp tài nguyên và tắc nghẽn bộ nhớ. | Lập lịch thời gian cân bằng chia sẻ tài nguyên nhưng có thể giảm thông lượng tổng thể. |
| Tính cục bộ của bộ nhớ và dữ liệu | Đặt dữ liệu gần các đơn vị tính toán hơn giúp giảm thiểu độ trễ nhưng có thể làm giảm khả năng sẵn có của bộ nhớ tổng thể. | Cấp phát dữ liệu trên nhiều cấp bộ nhớ làm tăng dung lượng nhưng phát sinh chi phí truy cập cao hơn. |
| Giao tiếp và đồng bộ hóa | Đặt các đơn vị tính toán cùng vị trí giúp giảm độ trễ giao tiếp nhưng có thể gây ra tranh chấp. | Lập lịch các cơ chế đồng bộ hóa giúp giảm thiểu các điểm dừng nhưng có thể phát sinh chi phí bổ sung. |
| Dataflow và Execution Ordering | Static placement đơn giản hóa việc thực thi nhưng hạn chế khả năng thích ứng với các biến thể của khối lượng công việc (workload). | Dynamic scheduling cải thiện khả năng thích ứng nhưng làm tăng độ phức tạp của việc lập lịch. |
Sắp xếp thứ tự tính toán và thực thi
Các khối lượng công việc (workload) machine learning thường được tổ chức dưới dạng các vòng lặp lồng nhau, lặp qua nhiều chiều tính toán. Ví dụ, một kernel nhân ma trận có thể lặp qua kích thước batch (\(B\)), các đặc trưng đầu vào (\(C_{\text{in}}\)) và các đặc trưng đầu ra (\(C_{\text{out}}\)). Thứ tự thực thi các vòng lặp này ảnh hưởng sâu sắc đến tính cục bộ dữ liệu, mô hình tái sử dụng và hiệu quả tính toán.
Bỏ qua các phụ thuộc và các thứ tự tương đương, số cách sắp xếp \(n_{\text{loops}}\) vòng lặp có một giới hạn trên mang tính minh họa là: \[ N_{\text{order}} = n_{\text{loops}}! \] con số này tăng rất nhanh. Một lớp tích chập điển hình có thể liên quan đến tối đa bảy chiều vòng lặp, dẫn đến: \[ 7! = 5,040 \text{ possible execution orders.} \]
Các lựa chọn ánh xạ bùng nổ theo tổ hợp khi các chiều vòng lặp tăng lên.
Nếu mỗi cấp bộ nhớ có thể chọn một thứ tự độc lập, giới hạn trên minh họa tương ứng sẽ mở rộng như sau: \[ (n_{\text{loops}}!)^{N_{\text{mem}}} \] trong đó \(N_{\text{mem}}\) là số cấp của hệ thống phân cấp bộ nhớ. Sự mở rộng nhanh chóng này cho thấy vì sao tối ưu hóa thứ tự thực thi lại quan trọng: thứ tự vòng lặp kém có thể gây lưu lượng bộ nhớ quá lớn, trong khi một thứ tự tối ưu sẽ cải thiện việc sử dụng cache (Sze et al. 2017).
Song song hóa trên các phần tử xử lý
Các bộ tăng tốc AI hiện đại dùng hàng nghìn phần tử xử lý để tối đa hóa mức độ song song, nhưng quyết định phép tính nào nên song song hóa cần phân tích cẩn thận. Song song hóa quá mức có thể làm phát sinh chi phí đồng bộ và tăng nhu cầu băng thông, còn song song hóa không đủ sẽ khiến phần cứng bị khai thác kém.
Trước khi áp dụng các ràng buộc về tính hợp lệ và dung lượng, số cách có thứ tự để chọn các vòng lặp cho thực thi song song có giới hạn trên là: \[ \mathcal{P}_{\text{parallel}} = \frac{n_{\text{loops}}!}{(n_{\text{loops}}-k_{\text{parallel}})!} \] trong đó \(n_{\text{loops}}\) là số vòng lặp, và \(k_{\text{parallel}}\) là số vòng lặp được chọn để thực thi song song. Với một phép tính có sáu vòng lặp và chọn ba vòng lặp, số lượng không bị ràng buộc là: \[ \frac{6!}{(6-3)!} = 120. \]
Ngay cả với một lớp đơn, số lượng ứng viên có thể lên tới hàng trăm trước khi loại bỏ các chiến lược không hợp lệ hoặc tương đương. Mỗi chiến lược còn lại ảnh hưởng đến đồng bộ dữ liệu, tranh chấp bộ nhớ và hiệu quả tính toán tổng thể.
Bố trí bộ nhớ và luân chuyển dữ liệu
Cấu trúc hệ thống phân cấp bộ nhớ của các bộ tăng tốc AI đặt thêm nhiều ràng buộc, vì dữ liệu cần được bố trí hiệu quả trên các thanh ghi, cache, bộ nhớ dùng chung và DRAM ngoài chip. Cách bố trí dữ liệu ảnh hưởng đến độ trễ, băng thông tiêu thụ và hiệu quả năng lượng. Truy cập thường xuyên vào bộ nhớ chậm sẽ gây nút thắt, trong khi bố trí tối ưu giúp giảm các lần truyền dữ liệu tốn kém.
Nếu mỗi chiều tính toán có \(n\) lựa chọn độc lập ở mỗi cấp bộ nhớ, giới hạn trên (mang tính minh họa) sẽ là: \[ \mathcal{M}_{\text{placement}} = n^{N_{\text{comp}} \times N_{\text{mem}}} \] trong đó:
- \(n\) = số lựa chọn cách bố trí trên mỗi cấp,
- \(N_{\text{comp}}\) = số chiều tính toán,
- \(N_{\text{mem}}\) = số cấp của hệ thống phân cấp bộ nhớ.
Đối với một mô hình có:
- \(N_{\text{comp}} = 5\) chiều tính toán,
- \(N_{\text{mem}} = 3\) cấp bộ nhớ,
- \(n = 4\) lựa chọn cách bố trí khả thi trên mỗi cấp,
số lượng cách phân bổ bộ nhớ khả thi là: \[ 4^{5 \times 3} = 4^{15} = 1,073,741,824. \]
Không gian tìm kiếm ánh xạ
Ví dụ ánh xạ không ràng buộc này vượt quá một tỷ tổ hợp, dù nhiều tổ hợp là không hợp lệ, phụ thuộc lẫn nhau hoặc tương đương. Nhân các giá trị minh họa này cho ta một giới hạn trên minh họa của không gian tìm kiếm ánh xạ: \[ \mathcal{S}_{\text{mapping}} = \left( n^{N_{\text{comp}}} \times n_{\text{loops}}! \times \frac{n_{\text{loops}}!}{(n_{\text{loops}}-k_{\text{parallel}})!} \right)^{N_{\text{mem}}} \] trong đó:
- \(n^{N_{\text{comp}}}\) đại diện cho các lựa chọn cách bố trí bộ nhớ,
- \(n_{\text{loops}}!\) tính đến các lựa chọn thứ tự tính toán,
- \(\frac{n_{\text{loops}}!}{(n_{\text{loops}}-k_{\text{parallel}})!}\) thể hiện các khả năng song song hóa,
- \(N_{\text{mem}}\) là số cấp của hệ thống phân cấp bộ nhớ.
Phương trình này không đếm chính xác số lịch trình hợp lệ vì các lựa chọn có tương tác với nhau và các ràng buộc phần cứng sẽ cắt giảm không gian. Nó cho thấy vì sao không gian ứng viên có thể phình rất nhanh và vì sao việc tìm kiếm vét cạn trở nên không thực tế. Một ví dụ cụ thể sẽ giúp thấy rõ tác động của các lựa chọn này.
Example 1.4: Thứ tự vòng lặp trong một phép tích chập nhỏ
Xem xét một phép tích chập áp dụng 16 bộ lọc kích thước \(3{\times}3\) cho một đầu vào một kênh \(8{\times}8\). Phép tính này có thể được biểu diễn bằng năm vòng lặp lồng nhau, lặp qua các hàng đầu ra (\(H_{\text{out}}\)), các cột đầu ra (\(W_{\text{out}}\)), số lượng bộ lọc (\(C_{\text{out}}\)), chiều cao bộ lọc (\(F_h\)) và chiều rộng bộ lọc (\(F_w\)). Có \(5! = 120\) hoán vị, đây là một giới hạn trên không bị ràng buộc: các thứ tự vòng lặp hợp lệ giữ nguyên kết quả toán học (mặc dù thứ tự cộng dồn số dấu phẩy động có thể làm thay đổi làm tròn) và dẫn đến lưu lượng bộ nhớ khác nhau.
Thứ tự A (weight-stationary): Đặt các vòng lặp bộ lọc (\(C_{\text{out}}\), \(F_h\), \(F_w\)) ở ngoài cùng và các vòng lặp không gian (\(H_{\text{out}}\), \(W_{\text{out}}\)) ở trong cùng. Mỗi bộ lọc \(3{\times}3\) được nạp vào thanh ghi một lần, rồi áp dụng cho cả 36 vị trí đầu ra trước khi nạp bộ lọc tiếp theo. Tổng số lần nạp trọng số: \(16 \times 9 = 144\) giá trị, mỗi giá trị được nạp đúng một lần.
Thứ tự B (output-stationary): Đặt các vòng lặp không gian ở ngoài cùng và các vòng lặp bộ lọc ở trong cùng. Với mỗi vị trí đầu ra, phải nạp toàn bộ 16 bộ lọc, áp dụng chúng và tích lũy các tổng riêng phần trước khi chuyển sang vị trí tiếp theo. Nếu bộ thanh ghi không thể chứa đồng thời cả 16 bộ lọc, các bộ lọc sẽ liên tục được nạp lại từ cache hoặc DRAM. Trong trường hợp xấu nhất, mỗi trong số 36 vị trí đầu ra sẽ nạp lại toàn bộ 144 trọng số bộ lọc, tạo ra \(36 \times 144 = 5{,}184\) lần đọc trọng số.
Hiểu biết về hệ thống: Theo hai giả định giới hạn này, Thứ tự A giảm số lần đọc trọng số được mô hình hóa đi 36 lần so với trường hợp xấu nhất của Thứ tự B. Các kernel thực tế cũng tính đến lưu lượng activation và tổng riêng phần, dung lượng thanh ghi, hành vi cache và vector hóa. Tuy vậy, ví dụ này cho thấy vì sao hai thứ tự vòng lặp tương đương về mặt toán học có thể đặt ra những yêu cầu rất khác nhau cho hệ thống bộ nhớ.
Sự tăng trưởng theo tổ hợp được phân tích ở đây đặt ra một thách thức thực tế: vì sao người làm thực hành vẫn đạt hiệu suất cao dù không gian ứng viên rất lớn. Việc duyệt hết mọi khả năng thường không khả thi, nhưng các hệ thống triển khai thực tế vẫn thường xuyên tìm ra lịch thực thi hữu ích cho các kernel phổ biến. Câu trả lời nằm ở một tập nhỏ các mẫu luồng dữ liệu (dataflow) có cơ sở, giúp thu hẹp tìm kiếm xuống một tập lựa chọn mang tính chiến lược và ở mức có thể quản lý.
Self-Check: Question
In neural network hardware mapping, what distinguishes a spatial mapping decision from a temporal mapping decision?
- Spatial mapping refers to compiling graph IR, whereas temporal mapping refers to runtime CUDA kernel launches
- Spatial mapping determines precision formats (FP16 vs INT8), whereas temporal mapping determines memory allocation sizes
- Spatial mapping assigns computational tasks to specific physical execution units (e.g., PEs or SMs) simultaneously in parallel, whereas temporal mapping determines the execution ordering and loop scheduling over time on those units
- Spatial mapping operates only on convolutional layers, whereas temporal mapping operates only on transformer attention layers
Explain why finding the optimal hardware mapping (tiling sizes, loop orders, and spatial partitioning) for a deep neural network on a target accelerator is a combinatorially hard optimization problem.
Explain why reordering loop nests in a tensor contraction (e.g., changing from \(I \to J \to K\) to \(K \to I \to J\)) alters memory bandwidth demands and execution speed without changing the total mathematical operation count.
When mapping a tensor computation to a multi-level memory hierarchy, what is the primary objective function optimized by spatial and temporal tiling?
- Maximizing the total number of intermediate tensors written to host DDR memory
- Maximizing data reuse in the fastest, closest memory tiers (registers and SRAM) to minimize traffic to slower, energy-expensive DRAM
- Ensuring every warp thread executes different instruction streams simultaneously
- Converting all 2D matrix multiplications into 1D scalar operations
Tối ưu hóa luồng dữ liệu
Các chiến lược ánh xạ từ section 1.6 xác định nơi phép tính được thực thi và nơi dữ liệu được lưu trữ, nhưng chúng không chỉ rõ dataflow optimization: tức là cách dữ liệu luân chuyển qua các phần tử xử lý trong khi chạy. Ví dụ, một mảng systolic có thể xử lý phép nhân ma trận với trọng số trong bộ nhớ cục bộ, nhưng thứ tự mà trọng số, đầu vào và đầu ra đi qua mảng sẽ trực tiếp quyết định mức tiêu thụ băng thông bộ nhớ và hiệu quả năng lượng. Việc chọn chiến lược nào ảnh hưởng trực tiếp đến việc bộ tăng tốc hoạt động trong vùng bị giới hạn bởi tính toán (compute-bound) hay bị giới hạn bởi bộ nhớ (memory-bound) theo phân tích Roofline—đó là lý do các trình biên dịch (section 1.8) và hệ thống runtime (section 1.9) phải chọn các mẫu luồng dữ liệu phù hợp dựa trên đặc tính của khối lượng công việc (workload).
Ba quyết định lặp đi lặp lại dưới đây định hình các lựa chọn về luồng dữ liệu được xét đến:
- Locality: Các chiến lược như weight-stationary, output-stationary và input-stationary đưa ra những lựa chọn khác nhau về việc cache dữ liệu nào gần đơn vị tính toán, từ đó đánh đổi các kiểu truy cập bộ nhớ khác nhau.
- Organization: Bố cục tensor (NHWC so với NCHW) quyết định liệu truy cập bộ nhớ có ăn khớp với ưu tiên của phần cứng hay không; tác động hiệu suất có thể rất lớn khi việc chuyển đổi bố cục hoặc truy cập không kết hợp (uncoalesced access) cản trở đường xử lý nhanh.
- Combination: Hợp nhất kernel (kernel fusion) và phân ô (tiling) tái cấu trúc phép tính để giảm lưu lượng bộ nhớ, thường mang lại mức tăng tốc lớn cho các phép toán có cường độ số học thấp nhờ tránh ghi và tải lại dữ liệu trung gian.
Các mẫu này cung cấp một vốn từ gọn để suy luận về nhiều quyết định luồng dữ liệu mà không cần tìm kiếm vét cạn. Các phần tiếp theo sẽ lần lượt xem xét từng quyết định, rồi cho thấy cách chúng kết hợp trong các kiến trúc mạng nơ-ron cụ thể như ResNet-50, GPT-2 và MLP.
Các thành phần cơ bản của chiến lược ánh xạ
Ba quyết định này tương ứng với bốn kỹ thuật nền tảng: các mẫu di chuyển dữ liệu (weight-stationary, output-stationary, input-stationary), cách sắp xếp tensor tối ưu bộ nhớ (channels-last và channels-first), kết hợp kernel (kernel fusion) (gộp các phép toán để loại bỏ các thao tác ghi trung gian), và kỹ thuật phân ô (tiling) (chia nhỏ các phép tính thành các khối thân thiện với bộ nhớ). Nhờ các khối nền tảng này, không gian tìm kiếm ánh xạ được thu hẹp: các optimizer theo heuristic và dựa trên mô hình có thể kết hợp chúng, thay vì phải tự tìm lại các lựa chọn di chuyển dữ liệu từ đầu.
Các mẫu di chuyển dữ liệu
Dù ánh xạ tính toán quyết định nơi và khi nào các phép toán diễn ra, mức độ thành công lại phụ thuộc lớn vào việc dữ liệu được truy cập và truyền qua hệ thống phân cấp bộ nhớ có hiệu quả hay không. Một số khối lượng công việc (workload) machine learning có tính đều đặn nhưng vượt quá dung lượng cache; số khác, như tra cứu thưa thớt (sparse lookups) và mô hình định tuyến (routed models), có các mẫu truy cập không đều. Cả hai trường hợp này đều khiến chiến lược di chuyển dữ liệu trở nên then chốt đối với hiệu suất tổng thể của hệ thống.
Ngay cả khi các đơn vị tính toán được ánh xạ hiệu quả, các chiến lược di chuyển dữ liệu kém vẫn làm giảm hiệu suất do gây ra các lần đình trệ bộ nhớ thường xuyên và khiến tài nguyên phần cứng bị nhàn rỗi. Nếu dữ liệu không được cung cấp cho các phần tử xử lý với tốc độ cần thiết, các đơn vị tính toán sẽ bị đình trệ, làm tăng độ trễ, lưu lượng bộ nhớ và mức tiêu thụ năng lượng (Chen et al. 2016). Listing 15 minh họa cách việc di chuyển dữ liệu kém hiệu quả ảnh hưởng đến phép tính cốt lõi của nhiều mô hình machine learning qua một phép nhân ma trận điển hình.
## Matrix multiplication where:
## weights: [512x256] - model parameters
## input:   [256x32]  - batch of activations
## Z:       [512x32]  - output activations

## Computing each output element Z[i,j]:
for i in range(512):
    for j in range(32):
        for k in range(256):
            Z[i, j] += weights[i, k] * input[k, j]
Phép tính này bộc lộ vài thách thức quan trọng về luồng dữ liệu. Thứ nhất là số lần truy cập bộ nhớ cần thiết. Với mỗi đầu ra \(Z_{ij}\), ta phải lấy cả một hàng trọng số từ ma trận trọng số và cả một cột activation từ ma trận đầu vào. Vì ma trận trọng số có 512 hàng và ma trận đầu vào có 32 cột, việc này lặp lại nhiều lần và gây áp lực lớn lên băng thông bộ nhớ.
Thách thức thứ hai là tái sử dụng trọng số. Cùng một trọng số được áp dụng cho nhiều đầu vào, nên một chiến lược ánh xạ lý tưởng phải tối đa hóa tính cục bộ của trọng số để tránh tải dữ liệu trùng lặp. Nếu không tái sử dụng tốt, bộ tăng tốc sẽ lãng phí băng thông khi phải tải cùng một trọng số nhiều lần (Chen et al. 2018).
Thách thức thứ ba là tích lũy các kết quả trung gian. Mỗi phần tử \(Z_{ij}\) cần đóng góp từ 256 cặp trọng số–đầu vào khác nhau, nên các tổng trung gian phải được lưu và lấy ra trước khi tính giá trị cuối cùng. Nếu các giá trị này được lưu trữ không hiệu quả, hệ thống sẽ phải truy cập bộ nhớ thường xuyên hơn, làm tăng thêm nhu cầu băng thông.
Một cách giảm bớt các thách thức trên là dùng mô hình thực thi SIMD và SIMT, cho phép lấy nhiều giá trị song song. Tuy vậy, ngay cả khi đã tối ưu như vậy, việc di chuyển dữ liệu vẫn là nút thắt cổ chai. Điều cốt lõi không chỉ là tốc độ truy xuất, mà còn là tần suất truyền và vị trí dữ liệu trong hệ thống phân cấp bộ nhớ (Han et al. 2016).
Han, Song, Xingyu Liu, Huizi Mao, Jing Pu, Ardavan Pedram, Mark A. Horowitz, and William J. Dally. 2016. “EIE: Efficient Inference Engine on Compressed Deep Neural Network.” 2016 ACM/IEEE 43rd Annual International Symposium on Computer Architecture (ISCA), 243–54. https://doi.org/10.1109/isca.2016.30.
Vì việc di chuyển dữ liệu chiếm phần lớn ngân sách năng lượng như figure 9 minh họa, mục tiêu quan trọng nhất của bộ tăng tốc là giảm thiểu truy cập bộ nhớ. Các chiến lược luồng dữ liệu đạt được điều này bằng cách tối đa hóa tái sử dụng dữ liệu. Quyết định cốt lõi là giữ cục bộ loại dữ liệu nào. Bộ tăng tốc giải quyết bằng cách xác định dữ liệu nào được giữ cố định trong bộ nhớ và dữ liệu nào được luân chuyển động: chiến lược trọng số cố định (weight-stationary) giữ các tham số mô hình cục bộ, chiến lược đầu vào cố định (input-stationary) duy trì dữ liệu activation, còn chiến lược đầu ra cố định (output-stationary) giữ các kết quả trung gian. Mỗi cách tiếp cận đánh đổi các kiểu truy cập bộ nhớ khác nhau để tối đa hóa tái sử dụng dữ liệu và giảm các lần truyền tốn năng lượng, vốn là nút thắt chính trong tăng tốc AI.
Trọng số cố định
Chiến lược weight stationary giữ các trọng số cố định trong bộ nhớ cục bộ, còn các activation đầu vào và các tổng riêng phần được truyền qua hệ thống. Cách làm này đặc biệt hữu ích trong CNN và phép nhân ma trận, nơi cùng một tập trọng số được áp dụng cho nhiều đầu vào. Khi giữ trọng số cố định, phương pháp này giảm các lần truy xuất bộ nhớ lặp lại, nhờ đó giảm nghẽn băng thông và cải thiện hiệu quả năng lượng.
Một ưu điểm chính của weight stationary là tối đa hóa việc tái sử dụng trọng số, từ đó giảm tần suất truy cập bộ nhớ ngoài. Vì các trọng số thường được dùng chung cho nhiều phép tính, giữ chúng trong bộ nhớ cục bộ sẽ loại bỏ việc di chuyển dữ liệu không cần thiết, làm giảm tổng chi phí năng lượng cho tính toán. Điều này đặc biệt hiệu quả với những kiến trúc mà trọng số chiếm phần lớn chi phí bộ nhớ, như các mảng systolic và các bộ tăng tốc tùy chỉnh cho machine learning. Listing 16 minh họa cách thực thi Weight Stationary giữ trọng số cố định trong bộ nhớ cục bộ, đồng thời luồng đầu vào được đưa vào và các tổng riêng phần được tích lũy.
## Weight Stationary Matrix Multiplication
## - Weights remain fixed in local memory
## - Input activations stream through
## - Partial sums accumulate for final output

for weight_block in weights:  # Load and keep weights stationary
    load_to_local(weight_block)  # Fixed in local storage
    for input_block in inputs:  # Stream inputs dynamically
        for output_block in outputs:  # Compute results
            output_block += compute(weight_block, input_block)
            # Reuse weights across inputs
Trong cách thực thi weight stationary, trọng số được nạp một lần vào bộ nhớ cục bộ và giữ cố định suốt quá trình tính toán, còn đầu vào được truyền động (stream) liên tục, giúp giảm các truy cập bộ nhớ lặp lại. Các tổng riêng phần được tích lũy hiệu quả, hạn chế việc di chuyển dữ liệu không cần thiết. Vì không phải nạp lại trọng số cho mỗi phép tính mới, yêu cầu băng thông giảm đáng kể, khiến luồng dữ liệu này rất hiệu quả cho các khối lượng công việc (workload) có mức tái sử dụng trọng số cao như CNN và phép nhân ma trận.
Tuy giảm lưu lượng bộ nhớ liên quan đến trọng số, chiến lược này lại tạo ra những đánh đổi ở việc di chuyển đầu vào và đầu ra. Vì đầu vào phải được truyền động liên tục trong khi trọng số cố định, hiệu quả phụ thuộc vào việc đưa các activation đầu vào đến đơn vị tính toán có kịp thời mà không gây dừng hay không. Các tổng riêng phần, tức các kết quả trung gian, cũng cần được tích lũy cẩn thận để tránh phát sinh lưu lượng bộ nhớ quá lớn. Mức tăng hiệu năng tổng thể còn tùy vào kích thước bộ nhớ trên chip sẵn có, vì việc lưu trữ các ma trận trọng số lớn trong bộ nhớ cục bộ có thể trở thành hạn chế với các mô hình có hàng triệu hay hàng tỷ tham số.
Chiến lược trọng số cố định phù hợp với các khối lượng công việc (workload) có mức tái sử dụng trọng số cao và băng thông bộ nhớ là yếu tố hạn chế. Chiến lược này thường dùng trong CNN, mảng systolic và các nhân nhân ma trận, nơi việc tái sử dụng trọng số có cấu trúc mang lại cải thiện hiệu suất rõ rệt. Tuy nhiên, với các mô hình mà việc tái sử dụng đầu vào hoặc đầu ra quan trọng hơn, các chiến lược luồng dữ liệu khác như đầu ra cố định hoặc đầu vào cố định có thể mang lại cân bằng tốt hơn.
Đầu ra cố định
Chiến lược trọng số cố định giữ các trọng số cục bộ và truyền đầu vào qua hệ thống. Tuy nhiên, trọng tâm chi phí thay đổi khi nút thắt không còn là nạp trọng số mà là việc ghi các tổng riêng phần (partial sums) với tần suất cao. Trong các lớp kết nối đầy đủ và cơ chế attention của transformer, mỗi phần tử đầu ra tích lũy đóng góp từ hàng trăm hoặc hàng nghìn cặp trọng số–đầu vào. Ghi các tổng riêng phần trung gian đó ra bộ nhớ ngoài sau mỗi bước tích lũy sẽ tạo ra nút thắt băng thông ghi còn nghiêm trọng hơn chi phí đọc mà chiến lược trọng số cố định xử lý. Chiến lược đầu ra cố định đảo thứ tự ưu tiên: giữ các tổng riêng phần cố định trong bộ nhớ cục bộ, đồng thời truyền cả trọng số và activation đầu vào qua hệ thống, để mỗi phần tử đầu ra chỉ được ghi ra bộ nhớ ngoài một lần, sau khi mọi đóng góp đã được tích lũy (Chen et al. 2016).
Chen, Yu-Hsin, Joel S. Emer, and Vivienne Sze. 2016. “Eyeriss: A Spatial Architecture for Energy-Efficient Dataflow for Convolutional Neural Networks.” 2016 ACM/IEEE 43rd Annual International Symposium on Computer Architecture (ISCA), 367–79. https://doi.org/10.1109/ISCA.2016.40.
Listing 17 minh họa cách tích lũy các tổng riêng phần tại chỗ giúp giảm thao tác ghi bộ nhớ và nâng hiệu quả trong phép nhân ma trận. Trong triển khai này, bộ đệm tích lũy luôn nằm trong thanh ghi cục bộ hoặc vùng nhớ tạm (scratchpad) suốt vòng lặp bên trong; trọng số và đầu vào được truyền vào, đóng góp vào tổng đang chạy rồi được bỏ đi. Kết quả cuối cùng chỉ ghi một lần cho mỗi phần tử đầu ra, loại bỏ lưu lượng ghi lặp lại vốn sẽ chiếm phần lớn băng thông.
Cách tiếp cận này rất hợp với các mảng systolic, nơi phép tính tiến dần qua một lưới phần tử xử lý và các tổng riêng phần có thể luân chuyển dọc theo một trục mà không phải rời chip. Đổi lại, cả trọng số và activation giờ đây phải được truyền liên tục, nên hệ thống phải duy trì băng thông đọc cao cho hai luồng dữ liệu cùng lúc. Các triển khai song song cũng cần đồng bộ hóa cẩn thận khi nhiều PE cùng đóng góp vào cùng một phần tử đầu ra. Vì vậy, output stationary hiệu quả nhất cho các khối lượng công việc (workload) mà phép tích lũy chiếm ưu thế, như các lớp fully connected và cơ chế attention; nhưng kém phù hợp hơn khi tái sử dụng đầu vào là nút thắt cổ chai chính.
## - Partial sums remain in local memory
## - Weights and input activations stream through dynamically
## - Final outputs are written only once

for output_block in outputs:  # Keep partial sums stationary
    accumulator = 0  # Initialize accumulation buffer
    for weight_block, input_block in zip(weights, inputs):
        accumulator += compute(weight_block, input_block)
        # Accumulate partial sums
    store_output(accumulator)  # Single write to memory
Input stationary
Hai chiến lược đã xét đến nay mỗi chiến lược cố định một toán hạng khác nhau trong bộ nhớ cục bộ: weight stationary cố định trọng số để giảm băng thông đọc cho tham số, còn output stationary cố định các tổng riêng phần để giảm băng thông ghi cho các phép tích lũy. Chiến lược thứ ba hoàn thiện bức tranh bằng cách cố định toán hạng còn lại: activation đầu vào. Trong một lớp transformer, một activation có thể cấp cho nhiều phép chiếu (projection) hoặc attention head; lớp tiếp theo nhận một biểu diễn mới được tính thay vì cùng một activation token. Khi việc tái sử dụng activation là chi phí bộ nhớ chủ đạo, giữ đầu vào cố định và truyền trọng số qua hệ thống có thể giảm năng lượng và băng thông. Listing 18 minh họa cách tiếp cận này.
## - Input activations remain in local memory
## - Weights stream through dynamically
## - Partial sums accumulate and are written out

for input_block in inputs:  # Keep input activations stationary
    load_to_local(input_block)  # Fixed in local storage
    for weight_block in weights:  # Stream weights dynamically
        for output_block in outputs:  # Compute results
            output_block += compute(weight_block, input_block)
            # Reuse inputs across weights
Ở đây, activation đầu vào được nạp một lần và giữ nguyên trong khi trọng số được truyền liên tục. Các tổng riêng phần được tích lũy rồi cuối cùng được ghi ra; nhưng khác với output stationary, bộ đệm tích lũy không phải là đối tượng hưởng lợi chính từ tính cục bộ; thay vào đó, dữ liệu đầu vào mới là thành phần hưởng lợi chính.
Điểm đánh đổi phản chiếu hai chiến lược kia: trọng số giờ phải được truyền động, nên hệ thống cần duy trì băng thông đọc cho luồng trọng số, và các tổng riêng phần cần được đệm trước khi ghi trở lại. Input stationary hiệu quả nhất khi một khối activation cấp cho nhiều phép chiếu, head, cổng (gate), hoặc các phép tính khác trước khi bị loại bỏ.
Gộp lại, ba chiến lược dataflow này đưa ra một quy tắc lựa chọn, chứ không phải một thứ bậc về mức độ ưu việt. Weight stationary giảm lưu lượng đọc cho các tham số và hợp với CNN có bộ lọc nhỏ, tái sử dụng nhiều. Output stationary giảm lưu lượng ghi cho các giá trị tích lũy và hợp với các lớp fully connected có fan-in cao. Input stationary giảm lưu lượng đọc cho activation và hợp với transformers và xử lý batch khi activation được tái sử dụng nhiều. Không có chiến lược nào vượt trội tuyệt đối; lựa chọn tối ưu phụ thuộc vào phần tử dữ liệu nào có tỷ lệ tái sử dụng cao nhất so với kích thước của nó. Đây là quyết định mà trình biên dịch và nhà thiết kế phần cứng phải đưa ra dựa trên khối lượng công việc (workload) cụ thể và hệ thống phân cấp bộ nhớ. Các thiết kế chuyên cho tích chập còn thêm một nhãn thứ tư là row-stationary (như trong Eyeriss), nhưng đây không phải một nguyên thủy riêng: đó là một kiểu kết hợp, giữ các hàng đầu vào và tổng từng phần ở gần khi phép ánh xạ đó cho mức tái sử dụng cao hơn so với việc cố định bất kỳ một toán hạng nào (section 1.4.6.2).
Bố cục tensor hiệu quả về bộ nhớ
Các chiến lược dataflow trong section 1.7.1.1 quyết định dữ liệu nào được giữ gần khối tính toán; bố cục tensor quyết định liệu dữ liệu đó, khi đã đến nơi, có được truy cập hiệu quả hay không. Ngay cả khi chọn đúng dataflow weight stationary, hiệu năng vẫn kém nếu trọng số được lưu theo định dạng gây truy cập bộ nhớ rời rạc. Vì vậy, bố cục tensor là một hợp đồng của kernel: cách sắp xếp vật lý của dữ liệu đa chiều phải khớp với mẫu truy cập mà đường dẫn phần cứng đã chọn mong đợi; nếu không, bộ tăng tốc sẽ phải trả giá bằng các memory stall, sử dụng cache kém hiệu quả và tăng lưu lượng dữ liệu di chuyển.
Trong các bộ tăng tốc AI, tối ưu hóa bố cục tensor đặc biệt quan trọng vì dữ liệu thường được truy cập theo các mẫu do kiến trúc phần cứng quy định. Chọn đúng bố cục giúp các truy cập bộ nhớ ăn khớp với các mẫu truy cập thân thiện với phần cứng, từ đó giảm chi phí do các giao dịch bộ nhớ tốn kém (NVIDIA Corporation 2021).
Mặc dù đôi khi nhà phát triển có thể tự chỉ định bố cục tensor, nhưng phần lớn lựa chọn này được quyết định tự động bởi các machine learning framework như TensorFlow, PyTorch, JAX, bởi trình biên dịch, hoặc bởi runtime của bộ tăng tốc AI. Các công cụ tối ưu hóa cấp thấp như cuDNN (cho NVIDIA GPU), XLA (cho đồ thị TensorFlow), và các chuỗi trình biên dịch dựa trên MLIR có thể áp đặt hoặc biến đổi bố cục tensor khi hạ các phép toán xuống các kernel đặc thù của backend (NVIDIA Corporation 2021; Google 2025; Lattner et al. 2020). Trong các framework cấp cao, việc biến đổi bố cục thường diễn ra minh bạch; nhưng nếu bạn làm với các kernel tùy chỉnh hoặc thư viện cấp thấp như CUDA, Metal, hay OpenCL, bạn có thể trực tiếp kiểm soát việc chọn định dạng tensor.
Ví dụ, PyTorch cung cấp các phép toán view như tensor.permute() và dùng tensor.contiguous() để tạo lưu trữ liền kề khi một kernel ở bước sau cần (PyTorch Contributors 2026). TensorFlow khuyến nghị dùng channels-last (NHWC) cho các mô hình tích chập trên NVIDIA GPU, đồng thời cảnh báo rằng NCHW có thể làm phát sinh chi phí chuyển vị tự động (TensorFlow Developers 2024). Các thư viện tối ưu theo phần cứng như cuDNN cho GPU và oneDNN cho CPU sử dụng các bố cục bộ nhớ cụ thể để tối đa hóa tính cục bộ của cache và hiệu quả SIMD. Quy tắc thực tế là xem bố cục như một phần của đường dẫn backend đã chọn: định dạng tensor nhanh nhất là định dạng tránh được chi phí chuyển đổi và giúp các truy cập bộ nhớ của kernel liền kề.
PyTorch Contributors. 2026. Tensor Views.
TensorFlow Developers. 2024. Optimize TensorFlow Performance Using the Profiler.
Bố cục channels-last
Trong bố cục channels-last NHWC, chỉ số kênh thay đổi nhanh nhất trong một tensor liền kề, nên các giá trị kênh của mỗi pixel nằm liền kề nhau. NHWC mô tả thứ tự các chiều logic, chứ không nói bộ nhớ tuyến tính bên dưới có phải là row-major hay không. Cả tensor NHWC và NCHW đều có thể dùng cách tuyến tính hóa row-major cho các chiều tương ứng của chúng.
Để hiểu bố cục channels-last, hãy xem xét một ảnh RGB được biểu diễn dưới dạng một tensor có kích thước (Chiều cao, Chiều rộng, Kênh). Nếu ảnh có kích thước \(3{\times}3\) pixel với 3 kênh (RGB), tensor tương ứng sẽ có kích thước là (3, 3, 3). Các giá trị sẽ được lưu trữ trong bộ nhớ như sau: \[\begin{gather*} I(0,0,0), I(0,0,1), I(0,0,2), I(0,1,0), I(0,1,1), \\ I(0,1,2), I(0,2,0), I(0,2,1), I(0,2,2), \ldots \end{gather*}\]
Các kênh của mỗi pixel nằm liền kề nhau, và các pixel được duyệt theo chiều rộng trước, rồi mới đến chiều cao. Thứ tự này hỗ trợ truy cập tuần tự khi một kernel thực hiện vector hóa trên các giá trị kênh liền kề.
Lợi ích của định dạng lưu trữ channels-last phụ thuộc vào phép toán và backend. Các kernel trên CPU và bộ tăng tốc có thể vector hóa theo kênh sẽ tận dụng được chiều kênh liên tiếp. Ngược lại, các kernel khác có thể ưa chuộng bố cục channels-first hoặc các bố cục nội bộ dạng khối.
Tuy nhiên, việc chọn bố cục trở nên tinh tế hơn với các phép tích chập vì thứ tự chiều logic và định dạng bộ nhớ vật lý không trùng nhau. Một tensor có thể được mô tả là NHWC hoặc NCHW, nhưng điều mà backend thực sự quan tâm là các địa chỉ bộ nhớ mà kernel truy cập có liên tiếp, được căn chỉnh và được gom lại (coalesced) hay không, tùy thuộc vào phép toán và chế độ chính xác cụ thể.
TensorFlow thường dùng quy ước NHWC, trong khi PyTorch thường phơi bày các tensor NCHW kèm tùy chọn định dạng bộ nhớ channels-last riêng. Khi nhắm mục tiêu GPU, các framework và thư viện có thể chèn, truyền tiếp hoặc thực hiện các biến đổi bố cục bên trong để khớp với đường dẫn kernel nhanh nhất.
Bố cục channels-first
Trong bố cục NCHW channels-first liên tục, chỉ số chiều rộng thay đổi nhanh nhất và toàn bộ các giá trị không gian của một kênh được lưu trữ liền nhau trước khi sang kênh tiếp theo. GPU xử lý dữ liệu song song trên nhiều luồng; khi các luồng truy cập các địa chỉ bộ nhớ liên tiếp, phần cứng có thể gộp các yêu cầu này thành một giao dịch hiệu quả duy nhất (memory coalescing). Trước đây, nhiều đường dẫn tích chập trên GPU dùng NCHW rất hiệu quả, còn hiện nay các đường dẫn tích chập và hợp nhất dựa trên Tensor Core thường ưu tiên bố cục vật lý NHWC hoặc channels-last vì chúng phù hợp hơn với các kernel tensor-core được vector hóa.
Để hiểu bố cục channels-first, hãy xét cùng một tensor ảnh RGB với các chiều được sắp xếp lại thành (Kênh, Chiều cao, Chiều rộng) = (3, 3, 3). Giữ \(I(h,w,c)\) làm ký hiệu tọa độ ngữ nghĩa, dữ liệu được lưu trữ theo thứ tự channels-first như sau: \[\begin{gather*} I(0,0,0), I(0,1,0), I(0,2,0), I(1,0,0), I(1,1,0), I(1,2,0), \ldots, \\ I(0,0,1), I(0,1,1), I(0,2,1), \ldots, I(0,0,2), I(0,1,2), I(0,2,2), \ldots \end{gather*}\]
Ở định dạng này, toàn bộ giá trị của kênh đỏ cho cả ảnh được lưu trước, tiếp theo là kênh xanh lá, rồi đến kênh xanh lam. Thứ tự này có thể giúp một số bộ tăng tốc phần cứng tải và xử lý dữ liệu hiệu quả theo kênh song song, điều này quan trọng đối với các phép tích chập và các mô hình thực thi SIMD (Chetlur et al. 2014).
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
Ưu thế của một bố cục chỉ thật sự rõ khi đặt trong bối cảnh một backend cụ thể. Các lớp tích chập xử lý hình ảnh bằng cách áp dụng một tập bộ lọc dùng chung lên tất cả các kênh. Tùy vào cách triển khai kernel, các bố cục như NCHW, NHWC hoặc bố cục khối nội bộ có thể giảm truy xuất bộ nhớ phân tán, hạ độ trễ bộ nhớ và cải thiện tính cục bộ dữ liệu cho các phép nhân ma trận được chuyển đổi để hiện thực phép tích chập.
Vì GPU và TPU dựa vào kết hợp bộ nhớ,34 một kỹ thuật trong đó các luồng liên tiếp truy xuất các địa chỉ bộ nhớ liền kề, nên bố cục tốt nhất là bố cục khiến mẫu truy cập của các luồng trong kernel trở nên liên tiếp trên bộ nhớ. Ví dụ, trong các đường tích chập trên GPU NVIDIA, cuDNN có thể sử dụng hoặc nội bộ chuyển sang NHWC/channels-last cho các kernel Tensor Core, trong khi những kernel khác vẫn có thể chạy tốt với NCHW. Quy tắc này phụ thuộc vào backend và toán tử, chứ không phải một phân chia phổ quát kiểu CPU=NHWC, GPU=NCHW.
34 Kết hợp bộ nhớ: Cơ chế phần cứng của GPU hợp nhất các yêu cầu bộ nhớ từ các luồng trong một warp thành một giao dịch duy nhất khi các luồng đó truy cập các địa chỉ bộ nhớ liền kề. Bố cục tensor ảnh hưởng đến việc kết hợp bộ nhớ, nhưng chiều hướng ảnh hưởng phụ thuộc vào từng kernel: NCHW có thể hiệu quả với một số cách triển khai tích chập, trong khi NHWC/channels-last thường được ưu tiên cho các đường tích chập và hợp nhất Tensor Core hiện đại. Lựa chọn bố cục không phù hợp vẫn có thể tạo ra chênh lệch hiệu suất nhiều lần, nhưng cách khắc phục đúng là khớp bố cục với backend thay vì ghi nhớ một định dạng chung duy nhất.
Dù có lợi cho một số kernel trên bộ tăng tốc, bố cục kênh đầu tiên (channels-first) vẫn có thể làm kém hiệu quả các kernel được tối ưu cho truy cập kênh cuối cùng (channels-last). Bố cục hiệu quả nhất phụ thuộc vào phép toán, quy ước của framework và cách triển khai thư viện.
Các framework và trình biên dịch AI hiện đại thường biến đổi bố cục tensor theo môi trường thực thi, nhưng điều này không được đảm bảo cho mọi mô hình hay phép toán.35 TensorFlow, XLA, cuDNN và TensorRT có thể chèn hoặc lựa chọn các chuyển đổi bố cục bên trong; PyTorch thì cung cấp các đường dẫn chuyển đổi và truyền bá bố cục channels-last một cách rõ ràng. Các nhà phát triển vẫn cần profile các lựa chọn bố cục khi hiệu năng tích chập là yếu tố quan trọng.
35 NHWC so với NCHW: NHWC liệt kê các chiều theo thứ tự batch, chiều cao, chiều rộng, kênh; NCHW liệt kê batch, kênh, chiều cao, chiều rộng. Cách tổ chức bộ nhớ vật lý quyết định liệu các luồng (thread) liền kề có đọc được các địa chỉ bộ nhớ liền kề hay không, nên tác động hiệu suất sẽ phụ thuộc vào từng backend cụ thể. Việc bố cục dữ liệu không khớp với phần cứng không phải chỉ là một tinh chỉnh nhỏ; nó có thể tạo ra chênh lệch hiệu suất gấp nhiều lần, đặc biệt khi việc chuyển đổi bố cục ngăn cản sử dụng các đường dẫn tích chập hoặc hợp nhất (fusion) của Tensor Core.
So sánh bố cục channels-last và channels-first
Cả bố cục kênh cuối cùng (NHWC) và kênh đầu tiên (NCHW) đều có vai trò riêng trong các khối lượng công việc machine learning, và hiệu quả của chúng phụ thuộc nhiều vào kiến trúc phần cứng, mẫu truy cập bộ nhớ và yêu cầu tính toán. Việc lựa chọn bố cục ảnh hưởng trực tiếp đến việc sử dụng cache, hiệu quả băng thông bộ nhớ và thông lượng xử lý. Bảng Table 18 sẽ so sánh những đánh đổi về hiệu suất và khả năng tương thích phần cứng giữa hai cách tiếp cận này.
| Đặc trưng | Channels-Last (NHWC) | Channels-First (NCHW) |
|---|---|---|
| Thứ tự lưu trữ bộ nhớ | Pixel được lưu trữ từng hàng, xen kẽ kênh | Tất cả các giá trị cho một kênh đã cho được lưu trữ cùng nhau trước tiên |
| Tốt nhất cho | Các vòng lặp CPU, các phép toán từng phần tử, nhiều kernel channels-last | Nhiều đường dẫn tích chập GPU cũ và mã mô hình channel-first |
| Hiệu quả cache | Tính cục bộ cache cao cho truy cập tuần tự hàng/channels-last | Có thể cải thiện việc hợp nhất cho các kernel channel-first |
| Hiệu suất tích chập | Thường được ưu tiên bởi các đường dẫn tích chập/hợp nhất Tensor Core hiện đại | Hiệu quả cho nhiều kernel cuDNN và framework |
| Tìm nạp bộ nhớ | Tốt khi các kernel vector hóa trên dữ liệu kênh liền kề | Tốt khi các kernel xử lý các tile channel-major |
| Mặc định trong các framework | Quy ước TensorFlow phổ biến; tùy chọn channels-last của PyTorch | Quy ước hình dạng tensor PyTorch phổ biến |
Quyết định sử dụng bố cục kênh cuối cùng (NHWC) hay kênh đầu tiên (NCHW) không phải lúc nào cũng do nhà phát triển tự đặt. Thay vào đó, các framework machine learning và trình biên dịch AI thường xác định bố cục tối ưu dựa trên phần cứng mục tiêu và loại phép toán.
Trong thực tế, các trình biên dịch AI hiện đại như XLA của TensorFlow, cuDNN, TensorRT và các đường dẫn biên dịch của PyTorch có thể thực hiện biến đổi bố cục hoặc truyền metadata về bố cục. Kết quả là có thể đạt thông lượng cao mà không cần viết lại tensor thủ công, nhưng với các triển khai nhạy cảm về hiệu suất, vẫn nên đo hiệu năng đối với cả bố cục và chi phí chuyển đổi trên phần cứng mục tiêu.
Hợp nhất kernel
Một trong những kỹ thuật tối ưu hóa hiệu quả nhất trong tăng tốc AI là giảm chi phí di chuyển dữ liệu trung gian giữa các phép toán. Hợp nhất kernel36 biến nhiều phép tính riêng lẻ thành các phép toán thống nhất, giúp cải thiện đáng kể hiệu quả sử dụng bộ nhớ và hiệu suất thực thi. Các nút thắt về bộ nhớ do ghi dữ liệu trung gian tạo ra chính là động lực cho hợp nhất kernel, vốn giúp loại bỏ các bất hiệu quả này.
36 Hợp nhất kernel: Các kernel GPU riêng biệt thường lưu trữ kết quả trung gian vào bộ nhớ thiết bị, dù các cache có thể hấp thụ bớt lưu lượng này. Một kernel đã được hợp nhất có thể giữ các kết quả trung gian trong các thanh ghi hoặc bộ nhớ cục bộ, tránh các chu trình ghi/đọc ra bộ nhớ ngoài. Mức độ tăng tốc đạt được phụ thuộc vào hành vi của cache, mức độ chiếm dụng, chi phí khởi chạy và liệu lưu lượng bộ nhớ có phải là nút thắt cổ chai hay không; nó không nhất thiết tỷ lệ thuận với lượng byte giảm đi.
Ghi bộ nhớ trung gian
Hiệu suất mô hình AI thường bị giới hạn bởi băng thông bộ nhớ và việc ghi dữ liệu trung gian hơn là bởi các phép toán số học thuần túy. Mỗi khi một phép toán tạo ra kết quả trung gian cần được ghi vào bộ nhớ và sau đó đọc lại, quá trình thực thi sẽ bị đình trệ do chi phí di chuyển dữ liệu.
Hợp nhất kernel đóng vai trò là cầu nối quan trọng giữa các kỹ thuật tối ưu hóa phần mềm được giới thiệu trong Hợp nhất toán tử và các hạn chế về băng thông bộ nhớ được phân tích trong section 1.4.1. Nhiều khối lượng công việc (workload) AI tạo ra các thao tác ghi dữ liệu trung gian không cần thiết, làm tăng mức tiêu thụ băng thông bộ nhớ và giảm hiệu quả thực thi (NVIDIA Corporation 2017).
NVIDIA Corporation. 2017. NVIDIA Tesla V100 GPU Architecture. NVIDIA Whitepaper.
Listing 19 cho thấy mỗi phép toán trở thành một kernel riêng biệt trong một mô hình thực thi đơn giản, buộc các kết quả trung gian phải được ghi vào bộ nhớ rồi đọc lại cho phép toán tiếp theo. Hai phép toán đầu tiên tạo ra các tensor trung gian mà một mô hình thực thi đa kernel đơn giản sẽ phơi bày qua bộ nhớ thiết bị để phép toán kế tiếp sử dụng. Với các tensor lớn, việc di chuyển này thậm chí có thể tốn kém hơn chi phí tính toán (Jia et al. 2019). Table 19 minh họa dấu chân bộ nhớ của các tensor còn hoạt động khi không tái sử dụng bộ đệm.
import torch
import torch.nn.functional as F

## Input tensor
X = torch.randn(1024, 1024).cuda()
running_mean = torch.zeros(1024, device=X.device)
running_var = torch.ones(1024, device=X.device)

## Step-by-step execution (naïve approach)
X1 = torch.relu(X)  # Intermediate tensor stored in memory
X2 = F.batch_norm(
    X1, running_mean, running_var, training=False
)  # Frozen inference BatchNorm
Y = 2.0 * X2 + 1.0  # Final result
Hợp nhất kernel để tăng hiệu quả bộ nhớ
Hai tensor trung gian này chiếm dung lượng bộ nhớ khi chúng còn đang được sử dụng và tạo thêm lưu lượng truy cập bên ngoài khi các kernel riêng rẽ vật thể hóa chúng. Kỹ thuật hợp nhất kernel có thể loại bỏ các lần ghi và đọc lại dữ liệu trung gian đó (Jia et al. 2019) bằng cách truyền các giá trị qua thanh ghi hoặc bộ nhớ cục bộ ngay trong một kernel duy nhất.
| Tensor | Kích thước (MB) cho Tensor \(1024{\times}1024\) |
|---|---|
| X | 4.2 MB |
| X’ | 4.2 MB |
| X’’ | 4.2 MB |
| Y | 4.2 MB |
| Tổng bộ nhớ | 16.8 MB |
Một chuỗi suy luận machine learning có thể áp dụng ReLU, chuẩn hóa batch cố định (frozen batch normalization), rồi đến phép biến đổi affine với hệ số tỉ lệ \(\alpha\) và độ lệch \(\beta\). Trong một cách triển khai đơn giản, mỗi kernel riêng lẻ sẽ tạo ra một tensor trung gian; tensor này được ghi vào bộ nhớ và sau đó được kernel tiếp theo đọc lại: \[ \begin{aligned} \mathbf{X}' &= \text{ReLU}(\mathbf{X}) \\ \mathbf{X}'' &= \text{BatchNorm}(\mathbf{X}') \\ \mathbf{Y} &= \alpha \cdot \mathbf{X}'' + \beta \end{aligned} \]
Khi áp dụng hợp nhất kernel, các phép toán này được gộp lại thành một bước tính toán duy nhất, nhờ đó toàn bộ phép biến đổi có thể diễn ra mà không tạo ra các tensor trung gian không cần thiết: \[ \mathbf{Y} = \alpha \cdot \text{BatchNorm}\big(\text{ReLU}(\mathbf{X})\big) + \beta \]
Table 20 cho thấy tác động của việc hợp nhất các phép toán đến hiệu quả sử dụng bộ nhớ. Bằng cách giữ các kết quả trung gian trong thanh ghi hoặc bộ nhớ cục bộ thay vì ghi chúng ra bộ nhớ chính, hợp nhất giúp giảm lưu lượng truy cập bên ngoài. Với ba kernel suy luận độc lập thực hiện các phép toán pointwise, cách tiếp cận đơn giản lý tưởng sẽ đọc và ghi một tensor cho mỗi phép toán, trong khi cách tiếp cận hợp nhất chỉ đọc đầu vào một lần và ghi đầu ra một lần.
| Mô hình thực thi | Tải trọng tensor bên ngoài | Lưu lượng (MB) |
|---|---|---|
| Thực thi đơn giản | 3 lần đọc + 3 lần ghi | 25.2 MB |
| Thực thi hợp nhất | 1 lần đọc + 1 lần ghi | 8.4 MB |
Lợi ích và ràng buộc về hiệu năng
Hợp nhất kernel mang lại một số lợi thế quan trọng, giúp nâng cao hiệu quả sử dụng bộ nhớ và thông lượng tính toán. Khi giảm số lần truy cập bộ nhớ, các kernel đã hợp nhất sẽ giữ các giá trị trung gian trong thanh ghi thay vì liên tục ghi và đọc từ bộ nhớ. Điều này làm giảm đáng kể lưu lượng bộ nhớ, vốn là một trong những nút thắt cổ chai chính trong các khối lượng công việc (workload) machine learning. GPU và TPU đặc biệt hưởng lợi từ việc hợp nhất kernel, vì bộ nhớ băng thông cao là tài nguyên khan hiếm và việc giảm các giao dịch bộ nhớ giúp tận dụng tốt hơn các đơn vị tính toán (NVIDIA Corporation 2020a).
Tuy nhiên, không phải mọi phép toán đều có thể hợp nhất tùy ý. Các phép toán theo phần tử (element-wise operations) và chuẩn hóa suy luận cố định (frozen inference normalization) là những ứng viên tốt vì chúng không yêu cầu các phép giảm trên toàn bộ batch. Chuẩn hóa batch trong chế độ huấn luyện (training-mode batch normalization) tính toán các thống kê của batch và không hoàn toàn là phép toán theo phần tử. Phép nhân ma trận và tích chập (convolution) hạn chế việc hợp nhất vì chúng liên quan đến các phép giảm và di chuyển lượng dữ liệu lớn; chúng thường được hợp nhất với các phần hậu tố theo phần tử (element-wise epilogues) như độ chệch (bias) hoặc activation, nhưng không thể tự do hợp nhất với các phép toán toàn cục không liên quan.
Một cân nhắc lớn khác là áp lực thanh ghi. Khi hợp nhất nhiều phép toán, mọi giá trị tạm thời phải được giữ trong thanh ghi thay vì bộ nhớ. Điều này loại bỏ các lần ghi bộ nhớ dư thừa nhưng cũng làm tăng nhu cầu về thanh ghi. Nếu một kernel hợp nhất vượt quá số thanh ghi khả dụng cho mỗi luồng, trình biên dịch có thể spill các giá trị dư thừa sang bộ nhớ cục bộ theo luồng; bộ nhớ này đặt trên bộ nhớ thiết bị và có thể được cache, làm tăng độ trễ và có thể triệt tiêu lợi ích của việc hợp nhất. Trên GPU, nơi mức độ chiếm dụng luồng (thread occupancy, số luồng có thể chạy song song) bị giới hạn bởi số thanh ghi sẵn có, hợp nhất quá mức có thể làm giảm mức độ song song, dẫn đến lợi ích giảm dần.
Các bộ tăng tốc AI và trình biên dịch xử lý việc hợp nhất theo những cách khác nhau. Ví dụ, GPU NVIDIA ưa chuộng song song ở mức warp, nơi việc hợp nhất theo phần tử khá đơn giản (NVIDIA Corporation 2020a). Ngược lại, TPU ưu tiên thực thi bằng mảng systolic cho các phép toán ma trận dày đặc (Jouppi et al. 2017). Các stack trình biên dịch và suy luận như TVM, XLA, TensorRT và MLIR áp dụng các phép viết lại đồ thị, các pass lowering hoặc các heuristic xây dựng engine để cân bằng giữa tiết kiệm bộ nhớ và các ràng buộc khi thực thi (Chen et al. 2018; Google 2025; NVIDIA 2024b; Lattner et al. 2020).
Mặc dù có ưu điểm, hợp nhất không phải lúc nào cũng có lợi. Một số framework AI cho phép nhà phát triển tắt hợp nhất có chọn lọc, nhất là khi gỡ lỗi hiệu năng hoặc thường xuyên chỉnh sửa mô hình. Quyết định hợp nhất cần cân nhắc các đánh đổi giữa hiệu quả bộ nhớ, mức dùng thanh ghi và các ràng buộc thực thi phần cứng để đảm bảo lợi ích hiệu năng là rõ rệt.
Checkpoint 1.3: Di chuyển dữ liệu và hợp nhất kernel
Các khối nền tảng của luồng dữ liệu đã có đủ: tính cục bộ dữ liệu, bố cục tensor và hợp nhất kernel. Rốt cuộc, các quyết định hợp nhất đều xoay quanh tính cục bộ dữ liệu; nó gắn kết các chiến lược di chuyển dữ liệu cốt lõi của chương:
Các chiến lược tiling hiệu quả bộ nhớ
Mặc dù các bộ tăng tốc AI hiện đại có thông lượng tính toán rất cao, hiệu năng thường bị giới hạn bởi băng thông bộ nhớ hơn là công suất xử lý thô. Nếu không cung cấp dữ liệu đủ nhanh cho các đơn vị xử lý, việc thực thi sẽ bị đình trệ, dẫn đến chu kỳ xử lý bị lãng phí và phần cứng bị khai thác kém hiệu quả.
Tiling37 giảm nhẹ vấn đề này bằng cách tái cấu trúc phép tính thành các bài toán con nhỏ hơn, thân thiện với bộ nhớ. Khi không thể tăng băng thông bộ nhớ trực tiếp, hệ thống phải giảm số lần truy cập bộ nhớ chính. Thay vì xử lý toàn bộ ma trận hoặc tensor cùng một lúc, vốn tạo ra lưu lượng truy cập bộ nhớ quá mức, tiling chia các phép tính thành các khối nhỏ (tiles) vừa với bộ nhớ cục bộ nhanh (ví dụ: cache, bộ nhớ chia sẻ hoặc thanh ghi) (Lam et al. 1991).
37 Tiling (phân khối vòng lặp): Kỹ thuật tái cấu trúc này phân hoạch một phép tính thành các khối có kích thước phù hợp với tầng bộ nhớ cục bộ nhanh. Một vòng lặp đơn giản thường lặp lại truy cập vào cùng các phần tử; cache có thể bắt được một phần, còn kỹ thuật phân khối (blocking) chủ động gom việc tái sử dụng trước khi chúng bị đẩy ra khỏi cache (Lam et al. 1991). Việc giảm lưu lượng truy cập ở các tầng bộ nhớ thấp hơn là nguồn gốc chính tạo nên khoảng cách giữa phép nhân ma trận ngây thơ và các thủ tục nhân ma trận tổng quát (GEMM) đã được tối ưu hóa.
Lam, Monica D., Edward E. Rothberg, and Michael E. Wolf. 1991. “The Cache Performance and Optimizations of Blocked Algorithms.” Proceedings of the Fourth International Conference on Architectural Support for Programming Languages and Operating Systems - ASPLOS-IV, 63–74. https://doi.org/10.1145/106972.106981.
Phép nhân ma trận, được dùng rộng rãi trong các mô hình AI, sẽ truy cập bộ nhớ kém hiệu quả nếu triển khai một cách ngây thơ. Listing 20 cho thấy rằng, nếu không dùng tiling, việc lặp lại truy cập cùng một dữ liệu sẽ tiêu tốn băng thông không cần thiết.
for i in range(N):
    for j in range(N):
        for k in range(N):
            C[i, j] += A[i, k] * B[k, j]  # Repeatedly fetching
            # A[i, k] and B[k, j]
Vòng lặp liên tục tham chiếu các phần tử của \(\mathbf{A}\) và \(\mathbf{B}\). Một số tham chiếu có thể hit cache, nhưng với các ma trận lớn và thứ tự duyệt bất lợi, vẫn dễ gây ra lưu lượng truy cập quá mức tới các tầng bộ nhớ thấp hơn.
Tiling giải quyết vấn đề này bằng cách đảm bảo các phần nhỏ của ma trận được tải vào bộ nhớ nhanh, tái sử dụng hiệu quả và chỉ ghi về bộ nhớ chính khi thực sự cần. Kỹ thuật này đặc biệt quan trọng trong các bộ tăng tốc AI, nơi truy cập bộ nhớ chiếm phần lớn thời gian thực thi. Figure 14 gắn nhãn tích \(\mathbf{C} = \mathbf{A}\mathbf{B}\) theo ba chiều: \(\mathbf{A}\) có \(M\) hàng và \(K\) cột, \(\mathbf{B}\) có \(K\) hàng và \(N\) cột, và đầu ra \(\mathbf{C}\) có kích thước \(M{\times}N\). Mỗi tile được tô sáng là tập làm việc vừa khớp bộ nhớ nhanh tại một thời điểm: một dải hàng màu xanh lá cây \(M_{\text{tile}}{\times}K_{\text{tile}}\) của \(\mathbf{A}\) nhân với một dải cột màu hồng \(K_{\text{tile}}{\times}N_{\text{tile}}\) của \(\mathbf{B}\) để cộng dồn thành một khối đầu ra màu xanh lam \(M_{\text{tile}}{\times}N_{\text{tile}}\) (\(\text{Block}_{m,n}\)) của \(\mathbf{C}\). Xử lý hết các phép tính cho một tile trước khi chuyển sang tile tiếp theo giúp tránh phải trả lặp lại chi phí truy cập DRAM.

Các nguyên lý cơ bản của Tiling
Kỹ thuật Tiling chia một phép tính toán thành các tile nhỏ hơn, đủ nhỏ để nằm gọn trong bộ nhớ nhanh có sẵn, thay vì xử lý toàn bộ cấu trúc dữ liệu cùng lúc. Cách này tối đa hóa việc tái sử dụng dữ liệu, giảm truy cập bộ nhớ lặp lại không cần thiết và nâng cao hiệu quả.
Hãy xét phép nhân ma trận, một phép toán then chốt trong các khối lượng công việc (workload) của machine learning. Phép toán này tính \(\mathbf{C} = \mathbf{A} \times \mathbf{B}\) với mỗi phần tử \(C_{ij} = \sum_{k} A_{ik} \times B_{kj}\). Listing 20 nêu rõ vấn đề cốt lõi: mỗi lần lặp của vòng lặp trong cùng, bộ xử lý nạp các phần tử từ ma trận \(\mathbf{A}\) và \(\mathbf{B}\) từ bộ nhớ, thực hiện phép nhân, rồi cập nhật ma trận \(\mathbf{C}\). Vì ma trận thường lớn, bộ xử lý phải nạp đi nạp lại cùng những giá trị từ bộ nhớ, dù chúng vừa được dùng ở các phép tính trước.
Chi phí do di chuyển dữ liệu này rất lớn: truy cập DRAM có độ trễ và chi phí năng lượng cao hơn nhiều so với truy cập cache trên chip hoặc thanh ghi (Horowitz 2014; Sze et al. 2017). Giải pháp là tiling.
Lợi ích hiệu năng của tiling
Thay vì tính từng phần tử một và liên tục đưa dữ liệu vào/ra bộ nhớ chậm, tiling xử lý các ma trận con (tile) theo từng đợt, giữ các giá trị thường dùng trong bộ nhớ nhanh. Ý tưởng là chia ma trận thành các khối nhỏ hơn, đủ để nằm gọn trong cache của bộ xử lý hoặc bộ nhớ chia sẻ, để khi một khối được nạp, nó được tái sử dụng nhiều lần trước khi chuyển sang khối kế tiếp. Listing 21 minh họa kỹ thuật chặn vòng lặp (loop blocking) thân thiện với cache: giới hạn vòng lặp phân chia ma trận thành các tile, và hệ thống phân cấp cache phần cứng giữ dữ liệu của các tile vừa dùng gần các đơn vị tính toán khi thứ tự truy cập có tính cục bộ.
TILE_SIZE = 32  # Choose a tile size based on hardware constraints

# Cache blocking: partition data via loop bounds.
# Loads are implicit through the hardware cache hierarchy.
for i in range(0, N, TILE_SIZE):
    for j in range(0, N, TILE_SIZE):
        for k in range(0, N, TILE_SIZE):
            # Each tile computed independently
            for ii in range(i, min(i + TILE_SIZE, N)):
                for jj in range(j, min(j + TILE_SIZE, N)):
                    for kk in range(k, min(k + TILE_SIZE, N)):
                        C[ii, jj] += A[ii, kk] * B[kk, jj]
Việc tái cấu trúc này cải thiện đáng kể hiệu năng nhờ ba hiệu ứng hỗ trợ lẫn nhau. Thứ nhất, khả năng tái sử dụng bộ nhớ tăng lên: thuật toán truy cập lặp lại một tile nhỏ và tile này thường vẫn nằm trong cache trước khi chuyển sang tile tiếp theo, thay vì phải liên tục tải các phần tử của \(\mathbf{A}\) và \(\mathbf{B}\) từ bộ nhớ chậm. Nhờ đó, các lần truy cập bộ nhớ dư thừa được giảm thiểu. Thứ hai, mức sử dụng băng thông bộ nhớ giảm trực tiếp: vì mỗi tile được dùng nhiều lần trước khi bị đẩy khỏi cache, phần lớn dữ liệu cần thiết có sẵn trong cache L1/L2 hoặc bộ nhớ dùng chung thay vì DRAM, nên lưu lượng truy cập giảm và tốc độ thực thi tăng. Cuối cùng, hiệu quả tính toán cũng tăng vì bộ xử lý ít phải chờ dữ liệu hơn và dành nhiều thời gian hơn cho công việc hữu ích. Trên các kiến trúc như GPU và TPU, nơi hàng nghìn đơn vị xử lý song song hoạt động cùng lúc, tiling giúp đọc và xử lý dữ liệu có tổ chức, tránh những lần dừng không cần thiết.
Kỹ thuật này đặc biệt hiệu quả trong các bộ tăng tốc AI, nơi các khối lượng công việc (workload) machine learning thường bao gồm các phép nhân ma trận lớn và các biến đổi tensor. Nếu không áp dụng tiling, các khối lượng công việc (workload) này sẽ nhanh chóng bị giới hạn bởi băng thông bộ nhớ, tức hiệu năng bị ràng buộc bởi tốc độ truy xuất dữ liệu thay vì sức mạnh tính toán thô của bộ xử lý.
Các phương pháp tiling
Mặc dù nguyên tắc chung của tiling vẫn là chia một phép tính lớn thành các bài toán con để cải thiện khả năng tái sử dụng bộ nhớ, cách áp dụng có thể khác nhau tùy cấu trúc tính toán và các ràng buộc phần cứng. Hai chiến lược tiling chính là tiling theo không gian (spatial tiling) và tiling theo thời gian (temporal tiling). Mỗi chiến lược tối ưu một khía cạnh khác nhau của tính toán và truy cập bộ nhớ, và trong thực tế, chúng thường được kết hợp để đạt hiệu năng tốt nhất.
Phân ô không gian chia cấu trúc dữ liệu thành các khối nhỏ hơn để vừa với bộ nhớ nhanh. Ví dụ nhân ma trận dạng phân ô trong listing 21 minh họa cách chặn vòng lặp thân thiện với cache: mã không ra lệnh tải vào scratchpad một cách tường minh, nhưng kiểu truy cập theo ô cho phép các cache phần cứng tái sử dụng các giá trị lân cận trước khi chúng bị đẩy ra. Chiến lược này đặc biệt hữu ích cho các tensor lớn vượt quá dung lượng bộ nhớ nhanh—bằng cách chia nhỏ phép tính thành các ô (tile), việc di chuyển dữ liệu giữa các cấp bộ nhớ được giảm thiểu, giữ cho phép toán diễn ra cục bộ trong hệ phân cấp cache.
Phân ô thời gian bổ trợ cho phân ô không gian bằng cách đặt dữ liệu một cách tường minh vào bộ nhớ dùng chung hoặc thanh ghi, và tổ chức lại thứ tự tính toán xoay quanh phần dữ liệu đã được đặt sẵn đó. Nhiều khối lượng công việc (workload) ML truy cập cùng một dữ liệu nhiều lần qua các vòng lặp—nếu không có phân ô thời gian, điều này dẫn đến các lần truy xuất bộ nhớ dư thừa. Phân ô thời gian tái cấu trúc việc tính toán để dữ liệu thường dùng được giữ trong bộ nhớ nhanh càng lâu càng tốt trước khi bước tính tiếp theo bắt đầu.
Một ví dụ kinh điển mà phân ô thời gian mang lại lợi ích là các phép tích chập, nơi cùng một tập trọng số được áp dụng cho nhiều vùng đầu vào. Nếu không có chặn vòng lặp, các trọng số này có thể phải tải từ bộ nhớ nhiều lần cho mỗi phép tính. Với phân ô thời gian, thứ tự tính toán được sắp xếp lại để các trọng số vẫn nằm trong bộ nhớ nhanh khi xử lý nhiều đầu vào, giảm truy xuất bộ nhớ không cần thiết và cải thiện hiệu quả tổng thể. Listing 22 minh họa việc dàn ô (tile) một cách tường minh: đoạn mã tải các khối của \(\mathbf{A}\) và \(\mathbf{B}\) vào bộ nhớ nhanh tạm thời, rồi tái sử dụng chúng trong nhiều phép toán của vòng lặp bên trong.
# Explicit tile staging: load data into fast
# temporary storage before the inner loops.
for i in range(0, N, TILE_SIZE):
    for j in range(0, N, TILE_SIZE):
        for k in range(0, N, TILE_SIZE):
            # Pseudocode: map these tile objects to fast memory
            A_tile = A[i : i + TILE_SIZE, k : k + TILE_SIZE]
            B_tile = B[k : k + TILE_SIZE, j : j + TILE_SIZE]

            # Reuse loaded tiles for all inner iterations
            for ii in range(A_tile.shape[0]):
                for jj in range(B_tile.shape[1]):
                    for kk in range(A_tile.shape[1]):
                        C[i + ii, j + jj] += (
                            A_tile[ii, kk] * B_tile[kk, jj]
                        )
Việc dàn ô (tile) một cách tường minh giúp cải thiện hiệu năng khi backend đặt các ô tạm thời vào bộ nhớ nhanh và tái sử dụng chúng trước khi bị đẩy ra. Mã giả cũng xử lý các ô biên có kích thước rút gọn khi \(N\) không chia hết cho TILE_SIZE.
Kỹ thuật này đặc biệt hữu ích trong các khối lượng công việc (workload) mà một số giá trị được dùng lặp đi lặp lại, chẳng hạn như các phép tích chập, mạng nơ-ron hồi quy (RNN) và cơ chế tự chú ý trong transformers. Bằng cách áp dụng chặn vòng lặp, các bộ tăng tốc AI có thể giảm đáng kể tình trạng tắc nghẽn bộ nhớ và cải thiện thông lượng thực thi.
Các thách thức và đánh đổi của kỹ thuật phân ô
Tiling chỉ cải thiện hiệu suất khi kích thước tile phù hợp với “ngân sách” tính cục bộ của phần cứng. Nếu tile quá nhỏ, thời gian lấy dữ liệu từ bộ nhớ vẫn chi phối thời gian thực thi vì mức độ tái sử dụng quá thấp. Nếu tile quá lớn, nó vượt quá bộ nhớ nhanh và gây cache thrashing hoặc tràn scratchpad. Vì vậy, chọn đúng kích thước tile quyết định trực tiếp đến hiệu quả tính toán và mức sử dụng băng thông bộ nhớ.
Việc chọn tile cũng quyết định cân bằng tải. Trên các kiến trúc như GPU và TPU, phép tính được thực thi song song trên hàng nghìn đơn vị xử lý. Nếu các tile phân phối không đều, một số đơn vị sẽ rảnh rỗi trong khi số khác bị quá tải, dẫn đến sử dụng tài nguyên tính toán kém hiệu quả. Lập lịch tile hiệu quả giúp giữ cho thực thi song song cân bằng và hiệu quả.
Ngay cả sau khi áp dụng tiling, di chuyển dữ liệu vẫn là chi phí giới hạn chính. Dù tiling giảm số lần truy cập vào bộ nhớ chậm, việc chuyển các tile giữa các cấp bộ nhớ vẫn gây độ trễ và tốn năng lượng, đặc biệt khi dữ liệu bị đẩy khỏi cache hoặc scratchpad về DRAM. Chiến lược tiền nạp (prefetch) và lập lịch bộ nhớ hiệu quả sẽ giảm thiểu phần di chuyển còn lại này và đảm bảo dữ liệu sẵn sàng khi cần.
Tiling lai kết hợp chiến lược theo không gian và theo thời gian khi chỉ một chiều đơn lẻ không nắm bắt được mẫu tái sử dụng của khối lượng công việc (workload). Ví dụ, một số bộ tăng tốc AI dùng tiling theo không gian cho phép nhân ma trận, đồng thời áp dụng tiling theo thời gian để tái sử dụng trọng số trong các lớp tích chập, và có thể linh hoạt điều chỉnh kích thước tile hoặc sắp xếp lại phép tính theo điều kiện thực thi thời gian thực.
Register blocking, double buffering và hierarchical tiling đều mở rộng cùng nguyên lý tính cục bộ ở các tầng bộ nhớ từ nhỏ đến lớn. Các trình biên dịch AI và hệ thống runtime như TensorFlow XLA, TVM và MLIR tự động chọn các chiến lược tiling này dựa trên ràng buộc phần cứng, cho phép tối ưu hóa hiệu suất tinh chỉnh mà không cần can thiệp thủ công. Table 21 cung cấp cái nhìn tổng quan so sánh về các cách tiếp cận tiling theo không gian, theo thời gian và lai, nêu bật lợi ích và đánh đổi của từng phương pháp.
Khi các mô hình machine learning ngày càng lớn và phức tạp, tiling vẫn là công cụ quan trọng để nâng cao hiệu quả phần cứng, giúp các bộ tăng tốc AI vận hành gần với tiềm năng thực tế. Các chiến lược tiling thủ công có thể mang lại lợi ích đáng kể; đồng thời, trình biên dịch và các kỹ thuật tối ưu hóa nhận biết phần cứng còn nâng hiệu suất hơn nữa bằng cách tự động chọn chiến lược tiling hiệu quả cho một khối lượng công việc (workload) cụ thể.
| Khía cạnh | Tiling không gian (Data Tiling) | Tiling thời gian (Loop Blocking) | Tiling lai |
|---|---|---|---|
| Mục tiêu chính | Giảm số lần truy cập bộ nhớ bằng cách giữ dữ liệu trong bộ nhớ nhanh lâu hơn | Tăng khả năng tái sử dụng dữ liệu qua các lần lặp vòng lặp | Thích ứng linh hoạt với các ràng buộc của khối lượng công việc (workload) |
| Trọng tâm tối ưu hóa | Phân vùng cấu trúc dữ liệu thành các khối nhỏ hơn, thân thiện với bộ nhớ | Sắp xếp lại các phép tính để tối đa hóa việc tái sử dụng trước khi bị đẩy ra | Cân bằng các chiến lược tái sử dụng không gian và thời gian |
| Sử dụng bộ nhớ | Cải thiện tính cục bộ của cache và giảm truy cập DRAM | Giữ dữ liệu thường xuyên được sử dụng trong bộ nhớ nhanh cho nhiều lần lặp | Giảm thiểu di chuyển dữ liệu đồng thời đảm bảo tái sử dụng cao |
| Các trường hợp sử dụng phổ biến | Phép nhân ma trận, CNNs, cơ chế self-attention trong các transformer | Tích chập, mạng nơ-ron hồi quy (RNNs), các phép tính lặp | Bộ tăng tốc AI với hệ thống phân cấp bộ nhớ, khối lượng công việc (workload) hỗn hợp |
| Lợi ích về hiệu suất | Giảm yêu cầu băng thông bộ nhớ, sử dụng cache tốt hơn | Độ trễ tìm nạp bộ nhớ thấp hơn, cải thiện tính cục bộ của dữ liệu | Hiệu quả tối đa trên nhiều loại phần cứng |
| Thách thức | Yêu cầu lựa chọn kích thước tile cẩn thận, không hiệu quả đối với các khối lượng công việc (workload) có tái sử dụng không gian tối thiểu | Có thể làm tăng áp lực thanh ghi, yêu cầu tái cấu trúc vòng lặp | Độ phức tạp trong việc điều chỉnh kích thước tile và thứ tự thực thi một cách linh hoạt |
| Tốt nhất khi | Dữ liệu lớn và cần được phân vùng để xử lý hiệu quả | Cùng một dữ liệu được truy cập nhiều lần qua các lần lặp | Cả phân vùng dữ liệu và tái sử dụng dựa trên lần lặp đều quan trọng |
Áp dụng các chiến lược ánh xạ cho mạng nơ-ron
Mặc dù các kỹ thuật ánh xạ nền tảng này áp dụng rộng rãi, hiệu quả của chúng thay đổi theo cấu trúc tính toán, mẫu truy cập dữ liệu và cơ hội song song hóa của từng kiến trúc mạng nơ-ron. Mỗi kiến trúc áp đặt các ràng buộc riêng về di chuyển dữ liệu, hệ thống phân cấp bộ nhớ và lập lịch tính toán, nên cần những chiến lược ánh xạ phù hợp để tối ưu hóa hiệu suất.
Để xử lý bùng nổ tổ hợp các lựa chọn nảy sinh khi gán phép tính cho các bộ tăng tốc AI, cần một cách tiếp cận ánh xạ có cấu trúc. Thay vì xem mỗi mô hình là một bài toán tối ưu hóa riêng, cùng một tập nguyên tắc vẫn áp dụng cho nhiều kiến trúc; chỉ khác thứ tự ưu tiên tùy đặc tính của khối lượng công việc (workload). Mục tiêu là chọn và áp dụng có hệ thống các chiến lược ánh xạ nhằm tối đa hóa hiệu quả cho các mô hình machine learning khác nhau.
Các nguyên tắc này áp dụng cho ba khối lượng công việc (workload) AI tiêu biểu, mỗi loại có những yêu cầu tính toán riêng. CNN hưởng lợi từ việc tái sử dụng dữ liệu theo không gian, nên cách thực thi weight-stationary và tiling đặc biệt hiệu quả. Hành vi của Transformer phụ thuộc vào pha và hình dạng: các phép nhân ma trận trong giai đoạn huấn luyện và prefill có thể bị giới hạn bởi năng lực tính toán, trong khi giải mã với batch nhỏ thường phụ thuộc vào băng thông cho trọng số và KV-cache. MLP liên quan đến nhiều phép nhân ma trận và hưởng lợi từ tiling có cấu trúc, bố cục trọng số tối ưu, cùng cách thực thi có ý thức về bộ nhớ.
Mặc dù khác nhau, các mô hình này đều tuân theo một bộ nguyên tắc ánh xạ chung; khác biệt nằm ở cách ưu tiên các tối ưu hóa. Bảng Table 22 tổng hợp mức độ phù hợp của các chiến lược tối ưu khác nhau với CNN, transformer và MLP.
Mạng nơ-ron tích chập (ResNet-50)
Đối với ResNet-50 và các CNN tương tự, một cơ hội ánh xạ quan trọng là tái sử dụng trọng số theo không gian. Một bộ lọc nhỏ được áp dụng trên nhiều vị trí không gian, nên các trọng số của nó tham gia vào rất nhiều phép toán nhân-tích lũy. Các ánh xạ weight-stationary có thể khai thác điều này bằng cách giữ các filter tile cục bộ, trong khi các ánh xạ row-stationary hoặc output-stationary có thể cân bằng tốt hơn lưu lượng activation và tổng riêng phần trên các kiến trúc khác. Những cấu hình tích chập thuận lợi có thể đạt cường độ số học cao, khiến chúng rất phù hợp với các đường thực thi dạng ma trận và systolic. Dòng dữ liệu không bị ấn định bởi họ mô hình: hình dạng lớp, kích thước batch, dung lượng bộ nhớ cục bộ và các kernel mà phần cứng mục tiêu hỗ trợ sẽ quyết định mẫu tái sử dụng nào đáng giữ lại.
| Kỹ thuật tối ưu hóa | CNNs | Transformers | MLPs | Cơ sở lý luận |
|---|---|---|---|---|
| Chiến lược luồng dữ liệu | Trọng số (weight) cố định, hàng cố định hoặc đầu ra cố định | Phụ thuộc vào pha và kernel | Trọng số (weight) cố định hoặc đầu ra cố định | CNNs thể hiện tái sử dụng bộ lọc và không gian; cơ chế attention của transformer và các khối MLP áp đặt lưu lượng khác nhau; các MLP dày đặc tái sử dụng trọng số (weight) trên một batch và tích lũy đầu ra. |
| Bố cục tensor nhận biết bộ nhớ | Phụ thuộc vào backend (thường là NCHW cho các tích chập cuDNN, channels-last trên Tensor Cores) | Phụ thuộc vào backend (activation theo hàng là điển hình) | Theo hàng là điển hình | Việc lựa chọn bố cục phụ thuộc vào đường dẫn kernel của backend và chế độ chính xác (xem section 1.7.1.2); các mục này nêu tên các giá trị mặc định phổ biến, không phải các quy tắc phổ quát. |
| Hợp nhất Kernel | Tích chập + Activation | Attention hợp nhất | Hợp nhất GEMM | CNNs tối ưu hóa việc hợp nhất tích chập+activation; Transformers hợp nhất các cơ chế attention; MLPs hưởng lợi từ các phép nhân ma trận hợp nhất. |
| Chia khối để đạt hiệu quả bộ nhớ | Chia khối không gian | Chia khối thời gian | Chia khối dạng chặn | CNNs chia khối theo các chiều không gian; Transformers sử dụng chặn vòng lặp để cải thiện hiệu quả bộ nhớ chuỗi; MLPs sử dụng chia khối dạng chặn cho các phép nhân ma trận lớn. |
Tính đều đặn theo không gian này cũng cho phép hợp nhất và chia ô mạnh. Khi suy luận với các thống kê BatchNorm đã cố định, trình biên dịch có thể gộp hoặc hợp nhất các phép tích chập, chuẩn hóa và activation để tránh các lần ghi trung gian không cần thiết. BatchNorm ở chế độ huấn luyện yêu cầu các phép giảm trên thống kê theo batch và không tuân theo hợp nhất theo từng phần tử như vậy. Chia ô theo không gian sẽ phân tách bản đồ đặc trưng thành các vùng con vừa với SRAM trên chip, để kernel đã hợp nhất xử lý từng ô từ bộ nhớ nhanh trước khi chuyển sang ô tiếp theo.
Kiến trúc Transformer (GPT-2/Llama)
Trong khi CNN được đặc trưng bởi việc tái sử dụng trọng số, transformers lại được đặc trưng bởi áp lực bộ nhớ của KV cache. Trong quá trình tính toán attention, mỗi vector truy vấn phải truy cập các cặp key và value được lưu trên toàn bộ độ dài chuỗi. Khi độ dài chuỗi tăng lên, toàn bộ KV cache thường nằm trong HBM hoặc DRAM của thiết bị, trong khi các kernel attention sẽ lát các khối đang hoạt động qua SRAM, thanh ghi hoặc bộ nhớ chia sẻ. Mô hình truy cập này thúc đẩy cách thực thi theo kiểu activation stationary: giữ các tile KV đang dùng gần phần tính toán và truyền các truy vấn qua chúng, thay vì liên tục tạo ra các giá trị trung gian attention lớn trong bộ nhớ ngoài.
Lưu lượng bộ nhớ do các triển khai attention tiêu chuẩn tạo ra giải thích vì sao các kernel attention hợp nhất, chẳng hạn như FlashAttention (Dao et al. 2022), có thể mang lại mức tăng hiệu năng lớn: bằng cách hợp nhất tích vô hướng query-key, chuẩn hóa softmax và tổng có trọng số theo value vào một kernel duy nhất được lát theo chiều chuỗi, các triển khai này tránh phải tạo toàn bộ ma trận attention trong bộ nhớ chính. Cách chia ô theo thời gian này xử lý các khối chuỗi vừa với SRAM trên chip, giúp giảm đáng kể lưu lượng HBM trong khi vẫn giữ phép tính attention \(\mathcal{O}(S^2)\). Việc ánh xạ Transformer phụ thuộc vào giai đoạn và hình dạng: các GEMM huấn luyện và prefill có thể bị giới hạn bởi tính toán, còn giải mã tự hồi quy với batch thấp thường bị giới hạn bởi băng thông trọng số và KV-cache.
Mạng perceptron đa lớp và DLRM
MLP đặt ra bài toán ánh xạ đơn giản nhất vì việc tính toán chủ yếu quy về GEMM dày đặc (dense GEMM).38 Mỗi lớp fully connected nhân một ma trận activation với một ma trận trọng số. Ma trận trọng số được giữ cố định giữa các mẫu, nên việc phân batch cho phép tái sử dụng cùng một trọng số đã nạp cho nhiều activation hơn, từ đó tăng cường độ số học (arithmetic intensity). Kích thước batch bằng một gần như không tái sử dụng trọng số giữa các mẫu và thường không tận dụng hết các bộ xử lý ma trận rộng, trong khi batch lớn hơn có thể đưa thực thi tiến gần chế độ compute-bound. Nhân ma trận tổng quát (GEMM) suy ra mối quan hệ tỉ lệ (scaling) chi phối độ nhạy này.
38 GEMM: Phép toán \(\mathbf{C} = \alpha \mathbf{A}\mathbf{B} + \beta \mathbf{C}\) là phép toán đại số tuyến tính cơ bản trên ma trận dày đặc mà nhiều lớp học sâu được quy về. Các thư viện GEMM được tối ưu hóa như cuBLAS và oneDNN sử dụng kỹ thuật chặn thanh ghi (register blocking), vector hóa và phân chia theo cấp bậc (hierarchical tiling) để tiến sát giới hạn phần cứng trên những hình dạng thuận lợi (NVIDIA 2024a; Intel Corporation 2021b). Các bộ tăng tốc AI hiện đại được thiết kế chuyên biệt cho các khối (tile) kiểu GEMM: Tensor Cores, mảng systolic và các phần mở rộng ma trận đều tồn tại để tăng tốc phép toán này, đó là lý do hiệu suất GEMM là một chỉ báo quan trọng dự đoán thông lượng tổng thể trên nhiều kiến trúc.
NVIDIA. 2024a. cuBLAS: CUDA Basic Linear Algebra Subprograms.
Intel Corporation. 2021b. oneDNN: Intel’s Deep Learning Neural Network Library.
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, et al. 2019. “Deep Learning Recommendation Model for Personalization and Recommendation Systems.” arXiv Preprint arXiv:1906.00091.
Vì các lớp MLP thường theo sau bởi các hàm activation và phép cộng độ chệch (bias), kỹ thuật hợp nhất GEMM (GEMM fusion) gộp các bước này vào một kernel duy nhất, tránh ghi dữ liệu trung gian ra bộ nhớ. Kỹ thuật phân chia theo khối (blocked tiling) chia các phép nhân ma trận lớn thành những khối con có kích thước phù hợp với bộ nhớ chia sẻ của bộ tăng tốc, bảo đảm cache được tận dụng hiệu quả trong suốt quá trình tính toán. Sự đơn giản trong ánh xạ MLP, vốn bị chi phối bởi một primitive duy nhất với kiểu truy cập dữ liệu dễ dự đoán, chính là lý do các nhà cung cấp phần cứng tối ưu hóa thư viện GEMM rất quyết liệt: cải thiện hiệu suất GEMM sẽ chuyển hóa trực tiếp thành thông lượng MLP cao hơn. Tuy nhiên, DLRM không thuần túy là một khối lượng công việc (workload) MLP. Các bảng embedding thưa lớn và giai đoạn tương tác đặc trưng có thể chi phối dung lượng và lưu lượng bộ nhớ, nên ánh xạ dày đặc mô tả ở đây áp dụng cho các tháp MLP phía dưới và phía trên của mô hình, chứ không phải toàn bộ mô hình (Naumov et al. 2019).
Các chiến lược ánh xạ lai
Các phần kiến trúc trước xem từng kiến trúc một cách riêng lẻ, nhưng các mô hình thực tế hiếm khi chỉ có một loại lớp. Ví dụ, một vision transformer kết hợp giai đoạn patch embedding, các lớp self-attention và các khối MLP (Dosovitskiy et al. 2021). Những lớp này tạo ra các mẫu tái sử dụng khác nhau: giai đoạn embedding có thể hưởng lợi từ ánh xạ weight-stationary, attention nhấn mạnh việc di chuyển activation và chia ô (tiling), còn các khối MLP yêu cầu chia ô GEMM theo khối và hợp nhất. Không có chiến lược luồng dữ liệu nào tối ưu cho tất cả các lớp này, vì vậy ánh xạ phần cứng mang tính lai và đặc thù theo từng lớp.
Dosovitskiy, Alexey, Lucas Beyer, Alexander Kolesnikov, Dirk Weissenborn, Xiaohua Zhai, Thomas Unterthiner, Mostafa Dehghani, et al. 2021. “An Image Is Worth 16x16 Words: Transformers for Image Recognition at Scale.” International Conference on Learning Representations (ICLR).
Ánh xạ lai giải quyết sự không đồng nhất này bằng cách cho phép bộ tăng tốc chuyển chiến lược tại ranh giới giữa các lớp. Mỗi lớp có một cân bằng khác nhau giữa cường độ tính toán, mức độ tái sử dụng dữ liệu và kiểu truy cập bộ nhớ, nên ánh xạ tối ưu cũng phải thay đổi tương ứng (Sze et al. 2017). Thay vì cố định một luồng dữ liệu cho toàn bộ mô hình, các cách tiếp cận lai sẽ chọn chế độ thực thi weight stationary cho các lớp có tái sử dụng trọng số cao, activation stationary cho các lớp attention dùng KV cache lớn, và output stationary cho các lớp mà việc giảm lưu lượng ghi là quan trọng nhất.
Các bộ tăng tốc hiện đại cung cấp những tính năng kiến trúc cần thiết để hiện thực hóa ánh xạ lai trong thực tế. Các mảng systolic kiểu TPU, GPU của NVIDIA và các thiết kế bộ tăng tốc dựa trên tile (ô) cung cấp các tổ hợp khác nhau của bộ nhớ cục bộ, bố trí tensor, cơ chế hợp nhất (fusion) và điều khiển lập lịch, cho phép trình biên dịch và runtime chọn chiến lược riêng cho từng lớp thay vì một luồng dữ liệu chung cho cả mô hình (Jouppi et al. 2023; NVIDIA Corporation 2020a; Chen et al. 2018). Những triển khai này đòi hỏi hệ thống phân cấp bộ nhớ có thể lập trình, các liên kết liên kết hiệu quả và các pipeline thực thi chuyên biệt, qua đó củng cố nguyên tắc đồng thiết kế phần cứng-phần mềm.
Tuy nhiên, ánh xạ lai vẫn là một tối ưu hóa ở giai đoạn thiết kế. Trong các khối lượng công việc (workload) trong môi trường sản xuất, điều kiện thực thi thay đổi liên tục do kích thước đầu vào khác nhau, cạnh tranh truy cập bộ nhớ và mức độ sẵn có của tài nguyên phần cứng. Các trình biên dịch machine learning và hệ thống runtime mở rộng các lựa chọn ánh xạ tĩnh này bằng cách bổ sung lập lịch động, tối ưu hóa bộ nhớ và điều chỉnh tự động, đảm bảo các khối lượng công việc (workload) deep learning hoạt động hiệu quả trên nhiều bộ tăng tốc và các môi trường triển khai khác nhau.
Self-Check: Question
Why do modern deep learning libraries (e.g., cuDNN, TensorRT) strongly prefer the Channels-Last (NHWC) tensor layout over Channels-First (NCHW) when executing convolutions on NVIDIA Tensor Cores?
- NHWC eliminates the need for spatial convolutions by flattening images into 1D vectors
- NCHW requires floating-point numbers to be stored in big-endian byte order
- NHWC reduces model parameter count by sharing channel weights across batches
- NHWC places channel values for a given spatial location in contiguous memory, aligning with the packed vector/matrix multiply requirements of Tensor Cores
Explain the mechanism of vertical kernel fusion (e.g., fusing
Conv2D\(\to\)BatchNorm\(\to\)ReLU), and identify both its performance benefit and its primary architectural constraint.Place the following loop transformation steps in the logical order applied by an optimizing compiler when targeting a matrix multiplication dataflow to an accelerator:
- Loop Reordering: Permute loop indices to establish a specific stationary dataflow (e.g., Output-Stationary)
- Loop Unrolling: Fully or partially unroll the innermost loop to expose instruction-level parallelism and map to hardware registers
- Loop Tiling (Blocking): Partition global loop iterations into sub-tiles that fit into on-chip shared memory / SRAM
- Spatial Partitioning: Assign outer tile loops to physical hardware compute clusters (e.g., GPU thread blocks / SMs)
In a multi-head self-attention layer where a single input activation tensor is projected across multiple query, key, and value weight matrices (\(W_q, W_k, W_v\)), which stationary dataflow strategy provides the highest data reuse in local scratchpad memory?
- Input-Stationary (Activation-Stationary)
- Output-Stationary
- No Local Reuse (NLR)
- Weight-Stationary
True or False: Row-Stationary (RS) dataflow, as implemented in architectures like Eyeriss, keeps only the final output activation stationary in registers while streaming 2D convolutional filter rows and input rows from DRAM on every clock cycle.
Hỗ trợ của trình biên dịch
Một phép tích chập duy nhất có thể được triển khai bằng hàng chục chiến lược tiling (phân ô) hợp lệ, các biến thể kernel và cách bố trí bộ nhớ khác nhau. Tuy nhiên, hầu hết các cách này sẽ hoạt động kém hiệu quả trên một nền tảng cụ thể. Các trình biên dịch machine learning xử lý sự phức tạp này bằng cách chuyển các chiến lược luồng dữ liệu thành mã thực thi đặc thù cho từng nền tảng. Quá trình biên dịch ResNet-50 cho suy luận trên GPU là một ví dụ điển hình:
- Tối ưu hóa đồ thị hợp nhất các chuỗi thao tác lặp lại như Conv2D-BatchNorm-ReLU thành ít kernel hơn, loại bỏ các thao tác ghi dữ liệu trung gian vốn sẽ tiêu tốn băng thông.
- Lựa chọn kernel chọn các triển khai Tensor Core cho các tích chập tương thích, tận dụng cường độ số học cao được tính toán trong phân tích Roofline.
- Lập kế hoạch bộ nhớ xác định xem các activation trung gian có vừa trong bộ nhớ của bộ tăng tốc hay không và liệu các bộ đệm có thể được tái sử dụng an toàn hay không
- Lập lịch tính toán chồng chéo việc truyền dữ liệu bộ nhớ với tính toán khi các phụ thuộc cho phép, ẩn bớt một phần độ trễ truyền tải
Trong kịch bản minh họa này, thời gian suy luận giảm từ 47 ms xuống còn 8 ms, một cải thiện 5.9× mà không thay đổi hàm toán học của mô hình. Những con số này không phải là một benchmark ResNet-50. Chúng cho thấy cách các kỹ thuật như viết lại đồ thị, lựa chọn kernel, lập kế hoạch bộ nhớ và lập lịch có thể chuyển hợp nhất (section 1.7.1.3) và phân ô (tiling) (section 1.7.1.4) thành hiệu suất thực tế (Chen et al. 2018; NVIDIA 2024b).
Quá trình này minh họa nguyên tắc đồng thiết kế phần cứng-phần mềm được nêu trong Các nguyên tắc cơ bản của tăng tốc. Các trình biên dịch machine learning làm cầu nối giữa các biểu diễn mô hình cấp cao và thực thi cấp thấp bằng cách tái cấu trúc phép tính, chọn kernel và lập kế hoạch lưu trữ tensor (Chen et al. 2018). Chúng dựa trên các kỹ thuật biên dịch thông thường và bổ sung các biến đổi ở cấp tensor và cấp đồ thị.
Thiết kế trình biên dịch machine learning
Các trình biên dịch machine learning chuyên biệt hóa quá trình biên dịch thông thường cho các chương trình được biểu diễn dưới dạng đồ thị tensor và thư viện toán tử. Các trình biên dịch đa năng đã tối ưu hóa vòng lặp, lệnh vector, mã song song và truy cập bộ nhớ; các stack trình biên dịch machine learning bổ sung viết lại đồ thị, bố cục tensor, chuyên biệt hóa shape, chọn kernel cho bộ tăng tốc và lập kế hoạch thực thi (Li et al. 2021).
Li, Mingzhen, Yi Liu, Xiaoyan Liu, Qingxiao Sun, Xin You, Hailong Yang, Zhongzhi Luan, Lin Gan, Guangwen Yang, and Depei Qian. 2021. “The Deep Learning Compiler: A Comprehensive Survey.” IEEE Transactions on Parallel and Distributed Systems 32 (3): 708–27. https://doi.org/10.1109/tpds.2020.3030548.
Table 23 đối chiếu trọng tâm của hai tầng. Ranh giới không tuyệt đối: một stack machine learning thường hạ các chương trình tensor xuống backend LLVM, GPU hoặc backend của nhà cung cấp, nên biên dịch cấp đồ thị và cấp lệnh phối hợp với nhau.
| Khía cạnh | Trình biên dịch truyền thống | Trình biên dịch machine learning |
|---|---|---|
| Biểu diễn đầu vào | Chương trình mã nguồn hoặc biểu diễn trung gian | Đồ thị tensor hoặc biểu diễn trung gian cấp tensor |
| Mô hình thực thi | Luồng điều khiển, vòng lặp, luồng, vector và tác vụ | Các toán tử tensor, kernel, đồ thị và luồng bộ tăng tốc |
| Các ưu tiên tối ưu hóa | Chọn lệnh, biến đổi vòng lặp, vector hóa, thanh ghi | Viết lại đồ thị, hợp nhất, bố cục, hình dạng và chọn kernel |
| Quản lý bộ nhớ | Đối tượng, stack/heap, cache, tính cục bộ và nạp trước | Vòng đời tensor, tái sử dụng bộ đệm, bố cục, chia khối và truyền dữ liệu thiết bị |
| Phần cứng mục tiêu | CPU, GPU và các mục tiêu lập trình khác | CPU, GPU, TPU và các bộ tăng tốc tùy chỉnh |
| Đầu ra biên dịch | Mã máy hoặc biểu diễn trung gian cấp thấp hơn | Các kernel cùng với đồ thị hoặc kế hoạch thực thi dành riêng cho phần cứng |
Bảng này cho thấy vì sao chỉ thay đổi cấu hình trình biên dịch cũng có thể làm hiệu suất thay đổi, dù mã mô hình giữ nguyên. Trình biên dịch machine learning quản lý một lớp ẩn, ánh xạ các phép toán tensor ở cấp đồ thị xuống các kernel, bố cục và kế hoạch thực thi gắn với phần cứng; nếu ánh xạ kém, mô hình sẽ để các đơn vị tính toán số học rỗi hoặc phải di chuyển đi di chuyển lại cùng một lượng dữ liệu.
Pipeline biên dịch ML
Các mô hình machine learning, như được định nghĩa trong các frameworks hiện đại, ban đầu được biểu diễn dưới dạng đồ thị tính toán cấp cao mô tả các phép toán trên tensor. Các biểu diễn này cần được chuyển thành mã thực thi trên phần cứng đích như CPUs, GPUs, TPUs và các chip AI tùy chỉnh. Một pipeline biên dịch ML sẽ thực hiện quá trình biến đổi này (Chen et al. 2018; Google 2025; Lattner et al. 2020).
Một mô hình biên dịch hiệu quả có năm nhiệm vụ chính, dù trên thực tế các hệ thống thường thực hiện chúng đan xen. Tối ưu hóa đồ thị sắp xếp lại quá trình tính toán. Chọn kernel ánh xạ các phép toán tới cách triển khai cụ thể trên phần cứng đích. Lập kế hoạch bộ nhớ quyết định cách bố trí, cấp phát bộ đệm và quản lý vòng đời bộ nhớ. Lập lịch sắp xếp thứ tự thực hiện các kernel và truyền dữ liệu theo các phụ thuộc. Cuối cùng, sinh mã tạo ra hoặc đóng gói các thành phần thực thi dành riêng cho phần cứng đích.
Ở mỗi giai đoạn, trình biên dịch áp dụng các kỹ thuật tối ưu hóa đã được trình bày trong section 1.7, bao gồm: hợp nhất kernel, phân ô, các chiến lược di chuyển dữ liệu và bố trí vị trí tính toán. Các tối ưu hóa này được tích hợp một cách có hệ thống vào kế hoạch thực thi cuối cùng. Đây là lý do vì sao việc tăng tốc machine learning phụ thuộc nhiều vào tối ưu hóa phần mềm do trình biên dịch thực hiện, cũng như vào các cải tiến về phần cứng.
Tối ưu hóa đồ thị
Các bộ tăng tốc AI cung cấp phần cứng chuyên dụng để tăng tốc tính toán, nhưng các biểu diễn mô hình ở dạng thô không tự động được tối ưu để chạy trên những bộ tăng tốc này. Các framework machine learning định nghĩa mô hình bằng các đồ thị tính toán cấp cao, trong đó các nút đại diện cho các phép toán (như tích chập, nhân ma trận và activation), còn các cạnh xác định các phụ thuộc dữ liệu. Nếu cứ thực thi y như mô tả, các đồ thị này thường chứa phép toán dư thừa, kiểu truy cập bộ nhớ kém hiệu quả và trình tự thực thi chưa tối ưu, khiến phần cứng khó đạt hiệu suất đỉnh.
Ví dụ, self-attention của transformer có thể tạo ra các ma trận điểm và xác suất trung gian rất lớn. Một cách triển khai đơn giản mà tạo ra rồi đọc lại các giá trị trung gian này từ bộ nhớ băng thông cao sẽ phải gánh lưu lượng bộ nhớ quá lớn, trong khi các attention kernel tối ưu I/O sẽ chia ô việc tính toán qua bộ nhớ nhanh để tránh lưu lượng đó (Dao et al. 2022). Tương tự, trong một CNN, áp dụng batch normalization và các hàm activation như các phép toán riêng rẽ sau mỗi tích chập sẽ dẫn tới các lần ghi bộ nhớ trung gian không cần thiết, làm tăng mức sử dụng băng thông bộ nhớ. Những kém hiệu quả này được xử lý trong quá trình tối ưu hóa đồ thị, nơi trình biên dịch cấu trúc lại đồ thị tính toán để loại bỏ các phép toán không cần thiết và cải thiện tính cục bộ bộ nhớ (Chen et al. 2018).
Jia, Zhihao, James Thomas, Todd Warszawski, Mingyu Gao, Matei Zaharia, and Alex Aiken. 2019. “Optimizing DNN Computation with Relaxed Graph Substitutions.” Proceedings of Machine Learning and Systems (MLSys).
Quá trình tối ưu hóa đồ thị chuyển đồ thị tính toán cấp cao thành một kế hoạch thực thi tối ưu trước khi ánh xạ xuống phần cứng. Thay vì đòi hỏi tối ưu thủ công, trình biên dịch áp dụng có hệ thống các biến đổi giúp cải thiện di chuyển dữ liệu, giảm tính toán dư thừa và tái cấu trúc các phép toán để thực thi song song hiệu quả (Chen et al. 2018; Jia et al. 2019). Ở giai đoạn này, trình biên dịch làm việc ở mức không phụ thuộc phần cứng, tập trung vào tái cấu trúc cấp cao trước khi các tối ưu hóa đặc thù phần cứng được áp dụng ở các pha biên dịch tiếp theo (section 1.8.6.2).
Tối ưu hóa đồ thị trước hết loại bỏ lưu lượng dữ liệu thừa mà biểu diễn đồ thị cấp cao vốn sẽ tạo ra. Hợp nhất kernel (kernel fusion) gộp các phép toán liên tiếp để loại bỏ các lần ghi bộ nhớ không cần thiết và giảm số lần gọi kernel. Điều này đặc biệt hiệu quả trong các mạng nơ-ron tích chập, nơi tích chập, chuẩn hóa batch và các hàm activation thường xuất hiện theo chuỗi cố định. Việc sắp xếp lại phép tính điều chỉnh thứ tự thực thi để cải thiện tính cục bộ dữ liệu và khả năng thực thi song song; trong các mô hình transformer, cách sắp xếp lại này cho phép tái sử dụng các cặp khóa-giá trị đã được cache thay vì phải nạp lại từ bộ nhớ nhiều lần.
Việc loại bỏ phép tính dư thừa cũng nhằm cùng mục tiêu, nhưng từ phía tính toán. Bằng cách xác định và loại bỏ các phép toán trùng lặp hoặc không cần thiết, trình biên dịch tránh lặp lại công việc trong các mô hình có kết nối dư (residual connections), nơi các biểu thức con chung dễ bị tính lại. Tiếp đó, các điều chỉnh luồng dữ liệu có xét đến bộ nhớ sẽ tinh chỉnh bố cục tensor và tối ưu hóa việc di chuyển dữ liệu; ví dụ, chia ô (tiling) các phép nhân ma trận để đáp ứng yêu cầu cấu trúc của các mảng systolic trên TPU giúp đồ thị khớp với thế mạnh của bộ tăng tốc. Kết hợp lại, các kỹ thuật này chuẩn bị mô hình để tăng tốc bằng cách giảm thiểu chi phí phát sinh và cân bằng giữa tính toán với tài nguyên bộ nhớ.
Các trình biên dịch AI hiện đại thực hiện các chuyển đổi này thông qua nhận dạng mẫu tự động và các quy tắc có cấu trúc, nhưng trách nhiệm cốt lõi vẫn giống nhau giữa các ngăn xếp trình biên dịch: tìm các mẫu có thể gộp, chọn bố cục phù hợp với hệ thống phân cấp bộ nhớ mục tiêu, và giữ nguyên ý nghĩa toán học của mô hình đồng thời tạo điều kiện cho các cơ hội tối ưu hóa đặc thù phần cứng. XLA, TVM, TensorRT và MLIR là những hệ thống tiêu biểu, mỗi hệ thống nhấn mạnh các ràng buộc mục tiêu khác nhau, từ gộp ở cấp đồ thị đến tìm kiếm bố cục tensor và hạ tầng nhiều giai đoạn. Bài học về hệ thống không nằm ở danh sách sản phẩm; mà ở việc tái cấu trúc của trình biên dịch biến một đồ thị framework thành một kế hoạch thực thi mà bộ tăng tốc có thể duy trì. Nếu không có tái cấu trúc này, một mô hình transformer lớn trên thiết bị edge có thể gặp quá nhiều lần dừng chờ bộ nhớ; ngược lại, khi có nó, việc giảm băng thông tiêu thụ và độ trễ có thể khiến suy luận thời gian thực trở nên khả thi trên các thiết bị hạn chế tài nguyên.
Sau khi các bước viết lại ở cấp đồ thị làm rõ các phép toán khả dụng, bước chọn kernel sẽ quyết định mỗi phép toán được hiện thực bằng triển khai đặc thù cho phần cứng đích nào. Các quyết định về bộ nhớ và lập lịch ở các bước sau có thể phản hồi và ảnh hưởng trở lại lựa chọn đó.
Chọn kernel
Việc chọn kernel biến đồ thị đã được tối ưu hóa thành một ràng buộc với phần cứng. Kernel là một triển khai chuyên biệt của một thao tác tính toán, được thiết kế để chạy hiệu quả trên một kiến trúc phần cứng cụ thể. Hầu hết các bộ tăng tốc, bao gồm GPU, TPU và các chip AI tùy chỉnh, đều cung cấp nhiều triển khai kernel cho cùng một thao tác, mỗi triển khai được tối ưu hóa cho các kịch bản thực thi khác nhau. Việc chọn đúng kernel quyết định liệu bộ tăng tốc có tối đa hóa thông lượng tính toán, tránh nghẽn bộ nhớ và giữ cho các phần tử xử lý chuyên biệt luôn bận rộn hay không (Chen et al. 2018; Zheng et al. 2020).
Việc chọn kernel được xây dựng trên các tối ưu hóa ở cấp đồ thị, ánh xạ kế hoạch thực thi có cấu trúc tới triển khai hiệu quả nhất hiện có cho mỗi thao tác. Lựa chọn kernel không phù hợp có thể xóa sạch lợi ích của các tối ưu hóa trước đó, do gây thêm chi phí tính toán không cần thiết hoặc tạo nút thắt bộ nhớ (Chen et al. 2018).
Phép nhân ma trận trong Transformer là một ví dụ rõ ràng cho lựa chọn này. Với backend CPU, hệ thống có thể chọn một kernel thư viện đã được vector hóa; với backend GPU, có thể dùng Tensor Cores nếu kích thước và độ chính xác cho phép; còn với backend TPU, nó sẽ ánh xạ các ô tương thích vào đơn vị ma trận. Một kernel suy luận INT8 chỉ hữu ích khi mô hình đã được lượng tử hóa và kiểm chứng ở độ chính xác đó; dùng độ chính xác thấp hơn sẽ làm thay đổi cả hiệu suất lẫn hành vi số học.
Trong nhiều trường hợp, trình biên dịch quyết định nên tin tưởng vào triển khai sẵn có nào, thay vì tự sinh một kernel từ đầu. cuDNN và cuBLAS cung cấp các kernel tối ưu cho deep learning trên GPU NVIDIA; oneDNN cung cấp thực thi tối ưu cho các kiến trúc Intel; ACL (Arm Compute Library) nhắm đến các thiết bị dựa trên Arm; còn Eigen và BLIS cung cấp các triển khai hiệu quả trên CPU. Các thư viện này mã hóa kiến thức đặc thù phần cứng, giúp trình biên dịch chọn một kernel đã được tối ưu sẵn thay vì phải nghĩ lại chiến lược thực thi cho từng nền tảng.
Các trình biên dịch AI dùng heuristic,39 profiling và mô hình chi phí để lựa chọn giữa các phương án này. Cách chọn phụ thuộc vào mức độ bất định mà trình biên dịch chấp nhận trước khi bắt đầu thực thi.
39 Heuristic trong lựa chọn kernel: Một quy tắc thực tế giúp chọn một phương án triển khai có tiềm năng mà không cần benchmark toàn bộ không gian ứng viên. Các yếu tố như kích thước ô (tile size), bố cục (layout), chế độ độ chính xác, lựa chọn hợp nhất (fusion choices) và ràng buộc hình dạng (shape constraints) có thể tạo ra rất nhiều biến thể GEMM hợp lệ. Các heuristic giúp giảm chi phí tinh chỉnh nhưng có thể bỏ sót một ứng viên nhanh hơn, đó là lý do vì sao các bộ tự điều chỉnh (autotuner) như AutoTVM thực hiện profiling các tùy chọn đã chọn trên phần cứng mục tiêu.
Lựa chọn dựa trên quy tắc áp dụng các heuristic định sẵn dựa trên khả năng phần cứng. Chẳng hạn, XLA – trình biên dịch dùng trong TensorFlow – sẽ tự động chọn các kernel được tối ưu cho Tensor Core trên GPU NVIDIA khi bật thực thi độ chính xác hỗn hợp. Những quy tắc định sẵn này giúp đưa ra quyết định nhanh, đáng tin cậy mà không cần phân tích sâu.
Lựa chọn dựa trên profiling chấp nhận tốn thêm công tìm kiếm để giảm bất định. TVM dùng AutoTVM để benchmark các tùy chọn kernel theo cách thực nghiệm và tinh chỉnh chiến lược thực thi dựa trên thời gian chạy thực tế, nhờ đó các phép toán được gán cho các triển khai hoạt động tốt trong điều kiện triển khai thực tế.
Lựa chọn dựa trên mô hình chi phí ước tính thời gian thực thi và mức dùng bộ nhớ trước khi profiling mọi tùy chọn. MLIR cung cấp hạ tầng trình biên dịch, nơi các pass đặc thù theo mục tiêu có thể triển khai kiểu lựa chọn này (Lattner et al. 2020). Một trình biên dịch cụ thể có thể mô hình hóa cách các kernel ứng viên tương tác với các đơn vị tính toán và hệ thống phân cấp bộ nhớ của bộ tăng tốc, rồi chọn kernel tối thiểu hóa chi phí thực thi ước tính.
Lattner, Chris, Mehdi Amini, Uday Bondhugula, Albert Cohen, Andy Davis, Jacques Pienaar, River Riddle, Tatiana Shpeisman, Nicolas Vasilache, and Oleksandr Zinenko. 2020. “MLIR: Scaling Compiler Infrastructure for Domain Specific Computation.” 2021 IEEE/ACM International Symposium on Code Generation and Optimization (CGO), 2–14. https://doi.org/10.1109/cgo51591.2021.9370308.
Lựa chọn có xét đến độ chính xác sẽ bổ sung ràng buộc số học vào cùng quyết định chọn kernel. Các khối lượng công việc huấn luyện thường ưu tiên FP32 hoặc BF16 để giữ độ chính xác của mô hình, trong khi các khối lượng công việc suy luận ưu tiên FP16 hoặc INT8 để tăng tốc và giảm công suất tiêu thụ. Chẳng hạn, một GPU NVIDIA khi chạy suy luận với TensorRT có thể chọn giữa các hồ sơ engine FP16 và INT8 đã được hiệu chuẩn, được xây dựng theo các ràng buộc về độ chính xác và hình dạng đầu vào của mô hình. Sự đánh đổi giữa độ chính xác và hiệu suất là một yếu tố then chốt khi chọn kernel, đặc biệt trong môi trường hạn chế tài nguyên.
Một số trình biên dịch mở rộng việc lựa chọn thành điều chỉnh thích ứng, nơi các chiến lược thực thi tự điều chỉnh theo khối lượng công việc và điều kiện tài nguyên. AutoTVM trong TVM đo lường hiệu suất kernel trên nhiều khối lượng công việc và tinh chỉnh chiến lược thực thi; TensorRT áp dụng các hồ sơ engine đã được tối ưu dựa trên kích thước batch, ràng buộc bộ nhớ và độ chính xác được hỗ trợ; trình biên dịch TPU của Google chuyên biệt hóa kế hoạch thực thi cho cấu trúc liên kết TPU mục tiêu và hồ sơ hình dạng. Hậu quả của việc chọn kernel kém là đáng kể: một mô hình transformer bị gán kernel không dùng tensor core cho phép nhân ma trận có thể chỉ đạt một phần nhỏ hiệu suất tối đa, trong khi một mô hình thiết kế cho thực thi FP32 có thể mất độ chính xác nếu bị ép dùng kernel tối ưu cho INT8. Vì vậy, chọn kernel quan trọng không kém về tính đúng đắn số học lẫn hiệu năng.
Sau khi chọn kernel ban đầu, lập kế hoạch và lập lịch bộ nhớ sẽ xác định vòng đời của bộ đệm, vùng làm việc, thứ tự khởi chạy và mức chồng lắp hợp lệ. Những quyết định này cũng có thể buộc trình biên dịch xem lại một kernel nếu vùng làm việc hoặc bố cục của nó không còn phù hợp với kế hoạch đang hình thành.
Lập kế hoạch bộ nhớ
Giai đoạn lập kế hoạch bộ nhớ đảm bảo dữ liệu được cấp phát và truy cập theo cách giảm lượng băng thông bộ nhớ sử dụng, giảm độ trễ và tối đa hóa hiệu quả của cache (Roesch et al. 2018; Chen et al. 2018). Ngay cả khi kế hoạch thực thi đã được tối ưu hóa tốt nhất, một mô hình vẫn có thể suy giảm hiệu suất nghiêm trọng nếu bộ nhớ không được quản lý hiệu quả.
Khối lượng công việc (workload) machine learning thường rất nặng về bộ nhớ, đòi hỏi luân chuyển thường xuyên các tensor lớn giữa các tầng của hệ thống phân cấp bộ nhớ. Trình biên dịch cần quyết định cách lưu trữ tensor, cách truy cập chúng và cách xử lý kết quả trung gian để tránh biến bộ nhớ thành nút thắt cổ chai.
Giai đoạn lập kế hoạch bộ nhớ tối ưu hóa bố cục tensor, mẫu truy cập bộ nhớ và tái sử dụng bộ đệm để tránh đình trệ không cần thiết và tranh chấp bộ nhớ trong quá trình thực thi. Tensor được sắp xếp theo các định dạng ăn khớp với mẫu truy cập của phần cứng, giảm nhu cầu chuyển đổi định dạng. Các truy cập bộ nhớ được tổ chức để giảm trượt cache và các lần dừng, từ đó hạ mức tiêu thụ băng thông tổng thể. Việc tái sử dụng bộ đệm giúp giảm cấp phát bộ nhớ dư thừa bằng cách quản lý các kết quả trung gian sao cho bộ đệm đã hoàn thành được thu hồi kịp thời. Kết hợp lại, các chiến lược này đảm bảo dữ liệu được đặt và truy cập hiệu quả, cải thiện cả hiệu suất tính toán lẫn hiệu quả năng lượng.
Việc cân bằng giữa bộ nhớ sẵn có, tái sử dụng và hiệu quả truy cập trên nhiều tầng của hệ thống phân cấp bộ nhớ khiến lập kế hoạch bộ nhớ trở thành một trong những bài toán phức tạp nhất của trình biên dịch. Các trình biên dịch AI áp dụng nhiều chiến lược để quản lý bộ nhớ hiệu quả và tránh di chuyển dữ liệu không cần thiết.
Tối ưu hóa bố cục tensor quyết định cách sắp xếp tensor trong bộ nhớ để tối đa hóa tính cục bộ và tránh các chuyển đổi định dạng không cần thiết. Như section 1.7.1.2 đã nêu, các bộ tăng tốc phần cứng khác nhau ưa các bố cục vật lý khác nhau tùy thuộc vào kernel ở backend và chế độ độ chính xác. Lịch sử, đường dẫn tích chập của cuDNN (NVIDIA) thường kỳ vọng bố cục NCHW cho nhiều kernel FP32, trong khi bố cục NHWC (channels-last) phù hợp với việc gộp truy cập bộ nhớ của Tensor Core cho các đường dẫn FP16 và INT8; TensorFlow/XLA có thể chọn các bố cục nội bộ trong giai đoạn lowering cho backend mục tiêu. Ngăn xếp trình biên dịch và thư viện sẽ biến đổi bố cục tensor dựa trên kernel và độ chính xác đã chọn cho phần cứng mục tiêu, đảm bảo truy cập bộ nhớ được căn chỉnh để đạt hiệu quả tối đa (NVIDIA Corporation 2021; Google 2025).
Google. 2025. XLA: Optimizing Compiler for Machine Learning.
Roesch, Jared, Steven Lyubomirsky, Logan Weber, Josh Pollock, Marisa Kirisame, Tianqi Chen, and Zachary Tatlock. 2018. “Relay: A New IR for Machine Learning Frameworks.” Proceedings of the 2nd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, 58–68. https://doi.org/10.1145/3211346.3211348.
Phân bổ và tái sử dụng bộ đệm bổ sung cho tối ưu hóa bố cục: trình biên dịch giảm dung lượng bộ nhớ sử dụng bằng cách tái sử dụng vùng lưu trữ trung gian bất cứ khi nào có thể. Khối lượng công việc (workload) deep learning tạo ra rất nhiều tensor tạm thời, như activation và gradient; nếu không quản lý kỹ, chúng có thể nhanh chóng làm quá tải bộ nhớ on-chip. Thay vì cấp phát bộ nhớ mới cho mỗi tensor, trình biên dịch phân tích đồ thị tính toán để tìm cơ hội tái sử dụng bộ đệm, bảo đảm các giá trị trung gian được lưu và ghi đè một cách hiệu quả (Roesch et al. 2018).
Giảm di chuyển dữ liệu giữa các tầng bộ nhớ cũng quan trọng không kém. Các bộ tăng tốc AI thường có bộ nhớ on-chip tốc độ cao (như cache hoặc SRAM chia sẻ) cùng bộ nhớ DRAM ngoài dung lượng lớn nhưng chậm hơn. Nếu dữ liệu tensor liên tục bị chuyển qua lại giữa các tầng này, mô hình có thể bị giới hạn bởi bộ nhớ (memory bound), làm giảm hiệu quả tính toán. Để tránh điều đó, trình biên dịch dùng chiến lược chia lát (tiling) để tách các phép tính lớn thành những khối nhỏ, thân thiện với bộ nhớ, giúp việc thực thi nằm trong bộ nhớ cục bộ nhanh và giảm nhu cầu truy cập bộ nhớ off-chip tốn kém. Hậu quả của việc bỏ qua kế hoạch bộ nhớ là rất cụ thể: một CNN chạy trên GPU có thể đạt hiệu quả tính toán cao về mặt lý thuyết, nhưng nếu các bản đồ đặc trưng tích chập được lưu ở một bố cục không tương thích, buộc phải chuyển đổi định dạng lặp đi lặp lại, thì chi phí này có thể xóa sạch lợi ích từ tối ưu hóa đồ thị và chọn kernel. Khi việc phân bổ bộ nhớ đã được xác định, trình biên dịch phải quyết định tiếp khi nào và ở đâu thực thi từng phép tính.
Lập lịch tính toán
Khi tối ưu đồ thị, lựa chọn kernel và lập kế hoạch bộ nhớ đã xong, lập lịch tính toán quyết định thứ tự thực thi và cách phân bổ tài nguyên cho từng thao tác. Giai đoạn này xác định khi nào và ở đâu mỗi phép tính được thực thi, bảo đảm khối lượng công việc (workload) được phân phối hiệu quả trên các phần tử xử lý sẵn có, đồng thời tránh chờ đợi không cần thiết và tranh chấp tài nguyên (Zheng et al. 2020).
Nếu không có lập lịch hiệu quả, độ song song lớn sẽ bị lãng phí: các đơn vị tính toán bị nhàn rỗi, băng thông bộ nhớ không được tận dụng hết và hiệu suất thực thi suy giảm. Lập lịch tính toán giúp các phần tử xử lý luôn hoạt động, quản lý đúng các phụ thuộc trong quá trình thực thi, và phân phối khối lượng công việc (workload) trên không gian lập lịch của phần cứng (Chen et al. 2018; Zheng et al. 2020).
Giai đoạn lập lịch điều phối thực thi song song, đồng bộ hóa và phân bổ tài nguyên. Phân vùng tác vụ chia các phép tính thành các đơn vị có thể phân phối cho nhiều lõi tính toán. Tối ưu hóa thứ tự thực thi xác định trình tự khởi chạy các phép toán để tối đa hóa hiệu suất phần cứng và giảm thời gian chờ. Phân bổ tài nguyên và đồng bộ hóa bảo đảm các lõi tính toán, băng thông bộ nhớ và cache dùng chung được sử dụng mà không xảy ra tranh chấp.
Triển khai trong các trình biên dịch AI
Các chiến lược lập lịch phụ thuộc chặt chẽ vào kiến trúc phần cứng bên dưới, vì mỗi bộ tăng tốc AI có mô hình thực thi riêng. Các trình biên dịch AI áp dụng nhiều chiến lược để tối ưu hóa lập lịch nhằm đạt hiệu suất thực thi cao.
Phân vùng tác vụ chia các đồ thị tính toán lớn thành những đơn vị nhỏ hơn có thể thực thi song song. Trên GPU, điều này thường có nghĩa là ánh xạ phép nhân ma trận và tích chập lên hàng nghìn lõi CUDA; còn trên TPU, các tác vụ được phân vùng để phù hợp với các mảng systolic (systolic arrays) vận hành trên các luồng dữ liệu có cấu trúc (Norrie et al. 2021). Với CPU, việc phân vùng thường tập trung vào chia các phép tính thành các khối được vector hóa, phù hợp với cơ chế thực thi SIMD. Trong mọi trường hợp, mục tiêu là giữ cho mọi lõi luôn hoạt động trong suốt quá trình thực thi.
Norrie, Thomas, Nishant Patil, Doe Hyun Yoon, George Kurian, Sheng Li, James Laudon, Cliff Young, Norman Jouppi, and David Patterson. 2021. “The Design Process for Google’s Training Chips: TPUv2 and TPUv3.” IEEE Micro 41 (2): 56–63. https://doi.org/10.1109/mm.2021.3058217.
Ngoài phân vùng tác vụ, lập lịch còn tối ưu hóa thứ tự thực thi để giảm bớt các phụ thuộc và tối đa hóa thông lượng. Nhiều mô hình AI có các phép toán có thể tính độc lập (ví dụ: các batch khác nhau trong một pipeline xử lý batch) song song với các phép toán có phụ thuộc chặt chẽ (ví dụ: các lớp hồi tiếp trong một RNN). Các trình biên dịch AI phân tích các phụ thuộc này và cố gắng sắp xếp lại thứ tự thực thi khi có thể, giúp giảm thời gian nhàn rỗi và cải thiện hiệu quả song song. Trong cơ chế attention của transformer, các kernel nhận biết IO cụ thể hóa bài toán lập lịch bằng cách tải các khối truy vấn, khóa và giá trị vào bộ nhớ nhanh, sử dụng chúng khi còn cư trú tại đó, rồi đưa chúng ra theo một thứ tự giúp giảm lưu lượng truy cập bộ nhớ băng thông cao (Dao et al. 2022).
Việc phân bổ tài nguyên và đồng bộ hóa quyết định cách các lõi tính toán chia sẻ bộ nhớ và phối hợp thực thi. Các bộ tăng tốc AI hiện đại thường hỗ trợ chồng lấn tính toán với truyền dữ liệu: khi một tác vụ đang chạy, tác vụ kế tiếp có thể bắt đầu nạp dữ liệu cần thiết. Trình biên dịch tận dụng điều này bằng cách lập lịch tác vụ để ẩn độ trễ bộ nhớ, giúp quá trình thực thi bị ràng buộc bởi tính toán thay vì bởi bộ nhớ (Chen et al. 2018). Trong các ngăn xếp suy luận trong môi trường sản xuất, các runtime được tối ưu hóa và các lịch do trình biên dịch tạo ra sẽ điều phối thứ tự khởi chạy kernel, thực thi theo luồng và đồng bộ hóa, nhờ vậy bộ tăng tốc không bị dừng giữa các kernel phụ thuộc (NVIDIA 2024b; Zheng et al. 2020). Các quyết định lập lịch kém có thể xóa nhòa lợi ích của mọi giai đoạn biên dịch trước đó: một CNN với các kernel tối ưu và bố cục bộ nhớ hiệu quả vẫn bị giảm thông lượng nếu các đơn vị tính toán nhàn rỗi giữa các lần khởi chạy kernel; và một transformer trên TPU có thể hoạt động kém nếu các lớp attention không được lập lịch để chồng lấn với các lần truyền dữ liệu bộ nhớ.
Chen, Tianqi, Thierry Moreau, Ziheng Jiang, Lianmin Zheng, Eddie Q. Yan, Haichen Shen, Meghan Cowan, et al. 2018. “TVM: An Automated End-to-End Optimizing Compiler for Deep Learning.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI ’18), 578–94.
NVIDIA. 2024b. NVIDIA TensorRT: Programmable Inference Accelerator.
Zheng, Lianmin, Chengfan Jia, Minmin Sun, Zhao Wu, Cody Hao Yu, Ameer Haj-Ali, Yida Wang, et al. 2020. “Ansor: Generating High-Performance Tensor Programs for Deep Learning.” Proceedings of the 14th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 863–79.
Sinh mã
Sau khi lập lịch xong, giai đoạn biên dịch cuối cùng sẽ chuyển kế hoạch thực thi đã tối ưu này thành các lệnh đặc thù cho phần cứng. Khác với các giai đoạn trước vốn cần tối ưu hóa đặc thù cho AI, việc sinh mã ở đây tuân theo nhiều nguyên tắc giống các trình biên dịch truyền thống. Quá trình này gồm chọn lệnh, cấp phát thanh ghi và các bước tối ưu hóa cuối, nhằm đảm bảo việc thực thi tận dụng tối đa các tính năng của phần cứng như thực thi vector hóa, prefetch bộ nhớ và sắp xếp lại lệnh. Điều quan trọng là việc chọn lệnh cho các mục tiêu ML không hề chung chung: trình biên dịch phải phát các lệnh kích hoạt các phần mở rộng ISA dành cho phép toán ma trận của phần cứng. Trên GPU NVIDIA, điều này đồng nghĩa sinh các lệnh Parallel Thread Execution (PTX) như mma.sync.aligned để gọi trực tiếp Tensor Cores, như minh họa trong listing 14. Trên CPU Intel với Advanced Matrix Extensions (AMX), trình biên dịch nhắm tới các lệnh nhân ô (tile-multiply) hoạt động trên các ô thanh ghi 2D. Trên CPU Arm với Scalable Matrix Extension, mục tiêu là cộng dồn theo tích ngoài trên các ô ma trận có thể mở rộng. Nếu một backend sinh mã chỉ phát các lệnh dấu phẩy động chung thay vì các phần mở rộng này, các động cơ ma trận chính của phần cứng sẽ bị bỏ không, có thể làm giảm thông lượng hiệu quả khoảng một bậc độ lớn, bất kể các giai đoạn biên dịch trước đó làm tốt đến đâu. Với CPU và GPU, các trình biên dịch AI thường tạo mã máy hoặc lệnh hợp ngữ đã tối ưu. Còn với TPU, field-programmable gate arrays (FPGA),40 và các bộ tăng tốc khác, đầu ra có thể là bytecode đã tối ưu hoặc đồ thị thực thi được hệ thống runtime của phần cứng diễn giải.
40 Field-programmable gate array: “Field-programmable” nghĩa là lớp logic có thể cấu hình sau khi sản xuất, trái ngược với ASIC chức năng cố định. FPGA có thể cải thiện hiệu năng cho các dịch vụ trung tâm dữ liệu nhạy với độ trễ bằng cách hiện thực các pipeline tùy biến phù hợp với một khối lượng công việc (workload) cụ thể (Putnam et al. 2014). Khả năng cấu hình lại này khiến FPGA hấp dẫn với các kiến trúc ML thay đổi nhanh, nơi việc chốt vào một ASIC có nguy cơ nhanh lỗi thời; tuy nhiên, yêu cầu dùng ngôn ngữ mô tả phần cứng (Verilog/VHDL) và thời gian biên dịch tính bằng hàng giờ tạo ra một rào cản về năng suất, giới hạn việc áp dụng trong các trường hợp triển khai mà lợi ích về hiệu suất đủ bù chi phí kỹ thuật.
Putnam, Andrew, Adrian M. Caulfield, Eric S. Chung, Derek Chiou, Kypros Constantinides, John Demme, Hadi Esmaeilzadeh, et al. 2014. “A Reconfigurable Fabric for Accelerating Large-Scale Datacenter Services.” ACM SIGARCH Computer Architecture News 42 (3): 13–24. https://doi.org/10.1145/2678373.2665678.
Từ biên dịch đến runtime
Trình biên dịch biến một mô hình cấp cao thành kế hoạch thực thi được tùy chỉnh cho phần cứng đích, nhưng kế hoạch đó vẫn giả định trước một số điều kiện tương lai: shape, không gian làm việc, năng lực thiết bị và đôi khi là mức độ đồng thời. Tối ưu hóa đồ thị, chọn kernel, lập kế hoạch bộ nhớ và lập lịch có thể giúp thực thi hiệu quả; chúng không thể bảo đảm tận dụng tối đa tài nguyên trong mọi khối lượng công việc (workload) ở runtime.
Các tối ưu hóa của trình biên dịch ahead-of-time và quá trình xây dựng engine diễn ra trước khi thực thi bắt đầu. Tính chất tĩnh này cho phép tối ưu hóa đồ thị mạnh mẽ, nhưng hạn chế khả năng thích ứng khi shape đầu vào hoặc điều kiện tài nguyên lệch so với hồ sơ đã chuẩn bị. Vì vậy, tái cấu trúc đồ thị, gộp phép toán (fusion), chọn tactic, phân chia (tiling), lựa chọn độ chính xác và phần lớn lập kế hoạch bộ nhớ đều dựa trên shape và phần cứng đã biết tại thời điểm xây dựng. Các hệ thống biên dịch just-in-time có thể biên dịch thêm biến thể sau này, nhưng mỗi kernel được tạo ra vẫn có một cách triển khai cố định.
Các hệ thống AI vận hành trong môi trường động, nhiều khi không khớp với các giả định tĩnh nói trên. Kích thước batch thay đổi, nhiều khối lượng công việc (workload) có thể tranh nhau một bộ tăng tốc, và giới hạn nhiệt có thể làm hiệu suất duy trì thấp hơn mức đỉnh trong các benchmark ngắn. Runtime và hệ thống phục vụ (serving) phản hồi bằng cách chọn giữa các cấu hình được hỗ trợ, quản lý bộ đệm và luồng, gom yêu cầu thành batch và áp dụng admission control; chúng thường không phát minh các chiến lược gộp (fusion) hay phân chia (tiling) mới cho một engine đã xây dựng. Chương về phục vụ (serving) xem việc gom batch, admission control và mục tiêu mức dịch vụ như các vấn đề đầu-cuối của hệ thống (Phục vụ mô hình); ở đây, câu hỏi hẹp hơn là runtime của bộ tăng tốc điều phối các kế hoạch thực thi đã chuẩn bị như thế nào khi một yêu cầu hoặc một batch đến phần cứng.
Self-Check: Question
What is the primary purpose of lifetime analysis in an ML compiler’s static memory planner?
- To calculate the physical degradation and failure rate of HBM memory cells over time
- To determine the precise intervals during which each intermediate activation tensor is needed, allowing disjoint tensors to share the same physical memory buffer
- To predict the number of training epochs required for a neural network to converge
- To prevent the compiler from generating out-of-order instruction streams
Explain how double buffering (software pipelining) implemented by an ML compiler hides memory access latency during loop execution on an accelerator.
Place the following compilation stages in the correct order as an end-to-end ML compiler (such as TVM or XLA) transforms a high-level deep learning model into executable machine code:
- Target Code Generation: Emit hardware-specific binary (e.g., PTX or machine instructions)
- High-Level Graph Optimization: Perform operator fusion, constant folding, and dead code elimination on the computation graph
- Front-End Ingestion: Parse framework model (e.g., PyTorch/ONNX) into High-Level Graph IR
- Low-Level IR & Auto-Tuning: Lower fused operators to loop-level IR and optimize tile sizes, thread bindings, and unroll factors
- Static Memory Planning: Analyze tensor lifetimes and allocate shared physical buffers
How does an auto-tuning ML compiler (such as TVM/Ansor) differ from a traditional handwritten library approach (such as cuDNN) for kernel selection?
- Auto-tuning compilers execute code only on the host CPU, whereas handwritten libraries run on GPUs
- Handwritten libraries search an infinite combinatorial loop space at runtime, whereas auto-tuning compilers use static heuristics
- Auto-tuning compilers explore large parameterized search spaces of loop transformations and tile sizes using cost models to generate custom kernels, whereas handwritten libraries rely on expert-tuned templates for specific fixed shapes
- Auto-tuning compilers require all tensors to be quantized to 1-bit integers
The optimization where an ML compiler merges two or more independent operators at the same graph depth into a single batched kernel to maximize GPU parallelism is known as ____ fusion.
Hỗ trợ runtime
Các runtime AI thực thi các đồ thị và engine đã biên dịch, đồng thời quản lý các hình dạng phụ thuộc vào đầu vào, bộ đệm, luồng và các cấu hình thực thi được hỗ trợ; TensorRT là một ngăn xếp suy luận dùng trong sản xuất tiêu biểu. Trình xây dựng (builder) của TensorRT biên dịch mạng và chọn chiến thuật khi tạo engine, còn runtime của nó cung cấp đầu vào, chọn một cấu hình tối ưu hóa tương thích và điều phối phần triển khai đã chuẩn bị (NVIDIA Corporation 2026a, 2026b).
NVIDIA Corporation. 2026a. How TensorRT Works.
NVIDIA Corporation. 2026b. Working with Dynamic Shapes.
Huang, Y., Y. Cheng, A. Bapna, O. Firat, D. Chen, M. X. Chen, H. Lee, et al. 2019. “GPipe: Efficient Training of Giant Neural Networks Using Pipeline Parallelism.” Advances in Neural Information Processing Systems (NeurIPS) 32: 103–12.
Mirhoseini, Azalia, Hieu Pham, Quoc V. Le, Benoit Steiner, Rasmus Larsen, Yuefeng Zhou, Naveen Kumar, Mohammad Norouzi, Samy Bengio, and Jeff Dean. 2017. “Device Placement Optimization with Reinforcement Learning.” International Conference on Machine Learning (ICML) 70: 2430–39.
Các runtime AI quản lý ba khía cạnh thực thi có liên hệ chặt chẽ. Thứ nhất, chúng điều phối các kernel hoặc các biến thể đồ thị đã chuẩn bị sao cho hợp lệ với các hình dạng (shapes) và thiết bị hiện tại. Thứ hai, chúng liên kết và tái sử dụng các bộ đệm tensor, không gian làm việc, luồng (streams) và tài nguyên truyền dữ liệu. Thứ ba, các runtime framework cấp cao hơn có thể tham gia thực thi trên nhiều thiết bị, chẳng hạn như trong các hệ thống song song theo pipeline như GPipe (Huang et al. 2019) và các phương pháp gán thiết bị (Mirhoseini et al. 2017). Runtime suy luận cấp thấp, framework huấn luyện và bộ lập lịch phục vụ (serving) có thể phân chia các trách nhiệm này theo những cách khác nhau.
Các runtime AI bổ trợ cho các tối ưu hóa dựa trên trình biên dịch bằng cách xử lý linh hoạt các khía cạnh thực thi này. So sánh các runtime AI với các runtime phần mềm truyền thống sẽ giúp làm rõ vì sao các khối lượng công việc machine learning cần những chiến lược thực thi chuyên biệt.
Kiến trúc runtime ML
Các runtime đa năng quản lý luồng, tác vụ, đối tượng, bộ nhớ và I/O bất đồng bộ trên nhiều loại chương trình. Các runtime AI kế thừa các cơ chế đó nhưng biểu diễn công việc dưới dạng tensor, kernel, đồ thị, bộ đệm thiết bị và hàng đợi bộ tăng tốc.
Table 24 đối chiếu trọng tâm của chúng. Các runtime AI phải tuân thủ các phụ thuộc của đồ thị và các hình dạng (shapes) của tensor trong khi điều phối các kernel và việc truyền dữ liệu, nhưng chúng vẫn cùng tồn tại với các runtime ngôn ngữ, hệ điều hành và thiết bị truyền thống.
| Khía cạnh | Runtime truyền thống | Runtime AI |
|---|---|---|
| Mô hình thực thi | Hàm, luồng, tác vụ, sự kiện và I/O bất đồng bộ | Đồ thị tensor, kernel, luồng và sự kiện thiết bị |
| Lập lịch tác vụ | Các luồng và tác vụ trên các tài nguyên bộ xử lý | Điều phối kernel và truyền dữ liệu nhận biết phụ thuộc |
| Quản lý bộ nhớ | Đối tượng, stack, heap, pool và bộ nhớ ảo | Bộ đệm tensor, không gian làm việc, bộ nhớ thiết bị và tái sử dụng bộ đệm |
| Các ưu tiên tối ưu hóa | Khả năng phản hồi, thông lượng, tính cục bộ và chia sẻ tài nguyên | Tương thích hình dạng, chồng chéo truyền tải, tái sử dụng và tận dụng |
| Khả năng thích ứng | Lập lịch và cấp phát động trong ngữ nghĩa chương trình | Các lựa chọn runtime trong các đồ thị đã biên dịch và các kernel khả dụng |
| Phần cứng mục tiêu | CPUs và các thiết bị dị thể | CPU, GPU, TPU và các bộ tăng tốc tùy chỉnh |
Bộ nhớ tensor là một chuyên môn lớn. Các runtime AI thường phối hợp kế hoạch vòng đời tĩnh cho các shape cố định với pool hoặc cấp phát động cho các shape biến đổi, rồi liên kết các bộ đệm đó với kernel trên thiết bị và các thao tác truyền. Lập kế hoạch kém có thể làm tăng mức đỉnh bộ nhớ, cản trở tái sử dụng bộ đệm hoặc thêm các lần truyền; hành vi cache chủ yếu do các kernel đã biên dịch và phần cứng chi phối.
Các runtime AI hỗ trợ biến thiên trong phạm vi engine đã biên dịch hoặc các thư viện kernel sẵn có của chúng. Chúng có thể quản lý bộ đệm tensor động, chọn một shape profile phù hợp, điều phối các luồng và tham gia thực thi trên nhiều thiết bị. Việc gom batch các yêu cầu và phân bổ tài nguyên ở cấp độ fleet thường do bộ lập lịch phục vụ (serving) đảm nhiệm, chứ không phải runtime của bộ tăng tốc cấp thấp.
Điều kiện môi trường production có thể khác với khi benchmark. A100 SXM có công suất thiết kế nhiệt tối đa (TDP) là 400 W, trong khi A100 PCIe có TDP tối đa 300 W; đây là các form factor khác nhau với khả năng tản nhiệt khác nhau, nên một triển khai có thể không duy trì được thông lượng đo trên biến thể khác. Kích thước batch, mức bộ nhớ sẵn có và tranh chấp tài nguyên cũng có thể khác. Vì vậy, hệ thống cần chuẩn bị các profile engine phù hợp và dùng các cơ chế điều khiển phục vụ (serving) như gom batch và kiểm soát tiếp nhận, thay vì giả định runtime sẽ tự tinh chỉnh các kernel đã biên dịch để phản ứng với nhiệt độ hoặc tải.
Để thấy các cơ chế runtime này phối hợp ra sao, hãy xét một yêu cầu suy luận (inference) transformer đến máy chủ production. Hệ thống phục vụ (serving) tạo một batch được hỗ trợ, runtime chọn một profile dựng sẵn tương thích và quản lý bộ đệm, và engine phát lệnh các kernel đã được chọn trong quá trình biên dịch hoặc khi dựng engine. Các phần tiếp theo sẽ phân tích những lựa chọn runtime có giới hạn này, dùng yêu cầu đó làm ví dụ xuyên suốt.
Thực thi kernel động
Mặc dù biên dịch tĩnh tạo nền tảng, để thực thi hiệu quả đôi khi phải chọn giữa các biến thể đã chuẩn bị sẵn. Khi một yêu cầu transformer đến, kích thước batch và độ dài chuỗi của nó quyết định profile tối ưu hóa và các kernel được hỗ trợ nào có thể chạy. Các shape ngoài những profile đó sẽ cần một engine khác hoặc phải biên dịch bổ sung, chứ không phải runtime tự ý tinh chỉnh lại tại chỗ.
Các phép toán riêng lẻ được gán bản triển khai trong quá trình biên dịch hoặc khi xây dựng engine. Khi thực thi, runtime sẽ liên kết bộ đệm, chọn các biến thể hợp lệ (nếu engine cung cấp), và khởi chạy công việc theo thứ tự phụ thuộc.
Hạn chế tương tự cũng xuất hiện trong phân loại ảnh. Nếu một batch ảnh độ phân giải cao mới đến vượt quá giả định bộ nhớ của một profile đã chuẩn bị, hệ thống phục vụ (serving) phải chọn một profile hoặc engine tương thích, chia nhỏ batch, hoặc xây dựng lại engine. Runtime không thể tự bịa ra một chiến lược chia ô (tiling) mới cho một engine đã xây dựng.
Với yêu cầu suy luận transformer, độ dài chuỗi có thể khác nhau giữa các lần gọi. Một kế hoạch tối ưu cho một độ dài cố định có thể dùng kém hiệu quả tài nguyên tính toán với các chuỗi ngắn hơn, hoặc vượt quá giả định về không gian làm việc với các chuỗi dài hơn. Runtime có thể chọn một profile đã chuẩn bị tương thích và cấp phát các bộ đệm cần thiết; các độ dài không được hỗ trợ sẽ cần một biến thể đã biên dịch khác hoặc một kernel tổng quát hơn.
Chồng chéo tính toán với truyền dữ liệu có thể giảm nút thắt truyền tải. Khi các phụ thuộc, bộ đệm khóa trang (page-locked buffers), luồng (streams) và copy engines cho phép chạy đồng thời, thực thi bất đồng bộ và double buffering sẽ truyền batch \(n{+}1\) trong khi tính batch \(n\). Cách này có thể che bớt một phần độ trễ truyền từ host sang device, nhưng không loại bỏ được tình trạng dừng chờ khi thời gian truyền dài hơn thời gian tính, hoặc khi tài nguyên bị tuần tự hóa.
Các lớp tích chập cho thấy ranh giới này: TensorRT có thể hợp nhất phép toán và benchmark các chiến thuật tích chập khi xây dựng engine. Trong suy luận, runtime sẽ điều phối các lớp đã chuẩn bị đó; bộ lập lịch phần cứng của GPU sẽ đặt các thread block của chúng lên các SM sẵn có.
Việc chọn giữa các chiến lược thực thi đã chuẩn bị sẵn để phù hợp với shape của yêu cầu và điều kiện hệ thống có thể cải thiện hiệu suất huấn luyện và suy luận. Khả năng thích ứng này phụ thuộc vào việc có sẵn kernel phù hợp. Trong kịch bản suy luận với transformer, runtime phải chọn giữa các triển khai đã chuẩn bị cho shape và độ chính xác mà yêu cầu đó hỗ trợ.
Chọn kernel trong runtime
Trong khi các trình biên dịch thực hiện bước chọn kernel ban đầu dựa trên phân tích tĩnh, các runtime AI vẫn có thể chọn giữa các biến thể đã biên dịch sẵn hoặc do thư viện cung cấp trong lúc chạy. Các yếu tố thời gian thực, như bộ nhớ khả dụng, mức độ sử dụng phần cứng và ưu tiên của khối lượng công việc (workload), có thể khác với giả định khi biên dịch. Với một mô hình transformer, trình biên dịch và framework xác định các đường độ chính xác hợp lệ, còn runtime chọn biến thể kernel phù hợp nhất với độ dài chuỗi, shape của batch và tài nguyên phần cứng hiện có. Việc runtime chọn kernel giúp điều chỉnh thực thi theo điều kiện thay đổi, nhưng vẫn bị giới hạn bởi các định dạng số và các kernel mà mô hình đã được chuẩn bị để dùng.
Ví dụ, các mô hình ngôn ngữ dựa trên transformer dành nhiều thời gian cho phép nhân ma trận. Các hệ thống dùng độ chính xác hỗn hợp như Megatron-LM thường thực thi FP16 trên GPU Tensor Cores để tăng thông lượng (Shoeybi et al. 2019). Việc quyết định phép toán nào giữ ở FP32 là lựa chọn trong quá trình chuyển đổi mô hình hoặc xây dựng engine, và phải được xác thực trước khi triển khai; runtime không tự suy ra sự bất ổn số học để tự ý đổi độ chính xác.
Shoeybi, Mohammad, Mostofa Patwary, Raul Puri, Patrick LeGresley, Jared Casper, and Bryan Catanzaro. 2019. “Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism.” arXiv Preprint arXiv:1909.08053.
Các hạn chế về bộ nhớ cũng ảnh hưởng đến việc chọn kernel. Khi băng thông bộ nhớ bị hạn chế, runtime có thể chọn một kernel hoặc profile đã chuẩn bị sẵn sao cho yêu cầu về tiling và không gian làm việc phù hợp với tài nguyên hiện có. Tạo một chiến lược tiling mới đòi hỏi phải xây dựng engine hoặc biên dịch, chứ không phải một điều chỉnh tùy ý ở runtime.
Kích thước batch cũng ảnh hưởng đến việc chọn kernel. Khi một stack cung cấp nhiều biến thể tương thích, runtime có thể dùng một triển khai ưu tiên độ trễ cho các batch nhỏ và một triển khai ưu tiên thông lượng cho các batch lớn hơn. Lợi ích phụ thuộc vào tập kernel đã chuẩn bị sẵn và chi phí chuyển đổi giữa các profile. Giai đoạn cuối của pipeline sẽ quyết định thời điểm chạy từng kernel đã chọn.
Lập lịch và tận dụng kernel
Việc điều phối kernel là bước cuối cùng trong pipeline của runtime. Quay lại yêu cầu transformer, runtime khởi chạy các kernel attention, normalization và activation đã chuẩn bị trên các luồng, đồng thời tuân thủ các phụ thuộc của đồ thị. Trên GPU, các bộ lập lịch khối phần cứng sẽ gán các thread block cho các SM (Streaming Multiprocessor); runtime không trực tiếp phân phối từng phép toán riêng lẻ lên các lõi. Các bộ tăng tốc khác cũng cung cấp các hàng đợi hoặc lệnh thực thi tương tự (Jouppi et al. 2017).
Trong các mô hình nhận dạng hình ảnh, các kernel độc lập có thể chạy chồng nhau trên các luồng riêng biệt nếu phụ thuộc và tài nguyên cho phép. Tuy nhiên, bên trong mỗi kernel GPU, lưới (grid) sau biên dịch xác định công việc, và phần cứng GPU sẽ lên lịch các thread block của nó; runtime không phân phối từng bộ lọc riêng lẻ cho các đơn vị xử lý.
Quản lý bộ nhớ cũng phục vụ cùng mục tiêu thông qua tái sử dụng buffer, truyền dữ liệu bất đồng bộ và staging rõ ràng ở những nơi API hỗ trợ. Các cache phần cứng vẫn do phần cứng quản lý; runtime thường không thể tự ý đặt các tensor trung gian vào cache.
Tổng hợp lại, lựa chọn cấu hình (profile selection), quản lý buffer và điều phối kernel tạo thành pipeline của runtime. Với yêu cầu transformer, runtime chọn giữa các cách triển khai và hình dạng (shapes) do trình biên dịch hoặc công cụ dựng engine chuẩn bị, rồi khởi chạy chúng hiệu quả. Các thay đổi về hợp nhất (fusion), tiling hoặc độ chính xác hợp lệ (legal precision) thường cần dựng lại hoặc biên dịch lại, thay vì liên tục tinh chỉnh ở runtime.
Các hệ thống trình biên dịch và runtime đã xem xét tới đây tối ưu hóa việc thực thi trên từng bộ tăng tốc, nhưng các khối lượng công việc (workload) AI lớn nhất vượt quá khả năng của bất kỳ chip đơn lẻ nào. Tối ưu hóa trên một chip có thể mang lại kết quả ấn tượng nhờ tối ưu hóa trình biên dịch, lựa chọn luồng dữ liệu (dataflow selection), hợp nhất (fusion) và lập kế hoạch bộ nhớ. Dẫu vậy, với các khối lượng công việc (workload) AI lớn nhất, ngay cả việc thực thi đơn chip đã được tối ưu tốt vẫn là không đủ.
Hãy xét ước tính \(3.14 \times 10^{23}\) phép toán dấu phẩy động cho việc huấn luyện GPT-3 (Brown et al. 2020). Để so sánh quy mô, hãy chia tổng số phép toán đó cho tốc độ FP8 đỉnh của H100 đời sau là 1.98 PFLOP/s. Theo phép tính, giới hạn dưới vào khoảng 5 years trên một thiết bị; còn trong mức sử dụng minh họa 40–60 phần trăm thì là 8.4–12.6 years (Choquette 2023). Đây không phải là tái tạo quá trình huấn luyện GPT-3: độ chính xác, phần cứng, giao tiếp và khối lượng công việc (workload) đều là giả định. Mục đích chỉ để cho thấy vì sao khối lượng tính toán ở quy mô mô hình hoặc khối lượng yêu cầu ở quy mô dịch vụ có thể vượt quá dung lượng hữu ích của một bộ tăng tốc.
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Self-Check: Question
Why do deep learning frameworks implement custom caching memory allocators (such as PyTorch’s
caching_allocator) rather than directly invokingcudaMallocandcudaFreefor every intermediate tensor?cudaMallocoperates only in FP32 precision and cannot allocate FP16 memory buffers- Direct OS memory allocation encrypts all tensor data, introducing cryptographic decryption latency
- GPU DRAM can only be allocated once during system boot time
cudaMallocis a synchronous operation that stalls GPU execution and causes expensive driver and OS page-table synchronization overhead
Explain how CUDA Graphs eliminate CPU kernel launch overhead during repeated training or inference iterations on small or low-latency models.
True or False: In an asynchronous GPU runtime model, when a Python script executes
y = torch.matmul(a, b), the CPU thread blocks and waits until the GPU hardware finishes computing the matrix multiplication before executing the next line of Python code.A sequence of asynchronous GPU operations that execute strictly in FIFO order on an accelerator is called a CUDA ____.
An inference serving system processes dynamic batch sizes ranging from 1 to 32 tokens per request. Why does dynamic batching pose a significant challenge to runtime kernel selection and hardware efficiency?
- Optimal tile sizes, thread block configurations, and memory bandwidth requirements change across batch sizes, making a single static kernel inefficient across all shapes
- Dynamic batching forces the GPU to switch from FP16 to FP64 precision for even batch sizes
- Tensor Cores cannot execute matrix multiplication when batch dimensions are not powers of two
- The GPU memory controller must physically power down DRAM banks when batch size decreases
Mở rộng đa chip
Một H100 đơn lẻ có đỉnh FP8 lớn, nhưng để đạt mục tiêu về thời gian huấn luyện hoặc thông lượng, ta vẫn có thể cần nhiều bộ tăng tốc. Các kỹ thuật đã trình bày trước đó vẫn là nền tảng cho việc mở rộng đa chip; mỗi thiết bị vẫn cần một luồng dữ liệu hiệu quả. Bài học mới là giao tiếp làm xuất hiện thêm các ranh giới phân cấp. Khi dữ liệu đi qua bộ nhớ trên chip, HBM, liên kết nội nút và liên kết cụm, độ trễ và năng lượng tiêu thụ thường tăng, nên mở rộng không chỉ đơn giản là thêm chip.
Khi một bộ tăng tốc đơn lẻ không còn đủ, bài toán thiết kế chuyển từ việc cấp dữ liệu cho một chip sang lựa chọn ranh giới giao tiếp nào mà khối lượng công việc (workload) có thể chấp nhận. Trong thực tế, các kỹ sư vẫn gặp những ranh giới này trong môi trường sản xuất, ngay cả khi phần lớn công việc tối ưu hóa vẫn diễn ra bên trong một bộ tăng tốc.
Các cách tiếp cận mở rộng đa chip
Để mở rộng các hệ thống AI vượt ra ngoài khả năng của từng bộ tăng tốc riêng lẻ, chúng ta cần đẩy ranh giới giao tiếp ra xa hơn; và ở mỗi ranh giới, các đánh đổi chủ đạo lại thay đổi. Chuỗi này bắt đầu từ bên trong gói. Các kiến trúc dựa trên chiplet chia các thiết kế lớn thành các khuôn mô-đun nhỏ hơn, liên kết chúng trong cùng một gói. Cách này giúp vượt qua giới hạn sản xuất của chip nguyên khối mà vẫn giữ được độ trễ giao tiếp tương đối thấp. Ranh giới tiếp theo là nút (node): các máy chủ đa bộ tăng tốc kết nối nhiều chip thông qua các liên kết cấp bo mạch hoặc cấp máy chủ. Mỗi bộ tăng tốc có bộ nhớ và tài nguyên tính toán riêng, vì vậy khối lượng công việc (workload) có thể được chia thông qua song song dữ liệu (mỗi bộ tăng tốc xử lý các batch khác nhau) hoặc song song mô hình (các bộ tăng tốc khác nhau xử lý các lớp mạng khác nhau). Các liên kết nội nút có băng thông cao có thể giúp đồng bộ hóa gradient hiệu quả, nhưng hiệu suất thực tế còn phụ thuộc vào cấu trúc liên kết và hiệu quả của giao tiếp tập thể.
Vượt ra ngoài một nút đơn lẻ, ranh giới mở rộng đến toàn bộ cụm máy chủ. Hạ tầng mạng chuyên dụng trong các trung tâm dữ liệu điều phối hàng trăm bộ tăng tốc, khiến cấu trúc liên kết (topology) và các thuật toán giao tiếp tập thể trở thành yếu tố then chốt quyết định hiệu quả mở rộng. Với một số khối lượng công việc (workload), nếu kiểm soát tốt chi phí giao tiếp, có thể đạt khả năng mở rộng gần như tuyến tính. Ngược lại, tích hợp quy mô wafer (wafer-scale integration) đi theo hướng khác: thay vì đẩy ranh giới ra ngoài, nó gom nhiều phép tính hơn vào một thiết bị lớn duy nhất. Các nền tảng như hệ thống Cerebras WSE tích hợp số lượng bóng bán dẫn và lõi cực lớn trên một thiết bị, giúp giảm chi phí giao tiếp giữa các chip nhưng đồng thời cũng đặt ra những thách thức riêng về tản nhiệt, khả năng chịu lỗi và năng suất sản xuất.
Vì sao mở rộng kéo theo các ràng buộc mới
Khi chuyển từ kiến trúc đơn chip sang đa chip, chi phí giao tiếp và các ràng buộc khác sẽ xuất hiện, làm thay đổi cách chúng ta tối ưu hóa. Giao tiếp, đồng bộ hóa, cân bằng tải và lượng công việc song song trên mỗi thiết bị đều có thể giới hạn khả năng mở rộng. Định luật Amdahl41 đưa ra một mô hình sơ bộ cho phần công việc lộ ra, không giảm đi khi tăng số lượng thiết bị. Với các mô hình hàng trăm tỷ tham số, một tải trọng gradient đầy đủ không chia mảnh (unsharded) có thể chiếm hàng trăm gigabyte mỗi bước, và AllReduce42 phải gom tổng nó; độ chính xác, cách chia mảnh, nén và thuật toán tập thể sẽ làm thay đổi số byte mỗi thiết bị phải truyền.
41 Định luật Amdahl (giới hạn mở rộng): Định luật Amdahl và Định luật Gustafson xác lập giới hạn cho một phần công việc cố định không được tăng tốc. Chẳng hạn, nếu 5% của một khối lượng công việc (workload) cố định vẫn lộ ra và không bị ảnh hưởng bởi số lượng thiết bị, thì tốc độ tăng tối đa bị chặn ở mức 20\(\times\). Huấn luyện phân tán phức tạp hơn vì giao tiếp có thể chồng chéo với tính toán và chi phí của nó cũng có thể thay đổi theo quy mô, nhưng ví dụ này cho thấy vì sao phần đồng bộ hóa lộ ra cần được giảm bớt hoặc che giấu.
42 AllReduce: Một phép toán tập thể của MPI, dùng để tổng hợp các giá trị từ nhiều tiến trình (phần “reduce”) rồi phân phối kết quả trở lại cho tất cả tiến trình (phần “all”). Trong chương này, thuật ngữ này chỉ được nhắc để chỉ ra vì sao băng thông giữa các bộ tăng tốc quan trọng với các khối lượng công việc huấn luyện (training). Ở quy mô lớn, chi phí đồng bộ này phụ thuộc vào các thuật toán, lựa chọn cấu trúc liên kết và các giao thức runtime.
Yếu tố quan trọng hàng đầu ở đây là tải trọng gradient. Với một mô hình có \(P\) tham số, tải trọng này xấp xỉ bằng số tham số nhân với số byte lưu cho mỗi phần tử gradient, trước khi tính đến trạng thái optimizer, phần đệm và chi phí giao thức. Vì vậy, việc mở rộng chỉ có lợi khi thời gian tính toán tiết kiệm được lớn hơn thời gian cần để chuyển tải trọng này qua đường liên kết mạng và thuật toán tập thể đã chọn.
Phần chi phí phụ trợ này giải thích vì sao khi tăng số lượng bộ tăng tốc, hiệu quả có thể giảm dần, trừ khi hệ thống giảm dữ liệu trao đổi, chồng lấp giao tiếp với tính toán hữu ích, hoặc chọn một chiến lược song song hóa tốt hơn. Mô hình bộ nhớ cũng thay đổi: bộ nhớ riêng của từng bộ tăng tốc thường được quản lý tường minh, và các phép toán tập thể (collective operations) thiết lập sự đồng bộ cần thiết, thay vì cung cấp một không gian bộ nhớ hoàn toàn nhất quán trên toàn cụm. Một số hệ thống có các liên kết nhất quán (coherent links), nhưng phạm vi và chi phí của chúng phụ thuộc vào kiến trúc.
Khi tính toán trải rộng qua nhiều liên kết, chip và các tầng bộ nhớ (memory stacks), độ tin cậy và năng lượng trở thành một phần của câu chuyện mở rộng. Các hệ thống quy mô lớn phải xử lý lỗi thành phần một cách trơn tru, vì xác suất có ít nhất một lỗi tăng theo kích thước hệ thống. Đối với chương này, bài học phần cứng là đủ: các hệ thống TPU phân tán phải chịu được lỗi thành phần ở quy mô hệ thống (Jouppi et al. 2023), còn Cerebras dùng các lõi và liên kết fabric dự phòng để thay thế các lõi bị lỗi do sản xuất và khôi phục lưới logic của wafer (Lie 2021). Việc di chuyển dữ liệu cũng trở nên tốn kém hơn khi khoảng cách tăng lên, biến huấn luyện phân tán thành bài toán cân bằng giữa song song hóa tính toán và hiệu quả giao tiếp.
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
Lie, Sean. 2021. Thinking Outside the Die: Architecting the ML Accelerator of the Future.
Mở rộng trong trung tâm dữ liệu và triển khai tại edge nằm ở hai đầu của phổ triển khai, nhưng cùng chia sẻ các nguyên tắc cốt lõi. Mở rộng trong trung tâm dữ liệu điều phối nhiều bộ tăng tốc có thông lượng cao, còn mở rộng ở edge thì đưa AI hữu ích vào trong vài watt công suất hạn chế. Cả hai đều yêu cầu khớp đặc tính của khối lượng công việc (workload) với khả năng phần cứng, đồng thời tối thiểu hóa việc di chuyển dữ liệu. Các nguyên tắc về chuyên môn hóa tính toán, tối ưu hóa hệ thống phân cấp bộ nhớ và ánh xạ khối lượng công việc (workload) đều áp dụng ở cả hai quy mô; chỉ khác nhau ở các ràng buộc. Trung tâm dữ liệu tối ưu hóa thông lượng tổng hợp trong ngân sách công suất tính bằng megawatt; còn thiết bị edge tối ưu hóa độ phản hồi trong các giới hạn chặt chẽ về pin và nhiệt. Cùng một mô hình thị giác chạy thoải mái trong trung tâm dữ liệu có thể cần một chiến lược ánh xạ hoàn toàn khác khi chạy trên điện thoại thông minh hoặc vi điều khiển.
Self-Check: Question
Why have accelerator architectures increasingly shifted from monolithic single-die designs toward Multi-Chip Module (MCM) and chiplet architectures?
- Chiplets eliminate all need for semiconductor fabrication foundries
- Monolithic dies are constrained by the physical lithography reticle limit (\(\approx 858\text{ mm}^2\)) and suffer exponential yield loss as die size increases
- Monolithic dies cannot support high-bandwidth memory (HBM) interfaces
- Chiplets allow electrical signals to travel faster than the speed of light
Explain how the non-uniform memory access (NUMA) effect and interconnect bandwidth degradation impact performance when scaling a neural network workload across multiple chiplets or accelerator chips.
Describe the architectural rationale behind Cerebras’s Wafer-Scale Engine and explain how fabricating an accelerator across an entire uncut silicon wafer overcomes traditional multi-chip scaling bottlenecks.
What is the primary bottleneck introduced by inter-node scaling (scaling out across separate servers over Ethernet or InfiniBand) compared to intra-node NVLink scaling?
- Inter-node network adapters cannot transmit FP16 or BF16 floating-point values
- Inter-node communication requires GPUs to switch to single-threaded CPU emulation mode
- Inter-node network bandwidth (e.g., \(400\text{ Gbps} \approx 50\text{ GB/s}\)) is roughly an order of magnitude lower than intra-node NVLink bandwidth (\(\approx 900\text{ GB/s}\)), increasing collective communication latency
- Inter-node scaling eliminates the need for gradient synchronization in distributed training
Thiết kế SoC dị thể
Các hệ thống triển khai trên thiết bị di động, ô tô và IoT thường có giới hạn chặt chẽ hơn về công suất, nhiệt và độ trễ trên mỗi thiết bị so với phần cứng trong trung tâm dữ liệu. Các SoC dị thể tích hợp các lõi CPU, bộ đổ bóng GPU, bộ xử lý tín hiệu số (DSP) và các đơn vị xử lý nơ-ron (NPU) dùng chung bộ nhớ và ngân sách hệ thống. Bài toán ánh xạ vẫn quen thuộc, nhưng nay còn phải tính đến hỗ trợ toán tử, chi phí truyền dữ liệu, các hạn chót thời gian thực và trạng thái nhiệt.
Sự tiến hóa của kiến trúc SoC di động
Các công cụ AI di động hiện đại là ví dụ điển hình của điện toán dị thể khi điều phối các lõi CPU, bộ đổ bóng GPU, DSP và các NPU chuyên dụng43 qua một hệ thống phân cấp bộ nhớ dùng chung. Việc phân phối khối lượng công việc (workload) cho phép các nhân xử lý thị giác máy tính chạy trên GPU hoặc NPU, xử lý âm thanh dùng các đơn vị số học của DSP, và các lớp mạng nơ-ron nặng phép toán ma trận chạy trên các bộ máy tối ưu cho NPU khi tập toán tử được hỗ trợ. Sự phối hợp này cần lập lịch cẩn thận để đáp ứng ràng buộc thời gian thực, đồng thời quản lý hạn chế nhiệt và thời lượng pin.
43 NPU (neural processing unit): Các nhân ma trận chuyên dụng của NPU được tối ưu cho các phép toán tensor dày đặc, làm nền phần cứng cho cách phân phối khối lượng công việc (workload) đã nêu. Sự chuyên biệt này tạo ra một ràng buộc quan trọng cho bộ lập lịch: bất kỳ toán tử AI nào không nằm trên các đường dẫn dữ liệu mà NPU hỗ trợ sẽ phải “chuyển sang” (fall back) GPU hoặc CPU. Việc chuyển này có thể làm mất lợi thế về hiệu quả năng lượng của NPU, khiến ngân sách độ trễ thời gian thực khó kiểm soát hơn và gia tăng áp lực nhiệt trên thiết bị di động.
Example 1.5: Vi điều khiển dị thể
Tình huống: Một chuông cửa thông minh nhúng phải thực hiện phát hiện người định kỳ trong giới hạn chặt chẽ về bộ nhớ, năng lượng và độ trễ.
Chẩn đoán: Trong một môi trường triển khai được hỗ trợ, đường chạy trên bộ xử lý Cortex-M đa năng không đạt mục tiêu năng lượng hoặc độ trễ đo được. Một micro-NPU như Arm Ethos-U có thể giảm tải các toán tử tích chập tương thích, trong khi CPU vẫn đảm nhiệm luồng điều khiển và các toán tử không được hỗ trợ.
Bài học hệ thống: Việc chuyên môn hóa micro-NPU có thể giảm năng lượng tiêu thụ và độ trễ cho các toán tử được hỗ trợ, nhưng tính khả thi phải được đo lường trên toàn bộ pipeline, bao gồm cả các cơ chế dự phòng (fallback) và xử lý cảm biến.
Một số thiết kế SoC di động nhấn mạnh sự chuyên môn hóa đa dạng giữa các bộ xử lý, trong khi các chiến lược tích hợp theo chiều dọc cho thấy việc phối hợp chặt chẽ giữa phần cứng và phần mềm có thể cho phép thực thi dị thể được điều phối sát sao. Các kiến trúc bộ nhớ hợp nhất có thể giảm chi phí sao chép dữ liệu tường minh, và các khối tính toán khác nhau có thể được lập lịch cho từng loại toán tử (ví dụ: các lớp yêu cầu nhiều phép toán ma trận trên NPU, các toán tử tích chập trên GPU, và luồng điều khiển trên CPU). Sự phối hợp này hỗ trợ trải nghiệm tương tác ngay trên thiết bị, dù độ trễ đạt được còn phụ thuộc vào toàn bộ pipeline và điều kiện nhiệt của thiết bị.
Ngoài các giải pháp tích hợp theo chiều dọc, các mô hình cấp phép IP cho phép nhà thiết kế SoC tùy chỉnh tổ hợp bộ xử lý theo ứng dụng mục tiêu, kết hợp các khối CPU, GPU, DSP và NPU. Tính linh hoạt theo mô-đun này giúp SoC cho ô tô ưu tiên xử lý thời gian thực có tính xác định, trong khi SoC cho điện thoại thông minh tối ưu hóa hiệu năng tương tác và hiệu quả pin.
Các chiến lược phân phối khối lượng công việc (workload) động
Với nhiều bộ xử lý chuyên dụng trên các SoC dị thể, bài toán then chốt là phân phối khéo léo các phép toán của mạng nơ-ron lên các tài nguyên này để tối đa hóa hiệu năng, đồng thời vẫn đáp ứng các ràng buộc về công suất và độ trễ. Hãy xét một ví dụ cụ thể: một kỹ sư triển khai một pipeline phát hiện đối tượng thời gian thực trên một SoC di động có CPU, GPU và NPU. Pipeline này gồm ba giai đoạn: backbone MobileNet để trích xuất đặc trưng, nonmaximum suppression (NMS) cho hậu xử lý, và một display overlay để vẽ các hộp giới hạn. Backbone gồm các tích chập tách biệt theo chiều sâu với các mẫu truy cập đều đặn, dễ dự đoán và chi phí tính toán thấp, nên khi tập toán tử được hỗ trợ thì rất hợp với NPU, dù các lớp depthwise thường bị giới hạn bởi bộ nhớ hơn là các kernel có cường độ tính toán cao. Trái lại, NMS có phân nhánh có điều kiện trên các danh sách ứng viên độ dài biến đổi, với truy cập bộ nhớ không đều, nên khó phù hợp với luồng dữ liệu cố định của NPU. CPU xử lý NMS hiệu quả hơn nhờ bộ dự đoán nhánh và các cache lớn, phù hợp với luồng điều khiển khó đoán. Cuối cùng, display overlay liên quan đến phối trộn ở mức pixel trên toàn bộ khung hình, một khối lượng công việc (workload) song song rất lớn nhưng đơn giản về mặt số học, nên tự nhiên phù hợp với các lõi shader của GPU. Cách chia ba phần này — NPU cho backbone, CPU cho NMS, GPU cho overlay — đạt được độ trễ thấp hơn và mức công suất thấp hơn so với chạy toàn bộ pipeline trên bất kỳ một bộ xử lý đơn lẻ nào.
Ví dụ trên cho thấy các toán tử được hỗ trợ, chi phí truyền tải đo được và ngân sách hệ thống hiện tại sẽ quyết định cách phân vùng pipeline. Các tích chập thông thường thường phù hợp với GPU hoặc NPU, trong khi luồng điều khiển không đều có thể nên giao cho CPU. Hiệu suất của Attention phụ thuộc vào hình dạng, độ chính xác, khả năng sẵn có của kernel và chi phí thiết lập; chỉ riêng độ dài chuỗi không quyết định bộ xử lý tối ưu.
Cách phân bổ tối ưu có thể thay đổi theo chế độ hoạt động. Khi tình trạng pin, nhiệt và tải đồng thời biến động, hệ thống có thể giảm tốc độ khung hình, chọn mô hình nhỏ hơn, hạ tần số bộ tăng tốc, hoặc chọn một backend khác đã được kiểm chứng. Việc di chuyển khối lượng công việc (workload) không mặc nhiên hiệu quả hơn, vì chi phí truyền và các kernel dự phòng có thể lớn hơn lợi ích. Các ứng dụng quan trọng về an toàn còn ưu tiên độ trễ có giới hạn và hành vi đã được kiểm chứng hơn là thông lượng đỉnh.
Làm bài toán chọn bộ xử lý thêm khó, các kiến trúc bộ nhớ chia sẻ cần cơ chế phân xử khi nhiều bộ xử lý cùng truy cập LPDDR. Bộ điều khiển bộ nhớ di động có thể ưu tiên các đường dữ liệu camera hoặc hiển thị thời gian thực hơn các tác vụ AI chạy nền, buộc các runtime mạng nơ-ron phải điều chỉnh cách thực thi theo băng thông khả dụng. Việc phân xử này trở nên then chốt trong các thao tác ngốn bộ nhớ như suy luận mô hình ngôn ngữ lớn, nơi việc truyền tham số từ DRAM phải được phối hợp cẩn thận giữa các bộ xử lý.
Quản lý công suất và nhiệt
Các khối lượng công việc (workload) AI di động phải duy trì hiệu suất cao trong khi hoạt động trong các ngân sách công suất và giới hạn nhiệt nghiêm ngặt. Những ràng buộc này đòi hỏi sự phối hợp chặt chẽ giữa các bộ xử lý không đồng nhất.
Các SoC không đồng nhất sử dụng điều chỉnh điện áp và tần số động (DVFS) trên các miền công suất để quản lý hiệu suất trong một giới hạn chung. Tăng điểm hoạt động của một miền có thể làm giảm khoảng trống nhiệt hoặc điện cho các miền khác. Các chính sách điều khiển phản ứng theo mức sử dụng, thời hạn, nhiệt độ và giới hạn công suất đặc thù nền tảng; bản thân các lần chuyển trạng thái cũng gây ra độ trễ và chi phí ổn định.
Khi chỉ DVFS không giữ được giới hạn công suất, các SoC di động áp dụng điều tiết nhiệt (thermal throttling) bằng cách kết hợp giảm tần số, thích ứng mô hình và di chuyển tác vụ. Khi NPU tiến sát giới hạn nhiệt trong quá trình xử lý mạng nơ-ron cường độ cao, runtime có thể chuyển một số toán tử sang bộ xử lý khác được hỗ trợ, giảm tần số hoạt động trong lúc suy luận, hoặc chọn cấu hình mô hình nhỏ hơn. Cách tiếp cận này duy trì tính sẵn sàng của dịch vụ trong các sự cố nhiệt, nhưng đòi hỏi đặc tính hóa khối lượng công việc (workload) chi tiết để dự đoán thời gian thực thi và công suất tiêu thụ trên các bộ xử lý khác nhau.
Các hệ thống AI di động có thể điều chỉnh chất lượng, lựa chọn mô hình hoặc tần số suy luận theo trạng thái pin và sạc. Bộ xử lý tiết kiệm năng lượng nhất còn phụ thuộc vào khối lượng công việc (workload) và cách triển khai. Vì vậy, cần chọn chế độ hoạt động công suất thấp dựa trên các phương án đã được đo lường và xác thực, thay vì suy đoán từ nhãn (label) của bộ xử lý.
Hệ thống AI không đồng nhất cho ô tô
Các ứng dụng ô tô phải đối mặt với những hạn chế về công suất và làm mát, cùng với các hạn chót và yêu cầu an toàn chức năng nghiêm ngặt. Những đảm bảo cần thiết phụ thuộc vào phân loại an toàn của từng chức năng, nên không phải mọi khối lượng công việc (workload) ML trong xe đều là thời gian thực cứng (hard real time).
Các SoC ô tô kết hợp dự phòng, giám sát, phân vùng và lập lịch có giới hạn để đáp ứng các mục tiêu an toàn, trong khi các bộ tăng tốc đảm nhiệm chức năng nhận thức và các tác vụ tính toán chuyên sâu khác. Một rủi ro cụ thể là băng thông dùng chung: một khối lượng công việc (workload) tiện ích có thể gây nhiễu một pipeline nhận thức đã có hạn chót được xác thực. Phân vùng phần cứng, cơ chế kiểm soát băng thông hoặc lịch kích hoạt theo thời gian có thể cô lập tài nguyên liên quan, nhưng cơ chế và mức đảm bảo lại tùy từng nền tảng. Tương tự, các pipeline đa cảm biến cần có giới hạn về thời gian đầu-cuối (end-to-end timing), chứ không chỉ nhắm tới thông lượng trung bình cao.
Phương tiện có thể phân tán cảm biến và tính toán trên nhiều bộ điều khiển, hoặc hợp nhất các chức năng này lên các nền tảng trung tâm. Dù theo thiết kế nào, hệ thống cũng phải gắn dấu thời gian, truyền và căn chỉnh dữ liệu cảm biến theo đúng các giả định của pipeline hợp nhất. Chi phí đồng bộ và truyền thông phát sinh phải tính chung vào ngân sách độ trễ, cùng với thời gian thực thi của bộ tăng tốc.
Các đầu vào V2X (vehicle-to-everything) bên ngoài bổ sung một nguồn dữ liệu có đặc tính độ trễ và độ tin cậy khác biệt. Một thiết kế an toàn không thể giả định rằng các thông điệp này đến đúng thời điểm hoặc đáng tin như cảm biến cục bộ; mọi việc sử dụng trong chức năng liên quan đến an toàn đều phải được ràng buộc và xác thực tương ứng.
Thách thức của ngăn xếp phần mềm
Sự tinh vi trong kiến trúc của các SoC dị thể biến phần mềm thành lớp điều phối cho công suất, trạng thái nhiệt, tính xác định và phương án dự phòng khi toán tử không được hỗ trợ. OpenCL nhắm tới các thiết bị tính toán dị thể, còn Vulkan cung cấp GPU compute đa nền tảng; cả hai vẫn không loại bỏ nhu cầu tinh chỉnh theo từng thiết bị. Các runtime suy luận trên thiết bị di động thường dùng delegate hoặc backend cho CPU, GPU, DSP và NPU; nhưng khi gặp toán tử không được hỗ trợ, chúng có thể phải chuyển sang bộ xử lý khác, kéo theo chi phí truyền dữ liệu. Vì vậy, khi triển khai, cần xem chính phân vùng thực tế đã được tạo ra, không chỉ nhìn vào đồ thị của framework.
Các kiến trúc bộ nhớ dùng chung khiến bài toán phối hợp càng khó hơn. Quản lý bộ nhớ phải tính đến hành vi cache đặc thù của từng bộ xử lý, kiểu truy cập bộ nhớ và yêu cầu về tính nhất quán dữ liệu. Cache của CPU có thể làm ảnh hưởng đến kiểu truy cập bộ nhớ của GPU, trong khi các thao tác truy cập bộ nhớ trực tiếp (DMA) của NPU phải được đồng bộ với các thao tác cache của CPU để giữ dữ liệu nhất quán.
Các SoC dị thể xử lý sự phức tạp này bằng các mô hình chi phí có profiling, bộ quy tắc, chính sách điều khiển và đôi khi cả bộ dự đoán được huấn luyện. Telemetry về độ trễ, mức sử dụng, nhiệt độ và công suất có thể giúp chọn giữa các kế hoạch thực thi đã được thẩm định; nhưng điều đó không thay thế việc phải xác định rõ toán tử nào được hỗ trợ và hành vi ở trường hợp xấu nhất.
Không một kiến trúc bộ xử lý đơn lẻ nào tối ưu cho mọi kiểu tính toán trong ứng dụng AI, nên tăng tốc dị thể là bài toán phối hợp chứ không chỉ là kiểm kê phần cứng. Hệ thống AI trên thiết bị di động chỉ đạt hiệu năng cao khi việc phân công bộ xử lý, tính nhất quán bộ nhớ, giới hạn nhiệt và ràng buộc về độ trễ được quản lý cùng nhau.
Bài toán phối hợp này cũng kéo theo hệ quả về năng lượng. Nếu lựa chọn phần cứng quyết định lượng dữ liệu phải di chuyển, tần suất bộ tăng tốc bị nghẽn, và mức độ hiệu quả khi ánh xạ phép toán số học lên silicon, thì nó cũng quyết định lượng năng lượng mà quá trình triển khai tiêu thụ cho mỗi dự đoán hữu ích.
Self-Check: Question
On a modern mobile heterogeneous System-on-Chip (SoC) featuring big.LITTLE CPUs, a mobile GPU, and a dedicated NPU, which compute engine is most energy-efficient for running continuous, low-latency 8-bit quantized convolutional inference?
- The high-performance ‘big’ CPU core running single-threaded FP32 instructions
- The out-of-order system memory controller
- The dedicated Neural Processing Unit (NPU) optimized for quantized INT8 matrix operations
- The host operating system virtualization hypervisor
In automotive autonomous driving SoCs, explain why deterministic worst-case execution time and lockstep redundancy are required, even if they reduce peak average-case throughput.
True or False: In mobile SoCs with unified system memory (LPDDR), sharing physical RAM between the CPU, GPU, and NPU eliminates all data movement overhead between heterogeneous processors.
Describe how Dynamic Voltage and Frequency Scaling (DVFS) and thermal throttling constrain sustained AI inference performance on edge and mobile devices.
Tính bền vững của phần cứng
Ở quy mô toàn đội máy, năng lượng cho mỗi suy luận hữu ích trở thành một tiêu chí quan trọng khi chọn phần cứng. Khí thải vận hành phụ thuộc vào thông lượng khối lượng công việc (workload), công suất hệ thống đo được, mức độ sử dụng, phần phụ tải làm mát và cơ cấu nguồn điện; thêm vào đó, khí thải phát sinh trong quá trình chế tạo cũng là một chi phí vòng đời cần tính. Vì vậy, hiệu suất đỉnh trên mỗi watt chỉ là một chỉ số dùng để sàng lọc, không thể thay thế cho phép tính năng lượng từ đầu đến cuối trên mỗi yêu cầu. Kịch bản dưới đây cho thấy các giả định có thể cộng dồn như thế nào khi so sánh một đội máy dùng CPU thông thường với các bộ tăng tốc chuyên dụng.
Napkin Math 1.10: Một so sánh minh họa về năng lượng vận hành
Bài toán: Với giả định thông lượng tương đương, năng lượng vận hành thay đổi ra sao khi thay một đội máy CPU bằng các NPU (Neural Processing Units) chuyên dụng?
Giả định: So sánh mô phỏng này coi các mức đỉnh được liệt kê là thông lượng hữu ích của khối lượng công việc (workload), giả định cả hai đội máy chạy liên tục ở công suất đã nêu, và không tính đến công suất của máy chủ host, phụ tải làm mát, khí thải từ vật liệu và sản xuất, cũng như khác biệt về mức độ sử dụng. Đây là một phép tính độ nhạy, không phải kết quả mua sắm đã đo lường.
- Suy luận CPU: 100 W cho 1 TFLOP/s (hiệu suất = 0.01 TFLOP/s/W).
- Suy luận NPU: 5 W cho 10 TFLOP/s (hiệu suất = 2 TFLOP/s/W).
- Khoảng cách hiệu suất đỉnh giả định: 200×.
Tính toán:
- Khối lượng công việc (workload): 1 billion suy luận mỗi ngày.
- Năng lượng đội máy CPU: 1,000 máy chủ CPU \(\times\) 100 W \(\times\) 24 h \(\approx\) 2,400 kWh/ngày.
- Năng lượng đội máy NPU: 100 chip NPU \(\times\) 5 W \(\times\) 24 h \(\approx\) 12 kWh/ngày.
- Tiết kiệm carbon: Ở mức cường độ carbon 0.429 kg/kWh, chuyển sang NPU giúp tiết kiệm khoảng ~373.9 t CO2 mỗi năm.
Thông tin chuyên sâu về hệ thống: Các bộ tăng tốc chuyên dụng có thể giảm năng lượng vận hành khi khối lượng công việc (workload) đi đúng đường dẫn hiệu quả của chúng và khi đó cần ít thiết bị hơn để đạt thông lượng dịch vụ yêu cầu. Trước khi dùng những kết quả này để mua sắm hay tính toán lượng khí thải carbon, bạn cần thay thế các giả định trên bằng số yêu cầu trên giây đã đo và công suất đo tại nguồn (wall power).
Quan điểm bền vững nhấn mạnh lại một chủ đề xuyên suốt chương này: lựa chọn phần cứng không chỉ dựa vào tốc độ đỉnh. Cần cân nhắc năng lượng trên mỗi kết quả hữu ích, cường độ carbon, tác động phát sinh trong quá trình sản xuất và tổng chi phí sở hữu, bên cạnh các yếu tố như độ trễ, thông lượng và dung lượng bộ nhớ. Bước tiếp theo là nhận diện những ngộ nhận khiến các nhóm chọn sai hướng phần cứng.
Self-Check: Question
In the lifecycle carbon assessment of advanced deep learning accelerators, what constitutes ‘embodied carbon’?
- The electrical energy consumed by the GPU during model forward and backward passes
- The carbon emitted by datacenter air conditioning units during peak summer load
- The carbon credits purchased by cloud providers to offset datacenter energy usage
- The greenhouse gas emissions generated during raw material extraction, semiconductor silicon manufacturing, packaging, and hardware transportation
Explain why maximizing accelerator utilization (e.g., via multi-tenant sharing or continuous pipeline saturation) reduces the amortized carbon footprint per trained model.
True or False: In a datacenter with a Power Usage Effectiveness (PUE) of 1.1, the cooling and electrical distribution infrastructure consumes more power than the actual computing IT equipment (servers and accelerators).
Những ngụy biện và cạm bẫy
Tăng tốc phần cứng có những đặc tính hiệu suất dễ gây nhầm lẫn, vì các thông số kỹ thuật ấn tượng có thể che đi những nút thắt cổ chai đặc thù của từng khối lượng công việc (workload). Những ngụy biện và cạm bẫy dưới đây ghi lại các lỗi lựa chọn và tối ưu hóa khiến tài nguyên đắt tiền bị sử dụng kém hiệu quả.
Ngụy biện: Phần cứng chuyên dụng hơn luôn mang lại hiệu suất tốt hơn so với các lựa chọn thay thế đa năng.
Nhiều kỹ sư mặc định rằng các bộ tăng tốc chuyên dụng luôn vượt trội hơn bộ xử lý đa dụng cho mọi khối lượng công việc (workload) AI. Thực tế, phần cứng chuyên dụng chỉ đạt hiệu năng đỉnh khi workload khớp với các giả định kiến trúc—đây là cốt lõi của đồng thiết kế thuật toán–máy. Như đã trình bày trong section 1.5, để trở thành compute-bound (bị giới hạn bởi tính toán), phép toán phải vượt qua điểm ridge của bộ tăng tốc. Chẳng hạn, một GPU A100 có điểm ridge là 153 FLOP/byte. Điều này có nghĩa là các phép toán với cường độ số học dưới ngưỡng này sẽ bị giới hạn bởi bộ nhớ, bất kể khả năng tính toán đỉnh 312 TFLOP/s của bộ tăng tốc. Hàm softmax trong cơ chế attention của mô hình transformer với cường độ số học (AI) từ 2 FLOP/byte đến 5 FLOP/byte chỉ đạt 4.1 TFLOP/s–10.2 TFLOP/s (mức sử dụng 3.3 percent) trên A100. Các CPU có điểm ridge khoảng 10 FLOP/byte–20 FLOP/byte vẫn coi phép toán này là bị giới hạn bởi bộ nhớ, nhưng cùng dải AI đó tương ứng với khoảng 10 percent–50 percent trên mức đỉnh (thấp hơn) của CPU. Các mô hình có truy cập bộ nhớ không đều, kích thước batch nhỏ, hoặc đồ thị tính toán động có thể chạy tốt hơn trên các bộ xử lý linh hoạt. Việc lựa chọn phần cứng hiệu quả đòi hỏi phải khớp cường độ số học của workload với các điểm ridge kiến trúc, thay vì mặc định rằng phần cứng chuyên dụng luôn thắng.
Cạm bẫy: Bỏ qua các giới hạn băng thông bộ nhớ khi lựa chọn các chiến lược tăng tốc.
Nhiều người làm trong ngành thường chỉ chú ý đến TFLOP/s đỉnh mà không phân tích xem khối lượng công việc (workload) của họ có thể đạt trạng thái bị giới hạn bởi tính toán hay không. Như đã định lượng trong section 1.4.1, mô hình năng lượng ở đây ước tính một lần truy cập DRAM tiêu tốn khoảng 640 pJ, trong khi một lần truy cập SRAM L1 trên chip chỉ tốn 0.5 pJ, dẫn đến chênh lệch chi phí năng lượng lớn hơn nhiều lần. Một bộ tăng tốc có thông số 300 TFLOP/s và băng thông 2 TB/s sẽ có điểm đỉnh là 150 FLOP/byte; trong ví dụ này, các phép toán LayerNorm với AI = 1.5 FLOP/byte chỉ đạt 3 TFLOP/s (mức sử dụng 1 percent). Các tổ chức có thể triển khai các bộ tăng tốc đắt tiền có năng lực tính toán cao cho các khối lượng công việc (workload) bị giới hạn bởi bộ nhớ, nhưng vẫn chứng kiến mức sử dụng thấp nếu băng thông, chứ không phải năng lực tính toán, mới là nút thắt cổ chai. Vì vậy, các nhóm cần tính toán cường độ số học (arithmetic intensity) của khối lượng công việc (workload) và so sánh với các điểm đỉnh của phần cứng trước khi mua bộ tăng tốc.
Ngụy biện: Lợi ích của việc tăng tốc phần cứng sẽ tăng tuyến tính khi bổ sung thêm bộ tăng tốc.
Các nhóm thường kỳ vọng tám GPU sẽ huấn luyện nhanh hơn 8\(\times\) so với một GPU. Nhưng khi mở rộng sang nhiều bộ tăng tốc, chi phí giao tiếp xuất hiện và phá vỡ giả định về khả năng mở rộng tuyến tính. Như đã nêu ở section 1.10, các phép toán AllReduce để đồng bộ gradient có thể phải trao đổi các khối dữ liệu gradient rất lớn với các mô hình lớn. Trong một AllReduce vòng lý tưởng, mỗi rank truyền \(2(N-1)/N\) khối dữ liệu, tương đương 1.75× khối dữ liệu cho tám GPU. Với NVLink cung cấp băng thông 600 GB/s hai chiều (mỗi hướng bằng một nửa), đồng bộ một gradient 1 GB sẽ cần 5.83 ms; so với một bước tính toán 50 ms, đây là 11.7 percent trước khi tính thêm chi phí giao thức. Nếu không chồng lấn tính toán với giao tiếp, kịch bản tám GPU này chỉ đạt khoảng 7.2× mức tăng tốc (hiệu suất 89.6 percent), trước khi các yếu tố như mất cân bằng tải, rào cản đồng bộ và thiếu công việc song song làm giảm khả năng mở rộng hơn nữa.
Cạm bẫy: Lập kế hoạch dung lượng bộ tăng tốc dựa trên thông số FLOP/s đỉnh.
FLOP/s đỉnh là một khả năng của bộ tăng tốc, nhưng thông lượng thực tế còn phụ thuộc vào cường độ số học, hình dạng, độ chính xác, hiệu quả kernel và chi phí hệ thống. Mô hình Roofline (section 1.5) đặt giới hạn cho phần tính toán và băng thông của khoảng cách đó. Trong các kịch bản lập ngân sách đại diện ở đây, việc huấn luyện mô hình transformer trên A100 duy trì 120 TFLOP/s–180 TFLOP/s, trong khi một khối lượng công việc (workload) recommender dạng thưa duy trì 10 TFLOP/s–30 TFLOP/s. Các khoảng này là giả định phục vụ lập kế hoạch, không phải phép đo áp dụng mọi nơi. Kế hoạch dung lượng nên dùng thông lượng đo đạc đại diện khi có thể và ước tính theo Roofline khi chưa có số đo.
Ngụy biện: Bất kỳ chỉ số FLOP/s nào cũng có thể ước tính một khối lượng công việc (workload) độ chính xác thấp.
Các bộ tăng tốc có các đường dẫn dữ liệu tách biệt cho từng độ chính xác, và thông lượng đỉnh giữa chúng khác nhau rất lớn. Ví dụ, một H100 đạt khoảng 989 TFLOP/s cho các phép toán tensor FP16, nhưng chỉ khoảng 67 TFLOP/s cho các phép toán FP32 trên CUDA core: chênh lệch khoảng 15× ngay trong cùng một chip (Choquette 2023). Nếu ước tính thời gian huấn luyện bằng con số FP32 trong khi khối lượng công việc (workload) thực tế dùng BF16, mức sử dụng thu được sẽ trông như thảm họa một cách vô cớ. Tương tự, so khớp với đường roofline không đúng có thể khiến bạn gán nhầm kernel là bị giới hạn bởi tính toán trong khi thực tế chúng bị giới hạn bởi bộ nhớ (hoặc ngược lại). Hãy luôn chọn hằng số đỉnh khớp với độ chính xác mà khối lượng công việc (workload) thực sự phát lệnh, và ghi rõ độ chính xác khi báo cáo mức sử dụng FLOPS của mô hình.
Cạm bẫy: Triển khai các khối lượng công việc (workload) suy luận batch nhỏ trên các bộ tăng tốc có năng lực tính toán cao.
Suy luận với batch nhỏ có thể không tận dụng hết một bộ tăng tốc có năng lực tính toán cao. Trong mô hình lưu lượng của các lớp dày đặc này, với \(M=N=2048\), chỉ số AI (Arithmetic Intensity) là 1 FLOP/byte khi batch là 1 và là 204.8 FLOP/byte khi batch là 256. Với batch 1, trần roofline do bộ nhớ là khoảng 2.04 TFLOP/s trên A100 và 0.3 TFLOP/s trên T4. Hiệu năng đỉnh FP16 Tensor Core của T4 là 65 TFLOP/s, với điểm gãy (ridge point) là 203.1 FLOP/byte. Vì vậy, một bộ tăng tốc chi phí thấp hơn có thể kinh tế hơn trong chế độ này, nhưng cần đo đạc thêm các yếu tố như độ trễ, dung lượng bộ nhớ, khả năng đồng thời, hỗ trợ phần mềm và mức giá hiện tại. Hãy ghép phương án triển khai với batch thực tế và mục tiêu dịch vụ thay vì gán loại bộ tăng tốc chỉ theo tên.
Ngụy biện: Các tối ưu hóa dành riêng cho nhà cung cấp không có chi phí về tính di động lâu dài.
Nhiều tổ chức chỉ tối ưu cho một nhà cung cấp cụ thể để tối đa hiệu suất, mà không tính đến tính linh hoạt của hệ thống. Như đã thảo luận trong section 1.8, tích hợp sâu với các thư viện đặc thù nhà cung cấp (CUDA, TensorRT, XLA) và các kernel tùy chỉnh sẽ dẫn đến bị khóa vào nhà cung cấp. Một codebase có nhiều kernel cho bộ tăng tốc được viết thủ công có thể đòi hỏi lượng công sức kỹ thuật lớn để chuyển sang nhà cung cấp khác, làm chậm việc nâng cấp phần cứng và cản trở triển khai đa nhà cung cấp. Vì vậy, các tối ưu hóa đặc thù nhà cung cấp nên được cô lập phía sau các lớp trừu tượng phần cứng. Duy trì các đường dẫn mã portable giúp tạo cạnh tranh giữa các nhà cung cấp, tăng linh hoạt phần cứng và đẩy nhanh việc tiếp nhận các bộ tăng tốc mới, đồng thời vẫn thu được phần lớn lợi ích hiệu suất thông qua các tối ưu hóa ở cấp độ framework.
Checkpoint 1.4: Đánh giá tính khả thi: Bạn có chạy được không?
Trước khi mua sắm phần cứng, hãy kiểm chứng cả ba ràng buộc cứng. Những ngộ nhận và cạm bẫy trong phần này có thể rút gọn thành một phép thử mua sắm cụ thể:
Danh sách kiểm tra này tổng hợp các nguyên tắc đã phát triển trong chương, giúp chuyển hiểu biết lý thuyết thành các quyết định kỹ thuật thực tiễn. Cùng nhau, những sai lầm (fallacies) này khiến bộ công cụ của chương trở thành một thói quen chẩn đoán: bắt đầu từ khối lượng công việc (workload), chọn chỉ số nút thắt, khớp đường dẫn phần cứng phù hợp, và dự trù cho tính di động, khả năng mở rộng và hệ quả về năng lượng.
Self-Check: Question
A team prunes \(70\%\) of the weights in a large language model using unstructured magnitude pruning, setting those weights to zero. However, when executing the pruned model on standard GPU dense Tensor Cores, inference latency is identical to or slower than the unpruned baseline. What is the primary cause of this pitfall?
- Standard dense hardware cannot skip individual zero elements without structured patterns (e.g., 2:4) or specialized sparse matrix indexing, so dense matrix units still execute all multiplications while sparse formats add indexing overhead
- Floating-point units automatically convert zero values into infinite loops
- Unstructured pruning forces the GPU driver to downclock memory bandwidth to prevent overheating
- The operating system kernel intercepts every zero multiplication and raises a hardware page fault
Describe the pitfall of ‘micro-offloading’ small tensor operations from CPU to GPU, and explain why a sequence of scalar operations can run slower on an accelerator than on the host CPU.
Place the following diagnostic steps in the recommended sequence when troubleshooting an underperforming neural network training workload on an accelerator cluster:
- Roofline & Hardware Counter Analysis: Determine whether individual kernels are compute-bound, memory-bandwidth-bound, or latency-bound
- Amdahl & Host-Side Profiling: Identify serial bottlenecks, data loading stalls, and CPU-GPU synchronization delays
- Kernel-Level Optimization: Apply operator fusion, hierarchical tiling, or precision reduction targeted to the identified bottleneck
- Multi-Device Communication Profiling: Check for gradient all-reduce synchronization delays and interconnect saturation
Which of the following statements represents a classic fallacy regarding peak accelerator specifications?
- High-bandwidth memory reduces the latency of memory-bound operations compared to standard DDR5
- An accelerator with \(2\times\) higher peak theoretical TFLOP/s will automatically deliver a \(2\times\) speedup on any neural network workload
- Kernel fusion can improve arithmetic intensity by reducing global memory traffic
- Warp divergence reduces the execution efficiency of SIMT processor lanes
Tóm tắt
Trong tăng tốc phần cứng, chúng ta đồng thiết kế các khối xử lý tính toán, phân cấp bộ nhớ, định dạng số và luồng dữ liệu. Với một giao diện bộ nhớ đã chọn, quy luật sắt so sánh thời gian tính toán \(O/(R_{\text{peak}}\eta_{\text{hw}})\) với thời gian di chuyển dữ liệu \(D_{\text{vol}}/\text{BW}\). Mô hình roofline diễn tả lại sự cạnh tranh đó dưới dạng \(\min(R_{\text{peak}}, \text{BW}I)\). Độ trễ đầu-cuối còn bao gồm thời gian khởi chạy, đồng bộ hóa, giao tiếp và các chi phí cố định. Các bộ tăng tốc chỉ cải thiện hiệu quả khi các đường dẫn được hỗ trợ có thể tận dụng tái sử dụng dữ liệu cục bộ. Vì vậy, lựa chọn phần cứng phải bắt đầu từ nút thắt cổ chai đã đo được hoặc mô hình hóa của khối lượng công việc (workload), chứ không phải từ hiệu năng đỉnh nhà cung cấp công bố.
Key Takeaways: Di chuyển dữ liệu tốn kém hơn tính toán nó
- Mô hình Roofline xác định các nút thắt cổ chai: Hãy so sánh cường độ tính toán đo được của một kernel với điểm gờ (ridge point) theo độ chính xác của mục tiêu (153 FLOP/byte ở đây). Nếu kernel nằm dưới điểm đó, hãy giảm lưu lượng truy cập bộ nhớ; nếu nằm trên, hãy cải thiện mức sử dụng tính toán.
- Băng thông bộ nhớ hạn chế hiệu suất: Năng lực tính toán của GPU đã tăng nhanh hơn băng thông bộ nhớ. Nhiều giai đoạn suy luận bị giới hạn bởi bộ nhớ, đặc biệt là giải mã với batch nhỏ và tra cứu embedding, trong khi các phép toán GEMM với batch lớn có thể vẫn bị giới hạn bởi tính toán.
- Đồng thiết kế phần cứng-phần mềm cộng hưởng hiệu suất: Khớp các mẫu thuật toán với khả năng kiến trúc, như GEMM dày đặc trên các đơn vị systolic hoặc tensor và tận dụng tính thưa được hỗ trợ trên các đường dẫn thưa, có thể mang lại cải thiện lớn.
- Tensor Cores yêu cầu một đường dẫn tương thích: Độ chính xác, kích thước, layout và sự hỗ trợ từ thư viện phải khớp với kiến trúc. Kích thước batch và hình dạng dữ liệu ảnh hưởng đến mức tái sử dụng và mức tận dụng tài nguyên, nhưng không có ngưỡng batch cố định nào bảo đảm đạt hiệu suất đỉnh.
- Tăng tốc tổng thể (end-to-end) sẽ bị giới hạn bởi nút thắt cổ chai tiếp theo: Tăng tốc chỉ một kernel không làm thay đổi các phần còn lại như khởi chạy, truyền dữ liệu, đồng bộ hóa, giao tiếp và các tác vụ không được hỗ trợ. Hãy dùng định luật Amdahl và profiling để quyết định liệu bổ sung thêm silicon, ánh xạ tốt hơn, hay giảm di chuyển dữ liệu sẽ cải thiện toàn bộ khối lượng công việc (workload) hay không.
Một bộ tăng tốc không phải là một máy tính nhanh hơn mọi mặt; nó cung cấp các đường xử lý hiệu quả cho các phép toán và luồng dữ liệu cụ thể. Các kỹ thuật như tiling, fusion, lập lịch có nhận biết phân cấp và thực thi systolic chỉ giúp giảm lưu lượng qua các giao diện theo mô hình khi khối lượng công việc (workload), định dạng số và đường phần mềm có thể tận dụng chúng.
Mô hình Roofline đưa ra chẩn đoán ban đầu bằng cách sử dụng cường độ tính toán và ridge point để khoanh vùng nút thắt cổ chai tiềm năng; tiếp đó, profiling tính đến độ trễ, mức độ chiếm dụng (occupancy), giao tiếp và chi phí triển khai. Kết quả là một giả thuyết có thể kiểm chứng, không phải một dự đoán.
What’s Next: Từ tối ưu hóa đến xác thực
Ngăn xếp tối ưu hóa ML dựa trên ba trụ cột hiệu quả cốt lõi: lựa chọn dữ liệu (Lựa chọn dữ liệu) giúp giảm yêu cầu về mẫu huấn luyện, nén mô hình (Nén mô hình) giảm độ phức tạp về tham số thuật toán và độ chính xác, và bộ tăng tốc phần cứng (trình bày trong chương này) tối đa hóa thông lượng của máy vật lý. Tuy nhiên, tối ưu hóa thiếu đo lường thực nghiệm thì vẫn chưa đầy đủ. Benchmarking chuyển từ các giới hạn FLOP lý thuyết sang độ trễ thời gian thực (wall-clock latency), áp dụng các bộ benchmark tiêu chuẩn và các giao thức thống kê để kiểm tra các tuyên bố tối ưu hóa trong bối cảnh vận hành thực tế.
Self-Check: Question
What is the central architectural insight of the hardware acceleration chapter regarding the interaction between model architecture and accelerator efficiency?
- Accelerators will soon eliminate all memory hierarchies in favor of infinite register files
- Hardware efficiency depends entirely on maximizing clock frequency regardless of memory bandwidth
- High delivered hardware efficiency requires co-design across computational primitives, dataflow reuse strategies, memory hierarchies, and compiler-runtime systems
- General-purpose out-of-order CPUs remain superior to specialized TPUs for all deep learning workloads
Summarize how the Roofline model serves as a unified diagnostic bridge connecting high-level neural network operations to low-level hardware architecture choices.
Which combination correctly summarizes the primary function of each layer in the modern AI hardware acceleration software stack?
- Framework: Silicon manufacturing; Compiler: Host PCIe routing; Runtime: Floating-point unit logic
- Framework: Direct transistor clocking; Compiler: Operating system page fault handling; Runtime: Mathematical differentiation
- Compiler: Real-time sensor power regulation; Runtime: Neural network gradient backpropagation; Hardware: Python interpreter dispatch
- Framework: Graph definition and automatic differentiation; Compiler: Graph optimization, operator fusion, and tiling; Runtime: Memory pooling, stream scheduling, and kernel dispatch; Hardware: Parallel matrix/vector execution
Self-Check Answers
Self-Check: Answer
What primary physical limitation brought about the end of Dennard scaling in the mid-2000s, necessitating the transition from increasing CPU clock frequencies to domain-specific hardware accelerators?
- Lithography light diffraction preventing further reduction of transistor gate length below \(1\,\mu\text{m}\)
- Inability to lower operating voltage proportionally with transistor size, leading to unsustainable power density and heat dissipation limits
- Quantum tunneling in copper interconnect lines preventing data transmission between arithmetic units
- Depletion of global silicon substrate supplies requiring migration to gallium nitride semiconductors
Answer: The correct answer is B. Dennard scaling postulated that as transistors shrank, operating voltage could drop in proportion, keeping chip power density constant while operating frequencies increased. When threshold voltage and leakage currents prevented further voltage scaling around 2005, increasing clock frequency resulted in prohibitive power density and thermal dissipation limits (the power wall and ‘dark silicon’), forcing architects to seek energy efficiency through architectural specialization and parallelism. The lithography choice misidentifies lithography limits as the cause of the mid-2000s frequency stall. The quantum tunneling choice confuses gate oxide leakage with bulk copper transmission. The semiconductor depletion choice is physically fabricated.
Learning Objective: Explain the physical breakdown of Dennard scaling that led to domain-specific acceleration.
Contrast the architectural trade-offs of software-managed scratchpad memory (such as Google TPUv1’s Unified Buffer) with hardware-managed cache hierarchies when executing large-scale tensor workloads.
Answer: Software-managed scratchpads eliminate the hardware overhead of tag arrays, cache line state machines, coherence snooping, and dynamic replacement policies, allowing more silicon area and power to be dedicated to storage capacity and dense arithmetic units. When compilers can statically determine regular tensor access patterns, they can deterministically tile and stage data. However, scratchpads increase compiler complexity and software burden, and they perform poorly on irregular, dynamically indexed memory patterns that hardware caches manage automatically.
Learning Objective: Compare software-managed scratchpad memory with hardware-managed caches for deep learning workloads.
**Place the following computing milestones in chronological order (from earliest to most recent) as hardware evolved toward modern AI accelerators:
- Introduction of dedicated Tensor Cores and TPUs for deep learning matrix operations
- Emergence of fixed-function media codecs and network processors for video/packet streaming
- Integration of floating-point units (FPUs) and digital signal processors (DSPs) as discrete coprocessors
- General-purpose programmable GPUs and SIMD instruction set extensions for 3D graphics and multimedia**
Answer: The correct order is (3) Integration of floating-point units (FPUs) and digital signal processors (DSPs) as discrete coprocessors -> (4) General-purpose programmable GPUs and SIMD instruction set extensions for 3D graphics and multimedia -> (2) Emergence of fixed-function media codecs and network processors for video/packet streaming -> (1) Introduction of dedicated Tensor Cores and TPUs for deep learning matrix operations. During the 1980s, discrete FPUs and DSPs accelerated arithmetic. The 1990s introduced SIMD extensions and early 3D GPUs. The 2000s expanded fixed-function media engines and network processors. The 2010s ushered in deep learning DSAs like Google TPUs (2015/2017) and NVIDIA Volta Tensor Cores (2017).
Learning Objective: Explain the historical evolution of hardware specialization from FPUs to modern AI accelerators.
True or False: Google’s TPUv1 achieved substantial performance-per-watt improvements over contemporary general-purpose CPUs primarily by operating at significantly higher clock frequencies.
Answer: False. TPUv1 operated at a modest clock frequency (approximately \(700\text{ MHz}\)) and achieved \(30\times\text{--}80\times\) higher performance-per-watt than contemporary CPUs by omitting complex general-purpose features (such as out-of-order execution, branch prediction, and multi-level cache coherence) and dedicating silicon area to a massive \(256{\times}256\) INT8 systolic matrix multiplier and a large software-managed Unified Buffer.
Learning Objective: Evaluate the architectural source of energy efficiency in domain-specific accelerators like TPUv1.
In the context of hardware scaling, what phenomenon does the ‘Systems Gap’ describe since the 2012 deep learning breakthrough?
- The difference in memory bandwidth between high-end datacenter GPUs and consumer-grade mobile SoCs
- The latency discrepancy between on-chip SRAM access times and host DRAM access times over PCIe
- The exponential divergence between model compute demand (growing \(\approx 6\times\)/year) and single-device hardware supply (growing \(\approx 1.7\times\)/year)
- The mismatch between Python framework dispatch overhead and raw GPU kernel execution duration
Answer: The correct answer is C. The Systems Gap refers to the widening divergence between the computational demand of frontier AI models (growing at roughly \(6\times\) per year according to scaling law trends) and single-accelerator hardware performance growth (growing at roughly \(1.7\times\) per year under Huang’s Law / architectural scaling). Closing this massive exponential gap requires distributed parallelism, system co-design, and algorithmic optimizations. The mobile vs datacenter memory bandwidth choice describes edge heterogeneity rather than macro compute trends. The SRAM vs DRAM latency choice describes the physical memory hierarchy gap. The Python dispatch vs kernel duration choice describes host runtime overhead.
Learning Objective: Analyze the Systems Gap and its implications for AI systems co-design.
Self-Check: Answer
When executing a Transformer layer containing attention projection (\(Q = X W_q\)), Softmax (\(\text{Softmax}(S)\)), Layer Normalization (\(\text{LayerNorm}(X)\)), and GeLU activation (\(\text{GeLU}(Z)\)), which execution unit is specifically responsible for computing transcendental functions (exponential and error function approximations)?
- Systolic 2D Matrix Multiply Units
- Dense Tensor Cores
- Vector Load-Store Memory Controllers
- Special Function Units (SFUs)
Answer: The correct answer is D. Special Function Units (SFUs) are specialized hardware pipelines designed to evaluate transcendental and nonlinear mathematical functions—such as exponentials in Softmax, reciprocal square roots in LayerNorm, and Gaussian error approximations in GeLU—using hardware lookup tables and polynomial approximations. Matrix units and Tensor Cores are dedicated to high-throughput matrix multiply-accumulate operations, not transcendental approximations. Vector Load-Store Memory Controllers handle memory address generation and data movement across caches and DRAM.
Learning Objective: Classify deep learning mathematical operations to their corresponding hardware execution units.
Explain how the \(\text{im2col}\) (image-to-column) transformation allows standard 2D convolution operations to execute on high-throughput matrix multiplication hardware (GEMM engines), and describe the primary memory overhead associated with this approach.
Answer: The \(\text{im2col}\) transformation extracts overlapping local receptive field patches from an input tensor and flattens each patch into a column (or row) of a 2D matrix, while flattening the convolution filters into a weight matrix. This converts the sliding-window convolution into a standard GEMM (\(C = A \cdot B\)) that executes efficiently on Tensor Cores or systolic arrays. However, because receptive fields overlap, input pixel values are duplicated across multiple patches, expanding memory footprint by up to roughly the filter area (\(K_h \times K_w\)) unless implemented via implicit-GEMM address calculation without physical materialization.
Learning Objective: Explain the mechanism and memory trade-offs of the im2col transformation for accelerating convolutions.
True or False: In modern AI accelerators, element-wise vector operations such as residual additions (\(Y = X_1 + X_2\)) achieve higher arithmetic intensity than large matrix-matrix multiplications (\(C = A \cdot B\)).
Answer: False. Element-wise vector operations perform only one arithmetic operation per two operand reads and one write (arithmetic intensity \(\approx 1/12 \text{ FLOP/byte}\) in FP32), making them heavily memory bandwidth bound. In contrast, an \(N \times N\) matrix-matrix multiplication performs \(\mathcal{O}(N^3)\) operations on \(\mathcal{O}(N^2)\) data elements, allowing extensive data reuse in on-chip registers and shared memory to achieve high arithmetic intensity (\(\mathcal{O}(N) \text{ FLOP/byte}\)).
Learning Objective: Compare the arithmetic intensity of element-wise vector operations with matrix multiplications.
The hardware transformation technique that enables convolutional layers to execute as matrix multiplications without physically duplicating overlapping patch data in memory is known as ____ GEMM.
Answer: implicit. Implicit GEMM computes input tensor memory addresses on-the-fly inside kernel index calculations during tile loading, avoiding the large \(\mathcal{O}(K_h \cdot K_w)\) memory expansion of explicit im2col materialization while retaining matrix-unit execution efficiency.
Learning Objective: Explain how implicit GEMM eliminates memory duplication overhead in convolution acceleration.
Which of the following operations in a modern deep learning architecture exhibits the highest operational arithmetic reuse, making it most suitable for dense 2D systolic arrays and Tensor Cores?
- Batched linear layer matrix multiplication (\(Y = X W\))
- Element-wise ReLU activation (\(\max(0, x)\))
- Channel-wise Batch Normalization mean computation
- Token-wise embedding table lookup
Answer: The correct answer is A. Batched linear layers multiply an activation matrix by a weight matrix, enabling each weight element to be reused across all batch elements and each activation element to be reused across multiple output features, yielding high arithmetic intensity suitable for 2D matrix units. Element-wise ReLU performs only one comparison per element load. Batch Normalization mean computation performs reduction passes over data with minimal arithmetic reuse per byte transferred. Embedding table lookups are gather operations with zero arithmetic operations per byte fetched.
Learning Objective: Classify neural network layers based on operational reuse and hardware execution affinity.
Self-Check: Answer
In NVIDIA’s Ampere and Hopper architectures, how does 2:4 structured sparsity achieve an up to \(2\times\) theoretical speedup in Tensor Core matrix multiplication?
- Exactly two non-zero values are preserved in every contiguous four-element block, allowing weights to be stored in half the memory with 2-bit index metadata while sparse Tensor Cores perform math only on non-zeros
- Every alternate row of the weight matrix is dropped completely, allowing the GPU to halve the grid launch dimensions
- Four separate threads simultaneously execute one scalar multiply-accumulate instruction in a single clock cycle
- Floating-point numbers are converted to 2-bit integers, quadrupling register file capacity
Answer: The correct answer is A. The 2:4 structured sparsity pattern mandates that exactly two out of every four contiguous values in a weight tensor are non-zero. The compressed weight matrix stores only the two non-zero values per 4-element block along with 2-bit index metadata (4 bits total per 4 values), halving memory storage and bandwidth requirements, while Sparse Tensor Cores use the metadata to select matching activations and compute matrix multiply-accumulate operations at twice the throughput of dense Tensor Cores. The row-dropping choice describes coarse block pruning rather than fine-grained structured sparsity. The four-thread SIMT scalar choice confuses thread scheduling with tensor hardware sparsity mechanics. The 2-bit integer conversion choice describes extreme quantization rather than sparsity.
Learning Objective: Explain the mechanics and hardware benefits of 2:4 structured sparsity in Tensor Cores.
Contrast the data movement mechanics and primary use cases of Weight-Stationary (WS) and Output-Stationary (OS) systolic array dataflows.
Answer: In a Weight-Stationary dataflow, model weights are loaded into local PE registers and held stationary while input activations and partial sums stream through the array, maximizing weight reuse and making it optimal for CNNs where small filter weights are reused extensively across spatial dimensions. In an Output-Stationary dataflow, partial sums remain stationary in PE accumulators while weights and inputs stream through, eliminating intermediate memory traffic for partial sum write-backs and making it optimal for large-batch matrix multiplications with high accumulation depth.
Learning Objective: Compare Weight-Stationary and Output-Stationary systolic array dataflow strategies.
**Place the following steps in the correct execution sequence for processing a matrix multiplication on an accelerator with Sparse Tensor Cores using 2:4 structured sparsity:
- Fine-tune or prune the weight matrix to ensure exactly two non-zero values exist in every four-element contiguous group
- Sparse Tensor Cores load compressed weights and decode metadata to gather matching input activation elements
- Multiply non-zero weights by gathered activations and accumulate into output partial sums at \(2\times\) dense throughput
- Compress the sparse weight matrix by storing only the non-zero values alongside 2-bit per-value selection metadata**
Answer: The correct order is (1) Fine-tune or prune the weight matrix to ensure exactly two non-zero values exist in every four-element contiguous group -> (4) Compress the sparse weight matrix by storing only the non-zero values alongside 2-bit per-value selection metadata -> (2) Sparse Tensor Cores load compressed weights and decode metadata to gather matching input activation elements -> (3) Multiply non-zero weights by gathered activations and accumulate into output partial sums at \(2\times\) dense throughput. Structured sparsity begins with pruning/fine-tuning to satisfy the 2:4 constraint, followed by offline compression and metadata creation. At runtime, hardware loads compressed data, uses metadata to multiplex input activations, and computes the sparse GEMM.
Learning Objective: Apply the end-to-end execution workflow of 2:4 structured sparse matrix multiplication.
What is the primary difference between the FP8 E4M3 and FP8 E5M2 numerical formats used in modern AI accelerators (such as NVIDIA Hopper and Ada Lovelace)?
- E4M3 uses 4 sign bits and 3 exponent bits, whereas E5M2 uses 5 sign bits and 2 exponent bits
- E4M3 has 4 exponent bits and 3 mantissa bits providing higher precision for forward-pass activations/weights, whereas E5M2 has 5 exponent bits and 2 mantissa bits providing wider dynamic range for gradients
- E4M3 is exclusively an integer fixed-point format, whereas E5M2 is a standard IEEE floating-point format
- E4M3 requires twice as many memory bytes per element as E5M2
Answer: The correct answer is B. Both formats occupy 8 bits (1 sign bit + exponent + mantissa). FP8 E4M3 allocates 4 exponent bits and 3 mantissa bits, providing higher precision (lower rounding error) suitable for forward-pass weights and activations where values are well-scaled. FP8 E5M2 allocates 5 exponent bits (matching FP16 dynamic range) and 2 mantissa bits, offering a wider dynamic range essential for preventing underflow in backward-pass gradients. The sign bit claim is incorrect as floating-point formats use a single sign bit. The integer format claim is incorrect as both are floating-point representations. The byte size claim is incorrect because both are 8-bit (1-byte) formats.
Learning Objective: Compare the numerical properties and intended use cases of FP8 E4M3 and E5M2 formats.
True or False: In NVIDIA’s SIMT (Single Instruction, Multiple Threads) execution model, when threads within the same 32-thread warp execute divergent branches of an
if-elsecondition, both paths are executed concurrently in parallel at full hardware throughput.Answer: False. When threads within a warp diverge on conditional branches, the warp executes each branch path serially while masking off (disabling) threads that do not take that path. The total execution time becomes the sum of the times of both paths, reducing hardware utilization and throughput.
Learning Objective: Analyze the performance penalty of warp divergence in SIMT architectures.
Describe the Tiling Principle in deep learning hardware mapping and explain why multi-level hierarchical tiling (from global memory down to registers) is necessary for high-throughput GEMM kernels.
Answer: The Tiling Principle partitions large matrix multiplication loops into smaller, block-sized submatrices that fit into each successive level of the hardware memory hierarchy (HBM \(\to\) shared memory/SRAM \(\to\) register files). Hierarchical tiling ensures that data loaded from high-latency, limited-bandwidth memory (such as HBM) is reused dozens of times in high-bandwidth, low-latency on-chip storage before being evicted, preventing arithmetic pipelines from stalling on memory bandwidth.
Learning Objective: Explain how hierarchical tiling maximizes data reuse and sustains peak compute utilization.
Self-Check: Answer
An accelerator delivers \(R_{\text{peak}} = 1{,}000\text{ TFLOP/s}\) (\(10^{15}\text{ FLOP/s}\)) in FP16 and has a High-Bandwidth Memory (HBM) subsystem delivering \(\text{BW} = 2.0\text{ TB/s}\) (\(2\times 10^{12}\text{ bytes/s}\)). What is the hardware balance point (ridge point \(I_{\text{ridge}}\)) of this system?
- \(50\text{ FLOP/byte}\)
- \(200\text{ FLOP/byte}\)
- \(500\text{ FLOP/byte}\)
- \(2{,}000\text{ FLOP/byte}\)
Answer: The correct answer is C. The hardware ridge point is defined as \(I_{\text{ridge}} = \frac{R_{\text{peak}}}{\text{BW}} = \frac{10^{15}\text{ FLOP/s}}{2.0 \times 10^{12}\text{ bytes/s}} = 500\text{ FLOP/byte}\). Any kernel with an arithmetic intensity below \(500\text{ FLOP/byte}\) will be memory-bandwidth bound on this hardware, whereas kernels with arithmetic intensity above \(500\text{ FLOP/byte}\) can potentially achieve peak compute throughput. The other choices result from arithmetic miscalculations (\(50\), \(200\), or \(2{,}000\)).
Learning Objective: Calculate the hardware ridge point given peak compute throughput and memory bandwidth.
When training a 7-billion parameter model using standard mixed-precision (FP16/BF16) with the Adam optimizer, calculate the minimum memory required purely for model states (weights, gradients, and optimizer states) and explain why optimizer states dominate this footprint.
Answer: Model states require 16 bytes per parameter: 2 bytes for FP16 weights, 2 bytes for FP16 gradients, 4 bytes for FP32 master weights, 4 bytes for FP32 first momentum, and 4 bytes for FP32 second momentum (\(2 + 2 + 4 + 4 + 4 = 16\text{ bytes/param}\)). For a 7B model, this requires \(7 \times 10^9 \times 16\text{ bytes} = 112\text{ GB}\). Optimizer states dominate (\(12\text{ bytes/param}\), or \(75\%\) of the total) because maintaining FP32 precision for master weights and running statistical moments is numerically necessary to prevent gradient underflow and truncation errors during updates.
Learning Objective: Calculate and justify the memory footprint of model weights, gradients, and optimizer states during mixed-precision training.
**Arrange the following levels of a modern GPU memory hierarchy in order of access latency, from lowest latency (fastest) to highest latency (slowest):
- High-Bandwidth Memory (HBM3)
- Register File
- Pinned Host System Memory (DDR5 via PCIe)
- Shared Memory / L1 Cache
- On-Chip L2 Cache**
Answer: The correct order is (2) Register File -> (4) Shared Memory / L1 Cache -> (5) On-Chip L2 Cache -> (1) High-Bandwidth Memory (HBM3) -> (3) Pinned Host System Memory (DDR5 via PCIe). Registers are accessible in sub-nanosecond/single-cycle latency, followed by on-chip Shared Memory/L1 (~few cycles), L2 Cache (~tens of cycles), device HBM (~hundreds of cycles), and finally host DDR over the PCIe bus (~microseconds/thousands of cycles).
Learning Objective: Classify memory hierarchy levels by access latency and proximity to execution units.
Why does High-Bandwidth Memory (HBM) achieve significantly higher bandwidth (e.g., \(>2\text{ TB/s}\)) than traditional GDDR6X memory (e.g., \(\approx 760\text{ GB/s}\)) while maintaining comparable or lower power per bit?
- HBM operates at a \(10\times\) higher clock frequency than GDDR6X on standard PCB traces
- HBM uses optical photonic signaling to transmit data across the motherboard
- HBM eliminates all error correction codes and row buffer precharge cycles
- HBM vertically stacks DRAM dies using Through-Silicon Vias (TSVs) and connects to the GPU via a wide 1024-bit per stack silicon interposer bus at lower clock speeds
Answer: The correct answer is D. HBM achieves ultra-high bandwidth by vertically stacking DRAM dies with Through-Silicon Vias (TSVs) and interfacing with the accelerator through a silicon interposer with extremely wide memory buses (1024 bits per stack vs. 32/64 bits for standard GDDR channels). Because physical wire distances over the silicon interposer are short and the bus is wide, HBM can run at lower pin clock frequencies, significantly reducing energy per bit (\(pJ/\text{bit}\)) compared to driving high-frequency GDDR signals over long PCB traces. The higher clock frequency choice is incorrect because GDDR6X actually runs at higher pin clock frequencies than HBM. The optical photonics and error-correction elimination choices are physically false.
Learning Objective: Explain the architectural design differences and physical advantages of HBM over GDDR.
Memory allocated on the host CPU that is locked into physical RAM and prevents operating system paging, enabling direct DMA transfers over PCIe to the GPU, is called ____ host memory.
Answer: pinned (or page-locked). Pinned host memory allows GPU DMA engines to transfer data asynchronously across the PCIe bus without CPU staging copies or page faults.
Learning Objective: Explain the role of pinned host memory in optimizing host-to-accelerator data transfers.
True or False: The AI Memory Wall refers solely to the limited physical capacity (GBs) of GPU DRAM, meaning that if an accelerator has sufficient gigabytes to store model weights, memory bandwidth will never bottleneck execution.
Answer: False. The AI Memory Wall encompasses both capacity and bandwidth disparities. While capacity determines whether a model fits on a chip, memory bandwidth (\(\text{TB/s}\)) dictates how fast data can be fed to compute units. Even if a model fits entirely in DRAM, low-arithmetic-intensity kernels (such as LayerNorm or token-by-token decoding) remain heavily bottlenecked by memory bandwidth, underutilizing peak compute throughput.
Learning Objective: Analyze the dual dimensions (capacity and bandwidth) of the AI memory wall.
Self-Check: Answer
A developer runs a LayerNorm kernel on an accelerator with \(R_{\text{peak}} = 312\text{ TFLOP/s}\) and \(\text{BW} = 1.5\text{ TB/s}\) (\(I_{\text{ridge}} = 208\text{ FLOP/byte}\)). The LayerNorm has an arithmetic intensity of \(I = 4\text{ FLOP/byte}\). What is the maximum attainable performance of this kernel, and what is the binding bottleneck?
- \(6.0\text{ TFLOP/s}\), bound by memory bandwidth
- \(312\text{ TFLOP/s}\), bound by peak compute capacity
- \(78\text{ TFLOP/s}\), bound by warp scheduler instruction issue rate
- \(1.5\text{ TFLOP/s}\), bound by PCIe bus transfer limits
Answer: The correct answer is A. According to the Roofline model, \(\text{Attainable Performance} = \min(R_{\text{peak}}, I \cdot \text{BW}) = \min(312\text{ TFLOP/s}, 4\text{ FLOP/byte} \times 1.5\text{ TB/s}) = \min(312, 6.0) = 6.0\text{ TFLOP/s}\). Because \(I = 4 < I_{\text{ridge}} = 208\text{ FLOP/byte}\), the kernel operates deep within the memory-bound regime, achieving less than \(2\%\) of the chip’s peak arithmetic throughput. The peak compute choice incorrectly assumes compute limits apply regardless of arithmetic intensity. The instruction issue and PCIe bus choices confuse the primary memory bandwidth limit with secondary bottlenecks.
Learning Objective: Calculate attainable performance using the Roofline model and identify the binding bottleneck.
Why has the hardware ridge point (\(I_{\text{ridge}}\)) increased dramatically across successive GPU generations (e.g., from Volta to Ampere to Hopper), and what pressure does this trend place on compiler and kernel developers?
Answer: The ridge point \(I_{\text{ridge}} = R_{\text{peak}}/\text{BW}\) has increased because peak arithmetic throughput (driven by specialized Tensor Cores and lower-precision FP8/INT8 math) has grown much faster than physical HBM bandwidth. This shifts the knee of the roofline curve to the right, meaning kernels require significantly higher arithmetic intensity to achieve compute-bound peak efficiency. Developers and compilers are forced to implement aggressive kernel fusion, multi-level tiling, and activation caching to avoid being trapped in the memory-bound regime.
Learning Objective: Analyze the historical trend of increasing hardware ridge points and its architectural implications.
True or False: When a kernel operates in the memory-bound regime of the Roofline model (\(I < I_{\text{ridge}}\)), doubling the accelerator’s peak tensor compute capability (\(R_{\text{peak}}\)) without changing memory bandwidth will double the kernel’s execution speed.
Answer: False. In the memory-bound regime, performance is capped by \(I \cdot \text{BW}\), which depends strictly on arithmetic intensity and memory bandwidth. Increasing \(R_{\text{peak}}\) only raises the horizontal compute ceiling; the kernel’s execution time is dictated by the slanted bandwidth ceiling and will experience \(0\%\) speedup unless memory bandwidth is increased or the kernel is restructured to improve data reuse.
Learning Objective: Evaluate the effect of hardware upgrades on memory-bound workloads using the Roofline model.
In the Roofline model, the transition point on the horizontal axis where the memory-bandwidth ceiling intersects the peak-compute ceiling is known as the hardware ____ point.
Answer: ridge. The ridge point (\(I_{\text{ridge}} = R_{\text{peak}} / \text{BW}\)) defines the minimum arithmetic intensity required for an algorithm to potentially reach peak hardware computational throughput.
Learning Objective: Explain the significance of the ridge point in roofline performance modeling.
An engineer profiles a transformer inference workload and discovers that the attention Softmax kernel is heavily memory bandwidth bound. Which of the following optimization techniques directly increases arithmetic intensity to move the kernel closer to the compute-bound regime?
- Upgrading host CPU RAM to DDR5 to decrease kernel enqueue latency
- Fusing the scale, mask, Softmax, and dropout operations into a single kernel to keep intermediate activations in registers/SRAM
- Increasing the clock frequency of the GPU Tensor Cores by \(15\%\)
- Disabling warp scheduler out-of-order instruction issue
Answer: The correct answer is B. Fusing scale, mask, Softmax, and dropout into a single kernel eliminates intermediate writes to and reads from DRAM (HBM), keeping intermediate values in fast on-chip registers and shared memory. This drastically reduces the total memory traffic \(D_{\text{vol}}\), increasing the arithmetic intensity \(I = \text{FLOP}/\text{Byte}\) and moving the kernel closer to or into the compute-bound regime. Upgrading host CPU RAM does not affect GPU HBM memory traffic. Increasing Tensor Core clock frequency only raises the peak compute ceiling without improving memory-bound throughput. Disabling warp scheduling hurts instruction issue efficiency.
Learning Objective: Design optimization strategies to shift memory-bound kernels toward the compute-bound regime.
Self-Check: Answer
In neural network hardware mapping, what distinguishes a spatial mapping decision from a temporal mapping decision?
- Spatial mapping refers to compiling graph IR, whereas temporal mapping refers to runtime CUDA kernel launches
- Spatial mapping determines precision formats (FP16 vs INT8), whereas temporal mapping determines memory allocation sizes
- Spatial mapping assigns computational tasks to specific physical execution units (e.g., PEs or SMs) simultaneously in parallel, whereas temporal mapping determines the execution ordering and loop scheduling over time on those units
- Spatial mapping operates only on convolutional layers, whereas temporal mapping operates only on transformer attention layers
Answer: The correct answer is C. Spatial mapping decides how tensor dimensions and parallel operations are partitioned and assigned across physical execution resources (such as array PEs, GPU SMs, or SIMD vector lanes) to execute concurrently in space. Temporal mapping decides the chronological schedule, loop ordering, and time steps in which operations and tile iterations execute on those assigned physical units over time. The compiler IR vs runtime launch distinction confuses compilation phases with mapping dimensions. The precision vs memory allocation choice describes quantization and memory planning. The layer-specific choice is incorrect as both mapping types apply to all neural network operations.
Learning Objective: Compare spatial mapping and temporal mapping dimensions in AI hardware acceleration.
Explain why finding the optimal hardware mapping (tiling sizes, loop orders, and spatial partitioning) for a deep neural network on a target accelerator is a combinatorially hard optimization problem.
Answer: Mapping involves searching a discrete combinatorial space of loop transformations across multi-dimensional tensor operations. For an \(M\)-deep nested loop across \(K\) memory hierarchy levels, there are \(M!\) possible loop orderings at each level, multiplied by all possible tile factor combinations that divide loop bounds, unrolling factors, and spatial allocation strategies across processing elements. Furthermore, memory capacity constraints at each tier create complex non-linear dependencies, making exhaustive evaluation computationally intractable and requiring heuristic or learning-based search spaces.
Learning Objective: Analyze the combinatorial complexity of hardware mapping for neural network compilation.
Explain why reordering loop nests in a tensor contraction (e.g., changing from \(I \to J \to K\) to \(K \to I \to J\)) alters memory bandwidth demands and execution speed without changing the total mathematical operation count.
Answer: Loop reordering preserves the mathematical invariants and total scalar multiply-accumulate count (\(\mathcal{O}(I \cdot J \cdot K)\) operations) but fundamentally changes the data access patterns and residency in cache and scratchpad memory tiers. The inner loop dictates which tensor operand (\(A, B,\) or partial sum \(C\)) is held stationary in registers or fast SRAM while other operands stream through. Selecting a suboptimal loop ordering causes cache thrashing and repeated DRAM round-trips for the streamed operands, increasing memory bandwidth demand and drastically degrading execution performance.
Learning Objective: Explain why loop reordering impacts memory bandwidth demand without altering total arithmetic operations.
When mapping a tensor computation to a multi-level memory hierarchy, what is the primary objective function optimized by spatial and temporal tiling?
- Maximizing the total number of intermediate tensors written to host DDR memory
- Maximizing data reuse in the fastest, closest memory tiers (registers and SRAM) to minimize traffic to slower, energy-expensive DRAM
- Ensuring every warp thread executes different instruction streams simultaneously
- Converting all 2D matrix multiplications into 1D scalar operations
Answer: The correct answer is B. The primary goal of spatial and temporal mapping is to maximize data reuse in the highest levels of the memory hierarchy (registers and on-chip SRAM/shared memory), ensuring that each byte fetched from power-hungry, high-latency DRAM is reused as many times as possible before eviction, thereby minimizing DRAM bandwidth demand and maximizing compute throughput. Maximizing writes to host memory degrades performance. Executing different instructions causes severe warp divergence. Converting matrix operations to scalars eliminates vector and tensor unit acceleration.
Learning Objective: Justify the primary objective of tiling and memory hierarchy mapping.
Self-Check: Answer
Why do modern deep learning libraries (e.g., cuDNN, TensorRT) strongly prefer the Channels-Last (NHWC) tensor layout over Channels-First (NCHW) when executing convolutions on NVIDIA Tensor Cores?
- NHWC eliminates the need for spatial convolutions by flattening images into 1D vectors
- NCHW requires floating-point numbers to be stored in big-endian byte order
- NHWC reduces model parameter count by sharing channel weights across batches
- NHWC places channel values for a given spatial location in contiguous memory, aligning with the packed vector/matrix multiply requirements of Tensor Cores
Answer: The correct answer is D. In NHWC layout, the channel dimension \(C\) is the fastest-varying (innermost) dimension, placing all channel features for a specific spatial coordinate \((n, h, w)\) contiguously in memory. Tensor Cores execute matrix operations on contiguous vectors of channels (e.g., 8 or 16 channels per memory vector load), enabling coalesced memory access and direct loading into matrix unit registers without expensive transpose or gather operations. The 1D flattening, big-endian, and parameter sharing choices are technically incorrect.
Learning Objective: Compare the memory layout efficiency of Channels-Last (NHWC) versus Channels-First (NCHW) for Tensor Cores.
Explain the mechanism of vertical kernel fusion (e.g., fusing
Conv2D\(\to\)BatchNorm\(\to\)ReLU), and identify both its performance benefit and its primary architectural constraint.Answer: Vertical kernel fusion combines a sequence of producer-consumer operations into a single GPU kernel, passing intermediate activation values directly through fast on-chip registers or shared memory instead of writing them out to and re-reading them from global DRAM (HBM). This dramatically reduces memory traffic and kernel launch overhead. Its primary architectural constraint is register pressure: storing intermediate variables and fusing complex pipelines increases register usage per thread, which can reduce warp occupancy and limit available parallelism on the SM.
Learning Objective: Explain the performance benefits and hardware constraints of vertical kernel fusion.
**Place the following loop transformation steps in the logical order applied by an optimizing compiler when targeting a matrix multiplication dataflow to an accelerator:
- Loop Reordering: Permute loop indices to establish a specific stationary dataflow (e.g., Output-Stationary)
- Loop Unrolling: Fully or partially unroll the innermost loop to expose instruction-level parallelism and map to hardware registers
- Loop Tiling (Blocking): Partition global loop iterations into sub-tiles that fit into on-chip shared memory / SRAM
- Spatial Partitioning: Assign outer tile loops to physical hardware compute clusters (e.g., GPU thread blocks / SMs)**
Answer: The correct order is (3) Loop Tiling (Blocking): Partition global loop iterations into sub-tiles that fit into on-chip shared memory / SRAM -> (4) Spatial Partitioning: Assign outer tile loops to physical hardware compute clusters (e.g., GPU thread blocks / SMs) -> (1) Loop Reordering: Permute loop indices to establish a specific stationary dataflow (e.g., Output-Stationary) -> (2) Loop Unrolling: Fully or partially unroll the innermost loop to expose instruction-level parallelism and map to hardware registers. Optimization starts with hierarchical tiling to match memory capacities, partitions tiles spatially across SMs/PEs, reorders the inner loops to minimize data movement (dataflow choice), and finally unrolls inner loops for instruction issue efficiency.
Learning Objective: Apply loop transformation pipelines for optimizing matrix dataflow on accelerators.
In a multi-head self-attention layer where a single input activation tensor is projected across multiple query, key, and value weight matrices (\(W_q, W_k, W_v\)), which stationary dataflow strategy provides the highest data reuse in local scratchpad memory?
- Input-Stationary (Activation-Stationary)
- Output-Stationary
- No Local Reuse (NLR)
- Weight-Stationary
Answer: The correct answer is A. In an Input-Stationary (Activation-Stationary) dataflow, an input activation tile is loaded into fast local memory once and kept stationary while multiple weight matrices (\(W_q, W_k, W_v\)) stream through. This maximizes the reuse of the common activation tensor across multiple matrix multiplications, minimizing activation re-reads. Weight-Stationary would require repeatedly reloading activations for each distinct weight matrix. Output-Stationary minimizes accumulation write-backs but does not exploit cross-projection activation sharing. No Local Reuse streams all operands from memory without local caching.
Learning Objective: Design dataflow strategies for multi-head attention workloads.
True or False: Row-Stationary (RS) dataflow, as implemented in architectures like Eyeriss, keeps only the final output activation stationary in registers while streaming 2D convolutional filter rows and input rows from DRAM on every clock cycle.
Answer: False. Row-Stationary dataflow keeps 1D rows of convolutional weights stationary in PE registers, slides 1D rows of input activations through the PEs, and accumulates 1D rows of partial sums locally across a 2D array of PEs, maximizing 2D convolution spatial reuse across all three tensor components simultaneously.
Learning Objective: Evaluate the operational mechanics of Row-Stationary dataflow in convolution accelerators.
Self-Check: Answer
What is the primary purpose of lifetime analysis in an ML compiler’s static memory planner?
- To calculate the physical degradation and failure rate of HBM memory cells over time
- To determine the precise intervals during which each intermediate activation tensor is needed, allowing disjoint tensors to share the same physical memory buffer
- To predict the number of training epochs required for a neural network to converge
- To prevent the compiler from generating out-of-order instruction streams
Answer: The correct answer is B. Lifetime analysis tracks when each intermediate tensor is created (produced) and last referenced (consumed) during graph execution. By identifying tensors whose lifetimes do not overlap, the compiler’s static memory planner can assign them to the same physical memory addresses (buffer reuse/aliasing), significantly reducing the model’s peak runtime memory footprint and avoiding dynamic memory allocation overhead. The physical degradation choice confuses tensor lifecycle with semiconductor physics. The training convergence choice describes algorithmic optimization rather than compiler memory management. The instruction stream choice describes scheduling.
Learning Objective: Explain the role of tensor lifetime analysis in static memory planning.
Explain how double buffering (software pipelining) implemented by an ML compiler hides memory access latency during loop execution on an accelerator.
Answer: Double buffering allocates two alternating memory buffers in on-chip SRAM/shared memory: while compute units execute arithmetic operations on data in the first buffer (tile \(k\)), asynchronous DMA or copy engines concurrently load subsequent data (tile \(k+1\)) into the second buffer from DRAM. In the next iteration, the roles swap. By overlapping data transfer with arithmetic computation, memory transfer latency is completely hidden as long as the compute time equals or exceeds the transfer time.
Learning Objective: Explain the mechanism of double buffering in hiding memory transfer latency.
**Place the following compilation stages in the correct order as an end-to-end ML compiler (such as TVM or XLA) transforms a high-level deep learning model into executable machine code:
- Target Code Generation: Emit hardware-specific binary (e.g., PTX or machine instructions)
- High-Level Graph Optimization: Perform operator fusion, constant folding, and dead code elimination on the computation graph
- Front-End Ingestion: Parse framework model (e.g., PyTorch/ONNX) into High-Level Graph IR
- Low-Level IR & Auto-Tuning: Lower fused operators to loop-level IR and optimize tile sizes, thread bindings, and unroll factors
- Static Memory Planning: Analyze tensor lifetimes and allocate shared physical buffers**
Answer: The correct order is (3) Front-End Ingestion: Parse framework model (e.g., PyTorch/ONNX) into High-Level Graph IR -> (2) High-Level Graph Optimization: Perform operator fusion, constant folding, and dead code elimination on the computation graph -> (4) Low-Level IR & Auto-Tuning: Lower fused operators to loop-level IR and optimize tile sizes, thread bindings, and unroll factors -> (5) Static Memory Planning: Analyze tensor lifetimes and allocate shared physical buffers -> (1) Target Code Generation: Emit hardware-specific binary (e.g., PTX or machine instructions). Compilation begins with parsing graph IR, performs target-independent graph optimizations, lowers to loop IR for hardware auto-tuning and tiling, plans memory buffers, and generates native device code.
Learning Objective: Apply the multi-stage compilation pipeline of modern ML compilers.
How does an auto-tuning ML compiler (such as TVM/Ansor) differ from a traditional handwritten library approach (such as cuDNN) for kernel selection?
- Auto-tuning compilers execute code only on the host CPU, whereas handwritten libraries run on GPUs
- Handwritten libraries search an infinite combinatorial loop space at runtime, whereas auto-tuning compilers use static heuristics
- Auto-tuning compilers explore large parameterized search spaces of loop transformations and tile sizes using cost models to generate custom kernels, whereas handwritten libraries rely on expert-tuned templates for specific fixed shapes
- Auto-tuning compilers require all tensors to be quantized to 1-bit integers
Answer: The correct answer is C. Auto-tuning ML compilers define parameterized spaces of loop transformations (tiling, unrolling, vectorization, thread mapping) and evaluate configurations using statistical cost models or hardware measurements to generate custom kernels optimized for any arbitrary tensor shape and target architecture. In contrast, vendor libraries rely on human experts who write and optimize specific kernel templates for common fixed shapes and precisions. The host CPU only claim is false. The runtime infinite search claim is reversed. The 1-bit quantization claim is unrelated.
Learning Objective: Compare auto-tuning ML compilers with handwritten vendor libraries.
The optimization where an ML compiler merges two or more independent operators at the same graph depth into a single batched kernel to maximize GPU parallelism is known as ____ fusion.
Answer: horizontal. Horizontal fusion combines independent parallel operators (such as parallel projection layers or multi-head \(Q, K, V\) linear transformations) into a single batched kernel, improving hardware occupancy and amortizing kernel launch overhead.
Learning Objective: Classify horizontal versus vertical kernel fusion techniques.
Self-Check: Answer
Why do deep learning frameworks implement custom caching memory allocators (such as PyTorch’s
caching_allocator) rather than directly invokingcudaMallocandcudaFreefor every intermediate tensor?cudaMallocoperates only in FP32 precision and cannot allocate FP16 memory buffers- Direct OS memory allocation encrypts all tensor data, introducing cryptographic decryption latency
- GPU DRAM can only be allocated once during system boot time
cudaMallocis a synchronous operation that stalls GPU execution and causes expensive driver and OS page-table synchronization overhead
Answer: The correct answer is D.
cudaMallocandcudaFreeare synchronous system calls that require driver synchronization, virtual memory address mapping, and device-wide mutex locking, introducing significant latency (\(\approx 10\text{--}100\,\mu\text{s}\)) that stalls asynchronous execution streams. A caching memory allocator pre-allocates large memory blocks and manages a userspace pool of memory chunks on the device, servicing tensor allocations and deallocations in sub-microsecond time without GPU-host synchronization. Precision is independent of raw memory allocation. OS encryption is not part of standard cudaMalloc. GPU memory can be dynamically allocated at runtime.Learning Objective: Analyze the architectural necessity and performance advantages of caching memory allocators in ML runtimes.
Explain how CUDA Graphs eliminate CPU kernel launch overhead during repeated training or inference iterations on small or low-latency models.
Answer: In standard execution, every GPU kernel requires the CPU to enqueue a launch request via the driver, incurring \(\approx 5\text{--}10\,\mu\text{s}\) of CPU overhead per kernel, which severely bottlenecks short-duration kernels. CUDA Graphs capture the entire directed acyclic graph (DAG) of kernel launches, memory copies, and stream dependencies during an initial trace pass. In subsequent iterations, the entire graph is instantiated and replayed via a single driver call, offloading execution sequencing entirely to the GPU hardware scheduler and eliminating host-side dispatch overhead.
Learning Objective: Explain how CUDA Graphs capture and replay execution workflows to eliminate host launch latency.
True or False: In an asynchronous GPU runtime model, when a Python script executes
y = torch.matmul(a, b), the CPU thread blocks and waits until the GPU hardware finishes computing the matrix multiplication before executing the next line of Python code.Answer: False. GPU runtime calls are asynchronous:
torch.matmulenqueues the kernel execution command onto a CUDA stream queue in the driver and immediately returns control to the CPU thread. The CPU continues executing subsequent Python instructions while the GPU executes the kernel in the background, blocking only when synchronization is explicitly requested (e.g., viatorch.cuda.synchronize()or copying data back to CPU host memory).Learning Objective: Analyze the non-blocking execution model of asynchronous GPU runtime streams.
A sequence of asynchronous GPU operations that execute strictly in FIFO order on an accelerator is called a CUDA ____.
Answer: stream. CUDA streams allow operations enqueued within the same stream to execute sequentially while operations in different streams can execute concurrently in parallel when hardware resources permit.
Learning Objective: Explain the role of CUDA streams in managing concurrent and asynchronous GPU execution.
An inference serving system processes dynamic batch sizes ranging from 1 to 32 tokens per request. Why does dynamic batching pose a significant challenge to runtime kernel selection and hardware efficiency?
- Optimal tile sizes, thread block configurations, and memory bandwidth requirements change across batch sizes, making a single static kernel inefficient across all shapes
- Dynamic batching forces the GPU to switch from FP16 to FP64 precision for even batch sizes
- Tensor Cores cannot execute matrix multiplication when batch dimensions are not powers of two
- The GPU memory controller must physically power down DRAM banks when batch size decreases
Answer: The correct answer is A. For small batch sizes (e.g., \(B=1\)), operations are memory-bandwidth bound and require kernels tuned for low latency and high memory throughput, whereas for large batch sizes (e.g., \(B=32\)), operations become compute bound and require larger tile sizes and high-occupancy thread block configurations to saturate Tensor Cores. A single static kernel configuration cannot achieve peak efficiency across disparate tensor shapes, requiring runtime kernel dispatch or multi-version code generation. Precision switching, power-of-two Tensor Core limitations, and DRAM bank power-downs are incorrect.
Learning Objective: Analyze the performance challenges of dynamic shapes on runtime kernel selection.
Self-Check: Answer
Why have accelerator architectures increasingly shifted from monolithic single-die designs toward Multi-Chip Module (MCM) and chiplet architectures?
- Chiplets eliminate all need for semiconductor fabrication foundries
- Monolithic dies are constrained by the physical lithography reticle limit (\(\approx 858\text{ mm}^2\)) and suffer exponential yield loss as die size increases
- Monolithic dies cannot support high-bandwidth memory (HBM) interfaces
- Chiplets allow electrical signals to travel faster than the speed of light
Answer: The correct answer is B. Monolithic silicon dies are physically bounded by optical lithography reticle limits (typically \(\approx 858\text{ mm}^2\)). Furthermore, manufacturing defect density causes wafer yield to drop exponentially as die area approaches the reticle limit, making large monolithic chips prohibitively expensive. Chiplet/MCM architectures break the system into smaller, high-yield dies interconnected via high-density silicon bridges or interposers, enabling much larger aggregate compute and memory capacity. The elimination of foundries is absurd; HBM is supported on monolithic dies (e.g., A100/H100); physical constants cannot be exceeded.
Learning Objective: Justify the transition from monolithic dies to chiplet-based accelerator architectures.
Explain how the non-uniform memory access (NUMA) effect and interconnect bandwidth degradation impact performance when scaling a neural network workload across multiple chiplets or accelerator chips.
Answer: While on-chip or intra-die memory access delivers high bandwidth (\(>2\text{--}3\text{ TB/s}\)) and low latency, crossing chiplet boundaries via inter-die bridges or board interconnects (e.g., NVLink or PCIe) suffers an order-of-magnitude reduction in bandwidth and increased latency. If a tensor computation frequently requires operands from remote chiplets without local caching, execution stalls on inter-chip communication, creating a NUMA bottleneck that degrades parallel scaling efficiency unless data is carefully partitioned.
Learning Objective: Analyze the NUMA and interconnect bandwidth constraints in multi-chip scaling.
Describe the architectural rationale behind Cerebras’s Wafer-Scale Engine and explain how fabricating an accelerator across an entire uncut silicon wafer overcomes traditional multi-chip scaling bottlenecks.
Answer: Standard multi-chip scaling suffers significant latency and bandwidth penalties when signals cross chip package boundaries and PCB traces. Cerebras fabricates hundreds of thousands of cores across an entire uncut \(300\text{ mm}\) silicon wafer, utilizing on-wafer routing to connect adjacent reticle fields. This provides uniform, ultra-high-bandwidth, single-cycle communication and massive distributed on-chip SRAM across the entire wafer, eliminating discrete chip packaging, external SerDes transceivers, and NUMA interconnect bottlenecks.
Learning Objective: Explain the architectural rationale and communication advantages of wafer-scale computing systems.
What is the primary bottleneck introduced by inter-node scaling (scaling out across separate servers over Ethernet or InfiniBand) compared to intra-node NVLink scaling?
- Inter-node network adapters cannot transmit FP16 or BF16 floating-point values
- Inter-node communication requires GPUs to switch to single-threaded CPU emulation mode
- Inter-node network bandwidth (e.g., \(400\text{ Gbps} \approx 50\text{ GB/s}\)) is roughly an order of magnitude lower than intra-node NVLink bandwidth (\(\approx 900\text{ GB/s}\)), increasing collective communication latency
- Inter-node scaling eliminates the need for gradient synchronization in distributed training
Answer: The correct answer is C. Intra-node GPU interconnects like NVLink 4 deliver up to \(900\text{ GB/s}\) of bidirectional bandwidth per GPU, whereas inter-node network interfaces (e.g., \(400\text{ Gbps}\) InfiniBand or RoCE NICs) deliver \(\approx 50\text{ GB/s}\) per port. This sharp bandwidth drop across the node boundary makes inter-node collective communication (such as All-Reduce or All-to-All) a dominant bottleneck in distributed scaling, requiring hierarchical communication algorithms. The network adapter precision and CPU emulation choices are false. The gradient synchronization elimination choice is incorrect because distributed data parallelism requires gradient synchronization.
Learning Objective: Compare the bandwidth constraints of intra-node interconnects with inter-node scale-out networks.
Self-Check: Answer
On a modern mobile heterogeneous System-on-Chip (SoC) featuring big.LITTLE CPUs, a mobile GPU, and a dedicated NPU, which compute engine is most energy-efficient for running continuous, low-latency 8-bit quantized convolutional inference?
- The high-performance ‘big’ CPU core running single-threaded FP32 instructions
- The out-of-order system memory controller
- The dedicated Neural Processing Unit (NPU) optimized for quantized INT8 matrix operations
- The host operating system virtualization hypervisor
Answer: The correct answer is C. The Neural Processing Unit (NPU) is a domain-specific accelerator with fixed-point MAC arrays, specialized activation units, and local scratchpad SRAM designed specifically for INT8/INT4 neural network operations. It delivers an order-of-magnitude higher energy efficiency (TOPS/Watt) than general-purpose CPU cores or high-power GPUs by avoiding instruction fetch/decode overhead and general register file transfers. The big CPU core consumes substantially more power per operation. Memory controllers and hypervisors do not execute tensor math.
Learning Objective: Classify mobile SoC compute engines based on workload efficiency and architectural specialization.
In automotive autonomous driving SoCs, explain why deterministic worst-case execution time and lockstep redundancy are required, even if they reduce peak average-case throughput.
Answer: Automotive systems are subject to strict functional safety standards (such as ISO 26262 ASIL-D), where missing a perception or control deadline in real-time sensor processing can lead to catastrophic physical collisions. Dual-core lockstep execution runs identical computations redundantly across replicated hardware cores to detect transient hardware faults and bit flips immediately. While these safety mechanisms and strict scheduling guarantees introduce hardware overhead and reduce peak average throughput, they guarantee deterministic worst-case latency and fault tolerance necessary for life-critical autonomy.
Learning Objective: Explain the architectural trade-offs between safety-critical determinism and peak throughput in automotive AI SoCs.
True or False: In mobile SoCs with unified system memory (LPDDR), sharing physical RAM between the CPU, GPU, and NPU eliminates all data movement overhead between heterogeneous processors.
Answer: False. While unified memory eliminates physical PCIe bus transfers and duplicate memory copies across discrete devices, data must still be moved across the shared on-chip interconnect and through different cache hierarchy domains. Furthermore, cache coherency protocols, differing tensor layout requirements (e.g., NCHW vs NHWC), and memory bus contention between competing SoC engines still incur significant latency and energy overhead.
Learning Objective: Evaluate the memory movement and cache coherency trade-offs of unified SoC memory.
Describe how Dynamic Voltage and Frequency Scaling (DVFS) and thermal throttling constrain sustained AI inference performance on edge and mobile devices.
Answer: Mobile SoCs operate within a tight thermal design power (TDP) envelope (typically \(3\text{--}5\text{ W}\)) with passive cooling. When continuous AI workloads generate sustained heat, the thermal management system triggers DVFS to lower operating voltage and clock frequencies, preventing device overheating. This thermal throttling causes execution time to degrade over time, meaning peak burst performance cannot be sustained for continuous video or audio streaming workloads without proactive power-budget scheduling.
Learning Objective: Analyze the impact of thermal throttling and DVFS on sustained edge AI inference.
Self-Check: Answer
In the lifecycle carbon assessment of advanced deep learning accelerators, what constitutes ‘embodied carbon’?
- The electrical energy consumed by the GPU during model forward and backward passes
- The carbon emitted by datacenter air conditioning units during peak summer load
- The carbon credits purchased by cloud providers to offset datacenter energy usage
- The greenhouse gas emissions generated during raw material extraction, semiconductor silicon manufacturing, packaging, and hardware transportation
Answer: The correct answer is D. Embodied carbon refers to the total greenhouse gas emissions generated throughout the supply chain and manufacturing lifecycle of the hardware before it ever runs a workload, including silicon ingot purification, advanced extreme ultraviolet (EUV) lithography, cleanroom fabrication, multi-chip packaging, assembly, and transportation. Operational carbon refers to emissions resulting from electricity consumed during active operation and cooling of the hardware. Carbon credits are financial offsets, not physical emissions.
Learning Objective: Compare embodied carbon and operational carbon in AI hardware lifecycle analysis.
Explain why maximizing accelerator utilization (e.g., via multi-tenant sharing or continuous pipeline saturation) reduces the amortized carbon footprint per trained model.
Answer: The total carbon footprint of a machine learning model includes both operational carbon (energy consumed per training step) and a fractional share of the hardware’s embodied carbon amortized over its operational lifespan. When accelerator utilization is low (e.g., GPUs idling on data stalls), the embodied carbon is wasted on idle time. Maximizing utilization ensures that more useful compute operations are extracted over the device’s operational lifetime, minimizing the embodied carbon cost allocated to each trained model.
Learning Objective: Explain how hardware utilization impacts the amortized carbon footprint of AI workloads.
True or False: In a datacenter with a Power Usage Effectiveness (PUE) of 1.1, the cooling and electrical distribution infrastructure consumes more power than the actual computing IT equipment (servers and accelerators).
Answer: False. \(\text{PUE} = \frac{\text{Total Facility Power}}{\text{IT Equipment Power}}\). A PUE of 1.1 means that for every \(1.0\text{ Watt}\) consumed by the computing IT equipment, only \(0.1\text{ Watts}\) (roughly \(9\%\) of total power) is consumed by cooling, lighting, and power distribution overhead, indicating a highly efficient facility where computing equipment dominates power consumption.
Learning Objective: Calculate and interpret Power Usage Effectiveness (PUE) for AI datacenters.
Self-Check: Answer
A team prunes \(70\%\) of the weights in a large language model using unstructured magnitude pruning, setting those weights to zero. However, when executing the pruned model on standard GPU dense Tensor Cores, inference latency is identical to or slower than the unpruned baseline. What is the primary cause of this pitfall?
- Standard dense hardware cannot skip individual zero elements without structured patterns (e.g., 2:4) or specialized sparse matrix indexing, so dense matrix units still execute all multiplications while sparse formats add indexing overhead
- Floating-point units automatically convert zero values into infinite loops
- Unstructured pruning forces the GPU driver to downclock memory bandwidth to prevent overheating
- The operating system kernel intercepts every zero multiplication and raises a hardware page fault
Answer: The correct answer is A. Dense Tensor Cores and SIMT pipelines execute instructions in lockstep on dense contiguous matrices. Unstructured zero values do not change the dense matrix dimensions, so standard hardware still loads and computes all values. If converted to general sparse formats (e.g., CSR), irregular non-coalesced memory access and index metadata decoding overhead negate any FLOP reduction on GPUs unless sparsity is extremely high (\(>90\text{--}95\%\)) or structured (such as 2:4). The infinite loop, driver downclocking, and OS page fault choices are physically incorrect.
Learning Objective: Explain why unstructured sparsity fails to accelerate execution on dense hardware architectures.
Describe the pitfall of ‘micro-offloading’ small tensor operations from CPU to GPU, and explain why a sequence of scalar operations can run slower on an accelerator than on the host CPU.
Answer: Offloading small tensor operations incurs PCIe host-to-device data transfer latency, host driver scheduling overhead, and kernel launch latency (\(\approx 5\text{--}10\,\mu\text{s}\) per kernel). When a tensor contains only a few dozen or hundred elements, computation time is sub-microsecond, meaning fixed transfer and launch overhead completely dominates execution time. Furthermore, small tensors cannot provide enough parallel work to saturate thousands of GPU cores, making scalar or vector execution on low-latency CPU caches much faster.
Learning Objective: Analyze the performance pitfalls of kernel launch and data transfer overhead in micro-offloading.
**Place the following diagnostic steps in the recommended sequence when troubleshooting an underperforming neural network training workload on an accelerator cluster:
- Roofline & Hardware Counter Analysis: Determine whether individual kernels are compute-bound, memory-bandwidth-bound, or latency-bound
- Amdahl & Host-Side Profiling: Identify serial bottlenecks, data loading stalls, and CPU-GPU synchronization delays
- Kernel-Level Optimization: Apply operator fusion, hierarchical tiling, or precision reduction targeted to the identified bottleneck
- Multi-Device Communication Profiling: Check for gradient all-reduce synchronization delays and interconnect saturation**
Answer: The correct order is (2) Amdahl & Host-Side Profiling: Identify serial bottlenecks, data loading stalls, and CPU-GPU synchronization delays -> (1) Roofline & Hardware Counter Analysis: Determine whether individual kernels are compute-bound, memory-bandwidth-bound, or latency-bound -> (3) Kernel-Level Optimization: Apply operator fusion, hierarchical tiling, or precision reduction targeted to the identified bottleneck -> (4) Multi-Device Communication Profiling: Check for gradient all-reduce synchronization delays and interconnect saturation. Diagnostics begin at the macro level (Amdahl unaccelerated fractions and host bottlenecks), zoom in to single-device kernel roofline profiling, optimize the binding kernel bottlenecks, and finally scale up to inter-device communication analysis.
Learning Objective: Apply a systematic diagnostic sequence to identify and resolve accelerator performance bottlenecks.
Which of the following statements represents a classic fallacy regarding peak accelerator specifications?
- High-bandwidth memory reduces the latency of memory-bound operations compared to standard DDR5
- An accelerator with \(2\times\) higher peak theoretical TFLOP/s will automatically deliver a \(2\times\) speedup on any neural network workload
- Kernel fusion can improve arithmetic intensity by reducing global memory traffic
- Warp divergence reduces the execution efficiency of SIMT processor lanes
Answer: The correct answer is B. Assuming that doubling peak theoretical TFLOP/s automatically doubles real-world workload performance is a classic fallacy. If the workload is memory-bandwidth bound (e.g., LayerNorm, embedding lookup, or autoregressive decoding), bound by host communication (Amdahl’s law), or limited by kernel launch overhead, increasing peak compute capacity produces negligible or zero speedup. The other choices represent well-established architectural facts.
Learning Objective: Evaluate common fallacies regarding peak accelerator hardware specifications.
Self-Check: Answer
What is the central architectural insight of the hardware acceleration chapter regarding the interaction between model architecture and accelerator efficiency?
- Accelerators will soon eliminate all memory hierarchies in favor of infinite register files
- Hardware efficiency depends entirely on maximizing clock frequency regardless of memory bandwidth
- High delivered hardware efficiency requires co-design across computational primitives, dataflow reuse strategies, memory hierarchies, and compiler-runtime systems
- General-purpose out-of-order CPUs remain superior to specialized TPUs for all deep learning workloads
Answer: The correct answer is C. The core thesis of AI hardware acceleration is that raw compute scaling alone cannot sustain performance gains. Achieving high delivered efficiency (\(\eta_{\text{hw}}\)) requires comprehensive co-design: aligning neural network mathematical primitives (matrix, vector, transcendental) with specialized execution units (Tensor Cores, systolic arrays, SFUs), selecting dataflow strategies that maximize on-chip data reuse, and leveraging compilers and runtimes to optimize memory allocation, kernel fusion, and asynchronous execution. The other choices contradict the chapter’s fundamental principles.
Learning Objective: Evaluate the principles of hardware-software co-design across the AI acceleration stack.
Summarize how the Roofline model serves as a unified diagnostic bridge connecting high-level neural network operations to low-level hardware architecture choices.
Answer: The Roofline model characterizes any neural network operation by its arithmetic intensity (\(I = \text{FLOP}/\text{byte}\)) and maps it against the hardware’s peak compute capacity (\(R_{\text{peak}}\)) and memory bandwidth (\(\text{BW}\)). By comparing \(I\) to the hardware ridge point (\(I_{\text{ridge}} = R_{\text{peak}}/\text{BW}\)), the model immediately diagnoses whether an operator is memory-bound or compute-bound, directing engineers to the appropriate optimization: kernel fusion and tiling to increase data reuse for memory-bound operators, or Tensor Core utilization and parallelism tuning for compute-bound operators.
Learning Objective: Explain how the Roofline model bridges neural network algorithms and accelerator hardware design.
Which combination correctly summarizes the primary function of each layer in the modern AI hardware acceleration software stack?
- Framework: Silicon manufacturing; Compiler: Host PCIe routing; Runtime: Floating-point unit logic
- Framework: Direct transistor clocking; Compiler: Operating system page fault handling; Runtime: Mathematical differentiation
- Compiler: Real-time sensor power regulation; Runtime: Neural network gradient backpropagation; Hardware: Python interpreter dispatch
- Framework: Graph definition and automatic differentiation; Compiler: Graph optimization, operator fusion, and tiling; Runtime: Memory pooling, stream scheduling, and kernel dispatch; Hardware: Parallel matrix/vector execution
Answer: The correct answer is D. In the acceleration stack, the framework (e.g., PyTorch) defines the neural network computation graph and manages autograd; the compiler (e.g., TVM, XLA, TensorRT) performs graph-level optimizations, operator fusion, memory planning, and loop tiling; the runtime (e.g., CUDA runtime) manages device memory pools, asynchronous stream queues, and kernel launches; and the hardware executes instructions across specialized matrix units, vector lanes, and memory hierarchies. The other options misattribute responsibilities across the stack.
Learning Objective: Classify the functional responsibilities of frameworks, compilers, runtimes, and hardware accelerators.