Kỹ thuật có trách nhiệm
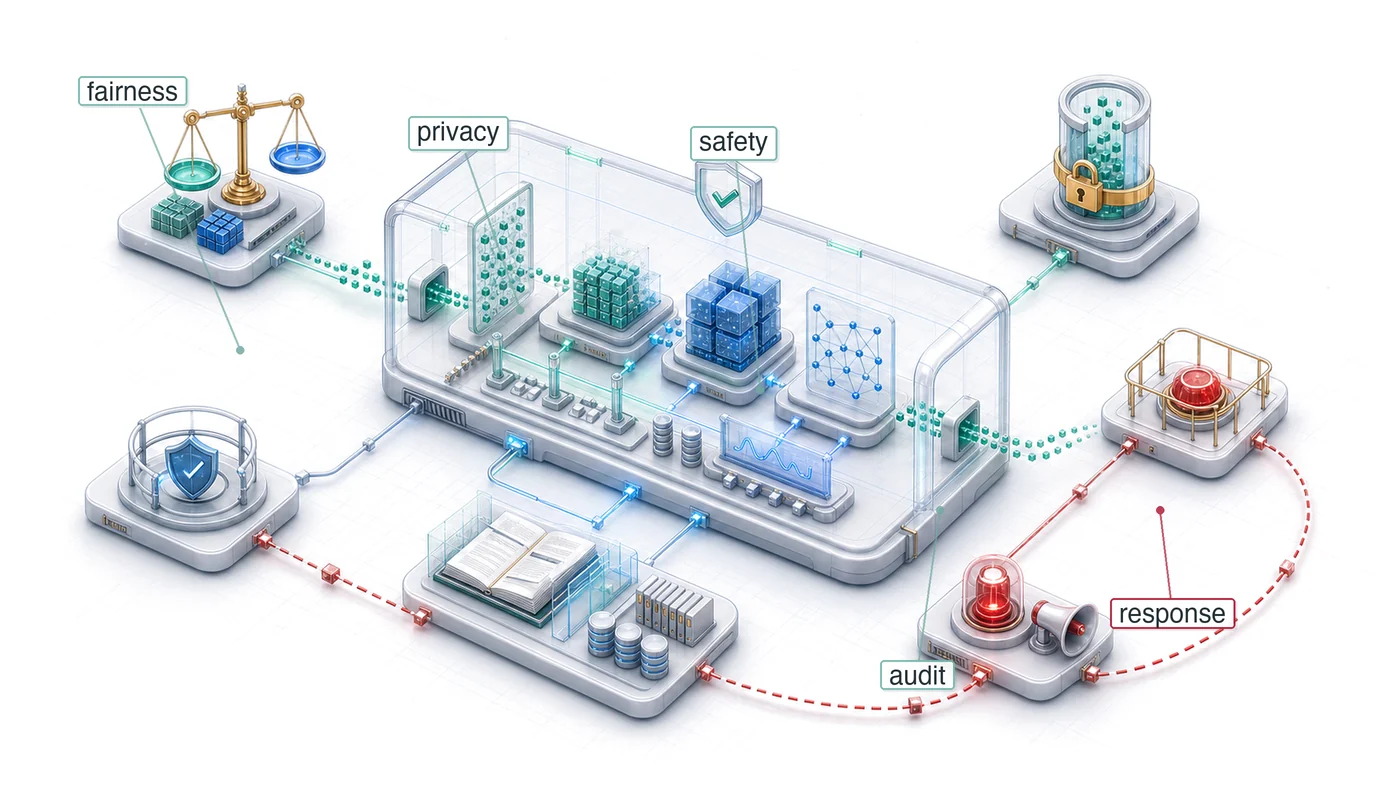
Mục đích
Tại sao một hệ thống làm chính xác những gì nó được yêu cầu vẫn có thể gây hại?
Vận hành nhắm tới độ trễ thấp, tính sẵn sàng cao và chất lượng dự đoán ổn định. Kỹ thuật có trách nhiệm đặt câu hỏi liệu các mục tiêu đó có mô tả đúng hành vi không, hệ thống phục vụ ai, và những chi phí nào trong đặc tả chưa được đo lường. Một hệ thống ML có thể đáp ứng yêu cầu về độ trễ, thông lượng và độ chính xác tổng hợp nhưng vẫn tái tạo phân biệt đối xử trong lịch sử, thưởng cho tương tác gây hại, tiêu thụ năng lượng không hợp lý, hoặc sử dụng dữ liệu khi thiếu kiểm soát quyền riêng tư và trách nhiệm giải trình phù hợp. Một hệ thống như vậy không hỏng; nó đang tối ưu hóa hiệu quả một đặc tả chưa đầy đủ. Các ràng buộc bị bỏ sót sẽ lộ ra dưới dạng kết quả chênh lệch giữa các nhóm, chi phí và phát thải suốt vòng đời, các quyết định mà con người không thể hiểu hay phản đối, và bằng chứng không thể khôi phục sau khi thiệt hại xảy ra. Nếu những hệ quả đó không được xác định là yêu cầu trước khi triển khai và được giám sát sau đó, các kiểm tra sức khỏe thông thường có thể vẫn “xanh” trong khi thiệt hại tích lũy. Kỹ thuật có trách nhiệm coi đó là lỗi hệ thống cần được chẩn đoán, đo lường và giảm thiểu với mức độ nghiêm ngặt tương tự như khi xử lý suy giảm độ trễ hoặc độ chính xác. Công việc này đòi hỏi chuyển các nghĩa vụ rộng thành các giới hạn có thể kiểm tra, giả định được ghi lại, dữ liệu có thể truy vết, và các đường dẫn ứng phó vẫn có thể thực thi trong môi trường sản xuất. Theo thuật ngữ D·A·M, trách nhiệm mở rộng định nghĩa về tính đúng: dữ liệu phải được xem xét về các tác hại được mã hóa và tính hợp pháp của việc sử dụng; thuật toán phải được giới hạn bởi các yêu cầu về kết quả và hiệu suất có cơ sở; và hạ tầng máy phải giám sát, ghi lại và thực thi các giới hạn đó trong suốt vòng đời hệ thống.
Learning Objectives
- Giải thích cách các hệ thống ML được tối ưu hóa có thể khuếch đại tác hại thông qua các biến đại diện, vòng lặp phản hồi và dịch chuyển phân phối
- Áp dụng chẩn đoán dữ liệu–thuật toán–máy để khoanh vùng các lỗi trách nhiệm nằm ở dữ liệu, mục tiêu thuật toán, hoặc hạ tầng giám sát
- Tính các chỉ số công bằng từ ma trận nhầm lẫn và so sánh các đánh đổi trên biên Pareto giữa công bằng và độ chính xác.
- Thiết kế đánh giá tách theo nhóm, kiểm thử chịu tải và giám sát để phơi bày các lỗi đặc thù theo nhóm phụ trước khi triển khai.
- Phân tích tổng chi phí, mức chi phối của suy luận, và tác động carbon như các ràng buộc về trách nhiệm có thể đo lường.
- Xây dựng thẻ mô hình, bảng dữ liệu, hồ sơ truy nguyên (lineage), và nhật ký kiểm toán để bảo đảm khả năng giải trình.
- Đánh giá các thiết kế về quyền riêng tư, kiểm soát truy cập và tuân thủ đối chiếu với các yêu cầu quy định pháp lý và yêu cầu thẩm định từ con người.
Trách nhiệm dưới góc nhìn kỹ thuật hệ thống
Năm 2014, Amazon phát triển một công cụ tuyển dụng AI1 phạt điểm những hồ sơ có chứa từ “women’s” (ví dụ: “women’s chess club captain” - đội trưởng câu lạc bộ cờ vua nữ) và hạ điểm các ứng viên tốt nghiệp từ các trường nữ sinh. Hệ thống tối ưu đúng theo mục tiêu đã nêu: xác định các ứng viên giống với những người từng được tuyển trước đây. Vấn đề không phải là mô hình bị trục trặc, mà là các khuôn mẫu tuyển dụng trong quá khứ đã chứa đựng độ chệch (bias) giới tính, và mô hình đã tái tạo lại độ chệch đó ở quy mô lớn.
1 Công cụ tuyển dụng của Amazon: Được đội ngũ kỹ sư của Amazon tại Edinburgh phát triển từ năm 2014 để chấm điểm ứng viên theo thang 1–5, hệ thống này được huấn luyện trên khoảng một thập kỷ hồ sơ—phần lớn từ ứng viên nam, phản ánh tỷ lệ giới tính trong ngành công nghệ. Đến năm 2015, độ chệch (bias) giới tính đã được phát hiện; đến năm 2017, dự án bị hủy bỏ sau nhiều lần cố gắng khắc phục (Dastin 2018). Chi phí kỹ thuật không nằm ở tính toán mà ở chi phí cơ hội: một dự án tuyển dụng kéo dài nhiều năm thất bại vì mục tiêu đã mã hóa độ chệch (bias) lịch sử, trở thành một lỗi đặc tả được ghi nhận trong các công cụ học máy (machine learning).
Dastin, Jeffrey. 2018. “Amazon Scraps Secret AI Recruiting Tool That Showed Bias Against Women.” Reuters.
National Aeronautics and Space Administration. 2016. NASA Systems Engineering Handbook. NASA/SP-2016-6105 Rev2. National Aeronautics; Space Administration.
Nếu MLOps là vòng lặp kiểm soát cho độ tin cậy, thì kỹ thuật có trách nhiệm là vòng lặp kiểm soát cho an toàn. MLOps giám sát tình trạng hệ thống và kích hoạt huấn luyện lại khi hiệu suất giảm, còn kỹ thuật có trách nhiệm giám sát chất lượng kết quả và kích hoạt can thiệp khi hệ thống gây hại. Một mô hình có thể tối ưu hóa hoàn hảo theo mục tiêu đề ra nhưng vẫn gây hại mang tính hệ thống, vì vấn đề không phải là lỗi mã nguồn mà là sai sót trong đặc tả. Trong ngôn ngữ kỹ thuật hệ thống, một hệ thống có thể đạt xác minh (tức là đáp ứng các yêu cầu đã nêu) nhưng lại trượt xác nhận (tức là không đáp ứng nhu cầu thực sự của người dùng) (National Aeronautics and Space Administration 2016).
Kỹ thuật phần mềm truyền thống thường cô lập lỗi trong các mô-đun, dù các phụ thuộc chung vẫn có thể lan truyền sự cố. Các hệ thống machine learning bổ sung sự phụ thuộc dựa trên dữ liệu: dữ liệu luân chuyển qua các biểu diễn chung, nên vấn đề ở một thành phần có thể ảnh hưởng đến nhiều đầu ra. Một tập dữ liệu huấn luyện có độ chệch (bias) không tạo ra một lỗi mã cục bộ; nó có thể làm lệch các dự đoán trên toàn hệ thống. Khung phân loại D·A·M hệ thống hóa một framework chẩn đoán để xác định nguồn gốc của các lỗi như vậy, phân rã theo ba trục: dữ liệu có độ chệch (bias), thuật toán bị lệch so với mục tiêu, hoặc cơ sở hạ tầng giám sát kết quả không đầy đủ. Điều này biến trách nhiệm thành một mối quan tâm ở tầng kiến trúc, chứ không phải chuyện nghĩ tới sau.
Trách nhiệm kỹ thuật do đó mở rộng ý nghĩa của “đúng” đối với các hệ thống machine learning. Tính đúng đắn theo nghĩa truyền thống (đáng tin cậy, hiệu suất cao và dễ bảo trì) vẫn cần thiết, nhưng các hệ thống machine learning còn phải đúng theo nghĩa rộng hơn: công bằng giữa các nhóm người dùng, hiệu quả về tiêu thụ tài nguyên và minh bạch trong quy trình ra quyết định. Tính đúng đắn mở rộng này chính là công việc kỹ thuật, áp dụng cho các kiểu lỗi mà những chỉ số thông thường không ghi nhận. Độ trễ tăng lên có thể nhìn thấy trên bảng điều khiển; còn sự suy giảm tính công bằng lại vô hình cho đến khi nó gây hại cho người dùng thực (nguyên tắc 13). Cả hai đều cần được phát hiện, đo lường và khắc phục một cách có hệ thống.
Để chẩn đoán, ngăn ngừa và giảm thiểu những thất bại này, chúng ta cần lần theo khoảng cách trách nhiệm xuyên suốt hệ thống. Các trường hợp cụ thể cho thấy khoảng cách giữa hiệu suất kỹ thuật và kết quả có trách nhiệm, cùng các cơ chế (biến đại diện, vòng lặp phản hồi, dịch chuyển phân phối) làm cho khoảng cách đó bộc lộ. Khoảng cách này thúc đẩy việc áp dụng các quy trình kỹ thuật có thể lặp lại cho đánh giá tác động, tài liệu mô hình, kiểm thử phân tách và ứng phó sự cố. Lượng tài nguyên tiêu thụ được định lượng trong sách này (năng lực tính toán cho huấn luyện, năng lượng cho suy luận, dấu chân carbon) trở thành ràng buộc đạo đức bên cạnh ràng buộc hiệu suất, vì tối ưu hóa hiệu quả phục vụ trách nhiệm cũng trực tiếp như phục vụ tốc độ. Cơ sở hạ tầng quản trị dữ liệu và tuân thủ (kiểm soát truy cập, bảo vệ quyền riêng tư, theo dõi nguồn gốc và hệ thống kiểm toán) giúp các thực hành đó có thể được áp dụng bắt buộc ở quy mô lớn.
Self-Check: Question
An AI recruiting tool meets its latency SLA, maintains 99.9% availability, and achieves 87% aggregate accuracy, yet it systematically downgrades resumes containing the word “women’s” or graduates of women’s colleges. Applying the systems-engineering verification-versus-validation framing, which diagnosis correctly explains this outcome?
- The system failed verification because any discriminatory outcome is by definition a low-level coding defect in the model implementation.
- The failure is primarily an operational reliability defect that responsible engineering addresses only after serving infrastructure destabilizes.
- The root cause is insufficient model capacity, which can be resolved by scaling up model parameters without altering the optimization objective.
- The system passed verification by meeting its stated technical requirements, but failed validation because the specification itself did not capture the organization’s true goal of fair hiring.
A team argues that a one-time ethics sign-off before deployment is sufficient because their model passes all latency and aggregate accuracy checks. Using the MLOps control-loop analogy, explain why responsible engineering must instead operate as a continuous control loop, and identify one specific production metric that a one-time pre-launch review cannot capture.
True or False: Because ML systems are constructed from modular software components, a fairness defect originating from biased training data can be isolated and patched within a single function without altering data pipelines, training objectives, or shared representations.
Khoảng cách trách nhiệm trong kỹ thuật
Một mô hình cho vay chấp thuận 95% người nộp đơn đủ điều kiện thuộc nhóm đa số nhưng lại từ chối 40% người nộp đơn đủ điều kiện tương đương thuộc nhóm thiểu số vẫn có thể đạt tổn thất tổng thể thấp. khoảng cách trách nhiệm giữa tính đúng đắn kỹ thuật và kết quả có trách nhiệm này là một thách thức trung tâm trong kỹ thuật hệ thống machine learning, mà các phương pháp kiểm thử hiện tại chưa được thiết kế để giải quyết. Khoảng cách này biểu hiện qua các cơ chế cụ thể: biến đại diện, vòng lặp phản hồi và dịch chuyển phân phối, mỗi cơ chế gây hại theo một đường dẫn riêng mà giám sát thông thường không nhìn thấy được.
Khi tối ưu hóa thành công nhưng hệ thống thất bại
Thất bại của công cụ tuyển dụng biến khoảng cách này thành một vấn đề dữ liệu thay vì lỗi mã. Một mô hình được huấn luyện trên dữ liệu tuyển dụng lịch sử của một thập kỷ đã tối ưu hóa trung thành theo mục tiêu được giao, nhưng các mẫu hình lịch sử đó mã hóa độ chệch (bias) giới tính mà hệ thống đã tái tạo trong đánh giá ứng viên (Dastin 2018).
Bolukbasi, Tolga, Kai-Wei Chang, James Y. Zou, Venkatesh Saligrama, and Adam Tauman Kalai. 2016. “Man Is to Computer Programmer as Woman Is to Homemaker? Debiasing Word Embeddings.” Advances in Neural Information Processing Systems (NeurIPS), 4349–57.
Cơ chế kỹ thuật dẫn đến kết quả này khá dễ hiểu. Mô hình học các mẫu ở cấp độ token từ dữ liệu lịch sử. Khi phần lớn các trường hợp tuyển dụng thành công trước đây là nam, những hồ sơ dùng ngôn ngữ gắn với hoạt động hoặc tổ chức của phụ nữ sẽ có mức tương quan thống kê thấp hơn với quyết định tuyển dụng tích cực. Mô hình đã nhận diện đúng các mẫu đó trong dữ liệu huấn luyện, nhưng lại rút ra kết luận sai từ việc nhận diện đúng. Rộng hơn, các biểu diễn văn bản mà mô hình học được có thể mã hóa và khuếch đại định kiến giới, kể cả trong các embeddings (Bolukbasi et al. 2016).

Thất bại của Amazon là một thất bại trên trục dữ liệu: tín hiệu lịch sử có độ chệch (bias).
2 Biến đại diện: Loại bỏ một biến đại diện có thể ít tác dụng khi các đặc trưng tương quan khác vẫn giữ tín hiệu tương tự. Ngược lại, chỉ dựa vào tương quan thì không chứng minh được có phân biệt đối xử hoặc xác định đúng can thiệp cần thiết. Việc loại bỏ thuộc tính được bảo vệ, đánh giá theo nhóm con, kiểm tra phản sự kiện, phân tích nhân quả và rà soát toàn bộ quy trình ra quyết định cung cấp các bằng chứng bổ sung; không một phép chẩn đoán đơn lẻ nào là hàng rào bảo vệ đầy đủ.
Amazon đã cố gắng khắc phục bằng cách loại bỏ các chỉ báo giới tính rõ ràng và các thuật ngữ mang tính giới khỏi quá trình huấn luyện. Tuy vậy, can thiệp này không chứng minh được rằng các gợi ý còn lại là không có độ chệch (bias), vì các đặc trưng khác trong hồ sơ vẫn có thể giữ tín hiệu liên quan đến giới tính.2 Nói chung, biến đại diện có thể mang tín hiệu nhân khẩu học gián tiếp: mã ZIP có thể tương quan với chủng tộc do phân hóa khu dân cư, tên có thể tương quan với giới tính hoặc sắc tộc, và mức sử dụng dịch vụ chăm sóc sức khỏe có thể tương quan với điều kiện kinh tế - xã hội. Trong trường hợp của Amazon, các mức phạt được báo cáo đối với các từ như “women’s” và đối với người tốt nghiệp từ hai trường cao đẳng dành cho nữ cho thấy văn bản hồ sơ có thể mã hóa các mẫu gắn với giới (Dastin 2018). Vì vậy, chỉ loại bỏ các thuộc tính được bảo vệ khỏi dữ liệu huấn luyện là chưa đủ để thiết lập công bằng.
War Story 1.1: Kiểm toán thuật toán tái phạm COMPAS (2016)
Bối cảnh: COMPAS là một công cụ đánh giá rủi ro được sử dụng trong các tòa án ở Mỹ để dự đoán nguy cơ tái phạm, phục vụ cho các quyết định về bảo lãnh và tuyên án (Angwin et al. 2016).
Cơ chế: Tối ưu hóa để đạt hiệu chỉnh nhất quán giữa các nhóm dân số có tỷ lệ tái phạm nền khác nhau buộc phải đánh đổi về mặt toán học giữa sự đồng đều trong xác suất dự báo và cân bằng tỷ lệ lỗi giữa các nhóm chủng tộc.
Tác động: Các bị cáo da đen không tái phạm bị phân loại nhầm là rủi ro cao với tỷ lệ gần gấp đôi so với các bị cáo da trắng (44,9 phần trăm so với 23,5 phần trăm), trong khi những người tái phạm da trắng lại thường xuyên bị phân loại nhầm là rủi ro thấp hơn nhiều.
Phản hồi: Cuộc kiểm toán cho thấy vì sao chỉ dựa vào hiệu chỉnh không thể kết luận liệu phân phối lỗi có chấp nhận được hay không. Bất kỳ khu vực pháp lý nào sử dụng các điểm số như vậy đều cần một chính sách rõ ràng về những tiêu chí công bằng nào là quan trọng, xác thực độc lập giữa các nhóm và xem xét cách điểm số được đưa vào quy trình ra quyết định.
Bài học về hệ thống: Các điểm số được hiệu chỉnh xấp xỉ theo từng nhóm chủng tộc, nhưng chúng vi phạm equalized odds vì tỷ lệ dương tính giả và âm tính giả không khớp giữa các nhóm. Các kết quả lý thuyết về công bằng cho thấy hiệu chỉnh và sự ngang bằng về tỷ lệ lỗi sẽ xung đột khi các tỷ lệ nền khác nhau, qua đó lý giải vì sao trách nhiệm của kỹ sư đòi hỏi phải lựa chọn rõ ràng ràng buộc công bằng nào là quan trọng.
Angwin, Julia, Jeff Larson, Surya Mattu, and Lauren Kirchner. 2016. Machine Bias. ProPublica investigation.
Sự can thiệp đúng đắn sẽ cần thay đổi ở nhiều cấp độ. Đánh giá riêng điểm số hồ sơ ứng tuyển cho ứng viên nam so với ứng viên nữ có thể đã lượng hóa được mức chênh lệch. Áp các ràng buộc công bằng hoặc dùng khử độ chệch (bias) đối kháng—trong đó một đối thủ phụ trợ cố gắng khôi phục tín hiệu thuộc tính được bảo vệ từ biểu diễn đã học và mô hình chính bị phạt nếu tín hiệu đó vẫn còn—có thể giảm bớt một số tín hiệu đã mã hóa, nhưng vẫn cần xác thực theo nhóm con. Xem xét thủ công các trường hợp sát ngưỡng có thể bổ sung một lớp an toàn nếu người đánh giá được đào tạo, trao quyền và giám sát, thay vì chỉ được yêu cầu đóng dấu chấp thuận. Theo dõi kết quả tuyển dụng thực tế theo giới tính theo thời gian sẽ cho phép giám sát kết quả vượt ra ngoài các chỉ số của mô hình. Amazon cuối cùng đã hủy bỏ dự án sau khi xác định rằng không thể khắc phục đủ mức cần thiết (Dastin 2018).
Trường hợp của Amazon cho thấy mục tiêu tối ưu hóa có thể lệch khỏi giá trị của tổ chức. Hệ thống đã tìm ra các mẫu hình thống kê có thật trong các quyết định tuyển dụng trước đây và tối ưu hóa trung thành theo chúng. Tuy nhiên, những mẫu hình này phản ánh các thực hành lịch sử mang độ chệch (bias), chứ không phải các tiêu chí đủ điều kiện thực sự liên quan đến công việc.
Các trường hợp của Amazon và COMPAS3 có một điểm chung đáng lo ngại: mỗi hệ thống đều đạt mục tiêu công bố, nhưng lại tạo ra kết quả mâu thuẫn với các giá trị mà hệ thống đó hướng tới. Thành công kỹ thuật theo chuẩn mực thông thường vẫn có thể đi kèm những thất bại hệ thống nghiêm trọng. Mẫu hình này đặt ra hai câu hỏi thiết kế: liệu hàm mất mát có phải là một đại diện có thể biện minh cho mục tiêu thực sự của hệ thống hay không, và liệu tỷ lệ lỗi có còn chấp nhận được trên các nhóm phụ mà hệ thống tác động hay không.
3 COMPAS (Hồ sơ quản lý tội phạm để xử phạt thay thế): Trong dữ liệu được phân tích, điểm COMPAS được hiệu chỉnh xấp xỉ theo chủng tộc, nghĩa là một điểm số nhất định tương ứng với xác suất tái phạm quan sát được là tương tự nhau giữa các nhóm. Vì tỷ lệ tái phạm khác nhau giữa các nhóm dân cư, việc hiệu chỉnh này vẫn tồn tại song song với các tỷ lệ lỗi khác nhau (Chouldechova 2017; Kleinberg et al. 2017). Do đó, chỉ kiểm tra hiệu chỉnh không thể thiết lập cân bằng về tỷ lệ lỗi, hay xác định liệu cách phân bổ lỗi có chấp nhận được hay không.
Kleinberg, Jon, Sendhil Mullainathan, and Manish Raghavan. 2017. “Inherent Trade-Offs in the Fair Determination of Risk Scores.” 8th Innovations in Theoretical Computer Science Conference (ITCS 2017), Leibniz international proceedings in informatics (LIPIcs), vol. 67: 43:1–23. https://doi.org/10.4230/LIPIcs.ITCS.2017.43.
Các bài kiểm tra thông thường chỉ tập trung vào mục tiêu đã định có thể không phát hiện ra các vấn đề này, vì đây là các lỗi đặc tả bài toán, khi mục tiêu kỹ thuật (giảm thiểu lỗi dự đoán trên các kết quả lịch sử) lệch khỏi mục tiêu xã hội mong muốn (đưa ra dự đoán công bằng và chính xác cho các nhóm nhân khẩu học). Các lỗi đặc tả rất khó phát hiện, vì theo các chỉ số kỹ thuật thông thường, hệ thống vẫn vận hành bình thường. Khi một hệ thống có vẻ ổn theo các chỉ số kỹ thuật được giám sát, các tác hại nằm ngoài những chỉ số đó có thể vẫn vô hình.
Checkpoint 1.1: Thiết kế có trách nhiệm
Trách nhiệm là thuộc tính của hệ thống, không phải của mô hình.
Các kiểu lỗi
Kiểm tra
Các dạng lỗi âm thầm

Một thay đổi ở thượng nguồn; nhiều bên âm thầm bị ảnh hưởng.
Hãy xem xét một mô hình nhiễm trùng huyết trong bệnh viện, mô hình này bắt đầu đề xuất điều trị tích cực cho bệnh nhân nguy cơ thấp sau khi một thay đổi trong quy trình làm việc của hồ sơ sức khỏe điện tử (EHR) làm đổi cách ghi lại các dấu hiệu sinh tồn. Không có cảnh báo nào được kích hoạt: điểm tin cậy của mô hình vẫn cao, độ trễ vẫn trong thỏa thuận mức dịch vụ (SLA), và tất cả các kiểm tra sức khỏe hệ thống đều báo xanh. Lỗi diễn ra âm thầm: phân phối dữ liệu đầu vào đã đổi, nhưng pipeline giám sát không có cơ chế phát hiện sự trôi dạt phân phối.
Definition 1.1: Thay đổi phân phối
Thay đổi phân phối, được giới thiệu trong Giới thiệu và được cụ thể hóa để phát hiện trôi dạt trong Vận hành machine learning, xảy ra khi phân phối dữ liệu lúc triển khai khác với phân phối dùng để phát triển hoặc đánh giá mô hình. Phương pháp giảm thiểu rủi ro thực nghiệm chuẩn thường giả định phân phối dữ liệu khi huấn luyện và khi triển khai là giống nhau. Covariate shift làm đổi \(p(x)\) trong khi giữ \(p(y \mid x)\) ổn định; label shift làm đổi \(p(y)\) trong khi giữ \(p(x \mid y)\) ổn định; concept drift làm đổi \(p(y \mid x)\).
- Ý nghĩa: Các thống kê phân kỳ, như độ phân kỳ Jensen-Shannon \(\mathcal{D}_{\text{JS}}(P_t \lVert P_0)\), đo sự thay đổi phân phối chứ không đo sự suy giảm độ chính xác. Các ngưỡng cảnh báo hữu ích cần được hiệu chỉnh theo kinh nghiệm cho từng tác vụ, cách biểu diễn, quy trình gán nhãn và môi trường triển khai, rồi liên hệ với các kết quả quan sát được khi có nhãn. Một giá trị \(\mathcal{D}_{\text{JS}}\) là 0.1 có thể vô hại với một không gian đặc trưng nhưng lại nghiêm trọng với một không gian khác, và việc giám sát phân kỳ ở đầu vào có thể bỏ sót trôi dạt khái niệm.
- Điểm khác biệt: Thay đổi phân phối mô tả sự khác nhau giữa điều kiện phát triển và triển khai. Nó không hàm ý rằng ánh xạ đã học là đúng ở thời điểm huấn luyện, và cũng không phải mọi sự thay đổi đều làm giảm hiệu suất.
- Lỗi thường gặp: Dịch chuyển phân phối là một thuật ngữ bao trùm, với nhiều phân loại chồng lấp. Chỉ giám sát \(p(x)\) có thể phát hiện một số thay đổi ở đặc trưng đầu vào, nhưng không xác định được liệu \(p(y \mid x)\) còn ổn định hay không; để phát hiện trôi khái niệm thường cần các kết quả đã gán nhãn hoặc các biến đại diện có căn cứ.
Tình huống nhiễm trùng huyết này minh họa một dạng lỗi mà các hệ thống giám sát tập trung vào tính khả dụng khó xử lý hiệu quả. Một số lỗi phần mềm rất “ồn ào”: ví dụ, ngoại lệ con trỏ null làm chương trình sập, hoặc hết thời gian chờ mạng trả về mã lỗi. Tuy vậy, phần mềm thông thường cũng có thể âm thầm trả về kết quả sai. Hệ thống ML còn có thêm các kiểu lỗi thống kê mà ở đó, các dự đoán suy giảm chất lượng lại trông như bình thường. Một cơ chế gây ra sự suy giảm âm thầm này là dịch chuyển phân phối.
Giả định tiêu chuẩn trong phân tích học có giám sát là phân phối dữ liệu ở giai đoạn huấn luyện và triển khai khớp nhau, dù các phương pháp thích nghi có thể nới lỏng giả định này dưới những giả định bổ sung. Dịch chuyển phân phối cũng có thể tác động không đồng đều lên các nhóm, khiến các chỉ số tổng hợp che giấu tác hại đối với các nhóm con.
Vượt qua điểm đầu gối, biến đại diện tách rời khỏi mục tiêu.
Systems Perspective 1.1: Khoảng cách căn chỉnh
Một mô hình tối ưu hóa một chỉ số đại diện (Số lượt nhấp) vì chỉ số thực (Mức độ hài lòng của người dùng) không quan sát được, và hai chỉ số này có thể lệch xa nhau. Goodhart’s Law cảnh báo rằng tối ưu hóa một thước đo có thể làm suy yếu mối quan hệ của nó với mục tiêu gốc. Trong một hệ thống minh họa, \(\text{Correlation}(\text{Clicks}, \text{Satisfaction})\) có thể ban đầu là 0.8; nhưng khi xếp hạng được tối ưu để tối đa hóa lượt nhấp, hệ thống có thể tìm ra nội dung “câu view” (clickbait) có nhiều nhấp nhưng mức hài lòng thấp, và mối tương quan có thể giảm xuống còn 0.2.
Về mặt khái niệm, giả sử các chỉ số được chuẩn hóa trên cùng một thang đo, equation 1 diễn tả khoảng cách này: \[ \text{Gap} = \mathbb{E}[\text{Proxy}] - \mathbb{E}[\text{True}] \tag{1}\]
Nếu mô hình tăng Số lượt nhấp thêm 20% nhưng làm giảm Mức độ hài lòng 5%, thì khoảng cách căn chỉnh có dấu tăng lên.
Hiểu biết về hệ thống: Kỹ sư không thể trực tiếp tối ưu hóa một mục tiêu không quan sát được. Họ cần một cách xác thực bằng biến đại diện có thể biện minh; các tập giữ lại ngẫu nhiên (randomized holdouts) chỉ ước tính được hiệu ứng nhân quả khi đầu ra thực sự đo chính mục tiêu hoặc một biến thay thế có cơ sở.
Dịch chuyển phân phối giải thích tại sao mô hình xuống cấp theo thời gian (các chiến lược phát hiện và giám sát vận hành cho hiện tượng trôi được trình bày trong Vận hành machine learning). Sự cố này mang tính môi trường: thế giới đã đổi khác sau khi mô hình được huấn luyện, và mô hình không có cơ chế nào để nhận ra. Huấn luyện lại với dữ liệu mới có thể phần nào khắc phục loại lỗi này, nhưng không xử lý được cơ chế thứ hai gây lỗi âm thầm, vốn vẫn diễn ra ngay cả khi phân phối dữ liệu hoàn toàn ổn định. Sai lệch chỉ số xảy ra khi đại lượng mà mô hình tối ưu hóa khác với kết quả mà tổ chức thực sự coi trọng. Diễn biến của sự lệch này được nêu rõ bởi Định luật Goodhart: khi một biến đại diện trở thành mục tiêu tối ưu hóa, nó sẽ thôi không còn phản ánh mục tiêu mà nó được chọn để đại diện.
Systems Perspective 1.2: Phân loại D·A·M
Khi một hệ thống gây hại, hãy dùng phân loại D·A·M để tìm nguyên nhân gốc rễ. Vấn đề về trách nhiệm hiếm khi là “lỗi thuật toán”; chúng thường là khiếm khuyết mang tính cấu trúc dọc theo một trong ba trục:
- Dữ liệu (thông tin): Dữ liệu huấn luyện có phản ánh độ chệch (bias) lịch sử không? (ví dụ: công cụ tuyển dụng của Amazon học từ lịch sử có độ chệch). Lỗi nằm ở Nhiên liệu.
- Thuật toán (logic): Hàm mục tiêu có đang tối ưu hóa một biến đại diện dẫn tới tác hại không? (ví dụ: tối ưu hóa “mức độ tương tác” làm gia tăng phân cực). Lỗi nằm ở Bản thiết kế.
- Máy móc (vật lý): Chi phí năng lượng có tương xứng với lợi ích xã hội không? (ví dụ: huấn luyện một mô hình khổng lồ cho một tác vụ tầm thường). Lỗi nằm ở Động cơ.
Xác định được lỗi chủ đạo trong phân loại này sẽ chỉ ra biện pháp khắc phục đầu tiên cần thử: chọn lọc dữ liệu tốt hơn (Dữ liệu), mục tiêu an toàn hơn (Thuật toán), hoặc hạ tầng hiệu quả hơn (Máy móc). Các lỗi thực tế có thể trải dọc nhiều trục, nên biện pháp can thiệp vẫn cần được đánh giá từ đầu đến cuối.
Khoảng cách căn chỉnh cho thấy một lỗi bắt nguồn từ trục thuật toán: mục tiêu tối ưu hóa được đặt sai, nên ngay cả một mô hình tổng quát hóa hoàn hảo trên dữ liệu mới cũng có thể tạo ra kết quả xung đột với mục tiêu của tổ chức hoặc xã hội. Ngược lại, dịch chuyển phân phối bắt nguồn từ trục dữ liệu: đầu vào đã thay đổi và phép ánh xạ mà mô hình đã học không còn phản ánh thực tế. Cả hai lỗi này đều diễn ra âm thầm, nhưng đòi hỏi các cách khắc phục khác nhau (mục tiêu tốt hơn vs. giám sát tốt hơn), và việc trộn lẫn hai lỗi sẽ lãng phí công sức kỹ thuật vào hướng sửa sai. Phân loại D·A·M được giới thiệu trong Giới thiệu ánh xạ mỗi lỗi về trục nơi nó bắt nguồn (Dữ liệu · Thuật toán · Máy), và được định nghĩa đầy đủ tại Khung phân loại D·A·M.
Trong khi Phân loại D·A·M giúp chẩn đoán nơi lỗi bắt nguồn, các kỹ sư cũng cần một framework để hiểu khi nào và bằng cách nào các kiểu lỗi khác nhau xuất hiện. Table 1 bổ sung cho framework chẩn đoán đó bằng cách phân loại lỗi theo thời điểm phát hiện, phạm vi tác động và yêu cầu khắc phục. Sự cố và suy giảm hiệu suất sẽ kích hoạt cảnh báo ngay qua hạ tầng hiện có. Các vấn đề về chất lượng dữ liệu, dịch chuyển phân phối và vi phạm công bằng cần cơ chế phát hiện chuyên biệt, vì hệ thống vẫn vận hành bình thường về mặt kỹ thuật trong khi tạo ra các đầu ra ngày càng có vấn đề.
| Loại lỗi | Thời gian phát hiện minh họa | Phạm vi minh họa | Phản hồi có thể | Ví dụ |
|---|---|---|---|---|
| Sự cố | Ngay lập tức | Hoàn toàn | Khởi động lại sau khi khắc phục nguyên nhân | Lỗi hết bộ nhớ |
| Giảm hiệu suất | Phút | Hoàn toàn | Giảm bớt tranh chấp tài nguyên | Độ trễ tăng đột biến do tranh chấp tài nguyên |
| Chất lượng dữ liệu | Giờ–ngày | Một phần | Có thể cần hiệu chỉnh dữ liệu | Đầu vào bị hỏng từ hệ thống thượng nguồn |
| Thay đổi phân phối | Ngày–tuần | Một phần hoặc toàn bộ | Có thể yêu cầu thích nghi | Thay đổi quần thể do phân khúc người dùng mới |
| Vi phạm tính công bằng | Tuần–tháng | Tập hợp con | Có thể yêu cầu thiết kế lại | Khuếch đại thiên vị trong các mẫu lịch sử |
Vòng lặp phản hồi đề xuất của YouTube (được xem xét như một mẫu nợ kỹ thuật trong Các dạng nợ trong môi trường sản xuất) minh họa rõ mô hình này ở quy mô lớn (M. H. Ribeiro et al. 2020).4 M. H. Ribeiro et al. (2020) đã kiểm toán các đường dẫn cực đoan hóa trên YouTube, phát hiện xu hướng người dùng dịch chuyển từ các kênh ôn hòa sang các kênh cực đoan hơn, và các đề xuất có thể đưa người dùng đi giữa những danh mục kênh đó. Bài học hệ thống rộng hơn là: các vòng lặp phản hồi có thể hoạt động đúng như thiết kế nhưng tạo ra kết quả mâu thuẫn với các giá trị xã hội. Vì vậy, mục tiêu đề xuất cần được kiểm tra đối chiếu với các tác hại về sau, chứ không chỉ với các proxy về tương tác.
Ribeiro, M. H., R. Ottoni, R. West, V. A. F. Almeida, and Jr. Meira Wagner. 2020. “Auditing Radicalization Pathways on YouTube.” Proceedings of the 2020 Conference on Fairness, Accountability, and Transparency, 131–41. https://doi.org/10.1145/3351095.3372879.
4 Định luật Goodhart: “Khi một thước đo trở thành mục tiêu, nó không còn là một thước đo tốt nữa” (sự khái quát hóa của Strathern về quan sát chính sách tiền tệ năm 1975 của Goodhart) (Strathern 1997; Goodhart 1984). Các vòng lặp phản hồi đề xuất là một ví dụ kinh điển trong học máy: gradient descent tối ưu hóa các proxy về thời gian xem với tốc độ mà không biên tập viên nào có thể sánh kịp, và chính các đầu ra của hệ thống lại định hình lại phân phối huấn luyện — người dùng xem nội dung cực đoan sẽ tạo ra dữ liệu củng cố thêm sự cực đoan đó, khiến proxy không còn phản ánh đúng phúc lợi người dùng, và điều này xảy ra nhanh hơn gấp nhiều lần so với các quy trình biên tập thủ công.
Strathern, Marilyn. 1997. “‘Improving Ratings’: Audit in the British University System.” European Review 5 (3): 305–21. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4.
Goodhart, Charles A. E. 1984. “Problems of Monetary Management: The UK Experience.” In Monetary Theory and Practice. Palgrave. https://doi.org/10.1007/978-1-349-17295-5_4.
Trường hợp News Feed có một điểm khác mà vòng lặp YouTube không có: một nền tảng chọn đánh đổi mức độ tương tác đo được để ưu tiên phúc lợi dài hạn, bằng chứng trực tiếp cho thấy ngay cả những người tối ưu hóa các proxy về tương tác cũng biết chúng không đầy đủ. Một kiểu lỗi khác hoạt động ở cấp độ dân số: các biến proxy có vẻ trung lập khi tổng hợp lại có thể mã hóa những chênh lệch có hệ thống giữa các nhóm nhân khẩu học. Sự dịch chuyển phân phối được định nghĩa trong phần này cũng biểu hiện dưới dạng không khớp quần thể, khi các mô hình được huấn luyện trên một quần thể lại hoạt động khác trên quần thể khác mà không có dấu hiệu rõ ràng. Cơ chế proxy tương tự từng cho phép mô hình tuyển dụng của Amazon suy ra lại giới tính cũng xuất hiện trong chăm sóc sức khỏe, nơi dùng chi phí làm đại diện cho nhu cầu đã tạo ra một trong những trường hợp gây hại do thuật toán được nghiên cứu rộng rãi nhất.
Example 1.1: Các dịch chuyển proxy trong News Feed
Tình huống: Facebook đã chuyển mục tiêu xếp hạng Bảng tin (News Feed) từ các thước đo gián tiếp cho tương tác ngắn hạn (như lượt nhấp, thời gian xem) sang các chỉ số về tương tác xã hội có ý nghĩa hơn (Mosseri 2018).
Chẩn đoán: Việc chỉ tối ưu theo các thước đo gián tiếp cho tương tác ngắn hạn đã tách rời kết quả xếp hạng khỏi lợi ích lâu dài của người dùng, làm gia tăng nội dung câu khách (clickbait) và hành vi xem thụ động.
Bài học hệ thống: Các chỉ số tương tác chỉ là thước đo gián tiếp (proxy) cho giá trị, chứ không phải bản thân giá trị. Các thuật toán đề xuất cần tối ưu hóa đa mục tiêu, kèm các ràng buộc an toàn rõ ràng để ngăn tình trạng proxy bị sụp đổ.
Mosseri, Adam. 2018. Bringing People Closer Together. Meta Newsroom.
Các kiểu lỗi âm thầm (silent failure modes) khiến việc kiểm thử trở nên phức tạp. Kiểm thử phần mềm truyền thống thường xác minh hành vi đã định thông qua các khẳng định chính xác. Trong khi đó, các hệ thống ML còn có hành vi học được từ dữ liệu và hiệu suất được đánh giá theo thống kê, khiến việc định nghĩa tính đúng đắn khó hơn. Những lỗi ở phần mở đầu có chung một điểm đáng lo: các kiểm tra kỹ thuật thông thường không bao quát được các tác hại đã xảy ra. Các tổ chức có thể thu hẹp khoảng cách này khi họ chuyển các mục tiêu về trách nhiệm thành thực hành kỹ thuật có cấu trúc.
War Story 1.2: Cái bẫy biến proxy (2019)
Bối cảnh: Năm 2019, Ziad Obermeyer và các đồng nghiệp tại UC Berkeley đã kiểm toán một thuật toán thương mại của Optum. Thuật toán này được các hệ thống y tế dùng để ghi danh bệnh nhân có nhu cầu phức tạp vào các chương trình quản lý chăm sóc rủi ro cao, và nghiên cứu đã xem xét khoảng năm mươi nghìn bệnh nhân tại một bệnh viện học thuật lớn (Obermeyer et al. 2019).
Cơ chế: Mô hình dự đoán “chi phí chăm sóc sức khỏe tương lai” như một thước đo gián tiếp cho “nhu cầu sức khỏe tương lai.” Vì hệ thống chăm sóc sức khỏe Hoa Kỳ chi tiêu ít hơn cho bệnh nhân da đen so với bệnh nhân da trắng có cùng mức độ bệnh, thuật toán đã học theo mẫu hình này và gán điểm rủi ro thấp hơn cho bệnh nhân da đen.
Tác động: Ở cùng một mức điểm rủi ro, bệnh nhân da đen mắc nhiều bệnh mãn tính hơn đáng kể so với bệnh nhân da trắng, làm giảm tỷ lệ bệnh nhân da đen được ghi danh vào các dịch vụ chăm sóc chuyên biệt.
Phản hồi: Nghiên cứu cho thấy nếu thay chi phí bằng một thước đo trực tiếp về nhu cầu sức khỏe, tỷ lệ bệnh nhân da đen được xác định cần chăm sóc bổ sung sẽ tăng từ 17,7 phần trăm lên 46,5 phần trăm tại ngưỡng được phân tích.
Bài học hệ thống: Tối ưu hóa dựa trên một thước đo gián tiếp (proxy) sẽ kế thừa độ chệch (bias) của chính hệ thống đã tạo ra thước đo đó. Vì vậy, cần kiểm toán mối quan hệ giữa proxy và mục tiêu trên mọi nhóm nhân khẩu học mà hệ thống phục vụ.
Khi kỹ thuật có trách nhiệm phát huy hiệu quả
Mỗi thành công được ghi nhận đều có chung một bước đi về mặt cấu trúc: một mục tiêu trách nhiệm mơ hồ được biến thành một ràng buộc kỹ thuật cụ thể, có thể nêu rõ, kiểm thử, truyền đạt và, khi cần thiết, dùng để dừng triển khai. Theo các phát hiện của Gender Shades, một cuộc kiểm toán năm 2018 đã chỉ ra sự chênh lệch nghiêm trọng về tỷ lệ lỗi trong phân loại giới tính thương mại (Buolamwini and Gebru 2018), Microsoft đã đầu tư để cải thiện hiệu suất phân loại giới tính trên các nhóm nhân khẩu học. Việc thu thập dữ liệu có mục tiêu, điều chỉnh mô hình và đánh giá tách biệt theo nhóm một cách có hệ thống đã giúp nhóm có một mục tiêu tỷ lệ lỗi rõ ràng. Microsoft báo cáo đã giảm đáng kể tỷ lệ lỗi đối với những người có làn da sẫm màu hơn, đưa tỷ lệ lỗi được kiểm toán xuống dưới 2% (Raji and Buolamwini 2019). Công ty công bố minh bạch những cải tiến này, biến các kết quả kiểm toán bên ngoài thành các mục tiêu kỹ thuật có thể đo lường.
Yee, Kyra, Uthaipon Tantipongpipat, and Shubhanshu Mishra. 2021. “Image Cropping on Twitter: Fairness Metrics, Their Limitations, and the Importance of Representation, Design, and Agency.” Proceedings of the ACM on Human-Computer Interaction 5 (CSCW2): 1–24. https://doi.org/10.1145/3479594.
Hệ thống cắt ảnh tự động của Twitter cũng cho thấy sự chặt chẽ tương tự, nhưng với một ràng buộc khác. Năm 2020, người dùng nêu lo ngại về độ chệch (bias) theo chủng tộc và giới tính trong việc khuôn mặt nào xuất hiện ở hình thu nhỏ xem trước. Twitter đã kiểm toán hệ thống, báo cáo các chênh lệch và hạn chế đo được, và chuyển sang các bản xem trước không cắt xén, cho người dùng nhiều quyền kiểm soát hơn (Yee et al. 2021). Trong trường hợp đó, kỹ thuật có trách nhiệm đã dẫn đến thay đổi thiết kế sản phẩm, thay vì chỉ dựa vào một ngưỡng xếp hạng tốt hơn.
Bảo mật vi phân chính thức hóa khuôn mẫu này: một yêu cầu về quyền riêng tư trở thành một đảm bảo toán học, thay vì chỉ là một mong muốn về chính sách (Dwork 2008).5 Các hệ thống sử dụng bảo mật vi phân phải hiệu chỉnh nhiễu để cân bằng giữa tính hữu ích và quyền riêng tư, theo dõi ngân sách quyền riêng tư qua các phân tích lặp lại và ghi lại các tham số quyền riêng tư đã chọn.
Dwork, Cynthia. 2008. “Differential Privacy: A Survey of Results.” In Theory and Applications of Models of Computation. Springer Berlin Heidelberg. https://doi.org/10.1007/978-3-540-79228-4_1.
5 Bảo mật vi phân: Được giới thiệu bởi Dwork et al. (2006), một cơ chế ngẫu nhiên \(\mathcal{M}\) thỏa mãn bảo mật vi phân \((\epsilon, \delta)\) nếu với mọi cặp tập dữ liệu lân cận \(D, D'\) chỉ khác nhau một bản ghi và mọi tập đầu ra \(\mathcal{S}\), ta có \(\mathbb{P}[\mathcal{M}(D) \in \mathcal{S}] \leq e^\epsilon \cdot \mathbb{P}[\mathcal{M}(D') \in \mathcal{S}] + \delta\). Ở đây, \(\epsilon\) giới hạn mức mất riêng tư, còn \(\delta\) cho phép một xác suất nhỏ vượt quá giới hạn đó; các giá trị chấp nhận được phụ thuộc vào mô hình đe doạ và chính sách. Đánh đổi ở cấp hệ thống nằm ở tính hữu dụng, không chỉ ở độ phức tạp triển khai: mức bảo mật mạnh hơn thường đòi hỏi thêm nhiễu hoặc lấy mẫu chặt chẽ hơn, và mức mất riêng tư sẽ cộng dồn qua các truy vấn lặp lại hoặc các bước huấn luyện. Do đó, các kỹ sư phải theo dõi mức mất riêng tư tích lũy bằng một bộ tính toán hợp lệ và báo cáo các giả định đằng sau ngân sách đã chọn.
Dwork, Cynthia, Frank McSherry, Kobbi Nissim, and Adam Smith. 2006. “Calibrating Noise to Sensitivity in Private Data Analysis.” In Theory of Cryptography Conference (TCC), edited by Shai Halevi and Tal Rabin, vol. 3876. Lecture Notes in Computer Science. Springer Berlin Heidelberg. https://doi.org/10.1007/11681878_14.
Có một điểm chung nối các trường hợp này: trách nhiệm chỉ tạo ra giá trị khi các biện pháp kỹ thuật (cải thiện dữ liệu, đánh giá tốt hơn, thay đổi kiến trúc, các đảm bảo chính thức, hoặc kiểm soát cho người dùng) kết hợp với các cam kết của tổ chức về minh bạch, đầu tư dài hạn và sẵn sàng loại bỏ các đặc trưng không thể làm cho an toàn. Mỗi thành công đều dựa trên các thực hành kiểm thử và đánh giá có hệ thống. Tuy nhiên, bản chất của kiểm thử có trách nhiệm khác căn bản với việc xác minh phần mềm truyền thống.
Thách thức kiểm thử
Trong kiểm thử phần mềm truyền thống, chúng ta xác minh rằng hệ thống hoạt động đúng vì khái niệm “đúng” có định nghĩa rõ ràng. Ví dụ, một hàm phải trả về tổng các đầu vào của nó, hay một cơ sở dữ liệu phải duy trì tính toàn vẹn tham chiếu. Những thuộc tính này có thể được diễn đạt thành các mệnh đề có thể kiểm thử.
Các thuộc tính của ML có trách nhiệm khó thể được công thức hóa đơn giản. Công bằng có nhiều định nghĩa toán học khác nhau và có thể xung đột trong các tình huống như tỷ lệ cơ bản không đồng đều hoặc dự đoán không hoàn hảo (Chouldechova 2017; Kleinberg et al. 2017). Điều gì được xem là công bằng còn tùy vào ngữ cảnh, giá trị và các đánh đổi mà hệ thống kỹ thuật không thể tự giải quyết. Công bằng cá nhân yêu cầu những cá nhân tương tự được đối xử giống nhau, trong khi công bằng nhóm yêu cầu kết quả công bằng giữa các nhóm nhân khẩu học. Các tiêu chí này có thể mâu thuẫn, và lựa chọn giữa chúng đòi hỏi phán xét về giá trị vượt ra ngoài phạm vi của tối ưu hóa.
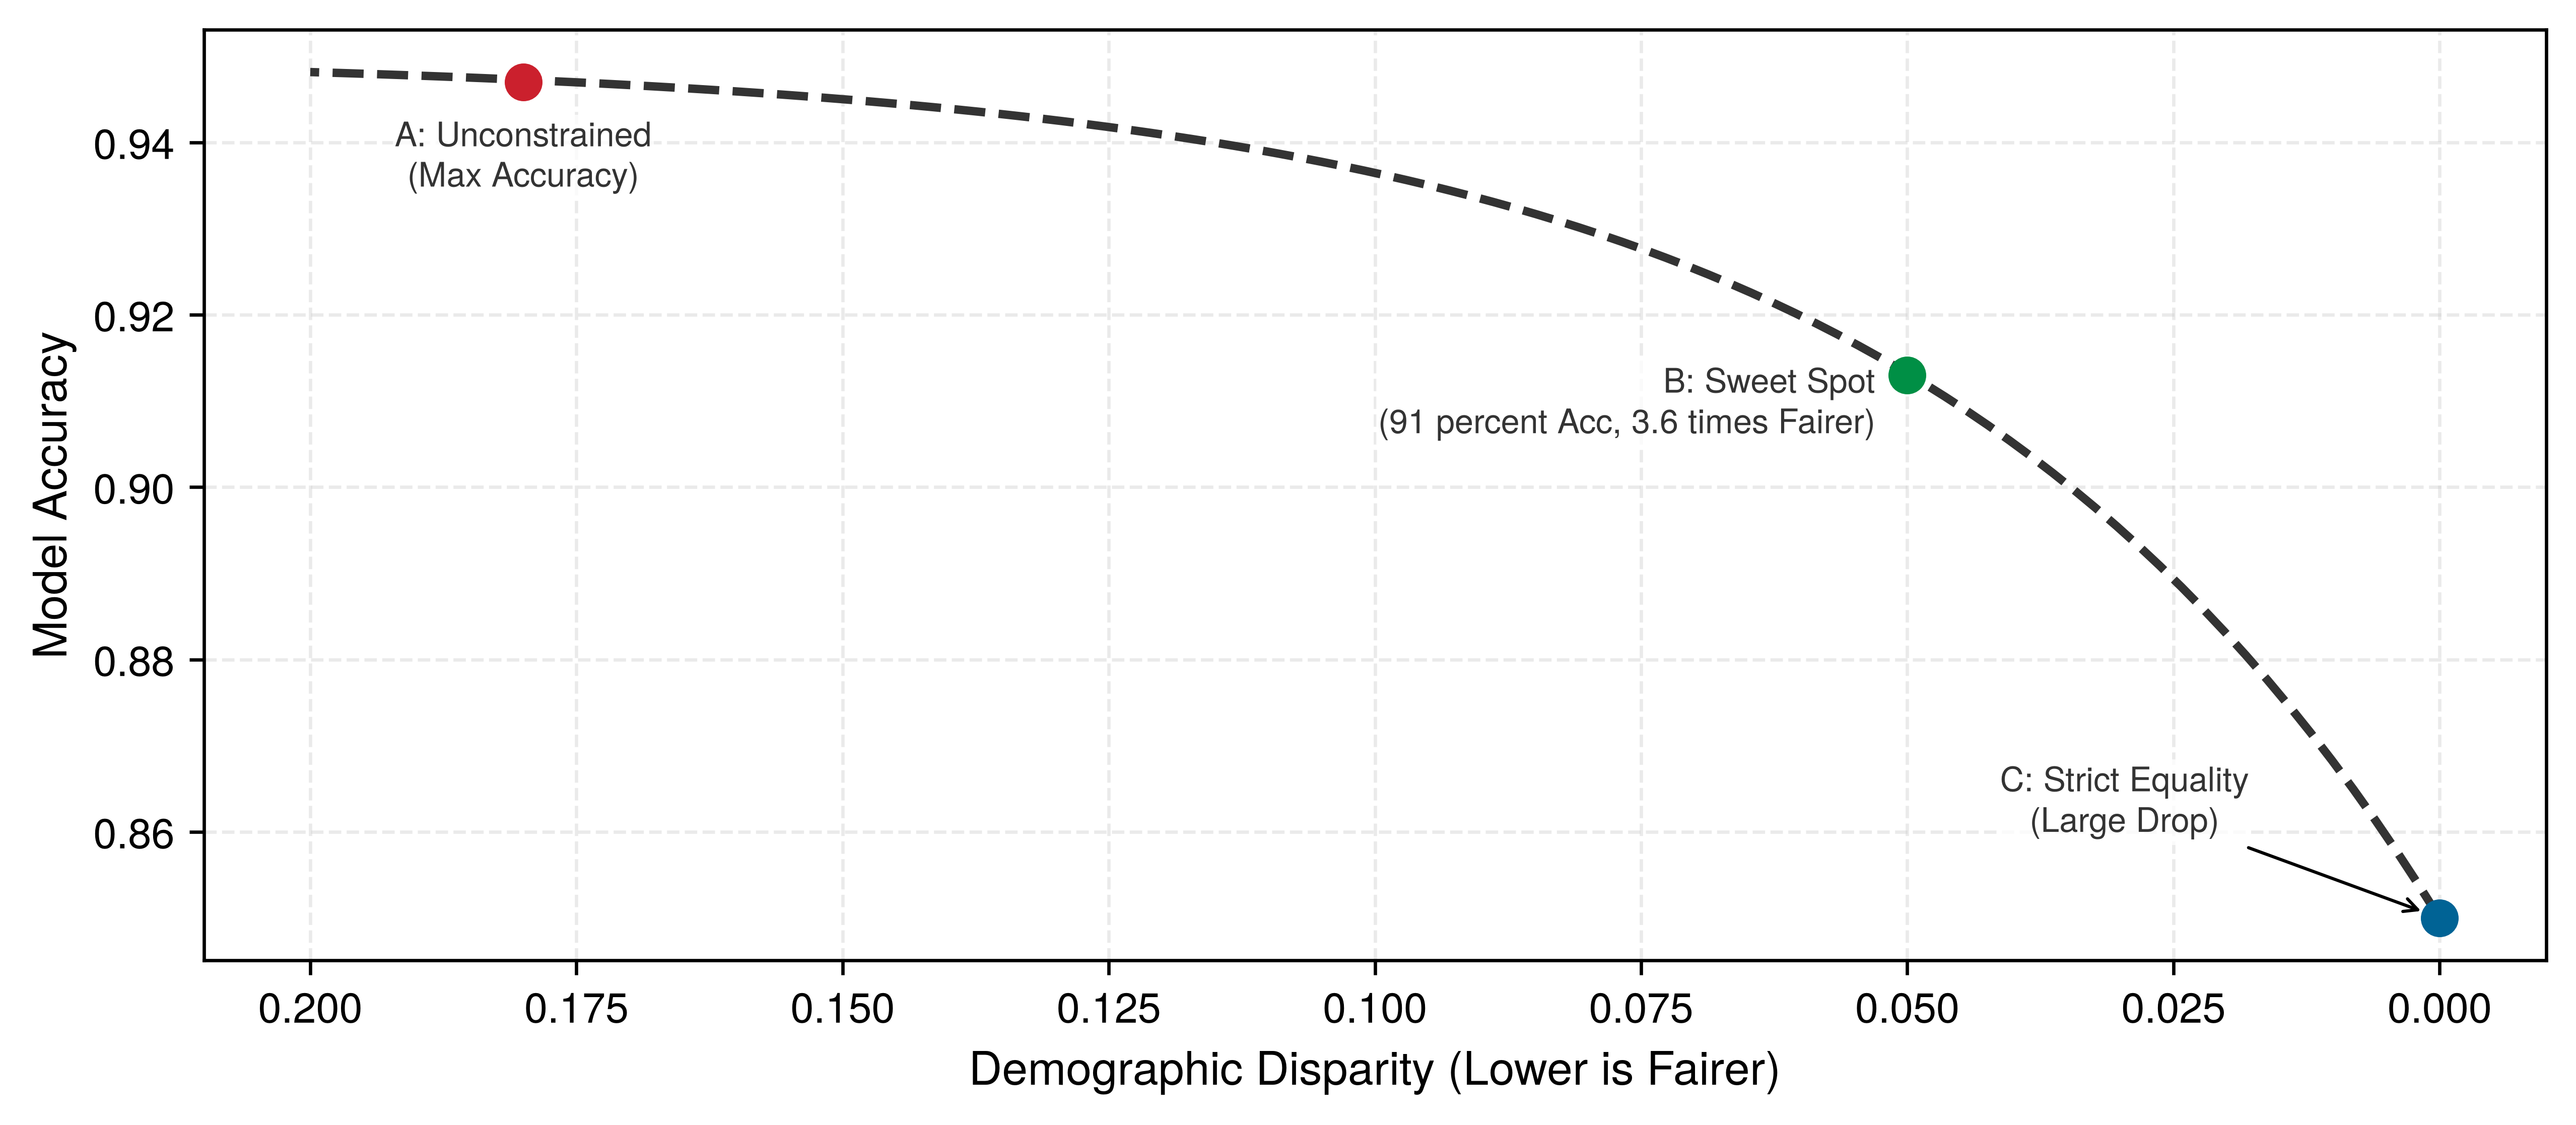
Các ràng buộc về công bằng và hiệu suất dự đoán có thể phải đánh đổi, nhưng mối quan hệ này phụ thuộc vào từng ứng dụng. Đường biên Pareto biểu diễn các cấu hình mà ở đó một mục tiêu không thể cải thiện thêm nếu không làm giảm mục tiêu còn lại. Figure 1 minh họa một đường biên công bằng-độ chính xác giả định. Ba điểm trên đường biên này minh họa các lựa chọn chính sách khả thi; chúng không hàm ý rằng huấn luyện không ràng buộc luôn tối đa hóa độ chính xác khi chênh lệch cao, rằng chênh lệch bằng 0 chắc chắn sẽ làm giảm độ chính xác, hay rằng mọi ứng dụng đều có một điểm cân bằng tối ưu.
Ranh giới này cho các kỹ sư biết họ có thể phải chọn đánh đổi nào, nhưng chưa thể vẽ ra cho đến khi đo được hiệu suất của từng nhóm con. Các thuộc tính về trách nhiệm chỉ trở nên kiểm thử được khi các kỹ sư cùng các bên liên quan xác định tiêu chí phù hợp cho từng ứng dụng cụ thể. Dự án Gender Shades6 đã cho thấy cách đánh giá phân tách theo các danh mục nhân khẩu học có thể bộc lộ những chênh lệch mà các chỉ số tổng hợp không nhìn thấy (Buolamwini and Gebru 2018), qua đó phơi bày các lỗi ở những nhóm con mà công tác giám sát trách nhiệm phải phát hiện trước khi triển khai. Table 2 cho thấy sự khác biệt lớn về tỷ lệ lỗi mà các hệ thống phân loại giới tính thương mại tạo ra giữa các nhóm nhân khẩu học. Cụ thể, một tập kiểm thử 10,000 mẫu đủ dùng với nhóm đa số chỉ cung cấp 100 mẫu cho một nhóm con thiểu số chiếm 1 percent dân số — đồng nghĩa với việc cần nhiều dữ liệu hơn 100× lần so với nhóm đa số để kiểm định với độ tin cậy cao.
6 Gender Shades: Một nghiên cứu năm 2018 của Joy Buolamwini (MIT Media Lab) và Timnit Gebru (Microsoft Research) đã kiểm tra các hệ thống phân loại giới tính thương mại từ Microsoft, IBM và Face++ bằng thang đo loại da Fitzpatrick — vốn là một phân loại da liễu do Thomas Fitzpatrick phát triển năm 1975 để đánh giá độ nhạy với tia UV, sau đó được xác nhận dùng trong lâm sàng (Fitzpatrick 1988), và ở đây được dùng lại như một benchmark nhân khẩu học cho kiểm tra thuật toán. Nghiên cứu này chứng minh giá trị của đánh giá phân tách; trong các kết quả của Face++ được tái hiện trong table 2, tỷ lệ lỗi của nữ da sẫm cao gấp 43.1× lần so với nam da sáng. Những giảm lỗi mà Microsoft báo cáo sau đó cho thấy các kết quả kiểm tra công khai có thể thúc đẩy các biện pháp khắc phục có thể đo lường được (Raji and Buolamwini 2019).
Fitzpatrick, Thomas B. 1988. “The Validity and Practicality of Sun-Reactive Skin Types i Through VI.” Archives of Dermatology 124 (6): 869. https://doi.org/10.1001/archderm.1988.01670060015008.
Raji, Inioluwa Deborah, and Joy Buolamwini. 2019. “Actionable Auditing: Investigating the Impact of Publicly Naming Biased Performance Results of Commercial AI Products.” Proceedings of the 2019 AAAI/ACM Conference on AI, Ethics, and Society, 429–35. https://doi.org/10.1145/3306618.3314244.
Buolamwini, Joy, and Timnit Gebru. 2018. “Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification.” Conference on Fairness, Accountability and Transparency, 77–91.
| Nhóm nhân khẩu học | Tỷ lệ lỗi (%) | So với nam giới da sáng |
|---|---|---|
| Nam giới da sáng | 0.8% | Mức cơ sở (1.0\(\times\)) |
| Nữ giới da sáng | 9.8% | 12.2× |
| Nam giới da sẫm màu | 0.7% | 0.9× |
| Nữ giới da sẫm màu | 34.5% | 43.1× |
Như table 2 cho thấy, đánh giá theo nhóm đã bộc lộ điều mà chỉ số tổng hợp che khuất. Face++ báo cáo tỷ lệ lỗi 0.8 percent cho nam giới da sáng và 34.5 percent cho nữ giới da sẫm màu (độ chính xác lần lượt là 99.2 percent và 65.5 percent). Chỉ số tổng hợp không hề cho thấy rằng tỷ lệ lỗi của nữ giới da sẫm màu cao gấp 43.1× lần so với nam giới da sáng.
Không có ngưỡng chung nào định nghĩa mức chênh lệch chấp nhận được, nhưng các nhóm cần đặt ra giới hạn rõ ràng, có cơ sở trước khi triển khai. Ví dụ, một nhóm có thể áp dụng chính sách phát hành cho ứng dụng của mình như: tỷ số lỗi dưới 1.25\(\times\) hoặc chênh lệch tỷ lệ dương tính giả dưới 5 điểm phần trăm. Trong luật lao động Hoa Kỳ, học thuyết tác động khác biệt7 định hình sự giám sát của cơ quan quản lý, trong khi quy tắc bốn phần năm8 là một công cụ chẩn đoán về tỷ lệ lựa chọn, không mang tính quyết định. Kỷ luật kỹ thuật then chốt là xác định tiêu chí phù hợp với ứng dụng và luật điều chỉnh, thay vì suy rộng ngưỡng của một lĩnh vực sang lĩnh vực khác.
7 Tác động khác biệt: Trong vụ Griggs v. Duke Power Co. (1971), Tòa án Tối cao Hoa Kỳ phán quyết theo Điều VII rằng một thực tiễn tuyển dụng có thể là bất hợp pháp vì cách thức vận hành của nó, ngay cả khi không có ý định phân biệt đối xử (Supreme Court of the United States 1971). Tác động khác biệt là một khiếu nại pháp lý với các yếu tố cụ thể theo luật định và ngữ cảnh, không phải là từ đồng nghĩa với bất kỳ chênh lệch thống kê nào. Kết quả mô hình và các biến đại diện có thể cung cấp bằng chứng liên quan, nhưng chỉ số đơn thuần không đủ để thiết lập trách nhiệm pháp lý.
Supreme Court of the United States. 1971. Griggs v. Duke Power Co., 401 U.S. 424. Legal decision.
8 Quy tắc bốn phần năm: Bộ Hướng dẫn Thống nhất về Quy trình Lựa chọn Nhân viên năm 1978 sử dụng quy tắc bốn phần năm như một công cụ chẩn đoán thực tiễn trong tuyển dụng (Equal Employment Opportunity Commission et al. 1978). Tỷ lệ lựa chọn dưới 80% so với nhóm có tỷ lệ cao nhất thường được coi là bằng chứng về tác động bất lợi, nhưng Hướng dẫn cũng thừa nhận rằng những khác biệt nhỏ hơn vẫn có thể đáng kể và tỷ lệ này không mang tính quyết định.
Equal Employment Opportunity Commission, Civil Service Commission, Department of Labor, and Department of Justice. 1978. Uniform Guidelines on Employee Selection Procedures. Code of Federal Regulations.
Mặc dù có những thách thức cố hữu, một số phương pháp kiểm thử cụ thể có thể giúp phát hiện các vấn đề về trách nhiệm trước khi triển khai:
- Đánh giá dựa trên phân đoạn: Phương pháp này chia dữ liệu kiểm thử thành các nhóm con có ý nghĩa và báo cáo các chỉ số riêng cho từng nhóm, nhằm kiểm tra xem hiệu suất tổng thể có đang che giấu lỗi ở một số nhóm hay không. Chẳng hạn, một mô hình có thể đạt độ chính xác tổng thể 95%, nhưng chỉ đạt 78% với người nộp đơn thu nhập thấp hoặc người dùng ở vùng nông thôn. Sự chênh lệch này sẽ không hiện rõ trong các báo cáo tổng hợp.
- Kiểm thử bất biến: Kiểm tra xem mô hình có thay đổi hành vi vì những lý do không chính đáng hay không. Ví dụ, thay tên “John” bằng “Jamal” trong đơn vay không nên làm thay đổi khả năng được chấp thuận nếu tên không phải là một đặc trưng hợp lệ để ra quyết định. Các framework kiểm thử hành vi như CheckList áp dụng ý tưởng này bằng cách tổ chức kiểm thử xoay quanh khả năng của mô hình và các kỳ vọng theo kiểu bất biến, thay vì chỉ dựa vào mỗi độ chính xác (M. T. Ribeiro et al. 2020).
- Kiểm thử biên và kiểm thử chịu tải: Thăm dò những vùng mà các bộ dữ liệu kiểm định thông thường ít cung cấp thông tin. Kiểm thử biên đánh giá hành vi của mô hình tại các edge của phân phối đầu vào (tuổi bất thường, giá trị cực đoan, danh mục hiếm), nơi dữ liệu huấn luyện có thể thưa và dự đoán kém tin cậy. Kiểm thử chịu tải mở rộng kiểm thử biên sang các điều kiện đối kháng: đầu vào bị hỏng, dịch chuyển phân phối, ví dụ đối kháng, và các trường hợp edge được thiết kế để thăm dò có hệ thống các dạng lỗi. Red-teaming của các bên liên quan bổ sung thêm bằng chứng từ chuyên gia lĩnh vực và các thành viên cộng đồng bị ảnh hưởng, qua đó làm lộ ra những dạng lỗi mà kiểm thử tự động không thể phát hiện vì cần đến trải nghiệm thực tế để hình dung.
Ribeiro, Marco Tulio, Tongshuang Wu, Carlos Guestrin, and Sameer Singh. 2020. “Beyond Accuracy: Behavioral Testing of NLP Models with CheckList.” Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, 4902–12. https://doi.org/10.18653/v1/2020.acl-main.442.
Các chiến lược kiểm thử có trách nhiệm bổ sung cho kiểm thử phần mềm truyền thống chứ không thay thế. Mỗi chiến lược đòi hỏi sự đánh giá chung để lựa chọn, cấu hình và diễn giải. Chẳng hạn, các chuyên gia pháp lý không thể tự mình xác định những lát cắt nhân khẩu học nào quan trọng đối với một thuật toán chăm sóc sức khỏe, và quản lý sản phẩm cũng không thể tự quyết định các kiểm thử bất biến phù hợp cho một mô hình cho vay. Chuyên gia lĩnh vực, các bên liên quan bị ảnh hưởng, chuyên gia chính sách và kỹ sư phải cùng nhau xác định các tác hại liên quan; sau đó, kỹ sư sẽ mã hóa các yêu cầu đó thành các kiểm thử đo lường được và các biện pháp kiểm soát trong môi trường sản xuất. Vì vậy, cần phân định rõ người chịu trách nhiệm trong đội ngũ kỹ thuật, đồng thời có cơ chế giám sát độc lập từ bên ngoài.
Lãnh đạo kỹ thuật về trách nhiệm
Đến khi Amazon từ bỏ công cụ tuyển dụng này, những nỗ lực khắc phục đã không đủ để đảm bảo rằng nó tránh được các khuyến nghị mang tính phân biệt đối xử (Dastin 2018). Các lựa chọn thiết kế ban đầu có thể thu hẹp đáng kể những phương án sửa chữa khả thi. Kỹ thuật AI có trách nhiệm không thể chỉ giao phó cho các hội đồng đạo đức hay bộ phận pháp lý. Mặc dù các nhóm này cung cấp sự giám sát cần thiết, họ lại thiếu quyền truy cập kỹ thuật để phát hiện vấn đề ngay từ giai đoạn đầu của quá trình phát triển.
Việc xem xét pháp lý hoặc đạo đức có thể phát hiện vấn đề khi hệ thống sắp được triển khai, nhưng không thể khôi phục các lựa chọn thiết kế đã bị loại trừ. Nếu nhóm đã huấn luyện mô hình mà không có ràng buộc về tính công bằng, chọn một kiến trúc không thể đáp ứng yêu cầu về khả năng giải thích, hoặc xây dựng một pipeline dữ liệu thiếu các thuộc tính nhân khẩu học cần cho giám sát, thì việc xem xét chỉ có thể chấp nhận, từ chối, hoặc yêu cầu thiết kế lại tốn kém. Vì vậy, kỹ sư giữ vai trò then chốt trong vòng đời phát triển ML, bởi các quyết định của họ định hình không gian giải pháp cho mọi can thiệp về sau: kiến trúc quyết định ràng buộc công bằng nào có thể áp dụng, mục tiêu tối ưu hóa quyết định các mẫu hình mà hệ thống học được, và pipeline dữ liệu quyết định liệu đánh giá tách theo nhóm có khả thi hay không.
Definition 1.2: Kỹ thuật AI có trách nhiệm
Kỹ thuật AI có trách nhiệm là một chuyên ngành kỹ thuật tập trung vào thiết kế, triển khai và vận hành các hệ thống có đầu ra mang tính xác suất, bằng cách biến các yêu cầu xã hội và quy định thành những ràng buộc có thể kiểm thử trên các trục D·A·M: nội dung, nguồn gốc và thành phần dữ liệu được phép; hành vi mô hình và các thuộc tính về độ vững được chấp nhận; và các giới hạn hạ tầng như độ trễ, năng lượng, ngân sách tính toán, lượng khí thải carbon và thời gian lưu giữ nhật ký kiểm tra.
- Ý nghĩa: Mỗi trục D·A·M có các ràng buộc quản trị cụ thể: trục dữ liệu bị chi phối bởi các quy định về quyền riêng tư như Quy định chung về bảo vệ dữ liệu (GDPR), giới hạn những bản ghi, trường và đặc trưng nào được phép thu thập; trục thuật toán bị ràng buộc bởi các thước đo về tính công bằng và độ vững (ví dụ: đảm bảo công bằng nhân khẩu học trong phạm vi \(\varepsilon = 5\%\) giữa các nhóm được bảo vệ, nghĩa là tỷ lệ dự đoán tích cực không được chênh lệch quá 5 điểm phần trăm; hoặc độ chính xác giảm dưới 2% khi có nhiễu đối kháng \(\|\delta\|_\infty \leq 0.01\), tức là mức thay đổi đầu vào tệ nhất bị chặn ở 0.01 trên mỗi đặc trưng đã chuẩn hóa theo chuẩn \(\ell_\infty\)); và trục máy bị ràng buộc bởi ngân sách tài nguyên và hạ tầng như độ trễ, năng lượng cho mỗi lần suy luận, lượng khí thải carbon và thời gian lưu giữ nhật ký kiểm tra. Vi phạm các giới hạn này là lỗi hệ thống, không phải thiếu sót nghiên cứu.
- Điểm khác biệt: Không giống đạo đức AI (nêu ra các giá trị mang tính lý tưởng), kỹ thuật AI có trách nhiệm chuyển các giá trị đó thành những bất biến có thể đo lường và kiểm thử, có thể xác minh bằng kiểm thử tự động và giám sát liên tục, sử dụng cùng các thực hành vòng đời như khi thực thi các SLO về độ trễ.
- Sai lầm phổ biến: Một hiểu lầm thường gặp là trách nhiệm được “thêm” ở cuối quá trình phát triển. Các ràng buộc về dữ liệu được phép thu thập ảnh hưởng đến những gì có thể học và kiểm tra, trong khi lựa chọn hạ tầng ảnh hưởng đến việc lưu giữ bằng chứng. Khắc phục ở giai đoạn cuối vẫn có thể làm, nhưng thường hẹp hơn, chậm hơn và tốn kém hơn.
Một cách tiếp cận lấy kỹ thuật làm trung tâm không làm giảm tầm quan trọng của việc lắng nghe nhiều góc nhìn để nhận diện các rủi ro tiềm ẩn. Các quản lý sản phẩm, nhà nghiên cứu người dùng, cộng đồng bị ảnh hưởng và chuyên gia chính sách đóng góp hiểu biết quan trọng về cách hệ thống có thể thất bại về mặt xã hội, dù vẫn thành công về mặt kỹ thuật. Kỹ sư chuyển những lo ngại đó thành các yêu cầu có thể đo lường và các thuộc tính có thể kiểm thử, để được xác minh xuyên suốt vòng đời phát triển. Để thực hiện trách nhiệm hiệu quả, kỹ sư cần vừa lắng nghe các bên liên quan, vừa có năng lực kỹ thuật để triển khai các biện pháp bảo vệ phù hợp.
Các nhóm kỹ thuật không hoạt động biệt lập. Như figure 2 cho thấy, các thực hành kỹ thuật được lồng trong những cấu trúc quản trị rộng hơn ở cấp tổ chức, ngành và quy định; mỗi lớp áp đặt ràng buộc lên các lớp bên trong. Sự xuất sắc kỹ thuật ở lớp trong cùng tạo điều kiện, nhưng không thể thay thế, việc tuân thủ các yêu cầu đi vào từ quản trị bên ngoài.

Shneiderman, B. 2022. Human-Centered AI. Oxford University Press. https://doi.org/10.1093/oso/9780192845290.001.0001.
Những lớp quản trị đó xác định ai chịu trách nhiệm, nhưng chúng vẫn chưa tính đến các chi phí mà các chỉ số hiệu năng thông thường bỏ qua.
Ngoài các yêu cầu đạo đức, kỹ thuật có trách nhiệm còn có thể mang lại giá trị kinh doanh thông qua ba cơ chế bổ trợ lẫn nhau. Cơ chế trực tiếp nhất là giảm thiểu rủi ro: sự cố trong hệ thống ML có thể tạo ra rủi ro pháp lý và tài chính, và các thực hành trách nhiệm mang tính hệ thống có thể giúp giảm bớt. Ví dụ, Amazon đã phải từ bỏ một mô hình tuyển dụng nội bộ sau khi phát hiện các chênh lệch gắn với giới tính trong các khuyến nghị của mô hình. Các tổ chức thực hiện đánh giá tách biệt, lập tài liệu và giám sát có thể giảm xác suất xảy ra các sự cố tốn kém và lưu giữ bằng chứng về quy trình kỹ thuật của họ nếu vấn đề phát sinh.
Cơ chế thứ hai là tuân thủ quy định, được thúc đẩy bởi các yêu cầu pháp lý khác nhau tùy theo khu vực tài phán và mức độ rủi ro của ứng dụng. Chẳng hạn, Đạo luật AI của EU phân loại các ứng dụng AI rủi ro cao và bắt buộc các yêu cầu kỹ thuật, bao gồm đánh giá rủi ro, quản trị dữ liệu, minh bạch và giám sát của con người. Các tổ chức xây dựng trách nhiệm ngay trong thực hành kỹ thuật có thể chứng minh tuân thủ thông qua tài liệu và giám sát sẵn có, thay vì phải tốn kém để trang bị thêm. Bài học kỹ thuật ở đây là các kiểm soát chủ động thường rẻ hơn việc phải tái tạo bằng chứng sau khi triển khai.
Systems Perspective 1.3: Chi phí đầy đủ của quy luật sắt
Quy luật sắt của các hệ thống ML (nguyên tắc 3) được nêu trong Định luật sắt của hệ thống ML khẳng định rằng hiệu suất hệ thống phụ thuộc vào sự tương tác giữa dữ liệu, năng lực tính toán và chi phí hệ thống. Các chương trước đã tối ưu hóa từng thành phần này bằng cách nén mô hình (Nén mô hình), tăng tốc phần cứng (Tăng tốc phần cứng) và tự động hóa vận hành (Vận hành machine learning). Tuy vậy, một tối ưu hóa có thể tạo ra hoặc dịch chuyển các chi phí mà benchmark không tính đến.
Một mô hình được lượng tử hoá để triển khai ở edge sẽ tiêu thụ ít năng lượng hơn, nhưng cũng có thể đưa ra các kết quả khác nhau giữa các nhóm nhân khẩu học. Một hệ thống khuyến nghị được tối ưu hoá cho mức độ tương tác có thể tối đa hoá một chỉ số kinh doanh, nhưng cũng có nguy cơ khuếch đại nội dung có hại. Kỹ thuật có trách nhiệm mở rộng phạm vi ghi nhận của chúng ta để bao gồm những tác động rộng hơn này: chi phí carbon của tính toán, chi phí về công bằng từ các lựa chọn tối ưu hoá, và chi phí xã hội khi triển khai ở quy mô lớn. Quy luật sắt chi phối tốc độ hệ thống của chúng ta vận hành; còn kỹ thuật có trách nhiệm chi phối mức độ tốt mà chúng phục vụ.
Khác biệt hoá cạnh tranh hoàn thiện lập luận kinh doanh. Niềm tin có thể thúc đẩy các quyết định mua sắm của doanh nghiệp đối với các dịch vụ được hỗ trợ bởi ML, và các tổ chức có thể chứng minh những thực hành trách nhiệm một cách có hệ thống thông qua thẻ mô hình, dấu vết kiểm toán, và kết quả đánh giá đã công bố có thể đủ điều kiện cho các triển khai mà đối thủ cạnh tranh không thể. Định vị về quyền riêng tư của Apple, các nguyên tắc AI có trách nhiệm của Microsoft, và nghiên cứu an toàn của Anthropic minh hoạ trách nhiệm như một khoản đầu tư chiến lược chứ không phải chỉ là một chi phí phòng thủ.
Các kỹ thuật lượng tử hoá từ Nén mô hình có thể giúp giảm năng lượng cho suy luận khi runtime và phần cứng triển khai tận dụng được cách biểu diễn, khiến năng lượng đo được cho khối lượng công việc (workload) giảm xuống. Cơ sở hạ tầng giám sát từ Vận hành machine learning có thể hỗ trợ đánh giá công bằng theo cách phân tách khi hệ thống hợp pháp thu thập các dữ liệu về kết quả và nhóm con cần thiết. Kỹ thuật có trách nhiệm tổng hợp các khả năng này thành thực hành có kỷ luật thông qua các framework có cấu trúc, giúp chuyển các nguyên tắc thành quy trình.
Các quy trình có hệ thống, nếu được áp dụng sớm, có thể đã giảm khả năng xảy ra hoặc mức độ nghiêm trọng của các sự cố được xem xét trong section 1.1. Các danh sách kiểm tra, tiêu chuẩn tài liệu, quy trình kiểm thử, và hạ tầng giám sát giúp chuyển các nguyên tắc trách nhiệm thành quy trình kỹ thuật có thể lặp lại, nhưng chúng không đảm bảo ngăn chặn hoàn toàn.
Self-Check: Question
In an audited commercial healthcare algorithm (Optum), predicting future healthcare costs as a proxy for health needs resulted in Black patients receiving lower risk scores despite having more chronic conditions than White patients with identical scores. What systems mechanism explains why this proxy failed?
- The model suffered from severe overfitting due to an excessive number of gradient descent epochs on a small training dataset.
- The proxy variable inherited historical systemic disparities in healthcare spending, so predicting costs faithfully reproduced unequal access to care rather than actual medical need.
- The failure was caused by real-time concept drift that occurred after deployment when hospital billing codes suddenly changed.
- The algorithm used an unconstrained loss function that optimized inference latency at the expense of regression calibration.
A hospital sepsis prediction model begins recommending aggressive treatments for low-risk patients after an EHR update alters how vital signs are logged. System health checks, latency, and prediction confidence remain normal. Explain why this constitutes a silent failure, and identify two specific monitoring signals that would detect it.
An engineering team is designing a pre-deployment fairness and robustness testing suite for a high-stakes loan approval classifier. Arrange the following testing stages in the logical sequence recommended by responsible engineering practices:
- Invariance testing on counterfactual pairs (e.g., perturbing applicant name while holding financials constant)
- Boundary and adversarial stress testing (evaluating performance on sparse input regions and corrupted data)
- Disaggregated slice-based evaluation (computing TPR, FPR, and approval rates across demographic subgroups)
- Pareto-frontier analysis and stakeholder review (quantifying fairness-accuracy trade-offs to select an operating threshold)
- Dataset slicing and representation auditing (verifying subgroup sample counts and statistical power in test sets)
A content recommendation service reports that optimizing a ranker for short-term user clicks increased click-through rate by 20%, but long-term user satisfaction dropped by 5% and 30-day retention declined. Which systems-engineering concept best explains this divergence, and what is the appropriate mitigation?
- The alignment gap governed by Goodhart’s Law, where optimizing an observable proxy metric degrades the unobserved true objective; mitigated by maintaining counterfactual holdouts and multi-objective optimization with explicit satisfaction constraints.
- Model capacity collapse, where the embedding table runs out of capacity for rare items; mitigated by increasing embedding dimension and memory bandwidth.
- Hardware-level numerical underflow in attention layers; mitigated by upgrading from FP16 to FP32 mixed precision across serving clusters.
- Training-serving skew in network protocol buffers; mitigated by implementing automated schema validation in feature pipelines.
A randomized algorithm \(\mathcal{M}\) satisfies \((\epsilon, \delta)\)-
____if for any two neighboring datasets \(D, D'\) differing by at most one record, the probability of any output set \(\mathcal{S}\) satisfies \(\mathbb{P}[\mathcal{M}(D) \in \mathcal{S}] \le e^\epsilon \cdot \mathbb{P}[\mathcal{M}(D') \in \mathcal{S}] + \delta\), providing a mathematical upper bound on privacy loss.
Danh sách kiểm tra Kỹ thuật có trách nhiệm
Một quy trình đánh giá trước triển khai có cấu trúc có thể đã phát hiện các tín hiệu gắn với giới tính mà công cụ tuyển dụng của Amazon học được, trong khi kiểm thử tách theo nhóm đã chỉ ra sự chênh lệch tỷ lệ lỗi của COMPAS. Cả hai thất bại này cùng chung một nguyên nhân: trách nhiệm bị coi là một giai đoạn đánh giá tách biệt thay vì được tích hợp vào quy trình phát triển. Một danh sách kiểm tra kỹ thuật có trách nhiệm sẽ gắn việc đánh giá vào mọi điểm mà các quyết định kỹ thuật có thể tạo ra rủi ro dài hạn: trước khi triển khai, trong tài liệu, trong các đánh giá theo nhóm dân số cụ thể, tại các ranh giới của giải thích và tuân thủ, và sau khi ra mắt thông qua giám sát. Các giai đoạn này bổ trợ cho nhau: đánh giá xác định những gì cần đo; tài liệu ghi lại các giả định; đánh giá công bằng kiểm tra xem hiệu suất có giữ vững giữa các nhóm hay không; khả năng giải thích và tuân thủ chuyển các quyết định thành nghĩa vụ; và giám sát liên kết các vi phạm được phát hiện với các biện pháp can thiệp.
Đánh giá trước triển khai
Trước khi một mô hình phê duyệt khoản vay được đưa vào sản xuất, nhóm cần xác định nguồn gốc dữ liệu huấn luyện, nhận diện ai được đại diện và ai bị bỏ sót, dự đoán các kiểu lỗi có thể xảy ra, và xác định biện pháp khắc phục cho người dùng bị ảnh hưởng. Table 3 cấu trúc việc đánh giá này thành năm giai đoạn, phân biệt các vấn đề chặn đường găng với các hạng mục ưu tiên cao có thể tiếp tục nếu rủi ro được ghi nhận và chấp nhận.
| Giai đoạn | Mức độ ưu tiên | Các câu hỏi chính | Tài liệu Yêu cầu |
|---|---|---|---|
| Dữ liệu | Đường găng | Dữ liệu này đến từ đâu? Ai được đại diện? Ai bị thiếu? Những sai lệch lịch sử nào có thể được mã hóa? | Hồ sơ nguồn gốc dữ liệu, phân tích thành phần nhân khẩu học, tài liệu về phương pháp thu thập |
| Huấn luyện | Ưu tiên cao | Chúng ta đang tối ưu hóa cho điều gì? Chúng ta có thể đang ngầm phạt điều gì? Các lựa chọn kiến trúc ảnh hưởng đến kết quả như thế nào? | Đặc tả hàm mục tiêu, các lựa chọn điều chuẩn (regularization), lý do lựa chọn siêu tham số |
| Đánh giá | Đường găng | Hiệu suất có duy trì trên các nhóm người dùng khác nhau không? Những trường hợp biên (edge case) nào tồn tại? Các tập kiểm thử được xây dựng như thế nào? | Các chỉ số được phân tách theo nhóm nhân khẩu học, kết quả kiểm thử trường hợp biên (edge case), phân tích thành phần tập kiểm thử |
| Triển khai | Đường găng | Hệ thống này sẽ ảnh hưởng đến ai? Điều gì xảy ra khi nó thất bại? Người dùng bị ảnh hưởng có biện pháp khắc phục nào? | Đánh giá tác động, xác định các bên liên quan, quy trình khôi phục (rollback), giao thức thông báo người dùng |
| Giám sát | Ưu tiên cao | Chúng ta sẽ phát hiện vấn đề như thế nào? Ai xem xét hành vi hệ thống? Điều gì kích hoạt sự can thiệp? | Đặc tả bảng điều khiển giám sát, ngưỡng cảnh báo, lịch trình xem xét, quy trình leo thang (escalation) |
Những hạng mục thuộc Đường găng là các yếu tố chặn triển khai: hệ thống không được đưa vào sản xuất cho đến khi trả lời xong các câu hỏi này. Các hạng mục Ưu tiên cao cần được xử lý, nhưng vẫn có thể tiếp tục với việc chấp nhận rủi ro bằng văn bản và một lộ trình khắc phục. Sự phân biệt này giúp các nhóm triển khai có trách nhiệm mà không đòi hỏi phải hoàn hảo trên mọi khía cạnh trước lần triển khai đầu tiên.
Hàng Đánh giá trong table 3 nêu câu hỏi then chốt: hiệu suất có giữ vững trên các nhóm người dùng khác nhau không? Để trả lời, cần các tập kiểm thử đủ ý nghĩa thống kê cho từng nhóm, điều này có thể dẫn tới những yêu cầu dữ liệu khắt khe đến bất ngờ khi mức độ đại diện giữa các nhóm không đồng đều.
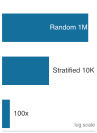
Lấy mẫu ngẫu nhiên hầu như không tiếp cận được các nhóm con nhỏ.
Napkin Math 1.1: Thống kê về sự đại diện
Vấn đề: Nhóm kỹ sư cần xác minh một mô hình Face ID hoạt động đúng với một nhóm thiểu số chiếm 1 percent trong tổng số người dùng. Để có sai số nhị thức trong kịch bản xấu nhất khoảng 1 percentage point ở mức tin cậy 95 percent, nhóm này cần khoảng 10,000 images.
Lấy mẫu ngẫu nhiên: Để có đủ 10,000 images dữ liệu cho một nhóm chiếm 1 percent bằng cách lấy mẫu ngẫu nhiên, nhóm cần thu thập và gán nhãn: \(D_{\text{eval,total}}\) = 10,000 images / 0.01 = 1,000,000 images
Lấy mẫu phân tầng: Nếu nhắm mục tiêu cụ thể vào nhóm này (ví dụ, thông qua học chủ động hoặc tiếp cận cộng đồng), chúng ta chỉ cần 10,000 images dữ liệu. Góc nhìn hệ thống: Việc dựa vào dữ liệu “phân phối tự nhiên” để đảm bảo tính công bằng sẽ cực kỳ tốn kém nếu dùng phương pháp lấy mẫu ngẫu nhiên. Để xác thực hiệu quả nhóm thiểu số, cần lượng dữ liệu nhiều hơn 100× lần so với nhóm đa số. Tính công bằng đòi hỏi kỹ thuật dữ liệu có chủ đích, chứ không chỉ đơn thuần là có nhiều dữ liệu hơn.
Kỹ thuật dữ liệu có chủ đích tập trung vào việc kiểm soát những gì mô hình được thấy trong giai đoạn đánh giá. Nhưng ngay cả một tập dữ liệu đại diện hoàn hảo cũng không thể ngăn tác hại khi triển khai nếu hệ thống thiếu giám sát của con người ở mức đủ. Chi phí đại diện suy ra từ phép tính sơ bộ 1.1 đóng vai trò như một chốt kiểm trước triển khai; câu hỏi tiếp theo là điều gì xảy ra khi mô hình đi vào hoạt động và đưa ra các quyết định ảnh hưởng đến con người.
War Story 1.3: Nghịch lý tự động hóa (2018)
Bối cảnh: Nhóm Công nghệ Tiên tiến (ATG) của Uber đang thử nghiệm xe tự lái ở Arizona, dựa vào một người lái an toàn để can thiệp nếu hệ thống nhận thức tự động gặp lỗi (National Transportation Safety Board 2019).
Cơ chế: Hệ thống nhận thức phát hiện một người đi bộ băng qua đường nhưng liên tục chuyển qua lại giữa các phân loại phương tiện, xe đạp và không xác định, khiến dự đoán quỹ đạo liên tục bị đặt lại, trong khi phanh khẩn cấp tự động đã bị vô hiệu hóa có chủ đích.
Tác động: Người lái an toàn bị phân tâm bởi điện thoại cá nhân và không kịp tiếp quản, dẫn đến một vụ va chạm chết người.
Khắc phục: Uber đã trang bị lại đội xe bằng camera giám sát người lái, kích hoạt lại hệ thống phanh khẩn cấp tự động và bố trí hai người vận hành trong quá trình thử nghiệm xe tự lái trên đường.
Bài học về hệ thống: Việc thêm một người dự phòng tạo ra một hệ thống mới với các chế độ lỗi riêng. Độ tin cậy tự động hóa cao có thể dẫn đến tự mãn và giảm cảnh giác, nên phương án dự phòng hiệu quả phải có thiết kế khối lượng công việc (workload), giám sát mức độ chú ý và một chứng minh an toàn cho hệ thống kết hợp người-máy.
National Transportation Safety Board. 2019. Collision Between Vehicle Controlled by Developmental Automated Driving System and Pedestrian, Tempe, Arizona, March 18, 2018. HAR-19/03. National Transportation Safety Board.
Nếu không có các biện pháp kiểm soát hiệu quả, tự động hóa đáng tin cậy có thể làm suy yếu sự cảnh giác.
Đối với các ứng dụng rủi ro cao, giai đoạn triển khai cần chỉ rõ những nơi bắt buộc phải có giám sát của con người. Các hệ thống người-trong-vòng lặp (HITL) sẽ chuyển các quyết định không chắc chắn, có hậu quả lớn hoặc bị gắn cờ cho người đánh giá thay vì hành động tự động. Thiết kế HITL hiệu quả phải nêu bốn điểm: phạm vi xem xét (những quyết định nào cần người tham gia), các ngưỡng độ tin cậy kích hoạt việc chuyển sang người, chương trình huấn luyện dành cho người đánh giá, và cơ chế theo dõi hiệu suất của họ. HITL không phải là thuốc chữa bách bệnh: người đánh giá có thể chỉ đóng dấu cho qua các quyết định tự động, đưa vào độ chệch (bias) của riêng mình, hoặc bị quá tải vì lượng cảnh báo. Thiết kế HITL hiệu quả đòi hỏi hiệu chỉnh ranh giới người-máy cho phù hợp với rủi ro của ứng dụng và năng lực của người đánh giá.
Framework đánh giá trước triển khai tương tự danh sách kiểm tra trước chuyến bay trong hàng không, vốn chuẩn hóa các bước kiểm tra quan trọng dưới áp lực thời gian. Việc triển khai ML trong môi trường sản xuất đòi hỏi kỷ luật tương đương và xác minh nghiêm ngặt. Một danh sách kiểm tra giúp đội ngũ đặt đúng câu hỏi, nhưng tự thân nó không chứng minh được hệ thống là an toàn; các tiêu chuẩn về tài liệu sẽ lưu lại câu trả lời và cho phép chúng đi kèm với mô hình.
Tiêu chuẩn tài liệu mô hình
Hãy hình dung bạn kế thừa một mô hình đang chạy trong sản xuất từ một đồng nghiệp đã nghỉ: mô hình đạt độ chính xác 94% trên tập kiểm tra, nhưng thiếu ba thông tin quan trọng: danh tính của tập kiểm tra, dữ liệu mà mô hình đã được huấn luyện, và các nhóm đối tượng mà nó đã được xác thực. Nếu thiếu những câu trả lời này, việc triển khai hoặc cập nhật mô hình là một canh bạc. Thẻ mô hình giải quyết vấn đề bằng cách cung cấp một định dạng tài liệu chuẩn hóa cho các mô hình ML9 (Mitchell et al. 2019). Ban đầu được phát triển tại Google, thẻ mô hình hoạt động như một “nhãn dinh dưỡng”, ghi lại thông tin thiết yếu cho triển khai có trách nhiệm và đi kèm với mô hình suốt vòng đời của nó.
9 Thẻ mô hình: Vấn đề chính mà thẻ mô hình giải quyết là mở rộng phạm vi (scope creep): tức là việc sử dụng mô hình dần mở rộng từ “nó hoạt động tốt cho trường hợp A” sang “hãy thử nó cho trường hợp B” mà không đánh giá lại mục đích sử dụng ban đầu. Trên thực tế, các thẻ này thường được viết sau khi quyết định triển khai đã được đưa ra, nhằm ghi lại hành vi quan sát được hơn là đặt giới hạn cho việc sử dụng. Tài liệu bổ trợ “Datasheets for Datasets” (Gebru et al. 2021) cũng áp dụng nguyên tắc tương tự cho dữ liệu huấn luyện. Nếu thiếu cả hai, thẻ mô hình sẽ trở thành một hồ sơ lịch sử, thay vì đóng vai trò như một hàng rào bảo vệ.
Gebru, Timnit, Jamie Morgenstern, Briana Vecchione, Jennifer Wortman Vaughan, Hanna Wallach, Hal Daumé III, and Kate Crawford. 2021. “Datasheets for Datasets.” Communications of the ACM 64 (12): 86–92. https://doi.org/10.1145/3458723.
Mitchell, Margaret, Simone Wu, Andrew Zaldivar, Parker Barnes, Lucy Vasserman, Ben Hutchinson, Elena Spitzer, Inioluwa Deborah Raji, and Timnit Gebru. 2019. “Model Cards for Model Reporting.” Proceedings of the Conference on Fairness, Accountability, and Transparency, 220–29. https://doi.org/10.1145/3287560.3287596.
Một thẻ mô hình hoàn chỉnh bao quát bảy mối quan tâm, kết hợp lại để giúp triển khai có trách nhiệm. Nó bắt đầu với các chi tiết kỹ thuật (kiến trúc, quy trình huấn luyện, siêu tham số) giúp bảo đảm khả năng tái lập và kiểm tra. Quan trọng hơn, thẻ mô hình chỉ rõ mục đích sử dụng cùng các trường hợp bị loại trừ rõ ràng, ngăn chặn việc mở rộng phạm vi, ví dụ như mô hình được thiết kế để sắp xếp ảnh lại bị dùng cho sàng lọc an ninh. Thẻ sau đó ghi lại những yếu tố (nhóm nhân khẩu học, điều kiện môi trường, khác biệt về thiết bị đo lường) có thể ảnh hưởng đến hiệu suất, từ đó định hướng chiến lược đánh giá và các giao thức giám sát.
Các phần còn lại thu hẹp khoảng cách giữa những gì một mô hình có thể làm và những gì nó nên làm. Các chỉ số hiệu suất phải bao gồm kết quả được phân tách theo những yếu tố đã nêu trong section 1.2.4, vì độ chính xác tổng thể thường che giấu các khác biệt mà chương này đã chỉ ra. Việc lập tài liệu cho dữ liệu huấn luyện và đánh giá giúp đánh giá các độ chệch (bias) tiềm ẩn và cung cấp ngữ cảnh cần thiết để diễn giải kết quả. Các cân nhắc về đạo đức giúp biến những đánh đổi ngầm định thành minh bạch bằng cách ghi lại các hạn chế đã biết, tác hại tiềm tàng và biện pháp giảm thiểu đã triển khai; trong khi đó, các lưu ý và khuyến nghị cung cấp hướng dẫn về cách sử dụng phù hợp và các dạng lỗi đã biết.
Một thẻ mô hình MobileNetV2 cụ thể sẽ biến các danh mục trừu tượng này thành hướng dẫn thực hành: table 4 cho thấy mỗi phần giải quyết các mối quan tâm cụ thể khi triển khai trên edge như thế nào.
| Mục | Nội dung |
|---|---|
| Chi tiết mô hình | Kiến trúc MobileNetV2 với các tham số 3.5M, được huấn luyện trên ImageNet sử dụng tích chập phân tách theo chiều sâu (depthwise separable convolutions). Được lượng tử hoá INT8 để triển khai trên edge. |
| Mục đích sử dụng | Phân loại hình ảnh thời gian thực trên thiết bị di động với yêu cầu độ trễ dưới 50 ms. Phù hợp cho các ứng dụng tiêu dùng bao gồm tổ chức ảnh và các tính năng trợ năng. |
| Các yếu tố | Hiệu suất thay đổi theo chất lượng hình ảnh (mờ, ánh sáng), kích thước đối tượng trong khung hình và các danh mục nằm ngoài phân phối ImageNet. |
| Các chỉ số | Độ chính xác top-1 71.8% trên tập kiểm định ImageNet (độ chính xác đầy đủ: 72.0%). Độ chính xác thay đổi theo danh mục: 85% trên các đối tượng phổ biến, 45% trên các phân biệt chi tiết. |
| Các cân nhắc về đạo đức | Dữ liệu huấn luyện phản ánh các sai lệch của ImageNet trong việc đại diện địa lý và nhân khẩu học. Chưa được xác thực cho các ứng dụng có rủi ro cao (chẩn đoán y tế, sàng lọc an ninh). Hiệu suất có thể suy giảm trên hình ảnh từ các khu vực ít được đại diện. |
Datasheets for datasets cung cấp tài liệu tương tự cho dữ liệu huấn luyện (Gebru et al. 2021). Các tài liệu này ghi lại nguồn gốc dữ liệu, phương pháp thu thập, thành phần nhân khẩu học, và những hạn chế đã biết có thể ảnh hưởng đến hành vi của mô hình ở các bước sau. Tài liệu hóa giúp xác định rõ mô hình được thiết kế để làm gì; còn kiểm thử xác minh liệu mô hình có hoạt động công bằng trên các nhóm đối tượng mà nó phục vụ hay không.
Kiểm thử trên các nhóm đối tượng
Việc đánh giá phân tách từng phơi bày các chênh lệch trong dự án Gender Shades (section 1.2.4) nay trở thành một bước chốt trước khi phát hành: chọn các lát cắt (slices), chỉ số (metrics), và ngưỡng (thresholds) để quyết định có cho phép triển khai hay không. Các chỉ số hiệu suất tổng hợp có thể che giấu chênh lệch giữa các nhóm người dùng, đây chính là sai lầm của số trung bình (Savage 2009); kiểm thử có trách nhiệm đòi hỏi đánh giá phân tách để xem xét hiệu suất cho từng nhóm con (subgroup) liên quan.
Savage, Sam L. 2009. The Flaw of Averages: Why We Underestimate Risk in the Face of Uncertainty. John Wiley & Sons.
Systems Perspective 1.4: Sai lầm của số trung bình
Trong kỹ thuật hệ thống, chúng ta hiếm khi thiết kế cho trường hợp “trung bình”; thay vào đó, chúng ta thiết kế cho các trường hợp ngoại lệ (tail cases) và điều kiện biên (boundary conditions). Một cây cầu “an toàn trung bình” nhưng sập dưới một chiếc xe tải nặng là một thất bại. Tương tự, một hệ thống ML “chính xác trung bình” nhưng thất bại với một nhóm dân tộc hoặc giới tính cụ thể cũng là một thất bại kỹ thuật. Cùng nguyên tắc thúc đẩy chúng ta đo độ trễ phần đuôi (p99) để đảm bảo độ tin cậy hệ thống cũng áp dụng cho sự công bằng: chúng ta phải dùng đánh giá phân tách để đo lường mức độ công bằng của hệ thống. Nếu chỉ nhìn vào độ chính xác tổng hợp, phân tích sẽ bỏ qua các lỗi hệ thống xảy ra ở phần rìa. Kỹ thuật có trách nhiệm đòi hỏi làm cho những “đuôi” này trở nên rõ ràng thông qua các phép đo chi tiết, cụ thể theo từng nhóm đối tượng.
Sai lầm của số trung bình dẫn tới nguyên tắc kiểm thử: các chỉ số tổng hợp là chưa đủ. Câu hỏi tiếp theo là nên làm rõ những phần đuôi nào của phân phối. Câu trả lời phụ thuộc vào mẫu hình khối lượng công việc (workload), vì mỗi mẫu hình tạo ra những cơ hội khác nhau để độ chệch (bias) len vào và kéo theo các chỉ số khác nhau để phát hiện.
Table 5 chuyển hạn chế của việc dùng giá trị trung bình thành một quy trình kỹ thuật: một mô hình thị giác máy tính thất bại theo cách khác với một hệ thống khuyến nghị, nên các chỉ số công bằng phải khớp với kiểu lỗi và các lát nhóm con phải xuất phát từ ngữ cảnh ứng dụng. Với ứng dụng chăm sóc sức khỏe, các yếu tố nhân khẩu học như chủng tộc, tuổi tác và giới tính là thiết yếu. Với kiểm duyệt nội dung, ngôn ngữ và bối cảnh văn hóa là quan trọng. Với dịch vụ tài chính, các nhóm đối tượng được bảo vệ theo luật cho vay công bằng cần được chú ý đặc biệt.
Cơ sở hạ tầng kiểm thử cần hỗ trợ đánh giá phân tầng, trong đó các chỉ số hiệu suất được tính riêng cho từng nhóm con liên quan, giúp so sánh tỷ lệ lỗi và loại lỗi giữa các tập người dùng khác nhau. Phân tích giao thoa xem xét các tổ hợp thuộc tính, vì tác hại có thể tập trung ở các giao điểm mà phân tích đơn nhân tố không nhìn thấy. Khoảng tin cậy giúp định lượng mức độ bất định cho các chỉ số của nhóm con khi kích thước nhóm nhỏ có thể tạo ra ước lượng kém tin cậy. Giám sát theo thời gian theo dõi hiệu suất của các nhóm con, phát hiện drift ảnh hưởng đến một số nhóm sớm hơn những nhóm khác.
Việc lựa chọn công cụ chỉ trở nên quan trọng sau khi nhóm đã xác định rõ chỉ số công bằng, các lát nhóm con và ngưỡng cảnh báo. Các thư viện mã nguồn mở như Fairlearn (Bird et al. 2020), AI Fairness 360 (Bellamy et al. 2019) và What-If Tool của Google (Wexler et al. 2020) giúp giảm chi phí triển khai đánh giá phân tách và giao thoa, nhưng một thư viện chỉ tính được chỉ số mà kỹ sư yêu cầu. Nó không thể tự quyết định định nghĩa nhóm con nào là quan trọng, ngưỡng chênh lệch nào đáng để cảnh báo nhóm, hay ràng buộc công bằng nào phù hợp với bối cảnh triển khai.
Bird, Sarah, Miro Dudı́k, Richard Edgar, Brandon Horn, Roman Lutz, Vanessa Milan, Mehrnoosh Sameki, Hanna Wallach, and Kathleen Walker. 2020. “Fairlearn: A Toolkit for Assessing and Improving Fairness in AI.” Microsoft Technical Report MSR-TR-2020-32.
Bellamy, Rachel K. E., Kuntal Dey, Michael Hind, Seung Hoffman, Sylvain Houde, Karthikeyan Kannan, Pradeep Lohia, et al. 2019. “AI Fairness 360: An Extensible Toolkit for Detecting and Mitigating Algorithmic Bias.” IBM Journal of Research and Development 63 (4/5): 4:1–15. https://doi.org/10.1147/jrd.2019.2942287.
Wexler, James, Mahima Pushkarna, Tolga Bolukbasi, Martin Wattenberg, Fernanda Viégas, and Jimbo Wilson. 2020. “The What-If Tool: Interactive Probing of Machine Learning Models.” IEEE Transactions on Visualization and Computer Graphics 26 (1): 56–65. https://doi.org/10.1109/TVCG.2019.2934619.
Một cổng phát hành (release gate) cần phân biệt rõ giữa việc thiếu bằng chứng và có bằng chứng về sự ngang bằng. Nếu một lát cắt dữ liệu (slice) không có đủ ví dụ được gán nhãn để đặt được giới hạn cho tỷ lệ lỗi liên quan, thì phải báo cáo là dữ liệu không đủ (chứ không phải là đạt), đồng thời thu thập thêm dữ liệu mục tiêu hoặc hạn chế mục đích sử dụng dự kiến. Do đó, kiểm thử theo quần thể sẽ cho ra ba kết quả vận hành: đạt, không đạt, hoặc không đủ bằng chứng.
Lighthouse 1.1: Các mối lo ngại về công bằng theo nguyên mẫu
Các rủi ro về công bằng khác nhau giữa các nguyên mẫu khối lượng công việc (workload) trong Hệ thống ML. Table 5 ánh xạ từng nguyên mẫu tới một rủi ro và một chỉ số chính.
Table 5: Rủi ro về công bằng theo nguyên mẫu ML: Các rủi ro về công bằng sẽ khác nhau tùy theo nguồn dữ liệu và ngữ cảnh triển khai của từng nguyên mẫu.
Kiến trúc không tự nó quyết định sự công bằng; mỗi dòng trong bảng chỉ ra một rủi ro cần kiểm tra trước, rủi ro này đặc thù cho ngữ cảnh triển khai, chứ không phải là một đặc tính chung của cả họ mô hình.
| Nguyên mẫu | Rủi ro công bằng chính | Chỉ số đánh giá chính | Ví dụ thực tế |
|---|---|---|---|
| ResNet-50 (Cỗ máy tính toán) | Sai lệch dữ liệu huấn luyện (sự thiếu đại diện của các nhóm liên quan đến triển khai) | Độ chính xác được phân tách theo nhóm nhân khẩu học | Đánh giá bộ phân loại đã triển khai trên các phân khúc nhân khẩu học cụ thể của ứng dụng; các giá trị Gender Shades không đo lường ResNet-50 |
| GPT-2 (Kẻ ngốn băng thông) | Sai lệch tập văn bản (corpus) (sự đại diện quá mức của các quan điểm đa số trong văn bản web) | Tỷ lệ độc hại theo ngữ cảnh lời nhắc nhân khẩu học; điểm định kiến | LLM tạo ra các phần hoàn thành độc hại hơn cho các lời nhắc đề cập đến các nhóm thiểu số |
| DLRM (Sparse Scatter) | Khuếch đại vòng lặp phản hồi (các mục phổ biến nhận được nhiều dữ liệu hơn) | Tỷ lệ hiển thị đề xuất theo danh mục mặt hàng và nhóm nhà cung cấp hoặc người tạo | Bong bóng lọc: hệ thống đề xuất nội dung tương tự cho người dùng tương tự, làm giảm khả năng khám phá những người tạo nội dung ngách |
| DS-CNN (Tiny Constraint) | Không khớp ngữ cảnh triển khai (được huấn luyện trên âm thanh sạch, được triển khai trong môi trường thực tế ồn ào) | Tỷ lệ dương tính giả theo môi trường âm thanh và giọng nói của người nói | Trợ lý giọng nói hoạt động kém hơn với giọng nói có ngữ điệu; từ khóa kích hoạt bị kích hoạt bởi âm thanh TV ở một số ngôn ngữ |
Thông tin chuyên sâu về hệ thống: Đánh giá công bằng phải phù hợp với kiểu lỗi của từng nguyên mẫu. Các mô hình thị giác cần độ chính xác nhân khẩu học phân tầng; các mô hình ngôn ngữ lớn (LLM) cần kiểm tra độc tính và định kiến; các hệ thống đề xuất cần kiểm tra mức độ hiển thị; TinyML cần các thử nghiệm môi trường âm thanh. Hệ thống phát hiện từ khóa (KWS) đóng vai trò lighthouse được giới thiệu trong Hệ thống ML như Tiny Constraint lighthouse đang đối mặt với đúng thách thức này đối với DS-CNN của nó, một mạng nơ-ron tích chập tách sâu (CNN): được huấn luyện trên âm thanh phòng thu sạch, nó phải hoạt động công bằng trên các giọng nói, mức độ tiếng ồn nền và nhân khẩu học của người nói trong môi trường thực tế tại nhà người dùng (một thách thức quản trị được đề cập trong section 1.5).
Ví dụ minh họa: Phân tích công bằng trong phê duyệt khoản vay
Một mô hình phê duyệt khoản vay báo cáo độ chính xác 85 percent trên nhóm đa số và độ chính xác tổng thể 82.5 percent trên tất cả các ứng viên được đánh giá—những con số này có thể đáp ứng một bảng điều khiển tổng hợp ở mức độ thô. Table 6 và table 7 tiết lộ những gì số liệu tổng hợp che giấu: kết quả phê duyệt khoản vay cho cùng một mô hình khi được đánh giá riêng biệt trên hai nhóm nhân khẩu học.
| Được chấp thuận (dự đoán) | Bị từ chối (dự đoán) | |
|---|---|---|
| Đã trả nợ (thực tế) | 4,500 (TP) | 500 (FN) |
| Vỡ nợ (thực tế) | 1,000 (FP) | 4,000 (TN) |
Table 6 thiết lập đường cơ sở cho nhóm đa số; sau các định nghĩa chỉ số, table 7 trình bày so sánh nhóm thiểu số.10
10 Sự không tương thích của các tiêu chí công bằng: Những khác biệt được đo lường trong ví dụ này cho thấy một bộ ma trận nhầm lẫn có thể vi phạm các tiêu chí như ngang bằng nhân khẩu học, cơ hội bình đẳng và odds cân bằng. Một kết quả bất khả thi riêng biệt chỉ ra rằng, khi tỷ lệ cơ sở của các nhóm không đồng đều và khả năng dự đoán không hoàn hảo, một số tiêu chí mong muốn—bao gồm ngang bằng dự đoán theo kiểu hiệu chuẩn và cân bằng tỷ lệ lỗi—thường không thể được đáp ứng đồng thời (Chouldechova 2017). Trong những tình huống này, tối ưu hóa một tiêu chí có thể làm giảm chất lượng của tiêu chí khác. Vì vậy, người thiết kế hệ thống cần làm rõ sự đánh đổi này, thay vì cho rằng mọi tiêu chí đều có thể được đảm bảo cùng lúc.
Chouldechova, Alexandra. 2017. “Fair Prediction with Disparate Impact: A Study of Bias in Recidivism Prediction Instruments.” Big Data 5 (2): 153–63. https://doi.org/10.1089/big.2016.0047.
Từ hai ma trận nhầm lẫn này, chúng ta có thể kiểm tra ba định nghĩa khác nhau về sự đối xử công bằng:
- Ngang bằng nhân khẩu học: Yêu cầu tỷ lệ được chọn là tích cực (phê duyệt) phải bằng nhau giữa các nhóm, bất kể trình độ thực sự của họ (\(P(\hat{Y}=1 \mid A=a) = P(\hat{Y}=1 \mid A=b)\)). Nhóm A được phê duyệt với tỷ lệ \((4,500 + 1,000) / 10,000 = 55\%\), trong khi Nhóm B được phê duyệt với tỷ lệ \((600 + 200) / 2,000 = 40\%\). Sự chênh lệch 15 percentage-point này cho thấy sự đối xử không đồng đều trong các quyết định phê duyệt.
- Cơ hội bình đẳng: Yêu cầu tỷ lệ dương tính đúng phải bằng nhau giữa các ứng viên đủ điều kiện (\(P(\hat{Y}=1 \mid Y=1, A=a) = P(\hat{Y}=1 \mid Y=1, A=b)\)). Nhóm A đạt TPR là \(4,500 / (4,500 + 500) = 90\%\), nghĩa là 90 percent trong số các ứng viên sẽ trả nợ được phê duyệt. Nhóm B chỉ đạt \(600 / (600 + 400) = 60\%\). Sự chênh lệch 30 percentage-point này cho thấy các ứng viên đủ điều kiện của Nhóm B bị từ chối với tỷ lệ cao hơn đáng kể so với các ứng viên đủ điều kiện tương tự ở Nhóm A.
- Equalized odds: Yêu cầu cả tỉ lệ dương tính đúng (TPR) và tỉ lệ dương tính sai (FPR) phải bằng nhau (\(P(\hat{Y}=1 \mid Y=y, A=a) = P(\hat{Y}=1 \mid Y=y, A=b)\) với \(y \in \{0,1\}\)).11 Nhóm A có FPR là \(1,000 / (1,000 + 4,000) = 20\%\), và Nhóm B có \(200 / (200 + 800) = 20\%\). Mặc dù tỉ lệ dương tính sai bằng nhau, nhưng sự chênh lệch về tỉ lệ dương tính đúng cho thấy tiêu chí Equalized odds bị vi phạm. Nhìn chung, do tỉ lệ cơ sở của các nhóm không đồng đều và khả năng dự đoán không hoàn hảo, nhiều tiêu chí công bằng có thể không tương thích với nhau. Do đó, tiêu chí công bằng áp dụng cần được chọn và biện minh rõ ràng, thay vì suy ra từ một chỉ số tổng hợp.
11 Equalized odds: Tiêu chí này được Hardt et al. (2016) định nghĩa chính thức, yêu cầu cả TPR (tỉ lệ dương tính đúng) và FPR (tỉ lệ dương tính sai) phải bằng nhau giữa các nhóm được bảo vệ; tiêu chí “cơ hội bình đẳng” (yếu hơn) chỉ yêu cầu TPR. Hậu xử lý theo Equalized odds có thể đòi hỏi các quyết định ngẫu nhiên, phụ thuộc vào từng nhóm, thay vì chỉ dựa vào các ngưỡng xác định. Việc này cũng đòi hỏi thông tin về nhóm được bảo vệ tại thời điểm ra quyết định và phải được đánh giá dựa trên luật pháp hiện hành; ví dụ, quy định tín dụng của Hoa Kỳ thường hạn chế sử dụng các yếu tố được bảo vệ để đánh giá khả năng tín dụng.
Hardt, Moritz, Eric Price, and Nathan Srebro. 2016. “Equality of Opportunity in Supervised Learning.” Advances in Neural Information Processing Systems (NeurIPS) 29: 3315–23.
| Được chấp thuận (dự đoán) | Bị từ chối (dự đoán) | |
|---|---|---|
| Đã trả nợ (thực tế) | 600 (TP) | 400 (FN) |
| Vỡ nợ (thực tế) | 200 (FP) | 800 (TN) |
Các chỉ số này đưa ra kết luận khác nhau vì chúng mã hóa những lựa chọn chính sách khác nhau về việc ưu tiên loại sai số nào.
Các số liệu cho thấy mô hình từ chối những ứng viên đủ điều kiện thuộc Nhóm B với tỉ lệ cao hơn đáng kể (tỉ lệ âm tính sai (FNR) là 40 percent so với 10 percent của Nhóm A), trong khi vẫn duy trì tỉ lệ dương tính sai tương tự. Các ma trận nhầm lẫn này chỉ ra một sự chênh lệch, nhưng không cho biết nguyên nhân của sự chênh lệch đó là do ngưỡng, nhãn, đặc trưng, cách lấy mẫu, phân biệt đối xử trong quá khứ hay một lý do nào khác.
Trong trường hợp việc thu thập và sử dụng các thuộc tính được bảo vệ là hợp pháp và chính đáng, các hệ thống vận hành có thể tự động hóa các phép tính này và kích hoạt việc xem xét khi sự chênh lệch vượt quá các ngưỡng được xác định trước. Listing 1 quy định rõ cách xử lý lỗi: tỷ lệ nhóm không xác định được báo cáo là dữ liệu không đủ thay vì so sánh với một ngưỡng.
def compute_fairness_metrics(confusion_matrix):
    tp, fp, tn, fn = (
        confusion_matrix[k] for k in ["TP", "FP", "TN", "FN"]
    )
    total = tp + fp + tn + fn
    return {
        # Demographic parity
        "approval_rate": (tp + fp) / total if total else None,
        # Equal opportunity
        "tpr": tp / (tp + fn) if (tp + fn) else None,
        # Equalized odds (with TPR)
        "fpr": fp / (fp + tn) if (fp + tn) else None,
    }


# Compare groups and flag disparities exceeding threshold
for metric in ["approval_rate", "tpr", "fpr"]:
    if metrics_a[metric] is None or metrics_b[metric] is None:
        report_insufficient_data(metric)
        continue
    disparity = abs(metrics_a[metric] - metrics_b[metric])
    # e.g., 0.05 for high-stakes applications
    if disparity > FAIRNESS_THRESHOLD:
        trigger_alert(metric, disparity)
Giám sát tự động đạt được điều mà kiểm toán thủ công không thể ở quy mô lớn: theo dõi liên tục các số liệu công bằng với cảnh báo tức thời khi sự chênh lệch xuất hiện. Sự chênh lệch TPR 30 percentage-point vượt xa ngưỡng cho phép triển khai 5 điểm phần trăm của kịch bản này, cho thấy mô hình cần được điều chỉnh để đảm bảo tính công bằng trước khi triển khai. Table 8 cho thấy xu hướng tổng thể của các số liệu và sự chênh lệch đã tính toán.
| Chỉ số | Nhóm A | Nhóm B | Chênh lệch |
|---|---|---|---|
| Tỷ lệ chấp thuận | 55% | 40% | 15 pp |
| Tỷ lệ dương tính thật | 90% | 60% | 30 pp |
| Tỷ lệ dương tính giả | 20% | 20% | 0 pp |
Để hiểu vì sao các số liệu tổng hợp có thể che giấu chênh lệch, hãy nhìn kỹ figure 3. Trong ví dụ được dựng này, mỗi ngưỡng dùng chung, khi áp vào các phân phối điểm khác nhau, sẽ tạo ra các kết quả khác nhau cho từng nhóm con (Barocas and Selbst 2016). Chỉ nhìn vào hiệu suất tổng hợp không quyết định được liệu các kết quả đó có chấp nhận được với từng nhóm hay không.
Barocas, Solon, and Andrew D. Selbst. 2016. “Big Data’s Disparate Impact.” California Law Review 104: 671–732. https://doi.org/10.2139/ssrn.2477899.
Có nhiều cách giảm thiểu, mỗi cách có những đánh đổi riêng:
- Điều chỉnh ngưỡng: Hạ ngưỡng chấp thuận cho Nhóm B để cân bằng TPR nhưng có thể làm tăng dương tính giả cho nhóm đó.
- Tái trọng số: Tăng trọng số của các mẫu Nhóm B trong quá trình huấn luyện để mô hình nhận được tín hiệu mạnh hơn về quần thể này, nhưng có thể làm giảm độ chính xác tổng thể.12
- Khử độ chệch (bias) đối kháng: Huấn luyện với một đối thủ nhằm ngăn biểu diễn mã hóa thông tin về thuộc nhóm, nhưng làm tăng độ phức tạp của quá trình huấn luyện.13
12 Tái trọng số: Một kỹ thuật tiền xử lý bắt nguồn từ importance sampling trong thống kê: các mẫu thuộc nhóm bị thiếu đại diện được gán trọng số mất mát (loss weights) cao hơn trong quá trình huấn luyện, qua đó tăng ảnh hưởng của chúng lên các cập nhật gradient mà không cần loại bỏ bất kỳ dữ liệu nào. Kamiran and Calders (2012) cho thấy nếu chọn trọng số phù hợp, có thể giảm tác động không đồng đều (disparate impact) từ dữ liệu huấn luyện. Đánh đổi ở cấp hệ thống phụ thuộc vào ứng dụng: tái trọng số làm thay đổi bề mặt mất mát (loss landscape) và có thể làm giảm hiệu suất ở các phân đoạn (slices) khác, nên cần cân nhắc chi phí này so với biên Pareto (Pareto frontier) của ứng dụng.
Kamiran, Faisal, and Toon Calders. 2012. “Data Preprocessing Techniques for Classification Without Discrimination.” Knowledge and Information Systems 33 (1): 1–33. https://doi.org/10.1007/s10115-011-0463-8.
13 Khử độ chệch (bias) đối kháng: Điểm khác biệt chính là áp lực lên biểu diễn: đối thủ (adversary) gây sức ép để mô hình chính không mã hóa thông tin của các thuộc tính được bảo vệ. Việc này giúp giảm rò rỉ thông tin thuộc tính được bảo vệ và đáp ứng các tiêu chí công bằng đã chọn trong phân phối được đánh giá (Zhang et al. 2018). Tuy nhiên, phương pháp này không đảm bảo công bằng tổng quát dưới các dịch chuyển khi triển khai bất kỳ; các đảm bảo phụ thuộc vào giả định về tính bất biến, nhãn, cấu trúc nhân quả và loại dịch chuyển. Các phương pháp hậu xử lý như điều chỉnh ngưỡng cũng có thể phù hợp dưới các giả định khác, nhưng phải được xác thực lại khi nhân khẩu học trong môi trường triển khai hoặc quy trình gán nhãn thay đổi. Chi phí là huấn luyện bổ sung, tinh chỉnh siêu tham số và xác thực ở cấp độ phân đoạn, chứ không phải một mức chi phí phần trăm chung cho mọi trường hợp.
Zhang, Brian Hu, Blake Lemoine, and Margaret Mitchell. 2018. “Mitigating Unwanted Biases with Adversarial Learning.” Proceedings of the 2018 AAAI/ACM Conference on AI, Ethics, and Society, 335–40. https://doi.org/10.1145/3278721.3278779.

Việc lựa chọn giữa các phương pháp này cần ý kiến của các bên liên quan về những đánh đổi nào chấp nhận được trong bối cảnh ứng dụng cụ thể. Kỹ sư nên trình bày các đánh đổi này hiệu quả bằng cách nêu rõ và định lượng được chúng.
Checkpoint 1.2: Tiêu chí công bằng
Công bằng không phải là một số liệu duy nhất; đó là một lựa chọn thiết kế có ràng buộc.
Định lượng sự đánh đổi giữa công bằng và độ chính xác
Kết quả bất khả thi trong Kleinberg et al. (2017) chỉ ra rằng các tiêu chí công bằng có thể mâu thuẫn với nhau, và figure 1 biến xung đột đó thành một đánh đổi kỹ thuật. Tuy nhiên, chỉ biết có sự đánh đổi là chưa đủ: các kỹ sư cần định lượng chi phí thực tế của các ràng buộc công bằng để cung cấp thông tin cho quyết định của các bên liên quan. Một kịch bản tuyển dụng gọn giúp làm rõ chi phí này, khác với ví dụ phê duyệt khoản vay trong section 1.3.3.1 và có mức độ chênh lệch khác để minh họa một điểm khác.
Napkin Math 1.2: Cái giá của sự công bằng
Vấn đề: Các bên liên quan yêu cầu loại bỏ sự chênh lệch tỷ lệ dương tính thật (TPR) 20 percentage-point trong một mô hình tuyển dụng. Vậy, “Cái giá của sự công bằng” xét về chất lượng tuyển dụng là gì?
Nguyên lý: Có thể cân bằng TPR bằng cách điều chỉnh ngưỡng phân loại \((\gamma_{\text{cls}})\) cho nhóm bị thiệt thòi.
- Trạng thái ban đầu: Nhóm A (\(\text{TPR} =\) 90 percent), Nhóm B (\(\text{TPR} =\) 70 percent). Độ chính xác tổng hợp = 85 percent.
- Can thiệp: Hạ thấp \(\gamma_{\text{cls},g=B}\) cho đến khi \(\text{TPR}_{g=B} =\) 90 percent.
- Chi phí: Hạ ngưỡng làm tăng số dương tính giả (tuyển các ứng viên không đạt tiêu chuẩn).
Toán học:
- Theo giả định về phản ứng với ngưỡng trong kịch bản này, việc đóng khoảng cách TPR 20 percentage-point làm tăng dương tính giả thêm 15 percentage-point cho nhóm bị thiệt thòi.
- Nếu tỷ lệ cơ sở dương tính là 20 percent, giá trị của một lần tuyển dụng thành công là $100,000, và chi phí của một lần tuyển dụng không tốt là $50,000, thì phải tính cả hai phía của can thiệp:
- \(\Delta\text{Utility} = \Delta\text{TPR} \times \text{Base Rate} \times \text{Hire Value} - \Delta\text{FPR} \times (1 - \text{Base Rate}) \times \text{Bad Hire Cost}\).
- Giá trị dương tính thật tăng thêm là $4,000 trên mỗi ứng viên Nhóm B, trong khi chi phí dương tính giả tăng thêm là $6,000, dẫn đến tổn thất ròng $2,000.
- Con số này tương đương 20 percent so với tiện ích cơ sở của Nhóm B. Với Nhóm B chiếm 30 percent số ứng viên, tổn thất trung bình dân số là $600 trên mỗi ứng viên; để có được tỷ lệ phần trăm tổng hợp còn cần tiện ích cơ sở của nhóm còn lại.
Hiểu biết về hệ thống: Trong kịch bản này, “Cái giá của sự công bằng” là mức mất mát tiện ích trong nhóm 20 percent, chứ không phải một tỷ lệ phần trăm tổng hợp có thể suy ra. Mất mát này không xảy ra một cách tự động: khi chênh lệch TPR phản ánh ngưỡng bị hiệu chỉnh sai, đóng chênh lệch có thể làm tăng tiện ích ròng. Nó xuất hiện khi ngưỡng ban đầu gần mức tối ưu về tiện ích và các trường hợp chấp nhận ở cận biên thiên về những người không đủ tiêu chuẩn. Chúng ta cần cung cấp cho các bên liên quan cả đường biên Pareto và những giả định đã tạo ra nó.
Cách tính này giúp các bên liên quan chọn một điểm trên đường biên giữa công bằng và độ chính xác, nhưng vẫn không giải thích được bất kỳ quyết định cụ thể nào. Khi một người nộp đơn vay bị từ chối, nói rằng “tỷ lệ dương tính thật (TPR) của mô hình cho nhóm nhân khẩu học này là 60 phần trăm so với 90 phần trăm cho các nhóm khác” không cung cấp thông tin hữu ích để người đó hành động. Người nộp đơn cần biết tại sao đơn bị từ chối và điều gì có thể thay đổi. Để trả lời những câu hỏi này, chúng ta cần khả năng giải thích (explainability) – tức là khả năng trình bày rõ ràng những đặc trưng đầu vào nào đã dẫn đến các dự đoán cụ thể.
Các yêu cầu về khả năng giải thích
Theo luật hiện hành, một người nộp đơn vay bị hệ thống thuật toán từ chối cấp tín dụng có thể có quyền được biết lý do hoặc các yếu tố cụ thể dẫn đến hành động bất lợi đó, chứ không chỉ là các thống kê tổng hợp. Khả năng giải thích14 hỗ trợ khả năng này: nó cho phép con người giám sát các quyết định tự động, hỗ trợ gỡ lỗi khi có vấn đề phát sinh và có thể đáp ứng các yêu cầu hiện hành về tính minh bạch của quyết định.
14 Khả năng giải thích và tính dễ hiểu: Tính dễ hiểu mô tả mức độ một người có thể nhanh chóng hiểu một mô hình hoặc cách nó hành xử, thường thông qua một cấu trúc được ràng buộc như danh sách quy tắc ngắn hoặc mô hình tuyến tính thưa. Khả năng giải thích rộng hơn và bao gồm các phương pháp hậu kiểm (post-hoc) như LIME và SHAP. Cả hai thuộc tính này đều không tự động: một mô hình tuyến tính với các đặc trưng khó hiểu vẫn có thể khó diễn giải, và gán đặc trưng không phải là một lời giải thích nhân quả cho một quyết định. Ở cấp hệ thống, các ràng buộc vốn có ảnh hưởng đến việc lựa chọn mô hình, trong khi các phương pháp hậu kiểm bổ sung một nhánh tính toán và xác thực với chi phí phụ thuộc vào phương pháp, mô hình và quy trình phục vụ (serving). Các quy định về quyền truy cập và quyết định tự động của GDPR dùng cụm từ “thông tin có ý nghĩa về logic liên quan” cho các quy trình xử lý được đề cập (European Parliament and Council of the European Union 2016), để ngỏ rằng cách tiếp cận kỹ thuật phù hợp sẽ phụ thuộc vào quyết định và luật điều chỉnh.
Mức độ khả năng giải thích cần thiết thay đổi theo ngữ cảnh ứng dụng và môi trường pháp lý. Table 9 liên kết các kịch bản triển khai phổ biến với nhu cầu khả năng giải thích của chúng.
| Lĩnh vực ứng dụng | Mức độ giải thích được | Yêu cầu điển hình |
|---|---|---|
| Quyết định tín dụng | Lý do cụ thể cho các hành động được đề cập | Các lý do chính có thể phải được tiết lộ cho người nộp đơn |
| Chẩn đoán y tế | Hỗ trợ ra quyết định | Hỗ trợ xem xét lâm sàng và tài liệu liên quan |
| Kiểm duyệt nội dung | Phụ thuộc vào ngữ cảnh | Hỗ trợ các thông báo hoặc kháng cáo khi cần thiết |
| Khuyến nghị | Phụ thuộc vào ngữ cảnh | Cung cấp sự minh bạch phù hợp với mục đích sử dụng và các quy tắc quản lý |
| Phát hiện gian lận | Tiết lộ có kiểm soát | Cân bằng các nghĩa vụ thông báo hiện hành với rủi ro tấn công đối kháng |
Các nhóm kỹ thuật nên chọn các cách tiếp cận khả năng giải thích dựa trên các yêu cầu lĩnh vực này:
- Các phương pháp giải thích hậu kiểm: Các phương pháp như SHapley Additive exPlanations (SHAP) và Local Interpretable Model-agnostic Explanations (LIME) tạo ra điểm quan trọng của đặc trưng cho từng dự đoán mà không cần thay đổi kiến trúc mô hình.15
- Các mô hình dễ hiểu vốn có: Các mô hình này bộc lộ cấu trúc quyết định thông qua các mô hình tuyến tính, cây quyết định hoặc danh sách quy tắc được ràng buộc phù hợp, nhưng có thể phải đánh đổi bằng hiệu suất dự đoán. Riêng các trọng số chú ý không nhất thiết là những giải thích đáng tin cậy về hành vi của mô hình.
- Giải thích dựa trên khái niệm: Ánh xạ hành vi của mô hình sang các khái niệm mà con người dễ hiểu, thay vì các đặc trưng thô.
15 LIME (giải thích cục bộ, dễ hiểu và không phụ thuộc mô hình) và SHAP (giải thích cộng tính Shapley): LIME (Ribeiro et al. 2016) xây dựng một mô hình thay thế cục bộ, dễ hiểu xung quanh mỗi dự đoán; SHAP (Lundberg and Lee 2017) áp dụng các giá trị Shapley từ lý thuyết trò chơi hợp tác để tính đóng góp của từng đặc trưng trong một khuôn khổ cộng tính thống nhất. Việc tính chính xác giá trị Shapley có thể rất tốn kém, nên các triển khai SHAP thực tế thường dùng xấp xỉ hoặc các thuật toán đặc thù cho từng mô hình. Bài học về hệ thống là: độ trung thực của giải thích, độ trễ và độ phức tạp triển khai phải được dự trù rõ ràng, không thể xem là “miễn phí”.
Ribeiro, Marco Tulio, Sameer Singh, and Carlos Guestrin. 2016. “Why Should I Trust You?: Explaining the Predictions of Any Classifier.” Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1135–44. https://doi.org/10.1145/2939672.2939778.
Lundberg, Scott M., and Su-In Lee. 2017. “A Unified Approach to Interpreting Model Predictions.” Advances in Neural Information Processing Systems (NeurIPS) 30: 4765–74.
Việc lựa chọn này đòi hỏi đánh đổi giữa độ trung thực của giải thích, chi phí tính toán và tính linh hoạt của mô hình.
Example 1.2: Lối tắt bệnh viện
Kịch bản: Các mô hình thị giác phát hiện viêm phổi, được huấn luyện tại Mount Sinai, đạt độ chính xác cao trên dữ liệu nội bộ nhưng thất bại trên các tập dữ liệu từ các bệnh viện bên ngoài (Zech et al. 2018).
Chẩn đoán: Mạng nơ-ron đã học các đặc trưng lối tắt (như nhiễu từ máy quét và thẻ văn bản đặc trưng của bệnh viện) thay vì các dấu hiệu bệnh lý phổi sinh học thực sự.
Bài học về hệ thống: Các mô hình có xu hướng tìm “con đường ít cản trở nhất” trong không gian đặc trưng. Vì vậy, xác thực bên ngoài là thiết yếu để phát hiện học lối tắt; bản đồ nổi bật (saliency maps) có thể cung cấp bằng chứng hỗ trợ nhưng không chứng minh rằng mô hình đã học đúng cơ chế mong muốn.
Zech, John R., Marcus A. Badgeley, Manway Liu, Anthony B. Costa, Joseph J. Titano, and Eric Karl Oermann. 2018. “Variable Generalization Performance of a Deep Learning Model to Detect Pneumonia in Chest Radiographs: A Cross-Sectional Study.” PLOS Medicine 15 (11): e1002683. https://doi.org/10.1371/journal.pmed.1002683.
Hiện tượng “lối tắt bệnh viện” cho thấy tính dễ hiểu là yêu cầu cốt lõi của hệ thống chứ không chỉ là phần trình bày cho bắt mắt: các nhóm cần đủ khả năng quan sát để điều tra lối tắt trước khi triển khai. Sơ đồ Figure 4 sắp xếp các đánh đổi này trên một trục duy nhất. Ở phía trái, các cây quyết định và mô hình tuyến tính (khi được ràng buộc phù hợp) cho phép kiểm tra trực tiếp, dù thiết kế đặc trưng và kích thước mô hình vẫn rất quan trọng. Ở phía phải, các mạng nơ-ron sâu và kiến trúc tích chập có năng lực cao hơn cho các tác vụ phức tạp nhưng khó kiểm tra trực tiếp, nên cần các phương pháp tóm tắt hậu nghiệm như LIME hoặc SHAP, vốn bản thân cũng phải được xác thực.

Việc lựa chọn mô hình phụ thuộc vào các yêu cầu về trách nhiệm giải trình của ứng dụng. Các luật về hành động bất lợi yêu cầu nêu lý do chính xác, cụ thể cho các quyết định tín dụng thuộc phạm vi điều chỉnh, nhưng không bắt buộc phải dùng một kiến trúc mô hình cụ thể. Các ứng dụng khác có thể có những nghĩa vụ khác nhau về minh bạch, an toàn hoặc khả năng tranh chấp. Phổ này không hàm ý “đơn giản thì luôn tốt hơn”, vì một mô hình rất dễ giải thích nhưng dự đoán không chính xác cũng có thể gây hại. Bài toán kỹ thuật là chọn một mô hình và quy trình giải thích đáp ứng đồng thời yêu cầu về khả năng dự đoán và trách nhiệm giải trình của ứng dụng.
Một số yêu cầu về khả năng giải thích và tính minh bạch có hiệu lực pháp lý. Đạo luật AI của EU, có hiệu lực từ ngày 1 tháng 8 năm 2024 và được áp dụng theo từng giai đoạn, đặt ra các nghĩa vụ về tài liệu hóa, minh bạch, giám sát của con người và quản lý rủi ro đối với các hệ thống rủi ro cao thuộc phạm vi điều chỉnh (European Parliament and Council of the European Union 2024). Quy định B yêu cầu phải có lý do chính cụ thể cho các hành động bất lợi thuộc phạm vi điều chỉnh, và phần diễn giải chính thức nêu rõ rằng các lý do được công bố phải mô tả chính xác các yếu tố thực sự đã được xem xét hoặc chấm điểm (12 C.F.R. § 1002.9; official interpretation). Cơ chế kỹ thuật áp dụng sẽ tùy thuộc vào hệ thống, quyết định, khu vực pháp lý và nghĩa vụ pháp lý cụ thể.
Bối cảnh pháp lý
Các quy định đã biến kỹ thuật có trách nhiệm từ một lập luận “thực hành tốt” thành các ràng buộc kiến trúc. Hãy hình dung một mô hình tín dụng từ chối hồ sơ của một người, người đó hỏi vì sao, khiếu nại quyết định, rồi sau đó yêu cầu được truy cập các dữ liệu đã được dùng về mình. Hệ thống không thể chỉ báo cáo một điểm đo độ chính xác. Nó phải đưa ra lời giải thích gắn với chính quyết định đó, lưu giữ lịch sử mô hình và nguồn gốc dữ liệu dẫn đến đầu ra này, chuyển khiếu nại sang một quy trình xem xét kỹ bởi con người, lưu trữ nhật ký kiểm toán, và hỗ trợ các quy trình xóa hoặc truy cập dữ liệu khi quyền dữ liệu được áp dụng. Giờ đây, kỹ thuật có trách nhiệm hoạt động trong các framework pháp lý rõ ràng, biến sự minh bạch, giám sát và trách nhiệm giải trình thành các yêu cầu kỹ thuật.
Quy định bắt đầu tác động đến kiến trúc thông qua việc phân loại rủi ro. Đạo luật AI của EU thiết lập một framework toàn diện, phân loại các hệ thống AI theo mức độ rủi ro và đưa ra các yêu cầu bắt buộc tương ứng.16 Đạo luật này có hiệu lực vào ngày 1 tháng 8 năm 2024 và được áp dụng theo từng giai đoạn: các quy tắc về thực hành bị cấm bắt đầu áp dụng từ năm 2025, trong khi các nghĩa vụ dành cho hệ thống rủi ro cao và các bên vận hành khác sẽ được triển khai dần theo từng danh mục hệ thống và hướng dẫn triển khai. Điều 99 đặt mức phạt tối đa là 35 triệu EUR hoặc 7% doanh thu toàn cầu đối với các thực hành AI bị cấm, trong khi nhiều nghĩa vụ khác của bên vận hành bị giới hạn ở mức 15 triệu EUR hoặc 3% (European Parliament and Council of the European Union 2024).
16 Đạo luật AI của EU (Quy định 2024/1689): Đây là framework pháp lý toàn diện đầu tiên về AI, quy định bốn mức rủi ro với các mức phạt khác nhau tùy loại vi phạm. Các hành vi AI bị cấm có thể bị phạt tới 35 triệu EUR hoặc 7% doanh thu toàn cầu. Nhiều nghĩa vụ khác, bao gồm nghĩa vụ của các nhà vận hành hệ thống rủi ro cao, được giới hạn ở 15 triệu EUR hoặc 3%. Đạo luật này có hiệu lực ngoài lãnh thổ: các tổ chức ngoài EU có thể phải tuân thủ khi họ đưa hệ thống của mình ra thị trường EU hoặc khi đầu ra của hệ thống được sử dụng tại EU. Hệ quả về kỹ thuật hệ thống là rất cụ thể: AI rủi ro cao yêu cầu hạ tầng ghi log để tạo dấu vết kiểm toán, cơ chế giám sát của con người phải được tích hợp sẵn vào kiến trúc, và phải có dán nhãn CE. Tất cả các năng lực này phải được thiết kế ngay từ đầu, không phải bổ sung sau khi triển khai.
European Parliament and Council of the European Union. 2024. Regulation (EU) 2024/1689 of the European Parliament and of the Council of 13 June 2024 Laying down Harmonised Rules on Artificial Intelligence (AI Act). Official Journal of the European Union, L 2024/1689.
17 AI rủi ro cao (Phụ lục III Đạo luật AI của EU): Phụ lục III liệt kê các trường hợp sử dụng trong các lĩnh vực như sinh trắc học, hạ tầng quan trọng, giáo dục, việc làm, dịch vụ thiết yếu, thực thi pháp luật, di cư và tư pháp. Việc phân loại phụ thuộc vào mục đích sử dụng và các tiêu chí tại Điều 6, bao gồm cả ngoại lệ cho một số hệ thống không ảnh hưởng đáng kể đến quyết định hoặc không gây rủi ro đáng kể; các hệ thống lập hồ sơ thuộc Phụ lục III vẫn được xếp loại rủi ro cao. Chỉ riêng kiến trúc mô hình không quyết định việc phân loại.
Với các kỹ sư, điều quan trọng không phải là mức phạt mà là các khả năng mà luật yêu cầu. Các hệ thống rủi ro cao thuộc phạm vi điều chỉnh17 phải triển khai quản lý rủi ro, quản trị dữ liệu, tài liệu kỹ thuật, tính minh bạch, giám sát của con người, cùng các yêu cầu về độ chính xác, độ vững và bảo mật. Vì vậy, một hệ thống quyết định tín dụng thuộc phạm vi điều chỉnh cần có khả năng kiểm toán ngay từ đầu: các phiên bản mô hình, nguồn gốc dữ liệu huấn luyện, bằng chứng kiểm định, thiết kế giám sát của con người, ghi nhật ký và giám sát sau triển khai phải là một phần của kiến trúc, chứ không phải các tài liệu được tập hợp sau khi hệ thống ra mắt.
Khả năng khiếu nại (contestability) đặt ra một yêu cầu kiến trúc thứ hai. GDPR đưa cùng quy trình xử lý đơn của người nộp đơn vào phạm vi quyền của chủ thể dữ liệu. Điều 22 trao cho các chủ thể dữ liệu EU quyền không bị chịu các quyết định chỉ dựa trên xử lý tự động mà tạo ra hệ quả pháp lý hoặc các hệ quả quan trọng tương tự, với các ngoại lệ và biện pháp bảo vệ được quy định cụ thể.18 Riêng Điều 15(1)(h) cho các chủ thể dữ liệu quyền được tiếp cận thông tin có ý nghĩa về logic liên quan đến việc ra quyết định tự động được nêu tại Điều 22. Các nhóm kỹ thuật cần xác định những quyết định nào thuộc phạm vi này và thiết kế phù hợp các khả năng giải thích và xem xét của con người. Khi cần một lộ trình xem xét thực chất, lộ trình đó phải được bố trí nhân sự vận hành và được hỗ trợ bởi các bản tóm tắt, thông tin về nguồn gốc (provenance) và các công cụ kiểm toán.
18 GDPR (Quy định chung về bảo vệ dữ liệu) điều 15 và 22: Điều 22 hạn chế một số quyết định hoàn toàn tự động có hiệu lực pháp lý hoặc có ảnh hưởng đáng kể tương tự. Đối với các ngoại lệ được chỉ định, yêu cầu có các biện pháp bảo vệ, bao gồm sự can thiệp của con người, quyền được bày tỏ quan điểm và quyền khiếu nại quyết định; điều 15(1)(h) quy định quyền được tiếp cận thông tin có ý nghĩa về logic liên quan đến các quyết định tự động đó (European Parliament and Council of the European Union 2016). Hướng dẫn của Ủy ban Bảo vệ Dữ liệu Châu Âu nhấn mạnh rằng sự giám sát của con người phải có thực chất, không chỉ là một hoạt động “đóng dấu” chiếu lệ (European Data Protection Board 2018). Nếu 0.1 percent trong số 1M quyết định hàng ngày bị kháng nghị hoặc chuyển cấp, hệ thống phải xử lý 1,000 cases/day. Đây là một giả định về khối lượng công việc (workload), không phải tỷ lệ lỗi của mô hình.
European Data Protection Board. 2018. Guidelines on Automated Individual Decision-Making and Profiling for the Purposes of Regulation 2016/679.
Luật chuyên ngành của Hoa Kỳ cũng đạt được các khả năng tương tự thông qua các yêu cầu bằng chứng theo từng lĩnh vực. Những quy định này kém thống nhất hơn so với Đạo luật AI của EU, nhưng có thể đặt ra các nghĩa vụ kỹ thuật liên quan. Trong ví dụ về tín dụng, Đạo luật Cơ hội Tín dụng Bình đẳng (ECOA) và Quy định B đi kèm yêu cầu nêu rõ các lý do chính cho những hành động bất lợi thuộc phạm vi điều chỉnh, và các lý do đó phải mô tả chính xác các yếu tố thực sự đã được xem xét hoặc chấm điểm (12 C.F.R. § 1002.9; giải thích chính thức). Nếu thông tin từ báo cáo người tiêu dùng hoặc điểm tín dụng ảnh hưởng đến quyết định, Đạo luật Báo cáo Tín dụng Công bằng (FCRA) bổ sung nghĩa vụ thông báo; nếu cùng cơ chế chấm điểm đó được dùng cho nhà ở, Đạo luật Nhà ở Công bằng (FHA) bổ sung ràng buộc cấm phân biệt đối xử. Hệ quả kỹ thuật mang tính thực tiễn: các hệ thống thuộc phạm vi điều chỉnh cần có bằng chứng và các biện pháp kiểm soát để đáp ứng các nghĩa vụ về lý do, thông báo, rà soát và không phân biệt đối xử.
Checkpoint 1.3: Triển khai có đạo đức
Triển khai là nơi các biện pháp bảo vệ phải đi vào hoạt động.
Mạng lưới an toàn
Kế hoạch giám sát
Các quy định trong lĩnh vực chăm sóc sức khỏe, như Đạo luật về Khả năng Chuyển đổi và Trách nhiệm Bảo hiểm Y tế (HIPAA)19 và hướng dẫn của Cục Quản lý Thực phẩm và Dược phẩm (FDA), tuân theo cùng một khuôn mẫu nhưng khác nhau về loại hồ sơ/bằng chứng: kiểm soát thông tin sức khỏe được bảo vệ, hồ sơ thẩm định, nhật ký kiểm toán và ứng phó sự cố. Tương tự, các hệ thống tuyển dụng cũng phải có bằng chứng cho thấy sàng lọc tự động không lặp lại các thực tiễn tuyển dụng mang tính phân biệt đối xử. Ở mọi lĩnh vực, nhiệm vụ là chuyển từng nghĩa vụ thành một năng lực cụ thể: giải thích, đánh giá của con người, truy xuất nguồn gốc, kiểm soát truy cập, xóa, giám sát hoặc ứng phó sự cố. Do đó, checkpoint triển khai không phải là một checklist theo từng ngành ở Mỹ; nó là một hợp đồng vận hành chung được ngầm định bởi bối cảnh pháp lý hiện hành.
19 HIPAA (Đạo luật về Khả năng Chuyển đổi và Trách nhiệm Bảo hiểm Y tế): Ban hành năm 1996, với các yêu cầu của Quy tắc Quyền riêng tư và Quy tắc Bảo mật đặt ra tiêu chuẩn cho thông tin sức khỏe được bảo vệ (United States Congress 1996; U.S. Department of Health and Human Services 2003, 2005); PHI có thể được dùng để huấn luyện theo sự cho phép phù hợp hoặc qua các lộ trình được phép khác, như miễn trừ của IRB hoặc Privacy Board; dữ liệu đã ẩn danh và các tập dữ liệu hạn chế kèm thỏa thuận sử dụng dữ liệu cũng mở thêm các lộ trình. Đầu ra của mô hình vẫn có thể là PHI khi chúng xác định hoặc có thể hợp lý xác định cá nhân, và yêu cầu lưu giữ tài liệu theo Quy tắc Bảo mật phải được phản ánh trong thiết kế kiểm toán và bằng chứng. Các hình phạt tiền dân sự được phân tầng và điều chỉnh theo lạm phát bằng quy định (U.S. Department of Health and Human Services 2026).
United States Congress. 1996. Health Insurance Portability and Accountability Act of 1996. Public Law 104-191.
U.S. Department of Health and Human Services. 2003. “Summary of the HIPAA Privacy Rule.”
U.S. Department of Health and Human Services. 2026. Annual Civil Monetary Penalties Inflation Adjustment. Federal Register.
Cách đáp ứng các yêu cầu quy định về mặt kỹ thuật là chủ động thiết kế kiến trúc. Các nhóm tích hợp tài liệu hóa, giám sát, khả năng giải thích và giám sát của con người vào hệ thống ngay từ đầu có thể chứng minh tuân thủ một cách hiệu quả. Ngược lại, các nhóm phải bổ sung các khả năng này về sau sẽ đối mặt với chi phí thiết kế lại lớn hoặc các ràng buộc khi triển khai. Quan điểm nền tảng ở đây là coi trách nhiệm như một yêu cầu kỹ thuật, chứ không phải một vấn đề pháp lý bị nghĩ tới sau cùng. Điều đó tạo điều kiện cho các chiến lược tuân thủ nhắm trúng đích hơn khi các framework quy định dần hoàn thiện. Tuy vậy, mức độ sẵn sàng về quy định vẫn chỉ bao quát con đường đã dự liệu; ngay cả các hệ thống được thiết kế tốt cũng có thể trục trặc, nên việc chuẩn bị ứng phó sự cố là điều thiết yếu.
Giám sát và ứng phó sự cố
Zillow đã báo cáo khoản ghi giảm hàng tồn kho ở mảng Bất động sản trị giá 304 triệu đô la Mỹ20 trong quý 3 năm 2021, sau khi mua nhà với giá cao hơn các ước tính đã điều chỉnh về giá bán trong tương lai (Zillow Group 2021). Một chẩn đoán ở góc độ hệ thống có thể diễn giải thất bại này là do kết hợp giữa bất định trong dự báo, dịch chuyển phân phối, giới hạn năng lực vận hành và các cơ chế an toàn (circuit breaker) chưa đủ. Lập kế hoạch cho các sự cố hệ thống trước khi chúng xảy ra là một thực hành kỹ thuật có trách nhiệm cốt lõi. Ứng phó sự cố và giám sát đòi hỏi phải chuẩn bị trước khi hệ thống gặp trục trặc. Dựa trên phân loại mức độ nghiêm trọng của sự cố và framework ứng phó sự cố từ Phản ứng sự cố cho các hệ thống ML, table 10 điều chỉnh framework tổng quát đó cho triển khai có trách nhiệm, nơi khâu phát hiện phải nêu bật cả các vi phạm tính công bằng và suy giảm trên các lát nhân khẩu học bên cạnh các sự cố ngừng hoạt động thông thường. Năm thành phần chủ yếu vẫn theo cung ứng phó sự cố tiêu chuẩn; điểm khiến bảng này trở nên thiết thực là cột cuối cùng. Các yêu cầu cho biết từng thành phần phải làm gì, còn cột xác minh trước khi triển khai nêu rõ những gì phải được chứng minh trước khi đưa vào hoạt động: một ngưỡng cảnh báo đã được kiểm thử, một lộ trình rollback đã được diễn tập, một danh sách liên hệ luôn cập nhật. Một yêu cầu mà không có kiểm soát đã được xác minh chỉ là ý định, không phải biện pháp bảo vệ; vì vậy cột này chính là cổng quyết định hệ thống đã sẵn sàng để triển khai hay chưa.
20 Sự cố D·A·M (dữ liệu · thuật toán · máy) của Zillow: Khoản ghi giảm giá trị năm 2021 của Zillow là một ca hệ thống đáng chú ý, vì thất bại kinh doanh đã được công bố này kết hợp cả bất định trong dự báo lẫn trục trặc trong khâu vận hành (Zillow Group 2021). Phân tích theo D·A·M diễn giải trục dữ liệu là sự lệch nhau giữa dữ liệu bán nhà lịch sử và biến động giá trong thời kỳ đại dịch; trục thuật toán là khó khăn khi định giá nhà với các ước tính độ không chắc chắn đáng tin cậy; và trục máy là một pipeline iBuying tự động cần các giới hạn năng lực xử lý và cơ chế ngắt mạch mạnh hơn. Đây là một cách diễn giải kỹ thuật dựa trên công bố công khai của Zillow, chứ không phải khẳng định rằng Zillow đã xác định một nguyên nhân kỹ thuật gốc rễ duy nhất.
Zillow Group. 2021. Zillow Group Reports Third-Quarter 2021 Financial Results and Shares Plan to Wind down Zillow Offers Operations. Investor Relations Press Release.
| Thành phần | Yêu cầu | Xác minh trước triển khai |
|---|---|---|
| Phát hiện | Hệ thống giám sát xác định các bất thường, hiệu suất suy giảm và các vi phạm công bằng | Ngưỡng cảnh báo đã được kiểm tra, lịch trực đã được thiết lập, các lộ trình leo thang đã được ghi lại |
| Đánh giá | Quy trình để đánh giá phạm vi và mức độ nghiêm trọng của sự cố | Phân loại mức độ nghiêm trọng đã được định nghĩa, các mẫu đánh giá tác động đã được chuẩn bị |
| Giảm thiểu | Khả năng kỹ thuật để giảm thiểu thiệt hại trong khi cuộc điều tra diễn ra | Quy trình khôi phục đã được kiểm tra, hệ thống dự phòng đang hoạt động, công tắc ngắt khẩn cấp đang hoạt động |
| Truyền thông | Giao thức để thông báo cho các bên liên quan | Danh sách liên hệ được cập nhật, các mẫu tin nhắn đã được chuẩn bị, chuỗi phê duyệt đã được định nghĩa |
| Khắc phục | Quy trình để khắc phục vĩnh viễn và cải tiến hệ thống | Quy trình phân tích nguyên nhân gốc rễ, tích hợp quản lý thay đổi |
Các hệ thống ML tạo ra những thách thức riêng về bảo trì và nợ kỹ thuật (Sculley et al. 2015). Các mô hình có thể âm thầm suy giảm chất lượng, các thành phần phụ thuộc có thể thay đổi bất ngờ, và các vòng lặp phản hồi có thể khuếch đại vấn đề nhỏ thành sự cố lớn. Kế hoạch ứng phó sự cố phải tính đến các kiểu lỗi đặc thù của ML này, và ứng phó hiệu quả phụ thuộc vào cơ sở hạ tầng giám sát liên tục để phát hiện vấn đề ngay từ đầu. Cơ sở hạ tầng giám sát tại Vận hành machine learning là nền tảng cho vận hành có trách nhiệm, bằng cách mở rộng các chỉ số vận hành truyền thống để bao gồm cả các thước đo chất lượng đầu ra.
Giám sát có trách nhiệm mở rộng theo nhiều khía cạnh liên kết với nhau:
- Theo dõi độ ổn định hiệu suất: Phát hiện sự suy giảm dần chất lượng dự đoán mà có thể không kích hoạt cảnh báo ngay. Việc độ chính xác giảm chậm trong nhiều tuần đặc biệt nguy hiểm vì dễ lọt qua các cảnh báo dựa trên ngưỡng.
- Giám sát bình đẳng nhóm con: Thêm góc nhìn công bằng vào theo dõi theo thời gian, so sánh tỷ lệ lỗi giữa các nhóm nhân khẩu học để phát hiện các chênh lệch mới xuất hiện trước khi chúng gây hại đáng kể.
- Giám sát phân phối đầu vào: Có thể cảnh báo về sự thay đổi trong phân phối dân số và nguy cơ bị thao túng bởi đối thủ, ngay cả trước khi các chỉ số kết quả quan sát được bắt đầu thay đổi.
- Giám sát kết quả: Xác nhận liệu các dự đoán có thực sự mang lại kết quả mong muốn trong thế giới thực hay không, chứ không chỉ xem điểm số của mô hình có ổn định hay không.
- Hệ thống phản hồi người dùng: Ghi nhận các khiếu nại và chỉnh sửa từ người dùng, giúp phát hiện những vấn đề mà các chỉ số tự động không thể nhận ra. Điều này bao gồm cả những tác hại mà chỉ những người dùng bị ảnh hưởng mới có thể diễn tả rõ.
Tổng hợp lại, các khía cạnh này kết nối các chỉ số ở cấp độ mô hình, những thay đổi ở phía dữ liệu, các kết quả thực tế và báo cáo từ con người, thành một giao diện giám sát thống nhất.
Để giám sát hiệu quả, cần có hạ tầng thu thập dữ liệu và các quy trình xem xét kỷ luật. Những bảng điều khiển (dashboard) mà không ai xem thì không bảo vệ được gì, nên các đội kỹ thuật phải thiết lập lịch xem xét định kỳ với trách nhiệm rõ ràng và quy trình báo cáo, xử lý theo cấp.
Các frameworks trong phần này giải quyết một khía cạnh của kỹ thuật có trách nhiệm: đảm bảo hệ thống hoạt động công bằng và đáng tin cậy trên các nhóm người dùng. Nhưng công bằng không phải là chi phí duy nhất mà các chỉ số kỹ thuật truyền thống bỏ qua. Mỗi lần huấn luyện mô hình, mỗi yêu cầu suy luận, và mỗi bảng điều khiển giám sát đều tiêu thụ điện, dẫn đến phát thải carbon và chi phí tiền tệ. Một hệ thống có thể hoàn toàn công bằng giữa các nhóm nhân khẩu học nhưng lại dùng tài nguyên nhiều hơn nhu cầu của tác vụ rất nhiều bậc, gây hại không chỉ cho nhóm người dùng cụ thể mà còn cho môi trường rộng hơn và cho các tổ chức phải chi trả. Vì vậy, kỹ thuật có trách nhiệm phải vượt ra ngoài câu hỏi hệ thống phục vụ ai để bao quát cả chi phí để phục vụ họ.
Self-Check: Question
An engineering team is evaluating a facial verification model. To estimate the error rate of a minority demographic group representing 1% of the population with a margin of error of \(\pm 1\) percentage point at 95% confidence, they require 10,000 labeled evaluation samples from that group. Under uniform random sampling from the natural population distribution, how many total images must the team collect and label in expectation?
- About 10,000 total images, because evaluating subgroup accuracy requires only that the total test set contains 10,000 images.
- About 100,000 total images, because statistical confidence intervals scale with the square root of the overall dataset size.
- About 1,000,000 total images in expectation, because a 1% subgroup yields only 1 target image per 100 randomly sampled images, imposing a \(100\times\) multiplier.
- About 10,000,000 total images, because the binomial confidence interval width expands exponentially for minority subgroups.
A team plans to write their model card six months after launch so that it accurately reflects observed production behavior. Explain why this timing constitutes a guard-rail failure, and describe one concrete scope-creep risk that a pre-deployment model card with automated deployment gates prevents.
A loan approval classifier is evaluated on two groups. Group A (Majority): 4,500 True Positives, 500 False Negatives (TPR = 90%), 1,000 False Positives, 4,000 True Negatives (FPR = 20%). Group B (Minority): 600 True Positives, 400 False Negatives (TPR = 60%), 200 False Positives, 800 True Negatives (FPR = 20%). Which statement accurately diagnoses the fairness metrics for this system?
- Demographic parity is satisfied because both groups share an identical False Positive Rate of 20%.
- Equalized odds is satisfied because matching False Positive Rates compensate for differences in True Positive Rates.
- Equal opportunity is violated due to the 30 percentage-point TPR gap, and equalized odds is also violated because equalized odds strictly requires parity in both TPR and FPR.
- Calibration is the only metric affected, because True Positive Rate disparities impact accuracy but do not constitute algorithmic bias.
In a hiring model, closing a 20 percentage-point TPR gap for a disadvantaged group via threshold adjustment adds \(\$4{,}000\) in successful-hire value but creates \(\$6{,}000\) in false-positive bad-hire costs per applicant from that group. Using the chapter’s two-sided accounting, calculate the net utility change per applicant and explain what deliverable engineers owe stakeholders.
An engineering team is establishing an incident response and deployment readiness pipeline for a high-risk ML service. Arrange the five operational components in their proper execution order from detection to long-term fix:
- Mitigation (triggering automated fallbacks, kill switches, or traffic rollbacks to a previous checkpoint)
- Detection (monitoring anomaly alerts, performance drift, and subgroup fairness threshold violations)
- Remediation (conducting root-cause analysis and integrating permanent model/pipeline fixes)
- Assessment (evaluating incident scope, affected demographics, and severity classification)
- Communication (notifying internal stakeholders and impacted external users via pre-approved channels)
A European financial institution deploys an automated machine learning system to make sole decisions on credit applications. Under the EU AI Act (high-risk classification) and GDPR Article 22, which set of architectural capabilities must the engineering team build into the system from inception?
- Post-hoc saliency map visualization tools only, because EU regulations apply strict requirements exclusively to generative foundation models.
- A manual spreadsheet of training dataset URLs and an annual retrospective fairness report submitted after year-end financial audits.
- An unconstrained deep neural network optimized for accuracy, since high aggregate predictive power automatically satisfies legal safety criteria.
- Automated risk management, training data provenance logging, explainable adverse-action factor generation, and an operational workflow supporting substantive human review and user contestability.
Nhận thức về môi trường và chi phí
Vào năm 2019, các nhà nghiên cứu ước tính rằng việc huấn luyện và tìm kiếm kiến trúc cho một mô hình Xử lý Ngôn ngữ Tự nhiên (NLP) lớn, ở quy mô phát triển, có thể thải ra lượng carbon tương đương với năm chiếc ô tô trong suốt vòng đời của chúng (Strubell et al. 2019). Phân tích sau đó cho thấy ước tính về tìm kiếm kiến trúc được trích dẫn nhiều nhất lại rất nhạy với các giả định về tác vụ proxy, phần cứng, hiệu quả của trung tâm dữ liệu và cường độ carbon của lưới điện (Patterson et al. 2021). Sự điều chỉnh này làm rõ thêm thông điệp về kỹ thuật có trách nhiệm, chứ không làm suy yếu nó: các lần chạy huấn luyện tiêu tốn hàng megawatt-giờ điện; khi suy luận ở quy mô lớn, những kém hiệu quả nhỏ ở mỗi yêu cầu cũng cộng dồn thành tác động môi trường đáng kể; và các mô hình tốn nhiều tài nguyên sẽ loại trừ các tổ chức không có ngân sách tính toán lớn. Do đó, các kỹ thuật tối ưu hóa được trình bày trong Nén mô hình, Tăng tốc phần cứng và Benchmarking đồng thời là công cụ của kỹ thuật có trách nhiệm, kết nối hiệu quả tính toán với tính bền vững môi trường, khả năng tiếp cận về mặt kinh tế và khả năng mở rộng dài hạn.
Strubell, Emma, Ananya Ganesh, and Andrew McCallum. 2019. “Energy and Policy Considerations for Deep Learning in NLP.” Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, 3645–50. https://doi.org/10.18653/v1/p19-1355.
Hiệu quả như một trách nhiệm
Việc huấn luyện một mô hình ngôn ngữ lớn (LLM) tiêu tốn hàng nghìn giờ GPU và năng lượng tính bằng megawatt-giờ. Tuy nhiên, phần lớn chi phí này không phải do bản chất của tác vụ học mà là sự phức tạp không cần thiết (accidental complexity): huấn luyện lại từ đầu khi chỉ cần tinh chỉnh (fine-tuning) là đủ, dùng mô hình lớn hơn mức tác vụ yêu cầu, hoặc chạy tìm kiếm siêu tham số với các cấu hình trùng lặp. Chi phí tính toán phụ thuộc vào lựa chọn kỹ thuật cũng như cấu trúc và nguyên lý hoạt động của mô hình. AI xanh (Green AI) xem hiệu quả là một tiêu chí hàng đầu, chứ không phải điều nghĩ đến sau cùng.21
21 AI xanh (Green AI): Schwartz et al. (2020) đã so sánh “AI đỏ (Red AI)” (hiệu suất bằng mọi giá) với “AI xanh (Green AI)” (lấy hiệu quả làm tiêu chí hàng đầu). Mỏ neo cho xu hướng tăng trưởng tính toán đến từ phân tích xu hướng giai đoạn 2012–2018 của AI and Compute, báo cáo mức tăng 300.000 lần về lượng tính toán trong các lần chạy huấn luyện AI lớn nhất (Amodei and Hernandez 2018). Đề xuất của AI xanh là báo cáo FLOPs cùng với độ chính xác cho mọi kết quả công bố, qua đó chuyển hiệu quả từ một ưu tiên kỹ thuật thành một nghĩa vụ báo cáo khoa học, giúp chi phí tài nguyên cho những cải thiện nhỏ về độ chính xác trở nên rõ ràng và có thể so sánh giữa các nhóm nghiên cứu.
Schwartz, Roy, Jesse Dodge, Noah A. Smith, and Oren Etzioni. 2020. “Green AI.” Communications of the ACM 63 (12): 54–63. https://doi.org/10.1145/3381831.
Amodei, Dario, and Danny Hernandez. 2018. “AI and Compute.” OpenAI Blog 6.
Hiệu quả tài nguyên và kỹ thuật có trách nhiệm liên kết trực tiếp qua ba kênh có liên hệ chặt chẽ:
- Tác động môi trường: Tính toán nhiều hơn có thể làm tăng năng lượng tiêu thụ và phát thải, nhưng mối quan hệ này còn phụ thuộc vào mức độ sử dụng phần cứng, công suất, runtime, chi phí phụ trợ của cơ sở hạ tầng và cường độ lưới điện. Các kỹ thuật nâng cao hiệu quả sẽ giảm tác động môi trường khi chúng làm giảm năng lượng đo được trong suốt vòng đời cho khối lượng công việc (workload) và mục tiêu chất lượng yêu cầu.
- Khả năng tiếp cận: Các mô hình hiệu quả tài nguyên có thể mở rộng các lựa chọn triển khai bằng cách chạy trên phần cứng rẻ hơn. Ví dụ, một mô hình được lượng tử hoá chạy trên điện thoại thông minh có thể giảm phụ thuộc vào kết nối mạng và chi phí API đám mây định kỳ.
- Tính bền vững ở quy mô lớn: Các hệ thống phục vụ hàng triệu người dùng sẽ nhân lên nhu cầu tài nguyên trên mỗi yêu cầu. Việc giảm độ trễ chỉ tiết kiệm thời gian của bộ tăng tốc khi nó thực sự giảm nhu cầu dịch vụ, thay vì chỉ chuyển công việc hoặc thời gian nhàn rỗi sang chỗ khác; mức tiết kiệm hằng năm phụ thuộc vào lưu lượng truy cập, batching, khả năng xử lý đồng thời và mức độ sử dụng.
Những kênh này biến tối ưu hoá thành một yêu cầu mang tính trách nhiệm, chứ không chỉ là một bài toán hiệu suất đơn thuần.
Các kỹ thuật tối ưu hoá có thể trực tiếp phục vụ các mục tiêu về trách nhiệm. Chẳng hạn, lượng tử hoá, tỉa (pruning), chưng cất tri thức và tăng tốc phần cứng có thể giúp giảm kích thước mô hình, khối lượng công việc thực thi, độ trễ hoặc năng lượng tiêu thụ. Tuy nhiên, lợi ích thực tế đạt được và tác động đến chất lượng sẽ phụ thuộc vào mô hình, khối lượng công việc (workload), runtime và phần cứng.
Các kỹ sư có trách nhiệm áp dụng các kỹ thuật này như yêu cầu thiết kế ngay từ đầu, chứ không phải nghĩ đến sau cùng. Câu hỏi không còn là chỉ tối đa hóa độ chính xác, mà là tối đa hóa độ chính xác trong các ràng buộc về hiệu quả.
Kỹ thuật hiệu quả trong thực tế
Thừa nhận rằng hiệu quả quan trọng là phần dễ; phần khó hơn là biến nguyên tắc đó thành các mục tiêu có thể đo lường. Mục tiêu là chọn mô hình nhỏ nhất đáp ứng yêu cầu của tác vụ, rồi áp dụng tối ưu hóa có hệ thống để tiếp tục giảm mức tiêu thụ tài nguyên. Các kịch bản triển khai ở edge khiến các ràng buộc này trở nên cụ thể, vì chúng đặt ra các giới hạn vật lý cứng không thể thương lượng.
Các kịch bản triển khai ở edge khiến các yêu cầu về hiệu quả trở nên cụ thể. Chẳng hạn, trong kịch bản minh họa này, một thiết bị đeo có ngân sách công suất 500 mW và phải suy luận liên tục trong 24 giờ chỉ với một viên pin nhỏ. Bảng Table 11 so sánh các ràng buộc giả định trên bốn ngữ cảnh triển khai khác nhau, từ điện thoại thông minh với ngân sách công suất 5 W đến các cảm biến IoT hoạt động với ngân sách 100 mW.
| Bối cảnh triển khai | Ngân sách công suất | Yêu cầu về độ trễ | Các trường hợp sử dụng điển hình |
|---|---|---|---|
| Điện thoại thông minh | 5 W | 100 ms | Cải thiện ảnh, trợ lý giọng nói |
| Cảm biến IoT | 100 mW | 1 second | Phát hiện bất thường, giám sát môi trường |
| Camera nhúng | 1 W | 30 FPS (33 ms) | Phát hiện đối tượng thời gian thực, giám sát |
| Thiết bị đeo | 500 mW | 500 ms | Giám sát sức khỏe, nhận dạng hoạt động |
Các kịch bản trong table 12 cung cấp định hướng cho việc tối ưu hóa hiệu quả. Những kỹ thuật cho phép triển khai trên các nền tảng bị giới hạn công suất có thể giảm tác động môi trường trên mỗi lần suy luận khi chúng hạ năng lượng đo được mà không đẩy chi phí sang nơi khác. Khoản tiết kiệm tài chính còn phụ thuộc vào cấp phát tài nguyên, mức độ sử dụng, chính sách định giá và lưu lượng.
| mô hình | Tham số | Công suất suy luận | độ trễ | Phù hợp với điện thoại thông minh? | Phù hợp với IoT? |
|---|---|---|---|---|---|
| MobileNetV2 | 3.5M | 1.2 W | 40 ms | Yes | No |
| EfficientNet-B0 | 5.3M | 1.8 W | 65 ms | Yes | No |
| ResNet-50 | 25.6M | 4.5 W | 180 ms | No | No |
| Mô hình TinyML | 200K | 50 mW | 200 ms | No | Yes |
Với ngân sách cho thiết bị đeo trong table 11, mô hình TinyML vẫn còn một khoảng dự phòng công suất 10×, trong khi MobileNetV2 vượt quá cùng ngân sách công suất đó 2.4× ngay cả trước khi tính đến giới hạn nhiệt khi vận hành lâu. Đáp ứng giới hạn thiết bị là cần thiết nhưng chưa đủ: công suất cho mỗi lần suy luận (inference) sẽ cộng dồn thành chi phí phục vụ (serving) trọn vòng đời khi mô hình chạy liên tục ở quy mô sản xuất.
Tổng chi phí sở hữu
Một nhóm chi $3.200 để huấn luyện một mô hình khuyến nghị và ăn mừng vì chi phí khiêm tốn đó. Sáu tháng sau, họ phát hiện đang chi $500.000 mỗi năm để phục vụ (serving) mô hình đó. Điều bất ngờ này cho thấy tổng chi phí sở hữu22 có thể bị chi phối bởi chi phí suy luận (inference) lặp lại khi lưu lượng truy cập cao. Với các hệ thống khác, chi phí có thể bị chi phối bởi huấn luyện, dữ liệu, nhân sự hoặc dung lượng nhàn rỗi, nên việc đo lường sẽ quyết định nên tập trung tối ưu ở đâu.
22 TCO (tổng chi phí sở hữu): TCO trong ML bao gồm gán nhãn, giám sát, huấn luyện lại, khắc phục, năng lượng, kiểm toán và tuân thủ. Khi lưu lượng đủ lớn, chi phí suy luận (inference) lặp lại có thể áp đảo một khoản huấn luyện một lần; mức độ sử dụng và tần suất cập nhật quyết định sự cân bằng này.

Ở quy mô sản xuất, chi phí suy luận (inference) lặp lại có thể chiếm phần lớn tổng chi phí vòng đời.
Hãy xem một ví dụ cụ thể về hệ thống khuyến nghị phục vụ 10M người dùng mỗi ngày. Chi phí huấn luyện có vẻ đáng kể: chuẩn bị dữ liệu mất 100 GPU-hours với đơn giá khoảng $4/hour ($400), tìm kiếm siêu tham số trên nhiều cấu hình cần 500 GPU-hours ($2,000), và lần chạy huấn luyện cuối cùng tốn 200 GPU-hours ($800). Tổng chi phí huấn luyện đạt khoảng $3,200.
Trong kịch bản này, chi phí suy luận chiếm ưu thế. Với 10M người dùng, mỗi người nhận 20 khuyến nghị mỗi ngày, hệ thống phục vụ 200M suy luận mỗi ngày. Nếu coi thời gian 10 milliseconds cho mỗi suy luận là nhu cầu phục vụ trên GPU chuyên dụng (không theo batch và không chồng chéo), thì sẽ cần khoảng 23.1 GPUs GPU chạy liên tục. Ở mức $2.50/GPU-hour, chi phí GPU hàng năm cho kịch bản này là $506,944.
Trong khoảng thời gian vận hành ba năm, việc huấn luyện lại mô hình theo quý tạo ra tổng chi phí huấn luyện khoảng $38,400, trong khi chi phí suy luận trong cùng kỳ là $1.5M. Tỷ lệ 40:1 này phụ thuộc vào các giả định đã nêu, nhưng nó cho thấy nên tập trung tối ưu hóa vào đâu trong kịch bản này: độ trễ suy luận và hiệu quả phục vụ (serving).
Tối ưu hóa theo từng truy vấn trở nên quan trọng khi hệ thống phải phục vụ hàng tỷ yêu cầu. Giảm 1/5 nhu cầu phục vụ trên bộ tăng tốc cho mỗi truy vấn có thể làm giảm phần cứng cần thiết, miễn là các giả định khác về khối lượng công việc (workload) không đổi. Việc lựa chọn phần cứng giữa CPU, GPU và Tensor Processing Units sẽ làm thay đổi chi phí và dấu chân carbon theo những cách phụ thuộc vào khối lượng công việc và cách triển khai. Nén mô hình thông qua lượng tử hoá và tỉa (pruning) có thể giảm chi phí suy luận khối lượng lớn, nếu nó làm giảm nhu cầu phục vụ đo được mà không gây suy giảm chất lượng ở mức không chấp nhận được.
Tổng chi phí sở hữu (TCO) bao gồm nhiều khía cạnh khác, không chỉ chi phí tính toán. Chi phí vận hành gồm giám sát, bảo trì, huấn luyện lại và ứng phó sự cố; tất cả những yếu tố này đều tăng theo độ phức tạp của hệ thống và tốc độ dịch chuyển phân phối dữ liệu trong miền ứng dụng. Chi phí cơ hội nhắc rằng các tài nguyên mà hệ thống ML tiêu thụ sẽ không thể dùng cho mục đích khác. Việc lãng phí tài nguyên ở một dự án sẽ hạn chế những gì các dự án khác có thể làm.
Các kỹ sư nên đánh giá lợi tức đầu tư (ROI): liệu giá trị mà một hệ thống ML mang lại có biện minh cho việc tiêu thụ tài nguyên của nó hay không. Một hệ thống khuyến nghị tăng mức độ tương tác thêm 1 phần trăm có thể không biện minh cho hàng triệu đô la chi phí tính toán, trong khi một hệ thống chẩn đoán y tế cứu sống người thì có. Việc nêu rõ các đánh đổi cho phép phân bổ tài nguyên có trách nhiệm.23
23 ROI của ML (lợi tức đầu tư): Tỷ lệ chi phí triển khai so với huấn luyện thay đổi tùy theo lưu lượng truy cập, mức độ sử dụng, phần cứng, nhịp độ cập nhật, nhân sự và gánh nặng sự cố. Lựa chọn mô hình phù hợp phụ thuộc vào chi phí vòng đời đo được và giá trị của bài toán chứ không phải một tỷ lệ cố định.
Phương pháp tính TCO
Để định lượng tác động carbon trong vận hành, cần đo lường hoặc ước tính mức sử dụng năng lượng, chi phí cơ sở vật chất và cường độ carbon của lưới điện tương ứng. Các kỹ sư có thể ước tính tổng chi phí sở hữu ba năm bằng cách sử dụng phương pháp tiếp cận có cấu trúc, tách riêng chi phí huấn luyện, suy luận và vận hành vào các sổ cái khác nhau. Huấn luyện thường là chi phí một lần hoặc định kỳ, suy luận phát sinh lặp lại với mỗi yêu cầu của người dùng, còn chi phí vận hành tích lũy dần thông qua giám sát, huấn luyện lại và ứng phó sự cố. Phương pháp sổ cái áp dụng cấu trúc đó cho ví dụ hệ thống khuyến nghị trong phần này.
Napkin Math 1.3: Chi phí carbon của tính toán
Vấn đề: Các sổ cái TCO phải chuyển đổi “giờ tính toán” thành “kg CO2tđ”. Một giờ GPU mang bao nhiêu hệ số carbon theo kịch bản cơ sở?
Các biến số:
- Công suất: 400 W trên mỗi GPU (kịch bản cơ sở).
- Cường độ: 0.4 kg/kWh CO2tđ (cơ sở lưới điện, đã làm tròn).
Công thức: Equation 2 thể hiện phép chuyển đổi tiêu chuẩn: \[ \text{Carbon} = \text{Energy (kWh)} \times \text{Carbon Intensity (kg/kWh)} \tag{2}\] Áp dụng các giả định cơ sở: \[\begin{gather*} \left(\text{0.4 kW} \times \text{1 hour}\right) \times \text{0.4 kg/kWh} = \text{0.16 kg CO}_2\text{eq per GPU-hour} \end{gather*}\] Thông tin chuyên sâu về hệ thống: Nhờ hệ số chuyển đổi này, các sổ cái có thể theo dõi “Chi phí Carbon” song song với “Chi phí Đô la”, biến phát thải thành một chỉ số kỹ thuật quan trọng hàng đầu trong các bảng TCO ở phần sau.
Chi phí huấn luyện
Chi phí huấn luyện bao gồm cả phát triển ban đầu và huấn luyện lại liên tục. Table 13 bóc tách các khoản chi này, cho thấy các chu kỳ huấn luyện lại hàng quý sẽ cộng dồn như thế nào trong suốt ba năm vận hành.
| Thành phần chi phí | Tính toán | Chi phí tài chính | Carbon (kg CO2) |
|---|---|---|---|
| Chuẩn bị dữ liệu ban đầu | giờ \(\times\) tỷ lệ | 100 GPU-hr \(\times\) $4 = $400 | 16 kg |
| Tìm kiếm siêu tham số | thử nghiệm \(\times\) chi phí/thử nghiệm | 50 \(\times\) $40 = $2,000 | 80 kg |
| Huấn luyện cuối cùng | giờ \(\times\) tỷ lệ | 200 GPU-hr \(\times\) $4 = $800 | 32 kg |
| Tổng phụ cho mỗi chu kỳ huấn luyện | $3,200 | 128 kg | |
| Tần suất huấn luyện lại | chu kỳ/năm \(\times\) năm | 4/year \(\times\) 3 years = 12 | hệ số nhân tương tự (12 chu kỳ) |
| Tổng chi phí huấn luyện | tổng phụ \(\times\) chu kỳ | $38,400 | 1,536 kg |
Chi phí suy luận
Table 14 mô tả chuỗi chuyển đổi biến lưu lượng truy cập thành chi phí: truy vấn hàng ngày được quy đổi thành giây GPU, giây GPU thành giờ GPU, và giờ GPU sau đó được chuyển thành cả đô la và carbon. Carbon chỉ được tính khi khối lượng công việc (workload) được biểu diễn bằng giờ GPU, nên các hàng truy vấn và giây GPU được để trống cột carbon theo thiết kế, không phải do thiếu dữ liệu. Lần theo chuỗi đến hàng cuối cùng sẽ cho ta phần chi phí suy luận để so sánh tổng chi phí trong table 16; mức độ chi phối chỉ thể hiện khi so sánh phần này với chi phí huấn luyện và vận hành.
| Thành phần chi phí | Tính toán | Chi phí tài chính | Carbon (kg CO2) |
|---|---|---|---|
| Truy vấn hàng ngày | người dùng \(\times\) truy vấn/người dùng | 10M \(\times\) 20 = 200M | - |
| GPU-giây/ngày | truy vấn \(\times\) nhu cầu dịch vụ | 200M \(\times\) 0.01 s = 2M sec | - |
| GPU-giờ/ngày | giây ÷ SEC_PER_HOUR | 556 GPU-hr | 88.9 kg |
| Chi phí GPU hàng năm | giờ \(\times\) 365 \(\times\) tỷ lệ | 556 \(\times\) 365 \(\times\) $2.50 = $507K | 32,444.4 kg |
| Chi phí suy luận 3 năm | hàng năm \(\times\) 3 | $1.52M | 97,333.3 kg |
Chi phí vận hành
Chi phí vận hành gồm cơ sở hạ tầng, nhân sự và ứng phó sự cố. Hệ thống ML tạo ra những gánh nặng vận hành mà phần mềm truyền thống không có: “ứng phó sự cố” thường là gỡ lỗi các lỗi ngầm (trôi dữ liệu, hỏng đặc trưng, hoặc dịch chuyển phân phối) thay vì những lần mất dịch vụ hoàn toàn; còn “hạ tầng giám sát” phải liên tục theo dõi các bất thường thống kê trong dự đoán của mô hình theo các lát cắt nhân khẩu học, chứ không chỉ mỗi tính sẵn sàng của dịch vụ. Table 15 liệt kê các khoản chi thường xuyên này, điều thường khiến các nhóm tập trung chủ yếu vào chi phí tính toán phải bất ngờ.
| Thành phần chi phí | Ước tính hàng năm | Tổng cộng 3 năm |
|---|---|---|
| Cơ sở hạ tầng giám sát | $50K | $150K |
| Kỹ thuật viên trực (0.5 FTE) | $100K | $300K |
| Phản ứng sự cố (ước tính) | $20K | $60K |
| Tổng chi phí vận hành | $510K |
Bảng phân tích chi tiết trong table 16 cho thấy rõ tiền được chi tiêu vào đâu: suy luận ở mức 73.5 percent, vận hành ở mức 24.6 percent, và huấn luyện chỉ ở mức 1.9 percent.
| Danh mục | Chi phí 3 năm | Tỷ lệ phần trăm | Carbon bộ tăng tốc được mô hình hóa |
|---|---|---|---|
| Huấn luyện | $38K | 1.9% | 1.5 t |
| Suy luận | $1.52M | 73.5% | 97.3 t |
| Hoạt động | $510K | 24.6% | Chưa được ước tính |
| Tổng TCO | $2.07M | 100% | ~98.9 t tổng phụ được mô hình hóa |
Những tỷ lệ này biến hiệu quả từ một lựa chọn tinh chỉnh thành một thước đo trách nhiệm.
Checkpoint 1.4: Hiệu quả như một trách nhiệm
Tổng chi phí sở hữu cho thấy tối ưu hóa có trách nhiệm tạo được đòn bẩy lớn nhất ở đâu.
Tác động môi trường
Phân tích TCO ở phần trước phản ánh các chi phí xuất hiện trên hóa đơn, nhưng tài nguyên tính toán còn có những chi phí không hề thể hiện trên hóa đơn. Lượng phát thải vận hành phụ thuộc vào năng lượng đo được, hiệu quả sử dụng năng lượng của cơ sở (PUE), và cường độ carbon của lưới điện khu vực (\(\text{gCO}_2\text{e}/\text{kWh}\)); còn tác động phát sinh từ quá trình sản xuất cần được hạch toán riêng. Một ước tính vận hành bậc nhất là \(\text{Energy}_{\text{hardware}} \times \text{PUE} \times \text{Carbon Intensity}\). Năng lượng trên mỗi yêu cầu được đo bằng joule trên mỗi lần suy luận, còn số joule trên mỗi FLOP đặc trưng cho hiệu suất làm việc của phần cứng. Một tối ưu hóa giúp giảm TCO có thể không làm giảm năng lượng hoặc phát thải nếu nó làm thay đổi mức độ sử dụng, phần cứng, hoặc vị trí đặt khối lượng công việc (workload). Việc sử dụng điện của trung tâm dữ liệu khiến thiết kế khối lượng công việc (workload), phần cứng, khu vực đám mây và thời điểm vận hành trở thành một phần của kỹ thuật có trách nhiệm (Henderson et al. 2020). Quy mô tác động sẽ rõ hơn qua phép tính ở quy mô lớn khi huấn luyện một mô hình nền tảng lớn.
Henderson, Peter, Jieru Hu, Joshua Romoff, Emma Brunskill, Dan Jurafsky, and Joelle Pineau. 2020. “Towards the Systematic Reporting of the Energy and Carbon Footprints of Machine Learning.” CoRR abs/2002.05651 (248): 1–43. https://doi.org/10.48550/arxiv.2002.05651.
Kịch bản huấn luyện này tạo ra lượng phát thải vượt quá mức tương đương 100 năm sử dụng xe ô tô cá nhân.
Tối ưu hóa hiệu quả và trách nhiệm môi trường đi cùng nhau khi năng lượng và phát thải vòng đời đo được giảm xuống cho khối lượng công việc (workload) và mục tiêu chất lượng yêu cầu. Các phương pháp kế toán carbon chi tiết hơn xây dựng trên nền tảng này: đánh giá vòng đời (lifecycle assessment) theo dõi tác động trong suốt vòng đời hệ thống; phát thải phạm vi 1/2/3 tách riêng phát thải trực tiếp, điện năng mua vào, và phát thải từ chuỗi cung ứng hoặc giai đoạn sử dụng; và lập lịch theo carbon dời công việc sang các thời điểm hoặc khu vực có lượng carbon thấp hơn.
Các đại lượng vật lý chi phối hiệu suất cũng ảnh hưởng đến trách nhiệm. Việc di chuyển dữ liệu và tính toán góp phần vào năng lượng ở cấp độ chip, trong khi phát thải của trung tâm dữ liệu còn phụ thuộc vào mức sử dụng, phụ tải vận hành của cơ sở, cường độ lưới điện và các tác động vòng đời. Phân tích Pareto áp dụng cho cả mục tiêu độ chính xác-công bằng và độ chính xác-độ trễ, nhưng thay đổi trọng số của một mục tiêu có thể cải thiện nhiều chỉ số khi lời giải hiện tại bị trội (dominated). Kỹ thuật có trách nhiệm mở rộng bài toán tối ưu hóa có ràng buộc mà cuốn sách này đã dạy để bao gồm các mục tiêu về tác động xã hội bên cạnh thông lượng và độ trễ.
Napkin Math 1.4: Chi phí carbon của quy mô
Bài toán: Một mô hình nền tảng đang được huấn luyện ở quy mô của GPT-3, tiêu thụ 1,287 MWh điện năng (Patterson et al. 2021). Tác động carbon vận hành theo giả định về cường độ lưới điện đã nêu là bao nhiêu?
Tính toán:
- Mức tiêu thụ năng lượng: 1,287 MWh = 1,287,000 kWh.
- Cường độ carbon: Kịch bản này sử dụng \(\approx\) 429 g/kWh CO2 (0.429 kg/kWh) (Patterson et al. 2021).
- Tổng lượng phát thải: 1,287,000 kWh \(\times\) 0.429 kg/kWh = 552,123 kg CO2 (552 t).
- So sánh: Kịch bản này giả định 4.6 t CO2 cho một năm-vận-hành của xe ô tô con.
Góc nhìn hệ thống: Theo kịch bản năng lượng huấn luyện này, phát thải trong vận hành tương đương với lượng phát thải hằng năm của 120 xe ô tô con. Giảm 1% tổng năng lượng huấn luyện (giữ nguyên hỗn hợp lưới điện) sẽ loại khỏi phép tính một lượng tương đương khoảng 1.2 cars xe ô tô con bị rút khỏi lưu thông trong một năm.
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. 2021. “Carbon Emissions and Large Neural Network Training.” arXiv Preprint arXiv:2104.10350.
Các danh sách kiểm tra, chỉ số công bằng, cơ chế giải thích và phân tích hiệu quả ở các phần trước cho các nhóm kỹ thuật biết cần đo lường gì và cách hành động. Câu hỏi tiếp theo một cách tự nhiên là hạ tầng nào sẽ ghi lại các kết quả đó, hỗ trợ kiểm toán và chuyển các vi phạm tới biện pháp can thiệp phù hợp, thay vì trông vào trí nhớ con người. Câu trả lời nằm ở quản trị dữ liệu—một lĩnh vực kỹ thuật biến các ý định chính sách thành các kiểm soát kỹ thuật có thể thực thi.
Self-Check: Question
A team optimizes an inference model using INT8 quantization and structured pruning, reducing dedicated accelerator compute by \(4\times\) while preserving accuracy. According to the chapter, why is this efficiency improvement classified as a responsible engineering intervention rather than a pure performance optimization?
- Because quantization mathematically guarantees that disparate impact across all protected demographic groups drops to zero.
- Because reducing model parameters eliminates the need for data governance and audit logging in production pipelines.
- Because efficiency optimizations are relevant only for one-time training runs, where carbon emissions are legally regulated.
- Because reducing service demand simultaneously lowers operational energy consumption, cuts lifecycle dollar costs, and broadens accessibility to lower-cost hardware.
A wearable health monitor has a strict power budget of 500 mW and an end-to-end latency limit of 500 ms. Based on the chapter’s edge deployment profiles (TinyML DS-CNN: 50 mW, 200 ms; MobileNetV2: 1.2 W, 40 ms; EfficientNet-B0: 1.8 W, 65 ms; ResNet-50: 4.5 W, 180 ms), which model selection represents the correct engineering decision?
- MobileNetV2, because its 40 ms latency is significantly faster than the 500 ms limit, and power overages can be mitigated by aggressive cloud offloading.
- TinyML DS-CNN, because its 50 mW power draw operates with a \(10\times\) safety margin under the 500 mW power budget and its 200 ms latency satisfies the 500 ms deadline.
- EfficientNet-B0, because modern smartphone battery management chips can absorb a 1.8 W draw in a wearable form factor without thermal throttling.
- ResNet-50, because large models achieve superior accuracy and batching amortizes per-sample energy consumption to zero.
In an illustrative three-year recommendation system TCO model (Training: ~2%, Operations: ~25%, Inference: ~73%), compare the financial impact of a 50% reduction in training time versus a 20% reduction in per-query dedicated accelerator service demand. Which optimization yields higher dollar savings, and by what approximate ratio?
True or False: For an identical serving workload, relocating an inference deployment from a carbon-intensive fossil-fuel grid region to a region powered predominantly by low-carbon renewable energy can reduce operational carbon emissions more than a modest algorithmic efficiency improvement.
In data-center environmental accounting, the metric defined as the ratio of total facility energy to the energy consumed specifically by computing equipment is known as
____(abbreviated PUE).
Quản trị Dữ liệu và Tuân thủ
Các mô hình đề xuất và nhắm mục tiêu có thể tiêu thụ dữ liệu người dùng ở quy mô rất lớn. Điều này có nghĩa là một trục trặc trong quản trị pipeline dữ liệu cũng đồng thời là một thất bại trong hạ tầng thu nạp và xác thực dữ liệu của hệ thống ML. Quản trị là lớp thực thi làm cho trách nhiệm giải trình trở nên khả thi: các chỉ số công bằng, thẻ mô hình và đánh giá tác động chỉ có ý nghĩa ở quy mô nếu hệ thống xác lập được đã dùng dữ liệu nào, ai đã truy cập, cơ sở pháp lý nào cho phép xử lý, và liệu các quyền xóa hoặc quyền tranh chấp áp dụng có được tôn trọng hay không.
Các khoản phạt của Meta làm cho câu chuyện quản trị trở nên cụ thể: một hệ thống phải thiết lập cơ sở pháp lý hợp lệ để xử lý và đồng thời bảo vệ dữ liệu. Tháng 1 năm 2023, Ủy ban Bảo vệ Dữ liệu Ireland đã ban hành các khoản phạt riêng EUR 210M và EUR 180M (tổng EUR 390M) đối với Meta Ireland. Các quyết định này xoay quanh việc dựa trái luật vào cơ sở “cần thiết theo hợp đồng” cho quảng cáo cá nhân hóa, cùng với các vi phạm về minh bạch và công bằng, chứ không phải do vi phạm dữ liệu (Data Protection Commission 2023).
Data Protection Commission. 2023. Data Protection Commission Announces Conclusion of Two Inquiries into Meta Ireland. Regulatory press release.
Các kiến trúc lưu trữ được bàn trong Kỹ thuật dữ liệu là những cơ chế thực thi quản trị dữ liệu. Chúng quyết định ai được truy cập dữ liệu, cách theo dõi việc sử dụng, và liệu hệ thống có tuân thủ yêu cầu pháp lý hay không. Mọi quyết định kiến trúc, từ chiến lược thu thập, qua các pipeline xử lý, đến thiết kế lưu trữ, đều kéo theo hàm ý về quản trị; các hàm ý này lộ rõ khi hệ thống bước vào kiểm toán theo quy định, gặp vi phạm quyền riêng tư, hoặc đối mặt thách thức đạo đức. Quản trị dữ liệu biến chính sách trừu tượng thành kỹ thuật cụ thể thông qua kiểm soát truy cập vào dữ liệu huấn luyện, hạ tầng kiểm toán ghi nhận truy cập dữ liệu, các kỹ thuật huấn luyện bảo vệ quyền riêng tư, và hệ thống truy xuất nguồn gốc dữ liệu từ các bản ghi âm thô đến mô hình sản xuất. Vì những nghĩa vụ này ràng buộc vào kiến trúc chứ không chỉ là giấy tờ, chúng đáng được nêu thành một nguyên tắc riêng của chương này, không phải một nguyên tắc mở đầu phần bao quát cả cuốn sách.
Principle: Tuân thủ như một ràng buộc kỹ thuật
Bất biến: Các nghĩa vụ quản trị dữ liệu là những yêu cầu kỹ thuật bắt buộc, chứ không phải là các chính sách tùy chọn được thêm vào.
Hàm ý: Các hệ thống xử lý dữ liệu chịu điều chỉnh bởi quy định phải ánh xạ các nghĩa vụ áp dụng thành các biện pháp kiểm soát kỹ thuật và tổ chức phù hợp. Tùy theo khu vực pháp lý, dữ liệu, tác nhân và trường hợp sử dụng, có thể cần hoặc nên áp dụng các biện pháp như kiểm soát truy cập, xóa dữ liệu, khả năng khiếu nại, kiểm toán và truy xuất nguồn gốc. Quy định chung về bảo vệ dữ liệu (GDPR), Đạo luật quyền riêng tư người tiêu dùng California (CCPA), Luật bảo vệ dữ liệu chung của Brazil (LGPD, Lei Geral de Proteção de Dados) và Luật bảo vệ thông tin cá nhân của Trung Quốc (PIPL) khác nhau về phạm vi và nghĩa vụ, nên không có một danh sách kiểm soát nào có thể bảo đảm tuân thủ đồng thời tất cả.
Quản trị dữ liệu bao quát bốn miền liên kết chặt chẽ, trong đó an ninh, quyền riêng tư, tuân thủ và truy xuất nguồn gốc là những ràng buộc thực thi phụ thuộc lẫn nhau:
- Hạ tầng an ninh: Bảo vệ dữ liệu thông qua kiểm soát danh tính, ủy quyền truy cập, mã hóa và quản lý khóa an toàn trong suốt vòng đời của dữ liệu.
- Cơ chế quyền riêng tư: Xác định thông tin nào được phép lộ ra, kể cả với người dùng đã được cấp quyền, vừa tôn trọng quyền cá nhân vừa cho phép huấn luyện mô hình.
- Các framework tuân thủ: Chuyển các yêu cầu quy định đặc thù theo từng khu vực pháp lý thành các ràng buộc kiến trúc, từ đó định hình cách dữ liệu đi qua hệ thống.
- Hệ thống truy xuất nguồn gốc và kiểm toán: Tạo ra các dấu vết trách nhiệm giúp ba lĩnh vực đầu tiên có thể kiểm chứng. Thiếu chúng, các chính sách bảo mật, cam kết về quyền riêng tư và tuyên bố tuân thủ rất khó chứng minh hoặc điều tra.
Hệ thống KWS “lighthouse”, tức trợ lý giọng nói phát hiện từ khóa được giới thiệu trong Hệ thống ML với tên “hải đăng Tiny Constraint”, cho thấy các rủi ro về công bằng nêu trong table 5 trở nên nghiêm trọng hơn ở cấp quản trị như thế nào. Một kiến trúc đã triển khai có thể xử lý âm thanh cục bộ tại nhà người dùng, duy trì lịch sử mẫu giọng nói đã được cho phép, và cache các mô hình được huấn luyện từ dữ liệu trên diện rộng. Những khả năng này kéo theo các nghĩa vụ quản trị về quản lý sự đồng ý, giảm thiểu dữ liệu, kiểm toán truy cập và quyền xóa.
Với hệ thống KWS, bốn lĩnh vực này trở thành các câu hỏi thực thi cụ thể. Bảo mật xác định ai có thể tiếp cận dữ liệu thông qua mã hóa khi lưu trữ và khi truyền, kiểm soát truy cập dựa trên vai trò, và ghi nhật ký các lần truy cập vào kho đặc trưng liên quan đến chính sách. Quyền riêng tư xác định hệ thống được phép giữ lại những gì thông qua giảm thiểu dữ liệu và, khi phù hợp, quyền riêng tư vi sai. Tuân thủ xác định các nghĩa vụ pháp lý nào ràng buộc luồng dữ liệu, bằng cách chuyển các yêu cầu áp dụng thành các pipeline xóa và API quản lý sự đồng ý. Truy xuất nguồn gốc và kiểm toán xác định cách hệ thống tái dựng những gì đã xảy ra thông qua tài liệu hóa nguồn gốc dữ liệu, nguồn gốc mô hình và các dấu vết kiểm toán quyết định. Figure 5 minh họa mô hình vận hành rộng hơn hỗ trợ các lĩnh vực này: tổ chức, chính sách, danh mục dữ liệu, nguồn cung dữ liệu, chất lượng dữ liệu, vận hành dữ liệu, bảo mật dữ liệu và các định nghĩa dùng chung. Các lĩnh vực này và mô hình vận hành rộng hơn phải phối hợp nhịp nhàng, vì một mắt xích thất bại sẽ làm suy yếu phần còn lại: dữ liệu được mã hóa mà không có kiểm soát truy cập vẫn dễ bị tổn thương, và lưu trữ “tuân thủ” nhưng không có dấu vết kiểm toán có thể kiểm chứng thì không vượt qua nổi một cuộc kiểm toán của cơ quan quản lý. Trong bối cảnh phân loại D·A·M, quản trị cung cấp chỗ dựa cấu trúc cho trục dữ liệu, giúp thông tin của hệ thống an toàn, tuân thủ và đáng tin cậy trong suốt vòng đời dữ liệu.

Kiến trúc bảo mật và kiểm soát truy cập.
Hãy xem xét một nhà khoa học dữ liệu truy vấn một kho đặc trưng để lấy dữ liệu huấn luyện. Cô ấy có thể đọc các đặc trưng giọng nói tổng hợp nhưng không thể truy cập các bản ghi âm thô mà chúng được tạo ra. Pipeline phục vụ (serving) có thể đọc các đặc trưng trực tuyến để suy luận nhưng không thể ghi vào tập dữ liệu huấn luyện. Cả hai đều không thể sửa đổi dữ liệu nguồn. Sự tách biệt này là có chủ ý: điều này phản ánh một kiến trúc bảo mật phân lớp nơi các yêu cầu quản trị được chuyển thành các biện pháp kiểm soát kỹ thuật có thể thực thi ở mỗi giai đoạn của pipeline. Các kho đặc trưng có thể triển khai kiểm soát truy cập dựa trên vai trò (RBAC) ánh xạ các chính sách của tổ chức thành quyền trong cơ sở dữ liệu, ngăn chặn truy cập trái phép. Các biện pháp kiểm soát này hoạt động trên nhiều tầng lưu trữ: lưu trữ đối tượng như S3 áp dụng các chính sách bucket, kho dữ liệu triển khai bảo mật cấp cột để ẩn các trường nhạy cảm, và các kho đặc trưng duy trì các đường dẫn đọc/ghi riêng với các yêu cầu quyền khác nhau.
Các cơ chế kiểm soát truy cập là chưa đủ nếu thiếu mã hóa. Mã hóa bảo vệ dữ liệu khi lưu trữ và khi truyền, nhưng không ngăn được việc lạm dụng sau khi giải mã hoặc sau khi đã được cấp quyền truy cập. Dữ liệu huấn luyện lưu trong các hồ dữ liệu có thể dùng mã hóa phía máy chủ với các khóa được quản lý qua các dịch vụ quản lý khóa chuyên dụng (AWS KMS, Google Cloud KMS). Kho đặc trưng có thể dùng mã hóa khi lưu trữ và mã hóa truyền tải khi dữ liệu di chuyển. Các thiết bị edge Lighthouse KWS có thể kết hợp mã hóa truyền tải để bảo đảm tính bí mật với code signing để xác minh tính toàn vẹn của bản cập nhật mô hình; cả hai biện pháp này vẫn cần quản lý khóa an toàn và ủy quyền cập nhật.
Các trọng số được tuần tự hóa, các bản xuất Open Neural Network Exchange, và các checkpoint cần được bảo vệ tương tự dữ liệu huấn luyện. Trọng số là tài sản trí tuệ đáng kể và cũng là một bề mặt tấn công: kẻ tấn công chèn một mô hình có cửa hậu vào kho đăng ký có thể làm nguy hại các triển khai chấp nhận tạo phẩm đó; kẻ tấn công truy xuất được trọng số có thể thăm dò liệu các bản ghi cụ thể có nằm trong quá trình huấn luyện hay không (Shokri et al. 2017); và các cuộc tấn công trích xuất mô hình có thể đánh cắp hành vi của mô hình qua các API dự đoán (Tramèr et al. 2016). Vì vậy, các kho đăng ký mô hình cần kiểm soát truy cập được ghim theo phiên bản, chữ ký mật mã để xác minh tính toàn vẹn của tạo phẩm trước khi phục vụ (serving), và các cổng thăng cấp có bảo vệ ghi để chỉ các checkpoint đã được pipeline xác thực mới có thể ghi đè các vị trí sản xuất. Bản thân các pipeline huấn luyện cũng phải được bảo vệ khỏi các cuộc tấn công làm nhiễm độc dữ liệu, nơi các mẫu được tạo có chủ đích để gây hại được chèn vào tập huấn luyện, khiến mô hình đã học thể hiện hành vi sai lệch có chủ đích tại thời điểm suy luận.
Tramèr, Florian, Fan Zhang, Ari Juels, Michael K Reiter, and Thomas Ristenpart. 2016. “Stealing Machine Learning Models via Prediction APIs.” 25th USENIX Security Symposium (USENIX Security 16), 601–18.
Kiểm soát truy cập và mã hóa xác định ai có thể tiếp cận dữ liệu và cách dữ liệu được bảo vệ khi truyền và khi lưu trữ. Kiểm soát truy cập chỉ giải quyết một nửa vấn đề: ngay cả người dùng được ủy quyền cũng có thể xâm phạm quyền riêng tư cá nhân nếu bản thân dữ liệu không được bảo vệ đủ mạnh.
Các phương pháp kỹ thuật bảo vệ quyền riêng tư
Một nhà khoa học dữ liệu có quyền truy cập hợp pháp vào dữ liệu huấn luyện không cần và không nên xem các bản ghi người dùng cá nhân khi các thống kê tổng hợp là đủ. Các kỹ thuật bảo vệ quyền riêng tư24 giải quyết khoảng trống này bằng cách xác định hệ thống được phép tiết lộ những gì ngay cả với người dùng đã được ủy quyền, bổ sung một lớp bảo vệ thứ hai bên cạnh kiểm soát truy cập. Quyền riêng tư vi phân đưa ra một giới hạn chính thức về mức độ một bản ghi có thể ảnh hưởng đến phân phối đầu ra. Triển khai quyền riêng tư vi phân trong môi trường sản xuất đòi hỏi kỹ thuật cẩn trọng: áp dụng cơ chế với nhiễu đã hiệu chỉnh, theo dõi ngân sách quyền riêng tư bằng một công cụ kế toán (accountant) hợp lệ xuyên suốt các phép hợp thành trong cách sử dụng dữ liệu, và kiểm thử việc triển khai. Các cuộc tấn công suy luận thành viên có thể bổ trợ cho các kiểm tra này nhưng không thể thiết lập đảm bảo chính thức.25
24 Các kỹ thuật bảo vệ quyền riêng tư: K-ẩn danh (Sweeney 2002) đảm bảo mỗi bản ghi không thể phân biệt với ít nhất \(k-1\) bản ghi khác dựa trên các định danh giả đã chọn; l-đa dạng bổ sung tính đa dạng thuộc tính trong các lớp tương đương (Machanavajjhala et al. 2007); và t-gần giới hạn khoảng cách của phân phối (Li et al. 2007). Những đảm bảo mang tính cú pháp này giải quyết các mối đe dọa khác với quyền riêng tư vi phân, và tự thân chúng không bảo vệ được trước mọi kiểu rò rỉ đặc thù của ML: một mô hình được huấn luyện trên dữ liệu đã được ẩn danh vẫn có thể ghi nhớ ví dụ hoặc để lộ tín hiệu thành viên trong một số điều kiện (Shokri et al. 2017). Ngược lại, quyền riêng tư vi phân giới hạn mức độ ảnh hưởng của một bản ghi trong một cơ chế và ngân sách quyền riêng tư được chỉ định, đưa ra một đảm bảo mang tính ngữ nghĩa được thiết kế để vẫn có ý nghĩa ngay cả khi tồn tại thông tin bổ sung. Vì vậy, các phương pháp này không tạo thành một thứ bậc mạnh–yếu đơn giản, và mức bảo vệ phù hợp phụ thuộc vào nội dung phát hành, mô hình đe dọa và yêu cầu về tính hữu dụng.
Sweeney, Latanya. 2002. “K-ANONYMITY: A MODEL for PROTECTING PRIVACY.” International Journal of Uncertainty, Fuzziness and Knowledge-Based Systems 10 (05): 557–70. https://doi.org/10.1142/s0218488502001648.
Li, Ninghui, Tiancheng Li, and Suresh Venkatasubramanian. 2007. “t-Closeness: Privacy Beyond k-Anonymity and l-Diversity.” 2007 IEEE 23rd International Conference on Data Engineering, 106–15. https://doi.org/10.1109/ICDE.2007.367856.
25 Tấn công suy luận thành viên: Cuộc tấn công này khai thác hành vi của mô hình để suy luận xem một bản ghi cụ thể có nằm trong tập dữ liệu huấn luyện hay không; hiện tượng overfitting có thể làm tăng tín hiệu suy luận này (Shokri et al. 2017). Trong thực tế, nếu mô hình có độ tự tin cao hơn với các mẫu trong tập huấn luyện, điều đó có thể giúp phân biệt các mẫu này với các mẫu không thuộc tập huấn luyện. Mức độ thành công của cuộc tấn công phụ thuộc vào mức độ truy cập mô hình, phân phối dữ liệu và các giả định về phòng thủ. Một cuộc tấn công thực nghiệm thành công cho thấy có rò rỉ thông tin trong thực tế, nhưng tự nó chưa đủ để chứng minh đã vi phạm giới hạn \((\epsilon, \delta)\) đã nêu. Quyền riêng tư vi phân chính thức xuất phát từ cơ chế và cách tính toán của nó.
Shokri, Reza, Marco Stronati, Congzheng Song, and Vitaly Shmatikov. 2017. “Membership Inference Attacks Against Machine Learning Models.” 2017 IEEE Symposium on Security and Privacy (SP), 3–18. https://doi.org/10.1109/SP.2017.41.
Các hệ thống KWS đối mặt với những thách thức riêng về quyền riêng tư, vì kiến trúc luôn lắng nghe buộc phải xử lý âm thanh liên tục đồng thời giảm tối đa việc lưu giữ và phơi lộ dữ liệu. Các hệ thống triển khai có thể xử lý rủi ro này thông qua ba lựa chọn kiến trúc:
- Xử lý trên thiết bị: Có thể giữ việc phát hiện từ kích hoạt ngay trên thiết bị; âm thanh chỉ được truyền đi sau khi phát hiện, đúng theo thiết kế đã nêu.
- Học liên kết: Cho phép các thiết bị huấn luyện trên âm thanh cục bộ và chỉ chia sẻ các cập nhật mô hình thay vì bản ghi âm thô; việc tổng hợp và kiểm soát quyền riêng tư vẫn rất quan trọng.26
- Chính sách xóa tự động: Áp dụng thời hạn lưu giữ đã nêu cho bộ nhớ chính và các kho lưu trữ phục vụ (serving). Việc xóa hoàn toàn cũng đòi hỏi phải xác minh trên mọi bản sao (replicas), bản sao lưu (backups), cache và các tạo phẩm phát sinh (derived artifacts) theo chính sách áp dụng.
26 Học liên kết: McMahan et al. (2017) đã giới thiệu Federated Averaging (FedAvg), trong đó mỗi thiết bị huấn luyện cục bộ và chỉ chia sẻ các cập nhật mô hình thay vì các bản ghi thô. Kiến trúc này có thể hạn chế việc chuyển dữ liệu thô thường xuyên, nhưng đó không phải là một bảo đảm về quyền riêng tư: các cập nhật mô hình vẫn có thể làm lộ thông tin huấn luyện qua các cuộc tấn công tái tạo (Zhu et al. 2019). Vì vậy, học liên kết có thể được kết hợp với tổng hợp an toàn, riêng tư vi phân và kiểm soát lưu giữ trong một thiết kế phòng thủ nhiều lớp; các bảo đảm đạt được phụ thuộc vào toàn bộ giao thức.
McMahan, Brendan, Eider Moore, Daniel Ramage, Seth Hampson, and Blaise Agüera y Arcas. 2017. “Communication-Efficient Learning of Deep Networks from Decentralized Data.” International Conference on Artificial Intelligence and Statistics (AISTATS), Proceedings of machine learning research, vol. 54: 1273–82.
Zhu, Ligeng, Zhijian Liu, and Song Han. 2019. “Deep Leakage from Gradients.” Advances in Neural Information Processing Systems (NeurIPS) 32: 14774–84.
Kết hợp lại, các lựa chọn này giúp giảm tối đa những gì rời khỏi thiết bị, những gì máy chủ có thể tái tạo, và thời gian các dấu vết nhạy cảm tồn tại.
Kiến trúc để tuân thủ quy định
Khi một người dùng châu Âu thực thi quyền được xóa theo GDPR, trợ lý giọng nói phải xác định dữ liệu cá nhân nào và các tạo phẩm hạ nguồn nào nằm trong phạm vi, rồi thực hiện quy trình phù hợp trong thời hạn phản hồi theo quy định (European Parliament and Council of the European Union 2016). Các yêu cầu tuân thủ biến nghĩa vụ pháp lý thành các ràng buộc kiến trúc hệ thống định hình thiết kế pipeline, lựa chọn lưu trữ và quy trình vận hành. Nguyên tắc giảm thiểu dữ liệu của GDPR yêu cầu chỉ thu thập và lưu giữ những gì cần cho các mục đích đã nêu. Quyền truy cập theo Điều 15 bao gồm dữ liệu cá nhân đang được xử lý và thông tin cụ thể về quá trình xử lý đó, không phải mọi tạo phẩm chỉ đơn thuần liên quan đến người dùng.
Các trợ lý giọng nói hoạt động toàn cầu phải đối mặt với các chế độ quy định chồng chéo vì yêu cầu khác nhau theo từng khu vực pháp lý và áp dụng khác nhau tùy theo độ tuổi người dùng và mức độ nhạy cảm của dữ liệu. Các quy tắc chuyển dữ liệu xuyên biên giới của GDPR cho phép chuyển giao thông qua các quyết định về mức độ đầy đủ, các biện pháp bảo vệ phù hợp hoặc các ngoại lệ hạn chế, thay vì áp đặt nội địa hóa dữ liệu theo kiểu cứng nhắc. Dù vậy, các quy tắc này vẫn có thể chi phối lựa chọn lưu trữ, sao chép và xử lý theo khu vực. Thẻ dữ liệu (Pushkarna et al. 2022) ghi lại nguồn gốc, mục đích sử dụng và rủi ro dưới dạng siêu dữ liệu vận hành, như minh họa trong figure 6, nhưng một thẻ hợp lệ tự thân không khiến một tập dữ liệu hoặc mô hình trở nên tuân thủ.

Pushkarna, Mahima, Andrew Zaldivar, and Oddur Kjartansson. 2022. “Data Cards: Purposeful and Transparent Dataset Documentation for Responsible AI.” Proceedings of the 2022 ACM Conference on Fairness, Accountability, and Transparency (FAccT), 1776–826. https://doi.org/10.1145/3531146.3533231.
Xây dựng hạ tầng truy vết nguồn gốc dữ liệu
Các trường trong thẻ dữ liệu sẽ trở thành các bước kiểm tra vận hành ngay khi chúng đi vào pipeline: siêu dữ liệu về nguồn gốc, mục đích sử dụng, rủi ro và thời gian lưu giữ sẽ quyết định tập dữ liệu nào được dùng để huấn luyện mô hình nào, và tạo phẩm nào phải được truy vết trong quá trình kiểm toán. Nghĩa vụ tuân thủ chỉ đáng tin cậy ở mức độ mà hạ tầng có thể chứng minh chúng. Khi cơ quan quản lý hỏi “dữ liệu huấn luyện nào đã tạo ra mô hình này?” hoặc người dùng thực thi quyền xóa dữ liệu áp dụng, tổ chức phải trả lời với độ chính xác kỹ thuật, không phải bằng điều tra thủ công. Truy xuất nguồn gốc dữ liệu cung cấp khả năng này, biến tài liệu tuân thủ thành hạ tầng vận hành, làm nền cho quản trị trong suốt vòng đời ML. Các hệ thống truy xuất nguồn gốc hiện đại như Apache Atlas và DataHub27 có thể tích hợp với các bộ điều phối pipeline như Airflow và Kubeflow để tự động ghi nhận các mối quan hệ. Ví dụ, khi một đồ thị có hướng không chu trình (DAG) của Airflow đọc các tệp âm thanh từ S3 và chuyển chúng thành spectrogram, hệ thống truy xuất nguồn gốc sẽ ghi lại từng bước và truy vết một đặc trưng về lại tệp âm thanh gốc của nó. Theo dõi tự động cũng hỗ trợ các yêu cầu xóa. Khi người dùng thực thi quyền xóa dữ liệu áp dụng, đồ thị truy xuất nguồn gốc sẽ xác định các tạo phẩm phái sinh tiềm năng—các đặc trưng, embedding và các phiên bản mô hình đã huấn luyện—để đưa vào quy trình phù hợp như xóa, vô hiệu hóa, hạn chế, unlearning, huấn luyện lại hoặc xem xét pháp lý.
27 Hệ thống truy xuất nguồn gốc dữ liệu: Apache Atlas và DataHub có thể thu thập siêu dữ liệu về cách dữ liệu luân chuyển trong quá trình chạy pipeline, tạo ra các đồ thị mà ở đó các nút là các tập dữ liệu, còn các edge thể hiện các phép biến đổi. Điều 30 của GDPR yêu cầu lưu trữ hồ sơ về các hoạt động xử lý (European Parliament and Council of the European Union 2016), chứ không yêu cầu cụ thể việc truy xuất nguồn gốc tự động ở cấp độ mô hình. Tuy vậy, truy xuất nguồn gốc vẫn có thể giúp xác định các tạo phẩm phái sinh ứng viên để xóa, hạn chế, huấn luyện lại hoặc xem xét pháp lý khi có yêu cầu phù hợp.
European Parliament, and Council of the European Union. 2016. Regulation (EU) 2016/679 of the European Parliament and of the Council of 27 April 2016. Official Journal of the European Union.
Một hệ thống KWS (Keyword Spotting) trong môi trường sản xuất có thể triển khai theo dõi truy xuất nguồn gốc xuyên suốt vòng đời kỹ thuật dữ liệu. Khâu thu nạp âm thanh nguồn có thể tạo bản ghi truy xuất, liên kết mỗi tệp âm thanh với phương thức thu thập, giúp xác minh yêu cầu về sự đồng ý. Khi pipeline xử lý chạy, đồ thị truy xuất được mở rộng khi âm thanh được chuyển thành các đặc trưng và embedding; mỗi bước biến đổi có thể ghi lại phiên bản mã và các siêu tham số. Các tác vụ huấn luyện tạo các cạnh truy xuất từ các tập hợp đặc trưng đến các tệp mô hình, ghi lại rõ phiên bản dữ liệu nào đã huấn luyện phiên bản mô hình nào. Khi thiết bị trợ lý giọng nói tải xuống bản cập nhật mô hình, theo dõi truy xuất có thể ghi nhận lần triển khai, giúp thu hồi nếu sau này phát hiện dữ liệu huấn luyện có vấn đề về chất lượng hoặc tuân thủ. Truy xuất nguồn gốc ghi lại xuất xứ, nhưng để vận hành có trách nhiệm giải trình, còn cần lịch sử truy cập: ai đã truy cập dữ liệu, khi nào và theo thẩm quyền nào.
Hạ tầng kiểm toán và trách nhiệm giải trình
Việc lưu giữ các sự kiện kiểm toán biến trách nhiệm giải trình thành một khối lượng công việc (workload) lưu trữ ngày càng lớn.
Truy xuất nguồn gốc theo dõi dữ liệu gì tồn tại và cách nó biến đổi qua pipeline. Công tác quản trị còn yêu cầu biết ai đã truy cập dữ liệu và khi nào, một khía cạnh trách nhiệm giải trình mà riêng truy xuất nguồn gốc không đáp ứng được. Các hệ thống kiểm toán ghi lại các sự kiện truy cập này, tạo dấu vết trách nhiệm giải trình cho các nghĩa vụ như HIPAA và Đạo luật Sarbanes-Oxley (SOX) khi áp dụng. Các hệ thống ML trong môi trường sản xuất có thể tạo ra khối lượng kiểm toán khổng lồ, đòi hỏi hạ tầng như nhật ký có khả năng phát hiện giả mạo và được kiểm soát truy cập, cơ chế lập chỉ mục hiệu quả để hỗ trợ truy vấn theo người dùng hoặc tập dữ liệu cụ thể, phân tích tự động phát hiện các mẫu bất thường, và các quy tắc lưu giữ/xóa phù hợp với nghĩa vụ quản trị.
Các hệ thống KWS triển khai kiến trúc kiểm toán đa tầng cân bằng độ chi tiết với hiệu suất và chi phí:
- Thiết bị edge: Ghi cục bộ các sự kiện quan trọng, với nhật ký được định kỳ tải lên bộ nhớ tập trung để lưu giữ theo quy định.
- Kho đặc trưng: Ghi lại các lượt truy cập liên quan đến chính sách kèm siêu dữ liệu giới hạn theo mục đích, chẳng hạn như dịch vụ gửi yêu cầu, định danh chủ thể được ủy quyền và các nhóm đặc trưng đã truy xuất.
- Cơ sở hạ tầng huấn luyện: Ghi nhật ký tác vụ nào đã đọc phân vùng dữ liệu nào, hỗ trợ điều tra và xác minh việc lưu giữ. Chỉ riêng nhật ký truy cập không thể chứng minh rằng dữ liệu người dùng đã xóa không còn xuất hiện trong các trọng số mô hình về sau.
Các tầng phân chia công việc kiểm toán theo nơi tạo ra bằng chứng, đồng thời giữ đủ ngữ cảnh để tái dựng các yêu cầu truy cập và xóa.
Các yêu cầu quy định mở rộng trách nhiệm kiểm toán sang hành vi tại thời điểm dự đoán. Trả lời “tại sao người nộp đơn cụ thể này bị từ chối khoản vay?” đòi hỏi đủ ngữ cảnh để tái dựng quyết định, nhưng không nhất thiết phải lưu một bản sao vĩnh viễn của mọi đặc trưng thô. Nếu không có ghi nhật ký tại thời điểm suy luận, dấu vết kiểm toán có thể trả lời các câu hỏi về truy cập mà không tái dựng được mô hình, ngưỡng và bằng chứng nào đã tạo ra một quyết định cụ thể. Cơ sở hạ tầng kiểm toán sản xuất nên lưu giữ mức bằng chứng tối thiểu cần thiết, chỉ dùng cho mục đích cụ thể—ví dụ: phiên bản mô hình, ngưỡng quyết định, đầu ra, mã lý do và nguồn gốc đầu vào được chọn—kèm kiểm soát truy cập, giới hạn thời gian lưu trữ và mã định danh phù hợp với các quy tắc quản lý. Mục tiêu là biến việc tái dựng từng quyết định thành một truy vấn có kiểm soát thay vì một cuộc điều tra thủ công.
Bốn lĩnh vực quản trị—bảo mật, quyền riêng tư, tuân thủ và kiểm toán28—kết hợp với nhau tạo thành một lớp thực thi, hỗ trợ các thực hành khác trong chương này. Quản trị dữ liệu giúp thu thập số đo, ghi lại hành động và lưu giữ bằng chứng để xem xét. Nếu thiếu cơ sở hạ tầng này, kỹ thuật có trách nhiệm sẽ chỉ là mong muốn; còn nếu có, các nhóm có thể chứng minh các biện pháp kiểm soát cụ thể và kiểm tra xem các cam kết đã được thực hiện hay chưa.
28 Dấu vết kiểm toán: Đảm bảo tính toàn vẹn kiểm toán đòi hỏi kiểm soát chống sửa đổi trái phép, nhưng nghĩa vụ lưu giữ và xóa khác nhau theo loại hồ sơ và luật áp dụng; kho lưu trữ đối tượng chỉ ghi thêm (append-only) với cơ chế kiểm soát lưu giữ, hoặc chuỗi băm mật mã (cryptographic hash chains), có thể cung cấp bằng chứng chống giả mạo mà không tạo ra quy tắc chung rằng hồ sơ không bao giờ được xóa. Một nền tảng lớn có thể ghi lại hàng tỷ sự kiện mỗi ngày; Quy tắc An ninh của HIPAA cũng áp đặt nghĩa vụ lưu giữ tài liệu nhiều năm cho các chính sách và thủ tục bắt buộc (U.S. Department of Health and Human Services 2005). Kế hoạch lưu giữ phải phân biệt những hồ sơ cần bảo tồn với dữ liệu cá nhân cần được giảm thiểu hoặc xóa.
U.S. Department of Health and Human Services. 2005. “Summary of the HIPAA Security Rule.”
Self-Check: Question
In 2023, European regulators fined Meta EUR 390 million for processing user data for behavioral advertising without a valid legal basis, transparent disclosure, or fair processing—an infraction involving no data breach or server compromise. Which systems-engineering principle does this case demonstrate?
- Security encryption at rest and in transit is sufficient to guarantee total regulatory compliance across all data privacy laws.
- Data governance is an enforceable technical constraint across the data lifecycle, requiring infrastructure to verify lawful basis, purpose limitation, and consent rather than relying on policy assertions.
- Regulatory compliance applies only to static tabular data lakes and exempts real-time streaming feature stores.
- Publishing a public datasheet for a dataset eliminates all downstream corporate liability for unlawful processing.
A user invokes their GDPR Article 17 right to erasure on a voice assistant service. Explain why manual database queries across storage systems fail in a modern distributed ML pipeline, and describe what automated infrastructure is required to execute the deletion.
A smart-home voice assistant (such as the Lighthouse KWS system) is designed with an always-listening microphone. Which combination of architectural choices best embodies privacy-by-design for this deployment?
- Stream continuous raw ambient audio to a centralized cloud cluster where access is protected exclusively by role-based access control (RBAC).
- Store all raw acoustic recordings permanently on local edge flash memory so that future model versions can be trained without cloud connectivity.
- Perform wake-word detection locally on-device, transmit audio to servers only after verified activation, apply strict retention/deletion policies to uploaded audio, and use federated learning with differential privacy for model improvements.
- Rely on third-party cloud data warehouses to handle all privacy filtering after raw audio ingestion has completed.
An organization is deploying an enterprise ML feature store and training pipeline with full data governance and auditability. Arrange the following governance actions in the correct operational sequence across the data lifecycle:
- Role-based access control (RBAC) and encryption applied at rest/in transit within the feature store
- Ingestion of raw source data with cryptographically signed consent and provenance metadata
- Multi-tier inference audit logging (recording model version, decision threshold, and reason codes)
- Automated feature transformation with fine-grained DAG-level lineage capture
- Lineage-driven artifact identification and automated deletion workflow upon user erasure request
- Privacy-preserving training incorporating calibrated differential privacy noise and budget tracking
- An empirical privacy attack in which an adversary analyzes model output probabilities to determine whether a specific individual’s record was part of the model’s training dataset is known as a
____.
Những ngụy biện và cạm bẫy
Các nhóm vẫn có thể thất bại ngay cả khi đã xây dựng các framework đánh giá, các chỉ số công bằng, cơ chế giải thích, phân tích hiệu quả và cơ sở hạ tầng quản trị. Chẳng hạn, một nhóm có thể chỉ bổ sung yếu tố công bằng sau khi đạt thành công trong benchmark, hoặc quá tin vào độ chính xác tổng thể, hoặc coi bằng chứng tuân thủ chỉ là thủ tục giấy tờ thay vì xem xét hành vi thực tế của hệ thống. Những điều này thường xuất phát từ trực giác trong kỹ thuật phần mềm truyền thống, nơi lỗi thường cục bộ và kiểm thử mang tính xác định. Nhận diện sớm các kiểu thất bại này, trước khi một ngụy biện định hình quyết định thiết kế, sẽ rẻ hơn rất nhiều so với phát hiện ra chúng sau khi triển khai.
Ngụy biện: Trách nhiệm có thể được giải quyết sau khi hệ thống đạt được các mục tiêu kỹ thuật.
Các nhóm thường cho rằng các ràng buộc về tính công bằng có thể được bổ sung sau khi mô hình đã đạt hiệu suất benchmark tốt. Tuy nhiên, khi vào vận hành, các quyết định kiến trúc ban đầu sẽ hạn chế những can thiệp còn khả thi. Công cụ tuyển dụng của Amazon (xem section 1.2.1) là một ví dụ điển hình cho cạm bẫy này: dù đã cố gắng khắc phục, họ vẫn không tin rằng hệ thống sẽ tránh được các đề xuất mang tính phân biệt đối xử, và Amazon đã từ bỏ dự án (Dastin 2018). Các tổ chức chần chừ trong việc gánh trách nhiệm có thể phải đối mặt với việc thiết kế lại, triển khai kèm rủi ro đã được ghi nhận, hoặc hủy dự án. Tích hợp các ràng buộc công bằng ngay từ đầu thường ít tốn kém hơn nhiều so với việc gắn thêm chúng sau khi các hợp đồng dữ liệu, cơ chế giám sát và các điểm kiểm soát phát hành đã được cố định.
Cạm bẫy: Dựa vào các chỉ số tổng hợp để đánh giá tính công bằng.
Các kỹ sư thường cho rằng độ chính xác tổng thể cao đồng nghĩa hệ thống hoạt động tốt cho mọi người dùng. Tuy nhiên, Sai lầm của các giá trị trung bình (section 1.3.3) cho thấy trực giác này sai: các chỉ số tổng hợp có thể che khuất những chênh lệch lớn giữa các nhóm con (section 1.2.4). Phân tích phê duyệt khoản vay trong section 1.3.3.1 cho thấy một chênh lệch TPR 30 percentage-point, với các ứng viên thiểu số đủ điều kiện bị từ chối ở mức 4× so với nhóm đa số. Những chênh lệch này có thể không bị phát hiện nếu giám sát chỉ theo dõi các chỉ số tổng hợp. Các hệ thống trong thực tế cần được đánh giá phân tách theo nhóm với các ngưỡng riêng theo từng ứng dụng, ví dụ như tỷ lệ lỗi 1.25\(\times\) hoặc chênh lệch TPR 5 điểm phần trăm như trong ví dụ này.
Ngụy biện: Loại bỏ các thuộc tính nhạy cảm khỏi dữ liệu huấn luyện sẽ loại bỏ độ chệch (bias).
Các nhóm thường loại bỏ các thuộc tính như giới tính, chủng tộc và các thuộc tính được bảo vệ khác với hy vọng điều này đảm bảo công bằng. Tuy nhiên, các đặc trưng khác có thể đóng vai trò là biến đại diện nếu chúng tương quan với các đặc điểm nhạy cảm. Ví dụ, mã ZIP, thói quen mua sắm, lịch sử duyệt web, tên trường đại học và lựa chọn ngôn ngữ đều có thể mang tín hiệu nhân khẩu học gián tiếp. Hệ thống của Amazon (xem section 1.2.1) từng phạt các thuật ngữ như “women’s” và những người tốt nghiệp từ hai trường đại học chỉ dành cho nữ (Dastin 2018). Một nghiên cứu về sức khỏe cộng đồng cho thấy, sửa một biến đại diện dựa trên chi phí có thể tăng tỷ lệ bệnh nhân Da đen nhận được hỗ trợ bổ sung từ 17.7% lên 46.5% (Obermeyer et al. 2019). Việc loại bỏ các thuộc tính được bảo vệ, tự thân, không đảm bảo công bằng.
Obermeyer, Ziad, Brian Powers, Christine Vogeli, and Sendhil Mullainathan. 2019. “Dissecting Racial Bias in an Algorithm Used to Manage the Health of Populations.” Science 366 (6464): 447–53. https://doi.org/10.1126/science.aax2342.
Cạm bẫy: Coi tài liệu là đủ để chịu trách nhiệm.
Các nhóm bỏ nhiều công sức làm thẻ mô hình rồi coi như đã đáp ứng xong các yêu cầu về trách nhiệm. Tài liệu giúp tăng minh bạch (section 1.3.2) chứ không tự động đảm bảo việc tuân thủ hay thực thi. Một thẻ mô hình ghi rõ “chưa được xác thực cho các quyết định có rủi ro cao” cũng vô nghĩa nếu hệ thống bị tái sử dụng để phê duyệt khoản vay mà không có ràng buộc kỹ thuật nào. Trách nhiệm giải trình đòi hỏi phải gắn vào vận hành: bảng điều khiển giám sát, các ngưỡng cảnh báo về chênh lệch giữa các nhóm phụ được ghi nhận, quy trình ứng phó sự cố, và kiểm soát quyền truy cập để ngăn triển khai vượt quá các trường hợp sử dụng đã được xác minh.
Ngụy biện: AI có trách nhiệm chủ yếu là một vấn đề tuân thủ pháp luật.
Các nhóm thường xem trách nhiệm như một khâu giám sát bên ngoài, không phải là thực hành kỹ thuật. Nhưng các quyết định kỹ thuật được đưa ra từ nhiều tháng trước khi có đánh giá pháp lý đã bó hẹp không gian giải pháp nhiều hơn bất kỳ đánh giá tuân thủ nào. Việc lựa chọn kiến trúc quyết định những can thiệp để đảm bảo công bằng nào khả thi, còn thiết kế pipeline dữ liệu thì quyết định liệu có thể thực hiện đánh giá tách theo nhóm hay không. Như section 1.2.5 đã nêu, các hệ thống được thiết kế với trách nhiệm là một mục tiêu kỹ thuật ngay từ đầu sẽ giúp xác thực hiệu quả; còn những hệ thống chỉ bổ sung trách nhiệm ở giai đoạn rà soát cuối sẽ phải thiết kế lại, hoặc chấp nhận triển khai kèm các rủi ro đã được ghi nhận.
Cạm bẫy: Đo lường tác động môi trường của huấn luyện nhưng không của suy luận.
Các cuộc thảo luận công khai thường tập trung vào carbon từ huấn luyện, và kỹ sư cũng hay bám theo cách khung đó khi đánh giá trách nhiệm môi trường. Phân tích TCO minh họa trong section 1.4.3 cho thấy cách tập trung này là chưa đủ: với giả định nhu cầu dịch vụ không batch, tỷ lệ chi phí suy luận so với huấn luyện vào khoảng 40:1. Một mô hình được huấn luyện định kỳ nhưng phục vụ hàng triệu lượt mỗi ngày có thể có tổng phát thải trong vòng đời bị chi phối bởi suy luận, không phải huấn luyện. Với hệ thống khuyến nghị trong table 16, huấn luyện chiếm 1.9 percent tổng chi phí ba năm, còn suy luận chiếm 73.5 percent. Trong ví dụ này, suy luận phát thải CO2 khoảng 63× lần so với huấn luyện. Kỹ sư chỉ tối ưu hiệu quả huấn luyện mà bỏ qua nhu cầu suy luận cho mỗi truy vấn có thể đang để phần lớn hơn trong kịch bản này “ngoài tầm ngắm”. Các giá trị này phụ thuộc từng kịch bản, nhưng chúng cho thấy vì sao tính toán chi phí vòng đời phải bao gồm cả hai yếu tố.
Ngụy biện: Trọng số mô hình được miễn trừ khỏi quản trị dữ liệu và các yêu cầu xóa.
Các nhóm thường cho rằng khi dữ liệu huấn luyện đã được gộp vào trọng số mô hình, thì dữ liệu đã “biến mất” và nghĩa vụ tuân thủ không còn áp dụng cho tạo phẩm nữa. Mô hình có thể ghi nhớ dữ liệu huấn luyện, và tấn công suy luận thành viên có thể tiết lộ một bản ghi có từng xuất hiện trong huấn luyện hay không (Shokri et al. 2017). Việc các trọng số cụ thể có phải dữ liệu cá nhân hay có cần hành động gì sau một yêu cầu xóa hay không là tùy trường hợp. Nhóm kỹ thuật nên theo dõi quan hệ từ dữ liệu tới mô hình và, khi có yêu cầu có thể ảnh hưởng đến tạo phẩm đang triển khai, phối hợp cùng chuyên gia pháp lý và quyền riêng tư để đánh giá các biện pháp như xóa, hạn chế, huấn luyện lại, machine unlearning, hoặc các kiểm soát bù đắp (Cao and Yang 2015; Bourtoule et al. 2021).
Cao, Yinzhi, and Junfeng Yang. 2015. “Towards Making Systems Forget with Machine Unlearning.” 2015 IEEE Symposium on Security and Privacy, 463–80. https://doi.org/10.1109/sp.2015.35.
Bourtoule, Lucas, Varun Chandrasekaran, Christopher A. Choquette-Choo, Hengrui Jia, Adelin Travers, Baiwu Zhang, David Lie, and Nicolas Papernot. 2021. “Machine Unlearning.” 2021 IEEE Symposium on Security and Privacy (SP), 141–59. https://doi.org/10.1109/sp40001.2021.00019.
Điểm lặp lại xuyên suốt các thất bại này là coi trách nhiệm như một tài liệu, một chỉ số, hoặc một bước rà soát cuối, thay vì một thuộc tính của hệ thống. Các ràng buộc đo lường được, giám sát liên tục và cơ chế quản trị có thể thực thi sẽ duy trì trách nhiệm trong suốt vòng đời.
Self-Check: Question
A deployed automated lending model achieves an impressive 88% overall accuracy on its global test set. However, a disaggregated audit reveals that qualified minority applicants experience a 60% True Positive Rate compared to 90% for majority applicants (a 30 percentage-point gap) and face \(4\times\) higher false rejection rates. Which engineering pitfall does this scenario illustrate?
- Relying on aggregate metrics to assess fairness, which conceals severe subgroup disparities behind strong overall averages (the Flaw of Averages).
- Treating documentation as sufficient accountability, assuming a model card automatically prevents operational misuse.
- The belief that model weights are exempt from data governance and right-to-erasure regulations.
- Assuming that edge deployment power budgets scale linearly with dataset sample size.
A team removes race and gender columns from their training dataset, asserting that “the model cannot discriminate on features it cannot see.” Drawing on the Amazon recruiting and Optum healthcare cases, explain why this naive attribute removal creates false confidence, and identify the specific engineering analyses required.
True or False: Because a model card explicitly specifies that a vision model is “not validated for high-stakes medical or security screening,” publishing the model card guarantees operational compliance without requiring technical access controls or deployment release gates.
True or False: For a high-traffic production ML service, measuring and reporting only the electricity consumed during model training runs provides an accurate accounting of the system’s long-term environmental carbon footprint.
Tóm tắt
Kỹ thuật có trách nhiệm không phải một lĩnh vực riêng, mà là cách làm kỹ thuật hệ thống ML cho trọn vẹn. Chương này lần theo hành trình từ chẩn đoán lỗi, qua phòng ngừa đến bảo đảm thực thi, bắt đầu từ khoảng cách trách nhiệm (khoảng cách giữa hiệu năng kỹ thuật và kết quả có trách nhiệm) và cho thấy các biến đại diện, vòng lặp phản hồi, và dịch chuyển phân phối có thể gây hại cho người dùng ngay cả khi các chỉ số thông thường vẫn đạt yêu cầu. Phản ứng kỹ thuật bao gồm các danh sách kiểm tra để hệ thống hóa đánh giá trước khi triển khai; các chỉ số công bằng để đo được mức chênh lệch; các cơ chế giải thích được lựa chọn theo yêu cầu của các bên liên quan và quy định; và hạ tầng giám sát có thể phát hiện các lỗi ngầm và nối các tín hiệu với hành động ứng phó.
Khi chuyển các mối quan ngại về trách nhiệm thành các thuộc tính có thể đo lường, chúng trở nên dễ xử lý. Một giới hạn có căn cứ và đặc thù theo ứng dụng về mức chênh lệch thì kiểm tra được; còn một yêu cầu chung chung như “hãy công bằng” thì không. Sự chuyển đổi này không chỉ áp dụng cho tính công bằng: trong kịch bản TCO minh họa của chương, việc giảm 20 percent nhu cầu dịch vụ bộ tăng tốc giúp tiết kiệm $304K và được mô hình hóa để tránh phát thải 19 t CO2 theo các giả định đã nêu. Tài liệu trở thành thẻ mô hình, nêu rõ mục đích sử dụng và các hạn chế đã biết. Công tác quản trị trở thành kiểm soát truy cập, theo dõi nguồn gốc và hạ tầng kiểm toán, khiến bằng chứng tuân thủ sẵn có thay vì chỉ là mong muốn. Trong tất cả các trường hợp này, các nghĩa vụ đạo đức trừu tượng được biến thành các yêu cầu kỹ thuật cụ thể, có thể nêu rõ, kiểm tra, giám sát và thực thi.
Những thực hành kỹ thuật có trách nhiệm được trình bày trong chương này là một phần không thể thiếu của một hệ thống kỹ thuật hoàn chỉnh, chứ không phải những lớp ràng buộc bên ngoài chồng lên công việc kỹ thuật. Các hệ thống bỏ qua tính công bằng, hiệu quả, minh bạch hay quản trị đều chưa hoàn thiện về mặt kỹ thuật. Mức độ chặt chẽ mà chúng ta áp dụng cho ngân sách độ trễ và các ràng buộc bộ nhớ cũng phải mở rộng sang các tiêu chí công bằng, tác động môi trường và các yêu cầu quy định liên quan. Tích hợp các yếu tố này ngay từ khi khởi tạo hệ thống giúp các nghĩa vụ trở nên có thể kiểm thử, bộc lộ các đánh đổi sớm hơn và giúp việc chẩn đoán cũng như quản trị trong môi trường sản xuất trở nên dễ dàng hơn.
Key Takeaways: Đáng tin cậy cho ai?
- Độ chính xác tổng thể có thể che giấu những tác hại: Một mô hình có thể có vẻ chính xác khi đánh giá tổng thể, nhưng tỷ lệ lỗi của một nhóm con lại cao gấp 43.1× lần so với nhóm khác, như đã thấy trong cuộc kiểm toán Gender Shades của Face++. Vì vậy, việc đánh giá có trách nhiệm phải bắt đầu bằng cách phân tích theo từng lát cắt nhóm nhỏ và các nhóm giao thoa, chứ không chỉ dựa vào độ chính xác tổng thể.
- Trách nhiệm trở nên kiểm chứng được thông qua các ngưỡng: “Hãy công bằng” không thể kiểm thử, nhưng các giới hạn về chênh lệch, tài liệu hóa mục đích sử dụng dự kiến và các yêu cầu về khả năng giải thích thì có. Việc chuyển các giá trị thành các ràng buộc đo lường được cho phép nhóm xem xét các đánh đổi giữa công bằng, độ chính xác, độ trễ và chi phí.
- Hiệu quả là một ràng buộc mang tính xã hội: Một mô hình hiệu quả có thể giúp giảm năng lượng và chi phí, đồng thời mở rộng đối tượng có thể triển khai nó. Trong kịch bản minh họa của chương, tỷ lệ chi phí suy luận trên huấn luyện là 40:1, khiến việc tối ưu hóa theo từng truy vấn trở thành một thực hành kỹ thuật có trách nhiệm.
- Việc giám sát phải theo dõi các kết quả đầu ra: Các lỗi liên quan đến độ chệch (bias) và quyền riêng tư vẫn có thể tiếp diễn ngay cả khi bảng điều khiển uptime hiện màu xanh, bởi vì các dự đoán gây hại vẫn trông bình thường về mặt vận hành. Vì vậy, giám sát trong môi trường sản xuất phải theo dõi kết quả theo từng nhóm nhỏ, lịch sử dữ liệu, các vòng lặp phản hồi và đường đi của sự cố với cùng mức độ chặt chẽ như khi theo dõi các hồi quy về độ trễ.
- Quản trị phải được tích hợp ngay từ đầu: Model cards, datasheets, kiểm soát truy cập, quy trình xóa dữ liệu, các bước xem xét của con người và audit trail đều là hạ tầng kỹ thuật, chứ không phải những lớp chính sách tùy chọn. Các quy định như GDPR yêu cầu những khả năng này phải được thiết kế ngay vào pipeline; việc khắc phục sau này có thể vẫn khả thi nhưng sẽ bị hạn chế và tốn kém hơn một khi hệ thống đã bắt đầu phục vụ (serving) các quyết định.
Một hệ thống làm đúng y điều được chỉ dẫn lại nguy hiểm chính vì không có chỉ dẫn nào trọn vẹn. Mỗi mục tiêu giao cho mô hình là một đặc tả còn lỗ hổng, và một optimizer là cỗ máy chuyên dò tìm những lỗ hổng đó. Nó có thể tái tạo độ chệch (bias) tiềm ẩn trong dữ liệu, đuổi theo chỉ báo thay thế thay vì mục tiêu thực, rồi gọi đó là thành công vì trong mục tiêu không hề nói điều ngược lại. Kỹ thuật có trách nhiệm là kỷ luật bổ sung lại những gì đặc tả bỏ sót. Các ràng buộc và giám sát giúp giảm rủi ro việc tối ưu hóa khuếch đại các tác hại đã được mã hóa trong dữ liệu. Những ràng buộc này cùng kiểu với các ràng buộc về độ trễ và bộ nhớ mà phần còn lại của cuốn sách đã áp dụng; khác là ở đây chúng bảo vệ những người mà mục tiêu chưa từng nêu tên. Một mô hình nhanh và chính xác nhưng xác định sai đối tượng nó phục vụ không hề ít thất bại hơn một mô hình bị sập; nó chỉ thất bại lặng lẽ hơn.
What’s Next: Từ kỹ thuật đến triết lý
Chương này khép lại vòng tròn bắt đầu với luật sắt của hệ thống ML (nguyên tắc 3). Các tối ưu hóa phát triển trong Nén mô hình, Tăng tốc phần cứng và Vận hành machine learning vốn được thúc đẩy bởi hiệu suất, nhưng cũng có thể hỗ trợ trách nhiệm. Cụ thể, hiệu quả có thể giảm năng lượng tiêu thụ và phát thải; nén có thể giảm yêu cầu tài nguyên khi triển khai; và giám sát kết quả có thể làm lộ độ chệch (bias). Các kỹ thuật này có thể chồng lấn, nhưng khi nhìn qua lăng kính trách nhiệm, ta sẽ thay đổi những kết quả cần đo lường. Kết luận kết nối những mảnh ghép này thành một triết lý mạch lạc về sự xuất sắc trong kỹ thuật.
Self-Check: Question
According to the chapter summary, what is the core relationship between responsible engineering and traditional ML systems engineering?
- Responsible engineering is ML systems engineering done completely: a system that ignores fairness, efficiency, transparency, or governance is technically incomplete, not merely ethically flawed.
- Responsible engineering is an optional ethical overlay applied exclusively by external legal teams after technical development finishes.
- Responsible engineering replaces performance optimization with ethical review, requiring teams to trade away latency and throughput entirely.
- Responsible engineering applies exclusively to regulated healthcare and judicial algorithms, having no relevance to consumer or enterprise ML systems.
The chapter summary emphasizes that ethical concerns become actionable only when translated into measurable engineering invariants. Contrast a vague principle with a concrete engineering invariant, and explain how that invariant integrates into existing production MLOps workflows.
True or False: Technical optimization methods such as quantization, pruning, hardware acceleration, and continuous monitoring serve a dual purpose in ML systems by simultaneously optimizing traditional performance metrics (latency, throughput) and responsible engineering objectives (energy efficiency, accessibility, subgroup error visibility).
Self-Check Answers
Self-Check: Answer
An AI recruiting tool meets its latency SLA, maintains 99.9% availability, and achieves 87% aggregate accuracy, yet it systematically downgrades resumes containing the word “women’s” or graduates of women’s colleges. Applying the systems-engineering verification-versus-validation framing, which diagnosis correctly explains this outcome?
- The system failed verification because any discriminatory outcome is by definition a low-level coding defect in the model implementation.
- The failure is primarily an operational reliability defect that responsible engineering addresses only after serving infrastructure destabilizes.
- The root cause is insufficient model capacity, which can be resolved by scaling up model parameters without altering the optimization objective.
- The system passed verification by meeting its stated technical requirements, but failed validation because the specification itself did not capture the organization’s true goal of fair hiring.
Answer: The correct answer is D. In systems engineering, verification asks whether the system was built correctly against stated specifications, while validation asks whether the right system was built to meet true needs. The tool met all monitored technical targets (passing verification) but optimized a flawed objective that reproduced historical hiring bias (failing validation). The low-level defect claim is incorrect because the code executed without error on the objective it was assigned. The operational reliability option conflates service uptime with specification correctness. The model capacity explanation is flawed because a larger model would simply fit and reproduce the biased historical patterns more faithfully.
Learning Objective: Classify an ML deployment failure using the systems-engineering verification-versus-validation framework.
A team argues that a one-time ethics sign-off before deployment is sufficient because their model passes all latency and aggregate accuracy checks. Using the MLOps control-loop analogy, explain why responsible engineering must instead operate as a continuous control loop, and identify one specific production metric that a one-time pre-launch review cannot capture.
Answer: MLOps functions as a continuous control loop for operational reliability because data distributions drift over time; responsible engineering is the corresponding control loop for safety because outcome quality degrades as downstream user populations, proxies, and deployment environments evolve. A one-time sign-off cannot detect post-deployment subgroup-level error rate disparities (such as a widening true-positive-rate gap between demographic slices) that emerge as input distributions shift while overall latency and availability dashboards remain green.
Learning Objective: Explain why responsible engineering requires a continuous production control loop analogous to MLOps rather than a static pre-deployment review.
True or False: Because ML systems are constructed from modular software components, a fairness defect originating from biased training data can be isolated and patched within a single function without altering data pipelines, training objectives, or shared representations.
Answer: False. Unlike traditional software where defects can often be isolated within a specific function or module, ML systems exhibit tight data-dependent coupling. Data flows through shared representations (such as embeddings and learned feature weights), meaning a biased training signal propagates across multiple downstream predictions. Remediating such a failure requires architectural interventions across the D·A·M axes—including data curation, constrained optimization objectives, and disaggregated outcome monitoring.
Learning Objective: Distinguish localized software bugs from data-coupled ML specification failures across shared representations.
Self-Check: Answer
In an audited commercial healthcare algorithm (Optum), predicting future healthcare costs as a proxy for health needs resulted in Black patients receiving lower risk scores despite having more chronic conditions than White patients with identical scores. What systems mechanism explains why this proxy failed?
- The model suffered from severe overfitting due to an excessive number of gradient descent epochs on a small training dataset.
- The proxy variable inherited historical systemic disparities in healthcare spending, so predicting costs faithfully reproduced unequal access to care rather than actual medical need.
- The failure was caused by real-time concept drift that occurred after deployment when hospital billing codes suddenly changed.
- The algorithm used an unconstrained loss function that optimized inference latency at the expense of regression calibration.
Answer: The correct answer is B. Because less money is spent on Black patients than on White patients with the same level of illness due to systemic barriers, using healthcare cost as a proxy for medical need meant the model learned to predict spending disparities rather than actual health need. Correcting the target from cost to chronic condition count raised the proportion of Black patients identified for high-risk care management from 17.7% to 46.5%. The overfitting distractor is incorrect because the model generalized its cost-prediction task accurately. The concept drift distractor misattributes the failure to post-deployment environmental change rather than training-target proxy bias. The latency optimization choice conflates infrastructure performance tuning with loss function specification.
Learning Objective: Analyze how proxy variables inherit and amplify systemic disparities in training targets.
A hospital sepsis prediction model begins recommending aggressive treatments for low-risk patients after an EHR update alters how vital signs are logged. System health checks, latency, and prediction confidence remain normal. Explain why this constitutes a silent failure, and identify two specific monitoring signals that would detect it.
Answer: This is a silent failure because the model continues to emit high-confidence predictions within its latency SLA despite an underlying covariate shift, producing no crashes or traditional operational alerts while generating harmful clinical recommendations. Two monitoring signals that would detect it are: (1) input-feature distribution drift detection using divergence metrics such as Jensen-Shannon divergence (\(\mathcal{D}_{\text{JS}}(P_t \parallel P_0)\)) on vital-sign feature distributions, and (2) disaggregated clinical outcome tracking comparing patient risk scores against actual diagnostic outcomes and intervention rates across hospital units.
Learning Objective: Analyze silent distribution-shift failures in production ML and identify statistical and outcome-based monitoring signals.
**An engineering team is designing a pre-deployment fairness and robustness testing suite for a high-stakes loan approval classifier. Arrange the following testing stages in the logical sequence recommended by responsible engineering practices:
- Invariance testing on counterfactual pairs (e.g., perturbing applicant name while holding financials constant)
- Boundary and adversarial stress testing (evaluating performance on sparse input regions and corrupted data)
- Disaggregated slice-based evaluation (computing TPR, FPR, and approval rates across demographic subgroups)
- Pareto-frontier analysis and stakeholder review (quantifying fairness-accuracy trade-offs to select an operating threshold)
- Dataset slicing and representation auditing (verifying subgroup sample counts and statistical power in test sets)**
Answer: The correct order is (5) Dataset slicing and representation auditing -> (3) Disaggregated slice-based evaluation -> (1) Invariance testing on counterfactual pairs -> (2) Boundary and adversarial stress testing -> (4) Pareto-frontier analysis and stakeholder review.
First, (5) the team audits test-set composition to ensure adequate sample counts across protected groups. Second, (3) slice-based evaluation calculates standard fairness metrics across those demographic partitions. Third, (1) behavioral invariance testing isolates causal effects by perturbing irrelevant attributes on matched pairs. Fourth, (2) boundary and stress testing evaluates model stability under extreme or corrupted inputs. Finally, (4) the team maps the empirical Pareto frontier to present explicit fairness-accuracy trade-offs to stakeholders for operating threshold selection.
Learning Objective: Design a structured pre-deployment testing sequence spanning slice-based, behavioral, stress, and trade-off evaluations.
A content recommendation service reports that optimizing a ranker for short-term user clicks increased click-through rate by 20%, but long-term user satisfaction dropped by 5% and 30-day retention declined. Which systems-engineering concept best explains this divergence, and what is the appropriate mitigation?
- The alignment gap governed by Goodhart’s Law, where optimizing an observable proxy metric degrades the unobserved true objective; mitigated by maintaining counterfactual holdouts and multi-objective optimization with explicit satisfaction constraints.
- Model capacity collapse, where the embedding table runs out of capacity for rare items; mitigated by increasing embedding dimension and memory bandwidth.
- Hardware-level numerical underflow in attention layers; mitigated by upgrading from FP16 to FP32 mixed precision across serving clusters.
- Training-serving skew in network protocol buffers; mitigated by implementing automated schema validation in feature pipelines.
Answer: The correct answer is A. When a measurable proxy (clicks) becomes the optimization target, Goodhart’s Law dictates that it ceases to be a reliable measure of the true underlying goal (user satisfaction), creating a signed alignment gap \((\text{Gap} = \mathbb{E}[\text{Proxy}] - \mathbb{E}[\text{True}])\). The appropriate mitigation combines multi-objective optimization with safety constraints and randomized counterfactual holdouts that track true long-term satisfaction. The capacity collapse option misattributes a loss-function specification failure to memory constraints. The numerical underflow option confuses mathematical representation limits with metric misalignment. The schema validation option addresses data pipeline serialization rather than proxy divergence.
Learning Objective: Apply Goodhart’s Law and alignment gap mechanics to diagnose metric divergence in recommendation systems.
A randomized algorithm \(\mathcal{M}\) satisfies \((\epsilon, \delta)\)-
____if for any two neighboring datasets \(D, D'\) differing by at most one record, the probability of any output set \(\mathcal{S}\) satisfies \(\mathbb{P}[\mathcal{M}(D) \in \mathcal{S}] \le e^\epsilon \cdot \mathbb{P}[\mathcal{M}(D') \in \mathcal{S}] + \delta\), providing a mathematical upper bound on privacy loss.Answer: The correct answer is differential privacy (or differential-privacy). Differential privacy provides a formal, worst-case mathematical guarantee that the addition or removal of a single individual’s record from a dataset does not significantly alter the probability distribution of the algorithm’s output, bounded by the privacy loss parameter \(\epsilon\) and failure probability \(\delta\).
Learning Objective: Explain the mathematical definition and core parameters of \((\epsilon, \delta)\)-differential privacy.
Self-Check: Answer
An engineering team is evaluating a facial verification model. To estimate the error rate of a minority demographic group representing 1% of the population with a margin of error of \(\pm 1\) percentage point at 95% confidence, they require 10,000 labeled evaluation samples from that group. Under uniform random sampling from the natural population distribution, how many total images must the team collect and label in expectation?
- About 10,000 total images, because evaluating subgroup accuracy requires only that the total test set contains 10,000 images.
- About 100,000 total images, because statistical confidence intervals scale with the square root of the overall dataset size.
- About 1,000,000 total images in expectation, because a 1% subgroup yields only 1 target image per 100 randomly sampled images, imposing a \(100\times\) multiplier.
- About 10,000,000 total images, because the binomial confidence interval width expands exponentially for minority subgroups.
Answer: The correct answer is C. Dividing the required subgroup sample size (\(10{,}000\)) by the subgroup prevalence (\(0.01\)) yields an expected total collection size of \(D_{\text{eval,total}} = 10{,}000 / 0.01 = 1{,}000{,}000\) images—a \(100\times\) data collection multiplier. This demonstrates why relying on natural random distributions for fairness evaluation is prohibitively expensive and why intentional stratified data engineering is required. The 10,000 total images choice confuses subgroup sample requirements with overall dataset size, yielding only ~100 minority samples. The 100,000 total images choice underestimates the collection requirement by a factor of 10. The 10,000,000 total images choice applies an incorrect \(1{,}000\times\) scaling factor.
Learning Objective: Calculate the expected data collection multiplier required for minority subgroup evaluation under random versus stratified sampling.
A team plans to write their model card six months after launch so that it accurately reflects observed production behavior. Explain why this timing constitutes a guard-rail failure, and describe one concrete scope-creep risk that a pre-deployment model card with automated deployment gates prevents.
Answer: A model card functions as an operational guard rail only when written before deployment to explicitly define intended use, validated populations, and excluded use cases that automated release gates can enforce. Writing the card after deployment turns it into a passive historical record that fails to constrain ongoing misuse. A concrete scope-creep risk prevented by pre-deployment gating is when a lightweight vision model validated only for consumer photo organization is repurposed without re-validation for high-stakes security screening or medical diagnostics.
Learning Objective: Explain how pre-deployment model cards operate as enforced guard rails to prevent deployment scope creep.
A loan approval classifier is evaluated on two groups. Group A (Majority): 4,500 True Positives, 500 False Negatives (TPR = 90%), 1,000 False Positives, 4,000 True Negatives (FPR = 20%). Group B (Minority): 600 True Positives, 400 False Negatives (TPR = 60%), 200 False Positives, 800 True Negatives (FPR = 20%). Which statement accurately diagnoses the fairness metrics for this system?
- Demographic parity is satisfied because both groups share an identical False Positive Rate of 20%.
- Equalized odds is satisfied because matching False Positive Rates compensate for differences in True Positive Rates.
- Equal opportunity is violated due to the 30 percentage-point TPR gap, and equalized odds is also violated because equalized odds strictly requires parity in both TPR and FPR.
- Calibration is the only metric affected, because True Positive Rate disparities impact accuracy but do not constitute algorithmic bias.
Answer: The correct answer is C. Equal opportunity requires equal True Positive Rates among qualified applicants (\(P(\hat{Y}=1 \mid Y=1, A=a) = P(\hat{Y}=1 \mid Y=1, A=b)\)); the 30 percentage-point gap (90% vs. 60%) directly violates it. Equalized odds requires equality in both TPR and FPR (\(P(\hat{Y}=1 \mid Y=y, A=a) = P(\hat{Y}=1 \mid Y=y, A=b)\) for \(y \in \{0,1\}\)); matching FPRs (20% vs. 20%) cannot satisfy the criterion when TPRs differ. Demographic parity requires equal overall approval rates regardless of true qualifications, which is not measured by FPR. The calibration-only option incorrectly dismisses severe true-positive-rate disparities as benign accuracy differences.
Learning Objective: Analyze equal-opportunity and equalized-odds violations directly from group confusion matrices.
In a hiring model, closing a 20 percentage-point TPR gap for a disadvantaged group via threshold adjustment adds \(\$4{,}000\) in successful-hire value but creates \(\$6{,}000\) in false-positive bad-hire costs per applicant from that group. Using the chapter’s two-sided accounting, calculate the net utility change per applicant and explain what deliverable engineers owe stakeholders.
Answer: The net change is \(\Delta\text{Utility} = \$4{,}000 - \$6{,}000 = -\$2{,}000\) per applicant for the disadvantaged group, representing a 20% within-group utility loss relative to that group’s baseline utility. Rather than treating threshold adjustment as an automatic fix or imposing a value judgment, engineers owe stakeholders the explicit Pareto frontier along with all economic and base-rate assumptions, showing the exact trade-offs between fairness metrics and utility.
Learning Objective: Calculate two-sided utility changes under fairness threshold adjustments and justify presenting Pareto frontiers to stakeholders.
**An engineering team is establishing an incident response and deployment readiness pipeline for a high-risk ML service. Arrange the five operational components in their proper execution order from detection to long-term fix:
- Mitigation (triggering automated fallbacks, kill switches, or traffic rollbacks to a previous checkpoint)
- Detection (monitoring anomaly alerts, performance drift, and subgroup fairness threshold violations)
- Remediation (conducting root-cause analysis and integrating permanent model/pipeline fixes)
- Assessment (evaluating incident scope, affected demographics, and severity classification)
- Communication (notifying internal stakeholders and impacted external users via pre-approved channels)**
Answer: The correct order is (2) Detection -> (4) Assessment -> (1) Mitigation -> (5) Communication -> (3) Remediation.
First, (2) Detection identifies anomalies and fairness violations via continuous monitoring. Second, (4) Assessment evaluates the severity, blast radius, and demographic impact. Third, (1) Mitigation deploys immediate technical safeguards such as rollbacks or circuit breakers to stop ongoing harm. Fourth, (5) Communication notifies stakeholders and affected users using pre-approved templates. Finally, (3) Remediation conducts root-cause analysis and integrates permanent pipeline improvements.
Learning Objective: Design an end-to-end incident response lifecycle for production ML failures.
A European financial institution deploys an automated machine learning system to make sole decisions on credit applications. Under the EU AI Act (high-risk classification) and GDPR Article 22, which set of architectural capabilities must the engineering team build into the system from inception?
- Post-hoc saliency map visualization tools only, because EU regulations apply strict requirements exclusively to generative foundation models.
- A manual spreadsheet of training dataset URLs and an annual retrospective fairness report submitted after year-end financial audits.
- An unconstrained deep neural network optimized for accuracy, since high aggregate predictive power automatically satisfies legal safety criteria.
- Automated risk management, training data provenance logging, explainable adverse-action factor generation, and an operational workflow supporting substantive human review and user contestability.
Answer: The correct answer is D. Covered high-risk systems under the EU AI Act and solely automated decision pipelines under GDPR Article 22 require technical infrastructure for risk management, dataset provenance and lineage logging, explainability (providing meaningful information about the automated logic), and substantive human oversight with the ability for affected individuals to contest decisions. Saliency maps alone do not satisfy comprehensive risk-management or adverse-action requirements. The retrospective spreadsheet option fails the requirement for continuous, built-in audit trails. The unconstrained optimization option ignores the explicit legal mandate that high accuracy does not exempt systems from governance, transparency, and human oversight controls.
Learning Objective: Analyze how EU AI Act and GDPR Article 22 mandates translate into technical architecture requirements for automated decision systems.
Self-Check: Answer
A team optimizes an inference model using INT8 quantization and structured pruning, reducing dedicated accelerator compute by \(4\times\) while preserving accuracy. According to the chapter, why is this efficiency improvement classified as a responsible engineering intervention rather than a pure performance optimization?
- Because quantization mathematically guarantees that disparate impact across all protected demographic groups drops to zero.
- Because reducing model parameters eliminates the need for data governance and audit logging in production pipelines.
- Because efficiency optimizations are relevant only for one-time training runs, where carbon emissions are legally regulated.
- Because reducing service demand simultaneously lowers operational energy consumption, cuts lifecycle dollar costs, and broadens accessibility to lower-cost hardware.
Answer: The correct answer is D. The chapter links efficiency to responsibility through three interconnected channels: environmental sustainability (reducing energy consumption and grid carbon emissions), economic accessibility (allowing models to run on affordable edge devices or lower-tier instances without costly cloud APIs), and long-term sustainability at scale. The demographic parity claim is false because compression can alter subgroup error rates and must be audited for disparity. The governance exemption claim is incorrect because compressed models remain subject to data governance, lineage, and audit rules. The training-only claim is contradicted by production TCO realities, where recurring inference typically dominates total energy and cost.
Learning Objective: Justify why efficiency optimizations serve environmental, economic, and accessibility responsibility goals simultaneously.
A wearable health monitor has a strict power budget of 500 mW and an end-to-end latency limit of 500 ms. Based on the chapter’s edge deployment profiles (TinyML DS-CNN: 50 mW, 200 ms; MobileNetV2: 1.2 W, 40 ms; EfficientNet-B0: 1.8 W, 65 ms; ResNet-50: 4.5 W, 180 ms), which model selection represents the correct engineering decision?
- MobileNetV2, because its 40 ms latency is significantly faster than the 500 ms limit, and power overages can be mitigated by aggressive cloud offloading.
- TinyML DS-CNN, because its 50 mW power draw operates with a \(10\times\) safety margin under the 500 mW power budget and its 200 ms latency satisfies the 500 ms deadline.
- EfficientNet-B0, because modern smartphone battery management chips can absorb a 1.8 W draw in a wearable form factor without thermal throttling.
- ResNet-50, because large models achieve superior accuracy and batching amortizes per-sample energy consumption to zero.
Answer: The correct answer is B. Only the TinyML model satisfies both physical constraints simultaneously: its 50 mW power draw fits comfortably within the 500 mW ceiling (a \(10\times\) margin) and its 200 ms latency meets the 500 ms requirement. MobileNetV2 draws 1.2 W (\(2.4\times\) the 500 mW budget), and EfficientNet-B0 draws 1.8 W (\(3.6\times\) the budget), causing immediate thermal and battery exhaustion. The smartphone-to-wearable assumption is a classic fallacy warned against in the text. ResNet-50’s 4.5 W draw violates the budget by \(9\times\), and batching cannot eliminate the continuous power ceiling of an edge wearable.
Learning Objective: Apply edge power and latency constraints to select viable model architectures.
In an illustrative three-year recommendation system TCO model (Training: ~2%, Operations: ~25%, Inference: ~73%), compare the financial impact of a 50% reduction in training time versus a 20% reduction in per-query dedicated accelerator service demand. Which optimization yields higher dollar savings, and by what approximate ratio?
Answer: The 20% inference reduction yields dramatically higher savings: 20% of the 73% inference share saves approximately 14.6% of total three-year TCO, whereas 50% of the 2% training share saves only 1.0% of total TCO. This represents a savings leverage ratio of approximately \(14.6 : 1.0\) (or roughly \(15\times\) to \(16\times\) greater savings from the inference optimization). This demonstrates why high-traffic production systems must prioritize per-query serving efficiency over training acceleration.
Learning Objective: Compare the financial leverage of training versus inference optimizations using a lifecycle TCO breakdown.
True or False: For an identical serving workload, relocating an inference deployment from a carbon-intensive fossil-fuel grid region to a region powered predominantly by low-carbon renewable energy can reduce operational carbon emissions more than a modest algorithmic efficiency improvement.
Answer: True. Operational carbon emissions are computed as \(\text{Carbon} = \text{Energy (kWh)} \times \text{PUE} \times \text{Carbon Intensity (kg CO}_2\text{e/kWh})\). Because regional grid carbon intensity varies widely (e.g., from over \(0.6\text{ kg/kWh}\) in fossil-heavy grids to under \(0.05\text{ kg/kWh}\) in renewable-dominated regions—more than a \(10\times\) difference), shifting workloads to cleaner regions or using carbon-aware scheduling can reduce emissions by factors that far exceed a typical 10% to 20% algorithmic speedup.
Learning Objective: Evaluate the carbon reduction impact of grid-carbon-intensity region selection versus algorithmic efficiency.
In data-center environmental accounting, the metric defined as the ratio of total facility energy to the energy consumed specifically by computing equipment is known as
____(abbreviated PUE).Answer: The correct answer is power usage effectiveness (or Power Usage Effectiveness). Power Usage Effectiveness (PUE) measures data center infrastructure energy efficiency by dividing total facility power (including cooling, lighting, and power distribution) by IT equipment power; an ideal PUE is 1.0, with modern hyperscale facilities typically achieving 1.1 to 1.2.
Learning Objective: Explain the definition and operational significance of power usage effectiveness (PUE) in ML data center carbon accounting.
Self-Check: Answer
In 2023, European regulators fined Meta EUR 390 million for processing user data for behavioral advertising without a valid legal basis, transparent disclosure, or fair processing—an infraction involving no data breach or server compromise. Which systems-engineering principle does this case demonstrate?
- Security encryption at rest and in transit is sufficient to guarantee total regulatory compliance across all data privacy laws.
- Data governance is an enforceable technical constraint across the data lifecycle, requiring infrastructure to verify lawful basis, purpose limitation, and consent rather than relying on policy assertions.
- Regulatory compliance applies only to static tabular data lakes and exempts real-time streaming feature stores.
- Publishing a public datasheet for a dataset eliminates all downstream corporate liability for unlawful processing.
Answer: The correct answer is B. Data governance requires demonstrable, technically enforceable controls across the entire data engineering lifecycle: establishing a lawful basis for processing, verifying purpose limitation in feature pipelines, tracking consent, and enforcing retention limits. Meeting encryption standards (security) does not satisfy lawful processing or transparency obligations (governance). The static lake exemption is incorrect because governance binds all storage and streaming tiers. The datasheet liability claim is false because documentation does not substitute for lawful processing and technical compliance.
Learning Objective: Explain why data governance requires enforceable technical infrastructure across the ML pipeline rather than standalone security or policy documents.
A user invokes their GDPR Article 17 right to erasure on a voice assistant service. Explain why manual database queries across storage systems fail in a modern distributed ML pipeline, and describe what automated infrastructure is required to execute the deletion.
Answer: Manual searches fail because a raw audio record fans out into derived feature tables, normalized embeddings, training caches, serialized model checkpoints, and edge device caches across distributed services. To satisfy erasure obligations, the architecture requires an automated data lineage system (such as Apache Atlas or DataHub integrated with workflow orchestrators) that tracks data provenance graphs, automatically identifies all downstream derived artifacts, and triggers appropriate workflows for record deletion, embedding invalidation, checkpoint retraining, or machine unlearning.
Learning Objective: Analyze why distributed ML pipelines require automated lineage infrastructure to fulfill right-to-erasure compliance requests.
A smart-home voice assistant (such as the Lighthouse KWS system) is designed with an always-listening microphone. Which combination of architectural choices best embodies privacy-by-design for this deployment?
- Stream continuous raw ambient audio to a centralized cloud cluster where access is protected exclusively by role-based access control (RBAC).
- Store all raw acoustic recordings permanently on local edge flash memory so that future model versions can be trained without cloud connectivity.
- Perform wake-word detection locally on-device, transmit audio to servers only after verified activation, apply strict retention/deletion policies to uploaded audio, and use federated learning with differential privacy for model improvements.
- Rely on third-party cloud data warehouses to handle all privacy filtering after raw audio ingestion has completed.
Answer: The correct answer is C. Privacy-by-design minimizes exposure at the architectural level: on-device wake-word detection ensures ambient audio never leaves the device unprompted; purpose limitation restricts transmission to post-activation audio; automated retention schedules delete stored voice samples; and federated learning with differential privacy allows model retraining without raw data aggregation. Continuous streaming with RBAC exposes massive personal data if credentials or network boundaries are breached. Permanent local raw audio retention creates a persistent vulnerability surface. Centralized post-ingestion filtering violates data minimization by unnecessarily collecting raw personal data.
Learning Objective: Design privacy-by-design architectures for always-listening edge ML systems using data minimization and on-device processing.
**An organization is deploying an enterprise ML feature store and training pipeline with full data governance and auditability. Arrange the following governance actions in the correct operational sequence across the data lifecycle:
- Role-based access control (RBAC) and encryption applied at rest/in transit within the feature store
- Ingestion of raw source data with cryptographically signed consent and provenance metadata
- Multi-tier inference audit logging (recording model version, decision threshold, and reason codes)
- Automated feature transformation with fine-grained DAG-level lineage capture
- Lineage-driven artifact identification and automated deletion workflow upon user erasure request
- Privacy-preserving training incorporating calibrated differential privacy noise and budget tracking**
Answer: The correct order is (2) Ingestion of raw source data with cryptographically signed consent and provenance metadata -> (4) Automated feature transformation with fine-grained DAG-level lineage capture -> (1) Role-based access control (RBAC) and encryption applied at rest/in transit within the feature store -> (6) Privacy-preserving training incorporating calibrated differential privacy noise and budget tracking -> (3) Multi-tier inference audit logging (recording model version, decision threshold, and reason codes) -> (5) Lineage-driven artifact identification and automated deletion workflow upon user erasure request.
First, (2) raw data is ingested with consent and provenance. Second, (4) transformation pipelines capture lineage graphs as features are generated. Third, (1) features are secured in feature stores using RBAC and encryption. Fourth, (6) models train with differential privacy noise and budget accounting. Fifth, (3) inference decisions generate audit logs with version and context. Finally, (5) when an erasure request arrives, lineage graphs automate the downstream artifact deletion workflow.
Learning Objective: Design the lifecycle of an ML data asset through governance, security, privacy-preserving training, audit logging, and lineage-driven erasure.
An empirical privacy attack in which an adversary analyzes model output probabilities to determine whether a specific individual’s record was part of the model’s training dataset is known as a
____.Answer: The correct answer is membership inference attack (or membership inference). In a membership inference attack, the adversary exploits the fact that machine learning models often exhibit higher confidence and lower loss on samples seen during training compared to unseen test samples, allowing them to infer individual participation in private training datasets.
Learning Objective: Analyze the mechanism and vulnerability surface of membership inference attacks in ML privacy auditing.
Self-Check: Answer
A deployed automated lending model achieves an impressive 88% overall accuracy on its global test set. However, a disaggregated audit reveals that qualified minority applicants experience a 60% True Positive Rate compared to 90% for majority applicants (a 30 percentage-point gap) and face \(4\times\) higher false rejection rates. Which engineering pitfall does this scenario illustrate?
- Relying on aggregate metrics to assess fairness, which conceals severe subgroup disparities behind strong overall averages (the Flaw of Averages).
- Treating documentation as sufficient accountability, assuming a model card automatically prevents operational misuse.
- The belief that model weights are exempt from data governance and right-to-erasure regulations.
- Assuming that edge deployment power budgets scale linearly with dataset sample size.
Answer: The correct answer is A. The Flaw of Averages demonstrates that aggregate accuracy is a weighted average across all samples that masks severe performance degradation in minority subgroups. A model can boast 88% aggregate accuracy while rejecting qualified minority applicants at \(4\times\) the majority rate (\(40\%\) vs. \(10\%\) False Negative Rate). The documentation-as-accountability choice addresses written model cards versus active deployment gates, not metric aggregation. The model-weights governance choice refers to post-training compliance, not metric illusions. The edge power budget choice confuses physical hardware limits with statistical evaluation metrics.
Learning Objective: Identify the pitfall of relying on aggregate metrics to assess system fairness.
A team removes race and gender columns from their training dataset, asserting that “the model cannot discriminate on features it cannot see.” Drawing on the Amazon recruiting and Optum healthcare cases, explain why this naive attribute removal creates false confidence, and identify the specific engineering analyses required.
Answer: Naive attribute removal fails because non-sensitive features act as proxy variables that reconstruct protected attributes through statistical correlations: Amazon’s tool penalized terms such as ‘women’s’ and women’s colleges without a gender label, and Optum’s algorithm used healthcare spending as a proxy for need, under-enrolling Black patients because of unequal historical access to care. Eliminating protected attributes creates false confidence while preserving discriminatory patterns. Engineers must instead conduct proxy and causal correlation analyses, perform disaggregated subgroup evaluations across demographic slices, implement constrained optimization objectives (such as equal opportunity constraints), and monitor per-group production outcomes continuously.
Learning Objective: Explain why proxy variables defeat naive attribute removal and specify the necessary statistical and monitoring countermeasures.
True or False: Because a model card explicitly specifies that a vision model is “not validated for high-stakes medical or security screening,” publishing the model card guarantees operational compliance without requiring technical access controls or deployment release gates.
Answer: False. This illustrates the pitfall of treating documentation as sufficient accountability. A model card provides transparency but has no technical enforcement mechanism. When downstream teams repurpose an artifact, documentation alone cannot prevent scope creep. True accountability requires operationalizing model card constraints through technical deployment gates, RBAC permissions, monitoring alerts, and automated policy enforcement that actively block unvalidated deployments.
Learning Objective: Evaluate why documentation without operational enforcement fails to prevent deployment scope creep.
True or False: For a high-traffic production ML service, measuring and reporting only the electricity consumed during model training runs provides an accurate accounting of the system’s long-term environmental carbon footprint.
Answer: False. This illustrates the pitfall of measuring the environmental impact of training while ignoring inference. In high-traffic production services (such as recommendation engines serving millions of daily queries), recurring inference and continuous serving infrastructure typically dominate the lifecycle footprint by an illustrative ratio of 40:1 (\(73\%\) inference vs. \(2\%\) training in the chapter’s TCO model). Responsible carbon accounting must track both training and per-query operational serving emissions across the full multi-year system lifecycle.
Learning Objective: Evaluate why training-only carbon accounting fails to capture lifecycle environmental impacts in production ML.
Self-Check: Answer
According to the chapter summary, what is the core relationship between responsible engineering and traditional ML systems engineering?
- Responsible engineering is ML systems engineering done completely: a system that ignores fairness, efficiency, transparency, or governance is technically incomplete, not merely ethically flawed.
- Responsible engineering is an optional ethical overlay applied exclusively by external legal teams after technical development finishes.
- Responsible engineering replaces performance optimization with ethical review, requiring teams to trade away latency and throughput entirely.
- Responsible engineering applies exclusively to regulated healthcare and judicial algorithms, having no relevance to consumer or enterprise ML systems.
Answer: The correct answer is A. The central thesis of the chapter is that responsible engineering represents engineering completeness. Just as a system that crashes or misses latency SLOs is technically defective, an ML system that operates with unmeasured subgroup harms, uncontrolled inference carbon waste, or unverifiable data lineage is technically incomplete. The ethical overlay option incorrectly isolates responsibility from core systems design. The trade-off option misrepresents optimization techniques (like quantization and pruning), which serve both efficiency and responsibility. The regulated-domains-only option ignores the universal relevance of cost, efficiency, and governance across all production deployments.
Learning Objective: Identify the chapter’s central thesis that responsible engineering represents complete systems engineering.
The chapter summary emphasizes that ethical concerns become actionable only when translated into measurable engineering invariants. Contrast a vague principle with a concrete engineering invariant, and explain how that invariant integrates into existing production MLOps workflows.
Answer: A vague principle such as ‘the system should be fair and unbiased’ provides no actionable engineering target, whereas a concrete invariant such as ‘the true-positive-rate difference between demographic slices must remain \(\le 5\) percentage points, evaluated hourly over a rolling 24-hour window’ defines an enforceable specification. This invariant integrates directly into existing MLOps infrastructure by configuring automated alerting thresholds alongside p99 latency SLOs, routing violations to on-call rotations, and triggering automated rollback or human-in-the-loop escalation paths when thresholds are breached.
Learning Objective: Explain how translating abstract ethical principles into measurable engineering invariants enables automated monitoring and SLO enforcement.
True or False: Technical optimization methods such as quantization, pruning, hardware acceleration, and continuous monitoring serve a dual purpose in ML systems by simultaneously optimizing traditional performance metrics (latency, throughput) and responsible engineering objectives (energy efficiency, accessibility, subgroup error visibility).
Answer: True. The chapter synthesizes prior techniques by showing that optimization and responsibility share identical mechanisms: INT8 quantization and structured pruning reduce memory bandwidth and inference latency while lowering energy consumption and enabling deployment on affordable edge hardware; continuous monitoring infrastructure detects latency spikes while simultaneously exposing silent demographic drift and fairness regressions. Performance and responsibility are complementary dimensions of the same technical toolkit.
Learning Objective: Analyze how core ML systems optimization techniques serve both computational performance and responsible engineering goals.