Quy trình ML
Mục đích
Vì sao cần thấy toàn bộ bản đồ trước khi bước trên bất kỳ lối đi nào?
Phân loại D·A·M giúp chúng ta gọi tên các thành phần của mọi hệ thống ML, và vị trí triển khai quyết định các ràng buộc vật lý mà mỗi thành phần phải đáp ứng. Các nhóm thường xem đây là những mối quan tâm tách rời: một nhóm thu thập dữ liệu, nhóm khác thiết kế mô hình, và nhóm thứ ba lo phần cứng. Nhưng bài học sâu sắc nhất của phân loại này là các thành phần đó tương tác với nhau. Dữ liệu thu thập được giới hạn các thuật toán khả thi. Thuật toán được chọn quyết định phần cứng nào có thể chạy nó. Phần cứng mục tiêu lại định hình loại dữ liệu có thể xử lý. Kéo một sợi chỉ, cả hệ thống dịch chuyển. Những tương tác này diễn ra cả giữa các thành phần lẫn theo thời gian. Một mô hình hoạt động tốt lúc ra mắt có thể suy giảm khi phân phối dữ liệu thay đổi, buộc phải điều tra và, khi có bằng chứng, cập nhật mô hình hoặc dữ liệu. Tối ưu từng phần một cách cô lập dễ dẫn đến mô hình chính xác nhưng không thể triển khai, hoặc pipeline hiệu quả nhưng cấp sai dữ liệu. Một kỹ sư dữ liệu hiểu cách các quyết định tiền xử lý ràng buộc kiến trúc hạ nguồn sẽ xây dựng pipeline khác hẳn người coi chuẩn bị dữ liệu là một nhiệm vụ tách biệt; một nhà phát triển mô hình biết ngân sách bộ nhớ của mục tiêu triển khai ngay từ đầu sẽ chọn kiến trúc khác với người chỉ theo đuổi độ chính xác trong khoảng trống, không gắn với bối cảnh. Trước khi đi sâu vào chi tiết của bất kỳ thành phần nào, chúng ta cần một bức bản đồ đầy đủ cho thấy hệ thống ML được xây dựng, đánh giá và vận hành bền vững như một chỉnh thể. Quy trình ML đưa bức bản đồ đó vào chuyển động thông qua đồng thiết kế D·A·M lặp đi lặp lại giữa dữ liệu, thuật toán và máy, cho đến khi năng lực tổng hợp của chúng đáp ứng yêu cầu của thế giới thực.
Learning Objectives
- Giải thích sáu giai đoạn của vòng đời ML như các quyết định phối hợp giữa dữ liệu, thuật toán và máy, có phản hồi.
- So sánh quy trình ML với phần mềm truyền thống dựa trên các yếu tố như trôi dạt, tính không xác định và phản hồi vận hành.
- Phân tích cách các ràng buộc từ phần định nghĩa vấn đề ảnh hưởng qua các giai đoạn dữ liệu, mô hình, xác thực và triển khai.
- Tính chi phí tích hợp khi phát hiện muộn dựa trên nguyên tắc truyền ràng buộc của quy trình làm việc.
- Đánh giá các đánh đổi về độ chính xác, hiệu quả, khả năng tái lập và mức độ sẵn sàng triển khai xuyên suốt các giai đoạn của vòng đời.
- Thiết kế các vòng lặp phản hồi để kết nối tín hiệu giám sát với quá trình huấn luyện lại, bảo trì và các yêu cầu đã sửa đổi.
Vòng đời ML
Hãy xem xét một kịch bản thất bại minh họa. Ngày 1: “Xây dựng một mô hình chẩn đoán cho các phòng khám ở nông thôn.” Ngày 90: đạt độ chính xác 95% trên tập kiểm thử. Ngày 120: độ chính xác tăng lên 96% sau một tháng tinh chỉnh kiến trúc. Ngày 150: mô hình được bàn giao cho các kỹ sư triển khai. Ngày 151: các kỹ sư triển khai báo cáo mô hình cần 4 GB bộ nhớ. Ngày 152: có người kiểm tra mục tiêu triển khai—máy tính bảng ở các phòng khám di động chỉ có 512 MB bộ nhớ khả dụng. Ngày 153: năm tháng công sức bị bỏ đi.
Độ chính xác của mô hình rất tốt. Kỹ năng machine learning của nhóm cũng rất xuất sắc. Thất bại là thất bại về quy trình làm việc. Một ràng buộc về triển khai lẽ ra phải định hình mọi quyết định ngay từ ngày đầu, nhưng chỉ được phát hiện sau khi công việc đã hoàn tất. Giới hạn bộ nhớ của máy tính bảng đáng lẽ phải được đưa ngược về cuộc họp kiến trúc đầu tiên, để giới hạn những mô hình nào đáng cân nhắc. Thay vào đó, nhóm tối ưu từng thành phần tách rời (thu thập dữ liệu, lựa chọn kiến trúc, huấn luyện), và lỗi tích hợp chỉ lộ ra khi ghép các phần lại. Một ca triển khai bệnh võng mạc tiểu đường (DR) đã được ghi nhận cho thấy những lỗ hổng tương tự về quy trình làm việc và hạ tầng.1
1 Khoảng cách từ phòng thí nghiệm đến triển khai: Beede et al. (2020) đã ghi nhận thực nghiệm điều này với một hệ thống sàng lọc bệnh võng mạc tiểu đường dùng học sâu, được triển khai tại các phòng khám ở Thái Lan. Mặc dù hệ thống đạt độ chính xác ở mức chuyên gia trong các lần kiểm định trước đó, 393 trong số 1.838 hình ảnh gửi lên (21%) không đạt yêu cầu về chất lượng. Nguyên nhân thường do ánh sáng trong phòng khám, bảo trì máy ảnh, hoặc thực hành giãn đồng tử không khớp với các giả định của hệ thống. Những lần bị từ chối này làm tăng khối lượng công việc cho y tá, buộc chụp lại hoặc chuyển tuyến, và phơi bày các rào cản về workflow và hạ tầng, chứ không đơn thuần là vấn đề về độ chính xác của mô hình.
Các hệ thống ML kết hợp dữ liệu, thuật toán và máy móc, hoạt động dưới các ràng buộc vật lý, từ đó chia việc triển khai thành các môi trường như Đám mây, Edge, Di động và TinyML. Các thành phần và môi trường vận hành đã sẵn sàng. Mảnh ghép còn thiếu là cách các thành phần này kết nối để tạo thành một hệ thống vận hành hoàn chỉnh.
Quy trình ML là một framework kỹ thuật được thiết kế để ngăn những sự cố như vậy bằng cách làm rõ các ràng buộc ở từng giai đoạn phát triển và theo dõi cách chúng lan truyền qua Dữ liệu, Thuật toán và Máy. Quy trình này đánh dấu bước chuyển từ nhà nghiên cứu mô hình sang kỹ sư hệ thống. Nhà nghiên cứu tối ưu từng thành phần: kiến trúc tốt hơn, tập dữ liệu sạch hơn, bộ tăng tốc nhanh hơn. Kỹ sư hệ thống thì phối hợp những thành phần đó thành các hệ thống vận hành ổn định, đem lại giá trị một cách đáng tin cậy. Sự cố ngày 153 không phải chỉ là vấn đề dữ liệu, vấn đề mô hình, hay vấn đề phần cứng; nó là mắt xích bị thiếu giữa cả ba. Quy trình này cung cấp một bản đồ tư duy giúp các quyết định kỹ thuật luôn gắn với bức tranh hệ thống tổng thể.
Vòng đời machine learning là framework để điều phối công việc này: một quy trình có cấu trúc, lặp đi lặp lại2, định hướng việc phát triển, đánh giá và cải tiến các hệ thống ML (Amershi et al. 2019). Theo định nghĩa chính thức, vòng đời này nhấn mạnh quản lý liên tục thay vì một lần phát hành duy nhất.
2 CRISP-DM (quy trình tiêu chuẩn liên ngành cho khai phá dữ liệu): CRISP-DM đã chuẩn hóa quá trình phát triển các hệ thống chuyên sâu về dữ liệu thành sáu giai đoạn có liên kết chặt chẽ và lặp đi lặp lại, thay vì mô hình thác nước tuyến tính (Chapman et al. 2000). Nguyên tắc thiết kế cốt lõi của CRISP-DM – các vòng lặp phản hồi giữa tất cả các giai đoạn – đã trực tiếp định hình cấu trúc của vòng đời ML hiện đại. Các nghiên cứu về kinh tế kỹ thuật phần mềm của Boehm đã chỉ ra rằng việc sửa lỗi càng muộn thì chi phí càng cao (Boehm 1981). Sau này, mô hình quy trình sử dụng công thức \(2^{N_{\text{stage}}-1}\) (trong đó \(N_{\text{stage}}\) là chỉ số giai đoạn của vòng đời) như một kịch bản minh họa về độ nhạy, chứ không phải là một quy luật chi phí thực nghiệm.
Chapman, Pete, Julian Clinton, Randy Kerber, Thomas Khabaza, Thomas Reinartz, Colin Shearer, and Rudiger Wirth. 2000. “CRISP-DM 1.0: Step-by-Step Data Mining Guide.” SPSS Inc 1: 78.
Amershi, Saleema, Andrew Begel, Christian Bird, Robert DeLine, Harald Gall, Ece Kamar, Nachiappan Nagappan, Besmira Nushi, and Thomas Zimmermann. 2019. “Software Engineering for Machine Learning: A Case Study.” 2019 IEEE/ACM 41st International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP), 291–300. https://doi.org/10.1109/icse-seip.2019.00042.
Ở đây, vòng đời mô tả chính các giai đoạn, còn quy trình làm việc nói về kỹ thuật điều phối những giai đoạn đó; vòng đời là những gì được đi qua, còn quy trình làm việc là cách quản lý việc đi qua đó. Sự phân biệt này đòi hỏi tư duy hệ thống: phân tích cách các bộ phận của một hệ thống tương tác với nhau thay vì xem xét chúng riêng lẻ. Các mẫu hình được hệ thống hóa trong section 1.9 và được minh họa qua một nghiên cứu tình huống chi tiết cho thấy vì sao các hệ thống ML cần cách tiếp cận kỹ thuật tích hợp thay vì tối ưu tuần tự từng thành phần.
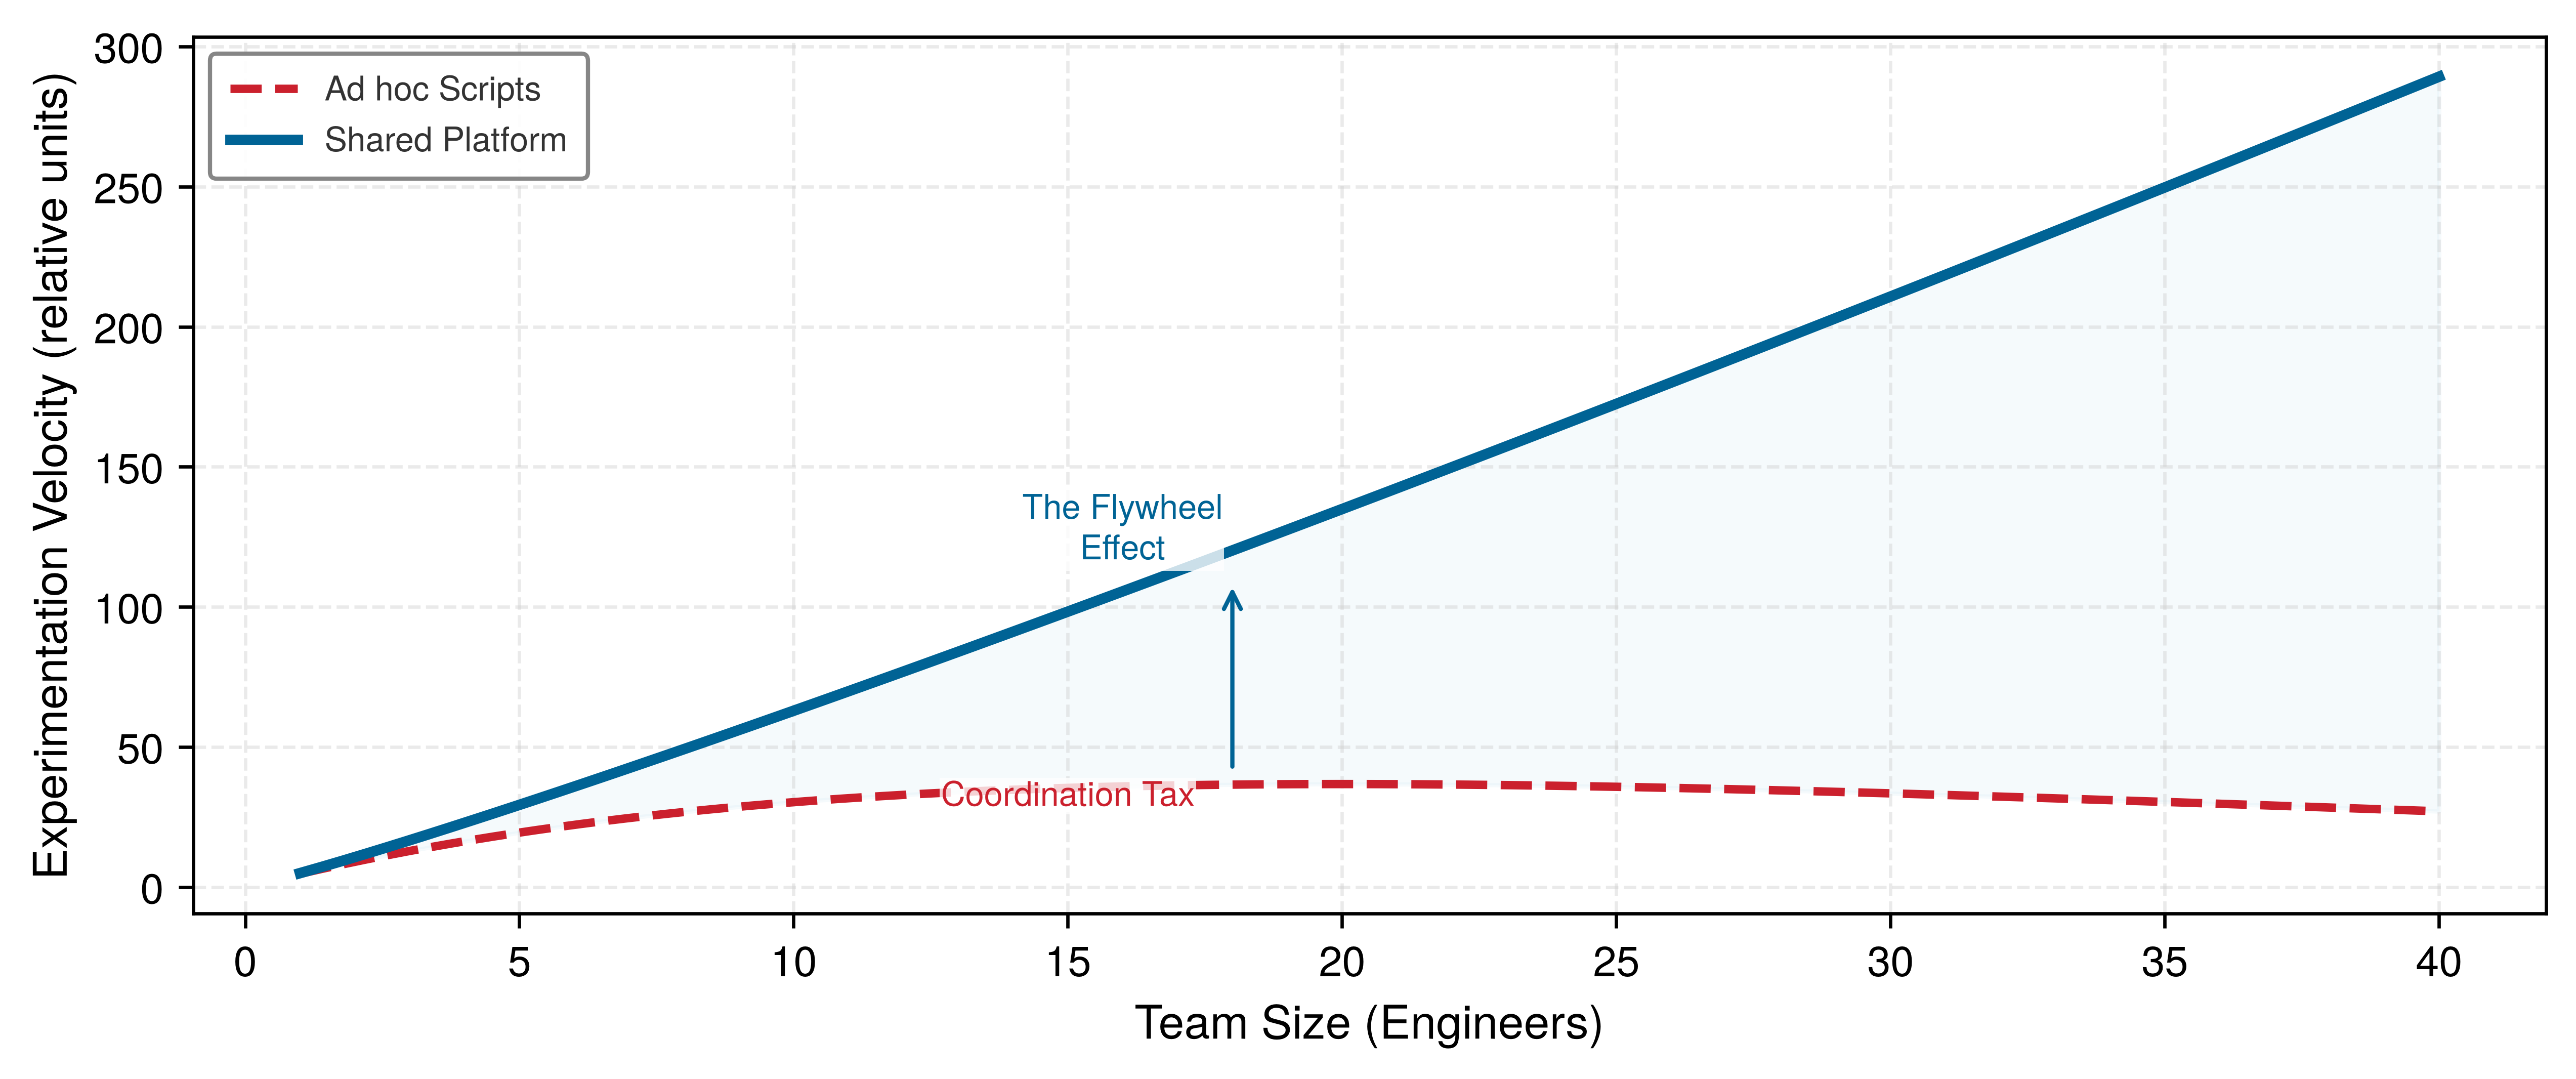
Để điều phối machine learning, chúng ta cần quản lý sự tiến hóa của dữ liệu sao cho đồng bộ với các cập nhật mô hình. Trong figure 1, bố cục ngang tách pipeline dữ liệu ở phía trên khỏi pipeline phát triển mô hình ở phía dưới, với các vector hồi quy cong minh họa cách thông tin vận hành và lỗi dữ liệu quay ngược về các giai đoạn trước.
Definition 1.1: Vòng đời machine learning
Vòng đời machine learning là quy trình kỹ thuật lặp, bao gồm xây dựng, triển khai, giám sát và cập nhật các hệ thống ML, trong đó bằng chứng từ các giai đoạn sau có thể phản hồi về các giai đoạn trước vì hiệu suất mô hình có thể thay đổi sau triển khai.
- Ý nghĩa: Vòng đời là một vòng lặp kín, không phải pipeline tuyến tính. Mức phân kỳ phân phối \(\mathcal{D}(P_t \lVert P_0)\) giữa lưu lượng hiện tại và lưu lượng huấn luyện là tín hiệu cảnh báo làm tăng xác suất mất độ chính xác; mối quan hệ cụ thể phụ thuộc vào mô hình, nhãn, hàm mất mát và phân phối khi triển khai. Một lần huấn luyện lại đầy đủ phát sinh chi phí tính toán \(O/(R_{\text{peak}} \cdot \eta_{\text{\!hw}})\), trong khi các cập nhật một phần hoặc tăng dần có thể rẻ hơn. Vì vậy, tốc độ trôi và độ trễ xác thực khiến việc duy trì vòng đời trở thành một bài toán ngân sách, không chỉ là một quy trình kỹ thuật.
- Điểm khác biệt: Khác với phần mềm truyền thống, hành vi chỉ đổi khi mã, cấu hình, phụ thuộc hoặc môi trường thay đổi, hành vi của hệ thống ML còn có thể đổi khi thế giới thay đổi. Độ chính xác của mô hình đã triển khai có thể thay đổi do dịch chuyển phân phối, ngay cả khi mã, hạ tầng và cấu hình vẫn giữ nguyên.
- Lỗi thường gặp: Một hiểu lầm phổ biến là vòng đời kết thúc ở giai đoạn triển khai. Thực ra, triển khai là điểm bắt đầu của vòng lặp phản hồi: giám sát trong môi trường sản xuất phát hiện drift; drift kích hoạt điều tra; và bằng chứng từ kết quả sẽ quyết định liệu một mô hình đã được huấn luyện lại có nên quay lại giai đoạn triển khai hay không.
Hiểu cách các giai đoạn này liên kết với nhau là điều thiết yếu trước khi đi sâu vào từng lớp riêng lẻ, vì mỗi lĩnh vực kỹ thuật—từ các pipeline lưu trữ (Kỹ thuật dữ liệu) đến huấn luyện mô hình (Huấn luyện mô hình), các framework thực thi (Các Framework ML) và cơ sở hạ tầng phục vụ (serving) (Phục vụ mô hình)—đều vận hành như một hệ thống phụ thuộc lẫn nhau.

Các giai đoạn mang tính khái niệm của vòng đời ML xác định cái gì và tại sao của quá trình phát triển. Còn lớp vận hành là cách thức: triển khai vòng đời này bằng tự động hóa, công cụ và hạ tầng. Vận hành machine learning đặt tên và phát triển chi tiết các thực hành đó. Sự phân biệt này rất quan trọng: vòng đời là một khuôn khổ mang tính khái niệm; còn hạ tầng vận hành là bộ máy để hiện thực hóa nó ở quy mô lớn.
Định lượng vòng đời ML
Cách người làm nghề phân bổ thời gian giúp đo lường được các điểm nghẽn trong vòng đời ML: không ít khi những giai đoạn tốn nhiều công sức kỹ thuật lại không phải là những giai đoạn được chú ý nhiều nhất. Hiểu vòng đời ML ở mức khái niệm là cần nhưng chưa đủ để ra quyết định kỹ thuật; mô tả định lượng mới cho thấy công sức và tài nguyên tính toán thực sự được dùng vào đâu trong các dự án ML, qua đó chỉ ra giai đoạn nào đang gây tắc nghẽn và nên đầu tư tối ưu hóa ở đâu để thu được hiệu quả cao nhất.
Các khảo sát với người làm nghề cho thấy sự lệch lớn giữa nơi nghiên cứu tập trung và nơi giờ công kỹ thuật thực sự được bỏ ra, với việc thu thập và chuẩn bị dữ liệu chiếm 79 percent thời gian của họ. Trong figure 2, một biểu đồ tròn phân rã các hạng mục tiêu tốn thời gian chính, đối chiếu phần lớn dành cho thu thập và chuẩn bị dữ liệu với phần rất hẹp dành cho kiến trúc mô hình và tinh chỉnh thuật toán.

Bên cạnh việc phân bổ thời gian, các chu kỳ lặp (iteration cycles) là đặc trưng của những dự án machine learning thành công. Hãy quay lại figure 1 và để ý các vòng lặp phản hồi (feedback loops) thúc đẩy các chu kỳ này: mỗi mũi tên biểu thị một lộ trình mà các nhóm phải đi lại nhiều lần. Các hệ thống machine learning trong sản xuất thường lặp đi lặp lại qua các giai đoạn dữ liệu, mô hình và hạ tầng, trong đó mỗi chu kỳ có thể quay lại nhiều giai đoạn. Hiểu rõ điều gì kích hoạt các chu kỳ này giúp định hướng phân bổ nguồn lực. Các vấn đề chất lượng dữ liệu (thiếu nhãn, lệch phân phối, lỗi tiền xử lý) thường là nguồn chính gây phải làm lại. Các lựa chọn về kiến trúc và huấn luyện (dung lượng mô hình, các thiết lập có thể điều chỉnh như tốc độ học và kích thước batch, bất ổn trong huấn luyện) cùng các vấn đề hạ tầng (vi phạm độ trễ, hạn chế tài nguyên, lỗi tích hợp) tạo thêm các vòng lặp mà các nhóm cần dự trù chi phí rõ ràng.
Với các giả định đã nêu, mô hình có chu kỳ nhanh hơn sẽ hoàn thành sớm hơn một chút sau 26 tuần.
Napkin Math 1.1: Chi phí lặp
Bài toán: Một hệ thống sàng lọc DR cho các phòng khám ở vùng nông thôn cần chọn giữa hai lựa chọn: một ensemble lớn được huấn luyện trên ảnh đáy mắt độ phân giải cao (thời gian huấn luyện: 1 week, độ chính xác: 95 percent) và một mô hình nhẹ, phù hợp để triển khai trên edge tại phần cứng của phòng khám (thời gian huấn luyện: 1 hour, độ chính xác: 90 percent). Theo các giả định này, mô hình nào có độ chính xác ước tính cao hơn sau sáu tháng?
Tính toán: Trong sáu tháng (~26 weeks), số lượng thử nghiệm có thể là:
- Mô hình lớn: Tổng thời gian theo lịch là 26 weeks, với mỗi thử nghiệm tốn 1 week. Mỗi thử nghiệm được giả định cải thiện độ chính xác một lượng hằng số ~0.15 percentage points.
- Mô hình nhỏ: Với 26 weeks thời gian theo lịch và 168 h/week giờ mỗi tuần, ta có thể chạy tổng cộng 4,368 thử nghiệm, mỗi thử nghiệm tốn 1 hour. Ở độ dài chu kỳ này, thời gian máy tính không phải là nút thắt. Vì vậy, kịch bản này chỉ tính 100 trong số đó là các thử nghiệm hiệu quả — số mà một nhóm thực sự có thể thiết kế, chạy và rút kinh nghiệm trong sáu tháng. Phần năng lực còn lại bị bỏ trống vì thiếu giả thuyết. Ngay cả khi giả định mức tăng mỗi vòng lặp nhỏ hơn, nhiều vòng lặp hữu ích hơn vẫn có thể mang lại mức tăng tích lũy lớn hơn.
Kết quả: Nếu mỗi lần lặp cải thiện độ chính xác trung bình là 0.1 percentage points, mô hình nhỏ bắt đầu ở 90 percent và đạt 100 percent sau 100 lần lặp hiệu quả, trước khi áp dụng giới hạn trần 99 percent. Do đó, độ chính xác cuối cùng của nó là 99 percent. Mô hình lớn bắt đầu ở 95 percent và đạt 98.9 percent sau 26 lần lặp chậm hơn. Trong thực tế, tốc độ lặp nhanh của mô hình nhỏ giúp khám phá các kiến trúc tốt hơn, các phép tăng cường dữ liệu bảo toàn nhãn và các thiết lập huấn luyện có thể điều chỉnh.
Góc nhìn hệ thống: Tốc độ lặp là một đặc trưng. Khi các hệ thống tiềm năng có chất lượng tương đương và các thử nghiệm có giá trị kỳ vọng tương tự, những chu kỳ ngắn hơn sẽ mở rộng phạm vi thiết kế mà nhóm có thể kiểm thử. Chỉ riêng tốc độ không đảm bảo một mô hình nhỏ sẽ vượt trội hơn mô hình lớn. Với kịch bản sàng lọc DR của chúng ta, chu kỳ lặp nhanh của mô hình gọn nhẹ cho phép nhóm thử nghiệm các phép biến đổi đầu vào giữ nguyên nhãn, các pipeline tiền xử lý và các biến thể kiến trúc nhanh hơn rất nhiều.
Những tỷ lệ này cho thấy vì sao năng lực kỹ thuật dữ liệu cần được lập kế hoạch rõ ràng, thay vì chỉ coi là công việc chuẩn bị. Đây cũng là lý do Phần I kết thúc ở Kỹ thuật dữ liệu: công việc với dữ liệu là nguồn chính của công sức, lặp và rủi ro dự án. Hiểu pipeline dữ liệu trước tiên sẽ tạo đòn bẩy, trước khi đi vào các kỹ thuật mô hình, huấn luyện và tối ưu hóa tiếp theo.
Việc phát hiện vấn đề muộn có thể rất tốn kém,3 như sẽ được trình bày cụ thể hơn sau này qua nguyên tắc lan truyền ràng buộc (section 1.9.1). Những vi phạm được phát hiện muộn có thể đòi hỏi phải chỉnh sửa ở nhiều giai đoạn trước đó. Rủi ro này thúc đẩy nhu cầu có các hợp đồng giao diện giai đoạn rõ ràng: xác thực đầu ra tại mỗi lần chuyển tiếp giữa các giai đoạn giúp phát hiện vi phạm sớm, khi chi phí sửa chữa còn trong tầm kiểm soát. Section 1.2.2 sẽ chính thức hóa các hợp đồng này sau khi sáu giai đoạn đã được giới thiệu.
3 Chi phí sửa chữa muộn: Software Engineering Economics của Boehm (Boehm 1981) phân tích rằng các lỗi được phát hiện muộn sẽ tốn kém hơn để sửa so với những lỗi được tìm thấy ngay ở giai đoạn yêu cầu. Trong các hệ thống ML, những ràng buộc được phát hiện muộn có thể đòi hỏi phải huấn luyện lại, thay đổi pipeline dữ liệu và xác thực lại. Quy tắc nhân đôi chỉ là một kịch bản minh họa về độ nhạy, không phải một quy luật chi phí thực nghiệm.
Boehm, Barry W. 1981. Software Engineering Economics. Prentice-Hall.
Chi phí cơ hội do lặp chậm tạo ra thuế lặp lại. Một phép tính nhanh sẽ giúp hình dung rõ nút thắt cổ chai này.
Thuế lặp lại cho thấy một điều rộng hơn: Các workflow của ML không phải là phiên bản chậm của vòng đời phần mềm truyền thống. Chúng khác nhau về cấu trúc, và điều này thể hiện ở nơi thời gian được dùng, cách các vòng lặp phản hồi vận hành, và cách những phát hiện muộn có thể làm tăng phần việc phải làm lại.
ML so với phần mềm truyền thống
Các hệ thống truyền thống và hệ thống ML đều có thể dùng vòng đời lặp và thể hiện hành vi không xác định.4 Điểm khác biệt quan trọng nằm ở cách đặc tả hành vi ứng dụng. Phần mềm dựa trên quy tắc mã hóa logic tường minh, trong khi các hệ thống ML học các ánh xạ thống kê từ dữ liệu (machine learning so với phần mềm truyền thống). Điều này bổ sung thêm các mối quan tâm về dữ liệu, đánh giá và giám sát vào các thực tiễn kỹ thuật phần mềm hiện có.
4 Mô hình thác nước: Vòng đời định hướng kế hoạch thường được mô tả như một chuỗi các bước: yêu cầu, triển khai và kiểm thử. Tuy nhiên, Royce (1970) cảnh báo rằng cách thực hiện thuần tuần tự tiềm ẩn rủi ro, và ông mô tả sự lặp lại giữa các giai đoạn kế tiếp. Các hệ thống ML bổ sung phản hồi từ dữ liệu và mô hình, cần được quản lý một cách tường minh. Chương này sử dụng một mô hình độ nhạy minh họa cho các giai đoạn của vòng đời ML.
Royce, Winston W. 1970. “Managing the Development of Large Software Systems.” Proceedings of IEEE WESCON 26: 328–88.
Vì vậy, các hệ thống machine learning cần thêm cơ chế kiểm soát quy trình. Xét xử lý giao dịch tài chính: một quy tắc cấp phép mang tính xác định tuân theo logic tường minh và có thể thực thi nhanh khi đầu vào sẵn sàng. Ngược lại, một hệ thống phát hiện gian lận dựa trên machine learning bổ sung các thành phần như tính điểm đã học, truy xuất đặc trưng và logic quyết định thống kê. Giai đoạn mô hình có thể chỉ mất vài mili giây, nhưng độ trễ đầu-cuối còn phụ thuộc vào lưu trữ, mạng và các dịch vụ xung quanh. Sự chuyển dịch từ lập trình tường minh sang hành vi học được làm thay đổi vòng đời phát triển, qua đó thay đổi cách các nhóm xây dựng độ tin cậy và độ vững của hệ thống.
Những khác biệt này làm thay đổi cách các giai đoạn trong vòng đời tương tác. Kỹ thuật phần mềm truyền thống dựa vào phản hồi từ môi trường sản xuất để tinh chỉnh mã và yêu cầu, còn các hệ thống ML tạo ra các vòng lặp phản hồi, nơi dữ liệu vận hành làm thay đổi phân phối huấn luyện, việc phát hiện trôi dạt (drift) thúc đẩy điều tra, và lỗi runtime phơi bày các điểm mù trong tập dữ liệu. Table 1 so sánh kỹ thuật phần mềm truyền thống và kỹ thuật ML qua sáu khía cạnh cốt lõi của vòng đời, nhấn mạnh cách sự tiến hóa của dữ liệu định nghĩa lại kiểm thử, triển khai và bảo trì liên tục.5
5 Quản lý phiên bản dữ liệu: Không giống như code thay đổi qua các commit rời rạc, có thể kiểm chứng, dữ liệu có thể dịch chuyển dần (distribution shift), đột ngột (thay đổi schema), hoặc tinh vi (chất lượng nhãn suy giảm). Git thuần không thực tế với nhiều tập dữ liệu cỡ nhiều terabyte, nên các nhóm thường phiên bản hóa các tệp manifest hoặc con trỏ tới dữ liệu ngoài bằng các công cụ như DVC và Git LFS. Nếu không có quản lý phiên bản dữ liệu, các nhóm không thể tái lập đáng tin cậy một lần huấn luyện trước đó hoặc xác định việc giảm độ chính xác là do thay đổi code hay thay đổi dữ liệu.
| Khía cạnh | Vòng đời phần mềm truyền thống | Vòng đời machine learning |
|---|---|---|
| Định nghĩa vấn đề | Các đặc tả chức năng chính xác được định nghĩa ngay từ đầu. | Các mục tiêu dựa trên hiệu suất phát triển khi không gian vấn đề được khám phá. |
| Quy trình phát triển | Phát triển lặp đi lặp lại mã, cấu hình và giao diện. | Thử nghiệm lặp đi lặp lại với dữ liệu, đặc trưng và mô hình. |
| Kiểm thử và xác thực | Nhiều kiểm thử chức năng có kết quả mong đợi chính xác; hiệu suất và độ tin cậy vẫn mang tính định lượng. | Xác thực thống kê và các số liệu liên quan đến sự không chắc chắn. |
| Triển khai | Hành vi vẫn tĩnh cho đến khi được cập nhật rõ ràng. | Hiệu suất có thể thay đổi theo thời gian do sự dịch chuyển trong phân phối dữ liệu. |
| Bảo trì | Bảo trì liên quan đến việc sửa đổi mã để khắc phục lỗi hoặc thêm đặc trưng. | Giám sát liên tục, cập nhật các pipeline dữ liệu, huấn luyện lại mô hình và thích ứng với các phân phối dữ liệu mới. |
| Vòng lặp phản hồi | Phản hồi từ sản xuất thường thay đổi mã, cấu hình và yêu cầu. | Thông tin chi tiết từ việc triển khai và giám sát thường tinh chỉnh các giai đoạn trước đó như chuẩn bị dữ liệu và thiết kế mô hình. |
Checkpoint 1.1: ML so với phần mềm truyền thống
Các hệ thống ML không đơn thuần là phần mềm truyền thống được gắn thêm một mô hình. Hãy xem những điểm khác biệt buộc phải có một quy trình làm việc riêng biệt:
Tính cục bộ dữ liệu ở quy mô lớn
Các pipeline dữ liệu ML lớn có thể bộc lộ giới hạn của các tối ưu hóa tính cục bộ mà hệ điều hành hiện đại dùng. Kernel hệ điều hành tận dụng tính cục bộ theo không gian và thời gian,6 tức là một chương trình nếu đọc byte \(X\) thì thường sẽ sớm đọc các byte lân cận và tái sử dụng vùng nhớ vừa truy cập.
6 Tính cục bộ của tham chiếu: Denning (1968) đã chính thức hóa nguyên tắc tập làm việc (working-set principle) cho bộ nhớ ảo. Các ví dụ được sắp xếp ngẫu nhiên có thể làm giảm tính cục bộ khi thứ tự logic của chúng dẫn đến các lần đọc vật lý bị phân tán, nhưng mức độ ảnh hưởng còn phụ thuộc vào bố cục lưu trữ, batching, caching và prefetching.
Denning, Peter J. 1968. “The Working Set Model for Program Behavior.” Communications of the ACM 11 (5): 323–33. https://doi.org/10.1145/363095.363141.
Khi thứ tự các mẫu được ngẫu nhiên hóa dẫn đến các lần đọc vật lý bị phân tán, việc xáo trộn có thể làm giảm hiệu quả của bộ đệm hệ thống tệp và các bộ nạp trước (prefetcher) của bộ nhớ ảo. Mức độ ảnh hưởng phụ thuộc vào cách các ví dụ logic được ánh xạ tới lưu trữ vật lý. Các lần đọc liên tục từ các phân đoạn (shard) đã xáo trộn có thể vẫn giữ được tính cục bộ hữu ích, trong khi các lần đọc nhỏ rải rác trên nhiều phân đoạn sẽ làm lộ rõ độ trễ của lưu trữ và mạng. Batching, caching và prefetching tường minh có nhận biết bố cục có thể khôi phục tính cục bộ và giảm các điểm nghẽn này. Biến số hệ thống quan trọng ở đây là mẫu truy cập vật lý được đưa đến hệ thống phân cấp bộ nhớ, chứ không phải chỉ riêng việc ngẫu nhiên hóa.
Chính sự khác biệt này quyết định nơi cần tối ưu hóa. Nếu bộ nạp (loader) đã thực hiện các lượt đọc tuần tự lớn, bổ sung thêm cache có thể không mang lại nhiều lợi ích. Ngược lại, nếu nó phân tán các lượt đọc nhỏ, thì việc đóng gói lại các bản ghi (record) hoặc tăng kích thước lượt đọc có thể quan trọng hơn nhiều so với việc bổ sung năng lực tính toán. Do đó, khi lập hồ sơ (profiling), chúng ta nên xem xét cùng lúc kích thước yêu cầu lưu trữ, độ sâu hàng đợi, tỷ lệ truy cập cache và thời gian nhàn rỗi của bộ tăng tốc. Các tối ưu hóa về kỹ thuật dữ liệu và tối ưu hóa có nhận biết phần cứng được trình bày trong các Phần sau sẽ giúp xử lý các chi phí này. Việc chẩn đoán cần theo dõi toàn bộ đường dẫn truy cập từ lưu trữ đến bộ tăng tốc.
Self-Check: Question
Team A ships a diabetic retinopathy (DR) screening model and freezes all development once the model clears validation in the lab, treating subsequent tasks as standard server operations. Team B treats the launch as the beginning of an ongoing feedback loop, monitoring operational telemetry and data distributions to guide investigation and evidence-based model updates. Which team’s posture aligns with the ML lifecycle as defined in this chapter, and why?
- A. Team B, because the ML lifecycle is a closed loop where operational feedback, distribution drift, and real-world performance continuously reshape upstream data and model decisions.
- B. Team A, because once a model meets its offline validation thresholds, its statistical properties remain fixed and require only standard infrastructure maintenance.
- C. Team A, because changing a validated model in production introduces regulatory risk that outweighs the benefits of adapting to data drift.
- D. Team B, because the ML lifecycle mandates automatic daily retraining of production models regardless of whether input distributions have drifted.
In the chapter’s opening failure scenario, a team spends five months developing a diagnostic model that reaches 96 percent accuracy, only to have the entire project discarded on day 153. Explain the root cause of this failure from a workflow perspective and state the systems engineering rule that would have prevented it.
In the 2016 CrowdFlower data scientist survey cited in the text, respondents indicated that data-related tasks dominated their time, with 60 percent selecting ____ and organizing data as their largest time sink, compared to only 4 percent for refining algorithms.
True or False: Traditional software workflows and ML lifecycles differ fundamentally because ML system behavior can degrade through data distribution drift over time even when application source code, execution environment, and hardware configuration remain completely untouched.
A training pipeline randomly shuffles a multi-terabyte dataset across samples on every epoch, pulling records from storage backed by NVMe and spinning disks. Even though the hardware accelerator has ample peak compute capacity, training throughput stalls. Which explanation correctly identifies the systems-level bottleneck according to the chapter?
- A. Random shuffling makes the training workload strictly compute-bound, so the accelerator cores become overloaded by stochastic gradient calculations.
- B. Random sample access across multi-terabyte storage defeats operating system spatial and temporal locality, causing page cache misses and I/O latency stalls that additional compute cannot resolve.
- C. Shuffling multi-terabyte datasets bypasses the operating system page cache entirely, forcing floating-point arithmetic units to stall on instruction decoding.
- D. The memory hierarchy becomes saturated because the accelerator requires deterministic sample ordering to maintain kernel pipeline parallelism.
Các giai đoạn vòng đời
Thất bại của phòng khám nông thôn cho thấy vì sao các dự án machine learning cần một framework sáu giai đoạn cụ thể: các ràng buộc về triển khai chỉ lộ rõ sau khi các quyết định về dữ liệu, mô hình và đánh giá đã được chốt quanh một mục tiêu không phù hợp. Cả vòng đời phát triển phần mềm truyền thống lẫn vòng đời machine learning đều có tính lặp, và các hệ thống machine learning còn bổ sung phản hồi từ triển khai vào dữ liệu, huấn luyện và đánh giá. Framework sáu giai đoạn này nắm bắt vòng lặp đó.
Vòng đời machine learning hoàn chỉnh được chắt lọc thành sáu giai đoạn cốt lõi, bố trí trên hai hàng chức năng. Trong figure 3, hãy lần theo hàng trên, từ xác định bài toán đến đánh giá mô hình; và theo dõi hàng dưới, nơi triển khai đưa các tín hiệu giám sát quay lại khâu thu thập dữ liệu ở đầu nguồn.

Để cụ thể hóa các giai đoạn này, hãy xem chúng áp dụng ra sao với MobileNetV2, một mô hình thị giác cho thiết bị di động có kích thước nhỏ, nhờ đó các ràng buộc khi triển khai được bộc lộ rõ. Với MobileNetV2, giai đoạn Định nghĩa Vấn đề đặt ra các ràng buộc rất chặt: kích thước mô hình khoảng 14 MB, khoảng 600 MFLOP, và yêu cầu suy luận thời gian thực trên phần cứng cấp độ di động. Những ràng buộc này lập tức định hình các bước còn lại của quy trình. Thu thập Dữ liệu phải tính đến hạn chế tiền xử lý ngay trên thiết bị, và Phát triển Mô hình phải chọn kiến trúc có các phép toán phù hợp với ngân sách. MobileNetV2 đạt được điều đó bằng các tích chập tách sâu,7 chứ không chỉ đơn thuần giảm số tham số. Đánh giá kiểm chứng cả độ chính xác lẫn độ trễ trên thiết bị mục tiêu, Triển khai kiểm tra xem mô hình có phù hợp với bộ nhớ và giới hạn công suất của thiết bị hay không, và Giám sát theo dõi hiệu suất trên nhiều nhóm thiết bị khác nhau. Quyết định ở mỗi giai đoạn sẽ lan sang các giai đoạn tiếp theo, và framework của quy trình giúp làm rõ các phụ thuộc này. Một mô hình sàng lọc DR được tối ưu để triển khai tại phòng khám nông thôn cũng chịu các áp lực tương tự: bộ nhớ thiết bị hạn chế, ngân sách công suất nghiêm ngặt, và yêu cầu suy luận thời gian thực dù không có kết nối đáng tin cậy. Những ràng buộc chung này khiến DR trở thành một nghiên cứu tình huống xuyên suốt hiệu quả.
7 Tích chập tách sâu: Thay một tích chập tiêu chuẩn bằng phép phân tách rẻ hơn này giúp giảm khối lượng tính toán khoảng 8–9\(\times\) với các kích thước bộ lọc điển hình (Sandler et al. 2018), nhờ đó ngân sách suy luận khoảng 600 MFLOP trở nên khả thi trên phần cứng cấp độ di động. Kiến trúc mạng sẽ trình bày chi tiết cơ chế kiến trúc này.
Sandler, Mark, Andrew Howard, Menglong Zhu, Andrey Zhmoginov, and Liang-Chieh Chen. 2018. “MobileNetV2: Inverted Residuals and Linear Bottlenecks.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 4510–20. https://doi.org/10.1109/cvpr.2018.00474.
Figure 3 gợi ý một tiến trình tuyến tính, nhưng vòng lặp phản hồi cho thấy bản chất lặp lại thực sự của quá trình phát triển ML.
Checkpoint 1.2: Chu trình workflow
Các câu hỏi gợi ý theo từng giai đoạn giúp kiểm tra liệu vòng đời có thể được xem như một hệ thống liên kết chặt chẽ hay không.
Các Giai đoạn
Figure 3 mô tả vòng lặp này, nhưng ý nghĩa sâu hơn của nó mang tính định lượng: mỗi giai đoạn tương ứng với các thuật ngữ cụ thể trong phương trình hiệu suất, và sự ánh xạ này cho thấy một phiên bản của định luật sắt ở cấp độ quy trình làm việc: các quyết định trong quá trình thu thập dữ liệu sẽ giới hạn những gì có thể đạt được khi phát triển mô hình, và điều đó lại quyết định các yêu cầu khi triển khai. Sự ánh xạ theo từng giai đoạn kết nối vòng đời với định luật sắt của các hệ thống ML được định nghĩa trong Định luật sắt của hệ thống ML.
Ràng buộc chi phối khác nhau rất nhiều giữa các dạng khối lượng công việc (workload), nên mỗi giai đoạn trong vòng đời sẽ tối ưu các thuật ngữ khác nhau của định luật sắt. ResNet-50, DLRM và phát hiện từ khóa (KWS) là những điểm tựa hữu ích vì mỗi loại nhấn mạnh một phần khác nhau của hệ thống: huấn luyện thị giác với dữ liệu dày đặc cố gắng giữ cho các bộ tăng tốc luôn bận rộn, khuyến nghị với dữ liệu thưa thớt dành nhiều thời gian để di chuyển các hàng embedding, còn phát hiện từ khóa bị giới hạn trước hết bởi bộ nhớ rất nhỏ và ngân sách năng lượng luôn bật. Table 2 cho thấy ba giai đoạn quy trình làm việc được chọn biểu hiện như thế nào đối với các dạng khối lượng công việc (workload) phổ biến này.
Các hệ thống sản xuất hiếm khi khớp gọn với một nguyên mẫu duy nhất. Ví dụ, một bộ phân loại hình ảnh y tế có thể cần tính toán liên tục khi được huấn luyện trên các tập dữ liệu hình ảnh lớn, nhưng lại đối mặt với các ràng buộc nghiêm ngặt về năng lượng và bộ nhớ khi triển khai trên các thiết bị phòng khám di động. Hiểu cách cùng một framework quy trình làm việc thích ứng với từng nguyên mẫu, và cách một dự án đơn lẻ có thể đồng thời trải rộng qua nhiều nguyên mẫu, là điều thiết yếu để đưa ra các quyết định kỹ thuật đúng đắn.
| Giai đoạn | Huấn luyện thị giác ResNet-50 | Đề xuất DLRM | KWS TinyML |
|---|---|---|---|
| Kỹ thuật dữ liệu | Giữ các batch hình ảnh sẵn sàng đủ nhanh để duy trì mức sử dụng GPU cao. | Giữ các tra cứu feature-store trực tuyến trong giới hạn ngân sách độ trễ phục vụ (serving); các bảng embedding chiếm ưu thế về lưu trữ và độ tươi mới. | Tuyển chọn các đoạn âm thanh ngắn cho một thiết bị bị giới hạn SRAM. |
| Huấn luyện | Phối hợp tiền xử lý, tạo batch, độ chính xác hỗn hợp và thực thi mô hình để giảm thời gian nhàn rỗi của bộ tăng tốc. | Tối ưu hóa các tra cứu embedding thưa thớt vì băng thông bộ nhớ giới hạn thông lượng. | Tìm kiếm họ mô hình nhỏ nhất vẫn nhận diện cụm từ kích hoạt một cách đáng tin cậy. |
| Triển khai | Sử dụng các batch lớn khi thông lượng và chi phí quan trọng hơn độ trễ của một yêu cầu đơn lẻ. | Đáp ứng các mục tiêu độ trễ p99 tương tác nghiêm ngặt trong khi vẫn giữ các đặc trưng tươi mới. | Duy trì trong một ngân sách năng lượng luôn bật nghiêm ngặt. |
Mỗi giai đoạn của quy trình làm việc này đặt ra những thách thức kỹ thuật riêng, từ tuyển chọn các tập dữ liệu chất lượng cao cho đến duy trì hiệu suất của mô hình khi đưa vào vận hành. Sàng lọc DR được chọn làm nghiên cứu điển hình xuyên suốt mọi giai đoạn vì đáp ứng ba tiêu chí: bề ngoài có vẻ đơn giản nhưng trong thực tế lại rất phức tạp; bao quát đủ phổ triển khai để kiểm chứng workflow framework; và có thể ghép các nghiên cứu đã được tài liệu hóa với các kịch bản minh họa rõ ràng.
Systems Perspective 1.1: Luật sắt của quy trình làm việc
Sáu giai đoạn của vòng đời không chỉ là các bước thủ tục. Mỗi giai đoạn có thể làm thay đổi một số biến trong luật sắt của các hệ thống ML \((T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}})\), vì vậy các liên hệ dưới đây là những điểm xuất phát để chẩn đoán, không phải là sự tương ứng một-một:
- Định nghĩa vấn đề: Thiết lập các ràng buộc mục tiêu: độ chính xác, độ trễ, chi phí, quyền riêng tư và cách thức triển khai. Các mục tiêu này xác định những thành phần nào trong phương trình được phép tăng và những thành phần nào phải được giới hạn ngay từ đầu.
- Thu thập và chuẩn bị dữ liệu: Định hình thành phần của tập dữ liệu và tổng số byte \((D_{\text{vol}})\) được đưa vào các pipeline phía sau. Việc tuyển chọn cũng có thể làm thay đổi khối lượng công việc cần thiết để đạt mục tiêu chất lượng.
- Phát triển và huấn luyện mô hình: Tác động đến số lượng phép toán \((O)\), khả năng tái sử dụng dữ liệu, việc di chuyển tham số và hiệu suất phần cứng có thể đạt được \((\eta_{\text{hw}})\).
- Đánh giá và xác thực: Kiểm tra xem chất lượng mô hình và hiệu suất đầu-cuối có đáp ứng các yêu cầu triển khai trên hệ thống mục tiêu hay không.
- Triển khai và tích hợp: Xác định cơ chế phục vụ (serving), bao gồm di chuyển dữ liệu, hiệu quả thực thi và chi phí cố định \((L_{\text{lat}})\).
- Giám sát và bảo trì: Theo dõi drift, độ trễ, thông lượng và chi phí sau khi đưa vào hoạt động, rồi phản hồi các vi phạm về các giai đoạn trước để tối ưu hóa lại.
Khi nhìn các giai đoạn của vòng đời qua luật sắt, phương trình đó cho ta một góc nhìn định lượng về độ trễ và chi phí. Việc quản lý quy trình làm việc còn phải tính đến độ chính xác, an toàn, quyền riêng tư và các ràng buộc tổ chức không nằm trong biểu thức này.
Nghiên cứu điển hình: Sàng lọc DR
Các tài liệu về sàng lọc DR bao quát cả hai phía từ phòng thí nghiệm đến thực địa: Gulshan et al. (2016) trình bày nghiên cứu xác thực quy mô lớn về phát hiện DR tự động, còn Beede et al. (2020) ghi nhận những thay đổi khi một hệ thống học sâu có liên quan được sử dụng tại các phòng khám ở Thái Lan. Bài toán có vẻ đơn giản (phân loại ảnh võng mạc là khỏe hay bệnh), nhưng con đường từ thành công trong phòng thí nghiệm đến sử dụng lâm sàng lại cho thấy vòng đời hệ thống phức tạp thế nào. Gộp lại, các nguồn này cung cấp một lộ trình được ghi nhận từ thu thập và xác thực dữ liệu đến tích hợp vào quy trình làm việc và các ràng buộc về cơ sở hạ tầng.
8 Bệnh võng mạc tiểu đường (DR): DR là một biến chứng phổ biến của bệnh tiểu đường; phát hiện sớm có thể ngăn ngừa mất thị lực, nhưng mức độ tiếp cận chuyên gia khác nhau đáng kể giữa các quốc gia. Khoảng cách này thúc đẩy việc phát triển các chương trình sàng lọc có khả năng mở rộng. Ở các phòng khám có phần cứng hạn chế hoặc kết nối không ổn định, kích thước mô hình, khả năng hoạt động ngoại tuyến, độ trễ và việc tích hợp vào quy trình làm việc có thể trở thành các ràng buộc then chốt khi triển khai.
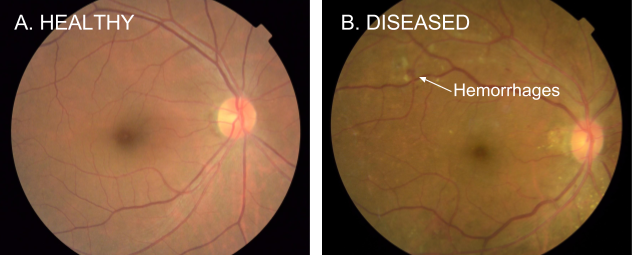
Bệnh võng mạc tiểu đường là nguyên nhân hàng đầu gây mù lòa có thể phòng ngừa được.8 Để hình dung mô hình cần học điều gì, hãy nhìn kỹ Xuất huyết võng mạc trong sàng lọc DR: thách thức lâm sàng là phát hiện các xuất huyết đặc trưng (các đốm đỏ sẫm) cho thấy bệnh đang tiến triển. Việc hạn chế tiếp cận chuyên gia ở một số khu vực thúc đẩy các chương trình sàng lọc có khả năng mở rộng, trong đó hỗ trợ từ AI có thể đóng vai trò.
::: {#fig-eye-dr fig-env=“figure” fig-pos=“htb” fig-cap=“Xuất huyết võng mạc trong sàng lọc DR: Các ảnh đáy mắt đặt cạnh nhau minh họa những đặc trưng thị giác tinh tế mà một hệ thống sàng lọc ML cần phát hiện. Việc nhận diện các tổn thương vi mạch cục bộ (như vùng xuất huyết được đánh dấu) đòi hỏi duy trì độ phân giải không gian cao trong toàn bộ pipeline thị giác và thiết lập quy trình xác thực chất lượng đầu vào nghiêm ngặt để xử lý các biến thiên về ánh sáng và camera trong các triển khai thực tế tại phòng khám. Nguồn: Google.” fig-alt=“Hai ảnh đáy mắt võng mạc đặt cạnh nhau, được gắn nhãn A. KHỎE MẠNH và B. BỊ BỆNH. Một mũi tên nhãn Hemorrhages chỉ vào một tổn thương nhỏ trên võng mạc bị bệnh.”Xuất huyết” chỉ vào một tổn thương nhỏ trong võng mạc bị bệnh.”}
:::
Nghiên cứu ban đầu đạt hiệu suất ngang chuyên gia trong môi trường kiểm soát. Tuy nhiên, khi đưa vào triển khai lâm sàng, chúng ta thấy năng lực kỹ thuật phải đi cùng việc xử lý các vấn đề về chất lượng dữ liệu, các ràng buộc hạ tầng ở phòng khám nông thôn, các yêu cầu quy định, và việc tích hợp vào quy trình làm việc.9 Với các chỉ số lặp lại trong trường hợp này, độ nhạy là tỷ lệ dương tính thật, độ đặc hiệu là tỷ lệ âm tính thật, và AUC là diện tích dưới đường cong ROC. Cùng một cơ chế lan truyền ràng buộc áp dụng dù mục tiêu là hệ thống ảnh y tế hay ứng dụng di động như MobileNetV2; các giai đoạn vòng đời phía trước sẽ diễn giải cụ thể những cơ chế này.
9 Khoảng cách triển khai AI trong chăm sóc sức khỏe: Trong ca triển khai DR tại Thái Lan do Beede et al. (2020) nghiên cứu, các phòng khám thực tế bộc lộ những hạn chế về quy trình làm việc, chất lượng hình ảnh, hạ tầng và yếu tố con người, những điều không xuất hiện trong các đánh giá có kiểm soát. Trường hợp này cho thấy vì sao chỉ dựa vào các chỉ số trong phòng thí nghiệm là chưa đủ để khẳng định mức độ sẵn sàng triển khai.
Beede, Emma, Elizabeth Baylor, Fred Hersch, Anna Iurchenko, Lauren Wilcox, Paisan Ruamviboonsuk, and Laura M. Vardoulakis. 2020. “A Human-Centered Evaluation of a Deep Learning System Deployed in Clinics for the Detection of Diabetic Retinopathy.” Proceedings of the CHI Conference on Human Factors in Computing Systems (CHI), 1–12. https://doi.org/10.1145/3313831.3376718.
Đặc tả giao diện giữa các giai đoạn
Mỗi giai đoạn trong vòng đời là một pha kỹ thuật riêng, có đầu vào, đầu ra và các bất biến chất lượng được xác định rõ. Hãy coi đó như API contracts giữa các nhóm. Một microservice dựa vào đặc tả giao diện để làm rõ các giả định tích hợp; một pipeline dữ liệu cũng vậy, dựa vào các hợp đồng về lược đồ và phân phối để phát hiện bất tương thích trước khi chúng lan truyền. Table 3 chuẩn hóa những hợp đồng này, nêu rõ mỗi giai đoạn phải nhận gì và tạo ra gì. Nhờ vậy, sơ đồ vòng đời trừu tượng (figure 3) được chuyển thành các yêu cầu kỹ thuật có thể thực thi. Khi đầu ra của một giai đoạn không đáp ứng hợp đồng, thiếu sót đó có thể lan sang các giai đoạn phụ thuộc.
| Giai đoạn | Hợp đồng đầu vào | Hợp đồng đầu ra | Bất biến chất lượng |
|---|---|---|---|
| Định nghĩa vấn đề | Yêu cầu kinh doanh; bối cảnh vận hành | Mục tiêu có thể đo lường; lựa chọn mô hình triển khai; ràng buộc tài nguyên | Tất cả các tiêu chí thành công đều có thể định lượng; mô hình triển khai mục tiêu được xác định rõ ràng |
| Thu thập & Chuẩn bị dữ liệu | Mục tiêu; mục tiêu triển khai; yêu cầu chất lượng | Tập dữ liệu có phiên bản kèm lược đồ; pipeline tiền xử lý; quy tắc xác thực dữ liệu | Phân phối gần đúng với môi trường sản xuất dự kiến; việc gán nhãn đáp ứng yêu cầu độ chính xác |
| Phát triển & Huấn luyện mô hình | Tập dữ liệu; mục tiêu độ chính xác; ràng buộc tài nguyên | Trọng số mô hình đã huấn luyện; cấu hình huấn luyện; nhật ký thử nghiệm | Đạt ngưỡng độ chính xác trong giới hạn ngân sách tính toán; kiến trúc tương thích với mục tiêu triển khai |
| Đánh giá & Xác thực | Mô hình đã huấn luyện; dữ liệu kiểm thử giữ lại; tiêu chí đánh giá | Các chỉ số hiệu suất trên các nhóm con; phân tích chế độ lỗi; chứng nhận xác thực | Không có nhóm con quan trọng nào dưới ngưỡng tối thiểu; hiệu chuẩn độ tin cậy đáp ứng yêu cầu miền |
| Triển khai & Tích hợp | Mô hình đã xác thực; yêu cầu hạ tầng; mục tiêu thỏa thuận mức dịch vụ (SLA) | Điểm cuối phục vụ (serving); công cụ giám sát; quy trình khôi phục | Độ trễ và thông lượng đáp ứng yêu cầu mô hình; các kiểm thử tích hợp vượt qua |
| Giám sát & Bảo trì | Hệ thống trực tiếp; đường cơ sở hiệu suất; ngưỡng cảnh báo | Cảnh báo phát hiện trôi dạt; tiêu chí xem xét cập nhật; báo cáo sự cố | Phạm vi cảnh báo và cửa sổ phát hiện được xác định; suy giảm được phát hiện kích hoạt xem xét |
Tài liệu đặc tả này lý giải vì sao các dự án ML trải qua các chu kỳ lặp như trong figure 3. Khi một giai đoạn sau phát hiện một hợp đồng ở giai đoạn trước bị vi phạm (ví dụ: đánh giá cho thấy phân bố dữ liệu huấn luyện không khớp với dữ liệu ở môi trường sản xuất), dự án phải quay lại để xử lý tận gốc. Nhóm nào kiểm tra các hợp đồng ở mỗi lần chuyển giao giữa các giai đoạn sẽ bắt lỗi sớm, khi chi phí sửa chữa thấp nhất. Quá trình kiểm tra này được hiểu rõ nhất là kiểm toán các bước chuyển giao giữa các giai đoạn.
Example 1.1: Kiểm toán các bước chuyển giao giữa các giai đoạn
Tình huống: Một nhóm kỹ thuật cho rằng đã hoàn thành giai đoạn Định nghĩa Vấn đề cho một hệ thống phân loại hình ảnh y tế, và muốn chuyển sang giai đoạn Thu thập Dữ liệu mà không xác định các ràng buộc cho mục tiêu triển khai.
Chẩn đoán: Hợp đồng đầu ra thiếu lựa chọn cách thức triển khai và các ràng buộc về tài nguyên (mục tiêu về độ trễ và bộ nhớ). Cố gắng triển khai muộn trong vòng đời mới lộ ra vi phạm (ví dụ: giới hạn bộ nhớ thiết bị edge < 200 MB), khiến chi phí sửa chữa tăng gấp 16× lần so với phát hiện và sửa sớm.
Bài học về hệ thống: Các bước chuyển giao giữa các giai đoạn đóng vai trò như các cổng kiểm soát chất lượng ở lớp điều khiển trong vòng đời ML. Bắt buộc kiểm tra chặt chẽ các hợp đồng đầu ra trước khi đi tiếp xuống các giai đoạn sau giúp tránh việc phải làm lại tốn kém ở phía trước và đảm bảo dữ liệu thu thập phù hợp với phần cứng mục tiêu triển khai mô hình.
Nghiên cứu điển hình về DR và Đặc tả Giao diện Giai đoạn cung cấp bối cảnh cụ thể và các hợp đồng chính thức làm nền cho từng giai đoạn của vòng đời. Giai đoạn đầu tiên, Định nghĩa Vấn đề, ghi lại các ràng buộc mà các giai đoạn sau phải đáp ứng.
Self-Check: Question
Order the following lifecycle phases in the canonical sequence established in the chapter for a new ML system project: (1) Deployment and Integration, (2) Problem Definition, (3) Monitoring and Maintenance, (4) Data Collection and Preparation, (5) Model Development and Training, (6) Evaluation and Validation.
An engineering team completes Problem Definition with clinical sensitivity targets but marks the target deployment paradigm as ‘TBD — to be determined after model training.’ According to the Stage Interface Specification, what should the transition audit verdict be, and why?
- A. Approved, because decoupling model development from hardware targets allows researchers to maximize accuracy before applying post-hoc pruning.
- B. Approved with warning, provided the team commits to using cloud inference if the model exceeds edge memory budgets.
- C. Blocked, because Problem Definition’s output contract explicitly requires deployment paradigm and resource constraints to be established before data collection and modeling begin.
- D. Blocked only if the model architecture requires distributed multi-GPU training, since single-device models can adapt to any deployment target.
The chapter discusses MobileNetV2 with its ~600 MFLOPs inference budget as a lighthouse case study for workflow thinking. Explain how establishing this mobile constraint at Problem Definition propagates across Data Collection, Model Development, and Evaluation.
Which mapping between lifecycle stages and the terms in the Iron Law of ML Systems ( = + + L_{}$) is conceptually correct according to the chapter?
- A. Problem Definition governs {}$; Evaluation governs $; Monitoring governs \(\text{BW}\).
- B. Data Collection sets {}$; Model Development sets \(\text{BW}\); Deployment sets {}$.
- C. Deployment governs \(; Model Development governs {\text{vol}}\); Data Collection governs {}$.
- D. Data Collection and Preparation shapes $ and {}$; Model Development and Training sets \(; Deployment and Integration minimizes {\text{lat}}\).
To prevent defect propagation across lifecycle boundaries, the chapter formalizes each stage boundary using a(n) ____ contract, which defines required inputs, output deliverables, and non-negotiable quality invariants.
Định nghĩa Vấn đề
Việc định nghĩa vấn đề trong ML thường bắt đầu bằng những câu nghe có vẻ rất đơn giản. Một quản lý sản phẩm viết: “Xây dựng một mô hình phát hiện bệnh võng mạc tiểu đường.” Câu ngắn gọn đó ẩn chứa hàng loạt quyết định kỹ thuật: đặt ngưỡng độ nhạy để đảm bảo an toàn cho bệnh nhân, đánh giá năng lực phần cứng ở các phòng khám nông thôn, xác định “ngân sách” độ trễ để bác sĩ vẫn duy trì tương tác, và tuân theo các khung quy định về phê duyệt. Một số yêu cầu thông thường có thể chuyển trực tiếp thành các quy tắc triển khai. Trong các hệ thống ML, việc xác định hệ thống cần làm gì gắn liền với việc xác định nó sẽ học cách làm điều đó như thế nào và các ràng buộc vật lý mà nó phải tuân theo. Giai đoạn đầu tiên này, là hộp ngoài cùng bên trái trong figure 3, đặt nền móng cho tất cả các giai đoạn tiếp theo trong vòng đời ML.
Ví dụ sàng lọc DR minh họa cụ thể điều này. Một nhiệm vụ tưởng như đơn giản là phân loại (phát hiện bệnh trong ảnh chụp võng mạc) thực ra đòi hỏi cân bằng năm ràng buộc đối nghịch: độ chính xác chẩn đoán (an toàn bệnh nhân), hiệu quả tính toán (phần cứng phòng khám nông thôn), tích hợp vào quy trình làm việc (để được chấp nhận trong lâm sàng), tuân thủ quy định (phê duyệt của FDA), và hiệu quả chi phí (triển khai bền vững trong môi trường hạn chế tài nguyên). Mỗi ràng buộc lại thu hẹp không gian thiết kế khả thi của các ràng buộc khác: theo đuổi độ chính xác cao hơn bằng cách dùng mô hình lớn hơn sẽ xung đột với ngân sách phần cứng; đáp ứng yêu cầu quy định đòi hỏi các giao thức gán nhãn, làm tăng chi phí thu thập dữ liệu. ML bổ sung hành vi thống kê đã học vào một bài toán tối ưu hóa đa ràng buộc vốn cũng xuất hiện trong các hệ thống truyền thống.
Các lớp ràng buộc
Ví dụ DR cho thấy định nghĩa vấn đề trong ML không phải là một yêu cầu đơn lẻ mà là một chồng các lớp ràng buộc tương tác. Các ràng buộc về độ chính xác (độ nhạy >90 phần trăm, độ đặc hiệu >80 phần trăm trên nhiều quần thể và thiết bị) xếp trên các ràng buộc về hạ tầng (thiết bị edge có năng lực tính toán hạn chế, kết nối không liên tục, suy luận trong khung thời gian của quy trình làm việc lâm sàng), rồi đến các ràng buộc về quy định (xác thực của FDA, audit trails, tuân thủ quyền riêng tư). Mỗi lớp lại thu hẹp không gian thiết kế khả thi của các lớp nằm phía trên.
Tuân thủ quyền riêng tư trong một hệ thống ML mang một gánh nặng vận hành riêng mà các quy tắc xử lý dữ liệu thông thường không phản ánh hết. Trong cơ sở dữ liệu truyền thống, xóa hồ sơ bệnh nhân chỉ là một câu lệnh DELETE. Còn trong hệ thống ML, các trọng số của mô hình có thể đã mã hóa các mẫu thống kê học từ hồ sơ đó; khi luật hoặc cơ quan quản lý yêu cầu loại bỏ ảnh hưởng này, tuân thủ có thể đòi hỏi machine unlearning (một lĩnh vực nghiên cứu đang phát triển với các đảm bảo còn chưa đầy đủ) hoặc huấn luyện lại trên phần dữ liệu còn lại. Nghĩa vụ và cách xử lý phụ thuộc vào quy định và hệ thống áp dụng; ở quy mô hệ thống DR, cả hai lựa chọn này đều có thể biến tuân thủ quyền riêng tư thành một khoản chi phí tính toán định kỳ và biến nguồn gốc của quá trình huấn luyện thành một ràng buộc kiến trúc.
Cấu trúc phân lớp này mở rộng vượt ra ngoài lĩnh vực chăm sóc sức khỏe. Khi xác định bất kỳ bài toán ML nào, ta cần xét ít nhất ba lớp ràng buộc: thống kê (độ chính xác cần đạt là bao nhiêu, trên những nhóm dân số phụ nào), vật lý (phần cứng nào, với ngân sách độ trễ và bộ nhớ ra sao), và vận hành (những yêu cầu về quy định, tổ chức hoặc quy trình làm việc nào áp dụng). Nguyên tắc lan truyền ràng buộc (section 1.9.1) giải thích vì sao: một ràng buộc tồn tại nhưng chưa được nêu rõ sẽ không biến mất—it có thể lộ diện về sau, khi các quyết định phụ thuộc đã bị cố định.
Các ràng buộc cụ thể của hệ thống DR không chỉ đến từ phân tích kỹ thuật thuần túy. Chúng cần có sự hợp tác bài bản giữa các kỹ sư, bác sĩ nhãn khoa và quản trị phòng khám để chuyển nhu cầu lâm sàng thành các yêu cầu kỹ thuật đo lường được. Những quyết định then chốt (cân bằng độ phức tạp của mô hình với giới hạn phần cứng, bảo đảm khả năng diễn giải cho nhà cung cấp dịch vụ chăm sóc sức khỏe, và tính đến quyền riêng tư của bệnh nhân) đều xuất phát từ quá trình liên ngành này. Thiếu chuyên môn miền, đội ngũ kỹ sư có thể tối ưu cho độ chính xác tổng thể mà bỏ qua ngưỡng độ nhạy quyết định an toàn lâm sàng.
War Story 1.1: Khi nhãn là độ chệch (bias) (2018)
Bối cảnh: Năm 2014, Amazon tập hợp một đội ngũ kỹ sư tại trung tâm Edinburgh để xây dựng một hệ thống học máy nội bộ nhằm xếp hạng các ứng viên kỹ thuật, huấn luyện nó trên mười năm hồ sơ ứng tuyển gửi đến Amazon (Dastin 2018).
Cơ chế: Vì lịch sử tuyển dụng trước đây thiên lệch về nam giới, mô hình học rằng ngôn ngữ mang dấu hiệu nam giới có tương quan với thành công trong tuyển dụng, nên đã hệ thống hóa việc trừ điểm các từ như “women’s” và hạ điểm ứng viên tốt nghiệp từ các trường cao đẳng nữ sinh.
Tác động: Mô hình đã tái tạo lại độ chệch (bias) trong tuyển dụng từ quá khứ, khiến việc sàng lọc hồ sơ tự động không còn phù hợp để đưa vào quy trình tuyển dụng thực tế.
Khắc phục: Amazon đã loại bỏ công cụ thử nghiệm này sau khi các nỗ lực nhằm xóa bỏ các tín hiệu giới tính rõ ràng vẫn không thể đảm bảo rằng mô hình sẽ không học các tín hiệu thay thế mang tính phân biệt đối xử khác.
Bài học về hệ thống: Khi định nghĩa vấn đề, cần nêu rõ các tiêu chí về công bằng, khả năng kiểm toán (auditability) và tiêu chí loại bỏ trước khi thu thập dữ liệu và huấn luyện. Một quy trình được huấn luyện trên các nhãn có độ chệch (bias) sẽ không học mục tiêu vận hành; nó chỉ học cách tái tạo các nhãn đó.
Dastin, Jeffrey. 2018. “Amazon Scraps Secret AI Recruiting Tool That Showed Bias Against Women.” Reuters.
Định nghĩa bài toán thay đổi theo thời gian
Các định nghĩa vấn đề trong ML có thể thay đổi khi hệ thống mở rộng. Giả sử một chương trình DR ban đầu chỉ hoạt động ở một vài phòng khám với cấu hình chụp ảnh đồng nhất, nhưng sau đó phát triển tới hàng trăm phòng khám với thiết bị, trình độ chuyên môn của nhân viên và nhân khẩu học của bệnh nhân khác nhau.10 Sự phát triển này có thể đòi hỏi các mục tiêu độ chính xác phân tầng, hỗ trợ phần cứng đa dạng và các yêu cầu báo cáo được điều chỉnh.
10 Dịch chuyển nhân khẩu học: Những thay đổi trong dân số có thể làm bộc lộ các lỗ hổng về hiệu suất mà việc đánh giá tổng thể thường bỏ qua. Các benchmark về phân tích khuôn mặt đã phát hiện sự chênh lệch lớn về tỷ lệ lỗi giữa các nhóm nhân khẩu học khác nhau (Buolamwini and Gebru 2018), trong khi một nghiên cứu về chấm điểm rủi ro trong chăm sóc sức khỏe phát hiện sự phân bổ mang độ chệch (bias) chủng tộc từ một nhãn đại diện, dù nhu cầu tương tự (Obermeyer et al. 2019). Những ví dụ này cho thấy lý do tại sao một chương trình DR đang phát triển cần đánh giá hiệu suất theo từng nhóm phụ, thay vì chỉ tuyên bố rằng việc triển khai như vậy đã diễn ra.
Buolamwini, Joy, and Timnit Gebru. 2018. “Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification.” Conference on Fairness, Accountability and Transparency, 77–91.
Obermeyer, Ziad, Brian Powers, Christine Vogeli, and Sendhil Mullainathan. 2019. “Dissecting Racial Bias in an Algorithm Used to Manage the Health of Populations.” Science 366 (6464): 447–53. https://doi.org/10.1126/science.aax2342.
Tiến trình này không phải dấu hiệu của việc lập kế hoạch ban đầu kém; đó là đặc tính vốn có của các hệ thống ML. Khi mở rộng quy mô, các trường hợp edge vốn không thấy ở giai đoạn thử nghiệm sẽ lộ ra, và dữ liệu vận hành bộc lộ những đặc tính phân phối mà không một tập dữ liệu huấn luyện nào nắm bắt trọn vẹn. Định nghĩa bài toán phải chấp nhận thực tế này bằng cách nêu rõ cả mục tiêu hiện tại lẫn cơ chế điều chỉnh: những chỉ số nào sẽ kích hoạt việc đánh giá lại, ai phê duyệt các ngưỡng đã điều chỉnh, và các thay đổi được truyền sang các giai đoạn phía sau như thế nào.
Self-Check: Question
Why does the statement ‘Build a computer vision model that detects diabetic retinopathy’ fail as a complete problem definition for an ML system?
- A. It specifies only a high-level task while omitting the statistical constraint layers (sensitivity/specificity floors across subgroups), physical constraints (edge device memory/latency budgets), and operational constraints (regulatory compliance, clinical workflow integration).
- B. It fails to specify which exact deep neural network backbone and learning rate schedule must be used during training.
- C. It defines an image classification problem when medical AI systems must always be framed as unsupervised anomaly detection tasks.
- D. It defines quantifiable objectives before data collection has occurred, which violates standard ML agile practices.
Explain why ophthalmologists and clinic administrators must participate directly in Problem Definition for a DR screening system, rather than being consulted only during clinical evaluation.
In the 2018 Amazon automated recruiting war story cited in the chapter, an ML model trained on ten years of resumes was abandoned because it systematically penalized female applicants. What fundamental systems lesson does this case illustrate regarding Problem Definition?
- A. Resume screening models require recurrent neural networks rather than transformer architectures to avoid learning gendered proxies.
- B. Offline evaluation metrics are inherently incapable of measuring demographic disparities in supervised learning models.
- C. A model trained on historical data learns to reproduce historical label biases rather than the intended operational goal; fairness criteria and auditability must be explicitly defined at Problem Definition.
- D. Multi-class classification algorithms should not be applied to human evaluation tasks where ground truth is subjective.
True or False: When a diabetic retinopathy screening deployment scales from a 3-clinic pilot to 200 clinics across diverse regions, the high-level clinical intent (detect referable retinopathy early) remains stable, but the specific engineering targets (subgroup sensitivity thresholds, device latency budgets, and camera-specific preprocessing rules) must evolve.
Thu thập dữ liệu
Sau khi xác định mục tiêu và xếp các ràng buộc, nhiệm vụ thực tế tiếp theo là xác định dữ liệu có thể dùng để huấn luyện mô hình đạt các mục tiêu đó. Các ràng buộc, chỉ số và mục tiêu triển khai trong bước định nghĩa vấn đề chỉ nằm trên giấy cho đến khi nhóm thu thập được dữ liệu để huấn luyện mô hình đáp ứng chúng. Sự chuyển đổi từ việc đặt mục tiêu sang thu thập dữ liệu là một ngưỡng then chốt nơi nhiều dự án thất bại. Như khảo sát trong section 1.1.1 cho thấy, người thực hành thường báo cáo các hoạt động liên quan đến dữ liệu là phần ngốn thời gian nhất. Theo “định luật sắt”, giai đoạn này chủ yếu quyết định kích thước và thành phần của tập dữ liệu \((D)\), cùng khối lượng byte \((D_{\text{vol}})\) mà các giai đoạn phía sau phải chuyển. Các ràng buộc triển khai đặt ra ở bước định nghĩa vấn đề giờ trở thành yêu cầu dữ liệu: nếu mô hình phải chạy trên thiết bị edge, pipeline dữ liệu phải tạo ra đầu vào tương thích với tiền xử lý trên edge. Nếu mô hình cần đạt độ nhạy 90% trên các nhóm dân số đa dạng, thì dữ liệu phải bao gồm đủ ví dụ từ mỗi nhóm.
Thu thập và chuẩn bị dữ liệu không chỉ là bước mở đầu mà còn thường là một hoạt động kỹ thuật lớn. Kỹ thuật dữ liệu tập trung cốt lõi vào kỹ thuật dữ liệu. Với sàng lọc bệnh võng mạc tiểu đường (DR), thách thức rất đáng kể: dữ liệu phải đủ đa dạng về mặt thống kê để huấn luyện một mô hình tổng quát tốt trên nhiều nhóm dân số, việc thu thập phải khả thi trong các phòng khám hạn chế nguồn lực, và dữ liệu phải được gán nhãn với độ nghiêm ngặt lâm sàng đủ cao để đáp ứng yêu cầu giám sát của cơ quan quản lý.
Các quyết định trong bước định nghĩa vấn đề sẽ định hình yêu cầu về dữ liệu, như trong ví dụ về bệnh võng mạc tiểu đường (DR). Các tiêu chí thành công đa chiều đã được thiết lập (bao gồm độ chính xác trên các nhóm dân số đa dạng, hiệu quả phần cứng và tuân thủ quy định) đòi hỏi một chiến lược thu thập dữ liệu vượt ra ngoài các tập dữ liệu thị giác máy tính thông thường. Không phải tất cả dữ liệu đều đóng góp như nhau vào quá trình học—Lựa chọn dữ liệu chỉ ra rằng việc chọn lọc dữ liệu có thể duy trì hiệu suất tương đương với ít tính toán hơn khi một tập dữ liệu có dư thừa, miễn là tập con được chọn vẫn giữ được bằng chứng cần thiết cho tác vụ.
Hệ thống DR cần khoảng \(10^5\) ảnh đáy mắt, mỗi ảnh được nhiều chuyên gia nhãn khoa đánh giá. Sự đồng thuận từ các chuyên gia giúp giải quyết tính chủ quan vốn có trong chẩn đoán y tế (hai bác sĩ nhãn khoa có thể không đồng ý về các trường hợp ranh giới), đồng thời thiết lập các nhãn ground truth đáng tin cậy, đủ vững trước giám sát của cơ quan quản lý. Quá trình chú thích phải ghi nhận các đặc trưng lâm sàng quan trọng như vi phình mạch, xuất huyết và xuất tiết cứng, trên toàn bộ các mức độ nghiêm trọng của bệnh.
Các ảnh quét võng mạc độ phân giải cao dạng thô có thể lên tới hàng chục megabyte mỗi ảnh trước khi nén, gây ra những thách thức lớn về hạ tầng. Một phòng khám xử lý hàng chục bệnh nhân mỗi ngày có thể tạo ra từ vài đến hàng chục gigabyte dữ liệu hình ảnh mỗi tuần. Lượng dữ liệu này có thể chiếm phần lớn băng thông đường truyền uplink bị giới hạn trong giờ làm việc của phòng khám. Do đó, xử lý cục bộ là một lựa chọn, bên cạnh các giải pháp khác như nén, batching, lập lịch hoặc tăng băng thông đường truyền.
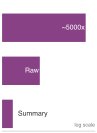
Các bản tóm tắt edge* hiệu quả hơn việc tải lên ảnh y tế thô khi băng thông là yếu tố chi phối.*
Napkin Math 1.2: Băng thông so với tính toán
Vấn đề: Một phòng khám nông thôn chụp ảnh võng mạc để sàng lọc DR. Việc tải lên dữ liệu thô sẽ chiếm bao nhiêu thời gian trong khung giờ uplink giả định của cùng ca làm việc, và có những giải pháp thay thế nào để giảm thời gian chiếm dụng đó?
Tính toán:
- Dữ liệu hàng ngày: Với 150 patients/day bệnh nhân, 10 photos/patient ảnh và 5 MB/photo mỗi ảnh, phòng khám tạo ra 7.5 GB/day dữ liệu mỗi ngày.
- Thời gian tải lên: Uplink có tốc độ 2 Mb/s, tương đương 0.25 MB/s. Chia 7,500 MB cho tốc độ này sẽ ra 30,000 s, xấp xỉ 8.3 h.
- Ràng buộc: Nếu phòng khám yêu cầu tải lên trong cùng ca làm việc, trong khung giờ hoạt động 8 h, thì riêng việc truyền này đã chiếm 104.2 percent thời gian của khung giờ đó và có thể cạnh tranh với các lưu lượng mạng khác.
Hiểu biết về hệ thống: Suy luận cục bộ với các bản tóm tắt kết quả phát hiện được tải lên (10 KB/patient) giúp giảm mức sử dụng băng thông đi 5,000× lần. Các phương án thay thế như gộp batch qua đêm, nén, lập lịch hoặc dùng đường truyền nhanh hơn không được so sánh trong phép tính này.
Khoảng cách dữ liệu giữa phòng thí nghiệm và thực địa
Dữ liệu phòng thí nghiệm và dữ liệu thực tế (sản xuất) thuộc về hai “thế giới” khác nhau. Khoảng cách từ phòng thí nghiệm đến thực địa này bộc lộ khi hệ thống sàng lọc DR được triển khai tại các phòng khám nông thôn trên khắp Thái Lan và Ấn Độ: hình ảnh đến từ nhiều loại camera khác nhau, do nhân viên với trình độ không đồng đều vận hành, thường trong điều kiện ánh sáng chưa tối ưu và tư thế bệnh nhân không nhất quán. Một mô hình được huấn luyện trên các ảnh nghiên cứu chất lượng cao từ camera chụp đáy mắt tiêu chuẩn có thể thất bại với các ảnh mờ, thiếu sáng từ thiết bị cũ hơn—không phải vì thuật toán sai, mà vì phân phối dữ liệu đã thay đổi, vượt ra ngoài phạm vi huấn luyện.
Như bài tập Bandwidth vs. Compute đã định lượng, khối lượng dữ liệu này khiến việc tải lên dữ liệu thô trong cùng ca làm việc trở nên khó theo các giả định của kịch bản. Do đó, kịch bản này đánh giá việc triển khai edge với phần cứng chuyên dụng như NVIDIA Jetson.11 Tiền xử lý cục bộ giúp giảm yêu cầu băng thông đi nhiều bậc, nhưng đồng thời đòi hỏi năng lực tính toán tại chỗ cao hơn, dẫn đến đánh đổi: dùng mô hình đơn giản hơn để chạy trên phần cứng hạn chế, hoặc dùng thiết bị edge mạnh hơn nhưng tăng chi phí cho mỗi phòng khám.
11 NVIDIA Jetson: Dòng sản phẩm Jetson của NVIDIA bao phủ nhiều SKU, từ Jetson Orin Nano (7–15 W) qua Jetson Orin NX (10–25 W) đến Jetson AGX Orin (15–60 W). Kịch bản này sử dụng một thiết bị thuộc lớp Orin Nano (LPDDR5 dùng chung 4–8 GB, mức công suất 7–15 W) làm mục tiêu edge cụ thể. Ngân sách bộ nhớ và công suất của thiết bị này giới hạn độ phức tạp của mô hình, trong khi chọn một thiết bị lớn hơn sẽ làm thay đổi cả mô hình khả thi và chi phí cho mỗi phòng khám.
Hạn chế về băng thông khiến việc thiết kế cơ sở hạ tầng trở thành một quyết định gắn với thu thập dữ liệu ngay từ đầu, chứ không phải một chi tiết triển khai muộn. Kiến trúc của kịch bản này kết hợp các thiết bị edge để suy luận và tiền xử lý cục bộ, các máy chủ tổng hợp tại phòng khám để quản lý và đệm dữ liệu, cùng cơ sở hạ tầng huấn luyện trên đám mây để cập nhật mô hình định kỳ. Mục tiêu là đạt độ trễ đầu cuối dưới 100 mili giây và vận hành mà không phát sinh độ trễ do kết nối gây ra.
Tương tự, các ràng buộc về quyền riêng tư cũng dẫn tới những quyết định kiến trúc tương ứng. Các quy định về quyền riêng tư của bệnh nhân có thể khuyến khích lưu trữ dữ liệu cục bộ hoặc áp dụng huấn luyện phân tán, nhưng nói chung chúng quy định các biện pháp bảo vệ và mục đích sử dụng được phép hơn là áp đặt một kiến trúc huấn luyện duy nhất. Các quy trình giữ dữ liệu thô của phòng khám ở tại chỗ và chỉ chia sẻ các bản cập nhật hoặc tóm tắt đã được phê duyệt sẽ làm tăng độ phức tạp cho cả hạ tầng thu thập dữ liệu và hạ tầng huấn luyện mô hình.
Cơ sở hạ tầng dữ liệu phân tán
Khi một triển khai mở rộng từ vài phòng khám lên đến hàng trăm, cơ sở hạ tầng dữ liệu cũng phải mở rộng tương ứng. Mỗi ảnh võng mạc đi qua nhiều giai đoạn: camera tại phòng khám chụp ảnh, hệ thống cục bộ lưu trữ và xử lý ban đầu, các bước kiểm tra chất lượng để đảm bảo khả dụng, truyền dữ liệu an toàn tới các hệ thống trung tâm, và cuối cùng là tích hợp vào các tập dữ liệu huấn luyện để hoàn tất pipeline. Các quyết định hạ tầng ở mỗi giai đoạn đều được định hình bởi các ràng buộc triển khai đã được xác lập trong giai đoạn định nghĩa vấn đề.
Các tầng lưu trữ là một điểm nữa nơi pipeline dữ liệu có thể giữ vững hoặc làm hao hụt nhịp độ lặp ở các bước sau. Vì các kiểu truy cập dữ liệu khác nhau cần các giải pháp lưu trữ khác nhau, các nhóm thường triển khai kiến trúc lưu trữ phân tầng,12 trong đó mỗi tầng được hiệu chỉnh theo tần suất truy cập và yêu cầu hiệu năng.
12 Lưu trữ phân tầng: Đặt dữ liệu trên các phương tiện lưu trữ khác nhau dựa trên tần suất truy cập và yêu cầu hiệu năng. Trong ví dụ này, chênh lệch giá lưu trữ xấp xỉ 4.3×: SSD NVMe (Non-Volatile Memory Express) cung cấp 500.000+ thao tác nhập/xuất mỗi giây (IOPS) với chi phí ~$0.10/GB/month, trong khi lưu trữ đối tượng có giá ~$0.023/GB/month nhưng độ trễ 100–200 ms. Với các vòng lặp huấn luyện ML cần đọc tuần tự bền bỉ ở 1–10 GB/s, chọn sai tầng sẽ biến một pipeline huấn luyện vốn bị giới hạn bởi tính toán thành một pipeline bị giới hạn bởi I/O, trực tiếp làm tăng thành phần dữ liệu \((D_{\text{vol}}/\text{BW})\) của định luật sắt.
Lưu trữ nóng dùng SSD NVMe có thông lượng cao cho dữ liệu đang được dùng trong các vòng lặp huấn luyện. Lưu trữ ấm dùng lưu trữ đối tượng tương thích S3 cho các tập dữ liệu gần đây và các tập xác thực đang hoạt động. Lưu trữ lạnh dùng các hệ thống lưu trữ chi phí thấp, như AWS Glacier, cho dữ liệu lịch sử cần cho kiểm toán theo quy định nhưng hiếm khi được truy cập.
Trong thực tế, ranh giới giữa các tầng là linh hoạt: một tập dữ liệu chuyển từ ấm sang nóng khi được chọn cho lần chạy huấn luyện tiếp theo, và từ nóng sang lạnh khi mô hình được huấn luyện từ tập đó bị thay thế. Các chính sách vòng đời tự động quản lý các chuyển đổi này, nâng cấp dữ liệu dựa trên lịch trình huấn luyện và hạ cấp dựa trên độ gần đây của truy cập—một mô hình mà Kỹ thuật dữ liệu sẽ khám phá chi tiết.
Các phòng khám nông thôn khi triển khai thường gặp hạn chế kết nối nghiêm trọng, buộc phải chọn chiến lược truyền tải phù hợp. Phòng khám có băng thông rộng ổn định có thể truyền ảnh gần thời gian thực để xử lý tập trung. Ngược lại, những nơi chỉ có liên kết vệ tinh chập chờn — phổ biến ở vùng sâu vùng xa của Ấn Độ và châu Phi cận Sahara — cần kiến trúc lưu trữ và chuyển tiếp, trong đó ảnh được gom theo batch trong các khoảng có kết nối và đối chiếu kết quả một cách không đồng bộ. Lựa chọn này ảnh hưởng đến toàn bộ stack: các phòng khám dùng kiến trúc lưu trữ và chuyển tiếp cần bộ đệm lưu trữ cục bộ lớn hơn, năng lực suy luận cục bộ mạnh hơn, và logic giải quyết xung đột khi dự đoán tạo tại chỗ khác với phân tích trên đám mây về sau.
Khả năng mở rộng của hạ tầng là bài toán khó hơn so với chỉ tăng dung lượng thô. Khi hệ thống đi từ vài phòng khám thí điểm lên hàng trăm điểm vận hành, độ không đồng nhất của dữ liệu tăng cùng với khối lượng: mẫu máy ảnh, môi trường ánh sáng và thói quen vận hành ở mỗi phòng khám có thể tạo ra một phân bố ảnh khác nhau. Hạ tầng phải vừa xử lý thông lượng tăng dần, vừa theo dõi nguồn gốc dữ liệu. Siêu dữ liệu về nguồn gốc này rất quan trọng để gỡ lỗi các suy giảm độ chính xác tại những địa điểm cụ thể và để đáp ứng yêu cầu về dấu vết kiểm toán trong xác thực theo quy định. Việc mở rộng từ các phòng khám ban đầu ra mạng lưới rộng hơn vì thế làm nảy sinh độ phức tạp mới: đa dạng về thiết bị, quy trình làm việc, điều kiện vận hành, và kích thước ảnh khi các phòng khám mới bổ sung thiết bị độ phân giải cao hơn. Mỗi phòng khám trở thành một nguồn dữ liệu riêng biệt,13 nhưng hệ thống vẫn phải đánh giá hiệu suất trên toàn mạng lưới.
13 Dữ liệu phòng khám phân tán: Huấn luyện trên nhiều cơ sở phòng khám mà không đơn thuần gộp tất cả dữ liệu thô giúp đáp ứng các ràng buộc về quyền riêng tư và quản trị, nhưng chi phí lại chuyển sang khâu điều phối. Mỗi cơ sở có thể dùng loại camera khác nhau, phục vụ nhóm bệnh nhân khác nhau và vận hành theo quy trình khác nhau, nên hệ thống phải theo dõi nguồn gốc dữ liệu và đặc thù của từng nơi. Vì vậy, chi phí quy trình không chỉ là dung lượng lưu trữ; còn là khối lượng công việc kỹ thuật để so sánh, xác thực và cập nhật mô hình giữa các cơ sở có dữ liệu không đồng nhất.
Phản ứng về mặt quy trình là xây dựng hạ tầng điều phối. Các kho tạo phẩm dùng chung, API được phiên bản hóa và các pipeline kiểm thử tự động giúp thấy rõ khác biệt theo từng phòng khám trước khi chúng trở thành lỗi mô hình. Chính sự không đồng nhất đó khiến việc xác thực tại điểm thu thập là cần thiết: mạng lưới phòng khám càng lớn và đa dạng, việc phát hiện lỗi chất lượng vài tuần sau trong một lần chạy huấn luyện tập trung càng kém hữu ích.
Đảm bảo chất lượng và xác thực
Một ảnh võng mạc mờ nếu lọt qua khâu kiểm tra chất lượng thì không chỉ tốn chỗ lưu trữ. Nếu những ảnh như vậy đi vào huấn luyện với nhãn không đáng tin cậy hoặc xuất hiện thường xuyên trong môi trường vận hành, chúng có thể làm sai lệch cơ sở mà mô hình dựa vào và tăng rủi ro sai lỗi. Đảm bảo chất lượng giúp dữ liệu đáp ứng các yêu cầu mà các bước phía sau phụ thuộc. Trong ví dụ về DR của chúng ta, các kiểm tra tự động ngay tại điểm thu thập sẽ gắn cờ các vấn đề như lấy nét kém hoặc khung hình sai, cho phép nhân viên phòng khám chụp lại ảnh ngay lập tức thay vì vài tuần sau, đến khi huấn luyện mô hình mới phát hiện ra.
Xác thực không chỉ dừng ở chất lượng hình ảnh mà còn kiểm tra nhãn có đúng không, dữ liệu có được gắn với đúng bệnh nhân không và có tuân thủ quyền riêng tư không. Xác thực cục bộ phát hiện vấn đề ngay tại thời điểm thu thập; còn xác thực tập trung phát hiện những bất thường về phân phối trên toàn bộ mạng lưới phòng khám—chẳng hạn, gắn cờ khi ảnh từ một cơ sở nào đó nghiêng về một dải nhân khẩu học hẹp, có thể gây ra độ chệch (bias) cho tập huấn luyện.
Các quyết định về thu thập dữ liệu ảnh hưởng trực tiếp đến phát triển mô hình: giới hạn băng thông quyết định những kiến trúc nào khả thi, yêu cầu về quyền riêng tư định hình các pipeline huấn luyện, và chênh lệch chất lượng giữa các môi trường phòng khám quyết định yêu cầu về tính vững của mô hình. Figure 4 minh họa cụ thể các luồng phản hồi này. Hãy theo dõi từng mũi tên được gắn nhãn: đánh giá cho thấy mô hình DR hoạt động kém trên ảnh từ các máy ảnh đáy mắt đời cũ, từ đó kích hoạt việc thu thập dữ liệu có mục tiêu từ các phòng khám đang dùng thiết bị đó. Xác thực trên các quần thể bệnh nhân đa dạng cho thấy độ nhạy thấp hơn với bệnh nhân bị đục thủy tinh thể, dẫn đến các chiến lược tăng cường dữ liệu mô phỏng độ mờ của thủy tinh thể. Giám sát phát hiện hiện tượng trôi độ chính xác (accuracy drift) ở các phòng khám đã nâng cấp thiết bị hình ảnh, và phản hồi này được dùng để cập nhật các bước tiền xử lý.

Những luồng phản hồi này củng cố một điểm quan trọng: việc thu thập dữ liệu không kết thúc khi quá trình huấn luyện bắt đầu. Chất lượng, khối lượng và sự đa dạng của dữ liệu luân chuyển qua các pipeline này giờ đây trở thành nguyên liệu thô cho giai đoạn tiếp theo—biến các tập dữ liệu đã được chọn lọc thành các mô hình đã được huấn luyện.
Self-Check: Question
A rural clinic captures 150 patients per day for DR screening, with 10 retinal photos per patient at 5 MB per photo. The clinic operates on an 8-hour daily shift with a 2 Mbps uplink. According to the chapter’s Bandwidth vs. Compute analysis, what operational bottleneck arises, and how does edge inference resolve it?
- A. Daily raw image upload requires ~2.5 hours, which fits comfortably within the 8-hour window without needing edge processing.
- B. Daily raw image upload generates 7.5 GB of data requiring ~8.3 hours to transfer—saturating the entire 8-hour clinic shift—whereas edge inference uploading 10 KB detection summaries reduces network traffic by roughly 5,000\(\times\).
- C. Daily raw image upload generates 75 GB of data, which exceeds daily satellite uplink capacity by a factor of 100\(\times\) regardless of compression.
- D. Raw uploads complete in 45 minutes, but cloud GPU queuing delay adds 12 hours of fixed inference latency.
Explain why a DR screening model achieving an AUC of 0.99 on a curated laboratory research dataset can experience a severe drop in sensitivity (e.g., falling to 78 percent) when deployed to rural clinics across Thailand and India.
In tiered storage architectures for ML pipelines, placing active training data in cold or warm object storage (e.g., S3 Standard with 100–200 ms latency) instead of local high-throughput NVMe SSDs directly degrades training performance by affecting which term in the Iron Law of ML Systems?
- A. It increases the Operations ($) term by forcing the model to compute extra gradient updates.
- B. It decreases peak hardware performance ({}$) by downclocking GPU compute cores.
- C. It decreases hardware utilization efficiency (\(\eta_{\text{hw}}\)) solely through floating-point precision mismatches.
- D. It inflates the data movement time (\(\frac{D_{\text{vol}}}{\text{BW}}\)), converting a compute-bound training pipeline into an I/O-bound stall where accelerators sit idle waiting for data batches.
True or False: In large-scale medical data collection, if collected images pass basic file format and schema validation, image-quality defects (such as blur, low contrast, or partial occlusion) can be safely ignored because deep neural networks naturally learn to filter out bad samples when trained on sufficiently large datasets.
In rural clinics with intermittent connectivity, an architecture that buffers captured images locally and reconciles inference results asynchronously with the central cloud during available network windows is known as a(n) ____ architecture.
Phát triển mô hình
Nhóm DR có 128.000 ảnh võng mạc đã được gán nhãn, một pipeline tiền xử lý đã được xác thực và một mục tiêu: đạt độ nhạy trên 90% trên phần cứng edge với độ trễ suy luận dưới 50 ms. Câu hỏi không còn là thu thập dữ liệu gì mà là xây dựng mô hình nào—và câu hỏi đó không thể tách rời các ràng buộc triển khai đã xác lập. Theo “iron law”, giai đoạn này xác định thành phần Operations \((O)\): các lựa chọn kiến trúc đặt ra mức tối thiểu về tính toán mà phần cứng phải đáp ứng. Thách thức không chỉ dừng ở việc chọn thuật toán và tinh chỉnh siêu tham số.14 Huấn luyện mô hình sẽ trình bày chi tiết các phương pháp huấn luyện, yêu cầu hạ tầng và chiến lược huấn luyện phân tán. Trong các lĩnh vực có rủi ro cao như chăm sóc sức khỏe, mọi quyết định thiết kế đều ảnh hưởng đến kết quả lâm sàng, nên cần tích hợp hiệu suất kỹ thuật và các ràng buộc vận hành ngay từ đầu.
14 Siêu tham số: Các lựa chọn về kiến trúc và optimizer (ví dụ: tốc độ học và độ sâu mạng) ảnh hưởng đến khối lượng tính toán trong quá trình huấn luyện. Một lưới tổ hợp kiểu Cartesian, khi huấn luyện độc lập mọi tổ hợp, sẽ phát sinh chi phí tìm kiếm theo kiểu nhân bội: 5 hyperparameters với 4 values mỗi tham số tạo ra 1,024 (\(4^{5}\)) cấu hình. Dừng sớm, các phương pháp đa độ trung thực và tìm kiếm thích ứng có thể tránh phải hoàn tất mọi lượt chạy, vì thế lưới chỉ là một đường cơ sở chứ không phải chi phí bắt buộc.
15 Học chuyển giao: Đối với cùng một kiến trúc, học chuyển giao thay đổi cách khởi tạo và tối ưu hóa các tham số, chứ không phải các phép toán cần thiết trong quá trình suy luận.
Russakovsky, Olga, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, et al. 2015. “ImageNet Large Scale Visual Recognition Challenge.” International Journal of Computer Vision 115 (3): 211–52. https://doi.org/10.1007/s11263-015-0816-y.
Yosinski, Jason, Jeff Clune, Yoshua Bengio, and Hod Lipson. 2014. “How Transferable Are Features in Deep Neural Networks?” Advances in Neural Information Processing Systems 27.
Hệ thống DR đối mặt với một thách thức huấn luyện rõ rệt: đạt độ chính xác chẩn đoán ở mức chuyên gia với dữ liệu có nhãn và ngân sách tối ưu hóa đều hữu hạn. Học chuyển giao15 giải quyết ràng buộc này bằng cách điều chỉnh một mô hình đã được huấn luyện trước (pretrained) trên tác vụ nguồn để áp dụng cho tác vụ đích. Tập huấn luyện của thử thách ImageNet Large Scale Visual Recognition Challenge (ILSVRC) 2012 chứa 1.3 million ảnh có nhãn (Russakovsky et al. 2015). Tái sử dụng các biểu diễn đã học có thể giúp tối ưu hóa và tổng quát hóa cho tác vụ đích tốt hơn so với khởi tạo ngẫu nhiên; mức lợi ích phụ thuộc vào độ tương đồng giữa tác vụ nguồn và đích, những lớp nào được chuyển, và các hiệu ứng tối ưu hóa liên quan đến học chuyển giao (Yosinski et al. 2014).
Trong nghiên cứu kiểm chứng có kiểm soát do Gulshan et al. (2016) báo cáo, học chuyển giao cùng một tập dữ liệu có nhãn gồm 128.000 hình ảnh đạt AUC16 0.99, với độ nhạy 97.5% và độ đặc hiệu 93.4% tại một điểm vận hành. Kết quả này cho thấy tiềm năng của tiền huấn luyện quy mô lớn kết hợp tinh chỉnh (fine-tuning) theo miền trong các điều kiện nghiên cứu; bản thân nó không xác lập được hiệu suất khi triển khai. Chiến lược huấn luyện dùng gradient lỗi để điều chỉnh các trọng số của mô hình; Tính toán nơ-ron trình bày cơ chế này trước khi Huấn luyện mô hình phát triển các hệ thống huấn luyện xoay quanh cơ chế đó.
Gulshan, Varun, Lily Peng, Marc Coram, Martin C. Stumpe, Derek Wu, Arunachalam Narayanaswamy, Subhashini Venugopalan, et al. 2016. “Development and Validation of a Deep Learning Algorithm for Detection of Diabetic Retinopathy in Retinal Fundus Photographs.” JAMA 316 (22): 2402. https://doi.org/10.1001/jama.2016.17216.
16 AUC (diện tích dưới đường cong ROC): Đo diện tích dưới đường cong đặc trưng hoạt động của bộ nhận (ROC) biểu diễn tỷ lệ dương tính thật (true positive rate) so với tỷ lệ dương tính giả (false positive rate) trên tất cả các ngưỡng phân loại, có giá trị từ 0 đến 1. Giá trị 0.5 cho thấy khả năng phân biệt ngẫu nhiên, và các giá trị dưới 0.5 vẫn có thể xảy ra. Không giống như độ chính xác, AUC không phụ thuộc ngưỡng và ít nhạy với tỷ lệ phổ biến của lớp (class prevalence), nên là một chỉ số phổ biến trong các hệ thống sàng lọc y tế. Hệ quả ở cấp hệ thống: một mô hình có AUC 0.99 vẫn có thể cho độ nhạy không chấp nhận được tại ngưỡng vận hành cụ thể được chọn để triển khai; vì vậy, chỉ số AUC thôi không đủ để xác nhận đã sẵn sàng triển khai.
Đạt độ chính xác cao mới chỉ là thách thức đầu tiên. Các ràng buộc khi triển khai trên edge áp đặt yêu cầu hiệu quả nghiêm ngặt: mô hình có thể phải gói gọn trong vài chục đến vài trăm megabyte, hoàn tất suy luận trong vài chục mili giây, và vận hành trong ngân sách bộ nhớ hạn hẹp.
Từ góc độ quy trình làm việc, mọi cải thiện về độ chính xác luôn cần cân nhắc cùng tính khả thi khi triển khai. Học tập tổ hợp17 là ví dụ điển hình cho sự đánh đổi này: kết hợp dự đoán từ nhiều mô hình thường cho hiệu suất tốt hơn bất kỳ mô hình đơn lẻ nào, nhưng làm tăng khối lượng suy luận và mức sử dụng bộ nhớ. Bagging huấn luyện nhiều mô hình trên các tập con dữ liệu khác nhau; boosting huấn luyện tuần tự để sửa lỗi của các mô hình trước; còn stacking sử dụng một siêu mô hình (meta-model) để kết hợp dự đoán từ các mô hình cơ sở. Các phương pháp này tạo đa dạng theo những cách khác nhau, nhưng mỗi mô hình thành phần đều thêm công việc phục vụ (serving) và phải nằm trong ngân sách triển khai. Giải thưởng Netflix cho thấy độ phức tạp của tổ hợp có thể cản trở triển khai sản xuất như thế nào.18
17 Học tổ hợp: Kết hợp các dự đoán từ nhiều mô hình (bagging, boosting, stacking). Chi phí tính toán cho suy luận và dung lượng lưu trữ mô hình thường cộng dồn theo các thành phần. Thực thi tuần tự có thể làm tăng độ trễ, trong khi thực thi song song có thể giảm độ trễ nhưng phải đánh đổi bằng thêm phần cứng và điều phối. Không có hệ số nhân độ trễ cố định nào tỉ lệ trực tiếp với kích thước của tổ hợp.
18 Khoảng cách giữa cuộc thi và sản xuất: Người chiến thắng Giải thưởng Netflix đã sử dụng một tổ hợp phức tạp, nhưng Netflix đã không triển khai phương pháp chiến thắng vì mức tăng độ chính xác không đủ để bù chi phí kỹ thuật cần bỏ ra (Johnston 2012).
Johnston, Casey. 2012. “Netflix Never Used Its $1 Million Algorithm Due to Engineering Costs.” Ars Technica, April.
Các mô hình nghiên cứu ban đầu thường rất lớn (đôi khi lên đến vài gigabyte khi dùng các mô hình tổ hợp). Điều này vi phạm các ràng buộc khi triển khai, nên cần tối ưu hóa có hệ thống để đạt dạng phù hợp để triển khai mà vẫn giữ được giá trị lâm sàng. Những ràng buộc này thúc đẩy việc nén mô hình và tối ưu hóa có hệ thống, thay vì chỉ điều chỉnh độ chính xác đơn lẻ. Các kỹ thuật nén mô hình ở giai đoạn sau giúp giảm chi phí tính toán và mức sử dụng bộ nhớ, nhưng mỗi lần giảm đều phải được xác thực lại dựa trên độ chính xác lâm sàng. Nén mô hình sẽ trình bày chi tiết các kỹ thuật này. Quá trình phát triển đòi hỏi lặp lại liên tục giữa tối ưu hóa độ chính xác và tối ưu hóa hiệu quả: dung lượng mô hình, các lựa chọn tiền xử lý và chi phí thực thi đều đồng thời tác động lên cả hai khía cạnh.
Các tạo phẩm hệ thống có thể tái tạo
Việc cân bằng giữa độ chính xác và hiệu quả tạo ra nhiều hơn chỉ mỗi trọng số đã huấn luyện. Một lỗi thường gặp là chỉ xem các trọng số của mô hình đã huấn luyện là đầu ra duy nhất của giai đoạn này. Trong một quy trình ML trưởng thành, sản phẩm bàn giao là một tạo phẩm hệ thống có thể tái tạo với bốn thành phần:
- Trọng số mô hình: Các tham số đã học.
- Mã suy luận: Mã chính xác dùng để chạy mô hình, bao gồm cả logic tiền xử lý.
- Đặc tả môi trường: Đồ thị phụ thuộc đầy đủ (ví dụ: container Docker,
requirements.txt, trình điều khiển CUDA) cần thiết để thực thi mã. - Cấu hình: Các siêu tham số và cài đặt runtime.
Nếu không đóng gói môi trường cùng với mô hình, các sai khác về phụ thuộc có thể dẫn đến sự cố nguy hiểm. Một số bất tương thích, như các tổ hợp CUDA không được hỗ trợ hoặc thiếu thư viện, sẽ báo lỗi rõ ràng và ngay lập tức. Các khác biệt khác ở kernel, thư viện đại số tuyến tính, hoặc các quy trình thay đổi kích thước ảnh như OpenCV và PIL, dù “tương thích”, vẫn có thể làm thay đổi kết quả số dấu phẩy động hoặc nội suy pixel mà không làm sập tiến trình phục vụ (serving). Những thay đổi này có thể làm lệch đầu ra của mô hình và ảnh hưởng đến độ chính xác. Vì vậy, khả năng tái tạo môi trường là cần thiết không chỉ để chạy thành công mà còn để xác thực hành vi suy luận tương đương. Một mô hình đạt độ chính xác 99 phần trăm trong giai đoạn phát triển phải được đánh giá lại nếu môi trường sản xuất thay đổi, ngay cả khi quá trình suy luận hoàn tất mà không có ngoại lệ.
Độ chính xác và hiệu quả
Các ứng dụng y tế đòi hỏi những chỉ số hiệu suất cụ thể19 khác với các đầu ra và hàm mất mát phân loại tiêu chuẩn mà Tính toán nơ-ron giới thiệu. Một hệ thống DR cần có độ nhạy cao (để hạn chế bỏ sót bệnh cần chuyển tuyến) và độ đặc hiệu cao (để tránh làm quá tải hệ thống chuyển tuyến). Các chỉ số này phải được duy trì trên các quần thể bệnh nhân đa dạng và trong các điều kiện chất lượng hình ảnh khác nhau.
19 Các chỉ số hiệu suất AI y tế: Đánh giá AI y tế nhấn mạnh độ nhạy (tỷ lệ dương tính thật) và độ đặc hiệu (tỷ lệ âm tính thật) cùng với độ chính xác tổng thể. Kịch bản DR này đặt mục tiêu độ nhạy >90 phần trăm vì bỏ sót bệnh cần chuyển tuyến có thể làm chậm chăm sóc và góp phần gây mất thị lực có thể tránh được; các tiêu chí chấp nhận thực tế phụ thuộc vào sản phẩm và cơ quan quản lý. Cạm bẫy hệ thống tinh vi hơn là giá trị dự đoán dương tính (PPV): ngay cả một mô hình có độ chính xác cao cũng có thể có PPV thấp trong quần thể có tỷ lệ mắc bệnh thấp. Sự phụ thuộc vào tỷ lệ mắc bệnh này có thể yêu cầu các ngưỡng vận hành khác nhau giữa các địa điểm triển khai, một ràng buộc vô hình trong đánh giá ML tiêu chuẩn.
20 Pipeline nén mô hình: Để thu hẹp khoảng cách giữa độ chính xác trong nghiên cứu và việc triển khai trên edge, chúng ta cần một quy trình lặp đi lặp lại gồm các bước “nén-kiểm định-điều chỉnh”. Mỗi bước nén có thể giúp giảm kích thước mô hình hoặc chi phí thực thi, nhưng cũng có thể âm thầm làm giảm độ nhạy xuống dưới ngưỡng lâm sàng. Việc tìm một mô hình vừa vặn với bộ nhớ thiết bị mà vẫn giữ được độ nhạy lâm sàng thường cần nhiều vòng lặp, vì chỉ có bộ kiểm định đầy đủ mới cho biết liệu mô hình nhỏ hơn có còn đáp ứng định nghĩa bài toán hay không.
Tối ưu hóa riêng hiệu suất lâm sàng là chưa đủ. Trong kịch bản này, tệp mô hình phải nhỏ hơn 500 MB để có thể vừa vặn thoải mái trong bộ nhớ hệ thống dùng chung 4–8 GB của thiết bị edge, đồng thời thiết bị vận hành trong mức công suất dưới 20 watt và đáp ứng ngân sách độ trễ lâm sàng. Việc cải thiện ở một khía cạnh thường phải đánh đổi với các khía cạnh khác: thành phần Operations \((O)\), dấu chân byte của mô hình (góp phần vào \(D_{\text{vol}}\)), và chi phí phục vụ (serving) cố định \((L_{\text{lat}})\) có thể kéo theo các hướng khác nhau. Kiến trúc mạng xem xét năng lực mô hình, trong khi Hệ thống ML thảo luận về tính khả thi của việc triển khai, và sự căng thẳng cố hữu giữa chúng định hình các quyết định kiến trúc. Việc nén và tái kiểm định có hệ thống20 có thể thu hẹp khoảng cách, đáp ứng các yêu cầu triển khai đồng thời vẫn hướng tới việc duy trì giá trị lâm sàng.
Sự đánh đổi khi sử dụng tập hợp mô hình minh họa một quy luật chung hơn: chọn một tập hợp các mô hình nhẹ thay vì một mô hình lớn duy nhất sẽ giảm độ phức tạp của từng mô hình (giúp triển khai trên edge) nhưng lại tăng độ phức tạp của pipeline (đòi hỏi logic điều phối và giám sát nhiều mô hình). Mỗi quyết định kiến trúc đều tạo ra những hiệu ứng lan truyền như vậy.
Phát triển dựa trên ràng buộc
Các ràng buộc thực tế định hình việc phát triển mô hình từ giai đoạn khám phá ban đầu đến tối ưu hóa cuối cùng, nên cần thử nghiệm một cách có hệ thống. Quá trình phát triển bắt đầu khi các nhà khoa học dữ liệu phối hợp với chuyên gia lĩnh vực (ví dụ: bác sĩ nhãn khoa trong trường hợp DR) để xác định các tổn thương tinh vi và các yêu cầu về chất lượng ảnh có ý nghĩa lâm sàng. Thiếu hiểu biết miền, một kiến trúc sư mô hình có thể chọn độ phân giải hoặc trường tiếp nhận (vùng đầu vào mà mỗi đặc trưng nội bộ có thể “nhìn thấy”) làm mất chi tiết quan trọng trước khi mạng kịp sử dụng. Cách tiếp cận liên ngành này giúp các kiến trúc mô hình giữ lại bằng chứng có ý nghĩa lâm sàng, đồng thời tuân theo các ràng buộc tính toán đã được xác định trong quá trình thu thập dữ liệu.
Các ràng buộc về tính toán ảnh hưởng sâu sắc đến cách tiếp cận thử nghiệm. Nhiều biến thể mô hình, quét siêu tham số và các phương pháp tiền xử lý khác nhau có thể khiến thử nghiệm toàn diện trở nên tốn kém. Thực tế này thúc đẩy đầu tư vào lập lịch tác vụ tốt hơn, dùng bộ nhớ đệm cho kết quả trung gian, dừng sớm và tối ưu hóa tài nguyên tự động. Tối ưu hóa siêu tham số có hệ thống và thiết kế thí nghiệm có kỷ luật có thể giảm nhu cầu tính toán so với tìm kiếm toàn diện.
Tính không chắc chắn vốn có của các kết quả ML đòi hỏi phương pháp luận khoa học: kiểm soát biến bằng cách cố định seed ngẫu nhiên và phiên bản môi trường; thực hiện các nghiên cứu loại bỏ21 một cách có hệ thống để tách đóng góp của từng thành phần; phân tích các yếu tố gây nhiễu để tách ảnh hưởng của kiến trúc khỏi ảnh hưởng của tối ưu hóa; và kiểm định ý nghĩa thống kê trên nhiều lần huấn luyện bằng các phép thử ngoại tuyến theo cặp, thay vì kiểm thử A/B22 vốn dành cho việc so sánh mô hình trên lưu lượng sản xuất trực tiếp. Thiếu sự chặt chẽ này, các nhóm không thể phân biệt được cải thiện hiệu suất thực sự với nhiễu thống kê—một phân biệt trở nên then chốt khi chỉ 0.5% chênh lệch độ chính xác cũng quyết định liệu mô hình có đạt ngưỡng nhạy cảm lâm sàng hay không.
21 Nghiên cứu loại bỏ: Tên gọi xuất phát từ thao tác loại bỏ mô trong phẫu thuật. Các nghiên cứu này vô hiệu hóa có hệ thống từng thành phần để cô lập và đo lường đóng góp của chúng vào hiệu suất. Tính chặt chẽ là rất quan trọng, vì chỉ 0.5% chênh lệch độ chính xác cũng có thể quyết định liệu mô hình DR có đạt ngưỡng nhạy cảm lâm sàng hay không. Nếu không có nghiên cứu loại bỏ, nhóm sẽ không phân biệt được đâu là cải tiến kiến trúc thực sự và đâu là nhiễu do seed ngẫu nhiên khác, dẫn đến lãng phí các vòng lặp vào những “cải thiện” ảo.
22 Kiểm thử A/B trong ML: So sánh một mô hình mới (B) với mô hình chuẩn đang chạy sản xuất (A) bằng cách phân bổ ngẫu nhiên lưu lượng thực tế, nhằm ước tính hiệu ứng nhân quả của mô hình. Kích thước mẫu cần thiết phụ thuộc vào tỷ lệ sự kiện cơ sở, kích thước hiệu ứng, phương sai, phân bổ, mức ý nghĩa và công suất thống kê; không có một số lượng tương tác hay thời lượng thử nghiệm mang tính phổ quát chỉ từ riêng một thay đổi 0.5 điểm phần trăm.
Tại mỗi cột mốc phát triển, các nhóm đối chiếu mô hình với các ràng buộc triển khai đã xác định ở những giai đoạn trước của vòng đời. Mỗi đổi mới kiến trúc phải được đánh giá cả về mức cải thiện độ chính xác lẫn khả năng tương thích với giới hạn của thiết bị edge và yêu cầu của quy trình làm việc lâm sàng. Cách tiếp cận xác thực kép này giúp các nỗ lực phát triển bám sát mục tiêu triển khai, thay vì tối ưu cho điều kiện phòng thí nghiệm không phản ánh hiệu suất ngoài thực tế.
Từ nguyên mẫu đến sản xuất
Một nhóm ba nhà khoa học dữ liệu có thể quản lý thử nghiệm bằng bảng tính và sổ ghi chép dùng chung, còn một nhóm 30 người nhiều khả năng cần hạ tầng quy trình làm việc dùng chung. Khi dự án tiến từ nguyên mẫu sang sản xuất, độ phức tạp tăng đồng thời trên nhiều chiều: tập dữ liệu lớn hơn, mô hình tinh vi hơn, thử nghiệm song song nhiều hơn và hạ tầng huấn luyện phân tán. Ở quy mô sản xuất, phối hợp không chính thức có thể trở thành nút thắt cổ chai khi các nhóm phải chia sẻ các phần chia dữ liệu, giải quyết xung đột thử nghiệm và đối chiếu phiên bản sổ ghi chép. Động lực của việc Tự động hóa Quy trình làm việc (minh họa) minh họa một sự tương phản giả định giữa phối hợp thủ công và nền tảng quy trình làm việc dùng chung. Các trục là các đơn vị tương đối để thể hiện hình dạng, không phải thông lượng tuyệt đối.
::: {#fig-mlops-returns fig-env=“figure” fig-pos=“htb” fig-cap=“Động lực của việc Tự động hóa Quy trình làm việc (minh họa): Các đường cong mở rộng quy mô mang tính khái niệm cho thấy sự khác biệt về tốc độ thử nghiệm giữa quy trình thủ công và nền tảng quy trình dùng chung khi quy mô nhóm tăng. Các script ad hoc thiếu cấu trúc cuối cùng sẽ phải chịu “chi phí phối hợp” do xung đột khi gộp (merge) và các tạo phẩm không có phiên bản, trong khi nền tảng dùng chung có thể giảm công việc trùng lặp nhờ các thành phần tái sử dụng và theo dõi nguồn gốc tự động. Các đường cong này minh họa các giả định, không phải các quy luật mở rộng dựa trên thực nghiệm.”chi phí phối hợp” do xung đột khi hợp nhất mã và các tạo phẩm không được quản lý phiên bản. Trong khi đó, các nền tảng dùng chung có thể giảm bớt công việc trùng lặp nhờ các thành phần có thể tái sử dụng và khả năng theo dõi nguồn gốc tự động. Các đường cong này chỉ minh họa các giả định chứ không phải là các quy luật mở rộng quy mô thực nghiệm.”chi phí phối hợp” từ các xung đột hợp nhất và các tạo phẩm không được lập phiên bản, trong khi các nền tảng dùng chung có thể giảm công việc trùng lặp thông qua các thành phần có thể tái sử dụng và theo dõi nguồn gốc tự động. Các đường cong minh họa các giả định hơn là các quy luật mở rộng quy mô thực nghiệm.” fig-alt=“Biểu đồ đường minh họa so sánh tốc độ thử nghiệm giả định với quy mô nhóm. Đường cong quy trình làm việc thủ công cuối cùng giảm xuống, trong khi đường cong nền tảng dùng chung tiếp tục tăng lên.”}
:::
Các đường cong trong Động lực của việc Tự động hóa Quy trình làm việc (minh họa) thể hiện các hàm giả định, chứ không phải là các quy luật mở rộng quy mô nhóm đã được đo lường cụ thể. Đường cong quy trình làm việc thủ công cho thấy chi phí phối hợp phát sinh từ việc chia sẻ các tập chia dữ liệu, giải quyết xung đột thử nghiệm và đối chiếu các phiên bản notebook. Đường cong nền tảng thể hiện những lợi ích từ các thành phần tiền xử lý có thể tái sử dụng, khả năng theo dõi thử nghiệm có phiên bản và việc lập lịch tự động. Thông lượng thực tế không nhất thiết phải đạt đến mức bão hòa hoặc tăng trưởng siêu tuyến tính; nó phụ thuộc vào mức độ song song hóa của khối lượng công việc (workload), chi phí vận hành nền tảng, cấu trúc nhóm và chất lượng thử nghiệm. Động lực của việc Tự động hóa Quy trình làm việc (minh họa) do đó minh họa vì sao cơ sở hạ tầng dùng chung có thể giảm công việc trùng lặp và các thao tác chuyển giao thủ công, nhưng không dự đoán một mức lợi ích chung cho mọi nhóm.
Khả năng tái tạo và nợ kỹ thuật
Cơ sở hạ tầng dùng chung có thể đẩy nhanh quá trình thử nghiệm—nhưng việc lặp nhanh tạo ra một gánh nặng tiềm ẩn. Nếu các thử nghiệm không thể tái tạo, nhóm sẽ không thể phân biệt một cách đáng tin cậy đâu là cải tiến thực sự và đâu là nhiễu, và mã nguồn sẽ tích lũy nợ kỹ thuật23 ngày càng trầm trọng với mỗi kết quả không thể tái tạo.
23 Sự phụ thuộc lẫn nhau của tạo phẩm ML: Các tạo phẩm ML phụ thuộc chặt chẽ vào nhau. Độ chính xác đo được của một mô hình gắn với phiên bản dữ liệu, pipeline tiền xử lý và cấu hình siêu tham số dùng để tạo ra nó. Nếu không theo dõi nguồn gốc, nhóm có thể không xác định được liệu sự suy giảm hiệu năng xuất phát từ mã nguồn, dữ liệu hay biến thiên giữa các lần chạy, buộc phải chạy lại tốn kém các thử nghiệm đã mất dấu nguồn gốc.
Để tái tạo kết quả ML, chúng ta cần theo dõi các phiên bản dữ liệu, seed ngẫu nhiên, cấu hình phần cứng và phiên bản thư viện, cùng với logic chương trình. Vì phần cứng và các thao tác phi xác định có thể làm thay đổi kết quả huấn luyện, nên các nhóm cần theo dõi nguồn gốc để phân biệt các thay đổi về kiến trúc với biến động giữa các lần chạy. Việc theo dõi thử nghiệm một cách có hệ thống sẽ ghi lại mã định danh duy nhất cho mỗi lần chạy và các phiên bản tạo phẩm. Các hệ thống như MLflow và Weights & Biases liên kết các phiên bản dữ liệu, các commit mã nguồn, các siêu tham số và các mô hình thu được, giúp các nhóm tái tạo và tái dựng sự khác biệt giữa các lần chạy.
Việc bỏ qua khả năng tái tạo gây thiệt hại về kinh tế, không chỉ là vấn đề khoa học. Các nhóm không thể tái tạo một kết quả sẽ lãng phí công sức chạy lại các thử nghiệm mà có thể không hội tụ về cùng một kết quả. Hạ tầng hỗ trợ khả năng tái tạo, như môi trường được quản lý phiên bản, các pipeline được kiểm soát và checkpoint tự động, giúp giảm tính toán trùng lặp và hỗ trợ đưa ra các quyết định kiến trúc tự tin hơn.
Các mô hình có khả năng tái tạo và đã được tối ưu hóa là cần thiết, nhưng chưa đủ. Một mô hình đạt độ chính xác cấp chuyên gia trên dữ liệu nghiên cứu được chọn lọc vẫn có thể thất bại khi vận hành thực tế. Ở giai đoạn tiếp theo, các tạo phẩm đã huấn luyện này sẽ được kiểm thử có hệ thống đối chiếu với những điều kiện chúng thực sự sẽ gặp.
Self-Check: Question
According to the chapter, which bundle of deliverables constitutes a complete, reproducible system artifact from the Model Development and Training stage, and why are model weights alone insufficient?
- A. Model weights, inference/preprocessing code, environment specification (e.g., container or locked dependency graph), and runtime configuration; weights alone fail because library version mismatches or preprocessing differences alter outputs without crashing.
- B. Model weights and a serialized training log; the execution environment can always be inferred from the framework version tag.
- C. Model weights, a test-set evaluation scorecard, and an architecture diagram; deployment engineers reconstruct dependencies during serving containerization.
- D. Source code repository commits and hyperparameters; weights can be deterministically reproduced from random seeds on any hardware.
Explain why a competition-winning 50-model ensemble that achieves state-of-the-art accuracy on a benchmark may be discarded for production edge deployment, citing the Netflix Prize as an empirical reference.
In the chapter’s Iteration Tax scenario, a team compares Model L (large ensemble, starts at 95% accuracy, 1-week training cycle, +0.15% gain/iter) with Model S (lightweight model, starts at 90% accuracy, 1-hour training cycle, +0.1% gain/iter, 100 effective iters) over a 26-week window with a 99% ceiling. What is the modeled outcome after 26 weeks, and what systems lesson does it demonstrate?
- A. Model L reaches 99.0% while Model S reaches 92.6%, proving that starting accuracy dominates iteration speed over six months.
- B. Model S reaches the 99.0% ceiling while Model L reaches 98.9%, demonstrating that shorter training cycles permit more iterative experiments that can overcome a lower starting accuracy.
- C. Both models reach exactly 95.0% accuracy because human hypothesis generation saturates at 26 experiments regardless of training speed.
- D. Model L fails to converge due to training instability, while Model S converges to 90.0% without improvement.
A team observes that model validation accuracy drops 2 percent between run 47 and run 48. Explain how an automated experiment tracking lineage record resolves this regression compared to an ad hoc notebook workflow.
Arrange the following model development milestones in the logical order prescribed for a constraint-driven ML workflow: (1) Baseline transfer-learning fine-tuning from pretrained weights, (2) Physical constraint profiling (target latency, memory ceiling, power envelope), (3) Systematic ablation studies to isolate component contributions, (4) Model compression (pruning/quantization) and hardware-in-the-loop latency validation, (5) Packaging weights, preprocessing code, dependencies, and configuration into a reproducible system artifact.
Đánh giá và Xác thực
Trong kịch bản minh họa này, mô hình của nhóm DR đạt AUC 0.99 trên tập dữ liệu nghiên cứu đã được chọn lọc. Sau đó, họ thử nghiệm mô hình này trên hình ảnh từ một phòng khám nông thôn ở Chiang Mai, nơi một kỹ thuật viên chỉ với hai tuần huấn luyện đang vận hành một máy ảnh đáy mắt đã năm tuổi. Kết quả là độ nhạy giảm xuống còn 78 phần trăm. Mã không hề bị lỗi hay báo ngoại lệ; đơn giản là mô hình chưa từng thấy những hình ảnh mờ, thiếu sáng hoặc khung hình không nhất quán như vậy. Thành công trong phòng thí nghiệm không đảm bảo giá trị khi đưa vào sản xuất, và khoảng cách giữa hai môi trường này là nơi nhiều dự án ML thất bại. Trước khi triển khai, các mô hình đã huấn luyện phải trải qua đánh giá và xác thực nghiêm ngặt để xác nhận chúng đáp ứng yêu cầu hiệu suất trong nhiều điều kiện khác nhau của môi trường sản xuất. Giai đoạn này là cầu nối giữa phát triển mô hình và triển khai, biến các tạo phẩm thử nghiệm thành hệ thống sẵn sàng sản xuất thông qua kiểm thử có hệ thống dựa trên các chỉ số định trước, các trường hợp edge và các kịch bản thế giới thực.
Xác thực sản xuất là một cổng kiểm: nếu độ nhạy khi vận hành thực tế thấp hơn mức tối thiểu yêu cầu thì sẽ không được triển khai.
Definition 1.2: Xác thực mô hình
Xác thực mô hình là một cổng kiểm dựa trên bằng chứng để quyết định liệu một mô hình đã huấn luyện có phù hợp để triển khai cho một mục đích sử dụng cụ thể hay không. Nó kiểm tra mô hình theo các ràng buộc khi triển khai như mục tiêu về độ trễ, mục tiêu hiệu suất cho các nhóm nhỏ, ngân sách chi phí và độ bền vững khi phân phối thay đổi, nhưng không thể chứng nhận an toàn trong mọi điều kiện có thể xảy ra.
- Ý nghĩa: Việc xác thực bổ sung những chiều đo mà độ chính xác trên tập kiểm tra thường bỏ qua. Một mô hình đạt độ chính xác 95% trên một tập kiểm tra tĩnh vẫn có thể không đạt mục tiêu độ trễ 100 ms trên các yêu cầu chậm nhất, kém hơn ngưỡng yêu cầu cho các nhóm nhỏ (ví dụ chênh lệch hiệu suất tối đa năm điểm phần trăm giữa các nhóm nhân khẩu học), hoặc mất hơn mười điểm phần trăm độ chính xác khi gặp các vấn đề chất lượng hình ảnh phổ biến như mờ và chói. Mỗi chiều đo không được kiểm soát là một rủi ro triển khai có thể âm thầm tích tụ trong môi trường sản xuất.
- Điểm khác biệt: Đánh giá đo lường hành vi của mô hình dựa trên các tập dữ liệu, số liệu và thử nghiệm đã chọn, có thể bao gồm cả các thử nghiệm với dữ liệu ngoài phân phối hoặc trên các nhóm con. Còn xác thực thì tổng hợp các bằng chứng rộng hơn cần cho một quyết định triển khai cụ thể, bao gồm độ trễ hệ thống, thông lượng, độ bền vững, mức độ sẵn sàng vận hành và chi phí.
- Sai lầm phổ biến: Nhiều người nhầm rằng xác thực chỉ là “thêm một bài kiểm tra”. Thực ra, đó là một cổng kiểm đa chiều: một mô hình có thể vượt qua bài kiểm tra độ chính xác nhưng vẫn trượt xác thực vì vi phạm các ràng buộc về độ trễ, độ tin cậy theo nhóm con, hoặc chi phí — những thứ độ chính xác đơn thuần không đo được.
Đánh giá và xác thực trả lời những câu hỏi khác nhau. Đánh giá mô tả hành vi của mô hình với các tập dữ liệu, chỉ số và thử nghiệm đã chọn. Xác thực xem liệu các bằng chứng tích lũy về mô hình và hệ thống có đủ để hỗ trợ một mục đích sử dụng cụ thể trong một môi trường cụ thể hay không, bao gồm các trường hợp edge, dịch chuyển phân phối, ràng buộc vận hành và điều kiện đầu vào bất thường. Hai quy trình này cùng nhau tạo nên cơ sở bằng chứng cần thiết cho các quyết định triển khai, đồng thời nhấn mạnh rằng xác thực là một hoạt động quản lý rủi ro.
Chỉ số và ngưỡng đánh giá
Đánh giá hiệu quả bắt đầu từ các chỉ số phù hợp với mục tiêu của bài toán. Với hệ thống sàng lọc bệnh võng mạc tiểu đường (DR) của chúng ta, các chỉ số phân loại tiêu chuẩn như độ chính xác thường là chưa đủ. Ví dụ, các yêu cầu minh họa đặt độ nhạy trên 90% để hạn chế bỏ sót các ca cần chuyển tuyến, và độ đặc hiệu trên 80% để tránh làm quá tải hệ thống chuyển tuyến bởi dương tính giả. Các ngưỡng cụ thể sẽ phụ thuộc vào mục đích sử dụng, nhóm dân số mục tiêu và bằng chứng theo quy định.
Ngoài các chỉ số tổng hợp, đánh giá phân tầng cho thấy sự khác biệt hiệu suất giữa các nhóm bệnh nhân. Một mô hình có thể đạt độ chính xác tổng thể 94% nhưng lại giảm xuống dưới 80% đối với bệnh nhân có các bệnh lý đi kèm cụ thể, ở những nhóm tuổi nhất định, hoặc với ảnh chụp trong một số điều kiện ánh sáng nhất định. Những khác biệt này, vốn không lộ rõ qua các chỉ số tổng hợp, lại rất quan trọng khi đưa vào vận hành thực tế, vì mọi bệnh nhân đều xứng đáng nhận được dự đoán đáng tin cậy. Benchmarking sẽ trình bày có hệ thống các phương pháp đánh giá này.
Đánh giá cũng cần xem xét hiệu chuẩn:24 liệu mức tin cậy dự đoán 80% có thực sự tương ứng với 80% trường hợp đúng quan sát được hay không. Mô hình hiệu chuẩn kém sẽ làm giảm niềm tin lâm sàng ngay cả khi chỉ số độ chính xác có vẻ cao. Các bác sĩ lâm sàng dựa vào điểm tin cậy để ra quyết định phân loại ưu tiên cần những điểm số đó phản ánh đúng mức độ bất định thực tế.
24 Hiệu chuẩn: Một mô hình được hiệu chuẩn tốt có xác suất dự đoán khớp với tần suất quan sát thực tế: độ tin cậy 80% thì tương ứng đúng khoảng 80% số lần. Hiệu chuẩn khác với độ chính xác, và hệ quả đối với hệ thống DR là rất nghiêm trọng: bác sĩ lâm sàng dùng điểm tin cậy để đưa ra quyết định phân loại ưu tiên (triage). Vì vậy, một mô hình bị sai hiệu chuẩn, gán độ tin cậy 90% cho các ca không chắc chắn, có thể làm chệch quy trình công việc lâm sàng, nguy hiểm hơn cả một mô hình kém chính xác hơn nhưng được hiệu chuẩn tốt. Platt scaling và temperature scaling có thể cải thiện hiệu chuẩn sau huấn luyện, nhưng hiệu quả của chúng phải được đánh giá trên dữ liệu đại diện.
Đánh giá ngoại tuyến và trực tuyến
Quy trình xác thực bắt đầu ở môi trường ngoại tuyến, rồi dần tiến gần hơn tới môi trường sản xuất. Đánh giá ngoại tuyến trên các tập kiểm tra được giữ riêng giúp xác lập hiệu suất cơ bản, nhưng không thể bảo đảm hành vi của mô hình trong sản xuất. Đánh giá trực tuyến triển khai các mô hình trong điều kiện sản xuất có kiểm soát thông qua triển khai theo giai đoạn:25 chế độ shadow chạy mô hình nhưng không phục vụ (serving) các dự đoán của nó; triển khai canary chỉ cho một phần nhỏ lưu lượng truy cập; và thử nghiệm A/B dùng phân bổ ngẫu nhiên để so sánh kết quả với một chuẩn cơ sở. Lưu lượng cần thiết cho mỗi phương pháp phụ thuộc vào hiệu ứng mong đợi và mức bằng chứng muốn đạt. Ý nghĩa của triển khai theo giai đoạn ở đây khác với mẫu nén đa tầng gọi là triển khai lũy tiến trong Hệ thống ML; tại đây trọng tâm là rủi ro trong xác thực, không phải tạo ra các biến thể mô hình nhỏ hơn.
25 Triển khai theo giai đoạn: Chế độ shadow chạy mô hình mới song song, ghi lại các dự đoán nhưng không phục vụ (serving) chúng. Triển khai canary (được đặt tên theo chim hoàng yến trong mỏ than) sau đó cho mô hình mới xử lý một phần lưu lượng truy cập nhỏ, có thể cấu hình, và tăng dần nếu các chỉ số giữ vững. Mức độ bao phủ phụ thuộc vào lưu lượng, khả năng quan sát, thời lượng, và các kiểu lỗi được kiểm tra; vì vậy, triển khai theo giai đoạn giúp giảm rủi ro nhưng không đảm bảo phát hiện một tỷ lệ cố định các vấn đề trong môi trường sản xuất. Vận hành machine learning trình bày chi tiết các chiến lược triển khai này.
Mỗi giai đoạn xác thực bổ sung các bằng chứng khác nhau và có phần chồng lấp, như table 4 tóm tắt.
| Giai đoạn xác thực | Bằng chứng điển hình nó bổ sung |
|---|---|
| Đánh giá ngoại tuyến | Hành vi thuật toán |
| Chế độ bóng (Shadow mode) | Hành vi tích hợp |
| Triển khai Canary | Hành vi với lưu lượng hạn chế |
| Kiểm thử A/B | Kết quả so sánh |
Các nhóm nên lập kế hoạch cho quy trình xác thực theo giai đoạn này ngay từ đầu, vì việc bổ sung triển khai theo giai đoạn vào một hệ thống đã triển khai thường khó hơn nhiều so với thiết kế nó ngay trong kiến trúc triển khai ban đầu.
Xác thực điều kiện sản xuất
Sau khi đánh giá theo giai đoạn thiết lập hành vi cơ bản, xác thực điều kiện sản xuất kiểm tra xem mô hình có vận hành ổn định trong môi trường cụ thể đã được nêu khi định nghĩa vấn đề hay không. Quá trình này phát hiện các kiểu lỗi mà đánh giá tiêu chuẩn không nhận ra được, và ba bước kiểm tra của nó mở rộng dần phạm vi: từ các địa điểm nơi mô hình được triển khai, đến các đầu vào riêng lẻ mà mô hình thấy trong quá trình suy luận, rồi đến sự thay đổi dần dần của môi trường mà mô hình hoạt động.
Xác thực bên ngoài và đa địa điểm giải quyết câu hỏi ở cấp độ địa điểm: liệu mô hình đã học được các mẫu có thể tổng quát hóa, hay đã quá khớp với các đặc điểm riêng của nguồn phát triển. Ví dụ, một mô hình DR được huấn luyện chủ yếu trên ảnh từ các máy ảnh nghiên cứu chất lượng cao phải thể hiện hiệu suất mạnh mẽ trên ảnh từ các thiết bị đa dạng được triển khai trên mạng lưới phòng khám. Các tập dữ liệu xác thực nên bao gồm ảnh từ nhiều hãng thiết bị, các điều kiện ánh sáng và mức độ kỹ năng của người vận hành, sao cho đại diện cho các ngữ cảnh triển khai thực tế.
Ngay cả trong một cơ sở đã được thẩm định, các đầu vào cụ thể vẫn khác nhau. Vì vậy, kiểm thử độ vững (robustness testing) thu hẹp phạm vi về từng suy luận, cho mô hình đối mặt với các nhiễu và tình huống hiếm gặp mang tính thực tế. Với hệ thống xử lý ảnh, việc này gồm kiểm thử ở nhiều mức độ sáng, độ tương phản, chất lượng lấy nét và các trường hợp bị che khuất một phần. Trong ví dụ DR của chúng ta, các nhóm nhận ra rằng những mô hình tối ưu cho ảnh chất lượng nghiên cứu có thể thất bại với ảnh do kỹ thuật viên ít được đào tạo chụp, nên cần các pipeline tiền xử lý để chuẩn hóa chất lượng ảnh trước khi suy luận.
Một mô hình vượt qua các kiểm tra hôm nay vẫn có thể thất bại vào năm sau. Vì thế, xác thực theo thời gian (temporal validation) mở rộng tầm nhìn, đánh giá liệu mô hình có duy trì hiệu suất theo thời gian hay không. Phân phối dữ liệu thay đổi khi quần thể bệnh nhân biến động, thiết bị xuống cấp và thực hành lâm sàng tiến hóa. Các mô hình chỉ xác thực trên dữ liệu lịch sử có thể bất ngờ suy giảm khi triển khai. Điều này gồm sự trôi dạt dữ liệu (data drift) và trôi dạt đồng biến (covariate drift) khi phân phối đầu vào đổi khác, và trôi dạt khái niệm khi mối quan hệ giữa đầu vào và nhãn thay đổi; cả hai đều thúc đẩy nhu cầu giám sát liên tục như đã bàn trong section 1.8.
Xác thực theo quy định
Các hệ thống AI trong chăm sóc sức khỏe phải đáp ứng các yêu cầu xác thực cụ thể theo từng thiết bị và lộ trình quy định tương ứng. Khi cần FDA xem xét trước khi đưa ra thị trường, bằng chứng về an toàn và hiệu suất phải phù hợp với thiết bị và lộ trình đó; dữ liệu lâm sàng được yêu cầu cho một số hồ sơ, nhưng không phải tất cả.26
26 Quy định AI/ML của FDA: Để được FDA cấp phép tiếp thị, cần có bằng chứng phù hợp với thiết bị, mục đích sử dụng, rủi ro và lộ trình quy định. Kế hoạch hành động AI/ML SaMD năm 2021 của FDA xác định quản lý vòng đời, giám sát hiệu suất trong môi trường thực tế và lập kế hoạch kiểm soát thay đổi định trước là các vấn đề trọng tâm đối với phần mềm thiết bị y tế thích ứng (U.S. Food and Drug Administration 2021). Những mối quan tâm này khiến phiên bản mô hình, nguồn gốc quá trình huấn luyện, hoạt động giám sát và tài liệu về thay đổi trở thành các thành phần quan trọng của quy trình làm việc, mà không áp đặt một tài liệu kiểm toán giống hệt nhau ở mọi giai đoạn vòng đời.
U.S. Food and Drug Administration. 2021. Artificial Intelligence/Machine Learning (AI/ML)-Based Software as a Medical Device (SaMD) Action Plan. U.S. Department of Health; Human Services.
Xác thực đặc thù theo từng lĩnh vực không chỉ dừng ở tuân thủ quy định mà còn phải đáp ứng yêu cầu của các bên liên quan. Trong ví dụ về bệnh võng mạc tiểu đường (DR), các nghiên cứu xác thực lâm sàng triển khai hệ thống song song với các chuyên gia chấm điểm, rồi so sánh dự đoán của hệ thống với nhãn chuẩn (ground truth) do hội đồng bác sĩ nhãn khoa đồng thuận xác lập. Các nghiên cứu này cần chứng minh độ chính xác tương đương và các kiểu lỗi ở mức chấp nhận được: những hệ thống thất bại an toàn (chuyển các ca không chắc chắn cho chuyên gia) được tin cậy về mặt lâm sàng hơn những hệ thống thất bại âm thầm.
Xác thực yếu tố con người đánh giá cách bác sĩ lâm sàng tương tác với các dự đoán của hệ thống và liệu toàn bộ quy trình làm việc có đạt mục tiêu hay không. Một mô hình chính xác về mặt kỹ thuật nhưng không được bác sĩ lâm sàng tin tưởng hoặc bị dùng sai cách sẽ không mang lại giá trị lâm sàng. Các nghiên cứu xác thực cần đo lường kết quả của toàn bộ quy trình (như mức độ tự tin của bác sĩ lâm sàng, tính phù hợp của việc chuyển tuyến, và sự hài lòng của bệnh nhân), song song với các chỉ số hiệu suất của mô hình.
Sẵn sàng triển khai
Xác thực thành công tạo ra gói bằng chứng phục vụ quyết định triển khai: tài liệu về hiệu suất trên các chỉ số và các nhóm liên quan, mô tả các kiểu lỗi và tần suất của chúng, các pipeline tiền xử lý và suy luận đã được xác thực, cùng bằng chứng tuân thủ quy định khi được yêu cầu. Giai đoạn chuyển từ xác thực sang triển khai là một điểm quyết định: các nhóm đánh giá liệu bằng chứng tích lũy đã đủ để phát hành vào môi trường sản xuất hay chưa. Quyết định này cần cân bằng giữa các chỉ số hiệu suất kỹ thuật, mức độ sẵn sàng vận hành, tình trạng tuân thủ quy định, và năng lực tổ chức trong giám sát, bảo trì. Xác thực chưa đầy đủ sẽ tạo ra rủi ro triển khai và những rủi ro này sẽ chồng chất trong suốt vòng đời hệ thống.
Những thất bại trong giai đoạn xác thực thúc đẩy việc chỉnh sửa kiến trúc mô hình, bổ sung dữ liệu huấn luyện và cải tiến các pipeline tiền xử lý. Ngược lại, những thành công trong xác thực thiết lập các mức hiệu suất cơ bản (baseline) và ngưỡng giám sát, làm cơ sở định hướng vận hành sản xuất. Khi bằng chứng về mô hình đã vượt qua bước kiểm này, việc triển khai vẫn còn phụ thuộc vào mức độ sẵn sàng của hệ thống: các đường dẫn tiền xử lý và phục vụ (serving) đã được xác thực, khả năng quan sát (observability), quy trình quay lui (rollback), trách nhiệm vận hành, và mọi phê duyệt theo quy định cần có. Trọng tâm lúc này không còn là hiệu suất trong phòng thí nghiệm, mà là liệu hệ thống hoàn chỉnh có thể vận hành ổn định, đáng tin cậy trong môi trường mục tiêu hay không.
Self-Check: Question
What is the primary conceptual distinction between Model Evaluation and Model Validation as defined in this chapter?
- A. Evaluation is conducted by internal software engineers, whereas validation is conducted exclusively by government regulatory agencies.
- B. Evaluation tests software execution speed on accelerators, whereas validation tests algorithm mathematical convergence on CPUs.
- C. Evaluation measures model behavior on chosen datasets and metrics; validation is a multi-dimensional evidence gate confirming the model satisfies all operational, latency, subgroup fairness, robustness, and cost constraints under production-representative conditions.
- D. Evaluation is performed on live production traffic, whereas validation is performed exclusively on synthetic offline data.
A diabetic retinopathy screening model achieves 94 percent aggregate accuracy on held-out validation data. However, stratified evaluation reveals that sensitivity drops to 76 percent for patients with cataracts and falls below the 90 percent sensitivity floor for one demographic subpopulation. How should the engineering team respond?
- A. Proceed to full deployment immediately, because aggregate accuracy above 90 percent statistically compensates for minor subpopulation variations.
- B. Apply post-hoc temperature scaling to increase overall prediction confidence, which automatically resolves subgroup sensitivity deficits.
- C. Deploy the model in shadow mode permanently, since shadow mode bypasses clinical subgroup safety requirements.
- D. Block deployment, because the model violates non-negotiable clinical sensitivity safety thresholds for vulnerable subgroups; stratified validation exists precisely to prevent aggregate metrics from masking localized clinical harm.
Explain why a medical diagnostic model with an outstanding Area Under the ROC Curve (AUC) of 0.99 on a research dataset may still fail deployment validation for clinical screening.
Order the stages of progressive online validation from lowest initial user risk to broadest comparative evaluation: (1) Canary deployment exposing 1–5% of live traffic, (2) Offline evaluation on held-out and stratified test sets, (3) A/B testing comparing outcomes against the production baseline, (4) Shadow mode running in parallel on live requests without serving predictions to users.
True or False: Model calibration—ensuring that a predicted confidence score of 0.80 corresponds to an empirical 80 percent probability of correctness—is critical for medical AI systems because clinical triage workflows rely directly on confidence scores to route ambiguous cases to human specialists.
Triển khai và Tích hợp
Một mô hình dù vượt qua mọi kiểm thử xác thực trong phòng thí nghiệm vẫn phải đối mặt với kỳ thi khó nhất khi bước ra thế giới thực. Hãy xem xét kịch bản DR: một mô hình đã được xác thực nay phải chạy trên máy tính bảng ở các phòng khám nông thôn với kết nối chập chờn, tích hợp với những hệ thống thông tin bệnh viện mà nó chưa từng được kiểm thử, và tạo ra kết quả đủ tin cậy để bác sĩ lâm sàng dựa vào đó hành động. Với các giả định về độ trễ và kết nối trong kịch bản này, việc khứ hồi lên đám mây là không khả thi. Giai đoạn triển khai là lúc các ràng buộc trừu tượng từ phần định nghĩa bài toán trở thành các yêu cầu kỹ thuật cụ thể. Theo quy luật sắt, đường dẫn phục vụ (serving path) đồng thời quyết định cách dữ liệu di chuyển, hiệu quả thực thi và chi phí cố định; yếu tố nào trở thành nút thắt sẽ khác nhau theo từng loại hình. Các khối lượng công việc (workload) về thị giác lớp ResNet-50 có thể dùng batching để tăng thông lượng; các khối lượng công việc (workload) gợi ý kiểu DLRM nhấn mạnh độ trễ tương tác và truy cập embedding; còn các khối lượng công việc (workload) âm thanh thuộc lớp TinyML phải hoạt động dưới ngân sách năng lượng rất hạn chế (table 2). Vận hành machine learning trình bày chi tiết các khía cạnh vận hành của triển khai và bảo trì.
Yêu cầu triển khai
Các yêu cầu triển khai xuất phát từ đặc tả kỹ thuật của mô hình và các ràng buộc vận hành của môi trường dự kiến. Trong ví dụ DR của chúng ta, mô hình phải chạy ở các phòng khám nông thôn với tài nguyên tính toán hạn chế và kết nối internet chập chờn, đồng thời các kiểm tra chất lượng tự động sẽ đánh dấu ảnh kém chất lượng để chụp lại. Mô hình cũng phải hòa vào quy trình lâm sàng hiện có, trả về kết quả nhanh, dễ hiểu để hỗ trợ nhân viên y tế mà không làm gián đoạn công việc.
Napkin Math 1.3: Kinh tế triển khai: đám mây so với edge
Vấn đề: Một mô hình sản xuất xử lý khoảng 760,000 hình ảnh sàng lọc có tính phí mỗi tháng tại 500 phòng khám, với giả định hoạt động hàng ngày và mỗi bệnh nhân chỉ có một hình ảnh được xử lý sau khi đã chọn lọc và kiểm tra chất lượng tại chỗ. Vậy, việc triển khai nên dùng điểm cuối suy luận trên đám mây hay suy luận tại edge (trên máy chủ đặt tại chỗ)?
Tùy chọn A: Suy luận trên đám mây.
- Mô hình chạy trên các máy chủ GPU tập trung
- Chi phí suy luận: ~$0.01/image (thời gian dùng GPU trên đám mây + phụ phí API)
- Chi phí suy luận hàng năm, tính cho 500 phòng khám, 50 patients/day bệnh nhân/ngày, 1 ảnh tính phí/bệnh nhân, trong 365 days/year ngày, và với $0.01/image chi phí đám mây cho mỗi ảnh, là $91,250/year.
- Cộng thêm: Chi phí giả định cho kết nối và vận hành mạng để tải lên 5 MB mỗi ảnh tính phí, ước tính khoảng ~$45,000/year.
- Tổng cộng: ~$136,250/year chi phí vận hành
- Rủi ro: 200 ms+ vượt mục tiêu độ trễ của kịch bản; khi mất kết nối, việc sàng lọc sẽ dừng lại
Tùy chọn B: Triển khai edge trên thiết bị phòng khám.
- Chi phí phần cứng một lần: Mỗi phòng khám cần một thiết bị trị giá $500/device. Với 500 phòng khám, tổng chi phí vốn (capex) là $250,000.
- Chi phí suy luận: ~$0.001/image (giả định đã bao gồm toàn bộ phần chi phí vận hành biến đổi)
- Chi phí hàng năm: khoảng $25,000/year cho bảo trì, cộng thêm khoảng $9,125/year cho chi phí suy luận biến đổi, tổng khoảng $34,125/year.
- Tổng cộng: $250,000 chi phí ban đầu + ~$34,125/year
- Lợi ích: độ trễ dưới 50 ms; hoạt động ngoại tuyến; chi phí mỗi lần suy luận thấp hơn nhiều
Tính toán:
- Tiết kiệm hàng năm: $136,250/year (đám mây) − $34,125/year (edge) = $102,125/year
- Hoàn vốn: $250,000 (phần cứng) ÷ $102,125/year = ~2.4 years
Thông tin chuyên sâu về hệ thống: Với các giả định kịch bản này, triển khai edge sẽ hoàn vốn trong ~2.4 years và cho phép suy luận ngay cả khi mất kết nối. Tuy nhiên, nó đòi hỏi tối ưu hóa mô hình chặt chẽ hơn (để vừa với bộ nhớ của thiết bị edge) và các pipeline cập nhật phức tạp hơn. Phương thức triển khai được chọn trong giai đoạn Định nghĩa Vấn đề sẽ quyết định liệu tùy chọn edge có khả thi hay không.
Chi phí đám mây tăng nhanh hơn chi phí edge khi quy mô triển khai mở rộng.
Sự so sánh này làm rõ việc đánh đổi trong triển khai. Trong kịch bản này, các ràng buộc về băng thông, độ trễ, kết nối và quy trình làm việc khiến triển khai edge trở nên phù hợp hơn. Do đó, chúng đặt ra các giới hạn chặt chẽ về kích thước mô hình, độ trễ và bộ nhớ mà các kỹ thuật nén có hệ thống trong Nén mô hình phải đáp ứng. Sau khi được nén, mô hình phải được phục vụ (serving) hiệu quả dưới các ràng buộc về độ trễ và thông lượng; Phục vụ mô hình đề cập đến cơ sở hạ tầng phục vụ (serving), nối giữa các mô hình đã tối ưu và lưu lượng sản xuất.
Việc tích hợp với các hệ thống hiện có đặt ra thêm nhiều thách thức. Hệ thống ML phải kết nối với các hệ thống thông tin bệnh viện (HIS) để truy cập hồ sơ bệnh nhân và lưu trữ kết quả. Tích hợp HIS cho một mô hình ML xác suất khác căn bản so với tích hợp một cảm biến xác định: thay vì chỉ lưu một giá trị đơn lẻ, rõ ràng như chỉ số huyết áp, hệ thống phải truyền tải các điểm tin cậy và ước lượng độ bất định để HIS hiển thị và bác sĩ lâm sàng dựa vào đó để hành động. Thỏa thuận giao diện phải mã hóa một chính sách định tuyến đã được thẩm định lâm sàng, quy định rõ trường hợp nào được tự động chuyển và trường hợp nào cần bác sĩ xem xét; không có ngưỡng tin cậy nào tự thân an toàn nếu đứng ngoài chính sách đó và bằng chứng đi kèm. Các quy định về quyền riêng tư còn đặt ra một ràng buộc riêng cho ML: HIPAA và các framework tương tự không chỉ điều chỉnh việc lưu trữ và truyền tải an toàn mà còn cả việc liệu các suy luận trong môi trường sản xuất có được phép lưu giữ, liên kết lại với hồ sơ bệnh nhân và hợp pháp đưa trở lại vào quy trình cập nhật mô hình hay không. Nếu hệ thống không được phép lưu giữ một số đầu ra nhất định, con đường cải tiến phải dựa vào các bằng chứng đã được phê duyệt khác, khiến việc tuân thủ quyền riêng tư trở thành một ràng buộc đối với bảo trì mô hình chứ không chỉ với luân chuyển dữ liệu. Vận hành machine learning trình bày chi tiết các cân nhắc vận hành áp dụng cho các triển khai này.
Từ thí điểm đến triển khai đầy đủ
Quá trình triển khai diễn ra theo từng giai đoạn, dần dần đưa hệ thống tiếp xúc với sự phức tạp của thế giới thực, vì mỗi giai đoạn bổ sung những bằng chứng khác nhau. Môi trường mô phỏng có thể giúp phát hiện các vấn đề tích hợp trước khi ảnh hưởng đến bất kỳ người dùng thực nào. Các địa điểm thí điểm sẽ bộc lộ những khác biệt mà mô phỏng có thể bỏ qua, như chênh lệch về thiết bị, trình độ người vận hành và quần thể bệnh nhân. Khi triển khai rộng hơn, hệ thống sẽ gặp dải dài hơn các lỗi ảnh, điều kiện ánh sáng và những biểu hiện lâm sàng hiếm gặp. Những điều kiện vắng mặt hoặc rất ít trong dữ liệu phát triển cần được giám sát rõ ràng và xử lý có ý thức về độ bất định, nhưng chỉ riêng việc chúng hiếm gặp không chứng minh rằng mọi dự đoán đều không đáng tin cậy.
Việc mở rộng quy mô trên nhiều địa điểm càng làm tăng thêm những thách thức này. Mỗi phòng khám có những ràng buộc riêng (thiết bị hình ảnh khác nhau, độ tin cậy mạng thay đổi, trình độ chuyên môn của người vận hành đa dạng và các quy trình làm việc đặc thù), dẫn đến chất lượng dữ liệu không nhất quán, đòi hỏi phải điều chỉnh các bước tiền xử lý có thể chưa lộ ra trong giai đoạn thí điểm. Bản thân phương thức triển khai cũng giới hạn cách giải quyết: triển khai edge có thể giảm độ trễ mạng nhưng buộc phải giới hạn chặt chẽ độ phức tạp của mô hình, trong khi triển khai đám mây linh hoạt hơn nhưng đưa thêm độ trễ mạng, có thể vi phạm yêu cầu của quy trình làm việc lâm sàng.
Để triển khai thành công, cần nhiều hơn là chỉ tối ưu hóa kỹ thuật. Niềm tin của bác sĩ lâm sàng phụ thuộc vào việc hiệu chuẩn mô hình và các giải thích dễ hiểu, chứ không chỉ là độ chính xác tổng thể: một bác sĩ lâm sàng nếu không thể diễn giải được mức độ không chắc chắn của hệ thống thì sẽ không biết khi nào cần xem xét thêm. Định tuyến có sự tham gia của con người áp dụng một chính sách đã được kiểm chứng để gửi các trường hợp được chỉ định đến chuyên gia, thay vì coi mọi dự đoán đều là kết quả cần hành động ngay. Việc kiểm tra chất lượng hình ảnh tự động, các quy tắc định tuyến đã được hiệu chuẩn và kiểm thử chịu tải ở thời điểm cao điểm đều góp phần đưa ra bằng chứng về vận hành đáng tin cậy; tuy nhiên, không điều gì có thể thay thế cho việc xác nhận quy trình làm việc lâm sàng.
Việc quản lý các cải tiến trên các triển khai phân tán đòi hỏi kiểm soát phiên bản tập trung và các pipeline cập nhật tự động. Phản hồi từ quá trình triển khai (như các vấn đề về khả năng sử dụng, suy giảm hiệu suất, hay những bất ngờ trong tích hợp) sẽ định hình các chiến lược giám sát, giúp hệ thống duy trì hoạt động ổn định theo thời gian. Triển khai không phải là điểm kết thúc mà là bước chuyển sang vận hành liên tục, nơi hành vi của hệ thống cần được theo dõi cẩn thận như bất kỳ bệnh nhân nào mà hệ thống đang sàng lọc.
Self-Check: Question
A deployment model processes ~760,000 screening images per month across 500 rural clinics. Cloud inference costs zsh.01/image plus ,000/year for connectivity/network operations (,200/year total). Edge deployment requires a device per clinic (,000 CapEx), ,000/year maintenance, and zsh.001/image (,120/year total OpEx). According to the chapter’s economics calculation, what is the annual operating savings of edge deployment and its payback period?
- A. ~,080 annual savings with a payback period of approximately 2.4 to 2.5 years, while enabling offline operation during connectivity outages.
- B. ~,000 annual savings with a payback period of 10 years, making cloud deployment far more economical.
- C. ~,000 annual savings with an immediate 3-month payback period.
- D. Zero annual savings, because edge hardware maintenance costs exactly equal cloud inference fees at 500 clinics.
Explain why integrating a probabilistic ML model into a Hospital Information System (HIS) differs fundamentally from integrating a deterministic clinical sensor (such as a digital blood pressure monitor).
An edge-deployed DR screening tablet has a 100 ms total latency budget. Profiling reveals the following execution breakdown: on-device model inference = 15 ms, remote cloud lookup for patient metadata = 60 ms, and local serialization/HIS formatting = 40 ms (total = 115 ms). Which engineering modification directly reduces the Iron Law fixed overhead ({}$) term to meet the 100 ms budget?
- A. Prune the neural network weights to reduce on-device model inference time from 15 ms to 5 ms.
- B. Cache patient metadata locally on the tablet to eliminate the 60 ms remote network round-trip.
- C. Quantize the model from FP32 to INT8 to increase arithmetic operational intensity ($).
- D. Increase the GPU clock frequency on the edge tablet to accelerate tensor core processing.
True or False: Phased deployment progressing from simulation to pilot clinics to full production rollout is recommended because each phase is designed to expose a distinct, non-overlapping class of system failures: simulation catches software integration and schema bugs; pilots catch real-world camera and workflow heterogeneity; and full production catches distributed concurrency contention and rare clinical tail cases.
A deployment policy that automatically routes low-confidence or high-uncertainty model predictions to an expert specialist for manual review, while allowing high-confidence predictions to proceed automatically, is known as ____ routing.
Giám sát và Bảo trì
Hãy xét một ví dụ sáu tháng sau khi hệ thống sàng lọc DR được triển khai. Một phòng khám nâng cấp camera đáy mắt, và thiết bị mới tạo ra ảnh với dải màu khác. Độ nhạy của mô hình tại cơ sở đó giảm vì phân bố pixel mà nó học trong giai đoạn huấn luyện không còn khớp với ảnh nhận vào. Không hề có thay đổi mã nguồn. Dữ liệu đã trôi dạt ra ngoài phạm vi huấn luyện, và mô hình âm thầm suy giảm. Các hệ thống ML có thể suy giảm do trôi dạt dữ liệu ngay cả khi các thành phần của chúng vẫn nguyên vẹn. Điều này có nghĩa là triển khai không phải là kết thúc của vòng đời mà là khởi đầu của một giai đoạn vận hành liên tục. Giám sát cung cấp các chỉ số thống kê để phát hiện sự suy giảm; bảo trì đảm bảo hệ thống phát triển để thích ứng. Vận hành machine learning sẽ trình bày chi tiết các thực hành vận hành này.
Trong kịch bản này, giám sát theo dõi hiệu suất giữa các phòng khám để phát hiện liệu thay đổi nhân khẩu học bệnh nhân, công nghệ camera, hoặc thiết bị xuống cấp có ảnh hưởng đến độ chính xác hay không. Việc bổ sung một phương thức chẩn đoán ảnh mới như optical coherence tomography là một thay đổi sản phẩm, đòi hỏi dữ liệu mới, xác thực, tích hợp vào quy trình làm việc, và mọi đánh giá theo quy định áp dụng, chứ không phải bảo trì thường kỳ. Ba kênh phản hồi dẫn dắt quyết định cập nhật: bằng chứng về hiệu suất có thể thúc đẩy thu thập dữ liệu có mục tiêu; các phát hiện về chất lượng dữ liệu có thể dẫn tới thay đổi quy trình chuẩn bị; và khi xác nhận mô hình suy giảm, có thể biện minh cho việc huấn luyện lại hoặc can thiệp khác. Ngưỡng trôi dạt khởi động quá trình xem xét; chúng không tự động quyết định biện pháp xử lý.
Giám sát sản xuất
Giám sát phải đồng thời phục vụ hai nhóm: đội kỹ thuật theo dõi các chỉ số sức khỏe hệ thống và nhân viên lâm sàng cần thông tin có thể hành động. Triển khai ban đầu có thể bộc lộ những điểm mù mà giai đoạn xác thực trong phòng thí nghiệm không thấy.27 Các phòng khám dùng thiết bị cũ hơn có thể ghi nhận độ chính xác giảm. Một số nhóm bệnh nhân cụ thể, như người bị bệnh võng mạc tăng sinh hoặc đục thủy tinh thể làm phức tạp ảnh đáy mắt, có thể làm tăng tỷ lệ lỗi. Những phát hiện này thúc đẩy thu thập dữ liệu có mục tiêu và cải tiến kiến trúc.
27 Khoảng cách hiệu suất từ lab đến lâm sàng: Các hệ thống AI y tế có thể thay đổi hiệu suất đáng kể khi dòng camera, chất lượng hình ảnh, quần thể bệnh nhân hoặc quy trình vận hành của kỹ thuật viên khác với dữ liệu phát triển; khoảng cách này xuất hiện vì dữ liệu huấn luyện không thể bao quát hết sự đa dạng của điều kiện vận hành thực tế. FDA đã nhấn mạnh việc giám sát xuyên suốt vòng đời sản phẩm và theo dõi hiệu suất trong môi trường thực tế đối với các thiết bị y tế tích hợp AI/ML, và hồ sơ nộp thiết bị có thể cần bằng chứng phù hợp với mục đích sử dụng và mức rủi ro của sản phẩm. Với các kỹ sư hệ thống ML, điều này có nghĩa là hạ tầng giám sát phải là điều kiện tiên quyết khi triển khai, chứ không phải phần bổ sung sau khi sản phẩm ra mắt.
28 Chỉ số ổn định quần thể (PSI) và kiểm định Kolmogorov-Smirnov (KS): Hai phương pháp thống kê nhẹ để phát hiện dịch chuyển phân phối; PSI chia các đặc trưng thành các khoảng (bin) và tính độ phân kỳ; các ngưỡng như 0.1 và 0.2 là quy ước vận hành, không phải mức ý nghĩa thống kê phổ quát. Kiểm định KS đo khoảng cách lớn nhất giữa các phân phối tích lũy thực nghiệm. Cả hai đều đủ nhẹ để giám sát thường xuyên, nhưng phát hiện dịch chuyển ở đầu vào không tự thân chứng minh có thay đổi về độ chính xác; cần nhãn hoặc bằng chứng kết quả khác. Vận hành machine learning sẽ trình bày sâu về các pipeline phát hiện dịch chuyển.
Một hệ thống sàng lọc DR, nơi việc bỏ sót bệnh lý cần chuyển tuyến có thể làm chậm điều trị và dẫn đến mất thị lực đáng ra có thể tránh, đòi hỏi giám sát vận hành liên tục và đánh giá hiệu suất định kỳ khi có nhãn. Các nhóm thiết lập các ngưỡng định lượng cho độ trễ, độ chính xác và sự ổn định của phân phối dữ liệu. Các phép kiểm định thống kê nhẹ như chỉ số ổn định quần thể (PSI) và kiểm định Kolmogorov-Smirnov (KS)28 có thể kích hoạt các phản ứng, từ cảnh báo cho người trực đến xem xét huấn luyện lại mô hình. Vận hành machine learning sẽ phát triển các pipeline giám sát xoay quanh những kiểm định này.
Một hệ thống DR đang vận hành có thể theo dõi bốn nhóm chỉ số ở các thang thời gian khác nhau. Các ngưỡng dưới đây minh họa một chính sách trong một kịch bản cụ thể; các nhóm lâm sàng và vận hành phải xác thực chúng cho phù hợp với sản phẩm, quần thể bệnh nhân và môi trường triển khai mục tiêu.
- Các chỉ số hiệu suất mô hình (cần nhãn chuẩn và thường chỉ có sau một khoảng trễ): độ nhạy (mục tiêu là trên 90 percent, cảnh báo nếu trung bình trượt bảy ngày giảm xuống dưới 88 percent), độ đặc hiệu (mục tiêu là trên 80 percent, cảnh báo nếu giảm xuống dưới 78 percent), và hiệu suất theo nhóm con (cảnh báo nếu bất kỳ nhóm nhân khẩu học nào giảm hơn 5 điểm phần trăm so với mức cơ sở).
- Các chỉ số proxy (có ngay, không cần nhãn chuẩn): phân phối độ tin cậy của dự đoán (cảnh báo nếu độ tin cậy trung bình giảm hơn 10% so với mức cơ sở), tỷ lệ giới thiệu (cảnh báo nếu tỷ lệ này thay đổi hơn 15% so với mức cơ sở), và tỷ lệ bị loại do chất lượng hình ảnh (cảnh báo nếu hơn 20% số ảnh không đạt kiểm tra chất lượng).
- Các chỉ số vận hành: Độ trễ suy luận (p95 phải dưới 50 ms, cảnh báo nếu vượt quá 100 ms), thông lượng (cảnh báo nếu độ sâu hàng đợi vượt quá 50 ảnh), và tỷ lệ lỗi (cảnh báo nếu hơn 0.1% số yêu cầu bị lỗi).
- Các chỉ số ổn định dữ liệu: So sánh phân phối của các đặc trưng và dự đoán với mức cơ sở, và cảnh báo khi lưu lượng truy cập gần đây nằm ngoài phạm vi dự kiến.
Việc phân cấp các chỉ số này rất quan trọng: các chỉ số vận hành có thể giúp phát hiện ngay các vấn đề, các chỉ số proxy có thể báo hiệu các vấn đề tiềm ẩn của mô hình mà không cần chờ nhãn chuẩn, còn các chỉ số hiệu suất thường chỉ có sau này vì chúng cần dữ liệu có nhãn.
Bảo trì ở quy mô lớn
Các bản cập nhật mô hình cần được xác thực cẩn thận và triển khai có kiểm soát. Các nhóm thường dùng các framework thử nghiệm A/B để đánh giá các bản cập nhật và áp dụng các cơ chế rollback29 để nhanh chóng xử lý vấn đề. Các hệ thống ML cũng phải tính đến sự thay đổi của dữ liệu theo thời gian, vì điều này có thể ảnh hưởng đến hành vi độc lập với các thay đổi về mã.
29 Độ phức tạp khi khôi phục trạng thái của mô hình ML: Tính hợp lệ của một mô hình ML gắn với phân phối dữ liệu mà nó được huấn luyện, chứ không chỉ mã của nó. “Dữ liệu thay đổi theo thời gian” có nghĩa là một thao tác khôi phục đơn giản chỉ phục hồi hiện vật mô hình, chứ không thể đưa môi trường dữ liệu về trạng thái quá khứ, dẫn đến lệch trạng thái theo thời gian. Vì vậy, ngay cả khi khôi phục rất nhanh, đó vẫn chỉ là biện pháp giảm thiểu rủi ro chứ không phải khôi phục hệ thống hoàn chỉnh, vì hiệu suất của mô hình cũ trên dữ liệu thực tế không được đảm bảo.
30 Nguồn gốc dữ liệu: Quá trình tự động ghi lại siêu dữ liệu, liên kết nhật ký sản xuất của từng phòng khám với đúng dữ liệu, mã và phiên bản mô hình đã tạo ra chúng. Nếu không có chuỗi thông tin rõ ràng này, việc đối chiếu một mức sụt giảm độ chính xác tại địa điểm cụ thể với một thử nghiệm huấn luyện có thể đòi hỏi phân tích điều tra thủ công, làm chậm việc xác định nguyên nhân gốc rễ.
Trong kịch bản minh họa, mở rộng từ các điểm thí điểm lên hàng trăm phòng khám làm tăng độ phức tạp của việc giám sát. Lượng nhật ký thu được phụ thuộc vào tỷ lệ yêu cầu, lấy mẫu, kích thước tải trọng, chính sách lưu giữ và cả số lượng phòng khám. Cơ sở hạ tầng giám sát phải theo dõi cả các chỉ số toàn cục và hành vi đặc thù theo từng địa điểm, duy trì nguồn gốc dữ liệu,30 tức là chuỗi siêu dữ liệu liên kết nhật ký sản xuất với dữ liệu, mã và phiên bản mô hình (khi cần cho việc tuân thủ quy định), và đối chiếu các sự cố trong sản xuất với các thử nghiệm huấn luyện để phân tích nguyên nhân gốc rễ.
Bảo trì chủ động khép kín vòng đời: các tín hiệu vận hành chỉ ra các vấn đề tiềm ẩn, quá trình xem xét quyết định có cần dữ liệu mới đã được xác thực hoặc thay đổi khác không, và các bằng chứng từ môi trường sản xuất được dùng để tinh chỉnh định nghĩa vấn đề, tiêu chuẩn chất lượng dữ liệu và các quyết định kiến trúc. Khi chọn huấn luyện lại, các pipeline chạy theo lịch hoặc kích hoạt bởi bằng chứng có thể đưa dữ liệu đã phê duyệt vào và đưa ứng viên quay lại qua bước xác thực. Các mô hình lặp lại đứng sau những động lực này (vì sao ràng buộc lan truyền, vì sao phản hồi diễn ra ở nhiều thang thời gian, và vì sao hành vi cấp hệ thống khác với hành vi cấp thành phần) sẽ được thảo luận chi tiết trong section 1.9.
Self-Check: Question
Why does production ML monitoring structure its telemetry into a four-tier hierarchy of operational, proxy, performance, and data stability metrics rather than relying on a single metric class?
- A. Because cloud monitoring vendors charge lower fees when metrics are divided into multiple dashboard tabs.
- B. Because operational metrics like latency and CPU load are sufficient to detect model accuracy degradation in real time.
- C. Because different failure modes emerge across different timescales: operational metrics catch service crashes in seconds, proxy metrics (confidence, referral rate) detect distribution shifts in hours without labels, and performance metrics (sensitivity, specificity) confirm diagnostic accuracy weeks later when ground truth arrives.
- D. Because ground-truth diagnostic labels are instantly available in real time for every inference request in production.
Explain why reverting an ML system to an older model checkpoint during a production degradation incident is only a mitigation tactic rather than a true system state restoration.
Six months after launch, a clinic network upgrades its fundus cameras to a newer model with a distinct color profile. System latency and server error rates remain perfectly stable at 0.0%, but clinical sensitivity drops from 92% to 77%. What systems phenomenon does this scenario illustrate?
- A. A deterministic crash in the GPU serving container caused by CUDA driver incompatibility.
- B. An adversarial perturbation attack executed against the clinic edge devices.
- C. Concept drift caused by a sudden biological mutation in the underlying disease pathology.
- D. Silent degradation caused by covariate/data drift; input pixel distributions shifted beyond the training envelope while traditional infrastructure monitoring showed healthy green dashboards.
True or False: In production ML monitoring, lightweight statistical tests such as the Population Stability Index (PSI) and Kolmogorov-Smirnov (KS) test can detect shifts in input feature distributions, but an alert from these tests does not by itself prove that model classification accuracy has degraded until ground-truth outcome evidence is evaluated.
Describe what metadata elements must be linked in an automated data lineage audit trail for medical ML systems, and explain how lineage reduces the engineering cost of investigating a site-specific accuracy regression.
Tư duy hệ thống
Kịch bản DR cho thấy vòng đời hoạt động như một hệ thống có liên kết chặt chẽ: các ràng buộc về băng thông, độ trễ, kết nối và quy trình khiến triển khai trên edge trở thành lựa chọn phù hợp; triển khai trên edge lại giới hạn kích thước mô hình; và kích thước mô hình định hình lại bước tiền xử lý. Ba mẫu hình cấu trúc giải thích chuỗi hiệu ứng đó. Nhận ra chúng giúp chúng ta chuyển từ gỡ lỗi kiểu phản ứng khi triển khai thất bại sang thiết kế chủ động, để sớm phơi bày các ràng buộc ở những bước về sau.
Nguyên lý lan truyền ràng buộc

Một kịch bản nhân đôi minh họa rõ ràng sự nhạy cảm khi phát hiện ràng buộc muộn.
Kịch bản DR nhiều lần minh họa sự lan truyền ràng buộc: các ràng buộc về băng thông, độ trễ, kết nối và quy trình khiến triển khai trên edge trở thành lựa chọn phù hợp, từ đó giới hạn kích thước mô hình và định hình lại tiền xử lý dữ liệu. Mỗi quyết định như vậy đều thu hẹp không gian thiết kế khả thi cho các giai đoạn phụ thuộc. Chính sự thu hẹp này tạo nên tên gọi của mẫu hình.
Definition 1.3: Nguyên lý lan truyền ràng buộc
Nguyên lý lan truyền ràng buộc nêu rằng một ràng buộc được phát hiện muộn trong vòng đời ML có thể buộc chúng ta phải làm lại các công việc ở những giai đoạn trước đó bị ảnh hưởng. Chi phí sửa chữa thực tế phụ thuộc vào những hiện vật và quyết định nào cần thay đổi. Quy tắc \(2^{N_{\text{stage}}-1}\) của chương này chỉ là một kịch bản minh họa về độ nhạy, không phải một định luật chi phí thực nghiệm.
- Ý nghĩa: Một mục tiêu độ trễ 100 ms được phát hiện ở giai đoạn triển khai (giai đoạn 5) có thể lan truyền ngược để giới hạn kích thước mô hình (giai đoạn 3: độ phức tạp thuật toán \(O\)), yêu cầu về tập dữ liệu (giai đoạn 2: kích thước tập dữ liệu \(D\)), và định nghĩa vấn đề (giai đoạn 1: mức độ chính xác có thể đạt). Khối lượng làm lại phụ thuộc vào những quyết định trước đó đã dựa trên ràng buộc bị thiếu. Trong khuôn khổ định luật sắt, một ràng buộc triển khai đối với \(L_{\text{lat}}\) hoặc \(R_{\text{peak}}\) có thể định nghĩa lại vùng khả thi cho \(O\), \(D_{\text{vol}}\) và \(\eta_{\text{hw}}\).
- Điểm khác biệt: Khác với phân rã theo mô-đun (khuyến khích tối ưu hóa độc lập từng thành phần), nguyên lý này yêu cầu lập luận end-to-end: tối ưu độ chính xác một cách tách biệt có thể tạo ra một mô hình không khả thi để triển khai, biến “local maximum” về độ chính xác thành “global minimum” về tính khả thi của hệ thống.
- Cạm bẫy thường gặp: Một hiểu lầm phổ biến là cho rằng triển khai là “bước cuối cùng”. Thực tế, môi trường triển khai là ràng buộc ngay từ ngày đầu: ngân sách độ trễ, dung lượng bộ nhớ và giới hạn công suất của nó xác định phạm vi cho mọi quyết định ở các giai đoạn phía trước.
Sự lan truyền diễn ra hai chiều, tạo thành các mạng ràng buộc linh hoạt thay vì các phụ thuộc tuyến tính. Khi triển khai tại các phòng khám nông thôn cho thấy băng thông rất hạn chế, các nhóm có thể thiết kế lại pipeline để chỉ truyền các đầu ra gọn nhẹ sau khi suy luận cục bộ. Nếu hệ thống thay vào đó nén dữ liệu đầu vào cho mô hình, thì kiến trúc mô hình và chiến lược huấn luyện phải tính đến sự suy giảm dữ liệu kéo theo. Hiểu rõ những mối quan hệ dây chuyền này giúp các nhóm đưa ra quyết định kiến trúc biết thích ứng, thay vì cố gắng chống lại các ràng buộc của hệ thống.
Nguyên lý lan truyền ràng buộc chính thức hóa điều mà các kỹ sư ML giàu kinh nghiệm vẫn cảm nhận trực giác: quyết định được đưa ra mà không hiểu rõ các ràng buộc ở giai đoạn sau có thể tạo ra nợ kỹ thuật.31 Đặc tả giao diện giai đoạn (table 3) hiện thực hóa nguyên lý này bằng cách làm rõ các ràng buộc tại ranh giới mỗi giai đoạn, phù hợp với các thực hành hợp đồng về mô hình, dữ liệu và hạ tầng đã thảo luận trong Vận hành machine learning. Những hợp đồng này giúp phát hiện ràng buộc sớm hơn. Khi sự lan truyền diễn ra cụ thể qua các lỗi chất lượng dữ liệu, mẫu lỗi thu được được gọi là thác dữ liệu: một chuỗi lỗi ở các giai đoạn sau, bị kích hoạt bởi dữ liệu kém chất lượng (Sambasivan et al. 2021). Kỹ thuật dữ liệu chính thức hóa kiểu lỗi này và lần theo cách nó diễn ra qua từng giai đoạn.
31 Nợ kỹ thuật ML: Sculley et al. (2015) xác định các cơ chế nợ kỹ thuật đặc thù trong ML như entanglement (khi thay đổi một đặc trưng ảnh hưởng đến các đặc trưng khác vì mô hình đã học các phân phối chung), vòng lặp phản hồi ẩn (dự đoán ảnh hưởng đến dữ liệu huấn luyện trong tương lai), và người tiêu dùng không khai báo (các hệ thống hạ nguồn phụ thuộc vào đầu ra mà không có hợp đồng). Vì mã ML thường chỉ chiếm một phần nhỏ trong hệ thống sản xuất, cấu hình, các pipeline và hạ tầng xung quanh có thể khiến khoản nợ này âm thầm tích lũy.
Sambasivan, Nithya, Shivani Kapania, Hannah Highfill, Diana Akrong, Praveen Paritosh, and Lora M Aroyo. 2021. “‘Everyone Wants to Do the Model Work, Not the Data Work’: Data Cascades in High-Stakes AI.” Proceedings of the 2021 CHI Conference on Human Factors in Computing Systems, 1–15. https://doi.org/10.1145/3411764.3445518.
Phản hồi đa quy mô
Các hệ thống ML thành công nhờ điều phối các vòng phản hồi trên nhiều thang thời gian, mỗi thang phục vụ một mục đích khác nhau. Một kế hoạch vận hành minh họa cho kịch bản DR gồm: kiểm tra theo phút để phát hiện camera cấu hình sai trước khi nó tạo ra cả một ca đầy ảnh không dùng được; đánh giá hằng ngày các chỉ báo thay thế như tỷ lệ giới thiệu, độ tin cậy, tỷ lệ từ chối, hoặc thay đổi camera theo từng cơ sở; tổng hợp hằng tuần các thống kê độ chính xác có nhãn và kiểm tra độ trôi khi có nhãn chuẩn; phân tích hằng tháng mức độ bao phủ quần thể; và rà soát hằng quý xem kiến trúc còn đáp ứng nhu cầu lâm sàng hay không. Nhịp độ thực tế phụ thuộc vào độ trễ nhãn, rủi ro sản phẩm, lưu lượng và chi phí hành động theo từng tín hiệu.
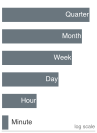
Một kế hoạch giám sát minh họa trải từ phút đến quý trên năm bậc độ lớn.
Cấu trúc theo thời gian của các vòng phản hồi này phản ánh tính động vốn có của hệ thống ML. Các vòng nhanh cho phép chỉnh nhanh các vấn đề vận hành—ví dụ, camera bị cấu hình sai ở một phòng khám có thể được phát hiện và sửa trong vài phút. Các vòng chậm hơn hỗ trợ thích ứng chiến lược; chẳng hạn, nhận ra rằng dịch chuyển nhân khẩu học đòi hỏi mở rộng dữ liệu huấn luyện thường cần nhiều tháng giám sát để phát hiện một cách đáng tin cậy. Cách tiếp cận đa thang thời gian giúp tránh cả thay đổi mang tính phản ứng (phản ứng thái quá với biến động hằng ngày) lẫn thích ứng chậm (phản ứng chưa đủ với các xu hướng có ý nghĩa). Cụ thể, lặp nhanh không chỉ là một chỉ số năng suất; đó là một đặc trưng của hệ thống, mở rộng cơ hội khám phá các kiến trúc và siêu tham số tốt hơn.
Độ phức tạp phát sinh và sự đánh đổi tài nguyên
Các hệ thống phức tạp thường sinh ra hành vi phát sinh mà ta khó thấy khi chỉ phân tích từng thành phần. Trong một triển khai DR đa địa điểm, từng phòng khám có thể vẫn giữ hiệu suất tổng thể ổn định, nhưng phân tích toàn hệ thống lại phát hiện sự suy giảm ảnh hưởng đến một số nhóm nhân khẩu học cụ thể—những mẫu hình không hiện ra khi chỉ giám sát từng địa điểm, nhưng lại then chốt để bảo đảm chăm sóc sức khỏe công bằng. Các hệ thống ML có thể suy giảm mang tính xác suất do trôi dữ liệu và khuếch đại độ chệch (bias), trong khi cả hệ thống ML và các hệ thống phân tán truyền thống đều có thể thất bại theo các chuỗi sự kiện mang tính xác định như sự cố máy chủ hoặc cạn kiệt tài nguyên. Dạng suy giảm mang tính xác suất này có thể không tạo ra các tín hiệu lỗi rõ ràng để kích hoạt quy trình ứng phó sự cố truyền thống.
Checkpoint 1.3: Chi phí của việc phát hiện muộn
Hãy áp dụng nguyên tắc lan truyền ràng buộc vào tình huống này:
Một nhóm phát hiện trong quá trình giám sát (Giai đoạn 6) rằng mô hình DR của họ bị lỗi đối với bệnh nhân trên 70 tuổi. Yêu cầu nhân khẩu học này lẽ ra phải được nêu rõ ngay ở bước Định nghĩa Vấn đề (Giai đoạn 1).
Tối ưu hóa tài nguyên kéo theo các đánh đổi đa chiều vốn đã có trong phần mềm truyền thống, và ML còn bổ sung hành vi thống kê được học. Ví dụ, cải thiện độ chính xác có thể đòi hỏi tăng kích thước mô hình, buộc phải triển khai trên phần cứng mạnh hơn; khi nhân rộng ở nhiều phòng khám, mức cải thiện nhỏ này sẽ chuyển thành chi phí vốn. Những đánh đổi này thể hiện rõ “giới hạn công suất” và “giới hạn bộ nhớ” trong Hệ thống ML: triển khai trên edge có thể giảm độ trễ mạng nhưng hạn chế độ phức tạp của mô hình; triển khai trên đám mây mang lại sự linh hoạt nhưng thêm độ trễ mạng, có thể vi phạm yêu cầu của quy trình làm việc. Khi lần theo các mối quan hệ này trên toàn hệ thống, ta có thể đưa ra quyết định kiến trúc mang tính chiến lược thay vì chỉ tối ưu hóa từng thành phần riêng lẻ.
Tổng hợp lại, ba mô hình này (lan truyền ràng buộc, phản hồi đa cấp độ và sự phức tạp nổi lên kèm theo những đánh đổi về tài nguyên) tạo nên một khuôn khổ kỹ thuật, giúp biến phát triển ML từ các thử nghiệm tùy hứng thành thực hành có hệ thống. Một kịch bản phát hiện muộn sẽ kiểm tra mô hình có tác động lớn nhất.
Trong mô hình minh họa của chương, phát hiện ở giai đoạn giám sát (giai đoạn cuối) có hệ số nhân lớn nhất. Trên thực tế, việc sửa chỉ lan truyền qua các giai đoạn bị ảnh hưởng. Những nguyên tắc này giúp dự đoán các kiểu lỗi cụ thể; các ngụy biện và cạm bẫy trong section 1.10 nêu lên những cách phổ biến nhất mà các nhóm thường phạm phải.
Self-Check: Question
What does the Constraint Propagation Principle assert regarding the engineering cost of discovering constraints late in the ML lifecycle?
- A. Correction costs scale exponentially as roughly ^{N_{}-1}$ times the base effort when discovery is delayed to stage {}$, because artifacts produced across all intervening stages inherit the violation and must be rebuilt.
- B. Correction costs grow strictly linearly with stage index, because each stage requires exactly one day of rework.
- C. Correction costs remain constant across all stages because modular software abstractions isolate upstream stages from downstream changes.
- D. Correction costs decrease over time as downstream profiling provides more performance telemetry to guide optimization.
A demographic fairness requirement (e.g., minimum sensitivity floor for patients over 70) should have been specified at Problem Definition (Stage 1) but is discovered only during Monitoring and Maintenance (Stage 6). Calculate the illustrative cost multiplier and enumerate the lifecycle stages that must be revisited to correct the system.
In a multi-site distributed ML deployment spanning hundreds of clinics, why can system-wide emergent behaviors produce failures that are completely invisible when examining individual clinics in isolation?
- A. Because distributed communication protocols inject pseudo-random noise into inference predictions.
- B. Because local monitoring averages away subpopulation variance; an underserved demographic group that represents only 1–2% of patients at each clinic appears as statistical noise locally, but forms a significant, systematically failing population in aggregate.
- C. Because modern ML models are strictly non-deterministic on edge devices and deterministic in the cloud.
- D. Because individual clinics never experience data drift, which occurs only across wide-area networks.
Arrange the following feedback loop cadences in order from shortest operating timescale (most rapid) to longest operating timescale (slowest): (1) Weekly aggregation of labeled accuracy metrics and statistical drift tests, (2) Minute-level operational health and image-capture focus checks, (3) Quarterly architectural review of model families and regulatory compliance, (4) Daily monitoring of proxy metrics such as referral rates and confidence distributions.
When an undetected data quality failure at data collection propagates downstream to cause compounding failures in model training, validation, and deployment, this systemic failure pattern is known as a(n) ____.
Ngụy biện và Cạm bẫy
Các quy trình làm việc ML đưa vào những phức tạp khó trực giác, khiến các nhóm áp dụng các mô hình phần mềm quen thuộc cho những vấn đề có cấu trúc khác. Những ngụy biện và cạm bẫy này ghi nhận các lỗi làm lãng phí vòng đời phát triển, gây ra sự cố sản xuất và tạo ra nợ kỹ thuật tích lũy khi hệ thống mở rộng.
Ngụy biện: Phát triển ML có thể tuân theo các quy trình làm việc phần mềm truyền thống mà không cần sửa đổi.
Các kỹ sư thường giả định rằng quy trình thác nước (waterfall) hoặc agile tiêu chuẩn có thể áp dụng cho dự án ML mà không cần sửa đổi. ML bổ sung hành vi học được, đánh giá thống kê và phản hồi từ dữ liệu vào các mối quan tâm vốn có của kỹ thuật phần mềm (table 1). Các quy trình làm việc coi yêu cầu là cố định và mọi kiểm thử đều nhị phân (đạt/không đạt) sẽ không phù hợp với thử nghiệm lặp, nơi định nghĩa vấn đề tiến hóa qua quá trình khám phá. Nhiều khảo sát thực nghiệm cho thấy công việc với dữ liệu chiếm phần lớn thời gian của người làm nghề (section 1.1.1), và các cổng giai đoạn cứng nhắc có thể ngăn nhóm quay lại xem xét các giả định về dữ liệu, mô hình và triển khai.
Cạm bẫy: Coi việc chuẩn bị dữ liệu là một bước tiền xử lý một lần.
Các nhóm thường nghĩ họ có thể “xong” phần chuẩn bị dữ liệu rồi chuyển sang xây dựng mô hình. Nhưng trong môi trường sản xuất, phân bố dữ liệu có thể thay đổi theo thời gian. Kiến trúc hai pipeline trong figure 1 cho thấy pipeline dữ liệu và pipeline mô hình chạy song song với phản hồi liên tục, chứ không theo trình tự. Như section 1.4 nêu rõ, các quyết định về chất lượng dữ liệu sẽ lan sang giai đoạn huấn luyện, xác thực và triển khai mô hình. Vấn đề chất lượng dữ liệu là nguyên nhân phổ biến gây lỗi trong hệ thống ML sản xuất. Hệ thống khuyến nghị, mô hình chống gian lận và mô hình lâm sàng đều có thể cần cập nhật đặc trưng, nhãn hoặc bước tiền xử lý khi bối cảnh thay đổi. Nếu không kiểm soát, drift có thể làm giảm độ chính xác hoặc gây ra lỗi nghiêm trọng hơn do sai lệch giữa dữ liệu huấn luyện và dữ liệu phục vụ (serving). Nếu không có xác thực liên tục, drift có thể chỉ bị phát hiện sau khi người dùng hoặc người vận hành nhận thấy hệ thống xuống cấp. Nhóm nào xây dựng pipeline xác thực dữ liệu ngay từ đầu có thể phát hiện drift sớm hơn và kích hoạt quy trình xem xét cập nhật.
Ngụy biện: Vượt qua đánh giá mô hình có nghĩa là hệ thống đã sẵn sàng để triển khai.
Các kỹ sư thường xem pipeline phát triển mô hình là toàn bộ quy trình, và nghĩ rằng chỉ số đánh giá tốt nghĩa là hệ thống đã hoàn chỉnh. Đây là tư duy một chiều. Kiến trúc hai pipeline trong figure 1 chỉ ra điểm mù: các vòng phản hồi ở pipeline dữ liệu, tích hợp khi triển khai, và giám sát vận hành vẫn bị bỏ ngỏ. Nghiên cứu điển hình về sàng lọc bệnh võng mạc tiểu đường (section 1.2.1) cho thấy khoảng trống này: đánh giá mô hình trên dữ liệu được chọn lọc kỹ không phản ánh hành vi trên thiết bị phòng khám, quy trình của người vận hành và các nhóm bệnh nhân khác nhau. Đánh giá có thể mô tả nhiều chiều của hành vi mô hình, nhưng để sẵn sàng cho sản xuất cần thêm bằng chứng ở cấp hệ thống, gồm dữ liệu luôn mới, tính nhất quán của tiền xử lý, độ trễ khi chịu tải, khả năng giám sát và khả năng phục hồi sau lỗi. Nguyên tắc lan truyền các ràng buộc (section 1.9.1) giải thích vì sao phát hiện muộn có thể đòi hỏi phạm vi sửa chữa lớn hơn. Nhóm nào đồng nhất chỉ số mô hình tốt với mức sẵn sàng triển khai sẽ đánh giá thấp khối lượng công việc tích hợp.
Cạm bẫy: Mở rộng quy mô thu thập dữ liệu trước khi kiểm tra giá trị tăng thêm của mô hình.
Các nhóm thường cho rằng cứ tăng kích thước tập dữ liệu là cách đáng tin cậy nhất để cải thiện độ chính xác, coi việc thu thập dữ liệu là khoản đầu tư luôn có lợi. Nhưng trên thực tế, khi phân phối mục tiêu đã được bao phủ đủ, thêm dữ liệu có thể không mang lại nhiều lợi ích, trong khi chi phí gán nhãn, lưu trữ và tiền xử lý vẫn tăng. Các vòng lặp phản hồi trong figure 1 cho thấy vì sao: hiệu suất của mô hình phụ thuộc vào sự tương tác giữa chất lượng dữ liệu, khả năng của mô hình và điều kiện triển khai, chứ không chỉ do khối lượng dữ liệu. Một tập dữ liệu nhỏ hơn, nhưng được kiểm soát chất lượng nhãn kỹ lưỡng và có tỷ lệ các lớp cân bằng, có thể cho kết quả tốt hơn một tập dữ liệu lớn hơn nhưng nhãn nhiễu và phân phối lệch. Giai đoạn Thu thập và Chuẩn bị Dữ liệu (section 1.4) khẳng định rằng các quyết định về chất lượng dữ liệu sẽ chi phối mọi giai đoạn tiếp theo. Các nhóm nên so sánh lợi ích tăng thêm của việc làm sạch dữ liệu hiện có với việc thu thập thêm dữ liệu.
Ngụy biện: Bỏ qua các giai đoạn xác thực sẽ đẩy nhanh việc bàn giao.
Các nhóm thường nghĩ rằng cắt giảm thời gian xác thực sẽ giúp bàn giao nhanh hơn. Tuy nhiên, trong môi trường sản xuất, quy trình xác thực đa giai đoạn tồn tại vì mỗi giai đoạn phát hiện các kiểu lỗi khác nhau (section 1.6). Việc bỏ qua thử nghiệm chế độ bóng (shadow mode) có thể khiến các vấn đề tích hợp, như tăng độ trễ, chỉ lộ ra sau khi ra mắt. Bỏ qua triển khai canary có thể biến các lỗi mô hình cục bộ thành sự cố diện rộng ảnh hưởng đến người dùng. Việc sửa lỗi sau khi triển khai thường tốn kém hơn so với phát hiện vấn đề trong quá trình xác thực, vì phải vừa ứng phó sự cố, quay lui, phân tích nguyên nhân gốc, sửa dữ liệu, vừa xác thực lại. Một nhóm “tiết kiệm” thời gian bằng cách bỏ qua xác thực có thể sẽ phải mất nhiều thời gian hơn đáng kể để khắc phục khẩn cấp. Các tổ chức đầu tư vào hạ tầng xác thực bài bản có thể phát hiện sớm hơn các lỗi dưới điều kiện sản xuất.
Cạm bẫy: Trì hoãn việc lựa chọn phương pháp triển khai cho đến sau khi phát triển mô hình.
Các nhóm thường nghĩ có thể “tính chuyện triển khai sau” và trước hết tập trung vào độ chính xác của mô hình. Nhưng trong production, mô hình triển khai (đám mây, Edge, Mobile, TinyML) không phải chi tiết ở cuối; đó là ràng buộc then chốt, định hình mọi giai đoạn trước đó (table 3). Giả sử một nhóm xây một mô hình ensemble 2 GB, rồi mới biết mục tiêu TinyML chỉ có 256 KB bộ nhớ. Hệ quả là họ phải quay lại xem xét các bước Data Collection, Model Development và Evaluation. Mô hình minh họa lan truyền ràng buộc của chương này cho thấy một phát hiện ở giai đoạn 5 (ví dụ \(2^{4} = 16\times\)) sẽ bị tính chi phí như phát hiện ngay từ giai đoạn 1. Nhóm nào trì hoãn việc chọn mô hình triển khai sẽ tự tạo ra các vòng lặp không cần thiết và rủi ro tiến độ. Mô hình triển khai quyết định những gì có thể xây dựng, không chỉ đơn giản là nơi hệ thống chạy.
Self-Check: Question
Why does the chapter characterize ‘scaling dataset size is always the best way to improve model accuracy’ as a major engineering pitfall?
- A. Because deep learning models degrade in accuracy when trained on more than ^5$ samples due to parameter saturation.
- B. Because collecting additional data increases the Operations ($) term during inference execution.
- C. Because once a target distribution is sufficiently covered, adding raw data yields sharply diminishing returns, whereas investing in label cleaning, balanced subgroup representation, and edge-case curation produces higher accuracy gains at lower compute and storage cost.
- D. Because data privacy regulations strictly limit training set sizes to under 100,000 images in healthcare applications.
True or False: Deferring deployment paradigm selection (Cloud, Edge, Mobile, or TinyML) until after model architecture design and training are complete is an effective engineering strategy because modern model compression techniques can universally fit any trained model onto any target hardware without compromising accuracy.
A software engineering team decides to skip shadow-mode validation and canary deployment to accelerate product delivery, relying entirely on strong test-set accuracy scores. According to the chapter’s analysis of workflow fallacies, why does this practice usually increase total time-to-production rather than shortening it?
- A. Because skipping canary deployment causes compilers to emit unoptimized serving binaries.
- B. Because offline test sets are mathematically incapable of computing classification accuracy.
- C. Because modern cloud orchestrators refuse to route traffic to containers that have not completed shadow mode.
- D. Because skipping progressive validation exports integration bugs, latency spikes, and distribution mismatches directly into production, where emergency triage, rollback, and data repair take far longer than staged validation.
Tóm tắt
Vòng đời là một vòng lặp phản hồi, không phải danh sách kiểm tra. Pipeline dữ liệu biến đổi đầu vào thô qua các bước thu thập, nạp vào, phân tích, gán nhãn, xác thực và chuẩn bị để tạo ra các tập dữ liệu sẵn sàng cho ML. Pipeline phát triển mô hình sử dụng các tập dữ liệu này, qua các bước huấn luyện, đánh giá, xác thực và triển khai để tạo ra hệ thống production. Khi đặt trong toàn bộ ngữ cảnh chương, các mũi tên phản hồi trong figure 1 mang ý nghĩa cốt lõi: mỗi mũi tên là một bài học từ production được đưa ngược trở lại để củng cố các giai đoạn trước, làm cho phản hồi về dữ liệu và mô hình trở nên rõ ràng trong chu trình phát triển.
Hiểu framework này cho thấy vì sao các hệ thống machine learning cần bổ sung chuyên biệt so với các thực tiễn kỹ thuật phần mềm đã có. Các quy trình machine learning thêm vào tối ưu hóa theo xác suất, hành vi thống kê học được, và các vòng lặp phản hồi phụ thuộc dữ liệu. Quy luật sắt cung cấp một góc nhìn định lượng: các quyết định xuyên suốt vòng đời cùng lúc làm thay đổi luân chuyển dữ liệu, số phép tính, hiệu quả phần cứng và độ trễ cố định, được thể hiện qua công thức \((T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}})\). Bằng chứng từ môi trường sản xuất cũng phản hồi các vi phạm ràng buộc để xem xét lại. Góc nhìn này thừa nhận rằng thành công không đến từ việc hoàn thiện từng giai đoạn một cách riêng lẻ, mà từ việc hiểu rõ dữ liệu tốt đến đâu ảnh hưởng thế nào đến hiệu suất mô hình, các ràng buộc triển khai định hình chiến lược huấn luyện ra sao, và các hiểu biết từ môi trường sản xuất dẫn dắt mỗi vòng lặp phát triển tiếp theo như thế nào.
Có ba mẫu hình định nghĩa nên kỷ luật kỹ thuật của vòng đời machine learning. Nhiều người thực hành cho biết thu thập, làm sạch, gán nhãn, xác thực hoặc chuẩn bị dữ liệu là những phần ngốn nhiều thời gian, còn phát triển mô hình chỉ là một phần của vòng đời. Các hệ thống sẵn sàng triển khai cũng cần lặp đi lặp lại qua các giai đoạn về dữ liệu, mô hình và hạ tầng, nên đầu tư vào kỹ thuật dữ liệu có thể tạo đòn bẩy lớn khi chất lượng dữ liệu là nguồn chính gây phải làm lại. Cuối cùng, các ràng buộc xuất hiện muộn có thể làm tăng việc làm lại: mô hình lan truyền ràng buộc minh họa trong chương này gán cho một ràng buộc được phát hiện ở giai đoạn \(N_{\text{stage}}\) chi phí sửa khoảng \(2^{N_{\text{stage}}-1}\) lần so với sửa ở giai đoạn 1, và gán cho một kiểu triển khai không phù hợp được phát hiện ở giai đoạn 5 một hệ số nhân chi phí 16×. Khối lượng làm lại thực tế còn tùy các giai đoạn bị ảnh hưởng. Phát hiện ràng buộc sớm không đồng nghĩa phải “đóng băng” quy trình. Nó thiết lập một giới hạn vận hành qua các yêu cầu về độ trễ, bộ nhớ, công suất, an toàn và xác thực, trong khi các lựa chọn về dữ liệu và mô hình vẫn tiếp tục được lặp trong những giới hạn đó.
Key Takeaways: Hãy xem toàn bộ bản đồ trước.
- Vòng đời là một vòng lặp, không phải một danh sách kiểm tra: Các pipeline dữ liệu và mô hình tiến triển song song, nhưng chính phản hồi từ quá trình sản xuất mới biến chúng thành một hệ thống hoàn chỉnh. Việc giám sát, xác thực và huấn luyện lại sẽ đưa các bài học từ quá trình triển khai trở lại để cải thiện các quyết định về thu thập, gán nhãn, kiến trúc và hạ tầng.
- Các ràng buộc muộn có thể làm tăng việc làm lại: Mô hình minh họa cho thấy một giới hạn triển khai được phát hiện ở giai đoạn \(N_{\text{stage}}\) sẽ có chi phí sửa chữa gấp khoảng \(2^{N_{\text{stage}}-1}\) lần so với chi phí sửa chữa ở giai đoạn 1. Hệ số nhân 16× cho sự không khớp ở giai đoạn 5 minh họa rõ vì sao các yêu cầu cần được truyền ngược lại từ sớm.
- Tốc độ lặp mở rộng cơ hội tìm kiếm: Với các giả định đã được đưa ra, một mô hình “nhẹ” (lightweight) dù bắt đầu với hiệu suất thấp hơn 5 điểm phần trăm vẫn có thể đạt đến ngưỡng chung 99 phần trăm. Điều này là do các chu kỳ lặp ngắn hơn cho phép nhiều cải tiến giả định hơn. Tuy nhiên, tốc độ của quy trình làm việc đơn thuần không thể đảm bảo chất lượng của mô hình.
- Giao diện biến phản hồi thành hành động: Các thỏa thuận giữa các giai đoạn (stage contracts) định nghĩa rõ ràng đầu vào, đầu ra và các chuẩn chất lượng không đổi để các nhóm dữ liệu, mô hình và triển khai có thể phát hiện vi phạm trước khi tích hợp. Nếu không có các thỏa thuận rõ ràng này, mỗi giai đoạn có thể tối ưu hóa cục bộ trong khi hệ thống lại thất bại ở mức tổng thể.
- Trong môi trường sản xuất, các hoạt động diễn ra theo nhiều chu kỳ khác nhau: Việc giám sát suy luận theo thời gian thực, xem xét các cập nhật theo batch và đánh giá kiến trúc hàng quý đều nhằm ứng phó với các dạng lỗi khác nhau. Nếu coi tất cả các phản hồi này là một vòng lặp duy nhất, chúng ta có thể phản ứng quá chậm với drift hoặc làm quay cuồng các workflow tốn kém mà không có tín hiệu.
- Workflow mang các ràng buộc theo thời gian: Việc định nghĩa vấn đề sẽ ghi lại các mục tiêu cần đạt; thu thập dữ liệu sẽ định hình bằng chứng và khối lượng byte; phát triển mô hình sẽ thay đổi các hoạt động và khả năng tái sử dụng; triển khai sẽ hoàn thiện đường dẫn phục vụ (serving) đầy đủ; và giám sát sẽ gửi các vi phạm trở lại để xem xét. Tóm lại, vòng đời này là sự ghép nối giữa dữ liệu, thuật toán và máy, dần mở ra theo thời gian.
Framework workflow này biến các thử nghiệm ML tùy tiện thành một thực hành kỹ thuật có kỷ luật hơn. Khi hiểu rõ cách các pipeline dữ liệu và quá trình phát triển mô hình tương tác qua các vòng lặp phản hồi, các nhóm có thể sớm nhận diện rủi ro tích hợp và phân bổ tài nguyên có chủ đích hơn. Nguyên tắc lan truyền ràng buộc cho thấy quản lý workflow một cách có hệ thống là để giảm thiểu rủi ro, chứ không phải gánh nặng hành chính.
Nếu nhìn như một danh sách kiểm tra, vòng đời là chuỗi các giai đoạn cần hoàn thành theo thứ tự. Còn nhìn cho đúng, nó là một vòng lặp. Một ràng buộc được phát hiện ở giai đoạn triển khai sẽ không nằm yên tại đó; nó có thể buộc phải làm lại các quyết định phụ thuộc về mô hình và dữ liệu. Vì vậy, một workflow là một hệ thống ghép nối chặt chẽ chứ không đơn thuần là một pipeline — chính là kiểu ghép nối mà phân loại D·A·M mô tả trong không gian, nay diễn ra theo thời gian. Tối ưu hóa một giai đoạn đơn lẻ chỉ đẩy thất bại sang chỗ khác thay vì loại bỏ nó, nên kỷ luật ở đây là phải nhìn toàn bộ bản đồ trước khi đụng vào bất kỳ phần nào.
What’s Next: Từ bản thiết kế đến nhiên liệu
Framework workflow được thiết lập ở đây cung cấp bản thiết kế cho mọi chương kỹ thuật tiếp theo. Tuy nhiên, một động cơ không có nhiên liệu thì chỉ là một khối kim loại nặng; với hệ thống ML, nhiên liệu đó là dữ liệu. Do đó, Kỹ thuật dữ liệu phát triển trục D·A·M đầu tiên: Dữ liệu. Phần II xây dựng hệ thống cốt lõi (tính toán mạng nơ-ron, kiến trúc mô hình, framework, huấn luyện), Phần III tối ưu hóa để triển khai (lựa chọn dữ liệu, nén mô hình, tăng tốc phần cứng, benchmarking), và Phần IV triển khai, vận hành trong môi trường sản xuất (phục vụ (serving) mô hình, thực tiễn vận hành, kỹ thuật có trách nhiệm). Mỗi chương giả định bạn đã quen với vị trí các kỹ thuật của nó trong workflow hoàn chỉnh này, dựa trên góc nhìn hệ thống được phát triển ở đây.
Self-Check: Question
Which pair of parallel pipelines organizes the complete ML workflow in this chapter, and how do they interact through feedback loops?
- A. A research pipeline and a regulatory compliance pipeline that operate independently until final market authorization.
- B. A data pipeline (collection through preparation) and a model development pipeline (training through deployment), running in parallel and continuously coupled by forward artifact handoffs and backward operational feedback.
- C. A hardware provisioning pipeline and a software compiler pipeline that execute sequentially in a waterfall structure.
- D. An offline training pipeline and a real-time streaming pipeline that never share data artifacts.
Summarize how the chapter’s three primary quantitative takeaways—the CrowdFlower survey finding on data work, the Iteration Tax on development speed, and the exponential Constraint Propagation multiplier—jointly reshape how an engineering team should allocate resources on a new ML project.
True or False: An ML workflow is fundamentally a coupled, closed-loop system rather than a linear checklist, meaning that optimizing any individual stage in isolation merely shifts and compounds failures across data, algorithm, and machine dimensions rather than eliminating them.
Self-Check Answers
Self-Check: Answer
Team A ships a diabetic retinopathy (DR) screening model and freezes all development once the model clears validation in the lab, treating subsequent tasks as standard server operations. Team B treats the launch as the beginning of an ongoing feedback loop, monitoring operational telemetry and data distributions to guide investigation and evidence-based model updates. Which team’s posture aligns with the ML lifecycle as defined in this chapter, and why?
- A. Team B, because the ML lifecycle is a closed loop where operational feedback, distribution drift, and real-world performance continuously reshape upstream data and model decisions.
- B. Team A, because once a model meets its offline validation thresholds, its statistical properties remain fixed and require only standard infrastructure maintenance.
- C. Team A, because changing a validated model in production introduces regulatory risk that outweighs the benefits of adapting to data drift.
- D. Team B, because the ML lifecycle mandates automatic daily retraining of production models regardless of whether input distributions have drifted.
Answer: The correct answer is A. The chapter defines the ML lifecycle as an iterative, closed-loop engineering process where deployment is the start of the feedback loop rather than its conclusion. Production inputs, patient demographics, and equipment can shift even when code remains untouched, requiring continuous monitoring and evidence-based updates. The view that offline validation permanently freezes statistical behavior ignores real-world distribution drift. The claim that updates should be avoided due to regulatory risk misinterprets compliance frameworks, which mandate lifecycle management and change control. Furthermore, the lifecycle prescribes evidence-driven investigation and retraining when justified, not unconditional automatic daily retraining.
Learning Objective: Classify post-deployment engineering practices against the chapter’s closed-loop lifecycle definition.
In the chapter’s opening failure scenario, a team spends five months developing a diagnostic model that reaches 96 percent accuracy, only to have the entire project discarded on day 153. Explain the root cause of this failure from a workflow perspective and state the systems engineering rule that would have prevented it.
Answer: The failure was a workflow breakdown caused by optimizing model accuracy in isolation while ignoring downstream physical constraints. The team discovered only after development that the target clinic tablets had only 512 MB of memory available, whereas the model required 4 GB. The systems engineering rule that prevents this is backward constraint propagation: physical deployment limits (memory, latency, power budgets) must be established at Problem Definition on day one and propagate backward to constrain feasible model architectures before development begins.
Learning Objective: Explain how late discovery of deployment constraints invalidates isolated model development and forces backward propagation of physical limits.
In the 2016 CrowdFlower data scientist survey cited in the text, respondents indicated that data-related tasks dominated their time, with 60 percent selecting ____ and organizing data as their largest time sink, compared to only 4 percent for refining algorithms.
Answer: cleaning. The survey highlights that cleaning and organizing data accounted for 60 percent of responses, and collecting datasets accounted for 19 percent, demonstrating that data engineering and preparation consume the vast majority of engineering effort compared to model refinement.
Learning Objective: Analyze the primary empirical time sinks reported by ML practitioners in the chapter’s survey analysis.
True or False: Traditional software workflows and ML lifecycles differ fundamentally because ML system behavior can degrade through data distribution drift over time even when application source code, execution environment, and hardware configuration remain completely untouched.
Answer: True. Traditional software behavior changes only when code, configuration, dependencies, or environment change. In contrast, ML systems learn statistical mappings from data; as real-world input distributions shift (such as new clinic cameras or changing patient demographics), model accuracy can degrade silently without any code modification or infrastructure error.
Learning Objective: Compare the fundamental failure mechanisms of ML systems against traditional software systems under distribution drift.
A training pipeline randomly shuffles a multi-terabyte dataset across samples on every epoch, pulling records from storage backed by NVMe and spinning disks. Even though the hardware accelerator has ample peak compute capacity, training throughput stalls. Which explanation correctly identifies the systems-level bottleneck according to the chapter?
- A. Random shuffling makes the training workload strictly compute-bound, so the accelerator cores become overloaded by stochastic gradient calculations.
- B. Random sample access across multi-terabyte storage defeats operating system spatial and temporal locality, causing page cache misses and I/O latency stalls that additional compute cannot resolve.
- C. Shuffling multi-terabyte datasets bypasses the operating system page cache entirely, forcing floating-point arithmetic units to stall on instruction decoding.
- D. The memory hierarchy becomes saturated because the accelerator requires deterministic sample ordering to maintain kernel pipeline parallelism.
Answer: The correct answer is B. Randomly accessing multi-terabyte records across storage defeats the fundamental assumptions of OS memory management: spatial locality (reading sequential memory addresses) and temporal locality (reusing recently accessed pages). When sample fetches scatter across storage, file system buffers and prefetchers suffer cache misses, forcing expensive storage accesses. Because the stall occurs in the data delivery path ({}/\(), adding more peak compute ({\text{peak}}\)) cannot resolve the bottleneck. The claim that shuffling makes the workload compute-bound misidentifies a data-movement stall as a compute limitation. The assertion regarding instruction decoding confusion is technically incorrect, and accelerator parallelism does not depend on deterministic data ordering.
Learning Objective: Analyze how randomized data access patterns in ML training defeat OS locality mechanisms and cause data-delivery bottlenecks.
Self-Check: Answer
Order the following lifecycle phases in the canonical sequence established in the chapter for a new ML system project: (1) Deployment and Integration, (2) Problem Definition, (3) Monitoring and Maintenance, (4) Data Collection and Preparation, (5) Model Development and Training, (6) Evaluation and Validation.
Answer: The correct order is: (2) Problem Definition, (4) Data Collection and Preparation, (5) Model Development and Training, (6) Evaluation and Validation, (1) Deployment and Integration, (3) Monitoring and Maintenance. Each stage consumes artifacts and contracts produced by preceding stages: Problem Definition sets measurable objectives and physical constraints; Data Collection acquires and curates versioned datasets satisfying those constraints; Model Development trains candidate models within the computational budget; Evaluation and Validation gates models against stratified safety thresholds; Deployment and Integration delivers serving infrastructure meeting latency SLAs; and Monitoring and Maintenance tracks live operational telemetry and feeds drift evidence back into upstream stages.
Learning Objective: Classify and sequence the six core ML lifecycle stages and justify the prerequisite artifact dependencies across stage boundaries.
An engineering team completes Problem Definition with clinical sensitivity targets but marks the target deployment paradigm as ‘TBD — to be determined after model training.’ According to the Stage Interface Specification, what should the transition audit verdict be, and why?
- A. Approved, because decoupling model development from hardware targets allows researchers to maximize accuracy before applying post-hoc pruning.
- B. Approved with warning, provided the team commits to using cloud inference if the model exceeds edge memory budgets.
- C. Blocked, because Problem Definition’s output contract explicitly requires deployment paradigm and resource constraints to be established before data collection and modeling begin.
- D. Blocked only if the model architecture requires distributed multi-GPU training, since single-device models can adapt to any deployment target.
Answer: The correct answer is C. The Stage Interface Specification requires that Problem Definition’s Output Contract specify measurable objectives, deployment paradigm selection (Cloud, Edge, Mobile, or TinyML), and resource constraints. Deferring deployment paradigm selection violates the contract because target hardware constraints (such as memory limits and latency budgets) directly determine what data preprocessing is feasible and pre-eliminate unviable model architectures. Under the Constraint Propagation Principle, deferring this constraint to deployment causes exponential rework costs (^{N_{}-1}$). The argument for unconstrained accuracy optimization ignores physical deployment realities. Promising fallback to cloud inference ignores connectivity and latency requirements, and single-device models cannot universally run on resource-constrained edge hardware.
Learning Objective: Apply stage interface contracts to audit lifecycle transitions and enforce early constraint binding.
The chapter discusses MobileNetV2 with its ~600 MFLOPs inference budget as a lighthouse case study for workflow thinking. Explain how establishing this mobile constraint at Problem Definition propagates across Data Collection, Model Development, and Evaluation.
Answer: Establishing the ~600 MFLOPs mobile constraint at Problem Definition immediately reshapes all downstream stages: in Data Collection, input image resolution and preprocessing pipelines must be designed to execute within mobile memory and compute limits; in Model Development, it forces the selection of efficient operators (such as depthwise separable convolutions) rather than dense convolutions or large ensembles; in Evaluation, it requires validating on-device latency, power dissipation, and memory footprint on target mobile hardware alongside classification accuracy.
Learning Objective: Explain how mobile hardware constraints propagate backward through Problem Definition, Data Collection, Model Development, and Evaluation.
Which mapping between lifecycle stages and the terms in the Iron Law of ML Systems ( = + + L_{}$) is conceptually correct according to the chapter?
- A. Problem Definition governs {}$; Evaluation governs $; Monitoring governs \(\text{BW}\).
- B. Data Collection sets {}$; Model Development sets \(\text{BW}\); Deployment sets {}$.
- C. Deployment governs \(; Model Development governs {\text{vol}}\); Data Collection governs {}$.
- D. Data Collection and Preparation shapes $ and {}$; Model Development and Training sets \(; Deployment and Integration minimizes {\text{lat}}\).
Answer: The correct answer is D. In the chapter’s iron law perspective, Data Collection and Preparation directly determines dataset size (\() and the data movement byte volume ({\text{vol}}\)); Model Development and Training establishes model architecture and operations (\() along with achievable hardware efficiency (\)_{}\(); and Deployment and Integration engineers the serving pipeline to minimize fixed latency and network overhead ({\text{lat}}\)). The other mappings confuse stages that measure system performance with stages that physically set the underlying mathematical terms; for example, {}$ is a hardware specification rather than an output of Problem Definition, and {}$ is determined by deployment serving infrastructure rather than data collection.
Learning Objective: Apply the Iron Law of ML Systems to classify each core lifecycle stage by its governing parameter.
To prevent defect propagation across lifecycle boundaries, the chapter formalizes each stage boundary using a(n) ____ contract, which defines required inputs, output deliverables, and non-negotiable quality invariants.
Answer: stage interface. Stage interface contracts establish formal quality gates at each transition boundary in the ML lifecycle, ensuring that prerequisites (such as deployment paradigm selection or schema validation) are met before downstream engineering begins.
Learning Objective: Explain the role of stage interface contracts as control-plane quality gates in ML workflows.
Self-Check: Answer
Why does the statement ‘Build a computer vision model that detects diabetic retinopathy’ fail as a complete problem definition for an ML system?
- A. It specifies only a high-level task while omitting the statistical constraint layers (sensitivity/specificity floors across subgroups), physical constraints (edge device memory/latency budgets), and operational constraints (regulatory compliance, clinical workflow integration).
- B. It fails to specify which exact deep neural network backbone and learning rate schedule must be used during training.
- C. It defines an image classification problem when medical AI systems must always be framed as unsupervised anomaly detection tasks.
- D. It defines quantifiable objectives before data collection has occurred, which violates standard ML agile practices.
Answer: The correct answer is A. An ML problem definition is not a one-sentence task label; it is a multi-constraint optimization problem spanning statistical layers (>90% sensitivity and >80% specificity across diverse populations), physical layers (inference on edge hardware within 50 ms and under 500 MB memory), and operational layers (FDA regulatory compliance, HIS workflow integration, patient privacy). Omitting these layers leaves downstream teams without the constraints needed to bound the design space. Specifying model backbones upfront inverts the workflow order, unsupervised anomaly detection is not mandatory for medical classification, and establishing quantifiable targets upfront is an essential requirement of the Problem Definition output contract.
Learning Objective: Explain why complete ML problem definitions require layered statistical, physical, and operational constraints.
Explain why ophthalmologists and clinic administrators must participate directly in Problem Definition for a DR screening system, rather than being consulted only during clinical evaluation.
Answer: Engineers optimizing models in isolation tend to maximize aggregate accuracy, but clinical safety depends on domain-specific trade-offs that only medical experts understand. Ophthalmologists define the clinical penalty of false negatives (missed cases leading to blindness) versus false positives (overwhelming specialist clinics), translating medical needs into non-negotiable sensitivity (>90%) and specificity (>80%) floors. Clinic administrators identify physical and workflow constraints (such as 5-minute patient visit windows, older fundus cameras, and intermittent connectivity), ensuring engineering targets reflect real clinical operations from day one.
Learning Objective: Justify the necessity of cross-disciplinary domain collaboration during Problem Definition to establish valid engineering constraints.
In the 2018 Amazon automated recruiting war story cited in the chapter, an ML model trained on ten years of resumes was abandoned because it systematically penalized female applicants. What fundamental systems lesson does this case illustrate regarding Problem Definition?
- A. Resume screening models require recurrent neural networks rather than transformer architectures to avoid learning gendered proxies.
- B. Offline evaluation metrics are inherently incapable of measuring demographic disparities in supervised learning models.
- C. A model trained on historical data learns to reproduce historical label biases rather than the intended operational goal; fairness criteria and auditability must be explicitly defined at Problem Definition.
- D. Multi-class classification algorithms should not be applied to human evaluation tasks where ground truth is subjective.
Answer: The correct answer is C. The Amazon recruiting case demonstrated that when historical hiring was male-dominated, the model learned that male-coded terms correlated with past hiring decisions and penalized female-coded terms. Simply removing explicit gender words failed because the model identified correlated proxy features. The systems lesson is that Problem Definition must specify fairness, auditability, and validation criteria before data collection and training; an ML workflow trained on biased historical labels optimizes to reproduce the bias of those labels rather than the true organizational goal. The failure was not an architecture choice, offline metrics can measure disparities if stratified evaluation is performed, and binary/multi-class framing was not the root cause.
Learning Objective: Analyze how historical label bias corrupts ML workflows and justify why fairness criteria must be specified at Problem Definition.
True or False: When a diabetic retinopathy screening deployment scales from a 3-clinic pilot to 200 clinics across diverse regions, the high-level clinical intent (detect referable retinopathy early) remains stable, but the specific engineering targets (subgroup sensitivity thresholds, device latency budgets, and camera-specific preprocessing rules) must evolve.
Answer: True. Scaling exposes heterogeneity in patient demographics, camera manufacturers, lighting conditions, and operator training that was invisible at pilot scale. While the overarching clinical mission remains unchanged, the engineering problem definition is a living document that must be revised to include stratified subgroup thresholds, support for older hardware, and updated operational constraints.
Learning Objective: Compare stable clinical intent with evolving engineering targets during deployment scaling.
Self-Check: Answer
A rural clinic captures 150 patients per day for DR screening, with 10 retinal photos per patient at 5 MB per photo. The clinic operates on an 8-hour daily shift with a 2 Mbps uplink. According to the chapter’s Bandwidth vs. Compute analysis, what operational bottleneck arises, and how does edge inference resolve it?
- A. Daily raw image upload requires ~2.5 hours, which fits comfortably within the 8-hour window without needing edge processing.
- B. Daily raw image upload generates 7.5 GB of data requiring ~8.3 hours to transfer—saturating the entire 8-hour clinic shift—whereas edge inference uploading 10 KB detection summaries reduces network traffic by roughly 5,000\(\times\).
- C. Daily raw image upload generates 75 GB of data, which exceeds daily satellite uplink capacity by a factor of 100\(\times\) regardless of compression.
- D. Raw uploads complete in 45 minutes, but cloud GPU queuing delay adds 12 hours of fixed inference latency.
Answer: The correct answer is B. As calculated in the chapter: = 7,500 = 7.5 \(. Transmitting 7,500 MB over a 2 Mbps link (0.25 MB/s) requires ,500 / 0.25 = 30,000 \text{ seconds} \approx 8.33 \text{ hours}\). Because 8.33 hours exceeds the 8-hour operating window, raw upload continuously saturates the connection. Performing inference locally and transmitting compact 10 KB summaries per patient ( = 1.5 \() achieves a ,500 \text{ MB} / 1.5 \text{ MB} = 5,000\times\) bandwidth reduction, transferring in under 6 seconds. The 2.5-hour estimate reflects incorrect unit conversion, the 75 GB estimate miscalculates patient volume, and the 45-minute upload claim contradicts basic network physics.
Learning Objective: Calculate network transmission times for clinical data collection and evaluate edge preprocessing as a bandwidth mitigation strategy.
Explain why a DR screening model achieving an AUC of 0.99 on a curated laboratory research dataset can experience a severe drop in sensitivity (e.g., falling to 78 percent) when deployed to rural clinics across Thailand and India.
Answer: This drop illustrates the lab-to-field distribution gap. Curated research datasets are captured using standardized, high-end fundus cameras under controlled lighting with dilated pupils and experienced operators. In rural field clinics, images are captured on older, lower-resolution cameras by technicians with minimal training, leading to motion blur, poor illumination, glare, and improper framing. The model degrades not because the learning algorithm is broken, but because production inputs fall outside the training data distribution envelope.
Learning Objective: Analyze how distribution mismatches between curated research datasets and real-world field environments cause deployment performance gaps.
In tiered storage architectures for ML pipelines, placing active training data in cold or warm object storage (e.g., S3 Standard with 100–200 ms latency) instead of local high-throughput NVMe SSDs directly degrades training performance by affecting which term in the Iron Law of ML Systems?
- A. It increases the Operations ($) term by forcing the model to compute extra gradient updates.
- B. It decreases peak hardware performance ({}$) by downclocking GPU compute cores.
- C. It decreases hardware utilization efficiency (\(\eta_{\text{hw}}\)) solely through floating-point precision mismatches.
- D. It inflates the data movement time (\(\frac{D_{\text{vol}}}{\text{BW}}\)), converting a compute-bound training pipeline into an I/O-bound stall where accelerators sit idle waiting for data batches.
Answer: The correct answer is D. In the Iron Law ( = + + L_{}\(), storage throughput and access latency govern effective data bandwidth (\)\() and delivery time for training data volume ({\text{vol}}\)). High-throughput NVMe SSDs deliver 500,000+ IOPS and sequential reads at 1–10 GB/s, keeping accelerators saturated. Using high-latency object storage restricts effective \(\text{BW}\), causing data starvation where accelerators stall waiting for batches. It does not alter mathematical operations (\(), change hardware theoretical peak ({\text{peak}}\)), or alter floating-point formats.
Learning Objective: Analyze the impact of tiered storage choices on the Iron Law data movement term ({}/$) during model training.
True or False: In large-scale medical data collection, if collected images pass basic file format and schema validation, image-quality defects (such as blur, low contrast, or partial occlusion) can be safely ignored because deep neural networks naturally learn to filter out bad samples when trained on sufficiently large datasets.
Answer: False. Poor-quality images distort the training distribution and introduce label noise at the critical diagnostic boundary. A blurry fundus image where microaneurysms are obscured may be mislabeled as healthy or cause the network to learn spurious artifacts. Catching defects at the point of capture via real-time image-quality checks allows immediate recapture; allowing bad data into training triggers the Constraint Propagation Principle, where correcting the resulting model failures at stage 5 or 6 costs $ to $ more than catching them at stage 2.
Learning Objective: Evaluate why early point-of-capture data quality validation is essential despite large training set sizes.
In rural clinics with intermittent connectivity, an architecture that buffers captured images locally and reconciles inference results asynchronously with the central cloud during available network windows is known as a(n) ____ architecture.
Answer: store-and-forward. Store-and-forward architectures buffer data locally during network outages and transmit batched data when connectivity is restored, decoupling local clinical operations from central cloud availability.
Learning Objective: Classify store-and-forward architectures as the primary mechanism for managing intermittent network connectivity in distributed data pipelines.
Self-Check: Answer
According to the chapter, which bundle of deliverables constitutes a complete, reproducible system artifact from the Model Development and Training stage, and why are model weights alone insufficient?
- A. Model weights, inference/preprocessing code, environment specification (e.g., container or locked dependency graph), and runtime configuration; weights alone fail because library version mismatches or preprocessing differences alter outputs without crashing.
- B. Model weights and a serialized training log; the execution environment can always be inferred from the framework version tag.
- C. Model weights, a test-set evaluation scorecard, and an architecture diagram; deployment engineers reconstruct dependencies during serving containerization.
- D. Source code repository commits and hyperparameters; weights can be deterministically reproduced from random seeds on any hardware.
Answer: The correct answer is A. A mature ML workflow defines a reproducible system artifact as four co-dependent components: model weights, inference preprocessing code, environment specification (Docker image, CUDA driver, dependency graph), and runtime configuration. Packaging weights alone creates ‘works on my machine’ failures: subtle differences in linear algebra kernels, CUDA versions, or image-resizing libraries (e.g., OpenCV vs. PIL) alter floating-point outputs or pixel interpolation without throwing exceptions, silently degrading accuracy. Training logs or scorecards do not enable execution, and hardware differences make pure seed-based bitwise weight reconstruction unreliable across different accelerator architectures.
Learning Objective: Classify the four core components of a reproducible system artifact and explain why weights alone fail to guarantee consistent inference.
Explain why a competition-winning 50-model ensemble that achieves state-of-the-art accuracy on a benchmark may be discarded for production edge deployment, citing the Netflix Prize as an empirical reference.
Answer: Ensemble accuracy gains come with multiplicative operational costs: model size, memory footprint, and inference latency scale directly with the number of constituent models. In the Netflix Prize competition, the winning BellKor ensemble achieved a 10 percent RMSE improvement but was never deployed to production because the substantial engineering complexity and serving latency did not justify the incremental accuracy gain. On resource-constrained edge devices (such as clinic tablets with 512 MB memory), running a 50-model ensemble violates memory, latency, and power budgets, making lightweight single models or compressed architectures the only viable engineering choice.
Learning Objective: Analyze the competition-versus-production trade-off in ensemble methods and justify why benchmark-winning models may be unviable for edge serving.
In the chapter’s Iteration Tax scenario, a team compares Model L (large ensemble, starts at 95% accuracy, 1-week training cycle, +0.15% gain/iter) with Model S (lightweight model, starts at 90% accuracy, 1-hour training cycle, +0.1% gain/iter, 100 effective iters) over a 26-week window with a 99% ceiling. What is the modeled outcome after 26 weeks, and what systems lesson does it demonstrate?
- A. Model L reaches 99.0% while Model S reaches 92.6%, proving that starting accuracy dominates iteration speed over six months.
- B. Model S reaches the 99.0% ceiling while Model L reaches 98.9%, demonstrating that shorter training cycles permit more iterative experiments that can overcome a lower starting accuracy.
- C. Both models reach exactly 95.0% accuracy because human hypothesis generation saturates at 26 experiments regardless of training speed.
- D. Model L fails to converge due to training instability, while Model S converges to 90.0% without improvement.
Answer: The correct answer is B. As modeled in the Iteration Tax notebook: over 26 weeks, Model L runs 26 iterations at 1 week each, reaching .0% + (26 %) = 98.9%\(. Model S runs 100 effective iterations (capped by hypothesis generation), reaching an uncapped .0\% + (100 \times 0.1\%) = 100.0\%\), which hits the .0%$ ceiling. The systems lesson is that iteration velocity is a feature: shorter cycle times allow teams to test far more architectures, data augmentations, and hyperparameters, enabling an initially weaker but fast-iterating model to overtake a slow-training alternative across a fixed development timeline. The claim that Model L finishes higher contradicts the worked math, and the saturation/non-convergence claims contradict the chapter’s scenario parameters.
Learning Objective: Calculate the cumulative accuracy trajectory under the Iteration Tax model and explain how experimentation velocity acts as a systems optimization lever.
A team observes that model validation accuracy drops 2 percent between run 47 and run 48. Explain how an automated experiment tracking lineage record resolves this regression compared to an ad hoc notebook workflow.
Answer: In an ad hoc workflow without lineage, diagnosing the drop requires weeks of manual forensics and expensive trial-and-error experiment reruns because changes across code commits, dataset versions, hyperparameter values, random seeds, and library dependencies are unrecorded and entangled. With automated lineage tracking (e.g., MLflow, Weights & Biases), every run artifact is immutably indexed with its exact dataset snapshot, git commit hash, environment container, random seed, and hyperparameter dictionary. The team executes a single metadata diff between run 47 and run 48 to instantly isolate the causal variable.
Learning Objective: Explain how automated artifact lineage converts regression root-cause analysis from manual forensics into an immediate metadata query.
Arrange the following model development milestones in the logical order prescribed for a constraint-driven ML workflow: (1) Baseline transfer-learning fine-tuning from pretrained weights, (2) Physical constraint profiling (target latency, memory ceiling, power envelope), (3) Systematic ablation studies to isolate component contributions, (4) Model compression (pruning/quantization) and hardware-in-the-loop latency validation, (5) Packaging weights, preprocessing code, dependencies, and configuration into a reproducible system artifact.
Answer: The correct order is: (2) Physical constraint profiling (target latency, memory ceiling, power envelope), (1) Baseline transfer-learning fine-tuning from pretrained weights, (3) Systematic ablation studies to isolate component contributions, (4) Model compression (pruning/quantization) and hardware-in-the-loop latency validation, (5) Packaging weights, preprocessing code, dependencies, and configuration into a reproducible system artifact. Development must begin by establishing physical constraint boundaries; next, transfer learning establishes a functional baseline; ablation studies systematically isolate architectural improvements; model compression adapts the architecture to target device constraints; and finally, all code, weights, environment specs, and configs are packaged into a reproducible artifact.
Learning Objective: Design the sequence of stages in a constraint-driven model development and optimization pipeline.
Self-Check: Answer
What is the primary conceptual distinction between Model Evaluation and Model Validation as defined in this chapter?
- A. Evaluation is conducted by internal software engineers, whereas validation is conducted exclusively by government regulatory agencies.
- B. Evaluation tests software execution speed on accelerators, whereas validation tests algorithm mathematical convergence on CPUs.
- C. Evaluation measures model behavior on chosen datasets and metrics; validation is a multi-dimensional evidence gate confirming the model satisfies all operational, latency, subgroup fairness, robustness, and cost constraints under production-representative conditions.
- D. Evaluation is performed on live production traffic, whereas validation is performed exclusively on synthetic offline data.
Answer: The correct answer is C. The chapter defines Model Evaluation as characterizing algorithmic performance using selected datasets, loss metrics, and test benchmarks. Model Validation is an evidence-based decision gate for deployment readiness, verifying that the integrated model and system satisfy all physical constraints (latency, memory, power), subgroup safety floors (demographic fairness, comorbidity performance), robustness under distribution shift (blur, lighting, camera variation), and cost budgets. Confining validation to external regulators misses its internal engineering function, splitting evaluation/validation by hardware architecture is incorrect, and online vs. offline execution is handled within staged validation rather than defining the conceptual boundary.
Learning Objective: Compare Model Evaluation and Model Validation to classify their distinct roles in deployment readiness gating.
A diabetic retinopathy screening model achieves 94 percent aggregate accuracy on held-out validation data. However, stratified evaluation reveals that sensitivity drops to 76 percent for patients with cataracts and falls below the 90 percent sensitivity floor for one demographic subpopulation. How should the engineering team respond?
- A. Proceed to full deployment immediately, because aggregate accuracy above 90 percent statistically compensates for minor subpopulation variations.
- B. Apply post-hoc temperature scaling to increase overall prediction confidence, which automatically resolves subgroup sensitivity deficits.
- C. Deploy the model in shadow mode permanently, since shadow mode bypasses clinical subgroup safety requirements.
- D. Block deployment, because the model violates non-negotiable clinical sensitivity safety thresholds for vulnerable subgroups; stratified validation exists precisely to prevent aggregate metrics from masking localized clinical harm.
Answer: The correct answer is D. In medical AI systems, aggregate accuracy is deceptive: high overall accuracy can obscure catastrophic error rates in specific sub-populations. A sensitivity drop to 76 percent in cataract patients or below the 90 percent safety floor means referable eye disease will be missed, leading to preventable blindness. Problem Definition establishes that subgroup sensitivity floors are hard quality invariants; failing them must block deployment regardless of aggregate accuracy. Relying on aggregate metrics to override subgroup failure violates medical safety principles, temperature scaling modifies confidence scores without altering underlying class sensitivity, and shadow mode is an evaluation stage rather than a permanent production workaround.
Learning Objective: Evaluate stratified subgroup validation results and justify blocking deployment when subgroup safety thresholds are violated.
Explain why a medical diagnostic model with an outstanding Area Under the ROC Curve (AUC) of 0.99 on a research dataset may still fail deployment validation for clinical screening.
Answer: AUC is a threshold-independent metric that evaluates ranking quality across all possible classification cutoffs from 0 to 1. In production clinical screening, however, the model operates at a single, fixed decision threshold. At that specific operating point, the model must simultaneously satisfy strict clinical floors: sensitivity >90 percent (to prevent missed diagnoses) and specificity >80 percent (to prevent overwhelming referral clinics) on production-representative data with diverse camera models and lighting. A high AUC does not guarantee that any single operating threshold meets both clinical floors under real-world distribution shift.
Learning Objective: Explain why threshold-free AUC metrics do not establish clinical deployment readiness at fixed operating thresholds.
Order the stages of progressive online validation from lowest initial user risk to broadest comparative evaluation: (1) Canary deployment exposing 1–5% of live traffic, (2) Offline evaluation on held-out and stratified test sets, (3) A/B testing comparing outcomes against the production baseline, (4) Shadow mode running in parallel on live requests without serving predictions to users.
Answer: The correct order is: (2) Offline evaluation on held-out and stratified test sets, (4) Shadow mode running in parallel on live requests without serving predictions to users, (1) Canary deployment exposing 1–5% of live traffic, (3) A/B testing comparing outcomes against the production baseline. Progressive validation begins offline with static benchmark testing; next, shadow mode tests end-to-end serving integration and performance under live production load with zero user exposure; canary deployment routes a small, controlled fraction of traffic to verify stability under real user interactions; and finally, A/B testing establishes statistically significant comparative efficacy against the incumbent baseline.
Learning Objective: Design the sequence of progressive online validation stages from zero-exposure integration testing to live comparative evaluation.
True or False: Model calibration—ensuring that a predicted confidence score of 0.80 corresponds to an empirical 80 percent probability of correctness—is critical for medical AI systems because clinical triage workflows rely directly on confidence scores to route ambiguous cases to human specialists.
Answer: True. Calibration is distinct from classification accuracy. In clinical triage, physicians use model confidence scores to determine whether automated decisions can be trusted or require specialist review. An uncalibrated model that outputs 95% confidence on borderline, uncertain cases can dangerously mislead clinicians into skipping necessary specialist referrals, creating severe safety risks even if aggregate accuracy appears acceptable.
Learning Objective: Evaluate the role of model calibration in supporting safe clinical triage and human-in-the-loop routing.
Self-Check: Answer
A deployment model processes ~760,000 screening images per month across 500 rural clinics. Cloud inference costs zsh.01/image plus ,000/year for connectivity/network operations (,200/year total). Edge deployment requires a device per clinic (,000 CapEx), ,000/year maintenance, and zsh.001/image (,120/year total OpEx). According to the chapter’s economics calculation, what is the annual operating savings of edge deployment and its payback period?
- A. ~,080 annual savings with a payback period of approximately 2.4 to 2.5 years, while enabling offline operation during connectivity outages.
- B. ~,000 annual savings with a payback period of 10 years, making cloud deployment far more economical.
- C. ~,000 annual savings with an immediate 3-month payback period.
- D. Zero annual savings, because edge hardware maintenance costs exactly equal cloud inference fees at 500 clinics.
Answer: The correct answer is A. As calculated in the Deployment Economics notebook: Total Cloud Annual OpEx = ,200. Total Edge Annual OpEx = ,000 (maintenance) + ,120 (variable inference) = ,120. Annual Savings = ,200 - ,120 = ,080. Edge Hardware CapEx = 500 clinics \(\times\) /device = ,000. Payback Period = ,000 / ,080 \(\approx\) 2.45 years (~2.5 years). Beyond cost recovery, edge deployment provides the critical operational advantage of functioning without internet connectivity during network outages. The alternative figures miscalculate either CapEx, OpEx, or the payback quotient.
Learning Objective: Calculate total cost of ownership, annual operating savings, and payback period for cloud versus edge ML deployment.
Explain why integrating a probabilistic ML model into a Hospital Information System (HIS) differs fundamentally from integrating a deterministic clinical sensor (such as a digital blood pressure monitor).
Answer: A deterministic sensor outputs a discrete measurement with fixed units and deterministic error bounds that writes directly to database records. A probabilistic ML model outputs class probabilities and uncertainty estimates that reflect statistical distributions. HIS integration for ML must incorporate calibrated confidence thresholds, interpretable visual evidence (e.g., lesion localization), and validated human-in-the-loop clinical routing policies (e.g., automatically referring low-confidence cases to specialists). Furthermore, privacy regulations (e.g., HIPAA) constrain how inference outputs and patient images can be stored, audited, or fed back into retraining loops.
Learning Objective: Compare the architectural and operational integration requirements of probabilistic ML models against deterministic medical sensors.
An edge-deployed DR screening tablet has a 100 ms total latency budget. Profiling reveals the following execution breakdown: on-device model inference = 15 ms, remote cloud lookup for patient metadata = 60 ms, and local serialization/HIS formatting = 40 ms (total = 115 ms). Which engineering modification directly reduces the Iron Law fixed overhead ({}$) term to meet the 100 ms budget?
- A. Prune the neural network weights to reduce on-device model inference time from 15 ms to 5 ms.
- B. Cache patient metadata locally on the tablet to eliminate the 60 ms remote network round-trip.
- C. Quantize the model from FP32 to INT8 to increase arithmetic operational intensity ($).
- D. Increase the GPU clock frequency on the edge tablet to accelerate tensor core processing.
Answer: The correct answer is B. In the Iron Law ( = + + L_{}\(), the 60 ms network round-trip and 40 ms serialization overhead represent fixed serving overhead ({\text{lat}}\)), accounting for 100 ms of the 115 ms total. Pruning or quantizing the model can only save a fraction of the 15 ms inference time, leaving total latency above 100 ms. Caching patient metadata locally replaces the 60 ms network round-trip with a sub-millisecond local read, cutting {}$ from 100 ms to ~40 ms and reducing total latency to ~55 ms, well within the 100 ms budget.
Learning Objective: Apply the Iron Law fixed overhead term ({}$) to analyze latency bottlenecks and evaluate caching strategies.
True or False: Phased deployment progressing from simulation to pilot clinics to full production rollout is recommended because each phase is designed to expose a distinct, non-overlapping class of system failures: simulation catches software integration and schema bugs; pilots catch real-world camera and workflow heterogeneity; and full production catches distributed concurrency contention and rare clinical tail cases.
Answer: True. Staged rollout acts as structured risk segmentation. Testing in simulation isolates interface defects without risking patients; pilot deployment exposes environmental and human factors (such as clinic lighting, operator habits, and varying camera models) that simulations cannot replicate; and full-scale rollout surfaces system contention, network bottlenecks, and rare pathologies that appear only across large patient volumes. Skipping phases exports localized failure modes into expensive full-scale incidents.
Learning Objective: Analyze how phased deployment segments risk across distinct failure classes from simulation to full production.
A deployment policy that automatically routes low-confidence or high-uncertainty model predictions to an expert specialist for manual review, while allowing high-confidence predictions to proceed automatically, is known as ____ routing.
Answer: human-in-the-loop. Human-in-the-loop routing uses calibrated model uncertainty to triage decisions, ensuring that ambiguous or borderline cases receive expert human oversight while automating routine, high-confidence cases.
Learning Objective: Explain human-in-the-loop routing as an operational mechanism for managing model uncertainty in high-stakes deployments.
Self-Check: Answer
Why does production ML monitoring structure its telemetry into a four-tier hierarchy of operational, proxy, performance, and data stability metrics rather than relying on a single metric class?
- A. Because cloud monitoring vendors charge lower fees when metrics are divided into multiple dashboard tabs.
- B. Because operational metrics like latency and CPU load are sufficient to detect model accuracy degradation in real time.
- C. Because different failure modes emerge across different timescales: operational metrics catch service crashes in seconds, proxy metrics (confidence, referral rate) detect distribution shifts in hours without labels, and performance metrics (sensitivity, specificity) confirm diagnostic accuracy weeks later when ground truth arrives.
- D. Because ground-truth diagnostic labels are instantly available in real time for every inference request in production.
Answer: The correct answer is C. Different system failures surface on distinct timescales. Operational metrics (latency, error rate, queue depth) detect infrastructure crashes within seconds but reveal nothing about statistical prediction quality. Proxy metrics (confidence distributions, referral rates, image quality rejection rates) provide real-time indicators of data drift within hours without waiting for labels. Performance metrics (sensitivity, specificity) measure true accuracy but require adjudicated ground-truth labels that arrive with weeks of delay. Relying on any single tier creates blind spots: operational metrics miss silent drift, while performance metrics respond too slowly to active incidents.
Learning Objective: Analyze the multi-timescale hierarchy of operational, proxy, and performance metrics in production ML monitoring.
Explain why reverting an ML system to an older model checkpoint during a production degradation incident is only a mitigation tactic rather than a true system state restoration.
Answer: In traditional software, reverting to an older binary restores the exact prior system behavior because program logic is deterministic. In ML systems, however, model validity is coupled to the specific data distribution on which it was trained. When production data has drifted (e.g., clinics upgraded camera hardware or patient demographics shifted), rolling back to an older model restores stale weights against a permanently altered live data environment. The rolled-back model may perform even worse on current inputs than the newly deployed model, creating a temporal state mismatch.
Learning Objective: Explain why model rollback is a temporary mitigation rather than a true system restore due to temporal data mismatch.
Six months after launch, a clinic network upgrades its fundus cameras to a newer model with a distinct color profile. System latency and server error rates remain perfectly stable at 0.0%, but clinical sensitivity drops from 92% to 77%. What systems phenomenon does this scenario illustrate?
- A. A deterministic crash in the GPU serving container caused by CUDA driver incompatibility.
- B. An adversarial perturbation attack executed against the clinic edge devices.
- C. Concept drift caused by a sudden biological mutation in the underlying disease pathology.
- D. Silent degradation caused by covariate/data drift; input pixel distributions shifted beyond the training envelope while traditional infrastructure monitoring showed healthy green dashboards.
Answer: The correct answer is D. This scenario illustrates silent degradation through covariate/data drift. The upgraded cameras alter the input image distribution (color spectrum, contrast, sensor noise), moving incoming data outside the envelope learned during training. Because the model executes without code errors, traditional software monitoring (uptime, latency, error codes) reports healthy green dashboards while clinical diagnostic performance degrades severely. It is not an infrastructure crash, not an adversarial attack, and not concept drift (the biological relationship between retina lesions and diabetes did not change; the imaging sensor distribution shifted).
Learning Objective: Analyze silent model degradation caused by data drift and explain why traditional infrastructure monitoring fails to detect it.
True or False: In production ML monitoring, lightweight statistical tests such as the Population Stability Index (PSI) and Kolmogorov-Smirnov (KS) test can detect shifts in input feature distributions, but an alert from these tests does not by itself prove that model classification accuracy has degraded until ground-truth outcome evidence is evaluated.
Answer: True. PSI and KS tests detect distribution divergence \(\mathcal{D}(P_t \parallel P_0)\) between current inference traffic and baseline training data. An input shift indicates that incoming data has drifted, which raises the probability of accuracy loss and triggers investigation; however, it does not prove that accuracy has degraded (the model might be robust to the specific feature shift). Confirming accuracy degradation requires evaluating labeled outcomes or verified clinical feedback.
Learning Objective: Evaluate the diagnostic scope of statistical drift tests (PSI, KS) and distinguish input distribution shifts from confirmed accuracy loss.
Describe what metadata elements must be linked in an automated data lineage audit trail for medical ML systems, and explain how lineage reduces the engineering cost of investigating a site-specific accuracy regression.
Answer: An automated data lineage record must link every production inference request to its exact model version, training dataset snapshot, preprocessing pipeline commit, hyperparameter configuration, framework environment, and clinic hardware identifier. Without lineage, investigating a regression requires weeks of forensic guesswork across unindexed logs. With lineage, engineers execute a single query to trace the exact causal chain of artifacts, instantly isolating whether a sensitivity drop at Site X resulted from a recent camera change, a preprocessing version bump, or a specific training data split.
Learning Objective: Analyze the metadata links required in a data lineage audit trail and justify how lineage streamlines regression root-cause analysis.
Self-Check: Answer
What does the Constraint Propagation Principle assert regarding the engineering cost of discovering constraints late in the ML lifecycle?
- A. Correction costs scale exponentially as roughly ^{N_{}-1}$ times the base effort when discovery is delayed to stage {}$, because artifacts produced across all intervening stages inherit the violation and must be rebuilt.
- B. Correction costs grow strictly linearly with stage index, because each stage requires exactly one day of rework.
- C. Correction costs remain constant across all stages because modular software abstractions isolate upstream stages from downstream changes.
- D. Correction costs decrease over time as downstream profiling provides more performance telemetry to guide optimization.
Answer: The correct answer is A. The Constraint Propagation Principle models the compounding cost of late constraint discovery: discovering an unmet constraint at stage {}$ carries an illustrative cost multiplier of ^{N_{}-1}$ relative to specifying it at stage 1 (Problem Definition). This exponential growth occurs because each traversed stage produces dependent artifacts (curated datasets, trained weights, validation suites, serving infrastructure) that inherit the invalid assumption and must be invalidated, redesigned, and re-executed. Linear, constant, or decreasing cost models ignore the structural coupling across ML lifecycle stages.
Learning Objective: Analyze the core claim and exponential cost formulation (^{N_{}-1}$) of the Constraint Propagation Principle.
A demographic fairness requirement (e.g., minimum sensitivity floor for patients over 70) should have been specified at Problem Definition (Stage 1) but is discovered only during Monitoring and Maintenance (Stage 6). Calculate the illustrative cost multiplier and enumerate the lifecycle stages that must be revisited to correct the system.
Answer: Under the chapter’s illustrative doubling model, the cost multiplier is ^{6-1} = 2^5 = 32$ the base effort. The team must revisit: (1) Problem Definition to codify stratified demographic sensitivity thresholds; (2) Data Collection to gather representative retinal images from patients over 70; (3) Model Development to retrain and re-tune architectures on the balanced dataset; (4) Evaluation and Validation to re-audit stratified subgroup metrics against clinical safety floors; and (5) Deployment and Integration to redeploy updated models with calibrated monitoring alerts.
Learning Objective: Calculate late-discovery cost multipliers using the ^{N_{}-1}$ formula and enumerate all intermediate lifecycle stages requiring rework.
In a multi-site distributed ML deployment spanning hundreds of clinics, why can system-wide emergent behaviors produce failures that are completely invisible when examining individual clinics in isolation?
- A. Because distributed communication protocols inject pseudo-random noise into inference predictions.
- B. Because local monitoring averages away subpopulation variance; an underserved demographic group that represents only 1–2% of patients at each clinic appears as statistical noise locally, but forms a significant, systematically failing population in aggregate.
- C. Because modern ML models are strictly non-deterministic on edge devices and deterministic in the cloud.
- D. Because individual clinics never experience data drift, which occurs only across wide-area networks.
Answer: The correct answer is B. Emergent complexity means system-level behaviors cannot be understood by observing individual components in isolation. At any single clinic, an underrepresented patient subpopulation (e.g., elderly patients with rare comorbidities) may comprise only a handful of cases, making local accuracy metrics appear stable and healthy. When aggregated across hundreds of clinics, however, the model may systematically fail for thousands of patients in that demographic. Global cross-site telemetry is essential to surface systemic disparities that local averages conceal. Network noise, deterministic execution claims, and local drift immunity are technically incorrect.
Learning Objective: Analyze how emergent complexity creates systemic demographic disparities that local component monitoring obscures.
Arrange the following feedback loop cadences in order from shortest operating timescale (most rapid) to longest operating timescale (slowest): (1) Weekly aggregation of labeled accuracy metrics and statistical drift tests, (2) Minute-level operational health and image-capture focus checks, (3) Quarterly architectural review of model families and regulatory compliance, (4) Daily monitoring of proxy metrics such as referral rates and confidence distributions.
Answer: The correct order is: (2) Minute-level operational health and image-capture focus checks, (4) Daily monitoring of proxy metrics such as referral rates and confidence distributions, (1) Weekly aggregation of labeled accuracy metrics and statistical drift tests, (3) Quarterly architectural review of model families and regulatory compliance. Multi-scale feedback operates across five orders of magnitude: minute-level checks catch immediate operational and hardware misconfigurations; daily proxy tracking detects distribution shifts without waiting for labels; weekly performance reviews incorporate adjudicated ground-truth outcomes; and quarterly strategic reviews evaluate model architectures, lifecycle costs, and regulatory compliance.
Learning Objective: Compare multi-scale feedback loops across operational, proxy, performance, and strategic timescales.
When an undetected data quality failure at data collection propagates downstream to cause compounding failures in model training, validation, and deployment, this systemic failure pattern is known as a(n) ____.
Answer: data cascade. A data cascade is an compounding chain of downstream engineering and operational failures triggered by undetected data quality issues (such as poor labeling, sensor noise, or unrepresentative sampling) at upstream data collection.
Learning Objective: Explain data cascades as compounding downstream failure chains caused by upstream data quality defects.
Self-Check: Answer
Why does the chapter characterize ‘scaling dataset size is always the best way to improve model accuracy’ as a major engineering pitfall?
- A. Because deep learning models degrade in accuracy when trained on more than ^5$ samples due to parameter saturation.
- B. Because collecting additional data increases the Operations ($) term during inference execution.
- C. Because once a target distribution is sufficiently covered, adding raw data yields sharply diminishing returns, whereas investing in label cleaning, balanced subgroup representation, and edge-case curation produces higher accuracy gains at lower compute and storage cost.
- D. Because data privacy regulations strictly limit training set sizes to under 100,000 images in healthcare applications.
Answer: The correct answer is C. The pitfall of blind data scaling ignores the law of diminishing returns: once core data distributions are covered, collecting more uncurated examples adds storage, labeling, and compute costs while yielding negligible accuracy gains. In contrast, improving data quality—such as correcting noisy labels, balancing underrepresented subgroups (e.g., cataract patients), and filtering blurred images—directly addresses critical error modes at lower cost. Deep learning models do not degrade from parameter saturation on large datasets, training set size does not alter inference operation count ($), and privacy regulations do not impose arbitrary sample-count caps.
Learning Objective: Evaluate the diminishing marginal returns of raw data volume and justify prioritizing data quality, curation, and subgroup balance.
True or False: Deferring deployment paradigm selection (Cloud, Edge, Mobile, or TinyML) until after model architecture design and training are complete is an effective engineering strategy because modern model compression techniques can universally fit any trained model onto any target hardware without compromising accuracy.
Answer: False. Deployment paradigm is a primary day-one constraint, not an afterthought. A TinyML target with 256 KB of memory or an edge tablet with 512 MB cannot run a 2 GB ensemble model regardless of compression. Discovering hardware constraints after model development triggers the Constraint Propagation Principle (^{5-1} = 16$ rework cost), forcing teams to discard months of work and revisit Data Collection and Model Development from scratch.
Learning Objective: Evaluate why deferring deployment paradigm selection causes severe workflow failure and exponential rework.
A software engineering team decides to skip shadow-mode validation and canary deployment to accelerate product delivery, relying entirely on strong test-set accuracy scores. According to the chapter’s analysis of workflow fallacies, why does this practice usually increase total time-to-production rather than shortening it?
- A. Because skipping canary deployment causes compilers to emit unoptimized serving binaries.
- B. Because offline test sets are mathematically incapable of computing classification accuracy.
- C. Because modern cloud orchestrators refuse to route traffic to containers that have not completed shadow mode.
- D. Because skipping progressive validation exports integration bugs, latency spikes, and distribution mismatches directly into production, where emergency triage, rollback, and data repair take far longer than staged validation.
Answer: The correct answer is D. Skipping progressive validation stages (shadow mode, canary rollout) does not eliminate deployment risks; it merely exports unvetted integration bugs, serialization bottlenecks, and distribution mismatches into live production. Remediating failures in a live production environment requires emergency on-call response, live service rollbacks, forensic debugging under pressure, and emergency patch validation—consuming far more calendar time and engineering effort than planned staged validation. Canary deployment does not affect binary compilation, offline test sets can compute accuracy, and cloud orchestrators do not enforce shadow mode policies.
Learning Objective: Analyze why skipping progressive validation stages increases total time-to-production through emergency production remediation.
Self-Check: Answer
Which pair of parallel pipelines organizes the complete ML workflow in this chapter, and how do they interact through feedback loops?
- A. A research pipeline and a regulatory compliance pipeline that operate independently until final market authorization.
- B. A data pipeline (collection through preparation) and a model development pipeline (training through deployment), running in parallel and continuously coupled by forward artifact handoffs and backward operational feedback.
- C. A hardware provisioning pipeline and a software compiler pipeline that execute sequentially in a waterfall structure.
- D. An offline training pipeline and a real-time streaming pipeline that never share data artifacts.
Answer: The correct answer is B. The chapter’s structural blueprint organizes the ML workflow into two parallel, coupled pipelines: the top Data Pipeline (data collection, ingestion, curation, labeling, validation, preparation) and the bottom Model Development Pipeline (model training, evaluation, validation, deployment). Rather than executing as a one-way handoff, outer-loop feedback vectors from production monitoring and validation continuously cycle operational insights, data defects, and updated requirements back into upstream data and modeling stages. The other options propose disconnected, non-standard, or purely sequential pipeline architectures that contradict the chapter’s core closed-loop framework.
Learning Objective: Analyze the dual-pipeline architecture of the ML lifecycle and explain how feedback loops couple data and model development.
Summarize how the chapter’s three primary quantitative takeaways—the CrowdFlower survey finding on data work, the Iteration Tax on development speed, and the exponential Constraint Propagation multiplier—jointly reshape how an engineering team should allocate resources on a new ML project.
Answer: The three takeaways jointly mandate a data-first, iteration-focused, and constraint-driven strategy: (1) The survey finding (79% of responses citing cleaning or collection as primary time sinks) dictates reserving substantial engineering budget and infrastructure for data engineering rather than model tuning alone; (2) The Iteration Tax demonstrates that faster experiment cycle times allow teams to explore more hypotheses and achieve higher final quality, justifying early investment in automated platforms and experiment tracking; and (3) The Constraint Propagation Principle (^{N_{}-1}$) proves that early constraint discovery prevents exponentially compounding rework, requiring physical deployment and safety constraints to be bound at Problem Definition on day one.
Learning Objective: Evaluate the chapter’s three core quantitative takeaways to formulate an integrated resource allocation and workflow management strategy.
True or False: An ML workflow is fundamentally a coupled, closed-loop system rather than a linear checklist, meaning that optimizing any individual stage in isolation merely shifts and compounds failures across data, algorithm, and machine dimensions rather than eliminating them.
Answer: True. The central thesis of the chapter is that data, algorithms, and hardware form an interdependent system. Optimizing model accuracy without considering hardware memory budgets produces undeployable artifacts; optimizing data pipelines without understanding model needs produces irrelevant datasets; and launching without monitoring leaves systems vulnerable to silent degradation. Seeing the whole map first and managing continuous feedback across stages is what transforms ad hoc ML experimentation into disciplined systems engineering.
Learning Objective: Evaluate why the ML lifecycle functions as a coupled closed-loop system rather than an isolated linear checklist.