Từ Logic đến Số học
Tính toán nơ-ron
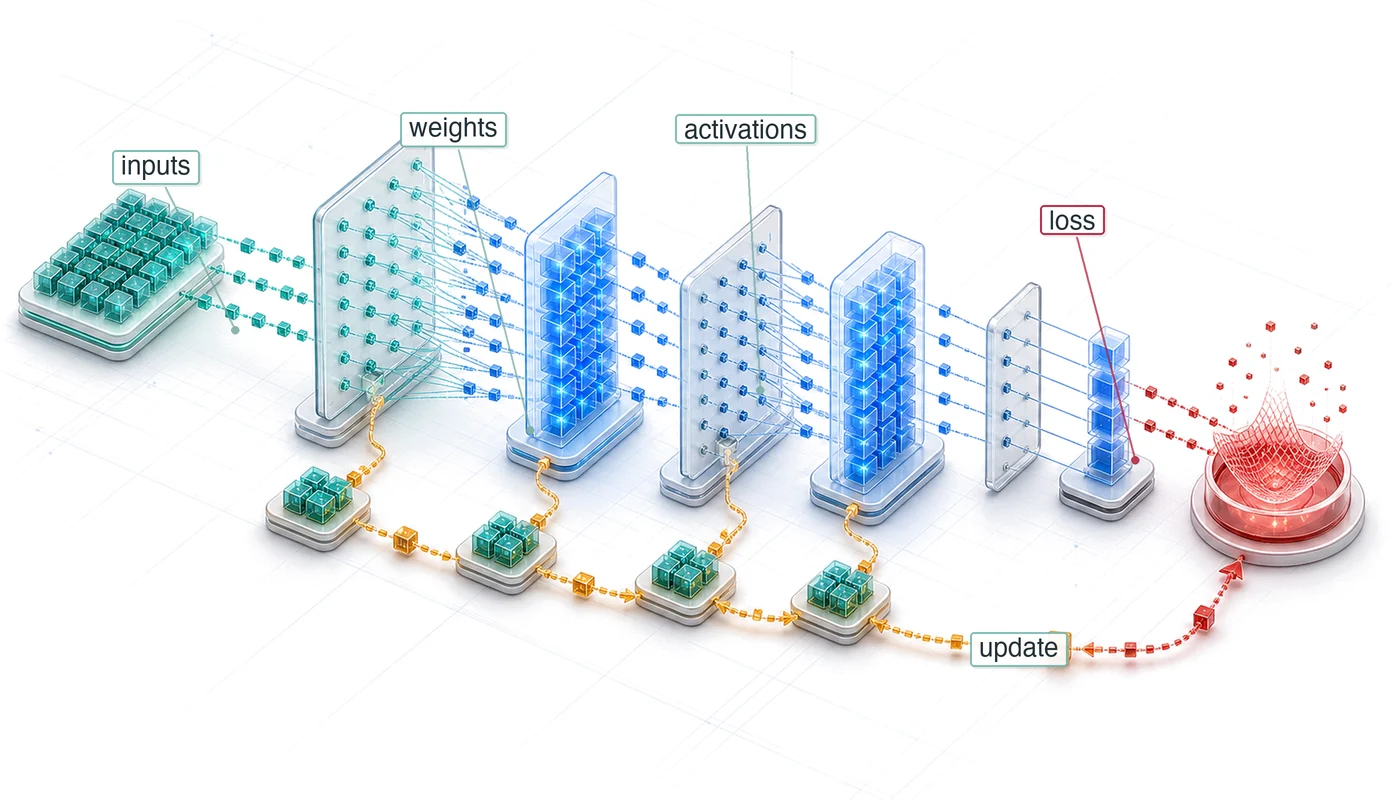
Mục đích
Vì sao hiểu phần toán của một mạng nơ-ron quan trọng hơn đọc mã của nó?
Mã của mạng nơ-ron trông có vẻ đơn giản vì chỉ vài phép toán tensor đã che đi khối lượng công việc (workload) mà mỗi lớp phải thực hiện. Kích thước ma trận quyết định phép toán số học và luân chuyển dữ liệu; các giá trị trung gian quyết định áp lực bộ nhớ; miền giá trị số và gradient quyết định việc huấn luyện có ổn định hay không. Một phép toán trông rẻ khi đứng riêng lẻ có thể trở thành chi phí chi phối khi lặp trên một batch hoặc khi đầu ra của nó phải giữ lại cho việc huấn luyện, nên độ dài mã nguồn hầu như không phản ánh chi phí tài nguyên. Hai cách triển khai cùng một mô hình có thể chạy rất khác nhau vì hình dạng batch, độ chính xác và máy mục tiêu quyết định cái gì vừa bộ nhớ, chạy nhanh đến mức nào, và các phép tính có còn hợp lệ về mặt số học hay không. Khi huấn luyện bị chững lại hoặc triển khai cạn bộ nhớ, đọc một lệnh gọi framework hiếm khi chỉ ra ràng buộc then chốt. Lỗi số học, nút thắt bộ nhớ và một cách triển khai kém hiệu quả có thể tạo ra những triệu chứng bề mặt giống nhau nhưng đòi hỏi các cách khắc phục khác nhau. Vì vậy, chẩn đoán và lập kế hoạch cần suy luận từ các phép toán nền tảng ra số byte được luân chuyển, các giá trị phải giữ lại, và phần việc bị lặp lại. Cách nhìn này có thể lộ ra một bất khớp trước khi bạn tốn kém cho một lượt huấn luyện hoặc một lần thử triển khai. Các phép toán cơ sở đó tạo nên một vốn từ vựng ổn định xuyên kiến trúc và giúp các lớp trừu tượng phần mềm có thể kiểm chứng, biến mã khó hiểu thành một khối lượng công việc (workload) có thể đo, chẩn đoán và ánh xạ lên phần cứng. Theo thuật ngữ D·A·M, tính toán nơ-ron là giao diện nơi cấu trúc thuật toán trở thành công việc của máy và nơi các giới hạn vật lý phản hồi trở lại thiết kế mô hình.
Learning Objectives
- Giải thích vì sao số học học được đã thay thế logic dựa trên quy tắc trong nhận dạng mẫu đa chiều.
- Tính toán số lượng tham số, số phép nhân-tích lũy, lưu trữ activation và lưu lượng bộ nhớ cho các mạng đa lớp
- So sánh các hàm activation theo độ phi tuyến tính, hành vi gradient và chi phí thực thi trên phần cứng
- Áp dụng hàm mất mát cross-entropy và các cập nhật gradient để phân tích động thái của học có giám sát.
- Suy ra lan truyền thuận và lan truyền ngược dưới dạng các phép toán ma trận trên các batch.
- Phân tích khối lượng công việc (workload) của huấn luyện so với suy luận dưới các ràng buộc về tính toán, bộ nhớ và triển khai.
- Đánh giá một pipeline nhận dạng tài liệu end-to-end, từ tiền xử lý đến các ngưỡng quyết định và bước đánh giá thủ công.
Một tập dữ liệu đã hoàn tất các giai đoạn kỹ thuật trước đó sẽ sẵn sàng cho việc phát triển mô hình, nhưng các ví dụ thì không thể tự học. Ranh giới hệ thống tiếp theo là mô hình, nơi dữ liệu được chuyển thành hành vi đã học thông qua các phép nhân ma trận, các hàm activation và các cập nhật gradient. Một mô hình chạy đúng trên máy này nhưng lại lỗi trên máy khác không nhất thiết là do lỗi phần cứng. Kích thước các lớp của mô hình có thể tạo ra các activation trung gian — các đầu ra theo từng lớp mà quá trình huấn luyện giữ lại cho bước lan truyền ngược — vượt quá bộ nhớ khả dụng. Lỗi này phát sinh do sự không tương thích giữa khối lượng công việc (workload) của mô hình và ngân sách tài nguyên của máy.
Cái gọi là ‘hợp đồng silicon’ nói rằng mọi kiến trúc mô hình đều có một sự đánh đổi về tính toán với phần cứng mà nó chạy trên đó. Ở phía thuật toán, các toán tử của kiến trúc quyết định khối lượng tính toán và trạng thái cần thiết. Sau đó, độ chính xác, cách triển khai, khả năng tái sử dụng dữ liệu, runtime và phần cứng sẽ quyết định lưu lượng bộ nhớ, độ trễ và năng lượng thực tế. Để tuân thủ ‘hợp đồng’ này, một kỹ sư hệ thống phải hiểu cả các toán tử và cách chúng được ánh xạ lên máy.
Các toán tử được nêu dưới đây không phải lý thuyết trừu tượng mà là đặc tả cho các khối lượng công việc (workload) tính toán. Tính toán nơ-ron chuyển trọng tâm từ các lệnh logic rõ ràng (if-then-else) sang những chuỗi dài các phép biến đổi toán học liên tục (nhân-cộng-tích lũy). Sự chuyển dịch từ Logic sang Số học này tạo ra các khối lượng công việc tensor dày đặc, mà điểm nghẽn phụ thuộc vào cường độ số học, kích thước batch, mức độ tái sử dụng và “đường bao” hiệu năng phần cứng (hardware roofline: phạm vi hiệu năng do đỉnh năng lực tính toán và băng thông bộ nhớ của chip quyết định). Lỗi trong một hệ như vậy có thể xuất phát từ bất ổn số học, gradient co về 0, hoặc hàm activation ngừng thay đổi theo đầu vào của nó, chứ không phải từ lỗi cú pháp. Cụ thể, nhận dạng một chữ số viết tay đơn lẻ trong mạng MNIST đang chạy cần 109,184 MACs mà không có nhánh logic nào trong quá trình tính toán của mô hình.
Số học không có nhánh không đồng nghĩa không có rủi ro: một số vượt quá dải biểu diễn của định dạng có thể gây ra exception hoặc âm thầm trở thành giá trị vô hạn (infinite) hay không hợp lệ (invalid), tùy phép toán và runtime. Một ví dụ kinh điển về vấn đề này thậm chí còn nằm ngoài lĩnh vực machine learning.
War Story 1.1: Sự cố tràn số trở thành dẫn hướng (1996)
Bối cảnh: Chuyến bay Ariane 5 Flight 501 của Cơ quan Vũ trụ Châu Âu tái sử dụng phần mềm tham chiếu quán tính từ Ariane 4, trong đó có các phép chuyển đổi số với những giả định chỉ phù hợp với đặc tính bay của phương tiện đời trước (European Space Agency 1996).
Cơ chế: Đặc tính bay của Ariane 5 khiến một giá trị dấu phẩy động 64-bit vượt quá dải của số nguyên 16-bit có dấu trong quá trình chuyển đổi, kích hoạt một lỗi toán hạng không được xử lý (unhandled operand error).
Tác động: Máy tính điều khiển chuyến bay sập sau 36 giây kể từ khi phóng, khiến tên lửa chệch quỹ đạo, vỡ tan và tự hủy, phá hủy tải trọng vệ tinh trị giá 370 triệu đô la.
Phản ứng: Ủy ban điều tra khuyến nghị giới hạn phần mềm ở các chức năng cần thiết trong chuyến bay, rà soát lại các giả định về dải giá trị, và thiết kế cơ chế xử lý exception sao cho một lỗi chuyển đổi đơn lẻ không thể vô hiệu hóa các đơn vị dự phòng (European Space Agency 1996).
Bài học về hệ thống: Khoảng giá trị số, cơ chế xử lý ngoại lệ (exception handling) và các giả định khi tái sử dụng là một phần của ràng buộc hệ thống. Một phép tính có thể đúng về cú pháp nhưng vẫn không hợp lệ trong miền vận hành vật lý nơi nó chạy. Hệ thống ML gặp điều này khi khoảng biểu diễn của một định dạng số không khớp với độ lớn giá trị đi qua: chẳng hạn, một phép nhân độ chính xác thấp bị tràn sẽ tạo ra Inf hoặc NaN và các giá trị này âm thầm lan qua phần còn lại của phép tính, khiến các chế độ số học quan trọng với gỡ lỗi chẳng kém luồng điều khiển.
European Space Agency. 1996. Ariane 501: Presentation of Inquiry Board Report. European Space Agency press release.
Definition 1.1: Deep learning
Deep learning là một mô hình tính toán học các biểu diễn đặc trưng theo lớp từ dữ liệu bằng cách ghép các phép biến đổi phi tuyến. Với các tác vụ phù hợp, những biểu diễn học được này có thể giảm thiết kế đặc trưng thủ công, đồng thời làm tăng khối lượng tính toán \((O)\) và trạng thái.
- Ý nghĩa: Với các lớp hàm có tính chất tổ hợp phù hợp, độ sâu có thể biểu diễn một hệ phân cấp hiệu quả về tham số hơn nhiều so với mạng nông. Mỗi lớp đều thêm khối lượng công việc và trạng thái, và ràng buộc chi phối có thể nằm ở trục dữ liệu, thuật toán, hoặc máy, tùy theo khối lượng công việc (workload).
- Điểm khác biệt: Các phương pháp nông như hồi quy logistic và máy vector hỗ trợ có thể hoạt động tốt với các biểu diễn phù hợp. Thay vào đó, deep learning sử dụng nhiều giai đoạn phi tuyến để học các biểu diễn đồng thời với tác vụ dự đoán, điều này có thể giảm bớt việc thiết kế đặc trưng thủ công và đôi khi hỗ trợ chuyển giao giữa các tác vụ.
- Lỗi thường gặp: Một quan niệm sai lầm phổ biến là chỉ riêng số lượng tham số đã giải thích được deep learning. Chiều rộng có thể xấp xỉ các lớp hàm rộng, nhưng chiều sâu có thể mã hóa một số hàm tổ hợp hiệu quả hơn nhiều. Kiến trúc, dữ liệu, tối ưu hóa và quy mô cùng nhau quyết định kết quả thực tế.
Phân tích này xem deep learning như một khối lượng công việc (workload) tính toán ở mức vật lý: xem xét các phép toán mà các mạng truyền thẳng trong chương này sử dụng, đánh giá cách chúng ghép lại thành các cấu trúc kiến trúc, và đo lường phần cứng phải đáp ứng gì cho huấn luyện và suy luận trong phân loại D·A·M. Một bộ nhận dạng chữ số viết tay đơn giản giúp cụ thể hóa từng loại chi phí. Bài tổng quan mang tính cột mốc trên Nature của LeCun, Bengio và Hinton1 (LeCun et al. 2015) đã tổng hợp khuôn khổ này.
1 LeCun, Bengio, và Hinton: Những người nhận Giải thưởng Turing ACM 2018 vì những đột phá về khái niệm và kỹ thuật đã biến các mạng nơ-ron sâu thành một thành phần quan trọng của điện toán. Công trình tập thể của họ đã thúc đẩy học biểu diễn, kiến trúc mạng và các phương pháp huấn luyện làm nền tảng cho deep learning hiện đại.
Machine learning cổ điển thường yêu cầu các chuyên gia thiết kế bộ trích xuất đặc trưng cho mỗi bài toán mới, một quá trình tốn nhiều công sức khi phải mã hóa kiến thức miền vào các biểu diễn làm tay. Deep learning có thể giảm gánh nặng này bằng cách học các biểu diễn từ dữ liệu thông qua các lớp biến đổi phi tuyến tính theo cấu trúc phân cấp. Để thấy mạng nơ-ron nằm ở đâu trong bức tranh rộng hơn, figure 1 kết hợp hai góc nhìn: một dòng thời gian lịch sử các cột mốc lớn và một phân loại lồng nhau trong đó deep learning là tập con của machine learning, và machine learning lại là tập con của trí tuệ nhân tạo.

Sự chuyển dịch này kéo theo những bài toán kỹ thuật mà cách gỡ lỗi phần mềm truyền thống không xử lý được. Lỗi trong deep learning có thể bộc lộ bằng những dấu hiệu khó nhận ra: mất ổn định gradient2 khiến việc huấn luyện không tiến triển, lỗi độ chính xác số làm sai lệch trọng số của mô hình sau nhiều vòng lặp, hoặc kiểu truy cập bộ nhớ kém hiệu quả trong các phép toán tensor3 khiến các đơn vị tính toán của bộ tăng tốc không được tận dụng hết. Đây là những vấn đề ở cấp hệ thống, đòi hỏi hiểu rõ cơ chế toán học bên dưới, chứ không chỉ đơn giản là lần theo từng dòng mã.
2 Mất ổn định gradient: Trong một đường truyền sigmoid gồm 20 lớp được đơn giản hóa, chỉ riêng các thừa số là đạo hàm của activation đã không vượt quá \(0.25^{20}\), hay \(9.1 \times 10^{-13}\). Gradient đầy đủ còn bao gồm trọng số và các phép toán khác, nhưng việc lặp lại các đạo hàm bị bão hòa vẫn có thể khiến các cập nhật ở các lớp đầu trở nên không đáng kể. Các đoạn phẳng (plateaus) hoặc giá trị NaN có thể bộc lộ triệu chứng mà không chỉ ra nguyên nhân; activation ReLU (rectified linear unit), khởi tạo cẩn thận, chuẩn hóa, các phương pháp tối ưu hóa, và các kết nối dư đều đã giúp các mạng sâu có thể huấn luyện được, và Kết nối bỏ qua: Giải quyết vấn đề độ sâu trình bày chi tiết về các kết nối dư.
3 Các phép toán tensor: Các chiều logic của một tensor được ánh xạ xuống một bố cục vật lý phẳng, và một kernel có thể ưa thích một thứ tự khác. Nếu đổi một đầu vào ImageNet điển hình (224×224×3, khoảng 151 KB) từ kênh-đứng-trước sang kênh-đứng-sau mà phải sắp xếp lại dữ liệu thực trên bộ nhớ, thì sẽ phát sinh khoảng 301 KB lưu lượng đọc và ghi cho mỗi ảnh mà không làm thay đổi kết quả toán học của mô hình. Một số runtime tránh việc sao chép thông qua các view, fusion, hoặc một kernel tương thích. Khi không tránh được việc sắp xếp lại, nó có thể ngốn một phần ngân sách suy luận vốn rất chặt trước khi các phép tính chính của mô hình bắt đầu.
Chẩn đoán và xử lý các lệch về bố cục như vậy đòi hỏi hiểu rõ cách những lựa chọn toán học chuyển trực tiếp thành khối lượng công việc (workload) tính toán. Nhu cầu cấu trúc của mô hình phụ thuộc vào cách hệ thống biểu diễn các mẫu—bằng các quy tắc tường minh, các đặc trưng được thiết kế, hay các biểu diễn học từ đầu đến cuối. Một chữ số MNIST cụ thể làm rõ sự chuyển đổi đó khi nó đi qua ba cách tiếp cận tính toán, và mỗi bước lại định hình lại phần việc của hệ thống.
Tính toán với các mẫu
Sự chuyển từ logic sang số học làm thay đổi cách máy tính mã hóa các mẫu trong thế giới thực. Phân tích này theo dõi một tác vụ xuyên suốt cả ba cách tiếp cận: phân loại một chữ số viết tay từ ảnh \(28{\times}28\) pixel của tập dữ liệu MNIST (cùng đầu vào được dùng trong suốt chương này). Bức tranh tính toán thay đổi khi các chiến lược biểu diễn tiến hóa.
Từ logic tường minh đến các mẫu học được
Lập trình dựa trên quy tắc yêu cầu các nhà phát triển chỉ rõ các thủ tục để ánh xạ đầu vào thành đầu ra. Hãy xem một trò chơi đơn giản như Breakout.4 Trình mô phỏng của nó sử dụng các quy tắc va chạm tường minh: khi quả bóng chạm vào một viên gạch, mã sẽ loại bỏ viên gạch và đảo ngược hướng bóng (figure 2). Những quy tắc tổng quát như vậy hoạt động tốt cho vật lý trò chơi được định nghĩa rõ ràng, nhưng việc tự tay xây dựng một chính sách nhận dạng cho mọi biến thể trong dữ liệu thực tế lộn xộn, không có cấu trúc thì không thể mở rộng.
4 Breakout (DQN - deep Q-network): Trò chơi arcade Breakout năm 1976 của Atari đã trở thành một cột mốc trong AI khi DQN của DeepMind học được một chính sách chơi từ các pixel (năm 2015) mà không cần một chính sách được viết thủ công cho từng tình huống. Môi trường, không gian hành động, phần thưởng và tiền xử lý vẫn được lập trình. DQN đưa khung hình về kích thước \(84{\times}84\), xếp chồng 4 khung hình làm đầu vào, và cứ mỗi 4 khung hình lại chọn một hành động mới, minh họa rằng điều khiển học được vẫn phụ thuộc vào một vòng lặp suy luận thời gian thực do con người thiết kế.

Luồng dữ liệu trong figure 3 làm rõ mối quan hệ của lập trình truyền thống: một chương trình áp dụng các thủ tục định sẵn lên dữ liệu đầu vào để tạo ra đầu ra. Nghiên cứu trí tuệ nhân tạo thời kỳ đầu từng xem liệu các quy tắc ký hiệu do con người viết tay có thể mở rộng để xử lý các tác vụ suy luận và nhận dạng phức tạp hay không.

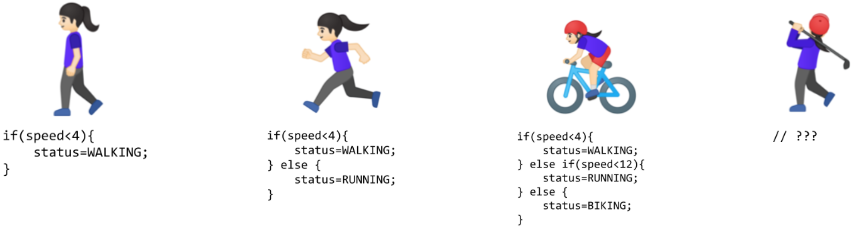
Dù nhìn có vẻ đơn giản, các hệ thống dựa trên quy tắc bộc lộ hạn chế rất nhanh khi gặp các tác vụ phức tạp ngoài đời thực. Nhận dạng hoạt động của con người là một ví dụ điển hình cho thách thức này. Phân loại chuyển động dưới 4 km/h là đi bộ tưởng như đơn giản, cho đến khi sự phức tạp của thế giới thực xuất hiện. Các biến thiên về tốc độ, chuyển đổi giữa các hoạt động và những trường hợp không lường trước đều đòi hỏi phải bổ sung thêm quy tắc, như các đoạn mã kế tiếp trong figure 4 cho thấy. Các bài toán thị giác máy tính còn làm những khó khăn này trầm trọng hơn. Để phát hiện mèo, cần có các quy tắc về tai, ria mép và hình dạng cơ thể, đồng thời phải tính đến góc nhìn, ánh sáng, vật cản và các biến thiên tự nhiên. Các hệ thống thời kỳ đầu chỉ thành công trong những môi trường được kiểm soát với các ràng buộc được xác định rõ ràng.
Nhận ra những hạn chế đó, cách tiếp cận kỹ thuật tri thức, vốn đặc trưng cho nghiên cứu AI trong thập niên 1970–1980, tìm cách hệ thống hóa việc tạo luật. Các hệ thống chuyên gia5 mã hóa kiến thức lĩnh vực thành các quy tắc tường minh. Chúng cho thấy nhiều triển vọng trong các miền cụ thể với các tham số được xác định rõ ràng, nhưng lại chật vật với những tác vụ con người làm tự nhiên như nhận dạng đối tượng, hiểu lời nói và diễn giải ngôn ngữ tự nhiên. Những thất bại này làm nổi bật một thách thức sâu sắc hơn: nhiều khía cạnh của hành vi thông minh dựa vào kiến thức ngầm, khó thể hiện bằng các quy tắc tường minh.
5 Hệ thống chuyên gia: Các hệ thống này chuyển kiến thức chuyên môn của con người thành các luật IF-THEN tường minh. Cách tiếp cận kỹ thuật tri thức này khó mở rộng cho những tác vụ như nhận dạng đối tượng, nơi rất khó liệt kê hết các biến thiên liên quan. Ngay cả các hệ thống thành công như XCON của DEC cũng tích lũy hàng nghìn luật viết tay, khiến việc thu thập luật, đảm bảo tính nhất quán và bảo trì trở thành những chi phí kỹ thuật trọng yếu.
Hãy xem xét một bộ phân loại dựa trên luật minh họa cho một chữ số 28x28: so sánh cường độ pixel với các ngưỡng, kiểm tra các mẫu nét vẽ trong những vùng cụ thể, rồi rẽ nhánh theo kết quả. Với bản cài đặt minh họa này, lượng tính toán vào khoảng 100 comparisons trên 784 bytes dữ liệu pixel—nhỏ, có thể dự đoán và tương thích với cache của CPU thông thường. So sánh này thiết lập một đường cơ sở cho khối lượng công việc (workload), không phản ánh độ chính xác của một hệ thống luật trong môi trường sản xuất.
Nút thắt cổ chai trong kỹ thuật đặc trưng
Những thất bại của các hệ thống dựa trên luật gợi ý một hướng khác: thay vì mã hóa kiến thức của con người thành các luật tường minh, hãy để hệ thống tự khám phá các mẫu từ dữ liệu. machine learning mở ra hướng đi này—thay vì viết luật cho mọi tình huống, các nhà nghiên cứu viết các chương trình để nhận diện các mẫu trong các ví dụ. Tuy vậy, thành công của các phương pháp này vẫn phụ thuộc rất nhiều vào trực giác của con người để xác định cần tìm những mẫu nào, một quá trình gọi là kỹ thuật đặc trưng.
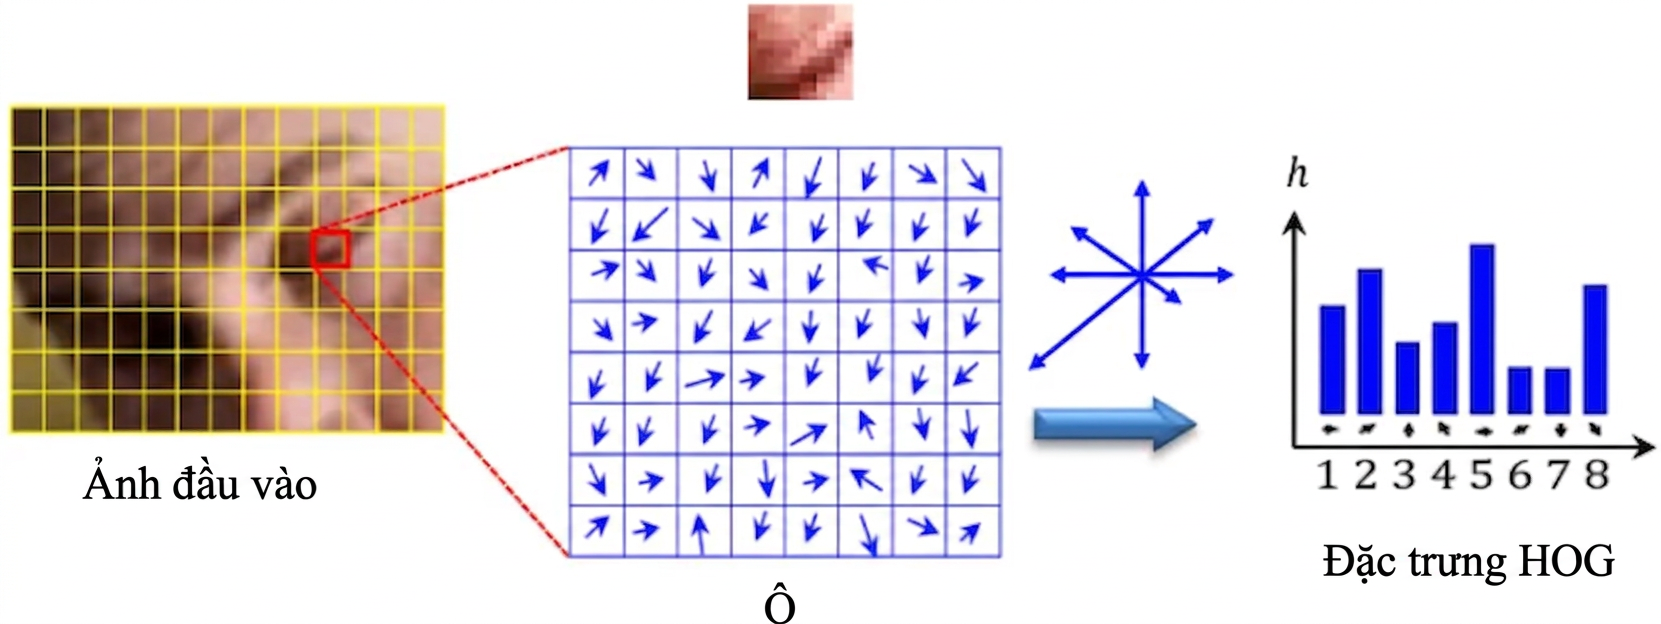
Kỹ thuật đặc trưng biến dữ liệu thô thành các biểu diễn giúp thuật toán học nhận ra mẫu dễ hơn. Phương pháp histogram of oriented gradients (HOG)6 (Dalal and Triggs 2005) là ví dụ tiêu biểu: nó xác định các edge nơi độ sáng thay đổi mạnh, chia ảnh thành các ô (cell), và đo hướng edge trong từng ô (figure 5). Nhờ vậy, các pixel thô được chuyển thành các mô tả hình dạng ít bị ảnh hưởng bởi thay đổi ánh sáng và những dịch chuyển nhỏ.
6 Biểu đồ gradient định hướng (HOG): Một bộ mô tả thủ công có ảnh hưởng để phát hiện người đi bộ trước thời deep learning (Dalal and Triggs 2005). Một cấu hình phổ biến của HOG là tính toán hướng gradient trong các ô \(8{\times}8\) pixel, trong đó kích thước ô và các lựa chọn khác được tinh chỉnh cho từng tác vụ. Quy trình tính toán cố định của HOG có thể chạy hiệu quả trên CPU với độ trễ dự đoán được, trong khi các đặc trưng được học (learned features) có thể giảm công sức thiết kế lại bộ mô tả nhưng không tự động chuyển sang miền khác và thường chỉ bắt đầu hưởng lợi từ các bộ tăng tốc khi quy mô mô hình và kích thước batch tăng.
Dalal, Navneet, and Bill Triggs. 2005. “Histograms of Oriented Gradients for Human Detection.” 2005 IEEE Computer Society Conference on Computer Vision and Pattern Recognition (CVPR’05) 1: 886–93. https://doi.org/10.1109/cvpr.2005.177.
Bakheet, Samy, and Ayoub Al-Hamadi. 2021. “A Framework for Instantaneous Driver Drowsiness Detection Based on Improved HOG Features and Naïve Bayesian Classification.” Brain Sciences 11 (2): 240. https://doi.org/10.3390/brainsci11020240.
Các phương pháp bổ trợ như scale-invariant feature transform (SIFT)7 (Lowe 1999) và bộ lọc Gabor8 giúp nắm bắt các mẫu thị giác khác nhau. SIFT phát hiện các keypoint ổn định trước thay đổi về tỷ lệ và hướng, còn bộ lọc Gabor nhận biết kết cấu và tần số. Mỗi phương pháp này đều mã hoá hiểu biết chuyên môn về nhận dạng mẫu thị giác.
7 Biến đổi đặc trưng bất biến theo tỷ lệ (SIFT): SIFT mã hóa phần hiểu biết miền này thành một thuật toán bốn bước, xác định các điểm đặc trưng ổn định theo tỷ lệ và góc xoay. Số lượng điểm đặc trưng phát hiện được thay đổi theo từng ảnh, nên khó tạo batch có hình dạng cố định. Hệ thống có thể chuẩn hóa cách biểu diễn bằng cách đặt ngưỡng (caps), đệm (padding), gộp (pooling) hoặc dùng mã hóa cố định, nhưng lựa chọn nào cũng hoặc tăng chi phí tính toán, hoặc làm mất thông tin.
Lowe, David G. 1999. “Object Recognition from Local Scale-Invariant Features.” Proceedings of the Seventh IEEE International Conference on Computer Vision 2: 1150–1157 vol.2. https://doi.org/10.1109/iccv.1999.790410.
8 Bộ lọc Gabor: Ban đầu được phát triển cho phân tích thời gian–tần số cục bộ (Gabor 1946), các bộ lọc này phát hiện edge và texture ở những hướng và tần số cụ thể. Một ngân hàng bộ lọc điển hình gồm nhiều bộ lọc được thiết kế thủ công, bao phủ các hướng và tần số khác nhau. Ngược lại, các lớp tích chập sâu học các kernel nhỏ trực tiếp từ dữ liệu; ở các mạng nơ-ron tích chập (CNN) giai đoạn đầu, các bộ lọc thường trở thành những bộ phát hiện nhạy với edge, màu sắc và texture, chuyển việc thiết kế đặc trưng từ các ngân hàng bộ lọc thủ công sang tối ưu hóa dựa trên dữ liệu (Krizhevsky et al. 2012; LeCun et al. 2015).
Gabor, D. 1946. “Theory of Communication. Part 1: The Analysis of Information.” Journal of the Institution of Electrical Engineers - Part III: Radio and Communication Engineering 93 (26): 429–41. https://doi.org/10.1049/ji-3-2.1946.0074.
LeCun, Yann, Yoshua Bengio, and Geoffrey Hinton. 2015. “Deep Learning.” Nature 521 (7553): 436–44. https://doi.org/10.1038/nature14539.
Những nỗ lực kỹ thuật này đã thúc đẩy các tiến bộ trong thị giác máy tính suốt thập niên 2000. Hệ thống nay có thể nhận biết vật thể khá vững trước các biến thiên ngoài đời thực, dẫn tới các ứng dụng như phát hiện khuôn mặt, phát hiện người đi bộ và nhận dạng vật thể. Dù vậy, cách tiếp cận này vẫn có hạn chế. Chuyên gia phải thiết kế thủ công bộ trích xuất đặc trưng cho từng bài toán mới, và các đặc trưng tạo ra có thể bỏ lỡ những mẫu quan trọng không được lường trước khi thiết kế. Điểm nghẽn vẫn còn: chuyên môn của con người không thể mở rộng kịp với mức độ phức tạp và đa dạng của các mẫu thị giác ngoài đời thực.
Quay lại chữ số 28×28 đó. Trong ví dụ minh họa này, HOG chia ảnh thành lưới 7 × 7 với các ô 4×4, tính độ lớn và hướng gradient, gom chúng vào 9 biểu đồ hướng cho mỗi ô, rồi tạo một vector đặc trưng 441 phần tử. Một bộ phân loại Support Vector Machine (SVM) tuyến tính sau đó thực hiện mười phép tích vô hướng trên vector này. Kết quả tốn khoảng 8,000 operations phép toán và khoảng 2 KB bộ nhớ làm việc—khoảng 80× lần khối lượng công việc so với đường cơ sở dựa trên luật đơn giản, nhưng vẫn có cấu trúc và tận dụng tốt các đơn vị vector của CPU nhờ một lệnh, nhiều dữ liệu (SIMD). Kích thước bộ mô tả, số lớp và cách triển khai đều làm thay đổi chi phí này.
Khám phá mẫu tự động
Do những hạn chế của các đặc trưng thiết kế thủ công, ta cần một cách tiếp cận triệt để hơn: thay vì tự tay mã hóa đặc trưng, hệ thống sẽ tự tìm ra chúng. Mạng nơ-ron thể hiện chính xác sự chuyển dịch này—thay vì tuân theo các quy tắc rõ ràng hay dựa vào bộ trích xuất đặc trưng do con người thiết kế, hệ thống học các biểu diễn trực tiếp từ dữ liệu thô.
Học có giám sát làm thay đổi mối quan hệ lập trình truyền thống. Thay vì phải tự mã hóa từng quy tắc quyết định, kỹ sư cung cấp các ví dụ cùng đáp án mong muốn, và quá trình tối ưu hóa tạo ra một mô hình đã học. Figure 6 khiến mối quan hệ này trở nên hữu hình bằng cách cho thấy các quy tắc đã học xuất hiện ở đầu ra thay vì đầu vào. Dù vậy, con người vẫn định hình bài toán thông qua dữ liệu, mục tiêu, kiến trúc và cách đánh giá.

Thông qua quá trình tự động này, hệ thống khám phá các mẫu từ ví dụ. Chẳng hạn, khi được cung cấp hàng triệu ảnh mèo, nó học cách nhận diện các mẫu thị giác ngày càng phức tạp, bắt đầu từ những đường biên đơn giản cho đến các tổ hợp tạo thành các đặc trưng giống mèo. Điều này tương tự cách các hệ thống thị giác sinh học hoạt động: xây dựng hiểu biết từ những yếu tố thị giác cơ bản đến các vật thể phức tạp.
Việc xếp chồng các mẫu một cách tuần tự cho thấy rõ tại sao độ sâu của mạng nơ-ron lại quan trọng. Với một số lớp hàm có tính chất tổng hợp, các mạng sâu có thể biểu diễn những hàm mà mạng nông phải rộng hơn rất nhiều mới làm được. Ưu thế này đã được chính thức hóa trong section 1.2.1.
Deep learning thường thể hiện khả năng mở rộng theo thực nghiệm: trong một miền nhất định, hiệu suất có thể cải thiện khi tận dụng hiệu quả thêm dữ liệu, tài nguyên tính toán và dung lượng mô hình, dù mức độ tăng còn phụ thuộc vào chất lượng dữ liệu, tối ưu hóa, kiến trúc và điều kiện đánh giá. Trong cuộc thi ImageNet, các phương pháp truyền thống năm 2011 đạt tỷ lệ lỗi top-5 khoảng 25.8%. Năm 2012, AlexNet9 giảm xuống còn 15.3%. Đến 2015, ResNet đạt 3.6% lỗi top-5, thấp hơn mốc chuẩn của con người đã công bố, khoảng 5.1% theo giao thức đánh giá đó.
9 Phân chia bộ nhớ của AlexNet: Nhóm của Krizhevsky đã chia AlexNet chạy trên hai GPU NVIDIA GTX 580, mỗi GPU có 3 GB VRAM, để mô hình và trạng thái huấn luyện được phân bổ trên hai thiết bị. Cách làm này minh họa một bài học về hệ thống: một cấu hình huấn luyện có thể vượt ngân sách bộ nhớ của một thiết bị, buộc kỹ sư phải phân chia công việc và trao đổi giữa nhiều thiết bị.
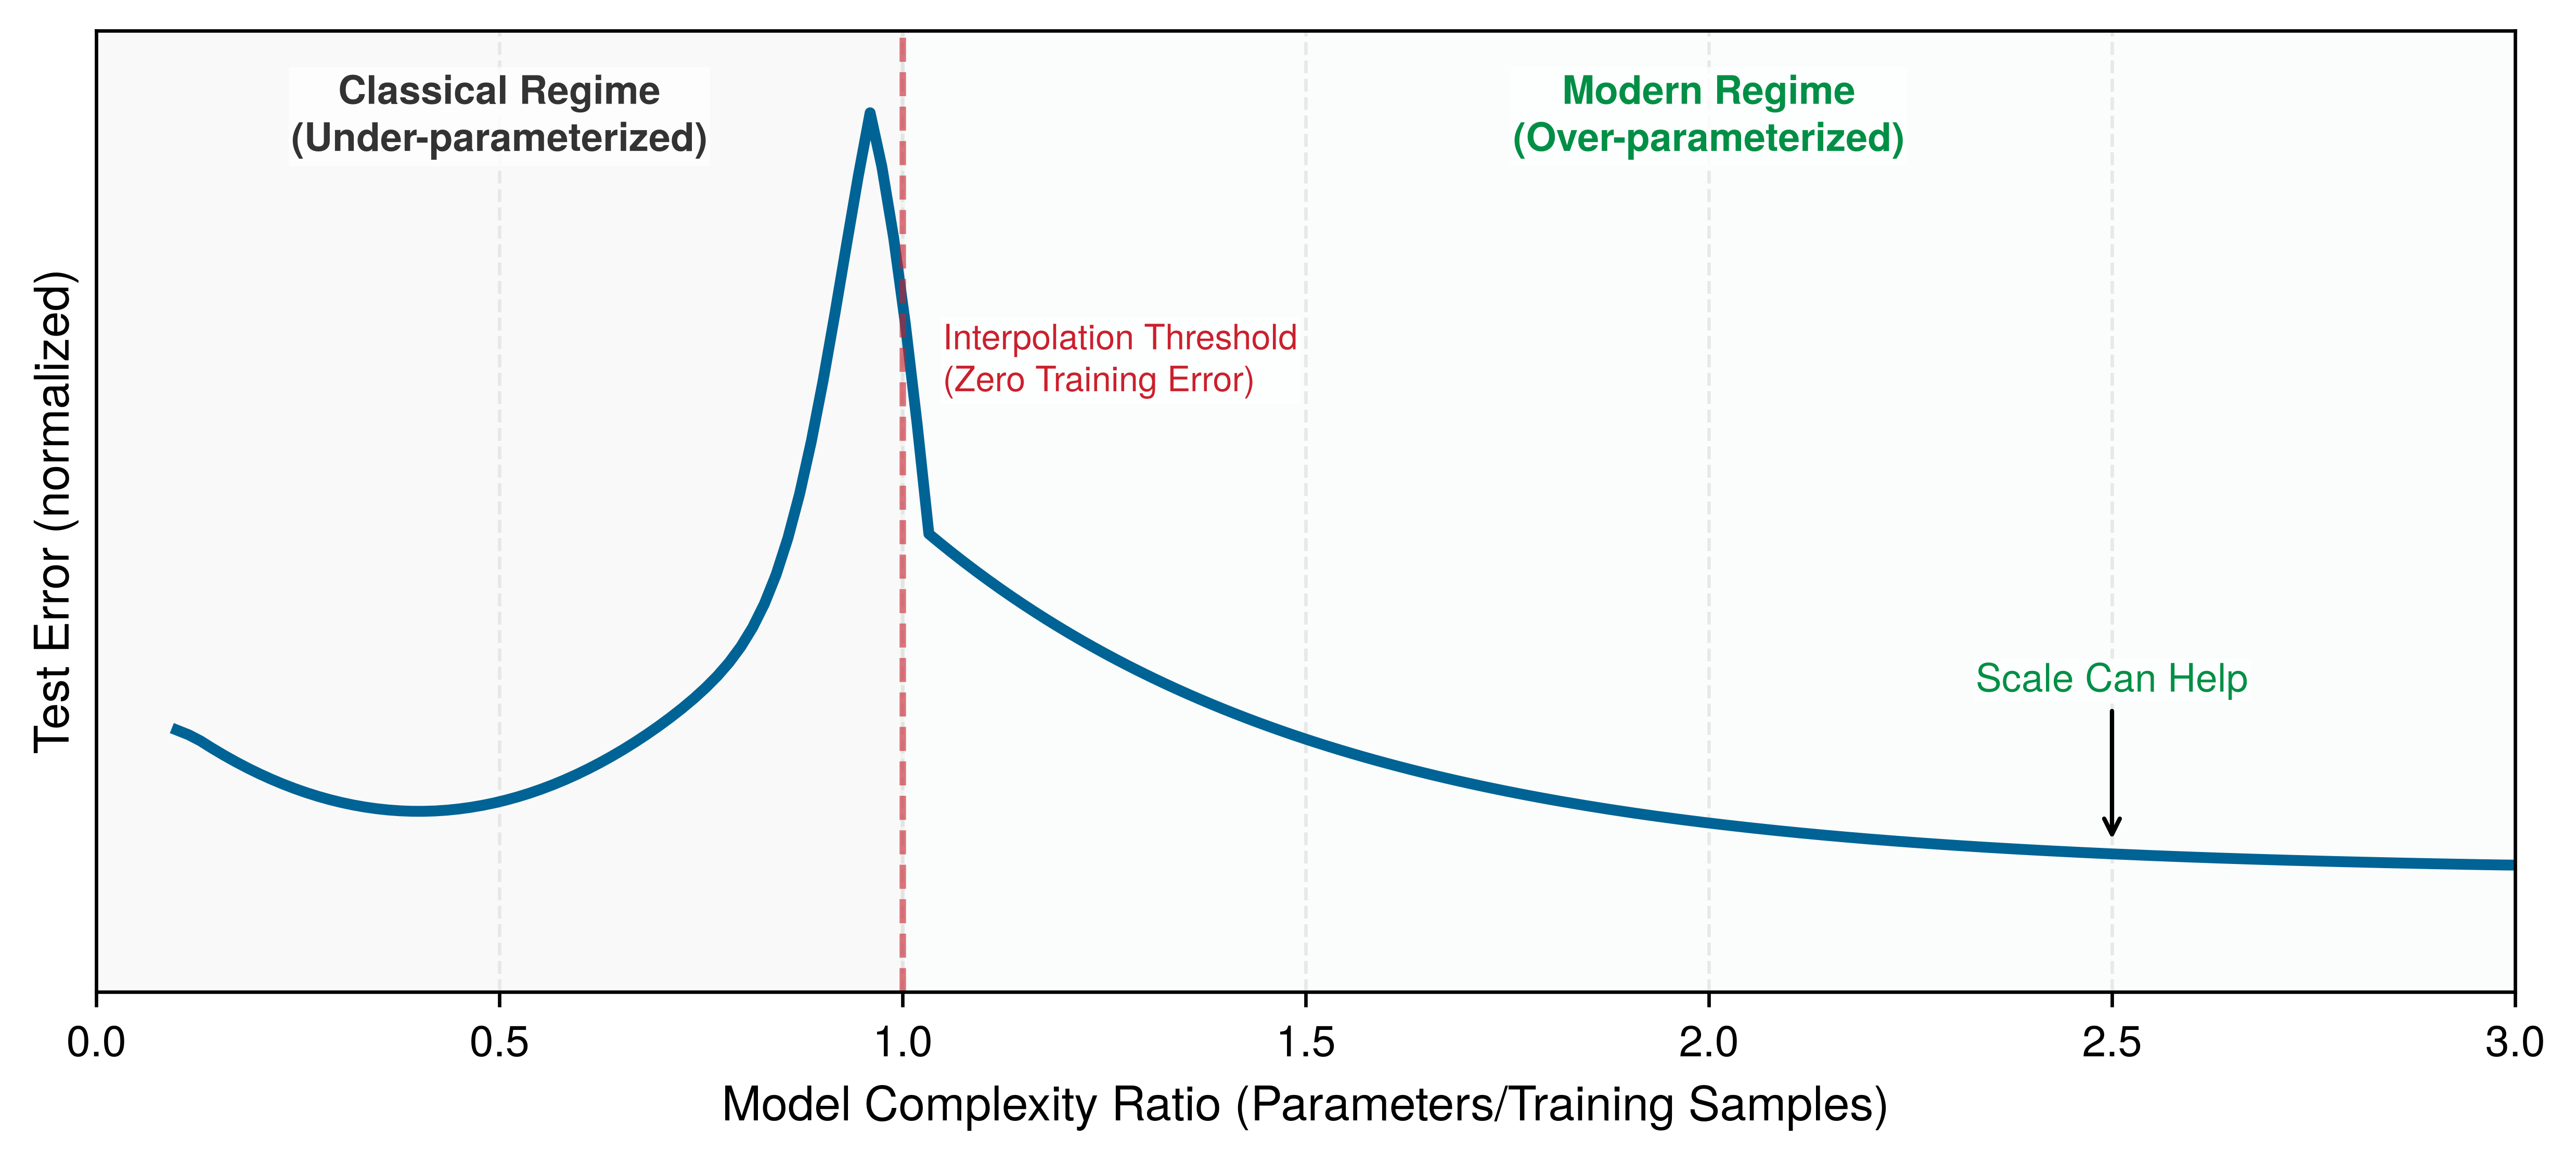
Figure 7 phác thảo một hiện tượng được quan sát dưới một số tập dữ liệu, họ mô hình và quy trình huấn luyện. Các cơ chế nền tảng (lỗi huấn luyện, overfitting, học dựa trên gradient) sẽ được trình bày ở các phần sau; phần này chỉ xác lập hình dạng có thể có. Trong miền cổ điển, đường cong lỗi có dạng chữ U. Ngưỡng nội suy đánh dấu dung lượng đủ để khớp mẫu huấn luyện, và lỗi có thể giảm trở lại trong miền quá tham số hóa. Các trục được chuẩn hóa để nhấn mạnh hình dạng thay vì gắn với một tập dữ liệu cụ thể.
Hình dạng phản trực giác này quan trọng vì lỗi kiểm thử — lỗi trên các ví dụ giữ lại, khác với các ví dụ huấn luyện mà mô hình thấy trực tiếp — ban đầu đi theo đường cong chữ U như kỳ vọng, rồi lại giảm khi mô hình có nhiều tham số hơn so với dự đoán của những lý thuyết đơn giản nhất. Hành vi này làm phức tạp cách lý giải cổ điển về quá tham số hóa. Đánh đổi độ chệch (bias) - phương sai (bias-variance trade-off)10 gợi ý rằng mô hình quá nhỏ sẽ underfit, còn mô hình có dung lượng quá mức dễ khớp cả nhiễu. Double descent (Belkin et al. 2019) cho thấy sau ngưỡng nội suy, những mô hình lớn hơn đôi khi tổng quát hóa tốt hơn mô hình nhỏ hơn. Hiệu ứng quá tham số hóa này có nghĩa là quy mô có thể là một đòn bẩy kỹ thuật, chứ không đồng nghĩa quy mô luôn an toàn: phân phối dữ liệu, quy trình huấn luyện và regularization vẫn quyết định liệu dung lượng thêm vào giúp ích hay chỉ ghi nhớ. Overfitting và các kỹ thuật regularization kiểm soát nó sẽ được trình bày chính thức trong section 1.3.4.8; phần giới thiệu này chỉ cần hình dạng của đường cong.
10 Bias-variance trade-off: Trong một số chế độ quá tham số hóa, lỗi trên tập kiểm thử giảm trở lại sau ngưỡng nội suy, nên mô tả cổ điển dạng một đường cong hình chữ U đơn là chưa đầy đủ. Hệ quả ở cấp hệ thống là không thể coi kích thước mô hình như một rủi ro overfitting luôn tăng đơn điệu trong mọi trường hợp. Mô hình lớn hơn vẫn có thể là lựa chọn kỹ thuật hữu ích, miễn là dữ liệu đo lường được, quy trình tối ưu hóa, và chế độ điều chuẩn hỗ trợ được lợi ích này.
Belkin, Mikhail, Daniel Hsu, Siyuan Ma, and Soumik Mandal. 2019. “Reconciling Modern Machine-Learning Practice and the Classical Bias–Variance Trade-Off.” Proceedings of the National Academy of Sciences 116 (32): 15849–54. https://doi.org/10.1073/pnas.1903070116.
Hiệu suất của mạng nơ-ron tuân theo các quan hệ tỉ lệ thực nghiệm, kéo theo các hệ quả trực tiếp cho hệ thống. Điểm tựa bền vững là kích thước các mô hình tiên phong và ngân sách tính toán dành cho huấn luyện đã tăng lên hàng bậc độ lớn trong thập kỷ qua (section 1.1.7 định lượng quỹ đạo này). Sự tăng trưởng đó khiến thông lượng phép tính số học, băng thông bộ nhớ, dung lượng lưu trữ và năng lực truyền thông trở thành các nút thắt cổ chai tiềm tàng, với mức độ quan trọng tùy thuộc vào khối lượng công việc (workload) và máy. Huấn luyện mô hình phát triển các công thức tỉ lệ định lượng, bao gồm cách kích thước mô hình, dữ liệu và tài nguyên tính toán đánh đổi lẫn nhau; Nén mô hình trình bày các phản ứng thực tiễn.
Không mối quan hệ nào trong số này biến kích thước mô hình thành một quy tắc quyết định. Double descent mô tả khả năng tổng quát hóa được đo lường dưới một chế độ dữ liệu và huấn luyện cụ thể, trong khi quan hệ tỉ lệ lịch sử mô tả cách đầu tư tài nguyên trên các hệ thống được lựa chọn. Việc chọn mô hình vẫn đòi hỏi so sánh các ứng viên trên dữ liệu triển khai mang tính đại diện, và tính cả tổng chi phí huấn luyện, phục vụ (serving), giám sát và bảo trì. Câu hỏi hữu ích không phải là liệu tăng quy mô có giúp ích hay không, mà là liệu lợi ích đo được có xứng đáng với các chi phí hệ thống đó hay không. So sánh này cũng cần tính đến độ bất định ở cả lợi ích lẫn chi phí.
Systems Perspective 1.1: Khi nào nên sử dụng mạng nơ-ron
Không phải mọi vấn đề đều phù hợp với deep learning. Mạng nơ-ron là lựa chọn mạnh khi dữ liệu có cấu trúc không gian, tuần tự hoặc phân cấp mà một kiến trúc có thể khai thác; khi các đường cơ sở (baseline) đơn giản không đạt chất lượng tác vụ cần thiết; và khi các lợi ích đo được đủ để bù chi phí hệ thống tổng thể (table 1). Ngược lại, với số lượng nhãn hạn chế, dữ liệu bảng có chiều thấp, các mối quan hệ gần tuyến tính, giới hạn độ trễ nghiêm ngặt hoặc yêu cầu kiểm toán chặt chẽ, các phương pháp cổ điển có thể đạt hiệu quả hữu ích tương đương mạng nơ-ron với ít công sức hơn cho huấn luyện, phục vụ (serving) và bảo trì (table 2).
| Điều kiện | Bằng chứng cần tìm | Cơ sở lý luận |
|---|---|---|
| Dữ liệu đại diện | Huấn luyện và kiểm định bao phủ các điều kiện triển khai | Năng lực không thể thay thế phạm vi thiếu sót |
| Cấu trúc có thể khai thác | Các mẫu không gian, tuần tự hoặc phân cấp | Kiến trúc có thể mã hóa thông tin tiên nghiệm hữu ích |
| Khoảng cách đường cơ sở | Các phương pháp đơn giản hơn không đạt được mục tiêu chất lượng nhiệm vụ yêu cầu | Độ phức tạp mang lại lợi ích có thể đo lường |
| Phù hợp vận hành | Lợi ích vượt qua các giới hạn về độ trễ, bộ nhớ và chi phí | Chỉ riêng độ chính xác ngoại tuyến là không đủ |
| Lợi thế bảo trì | Các đặc trưng đã học giảm các cập nhật thủ công lặp lại | Bảo trì toàn hệ thống trở nên đơn giản hơn |
| Điều kiện | Đường cơ sở để kiểm tra | Lý do để ưu tiên nó |
|---|---|---|
| Dữ liệu được gán nhãn hạn chế | Mô hình tuyến tính hoặc tập hợp cây | Phương sai thấp hơn và kiểm định dễ dàng hơn |
| Đầu vào dạng bảng có cấu trúc | Gradient boosting hoặc mô hình tuyến tính | Độ chính xác cao mà không cần các đặc trưng đã học |
| Tín hiệu gần như tuyến tính | Mô hình tuyến tính hoặc cộng tính | Thực thi minh bạch và không tốn kém |
| Giới hạn tài nguyên cứng | Các quy tắc hoặc mô hình cổ điển nhỏ gọn | Độ trễ, sử dụng bộ nhớ và nhu cầu năng lượng có thể dự đoán |
| Cần khả năng kiểm toán trực tiếp | Cây bị ràng buộc hoặc mô hình tuyến tính | Các quyết định dễ kiểm tra hơn |
Bài học hệ thống: Hãy thiết lập một đường cơ sở (baseline) đơn giản trước khi xây dựng mạng nơ-ron. So sánh các phương án theo chỉ số quan trọng của tác vụ và theo tài nguyên cần để huấn luyện, phục vụ (serving), giám sát và cập nhật. Chỉ giữ cách tiếp cận bằng mạng nơ-ron khi lợi ích đo được xứng đáng với hệ thống bổ sung đó. Lịch sử nhận dạng tài liệu trong section 1.5 cho thấy vì sao phép so sánh phải tính cả tiền xử lý, chính sách từ chối và chi phí rà soát của con người, chứ không chỉ độ chính xác của mô hình.
Học biểu diễn từ dữ liệu đang làm thay đổi cách xây dựng hệ thống AI. Việc giảm đặc trưng thủ công kéo theo những yêu cầu mới: cần hạ tầng để xử lý các tập dữ liệu lớn, phần cứng có thông lượng cao để xử lý chúng, và các bộ tăng tốc chuyên dụng để thực hiện phép tính toán học hiệu quả. Những yêu cầu tính toán này đã thúc đẩy phát triển các chip được tối ưu hóa cho các hoạt động của mạng nơ-ron. Hiện nay, deep learning là nền tảng của nhiều hệ thống lớn trong thị giác máy tính, nhận dạng giọng nói, chơi game và xử lý ngôn ngữ tự nhiên.
Quay lại chữ số 28×28, giờ được xử lý bằng mạng nơ-ron ba lớp (784 → 128 → 64 → 10) của chương này. Với các triển khai đã nêu, một lượt truyền xuôi cần 109,184 MACs phép tính, gấp 1,091.8× lần so với baseline dựa trên luật kiểu “đồ chơi”. 109,386 parameters tiêu tốn 438 KB bộ nhớ ở định dạng dấu phẩy động độ chính xác đơn 32-bit (FP32), vượt quá hầu hết cache L1 và tạo thêm lưu lượng giữa các cấp cache trong quá trình suy luận. Huấn luyện còn đội chi phí lên nữa: mỗi ảnh được xử lý cả xuôi lẫn ngược trước khi cập nhật trọng số, với số học của các lớp dày đặc (đã đơn giản hóa) xấp xỉ ba lượt truyền xuôi, lặp lại trên 60,000 ảnh qua nhiều epoch. Lúc này, các phép nhân ma trận dày đặc chiếm ưu thế trong phép toán và phù hợp với phần cứng xử lý song song. Sự thay đổi khối lượng công việc (workload) này dẫn tới một câu hỏi thực tế: khi nào kỹ sư nên đầu tư vào mạng nơ-ron thay vì các lựa chọn đơn giản hơn?
Yêu cầu về hạ tầng tính toán
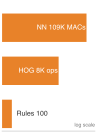
Trong so sánh MNIST này, các đặc trưng đã học tiêu tốn nhiều phép tính hơn hẳn.
Ví dụ MNIST đã lần lượt đi từ ~100 comparisons (dựa trên luật) qua ~8,000 operations (HOG) đến 109,184 MACs (mạng nơ-ron): mức tăng gấp 1,091.8× lần theo các mô hình phép toán đã nêu, kèm theo sự chuyển dịch sang các phép toán ma trận song song. Table 3 tóm tắt những xu hướng rút ra từ so sánh này.
So sánh này quan trọng vì mỗi bước làm thay đổi nút thắt cổ chai tiềm tàng: từ điều khiển CPU nhiều nhánh rẽ, sang pipeline đặc trưng theo batch, rồi đến song song ma trận với dữ liệu cấp từ bộ nhớ. CPU vẫn hiệu quả cho các mạng nhỏ và khối lượng công việc (workload) nhạy cảm với độ trễ, còn các phép toán ma trận dày đặc cỡ lớn thường được ánh xạ hiệu quả hơn sang các bộ tăng tốc.
Sự chuyển dịch sang xử lý song song tạo ra những nút thắt cổ chai mới. Thách thức trung tâm là bức tường bộ nhớ (memory wall):11 thông lượng tính toán tăng nhanh hơn băng thông bộ nhớ ngoài chip. Một phép toán ma trận bị giới hạn bởi bộ nhớ hay bởi khả năng tính toán phụ thuộc vào cường độ số học của nó: phép nhân ma trận-ma trận lớn, được xếp lát tốt, có thể bị giới hạn bởi khả năng tính toán, trong khi các lớp dạng ma trận-vector, nhỏ, mảnh (skinny) hoặc ít tái sử dụng dữ liệu thường bị giới hạn bởi băng thông.12 Các hướng đáp ứng từ phần cứng được xem xét trong Hiểu về bức tường bộ nhớ AI, còn Hệ thống phân cấp bộ nhớ trình bày chi tiết về hệ thống phân cấp bộ nhớ.
11 Bức tường bộ nhớ (Memory wall): Bộ nhớ trên chip nhanh, phản hồi trong nanô giây, còn bộ nhớ ngoài chip lớn hơn thì có độ trễ và mức tiêu thụ năng lượng cao hơn hàng bậc. Trọng số của mạng nơ-ron thường vượt quá dung lượng các cache nhỏ nhất, nên hiệu suất phụ thuộc vào xếp lát (tiling), các cấp cache lớn hơn, RAM tĩnh trên chip (SRAM) và bộ nhớ băng thông cao (HBM) để tái sử dụng dữ liệu trước khi phải đọc lại từ bộ nhớ ngoài chip. Tái sử dụng không đủ có thể khiến các đơn vị tính toán rảnh rỗi ngay cả khi đỉnh thông lượng số học rất cao.
12 Các phép toán bị giới hạn bởi bộ nhớ (Memory-bound operations): Cường độ số học của phép nhân ma trận (FLOP/byte được tải) quyết định một lớp bị giới hạn bởi tính toán hay bộ nhớ. Các lớp dưới điểm giao cắt roofline của phần cứng sẽ hoàn thành phép toán trước khi lát trọng số tiếp theo được nạp từ bộ nhớ. Hệ quả: hiệu suất sử dụng phần cứng có thể giảm mạnh, và thêm các đơn vị tính toán cũng ít mang lại tăng tốc cho đến khi băng thông bộ nhớ hoặc mức tái sử dụng dữ liệu được cải thiện.
| Khía cạnh hệ thống | Lập trình truyền thống | machine learning với các đặc trưng | deep learning |
|---|---|---|---|
| Tính toán | Thường hướng luồng điều khiển | Các phép toán song song có cấu trúc | Thường song song ma trận |
| Truy cập bộ nhớ | Phụ thuộc vào workload | Thường hướng batch | Tập làm việc tensor lớn |
| Di chuyển dữ liệu | Phụ thuộc vào chương trình và đầu vào | Di chuyển pipeline đặc trưng | Di chuyển tham số và activation |
| Nhu cầu phần cứng | Thường tập trung vào CPU | Thường là CPU với các đơn vị vector | Thường thân thiện với bộ tăng tốc |
| Mở rộng tài nguyên | Phụ thuộc vào đầu vào và chương trình | Theo hướng mô tả và dữ liệu | Được thúc đẩy bởi chiều rộng, batch, trạng thái và khả năng tái sử dụng |
Năng lượng là một ràng buộc bổ sung bên cạnh tốc độ. Việc di chuyển dữ liệu từ bộ nhớ chính đến các đơn vị xử lý có thể tiêu tốn năng lượng nhiều hơn hẳn so với một phép toán số học đơn giản (Horowitz 2014). Thứ bậc năng lượng này giải thích vì sao các bộ tăng tốc mạng nơ-ron tối đa hóa việc tái sử dụng dữ liệu: chúng giữ các giá trị được truy cập thường xuyên trong bộ nhớ cục bộ và lên lịch thao tác để giảm dịch chuyển. Việc di chuyển hay tính toán chiếm ưu thế còn tùy vào độ chính xác, mức tái sử dụng, hình dạng khối lượng công việc (workload) và phần cứng; nhưng chi phí di chuyển dữ liệu đã thúc đẩy các kiến trúc chuyên biệt, từ GPU ở trung tâm dữ liệu đến các bộ tăng tốc TinyML.
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
Sự đánh đổi giữa bộ nhớ và tính toán biểu hiện khác nhau dọc theo phổ đám mây–edge được giới thiệu trong Hệ thống ML. Máy chủ đám mây có thể dùng nhiều bộ nhớ và công suất hơn để theo đuổi thông lượng, trong khi thiết bị di động phải hoạt động trong ngân sách công suất chặt chẽ hơn. Huấn luyện với batch lớn thường nhấn mạnh thông lượng; còn suy luận nhạy cảm với độ trễ hoặc chạy bằng pin có thể ưu tiên thời gian phản hồi hoặc năng lượng cho mỗi dự đoán. Mức ưu tiên cụ thể phụ thuộc vào khối lượng công việc (workload) triển khai.
Những ràng buộc trên một máy trở nên nghiêm trọng hơn khi mở rộng sang nhiều máy: các lớp dày đặc mở rộng theo các chiều liền kề, quy mô batch làm tăng nhu cầu lưu trữ activation và thông lượng, và huấn luyện còn nhân thêm chi phí cho lượt truyền ngược (backward-pass), activation và trạng thái optimizer. Các kỹ thuật nén mô hình, tăng tốc phần cứng và hệ thống huấn luyện đều phản ứng trước áp lực này bằng cách giảm khối lượng công việc (workload), nâng tốc độ hữu ích của máy, hoặc thay đổi nơi trạng thái cư trú.
Những yêu cầu hạ tầng đã nêu (tính song song, bức tường bộ nhớ và di chuyển dữ liệu chi phối năng lượng) bắt nguồn từ cách mạng nơ-ron tính toán: trọng số thay đổi trong quá trình huấn luyện; nhiều đơn vị đơn giản chạy đồng thời; các lớp ghép các đặc trưng cấp thấp thành khái niệm cấp cao; và tái sử dụng dữ liệu để giảm dịch chuyển tốn năng lượng. Những tính chất này hiện hữu rõ ràng trong khối xây dựng nền tảng của tính toán nơ-ron: nơ-ron nhân tạo.13 Cũng như hiểu một bóng bán dẫn đơn lẻ giúp ta thấy bộ xử lý phức tạp vận hành thế nào, hiểu nơ-ron nhân tạo cho ta thấy các mạng với hàng triệu tham số hoạt động ra sao.
13 Nơ-ron: McCulloch and Pitts (1943) đã giới thiệu một mô hình ngưỡng toán học cho hoạt động thần kinh: các đầu vào được cộng gộp và đầu ra kiểu “tất cả hoặc không” phát khi đạt ngưỡng. Nơ-ron logic đó là điểm khởi đầu cho phép trừu tượng hóa nơ-ron nhân tạo và cho các mạng ghép từ nhiều đơn vị đơn giản. Về sau, các trọng số học được, các phân cấp sâu, và các đường dữ liệu FMA hợp nhất trong bộ tăng tốc hiện đại đã biến phép trừu tượng này thành các khối lượng công việc (workload) nặng về ma trận mà chúng ta sẽ nghiên cứu trong chương này.
McCulloch, Warren S., and Walter Pitts. 1943. “A Logical Calculus of the Ideas Immanent in Nervous Activity.” The Bulletin of Mathematical Biophysics 5 (4): 115–33. https://doi.org/10.1007/bf02478259.
Nơ-ron nhân tạo như phần tử tính toán cơ bản
Đơn vị cơ bản của tính toán nơ-ron, nơ-ron nhân tạo (hoặc nút), là một mô hình toán học đơn giản hóa của hoạt động thần kinh (McCulloch and Pitts 1943). Các triển khai mạng nơ-ron số về sau đã đưa phép trừu tượng này vào một đơn vị xử lý tiêu chuẩn hóa. Nhờ khối xây dựng đó, các mạng phức tạp có thể được tạo nên từ những thành phần đơn giản phối hợp với nhau. Hãy so sánh nơ-ron sinh học và nơ-ron nhân tạo đặt cạnh nhau trong figure 8 để thấy cách mô hình tính toán này chắt lọc sự phức tạp sinh học thành một dạng tính toán đơn giản hơn.

Phần bên phải của figure 8 lần theo tín hiệu qua bốn giai đoạn, mỗi giai đoạn chuyển một cấu trúc sinh học thành một phép toán:
- Tiếp nhận Đầu vào (Sợi nhánh → \(x_1, x_2, \dots, x_n\)): Nơ-ron nhân tạo tiếp nhận một vector các đặc trưng đầu vào \(\mathbf{x}\). Ví dụ, trong bài toán nhận dạng chữ số MNIST, các đặc trưng này đại diện cho cường độ điểm ảnh. Phép so sánh với sợi nhánh giúp hình dung việc tiếp nhận nhiều tín hiệu, nhưng không ngụ ý có sự tương đương sinh học.
- Điều chỉnh bằng Trọng số (Khớp thần kinh → \(w_1, w_2, \dots, w_n\)): Mỗi đầu vào được nhân với một trọng số \(w_i\) có thể học được, tương tự cách cường độ của khớp thần kinh điều chỉnh tín hiệu sinh học. Các trọng số này như các “bộ điều chỉnh ‘gain’”, quyết định mức độ ảnh hưởng của mỗi đặc trưng lên quyết định cuối cùng. Một tham số độ chệch (bias) \(b\) (được thể hiện là đầu vào trên cùng \(x_0 = 1\) trong figure 8) giúp dịch chuyển ngưỡng activation. Trên toàn mạng, hành vi đã học được phân tán trên nhiều tham số như vậy, chứ không lưu trong một trọng số duy nhất.
- Tổng hợp Tín hiệu (Thân tế bào → Hàm tuyến tính \(z\)): Nơ-ron tích hợp các tín hiệu đã được nhân với trọng số, tạo ra một giá trị vô hướng duy nhất \(z = \sum (x_i \cdot w_i) + b\). Điều này giống cách thân tế bào sinh học cộng các tín hiệu điện hóa đi vào để quyết định xem nơ-ron đã có đủ “bằng chứng” cho một mẫu cụ thể hay chưa.
- Activation phi tuyến (Sợi trục → Hàm Activation \(f\)): Tín hiệu tổng hợp được đưa qua một hàm activation \(f(z)\) để tạo ra đầu ra \(y\). Điều này phản ánh quyết định bắn tín hiệu kiểu “được ăn cả ngã về không” (all-or-nothing) trên sợi trục: tính phi tuyến quyết định xem nơ-ron có “phát” tín hiệu sang lớp tiếp theo hay không. Khác với sinh học, \(f\) có thể tạo ra đầu ra nhiều mức (ví dụ, ReLU truyền các giá trị dương và đặt các giá trị âm về 0), nhưng nguyên tắc vẫn vậy — đặt ngưỡng rồi truyền tín hiệu. Bảng Table 4 sẽ trình bày chi tiết hơn về các điểm tương ứng này.
| Cấu trúc sinh học | Thành phần nhân tạo | Phép toán toán học | Vai trò kỹ thuật |
|---|---|---|---|
| Dendrites (nhận tín hiệu) | Vector đầu vào | \(\mathbf{x} = [x_1, \dots, x_n]\) | Thu nạp dữ liệu từ cảm biến hoặc các lớp trước |
| Synapses (điều chỉnh cường độ) | Vector trọng số | \(\mathbf{w} = [w_1, \dots, w_n]\) | Các tham số có thể học mã hóa tầm quan trọng |
| Cell Body (tích hợp tín hiệu) | Hàm tuyến tính \(z\) | \(z = \sum (x_i \cdot w_i) + b\) | Tích hợp tuyến tính các tín hiệu đặc trưng |
| Axon (phát ra đầu ra) | Hàm Activation \(f\) | \(a = f(z)\) | Ngưỡng phi tuyến và lan truyền tín hiệu |
Từ góc độ kỹ thuật hệ thống, cách quy đổi này cho thấy tại sao mạng nơ-ron lại có nhu cầu tính toán cao. Khi tính vô hướng trực tiếp cho một nơ-ron, ta thực hiện \(N\) phép nhân-tích lũy (MAC)14 và, nếu không tái sử dụng, phải nạp \(N\) đầu vào, \(N\) trọng số và một độ chệch (bias) trước khi ghi đầu ra. Các kernel theo batch và chia ô (tiled) tái sử dụng đầu vào và trọng số qua nhiều lần tính nơ-ron, giúp giảm lưu lượng dữ liệu trên mỗi MAC. Ở cấp độ toàn mạng, hiệu suất phụ thuộc cả vào số phép toán lẫn mức độ tái sử dụng dữ liệu của bản triển khai.
14 MAC (multiply-accumulate): Phép toán cốt lõi trong các lớp dày đặc và tích chập là \(a \leftarrow a + (b \times c)\). Các bảng dữ liệu phần cứng thường báo cáo thông lượng nhân-cộng hợp nhất (fused multiply-add throughput) theo FLOPS, vì một phép nhân và một phép cộng được tính là hai phép toán dấu phẩy động. Theo quy ước này, tốc độ FLOP/s được báo cáo sẽ gấp đôi tốc độ MAC/s khi một MAC được tính là một phép nhân-tích lũy. Các lựa chọn về lớp và batch cũng kéo theo chi phí cho activation, truyền thông và di chuyển dữ liệu, nên số lượng MAC là cần thiết nhưng chưa đủ cho một ngân sách hệ thống.
Việc chuyển từ các nơ-ron riêng lẻ sang các hệ thống tích hợp đòi hỏi phải xử lý sự đánh đổi cốt lõi giữa khả năng biểu diễn và chi phí tính toán. Phần cứng số thực hiện số học rất nhanh, nhưng khối lượng phép toán và di chuyển dữ liệu trong các mạng sâu tạo ra những nút thắt cổ chai mà một góc nhìn ở mức nơ-ron đơn lẻ không bộc lộ.
Tái tạo hành vi thông minh trên silicon đối mặt với ba ràng buộc ở cấp hệ thống, có liên hệ với nhau. Khi mô hình lớn dần, việc di chuyển tham số và activation có thể trở thành yếu tố hạn chế hơn cả thông lượng tính toán. Tính song song xung đột với sự phụ thuộc: nhiều phép toán trong một lớp có thể chạy song song, nhưng lớp \(\ell+1\) vẫn phụ thuộc vào lớp \(\ell\), đặt ra giới hạn dưới cho độ trễ đầu-cuối. Độ chính xác cũng đánh đổi với bộ nhớ, thông lượng và năng lượng: biểu diễn rộng hơn tốn nhiều lưu trữ và di chuyển dữ liệu hơn, còn định dạng hẹp hơn cần bằng chứng cho thấy chất lượng tác vụ vẫn chấp nhận được. Nén mô hình trình bày việc tìm kiếm mức độ chính xác tối thiểu có thể chấp nhận.
Để giải quyết các ràng buộc này, chúng ta cần hai chiến lược bổ trợ. Thiên kiến quy nạp kiến trúc (architectural inductive bias) là các giả định cấu trúc được tích hợp sẵn về dữ liệu: mạng tích chập giả định các pixel lân cận trong ảnh có ý nghĩa cùng nhau, còn mạng hồi tiếp giả định thứ tự trong chuỗi là quan trọng. Mã hóa các giả định đó sẽ thu hẹp lớp hàm về các cấu trúc được kỳ vọng là hữu ích (Mitchell 1980). Mở rộng quy mô tính toán bổ sung thêm năng lực và nỗ lực tối ưu hóa. Kỹ thuật AI hiện đại kết hợp cả hai hướng, dùng cấu trúc ở cấp kiến trúc để tận dụng hiệu quả quy mô sẵn có.
Mitchell, Tom M. 1980. The Need for Biases in Learning Generalizations. CBM-TR-117. Rutgers University, Department of Computer Science.
Yêu cầu phần cứng và phần mềm
Việc chuyển các khái niệm về mạng nơ-ron sang silicon có chi phí vật lý. Trích xuất đặc trưng có thể được hiện thực bằng các tổng tuyến tính có trọng số, theo sau là các activation phi tuyến; còn các tương tác dày đặc trở thành các phép toán ma trận mà phần cứng phải thực thi hiệu quả. Tuy nhiên, đồ thị toán học không tự quy định một kế hoạch thực thi. Framework và trình biên dịch phải chọn kernel, bố cục tensor, ranh giới hợp nhất và lịch thực thi phù hợp cho từng bộ xử lý. Vì vậy, hai cách triển khai có thể tính cùng một hàm với cùng số phép toán số học danh nghĩa nhưng khác nhau đáng kể về lưu lượng dữ liệu, bộ nhớ tạm và độ trễ. Phần cứng cung cấp các đơn vị số học, bộ nhớ và các liên kết truyền thông; phần mềm quyết định cách đồ thị sử dụng chúng. Lớp dịch này quyết định liệu tính song song nhìn thấy trong mô hình có thực sự biến thành mức sử dụng máy hiệu quả hay không.
Hành vi mà một mạng nơ-ron học được được phân tán trên các tham số, vốn lưu ở các địa chỉ bộ nhớ thông thường. Khi suy luận, hệ thống truy xuất các tham số và activation; còn khi huấn luyện, ngoài ra còn cần lưu các trung gian, gradient và trạng thái của optimizer. Vì vậy, cả dung lượng lưu trữ lẫn băng thông đều quan trọng. Trong khi các synapse sinh học kết hợp cả lưu trữ và xử lý cục bộ, các bộ tăng tốc số lại di chuyển các giá trị qua một hệ thống phân cấp bộ nhớ. Não bộ tiêu thụ khoảng 20% lượng oxy và calo của cơ thể khi nghỉ ngơi (Raichle and Gusnard 2002), tuy nhiên so sánh hiệu quả trực tiếp có thể gây hiểu lầm vì hệ sinh học và hệ nhân tạo thực hiện các tác vụ khác nhau, với các ràng buộc về độ chính xác và độ trễ khác nhau. Bài học ở góc độ hệ thống là việc di chuyển dữ liệu quan trọng đến mức đã thúc đẩy sự ra đời của phần cứng chuyên dụng (như trình bày ở Tăng tốc phần cứng) và các chiến lược nén mô hình (như trong Nén mô hình).
Raichle, Marcus E., and Debra A. Gusnard. 2002. “Appraising the Brain’s Energy Budget.” Proceedings of the National Academy of Sciences 99 (16): 10237–39. https://doi.org/10.1073/pnas.172399499.
Những yêu cầu về phần cứng này không xuất hiện trong một sớm một chiều. Sự giằng co giữa tham vọng thuật toán và silicon sẵn có đã định hình toàn bộ quỹ đạo nghiên cứu mạng nơ-ron, từ những perceptron đầu tiên đến các mô hình hàng nghìn tỷ tham số ngày nay.
Sự tiến hóa của tính toán mạng nơ-ron
Perceptron15 đã giới thiệu một mô hình nơ-ron xác suất để học và lưu trữ thông tin (Rosenblatt 1958). Dù có nền tảng toán học đơn giản, perceptron vẫn vấp phải giới hạn phần cứng: các mạng lớn hơn đòi hỏi nhiều năng lực xử lý và bộ nhớ hơn. Deep learning phát triển nhờ quá trình đồng tiến hóa giữa thuật toán và silicon; khái niệm trừu tượng về nơ-ron vẫn quen thuộc, trong khi phần cứng thực thi nó liên tục biến đổi. Chính sự đồng tiến hóa này tạo khung cho lịch sử tiếp theo: muốn tiến bộ cần cả phương pháp tốt hơn lẫn máy móc tốt hơn.
15 Perceptron: Một cỗ máy được thiết kế để thực thi thuật toán học, liên kết trực tiếp phần cứng và phần mềm ngay từ đầu. Một lớp ngưỡng tuyến tính đơn lẻ không thể biểu diễn các hàm phi tuyến không thể tách rời, ví dụ như XOR, cho dù có bổ sung thêm phần cứng đầu vào nào đi nữa. Các mạng phi tuyến nhiều lớp mở rộng lớp hàm có thể biểu diễn, nhưng đồng thời cũng kéo theo chi phí về huấn luyện và hệ thống, như sẽ được trình bày trong chương này.
Rosenblatt, Frank. 1958. “The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain.” Psychological Review 65 (6): 386–408. https://doi.org/10.1037/h0042519.
16 Lan truyền ngược: Viết tắt của “backward propagation of errors” (lan truyền ngược lỗi), thuật toán này sử dụng quy tắc chuỗi để tính độ nhạy cục bộ của hàm mất mát đối với hàng triệu trọng số. Thuật toán không xác định trọng số nào đã gây ra lỗi trong quá khứ. Werbos áp dụng nó cho mạng nơ-ron vào năm 1974 (Werbos 1974), và công bố năm 1986 của Rumelhart, Hinton và Williams chứng minh hiệu quả thực tiễn (Rumelhart et al. 1986). Về chi phí hệ thống: lan truyền ngược yêu cầu lưu các activation của lượt truyền xuôi và các trạng thái huấn luyện bổ sung, khiến dấu chân bộ nhớ tăng lên gấp nhiều lần; con số này sẽ được định lượng ở phần sau của chương.
Thuật toán lan truyền ngược16 được Paul Werbos áp dụng cho mạng nơ-ron trong luận án tiến sĩ năm 1974 (Werbos 1974), dựa trên công trình về vi phân tự động năm 1970 của Seppo Linnainmaa (Linnainmaa 1970). Sau đó, Rumelhart, Hinton và Williams đã phổ biến rộng rãi thuật toán này (Rumelhart et al. 1986). Công bố của họ chứng minh hiệu quả thực tiễn của thuật toán, đưa nó đến với cộng đồng machine learning và khơi dậy sự quan tâm trở lại đối với mạng nơ-ron. Chương này sẽ quay lại thuật toán ở section 1.3.4; Cơ chế lan truyền ngược phát triển cách triển khai ở cấp độ hệ thống. Bản trình diễn năm 1986 cho thấy các đơn vị ẩn có thể học được các đặc trưng nội bộ hữu ích, nhưng chưa giải quyết được bài toán hệ thống về mở rộng quy mô huấn luyện. Khi mô hình lớn hơn, số phép toán truyền xuôi, activation cần lưu, phép tính gradient và lần cập nhật tham số đều tăng lên theo bội số. Vì vậy, việc áp dụng thực tế phụ thuộc vào các cải tiến trên toàn bộ ngăn xếp công nghệ, không chỉ riêng quy tắc học.
Lịch sử này cho thấy một bài học hệ thống lặp đi lặp lại: một thuật toán chỉ thực sự hữu ích khi cả hệ thống có thể huấn luyện và đánh giá nó hiệu quả. Độ trễ từ các công trình lan truyền ngược ban đầu17 đến khi được ứng dụng rộng rãi phản ánh sự trưởng thành của phần cứng, dữ liệu, cách khởi tạo, các hàm phi tuyến, phương pháp tối ưu hóa, các benchmark và hạ tầng phần mềm. Vì vậy, một thuật toán có thể khả thi trên lý thuyết rất lâu trước khi hệ thống xung quanh nó đủ hoàn thiện để hữu ích trong thực tế. Deep learning đến từ sự hội tụ này, không chỉ từ một khám phá toán học mới.
17 Độ trễ áp dụng thuật toán-hệ thống: Lan truyền ngược đã xuất hiện dưới dạng mạng nơ-ron từ năm 1974 (Werbos 1974), và đến bản trình diễn năm 1986 của Rumelhart, Hinton và Williams (Rumelhart et al. 1986) thì nó mới được biết đến rộng rãi. Các cơ chế attention xuất hiện trong dịch máy nơ-ron vào năm 2014, transformers đưa chúng thành trung tâm vào năm 2017, và sau đó hạ tầng ở quy mô TPU và GPU đã cho phép các triển khai lớn hơn nhiều. Những lịch sử này không có nghĩa là mọi ý tưởng tốn kém về tính toán đều sẽ thành công. Chúng cho thấy một thuật toán cần được đánh giá cùng với dữ liệu, các phương pháp tối ưu hóa, phần mềm, phần cứng và bối cảnh tác vụ cần thiết để làm cho nó thực sự hữu ích.
Werbos, Paul. 1974. “Beyond Regression: New Tools for Prediction and Analysis in the Behavioral Sciences.” PhD thesis, Harvard University.
Rumelhart, David E., Geoffrey E. Hinton, and Ronald J. Williams. 1986. “Learning Representations by Back-Propagating Errors.” Nature 323 (6088): 533–36. https://doi.org/10.1038/323533a0.
Thuật ngữ này trở nên nổi bật vào những năm 2010, cùng với tiến bộ về công suất tính toán và khả năng tiếp cận dữ liệu. Quy mô của làn sóng bùng nổ tính toán này rất khó hình dung nếu không có trực quan hóa. Figure 9 trình bày các ước tính tiêu biểu về lượng tính toán huấn luyện AI trong gần bảy thập kỷ trên thang logarit, cho thấy hai xu hướng được khớp: tổng lượng tính toán huấn luyện, đo bằng các phép toán dấu phẩy động (FLOPs), đi theo một xu hướng tương đối chậm trước 2010, rồi biên giới deep learning sau 2012 tăng tốc mạnh. Các mô hình quy mô lớn sau 2015 nằm cao hơn quỹ đạo trước 2010 nhiều bậc, cho thấy tiến bộ hiện đại đang tái đầu tư các lợi ích từ phần cứng và thuật toán vào những lượt huấn luyện lớn hơn rất nhiều.
Ngoài năng lực tính toán thuần, sự tăng trưởng này kéo theo chi phí năng lượng mà các kỹ sư hệ thống không thể bỏ qua. Theo các giả định kịch bản đã nêu, một lần chạy LeNet-1 trên máy trạm trong ba ngày sẽ tiêu thụ khoảng 54 kWh. Nếu áp dụng ước tính số ngày GPU cho GPT-4 và cộng thêm hệ số chi phí vận hành trung tâm dữ liệu, con số này vào khoảng 33,600 MWh, tương đương lượng điện tiêu thụ hàng năm của khoảng 3,200 hộ gia đình tiêu biểu ở Hoa Kỳ.18 Đây là các ước tính sơ bộ, không phải số liệu tiện ích đo đạc, và chúng thay đổi theo mức độ tận dụng bộ tăng tốc, chi phí chung của cơ sở và ranh giới phạm vi tính toán. Dù vậy, quy mô này khiến năng lượng trên mỗi phép toán và mức độ tận dụng đạt được trở thành mối quan tâm thiết kế, song hành với FLOP/s đỉnh. Phân tích năng lượng định lượng được trình bày ở Tăng tốc phần cứng.
18 Quy mô năng lượng huấn luyện: Ước tính này giả định một máy trạm 750 W cho lần chạy lịch sử và sử dụng 10.5 MWh/year làm ngân sách điện năng của một hộ gia đình tiêu biểu ở Hoa Kỳ. Trong kịch bản mô hình đóng, ước tính số ngày GPU được coi là thời gian sử dụng bộ tăng tốc tương đương A100 và áp dụng một hệ số chi phí chung của trung tâm dữ liệu đơn giản. Kết quả nhằm minh họa quy mô; nó không xác định năng lượng thực tế dùng để huấn luyện GPT-4.
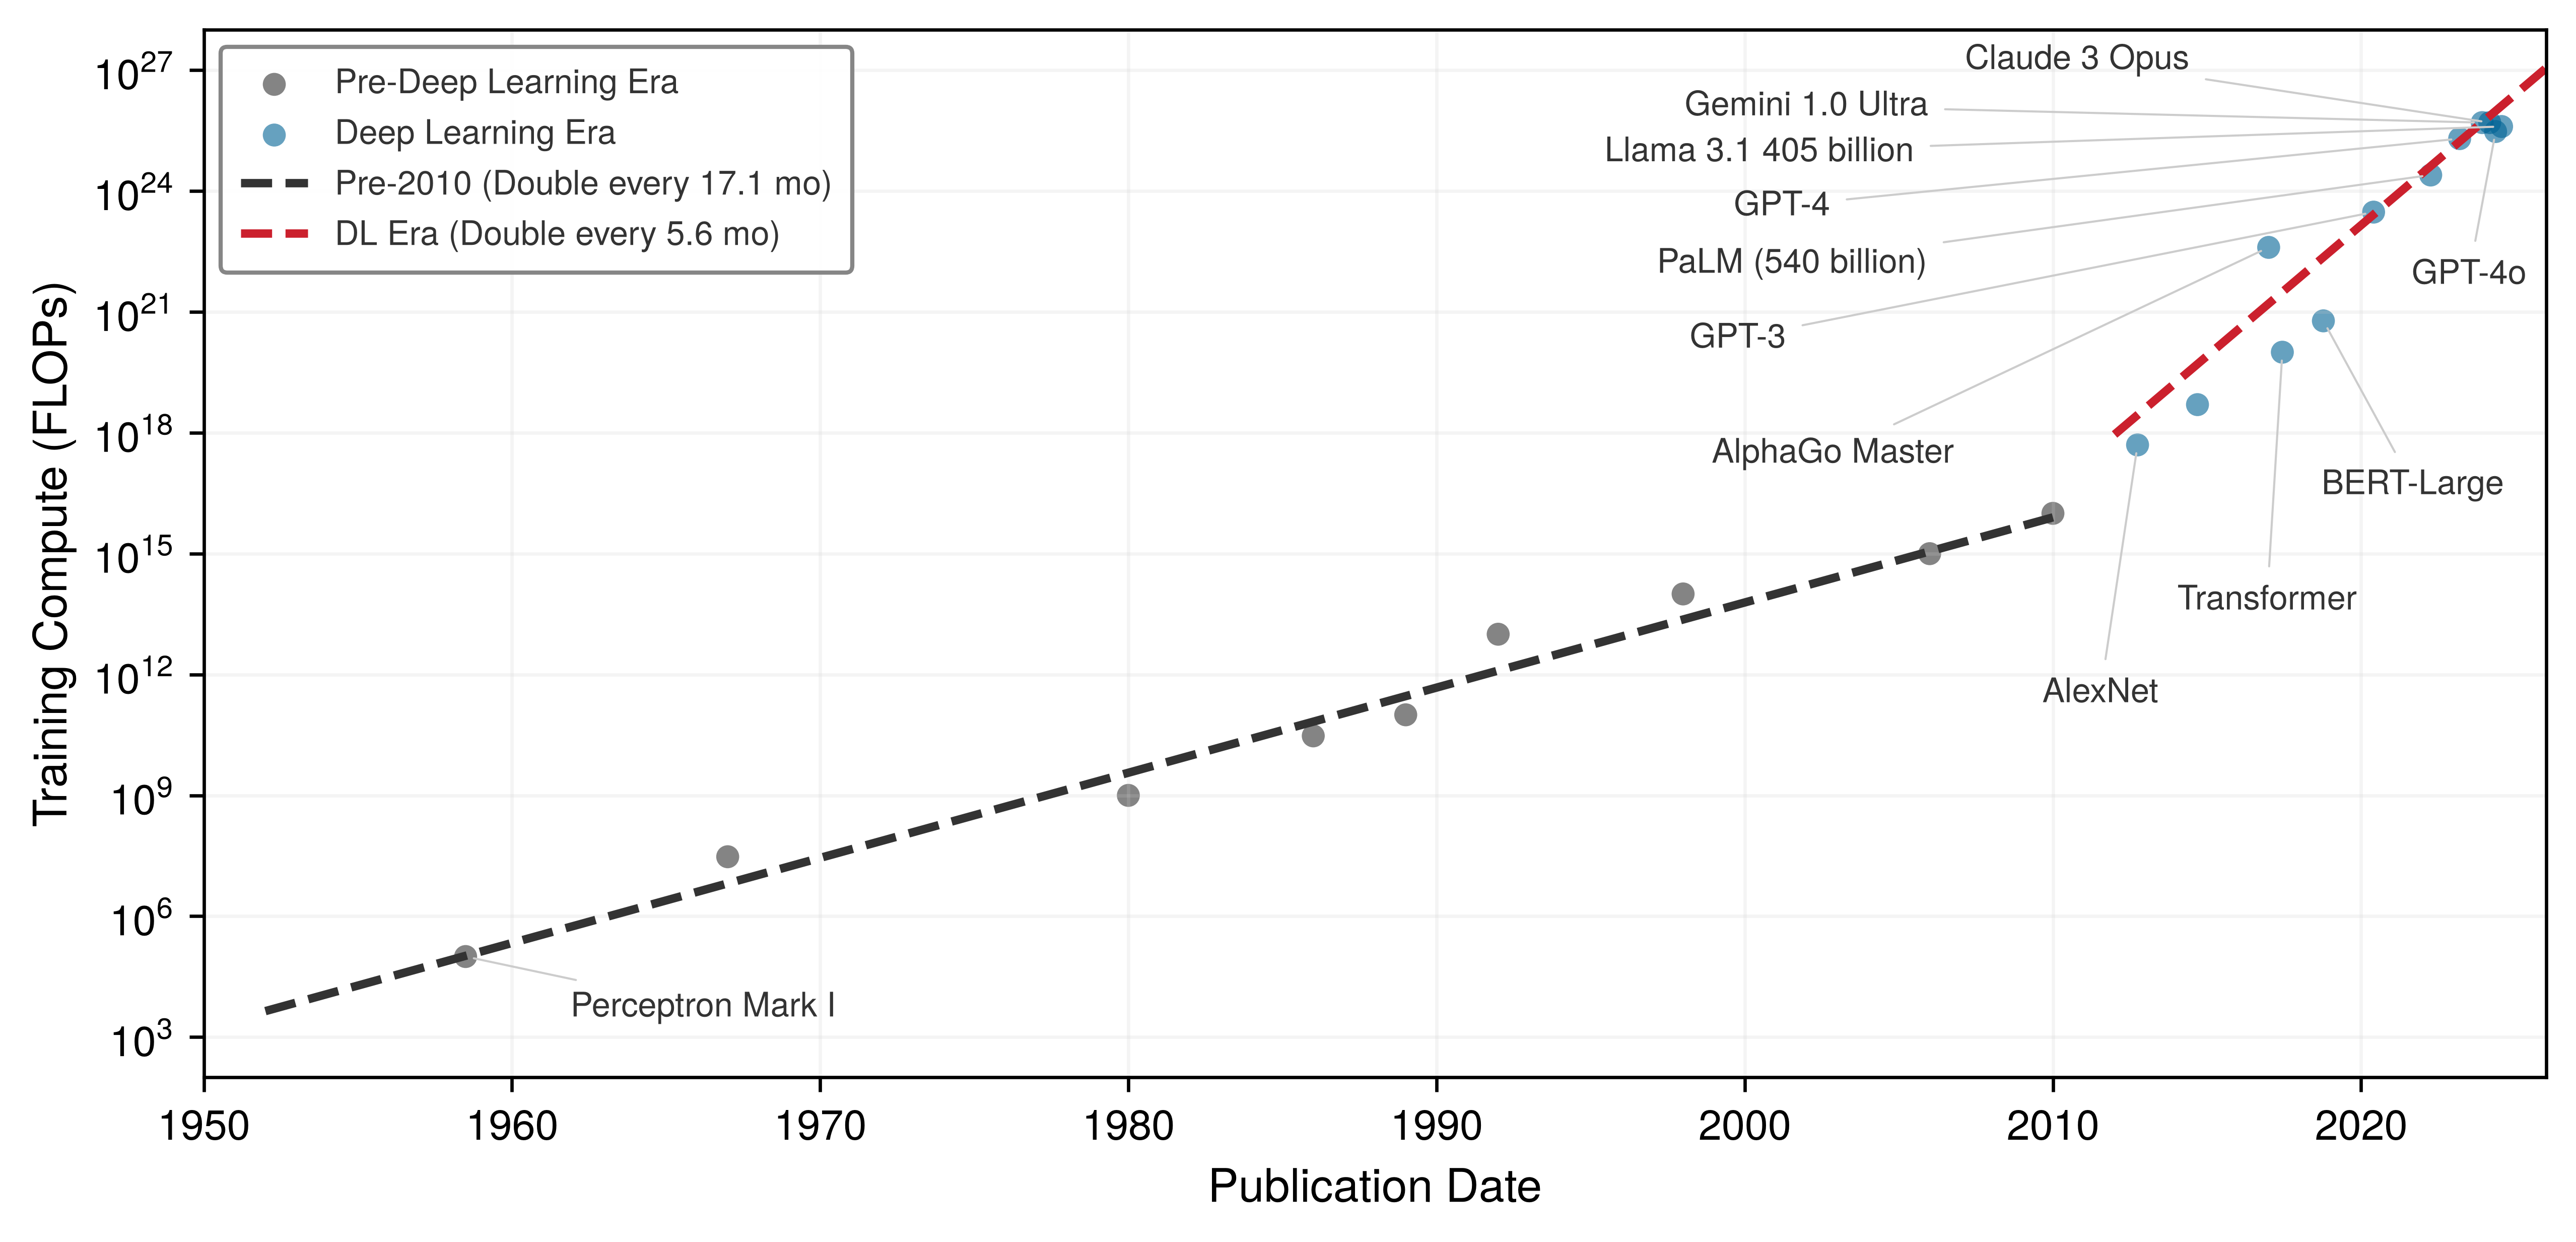
Table 5 đặt các xu hướng này vào các hệ thống tiêu biểu, cho thấy tham số, compute và phần cứng đã đồng tiến hóa trong suốt bốn thập kỷ phát triển mạng nơ-ron. Có ba điểm cần bàn riêng. Thứ nhất, đường biên compute huấn luyện sau năm 2012 tăng theo thang thời gian tính bằng tháng, dù tốc độ khớp phụ thuộc các hệ thống được chọn và các ước tính còn nhiều bất định. Thứ hai, tiến bộ về thuật toán và hệ thống đã giảm lượng compute cần để đạt các mục tiêu benchmark cố định trong một số lĩnh vực, nên xu hướng frontier-compute không phản ánh hiệu quả khi giữ cố định năng lực. Thứ ba, mức tận dụng phần cứng, độ chính xác thấp hơn, độ trưởng thành của phần mềm và điều kiện mua sắm đều chi phối mối quan hệ giữa compute thô và chi phí tiền tệ; chúng không đảm bảo chi phí sẽ tăng chậm hơn. Với kỹ sư hệ thống, các khác biệt này ảnh hưởng đến mốc thời gian hạ tầng, ngân sách thí nghiệm và quyết định tự xây hay mua. Vì vậy, lập kế hoạch cần có số đo hiệu quả, mục tiêu so sánh nêu rõ, và mức độ không chắc chắn được chỉ ra, đặc biệt với các mô hình đóng, nơi kiến trúc và cấu hình huấn luyện không được công bố.
| Năm | Hệ thống | Tham số | FLOPs huấn luyện | Phần cứng | Thời gian huấn luyện | Lỗi/Tác vụ |
|---|---|---|---|---|---|---|
| 1989 | LeNet-1 | ~10K | \(10^{11}\)–\(10^{12}\) | máy trạm Sun-4/260 | 3 ngày | 1% với 12.1% từ chối (chữ số USPS) |
| 1998 | LeNet-5 | \(60\text{K} \pm 1\text{K}\) | \(10^{14} \pm 1\text{ OoM}\) | SGI Origin 2000 (200 MHz) | 2–3 ngày | 0.95% (MNIST) |
| 2012 | AlexNet | ~60M | \(5 \times 10^{17}\) | 2\(\times\) GPU GTX 580 | 5–6 ngày | 15.3% (ImageNet) |
| 2015 | ResNet-152 | ~60M | \(10^{19} \pm 0.5\text{ OoM}\) | 8\(\times\) GPU Tesla K80 | ~3 tuần | 3.6% (ImageNet) |
| 2020 | GPT-3 | 175B (chính xác) | \(3 \times 10^{23}\) | Không tiết lộ | Không tiết lộ | Không áp dụng (ngôn ngữ) |
| 2023 | GPT-4 | Không tiết lộ | \(10^{24}\)–\(10^{25}\) (ước tính bên ngoài) | Không tiết lộ | Không tiết lộ | Không áp dụng (ngôn ngữ) |
Những tiến bộ trên ba chiều đã củng cố các xu hướng này: dữ liệu sẵn có, các đổi mới về thuật toán, và cơ sở hạ tầng tính toán. Hãy theo dõi các mũi tên trong figure 10 để thấy sự tương tác: cơ sở hạ tầng nhanh hơn khiến dữ liệu và mô hình lớn trở nên khả thi; tập dữ liệu lớn hơn tạo ra cả cơ hội lẫn áp lực mới cho thuật toán; và những tiến bộ về thuật toán lại thay đổi yêu cầu đặt lên các hệ thống tính toán. Chu trình này mang tính tạo điều kiện chứ không tự động: tiến bộ ở một chiều có thể làm lộ nút thắt cổ chai ở chiều khác, thay vì mang lại lợi ích ngay lập tức.

Dữ liệu sẵn có đã cung cấp lượng lớn ví dụ mà các biểu diễn học được cần. Sự trỗi dậy của internet và thiết bị số tạo ra vô số nguồn dữ liệu huấn luyện mới: các nền tảng chia sẻ hình ảnh cung cấp hàng triệu ảnh có nhãn, các bộ sưu tập văn bản số cho phép xử lý ngôn ngữ ở quy mô lớn, và các mạng cảm biến tạo ra luồng dữ liệu thực tế liên tục. Sự dồi dào này chính là “nguyên liệu thô” để các mạng nơ-ron học hiệu quả các mẫu phức tạp.
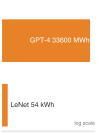
Lịch sử phát triển của mạng nơ-ron cho thấy sự bùng nổ về quy mô năng lượng huấn luyện.
Các đổi mới về thuật toán đã biến khối lượng đó thành các hệ thống có thể huấn luyện. Các phương pháp mới để khởi tạo mạng và điều chỉnh tốc độ học giúp quá trình huấn luyện ổn định hơn. Các kỹ thuật kiểm soát overfitting cũng cải thiện khả năng tổng quát hóa trong các bối cảnh được đánh giá. Các nhà nghiên cứu còn ghi nhận những mối quan hệ thực nghiệm giữa kích thước mô hình, năng lực tính toán, lượng dữ liệu và hiệu suất, từ đó thúc đẩy các kiến trúc ngày càng tham vọng hơn, đồng thời cho thấy miền mở rộng hữu ích phụ thuộc vào từng tác vụ.
Checkpoint 1.1: Hiểu vì sao deep learning xuất hiện
Trước khi liên hệ lịch sử này với các hệ quả về hạ tầng, hãy kiểm tra xem bạn đã hiểu vì sao deep learning xuất hiện chưa:
Nếu có khái niệm nào chưa rõ, hãy xem lại các phần liên quan trước khi tiếp tục. Những hệ quả về hệ thống mà chúng ta sẽ tìm hiểu sau đây đều dựa trực tiếp trên nền tảng kiến thức này.
Các khối lượng công việc (workload) này tạo ra nhu cầu về hạ tầng tính toán có thông lượng cao hơn, và hạ tầng đã phát triển để đáp ứng. Về phần cứng, GPU cung cấp khả năng xử lý song song cần thiết cho tính toán mạng nơ-ron hiệu quả, còn TPUs (Tensor Processing Units)19 (Jouppi et al. 2023) đẩy hiệu suất lên cao hơn nữa. Hệ thống bộ nhớ băng thông cao và liên kết tốc độ cao giải quyết các thách thức về luân chuyển dữ liệu. Ở phía phần mềm, các tiến bộ cũng đi cùng: frameworks và thư viện đơn giản hóa việc xây dựng và huấn luyện mạng, các hệ thống tính toán phân tán cho phép huấn luyện ở quy mô lớn, và các công cụ tối ưu hóa triển khai mô hình thu hẹp khoảng cách giữa nghiên cứu và sản xuất.
19 TPU (tensor processing unit): bộ tăng tốc do Google thiết kế riêng, được triển khai nội bộ lần đầu vào năm 2015, được tối ưu hóa đặc biệt cho các phép nhân ma trận vốn chiếm ưu thế trong các khối lượng công việc (workload) của mạng nơ-ron. TPU v1 đạt 92 TOPS (INT8 tera-operations/s do nhà cung cấp báo cáo) cho suy luận ở 75 W, một mức hiệu quả công suất mà các GPU đa năng cùng thời không thể sánh kịp. Tên gọi “Tensor Processing Unit” phản ánh quyết định thiết kế hy sinh tính linh hoạt tổng quát để đạt thông lượng tối đa cho các phép toán mà mạng nơ-ron cần nhất.
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
Sự hội tụ của dữ liệu sẵn có, đổi mới thuật toán và hạ tầng tính toán đã tạo nên nền tảng cho deep learning hiện đại. Checkpoint trước đó đã tổng hợp lại hành trình này, trước khi chương quay lại các phép toán tính toán thúc đẩy nó.
Lịch sử phát triển từ perceptron, qua các giai đoạn ít được quan tâm, đến deep learning thời GPU cho thấy một khuôn mẫu hệ thống lặp lại: một thuật toán có thể xuất hiện trước cả khi dữ liệu, tối ưu hóa, phần mềm, benchmark và phần cứng đủ phát triển để biến nó thành thực tế. Các mô hình tiên tiến hiện đại một lần nữa đối mặt với giới hạn bộ nhớ và năng lượng. Để hiểu các phép toán tạo ra những áp lực đó, cần xem xét các phép toán cơ bản.
Self-Check: Question
A team replaces a hand-coded digit recognition system (\(\approx 100\) conditional comparisons, \(784\text{ bytes}\) of working state) with a \(784 \to 128 \to 64 \to 10\) MLP (\(\approx 109{,}184\text{ MACs}\), \(\approx 438\text{ KB}\) of weights) on the same MNIST input. Which systems consequence should they expect when deploying this new model on a commodity CPU?
- The workload becomes dominated by branch mispredictions because artificial neurons execute frequent if-then branching decisions.
- The workload transitions from branch-heavy scalar code to dense matrix arithmetic whose weight footprint exceeds L1 cache capacity, generating cache-level memory traffic absent in the rule-based system.
- Execution memory traffic drops to zero because the \(438\text{ KB}\) weight footprint fits entirely within standard CPU register files.
- The model executes without using arithmetic logic units (ALUs) because learned representations bypass hardware compute pipelines.
A hardware vendor claims that increasing single-threaded CPU clock frequencies by \(5\times\) will eliminate the necessity of specialized accelerators (such as GPUs or TPUs) for deep neural networks. Based on the computational profile of neural networks, what is the strongest technical refutation of this claim?
- Deep learning is dominated by massive parallel matrix multiplications bounded by arithmetic throughput and memory bandwidth, which benefit from thousands of parallel SIMD/tensor units rather than higher scalar clock speeds.
- Higher CPU clock frequencies force the loss function to become non-convex, destabilizing gradient descent.
- Modern neural networks require asynchronous analog circuits that cannot be simulated on digital CPU cores.
- Increasing CPU clock frequencies reduces the numerical precision of floating-point registers to 4-bit integers.
A computer vision team evaluates two approaches for a multi-class recognition task: (a) a handcrafted feature pipeline (e.g. HOG + SVM) and (b) an end-to-end convolutional neural network. Compare the systems engineering trade-offs between these two approaches when the product must scale from 2 initial categories to 50 diverse object categories.
Explain the systems-level concept of the ‘algorithm-hardware adoption lag’ using the historical trajectory of backpropagation (Werbos 1974 / Rumelhart et al. 1986) and modern deep learning. What three converging factors were necessary for the algorithm to achieve widespread practical viability?
True or False: The artificial neuron is an exact biological model that reproduces the electrochemical ion channels and temporal spike-timing dynamics of human cortical neurons in digital silicon.
Order the historical evolution of pattern-computing paradigms and milestones from earliest to latest: (1) Deep learning with automatic hierarchical feature discovery on parallel accelerators, (2) Rule-based programming with explicit hand-authored logical branches, (3) The Rosenblatt single-layer Perceptron, (4) Classical machine learning pairing hand-engineered feature extractors (e.g. HOG/SIFT) with statistical classifiers.
Các khái niệm cơ bản về mạng nơ-ron
Câu hỏi bây giờ là tại sao các yêu cầu tính toán có thể trở nên cực lớn. Với các khối lượng công việc (workload) phù hợp với mạng nơ-ron, GPU có thể vượt trội hơn CPU vì cung cấp thông lượng song song cao và tái sử dụng dữ liệu hiệu quả cho các phép toán ma trận và tensor, chứ không chỉ vì tốc độ xung nhịp. Cấu trúc của các thành phần cơ bản trong mạng—nơ-ron, các lớp và các activation phi tuyến—quyết định cách dữ liệu đi qua phần cứng và cách nhu cầu bộ nhớ mở rộng trong quá trình huấn luyện và suy luận. Hiểu rõ các phép toán này cho thấy cách các phép tính số học đơn giản ở từng nơ-ron cộng dồn thành những yêu cầu hạ tầng đã định hình nên AI hiện đại.
Các khái niệm ở đây áp dụng cho các mạng nơ-ron lan truyền thẳng, nền tảng của chương này và còn xuất hiện trong nhiều kiến trúc lớn hơn. Các nền tảng chung của chúng là tổng có trọng số, activation phi tuyến, và học dựa trên gradient. Nắm vững các phép toán này cùng đặc tính tính toán của chúng sẽ giúp bạn suy luận về các mạng chuyên biệt hơn; các chương sau sẽ giới thiệu thêm các toán tử và kiểu thực thi mà mô hình đơn giản này không có.
Tại sao chiều sâu lại quan trọng: Sức mạnh của các biểu diễn phân cấp
Một mạng một lớp cố gắng phân loại chữ số viết tay phải ánh xạ trực tiếp các pixel thô sang các nhãn. Thay vào đó, một mạng sâu hơn có thể khai thác cấu trúc phân cấp khi hàm mục tiêu có tính chất cấu thành. Câu hỏi là tại sao chiều sâu có thể mang lại lợi thế biểu diễn như vậy, và câu trả lời sẽ là nền tảng cho mọi phát triển toán học tiếp theo.
Các mạng sâu có thể khai thác tính cấu thành: các mẫu phức tạp có thể phân rã thành các mẫu đơn giản hơn, và bản thân chúng lại có thể phân rã tiếp. Trong nhận dạng hình ảnh, các biểu diễn đã học có thể tiến triển từ các edge và kết cấu cục bộ đến các bộ phận rồi đến đối tượng. Những quy luật phân cấp như vậy xuất hiện trong nhiều tập dữ liệu và là động lực cho các mô hình nhiều lớp, dù một mạng đã huấn luyện không nhất thiết phải khôi phục đúng trình tự này.
Hãy xem xét việc nhận dạng chữ số “bảy” trong ví dụ MNIST. Một mạng một lớp ánh xạ trực tiếp tất cả 784 giá trị pixel thành một quyết định. Khi tác vụ có cấu trúc mang tính cấu thành, một mạng sâu có thể tính quyết định một cách hiệu quả hơn về số lượng tham số bằng cách tái sử dụng các đặc trưng trung gian:
- Lớp 1 học các bộ dò edge đơn giản: đường thẳng đứng, đường ngang, nét chéo
- Lớp 2 kết hợp các edge thành các hình dạng: nét ngang trên cùng của số “bảy”, nét chéo đi xuống
- Lớp 3 kết hợp các hình dạng thành các mẫu chữ số hoàn chỉnh
Mỗi lớp được xây dựng dựa trên lớp trước đó, cho phép các phép tính ở các lớp sau tái sử dụng các đặc trưng đã học từ trước. Cấu trúc phân cấp này có thể tiết kiệm tham số hơn nhiều so với một biểu diễn nông khi tác vụ có cấu trúc hợp thành phù hợp. Các bộ phát hiện edge học để nhận diện số “bảy” cũng có thể góp phần nhận diện “một”, “bốn” và các chữ số khác. Việc tái sử dụng tham số này giúp giải thích vì sao chiều sâu là một lựa chọn thiết kế hiệu quả, nhưng không hàm ý một lợi thế tham số cố định cho mọi tác vụ. Tuy nhiên, lựa chọn giữa thêm lớp mới và làm rộng các lớp hiện có không đối xứng: chiều sâu và chiều rộng đóng góp vào khả năng biểu diễn thông qua những cơ chế khác nhau.
Quá trình xử lý theo lớp trong thị giác sinh học đã góp phần gợi ý các mô hình phân cấp, nhưng điều này không ngụ ý rằng các mạng nơ-ron nhân tạo tái tạo đúng các cơ chế tương tự. Các kiến trúc được xem xét trong Kiến trúc mạng mã hóa những giả định cấu trúc khác nhau cho hình ảnh, chuỗi và các loại dữ liệu khác. Chiều sâu giải thích vì sao các biểu diễn theo lớp có thể hữu ích; phần còn lại là cơ chế cho biết hệ phân cấp được triển khai như thế nào. Các phần tiếp theo sẽ trình bày các cơ chế đó: nơ-ron tính toán ra sao, các lớp kết nối thế nào, và thông tin đi từ đầu vào tới đầu ra ra sao.
Systems Perspective 1.2: Sự đánh đổi giữa chiều sâu và chiều rộng
Đối với một số lớp hàm nhất định, chiều sâu mang lại lợi thế biểu diễn theo cấp số nhân: một mạng nơ-ron với \(N_L\) lớp có thể biểu diễn những hàm mà một mạng nơ-ron nông sẽ cần số lượng đơn vị nhiều hơn theo cấp số nhân (Telgarsky 2016). Kết quả lý thuyết có giới hạn này giải thích vì sao hợp thành phi tuyến tính có thể tiết kiệm tham số; nó không phải là một đảm bảo phổ quát cho mọi tác vụ.
Tuy nhiên, chiều sâu đưa thêm ba thách thức kỹ thuật với mỗi lớp bổ sung:
- Thêm các phụ thuộc tuần tự (tức là lớp \(\ell+1\) phải chờ lớp \(\ell\)), hạn chế mức độ song song
- Tăng độ dài đường đi của gradient, dễ dẫn tới gradient biến mất hoặc bùng nổ
- Yêu cầu lưu trữ các activation trung gian để thực hiện quá trình lan truyền ngược.
Các kiến trúc hiện đại cân bằng giữa chiều sâu và chiều rộng. Một mạng nơ-ron có mười lớp, mỗi lớp 100 nơ-ron, sẽ có tổng cộng 1.000 đơn vị ẩn, tương tự như một mạng có hai lớp, mỗi lớp 500 nơ-ron. Tuy nhiên, chúng không có cùng số lượng tham số, họ hàm hay đồ thị thực thi. Cả hai đều bộc lộ tính song song trong mỗi lớp; mạng sâu hơn bổ sung các phụ thuộc tuần tự và có thể biểu diễn một số hàm hợp thành hiệu quả hơn.
Telgarsky, Matus. 2016. “Benefits of Depth in Neural Networks.” Proceedings of the 29th Annual Conference on Learning Theory, 1517–39.
Các nguyên tắc cơ bản của kiến trúc mạng
Kiến trúc của một mạng nơ-ron quyết định cách thông tin đi từ đầu vào đến đầu ra. Các mạng nơ-ron hiện đại có thể cực kỳ phức tạp, nhưng tất cả đều dựa trên một vài nguyên tắc tổ chức cơ bản. Những nguyên tắc này định hình cả cách triển khai lẫn cơ sở hạ tầng tính toán mà chúng yêu cầu.
Để làm rõ các khái niệm này, chúng ta sẽ xem xét một ví dụ cụ thể là nhận dạng chữ số viết tay, cụ thể hơn là nhiệm vụ phân loại hình ảnh từ tập dữ liệu MNIST (LeCun et al. 1998). Nhiệm vụ tưởng chừng đơn giản này sẽ cho thấy tất cả các nguyên tắc cốt lõi của mạng nơ-ron, đồng thời mang lại cái nhìn trực quan cho các ứng dụng phức tạp hơn.
Mỗi lựa chọn kiến trúc, từ cách các nơ-ron được kết nối đến cách các lớp được tổ chức, đều tạo ra các mẫu hình tính toán đặc thù cần được ánh xạ hiệu quả lên phần cứng. Việc ánh xạ giữa kiến trúc mạng và các yêu cầu tính toán này là yếu tố thiết yếu để xây dựng các hệ thống ML có khả năng mở rộng.
Example 1.1: Ví dụ minh họa: Nhận dạng chữ số MNIST
Tình huống: Triển khai một bộ phân loại chữ số viết tay cơ bản trên các hình ảnh thang độ xám \(28{\times}28\) cho 10 lớp đầu ra.
Phân tích: Kiến trúc minh họa của chương sẽ ánh xạ 784 đặc trưng pixel thô qua các đơn vị ẩn 128 và 64 để tạo ra 10 đầu ra, với khoảng 100K tham số.
Bài học hệ thống: Việc kiểm tra kích thước véc-tơ đầu vào và các tham số lớp trên một tập dữ liệu nhỏ gọn giúp xác định các yêu cầu ở mức cơ sở về tính toán và băng thông bộ nhớ, trước khi mở rộng sang các khối lượng công việc (workload) thực tế với dữ liệu nhiều chiều.
Tổng có trọng số của perceptron
Cơ chế tính toán bên trong mỗi lớp dày đặc là một nơ-ron nhân tạo kiểu perceptron. Đường dẫn tín hiệu của nó (đầu vào, trọng số, độ chệch (bias), cộng gộp, activation) section 1.1.5 có thể được lần theo về nguồn gốc sinh học. Việc còn lại là mô tả đường dẫn này bằng toán học, vì phép toán lặp lại này sẽ trở thành nhân (kernel) ở cấp độ lớp mà phần cứng thực thi. Trong mạng nơ-ron MNIST, một đơn vị ở lớp đầu tiên kết hợp toàn bộ 784 cường độ điểm ảnh thành một activation có thể phản ứng với một mẫu đã học, chẳng hạn như một edge dọc thường thấy ở cả chữ số “một” và “bảy”. Hãy xem figure 11 từ trái sang phải: mỗi đầu vào \(x_i\) được nhân với trọng số \(w_{ij}\) tương ứng, các tích này được cộng dồn với một độ chệch (bias), và một hàm activation sẽ biến đổi điểm số thu được. Các nơ-ron khác nhau lặp lại cùng cấu trúc nhưng với các trọng số đã học khác nhau, cho phép một lớp kiểm tra nhiều mẫu trên cùng một đầu vào.

Mỗi đầu vào \(x_i\) có một trọng số \(w_{ij}\) tương ứng, và perceptron nhân mỗi đầu vào với trọng số tương ứng đó. Đầu ra trung gian \(z\) được tính như tổng có trọng số của các đầu vào trong equation 1: \[ z = \sum (x_i \cdot w_{ij}) \tag{1}\]
Ở đây, \(j\) xác định nơ-ron nhận khi các perceptron được ghép thành một lớp, và phép tổng chạy trên tất cả các chỉ số đầu vào \(i\). Nói đơn giản, mỗi đặc trưng đầu vào được nhân theo mức độ quan trọng của nó (trọng số), rồi các kết quả được cộng lại thành một điểm số duy nhất. Đây là tích vô hướng của hai véc-tơ—phép toán cơ bản mà các bộ tăng tốc được thiết kế để thực thi với thông lượng tối đa; cũng vì vậy hiệu suất mạng nơ-ron được đo bằng số lượng phép toán MAC hoàn thành mỗi giây.
Một thành phần độ chệch (bias) \(b\) dịch chuyển đầu ra tuyến tính lên hoặc xuống, giúp mô hình linh hoạt hơn để khớp dữ liệu. Vì vậy, phép tổ hợp tuyến tính trung gian mà perceptron tính toán, khi bao gồm cả bias, là equation 2: \[ z = \sum (x_i \cdot w_{ij}) + b \tag{2}\]
Khi đã có tổng trọng số này, chọn một hàm activation đầu ra và một hàm mất mát (loss) phù hợp sẽ hỗ trợ cả hồi quy lẫn phân loại. Bộ phân loại ngưỡng tuyến tính nhị phân chọn một trong hai lớp quanh một ngưỡng; còn các mạng phân loại nhiều lớp (multiclass) thì tạo ra nhiều điểm số và thường chuẩn hóa chúng bằng softmax.
Theo cách hạch toán trực tiếp, không tái sử dụng (scalar, no-reuse) đã nêu trước đó, một nơ-ron thực hiện \(N\) phép nhân-tích lũy (MAC) và di chuyển các đầu vào, trọng số, độ chệch (bias), cùng đầu ra của nó. Điều mà cách hình thức hóa này bổ sung là góc nhìn theo lớp. Một lớp dày đặc (dense layer) gồm \(M\) nơ-ron lặp lại phép tổng trọng số \(M\) lần, nên chi phí số học của nó là \(M \times N\) MACs — đúng bằng phép nhân ma trận \(\mathbf{x}\mathbf{W}\) mà phần cứng phải thực thi, và cũng là hình thức mà phần còn lại của chương này sẽ dùng để tính khối lượng công việc.
Các hàm activation phi tuyến tính
Các hàm activation là nơi khả năng biểu đạt, luồng gradient và chi phí phần cứng gặp nhau. Chúng biến đổi các tổng trọng số tuyến tính thành các đầu ra phi tuyến; nếu không có chúng, nhiều lớp tuyến tính sẽ gộp lại thành một phép biến đổi tuyến tính duy nhất, làm hạn chế nghiêm trọng khả năng biểu đạt của mạng. Figure 12 so sánh ba hàm activation theo từng phần tử (element-wise) thường dùng và một hàm ở cấp độ véc-tơ (softmax), mỗi hàm có những đặc tính toán học định hình cả hành vi học và chi phí thực thi.

Việc lựa chọn hàm activation ảnh hưởng đến cả quá trình học và hiệu suất tính toán, cho thấy các giới hạn của hệ thống định hình cách thiết kế thuật toán. ReLU (\(\max(0, x)\)) trở thành một activation phổ biến cho các lớp ẩn trong mạng truyền xuôi vì chi phí thấp, có đạo hàm cục bộ bằng 1 khi đầu vào dương và có thể tạo ra các activation thưa. Các mạng sâu khả vi trước đây thường dùng sigmoid hoặc tanh. Các đường cong S trơn của chúng có thể bão hòa, làm gradient suy giảm qua nhiều lớp và cản trở việc học ở các lớp đầu. Sự khác biệt này không phải một bảng xếp hạng đơn giản: sigmoid vẫn phù hợp cho một số đầu ra nhị phân, tanh vẫn hữu ích khi cần activation bị chặn và có trung bình quanh 0, và các kiến trúc hiện đại còn dùng thêm những họ activation khác. Câu hỏi thiết kế quan trọng là hàm nào cung cấp được ngữ nghĩa đầu ra và hành vi gradient cần thiết với chi phí thực thi chấp nhận được. Hiểu đúng các vai trò đó lý giải vì sao ReLU được ưa dùng, nhưng không biến nó thành lựa chọn mặc định cho mọi trường hợp.
Sigmoid
Hàm sigmoid logistic20 nén các đầu vào liên tục vào khoảng mở \((0,1)\) (equation 3): \[ \sigma(x) = \frac{1}{1 + e^{-x}} \tag{3}\]
20 Sigmoid: Từ tiếng Hy Lạp sigma + eidos (“có hình chữ sigma”), ám chỉ đường cong hình chữ S, ánh xạ các giá trị đầu vào vào khoảng giới hạn (0, 1). Phép ánh xạ này đòi hỏi một phép xấp xỉ hàm mũ, thường được thực hiện thông qua các lệnh chuyên dụng, bảng tra cứu hoặc phương pháp đa thức. Nó thường tốn kém hơn thao tác so sánh và lựa chọn của ReLU, dù mức chênh lệch đo được phụ thuộc vào độ chính xác, vector hóa và phần cứng. Việc ReLU được ưa dùng phản ánh cả việc gradient lưu thông dễ hơn trên nhánh dương của nó lẫn chi phí thực thi rẻ hơn.
Đường cong hình chữ S ánh xạ các logit vào khoảng \((0,1)\), nên sigmoid có thể biểu diễn một xác suất nhị phân. Nó tiến gần 1 khi đầu vào dương lớn và gần 0 khi đầu vào âm lớn. Mặc dù sigmoid trơn và khả vi mọi nơi, việc học dựa trên gradient thì không nhất thiết vậy: ReLU dùng một dưới-đạo hàm được gán tại điểm 0.
Sigmoid có một hạn chế lớn: với các đầu vào có giá trị tuyệt đối lớn (tức là rất xa 0), gradient của nó trở nên cực kỳ nhỏ. Hiện tượng này được gọi là vấn đề gradient biến mất.21 Trong quá trình lan truyền ngược, các gradient nhỏ này nhân với nhau qua các lớp, khiến gradient ở các lớp đầu trở nên cực kỳ nhỏ theo cấp số nhân. Điều này trên thực tế ngăn cản việc học trong các mạng sâu, vì các cập nhật trọng số trở nên không đáng kể.
21 Vấn đề gradient biến mất: Theo quy tắc chuỗi, việc nhân các thừa số Jacobian qua các lớp có thể làm gradient bị thu nhỏ. Đạo hàm của sigmoid tối đa là 0.25, nên dọc theo một đường dẫn đơn giản hóa 10 lớp, riêng các nhân tử đạo hàm activation đã chỉ đóng góp tối đa \(0.25^{10} \approx 10^{-6}\). Gradient đầy đủ còn bao gồm trọng số và các phép toán khác, nhưng các đạo hàm activation bị bão hòa lặp đi lặp lại vẫn có thể khiến cập nhật ở các lớp đầu tiên trở nên không đáng kể.
Đầu ra của sigmoid không được căn giữa quanh 0. Khi các đầu vào phục vụ cập nhật tham số cũng không âm, các gradient trọng số có thể đồng dấu (tương quan về dấu), dẫn đến các quỹ đạo tối ưu hóa ít trực diện hơn. Tuy vậy, gradient đầy đủ vẫn phụ thuộc vào lỗi từ các lớp phía trước và không phải lúc nào cũng cùng một dấu.
Tanh
Hàm tang hyperbol22 đưa activation đầu ra về quanh 0 trên khoảng \((-1,1)\) (equation 4): \[ \tanh(x) = \frac{e^x - e^{-x}}{e^x + e^{-x}} \tag{4}\]
22 Tanh (hàm tang hyperbol): Bằng cách đặt phạm vi đầu ra quanh 0, tanh có thể giảm hiện tượng các cập nhật đồng dấu, vốn thường xảy ra với các activation luôn dương. Chi phí tính toán của nó tương tự như sigmoid vì nó cũng dựa trên các xấp xỉ hàm mũ, trong khi đặc tính bão hòa vẫn có thể dẫn đến vấn đề gradient biến mất.
Tanh tạo ra đường cong hình chữ S giống sigmoid nhưng được căn giữa tại 0: đầu vào âm cho đầu ra âm, đầu vào dương cho đầu ra dương. Tính đối xứng này giúp cân bằng việc truyền gradient trong quá trình huấn luyện, thường cho hội tụ nhanh hơn sigmoid.
Giống sigmoid, tanh trơn tru và khả vi khắp miền, và vẫn chịu vấn đề gradient biến mất khi đầu vào có độ lớn lớn. Khi hàm bão hòa (tiệm cận -1 hoặc 1), gradient thu nhỏ về 0. Dù có hạn chế này, nhờ đầu ra được căn giữa quanh 0, tanh thường được ưu tiên hơn sigmoid cho các lớp ẩn trong nhiều kiến trúc, đặc biệt là trong các mạng nơ-ron hồi quy, nơi việc duy trì các activation cân bằng theo thời gian là rất quan trọng.
Sigmoid và tanh cùng chia sẻ một hạn chế quan trọng: gradient bão hòa ở các giá trị đầu vào cực đoan. Nhu cầu tìm một hàm activation tránh được vấn đề này mà vẫn hiệu quả về mặt tính toán đã dẫn tới một trong những đổi mới quan trọng nhất của deep learning.
ReLU
ReLU23 đặt các giá trị âm về 0, đồng thời giữ nguyên tuyến tính cho các đầu vào dương (equation 5): \[ \text{ReLU}(x) = \max(0, x) = \begin{cases} x & \text{if } x > 0 \\ 0 & \text{if } x \leq 0 \end{cases} \tag{5}\]
23 ReLU (đơn vị tuyến tính chỉnh lưu): Khác với các phép toán lũy thừa tốn kém trong các hàm activation trước đây, phép toán max(0, x) của ReLU chỉ tương đương với một phép so sánh và lựa chọn đơn giản. Sự hiệu quả này, cùng với việc gradient truyền tốt hơn ở các activation dương, đã giúp các kiến trúc sâu trong kỷ nguyên AlexNet trở nên khả thi về mặt tính toán (Nair and Hinton 2010; Krizhevsky et al. 2012).
Nair, Vinod, and Geoffrey E. Hinton. 2010. “Rectified Linear Units Improve Restricted Boltzmann Machines.” Proceedings of the 27th International Conference on Machine Learning (ICML-10), 807–14.
24 Dropout: Kỹ thuật Dropout ngẫu nhiên tắt các nơ-ron trong quá trình huấn luyện, buộc mạng phải học các biểu diễn dư thừa. Đây là một kỹ thuật điều chuẩn được sử dụng rộng rãi trong xu hướng phát triển các mô hình thị giác sâu thời AlexNet (Srivastava et al. 2014; Krizhevsky et al. 2012). Kỹ thuật này tạo ra sự khác biệt ở cấp độ hệ thống giữa đồ thị tính toán dùng cho huấn luyện (có yếu tố ngẫu nhiên) và đồ thị dùng cho suy luận (xác định). Việc không chuyển đổi từ đồ thị huấn luyện sang đồ thị suy luận là một lỗi phổ biến có thể âm thầm làm giảm độ chính xác của mô hình.
Srivastava, Nitish, Geoffrey E. Hinton, Alex Krizhevsky, Ilya Sutskever, and Ruslan Salakhutdinov. 2014. “Dropout: A Simple Way to Prevent Neural Networks from Overfitting.” Journal of Machine Learning Research 15 (1): 1929–58.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
Hình dạng đặc trưng của ReLU—một đường thẳng cho đầu vào dương và 0 cho đầu vào âm—mang lại ba lợi thế. Thứ nhất, đạo hàm cục bộ của nó bằng một khi đầu vào dương, giúp tránh bão hòa activation ở nhánh này; gradient của toàn bộ mạng vẫn có thể giảm hoặc tăng thông qua các trọng số và các phép toán khác. Thứ hai, ReLU tạo ra độ thưa activation một cách xác định bằng cách đưa các giá trị âm về 0; điều này khác với cơ chế che ngẫu nhiên của dropout.24 Việc xuất hiện các giá trị 0 không tự động mang lại tăng tốc, vì các kernel dày đặc thông thường vẫn xử lý các vị trí đó trừ khi hiện thực có tận dụng được độ thưa này. Thứ ba, ReLU dùng phép so sánh và lựa chọn, output = (input > 0) ? input : 0, thay vì một xấp xỉ hàm mũ. Đây là các tính chất cục bộ của toán tử, còn hiệu năng end-to-end phụ thuộc vào cách nó được hợp nhất với phần việc lân cận.
ReLU không phải là không có nhược điểm. Vấn đề ReLU chết—các nơ-ron luôn trả về 0 và ngừng học—xảy ra khi nơ-ron bị kẹt trong trạng thái không hoạt động. Nếu các trọng số của một nơ-ron thay đổi trong quá trình huấn luyện sao cho preactivation \(z = \mathbf{w}^T\mathbf{x} + b\) luôn âm với mọi ví dụ huấn luyện, nơ-ron đó sẽ trả về 0 cho mọi đầu vào. Vì gradient của ReLU cũng bằng 0 với đầu vào âm, không có gradient nào đi ngược qua nơ-ron này trong lan truyền ngược: các trọng số không thể cập nhật, và nơ-ron đó vẫn chết. Điều này có thể xảy ra khi tốc độ học lớn đẩy các trọng số vào những vùng bất lợi. Ở góc độ hệ thống, các nơ-ron chết là dung lượng bị lãng phí: các tham số đó tiêu tốn bộ nhớ và tài nguyên tính toán trong suy luận nhưng không đóng góp gì vào đầu ra. Khởi tạo cẩn thận (He et al. 2015), tốc độ học vừa phải, và các biến thể leaky ReLU giúp giảm bớt ReLU chết. Batch normalization25 thì ổn định đầu vào của các lớp và cho phép dùng tốc độ học cao hơn (Ioffe and Szegedy 2015).
25 Chi phí hệ thống của BatchNorm: BatchNorm thêm hai tham số học được cho mỗi đặc trưng (hệ số tỉ lệ \(\gamma\) và độ dịch \(\beta\)) và hoạt động khác nhau trong quá trình huấn luyện và suy luận: khi huấn luyện, nó dùng giá trị trung bình và phương sai trực tiếp từ mini-batch hiện tại; còn khi suy luận, nó dùng các thống kê tích lũy đã được cố định. Nhờ giữ cho phân phối activation ở tỉ lệ phù hợp hơn, BatchNorm giúp ổn định quá trình huấn luyện và có thể cho phép tốc độ học cao hơn, nhưng nó cũng làm cho lớp phụ thuộc vào các thống kê của batch. Các batch nhỏ có thể dẫn đến ước tính trung bình và phương sai nhiễu. Vì vậy, việc chọn một bộ ổn định toán học trở thành một quyết định ở cấp hệ thống, liên quan đến kích thước batch, bộ nhớ activation và sự nhất quán giữa huấn luyện và phục vụ (serving). Các kiến trúc về sau và các thiết lập huấn luyện quy mô lớn đã đưa ra thêm những biến thể khác nhau của cùng bài toán đánh đổi dựa trên thống kê batch.
Ioffe, Sergey, and Christian Szegedy. 2015. “Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift.” Proceedings of the 32nd International Conference on Machine Learning (ICML) 37: 448–56.
Softmax
Không giống các hàm activation từng phần tử (element-wise) chỉ hoạt động độc lập trên từng giá trị, softmax26 là một hàm cấp độ vector: nó xét tất cả các giá trị cùng lúc để tạo ra một phân phối xác suất. Trong các bộ phân loại đơn giản, softmax thường được dùng ở lớp đầu ra, chứ không phải là một activation ẩn từng phần tử. Nó cũng được dùng để chuẩn hóa các vector điểm quan trọng đã học trong các kiến trúc attention. Hàm softmax được định nghĩa trong equation 6: \[ \text{softmax}(z_i) = \frac{e^{z_i}}{\sum_{j=1}^K e^{z_j}} \tag{6}\]
26 Softmax: Tên gọi này phản ánh vai trò của nó như một phiên bản “mềm” hoặc khả vi (differentiable) của argmax – một hàm cần đánh giá toàn bộ một vector để tìm giá trị lớn nhất. Phép toán cấp vector này không được dùng như một sự thay thế trực tiếp cho các phi tuyến tính từng phần tử (element-wise nonlinearities) như ReLU, nhưng nó lại rất quan trọng mỗi khi một mô hình cần chuẩn hóa một vector điểm số, bao gồm các đầu phân loại (classification heads) và các lớp attention. Tính lũy thừa trực tiếp có thể gây tràn số trong số học dấu phẩy động 32-bit. Các triển khai ổn định sẽ trừ đi logit lớn nhất trước khi lũy thừa; phép dịch này giữ nguyên mọi xác suất softmax, đồng thời khiến số mũ lớn nhất bằng một.
27 Logits: Trong các bộ phân loại đa lớp của mạng thần kinh, logits là các điểm số đầu ra chưa được chuẩn hóa. Chênh lệch giữa các điểm số này tương ứng với tỷ số log xác suất sau khi áp dụng softmax, trong khi từng logit đa lớp riêng lẻ không phải là một đại lượng log-odds đã được hiệu chỉnh. Vì argmax trên logits và argmax trên xác suất softmax đều chọn cùng một lớp, nên suy luận có thể bỏ qua softmax khi chỉ cần lớp đứng đầu.
Với một vector gồm \(K\) giá trị (thường gọi là logits27), softmax biến chúng thành \(K\) xác suất có tổng bằng 1. Một thành phần của đầu ra softmax được minh họa trong figure 12 (góc dưới bên phải); trên thực tế, softmax xử lý cả vector, và mỗi phần tử đầu ra phụ thuộc vào toàn bộ các giá trị đầu vào.
Trong các bộ phân loại đa lớp, softmax thường được dùng ở lớp đầu ra. Nó chuyển các logits có giá trị thực bất kỳ thành các xác suất dự đoán đã được chuẩn hóa, nhưng các giá trị này không nhất thiết là các ước lượng độ tin cậy đã được hiệu chỉnh. Lớp có xác suất cao nhất sẽ là lớp dự đoán, và các logits lớn hơn sẽ nhận xác suất cao hơn theo cách không cân xứng.
Mối quan hệ toán học giữa logits đầu vào và xác suất đầu ra là khả vi, cho phép gradient truyền ngược qua softmax trong quá trình huấn luyện. Khi kết hợp với hàm mất mát cross-entropy (được thảo luận trong section 1.3.3), softmax tạo ra các biểu thức gradient rất gọn, giúp dẫn dắt việc học hiệu quả. Ngoài các tính chất toán học, lựa chọn hàm activation còn ảnh hưởng trực tiếp đến hiệu quả phần cứng.
Systems Perspective 1.3: Các hàm activation và phần cứng
ReLU được dùng rộng rãi nhờ hiệu quả phần cứng, đồng thời tránh được vấn đề gradient biến mất. Tính \(\max(0,x)\) chỉ cần một phép so sánh, trong khi sigmoid và tanh cần tính hàm mũ—những phép toán đắt hơn nhiều về thời gian và năng lượng. Phép tính thuế transistor trong section 1.2.2.3 mô hình hóa khoảng cách này như một tỷ lệ chi phí logic, và Tăng tốc phần cứng đề cập rộng hơn đến benchmark và cách triển khai bộ tăng tốc.
Thuế transistor: Chi phí đơn vị logic
Ngoài hành vi gradient, quyết định chọn activation còn có một chi phí khác: diện tích silicon. Trong kiến trúc máy tính, chúng ta đánh giá chi phí đơn vị logic dựa trên số lượng transistor và năng lượng tiêu thụ cho mỗi phép toán.
Đường dẫn dữ liệu ReLU có thể được triển khai bằng mạch logic so sánh và lựa chọn, trong khi sigmoid hoặc tanh cần xấp xỉ một hàm siêu việt, ví dụ dùng bảng tra cứu hoặc tính toán đa thức. Các giả định minh họa ở đây gán 50 transistor tương đương cho ReLU và 2,500 cho một đường dẫn dữ liệu hàm mũ độ chính xác cao. Diện tích, độ trễ và năng lượng thực tế sẽ phụ thuộc vào độ chính xác, phương pháp xấp xỉ, việc chia sẻ tài nguyên, mục tiêu thông lượng và công nghệ phần cứng.
Sự chênh lệch minh họa này chính là thuế transistor: theo các giả định đã nêu, “chi phí” silicon (theo mô hình) của sigmoid cao gấp 50× lần so với ReLU. Tỷ lệ chính xác này không phải là một hằng số phần cứng cố định. Bài học lâu dài về hệ thống là các activation tuyến tính từng phần đơn giản thường rẻ hơn để triển khai so với các hàm siêu việt, và việc ReLU được ưa dùng cũng phản ánh hành vi tối ưu hóa và luồng gradient của nó.
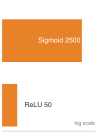
Một mô hình logic minh họa cho thấy tại sao ReLU thường rẻ hơn để triển khai.
Các phép biến đổi này chuyển tổng đầu vào tuyến tính thành đầu ra phi tuyến, tạo ra phép tính nơ-ron nhân tạo tổng quát như trong equation 7: \[ \hat{y} = f(z) = f\left(\sum (x_i \cdot w_{ij}) + b\right) \tag{7}\]
Tính phi tuyến này mở rộng những gì mạng đa lớp có thể biểu diễn. Nếu thiếu nó, một chuỗi các lớp tuyến tính về mặt đại số sẽ gộp lại thành một phép biến đổi tuyến tính duy nhất, bất kể triển khai có tính bao nhiêu ma trận trung gian. Trong figure 13, khung bên trái cho thấy một ranh giới tuyến tính không thể tách các lớp, còn khung bên phải cho thấy một ranh giới cong mà một mạng đa lớp với activation phi tuyến và các tham số được học phù hợp có thể biểu diễn. Hình này minh họa khả năng biểu diễn, chứ không đảm bảo rằng quá trình huấn luyện sẽ tìm ra ranh giới đó. Tối ưu hóa, độ phủ dữ liệu và kiến trúc vẫn quyết định hàm mà các tham số được học sinh ra.

Định lý xấp xỉ phổ quát28 cho biết rằng các mạng đủ rộng với các activation phù hợp có thể xấp xỉ nhiều lớp hàm với độ chính xác tùy ý. Nền tảng lý thuyết này, kết hợp với các đặc tính tính toán và tối ưu hóa của các activation cụ thể như ReLU và sigmoid, giải thích hiệu quả thực tế của mạng nơ-ron trong các tác vụ phức tạp. Tuy nhiên, định lý này là một kết quả tồn tại thuần túy dưới giả định độ rộng không giới hạn; nó không nói gì về bộ tăng tốc thực thi phép tính. Các hệ thống ML vật lý áp đặt những giới hạn cứng cho cả hai chiều của bài toán đánh đổi giữa độ rộng và độ sâu: một lớp ẩn đơn đủ rộng để xấp xỉ một hàm phức tạp đòi hỏi bộ nhớ cho tham số và activation đến mức có thể dùng hết VRAM của bộ tăng tốc, còn một mạng quá sâu đến mức không thể chứa activation trong bộ nhớ sẽ làm dừng backward pass vì cùng ràng buộc đó. Vậy nên, bài toán kỹ thuật không phải là liệu một mạng có độ rộng hoặc độ sâu đủ tồn tại hay không, mà là liệu nó có nằm trong giới hạn bộ nhớ và băng thông của phần cứng mục tiêu hay không.
28 Định lý xấp xỉ phổ quát: Với các điều kiện nhất định về activation, hàm mục tiêu, miền compact và dung sai xấp xỉ, một mạng một lớp ẩn đủ rộng có thể xấp xỉ mục tiêu với độ chính xác tùy ý. Kết quả tồn tại này mang tính không xây dựng (nonconstructive): nó không chỉ ra cách tìm các trọng số hay số lượng nơ-ron mà quá trình huấn luyện thực tế sẽ cần. Với một số lớp hàm, độ sâu mang lại lợi thế biểu diễn theo cấp số nhân so với các mạng nông, nhưng sự phân tách này không mang tính phổ quát.
Các lớp và kết nối
Mỗi nơ-ron riêng lẻ tính tổng có trọng số, áp dụng độ chệch (bias), rồi đưa kết quả qua các hàm activation. Tuy nhiên, sức mạnh của mạng nơ-ron đến từ cách tổ chức các nơ-ron này thành các lớp. Một lớp là tập hợp các nơ-ron cùng xử lý thông tin song song. Mỗi nơ-ron trong một lớp hoạt động độc lập trên cùng một đầu vào, nhưng có bộ trọng số và độ chệch (bias) riêng, nhờ đó lớp có thể học các đặc trưng khác nhau từ cùng một dữ liệu đầu vào.
Trong một mạng nơ-ron điển hình, ba loại lớp tạo thành cấu trúc phân cấp:
- Lớp đầu vào: Tiếp nhận các đặc trưng dữ liệu thô
- Các lớp ẩn: Xử lý và biến đổi dữ liệu qua nhiều giai đoạn
- Lớp đầu ra: Đưa ra dự đoán hoặc quyết định cuối cùng
Trong Kiến trúc mạng phân lớp, dữ liệu đi vào lớp đầu vào, đi qua nhiều lớp ẩn để dần trích xuất các đặc trưng trừu tượng hơn, và cuối cùng đến lớp đầu ra dưới dạng một dự đoán. Mỗi lớp kế tiếp biến đổi cách biểu diễn, xây dựng nên các đặc trưng ngày càng phức tạp—đây là một pipeline xử lý phân cấp, giúp các mạng nơ-ron sâu học được các mẫu phức tạp.
::: {#fig-layers fig-env=“figure” fig-pos=“htb” fig-cap=“Kiến trúc mạng phân lớp: Các mạng nơ-ron sâu biến đổi dữ liệu thông qua các lớp liên tiếp, nhờ đó có thể trích xuất các đặc trưng và mẫu ngày càng phức tạp. Mỗi lớp áp dụng các phép biến đổi phi tuyến tính lên kết quả đầu ra của lớp trước, cuối cùng ánh xạ các đầu vào thô thành các đầu ra mong muốn.” fig-alt=“Sơ đồ mạng nơ-ron cho thấy một lớp đầu vào gồm bốn nút ở bên trái; bốn lớp ẩn với số nút lần lượt là mười, tám, mười hai và tám, kèm dấu ba chấm cho biết còn các lớp khác; và một lớp đầu ra gồm hai nút ở bên phải. Các mũi tên chỉ luồng dữ liệu đi từ trái sang phải. Một dấu ngoặc nhọn phía trên các cột ẩn được ghi nhãn Hidden layers, còn Input layer và Output layer là các nhãn đơn ở hai góc trên.”Các lớp ẩn”, trong khi “Lớp đầu vào” và “Lớp đầu ra” là các nhãn đơn giản ở các góc trên cùng.”}
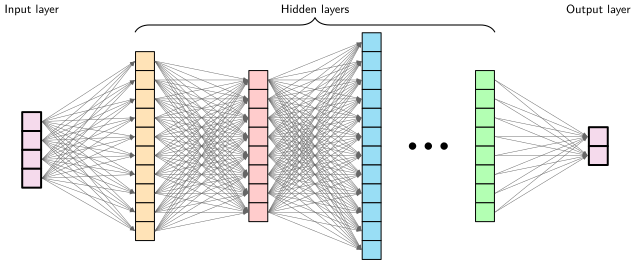
:::
Khi dữ liệu đi qua mạng, nó được biến đổi ở mỗi lớp để trích xuất các mẫu có ý nghĩa. Quá trình tổng trọng số và activation mà chúng ta đã giới thiệu cho từng nơ-ron riêng lẻ được mở rộng: mỗi lớp áp dụng các phép toán này song song trên tất cả các nơ-ron của mình, với đầu ra của một lớp trở thành đầu vào cho lớp kế tiếp. Điều này tạo ra một pipeline xử lý phân cấp, nơi các đặc trưng đơn giản được phát hiện ở các lớp đầu tiên kết hợp lại thành các mẫu ngày càng phức tạp hơn ở các lớp sâu hơn—giúp mạng nơ-ron học được các biểu diễn tinh vi từ dữ liệu thô.
Các tham số và kết nối
Các tham số có thể học được29 của mạng nơ-ron, bao gồm trọng số và độ chệch (bias), quyết định cách thông tin luân chuyển trong mạng và cách các phép biến đổi được áp dụng lên dữ liệu đầu vào. Cách tổ chức của chúng ảnh hưởng trực tiếp đến cả khả năng học và yêu cầu tính toán.
29 Chi phí bộ nhớ tham số: Số lượng tham số là một chỉ báo dễ gây hiểu lầm về tầm quan trọng đối với bộ nhớ; một số lớp thêm các tham số scale hoặc shift nhỏ đã học, gần như không ảnh hưởng đến ngân sách byte nhưng có thể tác động mạnh đến hành vi của mô hình khi thay đổi lựa chọn huấn luyện. Ngược lại, phần lớn tham số nằm trong các ma trận trọng số dày đặc lại cần thêm trạng thái trong quá trình huấn luyện: các gradient và thông tin theo dõi của optimizer, ngoài chính các trọng số được lưu. Vì thế, một mô hình vừa vặn bộ nhớ khi suy luận có thể cần nhiều lần dung lượng hơn để huấn luyện; chi phí này sẽ được lượng hóa ở phần ngân sách bộ nhớ huấn luyện phía sau.
Ma trận trọng số
Trọng số quyết định mức độ ảnh hưởng của đầu vào đến đầu ra của nơ-ron. Trong các lớp dày đặc, các trọng số này được tổ chức thành các ma trận, giúp ánh xạ hiệu quả tới các kernel đại số tuyến tính. Cụ thể, trong một lớp có \(n\) đặc trưng đầu vào và \(m\) nơ-ron, các trọng số tạo thành một ma trận \(\mathbf{W} \in \mathbb{R}^{n \times m}\), với mỗi cột đại diện cho các trọng số của một nơ-ron. Phép nhân ma trận-vectơ xử lý một đầu vào, trong khi phép nhân ma trận-ma trận xử lý một batch đầu vào, từ đó khai thác được nhiều song song và tái sử dụng dữ liệu hơn.
Nhắc lại rằng với một nơ-ron đơn lẻ, chúng ta tính \(z = \sum_{i=1}^n (x_i \cdot w_{ij}) + b\). Khi có một lớp gồm \(m\) nơ-ron, dù có thể tính đầu ra của từng nơ-ron riêng biệt, nhưng các phép toán ma trận lại mang đến một cách tiếp cận hiệu quả hơn nhiều. Thay vì tính toán từng nơ-ron một, phép nhân ma trận cho phép chúng ta tính đồng thời tất cả \(m\) đầu ra (equation 8): \[ \mathbf{z} = \mathbf{x}\mathbf{W} + \mathbf{b} \tag{8}\]
Phương trình này tính giá trị tiền activation của mỗi nơ-ron cho một đầu vào: vectơ \(\mathbf{x}\) nhân với ma trận trọng số \(\mathbf{W}\) tạo ra tất cả \(m\) giá trị, và vectơ độ chệch (bias) \(\mathbf{b}\) dịch mỗi giá trị đó. Với một batch, đầu vào trở thành một ma trận và cùng lớp đó trở thành một phép nhân ma trận-ma trận. Các kernel này đảm nhiệm phần lớn công việc trong các mạng truyền thẳng dày đặc. Tuy nhiên, việc chúng có chiếm phần lớn thời gian runtime hay không—và liệu chúng bị giới hạn bởi năng lực tính toán hay bởi bộ nhớ—còn phụ thuộc vào kích thước, kích thước batch, độ chính xác, cách triển khai và phần cứng mục tiêu.
Cách tổ chức ma trận này không chỉ thuận tiện về mặt toán học mà còn phản ánh cách các mạng nơ-ron hiện đại được triển khai để chạy hiệu quả. Mỗi trọng số \(w_{ij}\) biểu thị mức độ mạnh của kết nối giữa đặc trưng đầu vào \(i\) và nơ-ron \(j\) trong lớp.
Trường hợp tiêu biểu mà chúng ta xét ở đây là khi mỗi nơ-ron trong một lớp được kết nối với tất cả nơ-ron ở lớp trước, tạo thành một lớp “dày đặc” hay “kết nối đầy đủ”. Kiểu kết nối này cho phép mỗi nơ-ron sử dụng tất cả các đặc trưng từ lớp trước. Các lớp kết nối đầy đủ thiết lập những nguyên tắc toán học cần thiết cho phần này, trong khi các kiểu kết nối thay thế (được trình bày trong Kiến trúc mạng) khai thác cấu trúc của dữ liệu và có thể giảm lượng tính toán hoặc cải thiện hiệu quả thống kê.
Figure 14 minh họa rõ ràng kiểu kết nối dày đặc bằng cách trình bày một mạng ba lớp nhỏ, trong đó mọi trọng số kết nối đều được gắn nhãn. Mỗi đầu vào kết nối với mọi nơ-ron ẩn, và mỗi nơ-ron ẩn kết nối với mọi đầu ra. Mỗi edge được gắn nhãn đại diện cho một trọng số có thể học được, giúp ta thấy rõ số lượng tham số và cấu trúc phép tính. Hãy đọc từng nơ-ron đích một: các edge đi vào nó tạo thành một cột của ma trận trọng số ở lớp trước, và độ chệch (bias) của nơ-ron đó dịch chuyển tổng có trọng số thu được. Đọc tất cả nơ-ron đích cùng lúc sẽ lộ ra phép toán ma trận. Các nhãn số chỉ mang tính minh họa, không phải là kết quả của một lượt truyền thẳng đã được tính; điều quan trọng là hình dạng của ma trận. Với các lớp có kích thước \((n_1, n_2, n_3)\), các ma trận trọng số là \(\mathbf{W}^{(1)} \in \mathbb{R}^{n_1 \times n_2}\) và \(\mathbf{W}^{(2)} \in \mathbb{R}^{n_2 \times n_3}\), cần \(n_1n_2+n_2n_3\) trọng số (chưa tính độ chệch (bias)).

Các số hạng độ chệch (bias)
Mỗi nơ-ron trong một lớp cũng có một số hạng độ chệch (bias) đi kèm30. Trong khi các trọng số quyết định tầm quan trọng tương đối của các đầu vào, độ chệch (bias) cho phép nơ-ron dịch chuyển hàm activation của mình. Sự dịch chuyển này rất quan trọng cho việc huấn luyện, vì nó giúp mạng linh hoạt hơn để khớp các mẫu phức tạp.
30 Các số hạng độ chệch (bias): Các độ chệch (bias) thêm một tham số cho mỗi nơ-ron, trong khi một nơ-ron có \(n\) đầu vào sẽ có \(n\) trọng số. Như vậy, chúng chiếm \(1/(n+1)\) số tham số của lớp đó. Tỷ lệ của chúng trên toàn mô hình và ảnh hưởng đến độ chính xác phụ thuộc vào chiều rộng lớp, kiến trúc và chuẩn hóa. Một số kiến trúc hiện đại bỏ qua các độ chệch (bias) trong các lớp được theo sau bởi chuẩn hóa batch, vì phép biến đổi chuẩn hóa này đã bao gồm một dịch chuyển học được.
Đối với một lớp có \(m\) nơ-ron, các số hạng độ chệch (bias) tạo thành một vectơ \(\mathbf{b} \in \mathbb{R}^m\). Khi tính đầu ra của lớp, vectơ độ chệch (bias) này được cộng vào tổng có trọng số của các đầu vào (cùng dạng như equation 8). Nhờ đó, các số hạng độ chệch (bias) thực chất cho phép mỗi nơ-ron có một “ngưỡng” activation khác nhau, giúp mạng biểu diễn tốt hơn: \[ \mathbf{z} = \mathbf{x}\mathbf{W} + \mathbf{b} \]
Cách tổ chức các trọng số và độ chệch (bias) trong một mạng truyền thẳng tuân theo một cấu trúc có hệ thống. Đối với mỗi lớp affine được tham số hóa \(\ell\), có ba thành phần xác định phép tính của lớp; các trọng số và độ chệch (bias) được học, còn hàm activation thường do người thiết kế lựa chọn:
- Một ma trận trọng số \(\mathbf{W}^{(\ell)}\)
- Một vectơ độ chệch (bias) \(\mathbf{b}^{(\ell)}\)
- Một hàm activation \(f^{(\ell)}\)
Điều này cho ta phép tính hoàn chỉnh của lớp, như trong equation 9: \[ \mathbf{a}^{(\ell)} = f^{(\ell)}(\mathbf{z}^{(\ell)}) = f^{(\ell)}(\mathbf{a}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)}) \tag{9}\]
Ở đây, \(\mathbf{a}^{(\ell)}\) (hoặc \(\mathbf{A}^{(\ell)}\) khi làm việc với các batch) là đầu ra activation của lớp. Xuyên suốt tài liệu, chúng ta dùng quy ước vectơ hàng: mỗi mẫu dữ liệu là một hàng, và ma trận trọng số \(\mathbf{W}^{(\ell)} \in \mathbb{R}^{n_{\ell-1} \times n_\ell}\) ánh xạ từ chiều rộng của lớp trước sang chiều rộng của lớp hiện tại. Với phương trình này, các khái niệm cốt lõi về kiến trúc đã đủ để chúng ta tiếp tục.
Checkpoint 1.2: Những kiến thức cơ bản về kiến trúc mạng nơ-ron
Trước khi đi sâu vào cấu trúc liên kết mạng và huấn luyện, hãy tự kiểm tra xem bạn đã nắm vững các khái niệm nền tảng sau chưa:
Hãy dùng kiến trúc MNIST 784 → 128 → 64 → 10 làm ví dụ xuyên suốt để đối chiếu.
Nếu bạn thấy bất kỳ điểm nào chưa rõ, hãy xem lại các phần trước về nền tảng mạng nơ-ron, nơ-ron nhân tạo và các tham số trước khi tiếp tục. Các phần sắp tới về huấn luyện và tối ưu hóa sẽ được xây dựng trực tiếp trên những nền tảng này.
Thiết kế kiến trúc
Thiết kế kiến trúc quyết định cách các nơ-ron, hàm activation và ma trận trọng số kết nối với nhau để giải quyết những vấn đề mà một lớp đơn lẻ không thể xử lý. Thiết kế này có hệ quả trực tiếp ở cấp hệ thống, vì mỗi lựa chọn về cấu trúc liên kết (thêm một lớp, mở rộng chiều ẩn, thay đổi kết nối) đều làm thay đổi số lượng tham số, dung lượng bộ nhớ và chi phí tính toán.
Cấu trúc liên kết mạng mô tả cách các nơ-ron riêng lẻ được tổ chức thành các lớp và kết nối với nhau để tạo thành một mạng nơ-ron hoàn chỉnh. Để xây dựng trực giác về vấn đề này, chúng ta sẽ bắt đầu với một bài toán đơn giản nhưng rất nổi tiếng trong lịch sử AI.31
31 Bài toán XOR: XOR là ví dụ điển hình cho thấy kiến trúc mạng quan trọng như thế nào. Một lớp ngưỡng tuyến tính đơn lẻ không thể biểu diễn hàm không thể tách tuyến tính này, cho dù nó có bao nhiêu đơn vị đi chăng nữa. Ngược lại, một mạng nhỏ với một lớp ẩn phi tuyến tính có thể làm được. Số lượng đơn vị chính xác cần thiết phụ thuộc vào các quy ước activation và cách biểu diễn; bài học bền vững là việc thêm độ sâu phi tuyến tính sẽ thay đổi lớp hàm mà mạng có thể biểu diễn.
Ví dụ XOR gợi ý cần có một mạng với lớp ẩn, nhưng các mạng ngoài đời thực đòi hỏi phải xem xét có hệ thống các ràng buộc thiết kế và quy mô tính toán. Bài toán nhận dạng chữ số viết tay với tập dữ liệu MNIST (LeCun et al. 1998) cho thấy cấu trúc bài toán quyết định kích thước của mạng, trong khi cách cấu hình lớp ẩn vẫn là một quyết định thiết kế quan trọng.
Example 1.2: Xây dựng trực giác: Bài toán XOR
Hãy xét một mạng học hàm XOR, một bài toán kinh điển đòi hỏi tính phi tuyến. Với đầu vào \(x_1\) và \(x_2\) có thể là 0 hoặc 1, XOR cho ra 1 khi hai đầu vào khác nhau và 0 khi chúng giống nhau.
Thiết lập: Hai đầu vào → hai nơ-ron ẩn → một đầu ra
Ví dụ: Với đầu vào \((1, 0)\):
- Nơ-ron ẩn thứ nhất: \(h_1 = \text{ReLU}(1 \cdot w_{11} + 0 \cdot w_{12} + b_1)\)
- Nơ-ron ẩn thứ hai: \(h_2 = \text{ReLU}(1 \cdot w_{21} + 0 \cdot w_{22} + b_2)\)
- Đầu ra: \(y = \text{sigmoid}(h_1 \cdot w_{31} + h_2 \cdot w_{32} + b_3)\)
Góc nhìn hệ thống: Các lớp ẩn không chỉ tăng năng lực; chúng còn làm thay đổi loại hàm mà hệ thống có thể biểu diễn. Bài toán XOR là một ví dụ nhỏ nhưng cho thấy độ sâu là một yêu cầu mang tính cấu trúc, chứ không phải một lựa chọn thiết kế cho có (Minsky and Papert 1969).
Minsky, Marvin, and Seymour A. Papert. 1969. Perceptrons: An Introduction to Computational Geometry. The MIT Press.
Kiến trúc mạng truyền thẳng
Áp dụng kiến trúc ba lớp cho MNIST cho thấy đặc điểm dữ liệu và yêu cầu tác vụ ràng buộc thiết kế mạng như thế nào. Hãy so sánh hai hình trong figure 15 để nhìn kiến trúc này từ hai góc độ: hình (a) minh họa sơ đồ một ảnh thang độ xám \(28{\times}28\) pixel được nối với các lớp ẩn và lớp đầu ra, còn hình (b) cho thấy các giá trị đó được biến đổi thành một vector đặc trưng 784 chiều. Phép nhân ma trận có thể áp dụng cho mảng đa chiều, nhưng ở lớp kết nối đầy đủ này, mỗi đặc trưng đầu vào và mỗi đơn vị ẩn có một trọng số riêng, nên các trục của ảnh không được giữ trong tham số hóa. Ngược lại, các kiến trúc tích chập, sẽ được trình bày ở Kiến trúc mạng, mã hóa trực tiếp tính cục bộ theo không gian.
Độ rộng của lớp đầu vào được quyết định trực tiếp bởi định dạng dữ liệu. Với một ảnh 28×28 pixel, mỗi pixel là một đặc trưng đầu vào, nên cần 784 nơ-ron đầu vào. Cách nhìn tương đương: 28 hàng và 28 cột được làm phẳng thành 784 giá trị. Ta có thể coi đây là một lưới pixel 2D hoặc một vector đã làm phẳng, trong đó mỗi giá trị biểu diễn cường độ của một pixel.
Cấu trúc của lớp đầu ra được xác định bởi yêu cầu của tác vụ. Với bài toán phân loại chữ số, chúng ta dùng 10 nơ-ron đầu ra, mỗi nơ-ron ứng với một chữ số có thể có (0–9). Khi nhận một hình ảnh, mạng nơ-ron sẽ đưa ra một điểm số cho mỗi nơ-ron đầu ra; sau đó, một hàm softmax có thể chuyển các logits đó thành xác suất lớp dự đoán.
Giữa các lớp đầu vào và đầu ra cố định, ta có thể linh hoạt thiết kế cấu trúc liên kết của các lớp ẩn. Việc lựa chọn cấu trúc lớp ẩn—bao gồm số lớp và độ rộng của từng lớp—là một quyết định thiết kế quan trọng trong mạng nơ-ron. Thêm lớp làm tăng độ sâu của mạng nơ-ron, cho phép học các đặc trưng trừu tượng hơn qua các phép biến đổi liên tiếp. Độ rộng của mỗi lớp tạo thêm dung lượng để học các đặc trưng ở từng mức độ trừu tượng.
Mở rộng các lớp ẩn từ 100 lên 1000 nơ-ron làm số tham số tăng từ ~89.6K lên ~1.8M (~358 KB so với ~7 MB khi dùng FP32). Việc mạng rộng hơn có cải thiện độ chính xác hay không cần được huấn luyện và đánh giá; riêng việc tăng dung lượng lưu trữ đã là một yếu tố đáng kể đối với ngân sách triển khai trên thiết bị di động.

Các mẫu thiết kế kết nối giữa các lớp
Kiến trúc fully connected trong section 1.2.3 tối đa hóa tính linh hoạt bằng cách nối mọi neuron với mọi neuron ở lớp kế tiếp, nhưng bản thân cách kết nối là một quyết định kỹ thuật. Các mẫu kết nối dày đặc (dense), thưa (sparse) và bỏ qua (skip) đều đánh đổi giữa tính linh hoạt khi học với số lượng tham số, tính cục bộ và sự lan truyền gradient.
Kết nối dày đặc là mẫu tiêu chuẩn, trong đó mỗi neuron của một lớp nối với mọi neuron ở lớp kế tiếp. Trong ví dụ MNIST, nối lớp đầu vào 784 chiều với một lớp ẩn 128 neuron cần 100.352 tham số trọng số (\(784{\times}128\)). Kiểu kết nối đầy đủ này cho phép lớp học các tổ hợp tuyến tính tùy ý từ đầu vào; các activation phi tuyến tính đặt giữa các lớp dày đặc mở rộng các tổ hợp này thành các quan hệ phi tuyến tính. Số tham số tăng theo tích độ rộng của các lớp liền kề; vì vậy, tăng bề rộng một lớp làm số tham số tăng tuyến tính, còn tăng bề rộng cả hai lớp làm chúng tăng theo bậc hai.
Các mẫu kết nối thưa thớt đặt ra những giới hạn có chủ đích về cách các neuron kết nối giữa các lớp. Thay vì giữ mọi kết nối có thể, các neuron chỉ nối với một tập con neuron ở lớp liền kề. Cách tiếp cận này lấy cảm hứng từ hệ thần kinh sinh học, nơi neuron thường chỉ kết nối với một số lượng hạn chế neuron khác. Trong các tác vụ xử lý thị giác như ví dụ MNIST, neuron có thể chỉ nối với các đầu vào đại diện cho các pixel lân cận, phản ánh tính cục bộ của các đặc trưng thị giác.
Khi mạng trở nên sâu hơn, đường đi từ đầu vào đến đầu ra dài hơn, có thể làm quá trình học phức tạp hơn. Kết nối bỏ qua giải quyết điều này bằng cách thêm các đường dẫn trực tiếp giữa các lớp không liền kề. Chúng tạo ra lối đi thay thế cho thông tin, bổ sung cho tiến trình đi lần lượt qua từng lớp. Trong ví dụ nhận dạng chữ số của chúng ta, kết nối bỏ qua có thể giúp các lớp sau tham chiếu trực tiếp cả các mẫu mức cao lẫn các giá trị pixel gốc.
Các kiểu kết nối này không chỉ có ý nghĩa lý thuyết mà còn tác động trực tiếp đến phần cứng. Kết nối dày đặc tối đa hóa tính linh hoạt khi học và có thể ánh xạ hiệu quả vào các kernel nhân ma trận tổng quát (GEMM) trên phần cứng định hướng tensor. Kết nối thưa giúp giảm số tham số lý thuyết và FLOPS, nhưng một ma trận trọng số thưa không tự động chạy nhanh hơn ma trận dày trên phần cứng tiêu chuẩn—nếu không có hỗ trợ cho tính thưa có cấu trúc (chẳng hạn các mẫu 2:4 mà phần cứng có thể tận dụng qua các định dạng chỉ mục nén), việc giảm số phép tính sẽ không chuyển thành mức giảm tương ứng về thời gian thực thi. Kết nối bỏ qua giúp duy trì luồng thông tin hiệu quả trong các mạng sâu hơn, đồng thời giữ gìn các đường dẫn gradient, nhờ đó các kiến trúc rất sâu vẫn có thể huấn luyện được.
Kích thước mô hình và độ phức tạp tính toán
Cách sắp xếp các tham số (trọng số và độ chệch (bias)) quyết định cả khả năng học và chi phí tính toán—đây là phía của mô hình trong silicon contract (Định luật sắt của hệ thống ML): tổng số tham số, độ chính xác số của chúng, và các phép toán cần thiết cùng nhau xác lập thỏa thuận tính toán mà mô hình đạt với phần cứng. Trong khi topology định nghĩa cấu trúc của mạng, thì việc khởi tạo và tổ chức tham số ảnh hưởng trực tiếp đến quá trình học và hiệu suất cuối cùng của mô hình.
Ví dụ minh họa: Bộ nhớ huấn luyện so với bộ nhớ suy luận
Một lượt truyền xuôi qua mạng 784 → 128 → 64 → 10 tốn 109,184 MACs. Tuy nhiên, dấu chân bộ nhớ trong huấn luyện lại là câu chuyện khác. Chúng ta tính dấu chân bộ nhớ cho mạng này với kích thước batch 32 và độ chính xác dấu phẩy động 32-bit (4 byte), rồi so sánh với yêu cầu khi suy luận, lần lượt tính đến tham số, activations, gradients và trạng thái optimizer.
Yếu tố đóng góp đầu tiên là các tham số mô hình: bảng table 6 liệt kê tổng số trọng số và độ chệch (bias) của từng lớp. Tổng cộng có 109,386 parameters tham số, mỗi tham số chiếm 4 byte, tổng cộng là 437.5 KB.
| Lớp | Trọng số | Độ chệch (bias) | Tổng số tham số |
|---|---|---|---|
| Đầu vào → Lớp ẩn 1 | \(784{\times}128\) = 100,352 | 128 | 100,480 |
| Lớp ẩn 1 → Lớp ẩn 2 | \(128{\times}64\) = 8,192 | 64 | 8,256 |
| Lớp ẩn 2 → Đầu ra | \(64{\times}10\) = 640 | 10 | 650 |
| Tổng cộng | 109,386 parameters |
Các activation là đóng góp tiếp theo. Table 7 ghi lại tensor activation của mỗi lớp và chi phí bộ nhớ của nó ở kích thước batch 32.
| Lớp | Hình dạng activation | Giá trị | Bộ nhớ |
|---|---|---|---|
| Đầu vào | \(32{\times}784\) | 25,088 | 100.4 KB |
| Lớp ẩn 1 | \(32{\times}128\) | 4,096 | 16.4 KB |
| Lớp ẩn 2 | \(32{\times}64\) | 2,048 | 8.2 KB |
| Đầu ra | \(32{\times}10\) | 320 | 1.3 KB |
| Tổng cộng | 31,552 | 126 KB |
Quá trình huấn luyện cần thêm hai phần bộ nhớ mà suy luận không cần đến. Cụ thể, gradient chiếm dung lượng tương đương với các tham số mà chúng cập nhật, ở đây là 437.5 KB. Ngoài ra, optimizer Adam (Adaptive Moment Estimation) còn lưu trữ động lượng và vận tốc, chiếm dung lượng gấp đôi kích thước tham số, tức thêm 875.1 KB. Bảng Table 8 tóm tắt dung lượng bộ nhớ cần thiết cho từng thành phần khi huấn luyện so với suy luận.
| Thành phần | Huấn luyện | Suy luận |
|---|---|---|
| Tham số | 437.5 KB | 437.5 KB |
| Activations | 126 KB | 117 KB |
| Gradients | 437.5 KB | — |
| Trạng thái optimizer | 875.1 KB | — |
| Tổng cộng | ~1.9 MB | ~554 KB |
Quy mô là trọng tâm của bài học hệ thống này. Với kích thước batch 32, huấn luyện cần lượng bộ nhớ bằng 3.4× lần so với suy luận theo bảng tính đơn giản này. Độ chênh lệch tuyệt đối tăng theo phần lưu trữ tham số và activation; còn tỷ lệ phụ thuộc vào cân bằng giữa chúng và các lựa chọn triển khai như checkpointing, độ chính xác và tái sử dụng workspace.
Lighthouse 1.1: Sự mở rộng bộ nhớ từ MNIST đến GPT-2
Ví dụ xuyên suốt về MNIST và trường hợp GPT-2 cho thấy quy mô mô hình làm thay đổi số hạng dữ liệu \((D_{\text{vol}})\) trong định luật sắt như thế nào.
- MNIST (ví dụ minh họa): Với 109,386 tham số, trong đó mỗi tham số có kích thước 4 byte, mô hình này chiếm khoảng 438 KB bộ nhớ. Toàn bộ mô hình này có thể nằm gọn trong L2 cache của một bộ xử lý hiện đại.
- GPT-2 (ví dụ điển hình): Với 1,500,000,000 tham số, trong đó mỗi tham số có kích thước 4 byte, mô hình này chiếm khoảng 6 GB bộ nhớ, trước khi tính activations và runtime workspace. Dung lượng này vượt quá khả năng của bộ nhớ cache, khiến mô hình phải hoạt động dựa vào bộ nhớ thiết bị hoặc nhiều thiết bị, trừ khi giảm độ chính xác.
Hiểu biết về hệ thống: Việc chuyển từ ~109.4K sang 1.5B tham số là một bước nhảy 13,712.9×. Sự gia tăng này là một bước chuyển pha về mặt kỹ thuật, không chỉ đơn thuần là “nhiều tham số hơn”. MNIST có thể giữ các trọng số gần bộ xử lý; phục vụ (serving) GPT-2 phải quản lý một vùng nhớ làm việc lớn hơn nhiều. Việc một lớp cụ thể bị giới hạn bởi tính toán hay bộ nhớ vẫn phụ thuộc vào kích thước batch, độ chính xác, tái sử dụng và cân bằng phần cứng.
Số lượng tham số tăng theo cả chiều rộng lẫn chiều sâu của mạng. Với ví dụ MNIST, xét một mạng có lớp đầu vào 784 chiều, các lớp ẩn lần lượt 128 và 64 nơ-ron, và lớp đầu ra 10 nơ-ron (784 → 128 → 64 → 10). Lớp đầu tiên cần 100,352 trọng số và 128 độ chệch (bias); lớp thứ hai cần 8,192 trọng số và 64 độ chệch (bias); lớp đầu ra cần 640 trọng số và 10 độ chệch (bias), tổng cộng 109,386 parameters tham số. Mỗi tham số này phải được lưu trong bộ nhớ và cập nhật trong quá trình huấn luyện.
MNIST thuộc quy mô cache; GPT-2 thuộc quy mô VRAM.
Các yêu cầu về bộ nhớ được tóm tắt trong table 8 có vẻ khiêm tốn với bộ phân loại MNIST nhỏ của chúng ta. Khi mở rộng lên các mô hình cỡ sản xuất, những yêu cầu này thay đổi mạnh, kéo theo việc phải chuyển sang loại phần cứng khác.
Napkin Math 1.1: Ước tính nhanh cho kỹ sư ML
Các tính toán chi tiết là cần thiết cho tài liệu thiết kế, nhưng các kỹ sư giàu kinh nghiệm cũng rèn kỹ năng ước tính nhanh trong đầu. Những “tính toán nháp” này giúp kiểm tra nhanh tính khả thi trước khi dành công sức cho phân tích chi tiết.
Ước tính bộ nhớ:
- Tham số → byte: Nhân bốn nếu dùng độ chính xác đơn 32-bit (FP32), nhân hai nếu dùng độ chính xác 16-bit (FP16) hoặc brain floating point 16 (BF16, loại sau có phạm vi số mũ giống FP32), hoặc nhân một nếu dùng số nguyên 8-bit (INT8).
- Tham số của lớp fully connected (FC): Đầu vào \(\times\) Đầu ra (cộng thêm các độ chệch (bias) ở đầu ra, thường không đáng kể).
- Trạng thái huấn luyện: Các tham số, gradient và trạng thái của optimizer có thể cần bộ nhớ gấp khoảng ~3–4 lần so với chỉ riêng trọng số; activation đỉnh và workspace là phần bổ sung thêm.
- Chi phí phụ của optimizer Adam: 2\(\times\) bộ nhớ tham số (momentum + velocity).
- Kích thước batch tối đa: xấp xỉ (GPU VRAM \(-\) trạng thái duy trì \(-\) không gian làm việc) / activation đỉnh trên mỗi mẫu.
Ước tính tính toán:
- Số FLOPs của lớp FC: \(2 \times d_{\text{in}} \times d_{\text{out}} \times B\) (một phép nhân-cộng được tính là 2 phép toán).
- Chuyển đổi MACs sang FLOPs: Nhân với 2.
- Đại lượng xấp xỉ mức sử dụng tính toán: \(\text{achieved FLOP/s} / R_{\text{peak}}\).
Ví dụ: “Tôi có thể huấn luyện một mô hình 100M tham số trên một GPU 16 GB không?”
Tính toán nhẩm: 100M tham số, mỗi tham số 4 byte, cùng với 4 bản sao bộ nhớ phục vụ huấn luyện, sẽ cần 1.6 GB cho trạng thái mô hình được duy trì. Như vậy, còn khoảng 14.4 GB cho activation, không gian làm việc tạm thời và chi phí phụ của framework. Trả lời: tham số vừa, nhưng cấu hình huấn luyện chưa được kiểm chứng; kích thước batch, hình dạng activation và không gian làm việc của kernel sẽ quyết định liệu toàn bộ bước có vừa hay không.
Hiểu biết về hệ thống: Một ước tính sơ bộ về trạng thái duy trì có thể nhanh chóng loại bỏ các cấu hình không khả thi, nhưng kích thước batch vẫn phụ thuộc vào khoảng trống cho activation và không gian làm việc.
Ngoài ví dụ về việc mô hình có vừa hay không, table 9 còn chắt lọc ba câu hỏi khả thi phổ biến thành các công thức một dòng mà một kỹ sư có thể áp dụng trước khi cần đến profiler.
| Câu hỏi | Ước tính nhanh |
|---|---|
| “Mô hình này có vừa với bộ nhớ GPU không?” | \(\text{persistent training state} + \text{peak activations} + \text{workspace} < \text{VRAM}\) |
| “Mất bao lâu cho mỗi epoch trên MNIST?” | \(60\text{K} \times \text{forward-backward FLOPs/image} / \text{achieved FLOP/s}\) |
| “Đây là giới hạn tính toán hay giới hạn bộ nhớ?” | So sánh cường độ số học với \(R_{\text{peak}}/\text{BW}\) |
Bảng kê bộ nhớ theo từng thành phần trong table 8 rất rõ ràng nhưng được đơn giản hóa có chủ đích. Trên thực tế, các kỹ sư hệ thống làm việc với hai mức độ chi tiết: dự toán chi tiết cho tài liệu thiết kế và ước tính sơ bộ (order-of-magnitude) cho các giai đoạn đánh giá tính khả thi ban đầu. Bảng kê này xác nhận rằng mô hình MNIST vừa vặn dễ dàng trong cache, trong khi GPT-2 đòi hỏi một bậc bộ nhớ lớn hơn nhiều, ngay cả trước khi tính đến không gian làm việc runtime. Một ước tính nhanh trong đầu sẽ cho ra cùng kết luận chỉ trong vài giây, chứ không phải vài phút, và giúp chúng ta gắn cờ ngay những mô hình không thể vừa trên phần cứng mục tiêu về mặt vật lý, trước khi phải chạy bất kỳ dòng mã profiling nào.
Các phép tính về tính khả thi cho kỹ sư biết liệu một mô hình có phù hợp (về mặt tài nguyên) hay không; chúng không nói gì về việc nó có học được hay không. Điều đó phụ thuộc vào cách các tham số mà các byte đó chứa được thiết lập ban đầu. Việc khởi tạo tham số là then chốt đối với hành vi của mạng. Nếu đặt tất cả tham số về 0, các neuron trong một lớp sẽ hành xử giống hệt nhau, khiến mạng không học được các đặc trưng đa dạng. Thay vào đó, các trọng số thường được khởi tạo ngẫu nhiên, dùng những chiến lược như khởi tạo Xavier/Glorot32 (Glorot and Bengio 2010) hoặc khởi tạo He (He et al. 2015), còn độ chệch (bias) thường bắt đầu từ các giá trị hằng nhỏ hoặc bằng 0. Quy mô các giá trị khởi tạo này rất quan trọng: quá lớn hoặc quá nhỏ đều dẫn đến động lực học học kém.
32 Khởi tạo Xavier/Glorot: Đối với một lớp có \(n_{\text{in}}\) đầu vào và \(n_{\text{out}}\) đầu ra, một lựa chọn phổ biến của Glorot là dùng phương sai trọng số \(2/(n_{\text{in}}+n_{\text{out}})\) để cân bằng activation ở chiều truyền thuận (forward) và gradient ở chiều truyền ngược (backward) (Glorot and Bengio 2010). Cách khắc phục này không tốn thêm FLOPs nào; đơn thuần chỉ là thiết lập phân phối ngẫu nhiên ngay lúc khởi động.
Cách phân bố tham số ảnh hưởng đến luồng thông tin qua các lớp. Trong bài toán nhận dạng chữ số, nếu trọng số quá nhỏ, các chi tiết đầu vào quan trọng có thể không lan truyền tới các lớp sau. Nếu quá lớn, mạng có thể khuếch đại nhiễu. Độ chệch (bias) giúp điều chỉnh ngưỡng activation của từng neuron, cho phép mạng học được các ranh giới quyết định tối ưu.
Các kiến trúc khác nhau áp đặt những ràng buộc riêng lên cách tổ chức tham số. Có kiến trúc chia sẻ trọng số giữa các vùng của mạng để mã hoá khả năng nhận diện mẫu không phụ thuộc vị trí; cũng có kiến trúc đặt một số trọng số bằng 0 để tạo ra các kiểu kết nối thưa thớt.
Kiến trúc mạng, neuron và tham số đã có, nhưng còn một câu hỏi cốt lõi: cơ chế nào khiến các tham số khởi tạo ngẫu nhiên trở nên hữu ích? Một mạng nối ngẫu nhiên cho kết quả không khá hơn đoán mò. Kiến trúc trả lời mô hình tính cái gì; huấn luyện trả lời mô hình học như thế nào. Cơ chế huấn luyện phơi bày các ràng buộc hệ thống, vì nó thêm tính toán ngược, lưu activation, gradient và trạng thái của optimizer. Khi đó, kích thước batch là một quyết định vừa thống kê vừa phần cứng: nó ảnh hưởng đến nhiễu của gradient, bộ nhớ cho activation, mức độ tái sử dụng dữ liệu và hiệu quả xử lý song song. Quá trình học phối hợp các chi phí này, đồng thời biến 109,386 parameters từ các số ngẫu nhiên thành một bộ phân loại chữ số hoạt động.
Self-Check: Question
In a fully connected multilayer perceptron with layer dimensions \(784 \to 128 \to 64 \to 10\), which layer represents the primary parameter storage and computational hotspot, and what is its weight parameter count?
- The \(64 \to 10\) output layer with \(640\) weights, because the softmax denominator forces quadratic parameter expansion.
- The \(128 \to 64\) hidden layer with \(8{,}192\) weights, because it bridges intermediate representations.
- The \(784 \to 128\) input layer with \(100{,}352\) weights (\(784 \times 128\)), accounting for over \(91\%\) of the network’s total weight parameters and forward MACs.
- All three layers have identical parameter counts because linear algebra kernels require static square matrix padding.
From a hardware and systems engineering perspective, why has the Rectified Linear Unit (\(\text{ReLU}(z) = \max(0, z)\)) largely replaced Sigmoid (\(\sigma(z) = \frac{1}{1 + e^{-z}}\)) in deep hidden layers?
- ReLU bounds activation outputs strictly within \([0, 1]\), completely eliminating register overflow.
- ReLU requires only a simple comparison/max operation without expensive transcendental exponentiations and maintains a constant derivative of \(1\) for positive inputs, avoiding gradient saturation in deep networks.
- Sigmoid requires analog neuromorphic circuits, whereas ReLU executes natively on digital ALUs.
- ReLU eliminates the need for backpropagation by calculating parameter updates directly during the forward pass.
Explain why stacking multiple linear layers without nonlinear activation functions (\(\mathbf{y} = \mathbf{x} \mathbf{W}_1 \mathbf{W}_2 \mathbf{W}_3\)) fails to increase the expressive capacity of a neural network, and identify the systems inefficiency caused by such an architecture.
True or False: For compositional target functions where complex patterns decompose hierarchically into reusable sub-patterns, deep networks can represent the function with polynomially many layers and parameters, whereas a shallow two-layer network may require exponentially many neurons to achieve the same expressiveness.
In hardware accelerators for neural networks, calculating transcendental functions such as exponentials and divisions in Sigmoid or Softmax activations requires dedicated multi-cycle approximation units or lookup tables, imposing a silicon area and energy cost often referred to as the silicon ____.
Order the computational and memory staging steps required to execute the forward pass of a single dense hidden layer for a batch of input tokens: (1) Apply the element-wise nonlinear activation function (e.g. ReLU) to preactivations, (2) Load the input activation matrix \(\mathbf{X}\) and layer weight matrix \(\mathbf{W}\) into execution registers/caches, (3) Perform the dense matrix multiplication \(\mathbf{X}\mathbf{W}\), (4) Broadcast and add the bias vector \(\mathbf{b}\) to obtain layer preactivations \(\mathbf{Z}\).
Quá trình học
Mạng MNIST hiện giữ 109,386 parameters tham số khởi tạo ngẫu nhiên—những con số hoàn toàn chưa chứa tri thức. Để biến các giá trị này thành một bộ phân loại chữ số đạt hơn 95% độ chính xác, ta lặp bốn thao tác hàng triệu lần: lan truyền thẳng (forward propagation) để tính dự đoán, hàm mất mát để đo lỗi, lan truyền ngược để tính gradient mất mát của từng tham số, và một optimizer dùng các gradient đó để cập nhật tham số.
Học có giám sát từ các ví dụ được gán nhãn
Một mạng khởi tạo ngẫu nhiên phân loại chữ số không hơn đoán mò trong 10 lớp (khoảng 10% độ chính xác). Để biến nó thành một bộ phân loại đạt 95%, cần học có giám sát: cho mạng xem các ví dụ có nhãn và điều chỉnh trọng số dựa trên lỗi nó mắc. Xét bài toán nhận dạng chữ số MNIST: tập dữ liệu có 60,000 ảnh huấn luyện, mỗi ảnh là ảnh thang độ xám \(28{\times}28\) pixel kèm nhãn chữ số đúng. Mạng phải học mối quan hệ giữa các ảnh này và chữ số tương ứng thông qua vòng lặp dự đoán và điều chỉnh trọng số. Đảm bảo chất lượng và tính toàn vẹn của dữ liệu huấn luyện là yếu tố then chốt để mô hình thành công (Kỹ thuật dữ liệu).
Mối quan hệ giữa đầu vào và đầu ra quyết định cách ta huấn luyện. Quá trình huấn luyện diễn ra theo vòng lặp; mỗi vòng xử lý một tập con các ví dụ huấn luyện, gọi là một batch.33 Với mỗi batch, mạng thực hiện bốn bước: tính toán lan truyền tiến qua các lớp để tạo dự đoán; một hàm mất mát đánh giá độ chính xác của các dự đoán; tính các điều chỉnh trọng số dựa trên sai số dự đoán; và cập nhật trọng số của mạng để cải thiện các dự đoán về sau.
33 Xử lý batch: Việc dùng batch có hai mục đích chính. Batch lớn hơn giúp làm mịn nhiễu của gradient bằng cách lấy trung bình trên nhiều ví dụ hơn, và có thể cải thiện hiệu quả sử dụng phần cứng bằng cách biến công việc ma trận-vector thành các kernel ma trận-ma trận lớn hơn. Đồng thời, chúng cũng làm nhiều việc hơn tổng thể và thường tăng độ trễ của từng yêu cầu riêng lẻ; mức tăng thông lượng còn phụ thuộc vào shape và phần cứng. Mỗi lần kích thước batch tăng gấp đôi, bộ nhớ activation cũng tăng xấp xỉ gấp đôi. Vì vậy, chọn kích thước batch là một quyết định kết hợp giữa tối ưu hóa và thiết kế hệ thống, chứ không thuần túy là lựa chọn về thống kê hay phần cứng.
Cách tiếp cận lặp này có thể được biểu diễn bằng toán học. Với một ảnh đầu vào \(x\) và nhãn đúng \(y\), mạng tính dự đoán của nó theo equation 10: \[ \hat{y} = f(x; \theta) \tag{10}\]
Phương trình này tóm tắt toàn bộ lan truyền tiến: mạng \(f\) nhận đầu vào \(x\) (ví dụ, một ảnh chữ số \(28{\times}28\)) và, với các tham số hiện tại \(\theta\) (gồm tất cả các trọng số và độ chệch (bias) đã xét), tạo ra dự đoán \(\hat{y}\) (một vector gồm mười xác suất, mỗi xác suất ứng với một chữ số). Ký hiệu dấu chấm phẩy \(f(x; \theta)\) giúp phân biệt đầu vào \(x\), thứ thay đổi theo từng ví dụ, với \(\theta\), thứ giữ nguyên khi suy luận nhưng thay đổi trong quá trình huấn luyện. Sai số của mạng được đo bằng một hàm mất mát34 \(\mathcal{L}\) (equation 11): \[ \text{loss} = \mathcal{L}(\hat{y}, y) \tag{11}\]
34 Hàm mất mát: Được Abraham Wald hình thức hóa trong lý thuyết quyết định thống kê như “chi phí” của một quyết định sai, \(\mathcal{L}\) định lượng khoảng cách giữa dự đoán \(\hat{y}\) và giá trị thực \(y\). Lựa chọn hàm mất mát định hình hình học tối ưu hóa: nó quyết định địa hình gradient mà lan truyền ngược phải vượt qua. Một hàm mất mát có các vùng phẳng gần những dự đoán sai sẽ tạo ra gradient yếu, dễ làm chững quá trình học; ngược lại, hàm mất mát có gradient dốc gần biên quyết định sẽ thúc đẩy hội tụ nhanh hơn ở những chỗ quan trọng nhất—một hệ quả ở cấp hệ thống được phân tích trong section 1.3.3.
Việc đo lỗi dẫn dắt việc điều chỉnh tham số mạng thông qua lan truyền ngược, được trình bày trong section 1.3.4. Trong thực tế, huấn luyện thường xử lý các batch ví dụ thay vì từng đầu vào riêng lẻ. Với tập dữ liệu MNIST, mỗi vòng lặp huấn luyện có thể xử lý đồng thời 32, 64 hoặc 128 ảnh vì các lý do được giải thích trong section 1.3.4.6. Chu trình huấn luyện tiếp diễn cho đến khi mạng đạt độ chính xác đủ tốt hoặc đạt số vòng lặp đặt trước. Trong suốt quá trình, hàm mất mát đóng vai trò kim chỉ nam; tối thiểu hóa hàm này cho thấy hiệu suất đang được cải thiện. Việc thiết lập chỉ số và quy trình đánh giá phù hợp là thiết yếu để đo lường hiệu quả huấn luyện (Benchmarking).
Tính toán lan truyền xuôi
Một ảnh MNIST được biến đổi thành mười điểm số lớp bằng cách đi qua các lớp có trọng số và các activation phi tuyến. Quá trình tính toán đó chính là lan truyền xuôi: dữ liệu đầu vào đi qua các lớp của mạng để tạo ra dự đoán. Trong huấn luyện, các dự đoán này được so sánh với giá trị thực; giá trị hàm mất mát thu được đi vào vòng lặp lan truyền ngược và cập nhật, như minh họa trong figure 16. Bản thân lan truyền xuôi là nền tảng cho cả suy luận và huấn luyện.

Dữ liệu đi qua các lớp theo chiều xuôi (mũi tên màu đỏ trong figure 16), trong khi các gradient chảy ngược để cập nhật trọng số (mũi tên màu cam). Hình vẽ cho thấy một bất đối xứng quan trọng: lan truyền xuôi tạo ra đầu ra của mô hình, còn lan truyền ngược tính gradient cho các tham số. Chính sự phụ thuộc này khiến quá trình huấn luyện phải giữ lại các giá trị ở lượt truyền xuôi gắn với từng phép toán, vì chúng cần cho lượt truyền ngược.
Khi một ảnh chữ số viết tay đi vào mạng, nó trải qua một loạt phép biến đổi qua các lớp. Mỗi phép biến đổi kết hợp các đầu vào đã được gán trọng số với các mẫu đã học để dần dần trích xuất các đặc trưng liên quan. Với bộ phân loại chữ số 784-128-64-10, một ảnh \(28{\times}28\) pixel được xử lý qua nhiều lớp để cuối cùng đưa ra xác suất cho mỗi chữ số (0–9).
Quá trình bắt đầu từ lớp đầu vào, nơi giá trị thang độ xám của mỗi pixel trở thành một đặc trưng đầu vào. Với MNIST, điều này tương ứng với 784 giá trị đầu vào (\(28{\times}28\) = 784), mỗi giá trị được chuẩn hóa trong khoảng [0, 1]. Các giá trị này sau đó được truyền qua các lớp ẩn, tại đó mỗi nơ-ron tổng hợp các đầu vào theo các trọng số đã học và áp dụng một hàm activation phi tuyến.
Mỗi lượt truyền xuôi qua mạng MNIST (784-128-64-10) đòi hỏi nhiều phép toán ma trận. Riêng lớp đầu tiên thực hiện 100,352 MACs phép tính cho mỗi mẫu. Khi xử lý nhiều mẫu trong một batch, số phép toán này tăng lên tương ứng, đòi hỏi quản lý cẩn thận băng thông bộ nhớ và tài nguyên tính toán. Các phần cứng chuyên dụng như GPU thực hiện các phép toán này hiệu quả nhờ xử lý song song.
Xử lý từng lớp riêng lẻ
Quá trình lan truyền thuận qua một mạng nơ-ron diễn ra có hệ thống. Mỗi lớp biến đổi đầu vào thành các biểu diễn ngày càng trừu tượng hơn. Bộ phân loại chữ số là một ví dụ điển hình: quá trình biến đổi này diễn ra theo từng giai đoạn riêng biệt. Ở mỗi lớp, phép tính gồm hai bước chính: một biến đổi tuyến tính của đầu vào, rồi đến một activation phi tuyến. Biến đổi tuyến tính này áp dụng cùng phép toán tổng có trọng số đã được định nghĩa trong equation 2, nhưng dùng ký hiệu theo dõi chỉ số lớp (equation 12): \[ \mathbf{Z}^{(\ell)} = \mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)} \tag{12}\]
Ở đây, \(\mathbf{A}^{(\ell-1)}\) chứa các activation từ lớp trước (tức là đầu ra sau khi áp dụng các hàm activation), \(\mathbf{W}^{(\ell)} \in \mathbb{R}^{n_{\ell-1} \times n_\ell}\) là ma trận trọng số cho lớp \(\ell\), còn \(\mathbf{b}^{(\ell)}\) là vectơ độ chệch (bias) (được broadcast trên toàn bộ batch). Chỉ số trên \((\ell)\) cho biết tham số thuộc về lớp nào. Quy ước vectơ hàng này khớp với phương trình cho một mẫu đơn trong equation 2: mỗi hàng của \(\mathbf{A}\) là một mẫu, và việc nhân từ bên phải với \(\mathbf{W}\) sẽ biến đổi nó sang số chiều của lớp tiếp theo.
Sau biến đổi tuyến tính này, mỗi lớp sẽ áp dụng một hàm activation phi tuyến \(f\) (ở đây, \(f\) hoặc \(f^{(\ell)}\) biểu thị một hàm activation tổng quát tại lớp \(\ell\); còn trong section 1.2.2.1, \(\sigma\) đề cập cụ thể đến hàm sigmoid), như được thể hiện trong equation 13: \[ \mathbf{A}^{(\ell)} = f(\mathbf{Z}^{(\ell)}) \tag{13}\]
Quá trình này lặp lại ở mỗi lớp, tạo thành một chuỗi các biến đổi liên tiếp: \[ \text{Input} \rightarrow \text{Linear Transform} \rightarrow \text{Activation} \rightarrow \text{Linear Transform} \rightarrow \text{Activation} \rightarrow \cdots \rightarrow \text{Output} \]
Quay trở lại ví dụ nhận dạng chữ số, các giá trị pixel trước hết được biến đổi bởi các trọng số của lớp ẩn đầu tiên, chuyển đổi đầu vào 784 chiều thành một biểu diễn trung gian. Mỗi lớp tiếp theo tiếp tục biến đổi biểu diễn này, và cuối cùng tạo ra một vectơ điểm số lớp 10 chiều, trong đó mỗi phần tử tương ứng với một chữ số có thể.
Biểu diễn bằng phép nhân ma trận
Toàn bộ quá trình lan truyền thuận có thể được biểu diễn dưới dạng một hợp thành của các hàm, trong đó mỗi hàm đại diện cho biến đổi của một lớp. Ta sẽ diễn đạt chính xác điều này bằng toán học dựa trên ví dụ MNIST.
Đối với một mạng có \(N_L\) lớp, chúng ta có thể biểu diễn toàn bộ quá trình lan truyền thuận như trong equation 14: \[ \mathbf{A}^{(N_L)} = f^{(N_L)}\!\Big(\cdots f^{(2)}\!\Big(f^{(1)}(\mathbf{X}\mathbf{W}^{(1)} + \mathbf{b}^{(1)})\mathbf{W}^{(2)} + \mathbf{b}^{(2)}\Big)\cdots \mathbf{W}^{(N_L)} + \mathbf{b}^{(N_L)}\Big) \tag{14}\]

Phép nhân ma trận chiếm hơn 90% tổng số FLOPs của lượt truyền thuận trong mạng dày đặc này.
Cấu trúc này cho thấy rằng về cốt lõi, quá trình truyền thuận là một chuỗi phép nhân ma trận đan xen với các activation phi tuyến. Để hiểu tại sao phép nhân ma trận lại chiếm phần lớn trong các phép tính AI, chúng ta cần xem xét cường độ số học của từng phép toán.
Biểu thức lồng nhau này được khai triển theo từng lớp, mỗi bước lấy activation của lớp trước làm đầu vào:
Lớp đầu tiên: \[\begin{gather*} \mathbf{Z}^{(1)} = \mathbf{X}\mathbf{W}^{(1)} + \mathbf{b}^{(1)} \\[0.2ex] \mathbf{A}^{(1)} = f^{(1)}(\mathbf{Z}^{(1)}) \end{gather*}\]
Các lớp ẩn \((\ell = 2,\ldots, N_L-1)\): \[\begin{gather*} \mathbf{Z}^{(\ell)} = \mathbf{A}^{(\ell-1)}\mathbf{W}^{(\ell)} + \mathbf{b}^{(\ell)} \\[0.2ex] \mathbf{A}^{(\ell)} = f^{(\ell)}(\mathbf{Z}^{(\ell)}) \end{gather*}\]
Lớp đầu ra: \[\begin{gather*} \mathbf{Z}^{(N_L)} = \mathbf{A}^{(N_L-1)}\mathbf{W}^{(N_L)} + \mathbf{b}^{(N_L)} \\[0.2ex] \mathbf{A}^{(N_L)} = f^{(N_L)}(\mathbf{Z}^{(N_L)}) \end{gather*}\] Trong ví dụ MNIST, kích thước của các phép toán cho một batch \(B\) ảnh như sau:
- Đầu vào \(\mathbf{X}\): \(B{\times}784\)
- Trọng số lớp đầu tiên \(\mathbf{W}^{(1)}\): \(784{\times}n_1\)
- Trọng số lớp ẩn \(\mathbf{W}^{(\ell)}\): \(n_{\ell-1}{\times}n_\ell\)
- Trọng số lớp đầu ra \(\mathbf{W}^{(N_L)}\): \(n_{N_L-1}{\times}10\)
Cường độ số học quyết định liệu một kernel bị giới hạn bởi tính toán hay bộ nhớ. Phép nhân ma trận dày đặc dùng lát gạch (tiled) có thể tái sử dụng các giá trị, trong khi một phép toán trên từng phần tử không được hợp nhất (unfused) lại thực hiện rất ít công việc trên mỗi byte. Table 10 so sánh cường độ lý tưởng của hai loại phép toán này.
| Thao tác | Số lượng thao tác (\(O\)) | Di chuyển dữ liệu tối thiểu | Cường độ lý tưởng hóa | Tối ưu hóa điển hình |
|---|---|---|---|---|
| Nhân ma trận \((N{\times}N)\) | \(2N^3\) | \(3N^2s\) bytes | \(\approx 2N/(3s)\) | Tiling trên CPU/GPU/TPU |
| Từng phần tử (ReLU) | \(N^2\) | \(2N^2s\) bytes | \(1/(2s)\) | Vectorization và fusion |
Systems Perspective 1.4: Tại sao phép nhân ma trận chiếm ưu thế trong AI
Các bộ tăng tốc hiện đại có mảng tính toán lớn so với băng thông bộ nhớ ngoài chip. Chúng chỉ có thể đạt thông lượng số học đỉnh khi các phép toán phơi bày đủ mức tái sử dụng và công việc song song. Các lớp dày đặc và tích chập rất phù hợp với các kernel được tối ưu hóa; các chuỗi phép toán trên từng phần tử tùy chỉnh thường được hợp nhất để các giá trị trung gian của chúng nằm lại trên chip.
Đối với một mẫu, biểu thức \(\mathbf{x}\mathbf{W}\) là một Phép nhân ma trận–vectơ tổng quát (GEMV); khi gom các mẫu thành một batch, phép tính này trở thành \(\mathbf{X}\mathbf{W}\), một GEMM. Các phép toán đa chiều như tích chập 2D/3D được ánh xạ về cùng lõi GEMM thông qua các biến đổi lowering (như im2col), biến các vùng tiếp nhận (receptive field) trượt chồng lấp thành các cột của ma trận 2D để các thư viện Basic Linear Algebra Subprograms (BLAS) tối ưu của nhà cung cấp có thể chạy chúng ở hiệu suất phần cứng cao nhất. Các phép toán ma trận chiếm hơn 90% số phép toán dấu phẩy động trong ví dụ mạng dày đặc của chương này và chiếm ưu thế trong nhiều khối lượng công việc (workload) quan trọng của mạng deep learning, dù tỷ lệ này còn tùy thuộc vào kiến trúc và chế độ thực thi. Để cải thiện hiệu suất, kỹ sư dùng các kỹ thuật như blocking và tiling để tăng khả năng tái sử dụng cache hoặc bộ nhớ trên chip. Nguyên tắc đồng thiết kế phần cứng–phần mềm, tức thiết kế kiến trúc mô hình xoay quanh các phép toán mà phần cứng chuyên dụng có thể thực thi hiệu quả, là trọng tâm của deep learning hiện đại. Nhân ma trận tổng quát (GEMM) cung cấp phân tích chi tiết về cường độ số học của GEMM, các định dạng ma trận thưa và độ phức tạp tính toán của các loại lớp phổ biến, những yếu tố cần thiết để tối ưu hóa các phép toán này trong thực tế.
Trình tự tính toán từng bước
Để hiểu các phép toán này chuyển thành việc tính toán thực tế như thế nào, chúng ta cần xem xét quá trình lan truyền tiến (forward propagation) cho một batch ảnh MNIST. Quá trình này minh họa cách dữ liệu được biến đổi từ các giá trị pixel thô thành các dự đoán chữ số.
Hãy xét một batch gồm 32 ảnh đi vào mạng. Mỗi ảnh bắt đầu là một lưới \(28{\times}28\) điểm ảnh (pixel), sau đó được làm phẳng thành một vector 784 chiều. Với toàn bộ batch, ta có ma trận đầu vào \(\mathbf{X}\) kích thước \(32{\times}784\), trong đó mỗi hàng đại diện cho một ảnh. Các giá trị này thường được chuẩn hóa để nằm trong khoảng từ 0 đến 1.
Phép biến đổi ở mỗi lớp diễn ra như một chuỗi thay đổi hình dạng; chính các hình dạng này quyết định việc chọn kernel và cách lưu trữ activation. Mạng nhận ma trận đầu vào \(\mathbf{X}\) (\(32{\times}784\)) và biến đổi nó bằng trọng số của lớp đầu tiên. Nếu lớp ẩn đầu tiên có 128 neuron, \(\mathbf{W}^{(1)}\) là ma trận \(784{\times}128\), nên phép tính \(\mathbf{X}\mathbf{W}^{(1)}\) cho ra ma trận \(32{\times}128\). Mỗi phần tử trong ma trận này được cộng thêm độ chệch (bias) tương ứng và đi qua hàm activation. Ví dụ, với activation ReLU, mọi giá trị âm trở thành 0, còn giá trị dương giữ nguyên. Phép biến đổi phi tuyến này giúp mạng học các mẫu phức tạp trong dữ liệu. Lớp cuối cùng biến đổi đầu vào thành ma trận \(32{\times}10\), trong đó mỗi hàng chứa 10 điểm số cho các lớp. Gọi \(z_j\) là điểm thô (logit) cho chữ số \(j\), và để \(z_k\) chạy qua cả 10 chữ số. Thông thường, các điểm này được chuyển thành xác suất bằng hàm softmax trong equation 6: \[ p(\text{digit } j) = \frac{e^{z_j}}{\sum_{k=1}^{10} e^{z_k}} \]
Với mỗi ảnh trong batch, ta thu được một phân phối xác suất trên các chữ số có thể. Chữ số có xác suất cao nhất là dự đoán của mạng.
Napkin Math 1.2: Đếm số phép toán trong truyền tiến
Bài toán: Tổng số phép toán số học (\(O\)) cho một lần truyền tiến qua mạng MNIST (784 → 128 → 64 → 10) với kích thước batch 32 là bao nhiêu?
Bối cảnh: Một phép nhân ma trận kích thước \((M{\times}K) \times (K{\times}N)\) cần \(2 \times M \times K \times N\) FLOPs (một phép nhân và một phép cộng cho mỗi phần tử đầu ra, cộng trên \(K\) số hạng). Phép cộng độ chệch (bias) thêm \(M \times N\) phép cộng dấu phẩy động. activation ReLU thêm \(M \times N\) phép so sánh, nên bảng báo cáo tổng khối lượng công việc tương đương phép toán, thay vì chỉ FLOPs thuần cho các hàng activation.
Giải pháp: Table 11 phân tích số phép toán theo từng lớp. Tổng cộng ~7 MOp, hoặc 7 MOp ÷ 32 = ~219 KOp mỗi ảnh.
Thông tin chuyên sâu về hệ thống:
- Lớp 1 chiếm ưu thế: Lớp đầu tiên chiếm 91.9 percent trong tổng số phép toán vì nó xử lý đầu vào lớn nhất (784 chiều). Đây là lý do vì sao việc giảm chiều ở các lớp đầu có tác động lớn.
- Tính toán vs. bộ nhớ: Ở batch 1, 219 KOp phải gánh chi phí đọc tham số cho đúng một ảnh, nên cường độ số học khoảng ~0.5 FLOP/byte theo mô hình lưu lượng này. Ở batch 32, một lần đọc các tham số cộng với một lượt đi qua các activation của batch sẽ di chuyển ít nhất ~564 KB và nâng cường độ lên ~12.4 FLOP/byte. Các cache miss bổ sung và lưu lượng trung gian có thể làm giảm giá trị đạt được. So sánh này cho thấy vì sao batching cải thiện khả năng tái sử dụng, nhưng việc bị giới hạn bởi bộ nhớ hay tính toán vẫn phụ thuộc vào sự cân bằng của máy được giới thiệu trong Mô hình Roofline.
- Trực giác về mở rộng: Khi tăng gấp đôi chiều rộng của các lớp ẩn (784 → 256 → 128 → 10), số lượng phép toán tăng khoảng 2.1×, lên khoảng 15 MOp. Lý do là tính lại từng lớp: lớp 1 và 3 tăng gấp đôi, lớp 2 tăng gấp bốn, nên tổng tăng khoảng 2.15× chứ không phải bốn lần.
| Lớp | Thao tác | Kích thước | Các thao tác |
|---|---|---|---|
| Lớp 1 | MatMul | (\(32{\times}784\)) \(\times\) (\(784{\times}128\)) | \(2 \times 32 \times 784{\times}128\) = 6,422,528 |
| Lớp 1 | Độ chệch (bias) + ReLU | \(32{\times}128\) | \(2{\times}4,096\) = 8,192 |
| Lớp 2 | MatMul | (\(32{\times}128\)) \(\times\) (\(128{\times}64\)) | \(2 \times 32 \times 128{\times}64\) = 524,288 |
| Lớp 2 | Độ chệch (bias) + ReLU | \(32{\times}64\) | \(2{\times}2,048\) = 4,096 |
| Lớp 3 | MatMul | (\(32{\times}64\)) \(\times\) (\(64{\times}10\)) | \(2 \times 32 \times 64{\times}10\) = 40,960 |
| Lớp 3 | Độ chệch (bias) + Softmax | \(32{\times}10\) | ~640 (đơn giản hóa) |
| Tổng cộng | ~7 MOp |
Các cân nhắc về triển khai và tối ưu hóa
Lan truyền tiến dễ phát biểu bằng toán học, nhưng khi triển khai lại bị ràng buộc bởi việc lưu trữ activation, kích thước batch, bố cục bộ nhớ và mức độ phù hợp với phần cứng. Quản lý bộ nhớ đóng vai trò trung tâm trong quá trình lan truyền tiến vì activation của mỗi lớp phải được lưu lại cho lượt truyền ngược trong quá trình huấn luyện. Với ví dụ MNIST (784-128-64-10) và kích thước batch 32, nhu cầu lưu trữ activation là:
- Lớp đầu vào: \(32{\times}784\) = 25,088 giá trị
- Lớp ẩn đầu tiên: \(32{\times}128\) = 4,096 giá trị
- Lớp ẩn thứ hai: \(32{\times}64\) = 2,048 giá trị
- Lớp đầu ra: \(32{\times}10\) = 320 giá trị
Như vậy, tổng cộng có 31,552 giá trị cần được giữ trong bộ nhớ cho mỗi batch trong quá trình huấn luyện, phù hợp với ví dụ đã trình bày ở section 1.2.4.3. Yêu cầu bộ nhớ tăng tuyến tính theo kích thước batch và có thể trở nên đáng kể với các mạng nơ-ron lớn hơn.
Xử lý theo batch đi kèm những đánh đổi quan trọng. Batch lớn hơn giúp các phép toán ma trận hiệu quả hơn và tận dụng phần cứng tốt hơn, nhưng đòi hỏi nhiều bộ nhớ hơn. Ví dụ, nếu tăng gấp đôi kích thước batch lên 64, yêu cầu bộ nhớ cho các activation cũng sẽ tăng gấp đôi. Mối quan hệ giữa kích thước batch, mức dùng bộ nhớ và hiệu quả tính toán này là cơ sở để lựa chọn kích thước batch trong thực tế.
Cách tổ chức tính toán cũng ảnh hưởng đến hiệu suất. Các phép toán ma trận có thể được tối ưu thông qua bố trí bộ nhớ hợp lý và các thư viện chuyên biệt. Việc lựa chọn hàm activation ảnh hưởng đến cả khả năng học của mạng và hiệu quả tính toán, vì một số hàm (như ReLU) cần ít tính toán hơn các hàm khác (như tanh hoặc sigmoid).
Các đặc tính tính toán của mạng nơ-ron phù hợp với các kiến trúc xử lý song song. Dù CPU truyền thống có thể thực hiện các phép toán này, GPU được thiết kế cho tính toán song song có thể nhanh hơn đáng kể đối với các phép toán ma trận dày đặc lớn. Các bộ tăng tốc AI chuyên biệt còn đạt hiệu quả tốt hơn nhờ số học độ chính xác thấp, kiến trúc bộ nhớ chuyên biệt và tối ưu hóa luồng dữ liệu phù hợp với các mẫu tính toán của mạng nơ-ron.
Năng lượng trên mỗi lần suy luận có thể khác nhau đáng kể giữa các nền tảng phần cứng. CPU cho phép thực thi linh hoạt, GPU đạt thông lượng cao nhờ song song hóa, còn các bộ tăng tốc edge chuyên biệt đánh đổi tính tổng quát để thực thi hiệu quả một số toán tử được chọn. Công suất không tự quyết định năng lượng; đại lượng quan trọng là công suất được tích phân theo thời gian thực thi cho cùng một khối lượng công việc (workload) và mục tiêu chất lượng. Hệ thống phân cấp bộ nhớ và việc di chuyển dữ liệu thường giải thích phần lớn sự khác biệt. Những lưu ý này sẽ lặp lại trong các chương sau, đặc biệt ở Kiến trúc mạng, nơi các tối ưu hóa phụ thuộc kiến trúc đưa thêm những đánh đổi.
Lan truyền thuận biến đổi đầu vào thành các dự đoán, nhưng một dự đoán đơn thuần thì vô ích cho quá trình học. Vòng lặp huấn luyện cần một cách để đo lường mức độ sai của dự đoán đó, dưới dạng có thể hướng dẫn việc điều chỉnh các trọng số. Các hàm mất mát đảm nhiệm vai trò này: chúng chuyển đổi khoảng cách giữa dự đoán và thực tế thành một con số duy nhất mà quá trình tối ưu hóa có thể tìm cách giảm thiểu.
Các hàm mất mát
Quá trình lan truyền thuận được mô tả trong section 1.3.2 là đủ cho suy luận, nghĩa là sử dụng một mô hình đã được huấn luyện trước để đưa ra dự đoán. Tuy nhiên, để huấn luyện một mô hình, chúng ta cần một cách để đo lường mức độ phù hợp của các dự đoán đó với thực tế. Các hàm mất mát định lượng những lỗi này, đóng vai trò là cơ chế phản hồi để hướng dẫn quá trình học. Chúng biến mục tiêu trừu tượng là “đưa ra dự đoán tốt” thành một bài toán tối ưu hóa cụ thể.
Tiếp tục với ví dụ nhận dạng chữ số MNIST: khi mạng xử lý một hình ảnh chữ số viết tay, nó xuất ra mười điểm số cho các lớp, thường được chuyển đổi thành xác suất dự đoán cho các chữ số từ 0 đến 9. Hàm mất mát sẽ đo lường các dự đoán này so với mục tiêu thực tế. Chẳng hạn, nếu một hình ảnh hiển thị chữ “bảy”, hàm cross-entropy sẽ “phạt” mô hình khi nó gán quá ít xác suất cho chữ số bảy. Một giá trị hàm mất mát cao hơn cho thấy mô hình hoạt động kém hiệu quả hơn so với mục tiêu đã chọn trên ví dụ đó; tuy nhiên, bản thân giá trị này không tự động chẩn đoán nguyên nhân hay khẳng định rằng mọi chỉ số nhiệm vụ đều trở nên tệ hơn.
Các nguyên tắc cơ bản về đo lường lỗi
Một hàm mất mát gán một chi phí vô hướng cho một dự đoán và mục tiêu, theo mục tiêu đã chọn. Hàm mất mát càng thấp thì giá trị mục tiêu đó trên các ví dụ được đánh giá càng tốt, nhưng điều này không đồng nghĩa với độ chính xác cao hơn: mức độ tự tin và hiệu chỉnh có thể thay đổi dù lớp dự đoán không đổi. Trong huấn luyện, gradient của hàm mất mát dẫn hướng cập nhật tham số. Trong nhận dạng chữ số viết tay, cross-entropy phạt các dự đoán gán xác suất thấp cho chữ số đúng.
Về mặt toán học, một hàm mất mát \(\mathcal{L}\) nhận hai đầu vào: dự đoán \(\hat{y}\) của mạng và giá trị thực \(y\). Với một ví dụ huấn luyện đơn lẻ trong bài toán phân loại chữ số, hàm mất mát đo độ sai lệch giữa dự đoán và giá trị thực. Khi huấn luyện với các batch dữ liệu, ta thường tính trung bình hàm mất mát trên tất cả ví dụ trong batch đó (equation 15): \[ \mathcal{L}_{\text{batch}} = \frac{1}{B}\sum_{i=1}^B \mathcal{L}(\hat{y}_i, y_i) \tag{15}\] trong đó \(B\) là kích thước batch và \((\hat{y}_i, y_i)\) là dự đoán và giá trị thực của ví dụ thứ \(i\). Việc lấy trung bình giúp giữ cho giá trị hàm mất mát và quy mô gradient trung bình có thể so sánh được giữa các kích thước batch khác nhau; tuy nhiên, tốc độ học tối ưu vẫn có thể thay đổi theo kích thước batch và chế độ tối ưu hóa. Phép tổng này cũng phù hợp tự nhiên với phần cứng song song: hàm mất mát của mỗi ví dụ có thể được tính độc lập trước, rồi gộp lại bằng một phép gộp.
Việc chọn hàm mất mát phụ thuộc vào loại nhiệm vụ. Với phân loại chữ số, hàm mất mát phải: xử lý được các phân phối xác suất trên nhiều lớp, cung cấp gradient đủ ý nghĩa để dẫn dắt việc học, phạt các dự đoán sai tương xứng với mức độ nghiêm trọng của lỗi, và mở rộng hiệu quả khi xử lý theo batch. Hàm mất mát cross-entropy đáp ứng cả bốn yêu cầu này.
Cross-entropy và các hàm mất mát cho phân loại
Với các bài toán phân loại như nhận dạng chữ số MNIST, hàm mất mát cross-entropy là cách phổ biến để so sánh các phân phối xác suất dự đoán với nhãn lớp thực. Khái niệm entropy trong lý thuyết thông tin bắt nguồn từ Shannon (Shannon 1948); trong phân loại có giám sát, cross-entropy phạt việc gán xác suất thấp cho lớp đúng.
Shannon, Claude E. 1948. “A Mathematical Theory of Communication.” Bell System Technical Journal 27 (3): 379–423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x.
Hàm logarit định hình hành vi tối ưu hóa của hàm mất mát cross-entropy, vì xác suất gần 0 cho lớp đúng sẽ kéo theo mức phạt ngày càng lớn. Dạng hàm này tạo ra gradient mạnh khi mô hình tự tin nhưng dự đoán sai, và coi xác suất của lớp đúng là đại lượng trung tâm của hàm mục tiêu.
Đối với một ảnh chữ số đơn, mạng sẽ đưa ra phân phối xác suất trên 10 chữ số có thể có. Chúng ta biểu diễn nhãn đúng dưới dạng một vector one-hot35, trong đó tất cả các phần tử đều là 0, ngoại trừ vị trí của chữ số đúng là 1. Ví dụ, nếu chữ số đúng là “bảy”, nhãn sẽ là \(y = \big[0, 0, 0, 0, 0, 0, 0, 1, 0, 0\big]\).
35 Mã hóa one-hot: Là cách biểu diễn \(K\) lớp dưới dạng các vector nhị phân \(K\) chiều, trong đó chính xác một phần tử là 1. Mã hóa này thưa theo bản chất: ví dụ, với 10 lớp của MNIST, 90% các phần tử trong mỗi vector nhãn là số 0. Trong thực tế, người ta thường lưu trữ chỉ số lớp dưới dạng số nguyên thay vì tạo ra toàn bộ vector đó. Đối với các không gian đầu ra rất lớn, các phương pháp như sampled softmax cũng có thể giúp giảm chi phí tính toán cho đầu ra.
Hàm mất mát cross-entropy cho ví dụ này được định nghĩa trong equation 16: \[ \mathcal{L}(\hat{y}, y) = -\sum_{j=1}^{10} y_j \log(\hat{y}_j) \tag{16}\] trong đó \(\hat{y}_j\) là xác suất dự đoán của mạng cho chữ số \(j\). Nhờ mã hóa one-hot, công thức này được đơn giản hóa thành equation 17: \[ \mathcal{L}(\hat{y}, y) = -\log(\hat{y}_c) \tag{17}\] trong đó \(c\) là chỉ số của lớp đúng. Do đó, hàm mất mát chỉ phụ thuộc vào xác suất dự đoán cho chữ số đúng; mạng sẽ bị phạt dựa trên mức độ tự tin của nó vào đáp án đúng.
Ví dụ, nếu mạng dự đoán các xác suất sau cho một ảnh “bảy”:
Predicted: [0.1, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.8, 0.0, 0.1]
True: [0, 0, 0, 0, 0, 0, 0, 1, 0, 0]
Hàm mất mát sẽ là \(-\log(0.8)\), xấp xỉ 0.223. Nếu mạng tự tin hơn và dự đoán 0.9 cho chữ số đúng, hàm mất mát sẽ giảm xuống xấp xỉ 0.105.
Các phương pháp tính toán hàm mất mát theo batch
Việc tính toán hàm mất mát trong thực tế cần xem xét cả độ ổn định số và xử lý theo batch. Khi làm việc với các batch dữ liệu, chúng ta tính trung bình hàm mất mát trên tất cả các ví dụ trong batch.
Đối với một batch gồm \(B\) ví dụ, hàm mất mát cross-entropy trở thành equation 18: \[ \mathcal{L}_{\text{batch}} = -\frac{1}{B}\sum_{i=1}^B \sum_{j=1}^{10} y_{ij} \log(\hat{y}_{ij}) \tag{18}\]
Ở đây, \(i\) đánh chỉ số các ví dụ trong batch, \(j\) đánh chỉ số mười lớp đầu ra. \(y_{ij}\) là chỉ báo mục tiêu one-hot cho lớp \(j\) trên ví dụ \(i\), còn \(\hat{y}_{ij}\) là xác suất dự đoán cho lớp đó. Lấy trung bình theo \(B\) giữ cho thang đo của hàm mất mát tương đương khi kích thước batch thay đổi.
Để tính toán hàm mất mát này hiệu quả, cần cân nhắc kỹ về độ chính xác số học. Trường hợp nguy hiểm không phải là một xác suất nhỏ bình thường, mà là xác suất bị một softmax không ổn định làm tròn về 0. Nếu xác suất của lớp đúng trở thành 0, thì \(\log(0)\) là \(-\infty\), và các phép toán sau đó có thể tạo ra giá trị NaN (không phải là số).
Các triển khai ổn định tránh tạo ra một xác suất mong manh về số học trước khi lấy logarit của nó:
- Dịch các logit trước khi tính lũy thừa, đây là cốt lõi của kỹ thuật log-sum-exp (Logits và độ ổn định số), như trong equation 19: \[ \text{softmax}(z_i) = \frac{\exp\big(z_i - \max(z)\big)}{\sum_j \exp\big(z_j - \max(z)\big)} \tag{19}\]
Trừ cùng một \(\max(z)\) khỏi mọi logit không làm thay đổi xác suất softmax, vì thừa số chung bị triệt tiêu giữa tử số và mẫu số. Hiệu ứng về số học là quyết định: logit đã dịch chuyển lớn nhất trở thành 0, nên lũy thừa lớn nhất là \(\exp(0)=1\) thay vì một giá trị có thể gây tràn.
- Ưu tiên dùng cross-entropy được tính trực tiếp từ logit (fused cross-entropy). Với lớp mục tiêu \(c\) và \(m=\max(z)\), một triển khai ổn định sẽ tính: \[ \mathcal{L} = -(z_c-m) + \log\!\sum_j \exp(z_j-m) \tag{20}\] Equation 20 tương đương về mặt toán học với \(-\log p_c\), nhưng không bao giờ làm tròn một xác suất softmax cực nhỏ về 0 trước. Kẹp (clamping) một xác suất hoặc cộng thêm \(\epsilon\) có thể là phương án dự phòng, nhưng nó làm thay đổi hàm mục tiêu và không nên thay thế công thức ổn định.
Ảnh hưởng đến động lực học của quá trình học
Với kích thước batch 32 và 10 lớp đầu ra, mỗi bước huấn luyện xử lý 32 bộ gồm 10 điểm số, tính mất mát cho từng ví dụ và lấy trung bình thành một mất mát của batch. Trong huấn luyện, giá trị này có hai vai trò: gradient của nó cung cấp hướng cập nhật, và xu hướng của nó giúp chẩn đoán quá trình tối ưu hóa đang tiến triển, bị đình trệ hay phân kỳ. Độ chính xác tác vụ, hiệu chuẩn và các chỉ số đánh giá khác vẫn phải được đo riêng trên dữ liệu giữ lại (held-out).
Đối với bộ phân loại MNIST, hàm mất mát huấn luyện thường bắt đầu gần \(\log(10) \approx 2.3\) khi xác suất các lớp gần như đồng đều, giảm nhanh trong giai đoạn tối ưu hóa ban đầu, rồi cải thiện chậm hơn. Hàm mất mát huấn luyện thấp cho thấy mô hình tự tin trên các ví dụ huấn luyện, nhưng không phải là bằng chứng về khả năng tổng quát hóa. Hàm mất mát kiểm định và các chỉ số của tác vụ mới quyết định liệu hành vi đã học có chuyển được sang dữ liệu giữ lại hay không.
Các gradient của hàm mất mát theo các logit đầu ra của mạng cung cấp tín hiệu lỗi ban đầu để lan truyền ngược. Khi kết hợp softmax và cross-entropy, mỗi gradient theo logit có dạng đặc biệt đơn giản: hiệu giữa xác suất dự đoán và xác suất mục tiêu, \(p-y\). Thuộc tính toán học này làm cho hàm mất mát cross-entropy đặc biệt phù hợp cho các tác vụ phân loại, vì nó cung cấp các gradient mạnh ngay cả khi dự đoán còn cách xa mục tiêu.
Việc lựa chọn hàm mất mát cũng ảnh hưởng đến các quyết định huấn luyện khác. Độ lớn gradient tương tác với tốc độ học, trong khi việc lấy trung bình hàm mất mát trên các batch ảnh hưởng đến nhiễu gradient và do đó đến vùng kích thước batch hữu ích. Độ cong ảnh hưởng đến hành vi của optimizer, và các quyết định hội tụ cần dựa trên các chỉ số kiểm định và một quy tắc dừng, chứ không chỉ dựa vào quỹ đạo hàm mất mát huấn luyện.
Các hàm mất mát định lượng lỗi dự đoán, nhưng riêng tín hiệu lỗi không cho hệ thống biết hàm mất mát đó nhạy cảm đến mức nào với từng tham số. Với 109,386 parameters trong mạng MNIST, việc ước tính mọi đạo hàm thông qua các nhiễu loạn độc lập sẽ cực kỳ tốn kém về tính toán. Đây là bài toán phân bổ trách nhiệm: kết nối lỗi cuối cùng với các tham số và các giá trị trung gian có thể thay đổi nó. Phần tiếp theo giới thiệu lan truyền ngược, áp dụng quy tắc chuỗi để tính toàn bộ các độ nhạy cục bộ đó một cách hiệu quả.
Tính toán gradient và lan truyền ngược
Definition 1.2: Lan truyền ngược
Lan truyền ngược là thuật toán tính gradient mà các hệ thống huấn luyện dùng để áp dụng quy tắc chuỗi lên một đồ thị tính toán, sử dụng các phép toán đã ghi lại và các giá trị truyền xuôi được lưu hoặc tính lại để tính gradient của hàm mất mát theo mọi tham số trong một lần duyệt ngược duy nhất.
- Ý nghĩa: Với các lớp dày đặc, bước lan truyền ngược thường tốn số FLOPS vào khoảng gấp đôi bước lan truyền xuôi, và cần giữ lại hoặc tính lại các giá trị trung gian phục vụ quy tắc chuỗi. Với một mô hình có \(N_L\) lớp, kích thước batch \(B\) và bề rộng lớp \(n_1,\ldots,n_{N_L}\), một bảng lưu activation giản lược sẽ tỉ lệ theo \(\mathcal{O}\!\left(B\sum_{\ell=1}^{N_L} n_\ell\right)\). Gradient và trạng thái của optimizer còn làm tăng nhu cầu bộ nhớ; vì vậy, một mô hình có thể chạy suy luận trên một bộ tăng tốc nhưng lại không đủ bộ nhớ để huấn luyện trên cùng bộ tăng tốc đó.
- Điểm khác biệt: Phép vi phân số yêu cầu đánh giá lại với một nhiễu loạn nhỏ cho từng tham số trong số \(P\) tham số. Phép vi phân tự động ở chế độ ngược tính toàn bộ \(P\) gradient trong một lần duyệt ngược, với chi phí tỉ lệ theo đồ thị tính toán, nhờ đó tránh phải thực hiện \(P\) lượt truyền xuôi riêng biệt.
- Lỗi thường gặp: Một quan niệm sai lầm phổ biến là lan truyền ngược chính là quá trình học. Thực chất, đó là một thuật toán để tính gradient; còn gradient descent mới thực hiện việc cập nhật tham số. Nhầm lẫn hai khái niệm này sẽ che khuất sự phân tách ở cấp độ hệ thống: lan truyền ngược quyết định nhu cầu bộ nhớ (lưu trữ activation), trong khi optimizer quyết định các trạng thái bổ sung (như động lượng, bộ đệm phương sai).
Một nhà máy ô tô là một ví dụ cụ thể cho bài toán phân bổ trách nhiệm tương tự. Xe sẽ đi qua bốn trạm: lắp khung (A), lắp động cơ (B), lắp bánh xe (C) và lắp ráp cuối cùng (D). Khi phát hiện một chiếc xe bị lỗi, các thanh tra viên phải xác định trạm nào đã gây ra lỗi đó.
Giải pháp này đi ngược trở lại. Bắt đầu từ lỗi, các thanh tra viên truy vết trách nhiệm qua từng trạm: so sánh phần đóng góp của D trong lắp ráp với những gì D nhận từ C, và phần đóng góp của C với những gì C nhận từ B. Mỗi trạm nhận phản hồi điều chỉnh tỷ lệ với mức đóng góp của mình. Nếu việc lắp động cơ ở Trạm B là nguyên nhân chính, trạm đó sẽ nhận tín hiệu mạnh nhất để thay đổi.
Lan truyền ngược cũng truy vết ngược tương tự, nhưng nó tính độ nhạy chứ không phải quy lỗi nhân quả. Bắt đầu từ hàm mất mát, thuật toán này đánh giá xem một thay đổi nhỏ ở đầu vào của mỗi lớp sẽ làm thay đổi hàm mất mát như thế nào và lan truyền các đạo hàm đó ngược lại. Sau đó, optimizer sẽ chuyển các gradient tham số thu được thành các cập nhật thực tế.
Trong mạng nơ-ron, mỗi lớp giống như một trạm trên dây chuyền lắp ráp, và lan truyền ngược xác định mức độ ảnh hưởng của mỗi kết nối đến hàm mất mát cuối cùng. Để diễn giải trực giác này bằng toán học, chúng ta cần đến quy tắc chuỗi của giải tích. Quay lại phép tương tự nhà máy, “tín hiệu điều chỉnh của Trạm D” tương ứng với gradient tại lớp đầu ra; độ nhạy cục bộ được biểu diễn bằng một đạo hàm riêng; còn việc “gửi phản hồi ngược trở lại” chính là phép nhân theo quy tắc chuỗi để lan truyền gradient qua mạng.
Độ nhạy này chỉ mang tính cục bộ, phụ thuộc vào các giá trị tham số hiện tại, batch đầu vào và hàm mất mát. Nó giúp chúng ta trả lời một câu hỏi mang tính giả định—rằng một thay đổi rất nhỏ ở đây sẽ làm thay đổi hàm mất mát này như thế nào—chứ không phải liệu một trọng số có quan trọng vĩnh viễn hay đã từng gây ra dự đoán trong quá khứ. Đồ thị tính toán khiến câu hỏi này trở nên khả thi. Mỗi nút trong đồ thị ghi lại một phép toán, và quy tắc ngược của nó sẽ chuyển một gradient của hàm mất mát đi vào thành các gradient cho các đầu vào của nút đó. Quá trình duyệt ngược bắt đầu từ hàm mất mát vô hướng, áp dụng các quy tắc cục bộ này theo thứ tự phụ thuộc ngược, và tích lũy các đóng góp khi một giá trị ảnh hưởng đến hàm mất mát thông qua nhiều đường dẫn xuôi dòng khác nhau. Chính sự tích lũy này là lý do lan truyền ngược không chỉ đơn thuần là gửi một tín hiệu lỗi xuống một chuỗi: runtime phải tuân thủ các phụ thuộc của đồ thị và kết hợp mọi đường dẫn liên quan trước khi một gradient được xem là đầy đủ. Thuật toán dưới đây sẽ biến mô tả ở cấp độ đồ thị đó thành một quy trình từng lớp.
Các bước của thuật toán lan truyền ngược
Trong khi lan truyền xuôi tính toán các dự đoán, lan truyền ngược sẽ tính toán các gradient mà một optimizer sử dụng để điều chỉnh các trọng số. Hãy xét ví dụ minh họa khi mạng dự đoán là “ba” cho một hình ảnh “bảy”. Lan truyền ngược sẽ tính toán một cách có hệ thống xem hàm mất mát sẽ phản ứng như thế nào với một thay đổi nhỏ trong mỗi trọng số tại các giá trị tham số hiện tại.
Quá trình bắt đầu từ đầu ra của mạng, nơi xác suất chữ số dự đoán được so sánh với nhãn đúng. Gradient của hàm mất mát thu được sau đó sẽ lan truyền ngược qua mạng, cho biết độ nhạy cục bộ của hàm mất mát đối với các giá trị và trọng số của mỗi lớp. Việc tính toán này tuân theo quy tắc chuỗi của giải tích, phân tích mối quan hệ giữa các trọng số và hàm mất mát thành các bước dễ quản lý.
Nền tảng toán học của lan truyền ngược tạo cơ sở lý thuyết cho việc huấn luyện mạng nơ-ron, nhưng để chạy được trong thực tế, cần có phần mềm hỗ trợ. Wengert đã giới thiệu cách tính đạo hàm số tự động mà không cần các biểu thức đạo hàm giải tích (Wengert 1964). Các framework hiện đại cung cấp khả năng này thông qua hệ thống vi phân tự động, tự động xử lý việc tính gradient. Quy tắc chuỗi và tự động vi phân diễn giải quy tắc chuỗi một cách nghiêm ngặt và giải thích vì sao vi phân tự động chế độ ngược có thể tính tất cả gradient tham số chỉ trong một lượt truyền ngược. Thuật toán lan truyền ngược đi từng bước qua thuật toán lượt truyền ngược và nêu rõ vì sao chi phí FLOPS xấp xỉ gấp đôi lượt truyền xuôi. Triển khai tự động vi phân của framework sau đó xem xét các khía cạnh kỹ thuật hệ thống của những framework này. Nguyên tắc cốt lõi khi triển khai thể hiện trong algorithm 1: lượt truyền xuôi phải lưu lại các giá trị mà lượt truyền ngược sẽ cần.
Wengert, Ralph E. 1964. “A Simple Automatic Derivative Evaluation Program.” Communications of the ACM 7 (8): 463–64. https://doi.org/10.1145/355586.364791.
\begin{algorithm} \caption{Backpropagation training step} \begin{algorithmic} \Require mini-batch inputs $\mathbf{X}$, labels $\mathbf{y}$; $N_L$ layers with parameters $\{\mathbf{W}^{(\ell)}, \mathbf{b}^{(\ell)}\}_{\ell=1}^{N_L}$; loss $\mathcal{L}$ \Ensure parameter gradients $\{\nabla_{\mathbf{W}^{(\ell)}}\mathcal{L}, \nabla_{\mathbf{b}^{(\ell)}}\mathcal{L}\}$ for the optimizer \State $\mathbf{A}^{(0)} \gets \mathbf{X}$ \For{$\ell = 1$ to $N_L$} \Comment{forward pass} \State compute $\mathbf{Z}^{(\ell)}, \mathbf{A}^{(\ell)}$; save the values its derivative needs \EndFor \State compute loss $\mathcal{L}(\mathbf{A}^{(N_L)}, \mathbf{y})$; seed the output gradient $\nabla_{\mathbf{A}^{(N_L)}}\mathcal{L}$ \For{$\ell = N_L$ down to $1$} \Comment{same local rule repeats} \State use the saved forward values to compute $\nabla_{\mathbf{W}^{(\ell)}}\mathcal{L}, \nabla_{\mathbf{b}^{(\ell)}}\mathcal{L}$ \State propagate $\nabla_{\mathbf{A}^{(\ell-1)}}\mathcal{L}$ to the previous layer \EndFor \State \Return the accumulated parameter gradients \end{algorithmic} \end{algorithm}
Việc lưu các activation trong vòng lặp truyền xuôi của algorithm 1 là nơi phát sinh chi phí hệ thống: mỗi activation phải được giữ lại cho đến khi lượt truyền ngược chạm tới lớp tương ứng. Vì vậy, bộ nhớ activation tăng theo kích thước batch, số lượng lớp và độ rộng activation. Đây là lý do vì sao huấn luyện có thể tốn nhiều bộ nhớ hơn suy luận, ngay cả khi số tham số không đổi.
Lan truyền tín hiệu lỗi
Luồng gradient trong mạng nơ-ron đi ngược với truyền xuôi. Bắt đầu từ hàm mất mát tại lớp đầu ra, gradient lan truyền ngược để tính mức độ nhạy cục bộ của hàm mất mát với từng lớp, và cuối cùng là với từng trọng số.
Hãy hình dung khi bộ phân loại chữ số phân loại nhầm số “bảy” thành số “ba”. Hàm mất mát tạo ra một tín hiệu lỗi ban đầu ở lớp đầu ra, báo hiệu rằng xác suất của số “bảy” cần tăng, còn xác suất của số “ba” cần giảm. Tín hiệu lỗi này sau đó lan truyền ngược qua các lớp của mạng.
Đối với một mạng có \(N_L\) lớp, dòng gradient có thể được biểu diễn toán học. Tại mỗi lớp \(\ell\), ta có thể mô tả mức độ đầu ra của lớp đó ảnh hưởng đến hàm mất mát cuối cùng bằng quy tắc chuỗi36 và ký hiệu Jacobian dạng sơ đồ trong equation 21: \[ \frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell)}} = \frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell+1)}} \frac{\partial \mathbf{A}^{(\ell+1)}}{\partial \mathbf{A}^{(\ell)}} \tag{21}\]
36 Quy tắc chuỗi: Đồng nhất thức giải tích \(\frac{\partial \mathcal{L}}{\partial w} = \frac{\partial \mathcal{L}}{\partial a_n} \cdot \frac{\partial a_n}{\partial a_{n-1}} \cdots \frac{\partial a_1}{\partial w}\) trở thành một tích gồm \(n\) số hạng trong một mạng \(n\) lớp. Nếu mỗi đạo hàm riêng nhỏ hơn một chút, tích sẽ tiến về 0 theo cấp số nhân; nếu lớn hơn một chút, nó sẽ bùng nổ. Cấu trúc nhân này là lý do tại sao độ sâu là một ràng buộc mang tính hệ thống, chứ không chỉ là một lựa chọn thiết kế: nó chi phối các yêu cầu về độ chính xác số và các chiến lược khởi tạo (Glorot and Bengio 2010; He et al. 2015) cần thiết để giữ cho quá trình huấn luyện ổn định.
Glorot, Xavier, and Yoshua Bengio. 2010. “Understanding the Difficulty of Training Deep Feedforward Neural Networks.” Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics (AISTATS) 9: 249–56.
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2015. “Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification.” 2015 IEEE International Conference on Computer Vision (ICCV), 1026–34. https://doi.org/10.1109/iccv.2015.123.
Quá trình tính toán này lan truyền ngược qua mạng, trong đó gradient của mỗi lớp phụ thuộc vào gradient của lớp phía trên nó. Kết quả là một độ nhạy cục bộ, không phải là “truy lỗi”: các tham số hóa tương đương có thể biểu diễn cùng một hàm nhưng với các gradient có tỷ lệ khác nhau. Lan truyền ngược cung cấp các độ nhạy này, còn optimizer có thể chuẩn hóa, tích lũy hoặc biến đổi chúng trước khi cập nhật các trọng số.
Quá trình này gặp nhiều thách thức trong các mạng sâu. Khi gradient được truyền ngược qua nhiều lớp, chúng có thể bị tiêu biến hoặc bùng nổ. Việc nhân lặp lại có thể làm gradient nhỏ đi theo cấp số nhân, đặc biệt khi dùng các activation sigmoid hoặc tanh ở vùng bão hòa. Các giá trị nhỏ hơn số dương chuẩn tối thiểu (\(1.18 \times 10^{-38}\) trong FP32 hoặc \(6.10 \times 10^{-5}\) trong FP16) sẽ chuyển sang miền dưới chuẩn nếu định dạng và phần cứng có bảo toàn số dưới chuẩn; các giá trị nhỏ hơn nữa sẽ tràn dưới về 0, và một số chế độ của bộ tăng tốc còn xóa các số dưới chuẩn về 0 để tăng tốc. Ở cực kia, các giá trị vượt quá mức tối đa có thể biểu diễn được sẽ tràn thành Inf và lan truyền NaN, làm mất ổn định quá trình huấn luyện.
Quá trình tính toán đạo hàm
Để tính gradient, chúng ta cần tính một số đạo hàm riêng tại mỗi lớp: xem sự thay đổi của trọng số, độ chệch (bias) và activation ảnh hưởng thế nào đến hàm mất mát cuối cùng. Các phép tính này tuân theo trực tiếp quy tắc chuỗi của giải tích, nhưng phải được triển khai hiệu quả thì mới khả thi trong thực tế.
Ở mỗi lớp \(\ell\), chúng ta tính ba thành phần gradient chính. Mỗi thành phần có một vai trò riêng trong quá trình học.
Gradient trọng số đo mức độ nhạy cục bộ của hàm mất mát cuối cùng đối với từng trọng số. optimizer dùng các gradient này để xác định các cập nhật tham số (equation 22): \[ \frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(\ell)}} = {\mathbf{A}^{(\ell-1)}}^T \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} \tag{22}\]
Gradient độ chệch (bias) đo lường mức độ thay đổi mỗi độ chệch (bias) ảnh hưởng đến hàm mất mát. Vì độ chệch (bias) dịch chuyển ngưỡng activation của các nơ-ron, các gradient này cho biết liệu nơ-ron nên dễ được kích hoạt hơn hay ít hơn, như thể hiện trong equation 23: \[ \frac{\partial \mathcal{L}}{\partial \mathbf{b}^{(\ell)}} = \mathbf{1}^T \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} \tag{23}\]
Ở đây, \(\mathbf{1}\in\mathbb{R}^{B}\) là một vector toàn số một, nên phép nhân từ bên trái sẽ cộng các gradient độ chệch (bias) theo từng ví dụ trong batch.
Gradient đầu vào truyền ngược tín hiệu lỗi về lớp trước đó. Thay vì cập nhật trực tiếp tham số, các gradient này đóng vai trò như “tín hiệu điều chỉnh” giúp các lớp trước học từ lỗi dự đoán cuối cùng (equation 24): \[ \frac{\partial \mathcal{L}}{\partial \mathbf{A}^{(\ell-1)}} = \frac{\partial \mathcal{L}}{\partial \mathbf{Z}^{(\ell)}} {\mathbf{W}^{(\ell)}}^T \tag{24}\]
Ba loại đạo hàm này phải đối mặt với một ràng buộc thực tế của hệ thống: kích thước batch hiệu quả mong muốn có thể lớn hơn dung lượng bộ nhớ của bộ tăng tốc tại một thời điểm. Các kỹ sư xử lý điều này bằng tích lũy đạo hàm: batch đầy đủ được chia thành các micro-batches nhỏ hơn sao cho mỗi micro-batch vừa bộ nhớ, rồi cộng dồn các đạo hàm của chúng (kèm chuẩn hóa hàm mất mát phù hợp) trước khi thực hiện bước của optimizer. Ở góc nhìn của optimizer, kích thước batch hiệu quả bằng tổng của tất cả micro-batches; ở góc nhìn phần cứng, mỗi micro-batch là một lượt truyền xuôi–truyền ngược độc lập nằm trong ngân sách bộ nhớ. Với các phép tính độc lập theo từng ví dụ, nếu tích lũy các đạo hàm đã được chuẩn hóa nhất quán thì sẽ thu được cùng tổng hoặc trung bình đạo hàm ở cấp batch. Tuy nhiên, sự tương đương về mặt số học không phải lúc nào cũng đúng tuyệt đối: thứ tự cộng dồn dấu phẩy động, các phép toán phụ thuộc vào batch (như batch normalization), các lớp ngẫu nhiên và các hàm mất mát phụ thuộc vào batch có thể khiến việc thực thi theo micro-batch khác với một lượt chạy cả batch.
Hãy xem xét lớp cuối cùng nơi mạng đưa ra xác suất cho từng chữ số. Nếu mạng dự đoán \([0.1, 0.2, 0.5,\ldots, 0.05]\) cho một hình ảnh “số bảy”, đạo hàm sẽ lan truyền ngược qua ba bước:
- Bắt đầu với lỗi trong các xác suất này
- Tính toán xem việc điều chỉnh trọng số sẽ ảnh hưởng đến lỗi này như thế nào
- Truyền ngược các đạo hàm này để giúp điều chỉnh trọng số của các lớp phía trước.
Systems Perspective 1.5: Chi phí bộ nhớ của lan truyền ngược
Việc lưu giữ activation là một thành phần trong ngân sách trạng thái huấn luyện rộng hơn. Theo một cách tính giản lược cho một thiết bị đơn, bỏ qua các không gian làm việc tạm thời và overhead của framework, equation 25 nêu bốn con số byte chính: \[ \text{Training Memory} \approx \text{Model Weights} + \text{Gradients} + \text{Optimizer States} + \text{Activations} \tag{25}\]
Các phương trình đạo hàm cũng là một bảng ghi lại các phụ thuộc trạng thái:
- Đạo hàm trọng số trong equation 22 cần activation đầu vào \(\mathbf{A}^{(\ell-1)}\).
- Đạo hàm activation có thể cần \(\mathbf{Z}^{(\ell)}\) hoặc một mặt nạ gọn ghi lại những đơn vị phi tuyến tính nào đã được kích hoạt.
- Đạo hàm đầu vào trong equation 24 cần các trọng số của lớp \(\mathbf{W}^{(\ell)}\).
- Optimizer sử dụng các đạo hàm tham số đã tính toán xong và có thể thêm động lượng, phương sai hoặc các trạng thái khác sau khi quá trình lan truyền ngược đã tạo ra chúng.
Một hệ thống huấn luyện có thể giữ lại các giá trị này để lượt truyền ngược diễn ra nhanh nhất, tính toán lại một số giá trị để tiết kiệm bộ nhớ, hoặc offload và phân vùng trạng thái giữa các tầng bộ nhớ hay thiết bị. Không lựa chọn nào là miễn phí: tính toán lại sẽ tốn thêm FLOPS, còn offload và phân vùng làm phát sinh di chuyển và đồng bộ hóa dữ liệu. Với các mạng sâu có batch lớn, activation rộng, hoặc đầu vào độ phân giải cao, sự đánh đổi này có thể áp đảo năng lực của bộ tăng tốc. Chi phí bộ nhớ thực sự của huấn luyện cung cấp phương trình bộ nhớ hoàn chỉnh cho quá trình huấn luyện, cùng phân tích chi tiết chi phí của trọng số, gradient, trạng thái optimizer và activation.
Một mạng tối giản giúp cụ thể hóa phép tính gradient bằng cách lần theo các giá trị thực trong quá trình lan truyền ngược.
Napkin Math 1.3: Theo dõi gradient: Một ví dụ minh họa về lan truyền ngược
Thiết lập: Xem xét một mạng có hai đầu vào, một lớp ẩn gồm hai neuron (activation ReLU), và một neuron đầu ra (không có activation, để đơn giản). Giả sử các trọng số và độ chệch (bias) hiện tại là:
- Lớp ẩn: \(\mathbf{W}^{(1)} = \begin{bmatrix} 0.5 & -0.3 \\ 0.8 & 0.2 \end{bmatrix}\), \(\mathbf{b}^{(1)} = \begin{bmatrix} 0 \\ 0 \end{bmatrix}\)
- Lớp đầu ra: \(\mathbf{W}^{(2)} = \begin{bmatrix} 0.6 \\ -0.4 \end{bmatrix}\), \(\mathbf{b}^{(2)} = 0\)
Với đầu vào \(\mathbf{x} = [1.0,\; 0.5]\) và giá trị mục tiêu \(y = 1.0\), ta áp dụng hàm mất mát sai số bình phương trung bình: \(\mathcal{L} = \frac{1}{2}(\hat{y} - y)^2\).
Lượt truyền tiến (để xác định các giá trị cần thiết cho quá trình lan truyền ngược):
- Giá trị trước activation của lớp ẩn: \[\mathbf{z}^{(1)} = \mathbf{x}\mathbf{W}^{(1)} + \mathbf{b}^{(1)} = [1.0 \cdot 0.5 + 0.5 \cdot 0.8,\; 1.0 \cdot (-0.3) + 0.5 \cdot 0.2] = [0.9,\; -0.2]\]
- Activation lớp ẩn (ReLU): \(\mathbf{a}^{(1)} = [\max(0, 0.9),\; \max(0, -0.2)] = [0.9,\; 0.0]\)
- Đầu ra: \(\hat{y} = \mathbf{a}^{(1)}\mathbf{W}^{(2)} + b^{(2)} = 0.9 \cdot 0.6 + 0.0 \cdot (-0.4) = 0.54\)
- Hàm mất mát: \(\mathcal{L} = \frac{1}{2}(0.54 - 1.0)^2 = 0.1058\)
Lượt truyền ngược (áp dụng quy tắc chuỗi cho từng lớp):
Bước 1: Gradient của lớp đầu ra. Đạo hàm của hàm mất mát theo đầu ra là \[\frac{\partial \mathcal{L}}{\partial \hat{y}} = \hat{y} - y = 0.54 - 1.0 = -0.46.\] Bước 2: Gradient của trọng số đầu ra (áp dụng equation 22). Vì lớp đầu ra không có hàm activation \[\frac{\partial \mathcal{L}}{\partial z^{(2)}} = \frac{\partial \mathcal{L}}{\partial \hat{y}} = -0.46, \quad\text{and}\quad \frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(2)}} = {\mathbf{a}^{(1)}}^T \frac{\partial \mathcal{L}}{\partial z^{(2)}} = \begin{bmatrix} 0.9 \\ 0.0 \end{bmatrix} \cdot (-0.46) = \begin{bmatrix} -0.414 \\ 0.0 \end{bmatrix}\] Bước 3: Lan truyền đến lớp ẩn (áp dụng equation 24). Tín hiệu lỗi được truyền ngược lại là: \[\frac{\partial \mathcal{L}}{\partial \mathbf{a}^{(1)}} = \frac{\partial \mathcal{L}}{\partial z^{(2)}} {\mathbf{W}^{(2)}}^T = (-0.46) \cdot [0.6,\; -0.4] = [-0.276,\; 0.184]\]
Bước 4: Đi qua ReLU. Đạo hàm của ReLU bằng 1 khi \(z > 0\) và bằng 0 trong các trường hợp còn lại, nên \[\frac{\partial \mathcal{L}}{\partial \mathbf{z}^{(1)}} = [-0.276 \cdot 1,\; 0.184 \cdot 0] = [-0.276,\; 0.0].\] Gradient của neuron thứ hai bằng 0 vì ReLU đã chặn tín hiệu truyền tiến của nó.
Bước 5: Gradient của trọng số ở lớp ẩn (áp dụng equation 22): \[\frac{\partial \mathcal{L}}{\partial \mathbf{W}^{(1)}} = \mathbf{x}^T \cdot \frac{\partial \mathcal{L}}{\partial \mathbf{z}^{(1)}} = \begin{bmatrix} 1.0 \\ 0.5 \end{bmatrix} \cdot [-0.276,\; 0.0] = \begin{bmatrix} -0.276 & 0.0 \\ -0.138 & 0.0 \end{bmatrix}\]
Cập nhật trọng số (với tốc độ học \(\eta = 0.1\)): Mỗi trọng số được điều chỉnh theo hướng ngược với gradient của nó. Ví dụ, \(W^{(1)}_{11}\) cập nhật từ \(0.5\) thành \(0.5 - 0.1 \cdot (-0.276) = 0.5276\), giúp mạng tiến gần hơn đến đầu ra đúng. Các trọng số của neuron ẩn thứ hai không được cập nhật trong ví dụ này vì ReLU đã chặn activation của nó, minh họa cơ chế có thể dẫn đến neuron “chết” (dead neurons) nếu điều này xảy ra thường xuyên trên dữ liệu huấn luyện.
Góc nhìn về hệ thống: Lan truyền ngược không chỉ là một quy trình giải tích; nó còn là một đồ thị phụ thuộc dữ liệu. Các hệ thống huấn luyện phải lưu giữ các activation từ lượt truyền xuôi, vốn là dữ liệu cần thiết cho lượt truyền ngược. Đây là lý do vì sao bộ nhớ cho activation trở thành một khoản chi phí hệ thống quan trọng.
Mặc dù hiểu rõ các chi tiết toán học này rất quan trọng để gỡ lỗi và tối ưu hóa, người làm hiện đại hiếm khi tự cài đặt gradient thủ công. Đột phá về hệ thống nằm ở cách các framework tự động thực hiện các phép tính này. Hãy xem một phép toán đơn giản: nhân ma trận rồi áp dụng ReLU activation: output = relu(input @ weight). Về mặt toán học, gradient đòi hỏi tính đạo hàm của ReLU (0 với đầu vào âm, 1 với đầu vào dương) và áp dụng quy tắc dây chuyền cho phép nhân ma trận. Trong lượt truyền xuôi, framework ghi lại phép toán vào một đồ thị tính toán, lưu trữ các activation trước ReLU (cần cho việc tính gradient), gắn quy tắc lan truyền ngược cho từng phép toán, và lên lịch duyệt ngược để cân bằng giữa độ chính xác, mức dùng bộ nhớ và mức tận dụng phần cứng. Sự tự động hóa này biến việc tính gradient từ một quy trình thủ công, dễ lỗi và đòi hỏi kiến thức toán sâu thành một năng lực hệ thống đáng tin cậy, cho phép thử nghiệm và triển khai nhanh chóng.
Chi tiết triển khai tính toán
Lưu trữ activation chỉ là chi phí đầu tiên của lượt truyền ngược. Khi kích thước mô hình tăng lên, quá trình huấn luyện còn phát sinh thêm chi phí lưu trữ gradient, lưu lượng trạng thái của optimizer, và áp lực lên khâu lập lịch mà các ước tính bộ nhớ ở lượt truyền xuôi không phản ánh.
Hãy xem xét một biến thể lớn hơn của mạng MNIST (784 → 512 → 256 → 10) với kích thước batch là 32. Activation của mỗi lớp phải được giữ lại cho đến khi lượt truyền ngược đi tới lớp đó:
- Lớp đầu vào: \(32{\times}784\) giá trị (~100 KB sử dụng số 32-bit)
- Lớp ẩn 1: \(32{\times}512\) giá trị (~66 KB)
- Lớp ẩn 2: \(32{\times}256\) giá trị (~33 KB)
- Lớp đầu ra: \(32{\times}10\) giá trị (~1 KB)
Ngoài các activation, chúng ta còn phải lưu trữ gradient cho từng tham số. Với mạng lớn hơn này, có khoảng 535,818 parameters tham số, việc lưu trữ gradient sẽ tốn vài megabyte. Các optimizer nâng cao như Adam37 còn làm tăng dung lượng này lên gấp ba lần, vì chúng duy trì các giá trị momentum và velocity cho mỗi tham số.
37 Adam (adaptive moment estimation): Duy trì ước tính mô men bậc nhất và bậc hai theo từng tham số, nên cần thêm 2\(\times\) bộ nhớ FP32 ngoài chính các tham số (Kingma and Ba 2015). Với mô hình MNIST 100K tham số, chi phí phụ này không đáng kể, nhưng với một mô hình 7-billion tham số, nó sẽ tốn thêm ~56 GB, và đây thường là khác biệt giữa việc chạy vừa trên một GPU hay phải phân vùng. Adam được dùng rộng rãi vì các cập nhật thích ứng của nó hoạt động vững trên nhiều tác vụ, nhưng tốc độ học, lịch trình, điều chuẩn và chiến lược bộ nhớ vẫn cần được kiểm chứng.
Kingma, Diederik P., and Jimmy Ba. 2015. “Adam: A Method for Stochastic Optimization.” 3rd International Conference on Learning Representations (ICLR).
Băng thông bộ nhớ và lượng bộ nhớ cần dùng làm cho các yêu cầu về dung lượng này càng trở nên phức tạp. Trong một bước huấn luyện, hệ thống sẽ đọc các tham số, tạo ra các gradient, đồng thời giữ lại hoặc tính toán lại các giá trị của lượt truyền xuôi mà phép tính truyền ngược của mỗi lớp cần đến. Dung lượng lưu trữ activation thường tăng theo kích thước batch và độ sâu của mạng, khiến bộ nhớ huấn luyện tại đỉnh cao hơn bộ nhớ khi suy luận cho cùng một mô hình và cùng một batch. Với các mạng khiêm tốn như ví dụ MNIST, lưu lượng dữ liệu này vẫn có thể quản lý được. Khi mô hình lớn hơn, băng thông bộ nhớ và lưu trữ activation có thể trở thành những ràng buộc then chốt, thúc đẩy việc dùng bộ nhớ băng thông cao, độ chính xác hỗn hợp, phân vùng và activation checkpointing.
Mẫu hình tính toán của lan truyền ngược tuân theo trình tự chặt chẽ: tính gradient tại lớp hiện tại, cập nhật các gradient đã lưu, lan truyền tín hiệu lỗi về lớp trước đó, và lặp lại cho đến khi tới lớp đầu vào. Với xử lý theo batch, các phép tính này được thực hiện đồng thời cho mọi ví dụ trong batch, giúp tận dụng hiệu quả các phép toán ma trận và khả năng xử lý song song.
Các framework hiện đại xử lý các phép tính này bằng các engine autograd38 tinh vi. Đồ thị tính toán động ghi lại phép toán khi chúng được thực thi, trong khi đồ thị tính toán tĩnh trì hoãn thực thi để tạo thêm cơ hội tối ưu hóa. Khi một script huấn luyện yêu cầu gradient, framework tự động quản lý cấp phát bộ nhớ, lập lịch phép toán và tích lũy gradient trên toàn bộ đồ thị tính toán. Hệ thống theo dõi tensor nào cần gradient và lập lịch các phép toán sao cho lượt truyền ngược đi theo đúng các phụ thuộc đã hình thành trong lượt truyền xuôi. Nhờ quản lý tự động, người dùng có thể tập trung vào thiết kế mô hình thay vì các chi tiết phức tạp của việc triển khai tính toán gradient.
38 Autograd (vi phân tự động): Vi phân tự động chế độ ngược bắt nguồn từ công trình của Linnainmaa về vi phân các chương trình máy tính (1970). Các engine autograd hiện đại ghi lại các phép toán ở lượt truyền xuôi vào một đồ thị có hướng không chu trình (DAG), rồi duyệt ngược đồ thị đó và dùng quy tắc chuỗi để tự động tính gradient. Sự đánh đổi chính trong thiết kế hệ thống là: thực thi linh hoạt hơn cho phép ghi lại đúng những gì diễn ra ở mỗi vòng lặp, còn thực thi cố định hơn lại mở ra nhiều cơ hội tối ưu hóa trước. Các Framework ML trình bày chi tiết lựa chọn thiết kế framework này.
Linnainmaa, Seppo. 1970. “The Representation of the Cumulative Rounding Error of an Algorithm as a Taylor Expansion of the Local Rounding Errors.” Master's thesis, University of Helsinki.
Checkpoint 1.3: Lan truyền ngược
Bài toán gán trách nhiệm hỏi hàm mất mát phụ thuộc vào các tham số trong toàn bộ mạng như thế nào. Lan truyền ngược tính các gradient đó bằng quy tắc chuỗi; hãy kiểm lại rằng cơ chế này đã rõ:
Cơ chế
Huấn luyện và suy luận
Lan truyền ngược tính toán gradient cục bộ của hàm mất mát theo từng trọng số; sau đó optimizer chuyển tín hiệu này thành bản cập nhật tham số thực tế. Kích thước bước, cách tinh chỉnh hướng và động lượng qua các lần lặp đều do optimizer điều khiển. Không có optimizer nào là tốt nhất cho mọi bài toán (Wolpert and Macready 1997), nên việc huấn luyện mạng nơ-ron phụ thuộc vào việc chọn các quy tắc cập nhật và siêu tham số phù hợp với mô hình, dữ liệu và các ràng buộc phần cứng.
Wolpert, D. H., and W. G. Macready. 1997. “No Free Lunch Theorems for Optimization.” IEEE Transactions on Evolutionary Computation 1 (1): 67–82. https://doi.org/10.1109/4235.585893.
Các thuật toán cập nhật tham số
Definition 1.3: Gradient descent
Gradient descent là thuật toán tối ưu hóa lặp, cập nhật các tham số mô hình theo hướng gradient âm, \(\theta \leftarrow \theta - \eta \nabla_\theta \mathcal{L}\). Thuật toán này đánh đổi số bước tính toán \((O)\) để giảm hàm mất mát.
- Ý nghĩa: Việc lựa chọn optimizer ảnh hưởng đến bộ nhớ cần thiết cho quá trình huấn luyện. Ví dụ, trong một bảng kê đơn giản FP32: stochastic gradient descent (SGD) cần mỗi trọng số và gradient (8 byte cho mỗi tham số), trong khi Adam thêm hai bộ đệm moment, nâng bốn tensor đó lên 16 byte mỗi tham số. Huấn luyện hỗn hợp độ chính xác có thể giữ lại một số giá trị master FP32, đồng thời lưu các tensor khác với độ chính xác hẹp hơn; Huấn luyện mô hình sẽ trình bày cách hạch toán đầy đủ. Trạng thái của optimizer, các activation đã lưu, gradient, không gian làm việc tạm thời và bộ đệm giao tiếp cùng nhau quyết định cần bao nhiêu bộ tăng tốc cho quá trình huấn luyện.
- Phân biệt: Lan truyền ngược tính toán các gradient (tín hiệu “cần thay đổi gì”); còn optimizer áp dụng cập nhật (hành động “thay đổi nó”). Lượt truyền ngược quyết định những giá trị truyền xuôi nào phải được giữ lại, trong khi optimizer bổ sung trạng thái riêng và phép tính cập nhật của nó.
- Lỗi thường gặp: Nhiều người nghĩ gradient descent luôn tìm được cực tiểu toàn cục. Thực tế, bề mặt mất mát của mạng nơ-ron là không lồi, có nhiều cực tiểu cục bộ, điểm yên ngựa và các vùng phẳng. Trên thực tế, SGD và các biến thể thường hội tụ về những vùng có mất mát thấp và tổng quát hóa tốt, nhưng quỹ đạo phụ thuộc vào lịch trình tốc độ học, kích thước batch và khởi tạo ban đầu.
Giờ quá trình tối ưu cần một quy tắc cập nhật để biến gradient từ lan truyền ngược thành thay đổi tham số. Quy trình lặp này dùng độ nhạy cục bộ của mất mát đối với từng trọng số để cập nhật tham số, nhằm giảm mất mát qua các bước liên tiếp. Quy tắc cập nhật cơ bản kết hợp việc tính toán gradient từ lan truyền ngược với điều chỉnh tham số, như được định nghĩa trong equation 26: \[ \theta_{\text{new}} = \theta_{\text{old}} - \eta \nabla_{\theta}\mathcal{L} \tag{26}\] trong đó \(\theta\) đại diện cho tập tham số của mạng (trọng số và độ chệch (bias)), \(\eta\) là tốc độ học, và \(\nabla_{\theta}\mathcal{L}\) là gradient được tính bằng lan truyền ngược.
Đối với bộ phân loại chữ số, điều này đồng nghĩa với việc điều chỉnh trọng số để cải thiện độ chính xác phân loại. Chẳng hạn, nếu mạng thường xuyên nhầm “bảy” với “một”, gradient descent sẽ thay đổi các trọng số để phân biệt hai chữ số này tốt hơn. Tốc độ học \(\eta\)39 kiểm soát biên độ điều chỉnh: nếu quá lớn, các tham số có thể vượt quá điểm tối ưu; nếu quá nhỏ, quá trình hội tụ sẽ rất chậm.
39 Tốc độ học: Đại lượng vô hướng này ảnh hưởng mạnh đến hạ tầng huấn luyện, vì khi thay đổi kích thước batch, ta thường phải hiệu chỉnh lại lịch trình tối ưu. Quy tắc tỷ lệ tuyến tính tăng tốc độ học theo kích thước batch cho một chế độ huấn luyện ImageNet với batch lớn cụ thể (Goyal et al. 2017), nhưng chính sách tốt nhất còn phụ thuộc vào mô hình, optimizer, dữ liệu và quy mô. Áp dụng một quy tắc tỷ lệ ngoài phạm vi đã được kiểm chứng có thể gây phân kỳ khi chuyển từ huấn luyện trên một GPU sang nhiều GPU.
Goyal, Priya, Piotr Dollár, Ross Girshick, Pieter Noordhuis, Lukasz Wesolowski, Aapo Kyrola, Andrew Tulloch, Yangqing Jia, and Kaiming He. 2017. “Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour.” arXiv Preprint arXiv:1706.02677 abs/1706.02677.
Frankle, Jonathan, and Michael Carbin. 2019. “The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks.” International Conference on Learning Representations (ICLR).
Neyshabur, Behnam, Srinadh Bhojanapalli, David McAllester, and Nati Srebro. 2017. “Exploring Generalization in Deep Learning.” Advances in Neural Information Processing Systems 30.
Nakkiran, Preetum, Gal Kaplun, Yamini Bansal, Tristan Yang, Boaz Barak, and Ilya Sutskever. 2019. “Deep Double Descent: Where Bigger Models and More Data Hurt.” arXiv Preprint arXiv:1912.02292.
Mặc dù không gian hàm mất mát của mạng nơ-ron rất phi lồi, các phương pháp dựa trên gradient vẫn thường tìm được nghiệm hữu ích khi mô hình, dữ liệu, khởi tạo và chế độ tối ưu hóa phù hợp với nhau. Các lý giải về mặt lý thuyết cho hiện tượng này—như Giả thuyết Vé số (Lottery Ticket Hypothesis) (Frankle and Carbin 2019), độ chệch (bias) ngầm định (Neyshabur et al. 2017), và lợi ích của việc tham số hóa quá mức (Nakkiran et al. 2019)—vẫn là chủ đề nghiên cứu sôi nổi. Với kỹ thuật hệ thống ML thực tế, bài học mang tính thực nghiệm là: tốc độ học, khởi tạo, điều chuẩn và cấu hình huấn luyện cần được kiểm chứng cùng nhau.
Cập nhật gradient theo mini-batch
Các mạng nơ-ron thường xử lý nhiều ví dụ đồng thời trong quá trình huấn luyện, một phương pháp gọi là mini-batch gradient descent. Thay vì cập nhật trọng số sau từng ảnh, ta tính gradient trung bình trên một batch các ví dụ rồi mới thực hiện cập nhật.
Với một batch có kích thước \(B\), gọi \(\mathcal{L}_i\) là mất mát của ví dụ thứ \(i\); khi đó gradient trung bình của mất mát là equation 27: \[ \nabla_{\theta}\mathcal{L}_{\text{batch}} = \frac{1}{B}\sum_{i=1}^B \nabla_{\theta}\mathcal{L}_i \tag{27}\]
Với kích thước batch điển hình là 32, hệ thống thực hiện một lần truyền xuôi trên 32 ảnh, tính 32 mất mát theo từng ví dụ, lấy trung bình các gradient của chúng, rồi áp dụng một lần cập nhật trọng số. Trung bình này giúp làm mượt các gradient nhiễu theo từng ví dụ, nhưng cũng có nghĩa là bộ tăng tốc phải giữ các activation của batch sẵn cho đến khi lượt truyền ngược dùng đến chúng. Vì vậy, kích thước batch ảnh hưởng đến mức độ song song và mức độ tận dụng tài nguyên, cùng với hình dạng mô hình, cách triển khai kernel và phần cứng.
Quá trình học lặp lại
Quá trình huấn luyện hoàn chỉnh kết hợp lan truyền xuôi, lan truyền ngược và cập nhật trọng số thành một vòng lặp huấn luyện có hệ thống. Vòng lặp này lặp lại cho đến khi mạng đạt hiệu suất mong muốn hoặc đạt số lượt lặp định trước.
Một lượt đi qua toàn bộ tập dữ liệu huấn luyện được gọi là một epoch.40 Đối với MNIST, với 60,000 ảnh huấn luyện và kích thước batch 32, mỗi epoch gồm 1,875 lần lặp batch. Algorithm 2 trình bày vòng lặp SGD mini-batch: mỗi epoch xáo trộn dữ liệu, duyệt từng mini-batch với một lượt truyền xuôi và một lượt truyền ngược, và áp dụng một lần cập nhật tham số cho mỗi batch.
40 Epoch: Một lượt hoàn chỉnh qua toàn bộ tập dữ liệu huấn luyện. Số lượt này nhân thẳng vào tổng khối lượng công việc: ví dụ, một chạy MNIST 100 epoch sẽ thực hiện số lượt truyền xuôi và truyền ngược nhiều gấp 100 lần so với một epoch đơn lẻ. Việc huấn luyện các mô hình ngôn ngữ lớn thường được mô tả bằng một ngân sách token (token budget) thay vì chỉ đếm số epoch vì các nguồn dữ liệu có thể được trộn và lấy mẫu ở các tốc độ khác nhau. Nguyên tắc tính toán vẫn như vậy: mỗi token huấn luyện thêm tương ứng với thêm một phép tính truyền xuôi và truyền ngược.
\begin{algorithm} \caption{Mini-batch stochastic gradient descent} \begin{algorithmic} \Require training set $\{(x_i,y_i)\}_{i=1}^{D}$; rate $\eta$; batch size $B$; epochs $E$; initial $\theta_0$ \Ensure trained parameters $\theta$ \State $\theta \gets \theta_0$ \For{$e = 1$ to $E$} \State shuffle the training set \Comment{reduce order-dependent patterns} \For{each mini-batch $\mathcal{M}$ of size $B$} \State $\hat{y}_i \gets f_\theta(x_i)$ for all $(x_i,y_i) \in \mathcal{M}$ \State $\mathcal{L}_{\mathcal{M}} \gets \tfrac{1}{B}\sum_{(x_i,y_i)\in \mathcal{M}} \mathcal{L}(\hat{y}_i, y_i)$ \State $\theta \gets \theta - \eta\, \nabla_\theta \mathcal{L}_{\mathcal{M}}$ \Comment{backpropagate, then update} \EndFor \State evaluate on validation; stop if the convergence criterion is met \EndFor \State \Return $\theta$ \end{algorithmic} \end{algorithm}
Vòng lặp mini-batch biến kích thước batch \(B\) thành đơn vị công việc ở mức phần cứng: \(B\) lớn hơn có thể tăng hiệu suất sử dụng ma trận và mức sử dụng bộ tăng tốc, nhưng làm tăng bộ nhớ activation. Và vì cập nhật diễn ra một lần mỗi batch thay vì mỗi ví dụ, \(B\) cũng quy định nhịp cập nhật gradient. Vòng lặp bên trong ở algorithm 2 là đơn vị mà phần cứng lặp đi lặp lại. Truyền xuôi tạo ra các activation cho mọi ví dụ trong mini-batch hiện tại; truyền ngược dùng các giá trị đã lưu cần thiết để tính gradient; và optimizer cập nhật tham số một lần mỗi batch. Training loss theo dõi mục tiêu tối ưu trên các batch gần đây, còn validation accuracy đo lường hiệu suất tác vụ trên một tập kiểm định tách riêng (validation set). Tập kiểm thử (test set) vẫn được giữ lại để đánh giá cuối cùng sau khi đã cố định mô hình và các siêu tham số.
Cân nhắc về hội tụ và ổn định
Một mô hình đạt độ chính xác 99,5% trên dữ liệu huấn luyện nhưng chỉ 85% trên dữ liệu mới (chưa từng thấy) có liên quan thì đang có một khoảng cách khái quát hóa lớn — dấu hiệu rõ ràng của overfitting. Mô hình có thể đã học được các mẫu hữu ích nhưng đồng thời bám quá sát vào mẫu huấn luyện.
Definition 1.4: Overfitting
Overfitting là thất bại trong khái quát hóa khi hiệu suất trên tập dữ liệu huấn luyện được cải thiện, trong khi hiệu suất trên dữ liệu mới (chưa từng thấy) có liên quan lại không.
- Ý nghĩa: Dấu hiệu nhận biết có thể đo lường được: tổn thất huấn luyện (training loss) tiếp tục giảm trong khi tổn thất kiểm định (validation loss) tăng lên, hoặc chỉ số kiểm định có liên quan đạt mức ổn định (plateau), tạo ra một khoảng cách khái quát hóa ngày càng lớn. Chỉ riêng số lượng tham số không quyết định hành vi này; độ bao phủ dữ liệu, kiến trúc, tối ưu hóa, điều chuẩn (regularization), và mối quan hệ giữa phân phối dữ liệu huấn luyện và phân phối dữ liệu khi triển khai đều quan trọng.
- Khác biệt: Không như underfitting (khi mô hình không đủ khả năng học được hàm mục tiêu, dẫn đến lỗi huấn luyện và lỗi trên tập kiểm định đều cao), overfitting tạo ra lỗi huấn luyện thấp nhưng lỗi trên tập kiểm định cao, cho thấy mô hình đã chuyên biệt vào mẫu huấn luyện thay vì học được phân phối cơ bản của dữ liệu.
- Cạm bẫy thường gặp: Dữ liệu nhiều hơn chỉ hữu ích khi nó đại diện cho hành vi mà hệ thống cần khái quát hóa. Các can thiệp có thể gồm bổ sung thêm ví dụ, tăng cường dữ liệu, điều chuẩn, và dừng sớm. Tuy nhiên, mỗi giải pháp này đều phải được đánh giá trên dữ liệu tách riêng, lấy từ điều kiện hoạt động có liên quan.
Việc chọn tốc độ học ảnh hưởng mạnh đến quá trình huấn luyện. Nếu tốc độ học quá lớn so với optimizer, kích thước batch, phương pháp chuẩn hóa và lịch trình, tổn thất có thể dao động hoặc phân kỳ; nếu quá nhỏ, mô hình sẽ lãng phí nhiều epoch mà tiến triển không đáng kể. Không có một giá trị “vừa phải” dùng chung, nên kỹ sư cần thử các tốc độ học trong đúng cấu hình huấn luyện dự kiến và theo dõi cả độ ổn định của tối ưu hóa lẫn hiệu suất trên tập kiểm định.
Giám sát hội tụ cung cấp phản hồi thiết yếu trong quá trình huấn luyện và tiếp tục được duy trì khi triển khai sản xuất, như đã nêu ở Vận hành machine learning. Một đường cong mất mát huấn luyện phẳng dần cho thấy tối ưu hóa đang chậm lại, nhưng không chỉ ra nguyên nhân cụ thể: có thể phiên chạy đang tiến gần tới một nghiệm hữu ích, chạm trần tối ưu hóa, hoặc bị underfitting. Tương tự, đường cong kiểm định đi ngang cũng mang tính chẩn đoán hơn là kết luận. Khoảng cách giữa hiệu suất huấn luyện và kiểm định giúp phân biệt overfitting với những cải thiện thực sự chuyển giao được sang các ví dụ giữ lại. Sự phối hợp giữa kích thước batch, bộ nhớ sẵn có và tài nguyên tính toán cần được cân bằng cẩn thận để huấn luyện hiệu quả trong giới hạn phần cứng, đúng với các đánh đổi bộ nhớ–tính toán đã nêu trước đó trong phần này.
Checkpoint 1.4: Quy trình học của mạng nơ-ron
Bạn đã đi hết vòng đời huấn luyện, tức cơ chế toán học cho phép mạng nơ-ron học từ dữ liệu. Trước khi chuyển sang suy luận và triển khai, hãy tự kiểm tra mức độ hiểu của bạn:
Hãy sử dụng mạng MNIST (784 → 128 → 64 → 10) với kích thước batch 32 làm ví dụ kiểm tra xuyên suốt.
Nếu còn khái niệm nào chưa rõ, hãy xem lại các phần trước về lan truyền xuôi, hàm mất mát, lan truyền ngược và học trước khi tiếp tục. Những cơ chế này là nền tảng cho sự khác biệt giữa huấn luyện và suy luận trong phần tiếp theo.
Để chọn điểm dừng, chúng ta cần định kỳ đánh giá mô hình trên tập xác thực và lưu các trọng số vào bộ lưu trữ bền vững, một thực hành gọi là checkpointing. Với một mô hình nhỏ như mạng MNIST, việc ghi một checkpoint hầu như không đáng kể về thời gian. Nhưng với những mô hình có tham số cỡ hàng chục đến hàng trăm gigabyte, ghi checkpoint đồng bộ có thể làm khựng vòng huấn luyện trong lúc dữ liệu được ghi tuần tự xuống đĩa hoặc lưu trữ đối tượng; checkpointing không đồng bộ và phân tán giúp rút ngắn khoảng dừng này nhưng vẫn tiêu tốn bộ nhớ, mạng và băng thông lưu trữ. Bản thân việc xác thực cũng đòi hỏi một lần lan truyền xuôi đầy đủ trên tập dữ liệu giữ lại, và ở quy mô lớn nó tiêu tốn đáng kể thời gian của bộ tăng tốc vốn có thể dành cho huấn luyện. Vì vậy, checkpointing và xác thực không phải là các quan sát thống kê “miễn phí”: chúng gây ra chi phí I/O và tính toán lặp lại, và tần suất thực hiện cần được cân bằng với nhu cầu phục hồi và chọn mô hình. Lưu quá thưa khiến có nguy cơ mất các trọng số hữu ích khi xảy ra lỗi hoặc bị suy giảm về sau; lưu quá dày sẽ gây áp lực lên băng thông lưu trữ và thêm chi phí phụ. Đây là lý do vì sao giám sát hội tụ, dù đơn giản về mặt khái niệm, lại trở thành một bài toán hạ tầng hệ thống ở quy mô lớn.
Một pipeline huấn luyện hoàn chỉnh đi từ lan truyền xuôi, tính toán hàm mất mát đến cập nhật trọng số dựa trên gradient. Tuy nhiên, huấn luyện chỉ là bước chuẩn bị, không phải mục tiêu cuối cùng—khi các tham số đã được tối ưu, việc triển khai mô hình để dự đoán thời gian thực sẽ làm thay đổi hoàn toàn cấu hình tài nguyên.
Self-Check: Question
A classification model trained with softmax cross-entropy outputs a predicted probability \(\hat{y}_c = 0.99\) for the correct target class on Example 1, and outputs \(\hat{y}_c = 0.01\) for the correct class on Example 2. Based on the definition of cross-entropy loss (\(\mathcal{L} = -\log(\hat{y}_c)\)) and the combined softmax cross-entropy logit gradient (\(\frac{\partial \mathcal{L}}{\partial z_c} = \hat{y}_c - 1\)), what are the relative loss values and gradient magnitudes for these two examples?
- Example 1 produces loss \(\approx 4.61\) and logit gradient \(-0.99\), while Example 2 produces loss \(\approx 0.01\) and logit gradient \(-0.01\).
- Both examples generate identical gradient magnitudes because softmax normalization forces the sum of class gradients to equal zero.
- Example 2 produces negative loss because probabilities below \(0.5\) invert the sign of the cross-entropy objective.
- Example 2 produces high loss (\(-\log(0.01) \approx 4.61\)) and an error gradient of \(0.01 - 1 = -0.99\), while Example 1 produces near-zero loss (\(-\log(0.99) \approx 0.01\)) and an error gradient of \(0.99 - 1 = -0.01\), yielding an error signal roughly \(99\times\) stronger on the misclassified example.
What is the primary computational complexity advantage of reverse-mode automatic differentiation (backpropagation) over numerical differentiation (finite differences) when training a neural network with \(P\) parameters?
- Backpropagation computes exact gradients for all \(P\) parameters in a single reverse graph traversal costing approximately \(2\times\) forward-pass FLOPs, whereas numerical differentiation requires \(P\) separate forward passes costing \(\mathcal{O}(P \times \text{graph})\).
- Numerical differentiation is unstable for integer parameters, while backpropagation converts all tensors to complex numbers.
- Backpropagation eliminates the requirement to store or cache intermediate activations from the forward pass.
- Reverse-mode automatic differentiation executes without using the mathematical chain rule.
Distinguish between backpropagation and gradient descent (the optimizer) in terms of their computational roles and memory requirements during training.
Explain why the peak memory footprint during model training significantly exceeds the memory footprint during inference for the same model architecture and batch size. Identify the three major tensor categories present during training that are absent during inference.
True or False: In deep neural networks, vanishing gradients occur when multiplying chains of layer-wise Jacobian matrices and activation derivatives during backpropagation, causing early-layer gradients to diminish exponentially as network depth increases.
Order the computational phases executed within a single supervised mini-batch training step: (1) Update model weights using the optimizer update rule, (2) Evaluate the loss function by comparing predictions to ground-truth labels, (3) Perform the forward pass to compute layer activations and predictions, (4) Execute backpropagation via the chain rule to compute parameter gradients.
Pipeline suy luận
Huấn luyện biến các trọng số khởi tạo ngẫu nhiên thành các tham số mã hóa các mẫu hữu ích, nhưng triển khai sử dụng các tham số đó dưới một cấu hình tài nguyên khác. Trong quá trình suy luận,41 các toán tử giống nhau phải đáp ứng các ràng buộc khác: ưu tiên độ trễ hơn thông lượng như khi huấn luyện, không có trạng thái gradient, và phần cứng có thể trải từ thiết bị edge cho đến cụm GPU. Hiểu rõ sự chuyển đổi này là thiết yếu để thiết kế hệ thống thực tế.
41 Suy luận: Từ Latin inferre (“mang vào, kết luận”), mượn từ logic, nơi nó chỉ việc rút kết luận từ các tiền đề. Trong ML, cách dùng này đánh dấu một ranh giới hệ thống: huấn luyện thực hiện cả lan truyền xuôi và lan truyền ngược, đồng thời duy trì trạng thái của optimizer; còn suy luận thông thường chỉ chạy đồ thị xuôi với các tham số đã được cố định (frozen). Việc loại bỏ các gradient, trạng thái optimizer và hầu hết activations đã lưu có thể giảm đáng kể bộ nhớ và chi phí tính toán, nhưng tỉ lệ giảm còn tùy vào kiến trúc, kích thước batch, độ chính xác số, không gian làm việc của runtime và chiến lược phục vụ (serving).
Triển khai sản xuất và pipeline dự đoán
Giả sử một mô hình đạt 99% độ chính xác trên tập kiểm tra nhưng ba tháng sau khi triển khai, nó bắt đầu cho ra những đầu ra vô nghĩa, dù không có thay đổi mã. Trọng số của mô hình vẫn được giữ nguyên (frozen) và pipeline suy luận chạy bình thường, không lỗi. Một nguyên nhân có thể là thế giới vận hành đã đổi thay trong khi mô hình đứng yên.
Việc chuyển từ huấn luyện sang suy luận giới hạn cách một mô hình đã triển khai cố định có thể thích ứng. Các mô hình đã huấn luyện tổng quát hóa cho những đầu vào chưa thấy dựa trên các mẫu hình thống kê đã học, nhưng tham số không đổi trong suy luận thông thường. Khi dữ liệu vận hành lệch khỏi phân phối huấn luyện, mô hình vẫn tiếp tục áp dụng các mẫu hình đã học đó. Hãy xét một hệ thống nhận thức cho xe tự hành: nếu các khu vực công trường xuất hiện thường xuyên hơn hoặc có những cấu hình xe mới, phản ứng của hệ thống vẫn phản ánh bằng chứng trong huấn luyện. Các hệ thống không cập nhật tham số trực tuyến thích ứng thông qua việc thu thập dữ liệu được giám sát, kiểm định và huấn luyện lại — một quy trình kỹ thuật có chủ đích, được trình bày chi tiết trong Huấn luyện mô hình.
Sự khác biệt giữa các giai đoạn vận hành
Hoạt động của mạng nơ-ron được chia thành hai giai đoạn riêng biệt với yêu cầu tính toán rất khác nhau. Figure 17 minh họa trực quan sự khác biệt này. Suy luận chỉ thực hiện lan truyền xuôi, xử lý đầu vào qua các tham số đã học với kích thước batch thay đổi tùy nhu cầu. Huấn luyện thêm lan truyền ngược để tính gradient và cập nhật tham số, dùng các batch được chọn nhằm tối ưu và đạt thông lượng, đồng thời phải lưu trữ song song activations, gradient và trạng thái của optimizer, nên tốn bộ nhớ nhiều hơn đáng kể.42 Mô hình đã học có thể giống nhau, nhưng chế độ thực thi, trạng thái được giữ lại, và đôi khi cả đồ thị khi triển khai sẽ khác, vì các phép toán chỉ dùng cho huấn luyện có thể được loại bỏ, còn các phép toán cho suy luận có thể được hợp nhất hoặc lượng tử hóa.
42 Ngân sách công suất GPU huấn luyện: Yêu cầu về “bộ nhớ cao” xuất phát từ việc cần đồng thời giữ các tham số, gradient, trạng thái optimizer và các activation. Mức công suất tương ứng kéo theo nhu cầu về “hạ tầng làm mát đáng kể”, vì một GPU huấn luyện cao cấp tiêu thụ 400 W–700 W. Ngay cả khi so với một chip suy luận di động 4 W, đó vẫn cao hơn ít nhất 100× lần ngân sách công suất.

Những khác biệt về tính toán này bộc lộ trực tiếp ở yêu cầu phần cứng và chiến lược triển khai. Môi trường huấn luyện thường dùng các bộ tăng tốc có bộ nhớ lớn, kèm theo hạ tầng làm mát đáng kể. Ngược lại, khi triển khai suy luận trên phần cứng hạn chế, ưu tiên là độ trễ thấp và hiệu quả năng lượng trên nhiều nền tảng: thiết bị di động dùng bộ xử lý thần kinh tiêu thụ thấp (thường 2–4 W), máy chủ edge dùng các bộ tăng tốc suy luận chuyên dụng,43 còn các dịch vụ đám mây thường giảm độ chính xác số để tăng thông lượng.44 Các hệ thống suy luận trong môi trường sản xuất, phục vụ hàng triệu yêu cầu mỗi ngày, đòi hỏi những mối quan tâm về hạ tầng như định tuyến yêu cầu và xử lý lỗi, những điều thường không có trong một lần chạy huấn luyện đơn lẻ. Ở mức bộ nhớ, huấn luyện phải giữ lại các activation để phục vụ lan truyền ngược, trong khi suy luận giải phóng bộ đệm của các lớp càng sớm càng tốt; table 12 chuyển khác biệt đó thành một hồ sơ tài nguyên.
43 Bộ tăng tốc suy luận Edge: Edge TPU (Google Coral) hoạt động ở phân khúc di động/nhúng với công suất khoảng 2 W, đạt thông lượng 4 TOPS qua đường dẫn dữ liệu INT8. Các máy chủ edge thuộc một phân khúc khác: Jetson AGX Orin đạt thông lượng 275 TOPS với công suất từ 15 W đến 60 W, cho thông lượng cao hơn khoảng 68.8× lần, nhưng giả định dùng nguồn điện có dây.
44 Lượng tử hoá: Chuyển từ FP32 sang INT8 giúp giảm 4× dung lượng lưu trữ tham số và có thể tăng thông lượng trên phần cứng có đường dẫn dữ liệu INT8 hiệu quả, dù mức tăng thực tế còn phụ thuộc vào sự hỗ trợ của kernel, lưu lượng truy cập bộ nhớ và hình dạng khối lượng công việc (workload). Suy luận thường cho phép độ chính xác thấp hơn huấn luyện vì không cần biểu diễn các gradient nhỏ hay các cập nhật của optimizer qua nhiều bước học lặp lại. Đây không phải đánh đổi miễn phí: lượng tử hoá quá mạnh có thể làm giảm độ chính xác, đặc biệt với các đầu vào hiếm hoặc được biểu diễn kém. Vì vậy, cần hiệu chuẩn và đánh giá ở cấp độ tác vụ để xác định độ chính xác an toàn cho từng lần triển khai. Nén mô hình trình bày chi tiết các kỹ thuật lượng tử hoá.
| Đặc điểm | Lượt chuyển tiếp huấn luyện | Lượt chuyển tiếp suy luận |
|---|---|---|
| Lưu trữ activation | Giữ lại các giá trị cần thiết cho lượt lan truyền ngược | Giữ lại các bộ đệm đầu vào và đầu ra hiện tại |
| Kiểu bộ nhớ | Lưu hoặc tính toán lại các trạng thái trung gian được chọn | Tái sử dụng bộ đệm khi các lớp kế tiếp hoàn thành |
| Luồng tính toán | Được cấu trúc để chuẩn bị tính toán gradient | Được tối ưu hóa để tạo ra đầu ra trực tiếp |
| Hồ sơ tài nguyên | Yêu cầu bộ nhớ cao hơn cho các hoạt động huấn luyện | Giảm thiểu dung lượng bộ nhớ để thực thi hiệu quả |
Tài nguyên bộ nhớ và tính toán
Mạng nơ-ron tiêu thụ tài nguyên tính toán khác nhau giữa giai đoạn suy luận và giai đoạn huấn luyện. Trong suy luận, có hai loại yêu cầu về bộ nhớ. Thứ nhất là bộ nhớ cố định: các trọng số và độ chệch (bias) đã huấn luyện phải luôn sẵn sàng cho mọi yêu cầu. Thứ hai là bộ nhớ tạm thời: mỗi lớp tạo ra một bộ đệm activation, bộ đệm này chỉ cần thiết cho đến khi lớp tiếp theo sử dụng nó. Chính sự khác biệt này là lý do suy luận có thể gọn nhẹ hơn nhiều so với huấn luyện, dù các phép toán trong truyền xuôi là như nhau.
Với mạng MNIST tiêu chuẩn (784 → 128 → 64 → 10), khối tham số cố định chứa 109,386 parameters, tương đương khoảng 438 KB nếu dùng độ chính xác dấu phẩy động 32-bit. Bảng table 13 liệt kê số lượng tài nguyên theo từng lớp và cho thấy lý do: mỗi lớp kết nối đầy đủ thực hiện một phép nhân-cộng cho mỗi trọng số. Do đó, bộ nhớ tham số và lượng phép toán tăng cùng tỷ lệ.
| Lớp | Trọng số | Độ chệch (bias) | Phép nhân-cộng |
|---|---|---|---|
| Lớp 1 | \(784{\times}128\) = 100,352 | 128 | 100,352 |
| Lớp 2 | \(128{\times}64\) = 8,192 | 64 | 8,192 |
| Đầu ra | \(64{\times}10\) = 640 | 10 | 640 |
| Tổng cộng | 109,386 parameters | Được bao gồm trong tổng số | 109,184 |
Mô hình bộ đệm cố định kết hợp bộ đệm luân phiên này cũng lý giải các tối ưu hóa triển khai tiếp theo. Xử lý theo batch có thể tăng tái sử dụng phép tính và mức độ sử dụng phần cứng, nhưng làm tăng dung lượng lưu trữ cho các activation. Độ chính xác số học thấp hơn có thể thu nhỏ khối tham số cố định và các bộ đệm activation,45 nhưng chỉ khi chất lượng tác vụ vẫn giữ được với biểu diễn nhỏ hơn. Các bố cục dữ liệu đặc thù phần cứng có thể cải thiện tái sử dụng cache bằng cách giữ dữ liệu đang xử lý gần các đơn vị tính toán. Suy luận giúp việc lên kế hoạch các tối ưu hóa này dễ hơn vì tham số đã cố định và nhiều activation có vòng đời ngắn.
45 FP32 (single precision): Định dạng IEEE 754 binary32 sử dụng 32 bit: 1 bit dấu, 8 bit số mũ và 23 bit phần phân số được lưu trữ rõ ràng. Đây vẫn là một chuẩn số học cơ bản phổ biến cho tính toán mạng nơ-ron vì phạm vi số mũ của nó đủ rộng để chứa các giá trị mà các định dạng hẹp hơn có thể gặp tình trạng tràn số (overflow) hoặc tràn dưới (underflow). Việc chuyển các tensor được lưu trữ từ FP32 sang FP16 hoặc BF16 sẽ giảm một nửa dung lượng bộ nhớ (byte) của chúng, trong khi INT8 giảm xuống còn một phần tư. Thông lượng chỉ cải thiện khi phần cứng và các kernel thực thi các định dạng hẹp hơn một cách hiệu quả, và suy luận số nguyên thường cần hiệu chuẩn hoặc huấn luyện có nhận biết lượng tử hoá để giữ chất lượng tác vụ. Xem Biểu diễn số để so sánh chi tiết các định dạng số và sự đánh đổi giữa độ chính xác và thông lượng.
Các kỹ thuật nâng cao hiệu suất
Bản chất cố định của tính toán suy luận mang đến những cơ hội tối ưu hóa mà huấn luyện không có. Khi tham số đã được cố định, mẫu tính toán trở nên có thể dự đoán, cho phép cải thiện có hệ thống cả về mức sử dụng bộ nhớ lẫn hiệu quả tính toán.
Việc chọn kích thước batch là một đánh đổi quan trọng trong suy luận. Trong huấn luyện, batch lớn giúp ổn định tính toán gradient, còn suy luận linh hoạt hơn. Xử lý từng đầu vào giúp tối thiểu hóa độ trễ, phù hợp với ứng dụng thời gian thực cần phản hồi ngay lập tức. Ngược lại, xử lý theo batch cải thiện thông lượng bằng cách khai thác hiệu quả hơn khả năng tính toán song song. Với mạng MNIST, xử lý một ảnh cần lưu trữ 202 giá trị activation đầu ra của lớp (tổng cộng 986 giá trị, gồm cả bộ đệm đầu vào), trong khi một batch gồm 32 yêu cầu 6,464 giá trị activation đầu ra của lớp nhưng có thể xử lý nhiều ảnh hơn trong cùng một đơn vị thời gian trên phần cứng song song.
Quản lý bộ nhớ trong quá trình suy luận hiệu quả hơn nhiều so với huấn luyện. Vì các giá trị trung gian chỉ phục vụ tính toán truyền thẳng, các bộ đệm bộ nhớ có thể được tái sử dụng mạnh mẽ. Các giá trị activation của mỗi lớp chỉ cần tồn tại cho đến khi tính toán của lớp kế tiếp hoàn tất, cho phép thực hiện các phép toán tại chỗ, nhờ đó giảm tổng mức bộ nhớ chiếm dụng. Tính cố định của suy luận còn cho phép căn chỉnh bộ nhớ chính xác và các mẫu truy cập được tối ưu cho kiến trúc phần cứng bên dưới.
Các tối ưu hóa dành riêng cho phần cứng trở nên đặc biệt quan trọng trong quá trình suy luận. Trên CPU, có thể tổ chức phép tính để cải thiện việc sử dụng cache và khai thác tính song song SIMD. Khi triển khai trên bộ tăng tốc, hệ thống hưởng lợi từ các hàm nhân ma trận được tối ưu và các mẫu truyền dữ liệu bộ nhớ hiệu quả. Những tối ưu hóa này cũng có thể giảm tiêu thụ năng lượng và tăng mức độ tận dụng phần cứng, những yếu tố then chốt trong các triển khai thực tế.
Tính có thể dự đoán của suy luận cũng cho phép các tối ưu hóa như giảm độ chính xác số. Trong khi huấn luyện thường cần đủ độ chính xác dấu phẩy động để giữ cho việc học ổn định, suy luận thường có thể chạy với độ chính xác thấp hơn mà vẫn giữ độ chính xác chấp nhận được. Với mạng MNIST, giảm một nửa độ rộng lưu trữ sẽ giảm một nửa lượng byte dành cho tham số và activation; còn tăng tốc bao nhiêu vẫn phụ thuộc vào phần cứng và hỗ trợ của kernel.
Những nguyên tắc tối ưu hóa này, dù được minh họa qua mạng truyền thẳng MNIST đơn giản, cũng chỉ là nền tảng cho tối ưu hóa mạng nơ-ron. Các kiến trúc phức tạp hơn mở ra thêm nhiều yếu tố cần xem xét và cơ hội, bao gồm các thiết kế chuyên biệt cho dữ liệu không gian, chuỗi và tính toán phụ thuộc ngữ cảnh. Các biến thể kiến trúc này cùng các tối ưu hóa tương ứng sẽ được trình bày trong Kiến trúc mạng và Nén mô hình. Các yếu tố cần cân nhắc khi triển khai sản xuất, bao gồm các chiến lược batch và tối ưu hóa runtime, được đề cập trong Tối ưu hóa thông lượng và Vận hành machine learning.
Diễn giải đầu ra và ra quyết định
Đầu ra của mạng nơ-ron chỉ thực sự hữu ích khi được chuyển lại thành các quyết định mà một hệ thống thông thường có thể hành động. Tiền xử lý đưa dữ liệu thực tế vào dạng tensor; hậu xử lý ánh xạ đầu ra của mạng nơ-ron thành nhãn, ngưỡng quyết định, logic xác thực, xử lý lỗi và các thông điệp gửi tiếp. Trong ví dụ MNIST, chỉ có logits là chưa đủ: một hệ thống nhận dạng chữ số cần chữ số có khả năng cao nhất, một điểm số đã được đánh giá độ tin cậy, và một kênh để chuyển các trường hợp chưa chắc chắn cho con người xem xét hoặc cho một bộ nhận dạng thứ cấp.
Các bước này có đặc tính hiệu năng khác với lượt truyền xuôi. Suy luận hưởng lợi từ các phép toán ma trận theo batch trên các bộ tăng tốc, trong khi đặt ngưỡng, định dạng, xác thực và xử lý ngoại lệ thường chạy dưới dạng logic tuần tự trên CPU. Nếu bỏ qua phần code bao quanh đó, tiền xử lý và hậu xử lý có thể chiếm phần lớn độ trễ đầu-cuối, ngay cả khi bản thân mạng nơ-ron rất nhanh.
Toàn bộ vòng đời của một mạng nơ-ron, từ thiết kế kiến trúc, qua huấn luyện, đến triển khai suy luận, là một tập các phép toán có chi phí tài nguyên có thể đo đếm được. Cho đến nay, các phép toán này vẫn nằm trong môi trường kiểm soát của ví dụ MNIST chúng ta dùng, nơi dữ liệu sạch, độ trễ không bị ràng buộc, và phần cứng không bị thử thách. Nghiên cứu tình huống lịch sử sẽ thử nghiệm chúng trong một môi trường triển khai sản xuất, nơi những điều kiện đó đều không còn đúng.
Checkpoint 1.5: Hệ thống mạng nơ-ron hoàn chỉnh
Trước khi xem xét cách các khái niệm này tích hợp trong một triển khai thực tế, hãy kiểm tra lại hiểu biết của bạn về toàn bộ vòng đời của một mạng nơ-ron:
Sử dụng mô hình phân loại MNIST (784 → 128 → 64 → 10) làm hệ thống sản xuất đang chạy.
Nhận dạng chữ số viết tay cho thấy cách các lựa chọn kiến trúc, tiền xử lý, ngưỡng quyết định và đánh giá của con người kết hợp với nhau trong một pipeline xử lý tài liệu đang vận hành.
Self-Check: Question
A real-time voice transcription service has a strict p99 end-to-end latency budget of \(50\text{ ms}\). In configuring the serving infrastructure for the acoustic model, which batching strategy best aligns with this requirement?
- Batch size 512, because maximizing accelerator compute utilization is the primary metric for latency-critical SLOs.
- Dynamic queueing that buffers incoming audio requests until at least 64 concurrent streams are assembled.
- Batch size 1 (single-item serving) or very small micro-batches, trading lower hardware utilization for minimal request queueing delay.
- Asynchronous gradient accumulation that processes inputs in the background.
Why can an inference serving runtime for a sequential feed-forward network achieve a significantly smaller memory footprint than a training runtime for the exact same model architecture, beyond the omission of optimizer states and gradients?
- Inference converts all parameter tensors into single-bit binary hash tables.
- Inference requires no backward pass, allowing intermediate activation buffers to be immediately recycled or overwritten once their single downstream consumer layer finishes execution.
- Inference executes all network layers simultaneously in parallel, eliminating the need for intermediate buffers.
- Inference executes exclusively within on-chip CPU registers, bypassing main memory completely.
Why is reduced numerical precision (such as 8-bit integer quantization, INT8) generally much more practical to deploy during inference than during model training?
- Inference performs a single forward evaluation without weight updates, so rounding errors do not compound, whereas training accumulates gradient precision errors across tens of thousands of iterative parameter updates.
- Quantization increases model parameter counts to compensate for reduced numerical precision.
- INT8 arithmetic is slower than FP32 on modern tensor accelerators, making it undesirable during training.
- Quantization replaces nonlinear activation functions with linear identity mappings.
A computer vision inference service has a target p99 latency SLO of \(100\text{ ms}\). Profiling reveals: image JPEG decoding takes \(45\text{ ms}\), resizing and normalization take \(30\text{ ms}\), neural network inference takes \(15\text{ ms}\), and JSON response serialization takes \(25\text{ ms}\) (total \(115\text{ ms}\)). Explain why compressing the neural model by \(2\times\) will fail to meet the SLO, and state the highest-leverage engineering intervention.
True or False: Applying the softmax function \(\hat{y}_i = \frac{e^{z_i}}{\sum_j e^{z_j}}\) to raw neural network output logits alters the argmax classification decision, meaning the class with the highest raw logit is not guaranteed to have the highest predicted probability.
In high-reliability inference pipelines, when the model’s highest predicted probability falls below a predetermined confidence ____, the system triggers an abstention or routes the transaction to human review to prevent automated errors.
Nhận dạng chữ số viết tay
Vào cuối những năm 1980, LeCun và cộng sự trình diễn khả năng nhận dạng chữ số mã ZIP viết tay dựa trên lan truyền ngược từ ảnh do USPS cung cấp (LeCun et al. 1989). Các nghiên cứu liên quan về nhận dạng tài liệu dùng tích chập sau đó đã hỗ trợ các máy đọc séc ngân hàng được triển khai thương mại (LeCun et al. 1998). Đây là những hệ thống khác nhau, nhưng cùng bộc lộ một mô hình kỹ thuật chung: tiền xử lý để chuẩn hóa chữ viết tay đa dạng, suy luận của mạng nơ-ron tạo ra các chữ số ứng viên, các ngưỡng từ chối chuyển những dự đoán không chắc chắn cho con người xem xét, và logic phía sau biến các dự đoán đã chấp nhận thành các quyết định vận hành. Phần này dùng mô hình chung đó như một nghiên cứu tình huống về hệ thống, chứ không gán toàn bộ pipeline cho một lần triển khai của USPS.
Thách thức nhận dạng tài liệu
Mã ZIP viết tay là một bài toán nghiên cứu sớm trong bưu chính, còn séc ngân hàng cung cấp một bối cảnh triển khai quy mô lớn đã được ghi nhận. Cả hai đều yêu cầu mô hình xử lý được sự khác biệt về kiểu viết, loại bút, độ dày nét và cách tạo ký tự. Sai sót kéo theo chi phí vận hành, nên chỉ độ chính xác thôi là chưa đủ: hệ thống còn cần điểm số quyết định và các ngưỡng từ chối đã được kiểm chứng để chuyển những mục không chắc chắn cho người vận hành. Các mẫu trong figure 18 minh họa mức độ đa dạng mà tiền xử lý và nhận dạng phải xử lý.
Bài học về hệ thống bền vững nằm ở pipeline chung mà các ứng dụng này dùng. Khâu thu nhận và tiền xử lý hình ảnh ràng buộc đầu vào cho mô hình, suy luận tạo ra điểm số cho từng lớp, các ngưỡng từ chối đánh đổi mức độ bao phủ tự động với lỗi, và con người xử lý các trường hợp nằm ngoài khoảng tin cậy cho phép.
Quy trình kỹ thuật và các quyết định thiết kế
Nhận dạng một chữ số rõ ràng, được căn giữa thì đơn giản. Còn nhận dạng chữ viết tay giữa nền, tỷ lệ, căn chỉnh và chất lượng hình ảnh biến đổi đòi hỏi quyết định kỹ thuật ở mọi giai đoạn, từ chuẩn bị dữ liệu đến triển khai.
Lịch sử của các tập dữ liệu này cần được giữ riêng. Ban đầu, nghiên cứu về mã ZIP dùng các ảnh chữ số bưu chính được cung cấp riêng cho nhiệm vụ đó (LeCun et al. 1989). Sau này, MNIST được xây dựng từ các cơ sở dữ liệu chữ số viết tay của Viện Tiêu chuẩn và Công nghệ Quốc gia (NIST) và được chuẩn hóa thành ảnh benchmark có kích thước đồng nhất (LeCun et al. 1998). MNIST không xuất phát từ việc thu thập phong bì thật với nhiều màu sắc, kết cấu, ánh sáng và hướng khác nhau. Tuy vậy, yêu cầu kỹ thuật ở cả hai tập dữ liệu là như nhau: tiền xử lý phải giảm bớt các biến thiên không liên quan mà không xóa mất thông tin nét cần cho nhận dạng.
Thiết kế kiến trúc cần cân bằng giữa độ chính xác, thời gian xử lý và chi phí bộ nhớ. Với đầu vào chữ số \(28{\times}28\) đã được chuẩn hóa trong chương này, câu hỏi trung tâm là độ trễ và ngân sách phần cứng hiện có cho phép dung lượng mô hình đến mức nào.
Huấn luyện phải bao quát các biến thể chữ viết tay, thay vì chỉ tối ưu cho một tập kiểm tra được tuyển chọn. Tiền xử lý chuẩn hóa kích thước và hướng, còn augmentation giúp mô hình tiếp xúc thêm với các biến thể hợp lý. Tiếp đó, đánh giá cần đo lường hiệu suất trên các kiểu viết và điều kiện vận hành phù hợp, theo quy trình làm việc có hệ thống mô tả trong Quy trình ML.
Ngưỡng tin cậy xác định ranh giới công việc giữa tự động hóa và xem xét thủ công. Ngưỡng cao sẽ chuyển nhiều mục sang xử lý thủ công; ngưỡng thấp chấp nhận nhiều lỗi của mô hình hơn. Một quy tắc chi phí kỳ vọng chọn ngưỡng \(t\) để tối thiểu hóa \(\text{manual\_rate}(t)C_{\text{manual}} + \text{error\_rate}(t)C_{\text{error}}\) với điều kiện ràng buộc về thông lượng và độ trễ.
Kiến trúc pipeline dùng chung
Các nghiên cứu về mã ZIP bưu chính và các hệ thống đọc séc ngân hàng đã triển khai dùng những hệ thống vận hành khác nhau, nhưng cả hai đều đi theo mẫu trong figure 19. Thu nhận ảnh và các bước tiền xử lý thông thường chuẩn bị đầu vào; suy luận nơ-ron tạo điểm số cho từng chữ số; và hậu xử lý sẽ hoặc chấp nhận kết quả, hoặc chuyển các mục không chắc chắn để xem xét. Hình này trình bày kiến trúc dùng chung đó như một mẫu hình hệ thống tổng hợp.

Pipeline bắt đầu bằng thu nhận ảnh. Trong nghiên cứu bưu chính, đầu vào là ảnh vùng mã ZIP viết tay; các hệ thống đọc séc đã triển khai cũng tương tự, bắt đầu từ ảnh tài liệu được quét. Chất lượng ảnh thu được quyết định mức độ biến đổi mà các giai đoạn tiền xử lý và nhận dạng phía sau phải hấp thụ.
Tiền xử lý xác định vùng liên quan, tách hoặc nhận diện các ký tự, rồi chuẩn hóa các ảnh thu được. Ngưỡng hóa, phân tích thành phần liên thông, và chuẩn hóa kích thước là những kỹ thuật tiêu biểu. Chương này dùng ảnh chuẩn \(28{\times}28\) cho các tính toán MNIST; đó là một quy ước giảng dạy ở đây, không phải khẳng định rằng mọi hệ thống triển khai trong bưu chính hay đọc séc đều dùng kích thước này.
Tiếp theo, mạng nơ-ron xử lý từng ảnh chữ số đã được chuẩn hóa. Hệ thống nghiên cứu mã ZIP năm 1989 dùng một biến thể LeNet đời đầu (LeCun et al. 1989) với khoảng 10,000 parameters, đáng chú ý là gọn hơn nhiều so với 109.4K trong mạng MNIST của chương này. Cả hai đều tạo điểm số cho chữ số thông qua tính toán theo các lớp nơ-ron, dù kiến trúc và bối cảnh vận hành khác nhau.
Hậu xử lý chuyển các điểm số chữ số thành quyết định ứng dụng. Với tác vụ mã ZIP, chỉ một chữ số không chắc chắn cũng có thể khiến toàn bộ mã được chuyển sang xử lý tiếp hoặc nhờ con người xem xét. Các hệ thống đọc tài liệu triển khai thực tế cũng theo nguyên tắc này: chấp nhận các dự đoán đủ tin cậy và từ chối các trường hợp không chắc chắn, thay vì buộc phải đưa ra câu trả lời.
Các hệ thống đọc tài liệu triển khai thực tế phải đáp ứng các ràng buộc thời gian đầu-cuối, bao trùm các bước thu nhận, tiền xử lý, suy luận, hậu xử lý và hành động kế tiếp. Cơ chế cụ thể khác nhau giữa ứng dụng thư tín và tài liệu tài chính, nhưng thông lượng phụ thuộc vào toàn bộ pipeline, không chỉ riêng độ trễ của mạng nơ-ron.
Kết quả hiệu suất và tác động vận hành
Nghiên cứu mã ZIP năm 1989 báo cáo các số đo về mô hình, nhận dạng, thông lượng và huấn luyện trong một hệ thống thử nghiệm duy nhất. Table 14 giữ các số đo này cùng nhau, cho thấy chính sách từ chối và tiền xử lý ảnh hưởng ra sao đến ý nghĩa của tốc độ bộ phân loại thô (LeCun et al. 1989).
LeCun, Yann, Bernhard Boser, John S. Denker, Donald Henderson, Richard E. Howard, Wayne Hubbard, and Lawrence D. Jackel. 1989. “Backpropagation Applied to Handwritten Zip Code Recognition.” Neural Computation 1 (4): 541–51. https://doi.org/10.1162/neco.1989.1.4.541.
| Số liệu | Kết quả được báo cáo |
|---|---|
| Lỗi và từ chối | Lỗi phân loại 1% sau khi từ chối 12.1% các chữ số thử nghiệm |
| Thông lượng | 10–12 phân loại/giây bao gồm cả việc thu thập; hơn 30/giây sau khi chuẩn hóa |
| Các tham số mô hình | ~10,000 |
| Huấn luyện | 23 lượt; khoảng 3 ngày trên một máy trạm Sun-4/260 |
Các phép đo này kể một câu chuyện về hệ thống hơn là về độ chính xác. Thí nghiệm mã ZIP cho thấy nhận dạng học được có thể xử lý các chữ số viết tay thực tế với một chính sách từ chối rõ ràng. Đến cuối những năm 1990, các bộ đọc séc ngân hàng dựa trên LeNet đã xử lý tài liệu ở quy mô thương mại (LeCun et al. 1998). Đây là những cột mốc riêng, được nối lại bởi quyết định giữ một đường đi dành cho các đầu vào không chắc chắn.
LeCun, Yann, Léon Bottou, Yoshua Bengio, and Patrick Haffner. 1998. “Gradient-Based Learning Applied to Document Recognition.” Proceedings of the IEEE 86 (11): 2278–324. https://doi.org/10.1109/5.726791.
Chính đường dẫn từ chối, chứ không phải tỷ lệ lỗi thuần, đã giúp việc triển khai vận hành hiệu quả. Các trường hợp không chắc chắn được chuyển cho người vận hành thay vì buộc mọi ví dụ đều đi qua mô hình, nhờ đó hệ thống đạt độ tin cậy bằng cách chọn điểm dừng tin tưởng vào mạng.
Hiệu suất phụ thuộc vào việc các đầu vào khi vận hành giống mức biến thiên đã có trong dữ liệu huấn luyện đến đâu. Chất lượng ảnh, kiểu viết và hành vi tiền xử lý đều có thể làm dịch chuyển độ chính xác nhận dạng, nên cần đánh giá cùng lúc cả pipeline vật lý lẫn pipeline thống kê.
Cơ chế kinh tế đến từ việc dịch chuyển điểm vận hành, không phải từ việc loại bỏ hoàn toàn con người. Tự động hóa xử lý các chữ số có độ tin cậy cao, còn người vận hành giải quyết các trường hợp không chắc chắn và duy trì phương án dự phòng cho các đầu vào nằm ngoài vùng đáng tin cậy của mô hình.
Lịch sử này cũng chỉ ra các yêu cầu vận hành bền vững. Các nhóm cần giám sát chất lượng đầu vào và tỷ lệ từ chối, cập nhật dữ liệu huấn luyện khi phân phối trong vận hành thay đổi, và duy trì cả mô hình nhận dạng lẫn hệ thống thu thập và tiền xử lý đi kèm. Đây là các hệ quả vòng đời của một mẫu hình hệ thống kết hợp, chứ không phải những tính năng được ghi chép của một lần triển khai của USPS.
Các bài học kỹ thuật và nguyên tắc thiết kế chính
Xuyên suốt nghiên cứu mã ZIP bưu chính và các bộ đọc séc đã triển khai, bài học trung tâm là tính toán mạng nơ-ron chỉ thành công khi pipeline xung quanh chia sẻ cùng ràng buộc vận hành. Tiền xử lý, suy luận, hậu xử lý, từ chối và các hành động hạ nguồn phải cùng nhau đáp ứng thông lượng và ngân sách lỗi yêu cầu.
Lịch sử kết hợp này cho thấy vì sao cả nền tảng lý thuyết và tích hợp hệ thống đều quan trọng. Việc chuyển các ký hiệu viết tay thành các quyết định vận hành đáng tin cậy đòi hỏi các lựa chọn phối hợp về kiến trúc mạng, huấn luyện, tiền xử lý, chính sách độ tin cậy và xử lý hạ nguồn.
Tổng hợp lại, các bản trình diễn nghiên cứu và các hệ thống đọc tài liệu được triển khai sau này minh họa các thực tiễn vẫn là tiêu chuẩn: dữ liệu huấn luyện đại diện, chỉ số độ tin cậy, tiền xử lý và hậu xử lý, các nhánh từ chối, và tối ưu hóa end-to-end. Những cân nhắc vận hành này được hệ thống hóa trong Vận hành machine learning.
Các hệ thống edge hiện đại hoạt động dưới những ràng buộc khác nhau về công suất, độ trễ và triển khai, nhưng các nguyên tắc kỹ thuật vẫn giữ nguyên: tiền xử lý để đối phó biến thiên thực tế, định tuyến dựa trên độ tin cậy sang bước đánh giá của con người, và tối ưu hóa pipeline end-to-end. Vì vậy, lịch sử kết hợp về nhận dạng tài liệu cung cấp một mẫu hệ thống có thể tái sử dụng, mà không cần coi nghiên cứu bưu chính, triển khai hệ thống đọc séc và MNIST là một ứng dụng duy nhất.
Systems Perspective 1.6: Cách đọc các so sánh hệ thống trong lịch sử
Hệ thống đọc lớp LeNet đời đầu và perceptron đa lớp MNIST trong chương này cho thấy sự liên tục về tính toán, chứ không phải một benchmark hiệu suất được kiểm soát. Các tập dữ liệu, kiến trúc, ngăn xếp phần mềm, máy và mục tiêu vận hành của chúng đều khác nhau. So sánh hợp lý nằm ở cấu trúc: cả hai đều biến các pixel đã chuẩn hóa thành điểm số cho chữ số, đều phụ thuộc vào các tham số đã học và một pipeline tiền xử lý, và đều cần một chính sách rõ ràng cho các đầu ra không chắc chắn.
Số lượng tham số tạo nên một điểm đối chiếu cụ thể. Mạng ZIP-code năm 1989 có khoảng 10,000 tham số, trong khi mạng kết nối đầy đủ trong chương này có 109,386. Sự khác biệt này mô tả trạng thái của mô hình; tự nó không xác lập độ trễ, năng lượng, thông lượng hay chi phí. Những kết quả đó đòi hỏi một khối lượng công việc (workload) cố định và các phép đo nêu rõ phần cứng, độ chính xác số, runtime, kích thước batch, và đường đi ra quyết định end-to-end. Việc tách bạch các biến này giúp tránh việc quy toàn bộ một triển khai nhanh hơn cho silicon, trong khi dữ liệu, mô hình, phần mềm hoặc chính sách vận hành cũng đã thay đổi.
Tổng hợp lịch sử này là một ví dụ cho một mô hình phối hợp rộng hơn: các hệ thống ML thành công luôn phối hợp nhịp nhàng giữa nhiệm vụ, dữ liệu, thuật toán và máy. Phần tiếp theo sẽ chính thức hóa mô hình này.
Self-Check: Question
Which set of operational performance metrics accurately matches the benchmark results reported for the 1989 USPS handwritten digit recognition prototype developed by LeCun et al.?
- \(0\%\) error rate at \(0\%\) rejection rate, processing over \(1{,}000\) mailpieces per second.
- \(10\%\) error rate at \(50\%\) rejection rate, operating exclusively as an offline batch indexing system.
- \(5\%\) error rate at \(2\%\) rejection rate, requiring human video coding for every mailpiece.
- \(1\%\) error rate achieved at a \(12.1\%\) rejection rate, processing \(10\text{–}12\) classifications per second end-to-end and over \(30\) digits per second on pre-normalized inputs.
The chapter presents an illustrative ‘Then vs. Now’ comparison showing that running the 1989 LeNet architecture on modern edge silicon achieves \(\approx 1{,}000\times\) lower latency and \(\approx 20{,}000\times\) lower energy per inference. What is the fundamental systems engineering takeaway from this analysis?
- The algorithmic model was completely redesigned, accounting for all observed throughput gains.
- Semiconductor and accelerator advances multiplied the viable deployment envelope of the same neural computation, while core pipeline principles (preprocess, infer, threshold, route) remained durable.
- Modern edge accelerators eliminate the need for confidence thresholds and manual human review.
- Optical scanning and digit segmentation preprocessing are no longer necessary on modern hardware.
In the USPS postal sorting pipeline, explain why setting the rejection threshold to zero (forcing an automated prediction on \(100\%\) of mailpieces) is economically and operationally undesirable.
Describe how the 1989 USPS digit recognition system decomposed the document recognition challenge into a multi-stage pipeline, and explain why the neural classifier alone was not sufficient.
In the USPS document recognition pipeline, the preprocessing operation that isolates individual handwritten character bounding boxes from a continuous multi-digit ZIP code block is termed digit ____.
Order the physical and computational stages of the end-to-end USPS mail sorting pipeline: (1) Route accepted mail to physical sorting bins or rejected mail to human review, (2) Evaluate confidence thresholds on model output probabilities to accept or reject predictions, (3) Optically scan the mailpiece envelope to capture raw image data, (4) Execute neural network forward inference on normalized digit tensors, (5) Locate the ZIP code region, segment individual digits, and scale-normalize them.
Phân loại D·A·M
Trong lịch sử nhận dạng tài liệu, các nguồn lực khác nhau phục vụ những mục đích khác nhau. Ảnh mã ZIP do USPS cung cấp đặt nền cho các nghiên cứu nhận dạng ban đầu; LeNet cung cấp một cơ chế thuật toán; các bộ đọc séc ngân hàng về sau cung cấp một bối cảnh triển khai được ghi chép rõ; và MNIST cung cấp một benchmark chuẩn hóa được suy ra từ dữ liệu NIST. Chúng không tạo thành một hệ thống duy nhất, nhưng khi đặt cạnh nhau, chúng nêu bật ba câu hỏi trong phân loại D·A·M: dữ liệu có đại diện cho nhiệm vụ cần giải quyết không, thuật toán có thể học được hành vi mong muốn không, và máy có thể thực thi được trong giới hạn ngân sách vận hành không? Khung phân loại D·A·M phát triển các giao điểm giữa các trục này.
Trục Dữ liệu đặt câu hỏi liệu các ví dụ và nhãn có mô tả đúng hành vi mà hệ thống đã triển khai phải nhận dạng hay không. Ảnh mã ZIP của USPS, chữ số MNIST và đầu vào séc ngân hàng có liên quan nhưng không thể thay thế cho nhau: mỗi loại phản ánh một quy trình thu thập, phân bố đầu vào và mục tiêu vận hành khác nhau. Tiền xử lý có thể chuẩn hóa một số khác biệt, nhưng không thể tạo ra các kiểu chữ viết tay còn thiếu hoặc sửa một chính sách gán nhãn không khớp với quyết định ở bước sau. Dữ liệu cũng có dấu chân vật lý. Kích thước batch, độ phân giải hình ảnh, cách biểu diễn số và bố cục lưu trữ quyết định có bao nhiêu byte phải đi vào pipeline huấn luyện hoặc suy luận.
Trục Thuật toán đặt câu hỏi về phép biến đổi nào có thể học được hành vi mong muốn từ bằng chứng đó. Trong một mạng đang hoạt động, lớp đầu tiên (từ 784 sang 128) vừa quyết định khả năng biểu diễn ban đầu của mô hình vừa chi phối phần lớn số tham số. Các hàm activation quyết định những ranh giới phi tuyến có thể biểu diễn và cách gradient lan truyền; hàm mất mát và optimizer quyết định loại lỗi nào dẫn dắt việc cập nhật tham số. Những lựa chọn này định hình khối lượng công việc hệ thống phải thực hiện, nhưng một quy tắc học tinh tế chỉ hữu ích khi giả định của nó khớp với dữ liệu và các phép toán của nó phù hợp với ngân sách triển khai.
Trục Máy móc đặt câu hỏi liệu các thao tác đó có thể chạy với độ trễ, thông lượng, dung lượng bộ nhớ và mức năng lượng yêu cầu hay không. Lan truyền tiến (forward propagation) di chuyển các tham số và activation qua các phép toán ma trận; lan truyền ngược (backpropagation) bổ sung việc dùng các giá trị đã lưu, gradient, trạng thái của optimizer và duyệt ngược các phụ thuộc. Kích thước batch có thể tăng mức tái sử dụng đồng thời làm tăng lượng lưu trữ cho activation. Độ chính xác thấp hơn có thể giảm số byte và mở ra khả năng dùng các kernel nhanh hơn, nhưng chỉ sau khi đánh giá ở cấp tác vụ cho thấy sai số số học là chấp nhận được. Vì vậy, trục Máy móc không chỉ giới hạn tốc độ chạy của một mạng cố định, mà còn giới hạn mạng nào, batch nào và độ chính xác nào là khả thi.
Các giao điểm giữa từng cặp trục giải thích vì sao chúng không thể được tối ưu hóa độc lập. Cụ thể: Dữ liệu và Thuật toán quyết định những gì hệ thống có thể học được; Dữ liệu và Máy móc quyết định cách thông tin được biểu diễn và di chuyển; còn Thuật toán và Máy móc quyết định cách tính toán được thực thi hiệu quả. Ở trung tâm, cả ba câu hỏi này phải được trả lời đồng thời. Ví dụ, một tập dữ liệu lớn hơn có thể cải thiện độ bao phủ nhưng làm tăng lưu lượng dữ liệu đầu vào; một mạng rộng hơn có thể tăng dung lượng nhưng vượt quá bộ nhớ; và một kernel có độ chính xác thấp hơn có thể cải thiện thông lượng nhưng lại làm thay đổi độ chính xác.
Các tính toán trong chương này giúp quy trình chẩn đoán trở nên cụ thể, rõ ràng. Bắt đầu từ một triệu chứng quan sát được, chẳng hạn như độ chính xác thấp, độ trễ không đạt yêu cầu, hoặc hết bộ nhớ. Đưa ra các giả thuyết cạnh tranh trên cả ba trục, rồi đo các đại lượng phân biệt chúng: phạm vi bao phủ và chất lượng nhãn cho Dữ liệu; các lát cắt lỗi (error slices) và hành vi học cho Thuật toán; hoặc mức độ sử dụng, băng thông và dung lượng cho Máy. Một can thiệp trên một trục có thể chuyển nút thắt cổ chai sang trục khác, nên bài kiểm tra cuối cùng luôn là hành vi đầu-cuối dưới khối lượng công việc (workload) dự kiến. Khung phân loại D·A·M biến chẩn đoán vòng đầu này thành một bản đồ chi tiết về các kỹ thuật giao thoa được dùng xuyên suốt cuốn sách.
Những nền tảng này trang bị cho kỹ sư khả năng suy luận về mạng nơ-ron dựa trên các nguyên tắc cơ bản. Tuy nhiên, chỉ hiểu biết khái niệm thôi là chưa đủ: người làm thực tế còn phải nhận diện các ngộ nhận lặp lại dễ làm chệch hướng dự án.
Self-Check: Question
Under the D·A·M (Data, Algorithm, Machine) taxonomy presented in the chapter, which statement correctly describes the primary responsibility of each axis and their systems interplay?
- Data determines GPU clock speed, Algorithm dictates physical memory capacity, and Machine formats training labels.
- Algorithm determines whether data is collected, Machine ensures 100% training accuracy, and Data operates independently of both.
- Data, Algorithm, and Machine can be optimized independently without cross-axis trade-offs.
- Algorithm defines computational transformations and capacity, Data determines whether the model can learn the task from representative evidence, and Machine determines whether those operations execute within latency, throughput, memory, and energy budgets.
A computer vision model deployed in production exhibits high accuracy during offline benchmark evaluations but suffers severe error rates on live camera feeds, while hardware GPU utilization is only \(15\%\). Use the D·A·M taxonomy to outline a structured diagnostic sequence to isolate the root causes.
According to the D·A·M taxonomy, if a deployed computer vision model suffers elevated error rates in production due to a distribution shift in ambient lighting and camera angles, why will scaling the Machine axis (allocating a larger cluster of faster GPUs) fail to resolve the operational failure?
- Hardware accelerators automatically reduce optimizer learning rates when cluster size increases.
- Faster GPU accelerators cannot process image tensors captured at non-standard aspect ratios.
- Machine scaling accelerates computational throughput but cannot supply the missing visual patterns or domain coverage required on the Data axis to learn the shifted distribution.
- The D·A·M framework requires all production deployments to execute on single-thread CPU cores.
Ngụy biện và Cạm bẫy
Học thống kê bổ sung những kiểu lỗi mà chỉ kiểm tra mã từng dòng thì không thấy được. Các ngụy biện và cạm bẫy dưới đây có thể khiến các nhóm phân bổ sai công sức hoặc triển khai những giải pháp không phù hợp.
Ngụy biện: Mạng nơ-ron hoàn toàn mù mờ và không thể gỡ lỗi.
Mạng nơ-ron không cung cấp vết truy nguyên nhân từng dòng như mã truyền thống, nhưng không phải là không thể chẩn đoán. Trực quan hóa activation có thể hé lộ các mẫu đã học, phân tích gradient đo độ nhạy cục bộ với đầu vào, và các thí nghiệm ablation ước lượng đóng góp của từng thành phần. Những công cụ này cung cấp bằng chứng một phần chứ không phải lời giải thích trọn vẹn: saliency có thể không ổn định, các đặc trưng tương quan làm phức tạp việc quy gán, và một ablation có thể làm thay đổi chính hành vi mà ta muốn thăm dò. Với bộ phân loại MNIST trong section 1.2.2, các trọng số của lớp đầu tiên vẫn là một phép kiểm tra hữu ích về những mẫu mà mô hình đã học. Vì vậy, gỡ lỗi một hệ thống thống kê cần kết hợp các phép thăm dò ở cấp mô hình với các lát cắt dữ liệu, các can thiệp có kiểm soát và đánh giá end-to-end.
Cạm bẫy: Bỏ qua kiến thức miền vì có sẵn một mô hình học sâu.
Các nhóm thường cho rằng học tự động đặc trưng sẽ loại bỏ nhu cầu về kiến thức miền. Tuy nhiên, các hệ thống thành công cần kiến thức miền ở mọi giai đoạn: lựa chọn kiến trúc, thiết kế mục tiêu huấn luyện, tuyển chọn tập dữ liệu, và diễn giải đầu ra. Lịch sử nhận dạng tài liệu trong section 1.5 cho thấy vì sao ngưỡng tin cậy phải phản ánh kinh tế vận hành và chuyển các trường hợp không chắc chắn cho người vận hành. Thiếu kiến thức miền, các nhóm có thể triển khai các mạng nơ-ron trông mạnh trên tập kiểm tra nhưng lại thất bại khi chạy thực tế vì ngưỡng, đường dự phòng, hoặc chi phí lỗi đặt sai.
Ngụy biện: Mạng sâu hơn luôn chính xác hơn mạng rộng hơn.
Các kỹ sư thường nghĩ rằng cứ xếp thêm nhiều lớp là con đường chính để tăng độ chính xác, vì độ sâu cho phép trích xuất đặc trưng theo tầng bậc. Nhưng trên thực tế, chỉ tăng độ sâu thôi sẽ sớm gặp hiện tượng lợi ích gia tăng giảm dần. ResNet cho thấy các mạng residual rất sâu có thể được huấn luyện hiệu quả, nhưng kết quả trên ImageNet cũng chỉ ra rằng việc thêm lớp phải được cân nhắc so với chi phí huấn luyện và suy luận tăng thêm (He et al. 2016). Sau đó, EfficientNet chứng minh rằng mở rộng đồng thời chiều rộng, chiều sâu và độ phân giải đầu vào có thể vượt trội hơn việc chỉ mở rộng theo chiều sâu trong cùng mức tài nguyên (Tan and Le 2019). Bài học không phải là độ sâu “xấu”; mà là các nhóm nên đo đạc mức tận dụng năng lực và mở rộng theo chiều của kiến trúc mang lại độ chính xác tốt nhất trên mỗi FLOP.
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2016. “Deep Residual Learning for Image Recognition.” 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 770–78. https://doi.org/10.1109/cvpr.2016.90.
Tan, Mingxing, and Quoc V Le. 2019. “EfficientNet: Rethinking Model Scaling for Convolutional Neural Networks.” International Conference on Machine Learning (ICML), 6105–14.
Cạm bẫy: Sử dụng mạng nơ-ron cho các vấn đề có thể giải quyết bằng các phương pháp đơn giản hơn.
Các nhóm thường cho rằng deep learning luôn cho kết quả tốt hơn. Tuy nhiên, với các tập dữ liệu nhỏ hoặc các quan hệ xấp xỉ tuyến tính, một mô hình đơn giản như hồi quy logistic có thể ngang bằng hoặc thậm chí vượt mạng nơ-ron, đồng thời cần ít huấn luyện, bộ nhớ và công bảo trì hơn. Mức lợi thế đó phụ thuộc vào khối lượng công việc (workload), vì vậy các nhóm nên benchmark với một mô hình cơ sở đơn giản và biện minh cho độ phức tạp tăng thêm bằng các lợi ích đo được theo từng tác vụ. Mạng nơ-ron rất mạnh trong việc khám phá mẫu phân cấp (section 1.1.3) nhưng cũng kéo theo chi phí bổ sung. Hãy dùng chúng khi khả năng biểu diễn mang lại lợi ích đủ lớn để xứng đáng với chi phí hệ thống đã được đo lường.
Các khối lượng công việc (workload) mạng nơ-ron nhỏ vẫn chịu giới hạn của bộ nhớ, ngay cả khi chạy trên các GPU lớn.
Ngụy biện: Các vấn đề về phân phối dữ liệu huấn luyện có thể xử lý sau khi đã thiết kế mô hình.
Các nhóm thường coi huấn luyện như việc máy móc nhồi dữ liệu qua kiến trúc. Các mạng trên các tập dữ liệu mất cân bằng có thể cho hiệu suất kém ở lớp thiểu số: ví dụ, một hệ thống phát hiện gian lận với tỷ lệ mất cân bằng 99:1 có thể đạt độ chính xác 99 percent chỉ bằng cách luôn dự đoán “không gian lận”, nhưng lại không bắt được bất kỳ ca gian lận nào. Một hàm mục tiêu rủi ro thực nghiệm trung bình không trọng số có thể khiến các lớp hiếm nhưng quan trọng bị xem nhẹ, trừ khi việc lấy mẫu, gán trọng số, thiết kế hàm mất mát và đánh giá được xây dựng để xử lý mất cân bằng. Các nhóm bỏ qua phân tích dữ liệu khám phá có thể triển khai các mô hình có chỉ số tổng thể tốt nhưng hiệu suất với lớp thiểu số lại không chấp nhận được.
Cạm bẫy: Triển khai các mô hình từ nghiên cứu vào môi trường sản xuất mà không tính đến các ràng buộc của hệ thống.
Môi trường sản xuất đặt ra những ràng buộc không có trong nghiên cứu: ngân sách độ trễ (50–100 ms end-to-end), giới hạn bộ nhớ (2–4 GB cho thiết bị edge), và tải đồng thời (100–1.000 yêu cầu mỗi giây (RPS)). Một pipeline hoàn chỉnh bao gồm tiền xử lý, suy luận và hậu xử lý (section 1.4). Một mô hình có độ trễ suy luận 20 ms vẫn vượt ngân sách độ trễ pipeline 50 ms nếu tiền xử lý thêm 25 ms và hậu xử lý thêm 10 ms (tổng 55 ms). Vì vậy, tách rời phát triển mô hình khỏi thiết kế hệ thống sẽ lãng phí công sức vào độ chính xác mà bỏ qua tính khả thi khi triển khai.
Ngụy biện: Càng nhiều tài nguyên tính toán thì quá trình huấn luyện sẽ tự động nhanh hơn.
Các nhóm thường mua GPU đắt tiền với kỳ vọng hiệu suất tăng tương ứng, nhưng lưu lượng bộ nhớ hoặc chi phí khởi chạy có thể mới là yếu tố giới hạn. Arithmetic intensity giúp xác định tài nguyên đang gây nghẽn. Theo một mô hình lưu lượng đơn giản, trong đó tham số được đọc một lần và mỗi activation của mỗi batch được di chuyển một lần, lan truyền tiến (forward pass) của MNIST trong table 11 đạt xấp xỉ 12.4 FLOP/byte ở batch 32 và còn thấp hơn nữa ở batch 1. Con số này thấp hơn rất nhiều so với các điểm đỉnh của nhiều bộ tăng tốc có thông lượng cao. Mô hình Roofline trong Mô hình Roofline giải thích vì sao tăng thêm FLOP/s đỉnh cũng không giúp gì cho đến khi khối lượng công việc (workload) cung cấp đủ công việc có thể tái sử dụng trên mỗi byte dữ liệu. Cache, fusion, vectorization và chi phí khởi chạy khiến mức tăng tốc đo được mới là phép thử cuối cùng.
Cạm bẫy: Ngoại suy mức cải thiện độ chính xác mà không tính đến lợi ích giảm dần.
Các nhóm có thể ngoại suy mức tăng 5 điểm khi mở rộng từ 10 nghìn tham số lên 100 nghìn, rồi kỳ vọng thêm 5 điểm nữa khi lên 1 triệu. Tuy nhiên, trên thực tế, mức cải thiện sẽ giảm dần theo quy mô, tùy thuộc vào tác vụ, metric, chất lượng dữ liệu, họ mô hình và chế độ mở rộng (scaling regime). Trong table 5, các dòng về ImageNet cho thấy lỗi giảm từ 15,3% của AlexNet xuống 3,6% của ResNet-152, trong khi FLOPs dùng để huấn luyện tăng từ \(5 \times 10^{17}\) lên khoảng \(10^{19}\). Vì vậy, các nhóm cần đo lường lợi ích cận biên trong bối cảnh của chính mình thay vì ngoại suy tuyến tính.
Những ngụy biện và cạm bẫy này cùng xuất phát từ một điều: coi hành vi thống kê như thể chỉ do hành vi của mã quyết định. Nhận ra sớm sẽ giúp tập trung vào các phép đo và chẩn đoán phù hợp.
Self-Check: Question
An engineering team migrates a small multilayer perceptron inference workload with low arithmetic intensity from a CPU to a high-end GPU featuring \(10\times\) higher peak TFLOP/s, but observes less than a \(1.2\times\) end-to-end speedup. Which systems explanation correctly diagnoses this outcome?
- The workload has low arithmetic intensity (FLOPs per byte) and is memory bandwidth-bound, meaning execution time is dominated by streaming parameters and activations from memory rather than floating-point computation in ALUs.
- The GPU driver automatically converts floating-point matrix multiplications into sequential scalar instructions.
- Neural networks are prohibited from executing in parallel on GPUs if their parameter count is under one million.
- The loss function becomes non-differentiable when running on accelerator hardware.
On a fraud detection dataset where \(99.5\%\) of transactions are legitimate and \(0.5\%\) are fraudulent, a newly trained classifier achieves \(99.4\%\) aggregate accuracy on held-out test data. Why is this aggregate metric deceptive from an ML systems engineering standpoint?
- Cross-entropy loss is undefined when class proportions differ by more than \(10\times\).
- An accuracy of \(99.4\%\) exceeds the theoretical mathematical limit of floating-point representation.
- A naive baseline that blindly predicts ‘legitimate’ for every transaction achieves \(99.5\%\) accuracy; an aggregate \(99.4\%\) accuracy can conceal a near-\(100\%\) failure rate on detecting actual fraud cases.
- High accuracy on an imbalanced dataset causes immediate GPU out-of-memory errors during inference.
A development team attempts to improve model accuracy by repeatedly stacking additional layers to a neural network (scaling depth alone) without modifying layer widths or input resolution. Why does this depth-only scaling strategy typically suffer from diminishing returns and training instability?
- Adding layers automatically reduces total parameter count by compressing intermediate representations.
- Increasing depth alone elongates the backpropagation chain-rule path, amplifying vanishing and exploding gradient risks while increasing sequential execution latency, without providing the balanced capacity gains of compound scaling across width, depth, and resolution.
- Modern GPU hardware architectures cannot allocate computational graphs with more than 10 layers.
- Deeper networks are legally restricted from using nonlinear activation functions.
A colleague argues that ‘because neural networks contain millions of weights functioning as an uninterpretable black box, they cannot be systematically debugged when prediction errors occur.’ Refute this claim by describing three concrete systems diagnostic techniques used to debug neural models.
During a model training run, an engineer observes that training loss continuously decreases across 50 epochs, but validation loss reaches a minimum at epoch 20 and increases steadily thereafter. Diagnose the model’s operational regime and describe two systems interventions to resolve it.
True or False: For a tabular dataset with 500 records and linear relationships between features and targets, deploying a deep neural network is generally superior to a linear regression model because deep networks inherently generalize better across all problem scales.
Tóm tắt
Tính toán mạng nơ-ron chuyển các biểu thức toán học thành thao tác chạy trên máy. Đại số tuyến tính và giải tích xác định chi phí tính toán theo “định luật sắt” của hệ thống ML (\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\)). Lan truyền tiến xác lập khối lượng công việc tính toán \(O\), thường do các phép nhân ma trận chi phối; còn lan truyền ngược giữ lại một số giá trị trung gian và thêm gradient cùng trạng thái của optimizer. Dung lượng bộ nhớ \(D_{\text{vol}}\) phụ thuộc vào kiến trúc, kích thước batch, độ chính xác, optimizer và chiến lược tính toán lại. Những cơ chế này giúp ước lượng trước khi triển khai: dấu chân bộ nhớ, cường độ tính toán và các giới hạn độ trễ.
Mạng nơ-ron thay thế một số quy tắc quyết định và đặc trưng được thiết kế thủ công bằng các tham số học từ dữ liệu. Các phép tổng có trọng số, activation phi tuyến tính và học dựa trên gradient là những phép toán lặp lại cấu thành nhiều kiến trúc hiện đại.
Kiến trúc mạng nơ-ron thể hiện xử lý phân cấp, nơi các lớp có thể biến đổi đầu vào thô thành các biểu diễn hữu ích cho dự đoán. Huấn luyện điều chỉnh các trọng số kết nối thông qua tối ưu hóa lặp, còn suy luận áp dụng các tham số đã học cho dữ liệu mới. Hai giai đoạn này tạo ra các yêu cầu khác nhau về tính toán, bộ nhớ, thông lượng và độ trễ. Trong bảng tính FP32 rút gọn của chương này, một bước huấn luyện với kích thước batch 32 cần bộ nhớ gấp ~3.4× so với suy luận với batch 32 vì phải thêm gradient, trạng thái optimizer và các activation đã lưu; tỷ lệ này thay đổi theo optimizer, độ chính xác, checkpointing và kiến trúc. Nghiên cứu điển hình về nhận dạng tài liệu cho thấy các nguyên lý toán học này đi vào một pipeline sản xuất, trong đó tiền xử lý, suy luận nơ-ron, bước loại bỏ và hậu xử lý đều phải đáp ứng cùng một ngân sách độ trễ và độ tin cậy.
Key Takeaways: Toán học đằng sau mô hình
- Mỗi lần đổi cách tiếp cận đều làm thay đổi chi phí hệ thống cho việc biểu diễn: Trong ví dụ chữ số \(28{\times}28\) này, số lượng phép toán tăng từ khoảng ~100 comparisons (dựa trên quy tắc) qua ~8,000 operations (ML cổ điển) đến 109,184 MACs (deep learning)—một mức tăng gấp 1,091.8× lần trong kịch bản này, làm thay đổi các yêu cầu về phần cứng.
- Mạng nơ-ron học các biểu diễn từ dữ liệu: Các mạng này thay thế một số đặc trưng được mã hóa thủ công bằng các biểu diễn phân cấp học từ các ví dụ. Sự linh hoạt này chuyển gánh nặng sang việc có dữ liệu đủ đại diện, tính toán cho quá trình huấn luyện và bước xác thực.
- Huấn luyện và suy luận thường ưu tiên những mục tiêu khác nhau: Huấn luyện thường ưu tiên thông lượng hiệu quả qua các lần cập nhật lặp lại, trong khi suy luận trực tuyến (online inference) thường ưu tiên độ trễ cho từng yêu cầu; còn suy luận ngoại tuyến (offline inference) có thể ưu tiên thông lượng. Kích thước batch liên kết hiệu suất sử dụng, bộ nhớ, thông lượng, độ trễ và hành vi thống kê giữa các chế độ này.
- Các activation gắn với cả toán học lẫn phần cứng: ReLU thường rẻ hơn khi triển khai so với sigmoid hoặc tanh, và gradient đơn vị của nó với đầu vào dương giúp tránh bão hòa activation ở nhánh đó. Ưu thế thực tế của ReLU là sự kết hợp giữa chi phí triển khai và hành vi tối ưu hóa.
- Lan truyền xuôi thường xoay quanh công việc ma trận: Trong ví dụ mạng dày đặc của chương này, các nhân ma trận dày đặc chiếm hơn 90% tổng số FLOPs và chi phối nhiều khối lượng công việc (workload) quan trọng của mạng nơ-ron. Đây là lý do phần cứng ma trận chuyên dụng có thể vượt trội đáng kể so với thực thi đa năng cho các phép toán đó.
- Lan truyền ngược cần đường dẫn: Để giải quyết bài toán phân bổ công lao (credit assignment), cần giữ lại hoặc tính toán lại các giá trị dùng cho lượt truyền ngược, nên chi phí bộ nhớ thường quyết định liệu một mô hình có thể được huấn luyện trên một thiết bị cụ thể hay không, và thúc đẩy các kỹ thuật nhằm giảm, tính toán lại hoặc phân chia trạng thái huấn luyện.
- Toàn bộ pipeline ML quyết định hiệu suất từ đầu đến cuối: Các bước tiền xử lý, tính toán nơ-ron và hậu xử lý đều góp phần vào độ trễ và độ tin cậy. Các ví dụ về nhận dạng tài liệu cho thấy thành công trong môi trường thực tế phụ thuộc vào việc toàn bộ pipeline vận hành trong các ràng buộc thực tế, chứ không chỉ dựa vào độ chính xác của mô hình trên tập kiểm thử.
Ví dụ MNIST đã minh họa rõ ràng mức tăng này: cùng một chữ số 28 x 28 trước đây chỉ cần khoảng 100 comparisons thì nay lại đòi hỏi 109,184 MACs ngay cả trong một mạng ba lớp khiêm tốn—tăng gấp 1,091.8× lần, và xu hướng này khái quát cho các chiều hệ thống được trình bày trong table 3. Những nguyên lý cơ bản này chủ yếu phát triển trục thuật toán của phân loại D·A·M, đồng thời cho thấy cách các lựa chọn thuật toán lan sang các ràng buộc của máy.
Những hệ quả về toán học và hệ thống bộc lộ rõ trong các kiến trúc kết nối đầy đủ. Các perceptron đa lớp được khảo sát ở đây cho thấy một quy luật tài nguyên rõ ràng: kết nối dày đặc khiến cả lưu trữ tham số lẫn số phép nhân-tích lũy tăng theo kích thước các lớp liền kề. Sự linh hoạt này đi kèm với chi phí tính toán. Một ảnh MNIST 28 x 28 chứa 784 giá trị đầu vào, và lớp kết nối đầy đủ đầu tiên học 100,352 trọng số bằng cách nối mọi đầu vào với 128 nơ-ron. Kiểu kết nối dày đặc đó không giả định sẵn tính cục bộ theo không gian: mô hình phải học từ dữ liệu xem các quan hệ pixel gần và xa nào là quan trọng, đồng thời phải trả chi phí lưu trữ và tính cho mọi kết nối.
Những nền tảng này đặt ra ngôn ngữ toán học và hệ thống để suy luận về hành vi của mạng nơ-ron. Chu trình lan truyền tiến-lùi, lựa chọn hàm activation, và các đánh đổi giữa bộ nhớ và tính toán sẽ lặp lại xuyên suốt các chương tiếp theo—dù là khi phân tích vì sao một số kiến trúc huấn luyện nhanh hơn, vì sao các phép xấp xỉ độ chính xác thấp hơn vẫn giữ được độ chính xác ở một số lớp nhưng không ở lớp khác, hay vì sao huấn luyện trên nhiều máy đòi hỏi sự phối hợp cẩn thận. Hiểu vững những điều cơ bản này giúp kỹ sư không còn xem mạng nơ-ron như một hộp đen, mà tiến tới thiết kế hệ thống một cách có nguyên tắc.
Đọc mã cho thấy mạng nơ-ron được yêu cầu làm gì; đọc phần toán cho thấy cái giá phải trả để làm điều đó. Đó là lý do chương này tập trung vào số học. Mạng nơ-ron là điểm gặp giữa thuật toán và máy: trọng số phải được lưu và di chuyển, các lớp dày đặc ánh xạ thành phép toán ma trận, và các activation đã lưu chiếm bộ nhớ, có thể quyết định mô hình có đủ chỗ trong bộ nhớ hay không. Phần toán là nơi thuật toán ký “hợp đồng” với phần cứng, cam kết trước các phép toán mà máy phải thực thi. Đọc “hợp đồng” đó giúp kỹ sư ước tính các điểm nghẽn tiềm tàng, trước khi việc profiling xác nhận chỗ nào mạng chạy nhanh và chỗ nào bị tắc nghẽn.
What’s Next: Từ tổng quát đến chuyên dụng
Dựa trên phân loại hệ thống ở Hệ thống ML và các yêu cầu pipeline end-to-end trong Quy trình ML, chương này cho thấy các mạng kết nối đầy đủ tổng quát biến mỗi kết nối từ đầu vào đến nơ-ron thành lưu lượng bộ nhớ \(D_{\text{vol}}\) và khối lượng tính toán \(O\). Dữ liệu thực tế có cấu trúc có thể khai thác: hình ảnh thể hiện tính cục bộ theo không gian, văn bản chứa các phụ thuộc có thứ tự và theo ngữ cảnh, còn dữ liệu chuỗi thời gian có các mẫu theo thời gian. Kiến trúc mạng phát triển các kiến trúc chuyên biệt như tích chập và self-attention để mã hóa các giả định cấu trúc khác nhau. Những lựa chọn đó có thể giảm bớt một số công việc dư thừa hoặc cải thiện khả năng tái sử dụng, nhưng chúng cũng mang đến các đánh đổi mới về lưu trữ activation, truy cập bộ nhớ, cường độ số học và khả năng song song hóa trên bộ tăng tốc.
Self-Check: Question
What is the chapter’s fundamental conclusion regarding why machine learning systems engineers must understand the mathematical primitives inside neural networks?
- Because deployment failures are primarily syntax errors in framework Python code.
- Because systems engineers are expected to manually derive and hand-code backpropagation routines for every production model.
- Because mathematical operators (matrix multiplications, activations, loss functions, and gradients) establish the Silicon Contract—directly defining the operation count \(O\), memory volume \(D_{\text{vol}}\), numerical stability, and hardware utilization that govern physical execution.
- Because neural network architectures change too rapidly for hardware accelerators to support standardized linear algebra primitives.
Compare the systems priorities, memory demands, and optimization objectives of neural network training versus inference for the same model architecture.
In the iron law of ML systems (\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\)), the computational bargain where model architecture operators dictate the operation count \(O\) and memory volume \(D_{\text{vol}}\), while hardware and software determine realized bandwidth, latency, and throughput, is defined as the ____ contract.
Self-Check Answers
Self-Check: Answer
A team replaces a hand-coded digit recognition system (\(\approx 100\) conditional comparisons, \(784\text{ bytes}\) of working state) with a \(784 \to 128 \to 64 \to 10\) MLP (\(\approx 109{,}184\text{ MACs}\), \(\approx 438\text{ KB}\) of weights) on the same MNIST input. Which systems consequence should they expect when deploying this new model on a commodity CPU?
- The workload becomes dominated by branch mispredictions because artificial neurons execute frequent if-then branching decisions.
- The workload transitions from branch-heavy scalar code to dense matrix arithmetic whose weight footprint exceeds L1 cache capacity, generating cache-level memory traffic absent in the rule-based system.
- Execution memory traffic drops to zero because the \(438\text{ KB}\) weight footprint fits entirely within standard CPU register files.
- The model executes without using arithmetic logic units (ALUs) because learned representations bypass hardware compute pipelines.
Answer: The correct answer is B. Replacing rule-based logic with an MLP shifts the workload from branch-heavy scalar instructions to dense linear algebra (\(\approx 109{,}184\text{ MACs}\)). The \(\approx 438\text{ KB}\) parameter footprint exceeds typical CPU L1 data cache sizes (typically \(32\text{ KB}\) to \(48\text{ KB}\)), creating cache-level memory traffic to stream weights. Dense neural layers execute regular arithmetic without if-then branches, making branch prediction irrelevant. CPU register files hold at most a few kilobytes and cannot store hundreds of kilobytes of weights. Matrix arithmetic heavily utilizes ALU and SIMD execution units.
Learning Objective: Apply the MNIST paradigm workload numbers to predict the primary hardware bottleneck when switching from rule-based to dense neural computation
A hardware vendor claims that increasing single-threaded CPU clock frequencies by \(5\times\) will eliminate the necessity of specialized accelerators (such as GPUs or TPUs) for deep neural networks. Based on the computational profile of neural networks, what is the strongest technical refutation of this claim?
- Deep learning is dominated by massive parallel matrix multiplications bounded by arithmetic throughput and memory bandwidth, which benefit from thousands of parallel SIMD/tensor units rather than higher scalar clock speeds.
- Higher CPU clock frequencies force the loss function to become non-convex, destabilizing gradient descent.
- Modern neural networks require asynchronous analog circuits that cannot be simulated on digital CPU cores.
- Increasing CPU clock frequencies reduces the numerical precision of floating-point registers to 4-bit integers.
Answer: The correct answer is A. Neural network forward and backward passes consist of large-scale, uniform matrix-matrix and matrix-vector multiplications. These workloads are bounded by parallel arithmetic throughput and off-chip memory bandwidth (the Memory Wall). Accelerators succeed by providing thousands of arithmetic execution units and high-bandwidth memory (HBM), whereas raising scalar clock speed provides only linear improvement to sequential execution without increasing memory bandwidth or SIMD parallel width. The geometry of the loss surface is an algorithmic property independent of processor frequency. Neural networks execute on digital floating-point hardware. Clock frequency scaling does not alter IEEE floating-point precision.
Learning Objective: Evaluate why parallel matrix arithmetic maps to specialized accelerator architectures rather than higher-frequency scalar processors
A computer vision team evaluates two approaches for a multi-class recognition task: (a) a handcrafted feature pipeline (e.g. HOG + SVM) and (b) an end-to-end convolutional neural network. Compare the systems engineering trade-offs between these two approaches when the product must scale from 2 initial categories to 50 diverse object categories.
Answer: Handcrafted feature pipelines (HOG + SVM) offer low per-image inference compute but require extensive manual engineering to design and tune descriptors for new object classes, creating a human labor bottleneck and fragmented preprocessing code. End-to-end neural networks automate feature discovery by learning hierarchical representations directly from data using uniform tensor operations, replacing ongoing feature-engineering labor with increased training data collection, accelerator compute requirements, and memory bandwidth demands.
Learning Objective: Compare the systems and maintenance trade-offs of handcrafted feature engineering against end-to-end learned representations
Explain the systems-level concept of the ‘algorithm-hardware adoption lag’ using the historical trajectory of backpropagation (Werbos 1974 / Rumelhart et al. 1986) and modern deep learning. What three converging factors were necessary for the algorithm to achieve widespread practical viability?
Answer: An algorithm can be theoretically viable long before surrounding systems make it practical. Backpropagation was established in the 1970s and 1980s, but scaling it required three converging factors: (1) high-throughput parallel compute hardware (GPUs/TPUs) capable of executing billions of MACs efficiently, (2) large-scale labeled datasets (such as ImageNet) to train high-capacity models without overfitting, and (3) optimized software ecosystems (automatic differentiation frameworks, BLAS/cuBLAS libraries) that bridged abstract math to physical silicon.
Learning Objective: Explain how the co-evolution of hardware, datasets, and software infrastructure resolves algorithm-hardware adoption lags
True or False: The artificial neuron is an exact biological model that reproduces the electrochemical ion channels and temporal spike-timing dynamics of human cortical neurons in digital silicon.
Answer: False. The artificial neuron is a severe mathematical abstraction that distills biological neural structures into weighted linear sums, scalar bias additions, and continuous activation functions (\(\mathbf{z} = \mathbf{x}\mathbf{W} + \mathbf{b}\)). It completely discards electrochemistry, dendritic morphology, and temporal spike dynamics in favor of uniform linear algebra that maps efficiently onto digital matrix-multiplication hardware.
Learning Objective: Compare the mathematical abstraction of an artificial neuron with biological neural mechanisms
Order the historical evolution of pattern-computing paradigms and milestones from earliest to latest: (1) Deep learning with automatic hierarchical feature discovery on parallel accelerators, (2) Rule-based programming with explicit hand-authored logical branches, (3) The Rosenblatt single-layer Perceptron, (4) Classical machine learning pairing hand-engineered feature extractors (e.g. HOG/SIFT) with statistical classifiers.
Answer: The correct order is: (2) Rule-based programming with explicit hand-authored logical branches, (3) The Rosenblatt single-layer Perceptron, (4) Classical machine learning pairing hand-engineered feature extractors (e.g. HOG/SIFT) with statistical classifiers, (1) Deep learning with automatic hierarchical feature discovery on parallel accelerators. Early computing and AI relied on hand-coded deductive rules (2); the 1950s Perceptron introduced early linear threshold learning on dedicated hardware (3); classical ML in the 1990s-2000s scaled recognition by combining domain-expert feature descriptors with statistical models (4); and modern deep learning replaced manual feature engineering with end-to-end representation learning powered by parallel accelerator hardware (1).
Learning Objective: Classify the historical progression of pattern computation paradigms from explicit logic to automatic deep representations
Self-Check: Answer
In a fully connected multilayer perceptron with layer dimensions \(784 \to 128 \to 64 \to 10\), which layer represents the primary parameter storage and computational hotspot, and what is its weight parameter count?
- The \(64 \to 10\) output layer with \(640\) weights, because the softmax denominator forces quadratic parameter expansion.
- The \(128 \to 64\) hidden layer with \(8{,}192\) weights, because it bridges intermediate representations.
- The \(784 \to 128\) input layer with \(100{,}352\) weights (\(784 \times 128\)), accounting for over \(91\%\) of the network’s total weight parameters and forward MACs.
- All three layers have identical parameter counts because linear algebra kernels require static square matrix padding.
Answer: The correct answer is C. The first dense layer connects 784 inputs to 128 hidden neurons, requiring \(784 \times 128 = 100{,}352\) weights. The second layer requires \(128 \times 64 = 8{,}192\) weights, and the output layer requires \(64 \times 10 = 640\) weights (totaling \(109{,}184\) weights). The first layer accounts for over \(91\%\) of the weights and forward multiply-accumulate operations. The output layer contains only 640 weights, and softmax normalization does not add weights. The second layer contains less than one-tenth the parameters of the first. Layer dimensions reflect actual weight matrices rather than mandatory square padding.
Learning Objective: Calculate and identify the parameter and computational hotspots across layers of a fully connected neural network
From a hardware and systems engineering perspective, why has the Rectified Linear Unit (\(\text{ReLU}(z) = \max(0, z)\)) largely replaced Sigmoid (\(\sigma(z) = \frac{1}{1 + e^{-z}}\)) in deep hidden layers?
- ReLU bounds activation outputs strictly within \([0, 1]\), completely eliminating register overflow.
- ReLU requires only a simple comparison/max operation without expensive transcendental exponentiations and maintains a constant derivative of \(1\) for positive inputs, avoiding gradient saturation in deep networks.
- Sigmoid requires analog neuromorphic circuits, whereas ReLU executes natively on digital ALUs.
- ReLU eliminates the need for backpropagation by calculating parameter updates directly during the forward pass.
Answer: The correct answer is B. ReLU replaces transcendental exponentiations (\(e^{-z}\)) and divisions with a single hardware comparison/max operation, saving silicon area and execution cycles. Furthermore, for all positive preactivations (\(z > 0\)), ReLU’s derivative is exactly 1, preventing the gradient vanishing caused by Sigmoid’s maximum derivative of \(0.25\). ReLU is unbounded above for positive inputs rather than bounded in \([0, 1]\). Sigmoid runs on standard digital hardware rather than requiring neuromorphic circuits. ReLU still requires standard backpropagation to compute parameter updates.
Learning Objective: Compare activation functions by analyzing their hardware implementation complexity and gradient flow characteristics
Explain why stacking multiple linear layers without nonlinear activation functions (\(\mathbf{y} = \mathbf{x} \mathbf{W}_1 \mathbf{W}_2 \mathbf{W}_3\)) fails to increase the expressive capacity of a neural network, and identify the systems inefficiency caused by such an architecture.
Answer: Because matrix multiplication is associative, the composition of multiple linear transformations algebraically collapses into a single linear transformation \(\mathbf{W}_{\text{eff}} = \mathbf{W}_1 \mathbf{W}_2 \mathbf{W}_3\). As a result, the deep linear network can express only linear decision boundaries (failing even on simple nonlinearly separable problems like XOR). From a systems perspective, intermediate layers waste memory bandwidth and compute operations calculating intermediate matrix products that add redundant parameters without expanding representational capacity.
Learning Objective: Explain why nonlinear activation functions are required for representational capacity and evaluate the systems cost of unactivated linear layers
True or False: For compositional target functions where complex patterns decompose hierarchically into reusable sub-patterns, deep networks can represent the function with polynomially many layers and parameters, whereas a shallow two-layer network may require exponentially many neurons to achieve the same expressiveness.
Answer: True. Deep architectures exploit compositionality by reusing learned intermediate features (e.g. low-level edges composing into shapes, which compose into parts and objects). For compositional function classes, hierarchical feature reuse enables compact representations with polynomial parameters, whereas a shallow wide network with only a single hidden layer must independently memorize all input combinations, requiring an exponential number of hidden units.
Learning Objective: Justify how hierarchical feature reuse provides depth with a parameter-efficiency advantage for compositional function classes
In hardware accelerators for neural networks, calculating transcendental functions such as exponentials and divisions in Sigmoid or Softmax activations requires dedicated multi-cycle approximation units or lookup tables, imposing a silicon area and energy cost often referred to as the silicon ____.
Answer: tax (or silicon tax). Computing transcendental functions like \(e^z\) or \(\frac{1}{1+e^{-z}}\) requires iterative algorithms (such as CORDIC or Taylor polynomial expansions) or large lookup tables, consuming substantial silicon area and energy compared to simple single-cycle operations like \(\text{ReLU}(z) = \max(0, z)\).
Learning Objective: Explain the hardware implementation penalty associated with transcendental activation functions
Order the computational and memory staging steps required to execute the forward pass of a single dense hidden layer for a batch of input tokens: (1) Apply the element-wise nonlinear activation function (e.g. ReLU) to preactivations, (2) Load the input activation matrix \(\mathbf{X}\) and layer weight matrix \(\mathbf{W}\) into execution registers/caches, (3) Perform the dense matrix multiplication \(\mathbf{X}\mathbf{W}\), (4) Broadcast and add the bias vector \(\mathbf{b}\) to obtain layer preactivations \(\mathbf{Z}\).
Answer: The correct order is: (2) Load the input activation matrix \(\mathbf{X}\) and layer weight matrix \(\mathbf{W}\) into execution registers/caches, (3) Perform the dense matrix multiplication \(\mathbf{X}\mathbf{W}\), (4) Broadcast and add the bias vector \(\mathbf{b}\) to obtain layer preactivations \(\mathbf{Z}\), (1) Apply the element-wise nonlinear activation function (e.g. ReLU) to preactivations. Operands must first be staged from memory into caches and processor registers (2); the compute cores then execute the matrix-matrix multiply-accumulate operations (3); the bias vector is broadcast and added to form preactivations \(\mathbf{Z} = \mathbf{X}\mathbf{W} + \mathbf{b}\) (4); and finally the nonlinear activation function is applied element-wise to generate the layer output activations \(\mathbf{A} = \sigma(\mathbf{Z})\) (1).
Learning Objective: Analyze the execution sequence of computational and memory staging steps in a dense layer forward pass
Self-Check: Answer
A classification model trained with softmax cross-entropy outputs a predicted probability \(\hat{y}_c = 0.99\) for the correct target class on Example 1, and outputs \(\hat{y}_c = 0.01\) for the correct class on Example 2. Based on the definition of cross-entropy loss (\(\mathcal{L} = -\log(\hat{y}_c)\)) and the combined softmax cross-entropy logit gradient (\(\frac{\partial \mathcal{L}}{\partial z_c} = \hat{y}_c - 1\)), what are the relative loss values and gradient magnitudes for these two examples?
- Example 1 produces loss \(\approx 4.61\) and logit gradient \(-0.99\), while Example 2 produces loss \(\approx 0.01\) and logit gradient \(-0.01\).
- Both examples generate identical gradient magnitudes because softmax normalization forces the sum of class gradients to equal zero.
- Example 2 produces negative loss because probabilities below \(0.5\) invert the sign of the cross-entropy objective.
- Example 2 produces high loss (\(-\log(0.01) \approx 4.61\)) and an error gradient of \(0.01 - 1 = -0.99\), while Example 1 produces near-zero loss (\(-\log(0.99) \approx 0.01\)) and an error gradient of \(0.99 - 1 = -0.01\), yielding an error signal roughly \(99\times\) stronger on the misclassified example.
Answer: The correct answer is D. Cross-entropy loss is \(-\log(\hat{y}_c)\). For Example 2, \(-\log(0.01) \approx 4.61\) and its logit gradient is \(\hat{y}_c - 1 = 0.01 - 1 = -0.99\). For Example 1, \(-\log(0.99) \approx 0.010\) and its logit gradient is \(0.99 - 1 = -0.01\). The misclassified example generates a loss over \(400\times\) higher and an update gradient magnitude \(99\times\) stronger than the confident correct prediction. Reversing the loss values confuses high error with correct classification. Softmax probabilities sum to 1 across classes for an individual sample, but gradients on different samples depend on model confidence. Logarithmic cross-entropy on probabilities in \([0, 1]\) is strictly non-negative.
Learning Objective: Calculate and interpret the loss values and gradient signals produced by softmax cross-entropy on confident versus misclassified examples
What is the primary computational complexity advantage of reverse-mode automatic differentiation (backpropagation) over numerical differentiation (finite differences) when training a neural network with \(P\) parameters?
- Backpropagation computes exact gradients for all \(P\) parameters in a single reverse graph traversal costing approximately \(2\times\) forward-pass FLOPs, whereas numerical differentiation requires \(P\) separate forward passes costing \(\mathcal{O}(P \times \text{graph})\).
- Numerical differentiation is unstable for integer parameters, while backpropagation converts all tensors to complex numbers.
- Backpropagation eliminates the requirement to store or cache intermediate activations from the forward pass.
- Reverse-mode automatic differentiation executes without using the mathematical chain rule.
Answer: The correct answer is A. Reverse-mode automatic differentiation (backpropagation) applies the chain rule in a single backward sweep, computing gradients with respect to all \(P\) parameters simultaneously with a computational cost proportional to the graph size (roughly \(2\times\) forward FLOPs). Numerical differentiation requires perturbing each parameter individually and evaluating the entire network, scaling as \(\mathcal{O}(P \times \text{graph})\)—which is computationally intractable for networks with millions or billions of parameters. Differentiation applies to continuous parameters rather than complex-number conversions. Backpropagation specifically requires caching intermediate forward activations to evaluate derivatives during the reverse pass. Backpropagation fundamentally relies on the chain rule.
Learning Objective: Compare reverse-mode automatic differentiation to numerical differentiation in terms of computational complexity and graph traversal
Distinguish between backpropagation** and gradient descent (the optimizer) in terms of their computational roles and memory requirements during training.**
Answer: Backpropagation is a gradient-computation algorithm that applies the chain rule across the computational graph in reverse; its memory requirement is determined by retaining (or recomputing) intermediate forward-pass activations (\(\mathcal{O}(B \sum n_\ell)\)). Gradient descent (and optimizers like Adam) is the parameter update algorithm that consumes those gradients; its memory requirement is determined by maintaining optimizer state tensors, such as momentum buffers, second-moment estimates, and FP32 master weights.
Learning Objective: Compare backpropagation and gradient descent in terms of computational execution and memory footprint
Explain why the peak memory footprint during model training significantly exceeds the memory footprint during inference for the same model architecture and batch size. Identify the three major tensor categories present during training that are absent during inference.
Answer: Inference requires memory only for model parameters and a small rotating buffer for the current layer’s activations. Training requires substantially more memory because it must store: (1) intermediate forward-pass activation tensors across all layers to evaluate chain-rule derivatives during backpropagation, (2) gradient tensors matching the shape of all trainable parameters, and (3) optimizer state buffers (such as Adam’s first and second momentum vectors and FP32 master weights, which can add \(2\times\) to \(4\times\) the parameter footprint).
Learning Objective: Analyze why training memory exceeds inference memory by decomposing the training memory ledger into activations, gradients, and optimizer state
True or False: In deep neural networks, vanishing gradients occur when multiplying chains of layer-wise Jacobian matrices and activation derivatives during backpropagation, causing early-layer gradients to diminish exponentially as network depth increases.
Answer: True. Backpropagation applies the chain rule multiplicatively across layers (\(\frac{\partial \mathcal{L}}{\partial \mathbf{a}_1} = \frac{\partial \mathcal{L}}{\partial \mathbf{a}_L} \prod_{\ell=2}^L \mathbf{J}_\ell\)). When using activation functions with derivative magnitudes strictly less than 1 (such as Sigmoid, where \(\sigma'(z) \le 0.25\), yielding \(\le 0.25^{20} \approx 10^{-12}\) over 20 layers), the compounded product causes error signals to decay exponentially toward zero before reaching the earliest layers.
Learning Objective: Explain the numerical mechanism of vanishing gradients as an exponential chain-rule decay with depth
Order the computational phases executed within a single supervised mini-batch training step: (1) Update model weights using the optimizer update rule, (2) Evaluate the loss function by comparing predictions to ground-truth labels, (3) Perform the forward pass to compute layer activations and predictions, (4) Execute backpropagation via the chain rule to compute parameter gradients.
Answer: The correct order is: (3) Perform the forward pass to compute layer activations and predictions, (2) Evaluate the loss function by comparing predictions to ground-truth labels, (4) Execute backpropagation via the chain rule to compute parameter gradients, (1) Update model weights using the optimizer update rule. The forward pass (3) must first compute output predictions and cache intermediate activations; the loss function (2) then compares these predictions against target labels to produce a scalar error; backpropagation (4) traverses the graph in reverse from the loss to compute gradients for all parameters; and finally the optimizer (1) applies the weight update rule using the newly computed gradients.
Learning Objective: Analyze the four sequential phases of a supervised training iteration and justify their causal dependencies
Self-Check: Answer
A real-time voice transcription service has a strict p99 end-to-end latency budget of \(50\text{ ms}\). In configuring the serving infrastructure for the acoustic model, which batching strategy best aligns with this requirement?
- Batch size 512, because maximizing accelerator compute utilization is the primary metric for latency-critical SLOs.
- Dynamic queueing that buffers incoming audio requests until at least 64 concurrent streams are assembled.
- Batch size 1 (single-item serving) or very small micro-batches, trading lower hardware utilization for minimal request queueing delay.
- Asynchronous gradient accumulation that processes inputs in the background.
Answer: The correct answer is C. In latency-critical real-time systems, waiting to assemble large batches introduces request queueing latency that violates tight deadlines. Single-item (batch size 1) or minimal micro-batching processes requests immediately upon arrival, trading lower hardware compute efficiency for minimized response latency. Large batch sizes maximize throughput at the cost of queueing delay. Buffering to reach 64 streams introduces unacceptable latency. Gradient accumulation is a training technique for simulating large batches and does not apply to inference serving.
Learning Objective: Evaluate an inference batching policy to align with low-latency real-time SLOs versus high-throughput batch processing
Why can an inference serving runtime for a sequential feed-forward network achieve a significantly smaller memory footprint than a training runtime for the exact same model architecture, beyond the omission of optimizer states and gradients?
- Inference converts all parameter tensors into single-bit binary hash tables.
- Inference requires no backward pass, allowing intermediate activation buffers to be immediately recycled or overwritten once their single downstream consumer layer finishes execution.
- Inference executes all network layers simultaneously in parallel, eliminating the need for intermediate buffers.
- Inference executes exclusively within on-chip CPU registers, bypassing main memory completely.
Answer: The correct answer is B. During training, all intermediate activations must be retained throughout the forward pass to be consumed by the backward pass. During inference, because there is no backward pass, an activation tensor is no longer needed once its downstream consuming layer has computed its output. The serving engine can therefore recycle memory using a ping-pong buffer of just two activation tensors for a sequential graph. Model weights are stored in standard floating-point or quantized formats rather than single-bit hashes. Sequential layers have data dependencies and cannot execute concurrently without inputs. Intermediate buffers reside in device memory rather than fitting entirely in registers.
Learning Objective: Explain how intermediate activation buffer recycling reduces peak memory consumption during inference
Why is reduced numerical precision (such as 8-bit integer quantization, INT8) generally much more practical to deploy during inference than during model training?
- Inference performs a single forward evaluation without weight updates, so rounding errors do not compound, whereas training accumulates gradient precision errors across tens of thousands of iterative parameter updates.
- Quantization increases model parameter counts to compensate for reduced numerical precision.
- INT8 arithmetic is slower than FP32 on modern tensor accelerators, making it undesirable during training.
- Quantization replaces nonlinear activation functions with linear identity mappings.
Answer: The correct answer is A. During training, parameters are iteratively updated by small gradient steps; low numerical precision can cause gradient underflow, catastrophic cancellation, and rounding errors that compound over thousands of steps, destabilizing convergence. In contrast, inference executes a single forward pass where small quantization perturbations produce minor shifts in output logits that rarely alter the final classification decision. Quantization decreases bitwidth per parameter without changing the parameter count. INT8 matrix operations execute significantly faster and with higher memory bandwidth efficiency than FP32 on modern tensor hardware. Quantization scales tensor representations without altering activation function mathematics.
Learning Objective: Justify why neural networks tolerate lower numerical precision during inference compared to iterative training
A computer vision inference service has a target p99 latency SLO of \(100\text{ ms}\). Profiling reveals: image JPEG decoding takes \(45\text{ ms}\), resizing and normalization take \(30\text{ ms}\), neural network inference takes \(15\text{ ms}\), and JSON response serialization takes \(25\text{ ms}\) (total \(115\text{ ms}\)). Explain why compressing the neural model by \(2\times\) will fail to meet the SLO, and state the highest-leverage engineering intervention.
Answer: Model inference accounts for only \(15\text{ ms}\) of the \(115\text{ ms}\) total pipeline latency (\(13\%\)). Per Amdahl’s law, a \(2\times\) model compression saves only \(7.5\text{ ms}\), resulting in an end-to-end latency of \(107.5\text{ ms}\) which still violates the \(100\text{ ms}\) SLO. The non-neural stages (JPEG decoding and preprocessing) consume \(75\text{ ms}\) (\(65\%\) of total time); the highest-leverage intervention is optimizing these stages, such as by offloading JPEG decoding and tensor resizing to hardware accelerators or GPU preprocessing pipelines.
Learning Objective: Analyze end-to-end inference latency bottlenecks by evaluating the non-neural pipeline stages against Amdahl’s law
True or False: Applying the softmax function \(\hat{y}_i = \frac{e^{z_i}}{\sum_j e^{z_j}}\) to raw neural network output logits alters the argmax classification decision, meaning the class with the highest raw logit is not guaranteed to have the highest predicted probability.
Answer: False. Because the exponential function \(e^z\) is strictly monotonically increasing, applying softmax preserves the exact relative ranking of all logits: \(\arg\max_i(z_i) = \arg\max_i(\hat{y}_i)\). Softmax scales logits into a normalized probability distribution summing to 1, but it never alters which class has the highest value or changes the top-1 prediction.
Learning Objective: Explain the monotonicity property of the softmax function and its impact on classification decision-making
In high-reliability inference pipelines, when the model’s highest predicted probability falls below a predetermined confidence ____, the system triggers an abstention or routes the transaction to human review to prevent automated errors.
Answer: threshold (or decision threshold / rejection threshold). A confidence threshold enables an inference pipeline to reject ambiguous, low-certainty predictions (abstention), trading automation coverage to maintain low production error rates.
Learning Objective: Apply confidence thresholding to manage the trade-off between automated decision coverage and prediction error
Self-Check: Answer
Which set of operational performance metrics accurately matches the benchmark results reported for the 1989 USPS handwritten digit recognition prototype developed by LeCun et al.?
- \(0\%\) error rate at \(0\%\) rejection rate, processing over \(1{,}000\) mailpieces per second.
- \(10\%\) error rate at \(50\%\) rejection rate, operating exclusively as an offline batch indexing system.
- \(5\%\) error rate at \(2\%\) rejection rate, requiring human video coding for every mailpiece.
- \(1\%\) error rate achieved at a \(12.1\%\) rejection rate, processing \(10\text{–}12\) classifications per second end-to-end and over \(30\) digits per second on pre-normalized inputs.
Answer: The correct answer is D. The 1989 USPS prototype paper reported achieving a \(1\%\) error rate when rejecting \(12.1\%\) of ambiguous digits for manual review, with an end-to-end throughput of \(10\text{–}12\) digits per second and over \(30\) digits per second on pre-normalized inputs. Zero error with zero rejection is unachievable on noisy real-world postal data. A 10% error rate at 50% rejection represents an unacceptable operational failure. Requiring human video coding for every mailpiece defeats the purpose of postal automation.
Learning Objective: Calculate the quantitative accuracy, rejection, and throughput benchmarks achieved by the 1989 USPS digit recognition system
The chapter presents an illustrative ‘Then vs. Now’ comparison showing that running the 1989 LeNet architecture on modern edge silicon achieves \(\approx 1{,}000\times\) lower latency and \(\approx 20{,}000\times\) lower energy per inference. What is the fundamental systems engineering takeaway from this analysis?
- The algorithmic model was completely redesigned, accounting for all observed throughput gains.
- Semiconductor and accelerator advances multiplied the viable deployment envelope of the same neural computation, while core pipeline principles (preprocess, infer, threshold, route) remained durable.
- Modern edge accelerators eliminate the need for confidence thresholds and manual human review.
- Optical scanning and digit segmentation preprocessing are no longer necessary on modern hardware.
Answer: The correct answer is B. The comparison evaluates unchanged LeNet weights on modern silicon, showing that hardware progress expanded the deployment envelope by orders of magnitude while the fundamental pipeline structure (capture, preprocess, infer, reject, route) remained necessary. The weights and algorithm were held constant in the comparison. Real-world ambiguity still requires confidence thresholding and human fallback. Physical mail sorting still requires image capture, binarization, and segmentation regardless of accelerator speed.
Learning Objective: Evaluate how hardware progress expands the deployment envelope of neural algorithms while core pipeline architecture remains durable
In the USPS postal sorting pipeline, explain why setting the rejection threshold to zero (forcing an automated prediction on \(100\%\) of mailpieces) is economically and operationally undesirable.
Answer: Setting the rejection threshold to zero forces the model to classify ambiguous, degraded, or poorly written digits where prediction confidence is low. While this achieves \(100\%\) automated coverage, it sharply increases the misclassification error rate, routing mail to incorrect postal destinations—which incurs far higher correction, re-handling, and delay costs than routing the \(\approx 12\%\) most uncertain digits to human video coding for review.
Learning Objective: Analyze the operational and economic trade-off between automated rejection rates and misclassification error in production systems
Describe how the 1989 USPS digit recognition system decomposed the document recognition challenge into a multi-stage pipeline, and explain why the neural classifier alone was not sufficient.
Answer: The production system required an integrated pipeline: (1) optical scanning of envelopes, (2) image binarization and ZIP code region localization, (3) digit segmentation and scale normalization, (4) convolutional neural network inference (LeNet), (5) confidence thresholding to accept or reject predictions, and (6) mechanical bin sorting or human routing. The neural classifier alone could not process unsegmented full envelopes or control postal mechanics; overall system success required every stage to operate within strict error and latency budgets.
Learning Objective: Explain why production document recognition requires an integrated multi-stage pipeline surrounding the neural network classifier
In the USPS document recognition pipeline, the preprocessing operation that isolates individual handwritten character bounding boxes from a continuous multi-digit ZIP code block is termed digit ____.
Answer: segmentation (or character segmentation). Digit segmentation extracts individual character images from the continuous ZIP code region so they can be normalized to standard dimensions (e.g. \(16\times16\) or \(28\times28\)) and evaluated by the neural network.
Learning Objective: Explain the role of digit segmentation in preparing raw image data for neural network inference
Order the physical and computational stages of the end-to-end USPS mail sorting pipeline: (1) Route accepted mail to physical sorting bins or rejected mail to human review, (2) Evaluate confidence thresholds on model output probabilities to accept or reject predictions, (3) Optically scan the mailpiece envelope to capture raw image data, (4) Execute neural network forward inference on normalized digit tensors, (5) Locate the ZIP code region, segment individual digits, and scale-normalize them.
Answer: The correct order is: (3) Optically scan the mailpiece envelope to capture raw image data, (5) Locate the ZIP code region, segment individual digits, and scale-normalize them, (4) Execute neural network forward inference on normalized digit tensors, (2) Evaluate confidence thresholds on model output probabilities to accept or reject predictions, (1) Route accepted mail to physical sorting bins or rejected mail to human review. The envelope must first be optically scanned (3); computer vision algorithms then locate, segment, and normalize individual digit images (5); the neural network runs inference on the normalized tensors (4); confidence scoring determines whether predictions meet the reliability threshold (2); and the mechanical sorter routes the mailpiece to destination bins or human review (1).
Learning Objective: Classify the sequential stages of an end-to-end automated postal mail sorting pipeline
Self-Check: Answer
Under the D·A·M (Data, Algorithm, Machine) taxonomy presented in the chapter, which statement correctly describes the primary responsibility of each axis and their systems interplay?
- Data determines GPU clock speed, Algorithm dictates physical memory capacity, and Machine formats training labels.
- Algorithm determines whether data is collected, Machine ensures 100% training accuracy, and Data operates independently of both.
- Data, Algorithm, and Machine can be optimized independently without cross-axis trade-offs.
- Algorithm defines computational transformations and capacity, Data determines whether the model can learn the task from representative evidence, and Machine determines whether those operations execute within latency, throughput, memory, and energy budgets.
Answer: The correct answer is D. The D·A·M taxonomy assigns computational structure and hypothesis class to Algorithm, statistical evidence and learnability to Data, and execution efficiency, throughput, memory, and energy to Machine. Deep learning systems succeed only when all three axes align. Cross-assigning hardware constraints to data and algorithms misclassifies axis responsibilities. Asserting guaranteed 100% accuracy ignores statistical learning limitations. Claiming the axes can be optimized independently contradicts the core thesis that changes on one axis (such as increasing model width or batch size) directly impact the others.
Learning Objective: Classify the distinct responsibilities of the Data, Algorithm, and Machine axes within the D·A·M taxonomy
A computer vision model deployed in production exhibits high accuracy during offline benchmark evaluations but suffers severe error rates on live camera feeds, while hardware GPU utilization is only \(15\%\). Use the D·A·M taxonomy to outline a structured diagnostic sequence to isolate the root causes.
Answer: First, investigate the Data axis by comparing live camera feeds against training data to identify distribution shift (lighting, blur, camera angles) or missing classes causing the accuracy drop. Second, investigate the Machine and Algorithm axes by profiling data ingestion pipelines, CPU-side image decoding, and batch sizes to determine why GPU compute units are starved of work (e.g. I/O bottlenecks or un-batched kernel launches). The D·A·M framework separates statistical data mismatches from computational execution bottlenecks.
Learning Objective: Apply the D·A·M taxonomy to systematically diagnose accuracy drops and hardware underutilization in deployed ML systems
According to the D·A·M taxonomy, if a deployed computer vision model suffers elevated error rates in production due to a distribution shift in ambient lighting and camera angles, why will scaling the Machine axis (allocating a larger cluster of faster GPUs) fail to resolve the operational failure?
- Hardware accelerators automatically reduce optimizer learning rates when cluster size increases.
- Faster GPU accelerators cannot process image tensors captured at non-standard aspect ratios.
- Machine scaling accelerates computational throughput but cannot supply the missing visual patterns or domain coverage required on the Data axis to learn the shifted distribution.
- The D·A·M framework requires all production deployments to execute on single-thread CPU cores.
Answer: The correct answer is C. The failure stems from the Data axis (unrepresented deployment lighting conditions and covariate shift). Allocating additional compute hardware on the Machine axis merely executes the training of an unrepresentative model faster without correcting the underlying data deficiency. Hardware accelerators do not alter optimizer learning rates automatically. GPU kernels process arbitrary tensor shapes and aspect ratios. The D·A·M taxonomy provides an analysis framework and does not mandate specific hardware platforms.
Learning Objective: Justify why hardware scaling alone cannot resolve data distribution or algorithmic modeling deficiencies
Self-Check: Answer
An engineering team migrates a small multilayer perceptron inference workload with low arithmetic intensity from a CPU to a high-end GPU featuring \(10\times\) higher peak TFLOP/s, but observes less than a \(1.2\times\) end-to-end speedup. Which systems explanation correctly diagnoses this outcome?
- The workload has low arithmetic intensity (FLOPs per byte) and is memory bandwidth-bound, meaning execution time is dominated by streaming parameters and activations from memory rather than floating-point computation in ALUs.
- The GPU driver automatically converts floating-point matrix multiplications into sequential scalar instructions.
- Neural networks are prohibited from executing in parallel on GPUs if their parameter count is under one million.
- The loss function becomes non-differentiable when running on accelerator hardware.
Answer: The correct answer is A. Peak compute throughput (TFLOP/s) can only be realized when a workload has sufficient arithmetic intensity (operational intensity) to saturate compute pipelines. Small MLPs with small batch sizes have low arithmetic intensity and are memory bandwidth-bound: the execution time is governed by the memory volume term \(\frac{D_{\text{vol}}}{\text{BW}}\) rather than the compute term \(\frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\). GPU drivers execute floating-point linear algebra directly on vector/tensor cores rather than converting to sequential instructions. Small models run in parallel on GPUs although low thread occupancy limits efficiency. Hardware execution does not alter mathematical loss differentiability.
Learning Objective: Evaluate why high-peak-compute accelerators fail to provide proportional speedups on memory-bandwidth-bound workloads
On a fraud detection dataset where \(99.5\%\) of transactions are legitimate and \(0.5\%\) are fraudulent, a newly trained classifier achieves \(99.4\%\) aggregate accuracy on held-out test data. Why is this aggregate metric deceptive from an ML systems engineering standpoint?
- Cross-entropy loss is undefined when class proportions differ by more than \(10\times\).
- An accuracy of \(99.4\%\) exceeds the theoretical mathematical limit of floating-point representation.
- A naive baseline that blindly predicts ‘legitimate’ for every transaction achieves \(99.5\%\) accuracy; an aggregate \(99.4\%\) accuracy can conceal a near-\(100\%\) failure rate on detecting actual fraud cases.
- High accuracy on an imbalanced dataset causes immediate GPU out-of-memory errors during inference.
Answer: The correct answer is C. On highly imbalanced datasets, aggregate accuracy is dominated by the majority class. A trivial constant predictor that always predicts the majority class achieves \(99.5\%\) accuracy without detecting a single fraudulent transaction; thus, \(99.4\%\) accuracy could represent a model that fails on almost every fraud instance. Systems engineers must evaluate class-specific metrics such as precision, recall, and confusion matrices. Cross-entropy is mathematically well-defined regardless of class proportions. A 99.4% accuracy is a standard statistical proportion well within floating-point ranges. Accuracy metrics do not cause GPU memory exhaustion.
Learning Objective: Evaluate the failure of aggregate accuracy on imbalanced datasets and justify the requirement for class-specific metrics
A development team attempts to improve model accuracy by repeatedly stacking additional layers to a neural network (scaling depth alone) without modifying layer widths or input resolution. Why does this depth-only scaling strategy typically suffer from diminishing returns and training instability?
- Adding layers automatically reduces total parameter count by compressing intermediate representations.
- Increasing depth alone elongates the backpropagation chain-rule path, amplifying vanishing and exploding gradient risks while increasing sequential execution latency, without providing the balanced capacity gains of compound scaling across width, depth, and resolution.
- Modern GPU hardware architectures cannot allocate computational graphs with more than 10 layers.
- Deeper networks are legally restricted from using nonlinear activation functions.
Answer: The correct answer is B. Stacking layers increases the chain-rule path length during backpropagation, compounding vanishing/exploding gradients and making optimization increasingly difficult. Furthermore, depth increases sequential dependency chains during the forward pass, raising latency. Empirical systems research demonstrates that compound scaling (co-scaling depth, width, and input resolution) provides superior accuracy and efficiency trade-offs compared to depth-only scaling. Adding layers increases parameter count and activation storage rather than reducing it. Modern accelerators routinely support networks with hundreds of layers. Activation functions are mathematical operators with no legal restrictions.
Learning Objective: Explain the architectural and optimization limitations of scaling network depth in isolation
A colleague argues that ‘because neural networks contain millions of weights functioning as an uninterpretable black box, they cannot be systematically debugged when prediction errors occur.’ Refute this claim by describing three concrete systems diagnostic techniques used to debug neural models.
Answer: Neural networks can be systematically debugged using: (1) activation and gradient distribution histograms to detect vanishing gradients, activation saturation, or dead neurons across layers; (2) numerical assertion checks and tensor statistics to catch NaNs, Infs, and loss plateaus; and (3) ablation studies, feature attribution maps, and slice-based error analysis to verify whether the model relies on valid task features or spurious dataset correlations.
Learning Objective: Evaluate neural network interpretability and justify systematic debugging techniques against the black-box fallacy
During a model training run, an engineer observes that training loss continuously decreases across 50 epochs, but validation loss reaches a minimum at epoch 20 and increases steadily thereafter. Diagnose the model’s operational regime and describe two systems interventions to resolve it.
Answer: The model is overfitting: it has ceased learning generalizable patterns and is memorizing training-set noise. To resolve this, the engineer should: (1) apply early stopping to restore and deploy the model checkpoint from epoch 20 where validation loss was lowest, and (2) incorporate regularization techniques (such as weight decay, dropout, or data augmentation) to constrain model capacity and improve generalization to unseen data.
Learning Objective: Analyze overfitting from diverging training and validation loss curves and apply appropriate mitigation interventions
True or False: For a tabular dataset with 500 records and linear relationships between features and targets, deploying a deep neural network is generally superior to a linear regression model because deep networks inherently generalize better across all problem scales.
Answer: False. On small tabular datasets (\(<1{,}000\) samples) with linear relationships, deep neural networks are prone to severe overfitting, require substantial hyperparameter tuning and compute resources, and introduce complex deployment and monitoring pipelines. Simple linear or logistic regression models generalize robustly with small sample sizes, train instantly on CPUs, provide directly interpretable coefficients, and have minimal maintenance overhead.
Learning Objective: Justify selecting simpler linear models over deep neural networks for small sample size tabular workloads
Self-Check: Answer
What is the chapter’s fundamental conclusion regarding why machine learning systems engineers must understand the mathematical primitives inside neural networks?
- Because deployment failures are primarily syntax errors in framework Python code.
- Because systems engineers are expected to manually derive and hand-code backpropagation routines for every production model.
- Because mathematical operators (matrix multiplications, activations, loss functions, and gradients) establish the Silicon Contract—directly defining the operation count \(O\), memory volume \(D_{\text{vol}}\), numerical stability, and hardware utilization that govern physical execution.
- Because neural network architectures change too rapidly for hardware accelerators to support standardized linear algebra primitives.
Answer: The correct answer is C. The chapter demonstrates that the mathematical operators inside neural networks form the specification for physical machine workloads. Matrix dimensions determine compute FLOPs and memory traffic; activation derivatives dictate gradient stability; and the choice between training and inference determines activation caching, gradients, and optimizer state. Understanding the math enables engineers to diagnose out-of-memory errors, memory-bandwidth bottlenecks, and numerical instabilities. Viewing failures as mere syntax bugs ignores operator-level resource demands. Engineers use optimized framework libraries rather than hand-coding every derivative. Standardized linear algebra primitives (GEMM) remain the foundational workload across neural network architectures.
Learning Objective: Explain why neural computation primitives govern systems engineering decisions and physical hardware execution
Compare the systems priorities, memory demands, and optimization objectives of neural network training** versus inference for the same model architecture.**
Answer: Training requires high memory to store intermediate activations for backpropagation, parameter gradients, and optimizer state (such as Adam’s momentum buffers, creating a \(3\times\) to \(4\times\) memory multiplier over inference in FP32), and optimizes for throughput and time-to-accuracy. Inference requires forward-pass computation only, allows intermediate activation buffers to be recycled immediately after consumption, tolerates aggressive low-precision quantization (e.g. INT8), and optimizes for latency (SLO), throughput, energy efficiency, and cost.
Learning Objective: Compare the systems priorities, memory demands, and optimization objectives of training versus inference
In the iron law of ML systems (\(T = \frac{D_{\text{vol}}}{\text{BW}} + \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}}\)), the computational bargain where model architecture operators dictate the operation count \(O\) and memory volume \(D_{\text{vol}}\), while hardware and software determine realized bandwidth, latency, and throughput, is defined as the ____ contract.
Answer: silicon (or Silicon Contract). The Silicon Contract states that the mathematical choices in a neural network architecture define the fundamental computational work and memory footprint, which hardware and compiler runtimes must physically execute within given resource budgets.
Learning Objective: Explain the Silicon Contract as the bridge between neural network mathematical operators and physical hardware execution