Benchmarking
Mục đích
Làm sao so sánh công bằng các hệ thống ML khi phần cứng, mô hình, dữ liệu và triển khai đều tương tác?
Benchmarking tập hợp các quyết định đã hình thành từ việc chọn dữ liệu, nén mô hình và dùng bộ tăng tốc, rồi kiểm tra xem những lợi ích đó có giữ được dưới các điều kiện đại diện cho môi trường triển khai hay không. Mỗi quyết định thường nhắm vào một khía cạnh (độ trễ, độ chính xác, thông lượng hoặc năng lượng), trong khi một hệ thống ML lại là kết quả của tất cả các khía cạnh này cùng lúc. Một mô hình đã cắt tỉa có thể chạy nhanh hơn trên một bộ tăng tốc nhưng chậm hơn trên bộ khác. Kích thước batch lớn hơn giúp tăng mức tận dụng bộ tăng tốc nhưng có thể vi phạm thỏa thuận mức dịch vụ (SLA) về độ trễ. Một thiết bị edge có thể quảng bá thông lượng đỉnh, nhưng điều tiết nhiệt (thermal throttling) có thể làm giảm mạnh thông lượng khi chạy các khối lượng công việc (workload) kéo dài. Thách thức không phải là xem một chỉ số cục bộ có tốt hơn hay không, mà là cả hệ thống có thực sự tốt hơn dưới những điều kiện quan trọng trong thực tế hay không. Benchmarking làm cho các phép so sánh trở nên có hệ thống thay vì dựa trên giai thoại. Nó đòi hỏi xác định rõ sẽ đo cái gì (độ chính xác, độ trễ, thông lượng, năng lượng), ở mức độ chi tiết nào (một kernel đơn lẻ, một mô hình đầy đủ, hay một pipeline đầu-cuối), và trong những điều kiện nào (kích thước batch, phân phối đầu vào, trạng thái nhiệt, tải đồng thời). Nếu thiếu cấu trúc này, các nhóm sẽ so sánh những con số vốn không được đo trên cùng điều kiện, và những quyết định có vẻ hợp lý trên bảng tính sẽ sụp đổ trước khối lượng công việc (workload) sản xuất. Các chương trước đã tối ưu hóa mô hình, chọn dữ liệu và ghép phần cứng phù hợp. Benchmarking xác thực các tối ưu hóa đó, đối chiếu tuyên bố với bằng chứng và định lượng khoảng cách giữa lời hứa và kết quả. Theo D·A·M, benchmarking kiểm chứng tính đồng thiết kế bằng cách cho thấy liệu Dữ liệu, Thuật toán và Máy có được ghép đúng cách hay chỉ đơn giản là lắp lại với nhau.
Learning Objectives
- Giải thích benchmarking như một bước xác thực D·A·M, dùng để kiểm tra xem các tuyên bố tối ưu hóa có đúng trong các điều kiện đại diện hay không.
- So sánh các benchmark huấn luyện và suy luận theo thông lượng, các phân vị độ trễ, năng lượng, độ chính xác và phạm vi khối lượng công việc (workload).
- Chọn mức độ chi tiết vi mô, vĩ mô hoặc từ đầu đến cuối dựa trên quyết định kỹ thuật đang được kiểm tra.
- Áp dụng các quy tắc chạy benchmark đã tiêu chuẩn hóa để thống nhất tập dữ liệu, chỉ số, cấu hình phần cứng và cách thức báo cáo.
- Thiết kế các giao thức benchmark kiểm soát giới hạn công suất, phân phối đầu vào, kích thước batch và phương sai thống kê.
- Đánh giá chất lượng mô hình và dữ liệu bằng các chỉ số hiệu chuẩn, độ bền vững, tính đại diện và các chỉ số theo lát cắt.
- Chẩn đoán khoảng cách giữa benchmark và sản xuất do trôi, giới hạn nhiệt, tải động và suy giảm thầm lặng.
Framework benchmarking cho machine learning
Một mô hình được lượng tử hóa thành INT8 có thể benchmark nhanh hơn 2\(\times\) trên một khối lượng công việc (workload) tổng hợp, nhưng lại không cải thiện khi chạy dưới các mẫu lưu lượng thực tế với kích thước đầu vào biến thiên và yêu cầu đồng thời. Một mô hình đã được cắt tỉa có thể giữ được độ chính xác trên tập kiểm tra nhưng lại thất bại ở các trường hợp biên mà benchmark không hề bao quát. Việc chọn dữ liệu hứa hẹn huấn luyện hiệu quả hơn, nén mô hình hứa hẹn mô hình nhỏ gọn và nhanh hơn, còn tăng tốc phần cứng hứa hẹn thông lượng cao hơn. Xác thực những tuyên bố này có đúng trong môi trường sản xuất hay không, tự thân đã là một lĩnh vực kỹ thuật.
Definition 1.1: Benchmarking machine learning
Benchmarking machine learning là phép đo thực nghiệm các khối lượng công việc (workload) machine learning dưới các điều kiện được chỉ định, dùng để kiểm thử các tuyên bố về thành phần, mô hình hoặc hệ thống từ đầu đến cuối bằng bằng chứng mang tính đại diện thay vì chỉ dựa vào các thông số đỉnh.
- Ý nghĩa: Khoảng cách giữa hiệu suất đỉnh và hiệu suất duy trì có thể rất lớn. Một GPU A100 cung cấp 312 TFLOP/s (BF16) ở mức đỉnh, nhưng trong kịch bản MFU minh họa 30 percent–50 percent này, nó chỉ duy trì 93.6 TFLOP/s–156 TFLOP/s, tức chênh khoảng 2–3.3× do các yếu tố như nghẽn bộ nhớ, bong bóng trong pipeline và chi phí khởi chạy kernel. Benchmarking định lượng khoảng cách \(\eta_{\text{hw}}\) thực tế cho một khối lượng công việc (workload); các bảng thông số của nhà cung cấp thì không.
- Điểm cần phân biệt: Benchmark trong học máy (ML) có nhiều cấp độ. Micro-benchmark tách riêng các thao tác như nhân ma trận; benchmark cấp mô hình đánh giá toàn bộ khối lượng công việc (workload) khi huấn luyện hoặc suy luận; còn benchmark end-to-end (từ đầu đến cuối) bao gồm cả phần việc xung quanh như tải dữ liệu, tiền xử lý, tối ưu hóa, I/O checkpoint hoặc hạ tầng phục vụ (serving). Phạm vi của benchmark phải khớp với tuyên bố kỹ thuật.
- Cạm bẫy thường gặp: Một hiểu lầm phổ biến là nghĩ rằng các con số benchmark là tham chiếu ổn định. Cả khối lượng công việc (workload) (với các kiến trúc mô hình mới) và phần cứng (với các thế hệ GPU mới) đều liên tục thay đổi, nên một kết quả từng dẫn đầu một benchmark ở phiên bản này thường trở thành đường cơ sở (baseline) ở phiên bản sau. Vì vậy, so sánh qua các năm chỉ có ý nghĩa khi giữ nguyên phiên bản benchmark.
Benchmarking là nơi các định luật vật lý đã được trình bày ở các chương trước đối mặt với thực nghiệm. Khoảng cách giữa benchmark và sản xuất đo lường chênh lệch giữa kỳ vọng theo mô hình và hành vi quan sát được trong môi trường sản xuất. Thu hẹp khoảng cách đó đòi hỏi các phép đo biến những tuyên bố lý thuyết thành tri thức kỹ thuật đã được kiểm chứng.
Benchmarking trong ML vận hành trên ba chiều phụ thuộc lẫn nhau, ánh xạ trực tiếp tới các thành phần của bất kỳ hệ thống được triển khai nào. Benchmark hệ thống đo xem phần cứng có đạt hiệu suất như đã hứa hẹn dưới các khối lượng công việc (workload) thực tế hay không, hay các hiện tượng bão hòa băng thông bộ nhớ và chi phí điều phối phần mềm làm bào mòn các lợi ích đó. Benchmark mô hình đo xem các kỹ thuật tối ưu hóa có giữ được chất lượng mô hình trên toàn bộ phân phối đầu vào hay không, chứ không chỉ trên các tập kiểm thử được tuyển chọn. Benchmark dữ liệu đo xem mô hình có tổng quát hóa được sang dữ liệu thực tế, với mọi nhiễu, độ chệch (bias) và dịch chuyển phân phối hay không. Mỗi chiều có thể độc lập phát hiện những vấn đề mà các chiều khác không thấy, và một hệ thống vượt qua cả ba chiều sẽ mang lại độ tin cậy khi triển khai cao hơn nhiều so với hệ thống chỉ được đánh giá theo một trục duy nhất.
Một benchmark ML ghi lại một ảnh chụp nhanh về khối lượng công việc (workload) và phân phối dữ liệu, chứ không phải một đặc tả vĩnh viễn. Khoảng cách giữa hiệu suất đỉnh và hiệu suất duy trì cũng không cố định; nó thay đổi theo sự tiến hóa của khối lượng công việc (workload) và các thế hệ phần cứng, khiến mọi kết quả benchmark đơn lẻ đều gắn mốc thời gian chứ không mang tính phổ quát.
Systems Perspective 1.1: Benchmark như những mục tiêu di động
Trong các hệ thống truyền thống (ví dụ: SPEC CPU), benchmark là một đặc tả cứng nhắc. Một thuật toán sắp xếp được coi là đúng nếu nó sắp xếp được danh sách. Tính đúng đắn là tuyệt đối và không thay đổi. Trong các hệ thống ML, benchmark là một đặc tả mềm: tính đúng đắn được định nghĩa bởi một tập hữu hạn các ví dụ (ImageNet), còn thế giới thì luôn vận động. Một mô hình đạt điểm cao trên ImageNet vẫn có thể hoạt động kém trên ảnh người dùng được chụp nhiều năm sau khi benchmark đó được tạo.
Trong kiến trúc máy tính, các kỹ sư thiết kế theo benchmark vì benchmark đại diện cho khối lượng công việc (workload). Trong kỹ thuật ML, thiết kế chỉ để đạt benchmark là overfitting. Tính vững chắc đến từ việc thừa nhận rằng benchmark chỉ là đại diện cho một thực tế luôn dịch chuyển.
Xác thực triển khai MobileNetV2 làm cụ thể framework ba chiều. Nó là ví dụ xuyên suốt của chương vì bao trùm cả ba chiều đánh giá, cho thấy mỗi chiều phơi bày những vấn đề mà các chiều khác không thể.
Lighthouse 1.1: Xác thực triển khai MobileNetV2
MobileNetV2 (được giới thiệu trong Danh sách các mô hình tiêu biểu: Tiểu sử mô hình) là ví dụ chuẩn để kiểm chứng toàn bộ pipeline tối ưu hoá. MobileNetV2 tinh chỉnh thiết kế tách chập theo chiều sâu của v1 với các khối dư ngược (inverted residuals) và các nút cổ chai tuyến tính (linear bottlenecks), đồng thời giữ quy mô tham số tương tự (Sandler et al. 2018). Nó minh hoạ thách thức khi triển khai, nơi benchmark quyết định thành bại: nén có thể giảm kích thước mô hình, tăng tốc phần cứng có thể giảm độ trễ suy luận, và chỉ benchmark mới xác định liệu những lợi ích đó có thực sự giữ được qua toàn bộ pipeline triển khai hay không.
- Nén mô hình (Nén mô hình): Lượng tử hoá INT8 giúp giảm kích thước của ví dụ MobileNetV2 này từ 14 MB xuống 3.5 MB (tỷ lệ nén 4×).
- Tăng tốc phần cứng (Tăng tốc phần cứng): kịch bản EdgeTPU minh hoạ cho thấy độ trễ suy luận là 2 ms khi dùng EdgeTPU, so với 15 ms khi dùng CPU.
- Xác thực bằng benchmark: Kiểm chứng pipeline có thực sự đáp ứng trong thực tế
Các phần tiếp theo sẽ lần lượt đi vào từng khía cạnh của quá trình xác thực này, xây dựng một phương pháp có hệ thống để: tách biệt độ trễ của EdgeTPU khỏi chi phí tiền xử lý và truyền dữ liệu; xác nhận rằng lượng tử hoá INT8 vẫn giữ được độ chính xác ở các trường hợp đặc biệt như điều kiện ánh sáng bất thường; và kiểm tra xem hiệu năng có giữ vững trên ảnh chụp thực tế từ điện thoại thông minh, thay vì chỉ trên ảnh thử nghiệm của ImageNet.
Đánh giá nghiêm ngặt bắt đầu từ tư duy biết tách bạch bằng chứng có ý nghĩa khỏi những chỉ số dễ gây hiểu lầm. Ba nguyên tắc sau đây phân biệt những người thực hành hiệu quả.
Thứ nhất, benchmark chỉ là đại diện, không phải sự thật. Mỗi benchmark đo những điều kiện cụ thể có thể không trùng với môi trường triển khai mục tiêu. Một hệ thống có thể đạt thông lượng mẫu cao ở chế độ Offline (xử lý lô khi có sẵn mọi đầu vào) nhưng lại có số lượng truy vấn mỗi giây (QPS) thấp hơn nhiều ở chế độ Server (các yêu cầu bị ràng buộc bởi độ trễ và đến dần theo thời gian). Câu hỏi quan trọng luôn là: benchmark này không đo lường điều gì?
Thứ hai, Định luật Goodhart áp dụng ở mọi nơi.1 “Khi một thước đo trở thành mục tiêu, nó không còn là một thước đo tốt nữa.” Các nhóm tối ưu hóa để đạt thứ hạng cao trong benchmark thường tạo ra các hệ thống xuất sắc trong đánh giá nhưng lại thất bại khi đưa vào sản xuất. Các tối ưu hóa dành riêng cho benchmark thường làm suy giảm những đặc tính quan trọng khi triển khai: độ vững, hiệu chuẩn và hiệu quả.
1 Định luật Goodhart: Goodhart (1984) đã nêu quan sát ban đầu năm 1975 của Ngân hàng Anh về chính sách tiền tệ; Strathern (1997) đã khái quát hóa thành dạng trích dẫn ở trên. Bối cảnh ban đầu là kinh tế vĩ mô: khi một chỉ tiêu tiền tệ tổng hợp trở thành mục tiêu chính sách chính thức, các ngân hàng thay đổi hành vi để “chơi” số liệu, khiến nó mất giá trị dự báo. Trong ML, cùng kiểu trục trặc này tái diễn mang tính cấu trúc: BLEU thưởng sự trùng lặp n-gram (Papineni et al. 2002), ImageNet thưởng hiệu suất trên một phân phối hình ảnh cố định (Deng et al. 2009; Recht et al. 2019), và bảng xếp hạng benchmark có thể khuyến khích việc tinh chỉnh riêng cho tập kiểm tra.
Goodhart, Charles A. E. 1984. “Problems of Monetary Management: The UK Experience.” In Monetary Theory and Practice. Palgrave. https://doi.org/10.1007/978-1-349-17295-5_4.
Strathern, Marilyn. 1997. “‘Improving Ratings’: Audit in the British University System.” European Review 5 (3): 305–21. https://doi.org/10.1002/(SICI)1234-981X(199707)5:3<305::AID-EURO184>3.0.CO;2-4.
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2009. “ImageNet: A Large-Scale Hierarchical Image Database.” 2009 IEEE Conference on Computer Vision and Pattern Recognition, 248–55. https://doi.org/10.1109/cvpr.2009.5206848.
Recht, Benjamin, Rebecca Roelofs, Ludwig Schmidt, and Vaishaal Shankar. 2019. “Do ImageNet Classifiers Generalize to ImageNet?” Proceedings of the 36th International Conference on Machine Learning (ICML), 5389–400.
Thứ ba, đo lường end-to-end quan trọng hơn các chỉ số thành phần. Trong pipeline minh họa này, dù tăng tốc suy luận lên 3× cho một giai đoạn mô hình có độ trễ 10 ms bên trong một yêu cầu có tổng độ trễ 50 ms, thì cải thiện end-to-end chỉ khoảng 1.2×, hoặc còn tệ hơn nếu việc tối ưu làm tăng áp lực bộ nhớ. Những nguyên tắc này sẽ xuất hiện xuyên suốt phương pháp benchmark và được phân tích sâu hơn trong section 1.13.
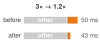
Tăng tốc thành phần hiếm khi chuyển thành tăng tốc benchmark end-to-end.
Tuy nhiên, biết cái gì cần đo chỉ là một nửa vấn đề. Đo lường sai (dùng khối lượng công việc (workload) không phù hợp, đường cơ sở có độ chệch (bias), hoặc các biến không được kiểm soát) cho ra những con số trông có vẻ chính xác nhưng lại dẫn đến quyết định sai. Lịch sử benchmark trong lĩnh vực tính toán đầy rẫy ví dụ về các chỉ số kỹ thuật hợp lý nhưng được áp dụng với phương pháp sai, từ điểm Whetstone bị trình biên dịch “lái” cho đến các benchmark GPU được chọn lọc khéo léo mà không dự báo được gì về khối lượng công việc (workload) chạy lâu dài. Hiểu quá trình tiến hóa của phương pháp đo lường, và những chỗ nó từng thất bại, là điều thiết yếu để thiết kế các benchmark có thể phân biệt cải tiến thực sự với những hiện tượng do cách đo lường gây ra.
Các nền tảng lịch sử của benchmark2 quan trọng vì chúng phơi bày những thất bại trong xác thực vẫn lặp lại trong ML: các chỉ số được tối ưu hóa nhưng không còn dự báo được khối lượng công việc (workload) thực tế, các con số về phần cứng bỏ qua trạng thái vận hành kéo dài, và điểm số của mô hình (model) không tính đến chi phí triển khai (deployment). Cùng một chuỗi xác thực này chi phối thực tiễn hiện đại: trước hết xác minh phần cứng có đạt hiệu suất như cam kết hay không; sau đó xác minh các tối ưu hóa mô hình (model) và dữ liệu xây trên phần cứng đó có thực sự mang lại lợi ích như đã hứa.
2 Benchmark: Xuất phát từ ngành khảo sát, nơi “bench mark” là một vết cắt ngang trên đá dùng làm mốc tham chiếu cao độ cố định. Đến thập niên 1970, thuật ngữ này đi vào lĩnh vực điện toán để chỉ các điểm so sánh được tiêu chuẩn hóa. Ẩn dụ từ ngành khảo sát cũng gợi một bài học cho hệ thống: cũng như phép đo cao độ vô nghĩa nếu thiếu mốc tham chiếu đã hiệu chuẩn, một con số thông lượng của ML cũng vô nghĩa nếu thiếu khối lượng công việc (workload) được kiểm soát, trạng thái nhiệt và cài đặt độ chính xác.
Self-Check: Question
In the three-dimensional ML benchmarking framework, what distinct failure mode does system benchmarking isolate compared to model and data benchmarking?
- Whether hardware accelerators, memory subsystems, and software runtimes deliver expected computational throughput and latency under workload execution patterns
- Whether model compression techniques preserve confidence calibration and accuracy on rare edge cases
- Whether the training dataset contains sufficient coverage, demographic balance, and resistance to covariate drift
- Whether human labeling errors and noisy annotations degrade model convergence rates
An ML serving pipeline has a baseline end-to-end request latency of \(50\text{ ms}\), of which the neural network inference model stage takes \(10\text{ ms}\) (the remaining \(40\text{ ms}\) is spent in request parsing, database feature fetching, image decoding, and response formatting). If the engineering team applies hardware acceleration to achieve a \(3\times\) speedup on the model inference stage alone, what is the resulting end-to-end pipeline speedup?
- Exactly \(3.0\times\) speedup
- Approximately \(1.2\times\) speedup (latency drops from \(50\text{ ms}\) to roughly \(43.3\text{ ms}\))
- Approximately \(2.1\times\) speedup (latency drops from \(50\text{ ms}\) to roughly \(23.8\text{ ms}\))
- No speedup (\(1.0\times\)) because non-model stages cancel out accelerator gains
True or False: Because ML benchmarks provide standardized datasets and metric formulas, a top-ranking benchmark score represents a permanent, universal verification of a model’s operational capability in production.
The ratio of sustained floating-point throughput achieved by an ML workload to the theoretical peak floating-point capability of the underlying hardware accelerator is known as Model FLOPs Utilization, abbreviated as ____.
Explain how Goodhart’s Law applies to ML systems benchmarking, and describe a concrete scenario where optimizing exclusively for a benchmark metric degrades real-world deployment quality.
Cơ sở lịch sử
Năm 1976, khi Whetstone trở thành một trong những benchmark tiêu chuẩn hóa đầu tiên trong điện toán, các nhà cung cấp bắt đầu tối ưu hóa trình biên dịch của họ chuyên cho các bài kiểm tra dấu phẩy động của benchmark này, tạo ra những con số ấn tượng nhưng lại không dự đoán tin cậy hiệu suất ứng dụng thực tế. Những cách “lách” tương tự cũng ảnh hưởng đến các thế hệ benchmark sau này. Để hiểu tại sao việc benchmark ML cần một cách tiếp cận ba chiều, chúng ta phải lần theo cách các phương pháp đo lường đã phát triển — và không ít lần thất bại — qua nhiều thập kỷ lịch sử điện toán. Mỗi thế hệ benchmark ra đời từ những hạn chế của thế hệ trước, mang đến những bài học trực tiếp định hình cách đánh giá ML hiện đại.
Trước khi đi vào lịch sử đó, có một điều kiện biên quan trọng: một benchmark chỉ hữu ích khi nó nêu rõ lớp (layer) nào của hệ thống mà nó đang xác nhận.
Chính vai trò xuyên lớp (cross-layer) đó giải thích vì sao lịch sử benchmark lại quan trọng: mỗi thế hệ đo lường hiệu năng chỉ tiến lên khi người làm thực tiễn nhận ra phương pháp trước đó không dự đoán đúng hành vi trong thế giới thực. Quá trình chuyển từ các chỉ số hiệu năng đơn giản sang benchmark cho ML cho thấy ba thay đổi lớn về phương pháp.
Các benchmark hiệu suất
Các benchmark máy tính thời kỳ đầu đã bộc lộ một vấn đề vẫn ám ảnh việc đánh giá cho đến hôm nay: thao túng benchmark. Chẳng hạn, Whetstone (Curnow and Wichmann 1976) dùng một hỗn hợp thao tác tổng hợp của chương trình khoa học, còn LINPACK3 (Dongarra et al. 1979) đo khả năng giải các hệ tuyến tính dày đặc. Các nhà cung cấp có thể tối ưu riêng cho những bài kiểm tra cố định này thay vì cho các khối lượng công việc (workload) rộng hơn. SPEC CPU (1989) đã mở rộng đánh giá thông qua một bộ chương trình định hướng ứng dụng, có thể chạy trên nhiều hệ (Dixit 1993). Bài học này trực tiếp định hình ML benchmarking: các tuyên bố tối ưu hóa từ Nén mô hình cần được kiểm chứng trên các tác vụ đại diện, và việc MLPerf đưa vào các mô hình như ResNet-50 và BERT giúp bao quát nhiều phần hơn của ngăn xếp triển khai (deployment) so với chỉ kiểm tra một kernel riêng lẻ.
3 Whetstone và LINPACK: Whetstone (Curnow and Wichmann 1976) được đặt tên theo cơ sở English Electric ở Whetstone, Leicestershire, nơi trình biên dịch ALGOL gốc được xây dựng; còn LINPACK (Dongarra et al. 1979) là một gói và benchmark cho các hệ tuyến tính dày đặc, sau này được danh sách Top500 sử dụng. Việc Whetstone dùng một chương trình tổng hợp cố định và LINPACK tập trung vào đại số tuyến tính dày đặc khiến chúng hữu ích nhưng hẹp hơn so với một bộ ứng dụng đa dạng. ML benchmarking thừa hưởng cùng một điểm yếu: tinh chỉnh kernel theo từng mô hình có thể khiến quá khớp (overfit) với một khối lượng công việc (workload) duy nhất, và đó là lý do MLPerf dùng nhiều khối lượng công việc (workload) trải rộng các lĩnh vực như thị giác, ngôn ngữ và hệ thống gợi ý (Mattson et al. 2020; Reddi et al. 2019).
Curnow, H. J., and B. A. Wichmann. 1976. “A Synthetic Benchmark.” The Computer Journal 19 (1): 43–49. https://doi.org/10.1093/comjnl/19.1.43.
Dongarra, J. J., J. R. Bunch, C. B. Moler, and G. W. Stewart. 1979. LINPACK Users’ Guide. SIAM. https://doi.org/10.1137/1.9781611971811.
Dixit, Kaivalya M. 1993. “Overview of the SPEC Benchmarks.” In The Benchmark Handbook for Database and Transaction Systems, 2nd ed., edited by Jim Gray. Morgan Kaufmann.
Khi các ngữ cảnh triển khai trở nên đa dạng hơn, một hạn chế thứ hai xuất hiện: đánh giá chỉ bằng một chỉ số duy nhất không còn đủ. Các benchmark đồ họa bắt đầu đo cả chất lượng kết xuất lẫn tốc độ khung hình; các benchmark di động bổ sung thời lượng pin như một yếu tố quan trọng ngang với hiệu suất. Những thách thức đa mục tiêu từ Giới thiệu (cân bằng độ chính xác, độ trễ và năng lượng) thể hiện trực tiếp trong đánh giá machine learning, nơi không có chỉ số đơn lẻ nào mô tả đầy đủ tính khả thi khi triển khai.
Sự thay đổi thứ ba xuất hiện khi điện toán phân tán cho thấy tối ưu hóa ở cấp thành phần không thể dự đoán hiệu năng ở cấp hệ thống. Một benchmark CPU không thể dự đoán thông lượng của cụm khi truyền thông mạng chi phối. Việc huấn luyện machine learning cũng tương tự, phụ thuộc vào sự tương tác giữa tính toán trên bộ tăng tốc (Tăng tốc phần cứng), các pipeline dữ liệu, đồng bộ hóa gradient và thông lượng lưu trữ. MLPerf đánh giá toàn bộ workflow, nhận thấy rằng hiệu suất xuất phát từ sự tương tác giữa các thành phần, chứ không phải từ từng thành phần tách rời.
DAWNBench (Coleman et al. 2019) là một benchmark machine learning đời đầu, tiên phong trong đánh giá thời gian đạt độ chính xác, ảnh hưởng trực tiếp tới phương pháp của MLPerf trong đo lường hiệu quả huấn luyện. Những bài học này hội tụ trong MLPerf4 (2018), nơi tổng hợp các khối lượng công việc (workload) đại diện, đánh giá đa mục tiêu và phép đo tích hợp, đồng thời giải quyết các thách thức đặc thù của machine learning (Mattson et al. 2020; Reddi et al. 2019).
Coleman, Cody, Deepak Narayanan, Daniel Kang, Tian Zhao, Jian Zhang, Luigi Nardi, Peter Bailis, Kunle Olukotun, Christopher Ré, and Matei Zaharia. 2019. “Analysis of DAWNBench, a Time-to-Accuracy Machine Learning Performance Benchmark.” ACM SIGOPS Operating Systems Review 53 (1): 14–25. https://doi.org/10.1145/3352020.3352024.
4 MLPerf: Được ra mắt vào năm 2018 bởi một liên minh các tổ chức công nghiệp và học thuật, MLPerf lấy tên từ “ML” kết hợp với “Perf” (performance), tiếp nối truyền thống benchmark của SPEC. Các nguyên tắc thiết kế của MLPerf—khối lượng công việc đại diện, đo lường toàn hệ thống và nộp kết quả mở—trực tiếp giải quyết vấn đề “gian lận” (gaming) từng gây khó khăn cho Whetstone và LINPACK: các nhà cung cấp trước đây có thể báo cáo thông lượng kernel cao nhất trên các kích thước bài toán được chọn lọc kỹ lưỡng, giờ đây phải báo cáo hiệu suất hệ thống đầu cuối trên các tác vụ tiêu chuẩn hóa (Mattson et al. 2020; Reddi et al. 2019).
Các benchmark năng lượng
Mô hình đánh giá đa mục tiêu tự nhiên mở rộng sang hiệu quả năng lượng khi điện toán đa dạng hóa vượt ra ngoài các máy tính lớn (mainframe), nơi ngân sách công suất ít bị ràng buộc. Thiết bị di động đòi hỏi tối ưu hóa thời lượng pin, còn các hệ thống ở quy mô trung tâm dữ liệu (warehouse-scale systems) phải đối mặt với chi phí năng lượng ngang với chi phí phần cứng. Sự dịch chuyển này đã đưa năng lượng trở thành một chỉ số hàng đầu bên cạnh hiệu suất, và sinh ra các benchmark như SPEC Power5 cho máy chủ và Green5006 cho siêu máy tính.
5 SPEC Power: Được giới thiệu vào năm 2007, SPEC Power đo hiệu suất trên mỗi watt ở 11 mức tải, từ không tải (0 phần trăm) đến 100 phần trăm, với các bước tăng 10 phần trăm (Lange 2009). Độ chi tiết này rất quan trọng đối với bài toán phục vụ (serving) machine learning: các khối lượng công việc (workload) suy luận hiếm khi duy trì tải 100 phần trăm. Những máy chủ hiệu quả ở tải đỉnh nhưng lãng phí khi tải một phần sẽ làm tăng chi phí năng lượng trong triển khai thực tế.
Lange, Klaus-Dieter. 2009. “Identifying Shades of Green: The SPECpower Benchmarks.” IEEE Computer 42 (3): 95–97. https://doi.org/10.1109/mc.2009.84.
6 Green500: Bắt đầu vào năm 2007 như một đối trọng với Top500, Green500 xếp hạng các hệ thống dựa trên FLOP/s trên mỗi watt thay vì hiệu suất thô (Feng and Cameron 2007). Bài học mang tính phương pháp luận cho các hệ thống machine learning là: cụm huấn luyện hiệu quả chi phí nhất không nhất thiết là cụm nhanh nhất, mà là hệ thống cung cấp công việc hữu ích trên mỗi watt, dưới khối lượng công việc (workload) và phạm vi đo lường có ý nghĩa.
Feng, Wu-chun, and Kirk W. Cameron. 2007. “The Green500 List: Encouraging Sustainable Supercomputing.” Computer 40 (12): 50–55. https://doi.org/10.1109/MC.2007.445.
MLCommons. 2024b. MLPerf Power Measurement.
Các mẫu khối lượng công việc (workload) đa dạng và cấu hình hệ thống khác nhau tiếp tục thách thức việc benchmark công suất trên nhiều môi trường điện toán. MLPerf Power (MLCommons 2024b) giải quyết điều này bằng các phương pháp chuyên biệt để đo lường tác động năng lượng của các khối lượng công việc (workload) machine learning, phản ánh vai trò trung tâm của hiệu quả năng lượng trong thiết kế hệ thống AI.
Việc benchmark năng lượng không chỉ đo công suất phần cứng mà còn đánh giá hiệu quả thuật toán. Các kỹ thuật nén mô hình như tỉa (pruning), lượng tử hoá và chưng cất tri thức có thể giảm năng lượng tiêu thụ bằng cách thay đổi chính công việc mà hệ thống thực hiện, không chỉ bằng cách thay đổi phần cứng thực thi. Các kiến trúc họ MobileNet dùng tích chập tách sâu để cắt giảm lượng tính toán so với các mạng nơ-ron tích chập (CNN) nặng hơn như ResNet (Howard et al. 2017; Sandler et al. 2018; He et al. 2016). Những kỹ thuật này, được trình bày chi tiết trong Nén mô hình, khẳng định rằng benchmark hướng tới năng lượng phải đánh giá hiệu quả thuật toán song song với mức tiêu thụ công suất phần hardware; Chi phí năng lượng định lượng cụ thể phân bổ năng lượng giữa INT8 và FP32. Khi các hệ thống AI mở rộng, bài học này trở thành trọng tâm của thực hành điện toán bền vững.
Howard, A. G., M. Zhu, B. Chen, D. Kalenichenko, W. Wang, T. Weyand, M. Andreetto, and H. Adam. 2017. “MobileNets: Efficient Convolutional Neural Networks for Mobile Vision Applications.” CoRR abs/1704.04861.
Các benchmark chuyên biệt theo từng lĩnh vực
Khi điện toán đa dạng vượt ra ngoài các máy chủ đa năng, những benchmark chung trở nên không đủ cho các lĩnh vực chuyên biệt. Ba hướng chuyên biệt hoá đã thúc đẩy sự chuyển dịch này, mỗi hướng bộc lộ các khía cạnh đo lường mà benchmark đa năng không thể bao quát.
Các ràng buộc khi triển khai định hình ưu tiên cho các chỉ số cốt lõi. Khối lượng công việc (workload) trong trung tâm dữ liệu tối ưu hoá thông lượng trong giới hạn công suất ở cấp rack và cụm, trong khi AI di động hoạt động trong giới hạn nhiệt nghiêm ngặt của thiết bị, và thiết bị IoT cần vận hành ở mức milliwatt. Những ràng buộc này, xuất phát từ các nguyên tắc hiệu quả trong Giới thiệu, quyết định benchmark nên ưu tiên tổng thông lượng hay năng lượng trên mỗi hoạt động.
Yêu cầu ứng dụng còn áp đặt các ràng buộc về chức năng và quy định, vượt ra ngoài hiệu suất thô. Chẳng hạn, AI trong chăm sóc sức khỏe đòi hỏi các chỉ số về khả năng diễn giải song song với độ chính xác; các hệ thống tài chính có thể yêu cầu độ trễ rất thấp kèm tuân thủ kiểm toán; còn phương tiện tự hành cần độ tin cậy quan trọng đối với an toàn và xác thực an toàn chức năng một cách chính thức. Những yêu cầu này mở rộng phạm vi đánh giá vượt ra ngoài các chỉ số hiệu suất truyền thống; sau đó, Kỹ thuật có trách nhiệm sẽ hệ thống hoá các nguyên tắc kỹ thuật có trách nhiệm phía sau các khía cạnh như công bằng, khả năng diễn giải và tuân thủ.
Các điều kiện vận hành thực tế quyết định tính khả thi trong đời sống. Xe tự hành phải chịu dải nhiệt độ rộng và tín hiệu cảm biến suy giảm; trung tâm dữ liệu phải xử lý lượng lớn yêu cầu đồng thời và cả sự cố mạng; còn hệ thống IoT công nghiệp phải vận hành bền bỉ trong thời gian dài mà không cần bảo trì. Các khả năng phần cứng ở Tăng tốc phần cứng chỉ thực sự mang lại giá trị khi được kiểm chứng dưới những điều kiện này.
machine learning là ví dụ điển hình cho bước chuyển sang đánh giá chuyên biệt theo từng lĩnh vực. Các benchmark CPU và GPU truyền thống là chưa đủ để đánh giá các khối lượng công việc (workload) machine learning, vốn có những tương tác phức tạp giữa tính toán, băng thông bộ nhớ và cách luân chuyển dữ liệu. MLPerf cung cấp phép đo hiệu suất tiêu chuẩn hóa cho các mô hình machine learning theo các danh mục sau: MLPerf Training giải quyết các ràng buộc khi triển khai trong trung tâm dữ liệu, với các benchmark về khả năng mở rộng đa nút (Mattson et al. 2020); MLPerf Inference đánh giá các yêu cầu ứng dụng nhạy cảm với độ trễ trên các triển khai từ máy chủ đến edge (Reddi et al. 2019); MLPerf Tiny đánh giá các điều kiện vận hành cực kỳ hạn chế cho các triển khai trên vi điều khiển (Banbury et al. 2021); và một hạng mục cắt ngang là MLPerf Power, đo lường hiệu quả năng lượng trong từng chế độ nói trên. Đọc table 1 theo cột ràng buộc cho thấy giới hạn ngày càng chặt chẽ khi quy mô triển khai thu hẹp: băng thông kết nối trong trung tâm dữ liệu nhường chỗ cho các thỏa thuận mức dịch vụ (SLA) về độ trễ ở máy chủ và edge, rồi đến yêu cầu vận hành công suất cực thấp với chỉ vài kilobyte bộ nhớ trên vi điều khiển. Vẫn là cùng một framework ba danh mục, nhưng khi áp dụng cho từng quy mô, bộ benchmark này đưa ra các chỉ số bám sát những gì thực sự giới hạn hệ thống ở quy mô đó thay vì một điểm số chung duy nhất.
| MLPerf Variant | Target Domain | Key Constraints | Primary Metrics |
|---|---|---|---|
| MLPerf Huấn luyện | Trung tâm dữ liệu | Multi-node scaling, interconnects băng thông cao | Time-to-quality, thông lượng (samples/sec) |
| MLPerf Suy luận | Server/Edge | SLAs độ trễ, requirements thông lượng | QPS, percentiles độ trễ, accuracy preservation |
| MLPerf Tiny | MCU/IoT | suy luận Ultra-low-power, memory hạn chế | Độ trễ, accuracy, năng lượng trên mỗi suy luận |
| MLPerf Công suất | Cross-cutting | Energy budgets, thermal constraints | Performance/W, năng lượng trên mỗi query |
MLPerf Power mở rộng cùng nguyên tắc đó sang đánh giá hiệu quả năng lượng. Ở đây, chỉ số benchmark là lượng công việc hữu ích trên mỗi watt, thay vì chỉ nhìn vào thông lượng thô. Các benchmark chuyên biệt theo từng lĩnh vực thúc đẩy tối ưu hóa phần cứng và phần mềm một cách có mục tiêu, đồng thời đảm bảo các cải tiến thực sự chuyển hóa thành thành công khi triển khai, chứ không chỉ hiệu quả trong điều kiện phòng thí nghiệm hạn hẹp.
Quá trình phát triển lịch sử này – từ các benchmark tính toán tổng quát, qua các phép đo chú trọng hiệu năng năng lượng, đến các framework đánh giá chuyên biệt theo từng lĩnh vực – đã tạo nền tảng để hiểu rõ những thách thức trong benchmark ML. Những bài học rút ra (sử dụng khối lượng công việc (workload) đại diện thay vì thử nghiệm tổng hợp; đánh giá đa mục tiêu thay vì chỉ một chỉ số; hệ thống tích hợp thay vì các thành phần riêng lẻ) đã trực tiếp định hình cách chúng ta đánh giá hệ thống AI. Table 2 tóm tắt tiến trình này và những bài học then chốt mà mỗi thế hệ đóng góp.
Những bài học đó kết tinh trong các bộ benchmark ML. Tuy nhiên, hệ thống ML còn bổ sung tính biến thiên thống kê và phụ thuộc dữ liệu bên cạnh các nguồn nhiễu hệ thống vốn có ở các khối lượng công việc (workload) khác. Chúng phải đáp ứng đủ ba bài học lịch sử (khối lượng công việc (workload) đại diện, đánh giá đa mục tiêu, đo lường tích hợp), đồng thời tính đến các kết quả có thể thay đổi theo dữ liệu huấn luyện, cách khởi tạo trọng số và thứ tự thực hiện các phép toán. Mức biến thiên bổ sung này đòi hỏi các biện pháp kiểm soát thống kê tương ứng.
Nhiều tổ chức đã tự mình học những bài học này, thường là qua không ít khó khăn. Nhưng các phép đo đơn lẻ, rời rạc thì không thể dẫn dắt cả ngành. Khi một nhóm đo độ trễ suy luận bao gồm cả tiền xử lý còn nhóm khác lại loại trừ; khi benchmark độ chính xác dùng các cách chia dữ liệu khác nhau; hoặc khi phép đo công suất đặt ranh giới hệ thống không giống nhau, các con số thu được sẽ không thể so sánh. Việc chuyển từ đo đạc tùy tiện sang các bộ benchmark tiêu chuẩn hóa đã biến hoạt động benchmark từ một bài tập xác thực nội bộ thành một ngôn ngữ chung, giúp các tổ chức mua sắm phần cứng, so sánh kiến trúc và ra quyết định triển khai trên quy mô liên tổ chức.
| Benchmark | Năm | Primary Focus | Key Metric(s) | Lesson cho ML Benchmarking |
|---|---|---|---|---|
| Whetstone | 1976 | Synthetic floating-point operations | MWIPS | Gaming synthetic tests làm suy yếu evaluation validity |
| LINPACK | 1979 | Linear algebra (matrix operations) | FLOP/s | Isolated operations bỏ lỡ system-level complexity và bottlenecks |
| SPEC CPU | 1989 | Khối lượng công việc (workload) ứng dụng thực tế | SPECrate, SPECspeed | Khối lượng công việc (workload) đại diện cho thấy hiệu suất triển khai thực tế |
| SPEC Công suất | 2007 | Server energy efficiency | ssj_ops/W trên các load levels | Hiệu quả năng lượng đòi hỏi đánh giá đa tải, không chỉ hiệu suất đỉnh |
| Green500 | 2007 | Hiệu quả năng lượng HPC | GFLOP/s per watt | Xếp hạng hiệu quả bổ sung cho xếp hạng hiệu suất thô |
| MLPerf | 2018 | Hệ thống ML (huấn luyện + suy luận) | Thời gian đạt chất lượng, QPS, độ trễ, độ chính xác | Tổng hợp tất cả các bài học: khối lượng công việc (workload) đại diện + đa mục tiêu + hệ thống |
Self-Check: Question
Why did computing benchmark methodology historically transition away from synthetic instruction-mix microbenchmarks (such as Whetstone and Dhrystone) to representative application suites (such as SPEC CPU)?
- Synthetic microbenchmarks required too much memory bandwidth to execute on modern microprocessors
- Representative application suites were easier to implement and did not require source code compilation
- Synthetic benchmarks lacked realistic memory access patterns and branch behavior, allowing optimizing compilers to artificially game scores via dead-code elimination and loop unrolling
- Hardware vendors refused to publish floating-point operations per second for synthetic loops
How do the constraints and primary evaluation metrics differ across the domain-specific variants of the MLPerf benchmark suite?
- All MLPerf variants evaluate identical metrics (pure TFLOPS) across different hardware form factors
- MLPerf Training focuses on latency SLAs, while MLPerf Inference evaluates multi-node interconnect bandwidth
- MLPerf Tiny measures data center power consumption, while MLPerf Power evaluates floating-point peak throughput
- MLPerf Training targets multi-node cluster scaling and time-to-quality, MLPerf Inference evaluates latency SLAs and QPS across server and edge, MLPerf Tiny targets microwatt-scale energy and memory constraints on microcontrollers, and MLPerf Power measures performance-per-watt
True or False: The introduction of energy-efficiency benchmarks like SPECpower and Green500 replaced raw throughput benchmarks, because computing systems are now evaluated solely on Joules per operation.
Explain how the historical evolution of computer benchmarking—from synthetic instruction loops to SPEC suites and Green500—directly informed the core design principles of MLPerf.
Order the following historical computing benchmark paradigms chronologically from earliest to most modern:
- Standardized domain-specific ML consortium suites (e.g., MLPerf) with multi-scenario serving and strict convergence run rules
- Synthetic instruction-mix microbenchmarks (e.g., Whetstone, Dhrystone) measuring isolated arithmetic throughput
- Multi-organization application suites (e.g., SPEC CPU) evaluating real-world compiler and scientific workloads
- High-Performance Computing dense linear algebra factorization benchmarks (e.g., LINPACK / TOP500)
- Multi-load energy efficiency and server power benchmarks (e.g., SPECpower_ssj2008, Green500)
Các bộ benchmark hệ thống
Một nhóm đang đánh giá phần cứng để triển khai trên edge cần so sánh năm thiết kế hệ thống trên chip (SoC) cho một sản phẩm camera thông minh. Nhà cung cấp A báo cáo 8 TOPS ở INT8; Nhà cung cấp B báo cáo 15 TOPS ở INT4; Nhà cung cấp C báo cáo độ trễ suy luận trên một mô hình độc quyền; Nhà cung cấp D trích dẫn điểm MLPerf từ hai thế hệ trước; còn Nhà cung cấp E chỉ đưa ra thông lượng đỉnh ở kích thước batch tối đa. Các con số này không thể so sánh với nhau. Nhóm không thể ra quyết định mua sắm vì mỗi nhà cung cấp đo một thứ khác, trong các điều kiện khác nhau và với các định nghĩa “hiệu năng” khác nhau. Vấn đề không phải thiếu dữ liệu mà là thiếu dữ liệu có thể so sánh. Các bộ benchmark tồn tại chính để giải quyết sự phân mảnh này.
Ba bài học từ lịch sử benchmark (các khối lượng công việc (workload) đại diện, đánh giá đa mục tiêu và đo lường tích hợp) gặp gỡ một thách thức riêng của ML: tính biến thiên xác suất vốn có. Các bộ benchmark hiện đại mã hóa những bài học này vào các framework tiêu chuẩn hóa, khiến kiểu so sánh xuyên tổ chức mà nhóm mua sắm phần cứng cần trở nên khả thi.
Các benchmark ML phải đánh giá sự tương tác giữa thuật toán, phần cứng và dữ liệu, chứ không chỉ hiệu quả tính toán. Các benchmark ban đầu tập trung vào hiệu năng thuật toán (LeCun et al. 1998), nhưng nhu cầu mở rộng quy mô đã mở rộng trọng tâm sang hiệu quả phần cứng (Jouppi et al. 2017), và những thất bại triển khai đình đám đã nâng chất lượng dữ liệu thành chiều đánh giá thứ ba (Gebru et al. 2021). Bản chất xác suất này đưa độ chính xác lên thành một chiều đánh giá hàng đầu bên cạnh tốc độ và mức tiêu thụ năng lượng: cùng một hệ thống ML có thể cho ra các kết quả khác nhau tùy vào dữ liệu nó gặp. Hiệu quả năng lượng là yếu tố xuyên suốt cả ba chiều của framework, vì lựa chọn thuật toán ảnh hưởng đến độ phức tạp tính toán (Hernandez and Brown 2020), khả năng phần cứng quyết định các đánh đổi năng lượng-hiệu năng, và đặc điểm của tập dữ liệu ảnh hưởng đến chi phí năng lượng khi huấn luyện.
Jouppi, Norman P., Cliff Young, Nishant Patil, David Patterson, Gaurav Agrawal, Raminder Bajwa, Sarah Bates, et al. 2017. “In-Datacenter Performance Analysis of a Tensor Processing Unit.” Proceedings of the 44th Annual International Symposium on Computer Architecture, ISCA ’17, 1–12. https://doi.org/10.1145/3079856.3080246.
Gebru, Timnit, Jamie Morgenstern, Briana Vecchione, Jennifer Wortman Vaughan, Hanna Wallach, Hal Daumé III, and Kate Crawford. 2021. “Datasheets for Datasets.” Communications of the ACM 64 (12): 86–92. https://doi.org/10.1145/3458723.
Hernandez, Danny, and Tom B. Brown. 2020. “Measuring the Algorithmic Efficiency of Neural Networks.” arXiv Preprint arXiv:2005.04305, ahead of print. https://doi.org/10.48550/arxiv.2005.04305.
Những thách thức đo lường trong ML
Các hệ thống ML kết hợp nhiều nguồn biến thiên trong phép đo mà nhiều benchmark truyền thống không được thiết kế để đánh giá cùng lúc. Các nguồn này gồm tính ngẫu nhiên ở cấp thuật toán (từ khởi tạo trọng số và xáo trộn dữ liệu), trạng thái nhiệt của phần cứng (ảnh hưởng đến tốc độ xung nhịp), biến thiên tải hệ thống do các tiến trình chạy đồng thời, và các yếu tố môi trường như điều kiện mạng và quản lý công suất. Cần áp dụng các phương pháp thống kê chặt chẽ để phân biệt cải tiến hiệu năng thực sự với nhiễu đo lường.
Để giải quyết sự biến thiên này, các giao thức benchmark hiệu quả cần lặp lại các lần chạy thí nghiệm, với các hạt giống ngẫu nhiên được ấn định theo thiết kế nghiên cứu. Số lần chạy nên được xác định theo mục tiêu về độ bất định hoặc công suất thống kê. Đồng thời, cần báo cáo các thước đo ngoài trung bình đơn giản (như độ lệch chuẩn hoặc khoảng tin cậy) để định lượng mức ổn định và tách bạch các cải tiến thực sự khỏi nhiễu đo lường.
Các nghiên cứu thực nghiệm đã chỉ ra rằng việc áp dụng thống kê thiếu chặt chẽ có thể dẫn đến các kết luận sai lệch. Các cải tiến trong học tăng cường thường nằm trong phạm vi nhiễu thống kê (Henderson et al. 2018), trong khi các so sánh mạng đối kháng tạo sinh (GANs) thường thiếu các giao thức thử nghiệm có kiểm soát, dẫn đến xếp hạng không nhất quán giữa các hạt giống khác nhau (Lucic et al. 2018). Những phát hiện này nhấn mạnh tầm quan trọng của việc thiết lập các giao thức đo lường có tính đến bản chất xác suất của ML.
Lucic, Mario, Karol Kurach, Marcin Michalski, Sylvain Gelly, and Olivier Bousquet. 2018. “Are GANs Created Equal? A Large-Scale Study.” Advances in Neural Information Processing Systems (NeurIPS) 31.

Một tập kiểm tra 1K không thể phát hiện một cách đáng tin cậy một sự suy giảm chỉ một điểm.
Napkin Math 1.1: Bẫy độ tin cậy thống kê
Vấn đề: Một bộ phân loại cơ sở đạt 95 percent, trong khi một phiên bản nén đạt 94 percent trên 1,000 ảnh. Liệu việc giảm một điểm này có đủ để khẳng định đây là một sự suy giảm không?
Toán:
Lỗi dự kiến: Các điểm số này tương ứng với 50 errors và 60 errors. Theo mô hình nhị thức cơ sở, số lỗi có độ lệch chuẩn xấp xỉ 7 errors.
Khoảng sai khác (95 percent): Gọi \(\hat p_1\) và \(\hat p_2\) lần lượt là độ chính xác ước tính của mô hình cơ sở và mô hình nén, và \(N\) là số lượng ảnh đánh giá cho mỗi mô hình. Nếu xem hai ước tính này là độc lập, thì sai số chuẩn của sự khác biệt giữa chúng là:
\[ \operatorname{SE}(\hat p_1-\hat p_2) = \sqrt{\frac{\hat p_1(1-\hat p_1)}{N} + \frac{\hat p_2(1-\hat p_2)}{N}}. \]
Sự khác biệt quan sát được là 1 percentage point, với khoảng xấp xỉ từ -1 percentage point đến 3 percentage points. Khoảng này bao gồm cả số 0.
Ý nghĩa: Vì khoảng này chứa số 0, nên kết quả chưa đủ để kết luận có suy giảm đến mức 1 điểm phần trăm. Nếu cả hai mô hình chạy trên cùng một tập ảnh, hãy giữ lại số trường hợp chúng bất đồng và dùng một kiểm định cặp như kiểm định McNemar; chỉ dựa vào độ chính xác biên là không đủ. Ước tính 1,825-mẫu cho một tỷ lệ đơn với độ chính xác ±1 percentage point không đủ công suất cho phép thực hiện so sánh này.
Góc nhìn hệ thống: Các benchmark nhỏ dễ rơi vào một ngộ nhận kiểu “phòng thí nghiệm”. Xem tập kiểm tra như một dụng cụ đo, nó phải đủ lớn để tương xứng với độ chính xác của mức thay đổi mà ta cần phát hiện.
Việc lựa chọn khối lượng công việc (workload) đại diện quyết định tính hợp lệ của một benchmark. Các microbenchmark tổng hợp (tạo các tensor ngẫu nhiên phân bố đều trong bộ nhớ) thường không phản ánh hết độ phức tạp của các khối lượng công việc (workload) ML thực tế, nơi việc luân chuyển dữ liệu, cấp phát bộ nhớ và ghép batch động tạo ra các đặc trưng hiệu suất không thấy được trong các bài thử giản lược. Ngược lại, benchmark dựa trên dấu vết phát lại các dấu vết yêu cầu đã ghi từ môi trường sản xuất—nắm bắt thời gian giữa các yêu cầu thực tế, phân phối đến mang tính bùng nổ, và độ dài chuỗi biến thiên—để kiểm thử chịu tải hạ tầng phục vụ (serving) trong đúng điều kiện sản xuất. Vì vậy, một benchmark toàn diện cần các khối lượng công việc (workload) phản ánh mẫu triển khai thực tế: độ dài chuỗi thay đổi trong mô hình ngôn ngữ, chế độ huấn luyện độ chính xác hỗn hợp, và các mẫu tải dữ liệu chân thực bao gồm cả chi phí tiền xử lý.
Example 1.1: Định luật Goodhart trong thực tế
Tình huống: Một nhóm kỹ sư tối ưu hóa một mô hình dịch NMT để đạt điểm BLEU ngoại tuyến, tăng kích thước beam search từ 1 lên 10.
Chẩn đoán: Trên giấy tờ, beam search lớn hơn mang lại mức tăng 0.5 điểm BLEU, nhưng làm số lượt đánh giá ứng viên tăng 10× lần, khiến độ trễ suy luận tăng vọt từ 50 ms lên 200 ms (chậm hơn 4× lần).
Bài học về hệ thống: Tối ưu hóa độ chính xác ngoại tuyến mà không ràng buộc độ trễ sẽ rơi vào thất bại theo Định luật Goodhart. Các benchmark sản xuất phải áp dụng các mục tiêu mức dịch vụ (SLO) nghiêm ngặt cho độ trễ phục vụ (serving) (ví dụ: độ trễ < 100 ms).
Ngoài tính đại diện của khối lượng công việc (workload), sự khác biệt giữa ý nghĩa thống kê và ý nghĩa thực tiễn cần được diễn giải cẩn thận. Một cải thiện nhỏ về hiệu suất có thể đạt ý nghĩa thống kê qua hàng trăm lần thử, nhưng lại vô nghĩa về mặt vận hành nếu nằm trong nhiễu đo lường hoặc chi phí vượt lợi ích. Đây là cái bẫy độ tin cậy thống kê: đánh giá có vẻ chặt chẽ vẫn có thể gây hiểu lầm.
Độ tin cậy thống kê là vấn đề về năng lực đo lường: benchmark có thể nhắm đúng đại lượng cần đo, nhưng tập kiểm thử quá nhỏ nên không phân biệt được sự thay đổi. Một kiểu lỗi thứ hai là lệch chỉ số (metric alignment). Ở đây, phép đo có thể chính xác và lặp lại được, nhưng vẫn khuyến khích những hành vi đi ngược mục tiêu của hệ thống đã triển khai. Ví dụ về dịch thuật làm rõ khác biệt này khi cho thấy điểm BLEU tăng có thể phải đánh đổi bằng độ trễ.
Những thất bại trong đo lường này có chung một hạn chế sâu hơn: một benchmark trên tập dữ liệu tĩnh chỉ đo nhận dạng dưới một phân phối cố định, chứ không đo được tính vững trước phân phối biến động như môi trường sản xuất đòi hỏi. Chiều dữ liệu của framework được phát triển sau trong chương này nhằm lấp đúng khoảng trống đó.
Những thách thức đo lường này dẫn tới việc đánh giá từng chiều của framework ba chiều (hệ thống, mô hình và dữ liệu) bằng các phương pháp riêng. Phần lớn chương này tập trung vào benchmark hệ thống (benchmark huấn luyện, benchmark suy luận và đo lường công suất) vì chúng là nền tảng cho đánh giá chuẩn hóa qua MLPerf. Section 1.11 sau đó trình bày các phương pháp riêng cần thiết cho benchmark mô hình và dữ liệu.
Benchmark hệ thống
Benchmark hệ thống đo nền tảng tính toán cho các khả năng của mô hình, xem xét kiến trúc phần cứng, hệ thống bộ nhớ và các liên kết ảnh hưởng đến hiệu năng tổng thể ra sao. Việc kiểm chứng này rất quan trọng vì thông số phần cứng thường mô tả đỉnh lý thuyết mà khối lượng công việc (workload) ứng dụng không duy trì được. Sự chênh lệch này phổ biến đến mức các tuyên bố về hiệu suất đỉnh trở nên không đầy đủ. Benchmark hệ thống phơi bày những khoảng trống đó bằng cách chạy các khối lượng công việc (workload) ML tiêu chuẩn, thay vì chỉ dựa vào tốc độ tính toán đỉnh.
Systems Perspective 1.3: Sai lầm về hiệu suất đỉnh
Dave Patterson thường nói hiệu suất đỉnh là “hiệu suất mà nhà sản xuất đảm bảo bạn sẽ không thể vượt qua.” Đối với các hệ thống ML, khoảng cách này có thể rất lớn do rào cản bộ nhớ (memory wall): khi một mô hình bị giới hạn bởi bộ nhớ, phần lớn FLOP/s được quảng cáo sẽ không thể đạt được, cho dù các đơn vị tính toán có chạy nhanh đến mấy. Các benchmark tiêu chuẩn hóa như MLPerf yêu cầu hệ thống chạy các mô hình và dữ liệu được chỉ định, cho thấy hiệu suất duy trì tại một điểm vận hành được ghi nhận, thay vì một tốc độ chung áp dụng cho mọi khối lượng công việc (workload).
Đối với các khối lượng công việc (workload) bị giới hạn bởi bộ nhớ, sự chênh lệch giữa hiệu suất đỉnh và hiệu suất duy trì bắt nguồn từ rào cản bộ nhớ; trong khi đó, các khối lượng công việc (workload) bị giới hạn bởi tính toán có thể tiến gần hiệu suất đỉnh. Sự phân biệt này biến việc đánh giá nhà cung cấp từ phỏng đoán thành một danh sách kiểm các tiêu chí cụ thể.
Checkpoint 1.1: Giải mã các tuyên bố benchmark của nhà cung cấp
Khi đánh giá phần cứng hoặc phần mềm dựa trên các benchmark do nhà cung cấp báo cáo, hãy kiểm tra xem tuyên bố đó có nêu rõ khối lượng công việc (workload), ranh giới đo lường và điều kiện vận hành hay không.
Kỹ sư nên bác bỏ bất kỳ tuyên bố benchmark nào mà không thể tái dựng được phạm vi khối lượng công việc (workload), độ chính xác và các chi phí bị loại trừ. Một con số thông lượng hay độ trễ chỉ trở nên hữu ích khi kỹ sư có thể ánh xạ nó tới mô hình thực tế, hình dạng batch, cách dữ liệu di chuyển, điểm vận hành duy trì và khung công suất.
Phần cứng nền tảng—CPU, GPU, Tensor Processing Units (TPU),7 và các mạch tích hợp chuyên dụng (ASIC)8—quyết định tốc độ, hiệu quả và quy mô của hệ thống machine learning. Các benchmark hệ thống cung cấp phương pháp chuẩn hóa để so sánh phần cứng giữa các khối lượng công việc (workload) AI dựa trên thông lượng tính toán, băng thông bộ nhớ, hiệu quả công suất, mức độ hỗ trợ toán tử và khả năng mở rộng (Reddi et al. 2019; Mattson et al. 2020).
7 TPU (tensor processing unit): là một ASIC tùy chỉnh của Google, thiết kế cho các khối lượng công việc (workload) mạng nơ-ron (chi tiết kiến trúc trong Tăng tốc phần cứng). Một pod TPU v4 (4.096 chip) đạt 1.1 exaFLOP/s đỉnh ở BF16 (Jouppi et al. 2023), nhưng khi benchmark TPU cần thận trọng: kiến trúc mảng systolic của chúng ưu tiên các phép toán tensor đều đặn, nên chỉ số FLOP/s đỉnh có thể đánh giá quá cao hiệu suất trên các khối lượng công việc (workload) không đều, như sparse attention hay dynamic control flow.
Jouppi, Norm, George Kurian, Sheng Li, Peter Ma, Rahul Nagarajan, Lifeng Nai, Nishant Patil, et al. 2023. “TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings.” Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14. https://doi.org/10.1145/3579371.3589350.
8 ASIC (application-specific integrated circuit): Giá trị TOPS đỉnh của một ASIC chỉ áp dụng cho các toán tử cụ thể mà nó được thiết kế để xử lý. Chỉ cần một lớp không được hỗ trợ, hệ thống sẽ phải quay về bộ xử lý đa năng, có thể làm mất toàn bộ lợi thế về hiệu suất. Vì vậy, mức độ hỗ trợ toán tử là câu hỏi đầu tiên trong bất kỳ benchmark ASIC nào: khoảng cách giữa thông lượng đỉnh và thông lượng thực tế đạt được không phải là giới hạn phần cứng, mà là giới hạn về khả năng tương thích với khối lượng công việc (workload).
Table 3 chuyển các cụm từ tiếp thị phổ biến thành những lưu ý kỹ thuật ẩn sau mỗi cụm.
| Tuyên bố của nhà cung cấp | Điều nó thường có nghĩa |
|---|---|
| “Up to 10,000 images/sec” | Thông lượng đỉnh ở kích thước batch tối đa, INT8, không cần tiền xử lý |
| “Độ trễ dưới mili giây” | Chỉ tính toán của bộ tăng tốc, không bao gồm truyền dữ liệu |
| “5\(\times\) more efficient” | Hiệu quả trên mỗi hoạt động, không phải hiệu quả hệ thống tổng thể |
| “Tối ưu hóa cho AI” | Có thể chỉ tăng tốc các hoạt động hoặc độ chính xác cụ thể |
Các benchmark hệ thống phục vụ hai mục đích. Với người thực hành, chúng cung cấp dữ liệu so sánh giữa các cấu hình để giúp chọn phần cứng một cách sáng suốt. Với nhà sản xuất, chúng lượng hóa cải tiến theo thế hệ và định hướng phát triển bộ tăng tốc. Khi GPU được áp dụng rộng rãi hơn, độ chính xác cũng tăng nhanh, cho thấy phần cứng và thuật toán có thể cùng nhau thúc đẩy tiến bộ.
Definition 1.2: Các benchmark hệ thống machine learning
Các benchmark hệ thống machine learning là các quy trình đánh giá chuẩn. Chúng giữ nguyên khối lượng công việc (workload) và mục tiêu chất lượng, đồng thời thay đổi ngăn xếp phần cứng-phần mềm. Mục tiêu là đo \(\eta_{\text{hw}} = R_{\text{sustained}} / R_{\text{peak}}\) và \(L_{\text{lat}}\) để tách hiệu quả của hạ tầng khỏi các cải tiến thuật toán.
- Ý nghĩa: Cùng một mô hình ResNet-50 có thể cho thông lượng rất khác nhau tùy theo ngăn xếp phần cứng-phần mềm, định dạng độ chính xác, kích thước batch và cấu hình trình biên dịch, nhưng vẫn đạt cùng độ chính xác ImageNet Top-1. Các benchmark hệ thống ghi nhận khoảng cách triển khai này, điều mà các benchmark thuật toán chỉ báo cáo độ chính xác nên không thấy được.
- Điểm khác biệt: Không giống các benchmark thuật toán (vốn thay đổi kiến trúc mô hình và quy trình huấn luyện để cải thiện độ chính xác hội tụ), các benchmark hệ thống giữ cố định thuật toán và thay đổi cách triển khai (thư viện kernel, định dạng lượng tử hoá, kích thước batch và các thế hệ phần cứng) nhằm đo mức độ hiệu quả của ngăn xếp phần cứng-phần mềm khi thực thi hạng mục \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\) trong định luật sắt.
- Sai lầm phổ biến: Một hiểu lầm thường gặp là kết quả benchmark hệ thống có thể áp dụng chung cho mọi khối lượng công việc (workload). Ví dụ, một bộ tăng tốc đạt mức sử dụng cao trên ResNet-50 (một workload thị giác thiên về tính toán) có thể đạt mức sử dụng thấp hơn nhiều trên một hệ thống khuyến nghị (một workload bị giới hạn bởi băng thông bộ nhớ). Các benchmark hệ thống mang tính đặc thù theo từng workload; không có một chỉ số duy nhất nào đặc trưng đầy đủ cho một nền tảng phần cứng.
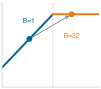
Batch lớn hơn đẩy suy luận của transformer từ trạng thái bị giới hạn bởi bộ nhớ sang trạng thái bị giới hạn bởi tính toán.
9 FLOP/s (phép toán dấu phẩy động mỗi giây): Khoảng cách giữa FLOP/s đỉnh được quảng cáo và FLOP/s thực tế đạt được là vấn đề cốt lõi trong benchmark phần cứng. A100 quảng cáo hiệu năng Tensor Core FP16 là 312 TFLOP/s, nhưng các khối lượng công việc (workload) thực tế thường chỉ đạt một phần mức đỉnh này, tùy vào cường độ số học, kiểu truy cập bộ nhớ, độ chính xác và chi phí runtime. Báo cáo FLOP/s đỉnh mà không có ngữ cảnh mức sử dụng là sự bóp méo phổ biến nhất khi benchmark.
Để diễn giải benchmark hiệu quả, ta cần nắm rõ các đặc điểm hiệu năng của phần cứng mục tiêu. Việc xác định một khối lượng công việc (workload) AI cụ thể bị giới hạn bởi năng lực tính toán (compute-bound) hay bởi bộ nhớ (memory-bound) sẽ cung cấp thông tin quan trọng cho các quyết định tối ưu hóa. Cường độ số học, đo bằng FLOP/byte,9 quyết định giới hạn hiệu năng. Hãy xét ví dụ về một GPU NVIDIA A100 có hiệu năng Tensor Core FP16 đạt 312 TFLOP/s (FP32 là 19.5 TFLOP/s) và băng thông bộ nhớ 2.04 TB/s (biến thể SXM). Khi chia hiệu năng tính toán đỉnh cho băng thông đỉnh, ta thu được ngưỡng cường độ số học là 153 FLOP/byte. Những workload có cường độ số học thấp hơn ngưỡng này sẽ bị giới hạn bởi băng thông bộ nhớ, còn những workload cao hơn sẽ bị giới hạn bởi năng lực tính toán. Mô hình Roofline trong Mô hình Roofline là nền tảng kiến trúc để diễn giải các kết quả benchmark này. Mô hình Roofline trình bày cách suy ra phương trình roofline và ngưỡng điểm ranh giới từ các nguyên tắc cơ bản, nhờ đó giới hạn cường độ số học ở đây có thể được tái dựng cho bất kỳ bộ tăng tốc nào.
Vị trí trên biểu đồ roofline10 phụ thuộc vào khối lượng công việc (workload). Trong ví dụ về A100 này, một khối lượng công việc (workload) minh họa là lan truyền thuận ResNet-50 với cường độ tính toán cao và kích thước batch lớn, có cường độ số học khoảng ~300 FLOP/byte. Giá trị này nằm trên điểm gãy của A100, nên đây là các kernel bị giới hạn bởi tính toán (He et al. 2016; Choquette et al. 2021). Các phép toán có cường độ thấp hơn sẽ nằm dưới điểm gãy, thuộc vùng bị giới hạn bởi bộ nhớ: ví dụ, một suy luận BERT với kích thước batch là một, chỉ tính lưu lượng tải trọng số, đạt cường độ số học khoảng ~100 FLOP/byte và có trần hiệu suất thấp hơn mức đỉnh. Tăng kích thước batch sẽ dịch chuyển khối lượng công việc này qua điểm gãy, từ bị giới hạn bởi bộ nhớ sang bị giới hạn bởi tính toán (Pope et al. 2023). Phần Một ví dụ cụ thể: Phân tích A100 trình bày chi tiết phép tính từ cường độ đến mức độ sử dụng trên A100, so sánh một kernel nhân ma trận bị giới hạn bởi tính toán với một kernel xử lý từng phần tử bị giới hạn bởi bộ nhớ, nên các bước này có thể áp dụng cho bất kỳ cặp mô hình-phần cứng nào.
10 Mô hình Roofline: Williams et al. (2009) đã giới thiệu mô hình Berkeley, được đặt tên theo hình dạng trực quan của giới hạn hiệu suất mà nó biểu diễn. Điểm gãy của mô hình (tính bằng FLOP/s đỉnh chia cho băng thông đỉnh) giúp phân tách các khối lượng công việc (workload) bị giới hạn bởi bộ nhớ khỏi các khối lượng công việc (workload) bị giới hạn bởi tính toán, từ đó cho biết việc tối ưu hóa nên tập trung vào di chuyển dữ liệu hay các phép tính số học.
Williams, Samuel, Andrew Waterman, and David Patterson. 2009. “Roofline: An Insightful Visual Performance Model for Multicore Architectures.” Communications of the ACM 52 (4): 65–76. https://doi.org/10.1145/1498765.1498785.
Choquette, Jack, Wishwesh Gandhi, Olivier Giroux, Nick Stam, and Ronny Krashinsky. 2021. “NVIDIA A100 Tensor Core GPU: Performance and Innovation.” IEEE Micro 41 (2): 29–35. https://doi.org/10.1109/mm.2021.3061394.
Pope, Reiner, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. 2023. “Efficiently Scaling Transformer Inference.” Proceedings of Machine Learning and Systems (MLSys) 5: 606–24.
Một ví dụ ước tính suy luận BERT sẽ cho thấy cách các nguyên tắc của mô hình roofline được áp dụng để đưa ra các dự đoán triển khai cụ thể.
Napkin Math 1.2: Phân tích roofline cho suy luận BERT
Vấn đề: Mô hình BERT-Base cần được triển khai để thực hiện suy luận trên một GPU A100. Bộ phận quản lý kỳ vọng mức sử dụng GPU cao. Vậy hiệu suất dự kiến là bao nhiêu, và làm thế nào để cải thiện nó?
Bước 1: Giới hạn phần cứng.
- Khả năng tính toán đỉnh: 312 TFLOP/s (FP16 Tensor Core)
- Băng thông bộ nhớ: 2.04 TB/s
- Điểm gãy: 312 TFLOP/s ÷ 2.04 TB/s = 153 FLOP/byte
Bất kỳ khối lượng công việc (workload) nào có cường độ tính toán thấp hơn 153 FLOP/byte thì bị giới hạn bởi bộ nhớ; cao hơn mức đó thì bị giới hạn bởi tính toán.
Bước 2: Đặc điểm của BERT-base.
- Tham số: 110M = 220 MB (FP16)
- Số FLOPs cho mỗi lần suy luận: ~22 GFLOP (lan truyền tiến với độ dài chuỗi \(S=128\))
- Di chuyển dữ liệu: ~220 MB (phải tải tất cả trọng số từ bộ nhớ)
- Cường độ tính toán: \((22 \times 10^{9}) \div (220 \times 10^{6})\) = 100 FLOP/byte (mô hình chỉ xét trọng số; xem ghi chú trong phần chính)
Bước 3: Dự đoán hiệu suất. Vì 100 FLOP/byte < 153 FLOP/byte, nên mô hình BERT với batch = 1 sẽ bị giới hạn bởi bộ nhớ: \[\begin{gather*}
\text{Achievable perf} = \text{100 FLOP/byte} \times \text{2.04 TB/s} = \text{203.9 TFLOP/s}
\\
\text{GPU utilization} = \text{203.9 TFLOP/s} / \text{312 TFLOP/s} = \text{$65.4\%$}
\end{gather*}\]
Bước 4: Tối ưu hóa bằng cách gộp batch. Tăng kích thước batch lên 32:
- Cùng 220 MB trọng số, nhưng khối lượng tính toán tăng 32× lần
- Số FLOPs mới: \(22 \times 10^{9} \times 32\) = 704 GFLOP
- Cường độ tính toán mới: \((704 \times 10^{9}) \div (220 \times 10^{6})\) = 3200 FLOP/byte
Vì 3200 FLOP/byte > 153 FLOP/byte, nên batch = 32 sẽ bị giới hạn bởi tính toán. Giả sử việc triển khai sau đó duy trì được 85 percent so với hiệu suất đỉnh: \[\begin{gather*}
\text{Achievable perf} \approx \text{$85\%$} \times \text{312 TFLOP/s} = \text{265.2 TFLOP/s}
\\
\text{GPU utilization} \approx 85\%
\end{gather*}\] Hiểu biết về hệ thống: Kích thước batch có thể chuyển một bài suy luận bị giới hạn bởi bộ nhớ thành bị giới hạn bởi tính toán, bằng cách tăng cường độ tính toán. Giá trị 85 percent hiển thị ở đây là giả định về hiệu quả triển khai, không phải dự đoán từ biểu đồ roofline. Việc gộp batch cũng làm tăng độ trễ vì hệ thống phải chờ tích lũy yêu cầu. Đây là sự đánh đổi cơ bản giữa thông lượng và độ trễ mà các kịch bản MLPerf thể hiện: SingleStream (batch = 1, tối ưu độ trễ) so với Offline (batch tối đa, tối ưu thông lượng).
Các benchmark ở cấp hệ thống đánh giá hiệu suất trên nhiều quy mô, từ cấu hình một chip đến các hệ thống phân tán lớn, bao quát cả huấn luyện và suy luận. Figure 1 đặt cạnh tỷ lệ lỗi top-5 của ImageNet (từ (Russakovsky et al. 2015; Krizhevsky et al. 2012)) với một bản tái dựng về mức độ các bài dự thi dùng GPU ngày càng tăng, suy từ số lượng bài dự thi mà NVIDIA đã biểu đồ hóa cho cuộc thi (Gray 2015). Hai chuỗi này cho thấy các xu hướng diễn ra đồng thời; chúng không phải là một ước lượng nhân quả về phần đóng góp của phần cứng so với thuật toán, dữ liệu hay thực hành huấn luyện.

Gray, Allison. 2015. NVIDIA and IBM Cloud Support ImageNet Large Scale Visual Recognition Challenge. NVIDIA Technical Blog.
Ví dụ ImageNet đặt việc áp dụng GPU cạnh sự suy giảm tỷ lệ lỗi, nhưng không tách riêng được đóng góp của từng yếu tố; section 1.11.1 sẽ xem lại tiến trình này qua các cột mốc kiến trúc gắn với từng mô hình. Tuy vậy, để xây dựng benchmark hệ thống hiệu quả, cần hiểu rõ mối quan hệ giữa đặc tính của khối lượng công việc (workload) và cách phần cứng được sử dụng. Các hệ thống AI hiện đại hiếm khi đạt mức hiệu suất đỉnh lý thuyết do tương tác giữa các mẫu tính toán, hệ thống phân cấp bộ nhớ và kiến trúc hệ thống. Khoảng cách giữa hiệu suất lý thuyết và hiệu suất đạt được này định hình cách ta thiết kế các benchmark hệ thống có ý nghĩa.
Hiểu đúng các mẫu sử dụng phần cứng trong điều kiện thực tế là chìa khóa để thiết kế benchmark hữu ích. Như phân tích roofline trước đó minh họa, mức sử dụng GPU thay đổi theo kích thước batch và kiến trúc mô hình; giá trị compute-bound 85 percent là một giả định, còn giá trị bị giới hạn bởi bộ nhớ cho một yêu cầu đơn lẻ là 65.4 percent. Các mẫu này còn mở rộng sang băng thông bộ nhớ: suy luận transformer nặng tham số và các khối lượng công việc (workload) tích chập nặng activation sẽ gây áp lực lên các phần khác nhau của hệ thống phân cấp bộ nhớ, từ đó ảnh hưởng trực tiếp đến hiệu suất đạt được ở các mức độ chính xác số khác nhau.
Benchmark hệ thống hiệu quả phải đo mức sử dụng thực tế thay vì chỉ dựa vào khả năng tối đa theo lý thuyết, và yêu cầu này đặt ra một số giới hạn phạm vi. Năng lượng là một phương diện: hiệu suất trên mỗi watt khác nhau rất lớn giữa các nền tảng, và một bộ tăng tốc bị sử dụng kém sẽ tiêu thụ công suất không tương xứng so với đầu ra của nó, làm tăng chi phí vận hành và gây tác động môi trường. Phân tán là một phương diện khác: huấn luyện nhiều nút thêm các nút thắt cổ chai trong truyền thông, hiệu ứng từ cấu trúc liên kết mạng, và chi phí điều phối mà benchmark một nút không nắm bắt được, nên cần được xem xét riêng ngoài phạm vi cuốn sách này. Trong phạm vi máy đơn ở đây, benchmark nhiều GPU tập trung vào giao tiếp trong cùng máy (intra-node), mức sử dụng băng thông bộ nhớ giữa các bộ tăng tốc, và hiệu quả đồng bộ hóa gradient giữa bộ nhớ của các bộ tăng tốc khác nhau kết nối qua NVLink hoặc PCIe. Tựu trung, một benchmark chỉ có giá trị khi điểm vận hành của nó khớp với thực tế triển khai, chứ không phải với thông số trên datasheet.
Tiêu chuẩn hóa do cộng đồng dẫn dắt
Các hiểu biết về mức sử dụng phần cứng chỉ có ý nghĩa so sánh khi được đo nhất quán, và điều này đòi hỏi tiêu chuẩn hóa do cộng đồng dẫn dắt. Nếu một nhóm đo độ trễ suy luận có tính cả tiền xử lý còn nhóm khác loại trừ; nếu benchmark độ chính xác dùng các cách chia dữ liệu khác nhau; hoặc nếu phép đo công suất xác định ranh giới hệ thống khác nhau, thì không thể so sánh một cách có ý nghĩa. Các tổ chức đơn lẻ không thể tự đặt ra chuẩn đo lường; sự bùng nổ benchmark theo ba phương diện dẫn đến phân mảnh mà chỉ nỗ lực phối hợp mới giải quyết được.
Các benchmark thành công nhất thường hình thành từ sự hợp tác rộng rãi giữa các tổ chức học thuật, đối tác công nghiệp và chuyên gia lĩnh vực. Ảnh hưởng lâu dài của ImageNet cho thấy việc cộng đồng gắn bó bền bỉ qua các hội thảo, thử thách và tập dữ liệu mở đã tạo nên uy tín mà các benchmark do doanh nghiệp dẫn dắt hiếm khi đạt được. Quá trình phát triển mang tính cộng đồng này tạo nền tảng cho việc tiêu chuẩn hóa chính thức: các nhóm làm việc của IEEE (IEEE Standards Association 2024) và các ủy ban kỹ thuật ISO/IEC (ISO 2024) chuẩn hóa các phương pháp do cộng đồng phát triển thành tiêu chuẩn chính thức (ví dụ: IEEE 2416 (IEEE Standards Association 2019) cho mô hình công suất hệ thống), cung cấp các đặc tả đo lường chính xác giúp so sánh đáng tin cậy giữa các tổ chức. Các dự án cung cấp bản triển khai tham chiếu mã nguồn mở, môi trường đánh giá đóng gói bằng container, và bộ kiểm định toàn diện sẽ tiếp tục giảm rào cản và bảo đảm cách hiểu thống nhất giữa các nhóm nghiên cứu.
IEEE Standards Association. 2024. IEEE Standards Association: Working Groups for AI and ML.
ISO. 2024. ISO/IEC JTC 1/SC 42 Artificial Intelligence.
IEEE Standards Association. 2019. IEEE 2416-2019: Standard for Power Modeling to Enable System-Level Analysis.
Các benchmark ML phải cân bằng giữa sự chặt chẽ học thuật và tính thực tiễn trong công nghiệp, vì các tiến bộ lý thuyết cần chuyển hóa thành cải thiện cụ thể trên các hệ thống triển khai (Mattson et al. 2020; Reddi et al. 2019). Những benchmark đạt được cân bằng này, với cơ chế quản trị minh bạch và được cập nhật đều đặn, sẽ trở thành điểm tham chiếu bền vững; còn các benchmark phát triển biệt lập thường khó đạt được sức hút, dù mức độ tinh vi kỹ thuật cao đến đâu. Các nguyên tắc về phương pháp đánh giá này sẽ định hướng việc thiết kế benchmark cho cả huấn luyện và suy luận trong suốt chương này.
Các tiêu chuẩn cộng đồng bảo đảm tính tái lập, nhưng không quy định mức độ chi tiết của phép đo. Một benchmark có thể đo thời gian cho một phép nhân ma trận đơn lẻ hoặc cho cả một lần huấn luyện — và mỗi lựa chọn sẽ cho thấy những thông tin khác nhau. Mức độ đo đạc, từ thao tác riêng lẻ đến hệ thống hoàn chỉnh, quyết định benchmark có thể cung cấp những hiểu biết gì và chẩn đoán được những vấn đề nào.
Self-Check: Question
In roofline analysis, an accelerator has a peak compute performance of \(312\text{ TFLOPS}\) (BF16) and a memory bandwidth of \(2.0\text{ TB/s}\), yielding a machine ridge point of \(I_{\text{knee}} = 156\text{ FLOP/byte}\). When serving a Transformer model with batch size \(b=1\), the arithmetic intensity is only \(I = 4.8\text{ FLOP/byte}\). What is the maximum achievable compute utilization (MFU) on this workload?
- Approximately \(3.1\%\) of peak compute throughput (memory-bandwidth bound)
- Exactly \(100\%\) because modern tensor cores execute batch \(b=1\) at peak speed
- Approximately \(50\%\) due to pipeline bubbles and kernel launches
- Approximately \(85\%\) because matrix-vector multiplications are compute-bound
A vendor publishes a marketing claim stating their new AI accelerator achieves ‘\(120\text{ TFLOPS}\) on Transformer inference.’ Which combination of parameters is essential to make this throughput figure technically actionable and reproducible?
- Only the silicon process node (e.g., \(4\text{ nm}\)) and the data center room temperature
- Numerical precision (e.g., INT8 vs. FP16), batch size, sequence length, software/compiler stack version, and sustained thermal operating state
- The brand of server power supply and the serial number of the host CPU
- Only the parameter count of the model, without specifying batch size or precision
Explain why a single benchmark run is insufficient to characterize ML system performance, identifying at least two distinct hardware or runtime sources of execution variance.
Compare the primary objectives and constraints of the MLPerf Closed Division versus the Open Division.
Explain how community-driven benchmarking consortia prevent vendor gaming and establish commensurable evidence for hardware procurement.
Order the following steps in the MLPerf benchmark execution and verification lifecycle from first to last:
- Submit execution logs, power traces, and configuration metadata to the MLCommons consortium
- Execute unmeasured warm-up iterations to populate caches and stabilize operating temperatures
- Lock down hardware frequencies, software environment, and driver configurations
- Execute the standardized benchmark harness while logging timestamped execution and energy metrics
- Undergo peer-review audit where competing organizations inspect logs for run-rule compliance
- Run the compliance validation suite to verify prediction outputs meet the target accuracy threshold
Mức độ chi tiết trong benchmark
Một kernel GPU dù chạy nhanh hơn 3\(\times\) khi chạy độc lập cũng có thể không mang lại bất kỳ tăng tốc tổng thể nào nếu pipeline dữ liệu không theo kịp. Sự thất bại trong chẩn đoán này khiến mức độ chi tiết khi đánh giá trở thành một quyết định thiết kế cốt lõi. Việc tiêu chuẩn hóa quy định cách đo lường sao cho nhất quán, trong khi độ chi tiết của benchmark xác định những gì cần đo. Mỗi khía cạnh đánh giá có thể được xem xét ở nhiều quy mô khác nhau, từ các thao tác riêng lẻ đến toàn bộ quy trình làm việc, và mỗi mức độ chi tiết sẽ hé lộ những loại vấn đề khác nhau:
- Micro benchmark tách riêng từng thành phần: thời gian thực thi kernel, mức sử dụng băng thông bộ nhớ, độ chính xác của từng lớp. Nhờ đó, chúng ta có thể chẩn đoán vấn đề xảy ra ở đâu.
- Macro benchmark đánh giá các hệ thống con: sự hội tụ khi huấn luyện toàn bộ mô hình, thông lượng của pipeline suy luận, các chỉ số độ chệch (bias) của tập dữ liệu. Các benchmark này sẽ cho biết những vấn đề gì đang tồn tại.
- Các benchmark đầu cuối đo lường toàn bộ quy trình làm việc, chẳng hạn như độ trễ từ lúc nhận yêu cầu đến khi trả phản hồi (bao gồm cả tiền xử lý), thời gian huấn luyện để đạt độ chính xác mong muốn (bao gồm cả thời gian tải dữ liệu), hay hiệu suất của mô hình trên phân phối dữ liệu thực tế trong môi trường sản xuất. Chúng cho thấy hệ thống có vận hành được hay không.
Các kỹ thuật tối ưu hóa từ Phần III hoạt động ở các mức độ chi tiết khác nhau (ví dụ, hợp nhất kernel (kernel fusion) hướng đến hiệu suất ở cấp độ vi mô, tỉa (pruning) tác động đến hành vi của mô hình ở cấp độ vĩ mô, còn quản lý dữ liệu quyết định khả năng tổng quát hóa của hệ thống từ đầu đến cuối), nên việc kiểm tra đánh giá cũng phải tương ứng. Một micro benchmark có thể cho thấy kernel được tăng tốc, nhưng một macro benchmark lại có thể chỉ ra các nút thắt cổ chai về bộ nhớ làm triệt tiêu lợi ích đó; tương tự, một benchmark đầu cuối có thể phát hiện các tắc nghẽn trong pipeline dữ liệu mà các cấp độ khác không thấy được.
Figure 2 minh họa các mức độ chi tiết này trên ngăn xếp ML bằng cách chia ngăn xếp thành bốn phạm vi đánh giá riêng biệt. Mỗi phạm vi lần lượt mở rộng ranh giới đo lường. Cụ thể, micro benchmark tập trung vào từng lớp mạng nơ-ron, macro benchmark bao quát toàn bộ mô hình, benchmark ứng dụng bổ sung các tính toán hỗ trợ, còn benchmark đầu cuối bao gồm toàn bộ ngữ cảnh triển khai, kể cả các thành phần không phải AI.

Micro benchmarks
Trong khi các benchmark đầu cuối giúp chúng ta thấy được hành vi tổng thể của hệ thống, thì việc tối ưu hóa đòi hỏi phải xác định chính xác thao tác nào đang tiêu tốn thời gian và năng lượng. Các micro benchmark phục vụ mục đích chẩn đoán này bằng cách cô lập từng phép toán tensor riêng lẻ, tức là các phép toán cơ bản được tối ưu hóa trong Tăng tốc phần cứng.
Hãy thử gỡ lỗi một pipeline suy luận chậm: các macro benchmark có thể chỉ ra độ trễ không thể chấp nhận được, nhưng chỉ các micro benchmark mới có thể tiết lộ liệu nút thắt cổ chai nằm ở các phép tích chập, cơ chế attention, sao chép bộ nhớ hay các hàm activation. Việc phân tách này giúp liên hệ khả năng lý thuyết của phần cứng với hiệu suất thực tế đạt được, bằng cách chỉ ra phép toán nào chịu chi phí.
Systems Perspective 1.4: Các quy tắc micro-benchmarking
Để tránh đo nhầm các yếu tố từ phần cứng thay vì hiệu suất thực sự của kernel, hãy tuân theo Các Quy tắc của Thám tử Hệ thống:
- Quy tắc khởi động (warm-up): Không đo các lần lặp khởi động lạnh (cold-start iterations) như thể đó là hiệu suất ở trạng thái ổn định. Phần cứng hiện đại sử dụng DVFS (điều chỉnh điện áp và tần số động) và tăng cường tần số động; vì vậy cache, kernel và xung nhịp cần được làm nóng trước khi vòng lặp đo đếm phản ánh hành vi bền vững.
- Quy tắc phương sai: Hãy báo cáo hệ số biến thiên (CV) \((\text{CV} = \sigma_{\text{run}} / \mu_{\text{run}})\), trong đó \(\sigma_{\text{run}}\) và \(\mu_{\text{run}}\) lần lượt là độ lệch chuẩn và giá trị trung bình trên các lần chạy lặp lại. Hãy điều tra các giá trị vượt quá ngưỡng dung sai đặc thù của khối lượng công việc (workload) trong giao thức; các nguyên nhân phổ biến gồm nhiễu từ hệ điều hành nền, điều tiết nhiệt (thermal throttling) và tranh chấp bộ nhớ. Lưu ý rằng 5 phần trăm không phải là một ngưỡng chung cho mọi trường hợp.
- Kiểm tra “tốc độ ánh sáng” (SOL): So sánh thông lượng đạt được với giới hạn lý thuyết (roofline). Nếu một kernel chỉ đạt 10 TFLOP/s trên H100 (trong khi đỉnh khoảng ~989 TFLOP/s cho FP16, hoặc ~1,979 TFLOP/s cho FP8 dense), bước chẩn đoán là xác định nguyên nhân khiến mức sử dụng thấp (thường do độ trễ khởi chạy vì có quá nhiều kernel nhỏ) trước khi tối ưu chính đoạn mã.
- Quy tắc trạng thái cache: Đặt trạng thái cache khớp với mục tiêu đo lường. Khi đo băng thông DRAM ở trạng thái “lạnh”, hãy xóa cache L2 hoặc dùng lượng dữ liệu vượt dung lượng L2; khi đo khả năng tái sử dụng ổn định, hãy giữ cache ở trạng thái “ấm”. Nếu không, kết quả băng thông DRAM thu được có thể chỉ phản ánh băng thông của cache (~5 TB/s–10 TB/s) thay vì băng thông thực của DRAM (~1 TB/s–2 TB/s).
Một mảng quan trọng của micro-benchmarking là các phép toán trên tensor, vốn là lõi tính toán của deep learning. Các thư viện như cuDNN11 (Chetlur et al. 2014) của NVIDIA cung cấp các hàm nguyên thủy được tối ưu cho những phép tính cốt lõi như tích chập và nhân ma trận trên nhiều cấu hình phần cứng. Micro-benchmark quanh các hàm này giúp nhà phát triển hiểu phần cứng của họ xử lý các phép toán toán học chiếm ưu thế trong khối lượng công việc (workload) của ML như thế nào.
11 cuDNN (thư viện mạng nơ-ron sâu CUDA): Được NVIDIA phát hành năm 2014, cuDNN cung cấp các kernel được tinh chỉnh thủ công cho các phép toán như tích chập, pooling và chuẩn hóa. Hệ quả với benchmarking: độ trễ suy luận được báo cáo phụ thuộc rất nhiều vào phiên bản cuDNN và các cài đặt của bộ điều chỉnh thuật toán được dùng, nên phiên bản cuDNN là yếu tố bắt buộc trong mọi đặc tả benchmark có thể tái tạo.
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
Đo lường đúng các phép toán này đòi hỏi tính kỷ luật. Một vài quy tắc đo lường ngắn gọn giúp tránh các lỗi thường gặp có thể khiến kết quả mất giá trị hoàn toàn.
Một profiler biến những quy tắc đo lường này thành bằng chứng vững chắc bằng cách phân rã thời gian thực thi thành ba phần: luân chuyển dữ liệu, thông lượng tính toán và chi phí độ trễ, như đã giới thiệu trong Định luật sắt của hệ thống ML.
Systems Perspective 1.5: Đo lường các số hạng của định luật sắt
Chuyển từ lý thuyết sang trace nghĩa là ánh xạ phương trình định luật sắt từ Định luật sắt của hệ thống ML lên dòng thời gian của một profiler (như Nsight Systems hay PyTorch Profiler).
Đo lường số hạng dữ liệu \(\left(\frac{D_{\text{vol}}}{\text{BW}}\right)\)
- Dấu hiệu nhận biết: Hãy tìm dòng “Memory Throughput” hoặc “DRAM Bandwidth”.
- Công thức: \(\text{BW}_{\text{effective}} = \frac{D_{\text{vol}}}{T_{\text{kernel}}}\).
- Chẩn đoán: Nếu \(\text{BW}_{\text{effective}} \approx \text{BW}_{\text{peak}}\) (ví dụ, gần với mức đỉnh 2.04 TB/s của A100), kernel bị giới hạn bởi bộ nhớ. Tối ưu hóa tính toán (\(O\)) sẽ không giúp gì.
Đo lường thông lượng tính toán đạt được \((R_{\text{peak}} \cdot \eta_{\text{hw}})\)
- Dấu hiệu nhận biết: Hãy tìm “SM Active” hoặc “Compute Throughput”.
- Công thức: \(\text{Achieved TFLOP/s} = \frac{O}{10^{12}\,T_{\text{kernel}}}\).
- Chẩn đoán: Nếu \(\text{Achieved TFLOP/s} \ll \text{Peak TFLOP/s}\) VÀ \(\text{BW}_{\text{effective}} \ll \text{BW}_{\text{peak}}\), hệ thống đang ở trong “Utilization Trap”: nhiều khả năng bị giới hạn bởi độ trễ (kernel quá nhỏ) hoặc bị giới hạn bởi lưới (không đủ luồng).
Đo lường số hạng độ trễ \((L_{\text{lat}})\)
- Dấu hiệu nhận biết: Hãy tìm các khoảng trống giữa các thanh kernel màu trên dòng thời gian.
- Công thức: \(\text{Overhead Ratio} = \frac{T_{\text{gap}}}{T_{\text{kernel}} + T_{\text{gap}}}\).
- Chẩn đoán: Mẫu hình “Răng cưa” (Tính toán, Khoảng trống, Tính toán, Khoảng trống) cho thấy chi phí phần mềm cao. Giải pháp là hợp nhất toán tử, được đề cập trong Hợp nhất kernel, hoặc CUDA Graphs, ghi lại một chuỗi các lần khởi chạy GPU lặp lại để runtime có thể phát lại với chi phí dispatch trên CPU thấp hơn.
Trong khi các benchmark như MLPerf cho biết một hệ thống nhanh đến mức nào, các công cụ micro-benchmark lại cho biết vì sao nó chậm. Để chẩn đoán, các kỹ sư dùng profiler cấp kernel để quan sát bên trong quá trình thực thi của từng phép toán.
Profiler của framework
Các công cụ như PyTorch Profiler ghi lại luồng thực thi logic của một bước huấn luyện hoặc suy luận. Chúng xác định lớp nào chi phối runtime, liệu công việc trên CPU và GPU có chồng lấp hay bị đồng bộ hóa không cần thiết, và liệu bộ nạp dữ liệu có cung cấp đủ dữ liệu cho bộ tăng tốc hay không. Chỉ số chẩn đoán là phân tích thời gian theo các phần tải dữ liệu, tính toán và giao tiếp, vì bức tranh này cho kỹ sư biết hệ con nào chịu trách nhiệm cho lần tối ưu tiếp theo.
Bộ phân tích kernel
Các công cụ như NVIDIA Nsight Systems and Compute ghi lại quá trình thực thi vật lý trên phần cứng. Chúng xác định xem một phép nhân ma trận bị giới hạn bởi tính toán hay bởi bộ nhớ, liệu các Streaming Multiprocessors có đạt mức sử dụng cao không, và liệu các truy cập bộ nhớ có tuân thủ các quy tắc hợp nhất không. Chỉ số chẩn đoán chính là vị trí trên biểu đồ roofline, vì tỉ lệ FLOP/s so với băng thông bộ nhớ sẽ cho biết liệu việc tăng thông lượng tính toán có giúp ích hay kernel đang phải chờ dữ liệu được di chuyển.
Quy trình làm việc được khuyến nghị là bắt đầu bằng Bộ phân tích framework để tìm ra lớp đang chạy chậm (ví dụ: “Attention Block chậm”). Sau đó, dùng Bộ phân tích kernel để chẩn đoán bản chất vật lý (ví dụ: “Kernel Softmax bị giới hạn bộ nhớ vì nó đọc quá nhiều byte trên mỗi FLOP”). Cách tiếp cận có mục tiêu này giúp tránh được cái bẫy “tối ưu hóa mà không đo lường”.
Các micro-benchmark cũng được dùng để kiểm tra riêng từng hàm activation và từng lớp mạng nơ-ron. Việc này bao gồm đo lường hiệu suất của các hàm activation khác nhau như rectified linear unit (ReLU), Sigmoid và Tanh trong điều kiện được kiểm soát, và đánh giá hiệu quả tính toán của các thành phần mạng nơ-ron riêng biệt như long short-term memory cells (ô nhớ dài-ngắn hạn) hay khối transformer khi xử lý các đầu vào tiêu chuẩn.
DeepBench (Baidu Research 2016), do Baidu phát triển, là một trong những dự án đầu tiên chứng minh giá trị của micro-benchmarking toàn diện. Công cụ này đánh giá các phép toán cốt lõi trên nhiều nền tảng phần cứng, cung cấp dữ liệu hiệu năng chi tiết giúp nhà phát triển tối ưu hóa các triển khai deep learning. Bằng cách tách và đo lường từng phép toán riêng lẻ, DeepBench cho phép so sánh chính xác giữa các nền tảng phần cứng và tìm ra các nút thắt hiệu năng tiềm ẩn.
Baidu Research. 2016. DeepBench: Benchmarking Deep Learning Operations on Different Hardware.
Những phép đo chi tiết này giúp tối ưu hóa chính xác, nhưng không cho thấy các thành phần tương tác ra sao khi ghép lại thành một mô hình hoàn chỉnh. Macro-benchmarks lấp đầy khoảng trống đó.
Macro-benchmarks
Micro-benchmarks xác nhận rằng các kernel tích chập riêng lẻ chạy nhanh. Macro-benchmarks cho biết mô hình hoàn chỉnh có vận hành tốt trong điều kiện thực tế hay không. Việc chuyển từ đánh giá ở mức thành phần sang mức mô hình cho thấy các lựa chọn kiến trúc và cách các thành phần tương tác ảnh hưởng thế nào đến hành vi tổng thể của mô hình. Chẳng hạn, micro-benchmarks có thể cho thấy hiệu năng tối ưu cho từng lớp tích chập, còn macro-benchmarks cho thấy các lớp đó phối hợp với nhau ra sao trong một mạng nơ-ron tích chập hoàn chỉnh.
Macro-benchmarks tồn tại để phục vụ một quyết định: chọn mô hình hoặc kiến trúc trong các điều kiện chuẩn hóa. Quyết định đó cần các khía cạnh hiệu năng chỉ lộ rõ ở cấp độ mô hình: độ chính xác dự đoán, cho biết mô hình tổng quát hóa tới dữ liệu mới tốt đến mức nào; kiểu tiêu thụ bộ nhớ theo các kích thước batch và độ dài chuỗi khác nhau; thông lượng dưới các mức tải tính toán khác nhau; và độ trễ trên các cấu hình phần cứng khác nhau. Những khía cạnh này tương tác theo những cách mà một micro-benchmark ở mức một lớp không thể bộc lộ. Một mô hình có thể thắng về độ chính xác nhưng lại thua khi dấu chân bộ nhớ ở độ dài chuỗi mục tiêu buộc phải giảm kích thước batch, kéo sụt thông lượng vốn là điểm hấp dẫn của nó—mối liên hệ chỉ thấy được khi đo cả mô hình như một khối hoàn chỉnh.
Việc đánh giá các mô hình hoàn chỉnh được thực hiện trong điều kiện chuẩn hóa, sử dụng các tập dữ liệu và tác vụ đã được thiết lập sẵn. Chẳng hạn, các mô hình thị giác máy tính có thể được đánh giá trên ImageNet (Deng et al. 2024), để đo lường cả hiệu quả tính toán lẫn độ chính xác dự đoán. Các mô hình xử lý ngôn ngữ tự nhiên có thể được đánh giá qua các tác vụ dịch thuật, xem xét cách chúng cân bằng giữa chất lượng và tốc độ trên các cặp ngôn ngữ khác nhau.
Ignatov, Andrey, and Radu Timofte. 2024. AI Benchmark.
Một số benchmark tiêu chuẩn ngành giúp việc so sánh các mô hình trở nên nhất quán và tái lập trên nhiều nền tảng khác nhau. Bộ benchmark MLPerf (Inference, Mobile, Client và Tiny) cung cấp các bộ thử nghiệm toàn diện, được điều chỉnh cho các môi trường tính toán từ trung tâm dữ liệu đến vi điều khiển, chi tiết tại section 1.8.4. Đối với các hệ thống nhúng, MLMark của EEMBC nhấn mạnh cả hiệu năng và hiệu quả sử dụng công suất, trong khi bộ AI-Benchmark (Ignatov and Timofte 2024) chuyên dùng cho các nền tảng di động.
Các benchmark đầu cuối
Các benchmark đầu cuối cung cấp đánh giá toàn diện nhất vì chúng bao trùm toàn bộ pipeline của một hệ thống AI, chứ không chỉ riêng mô hình. Điều này bao gồm xử lý dữ liệu theo mô hình extract, transform, load; suy luận của mô hình; hậu xử lý kết quả; và các thành phần hạ tầng thiết yếu như hệ thống lưu trữ và mạng.
Quá trình xử lý dữ liệu (trích xuất từ các hệ thống nguồn, chuyển đổi thông qua làm sạch và kỹ thuật đặc trưng, rồi tải vào các định dạng sẵn sàng cho mô hình) là nền tảng của pipeline. Các bước tiền xử lý này ảnh hưởng trực tiếp đến hiệu năng chung, và các benchmark đầu cuối phải đánh giá các tập dữ liệu chuẩn hóa thông qua các pipeline hoàn chỉnh để đảm bảo quá trình chuẩn bị dữ liệu không trở thành điểm nghẽn. Hậu xử lý cũng ảnh hưởng tương tự đến hiệu năng trong thực tế: một hệ thống thị giác máy tính cần hậu xử lý các biên phát hiện, áp dụng ngưỡng tin cậy và định dạng kết quả cho các ứng dụng tiếp theo trước khi người dùng nhận được phản hồi.
Các thành phần hạ tầng ảnh hưởng đáng kể đến hiệu năng chung, không chỉ riêng khối lượng công việc (workload) AI. Các giải pháp lưu trữ có thể chiếm phần lớn thời gian truy xuất dữ liệu khi làm việc với các tập dữ liệu AI lớn, và tương tác mạng trong các hệ thống phân tán có thể trở thành điểm nghẽn về hiệu năng. Các benchmark đầu cuối phải đánh giá các thành phần này dưới các điều kiện môi trường được quy định để đảm bảo các phép đo của toàn bộ hệ thống có thể lặp lại một cách nhất quán.
Các benchmark đầu-cuối công khai hiếm khi gói gọn trong một phép đo cả hiệu năng lưu trữ dữ liệu, mạng và tính toán. Mặc dù MLPerf Training và Inference tiệm cận việc đánh giá đầu-cuối, chúng vẫn chủ yếu tập trung vào hiệu năng mô hình hơn là các kịch bản triển khai thực tế. Dù vậy, chúng cung cấp các chỉ số chuẩn hữu ích để đánh giá năng lực hệ thống AI.
Vì tính đặc thù của benchmark đầu-cuối, các tổ chức thường tự thực hiện các đánh giá này bằng cách gắn công cụ đo vào các hệ thống đang triển khai trong môi trường sản xuất. Do các phép đo này rất nhạy cảm, chúng hiếm khi được công bố công khai; nhưng việc vắng bóng trong tài liệu không làm giảm tầm quan trọng của chúng.
Đánh đổi về mức độ chi tiết và tiêu chí lựa chọn
Table 4 cho thấy các thách thức khác nhau xuất hiện ở những giai đoạn khác nhau trong vòng đời của một hệ thống AI. Mỗi cách benchmark mang lại góc nhìn riêng: micro-benchmark giúp kỹ sư tối ưu những thành phần cụ thể như cách triển khai kernel trên GPU hoặc khâu nạp dữ liệu; macro-benchmark định hướng các quyết định về kiến trúc mô hình và lựa chọn thuật toán; còn các benchmark đầu-cuối làm lộ ra các nút thắt cổ chai ở cấp hệ thống trong môi trường sản xuất.
| Thành phần | Micro Benchmark | Macro Benchmark | End-to-End Benchmark |
|---|---|---|---|
| Trọng tâm | Các hoạt động riêng lẻ | Các mô hình hoàn chỉnh | pipeline hệ thống hoàn chỉnh |
| Phạm vi | Các hoạt động tensor, lớp, activation | Kiến trúc mô hình, huấn luyện, suy luận | Trích xuất, biến đổi, tải; mô hình; cơ sở hạ tầng |
| Ví dụ | Hiệu suất lớp tích chập trên cuDNN | ResNet-50 on ImageNet | Hệ thống đề xuất trong sản xuất |
| Ưu điểm | Xác định nút thắt chính xác, Tối ưu hóa thành phần | So sánh kiến trúc mô hình, Đánh giá tiêu chuẩn hóa | Đánh giá hiệu suất thực tế, Thông tin chi tiết toàn hệ thống |
| Thách thức | Có thể bỏ sót các hiệu ứng tương tác | Thông tin chi tiết về hạ tầng bị hạn chế | Phức tạp để chuẩn hóa, Thường là độc quyền |
| Sử dụng điển hình | Lựa chọn phần cứng, Tối ưu hóa hoạt động | Lựa chọn mô hình, So sánh nghiên cứu | Đánh giá hệ thống sản xuất |
Chỉ chọn một mức độ chi tiết hiếm khi đủ, vì luôn tồn tại sự đánh đổi giữa khả năng chẩn đoán chính xác và mức độ sát thực tế. Figure 3 mô tả sự đánh đổi này: micro-benchmark nằm ở đầu phổ có mức cô lập cao (chính xác nhưng phạm vi hẹp), còn các benchmark đầu-cuối nằm ở đầu có tính đại diện cao (thực tế nhưng khó chẩn đoán hơn). Không có điểm nào trên dải phổ này đáp ứng đồng thời cả hai: micro-benchmark chỉ ra chính xác kernel nào chậm nhưng bỏ sót các nút thắt ở cấp hệ thống, trong khi các benchmark đầu-cuối phản ánh hành vi trong sản xuất nhưng làm mờ nguyên nhân gốc. Điểm mấu chốt trong thực hành là: để đánh giá hệ thống học máy hiệu quả, cần kết hợp thông tin chuyên sâu từ cả ba cấp độ.

Sự tương tác giữa các thành phần thường tạo ra những hành vi bất ngờ mà các benchmark một cấp độ không phát hiện ra. Dù micro-benchmarks có thể cho thấy hiệu năng rất tốt cho từng thao tác riêng lẻ và macro-benchmarks có thể chứng minh độ chính xác của mô hình cao, đánh giá end-to-end có thể chỉ ra rằng khâu tiền xử lý dữ liệu lại tạo ra nút thắt cổ chai trong các giai đoạn lưu lượng cao. Những hiểu biết ở cấp độ hệ thống này sẽ bị che khuất nếu các thành phần được kiểm tra một cách cô lập.
Tuy nhiên, chọn mức độ chi tiết chỉ là một nửa bài toán thiết kế. Nửa còn lại là xác định rõ các thành phần cụ thể mà mọi benchmark đều cần: tác vụ, dữ liệu, mô hình và các chỉ số. Thiếu những thành phần này, dù chọn đúng mức độ chi tiết thì kết quả cũng chỉ là những con số vô nghĩa. Các thành phần của một benchmark quyết định liệu kết quả có chuyển hóa thành hiểu biết kỹ thuật có thể hành động hay chỉ tạo ra những con số trông ấn tượng nhưng sụp đổ khi xem xét kỹ.
Self-Check: Question
An e-commerce search service reports that production query latency has increased by \(40\%\), violating its SLA. Which benchmarking workflow represents the most effective top-down diagnostic strategy?
- Immediately rewrite all GEMM kernels in CUDA assembly without measuring the higher layers
- Run isolated microbenchmarks on the GPU memory bus to determine peak DRAM bandwidth
- Start with an end-to-end pipeline benchmark to isolate latency contributions across database lookup, tokenization, model inference, and reranking; next run macrobenchmarks on the slowest stage; then use microbenchmarks and kernel profilers to optimize the specific bottleneck operator
- Benchmark only the isolated tokenization library on CPU and assume the rest of the pipeline is unaffected
Consider the following three benchmarking tasks:
- Timing a single \(4096 \times 4096\) FP16 matrix multiplication in cuBLAS.
- Measuring the forward-pass execution time of a complete ResNet-50 model on a single GPU.
- Measuring total latency for an image upload, server decompression, feature extraction, neural network classification, and database metadata write. How are tasks (I), (II), and (III) classified by benchmarking granularity?
- End-to-end, (II) Micro, (III) Macro
- Macro, (II) Micro, (III) End-to-end
- Micro, (II) End-to-end, (III) Macro
- Microbenchmark, (II) Macrobenchmark (model-level), (III) End-to-end system benchmark
Compare microbenchmarks, macrobenchmarks, and end-to-end benchmarks along the axes of diagnostic isolation and real-world representativeness.
True or False: If an optimized FlashAttention kernel achieves a \(4\times\) microbenchmark speedup over a standard attention implementation, the complete language model inference service hosting that model is mathematically guaranteed to run \(4\times\) faster end-to-end.
Order the following benchmarking evaluation scopes from highest diagnostic isolation (lowest representativeness) to lowest diagnostic isolation (highest real-world representativeness):
- Complete serving system benchmark with web server, dynamic batching, and client network traffic
- Isolated cuBLAS FP16 matrix multiplication kernel microbenchmark
- Full Transformer neural network model forward-and-backward training pass (macrobenchmark)
- Fused multi-head self-attention layer subgraph benchmark
- End-to-end enterprise ML pipeline including database ETL, preprocessing, inference, and audit logging
Các thành phần của benchmark
Việc chọn mức độ chi tiết (micro, macro hay end-to-end) quyết định benchmark có thể chẩn đoán điều gì, nhưng ở mọi mức, mỗi benchmark vẫn phải nêu rõ tác vụ, dữ liệu, mô hình, các chỉ số, harness, ngữ cảnh hệ thống và các quy tắc chạy để kết quả có thể được diễn giải. Micro-benchmarks cần đầu vào tổng hợp để cô lập các mẫu tính toán cụ thể; macro-benchmarks cần các tập dữ liệu đại diện như ImageNet; end-to-end benchmarks phải dùng dữ liệu thực tế với mọi nhiễu và sự thay đổi phân phối của nó. Dù khác nhau, tất cả các benchmark đều có một vấn đề chung khi triển khai: mỗi thành phần phải ràng buộc thành phần kế tiếp để con số cuối cùng có ý nghĩa và có thể bảo vệ được.
Các thành phần thiết yếu liên kết với nhau thành một pipeline đánh giá hoàn chỉnh. Quy trình trong figure 4 mô tả chín giai đoạn của một benchmark phát hiện bất thường âm thanh công nghiệp, từ định nghĩa vấn đề, qua lượng tử hoá, đến triển khai nhúng trên ARM. Điểm mấu chốt là sự phụ thuộc tuần tự: định nghĩa bài toán giới hạn những tập dữ liệu hợp lệ; thuộc tính của tập dữ liệu quyết định kiến trúc mô hình nào khả thi; và phần cứng đích sẽ chi phối lựa chọn lượng tử hoá và biên dịch. Phát hiện bất thường là ví dụ minh hoạ tốt vì bao trùm toàn bộ quy trình, gắn độ chính xác suy luận ML với các ràng buộc của hệ thống nhúng như dung lượng bộ nhớ, ngân sách công suất và độ trễ thời gian thực. Một benchmark chỉ đo độ chính xác phân loại hoặc chỉ đo tốc độ suy luận sẽ bỏ qua sự tương tác giữa các giai đoạn này, nơi một quyết định ở bất kỳ điểm nào cũng truyền tiếp và thu hẹp mọi lựa chọn tiếp theo.

Thiết kế benchmark hiệu quả phải tính đến các kỹ thuật tối ưu hoá đã trình bày ở các chương trước. Lượng tử hoá và tỉa (pruning) ảnh hưởng đến đánh đổi độ chính xác–hiệu quả của mô hình, nên benchmark cần đo đồng thời cả mức tăng tốc và mức duy trì độ chính xác. Các kỹ thuật tăng tốc phần cứng tác động đến cường độ tính toán số học và mức sử dụng băng thông bộ nhớ, đòi hỏi phân tích bằng Roofline Model để diễn giải kết quả cho đúng. Nắm vững các nền tảng tối ưu hoá này giúp chọn benchmark phù hợp để xác thực các cải tiến đã công bố, thay vì đo các kịch bản không thực tế.
Định nghĩa vấn đề
Mọi benchmark đều bắt đầu bằng việc xác định chính xác hệ thống phải làm gì. Hệ thống phát hiện bất thường trong figure 4 xử lý tín hiệu âm thanh để nhận diện các sai lệch so với mẫu vận hành bình thường—một ứng dụng giám sát công nghiệp minh họa cách đặc tả nhiệm vụ chính thức được đưa vào triển khai thực tế. Dù từng lĩnh vực có nhiệm vụ rất khác nhau (xử lý ngôn ngữ tự nhiên gồm dịch máy, trả lời câu hỏi (Hirschberg and Manning 2015) và phân loại văn bản; thị giác máy tính dùng phát hiện đối tượng và phân đoạn hình ảnh (Everingham et al. 2009; Lin et al. 2014)), mọi đặc tả nhiệm vụ benchmark đều phải nêu rõ ba yếu tố cốt yếu: đặc tả đầu vào (hệ thống xử lý dữ liệu gì), đặc tả đầu ra (hệ thống phải tạo ra phản hồi gì) và đặc tả hiệu suất (các yêu cầu định lượng về độ chính xác, tốc độ và mức sử dụng tài nguyên).
Hirschberg, Julia, and Christopher D. Manning. 2015. “Advances in Natural Language Processing.” Science 349 (6245): 261–66. https://doi.org/10.1126/science.aaa8685.
Everingham, Mark, Luc Van Gool, Christopher K. I. Williams, John Winn, and Andrew Zisserman. 2009. “The Pascal Visual Object Classes (VOC) Challenge.” International Journal of Computer Vision 88 (2): 303–38. https://doi.org/10.1007/s11263-009-0275-4.
Thiết kế nhiệm vụ ảnh hưởng trực tiếp đến khả năng đánh giá hệ thống AI của benchmark. Ví dụ phát hiện bất thường âm thanh cho thấy điều này qua các yêu cầu cụ thể: xử lý dữ liệu tín hiệu liên tục, thích ứng với các điều kiện nhiễu khác nhau, và vận hành trong các ràng buộc thời gian nghiêm ngặt. Những ràng buộc thực tế này tạo ra một framework đánh giá phản ánh đúng yêu cầu vận hành ngoài đời. Mỗi giai đoạn tiếp theo của việc hiện thực benchmark, từ lựa chọn tập dữ liệu đến triển khai, đều xây dựng trực tiếp trên các đặc tả ban đầu này.
Các tập dữ liệu chuẩn hóa
Định nghĩa nhiệm vụ chỉ tốt tương ứng với dữ liệu dùng để đánh giá nó. Các tập dữ liệu chuẩn hóa đảm bảo mọi mô hình được kiểm tra trong cùng điều kiện, cho phép so sánh trực tiếp giữa các cách tiếp cận khác nhau—nếu không có chúng, mỗi nhóm sẽ đánh giá trên dữ liệu riêng, khiến việc so sánh giữa các phòng thí nghiệm trở nên bất khả thi. Trong thị giác máy tính, ImageNet (Deng et al. 2024, 2009), COCO (Lin et al. 2014) và CIFAR-10 (Krizhevsky 2009) là các chuẩn tham chiếu; trong xử lý ngôn ngữ tự nhiên, SQuAD12 (Rajpurkar et al. 2016), GLUE13 (Wang et al. 2018) và WikiText (Merity 2016; Merity et al. 2016) giữ vai trò tương tự, mỗi tập dữ liệu bao quát nhiều mức độ phức tạp và các trường hợp biên.
Deng, Jia, Wei Dong, Richard Socher, Li-Jia Li, Kai Li, and Li Fei-Fei. 2024. ImageNet.
Lin, Tsung-Yi, Michael Maire, Serge Belongie, James Hays, Pietro Perona, Deva Ramanan, Piotr Dollár, and C. Lawrence Zitnick. 2014. “Microsoft COCO: Common Objects in Context.” In European Conference on Computer Vision (ECCV). Springer. https://doi.org/10.1007/978-3-319-10602-1_48.
12 SQuAD (Tập dữ liệu trả lời câu hỏi của Stanford): Ra mắt năm 2016 với hơn 100.000 cặp câu hỏi–trả lời từ Wikipedia (Rajpurkar et al. 2016). Đến 2018, các hệ thống AI đã vượt mốc F1 của con người là 91,2% trên SQuAD 1.1 (Devlin et al. 2019), nhưng kết quả “siêu việt” này lại cho thấy một kiểu thất bại khi đánh giá bằng benchmark: định dạng trả lời trích xuất (câu trả lời là các đoạn văn bản nằm trong bài) khiến bài toán dễ hơn so với trả lời câu hỏi mở, làm thổi phồng năng lực so với các hệ thống NLP triển khai ngoài thực tế.
Rajpurkar, Pranav, Jian Zhang, Konstantin Lopyrev, and Percy Liang. 2016. “SQuAD: 100,000+ Questions for Machine Comprehension of Text.” Proceedings of the 2016 Conference on Empirical Methods in Natural Language Processing, 2383–92. https://doi.org/10.18653/v1/d16-1264.
13 GLUE (đánh giá hiểu ngôn ngữ tổng quát): Được giới thiệu vào năm 2018 như một benchmark hiểu ngôn ngữ rộng (Wang et al. 2018), GLUE nhanh chóng bị các hệ thống như BERT (Devlin et al. 2019) “bão hòa” (đạt điểm quá cao). Đây là Định luật Goodhart thể hiện rõ: khi GLUE trở thành mục tiêu, việc tối ưu hóa để leo bảng xếp hạng đã làm giảm khả năng phân biệt của nó. Xu hướng này thúc đẩy các đánh giá kế tiếp khó hơn như SuperGLUE và BIG-bench.
Wang, Alex, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy, and Samuel R. Bowman. 2018. “GLUE: A Multi-Task Benchmark and Analysis Platform for Natural Language Understanding.” Proceedings of the 2018 EMNLP Workshop BlackboxNLP: Analyzing and Interpreting Neural Networks for NLP, 353–55. https://doi.org/10.18653/v1/w18-5446.
Devlin, Jacob, Ming-Wei Chang, Kenton Lee, and Kristina Toutanova. 2019. “BERT: Pre-Training of Deep Bidirectional Transformers for Language Understanding.” Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, 4171–86. https://doi.org/10.18653/v1/n19-1423.
Merity, Stephen. 2016. The WikiText Long Term Dependency Language Modeling Dataset.
Merity, Stephen, Caiming Xiong, James Bradbury, and Richard Socher. 2016. “Pointer Sentinel Mixture Models.” arXiv Preprint arXiv:1609.07843.
14 ToyADMOS: Được NTT Communications phát triển năm 2019 cho bài toán phát hiện bất thường âm thanh, gồm các bản ghi âm từ ô tô đồ chơi, băng chuyền đồ chơi và các âm thanh vận hành của các máy móc thu nhỏ liên quan (Koizumi et al. 2019). Tiền tố “toy” (đồ chơi) là có chủ ý: môi trường kiểm soát cho phép benchmark có tính tái lập, nhưng có thể tạo ra khoảng cách miền (domain gap) khi đưa mô hình sang các môi trường công nghiệp ồn ào hơn, với máy móc, cảm biến, rung động và âm thanh nền khác biệt.
Koizumi, Yuma, Shoichiro Saito, Hisashi Uematsu, Noboru Harada, and Keisuke Imoto. 2019. “ToyADMOS: A Dataset of Miniature-Machine Operating Sounds for Anomalous Sound Detection.” 2019 IEEE Workshop on Applications of Signal Processing to Audio and Acoustics (WASPAA), 313–17. https://doi.org/10.1109/waspaa.2019.8937164.
Warden, Pete. 2018. “Speech Commands: A Dataset for Limited-Vocabulary Speech Recognition.” arXiv Preprint arXiv:1804.03209, ahead of print. https://doi.org/10.48550/arXiv.1804.03209.
Việc chọn tập dữ liệu là điểm đầu tiên nơi một benchmark có thể mất liên hệ với thực tế triển khai. Trong ví dụ phát hiện bất thường âm thanh (figure 4), tập dữ liệu phải bao gồm các mẫu dạng sóng đại diện cho hoạt động bình thường cùng với các ví dụ bao quát về điều kiện bất thường. Các bộ sưu tập theo từng miền phục vụ các tác vụ âm thanh khác nhau: ToyADMOS14 (Koizumi et al. 2019) hỗ trợ nghiên cứu phát hiện bất thường trong môi trường kiểm soát, còn Google Speech Commands (Warden 2018) hỗ trợ nhận dạng từ khóa. Để một tập dữ liệu benchmark thực sự hiệu quả, cần cân bằng hai yêu cầu: phản ánh chính xác các thách thức ngoài đời thực, đồng thời đủ phức tạp để phân biệt hiệu suất giữa các mô hình. Các tập dữ liệu đơn giản như ToyADMOS hữu ích cho việc phát triển phương pháp, nhưng có thể không bao quát hết độ phức tạp của môi trường vận hành thực tế.
Lựa chọn mô hình
Khi đã xác định tác vụ và dữ liệu, benchmark phải định nghĩa những mô hình nào sẽ được đánh giá và so sánh với các mô hình cơ sở nào. Lựa chọn này không đơn giản như nhìn qua: cách benchmark chọn mô hình sẽ quyết định kết quả phản ánh điều gì—đổi mới kiến trúc, chất lượng triển khai, hay chỉ là các tối ưu hóa đặc thù của framework. Quá trình lựa chọn dựa trên các nền tảng kiến trúc đã trình bày ở Kiến trúc mạng và cần tính đến các yếu tố về framework đã thảo luận tại Các Framework ML.
Các mô hình cơ sở đóng vai trò điểm tham chiếu, từ những triển khai cơ bản (hồi quy tuyến tính, hồi quy logistic) đến các kiến trúc tiên tiến đã chứng minh hiệu quả trong các miền tương tự. Trong NLP, các mô hình như BERT15 đã trở thành chuẩn cơ sở. Quan trọng là việc chọn mô hình cơ sở còn phụ thuộc vào framework dùng để triển khai: một triển khai PyTorch có thể có đặc tính hiệu năng khác với phiên bản TensorFlow tương đương do các tối ưu hóa và cách hiện thực toán tử đặc thù của từng framework, nên benchmark phải kiểm soát biến số này.
15 BERT (biểu diễn bộ mã hóa hai chiều dựa trên transformer): BERT-Large (340M tham số) là một khối lượng công việc (workload) xử lý ngôn ngữ trong MLPerf Inference. Benchmark này cố định tác vụ, dữ liệu, mục tiêu chất lượng và các kịch bản thực thi, nhờ đó các hệ thống có thể so sánh trên cùng một khối lượng công việc (workload). Độ trễ của BERT vẫn phụ thuộc vào độ dài chuỗi, cách thực hiện batch và cách triển khai.
Khi kiến trúc đã được chọn, quá trình phát triển mô hình đi theo hai hướng tối ưu hóa song song mà benchmark phải theo dõi. Tối ưu hóa huấn luyện tập trung vào việc đạt độ chính xác mục tiêu trong các giới hạn tính toán. Tối ưu hóa suy luận xử lý giai đoạn đưa vào sản xuất—đặc biệt là giảm độ chính xác số học từ FP32 xuống INT8 hoặc thấp hơn, đòi hỏi hiệu chuẩn cẩn thận để vừa giữ được độ chính xác, vừa giảm nhu cầu tài nguyên. Benchmark phải nêu rõ yêu cầu cho cả hai hướng, vì một mô hình huấn luyện hiệu quả nhưng triển khai kém (hoặc ngược lại) sẽ trượt bài đánh giá tổng thể. Việc tối ưu hóa kép này tự nhiên đòi hỏi các chỉ số định lượng bao phủ cả ba chiều của framework benchmarking.
Các chỉ số đánh giá
Các chỉ số đánh giá16 giúp biến hành vi thô của mô hình thành những con số có thể so sánh, xếp hạng và dùng để ra quyết định kỹ thuật. Thách thức là chọn đúng con số: một chỉ số nắm bắt độ chính xác nhưng bỏ qua độ trễ có thể tôn vinh một mô hình quá chậm để đưa vào sản xuất; một chỉ số ưu tiên thông lượng nhưng bỏ qua mức tiêu thụ năng lượng có thể dẫn đến tối ưu hóa cho một ngân sách triển khai không tồn tại.
16 Metric: Trong toán học, một metric là một hàm khoảng cách thỏa mãn các tiên đề chặt chẽ bao gồm bất đẳng thức tam giác. Trong ML, thuật ngữ này được mượn một cách lỏng để chỉ các phép đo định lượng như BLEU và perplexity, vốn là các quy tắc chấm điểm chứ không phải metric theo nghĩa toán học. Thứ hạng trên bảng xếp hạng có thể thay đổi khi giao thức đánh giá, lát cắt của tập dữ liệu, hoặc trọng số chỉ số thay đổi, khiến việc chọn chỉ số trở thành một quyết định kỹ thuật định hình hệ thống nào chiến thắng, chứ không chỉ là cách chúng ta đo lường.
Table 5 nên được xem như một công cụ hỗ trợ ra quyết định: nó phân loại các chỉ số theo kiểu lỗi mà mỗi chỉ số phơi lộ và ngữ cảnh triển khai mà nó phục vụ.
| Danh mục | Chỉ số | Đơn vị | Trường hợp sử dụng chính |
|---|---|---|---|
| Độ chính xác | Độ chính xác Top-1/Top-5 | Phần trăm | Phân loại |
| mAP (mean Average Precision) | Điểm số 0–1 | Phát hiện đối tượng | |
| BLEU/ROUGE | Điểm số 0–100 | Tạo sinh NLP | |
| Perplexity | Điểm số (càng thấp càng tốt) | Mô hình hóa ngôn ngữ | |
| Thông lượng | Mẫu/giây | Mẫu/s | Suy luận theo batch |
| Thông lượng token | tokens/s | Suy luận LLM | |
| Thời gian huấn luyện | Giờ/ngày | benchmarks huấn luyện | |
| Độ trễ | Độ trễ p50 | Mili giây | Thời gian phản hồi trung vị |
| Độ trễ p99 | Mili giây | Độ trễ đuôi (SLA) | |
| Độ trễ token đầu tiên | Mili giây | Khả năng phản hồi của LLM | |
| Hiệu quả | Mẫu/giây/watt | Mẫu/s/W | Hiệu quả năng lượng |
| Độ chính xác/FLOP | phần trăm/PFLOP | Hiệu quả thuật toán | |
| TCO mỗi suy luận | $/suy luận | Hiệu quả kinh tế |
Có vài điểm khác biệt quan trọng trong cách phân loại này cần được nhấn mạnh. Thông lượng đo tổng dung lượng xử lý (rất phù hợp cho xử lý batch), trong khi độ trễ đo thời gian phản hồi của từng yêu cầu riêng lẻ (rất quan trọng cho các ứng dụng tương tác). Các chỉ số này thường mâu thuẫn nhau: tối đa hóa thông lượng bằng batching thường làm tăng độ trễ cho mỗi yêu cầu. Độ trễ trung bình có thể che giấu vấn đề ở phần đuôi—ví dụ, một hệ thống có độ trễ trung bình 10 ms nhưng độ trễ p99 lên tới 500 ms sẽ không đáp ứng được yêu cầu SLA. Trong môi trường sản xuất, các phân vị (p50, p95, p99) cung cấp thông tin hữu ích hơn nhiều so với giá trị trung bình. Cuối cùng, các chỉ số tổng hợp như mẫu/giây/watt gộp nhiều chiều vào một con số duy nhất, giúp so sánh nhanh nhưng có thể che khuất các nút thắt cổ chai cụ thể. Báo cáo cả chỉ số đơn lẻ và chỉ số tổng hợp sẽ cho bức tranh đầy đủ.
Việc lựa chọn chỉ số phải phù hợp với mục tiêu của tác vụ và các ràng buộc triển khai, vì cùng một hành vi mô hình có thể cho ra các điểm số khác nhau giữa các framework. Các phương pháp huấn luyện ở Huấn luyện mô hình cho thấy mỗi framework xử lý việc tính toán hàm mất mát và tích lũy gradient khác nhau, từ đó ảnh hưởng đến các chỉ số báo cáo. Ngay cả khác biệt nhỏ trong cách triển khai, chẳng hạn cách xử lý batch normalization ở chế độ đánh giá, cũng có thể làm thay đổi độ chính xác đo được đủ lớn để trở nên đáng kể khi chênh lệch benchmark rất nhỏ.
Các chỉ số theo từng tác vụ giúp định lượng mức độ mô hình thực hiện đúng chức năng dự kiến. Chẳng hạn, các tác vụ phân loại dùng các chỉ số như accuracy (tỷ lệ dự đoán đúng tổng thể), precision (độ chính xác của các dự đoán dương), recall (tỷ lệ phát hiện các trường hợp dương), và F1 score (trung bình điều hòa giữa precision và recall) (Sokolova and Lapalme 2009). Bài toán hồi quy dùng các thước đo lỗi như Mean Squared Error (MSE) và Mean Absolute Error (MAE) để đánh giá độ chính xác của dự đoán. Nhiều ứng dụng theo miền đòi hỏi chỉ số chuyên biệt; ví dụ, dịch máy dùng BLEU17 để đo độ chính xác n-gram đã điều chỉnh khi so sánh với một hoặc nhiều bản dịch tham chiếu của con người (Papineni et al. 2002).
17 BLEU (bilingual evaluation understudy): Được IBM giới thiệu vào năm 2002, BLEU đo lường chất lượng bản dịch bằng cách tính độ chính xác n-gram đã điều chỉnh, kèm hình phạt độ ngắn, so với các bản dịch tham chiếu (Papineni et al. 2002). BLEU là một ví dụ điển hình của Định luật Goodhart trong ML: tối ưu hóa để khớp n-gram có thể thưởng cho mức độ trùng lặp từ ngữ ở bề mặt, ngay cả khi ý nghĩa, độ trôi chảy hoặc tính hữu dụng khi triển khai lệch khỏi mục tiêu.
Papineni, Kishore, Salim Roukos, Todd Ward, and Wei-Jing Zhu. 2002. “Bleu: A Method for Automatic Evaluation of Machine Translation.” Proceedings of the 40th Annual Meeting on Association for Computational Linguistics - ACL ’02, 311–18. https://doi.org/10.3115/1073083.1073135.
Khi đưa vào sản xuất, ta bổ sung các chỉ số triển khai bên cạnh chỉ số tác vụ. Kích thước mô hình, đo bằng số tham số hoặc mức chiếm dụng bộ nhớ, ảnh hưởng trực tiếp đến tính khả thi khi triển khai trên các nền tảng phần cứng khác nhau. Độ trễ xử lý, thường tính bằng mili giây trên mỗi suy luận, quyết định liệu mô hình có đáp ứng yêu cầu thời gian thực hay không. Mức tiêu thụ năng lượng, đo bằng watt hoặc joule trên mỗi suy luận, cho biết hiệu quả vận hành. Những cân nhắc thực tế này phản ánh nhu cầu ngày càng tăng về các giải pháp cân bằng giữa độ chính xác và hiệu quả tính toán. Các thách thức vận hành trong việc duy trì các chỉ số này trong môi trường sản xuất sẽ được trình bày trong các chiến lược triển khai (Vận hành machine learning).
Do đó, benchmark cần một bộ chỉ số phù hợp với cả yêu cầu tác vụ và các ràng buộc triển khai. Một chỉ số duy nhất hiếm khi bao quát hết các khía cạnh liên quan đến hiệu suất trong các tình huống thực tế. Ví dụ, trong các hệ thống phát hiện bất thường, chỉ riêng độ chính xác cao có thể không cho thấy hiệu suất tốt nếu mô hình tạo ra quá nhiều cảnh báo sai. Tương tự, một mô hình nhanh nhưng độ chính xác kém cũng sẽ không mang lại giá trị thực tiễn.
Cách tiếp cận đánh giá đa chỉ số này được thể hiện rõ trong hệ thống phát hiện bất thường, nơi hiệu suất được báo cáo theo nhiều khía cạnh: kích thước mô hình (270K tham số), độ trễ xử lý (10.4 ms/suy luận), độ chính xác phát hiện (0.86 AUC), và mức tiêu thụ năng lượng (516 μJ trên mỗi suy luận). Sự kết hợp các chỉ số này giúp đảm bảo mô hình đáp ứng cả yêu cầu kỹ thuật và vận hành trong các tình huống triển khai thực tế.
Bộ khung benchmark
Các chỉ số xác định đo cái gì; bộ khung benchmark quyết định đo như thế nào. Bộ khung này là hạ tầng kiểm thử, có nhiệm vụ cung cấp dữ liệu đầu vào cho hệ thống cần kiểm thử, thu thập các phép đo và đảm bảo toàn bộ quá trình có thể tái tạo được. Nếu không có một bộ khung được thiết kế tốt, ngay cả những chỉ số được chọn hoàn hảo cũng có thể cho ra số liệu không đáng tin cậy.
Thiết kế bộ khung phải phù hợp với kịch bản triển khai dự định. Chẳng hạn, khi triển khai trên máy chủ, bộ khung sẽ tạo ra các kiểu yêu cầu mô phỏng lưu lượng truy cập thực tế, thường dùng phân phối Poisson18 để mô phỏng các khối lượng công việc (workload) ngẫu nhiên nhưng có tính nhất quán thống kê, đồng thời quản lý các yêu cầu đồng thời và cường độ tải khác nhau.
18 Phân phối Poisson: Được đặt theo tên Siméon Denis Poisson, người đã chính thức hóa nó vào năm 1837 khi mô hình hóa tỷ lệ kết án sai trong các tòa án Pháp. Phân phối này mô tả các sự kiện độc lập xảy ra với tốc độ trung bình hằng số \((\lambda_{\text{arr}})\) và thường được dùng làm cơ sở để mô hình hóa các yêu cầu gửi đến máy chủ. Tuy nhiên, lưu lượng phục vụ (serving) ML thực tế hay vi phạm các giả định này do tính bùng nổ, tương quan và tốc độ thay đổi theo thời gian. Vì thế, một bộ kiểm thử theo Poisson có thể ước tính sai độ trễ ở phần đuôi, trừ khi các bản ghi (trace) hoặc các kịch bản kiểm thử chịu tải (stress case) bao phủ được các mẫu lưu lượng như ngoài thực tế.
Đối với các ứng dụng nhúng và di động, bộ kiểm thử tạo ra các kiểu đầu vào phản ánh đúng điều kiện triển khai thực tế. Ví dụ, nó có thể chèn ảnh tuần tự cho các ứng dụng thị giác trên thiết bị di động, hoặc tạo luồng dữ liệu nhiều cảm biến được đồng bộ cho các hệ thống tự hành. Việc tạo đầu vào chính xác và kiểm soát thời gian chặt chẽ như vậy giúp hệ thống trải nghiệm các kiểu vận hành thực tế, qua đó bộc lộ các đặc tính hiệu năng sẽ xuất hiện khi triển khai trên thiết bị.
Bộ kiểm thử cũng phải hỗ trợ các mô hình thông lượng khác nhau. Các kịch bản xử lý theo batch đòi hỏi khả năng đánh giá hiệu năng hệ thống với lượng lớn đầu vào song song, trong khi các ứng dụng thời gian thực cần kiểm soát thời gian chính xác cho xử lý tuần tự. Ở giai đoạn triển khai hệ thống nhúng, bộ kiểm thử phải hỗ trợ đo chính xác thời gian suy luận và năng lượng tiêu thụ cho mỗi thao tác.
Để bảo đảm khả năng tái lập, bộ kiểm thử cần duy trì điều kiện kiểm thử nhất quán giữa các lần chạy đánh giá. Điều này bao gồm kiểm soát các yếu tố môi trường như tiến trình chạy nền, điều kiện nhiệt và các trạng thái công suất có thể ảnh hưởng đến phép đo hiệu năng. Bộ kiểm thử cũng phải cung cấp cơ chế thu thập và ghi log các chỉ số hiệu năng mà không gây ảnh hưởng đáng kể đến hệ thống đang được kiểm thử.
Thông số kỹ thuật hệ thống
Bổ sung cho bộ kiểm thử điều khiển quá trình thực thi, thông số kỹ thuật hệ thống ghi lại đầy đủ môi trường tính toán: ngăn xếp phần cứng và phần mềm nơi benchmark chạy. Nếu thiếu thông số kỹ thuật chính xác, con số thông lượng được báo cáo sẽ mất ý nghĩa: cùng một mô hình có thể huấn luyện nhanh hơn nhiều trên bộ tăng tốc mới so với bộ tăng tốc cũ, nên bối cảnh phần cứng là yếu tố không thể tách rời khỏi kết quả.
Về phần cứng, các thông số kỹ thuật cần nêu rõ loại bộ xử lý và tốc độ xung nhịp, loại/bản mô hình bộ tăng tốc và bộ nhớ của nó (GPU, TPU hoặc ASIC tùy chỉnh), RAM hệ thống, loại lưu trữ, cũng như cấu hình mạng cho các thiết lập phân tán. Về phần mềm, cần ghi lại hệ điều hành, phiên bản framework (ví dụ: PyTorch 2.1 so với TensorFlow 2.14), các cờ biên dịch và công cụ quản lý môi trường như container Docker hoặc môi trường ảo. Mức độ chi tiết này giúp các nhà nghiên cứu khác tái tạo môi trường benchmark với độ chính xác cao và cung cấp bối cảnh quan trọng để diễn giải khác biệt về hiệu năng.
Nhiều benchmark báo cáo kết quả trên nhiều cấu hình phần cứng khác nhau, chính vì những đánh đổi giữa độ phức tạp của mô hình, tài nguyên tính toán và hiệu năng chỉ hiện rõ qua phân tích so sánh. Khi lĩnh vực này ngày càng ưu tiên tính bền vững, các thông số kỹ thuật nay còn bao gồm chỉ số tiêu thụ năng lượng như FLOP/s trên mỗi watt và tổng công suất tiêu thụ trong suốt thời gian huấn luyện, phản ánh nhận thức ngày càng rõ rằng hiệu quả tính toán là một yêu cầu kỹ thuật, chứ không chỉ là một mục tiêu vì môi trường.
Quy tắc chạy
Thông số kỹ thuật của hệ thống mô tả môi trường mà benchmark chạy trên đó; còn các quy tắc chạy sẽ quy định cách thức benchmark hoạt động. Những ràng buộc về quy trình này giúp kết quả có thể diễn giải và tái tạo được, điều này khó hơn nhiều so với tưởng tượng trong một lĩnh vực mà các quá trình ngẫu nhiên (như khởi tạo trọng số, xáo trộn dữ liệu và mặt nạ dropout) có nghĩa là hai lần chạy trên cùng một phần cứng có thể cho ra kết quả khác nhau. Một giao thức có thể cố định seed và thứ tự dữ liệu khi muốn tách biệt các ảnh hưởng của hệ thống, hoặc yêu cầu chạy nhiều lần và đặt ra ngưỡng chất lượng khi sự biến động ngẫu nhiên là một phần của khối lượng công việc (workload). Trong cả hai trường hợp, chính sách seed và các nguồn gây ra tính phi xác định đã biết phải được nêu rõ.
Việc lập tài liệu cho các siêu tham số cũng quan trọng không kém. Thay đổi tốc độ học có thể làm dịch chuyển điểm hội tụ và độ chính xác cuối cùng, nên để tái tạo được kết quả cần ghi lại mọi thiết lập cấu hình có thể ảnh hưởng đến kết quả. Tương tự, phải chỉ rõ phiên bản tập dữ liệu, cách chia tách và các bước tiền xử lý. Khi quyền riêng tư hoặc giấy phép ngăn cản việc chia sẻ dữ liệu trực tiếp, báo cáo phải nêu rõ hạn chế đó và lưu giữ đủ thông tin về nguồn gốc và các bước biến đổi để đánh giá khả năng so sánh.
Xuất xứ mã hoàn tất chuỗi tái lập. Các giao thức benchmark chặt chẽ phải giữ nguyên phiên bản hiện thực—không chỉ mô hình, mà cả mã tiền xử lý, huấn luyện và đánh giá liên quan—và nêu rõ liệu mã đó có thể chia sẻ hay không. Các bộ tham chiếu có thể phân phối các môi trường dạng container bao trùm phụ thuộc và cấu hình; trong khi đó, nhật ký thí nghiệm lưu lại các chỉ số huấn luyện, checkpoint và mọi điều chỉnh giữa chừng trong lúc chạy. Cùng nhau, những bản ghi này biến một phép đo một lần thành bằng chứng để nhóm khác có thể kiểm tra và, khi có quyền truy cập, tái lập.
Diễn giải kết quả
Việc tạo ra các con số benchmark thì dễ; diễn giải đúng mới là nơi hầu hết kỹ sư dễ mắc sai. Một con số thông lượng thô hoặc điểm độ chính xác sẽ vô nghĩa nếu không hiểu rõ các điều kiện tạo ra nó, độ tin cậy thống kê đằng sau nó, và ngữ cảnh triển khai quyết định liệu con số đó có quan trọng hay không.
Example 1.2: Benchmark mô hình thị giác để triển khai trên edge
Kịch bản: Một nhóm AI edge đánh giá MobileNetV2 cho bẫy camera động vật hoang dã trên Raspberry Pi 4 trong điều kiện giới hạn nghiêm ngặt về độ trễ và kích thước mô hình (Sandler et al. 2018).
Chẩn đoán: Khi thực thi FP32, độ trễ là 120 ms (8.3 FPS) và kích thước 14 MB. Lượng tử hoá INT8 giúp tăng tốc suy luận lên 3.4× lần, đưa độ trễ xuống 35 ms (28.6 FPS) và giảm kích thước mô hình 4× lần, đổi lại là giảm 0.9 percentage points độ chính xác Top-1.
Bài học về hệ thống: Để benchmark các mô hình trên edge, cần đánh giá các đánh đổi đa chiều giữa độ trễ, độ chính xác và dung lượng bộ nhớ. Lượng tử hoá cho phép thực thi trên edge với thông lượng cao, miễn là mức giảm độ chính xác vừa phải vẫn đáp ứng yêu cầu sản phẩm.
Trước khi rút ra kết luận từ kết quả benchmark, hãy áp dụng framework phân tích các tuyên bố của nhà cung cấp đã giới thiệu trước đó (xem danh sách kiểm tra “Decoding Vendor Benchmark Claims”) và bổ sung thêm hai bước kiểm tra. Thứ nhất, so sánh phải công bằng: so ResNet-50 với MobileNet sẽ trộn lẫn khác biệt kiến trúc với các lựa chọn tối ưu; khác biệt về độ chính xác số học (FP32 so với INT8) có thể ảnh hưởng đáng kể đến hiệu năng; và kích thước batch, thế hệ phần cứng, cũng như phần mềm framework đều phải được kiểm soát. Thứ hai, thống kê phải có ý nghĩa: kết quả đáng tin cậy cần nhiều lần chạy, báo cáo phương sai kèm khoảng tin cậy, cách xử lý ngoại lệ minh bạch, và đo ở trạng thái ổn định thay vì chịu ảnh hưởng của khởi động lạnh. Áp dụng các câu hỏi này vào một tuyên bố đại diện của nhà cung cấp sẽ cho thấy việc đặc tả không đầy đủ có thể làm mờ đi hiệu năng thực.
Ngoài các tuyên bố của nhà cung cấp, bối cảnh quyết định chỉ số nào quan trọng nhất. Việc cải thiện độ chính xác 1% có thể mang tính quyết định trong chẩn đoán y tế, nhưng lại không đáng kể đối với ứng dụng ưu tiên tốc độ suy luận. Người thực hành cũng cần cảnh giác với hiện tượng benchmark overfitting, khi mô hình bị tối ưu hóa quá mức cho các tác vụ benchmark cụ thể và đánh đổi khả năng tổng quát hóa trong thực tế. Để hạn chế điều này, hãy đánh giá hiệu suất trên các tác vụ liên quan nhưng khác biệt, và cân nhắc các kịch bản triển khai thực tế.
Systems Perspective 1.6: Giải thích một tuyên bố benchmark
Một nhà cung cấp tuyên bố: “Hệ thống của chúng tôi đạt 10,000 inferences/giây khi chạy ResNet-50.” Nếu đứng riêng, con số này chưa đủ để lập kế hoạch triển khai vì các điều kiện quyết định ý nghĩa của nó chưa được nêu rõ.
Có bốn điều kiện chưa được nêu nhưng quyết định ý nghĩa của tuyên bố:
- Kích thước batch: Batch lớn thường đạt thông lượng cao nhưng có thể không đáp ứng mục tiêu độ trễ; batch 1 cho độ trễ thấp nhưng thông lượng thấp hơn.
- Độ chính xác số học: Hiệu năng của INT8 so với FP32 phụ thuộc vào mô hình, các toán tử (operators), phần cứng và cách triển khai, và có thể ảnh hưởng đến độ chính xác hoặc quá trình hiệu chuẩn (calibration).
- Phạm vi đo lường: Cần nêu rõ con số đó chỉ tính phần suy luận hay đã bao gồm tiền xử lý.
- Độ chính xác: Cần nêu rõ mô hình có đạt 76.1% Top-1 như bản gốc hay ở mức thấp hơn.
Ví dụ: “10,000 inferences/giây khi chạy ResNet-50 với kích thước batch 32, độ chính xác INT8, đạt 76 percent độ chính xác Top-1, bao gồm cả giải mã JPEG, trên NVIDIA H100 ở mức công suất thiết kế nhiệt (TDP) 700 W.”
Góc nhìn hệ thống: Để biết một khác biệt hiệu năng có thực sự đáng kể hay không, ta cần cả sự chặt chẽ về thống kê lẫn kiểm chứng trong bối cảnh cụ thể. Một con số benchmark thiếu các chi tiết đó chỉ là một tuyên bố tiếp thị, không phải một đặc tả kỹ thuật.
Ví dụ benchmark
Để thấy các thành phần này phối hợp ra sao trong thực tế, hãy đi qua pipeline phát hiện bất thường trong figure 4 thêm một lần, lần này tập trung vào giai đoạn đầu ra. Benchmark này tạo ra ba phép đo bổ sung: kích thước mô hình 270K tham số với độ trễ 10.4 ms cho mỗi lần suy luận (tài nguyên tính toán); độ chính xác phát hiện đạt 0.86 AUC khi phân biệt mẫu âm thanh bình thường và bất thường (hiệu quả tác vụ); và mức tiêu thụ năng lượng 516 μJ cho mỗi lần suy luận (hiệu quả vận hành).
Chỉ số nào quan trọng nhất hoàn toàn phụ thuộc vào bối cảnh triển khai. Năng lượng cho mỗi lần suy luận đặc biệt quan trọng với thiết bị chạy pin, đồng thời vẫn ảnh hưởng đến chi phí vận hành máy chủ và công suất. Kích thước mô hình giới hạn các thiết bị nhúng có bộ nhớ ít, và quyết định dung lượng của bộ tăng tốc cũng như chi phí nhân bản trong các triển khai đám mây. Tốc độ xử lý quyết định hệ thống có thể chạy thời gian thực hay phải gom đầu vào theo batch. Các chỉ số này cũng cho thấy những đánh đổi vốn có: giảm kích thước mô hình từ 270K tham số có thể cải thiện tốc độ và hiệu quả năng lượng nhưng làm giảm độ chính xác phát hiện AUC 0.86. Việc các phép đo này có đạt “passing” benchmark hay không phụ thuộc vào các ràng buộc triển khai—framework cung cấp cấu trúc để đánh giá nhất quán, nhưng tiêu chí chấp nhận phải xuất phát từ yêu cầu của ứng dụng.
Các thành phần vừa liệt kê xác định cách lắp ghép một benchmark bất kỳ. Có hai loại benchmark xuất hiện đủ thường xuyên trong toàn bộ pipeline tối ưu hoá nên xứng đáng có checklist thành phần riêng: benchmark nén, là các bài kiểm tra mà mô hình đã được tỉa hoặc lượng tử hoá phải vượt qua trước khi triển khai; và benchmark cho di động và edge, do các đích nhắm bị giới hạn về công suất và nhiệt áp đặt. Mỗi loại vẫn gồm tác vụ, dữ liệu, mô hình, chỉ số, harness và quy tắc chạy như đã định nghĩa, đồng thời bổ sung các ràng buộc mà checklist chung không có. Cả hai đóng vai trò như phần xem trước cho những chiều cạnh sẽ được trình bày đầy đủ hơn sau này: xác thực nén sẽ trở lại trong section 1.11.1.3 với giao thức đa chỉ số đầy đủ, và hành vi công suất duy trì sẽ trở lại trong section 1.9.
Benchmark nén
Nén mạng nơ-ron (tỉa (pruning), lượng tử hoá, chưng cất tri thức và tối ưu kiến trúc) cần các benchmark chuyên biệt vì nén làm thay đổi bức tranh đánh đổi: mỗi byte tiết kiệm được hay mỗi phép toán bị loại bỏ đều phải cân nhắc với nguy cơ mất độ chính xác và tính tương thích phần cứng. Chỉ số cơ bản nhất của nén là mức giảm kích thước thô: số tham số, dung lượng bộ nhớ tính bằng byte, và nhu cầu lưu trữ sau khi nén. Tuy nhiên, chỉ nhìn vào kích thước thôi thì dễ gây hiểu lầm. Trên ImageNet, MobileNetV2 đạt độ chính xác top-1 xấp xỉ 72 percent với 3.5M tham số, trong khi ResNet-50 đạt 76 percent với 25.6M tham số, tức là MobileNetV2 dùng ít hơn khoảng 7.3× tham số ở mức độ chính xác tương đương, hay nói cách khác là đạt khoảng 6.9× độ chính xác trên mỗi tham số cao hơn (Sandler et al. 2018; He et al. 2016).
Li, Hao, Asim Kadav, Igor Durdanovic, Hanan Samet, and Hans Peter Graf. 2017. “Pruning Filters for Efficient ConvNets.” International Conference on Learning Representations (ICLR).
Các benchmark tỉa (pruning) cần phân biệt giữa cách làm có cấu trúc và không có cấu trúc, vì chúng cho ra kết quả khác biệt rõ rệt trên phần cứng thực. Tỉa có cấu trúc loại bỏ toàn bộ nơ-ron hoặc bộ lọc, tạo ra các phép toán dày đặc nhỏ hơn mà các kernel thông thường có thể tận dụng (Li et al. 2017). Ngược lại, tỉa không có cấu trúc loại bỏ từng trọng số riêng lẻ và có thể tạo ra các mô hình rất thưa. Nhưng để đạt tăng tốc thực sự, cần có hỗ trợ tính toán thưa chuyên biệt—nghĩa là giao thức benchmark phải nêu rõ nền tảng phần cứng và cách triển khai phần mềm (Han et al. 2015; Gale et al. 2019).
Các benchmark lượng tử hoá đánh giá mức giảm độ chính xác khi thay đổi kiểu dữ liệu. Trong ví dụ minh hoạ với MobileNetV2, INT8 giảm dung lượng lưu trữ trọng số đi 4\(\times\) và các giá trị độ trễ giả định mang lại mức tăng tốc như hiển thị; hiệu suất thực tế còn phụ thuộc vào phần cứng và cách triển khai. Sự đánh đổi giữa độ chính xác (precision) của phép tính và độ chính xác (accuracy) của mô hình được phân tích trong section 1.8.2, còn tác động đến năng lượng được trình bày ở section 1.9.1. Các phương pháp độ chính xác hỗn hợp còn tiến xa hơn bằng cách áp dụng các mức độ chính xác khác nhau cho từng lớp: các lớp quan trọng giữ FP16, trong khi các lớp nặng tính toán dùng INT8 hoặc INT4, giúp tối ưu hoá hiệu quả ở mức chi tiết. Chưng cất tri thức bổ sung một chiều hướng khác: một mô hình học sinh nhỏ hơn có thể giữ lại phần lớn hành vi của mô hình giáo viên đồng thời giảm kích thước và chi phí suy luận, nhưng benchmark phải xác minh rằng mô hình học sinh thật sự tổng quát hoá chứ không chỉ ghi nhớ đầu ra của mô hình giáo viên (Hinton et al. 2015).
Điều cốt yếu là các yếu tố tăng tốc khác nhau rất nhiều giữa các nền tảng phần cứng: mô hình thưa, mô hình giảm độ chính xác và kiến trúc hiệu quả chỉ mang lại tăng tốc khi runtime mục tiêu có các kernel, bố cục bộ nhớ và hỗ trợ từ bộ tăng tốc để khai thác chúng. Các bộ benchmark hiện tại như MLPerf chủ yếu tập trung vào các mô hình tham chiếu chuẩn, trong khi các triển khai sản xuất thường dùng các biến thể đã nén hoặc tối ưu theo phần cứng cụ thể. Khoảng cách giữa những gì benchmark đo và những gì thực sự chạy trong sản xuất vẫn là một trong những điểm mù hệ trọng nhất của lĩnh vực này.
Benchmark cho di động và edge
Các triển khai di động và edge chịu những ràng buộc rất khác so với môi trường đám mây. Vì vậy cần các phương pháp benchmark chuyên biệt để phản ánh đúng các đánh đổi trong bối cảnh tài nguyên hạn chế. Các ràng buộc này tạo thành một tam giác phụ thuộc lẫn nhau giữa công suất tiêu thụ, độ trễ suy luận và độ chính xác của mô hình; thường khi bạn cải thiện hai yếu tố thì yếu tố còn lại sẽ giảm. Triển khai edge buộc phải xử lý những đánh đổi mà phần lớn triển khai trên đám mây có thể bỏ qua, được tóm tắt trong table 6.
| Ràng buộc | Tác động đám mây | Tác động edge |
|---|---|---|
| Công suất | Chi phí vận hành | Ngân sách năng lượng thiết bị |
| Độ trễ | Mục tiêu cấp độ dịch vụ | Thời hạn phản hồi cục bộ |
| Độ chính xác | Mục tiêu chất lượng tác vụ | Cân bằng với công suất/độ trễ |
Ví dụ cụ thể, AI trên camera điện thoại thông minh để phát hiện đối tượng theo thời gian thực cần xử lý tín hiệu ở tốc độ khung hình video, đồng thời vẫn nằm trong giới hạn nhiệt chặt chẽ. Trong bối cảnh này, một mô hình họ MobileNet có thể là mục tiêu benchmark đúng, ngay cả khi một mô hình họ ResNet lớn hơn đạt độ chính xác cao hơn trong đám mây, vì benchmark edge phải tính đến độ trễ, công suất và hành vi nhiệt ở chế độ duy trì. Một benchmark edge kéo dài sẽ làm lộ rõ khoảng cách giữa thông số quảng cáo và hành vi vận hành thực. Khoảng cách giữa hiệu năng đỉnh và hiệu năng duy trì, được nêu ở section 1.1, trở nên nghiêm trọng ở edge vì một nguyên nhân vật lý không hiện diện trong trung tâm dữ liệu: thiết bị làm mát thụ động không thể tản nhiệt cho suy luận liên tục mãi mãi, nên các con số ở chế độ bùng nổ có thể suy giảm do điều tiết nhiệt. Chính cơ chế nhiệt này, chứ không phải đo lường cẩu thả, khiến benchmark edge là một bài toán khác hẳn so với benchmark đám mây.
Example 1.3: Benchmark cho edge
Kịch bản: Một nhóm kỹ thuật edge thực hiện benchmark một chip chuông cửa thông minh với thông số công suất “1 W AI” được nhà cung cấp quảng cáo.
Chẩn đoán: Các thử nghiệm ở chế độ bùng nổ ban đầu khớp với tuyên bố của nhà cung cấp, nhưng khi chạy vòng lặp suy luận liên tục, nhiệt độ điểm nối tăng lên, kích hoạt điều tiết nhiệt và làm giảm thông lượng ở trạng thái ổn định.
Bài học hệ thống: Các benchmark bùng nổ ngắn có thể che khuất hiện tượng điều tiết nhiệt về lâu dài. Khi benchmark khối lượng công việc (workload) ML trên edge, cần kiểm thử chạy liên tục, kéo dài để phản ánh đúng giới hạn phần cứng trong vận hành thực tế.
FPS của benchmark bùng nổ sụp khi cơ chế điều tiết nhiệt bắt đầu.
Systems Perspective 1.7: Thực tế benchmark trên edge
Khi đánh giá các tuyên bố về phần cứng edge, có bốn yếu tố quyết định liệu các con số của nhà cung cấp có chuyển thành hiệu suất thực tế hay không:
- Thông lượng đỉnh so với thông lượng duy trì: Nhà cung cấp có thể quảng cáo thông lượng đỉnh 45 TOPS, nhưng khi chạy liên tục dưới điều kiện nhiệt ổn định, thông lượng thực tế thường gần 20 TOPS hơn. Vì vậy, hãy luôn benchmark với khối lượng công việc (workload) duy trì lâu hơn 30 s.
- Công suất khi nhàn rỗi so với khi hoạt động: Trong kịch bản này, một thiết bị tiêu thụ 50 mW khi nhàn rỗi và 2 W khi hoạt động có thể được quảng cáo theo mức tiêu thụ khi hoạt động. Tuy nhiên, nếu ứng dụng chỉ chạy suy luận trong 1 percent tổng thời gian, thì công suất tiêu thụ hiệu dụng là ~69.5 mW, chứ không phải 2 W.
- Giới hạn nhiệt: Các thiết bị edge thường hoạt động trong một giới hạn TDP hẹp. Vượt quá giới hạn sẽ kích hoạt điều tiết, nên các báo cáo benchmark không nêu rõ điều kiện nhiệt là chưa đầy đủ.
- Đầu-cuối so với chỉ bộ tăng tốc: Các benchmark NPU thường không tính phần overhead truyền dữ liệu. Với các mô hình nhỏ, thời gian chuyển dữ liệu ảnh từ camera sang NPU rồi quay lại có thể còn lâu hơn cả thời gian suy luận.
Trong một không gian làm mát thụ động hạn chế, điều tiết nhiệt có thể bắt đầu ngay trong quá trình suy luận duy trì, khiến các benchmark ngắn hạn (chế độ burst) gây hiểu lầm cho ứng dụng luôn bật. Vì vậy, mọi đánh giá thiết bị edge phải tính đến công suất duy trì ở trạng thái nhiệt ổn định, không phải các đỉnh chế độ burst, và phải đo độ trễ đầu-cuối bao gồm cả overhead truyền dữ liệu.
Phối hợp bộ xử lý không đồng nhất
Các SoC di động tích hợp nhiều bộ xử lý không đồng nhất (CPU, GPU, DSP, NPU). Do đó, cần có các benchmark chuyên biệt để phản ánh độ phức tạp của việc phân phối khối lượng công việc (workload), đồng thời tính đến các giới hạn về nhiệt và pin. Phối hợp bộ xử lý hiệu quả có thể mang lại lợi ích lớn khi giao việc đúng với kiểu tính toán phù hợp của từng bộ xử lý. Mỗi bộ xử lý vượt trội ở những dạng khối lượng công việc (workload) khác nhau: CPU xử lý luồng điều khiển, các batch nhỏ và tác vụ tuần tự; GPU tăng tốc các phép toán dấu phẩy động song song và suy luận ML tổng quát; DSP nổi trội trong xử lý tín hiệu số fixed-point và các tác vụ phát hiện luôn bật; còn NPU nhắm đến các kiến trúc mạng nơ-ron cụ thể với độ chính xác INT8/INT4.
Các benchmark phải đánh giá cách phân bổ khối lượng công việc (workload), chứ không chỉ hiệu suất của từng bộ xử lý riêng lẻ. Chẳng hạn, một trợ lý giọng nói có thể dùng DSP công suất thấp để luôn bật tính năng phát hiện từ khóa đánh thức, sau đó chuyển sang NPU cho một đợt nhận dạng giọng nói ngắn, và dùng CPU để hiểu ngôn ngữ. Các benchmark chỉ tập trung vào một bộ xử lý sẽ bỏ qua hoàn toàn những động lực phối hợp này.
Benchmark về pin và nhiệt
Ảnh hưởng đến pin thay đổi đáng kể tùy theo từng trường hợp sử dụng: nhiếp ảnh tính toán có thể tiêu thụ vài watt khi đang chụp, trong khi AI chạy nền để nhận dạng hoạt động có thể cần giữ ở mức miliwatt để đảm bảo dùng cả ngày. Thử thách là mức tiêu thụ công suất tức thời trong quá trình suy luận chỉ cho biết một phần câu chuyện; điều quan trọng đối với thời lượng pin là tổng ngân sách năng lượng trong một mô hình sử dụng thực tế.
Yếu tố quan trọng nhất là chu kỳ làm việc của khối lượng công việc (workload): hệ thống thực sự chạy suy luận trong bao nhiêu phần trăm thời gian. Một camera chuông cửa chỉ xử lý khung hình thỉnh thoảng sẽ gần như luôn ở trạng thái nhàn rỗi, khi đó công suất chờ là mối quan tâm chính. Ngược lại, một pipeline phân tích video thời gian thực gần như liên tục bị ràng buộc bởi suy luận, khiến năng lượng trên mỗi lần suy luận trở thành chỉ số then chốt. Công suất nền — tức mức tiêu thụ năng lượng khi mô hình đã được nạp nhưng đang chờ đầu vào — nằm giữa hai thái cực này và thường còn lớn hơn năng lượng suy luận đối với các workload gián đoạn. Cuối cùng, cần đặc tả hành vi nhiệt bền vững theo thang phút thay vì giây, vì nhiều thiết bị edge dù có thể đạt hiệu năng bùng nổ ấn tượng vẫn thường bị điều tiết (throttle) khi nhiệt độ mối nối tăng, và rồi ổn định ở mức thông lượng trạng thái ổn định thấp hơn đáng kể.
Phối hợp edge-đám mây
Việc benchmark trên thiết bị di động cũng cần đánh giá sự phối hợp giữa edge và đám mây qua 5G/Wi-Fi, đặc biệt với URLLC19 nhấn mạnh độ trễ rất thấp và độ tin cậy cao cho các ứng dụng quan trọng. Sự phối hợp này tạo ra những chiều đo benchmark mà đánh giá cục bộ đơn thuần không có. Do độ trễ mạng biến thiên, các pipeline suy luận phân chia công việc giữa thiết bị và đám mây phải đối mặt với chi phí khứ hồi khó lường. Hành vi dự phòng quyết định điều gì xảy ra khi kết nối mất hoàn toàn: liệu thiết bị có chuyển dần sang một mô hình nhỏ hơn chạy tại chỗ hay xếp hàng yêu cầu cho đến khi kết nối được khôi phục. Các quyết định về cách chia workload (phần tính toán nào chạy cục bộ và phần nào chạy từ xa) và các ràng buộc quyền riêng tư (dữ liệu nào được phép truyền lên đám mây để suy luận) cũng định hình không gian thiết kế benchmark. Mỗi khía cạnh này cần được đo lường trong điều kiện mạng thực tế, thay vì chỉ trong môi trường phòng thí nghiệm lý tưởng.
19 URLLC (truyền thông độ trễ thấp siêu tin cậy): ITU-R định nghĩa mục tiêu độ trễ 1 ms cho mặt phẳng người dùng của giao diện vô tuyến và tỷ lệ phân phối thành công 99,999% trong vòng 1 ms cho gói 32 byte trong các điều kiện thử nghiệm được chỉ định. Tuy nhiên, các mục tiêu về giao diện vô tuyến này không đảm bảo rằng ứng dụng sẽ có độ trễ đầu cuối dưới 1 ms. Các benchmark suy luận edge cần báo cáo riêng rẽ và cả kết hợp độ trễ vô tuyến (hoặc mạng) và độ trễ tính toán, cùng với chất lượng mô hình.
Triển khai cho ô tô còn phải thêm xác thực Automotive Safety Integrity Level (ASIL), hợp nhất dữ liệu từ nhiều cảm biến, và thử nghiệm trong môi trường dải nhiệt độ rộng. Những yêu cầu đặc thù này đòi hỏi các framework toàn diện để đánh giá hiệu suất duy trì dưới ràng buộc nhiệt, hiệu quả pin theo các kiểu sử dụng khác nhau, và hành vi phụ thuộc vào kết nối, vượt ra ngoài các phép đo đỉnh đơn lẻ.
Tuy nhiên, dù benchmark máy chủ đám mây hay vi điều khiển, có một khác biệt quan trọng xuyên suốt mọi ngữ cảnh triển khai: cùng một mạng nơ-ron sẽ hành xử hoàn toàn khác tùy việc nó đang huấn luyện (training) hay suy luận (inference). Khác biệt này quyết định đo cái gì, đo thế nào, và chỉ số nào quan trọng — và nó cơ bản đến mức các framework benchmark riêng cho từng giai đoạn đã xuất hiện.
Self-Check: Question
Which core benchmark component is responsible for documenting the exact hardware model, CPU core pinning, GPU driver version, CUDA toolkit, compiler flags, and OS kernel version required to ensure experimental reproducibility?
- System specifications
- Dataset split definition
- Evaluation metric formula
- Problem definition
When designing a benchmark suite for an edge computer vision model deployed on a battery-powered security camera with passive cooling, which set of evaluation metrics provides the most complete assessment of deployment viability?
- Peak offline throughput in FP32 without thermal monitoring
- Energy per inference (mJ), active vs. idle power consumption across the device duty cycle, memory footprint (SRAM/DRAM usage), and sustained latency under thermal equilibrium
- Only the model parameter file size on disk in megabytes
- Top-1 validation accuracy measured on an uncompressed server GPU
True or False: When evaluating model compression techniques (such as INT8 quantization or structured pruning), validating that the compressed model achieves a \(4\times\) reduction in file size with \(<0.5\%\) top-1 accuracy loss is sufficient to guarantee proportional speedups and energy savings on any target deployment hardware.
In standardized benchmarking suites, the formal component that defines the mandatory execution constraints, convergence thresholds, warmup requirements, and statistical aggregation procedures to ensure fair cross-platform comparisons is called the ____.
Explain why compression evaluation must be framed as a multi-objective Pareto frontier across accuracy, latency, memory footprint, and energy, rather than relying on a single compression ratio.
Order the following execution steps of a standardized benchmark harness protocol from beginning to end:
- Execute the timed measurement loop while collecting high-resolution hardware timestamps
- Pin process affinities to dedicated CPU cores and lock accelerator clock frequencies
- Compute summary statistics (mean, median, p90, p99, standard deviation) and confidence intervals
- Execute unmeasured warm-up iterations to load model weights and warm instruction/data caches
- Perform verification check to ensure model output predictions match ground truth quality thresholds
Huấn luyện và suy luận
Cùng một bộ tăng tốc có thể thất bại theo những cách trái ngược: một tác vụ huấn luyện có thể lãng phí nhiều ngày vì đồng bộ gradient chiếm ưu thế, trong khi một dịch vụ suy luận có thể trượt SLO do độ trễ đuôi tăng vọt dưới lưu lượng bùng nổ. Vì vậy, huấn luyện và suy luận tạo ra các yêu cầu đánh giá khác biệt đến mức các framework benchmark riêng đã ra đời cho từng loại: MLPerf Training và MLPerf Inference (Mattson et al. 2020; Reddi et al. 2019). Câu hỏi cốt lõi là liệu TFLOP/s lý thuyết có chuyển thành thời gian huấn luyện thực tế hay số truy vấn mỗi giây hay không. Huấn luyện tìm kiếm tham số tối ưu qua tinh chỉnh lặp đi lặp lại (Huấn luyện mô hình), xử lý hàng tỷ ví dụ trong nhiều giờ hoặc nhiều ngày, gây áp lực lên băng thông bộ nhớ, khả năng mở rộng đa GPU và thông lượng duy trì. Suy luận áp dụng các tham số đó cho từng đầu vào trong các hệ thống phục vụ (serving) (Phục vụ mô hình), thường trong các hạn chót tính bằng mili giây, đòi hỏi độ trễ ổn định, thời gian khởi động nguội (độ trễ khởi động mô hình), và hiệu quả công suất; Vận hành machine learning kết nối các phép đo này với thực tiễn rollout và giám sát.
Những khác biệt này lan tỏa vào mọi khía cạnh của thiết kế hệ thống. Huấn luyện gồm cả truyền xuôi và truyền ngược, còn suy luận thường chỉ có truyền xuôi với tham số cố định. Việc cấp phát bộ nhớ khác biệt rõ: huấn luyện cần tham số, gradient, trạng thái optimizer và activation đã lưu, thường khiến nhu cầu bộ nhớ cao hơn nhiều lần so với suy luận chỉ dùng trọng số. Mức chênh lệch phụ thuộc vào optimizer, độ chính xác số học, activation checkpointing, hình dạng batch và chuỗi, cũng như các cache phục vụ suy luận. Để quản lý phần chi phí này, huấn luyện dùng tính toán mixed-precision và nén gradient; trong khi suy luận giảm độ chính xác mạnh tay hơn (chi tiết trong section 1.8.2) và áp dụng các kỹ thuật như lượng tử hoá sau huấn luyện và chưng cất tri thức. Mẫu sử dụng tài nguyên cũng khác nhau: huấn luyện hướng tới duy trì mức sử dụng GPU bão hòa, còn suy luận phải xử lý các mẫu yêu cầu biến động, dễ khiến phần cứng không được khai thác hết, như phân tích roofline trong section 1.3.2 đã cho thấy.
Chi phí năng lượng có những quy luật khác nhau. Chi phí năng lượng cho huấn luyện được phân bổ theo vòng đời của mô hình và đo bằng tổng năng lượng cho mỗi mô hình đã huấn luyện; các ước tính cho những lần huấn luyện lớn có thể lên tới hàng nghìn megawatt-giờ (GPT-3 được ước tính khoảng 1,287 MWh) (Patterson et al. 2021). Chi phí năng lượng cho suy luận tích lũy theo từng truy vấn và ở quy mô lớn có thể trở thành yếu tố vận hành chủ đạo. Cách bền vững để suy luận về năng lượng mỗi truy vấn là đồng nhất thức \(E_{\text{total}} = \text{Power} \times T\). Ví dụ, nếu công suất trung bình của bộ tăng tốc trong cửa sổ suy luận là 300 W, một lượt suy luận với độ trễ 10 ms tiêu thụ \(300 W \times 0.01 s = 3 J\), tức khoảng 0.0008 Wh; ở độ trễ 100 ms, con số này vào khoảng 0.0083 Wh. Mức TDP không thể thay thế cho phép đo công suất thực tế trong runtime.
Sự phân biệt giữa huấn luyện và suy luận định hướng cách thiết kế benchmark, làm rõ chỉ số nào quan trọng nhất cho từng giai đoạn và vì sao phương pháp đánh giá phải khác nhau. Benchmark huấn luyện tập trung vào thời gian hội tụ và hiệu quả khả năng mở rộng; còn benchmark suy luận ưu tiên tính ổn định của độ trễ và hiệu quả sử dụng tài nguyên trong nhiều kịch bản triển khai. Benchmark huấn luyện được đặt lên trước, vì chất lượng của mô hình đã huấn luyện sẽ đặt trần cho mọi thứ mà suy luận có thể mang lại.
Self-Check: Question
How do the primary benchmarking objectives and resource bottlenecks fundamentally differ between training systems and inference serving systems?
- Training is latency-critical with millisecond deadlines, whereas inference is throughput-oriented over weeks
- Training memory footprint is dominated solely by static weights, whereas inference requires large optimizer states
- Training optimizes for sustained throughput (samples/sec) and time-to-accuracy across multi-node accelerators with massive memory demands (weights, gradients, optimizer states, activations), whereas inference optimizes for latency percentiles (p50, p99), QPS, and energy per query under strict SLA constraints
- Training and inference have identical memory access patterns and evaluate the exact same metrics
Explain why training a 7-billion parameter language model requires over \(80\text{ GB}\) of accelerator memory, while serving inference for the same model in FP16 requires only around \(14\text{ GB}\) of weight memory.
True or False: If an accelerator achieves the top ranking in MLPerf Training on large-batch vision models, it can be assumed to deliver top-tier performance on low-batch, latency-critical interactive inference serving.
Benchmark huấn luyện
Một ví dụ thất bại trong mua sắm: một nhóm mua một cụm GPU lớn hơn, kỳ vọng tốc độ huấn luyện tăng tỷ lệ thuận, nhưng rồi phát hiện overhead giao tiếp và nút thắt bộ nhớ đã giới hạn mức tăng thực tế. Benchmark huấn luyện được dùng để phát hiện những khoảng cách như vậy trước khi mua sắm. Chúng chia thành ba nhóm: chỉ số hội tụ (đo tiến độ học), chỉ số thông lượng (đo hiệu quả tính toán), và chỉ số khả năng mở rộng (đo hiệu suất phân tán).
Definition 1.3: Benchmark huấn luyện machine learning
Benchmark huấn luyện machine learning là các benchmark của hệ thống machine learning, dùng để đo thời gian cần để đạt một chỉ số chất lượng mục tiêu (ví dụ: một mức độ chính xác kiểm định hoặc ngưỡng lỗi xác định) trên một tập dữ liệu và mô hình cố định, qua đó định lượng tốc độ hội tụ theo mỗi đơn vị tài nguyên.
- Ý nghĩa: Benchmark huấn luyện phơi bày những chênh lệch lớn mà thông số phần cứng không thể hiện. Khi giữ cố định mô hình và mục tiêu chất lượng, thời gian hội tụ có thể khác nhau rất nhiều giữa các tổ hợp phần cứng-phần mềm, vì hiệu suất huấn luyện phụ thuộc vào toàn bộ pipeline: tải dữ liệu \((D_{\text{vol}}/\text{BW})\), mức độ sử dụng tính toán \((\eta_{\text{hw}})\), đồng bộ gradient \((L_{\text{lat}})\), và overhead khôi phục lỗi. Một bảng thông số FLOP/s đỉnh không phản ánh những tương tác này.
- Điểm khác biệt: Không giống các benchmark suy luận, vốn đo độ trễ trên mỗi truy vấn và thông lượng khi có tải, benchmark huấn luyện đo thời gian để đạt độ chính xác trên toàn bộ vòng lặp tối ưu hóa: tải dữ liệu, truyền xuôi (forward pass), truyền ngược (backward pass), đồng bộ gradient và bước optimizer. Yếu tố hạn chế chính chuyển từ tính toán \((R_{\text{peak}})\) ở quy mô nhỏ sang truyền thông \((\text{BW})\) ở quy mô lớn.
- Sai lầm phổ biến: Một quan niệm thường gặp là benchmark huấn luyện đo “GPU chạy nhanh đến mức nào”. Ở quy mô lớn, băng thông liên kết \((\text{BW})\) phục vụ đồng bộ gradient và phần chi phí cho khả năng chịu lỗi (I/O checkpoint, giảm thiểu straggler) thường chi phối kết quả benchmark nhiều hơn FLOP/s đỉnh.
Benchmark huấn luyện xác nhận liệu tăng tốc phần cứng có thực sự mang lại thông lượng huấn luyện như đã hứa hay không. Các cụm GPU, TPU pods và chiến lược huấn luyện phân tán được xem xét trong Tăng tốc phần cứng đều tuyên bố tăng tốc đáng kể, và benchmark huấn luyện cho thấy tuyên bố nào giữ vững dưới các khối lượng công việc (workload) thực tế. Chúng đánh giá cách các cấu hình phần cứng, cơ chế tải dữ liệu và chiến lược huấn luyện phân tán vận hành khi huấn luyện các mô hình ở quy mô sản xuất. Những benchmark này rất quan trọng vì huấn luyện là khoản đầu tư vốn lớn nhất trong các hệ thống machine learning, và chỉ việc đo lường thời gian để đạt độ chính xác một cách chặt chẽ mới cho thấy liệu khoản vốn đó có mang lại giá trị tương xứng hay không, thay vì bị hao hụt vào kém hiệu quả khi mở rộng, nút thắt bộ nhớ hoặc chi phí truyền thông.
Ví dụ, các mô hình quy mô lớn như GPT-3 của OpenAI20 (Brown et al. 2020), với 175B tham số, được huấn luyện trên khoảng 570 GB văn bản CommonCrawl đã lọc (từ một tập dữ liệu thô khoảng 45 TB, kết hợp với các nguồn khác để tạo thành 300B token huấn luyện), cho thấy rõ nhu cầu tính toán khổng lồ của quá trình huấn luyện hiện đại. Các benchmark huấn luyện ML được tiêu chuẩn hóa cung cấp đánh giá có hệ thống về các hệ thống nền tảng, đảm bảo rằng cấu hình phần cứng và phần mềm có thể đáp ứng hiệu quả những nhu cầu chưa từng có này.
20 GPT-3 (Generative Pre-trained Transformer 3): mô hình ngôn ngữ năm 2020 của OpenAI (175B tham số, 300B token huấn luyện) đã tiêu thụ ước tính 3.640 petaFLOP-ngày trên 10.000 GPU V100 (Patterson et al. 2021). Quy mô này cho thấy vì sao các benchmark huấn luyện lại quan trọng để dự đoán liệu một đợt huấn luyện theo kế hoạch có khả thi về mặt vận hành hay không, trước khi cam kết sử dụng tài nguyên tính toán.
Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. 2021. “Carbon Emissions and Large Neural Network Training.” arXiv Preprint arXiv:2104.10350.
Động lực của benchmark huấn luyện
MLPerf Training (Mattson et al. 2020; MLCommons 2024c) cung cấp một framework chuẩn hóa để đo lường thời gian đạt chất lượng mục tiêu như thế này. Figure 5 cho thấy những cải thiện hiệu suất qua các phiên bản benchmark kế tiếp đã vượt xa đường cơ sở theo Định luật Moore trên biểu đồ, với một số khối lượng công việc (workload) đạt mức tăng lớn trong nhiều năm (Tschand et al. 2024). Sự so sánh này minh họa một nguyên tắc cốt lõi: cái gì được đo lường thì sẽ được cải thiện. Framework benchmark chuẩn hóa tạo ra áp lực cạnh tranh, từ đó thúc đẩy tối ưu hóa nhanh trên toàn bộ ngăn xếp tính toán ML.

Ngoài việc ghi nhận tiến bộ đó, các benchmark huấn luyện còn giúp phát hiện những điểm kém hiệu quả mà đánh giá có hệ thống làm lộ rõ: tải dữ liệu chậm, bộ tăng tốc không được tận dụng hết, overhead bộ nhớ quá lớn, và các nút thắt giao tiếp làm giảm hiệu quả mở rộng. Các khả năng phần cứng lý thuyết được nêu trong Tăng tốc phần cứng (ví dụ: TFLOP/s của GPU, thông lượng tensor của TPU) chỉ chuyển thành tốc độ huấn luyện thực sự nhanh hơn khi các benchmark xác thực chúng trong điều kiện thực tế.
Các benchmark huấn luyện đảm nhiệm bốn chức năng có liên hệ chặt chẽ với nhau. Thứ nhất, chúng giúp tối ưu hóa phần cứng và phần mềm bằng cách cung cấp các so sánh trung lập với nhà cung cấp giữa các kiến trúc bộ tăng tốc khác nhau và các framework (TensorFlow, PyTorch) trên các tác vụ chuẩn hóa, từ đó định hướng lựa chọn phần cứng cho trung tâm dữ liệu và môi trường đám mây. Các tối ưu hóa phần mềm, bao gồm huấn luyện hỗn hợp độ chính xác21 và tải dữ liệu tiết kiệm bộ nhớ, cũng được định lượng tương tự. Thứ hai, chúng đánh giá khả năng mở rộng: về lý thuyết, thêm GPU sẽ làm thời gian huấn luyện giảm tương ứng, nhưng trong thực tế, chi phí truyền thông, độ trễ đồng bộ hóa và nút thắt bộ nhớ hạn chế hiệu quả mở rộng. Các benchmark huấn luyện đo lường những hao hụt này, cho thấy liệu đầu tư hạ tầng có mang lại lợi ích tương xứng hay không. Thứ ba, chúng đảm bảo trách nhiệm về chi phí và năng lượng: với các lần huấn luyện quy mô lớn tiêu thụ hàng nghìn megawatt-giờ, các benchmark theo dõi chi phí cho mỗi lần huấn luyện và mức tiêu thụ công suất trên mỗi đơn vị tiến độ giúp tổ chức cân bằng sức mạnh tính toán với mục tiêu bền vững. Cuối cùng, các tiêu chí đánh giá chuẩn hóa, kiểm soát tính ngẫu nhiên, quy tắc nộp kết quả và hoạt động kiểm tra giúp so sánh có tính tái lập cao hơn và hạn chế các lối tắt phụ thuộc vào triển khai cụ thể.
21 Huấn luyện hỗn hợp độ chính xác: Sử dụng độ chính xác thấp hơn cho phần lớn phép tính số học, nhưng giữ độ chính xác cao hơn cho các phép tích lũy khi cần (Micikevicius et al. 2017). Hệ quả khi benchmark: các lần chạy dùng độ chính xác hỗn hợp và độ chính xác đầy đủ không thể so sánh trực tiếp, vì lưu lượng bộ nhớ giảm và khả năng dùng kích thước batch lớn hơn có thể làm thay đổi động lực hội tụ. MLPerf xử lý điều này bằng cách cố định mục tiêu độ chính xác, khiến thời gian để đạt độ chính xác trở thành đại lượng có thể so sánh được, bất kể chiến lược độ chính xác.
Micikevicius, Paulius, Sharan Narang, Jonah Alben, Gregory Diamos, Erich Elsen, David Garcia, Boris Ginsburg, et al. 2017. “Mixed Precision Training.” arXiv Preprint arXiv:1710.03740.
Các chỉ số huấn luyện
Từ góc độ hệ thống, các benchmark huấn luyện đánh giá mức độ hiệu quả khi một mô hình đạt tới ngưỡng độ chính xác đã định. Các chỉ số như thông lượng và khả năng mở rộng chỉ có ý nghĩa khi mô hình chạm tới độ chính xác mục tiêu; nếu không có ràng buộc này, tối ưu hóa mỗi tốc độ thuần có thể gây hiểu lầm. MLPerf Training cụ thể hóa điều đó bằng cách đặt các mục tiêu độ chính xác riêng cho từng tác vụ: một hệ thống huấn luyện nhanh nhưng không đạt mục tiêu là không hợp lệ, còn một hệ thống hội tụ chính xác nhưng quá chậm thì không thực tế. Benchmarking hiệu quả là cân bằng giữa tốc độ, hiệu quả và khả năng hội tụ về độ chính xác.
Thời gian và thông lượng
Một trong những chỉ số chính để đánh giá hiệu quả huấn luyện là thời gian cần thiết để đạt ngưỡng độ chính xác đã định. Thời gian huấn luyện \((T_{\text{train}})\) cho biết mô hình mất bao lâu để hội tụ tới mức hiệu suất chấp nhận được, qua đó phản ánh hiệu quả tính toán tổng thể của hệ thống. Gọi \(\text{Accuracy}(t)\) là độ chính xác của mô hình tại thời điểm huấn luyện \(t\), và độ chính xác mục tiêu là ngưỡng cụ thể do benchmark đặt ra (ví dụ, độ chính xác top-1 75.9 phần trăm cho ResNet-50 trên ImageNet trong MLPerf). Equation 1 đưa ra định nghĩa chính thức cho chỉ số này, giúp benchmark tập trung vào việc hệ thống đạt kết quả có ý nghĩa nhanh đến mức nào: \[T_{\text{train}} = \inf \big\{t \geq 0 : \text{Accuracy}(t) \geq \text{target accuracy} \big\} \tag{1}\]
Một lần chạy không bao giờ đạt mục tiêu thì không có thời gian đạt độ chính xác hữu hạn; điều này ngăn việc đánh giá cao một hệ thống chỉ vì tốc độ huấn luyện thuần khi nó không đáp ứng tiêu chí chất lượng của benchmark.
Thông lượng,22 thường được biểu thị bằng số mẫu huấn luyện xử lý được mỗi giây, là một thước đo bổ sung cho hiệu suất hệ thống. Gọi \(N_{\text{samples}}\) là tổng số mẫu huấn luyện đã xử lý và \(T_{\text{train}}\) là thời gian huấn luyện từ equation 1. Equation 2 làm rõ tốc độ này bằng cách lấy số mẫu đã xử lý chia cho thời gian huấn luyện: \[\text{Throughput} = \frac{N_{\text{samples}}}{T_{\text{train}}} \tag{2}\]
22 Thông lượng: Ban đầu, thuật ngữ này xuất phát từ lĩnh vực sản xuất, dùng để đo số lượng sản phẩm làm ra trong một đơn vị thời gian. Nó được đưa vào lĩnh vực điện toán trong kỷ nguyên xử lý theo batch vào những năm 1960. Nguồn gốc này gợi cho chúng ta một bài học về hệ thống: thông lượng và độ trễ vốn đối lập, vì batching giúp tăng thông lượng (nhiều đơn vị hơn mỗi giờ) nhưng phải trả giá bằng thời gian chờ của từng đơn vị riêng lẻ. Trong quá trình phục vụ (serving) mô hình ML, điều này thể hiện rõ qua sự đánh đổi về kích thước batch: batch lớn hơn giúp tận dụng GPU tốt hơn nhưng làm tăng độ trễ cho mỗi yêu cầu.
MLCommons. 2024c. MLPerf Training Benchmark.
Chỉ riêng thông lượng không đảm bảo kết quả có ý nghĩa, vì một mô hình có thể xử lý rất nhiều mẫu rất nhanh nhưng lại không đạt độ chính xác mong muốn. Ví dụ, MLPerf Training quy định các mục tiêu chất lượng cụ thể cho từng khối lượng công việc (workload); chẳng hạn, một kết quả ResNet-50 trên ImageNet phải đạt độ chính xác top-1 là 75.9% mới được coi là hợp lệ (Mattson et al. 2020; MLCommons 2024c). Một hệ thống dù xử lý được nhiều ảnh mỗi giây nhưng không đạt mục tiêu thì không phải là kết quả benchmark hợp lệ, trong khi một hệ thống chậm hơn nhưng hội tụ hiệu quả có thể đáng ưu tiên hơn. Điều này cho thấy thông lượng nên được đánh giá cùng với thời gian để đạt độ chính xác, thay vì coi nó là một thước đo hiệu suất độc lập.
Khả năng mở rộng và tính song song
Khả năng mở rộng đo lường mức độ hiệu quả khi hiệu suất huấn luyện cải thiện nhờ thêm tài nguyên. Lý tưởng nhất, nếu tăng gấp đôi số lượng GPU thì thời gian huấn luyện sẽ giảm một nửa. Tuy nhiên, trên thực tế, các yếu tố như chi phí truyền thông, giới hạn băng thông bộ nhớ và kém hiệu quả trong song song hóa sẽ kìm hãm khả năng mở rộng, khiến nó thấp hơn nhiều so với mức tuyến tính.
Napkin Math 1.3: Tính toán hiệu quả mở rộng
Bài toán: Một nhóm huấn luyện ResNet-50 trên ImageNet. Thời gian huấn luyện trên một GPU là 24 hours. Khi sử dụng 8 GPUs GPU, thời gian huấn luyện là 4 hours. Đây có phải là một ví dụ tốt về khả năng mở rộng không? Hiệu quả đã bị mất ở đâu?
Table 7: Nguồn Gây Mất Hiệu Suất Mở Rộng: Phân tích minh họa phần hiệu suất bị thiếu thành các hạng mục chi phí phụ có thể đo lường và tín hiệu đo lường tương ứng dùng để gán cho từng phần mất mát. Tỷ lệ phần trăm thực tế phụ thuộc vào mô hình, kết nối, lưu trữ, lịch trình batch và triển khai framework.
Bước 1: Định nghĩa hiệu suất mở rộng. Với strong scaling (giữ nguyên kích thước bài toán, tăng số bộ xử lý), gọi \(T(1)\) là thời gian huấn luyện trên một GPU, \(T(N_{\text{GPU}})\) là thời gian huấn luyện trên \(N_{\text{GPU}}\) GPU, và \(N_{\text{GPU}}\) là số GPU. Equation 3 định nghĩa hiệu suất: \[\text{Eff}_{\text{scaling}} = \frac{T(1)}{N_{\text{GPU}} \times T(N_{\text{GPU}})} \times 100\% \tag{3}\]
Bước 2: Tính hiệu suất. \(\text{Eff}_{\text{scaling}}(8) = \frac{24\,\text{hours}}{8 \times 4\,\text{hours}} \times 100\%\) = 24/32 = 75 percent
Với khả năng mở rộng hoàn hảo, 8 GPUs sẽ hoàn thành trong 3 hours (24 hours/8 GPUs). Thời gian thực tế 4 hours tương ứng với mức hiệu suất 75 percent.
Bước 3: Ghi nhận phần mất hiệu suất. Table 7 phân rã phần 25 percent bị thiếu vào các hạng mục chi phí phụ có thể đo được—đồng bộ gradient, sao chép bộ nhớ, mất cân bằng tải và hiệu ứng kích thước batch—mỗi hạng mục đều có thể đo bằng một tín hiệu profiling riêng.
| Nguồn | Đóng góp ví dụ | Đo lường |
|---|---|---|
| Đồng bộ hóa gradient | 10–15% | Thời gian AllReduce mỗi bước |
| Sao chép bộ nhớ (CPU\(\leftrightarrow\)GPU) | 3–5% | Lập hồ sơ truyền tải dữ liệu |
| Mất cân bằng tải | 2–5% | Phương sai thời gian bước trên mỗi GPU |
| Ảnh hưởng của kích thước batch | 2–5% | Các batch lớn hơn hội tụ khác nhau |
Bước 4: Nhận định hệ thống. Hiệu suất mở rộng giảm khi \(N_{\text{GPU}}\) tăng vì chi phí giao tiếp tăng theo số GPU trong khi lượng tính toán trên mỗi GPU giảm. Trong ví dụ này, tám GPU đạt 75 phần trăm hiệu suất; ở quy mô lớn hơn, phép tính tương tự cho thấy vì sao cần đến các tối ưu hóa giao tiếp và input pipeline ở mức tinh vi.
MLPerf báo cáo hiệu suất thô, còn hiệu suất mở rộng có thể được tính trên các bản nộp đối sánh: một hệ thống đạt thông lượng 2\(\times\) với hiệu suất 50 phần trăm có thể kém hơn hệ thống đạt thông lượng 1.5\(\times\) với hiệu suất 90 phần trăm, tùy theo ràng buộc chi phí.
Khi huấn luyện các mô hình lớn như GPT-3, OpenAI đã dùng một cụm lớn GPU NVIDIA V100 trong thiết lập huấn luyện phân tán (Brown et al. 2020; Patterson et al. 2021). Các hệ thống TPU v4 của Google cũng cho thấy bài học tương tự về hệ thống phân tán ở quy mô trung tâm dữ liệu: thêm tài nguyên tính toán sẽ tăng công suất tính toán thô, nhưng hiệu suất và khả năng phục hồi còn phụ thuộc vào giao tiếp mạng, cấu trúc mạng và quản lý vận hành (Jouppi et al. 2023; Zu et al. 2024). Các benchmark như MLPerf giúp định lượng khả năng mở rộng của một hệ thống trên nhiều bộ tăng tốc, từ đó chỉ ra những điểm kém hiệu quả trong huấn luyện phân tán.
Brown, Tom B., Benjamin Mann, Nick Ryder, Melanie Subbiah, Jared Kaplan, Prafulla Dhariwal, Arvind Neelakantan, et al. 2020. “Language Models Are Few-Shot Learners.” Advances in Neural Information Processing Systems 33: 1877–901. https://doi.org/10.48550/arxiv.2005.14165.
Zu, Y., A. Ghaffarkhah, H.-V. Dang, B. Towles, S. Hand, S. Huda, A. Bello, et al. 2024. “Resiliency at Scale: Managing Google’s TPUv4 Machine Learning Supercomputer.” 21st USENIX Symposium on Networked Systems Design and Implementation (NSDI 24), 761–74.
Trong huấn luyện, tính song song được chia thành song song dữ liệu, song song mô hình và song song pipeline (xem Huấn luyện mô hình). Mỗi loại đều có những thách thức riêng. Song song dữ liệu là chiến lược phổ biến nhất, trong đó tập dữ liệu huấn luyện được chia nhỏ và phân phối cho nhiều nút tính toán. Hiệu quả của cách tiếp cận này phụ thuộc vào cơ chế đồng bộ và chi phí giao tiếp gradient. Ngược lại, song song mô hình chia nhỏ chính mạng nơ-ron, đòi hỏi sự phối hợp hiệu quả giữa các bộ xử lý. Các benchmark đánh giá mức độ hệ thống quản lý các chiến lược song song này mà không làm suy giảm quá trình hội tụ độ chính xác. Một chỉ số quan trọng để đánh giá tính song song là hiệu suất mở rộng, dùng để đo xem công suất tính toán bổ sung được chuyển hóa thành tăng tốc thực tế đến mức nào.
Sử dụng tài nguyên
Hiệu quả của quá trình huấn luyện machine learning không chỉ phụ thuộc vào tốc độ và khả năng mở rộng, mà còn vào việc tận dụng tài nguyên phần cứng sẵn có tốt đến mức nào. Mức độ sử dụng tính toán đo lường xem các đơn vị xử lý, như GPU hoặc TPU, được sử dụng tích cực đến mức nào trong quá trình huấn luyện. Mức độ sử dụng thấp có thể cho thấy các điểm nghẽn trong việc di chuyển dữ liệu, truy cập bộ nhớ hoặc lập lịch khối lượng công việc (workload) không hiệu quả.
Ví dụ, khi huấn luyện BERT trên một cụm TPU, pipeline đầu vào kém hiệu quả có thể hạn chế thông lượng tổng thể, ngay cả khi các bộ tăng tốc có sức mạnh tính toán thô cao. Nếu việc truy xuất từ bộ lưu trữ hoặc tiền xử lý không theo kịp, hệ thống sẽ không thể giữ các TPU hoạt động hết công suất. Phân tích mức sử dụng tài nguyên giúp xác định nút thắt cổ chai, và các tối ưu như tải trước (prefetching), bộ nhớ đệm (caching) và tăng mức song song trong xử lý đầu vào có thể cải thiện hiệu suất duy trì.
Băng thông bộ nhớ là một yếu tố quan trọng khác, vì các mô hình deep learning cần truy cập thường xuyên vào lượng dữ liệu lớn trong quá trình huấn luyện. Nếu băng thông bộ nhớ trở thành yếu tố hạn chế, chỉ tăng sức mạnh tính toán cũng không cải thiện tốc độ huấn luyện. Các benchmark đánh giá mức độ mô hình khai thác băng thông bộ nhớ sẵn có, đảm bảo tốc độ truyền dữ liệu giữa bộ lưu trữ, bộ nhớ chính và các đơn vị xử lý không trở thành nút thắt cổ chai hiệu năng.
Hiệu suất I/O cũng ảnh hưởng trực tiếp đến hiệu quả huấn luyện, đặc biệt khi làm việc với các tập dữ liệu lớn không thể đặt hết trong bộ nhớ. Các benchmark đánh giá hiệu quả của các pipeline tải dữ liệu, bao gồm các thao tác tiền xử lý, cơ chế bộ nhớ đệm và tốc độ truy xuất từ bộ lưu trữ. Hệ thống không tối ưu hoá việc tải dữ liệu có thể bị chậm đáng kể, bất kể năng lực tính toán.
Hiệu quả năng lượng và chi phí
Huấn luyện các mô hình machine learning quy mô lớn đòi hỏi tài nguyên tính toán đáng kể, kéo theo mức tiêu thụ năng lượng và chi phí tài chính lớn. Các chỉ số hiệu quả năng lượng định lượng mức tiêu thụ năng lượng của các khối lượng công việc (workload) huấn luyện, giúp xác định những hệ thống tối ưu hoá hiệu quả tính toán đồng thời giảm lãng phí năng lượng. Sự chú trọng ngày càng tăng vào tính bền vững đã dẫn đến việc đưa vào các benchmark về năng lượng, chẳng hạn như trong MLPerf Training, đo lường mức tiêu thụ năng lượng cho mỗi lần chạy huấn luyện. Cách hạch toán công suất tương tự cũng áp dụng cho suy luận, nơi độ chính xác số trở thành đòn bẩy năng lượng chủ đạo; section 1.9 giải thích vì sao lượng tử hoá INT8 cắt giảm năng lượng trên mỗi lần suy luận bằng cách giảm cả lưu lượng truy cập bộ nhớ và chi phí phép toán số học.
Việc huấn luyện GPT-3 được ước tính tiêu thụ 1,287 MWh điện năng (Patterson et al. 2021). Nếu một hệ thống có thể đạt độ chính xác tương đương với ít vòng lặp huấn luyện hơn, mức tiêu thụ năng lượng sẽ giảm trực tiếp. Các benchmark chú trọng năng lượng giúp định hướng phát triển phần cứng và chiến lược huấn luyện nhằm tối ưu hóa hiệu quả sử dụng công suất, đồng thời giữ vững các mục tiêu về độ chính xác.
Các yếu tố chi phí không chỉ dừng ở mức sử dụng điện mà còn bao gồm chi phí phần cứng, chi phí tính toán đám mây và chi phí vận hành hạ tầng. Các benchmark huấn luyện cung cấp góc nhìn về hiệu quả chi phí của các cấu hình phần cứng và phần mềm khác nhau bằng cách đo thời gian huấn luyện tương ứng với mức tiêu tốn tài nguyên. Các tổ chức có thể dùng các benchmark này để cân bằng giữa hiệu suất và các ràng buộc ngân sách khi lựa chọn hạ tầng huấn luyện.
Khả năng chịu lỗi và độ vững
Các khối lượng công việc huấn luyện (workload) thường chạy trong thời gian dài, đôi khi kéo dài nhiều ngày hoặc nhiều tuần, nên khả năng chịu lỗi là yếu tố thiết yếu. Một hệ thống có khả năng phục hồi phải xử lý các sự cố bất ngờ (hỏng hóc phần cứng, gián đoạn mạng, lỗi bộ nhớ) mà không làm ảnh hưởng tới quá trình hội tụ về độ chính xác.
Trong quá trình huấn luyện quy mô lớn dựa trên đám mây, việc các nút bị lỗi là điều khó tránh khỏi trong thực tế vận hành. Nếu một nút GPU trong một cụm phân tán bị lỗi, quá trình huấn luyện vẫn phải tiếp tục mà không làm hỏng mô hình. Để đảm bảo khả năng chịu lỗi, các hệ thống sản xuất thường dùng kỹ thuật checkpointing: định kỳ lưu lại tiến độ để khi có lỗi xảy ra, quá trình huấn luyện không phải chạy lại từ đầu. Tuy nhiên, đối với huấn luyện mô hình ngôn ngữ lớn (LLM), checkpointing lại chính là một nút thắt cổ chai của hệ thống: một checkpoint phải ghi các trọng số của mô hình cùng với trạng thái của optimizer vào lưu trữ mạng. Ở quy mô mô hình 100 tỷ tham số, điều này có nghĩa là hàng trăm gigabyte dữ liệu cần được ghi trước khi quá trình huấn luyện có thể tiếp tục. Trong quá trình ghi này, các bộ tăng tốc có thể bị đứng chờ, kéo dài thời gian vòng lặp hiệu dụng và làm chậm thời gian đạt độ chính xác mong muốn. Các hệ thống huấn luyện LLM trong thực tế giải quyết vấn đề này bằng cách cho phép I/O của checkpoint chồng lấn với bước huấn luyện tiếp theo (checkpointing không đồng bộ), hoặc bằng cách sử dụng các hệ thống tệp song song có băng thông cao để giảm thời gian nhàn rỗi. Bản thân MLPerf Training chủ yếu đo thời gian đạt chất lượng dưới các khối lượng công việc (workload) tiêu chuẩn hóa và không benchmark trực tiếp khả năng phục hồi sau lỗi. Tuy nhiên, chi phí của checkpoint là một thành phần quan trọng trong bất kỳ con số thông lượng duy trì thực tế nào.
Khả năng tái lập và tiêu chuẩn hóa
Các nghiên cứu về khả năng tái lập đã nhiều lần chỉ ra rằng, những cải thiện benchmark nhỏ có thể không còn đúng khi các yếu tố như hạt ngẫu nhiên, phần cứng, phiên bản framework hay chi tiết triển khai thay đổi (Henderson et al. 2018). Kiểu lỗi này cho thấy một vấn đề phổ biến: các benchmark huấn luyện thường liên quan đến các quá trình ngẫu nhiên (như khởi tạo trọng số, xáo trộn dữ liệu, mặt nạ dropout). Các quá trình này lại tương tác với những hành vi đặc trưng của phần cứng (ví dụ: làm tròn số dấu phẩy động, bố cục bộ nhớ, tối ưu hóa trình biên dịch), dẫn đến kết quả có thể khác biệt đáng kể giữa các môi trường khác nhau.
Henderson, Peter, Riashat Islam, Philip Bachman, Joelle Pineau, Doina Precup, and David Meger. 2018. “Deep Reinforcement Learning That Matters.” Proceedings of the AAAI Conference on Artificial Intelligence 32 (1): 3207–14. https://doi.org/10.1609/aaai.v32i1.11694.
Một lớp không xác định sâu hơn bắt nguồn từ chính phần cứng song song. Các phép toán như cộng nguyên tử song song, dùng khi tích lũy gradient cho các embedding thưa trong các mô hình như mạng nơ-ron đồ thị, sẽ thực thi theo thứ tự không xác định giữa các luồng khi nhiều cập nhật đồng thời nhắm tới cùng một vị trí bộ nhớ. Khi đó, thứ tự cộng dồn số dấu phẩy động thay đổi giữa các lần chạy, tạo ra các gradient khác nhau từng bit dù đầu vào và seed giống hệt. Muốn tái lập chính xác từng bit (bit-exact reproducibility) trong các trường hợp này phải tắt các đường tích lũy song song, làm giảm thông lượng huấn luyện — một sự đánh đổi trực tiếp giữa tái lập và hiệu suất mà các giao thức benchmark cần nêu rõ. Nếu không kiểm soát rõ ràng tất cả các nguồn biến thiên này, các con số benchmark chỉ phản ánh một sự phối hợp điều kiện cụ thể, chứ không phải năng lực thực sự của hệ thống.
MLPerf Training giải quyết vấn đề này bằng tiền xử lý dữ liệu chuẩn hóa, các quy tắc về chất lượng mục tiêu, và các lần chạy lặp lại được chấp nhận để đặc trưng hóa biến thiên ngẫu nhiên (Mattson et al. 2020). Mục đích không chỉ là đạt một lần chạy nhanh, mà là chứng minh hiệu suất được báo cáo phản ánh đúng năng lực của hệ thống, chứ không phải do sự kết hợp ngẫu nhiên thuận lợi của các yếu tố.
Đối với một benchmark huấn luyện, khả năng tái lập vì thế bao quát toàn bộ bối cảnh của lần chạy, chứ không chỉ mỗi seed. Một báo cáo đáng tin cậy phải bảo toàn commit của mô hình, checksum của tập dữ liệu, pipeline tiền xử lý, kế hoạch seed, phiên bản framework và trình biên dịch, chính sách về độ chính xác, lịch trình batch, topology phần cứng, giới hạn nhiệt và công suất, cùng hành vi của checkpoint. Báo cáo cũng phải trình bày phân bố các lần chạy được chấp nhận, thay vì chỉ một lần chạy tốt nhất. Chỉ khi đó, benchmark mới có thể tách cải tiến thực sự của hệ thống khỏi một tương tác thuận lợi giữa phiên bản phần mềm, trạng thái phần cứng và quỹ đạo huấn luyện ngẫu nhiên.
Đánh giá hiệu suất huấn luyện
Một benchmark huấn luyện toàn diện xem xét nhiều khía cạnh trong hành vi của hệ thống, vì mỗi khía cạnh chỉ ra một cách khác nhau mà khoản đầu tư vào phần cứng có thể không dẫn tới hội tụ. Table 8 tóm tắt các danh mục chính và các chỉ số liên quan thường dùng để benchmark hiệu suất huấn luyện ở cấp độ hệ thống, qua đó cung cấp một framework để hiểu cách các hệ thống huấn luyện vận hành dưới các khối lượng công việc (workload) và cấu hình khác nhau.
| Danh mục | Các chỉ số chính | Ví dụ sử dụng benchmark |
|---|---|---|
| Thời gian huấn luyện và thông lượng | Thời gian đạt độ chính xác (seconds, minutes, hours); Thông lượng (samples/sec) | So sánh tốc độ huấn luyện trên các kiến trúc GPU khác nhau |
| Khả năng mở rộng và song song hóa | Hiệu quả mở rộng (phần trăm tăng tốc lý tưởng); Chi phí giao tiếp (độ trễ, băng thông) | Phân tích hiệu suất huấn luyện phân tán cho các mô hình lớn |
| Sử dụng Tài nguyên | Mức sử dụng tính toán (phần trăm sử dụng GPU/TPU); Băng thông bộ nhớ (GB/s); Hiệu quả I/O (tốc độ tải dữ liệu) | Tối ưu hóa các pipeline dữ liệu để cải thiện mức sử dụng GPU |
| Hiệu quả Năng lượng và Chi phí | Mức tiêu thụ năng lượng mỗi lần chạy (MWh, kWh); Thông lượng huấn luyện trên mỗi watt (FLOP/s/W) | Đánh giá các chiến lược huấn luyện tiết kiệm năng lượng |
| Khả năng Chịu lỗi và Độ bền vững | Chi phí checkpoint (thời gian mỗi lần lưu); Tỷ lệ thành công khôi phục (phần trăm) | Đánh giá khôi phục lỗi trong các hệ thống huấn luyện dựa trên đám mây |
| Khả năng Tái tạo và Tiêu chuẩn hóa | Phương sai giữa các lần chạy (phần trăm khác biệt về độ chính xác, thời gian huấn luyện); Tính nhất quán của framework (TensorFlow vs. PyTorch vs. JAX) | Đảm bảo tính nhất quán trong các kết quả benchmark trên các phần cứng khác nhau |
Các chiều đo này tương tác với nhau theo những cách mà bảng biểu không thể hiện hết. Thông lượng cao hơn nhờ giảm độ chính xác (ví dụ, TF32) trở nên vô nghĩa nếu làm tăng số vòng lặp để đạt độ chính xác mục tiêu; khi đó, time-to-accuracy là chỉ số hiệu chỉnh cốt lõi. Hiệu quả mở rộng có thể gần như tuyến tính khi số nút còn ít, nhưng sẽ giảm dần khi chi phí đồng bộ gradient trở nên chiếm ưu thế. Các chỉ số sử dụng tài nguyên cho thấy nguyên nhân: một tác vụ tiền huấn luyện BERT với mức sử dụng GPU vừa phải có thể đang bị nghẽn ở pipeline dữ liệu, không phải ở các bộ tăng tốc. Checkpointing để chịu lỗi cũng tạo thêm chi phí, đòi hỏi cân bằng giữa khả năng phục hồi và hiệu suất.
Trên mọi chiều đo, độ chính xác của phép đo phụ thuộc vào việc kiểm soát biến thiên phần cứng. Hành vi GPU boost clock23 và thermal throttling24 có thể làm dịch chuyển kết quả đủ nhiều để lấn át các cải thiện nhỏ được tuyên bố, nên việc chạy lặp lại và tuân thủ nghiêm ngặt về thống kê (như đã nêu trước đó) là điều thiết yếu để phân biệt khác biệt hiệu suất thực sự với nhiễu.
23 GPU boost clock: Đây là cơ chế điều chỉnh tần số động, giúp tăng xung nhịp vượt mức cơ bản khi còn dư địa nhiệt và công suất cho phép. Cái bẫy khi benchmark: các lần chạy benchmark ngắn có thể ghi nhận hiệu suất ở mức boost clock, nhưng huấn luyện ML kéo dài có thể ổn định ở tần số thấp hơn khi nhiệt độ điểm nối tăng lên. Báo cáo kết quả ở pha bùng nổ sẽ phóng đại thông lượng mà một khối lượng công việc (workload) sản xuất thực sự có thể duy trì.
24 Điều tiết nhiệt (Thermal throttling): Giảm tần số được kích hoạt khi nhiệt độ điểm nối vượt giới hạn an toàn. Với thiết bị edge không có làm mát chủ động, hiện tượng này có thể bắt đầu trong quá trình suy luận kéo dài, nghĩa là các con số thông lượng đỉnh từ benchmark ngắn có thể không phản ánh đúng hiệu suất ở trạng thái ổn định.
Mặc dù đã có các phương pháp benchmark rõ ràng, các nhóm vẫn dễ rơi vào kết luận sai khi lấy một chỉ số huấn luyện thay cho cả vòng lặp tối ưu. Những bẫy sau đây cho thấy benchmark phải giữ tốc độ, sự hội tụ, khả năng mở rộng và khả năng tái lập gắn chặt với nhau.
Các sai lệch trong benchmark huấn luyện thường bắt đầu khi coi thông lượng là mục tiêu thay vì chỉ là một phần của quá trình học. Hệ thống có thể tăng số ví dụ xử lý mỗi giây bằng cách hạ độ chính xác số học, giảm đồng bộ, hoặc thậm chí bỏ qua một số phép tính, nhưng các thay đổi đó chỉ hữu ích nếu vẫn giữ được sự hội tụ. Chẳng hạn, một lần chạy TF32 có thể nhanh hơn FP32 ở mỗi bước, nhưng vẫn thua chung cuộc nếu bất ổn số học làm tăng số vòng lặp cần để đạt độ chính xác mục tiêu. Vì vậy, benchmark phải báo cáo thông lượng cùng với thời gian để đạt độ chính xác (time-to-accuracy), để chắc rằng tối ưu tốc độ không đánh đổi bằng hiệu quả hội tụ.
Khả năng mở rộng cũng là một chiếc bẫy khác: kết quả trên ít nút có thể trông tuyến tính cho đến khi chi phí giao tiếp và đồng bộ bắt đầu lấn át. Ví dụ tính với tám GPU trước đó cho thấy vì sao không thể ngoại suy tuyến tính từ kết quả trên cụm nhỏ khi đồng bộ hóa trở thành yếu tố giới hạn.
Như phép tính hiệu quả khả năng mở rộng trong section 1.7.2.2 đã minh họa (nơi 8 GPUs chỉ đạt hiệu quả 75 percent), việc ngoại suy kết quả từ một nút đơn sang cả cụm là một lỗi phổ biến. Kinh nghiệm của Google với các cụm TPU v4 4.096 nút cho thấy rõ hiệu ứng này ở quy mô cực lớn, nơi thách thức đồng bộ trở thành yếu tố chi phối hiệu suất. Benchmark đúng cách cần đo lường hiệu quả khả năng mở rộng một cách rõ ràng, thay vì giả định cải thiện tuyến tính.
Nguyên tắc tương tự áp dụng cho sự cố và nhiễu. Nhiều benchmark giả định điều kiện lý tưởng, không có lỗi phần cứng, mạng luôn ổn định và không có nhiễu từ các khối lượng công việc (workload) khác, dù trên thực tế những điều này rất thường gặp ở quy mô lớn. Benchmark hiệu quả phải tính đến chi phí checkpoint, hiệu quả phục hồi khi lỗi, và tranh chấp tài nguyên, thay vì chỉ báo cáo hiệu suất trong kịch bản tốt nhất.
Tính tái lập cũng là một thách thức nữa. Kết quả phải tái lập được giữa các stack: một lần chạy TensorFlow với các tối ưu hóa Accelerated Linear Algebra có thể cho thấy hành vi hội tụ khác so với cùng mô hình được huấn luyện trong PyTorch với Automatic Mixed Precision (AMP), vì phép tính dấu phẩy động, bố trí bộ nhớ và chiến lược tối ưu hóa đều có thể làm thay đổi thời gian huấn luyện và độ chính xác.
Để tránh những vấn đề này, chúng ta cần đánh giá thông lượng cùng với mức độ hội tụ về độ chính xác, xem xét hiệu quả mở rộng một cách toàn diện, và tính đến các sự cố thực tế thay vì giả định điều kiện lý tưởng. Dù mô hình được huấn luyện hiệu quả, ta vẫn phải kiểm chứng hiệu năng khi triển khai, điều này kéo theo việc thay đổi hoàn toàn framework đánh giá.
Self-Check: Question
Why does MLPerf Training mandate time-to-accuracy (or time-to-quality) as its primary benchmark metric instead of raw throughput measured in samples per second?
- Samples per second cannot be measured accurately with digital timers
- Time-to-accuracy is easier to simulate without running actual GPUs
- Hardware vendors do not know the batch size used during training
- Raw sample throughput can be artificially inflated by using aggressive low precision or extreme batch sizes that destabilize training, whereas time-to-accuracy ensures throughput optimizations actually converge to the required model quality
A deep learning model trains on a single GPU in \(24\text{ hours}\). When distributed across \(8\text{ GPUs}\) on the same fixed total dataset (strong scaling), the training completes in \(4\text{ hours}\). What is the strong scaling efficiency, and what primary system factor prevents it from achieving \(100\%\)?
- \(75\%\) efficiency; inter-GPU gradient synchronization communication overhead and serialization bottlenecks reduce speedup below the ideal \(8\times\)
- \(100\%\) efficiency; the run achieved linear speedup because \(24 / 4 = 6\)
- \(50\%\) efficiency; GPU memory bandwidth is cut in half whenever multiple GPUs are connected
- \(12.5\%\) efficiency; training time only decreased by a factor of 6
Explain why a reduced-precision training configuration (such as FP8 or BF16) that achieves a \(1.8\times\) step-level throughput gain could result in a longer wall-clock time-to-accuracy than standard FP32 training.
In distributed training benchmarks, the scaling regime where the total workload/dataset size remains constant as the number of accelerator nodes increases is known as ____.
Explain why evaluating distributed training systems solely under idealized, failure-free conditions misrepresents large-scale cluster performance, and identify two system overheads required for production robustness.
Order the following operational stages of an MLPerf Training time-to-accuracy benchmark evaluation run from start to finish:
- Halt training execution and log total elapsed wall-clock time-to-accuracy
- Execute distributed forward-backward iterations with gradient synchronization across nodes
- Initialize model parameters and data loaders using fixed random seeds and standardized preprocessing
- Check whether the validation accuracy meets or exceeds the mandatory target quality threshold
- Perform periodic evaluation on the held-out validation dataset at predefined epoch intervals
Benchmark suy luận
Benchmark huấn luyện đo tốc độ học của một hệ thống; còn benchmark suy luận đo độ tin cậy của việc phục vụ (serving). Sự khác biệt này thay đổi gần như mọi khía cạnh của việc đánh giá. Huấn luyện chấp nhận thời gian lặp biến đổi miễn là quá trình hội tụ vẫn tiếp diễn; ngược lại, suy luận yêu cầu độ trễ nhất quán, vì người dùng sẽ cảm nhận mọi phản hồi chậm. Huấn luyện tối ưu hóa thông lượng tổng thể trong nhiều giờ; còn suy luận phải xử lý các mẫu yêu cầu khó đoán và các hạn chót theo từng kịch bản. Việc huấn luyện các benchmark lớn thường sử dụng phần cứng hiệu suất cao chuyên dụng, trong khi suy luận được triển khai trên nhiều môi trường khác nhau, từ GPU của trung tâm dữ liệu đến điện thoại di động và vi điều khiển.
Đây là điểm hội tụ của các chương về tối ưu hóa: phần cứng tăng tốc được đề cập trong Tăng tốc phần cứng sẽ chạy các mô hình đã nén từ Nén mô hình để đưa ra dự đoán theo thời gian thực. Các benchmark suy luận sẽ cho thấy liệu những cải thiện tốc độ trên lý thuyết có thực sự giúp giảm độ trễ trong điều kiện triển khai thực tế hay không.
Definition 1.4: Benchmark suy luận ML
Benchmark suy luận ML là các benchmark hệ thống machine learning dùng để định lượng khả năng của một hệ thống trong việc đáp ứng các ràng buộc về độ trễ \((L_{\text{lat}})\) tại các mức thông lượng được chỉ định, đồng thời đo lường các thống kê độ trễ theo từng kịch bản, thông lượng (số truy vấn mỗi giây) và hiệu quả công suất trong các kịch bản phục vụ (serving) tiêu biểu.
- Ý nghĩa: Benchmark suy luận giúp thấy rõ khoảng cách (đặc thù theo từng khối lượng công việc (workload) và hệ thống) giữa thông lượng không bị ràng buộc và thông lượng khi phải đáp ứng một mục tiêu mức dịch vụ (SLO), chẳng hạn mục tiêu độ trễ p99. Khi tải cao, độ trễ do xếp hàng có thể đẩy độ trễ đuôi vượt mục tiêu. Khoảng cách này sẽ không nhìn thấy nếu không có benchmark áp mục tiêu độ trễ ở mỗi mức thông lượng.
- Điểm khác biệt: Khác với benchmark huấn luyện (đo thời gian để đạt độ chính xác mong muốn trên một tập dữ liệu cố định), benchmark suy luận đo thời gian phản hồi cho từng truy vấn dưới các mẫu tải thực tế, phản ánh hiệu ứng xếp hàng, các đánh đổi khi dùng batch và chi phí khởi động nguội (cold-start) – những yếu tố quyết định hiệu quả kinh tế của việc phục vụ (serving) trong thực tế.
- Cạm bẫy phổ biến: Một ngộ nhận thường gặp là chỉ cần độ trễ trung bình để đánh giá. Một hệ thống có độ trễ trung bình thấp nhưng đuôi p99 dài vẫn có thể vi phạm SLO dựa trên phân vị trong môi trường sản xuất đối với 1% yêu cầu chậm nhất; khi tốc độ yêu cầu cao, tỷ lệ nhỏ đó tương ứng với số người dùng bị ảnh hưởng rất lớn. Benchmark phải báo cáo đúng thống kê độ trễ được nêu trong mục tiêu dịch vụ, thay vì mặc định rằng giá trị trung bình hay p99 luôn là yếu tố quyết định.
Lý do cần benchmark suy luận
Việc huấn luyện benchmark quy mô lớn thường diễn ra trên phần cứng chuyên dụng tại các trung tâm dữ liệu, trong khi suy luận lại được triển khai trong rất nhiều kịch bản – từ ứng dụng thời gian thực như xe tự lái, AI đàm thoại đến thiết bị di động, hệ thống IoT và bộ xử lý nhúng. Sự đa dạng này còn thể hiện ở phần cứng: dù GPU và TPU chiếm ưu thế trong huấn luyện quy mô lớn, khối lượng công việc (workload) suy luận thường dùng các bộ tăng tốc chuyên biệt như NPU, mảng cổng lập trình được, và các chip suy luận chuyên dụng như Edge TPU của Google.25 Benchmark suy luận đánh giá mức độ phối hợp hiệu quả giữa lựa chọn phần cứng, tối ưu hóa mô hình và thiết kế pipeline dữ liệu trong các môi trường triển khai này.
25 Edge TPU (đơn vị xử lý tensor): Đây là bộ tăng tốc AI edge chức năng cố định của Google. Nó minh họa một ràng buộc khi benchmark các bộ tăng tốc dạng chức năng cố định: thông lượng được quảng bá chỉ áp dụng cho các mô hình TensorFlow Lite đã lượng tử hóa và dùng các toán tử được hỗ trợ. Vì vậy, các mô hình cần toán tử không được hỗ trợ sẽ phải chạy rơi về CPU của máy chủ hoặc cần viết lại đồ thị trước khi kết quả trên bộ tăng tốc có ý nghĩa.
Khi mở rộng khối lượng công việc (workload) suy luận trên máy chủ đám mây, nền tảng edge, thiết bị di động và hệ thống TinyML, độ phức tạp sẽ tăng thêm. Figure 6 cho thấy sự chênh lệch công suất tiêu thụ rất lớn giữa các hệ thống này—trải dài hơn mười bậc độ lớn, từ microwatt ở các thiết bị nhúng siêu nhỏ đến hàng trăm kilowatt ở các cụm huấn luyện trong trung tâm dữ liệu. Các khoảng này mang tính đại diện chứ không phải đầy đủ. Sự trải rộng đó giải thích vì sao không có một benchmark nào phù hợp mọi ngữ cảnh triển khai: một số liệu có ý nghĩa để tối ưu hoá trung tâm dữ liệu (kilowatt mỗi rack) lại vô nghĩa với các thiết bị edge chạy pin (milliwatt mỗi suy luận). Các benchmark suy luận cần đánh giá các đánh đổi giữa độ trễ, chi phí và hiệu quả năng lượng ở từng quy mô để giúp tổ chức đưa ra quyết định triển khai thông thái.
Những khác biệt trong triển khai tạo ra động lực thực tế cho các benchmark suy luận: chúng đánh giá các nút thắt cổ chai xuất hiện khi mô hình chuyển từ giai đoạn phát triển sang phục vụ (serving) trong môi trường sản xuất. Các yếu tố thúc đẩy tương tự như trong huấn luyện (tối ưu hóa phần cứng, khả năng mở rộng, chi phí, so sánh công bằng) nhưng khác nhau ở chi tiết. Các framework tối ưu hóa phần mềm áp dụng những kỹ thuật đặc thù cho suy luận như hợp nhất toán tử (xem Nén mô hình và Tăng tốc phần cứng), hiệu chỉnh độ chính xác và tinh chỉnh kernel; tác động của chúng lên độ trễ, thông lượng và hiệu quả công suất cần được đo trong điều kiện thực tế để xác nhận rằng chúng mang lại cải tiến thực sự mà không làm giảm độ chính xác. Các trình biên dịch tự động tinh chỉnh (auto-tuning compilers) thêm một biến ẩn: bản thân trình biên dịch có thể mất hàng giờ để tối ưu hóa cho từng cặp mô hình-phần cứng, nên kết quả benchmark phản ánh ngân sách tinh chỉnh cũng nhiều như phản ánh năng lực phần cứng; vì vậy, khi so sánh các bài nộp, cần chuẩn hóa theo thời gian tối ưu hóa của trình biên dịch.
Những mối quan tâm về khả năng mở rộng cũng đổi khác. Huấn luyện mở rộng bằng cách thêm GPU để rút ngắn thời gian đạt độ chính xác mong muốn cho một khối lượng công việc (workload) cố định; còn suy luận phải mở rộng linh hoạt theo nhu cầu người dùng biến động, xử lý các đợt tăng đột biến lưu lượng mà vẫn không vi phạm các cam kết về độ trễ. Hiệu suất khởi động nguội (cold-start) — thời gian để mô hình được tải và bắt đầu xử lý truy vấn — là một vấn đề riêng của suy luận, không có tương đương trong huấn luyện. Các ứng dụng tải mô hình theo nhu cầu, chẳng hạn các triển khai AI không máy chủ (serverless AI deployments), đặc biệt nhạy với chi phí này.
Chi phí và đặc tính năng lượng của suy luận khác biệt rõ rệt so với huấn luyện. Huấn luyện dồn chi phí vào các lần chạy rời rạc, có thể lặp lại khi dữ liệu, mục tiêu hoặc mô hình thay đổi; còn chi phí suy luận tích lũy liên tục theo lưu lượng sản xuất. Vận hành một mô hình kém hiệu quả ở quy mô lớn có thể nhân lên chi phí tính toán trên đám mây, và trên các thiết bị chạy pin, tính toán quá mức ảnh hưởng trực tiếp đến khả năng sử dụng. Các benchmark đo chi phí trên mỗi yêu cầu suy luận và hiệu quả trên mỗi watt giúp tổ chức tối ưu cả hiệu suất lẫn tính bền vững trên các nền tảng triển khai.
MLPerf Inference mở rộng những nguyên tắc so sánh chuẩn hóa vốn áp dụng cho các benchmark huấn luyện sang các kịch bản triển khai. Đồng thời, nó định nghĩa các tiêu chí đánh giá cho những tác vụ như phân loại hình ảnh, phát hiện đối tượng và nhận dạng giọng nói trên nhiều nền tảng phần cứng khác nhau. Nhờ đó, các so sánh về hiệu suất suy luận vẫn giữ được ý nghĩa và khả năng tái tạo, đồng thời tính đến các ràng buộc đặc thù của triển khai, chẳng hạn như yêu cầu về độ trễ và hiệu quả năng lượng (Reddi et al. 2019).
Các chỉ số suy luận
Ví dụ, một trợ lý giọng nói phải phản hồi đủ nhanh để người dùng không cảm nhận được độ trễ, trong khi một công cụ gợi ý phải chấm điểm đủ số lượng ứng viên để theo kịp tốc độ cuộn của người dùng. Những ràng buộc này (độ trễ và thông lượng) xác định “vùng làm việc” về hiệu suất mà mọi tối ưu hóa phục vụ (serving) phải đáp ứng. Các chỉ số suy luận biến những yêu cầu thực tế đó thành các đại lượng có thể đo lường, và chúng khác với các chỉ số huấn luyện không chỉ ở mức độ mà còn ở bản chất, vì mục tiêu tối ưu đã chuyển từ “học nhanh đến đâu?” sang “phục vụ ổn định đến mức nào?”. Huấn luyện quan tâm đến thông lượng và thời gian để đạt độ chính xác mục tiêu; suy luận quan tâm đến tính nhất quán của độ trễ, hiệu quả sử dụng tài nguyên và tính thực tiễn khi triển khai, bao trùm từ các trung tâm dữ liệu đám mây xử lý hàng triệu yêu cầu đến các thiết bị edge hoạt động dưới những ràng buộc công suất nghiêm ngặt.
Độ trễ và độ trễ đuôi
Độ trễ (được giới thiệu trong Hệ thống ML) đo khoảng thời gian mà một hệ thống suy luận cần để xử lý một đầu vào và đưa ra một dự đoán. Độ trễ trung bình tuy hữu ích, nhưng nó không thể hiện được những độ trễ ở các phân vị cao, vốn làm giảm độ tin cậy của hệ thống trong các tình huống có nhu cầu lớn.
Để khắc phục hạn chế này, các benchmark thường đo độ trễ đuôi,26 tóm tắt phần đuôi có độ trễ cao thay vì chỉ xét trường hợp xấu nhất. Những giá trị này thường được báo cáo dưới dạng độ trễ ở phân vị 95 (p95) hoặc 99 (p99), tức là 95% hoặc 99% lượt suy luận được hoàn thành trong một khoảng thời gian nhất định. Các ứng dụng có thời hạn nghiêm ngặt (hard deadlines) đòi hỏi phải phân tích rõ ràng về việc bỏ lỡ thời hạn hoặc phân tích trường hợp xấu nhất, vượt ra ngoài các phân vị này.
26 Độ trễ đuôi: Thời gian phản hồi ở các phân vị cao, chẳng hạn p95 hoặc p99, chỉ dùng để xác định mức độ tuân thủ SLO hoặc SLA trong môi trường sản xuất khi mục tiêu hoặc thỏa thuận đó quy định rõ phân vị. Dean and Barroso (2013) chỉ ra rằng trong kiến trúc fan-out (phổ biến trong hệ thống gợi ý), ngay cả 1% phản hồi chậm cũng bị khuếch đại: một yêu cầu chạm tới 100 shard ở backend có khoảng 63% khả năng là sẽ có ít nhất một shard rơi vào nhóm 1% chậm nhất của nó. Các benchmark chỉ báo cáo độ trễ trung bình sẽ che giấu kiểu lỗi này.
Dean, Jeffrey, and Luiz André Barroso. 2013. “The Tail at Scale.” Communications of the ACM 56 (2): 74–80. https://doi.org/10.1145/2408776.2408794.
Các phép đo này là nền tảng để xây dựng Mục tiêu Mức dịch vụ (SLO) và Thỏa thuận Mức dịch vụ (SLA), qua đó chính thức hóa các kỳ vọng về hiệu suất.
Definition 1.5: SLO và SLA
SLO và SLA là các đặc tả cam kết hiệu suất cho các hệ thống phục vụ (serving) ML trong môi trường sản xuất: mục tiêu mức dịch vụ (SLO) là một giá trị hoặc một khoảng giá trị mục tiêu cho một chỉ số mức dịch vụ, còn SLA là một hợp đồng quy định các mục tiêu dịch vụ và những hậu quả nếu không đạt được chúng.
- Ý nghĩa: Một SLO về độ trễ giới hạn thành phần \(L_{\text{lat}}\) trong định luật sắt bằng cách đặt mục tiêu cho một chỉ số độ trễ cụ thể. Trong một thiết lập sản xuất điển hình, người ta có thể đặt SLO nội bộ chặt chẽ hơn so với SLA bên ngoài để chừa khoảng trống vận hành cho các đợt tăng đột biến tạm thời, các khoảng thời gian bảo trì và các lỗi dây chuyền.
- Điểm khác biệt: Bản thân một SLO không kéo theo hậu quả hợp đồng nào, trong khi việc không đạt mục tiêu SLA sẽ kích hoạt các hậu quả đã quy định trong thỏa thuận, có thể bao gồm bồi thường hoặc phạt. Các đội ngũ thường đặt SLO nội bộ chặt chẽ hơn so với thỏa thuận bên ngoài để tạo khoảng trống vận hành, nhưng đây là thông lệ chứ không phải yêu cầu mang tính định nghĩa.
- Lỗi thường gặp: Một hiểu lầm phổ biến là cho rằng đáp ứng độ trễ trung bình đã đủ để thỏa mãn một SLO về độ trễ đuôi. SLO có thể dùng giá trị trung bình, phân vị, tỷ lệ hoặc các chỉ số khác; khi mục tiêu được định nghĩa ở p99 hoặc p99.9, một giá trị trung bình xuất sắc vẫn không đủ để chứng minh tuân thủ.
Sự khác biệt này rất quan trọng trong thực tế: đội ngũ kỹ thuật tối ưu theo SLO, còn bộ phận kinh doanh cam kết theo SLA. Chọn sai chỉ số để tối ưu có thể làm lãng phí công sức kỹ thuật hoặc vi phạm cam kết với khách hàng.
Một mục tiêu độ trễ hữu dụng cũng cần cố định tập hợp yêu cầu và khoảng thời gian đo lường. Nếu không, hai đội có thể báo cáo cùng một ngưỡng phân vị trên các phối trộn lưu lượng khác nhau và đi đến những kết luận không tương thích về mức độ tuân thủ.
Checkpoint 1.2: Lựa chọn số liệu
Số liệu sẽ định hướng quá trình tối ưu hóa.
Hãy áp dụng ba quy tắc sau trước khi chốt việc lựa chọn số liệu:
Mối liên hệ giữa độ trễ đuôi và trải nghiệm người dùng ở quy mô lớn là cực kỳ quan trọng trong các hệ thống sản xuất đang phục vụ (serving) hàng triệu người dùng. Ngay cả những suy giảm nhỏ về độ trễ p99 cũng tạo ra hiệu ứng tích lũy khi có khối lượng yêu cầu lớn: nếu 1% yêu cầu gặp độ trễ gấp 10 lần (ví dụ, 1000 ms thay vì 100 ms), điều này sẽ ảnh hưởng đến 10.000 yêu cầu trong mỗi triệu, có thể dẫn đến lỗi hết thời gian chờ, trải nghiệm người dùng tệ và khách hàng rời bỏ. Các công cụ tìm kiếm và hệ thống đề xuất cho thấy sự nhạy cảm này: các thử nghiệm về độ trễ tìm kiếm của Google đã ghi nhận mức giảm có thể đo được về số lượt tìm kiếm hàng ngày trên mỗi người dùng khi có độ trễ phía máy chủ từ 100–400 ms (Brutlag 2009). Đây là lý do các dịch vụ tương tác thường đặt mục tiêu thiết kế là thời gian phản hồi dưới 100 ms.
Brutlag, Jake. 2009. Speed Matters for Google Web Search. Google Research Blog.
Do đó, các mục tiêu mức dịch vụ (SLO) trong các hệ thống sản xuất tập trung vào độ trễ đuôi thay vì độ trễ trung bình để đảm bảo trải nghiệm người dùng nhất quán. Các dịch vụ tương tác thường đặt ra các mục tiêu độ trễ dựa trên phân vị vì những phản hồi chậm không thường xuyên lại có tác động không cân xứng đến sự hài lòng của người dùng. Các hệ thống quy mô lớn có thể theo dõi các đuôi sâu hơn nữa, chẳng hạn như p99.9, khi lưu lượng truy cập tăng đột biến và sự thay đổi cơ sở hạ tầng ảnh hưởng đến độ tin cậy.
Thách thức trong việc đạt các mục tiêu độ trễ đuôi này là nguồn gốc của đuôi thường thuộc về kiến trúc, không phải thuật toán. Một runtime có cơ chế thu gom rác, một trình điều khiển kernel dùng chung, hoặc một lỗi đảo ngược ưu tiên trong ngăn xếp phục vụ (serving) có thể tạo ra các đợt tăng đột biến độ trễ mà không một tối ưu hóa mô hình nào loại bỏ được.
War Story 1.1: Viết lại Trạng thái Đã đọc của Discord (2019)
Bối cảnh: Discord, một nền tảng trò chuyện thời gian thực hỗ trợ hàng triệu người dùng đồng thời, ban đầu triển khai dịch vụ Read States bằng Go để theo dõi những kênh và tin nhắn mà mỗi người dùng đã đọc (Howarth 2020).
Cơ chế: Các đợt thu gom rác bắt buộc của Go quét một cache LRU chứa hàng chục triệu mục, gây ra các khoảng dừng GC “stop-the-world” định kỳ cứ mỗi hai phút, dù đã tinh chỉnh bộ nhớ thế nào.
Tác động: Độ trễ đuôi (\(P_{99}\)) tăng vọt mạnh cứ mỗi hai phút, làm giảm trải nghiệm người dùng trên hàng triệu kết nối đang hoạt động.
Giải pháp: Năm 2019, Discord viết lại dịch vụ Read States bằng Rust, loại bỏ các khoảng dừng do thu gom rác và giảm thời gian phản hồi trung bình xuống mức micro giây.
Bài học về hệ thống: Chỉ độ trễ trung bình thôi thì không phản ánh được trải nghiệm người dùng khi mục tiêu dịch vụ đặt ở phần đuôi (tail). Việc lựa chọn runtime của ngôn ngữ có thể đặt sàn cho độ trễ đuôi đó: các kho đặc trưng phục vụ (serving) các embedding thời gian thực cho mô hình khuyến nghị có thể dùng các runtime được quản lý, và các khoảng dừng do thu gom rác có thể trì hoãn mọi yêu cầu suy luận ở phía sau đang chờ truy xuất. Tối ưu hóa mô hình không thể bù đắp khi nút thắt cổ chai nằm ở đường truy xuất. Sự cố của Discord cho thấy cơ chế nền tảng nằm ngoài ML và lý giải vì sao toàn bộ ngăn xếp phục vụ (serving stack) cần nằm trong một benchmark độ trễ ở môi trường sản xuất.
Howarth, Jesse. 2020. “Why Discord Is Switching from Go to Rust.”
Độ trễ đầu cuối so với độ trễ thành phần
Trong benchmark suy luận, cần phân biệt rõ giữa độ trễ thành phần (thời gian dành cho tính toán của mô hình) và độ trễ đầu cuối (tổng thời gian từ lúc nhận yêu cầu đến khi gửi phản hồi). Nhiều benchmark chỉ báo cáo thời gian suy luận của mô hình, làm lu mờ các chi phí khác vốn quyết định trải nghiệm người dùng thực tế. Các chi phí này không hề nhỏ: tuần tự hóa, các bước nhảy qua mạng và thời gian chờ hàng đợi có thể chiếm phần lớn tổng thời gian xử lý yêu cầu, khiến tối ưu hóa chỉ riêng mô hình mang lại hiệu quả giảm dần.
Example 1.4: Cái bẫy tuần tự hóa JSON
Kịch bản: Khi đánh giá hệ thống phục vụ (serving) mô hình độ trễ thấp Clipper, các nhà nghiên cứu đã tách độ trễ đầu cuối của yêu cầu theo các phần: mạng, tuần tự hóa trên CPU và thực thi mô hình (Crankshaw et al. 2017).
Chẩn đoán: Với các mô hình nhẹ, việc giải tuần tự JSON phía CPU và sao chép dữ liệu qua IPC tiêu tốn nhiều thời gian thực hơn so với việc thực thi mạng nơ-ron trên bộ tăng tốc.
Bài học về hệ thống: Chỉ báo cáo độ trễ suy luận của mô hình sẽ bỏ sót các nút thắt trong quá trình phục vụ (serving) từ đầu đến cuối. Benchmark trong môi trường sản xuất phải tính cả việc phân tích dữ liệu trên CPU, tuần tự hóa IPC và chi phí truyền qua mạng.
Crankshaw, Daniel, Xin Wang, Guilio Zhou, Michael J. Franklin, Joseph E. Gonzalez, and Ion Stoica. 2017. “Clipper: A Low-Latency Online Prediction Serving System.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 613–27.
Table 9 đưa ra bảng phân tích độ trễ minh họa cho một yêu cầu suy luận. Giai đoạn suy luận mô hình mà các nhà cung cấp thường công bố là số “benchmark” của họ kéo dài khoảng 5 đến 100 ms, trong khi thời gian chờ hàng đợi phía trước có thể từ 0 đến hơn 1.000 ms. Khi hệ thống chịu tải, thành phần duy nhất mà benchmark đo (suy luận mô hình) bị lu mờ bởi thành phần mà benchmark không thấy (thời gian chờ hàng đợi), nên con số công bố có thể chỉ là một lát nhỏ so với trải nghiệm thực tế của người dùng.
| Thành phần | Phạm vi Ví dụ | Ghi chú |
|---|---|---|
| Chuyến đi khứ hồi mạng | 10–100 ms | Thay đổi theo khu vực |
| Phân tích cú pháp yêu cầu | 0.1–1 ms | JSON/protobuf |
| Tiền xử lý đầu vào | 1–50 ms | Tokenization, thay đổi kích thước hình ảnh |
| Thời gian chờ hàng đợi | 0–1000+ ms | Phụ thuộc vào tải |
| Suy luận mô hình | 5–100 ms | “benchmark” |
| Hậu xử lý đầu ra | 0.5–10 ms | Giải mã, định dạng |
| Tuần tự hóa phản hồi | 0.1–1 ms | JSON/protobuf |
Các đóng góp ở cấp thành phần giải thích vì sao tối ưu chỉ một giai đoạn sẽ cho hiệu quả giảm dần đối với hiệu năng đầu đến cuối, một giới hạn tối ưu hóa được Định luật Amdahl mô tả chính thức.
Napkin Math 1.4: Định luật Amdahl: Giới hạn tối ưu hóa
Vấn đề: Một pipeline xử lý ảnh tiêu tốn 8 ms cho tiền xử lý (giải mã JPEG, đổi kích thước, chuẩn hóa) và 10 ms cho suy luận. Nếu chỉ giai đoạn suy luận được tối ưu với hệ số 5×, thì độ trễ đầu đến cuối thực sự cải thiện bao nhiêu?
Toán học: Khi tối ưu hóa giai đoạn suy luận từ 10 ms xuống 2 ms, tổng độ trễ giảm từ 18 ms xuống chỉ còn 10 ms, tức cải thiện 1.8× lần, thay vì 5× lần như khi nhìn riêng phần suy luận. Định luật Amdahl chính thức hóa trần này: nếu tiền xử lý chiếm một phần \(f\) của tổng độ trễ, thì ngay cả khi suy luận được tăng tốc vô hạn, mức tăng tốc tối đa cũng chỉ là \(1/f\). Với tiền xử lý chiếm 44.4 percent tổng độ trễ, xác định phần chiếm ưu thế \(f\) = 0.444 cho thấy mức tăng tốc tối đa \(1/f\) là 2.25× lần, bất kể mô hình được tối ưu hóa đến mức nào.
Hiểu biết về hệ thống: Tối ưu hóa mô hình một cách mạnh tay thường cho kết quả đầu cuối không như kỳ vọng khi phần ngoài mô hình chiếm ưu thế. Bất kỳ mức tăng tốc nào của một thành phần khi được đo tách biệt cũng sẽ nhỏ lại khi đo cùng các giai đoạn chưa đụng tới, và khoảng chênh này càng lớn khi các giai đoạn đó chiếm tỷ trọng lớn hơn trong toàn bộ pipeline. Các benchmark toàn diện cần hoặc đưa cả tiền xử lý vào phép đo, hoặc nêu rõ rằng các mức tăng tốc được báo cáo chỉ áp dụng cho thành phần suy luận.
Trần theo Amdahl cho thấy vì sao phương pháp benchmark nghiêm ngặt là quan trọng. Báo cáo độ trễ một cách toàn diện đòi hỏi nêu rõ thành phần nào được tính, đo trong điều kiện tải thực tế, và phân biệt rạch ròi giữa chỉ số của từng thành phần với chỉ số đầu cuối. Trước khi diễn giải bất kỳ kết quả benchmark nào, hãy kiểm tra rằng chính cách đo lường là đúng đắn.
Thông lượng và hiệu quả batch đo lường liệu một hệ thống phục vụ (serving) có tận dụng được phần cứng sẵn có mà không vi phạm ràng buộc độ trễ hay không. Thông lượng đếm số yêu cầu suy luận mà hệ thống xử lý mỗi giây, thường được biểu thị bằng truy vấn mỗi giây (QPS) hoặc khung hình mỗi giây (FPS). Hệ thống đơn lẻ xử lý từng đầu vào độc lập ngay khi đến; hệ thống batch xử lý nhiều đầu vào song song, khai thác tính song song của phần cứng để đạt hiệu quả cao hơn.
Checkpoint 1.3: Phương pháp benchmark
Các benchmark không tốt sẽ dẫn đến việc tối ưu hóa sai mục tiêu.
Ba thực hành sau giúp phân biệt các benchmark nghiêm ngặt với các benchmark dễ gây hiểu lầm:
Ví dụ, các dịch vụ trên đám mây xử lý hàng triệu truy vấn mỗi giây được hưởng lợi từ suy luận batch, nơi các nhóm đầu vào lớn được xử lý cùng nhau để tối đa hóa hiệu quả tính toán. Ngược lại, các ứng dụng như robot, AI tương tác và thực tế tăng cường yêu cầu suy luận đơn lẻ có độ trễ thấp, nơi hệ thống phải phản hồi ngay với mỗi đầu vào mới. Các benchmark cần xem xét cả thông lượng đơn lẻ và batch throughput để cung cấp cái nhìn toàn diện về hiệu suất suy luận trong các kịch bản triển khai khác nhau.
Chỉ tốc độ thôi là chưa đủ, vì các tối ưu hóa suy luận có thể làm thay đổi cách mô hình hoạt động. Giảm độ chính xác số học có thể tăng tốc tính toán đồng thời giảm nhu cầu bộ nhớ và năng lượng, như ước tính năng lượng của MobileNetV2 minh họa (table 17). Tuy nhiên, các phép tính với độ chính xác thấp hơn có thể làm suy giảm độ chính xác. Vì vậy, các benchmark suy luận đánh giá mức độ mô hình hoạt động trong nhiều thiết lập số học khác nhau, như FP32, FP16 và INT8.27 Nhiều bộ tăng tốc AI hiện đại hỗ trợ suy luận với độ chính xác hỗn hợp, cho phép hệ thống chọn biểu diễn số phù hợp với yêu cầu của khối lượng công việc (workload). Các kỹ thuật nén mô hình28 còn giúp nâng cao hiệu quả, nhưng tác động của chúng đến độ chính xác mô hình thay đổi theo tác vụ và tập dữ liệu. Các benchmark giúp xác định liệu những tối ưu hóa này có khả thi để triển khai hay không, bảo đảm rằng cải thiện hiệu quả không phải đánh đổi bằng mức mất mát độ chính xác khó chấp nhận.
27 INT8 (số nguyên 8-bit): INT8 nằm ở phía “mạnh tay” của thang độ chính xác (FP32 là mức cơ sở, FP16 giảm một nửa dung lượng lưu trữ trọng số, còn INT8 chỉ còn một phần tư), và mỗi nấc hạ này đòi hỏi mức độ cẩn trọng tăng dần để giữ độ chính xác. Lượng tử hoá INT8 sau huấn luyện thường dùng một tập dữ liệu hiệu chuẩn đại diện; độ chính xác phụ thuộc vào mô hình, mức độ bao phủ của các toán tử, phương pháp lượng tử hoá, và việc dữ liệu hiệu chuẩn có đại diện tốt cho đầu vào khi triển khai hay không. Các benchmark INT8 phải nêu rõ liệu chúng dùng lượng tử hoá sau huấn luyện hay huấn luyện có nhận biết lượng tử hoá, và ghi lại chi tiết mọi quy trình hiệu chuẩn.
28 Benchmarking nén mô hình: Tác động của nén phải được đo đồng thời trên bốn khía cạnh: mức suy giảm độ chính xác, mức tăng tốc suy luận, mức giảm dùng bộ nhớ và mức tiết kiệm năng lượng. Một kỹ thuật đạt giảm kích thước 10\(\times\) với mất 1% độ chính xác vẫn có thể không phù hợp nếu độ trễ không cải thiện tương ứng; chẳng hạn, tỉa (pruning) không cấu trúc làm giảm số tham số nhưng hiếm khi cải thiện độ trễ trên phần cứng dày đặc, vì các phép toán thưa thiếu hỗ trợ phần cứng hiệu quả trên hầu hết các GPU.
29 Serverless AI: Mô hình triển khai trong đó các mô hình có thể mở rộng từ trạng thái không có phiên bản nào (zero instances) khi có nhu cầu. Thời gian khởi động nguội (cold start) thay đổi tùy theo mô hình, runtime, đường dẫn lưu trữ, phân bổ phần cứng và nhà cung cấp. Các benchmark cho khối lượng công việc (workload) gián đoạn phải nêu rõ liệu thời gian khởi tạo và tải mô hình có được tính vào hay không, vì chỉ tính độ trễ của phiên bản đã ấm (warm-instance latency) có thể khiến đánh giá thấp độ trễ thực tế mà người dùng cảm nhận.
Mức chiếm dụng bộ nhớ và thời gian tải mô hình quyết định liệu mô hình có thể khởi động, giữ thường trú và phản hồi trong giới hạn của môi trường triển khai hay không. Khác với huấn luyện, nơi mô hình có thể trải trên nhiều bộ tăng tốc, suy luận thường phải chạy trong ngân sách bộ nhớ rất chặt. Tổng kích thước mô hình quyết định yêu cầu lưu trữ; RAM sử dụng phản ánh bộ nhớ làm việc khi thực thi; và băng thông bộ nhớ có thể trở thành nút thắt khi truyền dữ liệu giữa các đơn vị xử lý. Hiệu năng khởi động lạnh (cold-start) trở nên then chốt khi mô hình được tải theo nhu cầu thay vì giữ sẵn trong bộ nhớ. Trong các môi trường AI phi máy chủ (serverless AI),29 nơi tài nguyên co giãn theo lưu lượng yêu cầu đến, thời gian từ trạng thái nhàn rỗi đến khi bắt đầu thực thi sẽ quyết định liệu người dùng có nhận được phản hồi trong mức chấp nhận được hay không.
Thời gian tải mô hình là khoảng thời gian cần để nạp một mô hình đã huấn luyện vào bộ nhớ trước khi có thể xử lý đầu vào. Trong một số trường hợp, đặc biệt trên các thiết bị có tài nguyên hạn chế, mô hình phải được nạp lại thường xuyên để giải phóng bộ nhớ cho các ứng dụng khác. Thời gian cho yêu cầu suy luận đầu tiên cũng là một yếu tố quan trọng, vì nó phản ánh tổng độ trễ mà người dùng cảm nhận khi tương tác với một dịch vụ AI. Các benchmark giúp định lượng những độ trễ này, bảo đảm hệ thống suy luận đáp ứng yêu cầu phản hồi trong thực tế.
Các số liệu ở quy mô triển khai áp dụng cùng một logic, nhưng mở rộng từ một yêu cầu đơn lẻ sang một khối lượng công việc (workload). Các dịch vụ đám mây phải xử lý hàng triệu người dùng đồng thời một cách hiệu quả, phân bổ tài nguyên linh hoạt theo nhu cầu mà không làm tăng độ trễ; thiết bị di động phải quản lý nhiều mô hình AI chạy song song mà không làm quá tải hệ thống. Khả năng mở rộng đo lường mức độ hiệu suất suy luận cải thiện khi cấp thêm tài nguyên tính toán. Trong một số trường hợp, thêm GPU hoặc TPU sẽ giúp tăng thông lượng tỷ lệ thuận; nhưng ở các tình huống khác, các nút thắt như giới hạn băng thông bộ nhớ hoặc độ trễ mạng có thể hạn chế hiệu quả mở rộng. Các benchmark cũng đánh giá khả năng hệ thống cân bằng nhiều mô hình chạy đồng thời trong triển khai thực tế, nơi các đặc trưng AI khác nhau có thể cần hoạt động cùng lúc mà không gây nhiễu.
Mức tiêu thụ năng lượng khép vòng vì khối lượng công việc (workload) suy luận chạy liên tục trong môi trường sản xuất. Thiết bị di động và edge chịu ràng buộc khắt khe nhất: tuổi thọ pin và giới hạn nhiệt làm hạn chế tài nguyên tính toán sẵn có. Ngay cả trong các môi trường đám mây quy mô lớn, hiệu quả năng lượng tác động trực tiếp đến chi phí vận hành và mục tiêu bền vững. Năng lượng cho một lần suy luận thường được đo bằng joule mỗi suy luận, phản ánh mức độ hệ thống xử lý đầu vào hiệu quả đồng thời giảm mức tiêu thụ công suất. Trong suy luận trên đám mây, hiệu quả thường được biểu diễn bằng truy vấn mỗi giây trên mỗi watt (QPS/W) để định lượng mức cân bằng giữa hiệu năng và mức tiêu thụ năng lượng. Với các ứng dụng AI trên di động, tối ưu hóa công suất suy luận giúp kéo dài thời lượng pin và cho phép mô hình chạy hiệu quả trên thiết bị hạn chế tài nguyên. Giảm năng lượng sử dụng cũng là chìa khóa để các hệ thống AI quy mô lớn thân thiện hơn với môi trường, bảo đảm tiến bộ tính toán đi đôi với các chiến lược triển khai chú trọng năng lượng.
Đánh giá hiệu suất suy luận
Không giống huấn luyện, các hệ thống suy luận phải xử lý đầu vào và trả dự đoán hiệu quả trên nhiều kịch bản triển khai khác nhau. Độ trễ, thông lượng, mức sử dụng bộ nhớ và hiệu quả năng lượng là những thước đo có cấu trúc để đánh giá hiệu suất này.
Table 10 nên được xem như một bộ lọc triển khai: mỗi số liệu nêu lên một ràng buộc có thể chi phối các môi trường phục vụ (serving) khác nhau. Độ trễ theo phân vị có thể mô tả đuôi độ trễ trong phục vụ (serving) tương tác, còn các hệ thống an toàn quan trọng với thời hạn cứng cần một xác suất trễ hạn hoặc một giới hạn trường hợp xấu nhất phù hợp với yêu cầu an toàn. Truy vấn mỗi giây trên mỗi watt (QPS/W) chi phối một triển khai di động bị giới hạn bởi pin, nơi cùng một mô hình được đánh giá theo độ bền thay vì tốc độ đỉnh. Các đánh đổi giữa các số liệu, như tốc độ so với độ chính xác và thông lượng so với mức tiêu thụ công suất, rất phổ biến; hiểu rõ những đánh đổi này là điều thiết yếu để thiết kế hệ thống hiệu quả.
| Danh mục | Các chỉ số chính | Ví dụ sử dụng benchmark |
|---|---|---|
| Độ trễ và Độ trễ đuôi | Độ trễ trung bình (ms/request); Độ trễ đuôi (p95, p99, p99.9) | Đánh giá hiệu suất tương tác và thời gian thực mềm |
| Thông lượng và Hiệu quả | Số truy vấn mỗi giây (QPS); Số khung hình mỗi giây (FPS); Thông lượng batch | So sánh các hệ thống suy luận đám mây quy mô lớn |
| Tác động của độ chính xác số học | Giảm độ chính xác (FP32 so với INT8); Tăng tốc từ độ chính xác giảm | Cân bằng độ chính xác so với hiệu quả trong suy luận được tối ưu hóa |
| Dấu chân bộ nhớ | Kích thước mô hình (MB/GB); Sử dụng RAM (MB); Mức sử dụng băng thông bộ nhớ | Đánh giá tính khả thi cho triển khai trên edge và thiết bị di động |
| Khởi động nguội và Thời gian tải | Thời gian tải mô hình (s); Độ trễ suy luận đầu tiên (s) | Đánh giá khả năng phản hồi trong AI phi máy chủ |
| Khả năng mở rộng | Hiệu quả dưới khối lượng công việc; Hiệu suất phục vụ (serving) đa mô hình | Đo lường tính mạnh mẽ cho các hệ thống động, có nhu cầu cao |
| Công suất và Hiệu quả năng lượng | Mức tiêu thụ công suất (W); Hiệu suất trên mỗi W (QPS/W) | Tối ưu hóa việc sử dụng năng lượng cho AI di động và bền vững |
Các số liệu này luôn có những đánh đổi không thể tránh. Chẳng hạn, tối ưu hóa để đạt thông lượng cao bằng cách dùng kích thước batch lớn sẽ làm tăng độ trễ, khiến hệ thống không phù hợp cho các ứng dụng thời gian thực. Việc giảm độ chính xác số giúp cải thiện hiệu quả về công suất và tốc độ, nhưng có thể làm giảm độ chính xác. Môi trường triển khai sẽ quyết định những đánh đổi nào là chấp nhận được: các hệ thống đám mây ưu tiên khả năng mở rộng và thông lượng, trong khi các thiết bị edge bị giới hạn bởi bộ nhớ và công suất. Do đó, việc đánh giá hiệu suất suy luận cần toàn diện, thay vì chỉ tập trung vào một số liệu duy nhất, để đảm bảo hệ thống đạt các mục tiêu về chức năng, tài nguyên và hiệu suất trong từng ngữ cảnh.
Kịch bản triển khai quyết định thứ tự ưu tiên giữa các số liệu. Các ràng buộc vận hành và tiêu chí thành công khác nhau rất nhiều giữa các bối cảnh, nên thứ tự ưu tiên giúp kỹ sư tập trung nỗ lực benchmark và diễn giải kết quả trong đúng khung ra quyết định. Table 11 minh họa cách các ưu tiên hiệu suất thay đổi trong năm ngữ cảnh triển khai chính, qua đó cho thấy mối quan hệ có hệ thống giữa các ràng buộc vận hành và mục tiêu tối ưu hóa.
| Bối cảnh triển khai | Ưu tiên chính | Ưu tiên thứ cấp | Ưu tiên thứ ba | Ràng buộc thiết kế chính |
|---|---|---|---|---|
| Ứng dụng thời gian thực | Độ trễ | Độ tin cậy | Dấu chân bộ nhớ | Trải nghiệm người dùng đòi hỏi phản hồi ngay lập tức |
| Dịch vụ quy mô đám mây | Thông lượng (QPS) | Hiệu quả chi phí | Độ trễ trung bình | Khả năng tồn tại của doanh nghiệp đòi hỏi quy mô lớn |
| Thiết bị edge/di động | Mức tiêu thụ công suất | Dấu chân bộ nhớ | Độ trễ | Tuổi thọ pin và giới hạn tài nguyên chi phối |
| Khối lượng công việc (workload) huấn luyện | Thời gian huấn luyện | Mức sử dụng GPU | Hiệu quả bộ nhớ | Tốc độ nghiên cứu cho phép thử nghiệm nhanh hơn |
| Khoa học/Y tế | Độ chính xác | Độ tin cậy | Khả năng giải thích | Tính đúng đắn không thể bị đánh đổi để đổi lấy hiệu suất |
Điểm mấu chốt là cùng một chỉ số có thể giữ vai trò chính trong bối cảnh này nhưng gần như không liên quan trong bối cảnh khác. Độ trễ xếp hàng đầu với ứng dụng thời gian thực (xe tự hành phải xử lý dữ liệu cảm biến trong các hạn chót thời gian nghiêm ngặt), nhưng chỉ là ưu tiên thứ yếu với dịch vụ đám mây (vốn chấp nhận độ trễ cao hơn để đổi lấy hiệu quả chi phí trên mỗi truy vấn). Một trợ lý AI trên điện thoại thông minh dù tăng thông lượng nhưng kéo theo công suất tiêu thụ cao hơn có thể trở nên tệ hơn khi thời lượng pin là ràng buộc quyết định. Một hệ thống chẩn đoán y tế cũng có thể hợp lý khi chọn một mô hình chậm hơn nhưng có độ chính xác đã được kiểm chứng cao hơn. Vì tính phụ thuộc ngữ cảnh đó, cải thiện thông lượng gấp 2\(\times\) mang lại giá trị lớn cho các triển khai trên đám mây, nhưng lợi ích rất nhỏ với thiết bị edge chạy pin, nơi giảm 20% công suất tiêu thụ tạo hiệu quả vận hành vượt trội hơn.
Ngay cả khi các chỉ số đã được xác định rõ, đánh giá suy luận vẫn thất bại nếu benchmark bỏ qua ràng buộc triển khai đang chi phối hệ thống phục vụ (serving). Những bẫy dưới đây cho thấy độ trễ trung bình, bộ nhớ, năng lượng, khởi động nguội (cold start), và các giả định về khả năng mở rộng có thể lần lượt khiến một kết quả tưởng chừng hợp lý trở nên vô giá trị.
Benchmark suy luận bắt đầu thất bại khi nó lấy trung bình và bỏ qua đúng sự kiện người dùng thực sự nhận ra. Độ trễ đuôi (p95, p99) quyết định độ tin cậy trong vận hành, chứ không phải độ trễ trung bình; một hệ thống AI đàm thoại bỏ lỡ mục tiêu độ trễ đuôi sẽ gây ra chậm phản hồi không thể chấp nhận, dù thời gian phản hồi trung bình trông có vẻ ổn. Các ràng buộc về tài nguyên cũng tạo ra một sự lệch tương tự. Một mô hình có thông lượng trên đám mây rất tốt vẫn có thể không dùng được trên điện thoại hoặc thiết bị edge nếu mức sử dụng bộ nhớ hoặc công suất tiêu thụ vượt ngân sách triển khai, nên benchmark suy luận thực tế phải tính cả bộ nhớ và năng lượng bên cạnh độ trễ.
Phục vụ phi máy chủ (serverless) và theo yêu cầu (on-demand) còn thêm một ràng buộc riêng cho yêu cầu đầu tiên. Độ trễ khởi động nguội30 đo thời gian cần để khởi tạo một mô hình và xử lý yêu cầu đầu tiên, nên nếu loại trừ thời gian tải mô hình sẽ tạo kỳ vọng không thực tế về khả năng phản hồi. Đánh giá cả thời gian tải mô hình và độ trễ suy luận đầu tiên giúp bảo đảm hệ thống được thiết kế cho đúng điều kiện chúng sẽ thực tế gặp phải.
30 Độ trễ khởi động nguội: Thời gian khởi tạo từ trạng thái nhàn rỗi gồm đọc từ lưu trữ, truyền từ máy chủ sang bộ tăng tốc, và thiết lập framework. Với một mô hình 7B-tham số ở FP16 (~14 GB) đã ở trong bộ nhớ máy chủ, chỉ riêng việc truyền qua PCIe 4.0 với băng thông hiệu dụng 25 GB/s đã mất ~560 ms; phần đọc lưu trữ và khởi tạo còn cộng thêm. Giới hạn dưới này khiến giảm thiểu độ trễ khởi động nguội (như dùng bộ nhớ đệm mô hình, tải dự đoán) trở thành một yêu cầu trong thiết kế hệ thống.
Các benchmark suy luận cũng dễ gây hiểu lầm khi chỉ tối ưu hoá một chỉ số đơn lẻ. Tối đa hoá thông lượng batch có thể làm tăng độ trễ, còn giảm độ chính xác quá mức có thể làm giảm độ chính xác. Một ví dụ về độ chính xác sẽ cụ thể hoá vấn đề so sánh này.
Tối ưu hoá độ chính xác số là một ví dụ điển hình cho thách thức này. Các bộ tăng tốc có thể cung cấp thông lượng phép toán INT8 cao hơn đáng kể31 so với thông lượng FP32, tạo ra các con số hiệu năng rất hấp dẫn. Tuy nhiên, những con số đó chỉ đáng tin khi benchmark cũng kiểm tra độ chính xác, phạm vi toán tử được hỗ trợ, và liệu các phép toán được báo cáo có so sánh được giữa các thiết bị hay không.
31 TOPS (tera operations per second): Một thước đo thông lượng tính toán thô (nghìn tỷ phép toán/giây). H100 cung cấp 1979 TOPS INT8 so với Apple M2 Neural Engine ở mức 15.8 TOPS và Edge TPU ở mức 4 TOPS, nhưng các con số này trộn lẫn nhiều loại phép toán khác nhau—nhân-tích lũy, tích lũy, hay activation. So sánh TOPS giữa các nhà cung cấp chỉ có ý nghĩa khi định nghĩa phép toán, độ chính xác, và các giả định về độ thưa thớt là giống hệt nhau, điều kiện hiếm khi xuất hiện trong thông số kỹ thuật của nhà cung cấp.
Khi đánh giá khả năng mở rộng và độ phù hợp với ứng dụng, chúng ta cũng cần giữ thái độ hoài nghi tương tự. Cái bẫy mở rộng tuyến tính mà chúng ta đã bàn cho benchmark huấn luyện cũng áp dụng cho suy luận, dù điểm nghẽn khác nhau: trong huấn luyện, khả năng mở rộng thường bị giới hạn bởi đồng bộ hóa gradient; còn trong suy luận, các vấn đề thường gặp là bão hòa băng thông bộ nhớ, giảm xung do nhiệt dưới tải kéo dài, và chi phí định tuyến yêu cầu (tức là thời gian phụ trội để gán yêu cầu cho các bản sao mô hình trong phục vụ (serving) phân tán). Những hạn chế này bắt nguồn từ các ràng buộc phần cứng vật lý và kiến trúc liên kết (Tăng tốc phần cứng). Vì vậy, một benchmark tối ưu cho đám mây có thể không phù hợp với một triển khai edge, nơi năng lượng và bộ nhớ là yếu tố chi phối. Do đó, việc lựa chọn benchmark phải theo yêu cầu của ứng dụng, chứ không dựa vào bảng xếp hạng tiện nhất.
Cuối cùng, kết quả suy luận cũng cần kỷ luật thống kê giống như kết quả huấn luyện. MLPerf thực hiện các lần chạy đủ dài và với số lượng truy vấn lớn, và chỉ số độ trễ phụ thuộc vào kịch bản: SingleStream báo cáo ước tính độ trễ ở phân vị thứ 90; Server áp đặt ràng buộc độ trễ ở phân vị thứ 99 đồng thời tối đa hóa thông lượng; còn Offline thì báo cáo thông lượng (Reddi et al. 2019). Những quy trình này phản ánh hành vi phục vụ (serving) mà một giá trị trung bình hoặc một phép đo thời gian đơn lẻ sẽ bỏ lỡ.
Các benchmark suy luận của MLPerf
Để tránh những cạm bẫy này, việc benchmark suy luận cần được xem là một quá trình cân bằng nhiều ưu tiên (độ trễ, thông lượng, bộ nhớ, năng lượng và độ chính xác), thay vì chỉ tối ưu hóa cho một chỉ số đơn lẻ. MLPerf Inference hiện thực hóa sự cân bằng này thông qua các kịch bản theo ngữ cảnh triển khai. MLPerf Inference quan trọng vì ngữ cảnh triển khai làm thay đổi ý nghĩa của kết quả. Benchmark này, do MLCommons phát triển,32 cung cấp một framework tiêu chuẩn để đánh giá hiệu suất suy luận machine learning trên nhiều môi trường triển khai khác nhau. MLPerf khởi đầu với các benchmark huấn luyện vào năm 2018; sau đó, MLPerf Inference được bổ sung để chuẩn hóa việc đánh giá ở thời điểm triển khai trên nhiều kịch bản. Khi các hệ thống machine learning mở rộng sang nhiều ứng dụng đa dạng, rõ ràng là một benchmark suy luận dùng chung cho mọi trường hợp là không đủ. Vì vậy, bộ benchmark suy luận MLPerf đã được xây dựng, trong đó mỗi benchmark được ánh xạ tới một thiết lập triển khai cụ thể, để điểm số được diễn giải theo các ràng buộc về độ trễ, thông lượng, bộ nhớ và công suất mà hệ thống sẽ phải đối mặt.
32 MLCommons: Ra mắt vào năm 2020 dưới dạng một liên minh phi lợi nhuận, phát triển từ nỗ lực MLPerf năm 2018, MLCommons quy tụ các thành viên từ giới công nghiệp và học thuật (MLCommons 2026a). Việc yêu cầu công bố thông số kỹ thuật hệ thống giúp cải thiện khả năng so sánh kết quả, nhưng điều này không ngăn cản người tham gia lựa chọn hệ thống hoặc khối lượng công việc (workload) nào để gửi. Các kết quả được công bố cho thấy sự khác biệt lớn về hiệu suất giữa các nhà cung cấp trên cùng một khối lượng công việc (workload), khiến MLCommons trở thành tổ chức gần nhất trong lĩnh vực này với phép so sánh phần cứng kiểu SPEC một cách công bằng (apples-to-apples).
MLCommons. 2026a. MLCommons: About Us.
MLPerf Inference
MLPerf Inference (Reddi et al. 2019) là một benchmark suy luận nền tảng, đưa ra các kịch bản chuẩn để đánh giá hiệu năng ở giai đoạn triển khai trong cả môi trường trung tâm dữ liệu và edge. Các bài nộp được chia thành hai hạng mục: hạng mục đóng buộc cấu trúc mô hình và độ chính xác phải tương đương chặt chẽ để đảm bảo so sánh trực tiếp giữa các phần cứng (apples-to-apples); trong khi hạng mục mở cho phép thay đổi kiến trúc mô hình, thuật toán lượng tử hoá hoặc huấn luyện lại mô hình để thể hiện đồng thiết kế thuật toán một cách sáng tạo. Bộ benchmark này đánh giá hiệu năng trên các khối lượng công việc (workload) deep learning như phân loại hình ảnh, phát hiện đối tượng, xử lý ngôn ngữ tự nhiên và hệ thống khuyến nghị. Phiên bản Inference của MLPerf là một mốc tham chiếu được sử dụng rộng rãi để so sánh các bộ tăng tốc AI, GPU, TPU và CPU, đặc biệt khi các quy tắc dự thi và kịch bản khối lượng công việc (workload) phù hợp với môi trường triển khai dự kiến.
33 DLRM (mô hình khuyến nghị deep learning): Kiến trúc khuyến nghị năm 2019 của Facebook kết hợp các bảng embedding cho các đặc trưng phân loại với các perceptron đa lớp cho các đặc trưng liên tục (Naumov et al. 2019). DLRM gây ảnh hưởng đến benchmark theo cách khác so với các mô hình thị giác hoặc ngôn ngữ: các bảng embedding của nó có thể rất lớn, đến mức dung lượng bộ nhớ và băng thông trở thành yếu tố chi phối, thay vì thông lượng tính toán. Nhờ đó, DLRM trở thành một khối lượng công việc (workload) khuyến nghị bị giới hạn bộ nhớ rất hữu ích trong các đánh giá suy luận kiểu MLPerf, giúp bộc lộ những hạn chế phần cứng mà các benchmark bị giới hạn tính toán không thấy được (Reddi et al. 2019).
Naumov, Maxim, Dheevatsa Mudigere, Hao-Jun Michael Shi, Jianyu Huang, Narayanan Sundaraman, Jongsoo Park, Xiaodong Wang, et al. 2019. “Deep Learning Recommendation Model for Personalization and Recommendation Systems.” arXiv Preprint arXiv:1906.00091.
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
Các công ty công nghệ lớn thường xuyên tham khảo kết quả MLPerf để ra quyết định mua sắm phần cứng. Khi đánh giá phần cứng cho hạ tầng hệ thống khuyến nghị, điểm benchmark MLPerf trên các khối lượng công việc (workload) DLRM33 có thể giúp định hướng lựa chọn giữa các thế hệ bộ tăng tốc khác nhau. Qua các thế hệ, kết quả benchmark thường cho thấy cải thiện đáng kể về thông lượng, dù mức cải thiện phụ thuộc vào khối lượng công việc (workload), ngăn xếp phần mềm và cấu hình hệ thống. Điều này minh họa cách các benchmark tiêu chuẩn hóa có thể dẫn đến những quyết định hạ tầng quan trọng.
Những đánh giá tiêu chuẩn hóa này mang lại các so sánh rất hữu ích, nhưng chi phí cao của việc benchmark toàn diện đã giới hạn số người có thể tham gia và mức độ đánh giá kỹ lưỡng các hệ thống.
Systems Perspective 1.8: Chi phí benchmark toàn diện
Việc nộp benchmark cho MLPerf đòi hỏi nỗ lực kỹ thuật chuyên sâu, quyền truy cập phần cứng, tinh chỉnh, xác thực và lập tài liệu cẩn thận cho các cấu hình liên quan. Chi phí này phụ thuộc nhiều vào khối lượng công việc (workload) và phạm vi, nhưng đủ cao để các bài nộp chủ yếu đến từ các công ty công nghệ lớn và nhà cung cấp phần cứng, trong khi các tổ chức nhỏ hơn thường phải dựa vào kết quả đã công bố thay vì tự mình thực hiện các đánh giá toàn diện. Rào cản này tạo động lực cho nhu cầu về những phương pháp benchmark nội bộ gọn nhẹ hơn, giúp các tổ chức đưa ra quyết định sáng suốt mà không phải gánh chi phí của benchmark tiêu chuẩn hóa quy mô lớn.
Phần còn lại trong bộ benchmark suy luận của MLPerf thu hẹp chuẩn tham chiếu theo ngữ cảnh triển khai. MLPerf Mobile (MLCommons 2024a) đánh giá xem một mô hình có thể duy trì khả năng phản hồi trong giới hạn công suất và bộ nhớ của điện thoại thông minh hay không (Janapa Reddi et al. 2022), đo lường các khối lượng công việc (workload) phân loại hình ảnh, phát hiện đối tượng, phân đoạn hình ảnh và xử lý ngôn ngữ. MLPerf Client [MLCommons (2026b)} giải quyết quyết định về tính toán cục bộ: liệu các thiết bị tiêu dùng có thể chạy trực tiếp các khối lượng công việc (workload) AI thay vì dựa vào suy luận đám mây. Với trọng tâm hiện tại là các khối lượng công việc (workload) AI tạo sinh cục bộ và LLM, MLPerf Client coi CPU, GPU rời và NPU tích hợp là một phần của hệ thống được benchmark, thay vì chỉ là phần cứng máy chủ đi kèm. MLPerf Tiny (Banbury et al. 2021) kiểm tra các trường hợp ràng buộc cực đoan: các hệ thống AI nhúng và công suất cực thấp, chẳng hạn như thiết bị IoT, thiết bị đeo và vi điều khiển. Các biến thể này vẫn giữ nguyên kỷ luật benchmark, nhưng đổi ràng buộc tài nguyên: từ thông lượng của trung tâm dữ liệu sang khả năng phản hồi phía máy khách, công suất trên thiết bị di động hoặc bộ nhớ của vi điều khiển.
MLCommons. 2024a. MLPerf Mobile Benchmark.
Janapa Reddi, Vijay et al. 2022. “MLPerf Mobile V2. 0: An Industry-Standard Benchmark Suite for Mobile Machine Learning.” Proceedings of Machine Learning and Systems (MLSys) 4: 806–23.
Các kịch bản thực thi MLPerf
Cùng một phần cứng có thể cho ra các con số benchmark rất khác nhau tùy thuộc vào cách yêu cầu đến hệ thống—điều này lý giải vì sao các tuyên bố của nhà cung cấp thường không phản ánh đúng hiệu suất khi đưa vào vận hành. MLPerf Inference phiên bản cổ điển định nghĩa bốn kịch bản thực thi, mỗi kịch bản đặc trưng cho một kiểu lưu lượng và đòi hỏi các chiến lược tối ưu hóa khác nhau (Reddi et al. 2019). Các biến thể benchmark hiện nay dành cho client và AI tạo sinh cũng bổ sung các phép đo tương tác cho các khối lượng công việc (workload) LLM nhạy cảm với độ trễ, trong đó các chỉ số như time-to-first-token và time-per-output-token trở nên then chốt (MLCommons 2026b).
MLCommons. 2026b. MLPerf Client Benchmark.
SingleStream
SingleStream xử lý từng yêu cầu một và đo độ trễ cho suy luận tuần tự. Kịch bản này mô phỏng các ứng dụng di động và nhúng, nơi một người dùng duy nhất tương tác với thiết bị: ví dụ ứng dụng camera trên điện thoại thông minh phân loại hình ảnh, trợ lý giọng nói xử lý lời nói, hoặc thiết bị đeo phát hiện cử chỉ. Chỉ số chính là độ trễ trên mỗi yêu cầu, và việc gom batch không mang lại lợi ích vì yêu cầu chỉ đến sau khi kết quả trước đó đã được tiêu thụ. Tối ưu hóa tập trung vào hiệu quả tiền xử lý và mức tiêu thụ công suất, thay vì thông lượng.
MultiStream
MultiStream xử lý đồng thời nhiều luồng đầu vào được đồng bộ hóa, mô phỏng các tình huống như xe tự hành với nhiều camera cần được xử lý cùng lúc để hợp nhất không gian. Khác với các yêu cầu tuần tự của SingleStream, MultiStream đòi hỏi xử lý các khung hình từ tất cả cảm biến trong các hạn chót nghiêm ngặt tương ứng với tốc độ video. Khác biệt then chốt so với chế độ Server là đầu vào của MultiStream đến đồng bộ theo từng nhịp, còn yêu cầu ở Server đến độc lập và khó đoán. Ràng buộc quan trọng là đồng bộ hóa: mọi luồng phải hoàn thành trước khi mô-đun lập kế hoạch có thể hành động. Tối ưu hóa tập trung vào xử lý jitter và đáp ứng các hạn chót cứng, thay vì thông lượng trung bình.
Server
Kịch bản Server phát sinh các yêu cầu theo phân phối Poisson, mô phỏng lưu lượng API đám mây nơi các yêu cầu đến độc lập, khó dự đoán. Kịch bản này mô hình hóa các dịch vụ web xử lý hàng triệu truy vấn từ nhiều người dùng khác nhau. Không giống SingleStream với các yêu cầu đến tuần tự được đảm bảo, lưu lượng Server tạo ra hiện tượng xếp hàng khi nhiều yêu cầu cùng tranh giành tài nguyên. Các chỉ số chính là thông lượng (số truy vấn mỗi giây) và độ trễ đuôi (p99). Việc ghép batch động có thể cải thiện hiệu quả bằng cách nhóm các yêu cầu đến trong cùng một khoảng thời gian. Tối ưu hóa cần cân bằng thông lượng với các mục tiêu về độ trễ (SLO).
Offline
Kịch bản Offline cung cấp tất cả dữ liệu đầu vào ngay từ đầu, đo thông lượng tối đa khi không còn ràng buộc về độ trễ. Kịch bản này mô hình hóa các pipeline xử lý batch như xử lý dữ liệu qua đêm, tính toán khoa học hoặc tính toán trước các đề xuất. Vì không có yêu cầu về độ trễ, các hệ thống có thể sử dụng kích thước batch tối đa để tận dụng tối đa phần cứng. Chỉ số chính là thông lượng thuần (số mẫu mỗi giây), và việc tối ưu hóa hoàn toàn tập trung vào hiệu quả phần cứng.
Table 12 ánh xạ các kịch bản thực thi cổ điển, cùng với trường hợp Interactive mới hơn dành cho LLM, tới các ngữ cảnh triển khai và chiến lược tối ưu hóa tương ứng.
| Kịch bản | Ngữ cảnh | Chiến lược | Trọng tâm |
|---|---|---|---|
| Luồng đơn | Ứng dụng di động, thiết bị nhúng | Không batching (batch = 1) | Tiền xử lý, hiệu quả công suất |
| Đa luồng | Lái xe tự hành, phân tích video | Hợp nhất cảm biến đồng bộ | Xử lý jitter, đảm bảo thời hạn |
| Máy chủ | API đám mây, dịch vụ web | Batching động với thời gian chờ | Điều chỉnh sự đánh đổi giữa thông lượng và độ trễ |
| Ngoại tuyến | Xử lý batch, các pipeline dữ liệu | Kích thước batch tối đa | Thông lượng, tận dụng phần cứng |
| Tương tác | Trò chuyện, tác nhân, AI tạo sinh cục bộ | Truyền phát token, quản lý KV-cache | Thời gian đến token đầu tiên, thời gian trên mỗi token đầu ra |
Mỗi kịch bản đóng vai trò như một hợp đồng cho khối lượng công việc (workload) bằng cách quy định dạng độ trễ hoặc thông lượng mà một kết quả hợp lệ phải duy trì.
Lighthouse 1.2: MobileNetV2 trên EdgeTPU
Mở rộng lighthouse 1.1, tuyên bố về tăng tốc phần cứng từ Tăng tốc phần cứng được đánh giá bằng cách sử dụng một kịch bản suy luận edge kiểu SingleStream minh họa (Reddi et al. 2019; Banbury et al. 2021).
Table 13: Kịch bản EdgeTPU so với Cortex-M7 MobileNetV2: Các số liệu minh họa về độ trễ suy luận kiểu SingleStream, độ trễ đầu cuối, công suất và năng lượng cho thấy chi phí tiền xử lý làm thu hẹp mức tăng tốc đáng chú ý của bộ tăng tốc; đây không phải là các phép đo được kiểm soát.
Tuyên bố tăng tốc phần cứng: Trong kịch bản minh họa với bộ tăng tốc edge này, giả sử suy luận INT8 MobileNetV2 mất khoảng ~2 ms trên bộ tăng tốc, nhanh hơn khoảng 7.5× so với CPU họ Cortex-M (khoảng ~15 ms). Kết quả thực tế phụ thuộc vào phạm vi toán tử được hỗ trợ, tần số xung nhịp, trạng thái nhiệt và cách triển khai.
Table 13 trình bày các giả định cho kịch bản kiểu SingleStream minh họa.
| Chỉ số | CPU (Cortex-M7) | EdgeTPU | Tỷ lệ tiêu đề | Tỷ lệ cấp hệ thống |
|---|---|---|---|---|
| Độ trễ suy luận | ~15 ms | ~2 ms | 7.5× nhanh hơn | — |
| Độ trễ đầu cuối | ~18 ms | ~6 ms | — | ~3× nhanh hơn |
| Mức tiêu thụ công suất | ~120 mW | ~500 mW | — | ~4.2× cao hơn |
| Năng lượng trên mỗi lần suy luận | ~1.8 mJ | ~1 mJ | — | ~1.8× hiệu quả hơn |
Điều này cho thấy: Theo các giả định này, mức tăng tốc suy luận 7.5× giảm xuống còn khoảng ~3× nếu tính đầu cuối, vì tiền xử lý đều chạy trên CPU trong cả hai trường hợp. EdgeTPU dùng công suất hoạt động cao hơn nhưng hoàn thành nhanh hơn, nên năng lượng suy luận thấp hơn; khi triển khai cần đo lường có kiểm soát.
Quyết định triển khai phụ thuộc vào khối lượng công việc (workload). Với thiết bị chạy pin và hoạt động không thường xuyên, nếu chỉ xét phần tính toán suy luận khi hoạt động thì EdgeTPU có lợi thế; nhưng tổng tác động lên pin còn phụ thuộc vào công suất khi ngủ, năng lượng đánh thức, chi phí truyền dữ liệu với host, và liệu bộ tăng tốc có gây rò rỉ công suất khi nhàn rỗi trong thời gian hệ thống chờ hay không. Với vận hành video liên tục, mức năng lượng hoạt động thấp hơn cho mỗi lần suy luận của EdgeTPU có nhiều khả năng chiếm ưu thế hơn.
Kết quả SingleStream cho thấy vì sao việc benchmark cần khớp kịch bản MLPerf với bối cảnh triển khai: SingleStream nhấn mạnh độ trễ, trong khi các benchmark Offline sẽ đưa ra kết luận khác vì tối ưu cho thông lượng hơn là độ trễ.
Banbury, Colby, Vijay Janapa Reddi, Peter Torelli, Jeremy Holleman, Nat Jeffries, Csaba Kiraly, Pietro Montino, et al. 2021. “MLPerf Tiny Benchmark.” arXiv Preprint.
Các kịch bản này cho thấy vì sao cùng một phần cứng lại có thể cho ra các số liệu benchmark khác biệt lớn. Ví dụ, một bộ tăng tốc có thông lượng Offline cao có thể chỉ đạt thông lượng Server thấp hơn nhiều khi phải tuân thủ ràng buộc độ trễ p99 và chi phí xếp hàng, vì chế độ Server không phải lúc nào cũng dùng được kích thước batch tối đa. Khi đánh giá phần cứng cho một ứng dụng cụ thể, chọn đúng kịch bản giúp các kết quả benchmark dự đoán đúng hiệu suất vận hành. Do đó, kết quả MobileNetV2 cho thấy việc chọn kịch bản là yêu cầu bắt buộc khi triển khai, chứ không phải lựa chọn tùy ý để báo cáo.
Benchmark huấn luyện đo tốc độ học; benchmark suy luận đo tốc độ phục vụ (serving). Tuy vậy, cả hai đều có một điểm mù quan trọng: không nói gì về lượng năng lượng hệ thống tiêu thụ để đạt tốc độ đó. Một hệ thống có thể lập kỷ lục thông lượng nhưng tiêu thụ tới hàng kilowatt công suất, khiến nó không bền vững về kinh tế hoặc không thể triển khai tại edge. Để bức tranh đánh giá được đầy đủ, cần đo công suất: tức là đo chi phí năng lượng cho hiệu suất.
Self-Check: Question
In a distributed serving architecture, a user request fans out in parallel to \(10\) backend ML model services before aggregating the results. If each service has a \(99^{\text{th}}\) percentile latency (\(p99\)) of \(20\text{ ms}\) (meaning a \(1\%\) probability of exceeding \(20\text{ ms}\)), what is the approximate probability that an incoming user request experiences a tail latency exceeding \(20\text{ ms}\)?
- Exactly \(1.0\%\)
- Approximately \(9.6\%\) (nearly \(1\) in every \(10\) user requests)
- Exactly \(0.1\%\)
- 0% because parallel aggregation hides individual service latency spikes
An image classification inference pipeline takes \(18\text{ ms}\) per request on a CPU baseline: \(8\text{ ms}\) in image decoding/preprocessing and \(10\text{ ms}\) in neural network execution. If the model execution is migrated to a specialized NPU that accelerates the neural network by \(5\times\) (reducing inference time from \(10\text{ ms}\) to \(2\text{ ms}\)), what is the resulting end-to-end pipeline latency and speedup?
- \(2.0\text{ ms}\) latency and \(9.0\times\) speedup
- \(3.6\text{ ms}\) latency and \(5.0\times\) speedup
- \(10.0\text{ ms}\) latency and \(1.8\times\) speedup
- \(16.0\text{ ms}\) latency and \(1.1\times\) speedup
A cloud provider is deploying an interactive web translation API where independent user requests arrive randomly according to a Poisson process, and all responses must satisfy a strict tail latency constraint of \(p99 \le 15\text{ ms}\). Which MLPerf Inference scenario directly benchmarks this operational deployment?
- Offline scenario
- SingleStream scenario
- MultiStream scenario
- Server scenario
In serverless and on-demand inference systems, the latency penalty incurred on the first request after an idle period—caused by loading weights into memory and compiling compute kernels—is termed a ____.
Explain why reporting an accelerator-only inference time (e.g., \(2\text{ ms}\) on an edge NPU) fails to predict actual mobile application performance, identifying at least two real-world system bottlenecks.
Order the following execution stages of an MLPerf Inference Server-scenario benchmark evaluation run from start to finish:
- LoadGen generates queries according to a Poisson arrival distribution at a target query-per-second (QPS) rate
- SUT receives queries, applies dynamic batching, executes neural network inference, and returns responses
- Warm up the System Under Test (SUT) with representative queries to populate weights and compile execution graphs
- Check that model output accuracy meets the required reference quality threshold
- Record end-to-end timestamps for each query and compute the empirical latency distribution (\(p50\), \(p90\), \(p99\)) to verify SLA compliance
Các kỹ thuật đo công suất
Một nhà cung cấp chip quảng cáo “10 TOPS tại 0.5 W”, nhưng dưới tải suy luận liên tục, cơ chế điều tiết nhiệt làm thông lượng thực tế giảm xuống còn 3 TOPS tại 2 W. Nếu không có đo công suất được chuẩn hóa, khoảng cách hiệu quả gấp 13.3× lần giữa tài liệu thông số và thực tế sẽ không bị phát hiện cho đến khi triển khai.
Chiều thứ ba này rất quan trọng vì Tăng tốc phần cứng đã đặt TOPS/W thành mục tiêu thiết kế chính bên cạnh TOPS thô. Các benchmark công suất dùng để xác thực xem các bộ tăng tốc được tối ưu hóa cho hiệu suất năng lượng có thực sự mang lại mức tiết kiệm như đã hứa hay không. TOPS/W đặc biệt dễ bị “lách luật” vì nó là tỉ lệ của hai đỉnh có thể công bố riêng: nhà cung cấp có thể đọc tử số (số phép toán) ở kích thước batch và độ chính xác làm tối đa hóa thông lượng, còn mẫu số (watt) thì đọc tại điểm làm việc gần như không tải; vì thế, mức hiệu quả được quảng cáo mô tả một trạng thái mà chip không bao giờ rơi vào dưới tải thực. Các benchmark công suất bịt lỗ hổng đó bằng cách cố định khối lượng công việc (workload) và cửa sổ đo lường, buộc tử số và mẫu số được đọc tại cùng một điểm làm việc.
Công suất triển khai trải dài gần tám bậc độ lớn, từ µW đến kW.
Henderson, Peter, Jieru Hu, Joshua Romoff, Emma Brunskill, Dan Jurafsky, and Joelle Pineau. 2020. “Towards the Systematic Reporting of the Energy and Carbon Footprints of Machine Learning.” CoRR abs/2002.05651 (248): 1–43. https://doi.org/10.48550/arxiv.2002.05651.
Tuy nhiên, đo mức tiêu thụ công suất trong các hệ thống machine learning có những thách thức khác hẳn so với đo thời gian hoặc thông lượng. Công suất thay đổi theo nhiệt độ, pha của khối lượng công việc (workload) và cấu hình hệ thống theo những cách mà các chỉ số hiệu năng không phản ánh. Table 14 định lượng mức độ nhu cầu năng lượng của các mô hình ML biến thiên mạnh giữa các môi trường triển khai, trải dài nhiều bậc độ lớn từ các thiết bị TinyML chỉ tiêu thụ microwatt đến các tủ trong trung tâm dữ liệu yêu cầu kilowatt. Phổ rộng này cho thấy thách thức cốt lõi khi xây dựng các phương pháp benchmark chuẩn hóa (Henderson et al. 2020).
| Danh mục | Loại thiết bị | Mức tiêu thụ công suất |
|---|---|---|
| Nhỏ | Bộ xử lý quyết định thần kinh (NDP) | 150 µW |
| Nhỏ | Vi điều khiển M7 | 25 mW |
| Di động | Raspberry Pi 4 | 3.5 W |
| Di động | Smartphone | 4 W |
| Edge | Camera thông minh | 10–15 W |
| Edge | Edge Server | 65–95 W |
| Đám mây | Nút máy chủ ML | 300–500 W |
| Đám mây | Giá máy chủ ML | 4–10 kW |
Phạm vi này trải dài gần tám bậc độ lớn và cần các phép đo theo đúng quy mô: TinyML ở mức microwatt cần dụng cụ đo khác với các rack ở mức kilowatt. Một framework toàn diện phải đảm bảo tính nhất quán, công bằng và khả năng tái lập trên toàn bộ các quy mô này.
Ranh giới đo công suất
Để giải quyết các thách thức đo lường này, chúng ta cần hiểu cách đo mức tiêu thụ công suất ở các quy mô hệ thống khác nhau, từ thiết bị TinyML đến các nút suy luận trong trung tâm dữ liệu. Figure 7 trình bày rõ các ranh giới đo lường riêng cho từng kịch bản: các thành phần màu xanh lá cây nằm trong ranh giới hạch toán năng lượng, còn các thành phần có đường viền đứt nét màu đỏ thì bị loại trừ khỏi phép đo công suất. Sự phân biệt này rất quan trọng, vì ranh giới được vạch ở đâu sẽ quyết định điều gì được coi là “hiệu quả.”

Figure 7 được chia thành ba nhóm ví dụ: Tiny, Suy luận và Huấn luyện, mỗi nhóm phản ánh phạm vi đo lường khác nhau tùy theo kiến trúc hệ thống và môi trường triển khai. Trong các hệ thống TinyML, toàn bộ SoC công suất thấp, gồm khối tính toán, bộ nhớ và các liên kết cơ bản, thường nằm trong phạm vi đo lường. Các nút suy luận thì phức tạp hơn: chúng tích hợp nhiều SoC, lưu trữ cục bộ, bộ tăng tốc và bộ nhớ, nhưng thường loại trừ lưu trữ từ xa và các thành phần ngoài chip. Các hệ thống huấn luyện được triển khai trên nhiều giá đỡ (rack), trong đó chỉ một số thành phần được chọn, như các nút tính toán và bộ chuyển mạch mạng, được đo lường; còn hệ thống lưu trữ, hạ tầng làm mát và một phần của mạng liên kết thường bị loại trừ.
Phạm vi đo lường xác định loại năng lượng nào được tính, còn thành phần của khối lượng công việc (workload) xác định nơi năng lượng đó được tiêu thụ. Các phép đo của TensorFlow Mobile cho thấy 57,3% năng lượng suy luận đến từ việc di chuyển dữ liệu (Boroumand et al. 2018), điều này giải thích vì sao các phép đo chỉ dựa trên từng thành phần và số lượng phép toán thô có thể bỏ qua chi phí hệ thống chủ đạo. Vì vậy, ví dụ tiếp theo sẽ phân tách năng lượng của MobileNetV2 thành năng lượng cho phép toán số học và năng lượng cho truy cập bộ nhớ.
Boroumand, Amirali, Saugata Ghose, Youngsok Kim, Rachata Ausavarungnirun, Eric Shiu, Rahul Thakur, Daehyun Kim, et al. 2018. “Google Workloads for Consumer Devices: Mitigating Data Movement Bottlenecks.” Proceedings of the Twenty-Third International Conference on Architectural Support for Programming Languages and Operating Systems, ASPLOS ’18, 316–31. https://doi.org/10.1145/3173162.3173177.
Napkin Math 1.5: Tại sao INT8 tiết kiệm năng lượng
Bài toán: Theo mô hình năng lượng thành phần 45 nm đã nêu, việc thay thế FP32 bằng INT8 giúp giảm bao nhiêu năng lượng đọc trọng số và năng lượng cho các phép toán số học của MobileNetV2?
Hãy nhớ từ Tăng tốc phần cứng rằng di chuyển dữ liệu tốn nhiều năng lượng hơn đáng kể so với tính toán trên dữ liệu (bất biến năng lượng–di chuyển được chính thức hóa trong Kỹ thuật dữ liệu và được định lượng bởi các ước tính năng lượng của Horowitz (Horowitz 2014)). Để hiểu tại sao lượng tử hoá giảm mức tiêu thụ năng lượng, ta cần phân tách năng lượng theo các nguồn vật lý của nó. Hai yếu tố chi phối năng lượng suy luận là: các phép toán và truy cập bộ nhớ.
Các kiểu dữ liệu hẹp hơn thường cần ít năng lượng chuyển mạch và lưu trữ trên mỗi phép toán, vì vậy table 15 cho thấy một khoảng chênh 18× về chi phí phép nhân giữa FP32 và INT8:
| Độ chính xác | Năng lượng bộ nhân | Chi phí tương đối |
|---|---|---|
| FP32 | ~3.7 pJ/FLOP | 1× |
| FP16 | ~1.1 pJ/FLOP | 0.3× |
| INT8 | ~0.2 pJ/FLOP | 0.05× |
Trong mô hình linh kiện 45 nm này, một bộ nhân 8-bit tiêu thụ năng lượng ít hơn khoảng ~18× lần so với bộ nhân dấu phẩy động 32-bit, vì số học với độ rộng nhỏ hơn làm giảm công việc chuyển mạch và lưu trữ (Horowitz 2014). Các con số cần biết liệt kê các ước tính năng lượng trên mỗi phép toán làm cơ sở cho các tỷ lệ này; các giá trị tuyệt đối và tỷ lệ thay đổi theo thiết kế mạch và công nghệ chế tạo.
Table 16 mở rộng phân tích sang việc truy cập bộ nhớ, với chi phí năng lượng trên mỗi byte ở từng cấp trong hệ thống phân cấp bộ nhớ:
| Mức bộ nhớ | Năng lượng trên mỗi Byte | Chi phí tương đối |
|---|---|---|
| Register | ~0.1 pJ/byte | 1× |
| L1 Cache | ~1 pJ/byte | 10× |
| L2 Cache | ~5 pJ/byte | 50× |
| DRAM | ~160 pJ/byte | 1,600× |
Truy cập bộ nhớ là yếu tố chi phối: đọc một byte từ DRAM tốn năng lượng nhiều hơn gấp 1,600× lần so với truy cập thanh ghi.
Phép tính: Năng lượng của từng thành phần được tính theo công thức \(E_{\text{load}}=\text{model bytes}\times\text{DRAM energy per byte}\) và \(E_{\text{compute}}=\text{FLOPs}\times\text{operation energy}\). Các hạng mục năng lượng cho FP32 tổng cộng là 2243 μJ + 2,220 μJ = 4,463 μJ; các hạng mục năng lượng cho INT8 tổng cộng là 561 μJ + 120 μJ = 681 μJ. Chia hai tổng cho nhau cho ra mức giảm 6.6× lần theo mô hình đơn giản này.
Table 17 kết hợp hai hiệu ứng trong một mô hình MobileNetV2 được đơn giản hóa có chủ đích. Mô hình này tính một lần đọc DRAM cho mỗi trọng số và áp mức năng lượng theo hệ số nhân cho mọi FLOP đã liệt kê, đồng thời không tính lưu lượng activation, hành vi cache, chi phí riêng cho phép cộng, chi phí điều khiển (control overhead) và công suất tĩnh (static power):
| Thành phần | FP32 (14 MB) | INT8 (3.5 MB) | Tiết kiệm |
|---|---|---|---|
| Một trọng số được đọc từ DRAM | 2243 μJ | 561 μJ | 4× |
| Tính toán (600 MFLOP) | 2,220 μJ | 120 μJ | 18.5× |
| Tổng cộng | 4,463 μJ | 681 μJ | 6.6× |
Thông tin chuyên sâu về hệ thống: Trong mô hình đơn giản này, việc đọc trọng số và phép toán số học đóng góp mức năng lượng FP32 tương đương (2243 μJ và 2,220 μJ), và INT8 làm giảm cả hai, đưa tổng năng lượng từ 4,463 μJ xuống 681 μJ. Điều này giải thích cơ chế vật lý đằng sau khả năng tiết kiệm tiềm năng, nhưng các tuyên bố về tuổi thọ pin hoặc năng lượng trên mỗi lần suy luận đòi hỏi các phép đo công suất toàn thiết bị được kiểm soát chặt chẽ.
Horowitz, Mark. 2014. “1.1 Computing’s Energy Problem (and What We Can Do about It).” 2014 IEEE International Solid-State Circuits Conference Digest of Technical Papers (ISSCC), 10–14. https://doi.org/10.1109/isscc.2014.6757323.
Cơ sở hạ tầng dùng chung đặt ra thêm nhiều thách thức. Trong các trung tâm dữ liệu, những tài nguyên như hệ thống làm mát và phân phối công suất được chia sẻ giữa các khối lượng công việc (workload), khiến việc quy gán mức tiêu thụ năng lượng cho từng tác vụ ML cụ thể trở nên phức tạp. Riêng hệ thống làm mát có thể chiếm 20–30 phần trăm tổng công suất tiêu thụ của toàn bộ cơ sở, nên là một yếu tố lớn trong đánh giá hiệu quả năng lượng (Barroso et al. 2019). Ngay cả ở edge, các thành phần như bộ nhớ và giao diện I/O có thể phục vụ cả tác vụ ML lẫn không phải ML, càng làm mờ ranh giới đo lường.
Trong một lượt truyền xuôi của Transformer, cường độ tính toán và công suất có thể thay đổi giữa các kernel. Các lớp feed-forward thường dùng phép nhân ma trận dày đặc, trong khi attention có thể bị giới hạn bởi tính toán hoặc bộ nhớ tùy thuộc vào giai đoạn prefill hay decode, hình dạng chuỗi và batch, cũng như cách triển khai kernel. Điều chỉnh điện áp và tần số động (DVFS) cũng có thể làm thay đổi công suất theo nhu cầu khối lượng công việc (workload) (Kim et al. 2008). Vì vậy, các benchmark về công suất cần các cửa sổ lấy mẫu và tích hợp đủ để ghi lại biến thiên ở cấp độ kernel, thay vì suy ra năng lượng của cả mô hình từ một lần đọc tức thời duy nhất.
Kim, Wonyoung, Meeta S. Gupta, Gu-Yeon Wei, and David Brooks. 2008. “System Level Analysis of Fast, Per-Core DVFS Using on-Chip Switching Regulators.” IEEE International Symposium on High-Performance Computer Architecture (HPCA), HPCA ’08, 123–34. https://doi.org/10.1109/hpca.2008.4658633.
Barroso, Luiz André, Urs Hölzle, and Parthasarathy Ranganathan. 2019. The Datacenter as a Computer: Designing Warehouse-Scale Machines. Synthesis Lectures on Computer Architecture. Springer International Publishing. https://doi.org/10.1007/978-3-031-01761-2.
Cơ sở hạ tầng hỗ trợ, đặc biệt là hệ thống làm mát, là thành phần lớn trong tiêu thụ năng lượng ở các triển khai quy mô lớn. Các trung tâm dữ liệu phải duy trì nhiệt độ vận hành, thường trong khoảng 20–25 °C, để đảm bảo độ tin cậy hệ thống. Phần chi phí làm mát được phản ánh qua chỉ số hiệu quả sử dụng công suất, dao động từ 1.1 ở những cơ sở hiệu quả cao đến trên 2.0 ở các cơ sở kém tối ưu hơn (Barroso et al. 2019). Sự tương tác giữa khối lượng công việc (workload) tính toán và hạ tầng làm mát tạo ra các phụ thuộc phức tạp; chẳng hạn, các kỹ thuật quản lý công suất như DVFS không chỉ giảm công suất động trực tiếp của bộ xử lý mà còn giảm nhiệt phát ra, kéo theo yêu cầu làm mát giảm theo. Ngay cả thiết bị edge cũng cần quản lý nhiệt ở mức cơ bản.
Hiệu quả tính toán so với tiêu thụ công suất
Mối quan hệ giữa hiệu năng tính toán và hiệu quả năng lượng là một sự đánh đổi cốt lõi trong thiết kế hệ thống ML hiện đại. Lịch sử cho thấy số phép tính trên mỗi kilowatt-giờ đã tăng gấp đôi khoảng mỗi 1,5 năm, phản ánh mức cải thiện nhanh và bền vững về hiệu quả tính toán (Koomey et al. 2011). Tuy nhiên, việc tăng tần số bộ xử lý bộc lộ một sự đánh đổi cục bộ: tần số cao hơn thường cần điện áp cao hơn, khiến công suất động có thể tăng nhanh hơn thông lượng đạt được. Điều này phản ánh mối quan hệ điện áp-tần số-công suất làm nền tảng cho DVFS và các lợi ích giảm dần của nó (Le Sueur and Heiser 2010).
Koomey, Jonathan, Stephen Berard, Marla Sanchez, and Henry Wong. 2011. “Implications of Historical Trends in the Electrical Efficiency of Computing.” IEEE Annals of the History of Computing 33 (3): 46–54. https://doi.org/10.1109/mahc.2010.28.
Le Sueur, Etienne, and Gernot Heiser. 2010. “Dynamic Voltage and Frequency Scaling: The Laws of Diminishing Returns.” Proceedings of the 2010 International Conference on Power Aware Computing and Systems, 1–8.
Wu, Hao, Patrick Judd, Xiaojie Zhang, Mikhail Isaev, and Paulius Micikevicius. 2020. “Integer Quantization for Deep Learning Inference: Principles and Empirical Evaluation.” arXiv Preprint arXiv:2004.09602 abs/2004.09602.
Gholami, Amir, Sehoon Kim, Zhen Dong, Zhewei Yao, Michael W. Mahoney, and Kurt Keutzer. 2021. “A Survey of Quantization Methods for Efficient Neural Network Inference.” arXiv Preprint arXiv:2103.13630 abs/2103.13630.
Trong các kịch bản triển khai có ràng buộc năng lượng nghiêm ngặt, đặc biệt là thiết bị edge chạy pin và ứng dụng di động, tối ưu hoá bài toán đánh đổi hiệu năng-năng lượng là điều kiện tiên quyết để khả thi trong thực tế. Các kỹ thuật tối ưu hoá mô hình đưa ra những hướng tiếp cận hứa hẹn để đạt hiệu quả cao hơn mà không làm suy giảm đáng kể độ chính xác. Các kỹ thuật tối ưu hoá độ chính xác số, giúp giảm yêu cầu tính toán trong khi vẫn duy trì chất lượng mô hình, minh hoạ rõ ràng sự đánh đổi này. Các nghiên cứu về lượng tử hoá số nguyên cho thấy tính toán với độ chính xác giảm thường vẫn giữ được chất lượng mô hình, đồng thời cải thiện tốc độ suy luận, lưu lượng bộ nhớ và hiệu quả năng lượng; dù vậy, lợi ích thực tế còn phụ thuộc vào mô hình, phương pháp hiệu chuẩn và hỗ trợ phần cứng (Jacob et al. 2018; Wu et al. 2020; Gholami et al. 2021).
Các chiến lược tối ưu hóa xoay quanh ba khía cạnh gắn kết: độ chính xác, hiệu suất tính toán và hiệu quả năng lượng. Các phương pháp tối ưu hóa tiên tiến giúp chúng ta điều chỉnh linh hoạt các đánh đổi giữa những yếu tố này. Tương tự, các kỹ thuật tối ưu hóa và nén mô hình đòi hỏi phải cân bằng cẩn thận giữa mức giảm độ chính xác và lợi ích về hiệu quả. Điểm vận hành tối ưu giữa các yếu tố phụ thuộc chặt vào yêu cầu và ràng buộc khi triển khai; ứng dụng di động thường ưu tiên hiệu quả năng lượng để kéo dài thời lượng pin, trong khi các dịch vụ trên đám mây có thể tối ưu cho độ chính xác dù phải chấp nhận mức tiêu thụ công suất cao hơn, nhờ lợi thế kinh tế theo quy mô và hạ tầng làm mát chuyên dụng.
Các chỉ số hiệu quả năng lượng hiện giữ vai trò trung tâm trong đánh giá hệ thống AI. Các tiêu chuẩn đo lường công suất như MLPerf Power (Tschand et al. 2024) cung cấp các framework chuẩn hóa để so sánh hiệu quả năng lượng giữa các nền tảng phần cứng và các kịch bản triển khai. Nhờ các tiêu chuẩn này, kỹ sư có thể cân bằng một cách có hệ thống giữa hiệu suất, mức tiêu thụ công suất và tác động môi trường khi lựa chọn phần cứng và chiến lược tối ưu hóa.
Đo lường công suất chuẩn hóa
Các kỹ thuật đo lường công suất như SPEC Power đã được dùng lâu năm trong lĩnh vực tính toán tổng quát (Lange 2009), nhưng khối lượng công việc (workload) ML bộc lộ một khó khăn cơ bản: mức tiêu thụ công suất tức thời trong một lần suy luận có thể chuyển rất nhanh giữa pha nhân ma trận đòi hỏi tính toán cao và pha tắc nghẽn bộ nhớ. MLPerf Power chính thức hóa vấn đề này cho hệ thống ML bằng cách quy định ranh giới đo lường, thiết bị đo và quy tắc báo cáo trên một dải công suất rộng (Tschand et al. 2024). Sự biến động đó khiến mọi phép đo tại một thời điểm đơn lẻ đều dễ gây hiểu lầm, và bản thân việc đo lường (chi phí do gắn thiết bị đo, độ trễ do lấy mẫu) có thể làm nhiễu chính hồ sơ công suất đang được đặc trưng.
Thách thức cốt lõi vì thế nằm ở yếu tố thời gian: cần đặc trưng một đại lượng dao động nhanh hơn khả năng lấy mẫu của nhiều thiết bị đo. Các phép toán ma trận dày đặc trong các lớp transformer tạo ra các đỉnh công suất ngắn, cường độ cao, đòi hỏi tần số lấy mẫu cao để ghi nhận chính xác; trong khi suy luận của CNN thường có mức tiêu thụ công suất ổn định hơn, nên có thể dùng tốc độ lấy mẫu thấp hơn. Khoảng thời gian đo cũng phải tính đến giai đoạn khởi động đặc thù của ML, khi các suy luận ban đầu tiêu thụ nhiều công suất hơn do cache được lấp đầy và pipeline được khởi tạo. Lấy trung bình theo cửa sổ trượt qua nhiều lần suy luận liên tiếp sẽ làm mượt các dao động này, cho ra các con số hiệu suất có ý nghĩa. Tuy nhiên, chính kích thước của cửa sổ lại trở thành một tham số thiết kế, có thể che giấu hoặc làm lộ những khía cạnh khác nhau của hồ sơ công suất.
Các mẫu truy cập bộ nhớ khiến vấn đề đo lường phức tạp hơn, vì hệ thống ML thường tiêu tốn nhiều năng lượng để di chuyển dữ liệu hơn là để tính toán trên dữ liệu đó. Chẳng hạn, các mô hình khuyến nghị như DLRM có thể tiêu thụ nhiều năng lượng cho truy cập bộ nhớ hơn là cho tính toán—một đặc điểm mà các phương pháp đo công suất truyền thống tập trung vào tính toán bỏ sót hoàn toàn. Để ghi nhận được mức tiêu thụ công suất của cả hệ thống con tính toán và bộ nhớ, cần gắn đo trên toàn bộ đường đi của dữ liệu, không chỉ ở bộ xử lý.
Các cấu hình bộ tăng tốc không đồng nhất làm tăng thêm độ phức tạp. GPU, TPU và NPU mỗi loại có cơ chế quản lý công suất độc lập, và các SoC hiện đại có thể linh hoạt chuyển giữa các tài nguyên tính toán tùy theo đặc điểm của khối lượng công việc (workload). Đo lường chính xác ở cấp độ hệ thống đòi hỏi thu thập công suất đồng bộ trên tất cả các đơn vị tính toán đang hoạt động—một thách thức tăng theo quy mô hệ thống. Các cấu hình đa GPU cần tính cả năng lượng cho đồng bộ hóa gradient bên cạnh năng lượng tính toán, và các triển khai đa nút phải cộng thêm công suất của hạ tầng mạng, vốn không hề nhỏ. Ở phía còn lại, các triển khai edge phải ghi nhận chi phí năng lượng cho cập nhật mô hình và tiền xử lý dữ liệu, bên cạnh chính quá trình suy luận.
Kích thước batch tạo ra mối quan hệ phi tuyến với mức tiêu thụ công suất mà các phép đo tại một điểm không thể mô tả đầy đủ. Batch lớn hơn giúp cải thiện hiệu quả tính toán (tận dụng tốt hơn các lần nạp bộ nhớ) nhưng lại làm tăng áp lực bộ nhớ và yêu cầu công suất đỉnh. Vì vậy, kích thước batch hiệu quả nhất cho thông lượng có thể khác với kích thước batch hiệu quả nhất cho năng lượng. Cần đo lường trên nhiều kích thước batch để có hồ sơ hiệu quả đầy đủ. Các trạng thái nhàn rỗi của hệ thống cũng cần được chú ý, đặc biệt với các khối lượng công việc (workload) edge gián đoạn: một hệ thống TinyML phát hiện từ khóa đánh thức, chỉ xử lý âm thanh trong một phần nhỏ thời gian hoạt động, có thể bị chi phối bởi công suất lúc nhàn rỗi hơn là năng lượng cho quá trình suy luận. Cuối cùng, các khối lượng công việc (workload) ML chạy liên tục có thể làm tăng nhiệt độ, kích hoạt cơ chế điều tiết nhiệt và làm thay đổi kiểu tiêu thụ công suất—hiệu ứng này đặc biệt rõ ở thiết bị edge, nơi các ràng buộc về nhiệt giới hạn hiệu năng duy trì và các lượt chạy benchmark kéo dài là cần thiết để đặc tả thực tế.
Nghiên cứu điển hình về công suất MLPerf
MLPerf Power (Tschand et al. 2024) chuyển phép đo công suất từ một chỉ số riêng của từng thiết bị thành một tuyên bố về hiệu quả có thể so sánh được: một hệ thống cung cấp bao nhiêu suy luận hữu ích trên mỗi watt dưới các ranh giới xác định. Phương pháp này áp dụng các nguyên tắc đánh giá tiêu chuẩn hóa cho các bối cảnh suy luận như trung tâm dữ liệu, edge và tiny, trong đó yếu tố quyết định chuyển từ chi phí vận hành tủ rack sang tuổi thọ pin, rồi tới khả năng chịu đựng ở mức microwatt.
Việc tiêu chuẩn hóa có tính đến các ranh giới là rất quan trọng vì cùng một dòng phần cứng có thể trông hiệu quả hoặc lãng phí tùy theo ranh giới và khối lượng công việc (workload). Bằng cách điều chỉnh giao thức cho CPU, bộ tăng tốc và các hệ thống không đồng nhất, đồng thời vẫn bảo toàn tính toàn vẹn của phép đo, MLPerf Power giúp các so sánh đa nền tảng trở nên có ý nghĩa trên các quy mô tính toán khác nhau.
Bộ benchmark này đã tích lũy nhiều phép đo có thể tái lập do các tổ chức trong ngành gửi lên, cho thấy năng lực của phần cứng được nộp và sự tập trung của toàn ngành vào công nghệ AI tiết kiệm năng lượng. Biểu đồ trung tâm dữ liệu trong figure 8 minh họa cách hiệu quả năng lượng được chuẩn hóa đã thay đổi qua các phiên bản MLPerf Inference liên tiếp. Mức tăng khác nhau theo khối lượng công việc (workload) và phiên bản bắt đầu: RetinaNet và ResNet cho thấy mức tăng lớn nhất trên biểu đồ, trong khi GPT-J, DLRM-v2 và Llama 2 chỉ tham gia ít vòng benchmark hơn, nên mức tăng của chúng khó so sánh trực tiếp.
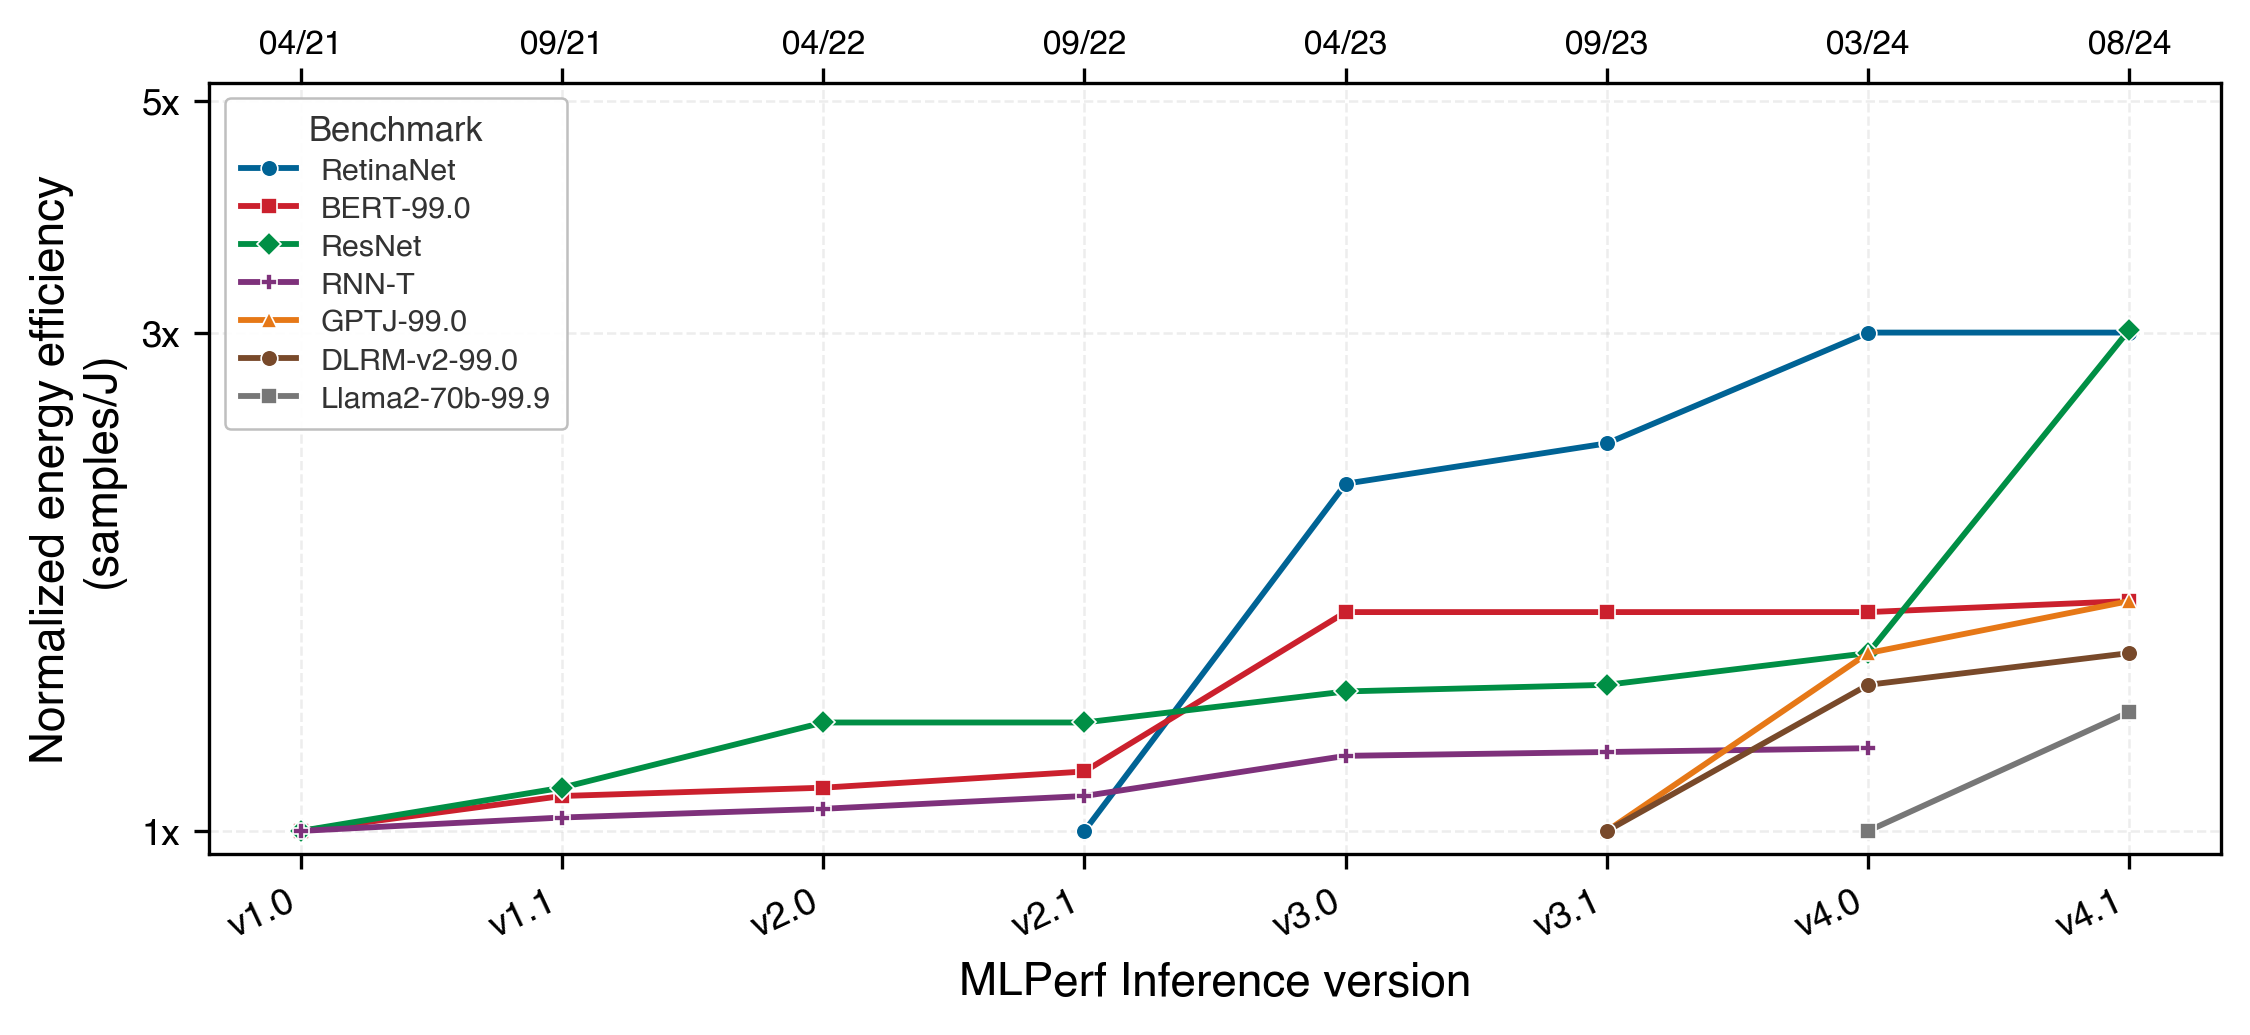
Tschand, Arya, Arun Tejusve Raghunath Rajan, Sachin Idgunji, Anirban Ghosh, Jeremy Holleman, Csaba Kiraly, Pawan Ambalkar, et al. 2024. “MLPerf Power: Benchmarking the Energy Efficiency of Machine Learning Systems from \(\mu\)Watts to MWatts for Sustainable AI.” 2025 IEEE International Symposium on High Performance Computer Architecture (HPCA), 1201–16. https://doi.org/10.1109/hpca61900.2025.00092.
RetinaNet và ResNet cho thấy mức tăng lớn nhất trên biểu đồ, mỗi loại đạt 3\(\times\) hiệu quả chuẩn hóa ban đầu. BERT và GPT-J đạt khoảng 1,9\(\times\), trong khi DLRM-v2 đạt khoảng 1,7\(\times\), Llama 2 khoảng 1,5\(\times\) và RNN-T khoảng 1,3\(\times\).
Các giao thức thời gian và thiết bị đo công suất cung cấp dữ liệu thô cho việc benchmarking. Tuy nhiên, chỉ dữ liệu thô thôi thì không đảm bảo rút ra được kết luận vững chắc. Để biến các phép đo thành so sánh có ý nghĩa, cần hiểu các nguồn lỗi, độ chệch (bias) và lệch khớp có tính hệ thống—những yếu tố có thể khiến ngay cả các con số benchmark được thu thập kỹ lưỡng cũng trở nên gây hiểu lầm.
Self-Check: Question
A vendor advertises an AI accelerator as delivering ‘\(10\text{ TOPS}\) at \(0.5\text{ W}\).’ When deployed in a production server, the total power consumption measured at the wall socket increases by \(4.5\text{ W}\) for that same workload. What explains this discrepancy in benchmarking methodology?
- The vendor drew an isolated power measurement boundary around the compute core silicon only, omitting DRAM interfaces, PCIe host transfers, voltage regulators, CPU preprocessing, and cooling fans
- The electrical wall outlet was defective and provided improper alternating current
- Power consumption in digital circuits is inherently non-deterministic and varies by \(10\times\) between runs
- The vendor measured power during sleep mode rather than active compute
An accelerator increases its operating clock frequency to achieve a \(5\%\) increase in inference throughput, but this requires increasing the supply voltage by \(15\%\). Because dynamic power scales as \(P \propto V^2 f\), active power consumption increases by approximately \(39\%\). What is the systems consequence of this operating point for a power-constrained edge deployment?
- It is an optimal trade-off because throughput is always the only metric that matters
- It represents a severe energy efficiency regression, reducing performance-per-watt by roughly \(24\%\) and accelerating battery drain and thermal throttling
- Performance-per-watt increases because higher frequency reduces static leakage
- The device will operate cooler because inferences finish \(5\%\) sooner
Explain why instantaneous power sampling during an ML inference workload produces misleading results, and describe how standardized protocols calculate total energy.
True or False: In standardized ML power benchmarking, measuring the power draw of the arithmetic compute units (ALUs and tensor cores) is sufficient because the energy required to read and write data from DRAM is negligible in comparison.
Order the following steps in a standardized MLPerf Power measurement protocol from start to finish:
- Integrate instantaneous power readings over the full run duration (\(E = \int P(t) \, dt\)) and compute Joules per inference
- Establish the physical measurement boundary and connect a calibrated power analyzer in series with the system power supply
- Execute unmeasured warm-up iterations until the device achieves thermal equilibrium (steady-state junction temperature)
- Measure and record the baseline idle/quiescent power consumption while the system is waiting for requests
- Execute the synchronized inference benchmark workload while logging continuous high-frequency time-series power and temperature data
Các thực hành tốt nhất cho benchmarking
Một ngăn xếp suy luận có thể vượt qua bài chạy phòng lab ở trạng thái ổn định nhưng vẫn trượt mục tiêu độ trễ khi lưu lượng thực tế đến theo đợt, hoặc khi cơ cấu đầu vào dịch chuyển về phía các ví dụ tốn kém. Thông lượng huấn luyện, độ trễ suy luận và hiệu quả công suất đều có các giao thức đo lường đã được thiết lập và xác thực qua MLPerf. Nhưng biết cần đo gì là chưa đủ nếu không hiểu những gì benchmark không thể phản ánh và vì sao khoảng trống đó đã làm trật hướng vô số lần triển khai.
Các benchmark thường đặt ra những giả định đơn giản hóa để so sánh theo chuẩn, nhưng có thể lệch khỏi thực tế sản xuất. Chẳng hạn, các bộ benchmark huấn luyện có thể đóng băng tập dữ liệu và kiểm soát chặt yếu tố ngẫu nhiên; trong khi dữ liệu và điều kiện huấn luyện ở môi trường sản xuất lại liên tục thay đổi. Các bộ benchmark suy luận thường nhấn mạnh một kịch bản trạng thái ổn định đã định nghĩa; còn lưu lượng thực tế trong sản xuất có thể bùng nổ và biến thiên theo thời gian. Các benchmark về công suất kiểm soát điều kiện nhiệt; trong khi phần cứng khi triển khai có thể gặp nhiệt độ môi trường và hành vi dưới tải kéo dài khác biệt. Bốn nhóm hạn chế chính (liên quan đến thống kê, triển khai, thiết kế hệ thống và tổ chức) quyết định liệu kết quả benchmark có chuyển hóa thành thành công khi triển khai hay không.
Các vấn đề thống kê và phương pháp luận
Kết quả benchmark chỉ đáng tin cậy bằng chính các phép đo tạo ra chúng. Ba vấn đề phổ biến dưới đây sẽ làm suy giảm độ tin cậy nếu không được xử lý.
Độ bao phủ vấn đề không đầy đủ là một trong những hạn chế phổ biến nhất. Nhiều benchmark, dù hữu ích cho so sánh có kiểm soát, vẫn không nắm bắt được đầy đủ sự đa dạng của các ứng dụng thực tế. Ví dụ, các tập dữ liệu phân loại ảnh như CIFAR-10 (Krizhevsky 2009) chỉ bao quát phạm vi hình ảnh hạn chế. Các mô hình đạt kết quả tốt trên những tập dữ liệu này có thể gặp khó khăn khi áp dụng vào các kịch bản thực tế phức tạp hơn, với biến thiên lớn hơn về ánh sáng, góc chụp và bố cục đối tượng. Khoảng cách giữa các tác vụ benchmark và độ phức tạp ngoài đời thực đồng nghĩa với việc hiệu suất benchmark cao chỉ đảm bảo hạn chế cho thành công khi triển khai.
Krizhevsky, Alex. 2009. Learning Multiple Layers of Features from Tiny Images. University of Toronto.
Thiếu ý nghĩa thống kê xuất hiện khi đánh giá benchmark trên quá ít mẫu dữ liệu hoặc quá ít lần thử. Vấn đề này trở nên nghiêm trọng nhất khi chính phương thức đánh giá tạo thêm biến động. Đánh giá mô hình ngôn ngữ lớn (LLM) là ví dụ điển hình: dù chấm một LLM mới so với mô hình tham chiếu bằng xếp hạng ưu tiên của con người hay theo giao thức LLM-as-judge, tín hiệu đánh giá có độ biến động cao vì giám khảo phản ứng khác nhau trước cách diễn đạt prompt, hiệu ứng thứ tự và độ dài phản hồi. Một mức chênh ưu tiên hai điểm được báo cáo có thể biến mất hoàn toàn khi đổi cấu hình giám khảo hoặc mẫu prompt. Vì vậy, benchmark LLM một cách chặt chẽ cần áp dụng các phương pháp thống kê—như khoảng tin cậy bootstrap hoặc kiểm định ý nghĩa theo cặp—trên đủ số lượng prompt và cặp phản hồi để tách bạch cải thiện năng lực thực sự khỏi nhiễu đánh giá. Nếu không có đủ lần thử và phân phối đầu vào đa dạng, kết quả benchmark sẽ gây hiểu lầm: khác biệt được báo cáo phản ánh nhiễu đánh giá chứ không phải năng lực thực sự. Các khoảng tin cậy thống kê quanh điểm benchmark thường không được báo cáo, khiến khó biết sự khác biệt đo được là cải thiện thật hay chỉ là nhiễu của phép đo.
Khả năng tái lập là một thách thức lớn kéo dài. Kết quả benchmark có thể thay đổi thấy rõ tùy theo cấu hình phần cứng, phiên bản phần mềm và các phụ thuộc hệ thống. Chỉ khác biệt nhỏ ở trình biên dịch, độ chính xác số học hoặc cập nhật thư viện cũng có thể làm phép đo hiệu suất không nhất quán giữa các môi trường. Để giảm thiểu, MLPerf cải thiện khả năng tái lập bằng cách cung cấp bản triển khai tham chiếu, khối lượng công việc (workload) và quy tắc chạy chuẩn hóa, cùng hướng dẫn nộp bài nghiêm ngặt. Dù vậy, đạt được sự nhất quán thực sự trên nhiều nền tảng phần cứng vẫn là thách thức. Sự phong phú của thư viện tối ưu hóa, phiên bản framework và cờ biên dịch tạo nên một không gian cấu hình rất lớn, nơi chỉ một thay đổi nhỏ cũng có thể cho ra kết quả khác.
Khoảng cách hiệu suất giữa phòng thí nghiệm và triển khai
Tính chặt chẽ về thống kê đảm bảo các phép đo benchmark là chính xác. Nhưng đo lường chính xác nhầm thứ vẫn dẫn đến thất bại khi triển khai. Benchmark cũng phải phù hợp với các mục tiêu triển khai thực tế.
Sự lệch pha với mục tiêu thực tế xảy ra khi các benchmark nhấn mạnh các chỉ số như tốc độ, độ chính xác và thông lượng, trong khi các triển khai AI ngoài đời đòi hỏi cân bằng nhiều mục tiêu, gồm hiệu quả năng lượng, chi phí và độ bền/khả năng chống chịu. Một mô hình đạt độ chính xác hàng đầu trên benchmark vẫn có thể khó triển khai nếu tiêu thụ quá nhiều năng lượng hoặc cần phần cứng đắt đỏ. Tương tự, tối ưu cho hiệu suất trung bình trên các tập dữ liệu benchmark có thể bỏ qua các yêu cầu về độ trễ ở đuôi, vốn quyết định trải nghiệm người dùng trong hệ thống sản xuất. Bản chất đa mục tiêu của triển khai thực tế — với các ràng buộc tài nguyên, chi phí vận hành, độ phức tạp bảo trì và yêu cầu kinh doanh — vượt xa kiểu tối ưu một chỉ số mà hầu hết benchmark đang khuyến khích.
Thách thức trong thiết kế hệ thống
Phương pháp luận thống kê và việc căn chỉnh với triển khai xác định cách đo hiệu suất và tối ưu hóa điều gì. Một nhóm hạn chế thứ ba lại xuất phát từ chính các hệ thống vật lý được đem ra đo. Hành vi phần cứng phụ thuộc vào điều kiện môi trường, khả năng tương thích kiến trúc và bối cảnh vận hành theo những cách khiến việc so sánh công bằng trở nên phức tạp.
Các điều kiện môi trường ảnh hưởng đến benchmark theo những cách có thể đo được. Kết quả benchmark phụ thuộc vào điều kiện vật lý (nhiệt độ môi trường, độ ẩm, độ cao) và bối cảnh vận hành (các tiến trình nền, tải mạng, độ ổn định nguồn điện) theo những cách tinh vi nhưng vẫn đo được. Nhiệt độ cao có thể kích hoạt cơ chế giới hạn nhiệt, làm giảm tốc độ tính toán; các tiến trình nền tranh giành tài nguyên và làm thay đổi đặc tính hiệu suất. Để đảm bảo benchmark có giá trị, cần kiểm soát các yếu tố này trong khả năng cho phép (ví dụ: môi trường kiểm soát nhiệt độ, trạng thái hệ thống được chuẩn hóa, tải nền được ghi lại). Khi không thể kiểm soát hoàn toàn (như với benchmarking phân tán hoặc trên đám mây), cần báo cáo chi tiết các điều kiện để người khác có thể tính đến biến thiên tiềm ẩn khi diễn giải kết quả.
Vấn đề hardware lottery34 (Hooker 2021) nêu lên một khía cạnh quan trọng khác. Thành công của một mô hình machine learning không chỉ phụ thuộc vào kiến trúc và dữ liệu huấn luyện, mà còn vào mức độ ăn khớp của nó với phần cứng bên dưới. Một số mô hình hoạt động rất tốt không phải vì bản thân chúng vượt trội, mà vì chúng tự nhiên phù hợp với khả năng xử lý song song của GPU hoặc TPU. Ngược lại, những kiến trúc đầy hứa hẹn khác có thể bị bỏ qua có hệ thống chỉ vì chúng không phù hợp với các nền tảng phần cứng chiếm ưu thế.
34 Hardware lottery: Thuật ngữ do Hooker (2021) đặt ra để mô tả việc thành công của một thuật toán phụ thuộc vào mức độ tương thích với phần cứng và phần mềm hiện có. Các khối lượng công việc (workload) của Transformer được hưởng lợi từ các phép toán ma trận dày đặc, vốn ánh xạ hiệu quả lên các bộ tăng tốc hiện đại. Ngược lại, các mạng nơ-ron đồ thị và các mô hình hỗn hợp chuyên gia thưa thớt lại khó đánh giá hơn khi silicon và các ngăn xếp phần mềm hiện có ưu tiên các kernel dày đặc. Vì vậy, các bảng xếp hạng (leaderboard) dành riêng cho phần cứng thường ưu ái những kiến trúc phù hợp với nền tảng được đo lường, và có thể làm lu mờ các lựa chọn thay thế vốn có thể cho kết quả khác nếu giả định phần cứng khác đi.
Hooker, Sara. 2021. “The Hardware Lottery.” Communications of the ACM 64 (12): 58–65. https://doi.org/10.1145/3467017.
Sự phụ thuộc vào khả năng tương thích phần cứng tạo ra những độ chệch (bias) tinh tế nhưng đáng kể trong kết quả benchmark. Một mô hình đạt hiệu suất cao trên một GPU cụ thể có thể lại kém trên CPU hoặc một bộ tăng tốc AI tùy chỉnh. Figure 9 cụ thể hóa sự phụ thuộc này bằng cách so sánh hiệu suất mô hình trên các nền tảng khác nhau. Với cấu hình CPU uint8 và GPU, các mô hình đa phần cứng bám sát đường cơ sở “MobileNetV3 Large min”, đạt độ chính xác top-1 ImageNet khoảng 77%, trong khi đường cơ sở đạt khoảng 75%. Trên phần cứng EdgeTPU và DSP, các mô hình đa phần cứng tương tự vẫn giữ mức 77% đó với độ trễ thấp hơn đáng kể, trong khi một mô hình chỉ tinh chỉnh cho CPU sẽ bỏ lỡ những lợi ích này. Điều đó cho thấy mô hình “tốt nhất” phụ thuộc hoàn toàn vào mục tiêu triển khai — một kết luận không thể rút ra từ các benchmark chỉ chạy trên một nền tảng.

Chu, Grace, Okan Arikan, Gabriel Bender, Weijun Wang, Achille Brighton, Pieter-Jan Kindermans, Hanxiao Liu, Berkin Akin, Suyog Gupta, and Andrew Howard. 2021. “Discovering Multi-Hardware Mobile Models via Architecture Search.” 2021 IEEE/CVF Conference on Computer Vision and Pattern Recognition Workshops (CVPRW), 3016–25. https://doi.org/10.1109/cvprw53098.2021.00337.
Nếu không benchmark kỹ lưỡng trên nhiều cấu hình phần cứng khác nhau, cả lĩnh vực có nguy cơ ưu ái những kiến trúc “trúng số” phần cứng, thay vì chọn các mô hình dựa trên điểm mạnh nội tại của chúng. Độ chệch (bias) này có thể định hình hướng nghiên cứu, ảnh hưởng đến phân bổ tài trợ và tác động đến thiết kế các hệ thống AI thế hệ tiếp theo. Ở mức cực đoan, nó còn có thể kìm hãm đổi mới bằng cách làm nản lòng việc khám phá các kiến trúc thay thế không ăn khớp với xu hướng phần cứng hiện tại.
Các vấn đề tổ chức và chiến lược
Những hạn chế được thảo luận trong phần này bắt nguồn từ các thách thức kỹ thuật: nhiễu thống kê, lệch so với bối cảnh triển khai, biến thiên môi trường và khả năng tương thích phần cứng. Một nhóm hạn chế thứ tư xuất phát từ yếu tố con người—và đây có thể là nhóm khó giảm thiểu nhất vì chúng liên quan đến động cơ khuyến khích hơn là công cụ đo lường. Áp lực cạnh tranh và các ưu đãi nghiên cứu tạo ra các độ chệch (bias) có hệ thống trong cách các benchmark được sử dụng và diễn giải. Những động lực tổ chức này đòi hỏi cơ chế quản trị và tiêu chuẩn cộng đồng để duy trì tính toàn vẹn của benchmark.
Kỹ thuật benchmark
Trong khi “xổ số” phần cứng là một hệ quả ngoài ý muốn của xu hướng phần cứng, benchmark engineering là một thực hành có chủ đích, trong đó các mô hình hoặc hệ thống được tối ưu hóa rõ ràng để đạt thành tích vượt trội trên các bài kiểm tra benchmark cụ thể. Thực hành này có thể dẫn đến các tuyên bố hiệu suất gây hiểu lầm và những kết quả không thể tổng quát hóa ra ngoài môi trường benchmark.
Hiện tượng kỹ thuật benchmark (benchmark engineering) xảy ra khi các nhà phát triển AI tinh chỉnh siêu tham số, kỹ thuật tiền xử lý hoặc kiến trúc mô hình với mục tiêu tối đa hóa điểm benchmark thay vì cải thiện hiệu suất trong thực tế. Ranh giới giữa tối ưu hóa hợp lệ và kỹ thuật benchmark thường mờ, nằm ở ngưỡng nơi việc tinh chỉnh cho một benchmark cụ thể chuyển thành overfitting vào chính benchmark đó. Chẳng hạn, một mô hình phát hiện đối tượng có thể được tối ưu cẩn thận để đạt độ trễ thấp kỷ lục trên một benchmark, nhưng lại thất bại khi triển khai trong các môi trường thực tế năng động với điều kiện ánh sáng thay đổi, nhòe do chuyển động và hiện tượng che khuất. Tương tự, một mô hình ngôn ngữ có thể được tinh chỉnh để đạt kết quả xuất sắc trên các tập dữ liệu benchmark, nhưng lại gặp khó khăn khi xử lý lời nói hội thoại với cách diễn đạt không trang trọng và hiện tượng code-switching.
Áp lực phải đạt điểm benchmark cao thường xuất phát từ cạnh tranh, marketing và sự ghi nhận trong nghiên cứu. Benchmark thường được dùng để xếp hạng các mô hình và hệ thống AI, tạo động lực tối ưu hóa riêng cho chúng. Dù điều này có thể thúc đẩy tiến bộ kỹ thuật, nó cũng dễ dẫn đến việc ưu tiên các tối ưu hóa chỉ phục vụ benchmark, làm suy giảm khả năng khái quát hóa rộng hơn — đúng với động lực theo Định luật Goodhart đã được giới thiệu trong section 1.1 và được minh họa bằng ví dụ về điểm BLEU trong section 1.3.1.
Độ chệch (bias) và tối ưu hóa quá mức
Người thực hành sử dụng kết quả benchmark cần xác định xem một con số phản ánh tối ưu hóa hợp lệ hay chỉ là kỹ nghệ benchmark. Có một số cách giúp phân biệt, mỗi cách bắt lỗi một dạng thất bại cụ thể với một mức chi phí nhất định. Minh bạch là tuyến phòng thủ đầu tiên: một bài nộp ghi lại mọi tối ưu hóa đã áp dụng sẽ giúp người đọc tách biệt được cải tiến mang tính tổng quát khỏi tinh chỉnh chỉ phục vụ benchmark, đổi lại là nguy cơ phải công khai những kỹ thuật mà nhà cung cấp có thể muốn giữ bí mật. Báo cáo cả kết quả benchmark lẫn kết quả triển khai trong thực tế khép lại khoảng cách đó từ phía còn lại. Đánh giá đa dạng trên nhiều benchmark được cập nhật liên tục làm tăng chi phí của overfitting với bất kỳ tập kiểm tra đơn lẻ nào, vì một mô hình được “độ” để thắng một benchmark khó mà thắng tất cả; chi phí ở đây là công sức kỹ thuật để duy trì nhiều benchmark.
Việc tiêu chuẩn hóa và xác minh bởi bên thứ ba nâng tiêu chuẩn lên thêm một bậc. Các cuộc kiểm toán độc lập phát hiện những kết quả không thể tái lập ở các bối cảnh khác nhau, và bằng chứng cho cơ chế này xuất hiện ở hai phần sau trong phần xác thực “tham chiếu so với bài nộp” của MLPerf (section 1.10.5), nơi mọi bài nộp không đạt mục tiêu độ chính xác tham chiếu đều bị loại. Kiểm thử theo ứng dụng cụ thể bắt được những lỗi mà các benchmark có kiểm soát chặt chẽ không thể: một mô hình lái xe tự hành phải được thử trong các điều kiện thời tiết, ánh sáng và môi trường đô thị thực tế mà nó sẽ gặp, chứ không chỉ dựa vào một tập dữ liệu đã được chọn lọc. Kiểm thử trên nhiều phần cứng bắt nốt trường hợp cuối cùng — hiệu suất thực chất là “ăn may” nhờ trúng cấu hình phần cứng chứ không phải do chất lượng mô hình — bằng cách xác nhận rằng kết quả không phụ thuộc vào việc tương thích với một nền tảng duy nhất.
Sự phát triển của benchmark
Một thách thức thường trực trong hoạt động benchmarking là benchmark hiếm khi đứng yên. Khi các hệ thống AI phát triển, các benchmark dùng để đánh giá chúng cũng phải thay đổi theo. Một mục tiêu hiệu suất phân biệt tốt dưới một thế hệ mô hình, phần cứng và ứng dụng có thể mất ý nghĩa ở thế hệ khác. Dù benchmark rất cần thiết để theo dõi tiến bộ, chúng cũng có thể lỗi thời, dẫn đến tối ưu hóa quá mức cho các chỉ số cũ thay vì cải thiện hiệu suất trong thực tế.
Sự phát triển này thể hiện rõ trong lịch sử các benchmark AI. Chẳng hạn, các benchmark mô hình ban đầu tập trung nhiều vào phân loại hình ảnh và phát hiện đối tượng, vì đây là một số nhiệm vụ deep learning được nghiên cứu rộng rãi sớm nhất. Tuy nhiên, khi AI mở rộng sang xử lý ngôn ngữ tự nhiên, hệ thống khuyến nghị và AI tạo sinh, dễ thấy là những benchmark ban đầu không còn phản ánh đúng các thách thức quan trọng nhất trong lĩnh vực. Đáp lại, các benchmark mới đã xuất hiện để đo lường khả năng hiểu ngôn ngữ (Wang et al. 2018, 2019) và AI tạo sinh (Liang et al. 2022).
Wang, Alex, Yada Pruksachatkun, Nikita Nangia, Amanpreet Singh, Julian Michael, Felix Hill, Omer Levy, and Samuel R. Bowman. 2019. “SuperGLUE: A Stickier Benchmark for General-Purpose Language Understanding Systems.” arXiv Preprint arXiv:1905.00537.
Sự tiến hóa của các benchmark không chỉ dừng ở việc bổ sung tác vụ mới, mà còn mở rộng sang những chiều đo hiệu suất mới. Trong khi các benchmark AI truyền thống nhấn mạnh độ chính xác và thông lượng, các ứng dụng triển khai thực tế cần được đánh giá theo nhiều tiêu chí: tính công bằng, độ vững, khả năng mở rộng và hiệu quả năng lượng. Figure 10 cụ thể hóa các yêu cầu khác nhau này bằng cách ánh xạ các ứng dụng khoa học theo tốc độ dữ liệu và thời gian tính toán. Cụ thể, các cảm biến của Máy Va chạm Hadron Lớn (Large Hadron Collider) phải xử lý dữ liệu gần \(10^{14}\) byte mỗi giây với thời gian tính toán ở mức nanogiây, trong khi ứng dụng di động hoạt động ở khoảng \(10^{4}\) byte mỗi giây với cửa sổ tính toán dài hơn—chênh nhau khoảng mười bậc độ lớn về tốc độ dữ liệu và sáu đến bảy bậc về thời gian tính toán. Phạm vi yêu cầu rộng như vậy đòi hỏi các benchmark chuyên biệt. Ví dụ, các ứng dụng edge AI hưởng lợi từ các benchmark như MLPerf, vốn đánh giá hiệu suất dưới những ràng buộc tài nguyên, và các lĩnh vực ứng dụng khoa học cần các benchmark “Fast ML for Science” riêng (Duarte et al. 2022).

Duarte, Javier, Nhan Tran, Ben Hawks, Christian Herwig, Jules Muhizi, Shvetank Prakash, and Vijay Janapa Reddi. 2022. “FastML Science Benchmarks: Accelerating Real-Time Scientific Edge Machine Learning.” arXiv Preprint arXiv:2207.07958.
Nhu cầu để benchmark tiếp tục tiến hóa cũng đặt ra một bài toán: ổn định hay thích ứng. Một mặt, benchmark cần đủ ổn định trong một khoảng thời gian đủ dài để có thể so sánh có ý nghĩa theo thời gian. Nếu benchmark thay đổi quá thường xuyên, sẽ khó theo dõi tiến bộ dài hạn và đối chiếu kết quả mới với hiệu suất trong quá khứ. Mặt khác, nếu không cập nhật benchmark, chúng ta sẽ rơi vào trì trệ, khi mô hình được tối ưu cho những tác vụ đã lỗi thời thay vì thúc đẩy lĩnh vực tiến lên. Tìm đúng điểm cân bằng giữa “tuổi thọ” của benchmark và khả năng thích ứng vẫn là một thách thức thường trực đối với cộng đồng AI.
Việc benchmark không ngừng tiến hóa là thiết yếu để đo lường tiến độ một cách có ý nghĩa. Nếu không cập nhật, benchmark sẽ tách rời nhu cầu thực tế, khiến các nhà nghiên cứu tối ưu cho các ca kiểm thử nhân tạo thay vì những thách thức thực tiễn. Sự chuyển dịch từ các benchmark về độ chính xác thời ImageNet sang các đánh giá đa chiều bao gồm công bằng, độ vững và hiệu quả năng lượng minh họa rõ quá trình tiến hóa này trong thực tế.
Tổng hợp MLPerf và gian lận benchmark
Gian lận benchmark bắt đầu khi một trình biên dịch, runtime hoặc ngăn xếp phần cứng được tối ưu cho chính benchmark thay vì khối lượng công việc (workload) mà nó đại diện. MLPerf đối phó rủi ro đó bằng cách tổng hợp các nguyên tắc đã thảo luận xuyên suốt chương này vào một framework thống nhất và luôn tiến hóa: các triển khai tham chiếu và quy tắc đệ trình nghiêm ngặt đảm bảo khả năng tái lập; các bộ bài kiểm chuẩn theo từng bối cảnh triển khai (Inference, Mobile, Client, Tiny) phù hợp với framework đánh giá ba chiều; và các cập nhật tác vụ thường xuyên (bao gồm AI tạo sinh và tính toán hiệu quả năng lượng) ngăn benchmark trì trệ. Theo truyền thống Hennessy & Patterson về các hệ thống định lượng, benchmark là mục tiêu, không chỉ là phép đo thụ động. Động lực Goodhart được giới thiệu trong section 1.1 áp dụng hoàn toàn ở đây. Trong thế giới phần cứng AI nơi đặt cược rất lớn, điều đó biểu hiện thành gian lận benchmark: tối ưu phần cứng hoặc trình biên dịch đặc biệt cho những đặc điểm riêng của benchmark, thay vì cho hiệu suất trong môi trường thực.
Ba lối tắt giả định dưới đây minh họa những hành vi mang tính đặc thù benchmark mà các quy tắc chạy nghiêm ngặt phải cấm:
- Hạ độ chính xác: Trình biên dịch âm thầm hạ độ chính xác chỉ khi chạy benchmark, mà không công bố việc thay đổi ràng buộc số học.
- Loại bỏ toán tử đặc thù cho benchmark: Một triển khai lợi dụng tập đánh giá hoặc ngưỡng chất lượng để bỏ qua phần việc mà một triển khai chung phải làm.
- Phát hiện benchmark: Hệ thống nhận diện khối lượng công việc (workload) của benchmark và chọn một đường xử lý không áp dụng cho các đầu vào thông thường.
MLPerf hạn chế việc khai thác kẽ hở này thông qua các triển khai tham chiếu, mục tiêu chất lượng, quy tắc nộp bài và kiểm toán. Trong Hạng mục Đóng, tiền xử lý, hậu xử lý và mô hình phải tương đương với bản tham chiếu, trong khi người nộp bài có thể thay đổi framework, bố cục, kernel và cách biểu diễn số trong phạm vi các quy tắc đó. Các bài nộp Hạng mục Mở có thể thay thế hoặc huấn luyện lại mô hình, nhưng sẽ được gắn nhãn riêng. Độ chính xác là một hàng rào an toàn; các quy tắc khác cấm phát hiện benchmark và tối ưu hóa phụ thuộc vào đầu vào.
Tuy nhiên, ngay cả các benchmark hệ thống nghiêm ngặt nhất cũng chỉ xác thực một khía cạnh của sự sẵn sàng triển khai. Một hệ thống đạt thông lượng và hiệu suất kỷ lục trên MLPerf không cho biết liệu mô hình nó chạy có chính xác trên các đầu vào thực tế hay không, hoặc liệu dữ liệu dùng để huấn luyện mô hình đó có đại diện cho nhóm đối tượng mà nó sẽ phục vụ hay không. Phần cứng cung cấp TFLOP/s như đã hứa là cần thiết nhưng chưa đủ; mô hình chạy trên phần cứng đó phải duy trì chất lượng mà người dùng mong đợi, và dữ liệu đã định hình mô hình đó phải đại diện cho thế giới mà nó sẽ gặp phải. Để hoàn tất quá trình xác thực, chúng ta cần chuyển từ khía cạnh phần cứng sang các khía cạnh về mô hình và dữ liệu trong framework ba chiều.
Self-Check: Question
An image classification model achieves \(95\%\) accuracy on the CIFAR-10 benchmark test set, but when deployed on a mobile robot operating in a warehouse, its accuracy drops to \(70\%\). Which benchmarking limitation directly explains this performance collapse?
- The mobile robot CPU lacked 64-bit floating-point registers
- The CIFAR-10 evaluation used too few random seeds during training
- Incomplete benchmark coverage and distributional narrowness: the benchmark dataset contained clean, centered, low-resolution web images that failed to represent warehouse camera noise, lighting variations, and motion blur
- The benchmark harness executed the test set in the wrong order
Which set of governance and methodological rules does the MLPerf consortium implement to prevent submitters from ‘gaming’ the benchmark through benchmark-specific shortcuts?
- Allowing submitters to create proprietary synthetic test datasets that are kept secret from competitors
- Permitting compilers to silently lower numerical precision below IEEE standards without reporting the accuracy impact
- Evaluating systems solely on peak theoretical arithmetic operations per second without measuring execution time
- Enforcing strict Closed Division rules (requiring exact reference model equivalence, fixed preprocessing, and mandatory quality targets), prohibiting benchmark detection code branching, and requiring open peer-review log audits
What is the core insight of the ‘Hardware Lottery’ concept (coined by Sara Hooker in 2021) regarding the relationship between ML benchmarks and research progress?
- An algorithmic research idea often succeeds not because it is universally superior, but because existing hardware accelerators and software compilers happen to be highly optimized for its specific computational pattern (such as dense GEMM)
- Hardware performance is purely random and cannot be measured with scientific accuracy
- Researchers should purchase computer hardware using randomized government lotteries
- Deep neural networks perform identically across all hardware architectures regardless of compiler support
True or False: If a benchmark measurement is conducted with flawless statistical rigor—using 1,000 independent runs, narrow confidence intervals, and controlled thermal states—its results are guaranteed to predict real-world production system performance.
The structural phenomenon where a machine learning algorithm achieves prominence primarily because specialized hardware and software compilers were already co-optimized for its execution pattern is called the ____.
Explain the fundamental tension between benchmark stability and benchmark evolution, and describe how benchmark consortia manage this trade-off.
Đánh giá Mô hình và Dữ liệu
Một mô hình nén chạy trên phần cứng tăng tốc vẫn có thể thất bại nếu nó được huấn luyện trên dữ liệu có độ chệch (bias). Các benchmark hệ thống có thể xác nhận rằng phần cứng cung cấp thông lượng huấn luyện, độ trễ suy luận và hiệu quả công suất như đã hứa, nhưng chỉ xác thực phần cứng thôi thì không đủ để đảm bảo triển khai thành công. Pipeline tối ưu hóa từ Phần III cũng bao gồm nén mô hình (Nén mô hình) và lựa chọn dữ liệu (Lựa chọn dữ liệu), mỗi bước đều yêu cầu xác thực riêng. Hai khía cạnh còn lại của framework sẽ lấp khoảng trống này: các benchmark mô hình xác minh rằng việc nén đã bảo toàn độ chính xác và các thuộc tính quan trọng của mô hình, trong khi các benchmark dữ liệu xác minh rằng dữ liệu huấn luyện cho phép mô hình tổng quát hóa mạnh mẽ.
Benchmark mô hình
Các benchmark mô hình giúp kiểm chứng liệu các kỹ thuật nén từ Nén mô hình có giữ được những đặc tính quan trọng cho triển khai hay không. Điều này không chỉ dừng ở con số độ chính xác tổng thể. Một mô hình đã được cắt tỉa có thể giữ độ chính xác trên ImageNet nhưng mất tính vững trước các đầu vào đối kháng. Một mô hình lượng tử hóa có thể giữ hiệu năng trung bình nhưng xuống cấp ở những trường hợp edge hiếm gặp nhưng quan trọng. Một mô hình chưng cất có thể đạt độ chính xác ngang thầy nhưng mất đi khả năng hiệu chuẩn. Trước đây, các benchmark gần như chỉ tập trung vào độ chính xác; còn với nén mô hình, đánh giá đa chiều trở nên thiết yếu.
ImageNet nối việc benchmark mô hình với câu chuyện phần cứng trong figure 1: tỷ lệ lỗi giảm khi các kiến trúc tận dụng GPU trở nên khả thi. Figure 11 cho thấy tiến trình đó, từ 28.2 phần trăm vào năm 2010 xuống 3.57 phần trăm trong ImageNet Large Scale Visual Recognition Challenge (Russakovsky et al. 2015). Khi AlexNet35 xuất hiện, tỷ lệ lỗi giảm từ 25.8 phần trăm xuống 16.4 phần trăm. Các mô hình tiếp theo như ZFNet, VGGNet, GoogLeNet và ResNet36 tiếp tục xu hướng này, với ResNet đạt 3.57 phần trăm (He et al. 2016). Chuỗi kết quả đó thiết lập các đường cơ sở để so sánh khi đánh giá kỹ thuật nén: chẳng hạn, một ResNet đã được cắt tỉa phải cho thấy nó đánh đổi bao nhiêu độ chính xác để đổi lấy một mức tăng hiệu quả nhất định.
35 AlexNet: là một CNN tám lớp (60 triệu tham số) giúp giảm lỗi top-5 của ImageNet từ 25.8 phần trăm xuống 16.4 phần trăm vào năm 2012, được huấn luyện trên hai GPU GTX 580, mỗi GPU có 3 GB bộ nhớ (Krizhevsky et al. 2012). AlexNet đã tạo ra một khuôn mẫu benchmark vẫn định hình cách đánh giá thị giác đến nay: coi độ chính xác trên một tập dữ liệu cố định là chỉ số chính, còn cấu hình phần cứng là thông số phụ. Các kết quả ImageNet sau đó kế thừa cấu trúc so sánh dựa trên đường cơ sở này.
Krizhevsky, Alex, Ilya Sutskever, and Geoffrey E. Hinton. 2012. “ImageNet Classification with Deep Convolutional Neural Networks.” Advances in Neural Information Processing Systems (NeurIPS) 25.
36 ResNet (mạng residual): Được giới thiệu bởi He et al. (2016), các kết nối bỏ qua (skip connections) cho phép xây dựng các mạng sâu từ 152+ lớp và đạt tỉ lệ lỗi top-5 trên ImageNet là 3.57% (khi dùng ensemble), vượt mức lỗi ước tính của con người trong bối cảnh cuộc thi ImageNet (Russakovsky et al. 2015). ResNet-50 trở thành một khối lượng công việc (workload) tham chiếu phổ biến trong MLPerf Training vì kích thước vừa phải (với 25.6M tham số) và đặc điểm tính toán đã được hiểu rõ (8.2 GFLOP trên mỗi hình ảnh) khiến nó nhạy với các tối ưu hóa phần cứng lẫn phần mềm, mà không cần đến các hệ thống đa nút (Mattson et al. 2020).
He, Kaiming, Xiangyu Zhang, Shaoqing Ren, and Jian Sun. 2016. “Deep Residual Learning for Image Recognition.” 2016 IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 770–78. https://doi.org/10.1109/cvpr.2016.90.
Russakovsky, Olga, Jia Deng, Hao Su, Jonathan Krause, Sanjeev Satheesh, Sean Ma, Zhiheng Huang, et al. 2015. “ImageNet Large Scale Visual Recognition Challenge.” International Journal of Computer Vision 115 (3): 211–52. https://doi.org/10.1007/s11263-015-0816-y.
Mattson, Peter, Christine Cheng, Cody Coleman, Greg Diamos, Paulius Micikevicius, David Patterson, Hanlin Tang, et al. 2020. “MLPerf Training Benchmark.” Proceedings of Machine Learning and Systems (MLSys) 2: 336–49.
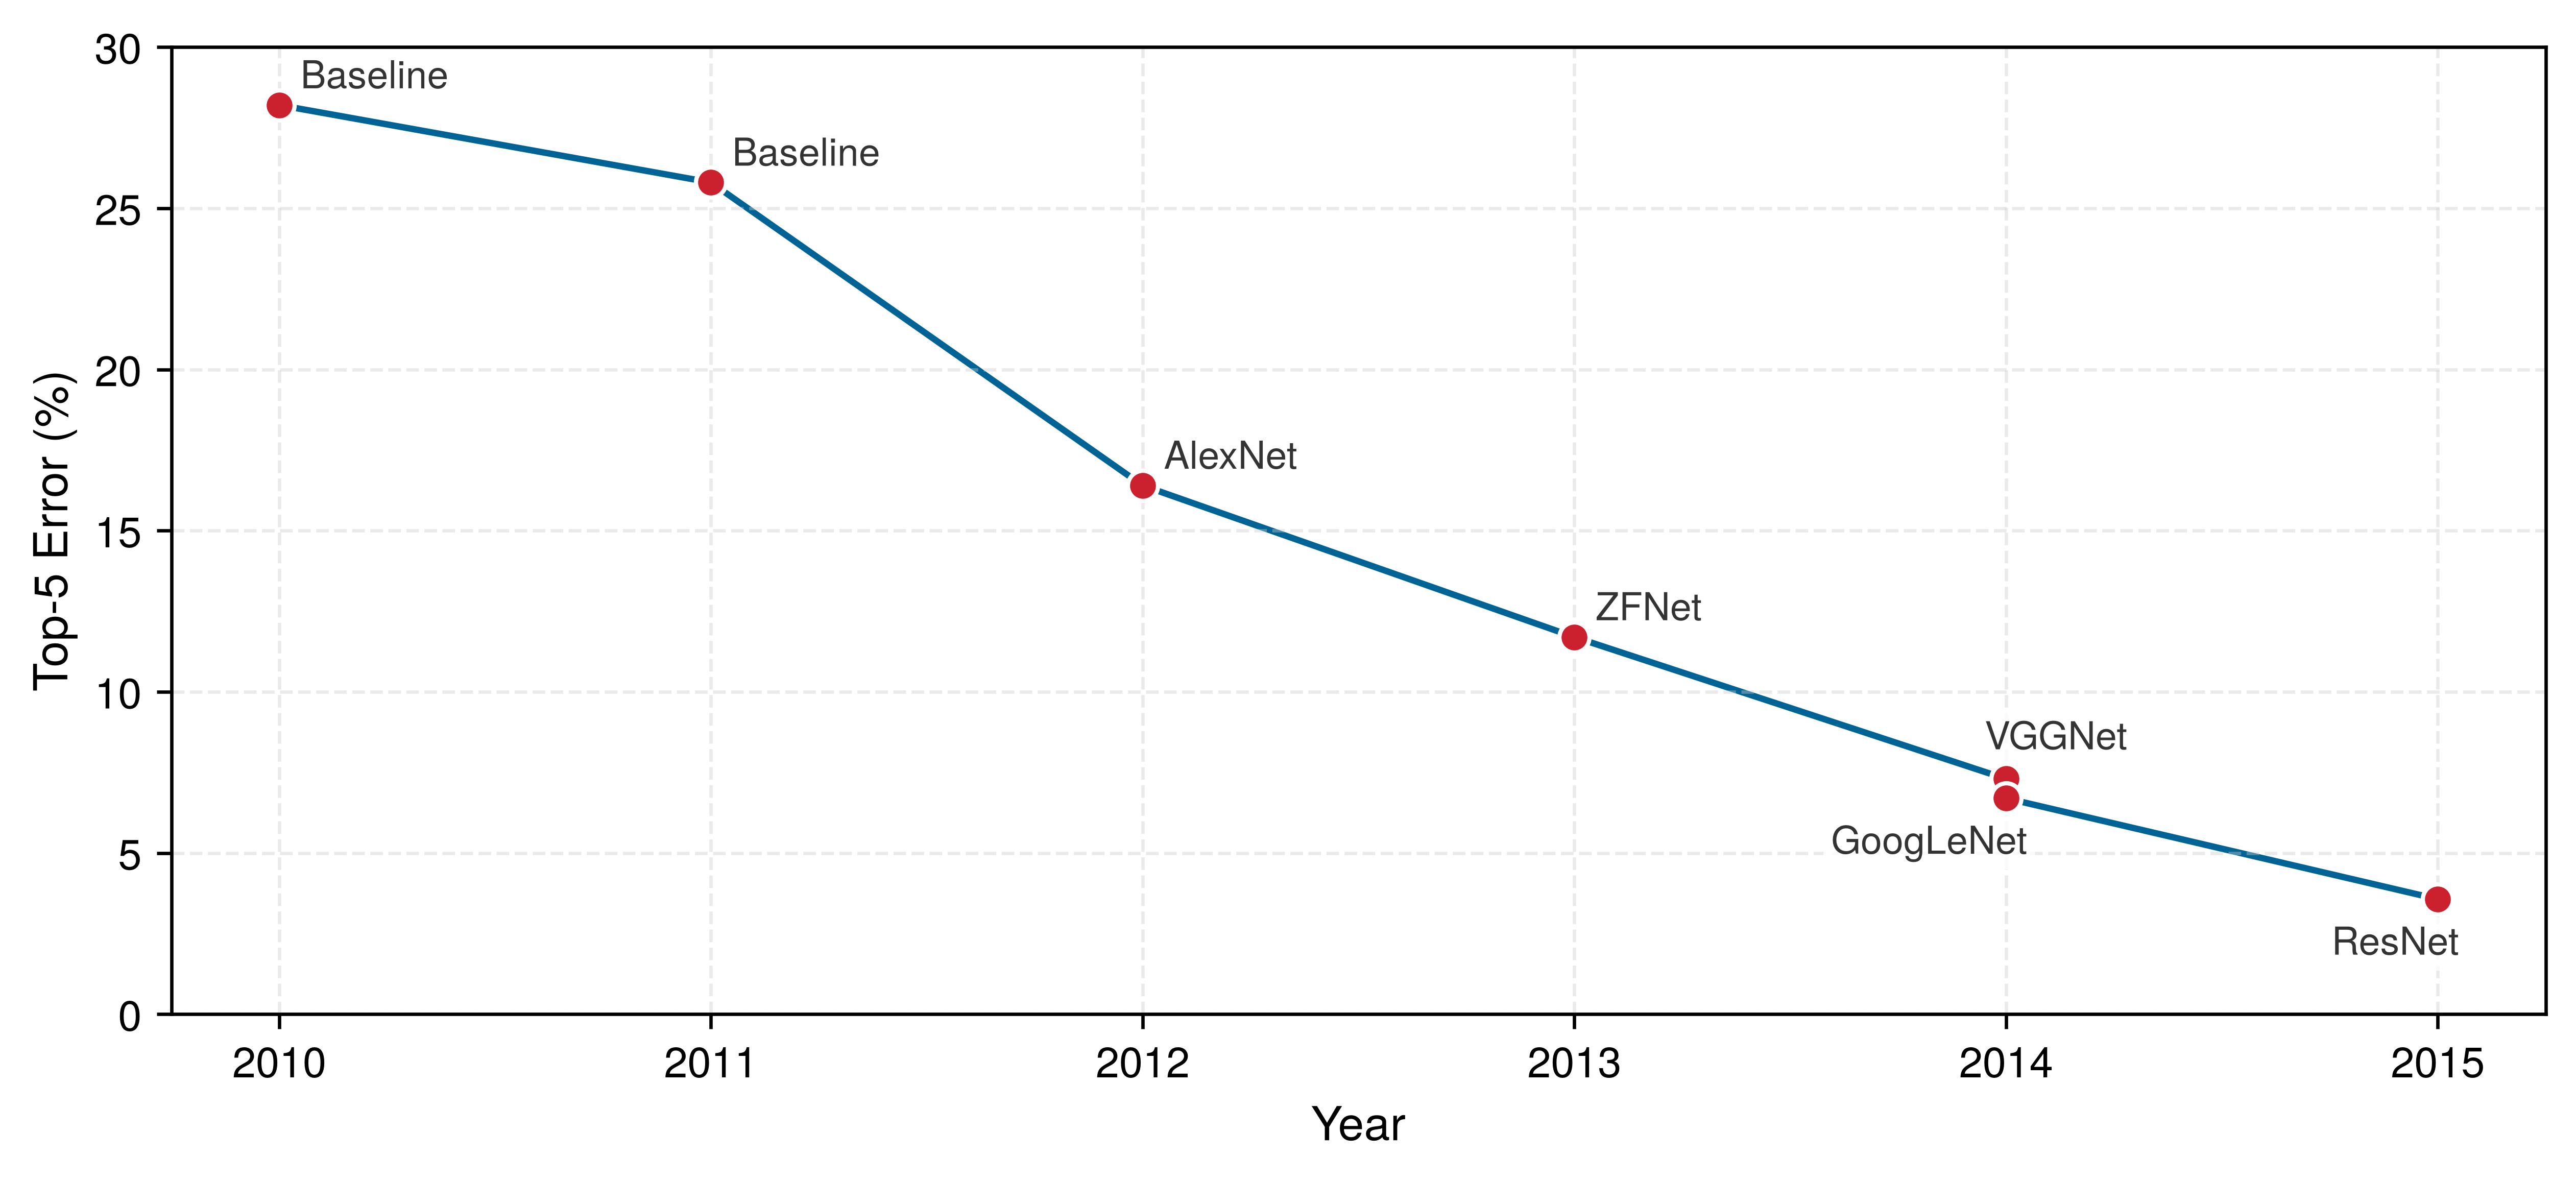
Các chỉ số độ chính xác và điểm mù của chúng
Các chỉ số mô hình phổ biến nhất (độ chính xác, độ đúng, độ phủ, F1) mỗi chỉ số cho thấy một khía cạnh khác nhau của hành vi mô hình, đồng thời che khuất những khía cạnh khác. Hiểu rõ các điểm mù này là điều thiết yếu để xác thực nén mô hình. Top-\(k\) accuracy đo xem nhãn đúng có nằm trong \(k\) dự đoán hàng đầu của mô hình hay không. Top-1 thì nghiêm ngặt; Top-5 thì dễ hơn. Khoảng cách giữa hai chỉ số cho thấy mức độ không chắc chắn của mô hình: một mô hình có Top-1 là 75% nhưng Top-5 là 95% “biết” đáp án nằm trong vài lựa chọn, nhưng khó đưa ra quyết định cuối cùng. Khi triển khai, mức chênh lệch chấp nhận được phụ thuộc vào việc các hệ thống phía sau có thể dùng dự đoán xếp hạng hay cần một câu trả lời duy nhất.
Precision và recall trở nên quan trọng khi các lớp bị mất cân bằng hoặc chi phí lỗi bất đối xứng (Sokolova and Lapalme 2009). Một mô hình phát hiện gian lận có độ chính xác 99% nhưng recall với các ca gian lận thực chỉ 10% (tức chỉ bắt được 1 trong 10 giao dịch gian lận) là một thất bại nghiêm trọng, dù độ chính xác nhìn thì cao. Precision (trong các dự đoán dương tính, có bao nhiêu là đúng?) và recall (trong các dương tính thực, tìm được bao nhiêu?) phơi bày những điểm yếu mà chỉ số độ chính xác che khuất.
Sokolova, Marina, and Guy Lapalme. 2009. “A Systematic Analysis of Performance Measures for Classification Tasks.” Information Processing &Amp; Management 45 (4): 427–37. https://doi.org/10.1016/j.ipm.2009.03.002.
Buolamwini, Joy, and Timnit Gebru. 2018. “Gender Shades: Intersectional Accuracy Disparities in Commercial Gender Classification.” Conference on Fairness, Accountability and Transparency, 77–91.
Đáng ngại nhất là các chỉ số tổng hợp có thể che giấu thất bại ở những nhóm con. Một mô hình đạt 95% độ chính xác tổng thể có thể chỉ đạt 60% trên một nhóm nhân khẩu học quan trọng. Dự án Gender Shades (Buolamwini and Gebru 2018) cho thấy các hệ thống phân loại giới tính thương mại cho phân tích khuôn mặt hoạt động kém hơn đáng kể với phụ nữ da sẫm so với nam giới da sáng, một chênh lệch mà benchmark tổng hợp không hề lộ ra. Đánh giá tách theo các nhóm liên quan đến triển khai là điều thiết yếu; Kỹ thuật có trách nhiệm xem xét có hệ thống việc đánh giá tính công bằng.
Hiệu chuẩn: Khi điểm tin cậy quan trọng
Trong nhiều bối cảnh triển khai, mức độ tự tin của mô hình quan trọng không kém điều mà nó dự đoán. Một mô hình được hiệu chuẩn tốt37 có điểm tin cậy ăn khớp với xác suất đúng thực tế: khi nó nói “tự tin 90%”, thì nên đúng 90% số lần.
37 Hiệu chuẩn: Từ tiếng Ả Rập qalib (khuôn đúc kim loại) qua tiếng Latin calibrare, ban đầu mô tả việc điều chỉnh dụng cụ đo theo các chuẩn đã biết. Trong ML, hiệu chuẩn đảm bảo các xác suất dự đoán khớp với tần suất quan sát; Guo et al. (2017) đã chính thức hóa mối quan tâm này cho các mạng nơ-ron hiện đại và chỉ ra rằng điều chỉnh nhiệt độ (temperature scaling) là một biện pháp hậu xử lý đơn giản nhưng hiệu quả. Từ nguyên này rất xác đáng: cũng như một dụng cụ chưa được hiệu chuẩn cho ra các phép đo rất đều nhưng sai, một mô hình chưa được hiệu chuẩn sẽ đưa ra các dự đoán rất tự tin nhưng không đáng tin cậy, khiến các hệ thống hạ nguồn đặt ngưỡng theo điểm tin cậy ra quyết định sai một cách có hệ thống.
Guo, Chuan, Geoff Pleiss, Yu Sun, and Kilian Q. Weinberger. 2017. “On Calibration of Modern Neural Networks.” International Conference on Machine Learning (ICML) 70: 1321–30.
Nén có thể làm lệch hiệu chuẩn, ngay cả khi độ chính xác vẫn được giữ nguyên. Đây là một điểm cần đặc biệt lưu ý khi đánh giá các kỹ thuật lượng tử hoá (xem Lượng tử hoá và Độ chính xác). Cụ thể, một mô hình đã lượng tử hoá có thể vẫn giữ được độ chính xác tổng thể, nhưng lại trở nên quá tự tin ở những ví dụ mà nó dự đoán sai. Điều này quan trọng vì các kỹ thuật hiệu chuẩn hậu kỳ như điều chỉnh nhiệt độ chỉ sửa được vấn đề nếu ta đo lường hiệu chuẩn một cách tường minh (Guo et al. 2017).
Các lỗi hiệu chuẩn sẽ gây ra vấn đề ở các bước phía sau. Một mô hình quá tự tin sẽ tự động hoá những trường hợp lẽ ra nên trì hoãn (dự đoán độ tin cậy 95% nhưng lại sai tới 30% số lần). Ngược lại, một mô hình thiếu tự tin sẽ đưa quá nhiều dự đoán đúng vào bước rà soát, thay vì tự động hoá những quyết định mà nó có thể xử lý (dự đoán độ tin cậy 70% nhưng lại đúng tới 95% số lần). Sai số hiệu chuẩn kỳ vọng (ECE) đo khoảng cách giữa độ tin cậy và độ chính xác trên các khoảng tin cậy; biểu đồ độ tin cậy (reliability diagrams) trực quan hoá mối quan hệ này.
Xác thực nén: Biên hiệu quả-chất lượng
Nén mô hình (Nén mô hình) là việc đánh đổi dung lượng mô hình để đạt hiệu quả cao hơn. Quá trình xác thực phải xác định liệu việc nén có đạt một mức đánh đổi chấp nhận được hay đã làm tổn hại các khả năng quan trọng.
Đánh giá theo biên Pareto38 giúp xác định liệu một mô hình đã được nén có đạt được sự đánh đổi tốt hay không. Vẽ đồ thị độ chính xác theo chỉ số hiệu quả mục tiêu (độ trễ, kích thước mô hình, năng lượng) sẽ cho thấy đường biên đánh đổi. Các mô hình nằm trên biên Pareto không thể cải thiện một chỉ số mà không làm giảm chỉ số khác; còn các mô hình nằm dưới biên này thì bị các lựa chọn tốt hơn lấn át.
38 Biên Pareto: Được đặt theo tên nhà kinh tế học Pareto (1896), biên này tập hợp mọi phương án mà muốn cải thiện một mục tiêu thì buộc phải làm giảm mục tiêu khác. Trong bối cảnh benchmark nén, hình dạng của biên cho ta thông tin chẩn đoán quan trọng: một vùng dốc cho thấy có thể tăng hiệu quả với chi phí thấp (tỉa (pruning) ở đây), còn một vùng phẳng cho thấy nén thêm sẽ làm mất độ chính xác một cách không tương xứng (dừng ở đây). Các điểm nằm dưới biên là các phương án kém hơn hoàn toàn và cho thấy dung lượng đang bị lãng phí.
Pareto, Vilfredo. 1896. Cours d’économie Politique. F. Rouge.

Một mô hình bị chi phối thua kém trên cả hai trục của biên Pareto.
Han, Song, Jeff Pool, John Tran, and William J. Dally. 2015. “Learning Both Weights and Connections for Efficient Neural Networks.” Advances in Neural Information Processing Systems 28 (NeurIPS 2015), 1135–43.
Gale, Trevor, Erich Elsen, and Sara Hooker. 2019. “The State of Sparsity in Deep Neural Networks.” arXiv Preprint arXiv:1902.09574.
Hinton, Geoffrey, Oriol Vinyals, and Jeff Dean. 2015. “Distilling the Knowledge in a Neural Network.” arXiv Preprint.
Các kỹ thuật nén khác nhau có những đánh đổi khác nhau giữa hiệu quả và chất lượng. Lượng tử hoá giảm độ chính xác biểu diễn nhưng thường vẫn giữ được độ chính xác tổng thể (Jacob et al. 2018). Tỉa (pruning) tạo độ thưa (sparsity) trong khi vẫn duy trì các mức hiệu suất kiểm tra khác nhau (Han et al. 2015; Gale et al. 2019). Chưng cất (distillation) chuyển giao kiến thức từ một mô hình giáo viên lớn hơn hoặc từ một tập hợp (ensemble) sang một mô hình nhỏ hơn (Hinton et al. 2015). Vì các kết quả tổng hợp này không khẳng định rằng hiệu chuẩn hoặc hành vi ở phần đuôi được giữ nguyên, nên quá trình xác thực phải đo lường trực tiếp các thuộc tính đó (Guo et al. 2017).
Hiệu chuẩn là một kiểu lỗi mà độ chính xác tổng thể có thể che giấu, và lỗi hiệu chuẩn kỳ vọng (ECE) là một phép chẩn đoán phổ biến. ECE so sánh độ tin cậy dự đoán với độ chính xác thực nghiệm, nhưng không có các ngưỡng “tốt”, “trung bình” hay “kém” áp dụng chung. Ước lượng này phụ thuộc vào cách chia nhóm, số nhóm, kích thước mẫu và phân phối dự đoán. Vì vậy, một benchmark phải cố định bộ ước lượng và so sánh nó với ngưỡng dung sai theo tác vụ và đường cơ sở không nén. Nén có thể giữ nguyên độ chính xác top-1 nhưng thay đổi đáng kể ECE, nên giao thức nén phải đo lường trực tiếp chỉ số này.
Tối ưu Pareto xác định các lựa chọn không bị chi phối; nó không khẳng định rằng lựa chọn nào cũng vượt ngưỡng chất lượng tối thiểu tuyệt đối của triển khai. Mức suy giảm chấp nhận được phụ thuộc vào ngữ cảnh triển khai. Giảm 2 phần trăm độ chính xác có thể chấp nhận được với hệ thống gợi ý (người dùng vẫn chấp nhận gợi ý chưa hoàn hảo) nhưng lại không chấp nhận được với chẩn đoán y tế (mỗi lỗi đều có hậu quả đáng kể). Hãy xác định ngưỡng độ chính xác trước khi nén, rồi xác thực so với các ngưỡng đó. “Cổng” chấp nhận phải bao phủ độ chính xác tổng thể, hiệu chuẩn và các lát cắt quan trọng đối với triển khai. Ngọn hải đăng MobileNetV2 giúp cụ thể hoá giao thức xác thực INT8 hoàn chỉnh.
Lighthouse 1.3: Nén MobileNetV2 INT8
Quay lại ngọn hải đăng 1.1, hãy xem một giao thức xác thực minh hoạ cho lượng tử hoá INT8, dựa trên kiến trúc MobileNetV2 (Sandler et al. 2018) và thực hành lượng tử hoá sau huấn luyện (Jacob et al. 2018). Các giá trị trong table 18 được giả định:
Đường cơ sở trước khi nén: MobileNetV2 đạt độ chính xác top-1 71.8 percent trên ImageNet với 3.5M tham số (14 MB FP32).
Trong table 18, có thể thấy độ chính xác tổng thể hầu như không đổi sau khi lượng tử hoá INT8 xuống 3.5 MB, nhưng lỗi hiệu chuẩn và độ chính xác ở các trường hợp biên lại kể câu chuyện khác. ECE của mô hình INT8 tăng từ 0.031 lên 0.089; việc mức tăng này có chấp nhận được hay không phụ thuộc vào ngưỡng dung sai theo giao thức ECE cố định của tác vụ.
| Chỉ số | FP32 | INT8 | Chấp nhận được không? |
|---|---|---|---|
| Độ chính xác Top-1 | 71.8% | 70.9% | ✓ (0.9 pp giảm; dưới ngưỡng 1 điểm phần trăm) |
| Độ chính xác Top-5 | 91% | 90.4% | ✓ |
| ECE hiệu chuẩn | 0.031 | 0.089 | Không (suy giảm) |
| Độ chính xác trường hợp biên | 68.2% | 61.4% | Không (giảm 6.8 pp) |
Định nghĩa trường hợp biên: Hình ảnh có độ che khuất > 50 percent, độ sáng < 100 lux, hoặc bị xoay lệch > 30° so với phân phối dữ liệu huấn luyện (xấp xỉ 5 percent trong các đầu vào thực tế).
Điều này cho thấy: Dưới các giả định này, độ chính xác trung bình vẫn ở mức chấp nhận được (giảm 0.9 percentage-point), nhưng hiệu chuẩn suy giảm và độ chính xác ở các trường hợp biên giảm 6.8 percentage points. Nếu quá trình triển khai dùng ngưỡng độ tin cậy (ví dụ: “chỉ hành động nếu độ tin cậy > 85 percent”) hoặc thường xuyên gặp nhiều trường hợp biên (ánh sáng bất thường, che khuất một phần), MobileNetV2 INT8 vẫn có thể thất bại dù đã vượt qua các benchmark tổng thể.
Cách khắc phục: Áp dụng temperature scaling sau đó để cải thiện hiệu chuẩn (Guo et al. 2017). Temperature scaling học một giá trị vô hướng duy nhất \(T_{\text{cal}}\) để chia các logit trước khi đưa vào softmax: \(\text{softmax}(z_i/T_{\text{cal}})\). Đồng thời, bổ sung các ví dụ về trường hợp biên vào tập kiểm thử để liên tục theo dõi dạng lỗi này.
Jacob, Benoit, Skirmantas Kligys, Bo Chen, Menglong Zhu, Matthew Tang, Andrew Howard, Hartwig Adam, and Dmitry Kalenichenko. 2018. “Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2704–13. https://doi.org/10.1109/cvpr.2018.00286.
Sandler, Mark, Andrew Howard, Menglong Zhu, Andrey Zhmoginov, and Liang-Chieh Chen. 2018. “MobileNetV2: Inverted Residuals and Linear Bottlenecks.” 2018 IEEE/CVF Conference on Computer Vision and Pattern Recognition, 4510–20. https://doi.org/10.1109/cvpr.2018.00474.
Frankle, Jonathan, and Michael Carbin. 2019. “The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks.” International Conference on Learning Representations (ICLR).
Giả thuyết Vé số (Giả thuyết vé số (Lottery ticket hypothesis)) cung cấp dữ liệu benchmark cụ thể, minh họa rõ nén hiệu quả theo Pareto. Thông qua quá trình tỉa (pruning) lặp, Frankle and Carbin (2019) đã tìm thấy các mạng con thưa (“vé trúng thưởng”) trong các mạng kết nối đầy đủ và mạng tích chập; các mạng con này có thể đạt độ chính xác kiểm thử tương đương mạng gốc khi được huấn luyện độc lập.
Kết quả từ Giả thuyết Vé số cho thấy hình thái các đánh đổi khi nén: tỉa (pruning) mạnh có thể giữ nguyên độ chính xác cho một số kiến trúc và tác vụ, nhưng ngưỡng thưa thớt chấp nhận được là thực nghiệm, không mang tính phổ quát. Việc xác thực nén cần thiết lập các đường cong đánh đổi tương tự cho từng mô hình và tác vụ cụ thể, xác định vị trí mô hình trên biên Pareto và liệu nén thêm có mang lại hiệu quả đáng kể hay chỉ làm giảm chất lượng.
Các benchmark mô hình ngôn ngữ lớn
Framework đánh giá nén hoạt động tốt khi tác vụ có nhãn ổn định: độ chính xác phân loại, mAP phát hiện, IoU phân đoạn. Các mô hình ngôn ngữ lớn lại phá vỡ khuôn mẫu này. Một nhóm có thể chọn một mô hình vì nó đạt điểm cao trên benchmark công khai, rồi khi triển khai mới phát hiện mô hình chỉ nhận ra các thông tin dạng trắc nghiệm nhiều lựa chọn mà không thể tạo ra câu trả lời có căn cứ, phản hồi quá chậm cho sản phẩm tương tác, hoặc tự tin tạo ra văn bản không an toàn mà benchmark chưa từng kiểm tra. Vì vậy, benchmark LLM bắt đầu bằng việc nêu rõ lỗi triển khai mà điểm số được dùng để loại trừ.
Bảng phân loại các chỉ số LLM hữu ích trong table 19 là công cụ hỗ trợ ra quyết định, không phải bảng xếp hạng. Các hàng trong bảng dùng Massive Multitask Language Understanding (MMLU),39 HELM (Holistic Evaluation of Language Models),40 và perplexity41 làm ví dụ về các điểm số trả lời những câu hỏi triển khai khác nhau:
39 MMLU (massive multitask language understanding): Được giới thiệu bởi Hendrycks et al. (2020) với 15.908 câu hỏi trắc nghiệm thuộc năm mươi bảy chủ đề. Hạn chế của benchmark MMLU nằm ở định dạng: nhận diện theo dạng trắc nghiệm nhiều lựa chọn không phải là cùng một tác vụ với tạo sinh mở. Vì vậy, điểm MMLU không nên được xem là bằng chứng trực tiếp rằng một mô hình có thể tạo ra câu trả lời tự do, có căn cứ trong môi trường sản xuất.
Hendrycks, Dan, Collin Burns, Steven Basart, Andy Zou, Mantas Mazeika, Dawn Song, and Jacob Steinhardt. 2020. “Measuring Massive Multitask Language Understanding.” arXiv Preprint.
40 HELM (holistic evaluation of language models): framework đánh giá do Stanford công bố năm 2022 kiểm thử nhiều mô hình trên bảy chiều (độ chính xác, hiệu chuẩn, độ mạnh mẽ, tính công bằng, độ chệch (bias), độc tính, hiệu quả) (Liang et al. 2022). Đóng góp của HELM nằm ở phương pháp: bằng cách đánh giá các mô hình có điểm độ chính xác tương tự nhưng khác ở hiệu chuẩn hoặc độc tính, HELM cho thấy các bảng xếp hạng chỉ dùng một chỉ số thường che giấu những lỗi quan trọng đối với việc triển khai sản phẩm.
Liang, Percy, Rishi Bommasani, Tony Lee, Dimitris Tsipras, Dilara Soylu, Michihiro Yasunaga, Yian Zhang, et al. 2022. “Holistic Evaluation of Language Models.” arXiv Preprint arXiv:2211.09110.
41 Perplexity: Từ tiếng Latin perplexus (rối rắm); trong lý thuyết thông tin là \(2^{H(p)}\) với \(H\) là entropy. Perplexity bằng 10 nghĩa là trung bình mô hình “bối rối theo 10 hướng”. Hàm ý đối với hệ thống mang tính diễn giải; đây không phải phép tính bộ nhớ trực tiếp: perplexity đo lường dự đoán token tiếp theo trên một corpus, trong khi áp lực bộ nhớ khi phục vụ (serving) phụ thuộc vào độ dài ngữ cảnh, kích thước batch, hình dạng mô hình và trạng thái giải mã; quản lý KV-cache là một vấn đề phục vụ (serving) riêng (Kwon et al. 2023).
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 2023. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th Symposium on Operating Systems Principles, 611–26. https://doi.org/10.1145/3600006.3613165.
| Lỗi triển khai cần loại trừ | Nhóm chỉ số hoặc benchmark | Điểm số tiết lộ điều gì | Điểm số không thể chứng minh điều gì |
|---|---|---|---|
| Mô hình nhận diện sự kiện kém | MMLU (Massive Multitask Language Understanding) | Kiến thức thực tế và chuyên ngành rộng khắp năm mươi bảy môn học, với điểm số có thể diễn giải dựa trên hiệu suất trắc nghiệm ngẫu nhiên | Liệu mô hình có thể tạo ra các câu trả lời mở, có căn cứ thay vì chọn trong số các lựa chọn trắc nghiệm |
| Mô hình có khả năng nhưng không an toàn | HELM (Holistic Evaluation of Language Models) | Độ chính xác cùng với hiệu chuẩn, mạnh mẽ, công bằng, độ chệch (bias), độc hại và hiệu quả | Liệu một điểm số tổng hợp có thể nắm bắt rủi ro triển khai; một mô hình có thể mạnh về độ chính xác nhưng yếu về hiệu chuẩn, an toàn, chi phí hoặc độ ổn định của prompt |
| Mô hình dự đoán corpus của nó tốt | Perplexity | Dự đoán token tiếp theo trên cùng một corpus; độ phức tạp (perplexity) là 10 có nghĩa là mô hình “bị nhầm lẫn 10 cách” trung bình | Liệu các câu trả lời được tạo ra có hữu ích, an toàn hoặc có căn cứ bên ngoài corpus đó hay không |
| Mô hình có cảm giác chậm khi sử dụng | Độ trễ token đầu tiên, độ trễ giữa các token và thông lượng token | Độ trễ xử lý prompt trước khi quá trình tạo bắt đầu và tốc độ giải mã sau khi quá trình tạo bắt đầu | Liệu một con số thông lượng duy nhất có che giấu khả năng phản hồi tương tác kém, đặc biệt khi batching cải thiện thông lượng nhưng làm trầm trọng thêm độ trễ token đầu tiên |
Hàng về khả năng phản hồi cần một mốc thời gian cụ thể, vì các benchmark LLM thường chỉ báo cáo một con số thông lượng duy nhất, trong khi người dùng trải nghiệm quá trình tạo sinh theo nhiều giai đoạn. Một mô hình có thể trông hiệu quả nếu tính theo số token mỗi giây nhưng vẫn gây cảm giác chậm nếu token đầu tiên đến muộn; hoặc nó có thể cải thiện độ trễ token đầu tiên nhưng lại tạo phần còn lại của câu trả lời quá chậm, không phù hợp với quy trình tương tác. Phép tính thông lượng token chuyển các chỉ số tốc độ token đó thành thời gian thực mà người dùng nhìn thấy.
Thông lượng token quy đổi sự đánh đổi đó ra thời gian thực (wall-clock time). Với một phản hồi khoảng 750 tokens, thông lượng 25 tokens/s tương ứng 30 seconds thời gian tạo, còn thông lượng 100 tokens/s tương ứng 7.5 seconds. Vì vậy, thời gian đến token đầu tiên và độ trễ giữa các token cần được báo cáo cùng nhau: một chỉ số phản ánh khả năng phản hồi ở đầu cuộc trao đổi, còn chỉ số kia cho biết tốc độ phần còn lại của câu trả lời đến nơi.
Thất bại cuối cùng là khi điểm số đo khả năng nhớ thay vì năng lực. Benchmark contamination là một rủi ro đặc thù của các LLM, vì các mô hình được huấn luyện trên kho dữ liệu quy mô web có thể đã gặp câu hỏi benchmark trong tiền huấn luyện, làm tăng điểm do ghi nhớ chứ không phải kỹ năng (Xu et al. 2024). Việc phát hiện rò rỉ giúp các nhà thiết kế benchmark có thể kiểm tra rủi ro này thay vì chỉ nghi ngờ. Giữ lại theo thời gian dùng nội dung xuất bản sau thời điểm cắt huấn luyện, benchmark động tạo ra các trường hợp mới liên tục, và bài kiểm tra nhiễm bẩn hỏi liệu mô hình có nhớ đúng câu chữ của benchmark hay không. Các kỹ thuật này giữ cho benchmark bám sát bài toán triển khai thay vì thưởng cho việc đã từng tiếp xúc với tập kiểm tra.
Xu, Ruijie, Zengzhi Wang, Run-Ze Fan, and Pengfei Liu. 2024. “Benchmarking Benchmark Leakage in Large Language Models.” arXiv Preprint arXiv:2404.18824.
Benchmark dữ liệu
Các benchmark mô hình xác nhận liệu quá trình nén có bảo toàn chất lượng mô hình hay không. Tuy nhiên, chất lượng mô hình phụ thuộc hoàn toàn vào dữ liệu dùng để huấn luyện và đánh giá, và chính sự phụ thuộc này tạo ra dạng thất bại ngấm ngầm nhất trong triển khai ML. Một mô hình được bảo toàn hoàn hảo nhưng huấn luyện trên dữ liệu có độ chệch (bias) hoặc không đại diện vẫn sẽ thất bại khi đưa vào sản xuất. Các benchmark dữ liệu đánh giá liệu các chiến lược hiệu quả từ Lựa chọn dữ liệu (học chủ động, thiết kế chương trình học, tăng cường dữ liệu và tạo dữ liệu tổng hợp) có tạo ra các tập huấn luyện cho phép triển khai đáng tin cậy hay không. Đây thường là bước xác nhận cuối cùng mới bộc lộ lỗi và cũng là bước khó chẩn đoán nhất: một mô hình đạt độ chính xác xuất sắc trên dữ liệu kiểm tra giữ lại có thể sụp đổ khi gặp các đầu vào thực tế ở môi trường sản xuất mà dữ liệu huấn luyện chưa từng đại diện đầy đủ.
Sự phát triển AI hiện nay cho thấy chất lượng dữ liệu có thể đặt ra một giới hạn hiệu suất mà chỉ thay đổi kiến trúc thôi thì không vượt qua được. Nhận thức này đã đưa benchmark dữ liệu từ một điều bị xem nhẹ trở thành một lĩnh vực then chốt.
Vì vậy, một data benchmark phải bắt đầu từ một protocol trước khi nói đến điểm số. Hãy xác định rõ phạm vi triển khai mà mô hình phải phục vụ, dành riêng một tập dữ liệu kiểm định (holdout) có khả năng chống rò rỉ, kiểm tra kỹ việc tách biệt các bản sao và bản gần giống nhau giữa các phân vùng, đặt mức bao phủ tối thiểu cho các lớp và nhóm con hiếm, kiểm tra chất lượng nhãn, và thiết lập các ngưỡng trôi dạt (drift thresholds) để xác định khi nào benchmark không còn đại diện cho môi trường sản xuất. Chỉ khi những điều kiện này được nêu rõ, các chỉ số tổng hợp mới có thể diễn giải.
Các chỉ số bao phủ
Câu hỏi đầu tiên mà data benchmarking cần trả lời là dữ liệu huấn luyện có đại diện cho đầu vào mà mô hình sẽ gặp khi triển khai hay không. Một mô hình không thể học được những mẫu mà nó chưa từng thấy, và những cách mà dữ liệu huấn luyện không đại diện đúng thực tế triển khai thường rất tinh vi.
Hãy xét bài toán cân bằng lớp: giả sử một tập dữ liệu phát hiện gian lận có 99% giao dịch hợp lệ và 1% giao dịch gian lận. Mô hình huấn luyện trên tập này có thể đạt 99% độ chính xác chỉ bằng cách gán nhãn tất cả giao dịch là hợp lệ. Mô hình đó vô dụng, nhưng chỉ số độ chính xác lại trông xuất sắc. Mất cân bằng nghiêm trọng thường cần khắc phục bằng oversampling, gán trọng số cho các lớp (class weighting) hoặc điều chỉnh ngưỡng (threshold adjustment). Tinh vi hơn là mất cân bằng nhóm con ngay trong các lớp: tổng thể có thể cân bằng giữa ví dụ dương và âm, nhưng ví dụ âm lại chủ yếu đến từ một nhóm nhân khẩu học cụ thể, tạo ra chênh lệch mà các chỉ số cân bằng lớp tổng hợp không nhìn thấy.
Độ bao phủ đặc trưng còn khó hơn, vì cần kiến thức miền để biết những biến thể nào thật sự quan trọng. Ví dụ, một mô hình thị giác máy tính chỉ được huấn luyện trên ảnh ban ngày sẽ thất bại với ảnh chụp ban đêm; một mô hình ngôn ngữ chỉ học trên văn bản trang trọng sẽ lúng túng với ngôn ngữ đời thường. Khác với cân bằng lớp, thứ có thể tính chỉ từ nhãn, độ bao phủ đặc trưng đòi hỏi hiểu rõ bối cảnh triển khai. Những yếu tố như điều kiện ánh sáng mà camera sẽ gặp, các phương ngữ người dùng sẽ nói, và các edge case xuất hiện trong môi trường sản xuất nhưng không có trong tập kiểm thử đều nằm ngoài phạm vi mà chỉ nhãn có thể dự đoán. Các câu hỏi này không có lời giải mang tính thuật toán; chúng cần sự phối hợp giữa kỹ sư ML và các chuyên gia hiểu sâu về môi trường triển khai.
Với các ứng dụng ảnh hưởng đến con người, đại diện nhân khẩu học trở thành một chiều của độ bao phủ, kèm theo hệ quả về đạo đức. Dữ liệu huấn luyện phải đại diện cho quần thể khi triển khai trên các khía cạnh liên quan như độ tuổi, giới tính, sắc tộc, khu vực địa lý, ngôn ngữ. Một hệ thống nhận dạng khuôn mặt được huấn luyện chủ yếu trên một nhóm nhân khẩu học có thể hoạt động kém trên các nhóm khác, ngay cả khi các chỉ số độ chính xác tổng thể trông vẫn chấp nhận được. Thách thức là metadata nhân khẩu học thường thiếu hoặc không đáng tin, khiến các khoảng trống đại diện khó phát hiện và đo lường.
Các chỉ số chất lượng
Ngay cả khi dữ liệu huấn luyện bao phủ đúng các đầu vào cần thiết, nhãn có thể vẫn không đáng tin cậy. Nhiều nghiên cứu cho thấy tỷ lệ lỗi nhãn 3–6 phần trăm trong các tập dữ liệu lớn, như ImageNet (Northcutt et al. 2021). Những lỗi này không chỉ là nhiễu; chúng trở thành “sự thật” mà mô hình học theo. Chẳng hạn, một mô hình được huấn luyện trên dữ liệu mà thỉnh thoảng sói bị gán nhãn là chó sẽ học quy tắc sai rằng một số con sói là chó. Benchmark sẽ báo đây là hành vi đúng, vì mô hình khớp với các nhãn (dù không chính xác).
Northcutt, Curtis G., Anish Athalye, and Jonas Mueller. 2021. “Pervasive Label Errors in Test Sets Destabilize Machine Learning Benchmarks.” arXiv Preprint arXiv:2103.14749 34: 19075–90. https://doi.org/10.48550/arxiv.2103.14749.
Với các tập dữ liệu nhỏ, ta có thể ước tính độ chính xác của nhãn bằng cách đánh giá thủ công trên một mẫu ngẫu nhiên. Với các tập dữ liệu lớn, các kỹ thuật confident learning xác định những ví dụ có khả năng bị gán nhãn sai bằng cách tìm các trường hợp mà dự đoán của mô hình liên tục không trùng với nhãn. Trực giác ở đây là: khi mô hình tự tin dự đoán một nhãn khác với nhãn đúng (ground truth), thì hoặc mô hình đã học sai, hoặc nhãn bị sai. Tuy nhiên, phát hiện chỉ là bước đầu; việc sửa cần có sự xem xét của con người, và việc mở rộng quy mô xem xét này lên đến hàng triệu ví dụ cũng mang những thách thức riêng.
Độ đồng thuận giữa những người gán nhãn cung cấp một góc nhìn khác về chất lượng nhãn bằng cách đo mức độ nhất quán giữa các người gán nhãn. Kappa của Cohen hoặc kappa của Fleiss định lượng mức độ đồng thuận vượt quá những gì có thể xảy ra do ngẫu nhiên (Cohen 1960; Fleiss 1971). Khi độ đồng thuận thấp hơn các ngưỡng thông thường đối với các tác vụ có ground truth rõ ràng, tức là có vấn đề: hoặc hướng dẫn gán nhãn mơ hồ, hoặc bản thân tác vụ mang tính chủ quan, hoặc chất lượng người gán nhãn khác biệt đáng kể. Các dải kappa định tính của Landis và Koch thường được trích dẫn như một hướng dẫn diễn giải mang tính tham khảo, dù chúng không thể thay thế cho đánh giá theo miền chuyên môn (Landis and Koch 1977).
Cohen, Jacob. 1960. “A Coefficient of Agreement for Nominal Scales.” Educational and Psychological Measurement 20 (1): 37–46. https://doi.org/10.1177/001316446002000104.
Fleiss, Joseph L. 1971. “Measuring Nominal Scale Agreement Among Many Raters.” Psychological Bulletin 76 (5): 378–82. https://doi.org/10.1037/h0031619.
Landis, J. Richard, and Gary G. Koch. 1977. “The Measurement of Observer Agreement for Categorical Data.” Biometrics 33 (1): 159–74. https://doi.org/10.2307/2529310.
Phân biệt giữa lỗi ngẫu nhiên và lỗi hệ thống là cực kỳ quan trọng vì chúng gây ra những tác động khác nhau về sau. Nhiễu nhãn không có cấu trúc (random label noise) có thể ít gây hại hơn một độ chệch (bias) nhất quán, vì các lỗi của nó không cùng củng cố một quy tắc sai, dù các mô hình hiện đại vẫn có thể ghi nhớ những nhiễu này. Ngược lại, lỗi hệ thống (chẳng hạn liên tục gán nhãn sai cho một lớp con cụ thể) lại dạy cho mô hình một liên hệ mạch lạc nhưng sai. Ví dụ, một tập dữ liệu mà tất cả những con sói chụp trong tuyết đều được gán nhãn là “chó” có thể khiến mô hình gọi sói trong tuyết là chó, và việc thêm nhiều dữ liệu hơn với cùng quy tắc gán nhãn chỉ càng củng cố lỗi đó.
Căn chỉnh phân phối
Danh mục cuối cùng của benchmark dữ liệu đặt câu hỏi liệu các mô hình có tổng quát hóa được từ điều kiện huấn luyện sang thực tế triển khai hay không. Chính câu hỏi về sự căn chỉnh từ huấn luyện đến triển khai là nơi khoảng cách giữa hiệu suất benchmark và hiệu suất khi triển khai thực tế thường xuất hiện rõ nhất.
Giả định chuẩn của đánh giá trên tập giữ lại cho rằng dữ liệu kiểm thử đến từ cùng một phân phối với dữ liệu huấn luyện — nhưng trong thực tế điều này thường không đúng. Các tập kiểm thử được tạo ra nhiều năm sau thời điểm huấn luyện có thể phản ánh sự trôi phân phối khi thế giới thay đổi. Các tập kiểm thử từ những vùng địa lý khác nhau có thể phản ánh sự dịch chuyển về dân số. Một mô hình đạt độ chính xác cao trên tập giữ lại vẫn có thể tụt mạnh khi triển khai ở một khu vực hoặc giai đoạn thời gian mà tập kiểm thử không đại diện. Khi giả định i.i.d. (độc lập và phân phối đồng nhất) không còn giữ, kết quả trên tập giữ lại không còn phản ánh đúng hiệu quả khi triển khai và thường lạc quan hơn nếu phân phối lúc triển khai khó hơn.
Thước đo thực sự là mức độ khớp giữa huấn luyện và môi trường sản xuất; và điều này khó đo hơn nhiều vì dữ liệu sản xuất khác dữ liệu huấn luyện theo những cách mà các tập kiểm thử giữ lại thường không nắm bắt được. Ảnh trong sản xuất đến từ các camera khác nhau với các đặc tính khác nhau. Người dùng trong sản xuất đến từ các nhóm dân số khác nhau với các hành vi khác nhau. Đầu vào trong sản xuất bao gồm cả các trường hợp edge mà các tập kiểm thử được chọn lọc thường loại trừ có hệ thống. Benchmark WILDS42 (Koh et al. 2021) được thiết kế riêng để đánh giá các mô hình dưới những dịch chuyển phân phối thực tế: hệ thống bệnh viện với các quần thể bệnh nhân khác nhau, camera quan sát động vật hoang dã ở các địa điểm khác nhau, ảnh vệ tinh ở các giai đoạn thời gian khác nhau. Trên Camelyon17-WILDS, baseline ERM được báo cáo đạt độ chính xác trung bình 93,2 phần trăm trong phân phối và 70,3 phần trăm ngoài phân phối.
42 WILDS: Benchmark năm 2021 của Stanford gồm mười tập dữ liệu với các dịch chuyển phân phối trong thế giới thực: thay đổi hệ thống bệnh viện (Camelyon17), dịch chuyển vị trí camera quan sát động vật hoang dã (iWildCam), và trôi theo thời gian của ảnh vệ tinh (PovertyMap). Với baseline ERM của Camelyon17-WILDS được báo cáo, độ chính xác trung bình giảm từ 93,2 phần trăm trong phân phối xuống 70,3 phần trăm ngoài phân phối, cho thấy đánh giá giữ lại tiêu chuẩn có thể đánh giá quá cao hiệu suất khi giả định i.i.d. không còn giữ.
Koh, Pang Wei, Shiori Sagawa, Henrik Marklund, Sang Michael Xie, Marvin Zhang, Akshay Balsubramani, Weihua Hu, et al. 2021. “WILDS: A Benchmark of in-the-Wild Distribution Shifts.” In Proceedings of the 38th International Conference on Machine Learning, ICML 2021, 18-24 July 2021, Virtual Event, edited by Marina Meila and Tong Zhang, vol. 139. Proceedings of Machine Learning Research. PMLR.
Berger, Vance W., and YanYan Zhou. 2014. “Kolmogorov–Smirnov Test: Overview.” In Wiley StatsRef: Statistics Reference Online. Wiley. https://doi.org/10.1002/9781118445112.stat06558.
Gretton, Arthur, Karsten M. Borgwardt, Malte J. Rasch, Bernhard Schölkopf, and Alexander Smola. 2012. “A Kernel Two-Sample Test.” Journal of Machine Learning Research 13 (25): 723–73.
Trước những thách thức này, các phương pháp phát hiện dịch chuyển trở nên thiết yếu cho việc giám sát trong môi trường sản xuất. Các kiểm định thống kê như kiểm định Kolmogorov-Smirnov (Berger and Zhou 2014) hoặc các kiểm định hai mẫu dựa trên kernel như độ lệch trung bình tối đa (Maximum Mean Discrepancy) (Gretton et al. 2012) có thể phát hiện dịch chuyển hiệp biến—tức là khi phân phối đầu vào thay đổi dù quan hệ giữa đầu vào và đầu ra vẫn ổn định. Việc theo dõi phân phối độ tin cậy của mô hình cũng giúp phát hiện khi mô hình gặp những đầu vào không giống với dữ liệu huấn luyện. Mục tiêu là phát hiện sớm: nhận diện dịch chuyển phân phối trước khi nó gây suy giảm hiệu suất nghiêm trọng, để có thể kịp can thiệp bằng cách cập nhật mô hình, thu thập thêm dữ liệu hoặc áp dụng các ràng buộc khi triển khai.
Những thách thức trong việc căn chỉnh phân phối làm nổi bật một căng thẳng dai dẳng trong phát triển ML giữa hai hướng tiếp cận: giữ dữ liệu cố định và lặp trên mô hình, hoặc giữ mô hình cố định và lặp trên dữ liệu. Figure 12 đặt hai hướng tiếp cận này cạnh nhau, cho thấy chính xác vòng lặp phản hồi khác nhau ở đâu. Trong sơ đồ lấy mô hình làm trung tâm, chu kỳ lặp nhắm vào kiến trúc trong khi dữ liệu được giữ nguyên; còn trong sơ đồ lấy dữ liệu làm trung tâm, kiến trúc được giữ nguyên trong khi chu kỳ nhắm vào chất lượng dữ liệu. Hai cách tiếp cận này bổ sung cho nhau, chứ không phải một thang xếp hạng phổ quát về nơi cải tiến sẽ đến.

AI lấy dữ liệu làm trung tâm phản ánh một chuyển dịch quan trọng trong cách nhìn, thách thức giả định “càng nhiều dữ liệu càng tốt”: thành phần của tập dữ liệu quan trọng không kém quy mô. Các sáng kiến như DataPerf (Mazumder et al. 2023) và DataComp43 đã ra đời để đánh giá có hệ thống cách xây dựng tập dữ liệu ảnh hưởng đến hiệu suất mô hình. Trong thiết lập kiểm soát tài nguyên tính toán của DataComp, một baseline được tạo bằng cách giữ lại 30% ứng viên hàng đầu thông qua lọc dựa trên CLIP đã vượt baseline dùng tập ứng viên không lọc trên đánh giá downstream tổng hợp (Gadre et al. 2023). Kết quả này khẳng định giá trị của việc tuyển chọn dữ liệu theo giao thức đó, chứ không phải một tỷ lệ tối ưu áp dụng chung.
Mazumder, Mark, Colby Banbury, Xiaozhe Yao, Bojan Karlaš, et al. 2023. “DataPerf: Benchmarks for Data-Centric AI Development.” Advances in Neural Information Processing Systems 36.
43 DataComp: Được giới thiệu vào năm 2023, DataComp cố định họ mô hình, mã huấn luyện và ngân sách tính toán, trong khi người tham gia thay đổi cách xây dựng tập dữ liệu. Hạng mục lọc của nó tách riêng ảnh hưởng của việc chọn mẫu từ một tập ứng viên chung, giúp so sánh các chiến lược tuyển chọn dữ liệu một cách công bằng mà không phải tính mọi cải thiện vào việc tăng thêm tài nguyên huấn luyện.
Gadre, Samir Yitzhak, Gabriel Ilharco, Alex Fang, Jonathan Hayase, Georgios Smyrnis, Thao Nguyen, Ryan Marten, et al. 2023. “DataComp: In Search of the Next Generation of Multimodal Datasets.” Advances in Neural Information Processing Systems (NeurIPS) 36: 27092–112. https://doi.org/10.52202/075280-1179.
Một thách thức dai dẳng trong benchmark dữ liệu xuất phát từ hiện tượng bão hòa tập dữ liệu. Khi các mô hình đạt độ chính xác gần như hoàn hảo trên các benchmark như ImageNet, người thực hành cần phân biệt liệu các cải thiện hiệu suất phản ánh những tiến bộ thực sự về khả năng hay chỉ là tối ưu hóa vào các tập kiểm thử hiện có. Như dòng thời gian trong figure 13 minh họa, các benchmark AI được theo dõi rộng rãi đã nhiều lần vượt mức hiệu suất của con người được báo cáo, khiến mỗi benchmark tương ứng kém hữu ích hơn để phân biệt (Maslej et al. 2024).

Maslej, Nestor, Loredana Fattorini, C. Raymond Perrault, Vanessa Parli, Anka Reuel, Erik Brynjolfsson, John Etchemendy, et al. 2024. “Artificial Intelligence Index Report 2024.” In CoRR, abs/2405.19522. https://doi.org/10.48550/ARXIV.2405.19522.
Bão hòa tập dữ liệu và benchmark động
Figure 13 đặt ra một vấn đề phương pháp luận cốt lõi: khi các mô hình vượt qua hiệu suất của con người trên các benchmark, kết quả có thể phản ánh hoặc là tiến bộ năng lực thực sự, hoặc chỉ là tối ưu hóa cho các tập đánh giá tĩnh. Hai khả năng này rất khó phân biệt chỉ dựa trên điểm số bảng xếp hạng. MNIST, được giới thiệu trong công trình kinh điển về nhận dạng chữ số viết tay của LeCun và cộng sự (LeCun et al. 1998), minh họa rõ mối lo ngại này: các ảnh kiểm tra tĩnh có thể chứa những dấu hiệu đặc thù của tập dữ liệu mà mô hình học cách khai thác. Câu hỏi “Chúng ta đã xong với ImageNet chưa?” (Beyer et al. 2020) khái quát hóa mối lo này.
LeCun, Yann, Léon Bottou, Yoshua Bengio, and Patrick Haffner. 1998. “Gradient-Based Learning Applied to Document Recognition.” Proceedings of the IEEE 86 (11): 2278–324. https://doi.org/10.1109/5.726791.
Beyer, Lucas, Olivier J. Hénaff, Alexander Kolesnikov, Xiaohua Zhai, and Aäron van den Oord. 2020. “Are We Done with ImageNet?” arXiv Preprint arXiv:2006.07159.
44 Dynabench: Nền tảng của Facebook AI Research ra mắt năm 2021 để tạo benchmark động, nơi con người soạn các đầu vào đối nghịch nhằm đánh lừa những mô hình tốt nhất hiện có. Dynabench giải quyết vấn đề bão hòa, tức là tình trạng độ chính xác rất cao trên các benchmark tĩnh có thể phản ánh sự quen thuộc với tập kiểm tra hơn là năng lực thật sự vững chắc, nhưng cũng có đánh đổi riêng: benchmark động khó so sánh theo thời gian vì tập đánh giá thay đổi. Benchmark tĩnh và động đóng vai trò chẩn đoán bổ trợ cho nhau.
Kiela, Douwe, Max Bartolo, Yixin Nie, Divyansh Kaushik, Atticus Geiger, Zhengxuan Wu, Bertie Vidgen, et al. 2021. “Dynabench: Rethinking Benchmarking in NLP.” Proceedings of the 2021 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies 9: 4110–24. https://doi.org/10.18653/v1/2021.naacl-main.324.
Các phương pháp benchmark động như Dynabench44 (Kiela et al. 2021) xử lý bão hòa bằng cách liên tục cập nhật dữ liệu kiểm tra dựa trên hiệu suất của mô hình, đảm bảo benchmark vẫn thách thức khi năng lực được cải thiện. Tuy vậy, benchmark động là bổ sung chứ không thay thế các chỉ số về độ bao phủ, chất lượng và phân phối đã nêu trước đó: chúng giúp ngăn bão hòa nhưng không chỉ ra nguyên nhân.
Đánh giá toàn diện hệ thống-mô hình-dữ liệu
Việc vượt qua các benchmark về hệ thống, mô hình và dữ liệu một cách riêng lẻ là chưa đủ. Benchmark hệ thống có thể xác nhận hiệu suất phần cứng, benchmark mô hình có thể kiểm tra xem nén có giữ được chất lượng hay không, và benchmark dữ liệu có thể đánh giá tính đại diện của tập dữ liệu huấn luyện. Tuy vậy, hệ thống khi triển khai vẫn có thể thất bại vì ba khía cạnh này tương tác với nhau. Hiệu suất AI trong thế giới thực xuất hiện từ chính sự tương tác đó, và tối ưu hoá một khía cạnh có thể làm lộ điểm yếu ở khía cạnh khác.
Hãy xem một chuỗi lỗi cụ thể: một nhóm đạt điểm MLPerf Inference rất cao bằng cách triển khai mô hình lượng tử hoá INT8 trên phần cứng đã tối ưu. Các benchmark hệ thống đều đạt. Tuy nhiên, mô hình lượng tử hoá này chỉ được kiểm thử trên dữ liệu thử nghiệm phân phối theo ImageNet; khi triển khai, độ chính xác giảm trên các ảnh chụp tại nhà máy, nơi điều kiện ánh sáng khác biệt. Các benchmark chất lượng mô hình lẽ ra đã có thể phát hiện độ nhạy với lượng tử hoá. Điều tra sâu hơn cho thấy dữ liệu huấn luyện không hề có ảnh dưới ánh sáng công nghiệp—một lỗ hổng chất lượng dữ liệu mà tối ưu hệ thống hay mô hình cũng không thể bù đắp.
Chính vì sự phụ thuộc lẫn nhau này, kết quả benchmark ở một khía cạnh có thể trở nên vô giá trị nếu có lỗi ở khía cạnh khác:
- Hệ thống thành công + Mô hình thất bại: Phần cứng đạt thông lượng như cam kết, nhưng nén làm giảm độ chính xác xuống dưới ngưỡng triển khai
- Hệ thống thành công + Dữ liệu thất bại: Suy luận nhanh trên các đầu vào đại diện, nhưng độ chệch (bias) trong dữ liệu huấn luyện gây lỗi ở một số nhóm nhân khẩu học
- Mô hình thành công + Hệ thống thất bại: Dự đoán chính xác, nhưng độ trễ biến thiên khi chịu tải khiến hệ thống vi phạm các yêu cầu SLA
- Mô hình thành công + Dữ liệu thất bại: Độ chính xác cao trên tập kiểm thử độc lập, nhưng sự dịch chuyển phân phối trong môi trường sản xuất gây suy giảm âm thầm
Sự phụ thuộc lẫn nhau này gợi lại bức tranh D·A·M đã nêu ở Giới thiệu (Bức tranh giao thoa D·A·M), nhưng các lăng kính benchmark không khớp một-đối-một với các trục đó. Các benchmark dữ liệu chủ yếu kiểm tra phần dữ liệu cung cấp cho quá trình học; các benchmark mô hình chủ yếu kiểm tra hành vi thuật toán mà mô hình đã học; còn các benchmark hệ thống cho thấy cách máy thực thi, cùng với luồng dữ liệu và phần mềm cần thiết để vận hành. Đánh giá tổng thể kiểm chứng rằng các giả định đưa ra dưới một lăng kính vẫn đúng khi các trục D·A·M tương tác. Pipeline tối ưu hóa ở Phần III (dữ liệu → mô hình → phần cứng) tạo ra các phụ thuộc mà việc benchmark phải xác minh một cách tường minh.
Phân loại D·A·M cung cấp một framework chẩn đoán để xác định có hệ thống trục nào đang giới hạn hiệu suất. Tóm tắt chẩn đoán ánh xạ mỗi trục tới ràng buộc vật lý tương ứng và lộ trình tối ưu hóa để tháo gỡ, qua đó đưa ra bước chẩn đoán đầu tiên khi một benchmark cho thấy mức tận dụng thấp. Table 20 cụ thể hóa cách tiếp cận này bằng cách bắt cặp từng trục D·A·M với ba loại nút thắt cổ chai cơ bản; Khung phân loại D·A·M cung cấp hướng dẫn chẩn đoán đầy đủ, bao gồm các công cụ profiling và các chỉ báo sàng lọc hiệu quả.
| Thành phần | Giới hạn bởi tính toán (Compute-Bound) | Giới hạn bởi bộ nhớ (Memory-Bound) | Giới hạn bởi I/O (I/O-Bound) |
|---|---|---|---|
| Dữ liệu | Tiền xử lý quá chậm (tăng cường, tokenization) | Tập dữ liệu vượt quá RAM (tràn ra đĩa) | Bộ nhớ không thể cung cấp cho GPU (giới hạn thông lượng đĩa) |
| Thuật toán | Mô hình quá lớn so với phần cứng (FLOPs vượt quá dung lượng) | Activations vượt quá bộ nhớ (kích thước batch bị giới hạn) | Đồng bộ gradient chậm hơn tính toán (huấn luyện phân tán) |
| Máy | Mức sử dụng GPU bão hòa (cần bộ tăng tốc nhanh hơn) | Băng thông bộ nhớ bão hòa (cần nhiều băng thông HBM hơn) | Băng thông mạng/PCIe bão hòa (cần các liên kết nhanh hơn) |
Giá trị chẩn đoán của ma trận này thể hiện rõ khi các benchmark cho ra kết quả bất ngờ—đặc biệt là khi hiệu suất thấp hơn kỳ vọng. Nếu benchmark hệ thống cho thấy mức sử dụng GPU thấp dù phần cứng đã đủ, thì nút thắt cổ chai nhiều khả năng nằm ở chỗ khác. Chẳng hạn, nếu trong quá trình huấn luyện chỉ quan sát thấy GPU sử dụng 30%, ban đầu ta có thể nghi ngờ kiến trúc mô hình (hàng Thuật toán) kém hiệu quả; nhưng profiling cho thấy thao tác tăng cường ảnh (image augmentation) chạy trên CPU và không kịp cung cấp cho GPU (hàng Dữ liệu, cột Compute-Bound: “Preprocessing too slow”). Chẩn đoán có hệ thống bằng ma trận này giúp tránh lỗi phổ biến là tối ưu hóa nhầm thành phần.
Kiểm chứng trong điều kiện phòng thí nghiệm có kiểm soát khác với kiểm chứng ngoài môi trường sản xuất. Trong phòng thí nghiệm, phân phối dữ liệu giữ nguyên, mẫu yêu cầu đồng đều, và các hệ thống chạy tách biệt. Khi ra sản xuất, cả ba giả định này có thể đồng thời sụp đổ—dữ liệu thay đổi, lưu lượng tăng đột biến khó lường, và các thành phần hệ thống tương tác theo những cách mà các benchmark tách biệt không ghi nhận được. Khía cạnh cuối cùng của việc benchmark đặt câu hỏi: liệu các kết quả trong phòng thí nghiệm còn đúng dưới điều kiện vận hành thực tế hay không.
Self-Check: Question
An image classifier deployed in an autonomous vehicle achieves \(94\%\) top-1 accuracy on ImageNet. However, post-training INT8 quantization causes the model to output confidence scores of \(0.99\) on inputs where it actually predicts the wrong class. Which model evaluation metric directly quantifies this divergence between predicted probability and empirical accuracy?
- Peak Signal-to-Noise Ratio (PSNR)
- Expected Calibration Error (ECE)
- Top-5 classification error
- Hardware FLOPs Utilization (HFU)
A clinical risk prediction model achieves an outstanding \(0.92\) ROC-AUC score on a held-out test split from Hospital A’s electronic health records. When deployed at Hospital B in a different city, its ROC-AUC drops to \(0.61\). Why did the standard held-out test benchmark fail to predict this clinical failure?
- Hospital B used GPUs with different floating-point rounding modes
- The ROC-AUC metric is mathematically invalid for clinical applications
- The held-out test split shared the exact same patient demographic distribution, lab equipment calibration, and clinical protocols as the training data, concealing the model’s inability to generalize under covariate and concept shift
- The training algorithm suffered from underfitting on Hospital A’s dataset
True or False: If an ML deployment passes both system benchmarking (achieving target throughput and low latency) and model benchmarking (preserving validation accuracy and calibration), data benchmarking is unnecessary because software execution and model mathematics are fully verified.
The metric that partitions model prediction confidences into discrete bins and calculates the weighted average difference between confidence and accuracy across all bins is called ____.
Explain why compression evaluation should be framed as a multi-objective Pareto frontier across accuracy, latency, model size, and memory footprint, rather than a single scalar delta.
A team deploys an INT8-quantized vision model to an edge TPU for factory defect detection. The deployment passes MLPerf Inference benchmarks and ImageNet validation, but in production, defect detection accuracy collapses from \(98\%\) to \(74\%\). Use the three-dimensional benchmarking framework (System, Model, Data) to diagnose this failure cascade.
Các cân nhắc trong môi trường sản xuất
Một hệ thống dù vượt qua cả ba hạng mục benchmark vẫn có thể thất bại khi vận hành thực tế. Framework ba chiều này đã kiểm chứng hiệu năng phần cứng, chất lượng mô hình, và tính đại diện của dữ liệu trong các điều kiện được kiểm soát—nhưng khi ra sản xuất, những điều kiện đó liên tục bị vi phạm. Khoảng cách giữa benchmark thành công và triển khai thành công dẫn tới một mối quan tâm cuối cùng khi benchmark: kiểm chứng hệ thống dưới các điều kiện sát với thực tế vận hành.
Từ phòng thí nghiệm đến môi trường sản xuất
Các benchmark trong phòng thí nghiệm xác lập hệ thống có thể làm gì dưới điều kiện lý tưởng. Còn kiểm chứng khi vận hành thực tế xác định liệu hệ thống đó có đang hoạt động đúng ngay lúc này, trong điều kiện thực tế hay không.
Sự khác biệt này rất quan trọng vì các benchmark trong phòng thí nghiệm thường giả định những điều kiện mà môi trường sản xuất liên tục vi phạm. Sự suy giảm âm thầm là thách thức khó nhận biết nhất: mô hình có thể tạo ra kết quả có vẻ hợp lý nhưng sai mà không hề có tín hiệu lỗi rõ ràng; tương tự, một hệ thống gợi ý đưa ra các đề xuất “hợp lý” nhưng chưa tối ưu cũng không có cơ chế báo lỗi sẵn có. Khối lượng công việc (workload) động lại gây ra một kiểu lỗi khác: một hệ thống được benchmark ở mức 1.000 QPS ổn định có thể sập khi lưu lượng tăng đột biến lên 10.000 QPS, cho thấy “thông lượng” trong benchmark đã giả định yêu cầu đến đều đặn thay vì theo từng đợt như trong sản xuất. Sự dịch chuyển phân phối dữ liệu còn làm các vấn đề này trầm trọng dần theo thời gian, khi dữ liệu sản xuất thay đổi và lệch khỏi phân phối dùng để huấn luyện—ví dụ, một bộ phân loại hình ảnh được huấn luyện trên ảnh chuyên nghiệp có thể xuống cấp khi người dùng gửi ảnh chụp bằng điện thoại thông minh với ánh sáng, góc chụp và các lỗi do nén khác nhau. Cuối cùng, môi trường sản xuất đặt ra các ràng buộc đa mục tiêu mà benchmark thường xem xét tách biệt: độ chính xác, độ trễ, chi phí và mức sử dụng tài nguyên đều phải được đáp ứng đồng thời; tối ưu một yếu tố mà hy sinh các yếu tố khác sẽ dẫn đến thất bại khi triển khai.
Thu hẹp khoảng cách từ benchmark đến triển khai
Trước khi triển khai, hãy kiểm chứng lại các kết luận từ benchmark dưới các điều kiện đại diện cho môi trường sản xuất. Table 21 liệt kê giả định của benchmark, thực tế sản xuất vi phạm giả định đó ra sao, và bước xác thực để thu hẹp khoảng cách. Checkpoint phía sau sẽ chuyển những dòng đó thành các hành động sẵn sàng phát hành.
| Giả định Benchmark | Thực tế sản xuất | Phương pháp xác thực |
|---|---|---|
| Lượt yêu cầu đến đồng đều | Các mẫu lưu lượng truy cập đột biến | Kiểm tra tải với phát lại dấu vết sản xuất |
| Đầu vào sạch, đã được tiền xử lý | Đầu vào chất lượng thay đổi | Đánh giá trên mẫu dữ liệu sản xuất |
| Trạng thái hệ thống ấm | Khởi động lạnh, cache misses | Đo lường hiệu suất khởi động lạnh |
| Thực thi cô lập | Tranh chấp tài nguyên | Benchmark dưới tải hệ thống thực tế |
| Phiên bản mô hình cố định | A/B testing, triển khai dần dần | Thiết lập đường cơ sở để so sánh |
Giám sát sản xuất như một quá trình benchmark liên tục
Giám sát sản xuất mở rộng benchmark từ một bước kiểm tra một lần thành một quy trình liên tục. Các nguyên tắc cơ bản vẫn giữ nguyên (số liệu tiêu chuẩn hóa, đo lường có thể tái lập, chặt chẽ về thống kê), nhưng trọng tâm chuyển từ câu hỏi “liệu hệ thống này có hoạt động không?” sang “hệ thống này có đang hoạt động không?”
Khi một mô hình đi vào hoạt động, benchmark trở thành quá trình so sánh liên tục với các đường cơ sở vừa thiết lập. Các kiểm tra ngay lập tức vẫn rất cụ thể: liệu phân phối đầu vào còn gần với phân phối benchmark hay không, liệu độ trễ và thông lượng có nằm trong dải đo lường đã ghi nhận hay không, và liệu chất lượng mô hình có vượt ra ngoài phạm vi mong đợi hay không. Để trả lời các kiểm tra này, cần kỷ luật đo lường giống như benchmark ngoại tuyến, nhưng giờ đây các phép đo đến liên tục và dưới lưu lượng thực tế.
Checkpoint 1.4: Danh sách kiểm tra benchmark trước triển khai
Trước khi triển khai một mô hình dựa trên kết quả benchmark:
Chương MLOps sau này sẽ biến vòng lặp đo lường này thành cơ chế phát hành và phục hồi: triển khai theo giai đoạn, đánh giá bóng (shadow evaluation) [chạy mô hình mới song song với môi trường sản xuất mà không phục vụ đầu ra của nó], xác thực liên tục và hoàn tác. Ở giai đoạn này, phạm vi bàn giao hẹp hơn: benchmark định nghĩa các đường cơ sở và ngưỡng thất bại; bộ phận vận hành tiếp tục đo lường đối chiếu với các đường cơ sở và ngưỡng đó sau khi triển khai.
Chính khoảng cách giữa điều kiện benchmark và điều kiện sản xuất giải thích vì sao ngay cả các nhóm cẩn trọng vẫn mắc những lỗi có thể đoán trước. Phần cuối sẽ nêu những ngộ nhận khiến thành công trên benchmark lại dẫn đến thất bại khi triển khai.
Self-Check: Question
Which benchmark harness assumption is most frequently violated when an ML serving system transitions from laboratory evaluation to live production?
- Floating-point numbers lose precision when transmitted over HTTP
- The neural network architecture dynamically changes its layer count in production
- GPUs execute instructions in reverse order under high temperature
- Production requests arrive with non-stationary, bursty traffic patterns, correlated user surges, and variable payload sizes, violating the stationary Poisson or constant-rate arrival assumptions of synthetic test harnesses
Explain why replaying recorded production traffic traces during predeployment validation is a more dependable test of system readiness than relying solely on synthetic load generators.
True or False: Once an ML system passes all predeployment benchmarks, production monitoring is merely a passive operational task to check server uptime, having no connection to benchmarking methodology.
Các ngụy biện và cạm bẫy
Benchmarking dễ tạo ra sự tự tin thái quá khi các phép đo tiêu chuẩn hóa che mờ thực tế triển khai. Các nhóm thường giả định rằng đánh giá trong môi trường kiểm soát có thể dự đoán hiệu suất trong sản xuất. Nhưng hệ thống thực tế phải đối mặt với biến thiên, giới hạn tài nguyên và các đánh đổi đa mục tiêu mà benchmark không phản ánh, khiến công sức kỹ thuật bị lãng phí vào việc tối ưu cho bài đánh giá thay vì cho triển khai.
Ngụy biện: Hiệu suất trên benchmark sẽ trực tiếp phản ánh hiệu suất của ứng dụng trong thế giới thực.
Sự rõ ràng đầy hấp dẫn của các bảng xếp hạng benchmark khiến các nhóm chọn hệ thống như thể vị trí trên bảng xếp hạng dự đoán được hành vi trong sản xuất. Hiếm khi đúng như vậy. Như section 1.3.1 cho thấy, các hệ thống ML vốn có biến thiên do chất lượng dữ liệu, dịch chuyển phân phối và các ràng buộc tài nguyên — những yếu tố vắng mặt trong môi trường đánh giá có kiểm soát. Một kịch bản thất bại tiêu biểu: một mô hình ngôn ngữ đạt độ chính xác benchmark 92 percent nhưng khi xử lý văn bản do người dùng tạo (có lỗi chính tả, ngôn ngữ đời thường và thuật ngữ chuyên ngành) thì độ chính xác trong sản xuất chỉ còn 78–82 percent. Một hệ thống suy luận có độ trễ trung bình 15 ms trên MLPerf lại gặp độ trễ p99 150–200 ms trong sản xuất (suy giảm 10–13.3× lần) do tải đồng thời, các khoảng dừng của cơ chế thu gom rác và biến động mạng. Các nhóm chỉ dựa vào bảng xếp hạng benchmark thường đánh giá thấp độ phức tạp khi triển khai, dẫn đến ra mắt thất bại và tốn kém cho tái thiết kế.
Độ trễ trung bình trên benchmark đánh giá thấp phần đuôi độ trễ trong sản xuất ở mức một bậc độ lớn.
Cạm bẫy: Chỉ tập trung tối ưu hóa cho các số liệu benchmark mà bỏ qua các yêu cầu tổng thể của hệ thống.
Các bảng xếp hạng benchmark khuyến khích tối ưu hoá quyết liệt, nhưng những tối ưu để leo hạng lại thường làm giảm chính các đặc tính mà môi trường sản xuất đòi hỏi. Đây là một ví dụ điển hình của Định luật Goodhart (section 1.10.4): khi điểm benchmark trở thành mục tiêu tối ưu, chúng không còn là thước đo có ý nghĩa về chất lượng hệ thống. Chẳng hạn, trong một tình huống, một nhóm giảm độ trễ suy luận từ 12 ms xuống 8 ms bằng lượng tử hoá quyết liệt, leo hạng MLPerf thêm 15 bậc nhưng lại làm hỏng hiệu chuẩn, khiến điểm tin cậy dự đoán không còn đáng tin cho các quyết định ở các bước tiếp theo. Một nhóm khác cải thiện độ chính xác trên ImageNet thêm 2.1 percent nhờ tinh chỉnh siêu tham số quy mô lớn, nhưng mô hình tối ưu xong lại tiêu thụ năng lượng nhiều hơn 40 percent và kém đi 25 percent trên các ảnh ngoài phân phối (out-of-distribution) từ camera trong môi trường sản xuất. Những tổ chức thưởng theo thứ hạng benchmark hơn là thành công khi triển khai sẽ có xu hướng tạo ra các hệ thống xuất sắc trong đánh giá nhưng thất bại trong sản xuất.
Ngụy biện: Đánh giá bằng một chỉ số duy nhất là đủ để hiểu hiệu suất của hệ thống.
Một con số đơn lẻ có thể nghe rất hấp dẫn (“độ chính xác 94 phần trăm” hoặc “1.200 QPS”). Nhưng để thành công trong môi trường sản xuất, chúng ta phải cân bằng nhiều mục tiêu thường mâu thuẫn, điều mà một chỉ số đơn lẻ không thể hiện hết. Các hệ thống suy luận hiện đại cần được đánh giá trên nhiều khía cạnh như độ chính xác, độ trễ, thông lượng, năng lượng và độ vững (section 1.8.2). Ví dụ về một đánh đổi: một mô hình khuyến nghị đạt độ chính xác 94 percent với độ trễ p99 180 ms vẫn không đạt mục tiêu mức dịch vụ yêu cầu p99 < 100 ms, dù độ chính xác rất cao. Ngược lại, một hệ thống được tối ưu để đạt thông lượng 1,200 QPS sẽ đạt mức đó nhưng tiêu thụ công suất 4.2 W, trong khi một hệ thống chậm hơn một chút với thông lượng 1,000 QPS chỉ dùng 1.8 W (chênh lệch công suất gấp 2.3× lần). Với các thiết bị edge chạy pin, chấp nhận giảm thông lượng 17 percent sẽ giúp thời gian hoạt động kéo dài gấp 2.3× lần. Các bên liên quan ưu tiên các chỉ số khác nhau: kỹ sư ML chú trọng độ chính xác, đội hạ tầng quan tâm thông lượng và chi phí, quản lý sản phẩm để ý các phân vị độ trễ. Tối ưu theo một chỉ số duy nhất sẽ có hệ thống vượt trội ở một khía cạnh nhưng lại không đáp ứng yêu cầu triển khai ở các khía cạnh khác.
Cạm bẫy: Sử dụng các benchmark lỗi thời không còn phản ánh đúng các thách thức và yêu cầu triển khai.
Các benchmark có quán tính: nhiều nhóm vẫn tiếp tục báo cáo trên các benchmark quen thuộc ngay cả khi chúng không còn giúp phân biệt hữu ích. Bão hòa xảy ra khi nhiều cách tiếp cận đạt hiệu năng gần như nhau, làm mất đi khả năng so sánh có ý nghĩa. Ví dụ, lỗi phân loại top-5 trên ImageNet đã giảm từ 28.2 percent năm 2010 (Russakovsky et al. 2015) xuống 3.57 percent vào năm 2015 (He et al. 2016), làm thu hẹp mạnh “khoảng trống” mà chỉ số đó đo được. Khi chênh lệch thu hẹp, các khoảng tin cậy thống kê (đã bàn trong section 1.10.1) và mức độ phù hợp với bối cảnh triển khai quan trọng hơn thứ hạng trên leaderboard. Việc bối cảnh triển khai thay đổi còn làm vấn đề trầm trọng thêm: các benchmark thiết kế cho phần cứng máy chủ trở nên sai lệch khi áp vào thiết bị edge, vốn có bộ nhớ ít hơn 10× và ngân sách công suất thấp hơn 100×. Để benchmark hiệu quả, cần “nghỉ hưu” các benchmark đã bão hòa và xây dựng các framework đánh giá phù hợp với thực tế triển khai mục tiêu.
Ngụy biện: Các benchmark trong nghiên cứu có thể dự đoán hành vi của hệ thống khi triển khai thực tế dưới lưu lượng truy cập thật.
Các benchmark nghiên cứu dùng để so sánh thuật toán trong điều kiện được kiểm soát; hệ thống sản xuất thì phải phục vụ người dùng trong những điều kiện biến động. Nếu xem kết quả benchmark nghiên cứu như dự báo cho hệ thống sản xuất, ta thường sẽ quá lạc quan, vì các benchmark này có thể bỏ qua tranh chấp tài nguyên, biến thiên chất lượng đầu vào và các chế độ lỗi trong vận hành. Thực thi benchmark không đúng cách còn tạo thêm lỗi: nếu bỏ qua warmup runs, các chi phí như khởi tạo ban đầu, biên dịch just-in-time, nạp cache và cấp phát bộ nhớ có thể bị trộn vào độ trễ ở trạng thái ổn định; nếu không quy định rõ trạng thái cache, một benchmark bộ nhớ có thể vô tình đo cả tái sử dụng cache nóng lẫn truy cập bộ nhớ lạnh; và nếu để thay đổi điện áp và tần số động (DVFS) tự do mà không báo cáo, những khác biệt nhỏ sẽ rất khó tái tạo. Hệ thống sản xuất phải gánh tải người dùng đồng thời, chất lượng đầu vào biến thiên, độ trễ mạng và lỗi hệ thống, tất cả đều làm suy giảm hiệu năng (section 1.10.2). Một hệ thống có thể đạt thông lượng 800 QPS trong các benchmark cô lập, nhưng dưới tải sản xuất, nó chỉ duy trì được 400–500 QPS với mức sử dụng 90 percent (giảm 37.5–50 percent) do tranh chấp hàng đợi và các lần tạm dừng thu gom rác. Các benchmark nghiên cứu thường chỉ báo cáo thời gian suy luận mô hình (5–10 ms), trong khi độ trễ đầu-cuối trong sản xuất còn gồm chi phí tiền xử lý, xếp hàng và hậu xử lý, tổng cộng 50–100 ms. Hệ thống sản xuất đòi hỏi khả năng sẵn sàng 99.9 percent (tức chỉ được ngừng hoạt động 43 minutes mỗi tháng) và khả năng suy giảm có kiểm soát khi gặp lỗi, những đặc tính mà benchmark nghiên cứu thường bỏ qua. Đánh giá hiệu quả trong sản xuất cần các chỉ số vận hành: thông lượng duy trì dưới tải, thời gian phục hồi sau lỗi, và phân rã độ trễ đầy đủ.
Cạm bẫy: Sử dụng các benchmark nghiên cứu làm điều kiện thông qua phát hành vào sản xuất.
Đôi khi các nhóm quyết định đưa một mô hình lên sản xuất chỉ vì nó vượt qua benchmark nghiên cứu, rồi chỉ sau khi ra mắt mới phát hiện benchmark đó chưa hề kiểm tra tuyến vận hành thực tế. Một điều kiện phát hành cho hệ thống phục vụ (serving) phải bao gồm kiểm thử tải, đo độ trễ đuôi, kiểm tra chất lượng dữ liệu, diễn tập sự cố và tiêu chí hoàn nguyên. Các benchmark trong nghiên cứu vẫn hữu ích để so sánh thuật toán, nhưng khi vào sản xuất, hệ thống đã triển khai phải được đo lường dưới các điều kiện về lưu lượng, phần cứng và lỗi mà nó thực sự sẽ gặp.
Self-Check: Question
What is the primary fallacy in using an accelerator’s peak advertised TFLOPS to estimate the serving capacity of an ML inference deployment?
- Peak TFLOPS assumes 100% compute saturation on dense arithmetic, ignoring memory bandwidth bottlenecks, runtime kernel launch overhead, non-compute pipeline stages, and variable batch sizes
- Peak TFLOPS is an obsolete metric that is no longer measured by hardware vendors
- Accelerators always run at exactly 50% of their peak TFLOPS due to hardware safety limiters
- Peak TFLOPS applies only to CPU floating-point units and has no meaning for GPUs or TPUs
An engineering team modifies an inference server configuration, increasing throughput from \(1,000\text{ QPS}\) at \(1.8\text{ W}\) to \(1,200\text{ QPS}\) at \(4.2\text{ W}\) (\(20\%\) throughput gain at \(2.33\times\) power). What is the systems consequence of this change?
- It is an unambiguous improvement because throughput is \(20\%\) higher
- The system suffered a \(48.6\%\) reduction in energy efficiency (dropping from \(556\text{ QPS/W}\) to \(286\text{ QPS/W}\)), making it economically and thermally inferior for constrained deployments
- The system will run cooler because queries complete faster
- Operating cost is reduced because higher throughput always decreases data center power bills
True or False: If a newly released open-source model ranks #1 on a public benchmark leaderboard, an enterprise can deploy it into production with confidence that it will outperform existing models on company workloads.
Explain why saturated benchmarks (such as MNIST or mature ImageNet evaluation sets) cease to be useful progress indicators for ML systems, and describe what should replace them.
Explain how Goodhart’s Law manifests when teams optimize exclusively for benchmark scores, using a concrete systems example where metric chasing degrades production quality.
Tóm tắt
Benchmarking hoàn thiện pipeline tối ưu hóa ở Phần III bằng cách xác nhận liệu những cải thiện về hiệu suất từ việc chọn dữ liệu (Lựa chọn dữ liệu), nén mô hình (Nén mô hình) và tăng tốc phần cứng (Tăng tốc phần cứng) có thực sự hiệu quả trong thực tế hay không. Ba khía cạnh chính của benchmark sẽ xem xét riêng biệt việc thực thi hệ thống, hành vi của mô hình và tính đại diện của dữ liệu, rồi kiểm tra xem các giả định ban đầu có còn đúng không khi toàn bộ hệ thống chạy trong điều kiện triển khai thực tế.
Các khía cạnh này làm lộ ra những kiểu lỗi khác nhau. Các benchmark hệ thống sẽ phơi bày các vấn đề như thông lượng không đạt, độ trễ đuôi và hành vi nhiệt. Các benchmark mô hình kiểm tra độ chính xác, hiệu chuẩn, độ mạnh mẽ và các thuộc tính khác mà một tối ưu hóa có thể làm thay đổi. Các benchmark dữ liệu kiểm tra độ bao phủ, chất lượng nhãn, rò rỉ và mức độ phù hợp với triển khai. Các bộ tiêu chuẩn như MLPerf Training và Inference cung cấp bằng chứng có thể so sánh về hệ thống; trong khi đó, các giao thức cho mô hình và dữ liệu cung cấp bằng chứng về chất lượng và tính đại diện — những điều mà một kết quả phần cứng không thể xác lập.
Việc benchmark một cách chặt chẽ là yếu tố phân biệt giữa các khẳng định kỹ thuật có cơ sở và những suy đoán. Những người làm kỹ thuật nếu xác thực các tối ưu hóa của mình nghiêm ngặt — bằng cách đo độ trễ thực (wall-clock latency) thay vì chỉ tin vào số lượng phép tính FLOP, phân tích độ trễ đuôi thay vì chỉ số trung bình, và kiểm tra trên dữ liệu đại diện cho môi trường sản xuất thay vì các benchmark tiện lợi — sẽ xây dựng được những hệ thống hoạt động đúng như mong đợi khi triển khai. Khi các hệ thống AI ngày càng có tầm ảnh hưởng trong các ứng dụng quan trọng, sự chặt chẽ trong đo lường sẽ quyết định liệu các tuyên bố về tối ưu hóa có thực sự mang lại tác động trong thế giới thực hay không.
Key Takeaways: Đo lường những gì quan trọng
- Benchmarks xác thực đồng thiết kế: Các benchmark về hệ thống, mô hình và dữ liệu sẽ phơi bày phần cứng không đạt kỳ vọng, mất chất lượng do nén và lệch phân phối. Một hệ thống chỉ đạt ở một khía cạnh vẫn có thể thất bại khi các ràng buộc về Dữ liệu, Thuật toán và Máy cùng hội tụ dưới khối lượng công việc (workload) sản xuất.
- Các số liệu proxy cần có giới hạn rõ ràng: Các quy tắc chạy tiêu chuẩn hóa giúp so sánh trung thực hơn, nhưng các khối lượng công việc (workload) cố định vẫn chỉ là proxy. Kích thước batch, trạng thái nhiệt, phân phối đầu vào, mức độ đồng thời và các cửa sổ hạn chót dịch vụ sẽ quyết định liệu kết quả trong phòng thí nghiệm có vượt qua khoảng cách giữa benchmark và sản xuất hay không.
- Mức độ chi tiết đánh đổi giữa khả năng chẩn đoán và tính thực tế: Micro-benchmark tách riêng các kernel, macro-benchmark cho thấy chi phí ở mức mô hình, còn end-to-end benchmark ghi nhận hành vi mà người dùng nhìn thấy. Đo lường hiệu quả là xếp chồng cả ba để các nhóm vừa thấy triệu chứng vừa thấy lớp gây ra vấn đề.
- Độ trễ đuôi là benchmark: Các hệ thống tương tác thường hỏng ở các phân vị p95 và p99 trước khi giá trị trung bình kịp dịch chuyển. Báo cáo độ trễ theo phân vị dưới tải đại diện sẽ tránh việc một benchmark thông qua một hệ thống có trung bình đạt yêu cầu nhưng những yêu cầu bị phục vụ tệ nhất lại vi phạm SLO.
- Định luật Amdahl giới hạn mọi tuyên bố tối ưu hóa: Một mô hình nhanh hơn cũng không thể kéo phần còn lại của pipeline nhanh tương ứng; nếu tiền xử lý chiếm 50% tổng độ trễ, thì dù mô hình có nhanh đến vô hạn, hệ thống cũng chỉ cải thiện được 2\(\times\). Hãy benchmark toàn bộ đường dẫn xử lý yêu cầu trước khi ăn mừng việc tăng tốc kernel.
- Hiệu quả vẫn cần bằng chứng chất lượng: INT8 có thể giảm dung lượng lưu trữ trọng số thô đi 4\(\times\); mô hình thành phần đơn giản hóa ước tính mức giảm năng lượng khoảng 6.6×. Nhưng việc mô hình nén có triển khai được hay không còn phụ thuộc vào đo lường trên toàn thiết bị, hiệu chuẩn, độ vững của các nhóm con và hành vi ở các trường hợp biên.
Mỗi chương trong phần này đều hứa hẹn giảm FLOPS, thu nhỏ mô hình, hoặc tăng thông lượng. Benchmark đánh giá những lời hứa đó trên toàn bộ hệ thống. Khoảng cách giữa cải tiến được tuyên bố và cải tiến đo được cho thấy nơi Dữ liệu, Thuật toán và Máy bị ghép lại thay vì ăn khớp. Định luật Amdahl cho thấy dù mô hình có nhanh đến vô hạn, pipeline vẫn bị giới hạn bởi mọi thứ bên ngoài nó; còn độ trễ đuôi (tail latency) cho thấy trung bình có thể đạt trong khi các yêu cầu bị phục vụ kém nhất vẫn thất bại. Đây là đồng thiết kế khi phải chịu trách nhiệm. Một hệ thống ML là thứ phải được kỹ sư thiết kế, không phải nói suông; chỉ đo lường trên khối lượng công việc (workload) thực tế mới phân biệt được hai điều đó.
What’s Next: Từ phòng thí nghiệm đến thực tế
Một hệ thống vượt qua mọi benchmark vẫn có thể không dự đoán được điều gì? Các benchmark tĩnh không thể phản ánh đầy đủ các đợt bùng nổ lưu lượng, trôi dữ liệu, hay lỗi dây chuyền dưới các khối lượng công việc (workload) thực tế. Phần IV rời môi trường benchmark được kiểm soát để bước vào sản xuất, bắt đầu với Phục vụ mô hình.
Self-Check: Question
Which statement best summarizes the chapter’s core thesis regarding the role of benchmarking in ML systems engineering?
- Benchmarking is a one-time marketing exercise used by hardware vendors to rank accelerators by peak FLOPs
- Benchmarking is an academic tool that becomes obsolete once systems are deployed to cloud servers
- Benchmarking is the empirical validation discipline that tests whether data selection, model compression, and hardware acceleration deliver their promised gains under realistic deployment constraints, converting theoretical claims into verified engineering knowledge
- Benchmarking replaces the need for live production monitoring and error handling
Explain why the textbook frames empirical benchmarking—measuring tail latency, wall-clock time-to-accuracy, and out-of-distribution robustness—as constitutive of dependable ML systems engineering rather than an optional verification step.
In an ML serving pipeline where model inference accounts for \(20\%\) of total request latency and non-model operations (data fetching, parsing, network I/O) account for the remaining \(80\%\), what is the theoretical maximum end-to-end speedup achievable by accelerating the neural network inference engine, even if inference time is reduced to zero?
- \(5.0\times\) speedup
- \(3.0\times\) speedup
- \(2.0\times\) speedup
- \(1.25\times\) speedup (\(1 / (1 - 0.20) = 1 / 0.80 = 1.25\))
Self-Check Answers
Self-Check: Answer
In the three-dimensional ML benchmarking framework, what distinct failure mode does system benchmarking isolate compared to model and data benchmarking?
- Whether hardware accelerators, memory subsystems, and software runtimes deliver expected computational throughput and latency under workload execution patterns
- Whether model compression techniques preserve confidence calibration and accuracy on rare edge cases
- Whether the training dataset contains sufficient coverage, demographic balance, and resistance to covariate drift
- Whether human labeling errors and noisy annotations degrade model convergence rates
Answer: The correct answer is A. System benchmarking specifically evaluates machine execution (hardware utilization, memory bandwidth saturation, runtime dispatch overhead, and latency), isolating execution bottlenecks from algorithmic or data quality defects. Evaluating compression impact on accuracy and calibration pertains to model benchmarking; assessing dataset coverage and demographic drift belongs to data benchmarking; examining annotation noise is a data-centric evaluation concern.
Learning Objective: Analyze how the three-dimensional benchmarking framework (system, model, data) isolates independent failure modes in deployed ML pipelines.
An ML serving pipeline has a baseline end-to-end request latency of \(50\text{ ms}\), of which the neural network inference model stage takes \(10\text{ ms}\) (the remaining \(40\text{ ms}\) is spent in request parsing, database feature fetching, image decoding, and response formatting). If the engineering team applies hardware acceleration to achieve a \(3\times\) speedup on the model inference stage alone, what is the resulting end-to-end pipeline speedup?
- Exactly \(3.0\times\) speedup
- Approximately \(1.2\times\) speedup (latency drops from \(50\text{ ms}\) to roughly \(43.3\text{ ms}\))
- Approximately \(2.1\times\) speedup (latency drops from \(50\text{ ms}\) to roughly \(23.8\text{ ms}\))
- No speedup (\(1.0\times\)) because non-model stages cancel out accelerator gains
Answer: The correct answer is B. By Amdahl’s Law, the new model latency is \(10\text{ ms} / 3 \approx 3.33\text{ ms}\), making the new total latency \(40\text{ ms} + 3.33\text{ ms} = 43.33\text{ ms}\). The end-to-end speedup is \(50 / 43.33 \approx 1.154\times\) (about \(1.2\times\)). Assuming the whole pipeline speeds up by \(3.0\times\) commits the classic fallacy of ignoring the unaccelerated \(80\%\) of execution time; claiming \(2.1\times\) overestimates the fraction of time spent in inference; asserting no speedup incorrectly ignores the genuine \(6.67\text{ ms}\) reduction in inference latency.
Learning Objective: Calculate end-to-end speedup using Amdahl’s Law when an isolated model component is accelerated within a multi-stage serving pipeline.
True or False: Because ML benchmarks provide standardized datasets and metric formulas, a top-ranking benchmark score represents a permanent, universal verification of a model’s operational capability in production.
Answer: False. Unlike traditional computing specifications (such as sorting algorithms where correctness is absolute), ML benchmarks are soft specifications and proxy measurements captured at a specific point in time. As real-world data distributions drift and production traffic patterns vary, a static benchmark score degrades in predictive value, and designing solely to maximize benchmark leaderboards leads to benchmark overfitting.
Learning Objective: Evaluate whether ML benchmark scores represent permanent performance baselines or time-stamped proxy measurements.
The ratio of sustained floating-point throughput achieved by an ML workload to the theoretical peak floating-point capability of the underlying hardware accelerator is known as Model FLOPs Utilization, abbreviated as ____.
Answer: MFU. MFU completes the statement regarding the ratio of sustained floating-point throughput achieved by.
Learning Objective: Explain the concept of Model FLOPs Utilization (MFU) as the ratio of sustained compute throughput to theoretical hardware peak.
Explain how Goodhart’s Law applies to ML systems benchmarking, and describe a concrete scenario where optimizing exclusively for a benchmark metric degrades real-world deployment quality.
Answer: Goodhart’s Law states that ‘when a measure becomes a target, it ceases to be a good measure.’ In ML benchmarking, benchmarks are imperfect proxies for deployment reality. When engineering teams optimize exclusively to maximize a single benchmark metric (such as top-1 validation accuracy or peak offline throughput), they incentivize shortcuts—such as aggressive quantization that damages confidence calibration, or fixed-batch optimizations that spike tail latency under variable traffic. For example, a vision model compressed to maximize ImageNet top-1 accuracy may exploit dataset-specific lighting artifacts while failing completely on real-world factory camera images with novel shadows, demonstrating how optimizing a proxy metric can anti-correlate with production reliability.
Learning Objective: Justify why benchmarks act as proxies rather than ground truth and explain how Goodhart’s Law distorts single-metric optimization.
Self-Check: Answer
Why did computing benchmark methodology historically transition away from synthetic instruction-mix microbenchmarks (such as Whetstone and Dhrystone) to representative application suites (such as SPEC CPU)?
- Synthetic microbenchmarks required too much memory bandwidth to execute on modern microprocessors
- Representative application suites were easier to implement and did not require source code compilation
- Synthetic benchmarks lacked realistic memory access patterns and branch behavior, allowing optimizing compilers to artificially game scores via dead-code elimination and loop unrolling
- Hardware vendors refused to publish floating-point operations per second for synthetic loops
Answer: The correct answer is C. Synthetic benchmarks contained artificial, repetitive loops that optimizing compilers could easily recognize, unroll, or eliminate, inflating scores without providing real-world application speedups. SPEC CPU solved this by using complete, realistic application programs (like compilers, ray tracers, and fluid dynamics simulations) that exercised complex instruction flows, cache hierarchies, and memory subsystems. Memory bandwidth requirements were not the primary historical driver; representative application suites are substantially more complex to standardize and compile; hardware vendors actively published synthetic results until their lack of correlation with real software forced an industry transition.
Learning Objective: Analyze why the transition from synthetic microbenchmarks to representative application suites was necessary to prevent compiler gaming.
How do the constraints and primary evaluation metrics differ across the domain-specific variants of the MLPerf benchmark suite?
- All MLPerf variants evaluate identical metrics (pure TFLOPS) across different hardware form factors
- MLPerf Training focuses on latency SLAs, while MLPerf Inference evaluates multi-node interconnect bandwidth
- MLPerf Tiny measures data center power consumption, while MLPerf Power evaluates floating-point peak throughput
- MLPerf Training targets multi-node cluster scaling and time-to-quality, MLPerf Inference evaluates latency SLAs and QPS across server and edge, MLPerf Tiny targets microwatt-scale energy and memory constraints on microcontrollers, and MLPerf Power measures performance-per-watt
Answer: The correct answer is D. MLPerf partitions into specialized tracks because different deployment domains face fundamentally distinct physical constraints: Training is constrained by distributed interconnect scaling and convergence time; Inference is constrained by latency percentiles and serving throughput; Tiny is bounded by strict kilobyte memory and milliwatt budgets; and Power provides a cross-cutting measure of useful work per Joule. Claiming identical metrics across suites contradicts the domain-specific design of MLPerf; swapping Training and Inference constraints reverses their core purposes; mischaracterizing Tiny as data-center power evaluation contradicts its microcontroller focus.
Learning Objective: Compare the primary constraints and evaluation metrics across different MLPerf suite variants (Training, Inference, Tiny, Power).
True or False: The introduction of energy-efficiency benchmarks like SPECpower and Green500 replaced raw throughput benchmarks, because computing systems are now evaluated solely on Joules per operation.
Answer: False. Energy-efficiency benchmarks were established to complement raw performance rankings, not replace them. Modern evaluation frameworks employ multi-objective evaluation where performance (throughput/latency) and efficiency (performance-per-watt) are reported together, allowing practitioners to analyze trade-offs along an efficiency-performance Pareto frontier rather than collapsing evaluation to a single metric.
Learning Objective: Evaluate how energy-efficiency benchmarks (SPECpower, Green500) integrated with existing performance rankings rather than replacing them.
Explain how the historical evolution of computer benchmarking—from synthetic instruction loops to SPEC suites and Green500—directly informed the core design principles of MLPerf.
Answer: The history of computer benchmarking taught three fundamental lessons that directly shaped MLPerf: (1) Synthetic operations are vulnerable to vendor and compiler gaming, requiring representative end-to-end workloads and strict reference implementations; (2) Single peak metrics (like MIPS or peak FLOP/s) fail to reflect sustained execution bottlenecks, requiring holistic system-level measurement; and (3) Raw speed without energy accounting produces unsustainable systems, requiring integrated power-and-performance evaluation. MLPerf synthesizes these lessons by coupling representative model architectures with strict closed-division run rules, domain-specific execution scenarios (Server, SingleStream, Offline), and mandatory target accuracy thresholds.
Learning Objective: Explain how historical lessons from general computing benchmarks shaped the multi-objective design of MLPerf.
**Order the following historical computing benchmark paradigms chronologically from earliest to most modern:
- Standardized domain-specific ML consortium suites (e.g., MLPerf) with multi-scenario serving and strict convergence run rules
- Synthetic instruction-mix microbenchmarks (e.g., Whetstone, Dhrystone) measuring isolated arithmetic throughput
- Multi-organization application suites (e.g., SPEC CPU) evaluating real-world compiler and scientific workloads
- High-Performance Computing dense linear algebra factorization benchmarks (e.g., LINPACK / TOP500)
- Multi-load energy efficiency and server power benchmarks (e.g., SPECpower_ssj2008, Green500)**
Answer: The correct order is (2) Synthetic instruction-mix microbenchmarks -> (4) High-Performance Computing dense linear algebra factorization benchmarks -> (3) Multi-organization application suites -> (5) Multi-load energy efficiency and server power benchmarks -> (1) Standardized domain-specific ML consortium suites.
Justification: - (2) Synthetic microbenchmarks (Whetstone 1976, Dhrystone 1984) emerged first in early computing. - (4) LINPACK (1979) established matrix factorization benchmarking for supercomputing. - (3) SPEC CPU (1989) was founded to overcome synthetic gaming by using real application workloads. - (5) SPECpower (2007) and Green500 (2007) introduced energy-aware multi-load efficiency metrics. - (1) MLPerf (2018) synthesized representative ML workloads, convergence thresholds, and power measurement into a modern domain-specific consortium standard.
Learning Objective: Classify and order the historical evolution of benchmark design from synthetic microbenchmarks to domain-specific ML suites.
Self-Check: Answer
In roofline analysis, an accelerator has a peak compute performance of \(312\text{ TFLOPS}\) (BF16) and a memory bandwidth of \(2.0\text{ TB/s}\), yielding a machine ridge point of \(I_{\text{knee}} = 156\text{ FLOP/byte}\). When serving a Transformer model with batch size \(b=1\), the arithmetic intensity is only \(I = 4.8\text{ FLOP/byte}\). What is the maximum achievable compute utilization (MFU) on this workload?
- Approximately \(3.1\%\) of peak compute throughput (memory-bandwidth bound)
- Exactly \(100\%\) because modern tensor cores execute batch \(b=1\) at peak speed
- Approximately \(50\%\) due to pipeline bubbles and kernel launches
- Approximately \(85\%\) because matrix-vector multiplications are compute-bound
Answer: The correct answer is A. In the memory-bound regime (\(I < I_{\text{knee}}\)), the maximum achievable throughput is bounded by \(\text{Bandwidth} \times I = 2.0\text{ TB/s} \times 4.8\text{ FLOP/byte} = 9.6\text{ TFLOPS}\). Compute utilization is \(9.6 / 312 \approx 3.08\%\) (\(\sim 3.1\%\)). Claiming \(100\%\) ignores memory bandwidth limits on matrix-vector operations; \(50\%\) and \(85\%\) assume compute-bound saturation that cannot occur when arithmetic intensity is \(32\times\) below the machine ridge point.
Learning Objective: Apply roofline model principles to diagnose why sustained throughput deviates from theoretical peak FLOP/s at low arithmetic intensity.
A vendor publishes a marketing claim stating their new AI accelerator achieves ‘\(120\text{ TFLOPS}\) on Transformer inference.’ Which combination of parameters is essential to make this throughput figure technically actionable and reproducible?
- Only the silicon process node (e.g., \(4\text{ nm}\)) and the data center room temperature
- Numerical precision (e.g., INT8 vs. FP16), batch size, sequence length, software/compiler stack version, and sustained thermal operating state
- The brand of server power supply and the serial number of the host CPU
- Only the parameter count of the model, without specifying batch size or precision
Answer: The correct answer is B. Floating-point throughput varies by orders of magnitude based on numerical precision (e.g. FP32 vs. INT8), batch size (which dictates arithmetic intensity along the roofline), sequence length (which shapes attention memory scaling), compiler optimization flags, and thermal throttling state. Silicon process node and ambient room temperature alone do not provide execution context; power supply brand is irrelevant to computational reproducibility; model parameter count without precision or batch configuration leaves arithmetic intensity and memory traffic completely undefined.
Learning Objective: Evaluate the minimum execution parameters and workload context required to interpret vendor throughput claims.
Explain why a single benchmark run is insufficient to characterize ML system performance, identifying at least two distinct hardware or runtime sources of execution variance.
Answer: A single benchmark run is vulnerable to transient system perturbations and dynamic hardware states. Two primary sources of variance are: (1) Dynamic clock frequency scaling (e.g., GPU boost clocks temporarily inflating initial throughput before junction temperatures trigger steady-state throttling), and (2) Runtime/driver nondeterminism (e.g., asynchronous CUDA kernel launch queues, lazy memory allocation, and OS thread preemption). A sound benchmarking protocol requires explicit unmeasured warmup runs to reach thermal and memory steady state, followed by multiple independent runs reporting mean, variance, and confidence intervals.
Learning Objective: Explain why multi-run statistical replication and warmup phases are necessary to eliminate measurement noise in ML benchmarks.
Compare the primary objectives and constraints of the MLPerf Closed Division versus the Open Division.
Answer: The MLPerf Closed Division is designed for direct, apples-to-apples hardware and systems software comparisons: submitters must use identical reference model architectures, exact numerical precision equivalence rules, and fixed preprocessing/accuracy thresholds. The Open Division, in contrast, encourages algorithmic innovation: submitters can modify model architectures, employ aggressive pruning or quantization schemes, and change training/inference algorithms, provided the submission documents the technique and reports the achieved accuracy alongside throughput.
Learning Objective: Compare the evaluation objectives and submission rules of the MLPerf Closed Division versus the Open Division.
Explain how community-driven benchmarking consortia prevent vendor gaming and establish commensurable evidence for hardware procurement.
Answer: Community-driven consortia (like MLPerf / MLCommons) establish standardized rules, open-source reference code, and a mandatory peer-review audit process where competitors inspect each other’s submission logs and code. This prevents deceptive practices such as benchmark-specific compiler optimizations, stealth precision degradation, or cherry-picked execution intervals. The resulting standardized metrics provide commensurable evidence that allows buyers to compare platforms fairly based on verified performance rather than marketing datasheets.
Learning Objective: Justify why community-driven standardization and open auditing prevent vendor gaming in ML system benchmarking.
**Order the following steps in the MLPerf benchmark execution and verification lifecycle from first to last:
- Submit execution logs, power traces, and configuration metadata to the MLCommons consortium
- Execute unmeasured warm-up iterations to populate caches and stabilize operating temperatures
- Lock down hardware frequencies, software environment, and driver configurations
- Execute the standardized benchmark harness while logging timestamped execution and energy metrics
- Undergo peer-review audit where competing organizations inspect logs for run-rule compliance
- Run the compliance validation suite to verify prediction outputs meet the target accuracy threshold**
Answer: The correct order is (3) Lock down hardware frequencies, software environment, and driver configurations -> (2) Execute unmeasured warm-up iterations to populate caches and stabilize operating temperatures -> (4) Execute the standardized benchmark harness while logging timestamped execution and energy metrics -> (6) Run the compliance validation suite to verify prediction outputs meet the target accuracy threshold -> (1) Submit execution logs, power traces, and configuration metadata to the MLCommons consortium -> (5) Undergo peer-review audit where competing organizations inspect logs for run-rule compliance.
Justification: - (3) System environment lockdown is the mandatory prerequisite before testing. - (2) Warmup iterations establish steady-state thermal and memory conditions. - (4) The timed benchmark execution loop collects the primary performance data. - (6) Compliance validation confirms the run achieved the required accuracy before packaging. - (1) Submission of raw logs and artifacts occurs after internal verification. - (5) Formal peer-review auditing is the final consortium verification stage before publication.
Learning Objective: Classify and order the operational stages of the MLPerf benchmark submission and verification lifecycle.
Self-Check: Answer
An e-commerce search service reports that production query latency has increased by \(40\%\), violating its SLA. Which benchmarking workflow represents the most effective top-down diagnostic strategy?
- Immediately rewrite all GEMM kernels in CUDA assembly without measuring the higher layers
- Run isolated microbenchmarks on the GPU memory bus to determine peak DRAM bandwidth
- Start with an end-to-end pipeline benchmark to isolate latency contributions across database lookup, tokenization, model inference, and reranking; next run macrobenchmarks on the slowest stage; then use microbenchmarks and kernel profilers to optimize the specific bottleneck operator
- Benchmark only the isolated tokenization library on CPU and assume the rest of the pipeline is unaffected
Answer: The correct answer is C. A disciplined top-down diagnostic workflow starts at the end-to-end level to isolate which pipeline stage caused the SLA violation, zooms into macrobenchmarks (subgraphs/models) for that component, and finally uses microbenchmarks and kernel profilers (e.g. Nsight) to identify the specific hardware or algorithmic bottleneck. Rewriting kernels blindly wastes effort on non-bottlenecks; testing memory bus bandwidth in isolation does not pinpoint where time is spent in the request path; testing tokenization alone ignores interactions with database retrieval and model execution.
Learning Objective: Design a multi-granularity benchmarking strategy that combines end-to-end, macro, and micro evaluations to diagnose system bottlenecks.
**Consider the following three benchmarking tasks:
- Timing a single \(4096 \times 4096\) FP16 matrix multiplication in cuBLAS.
- Measuring the forward-pass execution time of a complete ResNet-50 model on a single GPU.
- Measuring total latency for an image upload, server decompression, feature extraction, neural network classification, and database metadata write. How are tasks (I), (II), and (III) classified by benchmarking granularity?**
- End-to-end, (II) Micro, (III) Macro
- Macro, (II) Micro, (III) End-to-end
- Micro, (II) End-to-end, (III) Macro
- Microbenchmark, (II) Macrobenchmark (model-level), (III) End-to-end system benchmark
Answer: The correct answer is D. Task (I) isolates an individual mathematical operator (microbenchmark); Task (II) evaluates a complete neural network architecture (macrobenchmark); Task (III) exercises the complete production data pipeline including networking, I/O, preprocessing, model execution, and storage (end-to-end system benchmark). The other combinations scramble these standardized granularity levels.
Learning Objective: Classify benchmark scenarios into micro, macro, and end-to-end granularity levels based on workload scope.
Compare microbenchmarks, macrobenchmarks, and end-to-end benchmarks along the axes of diagnostic isolation and real-world representativeness.
Answer: Benchmarking granularity exists on a fundamental trade-off curve between diagnostic isolation and real-world representativeness:
Microbenchmarks (e.g., isolated GEMM kernels) offer high diagnostic isolation—pinpointing exact hardware execution bottlenecks or compiler code generation efficiency—but low real-world representativeness because they ignore framework overhead, memory transfers, and surrounding pipeline stages.
Macrobenchmarks (e.g., full ResNet or Transformer forward passes) offer moderate diagnostic power and moderate representativeness, evaluating model architecture and framework execution while excluding external I/O.
End-to-end benchmarks (e.g., full serving pipelines with network ingestion, preprocessing, inference, and database writes) offer high real-world representativeness—capturing true user experience—but low diagnostic isolation because a latency spike could stem from network congestion, garbage collection, data loading, or compute.
Learning Objective: Compare the diagnostic power and real-world representativeness across micro, macro, and end-to-end benchmarks.
True or False: If an optimized FlashAttention kernel achieves a \(4\times\) microbenchmark speedup over a standard attention implementation, the complete language model inference service hosting that model is mathematically guaranteed to run \(4\times\) faster end-to-end.
Answer: False. By Amdahl’s Law, the end-to-end speedup is strictly bounded by the fraction of total execution time accounted for by the attention kernel. In a complete LLM serving system, non-attention operations (linear projection layers, LayerNorm, activations), host-to-device memory copies, token sampling, request queueing, and network serialization remain unaccelerated, capping the system-level speedup substantially below \(4\times\).
Learning Objective: Evaluate why isolated microbenchmark speedups fail to translate proportionally to full pipeline performance.
**Order the following benchmarking evaluation scopes from highest diagnostic isolation (lowest representativeness) to lowest diagnostic isolation (highest real-world representativeness):
- Complete serving system benchmark with web server, dynamic batching, and client network traffic
- Isolated cuBLAS FP16 matrix multiplication kernel microbenchmark
- Full Transformer neural network model forward-and-backward training pass (macrobenchmark)
- Fused multi-head self-attention layer subgraph benchmark
- End-to-end enterprise ML pipeline including database ETL, preprocessing, inference, and audit logging**
Answer: The correct order is (2) Isolated cuBLAS FP16 matrix multiplication kernel microbenchmark -> (4) Fused multi-head self-attention layer subgraph benchmark -> (3) Full Transformer neural network model forward-and-backward training pass (macrobenchmark) -> (1) Complete serving system benchmark with web server, dynamic batching, and client network traffic -> (5) End-to-end enterprise ML pipeline including database ETL, preprocessing, inference, and audit logging.
Justification: - (2) Operator microbenchmarks have maximum diagnostic isolation on specific hardware units. - (4) Layer/subgraph benchmarks evaluate fused multi-op kernels within a local block. - (3) Model-level macrobenchmarks evaluate the entire neural network computational graph. - (1) Serving benchmarks add request queues, scheduling, dynamic batching, and networking. - (5) End-to-end enterprise pipelines encompass the full multi-tier architecture from storage to application logic, maximizing representativeness.
Learning Objective: Classify and order benchmark evaluation scopes along the spectrum from isolated component diagnostics to end-to-end production pipelines.
Self-Check: Answer
Which core benchmark component is responsible for documenting the exact hardware model, CPU core pinning, GPU driver version, CUDA toolkit, compiler flags, and OS kernel version required to ensure experimental reproducibility?
- System specifications
- Dataset split definition
- Evaluation metric formula
- Problem definition
Answer: The correct answer is A. System specifications define the complete hardware and software environment—including CPU/GPU architectures, interconnect topology, OS version, kernel drivers, compiler flags, and library versions—necessary for third parties to replicate results. Dataset splits define training/validation partitioning; evaluation metrics define scoring mathematics; problem definitions specify the high-level task and domain objectives.
Learning Objective: Analyze which benchmark component captures the software and hardware execution environment necessary for reproducibility.
When designing a benchmark suite for an edge computer vision model deployed on a battery-powered security camera with passive cooling, which set of evaluation metrics provides the most complete assessment of deployment viability?
- Peak offline throughput in FP32 without thermal monitoring
- Energy per inference (mJ), active vs. idle power consumption across the device duty cycle, memory footprint (SRAM/DRAM usage), and sustained latency under thermal equilibrium
- Only the model parameter file size on disk in megabytes
- Top-1 validation accuracy measured on an uncompressed server GPU
Answer: The correct answer is B. Edge deployments are constrained by battery capacity, passive thermal envelopes, and limited memory. A complete edge benchmark must measure energy per inference, idle vs. active duty-cycle power, memory footprint, and sustained performance over time (to detect thermal throttling). Peak offline throughput ignores thermal throttling and latency; file size on disk ignores runtime memory allocation and energy; server GPU accuracy ignores edge quantization and hardware execution constraints.
Learning Objective: Design an evaluation metric suite for resource-constrained edge deployments with strict thermal and battery envelopes.
True or False: When evaluating model compression techniques (such as INT8 quantization or structured pruning), validating that the compressed model achieves a \(4\times\) reduction in file size with \(<0.5\%\) top-1 accuracy loss is sufficient to guarantee proportional speedups and energy savings on any target deployment hardware.
Answer: False. Model size reduction does not guarantee proportional latency speedups or energy savings on hardware. Unstructured sparsity, non-standard quantization precisions, or unsupported operator layouts can trigger CPU fallbacks, memory realignment stalls, or inefficient execution on edge NPUs that lack specialized hardware acceleration, sometimes making a compressed model slower than the dense baseline.
Learning Objective: Evaluate why compression benchmarking requires multi-objective Pareto analysis rather than single-metric compression ratios.
In standardized benchmarking suites, the formal component that defines the mandatory execution constraints, convergence thresholds, warmup requirements, and statistical aggregation procedures to ensure fair cross-platform comparisons is called the ____.
Answer: run rules. run rules completes the statement regarding in standardized benchmarking suites, the formal component th.
Learning Objective: Explain the function of benchmark run rules in enforcing fair and reproducible execution across submissions.
Explain why compression evaluation must be framed as a multi-objective Pareto frontier across accuracy, latency, memory footprint, and energy, rather than relying on a single compression ratio.
Answer: Compression techniques (quantization, pruning, distillation) introduce multidimensional trade-offs that cannot be summarized by a single compression ratio. A 4-bit quantized model may offer high memory reduction but suffer latency penalties if the target accelerator lacks native INT4 ALUs and must unpack weights into INT8 at runtime. Furthermore, aggressive compression can preserve top-1 accuracy while degrading confidence calibration, out-of-distribution robustness, or subgroup fairness. Evaluating models along a Pareto frontier across accuracy, latency, peak memory, and energy ensures system designers select configurations that satisfy all operational constraints simultaneously.
Learning Objective: Justify why compression evaluation must measure latency, memory footprint, and accuracy across target hardware backends.
**Order the following execution steps of a standardized benchmark harness protocol from beginning to end:
- Execute the timed measurement loop while collecting high-resolution hardware timestamps
- Pin process affinities to dedicated CPU cores and lock accelerator clock frequencies
- Compute summary statistics (mean, median, p90, p99, standard deviation) and confidence intervals
- Execute unmeasured warm-up iterations to load model weights and warm instruction/data caches
- Perform verification check to ensure model output predictions match ground truth quality thresholds**
Answer: The correct order is (2) Pin process affinities to dedicated CPU cores and lock accelerator clock frequencies -> (4) Execute unmeasured warm-up iterations to load model weights and warm instruction/data caches -> (1) Execute the timed measurement loop while collecting high-resolution hardware timestamps -> (5) Perform verification check to ensure model output predictions match ground truth quality thresholds -> (3) Compute summary statistics (mean, median, p90, p99, standard deviation) and confidence intervals.
Justification: - (2) Hardware frequency locking and core pinning must occur first to eliminate execution jitter. - (4) Warm-up iterations ensure memory caches and hardware pipelines reach steady state before timing begins. - (1) The measurement loop collects the timestamped performance data. - (5) Output verification ensures the measured workload computed valid mathematical results. - (3) Statistical aggregation computes the final reported metrics and confidence intervals.
Learning Objective: Classify and order the execution steps of a standardized benchmark harness protocol.
Self-Check: Answer
How do the primary benchmarking objectives and resource bottlenecks fundamentally differ between training systems and inference serving systems?
- Training is latency-critical with millisecond deadlines, whereas inference is throughput-oriented over weeks
- Training memory footprint is dominated solely by static weights, whereas inference requires large optimizer states
- Training optimizes for sustained throughput (samples/sec) and time-to-accuracy across multi-node accelerators with massive memory demands (weights, gradients, optimizer states, activations), whereas inference optimizes for latency percentiles (p50, p99), QPS, and energy per query under strict SLA constraints
- Training and inference have identical memory access patterns and evaluate the exact same metrics
Answer: The correct answer is C. Training is long-running and stateful, requiring substantial memory for forward activations, backward gradients, and optimizer states (e.g. Adam 8 bytes/param) while scaling across distributed nodes to minimize time-to-accuracy. Inference is request-driven, stateless or session-scoped, dominated by forward passes, and constrained by latency deadlines (p90/p99), cold-start overheads, and per-query energy costs. Claiming training is latency-critical with millisecond deadlines swaps the definitions; asserting training memory is only weights ignores gradients and optimizer states; claiming identical access patterns ignores the backward pass.
Learning Objective: Compare the primary benchmark objectives, memory demands, and latency constraints between training and inference workloads.
Explain why training a 7-billion parameter language model requires over \(80\text{ GB}\) of accelerator memory, while serving inference for the same model in FP16 requires only around \(14\text{ GB}\) of weight memory.
Answer: Training requires storing not only the model weights (\(14\text{ GB}\) in FP16) but also: (1) Gradients (\(14\text{ GB}\)), (2) Optimizer states (e.g., FP32 master weights, momentum, and variance in Adam require \(16\text{ bytes/parameter}\), or \(28\text{ GB}\)), and (3) Intermediate activation tensors saved during the forward pass for backward gradient computation, which scale with batch size and sequence length. In contrast, standard inference executes only the forward pass, requiring memory solely for the static model weights (\(14\text{ GB}\)) plus a transient activation and KV cache buffer.
Learning Objective: Explain why training and inference impose drastically different memory footprints and execution patterns on the same accelerator.
True or False: If an accelerator achieves the top ranking in MLPerf Training on large-batch vision models, it can be assumed to deliver top-tier performance on low-batch, latency-critical interactive inference serving.
Answer: False. Training benchmarks evaluate high-throughput, large-batch, compute-bound workloads with high arithmetic intensity across multi-GPU interconnects. In contrast, single-request interactive inference operates at small batch sizes (\(b=1\)) where workloads are memory-bandwidth-bound and sensitive to kernel launch overhead, software runtime dispatch latency, and cold-start delays—characteristics where high-throughput training accelerators may underperform.
Learning Objective: Evaluate whether an accelerator’s training benchmark throughput reliably predicts its performance on latency-constrained inference tasks.
Self-Check: Answer
Why does MLPerf Training mandate time-to-accuracy (or time-to-quality) as its primary benchmark metric instead of raw throughput measured in samples per second?
- Samples per second cannot be measured accurately with digital timers
- Time-to-accuracy is easier to simulate without running actual GPUs
- Hardware vendors do not know the batch size used during training
- Raw sample throughput can be artificially inflated by using aggressive low precision or extreme batch sizes that destabilize training, whereas time-to-accuracy ensures throughput optimizations actually converge to the required model quality
Answer: The correct answer is D. Measuring throughput (samples/sec) in isolation creates an optimization trap: a system could double sample throughput by using numerical shortcuts (e.g., aggressive low precision or excessive learning rates) that cause divergence or require \(3\times\) more iterations to reach the target loss. Time-to-accuracy ties computational speed directly to algorithmic convergence, ensuring that reported performance gains translate into reduced wall-clock training time. Digital timers measure throughput accurately; time-to-accuracy requires full execution rather than simple simulation; batch sizes are fully defined in benchmark configurations.
Learning Objective: Analyze why time-to-accuracy is the primary benchmark metric for training systems rather than raw sample throughput.
A deep learning model trains on a single GPU in \(24\text{ hours}\). When distributed across \(8\text{ GPUs}\) on the same fixed total dataset (strong scaling), the training completes in \(4\text{ hours}\). What is the strong scaling efficiency, and what primary system factor prevents it from achieving \(100\%\)?
- \(75\%\) efficiency; inter-GPU gradient synchronization communication overhead and serialization bottlenecks reduce speedup below the ideal \(8\times\)
- \(100\%\) efficiency; the run achieved linear speedup because \(24 / 4 = 6\)
- \(50\%\) efficiency; GPU memory bandwidth is cut in half whenever multiple GPUs are connected
- \(12.5\%\) efficiency; training time only decreased by a factor of 6
Answer: The correct answer is A. The speedup is \(S = T_1 / T_8 = 24 / 4 = 6\times\). Strong scaling efficiency is \(E = S / N = 6 / 8 = 0.75\) (\(75\%\)). The \(25\%\) efficiency loss is caused by inter-GPU gradient communication (all-reduce synchronization), Amdahl’s serial fraction (data loading/master coordination), and straggler delays. Linear speedup would require completing in \(3\text{ hours}\) (\(8\times\)); GPU memory bandwidth is not halved by multi-GPU scaling; \(12.5\%\) confuses \(1/8\) with scaling efficiency.
Learning Objective: Calculate strong-scaling efficiency across distributed accelerator nodes and diagnose sources of sub-linear speedup.
Explain why a reduced-precision training configuration (such as FP8 or BF16) that achieves a \(1.8\times\) step-level throughput gain could result in a longer wall-clock time-to-accuracy than standard FP32 training.
Answer: While reduced-precision arithmetic increases hardware FLOPS and reduces memory traffic—yielding faster per-step execution—it introduces numerical rounding errors and smaller dynamic range. In sensitive architectures or uncalibrated loss scalers, these numerical perturbations can cause gradient underflow/overflow, slowing the loss convergence rate. If the model requires \(2.5\times\) more optimization steps to achieve the target validation accuracy, the \(1.8\times\) step speedup is completely erased, resulting in a net increase in total wall-clock training time.
Learning Objective: Evaluate how reduced-precision math affects both step-level throughput and epoch-level convergence trajectories.
In distributed training benchmarks, the scaling regime where the total workload/dataset size remains constant as the number of accelerator nodes increases is known as ____.
Answer: strong scaling. strong scaling completes the statement regarding in distributed training benchmarks, the scaling regime where.
Learning Objective: Explain the distinction between strong scaling and weak scaling in distributed ML training evaluation.
Explain why evaluating distributed training systems solely under idealized, failure-free conditions misrepresents large-scale cluster performance, and identify two system overheads required for production robustness.
Answer: Large-scale distributed training runs across hundreds or thousands of accelerator nodes over weeks, where hardware failures (GPU errors, bad network links, silent data corruption) are statistical certainties rather than rare exceptions. Benchmarks that ignore fault tolerance miss two critical system overheads: (1) Periodic checkpointing overhead (I/O latency to serialize terabytes of state to persistent storage), and (2) Straggler latency and recovery costs (synchronous distributed algorithms stall waiting for the slowest node, and node failures require rolling back to the last checkpoint and reinitializing communication meshes).
Learning Objective: Justify why fault-tolerance mechanisms and straggler latency must be incorporated into large-scale training benchmarks.
**Order the following operational stages of an MLPerf Training time-to-accuracy benchmark evaluation run from start to finish:
- Halt training execution and log total elapsed wall-clock time-to-accuracy
- Execute distributed forward-backward iterations with gradient synchronization across nodes
- Initialize model parameters and data loaders using fixed random seeds and standardized preprocessing
- Check whether the validation accuracy meets or exceeds the mandatory target quality threshold
- Perform periodic evaluation on the held-out validation dataset at predefined epoch intervals**
Answer: The correct order is (3) Initialize model parameters and data loaders using fixed random seeds and standardized preprocessing -> (2) Execute distributed forward-backward iterations with gradient synchronization across nodes -> (5) Perform periodic evaluation on the held-out validation dataset at predefined epoch intervals -> (4) Check whether the validation accuracy meets or exceeds the mandatory target quality threshold -> (1) Halt training execution and log total elapsed wall-clock time-to-accuracy.
Justification: - (3) Deterministic initialization of weights, data loaders, and seeds is the starting prerequisite. - (2) The core distributed training execution loop processes batches and updates weights. - (5) Periodic validation evaluation occurs at fixed intervals without contributing to gradient updates. - (4) Validation accuracy is compared against the target threshold (e.g. 75.9% on ImageNet). - (1) Training terminates immediately upon satisfying the convergence rule, recording wall-clock time.
Learning Objective: Classify and order the operational stages of an MLPerf Training time-to-accuracy evaluation loop.
Self-Check: Answer
In a distributed serving architecture, a user request fans out in parallel to \(10\) backend ML model services before aggregating the results. If each service has a \(99^{\text{th}}\) percentile latency (\(p99\)) of \(20\text{ ms}\) (meaning a \(1\%\) probability of exceeding \(20\text{ ms}\)), what is the approximate probability that an incoming user request experiences a tail latency exceeding \(20\text{ ms}\)?
- Exactly \(1.0\%\)
- Approximately \(9.6\%\) (nearly \(1\) in every \(10\) user requests)
- Exactly \(0.1\%\)
- 0% because parallel aggregation hides individual service latency spikes
Answer: The correct answer is B. When a request fans out to \(k\) independent backend calls, the probability that all \(k\) complete within the deadline is \((1 - p)^k\). For \(k=10\) and \(p=0.01\), the probability of all completing on time is \(0.99^{10} \approx 0.9044\), meaning the probability that at least one service exceeds \(p99\) is \(1 - 0.9044 = 0.0956\) (\(\approx 9.6\%\)). Assuming \(1.0\%\) ignores the fan-out amplification effect; \(0.1\%\) erroneously multiplies probabilities as if all services had to fail simultaneously; asserting 0% ignores the reality that total request latency is bounded by the slowest parallel response.
Learning Objective: Analyze why tail latency (p99) dominates user-perceived response times in fan-out distributed inference pipelines.
An image classification inference pipeline takes \(18\text{ ms}\) per request on a CPU baseline: \(8\text{ ms}\) in image decoding/preprocessing and \(10\text{ ms}\) in neural network execution. If the model execution is migrated to a specialized NPU that accelerates the neural network by \(5\times\) (reducing inference time from \(10\text{ ms}\) to \(2\text{ ms}\)), what is the resulting end-to-end pipeline latency and speedup?
- \(2.0\text{ ms}\) latency and \(9.0\times\) speedup
- \(3.6\text{ ms}\) latency and \(5.0\times\) speedup
- \(10.0\text{ ms}\) latency and \(1.8\times\) speedup
- \(16.0\text{ ms}\) latency and \(1.1\times\) speedup
Answer: The correct answer is C. The unaccelerated preprocessing time remains \(8\text{ ms}\), while the accelerated inference time becomes \(10\text{ ms} / 5 = 2\text{ ms}\). Total end-to-end latency is \(8\text{ ms} + 2\text{ ms} = 10\text{ ms}\). The end-to-end speedup is \(18\text{ ms} / 10\text{ ms} = 1.8\times\). Claiming \(2.0\text{ ms}\) ignores preprocessing entirely; claiming \(3.6\text{ ms}\) incorrectly applies the \(5\times\) speedup to the entire pipeline; claiming \(16.0\text{ ms}\) undercalculates the impact of the accelerator.
Learning Objective: Calculate end-to-end speedup using Amdahl’s Law when model inference latency is accelerated relative to fixed preprocessing overhead.
A cloud provider is deploying an interactive web translation API where independent user requests arrive randomly according to a Poisson process, and all responses must satisfy a strict tail latency constraint of \(p99 \le 15\text{ ms}\). Which MLPerf Inference scenario directly benchmarks this operational deployment?
- Offline scenario
- SingleStream scenario
- MultiStream scenario
- Server scenario
Answer: The correct answer is D. The MLPerf Server scenario generates queries following a Poisson arrival distribution and measures the maximum sustainable throughput (QPS) subject to a strict tail-latency SLA (e.g. \(p99 \le 15\text{ ms}\)). The Offline scenario sends all queries simultaneously in a batch without arrival intervals; the SingleStream scenario issues one query at a time (waiting for completion before sending the next); the MultiStream scenario sends batches of fixed query streams at regular intervals (typical of multi-camera feeds).
Learning Objective: Compare the four MLPerf Inference scenarios (SingleStream, MultiStream, Server, Offline) based on their query arrival patterns and target metrics.
In serverless and on-demand inference systems, the latency penalty incurred on the first request after an idle period—caused by loading weights into memory and compiling compute kernels—is termed a ____.
Answer: cold start. cold start completes the statement regarding in serverless and on-demand inference systems, the latency p.
Learning Objective: Explain the cause and impact of cold start latency in on-demand serverless inference deployments.
Explain why reporting an accelerator-only inference time (e.g., \(2\text{ ms}\) on an edge NPU) fails to predict actual mobile application performance, identifying at least two real-world system bottlenecks.
Answer: Accelerator-only measurements isolate the raw tensor execution while excluding critical end-to-end system overheads: (1) Host-to-device memory copy latency (moving camera image buffers across system buses into NPU SRAM/DRAM often exceeds the \(2\text{ ms}\) compute time), (2) CPU preprocessing and postprocessing (sensor formatting, non-maximum suppression, bounding box scaling), and (3) Thermal throttling (under sustained passive cooling, rising device temperatures force the SoC to throttle clock frequencies, doubling steady-state latency compared to burst-mode tests).
Learning Objective: Evaluate why accelerator-only inference times fail to predict end-to-end mobile performance under realistic preprocessing and thermal constraints.
**Order the following execution stages of an MLPerf Inference Server-scenario benchmark evaluation run from start to finish:
- LoadGen generates queries according to a Poisson arrival distribution at a target query-per-second (QPS) rate
- SUT receives queries, applies dynamic batching, executes neural network inference, and returns responses
- Warm up the System Under Test (SUT) with representative queries to populate weights and compile execution graphs
- Check that model output accuracy meets the required reference quality threshold
- Record end-to-end timestamps for each query and compute the empirical latency distribution (\(p50\), \(p90\), \(p99\)) to verify SLA compliance**
Answer: The correct order is (3) Warm up the System Under Test (SUT) with representative queries to populate weights and compile execution graphs -> (1) LoadGen generates queries according to a Poisson arrival distribution at a target query-per-second (QPS) rate -> (2) SUT receives queries, applies dynamic batching, executes neural network inference, and returns responses -> (5) Record end-to-end timestamps for each query and compute the empirical latency distribution (\(p50\), \(p90\), \(p99\)) to verify SLA compliance -> (4) Check that model output accuracy meets the required reference quality threshold.
Justification: - (3) Pre-test warmup primes caches and establishes steady execution state. - (1) LoadGen injects Poisson-distributed requests at the target rate. - (2) The System Under Test processes the dynamic request stream. - (5) End-to-end response timestamps are aggregated into latency percentiles. - (4) Output quality validation verifies that predictions meet accuracy constraints at that QPS.
Learning Objective: Classify and order the execution stages of an MLPerf Inference Server scenario benchmark run.
Self-Check: Answer
A vendor advertises an AI accelerator as delivering ‘\(10\text{ TOPS}\) at \(0.5\text{ W}\).’ When deployed in a production server, the total power consumption measured at the wall socket increases by \(4.5\text{ W}\) for that same workload. What explains this discrepancy in benchmarking methodology?
- The vendor drew an isolated power measurement boundary around the compute core silicon only, omitting DRAM interfaces, PCIe host transfers, voltage regulators, CPU preprocessing, and cooling fans
- The electrical wall outlet was defective and provided improper alternating current
- Power consumption in digital circuits is inherently non-deterministic and varies by \(10\times\) between runs
- The vendor measured power during sleep mode rather than active compute
Answer: The correct answer is A. Power and energy efficiency claims are meaningless without defining the measurement boundary. Vendors often quote core silicon TDP under narrow microbenchmarks, excluding off-chip memory interfaces (DRAM/HBM), host bus communication (PCIe), power delivery losses (VRMs), host CPU driver overhead, and cooling infrastructure, all of which contribute to total system power draw. Defective outlets do not explain systematic boundary differences; power consumption under controlled workloads is deterministic; active core TDP differs from full-system load rather than sleep mode.
Learning Objective: Analyze why explicit power-measurement boundaries (chip TDP vs. wall-socket system power) are critical for fair energy-efficiency comparisons.
An accelerator increases its operating clock frequency to achieve a \(5\%\) increase in inference throughput, but this requires increasing the supply voltage by \(15\%\). Because dynamic power scales as \(P \propto V^2 f\), active power consumption increases by approximately \(39\%\). What is the systems consequence of this operating point for a power-constrained edge deployment?
- It is an optimal trade-off because throughput is always the only metric that matters
- It represents a severe energy efficiency regression, reducing performance-per-watt by roughly \(24\%\) and accelerating battery drain and thermal throttling
- Performance-per-watt increases because higher frequency reduces static leakage
- The device will operate cooler because inferences finish \(5\%\) sooner
Answer: The correct answer is B. In dynamic CMOS circuits, power scales with \(V^2 f\). A \(1.15^2 \times 1.05 \approx 1.389\) (\(39\%\) power increase) for only a \(5\%\) speedup causes throughput-per-watt to drop from \(1.0 / 1.0 = 1.0\) to \(1.05 / 1.389 \approx 0.756\) (a \(24.4\%\) reduction in efficiency). In edge/mobile systems, this sharp efficiency loss exhausts battery budgets and triggers thermal throttling. Claiming throughput is the only metric denies energy constraints; performance-per-watt clearly dropped; drawing \(39\%\) more power increases heat dissipation, making the device run hotter.
Learning Objective: Evaluate how voltage-frequency scaling curves cause cubic power growth relative to modest throughput improvements.
Explain why instantaneous power sampling during an ML inference workload produces misleading results, and describe how standardized protocols calculate total energy.
Answer: ML workloads fluctuate rapidly across distinct execution phases—transitioning between compute-bound matrix multiplications (intense power spikes), memory-bound data shuffling (moderate power), and idle host-synchronization intervals (low power). An instantaneous reading captures an arbitrary snapshot rather than true workload cost. Standardized protocols (like MLPerf Power) connect a high-frequency power analyzer in series with the power rail, log time-series power \(P(t)\) continuously over hundreds of warm iterations under thermal steady state, and compute total energy by integration (\(E = \int P(t) \, dt\)), dividing by query count to report Joules per inference.
Learning Objective: Explain why time-varying execution phases and thermal steady states require integrated energy measurement rather than instantaneous sampling.
True or False: In standardized ML power benchmarking, measuring the power draw of the arithmetic compute units (ALUs and tensor cores) is sufficient because the energy required to read and write data from DRAM is negligible in comparison.
Answer: False. In modern computer architectures, moving data across the memory hierarchy (from off-chip DRAM to on-chip SRAM/registers) frequently consumes significantly more energy per byte than executing an arithmetic operation on that data. In memory-bound workloads (such as recommendation systems like DLRM or auto-regressive Transformer token generation), memory access energy dominates total system power consumption.
Learning Objective: Evaluate whether memory movement contributes substantially to total system energy consumption in ML workloads.
**Order the following steps in a standardized MLPerf Power measurement protocol from start to finish:
- Integrate instantaneous power readings over the full run duration (\(E = \int P(t) \, dt\)) and compute Joules per inference
- Establish the physical measurement boundary and connect a calibrated power analyzer in series with the system power supply
- Execute unmeasured warm-up iterations until the device achieves thermal equilibrium (steady-state junction temperature)
- Measure and record the baseline idle/quiescent power consumption while the system is waiting for requests
- Execute the synchronized inference benchmark workload while logging continuous high-frequency time-series power and temperature data**
Answer: The correct order is (2) Establish the physical measurement boundary and connect a calibrated power analyzer in series with the system power supply -> (4) Measure and record the baseline idle/quiescent power consumption while the system is waiting for requests -> (3) Execute unmeasured warm-up iterations until the device achieves thermal equilibrium (steady-state junction temperature) -> (5) Execute the synchronized inference benchmark workload while logging continuous high-frequency time-series power and temperature data -> (1) Integrate instantaneous power readings over the full run duration (\(E = \int P(t) \, dt\)) and compute Joules per inference.
Justification: - (2) Instrumentation and boundary setup must be established first. - (4) Quiescent idle power baseline is recorded before workload launch. - (3) Warmup runs stabilize hardware temperature and prevent boost clock inflation. - (5) The timed benchmark runs with synchronized power logging. - (1) Mathematical integration computes total energy consumption and efficiency metrics.
Learning Objective: Classify and order the operational steps of a standardized MLPerf Power measurement run.
Self-Check: Answer
An image classification model achieves \(95\%\) accuracy on the CIFAR-10 benchmark test set, but when deployed on a mobile robot operating in a warehouse, its accuracy drops to \(70\%\). Which benchmarking limitation directly explains this performance collapse?
- The mobile robot CPU lacked 64-bit floating-point registers
- The CIFAR-10 evaluation used too few random seeds during training
- Incomplete benchmark coverage and distributional narrowness: the benchmark dataset contained clean, centered, low-resolution web images that failed to represent warehouse camera noise, lighting variations, and motion blur
- The benchmark harness executed the test set in the wrong order
Answer: The correct answer is C. Benchmarks are limited by the distributional diversity of their datasets. CIFAR-10 contains curated, centered, canonical images; high accuracy on such narrow distributions does not reflect generalization to real-world deployment environments where lighting changes, perspective shifts, lens distortion, and motion blur occur. CPU register width does not cause a \(25\%\) accuracy drop; seed variance alone cannot explain massive real-world domain collapse; test set execution order has no impact on mathematical classification accuracy.
Learning Objective: Analyze why distributional narrowness in training/test datasets causes models with high benchmark accuracy to fail in deployment.
Which set of governance and methodological rules does the MLPerf consortium implement to prevent submitters from ‘gaming’ the benchmark through benchmark-specific shortcuts?
- Allowing submitters to create proprietary synthetic test datasets that are kept secret from competitors
- Permitting compilers to silently lower numerical precision below IEEE standards without reporting the accuracy impact
- Evaluating systems solely on peak theoretical arithmetic operations per second without measuring execution time
- Enforcing strict Closed Division rules (requiring exact reference model equivalence, fixed preprocessing, and mandatory quality targets), prohibiting benchmark detection code branching, and requiring open peer-review log audits
Answer: The correct answer is D. MLPerf prevents vendor gaming through four explicit mechanisms: (1) Closed Division reference model equivalence, (2) Mandatory target accuracy thresholds, (3) Explicit rules banning benchmark detection and special-case code branches, and (4) An open peer-review audit process where competitors inspect submission code and logs. Secret datasets prevent verification; silent precision degradation is explicitly banned; evaluating only peak theoretical specs is the exact failure mode MLPerf was created to eliminate.
Learning Objective: Evaluate the governance and run-rule mechanisms used by MLPerf (closed division, audits, reference models) to prevent benchmark gaming.
What is the core insight of the ‘Hardware Lottery’ concept (coined by Sara Hooker in 2021) regarding the relationship between ML benchmarks and research progress?
- An algorithmic research idea often succeeds not because it is universally superior, but because existing hardware accelerators and software compilers happen to be highly optimized for its specific computational pattern (such as dense GEMM)
- Hardware performance is purely random and cannot be measured with scientific accuracy
- Researchers should purchase computer hardware using randomized government lotteries
- Deep neural networks perform identically across all hardware architectures regardless of compiler support
Answer: The correct answer is A. The Hardware Lottery describes how research directions are heavily shaped by hardware availability: algorithms that match prevailing hardware architectures (e.g. dense matrix multiplications on GPUs) achieve high benchmark scores and attract funding, while alternative algorithms (e.g. dynamic sparse graphs, spiking networks) appear slow simply because hardware and software ecosystems are not optimized for them. Claiming hardware performance is random misinterprets the metaphor; lotteries for purchasing hardware is a literal confusion; algorithms vary drastically across hardware architectures.
Learning Objective: Explain how the hardware lottery influences AI research trajectories and architectural preferences.
True or False: If a benchmark measurement is conducted with flawless statistical rigor—using 1,000 independent runs, narrow confidence intervals, and controlled thermal states—its results are guaranteed to predict real-world production system performance.
Answer: False. Statistical rigor guarantees precision and internal validity under the benchmark’s specific experimental conditions, but it does not guarantee external validity (deployment alignment). If the benchmark workload, batch size distribution, or input dataset does not match production operational reality, the benchmark is ‘precisely wrong’—measuring an irrelevant condition with high statistical confidence.
Learning Objective: Evaluate whether statistical rigor and narrow confidence intervals in laboratory benchmarks guarantee production reliability.
The structural phenomenon where a machine learning algorithm achieves prominence primarily because specialized hardware and software compilers were already co-optimized for its execution pattern is called the ____.
Answer: hardware lottery. hardware lottery completes the statement regarding the structural phenomenon where a machine learning algorithm.
Learning Objective: Explain the concept of the hardware lottery as a structural bias favoring algorithms that align with prevailing hardware architectures.
Explain the fundamental tension between benchmark stability and benchmark evolution, and describe how benchmark consortia manage this trade-off.
Answer: Benchmark design faces an inherent tension: (1) Benchmark stability is required to enable longitudinal tracking, allowing engineers to compare new hardware generations against historical baselines over multiple years; (2) Benchmark evolution is necessary because static benchmarks eventually saturate (models reach ceiling accuracy), get gamed by over-specialized compilers, and become obsolete as model architectures evolve (e.g., from CNNs to Transformers). Consortia like MLCommons manage this by maintaining fixed benchmark version numbers (e.g., MLPerf v3.0 vs v4.0) with deprecation schedules, retiring saturated tasks, and introducing new representative workloads in scheduled versioned releases.
Learning Objective: Justify the trade-off between benchmark stability for historical comparison and benchmark evolution to reflect modern workloads.
Self-Check: Answer
An image classifier deployed in an autonomous vehicle achieves \(94\%\) top-1 accuracy on ImageNet. However, post-training INT8 quantization causes the model to output confidence scores of \(0.99\) on inputs where it actually predicts the wrong class. Which model evaluation metric directly quantifies this divergence between predicted probability and empirical accuracy?
- Peak Signal-to-Noise Ratio (PSNR)
- Expected Calibration Error (ECE)
- Top-5 classification error
- Hardware FLOPs Utilization (HFU)
Answer: The correct answer is B. Expected Calibration Error (ECE) measures the difference between a model’s predicted confidence probabilities and its actual empirical accuracy across confidence bins. A poorly calibrated model may maintain top-1 accuracy while becoming severely overconfident on misclassifications, leading downstream decision systems (such as emergency braking) to make catastrophic errors. PSNR measures image reconstruction fidelity; top-5 error only measures rank-order accuracy; HFU measures accelerator compute efficiency.
Learning Objective: Analyze how Expected Calibration Error (ECE) measures confidence reliability independent of top-1 accuracy.
A clinical risk prediction model achieves an outstanding \(0.92\) ROC-AUC score on a held-out test split from Hospital A’s electronic health records. When deployed at Hospital B in a different city, its ROC-AUC drops to \(0.61\). Why did the standard held-out test benchmark fail to predict this clinical failure?
- Hospital B used GPUs with different floating-point rounding modes
- The ROC-AUC metric is mathematically invalid for clinical applications
- The held-out test split shared the exact same patient demographic distribution, lab equipment calibration, and clinical protocols as the training data, concealing the model’s inability to generalize under covariate and concept shift
- The training algorithm suffered from underfitting on Hospital A’s dataset
Answer: The correct answer is C. A standard held-out test split is sampled i.i.d. (independent and identically distributed) from the same underlying dataset as the training split. It validates in-distribution generalization but is blind to covariate shift (differing patient demographics, novel lab assays) and concept drift present at new deployment sites. Floating-point rounding on GPUs cannot cause a 31-point ROC-AUC collapse; ROC-AUC is a standard clinical evaluation metric; achieving 0.92 ROC-AUC rules out underfitting.
Learning Objective: Evaluate why held-out test sets from training distributions fail to detect real-world covariate and concept shifts.
True or False: If an ML deployment passes both system benchmarking (achieving target throughput and low latency) and model benchmarking (preserving validation accuracy and calibration), data benchmarking is unnecessary because software execution and model mathematics are fully verified.
Answer: False. A system can execute at peak hardware efficiency and achieve high benchmark accuracy, yet fail catastrophically in deployment if the training dataset contained systematic label noise, demographic bias, or distributional blind spots that unrepresentative validation sets failed to expose.
Learning Objective: Evaluate whether independent success on system and model benchmarks guarantees deployment readiness without data validation.
The metric that partitions model prediction confidences into discrete bins and calculates the weighted average difference between confidence and accuracy across all bins is called ____.
Answer: Expected Calibration Error. Expected Calibration Error completes the statement regarding the metric that partitions model prediction confidences into.
Learning Objective: Explain the concept and calculation of Expected Calibration Error across partitioned confidence bins.
Explain why compression evaluation should be framed as a multi-objective Pareto frontier across accuracy, latency, model size, and memory footprint, rather than a single scalar delta.
Answer: Model compression involves non-linear, multidimensional trade-offs: pruning reduces parameter count and FLOPs but may require specialized sparse hardware to achieve latency speedups; INT8 quantization reduces memory footprint \(4\times\) and cuts memory bandwidth pressure, but can degrade calibration or subgroup accuracy. Framing candidates along a Pareto frontier allows system designers to identify dominant configurations that maximize accuracy for a given latency or memory budget on specific target hardware, rather than arbitrarily collapsing complex trade-offs into a single metric.
Learning Objective: Compare compression candidates using multi-objective Pareto frontiers across accuracy, latency, and memory footprint.
A team deploys an INT8-quantized vision model to an edge TPU for factory defect detection. The deployment passes MLPerf Inference benchmarks and ImageNet validation, but in production, defect detection accuracy collapses from \(98\%\) to \(74\%\). Use the three-dimensional benchmarking framework (System, Model, Data) to diagnose this failure cascade.
Answer: The three-dimensional framework isolates the failure across layers:
System Benchmarking passed: The hardware accelerator delivered expected low latency and high throughput.
Model Benchmarking failed: INT8 quantization was validated only on clean ImageNet images; post-training quantization caused loss of dynamic range on low-contrast industrial defects.
Data Benchmarking failed: The training dataset contained no images under factory-floor conditions (fluorescent lighting, oil smudges, camera vibrations). The system failed because success along the system dimension masked severe blind spots in data representativeness and model quantization sensitivity.
Learning Objective: Apply the three-dimensional evaluation framework (system, model, data) to diagnose multi-faceted deployment failures.
Self-Check: Answer
Which benchmark harness assumption is most frequently violated when an ML serving system transitions from laboratory evaluation to live production?
- Floating-point numbers lose precision when transmitted over HTTP
- The neural network architecture dynamically changes its layer count in production
- GPUs execute instructions in reverse order under high temperature
- Production requests arrive with non-stationary, bursty traffic patterns, correlated user surges, and variable payload sizes, violating the stationary Poisson or constant-rate arrival assumptions of synthetic test harnesses
Answer: The correct answer is D. Laboratory benchmark harnesses typically assume stationary, independent arrival distributions (such as idealized Poisson processes or fixed rates). In production, real-world traffic exhibits severe diurnal swings, sudden flash-crowd bursts (e.g., Black Friday), network retries, and variable sequence lengths, which create queue buildup and tail latency spikes that synthetic benchmarks fail to capture. Floating-point precision over HTTP is unchanged; layer counts do not spontaneously change; GPUs do not reverse instruction execution.
Learning Objective: Analyze how production traffic patterns invalidate the arrival-rate assumptions embedded in benchmark harnesses.
Explain why replaying recorded production traffic traces during predeployment validation is a more dependable test of system readiness than relying solely on synthetic load generators.
Answer: Synthetic load generators use idealized statistical models (e.g., constant rate or Poisson arrivals with fixed input sizes) that cannot capture the idiosyncratic temporal correlations, sudden concurrency spikes, packet jitter, and heterogeneous payload distributions of real user traffic. Replaying authentic production traces subjects the serving pipeline to real-world queueing dynamics, memory allocation spikes, cache thrashing, and batching edge cases, validating whether the system can maintain its latency SLOs under actual operational stress.
Learning Objective: Explain how trace replay converts benchmark results into deployment-specific predeployment validation.
True or False: Once an ML system passes all predeployment benchmarks, production monitoring is merely a passive operational task to check server uptime, having no connection to benchmarking methodology.
Answer: False. Production monitoring is continuous benchmarking in the wild. Live monitoring tracks the exact same metrics evaluated during benchmarking—\(p50/p90/p99\) tail latency, throughput, GPU utilization, covariate data drift, and confidence calibration—detecting performance regressions and distribution shifts that signal when models need retraining or systems need recalibration.
Learning Objective: Evaluate whether production monitoring functions as an ongoing extension of benchmarking rather than a detached alerting system.
Self-Check: Answer
What is the primary fallacy in using an accelerator’s peak advertised TFLOPS to estimate the serving capacity of an ML inference deployment?
- Peak TFLOPS assumes 100% compute saturation on dense arithmetic, ignoring memory bandwidth bottlenecks, runtime kernel launch overhead, non-compute pipeline stages, and variable batch sizes
- Peak TFLOPS is an obsolete metric that is no longer measured by hardware vendors
- Accelerators always run at exactly 50% of their peak TFLOPS due to hardware safety limiters
- Peak TFLOPS applies only to CPU floating-point units and has no meaning for GPUs or TPUs
Answer: The correct answer is A. Theoretical peak TFLOPS represents the absolute hardware ceiling achievable only when all execution units perform arithmetic operations every clock cycle with zero memory stalls. Real workloads are constrained by memory bandwidth (low arithmetic intensity), kernel launch latency, framework dispatch overheads, and data transfer bottlenecks, often achieving only 10% to 50% MFU. Hardware vendors actively publish peak TFLOPS; accelerators do not have a hardcoded 50% limiter; peak TFLOPS is a standard specification across GPUs, TPUs, and NPUs.
Learning Objective: Analyze why peak hardware specification claims fail to predict sustained application performance in production systems.
An engineering team modifies an inference server configuration, increasing throughput from \(1,000\text{ QPS}\) at \(1.8\text{ W}\) to \(1,200\text{ QPS}\) at \(4.2\text{ W}\) (\(20\%\) throughput gain at \(2.33\times\) power). What is the systems consequence of this change?
- It is an unambiguous improvement because throughput is \(20\%\) higher
- The system suffered a \(48.6\%\) reduction in energy efficiency (dropping from \(556\text{ QPS/W}\) to \(286\text{ QPS/W}\)), making it economically and thermally inferior for constrained deployments
- The system will run cooler because queries complete faster
- Operating cost is reduced because higher throughput always decreases data center power bills
Answer: The correct answer is B. Efficiency dropped from \(1,000 / 1.8 = 555.6\text{ QPS/W}\) to \(1,200 / 4.2 = 285.7\text{ QPS/W}\), a \(48.6\%\) efficiency loss. For battery-powered edge devices or thermal- and power-constrained data centers, purchasing a \(20\%\) throughput gain at a \(133\%\) power increase is a severe regression. Throughput alone does not define system value; drawing \(4.2\text{ W}\) instead of \(1.8\text{ W}\) generates more heat; increasing power draw increases electricity and cooling costs.
Learning Objective: Calculate the efficiency impact when throughput improvements require disproportionate increases in power consumption.
True or False: If a newly released open-source model ranks #1 on a public benchmark leaderboard, an enterprise can deploy it into production with confidence that it will outperform existing models on company workloads.
Answer: False. Leaderboard rankings reflect performance under specific, static benchmark conditions that often reward test-set overfitting, excessive compute scaling, and uncalibrated predictions. Production deployments operate under different data distributions, strict latency SLAs, cost constraints, and safety requirements that public leaderboards do not capture.
Learning Objective: Evaluate whether high rankings on public benchmark leaderboards guarantee superior production performance.
Explain why saturated benchmarks (such as MNIST or mature ImageNet evaluation sets) cease to be useful progress indicators for ML systems, and describe what should replace them.
Answer: When models reach accuracy ceilings on a static benchmark (e.g. \(>99\%\) on MNIST or \(>90\%\) on ImageNet), incremental score differences more often reflect random seed variation, test-set labeling artifacts, or hyperparameter over-tuning rather than genuine architectural breakthroughs. Saturated benchmarks fail to discriminate between model capabilities and hide deployment-critical flaws (like calibration drift or OOD fragility). They should be replaced by dynamic benchmarks (e.g., Dynabench), robustness stress-tests under distribution shift, and multi-objective evaluations measuring latency, energy, and memory efficiency.
Learning Objective: Explain why saturated benchmarks fail to provide meaningful progress signals and identify modern alternatives.
Explain how Goodhart’s Law manifests when teams optimize exclusively for benchmark scores, using a concrete systems example where metric chasing degrades production quality.
Answer: Goodhart’s Law states that ‘when a measure becomes a target, it ceases to be a good measure.’ When benchmark score is the sole target, teams exploit benchmark quirks rather than improving general capability. For example, a team optimizing an LLM for public multiple-choice benchmarks might format prompt templates to game option letters or prune safety guardrails to boost raw perplexity scores, resulting in a model that ranks high on leaderboards but generates hallucinations, toxic outputs, and severe tail latencies when handling real user conversations.
Learning Objective: Explain how benchmark-targeted optimization distorts engineering priorities through Goodhart’s Law.
Self-Check: Answer
Which statement best summarizes the chapter’s core thesis regarding the role of benchmarking in ML systems engineering?
- Benchmarking is a one-time marketing exercise used by hardware vendors to rank accelerators by peak FLOPs
- Benchmarking is an academic tool that becomes obsolete once systems are deployed to cloud servers
- Benchmarking is the empirical validation discipline that tests whether data selection, model compression, and hardware acceleration deliver their promised gains under realistic deployment constraints, converting theoretical claims into verified engineering knowledge
- Benchmarking replaces the need for live production monitoring and error handling
Answer: The correct answer is C. The chapter concludes that benchmarking is the empirical validation layer for the entire ML systems optimization pipeline: it verifies whether the physical and algorithmic efficiency gains promised in Part III survive when Data, Algorithm, and Machine interact under production conditions. Vendor marketing rankings reflect isolated claims rather than system engineering; benchmarking remains essential in production; benchmarking informs and complements production monitoring rather than replacing it.
Learning Objective: Analyze the overarching role of benchmarking as the empirical validation discipline that connects ML co-design to deployment.
Explain why the textbook frames empirical benchmarking—measuring tail latency, wall-clock time-to-accuracy, and out-of-distribution robustness—as constitutive of dependable ML systems engineering rather than an optional verification step.
Answer: ML systems operate at the complex intersection of physical hardware physics, statistical algorithmic learning, and dynamic data distributions. Theoretical modeling and component FLOP counts cannot predict system behavior because memory bandwidth saturation, kernel launch queues, cache contention, thermal throttling, and covariate data shift interact non-linearly. Without empirical benchmarking under representative deployment conditions, optimization claims remain plausible speculation; empirical measurement provides the evidence required to engineer dependable, predictable, and robust ML systems.
Learning Objective: Explain why empirical measurement across system, model, and data dimensions is necessary to substantiate optimization claims.
In an ML serving pipeline where model inference accounts for \(20\%\) of total request latency and non-model operations (data fetching, parsing, network I/O) account for the remaining \(80\%\), what is the theoretical maximum end-to-end speedup achievable by accelerating the neural network inference engine, even if inference time is reduced to zero?
- \(5.0\times\) speedup
- \(3.0\times\) speedup
- \(2.0\times\) speedup
- \(1.25\times\) speedup (\(1 / (1 - 0.20) = 1 / 0.80 = 1.25\))
Answer: The correct answer is D. By Amdahl’s Law, maximum speedup \(S_{\text{max}} = 1 / (1 - f)\), where \(f\) is the fraction of execution time that is accelerated. With \(f = 0.20\), \(S_{\text{max}} = 1 / (1 - 0.20) = 1 / 0.80 = 1.25\times\). Even an infinitely fast accelerator that executes inference in \(0\text{ ms}\) leaves the \(80\%\) non-model latency untouched, capping the overall system speedup at \(1.25\times\). Claiming \(5.0\times\), \(3.0\times\), or \(2.0\times\) commits the classic Amdahl fallacy of ignoring the unaccelerated baseline stages.
Learning Objective: Apply Amdahl’s Law to calculate the system-level speedup ceiling when accelerating an isolated pipeline component.