Phục vụ mô hình
Mục đích
Vì sao phục vụ (serving) lại làm thay đổi các ưu tiên tối ưu hóa vốn giúp huấn luyện (training) thành công?
Huấn luyện và phục vụ (serving) nhấn mạnh các mục tiêu vận hành khác nhau. Huấn luyện thường tối đa hóa thông lượng với các batch lớn và các phiên chạy dài, còn phục vụ phải trả lời từng yêu cầu trong mục tiêu về độ trễ. Huấn luyện phân bổ chi phí phần cứng trên nhiều ví dụ; còn phục vụ phải trả chi phí cho mỗi yêu cầu, nơi những kém hiệu quả nhỏ tích tụ thành gánh nặng vận hành. Vì vậy, mô hình huấn luyện hiệu quả vẫn có thể phục vụ kém. Hệ thống chạy thật có một “ngân sách” độ trễ toàn trình, nên việc xếp hàng, tiền xử lý, truyền qua mạng và hậu xử lý có thể xóa nhòa lợi ích của một tối ưu chỉ nằm trong mô hình. Các kiến trúc thiên về batch và các tối ưu tốn nhiều bộ nhớ nhằm tận dụng tối đa bộ tăng tốc có thể không phù hợp với lưu lượng sản xuất đột biến, yêu cầu độ trễ thấp và nhạy cảm chi phí. Nhưng phục vụ không chỉ là câu chuyện độ trễ. Hệ thống phục vụ phải xử lý lưu lượng dao động giữa lúc cao điểm và thấp điểm, dành sẵn headroom cho sự cố, biết giảm tải hoặc hạ cấp một cách mềm mại khi quá tải, và giữ tính dự đoán khi cơ cấu yêu cầu và nhu cầu thay đổi theo thời gian. Các mô hình đã chứng minh giá trị trong huấn luyện, vượt qua nén và benchmark, cuối cùng sẽ đến lớp phục vụ — giai đoạn triển khai và tích hợp trong vòng đời ML. Câu hỏi chuyển từ “mô hình có chạy được không” sang “mô hình có chạy ổn định ở quy mô lớn trong môi trường sản xuất không”. Hạ tầng phục vụ là nơi hệ thống ML gặp người dùng, và duy trì tương tác đó đòi hỏi kiểu kỹ thuật khác với việc tạo ra mô hình. Đây cũng là nơi thuật toán đã huấn luyện gặp dữ liệu thực tế trong giới hạn độ trễ của máy, nơi cả ba ràng buộc D·A·M cùng hội tụ trên mỗi yêu cầu.
Learning Objectives
- Giải thích sự đảo chiều trong phục vụ: từ tối ưu thông lượng khi huấn luyện sang tối ưu độ trễ trên mỗi yêu cầu, headroom và hành vi đuôi.
- Phân rã độ trễ của mỗi yêu cầu theo các phần: tuần tự hoá, tiền xử lý, suy luận, xếp hàng, hậu xử lý và chi phí mạng.
- Áp dụng các định luật hàng đợi và các mô hình hàng đợi đơn giản để lập kế hoạch dung lượng nhằm đáp ứng các mục tiêu độ trễ theo phân vị.
- Chẩn đoán sự chênh lệch giữa huấn luyện và phục vụ (training-serving skew) cũng như các vấn đề khởi động nguội (cold start) do tiền xử lý bất nhất, cách thức tải mô hình, hoặc hành vi của cache.
- Lựa chọn các chiến lược về batching, giảm tải (load shedding), tự động điều chỉnh quy mô (autoscaling) và runtime phù hợp với đặc điểm lưu lượng truy cập và giới hạn độ trễ cho phép.
- Đánh giá các nút thắt trong quá trình phục vụ (serving) LLM dựa trên độ trễ của token, bộ nhớ KV-cache và các ràng buộc của batching liên tục.
- Tính toán chi phí cho mỗi lượt suy luận (inference) dựa trên độ chính xác, mức độ sử dụng phần cứng, số lượng bản sao và thông lượng (throughput) của runtime.
Mô hình phục vụ
Phục vụ (Serving) bắt đầu từ nơi benchmark dừng lại: một mô hình đã được đo kiểm trong điều kiện kiểm soát nay phải tạo ra dự đoán dưới một khối lượng công việc (workload) vận hành. Đám mây (Cloud), Edge, Di động (Mobile) và TinyML mỗi môi trường đều đặt ra những thách thức phục vụ riêng. Trong phục vụ trực tuyến (online serving), ưu tiên thường đảo ngược: từ thông lượng trong các chạy dài hạn sang độ trễ của từng yêu cầu. Sự đảo ngược trong phục vụ này có những hệ quả kỹ thuật cụ thể, lan khắp toàn bộ ngăn xếp. Theo định luật sắt của các hệ thống ML, hạng mục độ trễ \((L_{\text{lat}})\) giờ bao gồm lập lịch yêu cầu, các vòng khứ hồi mạng (network round-trips) và điều phối hệ thống, và có thể trở thành ràng buộc chính. Các benchmark có kiểm soát xác lập hiệu năng dưới những điều kiện đã biết; trong khi đó, quá trình phục vụ phải đối mặt với các mẫu lưu lượng mà không một benchmark nào có thể lường hết. Lượng tử hoá (quantization) có thể giảm kích thước mô hình; tuy nhiên, quá trình phục vụ phải xác nhận rằng các tối ưu hoá này vẫn giữ được độ chính xác dưới các phân phối lưu lượng thực tế. Những xác nhận lại này cùng nhau làm thay đổi thứ tự ưu tiên giữa dữ liệu, thuật toán và phần cứng khi các yêu cầu đến trong giới hạn độ trễ cho phép của vận hành.
Phân loại D·A·M làm cho sự đảo chiều này trở nên rõ ràng. Với một dịch vụ trực tuyến, ràng buộc về dữ liệu chuyển từ khối lượng tập huấn luyện sang tốc độ, độ mới và hình dạng của các yêu cầu đang hoạt động. Thuật toán thường được cố định theo phiên bản mô hình đã triển khai, thay vì được cập nhật bằng lan truyền ngược ngay trên đường xử lý yêu cầu. Ràng buộc về tài nguyên máy chuyển từ mục tiêu sử dụng tối đa sang duy trì headroom: vận hành dưới ngưỡng bão hòa để chừa dung lượng cho các đợt tăng lưu lượng đột biến; còn khi bộ tăng tốc bị bão hòa, chỉ một thay đổi tải nhỏ cũng có thể gây ra sự cố do độ trễ đuôi. Mức dự phòng cần thiết phụ thuộc vào quá trình yêu cầu đến, phân phối thời gian phục vụ và mục tiêu mức dịch vụ (SLO). Vì vậy, phục vụ (serving) tối ưu số lượng công việc hữu ích được hoàn thành trong cam kết về độ trễ, thay vì dồn mọi nỗ lực để phần cứng luôn kín tải.
Lời hứa đó gắn kết các phần còn lại của ngăn xếp phục vụ với nhau. Định tuyến yêu cầu, tiền xử lý, thực thi mô hình, hậu xử lý, batching, caching, lựa chọn runtime và lập kế hoạch dung lượng đều phải chia sẻ cùng một ngân sách độ trễ. Nhiệm vụ kỹ thuật trung tâm là quyết định công việc nào cần nằm trong đường xử lý yêu cầu trực tiếp, công việc nào có thể chuyển ra ngoài, và hệ thống phải dành bao nhiêu headroom trước khi thông lượng hữu ích trở nên mong manh.
Self-Check: Question
When transitioning a deep learning model from training to an online serving environment, how does the system constraint in the D·A·M (Data-Algorithm-Machine) taxonomy fundamentally shift regarding machine utilization and algorithm state?
- Machine utilization must be maximized at 100% to amortize capital costs, while the algorithm continues parameter backpropagation during request serving.
- Machine capacity must maintain operational headroom below saturation to prevent tail-latency queueing collapse, while the algorithm’s weights remain fixed for a deployed version.
- Machine allocation switches from accelerators to general-purpose CPUs exclusively, while the algorithm dynamically modifies its architecture per incoming user payload.
- Machine throughput replaces latency as the primary operational constraint, while data volume shifts from live request streams to historical offline batches.
True or False: In online model serving, the latency term (\(L_{\text{lat}}\)) in the iron law of ML systems must encompass external factors such as network round-trip time, request serialization, and system orchestration, rather than solely the accelerator kernel execution time.
Explain why achieving high average throughput during offline benchmarking does not guarantee that an online serving system will satisfy its tail-latency Service-Level Objective (SLO) during production traffic spikes.
Tải phục vụ, độ trễ và kiến trúc
Example 1.1: Đợt tăng đột biến lưu lượng 'Black Friday'
Kịch bản: Một hệ thống phục vụ đề xuất thương mại điện tử trải qua một đợt tăng đột biến lưu lượng 10× (10,000 QPS) trong các sự kiện bán hàng Black Friday.
Chẩn đoán: Khi mức sử dụng máy chủ tiếp cận 100 percent, độ dài hàng đợi bùng nổ phi tuyến tính, làm tăng độ trễ lên 10 s và gây ra lỗi hết thời gian chờ của khách.
Bài học về hệ thống: Thông lượng trung bình cao không ngăn được hàng đợi sụp đổ khi có các đợt tăng đột biến lưu lượng. Tùy dịch vụ, để giữ mục tiêu độ trễ đuôi, có thể cần giảm tải, suy giảm chức năng có kiểm soát, hoặc tự động điều chỉnh quy mô trước khi mức sử dụng chạm tới điểm uốn hàng đợi của khối lượng công việc (workload).
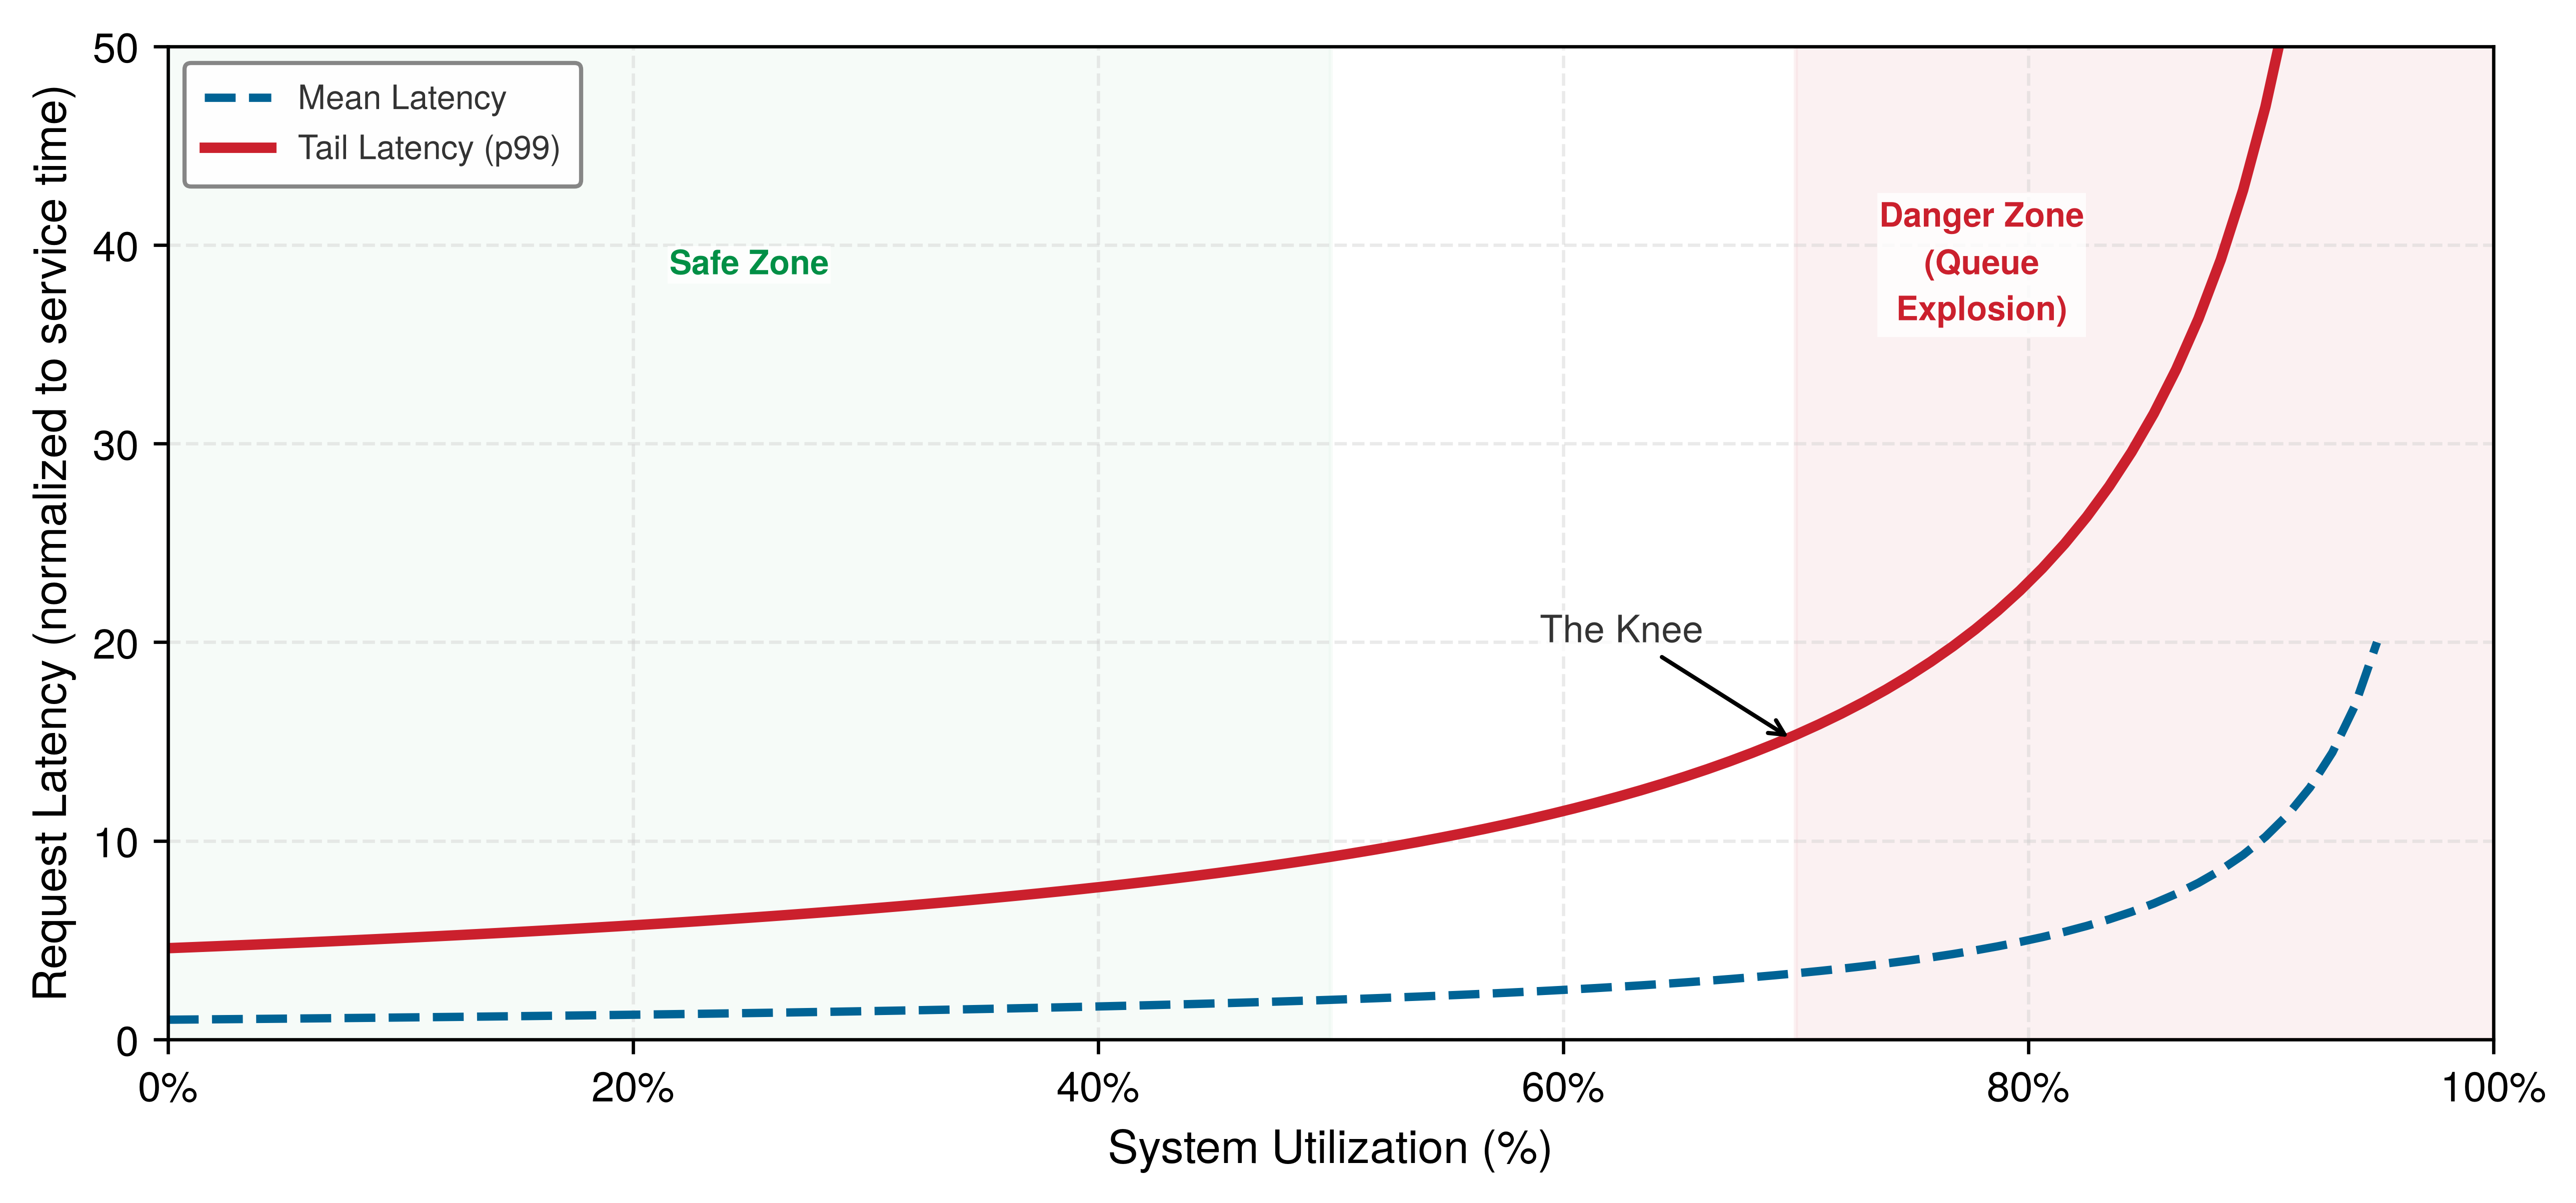
Các hệ thống phục vụ trực tuyến có thể nhận các luồng yêu cầu biến thiên, không theo batch, nhưng vẫn cần thời gian phản hồi có thể dự đoán được trên các môi trường vật lý đa dạng. Khi một đợt tăng đột biến lưu lượng vượt quá khoảng dự phòng của hệ thống, hiệu suất sẽ suy giảm theo kiểu phi tuyến.
Figure 1 cho thấy độ trễ vẫn ở mức chấp nhận được khi mức sử dụng vừa phải, rồi tăng nhanh khi hệ thống tiến gần trạng thái bão hòa; đây là lý do các hệ thống nhạy cảm với độ trễ thường dành khoảng dự phòng thay vì lập kế hoạch để bộ tăng tốc luôn bão hòa. Các phân phối và đuôi dài trình bày xử lý toán học cho các phân phối đuôi dài và giải thích vì sao độ trễ ở các phân vị cao lại quan trọng khi một SLO bao gồm cả những yêu cầu chậm nhất. Đường cong này là một xấp xỉ hàng đợi đơn giản, nhằm mục đích trực quan hơn là áp dụng cho một khối lượng công việc (workload) cụ thể.
Ngoài các giới hạn kỹ thuật về độ trễ, kinh tế của hoạt động phục vụ (serving) cũng đã thay đổi nhanh chóng. Khi các mô hình trở nên hiệu quả hơn và phần cứng chuyên biệt hơn, chi phí cho mỗi suy luận đã giảm.1 Kinh nghiệm của Facebook ở quy mô toàn đội máy cho thấy mức độ lớn của bài toán chi phí phục vụ (serving) này.
1 Nghịch lý Jevons: Năm 1865, William Stanley Jevons nhận thấy rằng việc cải thiện hiệu suất của động cơ hơi nước chạy bằng than đã làm tăng tổng lượng than tiêu thụ, vì năng lượng hơi nước trở nên khả thi về mặt kinh tế cho những ứng dụng trước đây quá đắt đỏ (Jevons 1865). Động lực tương tự cũng có thể áp dụng cho suy luận AI: mỗi khi chi phí giảm 10\(\times\), các lớp ứng dụng mới sẽ trở nên khả thi về kinh tế ở mức giá mới, mở rộng tổng cầu nhiều hơn mức tăng hiệu suất. Đây là lý do tại sao suy luận rẻ hơn có thể làm tăng, chứ không phải giảm, tổng nhu cầu GPU của toàn đội. Trong AI, hiệu suất và nhu cầu thường là các yếu tố bổ sung, chứ không phải thay thế.
Jevons, William Stanley. 1865. The Coal Question: An Inquiry Concerning the Progress of the Nation, and the Probable Exhaustion of Our Coal Mines. Macmillan; Co.
Example 1.2: Gánh nặng chi phí suy luận tại Facebook
Kịch bản: Tại Meta, các hệ thống phục vụ (serving) ML trong môi trường sản xuất thực hiện hàng chục nghìn tỷ suy luận mỗi ngày trên các dịch vụ hướng tới người dùng toàn cầu (Hazelwood et al. 2018).
Chẩn đoán: Chi phí tính toán và năng lượng định kỳ cho việc phục vụ suy luận vượt xa chi phí huấn luyện mô hình ban đầu (offline). Mẫu hình yêu cầu đến trực tiếp và các giới hạn độ trễ nghiêm ngặt hạn chế khả năng tạo batch cho GPU.
Bài học về hệ thống: Các kiến trúc mô hình có chi phí huấn luyện thấp có thể trở nên không khả thi khi phục vụ (serving) ở quy mô toàn hệ thống. Cơ sở hạ tầng phục vụ trong môi trường sản xuất cần đồng thiết kế giữa phần cứng và phần mềm để cân bằng giữa độ trễ đuôi, kích thước batch và tổng chi phí sở hữu vận hành định kỳ.
Hazelwood, Kim, Sarah Bird, David Brooks, Soumith Chintala, Utku Diril, Dmytro Dzhulgakov, Mohamed Fawzy, et al. 2018. “Applied Machine Learning at Facebook: A Datacenter Infrastructure Perspective.” 2018 IEEE International Symposium on High Performance Computer Architecture (HPCA), 620–29. https://doi.org/10.1109/hpca.2018.00059.
OpenAI. 2023b. Introducing ChatGPT and Whisper APIs.
OpenAI. 2023a. GPT-4.
OpenAI. 2024. GPT-4o Mini: Advancing Cost-Efficient Intelligence.
OpenAI Developer Community. 2024. Announcing GPT-4o in the API.
Anthropic. 2024. Introducing the Next Generation of Claude.
Google Developers Blog. 2024. Gemini 1.5 Flash Price Drop with Tuning Rollout Complete, and More.
DeepSeek. 2024. Introducing DeepSeek-V3.
Áp lực kinh tế tương tự đối với việc phục vụ (serving) cũng thể hiện rõ qua giá API công khai. Đường biểu diễn giá theo thang log trong figure 2 cho thấy tốc độ sụt giảm chi phí này, bằng cách theo dõi các ảnh chụp giá niêm yết API công khai đại diện như một chỉ số thị trường. Giá của các nhà cung cấp thay đổi thường xuyên, vì vậy những điểm dữ liệu này nên được xem như minh chứng lịch sử cho xu hướng, hơn là hướng dẫn mua hàng hiện tại (OpenAI 2023b, 2023a, 2024; OpenAI Developer Community 2024; Anthropic 2024; Google Developers Blog 2024; DeepSeek 2024). Mỗi lần giảm một bậc (10\(\times\)) sẽ làm thay đổi những ứng dụng nào là khả thi.
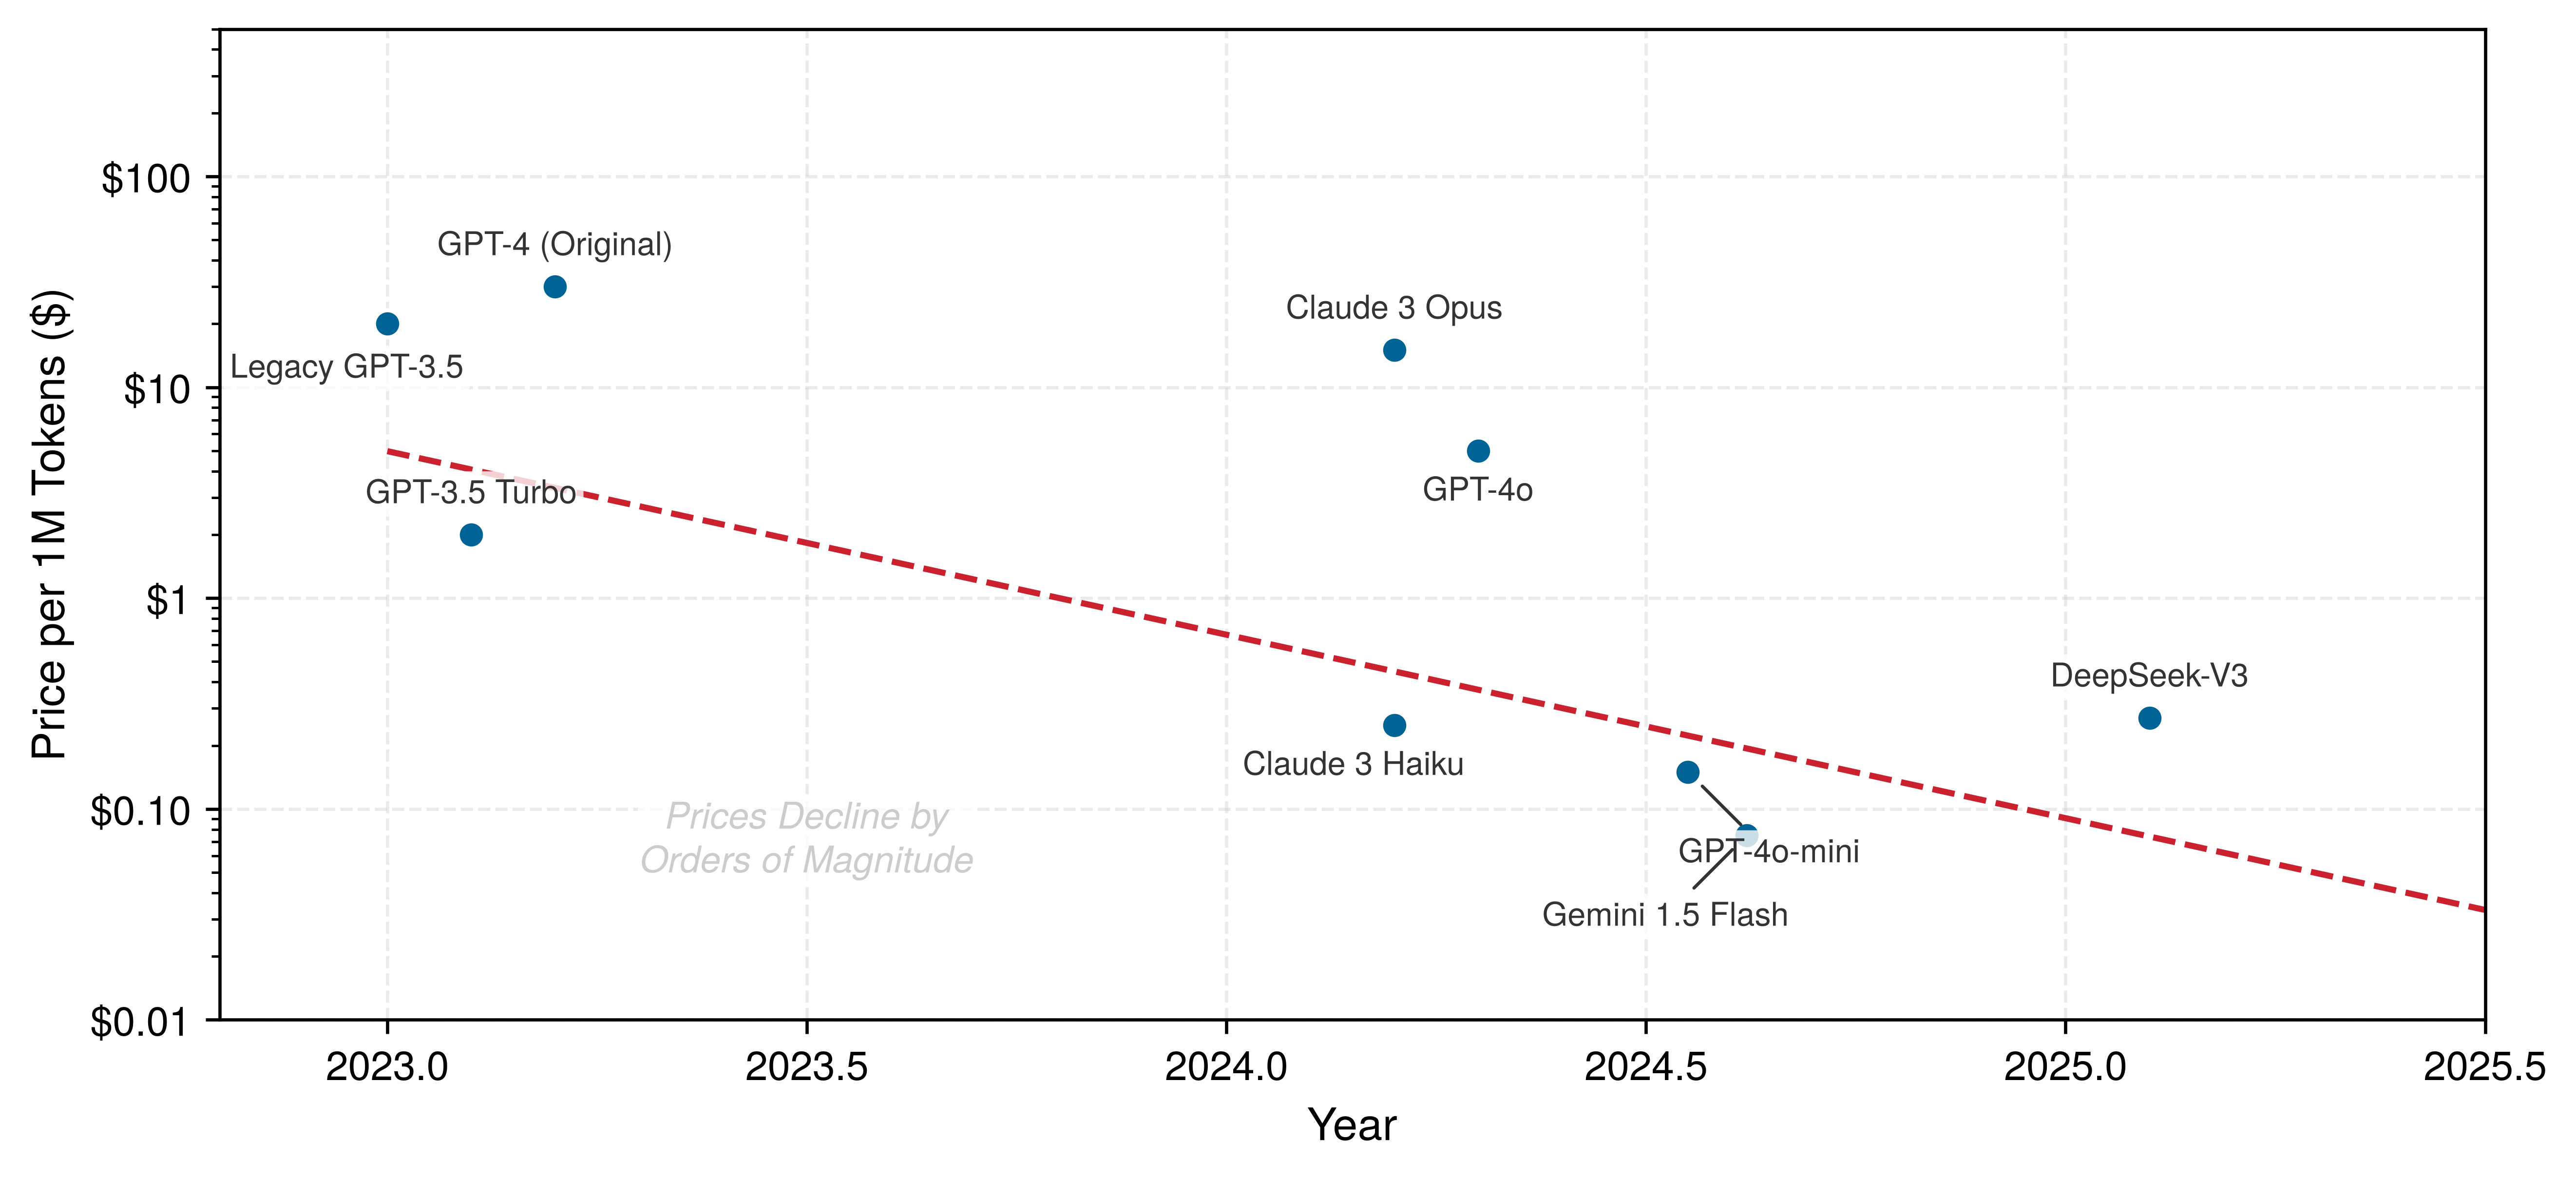
Hiện có hai áp lực chính đang định hình vấn đề phục vụ (serving): thứ nhất là độ trễ đuôi tăng vọt khi mức sử dụng vượt qua điểm knee của hàng đợi, và thứ hai là chi phí cho mỗi lần suy luận giảm nhiều bậc khi hiệu suất được cải thiện. Hai yếu tố này buộc chúng ta phải đưa ra một định nghĩa chính thức về phục vụ, xoay quanh độ trễ thay vì thông lượng.
Definition 1.1: Phục vụ mô hình
Phục vụ mô hình là giai đoạn vận hành cung cấp các dự đoán của mô hình cho người dùng cuối hoặc các hệ thống hạ nguồn, với các ràng buộc về độ trễ, thông lượng, tính khả dụng và chi phí.
- Ý nghĩa: Phục vụ trực tuyến (online serving) biến ưu tiên thông lượng của quá trình huấn luyện (\(\eta_{\text{hw}}\)) thành một ràng buộc về độ trễ của yêu cầu \((L_{\text{lat}})\), đòi hỏi một stack được thiết kế xoay quanh phân vị được nêu trong SLO (Service Level Objective) của nó.
- Điểm khác biệt: Không giống như huấn luyện mô hình (training) thường xử lý các batch theo lịch trình, phục vụ (serving) có thể xử lý các yêu cầu trực tuyến ngẫu nhiên, các luồng dữ liệu đồng bộ hoặc các batch ngoại tuyến.
- Lỗi thường gặp: Một hiểu lầm phổ biến là phục vụ (serving) chỉ là forward pass. Thực tế, đây là một bài toán hệ thống: việc chạy mô hình chỉ là một thành phần trong stack, vốn có thể bao gồm định tuyến yêu cầu, cân bằng tải và chuyển đổi dữ liệu.
SLO2 xác định mục tiêu độ trễ, từ đó chi phối mọi quyết định kiến trúc trong ngăn xếp phục vụ (serving), bao gồm cách hệ thống phân bổ thời gian cho tiền xử lý, thực thi mô hình, hậu xử lý và truyền tải. Khi một máy chủ suy luận nhận yêu cầu, thực thi mô hình chỉ là một phần trong pipeline xử lý đầu-cuối, trải qua truyền tải mạng, tuần tự hóa, tiền/hậu xử lý trên CPU và quản lý hàng đợi. Figure 3 cho thấy dữ liệu đầu vào thô đi qua tiền xử lý (tính toán truyền thống), suy luận mạng nơ-ron (deep learning), và hậu xử lý (tính toán truyền thống) trước khi tạo ra đầu ra cuối cùng. Bất kỳ giai đoạn nào trong số này cũng có thể trở thành nút thắt về độ trễ. Section 1.4.1 định lượng chính xác thời gian được dùng vào đâu, qua đó hé lộ một kết quả trái trực giác về giai đoạn nào chi phối.
2 Mục tiêu mức dịch vụ (SLO) so với thỏa thuận mức dịch vụ (SLA): SLO là một mục tiêu nội bộ (ví dụ: “độ trễ p99 dưới 50 ms”); còn SLA là một cam kết hợp đồng bên ngoài, nếu vi phạm có thể dẫn đến các biện pháp khắc phục hoặc hình phạt. Các nhóm thường đặt SLO chặt chẽ hơn SLA để duy trì một biên độ an toàn. Trong phục vụ (serving) ML, chất lượng tác vụ và độ trễ suy luận đều có thể góp phần vào SLO, tạo ra các mục tiêu đa chiều. Khi đó, việc cải thiện một khía cạnh (ví dụ: triển khai một mô hình lớn hơn để tăng độ chính xác) có thể vi phạm một khía cạnh khác (độ trễ).

Pipeline này biến việc phục vụ (serving) thành một bài toán điều phối: tiền xử lý, thực thi mô hình, hậu xử lý và truyền tải đều cạnh tranh cùng một ngân sách độ trễ. Trước khi tối ưu hóa bất kỳ giai đoạn nào, hệ thống phải quyết định liệu các dự đoán sẽ được tính toán trước hay theo yêu cầu (on demand).
Suy luận tĩnh và suy luận động
Trước khi tối ưu cách giảm độ trễ suy luận, hệ thống phải quyết định khi nào tính toán dự đoán. Một quyết định kiến trúc sớm là dự đoán diễn ra trước hay ngay trong lúc xử lý yêu cầu của người dùng (Google 2024). Lựa chọn này định hình thiết kế hệ thống, cấu trúc chi phí và các giới hạn về khả năng.
Google. 2024. Static Vs. Dynamic Inference. Google Machine Learning Crash Course.
Suy luận tĩnh
Suy luận tĩnh (còn gọi là suy luận ngoại tuyến hoặc batch) tính trước các dự đoán cho những đầu vào đã dự kiến và lưu lại để truy xuất khi cần. Ví dụ, một hệ thống khuyến nghị tạo dự đoán cho tất cả các cặp người dùng-mục mỗi đêm. Khi người dùng yêu cầu khuyến nghị, hệ thống truy xuất kết quả đã tính sẵn từ một bảng tra cứu, thay vì chạy suy luận lúc đó. Cách tiếp cận này đưa việc tính toán ra khỏi đường xử lý yêu cầu, cho phép kiểm tra chất lượng ngoại tuyến và có thể giảm chi phí phục vụ (serving) với những đầu vào có thể dự đoán. Tuy nhiên, suy luận tĩnh cần một đường dự phòng trực tuyến (online fallback) hoặc phải chạy lại batch khi có yêu cầu chứa đầu vào không lường trước, hoặc khi mô hình vừa được cập nhật.
Suy luận động
Suy luận động (còn gọi là suy luận trực tuyến hoặc thời gian thực) tính toán dự đoán theo yêu cầu ngay khi có request đến. Cách này có thể xử lý các đầu vào chưa từng thấy trước đây, miễn là chúng phù hợp với lược đồ (schema) mà dịch vụ hỗ trợ, và sẽ phản ánh phiên bản mô hình mới ngay khi phiên bản đó được triển khai. Cái giá phải trả là một ngân sách độ trễ chặt chẽ, hạn chế độ phức tạp của mô hình và đòi hỏi hạ tầng giám sát mạnh.
Example 1.3: Chi phí của độ trễ
Những ràng buộc về độ trễ quyết định trực tiếp chi phí hạ tầng. Hãy xem xét một máy chủ GPU được thuê với giá $4/hour.
Kịch bản A (độ trễ thấp): Kích thước batch 1.
- Độ trễ: 5 ms.
- Thông lượng: 200 req/s.
- Chi phí cho một triệu truy vấn: $5.56.
Kịch bản B (thông lượng cao): Kích thước batch 8.
- Độ trễ: 10 ms (tăng gấp đôi do phần chi phí bổ sung khi batching).
- Thông lượng: 800 req/s (tăng gấp bốn lần nhờ hiệu quả song song).
- Chi phí cho một triệu truy vấn: $1.39.
Góc nhìn hệ thống: Giảm độ trễ từ 10 ms xuống 5 ms sẽ làm chi phí phần cứng tăng 300 percent. Kỹ sư cần lượng hóa xem mức tăng tốc đó có tạo đủ giá trị kinh doanh để biện minh cho việc chi phí tăng gấp 4× lần hay không.
Đối với mô hình phân loại ảnh ResNet-50 của chúng ta, hãy cân nhắc hai kịch bản triển khai. Cách tiếp cận tĩnh phù hợp với ứng dụng tổ chức ảnh, nơi tất cả ảnh trong thư viện của người dùng được phân loại trước qua đêm. Với 10,000 photos ảnh và mỗi lần suy luận mất 5 ms, xử lý theo batch mất tổng cộng khoảng ~50 s. Nhờ vậy, người dùng sẽ thấy kết quả phân loại ngay khi duyệt. Cách tiếp cận động phù hợp với API kiểm duyệt nội dung, nơi phải phân loại ảnh người dùng tải lên theo thời gian thực. Mỗi ảnh cần đi qua toàn bộ pipeline tiền xử lý → suy luận → hậu xử lý, với ngân sách độ trễ 100 ms. Một hệ thống phân loại ảnh trong sản xuất có thể kết hợp cả hai: những ảnh thường được yêu cầu (như sản phẩm phổ biến hoặc meme quen thuộc) được phân loại trước và lưu vào cache, còn các ảnh mới tải lên sẽ kích hoạt suy luận động.
Việc lựa chọn giữa phục vụ tĩnh và động có tác động kinh tế trực tiếp. Yêu cầu độ trễ nghiêm ngặt hơn có thể làm chi phí hạ tầng tăng khi phải dùng batch nhỏ hơn, thêm bản sao hoặc phần cứng mạnh hơn. Lượng hóa sự đánh đổi này bằng tiền sẽ cho thấy liệu việc giảm độ trễ có đáng với phần chi phí tăng thêm hay không.
Nhiều hệ thống sản xuất kết hợp cả hai cách tiếp cận. Các truy vấn phổ biến có thể truy cập vào cache được làm đầy bởi suy luận theo batch, còn các yêu cầu ít phổ biến hơn sẽ kích hoạt tính toán động. Hiểu rõ phổ này rất quan trọng vì nó quyết định các chiến lược tối ưu hóa tiếp theo nào áp dụng được. Suy luận tĩnh tối ưu hóa thông lượng trong tính toán theo batch và hiệu quả lưu trữ khi phục vụ. Suy luận động tối ưu hóa độ trễ cho từng yêu cầu dưới tải đồng thời, điều này đòi hỏi phải hiểu thời gian được dành cho việc gì trong mỗi yêu cầu.
Quyết định giữa tĩnh và động là lựa chọn kiến trúc đầu tiên trong số nhiều lựa chọn định hình thiết kế hệ thống phục vụ. Quan trọng không kém là nơi mô hình được thực thi, vì ngữ cảnh triển khai sẽ giới hạn mọi tối ưu hóa tiếp theo.
Tất cả các phân tích chi phí trong phần này đều giả định một lượt truyền xuôi (forward pass) truyền thống: một đồ thị tính toán cố định chạy một lần cho mỗi yêu cầu và tạo ra kết quả. Một lớp mô hình mới đang đảo lộn giả định này bằng cách cố ý tăng lượng tính toán cho mỗi truy vấn, đánh đổi độ trễ để lấy chất lượng câu trả lời, và điều đó kéo theo tác động lớn đến chi phí phục vụ (serving).
Systems Perspective 1.1: Nhìn về phía trước: Dùng nhiều tính toán hơn cho mỗi truy vấn
Phục vụ (serving) truyền thống tối ưu để giảm thiểu độ trễ \((L_{\text{lat}} \to 0)\). Ở đây, mục tiêu tối ưu hóa được mở rộng để bao gồm cả chất lượng câu trả lời. Một số hệ thống cố ý dành thêm chu kỳ tính toán trong lúc suy luận để cải thiện chất lượng câu trả lời. Việc tạo token thường bị giới hạn bởi băng thông bộ nhớ khi xử lý các batch nhỏ, nhưng với các batch lớn hơn hoặc ngữ cảnh dài, nút thắt cổ chai có thể chuyển sang phần tính toán hoặc lưu lượng KV-cache. Các hệ thống này có thể tạo ra nhiều token hơn đáng kể cho mỗi yêu cầu, bao gồm cả các token suy luận hoặc tìm kiếm trung gian, từ đó làm tăng tổng lượng tính toán và năng lượng tiêu thụ cho mỗi truy vấn.
Dù hệ thống thực hiện một lượt truyền xuôi hay nhiều bước suy luận cho mỗi truy vấn, ngữ cảnh triển khai vẫn quyết định phạm vi độ trễ và chi phí khả thi. Đó là biến số tiếp theo.
Phổ kiến trúc phục vụ (serving)
Mặc dù “phục vụ (serving)” thường gợi hình ảnh một máy chủ nối mạng xử lý các yêu cầu API, nhưng mẫu kiến trúc sẽ thay đổi theo môi trường triển khai. Framework về mô hình triển khai đã giới thiệu bốn mô hình triển khai (đám mây, edge, di động và TinyML) cùng các ràng buộc vật lý (rào cản ánh sáng, giới hạn công suất và giới hạn bộ nhớ) dẫn tới các mô hình đó. Về mặt kiến trúc, phục vụ trải dài từ microservice nối mạng tập trung (gộp các bộ tăng tốc để tối ưu hóa thông lượng và chi phí mỗi truy vấn, đổi lại là chi phí vòng khứ hồi mạng và độ trễ khởi động nguội) đến phục vụ (serving) edge nhúng trong ứng dụng (chạy mô hình bên trong tiến trình máy khách qua các lời gọi hàm trực tiếp, loại bỏ độ trễ mạng và bảo toàn quyền riêng tư, nhưng chịu các ràng buộc nghiêm ngặt về bộ nhớ và công suất thiết bị). Những ràng buộc này không biến mất khi phục vụ; trái lại, phục vụ còn đặt thêm các SLO về độ trễ và áp lực chi phí, chồng lên các giới hạn phần cứng mà giai đoạn huấn luyện còn có thể hấp thụ nhờ thời gian. Cùng một mô hình có thể cần các chiến lược phục vụ khác nhau tùy nơi nó chạy.
Phục vụ (serving) nối mạng (đám mây/trung tâm dữ liệu)
Trong phục vụ (serving) nối mạng, mô hình chạy như một dịch vụ độc lập (microservice), khớp với mô hình triển khai trên đám mây mà ML trên đám mây: Sức mạnh tính toán mô tả là đánh đổi độ trễ để lấy cụm tài nguyên tính toán lớn hơn. Giao diện chính là mạng, qua các giao thức như HTTP hoặc gRPC, nên truyền tải mạng và tuần tự hóa, cùng với việc thực thi mô hình, có thể trở thành các ràng buộc then chốt. Phần cứng tại trung tâm dữ liệu như GPU NVIDIA (V100, A100, H100), Google Tensor Processing Units (TPU) và AWS Inferentia hỗ trợ batching và chạy đồng thời với thông lượng cao, nhưng khởi động nguội vẫn có thể kéo dài từ vài giây đến vài phút vì khởi động container, tải mô hình và làm nóng nằm ngoài luồng suy luận ở trạng thái ổn định.
Phục vụ (serving) nhúng trong ứng dụng (di động/edge)
Trong phục vụ (serving) nhúng vào ứng dụng, mô hình chạy trong tiến trình của chính ứng dụng người dùng (ví dụ: ứng dụng trên điện thoại thông minh dùng CoreML hoặc TensorFlow Lite), theo mô hình nhúng mà Edge ML: Độ trễ và quyền riêng tư và ML di động: Trí tuệ ngoại tuyến đã phân tích về các lợi ích về độ trễ, quyền riêng tư và khả năng hoạt động ngoại tuyến. Không có “server”. Giao diện là một lời gọi hàm, nên việc tối ưu hóa tập trung vào năng lượng và độ phản hồi (SingleStream), thay vì thông lượng của máy chủ dùng chung.
Một lợi thế quan trọng là suy luận không sao chép: khi dữ liệu đi qua hệ thống, mỗi lần sao chép sẽ tiêu tốn chu kỳ CPU và băng thông bộ nhớ. Trong phục vụ (serving) trên đám mây, một khung hình từ camera có thể đi từ bộ đệm mạng vào bộ nhớ ứng dụng, rồi đến bộ đệm tiền xử lý, bộ nhớ host mà GPU có thể truy cập, và cuối cùng là bộ nhớ của bộ tăng tốc. Một pipeline di động có thể loại bỏ một số bước sao chép này khi camera, bộ xử lý tín hiệu hình ảnh, CPU và NPU dùng các vùng bộ đệm dùng chung tương thích. Điều này giảm độ trễ và năng lượng tiêu thụ, dù tiền xử lý hoặc chuyển đổi định dạng vẫn có thể phải dùng CPU hoặc bộ xử lý tín hiệu hình ảnh. Cơ chế này cần phần cứng và phần mềm phối hợp đồng bộ, như trong các thiết kế hệ thống trên chip (SoC) dùng bộ nhớ hợp nhất, ví dụ các bộ xử lý Apple A- và M-series và Qualcomm Snapdragon.
Phần cứng điển hình gồm NPU di động (Apple Neural Engine, Qualcomm Hexagon) và GPU nhúng (Jetson). Khi mô hình đã được nạp sẵn và biên dịch, thời gian khởi động có thể chỉ tính bằng mili giây; nhưng lần suy luận đầu tiên có thể lâu hơn nhiều nếu phải tải thêm hoặc biên dịch tức thời. Giới hạn về công suất và nhiệt trên thiết bị di động khác nhau theo từng máy, và suy luận kéo dài có thể kích hoạt cơ chế giảm hiệu năng.
Phục vụ (serving) trên phần cứng trần (TinyML)
Trong phục vụ (serving) TinyML, mô hình thường được biên dịch trực tiếp vào firmware của vi điều khiển, chạm tới cực biên của phổ triển khai mà TinyML: Cảm biến mọi nơi mô tả là cảm biến phổ quát với ngân sách công suất ở mức microwatt. Nhiều bản triển khai không có hệ điều hành đa năng hay bộ cấp phát runtime; việc “phục vụ” chỉ là một vòng lặp chặt chẽ đọc cảm biến và gọi một trình thông dịch. Tối ưu hóa tập trung vào việc đưa trọng số và bộ nhớ làm việc được cấp phát trước (chẳng hạn như Tensor Arena) vào bộ nhớ truy cập ngẫu nhiên tĩnh (SRAM), và việc gom yêu cầu thành batch (request batching) thường là bất khả thi. Phần cứng điển hình gồm dòng ARM Cortex-M, ESP32 và các bộ tăng tốc TinyML chuyên dụng. Thời gian khởi động có thể cực kỳ ngắn khi trọng số nằm trong bộ nhớ flash và bộ nhớ làm việc đã được cấp phát trước, trong khi ngân sách công suất dao động từ microwatt đến milliwatt, cho phép chạy bằng pin trong nhiều tháng hoặc nhiều năm.
Các tầng triển khai khác nhau trước hết ở các giới hạn hoạt động của chúng. Table 1 so sánh các ràng buộc về độ trễ, batch, bộ nhớ, công suất, cập nhật, lỗi và giám sát phát sinh từ mỗi môi trường.
| Đặc điểm | Đám mây/Trung tâm dữ liệu | Di động/Edge | TinyML |
|---|---|---|---|
| Mục tiêu độ trễ | 10–100 ms | 20–50 ms | 1–100 ms |
| Kích thước batch | 1–128 (động) | 1 (cố định) | 1 (cố định) |
| Bộ nhớ | 16–80 GB VRAM | 2–8 GB chia sẻ | 256 KB–2 MB SRAM |
| Công suất | 300–700 W | 1–10 W | 1–100 mW |
| Cơ chế cập nhật | Triển khai container | Cập nhật qua cửa hàng ứng dụng | Firmware qua mạng (OTA) |
| Chế độ lỗi | Thử lại/chuyển đổi dự phòng | Giảm hiệu suất có kiểm soát | Im lặng hoặc đặt lại |
| Giám sát | Đo từ xa đầy đủ | Phân tích hạn chế | Chỉ nhịp tim |
Systems Perspective 1.2: ResNet-50 trên toàn phổ phục vụ
Góc nhìn hệ thống: Khẳng định “cùng một mô hình” là sai lệch: các tầng đám mây và di động có thể chia sẻ đồ thị ResNet-50 nhưng dùng độ chính xác và các runtime khác nhau, trong khi tầng TinyML không thể chạy ResNet-50 và phải thay bằng một kiến trúc thiết kế cho các ràng buộc của nó. Gộp tất cả thành một mô hình duy nhất sẽ che khuất phần công việc giúp từng bản triển khai khả thi.
Áp các giới hạn đó vào một khối lượng công việc (workload) phân loại ảnh, table 2 cho thấy vì sao đám mây và di động có thể điều chỉnh ResNet-50, còn TinyML phải thay bằng MobileNetV2.
| Kích thước | Cloud | Mobile | TinyML |
|---|---|---|---|
| Định dạng mô hình | TensorRT FP16 engine | TensorFlow Lite INT8 | Không khả thi (25.6 MB); thay thế: MobileNetV2 INT8 (3.5 MB) |
| Suy luận (batch-1) | 1.4 ms (batch-16: 14 ms) | 12 ms (NPU), 45 ms (CPU) | 120 ms |
| Thông lượng | 1,143 img/s (theo batch) | ~80 img/s (luồng đơn) | ~8 img/s |
| Bộ nhớ | 2 GB VRAM (batch-32) | 150 MB đỉnh (chia sẻ với ứng dụng) | 320 KB vùng nhớ (vừa với 512 KB SRAM) |
| Năng lượng/suy luận | — | 0.8 mJ (NPU), 4.2 mJ (CPU) | 12 mJ |
Lớp cân bằng tải
Khi lưu lượng truy cập vượt quá khả năng xử lý của một máy đơn, các hệ thống triển khai trên đám mây và trung tâm dữ liệu, vốn chạy nhiều bản sao của cùng một mô hình, cần thêm một lớp hạ tầng: bộ cân bằng tải. Trong các hệ thống phục vụ (serving) thực tế, bộ cân bằng tải được đặt giữa máy khách và máy chủ mô hình, đảm nhiệm ba chức năng thiết yếu của hạ tầng phục vụ (serving).
Chức năng đầu tiên là phân phối yêu cầu, tức định tuyến các yêu cầu đến các bản sao mô hình sẵn có, dùng các thuật toán như round-robin hoặc least-connections. Với các hệ thống phục vụ (serving) ML nhạy cảm với độ trễ, các thuật toán định tuyến tránh các bản sao chậm hoặc quá tải sẽ giúp cải thiện độ trễ đuôi. Chức năng thứ hai là giám sát tình trạng, liên tục xác minh rằng các bản sao đã sẵn sàng phục vụ, và chuyển hướng lưu lượng khỏi các bản sao không khỏe. Với các hệ thống ML, kiểm tra tình trạng cần xác minh cả tiến trình còn hoạt động và mô hình đã sẵn sàng, tức là các trọng số đã được tải và quá trình khởi động đã hoàn tất. Chức năng thứ ba là hỗ trợ triển khai, cho phép cập nhật mô hình an toàn bằng cách dần dần chuyển lưu lượng giữa các phiên bản, thay vì coi việc phát hành là một lần gạt công tắc. Triển khai mô hình sau đó sẽ phát triển ý tưởng chuyển lưu lượng cơ bản này thành các chiến lược triển khai và xác thực hoàn chỉnh.
Với phục vụ (serving) trên một máy đơn có nhiều phiên bản mô hình, chẳng hạn chạy nhiều phiên Open Neural Network Exchange (ONNX) Runtime, framework và hệ điều hành sẽ xử lý việc xếp hàng yêu cầu. Toàn bộ độ phức tạp của cân bằng tải chỉ trở nên cần thiết khi mở rộng sang các hệ thống suy luận phân tán, nơi nhiều máy cùng phục vụ một mô hình. Các chi tiết triển khai của thuật toán phân phối yêu cầu và kiến trúc nhiều bản sao thuộc về bối cảnh phân tán đó.
Trong phân tích phục vụ (serving) trên một máy đơn lẻ này, khi lập kế hoạch năng lực nhắc đến “máy chủ”, ý là khả năng phục vụ (serving) mô hình của chính máy đó. Các cơ chế xếp hàng được phân tích trong section 1.5 giúp ta hiểu hành vi của một máy đơn lẻ và xác định khi nào cần mở rộng sang nhiều máy.
Mặc dù bộ cân bằng tải phân phối các yêu cầu giữa các bản sao, để đạt được độ trễ có thể dự đoán, ta cũng phải kiểm soát những gì diễn ra bên trong mỗi máy. Môi trường hệ điều hành tự nó cũng tạo ra những nguồn biến động riêng.
Độ trễ xác định và cách ly tài nguyên

Một “hàng xóm ồn ào” làm nhiễu loạn mọi khối lượng công việc (workload) cùng chia sẻ nút đó.
Một máy chủ suy luận không hoạt động biệt lập. Trên một máy đơn lẻ, hệ điều hành quản lý nhiều tiến trình cạnh tranh (như tác nhân ghi nhật ký, công cụ giám sát và các ngắt hệ thống) có thể thỉnh thoảng lấy bớt chu kỳ CPU khỏi pipeline suy luận. Những “hàng xóm ồn ào” này là nguyên nhân chính gây ra dao động độ trễ (latency jitter), khi thời gian cần để xử lý các yêu cầu giống hệt nhau thay đổi đáng kể, khiến độ trễ ở phân vị thứ 99 (p99) tăng vọt ngay cả khi phần cứng chưa được khai thác hết. Vì vậy, tranh chấp tài nguyên có thể làm tăng độ trễ đuôi thông qua dao động thời gian phục vụ (service-time jitter), một cơ chế khác với việc hàng đợi phình to do mức sử dụng tài nguyên cao như minh họa trong figure 1.
Để đạt được hiệu năng có tính xác định (deterministic performance) trên một nút đơn, cần giảm nhiễu từ hành vi chia sẻ tài nguyên bình thường của hệ điều hành. Các hệ thống phục vụ (serving) có tính dự đoán như Clockwork cho thấy suy luận mạng nơ-ron sâu (DNN) có thể đáp ứng các SLO ở cấp yêu cầu nếu việc lập lịch và thực thi được kiểm soát chặt chẽ (Gujarati et al. 2020). CPU affinity (pinning) là một công cụ cách ly cục bộ: nó giới hạn các luồng của máy chủ suy luận trên các lõi vật lý cụ thể, nhờ đó các tác vụ nhạy cảm với độ trễ ít bị ảnh hưởng bởi dịch chuyển luồng và mất tính cục bộ của cache. Pinning có thể loại bỏ một nguồn gây dao động độ trễ, nhưng chỉ là một phần của chiến lược cách ly tài nguyên rộng hơn chứ không phải giải pháp hoàn chỉnh.
Khóa bộ nhớ (mlock) giải quyết một nguyên nhân gây dao động (jitter) có liên quan nhưng khác biệt. Theo mặc định, khi bộ nhớ chịu áp lực, hệ điều hành có thể phân trang các vùng bộ nhớ trên host ra đĩa. Nếu bộ máy truy cập bộ nhớ trực tiếp (DMA) của CPU hoặc GPU truy cập vào một vùng đã bị phân trang ra đĩa, quá trình truyền sẽ bị dừng cho đến khi dữ liệu được nạp lại vào RAM. Khóa các trọng số lưu trên RAM, các bộ đệm trung gian (staging buffers) hoặc một cache KV đã được chuyển tải (offloaded) sẽ ngăn các lần dừng này, dù rằng các trang đã khóa không thể được tiến trình khác thu hồi. mlock không khóa bộ nhớ băng thông cao (HBM) của bộ tăng tốc.
Kỹ thuật thứ ba, che chắn ngắt (interrupt shielding), giúp hoàn thiện bức tranh cách ly. Các ngắt từ mạng và lưu trữ nếu được định tuyến vào các lõi phục vụ suy luận có thể bất chợt làm gián đoạn việc gửi lệnh lên GPU. Chuyển hướng các ngắt này sang những lõi không dùng cho suy luận sẽ đảm bảo các đợt lưu lượng đến dồn dập không làm gián đoạn luồng lệnh của GPU, điều này đặc biệt quan trọng để duy trì độ trễ đuôi (tail latency) ổn định khi hệ thống chịu tải.
Những nguyên tắc cách ly này biến một “script mô hình” đơn giản thành một dịch vụ mang tính xác định. Đây là một sự chuyển đổi cần thiết cho các ứng dụng đòi hỏi an toàn cao như xe tự lái hoặc điều khiển công nghiệp thời gian thực. Phổ triển khai (deployment spectrum), cân bằng tải và cách ly tài nguyên xác định nơi các mô hình được phục vụ (serving) và cơ sở hạ tầng nào hỗ trợ chúng. Câu hỏi còn lại là cách phần mềm phục vụ (serving) được tổ chức ra sao, cụ thể là những thành phần nào tạo nên một máy chủ suy luận (inference server) và cách chúng phối hợp để biến lưu lượng người dùng không đều thành việc sử dụng phần cứng hiệu quả.
Self-Check: Question
An e-commerce platform evaluates precomputing product recommendations offline (static inference) versus computing them on demand when a user visits the homepage (dynamic inference). Which trade-off correctly characterizes static inference compared to dynamic inference?
- Static inference eliminates database storage costs but increases real-time p99 latency by executing large batched matrix multiplications during user page loads.
- Static inference guarantees real-time contextual adaptation to intra-session user clicks but requires dedicated high-end GPUs on the critical request path.
- Static inference trades storage capacity and potential prediction staleness for predictable sub-millisecond retrieval latency, whereas dynamic inference provides fresh predictions from live context at the expense of computational latency and variable serving capacity.
- Static inference requires running unbatched single-sample inferences across microcontrollers, whereas dynamic inference processes large offline shards across cloud clusters.
Why does bare-metal TinyML serving on microcontrollers (e.g., ARM Cortex-M) preclude the use of standard cloud serving frameworks (like Triton or vLLM), and what architectural adaptations are required?
True or False: Under a simple \(M/M/1\) queueing model approximation, when server utilization (\(\rho_{\text{serv}}\)) reaches 90%, the 99th percentile (p99) tail latency is approximately equal to 1.5 times the mean latency.
To prevent OS scheduler thread migration and cross-socket memory bus contention from causing latency jitter on multi-socket CPU serving nodes, engineers bind worker threads to specific processor cores and local memory nodes using the ____ utility.
A high-throughput model serving cluster sits behind a Layer 7 load balancer. Which routing algorithm is best suited for minimizing p99 tail latency when inference execution times vary significantly across requests due to variable input sequence lengths?
- Peak exponentially weighted moving average (Peak-EWMA) or least-pending-requests routing, which steers traffic away from replicas currently processing long-running requests.
- Static round-robin routing, which deterministically rotates incoming connections across all healthy replicas regardless of current queue depths.
- Random routing with hash-based sticky IP assignment, which pins client IP addresses permanently to specific backends without monitoring load.
- Maximum-throughput greedy allocation, which concentrates all incoming traffic onto a single primary replica until its memory is completely saturated before spilling over.
Kiến trúc hệ thống phục vụ (Serving System Architecture)
Các yêu cầu từ người dùng thường đến theo từng đợt khó lường: có lúc cách nhau chỉ một mili giây, rồi lại im lặng năm giây. Trong khi đó, các bộ tăng tốc (accelerator) cần các batch ổn định, kích thước đồng đều. Để lấp khoảng cách này, không chỉ là một script Python gọi model.predict(), mà cần một kiến trúc phần mềm chuyên biệt có khả năng hấp thụ biến động lưu lượng, tạo các batch hiệu quả và giữ cho phần cứng luôn hoạt động hết công suất mà không vi phạm các SLO về độ trễ.
Kiến trúc nội bộ và luồng yêu cầu
Tối ưu hóa mô hình tập trung vào phần toán học của mô hình, trong khi phục vụ mô hình đòi hỏi một kiến trúc phần mềm chuyên biệt để quản lý các dòng yêu cầu tần suất cao và việc sử dụng phần cứng. Một máy chủ suy luận3 (như NVIDIA Triton hay TensorFlow Serving) không phải chỉ là lớp bao bọc đơn giản quanh một script mô hình; đó là một bộ lập lịch hiệu suất cao, quản lý đồng thời, bộ nhớ và việc di chuyển dữ liệu.
3 Máy chủ suy luận: TensorFlow Serving của Google (Olston et al. 2017) đã góp phần thiết lập việc tách biệt giữa logic của mô hình và cơ sở hạ tầng phục vụ; Triton của NVIDIA (NVIDIA 2024b) mở rộng cách tiếp cận này trên nhiều framework mô hình và backend khác nhau. Điểm cốt lõi trong thiết kế là dùng một bộ lập lịch và bộ gom batch động để chuyển các yêu cầu đơn lẻ không đều thành thực thi thân thiện với bộ tăng tốc, cải thiện mức sử dụng khi ngân sách độ trễ cho phép gom batch. Mức cải thiện hiệu suất sử dụng cụ thể phụ thuộc vào mô hình, phần cứng, tốc độ yêu cầu đến và cửa sổ gom batch đã cấu hình.
Olston, Christopher, Noah Fiedel, Kiril Gorovoy, Jeremiah Harmsen, Li Lao, Fangwei Li, Vinu Rajashekhar, Sukriti Ramesh, and Jordan Soyke. 2017. “TensorFlow-Serving: Flexible, High-Performance ML Serving.” CoRR abs/1712.06139. https://doi.org/10.48550/arXiv.1712.06139.
NVIDIA. 2024b. NVIDIA Triton Inference Server.
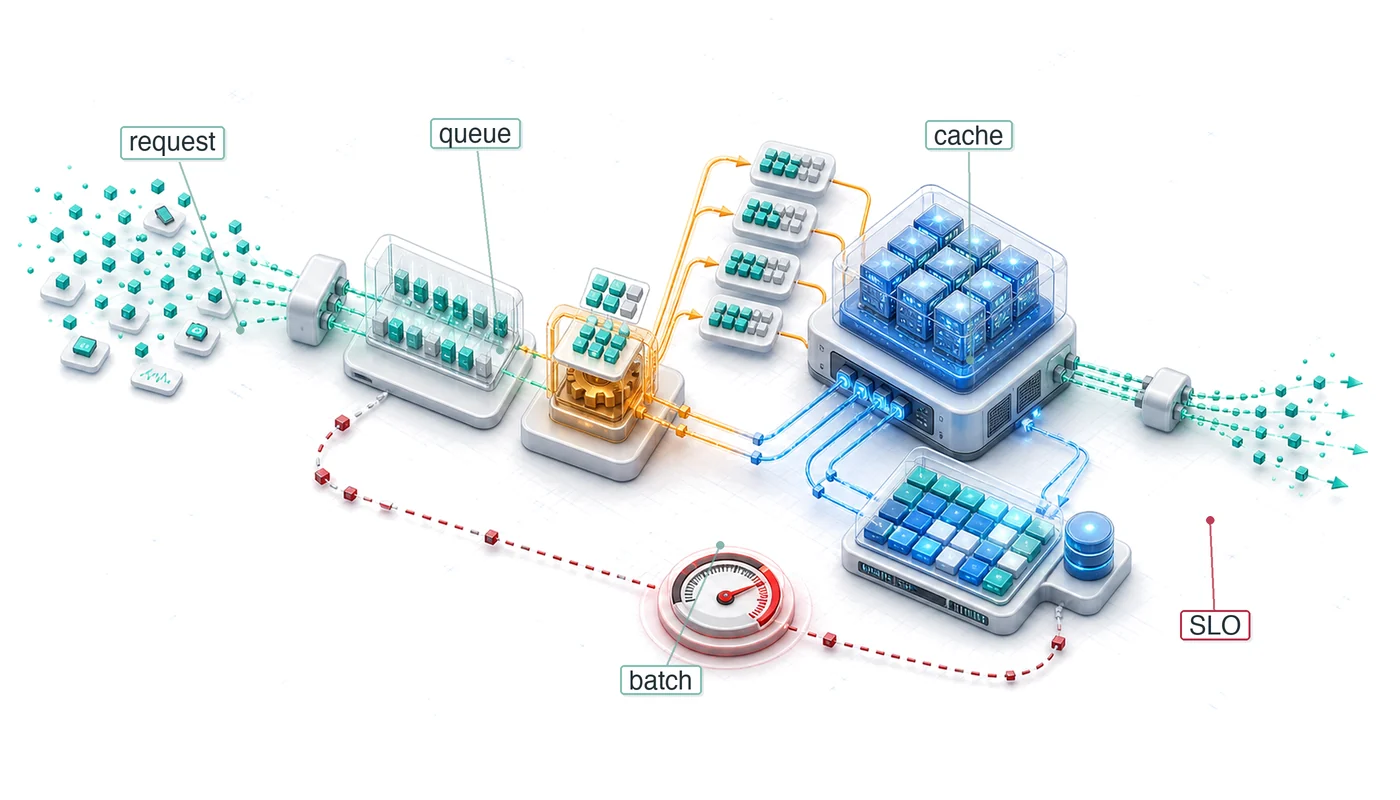
Cấu trúc bên trong của các máy chủ này cho thấy cách chúng bắc cầu khoảng cách giữa lưu lượng người dùng thất thường và các yêu cầu theo batch rất đều đặn mà bộ tăng tốc cần. Mỗi yêu cầu đi qua một pipeline nhiều giai đoạn, được thiết kế để tối đa hóa thông lượng phần cứng đồng thời giảm thiểu độ trễ phát sinh. Figure 4 tách rõ sáu giai đoạn để nêu bật vai trò của từng thành phần trong việc hấp thụ lưu lượng, xếp hàng, gom batch và thực thi trên bộ tăng tốc.

Kiến trúc này phục vụ ba chức năng. Thứ nhất, quản lý đồng thời: máy chủ dùng vòng lặp sự kiện bất đồng bộ hoặc nhóm luồng để xử lý nhiều kết nối client đồng thời mà không bị chặn, nhờ đó I/O mạng không làm bộ tăng tốc phải rảnh việc. Thứ hai, request transformation: máy chủ chuyển đổi payload mạng, như JSON hoặc Protobuf, sang các định dạng tensor mà runtime được chọn yêu cầu. Ví dụ, tensor hình ảnh có thể dùng NCHW4 (batch, kênh, chiều cao, chiều rộng) hoặc NHWC (batch, chiều cao, chiều rộng, kênh). Bố cục nào nhanh hơn phụ thuộc vào kernel của toán tử, kiểu dữ liệu, phần cứng và runtime; việc chuyển đổi không cần thiết giữa các bố cục cũng có thể trở thành một phần trong ngân sách độ trễ.
4 NCHW và NHWC (bố cục bộ nhớ tensor): Các từ viết tắt này mã hóa thứ tự các chiều của tensor hình ảnh 4D: N (batch), C (kênh), H (chiều cao) và W (chiều rộng). Với bố cục NCHW liên tục, mỗi mặt phẳng kênh nằm liên tiếp trong bộ nhớ; còn với NHWC, các kênh tại cùng một vị trí không gian nằm kề nhau. Các kernel được tối ưu có thể ưu tiên bố cục này hoặc kia, và chỉ cần hiểu sai ý nghĩa thứ tự chiều là đủ để làm lẫn lộn giá trị, dù số phần tử vẫn đúng. Vì vậy, mã phục vụ (serving) cần làm rõ ý nghĩa của các chiều và mọi chuyển đổi bố cục vật lý.
Thứ ba, quản lý mô hình: các máy chủ suy luận quản lý vòng đời của các tạo phẩm mô hình đã nạp, bao gồm nạp trọng số vào VRAM, theo dõi phiên bản tạo phẩm nào đang hoạt động, và chạy các suy luận khởi động (warmup inferences) trước khi đưa mô hình vào phục vụ lưu lượng thực tế. Các kho lưu trữ đầy đủ (kho tạo phẩm có phiên bản), cổng phát hành (kiểm tra trước khi phát hành) và quản trị hoàn tác (quy tắc để hoàn nguyên một bản phát hành lỗi) thuộc về Vận hành machine learning; ở phía phục vụ (serving) tại chỗ, điều cần quan tâm là tạo phẩm phù hợp đã được nạp và sẵn sàng hay chưa. Trong số các thành phần này, bộ lập lịch cần được chú ý đặc biệt vì nó hiện thân cho sự đánh đổi cốt lõi của phục vụ (serving) giữa thông lượng và độ trễ.
Bộ lập lịch là “bộ não” của máy chủ suy luận. Nó triển khai logic batching động được thảo luận trong section 1.7. Bộ lập lịch phải quyết định nên chạy ngay một yêu cầu đơn lẻ để giảm độ trễ của nó, hay đợi năm mili giây cho yêu cầu thứ hai rồi xử lý chúng cùng nhau để tối đa hóa thông lượng.
Các nhà thiết kế hệ thống sử dụng tham số cửa sổ batching để tinh chỉnh sự đánh đổi này. Cửa sổ 0 ms tối ưu cho độ trễ thuần túy (không batching), trong khi một cửa sổ nhỏ có giới hạn cho phép bộ lập lịch chấp nhận một khoảng chờ có kiểm soát để đổi lấy mức sử dụng bộ tăng tốc cao hơn. Quyết định này quyết định mức độ bận của bộ tăng tốc: phần cứng dành thời gian để tính toán hay chờ việc.
Giao thức giao diện và tuần tự hóa
Cơ chế truyền dữ liệu giữa máy khách và máy chủ ảnh hưởng trực tiếp đến ngân sách độ trễ. Suy luận của mô hình thường được tối ưu hóa rất cao, nhưng chi phí đưa dữ liệu vào mô hình (tuần tự hóa và chi phí giao thức mạng) có thể trở thành nút thắt cổ chai chính, đặc biệt với các mô hình nhẹ có thời gian suy luận ngắn.
Nút thắt tuần tự hóa
Các tải trọng phục vụ (serving) ML về cơ bản khác với các tải trọng API web thông thường: chúng thường là các mảng float đa chiều (như tensor hình ảnh, vector embedding, chuỗi ID token) có cấu trúc dày đặc, dạng nhị phân và kích thước lớn. Các định dạng văn bản như JSON tuy phổ biến nhưng tốn kém về mặt tính toán cho loại dữ liệu này. Chi phí tuần tự hóa xuất hiện khi phân tích cú pháp một đối tượng JSON, vì hệ thống phải đọc từng byte, xác thực cú pháp và chuyển đổi các biểu diễn văn bản thành kiểu dữ liệu gốc của máy. Với các tải trọng tensor, chi phí này còn tăng thêm: các giá trị dấu phẩy động trước tiên phải được mã hóa thành chuỗi ASCII độ dài biến đổi (kích thước phụ thuộc vào giá trị và định dạng), còn dữ liệu nhị phân như byte hình ảnh thì cần mã hóa Base64, làm tăng thêm 33% kích thước trước khi quá trình phân tích cú pháp JSON bắt đầu. Đối với các hệ thống có thông lượng cao, các giải pháp nhị phân như Protocol Buffers5 và FlatBuffers6 giúp tiết kiệm chu kỳ CPU cho việc xử lý yêu cầu hoặc tiền xử lý.
5 Protocol Buffers (Protobuf): Protobuf sử dụng một lược đồ định sẵn (từ tệp .proto) để mã hóa dữ liệu có cấu trúc thành định dạng nhị phân nhỏ gọn (Protocol Buffers Authors 2026). Vì lược đồ chứa tên và kiểu của các trường, nên dữ liệu truyền qua mạng (wire payload) không cần lặp lại thông tin này như JSON. Định dạng dữ liệu truyền qua mạng của Protobuf vẫn không giống với cách bố trí trong bộ nhớ của một đối tượng C++, do đó cần một bước phân tích cú pháp và không cung cấp cùng mẫu truy cập trực tiếp không sao chép (zero-copy) như FlatBuffers hướng tới.
Protocol Buffers Authors. 2026. Overview: Protocol Buffers.
6 FlatBuffers: Chữ “flat” trong tên gọi nói lên thiết kế: bộ đệm nhị phân đồng thời là biểu diễn đã được tuần tự hóa và là cấu trúc dữ liệu đang được đọc, nhờ đó tránh được bước phân tích cú pháp hoặc tháo gói riêng cho các kiểu truy cập được hỗ trợ (FlatBuffers Authors 2026). Trong suy luận ML, điều này cho phép truy cập không sao chép vào siêu dữ liệu của tensor—hệ thống phục vụ (serving) đọc hình dạng và các offset của tensor trực tiếp từ bộ đệm, thay vì phải cấp phát thêm một đối tượng để biểu diễn.
FlatBuffers Authors. 2026. FlatBuffers Documentation.
Các định dạng này giảm tình trạng phình to bằng cách sử dụng mã hóa nhị phân có nhận biết lược đồ thay vì mã hóa văn bản. Các mảng float gốc có thể được truyền dưới dạng byte IEEE 754 nhỏ gọn mà không cần chuyển đổi ASCII hay lớp bọc Base64. FlatBuffers cũng có thể cho phép truy cập không sao chép (zero-copy) trong các trường hợp được hỗ trợ, tức là bộ đệm mạng có thể được đọc trực tiếp mà không cần cấp phát một biểu đồ đối tượng riêng.
REST so với gRPC
Hai kiểu giao diện phổ biến có các đặc điểm hệ thống khác nhau. REST (Representational State Transfer) thường sử dụng HTTP với JSON. Nó được hỗ trợ rộng rãi và dễ đọc, nên thường là lựa chọn cho các API công khai. Một yêu cầu REST không trạng thái cần mang theo thông tin để xác định hoặc xử lý trạng thái của nó, nhưng có thể tham chiếu trạng thái hội thoại phía máy chủ bằng một định danh thay vì gửi lại toàn bộ ngữ cảnh của mô hình ngôn ngữ lớn (LLM). Phiên bản giao thức truyền tải và định dạng payload là những lựa chọn tách biệt: REST có thể dùng HTTP/2, và một API HTTP không nhất thiết phải dùng JSON. Khi dùng HTTP/1.1 kết hợp với JSON, việc quản lý kết nối và tuần tự hóa văn bản có thể trở thành chi phí đáng kể đối với lưu lượng tensor có QPS cao.
Ngược lại, gRPC (gRPC Remote Procedure Call)7 sử dụng HTTP/2 và thường dùng Protobuf. HTTP/2 cho phép ghép kênh nhiều yêu cầu trên một kết nối TCP duy trì duy nhất, giúp giảm chi phí quản lý kết nối và cho phép truyền nhị phân hiệu quả theo dạng dòng. Protobuf cung cấp lược đồ có kiểu và khả năng tuần tự hóa nhị phân hiệu quả, khiến gRPC trở thành lựa chọn phổ biến cho giao tiếp nội bộ giữa các dịch vụ, đặc biệt khi độ trễ và các giao diện có kiểu là yếu tố quan trọng.
7 gRPC (gRPC remote procedure call): gRPC kết hợp lớp truyền tải HTTP/2 với một ngôn ngữ định nghĩa giao diện và định dạng thông điệp, phổ biến nhất là Protocol Buffers (gRPC Authors 2026). Ưu điểm của gRPC trong việc phục vụ (serving) là sự kết hợp giữa các hợp đồng định kiểu, các kết nối đa kênh (multiplexed) được duy trì, hỗ trợ truyền dữ liệu liên tục (streaming), và các thông điệp nhị phân nhỏ gọn. Lợi ích về kích thước và độ trễ so với REST/JSON phụ thuộc vào dạng tải trọng, cách triển khai ở phía máy khách/máy chủ, và việc tuần tự hóa có chiếm tỷ trọng đáng kể trong ngân sách độ trễ đầu-cuối hay không.
gRPC Authors. 2026. Introduction to gRPC.
Một so sánh tải trọng cụ thể cho thấy lựa chọn tuần tự hóa ảnh hưởng đến cả kích thước dữ liệu trên đường truyền và chi phí phân tích.
Napkin Math 1.1: Tuần tự hóa JSON so với Protobuf
Hãy xem xét một tải trọng yêu cầu chứa 1,000 số thực dấu phẩy động (ví dụ, một vector embedding).
- JSON: Sử dụng khoảng ~9 KB dữ liệu trên đường truyền. Cần khoảng ~50 μs để phân tích.
- Protobuf: Sử dụng khoảng ~4 KB dữ liệu trên đường truyền. Cần khoảng ~5 μs để phân tích.
Tính toán: Chuyển một yêu cầu sang tải trọng nhị phân sẽ tiết kiệm được 50 μs − 5 μs = 45 μs thời gian phân tích. Với hệ thống minh họa này xử lý 10,000 yêu cầu mỗi giây, mức tiết kiệm này sẽ cộng dồn thành 10,000 \(\times\) 45 μs = 0.45 s thời gian CPU được giải phóng mỗi giây thực tế, tương đương 45 percent của một lõi CPU được giải phóng chỉ nhờ giảm chi phí tuần tự hóa.
Góc nhìn hệ thống: Mức tăng hiệu quả 10× trong kịch bản này cho thấy gRPC/Protobuf, FlatBuffers, hoặc các giao thức nhị phân khác là lựa chọn mạnh cho các microservice nội bộ cần thông lượng cao, đặc biệt khi quá trình tuần tự hóa chiếm một phần đáng kể trong tổng ngân sách độ trễ.
Việc chọn hệ thống phụ thuộc vào các ràng buộc cụ thể. REST/HTTP thường được dùng khi ưu tiên khả năng tương thích rộng rãi, dễ gỡ lỗi và tận dụng hệ sinh thái. Ngược lại, gRPC/Protobuf hoặc các giao thức nhị phân khác được ưu tiên khi xử lý lưu lượng tensor nội bộ với QPS cao, cần tái sử dụng kết nối hoặc streaming, vì khi đó việc tuần tự hóa chiếm đáng kể trong ngân sách độ trễ và CPU.
Các thành phần kiến trúc và giao thức mà chúng ta đã xem xét đến giờ mô tả cách các hệ thống phục vụ (serving) được xây dựng. Để hiểu tại sao một số cấu hình hoạt động tốt hơn, ta cần phân tích điều gì xảy ra với từng yêu cầu khi chúng đi qua các thành phần này.
Self-Check: Question
- Order the sequential stages of a request passing through a high-performance decoupled inference serving pipeline from initial arrival to client response:
- Hardware Accelerator Execution (tensor kernel execution on GPU/NPU)
- Dynamic Batcher (aggregating incoming items up to max batch size or timeout)
- Network Ingress & Gateway (TLS termination, authentication, protocol deserialization)
- Postprocessing & Response Dispatch (logit normalization, top-\(k\) filtering, response serialization)
- Request Queue (absorbing traffic bursts and buffering pending requests)
- Inference Runner / Engine (tensor memory management, CUDA stream scheduling)
In a microservices architecture where an internal fraud detection service processes \(10^5\) queries per second with a 5 ms SLA, why is gRPC with Protocol Buffers preferred over HTTP/1.1 with JSON?
- JSON text parsing is performed directly inside GPU Tensor Cores, whereas Protocol Buffers require host CPU preprocessing.
- HTTP/1.1 provides automatic iteration-level continuous batching, whereas gRPC only supports static batching.
- Protocol Buffers eliminate the need for schema definitions, enabling zero-copy dynamic typing across heterogeneous languages.
- Protocol Buffers use compact binary encoding with pre-compiled schema parsers that drastically reduce CPU serialization latency, and gRPC multiplexes requests over persistent HTTP/2 TCP connections.
What is the ‘serialization bottleneck’ in model serving, and under what operational conditions (model size, request payload, query rate) does it become the dominant factor in the end-to-end latency budget?
True or False: Replacing HTTP/1.1 REST endpoints with gRPC automatically accelerates the GPU kernel execution time of deep learning models by \(2\times\) to \(4\times\).
In an inference server architecture, what is the primary role of decoupling the request queue from the dynamic batcher?
- It allows the server to permanently cache all intermediate GPU activations across independent client requests.
- It allows the system to absorb stochastic arrival bursts without dropping connections while providing the batcher with a pool of pending requests to construct optimal batch sizes within a timeout budget.
- It eliminates the need for GPU kernel compilation by converting dynamic input shapes into fixed static tensors in the queue.
- It bypasses host RAM by streaming network packets directly from the NIC into the accelerator’s L2 cache via PCIe peer-to-peer transfers.
Vòng đời của yêu cầu
Một yêu cầu HTTP duy nhất mang một ảnh JPEG \(224{\times}224\) đến máy chủ suy luận. Từ lúc byte đầu tiên đi vào ngăn xếp mạng đến khi trả về kết quả phân loại, yêu cầu đó đi qua sáu giai đoạn của pipeline, mỗi giai đoạn tiêu tốn vài mili giây mà người dùng cảm nhận là thời gian chờ. Hiểu rõ thời gian bị tiêu tốn ở đâu trong mỗi yêu cầu là điều thiết yếu để tối ưu hiệu quả: chúng ta không thể cải thiện những gì mình không đo lường.
Ngân sách độ trễ
Với các hệ thống suy luận động, sự đảo ngược trong phục vụ (serving) được trình bày tại section 1.1 tạo ra một ngân sách độ trễ định hình thiết kế hệ thống (Gujarati et al. 2020). Một hệ thống phục vụ có độ trễ mỗi yêu cầu ở mức giây có thể bỏ lỡ nhiều SLO tương tác, ngay cả khi thông lượng rất cao.
Gujarati, Arpan, Reza Karimi, Safya Alzayat, Wei Hao, Antoine Kaufmann, Ymir Vigfusson, and Jonathan Mace. 2020. “Clockwork: Predictable and Scalable DNN Inference in the Cloud.” USENIX Symposium on Operating Systems Design and Implementation (OSDI), 443–62.
8 Độ trễ đuôi (Tail latency): Khác với trung bình, độ trễ theo phân vị cho thấy tác động hiệu năng của các trường hợp ngoại lệ thường gặp trong quá trình phục vụ (serving) ML, như bỏ lỡ cache mô hình hoặc các lần tạm dừng thu gom rác (garbage collection). Những yêu cầu hiếm nhưng có độ trễ cao này có thể gây tổn hại đáng kể đến trải nghiệm người dùng và kết quả kinh doanh. Vì mức độ ảnh hưởng phụ thuộc vào khối lượng công việc (workload) cụ thể, các dịch vụ cần kiểm chứng các mục tiêu phân vị (p95, p99) dựa trên người dùng và SLO của chính mình.
Các chỉ số liên quan mở rộng từ thông lượng tổng hợp và độ trễ trung bình sang phân bố độ trễ. Giá trị trung bình và p50 mô tả phần trung tâm, còn p95 và p99 phơi bày “đuôi chậm”. Ví dụ, nếu độ trễ trung bình là 50 ms nhưng p99 là hai giây, thì ngưỡng p99 là 40× lần so với trung bình, nghĩa là khoảng 1% yêu cầu có độ trễ bằng hoặc vượt quá hai giây. Đuôi chậm đó có quan trọng hay không còn tùy dịch vụ và người dùng, nên các mục tiêu percentile nên xuất phát từ SLO thay vì theo thông lệ.8
Việc quản lý các ràng buộc theo phân vị này đòi hỏi chia nhỏ tổng thời gian phản hồi cho phép thành một ngân sách độ trễ để phân bổ thời gian cho từng giai đoạn xử lý.
Definition 1.2: Ngân sách độ trễ
Ngân sách độ trễ là thời gian được phân bổ cho các giai đoạn xử lý yêu cầu trong một thời hạn end-to-end; SLO cũng quy định phân vị hoàn thành bắt buộc.
- Ý nghĩa: Nó hoạt động như một hệ thống ràng buộc tổng-bằng-không, trong đó bất kỳ mili giây nào tiêu tốn cho tuần tự hóa hoặc chi phí mạng đều trực tiếp làm giảm ngân sách độ trễ \((L_{\text{lat}})\) dành cho quá trình suy luận mô hình.
- Điểm khác biệt: Một SLO về độ trễ kết hợp một hạn chót (ví dụ, \(<50\text{ ms}\)) với một phân vị hoàn thành (\(\text{p99}\) hoặc \(\text{p99.9}\)). Chỉ số mức dịch vụ (SLI) là đại lượng đo lường dùng để đánh giá mục tiêu đó. Không đạt một SLO nội bộ sẽ làm giảm biên độ tin cậy; vượt ngưỡng SLA bên ngoài có thể kích hoạt các biện pháp khắc phục được quy định trong hợp đồng. Các đỉnh độ trễ đuôi có thể bắt nguồn từ xếp hàng, hình thành batch, trạng thái cache, nhiễu, hoặc di chuyển dữ liệu.
- Sai lầm phổ biến: Một hiểu lầm thường gặp là “mô hình” được cấp toàn bộ ngân sách. Trong phân tích minh họa tại table 3, phần ngân sách còn lại bị tiêu tốn bởi vòng đời xử lý yêu cầu (DNS, TLS, cân bằng tải, tuần tự hóa).
Trước khi tính toán một ngân sách đầy đủ, checkpoint này đặt nền tảng các kỹ năng phân tích độ trễ mà mọi kỹ sư phục vụ (serving) đều cần.
Mỗi yêu cầu phục vụ (serving) được chia thành ba giai đoạn, mỗi giai đoạn tiêu tốn một phần ngân sách độ trễ. Tiền xử lý chuyển dữ liệu đầu vào thô như byte hình ảnh hoặc chuỗi văn bản thành các tensor sẵn sàng cho mô hình. Suy luận thực hiện tính toán của mô hình. Hậu xử lý chuyển đầu ra của mô hình thành phản hồi hiển thị cho người dùng.
Checkpoint 1.1: Độ trễ đuôi và ngân sách
Phục vụ (serving) tối ưu hóa độ trễ đuôi khi chịu tải. Sử dụng checkpoint này để tách riêng tác động của xếp hàng và batching trước khi chọn phương án tối ưu hóa.

Suy luận chỉ là một phần của ngân sách độ trễ; tiền xử lý cũng quan trọng không kém.
Phần cứng nhanh hơn không tự động đồng nghĩa với việc phục vụ (serving) nhanh hơn. Trong thực tế, tiền xử lý và hậu xử lý có thể chiếm phần lớn tổng độ trễ khi suy luận chạy trên các bộ tăng tốc đã được tối ưu hóa. Chỉ tối ưu hóa riêng giai đoạn suy luận sẽ cho lợi ích giảm dần nếu pipeline xung quanh vẫn bị nghẽn bởi các tác vụ trên CPU.
Phân tích phân phối độ trễ
Để hiểu thời gian được dùng vào đâu, cần đo lường độc lập từng giai đoạn. Phân rã ngân sách độ trễ của ResNet-50 cho thấy chính xác mỗi mili giây được tiêu ở đâu khi bộ phân loại của chúng ta nhận một ảnh JPEG.
Example 1.4: ResNet-50: Phân tích ngân sách độ trễ
Table 3 cung cấp một phân rã minh họa yêu cầu phục vụ (serving) ResNet-50 theo từng giai đoạn:
Table 3: Ngân sách độ trễ của ResNet-50: Biểu đồ phân tích minh họa độ trễ theo từng giai đoạn cho một yêu cầu phục vụ, cho thấy tổng thời gian tiền xử lý và truyền dữ liệu có thể ngang bằng với thời gian của chính bước chuyển tiếp (forward pass) của ResNet-50. Các tỷ lệ phần trăm này cho thấy nên dồn công sức kỹ thuật vào đâu trong kịch bản này. Tỷ lệ phần trăm của mỗi giai đoạn được làm tròn đến số nguyên gần nhất, nên tổng có thể không đúng chính xác 100%.
| Giai đoạn | Thao tác | Thời gian | Tỷ lệ phần trăm |
|---|---|---|---|
| Tiền xử lý | Giải mã JPEG | 3 ms | 30% |
| Tiền xử lý | Thay đổi kích thước thành \(224{\times}224\) | 1 ms | 10% |
| Tiền xử lý | Chuẩn hóa (trung bình/độ lệch chuẩn) | 0.5 ms | 5% |
| Truyền tải dữ liệu | Sao chép CPU→GPU | 0.5 ms | 5% |
| Suy luận | Chuyển tiếp ResNet-50 | 5 ms | 50% |
| Hậu xử lý | Softmax + top-5 | 0.1 ms | ~1% |
| Tổng cộng | 10.1 ms | 100% |
Nhận định về hệ thống: Trong ngân sách phục vụ (serving) ResNet-50 minh họa này, tiền xử lý chiếm 44.6 percent tổng độ trễ dù suy luận mô hình là giai đoạn tốn tính toán nhất. Nếu TensorRT giảm thời gian suy luận xuống mức giả định 2 ms, thì tiền xử lý sẽ trở thành phần chiếm ưu thế, đạt 63.4 percent.
Ví dụ về ResNet minh họa trường hợp suy luận bị giới hạn bởi tính toán, trong đó các phép toán của bước chuyển tiếp (forward pass) chiếm phần lớn ngân sách độ trễ. Khi áp dụng cùng một framework cho một kiến trúc mô hình khác, ta thường thấy nút thắt cổ chai chuyển từ tính toán sang băng thông bộ nhớ, khiến các chiến lược tối ưu hóa từng hiệu quả cho mô hình thị giác không còn phù hợp. Các hệ thống khuyến nghị chính là ví dụ điển hình cho sự dịch chuyển này.
Lighthouse 1.1: Ví dụ điển hình: Phục vụ (serving) DLRM
Kịch bản: Phục vụ (serving) DLRM với ngân sách độ trễ p99 là 10 ms.
Phân tích: Trong khi giai đoạn mô hình của ResNet-50 chủ yếu bị chi phối bởi các phép tính của mạng nơ-ron tích chập, thì chi phí chính ở giai đoạn mô hình của DLRM là truy cập bộ nhớ bảng embedding. Để xác định nút thắt cổ chai trong quá trình phục vụ (serving) từ đầu đến cuối, ta vẫn cần đo lường toàn bộ chuỗi: tiền xử lý, suy luận, hậu xử lý và luân chuyển dữ liệu. Table 4 phân rã yêu cầu khuyến nghị theo từng giai đoạn như sau:
| Giai đoạn | Thao tác | Thời gian | Nút thắt cổ chai |
|---|---|---|---|
| Phân tích cú pháp đầu vào | Phân tích cú pháp yêu cầu | 0.5 ms | CPU |
| Tra cứu embedding | Lấy 100+ vector dày đặc | 6 ms | băng thông bộ nhớ |
| Suy luận | Chuyển tiếp MLP | 1.5 ms | Tính toán |
| Hậu xử lý | Xếp hạng & Lọc | 1 ms | CPU |
| Tổng cộng | 9 ms |
Góc nhìn hệ thống: Trong DLRM, giai đoạn “Inference” của multilayer perceptron chỉ chiếm khoảng ~17 percent tổng độ trễ. Phần lớn thời gian dành cho việc tra cứu embedding, tức truy xuất các vector embedding 128 chiều rất lớn từ các bảng ở quy mô terabyte. Đây là khối lượng công việc (workload) bị giới hạn bởi băng thông và dung lượng bộ nhớ; thêm tài nguyên tính toán sẽ không giúp ích nếu không phục vụ (serving) các bảng embedding nhanh hơn.
Tổng hợp lại, table 3 và table 4 phơi bày cùng một dạng thất bại: các nỗ lực tối ưu hoá thường nhắm vào nơi chuyên môn ML can thiệp được (lượng tử hoá mô hình, tỉa (pruning)), trong khi ràng buộc then chốt lại nằm chỗ khác (giải mã hình ảnh trên CPU với ResNet-50, băng thông bộ nhớ của bảng embedding với DLRM). Mẫu hình này khái quát tốt: bất kỳ hệ thống phục vụ (serving) nào mà mô hình chiếm dưới một nửa tổng độ trễ sẽ nhận thấy hiệu quả giảm dần từ các tối ưu hoá chỉ nhắm vào mô hình, bất kể các tăng tốc đơn lẻ lớn đến đâu. Định luật Amdahl định lượng trần tăng tốc này. Áp dụng cách tiếp cận định lượng cho phục vụ (serving) giúp lộ ra các nút thắt cổ chai ẩn trước khi công sức kỹ thuật bị phân bổ sai chỗ.
Systems Perspective 1.3: Cách tiếp cận định lượng cho phục vụ (serving)
Phân tích: Định luật Amdahl đang phát huy tác dụng (Định luật Amdahl và Định luật Gustafson đưa ra dẫn xuất chính thức): tiền xử lý (4.5 ms) và truyền dữ liệu (0.5 ms) chiếm 49.5 percent tổng độ trễ. Dù tối ưu hoá để mô hình nhanh hơn 10\(\times\) (5 ms → 0.5 ms), ta chỉ thu được mức tăng tốc đầu-cuối là 1.8× (từ 10.1 ms xuống 5.6 ms). Đây là lý do vì sao chỉ tập trung tối ưu hoá mô hình (lượng tử hoá, tỉa (pruning)) thường gây thất vọng: nút thắt cổ chai nằm ở nơi khác.
Cơ chế: Các DSA như TPU và Tensor Cores thay thế logic điều khiển phức tạp bằng các mảng nhân-tích lũy dày đặc, cải thiện thông lượng thực tế cho các kernel tương thích. Điều này khiến tăng tốc phần cứng trở thành một yêu cầu về kinh tế đối với nhiều khối lượng công việc (workload) phục vụ (serving) đòi hỏi thông lượng cao hoặc độ trễ thấp.
Góc nhìn hệ thống: Hãy profile trước khi tối ưu. Nếu bước tiền xử lý chiếm phần lớn thời gian, các pipeline tăng tốc bằng GPU (NVIDIA DALI) có thể hiệu quả hơn so với lượng tử hoá mô hình.
Đưa bước tiền xử lý gần bộ tăng tốc có thể giảm các lần truyền dữ liệu không cần thiết giữa CPU và GPU, nhưng lợi ích tổng thể (end-to-end) còn phụ thuộc vào từng pipeline. Tối ưu hiệu quả là nhắm vào những phần tốn thời gian nhất trước.
Khoản “thuế” của phục vụ (serving)
Ngoài bản thân việc thực thi mô hình, mỗi yêu cầu còn phải “đóng thuế” cho hạ tầng phục vụ (serving). Các chi phí phụ trội (overhead) bao gồm I/O mạng, tuần tự hóa, xếp hàng, điều phối và di chuyển dữ liệu.
Bài toán micro giây chết người
Barroso, Patterson và các cộng sự đã chỉ ra một khoảng cách lớn trong cách các hệ thống xử lý độ trễ ở các thang thời gian khác nhau (Barroso et al. 2017). Các hoạt động ở mức micro giây quá ngắn để hệ điều hành truyền thống lập lịch (vốn hoạt động ở độ phân giải mili giây), nhưng lại quá dài để chỉ bận chờ (spin-wait) mà không lãng phí chu kỳ CPU. “Micro giây chết người” đặc biệt quan trọng trong các khối lượng công việc (workload) phục vụ (serving) hiện đại. Dựa trên các khoảng đại diện trong table 5, tuần tự hóa ở 50–500 μs, điều phối ở 10–50 μs và sao chép dữ liệu ở 100–500 μs đều nhỏ nếu xét riêng lẻ. Tuy vậy, với một dịch vụ suy luận có độ trễ mục tiêu 5 ms, tổng các overhead ở mức micro giây này có thể chiếm khoảng 3.2 percent đến 21 percent trong ngân sách độ trễ, ngay cả trước khi tính độ trễ mạng và hàng đợi. Không một overhead nào tự nó đủ lớn để đáng tối ưu hóa riêng lẻ, nhưng cộng lại, chúng quyết định hệ thống có đáp ứng SLO hay không.
Barroso, Luiz, Mike Marty, David Patterson, and Parthasarathy Ranganathan. 2017. “Attack of the Killer Microseconds.” Communications of the ACM 60 (4): 48–54. https://doi.org/10.1145/3015146.
| Thành phần chi phí | Chi phí điển hình | Hành vi mở rộng | Chiến lược tránh chi phí |
|---|---|---|---|
| I/O mạng | 1–5 ms | Tuyến tính theo tải trọng | Nén, Đồng vị trí khu vực |
| Tuần tự hóa | 50–500 \(\mu\text{s}\) | Tuyến tính theo tải trọng | gRPC/Protobuf (so với JSON) |
| Xếp hàng đợi | 0.1–10 ms | Phân kỳ gần công suất tối đa | Dynamic Batching, Autoscaling |
| Điều phối | 10–50 \(\mu\text{s}\) | Hằng số trên mỗi batch | Kernel Fusion (giảm số lần khởi chạy) |
| Sao chép dữ liệu | 100–500 \(\mu\text{s}\) | Tuyến tính với tensor | Zero-Copy/Bộ nhớ chia sẻ |
Framework ngân sách độ trễ cung cấp một cách tiếp cận có hệ thống cho bài toán phức hợp này. Trước hết phải đo lường: nếu không có đo lường theo từng giai đoạn, kỹ sư sẽ không phân biệt được nút thắt ở bước tiền xử lý với nút thắt do tuần tự hóa, và nỗ lực tối ưu hóa dễ bị dồn vào thành phần dễ thấy nhất (mô hình) thay vì thành phần tốn kém nhất. Khi việc đo lường đã cho thấy phân bổ thời gian thực tế, nỗ lực kỹ thuật nên được phân bổ theo tỉ lệ: một giai đoạn chiếm 50% độ trễ đáng được chú ý hơn giai đoạn chỉ chiếm 5%, bất kể giai đoạn nào có vẻ dễ xử lý hơn. Các thay đổi kiến trúc như tiền xử lý tăng tốc bằng GPU hoặc batching mạnh có thể chuyển tải công việc giữa các giai đoạn, đôi khi loại bỏ hẳn một nút thắt chứ không chỉ giảm bớt.
Đánh đổi giữa độ phân giải và kích thước đầu vào
Độ phân giải đầu vào ảnh hưởng đến cả độ trễ tiền xử lý và suy luận, nhưng mối quan hệ này khác nhau tùy hệ thống bị compute bound (giới hạn bởi thông lượng số học) hay memory-bound (giới hạn bởi việc di chuyển dữ liệu). Hệ thống compute-bound sẽ chậm lại khi lượng tính toán tăng; hệ thống memory-bound sẽ chậm lại khi số byte cần truyền tăng. Chỉ vừa khít dung lượng không loại bỏ được chi phí băng thông. Phân tích roofline trong Mô hình Roofline đào sâu sự khác biệt này, là cơ sở quan trọng để ra quyết định về độ phân giải một cách hiểu biết.
Với các mô hình chủ yếu dùng tích chập và bị giới hạn bởi tính toán, equation 1 đưa ra một xấp xỉ bậc nhất, trong đó thông lượng tỷ lệ nghịch với bình phương độ phân giải: \[\frac{\text{Throughput}(r_2)}{\text{Throughput}(r_1)} = \left(\frac{r_1}{r_2}\right)^2 \tag{1}\]
Tăng gấp đôi độ phân giải từ 224 lên 448 cho ước tính tỉ lệ chậm lại do tính toán là 4×; kịch bản minh họa 3.6× có tính cả chi phí cố định. Độ phân giải cao hơn có thể làm tăng cường độ số học của tích chập vì các trọng số được dùng lại trên nhiều vị trí không gian hơn, nhưng việc toàn bộ mô hình có trở thành compute-bound hay không còn phụ thuộc vào số byte mà các kernel của nó phải di chuyển.
Table 6 định lượng cách việc tăng độ phân giải giúp phân bổ đều lưu lượng trọng số cố định trong mô hình đơn giản hóa này, nhưng vẫn chưa giải quyết được nút thắt do kernel đang thực thi.
| Độ phân giải | Thuật ngữ Activation giả định | Cường độ số học được mô hình hóa | Phân loại nút thắt cổ chai |
|---|---|---|---|
| \(224{\times}224\) | 12.5 MB | 64.4 FLOP/byte | Chưa được thiết lập |
| \(384{\times}384\) | 36.7 MB | 137 FLOP/byte | Chưa được thiết lập |
| \(512{\times}512\) | 65.3 MB | 183.9 FLOP/byte | Chưa được thiết lập |
| \(640{\times}640\) | 102.0 MB | 218.4 FLOP/byte | Chưa được thiết lập |
Các chiến lược độ phân giải trong triển khai
Các ngữ cảnh triển khai khác nhau đặt ra yêu cầu độ phân giải khác nhau, tùy theo các ràng buộc chính. Một ứng dụng di động có thể chấp nhận độ phân giải thấp hơn (\(224{\times}224\)) khi độ trễ và thời lượng pin quan trọng hơn những cải thiện nhỏ về độ chính xác. Một số khối lượng công việc (workload) xử lý ảnh y tế dùng \(512{\times}512\) hoặc cao hơn khi cần chi tiết chẩn đoán, dù tốn thêm tính toán. Một pipeline nhận thức (perception pipeline) có thể dùng độ phân giải thấp cho trường nhìn rộng, và dùng các vùng cắt (crop) độ phân giải cao để nhận dạng chi tiết. Thay vào đó, một API công cộng có thể chuẩn hóa các dữ liệu tải lên tùy ý theo một hợp đồng cố định, hoặc chọn trong số các cấu hình độ phân giải đã được xác thực. Độ phân giải thích ứng chỉ hữu ích khi chính sách lựa chọn và mọi cấu hình được chọn vẫn đảm bảo các yêu cầu chất lượng của tác vụ.
Độ phân giải thích ứng
Độ phân giải thích ứng cho phép hệ thống trong triển khai chọn độ phân giải động dựa trên nội dung. Một cách tiếp cận là chạy một bộ phân loại nhẹ ở \(128{\times}128\) để nhận diện loại nội dung, rồi chọn độ phân giải phù hợp với tác vụ: tài liệu ở \(512{\times}512\), phong cảnh ở \(224{\times}224\), và khuôn mặt ở \(384{\times}384\). Trong kịch bản minh họa này, chính sách giúp cải thiện thông lượng 1.4× trong khi vẫn giữ được độ chính xác 99.2 percent so với dùng độ phân giải cao cố định. Mẫu thiết kế này chấp nhận chi phí tiền xử lý từ việc chạy bộ phân loại nhẹ để đổi lấy tiết kiệm chi phí suy luận trên mô hình chính.
Đến đây, phân tích độ trễ tập trung vào xử lý tuần tự: một yêu cầu hoàn tất rồi yêu cầu tiếp theo mới bắt đầu. Các giai đoạn tiền xử lý, suy luận và hậu xử lý dùng những tài nguyên phần cứng khác nhau. Sự tách biệt này tạo cơ hội xử lý nhiều yêu cầu cùng lúc.
Hiệu suất sử dụng phần cứng và request pipelining
Tối ưu từng giai đoạn của yêu cầu một cách tách biệt sẽ bỏ lỡ một cơ hội quan trọng: các giai đoạn dùng những tài nguyên phần cứng khác nhau. Phân tích ngân sách độ trễ trong section 1.4.1 cho thấy suy luận mô hình chỉ là một thành phần trong vòng đời của một yêu cầu. Từ góc độ phần cứng, mục tiêu chính của một hệ thống phục vụ (serving) là tối đa hóa chu kỳ hoạt động của bộ tăng tốc, tức tỷ lệ thời gian GPU thực hiện tính toán hữu ích.
Trong một hệ thống phục vụ tuần tự, phần cứng sẽ nhàn rỗi trong lúc I/O mạng và tiền xử lý bằng CPU. Các hệ thống phục vụ hiệu suất cao dùng request pipelining để chồng chéo các giai đoạn này, đảm bảo GPU luôn nhận được luồng tensor liên tục.
Chồng chéo I/O và tính toán
Hai biểu đồ thời gian trong figure 5 minh họa tác động của pipelining. Trong trường hợp tuần tự (A), mỗi yêu cầu phải hoàn thành toàn bộ vòng đời của nó (Mạng \(\rightarrow\) Tiền xử lý CPU \(\rightarrow\) Suy luận GPU \(\rightarrow\) Hậu xử lý) trước khi yêu cầu tiếp theo bắt đầu, và các khoảng trống nhàn rỗi màu xám khiến GPU không được sử dụng trong hơn 50% thời gian. Trong trường hợp pipelined (B), những khoảng trống đó biến mất.

Pipelining được kích hoạt nhờ I/O bất đồng bộ và các mô hình đồng thời. Thay vì chờ một kernel GPU hoàn thành, luồng CPU của máy chủ gửi công việc vào hàng đợi lệnh của GPU và ngay lập tức bắt đầu tiền xử lý cho yêu cầu mới đến.
Chỉ số hệ thống: Chu kỳ hoạt động của phần cứng
Hiệu suất hệ thống đo mức độ hệ thống phục vụ bão hòa được tài nguyên bị nghẽn của nó, thường là các nhân tính toán của GPU hoặc băng thông bộ nhớ. Equation 2 định nghĩa chu kỳ hoạt động phần cứng này. \[\text{System Efficiency} = \frac{\sum T_{\text{compute}}}{\text{Wall Clock Time} \times \text{Resource Count}} \tag{2}\]
Nếu một yêu cầu ResNet-50 mất tổng cộng 10 ms (5 ms trên GPU, 5 ms trên CPU), một hệ thống tuần tự chỉ đạt 50% hiệu suất. Chỉ cần dùng pipeline cho hai yêu cầu, hiệu suất có thể tiệm cận 100% (giả sử CPU theo kịp GPU). Nếu CPU quá chậm để cấp dữ liệu cho GPU, hệ thống sẽ bị giới hạn bởi CPU, và tối ưu hóa mô hình thêm nữa sẽ không mang lại bất kỳ lợi ích nào về thông lượng. Đây là Định luật Amdahl từ Định luật Amdahl và Định luật Gustafson áp dụng cho phục vụ (serving): nếu tiền xử lý chiếm 50% tổng độ trễ, tốc độ tối đa chỉ có thể tăng 2\(\times\), bất kể mô hình chạy nhanh đến mức nào. Xu hướng phần cứng khiến trần hiệu năng này ngày càng chặt hơn. Thông lượng tính toán (FLOPS) của các bộ tăng tốc đã tăng nhanh hơn nhiều so với hiệu năng đơn luồng của CPU qua các thế hệ phần cứng, nên phần suy luận trong pipeline ngày càng ngắn lại, trong khi phần tiền xử lý bị giới hạn bởi CPU vẫn không đổi. Một hệ thống từng bị giới hạn bởi tính toán trên một bộ tăng tốc cũ có thể trở nên bị giới hạn bởi CPU sau khi nâng cấp phần cứng—không phải vì tiền xử lý chậm đi, mà vì mô hình nhanh hơn rất nhiều trong khi CPU thì không.
Hậu xử lý
Chu trình xử lý yêu cầu kết thúc ở bước hậu xử lý, giai đoạn chuyển đầu ra của mô hình thành các kết quả có thể sử dụng. Một mạng nơ-ron tạo ra các tensor thô (các mảng số thực dấu phẩy động, tự chúng không mang ý nghĩa với ứng dụng hay người dùng). Một xác suất 0.95 chỉ trở thành nhãn “chó” đáng tin cậy sau khi được hậu xử lý chuyển đổi; một chuỗi các ID token được chuyển thành văn bản dễ đọc; một tensor hộp giới hạn trở thành một vùng được đánh dấu trên ảnh. Hậu xử lý ảnh hưởng đáng kể đến cả độ trễ và mức độ hữu ích của các dự đoán.
Từ logits đến dự đoán
Các mô hình phân loại xuất ra logits hoặc xác suất theo từng lớp. Để biến các đầu ra thô này thành dự đoán, cần qua vài bước. Cách đơn giản nhất là chọn argmax, trả về lớp có xác suất cao nhất. Thresholding áp dụng một ngưỡng tin cậy, chỉ trả về dự đoán khi mô hình đủ chắc chắn. Trích xuất top-\(k\) trả về nhiều lớp có xác suất cao cùng với điểm của chúng, hữu ích khi ứng dụng cần các lựa chọn thay thế được xếp hạng. Hiệu chuẩn (Calibration) điều chỉnh các xác suất thô để phản ánh đúng hơn khả năng thực tế; bước này tốn thêm tính toán nhưng rất cần khi các hệ thống hạ nguồn ra quyết định dựa trên điểm tin cậy. Với bài toán phân loại ảnh ResNet-50, listing 1 minh họa toàn bộ đường hậu xử lý từ logits thô đến một phản hồi sẵn sàng cho API, gồm chuẩn hóa xác suất, trích xuất top-\(k\), tra cứu nhãn và định dạng phản hồi.
# Normalize raw logits into probabilities
# Input: logits tensor of shape (1, 1000), one score per ImageNet
# class
probs = torch.softmax(logits, dim=-1)  # Normalize to sum=1 on GPU

# Extract top-5 predictions for multi-class response
# topk returns (values, indices) sorted by probability
top5_probs, top5_indices = probs.topk(5)  # GPU operation
top5_probs = top5_probs.squeeze(0).tolist()
top5_indices = top5_indices.squeeze(0).tolist()

# Map class indices to human-readable labels
# imagenet_labels: list of 1000 class names from synset mapping
labels = [imagenet_labels[i] for i in top5_indices]  # CPU lookup

# Format response with predictions and metadata for API contract
response = {
    "predictions": [
        {"label": label, "confidence": float(prob)}
        for label, prob in zip(labels, top5_probs)
    ],
    "model_version": "resnet50-v2.1",  # Client-side version tracking
    "inference_time_ms": 5.2,  # Observability for latency monitoring
}
Trong ví dụ này, tổng thời gian hậu xử lý khoảng 0.1 ms, không đáng kể so với tiền xử lý và suy luận. Mỗi bước đều làm tăng độ trễ, nhưng giúp phản hồi hữu ích hơn. Việc khớp một ánh xạ hiệu chuẩn là tác vụ ngoại tuyến; áp dụng một ánh xạ đã khớp đơn giản ở môi trường trực tuyến thường rẻ, nhưng chỉ thực sự có giá trị khi các quyết định hạ nguồn cần các điểm tin cậy có ý nghĩa thực nghiệm đã được kiểm chứng.
Định dạng đầu ra
Các hệ thống sản xuất hiếm khi trả về dự đoán thô. Đầu ra phải tuân thủ các hợp đồng API, trong đó quy định lược đồ tuần tự hóa JSON, cách định dạng điểm tin cậy và các quy tắc ngưỡng. Xử lý lỗi phải bao quát các edge cases: hệ thống cần định nghĩa hành vi khi không có dự đoán nào vượt ngưỡng tin cậy hoặc khi đầu vào có vẻ ngoài phân phối. Siêu dữ liệu phản hồi (phiên bản mô hình, thời gian suy luận, phân bổ đặc trưng) giúp các hệ thống hạ nguồn giám sát và gỡ lỗi.
Phân tích ngân sách độ trễ cho thấy thời gian được dùng ở đâu trong một yêu cầu đơn lẻ. Tuy vậy, trong sản xuất, hệ thống không xử lý các yêu cầu một cách tách biệt: chúng phải phục vụ hàng trăm, thậm chí hàng nghìn yêu cầu đồng thời cùng tranh chấp các tài nguyên hữu hạn. Để hiểu rõ tính đồng thời này, cần một analytical framework khác.
Theo dõi một yêu cầu giúp xác định khối lượng công việc và độ trễ ở từng giai đoạn; khi các yêu cầu bắt đầu chồng lấn, các giai đoạn đó phải cạnh tranh tài nguyên hữu hạn và độ trễ do xếp hàng sẽ được tính vào ngân sách độ trễ.
Self-Check: Question
An image classification service has an end-to-end SLA of 30 ms. The request path consists of: network ingress/egress (8 ms), CPU image decoding and normalization (10 ms), GPU forward pass (8 ms), and postprocessing/top-\(k\) filtering (2 ms). If an engineer optimizes the GPU model forward pass to run in 4 ms (a \(2\times\) speedup), what is the new total latency and what architectural principle explains the resulting overall speedup?
- Total latency decreases from 28 ms to 24 ms (a 14.3% overall improvement), demonstrating Amdahl’s law where unaccelerated preprocessing and network stages bound the system gains.
- Total latency decreases from 28 ms to 14 ms (a 50% overall improvement), because GPU acceleration propagates linearly across all pipeline stages.
- Total latency remains 28 ms because dynamic batching automatically inserts artificial delay to fill GPU occupancy.
- Total latency increases to 32 ms due to host-device synchronization overhead incurred by faster kernel launches.
What is the ‘killer microseconds’ problem in low-latency ML serving systems, and why do standard operating system scheduling and hardware primitives struggle to handle it efficiently?
In a high-throughput vision serving pipeline, engineers overlap CPU image preprocessing of request \(N+1\) with GPU inference of request \(N\) using multiple CUDA streams and pinned host memory buffers, thereby increasing accelerator ____ without modifying the underlying model architecture.
True or False: For computer vision models utilizing standard 2D convolutions or self-attention mechanisms, increasing the input image resolution from \(224 \times 224\) to \(448 \times 448\) quadruples the number of input pixels (\(4\times\)), which results in an approximately \(4\times\) increase in FLOPs for standard convolutional layers and up to a \(16\times\) increase for unwindowed full self-attention layers.
In an object detection serving pipeline (e.g., YOLO or Faster R-CNN), why can postprocessing operations like Non-Maximum Suppression (NMS) create unpredictable tail-latency spikes if executed naively on the CPU?
- NMS requires running backward gradient passes to rank candidate bounding boxes.
- NMS forces the GPU to reload its weight matrices from host memory over PCIe.
- NMS has input-dependent computational complexity \(\mathcal{O}(M^2)\) based on the number of candidate boxes \(M\) surviving confidence thresholding, causing high latency variance on crowded scenes with many detections.
- NMS converts floating-point logits into 64-bit double precision, exhausting CPU L1 instruction caches.
Lý thuyết xếp hàng
Trong môi trường sản xuất, các yêu cầu đồng thời cạnh tranh các tài nguyên hữu hạn, và lý thuyết xếp hàng dự đoán cạnh tranh này ảnh hưởng đến độ trễ ra sao. Các nguyên tắc đó giải thích hiện tượng có vẻ phản trực giác: những hệ thống được cấp phát tốt vẫn có thể vi phạm các SLO về độ trễ khi tải chỉ tăng nhẹ.
Định luật Little
Các kỹ sư phục vụ (serving) thường xuyên phải đưa ra quyết định cụ thể về năng lực: khi đã biết tốc độ yêu cầu dự kiến và thời gian phản hồi trung bình đo được, hệ thống cần xác định có bao nhiêu công việc đang trong hệ thống trước khi quyết định cấp phát bao nhiêu GPU. Định luật Little (Định luật Little) trả lời câu hỏi đầu tiên bằng cách liên hệ số lượng trung bình với thông lượng; còn SLO về độ trễ đuôi chỉ có thể dùng làm chỉ báo gần đúng cho việc lập kế hoạch. Mô hình M/M/1 sau đó trả lời câu hỏi thứ hai bằng cách dự đoán độ trễ sẽ xấu đi như thế nào khi tải tăng. Kết hợp lại, chúng cung cấp một framework định lượng cho lập kế hoạch năng lực.
Systems Perspective 1.4: Lưu ý ký hiệu: L so với độ trễ
Trong lý thuyết xếp hàng, \(T_{\text{lat}}\) biểu thị thời gian phản hồi hoặc thời gian trong hệ thống cho mỗi yêu cầu; thời gian chỉ chờ trong hàng đợi là \(W_q\). Ở đây, \(Q_{\text{req}}\) là số lượng yêu cầu trung bình trong hệ thống, \(\lambda_{\text{arr}}\) là tốc độ đến, và \(\rho_{\text{serv}}=\lambda_{\text{arr}}/\mu\) là mức sử dụng phục vụ (serving). Các chỉ số dưới được dùng để phân biệt ký hiệu xếp hàng với tham số độ nhạy \(\lambda\) của phương trình suy giảm, và để tránh để mức sử dụng phục vụ chiếm dụng ký hiệu \(\rho\) trần. Trong các phương trình ngân sách độ trễ tiếp theo (chẳng hạn equation 4 và equation 7), các ký hiệu mô tả \(L_{\text{lat,*}}\) đặt tên cho các thành phần của ngân sách, ví dụ thời gian chờ và thời gian tính toán. Trong phân tích batching sau đây (section 1.7.3), \(L_{\text{lat,wait}}\) tương ứng với thành phần chờ trong hàng đợi \(W_q\), và \(L_{\text{lat,compute}}\) bao gồm thời gian suy luận.
Các kỹ sư phục vụ (serving) cần một công cụ nối các chỉ số quan sát được với yêu cầu dung lượng. Kết quả nổi tiếng nhất trong lý thuyết xếp hàng là định luật Little,9, được equation 3 biểu diễn như một mối quan hệ đơn giản giữa ba đại lượng trong bất kỳ hệ thống ổn định nào: \[Q_{\text{req}} = \lambda_{\text{arr}} \cdot T_{\text{lat}} \tag{3}\] trong đó \(Q_{\text{req}}\) là số lượng yêu cầu trung bình trong hệ thống, \(\lambda_{\text{arr}}\) là tốc độ yêu cầu đến (số yêu cầu mỗi giây), và \(T_{\text{lat}}\) là thời gian trung bình mỗi yêu cầu ở trong hệ thống.
9 Định luật Little: John D. C. Little (1961) đã chứng minh rằng \(Q_{\text{req}} = \lambda_{\text{arr}} T_{\text{lat}}\) đúng với các trung bình ổn định trong dài hạn, dưới các ranh giới hệ thống nhất quán, bất kể phân phối của yêu cầu đến, phân phối thời gian phục vụ hay nguyên tắc lập lịch; tính phổ quát này là nền tảng cho việc lập kế hoạch dung lượng hệ thống ML: công thức không yêu cầu giả định sự kiện đến theo phân phối Poisson hay thời gian phục vụ theo phân phối hàm mũ. Tuy nhiên, nó đòi hỏi các trung bình dài hạn được xác định rõ ràng, cùng các định nghĩa nhất quán về tốc độ yêu cầu đến, thời gian trong hệ thống và quy mô dân số (population).
Cụ thể, với tốc độ yêu cầu đến mục tiêu là 1000 QPS và thời gian phản hồi trung bình là 50 ms, Định luật Little chuyển cặp giá trị này thành số yêu cầu trung bình trong hệ thống; nó không ấn định kích thước batch GPU tối thiểu hay một ngưỡng cứng cho bộ nhớ activation. Ví dụ minh họa dưới đây thực hiện phép tính đó.
Mối quan hệ này đúng bất kể phân phối của yêu cầu đến, phân phối thời gian phục vụ hay chính sách lập lịch. Một phép tính dung lượng thực tế sẽ cho thấy vì sao tính phổ quát này quan trọng với bộ nhớ phục vụ (serving).
Napkin Math 1.2: Tính toán dung lượng theo Định luật Little
Bài toán: Trung bình có bao nhiêu yêu cầu trong hệ thống khi thông lượng là 1,000 QPS?
Phép tính: Định luật Little cho ta \(Q_{\text{req}} = \lambda_{\text{arr}} T_{\text{lat}}\), suy ra số lượng trung bình trong hệ thống bằng thông lượng nhân với thời gian trung bình trong hệ thống (Định luật Little chứng minh định luật này).
Cho biết:
- Mục tiêu thông lượng \((\lambda_{\text{arr}})\): 1,000 QPS.
- Thời gian trung bình một yêu cầu trong hệ thống \((T_{\text{lat}})\): 50 ms (0.05 s).
Phép tính: \(Q_{\text{req}}\) = 1,000 QPS \(\times\) 0.05 s = 50 yêu cầu đồng thời trung bình
Góc nhìn hệ thống: Trung bình, hệ thống giữ 50 yêu cầu (gồm cả trong batch và trong hàng đợi). Giới hạn kích thước batch của GPU là 32 không đồng nghĩa 1.000 QPS là bất khả thi, vì các yêu cầu đang chờ có thể nằm trong bộ nhớ máy chủ; tính khả thi phụ thuộc vào tốc độ phục vụ, hành vi xếp hàng và phân phối đuôi.
Định luật Little có những ứng dụng thực tế ngay lập tức. Chẳng hạn, nếu một dịch vụ suy luận có độ trễ trung bình 10 ms cho mỗi yêu cầu \((T_{\text{lat}} = 0.01 \text{ s})\) và hệ thống đang xử lý trung bình 50 yêu cầu đồng thời \((Q_{\text{req}} = 50)\), thì tốc độ đến của yêu cầu phải là \(\lambda_{\text{arr}} = Q_{\text{req}} / T_{\text{lat}} = 5000\) yêu cầu mỗi giây. Ngược lại, nếu hệ thống giới hạn số lượng yêu cầu trung bình trong hệ thống là 10 và đo được thời gian trung bình mỗi yêu cầu trong hệ thống là 10 ms, thì thông lượng tương ứng sẽ là 1.000 yêu cầu mỗi giây.
Thuế batching: Đường biên trễ-thông lượng
Trong khi Định luật Little liên hệ độ sâu hàng đợi với thông lượng, nó không tính đến thuế batching: tức là độ trễ cố ý được đưa vào nhằm tối đa hóa việc sử dụng phần cứng. Chính độ trễ này tạo ra một vấn đề xếp hàng.
Khi một máy chủ suy luận dùng batching kích thước cố định kích hoạt bởi yêu cầu, nó tạo ra hai nguồn độ trễ riêng biệt. Độ trễ hình thành batch \((L_{\text{lat,form}})\) là thời gian mỗi yêu cầu chờ để batch được lấp đầy; yêu cầu đầu tiên chờ lâu nhất, còn yêu cầu cuối cùng thì không. Lạm phát suy luận là sự tăng thời gian suy luận \(T_{\text{inf}}(B)\) khi GPU xử lý \(B\) mẫu thay vì 1. Kết quả là một đường biên Pareto về độ trễ-thông lượng: tập hợp các cấu hình mà không thể tăng thông lượng nếu không “trả thuế” bằng việc tăng độ trễ. Với các yêu cầu đến theo Poisson tĩnh, equation 4 ước tính độ trễ trung bình trên mỗi yêu cầu cho kích thước batch \(B\) và tốc độ đến \(\lambda_{\text{arr}}\): \[ L_{\text{lat,total}} \approx \underbrace{ \frac{B-1}{2\lambda_{\text{arr}}} }_{\text{Formation delay}} + \underbrace{ T_{\text{inf}}(B) }_{\text{Inference time}} \tag{4}\]
Equation 4 cho thấy “cái giá của thông lượng.” Tăng \(B\) (kích thước batch) để tận dụng tối đa GPU giúp phân bổ chi phí phần cứng, nhưng đồng thời làm tăng độ trễ trên mỗi yêu cầu. Cụ thể, ở 500 QPS, khi chuyển từ batch-1 sang batch-32, thời gian chờ tăng từ 0 ms lên 31 ms, góp phần khiến tổng độ trễ tăng 23× lần (2 ms → 46 ms). Với kỹ sư hệ thống, “khoản thuế” này là bộ điều tiết chính của hiệu quả kinh tế: họ chọn kích thước batch để tối đa hóa thông lượng (giảm chi phí mỗi truy vấn) mà không vi phạm SLO về độ trễ \((L_{\text{lat}})\).
Mối quan hệ giữa mức sử dụng và độ trễ
Định luật Little mô tả hành vi trung bình của một hệ thống, nhưng nó không cho biết độ trễ thay đổi như thế nào khi tải tiến gần đến giới hạn khả năng xử lý. Mô hình hàng đợi M/M/1 giúp trả lời câu hỏi quan trọng: một hệ thống phục vụ (serving) cần bao nhiêu dung lượng dự phòng (Harchol-Balter 2013).10 Đối với một hệ thống có các yêu cầu đến theo phân phối Poisson và thời gian dịch vụ theo phân phối hàm mũ, equation 5 cho biết thời gian trung bình một yêu cầu ở trong hệ thống: \[T_{\text{lat}} = \frac{1}{\mu - \lambda_{\text{arr}}} = \frac{\text{service time}}{1 - \rho_{\text{serv}}} \tag{5}\] trong đó \(\lambda_{\text{arr}}\) là tốc độ đến, \(\mu\) là tốc độ dịch vụ (số yêu cầu mỗi giây mà máy chủ có thể xử lý), và \(\rho_{\text{serv}} = \lambda_{\text{arr}}/\mu\) là mức sử dụng (tỷ lệ thời gian máy chủ bận).
10 Hàng đợi M/M/1: Lý thuyết hàng đợi bắt nguồn từ phân tích năm 1909 của Agner Krarup Erlang về Tổng đài điện thoại Copenhagen, nơi các cuộc gọi đến được mô hình hóa theo phân phối Poisson (không phụ thuộc vào lịch sử). Giả định thời gian phục vụ theo phân phối hàm mũ của mô hình M/M/1 tạo ra độ biến động lớn hơn so với nhiều khối lượng công việc (workload) suy luận ML có hình dạng phân bố cố định. Với cùng mức sử dụng và thời gian phục vụ trung bình, thời gian chờ trung bình trong hàng đợi của M/M/1 gấp đôi so với M/D/1; tỷ lệ này đối với tổng thời gian phản hồi chỉ tiệm cận 2 khi mức sử dụng rất cao. Vì vậy, mô hình này là một ước lượng an toàn (conservative approximation) hữu ích, chứ không phải mô tả phổ quát cho lưu lượng suy luận.
11 Phân kỳ độ trễ siêu tuyến tính: Điểm khuỷu dùng để lập kế hoạch thường xuất hiện sớm hơn nhiều so với trạng thái bão hòa hoàn toàn; trong phương trình thời gian phản hồi trung bình của M/M/1, \(E[T] = \frac{1/\mu}{1-\rho_{\text{serv}}}\), trong đó \(\rho_{\text{serv}} = \lambda_{\text{arr}}/\mu\) là mức sử dụng. Số hạng \((1-\rho_{\text{serv}})^{-1}\) phân kỳ khi \(\rho_{\text{serv}} \to 1\): tại \(\rho_{\text{serv}} = 0.7\), thời gian phản hồi trung bình đã gấp 3.3\(\times\) thời gian phục vụ cơ bản; tại \(\rho_{\text{serv}} = 0.9\), nó gấp 10\(\times\). Giới hạn vận hành cụ thể là lựa chọn về chính sách và khối lượng công việc (workload), nhưng cố gắng kéo một hàng đợi nhạy cảm với độ trễ đến gần bão hòa sẽ làm độ trễ tăng không cân xứng.
Equation 5 cho thấy vì sao các hệ thống phục vụ (serving) lại có hành vi phi tuyến: chỉ cần tăng nhẹ tải khi gần ngưỡng công suất đã khiến độ trễ tăng không cân xứng.11 Table 7 định lượng mối quan hệ này, chỉ ra rằng thời gian trung bình trong hệ thống tăng nhanh khi mức sử dụng tiến sát 100 phần trăm.
Mô hình M/M/1 giả định thời gian phục vụ phân phối mũ, trong khi suy luận với hình dạng cố định và kích thước batch cố định có thể có phương sai thời gian phục vụ thấp hơn. Khi đó, mô hình M/D/1 có thể xấp xỉ thời gian chờ trung bình trong hàng đợi sát hơn. Chương này dùng M/M/1 vì nó có nghiệm dạng đóng và, khi các giả định được nêu rõ, vẫn giữ một biên độ an toàn bảo thủ. Các dịch vụ thực tế vẫn cần đo đạc phân phối thời gian đến và thời gian phục vụ, đặc biệt khi hình dạng đầu vào, ghép batch, tiền xử lý hoặc trạng thái cache thay đổi.12
12 Ký hiệu Kendall: Trong ký hiệu A/S/c (đến/phục vụ/máy chủ), “M” biểu thị một quá trình Markov (không nhớ) và “D” nghĩa là xác định. Với thời gian phục vụ gần như xác định, M/M/1 là lựa chọn bảo thủ hơn M/D/1 đối với thời gian chờ trung bình trong hàng đợi, nhưng không mô hình nào thay thế được việc đo lường quá trình đến, phương sai thời gian phục vụ, hoặc hành vi đuôi của một khối lượng công việc (workload) trong môi trường sản xuất.
| Tỷ lệ sử dụng \((\rho_{\text{serv}})\) | Bội số độ trễ | Ví dụ (5 ms service) |
|---|---|---|
| 50% | 2× | 10 ms |
| 70% | 3.3× | 17 ms |
| 80% | 5× | 25 ms |
| 90% | 10× | 50 ms |
| 95% | 20× | 100 ms |
Những lưu ý cho hệ nhiều máy chủ
Phân tích hàng đợi nút đơn trong phần này tập trung vào một nút phục vụ (serving) duy nhất — một máy xử lý các yêu cầu suy luận. Mục tiêu là giúp bạn nắm vững đơn vị cơ bản của hệ thống ML. Hiểu rõ cách hàng đợi vận hành ở một nút đơn là điều kiện tiên quyết để mở rộng hiệu quả. Các kỹ sư không thể tối ưu hóa một hệ thống phân tán nếu không hiểu rõ hành vi của từng thành phần.
Phân tích M/M/1 là một phép xấp xỉ ban đầu để định cỡ đúng cho từng nút, xác định ngưỡng kích hoạt mở rộng, và tránh mở rộng quá sớm. Nó giúp kiểm tra liệu một máy chủ được mô hình hóa có đủ dư công suất ở tốc độ đến dự kiến hay không, và cho thấy độ trễ tăng ra sao khi tải được mô hình hóa tiến sát công suất. Sau đó, các phép đo thực tế phải xác định xem nút thắt cổ chai thực sự nằm ở đâu: công suất của nút, chính sách batch, tiền xử lý, khởi động nguội (cold start), cấu hình runtime, hay do hệ thống lệch khỏi các giả định của mô hình hàng đợi.
Khi lưu lượng thực sự vượt quá sức chứa của một nút đơn, bước tiếp theo là mở rộng ở cấp độ bản sao (replica-level scale-out): nhiều nút phục vụ (serving) độc lập đặt sau bộ cân bằng tải, và mỗi nút chạy cùng một mô hình. Mô hình hàng đợi M/M/c mở rộng M/M/1 cho \(c\) máy chủ song song, cho thấy các bản sao có thể cải thiện độ trễ khi lưu lượng được cân bằng trên các máy chủ độc lập. Mức cải thiện p99 cụ thể phụ thuộc vào quá trình đến, phương sai thời gian phục vụ, chính sách điều phối và mức sử dụng của từng bản sao. Mô hình bản sao này vẫn khác với suy luận phân tán, nơi một yêu cầu được chia nhỏ trên các GPU thông qua chia mảnh mô hình (model sharding), song song hóa tensor (tensor parallelism) hoặc song song hóa pipeline (pipeline parallelism). Chương này đặt nền tảng về nút đơn và bản sao; suy luận phân tán kéo theo chi phí phối hợp và thách thức về tính nhất quán nằm ngoài phạm vi của chương này.
Độ trễ đuôi
Các SLO trong môi trường sản xuất thường đặt mục tiêu theo phân vị (p95, p99) thay vì trung bình, vì độ trễ đuôi quyết định trải nghiệm của người dùng ở các yêu cầu chậm nhất (Dean and Barroso 2013). Với hàng đợi M/M/1, độ trễ p99 được tính như sau: \[T_{\text{lat},\text{p99}} \approx \frac{\text{service time}}{1 - \rho_{\text{serv}}} \cdot \ln\left(\frac{1}{1 - 0.99}\right) \approx \frac{4.6 \cdot \text{service time}}{1 - \rho_{\text{serv}}} \tag{6}\]
Ở mức sử dụng 70%, xấp xỉ p99 của M/M/1 vào khoảng 15 lần thời gian phục vụ \((4.6/0.3 \approx 15.3)\), trong khi độ trễ trung bình chỉ khoảng 3.3 lần. Với các mô hình có thời gian phục vụ xác định như M/D/1, các giá trị đuôi cần được tính theo từng mô hình cụ thể thay vì một hệ số nhân chung. Điều quan trọng không đổi: những hệ thống trông có vẻ ổn với độ trễ trung bình thấp vẫn có thể có độ trễ đuôi không chấp nhận được, vì giá trị trung bình che lấp trải nghiệm của các yêu cầu kém may mắn nhất.
Vấn đề đuôi ở quy mô
Phân tích của Dean và Barroso giải thích vì sao độ trễ đuôi trở nên then chốt khi hệ thống mở rộng vượt khỏi một máy đơn lẻ (Dean and Barroso 2013). Khi yêu cầu được phân tán tới nhiều máy chủ, xác suất gặp ít nhất một phản hồi chậm tăng nhanh theo số lượng máy chủ. Hiệu ứng “đuôi ở quy mô” này khiến độ trễ đuôi của từng máy chủ trở thành yếu tố quyết định đối với hiệu năng tổng thể của hệ thống.
Đối với phục vụ (serving) trên một máy, nguyên tắc này có hai hàm ý. Thứ nhất, độ trễ đuôi trên từng máy rất quan trọng vì khi hệ thống mở rộng, nó sẽ cộng dồn. Thứ hai, các kỹ thuật chống độ trễ đuôi được mô tả trong section 1.5.6 (hedging, suy giảm có kiểm soát) vẫn mang lại giá trị ngay cả trên một máy và trở nên không thể thiếu khi hệ thống mở rộng quy mô.
Các kỹ thuật chống độ trễ đuôi, như hedging yêu cầu, sẽ gửi yêu cầu dự phòng sau khi hết thời gian chờ và chấp nhận phản hồi đến trước. Các yêu cầu dự phòng và cân bằng tải khỏi các máy chủ chậm tác động trực tiếp vào việc giảm độ biến thiên độ trễ. Những kỹ thuật này áp dụng rất tốt cho nhiều bản sao mô hình, và một số hệ thống một nút cũng có thể xấp xỉ chúng bằng các luồng hoặc phiên bản đồng thời, miễn là ngữ nghĩa hủy và cách ly tài nguyên cho phép. Chúng trở nên thiết yếu khi mở rộng lên các hệ thống suy luận phân tán.
Mô hình hàng đợi và phân tích độ trễ đuôi cung cấp đầu vào cho lập kế hoạch năng lực. Một triển khai cụ thể làm cho các đánh đổi trở nên rõ ràng.
Áp dụng mô hình thời gian phản hồi đuôi M/M/1 cho ResNet-50 giúp làm rõ các ràng buộc về năng lực.
Napkin Math 1.3: Lập kế hoạch năng lực ResNet-50
Hãy xem xét thiết kế một hệ thống phục vụ (serving) ResNet-50 với các yêu cầu sau:
- Độ trễ p99 mục tiêu: 50 ms
- Lưu lượng truy cập dự kiến cao nhất: 5,000 QPS
- Thời gian phục vụ (TensorRT FP16): 5 ms
Bước 1: Tìm mức sử dụng an toàn. Từ equation 6, \(T_{\text{lat},\text{p99}} \approx\) 4.6 \(\times\) thời gian phục vụ / \((1 - \rho_{\text{serv}})\). Đặt \(T_{\text{lat},\text{p99}} \leq 50\) ms với thời gian phục vụ 5 ms, ta được \(\rho_{\text{serv}} \leq 1 - (4.6 \times 5\,\mathrm{ms})/50\,\mathrm{ms} = 0.54\) (mức sử dụng tối đa 54 percent). Cách này dùng giới hạn p99 M/M/1 mang tính thận trọng từ phương trình đã cho, thay vì áp dụng điều chỉnh M/D/1 theo thời gian chờ trung bình cho một SLO về độ trễ ở đuôi.
Bước 2: Tính toán tốc độ phục vụ cần thiết. \(\mu_{\text{required}} = 5,000\,\mathrm{QPS} / 0.54 = 9259.3\,\mathrm{req}/\mathrm{s}\)
Bước 3: Xác định số lượng GPU. Trong mô hình M/M/1 này, tốc độ của một GPU là 200 req/s.
Số GPU cần thiết = 9259.3 req/s / 200 req/s = 46.3 → 47 GPU
Bước 4: Thêm khoảng dự phòng cho biến động. Kịch bản này thêm 30 percent khoảng dự phòng để xử lý các đỉnh lưu lượng và biến động: số lượng cuối cùng = 47 \(\times\) 1.3 = 61.1, làm tròn lên thành 62.
Bước 5: Kiểm tra khả năng chịu lỗi. Khoảng dự phòng 30 percent giúp xử lý biến động lưu lượng, nhưng các hệ thống vận hành cũng cần khả năng chịu lỗi. Với 62 GPU, nếu mất một GPU, ta còn 61 GPU để xử lý 5,000 QPS. Khi đó, mức sử dụng sau lỗi là 5,000 QPS / (200 req/s \(\times\) 61) = \(41.0\%\).
Mức này vẫn thấp hơn nhiều so với ngưỡng sử dụng an toàn 54 percent, xác nhận rằng yêu cầu dự phòng N+1 được đáp ứng. Với yêu cầu chịu lỗi nghiêm ngặt hơn, dự phòng N+2 (chịu được hai lỗi xảy ra đồng thời) sẽ cần 49 GPUs GPU dưới cùng ngưỡng sử dụng an toàn, hoặc khoảng 64 GPUs GPU nếu cần giữ 30 percent khoảng dự phòng ngay cả sau khi xảy ra hai lỗi đồng thời.
Kết quả: Cấp phát 62 GPU V100 để phục vụ 5,000 QPS với độ trễ p99 50 ms và khả năng chịu lỗi N+1.
Phân tích hàng đợi làm rõ cách tiếp cận lập kế hoạch dung lượng trình bày trong section 1.11.3 và liên hệ trực tiếp với kịch bản MLPerf Server. Các kịch bản thực thi MLPerf nêu rằng một kết quả MLPerf Server chỉ hợp lệ khi lượt chạy đáp ứng ràng buộc về độ trễ theo phân vị; nếu không, phải giảm QPS mục tiêu và chạy lại.
Các kỹ thuật chịu đựng phần đuôi
Không thể thực tế loại bỏ hết mọi nguồn gây biến thiên độ trễ. Thay vào đó, các hệ thống sản xuất dùng các kỹ thuật có thể chịu đựng biến thiên mà vẫn đáp ứng SLO (Dean and Barroso 2013; Dean 2012). Cách tổ chức hữu ích là theo dạng lỗi: một bản sao chậm (straggler replica) thì dùng cơ chế đua (race), fan-out thì cần phát hiện sớm, quá tải thì dùng kiểm soát tiếp nhận (admission control) hoặc giảm cấp dịch vụ một cách linh hoạt (graceful degradation), còn khuếch đại do thử lại (retry amplification) thì cần giảm tải phối hợp (coordinated shedding).
Dean, Jeffrey, and Luiz André Barroso. 2013. “The Tail at Scale.” Communications of the ACM 56 (2): 74–80. https://doi.org/10.1145/2408776.2408794.
Dean, Jeffrey. 2012. Achieving Rapid Response Times in Large Online Services. Berkeley AMPLab Cloud Seminar.
13 Hedging: Thuật ngữ này mượn từ tài chính, nơi một cược bù trừ giúp giảm rủi ro; ở đây, yêu cầu dự phòng là một “cược” chống lại máy chủ chậm. Cách làm này không miễn phí: với các hệ thống ML, yêu cầu hedging thất bại vẫn có thể chiếm thời gian của bộ tăng tốc nếu suy luận đã được khởi chạy, vì các kernel GPU thông thường không thể hủy rẻ giữa chừng. Do đó, một chính sách hedging phải tính ngân sách cho công việc trùng lặp bên cạnh lợi ích về độ trễ.
Với một bản sao chậm, hệ thống có thể “đua” với đường đi chậm. Với kỹ thuật hedging, khi một yêu cầu chưa hoàn tất trong thời gian kỳ vọng, hệ thống sẽ gửi một yêu cầu trùng lặp tới máy chủ khác.13 Máy khách dùng phản hồi đến trước và hủy yêu cầu còn lại. Trong bối cảnh phục vụ (serving) mô hình, điều này đồng nghĩa duy trì nhiều bản sao mô hình và định tuyến các yêu cầu chậm sang các bản sao khác. Nếu phân phối độ trễ ổn định, đặt ngưỡng ở mức phân vị 95 theo lịch sử sẽ kích hoạt yêu cầu trùng lặp cho khoảng 5% yêu cầu; các đợt chậm có tương quan có thể làm tỷ lệ này tăng lên và khiến hedging khuếch đại quá tải thay vì giảm đuôi độ trễ.
Các kernel suy luận thông thường, một khi đã khởi chạy, không dễ bị gián đoạn giữa chừng. Khi một yêu cầu hedging hoàn thành, bản sao của nó phải bị hủy. Tuy nhiên, nếu suy luận đã bắt đầu trên GPU, có thể hủy theo các cách sau: kiểm tra cờ hủy trước khi khởi chạy suy luận, chấp nhận lãng phí tài nguyên tính toán cho kernel đang chạy, hoặc dùng cơ chế ưu tiên yêu cầu để hạ ưu tiên bản sao. Vì hedging thường chỉ áp dụng cho một phần nhỏ các yêu cầu, chi phí do thi thoảng lãng phí tài nguyên tính toán vẫn có thể chấp nhận được nếu chính sách được tinh chỉnh cẩn thận.
Các yêu cầu ràng buộc làm “cuộc đua” này quyết liệt hơn bằng cách đặt cùng một yêu cầu vào nhiều hàng đợi máy chủ đồng thời, kèm theo cơ chế phối hợp để hủy các bản sao còn lại ngay khi một máy chủ bắt đầu xử lý. Cách này giúp tránh phải chờ phát hiện phản hồi chậm trước khi áp dụng hedging, đồng thời có thể giảm độ trễ xếp hàng khi có nhiều bản sao sẵn sàng. Tuy nhiên, nó cũng tạo ra các mục trùng lặp trong hàng đợi, nên cơ chế phối hợp phải hủy các bản sao thua cuộc trước khi chúng tiêu tốn thời gian quý giá của bộ tăng tốc.
Đối với các hệ thống fan-out, cần một điểm can thiệp khác vì một backend chậm có thể làm tắc nghẽn toàn bộ yêu cầu phân tán. Yêu cầu Canary trước tiên gửi yêu cầu đến một tập con nhỏ gồm 1–2 máy chủ.14 Nếu các máy chủ này phản hồi trong thời gian dự kiến, hệ thống sẽ gửi đến phần còn lại. Nếu canary chậm, hệ thống có thể thử lại ở nơi khác hoặc sử dụng kết quả trong cache trước khi thực hiện fan-out đầy đủ. Kỹ thuật này biến một vấn đề tiềm ẩn về khuếch đại độ trễ đuôi thành một tín hiệu cảnh báo sớm.
14 Canary: Tên gọi này xuất phát từ thực tiễn khai thác than (đầu những năm 1900–1980), nơi người ta dùng những chú chim có tốc độ trao đổi chất cao nên chúng nhạy cảm với khí độc trước khi nồng độ khí đạt mức gây chết người cho con người. Trong phục vụ mô hình học máy (ML serving), các yêu cầu canary cũng đóng vai trò cảnh báo sớm tương tự cho các truy vấn fan-out: bằng cách kiểm tra 1–2 backend trước khi thực hiện fan-out toàn bộ, hệ thống có thể phát hiện các bản sao (replica) bị chậm hoặc lỗi, trước khi một bản sao đơn lẻ làm đình trệ toàn bộ yêu cầu suy luận phân tán. Đây là một biện pháp bảo vệ rất quan trọng, đặc biệt khi độ rộng fan-out lớn, vì khi đó độ trễ đuôi sẽ tăng theo thời gian phản hồi lớn nhất của tất cả backend.
Khi vấn đề là quá tải hệ thống, chứ không phải do một replica chậm lẻ loi, thì việc racing sẽ làm mọi thứ tệ hơn vì tạo thêm công việc trùng lặp. Lúc này, hệ thống cần ưu tiên bảo vệ khả năng phản hồi nhìn thấy được bởi người dùng và độ trễ của các yêu cầu đã được chấp nhận. Graceful degradation trả về kết quả xấp xỉ thay vì để timeout: hệ thống phân loại có thể trả về dự đoán đã được cache cho các đầu vào tương tự; mô hình sinh (generative models) có thể trả về đầu ra ngắn hơn; và ensemble có thể trả về dự đoán từ một tập con mô hình. Giảm số lượng thành viên đang hoạt động trong một ensemble khi quá tải sẽ trực tiếp rút ngắn thời gian phục vụ (\(T_{\text{svc}}\)). Điều này làm tăng tốc độ phục vụ \(\mu\) của máy chủ và đưa mức sử dụng \(\rho_{\text{serv}} = \lambda_{\text{arr}} / \mu\) xuống dưới “điểm gối” của hàng đợi (figure 1), chấp nhận giảm độ chính xác có kiểm soát để giữ SLO, thay vì để độ trễ sụp đổ ngoài kiểm soát. Admission control thì nghiêm ngặt hơn. Khi độ sâu hàng đợi vượt một ngưỡng, hệ thống sẽ chủ động từ chối yêu cầu bằng cách trả về 503 ngay lập tức, thay vì nhận vào những công việc nhiều khả năng sẽ timeout. Cách này hy sinh thông lượng để bảo vệ độ trễ cho các yêu cầu đã được chấp nhận.
Checkpoint 1.2: Hàng đợi và khoảng dự phòng SLO
SLO về độ trễ không được đảm bảo chỉ nhờ suy luận nhanh; mà nhờ khoảng dự phòng.
Một điểm khởi đầu mang tính minh họa là một hàng đợi chứa khoảng hai đến ba đơn vị thời gian phục vụ cho mỗi worker; với bốn worker, điều đó tương ứng 8 đến 12 yêu cầu đang chờ. Đây là một giả thuyết cần kiểm chứng, không phải một ngưỡng có thể dùng chung. Cơ chế kiểm soát nhận vào thích ứng (adaptive admission control) có thể siết chặt giới hạn khi độ trễ p99 quan sát được vượt mục tiêu, và nới lỏng khi đo vẫn còn dư địa (headroom). Các hệ thống suy luận đã biên dịch với hình dạng cố định (fixed-shape compiled inference) đôi khi có phân bố thời gian phục vụ hẹp hơn so với yêu cầu web nói chung, giúp ước tính ngưỡng dễ hơn. Tuy nhiên, các yếu tố như đầu vào biến thiên, gộp batch, trạng thái cache, tiền xử lý và tài nguyên dùng chung có thể làm mất lợi thế này. Vì vậy, các bộ điều khiển trong môi trường sản xuất vẫn cần dựa vào các phân bố đo được thực tế, thay vì giả định một hàng đợi M/D/1.
Một dạng lỗi khó nhận biết xảy ra khi tất cả các replica đều bị quá tải cùng lúc. Nếu bộ cân bằng tải thử lại các yêu cầu bị từ chối ở những replica khác cũng đang quá tải, lưu lượng thử lại sẽ làm quá tải trầm trọng hơn. Kỹ thuật giảm tải phối hợp (Coordinated load shedding) giải quyết vấn đề này bằng cách chia sẻ thông tin tải giữa các replica, cho phép ra quyết định ở phạm vi toàn hệ thống về việc yêu cầu nào được chấp nhận. Khi tổng tải vượt quá năng lực, các replica cùng nhau từ chối cùng một tỷ lệ yêu cầu, thay vì mỗi replica tự từ chối độc lập và kích hoạt các lần thử lại.
Những kỹ thuật này trở nên thiết yếu ở quy mô lớn khi hiện tượng fan-out amplification khiến độ trễ đuôi của từng máy chủ trở nên thấy rõ với người dùng. Các hệ thống phục vụ (serving) trên một máy có thể triển khai các yêu cầu hedged và tied trên các luồng GPU hoặc trên các bản sao mô hình. Phân tích hàng đợi ở đây giả định xử lý vào trước ra trước (FIFO), nhưng các hệ thống sản xuất thường áp dụng lập lịch ưu tiên như các phương pháp nhận biết thời hạn (deadline-aware) hoặc ưu tiên công việc ngắn nhất (shortest-job-first) để tiếp tục giảm độ trễ đuôi cho các khối lượng công việc (workload) không đồng nhất (Harchol-Balter 2013).
Các kỹ thuật chống độ trễ đuôi được bàn ở đây tối ưu hóa luồng yêu cầu trong một hệ thống phục vụ (serving) đang vận hành. Tuy nhiên, phân tích hàng đợi giả định hai điều kiện tiên quyết quan trọng: mô hình đã được nạp và sẵn sàng xử lý yêu cầu, và dự đoán khớp với những gì đã được xác thực trong giai đoạn phát triển. Trong môi trường sản xuất, giả định này thường xuyên không đúng: khi triển khai, các instance mới phải tải mô hình từ đầu; khi mở rộng hệ thống, độ trễ khởi động nguội ảnh hưởng đến các yêu cầu đầu tiên gửi đến các bản sao (replica) mới; và khi các pipeline tiền xử lý lệch so với huấn luyện, độ chính xác âm thầm suy giảm. Section 1.6 xem xét những thách thức về vòng đời cần được giải quyết trước khi tối ưu hóa hàng đợi trở nên hữu ích.
Self-Check: Question
An online recommendation service handles an arrival rate of \(\lambda = 500\) queries per second. Instrumented telemetry reveals an average residency time (waiting time in queue + inference service time) of \(W = 40\text{ ms}\) (\(0.04\text{ s}\)). According to Little’s Law, what is the average number of concurrent requests (\(L\)) present in the serving system?
- \(L = 12.5\text{ requests}\)
- \(L = 200\text{ requests}\)
- \(L = 2\text{,}000\text{ requests}\)
- \(L = 20\text{ requests}\)
Explain the ‘tail at scale’ phenomenon in distributed microservice architectures, and calculate the probability that an aggregate user request suffers tail latency if it fans out in parallel to 50 leaf model servers, each having a 99th percentile (p99) latency SLA violation probability of 1% (\(p = 0.01\)).
True or False: Hedged requests (speculative backup requests) reduce p99 tail latency by sending identical duplicate requests to multiple servers simultaneously for every incoming query upon arrival, without incurring any additional cluster compute overhead.
A serving cluster experiences an unexpected traffic surge that threatens to overwhelm its capacity and violate latency SLAs. Order the progressive defensive mitigation mechanisms from least intrusive (initial arrival surge) to most aggressive (extreme overload):
- Load Shedding / Circuit Breaking (dropping low-priority non-critical requests with HTTP 429/503)
- Dynamic Batch Timeout Shortening (flushing smaller batches sooner to protect latency budget)
- Hedged Request Throttling / Disabling (canceling speculative retries to prevent self-inflicted load)
- Model Graceful Degradation (switching to a smaller, quantized fallback model or skipping optional ensemble branches)
An inference node modeled as an \(M/M/1\) queue has an average execution service time of \(T_{\text{svc}} = 10\text{ ms}\). If the arrival rate increases such that system utilization \(\rho\) increases from \(50\%\) (\(\rho = 0.5\)) to \(90\%\) (\(\rho = 0.9\)), what happens to the mean total response time \(W\)?
- \(W\) increases linearly from 10 ms to 18 ms.
- \(W\) increases nonlinearly from 20 ms to 100 ms (\(5\times\) increase).
- \(W\) decreases from 20 ms to 11.1 ms due to batching efficiency.
- \(W\) remains fixed at 10 ms because service time is independent of arrival rate.
Quản lý vòng đời mô hình
Lý thuyết hàng đợi và các kỹ thuật chống độ trễ đuôi tối ưu hóa luồng yêu cầu ở trạng thái ổn định, nhưng chúng vô dụng nếu hệ thống không bao giờ đạt trạng thái ổn định. Ví dụ minh họa: một bản sao mới triển khai mất 35 giây để biên dịch engine TensorRT, trong khi sự lệch nhau trong tiền xử lý giữa PIL/OpenCV làm giảm độ chính xác 5 điểm phần trăm. Để xử lý các lỗi vòng đời như vậy, cần kỷ luật kỹ thuật ở hai mảng: chuẩn bị mô hình sẵn sàng phục vụ (serving) (khởi động nguội và khởi tạo) và giữ cho dự đoán trung thực với những gì đã được xác thực (độ lệch huấn luyện-phục vụ).
Độ lệch huấn luyện-phục vụ
Một mô hình hoạt động tốt trong giai đoạn xác thực có thể âm thầm suy giảm khi triển khai. Hiện tượng này, gọi là độ lệch huấn luyện-phục vụ, là một trong những dạng lỗi tinh vi nhất trong ML sản xuất vì nó không hiện trên giám sát độ trễ hay theo dõi ngoại lệ (Sculley et al. 2015; Baylor et al. 2017).
Baylor, Denis, Eric Breck, Heng-Tze Cheng, Noah Fiedel, Chuan Yu Foo, Zakaria Haque, Salem Haykal, et al. 2017. “TFX: A TensorFlow-Based Production-Scale Machine Learning Platform.” Proceedings of the 23rd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1387–95. https://doi.org/10.1145/3097983.3098021.
Definition 1.3: Độ lệch huấn luyện-phục vụ
Độ lệch huấn luyện-phục vụ là sự khác biệt về phân phối giữa môi trường huấn luyện và môi trường suy luận, do logic hoặc trạng thái không nhất quán gây ra.
- Ý nghĩa: Hiện tượng này vi phạm nguyên tắc nhất quán và có thể gây suy giảm độ chính xác âm thầm khi các hàm biến đổi khác nhau \((f_{\text{train}}(x) \neq f_{\text{serve}}(x))\).
- Điểm khác biệt: Khác với trôi dữ liệu (một sự thay đổi bên ngoài môi trường), độ lệch huấn luyện-phục vụ là lỗi nội bộ của ngăn xếp kỹ thuật.
- Cạm bẫy thường gặp: Một hiểu lầm phổ biến là độ lệch (skew) chỉ được ‘phát hiện’ khi có lỗi. Thực tế, nó không gây ra ngoại lệ nào cả: hệ thống vẫn chạy trơn tru, độ trễ thấp, nhưng các dự đoán lại sai lệch về mặt thống kê.
Kho đặc trưng trình bày cách chẩn đoán, giám sát và ngăn chặn độ lệch ở cấp độ tổ chức. Biểu hiện của độ lệch này trong quá trình phục vụ (serving) là sự phân kỳ tiền xử lý: pipeline suy luận thời gian thực xử lý dữ liệu thô khác với pipeline huấn luyện theo batch. Đây là một lỗi thường gặp khi huấn luyện dùng Python/Pandas còn phục vụ dùng C++/Java hoặc các máy chủ suy luận được tối ưu hóa. Khác với trôi dữ liệu (data drift), sự phân kỳ này phát sinh từ bên trong hệ thống và thường có thể ngăn chặn được bằng cách dùng chung các phép biến đổi, kiểm tra tính tương đồng (parity tests) và kỹ thuật thiết kế cẩn thận.
Example 1.5: ResNet-50: Độ lệch tiền xử lý ảnh
Kịch bản: Các mô hình thị giác ResNet-50 khi phục vụ (serving) gặp tình trạng độ chính xác dự đoán bị giảm sút một cách âm thầm giữa pipeline huấn luyện ngoại tuyến và pipeline phục vụ trực tuyến.
Chẩn đoán: Pipeline phục vụ (serving) thực hiện tiền xử lý bằng C++/OpenCV (cv2.INTER_LINEAR, thứ tự kênh BGR), trong khi quá trình huấn luyện lại dùng Python/PIL (PIL.BILINEAR, thứ tự kênh RGB, với các hằng số chuẩn hóa khác nhau).
Bài học hệ thống: Sự phân kỳ tiền xử lý gây ra độ lệch giữa huấn luyện và phục vụ một cách âm thầm, không hề báo lỗi runtime. Việc chuẩn hóa các pipeline biến đổi dữ liệu trên cả môi trường huấn luyện và phục vụ giúp ngăn việc làm sai lệch phân bố dữ liệu đầu vào.
Khởi động nguội và cơ chế khởi tạo
Với các pipeline tiền xử lý được thiết kế để tránh độ lệch giữa huấn luyện và phục vụ, thách thức tiếp theo là làm sao để các mô hình sẵn sàng phục vụ. Trước khi xử lý bất kỳ yêu cầu nào, các mô hình phải được tải từ bộ nhớ lưu trữ vào bộ nhớ (RAM) và chuẩn bị cho quá trình suy luận (Romero et al. 2021). Độ trễ khởi tạo này, còn gọi là khởi động nguội, ảnh hưởng đến khả năng phản hồi của hệ thống trong quá trình triển khai, các sự kiện mở rộng (scaling events) và phục hồi sau lỗi.
Romero, Francisco, Qian Li, Neeraja J. Yadwadkar, and Christos Kozyrakis. 2021. “INFaaS: Automated Model-Less Inference Serving.” 2021 USENIX Annual Technical Conference (USENIX ATC 21), 397–411.
Definition 1.4: Khởi động nguội
Cold start là độ trễ khởi tạo xảy ra khi khởi tạo một bản sao mô hình mới.
- Ý nghĩa: Nó thể hiện chi phí cố định để khởi tạo trạng thái (tải trọng số, biên dịch đồ thị), quá trình này có thể mất vài giây hoặc vài phút. Điều này cản trở khả năng mở rộng linh hoạt của hệ thống khi cần đáp ứng các đợt lưu lượng truy cập tăng đột biến.
- Điểm khác biệt: Khác với độ trễ suy luận \((L_{\text{lat}})\), vốn là chi phí tính cho từng yêu cầu, cold start là chi phí khởi tạo phải trả khi tạo một bản sao (replica) hoặc một phiên bản mô hình. Chi phí này bao gồm triển khai, mở rộng quy mô (scale-out), khôi phục và tải mô hình theo yêu cầu.
- Sai lầm phổ biến: Nhiều người nghĩ cold start “chỉ là nạp trọng số”. Thực tế, nó còn bao gồm biên dịch đồ thị và cấp phát bộ nhớ, những phần này thường mất lâu hơn cả thời gian truyền dữ liệu bị giới hạn bởi băng thông \((D_{\text{vol}}/\text{BW})\).
Các yếu tố ảnh hưởng đến cold start quyết định liệu hệ thống có đáp ứng yêu cầu độ trễ ngay từ lúc bắt đầu phục vụ (serving) lưu lượng hay không. Khi tách một quy trình khởi động điển hình thành nhiều giai đoạn, ta sẽ thấy mỗi phần đóng góp thế nào vào tổng độ trễ khởi tạo.
Độ trễ cold start tích lũy từ nhiều nguồn, mỗi nguồn đều kéo dài thời gian từ lúc triển khai đến khi sẵn sàng phục vụ (serving). Tải trọng số là quá trình đọc các tham số của mô hình từ đĩa hoặc lưu trữ qua mạng. Biên dịch đồ thị thực hiện biên dịch tức thời (just-in-time) các phép toán cho phần cứng cụ thể. Cấp phát bộ nhớ sẽ dành riêng bộ nhớ GPU cho các activation và các giá trị trung gian. Thực thi warmup15 chạy các suy luận ban đầu để điền dữ liệu vào cache và kích hoạt cơ chế khởi tạo lười (lazy initialization).
15 Warmup: Thuật ngữ này được mượn từ biên dịch tức thời (JIT), nơi các lần thực thi ban đầu sẽ biên dịch các nhánh “nóng” thành mã máy tối ưu. Với phục vụ (serving) ML, các suy luận warmup sẽ kích hoạt biên dịch kernel CUDA, tự động tinh chỉnh (auto-tuning) thuật toán cuDNN và cấp phát pool bộ nhớ mà các framework thường trì hoãn đến lần dùng đầu tiên. Nếu không có warmup, yêu cầu thật đầu tiên phải gánh toàn bộ phần thiết lập này và có thể chậm hơn trạng thái ổn định nhiều bậc độ lớn. Trong các sự kiện autoscaling, điều đó khiến các bản sao mới có thể vi phạm SLO trong vài giây đầu nhận lưu lượng.
16 CUDA (compute unified device architecture): Nền tảng tính toán song song của NVIDIA (Nickolls et al. 2008), được đặt tên theo mục tiêu hợp nhất các mô hình shader GPU đa dạng vào một kiến trúc đa dụng duy nhất. Trước CUDA, lập trình GPU phải ngụy trang các phép tính thành thao tác đồ họa. Ngữ cảnh CUDA—cấu trúc dữ liệu theo dõi cấp phát bộ nhớ, các kernel đã tải và trạng thái thiết bị—là cổng truy cập tài nguyên GPU theo tiến trình của CUDA runtime; trong các hệ thống phục vụ (serving) không máy chủ hoặc mở rộng nhanh, việc tạo ngữ cảnh và cơ chế lazy loading module có thể trở thành phần thấy rõ của độ trễ khởi động nguội (NVIDIA 2026a).
Nickolls, John, Ian Buck, Michael Garland, and Kevin Skadron. 2008. “Scalable Parallel Programming with CUDA: Is CUDA the Parallel Programming Model That Application Developers Have Been Waiting For?” Queue 6 (2): 40–53. https://doi.org/10.1145/1365490.1365500.
NVIDIA. 2026a. Lazy Loading: CUDA Programming Guide.
Ngữ cảnh CUDA16 là chi phí đầu tiên trong chuỗi khởi động nguội. Trước khi thực hiện bất kỳ thao tác GPU nào, CUDA runtime phải thiết lập một ngữ cảnh: một cấu trúc dữ liệu theo dõi việc cấp phát bộ nhớ, các kernel đã tải và trạng thái thiết bị. Việc tạo ngữ cảnh này cần giao tiếp với trình điều khiển GPU và cấp phát bộ nhớ GPU cho mục đích ghi nhận nội bộ. Giá trị 0.3–0.5 s trong table 8 là giả định về ngân sách khởi động nguội trong kịch bản này, không phải hằng số chung của CUDA. CUDA lazy loading hoãn việc tải một số module và kernel đến lần dùng đầu tiên, giúp giảm thời gian khởi động nhìn thấy nhưng chuyển một phần chi phí sang lần suy luận đầu tiên (NVIDIA 2026a).
CUDA MPS (Multi-Process Service)17 giải quyết bài toán chia sẻ GPU cho các hệ thống triển khai đa tiến trình. Thông thường, mỗi tiến trình tạo ngữ cảnh CUDA riêng và GPU sẽ luân phiên giữa các ngữ cảnh. MPS cho phép công việc từ nhiều tiến trình chồng lấn trên GPU thông qua một dịch vụ dùng chung, giảm chi phí chuyển đổi ngữ cảnh và cải thiện mức sử dụng khi từng tiến trình đơn lẻ chưa tận dụng hết thiết bị (NVIDIA 2026d). Đánh đổi là khả năng cách ly giảm: nếu một tiến trình gặp sự cố, các tiến trình khác dùng chung MPS server có thể bị ảnh hưởng.
17 CUDA MPS (dịch vụ đa tiến trình): MPS tạo một tiến trình nền điều khiển (control daemon) cho phép các tác vụ CUDA từ những tiến trình khác nhau chạy chồng lấn trên GPU, nhờ đó cải thiện mức sử dụng và giảm chi phí chuyển đổi ngữ cảnh khi từng tiến trình riêng lẻ không tận dụng hết bộ tăng tốc (NVIDIA 2026d). Với phục vụ (serving) đa mô hình, MPS có thể giúp các bản sao (replicas) chia sẻ hiệu quả các bộ xử lý luồng (streaming multiprocessors) của GPU. Đổi lại là khả năng cách ly lỗi: các client cùng chia sẻ trạng thái GPU do MPS quản lý. Vì vậy, phân vùng phần cứng bằng Multi-Instance GPU (MIG) mang lại khả năng cách ly mạnh hơn, nhưng phải chấp nhận kích thước phân vùng cố định.
NVIDIA. 2026d. NVIDIA CUDA Multi-Process Service.
Example 1.6: ResNet-50: Dòng thời gian khởi động nguội
Table 8 trình bày thời lượng của từng giai đoạn trong quá trình khởi động nguội của ResNet-50:
Table 8: Dòng thời gian khởi động nguội của ResNet-50: Thời lượng minh họa cho từng giai đoạn: tải các trọng số, tạo ngữ cảnh CUDA, biên dịch TensorRT và warmup. Bảng cũng tổng hợp thời gian cho trường hợp cục bộ đã tối ưu hóa và trường hợp triển khai lần đầu trên đám mây, qua đó cho thấy chi phí chủ yếu nằm ở đâu.
| Giai đoạn | Thời lượng | Ghi chú |
|---|---|---|
| Tải trọng số (SSD) | 0.5 s | 98 MB trọng số FP32 từ bộ nhớ cục bộ |
| Tải trọng số (S3) | 3–5 s | Độ trễ mạng chiếm ưu thế đối với lưu trữ đám mây |
| Ngữ cảnh CUDA | 0.3–0.5 s | Khởi tạo driver GPU và thiết lập bộ nhớ |
| Biên dịch TensorRT | 15–30 s | Chuyển đổi mô hình PyTorch thành engine được tối ưu hóa |
| Khởi động (10 suy luận) | 0.2 s | Kích hoạt phần khởi tạo lười biếng còn lại |
| Chi phí runtime | 0.4 s | Khởi động tiến trình, framework hooks và thiết lập runtime |
| Tổng cộng (cục bộ, tối ưu hóa) | ~1.5 s | Với engine TensorRT được biên dịch sẵn, container “nóng” |
| Tổng cộng (đám mây, triển khai lần đầu) | ~35 s | Bao gồm biên dịch từ trạng thái “lạnh” |
Thông tin chuyên sâu về hệ thống: Việc biên dịch trước các mô hình và lưu trữ engine đã tối ưu hóa sẽ loại bỏ giai đoạn biên dịch 30 giây trong các lần triển khai tiếp theo.
Nếu không có warmup, yêu cầu thực tế đầu tiên sẽ kích hoạt việc biên dịch và cấp phát bộ nhớ ngay trong khi suy luận, thường dẫn đến lỗi hết thời gian chờ. Một yêu cầu thường chỉ mất 5 ms có thể cần tới 500 ms trong quá trình khởi động nguội, vi phạm các SLO và làm suy giảm trải nghiệm người dùng.
Các chiến lược tải
Các chiến lược tải khác nhau đánh đổi giữa thời gian khởi động nguội với hiệu suất phục vụ (serving) và hiệu quả bộ nhớ. Cách đơn giản nhất, tải toàn bộ, là đọc toàn bộ mô hình vào bộ nhớ trước khi bắt đầu phục vụ (serving). Cách này tối đa hóa tốc độ suy luận vì mọi trọng số đều sẵn sàng ngay, nhưng kéo dài thời gian khởi động nguội và giới hạn kích thước mô hình trong phạm vi bộ nhớ khả dụng. Cách tiếp cận này phù hợp khi độ trễ khởi động nguội chấp nhận được và mô hình đủ nhỏ để nằm gọn trong bộ nhớ.
Ánh xạ bộ nhớ là một lựa chọn khác: ánh xạ các tệp mô hình vào không gian địa chỉ của tiến trình và nạp trang theo nhu cầu khi được truy cập. Cách này có thể giảm việc sao chép sớm và rút ngắn thời gian khởi động biểu kiến. Tuy vậy, một mô hình dày đặc rốt cuộc sẽ đụng tới gần như toàn bộ các trọng số, nên các lỗi trang bị hoãn có thể chuyển độ trễ tải sang những yêu cầu đầu tiên. Lợi ích rõ hơn với các thành phần ít được truy cập hoặc các kho mô hình chỉ tải từng phần khi cần; còn các dịch vụ nhạy cảm với độ trễ vẫn thường tải trước hoặc làm ấm các trang cần cho đường xử lý yêu cầu.
Một chiến lược thứ ba, khởi tạo lười, trì hoãn việc biên dịch và cấp phát cho đến lần dùng đầu tiên. Cách này giảm tối đa thời gian khởi động nhưng dồn độ trễ sang yêu cầu đầu tiên. Các hệ thống production thường kết hợp khởi tạo lười với các yêu cầu làm ấm giả lập để kích hoạt khởi tạo trước khi lưu lượng thực sự đến.
Hạ tầng cache mô hình
Các hệ thống production cache các trọng số mô hình ở tầng hạ tầng để giảm cold start cho các kịch bản triển khai phổ biến. Một cách là nhúng trực tiếp các trọng số mô hình vào ảnh container, gọi là container image embedding. Cách này tạo một tạo phẩm triển khai duy nhất và loại bỏ việc tải qua mạng khi khởi động, nhưng tạo ra các ảnh lớn (thường 10–50 GB), làm chậm việc kéo container và tiêu tốn dung lượng lưu trữ của registry. Cách tiếp cận này hợp nhất với các mô hình ít khi cập nhật.
Với tổ chức có nhiều mô hình và cập nhật thường xuyên, một hệ thống tệp chia sẻ (EFS, GCS FUSE) chứa các trọng số mô hình có phiên bản là giải pháp linh hoạt hơn. Nhiều replica có thể đọc cùng một tạo phẩm mà không phải nhúng từng phiên bản vào container. Dù vậy, cập nhật vẫn cần một lần chuyển phiên bản rõ ràng, nguyên tử và triển khai; cho phép tệp thay đổi trong khi các replica đang chạy sẽ làm suy yếu tính tái lập. Đổi lại, độ trễ mạng sẽ ảnh hưởng đến cold start và tính sẵn sàng của hệ thống tệp trở thành một phụ thuộc then chốt.
Khi độ trễ khởi động nguội là yếu tố then chốt với các mô hình lưu lượng cao, SSD cache cục bộ theo nút sẽ nạp sẵn các mô hình dùng thường xuyên vào SSD cục bộ trên các nút suy luận. Cách này cho phép tải nhanh từ ổ Non-Volatile Memory Express (NVMe) ở 500 MB/s trở lên mà không phụ thuộc mạng, nhưng yêu cầu quản lý cache để xử lý cập nhật mô hình và giới hạn dung lượng. Việc chọn giữa các chiến lược này tùy vào tần suất cập nhật mô hình: cập nhật ít thì ưu tiên container embedding, cập nhật thường xuyên thì dùng hệ thống tệp chia sẻ, còn các triển khai đòi hỏi hiệu năng cao sẽ hưởng lợi từ cache cục bộ với cơ chế làm mới nền.
Phục vụ (serving) đa mô hình
Các hệ thống sản xuất thường phục vụ nhiều mô hình từ một máy duy nhất, bao gồm các phiên bản mô hình khác nhau để thử nghiệm A/B, các thành phần ensemble, hoặc các mô hình hoàn toàn khác nhau cùng chia sẻ hạ tầng. Bộ nhớ GPU trở thành tài nguyên giới hạn, đòi hỏi các chiến lược quản lý cẩn thận.
Có ba chiến lược để quản lý bộ nhớ cho phục vụ đa mô hình. Ghép kênh theo thời gian (time-multiplexing) tải từng mô hình một và hoán đổi dựa trên định tuyến yêu cầu: cách này đơn giản nhưng gây thêm độ trễ hoán đổi. Chia sẻ bộ nhớ phân vùng bộ nhớ GPU giữa các mô hình, giới hạn số phiên thực thi đồng thời nhưng cho phép nhiều mô hình hơn lưu trú trong bộ nhớ. Ảo hóa mô hình, như được triển khai bởi các framework như Triton, tách vòng đời mô hình khỏi mã ứng dụng thông qua kho mô hình và các API điều khiển để tải, dỡ tải và quản lý phiên bản mô hình (NVIDIA 2024b, 2026c, 2026b). Việc lựa chọn phụ thuộc vào mẫu yêu cầu: nếu các mô hình nhận lưu lượng đều, tải đồng thời sẽ hiệu quả; nếu lưu lượng theo đợt và phụ thuộc từng mô hình, time-multiplexing với tải trước tường minh sẽ giảm độ trễ trung bình đồng thời tối đa hóa mức sử dụng GPU.
NVIDIA. 2026c. Model Repository: NVIDIA Triton Inference Server.
NVIDIA. 2026b. Model Management: NVIDIA Triton Inference Server.
Thực thi đa luồng
Khi nhiều mô hình hoặc nhiều phiên bản của cùng một mô hình cần chạy đồng thời trên một GPU duy nhất, phần cứng phải phân bổ tài nguyên giữa chúng. Công nghệ Multi-Instance GPU (MIG) của NVIDIA18 cho phép cô lập ở cấp phần cứng, chia một A100 thành tối đa bảy phiên bản GPU độc lập, mỗi phiên bản có bộ nhớ và tài nguyên tính toán riêng (NVIDIA 2026e). MIG có sẵn trên A100, A30 (tối đa bốn phiên bản), H100, H200 và các GPU dành cho trung tâm dữ liệu mới hơn. Với các GPU cũ hơn như V100 hoặc T4, lập lịch luồng CUDA cho phép chia sẻ theo lát thời gian nhưng không có cô lập phần cứng. Lựa chọn phụ thuộc vào việc bạn ưu tiên độ trễ ổn định với MIG hay tối đa hóa mức sử dụng bằng chia sẻ luồng.
18 MIG (GPU đa thực thể): Được giới thiệu cùng NVIDIA A100 (NVIDIA Corporation 2020) và được tài liệu hóa trên các GPU trung tâm dữ liệu được hỗ trợ (NVIDIA 2026e), MIG chia một GPU vật lý thành các phiên bản độc lập, mỗi phiên bản có tài nguyên tính toán và bộ nhớ chuyên dụng; khác với chia sẻ bằng phần mềm (MPS hoặc chia theo thời gian), MIG cung cấp cô lập ở cấp phần cứng giữa các phân vùng. Đổi lại là độ mịn phân chia—các phân vùng phải tuân theo các profile cố định, nên không thể chia tài nguyên tùy ý. Với phục vụ (serving) nhiều mô hình, MIG giảm rủi ro “hàng xóm ồn ào” trên phần cứng dùng chung, còn các đảm bảo SLO cho từng mô hình vẫn phụ thuộc vào chính sách bộ lập lịch, tải và profile phân vùng đã chọn.
NVIDIA Corporation. 2020. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
NVIDIA. 2026e. NVIDIA Multi-Instance GPU User Guide.
Hoán đổi mô hình và bộ nhớ máy chủ
Khi tổng kích thước của tất cả các mô hình vượt quá dung lượng bộ nhớ GPU, hệ thống phục vụ (serving) phải hoán đổi các mô hình giữa bộ nhớ truy cập ngẫu nhiên động (DRAM) trên máy chủ và bộ nhớ thiết bị (VRAM) theo yêu cầu. Điều này tạo thêm một thành phần độ trễ mới, phụ thuộc vào băng thông của bus PCIe.
Đối với một mô hình 10 GB trên PCIe Gen4 x16 (với băng thông lý thuyết 32 GB/s), thời gian tải mất ít nhất 312.5 ms trước khi giải tuần tự, thiết lập đồ thị hoặc khởi động nóng (warmup).

Việc tải mô hình vượt xa một SLO phục vụ nghiêm ngặt.
Để giảm vấn đề này, các hệ thống dùng bộ nhớ đã ghim (bộ nhớ host bị khóa trang). DMA của GPU cần các trang vật lý ổn định, trong khi các bộ đệm host thông thường lại có thể phân trang. Vì vậy, khi truyền dữ liệu từ bộ đệm có thể phân trang, dữ liệu thường phải đi qua một staging buffer tạm thời đã ghim, khiến có thêm một lần sao chép trên CPU và tăng độ trễ trước khi có thể chuyển sang GPU. Cấp phát mới hoặc tái sử dụng các bộ đệm đã ghim sẽ loại bỏ bước sao chép trung gian này, dù ghim quá nhiều sẽ làm giảm lượng bộ nhớ mà hệ điều hành có thể quản lý linh hoạt.
Ghim bộ nhớ là yêu cầu hệ điều hành giữ vùng đó cố định trong RAM vật lý. Khi đó, động cơ DMA của GPU có thể truyền dữ liệu trực tiếp từ vùng đã ghim mà không cần thêm bước sao chép từ vùng có thể phân trang sang vùng đã ghim. Đổi lại, bộ nhớ đã ghim làm giảm RAM khả dụng cho các tiến trình khác và không thể thu hồi khi bộ nhớ bị căng. Với phục vụ (serving) mô hình, lợi ích trên đường truyền dữ liệu thường đủ để ghim các trọng số của mô hình và các bộ đệm đầu vào dùng thường xuyên, còn những vùng ít quan trọng hơn thì để ở trạng thái có thể phân trang.
Khi mô hình đã được tải, làm nóng (warmed up) và cho ra dự đoán phù hợp với lúc huấn luyện, việc gom yêu cầu (request grouping) trở thành đòn bẩy tối ưu tiếp theo. Batching tác động trực tiếp đến cả thông lượng và các thành phần độ trễ trong các phương trình xếp hàng của chúng ta.
Self-Check: Question
A computer vision team trains a ResNet-50 model in PyTorch using torchvision’s PIL-based bilinear image resizing. In production, high-throughput C++ inference servers use OpenCV’s
cv::resizewith default bilinear interpolation. In production, top-1 accuracy drops by 1.8% despite identical model weights. What phenomenon is causing this degradation, and what is the proper engineering solution?- Training-serving skew caused by subtle implementation differences in resize anti-aliasing and pixel coordinate rounding between PIL and OpenCV; the solution is exporting a unified preprocessing graph (e.g., via ONNX or TorchScript) shared across training and serving.
- Accelerator thermal throttling caused by high frame rates; the solution is downclocking the GPU Tensor Cores.
- Floating-point precision drift between Python and C++; the solution is switching all production inference to 64-bit double precision.
- Catastrophic forgetting in the weights caused by static batching; the solution is retraining the model with dynamic dropout.
Why does simply copying model weights into GPU HBM upon container startup fail to prevent latency spikes on the very first incoming user requests, and how does executing a ‘warmup pass’ resolve this issue?
Sequence the stages of a complete cold-start initialization workflow when autoscaling an inference server pod from an idle state to serving live production traffic:
- Transfer model weights from host pinned DRAM to GPU High-Bandwidth Memory (HBM) over PCIe
- Fetch model checkpoint artifacts and configuration from remote object storage (e.g., S3) to local NVMe SSD cache
- Initialize runtime execution engine, allocate memory pools, and run synthetic dummy warmup passes
- Container initialization, environment bootstrap, and runtime dependency loading
- Register pod as healthy with load balancer gateway to begin receiving live traffic
- Memory-map (
mmap) or deserialize model weights from local SSD into host pinned DRAM
True or False: In multi-model serving on a shared GPU, NVIDIA Multi-Process Service (MPS) provides hard physical hardware partitioning of high-bandwidth memory (HBM) channels and compute cores, completely preventing memory out-of-memory (OOM) faults caused by co-located tenant models.
A multi-model serving platform hosts 50 distinct fine-tuned vision models on a single GPU node with 24 GB of VRAM. Each model requires 2 GB of memory, exceeding total VRAM capacity. Traffic to individual models is sporadic. What loading and memory management architecture enables serving all 50 models while minimizing request latency?
- Redeploy the cluster on 50 dedicated GPU nodes running continuous batching 24/7.
- Quantize all models to 1-bit weights to fit all 50 models into GPU L2 cache simultaneously.
- Maintain a tiered memory cache (storing active models in GPU VRAM and inactive models in host pinned DRAM), using asynchronous PCIe DMA transfers to swap weights into VRAM on demand with an LRU eviction policy.
- Compress all models into a single shared zip archive on remote S3 and download the entire archive over HTTP on each incoming request.
Tối ưu hóa thông lượng
Hãy xét một kịch bản phân loại ResNet-50 điển hình trên GPU V100 với kích thước batch bằng một: GPU xử lý một ảnh, rồi ở trạng thái nhàn rỗi trong khi CPU lấy và tiền xử lý ảnh tiếp theo—chỉ đạt 15% mức sử dụng phần cứng và 200 ảnh/giây. Cùng GPU đó khi xử lý đồng thời 32 ảnh đạt 95% mức sử dụng và 1.280 ảnh/giây, tức là thông lượng tăng 6,4\(\times\) trên cùng phần cứng vì chi phí cố định được chia đều cho nhiều yêu cầu. Sự khác biệt nằm ở batching, đòn bẩy cốt lõi để cải thiện hiệu quả chi phí của phục vụ (serving). Batching19 khác biệt rõ giữa huấn luyện và phục vụ (serving) (Crankshaw et al. 2017). Các batch dùng cho huấn luyện tối đa hóa thông lượng bằng cách xử lý hàng trăm hoặc hàng nghìn mẫu cùng lúc, không bận tâm đến độ trễ của từng mẫu. Các batch dùng cho phục vụ (serving) phải cân bằng thông lượng với độ trễ của từng yêu cầu; thường xử lý các batch nhỏ và đảm bảo không yêu cầu nào chờ quá lâu. Cách tiếp cận thích ứng này được gọi là dynamic batching vì hệ thống điều chỉnh thành phần batch theo thời gian thực dựa trên các yêu cầu đến.
19 Batch: Từ tiếng Pháp cổ bache (một lượng được nướng cùng một lúc), đi vào lĩnh vực điện toán vào những năm 1950 cho các công việc được xử lý cùng nhau mà không cần tương tác của con người. Trong phục vụ (serving) ML, cách dùng batch vẫn giữ nguyên sự đánh đổi này: nhóm các yêu cầu lại giúp phân bổ chi phí cố định (như khởi chạy kernel, di chuyển trọng số) cho nhiều đầu vào, nhưng một yêu cầu trực tuyến có thể phải chờ để một batch được hình thành. Trong huấn luyện, batch có thể lên tới hàng trăm hoặc hàng nghìn mẫu nếu bộ nhớ cho phép; còn kích thước batch trong phục vụ (serving) dao động từ một đến lớn hơn nhiều, tùy vào mô hình, tốc độ yêu cầu đến và mục tiêu độ trễ (SLO).
Crankshaw, Daniel, Xin Wang, Guilio Zhou, Michael J. Franklin, Joseph E. Gonzalez, and Ion Stoica. 2017. “Clipper: A Low-Latency Online Prediction Serving System.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 613–27.
Definition 1.5: Dynamic batching
Dynamic batching là một kỹ thuật tối ưu hóa trong phục vụ (serving) ML, đánh đổi độ trễ lấy thông lượng khi các yêu cầu đến theo kiểu ngẫu nhiên.
- Ý nghĩa: Bằng cách gom các yêu cầu vào một cửa sổ batching, bộ lập lịch sẽ phân bổ các chi phí cố định \((L_{\text{lat}})\) cho nhiều đầu vào, đẩy hệ thống rời khỏi trạng thái bị giới hạn bởi băng thông bộ nhớ \((\text{BW})\) và tiến tới trạng thái bị giới hạn bởi khả năng tính toán cực đại \((R_{\text{peak}})\).
- Điểm khác biệt: Không như các batch phục vụ (serving) có kích thước cố định, dynamic batching điều chỉnh kích thước batch thực tế tại thời điểm suy luận dựa trên lưu lượng truy cập đến, thời gian chờ (timeout), và giới hạn batch tối đa.
- Sai lầm phổ biến: Một quan niệm thường gặp là batching “luôn hữu ích.” Thực tế tồn tại một đường biên Pareto giữa độ trễ và thông lượng: nếu cửa sổ batching quá lớn, độ trễ xếp hàng tăng thêm có thể làm vi phạm SLO của hệ thống trước khi kịp thu được lợi ích về thông lượng.
Vì sao batching hữu ích
Các bộ tăng tốc hiện đại đạt hiệu suất cao nhất chỉ khi kích thước batch đủ lớn (Shen et al. 2019). Một yêu cầu suy luận đơn lẻ khiến phần lớn đơn vị tính toán bị nhàn rỗi vì GPU được thiết kế để thực thi song song trên hàng nghìn luồng. Batching giúp phân bổ chi phí cố định trên nhiều yêu cầu và cho phép thực thi song song theo chiều batch.
Shen, Haichen, Lequn Chen, Yuchen Jin, Liangyu Zhao, Bingyu Kong, Matthai Philipose, Arvind Krishnamurthy, and Ravi Sundaram. 2019. “Nexus: A GPU Cluster Engine for Accelerating DNN-Based Video Analysis.” Proceedings of the 27th ACM Symposium on Operating Systems Principles, 322–37. https://doi.org/10.1145/3341301.3359658.
20 Kernel (GPU): CUDA đã mượn thuật ngữ này từ các hệ điều hành vào khoảng năm 2007 vì các hàm GPU đóng vai trò “lõi” tính toán của các thuật toán song song. Khác với kernel hệ điều hành chạy liên tục, kernel GPU là các đơn vị công việc song song, rời rạc, do CPU khởi chạy. Mỗi lần khởi chạy mang 5–20 \(\mu\)s overhead, không phụ thuộc vào kích thước batch—không đáng kể với các batch lớn trong huấn luyện, nhưng lại trở thành chi phí chính khi phục vụ (serving) batch-1. Chẳng hạn, một mô hình 50 lớp có thể tích lũy 250–1000 \(\mu\)s overhead khởi chạy chỉ riêng cho mỗi lần suy luận.
Hai chi phí cố định chi phối ở kích thước batch nhỏ. Chi phí khởi chạy kernel20 là thời gian CPU chuẩn bị và gửi công việc lên GPU. Mỗi lớp trong một mạng nơ-ron thường cần một lần khởi chạy kernel riêng: CPU phải ráp các tham số kernel, sao chép chúng vào bộ nhớ mà GPU có thể truy cập, và báo hiệu cho GPU bắt đầu thực thi. Chi phí này thường là 5–20 μs cho mỗi kernel, không phụ thuộc vào kích thước batch. ResNet-50 có khoảng năm mươi lớp, nên chỉ riêng việc khởi chạy kernel đã thêm 250–1000 μs cho mỗi lần suy luận. Ở kích thước batch bằng một, chi phí này có thể lớn hơn thời gian tính toán thực tế; ở kích thước batch bằng ba mươi hai, cùng chi phí đó được phân bổ trên ba mươi hai ảnh. Nạp trọng số là đọc các tham số mô hình từ bộ nhớ GPU (VRAM) vào các đơn vị tính toán. Ở kích thước batch bằng một, GPU phải đọc toàn bộ trọng số để xử lý một ảnh; ở kích thước batch bằng ba mươi hai, cùng một lần đọc trọng số xử lý ba mươi hai ảnh, đạt hiệu quả bộ nhớ tốt hơn 32\(\times\). Đo lường hiệu quả batching trên một mô hình cụ thể sẽ định lượng cách những chi phí cố định này được phân bổ trong thực tế.
Table 9 minh họa sự đánh đổi giữa thông lượng và độ trễ: batch lớn hơn có thể cải thiện hiệu quả sử dụng phần cứng nhưng làm tăng độ trễ mỗi yêu cầu. Trong thực tế, kích thước batch tối ưu phụ thuộc vào cả SLO độ trễ và tốc độ yêu cầu đến. Câu hỏi kỹ thuật ở đây là định lượng: xác định kích thước batch lớn nhất vẫn đáp ứng SLO độ trễ đã cho. Trong kịch bản này, batch size 8 với cửa sổ batching 5 ms có độ trễ người dùng trong trường hợp xấu nhất khoảng 14 ms (5 ms chờ cộng 9 ms suy luận), thấp hơn ngân sách SLO 20 ms. Điều đó đạt được thông lượng phục vụ (serving) cao hơn 4.4× lần so với phục vụ (serving) batch-1 trên cùng phần cứng, miễn là tải liên tục đủ cao để lấp đầy cửa sổ batching. Vẽ cùng sự đánh đổi đó trong figure 6 cho thấy “điểm uốn” (knee) nơi việc batching thêm không còn xứng đáng với cái giá độ trễ: thông lượng đã bắt đầu đi vào vùng phẳng trong khi độ trễ bắt đầu tăng vọt, nên batching vượt qua điểm này chỉ đổi lấy chút ít năng lực phục vụ nhưng phải chịu thêm độ trễ do xếp hàng.
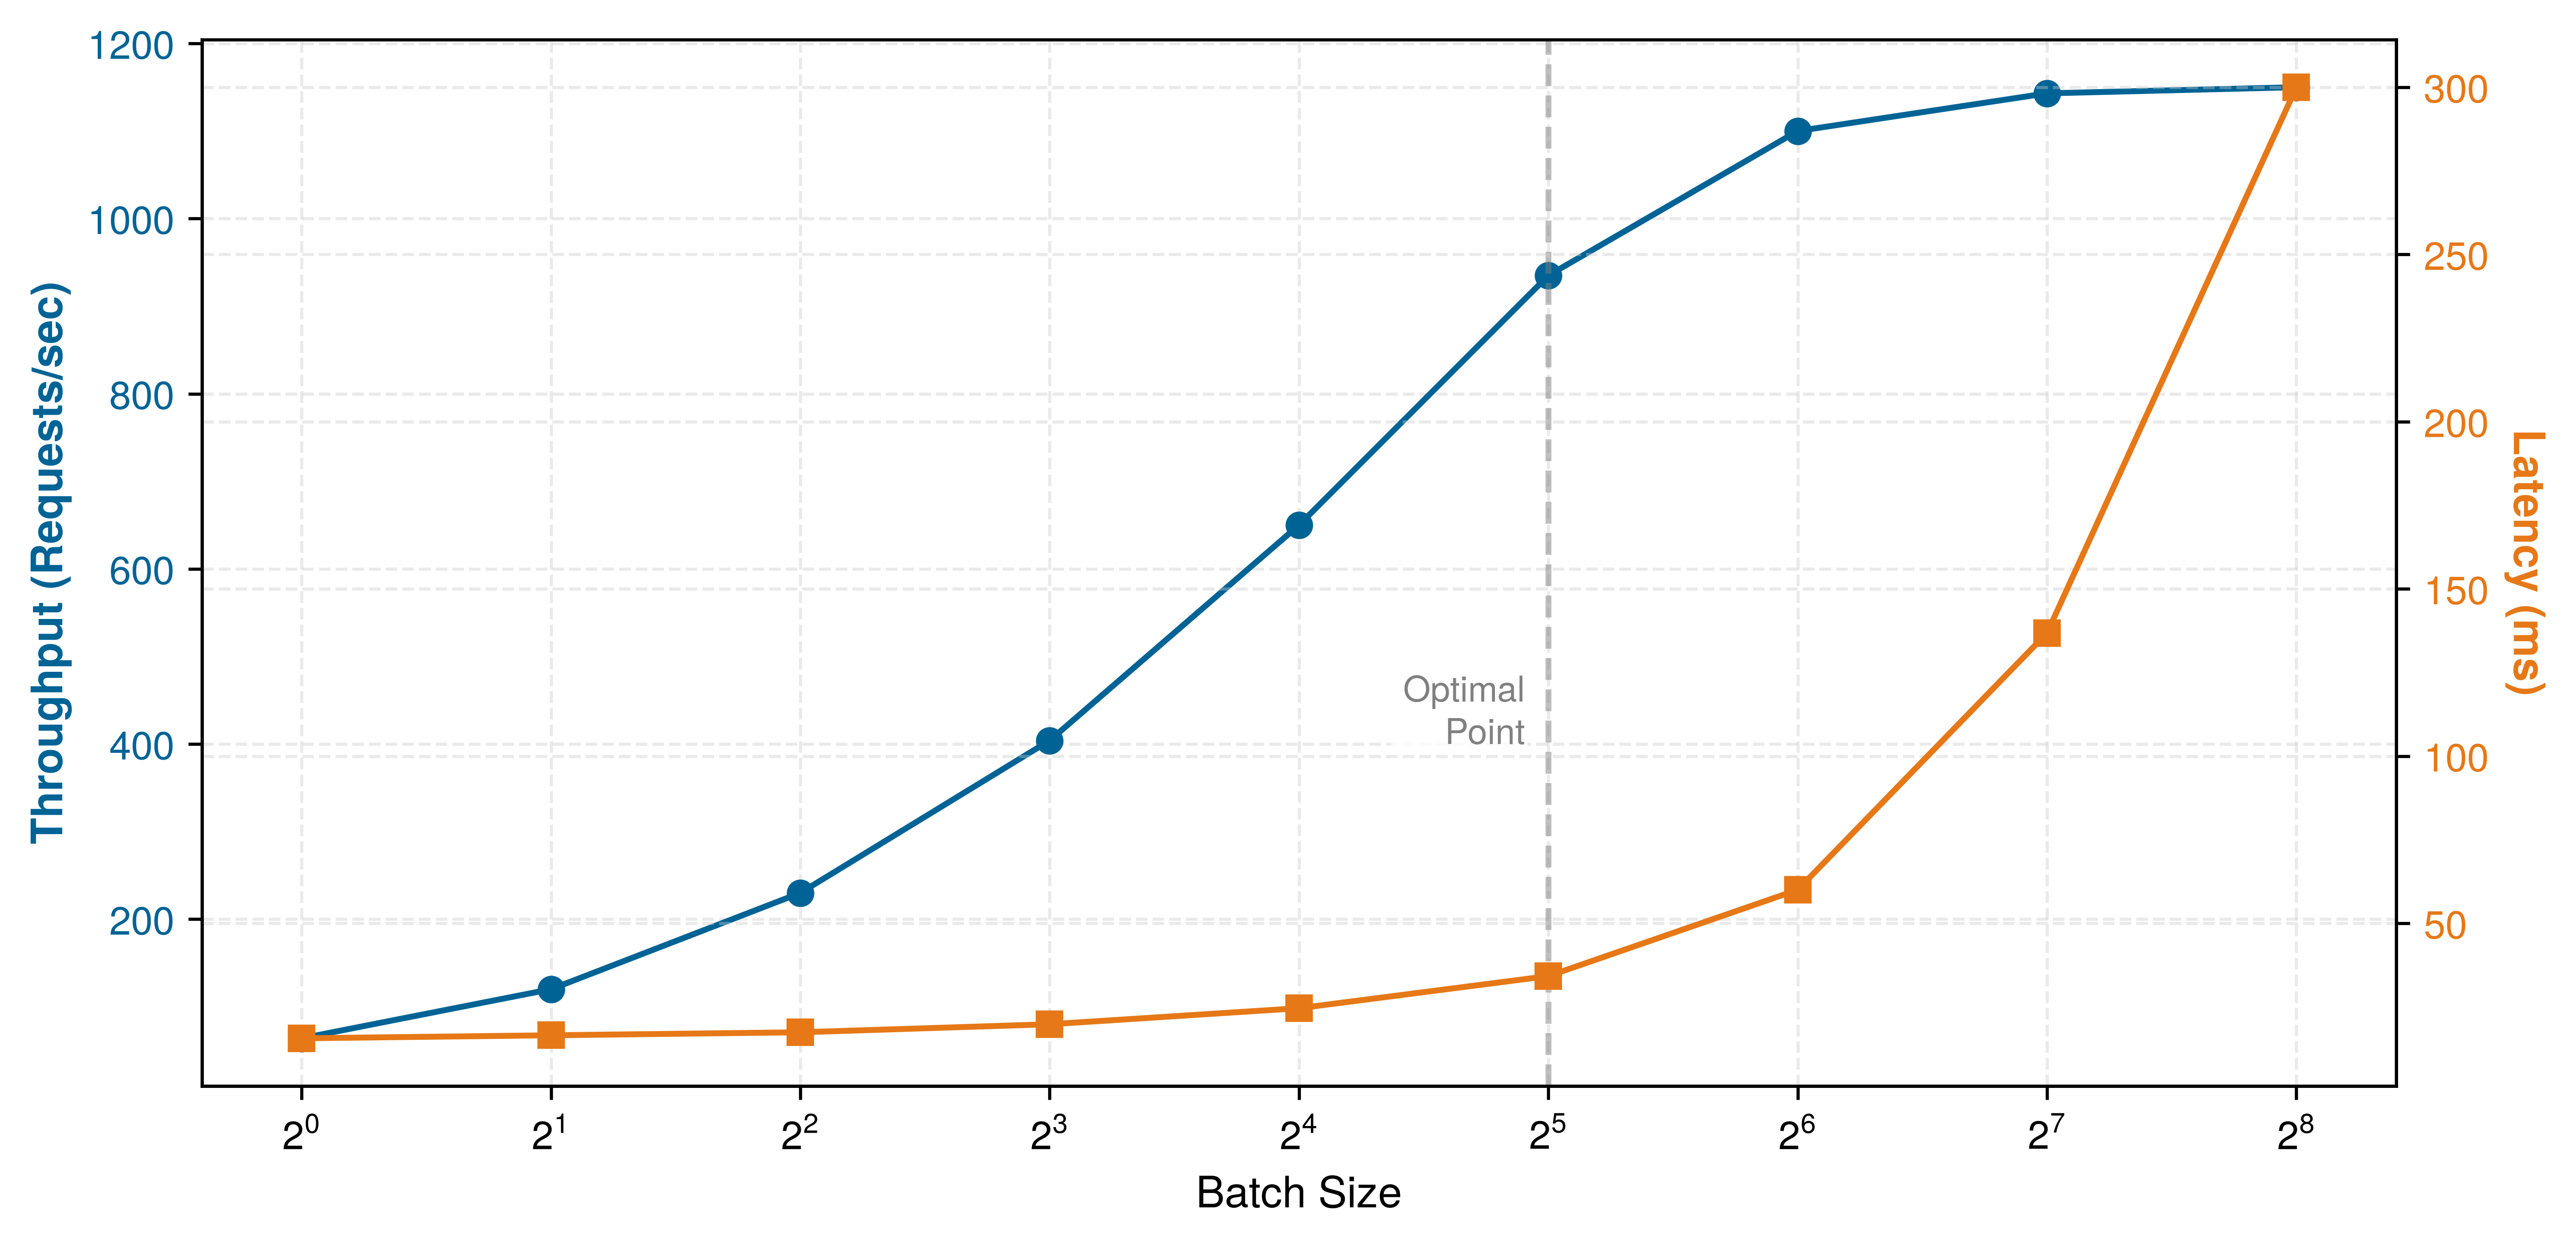
Điểm “uốn” trong figure 6 đánh dấu thời điểm đường thông lượng màu xanh bắt đầu phẳng ra, đồng thời đường độ trễ màu cam bắt đầu vọt lên mạnh. Đây là điểm uốn mang tính minh họa chứ không phải tối ưu chung: điểm vận hành được chọn phụ thuộc vào SLO về độ trễ, quá trình đến và mục tiêu chi phí. Các con số là đại diện, không gắn với một benchmark cụ thể.
Napkin Math 1.4: Hiệu quả batching của ResNet-50
Table 9 minh họa sự đánh đổi thông lượng–độ trễ trong một kịch bản ResNet-50/V100, với các kích thước batch từ một đến ba mươi hai. Kích thước batch, thời gian suy luận đo được và mức sử dụng GPU là các thông số đầu vào của kịch bản này; các cột thời gian xử lý trên mỗi hình ảnh và thông lượng được suy ra từ chúng.
Table 9: ResNet-50 batching sweep: Minh họa thời gian xử lý trên mỗi hình ảnh, thông lượng và mức sử dụng GPU với các kích thước batch từ một đến ba mươi hai trên V100. Thông lượng tăng 6.4× từ batch một đến batch ba mươi hai khi mức sử dụng GPU tăng từ 15 percent lên 95 percent, trong khi thời gian suy luận thuần túy kéo dài từ 5 ms đến 25 ms.
Math: Đối với hàng batch-8, chúng ta tính thời gian xử lý trên mỗi hình ảnh bằng cách chia độ trễ batch cho kích thước batch: 9.1 ms ÷ 8 hình ảnh ≈ 1.1 ms trên mỗi hình ảnh, và thông lượng bằng cách chia kích thước batch cho cùng độ trễ đó: 8 hình ảnh ÷ 9.1 ms ≈ 879 img/s. Chúng ta áp dụng hai phép chia này cho mọi hàng được suy ra.
| Kích thước batch | Thời gian suy luận | Tính toán trên mỗi hình ảnh | Thông lượng | Tỷ lệ sử dụng GPU |
|---|---|---|---|---|
| 1 | 5 ms | 5 ms | 200 img/s | 15% |
| 4 | 7.2 ms | 1.8 ms | 556 img/s | 42% |
| 8 | 9.1 ms | 1.1 ms | 879 img/s | 65% |
| 16 | 14 ms | 0.9 ms | 1,143 img/s | 85% |
| 32 | 25 ms | 0.8 ms | 1,280 img/s | 95% |
Thời gian hiển thị là thời gian suy luận thuần túy, không bao gồm thời gian chờ trong hàng đợi; section 1.7.6 phân tích cách độ trễ mà người dùng cảm nhận bao gồm thời gian chờ trong cửa sổ batching.
Góc nhìn hệ thống: Với kích thước batch 32, thông lượng cao hơn 6.4× lần so với batch 1. Tuy nhiên, độ trễ mà người dùng cảm nhận bao gồm cả thời gian chờ trong hàng đợi và thời gian suy luận. Cụ thể, với cửa sổ batching 10 ms và thời gian suy luận 25 ms, tổng độ trễ là 35 ms, so với 5 ms khi dùng batch 1.
Việc gom batch giúp tăng hiệu quả nhưng cũng đi kèm một cái giá: các yêu cầu phải chờ để batch được hình thành. Điều này tạo ra một mâu thuẫn trực tiếp giữa tối ưu hóa thông lượng (batch lớn hơn) và giảm thiểu độ trễ (xử lý ngay). Các chiến lược gom batch khác nhau và những đánh đổi của chúng sẽ định hướng cách kỹ sư điều chỉnh cân bằng này.
Gom batch tĩnh so với gom batch động
Gom batch tĩnh sẽ chờ đủ một kích thước batch cố định rồi mới xử lý. Cách này dễ triển khai nhưng dễ đuối khi lưu lượng thay đổi: khi lưu lượng thấp, yêu cầu phải chờ vô thời hạn để đủ batch; khi lưu lượng cao, batch lớn làm tăng độ trễ trên mỗi yêu cầu. Gom batch động khắc phục nhược điểm này bằng cách thu thập yêu cầu trong một cửa sổ thời gian giới hạn và xử lý tất cả những gì đã đến khi cửa sổ đóng lại (Olston et al. 2017; NVIDIA 2024b). Kích thước cửa sổ trở thành núm điều chỉnh chính: cửa sổ ngắn hơn giảm độ trễ nhưng hy sinh thông lượng; cửa sổ dài hơn cải thiện thông lượng nhưng tăng độ trễ. Các hệ thống triển khai nhạy cảm với độ trễ sẽ tinh chỉnh cả cửa sổ thời gian và kích thước batch tối đa theo mẫu đến, “hình dạng” mô hình và SLO.
Đánh đổi độ trễ-thông lượng của gom batch động
Gom batch động tạo ra một mâu thuẫn có thể định lượng giữa tối ưu hóa thông lượng và các ràng buộc về độ trễ. Khi hệ thống quá tải, cơ chế là hàng đợi phình ra chứ không phải suy luận chậm lại, nhờ vậy có thể đưa ra quyết định cấu hình một cách hệ thống thay vì phải thử-sai.
Systems Perspective 1.5: Tại sao độ trễ tăng đột biến khi có tải
Nhắc lại từ section 1.5.1 rằng Định luật Little \((Q_{\text{req}} = \lambda_{\text{arr}} T_{\text{lat}})\) chỉ áp dụng cho các giá trị trung bình dài hạn khi hàng đợi ổn định. Khi tốc độ yêu cầu đến tiến sát tốc độ phục vụ tối đa \(\mu\), độ dài và độ trễ của hàng đợi ổn định sẽ tăng nhanh. Nếu \(\lambda_{\text{arr}}\) vượt quá công suất trong một khoảng thời gian đủ lâu, sẽ không còn trạng thái ổn định hữu hạn: tồn đọng cứ tích lũy cho đến khi lưu lượng giảm, công suất tăng, hoặc công việc bị từ chối. Đây là lý do kiểm soát truy nhập (admission control) có thể giữ được độ trễ khi quá tải; mở rộng ngang (scale-out) hoặc hạ mức dịch vụ cũng có thể giúp khi khả dụng.
Equation 7 chia tổng độ trễ mà người dùng cảm nhận cho một yêu cầu được gom batch thành hai thành phần: \[L_{\text{lat}} = L_{\text{lat,wait}} + L_{\text{lat,compute}}(B) \tag{7}\] trong đó \(L_{\text{lat,wait}}\) là thời gian chờ trong hàng đợi batch (tương ứng với \(L_{\text{lat,queue}}\) trong ngân sách độ trễ tổng thể) và \(L_{\text{lat,compute}}(B)\) là thời gian suy luận cho kích thước batch \(B\) (bao gồm \(L_{\text{lat,infer}}\) cùng với một phần của \(L_{\text{lat,pre}}\) và \(L_{\text{lat,post}}\)). Cửa sổ batch \(T_{\text{window}}\) đặt giới hạn cho thời gian chờ (\(L_{\text{lat,wait}} \leq T_{\text{window}}\)), trong khi kích thước batch ảnh hưởng đến thời gian tính toán qua đặc tính tận dụng GPU.
Phân tích định lượng cho batch
Với các cửa sổ lịch cố định và yêu cầu đến theo phân phối Poisson dừng, thời điểm đến của yêu cầu phân bố đều trong mỗi cửa sổ. Một yêu cầu đến tại thời điểm \(t\) sẽ chờ \(T_{\text{window}} - t\) đến khi cửa sổ đó đóng, nên equation 8 cho thấy thời gian chờ trung bình bằng một nửa cửa sổ: \[E[L_{\text{lat,wait}}] = \frac{T_{\text{window}}}{2} \tag{8}\]
Mối quan hệ đơn giản này có các hệ quả trực tiếp. Một cửa sổ batch 20 ms sẽ cộng thêm 10 ms vào thời gian chờ trung bình (tối đa 20 ms cho yêu cầu đến đầu tiên trong cửa sổ; các yêu cầu đến sau chờ ít hơn) bất kể kích thước batch đạt được. Với SLO độ trễ trung bình 50 ms và thời gian suy luận 5 ms, thời gian chờ trung bình sẽ chiếm 20 percent ngân sách độ trễ trước khi bắt đầu tính toán; các SLO ở đuôi phải dành ngân sách cho toàn bộ cửa sổ.
Phân phối kích thước batch
Với các cửa sổ lịch cố định, số yêu cầu được gom trong \(T_{\text{window}}\) tuân theo phân phối Poisson với trung bình \(\lambda_{\text{arr}} T_{\text{window}}\). Equation 9 diễn tả mối quan hệ này một cách chính thức: \[\Pr(\text{batch size} = k) = \frac{(\lambda_{\text{arr}} T_{\text{window}})^k e^{-\lambda_{\text{arr}} T_{\text{window}}}}{k!} \tag{9}\]
Ở đây \(k\) là một số nguyên không âm biểu thị số yêu cầu đến trong cửa sổ.
Table 10 định lượng sự biến động này, chỉ ra cách kích thước batch thay đổi tùy theo mức lưu lượng, trong một cửa sổ 10 ms cố định:
| Tốc độ đến | Trung bình Batch | Độ lệch chuẩn | \(\Pr(\text{batch}=0)\) | \(\Pr(\text{batch} \ge 2 \times \text{mean})\) |
|---|---|---|---|---|
| 50 QPS | 0.5 | 0.7 | 61% | 39% |
| 200 QPS | 2 | 1.4 | 14% | 14% |
| 500 QPS | 5 | 2.2 | 0.7% | 3% |
| 1000 QPS | 10 | 3.2 | 0.005% | 0.3% |
Chiến lược tối đa hóa thông lượng
Để tối ưu hóa thông lượng, cần tách biệt độ trễ của từng yêu cầu khỏi dung lượng phục vụ bão hòa. Một yêu cầu sẽ chờ để batch được hình thành, sau đó chịu thời gian phục vụ của batch đó. Tuy nhiên, khi hệ thống chịu tải liên tục, việc hình thành batch có thể chồng lấn với quá trình xử lý batch trước đó, nên dung lượng được quyết định bởi thời gian phục vụ của batch đã sẵn sàng: \[\mu_{\text{eff}}(B) \approx \frac{B}{T_{\text{svc}}(B)}, \qquad \text{throughput} = \min(\lambda_{\text{arr}}, \mu_{\text{eff}}(B)) \tag{10}\]
Trong equation 10, \(\lambda_{\text{arr}}\) là tốc độ yêu cầu đến và \(\mu_{\text{eff}}(B)\) là dung lượng phục vụ bão hòa cho kích thước batch \(B\). Tử số tăng tuyến tính theo kích thước batch, trong khi thời gian phục vụ thường tăng chậm hơn tuyến tính trong một phạm vi hữu ích, vì khả năng song song của GPU được khai thác tốt hơn. Cửa sổ gom batch vẫn ảnh hưởng đến độ trễ yêu cầu và trong các chế độ lưu lượng thấp, nơi kích thước batch dự kiến bị giới hạn bởi số yêu cầu đến trong cửa sổ, xấp xỉ \(\lambda_{\text{arr}} T_{\text{window}}\).
Đối với ResNet-50 trên GPU V100, thời gian phục vụ xấp xỉ: \(T_{\text{svc}}(B) = 5 \text{ ms} + 0.6 B\) (5 ms chi phí cố định cộng với 0.6 ms cho mỗi ảnh trong batch). Phép xấp xỉ tuyến tính này thể hiện xu hướng chính; thời gian phục vụ thực tế có thể lệch nhẹ do các hiệu ứng của hệ thống phân cấp bộ nhớ. Với cửa sổ gom batch \(T_{\text{window}} = 10 \text{ ms}\), table 11 mở rộng kết quả đo lường suy luận thuần túy từ table 9: độ trễ bao gồm thời gian chờ tối đa của cửa sổ, trong khi thông lượng bão hòa chỉ tính dựa trên thời gian phục vụ:
| Kích thước batch | Thời gian phục vụ | Tổng độ trễ | Thông lượng | Hiệu quả |
|---|---|---|---|---|
| 1 | 5.6 ms | 15.6 ms | 179 img/s | Thấp |
| 4 | 7.4 ms | 17.4 ms | 541 img/s | Trung bình |
| 8 | 9.8 ms | 19.8 ms | 816 img/s | Tốt |
| 16 | 14.6 ms | 24.6 ms | 1096 img/s | Cao |
| 32 | 24.2 ms | 34.2 ms | 1322 img/s | Tối đa |
Những lợi ích về thông lượng trong table 11 xuất phát trực tiếp từ thành phần chi phí cố định trong định luật sắt đã nêu ở Quy luật sắt về hiệu suất huấn luyện, nơi batching phân bổ công việc trên nhiều yêu cầu.
Example 1.7: Định luật sắt về hiệu quả batching
Bối cảnh: Trong phục vụ (serving), batching cải thiện thông lượng bằng cách phân bổ các chi phí cố định cho mỗi batch, như công việc lập lịch và khởi chạy kernel; nó cũng có thể phân bổ chi phí truyền trọng số trên nhiều yêu cầu, trong khi thời gian chờ trong hàng đợi vẫn là một chi phí độ trễ riêng. Tạm thời bỏ qua thành phần di chuyển dữ liệu trong phép so sánh minh họa hai thành phần này, equation 11 tách riêng phần tính toán và chi phí cố định: \[ T = \frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}} + L_{\text{lat}} \tag{11}\]
Phân tích:
- Trường hợp 1 (batch 1): Chi phí cố định (5 ms) \(\gg\) thời gian tính toán (0.6 ms). Hiệu quả ≈ 10 percent. Phần lớn thời gian GPU đang chờ.
- Trường hợp 2 (batch 32): Chi phí cố định (5 ms) \(\ll\) thời gian tính toán (19.2 ms). Hiệu quả ≈ 79 percent. Lúc này GPU bận xử lý tính toán.
Thông tin chuyên sâu về hệ thống: Tăng kích thước batch cho đến khi chi phí cố định trở nên không đáng kể (nhỏ hơn 10 percent tổng thời gian) hoặc khi SLO về độ trễ không cho phép chờ thêm. Vượt qua điểm này, batching thêm chỉ mang lại lợi ích thông lượng tối thiểu nhưng làm tăng thời gian chờ trong hàng đợi một cách tuyến tính.
Ba kết quả này kết hợp lại thành một mô hình vận hành cho batching động: cửa sổ batching đặt thời gian chờ trung bình bằng một nửa độ dài của nó; các yêu cầu đến theo phân phối Poisson khiến kích thước batch thực tế dao động quanh \(\lambda_{\text{arr}} T_{\text{window}}\); và dung lượng phục vụ bão hòa \(\mu_{\text{eff}}(B)\) tăng theo kích thước batch cho đến khi chi phí cố định được khấu hao hết. Tuy nhiên, chưa kết quả nào trong số này đảm bảo SLO về độ trễ. Các phần tiếp theo sẽ bổ sung ràng buộc còn thiếu đó, bằng cách đi ngược từ một ngân sách phân vị chặt chẽ để xác định kích thước batch lớn nhất mà cửa sổ có thể tạo ra một cách an toàn.
Tối ưu hóa có ràng buộc độ trễ
Khi các SLO về độ trễ trở thành ràng buộc chính, bài toán tối ưu hóa là tìm kích thước batch tối đa có thể đáp ứng SLO đó. Với mục tiêu độ trễ \(L_{\text{lat,target}}\) và thời gian chờ trung bình \(T_{\text{window}}/2\), equation 12 xác định kích thước batch tối đa cho phép bằng phép xấp xỉ độ trễ trung bình bậc nhất: \[B_{\text{max}} = \max\left\{B : \frac{T_{\text{window}}}{2} + T_{\text{svc}}(B) \leq L_{\text{lat,target}}\right\} \tag{12}\]
Trong kịch bản minh họa với ResNet-50 này, với SLO độ trễ p95 là 50 ms, khi so sánh một cửa sổ batching thận trọng với một cửa sổ batching tích cực, ta sẽ thấy các cấu hình giả định này đánh đổi giữa thời gian chờ, ngân sách suy luận và dung lượng bão hòa như thế nào. Table 12 trình bày hai cấu hình này cạnh nhau.
| Chỉ số | Thận trọng (\(T_{\text{window}}\) = 5 ms) | Mạnh mẽ (\(T_{\text{window}}\) = 25 ms) |
|---|---|---|
| Thời gian chờ trung bình | 2.5 ms (thời gian chờ tối đa = 5 ms cho yêu cầu đầu tiên trong một cửa sổ) | 12.5 ms |
| Ngân sách độ trễ cho suy luận | 47.5 ms (lập kế hoạch độ trễ trung bình; SLO đuôi nên phân bổ toàn bộ cửa sổ) | 37.5 ms |
| Giới hạn kích thước batch | 32 images | 48 |
| Dung lượng bão hòa giả định | ~1,140 img/s | ~1,280 img/s |
Cấu hình tích cực giả định dung lượng bão hòa cao hơn 12.3 percent nhưng làm tăng thời gian chờ batching trung bình lên 10 ms và mức đóng góp tối đa từ phần chờ của cửa sổ lên 20 ms. Lưu ý rằng giá trị sau không phải là ước tính độ trễ p99.
Phân tích vi phạm SLO
Sự biến thiên kích thước batch có thể gây vi phạm SLO ngay cả khi độ trễ trung bình có vẻ an toàn. Một yêu cầu trong một cửa sổ cố định sẽ bao gồm chính nó và các yêu cầu đến khác, do đó \(B_{\text{req}}=1+\operatorname{Poisson}(\lambda_{\text{arr}}T_{\text{window}})\). Kết hợp toàn bộ cửa sổ với kích thước batch p99 mà yêu cầu “nhìn thấy” cho ta bao hàm bảo thủ như trong equation 13: \[L_{\text{lat,envelope}} = T_{\text{window}} + T_{\text{svc}}(B_{\text{req,p99}}) \tag{13}\] Với \(\lambda_{\text{arr}}\) = 500 QPS và \(T_{\text{window}}\) = 10 ms, kích thước batch trung bình trên mỗi yêu cầu là 6 và p99 của nó là 12. Độ trễ trung bình là 13.6 ms; còn giới hạn an toàn là 22.2 ms.
Giới hạn an toàn này gấp 1.63× lần giá trị trung bình. Đây không phải là p99 độ trễ của yêu cầu, vì việc phải chờ trọn cửa sổ và kích thước batch p99 không nhất thiết xảy ra cùng lúc trên cùng một yêu cầu.
Systems Perspective 1.6: Sự đánh đổi giữa độ trễ và thông lượng
Một con số “tốc độ suy luận” duy nhất không thể xác định nếu chưa biết kích thước batch, vì kích thước batch quyết định chế độ hoạt động và nút thắt cổ chai của hệ thống.
- Chế độ Batch-1: Ưu tiên độ trễ. Chi phí khởi tạo hoặc lưu lượng bộ nhớ thường là yếu tố hạn chế trên đường đi của yêu cầu. Chế độ này áp dụng cho các tương tác thời gian thực như trợ lý gõ phím và robot.
- Chế độ Batch-N: Ưu tiên thông lượng. Batch lớn hơn giúp phân tán chi phí chung và lưu lượng trọng số, và có thể đẩy nút thắt cổ chai sang phần tính toán. Chế độ này áp dụng cho xử lý ngoại tuyến và các dịch vụ lưu lượng cao.
Hai chế độ này tối ưu hóa những đại lượng đối lập. Vì vậy, một mô hình “nhanh” ở batch 1 có thể còn xa mới đạt thông lượng đỉnh, và ngược lại. Do đó, mọi số liệu về độ trễ hay thông lượng đều phải nêu rõ được đo ở độ trễ luồng đơn (batch 1) hay ở thông lượng tối đa (batch N).
Cửa sổ batching thích ứng
Sự phụ thuộc vào kích thước batch cũng quyết định cách hệ thống phục vụ (serving) ghép batch ngay từ đầu. Cửa sổ batching cố định lãng phí ngân sách độ trễ khi lưu lượng cao, vì batch lớn hình thành rất nhanh. Listing 2 minh họa cách các chiến lược thích ứng điều chỉnh cửa sổ dựa trên độ sâu hàng đợi.
Trong một kịch bản minh họa với lưu lượng dao động từ 200–1000 QPS, cửa sổ cố định 10 ms cho độ trễ trung bình 15 ms ở 650 img/s, trong khi heuristic thích ứng cho 11 ms ở 680 img/s. Sự tương tác giữa kích thước cửa sổ và các giới hạn của batch tạo ra một không gian cấu hình khả thi, mỗi cấu hình thể hiện một cân bằng khác nhau giữa thông lượng và độ trễ.
def adaptive_batching_window(
    queue_depth, arrival_rate, slo_ms, service_ms, fixed_overhead_ms
):
    """Compute a heuristic batching window.

    Based on current system state.
    """
    target_batch_size = 16  # Deployment-tuned target batch

    # Fast path: batch ready, close immediately to minimize latency
    if queue_depth >= target_batch_size:
        return 0

    # Compute maximum allowable wait from the remaining p99 budget.
    max_wait_ms = max(0, slo_ms - service_ms - fixed_overhead_ms)

    # Estimate time to accumulate target batch at current arrival
    # rate.
    # arrival_rate is requests/second, so convert seconds to
    # milliseconds.
    if arrival_rate > 0:
        requests_needed = target_batch_size - queue_depth
        estimated_wait_ms = requests_needed / arrival_rate * 1000.0
        # Return minimum of estimated wait and SLO-constrained maximum
        return min(estimated_wait_ms, max_wait_ms)

    return max_wait_ms  # Low traffic: use remaining budget to accumulate batch
Các cấu hình batching không bị chi phối tạo thành một biên Pareto, trong đó để tăng thông lượng phải chấp nhận độ trễ cao hơn. Table 13 trình bày năm cấu hình minh họa:
| Cửa sổ (ms) | Batch tối đa | Độ trễ trung bình | Độ trễ p99 | Thông lượng | Cấu hình |
|---|---|---|---|---|---|
| 2 | 16 | 8 ms | 18 ms | 890 img/s | Độ trễ cực thấp |
| 5 | 32 | 10 ms | 22 ms | 1,140 img/s | Cân bằng |
| 10 | 32 | 15 ms | 35 ms | 1,240 img/s | Độ trễ trung bình |
| 20 | 64 | 23 ms | 52 ms | 1,310 img/s | Tối ưu hóa thông lượng |
| 50 | 128 | 38 ms | 98 ms | 1,350 img/s | Thông lượng tối đa |
Hướng dẫn cấu hình thực tế
Biên Pareto trong table 13 cho thấy vì sao cần cấu hình ngược từ ngân sách độ trễ: sau điểm uốn, mở rộng cửa sổ chỉ mang lại mức tăng thông lượng ngày càng ít, trong khi độ trễ đuôi tăng mạnh. Trong ví dụ đã tính toán, dành 30% SLO cho thời gian chờ batching cho \(T_{\text{max}} = 0.3 \times L_{\text{lat,SLO}}\). Một khối lượng công việc (workload) khác có thể phân bổ tỷ lệ khác sau khi tính phần cho mạng, tiền xử lý, suy luận và hậu xử lý. Ước tính lưu lượng nên bao gồm cả đỉnh và thời lượng bùng nổ, thay vì chỉ dựa vào giá trị trung bình. Bộ nhớ GPU đặt ra một giới hạn riêng cho kích thước batch do các activation và không gian làm việc runtime. Cuối cùng, theo dõi phân phối kích thước batch và thời gian chờ thực tế sẽ cho biết mô hình đến giả định có còn đúng không và liệu nên dùng cửa sổ cố định hay thích ứng.
Với một hệ thống phục vụ (serving) ResNet-50 minh họa có SLO 50 ms và lưu lượng 500 QPS, phép tính sẽ chuyển các giả định về SLO và tốc độ đến thành hai nút điều chỉnh có thể triển khai: cửa sổ batching và kích thước batch tối đa. Table 14 tóm tắt cấu hình kết quả và điểm vận hành được mô hình hóa.
| Số lượng | Giá trị | Vai trò kỹ thuật |
|---|---|---|
| Ngân sách độ trễ cho việc batching | 15 ms | Phần SLO khả dụng cho độ trễ xếp hàng. |
| Cửa sổ tối đa | 15 ms | Giới hạn trên được ngụ ý bởi ngân sách độ trễ. |
| Batch dự kiến mà yêu cầu nhìn thấy | 7 | Kích thước batch trung bình mà một yêu cầu đến nhìn thấy. |
| Batch p99 được yêu cầu ghi nhận | 13 | Kích thước batch ở phần đuôi trong điều kiện các yêu cầu đến theo phân phối Poisson. |
| Batch giả định bị giới hạn bởi bộ nhớ | 32 | Giới hạn kịch bản cho bộ nhớ của bộ tăng tốc. |
| Cấu hình đã chọn | \(T_{\text{window}}\) = 12 ms, \(B_{\text{max}}\) = 32 | Thiết lập tham số thực tế cho triển khai. |
| Bao đuôi bảo thủ | 24.8 ms | Toàn bộ cửa sổ cộng với thời gian phục vụ batch p99 được yêu cầu ghi nhận. |
| Dung lượng bão hòa minh họa | 1,176.9 img/s | Ước tính sử dụng hệ số hiệu suất giả định là 0.89. |
| Thông lượng được phục vụ | 500 img/s | Tải bị giới hạn bởi lượt đến được cấu hình xử lý. |
Batching liên tục
Các mô hình tự hồi quy như mô hình ngôn ngữ tạo ra đầu ra từng token một: mỗi token mới phụ thuộc vào tất cả các token đã được tạo trước đó, nên quá trình tạo vốn dĩ là tuần tự. Batching động đã được xem xét trước đó trong phần này giả định đầu ra có độ dài cố định. Các LLM vi phạm giả định này: nếu một chuỗi trong một batch gồm tám chuỗi kết thúc sau mười token trong khi các chuỗi khác cần 100 token, 90 phần trăm tài nguyên tính toán cho vị trí chuỗi đó sẽ bị lãng phí (Yu et al. 2022).
21 Batching liên tục: Còn được gọi là “batching cấp độ lặp” (Yu et al. 2022) và, trong NVIDIA TensorRT-LLM, “in-flight batching” (NVIDIA 2026f); điểm khác biệt là mức độ chi tiết của lập lịch. Batching truyền thống cố định một batch cho toàn bộ chuỗi tạo (có thể là hàng trăm lần lặp), trong khi batching liên tục lập lịch lại ở mỗi bước tạo token — tương tự như lập lịch tiến trình có ngắt của hệ điều hành so với chạy đến khi hoàn thành. Độ chi tiết cao hơn này giúp giảm lãng phí do các chuỗi có độ dài khác nhau, nơi một vị trí trong batch bị chuỗi đã hoàn tất chiếm giữ sẽ phải nhàn rỗi cho đến khi tất cả các chuỗi khác kết thúc.
Yu, Gyeong-In, Joo Seong Jeong, Geon-Woo Kim, Soojeong Kim, and Byung-Gon Chun. 2022. “Orca: A Distributed Serving System for Transformer-Based Generative Models.” 16th USENIX Symposium on Operating Systems Design and Implementation (OSDI 22), 521–38.
NVIDIA. 2026f. NVIDIA TensorRT-LLM.
Batching liên tục21 (còn gọi là batching cấp độ lặp) giải quyết sự lãng phí này bằng cách cho phép yêu cầu mới tham gia batch giữa các bước tạo, và các chuỗi đã hoàn thành có thể rời khỏi batch (Yu et al. 2022; Kwon et al. 2023). Hệ thống quản lý thành phần batch một cách động ở mỗi lần lặp giải mã, thay vì ghép các batch tĩnh giữ nguyên trong suốt quá trình tạo.
Cơ chế này hoạt động như sau: khi một chuỗi tạo ra token kết thúc chuỗi, vị trí của chuỗi đó lập tức trở nên trống. Yêu cầu đang chờ có thể lấp vào vị trí đó ở lần lặp tiếp theo thay vì phải đợi cả batch hoàn tất. Tương tự, hệ thống có thể thêm yêu cầu mới vào các vị trí trống mà không làm gián đoạn quá trình tạo đang diễn ra. Cách tiếp cận động này giúp giữ mức sử dụng GPU cao ngay cả khi độ dài chuỗi khác nhau đáng kể.
Các hệ thống áp dụng continuous batching, như vLLM22 và TensorRT-LLM, tăng thông lượng bằng cách giữ các slot giải mã luôn bận khi các sequence lần lượt vào và ra (Kwon et al. 2023; NVIDIA 2026f). Sarathi-Serve tinh chỉnh bộ lập lịch này với chunked prefill và batching không tắc nghẽn (stall-free) để giảm nhiễu giữa xử lý prompt và giải mã token (Agrawal et al. 2024). Cải thiện đến từ hai nguồn: giảm lãng phí tính toán cho các sequence đã hoàn tất và giảm thời gian chờ trung bình cho yêu cầu mới. Với phục vụ (serving) mô hình ngôn ngữ trong môi trường sản xuất, nơi độ dài phản hồi có thể từ một token đến hàng nghìn, continuous batching đã trở thành kỹ thuật cốt lõi để triển khai hiệu quả về chi phí.
22 vLLM (virtual LLM): Một hệ thống phục vụ (serving) mã nguồn mở, cho phép continuous batching nhờ thuật toán PagedAttention (Kwon et al. 2023). Lấy cảm hứng từ bộ nhớ ảo của hệ điều hành, kỹ thuật này giúp giảm mạnh phân mảnh KV-cache và lãng phí do đặt chỗ (reservation waste) vốn hạn chế static batching. Nhờ giữ mức lãng phí KV-cache thấp, vLLM có thể phục vụ các batch hiệu dụng lớn hơn trên cùng phần cứng.
Agrawal, Amey, Nitin Kedia, Ashish Panwar, Jayashree Mohan, Nipun Kwatra, Bhargav S. Gulavani, Alexey Tumanov, and Ramachandran Ramjee. 2024. “Taming Throughput-Latency Tradeoff in LLM Inference with Sarathi-Serve.” 18th USENIX Symposium on Operating Systems Design and Implementation (OSDI 24), 117–34.
Quản lý bộ nhớ khiến continuous batching phức tạp hơn. Khi các sequence ra vào batch, KV-cache (bộ nhớ cache khóa-giá trị) lưu ngữ cảnh attention phải được cấp phát và giải phóng động. Hãy hình dung khi các sequence có độ dài khác nhau dùng chung bộ nhớ GPU: một sequence 100 token hoàn tất và trả lại cache, nhưng một sequence mới 150 token không thể dùng chỗ đó vì cần một khối bộ nhớ liền kề lớn hơn. Theo thời gian, các khoảng trống nhỏ khó dùng sẽ tích tụ giữa các vùng đã cấp phát, cuối cùng chặn các sequence mới bắt đầu, dù tổng bộ nhớ trống có vẻ vẫn đủ. Tình trạng phân mảnh bộ nhớ này có thể làm lãng phí 40–50% bộ nhớ khả dụng trong các triển khai đơn giản, nghiêm trọng hạn chế kích thước batch đồng thời – yếu tố quyết định thông lượng.
PagedAttention

PagedAttention khắc phục tình trạng lãng phí KV-cache do cấp phát liền kề.
23 PagedAttention: Tên gọi này trực tiếp tham chiếu cơ chế phân trang bộ nhớ ảo của hệ điều hành, lần đầu triển khai trên máy tính Atlas tại Manchester (1962) để giải quyết cùng một lớp vấn đề cấp phát: chương trình cần nhiều bộ nhớ hơn mức vật lý sẵn có, còn cấp phát liền kề thì lãng phí không gian (Kilburn et al. 1962). Ra mắt tại SOSP 2023, PagedAttention áp dụng mô hình trừu tượng sáu thập kỷ này vào bộ nhớ KV-cache trên GPU: trước đó, các hệ thống phục vụ (serving) LLM lãng phí 60–80% bộ nhớ KV cache do phân mảnh và đặt trước quá mức. PagedAttention giảm lãng phí xuống dưới 4%, cho phép tăng thông lượng 2–4\(\times\) trên cùng phần cứng (Kwon et al. 2023).
Kilburn, Tom, David B. G. Edwards, Michael J. Lanigan, and Frank H. Sumner. 1962. “One-Level Storage System.” IRE Transactions on Electronic Computers EC-11 (2): 223–35. https://doi.org/10.1109/TEC.1962.5219356.
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 2023. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th Symposium on Operating Systems Principles, 611–26. https://doi.org/10.1145/3600006.3613165.
PagedAttention,23 được giới thiệu trong vLLM, giải quyết vấn đề phân mảnh bằng cách áp dụng các khái niệm bộ nhớ ảo của hệ điều hành vào bộ nhớ GPU (Kwon et al. 2023). Với kiểu cấp phát liền kề tĩnh, việc đặt trước bộ nhớ cho độ dài chuỗi tối đa ngay từ đầu gây lãng phí bên trong; còn các vùng đã giải phóng có thể quá nhỏ hoặc nằm không thuận tiện để đáp ứng một yêu cầu cấp phát liền kề mới. Thay vì cấp phát một vùng liền mạch cho mỗi chuỗi, PagedAttention chia KV cache thành các khối kích thước cố định và ánh xạ chúng qua một bảng khối (block table). Nhờ vậy, cache của một chuỗi có thể nằm trên các khối vật lý không liền kề. Khi một chuỗi hoàn tất, các khối của nó được trả về bể khối trống để tái sử dụng. Bài báo vLLM cho biết lãng phí KV-cache giảm xuống dưới 4% và thông lượng cao hơn so với các hệ thống so sánh; mức cải thiện cụ thể phụ thuộc vào khối lượng công việc (workload) và cách triển khai.
Các kỹ thuật batching và bộ nhớ trình bày ở đây đặt nền tảng cho việc phục vụ (serving) LLM, nhưng vẫn còn nhiều chủ đề nâng cao cần nghiên cứu thêm.
Systems Perspective 1.7: Phục vụ (serving) LLM: Vượt ra ngoài những điều cơ bản
Việc phục vụ (serving) các mô hình ngôn ngữ đặt ra những thách thức vượt ra ngoài các nguyên tắc về batching và bộ nhớ đã trình bày ở đây. Bộ nhớ cache key-value lưu trữ ngữ cảnh attention tăng theo độ dài chuỗi và kích thước batch, thường tiêu tốn bộ nhớ nhiều hơn cả trọng số của mô hình. Các kỹ thuật như speculative decoding dùng các mô hình nháp nhỏ để đề xuất nhiều token, còn mô hình mục tiêu sẽ xác minh song song; các khối lượng công việc (workload) T5-XXL được đánh giá đã đạt tăng tốc khoảng 2–3\(\times\) (Leviathan et al. 2023), nhưng mức cải thiện này có thể khác nhau. Lượng tử hoá chỉ trọng số (weight-only quantization) (chẳng hạn như trọng số INT4 với activation FP16) đặc biệt phù hợp cho quá trình suy luận LLM bị giới hạn bởi băng thông bộ nhớ (Lin et al. 2024).
Những tối ưu hoá dành riêng cho LLM này được xây dựng trực tiếp trên các nền tảng mà chương này đã thiết lập: lý thuyết hàng đợi chi phối việc lập lịch yêu cầu, các đánh đổi của batching xác định đường cong thông lượng-độ trễ, và lựa chọn độ chính xác tuân theo cùng các nguyên tắc hiệu quả-độ chính xác. Các nguyên tắc phục vụ (serving) cốt lõi vẫn áp dụng được, còn phục vụ (serving) LLM bổ sung thêm các kỹ thuật đặc thù miền ở trên. Các tài liệu nâng cao trình bày chi tiết việc tối ưu hoá KV cache, bao gồm các kỹ thuật cho multi-tenant serving, nơi một cụm máy (fleet) chia sẻ năng lực cho nhiều người dùng, và distributed inference, nơi một yêu cầu có thể được chia tách trên nhiều máy.
Continuous batching được dùng rộng rãi cho phục vụ (serving) LLM có thông lượng cao, nhưng không phải mọi kịch bản triển khai đều hưởng lợi từ batching. Các kỹ thuật đã xét tới nay, từ dynamic batching windows đến PagedAttention, đều nhắm tới các khối lượng công việc (workload) trên máy chủ dùng chung. Chúng làm tăng độ phức tạp của bộ lập lịch và quản lý bộ nhớ, điều có thể không đáng trong mọi triển khai. Câu hỏi thực tế là khi nào batching gây hại hơn là giúp ích.
Một số tình huống ưu tiên xử lý từng yêu cầu riêng lẻ. Với mục tiêu p99 cực thấp, ngay cả thời gian chờ batching ngắn cũng có thể tiêu tốn quá nhiều ngân sách. Kích thước yêu cầu biến thiên lớn sẽ tạo chi phí đệm (padding overhead) vì các đầu vào ngắn hơn có thể cần được đệm để khớp với đầu vào dài nhất trong một batch. Bộ nhớ cũng có thể trở thành nút thắt khi các trọng số đã chiếm phần lớn bộ nhớ của bộ tăng tốc, vì các activation theo batch và trạng thái cache có thể gây lỗi hết bộ nhớ (out-of-memory).
Các ràng buộc về gắn kết phiên (session affinity)
Khi các yêu cầu từ cùng một người dùng hoặc cùng một phiên cần được chuyển đến cùng một bản sao (replica), batching sẽ bị hạn chế. Session affinity, còn gọi là sticky sessions, quan trọng vì ba lý do chính.
Trường hợp tác động lớn nhất là tái sử dụng KV-cache trong AI đàm thoại, nơi cache khóa-giá trị từ các lượt trước có thể tăng tốc đáng kể các cuộc hội thoại nhiều lượt. Nếu một yêu cầu tiếp theo được chuyển sang bản sao khác, hệ thống sẽ mất ngữ cảnh đã cache này, buộc phải tính lại hoặc tải lại trạng thái tiền tố cho các cuộc hội thoại dài.
Lý do thứ hai là các mô hình dành riêng cho người dùng: một số hệ thống phục vụ các mô hình hoặc adapter được cá nhân hóa cho từng người dùng. Chuyển yêu cầu đến bản sao đã tải sẵn adapter của người dùng đó giúp tránh chi phí tải lặp lại. Tương tự, tiền xử lý có trạng thái (stateful preprocessing) duy trì cache tokenizer hoặc chuẩn hóa theo phiên cũng phải xây lại trạng thái nếu yêu cầu được chuyển đến bản sao khác.
Sự xung đột với batching là rõ ràng vì gắn kết chặt (strict affinity) giới hạn những yêu cầu nào có thể gộp chung, có thể làm giảm kích thước batch và mức sử dụng GPU. Các hệ thống sản xuất thường áp dụng gắn kết mềm (soft affinity)\index{Soft affinity!load balancing) nghĩa là yêu cầu ưu tiên bản sao đã được gán, nhưng có thể chuyển sang bản sao khác khi bản sao đó quá tải. Cách này giữ được hầu hết lợi ích của gắn kết phiên đồng thời duy trì cân bằng tải.
Mẫu lưu lượng và chiến lược batching
Chiến lược batching phụ thuộc rất nhiều vào cách yêu cầu đến. Các ngữ cảnh triển khai khác nhau có các mẫu đến khác nhau. benchmark suy luận MLPerf cung cấp bốn kịch bản tiêu chuẩn hóa mô phỏng một số trường hợp phổ biến, như được giải thích chi tiết tại Các kịch bản thực thi MLPerf.
Lưu lượng máy chủ (Poisson arrivals)
Kịch bản máy chủ MLPerf mô phỏng lưu lượng suy luận kiểu đám mây/API với các yêu cầu đến theo quá trình Poisson (Reddi et al. 2019).24 Theo mô hình này, số yêu cầu trong các khoảng thời gian không giao nhau là độc lập và tốc độ đến trung bình không đổi. Equation 14 cho số lượng kỳ vọng trong một cửa sổ thời gian cố định với tốc độ \(\lambda_{\text{arr}}\) và độ dài \(T_{\text{window}}\): \[E[\text{batch size}] = \lambda_{\text{arr}} \cdot T_{\text{window}} \tag{14}\]
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
24 Quá trình Poisson: Được đặt theo tên nhà toán học người Pháp Simeon Denis Poisson (1781–1840), mô hình ngẫu nhiên này mô tả các sự kiện xảy ra liên tục và độc lập với tốc độ trung bình không đổi. Trong các cửa sổ thời gian cố định, phương sai bằng giá trị trung bình, nên với \(\lambda_{\text{arr}}=200\) req/s và cửa sổ 10 ms, số lượng kỳ vọng là hai và khoảng 14% cửa sổ sẽ trống, dù một trình lập lịch hiệu quả sẽ không khởi chạy tác vụ GPU nào cho các cửa sổ đó. Thay vào đó, một bộ hẹn giờ kích hoạt theo yêu cầu sẽ bắt đầu với một yêu cầu và chỉ đếm các yêu cầu đến bổ sung trong cửa sổ.
Với các cửa sổ thời gian cố định, phương sai bằng giá trị trung bình, nên kích thước batch dao động đáng kể ở mức lưu lượng vừa phải. Với \(\lambda_{\text{arr}} = 200\) yêu cầu mỗi giây và \(T_{\text{window}} = 10\) ms, số lượng kỳ vọng là hai, nhưng khoảng 14% cửa sổ không có yêu cầu nào (và không khởi chạy tác vụ GPU nào) trong khi những cửa sổ khác có thể có bốn hoặc nhiều hơn.
Một heuristic hữu ích cho cửa sổ tạo batch là cân bằng chi phí chờ đợi với lợi ích thông lượng. Equation 15 nêu một quy tắc như vậy: \[T_{\text{window}} \approx \min\left(L_{\text{lat,SLO}} - T_{\text{svc}}, \sqrt{\frac{T_{\text{svc}}}{\lambda_{\text{arr}}}}\right) \tag{15}\] trong đó \(L_{\text{lat,SLO}}\) là SLO độ trễ, \(T_{\text{svc}}\) là thời gian phục vụ (tính bằng giây), và \(\lambda_{\text{arr}}\) là tốc độ đến (tính bằng yêu cầu mỗi giây), để số hạng thứ hai có cùng đơn vị là giây. Dạng căn bậc hai là một heuristic dựa trên mô hình chi phí cục bộ: nó cân bằng lợi ích cố định trên mỗi batch với chi phí chờ đợi tăng theo khoảng thời gian đến. Đây không phải là một tối ưu dạng đóng (closed-form optimum) dành riêng cho phục vụ (serving) ML; các hệ thống sản xuất sẽ hiệu chỉnh cửa sổ một cách thực nghiệm dựa trên lưu lượng quan sát được. Một kết quả phản trực giác từ equation 15: khi lưu lượng tăng, cửa sổ tối ưu giảm trong khi kích thước batch đạt được vẫn tăng. Table 15 minh họa hiện tượng này ở bốn mức lưu lượng.

Khi QPS tăng, cửa sổ batching thu hẹp lại trong khi kích thước batch lại tăng lên.
| Tốc độ đến | Cửa sổ tối ưu | Kích thước Batch trung bình | Độ trễ xấp xỉ |
|---|---|---|---|
| 100 QPS | 15.8 ms | 1.6 | 40.8 ms |
| 500 QPS | 7.1 ms | 3.5 | 32.1 ms |
| 1,000 QPS | 5 ms | 5 | 30 ms |
| 5,000 QPS | 2.24 ms | 11.2 | 27.2 ms |
Lưu lượng truy cập của một người dùng (lượt đến tuần tự)
Lưu lượng streaming gắn kết thời điểm các yêu cầu đến thông qua đồng bộ cảm biến, khiến kích thước batch và hạn chót được ấn định từ bên ngoài. Ở thái cực kia, một số ứng dụng di động và nhúng mang tính tương tác hầu như không có cơ hội gom các yêu cầu độc lập thành batch. Khi đó, mục tiêu tối ưu hoá chuyển từ đáp ứng ngân sách đồng bộ dưới một hạn chót khung hình cứng sang tối ưu độ trễ và mức tiêu thụ năng lượng cho từng yêu cầu trong giới hạn công suất nhiệt.
Nhiều ứng dụng di động và nhúng tương tác thường xử lý từng luồng yêu cầu một. Kịch bản MLPerf SingleStream phản ánh đúng kiểu phục vụ tuần tự này. Với kịch bản ResNet-50 trên điện thoại ở đây, các chi phí chính không còn tập trung vào việc tạo batch mà chuyển sang độ trễ và năng lượng cho từng yêu cầu.
Các ràng buộc phục vụ (serving) di động
Các dịch vụ đám mây thường ưu tiên chi phí hạ tầng và độ trễ; phục vụ (serving) di động bổ sung ba ràng buộc gắn chặt với nhau. Đầu tiên là ngân sách năng lượng mà chỉ thông lượng thôi thì không thể hiện hết, vì mỗi lần suy luận đều tiêu tốn pin. Trong pipeline được mô hình hoá, 2.98 mJ ở tốc độ 22 FPS tiêu tốn khoảng 66 mW chỉ riêng cho đường suy luận, trước khi cộng thêm camera, màn hình, ISP và chi phí hệ điều hành trong một ứng dụng ảnh đầy đủ. Giảm hiệu năng do nhiệt có thể làm giới hạn này trầm trọng hơn khi công suất hệ thống duy trì chạm ngưỡng nhiệt đặc thù của thiết bị. Các ràng buộc về bộ nhớ khép lại tập ràng buộc vì mô hình phải chia sẻ RAM với ứng dụng và hệ điều hành. Thời gian tải lại phụ thuộc vào lưu trữ của thiết bị, runtime và trạng thái mô hình; lượng tử hoá và tải bằng cách ánh xạ bộ nhớ (section 1.6.3) có thể giảm footprint và công việc khởi động nhưng không loại bỏ được các phụ thuộc này.
Example 1.9: ResNet-50: Phục vụ (serving) di động
Table 17 phân tích độ trễ và năng lượng theo từng giai đoạn cho một suy luận thị giác di động của một người dùng:
| Giai đoạn | Thời lượng | Năng lượng | Ghi chú |
|---|---|---|---|
| Đọc bộ đệm camera | 8 ms | 0.08 mJ | API hệ thống |
| Giải mã JPEG (CPU) | 15 ms | 1.5 mJ | Đơn luồng |
| Thay đổi kích thước + Chuẩn hóa | 5 ms | 0.4 mJ | Tiền xử lý trên CPU |
| Suy luận trên NPU | 12 ms | 0.8 mJ | Mức sử dụng 82% |
| Hậu xử lý + Giao diện người dùng | 5 ms | 0.2 mJ | Kết xuất kết quả |
| Tổng cộng | 45 ms | 2.98 mJ | 22 FPS duy trì |
Nút phục vụ (serving) di động được đánh giá dựa trên bốn chỉ số:
- Năng lượng cho mỗi lần suy luận: Với 2.98 mJ, một viên pin 10 Wh (điện thoại thông minh điển hình) có thể thực hiện khoảng ~12.1M lần suy luận.
- Công suất suy luận được mô hình hóa: 2.98 mJ / 45 ms = 66 mW, số liệu này không bao gồm các phần còn lại của thiết bị, nên không đảm bảo có thể vận hành liên tục vô thời hạn.
- Đánh đổi giữa NPU và CPU: Chế độ dự phòng CPU thay thế giai đoạn suy luận NPU 12 ms, 0.8 mJ bằng giai đoạn CPU 45 ms, 4.2 mJ; toàn bộ pipeline sẽ tăng từ 45 ms và 2.98 mJ lên khoảng 78 ms và 6.4 mJ trước khi tính thêm chi phí hệ thống.
- Dung lượng bộ nhớ: 150 MB ở mức đỉnh (gồm mô hình + activations), cạnh tranh với bộ nhớ của ứng dụng.
Hiểu biết về hệ thống: Trong pipeline minh họa này, NPU di động đạt 82% mức sử dụng với kích thước batch là một, trong khi ví dụ ở trung tâm dữ liệu chỉ đạt 15%. Sự khác biệt này phụ thuộc vào khối lượng công việc (workload) và phần cứng cụ thể, nhưng nó cho thấy vì sao một bộ tăng tốc di động được thiết kế cho thực thi luồng đơn có thể hoạt động hiệu quả mà không cần các batch (thường dùng để tận dụng hiệu quả một GPU máy chủ lớn).
Những ràng buộc này khiến việc tối ưu hóa phục vụ (serving) trên thiết bị di động khác biệt căn bản so với tối ưu hóa trên đám mây. Mục tiêu không phải tối đa hóa thông lượng, mà là hiệu suất duy trì ổn định, giữ độ trễ ở mức chấp nhận được mà không bị giảm xung do quá nhiệt hay hao pin quá mức. Ngân sách độ trễ nghiêm ngặt khiến việc xử lý đồng bộ khung hình từ nhiều camera trở nên khó khăn (table 16). Trong một pipeline lái xe tự hành 30 FPS (tổng ngân sách 33 ms), việc thu nhận khung hình và dao động thời điểm đến (arrival jitter) đã chiếm 15 ms trước khi suy luận có thể bắt đầu. Gộp 6 luồng camera vào một lần gọi GPU hoàn tất trong 10 ms (tại \(T=25\) ms), còn lại 7 ms cho hậu xử lý, lập kế hoạch và kiểm tra an toàn. Nếu jitter làm thời điểm bắt đầu bị đẩy muộn hơn 15 ms, pipeline sẽ trễ hạn.
Tóm tắt kiểu lưu lượng
Batching thích ứng với lưu lượng truy cập điều chỉnh cửa sổ batching theo độ sâu hàng đợi và tốc độ yêu cầu. Table 18 liên hệ bốn kịch bản MLPerf với các ngữ cảnh triển khai đại diện và các chiến lược batching phổ biến.
Các kịch bản này là trừu tượng cho benchmark, không phải hướng dẫn triển khai. Chính sách batching thực tế vẫn phải tuân theo các ràng buộc hiện tại của dịch vụ về mức độ đồng thời, hạn chót và công suất.
| Kịch bản | Ngữ cảnh | Chiến lược | Trọng tâm |
|---|---|---|---|
| Máy chủ | API đám mây, dịch vụ web | Tạo batch động với thời gian chờ | Điều chỉnh cửa sổ, đường cong sử dụng-độ trễ |
| MultiStream | Lái xe tự hành, phân tích video | Hợp nhất cảm biến đồng bộ hóa | Xử lý jitter, đảm bảo thời hạn |
| SingleStream | Ứng dụng di động, thiết bị nhúng | Không tạo batch (\(B = 1\)) | Tiền xử lý, hiệu quả công suất |
| Ngoại tuyến | Xử lý theo batch, pipeline dữ liệu | Kích thước batch tối đa | Thông lượng, sử dụng phần cứng |
Kịch bản MLPerf Server mô tả lưu lượng API đám mây, MultiStream mô tả các khối lượng công việc (workload) cảm biến đồng bộ, còn suy luận Offline mô tả xử lý batch, nơi thông lượng được ưu tiên hơn độ trễ.
Các chiến lược batching đã xem xét đến nay dựa trên một giả định quan trọng: mỗi yêu cầu tạo ra một đầu ra duy nhất, kích thước cố định — ví dụ một nhãn phân loại, một hộp giới hạn, hoặc một vector embedding. Giả định này chi phối toán hàng đợi, phân tích đường biên Pareto và cách điều chỉnh cửa sổ thích ứng theo lưu lượng. Tuy nhiên, nhóm khối lượng công việc (workload) phục vụ (serving) đang tăng nhanh nhất lại hoàn toàn phá vỡ giả định đó. Các mô hình ngôn ngữ lớn tạo đầu ra theo từng token, và mỗi token phụ thuộc vào tất cả token trước đó. Một yêu cầu có thể tạo ra hàng trăm hoặc hàng nghìn token trong vài giây, nhưng người dùng vẫn phải có cảm giác phản hồi nhanh ngay từ token đầu tiên. Sự chuyển dịch cơ bản này — từ phục vụ (serving) đầu ra cố định sang đầu ra dài ngắn khác nhau, dạng luồng — kế thừa trực tiếp batching liên tục và phân trang KV-cache dùng cho sinh văn bản tự hồi quy. Phần bổ sung gồm các số liệu tách pha cho prefill và decode, các chiến lược giải mã cân bằng giữa chất lượng đầu ra và chi phí trên mỗi token, cùng các chiến thuật bộ nhớ như tái sử dụng tiền tố (prefix reuse) và offloading để tận dụng ngữ cảnh dùng chung.
Checkpoint 1.3: Batching và các mẫu lưu lượng
Batching là đòn bẩy chính cho bài toán kinh tế khi phục vụ (serving), nhưng chiến lược tối ưu còn tùy bối cảnh.
Self-Check: Question
Why does increasing the batch size during deep learning inference dramatically improve hardware throughput on modern GPUs, and at what point does throughput plateau on the Roofline model?
- Batching converts all floating-point operations into integer bitshifts, bypassing GPU ALUs entirely.
- Batching reduces the total parameter count of the neural network by sharing weights across batch samples.
- Batching eliminates PCIe bus data transfer overhead by generating synthetic input tensors on the device.
- Batching increases arithmetic intensity (FLOPs per byte of memory accessed) by reusing loaded weight matrices across multiple input samples, shifting the workload from memory-bandwidth-bound to compute-bound until compute saturates.
Contrast traditional request-level dynamic batching with iteration-level continuous batching (as introduced in Orca and vLLM) for Large Language Model (LLM) serving. Why is request-level batching severely inefficient for autoregressive generation?
True or False: PagedAttention resolves the primary memory waste in LLM KV-caching by allocating key and value states in non-contiguous, fixed-size physical memory blocks managed via a virtual page table, eliminating both internal fragmentation from over-allocation and external memory fragmentation.
An autonomous vehicle perceives its environment using 6 surround cameras that capture frames simultaneously at 30 Hz. Because all camera frames arrive at the perception server simultaneously in synchronized bursts, this represents a ____ arrival process that enables zero-wait co-batching across camera streams.
A cloud serving system with an end-to-end latency budget of 50 ms configures a dynamic batcher with
max_batch_size = 32andmax_batch_delay_ms = 20. Under low traffic (10 QPS), individual requests arrive 100 ms apart. What is the operational impact on latency and batch efficiency?- Every request waits the full 20 ms timeout in the queue and executes as a batch of size 1, incurring the maximum queueing delay penalty with zero throughput amortization gain.
- Requests are automatically dropped because the queue fails to reach the maximum batch size of 32 within 50 ms.
- The server achieves peak GPU utilization because small batches execute with sub-microsecond latency.
- The dynamic batcher disables timeouts and waits indefinitely until 32 requests accumulate, preserving throughput at the cost of infinite latency.
Phục vụ (serving) LLM
Các mô hình ngôn ngữ lớn làm nổi bật ba đặc tính rõ rệt hơn so với khi phục vụ (serving) các mô hình có đầu ra cố định: tự hồi quy khi sinh25 (mỗi token phụ thuộc vào tất cả token trước đó, nên đầu ra mang tính tuần tự), đầu ra có độ dài thay đổi (độ dài phản hồi không biết trước tại thời điểm yêu cầu, làm phức tạp giả định về batch cố định), và bộ nhớ có trạng thái (KV-cache tăng theo từng token sinh ra, tạo áp lực bộ nhớ động). Kết hợp lại, những đặc tính này tạo ra một bài toán phục vụ (serving) khác biệt về bản chất. Các số liệu p50, p95 và p99 vốn dùng cho phục vụ (serving) phân loại vẫn quan trọng, nhưng chúng áp dụng cho các pha khác nhau của một yêu cầu — xử lý lời nhắc ban đầu và giai đoạn sinh token tiếp theo. Những nguyên tắc quen thuộc như lý thuyết hàng đợi, đánh đổi khi dùng batch và ngân sách độ trễ vẫn áp dụng; phục vụ (serving) LLM bổ sung thêm các kỹ thuật chuyên biệt dựa trên các nguyên tắc đó.
25 Tự hồi quy: Từ tiếng Hy Lạp auto- (tự) và tiếng Latin regressus (quay lại) — đầu ra “hồi quy” trên chính nó. George Udny Yule đã giới thiệu các mô hình tự hồi quy vào năm 1927 để phân tích chu kỳ vết đen mặt trời. Trong mô hình ngôn ngữ, mỗi token đầu ra phụ thuộc vào tất cả token đã sinh trước đó, tạo ra một phụ thuộc tuần tự, khiến không thể tận dụng mức song song như khi huấn luyện. Quá trình giải mã thường bị giới hạn bởi băng thông trọng số khi batch nhỏ; batch lớn hơn giúp dàn trải chi phí truyền trọng số và có thể chuyển nút thắt cổ chai sang phía tính toán hoặc lưu lượng KV-cache (Pope et al. 2023).
Pope, Reiner, Sholto Douglas, Aakanksha Chowdhery, Jacob Devlin, James Bradbury, Jonathan Heek, Kefan Xiao, Shivani Agrawal, and Jeff Dean. 2023. “Efficiently Scaling Transformer Inference.” Proceedings of Machine Learning and Systems (MLSys) 5: 606–24.
Các số liệu hiệu suất: TTFT và TPOT
TTFT và TPOT chịu ảnh hưởng bởi các loại nút thắt cổ chai khác nhau.
Các mô hình tạo sinh tạo ra một luồng token liên tục, thay vì một tensor đầu ra duy nhất. Tính chất phát luồng này đòi hỏi các chỉ số hiệu suất LLM chuyên biệt để phản ánh việc chuyển từ prefill (xử lý prompt và điền KV cache) sang decode (tạo đầu ra). Hai thước đo chính là time to first token (TTFT) và time per output token (TPOT), dùng để đánh giá độ phản hồi và tốc độ sinh trung bình. Inter-Token Latency (ITL) theo từng khoảng (per-gap) đo phân bố các khoảng dừng giữa từng token được phát luồng; còn TPOT thì lấy trung bình khoảng thời gian sau token đầu tiên trên toàn bộ đầu ra.
Definition 1.6: Các chỉ số hiệu suất LLM
Các chỉ số hiệu suất LLM tách riêng độ phản hồi ban đầu khỏi nhịp độ của quá trình tạo tự hồi quy dạng luồng.
- Ý nghĩa: Các chỉ số này phân rã độ trễ người dùng cảm nhận thành thời gian đến token đầu tiên (TTFT) (giai đoạn prefill thường bị giới hạn bởi tính toán) và thời gian trên mỗi token đầu ra (TPOT) (giai đoạn decode thường bị giới hạn bởi băng thông khi batch nhỏ).
- Điểm khác biệt: Khác với các chỉ số đầu ra cố định (ví dụ: độ trễ đầu cuối), các chỉ số LLM đo mức độ trôi chảy của quá trình tạo, vì trải nghiệm người dùng phụ thuộc vào nhịp điệu token đến.
- Lỗi thường gặp: Nhiều người nghĩ rằng một “mô hình nhanh” sẽ có TTFT thấp. Thực tế, một mô hình có thể cho TTFT nhanh nhưng TPOT lại chậm (nếu “memory wall” \((\text{BW})\) là nút thắt), dẫn đến trải nghiệm khó chịu: câu trả lời bắt đầu nhanh nhưng sau đó lại “ngập ngừng”.
Mỗi chỉ số phản ánh một khía cạnh khác nhau của trải nghiệm người dùng, nên các dịch vụ tương tác thường đặt mục tiêu riêng cho TTFT, TPOT hoặc ITL, cùng với thông lượng tổng hợp.
Systems Perspective 1.8: Các mục tiêu độ trễ khi phục vụ (serving) LLM
Các dịch vụ LLM tương tác thường cần các SLO (Mục tiêu Mức độ Dịch vụ) riêng cho độ phản hồi, độ trôi chảy khi tạo và thông lượng của cả cụm. Các giá trị sau đây chỉ là mục tiêu minh họa, không phải yêu cầu chung:
- TTFT: < 500 ms (đối với prompt 1000 token)
- TPOT: < 50 ms (tương đương ~20 token/giây, nhanh hơn tốc độ đọc của con người)
- Thông lượng: > 1000 token/giây tổng hợp trên các bản sao phục vụ (serving) đang hoạt động
Vì vậy, một con số “độ trễ” duy nhất sẽ che khuất sự tách biệt giữa giai đoạn prefill và decode. TTFT là ngân sách cho thời gian màn hình trống (blank-screen budget), TPOT là ngân sách cho dòng đọc trôi chảy (reading-flow budget). Còn thông lượng phục vụ tổng hợp, được đo bằng số token/giây cộng gộp trên tất cả các bản sao phục vụ (serving) đang hoạt động, sẽ quyết định liệu các mục tiêu đó có được giữ vững dưới tải dùng chung hay không.
Các chiến lược giải mã
Để đạt các mục tiêu TPOT này, không chỉ phụ thuộc vào băng thông bộ nhớ: thuật toán dùng để chọn từng token cũng ảnh hưởng đến độ trễ mỗi token và chất lượng đầu ra. Các mô hình sinh cần các chiến lược giải mã cân bằng giữa chất lượng, đa dạng và độ trễ. Lựa chọn chiến lược giải mã ảnh hưởng mạnh đến cả chất lượng đầu ra lẫn chi phí tính toán.
Cách đơn giản nhất, giải mã tham lam, chọn token có xác suất cao nhất ở mỗi bước, với chi phí là một lượt chạy mô hình cho mỗi token. Nó nhanh nhưng có thể tạo đầu ra lặp lại vì không thể sửa các lựa chọn sớm. Tìm kiếm chùm duy trì nhiều chuỗi ứng viên và chọn một chuỗi hoàn chỉnh có điểm số cao, làm tăng khối lượng công việc và trạng thái cần giữ của bộ giải mã so với giải mã tham lam. Lấy mẫu với nhiệt độ, top-\(k\) và top-\(p\) (còn gọi là nucleus sampling) đưa vào ngẫu nhiên có kiểm soát để tăng đa dạng (Holtzman et al. 2020). Chi phí phục vụ của bất kỳ chiến lược nào phụ thuộc vào cách triển khai và phân phối độ dài đầu ra mà cơ chế batching liên tục phải hấp thụ.
Holtzman, Ari, Jan Buys, Li Du, Maxwell Forbes, and Yejin Choi. 2020. “The Curious Case of Neural Text Degeneration.” Proceedings of the 8th International Conference on Learning Representations (ICLR 2020).
Các dịch vụ LLM tương tác thường trả về token ngay khi được tạo ra, thay vì chờ xong toàn bộ. Kiểu phản hồi dạng luồng này thay đổi trải nghiệm người dùng: tổng thời gian tạo là hai giây vẫn thấy phản hồi nhanh nếu token được truyền liên tục, nhưng sẽ có cảm giác trục trặc nếu phải nhìn màn hình trống trong hai giây. Streaming đòi hỏi hạ tầng hỗ trợ phản hồi tăng dần và hiển thị phía máy khách. Hồ sơ độ trễ cũng thay đổi theo: TTFT quyết định khi nào đầu ra bắt đầu xuất hiện (tính phản hồi), còn TPOT quyết định tốc độ sinh mà người dùng cảm nhận (độ mượt). Khi quá trình tạo được truyền từng token một, đơn vị phục vụ không còn là một dự đoán đầu ra cố định nữa, mà trở thành một chuỗi có trạng thái với dung lượng bộ nhớ tăng lên ở mỗi bước.
Bộ nhớ và KV cache
Suy luận sinh đòi hỏi phải quản lý KV Cache26 – một cấu trúc bộ nhớ có trạng thái, dung lượng tăng theo độ dài chuỗi. Prefill tạo mục cache cho các token của prompt, và mỗi token được giải mã sẽ thêm một mục mới. Khi xử lý đồng thời nhiều chuỗi có độ dài khác nhau, trạng thái động này có thể chiếm phần lớn bộ nhớ bộ tăng tốc khả dụng và gây lãng phí cấp phát nếu không được quản lý chủ động.
26 KV cache (cache khóa-giá trị): Để tránh các tính toán lặp lại, hệ thống lưu vào cache các vector Khóa (Key) và Giá trị (Value) từ các token trước đó, và chúng vẫn còn hiệu lực trong suốt quá trình sinh token; chính lựa chọn thiết kế này trực tiếp dẫn tới hiện tượng bộ nhớ tăng động như đã mô tả: kích thước cache tăng tuyến tính theo mỗi token được sinh ra, biến quản lý bộ nhớ thành một ràng buộc chính. Trong ví dụ tính toán với mô hình thuộc lớp 70 tỷ tham số sử dụng grouped-query attention, KV cache FP16 khoảng 0.33 MB cho mỗi token trên mỗi chuỗi. Grouped-query attention (GQA), được dùng trong các mô hình họ Llama như Llama 3, chia sẻ các head khóa/giá trị giữa nhiều head truy vấn, giúp giảm kích thước cache so với multi-head attention đầy đủ (Dubey et al. 2024). Do đó, một batch gồm 32 yêu cầu với ngữ cảnh 8.000 token sẽ cần khoảng 80 GB chỉ riêng cho KV cache; con số này còn lớn hơn nhiều nếu không dùng grouped-query hoặc multi-query attention.
Dubey, Abhimanyu, Abhinav Jauhri, Abhinav Pandey, Abhishek Kadian, et al. 2024. The Llama 3 Herd of Models. arXiv preprint arXiv:2407.21783.
Cache tiền tố và giảm tải bộ nhớ
Các kỹ thuật continuous batching và PagedAttention được trình bày trong section 1.7.4 giúp giải quyết vấn đề lập lịch yêu cầu và phân trang cache; phần áp lực bộ nhớ còn lại có thể giảm thêm bằng các chiến lược kiến trúc tận dụng mẫu yêu cầu. Cache tiền tố lưu trữ các trạng thái KV của những tiền tố hướng dẫn thường gặp (ví dụ một system prompt dài 2.000 token hoặc ngữ cảnh RAG dùng chung), cho phép các yêu cầu độc lập tái sử dụng kết quả prefill cho cùng một tiền tố. Với \(N\) yêu cầu cùng chia sẻ một tiền tố dài \(S_{\text{prefix}}\) token, lượng công việc prefill tránh được xấp xỉ \((N-1)S_{\text{prefix}}\) bước token, tùy thuộc vào cache hit, cơ chế eviction và chi phí triển khai. Với các hội thoại nhiều lượt, nguyên tắc tương tự cho phép lượt kế tiếp chỉ xử lý phần hậu tố mới sau khi tái sử dụng trạng thái trước đó tương thích.
Napkin Math 1.5: Chi phí năng lượng của một cuộc trò chuyện
Vấn đề: Một dịch vụ trò chuyện sử dụng H100 tiêu thụ bao nhiêu năng lượng cho mỗi token được tạo ra và cho một phản hồi có 500 tokens?
Khi các LLM mở rộng, số joule trên mỗi token trở thành một chỉ số vận hành quan trọng hàng đầu, bên cạnh độ trễ. Giả sử H100 tiêu thụ công suất thiết kế nhiệt (TDP) là 700 W, ước tính cho kịch bản này dựa trên thông lượng và công suất (Choquette 2023):
- Thông lượng: 114 yêu cầu đồng thời \(\times\) 8 tokens/s mỗi yêu cầu ≈ 912 tokens/s.
- Công suất: 700 W (GPU) + 300 W (Máy chủ/Chi phí chung) = 1000 W.
- Năng lượng trên mỗi token: 1000 W / 912 tokens/s ≈ 1.0965 J/token
Góc nhìn hệ thống: Với các giả định này, một phản hồi gồm 500 tokens token tiêu thụ ≈ 548.2 J.
- Để so sánh, sạc một chiếc điện thoại thông minh tiêu thụ ≈ 40000 J.
- Đun sôi một cốc nước tiêu thụ ≈ 100000 J.
Cách chủ yếu để giảm J/token là tăng mức sử dụng phần cứng và loại bỏ tính toán dư thừa. Nếu GPU chỉ đạt 10 percent do batching kém, nó vẫn tiêu thụ ~300 W và máy chủ còn cộng thêm 300 W, khiến năng lượng trên mỗi token tăng lên 6.6 J/token (xấp xỉ 6× so với mức cơ bản). Các tối ưu hóa kiến trúc như prefix caching cũng bỏ qua giai đoạn prefill tốn năng lượng cho ngữ cảnh dùng chung, trực tiếp giảm dấu chân năng lượng của các ứng dụng tạo sinh tăng cường truy xuất (RAG) và ứng dụng trò chuyện. Bài học về phục vụ (serving) là hiệu quả không chỉ là một chỉ số về độ trễ hay chi phí; nó còn quyết định mỗi token hữu ích tiêu thụ bao nhiêu năng lượng.
27 Speculative decoding: Một mô hình “nháp” nhỏ tạo ra \(k\) token ứng cử viên theo cơ chế tự hồi quy; sau đó, mô hình đích lớn hơn sẽ xác minh khối token được đề xuất này một cách song song (Leviathan et al. 2023). Khi các đề xuất của mô hình nháp được chấp nhận với tỷ lệ \(\alpha\), thông lượng thực tế có thể tăng theo số lượng token được chấp nhận trên mỗi bước xác minh. Cách này phá vỡ nút thắt cổ chai do quá trình tự hồi quy tuần tự ở lớp runtime, chứ không phải ở lớp kiến trúc.
Leviathan, Yaniv, Matan Kalman, and Yossi Matias. 2023. “Fast Inference from Transformers via Speculative Decoding.” International Conference on Machine Learning (ICML), 19274–86.
Khi tổng dung lượng KV cache vượt quá VRAM trên GPU, các hệ thống có thể áp dụng KV cache offloading. Cách này sẽ đẩy các cửa sổ ngữ cảnh không hoạt động hoặc ưu tiên thấp sang RAM của CPU máy chủ hoặc ổ SSD NVMe, để giải phóng VRAM cho phần tạo sinh đang hoạt động. Chi phí tải lại tối thiểu bằng số byte cần di chuyển chia cho băng thông của PCIe hoặc NVMe, trước khi cộng thêm chi phí phần mềm và thời gian chờ. Nhờ vậy, offloading giúp tránh lỗi hết bộ nhớ (OOM) và cho phép dùng các cửa sổ ngữ cảnh lớn hơn; tuy nhiên, nó cũng tạo ra các rủi ro về affinity, invalidation và độ trễ hot-decode mà cần dự trù rõ ràng. Các kỹ thuật nâng cao như speculative decoding27 và song song hóa phân tán (khi một yêu cầu được chia trên nhiều thiết bị hoặc máy) sẽ được trình bày trong các phần chuyên sâu về hệ thống quy mô lớn.
Checkpoint 1.4: Kiến thức nền tảng về phục vụ (serving) LLM
Việc phục vụ (serving) LLM đặt ra những ràng buộc không có trong phục vụ các mô hình truyền thống.
Việc tính toán năng lượng cho trò chuyện đưa mức sử dụng tài nguyên thành một phần của ngân sách phục vụ (serving) LLM: chi phí cho mỗi token được tạo phụ thuộc vào cách các yêu cầu chia sẻ cùng một máy. Khác với suy luận có đầu ra cố định, năng lượng tiêu thụ của LLM tăng theo độ dài phản hồi. Mỗi bước giải mã truyền các trọng số một lần cho batch đang hoạt động, vì vậy batching giúp phân bổ lưu lượng truyền đó trên các chuỗi. Ngoài ra, việc hạch toán khí thải carbon còn cần một hệ số phát thải và một ranh giới xác định.
Hiệu quả năng lượng phụ thuộc vào các cơ chế batching, bộ nhớ và prefix-cache tương tự như những cơ chế chi phối độ trễ của LLM, nên bản tóm tắt hữu ích là một danh sách kiểm tra các ràng buộc thay vì một chỉ số đơn lẻ.
Self-Check: Question
In Large Language Model (LLM) serving, how do the computational and hardware characteristics of the Prefill phase (Time to First Token, TTFT) fundamentally differ from the Decode phase (Time Per Output Token, TPOT)?
- Prefill processes tokens autoregressively one by one and is memory-bandwidth bound, whereas Decode processes all output tokens simultaneously and is compute-bound.
- Prefill processes all prompt tokens concurrently in parallel matrix multiplications and is compute-bound, whereas Decode generates one token per step autoregressively and is memory-bandwidth bound due to repeated weight fetching.
- Prefill operates exclusively on host CPU DRAM, whereas Decode runs on GPU Tensor Cores.
- Prefill latency scales quadratically with batch size, whereas Decode latency is strictly independent of sequence length and KV-cache size.
Calculate the total memory footprint (in bytes) required to store the KV cache for a batch of \(B = 16\) requests, each with an active context length of \(S = 2\text{,}048\) tokens, for a model with \(L = 32\) transformer layers, \(H_{\text{kv}} = 8\) key-value attention heads (Grouped-Query Attention), head dimension \(D_{\text{head}} = 128\), stored in FP16 precision (\(P = 2\text{ bytes}\)).
Order the step-by-step execution cycle of Speculative Decoding for accelerating LLM inference:
- Target model runs a single parallel forward pass over the prompt plus all \(K\) draft candidate tokens to compute ground-truth verification logits
- Draft model (a lightweight autoregressive model) generates \(K\) candidate tokens sequentially in fast memory-bandwidth-efficient steps
- Engine appends the accepted tokens (plus one newly corrected token) to the KV cache and advances the generation context
- Verification logic evaluates draft tokens against target logits (using greedy matching or modified rejection sampling) to accept the first \(M\) matching tokens (\(M \le K\))
True or False: Speculative decoding alters the output token probability distribution of the target LLM, trading mathematical output fidelity and generation accuracy for higher decoding speed.
In a multi-turn conversational AI system with extensive system prompts (e.g., 2,000 tokens of instructions and few-shot examples shared across thousands of user sessions), what serving optimization eliminates redundant prefill compute across requests?
- Linear Attention Approximation, which drops system prompt tokens entirely from the attention window.
- Static Graph Compilation, which hardcodes user inputs directly into the weight tensors.
- Prefix Caching (e.g., RadixAttention), which stores the KV-cache states of common prompt prefixes in memory and reuses them across queries matching the prefix.
- Speculative Quantization, which quantizes prompt tokens into 1-bit binary representations during the decode phase.
Lựa chọn inference runtime
Các chiến lược batching và các kỹ thuật dành riêng cho LLM quyết định cách nhóm và xử lý yêu cầu. Các chiến lược này giả định có một công cụ thực thi nền tảng thật sự chạy các phép tính của mô hình. Động học tạo token được giới thiệu trong section 1.8 và các ngân sách độ trễ ở section 1.4.1 chỉ đạt được khi runtime ánh xạ các phép toán hiệu quả lên phần cứng. inference runtime, lớp phần mềm điều phối các hoạt động tensor và quản lý tài nguyên phần cứng, có thể thay đổi đáng kể hiệu suất cho cùng một mô hình. Vì vậy, công việc với runtime có hai giai đoạn: lựa chọn công cụ thực thi, và cấu hình để tinh chỉnh công cụ đó cho mô hình mục tiêu, phần cứng, hình dạng đầu vào và phân phối độ trễ.
Hệ sinh thái và cấu hình runtime
Việc lựa chọn nên bắt đầu từ ràng buộc then chốt, không phải từ framework đã dùng khi huấn luyện. Khi tốc độ triển khai và khả năng tương thích với framework là ưu tiên, các mô hình PyTorch và TensorFlow thường có thể được phục vụ (serving) trực tiếp bằng các runtime gốc mà không cần xuất sang một định dạng trao đổi khác. Cách này giữ lại được nhiều toán tử và luồng điều khiển của framework huấn luyện, dù các phép toán tùy chỉnh, hỗ trợ thiết bị và đóng gói cho sản xuất vẫn có thể hạn chế khả năng triển khai. Các runtime của framework cũng mang tính tổng quát, trong khi một công cụ suy luận nhắm mục tiêu cụ thể có thể đánh đổi tính tổng quát để tối ưu chặt hơn.
torch.export và TensorFlow SavedModel cung cấp các đồ thị đã tuần tự hóa để biến đổi và tối ưu hóa trước khi chạy (ahead-of-time), đồng thời vẫn duy trì tính tương thích với framework. TorchScript hiện là một định dạng cũ (legacy format) cho các triển khai đã có.
Tối ưu hóa mục đích chung
Khi tính di động giữa các loại phần cứng là ràng buộc then chốt, ONNX Runtime28 cung cấp một lớp tối ưu hóa không phụ thuộc phần cứng (Microsoft 2024). Mô hình được xuất sang định dạng ONNX, rồi ONNX Runtime áp dụng tối ưu hóa đồ thị và chọn nhà cung cấp thực thi (execution provider) cho phần cứng mục tiêu. Cách này cho phép triển khai một định dạng duy nhất trên CPU, GPU và các bộ tăng tốc chuyên biệt.
28 ONNX Runtime: Công cụ suy luận của Microsoft đóng vai trò như một lớp trừu tượng hóa phần cứng: cùng một mô hình ONNX có thể chạy trên CPU, NVIDIA GPU, AMD GPU hoặc các bộ tăng tốc tùy chỉnh thông qua các nhà cung cấp thực thi cắm thêm (pluggable execution providers). ONNX Runtime áp dụng các tối ưu hóa đồ thị như gập hằng số (constant folding), loại bỏ nút dư thừa (redundant-node elimination) và hợp nhất toán tử (operator fusion). Hiệu suất so với một công cụ được tinh chỉnh cho phần cứng mục tiêu như TensorRT phụ thuộc vào khối lượng công việc (workload), nhà cung cấp thực thi và phần cứng.
Microsoft. 2024. ONNX Runtime: Cross-Platform Inference and Training Machine-Learning Accelerator. GitHub.
Tính di động vẫn đòi hỏi kiểm tra cách bố trí toán tử (operator placement). Nếu một toán tử không được hỗ trợ, nó có thể rơi về một nhà cung cấp thực thi khác, kéo theo truyền dữ liệu giữa host và thiết bị và các bước đồng bộ: vẫn đúng chức năng nhưng làm mất mức tăng tốc kỳ vọng. Vì vậy, cần profiling để xác minh việc gán nhà cung cấp và mức bao phủ toán tử, không chỉ đơn giản là xem đồ thị đã xuất có chạy được hay không.
Các engine suy luận chuyên dụng
Khi độ trễ hoặc chi phí phần cứng là ràng buộc chặt hơn so với tính di động, TensorRT29 (NVIDIA GPUs), OpenVINO30 (phần cứng Intel) và các engine tương tự được tối ưu hóa đặc thù cho phần cứng đích của chúng (NVIDIA 2024a; Intel Corporation 2026; Chen et al. 2018). Chúng áp dụng các tối ưu hóa mạnh, chuyên biệt theo mục tiêu mà runtime gốc của framework có thể không áp dụng đồng nhất trên mọi loại phần cứng.
29 TensorRT: Nó từ bỏ tính di động của các framework đa dụng bằng cách yêu cầu một giai đoạn build để tối ưu hóa mô hình cho một kiến trúc GPU cụ thể (ví dụ: H100) (NVIDIA 2024a). Sự khóa chặt vào phần cứng này cho phép áp dụng các tối ưu hóa mạnh như hợp nhất lớp (layer fusion) và lựa chọn độ chính xác, những điều mà các runtime có tính di động có thể không áp dụng đồng nhất trên mọi đích. Engine không di động tạo ra nhờ đó có thể giảm đáng kể độ trễ, qua đó giảm số lượng GPU cần để đạt mục tiêu thông lượng.
NVIDIA. 2024a. NVIDIA TensorRT: Programmable Inference Accelerator.
30 OpenVINO (open visual inference and neural network optimization): Bộ công cụ suy luận hướng tới Intel, giúp chuyển đổi, tối ưu hóa và chạy các mô hình trên các đích Intel CPU, GPU và NPU (Intel Corporation 2026). Việc nhắm trực tiếp vào phần cứng là một kiểu tối ưu hóa “mạnh” vì nó chấp nhận đánh đổi một phần tính di động mà các runtime của framework thường phải đảm bảo, từ đó khai thác được các kernel và lựa chọn độ chính xác đặc thù cho từng đích. Mức tăng hiệu suất phụ thuộc vào khối lượng công việc (workload) và phần cứng, nhưng có thể giúp việc phục vụ (serving) các mô hình nhỏ, nhạy cảm với độ trễ trên CPU chuyên dụng hoặc thiết bị edge trở nên hiệu quả về mặt kinh tế.
Intel Corporation. 2026. OpenVINO Documentation.
Chen, Tianqi, Thierry Moreau, Ziheng Jiang, Lianmin Zheng, Eddie Q. Yan, Haichen Shen, Meghan Cowan, et al. 2018. “TVM: An Automated End-to-End Optimizing Compiler for Deep Learning.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI ’18), 578–94.
31 Hợp nhất lớp (Layer fusion): Tương tự hợp nhất vòng lặp (loop fusion) trong tối ưu hoá trình biên dịch, nơi các vòng lặp liền kề trên cùng một mảng được gộp để giảm lưu lượng truy cập bộ nhớ. Kernel fusion áp dụng cùng nguyên tắc này cho các phép toán trên GPU: các kernel chạy tuần tự phải ghi rồi đọc lại các tensor trung gian từ HBM sẽ được gộp thành một kernel duy nhất, nhờ đó có thể giữ dữ liệu trong các thanh ghi.
Hợp nhất lớp (Layer fusion)31 kết hợp nhiều phép toán tuần tự thành một kernel GPU duy nhất. Ví dụ chuỗi tích chập → chuẩn hóa batch → activation ReLU. Nếu không hợp nhất, cần ba lần khởi chạy kernel và hai lượt ghi/đọc trung gian. Khi hợp nhất, cả ba phép toán được gộp vào một kernel: đọc đầu vào một lần, tính kết quả gộp trong các thanh ghi, và chỉ ghi đầu ra cuối cùng một lần.
Tự động điều chỉnh kernel (Kernel auto-tuning) chọn thuật toán nhanh nhất cho từng phép toán trên một GPU cụ thể. Một phép tích chập (convolution) có thể được triển khai bằng hàng chục thuật toán như trực tiếp, dựa trên FFT, Winograd, và các chiến lược tiling; mỗi thuật toán lại tối ưu cho các kích thước đầu vào và kiến trúc GPU khác nhau. Cơ chế auto-tuning sẽ chạy benchmark cho từng ứng viên và lưu vào cache thuật toán thắng cuộc, chấp nhận tăng thời gian biên dịch để đổi lấy hiệu suất runtime cao hơn.
Những tối ưu hoá này có thể mang lại tốc độ đáng kể so với baseline gốc của framework chưa được tinh chỉnh. Tuy nhiên, chúng yêu cầu xuất hoặc biên dịch tường minh và có thể không hỗ trợ mọi phép toán hay shape động (dynamic shape). Phần so sánh runtime minh hoạ tiếp theo sẽ định lượng một lát cắt trong phổ tối ưu hoá này.
Example 1.10: ResNet-50: So sánh runtime
Table 19 đưa ra một kịch bản runtime minh hoạ cho ResNet-50/V100 với batch kích thước 1:
Table 19: So sánh runtime suy luận minh hoạ: Độ trễ giả định và mức tăng tốc đạt được cho ResNet-50 với batch-one trên PyTorch eager, TorchScript, ONNX Runtime và TensorRT trên V100.
| Runtime | Độ trễ | Tăng tốc | Ghi chú |
|---|---|---|---|
| PyTorch (eager) | 8.5 ms | 1× | Đường cơ sở, không tối ưu hóa |
| TorchScript | 6.2 ms | 1.4× | Biên dịch JIT |
| ONNX Runtime | 5.1 ms | 1.7× | Đa nền tảng |
| TensorRT FP32 | 2.8 ms | 3× | Đặc trưng của NVIDIA |
| TensorRT FP16 | 1.4 ms | 6.1× | Tăng tốc Tensor Core |
| TensorRT INT8 | 0.9 ms | 9.4× | Yêu cầu hiệu chuẩn |
Thông tin chuyên sâu về hệ thống: Trong so sánh minh hoạ này, TensorRT INT8 cung cấp mức tăng tốc 9.4× và yêu cầu dữ liệu hiệu chuẩn lượng tử hoá cùng triển khai dành riêng cho NVIDIA.
Bài toán đánh đổi giữa tối ưu hoá và khả năng tương thích là cố hữu. Tối ưu hoá mạnh hơn mang lại hiệu suất tốt hơn nhưng làm tăng độ phức tạp khi triển khai và có thể tạo ra khác biệt số học so với quá trình huấn luyện. Lựa chọn phụ thuộc vào yêu cầu về độ trễ, ràng buộc triển khai và nguồn lực kỹ thuật sẵn có.
Sau khi chọn runtime, việc cấu hình cũng áp dụng cùng một logic ưu tiên ràng buộc trước. Kích thước nhóm luồng (thread pool) kiểm soát mức song song cho suy luận trên CPU: quá ít luồng sẽ khiến các lõi CPU bị nhàn rỗi, còn quá nhiều sẽ gây tranh chấp. Các chiến lược cấp phát bộ nhớ (bộ đệm cấp phát trước so với cấp phát động) đánh đổi chi phí khởi động với tính linh hoạt. Việc chọn execution provider xác định ưu tiên backend phần cứng nào xử lý từng phép toán, và mức độ tối ưu hóa đồ thị đánh đổi thời gian biên dịch lấy hiệu suất runtime. Những cài đặt này không phải là một danh sách kiểm tra tách rời sau khi lựa chọn; chúng chính là cách biến runtime đã chọn trở nên “chân thật” dưới lưu lượng sản xuất. Vì vậy, trong môi trường sản xuất, người ta đo tác động của cấu hình lên phân phối độ trễ thay vì chỉ dựa vào mặc định.
Lựa chọn độ chính xác cho phục vụ (serving)
Trong một tình huống minh họa, một nhóm triển khai ResNet-50 trên GPU V100 giả định rằng việc chuyển từ FP32 sang INT8 (trên đường dẫn số nguyên không dùng Tensor Core) sẽ làm tăng thông lượng lên gấp ba lần, đồng thời chỉ làm giảm độ chính xác chưa đến 0,4 điểm phần trăm. Ví dụ này cho thấy mối liên hệ trực tiếp giữa độ chính xác số học và hiệu quả kinh tế của hạ tầng. Việc lựa chọn độ chính xác có liên quan đến các kỹ thuật lượng tử hoá được đề cập trong Lượng tử hoá và Độ chính xác. Biểu diễn số so sánh các định dạng số (FP32, FP16, BF16, FP8, INT8) và các đánh đổi giữa độ chính xác và phạm vi của chúng, còn Lượng tử hoá số nguyên trình bày chi tiết cơ chế của lượng tử hoá số nguyên đối xứng và bất đối xứng. Khi phục vụ (serving), cần lưu ý thêm các vấn đề runtime như tính sẵn có của dữ liệu hiệu chuẩn, độ nhạy của từng lớp dưới các đầu vào thực tế trong sản xuất, và việc lựa chọn độ chính xác động.
Mối quan hệ giữa độ chính xác và thông lượng
Đối với các thao tác bị giới hạn bởi băng thông bộ nhớ, việc giảm độ chính xác có thể làm tăng thông lượng bằng cách giảm lượng dữ liệu phải luân chuyển. Equation 16 đưa ra giới hạn trên (chỉ xét băng thông) có được từ việc giảm độ chính xác: \[ \frac{\text{Throughput}_{\text{INT8}}}{\text{Throughput}_{\text{FP32}}} = \frac{32}{8} = 4\times \text{ (theoretical maximum)} \tag{16}\]
Mức tăng tốc thực tế phụ thuộc vào phần cứng, tổ hợp toán tử, hiệu chuẩn và căn chỉnh kernel; vì vậy, mỗi khi có ràng buộc khác chi phối, mức này sẽ thấp hơn cận chỉ theo băng thông. Các kernel độ chính xác thấp hiệu quả nhất khi kích thước ma trận khớp với dạng ô (tile) ưa dùng của bộ tăng tốc mục tiêu. Các phiên bản cuBLAS và cuDNN hiện đại vẫn có thể dùng Tensor Cores cho nhiều kích thước khác, dù đôi lúc kém hiệu quả hơn hoặc phải đệm nội bộ. Tensor Cores cung cấp chi tiết kiến trúc Tensor Core để giải thích các ràng buộc căn chỉnh này. Các đánh đổi về độ chính xác ở một mô hình thị giác tiêu chuẩn cho thấy cách những giới hạn lý thuyết này xuất hiện trong thực tế.
Example 1.11: ResNet-50: Đánh đổi độ chính xác trên V100
Table 20 trình bày các giả định minh họa về độ trễ, bộ nhớ và độ chính xác cho ResNet-50 ở các định dạng FP32, FP16 và hai phương án INT8, kèm theo mức độ sử dụng Tensor Core (nếu có hỗ trợ):
Table 20: Đánh đổi độ chính xác minh họa trên V100: Độ trễ, dung lượng bộ nhớ và độ chính xác giả định cho ResNet-50 ở các định dạng FP32, FP16 và INT8 (PTQ và QAT), kèm theo mức độ sử dụng Tensor Core (nếu có hỗ trợ).
| Độ chính xác | Độ trễ | Bộ nhớ | Độ chính xác | Mức độ sử dụng Tensor Core | Hiệu chuẩn |
|---|---|---|---|---|---|
| FP32 | 2.8 ms | 98 MB | 76.13% | 0% | Không |
| FP16 | 1.4 ms | 49 MB | 76.13% | 85% | Không |
| INT8 (PTQ) | 0.9 ms | 25 MB | 75.80% | N/A | 1.000 mẫu |
| INT8 (QAT) | 0.9 ms | 25 MB | 76.05% | N/A | Huấn luyện bổ sung |
Góc nhìn hệ thống: Trong kịch bản minh họa này, INT8 mang lại mức tăng tốc 3.1× và mất 0.33 percentage points độ chính xác khi dùng PTQ. QAT khôi phục phần lớn mức mất đó nhưng cần huấn luyện lại.
Các ràng buộc khi lựa chọn độ chính xác
Việc lựa chọn độ chính xác bị ràng buộc bởi độ nhạy của lớp, dữ liệu hiệu chuẩn và chính sách runtime. Không phải lớp nào cũng chịu được độ chính xác thấp như nhau. Với một bộ lượng tử hoá vô hướng \(b\)-bit đồng nhất trên phạm vi đã hiệu chuẩn \([\alpha,\beta]\), bước và giới hạn lỗi làm tròn trong phạm vi được cho bởi equation 17 là \[\Delta = \frac{\beta-\alpha}{2^b-1}, \qquad |\epsilon_{\text{quant}}| \leq \frac{\Delta}{2} \tag{17}\] đối với các giá trị không bị cắt xén. Các giá trị nằm ngoài phạm vi hiệu chuẩn sẽ bị cắt xén và có thể gây lỗi lớn hơn. Lỗi đầu ra ở cấp lớp hoặc lỗi tác vụ còn phụ thuộc vào phân bố activation và độ nhạy của các lớp phía sau, nên phải đo lường trực tiếp thay vì suy theo một quy tắc chuẩn mang tính phổ quát. Điều này lý giải hiện tượng thường thấy: các lớp tích chập đầu tiên và lớp phân loại cuối cùng thường giữ ở FP16, còn các lớp ở giữa — khi hiệu chuẩn và đánh giá ở cấp tác vụ cho thấy chịu được độ chính xác thấp hơn — thì dùng INT8.
Lượng tử hoá sau huấn luyện đặt ra một ràng buộc về dữ liệu. Tập dữ liệu hiệu chuẩn quyết định các hệ số tỷ lệ dùng cho việc chuyển đổi sang INT8. Vì vậy, tập dữ liệu này phải đại diện cho lưu lượng phục vụ (serving) thực tế, chứ không chỉ đơn thuần tái sử dụng dữ liệu huấn luyện hoặc dữ liệu kiểm định sẵn có. Sự không khớp giữa dữ liệu hiệu chuẩn và dữ liệu phục vụ (serving) có thể làm giảm độ chính xác của tác vụ, một dạng lỗi sẽ được xem xét kỹ hơn trong section 1.12.
Các hệ thống phục vụ (serving) tiên tiến biến độ chính xác thành một chính sách runtime. Nếu hệ thống đang dẫn trước SLO độ trễ, nó có thể dùng độ chính xác cao hơn để cải thiện độ chính xác. Với các kết quả INT8 có độ tin cậy thấp, hệ thống có thể tính toán lại bằng FP16. Các nhóm khách hàng khác nhau có thể nhận các mức độ chính xác khác nhau. Cách tiếp cận này cho phép linh hoạt đánh đổi giữa chất lượng và độ trễ, đồng thời tối đa hóa thông lượng trong vận hành bình thường.
Quyết định về độ chính xác có tác động trực tiếp đến hạ tầng: ví dụ, với giả định thông lượng tăng gấp 3 lần, một khối lượng công việc (workload) cần 30 GPU ở FP32 sẽ chỉ cần 10 GPU nếu dùng INT8, miễn là các ràng buộc khác không đổi. Mối liên hệ giữa tối ưu hóa ở cấp mô hình và kinh tế hạ tầng là lý do vì sao việc chọn độ chính xác không thể chỉ được xem là vấn đề thuần túy của mô hình.
Self-Check: Question
An ML systems team is deploying a transformer-based ranking model on NVIDIA data center GPUs. They consider running the raw PyTorch model in eager Python mode versus compiling the model into an optimized NVIDIA TensorRT engine. Which optimization does TensorRT perform that PyTorch eager mode cannot achieve?
- TensorRT automatically converts the supervised classification task into an unsupervised reinforcement learning policy.
- TensorRT trains additional adapter layers during live request serving to adapt to data drift.
- TensorRT eliminates all GPU memory usage by running inferences exclusively in the CPU instruction cache.
- TensorRT performs aggressive vertical and horizontal operator fusion (e.g., combining Conv/MatMul, BiasAdd, and Activation into a single kernel), eliminates redundant memory round-trips, and selects hardware-tuned cuDNN/Tensor Core kernels.
Why does quantizing a model’s weights and activations from FP16 to INT8 for GPU serving often yield a \(2\times\) or greater throughput improvement, and what role does Post-Training Quantization (PTQ) calibration play in preserving accuracy?
True or False: In deep neural network quantization, certain layers (such as the initial embedding/convolution layer, final classification projection, and attention softmax score calculations) exhibit high sensitivity to precision loss, and preserving them in FP16/FP32 while quantizing remaining bulk layers to INT8/INT4 (mixed-precision serving) frequently prevents model accuracy collapse.
When deploying models to edge devices with Apple Silicon (such as iPhones and iPads), developers export models to the ____ framework to take full advantage of the dedicated Apple Neural Engine (ANE) hardware accelerator.
When calibrating an INT8 quantized model using Post-Training Quantization (PTQ), what is the primary danger of using a synthetic or unrepresentative calibration dataset (e.g., ImageNet validation images for a medical endoscopy model)?
- The activation dynamic ranges and outlier distributions in production will not match the calibration dataset, leading to severe clipping of real-world features or coarse quantization binning that degrades serving accuracy.
- The model compiler will fail to generate valid GPU assembly code and reject the weights.
- The server’s physical power consumption will double due to misaligned integer registers.
- The dynamic batcher will permanently lock its batch size to 1.
Tối ưu hóa cấp nút
Việc chọn runtime và chỉnh độ chính xác diễn ra ở cấp mô hình: chúng quyết định chạy phép tính nào và ở định dạng số nào. Nhưng giữa mô hình và silicon còn có một lớp tối ưu khác, bao gồm cơ chế biên dịch đồ thị thành các kernel, dịch chuyển byte từ đĩa vào bộ nhớ và phối hợp CPU–GPU. Công việc ở cấp nút giúp thu hẹp khoảng cách giữa benchmark của mô hình và toàn bộ đường dẫn xử lý yêu cầu, nhưng mức lợi thu được còn tùy vào ranh giới nào trong dấu vết đo lường đang là điểm nghẽn.
Xét một bộ phân loại ảnh mà benchmark của mô hình hứa hẹn suy luận trong vài mili giây, nhưng dấu vết thực tế trong sản xuất lại cho thấy đường dẫn xử lý chậm hơn. Tối ưu ở cấp nút giúp xác định ranh giới nào đang làm lãng phí thời gian trên máy đó. Dấu vết thường chỉ ra một trong bốn ranh giới chẩn đoán lặp đi lặp lại sau:
- Ranh giới đồ thị-sang-kernel: Đồ thị tính toán cần được chuyển thành một số ít kernel hiệu quả, thay vì một chuỗi dài chi phí khởi chạy.
- Ranh giới thực thi CPU: Công việc phía CPU cần tận dụng các đơn vị vector, tính cục bộ và các thư viện runtime, thay vì chạy Python theo kiểu scalar.
- Ranh giới tải: Byte của mô hình cần được chuyển từ đĩa vào bộ nhớ đủ nhanh để các lần khởi động lạnh không chi phối các sự kiện mở rộng quy mô.
- Ranh giới máy chủ-bộ tăng tốc: Máy chủ phải giữ cho bộ tăng tốc luôn được lập lịch liên tục, không bị ngắt quãng bởi tiền xử lý, truyền dữ liệu hoặc đồng bộ hóa.
Đây không phải những mẹo riêng lẻ. Chúng là các điểm mà dấu vết đo được có thể giải thích vì sao đường dẫn xử lý yêu cầu chậm hơn so với benchmark của mô hình.
Biên dịch đồ thị ở runtime
Các công cụ suy luận như TensorRT đã được giới thiệu trong section 1.9. Chúng có thể vượt một baseline eager chưa tinh chỉnh vì quá trình phục vụ (serving) thường mang đến cho trình biên dịch các toán tử ổn định hơn và một tập hữu hạn các cấu hình hình dạng đầu vào. Khi các điều kiện này đúng, trình biên dịch có thể dồn công việc vào lúc triển khai để loại bớt công việc lúc runtime; các dịch vụ có luồng điều khiển hoặc hình dạng quá động sẽ ít có cơ hội tận dụng lợi thế này hơn.
Lợi ích đầu tiên là operator fusion, cùng một kỹ thuật tối ưu gộp kernel như section 1.9.1.2 đã áp dụng cho TensorRT. Điểm khác biệt mà đồ thị phục vụ (serving) tĩnh mang lại là thời điểm hợp nhất: vì các toán tử và hình dạng đã được cố định trước khi có bất kỳ yêu cầu nào, trình biên dịch có thể phát hiện và chốt các kernel đã gộp từ trước thay vì phải tìm lại chúng ở runtime, nên không yêu cầu nào phải chịu chi phí phân tích này.
Tương tự, đồ thị tĩnh cũng cho phép constant folding. Nếu một biểu thức con chỉ phụ thuộc vào các trọng số hoặc hằng số cố định, ví dụ x * (sqrt(2) / 2), trình biên dịch sẽ thay thế bằng phép nhân đã tính sẵn x * 0.707.... Cách này giảm bớt công việc cho mỗi yêu cầu mà không làm thay đổi kết quả toán học của mô hình.
Memory planning áp dụng cùng ý tưởng, nhưng cho việc cấp phát bộ nhớ thay vì phép toán số học. Vì vòng đời của các tensor đã biết, runtime có thể tính trước các offset bộ nhớ và tái sử dụng buffer, thay vì cấp phát kiểu phản ứng ngay trong lúc xử lý yêu cầu. Điều này loại bớt các thao tác không cần thiết và tạo ra một đường dẫn phục vụ (serving) dễ dự đoán hơn, ít bị tắc nghẽn bộ cấp phát và giảm phân mảnh bộ nhớ.
Systems Perspective 1.9: Đánh đổi thời điểm biên dịch
Just-in-time compilation đợi đến khi đồ thị được thực thi lần đầu và có thể chuyên biệt hóa theo các hình dạng mà nó quan sát được. Sự chuyên biệt hóa này hữu ích khi lưu lượng thay đổi, nhưng lại đẩy việc biên dịch vào đường dẫn phục vụ (serving) và tạo ra một đỉnh độ trễ cho các yêu cầu lạnh.
Ahead-of-time compilation thực hiện công việc của trình biên dịch trước khi triển khai. Cách này cung cấp cho dịch vụ một đồ thị cố định và tránh được độ trễ biên dịch khi khởi động, đổi lại bạn phải định nghĩa rõ mọi hình dạng động hoặc biên dịch nhiều profile.
Chi phí biên dịch có thể được trả ở hai thời điểm. JIT trả chi phí này ngay trong đường dẫn phục vụ (serving) và có nguy cơ gây đỉnh độ trễ cho yêu cầu đầu tiên, trong khi ahead-of-time compilation trả trước khi triển khai và đòi hỏi kiểm soát chặt chẽ hơn đối với các hình dạng đầu vào.
Những tối ưu hóa này dẫn đến một lựa chọn khi triển khai. Biên dịch đúng lúc thích ứng với các hình dạng (shape) được quan sát tại runtime, nhưng yêu cầu đầu tiên sẽ phải chịu chi phí biên dịch. Ngược lại, biên dịch trước loại bỏ đỉnh độ trễ khi khởi động bằng cách đóng gói một tạo phẩm đã được tối ưu hóa, nhưng việc triển khai phải bao quát rõ ràng mọi hồ sơ hình dạng (shape profile) mà dịch vụ sẽ chấp nhận.
Tối ưu hóa suy luận trên CPU
Suy luận trên CPU có những vấn đề tối ưu hóa riêng, trong đó các kỹ thuật như vector hóa, tính cục bộ, tối ưu hóa đồ thị và lượng tử hoá phối hợp với nhau. CPU vẫn là lựa chọn khả thi cho nhiều khối lượng công việc (workload) suy luận, đặc biệt là các mô hình nhỏ, các tác vụ không nhạy với độ trễ, và các môi trường triển khai không thể giữ cho bộ tăng tốc luôn bận. Các CPU hiện đại32 (Intel Xeon, AMD EPYC) có các đơn vị vector và ma trận như AVX-512 và AMX, nhưng Python dạng scalar không sử dụng trực tiếp chúng. Các runtime chuyên biệt như OpenVINO ánh xạ các toán tử của mạng nơ-ron tới các kernel tối ưu hóa để dùng các lệnh này (Intel Corporation 2026).
32 SIMD (một lệnh, nhiều dữ liệu): Theo phân loại kiến trúc máy tính năm 1966 của Michael Flynn, SIMD cho phép một lệnh xử lý đồng thời nhiều phần tử dữ liệu. AVX-512 của Intel có thể xử lý mười sáu giá trị FP32 trong một vector 512-bit, trong khi AMX bổ sung các phép toán trên các khối (tile) ma trận. Tỷ lệ hiệu suất đạt được so với mức đỉnh phụ thuộc vào kiểu dữ liệu, hình dạng ma trận, hành vi bộ nhớ và cách triển khai, nhưng các kernel được tối ưu hóa có thể hiệu quả hơn đáng kể so với mã scalar.
33 NUMA (truy cập bộ nhớ không đồng nhất): Truy cập bộ nhớ gắn với cùng một socket CPU nhanh hơn so với bộ nhớ nằm ở socket khác; ghim một luồng suy luận vào một lõi là chưa đủ nếu bộ nhớ nó cần lại được cấp phát từ xa, buộc lưu lượng phải đi qua liên kết liên-socket chậm hơn. Việc không đồng định vị luồng và dữ liệu như vậy sẽ tạo thêm overhead về độ trễ phụ thuộc vào khối lượng công việc (workload). Mức phạt cụ thể phụ thuộc vào cấu trúc socket, cách đặt bộ nhớ và kiểu truy cập, nhưng có thể rất đáng kể với các workload ML bị giới hạn bởi bộ nhớ, vì trọng số mô hình có thể vượt quá dung lượng cache L3, dẫn đến các lần truy xuất xuyên socket khi bị bỏ lỡ cache.
Một yếu tố giới hạn tiếp theo của CPU là tính cục bộ. Trên các máy chủ đa socket,33 việc truy cập dữ liệu trên một socket CPU khác sẽ gây ra độ trễ do truy cập bộ nhớ không đồng nhất (NUMA). Vì vậy, một máy chủ suy luận cần nhận biết NUMA: các luồng nên được ghim vào các lõi cụ thể, và trọng số mô hình cùng các bộ đệm đầu vào mà các luồng đó sử dụng nên được cấp phát trên cùng một socket. Trọng số mô hình ML—hàng trăm megabyte cho một mạng cỡ trung bình và gigabyte cho một mô hình ngôn ngữ lớn—có thể vượt quá cache L3 của CPU, nên hình phạt NUMA có thể diễn ra liên tục chứ không chỉ thỉnh thoảng. Quá trình suy luận có thể liên tục truyền tải một phần đáng kể của tensor trọng số từ RAM chính, buộc phải tìm nạp dữ liệu qua liên kết giữa các socket chậm hơn nếu tính cục bộ không được giữ.
Với các mô hình đủ nhỏ và kích thước batch bằng một, CPU có thể vượt GPU khi chi phí khởi chạy, đồng bộ và truyền dữ liệu của bộ tăng tốc lớn hơn thời gian tính toán hữu ích. Kích thước mô hình không quyết định duy nhất điểm chuyển giao; tổ hợp toán tử, dữ liệu cư trú, runtime, khả năng vector hóa của CPU và mục tiêu độ trễ cần được đo đạc trực tiếp trên phần cứng ứng viên.
Tuần tự hóa mô hình và tải nhanh
Hệ thống tự động điều chỉnh quy mô (autoscaling) là các vòng lặp điều khiển vận hành, thêm hoặc bớt các bản sao phục vụ (serving replicas) theo tải. Trong các hệ thống này, thời gian để khởi động một nút mới là rất quan trọng. Một phần lớn của “Khởi động nguội” (section 1.6.2) đơn giản là đọc các trọng số mô hình từ đĩa vào bộ nhớ. Việc chọn định dạng tuần tự hóa quyết định tốc độ tải này.
Các checkpoint của PyTorch khi tải bằng torch.load() dùng một container tuần tự hóa dạng zip, trong đó siêu dữ liệu được mã hóa bằng pickle. Các chế độ tải an toàn giới hạn những đối tượng có thể được tái tạo, nhưng định dạng này vẫn phải thực hiện giải tuần tự hóa đặc thù theo framework. Một định dạng hướng tensor34 có thể giảm việc tái tạo đối tượng và các bản sao dữ liệu bổ sung trên phía host. Ánh xạ bộ nhớ, được giới thiệu trong section 1.6.3, còn cho phép đưa các byte của tensor ra trực tiếp từ tệp theo nhu cầu khi bố cục tuần tự hóa tương thích với view tensor trên CPU.
34 Safetensors: Tên gọi nhấn mạnh tính an toàn: không như việc giải tuần tự hóa Pickle không hạn chế, định dạng này không mã hóa các đối tượng Python có thể thực thi (Hugging Face 2026). Nó lưu tensor dưới dạng các byte thô liền kề kèm một tiêu đề nhỏ và hỗ trợ tải bằng ánh xạ bộ nhớ. Trong ví dụ benchmark cục bộ, cách này nhanh hơn 10× so với đường dẫn checkpoint của PyTorch; kết quả phụ thuộc vào khối lượng công việc (workload) và cách lưu trữ, và chưa tính phần truyền sang bộ tăng tốc rời.
Hugging Face. 2026. Safetensors Documentation.
Dựa trên nguyên tắc này, Safetensors là một định dạng tensor được thiết kế để tải an toàn và hiệu quả. Nó lưu siêu dữ liệu của tensor trong một tiêu đề nhỏ, còn giá trị tensor được lưu dưới dạng các byte liền kề. Cách này cho phép CPU truy cập bằng ánh xạ bộ nhớ mà không phải tái tạo các đối tượng Python. Việc chuyển các tensor này sang một bộ tăng tốc rời vẫn cần truyền giữa thiết bị, trừ khi nền tảng có đường dẫn bộ nhớ chung tương thích.
Example 1.12: Tốc độ tải: Safetensors so với Pickle
Tình huống: Một bản sao suy luận serverless tải một checkpoint mô hình 5 GB trong các sự kiện mở rộng quy mô khi khởi động nguội.
Chẩn đoán: torch.load() của PyTorch (Pickle) phải tái tạo đối tượng trên CPU, mất 15 s để khởi tạo. Safetensors dùng ánh xạ bộ nhớ để bỏ qua bước phân tích trên CPU, tải các trọng số trong 1.5 s (nhanh hơn 10×).
Bài học về hệ thống: Các định dạng xoay quanh tensor và dùng ánh xạ bộ nhớ có thể giảm chi phí tái tạo đối tượng trên CPU và chi phí sao chép eager khi khởi động nguội. Tuy vậy, thông lượng lưu trữ, lỗi trang, thời gian khởi tạo runtime và truyền sang bộ tăng tốc vẫn nằm trong phần chi phí cần tính khi mở rộng quy mô.
Lập hồ sơ nút phục vụ (serving)
Tối ưu hóa mà không đo lường thì chỉ là đoán mò. Chỉ số hiệu quả hệ thống được định nghĩa trong equation 2 nêu mục tiêu: tối đa hóa tỷ lệ thời gian thực (wall-clock) mà bộ tăng tốc dành cho tính toán hữu ích. Các công cụ lập hồ sơ theo dòng thời gian như PyTorch Profiler hoặc NVIDIA Nsight Systems (nsys) giúp hiện rõ mục tiêu này bằng cách hiển thị chính xác trình tự sự kiện trên CPU và GPU.
Cách đọc dấu vết hữu ích là bắt đầu từ nút thắt cổ chai. Các khoảng trống trên thanh GPU cho thấy phần cứng đang nhàn rỗi, thường vì GPU phải chờ CPU tiền xử lý hoặc I/O đĩa. Hàng nghìn lát nhỏ trên GPU cho thấy có quá nhiều kernel được khởi chạy, gợi ý cần hợp nhất toán tử hoặc biên dịch đồ thị. Các khối MemcpyHtoD cho thấy dữ liệu di chuyển từ host sang thiết bị; câu hỏi chẩn đoán là các lần truyền này có chồng lấp với tính toán hay chặn nó. Nhờ vậy, biểu đồ dòng thời gian biến một phàn nàn mơ hồ về phục vụ (serving) chậm thành một ranh giới cụ thể trên đường dẫn xử lý yêu cầu.
Example 1.13: Vòng lặp phân tích hiệu năng
Tình huống: Một nút phục vụ (serving) suy luận có độ trễ đuôi p99 cao dù mức sử dụng tính toán GPU trung bình thấp.
Chẩn đoán: Phân tích theo dòng thời gian (Nsight Systems/PyTorch Profiler) cho thấy các khoảng nhàn rỗi lớn giữa những kernel GPU rất nhỏ, nguyên nhân là nút thắt cổ chai ở khâu tiền xử lý phía CPU (host) và chi phí khởi chạy kernel.
Bài học về hệ thống: Tối ưu hóa nút phục vụ (serving) cần dựa trên phân tích theo dòng thời gian thực nghiệm. Việc lặp lại quy trình xác định các nút thắt qua dấu vết (chi phí khởi chạy kernel, chờ sao chép giữa host và thiết bị) sẽ dẫn dắt các tối ưu hóa có mục tiêu như hợp nhất toán tử và dùng bộ nhớ được ghim.
Table 21 là công cụ hỗ trợ ra quyết định hơn là danh sách kiểm tra: hãy chọn kỹ thuật có chỉ số mục tiêu khớp với nút thắt cổ chai đã đo, không phải hàng có mức tăng hiển thị lớn nhất.
| Kỹ thuật | Chỉ số mục tiêu | Mức tăng minh họa | Chi phí triển khai | Tốt nhất cho |
|---|---|---|---|---|
| Operator Fusion | Độ trễ và Thông lượng | 2–5\(\times\) | Trung bình (Compiler) | Các lớp giới hạn bộ nhớ |
| Lượng tử hoá INT8 | Thông lượng | 3–4\(\times\) | Cao (Hiệu chuẩn) | Các nút nặng về suy luận |
| Biên dịch đồ thị | Độ trễ | 1.5–3\(\times\) | Thấp (Một dòng) | Các mô hình đồ thị tĩnh |
| Zero-Copy Loading | Thời gian khởi động | 10–50\(\times\) | Thấp (Định dạng tệp) | Autoscaling/Cold Start |
| CPU Pinning | Độ trễ đuôi (p99) | Giảm 20–50% | Thấp (Cấu hình) | Các ứng dụng quan trọng về độ trễ |
Thứ bậc tác động này định hướng nên đầu tư công sức kỹ thuật vào đâu. Một checkpoint theo lớp giữ cho ưu tiên đó gắn chặt với ngăn xếp phục vụ (serving), từ lớp vận chuyển yêu cầu cho tới các kernel đã được hợp nhất.
Checkpoint 1.5: Thứ bậc tối ưu hóa
Tối ưu hóa suy luận bám theo đường đi của yêu cầu, từ ngoài vào trong.
Ngăn xếp có bốn cấp độ.
Self-Check: Question
Why does loading model weights from modern
safetensorsformat provide substantially faster container startup times than legacy PyTorch.ptor.bin(Pythonpickle) files?safetensorsfiles compress weights using gzip, reducing disk storage by \(10\times\).safetensorsfiles store pure, uncompressed raw byte arrays aligned to page boundaries, allowing zero-copy memory mapping (mmap) directly into host memory without running Python object deserialization or arbitrary code execution.safetensorsfiles compile PyTorch code directly into binary x86 machine instructions on disk.safetensorsfiles automatically quantize FP32 weights into 4-bit integers during read operations.
In a CPU-based model serving deployment, how do vector extensions like Intel Advanced Matrix Extensions (AMX) or Vector Neural Network Instructions (VNNI) accelerate inference throughput compared to standard scalar x86 execution?
Order the iterative steps of an end-to-end performance profiling workflow for diagnosing an inference serving bottleneck:
- Inspect timeline traces (e.g., via Nsight Systems or PyTorch Profiler) to identify gaps, CUDA stream stalls, CPU-GPU synchronization, and memory bandwidth utilization
- Implement targeted optimization (e.g., kernel fusion, precision reduction, or CPU pipelining) on the identified bottleneck stage
- Establish a reproducible baseline by driving realistic synthetic load with a benchmarking tool (e.g., Triton Perf Analyzer) and measuring latency percentiles (p50, p99)
- Re-benchmark under identical load to verify latency reduction and ensure model prediction accuracy remains intact
- Identify the binding bottleneck category (Compute-bound, Memory-bandwidth-bound, or Host/Pipeline-bound)
True or False: In Ahead-of-Time (AOT) graph compilation, operator fusion is restricted to combining adjacent layers of the exact same mathematical type (e.g., fusing two consecutive Conv2D operations).
When profiling a GPU inference server under high load, an engineer observes that the GPU utilization metric reported by
nvidia-smiis 95%, but Nsight Systems timeline traces reveal that the GPU is actually spending 40% of its time stalled on host CPU memory copies. What accounts for this discrepancy?nvidia-smimeasures fan speed and ambient temperature rather than compute kernel activity.- The GPU memory clock is automatically halved during Nsight Systems tracing.
- The CPU is running at 100% duty cycle, which forces
nvidia-smito report false GPU metrics. nvidia-smireports the percentage of time a GPU kernel or context was active on the device, treating memory-stalled or synchronous PCIe transfer states as ‘active’ utilization rather than measuring true compute ALU duty cycle.
Kinh tế và lập kế hoạch
Batching, điều chỉnh độ chính xác, hợp nhất toán tử và biên dịch đồ thị có thể giảm độ trễ, tăng dung lượng hoặc giảm chi phí cho một suy luận hoàn thành. Tuy nhiên, triển khai sản xuất đòi hỏi phải trả lời một câu hỏi ở cấp độ đội máy: cần bao nhiêu máy, loại nào, với tổng chi phí bao nhiêu. Một nhóm đạt 1.200 hình ảnh/giây trên V100 vẫn cần biết liệu 8 V100 với giá $3/giờ mỗi chiếc hay 24 T4 với giá $0,53/giờ mỗi chiếc sẽ rẻ hơn cho mục tiêu 5.000 QPS, đồng thời vẫn đáp ứng cùng SLO. Chi phí hạ tầng phục vụ (serving) tăng theo khối lượng yêu cầu duy trì (Zhang et al. 2019), trong khi chi phí huấn luyện phụ thuộc vào ngân sách riêng cho tập dữ liệu, mô hình và tối ưu hóa. Sự nén giá API công khai thể hiện trong figure 2 minh họa áp lực này: khi giá theo token giảm, hiệu quả hạ tầng trở thành đòn bẩy chính để đảm bảo khả năng tồn tại về kinh tế.
Zhang, Chengliang, Minchen Yu, Wei Wang, and Feng Yan. 2019. “MArk: Exploiting Cloud Services for Cost-Effective, SLO-Aware Machine Learning Inference Serving.” 2019 USENIX Annual Technical Conference (USENIX ATC 19), 1049–62.
Chi phí mỗi suy luận
Chi phí mỗi suy luận được tính bằng cách chia chi phí phục vụ (serving) đã phân bổ cho số lượng suy luận hoàn thành đáp ứng mục tiêu dịch vụ. Tử số có thể bao gồm thời gian CPU hoặc bộ tăng tốc được cấp phát, dung lượng bộ nhớ, truyền dữ liệu, lưu trữ và điều phối. Ở mức sử dụng cao, thông lượng hữu ích sẽ phân bổ chi phí đã cấp phát đó cho nhiều yêu cầu. Ở mức sử dụng thấp, dung lượng đã trả tiền bị bỏ trống, nên cùng một hóa đơn theo giờ sẽ được chia cho ít suy luận thành công hơn. Áp dụng framework cho ResNet-50 cho thấy cách giá theo giờ và thông lượng hợp lệ duy trì kết hợp lại thành chi phí đơn vị.
Kinh tế GPU so với CPU
Trong phân tích chi phí AWS minh họa tại section 1.11.1, các instance GPU đắt hơn theo giờ nhưng mang lại thông lượng song song cao hơn nhiều. Điểm giao nhau phụ thuộc vào đặc tính của mô hình và yêu cầu về độ trễ.
Suy luận trên CPU hợp lý về mặt kinh tế với các mô hình nhỏ, ít tham số và phép toán đơn giản; khi yêu cầu về độ trễ được nới lỏng (chấp nhận hàng trăm mili giây); khi lưu lượng yêu cầu thấp hoặc biến động mạnh (khiến việc giữ chỗ GPU trở nên lãng phí); hoặc khi các phép toán của mô hình không song song hóa tốt. Suy luận trên GPU hấp dẫn khi mô hình lớn với các phép toán phù hợp cho song song, yêu cầu độ trễ nghiêm ngặt (hàng chục mili giây), lưu lượng yêu cầu cao và đủ ổn định để duy trì mức sử dụng, và batching có thể phân bổ chi phí khởi chạy kernel GPU trên mỗi suy luận.
Ngoài chi phí trạng thái ổn định, thời gian khởi động cũng ảnh hưởng đến hiệu quả kinh tế của việc mở rộng. Khởi chạy instance, kéo image, khởi tạo driver, tải mô hình, biên dịch và làm nóng có thể khiến các bản sao của bộ tăng tốc sẵn sàng chậm hơn so với các bản sao CPU, dù thời gian cụ thể còn tùy nền tảng và artifact triển khai. Nếu lưu lượng tăng nhanh hơn tốc độ đưa năng lực hữu ích vào hoạt động, các SLO về độ trễ có thể bị vi phạm dù cuối cùng vẫn có đủ năng lực.
Khi các bản sao của bộ tăng tốc có độ trễ sẵn sàng dài, mở rộng theo dự đoán (predictive scaling) hoặc dùng warm pool có thể đáng tin cậy hơn so với chỉ phản ứng. Với một mô hình chạy chấp nhận được trên cả hai loại thiết bị, một thiết kế lai có thể dùng năng lực bộ tăng tốc luôn bật cho tải nền, và để CPU xử lý phần tải tràn khi có đột biến, đổi lấy chi phí đơn vị và đặc tính độ trễ khác để có năng lực dự phòng lên nhanh hơn. Thiết kế lai GPU+CPU này là một ví dụ trong các mẫu kiến trúc rộng hơn được nêu ở Kiến trúc lai; hiệu quả còn tùy vào khả năng tương thích của mô hình và ngữ nghĩa đầu ra đồng nhất giữa các runtime.
Example 1.14: ResNet-50: Phân tích chi phí
Table 22 đưa ra một kịch bản kiểu AWS để minh họa chi phí theo giờ, thông lượng, và chi phí trên mỗi triệu ảnh khi phục vụ (serving) ResNet-50:
Table 22: So sánh chi phí suy luận ResNet-50 trên đám mây (minh họa): Giả định chi phí theo giờ và thông lượng ở mức bão hòa, kèm chi phí cho mỗi một triệu hình ảnh đối với các instance CPU, T4 và V100.
| Loại phiên bản | Chi phí/Giờ | Thông lượng | Chi phí mỗi 1M Hình ảnh |
|---|---|---|---|
| c5.xlarge (CPU) | $0.17 | 50 img/s | $0.94 |
| g4dn.xlarge (T4 GPU) | $0.53 | 400 img/s | $0.37 |
| p3.2xlarge (V100 GPU) | $3.06 | 1,200 img/s | $0.71 |
Góc nhìn hệ thống: Instance GPU T4 có chi phí đơn vị thấp nhất theo các giả định này. V100 không vượt T4 về chi phí đơn vị ở các mức sử dụng tối đa đã nêu. Giá trên đám mây thay đổi theo khu vực và theo thời gian; hãy tham khảo bảng giá hiện tại khi lập kế hoạch vận hành.
Lập kế hoạch năng lực
Việc chọn GPU hay CPU sẽ quyết định chi phí cho mỗi lượt suy luận, nhưng để xác định cần cấp phát bao nhiêu hạ tầng, ta phải kết hợp phân tích chi phí với nền tảng lý thuyết hàng đợi từ section 1.5. Lập kế hoạch năng lực chuyển ba đầu vào thành các thông số hạ tầng: đặc điểm lưu lượng (tốc độ yêu cầu đỉnh, chu kỳ ngày/tuần, dự báo tăng trưởng), các SLO về độ trễ (mục tiêu p50, p95, p99), và đặc điểm mô hình (phân bố thời gian suy luận ở các kích thước batch khác nhau) (Harchol-Balter 2013).
Harchol-Balter, Mor. 2013. Performance Modeling and Design of Computer Systems: Queueing Theory in Action. Cambridge University Press. https://doi.org/10.1017/cbo9781139226424.
Ví dụ minh họa trong section 1.5 cho thấy toàn bộ quy trình: bắt đầu từ SLO p99 50 ms và mục tiêu 5.000 QPS, suy ra ngưỡng sử dụng an toàn theo M/M/1 là 54 percent từ equation 6, và xác định số GPU cần thiết với phần dự phòng là 62 V100s. Kịch bản này cấp phát cho tải đỉnh cộng thêm 30% dự phòng; mức dự phòng thực tế trong môi trường sản xuất phụ thuộc vào khối lượng công việc (workload) và chính sách. Autoscaling có thể giảm chi phí khi lưu lượng thấp, đồng thời vẫn đáp ứng mục tiêu độ trễ lúc cao điểm; Vận hành machine learning xây dựng lớp chính sách vận hành xoay quanh các phép tính phục vụ (serving) này. Các con số về thông lượng chỉ có ý nghĩa khi đi kèm các đảm bảo về độ trễ. Như phần hạch toán QPS hợp lệ ở section 1.5 đã nêu, năng lực phải được tính cho các yêu cầu thực sự đáp ứng SLO, không phải cho tổng số yêu cầu thô.
Nghiên cứu điển hình trong môi trường sản xuất: phục vụ (serving) Llama 3 8 tỷ tham số
Ngoài các trọng số thường trú, bộ nhớ KV-cache thường là một trong những hạng mục tốn dung lượng nhất khi phục vụ (serving) các mô hình ngôn ngữ lớn, và figure 7 cho thấy lý do. Để làm rõ hiệu ứng này, biểu đồ được vẽ ở quy mô 70 tỷ tham số: KV-cache tăng tuyến tính theo độ dài ngữ cảnh và kích thước batch, cho đến khi các ngữ cảnh dài làm cạn kiệt phần bộ nhớ còn lại sau khi tải trọng số và không gian làm việc của runtime. Hồ sơ Llama 3 8 tỷ tham số được phân tích trong phần còn lại cũng tuân theo cùng quy luật nhưng có nhiều dư địa hơn, khiến nó trở thành một khối lượng công việc mà kỹ sư có thể chạy trên một GPU và phân tích trọn vẹn từ đầu đến cuối.
Hồ sơ khối lượng công việc (workload)
Các giả định về khối lượng công việc (workload) cố định dưới đây định nghĩa trường hợp tham chiếu, được dùng xuyên suốt các tính toán về độ trễ, bộ nhớ và kinh tế trong phần này; đồng thời chúng cũng đặt giới hạn cho các phân tích tiếp theo.
- Mô hình: Llama 3 với 8 tỷ tham số (được lượng tử hoá xuống 4-bit bằng kỹ thuật lượng tử hoá trọng số có nhận biết activation (AWQ); xem Lượng tử hoá và Độ chính xác để tìm hiểu các kỹ thuật lượng tử hoá) (Dubey et al. 2024; Lin et al. 2024).
- Phần cứng: 1\(\times\) NVIDIA H100 SXM5 GPU (80 GB HBM3, 3.35 TB/s băng thông) (Choquette 2023).
- Đặc điểm yêu cầu: Prompt đầu vào 1.000 token (Prefill), phản hồi sinh 256 token (Decode).
- SLO mục tiêu: TTFT \(<\) 200 ms, TPOT \(<\) 20 ms.
Lin, Ji, Jiaming Tang, Haotian Tang, Shang Yang, Wei-Ming Chen, Wei-Chen Wang, Guangxuan Xiao, Xingyu Dang, Chuang Gan, and Song Han. 2024. “AWQ: Activation-Aware Weight Quantization for on-Device LLM Compression and Acceleration.” Proceedings of Machine Learning and Systems 6: 87–100.
Choquette, Jack. 2023. “NVIDIA Hopper H100 GPU: Scaling Performance.” IEEE Micro 43 (3): 9–17. https://doi.org/10.1109/mm.2023.3256796.
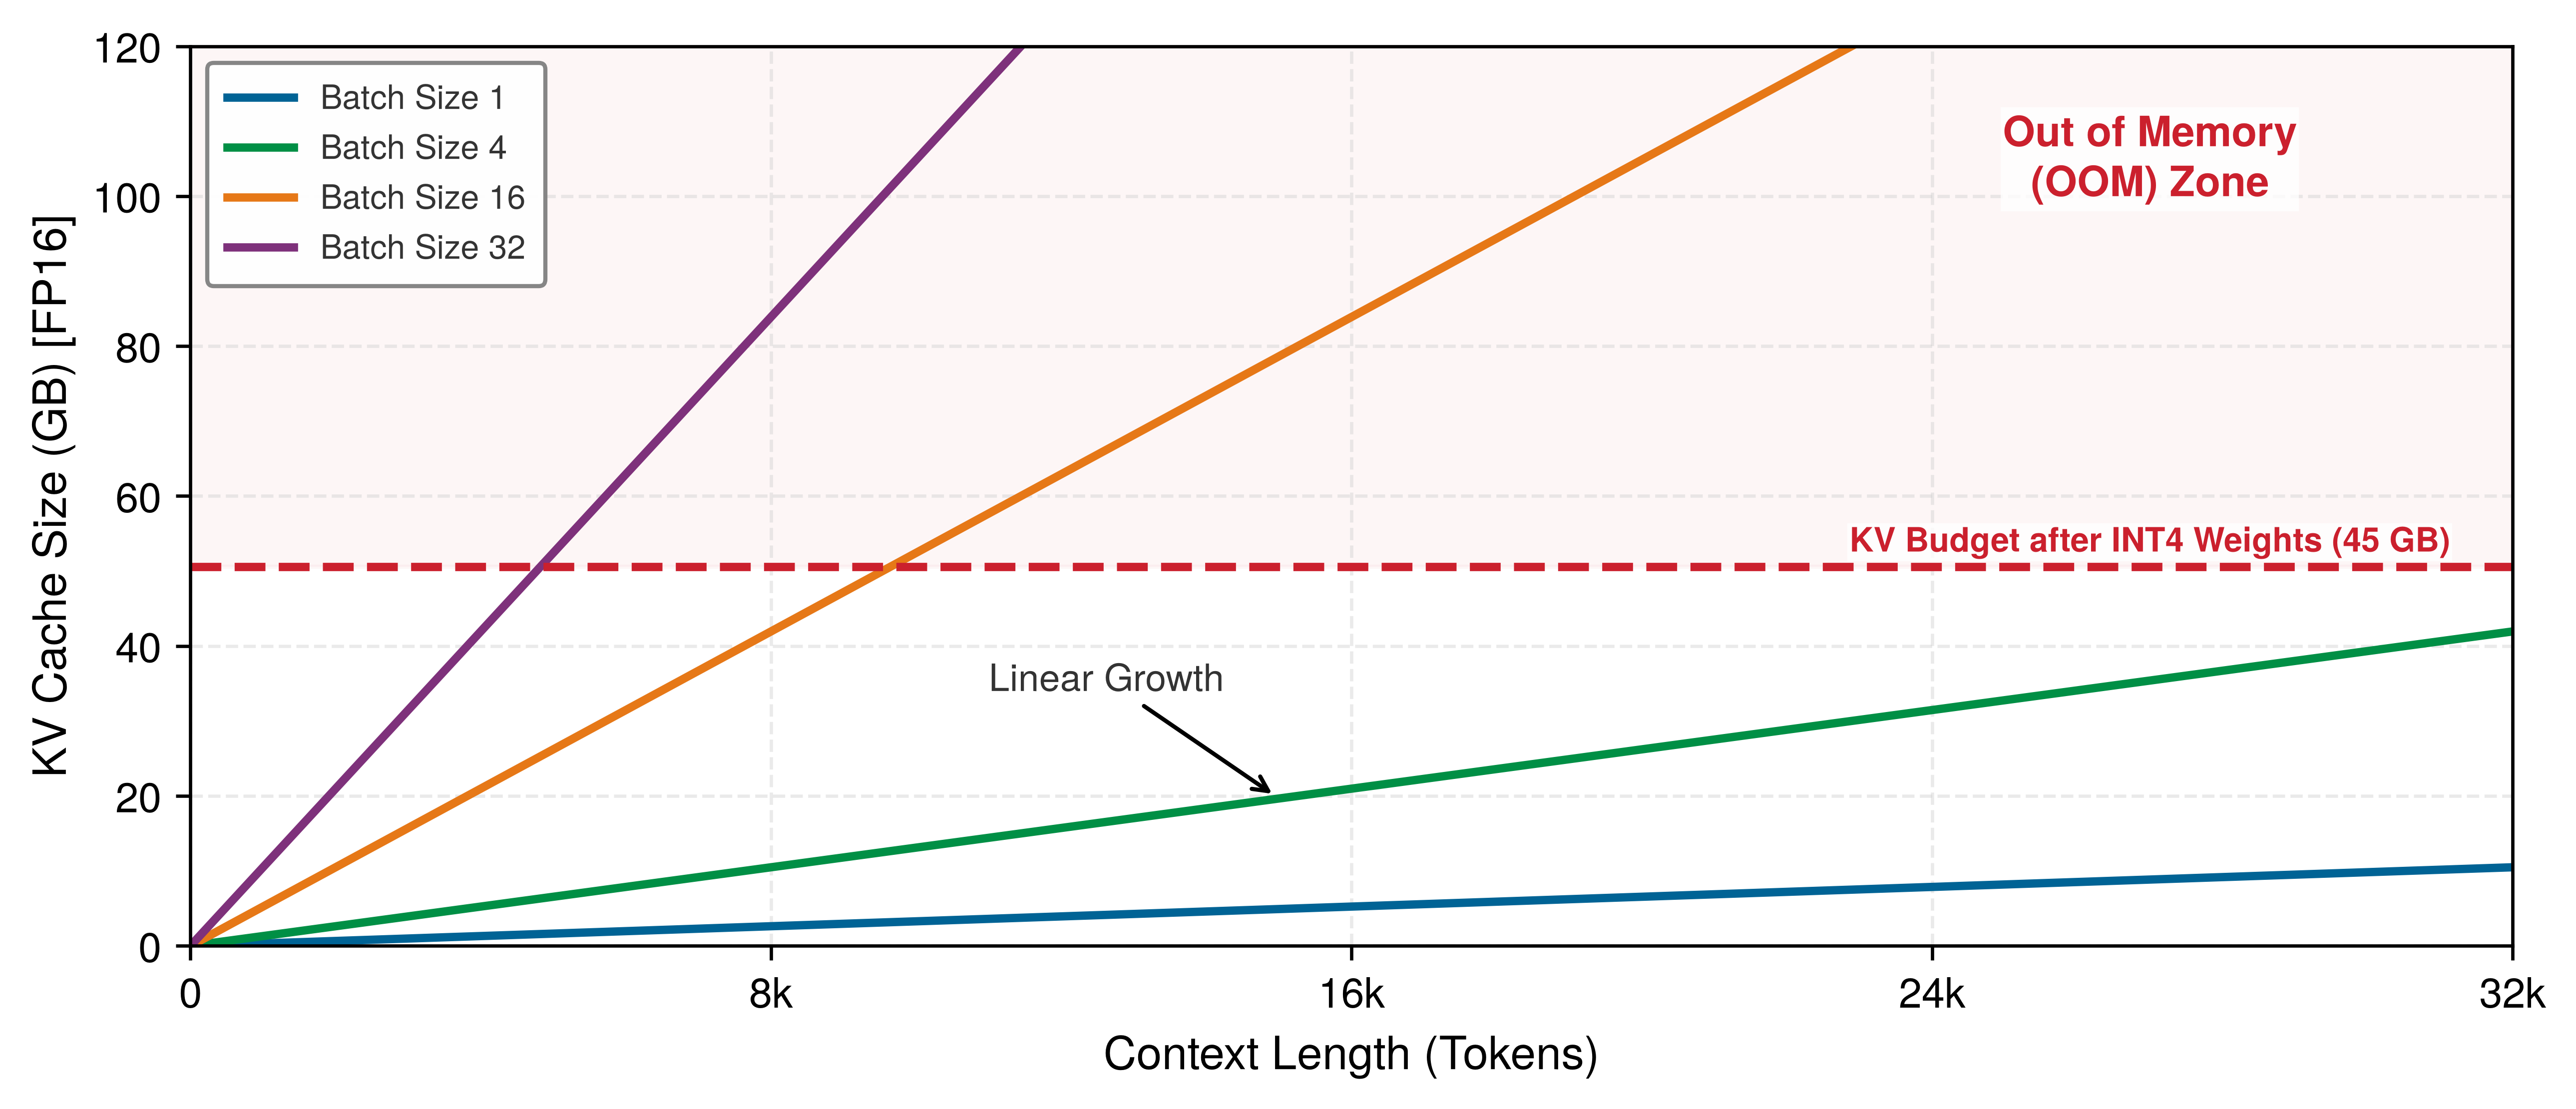
Vì vậy, khi ngữ cảnh dài hơn, ta phải dùng các batch đồng thời nhỏ hơn hoặc tăng thêm bộ nhớ, làm giảm hiệu suất thông lượng.
Những giả định này giúp nghiên cứu điển hình đủ hẹp để có thể tính toán, đồng thời vẫn giữ hai ràng buộc quan trọng nhất trong quá trình phục vụ (serving): ngân sách prefill cho thời gian đến token đầu tiên và ngân sách decode cho mỗi token được tạo ra.
Phân tích độ trễ
Độ trễ yêu cầu từ đầu đến cuối chịu chi phối bởi mô hình thực thi hai pha của các transformer tự hồi quy, áp dụng các chỉ số TTFT và TPOT đã được định nghĩa trong section 1.8.1. Giai đoạn Prefill quyết định liệu người dùng có sớm thấy phản hồi cho lời nhắc hay không; còn giai đoạn Decode quyết định liệu luồng token sinh ra có tiếp tục tiến đều sau khi bắt đầu hay không.
Systems Perspective 1.10: Vật lý của quá trình tạo token
Hãy nhớ lại nguyên lý bất biến năng lượng-chuyển động được lượng hóa trong Chi phí năng lượng khi di chuyển so với tính toán trên giá trị 32-bit: việc di chuyển một bit tốn kém hơn 100–1.000 lần so với việc tính toán trên chính bit đó. Trong pha giải mã, nguyên lý này quyết định “chi phí vật lý trên mỗi từ”.
Vật lý: Đối với quá trình giải mã theo batch đơn (batch-one) với các trọng số INT4, cường độ tính toán do trọng số chi phối xấp xỉ \(2\) FLOPs trên mỗi tham số chia cho \(0.5\) byte trên mỗi tham số, tức là \(4\) FLOPs/byte. Giá trị này thấp hơn nhiều so với điểm đỉnh của H100, nên bước xử lý này bị giới hạn bởi băng thông bộ nhớ. Các batch giải mã lớn hơn sẽ tái sử dụng luồng trọng số trên nhiều chuỗi và làm tăng cường độ tính toán (Pope et al. 2023). Ngưỡng băng thông cho batch đơn được thể hiện trong equation 18: \[ T_{\text{token}} \approx \frac{D_{\text{vol}}}{\text{BW}_{\text{memory}}} \tag{18}\]
Ý nghĩa: Mỗi khi tạo một token, hệ thống phải tốn năng lượng để di chuyển các trọng số của mô hình từ HBM vào các thanh ghi tính toán. Trên một A100 80 GB (2.04 TB/s HBM2e), cùng mô hình đó có ngưỡng thời gian tối thiểu theo luồng trọng số xấp xỉ 1.97 ms cho mỗi token. Khi quá trình giải mã vẫn bị giới hạn bởi băng thông, thêm nhiều lõi tính toán chỉ cải thiện độ trễ rất ít; bộ nhớ nhanh hơn (Physics), mô hình nhỏ hơn (Algorithm), hoặc batching và quản lý cache tốt hơn mới thay đổi được giới hạn này.
Pha prefill (thời gian đến token đầu tiên)
Mô hình xử lý lời nhắc 1.000 token theo kiểu song song. Với giả định hiệu suất tính toán 40% của solver, ước tính TTFT (Time To First Token) phía mô hình là 41.9 ms, thoải mái trong SLO 200 ms và để lại phần ngân sách còn lại cho đường vào mạng, token hóa và xếp hàng.
Pha giải mã (thời gian cho mỗi token đầu ra)
Mô hình tạo 256 token theo tuần tự. Với batch đơn, pha này bị giới hạn bởi băng thông bộ nhớ: mỗi bước sẽ stream tensor trọng số 4 GB từ VRAM. Khi xử lý theo batch, luồng đó được dàn đều cho các chuỗi đang hoạt động.
Để lấy mức sàn lý thuyết, ta chia tensor trọng số 4 GB cho băng thông 3.35 TB/s: \(T_{\text{token}} \approx\) 1.2 ms. Cộng thêm chi phí dispatch theo lớp của runtime cho ra TPOT được mô hình hóa là 1.57 ms. Vì vậy, tạo toàn bộ 256 tokens token sẽ mất 256 tokens \(\times\) 1.57 ms = 0.40 s.
Bộ nhớ và thông lượng
Với trọng số 4-bit chiếm 4 GB, khoảng ~81.9 GB còn lại dành cho KV cache và không gian làm việc của runtime. Mỗi token cần xấp xỉ 0.131 MB KV cache FP16 trong cấu hình Llama 3 8 tỷ tham số, vì grouped-query attention giảm dung lượng lưu trữ KV-head so với full multi-head attention; AWQ chỉ áp dụng cho trọng số và không biến cache đó thành INT4. Chia phần dự trữ 72 GB cho chi phí mỗi token sẽ cho sức chứa ≈ 0.6 million tokens token, nên với 1,256 tokens token mỗi yêu cầu, GPU có thể giữ kích thước batch đồng thời khoảng ~469 requests.
Kinh tế đơn vị
Hãy xem xét chi phí thuê một H100 SXM5 tiêu biểu, khoảng $3/hour. Lấy giá trị nhỏ nhất giữa năng lực prefill riêng và khả năng lưu trú KV cho ta một mức trần thông lượng lạc quan là 45.2 million tokens/hour và chi phí đơn vị ở mức thấp nhất là $0.066/million tokens. Phép tính này không mô hình hóa xung đột tài nguyên giữa prefill/decode hoặc khả năng decode theo batch.
Phân tích này cho thấy với LLM, dung lượng bộ nhớ (kích thước KV cache) quyết định số phiên lưu trú đồng thời tối đa; còn năng lực tính toán cho prefill và băng thông decode quyết định thông lượng token thực tế và chi phí dưới một cơ cấu lưu lượng cụ thể. Băng thông bộ nhớ thường chi phối độ trễ decode ở batch nhỏ; khi batch lớn hơn, giới hạn có thể chuyển sang phía compute hoặc lưu lượng qua KV cache.
Nghiên cứu tình huống này áp dụng các nguyên tắc cốt lõi trình bày xuyên suốt chương: ngân sách độ trễ được tách thành giai đoạn prefill và decode; lý thuyết xếp hàng định hướng việc chọn kích thước batch và lập kế hoạch dung lượng; và các ràng buộc phần cứng ở dạng băng thông và dung lượng bộ nhớ quyết định hiệu năng và chi phí có thể đạt được. Framework định lượng được thiết lập ở đây giúp đưa ra quyết định kỹ thuật có cơ sở, nhưng chỉ khi áp dụng đúng. Những hiểu lầm phổ biến có thể khiến ngay cả kỹ sư giàu kinh nghiệm cũng áp dụng sai các nguyên tắc này trong thực tế.
Self-Check: Question
A team evaluates deploying a small classification model with an average arrival rate of 5 QPS and a 200 ms latency SLA. A single CPU server instance costs $0.20/hour and achieves 20 QPS max throughput. A dedicated GPU server instance costs $2.00/hour and achieves 200 QPS max throughput. Which deployment option is more cost-effective for this specific workload, and why?
- The GPU server is more cost-effective because its raw cost per query at full capacity is lower ($0.010/query vs $0.010/query).
- The GPU server is more cost-effective because GPUs always have lower total cost of ownership regardless of arrival traffic.
- The CPU server is more cost-effective because at 5 QPS, the CPU server easily meets the SLA with adequate headroom at $0.20/hour, whereas the GPU server would run at only 2.5% utilization, wasting $1.80/hour on idle capacity.
- Neither option is viable because 5 QPS requires at least a 10-node cluster for high availability.
In capacity planning for a mission-critical model serving cluster with a peak expected traffic of \(\lambda_{\text{peak}} = 1\text{,}000\text{ QPS}\) and an individual replica capacity of \(R = 100\text{ QPS}\) at its target latency SLO, why would a capacity engineer provision 16 to 20 replicas (\(1.6\times\text{--}2.0\times\) headroom multiplier) rather than exactly 10 replicas?
True or False: For an 8-billion-parameter LLM deployed in FP16 precision (16 GB weight footprint) on an 80 GB GPU, serving long-context requests (e.g., 32k tokens) with large batch sizes causes the memory required by the KV cache to surpass the static weight footprint of the model itself.
An engineer serves an 8-billion parameter LLM on a GPU with 2 TB/s of High-Bandwidth Memory (HBM) bandwidth. Assuming weights are in FP16 (16 GB model size) and running with batch size \(B = 1\) during the autoregressive decode phase, what is the theoretical hardware-bound minimum Time Per Output Token (TPOT), neglecting KV-cache and compute time?
- \(8.0\text{ ms}\) (\(\text{TPOT} = 16\text{ GB} / 2\text{,}000\text{ GB/s}\))
- \(0.8\text{ ms}\) (\(\text{TPOT} = 1.6\text{ GB} / 2\text{,}000\text{ GB/s}\))
- \(80.0\text{ ms}\) (\(\text{TPOT} = 160\text{ GB} / 2\text{,}000\text{ GB/s}\))
- \(0.08\text{ ms}\) (\(\text{TPOT} = 16\text{ MB} / 2\text{,}000\text{ GB/s}\))
Why does serving an LLM with INT4 weight-only quantization (e.g., AWQ or GPTQ) dramatically reduce Time Per Output Token (TPOT) for small batch sizes, even if INT4 compute kernels provide no higher FLOPS than FP16 Tensor Cores?
Những ngụy biện và cạm bẫy
Phục vụ (serving) đảo ngược các ưu tiên của huấn luyện theo những cách đi ngược lại trực giác từ xử lý batch. Mối quan hệ phi tuyến giữa mức sử dụng và độ trễ, chi phí ẩn của bước tiền xử lý, và các chế độ lỗi thầm lặng do training-serving skew gây ra làm vi phạm SLO, lãng phí công sức tối ưu hóa, và suy giảm độ chính xác mà giám sát tiêu chuẩn không nhìn thấy.
Ngụy biện: Giảm độ trễ suy luận mô hình sẽ làm giảm độ trễ cảm nhận của người dùng một cách tỷ lệ thuận.
Các kỹ sư tối ưu hóa suy luận mô hình thường kỳ vọng độ trễ người dùng cảm nhận sẽ giảm tương ứng, nhưng các hệ thống phục vụ (serving) lại phát sinh những nguồn độ trễ mà benchmark ngoại tuyến không có. Khi hệ thống chịu tải, độ trễ do xếp hàng trở thành yếu tố chi phối: equation 5 cho thấy ở mức sử dụng 80 percent với thời gian phục vụ 5 ms, thời gian chờ trung bình là 20 ms trước cả khi suy luận kịp bắt đầu. Giảm thời gian suy luận từ 5 ms xuống 2 ms không chỉ thay đổi thời gian phục vụ mà còn kéo mức sử dụng từ 80 percent xuống 32 percent, qua đó giảm thời gian chờ xếp hàng từ 20 ms xuống 0.9 ms — một cải thiện xếp hàng gấp 21.2× lần, lấn át mức giảm thời gian suy luận chỉ là 3 ms. Sự tương tác phi tuyến giữa tốc độ suy luận và hành vi xếp hàng đồng nghĩa mức tăng tốc của toàn hệ thống (25 ms → 2.9 ms, hay 8.5×) vượt xa mức tăng tốc của riêng mô hình (5 ms → 2 ms, hay 2.5×). Ngay cả khi chỉ giảm 20% thời gian phục vụ, cải thiện người dùng cảm nhận vẫn có thể rất lớn ở mức sử dụng cao vì mức sử dụng giảm đồng thời với thời gian tính toán trực tiếp. Tối ưu hóa phục vụ (serving) đòi hỏi phân tích toàn bộ ngân sách độ trễ, bao gồm serialization, xếp hàng, tiền xử lý và hậu xử lý, dưới các điều kiện tải thực tế thay vì chỉ đo riêng độ trễ suy luận.
Cạm bẫy: Vận hành hạ tầng phục vụ (serving) ở mức sử dụng cao để tối đa hóa hiệu quả chi phí.
Các nhóm thường đặt mục tiêu mức sử dụng 90 percent để giảm công suất nhàn rỗi. Trong sản xuất, khi mức sử dụng tiến sát công suất, độ trễ tăng theo dạng phi tuyến. Equation 5 cho thấy ở mức 90 percent, thời gian trung bình trong hệ thống bằng 10× lần thời gian phục vụ. Chuyển từ mức sử dụng 70 percent sang 90 percent giúp cắt giảm chi phí hạ tầng ước tính 22.2 percent, nhưng lại làm độ trễ trung bình tăng gấp ba. Với một dịch vụ suy luận 5 ms, độ trễ p99 ước tính tăng từ ~76.7 ms lên ~230 ms theo giả định M/M/1. Trong kịch bản này, vận hành ở mức sử dụng 60 đến 70 phần trăm giữ lại được dư địa về độ trễ lớn hơn đáng kể so với 90 phần trăm. Do đó, mục tiêu vận hành trong sản xuất cần được xác định dựa trên quá trình đến đã đo được, phân phối thời gian phục vụ, SLO, dự phòng lỗi và mục tiêu chi phí.
Ngụy biện: Độ chính xác khi huấn luyện đảm bảo độ chính xác khi phục vụ (serving).
Nhiều kỹ sư cho rằng giữ nguyên trọng số của mô hình sẽ giữ nguyên hiệu suất trên tập xác thực. Trong sản xuất, khác biệt ở bước tiền xử lý có thể đẩy đầu vào ra ngoài phân phối dùng để huấn luyện. Section 1.6.1 giải thích cách nội suy khi thay đổi kích thước, độ chính xác số học và thời điểm lấy đặc trưng có thể tạo ra sai lệch dù trọng số không đổi. Trong kịch bản minh họa này, độ chính xác giảm từ 95 percent xuống 90 percent, tức mất 5 percentage-point. Các giá trị này chỉ mang tính minh họa, không phải một sự cố sản xuất đã được báo cáo. Hệ thống sản xuất cần tiền xử lý nhất quán và giám sát chất lượng tác vụ, vì kiểm tra độ trễ và ngoại lệ không thể phát hiện lỗi này.
Cạm bẫy: Sử dụng độ trễ trung bình để đánh giá hiệu suất của hệ thống phục vụ (serving).
Các kỹ sư thường giám sát độ trễ trung bình vì nó biến thiên trơn tru và dễ tính. Tuy nhiên, giá trị trung bình không cho biết phân vị mà SLO nêu ra có bị vi phạm hay không. Như section 1.5.5 minh họa, ở mức sử dụng 70 percent và thời gian phục vụ 5 ms, độ trễ trung bình là 16.7 ms, nhưng p99 theo mô hình đạt tới 76.7 ms, tức chênh 4.6× lần—một khoảng cách mà giám sát dựa trên trung bình không thấy được. Vì vậy, các dịch vụ nên báo cáo phân bố độ trễ và phân vị SLO liên quan, thay vì chỉ báo cáo mỗi giá trị trung bình.
Ngụy biện: Các batch phục vụ (serving) lớn hơn luôn cải thiện thông lượng mà không ảnh hưởng đến các SLO về độ trễ.
Các kỹ sư thường tối đa hóa kích thước batch với giả định rằng chạy đầy GPU sẽ giúp tiết kiệm chi phí khi hệ thống đang chịu tải sản xuất. Tuy nhiên, trong các hệ thống phục vụ (serving), batching tạo ra sự đánh đổi giữa độ trễ và thông lượng do động lực hàng đợi chi phối — điều mà các benchmark offline không phản ánh. Gom nhiều yêu cầu thành các batch lớn hơn làm tăng thời gian chờ của những yêu cầu đến sớm: một cửa sổ batch 10 ms nghĩa là yêu cầu đầu tiên phải chờ 10 ms trước khi suy luận bắt đầu, trực tiếp cộng vào độ trễ p99. Trong kịch bản đại diện ResNet-50/V100 ở section 1.7.6, tăng kích thước batch từ 16 lên 32 chỉ cải thiện thông lượng 12 percent nhưng gần như tăng gấp đôi thời gian suy luận cho mỗi batch, từ 14 ms lên 25 ms. Ngoài ra, kích thước đầu vào không đồng nhất trong một batch có thể tạo ra overhead do padding, khiến tài nguyên tính toán bị lãng phí cho các token padding. Section 1.7.3 cho thấy vì sao, với các mục tiêu p99 chặt chẽ, tăng kích thước batch có thể vi phạm SLO khi tổng độ trễ hình thành batch cộng với thời gian suy luận mỗi batch tăng thêm vượt quá ngân sách độ trễ. Tối ưu batch trong phục vụ (serving) đòi hỏi điều chỉnh đồng thời kích thước batch, timeout của batch và độ đồng thời theo các SLO về độ trễ dưới các mô hình lưu lượng thực tế, chứ không phải tối đa hóa thông lượng một cách tách rời.
Cạm bẫy: Hiệu chuẩn các mô hình đã lượng tử hóa bằng dữ liệu không đại diện.
Các nhóm đôi khi hiệu chỉnh bằng một tập mẫu tiện lợi dù tập này không đại diện cho phân phối khi triển khai được hỗ trợ. Lượng tử hoá sau huấn luyện xác định các hệ số tỉ lệ INT8 từ các dải activation trong dữ liệu hiệu chỉnh, nên độ phủ mang tính đại diện là rất quan trọng. Kịch bản minh hoạ này cho thấy độ chính xác giảm từ 76.1 percent xuống 72.9 percent, tương ứng với mức giảm 3.2 percentage-point; đây không phải là một sự cố sản xuất đã được báo cáo. Để lượng tử hoá hiệu quả, cần hiệu chỉnh và xác thực trên dữ liệu đại diện cho các đầu vào mà dịch vụ dự kiến sẽ xử lý.
Ngụy biện: Độ trễ khởi động nguội chỉ quan trọng đối với yêu cầu đầu tiên.
Các kỹ sư thường tối ưu hoá độ trễ ở trạng thái ổn định với giả định rằng hầu hết yêu cầu sẽ đến các phiên bản warm. Khởi động nguội có thể chồng chất trong các đợt tăng đột biến lưu lượng, quá trình triển khai và phục hồi. Trong kịch bản minh hoạ này, 10 phiên bản, mỗi phiên bản cần 30 s để biên dịch, tổng cộng 300 instance-seconds; làm ấm song song giúp dung lượng trở nên hữu ích sau khoảng 30 s. Độ trễ cho yêu cầu nguội được giả định là 500 ms so với 5 ms ở trạng thái ổn định.
Cạm bẫy: Mở rộng quy mô mà không có ngân sách cho warm-pool hoặc tải theo giai đoạn.
Các chính sách tự động mở rộng quy mô chỉ tính các bản sao ở trạng thái ổn định sẽ đánh giá thấp dung lượng cần thiết trong các đợt tăng lưu lượng và triển khai. Các hệ thống phục vụ (serving) cần warm pool (các bản sao dự phòng được khởi tạo trước), tải mô hình theo giai đoạn hoặc kiểm soát truy cập để các bản sao mới trở nên hữu ích trước khi yêu cầu của người dùng phụ thuộc vào chúng. Ngân sách nên bao gồm thời gian biên dịch, tải trọng số, khởi tạo cache và thời gian kiểm tra sức khỏe, vì những bước này quyết định việc mở rộng có thực sự thêm dung lượng hay chỉ thêm một nguồn độ trễ đuôi khác.
Self-Check: Question
A team attempts to maximize hardware cost efficiency by targeting 95% steady-state GPU utilization across their production serving cluster. Why is this strategy a dangerous engineering pitfall?
- High utilization permanently erases model weights from GPU memory registers.
- In stochastic serving systems, queue waiting times grow asymptotically toward infinity as utilization approaches 100%, causing minor traffic fluctuations to trigger massive tail-latency spikes and widespread SLO breaches.
- Running above 90% utilization forces the operating system to switch from 64-bit to 32-bit execution mode.
- Modern GPUs automatically shut down power when utilization exceeds 80% for more than 10 seconds.
True or False: Evaluating an online serving system using mean (average) latency is sufficient for capacity planning, because if the average latency is well below the SLA target, user-facing requests are guaranteed to experience good performance.
Why is the assumption that ‘cold-start latency only affects the very first request’ a critical fallacy in autoscaling serverless or Kubernetes-based serving environments with bursty traffic?
An engineering team increases the dynamic batch size on their vision model serving nodes from 8 to 64, observing that peak offline throughput doubles. However, in production, user-facing p99 latency violations increase by 40%. What fallacy explains this outcome?
- Model weights become corrupted when executed with batch sizes greater than 16.
- GPU Tensor Cores disable INT8 acceleration when batch size exceeds 32.
- High batch sizes reduce arithmetic intensity on the GPU Roofline model.
- The fallacy that larger serving batches always improve throughput without affecting latency; early-arriving requests must wait in the batcher queue for the batch to fill, consuming precious latency budget in queue waiting time.
Describe the pitfall of ‘Calibrating quantized models with unrepresentative data,’ and explain how it can lead to silent production failure despite passing offline validation checks.
Tóm tắt
Phục vụ (serving) đưa một mô hình đã được xác thực vào một khối lượng công việc (workload) vận hành. Yêu cầu trực tuyến thêm vào các yếu tố như phân phối độ trễ, xếp hàng, biến động lưu lượng và dự phòng lỗi, bên cạnh những mối quan tâm về thông lượng vốn quen thuộc từ huấn luyện. Định luật Little liên hệ quy mô ổn định trong dài hạn, tốc độ đến và thời gian phản hồi; M/M/1 cung cấp một mô hình đơn giản có chủ ý để mô tả tăng trưởng độ trễ phi tuyến khi hệ thống tiến gần bão hòa. Cả hai thứ này không thay thế được việc đo đạc, nhưng khi kết hợp, chúng biến khoảng trống (headroom) và dung lượng thành các giả thuyết rõ ràng để kiểm chứng bằng thử tải.
Tối ưu hóa phục vụ (serving) hiệu quả nghĩa là đo cả đường đi đầy đủ của yêu cầu, không chỉ riêng bước suy luận của mô hình. Lựa chọn giao thức và cách tuần tự hóa rất quan trọng khi phần truyền tải chiếm tỷ trọng đáng kể trong ngân sách; tiền xử lý quan trọng khi nó cấp dữ liệu cho bộ tăng tốc quá chậm; còn batching chỉ có ý nghĩa khi tốc độ yêu cầu đến và SLO cho phép chờ đợi. Lệch giữa huấn luyện và phục vụ (training-serving skew) gây ra một dạng lỗi khác: dịch vụ có thể vẫn nhanh và không báo lỗi, trong khi các phép biến đổi không nhất quán lại âm thầm làm thay đổi dự đoán.
Phương thức triển khai được chọn trong Framework về mô hình triển khai sẽ thay đổi các đường dẫn xử lý yêu cầu khả dĩ. Ví dụ, một API trên đám mây có thể dùng batching động dựa trên quá trình yêu cầu đến được đo lường; cảm biến đồng bộ áp đặt thời hạn khung hình; còn một khối lượng công việc (workload) di động với luồng đơn có thể chọn batch bằng 1 để giữ độ phản hồi và tiết kiệm năng lượng. Các kịch bản của MLPerf cung cấp các xấp xỉ tiêu chuẩn hóa cho những hình thái này; tuy vậy, thiết kế sản phẩm thực tế vẫn phải bắt đầu từ chính lưu lượng, phần cứng và mục tiêu của dịch vụ.
Key Takeaways: Đảo ngược mọi ưu tiên huấn luyện
- Phục vụ (serving) là kinh tế học độ trễ: Huấn luyện ưu tiên thông lượng cho các lần chạy dài, còn phục vụ (serving) chi tiêu một ngân sách thời gian cố định cho mỗi yêu cầu, phân bổ cho tuần tự hóa, tiền xử lý, xếp hàng, suy luận, hậu xử lý và mạng. Tối ưu hóa chỉ độ trễ của mô hình sẽ bỏ sót những giai đoạn người dùng thực sự phải chờ.
- Tỷ lệ sử dụng chuyển thành thời gian chờ: Trong xấp xỉ M/M/1 của chương, thời gian trung bình trong hệ thống tăng từ 5\(\times\) thời gian phục vụ ở mức sử dụng 80 phần trăm lên 10\(\times\) ở mức 90 phần trăm. Khoảng trống (headroom) giúp các đợt tăng lưu lượng vừa phải không trở thành vi phạm SLO.
- Mô hình nhanh bộc lộ chi phí pipeline: Khi suy luận đã nhanh, các bước như giải mã ảnh, tạo token và tiền xử lý khác có thể chiếm phần lớn tổng độ trễ. Lúc này, trọng tâm tối ưu hóa chuyển sang đường dẫn xử lý yêu cầu, chứ không còn là nhân của mạng nơ-ron.
- Batching theo lưu lượng, không theo thói quen: Các lượt truy cập web mô hình hóa theo Poisson có thể dùng batching động, các cảm biến đồng bộ cần các batch được căn chỉnh, còn khối lượng công việc (workload) di động luồng đơn có thể ít cơ hội để batching. Một cửa sổ hữu ích chuyển phần dư độ trễ sẵn có thành thông lượng mà không vi phạm SLO.
- Lệch dữ liệu làm giảm độ chính xác mà không báo lỗi: Cách thay đổi kích thước, thứ tự chuẩn hóa, dữ liệu hiệu chuẩn hoặc định nghĩa đặc trưng khác nhau giữa huấn luyện và phục vụ (serving) có thể làm thay đổi phân bố đầu vào hiệu dụng của mô hình. Áp dụng các biến đổi chung, kiểm tra tương đương (parity), và giám sát theo lát cắt trong môi trường sản xuất giúp giảm rủi ro này.
- Phục vụ (serving) LLM là quản lý bộ nhớ: Quá trình giải mã thường đọc các trọng số từ VRAM cho mỗi token được tạo ra, nên độ trễ mỗi token bị giới hạn bởi băng thông, trừ khi batching làm thay đổi ràng buộc này. Bố cục KV-cache, PagedAttention, continuous batching, độ chính xác và lựa chọn runtime quyết định cả mức độ đồng thời và chi phí trên mỗi token.
- Lựa chọn runtime trở thành hóa đơn hạ tầng: Độ chính xác, biên dịch đồ thị (graph compilation), hợp nhất toán tử (operator fusion) và runtime phục vụ (serving) chi phối trực tiếp số lượng bản sao (replica count) và chi phí trên mỗi suy luận. Lượng tử hoá và các runtime chuyên biệt có thể giảm đáng kể dung lượng phục vụ (serving) cần thiết, miễn là vẫn giữ được độ chính xác và phù hợp với phần cứng mục tiêu.
Tối ưu hóa cấp nút nối các thao tác của mô hình với máy chạy chúng. Profiling cho thấy liệu biên dịch, hợp nhất toán tử, độ chính xác, tính cục bộ, tuần tự hóa hay tải dữ liệu có thực sự là điểm nghẽn trên đường đi của yêu cầu hay không. Lợi ích chỉ có ý nghĩa khi vẫn đứng vững với các dạng đầu vào ở môi trường sản xuất, qua được kiểm tra độ chính xác và chịu được biến thiên độ trễ. Lập kế hoạch dung lượng chuyển thông lượng hợp lệ đó thành số bản sao (replica count) và chi phí đơn vị, như nghiên cứu trường hợp Llama 3 trong section 1.11.4 cho thấy. Một kernel nhanh hơn mà không giảm được dung lượng cấp phát hoặc không cải thiện SLO thì chưa tạo ra lợi ích kinh tế.
Huấn luyện được đánh giá bằng khối lượng công việc hữu ích đã hoàn thành; còn một dịch vụ trực tuyến được đánh giá bằng việc các yêu cầu có đạt mục tiêu độ trễ hay không. Mỗi giai đoạn đều tiêu tốn cùng một ngân sách: tuần tự hóa, tiền xử lý, hàng đợi, mô hình và phản hồi. Dữ liệu quyết định kích thước và hình dạng đầu vào, thuật toán quyết định lượng tính toán và trạng thái, còn máy quyết định tốc độ phục vụ và chi phí di chuyển. Xếp hàng ghép nối ba yếu tố này theo cách phi tuyến tính, nên một hệ thống vẫn trong ngân sách ở mức lưu lượng vừa phải có thể vượt ngân sách chỉ sau một đợt tăng nhỏ. Vì vậy, kỹ thuật phục vụ (serving) phân bổ ngân sách dọc theo đường dẫn yêu cầu, giữ lại khoảng trống để ứng phó biến động và lỗi, và xác minh rằng tỷ lệ yêu cầu cần thiết hoàn tất trước hạn.
What’s Next: Từ nút đến nhà máy
Một nút phục vụ (serving) đơn lẻ rất mong manh: mô hình có thể bị trôi (drift), các bản cập nhật phải đến tay người dùng mà không gián đoạn, và các bản sao phải vận hành như một hệ thống thống nhất, đáng tin cậy. Vận hành machine learning mở rộng đơn vị quan tâm từ một yêu cầu sang cả nhà máy sản xuất: CI/CD quản lý các tạo phẩm; kho đăng ký mô hình và kho đặc trưng giúp căn chỉnh phục vụ (serving) với huấn luyện; khả năng quan sát phát hiện độ trễ và sự trôi dạt về độ chính xác; và rollback ngăn các bản phát hành lỗi trở thành sự cố kéo dài.
Self-Check: Question
Which core architectural takeaway summarizes the fundamental difference between machine learning model training and production model serving?
- Training optimizes single-query tail latency under fixed memory bounds, whereas serving optimizes long-run epoch throughput across distributed cluster networks.
- Training requires specialized graph compilers and quantization, whereas serving relies exclusively on uncompiled Python eager execution.
- Training is throughput-centric optimization over long data runs with full hardware saturation, whereas serving is latency-constrained economics that allocates a per-request time budget across the entire pipeline and reserves headroom against nonlinear queueing collapse.
- Training runs on integer-only microcontrollers, whereas serving runs exclusively on floating-point supercomputers.
True or False: In production model serving, optimizing only the neural network accelerator kernel execution time yields diminishing returns if upstream preprocessing, transport serialization, and downstream postprocessing are not optimized concurrently.
Summarize how memory management—specifically KV-cache allocation, paging, and precision—acts as the primary throughput and concurrency bottleneck in Large Language Model (LLM) serving.
Self-Check Answers
Self-Check: Answer
When transitioning a deep learning model from training to an online serving environment, how does the system constraint in the D·A·M (Data-Algorithm-Machine) taxonomy fundamentally shift regarding machine utilization and algorithm state?
- Machine utilization must be maximized at 100% to amortize capital costs, while the algorithm continues parameter backpropagation during request serving.
- Machine capacity must maintain operational headroom below saturation to prevent tail-latency queueing collapse, while the algorithm’s weights remain fixed for a deployed version.
- Machine allocation switches from accelerators to general-purpose CPUs exclusively, while the algorithm dynamically modifies its architecture per incoming user payload.
- Machine throughput replaces latency as the primary operational constraint, while data volume shifts from live request streams to historical offline batches.
Answer: The correct answer is B. In online serving, the machine constraint shifts from maximizing utilization to maintaining sufficient operational headroom, because operating near saturation causes exponential queueing delays and p99 latency SLA violations. Simultaneously, the algorithm is fixed for a deployed model version rather than updated via online gradient backpropagation. Operating at 100 percent utilization causes severe queueing collapse rather than cost efficiency. Dedicated accelerators remain essential for high-throughput serving rather than abandoning them for CPUs exclusively. Latency per request becomes the primary binding constraint in online serving rather than total batch throughput.
Learning Objective: Analyze the fundamental architectural and operational shifts in the D·A·M taxonomy when transitioning machine learning models from offline training to online serving.
True or False: In online model serving, the latency term (\(L_{\text{lat}}\)) in the iron law of ML systems must encompass external factors such as network round-trip time, request serialization, and system orchestration, rather than solely the accelerator kernel execution time.
Answer: True. In an operational online serving system, user-perceived response time includes client-server network transport, ingress routing, payload serialization/deserialization, queue waiting time, and CPU preprocessing/postprocessing in addition to accelerator forward-pass execution. Consequently, optimizing only the raw accelerator kernel latency often yields diminishing returns if orchestration and transport overheads dominate the latency envelope.
Learning Objective: Evaluate how end-to-end serving latency budgets extend beyond isolated accelerator kernel execution times.
Explain why achieving high average throughput during offline benchmarking does not guarantee that an online serving system will satisfy its tail-latency Service-Level Objective (SLO) during production traffic spikes.
Answer: Offline benchmarks measure batched execution under steady, controlled conditions where accelerators operate near 100% saturation without queueing penalties. In contrast, online serving encounters stochastic, time-varying arrival processes (such as Poisson bursts); when instantaneous arrival rates approach capacity, queue lengths and waiting times grow nonlinearly (as modeled by \(M/M/1\) queueing behavior), causing severe p99 latency spikes and SLO timeouts despite high average throughput.
Learning Objective: Explain why steady-state throughput benchmarks fail to predict tail-latency degradation under stochastic online arrival workloads.
Self-Check: Answer
An e-commerce platform evaluates precomputing product recommendations offline (static inference) versus computing them on demand when a user visits the homepage (dynamic inference). Which trade-off correctly characterizes static inference compared to dynamic inference?
- Static inference eliminates database storage costs but increases real-time p99 latency by executing large batched matrix multiplications during user page loads.
- Static inference guarantees real-time contextual adaptation to intra-session user clicks but requires dedicated high-end GPUs on the critical request path.
- Static inference trades storage capacity and potential prediction staleness for predictable sub-millisecond retrieval latency, whereas dynamic inference provides fresh predictions from live context at the expense of computational latency and variable serving capacity.
- Static inference requires running unbatched single-sample inferences across microcontrollers, whereas dynamic inference processes large offline shards across cloud clusters.
Answer: The correct answer is C. Static inference precomputes predictions in offline batches and writes them to a low-latency key-value store, enabling sub-millisecond lookup latency and decoupling user traffic surges from GPU compute capacity, at the expense of high storage requirements and inability to reflect real-time context changes. Dynamic inference computes predictions on demand using fresh session context, but incurs accelerator execution latency and requires reserving headroom for traffic spikes. The claim that static inference eliminates storage confuses caching with real-time compute. Static precomputation cannot dynamically react to intra-session signals. Static workloads typically run in large cloud batch jobs rather than edge microcontrollers.
Learning Objective: Compare the trade-offs between static precomputation and dynamic on-demand inference regarding latency, freshness, storage, and compute provisioning.
Why does bare-metal TinyML serving on microcontrollers (e.g., ARM Cortex-M) preclude the use of standard cloud serving frameworks (like Triton or vLLM), and what architectural adaptations are required?
Answer: Microcontrollers have severe physical constraints—often less than 1 MB of SRAM and flash memory, no virtual memory/paging, no operating system (bare-metal or RTOS), and no dedicated floating-point units. Consequently, serving requires integer-only quantization (e.g., INT8/INT4), static memory planning with zero runtime dynamic allocation, and lightweight embedded runtimes (e.g., TFLite Micro) compiled ahead-of-time directly into the firmware binary.
Learning Objective: Analyze the hardware and runtime constraints that distinguish bare-metal TinyML deployment from networked cloud serving architectures.
True or False: Under a simple \(M/M/1\) queueing model approximation, when server utilization (\(\rho_{\text{serv}}\)) reaches 90%, the 99th percentile (p99) tail latency is approximately equal to 1.5 times the mean latency.
Answer: False. In an \(M/M/1\) queueing model, mean residence time scales as \(T_{\text{svc}} / (1 - \rho_{\text{serv}})\), and the 99th percentile tail latency is approximately \(4.6 \times\) the mean latency (since \(\ln(100) \approx 4.605\)). At 90% utilization (\(\rho_{\text{serv}} = 0.9\)), mean latency is \(10 \times T_{\text{svc}}\), making p99 latency roughly \(46 \times T_{\text{svc}}\), demonstrating the severe nonlinear divergence of tail latency from mean latency near saturation.
Learning Objective: Evaluate tail-latency divergence at high server utilization using queueing theory approximations.
To prevent OS scheduler thread migration and cross-socket memory bus contention from causing latency jitter on multi-socket CPU serving nodes, engineers bind worker threads to specific processor cores and local memory nodes using the ____ utility.
Answer: numactl. The numactl utility (and NUMA-aware thread affinity mechanisms) binds processes and execution threads to specific physical CPU cores and their local NUMA memory nodes. This avoids cross-socket interconnect traffic over UPI/QPI buses and eliminates OS scheduler migration jitter, ensuring deterministic inference latencies.
Learning Objective: Apply CPU core pinning and NUMA node affinity techniques to eliminate latency jitter in high-performance serving environments.
A high-throughput model serving cluster sits behind a Layer 7 load balancer. Which routing algorithm is best suited for minimizing p99 tail latency when inference execution times vary significantly across requests due to variable input sequence lengths?
- Peak exponentially weighted moving average (Peak-EWMA) or least-pending-requests routing, which steers traffic away from replicas currently processing long-running requests.
- Static round-robin routing, which deterministically rotates incoming connections across all healthy replicas regardless of current queue depths.
- Random routing with hash-based sticky IP assignment, which pins client IP addresses permanently to specific backends without monitoring load.
- Maximum-throughput greedy allocation, which concentrates all incoming traffic onto a single primary replica until its memory is completely saturated before spilling over.
Answer: The correct answer is A. When inference requests exhibit high service-time variance (e.g., dynamic sequence lengths in LLMs or variable image resolutions), static round-robin or random routing can inadvertently queue requests behind long-running tasks on busy nodes. Algorithms like Peak-EWMA or least-pending-requests track active connections and recent response latencies, directing traffic to nodes with the lowest instantaneous backlog to suppress tail latency. Static round-robin ignores current server queue depths, causing head-of-line blocking behind stragglers. Random IP stickiness exacerbates load imbalances. Saturating a single replica triggers severe nonlinear queue explosions.
Learning Objective: Design load balancing and request routing strategies to mitigate tail latency under variable service-time distributions.
Self-Check: Answer
- **Order the sequential stages of a request passing through a high-performance decoupled inference serving pipeline from initial arrival to client response:
- Hardware Accelerator Execution (tensor kernel execution on GPU/NPU)
- Dynamic Batcher (aggregating incoming items up to max batch size or timeout)
- Network Ingress & Gateway (TLS termination, authentication, protocol deserialization)
- Postprocessing & Response Dispatch (logit normalization, top-\(k\) filtering, response serialization)
- Request Queue (absorbing traffic bursts and buffering pending requests)
- Inference Runner / Engine (tensor memory management, CUDA stream scheduling)**
Answer: The correct order is: 1. (3) Network Ingress & Gateway (TLS termination, authentication, protocol deserialization) 2. (5) Request Queue (absorbing traffic bursts and buffering pending requests) 3. (2) Dynamic Batcher (aggregating incoming items up to max batch size or timeout) 4. (6) Inference Runner / Engine (tensor memory management, CUDA stream scheduling) 5. (1) Hardware Accelerator Execution (tensor kernel execution on GPU/NPU) 6. (4) Postprocessing & Response Dispatch (logit normalization, top-\(k\) filtering, response serialization)
Explanation: A request arrives at the Network Ingress for TLS termination and protocol handling, buffers in the Request Queue during bursts, gets grouped with other concurrent requests by the Dynamic Batcher, is prepared and scheduled by the Inference Runner onto GPU streams, executes on the Hardware Accelerator, and finally undergoes Postprocessing and response serialization before returning to the client.
Learning Objective: Design the end-to-end request pipeline of a modern inference server by ordering its architectural stages.
In a microservices architecture where an internal fraud detection service processes \(10^5\) queries per second with a 5 ms SLA, why is gRPC with Protocol Buffers preferred over HTTP/1.1 with JSON?
- JSON text parsing is performed directly inside GPU Tensor Cores, whereas Protocol Buffers require host CPU preprocessing.
- HTTP/1.1 provides automatic iteration-level continuous batching, whereas gRPC only supports static batching.
- Protocol Buffers eliminate the need for schema definitions, enabling zero-copy dynamic typing across heterogeneous languages.
- Protocol Buffers use compact binary encoding with pre-compiled schema parsers that drastically reduce CPU serialization latency, and gRPC multiplexes requests over persistent HTTP/2 TCP connections.
Answer: The correct answer is D. At high query rates (\(10^5\) QPS), parsing string-based JSON formats imposes substantial CPU serialization tax and memory allocations that can exceed model inference time. Protocol Buffers encode structured data in compact binary representations with fast generated deserializers, and gRPC leverages HTTP/2 multiplexing over persistent connections to avoid per-request TCP handshakes. JSON parsing is executed on host CPUs, not GPU Tensor Cores. Continuous batching is an engine scheduling mechanism, not a feature of HTTP/1.1. Protocol Buffers strictly enforce schemas rather than eliminating them.
Learning Objective: Evaluate interface protocols and serialization formats (REST/JSON vs. gRPC/Protobuf) for latency-critical serving pipelines.
What is the ‘serialization bottleneck’ in model serving, and under what operational conditions (model size, request payload, query rate) does it become the dominant factor in the end-to-end latency budget?
Answer: The serialization bottleneck occurs when the CPU time required to serialize/deserialize text-based payloads (such as JSON) and perform string-to-float conversions exceeds the time spent executing neural network inference on an accelerator. It becomes dominant when serving lightweight models (e.g., small tabular ML models, linear classifiers, or shallow CNNs with sub-millisecond inference times) under high request rates or large feature vectors, where CPU parsing accounts for 70–90% of the total request lifecycle.
Learning Objective: Analyze the conditions under which serialization overheads dominate model inference execution in serving architectures.
True or False: Replacing HTTP/1.1 REST endpoints with gRPC automatically accelerates the GPU kernel execution time of deep learning models by \(2\times\) to \(4\times\).
Answer: False. Interface protocols such as gRPC and REST operate at the transport and network serialization layer between clients and the server gateway; they reduce transport latency, CPU serialization overhead, and connection overhead, but have zero effect on the mathematical compute operations or kernel execution duration of the model running on the GPU accelerator.
Learning Objective: Evaluate transport/serialization layer optimizations and distinguish them from accelerator computation in model serving pipelines.
In an inference server architecture, what is the primary role of decoupling the request queue from the dynamic batcher?
- It allows the server to permanently cache all intermediate GPU activations across independent client requests.
- It allows the system to absorb stochastic arrival bursts without dropping connections while providing the batcher with a pool of pending requests to construct optimal batch sizes within a timeout budget.
- It eliminates the need for GPU kernel compilation by converting dynamic input shapes into fixed static tensors in the queue.
- It bypasses host RAM by streaming network packets directly from the NIC into the accelerator’s L2 cache via PCIe peer-to-peer transfers.
Answer: The correct answer is B. Decoupling the request queue from the dynamic batcher acts as an elastic buffer that absorbs traffic fluctuations (Poisson arrival bursts) and holds arriving requests so the dynamic batcher can inspect queue depth and aggregate individual queries into high-throughput batches before forwarding them to the execution engine. Queue decoupling does not cache intermediate GPU activations across independent requests. It does not replace or eliminate kernel compilation. Moving network packets to GPU memory still requires host memory management and engine orchestration.
Learning Objective: Explain the function of queue decoupling and dynamic batching in inference server design.
Self-Check: Answer
An image classification service has an end-to-end SLA of 30 ms. The request path consists of: network ingress/egress (8 ms), CPU image decoding and normalization (10 ms), GPU forward pass (8 ms), and postprocessing/top-\(k\) filtering (2 ms). If an engineer optimizes the GPU model forward pass to run in 4 ms (a \(2\times\) speedup), what is the new total latency and what architectural principle explains the resulting overall speedup?
- Total latency decreases from 28 ms to 24 ms (a 14.3% overall improvement), demonstrating Amdahl’s law where unaccelerated preprocessing and network stages bound the system gains.
- Total latency decreases from 28 ms to 14 ms (a 50% overall improvement), because GPU acceleration propagates linearly across all pipeline stages.
- Total latency remains 28 ms because dynamic batching automatically inserts artificial delay to fill GPU occupancy.
- Total latency increases to 32 ms due to host-device synchronization overhead incurred by faster kernel launches.
Answer: The correct answer is A. Total initial latency is \(8 + 10 + 8 + 2 = 28\text{ ms}\). Reducing GPU inference from 8 ms to 4 ms makes the new total latency \(8 + 10 + 4 + 2 = 24\text{ ms}\). The fractional speedup is \((28 - 24) / 28 \approx 14.3\%\). This illustrates Amdahl’s Law in serving systems: because non-inference stages (network RTT, CPU decoding, postprocessing) account for 20 ms of the 28 ms budget, isolated GPU speedups have a diminishing impact on user-perceived end-to-end latency. The claim of a 50% total reduction ignores unaccelerated pipeline components. Dynamic batching does not arbitrarily inflate latency when execution finishes faster. Faster GPU kernels do not inherently increase execution time.
Learning Objective: Calculate end-to-end latency improvements using Amdahl’s Law across multi-stage serving pipelines.
What is the ‘killer microseconds’ problem in low-latency ML serving systems, and why do standard operating system scheduling and hardware primitives struggle to handle it efficiently?
Answer: The ‘killer microseconds’ problem refers to operations that take between \(1\,\mu\text{s}\) and \(100\,\mu\text{s}\) (such as fast tensor copies, micro-batch inference, or inter-process IPC). This timescale falls into an architectural gap: it is too long to waste CPU cycles in busy-wait polling/spinlocks, but too short to amortize the overhead of operating system thread context switches, interrupts, and kernel transitions (which cost several microseconds), resulting in high CPU overhead or significant latency jitter.
Learning Objective: Analyze the system trade-offs underlying the killer microseconds problem in low-latency inference runtimes.
In a high-throughput vision serving pipeline, engineers overlap CPU image preprocessing of request \(N+1\) with GPU inference of request \(N\) using multiple CUDA streams and pinned host memory buffers, thereby increasing accelerator ____ without modifying the underlying model architecture.
Answer: duty cycle. Pipelining independent execution stages across CPU and GPU hardware resources using double buffering and non-blocking CUDA streams keeps the accelerator continuously busy, increasing its hardware duty cycle (and overall system throughput) without altering the model weights or architecture.
Learning Objective: Apply request pipelining and double-buffering techniques to maximize accelerator duty cycle.
True or False: For computer vision models utilizing standard 2D convolutions or self-attention mechanisms, increasing the input image resolution from \(224 \times 224\) to \(448 \times 448\) quadruples the number of input pixels (\(4\times\)), which results in an approximately \(4\times\) increase in FLOPs for standard convolutional layers and up to a \(16\times\) increase for unwindowed full self-attention layers.
Answer: True. Spatial scaling scales the token/pixel grid quadratically with linear dimensions: \((448/224)^2 = 4\times\). Standard 2D convolution FLOPs scale linearly with the number of spatial pixels (\(H \times W\)), yielding a \(4\times\) compute increase. Standard unwindowed self-attention scales quadratically with token count (\(N^2\)), meaning a \(4\times\) increase in spatial tokens leads to a \((4)^2 = 16\times\) increase in self-attention compute operations.
Learning Objective: Evaluate computational complexity and latency scaling across varying input resolutions in vision serving systems.
In an object detection serving pipeline (e.g., YOLO or Faster R-CNN), why can postprocessing operations like Non-Maximum Suppression (NMS) create unpredictable tail-latency spikes if executed naively on the CPU?
- NMS requires running backward gradient passes to rank candidate bounding boxes.
- NMS forces the GPU to reload its weight matrices from host memory over PCIe.
- NMS has input-dependent computational complexity \(\mathcal{O}(M^2)\) based on the number of candidate boxes \(M\) surviving confidence thresholding, causing high latency variance on crowded scenes with many detections.
- NMS converts floating-point logits into 64-bit double precision, exhausting CPU L1 instruction caches.
Answer: The correct answer is C. The computational complexity of Non-Maximum Suppression is quadratic (\(\mathcal{O}(M^2)\)) in the number of candidate bounding boxes \(M\) that exceed the initial confidence threshold. On complex or crowded images with hundreds of overlapping proposals, CPU-based sequential IoU comparisons take significantly longer than on simple images with few boxes, creating severe tail-latency spikes and pipeline stalls. NMS is an inference postprocessing step and does not involve gradient backpropagation. It operates on output coordinates and scores without reloading model weights. NMS evaluates intersection-over-union geometric overlap, not 64-bit precision conversion.
Learning Objective: Analyze the tail-latency implications of input-dependent postprocessing algorithms in computer vision serving.
Self-Check: Answer
An online recommendation service handles an arrival rate of \(\lambda = 500\) queries per second. Instrumented telemetry reveals an average residency time (waiting time in queue + inference service time) of \(W = 40\text{ ms}\) (\(0.04\text{ s}\)). According to Little’s Law, what is the average number of concurrent requests (\(L\)) present in the serving system?
- \(L = 12.5\text{ requests}\)
- \(L = 200\text{ requests}\)
- \(L = 2\text{,}000\text{ requests}\)
- \(L = 20\text{ requests}\)
Answer: The correct answer is D. Little’s Law states that the average number of requests in a stable system is \(L = \lambda W\). Substituting \(\lambda = 500\text{ requests/s}\) and \(W = 0.04\text{ s}\) yields \(L = 500 \times 0.04 = 20\text{ requests}\). The value 12.5 requests results from dividing arrival rate by residency time. The value 200 requests results from an arithmetic error using 400 ms. The value 2,000 requests confuses seconds with milliseconds (\(500 \times 40\)).
Learning Objective: Calculate system concurrency and queue capacity using Little’s Law.
Explain the ‘tail at scale’ phenomenon in distributed microservice architectures, and calculate the probability that an aggregate user request suffers tail latency if it fans out in parallel to 50 leaf model servers, each having a 99th percentile (p99) latency SLA violation probability of 1% (\(p = 0.01\)).
Answer: In distributed serving architectures where an aggregate query fans out in parallel to \(k\) leaf services and waits for all of them to complete (barrier synchronization), the overall request latency is governed by the slowest response (straggler). If each leaf service has an independent p99 SLA violation probability of \(p = 0.01\), the probability of at least one service exceeding its SLA is \(P(\text{tail}) = 1 - (1 - p)^k = 1 - (0.99)^{50} \approx 1 - 0.605 = 39.5\%\). Thus, nearly \(40\%\) of all user requests experience tail latency despite every individual microservice meeting its 99% SLA.
Learning Objective: Calculate fan-out tail-latency amplification in distributed multi-server inference architectures.
True or False: Hedged requests (speculative backup requests) reduce p99 tail latency by sending identical duplicate requests to multiple servers simultaneously for every incoming query upon arrival, without incurring any additional cluster compute overhead.
Answer: False. Sending duplicate requests simultaneously for 100% of incoming queries would double (\(2\times\)) the aggregate traffic load on the cluster, pushing utilization closer to saturation and worsening queueing delays. Instead, effective hedged requests send a secondary request only after the primary request has exceeded a high-percentile latency threshold (e.g., after the 95th percentile service time has elapsed), which caps the additional load to approximately 5% while eliminating long tail stragglers.
Learning Objective: Evaluate the trade-offs and operational mechanics of hedged requests for tail-latency mitigation.
**A serving cluster experiences an unexpected traffic surge that threatens to overwhelm its capacity and violate latency SLAs. Order the progressive defensive mitigation mechanisms from least intrusive (initial arrival surge) to most aggressive (extreme overload):
- Load Shedding / Circuit Breaking (dropping low-priority non-critical requests with HTTP 429/503)
- Dynamic Batch Timeout Shortening (flushing smaller batches sooner to protect latency budget)
- Hedged Request Throttling / Disabling (canceling speculative retries to prevent self-inflicted load)
- Model Graceful Degradation (switching to a smaller, quantized fallback model or skipping optional ensemble branches)**
Answer: The correct order is: 1. (2) Dynamic Batch Timeout Shortening (flushing smaller batches sooner to protect latency budget) 2. (3) Hedged Request Throttling / Disabling (canceling speculative retries to prevent self-inflicted load) 3. (4) Model Graceful Degradation (switching to a smaller, quantized fallback model or skipping optional ensemble branches) 4. (1) Load Shedding / Circuit Breaking (dropping low-priority non-critical requests with HTTP 429/503)
Explanation: As load rises, the system first dynamically adjusts batching timeouts to preserve remaining latency slack. If traffic continues to climb toward saturation, it disables speculative hedged requests to avoid compounding cluster queue depth. Under severe stress, it degrades service quality by routing to lightweight fallback models. Finally, under critical overload, it sheds traffic by rejecting low-priority requests to protect core system availability.
Learning Objective: Design a progressive multi-tier degradation and tail-mitigation strategy for overloaded serving systems.
An inference node modeled as an \(M/M/1\) queue has an average execution service time of \(T_{\text{svc}} = 10\text{ ms}\). If the arrival rate increases such that system utilization \(\rho\) increases from \(50\%\) (\(\rho = 0.5\)) to \(90\%\) (\(\rho = 0.9\)), what happens to the mean total response time \(W\)?
- \(W\) increases linearly from 10 ms to 18 ms.
- \(W\) increases nonlinearly from 20 ms to 100 ms (\(5\times\) increase).
- \(W\) decreases from 20 ms to 11.1 ms due to batching efficiency.
- \(W\) remains fixed at 10 ms because service time is independent of arrival rate.
Answer: The correct answer is B. For an \(M/M/1\) queue, mean total response time is given by \(W = \frac{T_{\text{svc}}}{1 - \rho}\). At \(\rho = 0.5\), \(W = \frac{10\text{ ms}}{1 - 0.5} = 20\text{ ms}\). At \(\rho = 0.9\), \(W = \frac{10\text{ ms}}{1 - 0.9} = \frac{10}{0.1} = 100\text{ ms}\). Thus, a 1.8\(\times\) increase in utilization causes a \(5\times\) non-linear explosion in average response time. The linear increase option incorrectly assumes response time scales proportionally with utilization. The decrease option incorrectly assumes queuing time drops with higher load. The fixed option ignores queuing waiting time entirely.
Learning Objective: Calculate mean queue residency time and analyze non-linear latency growth as utilization approaches saturation.
Self-Check: Answer
A computer vision team trains a ResNet-50 model in PyTorch using torchvision’s PIL-based bilinear image resizing. In production, high-throughput C++ inference servers use OpenCV’s
cv::resizewith default bilinear interpolation. In production, top-1 accuracy drops by 1.8% despite identical model weights. What phenomenon is causing this degradation, and what is the proper engineering solution?- Training-serving skew caused by subtle implementation differences in resize anti-aliasing and pixel coordinate rounding between PIL and OpenCV; the solution is exporting a unified preprocessing graph (e.g., via ONNX or TorchScript) shared across training and serving.
- Accelerator thermal throttling caused by high frame rates; the solution is downclocking the GPU Tensor Cores.
- Floating-point precision drift between Python and C++; the solution is switching all production inference to 64-bit double precision.
- Catastrophic forgetting in the weights caused by static batching; the solution is retraining the model with dynamic dropout.
Answer: The correct answer is A. This is a classic manifestation of training-serving skew. Different image processing libraries (e.g., PIL vs. OpenCV) implement resize filters, pixel center alignments, and rounding rules differently, creating a silent distribution shift between training images and serving tensors. The standard solution is packaging and executing the identical preprocessing pipeline (via a unified graph export or shared C++ library) across both offline training and online serving. Thermal throttling affects throughput and latency, not prediction accuracy. Floating-point differences between Python and C++ runtimes are negligible and do not account for a 1.8% accuracy drop. Static batching does not alter model weights or induce catastrophic forgetting.
Learning Objective: Analyze the root causes of training-serving skew and design unified preprocessing pipelines to maintain inference accuracy.
Why does simply copying model weights into GPU HBM upon container startup fail to prevent latency spikes on the very first incoming user requests, and how does executing a ‘warmup pass’ resolve this issue?
Answer: Even after weights reside in GPU memory, the first inference requests trigger lazy runtime initialization overheads—including CUDA context creation, memory allocator pool expansions, dynamic kernel compilation (JIT), cuDNN algorithm autotuning, and execution graph instantiations. A ‘warmup pass’ runs synthetic dummy tensors through the model across representative batch sizes during container initialization before marking the server healthy in the load balancer, ensuring all memory pools, engines, and execution paths are fully compiled and cached.
Learning Objective: Explain the systems mechanisms behind cold-start latency spikes and justify the use of synthetic warmup passes.
**Sequence the stages of a complete cold-start initialization workflow when autoscaling an inference server pod from an idle state to serving live production traffic:
- Transfer model weights from host pinned DRAM to GPU High-Bandwidth Memory (HBM) over PCIe
- Fetch model checkpoint artifacts and configuration from remote object storage (e.g., S3) to local NVMe SSD cache
- Initialize runtime execution engine, allocate memory pools, and run synthetic dummy warmup passes
- Container initialization, environment bootstrap, and runtime dependency loading
- Register pod as healthy with load balancer gateway to begin receiving live traffic
- Memory-map (
mmap) or deserialize model weights from local SSD into host pinned DRAM**
Answer: The correct order is: 1. (4) Container initialization, environment bootstrap, and runtime dependency loading 2. (2) Fetch model checkpoint artifacts and configuration from remote object storage (e.g., S3) to local NVMe SSD cache 3. (6) Memory-map (mmap) or deserialize model weights from local SSD into host pinned DRAM 4. (1) Transfer model weights from host pinned DRAM to GPU High-Bandwidth Memory (HBM) over PCIe 5. (3) Initialize runtime execution engine, allocate memory pools, and run synthetic dummy warmup passes 6. (5) Register pod as healthy with load balancer gateway to begin receiving live traffic
Explanation: The pod first boots its container environment, retrieves weights from remote storage to local SSD, maps weights into host pinned DRAM, transfers tensors to GPU VRAM over PCIe, executes synthetic warmup passes to compile kernels and allocate memory pools, and finally passes health checks to receive live user requests.
Learning Objective: Design the end-to-end cold-start and initialization lifecycle for autoscaling inference infrastructure.
True or False: In multi-model serving on a shared GPU, NVIDIA Multi-Process Service (MPS) provides hard physical hardware partitioning of high-bandwidth memory (HBM) channels and compute cores, completely preventing memory out-of-memory (OOM) faults caused by co-located tenant models.
Answer: False. NVIDIA MPS enables multiple CPU processes to multiplex kernels concurrently onto a single shared GPU context to improve utilization, but it shares a single unified memory address space without hardware-enforced memory isolation limits. An allocation spike in one model can cause an OOM crash across all co-located MPS processes. For hard hardware-level isolation of compute units and physical memory slices, Multi-Instance GPU (MIG) on supported architectures (such as A100/H100) is required.
Learning Objective: Compare GPU multi-tenant isolation mechanisms (MPS vs. MIG) regarding memory safety and compute partitioning.
A multi-model serving platform hosts 50 distinct fine-tuned vision models on a single GPU node with 24 GB of VRAM. Each model requires 2 GB of memory, exceeding total VRAM capacity. Traffic to individual models is sporadic. What loading and memory management architecture enables serving all 50 models while minimizing request latency?
- Redeploy the cluster on 50 dedicated GPU nodes running continuous batching 24/7.
- Quantize all models to 1-bit weights to fit all 50 models into GPU L2 cache simultaneously.
- Maintain a tiered memory cache (storing active models in GPU VRAM and inactive models in host pinned DRAM), using asynchronous PCIe DMA transfers to swap weights into VRAM on demand with an LRU eviction policy.
- Compress all models into a single shared zip archive on remote S3 and download the entire archive over HTTP on each incoming request.
Answer: The correct answer is C. For multi-model serving with sporadic demand and memory constraints, tiered memory management caches active model weights in GPU VRAM and holds warm standby models in host pinned DRAM. When a request targets an offloaded model, the server initiates an asynchronous PCIe direct memory access (DMA) transfer to swap weights into VRAM using an LRU eviction policy, achieving sub-100 ms load times without provisioning 50 dedicated GPUs. Provisioning 50 dedicated GPUs for sporadic traffic results in excessive hardware idle costs. 1-bit quantization causes severe accuracy degradation and does not eliminate runtime memory footprints. Downloading models from remote object storage per request introduces seconds of network latency.
Learning Objective: Design a tiered memory caching and dynamic model swapping architecture for multi-model serving under GPU memory constraints.
Self-Check: Answer
Why does increasing the batch size during deep learning inference dramatically improve hardware throughput on modern GPUs, and at what point does throughput plateau on the Roofline model?
- Batching converts all floating-point operations into integer bitshifts, bypassing GPU ALUs entirely.
- Batching reduces the total parameter count of the neural network by sharing weights across batch samples.
- Batching eliminates PCIe bus data transfer overhead by generating synthetic input tensors on the device.
- Batching increases arithmetic intensity (FLOPs per byte of memory accessed) by reusing loaded weight matrices across multiple input samples, shifting the workload from memory-bandwidth-bound to compute-bound until compute saturates.
Answer: The correct answer is D. In small batches (e.g., batch size 1), inference is heavily memory-bandwidth bound because large weight tensors must be fetched from HBM to on-chip SRAM for each individual input vector, yielding low arithmetic intensity. Batching amortizes the memory transfer of static weights across \(B\) inputs in parallel, increasing arithmetic intensity until the workload hits the GPU’s peak compute throughput ceiling (the roofline knee), after which further batching increases queue delay without increasing throughput. Batching does not convert floating-point operations into bitshifts. It does not reduce model parameter count. Batching increases input tensor sizes transferred over PCIe rather than eliminating transfers.
Learning Objective: Analyze the relationship between batch size, arithmetic intensity, memory bandwidth, and compute saturation on the Roofline model.
Contrast traditional request-level dynamic batching with iteration-level continuous batching (as introduced in Orca and vLLM) for Large Language Model (LLM) serving. Why is request-level batching severely inefficient for autoregressive generation?
Answer: In request-level dynamic batching, a batch of requests executes together until the longest sequence in the batch finishes generation; shorter requests that finish early remain trapped, wasting compute on padding tokens (head-of-line blocking). In continuous (iteration-level) batching, the execution engine schedules generation at the granularity of individual token iterations: as soon as a sequence generates an end-of-token (EOS) symbol, it is evicted immediately, and a new pending prompt (prefill) or active sequence (decode) is inserted into the batch for the very next iteration, eliminating idle padding bubbles.
Learning Objective: Compare request-level dynamic batching with iteration-level continuous batching in autoregressive LLM serving.
True or False: PagedAttention resolves the primary memory waste in LLM KV-caching by allocating key and value states in non-contiguous, fixed-size physical memory blocks managed via a virtual page table, eliminating both internal fragmentation from over-allocation and external memory fragmentation.
Answer: True. Naive KV-cache memory allocators statically pre-allocate contiguous memory buffers sized to the maximum possible context length (e.g., 2048 or 4096 tokens), resulting in 60–80% memory waste due to internal fragmentation (unused reserved slots) and external memory fragmentation. PagedAttention mimics virtual memory paging in operating systems: it allocates dynamic KV blocks (e.g., 16 tokens per block) on demand, enabling near-zero memory waste and unlocking significantly higher serving concurrency.
Learning Objective: Explain the memory management mechanics and fragmentation elimination of PagedAttention in LLM serving.
An autonomous vehicle perceives its environment using 6 surround cameras that capture frames simultaneously at 30 Hz. Because all camera frames arrive at the perception server simultaneously in synchronized bursts, this represents a ____ arrival process that enables zero-wait co-batching across camera streams.
Answer: streaming. Streaming traffic with synchronized sensor arrivals (such as multi-camera arrays on robotics or autonomous vehicles) features highly correlated inter-arrival times. Because all frames arrive together at fixed clock intervals, the serving system can form an optimal batch (e.g., batch size 6) immediately without waiting on dynamic batching timeout windows.
Learning Objective: Classify traffic arrival patterns (Poisson, correlated/streaming, single-user) and design appropriate batching strategies.
A cloud serving system with an end-to-end latency budget of 50 ms configures a dynamic batcher with
max_batch_size = 32andmax_batch_delay_ms = 20. Under low traffic (10 QPS), individual requests arrive 100 ms apart. What is the operational impact on latency and batch efficiency?- Every request waits the full 20 ms timeout in the queue and executes as a batch of size 1, incurring the maximum queueing delay penalty with zero throughput amortization gain.
- Requests are automatically dropped because the queue fails to reach the maximum batch size of 32 within 50 ms.
- The server achieves peak GPU utilization because small batches execute with sub-microsecond latency.
- The dynamic batcher disables timeouts and waits indefinitely until 32 requests accumulate, preserving throughput at the cost of infinite latency.
Answer: The correct answer is A. When the arrival rate is low (\(\lambda = 10\text{ QPS}\), mean inter-arrival time \(100\text{ ms}\)), the queue will rarely receive a second request within the 20 ms window. Consequently, every incoming request sits idle in the batcher for the full 20 ms
max_batch_delay_mstimeout before triggering an execution of batch size 1. This wastes 40% of the 50 ms latency budget without gaining any of the throughput advantages of batching. Requests are not dropped when batch timeouts expire; they are dispatched immediately. A batch size of 1 does not achieve peak GPU utilization. Dynamic batchers respect the configured timeout and do not wait indefinitely.Learning Objective: Evaluate dynamic batching timeout trade-offs under low-traffic and bursty arrival conditions.
Self-Check: Answer
In Large Language Model (LLM) serving, how do the computational and hardware characteristics of the Prefill phase (Time to First Token, TTFT) fundamentally differ from the Decode phase (Time Per Output Token, TPOT)?
- Prefill processes tokens autoregressively one by one and is memory-bandwidth bound, whereas Decode processes all output tokens simultaneously and is compute-bound.
- Prefill processes all prompt tokens concurrently in parallel matrix multiplications and is compute-bound, whereas Decode generates one token per step autoregressively and is memory-bandwidth bound due to repeated weight fetching.
- Prefill operates exclusively on host CPU DRAM, whereas Decode runs on GPU Tensor Cores.
- Prefill latency scales quadratically with batch size, whereas Decode latency is strictly independent of sequence length and KV-cache size.
Answer: The correct answer is B. The prefill phase takes the full prompt context and computes attention and feed-forward activations for all tokens simultaneously in large matrix-matrix multiplications (GEMM), making it compute-bound (high arithmetic intensity). In contrast, the autoregressive decode phase generates one token at a time: for each generated token, the entire model weight tensor (tens of gigabytes) must be streamed from VRAM to compute matrix-vector products (GEMV), making it memory-bandwidth bound (low arithmetic intensity). Autoregressive generation occurs during decode, not prefill. Both phases execute on the accelerator. Prefill scales quadratically with prompt length (\(N^2\)), while decode latency depends directly on KV-cache memory bandwidth and batch size.
Learning Objective: Compare the computational bottlenecks, arithmetic intensity, and hardware characteristics of the LLM prefill and decode phases.
Calculate the total memory footprint (in bytes) required to store the KV cache for a batch of \(B = 16\) requests, each with an active context length of \(S = 2\text{,}048\) tokens, for a model with \(L = 32\) transformer layers, \(H_{\text{kv}} = 8\) key-value attention heads (Grouped-Query Attention), head dimension \(D_{\text{head}} = 128\), stored in FP16 precision (\(P = 2\text{ bytes}\)).
Answer: The formula for KV cache memory is \(\text{Memory} = 2 \times L \times H_{\text{kv}} \times D_{\text{head}} \times P \times S \times B\text{ bytes}\) (where the factor of 2 accounts for both Keys and Values). Substituting the parameters: \[\text{Memory} = 2 \times 32 \times 8 \times 128 \times 2 \times 2048 \times 16\text{ bytes}\] \[\text{Memory} = 2 \times 32 \times 8 \times 128 \times 2 = 131\text{,}072\text{ bytes per token per sequence}\] \[\text{Total Memory} = 131\text{,}072 \times 2048 \times 16 = 4\text{,}294\text{,}967\text{,}296\text{ bytes} = 4\text{ GB (or } 4\text{ GiB)}.\]
Learning Objective: Calculate KV-cache memory capacity requirements for transformer models under varying batch sizes and context lengths.
**Order the step-by-step execution cycle of Speculative Decoding for accelerating LLM inference:
- Target model runs a single parallel forward pass over the prompt plus all \(K\) draft candidate tokens to compute ground-truth verification logits
- Draft model (a lightweight autoregressive model) generates \(K\) candidate tokens sequentially in fast memory-bandwidth-efficient steps
- Engine appends the accepted tokens (plus one newly corrected token) to the KV cache and advances the generation context
- Verification logic evaluates draft tokens against target logits (using greedy matching or modified rejection sampling) to accept the first \(M\) matching tokens (\(M \le K\))**
Answer: The correct order is: 1. (2) Draft model (a lightweight autoregressive model) generates \(K\) candidate tokens sequentially in fast memory-bandwidth-efficient steps 2. (1) Target model runs a single parallel forward pass over the prompt plus all \(K\) draft candidate tokens to compute ground-truth verification logits 3. (4) Verification logic evaluates draft tokens against target logits (using greedy matching or modified rejection sampling) to accept the first \(M\) matching tokens (\(M \le K\)) 4. (3) Engine appends the accepted tokens (plus one newly corrected token) to the KV cache and advances the generation context
Explanation: In speculative decoding, a fast draft model proposes \(K\) candidate tokens. The large target model processes all \(K\) tokens simultaneously in one parallel forward pass. The verification algorithm accepts valid tokens up to the first divergence, and the engine updates the KV cache with the verified tokens before starting the next speculative cycle.
Learning Objective: Analyze the algorithmic and system execution workflow of speculative decoding in LLM serving.
True or False: Speculative decoding alters the output token probability distribution of the target LLM, trading mathematical output fidelity and generation accuracy for higher decoding speed.
Answer: False. When implemented with exact rejection sampling (or greedy matching under temperature 0), speculative decoding is mathematically lossless: the output token probability distribution is provably identical to sampling directly from the large target model alone. The draft model acts purely as a proposal mechanism to convert sequential memory-bound operations into parallel verification steps.
Learning Objective: Evaluate the mathematical guarantees and distribution preservation of speculative decoding.
In a multi-turn conversational AI system with extensive system prompts (e.g., 2,000 tokens of instructions and few-shot examples shared across thousands of user sessions), what serving optimization eliminates redundant prefill compute across requests?
- Linear Attention Approximation, which drops system prompt tokens entirely from the attention window.
- Static Graph Compilation, which hardcodes user inputs directly into the weight tensors.
- Prefix Caching (e.g., RadixAttention), which stores the KV-cache states of common prompt prefixes in memory and reuses them across queries matching the prefix.
- Speculative Quantization, which quantizes prompt tokens into 1-bit binary representations during the decode phase.
Answer: The correct answer is C. Prefix Caching (implemented via Radix trees or hash-indexed prefix tables) retains the computed key-value tensors of shared prompt prefixes (such as system instructions, tools, or few-shot exemplars) in GPU memory. When subsequent requests share the identical prompt prefix, the server skips the expensive prefill matrix multiplications for those tokens, slashing Time to First Token (TTFT) and saving GPU compute. Linear attention approximation alters model behavior and may degrade prompt adherence. Static graph compilation optimizes kernel execution but does not cache dynamic KV tokens. Quantizing prompts to 1-bit does not eliminate prefill execution.
Learning Objective: Apply prefix caching and KV-reuse techniques to minimize Time to First Token in multi-turn conversational serving.
Self-Check: Answer
An ML systems team is deploying a transformer-based ranking model on NVIDIA data center GPUs. They consider running the raw PyTorch model in eager Python mode versus compiling the model into an optimized NVIDIA TensorRT engine. Which optimization does TensorRT perform that PyTorch eager mode cannot achieve?
- TensorRT automatically converts the supervised classification task into an unsupervised reinforcement learning policy.
- TensorRT trains additional adapter layers during live request serving to adapt to data drift.
- TensorRT eliminates all GPU memory usage by running inferences exclusively in the CPU instruction cache.
- TensorRT performs aggressive vertical and horizontal operator fusion (e.g., combining Conv/MatMul, BiasAdd, and Activation into a single kernel), eliminates redundant memory round-trips, and selects hardware-tuned cuDNN/Tensor Core kernels.
Answer: The correct answer is D. Dedicated inference runtimes like TensorRT perform ahead-of-time (AOT) graph transformations—including vertical operator fusion (combining matrix multiplications, bias additions, layer norms, and activations into unified CUDA kernels), horizontal fusion of parallel layers, dead-code elimination, and auto-tuning kernel execution against specific GPU architectures. In contrast, PyTorch eager mode launches separate CUDA kernels for each individual operation, incurring kernel launch overhead and writing intermediate activation tensors back and forth to global VRAM. TensorRT does not convert model tasks or train adapters during serving. It optimizes GPU execution rather than redirecting work to CPU caches.
Learning Objective: Compare framework-native serving against specialized inference engines (TensorRT, ONNX Runtime) regarding operator fusion and memory traffic.
Why does quantizing a model’s weights and activations from FP16 to INT8 for GPU serving often yield a \(2\times\) or greater throughput improvement, and what role does Post-Training Quantization (PTQ) calibration play in preserving accuracy?
Answer: Quantizing to INT8 halves the memory footprint (bytes transferred from HBM), doubling effective memory bandwidth for bandwidth-bound operations, while doubling the peak compute throughput on modern Tensor Cores (which execute \(2\times\) more INT8 MACs per clock than FP16). PTQ calibration uses a representative sample of unlabelled activation data to determine optimal clipping thresholds (scaling factors via min-max or KL-divergence minimization), mapping dynamic floating-point activation ranges into 8-bit integers without excessive clipping distortion or quantization noise.
Learning Objective: Analyze the hardware mechanisms of INT8 quantization speedups and evaluate calibration techniques in Post-Training Quantization.
True or False: In deep neural network quantization, certain layers (such as the initial embedding/convolution layer, final classification projection, and attention softmax score calculations) exhibit high sensitivity to precision loss, and preserving them in FP16/FP32 while quantizing remaining bulk layers to INT8/INT4 (mixed-precision serving) frequently prevents model accuracy collapse.
Answer: True. Outlier activations and sensitive dynamic ranges concentrate in specific architectural regions (such as the first input projection, final output logits, and softmax normalization). Applying mixed-precision serving—where sensitive boundary layers run in FP16/BF16 while intermediate compute-heavy GEMM/Conv layers run in INT8 or INT4—maintains model accuracy within acceptable margins while capturing the vast majority of quantization speedups.
Learning Objective: Design mixed-precision quantization strategies to balance inference speed with accuracy preservation.
When deploying models to edge devices with Apple Silicon (such as iPhones and iPads), developers export models to the ____ framework to take full advantage of the dedicated Apple Neural Engine (ANE) hardware accelerator.
Answer: CoreML. Apple’s CoreML runtime compiles neural network computational graphs into specialized binaries optimized for the Apple Neural Engine (ANE), GPU, and CPU, providing low-latency, energy-efficient on-device inference on Apple hardware.
Learning Objective: Classify platform-specific edge inference engines (CoreML, OpenVINO, TFLite) for specialized hardware accelerators.
When calibrating an INT8 quantized model using Post-Training Quantization (PTQ), what is the primary danger of using a synthetic or unrepresentative calibration dataset (e.g., ImageNet validation images for a medical endoscopy model)?
- The activation dynamic ranges and outlier distributions in production will not match the calibration dataset, leading to severe clipping of real-world features or coarse quantization binning that degrades serving accuracy.
- The model compiler will fail to generate valid GPU assembly code and reject the weights.
- The server’s physical power consumption will double due to misaligned integer registers.
- The dynamic batcher will permanently lock its batch size to 1.
Answer: The correct answer is A. PTQ calibration determines the static scale factors and zero-points by measuring the minimum and maximum activation values across the calibration set. If calibration data fails to reflect the true distribution and outlier magnitudes of live production inputs, real features will fall outside the calibrated range (causing saturation clipping) or will be mapped into overly coarse quantization bins, leading to silent accuracy degradation in production. The compiler generates valid assembly regardless of calibration dataset content. Power consumption does not double from integer register alignment. Dynamic batching logic is orthogonal to weight quantization calibration.
Learning Objective: Evaluate the risks of unrepresentative calibration datasets during post-training model quantization.
Self-Check: Answer
Why does loading model weights from modern
safetensorsformat provide substantially faster container startup times than legacy PyTorch.ptor.bin(Pythonpickle) files?safetensorsfiles compress weights using gzip, reducing disk storage by \(10\times\).safetensorsfiles store pure, uncompressed raw byte arrays aligned to page boundaries, allowing zero-copy memory mapping (mmap) directly into host memory without running Python object deserialization or arbitrary code execution.safetensorsfiles compile PyTorch code directly into binary x86 machine instructions on disk.safetensorsfiles automatically quantize FP32 weights into 4-bit integers during read operations.
Answer: The correct answer is B. Python
pickleserialization serializes complex object graphs, requiring CPU-heavy object construction, memory allocations, data copying, and presenting serious security vulnerabilities (arbitrary code execution). In contrast,safetensorsstores raw tensor data in a deterministic, uncompressed binary layout with a simple JSON header. This allows the OS to memory-map (mmap) weights directly from local storage into memory pages with zero copies, achieving saturation-level disk read throughput during model initialization while preventing malicious code execution.safetensorsdoes not use gzip compression. It stores tensor arrays rather than compiling Python code to machine instructions. It does not perform on-the-fly quantization during disk reads.Learning Objective: Compare model serialization formats (Safetensors vs. PyTorch Pickle) regarding memory-mapping, deserialization speed, and security.
In a CPU-based model serving deployment, how do vector extensions like Intel Advanced Matrix Extensions (AMX) or Vector Neural Network Instructions (VNNI) accelerate inference throughput compared to standard scalar x86 execution?
Answer: Standard scalar execution processes one or two arithmetic operations per instruction cycle on general-purpose registers. Vector extensions like AVX-512 VNNI and AMX introduce specialized hardware matrix/tile registers and fused multiply-accumulate (DP4A/TMUL) instructions that perform multiple integer (INT8/INT4) or Bfloat16 dot products in a single clock cycle, dramatically increasing arithmetic compute density and throughput per CPU socket for inference workloads.
Learning Objective: Explain how specialized CPU vector instruction sets (VNNI, AMX) accelerate low-precision neural network inference.
**Order the iterative steps of an end-to-end performance profiling workflow for diagnosing an inference serving bottleneck:
- Inspect timeline traces (e.g., via Nsight Systems or PyTorch Profiler) to identify gaps, CUDA stream stalls, CPU-GPU synchronization, and memory bandwidth utilization
- Implement targeted optimization (e.g., kernel fusion, precision reduction, or CPU pipelining) on the identified bottleneck stage
- Establish a reproducible baseline by driving realistic synthetic load with a benchmarking tool (e.g., Triton Perf Analyzer) and measuring latency percentiles (p50, p99)
- Re-benchmark under identical load to verify latency reduction and ensure model prediction accuracy remains intact
- Identify the binding bottleneck category (Compute-bound, Memory-bandwidth-bound, or Host/Pipeline-bound)**
Answer: The correct order is: 1. (3) Establish a reproducible baseline by driving realistic synthetic load with a benchmarking tool (e.g., Triton Perf Analyzer) and measuring latency percentiles (p50, p99) 2. (1) Inspect timeline traces (e.g., via Nsight Systems or PyTorch Profiler) to identify gaps, CUDA stream stalls, CPU-GPU synchronization, and memory bandwidth utilization 3. (5) Identify the binding bottleneck category (Compute-bound, Memory-bandwidth-bound, or Host/Pipeline-bound) 4. (2) Implement targeted optimization (e.g., kernel fusion, precision reduction, or CPU pipelining) on the identified bottleneck stage 5. (4) Re-benchmark under identical load to verify latency reduction and ensure model prediction accuracy remains intact
Explanation: The profiling loop begins by measuring baseline performance under realistic load, capturing timeline traces to observe execution gaps and synchronization stalls, categorizing the binding constraint, applying the specific targeted optimization, and re-benchmarking to validate that latency improved without compromising accuracy.
Learning Objective: Apply structured profiling methodologies and tracing tools to diagnose and resolve inference bottlenecks.
True or False: In Ahead-of-Time (AOT) graph compilation, operator fusion is restricted to combining adjacent layers of the exact same mathematical type (e.g., fusing two consecutive Conv2D operations).
Answer: False. Operator fusion most commonly combines heterogeneous adjacent operations along the vertical computation graph—such as fusing a 2D Convolution, a Bias Addition, a Batch Normalization scale, and a non-linear Activation function (e.g., ReLU or GELU)—into a single unified GPU kernel. This avoids intermediate memory round-trips to global VRAM, drastically saving memory bandwidth.
Learning Objective: Evaluate operator fusion capabilities across heterogeneous computational layers in inference graph compilers.
When profiling a GPU inference server under high load, an engineer observes that the GPU utilization metric reported by
nvidia-smiis 95%, but Nsight Systems timeline traces reveal that the GPU is actually spending 40% of its time stalled on host CPU memory copies. What accounts for this discrepancy?nvidia-smimeasures fan speed and ambient temperature rather than compute kernel activity.- The GPU memory clock is automatically halved during Nsight Systems tracing.
- The CPU is running at 100% duty cycle, which forces
nvidia-smito report false GPU metrics. nvidia-smireports the percentage of time a GPU kernel or context was active on the device, treating memory-stalled or synchronous PCIe transfer states as ‘active’ utilization rather than measuring true compute ALU duty cycle.
Answer: The correct answer is D. The coarse utilization metric in
nvidia-smimerely checks whether any GPU context or kernel was executing during a sample interval; it does not differentiate between productive compute (Tensor Core utilization) and unproductive stalls (such as kernels waiting on synchronous PCIe transfers, uncoalesced memory reads, or host synchronization barriers). Detailed profilers (like Nsight Systems) are required to inspect the actual timeline and hardware warp occupancy.nvidia-smidoes not confuse fan speed with utilization. Memory clocks are not halved by profilers. CPU duty cycle does not corruptnvidia-smimetrics.Learning Objective: Evaluate the limitations of coarse hardware utilization metrics and utilize fine-grained profilers to detect pipeline stalls.
Self-Check: Answer
A team evaluates deploying a small classification model with an average arrival rate of 5 QPS and a 200 ms latency SLA. A single CPU server instance costs $0.20/hour and achieves 20 QPS max throughput. A dedicated GPU server instance costs $2.00/hour and achieves 200 QPS max throughput. Which deployment option is more cost-effective for this specific workload, and why?
- The GPU server is more cost-effective because its raw cost per query at full capacity is lower ($0.010/query vs $0.010/query).
- The GPU server is more cost-effective because GPUs always have lower total cost of ownership regardless of arrival traffic.
- The CPU server is more cost-effective because at 5 QPS, the CPU server easily meets the SLA with adequate headroom at $0.20/hour, whereas the GPU server would run at only 2.5% utilization, wasting $1.80/hour on idle capacity.
- Neither option is viable because 5 QPS requires at least a 10-node cluster for high availability.
Answer: The correct answer is C. When traffic volume is low (5 QPS) and latency targets are modest (200 ms), a single CPU instance meets the demand with ample headroom (\(5 / 20 = 25\%\) utilization) at an hourly cost of $0.20. Provisioning a $2.00/hour GPU instance achieves 2.5% utilization (\(5 / 200\)), yielding a cost of \(\$2.00 / (5 \times 3600) \approx \$0.000111\) per query, which is \(10\times\) more expensive than the CPU instance at \(\$0.20 / (5 \times 3600) \approx \$0.000011\) per query. Comparing peak-capacity costs ignores idle capacity waste under low QPS. GPUs do not universally provide lower TCO for low-traffic applications. 5 QPS does not require a 10-node cluster.
Learning Objective: Evaluate GPU vs. CPU serving economics based on query volume, utilization, and cost per inference.
In capacity planning for a mission-critical model serving cluster with a peak expected traffic of \(\lambda_{\text{peak}} = 1\text{,}000\text{ QPS}\) and an individual replica capacity of \(R = 100\text{ QPS}\) at its target latency SLO, why would a capacity engineer provision 16 to 20 replicas (\(1.6\times\text{--}2.0\times\) headroom multiplier) rather than exactly 10 replicas?
Answer: Sizing capacity exactly to peak load (\(1000 / 100 = 10\) replicas) leaves zero margin for traffic surges, autoscaling warm-up lag (which takes minutes for containers and weights to load), zonal network shifts, or node failures (\(N+1\) redundancy). Furthermore, running nodes at 100% capacity triggers non-linear queueing collapse and tail-latency SLO violations. A headroom multiplier of \(1.5\times\text{--}2.0\times\) ensures nodes operate at 50–65% average utilization during peak traffic, preserving the latency knee and absorbing transient spikes.
Learning Objective: Design capacity sizing plans incorporating peak traffic multipliers, autoscaling delays, and operational headroom.
True or False: For an 8-billion-parameter LLM deployed in FP16 precision (16 GB weight footprint) on an 80 GB GPU, serving long-context requests (e.g., 32k tokens) with large batch sizes causes the memory required by the KV cache to surpass the static weight footprint of the model itself.
Answer: True. For an 8B model with 32 layers, 8 KV heads, and head dimension 128 in FP16 (\(P=2\)), each token across both K and V requires \(2 \times 32 \times 8 \times 128 \times 2 = 131\text{,}072\text{ bytes} = 128\text{ KB}\). For a batch size of 8 with a 32,768-token context, the KV-cache consumes \(128\text{ KB} \times 32\text{,}768 \times 8 \approx 33.55\text{ GB}\), which is more than double the 16 GB required for the model weights.
Learning Objective: Calculate and compare the dynamic KV-cache memory growth against static model weight footprints in LLM serving.
An engineer serves an 8-billion parameter LLM on a GPU with 2 TB/s of High-Bandwidth Memory (HBM) bandwidth. Assuming weights are in FP16 (16 GB model size) and running with batch size \(B = 1\) during the autoregressive decode phase, what is the theoretical hardware-bound minimum Time Per Output Token (TPOT), neglecting KV-cache and compute time?
- \(8.0\text{ ms}\) (\(\text{TPOT} = 16\text{ GB} / 2\text{,}000\text{ GB/s}\))
- \(0.8\text{ ms}\) (\(\text{TPOT} = 1.6\text{ GB} / 2\text{,}000\text{ GB/s}\))
- \(80.0\text{ ms}\) (\(\text{TPOT} = 160\text{ GB} / 2\text{,}000\text{ GB/s}\))
- \(0.08\text{ ms}\) (\(\text{TPOT} = 16\text{ MB} / 2\text{,}000\text{ GB/s}\))
Answer: The correct answer is A. During the autoregressive decode phase at batch size 1, generation is strictly memory-bandwidth bound: for every single output token, the GPU must stream all 16 GB of model weights from HBM to the compute cores. At an HBM bandwidth of \(2\text{ TB/s} = 2\text{,}000\text{ GB/s}\), the minimum transfer time per token is \(\frac{16\text{ GB}}{2\text{,}000\text{ GB/s}} = 0.008\text{ seconds} = 8.0\text{ ms}\) (equivalent to a maximum theoretical decode rate of 125 tokens/second). The other values represent unit conversion errors or arithmetic mistakes.
Learning Objective: Calculate the theoretical memory-bandwidth lower bound on Time Per Output Token (TPOT) for LLM decoding.
Why does serving an LLM with INT4 weight-only quantization (e.g., AWQ or GPTQ) dramatically reduce Time Per Output Token (TPOT) for small batch sizes, even if INT4 compute kernels provide no higher FLOPS than FP16 Tensor Cores?
Answer: For small batch sizes (e.g., \(B=1\text{ to }4\)), the decode phase is strictly memory-bandwidth bound rather than compute bound. Quantizing weights from 16-bit FP16 to 4-bit INT4 reduces the volume of data that must be fetched from HBM across the memory bus by \(4\times\) (e.g., from 16 GB down to 4 GB per token for an 8B model). Because the bottleneck is the memory bus transfer time rather than ALU compute capacity, transferring \(4\times\) fewer bytes cuts memory read time by up to \(4\times\), proportionally slashing TPOT.
Learning Objective: Explain why weight-only quantization accelerates memory-bound LLM decode steps without compute speedups.
Self-Check: Answer
A team attempts to maximize hardware cost efficiency by targeting 95% steady-state GPU utilization across their production serving cluster. Why is this strategy a dangerous engineering pitfall?
- High utilization permanently erases model weights from GPU memory registers.
- In stochastic serving systems, queue waiting times grow asymptotically toward infinity as utilization approaches 100%, causing minor traffic fluctuations to trigger massive tail-latency spikes and widespread SLO breaches.
- Running above 90% utilization forces the operating system to switch from 64-bit to 32-bit execution mode.
- Modern GPUs automatically shut down power when utilization exceeds 80% for more than 10 seconds.
Answer: The correct answer is B. As modeled by queueing theory (\(M/M/1\) and \(G/G/1\)), queue residency time scales as \(1 / (1 - \rho)\). When utilization \(\rho\) reaches 95%, the system has virtually no headroom to absorb natural Poisson arrival bursts; any minor traffic fluctuation causes queue lengths to explode, creating severe p99 tail-latency spikes and cascading timeout failures. High utilization does not erase model weights from registers. Operating systems do not switch execution modes under load. GPUs do not power off when utilized above 80%.
Learning Objective: Evaluate the operational hazards of operating model serving infrastructure near saturation utilization.
True or False: Evaluating an online serving system using mean (average) latency is sufficient for capacity planning, because if the average latency is well below the SLA target, user-facing requests are guaranteed to experience good performance.
Answer: False. Average latency conceals extreme tail outliers (p95, p99, p99.9) where requests experience severe queueing delays. In modern microservice architectures where a user query fans out to dozens of downstream models in parallel, the slowest component determines overall user latency, meaning a low average latency can co-exist with a large fraction of users experiencing SLA violations.
Learning Objective: Justify why tail-latency metrics (p99/p99.9) must be used over mean latency for evaluating online serving systems.
Why is the assumption that ‘cold-start latency only affects the very first request’ a critical fallacy in autoscaling serverless or Kubernetes-based serving environments with bursty traffic?
Answer: In elastic or serverless serving systems, unexpected traffic bursts trigger dynamic autoscaling events that spawn multiple new container replicas simultaneously. Every new replica incurs a full cold start (container boot, weight fetching, memory allocation, CUDA initialization, and kernel JIT compilation). During rapid traffic surges, a substantial fraction of all concurrent incoming requests are routed to these initializing instances, causing widespread p99 latency spikes and connection timeouts across many users rather than just an isolated single request.
Learning Objective: Analyze how autoscaling dynamics and traffic bursts amplify cold-start latency impacts across user populations.
An engineering team increases the dynamic batch size on their vision model serving nodes from 8 to 64, observing that peak offline throughput doubles. However, in production, user-facing p99 latency violations increase by 40%. What fallacy explains this outcome?
- Model weights become corrupted when executed with batch sizes greater than 16.
- GPU Tensor Cores disable INT8 acceleration when batch size exceeds 32.
- High batch sizes reduce arithmetic intensity on the GPU Roofline model.
- The fallacy that larger serving batches always improve throughput without affecting latency; early-arriving requests must wait in the batcher queue for the batch to fill, consuming precious latency budget in queue waiting time.
Answer: The correct answer is D. While larger batch sizes improve GPU compute throughput by amortizing weight loading, online serving requires requests to accumulate in the queue until the batch is filled or a timeout expires. Early-arriving requests spend a significant portion of their latency budget waiting for later requests to arrive; if arrival rates are insufficient to fill large batches rapidly, queue waiting time dominates, triggering p99 SLA violations. Model weights are not corrupted by larger batch sizes. Tensor Cores maintain INT8 acceleration across large batches. Larger batches increase arithmetic intensity rather than reducing it.
Learning Objective: Evaluate the fallacy that larger serving batches improve throughput without degrading online latency SLOs.
Describe the pitfall of ‘Calibrating quantized models with unrepresentative data,’ and explain how it can lead to silent production failure despite passing offline validation checks.
Answer: Post-Training Quantization (PTQ) establishes static scaling factors and clipping bounds based on the activation distributions observed during calibration. If the calibration dataset uses a standard benchmark (or clean training data) that lacks production artifacts (such as sensor noise, varied lighting, user slang, or domain shift), the clipping thresholds will misalign with live traffic. In production, outlier activations will be heavily clipped or quantized coarsely, leading to silent degradation in prediction accuracy despite the model operating with low latency and zero system error codes.
Learning Objective: Explain the mechanisms through which unrepresentative quantization calibration causes silent production accuracy degradation.
Self-Check: Answer
Which core architectural takeaway summarizes the fundamental difference between machine learning model training and production model serving?
- Training optimizes single-query tail latency under fixed memory bounds, whereas serving optimizes long-run epoch throughput across distributed cluster networks.
- Training requires specialized graph compilers and quantization, whereas serving relies exclusively on uncompiled Python eager execution.
- Training is throughput-centric optimization over long data runs with full hardware saturation, whereas serving is latency-constrained economics that allocates a per-request time budget across the entire pipeline and reserves headroom against nonlinear queueing collapse.
- Training runs on integer-only microcontrollers, whereas serving runs exclusively on floating-point supercomputers.
Answer: The correct answer is C. The central theme of model serving is the ‘serving inversion’: while training seeks to maximize hardware throughput and floating-point utilization across static datasets over long durations, online serving operates under strict latency budgets for individual, stochastic requests. Serving must allocate time across network ingress, preprocessing, queueing, model execution, and serialization while maintaining operational headroom to prevent tail-latency queueing collapse. Training focuses on throughput rather than single-query tail latency. Serving heavily utilizes graph compilers and quantization rather than uncompiled eager mode. Microcontrollers are edge serving targets, not training environments.
Learning Objective: Evaluate the overarching principles of the serving inversion and latency-constrained system design.
True or False: In production model serving, optimizing only the neural network accelerator kernel execution time yields diminishing returns if upstream preprocessing, transport serialization, and downstream postprocessing are not optimized concurrently.
Answer: True. As captured by Amdahl’s Law and the ‘serving tax bill,’ total user response time encompasses the entire request envelope: network transport, protocol deserialization, CPU image/token preprocessing, queue waiting time, GPU forward pass, postprocessing (e.g., top-\(k\), NMS), and response serialization. Once model inference is accelerated, unaccelerated pipeline stages quickly dominate the remaining latency budget.
Learning Objective: Evaluate end-to-end request path optimization across the full inference lifecycle.
Summarize how memory management—specifically KV-cache allocation, paging, and precision—acts as the primary throughput and concurrency bottleneck in Large Language Model (LLM) serving.
Answer: In LLM autoregressive decoding, every generated token requires loading model weights and previous KV-cache states from VRAM, making decoding memory-bandwidth bound. Furthermore, dynamic KV caches scale linearly with batch size and context length (\(2 \times L \times H_{\text{kv}} \times D_{\text{head}} \times P \times S \times B\)), rapidly consuming available VRAM. Memory optimizations—such as PagedAttention (eliminating fragmentation), FP8/INT8 KV-cache quantization (halving memory footprint and doubling bandwidth), and prefix caching (reusing shared prompts)—are essential to maximize concurrent request capacity and lower cost per token.
Learning Objective: Explain why memory management and KV-cache architectures govern throughput and concurrency in LLM serving.