Thuế điều phối: Chi phí phát sinh của Python so với thực tế GPU
Các Framework ML
Mục đích
Tại sao framework lại âm thầm ràng buộc mọi quyết định sau đó?
Các phương trình mô hình không tự thực thi. Một framework dịch một kiến trúc thành công việc mà phần cứng có thể chạy, và quá trình dịch đó không trung lập. Nó quyết định khi nào các phép toán thực thi, trạng thái trung gian nào quá trình huấn luyện giữ lại, cách bộ nhớ được cấp phát, và những mục tiêu triển khai nào có thể sử dụng kết quả tạo ra. Những lựa chọn này định hình không chỉ tốc độ: chúng quyết định những gì có thể được gỡ lỗi trực tiếp, những gì trình biên dịch có thể tối ưu hóa, và liệu cùng một mô hình có tồn tại được trên con đường từ môi trường nghiên cứu đến một runtime sản xuất hay không. Do đó, các trừu tượng hóa giúp việc thử nghiệm thuận tiện lại tạo ra những cam kết lâu dài. Một khi một dự án tích lũy các checkpoint, module, bộ nạp dữ liệu, định dạng phục vụ (serving) và chuyên môn của nhóm xung quanh một framework, việc thay đổi nó trở thành một cuộc di chuyển hệ thống chứ không phải là một sự thay thế thư viện. Một framework phù hợp cho việc khám phá nhanh chóng có thể để lộ quá ít cấu trúc để triển khai hiệu quả, trong khi một đường dẫn thực thi bị ràng buộc có thể hy sinh sự linh hoạt cần thiết trong quá trình khám phá. Bởi vì thực thi, vi phân và trừu tượng hóa gặp nhau trong cùng một lớp phần mềm, một sự tiện lợi cục bộ có thể trở thành một hạn chế về hiệu suất hoặc tính di động ở giai đoạn sau. Câu hỏi kỹ thuật không phải là framework nào là tốt nhất toàn diện, mà là những đánh đổi nào mà khối lượng công việc (workload), nhóm và máy mục tiêu có thể chấp nhận cố định. Do đó, việc hiểu các framework là về việc suy luận thông qua các lựa chọn hệ thống đó hơn là học cú pháp API nhất thời. Theo thuật ngữ D·A·M, framework làm trung gian cho việc đồng thiết kế thuật toán-máy bằng cách biến ý định thuật toán và biểu diễn dữ liệu thành công việc có thể thực thi dưới các ràng buộc của máy.
Learning Objectives
- Giải thích cách các framework làm trung gian cho việc đồng thiết kế thuật toán-máy thông qua thực thi, vi phân và trừu tượng hóa phần cứng
- So sánh các chiến lược thực thi bằng cách sử dụng chi phí điều phối, chi phí biên dịch và các ràng buộc triển khai
- Phân tích vi phân tự động và lưu trữ activation để chọn tính toán lại hoặc checkpointing
- Triển khai các mẫu trừu tượng hóa module cho việc khám phá tham số, hành vi chế độ, tuần tự hóa và các hook
- Tính toán FLOPs bước huấn luyện, lưu lượng bộ nhớ và chi phí điều phối để xác định các nút thắt cổ chai về fusion và bố cục
- Chọn TensorFlow, PyTorch, JAX hoặc các runtime edge dựa trên mô hình, phần cứng, nhóm và yêu cầu triển khai
Ba Vấn đề của Framework
Một kiến trúc là một đồ thị các cam kết: một transformer cam kết hệ thống với attention, phép nhân ma trận, trạng thái activation và lưu lượng bộ nhớ. Framework là lớp biến đồ thị đó thành công việc mà máy có thể thực thi. Một vài lệnh gọi như logits = model(tokens), loss = criterion(logits, targets) và loss.backward() ẩn chứa hàng tỷ phép toán dấu phẩy động trên các hệ thống phân cấp bộ nhớ, các gradient thông qua hàng triệu tham số qua vi phân tự động, hàng nghìn lần khởi chạy kernel GPU và gigabyte trạng thái trung gian. API trông đơn giản vì framework đang hoạt động như một trình biên dịch cho hợp đồng silicon.
Các kiến trúc chỉ định những phép tính mà mạng nơ-ron thực hiện, nhưng biết cái gì cần tính toán hoàn toàn khác với biết cách tính toán nó một cách hiệu quả. Cơ chế attention của một transformer yêu cầu phối hợp tính toán trên các hệ thống phân cấp bộ nhớ và các lõi bộ tăng tốc theo các mẫu mà các triển khai ngây thơ sẽ thực thi chậm hơn 100\(\times\) so với các triển khai được tối ưu hóa. Việc triển khai các phép toán này từ đầu cho mỗi mô hình sẽ khiến deep learning không khả thi về mặt kinh tế. Các ML framework tồn tại để thu hẹp khoảng cách này bằng cách hạ cấp các đồ thị mô hình trừu tượng thành các pipeline thực thi phù hợp với phần cứng, giúp trích xuất hiệu suất tối đa từ silicon.
Một framework đối với machine learning giống như một trình biên dịch đối với lập trình truyền thống. Một trình biên dịch C dịch mã dễ đọc của con người thành các lệnh máy được tối ưu hóa, quản lý cấp phát thanh ghi, lập lịch lệnh và bố cục bộ nhớ. Một ML framework dịch các định nghĩa mô hình cấp cao thành các kế hoạch thực thi dành riêng cho phần cứng, quản lý fusion toán tử, tái sử dụng bộ nhớ và đặt thiết bị. Sự tương đồng này không chỉ là phép ẩn dụ: các framework hiện đại thực sự bao gồm các trình biên dịch.
Mọi ML framework, bất kể API hay triết lý thiết kế, đều phải giải quyết ba vấn đề cốt lõi. Vấn đề đầu tiên là vấn đề thực thi: quyết định khi nào và cách thức tính toán chạy. Một framework có thể thực thi các phép toán ngay lập tức như đã viết (thực thi eager1) hoặc xây dựng một mô tả hoàn chỉnh trước—một đồ thị tính toán2 (một biểu diễn có cấu trúc của các phép toán và sự phụ thuộc của chúng)—và tối ưu hóa trước khi thực thi (thực thi đồ thị). Lựa chọn này định hình khả năng gỡ lỗi, tiềm năng tối ưu hóa và tính linh hoạt trong triển khai.
1 Thực thi tức thì (Eager execution): Chế độ này thực thi từng phép toán ngay lập tức, cho phép gỡ lỗi trực tiếp bằng các công cụ tiêu chuẩn nhưng hy sinh cái nhìn tổng thể cần thiết cho các tối ưu hóa cấp đồ thị. Nếu không nắm bắt một vùng tính toán lớn hơn, một runtime thực thi tức thì không thể kết hợp các phép toán trong vùng đó hoặc lập kế hoạch bộ nhớ trước, để lại các cơ hội tối ưu hóa phụ thuộc vào khối lượng công việc (workload) cho các trình biên dịch như torch.compile.
2 Đồ thị tính toán: Sự khác biệt “tối ưu hóa trước khi thực thi” trong câu kích hoạt là lựa chọn thiết kế then chốt. Việc nắm bắt chương trình dưới dạng cấu trúc dữ liệu cho phép một framework kết hợp các phép toán tương thích thành ít kernel GPU hơn trước khi thực thi, giảm chi phí khởi tạo và lưu lượng bộ nhớ trung gian. Chi phí kỹ thuật của khả năng hiển thị này là chương trình được thực thi khác với mã nguồn, khiến việc gỡ lỗi trở nên khó khăn hơn, một sự đánh đổi mà mọi framework dựa trên đồ thị phải biện minh so với lợi ích về hiệu suất.
Khi quá trình thực thi đã có hình dạng, framework phải giải quyết vấn đề vi phân: tính toán gradient tự động. Như đã thiết lập trong Tính toán nơ-ron, huấn luyện yêu cầu các đạo hàm của một hàm mất mát đối với hàng triệu hoặc hàng tỷ tham số, và vi phân thủ công dễ gây lỗi ở quy mô này. Do đó, các framework áp dụng các quy tắc đạo hàm đã đăng ký trên các thành phần phép toán được hỗ trợ trong khi quản lý số học dấu phẩy động và chi phí bộ nhớ của các giá trị đã lưu.
Vấn đề thứ ba là trừu tượng hóa phần cứng: nhắm mục tiêu nhiều loại phần cứng khác nhau từ một giao diện duy nhất. Định nghĩa mô hình tương tự phải có thể biểu diễn được trên CPU, GPU, Tensor Processing Units (TPU) và các thiết bị di động, mặc dù mỗi mục tiêu có các ràng buộc bộ nhớ và các mẫu thực thi tối ưu khác nhau. Trong phần liên quan đến GPU của vấn đề này, một số hệ sinh thái framework cung cấp các ngôn ngữ kernel tùy chỉnh để người dùng nâng cao có thể viết các kernel hiệu suất cao mà không cần chuyển hẳn sang CUDA cấp thấp (Tillet et al. 2019).
Tillet, Philippe, H. T. Kung, and David Cox. 2019. “Triton: An Intermediate Language and Compiler for Tiled Neural Network Computations.” Proceedings of the 3rd ACM SIGPLAN International Workshop on Machine Learning and Programming Languages, 10–19. https://doi.org/10.1145/3315508.3329973.
Ba vấn đề này có mối liên hệ sâu sắc. Mô hình thực thi xác định khi nào quá trình vi phân xảy ra và những tối ưu hóa nào có thể thực hiện được. Lớp trừu tượng phải hỗ trợ cả hai kiểu thực thi trên tất cả các mục tiêu phần cứng. Giải quyết bất kỳ vấn đề nào một cách riêng lẻ dẫn đến các framework xuất sắc trong các ngữ cảnh hẹp nhưng thất bại trong triển khai rộng hơn. Bởi vì những vấn đề này cuối cùng là về việc chuyển đổi toán học thành thực thi phần cứng hiệu quả, một quan điểm hữu ích là xem các framework không phải là thư viện mà là trình biên dịch.
Systems Perspective 1.1: Trình biên dịch ML
Trong bối cảnh định luật sắt (Định luật sắt của hệ thống ML), một framework là một trình biên dịch cho hợp đồng silicon.
“Mã nguồn” là kiến trúc mô hình (thuật ngữ \(O\)). Nhiệm vụ của framework là lấy toán học cấp cao này và biên dịch nó thành một chuỗi các lần khởi chạy kernel dành riêng cho phần cứng để:
- Giảm thiểu di chuyển dữ liệu \((D_{\text{vol}})\) thông qua các kỹ thuật như hợp nhất kernel.
- Tối đa hóa mức sử dụng \((\eta_{\text{hw}})\) bằng cách khớp các phép toán với các đơn vị phần cứng chuyên dụng như Tensor Cores.
- Giảm thiểu chi phí \((L_{\text{lat}})\) thông qua điều phối bất đồng bộ hiệu quả và nắm bắt đồ thị.
Việc chọn một framework có nghĩa là chọn trình biên dịch xác định mức độ hiệu quả của một mô hình khi sử dụng phần cứng; sự chính xác là quan trọng: một định nghĩa bao gồm cả ba trách nhiệm này sẽ phân biệt các framework thực sự với các thư viện số chỉ giải quyết một trách nhiệm.
Definition 1.1: Các framework machine learning
Các framework machine learning là các hệ thống phần mềm chuyển đổi các định nghĩa mô hình toán học cấp cao thành các kế hoạch thực thi được tối ưu hóa cho phần cứng bằng cách quản lý đồ thị tính toán, vi phân tự động, điều phối kernel và cấp phát bộ nhớ trên toàn bộ hệ thống phân cấp phần cứng.
- Ý nghĩa: Các framework trực tiếp xác định thuật ngữ hiệu suất hệ thống \((\eta_{\text{hw}})\) trong định luật sắt. Hợp nhất toán tử được hỗ trợ bởi trình biên dịch, ví dụ, có thể loại bỏ các thao tác ghi và đọc tiếp theo các giá trị trung gian giữa các phép toán tương thích. Việc hợp nhất phép nhân ma trận, cộng độ chệch (bias) và đơn vị tuyến tính chỉnh lưu (ReLU) thay đổi cách cùng một phép toán tiếp cận phần cứng mà không thay đổi mô hình.
- Điểm khác biệt: Không giống như một thư viện số như NumPy, thường đánh giá từng phép toán khi nó được gọi, một framework machine learning có thể nắm bắt hoặc trì hoãn việc thực thi để phân tích một đồ thị tính toán lớn hơn và áp dụng các tối ưu hóa giữa các phép toán: hợp nhất toán tử, biến đổi bố cục bộ nhớ và lập lịch song song. Những tối ưu hóa đó đòi hỏi khả năng hiển thị vượt ra ngoài các phép toán được điều phối riêng lẻ.
- Lỗi thường gặp: Một quan niệm sai lầm phổ biến là các framework là các trình bao API có thể thay thế cho nhau. Việc lựa chọn framework xác định các đường dẫn trình biên dịch nào có sẵn. PyTorch có thể khôi phục tối ưu hóa cấp đồ thị từ mã thực thi tức thì (eager code) thông qua
torch.compile(), trong khi TensorFlow và JAX thường dựa vào các đường dẫn biên dịch được hỗ trợ bởi XLA để chuyển đổi các phép toán xuống phần cứng mục tiêu. Việc chuyển từ thực thi tức thì sang đường dẫn trình biên dịch có thể thay đổi đáng kể thông lượng, nhưng lợi ích phụ thuộc vào cấu trúc mô hình, hình dạng, hỗ trợ toán tử và phần cứng.
Ẩn dụ về trình biên dịch không chỉ mang tính trang trí. Một framework machine learning chuyển đổi ý định logic thành thực thi vật lý dưới các ràng buộc của định luật sắt, quyết định cách phân chia tính toán trên các hệ thống phân cấp bộ nhớ, khi nào nên đánh đổi độ chính xác số học để lấy thông lượng, và cách lập lịch các phép toán để thuật ngữ chiếm ưu thế (di chuyển dữ liệu, tính toán hoặc chi phí) được giảm thiểu. Framework là nơi vật lý chi phối được phát triển trong suốt cuốn sách này trở thành mã có thể thực thi được.
Quy mô của phép chuyển đổi này không hiển nhiên từ bề mặt API. Một lệnh gọi duy nhất đến loss.backward() kích hoạt việc ghi lại hoạt động, cấp phát bộ nhớ cho gradient, duyệt đồ thị theo thứ tự ngược và điều phối kernel tối ưu hóa phần cứng—một bộ máy mà ngay cả đối với một mạng ba lớp cũng sẽ đòi hỏi hàng trăm dòng tính toán thủ công. Đối với một mô hình ngôn ngữ hiện đại, framework còn điều phối hàng tỷ phép toán dấu phẩy động trên các bộ tăng tốc, điều phối các hệ thống phân cấp bộ nhớ, độ chính xác số học và, khi hệ thống mở rộng vượt quá một thiết bị, các thư viện giao tiếp. Xây dựng điều này từ đầu sẽ tốn kém đến mức không thể thực hiện được về mặt kinh tế đối với hầu hết các tổ chức, đó là lý do tại sao lịch sử của các framework ML là lịch sử của việc tự động hóa dần dần các lớp này.
Ba vấn đề—thực thi, vi phân và trừu tượng hóa—không xuất hiện đồng thời. Mỗi vấn đề phát sinh như một phản ứng đối với những hạn chế về khả năng mở rộng trong thế hệ công cụ trước đó. Theo dõi sự tiến hóa này giải thích tại sao các framework hiện đại được thiết kế như hiện tại và tại sao chúng thể hiện những đánh đổi cụ thể này.
Self-Check: Question
A team reports that their model executes correctly on CPU but produces mismatched tensor shapes and silent numerical corruption when switched to a GPU backend because some operators silently default to a different memory layout (such as NCHW versus NHWC). Which of the three fundamental framework problems does this failure most directly expose?
- The hardware abstraction problem, because one unified model interface must preserve consistent semantic behavior, memory layouts, and numerical contracts across diverse hardware backends
- The execution problem, because the operators were evaluated eagerly instead of being captured into a static graph
- The differentiation problem, because the backward pass failed to propagate gradients through non-contiguous strides
- A data engineering pipeline defect unrelated to framework runtime responsibilities
Explain how viewing an ML framework as a compiler for the silicon contract—rather than merely a numerical library like NumPy—changes an engineer’s expectations regarding framework selection and optimization under the systems iron law.
True or False: Two frameworks that expose nearly identical user-facing Python tensor APIs and target the same GPU hardware will necessarily provide equivalent graph-level operator fusion and ahead-of-time compilation capabilities.
An engineering organization chose a specialized research framework for rapid prototyping, only to discover later that the framework lacks export paths to their production edge accelerators, requiring months of manual re-implementation. Applying the chapter’s infrastructure-commitment principle, what is the key systems insight?
- Framework choice is easily reversible because weight arrays can be loaded into any runtime with zero engineering overhead
- Framework selection functions as a durable infrastructure commitment whose reversal cost compounds across model checkpoints, serving runtimes, CI/CD pipelines, and hardware access
- The primary failure was selecting an overly compact model architecture that failed to saturate edge accelerator memory
- Hardware abstraction layers eliminate all differences between training frameworks and production inference engines
Thang trừu tượng hóa
Năm 1979, việc viết một phép nhân ma trận trong Fortran sử dụng phần cứng hiệu quả đòi hỏi kiến thức sâu sắc về dòng cache, lập lịch thanh ghi và đơn vị vector. Đến năm 2016, một dòng Python duy nhất (torch.matmul(A, W)) có thể điều phối đến một triển khai được tối ưu hóa cao mà không cần lập trình viên biết chi tiết về silicon. Sự nén nỗ lực đó không xảy ra trong một bước; nó tích lũy qua bốn thập kỷ trừu tượng hóa, mỗi lớp giải quyết một nút thắt cổ chai khiến thế hệ trước không thực tế để mở rộng. Kết quả là một thang trừu tượng hóa trong đó mỗi bậc tự động hóa những gì bậc dưới nó đã phơi bày.
- Giải quyết hiệu suất (1979–1992): Basic linear algebra subprograms (BLAS)3 ban đầu đã tiêu chuẩn hóa các nguyên thủy đại số tuyến tính cấp thấp có thể tái sử dụng (Lawson et al. 1979), trong khi LAPACK4 (Bai et al. 2006) xây dựng các routine số học cấp cao hơn dựa trên nền tảng đó. Cùng nhau, các thư viện này đã giải quyết vấn đề về các nguyên thủy phần cứng: các giao diện ổn định cho phép các framework ủy quyền các hoạt động như
C = A @ B5 cho các triển khai chuyên biệt thay vì viết thủ công mã dành riêng cho silicon. - Giải quyết khả năng sử dụng (2005–2006): NumPy6 đã giải quyết vấn đề về tốc độ phát triển của lập trình viên. Bằng cách bọc các routine BLAS cấp thấp trong Python cấp cao (Harris et al. 2020), nó cho phép các nhà khoa học viết mã bằng một ngôn ngữ thân thiện trong khi thực thi nó bằng C/Fortran được tối ưu hóa. Mô hình
- Giải quyết vi phân (2007–hiện tại): Các deep learning frameworks (Theano,7 TensorFlow (Abadi et al. 2016), PyTorch (Paszke et al. 2019)) đã giải quyết vấn đề tính toán gradient. Trong khi NumPy yêu cầu đạo hàm thủ công các gradient lan truyền ngược (dễ gây lỗi và chậm), các framework này đã biến vi phân tự động thông qua đồ thị tính toán thành một khả năng tiêu chuẩn. Điều này đã biến quy tắc chuỗi thành một nguyên thủy phần mềm, cho phép các nhà nghiên cứu định nghĩa các lượt chuyển tiếp và nhận các lượt chuyển ngược một cách tự động.
3 BLAS (basic linear algebra subprograms): Đặc tả API năm 1979 tạo thành bậc thang thấp nhất của thang được mô tả ở đây; nó đã tiêu chuẩn hóa một tập hợp cố định các phép toán vector có thể gọi từ Fortran, tách biệt tên routine công khai khỏi các quyết định triển khai dành riêng cho máy bên dưới chúng. Mọi framework phía trên nó đều kế thừa phiên bản rộng hơn của thỏa thuận này: gọi một nguyên thủy đại số tuyến tính tiêu chuẩn từ bất kỳ ngôn ngữ nào và để một thư viện nhà cung cấp được tinh chỉnh nhắm mục tiêu silicon. Đối với phép nhân ma trận tổng quát (GEMM) hiện đại trên NVIDIA GPUs, đường dẫn được tinh chỉnh đó là cuBLAS chứ không phải chính đặc tả BLAS năm 1979 (NVIDIA 2024a).
NVIDIA. 2024a. cuBLAS: CUDA Basic Linear Algebra Subprograms.
Lawson, Charles L., Richard J. Hanson, David R. Kincaid, and Fred T. Krogh. 1979. “Basic Linear Algebra Subprograms for Fortran Usage.” ACM Transactions on Mathematical Software 5 (3): 308–23. https://doi.org/10.1145/355841.355847.
4 LAPACK (linear algebra package): Mở rộng BLAS bằng cách cung cấp một API tiêu chuẩn cho các routine cấp cao hơn (SVD, phân tích giá trị riêng, bình phương nhỏ nhất) mà các nhà cung cấp triển khai bằng mã dành riêng cho chip được xếp lớp trên các kernel GEMM nhanh. Thiết kế phân lớp này là mẫu kiến trúc mà mọi framework ML kế thừa: các hoạt động cấp cao ủy quyền xuống các nguyên thủy được tinh chỉnh thủ công, do đó một lệnh gọi LAPACK được tối ưu hóa bởi nhà cung cấp có thể thực thi nhanh hơn hơn 10\(\times\) so với một triển khai ngây thơ mà không cần tác giả framework viết một dòng mã dành riêng cho phần cứng nào.
Bai, Zhaojun, James Demmel, Jack Dongarra, Julien Langou, and Jenny Wang. 2006. “LAPACK.” In Handbook of Linear Algebra. Chapman; Hall/CRC. https://doi.org/10.1201/9781420010572-75.
5 GEMM: Nguyên thủy ma trận-ma trận đằng sau C = A @ B. Các nhà cung cấp phần cứng tinh chỉnh thủ công GEMM cho các chip cụ thể của họ vì các lớp dày đặc, phép chiếu chú ý và hạ tích chập đều dựa vào phép nhân ma trận, biến routine này thành một ngưỡng hiệu suất cho nhiều framework phía trên nó trên thang. Cường độ số học cao của nó làm cho GEMM trở thành phép toán có khả năng tiếp cận thông lượng tính toán đỉnh cao nhất, trong khi các hình dạng nhỏ hoặc không thẳng hàng thường quay trở lại mức sử dụng thấp hơn nhiều.
6 NumPy (numerical Python): Năm 2005, Travis Oliphant đã hợp nhất hai thư viện mảng Python cạnh tranh (Numeric và Numarray) thành một gói duy nhất, mang đến cho cộng đồng tính toán khoa học một chuẩn mảng được hỗ trợ bởi BLAS vào thời điểm cần mở rộng quy mô. Hợp đồng “vector hóa” mà điều này tạo ra (viết logic bằng Python, thực thi các vòng lặp trong C/Fortran thông qua BLAS) đã trở thành khuôn mẫu thiết kế cho mọi machine learning framework sau này: các tensor của PyTorch và mảng của TensorFlow là hậu duệ trực tiếp, mở rộng cùng một trừu tượng mảng \(n\)-chiều sang GPU. Vai trò của Python trong cơ sở hạ tầng machine learning thừa hưởng phần lớn hình dạng của nó từ quyết định hợp nhất này.
Harris, Charles R., K. Jarrod Millman, Stéfan J. van der Walt, Ralf Gommers, Pauli Virtanen, David Cournapeau, Eric Wieser, et al. 2020. “Array Programming with NumPy.” Nature 585 (7825): 357–62. https://doi.org/10.1038/s41586-020-2649-2.
7 Theano: Được phát triển tại Viện Thuật toán Học tập Montreal (MILA) dưới sự chỉ đạo của Yoshua Bengio bắt đầu từ năm 2007, Theano là một framework Python ban đầu và có ảnh hưởng, biên dịch các biểu thức toán học ký hiệu thành mã CPU và GPU được tối ưu hóa thông qua đồ thị tính toán (Bergstra et al. 2010; Team et al. 2016). Nó đã chứng minh rằng một đồ thị tính toán được định nghĩa bằng Python có thể được biên dịch để thực thi trên GPU mà không yêu cầu nhà nghiên cứu phải viết mã CUDA. Mila đã chấm dứt phát triển tích cực Theano vào năm 2017 (Mila 2026).
Bergstra, James, Olivier Breuleux, Frédéric Bastien, Pascal Lamblin, Razvan Pascanu, Guillaume Desjardins, Joseph Turian, David Warde-Farley, and Yoshua Bengio. 2010. “Theano: A CPU and GPU Math Compiler in Python.” Proceedings of the Python in Science Conference 4: 18–24. https://doi.org/10.25080/majora-92bf1922-003.
Team, The Theano Development, Rami Al-Rfou, Guillaume Alain, Amjad Almahairi, Christof Angermueller, Dzmitry Bahdanau, Nicolas Ballas, et al. 2016. “Theano: A Python Framework for Fast Computation of Mathematical Expressions.” arXiv Preprint.
Mila. 2026. Open Source Software.
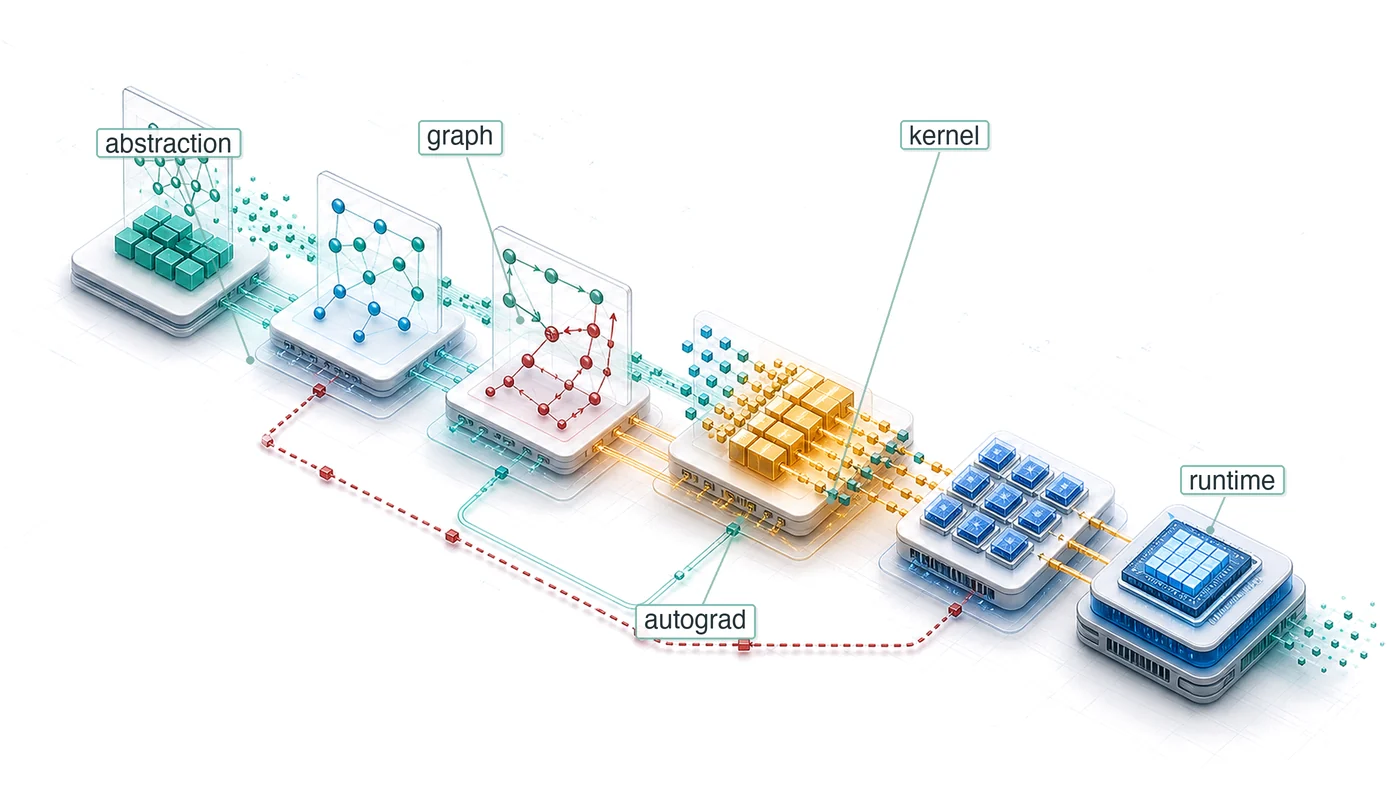
Các framework machine learning đã tiến hóa bằng cách dần dần trừu tượng hóa các chi tiết thực thi phần cứng thành các nguyên thủy API cấp cao hơn. Các framework thu hẹp khoảng cách giữa ý định toán học và thực tế silicon (figure 1), đưa phần mềm số học lên một tầm cao mới từ các hàm đại số tuyến tính cấp thấp đến các công cụ thực thi đồ thị được biên dịch.

Mỗi thế hệ trừu tượng hóa các chi tiết đã tiêu tốn nỗ lực kỹ thuật ở thế hệ trước, nhưng mỗi trừu tượng hóa lại giới thiệu những đánh đổi mới. BLAS ẩn tối ưu hóa cấp hợp ngữ nhưng cố định giao diện. NumPy ẩn quản lý bộ nhớ nhưng yêu cầu vi phân thủ công. Các framework hiện đại ẩn tính toán gradient nhưng giới thiệu một lựa chọn giữa các mô hình thực thi. Mô hình sâu hơn là mọi trừu tượng hóa đều ẩn các chi tiết bằng cách duy trì một hợp đồng về hình dạng, kiểu dữ liệu, thiết bị và đôi khi là đơn vị; khi hợp đồng đó trở nên ngầm định, các thành phần đúng vẫn có thể kết hợp thành một hệ thống sai.
Với rủi ro hợp đồng đó, các framework hiện đại hội tụ vào ba vấn đề cốt lõi giống nhau: cách thực thi tính toán, cách vi phân nó, và cách trừu tượng hóa trên phần cứng. Vấn đề thực thi được ưu tiên hàng đầu vì giải pháp của nó quyết định những tối ưu hóa nào mà hai vấn đề còn lại có thể khai thác.
War Story 1.1: Giao diện đã quên đơn vị của nó (1999)
Bối cảnh: Tàu quỹ đạo Mars Climate Orbiter của NASA phụ thuộc vào phần mềm mặt đất, phần mềm tàu vũ trụ, các đội điều hướng và giao diện nhà thầu đều đồng ý về ý nghĩa vật lý của các giá trị được trao đổi (Mars Climate Orbiter Mishap Investigation Board 1999).
Cơ chế: Phần mềm mặt đất do Lockheed Martin cung cấp tính toán xung lực đẩy bằng đơn vị Anh (pound-lực giây), trong khi phần mềm điều hướng của JPL sử dụng các giá trị giả định đơn vị SI (newton-giây)—một sự không khớp đơn vị ngầm định 4.45\(\times\).
Tác động: Vào ngày 23 tháng 9 năm 1999, tàu vũ trụ bị mất sau khi đi vào vùng che khuất. Điểm cận nhật đã điều chỉnh là 57 km, thay vì 226 km theo kế hoạch, được đánh giá là quá thấp để tồn tại.
Phản ứng: Hội đồng khuyến nghị kiểm tra tính nhất quán của đơn vị, kiểm toán đặc tả dữ liệu được truyền và xác minh đầu cuối mạnh mẽ hơn đối với phần mềm mặt đất.
Bài học hệ thống: Các trừu tượng của framework có giá trị vì chúng mang theo các hợp đồng: hình dạng, kiểu dữ liệu, vị trí thiết bị và đơn vị vật lý. Nếu những hợp đồng đó là ngầm định, hai đoạn mã đúng vẫn có thể kết hợp thành một hệ thống sai. Các framework machine learning gặp phải điều này bất cứ khi nào bố cục bộ nhớ tensor (chẳng hạn như NCHW so với NHWC), hệ số tỷ lệ lượng tử hoá hoặc các đơn vị đặc trưng vật lý khác nhau giữa các giai đoạn pipeline, tạo ra các đầu ra có vẻ hợp lý nhưng âm thầm làm hỏng suy luận hạ nguồn.
Mars Climate Orbiter Mishap Investigation Board. 1999. Mars Climate Orbiter Mishap Investigation Board Phase i Report. National Aeronautics; Space Administration.
Self-Check: Question
While NumPy provided high-performance linear algebra by wrapping BLAS in Python, what critical scaling bottleneck did it leave unaddressed that motivated the development of deep learning frameworks such as Theano, TensorFlow, and PyTorch?
- Inability to execute matrix multiplications on single-core CPU architectures
- Lack of an \(n\)-dimensional array data structure in scientific computing
- The requirement for manual gradient derivation and hand-written backpropagation passes for multi-layer neural networks
- Inability to run compiled Fortran and C routines through high-level scripting languages
Explain why the relationship between rungs on the ladder of abstraction (such as BLAS/LAPACK, NumPy, and modern deep learning frameworks) is characterized by inheritance rather than replacement.
Order the following historical computing milestones in the evolution of numerical and machine learning software abstractions, from earliest (1979) to most recent (2018):
JAX introduces functional composable transformations and XLA compilation
BLAS standardizes reusable low-level linear algebra primitives
Theano introduces compiled Python computational graphs for GPUs
NumPy establishes Python’s unified \(n\)-dimensional array and vectorization standard
PyTorch introduces dynamic define-by-run execution graphs
LAPACK extends BLAS with higher-level numerical routines (e.g., SVD, factorizations)
The architectural design pattern established by NumPy, where high-level control logic is written in an expressive interpreted language (such as Python) while inner numerical loops are delegated to compiled C/Fortran libraries, is known as ____.
Vấn đề thực thi
Hãy xem xét hai kỹ sư viết cùng một mạng nơ-ron. Người thứ nhất gỡ lỗi tương tác, in hình dạng tensor sau mỗi thao tác, kiểm tra các giá trị trung gian và chạy từng bước mã bằng pdb. Người thứ hai đợi 30 giây để biên dịch, sau đó xem mô hình chạy nhanh hơn 3\(\times\) trong khi mất đi cái nhìn trực tiếp, từng dòng về trạng thái trung gian. Cả hai đều đúng; họ đã đưa ra những lựa chọn khác nhau về vấn đề thực thi, câu hỏi liệu các thao tác có nên thực thi ngay lập tức như đã viết hay được ghi lại để thực thi sau. Lựa chọn này tạo ra một chuỗi các đánh đổi kỹ thuật định hình mọi khía cạnh của hành vi framework, từ quy trình gỡ lỗi đến các tùy chọn triển khai đến việc sử dụng phần cứng tối đa.
Tại sao chiến lược thực thi lại quan trọng: Bức tường bộ nhớ
Để hiểu tại sao chiến lược thực thi lại quan trọng đến vậy, hãy quay lại khoảng cách ngày càng lớn giữa tính toán và băng thông được định lượng bằng phương trình tường bộ nhớ (equation). Tốc độ tính toán của bộ xử lý đã tăng nhanh hơn băng thông bộ nhớ, tạo ra tường bộ nhớ. Các bộ tăng tốc hiện đại có thể thực hiện các phép tính nhanh hơn nhiều so với khả năng tìm nạp dữ liệu của chúng. Các phép toán từng phần tử như ReLU chỉ sử dụng một phần rất nhỏ công suất tính toán đỉnh, không phải vì phần cứng chậm, mà vì chúng dành gần như toàn bộ thời gian để chờ dữ liệu. Mô hình Roofline chính thức hóa sự đánh đổi này, cho thấy chính xác khi nào các phép toán bị giới hạn bởi bộ nhớ so với bị giới hạn bởi tính toán.
Tường bộ nhớ phân loại các phép toán là bị giới hạn bởi tính toán (bị giới hạn bởi thông lượng số học) hoặc bị giới hạn bởi bộ nhớ (bị giới hạn bởi di chuyển dữ liệu). Hầu hết các loại phép toán mạng nơ-ron riêng lẻ (activations, chuẩn hóa, phép toán từng phần tử) đều bị giới hạn bởi bộ nhớ, mặc dù các phép nhân ma trận lớn chiếm ưu thế về tổng thời gian tính toán có thể bị giới hạn bởi tính toán.
Tối ưu hóa chính cho các phép toán bị giới hạn bởi bộ nhớ là hợp nhất kernel, kết hợp nhiều phép toán thành một hàm GPU duy nhất (gọi là kernel)8 để tránh lưu lượng bộ nhớ trung gian. Việc hợp nhất một chuỗi các phép toán chuẩn hóa, dropout và activation vào một kernel có thể mang lại tốc độ tăng đáng kể bằng cách loại bỏ các ghi trung gian giữa các phép toán. Các kernel attention9 sử dụng cùng nguyên tắc ở quy mô lớn hơn: thay vì hiện thực hóa toàn bộ ma trận attention trong bộ nhớ băng thông cao (HBM), một triển khai hợp nhất có thể giữ các khối gần các đơn vị tính toán, giảm số lần truy cập HBM lên tới 9\(\times\), và tạo ra các cải thiện tốc độ cụ thể cho khối lượng công việc (workload) từ 15 phần trăm đến 3\(\times\) (Dao et al. 2022).
8 Kernel (GPU): Trong lập trình GPU, một kernel là hàm được điều phối để thực thi song song trên hàng nghìn luồng. Mỗi lần khởi chạy kernel phát sinh 5–20 \(\mu\)s chi phí phụ ở phía CPU cho việc lắp ráp tham số và tín hiệu GPU, điều này có nghĩa là các phép toán nhỏ, không hợp nhất dành nhiều thời gian cho chi phí khởi chạy \((L_{\text{lat}})\) hơn là cho các phép tính số học hữu ích. Do đó, việc giảm số lượng kernel thông qua hợp nhất là một cách tấn công trực tiếp vào thành phần chi phí phụ của định luật sắt.
9 Kernel attention hợp nhất: Một kernel attention hợp nhất kết hợp tích \(\mathbf{Q}\mathbf{K}^T\), softmax và đầu ra trọng số giá trị thành một triển khai dạng lát (tiled) giữ các giá trị trung gian trong bộ nhớ trên chip thay vì hiện thực hóa toàn bộ ma trận attention trong HBM. FlashAttention là ví dụ điển hình được giới thiệu trong Kiến trúc mạng và báo cáo giảm tới 9\(\times\) số lần truy cập HBM với các cải thiện tốc độ cụ thể cho khối lượng công việc (workload) từ 15 phần trăm đến 3\(\times\) (Dao et al. 2022). Bài học từ framework rộng hơn thuật toán cụ thể: hợp nhất có thể dịch chuyển vị trí của một phép toán trên Mô hình Roofline từ bị giới hạn bởi băng thông sang thực thi bị giới hạn bởi thông lượng bằng cách giảm các lượt truy cập khứ hồi qua bộ nhớ ngoài.
Dao, T., D. Y. Fu, S. Ermon, A. Rudra, and C. Ré. 2022. “FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness.” Advances in Neural Information Processing Systems (NeurIPS) 35: 16344–59. https://doi.org/10.52202/068431-1189.
Các framework chỉ có thể hợp nhất các phép toán hiển thị cùng nhau. Các phép toán eager được điều phối riêng lẻ che giấu các cơ hội tối ưu hóa giữa các phép toán, nhưng việc nắm bắt đồ thị có thể làm lộ chúng. Một đồ thị trì hoãn cho phép framework tối ưu hóa tính toán đã nắm bắt. Do đó, chiến lược thực thi quyết định những tối ưu hóa nào có thể thực hiện được và phạm vi của chúng.
Đồ thị tính toán
Hợp nhất kernel là tối ưu hóa chính cho các phép toán bị giới hạn bởi bộ nhớ, nhưng hợp nhất đòi hỏi phải nhìn thấy nhiều phép toán cùng nhau. Các framework tạo điều kiện cho khả năng hiển thị này thông qua đồ thị tính toán, một đồ thị có hướng không chu trình (DAG) trong đó các nút đại diện cho các phép toán và các cạnh đại diện cho các phụ thuộc dữ liệu. Đồ thị này là mô hình tính toán nội bộ của framework.
Các phép toán toán học có thể được tách rời khỏi thực thi vật lý thông qua các biểu diễn đồ thị. Đồ thị tính toán (figure 2) làm nền tảng cho sự trừu tượng này: các biến tensor ánh xạ tới các nút dữ liệu trong khi các phép toán ánh xạ tới các nút biến đổi.

Các mô hình machine learning thực tế yêu cầu cấu trúc đồ thị phức tạp hơn nhiều. Figure 3 mở rộng biểu diễn này để hiển thị đồ thị tính toán mạng nơ-ron cùng với các thành phần hệ thống suy luận về nó. Trong bảng bên trái, hãy chú ý cách dữ liệu chảy qua sáu nút phép toán trong một đồ thị có hướng không chu trình—đầu ra của mỗi nút trở thành đầu vào của nút tiếp theo. Bảng bên phải tiết lộ những gì framework thu được từ cấu trúc đồ thị rõ ràng này: nó có thể truy vấn cấu trúc để lập kế hoạch cấp phát bộ nhớ cho vòng đời của mỗi tensor, và nó có thể gán các phép toán cho các thiết bị dựa trên các phụ thuộc dữ liệu thay vì thứ tự thực thi. Thông tin quan trọng là đồ thị tồn tại độc lập với quá trình thực thi, cho phép framework tối ưu hóa trước khi bất kỳ phép tính số học nào xảy ra.

Biểu diễn đồ thị này không chỉ là một hình ảnh trực quan; nó là cấu trúc dữ liệu cho phép cả việc thực thi hiệu quả và vi phân tự động. Câu trả lời cho việc đồ thị này được xây dựng khi nào tạo ra một lựa chọn thiết kế với những hệ quả dây chuyền trên bốn khía cạnh. Gỡ lỗi được hưởng lợi từ khả năng hiển thị các giá trị trung gian và thực thi từng bước. Tối ưu hóa được hưởng lợi từ việc xem xét nhiều thao tác cùng lúc, điều này cho phép hợp nhất. Triển khai được hưởng lợi khi việc thực thi không còn phụ thuộc vào trình thông dịch Python. Tính linh hoạt được hưởng lợi khi luồng điều khiển có thể phụ thuộc vào các giá trị tensor đã tính toán.
Không có mô hình thực thi nào tối ưu hóa tất cả các khía cạnh này. Các framework phải chọn vị trí của mình trong không gian đánh đổi này, và các nhà thực hành phải hiểu những đánh đổi này để chọn công cụ phù hợp và viết mã hiệu quả. Ba nhóm thực thi sau đây là những câu trả lời khác nhau cho cùng một câu hỏi hệ thống: framework nên đánh đổi bao nhiêu khả năng hiển thị đồ thị để đổi lấy việc thực thi tức thì và gỡ lỗi?
Ba chiến lược thực thi
Biểu diễn đồ thị tính toán cho phép tối ưu hóa toàn cục, nhưng nó để lại một lựa chọn thiết kế quan trọng chưa được giải quyết: khi nào framework xây dựng đồ thị. Hãy xem xét một thao tác đơn giản như y = x * 2. Một cách tiếp cận thực hiện phép nhân ngay lập tức, lưu trữ kết quả vào y. Điều này tự nhiên và dễ gỡ lỗi, nhưng framework chỉ thấy một thao tác tại một thời điểm. Cách tiếp cận khác là trì hoãn việc thực thi, ghi lại ý định nhân và xây dựng một đồ thị các thao tác sẽ chạy sau khi được yêu cầu rõ ràng. Điều này ít trực quan hơn, nhưng framework thấy được toàn bộ quá trình tính toán, điều này cho phép tối ưu hóa.
Không có cách tiếp cận nào vượt trội; mỗi cách thể hiện những đánh đổi khác nhau giữa tính linh hoạt và tiềm năng tối ưu hóa. Các framework hiện đại đã khám phá ba chiến lược thực thi chính: thực thi eager với đồ thị động, đồ thị tính toán tĩnh và các cách tiếp cận lai kết hợp biên dịch đúng lúc (JIT) với phát triển eager. Mỗi chiến lược đều có những hàm ý hệ thống riêng biệt.
Thực thi eager với đồ thị động
Thực thi eager đánh giá từng thao tác ngay lập tức khi chương trình gọi nó, xây dựng đồ thị tính toán một cách động tại runtime. Một so sánh song song cho thấy điều này khác với thực thi dựa trên đồ thị ở cấp độ mã như thế nào.
Example 1.1: So sánh mã thực thi eager và đồ thị
PyTorch (thực thi eager):
import torch

x = torch.tensor([1.0, 2.0])
y = x * 2
print(f"Intermediate value: {y}")  # Works immediately
z = y.sum()
TensorFlow 1.x (đồ thị tĩnh):
import tensorflow as tf

x = tf.placeholder(tf.float32)
y = x * 2
# print(y) -> Prints Tensor("mul:0"...), not value!
z = tf.reduce_sum(y)

with tf.Session() as sess:
    result = sess.run(z, feed_dict={x: [1.0, 2.0]})
Hiểu biết hệ thống: Thực thi eager hiển thị các giá trị trung gian dưới dạng trạng thái runtime thông thường, giúp gỡ lỗi trực tiếp. Đồ thị tĩnh sắp xếp tính toán trước khi thực thi, điều này cho phép tối ưu hóa toàn bộ đồ thị nhưng thay đổi mô hình gỡ lỗi.
Thực thi eager chạy các thao tác ngay lập tức khi gặp phải, xây dựng đồ thị tính toán một cách động trong quá trình thực thi. Khi một lập trình viên viết y = x * 2, phép nhân xảy ra ngay lập tức và kết quả có sẵn để sử dụng ngay.
Điều này mang lại sự linh hoạt của lập trình thông thường: các nhà phát triển có thể in các giá trị trung gian, sử dụng các câu lệnh điều kiện dựa trên kết quả đã tính toán và gỡ lỗi bằng các công cụ tiêu chuẩn. Framework ghi lại các thao tác khi chúng xảy ra, xây dựng một đồ thị động phản ánh đường dẫn thực thi thực tế đã đi.
Để tính toán gradient, framework ghi lại lịch sử các thao tác trong cái gọi là autograd tape,10 một cấu trúc dữ liệu tạm thời được xây dựng trong quá trình thực thi. Mỗi thao tác tensor tạo ra một nút ghi lại: thao tác đã thực hiện, tham chiếu đến các tensor đầu vào và cách tính toán gradient. Các nút này tạo thành một DAG ghi lại đường dẫn thực tế đã đi trong quá trình thực thi lượt truyền xuôi thay vì một đồ thị được cố định trước. Listing 1 cho thấy PyTorch ghi lại các thao tác khi chúng thực thi trong chế độ eager mặc định của nó như thế nào.
10 Autograd tape: Một cấu trúc dữ liệu tạm thời được xây dựng trong quá trình thực thi truyền xuôi, nơi các nút ghi lại các thao tác, sự phụ thuộc và các hàm truyền ngược để đánh giá quy tắc chuỗi. Dấu chân bộ nhớ của nó tăng lên theo độ sâu mô hình và độ dài chuỗi khi các activation đã lưu tích lũy cho đến khi được giải phóng trong quá trình lan truyền ngược. Đối với các mô hình sâu, các framework giữ lại các activation được chọn và tính toán lại các activation khác thông qua checkpointing activation để ngăn chặn lỗi OOM.
import torch

x = torch.tensor([1.0], requires_grad=True)
y = x * 2  # Executes immediately; records MulBackward node
z = y + 1  # Executes immediately; records AddBackward node
# The autograd tape exists NOW, built during execution
Sau hai thao tác này, framework đã xây dựng một autograd tape với hai nút: một cho phép nhân và một cho phép cộng. Tape ghi lại rằng z phụ thuộc vào y, và y phụ thuộc vào x.
Gọi z.backward() duyệt qua tape này theo thứ tự tô pô ngược, áp dụng quy tắc chuỗi tại mỗi nút:
- Tính \(\frac{\partial z}{\partial z} = 1\) (gradient hạt giống)
- Gọi
AddBackward0.backward()\(\rightarrow \frac{\partial z}{\partial y} = 1\) - Gọi
MulBackward0.backward()\(\rightarrow \frac{\partial z}{\partial x} = 2\) - Tích lũy gradient trong
x.grad
Sau khi backward() hoàn tất, đồ thị autograd thường được giải phóng. Lượt truyền xuôi tiếp theo xây dựng một đồ thị mới. Các giá trị cần thiết cho gradient được lưu trong lượt truyền xuôi và vẫn còn tồn tại cho đến khi truyền ngược sử dụng chúng, vì vậy chi phí bộ nhớ của chúng trải dài cả hai giai đoạn thay vì chỉ xuất hiện trong quá trình truyền ngược.
Example 1.2: Các thao tác tại chỗ có thể làm hỏng gradient
Tình huống: Một kỹ sư áp dụng một phép biến đổi tại chỗ (
x += 1) trong một hàm activation PyTorch tùy chỉnh để giảm cấp phát bộ nhớ.
Chẩn đoán: Các thao tác tại chỗ ghi đè lên bộ nhớ tensor chứa các activation lượt truyền xuôi cần thiết cho autograd tape để tính toán gradient lượt truyền ngược, gây ra lỗi bộ đếm phiên bản runtime (PyTorch Contributors 2026a).
Bài học về hệ thống: Vi phân tự động của framework phụ thuộc vào các bản ghi activation của lượt truyền xuôi bất biến. Các thay đổi bộ nhớ tại chỗ không được kiểm soát phá vỡ các phụ thuộc của băng autograd, buộc dừng thực thi framework runtime.
PyTorch Contributors. 2026a. PyTorch Autograd Mechanics.
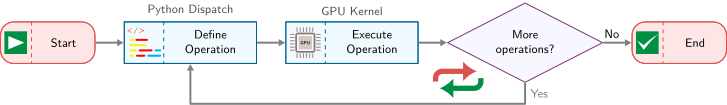
Trong các framework thực thi tức thì (eager execution), các phép toán được đánh giá một cách mệnh lệnh khi mã máy chủ gặp chúng. Theo dõi vòng lặp thực thi trong Luồng Thực thi Đồ thị Động, theo chuỗi định nghĩa và điều phối gửi các phép toán riêng lẻ trực tiếp đến các hàng đợi luồng của thiết bị.
::: {#fig-mlfm-dynamic-graph-flow fig-env=“figure” fig-pos=“htb” fig-cap=“Luồng Thực thi Đồ thị Động: Trong thực thi tức thì, mỗi phép toán được phát hành ngay khi chương trình gặp nó. Khối lượng công việc của bộ tăng tốc có thể thực thi không đồng bộ sau khi điều phối. Mô hình định nghĩa-theo-chạy này cho phép gỡ lỗi tự nhiên và luồng điều khiển phụ thuộc vào dữ liệu, đồng thời hạn chế tối ưu hóa trên các lệnh gọi Python.” fig-alt=“Sơ đồ luồng từ trái sang phải với Bắt đầu, Định nghĩa Phép toán dưới Điều phối Python, Thực thi Phép toán dưới Kernel GPU, một quyết định”Còn phép toán nào nữa không?“, và Kết thúc. Một nhánh”Có” quay lại Định nghĩa Phép toán; một nhánh “Không” tiếp tục đến Kết thúc.”}
:::
Hàm ý về hệ thống: Tính linh hoạt
Băng autograd động thể hiện hành vi phụ thuộc vào dữ liệu trực tiếp trong ngôn ngữ máy chủ. Các câu lệnh điều kiện và vòng lặp có thể phụ thuộc vào các giá trị tensor được tính toán trong quá trình thực thi, cho phép các thuật toán như tìm kiếm chùm (beam search), độ dài mạng nơ-ron hồi quy động, hoặc tính toán thích ứng điều chỉnh hành vi của chúng dựa trên kết quả trung gian. Đồ thị tĩnh cũng có thể biểu diễn luồng điều khiển phụ thuộc vào dữ liệu và các chiều động thông qua các phép toán đồ thị, nhưng thực thi tức thì làm cho các mẫu này tự nhiên hơn khi viết và gỡ lỗi trong Python. Bởi vì các phép toán được phát hành ngay lập tức, các nhà phát triển có thể in tensor, kiểm tra giá trị và sử dụng các trình gỡ lỗi tiêu chuẩn (pdb, breakpoints) để chẩn đoán lỗi giống như họ làm trong một chương trình Python khác.
Hàm ý về hệ thống: Chi phí phát sinh
Tính linh hoạt này đi kèm với chi phí hiệu suất liên quan trực tiếp đến định luật sắt (Định luật sắt của hệ thống ML). Mỗi lượt truyền xuôi huấn luyện xây dựng một băng autograd động, thêm chi phí phát sinh điều phối Python phía máy chủ và công việc ghi đồ thị vào \(L_{\text{lat}}\). Các phép toán đi qua bộ điều phối framework trước khi các kernel thiết bị được khởi chạy, do đó chi phí phát sinh trở nên đáng kể khi các kernel riêng lẻ ngắn. Thực thi tức thì một mình cũng thiếu một đồ thị tĩnh được nắm bắt toàn cục, ngăn trình biên dịch framework thực hiện hợp nhất kernel (kết hợp nhiều phép toán theo phần tử thành một lần khởi chạy kernel GPU duy nhất để loại bỏ các thao tác đọc/ghi HBM trung gian) hoặc cấp phát trước một vùng bộ nhớ tĩnh cho các activation trung gian (\(D_{\text{vol}}\)). Băng autograd giữ lại các giá trị được yêu cầu bởi các quy tắc ngược, gây thêm áp lực bộ nhớ cho đến khi các giá trị đó có thể được giải phóng. Tổng hợp lại, những chi phí này tạo ra một giới hạn hiệu suất trở nên rõ ràng khi các phép toán nhỏ hơn và chi phí phát sinh điều phối chiếm ưu thế trong tính toán.
Giới hạn hiệu suất của thực thi tức thì được thúc đẩy bởi sự không khớp cơ bản của hệ thống: tốc độ của trình thông dịch phía máy chủ so với tốc độ của silicon phía thiết bị. Thuế điều phối, được định nghĩa là tỷ lệ thời gian dành cho điều phối phía máy chủ (Python) so với thực thi thiết bị thực tế (GPU), định lượng sự không khớp này.
Khi khối lượng công việc tăng lên, tính toán hữu ích vượt trội chi phí điều phối cố định; thuế giảm.
Trong mô hình thực thi tức thì minh họa được sử dụng ở đây, mỗi phép toán phải trả một “thuế” cố định khoảng 15 \(\mu\)s cho việc điều phối phía máy chủ, kiểm tra kiểu và khởi chạy kernel. Chi phí phát sinh thực tế thay đổi tùy theo framework, backend và phần cứng, nhưng trọng số tương đối của nó vẫn phụ thuộc vào kích thước phép toán. Đối với một phép toán nhỏ như ReLU trên một vector nhỏ, kernel có thể thực thi chỉ trong 1 \(\mu\)s, do đó thuế điều phối được mô hình hóa đạt 94 percent và GPU dành phần lớn thời gian chờ lệnh tiếp theo. Đối với một phép toán lớn như phép nhân ma trận lớn, kernel thực thi trong 100 \(\mu\)s, thuế điều phối được mô hình hóa giảm xuống 13 percent, và hệ thống trở nên bị giới hạn bởi tính toán (compute bound).
Thuế điều phối giải thích tại sao các mô hình với nhiều lớp nhỏ chạy chậm hơn đáng kể so với dự đoán của số lượng FLOP thô của chúng. Chẩn đoán nút thắt cổ chai đặt triệu chứng này vào phân loại nút thắt cổ chai, phân loại một khối lượng công việc bị chi phối bởi điều phối là bị giới hạn bởi độ trễ (latency-bound) thay vì bị giới hạn bởi tính toán (compute-bound) và chỉ ra những tối ưu hóa nào thực sự thay đổi nó. Để tiếp cận thực thi hiệu quả, các framework phải chuyển từ điều phối từng kernel sang thực thi cấp độ đồ thị, nơi thuế điều phối được trả một lần cho toàn bộ đồ thị thay vì cho mỗi phép toán. Các chiến lược JIT lai và biên dịch trong section 1.3.3.3 tồn tại chính xác để giải quyết chi phí phát sinh này.
Chi phí phát sinh của thực thi tức thì thúc đẩy một thiết kế ngược lại: nắm bắt toàn bộ tính toán trước khi thực thi bất kỳ phần nào của nó. Đây chính xác là những gì đồ thị tính toán tĩnh cung cấp.
Đồ thị tính toán tĩnh
Thực thi đồ thị tĩnh định nghĩa toàn bộ đồ thị tính toán dưới dạng biểu diễn ký hiệu trước, sau đó thực thi riêng biệt. Mô hình thực thi “định nghĩa-rồi-chạy” này có nghĩa là đồ thị tồn tại trước khi bất kỳ tính toán nào xảy ra, cho phép tối ưu hóa trước thời điểm thực thi mạnh mẽ. Điểm mấu chốt là nếu framework nhìn thấy toàn bộ quá trình tính toán trước khi chạy, framework có thể phân tích, biến đổi và tối ưu hóa đồ thị một cách toàn cục—khả năng hiển thị này không có sẵn giữa các lệnh gọi eager riêng lẻ trừ khi một trình biên dịch nắm bắt chúng. Hợp nhất toán tử trình bày biến đổi toàn cục chuẩn tắc mà điều này cho phép: đối với \(N\) phần tử, mỗi phần tử \(b\) byte, việc hợp nhất một chuỗi \(k\) phép toán từng phần tử vào một kernel làm giảm lưu lượng đọc-ghi lý tưởng từ \(2kNb\) xuống \(2Nb\) byte.
Thực thi hai pha
Đồ thị tĩnh thực hiện sự phân tách rõ ràng giữa việc xây dựng đồ thị và thực thi. Listing 2 minh họa hai pha này bằng TensorFlow 1.x, một ví dụ điển hình cho cách tiếp cận này. Nó cố tình chạy phép tính x * 2 rồi + 1 tương tự như được trình bày trong thực thi eager ở listing 1, giữ nguyên phép toán số học để điều duy nhất thay đổi là thời điểm nó thực thi: định nghĩa ký hiệu tạo ra các phần giữ chỗ (placeholder) và các phép toán mà không tính toán, trong khi thực thi rõ ràng kích hoạt các phép toán số học thực tế.
# Phase 1: Graph Construction (symbolic, no computation)
import tensorflow.compat.v1 as tf

tf.disable_v2_behavior()

# Define graph symbolically
x = tf.placeholder(tf.float32, shape=[1])  # Just a placeholder
y = x * 2  # Not executed, just recorded
z = y + 1  # Still no execution
# At this point, nothing has been computed

# Phase 2: Graph Execution (actual computation)
with tf.Session() as sess:
    result = sess.run(z, feed_dict={x: [1.0]})
    # Now computation happens: result = [3.0]
Biên dịch đồ thị tĩnh tách biệt việc xây dựng đồ thị khỏi việc thực thi tensor. Quan sát sự phân chia pha trong figure 4, lưu ý cách định nghĩa đồ thị ký hiệu ở bên trái diễn ra trước quá trình tối ưu hóa trước thời điểm thực thi và thực thi runtime ở bên phải.

Sự khác biệt chính so với thực thi eager là trong quá trình xây dựng, x, y và z không phải là các tensor chứa giá trị mà là các nút ký hiệu trong một đồ thị. Các phép toán như * và + thêm các nút vào định nghĩa đồ thị mà không thực hiện bất kỳ phép toán số học nào. Dòng print(y) trong ví dụ mã sẽ cho thấy sự khác biệt này—nó sẽ in siêu dữ liệu của tensor, chứ không phải một giá trị đã được tính toán. Việc thực thi được kích hoạt rõ ràng thông qua sess.run(), tại thời điểm đó framework phân tích đồ thị hoàn chỉnh, tối ưu hóa nó và thực thi phiên bản đã tối ưu hóa với dữ liệu đầu vào được cung cấp.
Tối ưu hóa trước thời điểm thực thi
Vì framework có toàn bộ đồ thị trước khi thực thi, nó có thể thực hiện tối ưu hóa trước thời điểm thực thi [tối ưu hóa đồ thị trước runtime] mà không có sẵn giữa các lệnh gọi eager không được nắm bắt. Cơ hội hợp nhất kernel được giới thiệu trong section 1.3.1 trở nên khả thi ở đây: vì framework nhìn thấy y = x * 2 và z = y + 1 cùng nhau trong đồ thị, nó có thể hợp nhất chúng thành z = x * 2 + 1, loại bỏ y trung gian và giảm một nửa lưu lượng bộ nhớ lý tưởng. Khi biết hình dạng và vòng đời của tensor, trình biên dịch có thể lập kế hoạch bộ nhớ trước khi thực thi và tái sử dụng các bộ đệm có vòng đời không chồng chéo; các chiều động có thể yêu cầu giới hạn hoặc cấp phát runtime. Bố cục tensor cũng có thể được biến đổi toàn cục (ví dụ, NCHW sang NHWC) để phù hợp với ưu tiên phần cứng, mặc dù việc chuyển đổi bố cục vật lý vẫn có thể yêu cầu sao chép. Loại bỏ mã chết (DCE)11 loại bỏ các phép toán có kết quả không được sử dụng, và gập hằng số (constant folding) tính toán trước các phép toán trên các giá trị hằng khi đầu vào của chúng đã biết. Các tối ưu hóa này ánh xạ trực tiếp đến các thuật ngữ của định luật sắt: hợp nhất kernel có thể giảm \(D_{\text{vol}}\) bằng cách tránh ghi bộ nhớ trung gian, gập hằng số giảm công việc lặp lại, cấp phát theo kế hoạch có thể giảm chi phí runtime, và loại bỏ mã chết loại bỏ công việc và di chuyển dữ liệu liên quan khi có các tính toán không được sử dụng.
11 Loại bỏ mã chết (DCE): Loại bỏ các nút đồ thị có kết quả không ảnh hưởng đến đầu ra có thể quan sát được hoặc các tác dụng phụ. Trong đồ thị ML, mã chết phát sinh từ các nhánh không được sử dụng hoặc các tạo phẩm sau biến đổi; phân tích tác dụng phụ đảm bảo loại bỏ an toàn để ngăn chặn việc thực thi các phép toán chết và giảm chi phí khởi chạy kernel.
12 XLA (accelerated linear algebra): “Mã máy được tối ưu hóa” trong câu kích hoạt có nghĩa là XLA có thể hợp nhất các đồ thị con, chuyên biệt hóa bố cục và chuyển đổi các phép toán cấp cao thành mã dành riêng cho backend; hợp nhất giải quyết cả chi phí khởi chạy \((L_{\text{lat}})\) và ghi bộ nhớ trung gian \((D_{\text{vol}})\), nhưng tốc độ tăng thực tế phụ thuộc vào việc đồ thị có chứa đủ công việc có thể hợp nhất, bị giới hạn bởi bộ nhớ để trình biên dịch loại bỏ hay không. Các vùng lớn nặng GEMM có thể đã bị giới hạn bởi tính toán, trong khi các chuỗi phép toán từng phần tử nhỏ có thể hưởng lợi nhiều hơn vì hợp nhất loại bỏ các chuyến đi lặp lại qua bộ nhớ ngoài. Lợi ích không phải là một hệ số nhân cố định: XLA hữu ích khi nó có thể hợp nhất các phép toán, chuyên biệt hóa bố cục và hình dạng, và giảm chi phí khởi chạy hoặc bộ nhớ, do đó lợi ích phụ thuộc vào cấu trúc đồ thị, hỗ trợ backend và độ ổn định của hình dạng đầu vào.
Các framework biên dịch như XLA (accelerated linear algebra)12 (Google 2025) còn tiến xa hơn, biên dịch các đồ thị TensorFlow thành các tệp thực thi được tối ưu hóa cho phần cứng cụ thể.
Ý nghĩa hệ thống
Đồ thị tĩnh có thể đạt hiệu suất cao thông qua tối ưu hóa trước thời hạn. Hợp nhất kernel giảm yêu cầu băng thông bộ nhớ khi lưu lượng trung gian là nút thắt cổ chai, và biên dịch dành riêng cho phần cứng có thể đạt mức sử dụng cao khi các hình dạng, toán tử và bố cục khớp với các đường dẫn backend hiệu quả.
Chi phí của hiệu suất này là sự linh hoạt bị giảm. Luồng điều khiển Python tiêu chuẩn (if, for) không thể phụ thuộc vào các giá trị tensor đã tính toán trong đồ thị tĩnh. TensorFlow cung cấp các nguyên thủy luồng điều khiển cấp đồ thị (tf.cond và tf.while_loop) hỗ trợ các điều kiện phụ thuộc vào dữ liệu, nhưng chúng yêu cầu cú pháp đặc biệt khác với Python tiêu chuẩn, khiến mã khó viết và khó hiểu hơn. Gỡ lỗi khó khăn vì các dấu vết ngăn xếp trỏ đến mã xây dựng đồ thị, không phải mã thực thi. Thông báo lỗi thường tham chiếu tên nút tượng trưng thay vì các thao tác thực tế đã thất bại.
Các phương pháp lai: Biên dịch JIT
Biên dịch JIT theo đuổi cả gỡ lỗi tức thì và tối ưu hóa đồ thị cùng lúc bằng cách thu thập tính toán tại runtime. Sự đánh đổi cốt lõi là độ trung thực so với tính tổng quát. Dò vết (tracing) thu thập đường dẫn thực thi trong một lần chạy mẫu, tạo ra độ trung thực cao với đường dẫn đó nhưng bỏ sót các nhánh không được thực hiện. Biên dịch cấp mã nguồn (scripting) phân tích cấu trúc chương trình được hỗ trợ, bảo toàn luồng điều khiển được hỗ trợ nhưng yêu cầu một tập con ngôn ngữ bị hạn chế. Cả hai phương pháp đều tạo ra một biểu diễn trung gian (IR)13 cho phép tối ưu hóa đồ thị như hợp nhất toán tử, gấp hằng số, loại bỏ mã chết và tái sử dụng bộ đệm.
13 Biểu diễn trung gian (IR): Từ “trung gian” thể hiện vai trò kiến trúc của định dạng này: một lớp độc lập với ngôn ngữ, tách rời frontend (thu thập Python) khỏi backend (tạo mã phần cứng), chính xác như cách LLVM IR tách rời các frontend C/Rust/Swift khỏi các backend x86/ARM. Các framework ML đã áp dụng mẫu trình biên dịch này vì nó giảm chi phí \(\mathcal{O}(M \times N)\) để hỗ trợ \(M\) frontend và \(N\) backend xuống còn \(\mathcal{O}(M + N)\): một cơ chế thu thập đồ thị duy nhất (TorchDynamo, tf2xla) có thể nhắm mục tiêu nhiều backend phần cứng mà không cần viết lại logic thu thập.
Sự đánh đổi giữa thực thi tức thì và biên dịch có một hệ quả trực tiếp theo quy luật sắt. Biên dịch JIT phân bổ \(L_{\text{lat}}\) (chi phí điều phối) trên toàn bộ vùng được biên dịch. Các vùng được biên dịch càng dài thì chi phí phân bổ trên mỗi thao tác càng nhiều, điều này giải thích tại sao các điểm ngắt đồ thị lại quan trọng đối với hiệu suất: mỗi điểm ngắt buộc phải quay lại điều phối tức thì, đặt lại việc phân bổ.
Trong lịch sử, TorchScript của PyTorch đã minh họa cả hai chiến lược (PyTorch Contributors 2026c). TorchScript hiện đã bị loại bỏ để ưu tiên các đường dẫn thu thập và xuất mới hơn như torch.export (PyTorch Contributors 2026c, 2026b); nó vẫn hữu ích ở đây như một minh họa cụ thể về dò vết và scripting cấp mã nguồn. Dò vết thực thi một hàm với các đầu vào ví dụ và ghi lại các thao tác tensor được quan sát trên đường dẫn đó. Listing 3 minh họa cách một module được dò vết có thể được tuần tự hóa và thực thi độc lập với trình thông dịch Python.
import torch


def forward(x):
    y = x * 2
    z = y + 1
    return z


# Trace the function by running it once
x_example = torch.tensor([1.0])
traced = torch.jit.trace(forward, x_example)

# traced is now a compiled TorchScript module
# Can serialize: torch.jit.save(traced, "model.pt")
# Can optimize: fusion, constant folding
# Can run without Python interpreter
Hạn chế quan trọng của dò vết cho thấy rõ ràng sự đánh đổi giữa độ trung thực và tính tổng quát. Một dấu vết ghi lại các thao tác từ một đường dẫn được quan sát thay vì bảo toàn luồng điều khiển Python tùy ý. Listing 4 minh họa rủi ro về tính đúng đắn do đó.
TracerWarning when a tensor value is converted to a Python condition because the resulting trace may not generalize.
def conditional_forward(x):
    if x.sum() > 0:  # Data-dependent condition
        return x * 2
    else:
        return x * 3


traced = torch.jit.trace(conditional_forward, torch.tensor([1.0]))
# Tracing captures ONLY the x.sum() > 0 branch
# If input later has sum <= 0, traced version
# still executes x * 2 branch
Dò vết ghi lại nhánh được thực thi bởi đầu vào ví dụ. Trong ví dụ này, việc chuyển đổi điều kiện tensor thành một Boolean Python thường tạo ra TracerWarning; dấu vết kết quả vẫn có thể theo nhánh đã thu thập cho các đầu vào sau này yêu cầu nhánh khác. Do đó, việc coi các cảnh báo dò vết là lỗi về tính đúng đắn là điều cần thiết khi có luồng điều khiển Python phụ thuộc vào dữ liệu.
Giải pháp thay thế lịch sử của TorchScript, scripting, đã phân tích trực tiếp mã nguồn Python được hỗ trợ và biên dịch nó thành TorchScript IR mà không cần dò vết một đường dẫn mẫu (PyTorch Contributors 2026c). Trình biên dịch scripting bảo toàn cấu trúc phân nhánh được hỗ trợ nhưng chỉ chấp nhận một tập con Python bị hạn chế. Các dự án hiện tại nên tuân theo hướng dẫn torch.export và runtime mục tiêu được hỗ trợ thay vì chọn giữa dò vết TorchScript và scripting cho các pipeline triển khai mới (PyTorch Contributors 2026b). Trong quy trình làm việc TorchScript lịch sử, dò vết phù hợp với các mô hình truyền thẳng có đường dẫn tensor ổn định cho các đầu vào được hỗ trợ, trong khi scripting xử lý luồng điều khiển phụ thuộc vào dữ liệu được hỗ trợ mà không cần trình thông dịch Python. Ưu điểm chính của scripting là khả năng bảo toàn các điều kiện được hỗ trợ trong IR, như listing 5 cho thấy.
PyTorch Contributors. 2026c. TorchScript.
PyTorch Contributors. 2026b. torch.export.
@torch.jit.script
def conditional_forward(x: torch.Tensor) -> torch.Tensor:
    if x.sum() > 0:
        return x * 2
    else:
        return x * 3


# Both branches preserved in IR
# Correct branch executes based on runtime input values
Để hiểu những gì trình biên dịch tạo ra, listing 6 kiểm tra trực tiếp biểu diễn trung gian được tạo, nơi biểu thức Python duy nhất đã được hạ cấp thành các thao tác nguyên thủy có kiểu rõ ràng mà runtime có thể thực thi mà không cần trình thông dịch.
Scripting áp đặt các ràng buộc vì TorchScript phải phân tích mã mà Python thường thông dịch động. Chữ ký hàm và biến đôi khi cần chú thích kiểu, và các đối tượng Python không được hỗ trợ, các lệnh gọi thư viện hoặc lập trình siêu cấp có thể khiến quá trình biên dịch thất bại. Table 1 tóm tắt sự đánh đổi thiết kế lịch sử này thay vì hướng dẫn triển khai hiện tại.
IR của TorchScript biểu diễn các phép toán bằng cách sử dụng không gian tên aten cho các phép toán tensor cốt lõi, không gian tên prim cho các nguyên thủy và luồng điều khiển, các kiểu tĩnh cho mọi giá trị, và dạng gán tĩnh một lần (SSA), trong đó mỗi biến được gán chính xác một lần để đơn giản hóa phân tích của trình biên dịch. IR này cho phép các tối ưu hóa độc lập với Python: hợp nhất toán tử kết hợp các phép toán liền kề thành các kernel đơn lẻ, gấp hằng số đánh giá các biểu thức hằng số tại thời điểm biên dịch, loại bỏ mã chết loại bỏ các phép toán không sử dụng, và tối ưu hóa bộ nhớ tái sử dụng các bộ đệm khi có thể.
@torch.jit.script
def example(x: torch.Tensor) -> torch.Tensor:
    return x * 2 + 1


# Inspect generated IR:
print(example.graph)
# graph(%x : Tensor):
#   %1 : int = prim::Constant[value=2]()
#   %2 : Tensor = aten::mul(%x, %1)
#   %3 : int = prim::Constant[value=1]()
#   %4 : Tensor = aten::add(%2, %3, %3)
# return (%4)| Khía cạnh | Dò vết (Tracing) | Scripting |
|---|---|---|
| Yêu cầu đầu vào | Cần các đầu vào ví dụ | Không cần đầu vào |
| Luồng điều khiển | Không thể xử lý phụ thuộc vào dữ liệu | Hỗ trợ phụ thuộc vào dữ liệu |
| Dễ dàng chuyển đổi | Đơn giản hơn (chỉ cần chạy hàm) | Khó hơn (Python bị hạn chế) |
| Chú thích kiểu | Không bắt buộc | Bắt buộc khi suy luận thất bại |
| Phát hiện lỗi | Thời gian chạy (kết quả sai) | Thời gian biên dịch (lỗi cú pháp) |
| Tốt nhất cho | Các mô hình truyền thẳng | Các mô hình có điều kiện |
Biên dịch hiện đại: JIT bắt đồ thị
Các phương pháp tiếp cận trước đây buộc phải lựa chọn giữa thực thi eager linh hoạt và các đồ thị hiển thị với trình biên dịch. Biên dịch JIT hiện đại thu hẹp sự đánh đổi này bằng cách tự động bắt các vùng mã eager thành các đồ thị được tối ưu hóa với sự can thiệp hạn chế từ nhà phát triển.
Các hệ thống JIT bắt đồ thị tuân theo cùng một mẫu kiến trúc trên các framework. Lần thực thi đầu tiên quan sát các phép toán tensor, ghi lại một vùng đồ thị được bảo vệ bởi các giả định về hình dạng, kiểu dữ liệu (dtypes), bố cục và luồng điều khiển, hạ cấp vùng đó thành một biểu diễn trung gian, áp dụng các tối ưu hóa hợp nhất và bố cục, và lưu vào cache mã thực thi cho các lần gọi sau đó thỏa mãn các điều kiện bảo vệ tương tự. Mã Python không được hỗ trợ không biến mất; nó tạo thành một ranh giới đồ thị nơi thực thi quay trở lại runtime eager. torch.compile của PyTorch 2.0 (Ansel et al. 2024) là một ví dụ cụ thể của mẫu này, nhưng ý tưởng hệ thống rộng hơn API: biên dịch chỉ có lợi khi các vùng được bắt đủ dài và đủ ổn định để bù đắp chi phí bắt, hạ cấp, sinh mã và quản lý cache.
Ansel, Jason, Edward Yang, Horace He, Natalia Gimelshein, Animesh Jain, Michael Voznesensky, Bin Bao, et al. 2024. “PyTorch 2: Faster Machine Learning Through Dynamic Python Bytecode Transformation and Graph Compilation.” Proceedings of the 29th ACM International Conference on Architectural Support for Programming Languages and Operating Systems, Volume 2, 929–47. https://doi.org/10.1145/3620665.3640366.
Điều này giải thích khi nào biên dịch có thể hữu ích. Chi phí điều phối tưởng chừng không đáng kể cho một phép toán—vài micro giây mỗi lần—sẽ tích lũy qua hàng nghìn phép toán trong một lượt truyền xuôi. Một ước tính hợp nhất đơn giản làm cho chi phí phụ trội trở nên rõ ràng.
Napkin Math 1.1: Vật lý của chi phí phụ trội phần mềm
Liên hệ với định luật sắt: Thuật ngữ độ trễ \((L_{\text{lat}})\) trong định luật sắt bị chi phối bởi chi phí phụ trội phần mềm: điều phối các lệnh từ Python đến GPU. Mỗi phép toán phải trả chi phí điều phối Python khoảng ~10 μs cộng với chi phí khởi chạy kernel khoảng ~5 μs, tổng cộng chúng tạo nên chi phí phụ trội cho mỗi lần khởi chạy được áp dụng trong các kịch bản sau.
Kịch bản một: Chế độ Eager (Bẫy “Phép toán nhỏ”) Hãy xem xét một khối activation đơn giản, y = relu(x + bias), trong đó mỗi tensor chứa \(N\) phần tử, mỗi phần tử \(b\) byte.
- Các phép toán: Hai (Add, ReLU).
- Thực thi:
- Khởi chạy Kernel
Add: chi phí phụ trội 15 μs. - Đọc/Ghi Bộ nhớ: \(2Nb\) byte.
- Khởi chạy Kernel
ReLU: chi phí phụ trội 15 μs. - Đọc/Ghi Bộ nhớ: \(2Nb\) byte.
- Khởi chạy Kernel
- Tổng chi phí phụ trội: 30 μs.
- Tổng lưu lượng bộ nhớ: \(4Nb\) byte.
Kịch bản hai: Chế độ biên dịch (Hợp nhất) Trình biên dịch hợp nhất điều này thành một kernel: FusedAddRelu.
- Thực thi:
- Khởi chạy Kernel
Fused: chi phí phụ trội 15 μs. - Đọc/Ghi Bộ nhớ: \(2Nb\) byte (kết quả trung gian nằm trên chip).
- Khởi chạy Kernel
- Tổng chi phí phụ trội: 15 μs (tăng tốc 2×).
- Tổng lưu lượng bộ nhớ: \(2Nb\) byte (hiệu quả băng thông 2×).
Hiểu biết về hệ thống: Hợp nhất thắng lợi trên hai mặt cùng lúc. Gộp hai lần khởi chạy thành một giúp giảm một nửa chi phí phụ trội điều phối trên mỗi phép toán trong kịch bản này, và việc giữ kết quả trung gian trên chip cắt giảm lưu lượng bộ nhớ lý tưởng từ \(4Nb\) xuống còn \(2Nb\) byte. Đối với các phép toán từng phần tử nhỏ, việc tránh chuyến đi khứ hồi đến bộ nhớ ngoài có thể quan trọng hơn phép tính số học.
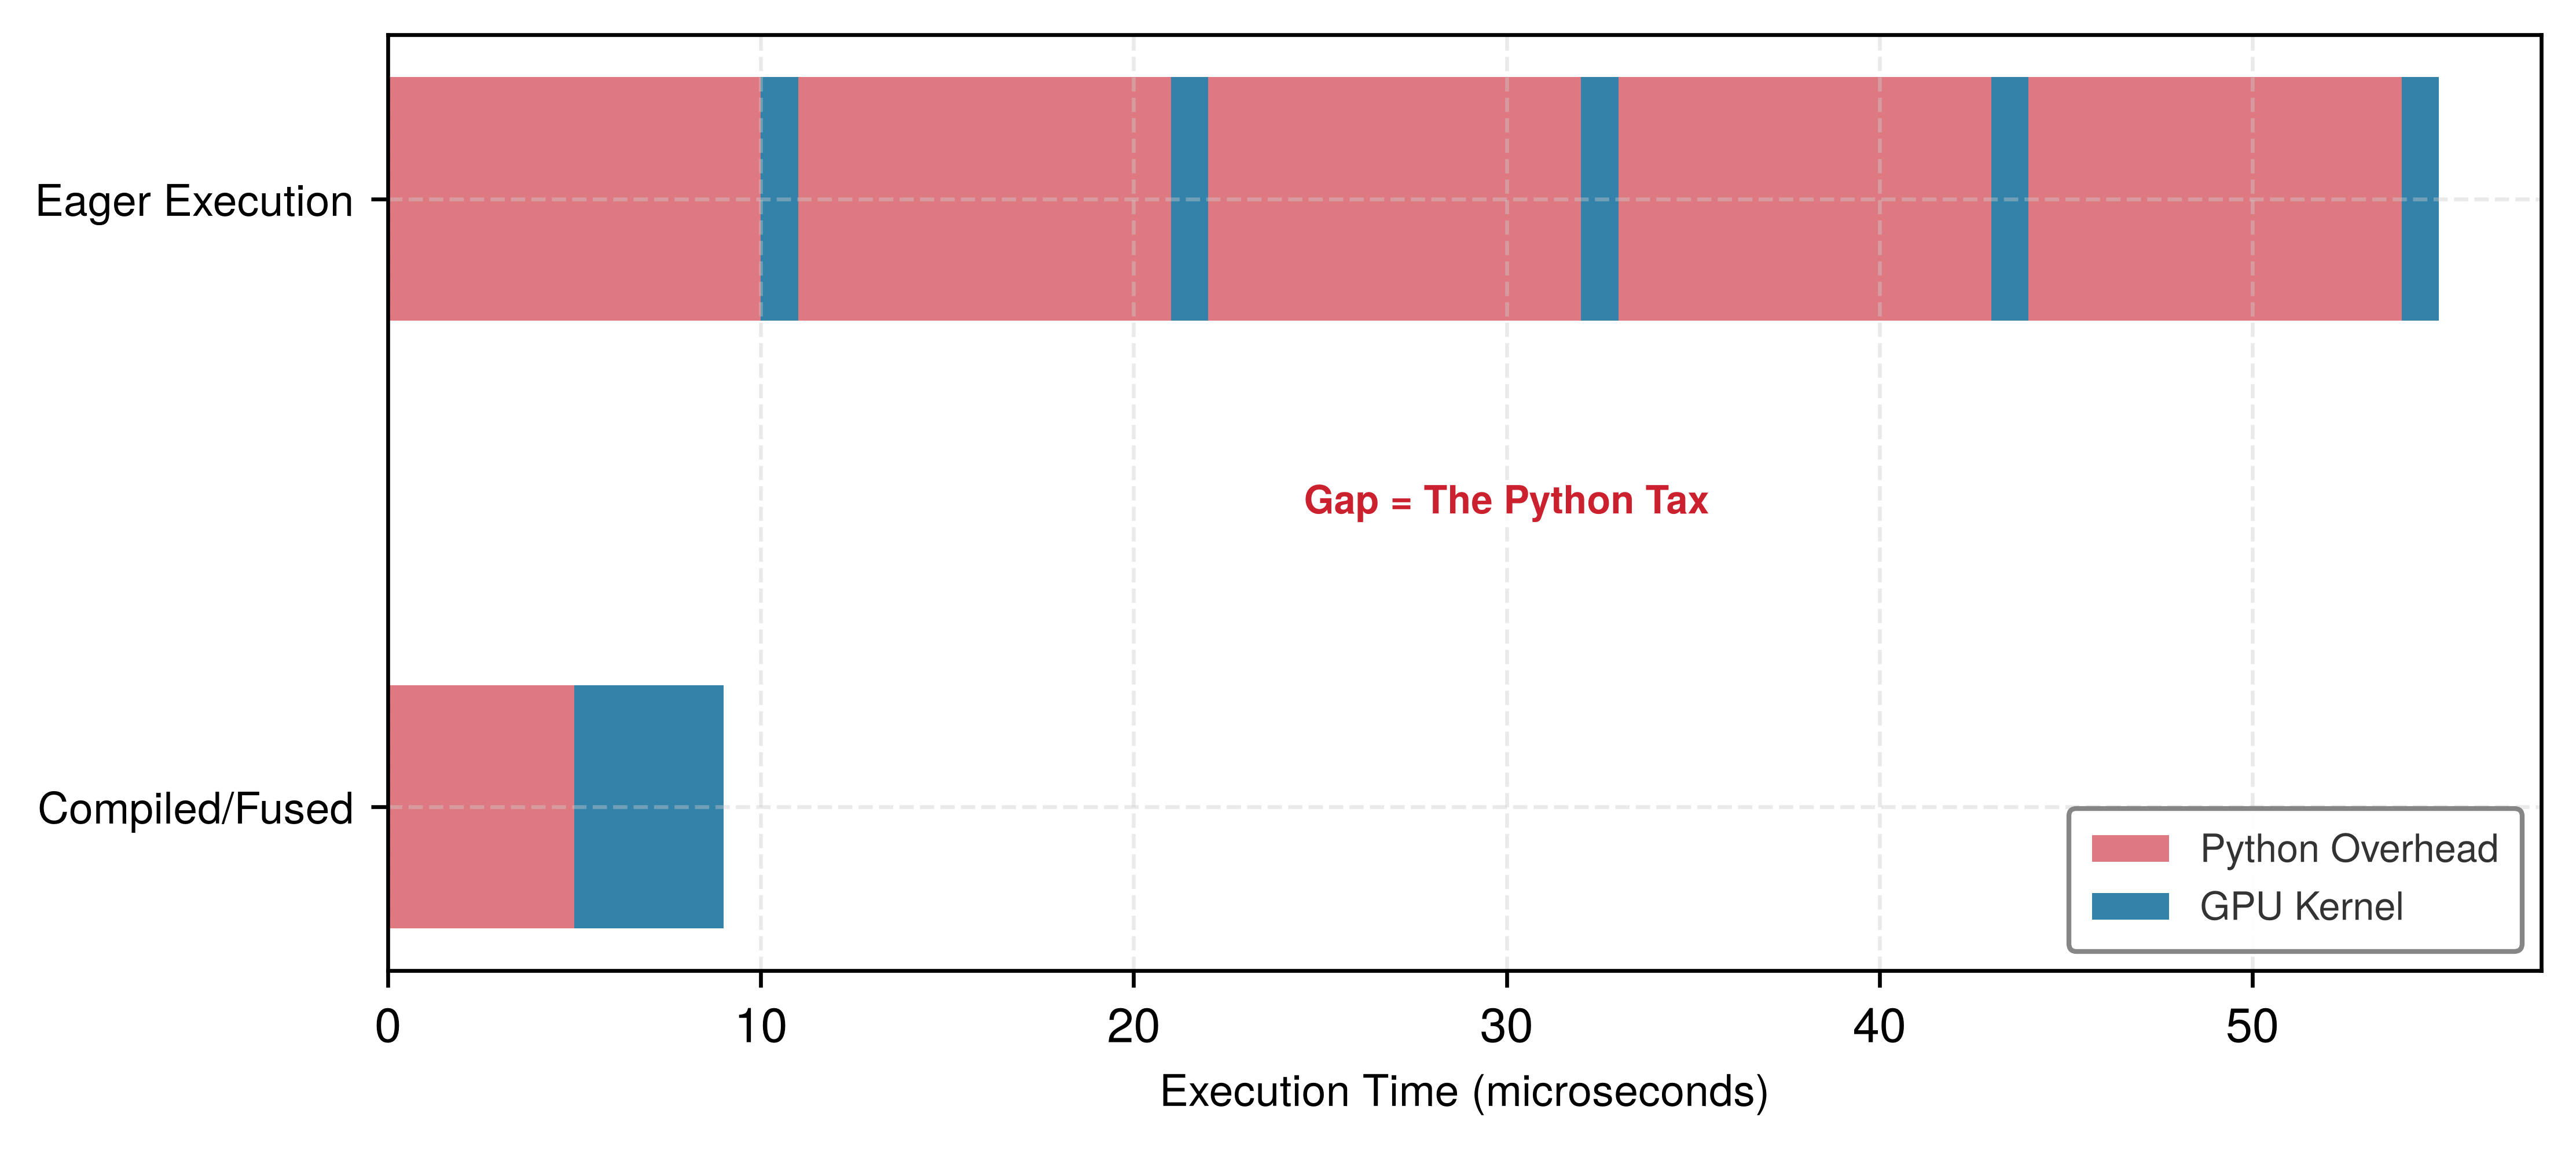
Figure 5 cho thấy rõ thuế điều phối: thực thi eager tạo ra các khoảng trống nơi GPU ở trạng thái nhàn rỗi trong khi Python điều phối kernel tiếp theo. Các vùng tính toán màu xanh lam ngắn; các vùng điều phối màu đỏ tương đối dài. Biên dịch hợp nhất các phép toán này thành một lần khởi chạy kernel duy nhất, thay thế nhiều khoảng trống điều phối bằng một khối điều phối và một khối tính toán hợp nhất.
Tự động hóa việc hợp nhất này là mục tiêu thiết kế đằng sau các trình biên dịch bắt đồ thị như torch.compile của PyTorch 2.0.14 Chúng bắt các vùng tensor eager và biên dịch chúng thành các kernel hợp nhất mà không yêu cầu kỹ sư phải viết CUDA tùy chỉnh.15
14 torch.compile: Đây là một triển khai PyTorch những năm 2020 của biên dịch JIT bắt đồ thị: chặn mã byte trích xuất các vùng tensor từ các chương trình eager, một biểu diễn trung gian mang các vùng đó đến các phần phụ trợ của trình biên dịch, và mã được tạo đã lưu vào cache được tái sử dụng trong khi các điều kiện bảo vệ vẫn còn hiệu lực.
15 CUDA (kiến trúc thiết bị tính toán hợp nhất): Nền tảng điện toán song song của NVIDIA (2007) đóng vai trò là lớp nền tảng giữa các thao tác Python cấp cao và silicon GPU; khi PyTorch thực thi torch.matmul(A, W), lệnh gọi đi qua bộ điều phối của framework, chọn một kernel cuBLAS và khởi chạy nó trên GPU. Mỗi lần khởi chạy phát sinh 5–20 \(\mu\)s chi phí phụ ở phía CPU. Đối với các thao tác nhỏ, chi phí điều phối này \((L_{\text{lat}})\) vượt quá thời gian tính toán hữu ích, đó là lý do tại sao biên dịch (hợp nhất \(N_{\text{ops}}\) thao tác thành một lần khởi chạy kernel) mang lại tốc độ tăng tỷ lệ thuận với việc giảm số lần khởi chạy thay vì giảm số phép toán số học.
Do đó, các câu hỏi kỹ thuật cốt lõi mang tính khái niệm, không đặc thù API. Một trình biên dịch thu thập cần một frontend xác định các vùng đồ thị trong một chương trình thực thi tức thì, một biểu diễn trung gian tách biệt phép tính được thu thập khỏi Python, và một backend chuyển vùng đó thành mã dành riêng cho phần cứng. Nó cũng cần một hệ thống bảo vệ (guard system): tạo phẩm đã biên dịch chỉ hợp lệ khi các giả định về hạng tensor, kiểu dữ liệu (dtype), bố cục (layout) và đường dẫn luồng điều khiển vẫn đúng. Khi một guard thất bại, runtime phải biên dịch lại hoặc quay về thực thi tức thì.
Điểm ngắt đồ thị (Graph breaks) đánh dấu ranh giới nơi quá trình biên dịch ngừng áp dụng. Luồng điều khiển Python phụ thuộc vào dữ liệu, các lệnh gọi thư viện không được hỗ trợ, I/O, các đối tượng Python tùy chỉnh và các hình dạng (shape) rất biến đổi đều rút ngắn các vùng đã biên dịch. Mỗi điểm ngắt tái tạo chi phí điều phối và có thể yêu cầu các tensor di chuyển giữa mã đã biên dịch và runtime thực thi tức thì. Đây là lý do tại sao phân tích điểm ngắt đồ thị thuộc về kỹ thuật hiệu năng: chỉ số liên quan không phải là liệu quá trình biên dịch có được bật hay không, mà là bao nhiêu phần của đường dẫn nóng (hot path) vẫn nằm trong các vùng đã biên dịch dài, ổn định.
Các backend chiếm các vị trí khác nhau trên phổ linh hoạt-hiệu năng. Một trình biên dịch JIT theo dõi quá trình thực thi mô hình tại runtime để tạo các kernel được tối ưu hóa một cách động, phát sinh độ trễ khởi động ban đầu trong lần chạy đầu tiên. Một trình biên dịch trước thời hạn (AOT) thay vào đó biên dịch phép tính được thu thập trước khi triển khai, chuyển quá trình biên dịch ra khỏi đường dẫn nóng và cho phép một runtime độc lập khi mục tiêu xuất hỗ trợ. Một backend JIT tổng quát tối ưu hóa các khối lượng công việc huấn luyện và phục vụ thông thường với chi phí biên dịch vừa phải; một backend suy luận chuyên biệt có thể áp dụng hợp nhất sâu hơn, hạ thấp độ chính xác và tự động điều chỉnh (autotuning) khi mục tiêu triển khai được cố định; một runtime di động hoặc nhúng trước thời hạn loại bỏ nhiều tính linh hoạt hơn nữa để đạt được dung lượng (footprint) và khả năng dự đoán. Cùng một quy tắc chi phối tất cả chúng: mục tiêu càng hẹp và đồ thị càng ổn định, trình biên dịch càng có thể thực hiện tối ưu hóa an toàn hơn.
Quy trình làm việc (workflow) kết quả là một quyết định về hệ thống. Tạo mẫu nhanh ưu tiên thực thi tức thì vì thay đổi kiến trúc và lỗi guard làm cho chi phí biên dịch lại trở nên rõ ràng. Các lần huấn luyện dài và suy luận khối lượng lớn phân bổ chi phí biên dịch trên nhiều lần thực thi, với điều kiện mô hình có hình dạng ổn định và ít điểm ngắt đồ thị. Gỡ lỗi thường bắt đầu ở chế độ thực thi tức thì vì lỗi ánh xạ trực tiếp đến mã nguồn; quá trình biên dịch được đưa vào lại sau khi hành vi mô hình chính xác và nút thắt hiệu năng có thể đo lường được.
So sánh các mô hình thực thi
Table 2 đối chiếu ba mô hình thực thi trên sáu khía cạnh, cho thấy cách biên dịch JIT lai có thể khôi phục tối ưu hóa cấp đồ thị trong các vùng được thu thập trong khi vẫn duy trì cơ chế quay về thực thi tức thì bên ngoài các vùng đó.
| Khía cạnh | Eager + Autograd Tape (mặc định của PyTorch) | Đồ thị tĩnh (TensorFlow 1.x) | Biên dịch JIT (torch.compile) |
|---|---|---|---|
| Mô hình thực thi | Tức thì | Trì hoãn | Lai |
| Xây dựng đồ thị | Trong quá trình truyền thẳng | Trước khi thực thi | Lần thực thi đầu tiên (được lưu vào cache) |
| Tối ưu hóa | Các kernel theo từng phép toán | Trước thời điểm thực thi | Biên dịch JIT |
| Luồng điều khiển động | Luồng điều khiển Python | Luồng điều khiển đồ thị | Các vùng được nắm bắt hoặc ngắt quãng |
| Gỡ lỗi | Dễ (Python tiêu chuẩn) | Khó (ký hiệu) | Trung bình (hỗn hợp) |
| Hiệu suất | Đường cơ sở | Cao (đã tối ưu hóa) | Cao (các vùng đã biên dịch) |
Giá trị chính của chế độ thực thi tức thì nằm trong vòng lặp lặp lại được định lượng trong Vòng đời ML: nó cho phép sử dụng các trình gỡ lỗi Python tiêu chuẩn (như pdb) để kiểm tra các biến trong quá trình thực thi, trong khi gỡ lỗi chế độ đồ thị thường yêu cầu các công cụ framework chuyên biệt. Phản hồi tức thì này đẩy nhanh giai đoạn tạo mẫu của vòng đời ML.
Ngoài những đánh đổi cốt lõi về thực thi này, table 3 làm nổi bật các khác biệt bổ sung ở cấp hệ thống giữa các phương pháp tĩnh và động.
Những đánh đổi này không phải là lựa chọn nhị phân. Các framework hiện đại cung cấp một phổ các tùy chọn, điều này đặt ra câu hỏi định lượng về vị trí trên phổ này mà một dự án nhất định nên hoạt động.
| Khía cạnh | Đồ thị tĩnh | Đồ thị động |
|---|---|---|
| Quản lý bộ nhớ | Lập kế hoạch cấp phát chính xác, sử dụng bộ nhớ tối ưu | Linh hoạt nhưng có thể kém hiệu quả hơn |
| Tận dụng phần cứng | Có thể tạo mã chuyên biệt cho phần cứng được tối ưu hóa cao | Có thể hy sinh các tối ưu hóa chuyên biệt cho phần cứng |
| Tốc độ nghiên cứu | Lặp lại chậm hơn do yêu cầu định nghĩa rồi chạy | Tạo mẫu nhanh hơn và thử nghiệm mô hình |
| Tích hợp với mã nguồn cũ | Phân tách nhiều hơn giữa định nghĩa và thực thi | Tích hợp tự nhiên với mã mệnh lệnh |
Các nguyên tắc định lượng của thực thi
Các mô hình thực thi này tạo thành một phổ, và hai nguyên tắc định lượng giúp việc lựa chọn có thể đo lường được trong thực tế. Nguyên tắc liên tục biên dịch hỏi khi nào lợi ích biên dịch biện minh cho chi phí phát triển bằng cách so sánh các lần thực thi sản xuất với các lần lặp phát triển. Định luật chi phí điều phối cho thấy tại sao thực thi tức thì có thể dành nhiều thời gian hơn để điều phối các thao tác nhỏ so với việc tính toán chúng.
Nguyên tắc liên tục biên dịch
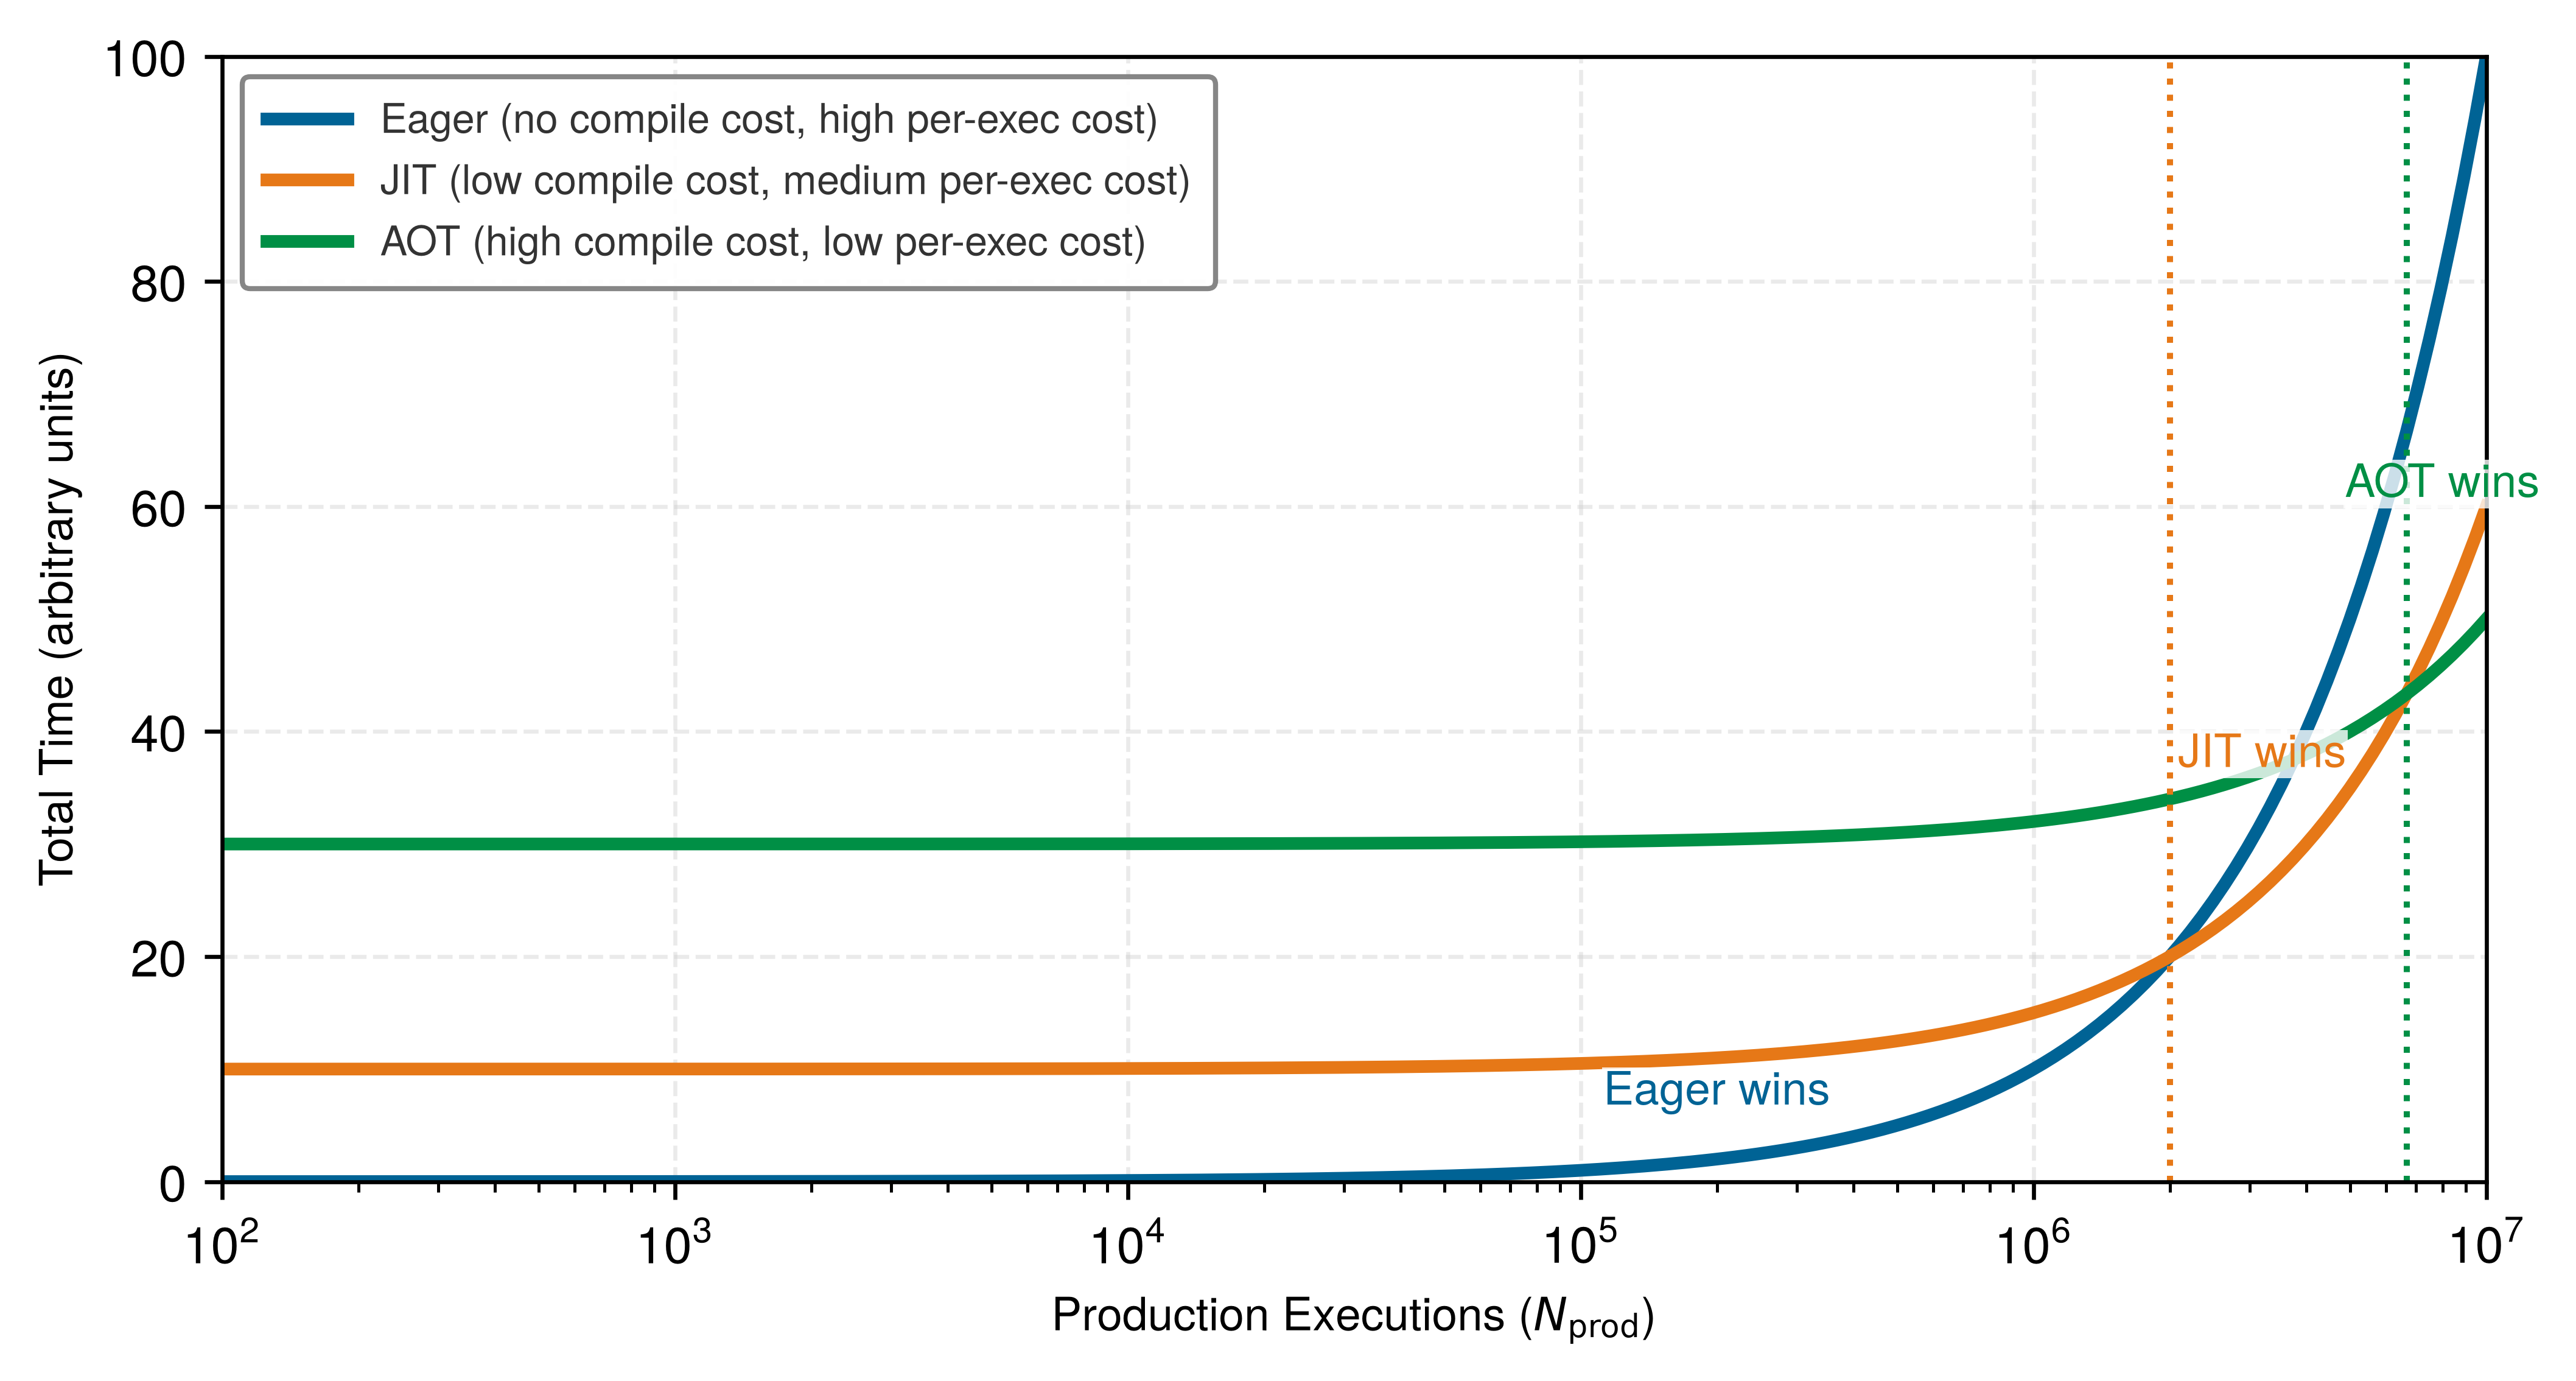
Bài toán thực thi đòi hỏi một nguyên tắc định lượng về thời điểm một dự án nên biên dịch. Các mô hình thực thi tạo thành một chuỗi liên tục từ tính linh hoạt tối đa đến tối ưu hóa tối đa. Equation 1 trình bày bốn vị trí trên trục đó, và mỗi mũi tên được gắn nhãn đặt tên cho cơ chế đưa một dự án tiến một bước sang phải về phía phần cứng.
\[ \text{Eager} \xrightarrow{\text{capture}} \text{Graph JIT} \xrightarrow{\text{export}} \text{AOT Runtime} \xrightarrow{\text{specialize}} \text{Hardware} \tag{1}\]
Mỗi bước dịch sang phải hy sinh tính linh hoạt để đổi lấy hiệu suất. Câu hỏi thực tế là dự án cụ thể nên được đặt ở đâu trên chuỗi liên tục này. Chiến lược biên dịch tối ưu phụ thuộc vào các lần thực thi sản xuất, các lần biên dịch lại trong quá trình phát triển và chi phí thời gian tương ứng của chúng, được kết hợp trong equation 2:
\[ \text{Compilation Benefit} = \frac{N_{\text{prod}} \cdot (T_{\text{eager}} - T_{\text{compiled}})}{T_{\text{compile}} + N_{\text{dev}} \cdot T_{\text{compile}}} \tag{2}\]
Trong đó:
- \(N_{\text{prod}}\) = số lần thực thi sản xuất (số đếm không thứ nguyên: yêu cầu suy luận, bước huấn luyện)
- \(N_{\text{dev}}\) = số lần lặp phát triển yêu cầu biên dịch lại (số đếm không thứ nguyên)
- \(T_{\text{eager}}\) = thời gian cho mỗi lần thực thi ở chế độ eager (giây)
- \(T_{\text{compiled}}\) = thời gian cho mỗi lần thực thi ở chế độ biên dịch (giây)
- \(T_{\text{compile}}\) = thời gian cho mỗi lần biên dịch hoặc biên dịch lại (giây; giả định là hằng số)
Mô hình này giả định rằng tạo phẩm đã biên dịch vẫn hợp lệ giữa các thay đổi trong quá trình phát triển và rằng lần biên dịch ban đầu cũng như mỗi lần biên dịch lại có cùng chi phí; theo các giả định này, quy tắc quyết định là biên dịch khi \(\text{Compilation Benefit} > 1\). Tỷ lệ này là không thứ nguyên.
Table 4 trình bày một kịch bản thông lượng giả định trên các chế độ thực thi và kiến trúc mô hình:
| Mô hình | Eager (ví dụ/giây) | torch.compile (ví dụ/giây) | TensorRT (ví dụ/giây) | Thời gian biên dịch (giây) |
|---|---|---|---|---|
| ResNet-50 | 1,450 | 2,150 | 3,800 | 15–30 |
| BERT-Base | 380 | 520 | 890 | 30–60 |
| ViT-B/16 | 620 | 950 | 1,650 | 25–45 |
| GPT-2 (124M) | 180 | 260 | 420 | 45–90 |
Những khác biệt về thông lượng này trên các chế độ thực thi đặt ra một câu hỏi thực tế—chiến lược thực thi framework nào phục vụ tốt nhất cho từng nguyên mẫu khối lượng công việc (workload). Chiến lược phù hợp phụ thuộc vào khối lượng công việc (workload), backend và thuật ngữ luật sắt chi phối, và table 5 ánh xạ mỗi nguyên mẫu lặp lại tới một chiến lược thực thi ứng cử viên.
| Nguyên mẫu | Thuật ngữ luật sắt thống trị | Chiến lược framework ứng cử viên | Cơ sở lý luận |
|---|---|---|---|
| ResNet-50 (Quái vật tính toán) | \(\frac{O}{R_{\text{peak}} \cdot \eta_{\text{hw}}}\) (Tính toán) | Các kernel dày đặc đã biên dịch | Các kernel dày đặc thông thường được hưởng lợi từ việc lựa chọn bố cục, giảm độ chính xác và chuyên biệt hóa backend; hợp nhất giúp ích nhiều nhất trong các vùng bị giới hạn bởi bộ nhớ hoặc khởi chạy xung quanh |
| GPT-2 (Kẻ ngốn băng thông) | \(\frac{D_{\text{vol}}}{\text{BW}}\) (Băng thông bộ nhớ) | Fused attention + biên dịch đồ thị | Fused attention và biên dịch giảm số lượt truy cập HBM khứ hồi và cải thiện tái sử dụng cache |
| DLRM (Sparse Scatter) | \(\frac{D_{\text{vol}}}{\text{BW}_{\text{random}}}+L_{\text{lat, network}}\) | Eager execution với các kernel chuyên biệt | Tra cứu embedding vốn không đều và động; lợi ích biên dịch nhỏ |
| DS-CNN (Tiny Constraint) | \(L_{\text{lat}}\) (Chi phí phụ trội) | Runtime vi điều khiển trước thời điểm thực thi | Suy luận dưới mili giây; mỗi micro giây chi phí phụ trội Python là không thể chấp nhận được |
Lighthouse 1.1: Chiến lược framework theo nguyên mẫu
Bốn nguyên mẫu lặp lại trong table 5 theo dõi một nguyên tắc xuyên suốt framework: lợi ích biên dịch tăng theo mức độ tối ưu hóa của khối lượng công việc (workload).
Thông tin chuyên sâu về hệ thống: Trong kịch bản minh họa, các Compute Beast như hàng ResNet-50 trong table 4 được hưởng lợi vì các kernel dày đặc của chúng bộc lộ bề mặt đáng kể cho việc lựa chọn bố cục, giảm độ chính xác và hợp nhất. Các khối lượng công việc (workload) Sparse Scatter như DLRM có thể thu được ít lợi ích hơn khi các tra cứu embedding không đều để lại phạm vi trình biên dịch hạn chế.
Nguyên tắc này có ý nghĩa cụ thể trên ba chế độ. Trong tạo mẫu nghiên cứu (\(N_{\text{dev}} \gg N_{\text{prod}}\)), các nhóm nên duy trì chế độ eager. Nếu kiến trúc thay đổi sau mỗi vài phút, chi phí biên dịch có thể chiếm ưu thế. Theo giả định biên dịch 30 giây của kịch bản, mười lần biên dịch mỗi giờ tiêu tốn năm phút.
Đối với các lần huấn luyện dài (\(N_{\text{prod}} \gg N_{\text{dev}}\)), biên dịch có thể mang lại lợi ích vì chi phí một lần của nó được phân bổ trên nhiều bước. Trong kịch bản ResNet-50 giả định trong table 4, torch.compile cung cấp thông lượng cao hơn 48.3 percent (2,150 img/s so với 1,450 img/s). Sử dụng chi phí biên dịch 30 s của kịch bản, điều này sẽ có lợi sau điểm hòa vốn trong equation 3:
\[ N_{\text{breakeven}} = \frac{T_{\text{compile}}}{T_{\text{eager}} - T_{\text{compiled}}} \tag{3}\]
Đánh giá equation 3 với các giá trị ResNet-50 giả định cho kết quả xấp xỉ 134,000 images, nằm trong phạm vi một lần huấn luyện duy nhất có độ dài thực tế.
Đối với suy luận sản xuất (\(N_{\text{dev}} \approx 0\), \(N_{\text{prod}} \rightarrow \infty\)), các nhóm nên tối đa hóa biên dịch. Không có lần lặp phát triển nào và có khả năng hàng triệu yêu cầu, mọi tối ưu hóa đều quan trọng. Tự động điều chỉnh mạnh mẽ có thể đáng giá ngay cả khi biên dịch mất nhiều thời gian hơn, vì chi phí được phân bổ trong suốt vòng đời triển khai.
Ba chế độ này tạo ra các vùng riêng biệt trong không gian quyết định biên dịch. Figure 6 phác thảo các vùng này để các kỹ sư có thể xác định chiến lược nào thắng thế. Hãy chú ý đến các điểm giao nhau: đường eager dốc (chi phí mỗi lần thực thi cao nhất) cuối cùng vượt qua độ dốc vừa phải của JIT, trong khi đường biên dịch nhẹ nhàng nhất (chi phí mỗi lần thực thi thấp nhất nhưng đầu tư ban đầu lớn nhất) chỉ thắng thế sau điểm giao nhau thứ hai trong mô hình minh họa này. Các độ dốc cho thấy chi phí mỗi lần thực thi; các độ lệch dọc cho thấy chi phí biên dịch. Khối lượng thực thi và chi phí đo được của một dự án xác định chiến lược nào giảm thiểu tổng thời gian.
Định luật chi phí điều phối
Một nguyên tắc thứ hai, định luật chi phí phụ trợ điều phối, xuất phát từ equation 4, xác định chế độ mà trong đó chi phí phụ trợ của framework, thay vì tính toán hoặc bộ nhớ, chiếm ưu thế về thời gian thực thi. Gọi \(N_{\text{ops}}\) là số lượng phép toán (đếm), \(t_{\text{dispatch}}\) là chi phí phụ trợ điều phối trên mỗi phép toán (giây), và \(T_{\text{compute}}\) và \(T_{\text{memory}}\) là tổng thời gian tính toán và bộ nhớ (giây). Tỷ lệ này sử dụng phép xấp xỉ cộng, không chồng chéo \(T_{\text{hw}} \approx T_{\text{compute}} + T_{\text{memory}}\); khi việc thực thi chồng chéo các chi phí đó, thời gian phần cứng đo được nên thay thế tổng của chúng. Chi phí phụ trợ của framework chiếm ưu thế khi các phép toán nhỏ so với chi phí điều phối:
\[ \text{Overhead Ratio} = \frac{N_{\text{ops}} \cdot t_{\text{dispatch}}}{T_{\text{compute}} + T_{\text{memory}}} \tag{4}\]
Khi Tỷ lệ Chi phí phụ trợ \(> 1\), mô hình bị giới hạn bởi chi phí phụ trợ. Biên dịch có thể mang lại lợi ích lớn nhất cho các khối lượng công việc (workload) bị giới hạn bởi chi phí phụ trợ vì việc hợp nhất làm giảm số lần điều phối. Dấu vết bước huấn luyện trong section 1.10 minh họa hiệu ứng này từ đầu đến cuối, được xem trước bằng các số liệu sau.
Tổng hợp trên \(N_{\text{ops}}\) phép toán, chi phí điều phối trên mỗi phép toán \(t_{\text{dispatch}}\) tích lũy thành một khoản phí trên mỗi lần gọi khi thực thi. Việc khoản phí đó có chiếm ưu thế hay không phụ thuộc vào cách thời gian thực thi phần cứng \(T_{\text{hw}}\) so sánh với chi phí phụ trợ phần mềm \(T_{\text{sw}}\) (cả hai đều được đo bằng giây), và các chế độ phân chia rõ rệt theo kích thước mô hình.
Ngụ ý của nguyên tắc này là các khối lượng công việc (workload) bao gồm các phép toán nhỏ có thể hưởng lợi không cân xứng từ việc biên dịch khi điều phối chiếm ưu thế trong quá trình thực thi. Chỉ riêng số lượng tham số mô hình không quyết định mức tăng.
Phân tích phí điều phối cho thấy các phép toán nhỏ trở nên bị giới hạn bởi chi phí phụ trợ khi thời gian điều phối vượt quá thời gian thực thi của thiết bị. Quan sát này quan trọng nhất ở rìa cực đoan của phổ triển khai, nơi bản thân runtime Python có thể vượt quá ngân sách tài nguyên của mục tiêu.
Napkin Math 1.2: Phí điều phối
Vấn đề: Khi nào chi phí phụ trợ của Python làm giảm hiệu suất?
Kịch bản một: Mạng perceptron đa lớp (MLP) nhỏ (Bị giới hạn bởi chi phí phụ trợ)
- Tính toán: 6 ops trên các phép toán ma trận/phần tử nhỏ.
- Thời gian phần cứng: \(T_{\text{hw}} \approx\) 2.6 μs (chủ yếu là độ trễ bộ nhớ).
- Chi phí phụ trợ phần mềm: \(T_{\text{sw}} \approx\) 6 ops \(\times\) 15 μs/op = 90 μs.
- Tỷ lệ: 90 μs/2.6 μs ≈ 34.6.
- Kết quả mô hình nhỏ: Hệ thống dành 97 percent thời gian cho việc điều phối phía máy chủ và chi phí phụ trợ khởi chạy kernel. Loại bỏ tất cả chi phí phụ trợ điều phối được mô hình hóa sẽ mang lại tốc độ tăng tối đa là 35.6×.
Kịch bản hai: Lớp GPT-3 (Bị giới hạn bởi tính toán)
- Tính toán: Các phép nhân ma trận khổng lồ.
- Thời gian phần cứng: \(T_{\text{hw}} \approx\) 100 ms = 100000 μs.
- Chi phí phụ trợ phần mềm: \(T_{\text{sw}} \approx 50 \, \mu s\).
- Tỷ lệ: 50 μs/100000 μs ≈ 0.0005.
- Kết quả mô hình lớn: Chi phí phụ trợ Python được mô hình hóa là không đáng kể. Biên dịch vẫn có thể cải thiện việc hợp nhất, bố cục hoặc chuyên môn hóa backend; việc loại bỏ điều phối đóng góp rất ít.
Thông tin chuyên sâu về hệ thống: Chi phí phụ trợ điều phối phụ thuộc vào chế độ. Biên dịch có thể giảm chi phí phụ trợ phía máy chủ cho các khối lượng công việc (workload) có phép toán nhỏ bằng cách hợp nhất các phép toán thành ít lần khởi chạy hơn, trong khi các mô hình lớn chủ yếu hưởng lợi từ các kernel hợp nhất và giảm di chuyển bộ nhớ.
Frameworks cho edge: TinyML và micro-runtimes
Liên tục biên dịch đạt đến cực điểm ở vùng edge xa. Trong khi các frameworks đám mây như PyTorch và TensorFlow 2.x ưu tiên tính linh hoạt thông qua thực thi eager, các hệ thống TinyML16 hoạt động trên MCU với bộ nhớ kilobyte không thể chịu được chi phí phụ trợ của trình thông dịch Python hoặc một runtime hoàn toàn động.
16 TinyML: Các hệ thống được thiết kế cho MCU không thể sử dụng trình thông dịch Python. Thay vào đó, micro-runtimes sử dụng các runtimes C/C++ nhỏ, lập kế hoạch bộ nhớ cố định và các toán tử dành riêng cho mô hình. TensorFlow Lite Micro vẫn dựa trên trình thông dịch: ứng dụng cung cấp một vùng tensor mà các bộ đệm của nó được lập kế hoạch và tái sử dụng mà không cần cấp phát heap sau khi thiết lập. Bộ nhớ có thể dự đoán được là bắt buộc vì việc vượt quá ngân sách thiết bị 256 KB có thể ngăn chặn quá trình khởi tạo hoặc suy luận.
Lighthouse 1.2: Ví dụ điển hình: KWS trên TinyML
Kịch bản: Triển khai mô hình phát hiện từ khóa (KWS) của Chuông cửa thông minh, DS-CNN Tiny Constraint lighthouse, lên ARM Cortex-M4 với 256 KB RAM và 1 MB Flash.
Ràng buộc: Một runtime PyTorch và Python đầy đủ vượt quá ngân sách bộ nhớ của thiết bị theo cấp số nhân.
Giải pháp framework: Các micro-frameworks như TensorFlow Lite Micro (TFLM) (David et al. 2021) giải quyết vấn đề này thông qua một runtime dựa trên trình thông dịch nhỏ với kỷ luật bộ nhớ cố định:
- Vùng bộ nhớ cố định: Ứng dụng cung cấp một vùng tensor liền kề, và framework lập kế hoạch và tái sử dụng các bộ đệm từ vùng đó thay vì dựa vào cấp phát động trong quá trình suy luận.
- Chọn kernel: Chỉ các kernel cụ thể được mô hình sử dụng (ví dụ: Conv2D, DepthwiseConv) mới cần được liên kết hoặc đăng ký với runtime.
- Thực thi trình thông dịch nhỏ gọn: MCU chạy một trình thông dịch C/C++ nhỏ trên một biểu diễn mô hình phẳng, với mô hình và vùng được liên kết khi khởi tạo thay vì được lắp ráp động tại runtime.
Hợp đồng silicon: Trên các thiết bị TinyML, hợp đồng bị ràng buộc chặt chẽ bởi bộ nhớ. Nhiệm vụ chính của framework là đảm bảo các activation trung gian của mô hình (tập hợp làm việc) nằm gọn trong SRAM nhỏ của MCU.
David, Robert, Jared Duke, Advait Jain, Vijay Janapa Reddi, Nat Jeffries, Jian Li, Nick Kreeger, et al. 2021. “TensorFlow Lite Micro: Embedded Machine Learning for TinyML Systems.” Proceedings of Machine Learning and Systems 3: 800–811.
Các micro-runtime này hy sinh tính linh hoạt động để giảm dung lượng và làm cho bộ nhớ có thể dự đoán được. Với các mô hình nhỏ gọn, phần cứng công suất thấp và chu kỳ hoạt động, nguyên tắc đó cho phép suy luận ở quy mô miliwatt với hầu hết các hoạt động di chuyển dữ liệu diễn ra trên chip.
Phổ các chiến lược thực thi, từ thực thi eager động đến biên dịch đồ thị tĩnh và các micro-runtime chuyên biệt, đòi hỏi các nhà phát triển phải đưa ra những đánh đổi có chủ đích. Các quyết định chế độ thực thi chính tóm tắt những lựa chọn kiến trúc này:
Checkpoint 1.1: Các mô hình thực thi
Việc lựa chọn chế độ thực thi quyết định cả tốc độ phát triển của lập trình viên và hiệu suất mô hình.
Khả năng gỡ lỗi so với tốc độ
Thỏa hiệp hiện đại
Vấn đề thực thi xác định khi nào tính toán xảy ra và những tối ưu hóa nào có thể thực hiện được. Tuy nhiên, huấn luyện mạng nơ-ron đòi hỏi một khả năng mà không có bất kỳ lịch trình thông minh nào có thể cung cấp: khả năng tự động tính toán gradient.
Hãy xem xét những gì huấn luyện thực sự yêu cầu: đối với mỗi trong số hàng triệu tham số, tính toán xem một thay đổi nhỏ sẽ ảnh hưởng đến hàm mất mát như thế nào. Thực hiện điều này thủ công ngay cả đối với một mạng ba lớp đơn giản cũng đòi hỏi phải suy ra và triển khai hàng tá đạo hàm riêng. Đối với một transformer hiện đại với hàng tỷ tham số, vi phân thủ công là không thể về mặt kinh tế. Một framework thực thi hiệu quả nhưng không thể vi phân thì có thể chạy suy luận nhưng không thể học.
Self-Check: Question
A GPU performance profile reveals that a sequence of LayerNorm, dropout, and GELU activation operations spends over 80% of its execution time reading and writing intermediate tensors to High Bandwidth Memory (HBM) with very low arithmetic intensity. Why is operator fusion the primary framework optimization for this workload?
- It replaces 16-bit floating-point arithmetic with 8-bit integer arithmetic
- It changes the model architecture to eliminate all non-linear activation functions
- It converts compute-bound matrix multiplications into memory-bound operations
- It fuses multiple sequential element-wise operations into a single GPU kernel, keeping intermediate values in on-chip SRAM/registers and eliminating redundant round trips to HBM
A developer attempts to trace a dynamic PyTorch model containing data-dependent control flow (
if tensor.sum() > 0: ...) using standard graph tracing (torch.jit.trace). What failure mode occurs, and how does modern bytecode graph capture (torch.compile/ TorchDynamo) resolve it?- Standard tracing crashes immediately on any tensor operation, whereas TorchDynamo rewires the Python interpreter into C++
- Standard tracing converts all dynamic control flow into static loops, whereas TorchDynamo disables all GPU acceleration
- Standard tracing records only the branch taken by the example input and silently bakes it into a static graph, whereas TorchDynamo inspects Python bytecode to capture straight-line subgraphs into FX graphs and falls back to the Python interpreter on graph breaks
- Standard tracing successfully compiles dynamic branches using AST inspection, whereas TorchDynamo rejects all conditional statements
State the dispatch overhead law and explain why a workload composed of many small tensor operations on an NVIDIA A100 GPU can be severely underutilized in eager mode even if the GPU has massive compute throughput.
True or False: In
torch.compile, encountering a “graph break” halts program execution and throws a fatal runtime exception because dynamic Python constructs cannot be represented in the computational graph.Order the stages of the
torch.compilecompilation and execution pipeline in PyTorch 2.0, from initial Python function call to hardware execution:AOTAutograd traces both the forward and backward computation graphs ahead of execution
TorchDynamo intercepts Python bytecode during frame evaluation and extracts computational subgraphs
TorchInductor generates optimized vendor-specific kernels (e.g., Triton for GPUs or C++/OpenMP for CPUs)
The high-level intermediate representation is structured as a PyTorch FX graph
The compiled fused kernels execute on the target hardware accelerator
In graph-capture JIT compilation systems like TorchDynamo, an event where the compiler encounters an unsupported dynamic Python construct (such as an unhandled C-extension call or dynamic side effect) and must pause graph capture to yield control to the Python interpreter is called a ____.
Vấn đề vi phân
Vấn đề vi phân là nhiệm vụ tự động tính toán gradient17. Huấn luyện mạng nơ-ron đòi hỏi các đạo hàm của một hàm mất mát vô hướng \(\mathcal{L}\) đối với hàng triệu hoặc hàng tỷ tham số, khiến việc vi phân thủ công trở nên không thực tế. Bởi vì một hàm mất mát vô hướng duy nhất phụ thuộc vào nhiều tham số, vi phân tự động chế độ ngược (AD)18 thường hiệu quả: một lần duyệt ngược tính toán tất cả các gradient tham số được yêu cầu, trong khi khôi phục cùng một gradient đầy đủ với chế độ thuận đòi hỏi một hướng tiếp tuyến cho mỗi tham số. Do đó, các framework ML lớn sử dụng AD chế độ ngược cho huấn luyện hàm mất mát vô hướng thông thường (Baydin et al. 2018).
17 Vi phân tự động (AD): Từ khóa “tự động” trong câu mở đầu là mấu chốt: AD cơ giới hóa quy tắc chuỗi như một phép duyệt đồ thị, loại bỏ việc tính toán đạo hàm thủ công vốn khiến việc mở rộng quy mô vượt ra ngoài các mạng đồ chơi trở nên không thực tế. Sự đánh đổi của hệ thống giúp điều này khả thi là lựa chọn chế độ ngược, tận dụng cấu trúc liên kết nhiều-đến-một của huấn luyện (nhiều tham số, một hàm mất mát vô hướng) để tính toán tất cả các gradient trong một lần truyền ngược duy nhất. Chế độ thuận sẽ yêu cầu một lần truyền cho mỗi tham số, khiến việc huấn luyện hàng tỷ tham số trở nên bất khả thi về mặt tính toán.
18 AD chế độ ngược: Sự bất đối xứng \(\mathcal{O}(1)\) so với \(\mathcal{O}(P)\) của chế độ ngược có một cái giá cụ thể: chế độ ngược giữ lại các giá trị phụ thuộc vào phép toán được yêu cầu bởi các quy tắc đạo hàm trong quá trình duyệt ngược. checkpoint activation thay đổi tập hợp đã lưu này bằng cách bỏ qua các giá trị được chọn và tính toán lại chúng trong quá trình truyền ngược.
Baydin, Atilim Gunes, Barak A. Pearlmutter, Alexey Andreyevich Radul, and Jeffrey Mark Siskind. 2018. “Automatic Differentiation in Machine Learning: A Survey.” Journal of Machine Learning Research 18 (153): 1–43.
Dựa trên thuật toán lan truyền ngược được giới thiệu trong Tính toán nơ-ron, kỹ thuật hệ thống của vi phân giải quyết cách các framework biểu diễn đồ thị tính toán, quản lý bộ nhớ cho các giá trị trung gian và điều phối quá trình truyền ngược hiệu quả trên các bộ tăng tốc. Vai trò của framework không phải là thực hiện phép tính vi tích phân mà là quản lý sổ sách ở quy mô lớn, điều này cần thiết cho các thuật toán huấn luyện được trình bày chi tiết trong Huấn luyện mô hình. Listing 7 minh họa ý tưởng cốt lõi với một hàm ba phép toán đơn giản.
def f(x):
    a = x * x  # Square
    b = sin(x)  # Sine
    c = a * b  # Product
    return c
Các framework phân tách hàm này thành các phép toán cơ bản, mỗi phép toán có một đạo hàm cục bộ đã biết, và sau đó kết hợp các đạo hàm cục bộ này thông qua quy tắc chuỗi để tính toán gradient thông qua các phép hợp được hỗ trợ. Thách thức của hệ thống là triển khai điều này một cách hiệu quả: framework phải ghi lại đồ thị tính toán trong quá trình truyền thuận, lưu trữ các giá trị trung gian và thực thi quá trình truyền ngược với chi phí bộ nhớ tối thiểu. Các framework sản xuất giải quyết từng vấn đề này thông qua việc ghi đồ thị có cấu trúc, quản lý trạng thái trung gian và duyệt chế độ ngược.
Vi phân chế độ thuận và ngược
Tồn tại hai phương pháp chính để vi phân tự động, và sự lựa chọn giữa chúng (chế độ thuận so với chế độ ngược) quyết định liệu việc tính toán gradient có tỷ lệ thuận với số lượng hướng đầu vào hay đầu ra. Sự khác biệt này giải thích tại sao huấn luyện mạng nơ-ron thường dựa vào chế độ ngược. Chế độ thuận hữu ích để hiểu trước vì nó trực tiếp phơi bày việc ghi sổ; chế độ ngược sau đó xuất hiện như một phản ứng của hệ thống đối với hình dạng nhiều tham số, một hàm mất mát của huấn luyện mạng nơ-ron.
Chế độ thuận
Huấn luyện mạng nơ-ron thường sử dụng chế độ ngược (sẽ được đề cập tiếp theo), nhưng chế độ xuôi làm sáng tỏ lý do tại sao chế độ ngược hiệu quả đối với hàm mất mát vô hướng với nhiều tham số. Vi phân tự động chế độ xuôi tính toán đạo hàm theo hướng cùng với phép tính gốc, theo dõi cách các thay đổi lan truyền từ đầu vào đến đầu ra. Cách tiếp cận này phản ánh việc tính toán đạo hàm thủ công, giúp dễ hiểu và triển khai một cách trực quan.
Chế độ xuôi lan truyền một tiếp tuyến cùng với mỗi giá trị gốc và không cần giữ lại một băng ngược để duyệt ngược sau này. Chi phí bộ nhớ và hoạt động của nó phụ thuộc vào phép tính và số lượng hướng tiếp tuyến được lan truyền. Một lần thực thi khởi tạo tạo ra một tích Jacobian-vector (JVP). Để khôi phục gradient đầy đủ đối với \(P\) đầu vào độc lập, cần \(P\) hướng tiếp tuyến, có thể được đánh giá riêng lẻ hoặc theo batch nhưng vẫn tỷ lệ với chiều đầu vào. Thay vào đó, chế độ ngược tính toán gradient hàm mất mát vô hướng trong một lần duyệt ngược mà chi phí của nó phụ thuộc vào các phép toán chứ không chỉ riêng số lượng tham số. Tính bất đối xứng này làm cho chế độ ngược trở thành lựa chọn tiêu chuẩn cho huấn luyện mạng nơ-ron, trong khi các JVP chế độ xuôi vẫn hữu ích khi số lượng hướng đầu vào nhỏ và trong các phương pháp vi phân bậc cao hơn.
Để thấy cơ chế một cách cụ thể, hãy xem xét việc tính toán cả giá trị và đạo hàm của \(f(x) = x^2 \sin(x)\). Listing 8 cho thấy cách chế độ xuôi lan truyền các phép tính đạo hàm cùng với mọi phép toán, áp dụng quy tắc chuỗi và quy tắc tích ở mỗi bước:
def f(x):  # Computing both value and derivative
    # Step 1: x -> x²
    a = x * x  # Value: x²
    da = 2 * x  # Derivative: 2x

    # Step 2: x -> sin(x)
    b = sin(x)  # Value: sin(x)
    db = cos(x)  # Derivative: cos(x)

    # Step 3: Combine using product rule
    result = a * b  # Value: x² * sin(x)
    dresult = a * db + b * da  # Derivative: x²*cos(x) + sin(x)*2x

    return result, dresult
Chế độ xuôi đạt được phép tính đạo hàm có hệ thống này bằng cách bổ sung cho mỗi số giá trị đạo hàm của nó, tạo ra cái mà các nhà toán học gọi là “số kép”. Listing 9 chạy cùng một hàm tại \(x = 2.0\), do đó việc ghi chép trở nên cụ thể: mỗi giá trị trung gian mang theo đạo hàm của nó qua một lần truyền duy nhất.
x, dx = 2.0, 1.0  # seed: track the derivative with respect to x

a = x * x  # value:      4.0
da = 2 * x  # derivative: 4.0
b = sin(x)  # value:      0.9093
db = cos(x)  # derivative: -0.4161
c = a * b  # value:      3.637
dc = a * db + b * da  # derivative: 1.973
Việc thực thi cặp đôi đó lan truyền một hướng tiếp tuyến khởi tạo cùng với các giá trị gốc. Chi phí của nó phụ thuộc vào các phép toán và cách triển khai chứ không chính xác là 2\(\times\). Đối với một hàm mất mát vô hướng với \(P\) tham số, việc khôi phục gradient đầy đủ thông qua chế độ xuôi yêu cầu \(P\) hướng tiếp tuyến độc lập, có thể được đánh giá riêng lẻ hoặc theo batch nhưng vẫn tỷ lệ với chiều đầu vào.
Do đó, chế độ xuôi không hiệu quả đối với hình dạng huấn luyện thông thường là một hàm mất mát vô hướng và hàng triệu tham số. Nó vẫn hữu ích khi số lượng hướng đầu vào khởi tạo nhỏ và trong các phương pháp chế độ hỗn hợp cho các đạo hàm chuyên biệt như tích Jacobian-vector và Hessian-vector. Đối với mục tiêu huấn luyện hàm mất mát vô hướng thông thường, chế độ ngược đảo ngược tỷ lệ này: một lần duyệt ngược tính toán các gradient được yêu cầu cho tất cả các tham số ảnh hưởng đến hàm mất mát.
Chế độ ngược
Các framework ML hiện đại thường sử dụng chế độ ngược cho huấn luyện hàm mất mát vô hướng vì tính bất đối xứng tính toán. Chế độ xuôi lan truyền đạo hàm cho các hướng đầu vào được chọn, trong khi một lần duyệt ngược lan truyền các adjoint từ hàm mất mát vô hướng đến tất cả các tham số được yêu cầu. Lợi thế này tăng theo số lượng tham số, mặc dù chi phí thực tế cũng phụ thuộc vào đồ thị và các quy tắc đạo hàm.
Tính bất đối xứng này làm cho chế độ ngược trở thành lựa chọn tiêu chuẩn cho huấn luyện mạng nơ-ron, trong khi chế độ xuôi và chế độ hỗn hợp vẫn hữu ích cho các dạng đạo hàm khác. Chế độ ngược chạy trên cùng một hàm ba phép toán \(f(x) = x^2\sin(x)\) từ listing 7, trong đó \(x\) đến đầu ra qua hai đường dẫn riêng biệt: bình phương và sin. Algorithm 1 nêu rõ hợp đồng chế độ ngược tổng quát trước khi một dấu vết đã thực hiện làm cho một đầu vào cụ thể hiển thị.
\begin{algorithm} \caption{Reverse-mode automatic differentiation} \begin{algorithmic} \Require directed acyclic graph with scalar output $y$; nodes $v_1,\dots,v_n$ in topological order; a local derivative rule for each node \Ensure adjoints $\bar{v}_i = \partial y / \partial v_i$ for the requested input or parameter nodes \For{$i = 1$ to $n$} \State compute $v_i$, record dependencies, and save values requested by its derivative rule \Comment{forward pass} \EndFor \State $\bar{v}_i \gets 0$ for all $i$; $\bar{y} \gets 1$ \For{$i = n$ down to $1$} \For{each parent $u$ of $v_i$} \State $\bar{u} \gets \bar{u} + \bar{v}_i \, \partial v_i / \partial u$ \Comment{accumulate via the chain rule} \EndFor \State release stored values once every rule that needs them has run \EndFor \State \Return the adjoints for the requested nodes \end{algorithmic} \end{algorithm}
Cấu trúc của algorithm 1 cũng chính là chi phí của nó. Lượt truyền xuôi ghi lại các phụ thuộc đồ thị và giữ lại các giá trị được yêu cầu bởi các quy tắc ngược cho đến khi lượt duyệt ngược tiêu thụ chúng. Do đó, chế độ ngược đánh đổi bộ nhớ activation và đồ thị để có gradient hiệu quả của một đầu ra vô hướng. Checkpointing có thể lưu ít giá trị hơn và tính toán lại chúng sau này.
Đối với hàm cụ thể trong listing 7 với \(x=2.0\), chúng ta ghi lại \(a=x^2=4.0\), \(b=\sin(x)\approx0.9093\), và \(c=ab\approx3.637\) trong lượt truyền xuôi. Khởi tạo \(\bar{c}=1.0\), phép nhân ngược cho \(\bar{a}=0.9093\) và \(\bar{b}=4.0\); đường dẫn bình phương đóng góp \(0.9093\cdot4.0\approx3.6372\) vào \(\bar{x}\), và đường dẫn sin thêm \(4.0\cos(2.0)\approx-1.6646\). Đạo hàm cuối cùng là \(\partial c/\partial x=\bar{x}\approx1.973\).
Quan sát quan trọng là lượt truyền ngược duy nhất này đã tính toán \(\partial c/\partial x\) bất kể có bao nhiêu đường dẫn kết nối \(x\) với \(c\). Trong một mạng nơ-ron, mỗi trọng số có thể ảnh hưởng đến hàm mất mát thông qua hàng nghìn đường dẫn qua các lớp, và chế độ ngược xử lý tất cả chúng trong một lần duyệt. Đây là lý do tại sao việc huấn luyện một mô hình 175B-tham số như GPT-3 là khả thi: các lượt truyền ngược \(\mathcal{O}(1)\) của chế độ ngược so với số lượng tham số giúp việc tính toán gradient có thể xử lý được.
Việc chuyển đổi sự tinh tế toán học này thành một hệ thống hoạt động đòi hỏi phải giải quyết một vấn đề kỹ thuật cụ thể: lượt truyền ngược cần các giá trị được tính toán trong lượt truyền xuôi, vì vậy framework phải quyết định lưu trữ cái gì, khi nào lưu trữ và khi nào giải phóng nó. Các framework hiện đại thực hiện điều này thông qua đồ thị tính toán và tích lũy gradient tự động.19
19 Gradient accumulation: Framework xử lý một batch logic lớn thành các mini-batch nhỏ hơn, giải phóng các activation đã lưu của mỗi mini-batch sau khi truyền ngược (backward) trong khi tích lũy gradient có kích thước bằng tham số. Việc xử lý 4.096 mẫu trong các mini-batch 64 mẫu có thể giảm đỉnh activation phụ thuộc vào batch lên tới 64\(\times\) khi bộ nhớ activation tăng tuyến tính theo kích thước batch; trọng số, gradient, trạng thái optimizer và các chi phí cố định khác không giảm. Đánh đổi là cần nhiều công việc tuần tự hơn trước mỗi lần cập nhật optimizer.
Listing 10 minh họa điều này với một mạng hai lớp, cho thấy cả phép tính truyền xuôi (forward computation) lưu trữ các giá trị trung gian và phép truyền ngược (backward pass) tiêu thụ chúng để tạo ra gradient cho mọi tham số cùng một lúc.
def simple_network(x, w1, w2):
    hidden = x * w1  # First layer
    activated = max(0, hidden)  # ReLU activation
    output = activated * w2  # Second layer
    return output


# --- Forward pass stores intermediates ---
x, w1, w2 = 1.0, 2.0, 3.0
hidden = x * w1
activated = max(0, hidden)
output = activated * w2

# --- Backward pass consumes them ---
d_output = 1.0  # Seed gradient
d_w2 = activated  # = 2.0
d_activated = w2  # = 3.0
d_hidden = d_activated * (1 if hidden > 0 else 0)  # ReLU gate: 3.0
d_w1 = x * d_hidden  # = 3.0
d_x = w1 * d_hidden  # = 6.0
Ba yêu cầu triển khai xuất hiện từ ví dụ này. Thứ nhất, framework phải theo dõi các phụ thuộc giữa các phép toán để xác định thứ tự duyệt ngược chính xác. Thứ hai, các giá trị trung gian (ẩn, đã kích hoạt) phải tồn tại trong bộ nhớ cho đến khi phép truyền ngược tiêu thụ chúng. Thứ ba, mọi phép toán đều cần cả một triển khai truyền xuôi (forward implementation) và một quy tắc truyền ngược (backward rule) tương ứng. Những yêu cầu này định nghĩa bề mặt kỹ thuật của bất kỳ hệ thống AD nào, và yêu cầu thứ hai, sự tồn tại của bộ nhớ, hóa ra lại là chi phí chiếm ưu thế.
Các chiến lược quản lý bộ nhớ
Một mô hình 175B tham số ở định dạng FP16 yêu cầu 350 GB chỉ riêng cho trọng số, vượt quá bộ nhớ của một GPU đơn lẻ. AD chế độ ngược cũng lưu các giá trị truyền xuôi (forward values) phụ thuộc vào phép toán cho truyền ngược (backward). Trong một mạng 100 lớp minh họa với một batch 64 hình ảnh, riêng các activation có thể thêm 8–12 GB cùng với trọng số, gradient và trạng thái optimizer. Do đó, dung lượng bộ nhớ có thể đặt ra giới hạn khả thi ngay cả khi có sẵn khả năng tính toán.
Dấu vết của các activation đã lưu tích lũy qua các lớp. Listing 11 cho thấy mỗi lớp được thêm vào có thể đóng góp một tensor activation khác mà phải tồn tại cho đến khi phép truyền ngược (backward pass) đạt đến nó.
def deep_network(x, w1, w2, w3):
    # Forward pass - must store intermediates
    hidden1 = x * w1
    activated1 = max(0, hidden1)  # Store for backward
    hidden2 = activated1 * w2
    activated2 = max(0, hidden2)  # Store for backward
    output = activated2 * w3
    return output
Các framework giải quyết rào cản bộ nhớ này bằng hai chiến lược chính. Đầu tiên là checkpointing activation (còn gọi là gradient checkpointing): thay vì lưu trữ mọi activation, framework giữ các giá trị biên được chọn và tính toán lại các giá trị trung gian bị thiếu trong quá trình truyền ngược (backward pass). Tại thời điểm này, ý tưởng hệ thống quan trọng là hợp đồng runtime, chứ không phải chính sách vị trí. Framework coi một số activation là các checkpoint bền vững và coi phần còn lại là các giá trị có thể được tạo lại khi quá trình duyệt ngược (backward traversal) đạt đến chúng; Cơ chế tích lũy gradient và checkpointing sau đó sẽ xem xét cách các hệ thống huấn luyện chọn các checkpoint. Listing 12 làm cho hợp đồng runtime hiển thị: phép truyền xuôi (forward pass) chỉ giữ các ranh giới phân đoạn, và phép truyền ngược (backward pass) chạy lại từng phân đoạn để tạo lại các activation mà nó đã bỏ qua thay vì đọc chúng từ bộ nhớ.
# Standard backward: every forward activation stays resident
h1 = layer1(x)  # kept for backward
h2 = layer2(h1)  # kept for backward
out = layer3(h2)  # kept for backward

# Checkpointed: keep only the boundary h1 and drop h2. The
# backward pass re-runs the wrapped segment to regenerate
# h2 on demand instead of holding it in memory.
h1 = layer1(x)  # boundary: kept
out = checkpoint(
    lambda a: layer3(layer2(a)), h1
)  # h2 recomputed in backward
Chiến lược thứ hai là hợp nhất phép toán (operation fusion).20 Thay vì thực hiện phép nhân ma trận, cộng độ chệch (bias) và ReLU dưới dạng ba phép toán riêng biệt tạo ra kết quả trung gian, các framework có thể hợp nhất các công việc tương thích thành một kernel duy nhất. Điều này có thể tăng tốc các phần bị giới hạn bởi bộ nhớ bằng cách giữ các giá trị trung gian trong các thanh ghi hoặc cache.
20 Hợp nhất phép toán (Operation fusion): Khi các phép toán tương thích thực thi dưới dạng các kernel riêng biệt, các kết quả trung gian có thể được ghi vào HBM và đọc lại bởi kernel tiếp theo. Việc hợp nhất có thể giữ các giá trị đó trên chip và tránh các lần truyền tương ứng. Lợi ích đạt được phụ thuộc vào các phép toán, hình dạng, trình biên dịch và phần cứng.
Chetlur, Sharan, Cliff Woolley, Philippe Vandermersch, Jonathan Cohen, John Tran, Bryan Catanzaro, and Evan Shelhamer. 2014. “cuDNN: Efficient Primitives for Deep Learning.” arXiv Preprint arXiv:1410.0759.
Phép truyền ngược (backward pass) tự nó được hưởng lợi từ việc tối ưu hóa dành riêng cho phần cứng. Thay vì dịch trực tiếp định nghĩa toán học của gradient tích chập thành mã, các framework triển khai các kernel truyền ngược (backward kernels) chuyên biệt khai thác các mẫu truy cập bộ nhớ và khả năng phần cứng của các bộ tăng tốc hiện đại (Chetlur et al. 2014). Những tối ưu hóa này, checkpointing, hợp nhất và các kernel chuyên biệt, hoạt động cùng nhau để làm cho việc huấn luyện trở nên khả thi đối với các kiến trúc mà nếu không sẽ làm cạn kiệt bộ nhớ GPU chỉ trong một lần truyền xuôi (forward pass).
Triển khai tự động vi phân của framework
Checkpointing, hợp nhất và các kernel chuyên biệt giải quyết các vấn đề hệ thống của AD. Các framework thường phơi bày các cơ chế này thông qua các API cấp cao. Một vòng lặp huấn luyện PyTorch—optimizer.zero_grad(), truyền xuôi (forward pass), loss.backward(), optimizer.step()—dường như là bốn lời gọi hàm. Tuy nhiên, đằng sau mỗi lời gọi, framework theo dõi các phép toán trong quá trình truyền xuôi (forward pass), xây dựng và duy trì đồ thị tính toán, quản lý bộ nhớ cho các giá trị trung gian, lên lịch tính toán gradient và giao tiếp với các bộ tăng tốc phần cứng. Cơ chế đồ thị tương tự mở rộng sang các kịch bản nâng cao: các lời gọi torch.autograd.grad lồng nhau tính toán đạo hàm bậc hai cho các kỹ thuật như gradient descent tự nhiên, và các ngữ cảnh độ chính xác hỗn hợp (autocast) chọn các kernel độ chính xác giảm cho các phép toán tốn nhiều tính toán trong khi vẫn duy trì FP32 để ổn định số học.
Các thành phần nội bộ của PyTorch autograd
Hệ thống autograd là thành phần framework giải quyết bài toán vi phân được mô tả trong section 1.1. Ba nguyên tắc hệ thống chi phối thiết kế của nó: cấu trúc dữ liệu cho phép tính toán gradient hiệu quả, chi phí bộ nhớ để duy trì cấu trúc dữ liệu đó và các cơ chế điều khiển mà hệ thống sản xuất yêu cầu. Việc hiểu các nguyên tắc này giải thích tại sao quá trình huấn luyện có thể tiêu thụ nhiều bộ nhớ hơn đáng kể so với suy luận chỉ dựa trên trọng số cho cùng một mô hình, và tại sao các framework cung cấp các cơ chế cụ thể để quản lý chi phí đó.
Cấu trúc đồ thị liên kết ngược
Trong lượt truyền xuôi, hệ thống autograd xây dựng một đồ thị liên kết ngược gồm các nút Function. Mỗi nút ghi lại thao tác được thực hiện và lưu trữ các tham chiếu đến các tensor mà nó cần để tính toán gradient. Đồ thị này là cấu trúc dữ liệu giúp vi phân tự động chế độ ngược trở nên khả thi: bất kể một mô hình có bao nhiêu tham số, một lượt truyền ngược duy nhất qua đồ thị này sẽ tính toán tất cả các gradient. Đối với một mô hình có \(P\) tham số, AD chế độ ngược yêu cầu \(\mathcal{O}(1)\) lượt truyền ngược (so với \(\mathcal{O}(P)\) đối với chế độ xuôi), đó là lý do tại sao mọi framework chính đều triển khai phương pháp này.
Cụ thể, mỗi tensor được tạo ra bởi một phép toán khả vi sẽ lưu trữ một thuộc tính grad_fn trỏ đến Function đã tạo ra nó. Mỗi Function liên kết với các đầu vào của nó thông qua next_functions, tạo thành một chuỗi từ hàm mất mát trở lại các tham số lá. Listing 13 minh họa cấu trúc này cho một tính toán đơn giản:
grad_fn links to the Function that created it, forming a reverse chain from output to leaf parameters that enables \(\mathcal{O}(1)\) backward passes.
import torch

x = torch.tensor([2.0], requires_grad=True)
y = x * 3
z = y.pow(2)


# Traverse the reverse-linked graph
print(z.grad_fn)  # PowBackward0
print(z.grad_fn.next_functions)  # -> MulBackward0
print(
    z.grad_fn.next_functions[0][0].next_functions
)  # -> AccumulateGrad (leaf)
Việc duyệt qua cho thấy chuỗi: PowBackward0 (cho z = y**2) liên kết với MulBackward0 (cho y = x * 3), kết thúc tại AccumulateGrad cho tensor lá x. Các tensor lá là các điểm cuối của đồ thị nơi gradient tích lũy vào thuộc tính .grad thay vì lan truyền xa hơn. Định dạng tuple (Function, index) theo dõi đầu ra nào của một phép toán đa đầu ra mà mỗi kết nối tương ứng.
Một cấu trúc autograd liên kết ngược có một ý nghĩa hệ thống quan trọng: toàn bộ đồ thị phải nằm trong bộ nhớ từ thời điểm một tensor được tạo cho đến khi lượt truyền ngược tiêu thụ nó. Bản thân đồ thị nhẹ (con trỏ và siêu dữ liệu), nhưng các tensor mà nó tham chiếu thì không, vì vậy mức tiêu thụ bộ nhớ tỷ lệ với độ sâu của mô hình.
Đánh đổi bộ nhớ-tính toán
Mọi giá trị được lưu cho lượt truyền ngược tồn tại cho đến khi quy tắc đạo hàm của nó tiêu thụ nó. Các giá trị đã lưu này là một lý do chính khiến huấn luyện sử dụng nhiều bộ nhớ hơn suy luận, cùng với gradient và trạng thái optimizer. Các phép toán khác nhau lưu các đầu vào hoặc đầu ra khác nhau, và checkpointing có thể thay thế một số lưu trữ bằng tính toán lại.
Đỉnh huấn luyện minh họa làm lu mờ riêng việc lưu trữ trọng số.
Xem xét một kịch bản huấn luyện ResNet-50 mẫu với 25.6M tham số (~102.4 MB trọng số FP32), kích thước batch 64 và ảnh \(224{\times}224\). Với 8 GB–12 GB các activation đã lưu, gradient thêm vào ~102.4 MB, và hai bộ đệm moment FP32 của thuật toán Ước lượng Moment Thích ứng (Adam) thêm vào ~204.8 MB. Tổng hợp bốn thành phần đó cho một kịch bản huấn luyện 8.4 GB–12.4 GB, khoảng 82.1–121.2× so với riêng việc lưu trữ trọng số FP32. Đây không phải là so sánh với bộ nhớ suy luận hoàn chỉnh, vốn cũng bao gồm các activation và không gian làm việc runtime.
Ví dụ cho thấy tại sao dung lượng huấn luyện không thể ước tính chỉ từ trọng số. Cả hai đều phụ thuộc vào các phép toán, triển khai và tái sử dụng bộ nhớ, như được suy ra trong Chi phí bộ nhớ thực sự của huấn luyện cho phương trình trạng thái huấn luyện bốn thành phần (\(M_{\text{total}} = M_{\text{weights}} + M_{\text{gradients}} + M_{\text{optimizer}} + M_{\text{activations}}\)) và bộ nhớ runtime bổ sung.
Các framework cung cấp ba cơ chế chính để quản lý sự đánh đổi này ở cấp độ đồ thị. Checkpointing gradient (Chen et al. 2016) thay đổi những gì đồ thị bảo toàn: thay vì lưu tất cả các activation, framework lưu các giá trị biên được chọn và xây dựng lại các giá trị trung gian bị thiếu trong lượt truyền ngược. Theo thuật ngữ luật sắt, checkpointing làm tăng số hạng \(O\) (tính toán lại) để giảm số hạng \(D_{\text{vol}}\) (lưu lượng bộ nhớ). Tách tensor cung cấp một cơ chế bổ sung: gọi .detach() trên một tensor sẽ thay đổi các cạnh đồ thị nào tham gia vào quá trình vi phân, ngăn framework lưu các activation thông qua đường dẫn đó. Điều này thiết yếu cho học chuyển giao, nơi các lớp được huấn luyện trước không nên tích lũy gradient, và nó làm giảm số hạng \(D_{\text{vol}}\) bằng cách loại bỏ việc lưu trữ activation không cần thiết. Huấn luyện độ chính xác hỗn hợp đưa ra một cách tiếp cận thứ ba: lưu trữ các activation và phép toán ma trận được chọn ở định dạng độ chính xác thấp hơn để framework giảm di chuyển dữ liệu trong khi vẫn bảo toàn công việc nhạy cảm về mặt số học ở FP32. Huấn luyện mô hình phát triển các cơ chế đồ thị này thành các quyết định về kích thước.
Chen, Tianqi, Bing Xu, Chiyuan Zhang, and Carlos Guestrin. 2016. “Training Deep Nets with Sublinear Memory Cost.” arXiv Preprint arXiv:1604.06174.
Khả năng mở rộng và kiểm soát
Hệ thống huấn luyện trong sản xuất yêu cầu kiểm soát chi tiết luồng gradient vượt ra ngoài lượt truyền ngược mặc định. Trong thực tế, có ba loại kiểm soát phát sinh. Thứ nhất, tính toán gradient có chọn lọc: học chuyển giao và tinh chỉnh (fine-tuning) yêu cầu đóng băng các tập con của tham số, mà framework hỗ trợ thông qua các cờ requires_grad=False và cơ chế .detach() đã mô tả trước đó. Thứ hai, kiểm tra và sửa đổi gradient: gỡ lỗi gradient biến mất hoặc bùng nổ, triển khai cắt gradient trên từng tensor, và ghi nhật ký thống kê gradient đều yêu cầu chặn gradient giữa quá trình tính toán, mà các framework cung cấp thông qua các API hook. Thứ ba, quy tắc vi phân tùy chỉnh: các phép toán không có trong thư viện tích hợp của framework (các kernel CUDA tùy chỉnh, các hàm activation mới lạ, các phép toán dành riêng cho miền) yêu cầu triển khai forward và backward do người dùng định nghĩa.
Các cơ chế kiểm soát này có chung một thiết kế hệ thống: chúng là các phần mở rộng dựa trên callback mà công cụ autograd gọi tại các điểm cụ thể trong quá trình duyệt đồ thị, mà không sửa đổi thuật toán vi phân cốt lõi. Mô hình khả năng mở rộng này cho phép framework duy trì một lượt truyền ngược được tối ưu hóa duy nhất trong khi hỗ trợ thao tác gradient phức tạp tùy ý. Trong thực tế, sự kiểm soát này xuất hiện thông qua một vài cơ chế PyTorch lặp lại: đồ thị được giữ lại, gradient tích lũy, quy tắc backward tùy chỉnh, hook và tách an toàn. Table 6 ánh xạ từng cơ chế với những gì nó kiểm soát và chi phí của nó.
| Cơ chế | Những gì nó kiểm soát | Chi phí hoặc rủi ro |
|---|---|---|
retain_graph=True |
Giữ trạng thái đồ thị đã lưu có sẵn cho một lần duyệt ngược khác | Giữ lại bộ nhớ mà lẽ ra sẽ được giải phóng; lượng phụ thuộc vào đồ thị và các giá trị đã lưu |
| Tích lũy gradient | Các lượt lan truyền ngược liên tiếp cộng dồn vào .grad cho đến khi zero_grad() đặt lại chúng, cho phép các batch hiệu quả lớn |
Quên đặt lại âm thầm trộn lẫn các gradient qua các bước tối ưu hóa |
autograd.Function tùy chỉnh |
Các quy tắc truyền xuôi và truyền ngược do người dùng định nghĩa cho các phép toán nằm ngoài thư viện tích hợp sẵn | Chuyển giao hợp đồng vi phân (những gì cần lưu, cách vi phân) cho người triển khai |
| Hook gradient | Kiểm tra hoặc sửa đổi gradient giữa quá trình duyệt (cắt bớt, ghi nhật ký, gỡ lỗi) | Chạy mã Python tùy ý cho mỗi tensor đã đăng ký trên mỗi lượt lan truyền ngược |
.detach() |
Cắt luồng gradient tại một ranh giới được chọn (các lớp đóng băng, đầu ra suy luận) | Thuộc tính .data cũ bỏ qua autograd và âm thầm làm hỏng gradient; nhân bản trước khi thay đổi tại chỗ |
Một cơ chế đáng được xem xét kỹ hơn vì nó thể hiện rõ nhất hợp đồng vi phân. Các hàm autograd tùy chỉnh chuyển một phần của hợp đồng đó từ framework sang người triển khai: nhà phát triển chỉ định rõ ràng những gì cần lưu cho lượt truyền ngược và cách tính toán gradient. Listing 14 minh họa mô hình này.
class MultiplyAdd(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x, y, z):
        # Save tensors needed for backward
        ctx.save_for_backward(x, y)
        return x * y + z

    @staticmethod
    def backward(ctx, grad_output):
        # Retrieve saved tensors
        x, y = ctx.saved_tensors

        # Compute gradients using chain rule
        grad_x = grad_output * y  # dL/dx = dL/dout * dout/dx
        grad_y = grad_output * x  # dL/dy = dL/dout * dout/dy
        grad_z = grad_output  # dL/dz = dL/dout * 1

        return grad_x, grad_y, grad_z


# Usage
x = torch.tensor([2.0], requires_grad=True)
y = torch.tensor([3.0], requires_grad=True)
z = torch.tensor([1.0], requires_grad=True)

output = MultiplyAdd.apply(x, y, z)
output.backward()

print(
    x.grad, y.grad, z.grad
)  # tensor([3.]), tensor([2.]), tensor([1.])
Ba nguyên tắc này liên hệ trực tiếp đến vai trò của framework như một trình biên dịch cho hợp đồng silicon. Đồ thị liên kết ngược xác định các phép toán mà lượt truyền ngược phải thực thi (số hạng \(O\)). Sự đánh đổi giữa bộ nhớ và tính toán chi phối lượng dữ liệu mà framework phải di chuyển qua hệ thống phân cấp bộ nhớ (số hạng \(D_{\text{vol}}\)). Các cơ chế mở rộng, đến lượt mình, cho phép các kỹ sư điều chỉnh cả hai số hạng cho khối lượng công việc (workload) cụ thể của họ. Sự tương tác giữa quản lý bộ nhớ autograd và độ chính xác số học dẫn tự nhiên đến huấn luyện hỗn hợp độ chính xác, điều này tiếp tục giảm số hạng \(D_{\text{vol}}\).
Hỗ trợ huấn luyện hỗn hợp độ chính xác
Độ chính xác hỗn hợp khai thác sự bất đối xứng phần cứng để cải thiện đồng thời hai số hạng của định luật sắt: Tensor Core thực hiện phép nhân ma trận FP16 với thông lượng cao hơn so với các lõi CUDA FP32 (tăng \(R_{\text{peak}}\) và giảm số hạng tính toán \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\)), trong khi các activation FP16 giảm một nửa dung lượng bộ nhớ (giảm \(D_{\text{vol}}\)). Cải thiện đồng thời cả hai số hạng là hiếm; hầu hết các tối ưu hóa đều cải thiện một số hạng này bằng cách hy sinh số hạng kia.
Các API độ chính xác hỗn hợp tự động sử dụng độ chính xác giảm cho các phép toán chuyên sâu về tính toán đủ điều kiện và độ chính xác cao hơn khi chính sách backend yêu cầu. Phép nhân ma trận và tích chập thường sử dụng FP16 trên các GPU được hỗ trợ, trong khi các phép toán nhạy cảm có thể sử dụng FP32; các lựa chọn chính xác phụ thuộc vào phép toán, thiết bị và framework. Điều này có thể bảo toàn chất lượng mô hình và cải thiện tốc độ trên phần cứng phù hợp. Vì FP16 có dải động hẹp hơn FP32, gradient có thể bị tràn dưới (underflow) trong quá trình lan truyền ngược. Loss scaling giải quyết vấn đề này bằng cách nhân loss trước lượt truyền ngược, sau đó chia gradient cho cùng một hệ số sau đó.
Các framework cũng hỗ trợ nhiều chế độ độ chính xác bao gồm FP16, BF16,21 và TF32, chế độ tính toán Tensor Core của NVIDIA cho các phép toán ma trận FP32 giữ nguyên dải số mũ FP32 trong khi sử dụng độ chính xác phần định trị thấp hơn. Mỗi chế độ tạo ra một sự đánh đổi khác nhau giữa dải và độ chính xác. BF16 duy trì dải động của FP32, đơn giản hóa quá trình huấn luyện bằng cách loại bỏ hầu hết các vấn đề tràn dưới gradient và thường loại bỏ nhu cầu loss scaling. Huấn luyện độ chính xác hỗn hợp xem xét chi tiết cơ chế của huấn luyện hỗn hợp độ chính xác, bao gồm các thuật toán loss scaling, phân tích tiết kiệm bộ nhớ và các cân nhắc về độ ổn định số học. Listing 15 minh họa API độ chính xác hỗn hợp của PyTorch: trình quản lý ngữ cảnh autocast tự động chọn FP16 cho các phép toán chuyên sâu về tính toán trong khi GradScaler ngăn chặn tràn dưới gradient bằng cách điều chỉnh động các giá trị loss.
21 Lý do thiết kế BF16: Được phát triển bởi Google Brain khoảng năm 2018 đặc biệt cho sự ổn định huấn luyện TPU, BF16 bảo toàn dải số mũ tám bit của FP32 trong khi giảm một nửa dung lượng bộ nhớ—một sự đánh đổi rõ ràng giữa độ chính xác phần định trị (7 bit so với 10 bit của FP16) để lấy dải động. Giá trị dương chuẩn nhỏ nhất của FP16 xấp xỉ \(6.10 \times 10^{-5}\), nhưng các giá trị dưới chuẩn mở rộng đến xấp xỉ \(5.96 \times 10^{-8}\); loss scaling đặc biệt quan trọng trên phần cứng hoặc trong các chế độ làm tròn các giá trị dưới chuẩn đó về 0. Số mũ khớp FP32 của BF16 phần lớn tránh được loại tràn dưới gradient này, loại bỏ nhu cầu loss scaling trong hầu hết các khối lượng công việc (workload), đó là lý do tại sao BF16 và FP16 không thể hoán đổi cho nhau: BF16 được ưu tiên khi sự ổn định huấn luyện quan trọng; FP16 được ưu tiên khi độ chính xác số học quan trọng hơn sự ổn định gradient.
import torch
from torch.amp import autocast, GradScaler

model = MyModel().cuda()
optimizer = torch.optim.Adam(model.parameters())
scaler = GradScaler("cuda")

for inputs, targets in dataloader:
    inputs, targets = inputs.cuda(), targets.cuda()
    optimizer.zero_grad()

    # Framework automatically selects precision per operation
    with autocast(device_type="cuda", dtype=torch.float16):
        outputs = model(inputs)
        loss = criterion(outputs, targets)

    # GradScaler handles gradient scaling for numerical stability
    scaler.scale(loss).backward()
    scaler.step(optimizer)
    scaler.update()
Huấn luyện BF16 thường không yêu cầu loss scaling. So sánh listing 16 với listing 15 từng dòng, việc khởi tạo GradScaler và các lệnh gọi scale, step, update của nó đều biến mất: phạm vi số mũ khớp FP32 của BF16 làm giảm rủi ro tràn số dưới của gradient thường buộc phải dùng loss scaling, do đó vòng lặp trở lại thành một lượt truyền ngược thông thường.
# BF16 training typically does not require loss scaling
with torch.autocast(device_type="cuda", dtype=torch.bfloat16):
    outputs = model(inputs)
    loss = criterion(outputs, targets)
loss.backward()  # No GradScaler needed
optimizer.step()
Trạng thái optimizer và checkpointing
Tiếp tục huấn luyện sau khi bị gián đoạn yêu cầu khôi phục đồng thời trọng số mô hình và trạng thái optimizer: bộ đệm động lượng, tốc độ học thích ứng và thống kê gradient. Đối với Adam, trạng thái optimizer bổ sung khoảng 4\(\times\) bộ nhớ trọng số FP16 (hai trạng thái FP32 cho mỗi tham số), do đó trọng số cộng với trạng thái optimizer yêu cầu khoảng 5\(\times\) dấu chân bộ nhớ trọng số FP16. Một mô hình 7 tỷ tham số do đó yêu cầu tổng cộng khoảng 70 GB (14 GB trọng số + 56 GB trạng thái optimizer). Kích thước checkpoint do đó giới hạn tốc độ phục hồi sau lỗi, kết nối khả năng chịu lỗi trực tiếp với số hạng \(D_{\text{vol}}\) của định luật sắt.
Huấn luyện mô hình đề cập đến các yêu cầu bộ nhớ optimizer và chiến lược tối ưu hóa cho huấn luyện quy mô lớn, nơi kích thước checkpoint trở thành một ràng buộc giới hạn. Các framework cung cấp giao diện state_dict() để truy cập trạng thái optimizer cho việc tuần tự hóa (listing 17), và việc tiếp tục huấn luyện yêu cầu tải cả tham số mô hình và trạng thái optimizer (listing 18).
import torch
import torch.nn as nn
import torch.optim as optim

model = nn.Linear(10, 5)
optimizer = optim.Adam(model.parameters(), lr=0.001)

# After training steps, optimizer accumulates state
loss = model(torch.randn(3, 10)).sum()
loss.backward()
optimizer.step()

# Access state for checkpointing
state = optimizer.state_dict()
# Contains: {'state': {...}, 'param_groups': [{'lr': 0.001, ...}]}
Toán học của vi phân tự động đã được thiết lập hàng thập kỷ trước sự trỗi dậy của deep learning. Điều thay đổi là kỹ thuật hệ thống. Trước khi có tự động hóa framework, việc triển khai tính toán gradient cho một lớp kết nối đầy đủ duy nhất có nghĩa là viết các hàm truyền xuôi và truyền ngược riêng biệt, theo dõi thủ công các giá trị trung gian và xác minh tính đúng đắn toán học trên hàng chục phép toán. Một transformer hiện đại liên quan đến hàng trăm phép toán với các phụ thuộc phức tạp; việc đạo hàm gradient thủ công cho attention, chuẩn hóa lớp và kết nối dư sẽ đòi hỏi hàng tháng làm việc cẩn thận cho mỗi biến thể kiến trúc.
# Saving checkpoint
checkpoint = {
    "epoch": epoch,
    "model_state_dict": model.state_dict(),
    "optimizer_state_dict": optimizer.state_dict(),
}
torch.save(checkpoint, "checkpoint.pt")

# Resuming training
checkpoint = torch.load("checkpoint.pt")
model.load_state_dict(checkpoint["model_state_dict"])
optimizer.load_state_dict(checkpoint["optimizer_state_dict"])
Bước đột phá là biến quá trình thủ công này thành cơ sở hạ tầng phần mềm. Một phép nhân ma trận duy nhất yêu cầu các tính toán gradient khác nhau tùy thuộc vào đầu vào nào cần gradient, hình dạng tensor, khả năng phần cứng và ràng buộc bộ nhớ. Các hệ thống Autograd xử lý những biến thể này một cách minh bạch, đó là lý do tại sao tốc độ đổi mới kiến trúc tăng tốc sau khi các framework trưởng thành. Toán học không thay đổi; kỹ thuật phần mềm đã làm cho toán học trở nên thực tế để áp dụng ở quy mô lớn.
Quản lý bộ nhớ trong tính toán gradient
Các chiến lược bộ nhớ từ section 1.4.1.2 (checkpointing, tích lũy gradient) tồn tại vì vi phân chế độ ngược yêu cầu bảo toàn lịch sử tính toán. Như listing 11 đã chứng minh, mỗi lớp thêm một tensor activation tồn tại cho đến khi lượt truyền ngược tiêu thụ nó, tạo ra một sóng bộ nhớ đạt đỉnh vào đầu quá trình lan truyền ngược và giảm dần khi các gradient được tính toán. Các framework hiện đại tự động theo dõi vòng đời của từng giá trị trung gian, giải phóng bộ nhớ ngay khi nó không còn cần thiết. Tuy nhiên, ngay cả với việc theo dõi vòng đời chính xác, một vấn đề sâu sắc hơn vẫn còn: chi phí thu nhận bộ nhớ từ GPU ngay từ đầu.
Chi phí cấp phát bộ nhớ GPU thô cung cấp một bài học kỹ thuật quan trọng: các hệ thống sản xuất yêu cầu trừu tượng hóa bộ nhớ. Cấp phát thiết bị có thể gây ra chi phí đáng kể và đồng bộ hóa. Do đó, các framework hiện đại sử dụng bộ cấp phát bộ nhớ đệm để giữ lại và tái sử dụng các khối thiết bị thay vì yêu cầu bộ nhớ cho mỗi tensor. Gộp làm giảm các lệnh gọi cấp phát và có thể giảm thiểu phân mảnh, nhưng nó không thể ngăn chặn phân mảnh trong mọi kiểu cấp phát.
Systems Perspective 1.2: Bộ cấp phát bộ nhớ đệm và sử dụng
Các bộ cấp phát bộ nhớ đệm chủ yếu giảm chi phí cấp phát và cải thiện việc tái sử dụng khối. Hai điểm cần xem xét vẫn còn:
- Độ trễ cấp phát: Tái sử dụng một khối được lưu vào bộ đệm tránh các lệnh gọi cấp phát thiết bị lặp lại, mà chi phí và hành vi đồng bộ hóa của chúng phụ thuộc vào bộ cấp phát và runtime.
- Phân mảnh: Các lớp kích thước và chia khối cải thiện việc tái sử dụng nhưng có thể để lại dung lượng trống trong các khối không đáp ứng được yêu cầu.
Lỗi hết bộ nhớ có thể phản ánh các cấp phát đang hoạt động, các khối được bộ cấp phát dành riêng, phân mảnh hoặc một tiến trình khác. nvidia-smi báo cáo mức sử dụng cấp thiết bị và bản thân nó không đủ để chẩn đoán bộ cấp phát của framework; cần có thống kê bộ nhớ dành riêng cho bộ cấp phát.
Thách thức tích hợp hệ thống sản xuất
Một lần lặp huấn luyện có thể chạy chậm hơn trong môi trường sản xuất so với trong một hồ sơ độc lập vì toàn bộ bước phối hợp với bộ cấp phát bộ nhớ, trình quản lý thiết bị, bộ lập lịch phép toán, pipeline dữ liệu và optimizer. Chi phí toàn hệ thống bao gồm công việc mà một benchmark vi mô của phép toán hoặc hồ sơ kernel độc lập không đo lường được. Tính toán gradient khởi chạy các kernel bộ tăng tốc và có thể yêu cầu cấp phát, đồng bộ hóa hoặc di chuyển dữ liệu theo đồ thị và triển khai. Những tương tác này có thể chi phối các khối lượng công việc (workload) phép toán nhỏ và vẫn có thể đo lường được ở quy mô lớn. Khoảng cách giữa những gì lập trình viên viết (một vòng lặp huấn luyện năm dòng) và những gì hệ thống thực thi (cấp phát, khởi chạy kernel và các điểm đồng bộ hóa) là mâu thuẫn trung tâm của thiết kế hệ thống AD.
Mức độ nghiêm trọng của chi phí phụ trội này phụ thuộc vào một lựa chọn kiến trúc sâu hơn: cách hệ thống AD ghi lại và phát lại tính toán ngay từ đầu. Một framework xây dựng vết động tại runtime phải trả chi phí ghi sổ theo từng phép toán trên mỗi lượt truyền xuôi, và bộ cấp phát bộ nhớ đệm của nó phải đáp ứng các mẫu cấp phát có thể thay đổi theo quá trình thực thi. Ngược lại, một framework thu thập một tính toán ổn định có thể lập kế hoạch trước cho các bộ đệm và tái sử dụng bộ nhớ trên các đồ thị truyền xuôi và truyền ngược vì nó có thể suy luận về vòng đời trước khi thực thi. Lợi ích phụ thuộc vào phạm vi thu thập, vòng đời của tensor, hình dạng và hỗ trợ từ backend.
Systems Perspective 1.3: Vi phân tự động dựa trên băng so với dựa trên biến đổi
PyTorch (dựa trên băng): Ghi lại các phép toán trên một “băng” động trong lượt truyền xuôi. Điều này linh hoạt và dễ gỡ lỗi nhưng khiến trình biên dịch khó nhìn thấy toàn bộ đồ thị cùng lúc để tối ưu hóa toàn cục.
JAX (dựa trên biến đổi): Coi vi phân tự động là một biến đổi hàm cấp cao (grad(f)). JAX theo dõi một hàm thuần túy cho các chữ ký đầu vào trừu tượng, cho phép các biến đổi tương thích như jit(grad(f)) hoặc vmap(grad(f)) kết hợp trước khi hạ cấp. Điều này phơi bày một chương trình đã biến đổi lớn hơn cho các trình biên dịch bộ tăng tốc mà không đảm bảo một kernel duy nhất hoặc lợi thế tốc độ phổ quát.
Hệ thống AD theo dõi các phụ thuộc để nó có thể duyệt qua các nhánh đồ thị độc lập theo một thứ tự hợp lệ và tích lũy gradient một cách chính xác. Các tác vụ máy chủ độc lập hoặc các luồng thiết bị được quản lý rõ ràng có thể phơi bày tính đồng thời, nhưng công việc autograd PyTorch thông thường trên CUDA tuân theo ngữ nghĩa luồng của framework thay vì tự động gán mọi nhánh độc lập cho một luồng riêng biệt. Sự chồng chéo thực tế phụ thuộc vào lập lịch runtime, các phụ thuộc và tài nguyên thiết bị có sẵn.
Các thách thức về bộ nhớ và tích hợp hệ thống được kiểm tra trong section 1.4.1.3 (bộ cấp phát bộ nhớ đệm, lưu trữ activation và chi phí phụ trội của checkpoint) ảnh hưởng đến tất cả các framework. Tuy nhiên, cách các framework triển khai vi phân tự động ngay từ đầu lại khác biệt đáng kể, với những hệ quả đối với cả tiềm năng tối ưu hóa và trải nghiệm nhà phát triển. Sự khác biệt giữa autodiff dựa trên băng và dựa trên biến đổi nắm bắt sự phân kỳ kiến trúc này. JAX22 minh họa cho phương pháp dựa trên biến đổi, nơi các biến đổi hàm có thể kết hợp thay thế việc ghi băng theo kiểu mệnh lệnh.
22 JAX: JAX phơi bày grad, jit và vmap dưới dạng các biến đổi trên các hàm; chúng có thể được kết hợp khi các hợp đồng đầu vào và đầu ra của chúng khớp nhau, nhưng thứ tự quan trọng: vector hóa gradient nói chung không phải là cùng một phép toán với việc vi phân một kết quả có giá trị vector. Biên dịch có thể tạo ra các vùng hợp nhất, các lời gọi thư viện và nhiều kernel thay vì một kernel phổ quát. Các hàm đã biến đổi nên là hàm thuần túy; các tác dụng phụ của Python có thể xảy ra trong quá trình theo dõi nhưng không được biểu diễn trong chương trình đã biên dịch, trong khi các callback được hỗ trợ thể hiện các hiệu ứng runtime có chủ ý.
Các framework khác nhau triển khai AD như thế nào
Các mô hình thực thi được đề cập trong section 1.3, cụ thể là eager, đồ thị tĩnh và lai, trực tiếp định hình cách mỗi framework triển khai vi phân tự động:
- PyTorch (Paszke et al. 2019) xây dựng băng autograd của nó một cách động trong quá trình thực thi truyền xuôi, cung cấp khả năng gỡ lỗi tức thì với chi phí là tối ưu hóa cấp đồ thị. Cơ chế chuỗi
grad_fnđược trình bày chi tiết trong section 1.4.2.1 cho phép luồng điều khiển linh hoạt nhưng yêu cầu lưu trữ toàn bộ đồ thị cho đến khi hoàn thành lượt truyền ngược. - TensorFlow (Abadi et al. 2016) (trong phiên bản 1.x của nó) thực hiện vi phân ký hiệu trong quá trình xây dựng đồ thị, cho phép tối ưu hóa trước thời hạn. TensorFlow 2.x hiện đại sử dụng thực thi eager theo mặc định nhưng cung cấp
tf.functionđể biên dịch đồ thị khi hiệu suất là quan trọng (TensorFlow Developers 2024). - JAX (Frostig et al. 2018) biến đổi các hàm thay vì theo dõi các phép toán. Biến đổi
jax.grad()trả về một hàm mới tính toán gradient, cho phép kết hợp vớijax.vmap()để vector hóa vàjax.jit()để biên dịch. Phương pháp này yêu cầu các hàm thuần túy nhưng cho phép các biến đổi chương trình có thể kết hợp, xâu chuỗi vi phân, vector hóa và biên dịch trong một biểu thức duy nhất.
Paszke, Adam, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, et al. 2019. “PyTorch: An Imperative Style, High-Performance Deep Learning Library.” Advances in Neural Information Processing Systems (NeurIPS) 32: 8024–35.
Abadi, Martı́n, Paul Barham, Jianmin Chen, Zhifeng Chen, Andy Davis, Jeffrey Dean, Matthieu Devin, et al. 2016. “TensorFlow: A System for Large-Scale Machine Learning.” Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 265–83.
Frostig, Roy, Matthew James Johnson, and Chris Leary. 2018. “Compiling Machine Learning Programs via High-Level Tracing.” Systems for Machine Learning.
Sự khác biệt trong triển khai autodiff xác định mức độ hiển thị gỡ lỗi, tối ưu hóa trình biên dịch và khả năng di động khi triển khai mà một nhóm có thể mong đợi từ mỗi framework. Một căng thẳng lặp đi lặp lại xuyên suốt mọi quyết định thiết kế AD: tính đúng đắn toán học đòi hỏi lưu trữ lịch sử tính toán, nhưng phần cứng áp đặt giới hạn bộ nhớ nghiêm ngặt. Mỗi framework giải quyết căng thẳng này khác nhau, chọn activation nào để checkpoint, phép toán nào để hợp nhất và mức độ tích cực để đánh đổi tính toán lại lấy bộ nhớ. Những lựa chọn này xác định mô hình nào có thể huấn luyện trên phần cứng nào, khiến thiết kế hệ thống AD trở thành một trong những quyết định kỹ thuật quan trọng nhất trong bất kỳ framework nào.
Checkpoint 1.2: Chi phí hệ thống của gradient
Huấn luyện vốn dĩ đắt hơn suy luận vì Vi phân Tự động.
Thực tế tính toán
Cơ chế tối ưu hóa
Các vấn đề thực thi và vi phân cùng nhau tạo nên vòng lặp huấn luyện: mô hình thực thi xác định thời điểm tính toán diễn ra, trong khi vi phân tự động tính toán các đạo hàm thúc đẩy quá trình học. Tuy nhiên, cả hai vấn đề này đều ngầm giả định một điều không thể coi là hiển nhiên: rằng cùng một mã có thể chạy trên nhiều phần cứng đa dạng. Một mô hình được huấn luyện trên NVIDIA A100 phải phục vụ suy luận trên CPU ARM của điện thoại di động, TPU của Google, hoặc một vi điều khiển với kilobyte bộ nhớ. Lệnh gọi torch.matmul tương tự phải điều phối đến cuBLAS trên một thiết bị và một kernel ARM NEON được tinh chỉnh thủ công trên thiết bị khác. Sự đa dạng phần cứng này tạo ra vấn đề thứ ba.
Self-Check: Question
For a neural network with \(N = 10^7\) parameters and a single scalar loss output \(M = 1\), why do deep learning frameworks uniformly employ reverse-mode automatic differentiation (backpropagation) instead of forward-mode differentiation?
- Reverse-mode computes all \(10^7\) parameter gradients in a single backward pass of complexity \(\mathcal{O}(M) = \mathcal{O}(1)\), whereas forward-mode would require \(10^7\) separate passes of complexity \(\mathcal{O}(N)\)
- Forward-mode differentiation cannot compute exact gradients and relies on finite-difference approximations
- Reverse-mode differentiation requires zero memory allocation for intermediate forward activations
- Forward-mode is restricted exclusively to non-linear activation functions and cannot differentiate matrix multiplications
A PyTorch user modifies an intermediate activation tensor using an in-place operation (
x.relu_()orx += 1) during the forward pass. Duringloss.backward(), autograd raises a runtime error: “one of the variables needed for gradient computation has been modified by an inplace operation”. What is the systems mechanism causing this failure?- In-place operations convert 32-bit floating point numbers to integers, corrupting floating-point precision
- The autograd tape recorded a reference to the forward tensor whose underlying storage was overwritten, destroying the original activation values required by the operation’s derivative formula
- In-place operations automatically set
requires_grad=Falseon all ancestor nodes in the computational graph - The GPU caching allocator prohibits in-place memory modifications during forward execution
Explain the difference between accumulating gradients in a tensor’s
.gradattribute across batches and retaining the autograd computational graph usingloss.backward(retain_graph=True).True or False: Because reverse-mode automatic differentiation computes exact gradients in a single backward pass, its peak memory consumption during training is identical to that of inference.
Order the sequence of events executed during reverse-mode automatic differentiation for a single training step:
Initialize the backward pass by seeding the output gradient adjoint with \(d\mathcal{L}/d\mathcal{L} = 1.0\)
Execute the forward pass while registering operations and saving required activation tensors on the autograd tape
Accumulate calculated parameter gradients into the
.gradattributes of leaf parametersCompute the scalar loss \(\mathcal{L}\) from model outputs and ground truth targets
Traverse the
GradFnDAG backward, applying operation-specific Vector-Jacobian Products (chain rule)To resolve GPU memory exhaustion caused by caching activations during long forward passes, the memory optimization technique that discards intermediate activations and recomputes them on-the-fly from saved boundary tensors during the backward pass is called activation ____ (or rematerialization).
Vấn đề Trừu tượng hóa
Sự đa dạng phần cứng này có tính nền tảng về kiến trúc. GPU cung cấp khả năng song song hóa dồi dào theo định hướng thông lượng nhưng có ngữ nghĩa bộ nhớ và thực thi khác với CPU. TPU ưu tiên các chương trình tensor thông thường và các hình dạng hiển thị với trình biên dịch. Một vi điều khiển có kilobyte trong khi máy chủ có gigabyte. Do đó, vấn đề trừu tượng hóa đòi hỏi các framework phải ẩn đi sự phức tạp này đằng sau một giao diện lập trình duy nhất, đồng thời vẫn cho phép tận dụng hiệu quả các khả năng độc đáo của từng mục tiêu.
Vấn đề được phân tách thành hai chiều tương tác. Chiều thứ nhất là biểu diễn dữ liệu: cách các framework mã hóa tensor, tham số và trạng thái tính toán dưới các dạng thức hoạt động trên nhiều phần cứng. Chiều thứ hai là ánh xạ thực thi: cách các thao tác cấp cao được dịch thành các triển khai dành riêng cho phần cứng. Những chiều này không phải là những mối quan tâm độc lập. Cách dữ liệu được biểu diễn (bố cục bộ nhớ, độ chính xác, vị trí thiết bị) ảnh hưởng trực tiếp đến những chiến lược thực thi nào có thể thực hiện được. Một tensor được lưu trữ theo định dạng hàng chính (row-major) trên GPU đòi hỏi các kernel khác với tensor theo định dạng cột chính (column-major) trên CPU. Một mô hình được lượng tử hóa thành INT8 cho phép các đường dẫn thực thi hoàn toàn khác so với FP32.
Giải quyết vấn đề trừu tượng hóa đòi hỏi cơ sở hạ tầng phần mềm phức tạp: các biểu diễn tensor mã hóa cả ngữ nghĩa toán học và các ràng buộc phần cứng, các biểu diễn trung gian cho phép biên dịch dành riêng cho phần cứng, và các hệ thống runtime quản lý việc di chuyển dữ liệu trên hệ thống phân cấp bộ nhớ. Để cụ thể hóa điều này, hãy theo dõi những gì phải xảy ra khi một lập trình viên viết model(input). Framework phải giải quyết năm quyết định liên tiếp nhanh chóng: biểu diễn dữ liệu (hình dạng tensor, bố cục bộ nhớ, độ chính xác số học), vị trí thiết bị (hệ thống phân cấp băng thông kết nối bộ nhớ CPU, GPU và bộ tăng tốc), cung cấp đầu vào (các pipeline dữ liệu duy trì hàng trăm MB/s để giữ cho bộ tăng tốc được cung cấp dữ liệu), tổ chức mô hình (các tham số, bộ đệm và các mô-đun con phải di chuyển cùng nhau), và thực thi kernel (điều phối, lập lịch và tối ưu hóa tài nguyên). Những quyết định này được xây dựng từ vùng chứa dữ liệu lên đến lớp thực thi phần cứng. Vị trí phân tán xem trước cùng một ranh giới trừu tượng: các framework hiển thị các phạm vi vị trí để các thành phần hệ thống có thể quản lý ranh giới thiết bị, trong khi Huấn luyện mô hình phân tích các thuật toán mở rộng và chi phí giao tiếp giúp các phạm vi đó hiệu quả.
Cấu trúc dữ liệu và các trừu tượng tensor
Một lượt truyền xuôi ResNet-50 chạm tới 25.6M tham số, tạo ra các activation trung gian ở mỗi lớp, và phải điều phối bộ nhớ trên các không gian địa chỉ CPU và GPU. Các framework tổ chức tất cả dữ liệu này để một lệnh gọi model(input) duy nhất thực thi hàng triệu thao tác mà không cần lập trình viên quản lý một con trỏ nào, bằng cách giải quyết bốn vấn đề theo trình tự: định nghĩa một vùng chứa dữ liệu phổ quát (tensor), đặt nó trên thiết bị phù hợp (quản lý bộ nhớ), cung cấp dữ liệu đủ nhanh (các pipeline dữ liệu), và điều phối kernel phần cứng phù hợp (các thao tác cốt lõi). Con đường này chạy từ biểu diễn dữ liệu đến thực thi phần cứng.
Đồ thị tính toán chỉ định luồng logic của các thao tác, nhưng cấu trúc dữ liệu xác định cách các thao tác đó truy cập và thao tác dữ liệu trong bộ nhớ vật lý. Sự phân biệt này quan trọng vì cùng một thao tác toán học có thể khác nhau về thông lượng theo một bậc độ lớn tùy thuộc vào việc dữ liệu có liền kề trong cache, được ghim để truyền truy cập bộ nhớ trực tiếp (DMA) hay phân tán trên các trang.
Bước đầu tiên là chính vùng chứa dữ liệu. Cấu trúc dữ liệu của framework phải duy trì băng thông bộ nhớ (hàng trăm GB/s trên các GPU hiện đại), phù hợp với các kiến trúc từ chuỗi 1D đến tensor video 5D, và ẩn quản lý thiết bị đằng sau các API rõ ràng. Tensor là câu trả lời phổ quát.
Tensor
Nền tảng của biểu diễn dữ liệu của mọi framework là một trừu tượng duy nhất: tensor, một mảng n chiều ghép nối các giá trị số với thông tin cần thiết để diễn giải và đặt chúng.
Mọi tính toán trong mạng nơ-ron đều hoạt động trên tensor.23 Các batch huấn luyện, bản đồ activation, đạo hàm tham số và trạng thái optimizer đều là tensor. Biểu diễn thống nhất này cho phép các framework tối ưu hóa một cấu trúc dữ liệu duy nhất cho phần cứng thay vì quản lý các vùng chứa riêng biệt cho từng vai trò.
23 Tensor: Trong toán học, tensor tuân theo các định luật biến đổi tọa độ; các framework ML sử dụng thuật ngữ này rộng hơn cho các mảng đa chiều mang theo hình dạng, kiểu dữ liệu (dtype), bước nhảy (strides), vị trí thiết bị và thường là siêu dữ liệu vi phân tự động. Một phép chuyển vị thường tạo ra một view có bước nhảy, trong khi thao tác reshape có thể trả về một view hoặc một bản sao tùy thuộc vào bố cục. Những ngữ nghĩa lưu trữ này làm cho bố cục trở nên liên quan đến việc lựa chọn kernel và di chuyển dữ liệu.
Definition 1.2: Tensor
Tensor là các mảng \(n\)-chiều với siêu dữ liệu về hình dạng, kiểu dữ liệu, bước nhảy và thiết bị. Các runtime của framework sử dụng thông tin này để chọn các thao tác và kernel phần cứng tương thích.
- Ý nghĩa: Một tensor FP32 liền kề có hình dạng \([1024, 1024]\) chiếm \(1024{\times}1024{\times}4 = 4{,}194{,}304\) byte (khoảng 4.2 MB). Một dạng xem không liền kề có thể được chấp nhận trực tiếp bởi một kernel có bước nhảy hoặc có thể yêu cầu hiện thực hóa khi một phép toán đòi hỏi một bố cục liền kề được hỗ trợ.
- Điểm khác biệt: Các mảng NumPy cũng mang siêu dữ liệu về hình dạng (shape), kiểu dữ liệu (dtype) và bước nhảy (stride). Các tensor của framework còn tích hợp việc đặt trên thiết bị, vi phân tự động và điều phối bộ tăng tốc.
- Lỗi thường gặp: Các phép toán tensor có thể trả về một cấp phát mới, một dạng xem chia sẻ bộ nhớ hiện có, hoặc một cập nhật tại chỗ, tùy thuộc vào phép toán và biến thể API. Tính toán bộ nhớ phải phân biệt các trường hợp này.
Trừu tượng hóa tensor tiêu thụ nhiều bộ nhớ hơn đáng kể so với những gì trọng số mô hình đơn thuần gợi ý. Các kỹ sư ước tính bộ nhớ chỉ từ số lượng tham số sẽ cấp phát tương ứng và gặp lỗi hết bộ nhớ có vẻ khó hiểu. Một tính toán bộ nhớ nhanh chóng làm cho chi phí ẩn trở nên rõ ràng: gradient, động lượng của optimizer và các activation được lưu trữ đi kèm với mỗi tensor trọng số.
Napkin Math 1.3: Chi phí quản lý
Phân tích minh họa ResNet-50 trong section 1.4.2.1 lớn hơn ~82.1–121.2× so với chỉ riêng bộ nhớ lưu trữ trọng số FP32. Kịch bản sau đây mở rộng tính toán sang gradient, trạng thái của optimizer và các activation đã lưu ở quy mô tỷ tham số.
Bài toán: Trạng thái huấn luyện thêm bao nhiêu bộ nhớ ngoài trọng số FP16 trong kịch bản tỷ tham số này?
Tính toán:
- Trọng số mô hình: 2 GB.
- Gradient: 2 GB (cùng kích thước với trọng số).
- Trạng thái của optimizer (Adam): 8 GB (\(4 \times\) bộ nhớ trọng số FP16 cho động lượng và vận tốc được lưu trữ ở định dạng FP32).
- Các activation: Đối với kích thước batch là 32 và một mạng 100-lớp, AD chế độ ngược giữ lại các giá trị phụ thuộc vào phép toán được yêu cầu bởi các quy tắc đạo hàm; checkpoint activation có thể bỏ qua các giá trị được chọn và tính toán lại chúng trong quá trình truyền ngược. \[ \text{Activations} \approx B \times N_L \times S \times d_{\text{model}} \times n_{\text{saved}} \times 2 \text{ bytes} \] Đối với một chuỗi token 1024, trạng thái ẩn có độ rộng 1024 và 1 tensor đã lưu trên mỗi lớp: \(32 \times 100 \times 1024 \times 1024 \times 1 \times 2 \approx \mathbf{6.7 GB}\). Các thành phần attention được hiện thực hóa có thể thêm một thành phần \(B \times N_{\text{heads}} \times S^2\) riêng biệt, đó là lý do tại sao các kernel attention tiết kiệm bộ nhớ rất quan trọng.
Hiểu biết về hệ thống: Một mô hình 2 GB mang trạng thái huấn luyện bền vững trước khi batch đầu tiên được xử lý (gradient 2 GB + trạng thái của optimizer 8 GB). Trong một bước huấn luyện, các activation phụ thuộc vào batch thêm 6.7 GB nữa, nâng chi phí quản lý đỉnh điểm lên ~16.7 GB ngoài trọng số. Trong quá trình huấn luyện, di chuyển dữ liệu bao gồm việc lưu và truy xuất các activation này.
Cấu trúc và chiều của tensor
Các tensor cấu trúc dữ liệu số bằng cách thêm các trục tổ chức vào bố cục bộ nhớ tuyến tính. Theo dõi sự mở rộng hạng từ trái sang phải trong figure 7, quan sát cách các vô hướng hạng 0 phát triển thành các tensor thể tích hạng 3.

Trong các ứng dụng thị giác, đầu vào hình ảnh thô ánh xạ trực tiếp vào bố cục tensor đa chiều. Kiểm tra cấu trúc tensor hạng 3 trong figure 8, quan sát cách các kênh màu đỏ, xanh lá và xanh dương xếp chồng lên nhau dọc theo chiều kênh.
Các tensor của framework mang nhiều hơn các con số thô. Mỗi tensor lưu trữ siêu dữ liệu tensor, thông tin runtime được sử dụng để xác thực các phép toán và chọn các đường dẫn thực thi nhanh: một bộ giá trị hình dạng (ví dụ: [64, 3, 224, 224] cho một batch hình ảnh), một kiểu dữ liệu (dtype) (các giá trị cố định của framework như float32, float16 hoặc int8), và một thẻ thiết bị (CPU, cuda:0). Ví dụ, một phép nhân ma trận kiểm tra tính tương thích hình dạng tại thời điểm điều phối và sử dụng dtype để định tuyến đến kernel phần cứng chính xác, cho dù đó là GEMM FP32 tiêu chuẩn hay đường dẫn Tensor Core FP16.

Việc triển khai bố cục bộ nhớ đặt ra những thách thức riêng biệt trong thiết kế tensor. Trong khi các tensor cung cấp sự trừu tượng hóa dữ liệu đa chiều, bộ nhớ vật lý của máy tính vẫn là tuyến tính. Các mẫu bước nhảy (stride) giải quyết sự khác biệt này bằng cách tạo ra các ánh xạ giữa các chỉ số tensor đa chiều và các địa chỉ bộ nhớ tuyến tính. Các mẫu này ảnh hưởng đáng kể đến hiệu suất tính toán bằng cách xác định các mẫu truy cập bộ nhớ trong các phép toán tensor. Figure 9 làm rõ điều này với một tensor \(2{\times}3\): theo dõi sáu giá trị giống nhau khi chúng ánh xạ vào hai thứ tự tuyến tính khác nhau—hàng chính (row-major) và cột chính (column-major)—và lưu ý cách các giá trị bước nhảy thay đổi để bù trừ.

Việc lựa chọn bước nhảy trở thành lựa chọn về hiệu suất. Bố cục kiểu hàng chính (được sử dụng bởi NumPy, PyTorch) lưu trữ các phần tử theo từng hàng, giúp các phép toán theo hàng thân thiện hơn với cache. Bố cục kiểu cột chính (được sử dụng bởi một số thư viện BLAS) lưu trữ các phần tử theo từng cột, tối ưu hóa các mẫu truy cập theo cột. Các giá trị bước nhảy mã hóa thông tin bố cục này: trong bố cục kiểu hàng chính cho một tensor \(2{\times}3\), việc di chuyển đến hàng tiếp theo yêu cầu bỏ qua ba phần tử (stride[0] = 3), trong khi di chuyển đến cột tiếp theo yêu cầu bỏ qua một phần tử (stride[1] = 1).
Những chi tiết về bố cục bộ nhớ này có ý nghĩa trực tiếp đến hiệu suất, nhưng không có thứ tự nào là vượt trội hơn một cách phổ biến. Truy cập hiệu quả phụ thuộc vào chiều mà một phép toán đi qua, các bố cục được kernel hỗ trợ, vector hóa và hệ thống phân cấp bộ nhớ mục tiêu. Một bố cục không khớp có thể yêu cầu truy cập theo bước nhảy hoặc chuyển đổi, trong khi một kernel được thiết kế cho bố cục đó có thể truy cập nó một cách hiệu quả.
dtype là đòn bẩy cấp tensor giúp cân bằng giữa dải số và di chuyển dữ liệu. Lựa chọn tiêu chuẩn trong machine learning là độ chính xác FP32, được thể hiện trong các framework thông qua các literal dtype như float32, mang lại sự cân bằng giữa độ chính xác và hiệu quả. Các framework hiện đại mở rộng điều này với nhiều kiểu số cho các nhu cầu khác nhau. Các kiểu số nguyên hỗ trợ các phép toán lập chỉ mục và embedding. Các kiểu độ chính xác giảm như FP16 cho phép triển khai di động hiệu quả. Độ chính xác INT8 cho phép suy luận nhanh trên phần cứng chuyên dụng. Việc lựa chọn kiểu số ảnh hưởng đến cả hành vi mô hình và hiệu quả tính toán: huấn luyện mạng nơ-ron thường yêu cầu độ chính xác FP32 cho các phép tích lũy quan trọng để duy trì các tính toán gradient ổn định, trong khi các tác vụ suy luận thường có thể sử dụng độ chính xác thấp hơn (các literal dtype của framework như int8 hoặc thậm chí int4, tương ứng với INT8 và INT4), giúp giảm mức sử dụng bộ nhớ và tăng tốc độ xử lý. Các phương pháp huấn luyện độ chính xác hỗn hợp kết hợp những lợi ích này bằng cách sử dụng FP32 cho các phép tích lũy quan trọng trong khi thực hiện hầu hết các tính toán ở độ chính xác thấp hơn.
Chuyển đổi kiểu trở thành một điểm khác nơi sự trừu tượng gặp gỡ vật lý. Thao tác trên các tensor với các kiểu khác nhau đòi hỏi các quy tắc chuyển đổi rõ ràng để bảo toàn tính đúng đắn về số học. Những chuyển đổi này gây ra chi phí tính toán và rủi ro mất độ chính xác. Các framework cung cấp khả năng ép kiểu nhưng dựa vào các nhà phát triển để duy trì độ chính xác số học trong các phép toán.
Tensor giải quyết vấn đề biểu diễn dữ liệu bằng cách mã hóa hình dạng, bố cục và độ chính xác vào một trừu tượng duy nhất. Tuy nhiên, một tensor có hình dạng hoàn hảo nhưng nằm trên thiết bị sai, hoặc một tensor phải vượt qua khoảng cách băng thông PCIe-to-HBM để đến được GPU, có thể xóa bỏ mọi tối ưu hóa bố cục. Vấn đề tiếp theo là vị trí: dữ liệu nằm ở đâu và di chuyển như thế nào.
Quản lý thiết bị và bộ nhớ
Tensor và bố cục bộ nhớ của chúng thiết lập những gì framework tính toán. Dữ liệu đó thực sự nằm ở đâu, và cách nó di chuyển giữa các vị trí, quyết định liệu tính toán diễn ra với tốc độ tối đa hay chậm chạp.
Frameworks như giao diện hệ điều hành
Trong khi API cấp cao tập trung vào toán học, phần backend của framework hoạt động như hệ điều hành của Ngăn xếp Máy đơn (Single-Machine Stack). Nó quản lý hai tài nguyên quan trọng của một nút đơn: lập lịch tính toán và di chuyển dữ liệu.
CUDA Runtime đóng vai trò là lớp hệ điều hành này, cung cấp các nguyên thủy cấp thấp để khởi chạy kernel và quản lý bộ nhớ thiết bị. Framework phối hợp với runtime này để triển khai DMA qua bus PCIe. Khoảng cách băng thông giữa máy chủ (CPU) và thiết bị (GPU) là “Nút thắt cổ chai tải dữ liệu” chính: Băng thông so với độ trễ mô hình hóa quá trình truyền này, tách biệt hai ràng buộc, \(T = L_{\text{lat}} + D_{\text{vol}}/\text{BW}\), quyết định liệu một chiến lược tải dữ liệu nhất định bị giới hạn bởi độ trễ trên mỗi lần truyền hay bởi băng thông duy trì. Các framework giảm thiểu điều này thông qua bộ nhớ được ghim (pinned memory) (bộ nhớ máy chủ bị khóa trang), cho phép truyền DMA mà không cần dàn xếp bộ nhớ có thể phân trang. Giao diện “HW/OS” này là thứ giúp các vòng lặp huấn luyện có thông lượng cao trở nên khả thi trên một máy đơn.
Mỗi tensor nằm trên một thiết bị cụ thể, và các phép toán giữa các thiết bị phát sinh chi phí truyền tải có thể chiếm ưu thế trong thời gian thực thi. PCIe 4.0 cung cấp 32 GB/s giữa CPU và GPU, trong khi HBM2e cung cấp 2.04 TB/s bên trong GPU. Khoảng cách băng thông 63.7× này có nghĩa là một lần truyền tensor đặt sai vị trí có thể xóa bỏ toàn bộ tốc độ tăng cường từ việc tăng tốc GPU.
Băng thông kết nối trải dài ~64\(\times\): HBM vượt xa NVLink, NVLink vượt xa PCIe.
Việc đặt thiết bị quan trọng đối với thiết kế framework bởi vì framework phải theo dõi vị trí của mỗi tensor và đảm bảo rằng các phép toán chỉ kết hợp các tensor trên cùng một thiết bị. Khi dữ liệu cần di chuyển, framework phải quyết định liệu có nên chặn thực thi hay chồng chéo việc truyền dữ liệu với các công việc khác. Những quyết định này, vốn vô hình đối với hầu hết người dùng, có thể chuyển một vòng lặp huấn luyện từ việc bị giới hạn bởi truyền dữ liệu sang việc tận dụng phần cứng cao hơn đáng kể.
Ba nguyên tắc hệ thống chi phối việc quản lý thiết bị và bộ nhớ hiệu quả: hiểu rõ hệ thống phân cấp băng thông giới hạn việc di chuyển dữ liệu, chồng chéo tính toán với giao tiếp để che giấu độ trễ truyền dữ liệu, và sử dụng đồng bộ hóa chi tiết để duy trì tính đúng đắn mà không làm giảm tính đồng thời, được hỗ trợ bởi phân tích định lượng dựa trên thuật ngữ di chuyển dữ liệu của định luật sắt. Hệ thống phân cấp băng thông cung cấp ràng buộc đầu tiên.
Chi phí di chuyển dữ liệu giữa các thiết bị thay đổi theo cấp số nhân tùy thuộc vào bộ kết nối.24 Table 7 cho thấy thời gian truyền dữ liệu cho một tensor float32 \(1000{\times}1000\) (4 MB)—gần bằng kích thước của một activation tensor điển hình trong một mô hình có kích thước vừa phải. Các con số này cho thấy tại sao việc đặt thiết bị bất cẩn có thể xóa bỏ mọi tăng tốc từ việc tăng tốc GPU.
24 NVLink: Bộ kết nối GPU-to-GPU băng thông cao của NVIDIA (xem Tăng tốc phần cứng), cung cấp băng thông hai chiều 600 GB/s (NVLink 3.0 trên A100) so với 64 GB/s cho PCIe 4.0 x16. Lợi thế băng thông gấp ~10\(\times\) này quyết định liệu song song hóa tensor, chia một phép tính tensor lớn trên nhiều GPU, có thực tế hay không đối với một kích thước mô hình nhất định: Các GPU chỉ được kết nối bằng PCIe có thể làm cho thuật ngữ giao tiếp \(D_{\text{vol}}/\text{BW}\) chiếm ưu thế trong tổng thời gian huấn luyện, xóa bỏ lợi ích của việc tính toán bổ sung.
| Kết nối liên mạch | Băng thông | Thời gian truyền | Đường dẫn |
|---|---|---|---|
| PCIe 3.0 x16 | 15.8 GB/s | 0.254 ms | Từ máy chủ đến thiết bị |
| PCIe 4.0 x16 | 32 GB/s | 0.125 ms | Từ máy chủ đến thiết bị |
| NVLink 3.0 | 300 GB/s mỗi hướng (600 GB/s hai chiều) | 0.013 ms | Từ GPU đến GPU |
| Bộ nhớ GPU | 2039 GB/s | 0.002 ms | Trên thiết bị |
Những con số này liên quan trực tiếp đến định luật sắt về hiệu suất. Mỗi lần truyền giữa các thiết bị đóng góp vào \((D_{\text{vol}}/\text{BW})\) với một phần nhỏ băng thông trên thiết bị. Chia 1 GB cho băng thông đỉnh PCIe 4.0 đã nêu cho ra 31.2 ms, một giới hạn dưới chỉ dựa trên băng thông, bỏ qua chi phí giao thức, khởi chạy, đồng bộ hóa, cấu trúc liên kết và tranh chấp. Các lần truyền có thể chiếm ưu thế trong các khối lượng công việc (workload) nhẹ hoặc batch nhỏ, vì vậy độ trễ triển khai phải được đo lường thay vì suy ra chỉ từ băng thông đỉnh.
Mỗi tensor nên nằm trên thiết bị nơi nó sẽ được sử dụng, và việc truyền dữ liệu chỉ nên xảy ra khi không thể tránh khỏi. Các framework theo dõi vị trí thiết bị cho mỗi tensor và báo lỗi khi các phép toán cố gắng kết hợp các tensor từ các thiết bị khác nhau, thực thi nguyên tắc này ở cấp độ API.
Chồng chéo tính toán và giao tiếp
Khi việc truyền dữ liệu là không thể tránh khỏi, tối ưu hóa tiếp theo là che giấu độ trễ của chúng bằng cách thực thi chúng đồng thời với tính toán. Các GPU hiện đại chứa các đơn vị phần cứng độc lập để tính toán (các cụm SM) và truyền dữ liệu (các công cụ sao chép), cho phép thực thi đồng thời thực sự. Trừu tượng hóa framework phơi bày sự song song phần cứng này là CUDA stream: một hàng đợi thực thi độc lập nơi các phép toán thực thi tuần tự trong một stream nhưng đồng thời trên các stream khác nhau.
Nếu không có kiểm soát đồng thời rõ ràng, GPU sẽ tuần tự hóa tất cả các phép toán trên một stream mặc định duy nhất, khiến các đơn vị thực thi nhàn rỗi trong khi việc truyền dữ liệu hoàn tất. Bằng cách đặt các lần truyền dữ liệu trên một stream và tính toán trên một stream khác, độ trễ hiệu quả tiếp cận mức tối thiểu lý thuyết là \(\max(\text{compute\_time}, \text{transfer\_time})\) thay vì tổng của chúng. Chồng chéo dựa trên stream che giấu hiệu quả hình phạt \(D_{\text{vol}}/\text{BW}\) khi tính toán là phép toán dài hơn (xem listing 19).

Chồng chéo sao chép và tính toán tốn chi phí max(sao chép, tính toán), không phải tổng của chúng.
Cờ non_blocking=True yêu cầu một bản sao bất đồng bộ đối với máy chủ khi backend hỗ trợ. Đối với các bản sao từ máy chủ đến thiết bị, bộ nhớ được ghim (pinned memory) thường được yêu cầu để chồng chéo việc truyền dữ liệu với các công việc khác của thiết bị; bộ nhớ có thể phân trang có thể được dàn dựng nội bộ, và hành vi chặn máy chủ của lệnh gọi phụ thuộc vào triển khai. Chồng chéo đúng cách cũng yêu cầu phần cứng tương thích, tài nguyên thực thi riêng biệt và quản lý phụ thuộc rõ ràng.
Mô hình đồng bộ hóa tương tự xuất hiện khi các giai đoạn mô hình chồng chéo trên các microbatch. Listing 20 cho thấy mỗi giai đoạn chạy trên stream riêng của nó, với các sự kiện chỉ thực thi các phụ thuộc nhà sản xuất-người tiêu dùng cần thiết cho tính đúng đắn.
compute_stream = torch.cuda.Stream()
transfer_stream = torch.cuda.Stream()

# Transfer next batch while computing
# current batch
with torch.cuda.stream(transfer_stream):
    next_batch = next_batch_cpu.to("cuda", non_blocking=True)

with torch.cuda.stream(compute_stream):
    output = model(current_batch)
    loss = criterion(output, labels)

# Pinned host memory can enable transfer overlap
x_pinned = torch.randn(1000, 1000).pin_memory()
x_gpu = x_pinned.to("cuda", non_blocking=True)  # Asynchronous

# A pageable source may require staging and
# should not be assumed to overlap
y_regular = torch.randn(1000, 1000)
y_gpu = y_regular.to("cuda", non_blocking=True)# Pipeline parallelism: place stages on separate GPUs
devices = [torch.device(f"cuda:{i}") for i in range(3)]
stages = [
Stage1().to(devices[0]),
Stage2().to(devices[1]),
Stage3().to(devices[2]),
]
streams = [torch.cuda.Stream(device=device) for device in devices]
events = [
[torch.cuda.Event() for _ in range(num_microbatches)]
for _ in stages
]
outputs = [[None] * num_microbatches for _ in stages]
for mb in range(num_microbatches):
for stage_idx, (stage, stream, device) in enumerate(
zip(stages, streams, devices)
):
with torch.cuda.device(device), torch.cuda.stream(stream):
if stage_idx > 0:
# Wait for previous stage to complete
# this microbatch
events[stage_idx - 1][mb].wait()
stage_input = outputs[stage_idx - 1][mb].to(
device, non_blocking=True
)
else:
stage_input = inputs[mb].to(device, non_blocking=True)
outputs[stage_idx][mb] = stage(stage_input)
events[stage_idx][mb].record()Nguyên tắc chồng chéo này mở rộng một cách tự nhiên sang chồng chéo giai đoạn mô hình trong một nút đơn. Các giai đoạn mô hình khác nhau trên các GPU riêng biệt có thể xử lý các microbatch khác nhau đồng thời, với tính toán của mỗi giai đoạn chồng chéo với việc tiếp nhận dữ liệu của giai đoạn tiếp theo (xem listing 20). Huấn luyện mô hình sau này sẽ đặt tên và phân tích các chiến lược huấn luyện phân tán được xây dựng từ mô hình lập lịch này; ở đây, việc triển khai nút đơn là đủ để phơi bày nguyên tắc đồng bộ hóa vẫn tồn tại ở quy mô lớn hơn. Khi tính toán và giao tiếp chồng chéo, thách thức còn lại là đảm bảo tính đúng đắn khi các phép toán hoàn thành không theo thứ tự.
Đồng bộ hóa và tính đúng đắn
Thực thi đồng thời đưa ra các ràng buộc về thứ tự. Khi đầu ra của một luồng trở thành đầu vào của luồng khác, hệ thống phải thực thi mối quan hệ happens-before mà không cần thiết phải tuần tự hóa các công việc độc lập. Có hai cơ chế đồng bộ hóa tồn tại, với những tác động hiệu suất khác biệt đáng kể.
Đồng bộ hóa thiết bị hoàn toàn (torch.cuda.synchronize()) chặn tất cả các luồng và CPU cho đến khi mọi thao tác được xếp hàng hoàn tất. Điều này tạo ra một điểm tuần tự hóa toàn cục, loại bỏ tất cả lợi ích của sự chồng chéo. Các sự kiện CUDA cung cấp một giải pháp thay thế: đồng bộ hóa chi tiết (fine-grained synchronization) chỉ chặn luồng phụ thuộc, cho phép các luồng khác và CPU tiếp tục thực thi (xem listing 21).
# Create streams and event
stream1 = torch.cuda.Stream()
stream2 = torch.cuda.Stream()
event = torch.cuda.Event()

# Stream 1: producer
with torch.cuda.stream(stream1):
    result1 = expensive_computation(data1)
    event.record()  # Mark completion point

# Stream 2: consumer (waits only for stream1's event)
with torch.cuda.stream(stream2):
    event.wait()  # Block stream2 until event is recorded
    result2 = dependent_computation(result1)  # Safe to use result1
Sự khác biệt về hiệu suất giữa các phương pháp này không phải là tăng dần mà là khác biệt về loại. Đồng bộ hóa hoàn toàn sau mỗi thao tác biến một pipeline đồng thời thành một pipeline tuần tự, hoàn toàn phủ nhận sự song song hóa phần cứng mà các luồng phơi bày. Đồng bộ hóa dựa trên sự kiện bảo toàn mô hình thực thi đồng thời trong khi chỉ thực thi các phụ thuộc mà tính đúng đắn yêu cầu.
Nguyên tắc đặt thiết bị bảo vệ hệ thống phân cấp băng thông khỏi lưu lượng PCIe ngẫu nhiên. Mỗi tensor mang một thuộc tính thiết bị, và các framework thực thi một bất biến nghiêm ngặt: các thao tác chỉ có thể kết hợp các tensor trên cùng một thiết bị. Một RuntimeError sẽ xảy ra khi trộn lẫn các tensor cuda:0 và cuda:1, ngăn chặn các chuyển đổi ngầm giữa các thiết bị.
Cơ chế di chuyển là tường minh. Tensor .to() trả về tensor gốc khi dtype và thiết bị của nó đã khớp với yêu cầu; nếu không, nó trả về một bản sao đã chuyển đổi trừ khi copy=True buộc phải tạo bản sao. Module .to() sửa đổi các tham số và bộ đệm đã đăng ký tại chỗ và trả về module.
Nguyên tắc hiệu suất xuất phát từ khoảng cách băng thông: cấp phát các tensor trên thiết bị đích ngay từ đầu thay vì tạo chúng trên CPU rồi chuyển đi, tái sử dụng bộ nhớ GPU qua các lần lặp thay vì cấp phát lại, và đặt các đầu vào, nhãn và tham số mô hình cùng trên một thiết bị để loại bỏ các chuyển đổi ngầm. Với 32 GB/s, việc vi phạm bất kỳ nguyên tắc nào trong số này sẽ chèn các chuyển đổi PCIe vào đường dẫn quan trọng, có thể chiếm ưu thế trong một lần lặp huấn luyện mà lẽ ra sẽ chạy ở tốc độ 2.04 TB/s trên thiết bị.
Cùng một nguyên tắc đồng bộ hóa có một cạm bẫy vận hành: mã gỡ lỗi thường để torch.cuda.synchronize() trong đường dẫn nóng (hot path), biến một pipeline chồng chéo thành một pipeline tuần tự. Khi sự chồng chéo vẫn kém, việc lập hồ sơ (profiling) phải tách biệt các tắc nghẽn lập lịch (scheduling stalls) khỏi sự kém hiệu quả của kernel. NVIDIA Nsight Systems (nsys profile) hiển thị hoạt động của CPU, các kernel GPU và các chuyển đổi bộ nhớ trên một dòng thời gian. NVIDIA Nsight Compute (ncu) sau đó giải thích hành vi của kernel bằng các bộ đếm phần cứng.
Table 8 là bản đồ chẩn đoán cho bước thứ hai đó. SM có nghĩa là bộ đa xử lý luồng (streaming multiprocessor), khối GPU lập lịch các nhóm luồng; một warp là một nhóm luồng đã được lập lịch.
| Số liệu | Ý nghĩa | Mục tiêu tối ưu hóa |
|---|---|---|
| Mức độ chiếm dụng SM | Số warps đang hoạt động/số warps tối đa | Tăng song song hóa nếu thấp |
| Thông lượng bộ nhớ | Băng thông đạt được/đỉnh | Tối ưu hóa các mẫu truy cập bộ nhớ |
| Thông lượng tính toán | FLOP/s đạt được/đỉnh | Giảm các nút thắt cổ chai bộ nhớ |
| Tensor Core hoạt động | Thời gian trong các hoạt động của Tensor Core | Xác minh việc sử dụng độ chính xác hỗn hợp |
Các pipeline dữ liệu và tải dữ liệu

Mỗi nút điều chỉnh của DataLoader giải quyết một nút thắt đầu vào cụ thể.
Các luồng và sự kiện giải quyết việc đặt và di chuyển bằng cách chồng chéo các chuyển đổi với tính toán để GPU hiếm khi bị tắc nghẽn bởi một tensor duy nhất. Tuy nhiên, chỉ riêng việc lập lịch không thể giúp ích nếu dữ liệu đến quá chậm ngay từ đầu. Ràng buộc tiếp theo là việc cung cấp đầu vào: dữ liệu phải đến đủ nhanh để duy trì thông lượng. Nguyên tắc hệ thống cốt lõi rất đơn giản: pipeline dữ liệu phải duy trì tốc độ tiêu thụ của bộ tăng tốc. Một GPU xử lý 1.000 hình ảnh mỗi giây ở độ phân giải 224 nhân 224 yêu cầu khoảng 150.5 MB/s thông lượng hình ảnh uint8 thô được duy trì. Nếu pipeline không thể duy trì tốc độ này, bộ tăng tốc sẽ ở trạng thái nhàn rỗi và thuật ngữ hiệu suất sử dụng hiệu quả trong định luật sắt sẽ giảm xuống dưới 1.
Các framework giải quyết yêu cầu thông lượng này thông qua ba cơ chế. Cơ chế đầu tiên là các tiến trình worker song song: DataLoader tạo ra nhiều tiến trình CPU, mỗi tiến trình độc lập tải và tiền xử lý các mẫu. Khi việc truy cập bộ nhớ, giải mã, tăng cường (augmentation) hoặc chuẩn hóa làm cho một tiến trình tải quá chậm để cấp dữ liệu cho bộ tăng tốc, nhiều worker có thể chồng chéo thời gian chờ I/O với tiền xử lý. Khi pipeline đầu vào đáp ứng được nhu cầu, các worker bổ sung sẽ làm tăng chi phí chung (overhead) thay vì tăng thông lượng. Khi num_workers > 0, DataLoader phân phối các chỉ mục mẫu cho các worker thông qua một hàng đợi chia sẻ, và các worker đẩy các mẫu đã hoàn thành vào một hàng đợi dữ liệu mà tiến trình chính sẽ tập hợp thành các batch.
Cơ chế thứ hai là prefetching. Khi đa xử lý được bật, prefetch_factor kiểm soát số lượng batch mà mỗi worker chuẩn bị trước. Bốn worker với prefetch_factor=2 có thể duy trì tới tám batch đã được prefetch, làm tăng khả năng công việc đầu vào chồng chéo với tính toán của bộ tăng tốc. Prefetching không thể đảm bảo rằng bộ tăng tốc sẽ không bao giờ bị tắc nghẽn; việc lưu trữ, giải mã, tăng cường (augmentation) và tranh chấp (contention) vẫn có thể làm cho quá trình sản xuất chậm hơn quá trình tiêu thụ. Chi phí là bộ nhớ host bổ sung tỷ lệ thuận với dữ liệu được xếp hàng.
Cơ chế thứ ba là bộ nhớ được ghim (pinned memory) cho các truyền DMA. Tùy chọn pin_memory=True đặt các batch vào bộ nhớ máy chủ được khóa trang (page-locked host memory), điều này có thể tránh việc dàn dựng bộ nhớ có thể phân trang (pageable-memory staging) và cho phép các bản sao từ máy chủ đến thiết bị chồng lấn với công việc của thiết bị. Đối với một batch gồm 64 ảnh FP32 có kích thước \(224{\times}224{\times}3\) (38.5 MB), chia cho thông lượng đỉnh PCIe 4.0 x16 đã nêu sẽ cho 1.2 ms; đây là giới hạn dưới chỉ dựa trên băng thông, không phải độ trễ truyền được ghim đã đo. Lợi ích thực tế so với bộ nhớ có thể phân trang phụ thuộc vào nền tảng, kích thước batch, pipeline và mức độ chồng lấn. Các trang được ghim cũng làm giảm bộ nhớ hệ thống có thể phân trang.
Cấu hình DataLoader chỉ hữu ích khi mỗi tham số được gắn với một nút thắt cổ chai. Trong cấu hình này, num_workers cho phép tải song song, prefetch_factor kiểm soát độ sâu của pipeline và pin_memory cho phép truyền DMA. Số lượng worker là một sự đánh đổi giữa thông lượng và bộ nhớ, không phải là một hằng số phổ quát. Một điểm khởi đầu thực tế là đặt num_workers bằng số lõi CPU có sẵn, sau đó điều chỉnh dựa trên việc tải là bị giới hạn bởi I/O (I/O-bound) hay bị giới hạn bởi CPU (CPU-bound). Đối với các khối lượng công việc (workload) bị giới hạn bởi I/O như đọc ảnh từ bộ nhớ mạng, nhiều worker hơn sẽ chồng lấn độ trễ đĩa và cải thiện thông lượng. Đối với các khối lượng công việc (workload) bị giới hạn bởi CPU liên quan đến việc tăng cường dữ liệu nặng, lợi ích sẽ bão hòa khi tất cả các lõi được sử dụng. Quá nhiều worker sẽ lãng phí bộ nhớ, vì mỗi worker duy trì một bản sao của đối tượng Dataset.
Khi thông lượng đủ cao, việc quản lý tiến trình worker trở thành một ràng buộc về tính đúng đắn. PyTorch gán cho mỗi worker một seed PyTorch riêng biệt. Một worker_init_fn vẫn hữu ích khi mã tập dữ liệu hoặc mã tăng cường dữ liệu cũng sử dụng NumPy hoặc module random của Python, như listing 22 minh họa. Trạng thái Python được chia sẻ thường là cục bộ theo tiến trình, vì vậy các sửa đổi trong một worker không tự động lan truyền đến các worker khác hoặc tiến trình chính; cần có bộ nhớ được chia sẻ rõ ràng hoặc được ánh xạ bộ nhớ khi các worker phải chia sẻ trạng thái có thể thay đổi.
Việc lựa chọn Dataset là một quyết định khác về thông lượng vì nó xác định cách các mẫu có thể được lên lịch. PyTorch hỗ trợ hai mô hình tập dữ liệu. Các tập dữ liệu kiểu bản đồ triển khai __len__ và __getitem__, cho phép truy cập ngẫu nhiên vào các mẫu theo chỉ mục—mô hình này hoạt động tốt cho các tập dữ liệu vừa với bộ nhớ hoặc hỗ trợ truy cập ngẫu nhiên hiệu quả trên đĩa. Các tập dữ liệu kiểu lặp thay vào đó triển khai __iter__, trả về các mẫu tuần tự cho các nguồn dữ liệu streaming mà việc truy cập ngẫu nhiên là không thực tế. Các tập dữ liệu kiểu bản đồ hỗ trợ xáo trộn dựa trên sampler, trong khi các tập dữ liệu kiểu lặp phải triển khai bất kỳ thứ tự hoặc xáo trộn đệm nào bên trong iterator hoặc nguồn dữ liệu.
num_workers parallelizes I/O and preprocessing across CPU cores, prefetch_factor controls pipeline depth, and pin_memory enables DMA transfers to the GPU.
import random

import numpy as np
import torch
from torch.utils.data import DataLoader


def seed_worker(worker_id):
    worker_seed = torch.initial_seed() % 2**32
    np.random.seed(worker_seed)
    random.seed(worker_seed)


loader = DataLoader(
    dataset,
    batch_size=64,
    shuffle=True,
    num_workers=4,  # Parallel worker processes (mechanism 1)
    prefetch_factor=2,  # Batches prepared ahead per worker (mechanism 2)
    pin_memory=True,  # Page-locked memory for DMA (mechanism 3)
    worker_init_fn=seed_worker,  # Reproducible augmentation per worker
)

# Pipeline effect: while GPU processes batch N,
# 4 workers load batches N+1..N+8 into pinned memory,
# ready for DMA transfer when the GPU finishes.
Collation là nơi cuối cùng mà các lựa chọn biểu diễn ảnh hưởng đến thông lượng. Tham số collate_fn xác định cách các mẫu riêng lẻ được kết hợp thành các batch. Collation mặc định xếp chồng các tensor dọc theo một chiều batch mới, điều này hoạt động khi tất cả các mẫu có hình dạng giống hệt nhau. Đối với dữ liệu có độ dài thay đổi như chuỗi văn bản, collation tùy chỉnh xử lý việc đệm, sắp xếp theo độ dài hoặc tạo mặt nạ chú ý—ảnh hưởng trực tiếp đến cả việc sử dụng bộ nhớ và thông lượng huấn luyện.
DataLoaders, Datasets và các hàm collation giải quyết việc cung cấp đầu vào bằng cách duy trì thông lượng ở tốc độ bộ tăng tốc thông qua song song hóa, prefetching và DMA. Tuy nhiên, các cấu trúc này chỉ xử lý dữ liệu phù du: các mẫu chảy qua pipeline một lần mỗi epoch và bị loại bỏ. Trách nhiệm tiếp theo của framework là trạng thái bền vững, đặc biệt là các trọng số của mô hình khi các trọng số đó vượt quá bộ nhớ của bất kỳ thiết bị đơn lẻ nào.
Cấu trúc tham số
Một mô hình quy mô GPT-3 lưu trữ 175B tham số, chiếm 350 GB trong FP16. Việc quản lý các tham số này trên các thiết bị, giữ cho gradient được đồng bộ hóa và duy trì trạng thái optimizer (riêng trạng thái Adam có thể thêm khoảng 4\(\times\) bộ nhớ trọng số FP16, như sổ tay Administrative Tax đã chỉ ra) là một trách nhiệm cốt lõi của framework. Vì các tham số tồn tại trong suốt quá trình huấn luyện và suy luận, các framework tổ chức chúng thành các cấu trúc nhỏ gọn nhằm giảm thiểu bộ nhớ đồng thời cho phép truy cập đọc và ghi nhanh chóng. Trong quá trình huấn luyện đa GPU, các framework có thể sao chép các tham số trên các thiết bị để tính toán song song trong khi vẫn giữ một bản sao chính được đồng bộ hóa; các hệ thống máy chủ tham số (parameter-server systems) là một thiết kế hiệu quả về giao tiếp để các worker đọc và ghi các tham số được chia sẻ toàn cục (Li et al. 2014). Việc đồng bộ hóa các mô hình hàng tỷ tham số có thể yêu cầu truyền hàng chục GB gradient mỗi bước, đó là lý do tại sao các framework cung cấp các backend giao tiếp có thể đồng bộ hóa các tensor một cách hiệu quả. Huấn luyện mô hình sau này sẽ nêu tên các phép toán tập thể cụ thể và các chiến lược mở rộng quy mô.
Li, Mu, David G. Andersen, Jun Woo Park, Alexander J. Smola, Amr Ahmed, Vanja Josifovski, James Long, Eugene J. Shekita, and Bor-Yiing Su. 2014. “Communication Efficient Distributed Machine Learning with the Parameter Server.” Advances in Neural Information Processing Systems (NeurIPS) 27: 19–27.
Các cấu trúc tham số cũng phải thích ứng với các yêu cầu độ chính xác khác nhau. Huấn luyện thường sử dụng FP32 để ổn định gradient, nhưng suy luận và huấn luyện quy mô lớn ngày càng sử dụng FP16 hoặc INT8. Các framework triển khai chuyển đổi kiểu và quản lý độ chính xác hỗn hợp để cho phép các tối ưu hóa này mà không ảnh hưởng đến độ chính xác số học.
Các ngữ cảnh thực thi phân tán
Đồ thị tính toán định nghĩa những gì cần tính toán, nhưng ở đâu và cách thức tính toán đó chạy trên các thiết bị là công việc của các ngữ cảnh thực thi. Trên một nút đơn, các ngữ cảnh thực thi quản lý các luồng và sự kiện CUDA (được giới thiệu trong section 1.5.1.3) để chồng lấn tính toán và truyền dữ liệu trên các GPU.
Khi huấn luyện mở rộng vượt ra ngoài một máy, những trừu tượng tương tự này mở rộng sang các nhóm thiết bị được đặt tên. Các framework sử dụng các cấu trúc như ProcessGroup (PyTorch) hoặc Mesh (JAX) để mô tả các tensor và phép toán nào thuộc về nhau, dựa vào các thư viện giao tiếp như NCCL để thực thi các phép toán nguyên thủy tập thể—chẳng hạn như ring-AllReduce để tổng hợp gradient và AllGather để thu thập tham số. Runtime quản lý các phép toán nguyên thủy này để tối đa hóa việc sử dụng kết nối: các liên kết NVLink nội nút cung cấp băng thông hai chiều lên tới \(900\text{ GB/s}\) mỗi GPU, trong khi các mạng InfiniBand hoặc Ethernet liên nút giảm xuống còn \(50\text{--}400\text{ Gbps}\) (\(6.25\text{--}50\text{ GB/s}\)), khiến hiệu quả giao tiếp tập thể trở thành nút thắt cổ chai chính trong việc mở rộng quy mô huấn luyện phân tán. Ý tưởng quan trọng của framework là ranh giới trừu tượng: mã người dùng đặt tên cho các mối quan hệ vị trí, và framework bảo toàn các mối quan hệ đó trong khi đường dẫn phần cứng thay đổi bên dưới.
Các khái niệm này xuất hiện ở đây vì chúng định hình thiết kế API của framework ngay cả trước khi sách yêu cầu người đọc suy luận về các thuật toán huấn luyện phân tán. Các chi tiết về đồng bộ hóa gradient, cấu trúc liên kết giao tiếp và khả năng chịu lỗi sẽ được xây dựng trên những nền tảng này sau. Hiện tại, điểm duy nhất cần thiết là khả năng biểu đạt vị trí: khi các mô hình vượt quá bộ nhớ của một thiết bị, các framework phải cung cấp cho hệ thống huấn luyện nhiều hơn một cách để đặt công việc. Chẳng hạn, một mô hình quy mô GPT-3 không thể vừa trên một GPU—chỉ riêng 175B tham số của nó đã yêu cầu 350 GB ở định dạng FP16, vượt xa bộ nhớ của bất kỳ GPU nào. Figure 10 xem trước ý tưởng đặt vị trí của framework mà chưa yêu cầu toàn bộ cơ chế huấn luyện phân tán: một hệ thống có thể chia công việc trên các nhóm lớp, trên các batch được nhân bản, hoặc trong các tensor rất lớn. Mở rộng quy mô hệ thống huấn luyện sau này sẽ chính thức hóa các chiều này thành các chiến lược huấn luyện và phân tích chi phí giao tiếp của chúng.

Các cấu trúc dữ liệu đã được xem xét cho đến nay—tensor, trình quản lý thiết bị, các pipeline dữ liệu, cấu trúc tham số và ngữ cảnh thực thi phân tán—định nghĩa dữ liệu mà một framework quản lý là gì và nơi nó tồn tại. Vấn đề trừu tượng còn lại là thực thi: điều gì thực sự chạy trên phần cứng.
Các phép toán cốt lõi
Khi một kỹ sư viết y = torch.matmul(x, w), khoảng cách giữa Python và GPU lớn hơn vẻ ngoài của nó. Khoảng cách giữa một dòng Python duy nhất và hàng nghìn luồng GPU song song được bắc cầu bởi ba nhóm phép toán hoạt động phối hợp. Figure 11 hiển thị toàn bộ ngăn xếp: các phép toán trừu tượng phần cứng quản lý việc thực thi dành riêng cho nền tảng, các phép toán số học cơ bản thực hiện tính toán toán học, và các phép toán cấp hệ thống điều phối lập lịch, bộ nhớ và tài nguyên trên toàn đồ thị. Văn xuôi sau đó sẽ đi theo sự xây dựng đó từ đường dẫn kernel dành riêng cho phần cứng đến điều phối hệ thống.

Các phép toán trừu tượng phần cứng
Lớp trừu tượng phần cứng cô lập mã framework khỏi các chi tiết dành riêng cho nền tảng. Nó giải quyết ba vấn đề cụ thể: chọn kernel tính toán phù hợp, di chuyển dữ liệu qua hệ thống phân cấp bộ nhớ, và điều phối việc thực thi trên các đơn vị xử lý.
Quản lý kernel tính toán
Trình quản lý kernel điều phối mỗi phép toán được hỗ trợ đến một triển khai cho backend hiện tại. Đối với phép nhân ma trận, đây có thể là một backend BLAS CPU như Intel oneMKL hoặc OpenBLAS (Intel Corporation 2026; OpenBLAS Project 2026), cuBLAS trên GPU NVIDIA (NVIDIA 2024a), hoặc các lệnh tensor dành riêng cho bộ tăng tốc. Việc lựa chọn phụ thuộc vào các chiều, dtype, bố cục, backend và các heuristic của thư viện. Một phép toán GEMM FP16 \(4096{\times}4096\) trên A100 có thể sử dụng đường dẫn Tensor Core với hiệu suất đỉnh được công bố ở đây là 312 TFLOP/s (Choquette et al. 2021; NVIDIA Corporation 2020). Nếu backend không có triển khai cho một toán tử, việc thực thi có thể quay lại, được phân vùng hoặc thất bại, tùy thuộc vào framework và runtime.
NVIDIA Corporation. 2020. NVIDIA A100 Tensor Core GPU Architecture. NVIDIA Whitepaper, V1.0.
Trừu tượng hóa hệ thống bộ nhớ
Lớp trừu tượng bộ nhớ di chuyển các tensor giữa bộ nhớ host có thể phân trang hoặc được ghim, bộ nhớ thiết bị và bộ nhớ hợp nhất, đồng thời chuyển đổi bố cục dữ liệu để phù hợp với ưu tiên phần cứng. Ví dụ, một lớp tích chập có thể lưu trữ các activation ở định dạng NCHW (batch, kênh, chiều cao, chiều rộng) trên các GPU NVIDIA nhưng chuyển đổi sang NHWC cho backend Metal của Apple. Yêu cầu căn chỉnh khác nhau từ 4 byte trên CPU đến 128 byte trên một số bộ tăng tốc, và truy cập không căn chỉnh có thể giảm một nửa băng thông bộ nhớ hiệu quả. Runtime cũng duy trì thứ tự phụ thuộc khi nhiều đơn vị thực thi truy cập cùng một tensor, ngăn chặn các race trong quá trình hoạt động đồng thời.
Kiểm soát thực thi
Bộ điều khiển thực thi điều phối công việc trên nhiều đơn vị xử lý và không gian bộ nhớ. Trên một GPU hiện đại, runtime đồ thị hoặc việc sử dụng stream rõ ràng có thể chồng chéo các kernel độc lập khi phân tích phụ thuộc chứng minh chúng đã sẵn sàng và các kernel để lại đủ tài nguyên chưa sử dụng để chạy đồng thời. Thực thi stream mặc định eager thường tuần tự hóa công việc này thay vì đó. Bộ điều khiển chèn các rào cản đồng bộ hóa khi các phụ thuộc dữ liệu yêu cầu, theo dõi việc hoàn thành sự kiện để kích hoạt các hoạt động phụ thuộc, và chuyển các lỗi phần cứng (lỗi ECC, watchdog timeout) đến đường dẫn xử lý lỗi của framework.
Các phép toán số học cơ bản
Với trừu tượng hóa phần cứng quản lý các chi tiết cụ thể của nền tảng, các framework xây dựng một lớp các phép toán toán học lên trên. GEMM chiếm ưu thế trong tính toán ML. Nhân ma trận tổng quát (GEMM) suy ra cách cường độ số học của GEMM thay đổi theo kích thước ma trận, dự đoán liệu một lớp nhất định bị giới hạn bởi tính toán hay bộ nhớ trước khi bất kỳ profiler nào chạy. Phép toán \(\mathbf{C} = \alpha \mathbf{A}\mathbf{W} + \beta \mathbf{C}\) chiếm phần lớn các phép toán số học trong mạng nơ-ron: một lượt chuyển tiếp ResNet-50 duy nhất thực hiện xấp xỉ 8.2 GFLOP, gần như tất cả đều quy về GEMM. Các framework tối ưu hóa GEMM thông qua tiling nhận biết cache (chia ma trận thành các khối vừa với cache L1/L2), mở vòng lặp để song song hóa cấp lệnh, và các kernel cụ thể theo hình dạng. Các lớp kết nối đầy đủ sử dụng GEMM dày đặc tiêu chuẩn, trong khi các lớp tích chập sử dụng biến đổi im2col để định hình lại các patch đầu vào thành các cột ma trận, chuyển đổi tích chập thành GEMM.
Ngoài GEMM, các framework triển khai các phép toán BLAS (AXPY cho phép cộng vector, GEMV cho các tích ma trận-vector) và các phép toán theo phần tử (hàm activation, chuẩn hóa). Các phép toán theo phần tử rẻ riêng lẻ nhưng đắt tổng thể do băng thông bộ nhớ. Mỗi phép toán đọc và ghi toàn bộ tensor, vì vậy một chuỗi năm phép toán theo phần tử trên một tensor 100 MB di chuyển 1 GB dữ liệu. Kết hợp năm phép toán đó thành một kernel duy nhất giảm lưu lượng bộ nhớ xuống 200 MB, tiết kiệm băng thông 5\(\times\) trực tiếp chuyển thành thực thi nhanh hơn.
Độ chính xác số học bổ sung một chiều khác. Huấn luyện trong FP32 sử dụng 4 byte cho mỗi tham số; lượng tử hóa sang INT8 giảm xuống còn 1 byte, cắt giảm bộ nhớ 4\(\times\) và cho phép cải thiện thông lượng 2–4\(\times\) trên phần cứng có tăng tốc INT8. Huấn luyện thường giữ các tích lũy nhạy cảm về mặt số học ở độ chính xác cao hơn, trong khi suy luận thường có thể chạy nhiều phép toán trong FP16 hoặc INT8 với ít mất mát chất lượng. Các framework duy trì các triển khai kernel riêng biệt cho mỗi định dạng độ chính xác và xử lý các quy trình làm việc trong đó các lớp khác nhau hoạt động ở các độ rộng bit khác nhau trong một lượt chuyển tiếp duy nhất.
Các phép toán cấp hệ thống
Trừu tượng hóa phần cứng và các phép toán số học cung cấp các khối xây dựng; các phép toán cấp hệ thống điều phối chúng. Lớp hệ thống kết nối lập lịch, quản lý bộ nhớ và tối ưu hóa tài nguyên thành một công cụ thực thi mạch lạc.
Bộ lập lịch phép toán sử dụng các phụ thuộc đồ thị để xác định các thứ tự thực thi hợp lệ và khả năng đồng thời. Chụp tĩnh có thể phơi bày nhiều cấu trúc phụ thuộc hơn trước khi thực thi, trong khi các runtime eager khám phá công việc một cách tăng dần. Cả hai khả năng hiển thị đều không đảm bảo một lịch trình tối ưu hoặc thực thi đồng thời: sự chồng chéo phụ thuộc vào các stream, quyết định của trình biên dịch và runtime, khả năng sẵn có của tài nguyên và bản thân các phép toán.
Trình quản lý bộ nhớ cấp phát và thu hồi bộ nhớ GPU trong suốt vòng đời của đồ thị tính toán. Các tham số mô hình (một mô hình 7 tỷ tham số tiêu thụ xấp xỉ 14 GB trong FP16) tồn tại trong suốt quá trình huấn luyện, trong khi các tensor activation chỉ tồn tại cho đến khi lượt truyền ngược tiêu thụ chúng. Bộ cấp phát caching của PyTorch duy trì một pool bộ nhớ, chia nhỏ và tái sử dụng các khối đã giải phóng mà không trả chúng về CUDA, điều này tránh các lệnh gọi cudaMalloc lặp lại có thể tốn hàng chục micro giây và có thể tệ hơn khi chúng đồng bộ hóa thiết bị. Đối với các mô hình vượt quá bộ nhớ GPU, trình quản lý có thể áp dụng checkpointing bằng cách loại bỏ các activation đã chọn trong lượt truyền tiến và tính toán lại chúng trong lượt truyền ngược. Câu hỏi chính sách—nên giữ activation nào, và chấp nhận bao nhiêu tính toán lại—thuộc về pipeline huấn luyện; trừu tượng hóa framework là thứ làm cho chính sách đó có thể thực thi được.
Checkpoint 1.3: Trừu tượng hóa phần cứng
Vấn đề trừu tượng hóa là cầu nối giữa mã di động và thực thi hiệu quả.
Bộ optimizer tài nguyên tích hợp các quyết định lập lịch và bộ nhớ với việc lựa chọn kernel backend. Các thư viện nhân ma trận chọn giữa các triển khai GEMM lát gạch (tiled GEMM) tùy theo hình dạng, kiểu dữ liệu (dtype), bố cục, không gian làm việc (workspace) và phần cứng. Winograd thay vào đó là một phép biến đổi dành riêng cho tích chập, và Strassen không phải là một lựa chọn thay thế thông thường được chọn bởi các bộ điều phối GEMM ML chính thống. Một lịch trình kém có thể khiến tài nguyên nhàn rỗi, trong khi sự phân mảnh vùng bộ nhớ (memory-pool fragmentation) hoặc trạng thái hoạt động quá mức (excessive live state) có thể gây ra lỗi hết bộ nhớ ngay cả khi tổng dung lượng thiết bị dường như đủ.
Các phần trước đã xem xét những gì xảy ra bên dưới bề mặt API: các tensor quản lý bố cục dữ liệu, các luồng chồng chéo tính toán với giao tiếp, và bộ điều phối kernel định tuyến các hoạt động đến phần cứng. Các cơ chế này hoạt động ở cấp độ của từng tensor và hoạt động—những nguyên liệu thô của tính toán machine learning. Tuy nhiên, các nhà thực hành hiếm khi viết mã ở cấp độ này. Một ResNet-50 có 25.6M tham số được tổ chức thành hàng chục lớp; việc theo dõi thủ công từng tensor, đăng ký nó với một optimizer và xử lý vị trí thiết bị sẽ dễ gây lỗi và tẻ nhạt. Vấn đề trừu tượng hóa không được giải quyết hoàn toàn chỉ bằng các cơ chế cấp phần cứng; nó cũng yêu cầu một mô hình lập trình tổ chức các nguyên thủy cấp thấp này thành các API rõ ràng mà các nhà thực hành thực sự sử dụng.
Các hoạt động riêng lẻ—phép nhân ma trận, các activation, các chuẩn hóa—là các nguyên tử của tính toán deep learning. Tuy nhiên, việc xây dựng các mô hình từ các hoạt động riêng lẻ sẽ giống như xây một ngôi nhà từ các nguyên tử riêng lẻ. Các framework cần một sự trừu tượng hóa tổ chức cho phép các kỹ sư kết hợp các hoạt động thành các khối xây dựng có thể tái sử dụng, có thể lồng vào nhau. Sự trừu tượng hóa đó là module.
Self-Check: Question
In framework tensor implementations (such as PyTorch
Tensoror NumPyndarray), what distinguishes a tensor view (e.g. created via.transpose()or.narrow()) from a tensor copy?- A view converts the underlying data format from floating-point to integer representation
- A view modifies only metadata (shape, strides, storage offset) while sharing the same underlying data storage buffer in \(\mathcal{O}(1)\) time without copying memory
- A view creates a duplicate memory buffer on the host CPU while leaving the GPU buffer unchanged
- A view enforces that the tensor elements are stored strictly in C-contiguous memory layout
A GPU training loop shows high GPU idle time because the CPU waits for data loading before launching training kernels. How does enabling
pin_memory=Trueon the DataLoader combined withtensor.to(device, non_blocking=True)alleviate this bottleneck?- It automatically quantizes all training data to 8-bit precision on the host CPU
- It bypasses the GPU memory hierarchy entirely by executing matrix multiplications directly in CPU L3 cache
- It allocates page-locked host RAM, allowing the GPU Direct Memory Access (DMA) engine to transfer data over PCIe asynchronously in parallel with GPU kernel compute
- It forces every CUDA kernel to execute synchronously on the default stream
Why do deep learning frameworks implement dedicated memory managers (such as PyTorch’s CUDA caching allocator) rather than calling the underlying driver’s
cudaMallocandcudaFreeon every tensor creation and destruction?Why can an accidental synchronous CPU-GPU tensor transfer (such as calling
.item()or printing a tensor inside a training loop) degrade throughput far more than the raw byte transfer time would suggest?Order the physical memory and execution lifecycle of a tensor batch as it moves from host storage to GPU execution in a high-throughput training pipeline:
CPU DataLoader loads raw data and copies it into page-locked (pinned) host memory
CUDA caching allocator assigns a GPU memory block from its pre-allocated pool
Host initiates an asynchronous Direct Memory Access (DMA) transfer over PCIe to GPU VRAM
Downstream consumer kernels execute on the GPU stream, reading the tensor from HBM/SRAM
Framework dispatches a compute kernel onto the active CUDA stream with tensor metadata and storage pointers
Host memory that is allocated in page-locked physical RAM, preventing the operating system from swapping it to virtual memory and enabling asynchronous Direct Memory Access (DMA) transfers to accelerator memory, is called ____ memory.
Trừu tượng hóa nn.Module
Nửa phần cứng của vấn đề trừu tượng hóa—các tensor, kernel, luồng và trình quản lý bộ nhớ—giúp các hoạt động riêng lẻ nhanh chóng trên nhiều loại silicon khác nhau. Tuy nhiên, một ResNet-50 chứa năm mươi lớp, mỗi lớp có nhiều tensor tham số, bộ đệm và các hành vi phụ thuộc vào chế độ. Việc kết nối thủ công từng tensor với thiết bị chính xác, đăng ký nó với một optimizer, chuyển đổi hành vi dropout giữa huấn luyện và suy luận, và tuần tự hóa trạng thái để checkpoint trên mỗi lớp sẽ khiến các nhà thực hành bị ngập trong công việc sổ sách không liên quan gì đến thiết kế mô hình. Lớp trên của vấn đề trừu tượng hóa là về tổ chức: kết hợp hàng nghìn nguyên thủy cấp thấp thành các API rõ ràng, có thể kết hợp mà các nhà thực hành thực sự sử dụng.
Mọi framework lớn đều trả lời câu hỏi này thông qua một trừu tượng hóa module gói gọn các tham số, tính toán chuyển tiếp (forward computation) và quản lý trạng thái vào một đơn vị có thể tái sử dụng duy nhất. nn.Module của PyTorch25 cung cấp một nghiên cứu điển hình mang tính hướng dẫn vì các mẫu thiết kế của nó lặp lại trên các framework: Keras sử dụng các trừu tượng hóa lớp tương tự (Chollet 2018), Flax của JAX sử dụng các cấu trúc module tương tự, và API chức năng của TensorFlow chia sẻ các điểm tương đồng về mặt khái niệm. Ba nguyên tắc thiết kế bền vững lặp lại bất kể cú pháp hay mô hình lập trình.
25 nn.Module: Tuyên bố “các mẫu thiết kế lặp lại” đúng vì nn.Module giải quyết một vấn đề tổ chức phổ quát: nó tự động đăng ký bất kỳ submodule hoặc tham số được gán nào vào một cây phân cấp, cho phép một lệnh gọi .to('cuda') duy nhất đệ quy đặt hàng triệu tham số lên một GPU. Các lớp của Keras, các module Flax của JAX và tf.Module của TensorFlow đều triển khai cùng một mẫu duyệt cây. Nếu không có nó, việc quản lý trạng thái mô hình sẽ yêu cầu công việc sổ sách thủ công tăng tuyến tính theo chiều sâu kiến trúc, một chi phí trở nên quá lớn đối với các mô hình có hàng trăm lớp.
Chollet, François. 2018. Deep Learning with Python. Manning Publications.
Khám phá tham số tự động
Một mạng nơ-ron hiện đại có thể chứa hàng triệu tham số có thể huấn luyện được trải rộng trên hàng chục lớp. Nếu không có tự động hóa, một lập trình viên sẽ cần liệt kê mọi tensor tham số và chuyển nó cho optimizer theo cách thủ công, một quy trình dễ gây lỗi và không mở rộng tốt với độ phức tạp của mô hình. Các framework giải quyết vấn đề này thông qua khám phá tham số tự động: hệ thống duyệt qua cây module, thu thập mọi tensor tham số để optimizer có thể cập nhật chúng trong một lần gọi duy nhất.
Đây là một vấn đề duyệt cây ở cốt lõi của nó. Module.__setattr__ của PyTorch đăng ký một nn.Parameter được gán hoặc nn.Module con vào các ánh xạ nội bộ của module. Một lệnh gọi đến .parameters() đệ quy duyệt qua các submodule đã đăng ký và trả về các tham số đã đăng ký. Các framework khác cũng cung cấp các cây tham số hoặc tập hợp tương tự, mặc dù cơ chế của chúng khác nhau.
Hậu quả về mặt hệ thống là đáng kể. Khám phá tham số tự động cung cấp cho optimizer một tập hợp tham số hoàn chỉnh hoặc các nhóm tham số, cho phép các đường dẫn cập nhật theo nhóm, foreach hoặc hợp nhất khi framework và backend hỗ trợ chúng. Lợi ích tức thì là tính đúng đắn và khả năng kết hợp: các submodule mới được gắn vào tham gia vào việc di chuyển thiết bị, tuần tự hóa và xây dựng optimizer mà không cần đăng ký thủ công riêng biệt. Nó cũng cho phép các đường dẫn cập nhật được tối ưu hóa hoạt động trên các tập hợp tham số mà không cần mã người dùng cho từng tham số. Listing 23 minh họa cơ chế cốt lõi: gán thuộc tính kích hoạt đăng ký, và .parameters() trả về tất cả các tensor được khám phá.
Sự phân biệt giữa tham số và bộ đệm minh họa một sự tinh tế của việc khám phá. Các tham số đã đăng ký xuất hiện trong .parameters() dù có thể huấn luyện hay bị đóng băng; requires_grad kiểm soát riêng biệt việc autograd có tích lũy gradient cho chúng hay không. Các bộ đệm đã đăng ký di chuyển cùng với module và có thể xuất hiện trong từ điển trạng thái của nó nhưng bị loại trừ khỏi .parameters() và quá trình khám phá optimizer thông thường. Thống kê chạy của chuẩn hóa batch là một trường hợp sử dụng bộ đệm phổ biến.
import torch
import torch.nn as nn


class CustomLayer(nn.Module):
    def __init__(self, input_size, output_size):
        super().__init__()
        self.weight = nn.Parameter(
            torch.randn(output_size, input_size)
        )
        self.bias = nn.Parameter(torch.randn(output_size))
        self.register_buffer("running_mean", torch.zeros(output_size))

    def forward(self, x):
        return torch.matmul(x, self.weight.t()) + self.bias


layer = CustomLayer(10, 20)
# Framework discovers both parameters automatically:
for name, param in layer.named_parameters():
    print(f"{name}: shape {param.shape}")
Table 9 cho thấy cùng một nguyên tắc biểu hiện khác nhau giữa các framework. Mặc dù có sự khác biệt về cú pháp, tất cả các framework đều giải quyết cùng một vấn đề: cho phép các optimizer khám phá và cập nhật các tham số có thể huấn luyện trong khi vẫn bảo toàn trạng thái không thể huấn luyện qua các lượt truyền xuôi.
| Framework | Truy cập tham số | Trạng thái không huấn luyện được |
|---|---|---|
| PyTorch | model.parameters() |
register_buffer() |
| Keras | layer.trainable_weights |
layer.non_trainable_weights |
| JAX/Flax | variables["params"] sau variables = model.init(key, x) |
Các tập hợp biến riêng biệt (ví dụ, batch_stats) |
| TensorFlow | module.trainable_variables |
module.non_trainable_variables |
Hành vi phụ thuộc chế độ
Huấn luyện và suy luận yêu cầu hành vi tính toán khác nhau từ cùng một đồ thị mô hình. Trong quá trình huấn luyện, các lớp dropout ngẫu nhiên đặt các phần tử về 0 với xác suất \(p_{\text{drop}} = \Pr(\text{drop})\) để điều chuẩn hóa mạng, trong khi trong quá trình suy luận, các lớp đó phải thực hiện ánh xạ đồng nhất để tạo ra các đầu ra xác định. Chuẩn hóa batch sử dụng thống kê theo batch trong quá trình huấn luyện nhưng chuyển sang thống kê chạy tích lũy trong quá trình suy luận. Nếu những thay đổi hành vi này được giao cho lập trình viên, việc quên một lần chuyển đổi chế độ duy nhất sẽ tạo ra các dự đoán sai một cách âm thầm trong sản phẩm.
Các framework giải quyết vấn đề này bằng một cờ trạng thái lan truyền qua hệ thống phân cấp module. Một lệnh gọi .eval() duy nhất trên module gốc sẽ đệ quy đặt self.training = False trên mọi module con, và mỗi lớp truy vấn cờ này để chọn hành vi của nó. Đây là một ví dụ về một nguyên tắc hệ thống rộng hơn: cùng một đồ thị tính toán phải tạo ra hành vi thực thi khác nhau tùy thuộc vào ngữ cảnh. Các trình biên dịch đối mặt với thách thức tương tự khi cùng một mã nguồn phải tạo ra các bản dựng gỡ lỗi (với kiểm tra giới hạn và bảng ký hiệu) so với các bản dựng phát hành (với tối ưu hóa mạnh mẽ). Mẫu lan truyền cờ đảm bảo tính đúng đắn bằng cách tập trung quyết định chế độ ở gốc thay vì yêu cầu phối hợp từng lớp.
Nguyên tắc này mở rộng đến việc đóng băng tham số cho học chuyển giao. Việc đặt requires_grad=False ngăn autograd tích lũy gradient trong các tham số đó và loại bỏ bộ lưu trữ gradient của chúng. Nó không nhất thiết loại bỏ tính toán ngược của lớp vì gradient vẫn có thể cần phải đi qua các hoạt động của nó để đến các đầu vào có thể huấn luyện hoặc các tham số trước đó. Do đó, việc tiết kiệm phụ thuộc vào vị trí của vùng đóng băng và các tensor nào yêu cầu gradient.
Cấu trúc phân cấp và tuần tự hóa
Các mô hình phức tạp được cấu tạo từ các module con có thể tái sử dụng, tạo ra một cấu trúc cây. Một ResNet không được triển khai như một khối hoạt động nguyên khối mà là một hệ thống phân cấp: module gốc chứa một chuỗi các khối residual, mỗi khối chứa các lớp tích chập và các lớp chuẩn hóa, và mỗi lớp chứa các tensor tham số. Cấu trúc phân cấp này phải hỗ trợ hai hoạt động quan trọng được cụ thể hóa trong listing 24: thu thập tham số đệ quy để huấn luyện và tuần tự hóa trạng thái để tạo checkpoint và triển khai.
import torch
import torch.nn as nn


class ResidualBlock(nn.Module):
    def __init__(self, channels):
        super().__init__()
        self.conv1 = nn.Conv2d(channels, channels, 3, padding=1)
        self.bn1 = nn.BatchNorm2d(channels)
        self.conv2 = nn.Conv2d(channels, channels, 3, padding=1)
        self.bn2 = nn.BatchNorm2d(channels)

    def forward(self, x):
        residual = x
        x = torch.relu(self.bn1(self.conv1(x)))
        x = self.bn2(self.conv2(x))
        return torch.relu(x + residual)


class ResNet(nn.Module):
    def __init__(self, num_blocks, channels=64):
        super().__init__()
        self.conv_in = nn.Conv2d(3, channels, 7, padding=3)
        self.blocks = nn.ModuleList(
            [ResidualBlock(channels) for _ in range(num_blocks)]
        )
        self.fc = nn.Linear(channels, 10)

    def forward(self, x):
        x = self.conv_in(x)
        for block in self.blocks:
            x = block(x)
        x = x.mean(dim=[2, 3])  # Global average pooling
        return self.fc(x)


model = ResNet(num_blocks=4)
total = sum(p.numel() for p in model.parameters())
print(f"Total parameters: {total}")
# state_dict() flattens the tree: 'blocks.0.conv1.weight', etc.
print(list(model.state_dict().keys())[:4])
Cấu trúc phân cấp phản ánh hệ thống phân cấp bộ nhớ phần cứng theo một cách liên quan đến hệ thống: các tham số của mỗi module con có thể được tải độc lập, cho phép đặt trên các thiết bị khác nhau. Khi một mô hình quá lớn đối với một GPU duy nhất, framework có thể gán các cây con khác nhau của hệ thống phân cấp module cho các thiết bị khác nhau, với cấu trúc cây cung cấp các ranh giới phân vùng tự nhiên.
Phương thức state_dict() tạo ra một ánh xạ có thứ tự mà các khóa có dấu chấm (ví dụ: blocks.0.conv1.weight) mã hóa vị trí trong hệ thống phân cấp module. Một checkpoint cho 7 tỷ tham số FP16 chứa khoảng 14 GB tải trọng trọng số trước siêu dữ liệu hoặc trạng thái bổ sung, nhưng định dạng tệp và đường dẫn lưu trữ xác định cách các byte đó được tuần tự hóa. load_state_dict() sao chép các giá trị tham số và bộ đệm phù hợp vào một module đã được xây dựng và báo cáo các khóa bị thiếu hoặc không mong muốn theo cài đặt nghiêm ngặt của nó; nó không tái tạo hệ thống phân cấp module. Trao đổi giữa các framework yêu cầu một biểu diễn đồ thị và toán tử tương thích ngoài các trọng số.
Cấu trúc phân cấp cũng cho phép duyệt cấp module cho các hoạt động có hệ thống. Các phương thức như .named_modules() lặp qua toàn bộ cây, hỗ trợ các phép biến đổi hàng loạt như thay thế tất cả các lớp BatchNorm bằng GroupNorm hoặc áp dụng khởi tạo Xavier cho mọi lớp Linear. Các hoạt động duyệt này phụ thuộc vào cùng một cấu trúc cây cho phép khám phá tham số, minh họa cách một quyết định thiết kế duy nhất lan truyền lợi ích trên nhiều trường hợp sử dụng.
Ba nguyên tắc này—khám phá tham số tự động, hành vi phụ thuộc chế độ và cấu trúc phân cấp với tuần tự hóa—không dành riêng cho PyTorch. Mọi framework đều phải giải quyết chúng. Các lớp của Keras, các module Flax của JAX, và ngay cả các phương pháp tiếp cận hàm đều giải quyết cùng một vấn đề về quản lý tham số, theo dõi trạng thái và thiết kế có tính cấu trúc. Sự khác biệt không nằm ở những vấn đề chúng giải quyết mà ở cách chúng ưu tiên giữa các giải pháp cạnh tranh. Hai mẫu thực tế cho thấy các nguyên tắc này trở thành các điều khiển hệ thống như thế nào: đóng băng tham số có chọn lọc giúp giảm công việc gradient không cần thiết cho học chuyển giao (listing 25), và các hook module cung cấp khả năng kiểm tra không xâm lấn (listing 26).
from torchvision.models import ResNet18_Weights, resnet18

# Freeze all parameters in a pretrained
# model
pretrained_model = resnet18(weights=ResNet18_Weights.DEFAULT)

for param in pretrained_model.parameters():
    param.requires_grad = False

# Replace final layer with trainable parameters
pretrained_model.fc = nn.Linear(512, 10)  # New layer is trainable

# Only fc.parameters() will receive
# gradients during training
optimizer = torch.optim.Adam(
    filter(lambda p: p.requires_grad, pretrained_model.parameters()),
    lr=0.001,
)
Các hook module là đối tác kiểm tra của việc đóng băng tham số: chúng chặn các phép tính trung gian mà không sửa đổi mã mô hình, cho phép chẩn đoán luồng gradient và giám sát activation. Listing 26 minh họa cả hai loại hook.
Cùng nhau, các mẫu này—khám phá tham số, đóng băng và hook—chứng minh cách ba nguyên tắc được chuyển thành các API thực tế. Các mẫu nn.Module này minh họa cách tiếp cận của PyTorch đối với vấn đề trừu tượng hóa. Tuy nhiên, PyTorch chỉ là một trong số các framework lớn, và các lựa chọn của nó (trạng thái có thể thay đổi, kế thừa lớp, thực thi eager theo mặc định) không phải là những điểm thiết kế hợp lệ duy nhất. TensorFlow tập trung trạng thái khác nhau, và JAX tránh hoàn toàn trạng thái có thể thay đổi. Đây không phải là những khác biệt API hời hợt; chúng phản ánh những câu trả lời khác biệt sâu sắc cho ba vấn đề mở đầu của chương.
import torch
import torch.nn as nn

model = nn.Sequential(nn.Linear(10, 20), nn.ReLU(), nn.Linear(20, 5))


# Forward hook to inspect activations
def forward_hook(module, input, output):
    print(
        f"Layer: {module.__class__.__name__}, "
        f"Output shape: {output.shape}, "
        f"mean={output.mean():.3f}, "
        f"std={output.std():.3f}"
    )


# Backward hook to inspect gradients
def backward_hook(module, grad_input, grad_output):
    print(f"Gradient norm: {grad_output[0].norm():.3f}")


# Register hooks on specific layer
handle_fwd = model[0].register_forward_hook(forward_hook)
handle_bwd = model[0].register_full_backward_hook(backward_hook)

# Execute forward and backward pass
x = torch.randn(32, 10)
y = model(x)
loss = y.sum()
loss.backward()

# Remove hooks when done
handle_fwd.remove()
handle_bwd.remove()
Self-Check: Question
In framework module abstractions like PyTorch’s
nn.Module, what systems mechanism enablesoptimizer = torch.optim.Adam(model.parameters())to find and optimize all model weights without the developer manually listing every weight tensor?- Python automatically compiles all local variables in memory into an optimization graph
- The GPU driver scans VRAM at runtime to detect all floating-point matrices
- The autograd engine injects global hooks into Python’s garbage collector
- Overridden attribute assignment (
__setattr__) detects instances ofnn.Parameterand automatically registers them into an internal hierarchical dictionary (_parameters)
Explain why setting
model.eval()is necessary for numerically correct inference in models containing BatchNorm or Dropout, and clarify whymodel.eval()is not a substitute fortorch.no_grad().In PyTorch’s
nn.Module, the dictionary data structure returned bymodel.____()serializes all learnable parameters and persistent non-parameter buffers (such as BatchNorm running statistics) into named tensor mappings for checkpointing.Why are modern production pipelines increasingly replacing standard Python
pickleserialization (the legacy.pt/.pthformat) with formats like Hugging Face’ssafetensorsfor model checkpoint storage and distribution?- safetensors prevents arbitrary code execution vulnerabilities inherent in pickle deserialization and enables zero-copy memory mapping (mmap) for instant model loading
- safetensors automatically quantizes all FP32 weights to 4-bit integers during serialization
- pickle files cannot store floating-point tensor data larger than 2 GB
- safetensors embeds the entire Python interpreter inside the model binary
Phân tích Nền tảng Framework
Một nhóm có thể tạo mẫu nhanh chóng nhưng không thể triển khai mô hình kết quả, hoặc triển khai đáng tin cậy nhưng không thể gỡ lỗi các lỗi huấn luyện, đã gặp phải sự đánh đổi trong thiết kế framework chứ không phải thiếu một lời gọi API. Mỗi framework lớn đều giải quyết cả ba vấn đề cốt lõi nhưng nhấn mạnh một con đường khác nhau để giải quyết chúng. TensorFlow kết hợp phát triển eager với việc nắm bắt đồ thị và một hệ sinh thái triển khai rộng lớn; PyTorch bắt đầu với thực thi eager và thêm các đường dẫn nắm bắt, biên dịch và xuất; JAX tổ chức vi phân, vector hóa và biên dịch dưới dạng các phép biến đổi hàm có thể kết hợp. Đây là những điểm nhấn kiến trúc, không phải khả năng độc quyền, và giá trị của chúng phụ thuộc vào khối lượng công việc (workload) và mục tiêu triển khai.

Mỗi framework tối ưu hóa cho một nút thắt cổ chai hệ thống khác nhau.
TensorFlow: Phát triển eager với triển khai đồ thị
Kiến trúc của TensorFlow trải dài từ phát triển eager đến tối ưu hóa dựa trên đồ thị trên các phần cứng từ TPU đám mây đến vi điều khiển. TensorFlow 2 thực thi eager theo mặc định. Các hàm nhạy cảm về hiệu suất có thể được nắm bắt bằng tf.function, và các định dạng triển khai định tuyến tính toán đã nắm bắt đến các runtime máy chủ, di động và trình duyệt. Con đường kép này bảo toàn các khả năng đồ thị sản xuất được kế thừa từ TensorFlow 1.x mà không yêu cầu mọi chương trình TensorFlow 2 phải xây dựng một đồ thị hoàn chỉnh trước khi chạy.
Trong một tf.function đã được nắm bắt, TensorFlow có thể áp dụng các tối ưu hóa đồ thị như gộp hằng số (constant folding), hợp nhất toán tử (operator fusion) và lập kế hoạch bố cục (layout planning). Figure 12 ánh xạ pipeline huấn luyện-đến-triển khai rộng hơn từ tiền xử lý dữ liệu và huấn luyện phân tán đến xuất SavedModel, TensorFlow Serving, TensorFlow Lite, TensorFlow.js và các liên kết ngôn ngữ.

Trong khi TensorFlow 2.0 giới thiệu thực thi eager để thu hẹp khoảng cách giữa nghiên cứu và sản xuất, TensorFlow 2.x vẫn cung cấp tf.function như là đường dẫn chuyển đổi đồ thị cho mã nhạy cảm về hiệu suất (TensorFlow Developers 2024). Sức mạnh cốt lõi của nó vẫn là đường dẫn biên dịch mạnh mẽ từ nghiên cứu đến triển khai quy mô toàn cầu. Huấn luyện mô hình và Phục vụ mô hình sau này sẽ xem xét cơ sở hạ tầng mở rộng và sản xuất sử dụng các đường dẫn xuất này.
TensorFlow Developers. 2024. Better Performance with tf.function.
PyTorch: Tiêu chuẩn nghiên cứu eager
Trong khi cách tiếp cận ưu tiên đồ thị của TensorFlow ưu tiên tối ưu hóa sản xuất, PyTorch lại thực hiện sự đánh đổi ngược lại: nó ưu tiên trải nghiệm nhà phát triển. Kiến trúc của PyTorch đại diện cho một câu trả lời khác biệt rõ rệt cho vấn đề thực thi, được xây dựng trên các đồ thị động (hoặc “Define-by-Run”). Thay vì xây dựng một bản thiết kế trước khi thực thi, PyTorch xây dựng đồ thị tính toán ngay lập tức khi mã chạy. Facebook AI Research (FAIR) đã áp dụng thiết kế này vì các nhà nghiên cứu cần phản hồi ngay lập tức khi thử nghiệm các kiến trúc mới lạ; chu trình định nghĩa-sau-đó-chạy của các đồ thị tĩnh đã tạo ra độ trễ biên dịch làm chậm quá trình tạo mẫu nhanh chóng cần thiết cho các quy trình làm việc nghiên cứu.
Cách tiếp cận của PyTorch phù hợp với nghiên cứu thăm dò vì lý do tương tự: nó coi deep learning như lập trình Python tiêu chuẩn. Các nhà phát triển có thể sử dụng các vòng lặp, câu lệnh điều kiện và trình gỡ lỗi Python (như pdb) trực tiếp trong quá trình truyền tiến của mô hình, không cần cú pháp đặc biệt, không cần bước biên dịch riêng biệt và không cần chờ xem mã có hoạt động hay không. Thực thi eager cho phép lặp lại nhanh chóng và thiết kế mô hình trực quan, điều này rất cần thiết khi các kiến trúc và mục tiêu huấn luyện vẫn đang thay đổi.
Giải pháp của PyTorch cho vấn đề vi phân là autograd dựa trên băng ghi (section 1.4.2.1): linh hoạt và dễ gỡ lỗi, nhưng khó tối ưu hóa toàn cục hơn vì băng ghi được xây dựng lại sau mỗi lần lặp. Giải pháp của nó cho vấn đề trừu tượng thì thực dụng hơn là toàn diện: hỗ trợ GPU mạnh mẽ thông qua cuBLAS và cuDNN, với các đường dẫn triển khai bao gồm torch.export, ExecuTorch nhắm mục tiêu edge, Open Neural Network Exchange (ONNX) và các runtime chuyên biệt.
Do đó, đánh đổi là một đường dẫn triển khai bị phân mảnh hơn. Vì đồ thị là động, framework không thể dễ dàng thực hiện các tối ưu hóa toàn cục trước khi thực thi. Một mô hình hoạt động hoàn hảo trong quá trình phát triển có thể gặp phải các rào cản hiệu suất trong sản xuất khi chi phí điều phối chiếm ưu thế đối với các thao tác nhỏ. Để thu hẹp khoảng cách từ nghiên cứu đến sản xuất này, PyTorch đã giới thiệu các đường dẫn chụp đồ thị và biên dịch, từ TorchScript trong lịch sử đến torch.compile và các quy trình xuất, cho phép các nhà phát triển chụp một mô hình động và biến nó thành một biểu diễn được tối ưu hóa để triển khai. Sự phát triển này cho thấy một framework thực thi ngay lập tức (eager) có thể di chuyển về phía cuối sản xuất của chuỗi biên dịch trong khi vẫn giữ được trải nghiệm tương tác đã thúc đẩy thiết kế.
JAX: Công cụ biến đổi hàm
Thực thi ngay lập tức (eager execution) của PyTorch và biên dịch đồ thị của TensorFlow đại diện cho hai điểm trên một phổ, nhưng cả hai đều chia sẻ một di sản lập trình mệnh lệnh nơi tính toán diễn ra như một chuỗi các thao tác có trạng thái. JAX đại diện cho một cách tiếp cận hướng người dùng khác biệt hoàn toàn, được xây dựng trên các nguyên tắc lập trình hàm và các biến đổi chương trình có thể kết hợp thay vì các băng ghi cấp đối tượng hoặc API đồ thị do người dùng tạo (Bradbury et al. 2018). Được phát triển bởi Google Research, JAX đặc biệt hữu ích cho các công việc yêu cầu vi phân tùy chỉnh, nghiên cứu tối ưu hóa nâng cao và huấn luyện phân tán quy mô lớn.
Bradbury, James, Roy Frostig, Peter Hawkins, Matthew James Johnson, Chris Leary, Dougal Maclaurin, George Necula, et al. 2018. JAX: Composable Transformations of Python+NumPy Programs.
Kiến trúc của JAX coi vi phân, vector hóa và biên dịch là các biến đổi trên các hàm. Hàm jax.grad trả về một hàm tính toán đạo hàm, sau đó có thể được biến đổi lại khi các giao diện tương thích. Ví dụ, vmap(grad(f)) có thể tính toán đạo hàm trên từng ví dụ và jit(vmap(grad(f))) có thể biên dịch phép tính batch đó. Thứ tự biến đổi có ý nghĩa ngữ nghĩa chứ không phải tùy ý.
Mô hình hàm của JAX chuyển mô hình lập trình từ “theo dõi trạng thái thông qua các đối tượng” sang “biến đổi các hàm thuần túy”. Trong khi PyTorch và TensorFlow chủ yếu phơi bày autograd thông qua các băng ghi động hoặc các đường dẫn biên dịch đồ thị, JAX yêu cầu người dùng viết các hàm Python thuần túy và sau đó áp dụng các biến đổi cho các hàm đó. Vi phân tự động, vector hóa và biên dịch JIT đều là các biến đổi chương trình có thể kết hợp. Listing 27 minh họa cách tiếp cận này.
import jax
import jax.numpy as jnp


def loss_fn(params, x, y):
    pred = jnp.dot(x, params["w"]) + params["b"]
    return jnp.mean((pred - y) ** 2)


# Transform: compute gradients
grad_fn = jax.grad(loss_fn)

# Transform: vectorize over batch dimension
batched_grad = jax.vmap(grad_fn, in_axes=(None, 0, 0))

# Transform: compile to XLA
fast_batched_grad = jax.jit(batched_grad)

# Compose all three: fast, batched gradient computation
Cách tiếp cận hàm này yêu cầu hàm thuần túy (không có tác dụng phụ) và dữ liệu bất biến (mảng không thể được sửa đổi tại chỗ). Những ràng buộc này có vẻ hạn chế khi đến từ mô hình đối tượng có thể thay đổi của PyTorch, nhưng chúng cho phép các đảm bảo chính thức: trình biên dịch có thể sắp xếp lại, hợp nhất và song song hóa các thao tác một cách an toàn vì đầu ra của hàm chỉ phụ thuộc vào đầu vào. Hạn chế chính là đặc trưng; sự thuần túy là điều làm cho việc kết hợp biến đổi trở nên khả thi.
Công suất của JAX xuất phát từ sự kết hợp. jax.grad trả về một hàm gradient; jax.vmap có thể vector hóa một hàm tương thích trên các trục được ánh xạ; và jax.jit có thể theo dõi và biên dịch một hàm đã biến đổi ổn định cho một chữ ký đối số cụ thể. jax.pmap ánh xạ một hàm trên các thiết bị, nhưng việc đồng bộ hóa hoặc tổng hợp gradient phải được thể hiện bằng các tập hợp như lax.psum hoặc lax.pmean. Các biến đổi này kết hợp theo loại và ngữ nghĩa của chúng, và các thứ tự khác nhau có thể tính toán các đại lượng khác nhau.
Cùng một lõi tối giản ủy quyền các trừu tượng mạng nơ-ron cho các thư viện đồng hành (Flax, Haiku, Equinox) và tối ưu hóa cho Optax. Sự tách biệt này phản ánh triết lý hàm: lõi cung cấp các biến đổi, trong khi các thư viện xây dựng các trừu tượng thông thường trên đó. Đánh đổi là sự sẵn sàng cho sản xuất không chỉ phụ thuộc vào mô hình biến đổi, mà còn phụ thuộc vào sự trưởng thành của các thư viện xung quanh, các đường dẫn xuất và các công cụ vận hành cho môi trường mục tiêu.
Các ràng buộc hàm mà JAX áp đặt trở thành lợi thế trong các lĩnh vực cụ thể. Vi phân tùy chỉnh—gradient bậc cao hơn, các quy tắc tích vector-Jacobian (VJP) và tích Jacobian-vector (JVP) tùy chỉnh—kết hợp một cách rõ ràng vì các hàm thuần túy làm cho các quy tắc vi phân có thể dự đoán được. Nghiên cứu về các thuật toán tối ưu hóa được hưởng lợi từ các biến đổi cho phép các nhà nghiên cứu thao tác tính toán gradient một cách tự nhiên như cách họ thao tác dữ liệu. Các khối lượng công việc (workload) bộ tăng tốc nặng về biên dịch sử dụng XLA để khai thác nhiều hơn khi chương trình có thể được biểu diễn theo phong cách hàm này. Tính toán khoa học với các yêu cầu AD được hưởng lợi từ tính thuần túy của hàm cho phép suy luận toán học về mã. JAX đòi hỏi đầu tư ban đầu nhiều hơn PyTorch: mô hình hàm có một đường cong học tập, quản lý trạng thái yêu cầu các mẫu rõ ràng và gỡ lỗi mã đã biên dịch khó hơn thực thi ngay lập tức (eager execution). Các nhóm nên chọn JAX khi thế mạnh của nó phù hợp với yêu cầu dự án, chứ không phải là lựa chọn mặc định.
Đánh đổi của framework dưới sự đo lường
Các phần trước đã mô tả triết lý thiết kế của từng framework theo các thuật ngữ định tính: đồ thị-trước so với thực thi-ngay-lập-tức-trước, có trạng thái so với hàm. So sánh hữu ích không phải là framework nào nhanh nhất một cách trừu tượng, vì câu trả lời đó thay đổi tùy theo hình dạng mô hình, kích thước batch, phần cứng backend và cấu hình trình biên dịch. So sánh hữu ích là mỗi thiết kế cho phép hệ thống nhìn thấy và tối ưu hóa điều gì. Do đó, Table 10 ánh xạ TensorFlow, PyTorch và JAX trở lại ba vấn đề của framework: khả năng hiển thị thực thi, mô hình vi phân và đường dẫn trừu tượng hóa phần cứng.
| Khía cạnh | TensorFlow | PyTorch | JAX |
|---|---|---|---|
| Loại đồ thị | Gốc tĩnh, giao diện người dùng động trong 2.x | Động | Các phép biến đổi hàm |
| Mô hình lập trình | Giao diện người dùng mệnh lệnh, đường dẫn chụp đồ thị | Mệnh lệnh | Hàm |
| Cấu trúc dữ liệu cốt lõi | Tensor với trạng thái được framework quản lý | Tensor với trạng thái được framework quản lý | Mảng bất biến |
| Chế độ thực thi | Eager theo mặc định, đồ thị để tối ưu hóa | Eager theo mặc định | Dò vết và biên dịch just-in-time |
| Đạo hàm tự động | Chế độ ngược trên tính toán đã được ghi lại | Chế độ ngược trên băng ghi eager | Các biến đổi thuận và ngược |
| Trừu tượng hóa phần cứng | Các runtime triển khai rộng rãi và đường dẫn XLA | Đường dẫn GPU gốc cộng với các runtime xuất/biên dịch | Biên dịch bộ tăng tốc tập trung vào XLA |
| Rủi ro tối ưu hóa | Ghi lại đồ thị và phạm vi bao phủ toán tử | Ngắt đồ thị sau phát triển eager | Tính thuần khiết, ổn định hình dạng và truy vết |
Ý nghĩa của việc đo lường rất đơn giản: lập hồ sơ cho ràng buộc mà mỗi framework làm cho rõ ràng nhất. Trong PyTorch, hãy kiểm tra xem việc điều phối ngay lập tức hay các lỗi đồ thị có chiếm ưu thế hay không. Trong TensorFlow, hãy kiểm tra xem đồ thị đã thu thập có bao gồm các toán tử và mục tiêu triển khai hay không. Trong JAX, hãy kiểm tra xem các hình dạng và tính thuần khiết có cho phép XLA biên dịch chương trình thực sự được thực thi hay không. Một so sánh hoặc bảng xếp hạng cấp framework có thể định hướng một quyết định, nhưng nó không thể thay thế việc lập hồ sơ cho khối lượng công việc (workload) cụ thể trên phần cứng mục tiêu.
Cùng một mạng đơn giản cho thấy mỗi triết lý thiết kế định hình mã như thế nào. Listing 28 triển khai một mạng nơ-ron, một lớp tuyến tính duy nhất ánh xạ mười đầu vào thành một đầu ra, trên cả ba framework.
Ba triển khai này giải quyết cùng một vấn đề toán học nhưng tiết lộ những câu trả lời khác biệt cho ba vấn đề. Sự khác biệt không phải là hình thức; chúng định hình quy trình gỡ lỗi, các tùy chọn triển khai và tiềm năng tối ưu hóa.
PyTorch liên kết trạng thái và tính toán với nhau thông qua kế thừa lớp (nn.Module), giải quyết vấn đề thực thi thông qua đánh giá ngay lập tức: đồ thị được xây dựng khi Python chạy, giúp các trình gỡ lỗi tiêu chuẩn và luồng điều khiển hoạt động tự nhiên. Nếu không có việc thu thập đồ thị, một optimizer không thể thấy toàn bộ quá trình tính toán trước khi thực thi bắt đầu.
TensorFlow/Keras cũng thực thi ngay lập tức theo mặc định trong TensorFlow 2, trong khi các mô hình có cấu trúc có thể được thu thập bằng tf.function và xuất ra các runtime triển khai được hỗ trợ. Tính di động vẫn phụ thuộc vào phạm vi bao phủ của toán tử và việc chuyển đổi cho từng mục tiêu.
JAX coi mô hình là một hàm thuần túy26 với dữ liệu bất biến và không có trạng thái nội bộ. Trong mô hình này, grad, vmap (vector hóa tự động) và jit (biên dịch đúng lúc27) là các phép biến đổi có thể kết hợp trên các hàm không trạng thái thay vì các phương thức gắn liền với một hệ thống đối tượng có thể thay đổi. Chi phí là việc quản lý tham số rõ ràng và một mô hình lập trình có thể không quen thuộc với các kỹ sư đến từ các framework có trạng thái.
26 Hàm thuần túy: Trả về các đầu ra được xác định bởi đầu vào của nó mà không dựa vào các tác dụng phụ không được theo dõi; Các phép biến đổi của JAX được thiết kế cho các hàm thuần túy. Các hiệu ứng Python thông thường có thể chạy trong quá trình theo dõi nhưng không được biểu diễn trong tính toán đã biên dịch, và mã không thuần túy có thể thất bại hoặc hoạt động không mong muốn. Việc in trong runtime hoặc các hiệu ứng bên ngoài yêu cầu các cơ chế được hỗ trợ như jax.debug.print hoặc các hàm gọi lại; việc lấy mẫu ngẫu nhiên yêu cầu các khóa được quản lý rõ ràng.
27 Biên dịch đúng lúc (JIT): Theo dõi một hàm cho một chữ ký đối số và hạ cấp nó thành mã thực thi dành riêng cho backend; lần gọi đầu tiên phải trả chi phí theo dõi và biên dịch; các lần gọi sau tương thích có thể sử dụng lại mã thực thi đã được cache. Các hình dạng, kiểu dữ liệu, thiết bị hoặc đối số tĩnh mới có thể kích hoạt một lần biên dịch khác. Cả thời gian biên dịch và chi phí gọi đã được cache đều phụ thuộc vào chương trình, backend và phần cứng.
# PyTorch - Dynamic, Pythonic
import torch.nn as nn


class SimpleNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc = nn.Linear(10, 1)

    def forward(self, x):
        return self.fc(x)


# TensorFlow/Keras - High-level API
import tensorflow as tf

model = tf.keras.Sequential(
    [tf.keras.layers.Dense(1, input_shape=(10,))]
)

# JAX - Functional approach
import jax.numpy as jnp
from jax import random


def simple_net(params, x):
    return jnp.dot(x, params["w"]) + params["b"]


key = random.PRNGKey(0)
key_w, key_b = random.split(key)
params = {
    "w": random.normal(key_w, (10, 1)),
    "b": random.normal(key_b, (1,)),
}
Không có framework nào tối đa hóa cả ba mục tiêu cùng lúc, và chương trình mười dòng làm cho sự đánh đổi này hiển thị rõ ràng trong mã nguồn thay vì bị chôn vùi trong nội bộ trình biên dịch: trạng thái nằm ở đâu, khi nào đồ thị tồn tại và trình biên dịch được phép nhìn thấy gì. Giá trị cốt lõi là khả năng hiển thị của trình biên dịch so với độ trễ lặp lại của con người. Thu thập đồ thị và biên dịch trước thời hạn có thể giảm chi phí runtime và di chuyển dữ liệu trung gian; đánh giá ngay lập tức rút ngắn vòng lặp lặp lại của con người, nằm ngoài phương trình runtime bất di bất dịch, với cái giá là khả năng hiển thị của trình biên dịch cho đến khi một đường dẫn thu thập đồ thị được sử dụng; tính thuần túy của hàm cho XLA nhiều tự do hơn để biến đổi một chương trình được theo dõi ổn định. Mỗi triết lý cũng định hình cú pháp mã, quy trình làm việc của nhóm, thực hành gỡ lỗi và các pipeline triển khai, do đó chi phí di chuyển tăng lên cùng với các tích hợp và giả định cụ thể của dự án.
Bản đồ ràng buộc runtime
Nguyên tắc tương tự mở rộng ra ngoài ba framework đa năng. Các họ runtime khác nhau vì chúng loại bỏ các mức độ linh hoạt khác nhau để đổi lấy khả năng hiển thị của trình biên dịch, các tệp nhị phân nhỏ hơn hoặc thực thi dành riêng cho phần cứng. Do đó, Table 11 là một bản đồ ràng buộc: mỗi hàng cho thấy runtime từ bỏ điều gì, đường dẫn tối ưu hóa nào được kích hoạt và chế độ lỗi nào cần kiểm tra trước khi cam kết.
| Họ runtime | Nơi nó phù hợp | Neo ràng buộc | Đường dẫn tối ưu hóa | Ràng buộc để kiểm tra |
|---|---|---|---|---|
| PyTorch eager | Nghiên cứu và lặp lại | Độ trễ đường cơ sở; dấu chân Python/runtime đầy đủ | Đồ thị động, gỡ lỗi eager | Chi phí điều phối và thiếu chế độ xem đồ thị |
| PyTorch/TensorFlow đã biên dịch | Huấn luyện và phục vụ (serving) trên máy chủ | Lợi ích phụ thuộc vào khối lượng công việc (workload) khi việc ghi lại đồ thị rõ ràng | Ghi lại đồ thị, hợp nhất, lập kế hoạch bố cục | Phạm vi bao phủ toán tử và ngắt đồ thị |
| TensorFlow Lite/Core ML | Suy luận trên thiết bị di động và edge | Độ trễ di động cụ thể cho mục tiêu và ngân sách kích thước gói | Lượng tử hoá, đồ thị tĩnh, đại diện NPU | Các ràng buộc chuyển đổi cụ thể cho mục tiêu |
| TF Lite Micro/microTVM | Suy luận trên vi điều khiển | Ngân sách RAM và flash của vi điều khiển cụ thể cho mục tiêu | Cấp phát tĩnh, kernel INT8 | Các toán tử được chọn và bộ nhớ bị hạn chế |
| ONNX Runtime | Phục vụ (serving) đa framework | Phụ thuộc vào backend; có thể khớp với các runtime gốc đối với các đồ thị được hỗ trợ | Định dạng đồ thị tiêu chuẩn, nhà cung cấp thực thi | Khoảng trống xuất và cơ chế dự phòng toán tử tùy chỉnh |
| TensorRT/TVM | Suy luận chuyên biệt hóa phần cứng | Lợi ích phụ thuộc mục tiêu so với các đường cơ sở eager chưa được tinh chỉnh | Hợp nhất kernel, giảm độ chính xác, tự động tinh chỉnh | Mục tiêu hẹp hơn và các giả định chuyển đổi |
Bản đồ này cho thấy một mẫu hệ thống hơn là một bảng xếp hạng sản phẩm. Mỗi bước tiến tới một runtime chuyên biệt hơn đều đánh đổi sự linh hoạt để có một kế hoạch thực thi dễ dự đoán hơn. Các runtime suy luận chuyên biệt như TensorRT và Apache TVM có thể mang lại những cải thiện đáng kể về độ trễ khi mô hình chuyển đổi trơn tru và mục tiêu triển khai đã biết. Các runtime di động và vi điều khiển giảm dung lượng bằng cách loại bỏ các cơ chế huấn luyện và dựa vào đồ thị tĩnh, lượng tử hoá, ủy quyền nền tảng hoặc vùng nhớ cố định. Một delegate là một plugin runtime chuyển các toán tử được hỗ trợ đến một bộ tăng tốc mục tiêu và quay lại khi toán tử không được hỗ trợ. Câu hỏi kỹ thuật luôn là những gì đã được loại bỏ để tối ưu hóa có thể thực hiện được, bởi vì các toán tử không được hỗ trợ, hình dạng động hoặc ngắt đồ thị có thể xóa bỏ lợi thế mong đợi.
Những khoảng cách hiệu quả này trở thành các ràng buộc cứng ngoài phòng máy chủ. Khoảng cách độ trễ gấp nhiều lần giữa thực thi tức thời và một công cụ suy luận chuyên biệt là một cơ hội tối ưu hóa trên một GPU đám mây. Trên một vi điều khiển, một framework vượt quá dung lượng bộ nhớ của thiết bị không thể chạy. Tiêu chí lựa chọn chuyển từ độ trễ thô sang việc liệu framework có phù hợp với giới hạn bộ nhớ và runtime hay không.
Self-Check: Question
An enterprise engineering team requires a unified workflow where models are trained in Python but must be deployed across cloud microservices (C++ runtime), mobile apps (Android/iOS), and web browsers without maintaining a Python runtime in production. Which framework ecosystem architecture was explicitly designed around this decoupled deployment model via the
SavedModelabstraction?- PyTorch 1.0 eager execution
- TensorFlow ecosystem (TensorFlow Serving, TFLite, and TF.js)
- Pure NumPy with custom Python socket servers
- Scikit-learn with standard pickle deserialization
What core programming model commitment distinguishes JAX from both PyTorch and TensorFlow, enabling seamless functional composition of
jax.jit,jax.grad, andjax.vmap?- Dynamic class inheritance with mutable object references for all layer parameters
- Global state mutation across all forward and backward passes
- Pure functions with no hidden side effects acting on immutable array data structures
- Graph capture via AST string parsing of Python script files
Compare the workflow and deployment trade-offs that led PyTorch to dominate academic research while TensorFlow established strong early dominance in enterprise production serving during the late 2010s.
True or False: Because the mathematical operations of a model are identical, compiling a model with a specialized inference engine (such as NVIDIA TensorRT) yields identical latency to running the model in framework eager mode.
Explain how JAX’s requirement that functions must be pure and free of side effects enables the XLA compiler to generate highly optimized accelerator kernels through
jax.jit.
Mục tiêu Triển khai
Khi các mô hình ML chuyển từ máy chủ đám mây sang thiết bị edge, các khoảng cách hiệu quả được đo lường trong section 1.7.4 chuyển từ cơ hội tối ưu hóa thành các ràng buộc triển khai cứng. Lựa chọn framework phải đánh giá lại đáng kể ba vấn đề cốt lõi ở edge. Vấn đề thực thi chuyển từ việc lựa chọn giữa thực thi tức thời và thực thi đồ thị sang việc phù hợp với tính toán trong giới hạn độ trễ và bộ nhớ của mục tiêu. Vấn đề vi phân thường biến mất hoàn toàn, vì các thiết bị edge chỉ chạy suy luận. Vấn đề trừu tượng hóa trở nên gay gắt hơn khi các hệ thống nhắm mục tiêu bộ xử lý ARM hoặc x86, NPU di động hoặc TPU edge, và vi điều khiển với bộ nhớ kilobyte.
Table 12 tiếp tục bản đồ ràng buộc tương tự trên toàn phổ từ đám mây đến edge: mỗi hàng xác định các giả định runtime phù hợp với giới hạn mục tiêu.
| Môi trường | Các giả định runtime thường phù hợp | Đòn bẩy tối ưu hóa | Ràng buộc liên kết |
|---|---|---|---|
| Đám mây/Máy chủ | Các frameworks huấn luyện/phục vụ (serving) đầy đủ | Biên dịch đồ thị, xử lý theo batch, độ chính xác thấp hơn | Thông lượng, chi phí |
| edge | Đồ thị tĩnh hoặc runtime phục vụ (serving) di động | Đồ thị tĩnh, các kernel độ chính xác thấp hơn | Độ trễ và bộ nhớ đặc thù khối lượng công việc (workload) |
| Di động | Runtime tích hợp ứng dụng với các delegate | Các delegate bộ tăng tốc, các định dạng mô hình nhỏ gọn | Giới hạn pin, nhiệt, kích thước ứng dụng |
| Vi điều khiển (TinyML) | Runtime nhỏ gọn với cấp phát cố định | Cấp phát tĩnh, các kernel số nguyên nhỏ | RAM hạn chế, không có bộ nhớ động |
Table 12 cho thấy tại sao mục tiêu triển khai là một ràng buộc cứng chứ không phải là một bước đóng gói muộn. Mô hình KWS của Chuông cửa thông minh từ section 1.3.5 là một ví dụ điển hình cho cấp vi điều khiển: một runtime với vùng nhớ cố định và dung lượng C/C++ nhỏ gọn không phải là một sự ưu tiên mà là một điều kiện để phù hợp với thiết bị. Ràng buộc này tạo ra vấn đề framework thực tế mà ONNX giải quyết: các tổ chức thường huấn luyện trong một môi trường nhưng triển khai vào một môi trường khác có các giả định runtime nghiêm ngặt hơn.
Định dạng ONNX28 giải quyết sự phân mảnh này bằng cách cho phép tính di động của mô hình trên nhiều runtime (ONNX Contributors 2019): huấn luyện trong PyTorch, xuất qua ONNX và triển khai qua ONNX Runtime hoặc một backend cụ thể cho phần cứng. TensorFlow Lite có đường dẫn chuyển đổi riêng thay vì là mục tiêu ONNX trực tiếp trong các quy trình làm việc thông thường. Các định dạng trao đổi tiêu chuẩn giảm công việc chuyển đổi thủ công khi di chuyển giữa môi trường phát triển và sản xuất, nhưng chúng không loại bỏ việc kiểm tra khả năng tương thích, các khoảng trống về phạm vi toán tử hoặc công việc kernel tùy chỉnh. Figure 13 thể hiện mô hình tương tác kiểu nan hoa và trung tâm này—hãy chú ý cách ONNX nằm ở trung tâm, chấp nhận các mô hình từ sáu công cụ hiển thị ở bên trái và cung cấp chúng cho ONNX Runtime cùng các công cụ tương thích hiển thị ở bên phải. Các lựa chọn nén và phục vụ trong Nén mô hình và Phục vụ mô hình nằm trên ranh giới xuất này.
28 ONNX: Sự “phân mảnh” mà ONNX giải quyết là framework được sử dụng để phát triển mô hình có thể không phù hợp với runtime tối ưu nhất cho mục tiêu triển khai. ONNX định nghĩa một biểu diễn đồ thị độc lập với phần cứng, tách rời hai yếu tố này, giảm số tháng công sức kỹ sư cho việc chuyển đổi mô hình thủ công mà lẽ ra sẽ cần mỗi khi mục tiêu triển khai thay đổi. Sự đánh đổi được chấp nhận là việc xuất ONNX có thể làm mất các tối ưu hóa dành riêng cho framework hoặc các toán tử tùy chỉnh, đòi hỏi các triển khai dự phòng.
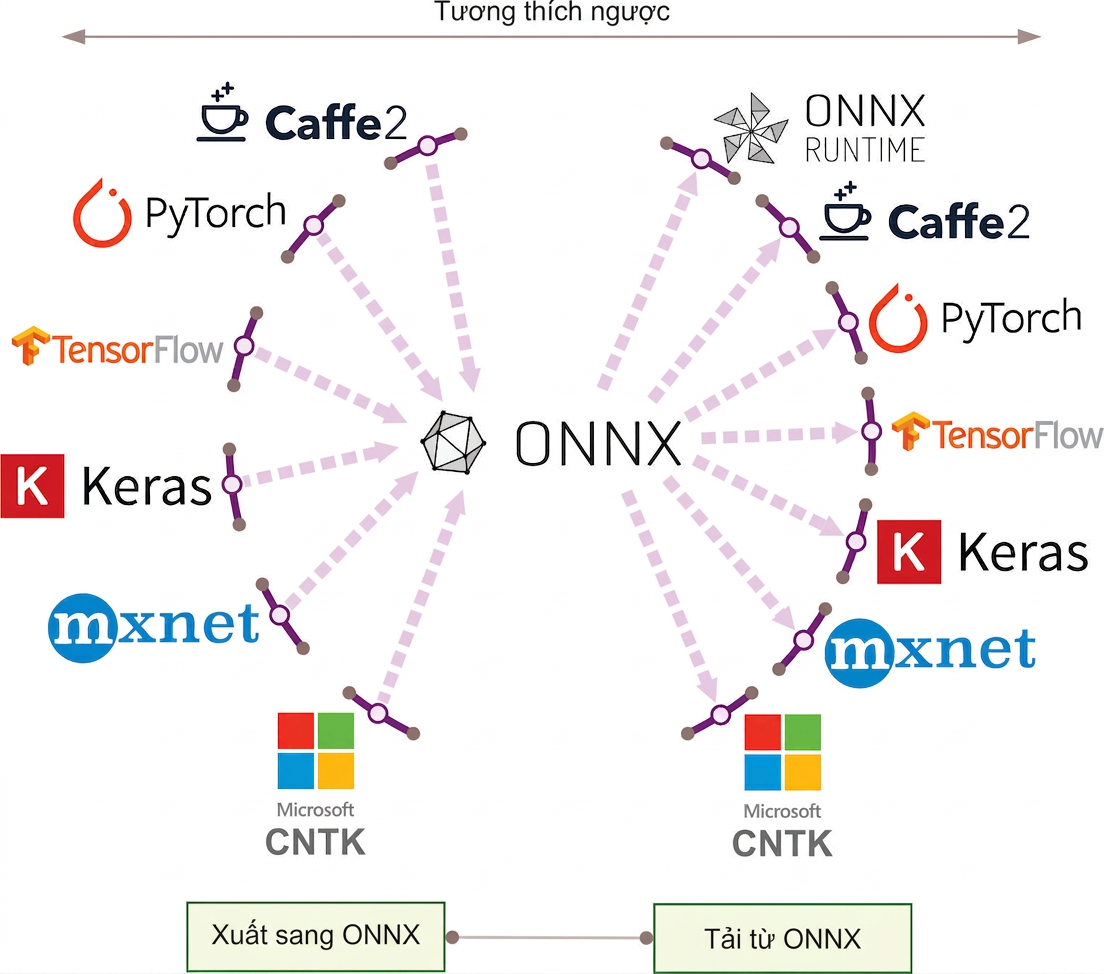
ONNX giảm chi phí phân mảnh framework, nhưng nó không loại bỏ quyết định lựa chọn ban đầu. Câu hỏi còn lại là làm thế nào để chọn một framework cho các ràng buộc của một dự án cụ thể.
Self-Check: Question
When deploying deep learning models to microcontroller hardware (TinyML) with less than 256 KB of SRAM, which set of framework runtime assumptions is strictly required?
- Dynamic memory allocation via system malloc, full Python runtime, and 64-bit floating point precision
- Dynamic graph construction with autograd tape tracking enabled
- Cloud-based gRPC client with streaming RPC serialization
- Static memory allocation in a fixed pre-allocated arena, ahead-of-time compiled C/C++ kernels, 8-bit integer quantization, and zero dynamic memory allocation
Explain how the three core framework problems (Execution, Differentiation, Abstraction) are dramatically reweighted when transitioning from cloud model training to edge/embedded inference.
Explain how ONNX acts as a hub-and-spoke bridge between training frameworks and production inference engines, and identify the main systems risk when exporting complex models through ONNX.
Lựa chọn Framework
Lựa chọn framework là một bài toán tối ưu hóa có ràng buộc trên ba vấn đề framework tương tự. Câu hỏi không phải là framework nào là “tốt nhất”; mà là mô hình thực thi, hệ thống vi phân và đường dẫn trừu tượng hóa nào có thể tồn tại dưới các ràng buộc của dự án.
Không gian đánh đổi trong lựa chọn framework
Việc lựa chọn framework liên quan đến ba mâu thuẫn có mối liên hệ với nhau. Đầu tiên là giữa tốc độ phát triển và hiệu suất sản xuất: thực thi eager ưu tiên tốc độ lặp, trong khi biên dịch đồ thị ưu tiên tối ưu hóa runtime. Các nhóm nghiên cứu cần kiểm tra mười biến thể kiến trúc mỗi ngày không thể chấp nhận mất vài phút biên dịch giữa các thử nghiệm; các nhóm sản xuất triển khai một mô hình duy nhất trong nhiều tháng không thể chấp nhận tổn thất thông lượng do điều phối eager. Điểm tối ưu thay đổi khi một dự án đi qua vòng đời của nó.
Mâu thuẫn giữa tốc độ và hiệu suất này trực tiếp dẫn đến mâu thuẫn thứ hai, tính linh hoạt so với độ sâu tối ưu hóa. Thực thi eager làm cho luồng điều khiển ngôn ngữ máy chủ trở nên tự nhiên nhưng giới hạn phạm vi trình biên dịch cho đến khi một vùng lớn hơn được nắm bắt. Đồ thị tĩnh có thể biểu diễn luồng điều khiển phụ thuộc vào dữ liệu thông qua các phép toán đồ thị đồng thời phơi bày nhiều phần hơn của chương trình để hợp nhất và tạo mã dành riêng cho phần cứng. Như table 3 đã chứng minh, sự đánh đổi này ảnh hưởng đến quản lý bộ nhớ, mức độ sử dụng và quy trình gỡ lỗi. Đây không phải là một quyết định thiết kế đơn lẻ mà là một ràng buộc trên toàn hệ thống.
Mâu thuẫn giữa tính linh hoạt và tối ưu hóa, đến lượt nó, bộc lộ mâu thuẫn thứ ba: độ rộng của hệ sinh thái so với chuyên môn hóa. Các framework đa năng bao gồm các tập hợp phép toán rộng nhưng thường hoạt động kém hơn các runtime chuyên biệt đối với các khối lượng công việc (workload) mà các runtime đó có thể tối ưu hóa sâu. TensorRT, TVM và các hệ thống tương tự tối ưu hóa cho các mục tiêu triển khai hẹp hơn thông qua hợp nhất, lựa chọn độ chính xác và lập lịch dành riêng cho phần cứng (NVIDIA 2024b; Chen et al. 2018). ONNX thu hẹp một phần khoảng cách này thông qua trao đổi tiêu chuẩn hóa (ONNX Contributors 2019). Việc chuyên môn hóa runtime vẫn phải được đánh giá riêng: runtime càng chuyên biệt thì càng phụ thuộc vào phạm vi chuyển đổi, các toán tử được hỗ trợ và hành vi dự phòng.
NVIDIA. 2024b. NVIDIA TensorRT: Programmable Inference Accelerator.
Chen, Tianqi, Thierry Moreau, Ziheng Jiang, Lianmin Zheng, Eddie Q. Yan, Haichen Shen, Meghan Cowan, et al. 2018. “TVM: An Automated End-to-End Optimizing Compiler for Deep Learning.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI ’18), 578–94.
ONNX Contributors. 2019. ONNX: Open Neural Network Exchange.
Systems Perspective 1.4: Các ràng buộc khi lựa chọn framework
Thay vì tìm kiếm framework “tốt nhất”, việc lựa chọn hiệu quả trước tiên loại bỏ các ứng cử viên không thể đáp ứng các ràng buộc cứng: mục tiêu triển khai, các phép toán cần thiết, đường dẫn trình biên dịch và chuyên môn của nhóm. Chỉ sau đó, các ưu tiên mềm như hiệu suất, tốc độ phát triển và hệ sinh thái mới nên được dùng để xếp hạng các ứng cử viên còn lại.
Hệ sinh thái TensorFlow minh họa cách các trục này tương tác một cách cụ thể. Ba biến thể của nó (TensorFlow, TensorFlow Lite, TensorFlow Lite Micro) theo dõi một triết lý thiết kế duy nhất trên các ràng buộc ngày càng chặt chẽ hơn, một mẫu hình có thể khái quát hóa cho bất kỳ họ framework nào. Table 13 theo dõi các đánh đổi.
| TensorFlow | TensorFlow Lite | TensorFlow Lite for Microcontrollers | |
|---|---|---|---|
| Huấn luyện | Có | Hạn chế | Không |
| Suy luận | Có | Có | Có |
| Phạm vi toán tử | Rộng | Tập trung vào suy luận | Tập con được mô hình chọn |
| Công cụ độ chính xác thấp hơn gốc | Có | Có | Có |
Nguyên tắc là ràng buộc lũy tiến dẫn đến tối ưu hóa lũy tiến: ít phép toán được hỗ trợ hơn cho phép các tệp nhị phân nhỏ hơn, ngân sách bộ nhớ chặt chẽ hơn và thực thi độ chính xác thấp tập trung vào triển khai. Ba chiều cấu trúc phân tích này: yêu cầu mô hình định nghĩa các phép toán được hỗ trợ, các phụ thuộc phần mềm định nghĩa môi trường runtime và các ràng buộc phần cứng định nghĩa các giới hạn vật lý.
Tiêu chí lựa chọn framework
Ba chiều cấu trúc việc đánh giá framework một cách có hệ thống: những gì mô hình yêu cầu (các phép toán được hỗ trợ và ngữ nghĩa đồ thị), những gì môi trường phần mềm cung cấp (hệ điều hành, quản lý bộ nhớ, ủy quyền bộ tăng tốc) và những gì phần cứng cho phép về mặt vật lý (tính toán, bộ nhớ, công suất). Mỗi chiều đóng vai trò như một bộ lọc: các ràng buộc cứng loại bỏ các ứng cử viên, và các ưu tiên mềm xếp hạng các ứng cử viên còn lại.
Yêu cầu mô hình
Câu hỏi đầu tiên là liệu một framework có thể biểu diễn các mô hình mà một dự án yêu cầu hay không. Hãy xem xét table 13. Phạm vi toán tử thu hẹp từ TensorFlow đầy đủ sang TensorFlow Lite và sau đó đến tập con được mô hình chọn liên kết vào TensorFlow Lite Micro. Mỗi lần giảm bớt sẽ thu hẹp khả năng huấn luyện và các phép toán đa năng trong khi tập trung vào các công cụ triển khai. Nguyên tắc kỹ thuật là khả năng biểu đạt thuật toán và hiệu quả máy móc đánh đổi lẫn nhau. Ít phép toán được hỗ trợ hơn cho phép tạo mã chặt chẽ hơn, các tệp nhị phân nhỏ hơn và các đường dẫn tối ưu hóa dành riêng cho phần cứng. Mô hình ràng buộc lũy tiến này áp dụng cho bất kỳ họ framework nào, không chỉ TensorFlow. Nằm trên phạm vi toán tử là một trục riêng biệt với sự đánh đổi của riêng nó, đó là liệu đồ thị được nắm bắt tĩnh trước khi thực thi hay được lắp ráp động tại runtime.
Systems Perspective 1.5: Đồ thị tính toán động so với tĩnh
Sự phân biệt đồ thị tĩnh so với động (được xem xét trong section 1.3) có ý nghĩa trực tiếp đối với phân tích yêu cầu mô hình. Đồ thị tĩnh yêu cầu luồng điều khiển và hành vi động phải được biểu diễn dưới các dạng mà runtime đồ thị hiểu được, điều này cho phép tối ưu hóa trước thời hạn cho việc triển khai. Thực thi eager tuân theo luồng điều khiển Python thông thường một cách trực tiếp, trong khi các đường dẫn nắm bắt đồ thị như
torch.compile và tf.function khôi phục các cơ hội tối ưu hóa khi chúng có thể biểu diễn chương trình được thực thi.
Các phụ thuộc phần mềm
Khi các yêu cầu mô hình được đáp ứng, framework phải tích hợp với môi trường phần mềm mục tiêu. Table 14 tiết lộ cách các yêu cầu hệ điều hành, quản lý bộ nhớ và hỗ trợ bộ tăng tốc khác nhau giữa các biến thể TensorFlow.
| TensorFlow | TensorFlow Lite | TensorFlow Lite for Microcontrollers | |
|---|---|---|---|
| Cần một hệ điều hành | Có | Có | Không |
| Truy cập mô hình | Hệ thống tệp hoặc dịch vụ | Ánh xạ lưu trữ dành riêng cho nền tảng | Lưu trữ đã biên dịch hoặc được ánh xạ dành riêng cho nền tảng |
| Hỗ trợ bộ tăng tốc | Có | Delegates | Các kernel và tích hợp được tối ưu hóa |
Các điểm khác biệt chính tuân theo cùng một mô hình ràng buộc tăng dần. TensorFlow Lite Micro loại bỏ hoàn toàn yêu cầu về hệ điều hành, cho phép thực thi trên phần cứng trần trên các vi điều khiển (mặc dù nó tích hợp với các RTOS như FreeRTOS và Zephyr khi có sẵn). Cách mỗi runtime Lite truy cập một mô hình phụ thuộc vào nền tảng và sự tích hợp. TensorFlow Lite sử dụng các delegates cho các bộ tăng tốc được hỗ trợ, trong khi TensorFlow Lite Micro có thể sử dụng các kernel DSP hoặc bộ tăng tốc được tối ưu hóa cho nền tảng mà không cần cơ chế delegate tiêu chuẩn. Mỗi sự phụ thuộc phần mềm được loại bỏ là một mục tiêu triển khai đạt được.
Các ràng buộc phần cứng
Chỉ riêng khả năng tương thích phần mềm không đảm bảo việc triển khai; framework phải phù hợp với các giới hạn phần cứng vật lý. Table 15 trình bày chiều ràng buộc cuối cùng này.
Kích thước tệp nhị phân và dung lượng bộ nhớ phụ thuộc vào bản dựng được chọn, các toán tử, delegates, mô hình và cấu hình runtime. Hỗ trợ kiến trúc bộ xử lý chuyển từ bộ xử lý x86, GPU và TPU trong các trung tâm dữ liệu, qua các nền tảng Arm Cortex-A ở cấp độ di động/edge, đến các bộ xử lý Arm Cortex-M, DSP và MCU trong các hệ thống nhúng. Đây không phải là các cấp độ kỹ thuật tùy ý—chúng phản ánh các ràng buộc vật lý (Rào cản ánh sáng, bức tường công suất, bức tường bộ nhớ) phân chia phổ triển khai thành các mô hình riêng biệt (Các ràng buộc vật lý: Vì sao các mô hình tồn tại). Bài học kỹ thuật này tổng quát hóa vượt ra ngoài TensorFlow: mọi họ framework trải rộng các cấp độ triển khai đều thực hiện các đánh đổi tương tự giữa khả năng và dung lượng tài nguyên, và công việc của framework là làm cho những đánh đổi đó dễ điều hướng hơn là vô hình.
| TensorFlow | TensorFlow Lite | TensorFlow Lite for Microcontrollers | |
|---|---|---|---|
| Kích thước nhị phân cơ sở | Phụ thuộc vào bản dựng và gói | Phụ thuộc vào bản dựng và delegate | Phụ thuộc vào mô hình và lựa chọn toán tử |
| Dung lượng bộ nhớ cơ sở | Phụ thuộc vào mô hình, runtime và bộ cấp phát | Phụ thuộc vào mô hình, delegate và bộ cấp phát | Vùng nhớ cố định cộng với trạng thái runtime |
| Các kiến trúc được tối ưu hóa | x86, TPUs, GPUs | Arm Cortex-A, x86 | Arm Cortex-M, DSPs, MCUs |
Các yếu tố đánh giá sẵn sàng cho sản xuất
Ngoài sự đánh đổi giữa tính biểu cảm và hiệu quả này, các thông số kỹ thuật thiết lập các điều kiện cần nhưng chưa đủ để lựa chọn. Các triển khai sản xuất cũng yêu cầu đánh giá chi phí di chuyển, gánh nặng bảo trì và độ tin cậy triển khai.
Những ràng buộc phần cứng này dẫn đến các đánh đổi hiệu suất gắn chặt. Độ trễ suy luận, dung lượng bộ nhớ, tiêu thụ công suất và mức độ sử dụng phần cứng phụ thuộc vào mô hình và thiết bị mục tiêu chứ không chỉ riêng họ runtime. Thực thi độ chính xác thấp hơn có thể giảm bộ nhớ, độ trễ và năng lượng với chi phí biên độ số học, và việc lựa chọn framework quyết định các đòn bẩy tối ưu hóa nào có sẵn. Khả năng mở rộng đưa ra một mối quan ngại khác. Triển khai nhất quán từ vi điều khiển đến máy chủ, chuyển đổi mượt mà từ nguyên mẫu sang sản xuất và quản lý phiên bản trên các đội thiết bị đã triển khai đều phụ thuộc vào chuỗi công cụ triển khai của framework. Phương pháp luận ba chiều được minh họa ở đây (yêu cầu mô hình, sự phụ thuộc phần mềm và ràng buộc phần cứng) áp dụng cho bất kỳ hệ sinh thái framework nào, không chỉ TensorFlow.
Hỗ trợ phát triển và đánh giá khả năng tồn tại lâu dài
Khả năng tồn tại của framework trong một triển khai sản xuất kéo dài năm năm phụ thuộc vào việc hệ sinh thái có giữ cho các đường dẫn thực thi, vi phân và trừu tượng hóa đã chọn có thể bảo trì được hay không. Thành phần cộng đồng rất quan trọng vì nó quyết định vấn đề nào nhận được sự chú ý của kỹ thuật: các hệ sinh thái nặng về nghiên cứu có xu hướng cải thiện thử nghiệm và khả năng tái tạo trước tiên, các hệ sinh thái nặng về sản xuất có xu hướng cải thiện phục vụ (serving), giám sát và khả năng tương thích trước tiên, và các hệ sinh thái chuyên biệt nhỏ hơn có xu hướng phát triển các khả năng toán học hoặc trình biên dịch hẹp hơn nhanh hơn so với các công cụ triển khai rộng rãi.
Tính hữu dụng thực tế của một framework thường phụ thuộc nhiều hơn vào các đường dẫn xung quanh này hơn là vào API tensor cốt lõi. Trung tâm mô hình, công cụ theo dõi thử nghiệm, serving runtimes, các dịch vụ ML đám mây và các định dạng trao đổi có thể giảm sự phụ thuộc nhà cung cấp hoặc làm sâu sắc thêm tối ưu hóa, nhưng mỗi yếu tố cũng thêm một sự phụ thuộc cần được duy trì. Những hiệu ứng tổng hợp này làm cho việc di chuyển framework ngày càng khó hơn: các pipeline CI/CD, cơ sở hạ tầng giám sát, các tích hợp đám mây và các toán tử tùy chỉnh biến một lựa chọn API thành một cam kết vận hành. Các chỉ số khả năng tồn tại có thể đo lường được do đó là sự đa dạng của người đóng góp, lịch sử tương thích ngược, nguồn nhân lực có sẵn và chi phí duy trì một đường thoát thông qua các định dạng tiêu chuẩn hóa như ONNX, các pipeline dữ liệu không phụ thuộc framework và các tùy chỉnh được ghi lại.
Ba vấn đề cốt lõi cho đến nay đã xuất hiện riêng lẻ: thực thi, vi phân và trừu tượng hóa được xem xét từng cái một, với các lựa chọn framework và tiêu chí lựa chọn được xếp lớp lên trên. Một bước huấn luyện duy nhất là nơi ba vấn đề này va chạm. Theo dõi một quy trình từ đầu đến cuối cho thấy cách thực thi framework, vi phân và trừu tượng hóa phần cứng hoạt động như một hệ thống tích hợp.
Self-Check: Question
An engineering team is architecting a new commercial computer vision system. In the chapter’s decision framework, why must deployment constraints (e.g. target mobile NPU delegates and memory budgets) act as hard filters evaluated before selecting the training framework?
- If a training framework cannot export or compile the required model operators to the target deployment runtime, the model cannot run in production regardless of its training speed or developer ergonomics
- Training frameworks automatically alter target hardware specifications to match model requirements
- Hard deployment filters guarantee that the model achieves 100% classification accuracy
- Research iteration speed is the only metric that matters in commercial system design
When evaluating framework viability for a production system expected to operate for 5+ years, which factor represents the greatest long-term architectural risk?
- Using Python instead of Fortran for high-level model definitions
- Adopting a niche or abandoned framework with dwindling maintainer support, which risks broken compiler toolchains, lack of support for new accelerator chips, and forced legacy stack maintenance
- Selecting an open-source framework backed by major hardware vendors
- Training on GPU clusters rather than single CPU workstations
Describe the three fundamental tensions in the framework selection trade-off space (velocity vs. performance, flexibility vs. optimization depth, ecosystem breadth vs. specialization).
True or False: Because model weights are stored as floating-point arrays, an engineering team can choose any training framework for research and assume that converting to a production embedded runtime is a trivial format conversion step.
Cấu trúc của một Bước huấn luyện
Tám câu lệnh Python có thể thực thi làm cho thực thi eager so với đồ thị, autodiff chế độ ngược, các trừu tượng hóa tensor và điều phối kernel tương tác bên trong một bước huấn luyện duy nhất. Theo dõi bước đó qua ngăn xếp PyTorch cho thấy cách bộ máy thực thi, vi phân và trừu tượng hóa hoạt động đồng thời.
Listing 29 trình bày một lần lặp huấn luyện tối thiểu cho một perceptron đa lớp hai lớp. Mặc dù chỉ có tám câu lệnh thực thi, đoạn mã này vận dụng toàn bộ ngăn xếp framework: cấp phát tensor, điều phối kernel, ghi lại autograd, tính toán gradient và cập nhật tham số. Theo dõi từng giai đoạn sẽ cho thấy ba vấn đề đang hoạt động và kết nối các nguyên tắc định lượng được phát triển trong section 1.1 với việc thực thi cụ thể.
# Single training step for a 2-layer MLP
x = torch.randn(32, 784, device="cuda")  # Input batch
y = torch.randint(0, 10, (32,), device="cuda")  # Labels

# Forward pass
optimizer.zero_grad()
h = torch.relu(x @ W1 + b1)  # Hidden layer
logits = h @ W2 + b2  # Output layer
loss = F.cross_entropy(logits, y)

# Backward pass
loss.backward()

# Parameter update
optimizer.step()
Giai đoạn 1: Lan truyền tiến (giải quyết vấn đề thực thi)
Trong quá trình lan truyền tiến, khi h = torch.relu(x @ W1 + b1) được thực thi, cơ chế thực thi tức thì của PyTorch kích hoạt tính toán ngay lập tức:
- Điều phối Python: Trình thông dịch Python gọi
torch.matmul, sau đó được định tuyến qua bộ điều phối của PyTorch để chọn phần phụ trợ CUDA, thêm chi phí phụ ở mức micro giây trước khi công việc trên thiết bị bắt đầu. - Chọn kernel: cuBLAS chọn một kernel GEMM được tối ưu hóa dựa trên kích thước ma trận (32 \(\times\) 784 \(\times\) 256). Đối với các kích thước này, nó có thể chọn một thuật toán xếp lát được tối ưu hóa cho bộ nhớ cache L2.
- Khởi chạy kernel: Kernel đã chọn được xếp hàng đợi vào bộ đệm lệnh của GPU, thêm vài micro giây chi phí phụ khởi chạy trong khi CPU tiếp tục ngay lập tức thông qua thực thi không đồng bộ.
- Thực thi trên GPU: Kernel tải W1 từ HBM29 vào bộ nhớ cache L2, thực hiện phép nhân ma trận trong Tensor Cores khi có sẵn và ghi kết quả trở lại HBM; đối với GEMM nhỏ này, khối lượng công việc (workload) thường chỉ kéo dài vài micro giây.
- Ghi lại Autograd: Đồng thời, công cụ autograd của PyTorch ghi lại một nút
MmBackwardtrên băng, lưu trữ các tham chiếu đếnxvàW1để tính toán gradient.
29 HBM (bộ nhớ băng thông cao): Cung cấp băng thông 2–3 TB/s trên các GPU hiện đại, biến nó thành tầng bộ nhớ cấp dữ liệu trực tiếp nhất cho các phép toán của bộ tăng tốc; băng thông HBM quyết định liệu các hoạt động có bị giới hạn bởi bộ nhớ hay giới hạn bởi tính toán, và dung lượng 80 GB của nó trên A100 đặt ra giới hạn cứng cho tổng trạng thái huấn luyện trực tiếp. Các trọng số, activations, gradient, trạng thái optimizer và không gian làm việc tạm thời phải vừa vặn trong quá trình thực thi. Khi không đủ, framework phải dùng đến việc chuyển tải, tính toán lại có chọn lọc hoặc đặt trên nhiều thiết bị, mỗi cách đều làm tăng độ phức tạp cho những gì lập trình viên coi là một lệnh gọi loss.backward() duy nhất.
Phép cộng độ chệch (bias) và ReLU tuân theo các mô hình tương tự, mỗi phép toán thêm một nút vào băng autograd.
Giai đoạn 2: Lan truyền ngược (giải quyết vấn đề vi phân)
Gọi loss.backward() kích hoạt một quá trình lan truyền ngược bốn giai đoạn:
- Duyệt băng: Công cụ autograd duyệt đồ thị đã ghi theo thứ tự tô-pô ngược.
- Tính toán Gradient: Đối với mỗi nút, nó gọi hàm backward đã đăng ký, trong đó \(W_1\) và \(W_2\) là các ma trận trọng số lớp tạo thành một phần của các tham số mô hình \(\theta\). Duyệt ngược lại,
CrossEntropyBackwardtính toán \(\frac{\partial \mathcal{L}}{\partial \text{logits}}\) sử dụng đạo hàm softmax;MmBackwardcho \(W_2\) tính toán \(\frac{\partial \mathcal{L}}{\partial W_2} = h^T \cdot \frac{\partial \mathcal{L}}{\partial \text{logits}}\) cùng với \(\frac{\partial \mathcal{L}}{\partial h}\);ReluBackwardáp dụng mặt nạ đạo hàm ReLU (bằng 0 khi \(h \leq 0\)); vàMmBackwardcho \(W_1\) tính toán \(\frac{\partial \mathcal{L}}{\partial W_1}\). Ví dụ này không yêu cầu gradient cho tensor đầu vàox. - Tích lũy Gradient: Các gradient được tích lũy vào các thuộc tính
.gradcủa các tensor lá. - Quản lý Bộ nhớ: Khi các tensor đã lưu của một nút backward không còn cần thiết và không có tham chiếu nào khác giữ chúng, framework có thể giải phóng trạng thái đó để tái sử dụng bộ nhớ.
Cùng nhau, các giai đoạn lan truyền ngược này biến đồ thị lan truyền tiến đã ghi thành gradient đồng thời giải phóng trạng thái trung gian ngay khi nó không còn cần thiết.
Giai đoạn 3: Phân tích lưu lượng bộ nhớ (vật lý đang hoạt động)
Áp dụng equation 4 cho bước này, table 16 phân tích FLOPs, lưu lượng bộ nhớ và cường độ số học cho từng thao tác:
| Thành phần | Công việc được mô hình hóa | Lưu lượng bộ nhớ | Cường độ số học |
|---|---|---|---|
| MatMul (x @ W1) | \(2 \times 32 \times 784{\times}256\) = 12.8 MFLOP | 0.9 MB | 13.7 FLOP/byte |
| ReLU | \(32{\times}256\) = 8.2 KFLOP | 65.5 KB | 0.125 FLOP/byte |
| MatMul (h @ W2) | \(2 \times 32 \times 256{\times}10\) = 163.8 KFLOP | 44.3 KB | 3.7 FLOP/byte |
| Entropy chéo (đơn giản hóa) | ~0.96 KFLOP | 2.6 KB | 0.4 FLOP/byte |
| Lan truyền ngược (giả định 2\(\times\) lan truyền tiến) | ~26 MFLOP | 3.1 MB | 8.3 FLOP/byte |
Cột cường độ số học là cột chẩn đoán. Các phép nhân ma trận tái sử dụng toán hạng đủ để tiến gần đến ngưỡng tính toán, trong khi ReLU và cross-entropy di chuyển quá ít công việc trên mỗi byte để thoát khỏi chế độ giới hạn bởi bộ nhớ và chi phí phụ khởi chạy. Đây là lý do tại sao việc hợp nhất và giảm điều phối lại quan trọng ngay cả khi mô hình được viết bằng mã tensor cấp cao.
Mô hình ước tính khoảng ~39.1 MFLOP công việc và ~4.2 MB lưu lượng bộ nhớ. Để có được các cận dưới lý tưởng, chúng ta chia các ước tính này cho tốc độ đỉnh của A100:
- \(T_{\text{compute}} \approx\) 39.1 MFLOP/19.5 TFLOP/s FP32 ≈ 2.0 μs
- \(T_{\text{bộ nhớ}} \approx\) 4.2 MB/2.04 TB/s ≈ 2.1 μs
- Giả sử 12 ops lần khởi chạy kernel, \(T_{\text{chi phí phát sinh}} \approx\) 12 ops \(\times\) 15 μs ≈ 180 μs
Với các giả định về số lần khởi chạy và chi phí mỗi lần khởi chạy đã nêu, bước huấn luyện được mô hình hóa bị giới hạn bởi chi phí phát sinh. Các mô hình nhỏ thường nhạy cảm với chi phí điều phối Python và khởi chạy kernel, điều này dẫn đến ba thực tiễn sản xuất phổ biến đều nhằm mục đích giảm thuật ngữ điều phối thay vì thay đổi công việc toán học của mô hình:
torch.compilecó thể tăng tốc các khối lượng công việc (workload) có ít thao tác thuận lợi bằng cách hợp nhất các thao tác và giảm số lần khởi chạy kernel- Tăng kích thước batch giúp phân bổ chi phí phát sinh trên mỗi batch
- Các thao tác lớn hơn, dày đặc tính toán có thể phân bổ chi phí phát sinh điều phối
Giai đoạn 4: Trừu tượng hóa phần cứng (giải quyết vấn đề trừu tượng hóa)
Cùng một mã Python chạy trên các phần cứng khác nhau thông qua các lớp trừu tượng, mỗi lớp kết hợp một thư viện backend với một cơ chế thực thi dành riêng cho phần cứng, như table 17 tóm tắt.
Mỗi backend triển khai ngữ nghĩa thao tác tensor chung với các tối ưu hóa dành riêng cho phần cứng. Do đó, một lệnh gọi loss.backward() duy nhất có thể kích hoạt các đường dẫn mã khác nhau tùy thuộc vào phần cứng. Độ chính xác dấu phẩy động, thứ tự giảm, lựa chọn kernel và các thao tác không xác định có thể tạo ra sự khác biệt số học giữa các backend, vì vậy sự tương đương phải được đánh giá trong phạm vi dung sai được tài liệu hóa và đảm bảo tính xác định của framework.
| Phần cứng | Thư viện backend | Cơ chế thực thi |
|---|---|---|
| CUDA GPU | cuBLAS (NVIDIA 2024a; Choquette et al. 2021) | Các kernel GEMM và các luồng CUDA để thực thi bất đồng bộ |
| CPU | Intel oneMKL hoặc OpenBLAS (Intel Corporation 2026; OpenBLAS Project 2026) | Song song hóa cấp độ luồng xung quanh các kernel được tối ưu hóa |
| TPU | XLA (Google 2025) | Biên dịch thành các phép toán của bộ tối ưu hóa cấp cao (HLO) dành riêng cho TPU |
| Apple Silicon | Metal Performance Shaders | MPS backend |
Choquette, Jack, Wishwesh Gandhi, Olivier Giroux, Nick Stam, and Ronny Krashinsky. 2021. “NVIDIA A100 Tensor Core GPU: Performance and Innovation.” IEEE Micro 41 (2): 29–35. https://doi.org/10.1109/mm.2021.3061394.
Intel Corporation. 2026. Intel oneAPI Math Kernel Library.
OpenBLAS Project. 2026. OpenBLAS: An Optimized BLAS Library.
Google. 2025. XLA: Optimizing Compiler for Machine Learning.
Dấu vết chi tiết này qua một bước huấn luyện duy nhất cho thấy mức độ tương tác sâu sắc của ba vấn đề cốt lõi. Ngay cả mã đơn giản cũng sử dụng toàn bộ ngăn xếp framework, và các quyết định tưởng chừng nhỏ—đặt thiết bị, kích thước batch, chế độ biên dịch—ảnh hưởng dây chuyền qua các lớp thực thi, vi phân và trừu tượng theo những cách khó dự đoán nếu không có hiểu biết cấp hệ thống. Những cạm bẫy sau đây là các chế độ lỗi phổ biến khi thiếu cái nhìn hệ thống đó.
Systems Perspective 1.6: Ba vấn đề trong thực tế
Dấu vết này tiết lộ ba vấn đề một cách cụ thể:
- Thực thi: Chế độ Eager cho phép gỡ lỗi từng dòng nhưng phát sinh chi phí điều phối
- Vi phân: Băng Autograd ghi lại các thao tác trong quá trình forward, phát lại theo thứ tự ngược lại trong quá trình backward
- Trừu tượng hóa: Cùng một mã chạy trên GPU/CPU/TPU thông qua các triển khai kernel dành riêng cho backend
Hiểu luồng này cho phép tối ưu hóa có thông tin: hợp nhất các thao tác để giảm chi phí phát sinh, sử dụng kích thước batch phù hợp và khớp quy mô mô hình với khả năng phần cứng.
Self-Check: Question
During the forward execution of an MLP layer
h = torch.relu(x @ W1 + b1)withrequires_grad=True, what two operations occur concurrently inside the framework?- It computes the forward output and immediately updates the weights
W1using gradient descent - It executes the matrix multiplication on the GPU and transmits the gradients back to the host CPU
- It computes the forward numerical activations on the hardware accelerator and constructs a dynamic autograd tape recording the operations and caching required intermediate tensors for the backward pass
- It compiles the entire Python script into a native standalone mobile application
- It computes the forward output and immediately updates the weights
In the chapter’s training step roofline analysis on an NVIDIA A100 GPU, the raw compute and memory transfer time for a 2-layer MLP batch takes ~4 \(\mu\text{s}\), but total eager-mode execution takes ~30–50 \(\mu\text{s}\). What systems bottleneck explains this discrepancy?
- Network congestion across distributed InfiniBand interconnects
- Thermal throttling of the GPU streaming multiprocessors
- Memory leakage inside the PyTorch dynamic class hierarchy
- CPU dispatch overhead, where launching ~12 separate small kernels across Python and CUDA runtimes incurs ~2–5 \(\mu\text{s}\) of launch latency per operation
Contrast the arithmetic intensity of a matrix multiplication (
MatMul) with an element-wise activation function (ReLU) in a neural network layer, and explain why their performance bottlenecks differ fundamentally on modern GPUs.Order the complete sequence of computational and system phases occurring inside a framework during a single standard training iteration:
Loss calculation: The criterion function evaluates the scalar training loss \(\mathcal{L}\)
Backward pass: Autograd traverses the reverse tape, executing Vector-Jacobian Products and populating
.gradbuffersOptimizer step: The optimizer reads
.gradvalues and updates parameter tensors in-place using the optimization algorithmForward pass: The model executes layer operations and records the dynamic autograd tape
Gradient reset:
optimizer.zero_grad()clears or sets.gradbuffers toNoneDuring the backward pass of a training step, why is memory traffic often significantly higher than in the forward pass, even though the number of mathematical operations is roughly comparable?
Ngụy biện và Cạm bẫy
Lựa chọn framework liên quan đến những đánh đổi tinh tế mà trực giác từ kỹ thuật phần mềm thông thường không còn hiệu quả. Bức tường bộ nhớ, các ràng buộc hợp nhất kernel và sự đa dạng của mục tiêu triển khai tạo ra những cạm bẫy làm lãng phí nỗ lực kỹ thuật và khiến các hệ thống sản xuất không đạt được mục tiêu độ trễ.
Ngụy biện: “Tất cả các framework đều cung cấp hiệu suất tương đương cho cùng một kiến trúc mô hình.”
Các kỹ sư cho rằng ResNet-50 mang lại hiệu suất giống hệt nhau giữa các framework vì toán học là như nhau, quên rằng hiệu suất là một thuộc tính nổi bật của thiết kế đồng thời thuật toán-máy. Trong sản xuất, việc triển khai rất quan trọng. Thực thi được biên dịch có thể cải thiện các khối lượng công việc (workload) eager được hỗ trợ, và các công cụ suy luận chuyên biệt phần cứng như TensorRT hoặc TVM có thể giảm độ trễ so với các đường cơ sở eager chưa được điều chỉnh khi chuyển đổi sạch sẽ. Sự khác biệt phát sinh từ độ sâu hợp nhất kernel, các chiến lược tối ưu hóa đồ thị, các mẫu truy cập bộ nhớ, hỗ trợ độ chính xác và các thư viện backend khác nhau giữa các framework. Các tổ chức giả định sự tương đương có thể bỏ lỡ các thỏa thuận mức dịch vụ về độ trễ và đòi hỏi các cuộc di chuyển framework tốn kém vào phút chót.
Cạm bẫy: Chọn framework dựa trên sự phổ biến thay vì yêu cầu dự án.
Các kỹ sư cho rằng framework phổ biến nhất hoạt động cho bất kỳ dự án nào. Trong thực tế, các ràng buộc triển khai chiếm ưu thế. Một runtime di động như ExecuTorch hoặc TensorFlow Lite và một runtime vi điều khiển như TensorFlow Lite Micro đưa ra các giả định khác nhau về cấp phát bộ nhớ, phạm vi toán tử và ủy quyền phần cứng; cái trước nhắm đến điện thoại có bộ nhớ quy mô GB, trong khi cái sau thường nhắm đến các thiết bị có hàng trăm KB RAM, thường dưới 256 KB cho các triển khai TinyML nhỏ. Các nhóm tạo mẫu ứng dụng edge mà không kiểm tra runtime cuối cùng có thể đối mặt với tình trạng phình to bộ nhớ vượt quá dung lượng thiết bị hoặc một cuộc di chuyển framework muộn sau khi phát triển hoàn tất. Đánh giá các mục tiêu triển khai theo section 1.8 trước khi chọn một framework huấn luyện.
Ngụy biện: “Các trừu tượng hóa framework loại bỏ nhu cầu về kiến thức hệ thống.”
Các kỹ sư cho rằng các API cấp cao tự động xử lý tất cả các tối ưu hóa. Mô hình Roofline (Mô hình Roofline) chứng minh điều ngược lại. Các thao tác từng phần tử như ReLU thực hiện ít phép toán trên mỗi byte di chuyển, do đó lưu lượng bộ nhớ và chi phí khởi chạy có thể chiếm ưu thế ngay cả trên các bộ tăng tốc có khả năng tính toán dồi dào. Section 1.3.1 giải thích cách sự mất cân bằng này có thể khiến tài nguyên tính toán không hoạt động. Các kỹ sư phải xác định tài nguyên giới hạn trước khi chọn các tối ưu hóa hợp nhất, batching, bố cục hoặc độ chính xác.
Cạm bẫy: Bỏ qua sự phụ thuộc nhà cung cấp từ các định dạng dành riêng cho framework.
Kỹ sư cho rằng việc di chuyển framework là đơn giản vì các mô hình “chỉ là toán học.” Việc chuyển đổi TensorFlow SavedModel sang PyTorch có thể yêu cầu viết lại các thao tác tùy chỉnh, xác thực sự tương đương về số học trên các bộ kiểm thử lớn, và huấn luyện lại khi các thao tác không có sự tương đương chính xác. ONNX (section 1.8) cải thiện tính di động, nhưng các toán tử tùy chỉnh, hình dạng động và các tối ưu hóa dành riêng cho backend vẫn có thể yêu cầu công việc thủ công. Các tổ chức bỏ qua điều này trong quá trình lựa chọn framework ban đầu sẽ phải đối mặt với các cuộc di chuyển tốn kém khi các yêu cầu triển khai thay đổi hoặc khi các framework tốt hơn xuất hiện.
Ngụy biện: Việc lựa chọn framework huấn luyện độc lập với hạ tầng sản xuất.
Kỹ sư cho rằng việc lựa chọn framework huấn luyện độc lập với hạ tầng triển khai. Trên thực tế, sự không khớp giữa framework và hạ tầng có thể gây ra chi phí vận hành đáng kể. Một số ngăn xếp phục vụ (serving stack) cung cấp khả năng hoán đổi mô hình nguyên tử, trong khi những ngăn xếp khác yêu cầu khởi động lại tiến trình hoặc container trừ khi kiến trúc triển khai thêm định tuyến phiên bản xung quanh chúng. Một số framework và runtime hiển thị các hook giám sát trực tiếp; những framework khác yêu cầu công cụ tùy chỉnh. Đây là những hệ quả sơ bộ của các lớp phục vụ (serving) và vận hành được phát triển trong Phục vụ mô hình và Vận hành machine learning; bài học rút ra là phải đánh giá toàn bộ ngăn xếp triển khai trong quá trình lựa chọn framework, bao gồm hạ tầng phục vụ (serving), giám sát và công cụ vận hành.
Cạm bẫy: Tăng kích thước batch mà không mô hình hóa bộ nhớ activation.
Kỹ sư cho rằng nếu có bộ nhớ, các batch lớn hơn luôn cải thiện thông lượng. Các mini-batch lớn hơn có thể phân bổ chi phí điều phối cố định, nhưng chúng cũng làm tăng bộ nhớ activation phải duy trì hoạt động trong quá trình huấn luyện. Một mô hình 7 tỷ tham số ở định dạng FP16 tiêu thụ 14 GB, để lại 71.9 GB trên một A100 80 GB trước khi tính đến các trạng thái huấn luyện khác. Tăng kích thước batch từ 8 lên 32 làm tăng gấp bốn lần dấu vết activation phụ thuộc vào batch; cơ chế attention của transformer thêm một số hạng \(\mathcal{O}(S^2)\) lớn theo độ dài chuỗi, làm cho mỗi mẫu trở nên tốn kém. Áp lực bộ nhớ gây ra có thể kích hoạt các chiến lược tính toán lại mà công việc bổ sung của chúng làm giảm thông lượng mặc dù batch lớn hơn. Các nhóm mù quáng tối đa hóa kích thước batch có thể đạt được thông lượng thấp hơn so với các batch nhỏ hơn tránh các đường dẫn quản lý bộ nhớ này; Các phương pháp tối ưu hóa dựa trên gradient chính thức hóa mục tiêu thông lượng.
Ngụy biện: Chi phí biên dịch là không đáng kể.
Kỹ sư cho rằng chi phí biên dịch là chi phí một lần và sẽ nhanh chóng mang lại lợi ích. Các giá trị giả định trong table 4 gán cho ResNet-50 thông lượng biên dịch cao hơn và một khoảng thời gian biên dịch từ 15 s đến 30 s cho mỗi thay đổi đồ thị. Với những giả định đó, một thử nghiệm 10,000 hình ảnh với 10 thay đổi mã sẽ hoàn thành trong 6.9 s ở chế độ eager và 304.7 s ở chế độ biên dịch, bao gồm chi phí biên dịch lại. Do đó, quy trình làm việc đã biên dịch chậm hơn khoảng 44.2× trong kịch bản tạo mẫu nhanh minh họa này. Các nhóm bật biên dịch trong quá trình tạo mẫu nhanh có thể lãng phí thời gian chờ đợi các lần biên dịch lại làm mất đi lợi ích về thông lượng.
Cạm bẫy: Sử dụng một chính sách thực thi cho cả khám phá và sản xuất.
Chế độ framework phù hợp phụ thuộc vào vòng lặp. Trong quá trình khám phá, thực thi eager và các kiểm thử nhỏ giúp rút ngắn phản hồi bằng cách tránh các lần chụp đồ thị và biên dịch lại lặp đi lặp lại. Trong quá trình phục vụ (serving) sản xuất hoặc các lần huấn luyện dài, biên dịch có thể phân bổ chi phí thiết lập trên nhiều yêu cầu hoặc mẫu. Các yếu tố quyết định là thời lượng và độ ổn định của khối lượng công việc (workload): biên dịch có lợi khi cấu trúc đồ thị và hình dạng lặp lại, trong khi việc thay đổi luồng điều khiển hoặc hình dạng đầu vào có thể làm mất hiệu lực các tạo phẩm đã được cache và khởi động lại quá trình phân bổ. Các nhóm nên chọn chính sách dựa trên độ trễ lặp đo được và thông lượng trạng thái ổn định. Một chính sách cho cả hai giai đoạn hoặc làm chậm quá trình lặp nghiên cứu hoặc để thông lượng sản xuất không được sử dụng.
Self-Check: Question
A research team exploring architecture modifications runs experiments where model code changes every 10 training steps. When they enable JIT graph compilation (
torch.compile), total training time increases by 5\(\times\) compared to standard eager mode. What systems principle explains this performance degradation?- Compilation incurs a large upfront compilation latency (\(T_{\text{compile}}\)); if graph structures or tensor shapes change frequently, the compilation cost cannot be amortized across executions (\(N_{\text{steps}} \times (T_{\text{eager}} - T_{\text{compiled}}) < T_{\text{compile}}\)), making repeated recompilation slower than eager execution
- Compiled kernels run at half the floating-point clock frequency of eager kernels on NVIDIA GPUs
- JIT compilers disable GPU hardware acceleration when running short training scripts
- Dynamic graph compilation automatically converts all FP32 operations to 64-bit double precision
Explain why choosing a framework based on community popularity or GitHub stars rather than binding deployment constraints is a severe engineering pitfall for edge and embedded ML projects.
True or False: Because standard neural network architectures (like ResNet-50 or Transformers) have identical mathematical definitions, any two frameworks running the same model on identical GPU hardware will produce identical throughput.
Tóm tắt
Các framework machine learning tồn tại để giải quyết ba vấn đề cơ bản mà nếu không có chúng thì deep learning sẽ không thực tế. Thứ nhất là thực thi: quyết định khi nào và cách thức tính toán chạy. Các framework điều hướng sự đánh đổi giữa thực thi eager (ngay lập tức, có thể gỡ lỗi, linh hoạt) và thực thi đồ thị (trì hoãn, có thể tối ưu hóa, có thể triển khai), trong khi các phương pháp lai hiện đại như torch.compile cố gắng cung cấp cả sự linh hoạt trong quá trình phát triển và tối ưu hóa cho sản xuất. Thứ hai là vi phân: tính toán gradient tự động. Các framework triển khai vi phân tự động chế độ ngược áp dụng quy tắc chuỗi trên các thành phần thao tác được hỗ trợ, tạo ra các đạo hàm tuân theo số học dấu phẩy động và quy tắc đạo hàm của từng thao tác. Nguyên thủy phần mềm này giúp việc huấn luyện các mô hình tỷ tham số trở nên khả thi thông qua một lệnh gọi loss.backward(). Thứ ba là trừu tượng hóa: nhắm mục tiêu đến nhiều phần cứng khác nhau từ một giao diện duy nhất. Các framework cung cấp các trừu tượng tensor, các biểu diễn trung gian và các hệ thống runtime giúp ẩn đi sự phức tạp của phần cứng đồng thời cho phép sử dụng hiệu quả trên CPU, GPU, TPU và các bộ tăng tốc chuyên dụng.
Những vấn đề này liên kết với nhau và bị ràng buộc bởi định luật sắt về hiệu năng (Định luật sắt của hệ thống ML): chiến lược thực thi xác định chi phí điều phối \((L_{\text{lat}})\), phép vi phân xác định lưu lượng bộ nhớ \((D_{\text{vol}})\), và trừu tượng hóa xác định tỷ lệ sử dụng phần cứng \((\eta_{\text{hw}})\). Rào cản bộ nhớ có thể làm cho việc di chuyển dữ liệu tốn kém hơn tính toán, giải thích tại sao các framework đầu tư vào hợp nhất kernel, tính toán lại có chọn lọc, thực thi độ chính xác thấp hơn và các pipeline biên dịch.
Key Takeaways: Lớp giữa toán học và phần cứng
- Mọi framework giải quyết ba vấn đề: Thực thi xác định cách chạy, phép vi phân xác định cách huấn luyện, và trừu tượng hóa xác định cách biểu diễn. TensorFlow kết nối việc thu thập đồ thị với các đường dẫn triển khai rộng rãi, PyTorch kết nối lặp lại kiểu eager với các đường dẫn thu thập và xuất, và JAX tổ chức phép vi phân và biên dịch dưới dạng các phép biến đổi hàm có thể kết hợp. Đây là những cam kết về hạ tầng, không phải là các lựa chọn công cụ.
- Rào cản bộ nhớ thúc đẩy tối ưu hóa: Khả năng tính toán đã tăng trưởng nhanh hơn nhiều so với băng thông bộ nhớ trong nhiều thập kỷ, làm rộng thêm khoảng cách tích lũy giới hạn việc di chuyển dữ liệu. Hợp nhất kernel, tính toán lại có chọn lọc, thực thi độ chính xác thấp hơn và tối ưu hóa bố cục dữ liệu đều nhắm vào thành phần di chuyển dữ liệu \((D_{\text{vol}})\) trong định luật sắt, chứ không phải thành phần tính toán.
- Biên dịch phải khấu hao chi phí thiết lập: Nguyên lý liên tục biên dịch trong equation 2 định lượng khi nào lợi ích thực thi vượt quá chi phí biên dịch. Các đồ thị thay đổi nhanh chóng thường ưu tiên chế độ eager, trong khi các đồ thị ổn định được thực thi lặp lại có thể hưởng lợi từ biên dịch lũy tiến từ JIT sang AOT. Định luật chi phí điều phối trong equation 4 giải thích tại sao các phép toán nhỏ có thể hưởng lợi không cân xứng khi biên dịch được tái sử dụng.
- Các trừu tượng hóa module tự động hóa quản lý trạng thái: Tự động khám phá tham số, hành vi phụ thuộc chế độ và cấu trúc phân cấp với tuần tự hóa xuất hiện trên các framework chính, cho phép tối ưu hóa hàng triệu tham số trong một bước optimizer duy nhất bất kể cú pháp API.
- Các ràng buộc triển khai nên định hướng lựa chọn: Các công cụ suy luận, runtime di động và runtime vi điều khiển đánh đổi phạm vi hỗ trợ toán tử, cấp phát bộ nhớ, biên dịch và tăng tốc theo những cách khác nhau. Khoảng cách giữa suy luận eager và suy luận chuyên biệt, hoặc giữa bộ nhớ máy chủ và bộ nhớ vi điều khiển, là những ràng buộc kiến trúc. Đánh giá mục tiêu triển khai trước khi chọn một framework.
Hiểu biết về nội bộ framework thay đổi cách các kỹ sư tiếp cận việc gỡ lỗi và tối ưu hóa hiệu năng. Khi một tác vụ huấn luyện chạy chậm hơn dự kiến, các kỹ sư hiểu về đồ thị thực thi có thể xác định liệu nút thắt cổ chai nằm ở chi phí chế độ eager, hợp nhất kernel không đủ, hay bố cục bộ nhớ không tối ưu. Khi triển khai thất bại trên phần cứng mục tiêu, pipeline biên dịch sẽ tiết lộ liệu vấn đề là hỗ trợ toán tử, khả năng tương thích lượng tử hoá, hay cấu hình runtime. Kiến thức này rất cần thiết để chẩn đoán và giải quyết các vấn đề hiệu năng trong các hệ thống sản xuất.
Một framework tự thể hiện mình như một sự tiện lợi, một cách viết mô hình sạch sẽ hơn, và chính điều đó khiến ảnh hưởng của nó dễ bị bỏ qua. Công việc thực sự của nó là dịch toán học thành các phép toán máy, và không có bản dịch nào là miễn phí: mọi lựa chọn nó đưa ra (thực thi eager hay đồ thị, khi nào hợp nhất kernel, độ chính xác nào cần giữ, biên dịch bao nhiêu) đều chuyển chi phí giữa các thành phần của định luật sắt thay vì loại bỏ nó. Do đó, cái trông giống như một API thực chất là một quyết định cố định về nơi hệ thống sẽ chi tiêu, được đưa ra chủ yếu trước khi kỹ sư bắt đầu làm việc. Framework không thể giảm nhẹ gánh nặng mà định luật sắt đặt ra; nó chỉ có thể quyết định thành phần nào trong ba thành phần sẽ gánh chịu gánh nặng đó.
What’s Next: Từ phòng điều khiển đến nhà máy điện
Các framework là nền tảng phần mềm dịch các kiến trúc trừu tượng thành các kernel có thể thực thi. Đồ thị tính toán, băng autograd và các pipeline điều phối kernel là các công cụ trong phòng điều khiển: chúng cung cấp cho các kỹ sư khả năng quan sát và kiểm soát quá trình huấn luyện. Bộ máy đã được xây dựng, nhưng mọi quyết định ngân sách mà nó phơi bày vẫn chưa được đưa ra: những activation nào cần checkpoint khi bộ nhớ cạn kiệt, kích thước batch mà phần cứng cho phép là bao nhiêu, và tại thời điểm nào một thiết bị duy nhất không còn đủ nữa. Huấn luyện mô hình là nơi những chi phí đó đến hạn, mở rộng việc thực thi framework, phép vi phân và bộ máy quản lý bộ nhớ thành các hệ thống huấn luyện cung cấp sức mạnh cho AI hiện đại.
Self-Check: Question
How do the three fundamental framework problems (Execution, Differentiation, Abstraction) map directly to the terms of the systems iron law (\(T_{\text{epoch}} = \frac{\text{Work}}{\text{Throughput}} \times \frac{1}{\eta_{\text{hw}}} + \text{Overhead}\))?
- Execution controls dataset size, differentiation controls network latency, and abstraction controls cloud server pricing
- All three problems affect only the floating-point precision of the weights
- Execution affects differentiation, while abstraction has no measurable impact on systems performance
- Execution strategy governs dispatch latency and kernel launch overhead (\(L_{\text{lat}}\)), differentiation governs intermediate activation memory volume and traffic (\(D_{\text{vol}}\)), and hardware abstraction governs silicon utilization efficiency (\(\eta_{\text{hw}}\))
Summarize why the memory wall—rather than raw floating-point arithmetic capacity—has become the primary driver of modern ML framework compiler innovations (such as kernel fusion and activation checkpointing).
True or False: An ML framework can eliminate the physical constraints imposed by the iron law of performance if an engineer writes clean, high-level declarative Python code.
Self-Check Answers
Self-Check: Answer
A team reports that their model executes correctly on CPU but produces mismatched tensor shapes and silent numerical corruption when switched to a GPU backend because some operators silently default to a different memory layout (such as NCHW versus NHWC). Which of the three fundamental framework problems does this failure most directly expose?
- The hardware abstraction problem, because one unified model interface must preserve consistent semantic behavior, memory layouts, and numerical contracts across diverse hardware backends
- The execution problem, because the operators were evaluated eagerly instead of being captured into a static graph
- The differentiation problem, because the backward pass failed to propagate gradients through non-contiguous strides
- A data engineering pipeline defect unrelated to framework runtime responsibilities
Answer: The correct answer is A. The hardware abstraction problem requires providing a unified interface across diverse hardware backends (CPUs, GPUs, TPUs) while ensuring consistent semantics, memory layouts, and numerical behaviors; a silent layout mismatch between backends is a direct failure of this abstraction. Blaming the execution problem confuses when operations are dispatched with how backends interpret tensor memory contracts. Attributing the issue to differentiation is incorrect because forward shape and layout divergences break before gradient propagation occurs. Dismissing it as a data pipeline defect overlooks that tensor layout conversion across backends is a core runtime responsibility.
Learning Objective: Classify a concrete framework failure into the execution, differentiation, or hardware abstraction problem
Explain how viewing an ML framework as a compiler for the silicon contract—rather than merely a numerical library like NumPy—changes an engineer’s expectations regarding framework selection and optimization under the systems iron law.
Answer: A numerical library executes individual operations immediately in isolation, where switching libraries primarily changes syntax without altering underlying execution. An ML framework acts as a compiler that translates an abstract computational graph into a physical execution plan, performing operator fusion, memory planning, and hardware-specific lowering. Consequently, framework selection sets an upper bound on achievable silicon efficiency and directly determines how effectively the system attacks the data movement (\(D_{\text{vol}}\)) and dispatch latency (\(L_{\text{lat}}\)) terms of the iron law.
Learning Objective: Explain how the compiler analogy changes an engineer’s expectations of what framework choice determines
True or False: Two frameworks that expose nearly identical user-facing Python tensor APIs and target the same GPU hardware will necessarily provide equivalent graph-level operator fusion and ahead-of-time compilation capabilities.
Answer: False. Syntactic API similarity does not imply compiler equivalence: one framework may support aggressive whole-graph intermediate representation lowering and kernel fusion via JIT/AOT compilers, whereas another may only perform eager single-kernel dispatch on the same GPU backend, resulting in substantial workload-dependent throughput gaps.
Learning Objective: Evaluate the misconception that matching tensor APIs imply matching compiler optimization capabilities
An engineering organization chose a specialized research framework for rapid prototyping, only to discover later that the framework lacks export paths to their production edge accelerators, requiring months of manual re-implementation. Applying the chapter’s infrastructure-commitment principle, what is the key systems insight?
- Framework choice is easily reversible because weight arrays can be loaded into any runtime with zero engineering overhead
- Framework selection functions as a durable infrastructure commitment whose reversal cost compounds across model checkpoints, serving runtimes, CI/CD pipelines, and hardware access
- The primary failure was selecting an overly compact model architecture that failed to saturate edge accelerator memory
- Hardware abstraction layers eliminate all differences between training frameworks and production inference engines
Answer: The correct answer is B. Framework decisions constrain reachable hardware targets, optimization passes, and deployment toolchains, meaning migration costs extend far beyond model code to include checkpoints, serving systems, CI/CD pipelines, and team expertise. Treating framework choice as freely reversible ignores the substantial engineering friction of cross-runtime translation. Blaming model capacity misidentifies the root cause, which is export toolchain incompatibility. Claiming hardware abstraction eliminates all deployment differences ignores real-world operator coverage gaps and runtime constraints.
Learning Objective: Analyze why framework selection functions as a long-term infrastructure commitment rather than a reversible tooling choice
Self-Check: Answer
While NumPy provided high-performance linear algebra by wrapping BLAS in Python, what critical scaling bottleneck did it leave unaddressed that motivated the development of deep learning frameworks such as Theano, TensorFlow, and PyTorch?
- Inability to execute matrix multiplications on single-core CPU architectures
- Lack of an \(n\)-dimensional array data structure in scientific computing
- The requirement for manual gradient derivation and hand-written backpropagation passes for multi-layer neural networks
- Inability to run compiled Fortran and C routines through high-level scripting languages
Answer: The correct answer is C. NumPy provided high-level array ergonomics and BLAS-backed performance, but practitioners still had to manually derive and implement analytical backpropagation gradients, creating an error-prone bottleneck for deep networks that automatic differentiation frameworks solved. Single-core CPU matrix multiplication was already solved at the BLAS layer. The \(n\)-dimensional array abstraction was NumPy’s primary feature rather than a missing capability. Python-to-C/Fortran bindings were the core mechanism of NumPy’s vectorization model rather than an unsolved problem.
Learning Objective: Analyze which scaling bottleneck NumPy left open for subsequent deep learning frameworks to solve
Explain why the relationship between rungs on the ladder of abstraction (such as BLAS/LAPACK, NumPy, and modern deep learning frameworks) is characterized by inheritance rather than replacement.
Answer: Higher rungs on the ladder do not replace the numerical primitives of lower rungs; instead, they wrap and orchestrate them while automating higher-level concerns such as automatic differentiation, memory planning, and graph compilation. For instance, a high-level PyTorch matrix multiplication
torch.matmul(A, B)ultimately delegates to vendor-optimized BLAS kernels (such as cuBLAS on NVIDIA GPUs), meaning an inefficient low-level primitive establishes a performance ceiling for all frameworks built above it.Learning Objective: Explain how successive ladder rungs inherit low-level primitives rather than replacing them
**Order the following historical computing milestones in the evolution of numerical and machine learning software abstractions, from earliest (1979) to most recent (2018):
JAX introduces functional composable transformations and XLA compilation
BLAS standardizes reusable low-level linear algebra primitives
Theano introduces compiled Python computational graphs for GPUs
NumPy establishes Python’s unified \(n\)-dimensional array and vectorization standard
PyTorch introduces dynamic define-by-run execution graphs
LAPACK extends BLAS with higher-level numerical routines (e.g., SVD, factorizations)**
Answer: The correct sequence is 2 -> 6 -> 4 -> 3 -> 5 -> 1:
- BLAS (1979): Standardized low-level linear algebra primitives.
- LAPACK (1992): Extended BLAS with higher-level matrix factorizations and numerical solvers.
- NumPy (2006): Unified Python scientific array abstractions and vectorized dispatch.
- Theano (2007): Introduced Python-defined symbolic computational graphs compiled to GPU code.
- PyTorch (2016): Popularized dynamic define-by-run computational graphs.
- JAX (2018): Introduced functional composable transformations (
grad,vmap,jit) backed by XLA.
- JAX (2018): Introduced functional composable transformations (
The architectural design pattern established by NumPy, where high-level control logic is written in an expressive interpreted language (such as Python) while inner numerical loops are delegated to compiled C/Fortran libraries, is known as ____.
Answer: The correct answer is vectorization (or vectorized execution). Vectorization allows developers to write clean array-level expressions in Python while delegating repetitive element-wise and matrix loops to optimized native code.
Learning Objective: Identify the vectorization design pattern that connects interpreted frontends to compiled numerical backends
Self-Check: Answer
A GPU performance profile reveals that a sequence of LayerNorm, dropout, and GELU activation operations spends over 80% of its execution time reading and writing intermediate tensors to High Bandwidth Memory (HBM) with very low arithmetic intensity. Why is operator fusion the primary framework optimization for this workload?
- It replaces 16-bit floating-point arithmetic with 8-bit integer arithmetic
- It changes the model architecture to eliminate all non-linear activation functions
- It converts compute-bound matrix multiplications into memory-bound operations
- It fuses multiple sequential element-wise operations into a single GPU kernel, keeping intermediate values in on-chip SRAM/registers and eliminating redundant round trips to HBM
Answer: The correct answer is D. Element-wise and normalization layers have low arithmetic intensity and are memory-bandwidth-bound; operator fusion combines these sequential passes into a single GPU kernel that passes intermediate values through fast on-chip registers and SRAM, drastically reducing global HBM memory traffic. Precision quantization changes numerical representation rather than performing fusion. Modifying network architecture mischaracterizes a compiler optimization as a model alteration. Converting operations to memory-bound would degrade rather than improve arithmetic efficiency.
Learning Objective: Analyze why operator fusion mitigates memory-wall bottlenecks for low arithmetic intensity layers
A developer attempts to trace a dynamic PyTorch model containing data-dependent control flow (
if tensor.sum() > 0: ...) using standard graph tracing (torch.jit.trace). What failure mode occurs, and how does modern bytecode graph capture (torch.compile/ TorchDynamo) resolve it?- Standard tracing crashes immediately on any tensor operation, whereas TorchDynamo rewires the Python interpreter into C++
- Standard tracing converts all dynamic control flow into static loops, whereas TorchDynamo disables all GPU acceleration
- Standard tracing records only the branch taken by the example input and silently bakes it into a static graph, whereas TorchDynamo inspects Python bytecode to capture straight-line subgraphs into FX graphs and falls back to the Python interpreter on graph breaks
- Standard tracing successfully compiles dynamic branches using AST inspection, whereas TorchDynamo rejects all conditional statements
Answer: The correct answer is C. Tracing executes the program with dummy inputs and records the executed trace, silently dropping untaken conditional branches; TorchDynamo intercepts Python frame evaluation bytecode, extracts valid computational subgraphs into FX graphs, and gracefully falls back to the Python interpreter (a graph break) when encountering unsupported dynamic constructs. Claiming tracing crashes on all tensor operations is factually incorrect. Asserting that tracing converts conditionals to static loops misrepresents trace capture. Suggesting tracing handles dynamic branches via AST confuses tracing with source-to-source compilers like TorchScript script mode.
Learning Objective: Compare graph tracing with bytecode frame interception for handling dynamic control flow
State the dispatch overhead law and explain why a workload composed of many small tensor operations on an NVIDIA A100 GPU can be severely underutilized in eager mode even if the GPU has massive compute throughput.
Answer: The dispatch overhead law states that a workload is overhead-bound when the overhead ratio \((N_{\text{ops}} \cdot t_{\text{dispatch}}) / (T_{\text{compute}} + T_{\text{memory}}) > 1\). Because eager execution incurs a CPU-to-GPU launch tax of ~\(2\text{--}5\ \mu\text{s}\) per operation, a small kernel executing in less than \(2\ \mu\text{s}\) forces the GPU to sit idle between launches, bottlenecking end-to-end throughput on CPU dispatch latency rather than GPU arithmetic capacity.
Learning Objective: Explain how the dispatch overhead law causes GPU underutilization on small eager-mode operations
True or False: In
torch.compile, encountering a “graph break” halts program execution and throws a fatal runtime exception because dynamic Python constructs cannot be represented in the computational graph.Answer: False. A graph break does not crash the program; instead, TorchDynamo captures the preceding operations as a compiled subgraph, safely falls back to the standard Python interpreter to execute the unsupported dynamic code, and then resumes graph capture for subsequent operations.
Learning Objective: Evaluate the operational behavior and performance impact of graph breaks in graph-capture JIT compilers
**Order the stages of the
torch.compilecompilation and execution pipeline in PyTorch 2.0, from initial Python function call to hardware execution:AOTAutograd traces both the forward and backward computation graphs ahead of execution
TorchDynamo intercepts Python bytecode during frame evaluation and extracts computational subgraphs
TorchInductor generates optimized vendor-specific kernels (e.g., Triton for GPUs or C++/OpenMP for CPUs)
The high-level intermediate representation is structured as a PyTorch FX graph
The compiled fused kernels execute on the target hardware accelerator**
Answer: The correct sequence is 2 -> 4 -> 1 -> 3 -> 5:
- TorchDynamo intercepts Python bytecode: Hooks frame evaluation to extract tensor operations.
- PyTorch FX graph generation: Produces a high-level Python-level intermediate representation.
- AOTAutograd tracing: Captures both forward and backward computational graphs.
- TorchInductor lowering: Compiles FX graphs into fused hardware-specific Triton/C++ kernels.
- Hardware execution: Dispatches the optimized kernels on the accelerator.
In graph-capture JIT compilation systems like TorchDynamo, an event where the compiler encounters an unsupported dynamic Python construct (such as an unhandled C-extension call or dynamic side effect) and must pause graph capture to yield control to the Python interpreter is called a ____.
Answer: The correct answer is graph break. A graph break splits the computational graph into multiple subgraphs separated by interpreted Python execution, which can increase kernel dispatch overhead.
Learning Objective: Identify the concept of a graph break in graph-capturing execution systems
Self-Check: Answer
For a neural network with \(N = 10^7\) parameters and a single scalar loss output \(M = 1\), why do deep learning frameworks uniformly employ reverse-mode automatic differentiation (backpropagation) instead of forward-mode differentiation?
- Reverse-mode computes all \(10^7\) parameter gradients in a single backward pass of complexity \(\mathcal{O}(M) = \mathcal{O}(1)\), whereas forward-mode would require \(10^7\) separate passes of complexity \(\mathcal{O}(N)\)
- Forward-mode differentiation cannot compute exact gradients and relies on finite-difference approximations
- Reverse-mode differentiation requires zero memory allocation for intermediate forward activations
- Forward-mode is restricted exclusively to non-linear activation functions and cannot differentiate matrix multiplications
Answer: The correct answer is A. Reverse-mode automatic differentiation (vector-Jacobian products) computes gradients of a scalar loss (\(M=1\)) with respect to all \(N\) input parameters in a single backward traversal with compute cost proportional to the forward pass, whereas forward-mode (Jacobian-vector products) scales with \(N\), requiring \(10^7\) forward passes. Forward-mode computes mathematically exact derivatives, not finite differences. Reverse-mode actually requires storing intermediate forward activations in memory, which is its primary drawback. Forward-mode applies to all differentiable operations including matrix multiplications.
Learning Objective: Calculate and compare the computational complexity scaling of forward-mode and reverse-mode automatic differentiation
A PyTorch user modifies an intermediate activation tensor using an in-place operation (
x.relu_()orx += 1) during the forward pass. Duringloss.backward(), autograd raises a runtime error: “one of the variables needed for gradient computation has been modified by an inplace operation”. What is the systems mechanism causing this failure?- In-place operations convert 32-bit floating point numbers to integers, corrupting floating-point precision
- The autograd tape recorded a reference to the forward tensor whose underlying storage was overwritten, destroying the original activation values required by the operation’s derivative formula
- In-place operations automatically set
requires_grad=Falseon all ancestor nodes in the computational graph - The GPU caching allocator prohibits in-place memory modifications during forward execution
Answer: The correct answer is B. Autograd saves pointers to intermediate activations during the forward pass via functions like
ctx.save_for_backward(); modifying those buffers in-place overwrites the numerical values needed to evaluate derivative formulas during the backward pass, triggering version-counter mismatch errors. In-place operations preserve data types and do not convert floats to integers. In-place operations do not alter therequires_gradflags of ancestor nodes. The hardware memory allocator does not restrict in-place buffer mutations; the error is enforced by framework autograd version tracking.Learning Objective: Analyze why in-place tensor mutations break autograd tape integrity during reverse-mode differentiation
Explain the difference between accumulating gradients in a tensor’s
.gradattribute across batches and retaining the autograd computational graph usingloss.backward(retain_graph=True).Answer: Gradient accumulation adds new derivative values into existing parameter
.gradbuffers (param.grad += dL/dParam), which is a lightweight numerical addition that allows simulating larger batch sizes. In contrast,retain_graph=Trueprevents autograd from freeing the intermediate activation tensors andGradFngraph nodes after the backward pass, keeping them pinned in memory and potentially causing GPU Out-Of-Memory errors if retained across iterations.Learning Objective: Distinguish gradient accumulation in tensor buffers from computational graph retention across backward passes
True or False: Because reverse-mode automatic differentiation computes exact gradients in a single backward pass, its peak memory consumption during training is identical to that of inference.
Answer: False. Inference only requires storing the current layer’s activations during execution, whereas reverse-mode differentiation requires caching all intermediate activation tensors across the entire forward pass (memory scaling as \(\mathcal{O}(L)\) with network depth) so they can be referenced during the backward pass.
Learning Objective: Evaluate the memory footprint differences between forward-only inference and reverse-mode training passes
**Order the sequence of events executed during reverse-mode automatic differentiation for a single training step:
Initialize the backward pass by seeding the output gradient adjoint with \(d\mathcal{L}/d\mathcal{L} = 1.0\)
Execute the forward pass while registering operations and saving required activation tensors on the autograd tape
Accumulate calculated parameter gradients into the
.gradattributes of leaf parametersCompute the scalar loss \(\mathcal{L}\) from model outputs and ground truth targets
Traverse the
GradFnDAG backward, applying operation-specific Vector-Jacobian Products (chain rule)**Answer: The correct sequence is 2 -> 4 -> 1 -> 5 -> 3:
- Forward pass & autograd tape recording: Evaluates operations and caches intermediate activations.
- Loss calculation: Produces the scalar objective value \(\mathcal{L}\).
- Gradient seed initialization: Sets the root adjoint \(d\mathcal{L}/d\mathcal{L} = 1.0\).
- Backward DAG traversal: Evaluates Vector-Jacobian Products along reverse-linked nodes.
- Gradient accumulation: Writes computed gradients to leaf parameter
.gradbuffers.
- Gradient accumulation: Writes computed gradients to leaf parameter
To resolve GPU memory exhaustion caused by caching activations during long forward passes, the memory optimization technique that discards intermediate activations and recomputes them on-the-fly from saved boundary tensors during the backward pass is called activation ____ (or rematerialization).
Answer: The correct answer is checkpointing (or activation checkpointing). Activation checkpointing trades an additional forward pass of compute (~33% overhead) to reduce peak activation memory from \(\mathcal{O}(L)\) to \(\mathcal{O}(\sqrt{L})\).
Learning Objective: Identify activation checkpointing as a compute-memory trade-off mechanism
Self-Check: Answer
In framework tensor implementations (such as PyTorch
Tensoror NumPyndarray), what distinguishes a tensor view (e.g. created via.transpose()or.narrow()) from a tensor copy?- A view converts the underlying data format from floating-point to integer representation
- A view modifies only metadata (shape, strides, storage offset) while sharing the same underlying data storage buffer in \(\mathcal{O}(1)\) time without copying memory
- A view creates a duplicate memory buffer on the host CPU while leaving the GPU buffer unchanged
- A view enforces that the tensor elements are stored strictly in C-contiguous memory layout
Answer: The correct answer is B. A tensor view shares the underlying storage buffer of the original tensor and merely updates metadata (such as strides, shape, and offset), making operations like slicing, transposing, and reshaping \(\mathcal{O}(1)\) operations that allocate no new array memory. Views do not change numerical data types. Views do not clone data to host CPU memory. Slicing or transposing a tensor frequently produces a non-contiguous view rather than enforcing C-contiguity.
Learning Objective: Distinguish tensor views from tensor copies in terms of metadata modification and memory allocation
A GPU training loop shows high GPU idle time because the CPU waits for data loading before launching training kernels. How does enabling
pin_memory=Trueon the DataLoader combined withtensor.to(device, non_blocking=True)alleviate this bottleneck?- It automatically quantizes all training data to 8-bit precision on the host CPU
- It bypasses the GPU memory hierarchy entirely by executing matrix multiplications directly in CPU L3 cache
- It allocates page-locked host RAM, allowing the GPU Direct Memory Access (DMA) engine to transfer data over PCIe asynchronously in parallel with GPU kernel compute
- It forces every CUDA kernel to execute synchronously on the default stream
Answer: The correct answer is C. Pinned (page-locked) host memory prevents the OS from paging data to disk, allowing the hardware DMA controller to copy data over PCIe to GPU VRAM without CPU intervention, enabling overlap between host-to-device transfers and GPU kernel execution when
non_blocking=Trueis used. Pinned memory does not perform precision quantization. It does not execute matrix operations in CPU cache. It enables asynchronous overlapping rather than forcing synchronous serial execution.Learning Objective: Analyze how pinned host memory and non-blocking asynchronous transfers overlap data movement with GPU compute
Why do deep learning frameworks implement dedicated memory managers (such as PyTorch’s CUDA caching allocator) rather than calling the underlying driver’s
cudaMallocandcudaFreeon every tensor creation and destruction?Answer: Standard driver allocations like
cudaMallocandcudaFreeare expensive system calls that synchronize the GPU device and incur substantial latency overhead (tens to hundreds of microseconds). A caching allocator maintains a pool of pre-allocated GPU memory blocks categorized by size, allowing sub-microsecond allocation and deallocation without device synchronization or driver overhead, while minimizing memory fragmentation across dynamic training iterations.Learning Objective: Explain the architectural rationale for framework caching memory allocators over direct driver allocation calls
Why can an accidental synchronous CPU-GPU tensor transfer (such as calling
.item()or printing a tensor inside a training loop) degrade throughput far more than the raw byte transfer time would suggest?Answer: Host-device synchronization calls like
.item()force the CPU thread to block until all previously queued GPU operations on the stream complete. This eliminates CPU-GPU execution concurrency, flushes the GPU work queue, exposes host dispatch latency, and prevents the framework from pipelining subsequent kernel launches.Learning Objective: Explain how host-device synchronization calls destroy execution concurrency and pipeline overlap
**Order the physical memory and execution lifecycle of a tensor batch as it moves from host storage to GPU execution in a high-throughput training pipeline:
CPU DataLoader loads raw data and copies it into page-locked (pinned) host memory
CUDA caching allocator assigns a GPU memory block from its pre-allocated pool
Host initiates an asynchronous Direct Memory Access (DMA) transfer over PCIe to GPU VRAM
Downstream consumer kernels execute on the GPU stream, reading the tensor from HBM/SRAM
Framework dispatches a compute kernel onto the active CUDA stream with tensor metadata and storage pointers**
Answer: The correct sequence is 1 -> 2 -> 3 -> 5 -> 4:
- Pinned host allocation: DataLoader stages batch in page-locked host RAM.
- GPU buffer reservation: Caching allocator selects/reserves GPU VRAM block.
- Asynchronous DMA transfer: Transfers data over PCIe bus to GPU memory.
- Kernel dispatch: CPU enqueues compute operation onto the CUDA stream.
- Kernel execution: GPU hardware executes kernel, consuming tensor data.
Host memory that is allocated in page-locked physical RAM, preventing the operating system from swapping it to virtual memory and enabling asynchronous Direct Memory Access (DMA) transfers to accelerator memory, is called ____ memory.
Answer: The correct answer is pinned (or pinned memory / page-locked memory). Pinned memory is essential for overlapping host-to-device data transfers with GPU kernel computation.
Learning Objective: Identify pinned memory as the mechanism enabling asynchronous DMA host-to-device transfers
Self-Check: Answer
In framework module abstractions like PyTorch’s
nn.Module, what systems mechanism enablesoptimizer = torch.optim.Adam(model.parameters())to find and optimize all model weights without the developer manually listing every weight tensor?- Python automatically compiles all local variables in memory into an optimization graph
- The GPU driver scans VRAM at runtime to detect all floating-point matrices
- The autograd engine injects global hooks into Python’s garbage collector
- Overridden attribute assignment (
__setattr__) detects instances ofnn.Parameterand automatically registers them into an internal hierarchical dictionary (_parameters)
Answer: The correct answer is D.
nn.Moduleoverrides Python’s__setattr__method so that whenever an attribute of typenn.Parameteris assigned, it is automatically added to the module’s_parametersdictionary; callingmodel.parameters()recursively walks this submodule tree to yield all trainable parameters. Python’s runtime does not automatically discover arbitrary variables for optimization. The GPU driver has no semantic awareness of model weight structures in host frameworks. Autograd hooks do not inspect garbage collector internals for parameter registration.Learning Objective: Explain the parameter registration mechanism in module abstractions like nn.Module
Explain why setting
model.eval()is necessary for numerically correct inference in models containing BatchNorm or Dropout, and clarify whymodel.eval()is not a substitute fortorch.no_grad().Answer: Setting
model.eval()toggles mode-dependent layer behaviors: it disables stochastic Dropout (setting it to identity) and switches BatchNorm from computing batch statistics to using accumulated running mean and variance buffers. However,model.eval()does not disable autograd graph construction or activation caching; wrapping inference intorch.no_grad()(ortorch.inference_mode()) is required to deactivate the autograd tape and prevent unnecessary memory allocation.Learning Objective: Distinguish the systems role of module evaluation mode from autograd gradient disabling contexts
In PyTorch’s
nn.Module, the dictionary data structure returned bymodel.____()serializes all learnable parameters and persistent non-parameter buffers (such as BatchNorm running statistics) into named tensor mappings for checkpointing.Answer: The correct answer is state_dict (or state_dict()). The state_dict maps string parameter/buffer names to tensor data, decoupling the saved weights from the Python class definition.
Learning Objective: Identify the state_dict abstraction used for model parameter and buffer serialization
Why are modern production pipelines increasingly replacing standard Python
pickleserialization (the legacy.pt/.pthformat) with formats like Hugging Face’ssafetensorsfor model checkpoint storage and distribution?- safetensors prevents arbitrary code execution vulnerabilities inherent in pickle deserialization and enables zero-copy memory mapping (mmap) for instant model loading
- safetensors automatically quantizes all FP32 weights to 4-bit integers during serialization
- pickle files cannot store floating-point tensor data larger than 2 GB
- safetensors embeds the entire Python interpreter inside the model binary
Answer: The correct answer is A. Python’s
pickleformat executes arbitrary code during unpickling, posing severe security risks when loading third-party model weights;safetensorsrestricts storage strictly to pure tensor data and metadata, eliminating code execution vulnerabilities while supporting zero-copy memory mapping (mmap) for high-speed loading. Thesafetensorsformat preserves original data precision without automatic quantization. Legacypickleis capable of storing large files, though unsafe.safetensorscontains no Python interpreter code.Learning Objective: Evaluate the security and performance advantages of safe tensor serialization formats over general-purpose object pickling
Self-Check: Answer
An enterprise engineering team requires a unified workflow where models are trained in Python but must be deployed across cloud microservices (C++ runtime), mobile apps (Android/iOS), and web browsers without maintaining a Python runtime in production. Which framework ecosystem architecture was explicitly designed around this decoupled deployment model via the
SavedModelabstraction?- PyTorch 1.0 eager execution
- TensorFlow ecosystem (TensorFlow Serving, TFLite, and TF.js)
- Pure NumPy with custom Python socket servers
- Scikit-learn with standard pickle deserialization
Answer: The correct answer is B. TensorFlow was architected around the
SavedModelboundary, which packages graph definitions, weights, and signature definitions into a language-neutral format directly executable by TensorFlow Serving (C++ server), TensorFlow Lite (mobile/edge), and TensorFlow.js (browsers) without Python dependencies. PyTorch 1.0 was strictly eager and historically lacked standalone non-Python serving tooling. NumPy and Scikit-learn require Python runtime environments and do not support native mobile/browser graph export.Learning Objective: Classify major framework platforms by their deployment architectures and serialization boundaries
What core programming model commitment distinguishes JAX from both PyTorch and TensorFlow, enabling seamless functional composition of
jax.jit,jax.grad, andjax.vmap?- Dynamic class inheritance with mutable object references for all layer parameters
- Global state mutation across all forward and backward passes
- Pure functions with no hidden side effects acting on immutable array data structures
- Graph capture via AST string parsing of Python script files
Answer: The correct answer is C. JAX is built on functional programming principles where models and operations are pure functions that take inputs (and explicit parameter dictionaries) and return outputs without mutating internal state or relying on global side effects; this purity allows transformations (
grad,vmap,jit) to compose arbitrarily. Class inheritance and mutable parameter objects represent PyTorch’s object-orientednn.Modulemodel. Global state mutation violates JAX’s transformation contract. JAX captures graphs via tracing during execution, not AST string parsing.Learning Objective: Explain the pure functional transformation model that distinguishes JAX architecturally
Compare the workflow and deployment trade-offs that led PyTorch to dominate academic research while TensorFlow established strong early dominance in enterprise production serving during the late 2010s.
Answer: PyTorch’s eager define-by-run execution model allowed researchers to write standard Python code, inspect intermediate tensors with standard debuggers (
pdb), and iterate rapidly on dynamic architectures without upfront graph compilation friction. In contrast, TensorFlow’s static graph architecture andSavedModelexport pipeline provided production-grade deployment infrastructure (TensorFlow Serving, C++ deployment, robust mobile runtimes) that enterprises prioritized for stable, high-throughput serving pipelines.Learning Objective: Compare the developer velocity and production deployment trade-offs that shaped PyTorch and TensorFlow adoption
True or False: Because the mathematical operations of a model are identical, compiling a model with a specialized inference engine (such as NVIDIA TensorRT) yields identical latency to running the model in framework eager mode.
Answer: False. Specialized inference engines perform target-specific optimizations including aggressive multi-node layer fusion, precision calibration (INT8/FP16), kernel auto-tuning for specific GPU microarchitectures, and removal of framework runtime overhead, often achieving multi-fold latency reductions over eager baselines.
Learning Objective: Evaluate why specialized inference engines outperform general-purpose framework eager execution
Explain how JAX’s requirement that functions must be pure and free of side effects enables the XLA compiler to generate highly optimized accelerator kernels through
jax.jit.Answer: Because pure functions guarantee that outputs depend solely on explicit inputs with no hidden state mutations or side effects, the XLA compiler can safely trace the entire computation, reorder operations, eliminate common subexpressions, fuse entire subgraphs into single hardware kernels, and allocate static memory buffers without risk of altering observable program behavior.
Learning Objective: Analyze how functional purity enables aggressive whole-program compiler optimizations in JAX and XLA
Self-Check: Answer
When deploying deep learning models to microcontroller hardware (TinyML) with less than 256 KB of SRAM, which set of framework runtime assumptions is strictly required?
- Dynamic memory allocation via system malloc, full Python runtime, and 64-bit floating point precision
- Dynamic graph construction with autograd tape tracking enabled
- Cloud-based gRPC client with streaming RPC serialization
- Static memory allocation in a fixed pre-allocated arena, ahead-of-time compiled C/C++ kernels, 8-bit integer quantization, and zero dynamic memory allocation
Answer: The correct answer is D. Microcontrollers operate in bare-metal environments without operating systems or virtual memory managers; runtimes like TensorFlow Lite Micro require a fixed pre-allocated memory arena, static kernel dispatch, integer quantization (INT8), and strictly zero dynamic heap allocation (
malloc). Dynamic allocation and full Python runtimes require megabytes to gigabytes of memory unavailable on microcontrollers. Dynamic autograd graphs are unnecessary and impossible in memory-constrained inference runtimes. Cloud streaming RPCs require continuous network connectivity and OS networking stacks.Learning Objective: Classify framework runtime constraints across the cloud-to-microcontroller deployment spectrum
Explain how the three core framework problems (Execution, Differentiation, Abstraction) are dramatically reweighted when transitioning from cloud model training to edge/embedded inference.
Answer: On inference-only edge devices, the differentiation problem disappears entirely because backward passes and gradient tracking are not executed. The execution problem shifts from maximizing cluster throughput to fitting within rigid hardware constraints (strict latency deadlines, limited memory footprints, and zero dynamic allocation). Meanwhile, the abstraction problem intensifies because edge runtimes must target highly fragmented hardware backends (microcontrollers, mobile NPUs, DSPs, and edge TPUs) with specialized instruction sets and integer formats.
Learning Objective: Explain how edge deployment reweights execution, differentiation, and abstraction relative to cloud training
Explain how ONNX acts as a hub-and-spoke bridge between training frameworks and production inference engines, and identify the main systems risk when exporting complex models through ONNX.
Answer: ONNX defines a standardized computational graph format and operator set that decouples training frameworks (PyTorch, TensorFlow) from deployment runtimes (ONNX Runtime, TensorRT). The primary systems risk is operator coverage mismatch: if a model contains custom, dynamic, or bleeding-edge operations unsupported in the standard ONNX operator set, export fails or requires writing custom C++ operator plugins for each deployment target.
Learning Objective: Analyze the role and operator coverage risks of ONNX as a cross-framework deployment bridge
Self-Check: Answer
An engineering team is architecting a new commercial computer vision system. In the chapter’s decision framework, why must deployment constraints (e.g. target mobile NPU delegates and memory budgets) act as hard filters evaluated before selecting the training framework?
- If a training framework cannot export or compile the required model operators to the target deployment runtime, the model cannot run in production regardless of its training speed or developer ergonomics
- Training frameworks automatically alter target hardware specifications to match model requirements
- Hard deployment filters guarantee that the model achieves 100% classification accuracy
- Research iteration speed is the only metric that matters in commercial system design
Answer: The correct answer is A. Deployment constraints represent hard feasibility boundaries: if the target hardware or runtime cannot execute the operators exported by the framework, the project fails at deployment time, incurring catastrophic rewriting costs; soft preferences like developer ergonomics only matter among viable paths. Frameworks cannot change physical hardware specifications. Deployment feasibility filters govern system execution capability, not statistical model accuracy. Prioritizing iteration speed while ignoring deployment feasibility leads to un-deployable research artifacts.
Learning Objective: Apply the hard-filter-then-soft-preference principle to framework selection decisions
When evaluating framework viability for a production system expected to operate for 5+ years, which factor represents the greatest long-term architectural risk?
- Using Python instead of Fortran for high-level model definitions
- Adopting a niche or abandoned framework with dwindling maintainer support, which risks broken compiler toolchains, lack of support for new accelerator chips, and forced legacy stack maintenance
- Selecting an open-source framework backed by major hardware vendors
- Training on GPU clusters rather than single CPU workstations
Answer: The correct answer is B. Framework selection represents a multi-year infrastructure commitment; choosing an unmaintained or niche framework exposes the organization to severe bit rot, lack of vendor compiler support for future accelerator hardware, security vulnerabilities, and eventual forced migration. Python is the universal standard frontend for ML systems. Vendor-backed open-source frameworks provide stability and active maintenance. GPU cluster training is standard industry practice rather than an architectural risk.
Learning Objective: Evaluate long-term maintenance and ecosystem health risks in framework selection
Describe the three fundamental tensions in the framework selection trade-off space (velocity vs. performance, flexibility vs. optimization depth, ecosystem breadth vs. specialization).
Answer: The first tension balances development velocity (rapid eager prototyping and debugging) against production performance (compiled, high-throughput execution). The second balances programming flexibility (arbitrary Python dynamic control flow) against compiler optimization depth (whole-graph visibility enabling deep operator fusion and memory planning). The third balances ecosystem breadth (broad operator coverage across many tasks) against specialization (narrow runtimes like TensorRT that achieve peak throughput on specific hardware).
Learning Objective: Analyze the three fundamental trade-off axes in framework selection
True or False: Because model weights are stored as floating-point arrays, an engineering team can choose any training framework for research and assume that converting to a production embedded runtime is a trivial format conversion step.
Answer: False. Converting between frameworks and deployment runtimes frequently encounters severe operator coverage gaps, custom kernel incompatibilities, unsupported dynamic control flow, and divergent numerical behaviors, making late-stage conversion a frequent source of project delays.
Learning Objective: Evaluate the fallacy that cross-framework model conversion is a frictionless post-training step
Self-Check: Answer
During the forward execution of an MLP layer
h = torch.relu(x @ W1 + b1)withrequires_grad=True, what two operations occur concurrently inside the framework?- It computes the forward output and immediately updates the weights
W1using gradient descent - It executes the matrix multiplication on the GPU and transmits the gradients back to the host CPU
- It computes the forward numerical activations on the hardware accelerator and constructs a dynamic autograd tape recording the operations and caching required intermediate tensors for the backward pass
- It compiles the entire Python script into a native standalone mobile application
Answer: The correct answer is C. The forward pass has a dual responsibility: computing the mathematical output tensors on the accelerator device, and recording the computational graph (
GradFnnodes) while saving necessary forward activations (such asxand intermediate pre-activations) on the autograd tape for use during backpropagation. Weight updates happen during the optimizer step after the backward pass, not during the forward pass. Gradients are computed during the backward pass, not during forward execution. Forward execution does not compile the script into mobile binaries.Learning Objective: Analyze the dual computational and autograd-recording responsibilities of a framework forward pass
- It computes the forward output and immediately updates the weights
In the chapter’s training step roofline analysis on an NVIDIA A100 GPU, the raw compute and memory transfer time for a 2-layer MLP batch takes ~4 \(\mu\text{s}\), but total eager-mode execution takes ~30–50 \(\mu\text{s}\). What systems bottleneck explains this discrepancy?
- Network congestion across distributed InfiniBand interconnects
- Thermal throttling of the GPU streaming multiprocessors
- Memory leakage inside the PyTorch dynamic class hierarchy
- CPU dispatch overhead, where launching ~12 separate small kernels across Python and CUDA runtimes incurs ~2–5 \(\mu\text{s}\) of launch latency per operation
Answer: The correct answer is D. On small models, the physical execution time of each kernel is tiny (~0.2–1 \(\mu\text{s}\)), making total step time dominated by CPU-to-GPU dispatch overhead (~2–5 \(\mu\text{s}\) per operation across ~12 operations = 24–60 \(\mu\text{s}\)), causing severe GPU underutilization that graph compilation resolves by fusing operations into fewer kernel launches. The analysis is for a single-GPU step, so network interconnect is not involved. Thermal throttling does not account for per-op dispatch latency gaps. The discrepancy is caused by kernel launch overhead, not memory leaks.
Learning Objective: Analyze why small model training steps on high-end accelerators are overhead-bound rather than compute-bound
Contrast the arithmetic intensity of a matrix multiplication (
MatMul) with an element-wise activation function (ReLU) in a neural network layer, and explain why their performance bottlenecks differ fundamentally on modern GPUs.Answer: MatMul has high arithmetic intensity (\(AI \approx 15\text{ FLOPs/Byte}\) for typical hidden dimensions), performing \(\mathcal{O}(N^3)\) operations on \(\mathcal{O}(N^2)\) data, making it compute-bound and capable of saturating GPU tensor cores. In contrast, ReLU performs only 1 FLOP per element while reading and writing 8 bytes in FP32 (\(AI = 0.125\text{ FLOPs/Byte}\)), making it severely memory-bandwidth-bound and bottlenecked entirely by HBM data movement.
Learning Objective: Compare the arithmetic intensity and hardware execution bottlenecks of matrix multiplication versus element-wise activation
**Order the complete sequence of computational and system phases occurring inside a framework during a single standard training iteration:
Loss calculation: The criterion function evaluates the scalar training loss \(\mathcal{L}\)
Backward pass: Autograd traverses the reverse tape, executing Vector-Jacobian Products and populating
.gradbuffersOptimizer step: The optimizer reads
.gradvalues and updates parameter tensors in-place using the optimization algorithmForward pass: The model executes layer operations and records the dynamic autograd tape
Gradient reset:
optimizer.zero_grad()clears or sets.gradbuffers toNone**Answer: The correct sequence is 5 -> 4 -> 1 -> 2 -> 3:
- Gradient reset: Clears accumulated gradients from previous iteration (
zero_grad()).
- Gradient reset: Clears accumulated gradients from previous iteration (
- Forward pass: Evaluates layer activations and builds the autograd tape.
- Loss calculation: Computes scalar objective \(\mathcal{L}\).
- Backward pass: Traverses tape backward to compute parameter gradients.
- Optimizer step: Updates model weights using computed gradients and momentum/decay state.
During the backward pass of a training step, why is memory traffic often significantly higher than in the forward pass, even though the number of mathematical operations is roughly comparable?
Answer: The backward pass requires loading saved forward activations from HBM, loading upstream gradient adjoints, computing parameter gradients, and writing gradient tensors to
.gradmemory buffers. For operations like MatMul and activations, evaluating Vector-Jacobian Products requires reading multiple cached inputs and writing multiple output gradient tensors, resulting in roughly \(2\times\) the memory traffic of the forward pass.Learning Objective: Analyze why the backward pass incurs higher memory traffic than the forward pass
Self-Check: Answer
A research team exploring architecture modifications runs experiments where model code changes every 10 training steps. When they enable JIT graph compilation (
torch.compile), total training time increases by 5\(\times\) compared to standard eager mode. What systems principle explains this performance degradation?- Compilation incurs a large upfront compilation latency (\(T_{\text{compile}}\)); if graph structures or tensor shapes change frequently, the compilation cost cannot be amortized across executions (\(N_{\text{steps}} \times (T_{\text{eager}} - T_{\text{compiled}}) < T_{\text{compile}}\)), making repeated recompilation slower than eager execution
- Compiled kernels run at half the floating-point clock frequency of eager kernels on NVIDIA GPUs
- JIT compilers disable GPU hardware acceleration when running short training scripts
- Dynamic graph compilation automatically converts all FP32 operations to 64-bit double precision
Answer: The correct answer is A. Compilation provides execution speedups by generating optimized fused kernels, but compiling incurs an upfront cost (\(T_{\text{compile}}\), often seconds to minutes); if frequent code or shape changes trigger continuous recompilation without sufficient execution steps to amortize the setup overhead, total runtime will be significantly worse than eager mode. GPU clock frequency is identical for compiled and eager kernels. JIT compilers do not disable GPU acceleration. JIT compilers preserve data types and do not convert FP32 to double precision.
Learning Objective: Calculate and analyze compilation break-even thresholds under frequent model recompilation
Explain why choosing a framework based on community popularity or GitHub stars rather than binding deployment constraints is a severe engineering pitfall for edge and embedded ML projects.
Answer: Popular frameworks are typically optimized for cloud GPU training and server environments where gigabytes of RAM and dynamic memory allocation are available. Deploying to edge devices or microcontrollers requires specific runtime characteristics—such as static memory arenas, microsecond latency budgets, INT8 quantization delegates, and bare-metal C++ runtimes (e.g., TFLite Micro or ExecuTorch). Selecting a framework without validating these binding constraints leads to models that cannot physically fit or execute on target silicon, forcing costly late-stage re-engineering.
Learning Objective: Explain why popularity is an insufficient criterion for framework selection in constrained deployment environments
True or False: Because standard neural network architectures (like ResNet-50 or Transformers) have identical mathematical definitions, any two frameworks running the same model on identical GPU hardware will produce identical throughput.
Answer: False. Execution throughput depends on framework compiler quality, kernel fusion depth, memory layout decisions (NCHW vs. NHWC), dispatch overhead efficiency, and backend library optimizations (e.g. cuBLAS vs custom Triton kernels), leading to substantial performance variations across frameworks for identical mathematical architectures.
Learning Objective: Critique the fallacy that identical model mathematics implies identical framework runtime performance
Self-Check: Answer
How do the three fundamental framework problems (Execution, Differentiation, Abstraction) map directly to the terms of the systems iron law (\(T_{\text{epoch}} = \frac{\text{Work}}{\text{Throughput}} \times \frac{1}{\eta_{\text{hw}}} + \text{Overhead}\))?
- Execution controls dataset size, differentiation controls network latency, and abstraction controls cloud server pricing
- All three problems affect only the floating-point precision of the weights
- Execution affects differentiation, while abstraction has no measurable impact on systems performance
- Execution strategy governs dispatch latency and kernel launch overhead (\(L_{\text{lat}}\)), differentiation governs intermediate activation memory volume and traffic (\(D_{\text{vol}}\)), and hardware abstraction governs silicon utilization efficiency (\(\eta_{\text{hw}}\))
Answer: The correct answer is D. The chapter establishes that framework mechanisms directly control the physical terms of the iron law: execution models dictate dispatch latency and launch tax (\(L_{\text{lat}}\)), autograd mechanisms dictate activation caching and memory traffic (\(D_{\text{vol}}\)), and hardware abstraction compilers dictate kernel mapping and hardware utilization (\(\eta_{\text{hw}}\)). Mapping execution to dataset size or differentiation to network latency misrepresents the framework’s internal scope. Asserting they only affect precision ignores execution planning and memory management. Claiming abstraction has no performance impact contradicts the core role of hardware-specific kernel lowering.
Learning Objective: Synthesize how execution, differentiation, and abstraction map to the governing terms of the systems iron law
Summarize why the memory wall—rather than raw floating-point arithmetic capacity—has become the primary driver of modern ML framework compiler innovations (such as kernel fusion and activation checkpointing).
Answer: Over recent decades, accelerator compute capacity has expanded at a much faster rate than memory bandwidth, creating a massive arithmetic-to-bandwidth gap where memory transfers are hundreds of times slower and more energy-intensive than floating-point math. Consequently, framework innovations focus on reducing memory traffic (\(D_{\text{vol}}\)): kernel fusion keeps intermediate activations in fast on-chip SRAM/registers to avoid round trips to global HBM, while activation checkpointing trades cheap compute to reduce peak memory footprint.
Learning Objective: Explain why the memory wall drives framework compiler optimizations like kernel fusion and rematerialization
True or False: An ML framework can eliminate the physical constraints imposed by the iron law of performance if an engineer writes clean, high-level declarative Python code.
Answer: False. A framework is a compiler for the silicon contract that shifts costs between the terms of the iron law (dispatch overhead, memory volume, hardware utilization) rather than eliminating them; no abstraction layer can bypass the physical limits of hardware bandwidth, latency, or compute capacity.
Learning Objective: Evaluate the systems reality that framework abstractions shift rather than eliminate iron law constraints