Vận hành machine learning
Mục đích
Vì sao một hệ thống ML có thể vừa luôn khả dụng lại vừa sai hoàn toàn cùng lúc?
Giám sát truyền thống thường phát hiện nhanh các sự cố, độ trễ tăng và lỗi khả dụng, nhưng lỗi ngữ nghĩa có thể âm thầm tồn tại trong bất kỳ hệ thống phần mềm nào. Các hệ thống ML còn thêm một dạng lỗi thầm lặng khác. Một mô hình bị trôi dạt dữ liệu có thể tiếp tục phục vụ (serving) các dự đoán trông bình thường trong khi độ chính xác giảm dần, mà không hề kích hoạt cảnh báo vì mọi chỉ số sức khỏe (độ trễ, thông lượng, thời gian hoạt động) vẫn xanh. Hạ tầng phục vụ đưa mô hình vào sản xuất; vận hành giúp giữ cho chúng đúng khi đã ở đó. Chất lượng mô hình có thể giảm vì thế giới thay đổi. Hành vi khách hàng dịch chuyển, danh mục sản phẩm mới xuất hiện, các mẫu theo mùa biến đổi, và phân phối dữ liệu mà mô hình đã học khác dần so với phân phối mà nó đang đối mặt. Trôi dạt không phải điều chắc chắn, nhưng là rủi ro dai dẳng với các mô hình đã triển khai. Khác với độ trễ hay thời gian hoạt động, tính đúng đắn của mô hình có thể chỉ thấy được sau khi có nhãn hoặc các kết quả đầu ra về sau, nên việc phát hiện suy giảm thường cần các tín hiệu chưa hoàn hảo và điều tra rõ ràng, chứ không chỉ một ngưỡng duy nhất. Để quản lý, cần giám sát liên tục theo dõi chất lượng dự đoán song song với sức khỏe hệ thống; tín hiệu trôi dạt để kích hoạt điều tra; huấn luyện lại khi bằng chứng về kết quả ủng hộ; và các chiến lược triển khai giúp xác thực phiên bản mô hình mới với lưu lượng sản xuất trước khi rollout hoàn toàn. Khoảng cách giữa phát triển và sản xuất không phải rào cản vượt qua một lần rồi thôi, mà là trạng thái phải quản lý liên tục. Vận hành machine learning tồn tại vì chỉ có thời gian hoạt động mà không đo được độ chính xác thì vẫn có thể trả lời sai ở quy mô lớn. Nó khiến đồng thiết kế D·A·M diễn ra liên tục, vì môi trường dữ liệu có thể vẫn là mục tiêu thay đổi liên tục rất lâu sau đợt triển khai ban đầu.
Learning Objectives
- Giải thích vì sao các hệ thống ML có thể vẫn khả dụng trong khi chất lượng dự đoán âm thầm suy giảm khi phân phối dữ liệu thay đổi.
- Chẩn đoán nợ kỹ thuật tại các ranh giới giao diện giữa dữ liệu–mô hình, mô hình–hạ tầng, và sản xuất–giám sát.
- Thiết kế các kho đặc trưng (feature store), registry và CI/CD pipeline để giữ nhất quán giữa huấn luyện và phục vụ (serving), đồng thời hỗ trợ rollback có thể tái lập.
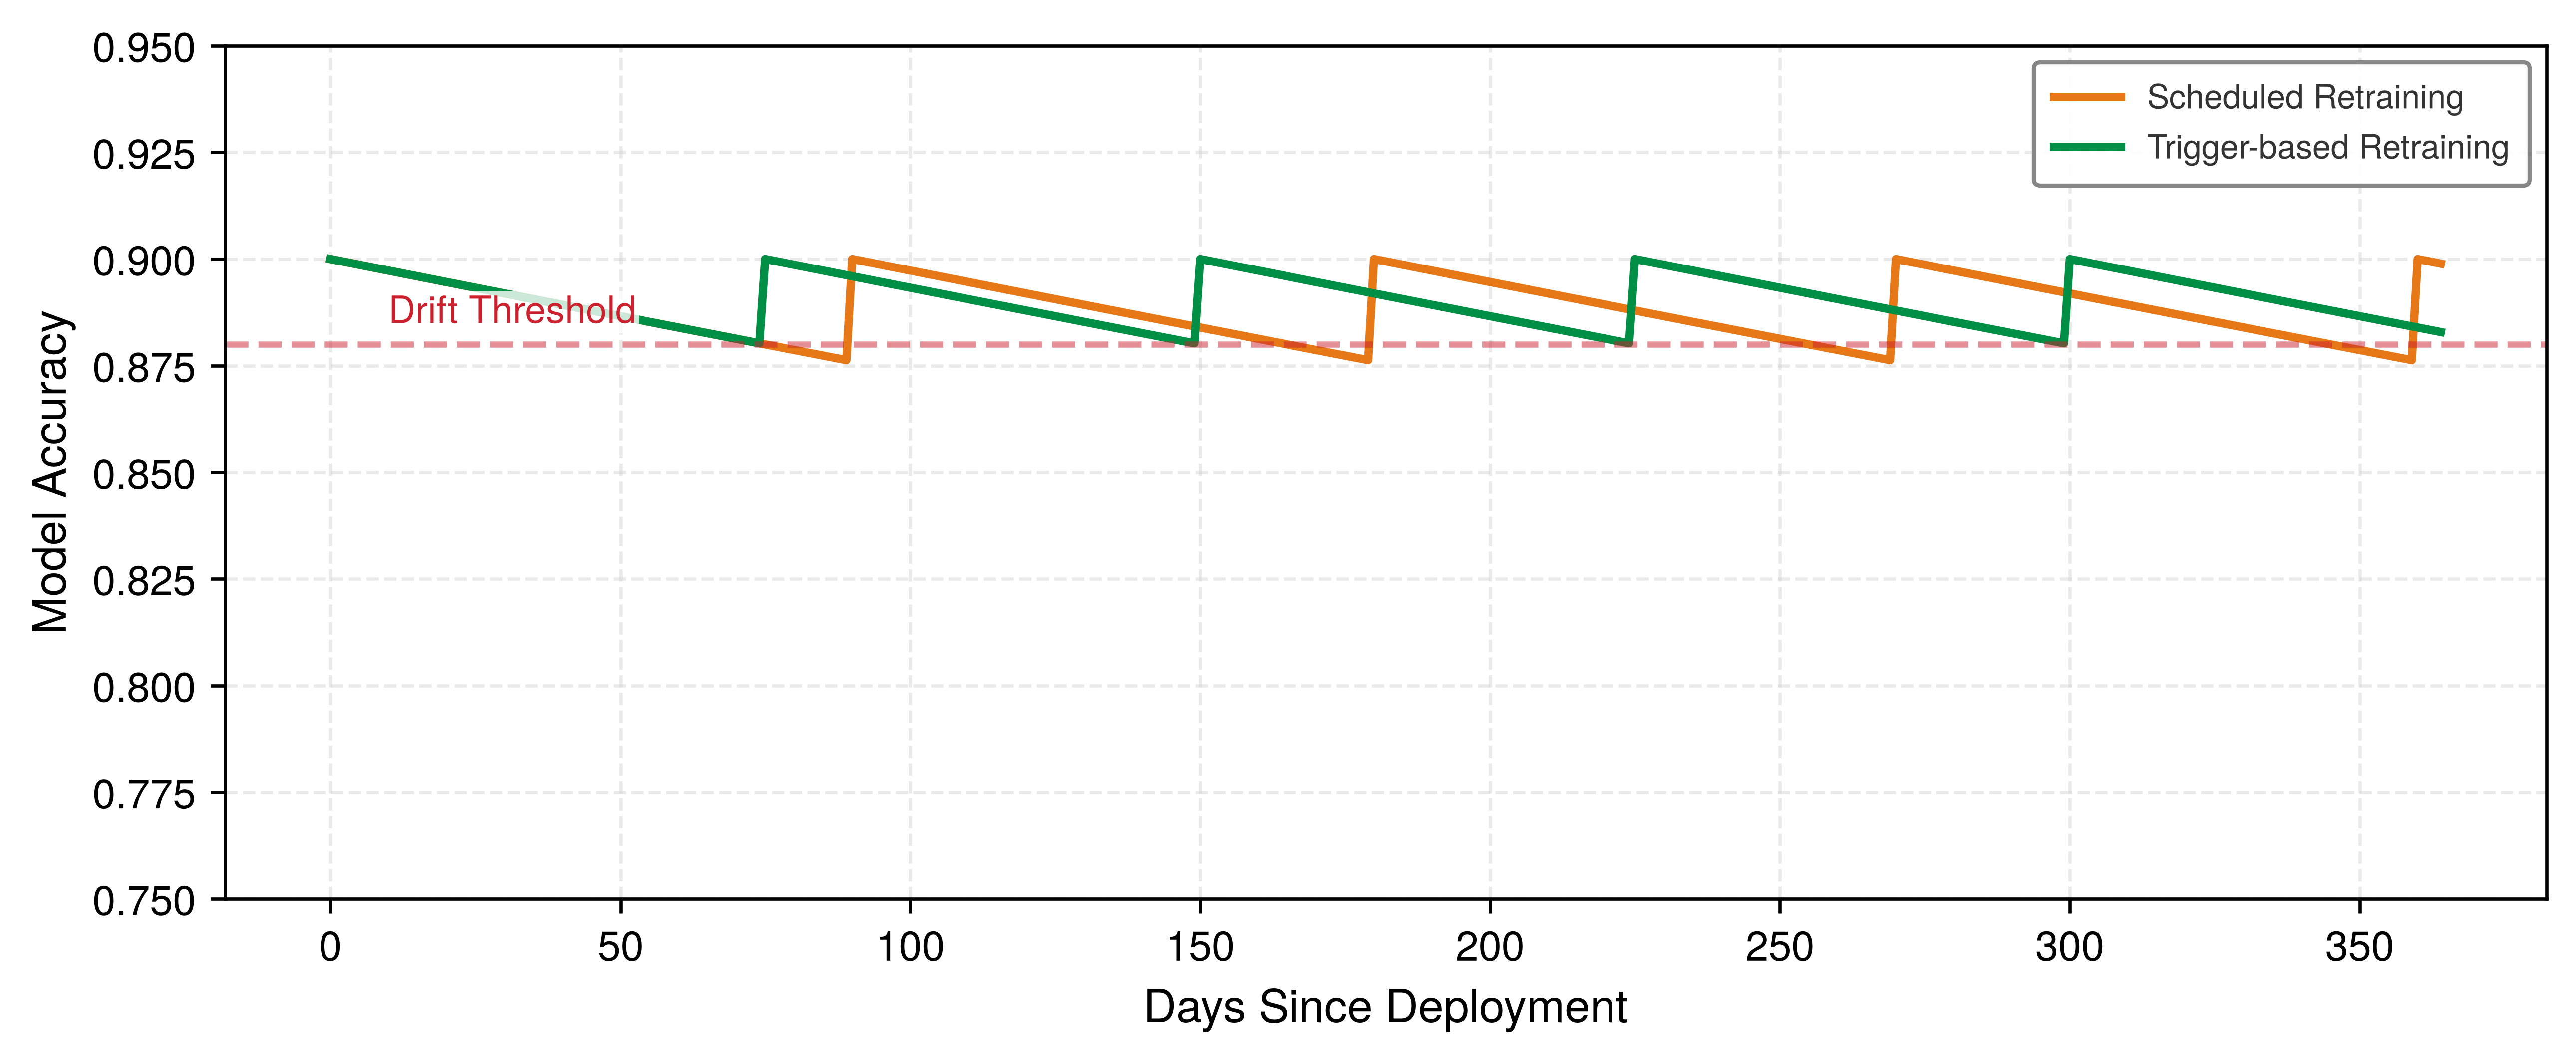
- Áp dụng mô hình độ lỗi thời cho huấn luyện lại để chọn các yếu tố kích hoạt và khoảng thời gian huấn luyện lại có cân nhắc chi phí.
- Triển khai giám sát phân lớp để theo dõi drift, skew, suy giảm hiệu suất, các chỉ số kinh doanh và độ tươi của dữ liệu.
- So sánh các chiến lược canary, blue-green, shadow và rollback để quản lý rủi ro khi phát hành mô hình vào môi trường sản xuất.
- Đánh giá mức độ trưởng thành vận hành và mức đầu tư dựa trên mức độ quan trọng của mô hình, rủi ro vận hành và mức độ sẵn sàng của tổ chức.
Tổng quan về MLOps
Sau khi mô hình được xây dựng, tối ưu hóa, benchmark và phục vụ (serving), hệ thống vẫn phải đảm bảo đúng đắn. Benchmark thiết lập hiệu suất tại một thời điểm; hạ tầng phục vụ (serving) đáp ứng yêu cầu trong vài mili giây. Nhóm triển khai lên môi trường sản xuất, và tuần đầu tiên trông rất khả quan. Thử thách bắt đầu từ tuần thứ hai.
Phân phối dữ liệu thay đổi, hành vi người dùng thay đổi, và thế giới cũng khác đi so với điều kiện khi mô hình được huấn luyện. Các mô hình machine learning dù thành công trong giai đoạn phát triển vẫn có thể không duy trì được sử dụng bền vững trong sản xuất nếu thiếu quyền sở hữu và giám sát sau triển khai. Nguyên nhân sâu xa là sự không tương thích trong vận hành: giám sát tập trung vào tính khả dụng thường theo dõi thời gian hoạt động của máy chủ, độ trễ phản hồi và tỷ lệ yêu cầu thành công, trong khi giám sát machine learning còn phải theo dõi tình trạng thống kê của mô hình, gồm độ chính xác theo thời gian, dịch chuyển phân phối dữ liệu đầu vào và chất lượng dự đoán theo từng phân đoạn. Một mô hình có thể suy giảm đáng kể mà không hề ném ngoại lệ, không kích hoạt cảnh báo hạ tầng nào và vẫn duy trì thời gian hoạt động hoàn hảo.
Lĩnh vực giúp làm rõ những lỗi tưởng như vô hình này chính là vận hành machine learning (MLOps). MLOps kết hợp giám sát, tự động hóa và quản trị vào các kiến trúc sản xuất, nhằm phát hiện suy giảm hiệu năng, kích hoạt huấn luyện lại và duy trì tình trạng ổn định của hệ thống trong suốt vòng đời hoạt động của mô hình. MLOps kế thừa di sản tự động hóa và vận hành từ DevOps (Kreuzberger et al. 2023), nhưng lại giải quyết một kiểu lỗi khác. Các dịch vụ truyền thống thường có thể được kiểm thử theo các luồng mã xác định, trong khi các hệ thống machine learning lại phụ thuộc vào phân phối dữ liệu huấn luyện, các tham số đã học và các điều kiện môi trường thay đổi liên tục.
Vấn đề của tuần thứ hai được thể hiện rõ qua một tình huống triển khai minh họa. Hãy xem xét một hệ thống dự đoán nhu cầu cho dịch vụ gọi xe. Ban đầu, hệ thống đạt độ chính xác 94%, độ trễ p99 là 15 ms và hoạt động tốt trên các phân khúc thử nghiệm. Đến tuần thứ tư, độ chính xác giảm xuống 88%, nhưng các chỉ số hạ tầng không cho thấy điều gì bất thường. Đến tuần thứ tám, một quản lý sản phẩm nhận thấy việc điều phối tài xế kém hiệu quả; khi điều tra, họ phát hiện mô hình chưa kịp thích nghi với chương trình khuyến mãi mới của đối thủ khiến hành vi người dùng thay đổi. Lẽ ra mô hình cần được huấn luyện lại từ sáu tuần trước, nhưng không có hệ thống nào theo dõi sự suy giảm này. MLOps cung cấp một framework để phát hiện những sự trôi dạt như vậy, kích hoạt huấn luyện lại và xác thực các mô hình mới trước khi người dùng phải chịu tác động.
Sự sai lệch trong vận hành gắn trực tiếp với các nền tảng phân tích của cuốn sách. Nếu benchmarking là các cảm biến của hệ thống, thì MLOps là hệ thống điều khiển hoàn chỉnh. Nó thu hẹp khoảng cách xác minh trong phương trình khoảng cách xác minh (equation) bằng cách liên tục hiệu chỉnh để thích nghi với một thế giới luôn thay đổi. MLOps có thể vận hành một phương trình suy giảm được khớp cục bộ (equation) khi dữ liệu về độ trôi và kết quả được ghép cặp cho thấy thay đổi phân phối dự báo việc giảm độ chính xác; chỉ riêng sự phân kỳ không chứng minh rằng suy giảm là điều tất yếu. MLOps cũng chuẩn hóa các giao diện và trách nhiệm giữa các lĩnh vực vốn thường tách rời (khoa học dữ liệu, kỹ thuật machine learning và vận hành hệ thống (Amershi et al. 2019)) thông qua huấn luyện lại liên tục, đánh giá A/B, triển khai theo giai đoạn và theo dõi các artifact theo tiêu chuẩn, hỗ trợ khả năng tái tạo và kiểm toán.
Việc triển khai, giám sát và duy trì một hệ thống ML trong môi trường sản xuất xác định đơn vị vận hành cho chương này: nút ML, một hệ thống hoàn chỉnh bao gồm các pipeline dữ liệu, tính toán đặc trưng, huấn luyện mô hình, hạ tầng phục vụ (serving) và giám sát dành cho một ứng dụng machine learning duy nhất. Các hoạt động nền tảng ở quy mô lớn hơn (quản lý hàng trăm mô hình, các phụ thuộc giữa mô hình, điều phối đa khu vực và kỹ thuật nền tảng machine learning cho toàn tổ chức) là các chủ đề nâng cao, được xây dựng dựa trên nền tảng của các mô hình đơn lẻ này.
Vòng đời của một nút ML trong môi trường sản xuất bắt đầu từ bài toán kiểm soát tuần thứ hai và đi theo các giao diện giúp hệ thống có thể quan sát được. Nợ kỹ thuật lý giải vì sao ML trong sản xuất trở nên tốn kém sau lần triển khai đầu tiên thành công; khi đó, kho đặc trưng, các pipeline CI/CD và theo dõi thử nghiệm sẽ xác định hạ tầng cần thiết để tái tạo dữ liệu, mã nguồn, tham số và cấu hình. Khi những artifact này có thể được tái tạo, việc giám sát, phát hiện độ trôi, chiến lược triển khai và ứng phó sự cố sẽ giữ cho mô hình khỏe mạnh theo thời gian. Các quyết định đầu tư và các nghiên cứu điển hình sau đó cho thấy cùng một nguyên tắc sẽ hiện lên khác nhau trong thiết bị đeo edge và trong các hoạt động AI lâm sàng.
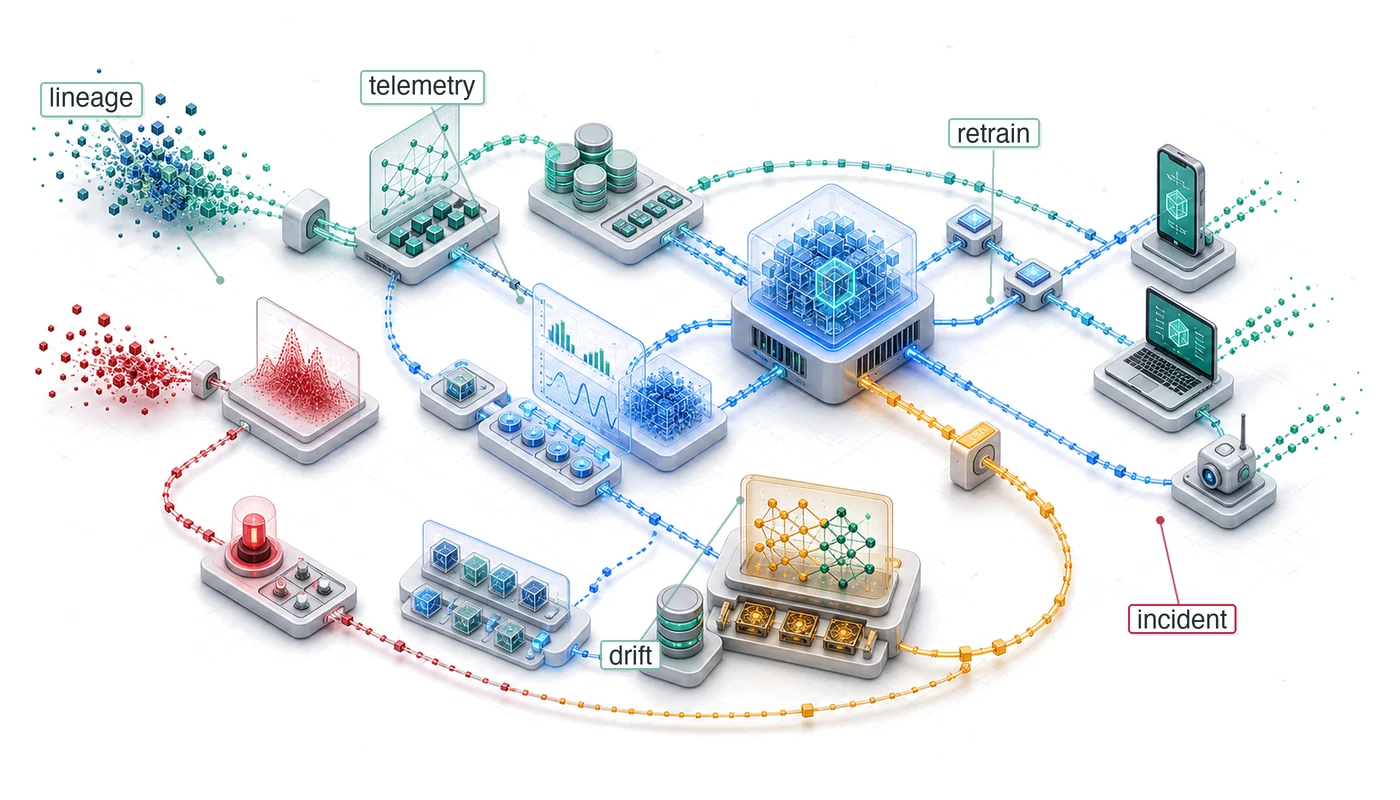
Thách thức vận hành một mô hình đơn lẻ tách thành ba giao diện riêng. Giao diện dữ liệu-mô hình là chốt bàn giao giữa hạ tầng dữ liệu và huấn luyện mô hình; mục tiêu là đảm bảo tính nhất quán đặc trưng, để các pipeline huấn luyện và phục vụ (serving) tính đặc trưng theo cùng một cách. Giao diện mô hình-cơ sở hạ tầng là bước chuyển từ các trọng số đã huấn luyện sang dịch vụ có khả năng mở rộng; thách thức là đồng nhất môi trường, vì một mô hình chạy tốt trong notebook có thể hỏng khi lên môi trường sản xuất do lệch phiên bản, phụ thuộc hoặc runtime. Giao diện giám sát sản xuất là vòng lặp phản hồi giúp hệ thống tự điều chỉnh, đưa telemetry thống kê từ sản xuất về huấn luyện, vì các hệ thống ML có thể suy giảm do drift mà không hề sập.
Các giao diện này quyết định vị trí của các thành phần hạ tầng trong chương. Kho đặc trưng giúp ổn định việc tính toán đặc trưng ở ranh giới dữ liệu-mô hình. Kho đăng ký mô hình và các pipeline triển khai giữ vững quá trình bàn giao giữa mô hình và hạ tầng. Bộ theo dõi drift, các trình kích hoạt huấn luyện lại và chính sách quản trị đóng kín vòng lặp giám sát sản xuất, trước khi sự suy giảm âm thầm trở thành thất bại kinh doanh.
Telemetry1 đi qua các giao diện này cung cấp dữ liệu cần thiết để đưa ra các quyết định vận hành có cơ sở. Chính phạm vi vận hành đó làm rõ nhiệm vụ tiếp theo: phân biệt MLOps với DevOps truyền thống, xác định các nguyên tắc nền tảng chi phối các quyết định trong sản xuất, và chỉ ra các dạng nợ kỹ thuật tích lũy khi những nguyên tắc ấy bị bỏ qua.
1 Telemetry: Kênh phản hồi giúp làm lộ rõ sự suy giảm của mô hình trước khi nó trở thành thất bại kinh doanh; các sự cố và mã lỗi có thể phơi bày một số lỗi phần mềm, nhưng lỗi ngữ nghĩa có thể im lặng trong bất kỳ ứng dụng nào. Hệ thống ML còn có thêm rủi ro dịch chuyển phân phối, điều này khó phát hiện nếu thiếu telemetry thống kê như phân phối đặc trưng, độ tin cậy dự đoán và chỉ báo drift. Chỉ số về tính khả dụng thôi sẽ không phơi bày được sự suy giảm này.
Self-Check: Question
A fraud detection service maintains a 12 ms P99 latency, 99.99% server availability, and zero HTTP error responses. However, over six weeks, the true positive rate drops from 96% to 78% due to evolving fraudster tactics. Which operational challenge does this scenario illustrate?
- The hardware compute capacity ceiling between GPU memory and host memory
- The protocol communication overhead between REST endpoints and gRPC streaming
- The operational mismatch between traditional infrastructure availability and statistical predictive correctness
- The serialization throughput bottleneck between CPU preprocessing and accelerator execution
Which scenario represents a direct failure of the Data-Model Interface in a production ML system?
- An inference container crashes upon startup because the host system has an incompatible CUDA driver
- A candidate model deployment is delayed because previous model weights were not cached in warm standby
- A statistical drift alert is routed to an unmonitored ticketing queue instead of the on-call engineer
- An online inference service computes user_session_duration in seconds while the offline training pipeline calculated it in minutes
Explain why MLOps treats a deployed model as a closed-loop control system rather than a terminal release pipeline.
True or False: An ML Node is defined solely as the trained neural network weight file packaged inside a container runtime.
Nguyên tắc và nền tảng
Một bản phát hành ML trong môi trường sản xuất không còn chỉ là khác biệt về mã nguồn: phân phối dữ liệu, tham số đã huấn luyện, các lát cắt đánh giá và các vòng lặp phản hồi từ giám sát đều trở thành các đối tượng phát hành có thể làm thay đổi hành vi của hệ thống. MLOps được xây dựng dựa trên DevOps nhưng tập trung giải quyết các yêu cầu đặc thù của phát triển và triển khai hệ thống ML (Kreuzberger et al. 2023; Amershi et al. 2019). CI/CD truyền thống thường lý giải chủ yếu dựa trên mã, cấu hình, kiểm thử và hạ tầng như những đối tượng phát hành chính; còn vận hành ML phải quản lý thêm các tạo phẩm mà tính hợp lệ của chúng phụ thuộc vào dữ liệu và môi trường đã tạo ra chúng.
Amershi, Saleema, Andrew Begel, Christian Bird, Robert DeLine, Harald Gall, Ece Kamar, Nachiappan Nagappan, Besmira Nushi, and Thomas Zimmermann. 2019. “Software Engineering for Machine Learning: A Case Study.” 2019 IEEE/ACM 41st International Conference on Software Engineering: Software Engineering in Practice (ICSE-SEIP), 291–300. https://doi.org/10.1109/icse-seip.2019.00042.
DevOps tích hợp và phân phối các hệ thống phần mềm. MLOps còn phải quản lý các quy trình làm việc mang tính thống kê và phụ thuộc dữ liệu, trải dài từ thu thập dữ liệu, tiền xử lý, huấn luyện mô hình, đánh giá, triển khai đến giám sát liên tục. Tất cả được vận hành trong một chu trình lặp kết nối thiết kế, phát triển mô hình và vận hành. Hãy quan sát cấu trúc “vòng lặp vô hạn” trong figure 1 để thấy các giai đoạn này liên tục phản hồi lẫn nhau; chính vòng lặp đó định hình cách lĩnh vực này vận hành.
Definition 1.1: MLOps
Machine learning operations (MLOps) là thực tiễn kỹ thuật đưa các hệ thống ML vào môi trường sản xuất thông qua CI/CD, điều phối workflow, đảm bảo khả năng tái tạo, quản lý phiên bản, cộng tác, huấn luyện và đánh giá liên tục, giám sát và các vòng lặp phản hồi (Kreuzberger et al. 2023).
- Ý nghĩa: Nếu không đóng vòng lặp này, chúng ta sẽ phải trả giá bằng các dự đoán lỗi thời, phát hiện chậm và những việc khắc phục lẽ ra tránh được. Các ngưỡng drift, tín hiệu kích hoạt huấn luyện lại và mục tiêu thời gian trung bình để phục hồi (MTTR) là các đại lượng đặc thù cho từng lần triển khai. Chúng được hiệu chỉnh dựa trên giá trị kinh doanh của các dự đoán, độ trễ nhãn, rủi ro xác thực và chi phí huấn luyện lại. Điều quan trọng không phải là một ngưỡng chung, mà là vòng lặp kiểm soát định lượng: đo lường dịch chuyển phân phối, ước tính chi phí do lỗi thời, chỉ kích hoạt huấn luyện lại khi lợi ích kỳ vọng lớn hơn rủi ro xác thực và triển khai, và phải xác minh mô hình thay thế trước khi đưa vào sử dụng chính thức.
- Điểm khác biệt: DevOps có thể giám sát tính đúng đắn chức năng và kết quả kinh doanh, cũng như tính khả dụng của hệ thống. MLOps bổ sung các kiểm soát thống kê cho độ chính xác của dự đoán, yếu tố có thể suy giảm ngay cả khi thời gian hoạt động, tỷ lệ lỗi và độ trễ vẫn ở trạng thái tốt.
- Cạm bẫy thường gặp: Một hiểu lầm phổ biến là cho rằng chỉ cần huấn luyện lại mô hình với dữ liệu mới là giải quyết được dịch chuyển phân phối. Thực tế, nếu huấn luyện lại mà không chẩn đoán rõ phân phối nào đã thay đổi (phân phối đặc trưng đầu vào (\(p(x)\)), mối quan hệ nhãn–đặc trưng (\(p(y \mid x)\)), hay cả hai), thì có thể giữ nguyên lỗi gốc hoặc làm tăng độ chệch (bias) khi lấy mẫu và gán nhãn. Dưới bối cảnh dịch chuyển hiệp biến (covariate shift) và các giả định về miền hỗ trợ (support), việc điều chỉnh trọng số hoặc lấy mẫu lại mang tính đại diện có thể hữu ích; còn dịch chuyển khái niệm (concept drift) thường đòi hỏi nhãn hiện tại và thích ứng mô hình.
Kreuzberger, Dominik, Niklas Kühl, and Sebastian Hirschl. 2023. “Machine Learning Operations (MLOps): Overview, Definition, and Architecture.” IEEE Access 11: 31866–79. https://doi.org/10.1109/access.2023.3262138.

Sự phức tạp vận hành và rủi ro kinh doanh khi triển khai machine learning mà thiếu các thực hành kỹ thuật có hệ thống trở nên rõ ràng qua một ví dụ bán lẻ đơn giản. Ban đầu, một mô hình khuyến nghị giúp tăng doanh số, nhưng drift dữ liệu âm thầm dần làm giảm chất lượng dự đoán. Nếu hệ thống giám sát chỉ theo dõi uptime của hệ thống thay vì kết quả của mô hình, khoản thất thoát này có thể bị che khuất cho đến tận một kỳ rà soát kinh doanh sau đó. MLOps cung cấp các cơ chế kiểm soát để khiến những lỗi như vậy lộ diện sớm, trước khi chúng tích tụ thành tổn hại đáng kể về vận hành và tài chính.
Các nguyên tắc nền tảng
Triển khai bán lẻ đó cho thấy một mô thức lặp lại. Thiếu các thực hành vận hành có hệ thống, ngay cả mô hình chính xác cũng có thể thất bại ngoài thực tế. Hãy đọc sự cố này như một chuỗi gỡ lỗi. Khi doanh thu giảm, câu hỏi đầu tiên là nhóm có tái tạo được mô hình đã triển khai hay không — điều này đòi hỏi khả năng tái tạo. Câu hỏi tiếp theo: pipeline dữ liệu, job huấn luyện, đường phục vụ (serving), và hệ thống giám sát có ranh giới đủ rõ để cô lập lỗi không — điều này đòi hỏi tách biệt trách nhiệm. Nếu đặc trưng phục vụ không còn khớp với đặc trưng huấn luyện, tính nhất quán là cơ chế kiểm soát ngăn sự cố lặp lại. Nếu drift khởi phát trước khi người dùng kịp phàn nàn, suy giảm có thể quan sát được là cơ chế biến lỗi âm thầm thành cảnh báo. Cuối cùng, nếu có thể huấn luyện lại nhưng tốn kém, tự động hóa có tính đến chi phí sẽ quyết định khi nào nên can thiệp, cân bằng rủi ro vận hành và chi phí tính toán. Những nguyên tắc này đặt tên cho các cơ chế kiểm soát theo đúng thứ tự mà một nhóm vận hành cần.
Khả năng tái tạo
Khả năng tái tạo yêu cầu mọi tạo phẩm2 ảnh hưởng đến hành vi của mô hình phải được phiên bản hóa và truy vết được. Nguyên tắc này vượt ra ngoài việc phiên bản hóa mã, bao gồm cả dữ liệu, cấu hình và môi trường. Equation 1 thể hiện phụ thuộc này một cách hình thức: \[\text{Model Output} = f(\text{Code}_v, \text{Data}_v, \text{Config}_v, \text{Environment}_v; \xi) \tag{1}\] trong đó \(v\) xác định phiên bản và \(\xi\) biểu diễn tính ngẫu nhiên khi thực thi. Việc tái tạo đòi hỏi cả bốn đầu vào đã được phiên bản hóa, và cũng có thể cần seed, thứ tự dữ liệu, kernel xác định, và phần cứng tương thích. Các công cụ hỗ trợ gồm kiểm soát phiên bản, phiên bản hóa dữ liệu, và quản lý cấu hình.
2 Tạo phẩm: Các trọng số mô hình là các đầu ra hữu hình của quá trình huấn luyện; các đầu vào và yếu tố ngẫu nhiên đã tạo ra chúng thường không thể suy ra từ các tham số. Vì vậy, chỉ quản lý phiên bản mã nguồn là không đủ, và ngay cả khi quản lý phiên bản mã nguồn, dữ liệu, cấu hình và môi trường, vẫn có thể không bảo đảm phát lại y hệt nếu các kernel hoặc quá trình huấn luyện là không xác định.
Tách biệt các mối quan tâm
Tách biệt các mối quan tâm phân tách các hệ thống MLOps thành các lớp chức năng riêng biệt có thể phát triển độc lập, như table 1 minh họa:
| Lớp | Trách nhiệm | Độ ổn định |
|---|---|---|
| Lớp Dữ liệu | Tính toán đặc trưng, lưu trữ, phục vụ (serving) | Thay đổi theo sự phát triển của lược đồ dữ liệu |
| Lớp Huấn luyện | Phát triển mô hình, tối ưu hóa siêu tham số | Thay đổi theo nghiên cứu thuật toán |
| Lớp Phục vụ (serving) | Suy luận, khả năng mở rộng, quản lý độ trễ | Thay đổi theo các mẫu lưu lượng truy cập |
| Lớp Giám sát | Phát hiện trôi dạt, theo dõi hiệu suất | Thay đổi theo yêu cầu kinh doanh |
Tính nhất quán là yếu tố then chốt
Sự tách biệt trong table 1 cho phép các nhóm cập nhật cơ sở hạ tầng phục vụ (serving) mà không cần huấn luyện lại mô hình, thay đổi ngưỡng giám sát mà không cần triển khai lại, và phát triển các pipeline dữ liệu trong khi vẫn giữ khả năng tương thích của mô hình. Sự độc lập đó chỉ an toàn khi môi trường huấn luyện và phục vụ (serving) xử lý dữ liệu giống hệt nhau, khiến sự tương ứng giữa huấn luyện và phục vụ (serving) trở thành một yêu cầu bắt buộc về tính nhất quán. Tác động tài chính của sự không nhất quán này được thể hiện trong equation 2: \[\text{Skew Cost} = \text{Rate}_{\text{skew}} \times Q \times C_{\text{error}} \tag{2}\] trong đó \(\text{Rate}_{\text{skew}}\) là tỷ lệ truy vấn bị ảnh hưởng bởi độ lệch giữa huấn luyện và phục vụ (serving), \(Q\) là tổng khối lượng truy vấn mỗi kỳ kế toán, và \(C_{\text{error}}\) là chi phí kinh doanh trung bình phát sinh cho mỗi dự đoán sai.
Đối với một hệ thống phục vụ 1,000,000 queries/day với 1 percent lỗi do độ lệch gây ra, mỗi lỗi có chi phí $0.10, chi phí độ lệch hàng năm đạt $365,000. Điều này lượng hóa vì sao các cơ chế đảm bảo tính nhất quán là những khoản đầu tư mang lại lợi nhuận có thể đo lường được. Các cơ chế này gồm kho đặc trưng (feature store), mã tiền xử lý dùng chung và kiểm tra xác thực.
Suy giảm có thể quan sát được
Suy giảm có thể quan sát được yêu cầu các hệ thống ML làm lộ rõ các lỗi thầm lặng thông qua đo lường liên tục. Hiệu suất mô hình có thể suy giảm dọc theo một phổ liên tục thay vì hỏng rời rạc; và dạng diễn tiến theo thời gian của một lỗi được quan sát—dù là tụt đột ngột, trôi dần, hay suy giảm ở một nhóm con—giúp quyết định cách phát hiện và cách hệ thống nên phản ứng.
Tự động hóa có cân nhắc chi phí
Tự động hóa có cân nhắc chi phí cần cân bằng giữa chi phí tính toán và mức cải thiện độ chính xác. Gọi \(\Delta\text{Accuracy}\) là số điểm phần trăm độ chính xác dự kiến tăng thêm, \(\text{Value per Point}\) là giá trị bằng tiền của mỗi điểm phần trăm tăng thêm trong suốt khoảng thời gian ra quyết định, \(\text{Training Cost}\) là chi phí tính toán và nhân lực cho một lượt huấn luyện lại, và \(\text{Deployment Risk}\) là chi phí kỳ vọng do khâu xác thực và các thất bại khi phát hành/triển khai. Equation 3 mô tả sự đánh đổi này: \[\text{Retrain if: } \Delta\text{Accuracy} \times \text{Value per Point} > \text{Training Cost} + \text{Deployment Risk} \tag{3}\]
Bất đẳng thức này là một ngưỡng quyết định, không phải cơ chế kích hoạt tự động. Chỉ huấn luyện lại khi bằng chứng về kết quả cho thấy lợi ích kỳ vọng vượt cả chi phí chạy huấn luyện và rủi ro khi phát hành/triển khai. Table 2 ghép mỗi dấu hiệu lỗi có thể quan sát được với một bộ phát hiện và phản ứng vận hành phù hợp.
| Loại suy giảm | Cơ chế phát hiện | Chiến lược phản hồi |
|---|---|---|
| Giảm độ chính xác đột ngột | Cảnh báo ngưỡng | Chẩn đoán; quay lại nếu liên quan đến bản phát hành |
| Trôi dạt dần dần | Phân tích xu hướng | Chẩn đoán, sau đó huấn luyện lại nếu cần thiết |
| Suy giảm nhóm con | Giám sát nhóm đối tượng | Thu thập dữ liệu có mục tiêu |
| Tăng độ trễ | Theo dõi phân vị | Mở rộng cơ sở hạ tầng |
Nguyên tắc này định hướng cách thiết kế các tín hiệu kích hoạt huấn luyện lại, ngưỡng xác thực và chiến lược triển khai sẽ được xem xét trong chương này. Các giá trị cụ thể khác nhau theo từng lĩnh vực, nhưng framework để ra quyết định đánh đổi có cơ sở thì vẫn giữ nguyên. Phân tích huấn luyện lại trong section 1.4.2.2 xây dựng mô hình kinh tế đầy đủ, kèm các ví dụ minh họa cách tính khoảng thời gian huấn luyện lại tối ưu. Khi chuỗi nhân quả đã rõ, năm nguyên tắc này có thể đóng vai trò framework đánh giá gọn nhẹ cho công cụ và thực tiễn. Luận điểm cốt lõi của table 3 là mỗi nguyên tắc chỉ thực sự vận hành khi được gắn với một chỉ số đo lường cụ thể: ghép mỗi nguyên tắc với chỉ số then chốt của nó, từ hash của artifact đến giá trị ròng của huấn luyện lại, là điều giúp framework này có thể kiểm toán, thay vì chỉ mang tính kỳ vọng.
| Nguyên tắc | Thông tin chuyên sâu cốt lõi | Chỉ số chính |
|---|---|---|
| Khả năng tái tạo | Lập phiên bản tất cả các artifact | Hash artifact hoàn chỉnh |
| Tách biệt các mối quan tâm | Sự phát triển lớp độc lập | Điểm ghép nối lớp |
| Tính nhất quán | Huấn luyện tương đương với phục vụ (serving) | Tỷ lệ lệch đặc trưng |
| Suy giảm có thể quan sát được | Làm cho các lỗi hiển thị | Thời gian phát hiện |
| Tự động hóa có tính đến chi phí | Tối ưu hóa tổng chi phí | Giá trị huấn luyện lại ròng |
Cách các nguyên tắc này thể hiện trong thực tế phụ thuộc vào khối lượng công việc (workload). Ví dụ, một hệ thống khuyến nghị có thể trôi mỗi ngày khi sở thích người dùng thay đổi; trong khi một mô hình TinyML được triển khai trên phần cứng nhúng có thể chạy không đổi trong nhiều tháng. Do đó, chiến lược giám sát phải phù hợp với từng nguyên mẫu.
Lighthouse 1.1: Chiến lược giám sát theo nguyên mẫu
Các dạng lỗi chính và ưu tiên giám sát khác nhau giữa các nguyên mẫu khối lượng công việc (workload). Bảng Table 4 so sánh bốn nguyên mẫu tiêu biểu theo kiểu trôi, chỉ số giám sát và ví dụ về tín hiệu kích hoạt huấn luyện lại:
| Nguyên mẫu | Mẫu trôi dạt chủ đạo | Chỉ số giám sát chính | Ví dụ về yếu tố kích hoạt huấn luyện lại |
|---|---|---|---|
| ResNet-50 (Quái vật tính toán) | Thay đổi phân phối hình ảnh (ánh sáng, máy ảnh, các lớp đối tượng mới) | Độ chính xác trên tập giữ lại (có sẵn sự thật cơ sở) | Độ chính xác giảm > 2% so với đường cơ sở (\(\sim\)hàng tháng đối với các lĩnh vực ổn định) |
| GPT-2 (Kẻ ngốn băng thông) | Trôi dạt từ vựng, thay đổi chủ đề, các thực thể mới nổi | Perplexity trên lưu lượng truy cập trực tiếp (không cần sự thật cơ sở) | Perplexity tăng > 10%; phát hiện từ vựng mới (\(\sim\)hàng tuần đối với các lĩnh vực tin tức) |
| DLRM (Phân tán thưa thớt) | Thay đổi hành vi người dùng, biến động danh mục mặt hàng, mặt hàng khởi động nguội | Chênh lệch CTR/CVR so với các nhóm đối tượng lịch sử | Mức độ tương tác giảm > 5%; làm mới danh mục (\(\sim\)hàng ngày đối với thương mại điện tử) |
| DS-CNN (Ràng buộc nhỏ) | Thay đổi môi trường âm thanh (thay đổi ngưỡng nhiễu) | Chu kỳ hoạt động (số lần thức dậy/giờ) + tỷ lệ dương tính giả | Tỷ lệ thức dậy sai > 1%; hao pin vượt quá thông số kỹ thuật (\(\sim\)cập nhật OTA hàng quý) |
Góc nhìn hệ thống: Việc có sẵn ground truth và các nút thắt vật lý quyết định cách thiết kế giám sát. Các mô hình thị giác thiên về tính toán (như ResNet-50), bị giới hạn bởi \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\), sẽ theo dõi độ chính xác trên tập holdout. Các mô hình ngôn ngữ và khuyến nghị tốn bộ nhớ (như GPT-2, DLRM), bị giới hạn bởi \(D_{\text{vol}}/\text{BW}\), có thể dựa vào chỉ số perplexity hoặc các lượt nhấp ngầm (implicit clicks). Các mô hình chạy trên vi điều khiển (như DS-CNN), chịu ràng buộc bởi độ trễ nghiêm ngặt \(L_{\text{lat}}\) và giới hạn năng lượng, sẽ giám sát chu kỳ hoạt động và tỷ lệ đánh thức sai. Nhịp huấn luyện lại bị chi phối bởi độ trễ của nhãn, khả năng truy cập hệ thống đã triển khai, chi phí xác thực và tốc độ thay đổi quan sát được.
Những nguyên tắc này nhằm ứng phó với các thách thức lặp đi lặp lại: trôi dạt khái niệm (concept drift),3 lỗi chất lượng dữ liệu (Schelter et al. 2018), và suy giảm hiệu suất thầm lặng sau khi triển khai. Tổng hòa các yếu tố đó thúc đẩy sự ra đời của các công cụ và quy trình chuyên biệt, tạo nên khác biệt giữa MLOps và DevOps truyền thống. Sự khác biệt này bắt nguồn từ vấn đề lỗi thầm lặng đã nêu ở đầu chương: sức khỏe hệ thống không thể chỉ đo bằng thời gian hoạt động (uptime) hay độ trễ. Kỷ luật vận hành trong ML đòi hỏi giám sát các thuộc tính thống kê của phân phối dữ liệu và đầu ra của mô hình, chuyển trọng tâm từ câu hỏi “máy chủ có đang chạy không?” sang “hệ thống có còn thông minh không?”
3 Trôi dạt khái niệm (Concept drift): Nghiên cứu về trôi dạt khái niệm (concept drift) và luồng dữ liệu đã chính thức hoá bài toán: mối quan hệ mục tiêu của một mô hình có thể thay đổi sau khi triển khai (Widmer and Kubat 1996; Gama et al. 2014). Trong các miền đối kháng (adversarial domains) như phát hiện thư rác, gian lận và lạm dụng, phân phối dữ liệu có thể chủ động thích ứng để phản ứng lại với mô hình, khiến việc giám sát và huấn luyện lại liên tục trở thành một yêu cầu mang tính cấu trúc, chứ không còn là một tiện nghi vận hành.
Widmer, Gerhard, and Miroslav Kubat. 1996. “Learning in the Presence of Concept Drift and Hidden Contexts.” Machine Learning 23 (1): 69–101. https://doi.org/10.1023/a:1018046501280.
Gama, João, Indrė Žliobaitė, Albert Bifet, Mykola Pechenizkiy, and Abdelhamid Bouchachia. 2014. “A Survey on Concept Drift Adaptation.” ACM Computing Surveys 46 (4): 1–37. https://doi.org/10.1145/2523813.
Schelter, Sebastian, Matthias Boehm, Johannes Kirschnick, Kostas Tzoumas, and Gunnar Ratsch. 2018. “Automating Large-Scale Machine Learning Model Management.” Proceedings of the 2018 IEEE International Conference on Data Engineering (ICDE), 137–48.
4 DVC (Data Version Control): DVC mang cơ chế lập phiên bản kiểu Git đến các tập dữ liệu và tạo phẩm mô hình (Iterative 2024), giải quyết khoảng trống về tạo phẩm mà equation 1 đã nêu rõ: nếu không có lập phiên bản dữ liệu, thành phần \(\text{Data}_v\) không thể khôi phục, và không có tổ hợp commit mã nào có thể tái tạo lại mô hình đã được triển khai.
Iterative. 2024. Data Version Control (DVC).
Table 5 so sánh mục tiêu, phương pháp luận, công cụ chính và kết quả điển hình của DevOps và MLOps, qua đó minh họa vì sao các yêu cầu đặc thù của machine learning đòi hỏi các thực hành vận hành riêng. MLOps phối hợp một hệ sinh thái bên liên quan rộng hơn và đưa vào các thực hành chuyên biệt như lập phiên bản dữ liệu,4 lập phiên bản mô hình và giám sát mô hình, vượt ra ngoài phạm vi DevOps truyền thống. Phạm vi mở rộng này biến vận hành mô hình thành một chu trình phản hồi thay vì một pipeline phát hành.
| Khía cạnh | DevOps | MLOps |
|---|---|---|
| Mục tiêu | Hợp lý hóa quy trình phát triển phần mềm và vận hành | Tối ưu hóa vòng đời của các mô hình machine learning |
| Phương pháp luận | Tích hợp liên tục và Phân phối liên tục (CI/CD) cho phát triển phần mềm | Tương tự như CI/CD nhưng tập trung vào các quy trình làm việc machine learning |
| Công cụ chính | Kiểm soát phiên bản (Git), công cụ CI/CD (Jenkins, Travis CI), Quản lý cấu hình (Ansible, Puppet) | Công cụ quản lý phiên bản dữ liệu, Công cụ huấn luyện và triển khai mô hình, pipeline CI/CD tùy chỉnh cho ML |
| Các mối quan tâm chính | Tích hợp mã, Kiểm thử, Quản lý phát hành, Tự động hóa, Cơ sở hạ tầng dưới dạng mã | Quản lý dữ liệu, Quản lý phiên bản mô hình, Theo dõi thử nghiệm, Triển khai mô hình, Khả năng mở rộng của các quy trình làm việc machine learning |
| Kết quả điển hình | Phát hành phần mềm nhanh hơn và đáng tin cậy hơn, Cải thiện sự hợp tác giữa các nhóm phát triển và vận hành | Quản lý và triển khai hiệu quả các mô hình machine learning, Tăng cường sự hợp tác giữa các nhà khoa học dữ liệu và kỹ sư |
Checkpoint 1.1: Vòng lặp MLOps
MLOps không tuyến tính; mà mang tính tuần hoàn.
Chu trình phản hồi
Các tạo phẩm
Các hệ thống ML phát sinh thêm nguồn nợ kỹ thuật so với phần mềm truyền thống. DevOps xử lý việc triển khai và mở rộng, còn MLOps phải đối mặt với độ phức tạp ẩn từ các phụ thuộc dữ liệu, tương tác giữa các mô hình và yêu cầu luôn thay đổi. Những phụ thuộc bổ sung này vừa là nguồn gốc nợ kỹ thuật, vừa cung cấp bộ từ vựng chẩn đoán cho hạ tầng MLOps chuyên biệt. Hiểu rõ boundary erosion (xói mòn ranh giới) cho thấy vì sao cần thiết kế các pipeline theo kiểu mô-đun. Nhận diện correction cascades (chuỗi hiệu chỉnh) làm rõ tầm quan trọng của quản lý phiên bản và khả năng khôi phục (rollback). Xác định undeclared consumers (các bên tiêu thụ không được khai báo) biện minh cho việc áp dụng các hợp đồng giao diện chặt chẽ. Những mẫu hình này chính là các kiểu lỗi cụ thể, là động lực cho các thành phần hạ tầng sẽ trình bày tiếp theo.
Mỗi vòng lặp có thể tạo thêm các phụ thuộc dữ liệu, tương tác giữa các mô hình và configuration drift (trôi cấu hình) mà kiểm thử phần mềm tiêu chuẩn không nhìn thấy. Những chi phí tích lũy đó chính là nợ kỹ thuật: một framework để chuyển các kiểu lỗi ML âm thầm thành các khoản nợ kỹ thuật có thể định lượng.
Self-Check: Question
A production recommendation service processes \(Q = 2 \times 10^6\) queries per day. Due to a feature encoding discrepancy between offline training and online serving, \(\text{Rate}_{\text{skew}} = 0.005\) (\(0.5\%\) of queries) receive incorrect predictions, each causing an estimated business loss of \(C_{\text{error}} = \$0.20\). Using the chapter’s skew-cost equation, what is the annual financial impact of this inconsistency over a 365-day year?
- \(\$730,000\) per year
- \(\$73,000\) per year
- \(\$200,000\) per year
- \(\$36,500\) per year
A team versions its model training code in Git, but datasets are pulled dynamically from unversioned live database queries and training hyperparameters are passed via ad hoc shell flags. Which foundational MLOps principle is violated, and what formal dependency does this break?
- Observable degradation; it prevents inference proxies from logging P99 latency percentiles
- Reproducibility; it breaks the requirement that Model Output is a deterministic function of versioned Code, Data, Config, and Environment artifacts
- Separation of concerns; it couples feature transformation code with neural loss calculation
- Cost-aware automation; it prevents the workload scheduler from executing batch inference
Explain how the principle of ‘Separation of Concerns’ across the four MLOps functional layers (Data, Training, Serving, Monitoring) limits the blast radius of operational updates.
An engineering team is designing a triage sequence to respond to an unexpected drop in business conversion for a production ML model. Place the five foundational MLOps principles in the operational sequence in which the team should apply them during the incident investigation:
- Consistency: Verify whether feature computation logic and schemas match between training and serving.
- Cost-aware automation: Evaluate whether expected accuracy gains justify the compute cost and deployment risk of retraining.
- Observable degradation: Analyze real-time statistical telemetry and drift metrics to identify the failure signature.
- Separation of concerns: Isolate the fault to a specific functional layer (Data, Training, Serving, or Monitoring).
- Reproducibility: Reconstruct the exact model, data snapshot, configuration, and environment of the running deployment.
- The formal decision gate governing whether a degraded model should be retrained balances expected accuracy improvement against training compute costs and deployment risk under the principle of ____.
Nợ kỹ thuật
Các kiểu lỗi âm thầm đã nêu trước đó biểu hiện cụ thể dưới dạng nợ kỹ thuật (Sculley et al. 2015): các thay đổi về dữ liệu, tương tác giữa các mô hình và yêu cầu luôn thay đổi gây ra sự xuống cấp dần dần, tích lũy theo thời gian. Những lỗi này có thể âm thầm tích lũy qua nhiều thành phần hệ thống, đòi hỏi cách tiếp cận kỹ thuật phải tính đến hành vi thống kê và các phụ thuộc dữ liệu. Khái niệm này được đề xuất trong kỹ thuật phần mềm từ thập niên 1990,5 phép ẩn dụ nợ kỹ thuật so sánh việc dùng lối tắt trong quá trình hiện thực với nợ tài chính: đánh đổi tốc độ ngắn hạn lấy khoản “tiền lãi” phải trả đều đặn dưới dạng chi phí bảo trì, tái cấu trúc (refactoring) và rủi ro hệ thống (Cunningham 1992). Trong ML, nợ này không chỉ nằm ở mã nguồn mà còn bao gồm các chi phí “ẩn” do mô hình thống kê và phụ thuộc dữ liệu. Các thang đánh giá có hệ thống, như ML Test Score (Breck et al. 2017), cung cấp các framework để định lượng nợ này và đánh giá mức độ sẵn sàng đưa vào sản xuất trên các thành phần dữ liệu, mô hình và hạ tầng.
5 Nợ kỹ thuật: Báo cáo kinh nghiệm WyCash năm 1992 của Ward Cunningham giới thiệu ẩn dụ nợ kỹ thuật cho việc ưu tiên viết mã nhanh và trì hoãn việc củng cố/gộp lại (Cunningham 1992). Trong machine learning, nợ này có thể âm thầm tích tụ qua các phụ thuộc về dữ liệu và mô hình mà các kiểm thử đơn vị và đánh giá mã tập trung vào mã nguồn khó phát hiện. Pipeline có thể giữ nguyên, trong khi thế giới mà nó mô hình hoá thì thay đổi. Bộ tiêu chí ML Test Score (Breck et al. 2017) làm rõ khoản nợ này bằng 28 bài kiểm tra mức độ sẵn sàng cho sản xuất, chia theo các nhóm: dữ liệu, mô hình, cơ sở hạ tầng và giám sát.
Cunningham, Ward. 1992. “The WyCash Portfolio Management System.” ACM SIGPLAN OOPS Messenger 4 (2): 29–30. https://doi.org/10.1145/157710.157715.
Breck, Eric, Shanqing Cai, Eric Nielsen, Michael Salib, and D. Sculley. 2017. “The ML Test Score: A Rubric for ML Production Readiness and Technical Debt Reduction.” Proceedings of the 2017 IEEE International Conference on Big Data (Big Data), 1123–32. https://doi.org/10.1109/bigdata.2017.8258038.
Definition 1.2: Nợ kỹ thuật trong ML
Nợ kỹ thuật trong machine learning là chi phí bảo trì và thay đổi tích luỹ, phát sinh từ các phụ thuộc dữ liệu ngầm, các đặc trưng bị đan cài (entangled features) và các bên tiêu thụ không được khai báo trong các hệ thống machine learning. Những hậu quả của nợ kỹ thuật cũng có thể biểu hiện dưới dạng suy giảm độ chính xác một cách âm thầm.
- Ý nghĩa: Phân tích của Google về các hệ thống machine learning trong sản xuất cho thấy phần mã của mô hình chỉ chiếm một phần nhỏ trong toàn bộ hệ thống. Phạm vi vận hành lớn hơn bao gồm thu thập dữ liệu, trích xuất đặc trưng, cấu hình, cơ sở hạ tầng phục vụ (serving), giám sát và quản lý quy trình (Sculley et al. 2015). Các tác nhân gây nợ kỹ thuật đặc thù của machine learning càng làm vấn đề phức tạp hơn: thay đổi một đặc trưng đầu vào có thể âm thầm làm dịch chuyển biểu diễn đã học của mọi đặc trưng khác (entanglement); một mô hình được huấn luyện để sửa lỗi của mô hình khác tạo ra chuỗi phụ thuộc mong manh (correction cascades); và các hệ thống hạ nguồn tiêu thụ đầu ra của mô hình mà không có hợp đồng rõ ràng trở thành các bên tiêu thụ không được khai báo (undeclared consumers), âm thầm hỏng khi mô hình được cập nhật.
- Điểm khác biệt: Nợ kỹ thuật trong machine learning bao gồm các phụ thuộc ở cấp hệ thống và cấp dữ liệu mà các đánh giá mã và các kiểm thử thông thường tập trung vào mã nguồn có thể bỏ sót. Nó có thể làm chậm quá trình phát triển và làm giảm chất lượng dự đoán, ngay cả khi các chỉ số về tính khả dụng vẫn ở mức tốt.
- Sai lầm phổ biến: Nhiều người nghĩ rằng “mã tốt hơn” sẽ xóa được nợ kỹ thuật trong ML. Thực ra đây là bài toán kiến trúc hệ thống: nợ tích tụ khi các giả định của phân phối huấn luyện (phạm vi đặc trưng, ý nghĩa nhãn, độ tươi mới của dữ liệu) không được áp dụng như các ràng buộc runtime tại ranh giới hệ thống.
Một phép tính hòa vốn giúp cụ thể hóa bức tranh chi phí của nợ kỹ thuật. Các nhóm thường do dự đầu tư tự động hóa vì quy trình thủ công có vẻ nhanh hơn trong ngắn hạn, nhưng lợi thế đó biến mất khi khối lượng công việc thủ công tích lũy vượt quá chi phí đầu tư tự động hóa ban đầu. Figure 2 cho thấy mã ML chỉ là một trong mười thành phần bao quanh một hệ thống ML vận hành thực tế, qua đó làm rõ bề mặt vận hành rộng hơn.
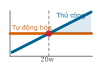
Tổng công việc thủ công vượt quá chi phí đầu tư tự động hóa ban đầu (một lần) vào khoảng tuần thứ 20.
Các thao tác thủ công sẽ đụng trần năng lực, nhưng bài toán chi phí không chỉ nằm ở thời gian của kỹ sư. Hệ thống ML tích lũy độ phức tạp ẩn thông qua các kiểu nợ kỹ thuật đặc thù, xuất phát từ những điểm riêng của ML: dựa vào dữ liệu thay vì logic xác định, hành vi mang tính thống kê thay vì chính xác tuyệt đối, và các phụ thuộc ngầm qua luồng dữ liệu thay vì các giao diện tường minh.

Napkin Math 1.1: Tổng chi phí của các hoạt động thủ công
Vấn đề: Tại sao phải xây dựng các pipeline tự động khi việc huấn luyện lại thủ công nhanh hơn?
Vật lý: Công việc thủ công tích lũy theo thời gian.
- Huấn luyện lại thủ công: 4 hours giờ công kỹ sư mỗi tuần.
- Xây dựng pipeline: 80 giờ công kỹ sư (một lần).
Toán:
- Kết quả: 80 giờ công kỹ sư \(\div\) 4 hours mỗi tuần = 20 weeks.
- Cạm bẫy: Điều này giả định mô hình không bao giờ thay đổi.
- Hạn chế: Việc bổ sung đặc trưng có thể làm tăng khối lượng công việc thủ công.
- Hậu quả: Sau 1 year, các nhóm làm thủ công vẫn tốn 4 hours mỗi tuần cho bảo trì. Với cách tính đơn giản này, các nhóm dùng pipeline sẽ phát sinh 0 giờ công định kỳ.
Bối cảnh: Một nguyên tắc cốt lõi trong kỹ thuật hệ thống là chi phí duy trì một hệ thống trong suốt vòng đời của nó có thể lấn át chi phí xây dựng nó. Trong ML, nợ kỹ thuật đặc biệt nguy hiểm vì nó thường phụ thuộc vào dữ liệu hơn là phụ thuộc vào mã nguồn: một đoạn mã hoàn hảo vẫn có thể thất bại nếu dữ liệu nó xử lý thay đổi. Đo lường là ranh giới của quản lý: nếu không có dữ liệu đo từ xa, nhóm sẽ không thể biết liệu công việc bảo trì đang thực sự giảm nợ hay chỉ che giấu nó.
Hiểu biết về hệ thống: Tự động hóa giúp giải quyết giới hạn về năng lực, không chỉ tăng tốc độ. Một nhóm làm việc thủ công cuối cùng sẽ chạm ngưỡng mà việc duy trì các mô hình hiện có ngăn họ triển khai mô hình mới. MLOps đáp ứng bằng khả năng quan sát và tự động hóa có hệ thống. Nếu thiếu hạ tầng giám sát để làm lộ các lỗi ngầm (silent failures), nhóm sẽ tích lũy nợ kỹ thuật và dựng nên một hệ thống ngày càng khó quản lý.
Figure 3 phân loại sáu dạng nợ kỹ thuật liên quan đến dữ liệu, mô hình và hạ tầng. Các ví dụ minh họa sau đây sẽ kết nối từng dạng với phản ứng kỹ thuật tương ứng mà nó đòi hỏi.

Xói mòn ranh giới
Kiểu nợ đầu tiên, và thường tai hại nhất, là sự bào mòn ranh giới hệ thống. Trong phần mềm truyền thống, mô-đun hóa và trừu tượng hóa tạo ra ranh giới rõ ràng giữa các thành phần, giúp cô lập thay đổi và giữ cho hành vi có thể dự đoán. Các hệ thống machine learning làm mờ các ranh giới này vì lý do cấu trúc: hành vi của mô hình phụ thuộc vào các thuộc tính thống kê của dữ liệu đi qua hệ thống, chứ không dựa vào các giao diện tường minh. Một thay đổi ở định dạng dữ liệu phía upstream có thể vượt qua mọi kiểm thử đơn vị nhưng âm thầm làm giảm độ chính xác của mô hình ở phía downstream. Sự phụ thuộc ngầm thông qua dữ liệu, thay vì qua mã nguồn, tạo ra các tương tác liên kết chặt giữa các pipeline dữ liệu, quá trình xây dựng đặc trưng, huấn luyện mô hình và khâu tiêu thụ downstream.
Sự bào mòn này gây ra sự đan xen: các phụ thuộc giữa các thành phần quấn chặt đến mức mọi chỉnh sửa cục bộ đều đòi hỏi hiểu biết và phối hợp ở tầm toàn hệ thống. Điều này được tóm gọn trong nguyên tắc CACE: Change Anything Changes Everything. Khi hệ thống thiếu ranh giới mạnh, việc điều chỉnh mã hóa đặc trưng, siêu tham số của mô hình, hoặc tiêu chí chọn dữ liệu có thể tác động đến hành vi downstream theo những cách khó lường. Chẳng hạn, thay đổi chiến lược chia khoảng (binning) cho một đặc trưng số có thể khiến mô hình vốn đã tinh chỉnh trước đó sa sút, kéo theo huấn luyện lại và thay đổi cách đánh giá downstream, lan xa vượt ngoài phạm vi sửa đổi ban đầu.
Phòng vệ chính chống bào mòn ranh giới là ở kiến trúc: mô-đun hóa và đóng gói ngay từ khi thiết kế. Các thành phần với giao diện rõ ràng cho phép kỹ sư cô lập lỗi, suy xét về các thay đổi và giảm rủi ro hồi quy trên toàn hệ thống. Việc tách bạch giữa thu nạp dữ liệu, xây dựng đặc trưng và logic mô hình tạo ra các lớp có thể xác thực, giám sát và bảo trì độc lập. Sự bào mòn ranh giới thường khó thấy ở giai đoạn đầu, vì sự liên kết chặt chỉ lộ rõ khi một thay đổi tưởng như cục bộ lại kích hoạt sự cố ở một nơi xa trong hệ thống. Các quyết định thiết kế chủ động duy trì trừu tượng, kiểm thử có hệ thống và tài liệu hóa giao diện là những phòng tuyến thực tế nhất trước mức độ phức tạp âm thầm gia tăng này.
Thác hiệu chỉnh
Nếu xói mòn ranh giới mô tả cách các hệ thống ML mất tính toàn vẹn cấu trúc, thì thác hiệu chỉnh mô tả điều gì xảy ra khi các nhóm cố gắng sửa chữa. Một thác hiệu chỉnh xuất hiện khi sửa một thành phần lại làm phát sinh lỗi ở chỗ khác, buộc phải sửa tiếp, và mỗi lần sửa lại tiếp tục gây ra lỗi mới. Trong các hệ thống ML, các thác này đặc biệt nghiêm trọng vì thay đổi lan qua các phụ thuộc thống kê, chứ không đi theo các đường dẫn mã tường minh. Huấn luyện lại một mô hình để khắc phục một kiểu lỗi có thể làm giảm hiệu suất trên những trường hợp trước đây vẫn hoạt động tốt. Điều chỉnh ngưỡng để giảm dương tính giả có thể làm tăng âm tính giả. Thêm đặc trưng để xử lý edge cases có thể tạo ra các tương quan làm mất ổn định toàn bộ hệ thống. Mỗi lần hiệu chỉnh lại kéo theo nhu cầu hiệu chỉnh tiếp, tạo thành một chuỗi hiệu chỉnh có thể ngốn nguồn lực kỹ thuật vượt xa so với chi phí sửa lỗi ban đầu.
Figure 4 làm hiện rõ cấu trúc thác như một chuỗi các mô hình phụ thuộc. Mỗi mô hình được huấn luyện để sửa lỗi của mô hình liền trước: mô hình B bù cho phần lỗi còn sót của mô hình A, mô hình C bù cho mô hình B, và cứ thế dọc theo chuỗi. Trật tự này giữ nguyên cho đến khi một mô hình thượng nguồn thay đổi. Khi mô hình A được huấn luyện lại để sửa một kiểu lỗi, mọi mô hình hạ nguồn từng được tinh chỉnh theo hành vi trước đó của A đều mất hiệu lực cùng lúc, và từng mô hình phải được hiệu chỉnh lại. Các cung màu đỏ cho thấy quỹ đạo lan truyền này, chỉ ra rằng một sửa chữa tưởng chừng cục bộ lại ảnh hưởng tới toàn bộ chuỗi. Một thay đổi gần đỉnh chuỗi buộc phải làm lại nhiều nhất, trong khi thay đổi gần đáy gần như “miễn phí”. Với một nhóm vận hành, chỉ một yêu cầu thay đổi cũng có thể kích hoạt việc huấn luyện lại phối hợp cả chuỗi.

Những cung đó quan trọng vì chúng biến các sửa chữa cục bộ thành các phụ thuộc trải dài suốt vòng đời. Phát triển mô hình theo chuỗi là một nguồn gốc phổ biến: tái sử dụng hoặc tinh chỉnh (fine-tuning) các mô hình sẵn có giúp tăng tốc phát triển cho tác vụ mới, nhưng cũng tạo ra những giả định ngầm khó gỡ về sau. Các giả định được nhúng trong các mô hình trước trở thành những ràng buộc ngầm cho các mô hình tương lai, làm giảm tính linh hoạt và tăng chi phí cho việc sửa ở hạ nguồn.
Hãy xét một nhóm tinh chỉnh (fine-tuning) một mô hình dự đoán khách hàng rời bỏ cho một sản phẩm mới. Mô hình gốc có thể chứa các hành vi đặc thù của sản phẩm hoặc cách mã hóa đặc trưng không chuyển được sang bối cảnh mới. Khi xuất hiện vấn đề hiệu suất, các nhóm có thể cố vá mô hình, nhưng rồi phát hiện vấn đề thực sự nằm ở các khâu thượng nguồn, như tiêu chí chọn đặc trưng hoặc tiêu chí gán nhãn ban đầu.
Để giảm thiểu các chuỗi sửa lỗi liên tiếp (correction cascades), các nhóm cần cân bằng giữa tái sử dụng và thiết kế lại. Tinh chỉnh (fine-tuning) có thể giảm nhu cầu tính toán và dữ liệu, nhưng đồng thời kế thừa các giả định từ mô hình gốc. Huấn luyện từ đầu (training from scratch) cho phép kiểm soát tốt hơn các giả định này, đổi lại là chi phí dữ liệu và tính toán cao hơn nhiều. Kích thước tập dữ liệu không tự nó quyết định lựa chọn; mà còn tùy vào mức độ tương đồng của tác vụ, độ phù hợp của mô hình gốc, dữ liệu sẵn có, ngân sách tính toán và chi phí của các phụ thuộc kế thừa.
Cơ chế cốt lõi là khi đầu ra của mô hình A ảnh hưởng tới dữ liệu huấn luyện của mô hình B, các phụ thuộc ngầm sẽ xuất hiện thông qua luồng dữ liệu chứ không phải qua các giao diện mã rõ ràng. Những phụ thuộc này vô hình với các công cụ phân tích phụ thuộc truyền thống. Ngăn các chuỗi sửa lỗi liên tiếp đòi hỏi các quyết định kiến trúc để giữ hệ thống có tính mô-đun: giữ cho các mô hình ghép nối lỏng lẻo, duy trì ranh giới phiên bản rõ ràng, và thiết kế để chúng có thể tiến hóa độc lập ngay cả khi tái sử dụng thành phần.
Thách thức về giao diện và phụ thuộc
Hiện tượng xói mòn ranh giới và chuỗi hiệu chỉnh đều xuất hiện khi các hệ thống ML hình thành các phụ thuộc giao diện mà bỏ qua các giao diện được định nghĩa rõ ràng. Trong phần mềm truyền thống, phụ thuộc thường dễ nhìn thấy (câu lệnh import, lời gọi API, tệp cấu hình) và có thể được công cụ phân tích được. Còn với ML, phụ thuộc ẩn trong dữ liệu. Khi dự đoán của mô hình A trở thành đặc trưng cho mô hình B, phụ thuộc đó chỉ tồn tại trong pipeline dữ liệu, và phân tích mã sẽ không thấy. Tương tự, khi một dashboard sử dụng đầu ra của mô hình để đưa ra quyết định kinh doanh, không có hợp đồng giao diện nào ràng buộc mối quan hệ này.
Hai mẫu vấn đề quan trọng sau đây minh họa rõ hơn những thách thức này. Người dùng không được khai báo xuất hiện khi đầu ra của mô hình được các thành phần hạ nguồn sử dụng mà không có theo dõi chính thức hay hợp đồng giao diện. Khi mô hình thay đổi, những phụ thuộc ẩn này âm thầm gây lỗi. Ví dụ, đầu ra của một mô hình chấm điểm tín dụng có thể được đưa vào một công cụ xét điều kiện, từ đó ảnh hưởng đến các nhóm ứng viên và dữ liệu huấn luyện tương lai, tạo ra các vòng lặp phản hồi không được theo dõi. Theo thời gian, điều này làm tăng độ chệch (bias) trong hành vi của mô hình. Nợ phụ thuộc dữ liệu làm vấn đề trầm trọng hơn khi pipeline ML tích lũy những phụ thuộc dữ liệu không ổn định và ít được dùng, khó truy vết hoặc xác thực. Các script tạo đặc trưng, các phép nối dữ liệu và quy ước gán nhãn thường thiếu các công cụ phân tích phụ thuộc như trong phát triển phần mềm truyền thống. Khi cấu trúc hoặc phân phối của nguồn dữ liệu thay đổi, các mô hình hạ nguồn có thể bất ngờ hỏng.
Giảm thiểu các thách thức về giao diện cần những cách tiếp cận có hệ thống: kiểm soát chặt chẽ quyền truy cập vào đầu ra mô hình, hợp đồng giao diện chính thức kèm lược đồ được ghi chép đầy đủ, hệ thống quản lý phiên bản và truy vết nguồn gốc dữ liệu, cùng việc giám sát liên tục cách thức sử dụng các dự đoán. Các mẫu hạ tầng MLOps được trình bày ở các phần tiếp theo sẽ đưa ra những triển khai cụ thể cho các giải pháp này.
Thách thức trong tiến hóa hệ thống
Các mẫu nợ được nêu ở section 1.3.3 phản ánh những lựa chọn thiết kế kém. Ngay cả các hệ thống ML được thiết kế tốt cũng đối mặt với những thách thức tiến hóa rất khác với phần mềm truyền thống.
Các vòng lặp phản hồi là thách thức tinh vi nhất trong tiến trình phát triển: mô hình tự ảnh hưởng đến hành vi tương lai của chính nó thông qua dữ liệu mà nó tạo ra. Hệ thống gợi ý là ví dụ điển hình: các mục được gợi ý định hình lượt nhấp của người dùng, những lượt nhấp này trở thành dữ liệu huấn luyện, từ đó có thể tạo ra độ chệch (bias) tự củng cố. Trong vận hành, dấu hiệu cảnh báo là khoảng cách lỗi giữa các nhóm con ngày càng nới rộng qua mỗi chu kỳ huấn luyện lại: một nhóm nhận dự đoán kém hơn, những dự đoán đó lại định hình hành vi hoặc nhãn trong tương lai của họ, và tập dữ liệu kế tiếp làm khoảng cách càng lớn. Bài học trong MLOps là phải giám sát theo nhóm trước khi các chỉ số tổng hợp che mất vòng lặp này. Những vòng lặp như vậy làm suy yếu giả định về tính độc lập của dữ liệu và có thể che giấu sự suy giảm hiệu suất trong nhiều tháng.
Nợ pipeline và cấu hình tích lũy khi các quy trình làm việc ML phát triển thành những “rừng pipeline” gồm các script ad hoc và các cấu hình rời rạc. Thiếu các giao diện mô-đun, các nhóm thường dựng thêm pipeline trùng lặp thay vì tái cấu trúc những pipeline giòn, dẫn đến xử lý không nhất quán và gánh nặng bảo trì tăng dần. Cộng thêm, việc tạo mẫu nhanh khuyến khích nhúng logic nghiệp vụ vào mã huấn luyện và thay đổi cấu hình mà không ghi chép. Dù những lối tắt đầu kỳ này cần thiết cho đổi mới, chúng sẽ trở thành gánh nặng khi hệ thống mở rộng và nhiều nhóm cùng tham gia. Quản lý quá trình tiến hóa đòi hỏi kỷ luật kiến trúc: giám sát theo nhóm để phát hiện vòng lặp, thiết kế pipeline theo hướng mô-đun với các công cụ điều phối quy trình làm việc, và coi cấu hình là một thành phần hạng nhất của hệ thống với quản lý phiên bản và xác thực.
Nợ mã và kiến trúc
Các phụ thuộc dữ liệu và tiến hóa hệ thống tạo ra nợ thông qua liên kết ngầm. Các hệ thống ML cũng tích lũy các dạng nợ ở cấp độ mã khác với phần mềm truyền thống. Sculley et al. (2015) nêu ra một số dạng đáng được chú ý riêng.
Mã keo chiếm ưu thế trong các cơ sở mã ML: nhiều hệ thống cần rất nhiều mã tích hợp để nối các gói ML đa năng với các pipeline dữ liệu và hệ thống phục vụ (serving) cụ thể, với phần mã keo chiếm tới 95% cơ sở mã, còn phần mã ML thực tế chỉ khoảng 5%. Mã keo tạo ra sự kết dính chặt giữa API của gói và hệ thống xung quanh, nghĩa là khi các gói cập nhật giao diện, toàn bộ mã keo phải sửa lại. Cách giảm thiểu là bọc các gói ML bên trong các API nội bộ ổn định và xem các phụ thuộc bên ngoài như những thành phần có thể thay thế.
Các đoạn mã thử nghiệm không còn dùng tích tụ dần vì phát triển ML phải thử nghiệm rất nhiều, để lại các nhánh điều kiện cho những hướng tiếp cận đã bị loại bỏ. Khác với mã chết truyền thống có thể phát hiện bằng phân tích tĩnh, các đường dẫn mã thử nghiệm trong ML thường vẫn “sống” vì được điều khiển bằng cờ cấu hình thay vì điều kiện tại thời điểm biên dịch. Theo thời gian, các đường dẫn này làm tăng gánh nặng kiểm thử và gây nhầm lẫn về việc rốt cuộc đoạn mã nào đang chạy trong môi trường sản xuất. Rà soát mã định kỳ với mốc thời gian ngừng hỗ trợ rõ ràng và kỷ luật với các cờ tính năng giúp quản lý khoản nợ này.
Nợ trừu tượng phát sinh vì kỹ thuật phần mềm truyền thống dựa vào các trừu tượng được định nghĩa rõ ràng như hàm, lớp và mô-đun, còn các hệ thống ML lại thiếu các trừu tượng đủ trưởng thành cho những khái niệm cốt lõi, ví dụ như giao diện phù hợp cho một “đặc trưng” hay cách đóng gói đúng đắn cho “hành vi mô hình”. Sự thiếu hụt này buộc các nhóm phải tự nghĩ lại trừu tượng, hoặc tệ hơn là bỏ qua trừu tượng hóa. Các mẫu phổ biến như kho đặc trưng (trừu tượng hóa việc tính toán đặc trưng), kho mô hình (trừu tượng hóa quản lý phiên bản mô hình) và dịch vụ suy luận (trừu tượng hóa quá trình suy luận) giúp giảm nợ trừu tượng theo từng dự án, miễn là chúng phù hợp với quy trình làm việc của nhóm.
Ngoài những mẫu này, Sculley et al. (2015) còn xác định các dấu hiệu cảnh báo, hay dấu hiệu phổ biến (common smells), cho thấy nợ đang tích lũy: Dấu hiệu Kiểu Dữ liệu Cơ bản (Plain-Old-Data Type Smell) (sử dụng các kiểu dữ liệu chung như chuỗi và số thực thay vì các kiểu ngữ nghĩa thể hiện ý nghĩa và ràng buộc), Dấu hiệu Đa Ngôn ngữ (Multiple-Language Smell) (các hệ thống trải dài Python, SQL, C++ và các script shell với quy ước không nhất quán), và Dấu hiệu Nguyên mẫu (Prototype Smell) (mã nghiên cứu “tạm thời” trở thành hạ tầng lâu dài mà không được tái cấu trúc). Các tổ chức làm tốt theo dõi những dấu hiệu này trong review mã và phân bổ thời gian rõ ràng để trả nợ, coi việc giảm nợ kỹ thuật là một hoạt động kỹ thuật hạng nhất chứ không phải điều nghĩ đến sau cùng.
Nợ kỹ thuật trong thực tế
Những dạng nợ đã mô tả trước đó không phải chuyện lý thuyết suông. Chúng đã góp phần quan trọng vào cách các hệ thống machine learning ngoài đời vận hành. Trong thực tế, các phụ thuộc khó thấy và những giả định lệch có thể âm thầm tích tụ, rồi theo thời gian trở thành khoản nợ lớn.
Các dạng nợ trong môi trường sản xuất
Cặp đầu tiên cho thấy sự phụ thuộc thông qua hành vi của mô hình. Hệ thống đề xuất của YouTube minh họa cách các hệ thống đề xuất quy mô lớn học từ những tín hiệu hành vi người dùng nhiễu, biến các mục tiêu xếp hạng, việc gán trọng số đồng đều theo mỗi người dùng, và đánh giá A/B trực tiếp thành một phần của thiết kế hệ thống, chứ không chỉ là chi tiết của đánh giá ngoại tuyến (Covington et al. 2016). Quy trình định giá và mua nhà của Zillow đã bộc lộ biến thể “thác hiệu chỉnh” trong dự án iBuying của họ.6 Các giả định về định giá và tồn kho lan sang các quyết định mua; những điều chỉnh về sau làm chao đảo các quyết định về tồn kho và giá, buộc phải xác thực lại, và cuối cùng là rút lui hoàn toàn khi công ty đóng cửa bộ phận iBuying vào năm 2021.
Covington, Paul, Jay Adams, and Emre Sargin. 2016. “Deep Neural Networks for YouTube Recommendations.” Proceedings of the 10th ACM Conference on Recommender Systems, 191–98. https://doi.org/10.1145/2959100.2959190.
6 Thất bại iBuying của Zillow: Zillow đã công bố kế hoạch ngừng hoạt động Zillow Offers vào tháng 11 năm 2021, bao gồm việc ghi giảm giá trị tồn kho trong quý 3 và cắt giảm nhân sự (Zillow Group 2021). Thất bại này minh họa vấn đề “nợ thác hiệu chỉnh” ở quy mô lớn: các lỗi định giá, các quyết định mua hàng và phản hồi về tồn kho có thể củng cố lẫn nhau, tạo ra một vòng lặp mà không một chu kỳ huấn luyện lại đơn lẻ nào có thể phá vỡ.
Zillow Group. 2021. Zillow Group Reports Third-Quarter 2021 Financial Results and Shares Plan to Wind down Zillow Offers Operations. Investor Relations Press Release.
National Transportation Safety Board. 2017. Collision Between a Car Operating with Automated Vehicle Control Systems and a Tractor-Semitrailer Truck Near Williston, Florida, May 7, 2016. HAR-17/02. National Transportation Safety Board.
Engineering, M. 2016. Introducing FBLearner Flow: Facebook’s AI Backbone. Engineering at Meta Blog.
Mosseri, Adam. 2018. Bringing People Closer Together. Meta Newsroom.
Cặp thứ hai cho thấy sự phụ thuộc thông qua quyền sở hữu và cấu hình. Tự động hóa lái xe, nơi an toàn là tối quan trọng, minh họa rủi ro “người tiêu dùng không khai báo” theo một hướng khác: khi đầu ra của hệ thống điều khiển tự động, kỳ vọng của người lái và trách nhiệm của các hệ thống con không được nêu rõ, các lỗi vận hành có thể vượt qua ranh giới thành phần thay vì chỉ khu trú cục bộ (National Transportation Safety Board 2017). Các lần lặp của Bảng tin Facebook cho thấy phiên bản cấu hình của cùng vấn đề quản trị. Nhịp thử nghiệm nhanh và thay đổi xếp hạng đòi hỏi các thiết lập truy vết được và mục tiêu minh bạch; nếu không, các thay đổi hành vi sẽ rất khó rà soát sau khi triển khai (Engineering 2016; Mosseri 2018).
Những ví dụ này không phải là các câu chuyện cảnh báo từ những tổ chức cẩu thả. Đây là các hệ quả có thể dự đoán khi triển khai những hệ thống ra quyết định dựa trên xác suất hoặc tự động mà không có hạ tầng làm lộ rõ các mối phụ thuộc/ghép nối. YouTube, Zillow, các hệ thống tự động hóa lái xe an toàn trọng yếu, và Facebook, mỗi bên bộc lộ một dạng nợ khác nhau: vòng lặp phản hồi, thác hiệu chỉnh, bên tiêu thụ không khai báo, và lan tràn cấu hình.
Mỗi kiểu nợ gợi ý các kiểm soát tương ứng: kho đặc trưng có thể giảm nợ phụ thuộc dữ liệu, hệ thống quản lý phiên bản giúp phơi bày nợ cấu hình, các pipeline CI/CD hạn chế nợ pipeline, và hệ thống giám sát giúp nhìn thấy các vòng lặp phản hồi. Đây không phải là thuốc chữa một-một mà là các phản ứng kỹ thuật trước những kiểu lỗi đã được chẩn đoán. Tuy nhận diện các kiểu nợ là quan trọng, đó mới chỉ là nửa chặng đường: các tổ chức trong các nghiên cứu điển hình này không thiếu kỹ sư giỏi, mà thiếu các kiểm soát có hệ thống để bắt các vấn đề cụ thể trước khi chúng chồng chất. Để chuyển từ chẩn đoán sang phòng ngừa, cần xem xét chi tiết từng thành phần hạ tầng: hiểu nó làm gì và quan trọng hơn là cách nó xử lý kiểu lỗi đã thúc đẩy sự ra đời của nó.
Self-Check: Question
According to Sculley et al. (2015), why is technical debt in machine learning systems fundamentally more challenging to detect and manage than conventional software debt?
- Because ML frameworks prevent developers from running unit tests or continuous integration jobs
- Because ML algorithms require more lines of raw mathematical code than supporting infrastructure software
- Because ML debt accumulates through implicit statistical relationships, data dependencies, and feedback loops that degrade predictive accuracy silently without throwing runtime exceptions
- Because neural network parameters cannot be serialized to disk or stored in artifact registries
A data engineering team spends 6 hours per week manually extracting features, executing training runs, and validating a customer churn model. Building an automated CI/CD retraining pipeline requires a one-time upfront investment of 120 engineering hours. What is the breakeven time for this automation investment, and what long-term capacity risk arises if the team remains manual?
- Breakeven is 6 weeks; manual processes remain more cost-effective for multi-model deployments
- Breakeven is 10 weeks; automated pipelines eliminate the need for future model monitoring
- Breakeven is 40 weeks; manual maintenance has zero ongoing engineering cost after the first year
- Breakeven is 20 weeks; manual maintenance scales linearly with the number of deployed models until engineering capacity is fully consumed by routine operations
Explain why ‘correction cascades’ create a severe maintenance trap in production ML architectures, and state the primary architectural remedy.
True or False: In production ML systems, ‘glue code’ refers to the core machine learning algorithm, which typically comprises over 90% of the total system codebase.
The systemic vulnerability where modifying a single input feature’s distribution or encoding alters the learned weights and contributions of all other features across an ML pipeline is known as the ____ principle.
Cơ sở hạ tầng phát triển
Cơ sở hạ tầng phát triển biến các kiểu nợ đã chẩn đoán thành các điểm thực thi. Một lược đồ đặc trưng bị trôi/chệch ở phía upstream không thể sửa chỉ bằng một bảng điều khiển; nó cần một hợp đồng dùng chung, một tạo phẩm được quản lý phiên bản, và một đường triển khai có thể từ chối các thay đổi không tương thích trước khi vào sản xuất. Table 6 ánh xạ trực tiếp từng thành phần tới một nguyên tắc nền tảng (section 1.2.1) và một kiểu lỗi cụ thể.
| Thành phần cơ sở hạ tầng | Nguyên tắc được triển khai | Mẫu nợ được giải quyết |
|---|---|---|
| Kho đặc trưng | Yêu cầu nhất quán | Nợ phụ thuộc dữ liệu, độ lệch huấn luyện-suy luận |
| Hệ thống quản lý phiên bản | Khả năng tái tạo thông qua quản lý phiên bản | Nợ cấu hình, thác sửa lỗi |
| Các pipeline CI/CD | Tự động hóa có ý thức về chi phí | Nợ pipeline, xói mòn ranh giới |
| Hệ thống giám sát | Suy giảm có thể quan sát được | Vòng lặp phản hồi, lỗi âm thầm |
Figure 5 tổ chức các thành phần này theo các lớp: mô hình ML, framework, điều phối, cơ sở hạ tầng và phần cứng. Hiểu cách các lớp này tương tác giúp người làm nghề thiết kế hệ thống để xử lý có hệ thống các mẫu nợ kỹ thuật đã nêu trước đó, đồng thời duy trì tính bền vững vận hành.

Hạ tầng dữ liệu và chuẩn bị dữ liệu
Các hệ thống machine learning đáng tin cậy cần cách xử lý dữ liệu có cấu trúc, có thể mở rộng và lặp lại được. Từ lúc thu nạp đến khi suy luận, mỗi giai đoạn đều phải đảm bảo chất lượng, tính nhất quán và khả năng truy xuất nguồn gốc, xuyên suốt các khâu phát triển ban đầu, huấn luyện lại liên tục, kiểm toán và phục vụ (serving). Để đáp ứng các yêu cầu này, chúng ta cần những hệ thống chính thức hóa việc chuyển đổi và quản lý phiên bản dữ liệu trong suốt vòng đời của machine learning.
Quản lý dữ liệu
Các dạng nợ kỹ thuật được mô tả trước đó phần lớn bắt nguồn từ quản lý dữ liệu kém: các tập dữ liệu không có phiên bản làm mờ ranh giới, việc tính toán đặc trưng không nhất quán gây ra các chuỗi điều chỉnh, và các phụ thuộc dữ liệu không được ghi chép đầy đủ tạo ra những bên tiêu thụ ẩn. Hạ tầng quản lý dữ liệu trực tiếp giải quyết những nguyên nhân gốc rễ này. Dựa trên các nền tảng kỹ thuật dữ liệu từ Kỹ thuật dữ liệu, việc thu thập dữ liệu, tiền xử lý và chuyển đổi đặc trưng trở thành các quy trình vận hành được chuẩn hóa. Trong khi kỹ thuật dữ liệu tập trung vào tính đúng đắn của một pipeline đơn lẻ, quản lý dữ liệu trong MLOps nhấn mạnh tính nhất quán giữa các pipeline, đảm bảo rằng quá trình huấn luyện và phục vụ (serving) tính ra các đặc trưng giống hệt nhau. Vì vậy, quản lý dữ liệu không chỉ dừng ở chuẩn bị ban đầu mà còn bao gồm xử lý liên tục các tạo phẩm dữ liệu trong suốt vòng đời của hệ thống ML.
Ba nguyên tắc định hình hạ tầng nhằm xử lý những nguyên nhân gốc rễ này: tính nhất quán, tính cập nhật và chất lượng. Mỗi nguyên tắc định hướng việc chọn công cụ cụ thể, chứ không phải ngược lại.
Yêu cầu đầu tiên là tính nhất quán của dữ liệu: mọi thành phần ảnh hưởng đến hành vi của mô hình, từ các tập dữ liệu thô đến các đặc trưng đã được xử lý, đều phải được quản lý phiên bản và có thể tái hiện. Nếu không quản lý phiên bản, các nhóm sẽ không thể truy vết dữ liệu nào đã tạo ra mô hình nào, khiến việc gỡ lỗi và quay lui trở nên bất khả thi. Việc triển khai thường kết hợp quản lý phiên bản mã nguồn, quản lý phiên bản tập dữ liệu và lưu trữ đối tượng bền vững. DVC (Data Version Control) (Iterative 2024), Git (Torvalds and Hamano 2024), Amazon S3 (Amazon Web Services 2024a), và Google Cloud Storage (Google Cloud 2024b) là các ví dụ cho cách làm này, nhưng điều bất biến mới là cốt lõi: các thành phần thô và đã xử lý phải luôn có thể được tham chiếu theo phiên bản. Section 1.4.1.3 sẽ đi sâu vào chi tiết triển khai, bao gồm tích hợp Git, theo dõi siêu dữ liệu và bảo toàn thông tin nguồn gốc. Ở cấp độ đặc trưng, một feature store có thể giảm sai lệch bằng cách tập trung hóa định nghĩa đặc trưng và các đường phục vụ (serving) trên cả pipeline huấn luyện và pipeline phục vụ (serving), nhưng để đạt được sự tương đồng, vẫn cần bước kiểm chứng. Nền tảng Michelangelo của Uber đã phổ biến mô hình này trong một nền tảng ML sản xuất lớn, và sau đó Feast đã cung cấp mô hình đó dưới dạng hạ tầng feature store mã nguồn mở (Hermann and Del Balso 2017; Gojek and Google 2019). Section 1.4.1.2 trình bày chi tiết các cách triển khai nhằm bảo đảm tính nhất quán giữa huấn luyện và phục vụ (serving).
Amazon Web Services. 2024a. Amazon Simple Storage Service (S3).
Google Cloud. 2024b. Google Cloud Storage.
Apache Software Foundation. 2024. Apache Airflow.
dbt Labs. 2024. Dbt (Data Build Tool).
Chỉ mỗi tính nhất quán là chưa đủ nếu dữ liệu nền đã cũ. Độ tươi của dữ liệu đảm bảo mô hình được huấn luyện và phục vụ trên dữ liệu hiện thời, thay vì những bản chụp lỗi thời. Các pipeline dữ liệu tự động duy trì độ tươi này bằng cách liên tục biến đổi dữ liệu thô thành định dạng sẵn sàng phân tích qua các giai đoạn có cấu trúc: tiếp nhận, kiểm tra schema, khử trùng lặp, biến đổi và tải. Các công cụ điều phối workflow như Apache Airflow (Apache Software Foundation 2024) và Prefect (Prefect Technologies, Inc. 2024), cùng với framework biến đổi dbt (dbt Labs 2024), giúp những giai đoạn này trở nên rõ ràng, có thể lập lịch và được rà soát dưới dạng mã. Khi pipeline được quản lý theo cách này, luồng dữ liệu có thể tiến hóa theo yêu cầu của mô hình mà vẫn giữ được quản lý phiên bản, tính mô-đun và tích hợp CI/CD.
Trụ cột thứ ba, chất lượng dữ liệu, quyết định liệu dữ liệu đến được mô hình có chính xác, đầy đủ và được gán nhãn nhất quán hay không. Trong các pipeline học có giám sát, chất lượng gán nhãn trực tiếp quyết định trần hiệu năng của mô hình. Các công cụ gán nhãn như Label Studio (HumanSignal 2024) hỗ trợ chú thích theo nhóm ở quy mô lớn, với các tính năng tích hợp như vết kiểm toán và lịch sử phiên bản. Những khả năng này trở nên thiết yếu khi quy ước gán nhãn thay đổi theo thời gian hoặc cần được tinh chỉnh qua nhiều vòng lặp dự án.
HumanSignal. 2024. Label Studio: Open Source Data Labeling Platform.
Để minh họa cách ba nguyên tắc này hỗ trợ lẫn nhau trong thực tế, hãy xem xét một ứng dụng bảo trì dự đoán trong môi trường công nghiệp. Một luồng dữ liệu cảm biến liên tục được thu nạp và ghép với các nhật ký bảo trì lịch sử thông qua một pipeline được lên lịch và quản lý bằng Airflow (freshness). Các đặc trưng thu được, bao gồm trung bình trượt và các tổng hợp thống kê, được lưu trong một kho đặc trưng để phục vụ cả việc huấn luyện lại và suy luận với độ trễ thấp (consistency). Kiểm tra lược đồ, kiểm tra dải giá trị cảm biến, kiểm tra thiếu dữ liệu và rà soát nhãn giúp phát hiện các bản ghi bảo trì sai định dạng hoặc không đáng tin cậy trước khi chúng đi vào huấn luyện (quality), trong khi quản lý phiên bản và tích hợp với model registry duy trì khả năng truy xuất nguồn gốc từ dữ liệu đến các dự đoán của mô hình đã triển khai. Quản lý dữ liệu, được tổ chức xoay quanh ba nguyên tắc này, xây dựng nền tảng vận hành cho khả năng tái lập mô hình, khả năng kiểm toán và triển khai bền vững ở quy mô lớn.
Kho đặc trưng
Nợ phụ thuộc dữ liệu và hiện tượng lệch huấn luyện-phục vụ được mô tả trong section 1.3 có chung một nguyên nhân cốt lõi: việc tính toán các đặc trưng không nhất quán giữa các giai đoạn của pipeline. Hãy hình dung khi không có kho đặc trưng: một nhà khoa học dữ liệu tính user_session_length trong Python để huấn luyện, còn một kỹ sư triển khai lại cùng phép tính đó trong Java để phục vụ (serving). Những khác biệt nhỏ sẽ nảy sinh: một bên dùng wall-clock time, bên kia dùng thời gian xử lý; một bên tính cả idle timeouts, bên kia thì không. Mô hình được huấn luyện theo một định nghĩa nhưng lại phục vụ theo định nghĩa khác, khiến độ chính xác âm thầm suy giảm. Kho đặc trưng7 giải quyết vấn đề này bằng cách tạo một lớp trừu tượng giữa kỹ thuật dữ liệu và machine learning, hiện thực hóa yêu cầu nhất quán thông qua một nguồn tham chiếu duy nhất cho các giá trị đặc trưng. Trong các pipeline thông thường, logic tạo đặc trưng thường bị lặp lại hoặc chệch nhau giữa các môi trường, gây ra rủi ro lệch huấn luyện-phục vụ, rò rỉ dữ liệu và trôi mô hình.
7 Kho đặc trưng: Nền tảng Michelangelo của Uber đã mô tả một kho đặc trưng tập trung để chia sẻ và phục vụ các đặc trưng trên các mô hình sản xuất (Hermann and Del Balso 2017). Ở quy mô lớn như vậy, việc đảm bảo tính nhất quán phải nằm trong giới hạn độ trễ trực tuyến cho phép: điều làm nên sự khác biệt giữa một kho đặc trưng và một thư viện mã đặc trưng dùng chung là đường dẫn đặc trưng dùng chung đó cũng phải phục vụ các đặc trưng mới đủ nhanh cho quá trình suy luận thời gian thực.
Hermann, Jeremy, and Mike Del Balso. 2017. Meet Michelangelo: Uber’s Machine Learning Platform. Uber Engineering Blog.
Kho đặc trưng quản lý việc truy cập các đặc trưng, cả ngoại tuyến (batch) và trực tuyến (thời gian thực), thông qua một kho lưu trữ tập trung. Trong quá trình huấn luyện, các đặc trưng được tính toán và lưu trữ trong môi trường batch cùng với các nhãn lịch sử. Khi suy luận, logic biến đổi tương ứng sẽ được áp dụng cho dữ liệu mới trong một hệ thống phục vụ (serving) trực tuyến. Kiến trúc này giúp các mô hình sử dụng các đặc trưng một cách nhất quán trong cả hai ngữ cảnh, nhưng các nhóm vẫn cần kiểm tra tính đúng tại thời điểm, độ tươi mới và sự đồng nhất giữa môi trường trực tuyến và ngoại tuyến. Về mặt hệ thống, kho đặc trưng là một cơ chế kỹ thuật giúp kiểm soát lệch huấn luyện-phục vụ: bằng cách tập trung hóa định nghĩa đặc trưng và phục vụ chúng qua một đường dẫn dùng chung, nó giúp giảm một nguồn gây ra sai lệch trong pipeline, vốn có thể dẫn đến việc giảm độ chính xác của mô hình trong môi trường sản xuất một cách âm thầm.
Ngoài tính nhất quán, kho đặc trưng còn hỗ trợ quản lý phiên bản, quản lý siêu dữ liệu và tái sử dụng các đặc trưng giữa các nhóm. Ví dụ, một mô hình phát hiện gian lận và một mô hình chấm điểm tín dụng có thể dùng chung các đặc trưng giao dịch. Những đặc trưng này có thể được duy trì, xác thực và chia sẻ một cách tập trung. Việc tích hợp với các pipeline dữ liệu và hệ thống đăng ký mô hình (model registry) cho phép theo dõi nguồn gốc: khi một đặc trưng được cập nhật hoặc ngừng sử dụng, các mô hình phụ thuộc sẽ được xác định và huấn luyện lại tương ứng.
Lệch huấn luyện-phục vụ: Chẩn đoán và phòng ngừa
Lệch huấn luyện-phục vụ (được định nghĩa chính thức trong Độ lệch huấn luyện-phục vụ) thể hiện trong vận hành thực tế thông qua sự không nhất quán của kho đặc trưng và sự sai lệch của pipeline. Table 7 tóm tắt các nguyên nhân phổ biến và phương pháp phát hiện chúng:
| Loại độ lệch | Ví dụ | Phương pháp phát hiện |
|---|---|---|
| Tiền xử lý đặc trưng | Chuẩn hóa sử dụng các thống kê khác nhau | So sánh thống kê các phân bố đặc trưng |
| Xử lý dữ liệu thiếu | Huấn luyện điền NaN bằng giá trị trung bình; suy luận sử dụng 0 | Xác thực lược đồ với xử lý null rõ ràng |
| Các đặc trưng phụ thuộc thời gian | Các đặc trưng được tính toán với các ngưỡng thời gian khác nhau | Xác thực dấu thời gian trong các pipeline đặc trưng |
| Lệch phiên bản thư viện | Sự khác biệt phiên bản NumPy hoặc Pandas | So sánh hash môi trường |
Nghiên cứu điển hình về lệch huấn luyện-phục vụ
Một ví dụ thực tế minh họa cách lệch huấn luyện-phục vụ xuất hiện trong hệ thống sản xuất. Hãy xem xét một hệ thống khuyến nghị có độ chính xác giảm 8% sau một tháng kể từ khi triển khai, mà không hề có bất kỳ thay đổi nào ở mã mô hình. So sánh phân phối đặc trưng cho thấy user_session_length có giá trị trung bình 45 phút khi huấn luyện, nhưng chỉ 12 phút khi phục vụ. Nguyên nhân gốc là lệch trong định nghĩa đặc trưng: pipeline huấn luyện ngoại tuyến tính thời lượng theo đồng hồ tường từ sự kiện đầu tiên đến sự kiện cuối cùng trong một phiên, trong khi đường phục vụ trực tuyến chỉ tính thời gian hoạt động ở tiền cảnh sau khi đã loại bỏ các khoảng thời gian không tương tác. Kết quả là mô hình học các ngưỡng gắn với một định nghĩa đặc trưng mà môi trường sản xuất thực tế không bao giờ phục vụ.
Kho đặc trưng (dựa trên các pipeline dữ liệu từ Kỹ thuật dữ liệu) giải quyết vấn đề này bằng cách tập trung các định nghĩa đặc trưng và các đường phục vụ cho cả pipeline huấn luyện và phục vụ. Listing 1 minh họa mẫu này: quá trình huấn luyện lấy các đặc trưng lịch sử tại một thời điểm cụ thể, còn quá trình phục vụ lấy các đặc trưng trực tuyến hiện tại. Cả hai đều trỏ tới cùng một định nghĩa đặc trưng có quản lý phiên bản, thay vì các nhánh mã trùng lặp. Dù vậy, vẫn cần xác minh tính tương đồng.
feature_definitions = registry.load(version="2026-06-01")

training_features = feature_definitions.materialize_historical(
    entities=training_entities,
    at_event_time=True,
    names=["user.session_length", "user.purchase_history"],
)

serving_features = feature_definitions.lookup_online(
    entities=[{"user_id": 12345}],
    names=["user.session_length", "user.purchase_history"],
)

assert training_features.schema == serving_features.schema
assert (
    training_features.definition_hash
    == serving_features.definition_hash
)
Bằng cách định nghĩa session_length một lần, huấn luyện và phục vụ dùng chung logic này; các kiểm tra tính tương đồng vẫn phải xác minh các giá trị đầu ra. Kho đặc trưng tập trung cũng hỗ trợ tái sử dụng đặc trưng và theo dõi siêu dữ liệu, giúp việc phát hiện và khắc phục lệch trở nên dễ dàng hơn khi định nghĩa đặc trưng thay đổi (Hermann and Del Balso 2017; Gojek and Google 2019).
Gojek, and Google. 2019. Feast: An Open Source Feature Store for Machine Learning. Google Cloud Blog.
Như yêu cầu về tính nhất quán đã định lượng (section 1.2.1.3), các lỗi do lệch ở quy mô sản xuất có thể chuyển thành chi phí hàng trăm nghìn đô la mỗi năm. Kho đặc trưng có thể giảm những tổn thất lặp lại này bằng cách đầu tư vào hạ tầng, mang lại lợi ích có thể đo lường. Bài toán kinh tế chỉ thật sự khả thi khi các định nghĩa dùng chung có thể phục vụ nhiều mô hình và nhiều nhóm.
Example 1.1: Kho đặc trưng Michelangelo của Uber
Tình huống: Nền tảng Michelangelo của Uber hỗ trợ các mô hình sản xuất như ước lượng thời gian đến và dùng chung hạ tầng đặc trưng cho cả huấn luyện ngoại tuyến và dự đoán trực tuyến (Hermann and Del Balso 2017). Nếu cùng một đặc trưng mà mỗi bên lại tự hiện thực riêng logic, sẽ dẫn đến lệch huấn luyện-phục vụ (training-serving skew).
Chẩn đoán: Một hợp đồng đặc trưng dùng chung giúp giảm khả năng các pipeline batch và online hiểu khác nhau về cùng một đặc trưng. Tuy vậy, việc tách riêng kho offline và online vẫn đòi hỏi kiểm tra tính đúng đắn theo đúng thời điểm (point-in-time) và kiểm tra sự đồng nhất (parity) giữa hai bên.
Bài học về hệ thống: Kho đặc trưng giúp giảm một nguồn gây lệch huấn luyện-phục vụ (training-serving skew) bằng cách tập trung các định nghĩa đặc trưng có lập phiên bản và các đường dẫn truy cập. Tuy nhiên, nó không loại bỏ hoàn toàn độ lệch: chúng ta vẫn cần các kiểm thử rõ ràng về tính đúng đắn theo đúng thời điểm, độ mới (freshness), và sự đồng nhất giữa online và offline.
Phát hiện độ lệch trong CI/CD
Các pipeline tự động nên kiểm tra tính nhất quán của đặc trưng trước khi triển khai. Listing 2 minh họa một hàm so sánh phân phối đặc trưng giữa dữ liệu huấn luyện và dữ liệu phục vụ bằng kiểm định Kolmogorov-Smirnov. Hàm này sẽ từ chối triển khai nếu có bất kỳ đặc trưng nào lệch vượt quá ngưỡng cho phép. Cơ chế kiểm tra này biến một sai khác phân phối quan sát được thành lỗi CI trước khi được thăng cấp triển khai, nhưng ngưỡng KS cần được hiệu chỉnh theo kích thước mẫu và mức độ quan trọng của đặc trưng; một thống kê đạt ngưỡng không chứng minh được sự đồng nhất về lược đồ, ngữ nghĩa hay tính đúng đắn theo đúng thời điểm.
def validate_no_skew(
    training_features, serving_features, threshold=0.1
):
    """Reject deployment if feature distributions diverge."""
    for feature in training_features.columns:
        ks_stat = ks_2samp(
            training_features[feature], serving_features[feature]
        )
        if ks_stat.statistic > threshold:
            raise SkewDetectedError(
                f"{feature}: KS={ks_stat.statistic:.3f}"
            )
Lập phiên bản và truy vết nguồn gốc
Theo dõi lineage và lập phiên bản giúp đảm bảo khả năng tái lập (section 1.2.1). Điều này đồng nghĩa mọi tạo phẩm ảnh hưởng đến hành vi của mô hình đều phải được lập phiên bản. Khác với phần mềm truyền thống, mô hình ML phụ thuộc vào nhiều tạo phẩm thường xuyên thay đổi: dữ liệu huấn luyện, logic xây dựng đặc trưng, tham số mô hình đã huấn luyện, và cấu hình. Các thực hành MLOps yêu cầu theo dõi phiên bản của tất cả thành phần trong pipeline để quản lý sự phức tạp này.
Việc lập phiên bản dữ liệu cho phép các nhóm chụp snapshot các tập dữ liệu tại những thời điểm cụ thể và liên kết chúng với các lần chạy mô hình tương ứng, bao gồm cả dữ liệu thô và dữ liệu đã xử lý. Việc lập phiên bản mô hình đăng ký các mô hình đã huấn luyện như các tạo phẩm bất biến, kèm siêu dữ liệu như tham số huấn luyện, chỉ số đánh giá và đặc tả môi trường. Các Model registry cung cấp giao diện có cấu trúc để thăng cấp, triển khai và quay lại phiên bản mô hình; một số còn hỗ trợ trực quan hóa lineage, truy vết toàn bộ đồ thị phụ thuộc từ dữ liệu thô đến dự đoán đã triển khai (MLflow Project 2026; Google Cloud 2024d).
MLflow Project. 2026. MLflow Model Registry.
Những thực hành bổ trợ này hợp thành lớp lineage của một hệ thống ML. Lớp này cho phép tự kiểm tra, thử nghiệm và quản trị bằng cách lưu giữ chuỗi bằng chứng cần để chẩn đoán khi mô hình tụt hiệu năng: phân phối đầu vào có khớp với dữ liệu huấn luyện không, định nghĩa đặc trưng có thay đổi không, và phiên bản mô hình đã triển khai có phù hợp với hạ tầng phục vụ (serving) không. Khi coi việc lập phiên bản và lineage là yếu tố hạng nhất trong thiết kế hệ thống, MLOps giúp các nhóm xây dựng và vận hành các quy trình ML đáng tin cậy, kiểm toán được và dễ phát triển ở quy mô lớn.
Pipeline liên tục và tự động hóa
Kho đặc trưng và hệ thống quản lý phiên bản giải quyết tính nhất quán dữ liệu theo cách tĩnh: chúng đảm bảo các đặc trưng được tính toán chính xác tại một thời điểm cụ thể. Tự động hóa cho phép các hệ thống này phát triển liên tục, đồng bộ hóa các bước tiền xử lý dữ liệu, huấn luyện, đánh giá và phát hành vào các quy trình tích hợp. Nhờ vậy, chúng có thể đáp ứng dữ liệu mới, mục tiêu thay đổi và các ràng buộc vận hành (Orr et al. 2021; Google Cloud 2026b).
Orr, Laurel, Atindriyo Sanyal, Xiao Ling, Karan Goel, and Megan Leszczynski. 2021. “Managing ML Pipelines: Feature Stores and the Coming Wave of Embedding Ecosystems.” Proceedings of the VLDB Endowment 14 (12): 3178–81. https://doi.org/10.14778/3476311.3476402.
Các pipeline CI/CD
Kho đặc trưng và hệ thống quản lý phiên bản giải quyết khía cạnh dữ liệu của tính nhất quán; các pipeline CI/CD giải quyết khía cạnh quy trình, đảm bảo rằng các thay đổi đi qua các giai đoạn đã được kiểm chứng thay vì những lần triển khai tự phát. Các pipeline CI/CD ML phải xử lý những phức tạp không có trong phần mềm truyền thống: phụ thuộc dữ liệu, quy trình huấn luyện mô hình, và quản lý phiên bản tạo phẩm gắn các thay đổi mã với thay đổi hành vi thống kê.
Một pipeline CI/CD ML điển hình gồm các giai đoạn phối hợp: lấy mã nguồn cập nhật, tiền xử lý dữ liệu đầu vào, huấn luyện một mô hình ứng viên, xác thực hiệu suất, đóng gói mô hình và triển khai lên môi trường phục vụ (serving). Trong một số trường hợp, pipeline còn có các trigger để huấn luyện lại tự động dựa trên drift dữ liệu hoặc suy giảm hiệu suất. Bằng cách chuẩn hóa các bước này bằng mã, các pipeline CI/CD8 giảm thiểu can thiệp thủ công, thực thi kiểm tra chất lượng và hỗ trợ cải tiến liên tục cho các hệ thống đã triển khai.
8 Idempotency: Thuộc tính này đảm bảo rằng khi thử lại một giai đoạn của pipeline, sẽ không tạo ra các tác động trùng lặp có thể quan sát được bên ngoài, không có đăng ký xung đột, cũng như không lặp lại các hành động triển khai. Việc tạo ra các mô hình giống hệt nhau từ các đầu vào giống hệt nhau là một thuộc tính khác — tính xác định và khả năng tái lập — và giai đoạn training có thể vi phạm thuộc tính này do các yếu tố ngẫu nhiên như khởi tạo trọng số. Vì vậy, trong môi trường sản xuất, để bảo đảm idempotency, hệ thống kết hợp các định danh lượt chạy ổn định và cơ chế xuất bản nguyên tử; còn để đạt khả năng tái lập, chúng sử dụng hạt giống ngẫu nhiên cố định, nhân xác định, phiên bản thư viện cố định và kiểm soát thứ tự dữ liệu.
CircleCI. 2024. CircleCI: Continuous Integration and Delivery Platform.
GitHub, Inc. 2024b. GitHub Actions.
Authors, Kubeflow. 2024. Kubeflow.
Netflix. 2024. Metaflow.
Prefect Technologies, Inc. 2024. Prefect: Workflow Orchestration Framework for Python.
CI/CD tập trung vào ML sử dụng hai tầng công cụ vì một lý do. Một bộ điều phối CI/CD đa năng (Jenkins, CircleCI (2024), hoặc GitHub Actions (GitHub, Inc. 2024b)) xử lý các sự kiện từ hệ thống kiểm soát phiên bản và logic thực thi, nhưng lớp ML còn phải quản lý phiên bản dữ liệu, đặt điều kiện dựa trên các chỉ số mô hình và kích hoạt huấn luyện lại. Vì vậy, các nhóm bổ sung một nền tảng ML hoặc bộ điều phối workflow (Kubeflow (Authors 2024), Metaflow (Netflix 2024), hoặc Prefect (Prefect Technologies, Inc. 2024)) để cung cấp các lớp trừu tượng cấp cao cho những tác vụ đó.
Nếu không tự động hóa, việc triển khai mô hình sẽ trở thành một quy trình thủ công, dễ lỗi: kỹ sư huấn luyện lại cục bộ, sao chép tạo phẩm lên máy chủ staging, rồi đẩy lên production mà không có gì đảm bảo dữ liệu, mã hay siêu tham số khớp với phiên bản đã được kiểm định. Chi phí cho các quy trình ad hoc như vậy tăng theo quy mô nhóm và tần suất triển khai, dẫn đến lệch cấu hình và những hồi quy âm thầm chỉ lộ ra sau khi mô hình đã trả về dự đoán sai.
Figure 6 minh họa cách một pipeline huấn luyện liên tục điển hình vận hành, bắt đầu từ nạp và xác thực tập dữ liệu, rồi qua các bước biến đổi, huấn luyện/tinh chỉnh, đánh giá, xác thực mô hình và cuối cùng là đăng ký mô hình. Một bộ kích hoạt huấn luyện lại khởi động quy trình này, trong khi các kho lưu trữ tập dữ liệu, mô hình, siêu dữ liệu và tạo phẩm giữ lại các đầu vào và đầu ra cần thiết cho truy vết nguồn gốc.

Google Cloud. 2026b. MLOps: Continuous Delivery and Automation Pipelines in Machine Learning.
Để minh họa các khái niệm này trong thực tế, hãy xem xét một mô hình phân loại hình ảnh đang trong quá trình phát triển. Khi nhà khoa học dữ liệu commit thay đổi vào kho GitHub (GitHub, Inc. 2024a), một pipeline Jenkins được kích hoạt. Pipeline này lấy dữ liệu cập nhật, thực hiện tiền xử lý và khởi động huấn luyện mô hình. Các thí nghiệm được theo dõi bằng MLflow (Databricks 2024), công cụ này ghi lại các chỉ số và lưu trữ artifact của mô hình. Sau khi vượt qua các bài kiểm thử đánh giá tự động, mô hình được đóng gói thành container và triển khai lên môi trường staging bằng Kubernetes (Cloud Native Computing Foundation 2024a). Nếu mô hình đáp ứng các tiêu chí xác thực trong staging, pipeline sẽ điều phối các chiến lược triển khai có kiểm soát như canary testing (chi tiết trong section 1.4.2.3), từng bước chuyển lưu lượng truy cập môi trường sản xuất sang mô hình mới, đồng thời giám sát các chỉ số chính để phát hiện bất thường. Nếu hiệu suất giảm sút, hệ thống có thể tự động quay lại phiên bản mô hình trước đó.
CI/CD trở thành nền tảng khi các hệ thống thường xuyên phát hành mô hình hoặc mang rủi ro đáng kể trong môi trường sản xuất, biến những thử nghiệm ad hoc thành quy trình triển khai có cấu trúc và lặp lại được. Để mở rộng vượt quá một pipeline, cần có các thành phần tái sử dụng được và các hợp đồng artifact rõ ràng.
Example 1.2: Các pipeline ML sản xuất TFX của Google
Tình huống: Kinh nghiệm sản xuất của Google là động lực để phát triển TensorFlow Extended (TFX) – một tập hợp các thành phần tái sử dụng cho các pipeline ML sản xuất (Baylor et al. 2017). Khi số lượng pipeline tăng, các bàn giao kiểu ad hoc khiến việc xác thực, truy xuất nguồn gốc và khả năng tái lập trở nên khó khăn.
Chẩn đoán: Mỗi giai đoạn cần có xác thực và siêu dữ liệu rõ ràng để một mô hình đã triển khai có thể được truy vết ngược về dữ liệu, các phép biến đổi, mã nguồn và quá trình đánh giá đã tạo ra nó.
Bài học về hệ thống: Việc điều phối bằng đồ thị có hướng không chu trình (DAG) thôi chưa đủ để đảm bảo khả năng tái lập. Các thành phần chuẩn hóa và ML Metadata (MLMD) giúp bảo toàn nguồn gốc thông qua việc ghi lại các đầu vào và các phép biến đổi.
Baylor, Denis, Eric Breck, Heng-Tze Cheng, Noah Fiedel, Chuan Yu Foo, Zakaria Haque, Salem Haykal, et al. 2017. “TFX: A TensorFlow-Based Production-Scale Machine Learning Platform.” Proceedings of the 23rd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 1387–95. https://doi.org/10.1145/3097983.3098021.
Các pipeline huấn luyện
Các pipeline CI/CD điều phối toàn bộ quy trình làm việc, nhưng bản thân việc huấn luyện cần hạ tầng chuyên biệt. Huấn luyện mô hình — nơi thuật toán được tối ưu để học các mẫu từ dữ liệu — dựa trên các khái niệm huấn luyện phân tán đã nêu ở Huấn luyện mô hình. Trong MLOps, hoạt động huấn luyện trở thành một phần của pipeline tự động, có khả năng tái tạo và mở rộng, hỗ trợ thử nghiệm liên tục và triển khai ra sản xuất một cách tin cậy.
Các framework như TensorFlow (Abadi et al. 2016), PyTorch (Paszke et al. 2019) và Keras (Chollet et al. 2024) cung cấp các thành phần mô-đun để xây dựng và huấn luyện mô hình, và các nguyên tắc lựa chọn framework từ Các Framework ML được giữ nguyên khi đưa vào sản xuất. Phần này thay vào đó xem xét: những phần logic huấn luyện mang tính khám phá nào được chuyển thành tác vụ huấn luyện lại có phiên bản, đã được kiểm thử, và khi nào.
Abadi, Martı́n, Paul Barham, Jianmin Chen, Zhifeng Chen, Andy Davis, Jeffrey Dean, Matthieu Devin, et al. 2016. “TensorFlow: A System for Large-Scale Machine Learning.” Proceedings of the 12th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 265–83.
Paszke, Adam, Sam Gross, Francisco Massa, Adam Lerer, James Bradbury, Gregory Chanan, Trevor Killeen, et al. 2019. “PyTorch: An Imperative Style, High-Performance Deep Learning Library.” Advances in Neural Information Processing Systems (NeurIPS) 32: 8024–35.
Chollet, François et al. 2024. Keras.
Torvalds, Linus, and Junio Hamano. 2024. Git.
GitHub, Inc. 2024a. GitHub.
Project Jupyter. 2024. Project Jupyter.
Ngoài khả năng mở rộng, khả năng tái tạo cũng là mục tiêu then chốt. Script huấn luyện và cấu hình được quản lý phiên bản bằng các công cụ như Git (Torvalds and Hamano 2024) và lưu trên các nền tảng như GitHub (GitHub, Inc. 2024a). Các môi trường phát triển tương tác, gồm cả sổ tay Jupyter (Project Jupyter 2024), gói gọn việc nạp dữ liệu, xây dựng đặc trưng, các quy trình huấn luyện và logic đánh giá trong một định dạng thống nhất. Trong sản xuất, sổ tay nên được coi là công cụ khám phá: các phép biến đổi đã được xác thực, mã huấn luyện và kiểm tra đánh giá phải được tách ra thành các mô-đun có phiên bản và đã kiểm thử trước khi trở thành các tác vụ huấn luyện lại chạy theo lịch.
Sổ tay trong sản xuất
Các pipeline CI/CD giả định việc thực thi mã là có thể tái tạo, nhưng sổ tay Jupyter lại thách thức giả định này theo những cách tinh vi. Dù rất mạnh cho khám phá và dựng mẫu, dùng trực tiếp sổ tay trong pipeline sản xuất sẽ đưa thêm rủi ro vận hành cần được giảm thiểu. Những lưu ý này đặc biệt quan trọng với các nhóm đang chuyển từ quy trình thử nghiệm sang hệ thống sản xuất.
Thách thức đầu tiên là khả năng tái tạo. Các ô trong notebook có thể được chạy không theo thứ tự, tạo ra các phụ thuộc trạng thái ẩn khiến kết quả không tái tạo được. Một lỗi thường gặp là trong giai đoạn phát triển, nhà khoa học dữ liệu chạy các ô một, ba, hai và mô hình vẫn chạy, nhưng pipeline sản xuất chạy các ô một, hai, ba thì lại hỏng.
Khó khăn trong kiểm thử càng làm bài toán này thêm rắc rối. Các framework kiểm thử đơn vị truyền thống không ăn khớp tự nhiên với cấu trúc notebook. Có thể kiểm thử ở mức từng ô, nhưng hiếm khi được áp dụng, khiến notebook thường được kiểm thử kém hơn so với các module Python tương đương.
Có một số chiến lược giảm thiểu để xử lý các lo ngại vận hành này. Papermill cho phép tham số hóa và thực thi notebook bằng lập trình, coi chúng như các giai đoạn pipeline có thể cấu hình (Papermill Project 2026). Công cụ nbconvert chuyển các notebook đã được xác thực sang các định dạng tĩnh, bao gồm cả script có thể thực thi để chạy trong môi trường sản xuất (Project Jupyter 2026). Ngoài ra, các công cụ cưỡng chế thứ tự thực thi ô sẽ chạy tất cả các ô từ trên xuống dưới và từ chối các phụ thuộc sai thứ tự.
Papermill Project. 2026. Papermill Documentation.
Project Jupyter. 2026. nbconvert: Convert Notebooks to Other Formats.
Napkin Math 1.2: Chi phí của các lỗi thầm lặng
Vấn đề: Việc xây dựng một hệ thống phát hiện drift (trôi) tự động có đáng với công sức kỹ thuật bỏ ra không?
Kịch bản: Hãy xem xét một công cụ đề xuất sản phẩm đang tạo ra $50M doanh thu hàng năm. Chế độ lỗi: Một lỗi trong quá trình triển khai gây ra chênh lệch giữa dữ liệu huấn luyện và dữ liệu phục vụ (serving), làm giảm chất lượng đề xuất 5 percent. Điều này làm tỷ lệ chuyển đổi giảm tương ứng.
Phân tích chi phí:
- Vận hành thủ công (đánh giá hàng tháng):
- Thời gian phát hiện: ~4 weeks (28 days).
- Tổn thất doanh thu: $50M \(\times\) 0.05 \(\times\) 28 days/365 days ≈ $191,780.8.
- MLOps tự động (kiểm tra hàng ngày):
- Thời gian phát hiện: 1 day.
- Tổn thất doanh thu: $50M \(\times\) 0.05 \(\times\) 1 day/365 days ≈ $6,849.3.
Góc nhìn hệ thống: Một lỗi thầm lặng duy nhất sẽ gây thêm $184,931.5 thiệt hại nếu không có MLOps. Với 4 incidents/year sự cố mỗi năm trong kịch bản này, rút ngắn thời gian phát hiện (TTD) giúp tránh được gần $739,726 thiệt hại hàng năm.
Việc tính toán chi phí làm rõ ranh giới giữa notebook và môi trường sản xuất. Notebook vẫn hữu ích cho khám phá và lặp nhanh, nhưng logic đã được xác thực nên chuyển vào các module Python đã kiểm thử trước khi đưa vào pipeline sản xuất. Chi phí tái cấu trúc là xứng đáng khi nó giúp rút ngắn thời gian phát hiện đối với lỗi thầm lặng; để trạng thái notebook và các giả định tiền xử lý ở dạng ngầm sẽ biến sự tiện lợi của giai đoạn khám phá thành rủi ro vận hành.
Khi logic huấn luyện có thể tái lập, tự động hóa có thể chuẩn hóa các bước xung quanh nó. Các quy trình MLOps tích hợp các kỹ thuật như tinh chỉnh siêu tham số (Ranjit et al. 2019; Li et al. 2017), tìm kiếm kiến trúc mạng nơ-ron (Elsken et al. 2019) và lựa chọn đặc trưng tự động (scikit-learn developers 2024a) để khám phá không gian thiết kế hiệu quả. Các tác vụ này được điều phối bằng các pipeline CI/CD, tự động hóa các bước tiền xử lý dữ liệu, huấn luyện mô hình, đánh giá, đăng ký và triển khai. Chẳng hạn, một pipeline Jenkins sẽ kích hoạt job huấn luyện lại khi có dữ liệu có nhãn mới. Mô hình thu được được đánh giá so với các chỉ số cơ sở, và nếu đạt ngưỡng hiệu suất yêu cầu, nó sẽ được triển khai tự động.
Ranjit, Mercy Prasanna, Gopinath Ganapathy, Kalaivani Sridhar, and Vikram Arumugham. 2019. “Efficient Deep Learning Hyperparameter Tuning Using Cloud Infrastructure: Intelligent Distributed Hyperparameter Tuning with Bayesian Optimization in the Cloud.” 2019 IEEE 12th International Conference on Cloud Computing (CLOUD), 520–22. https://doi.org/10.1109/cloud.2019.00097.
Li, Lisha, Kevin G. Jamieson, Giulia DeSalvo, Afshin Rostamizadeh, and Ameet Talwalkar. 2017. “Hyperband: A Novel Bandit-Based Approach to Hyperparameter Optimization.” Journal of Machine Learning Research 18: 185:1–52.
Elsken, Thomas, Jan Hendrik Metzen, and Frank Hutter. 2019. “Neural Architecture Search.” In The Springer Series on Challenges in Machine Learning, vol. 20. Springer International Publishing. https://doi.org/10.1007/978-3-030-05318-5_3.
scikit-learn developers. 2024a. Feature Selection — Scikit-Learn Documentation. Scikit-learn Documentation.
Gartner. 2024. Gartner Forecasts Worldwide Public Cloud End-User Spending to Total $679 Billion in 2024. Gartner, Inc.
9 Chi phí huấn luyện ML trên đám mây: Chi phí huấn luyện GPT-3 được ước tính lên đến hàng triệu đô la Mỹ, tính theo số giờ sử dụng GPU V100 (Li 2020). Chi phí tinh chỉnh (fine-tuning) thay đổi tùy theo kích thước mô hình, nhà cung cấp, tập dữ liệu và số bước huấn luyện. Spot Instances và Spot VMs có thể giúp giảm giá phiên bản, nhưng đi kèm đánh đổi: AWS Spot Instances và Google Cloud Spot VMs có thể bị gián đoạn hoặc thu hồi, đòi hỏi hạ tầng checkpoint-and-resume để huấn luyện chịu lỗi các khối lượng công việc (workload) (Amazon Web Services 2026; Google Cloud 2026c).
Li, Chengwei. 2020. Estimating the Training Cost of GPT-3.
Amazon Web Services. 2026. Amazon EC2 Spot Instances.
Google Cloud. 2026c. Spot VMs.
Google Cloud. 2024c. Tune Models Overview.
Lehdonvirta, Vili, Boxi Wu, Zoe Jay Hawkins, Celine Caira, and Lucia Russo. 2025. Measuring Domestic Public Cloud Compute Availability for Artificial Intelligence. No. 49. OECD Artificial Intelligence Papers. OECD Publishing. https://doi.org/10.1787/8602a322-en.
Các dự báo chi tiêu cho đám mây công cộng cho thấy quy mô của thị trường hạ tầng hỗ trợ huấn luyện và phục vụ (serving) theo yêu cầu (Gartner 2024). Điều này liên hệ với các mẫu điều phối quy trình làm việc được trình bày trong Quy trình ML, nền tảng để quản lý các quy trình huấn luyện phức tạp, nhiều giai đoạn trên các hệ thống phân tán. Các nhà cung cấp đám mây cấp phát tài nguyên điện toán hiệu năng cao theo yêu cầu, bao gồm các bộ tăng tốc GPU và Tensor Processing Unit (TPU).9 Tùy nền tảng, các nhóm có thể tự xây dựng quy trình huấn luyện của riêng mình hoặc dùng các dịch vụ quản lý hoàn toàn như Vertex AI Fine Tuning (Google Cloud 2024c), hỗ trợ tự động điều chỉnh các mô hình nền tảng cho tác vụ mới. Khả năng sẵn có của phần cứng theo khu vực vẫn là yếu tố quan trọng cần cân nhắc khi thiết kế các hệ thống huấn luyện dựa trên đám mây (Lehdonvirta et al. 2025).
Các thực hành này hội tụ về một ranh giới vận hành chung. Khi logic huấn luyện thử nghiệm được kiểm chứng trong notebook và tạo ra một mô hình đã được xác thực, nó sẽ được quản lý phiên bản và tách thành một job huấn luyện lại theo lịch, kích hoạt bởi cập nhật dữ liệu hoặc giám sát hiệu suất. Bộ khung thử nghiệm (exploration harness) giúp lặp nhanh không phải thứ chạy trong sản xuất; thay vào đó là module đã được kiểm thử và quản lý phiên bản. Sự kỷ luật ở bước bàn giao này là ranh giới giữa một pipeline có thể tái lập và một pipeline mong manh. Nhờ quy trình chuẩn hóa, môi trường có quản lý phiên bản và điều phối tự động, MLOps chuyển huấn luyện mô hình từ thử nghiệm ngẫu hứng sang hệ thống vững chắc, lặp lại được, đáp ứng tiêu chuẩn sản xuất về độ tin cậy, khả năng truy vết và hiệu suất.
Framework quyết định huấn luyện lại
Các pipeline huấn luyện tự động đặt ra một quyết định quan trọng về tần suất chạy. Quyết định thời điểm huấn luyện lại một mô hình đòi hỏi cân bằng giữa duy trì độ chính xác và chi phí tính toán. Có ba chiến lược phổ biến, mỗi chiến lược có những đánh đổi riêng. Table 8 đưa ra các lịch trình minh họa theo lĩnh vực, từ huấn luyện lại hằng ngày cho dự đoán nhấp quảng cáo biến động nhanh đến cập nhật hằng quý cho các ứng dụng ảnh y tế ổn định:
| Lĩnh vực | Lịch trình minh họa | Cơ sở lý luận |
|---|---|---|
| Dự đoán nhấp quảng cáo | Hàng ngày | Sở thích người dùng thay đổi nhanh chóng |
| Phát hiện gian lận | Hàng tuần | Các mẫu tấn công liên tục phát triển |
| Dự báo nhu cầu | Hàng tháng | Các mẫu theo mùa thay đổi chậm |
| Chẩn đoán hình ảnh y tế | Hàng quý | Biểu hiện bệnh ổn định |
Những lịch đó chỉ là điểm khởi đầu, không phải quy tắc. Huấn luyện lại theo lịch trình chạy theo một tần suất cố định, ví dụ hàng ngày, hàng tuần hoặc hàng tháng, bất kể các chỉ số hiệu suất. Cách này dễ triển khai và đảm bảo dữ liệu mới nhất rồi cũng sẽ được đưa vào mô hình, nhưng có thể lãng phí tài nguyên tính toán khi phân phối dữ liệu ổn định, hoặc phản ứng quá chậm nếu xảy ra thay đổi giữa hai lần chạy theo lịch.
Huấn luyện lại theo kích hoạt gắn quyết định huấn luyện lại với suy giảm hiệu suất quan sát được. Cách này tối ưu chi phí tính toán vì chỉ huấn luyện lại khi hệ thống giám sát phát hiện hiệu suất giảm hoặc có sự trôi dạt vượt ngưỡng, nhưng đòi hỏi hệ thống giám sát vững chắc và phải hiệu chỉnh cẩn thận để tránh cảnh báo sai (dương tính giả) hoặc bỏ sót suy giảm thực sự.
Huấn luyện lại liên tục cập nhật mô hình dần dần khi dữ liệu có nhãn mới đến, thông qua học trực tuyến hoặc các bản cập nhật nhỏ định kỳ. Cách này có thể giảm độ trễ cập nhật, nhưng làm tăng gánh nặng xác thực vì các nhãn nhiễu hoặc dữ liệu đối kháng có thể được đưa vào mô hình trước khi con người kịp xem xét sự thay đổi.
Do đó, lựa chọn cách huấn luyện lại phụ thuộc vào bốn ràng buộc: chi phí huấn luyện lại, hạ tầng xác thực, khả năng khôi phục (rollback) và mức độ sẵn có của nhãn. Các mô hình lớn có thể tốn hàng chục nghìn đô la cho mỗi lần chạy. Huấn luyện lại theo kích hoạt cần có bằng chứng về kết quả hoặc một chỉ báo thay thế có cơ sở. Và mọi lộ trình cập nhật tự động đều cần được xác thực và có khả năng khôi phục trước khi được đưa vào sử dụng. Huấn luyện lại theo lịch trình mang lại vận hành dễ dự đoán; huấn luyện lại theo kích hoạt gắn việc điều tra với những thay đổi đã đo được; còn huấn luyện lại liên tục giúp giảm độ trễ cập nhật nhưng đổi lại là một vòng xác thực chặt chẽ hơn nhiều. Chính sách phù hợp phụ thuộc vào cách triển khai, chứ không chỉ dựa vào lĩnh vực ứng dụng.
Các ràng buộc về kinh tế và xác thực được hiện thực hóa trong listing 3: hàm quyết định chỉ lên lịch chạy khi giá trị thu hồi ước tính lớn hơn chi phí và rủi ro của việc huấn luyện lại, xác thực và triển khai, và dữ liệu xác thực còn mới.
quality_loss = baseline_accuracy - current_accuracy
feature_drift = max(population_stability_index(features))
prediction_shift = distribution_distance(
    baseline_predictions, live_predictions
)

benefit = estimate_value_recovered(
    quality_loss=quality_loss,
    feature_drift=feature_drift,
    prediction_shift=prediction_shift,
)
risk = retraining_cost + validation_cost + rollout_risk

if benefit > risk and validation_data_is_fresh():
    schedule_retraining_run()
Cổng này tách việc phát hiện trôi dạt khỏi việc cho phép huấn luyện lại: trôi dạt góp phần vào lợi ích ước tính, còn dữ liệu xác thực mới và giá trị ròng dương sẽ quyết định có tự động hành động hay không. Với kịch bản minh họa đầy đủ được đánh giá ở phần tiếp theo, các tham số cho thấy khoảng thời gian tối ưu vào gần một ngày.
Kinh tế học định lượng cho huấn luyện lại
Quyết định huấn luyện lại một mô hình cân giữa chi phí suy giảm độ chính xác và chi phí huấn luyện lại. Khi dữ liệu đầu ra cho thấy có thể khớp theo hàm mũ cục bộ, tốc độ suy giảm ước tính mang lại một thang thời gian có thể đo lường.10 Chu kỳ bán rã11 cho biết khi nào độ chính xác khớp giảm xuống còn một nửa giá trị ban đầu, nhưng nó không quyết định khoảng thời gian huấn luyện lại tối ưu về mặt kinh tế. Phần suy luận trong equation 4 phân biệt chu kỳ bán rã đã khớp với khoảng thời gian huấn luyện lại tối ưu về kinh tế.
10 Entropy hệ thống: Tốc độ suy giảm ước tính \(\gamma\) có thể khác biệt đáng kể giữa các lần triển khai và cần được ước tính từ dữ liệu đầu ra. Thang thời gian suy giảm ngắn hơn đòi hỏi giám sát phản ứng nhanh hơn, nhưng tự nó không yêu cầu huấn luyện liên tục; độ trễ nhãn, rủi ro xác thực, chi phí huấn luyện lại và khả năng khôi phục sẽ quyết định nhịp vận hành.
11 Chu kỳ bán rã (từ vật lý hạt nhân, nơi nó đo thời gian để một nửa lượng mẫu phóng xạ bị phân rã): Trong vận hành ML, phép ẩn dụ này chỉ là một xấp xỉ tiện lợi, không phải một định luật phổ quát. Với phép khớp hàm mũ trong equation 5, chu kỳ bán rã là \(\ln(2)/\gamma\). Nhịp huấn luyện lại còn phụ thuộc vào lưu lượng, giá trị, chi phí huấn luyện lại và rủi ro; các thay đổi theo mùa, đột ngột hoặc do đối thủ gây ra đòi hỏi một quá trình trôi dạt phong phú hơn.
Napkin Math 1.3: Khoảng thời gian huấn luyện lại tối ưu
Vấn đề: Nhóm nên huấn luyện lại mô hình bao lâu một lần để tối đa hóa lợi nhuận?
Vật lý: Độ chính xác của mô hình \(\text{Accuracy}(t)\) suy giảm với tốc độ \(\gamma\) do trôi dạt dữ liệu.
- \(Q\): Khối lượng truy vấn hằng ngày (lưu lượng).
- \(V\): Giá trị tài chính trên mỗi truy vấn cho một đơn vị thay đổi của tỷ phần độ chính xác. Theo quy ước này, \(V = \$0.50\) nghĩa là 1 điểm phần trăm độ chính xác trị giá \(\$0.005\) cho mỗi truy vấn.
- \(C\): Chi phí cố định cho một lần chạy huấn luyện lại, bao gồm chi phí tính toán và chi phí vận hành.
Công thức: Công thức xấp xỉ trong equation 4 cho ta khoảng thời gian huấn luyện lại tối ưu \((T^*)\) giúp giảm thiểu tổng chi phí do mô hình lỗi thời và chi phí huấn luyện: \[ T^* \approx \sqrt{\frac{2 \cdot C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}} \tag{4}\] Toán học: Xem xét một mô hình phát hiện gian lận (lighthouse fraud model) (\(\text{Accuracy}_0\) = 0.95):
- Lưu lượng \((Q)\): 1,000,000 giao dịch/ngày.
- Giá trị \((V)\): $0.50/query cho mỗi đơn vị thay đổi độ chính xác.
- Chi phí huấn luyện lại \((C)\): $5,000.
- Tốc độ trôi \((\gamma)\): 2 percent mỗi ngày. \[ T^* \approx \sqrt{\frac{2 \times 5,000}{1,000,000 \times 0.50 \times 0.95 \times 0.02}} \approx \mathbf{1\text{ Day}} \]
Góc nhìn hệ thống: Nếu lưu lượng truy cập cao và độ chính xác quan trọng, nhóm không thể trì hoãn. Pipeline phải được tự động hóa. Nếu \(T^*\) nhỏ hơn thời gian triển khai thủ công của nhóm, hệ thống sẽ rơi vào tình trạng nợ kỹ thuật vĩnh viễn.
Phép suy luận tương tự có thể được chuẩn hóa thành một framework để hiệu chỉnh các ngưỡng giám sát dựa trên tác động kinh doanh có thể đo lường được. Framework định lượng này biến việc huấn luyện lại từ một quyết định tùy hứng thành một bài toán tối ưu hóa kỹ thuật, qua đó triển khai tự động hóa có cân nhắc chi phí (section 1.2.1).
Hàm chi phí lỗi thời
Độ chính xác của mô hình có thể giảm dần theo thời gian, kéo theo chi phí lỗi thời. Để lập kế hoạch kinh tế, một nhóm có thể khớp tác động quan sát được trong một khoảng ổn định bằng một quá trình suy giảm hàm mũ. Ở đây, \(\gamma\) là tốc độ suy giảm theo thời gian, giả định rằng mức suy giảm đo được tích lũy đều đặn; nó không chỉ do sự khác biệt của phân phối dữ liệu. Mô hình hàm mũ là một đơn giản hóa, cho phép phân tích kinh tế với công thức tường minh. Gọi \(\text{Accuracy}(t)\) là độ chính xác tại thời điểm \(t\) kể từ lần huấn luyện cuối cùng, và \(\text{Accuracy}_0\) là độ chính xác ban đầu. Equation 5 mô tả kịch bản đã được khớp này, trong đó tốc độ \(\gamma\) phụ thuộc vào mức độ biến động của miền và các kết quả quan sát được: \[\text{Accuracy}(t) = \text{Accuracy}_0 \cdot e^{-\gamma t} \tag{5}\]
Chi phí lỗi thời tích lũy dựa trên khối lượng truy vấn \(Q\) mỗi đơn vị thời gian và tác động giá trị \(V\) của mỗi đơn vị thay đổi trong tỉ lệ độ chính xác. Việc tích phân tổn thất độ chính xác tức thời \((\text{Accuracy}_0 - \text{Accuracy}(t))\) trong khoảng thời gian huấn luyện lại \(T\) sẽ cho ra equation 6: \[ \begin{array}{>{\displaystyle}c} \text{Staleness Cost}(T) = \int_0^T Q \cdot V \cdot (\text{Accuracy}_0 - \text{Accuracy}(t)) \, dt = \\ Q \cdot V \cdot \text{Accuracy}_0 \cdot \left(T - \frac{1-e^{-\gamma T}}{\gamma}\right) \end{array} \tag{6}\]
Tích phân này cộng dồn chi phí theo thời gian \(t\) từ 0 đến \(T\), và dạng đóng thu được bằng cách thay equation 5 vào biểu thức \(\text{Accuracy}(t)\).
Hàm chi phí huấn luyện lại
Mỗi lần huấn luyện lại sẽ phát sinh các chi phí cố định, bao gồm chi phí tính toán, xác thực và chi phí triển khai. Equation 7 phân tách các chi phí này như sau: \[\text{Retraining Cost} = C_{\text{compute}} + C_{\text{validation}} + C_{\text{deployment}} + C_{\text{risk}} \tag{7}\] trong đó \(C_{\text{compute}}\) là chi phí cho quá trình huấn luyện, \(C_{\text{validation}}\) là chi phí đánh giá mô hình mới trước khi phát hành, \(C_{\text{deployment}}\) là chi phí triển khai mô hình vào môi trường sản xuất, và \(C_{\text{risk}}\) là chi phí kỳ vọng do nguy cơ mô hình mới làm tụt hiệu năng.
Kéo dài thời gian huấn luyện lại quá mức và chi phí lỗi thời sẽ tăng vọt.
Khoảng thời gian huấn luyện lại tối ưu
Khoảng thời gian huấn luyện lại tối ưu \(T^*\) giúp giảm thiểu tổng chi phí trên một đơn vị thời gian, như equation 8 thể hiện: \[T^* = \operatorname{arg\,min}_T \frac{\text{Staleness Cost}(T) + \text{Retraining Cost}}{T} \tag{8}\]
Khi chúng ta giả định \(\gamma T \ll 1\), khai triển Taylor của hàm mũ sẽ cho ra công thức xấp xỉ căn bậc hai, vốn đã được dùng trong tính toán nháp ban đầu. Với các tham số trong table 9, phép xấp xỉ này cho thấy điểm tối ưu kinh tế nằm gần mốc một ngày; để tìm điểm tối ưu chính xác, ta cần tối thiểu hóa equation 8 mà không dùng khai triển.
| Tham số | Giá trị | Mô tả |
|---|---|---|
| \(Q\) | 1,000,000 | Giao dịch mỗi ngày |
| \(V\) | $0.50/query | Giá trị mỗi truy vấn cho một thay đổi đơn vị độ chính xác |
| \(\text{Accuracy}_0\) | 0.95 | Độ chính xác ban đầu |
| \(\gamma\) | 0.02 | Tốc độ suy giảm hàng ngày (2% mỗi ngày) |
| Chi phí huấn luyện lại | $5,000 | Tổng chi phí huấn luyện lại |
Phân tích độ nhạy
Theo công thức xấp xỉ căn bậc hai, \(T^*\) tỷ lệ thuận với căn bậc hai của các tham số này. Table 10 cho thấy rằng sự thay đổi gấp bốn lần trong chi phí huấn luyện lại, khối lượng truy vấn hoặc tốc độ suy giảm sẽ khiến khoảng thời gian xấp xỉ thay đổi gấp đôi.
| Thay đổi | Ảnh hưởng đến \(T^*\) |
|---|---|
| Chi phí huấn luyện lại gấp 4 lần | Khoảng thời gian dài hơn 2 lần |
| Khối lượng truy vấn gấp 4 lần | Khoảng thời gian ngắn hơn 2 lần |
| Tốc độ suy giảm gấp 4 lần | Khoảng thời gian ngắn hơn 2 lần |
Hạn chế của mô hình
Framework này cung cấp một xấp xỉ bậc nhất giúp đưa ra quyết định có cơ sở, nhưng người thực hành cần lưu ý các giả định của nó:
- Trôi dạt có thể dự đoán: Mô hình suy giảm theo hàm mũ giả định trôi dạt diễn ra dần dần với một tốc độ đã biết. Những thay đổi đột ngột về dữ liệu hoặc khái niệm đòi hỏi cơ chế phát hiện và phản ứng khác.
- Hàm giá trị đã biết: Mô hình giả định mỗi mức độ chính xác có một giá trị kinh doanh có thể định lượng. Trên thực tế, giá trị này có thể phi tuyến tính hoặc phụ thuộc vào ngữ cảnh.
- Các chu kỳ huấn luyện lại độc lập: Mô hình xem mỗi quyết định huấn luyện lại là độc lập, bỏ qua lợi ích tiềm năng từ học liên tục hoặc chuyển giao giữa các chu kỳ huấn luyện lại.
- Tỷ lệ chi phí tuyến tính: Giả định chi phí huấn luyện lại là cố định. Trên thực tế, chi phí hạ tầng có thể thay đổi theo mức độ sẵn có của tài nguyên tính toán và biến động giá.
Dù còn hạn chế, framework vẫn là một điểm khởi đầu có cơ sở cho các quyết định huấn luyện lại. Các tham số sẽ được cải thiện thông qua hiệu chuẩn dựa trên dữ liệu lịch sử và được tinh chỉnh khi tích lũy thêm kinh nghiệm vận hành. Bằng cách làm rõ và định lượng được các đánh đổi chi phí - lợi ích, framework này triển khai tự động hóa có tính đến chi phí (section 1.2.1), từ đó cho phép đưa ra các khoản đầu tư hạ tầng hợp lý và thiết lập ngưỡng giám sát dựa trên tác động kinh doanh đo lường được.
Xác thực mô hình
Các pipeline huấn luyện tạo ra các mô hình ứng viên; xác thực mô hình sẽ quyết định ứng viên nào xứng đáng đưa vào triển khai sản xuất. Khác với đánh giá trong nghiên cứu, nơi một mô hình có thể được coi là thành công nếu vượt một benchmark trên tập kiểm thử tĩnh, xác thực cho sản xuất phải đánh giá mức độ sẵn sàng vận hành dưới các điều kiện đại diện và thiết lập các cơ chế giám sát cùng kiểm soát rollback cần thiết khi phân phối thay đổi.
Quá trình đánh giá bắt đầu bằng kiểm thử hiệu năng trên một tập kiểm thử độc lập (holdout test set) được lấy mẫu từ cùng một phân phối với dữ liệu sản xuất. Các chỉ số cốt lõi như độ chính xác (accuracy), diện tích dưới đường cong (AUC), precision, recall và F1 (Rainio et al. 2024) được tính và theo dõi theo thời gian để phát hiện suy giảm do trôi dữ liệu (data drift) (IBM 2024). Ba bảng căn thẳng hàng trong figure 7 minh họa cụ thể kiểu suy giảm này. Bảng trên cùng cho thấy các mẫu dữ liệu đến theo thời gian, được tô màu theo loại. Bảng ở giữa cho thấy một thay đổi đi kèm: phân phối của đặc trưng (sales_channel) dần dịch từ chủ yếu trực tuyến sang chủ yếu ngoại tuyến. Bảng dưới cùng cho thấy độ chính xác của mô hình giảm trong cùng khoảng thời gian. Hình minh họa này nêu bật thách thức cốt lõi của việc xác thực mô hình: cần theo dõi cả đầu vào lẫn đầu ra để hiểu vì sao hiệu suất thay đổi.
Rainio, Oona, Jarmo Teuho, and Riku Klén. 2024. “Evaluation Metrics and Statistical Tests for Machine Learning.” Scientific Reports 14 (1): 6086. https://doi.org/10.1038/s41598-024-56706-x.
IBM. 2024. IBM Watson OpenScale: Data Drift Detection.

Ngoài đánh giá tĩnh, MLOps khuyến khích các chiến lược triển khai có kiểm soát để mô phỏng điều kiện sản xuất đồng thời giảm thiểu rủi ro. Một phương pháp phổ biến là canary testing (Fowler 2014), trong đó mô hình mới được triển khai cho một phần nhỏ người dùng hoặc truy vấn. Trong giai đoạn phát hành hạn chế này, các chỉ số hiệu suất thời gian thực được theo dõi để đánh giá độ ổn định của hệ thống và tác động đến người dùng. Ví dụ, một nền tảng thương mại điện tử triển khai mô hình gợi ý mới cho 5% lưu lượng web và theo dõi các chỉ số như tỷ lệ nhấp (click-through rate), độ trễ và độ chính xác dự đoán. Chỉ khi mô hình cho thấy hiệu suất ổn định, đáng tin cậy, nó mới được nâng lên triển khai toàn bộ trên môi trường sản xuất.
Fowler, Martin. 2014. Canary Release. Martin Fowler’s Blog.
Weights & Biases, Inc. 2024. Weights & Biases: The AI Developer Platform.
Việc đánh giá các ứng viên trong cùng điều kiện là điều kiện tiên quyết để đưa ra quyết định đưa mô hình lên sản xuất; bởi nếu một ứng viên thắng chỉ vì được đo trên lưu lượng, đặc trưng hoặc khoảng thời gian khác thì điều đó không nói lên điều gì cho nhóm. Các nền tảng ML trên đám mây hỗ trợ điều này thông qua ghi nhật ký thí nghiệm, phát lại yêu cầu và tạo ca kiểm thử tổng hợp; các công cụ như Weights & Biases (Weights & Biases, Inc. 2024) ghi nhận các tạo phẩm huấn luyện, cấu hình siêu tham số và các chỉ số, giúp các so sánh có thể tái lập và truy vết xuyên suốt pipeline huấn luyện và triển khai.
Mặc dù tự động hóa đóng vai trò trung tâm trong đánh giá MLOps, giám sát của con người vẫn rất cần thiết. Các kiểm thử tự động có thể bỏ sót những vấn đề hiệu suất tinh vi, như khả năng tổng quát hóa kém trên các nhóm đối tượng hiếm gặp hoặc những thay đổi trong hành vi người dùng. Các nhóm kết hợp đánh giá định lượng với rà soát định tính, đặc biệt với các mô hình được triển khai trong môi trường rủi ro cao hoặc chịu quản lý chặt chẽ. Quy trình đánh giá nhiều giai đoạn này nối liền kiểm thử offline với giám sát hệ thống thời gian thực, bảo đảm mô hình vận hành có thể dự đoán trong điều kiện thực tế, và hoàn thiện nền tảng hạ tầng phát triển cần cho triển khai sản xuất.
Tích hợp hạ tầng
Hạ tầng phát triển mà chúng ta đã xem xét trước đó giải quyết hai trong ba giao diện quan trọng nêu ở đầu chương. Kho đặc trưng và quản lý phiên bản dữ liệu giảm bất nhất tại giao diện dữ liệu–mô hình bằng cách tập trung và theo dõi việc truy cập đặc trưng xuyên suốt huấn luyện và phục vụ (serving). Các pipeline CI/CD, kho lưu trữ mô hình và các cổng xác thực giải quyết giao diện mô hình–hạ tầng bằng cách tự động hóa bước chuyển từ các trọng số đã huấn luyện sang các dịch vụ chạy trong container, kèm khả năng hoàn nguyên (rollback).
Dẫu vậy, đó mới chỉ là hai phần ba thách thức vận hành. Một mô hình dù đã vượt qua tất cả các cổng xác thực và được triển khai thành công vẫn có thể âm thầm thất bại trong sản xuất khi thế giới xung quanh thay đổi. Giao diện quan trọng thứ ba, giám sát sản xuất, đòi hỏi một bộ thực hành khác, tập trung không phải vào xây dựng mô hình mà là giữ cho chúng khỏe mạnh theo thời gian.
Self-Check: Question
A fraud detection system serves \(Q = 10^6\) queries/day with baseline accuracy \(\text{Accuracy}_0 = 0.95\), daily accuracy decay rate \(\gamma = 0.02\) (\(2\%\) decay per day), value per query for unit accuracy fraction \(V = \$0.50\), and fixed retraining cost \(C = \$5,000\). Using the square-root optimal retraining approximation \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\), what is the economically optimal retraining interval \(T^*\)?
- Approximately \(1.0\) day
- Approximately \(5.2\) days
- Approximately \(14.5\) days
- Approximately \(30.0\) days
In the optimal retraining formula \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\), how does the optimal interval \(T^*\) change if the fixed retraining compute and validation cost \(C\) increases by a factor of 4 while all other parameters remain constant?
- \(T^*\) increases by a factor of 4 (\(4\times\) longer interval), scaling linearly with cost
- \(T^*\) increases by a factor of 2 (\(2\times\) longer interval), because \(T^*\) scales with the square root of retraining cost \(\sqrt{C}\)
- \(T^*\) decreases by a factor of 2 (\(0.5\times\) shorter interval), forcing more frequent retraining
- \(T^*\) remains unchanged, because optimal retraining cadence is governed solely by query traffic and drift rate
Explain how a centralized feature store’s point-in-time (time-travel) query capability prevents data leakage during model training.
An automated MLOps continuous training and delivery pipeline executes upon receiving a drift alert. Place the following pipeline stages in their correct execution order:
- Data Validation Gate: Run schema and statistical boundary checks on newly ingested data.
- Staged Rollout / Canary Deployment: Route a small percentage of live production traffic to the new model.
- Model Training & Hyperparameter Optimization: Train candidate model weights on the validated dataset.
- Model Evaluation & Guardrail Gate: Evaluate candidate model against golden test slices and latency SLOs.
- Model Registry Registration: Tag and store the validated model binary, metadata, and container hash.
- True or False: In automated ML pipelines, a ‘reproducibility failure’ and an ‘operational idempotence failure’ describe the exact same defect.
Vận hành sản xuất
Một mô hình dù vượt qua mọi cổng xác thực vẫn có thể có chu kỳ bán rã. Ngay từ thời điểm triển khai, thế giới thực có thể bắt đầu lệch khỏi phân phối dùng để huấn luyện: khách hàng thay đổi hành vi, đối thủ tung sản phẩm mới, mùa vụ dịch chuyển, và các trường hợp edge mới xuất hiện mà không bộ kiểm thử nào lường trước. Vận hành sản xuất tồn tại để khiến sự suy giảm tiềm tàng này trở nên nhìn thấy được và có thể quản lý, triển khai giao diện giám sát sản xuất thông qua các chiến lược triển khai, giám sát, ứng phó sự cố và quản trị. Yêu cầu đặt ra rất khắt khe: xử lý tải biến thiên, duy trì độ trễ ổn định, phục hồi trơn tru sau lỗi và thích ứng với phân phối dữ liệu thay đổi, tất cả mà không làm gián đoạn dịch vụ. Những thực hành này hiện thực hóa khả năng quan sát suy giảm ngay trong runtime, biến trôi mô hình (model drift) được phát hiện thành cảnh báo để điều tra trước khi người dùng chịu ảnh hưởng.
Triển khai và phục vụ mô hình
Sau khi được huấn luyện và xác thực, mô hình cần được tích hợp vào môi trường sản xuất để cung cấp dự đoán ở quy mô lớn. Triển khai biến một tạo phẩm tĩnh thành một thành phần hệ thống đang chạy, còn phục vụ (serving) đảm bảo khả năng truy cập, độ tin cậy và hiệu quả khi đáp ứng các yêu cầu suy luận. Cùng nhau, chúng bắc cầu giữa phát triển mô hình và tác động trong thế giới thực.
Triển khai mô hình
Hãy xét một mô hình phát hiện gian lận đạt 99,2 phần trăm độ chính xác trong môi trường phát triển. Một kỹ sư xuất các trọng số, sao chép chúng sang máy chủ sản xuất, rồi phát hiện mô hình dự đoán mọi giao dịch đều hợp lệ: máy chủ sản xuất chạy một phiên bản khác của thư viện trích xuất đặc trưng, tạo ra đầu vào mà mô hình chưa từng thấy. Kịch bản này, tuy phổ biến và gây khó chịu, cho thấy việc triển khai không phải chỉ là chuyển tập tin mà là một bài toán kỹ thuật hệ thống. Để triển khai các mô hình ML vào sản xuất một cách đáng tin cậy, cần đóng gói, kiểm thử và theo dõi chúng, coi mô hình cùng các phụ thuộc và cấu hình của nó như một đơn vị triển khai duy nhất. Một cách tiếp cận phổ biến là container hóa mô hình bằng các công nghệ container,12 giúp đảm bảo tính di động giữa các môi trường.
12 Container hóa để triển khai ML: Docker (Merkel 2014) đóng gói mã cùng với các phụ thuộc thành các đơn vị di động; Kubernetes (Burns et al. 2016) điều phối các đơn vị này trên các cụm. Container hóa giúp xử lý một phần hạng mục \(\text{Environment}_v\) trong equation 1 bằng cách ghi nhận các phụ thuộc ở không gian người dùng dưới dạng một tạo phẩm có phiên bản; còn kernel máy chủ, trình điều khiển và phần cứng vẫn là các phụ thuộc bên ngoài.
Merkel, Dirk. 2014. “Docker: Lightweight Linux Containers for Consistent Development and Deployment.” Linux Journal 2014 (239).
Burns, Brendan, Brian Grant, David Oppenheimer, Eric Brewer, and John Wilkes. 2016. “Borg, Omega, and Kubernetes.” Communications of the ACM 59 (5): 50–57. https://doi.org/10.1145/2890784.
Chen, Andrew, Andy Chow, Aaron Davidson, Arjun DCunha, Ali Ghodsi, Sue Ann Hong, Andy Konwinski, et al. 2020. “Developments in MLflow: A System to Accelerate the Machine Learning Lifecycle.” Proceedings of the Fourth International Workshop on Data Management for End-to-End Machine Learning, 1–4. https://doi.org/10.1145/3399579.3399867.
13 Thẩm định ở giai đoạn staging: Giai đoạn staging trong ML bổ sung các kiểm tra về mức độ đầy đủ theo xác suất vào các bước thẩm định chức năng và vận hành thông thường. Một mô hình dù vượt qua kiểm thử đơn vị vẫn có thể thất bại khi chạy thực tế vì dữ liệu kiểm thử không phản ánh đúng phân phối khi triển khai. Vì vậy, các cổng triển khai (rollout gates) cần so sánh các thống kê về dự đoán, các lát cắt đánh giá (evaluation slices) và các rào chắn kinh doanh (business guardrails) với các ngưỡng đã được hiệu chỉnh, thay vì chỉ dựa vào kiểm thử đơn vị.
Triển khai vào sản xuất đòi hỏi các framework có khả năng xử lý đóng gói mô hình, quản lý phiên bản và tích hợp với hạ tầng phục vụ (serving). Các công cụ như MLflow và kho lưu trữ mô hình quản lý các tạo phẩm triển khai này (Chen et al. 2020), trong khi các framework chuyên cho phục vụ (serving) (trình bày chi tiết trong Phục vụ mô hình) đảm nhiệm tối ưu hóa runtime và yêu cầu mở rộng. Trước khi triển khai rộng rãi, các nhóm đưa mô hình cập nhật lên môi trường staging hoặc QA13 để kiểm thử hiệu năng một cách nghiêm ngặt.
Triển khai bóng (Shadow deployment)14 sao chép bất đồng bộ lưu lượng truy cập thực tế đến một mô hình ứng viên, nhưng không trả kết quả suy luận của mô hình này về cho người dùng. Cách này cho phép so sánh độ trễ và đầu ra mà không phơi bày trực tiếp với người dùng; còn độ chính xác vẫn cần nhãn hoặc một tham chiếu được chứng minh là đáng tin cậy. Triển khai canary15 chuyển hướng một phần nhỏ lưu lượng người dùng (tăng dần theo thời gian) đến mô hình mới để phát hiện hồi quy dưới tải thực tế. Triển khai blue-green16 duy trì hai môi trường song song để chuyển mạch ở cấp bộ định tuyến và khôi phục nhanh. Mỗi chiến lược giảm một dạng rủi ro phát hành khác nhau, nhưng vẫn không thể thiếu quy trình khôi phục đã được kiểm thử và giám sát môi trường sản xuất.
14 Triển khai bóng (Shadow deployment): Chiến lược này hợp lý về kinh tế khi lợi ích kỳ vọng từ việc giảm tổn thất trong quá trình rollout lớn hơn chi phí hạ tầng “bóng” dùng để chạy suy luận trùng lặp mà không phục vụ (serving) kết quả cho người dùng.
15 Triển khai canary: Chuyển hướng một phần nhỏ lưu lượng thực tế đến một mô hình ứng viên, dùng nó như “chim hoàng yến” báo hiệu sức khỏe môi trường sản xuất. Thách thức đặc thù trong ML là “lỗi” thường là suy giảm mang tính thống kê, không phải một cú sập hệ thống quyết định. Phát hiện một khác biệt nhỏ về độ chính xác với độ tin cậy cao có thể cần tới hàng nghìn lượt suy luận, tạo ra căng thẳng giữa tốc độ ra quyết định và công suất thống kê, yếu tố quyết định thời lượng tối thiểu của giai đoạn canary.
16 Triển khai blue-green: Phương pháp này duy trì hai môi trường sản xuất tương đương: “blue” (đang phục vụ lưu lượng hiện tại) và “green” (chạy bản ứng viên). Khi môi trường green vượt qua bước xác thực, lưu lượng được chuyển sang green bằng một thay đổi định tuyến. Vì hoàn tác chỉ là đảo chiều lưu lượng thay vì rút dần, thời gian phục hồi có thể nhanh hơn canary triển khai từ từ, đặc biệt với các dịch vụ không trạng thái. Đổi lại, phải duy trì thêm hạ tầng trong giai đoạn chuyển đổi. Do đó, blue-green hiệu quả hơn canary khi có thể chấp nhận tạm thời nhân đôi công suất và việc xác thực thống kê theo từng phân đoạn có chi phí cao.
War Story 1.1: Lỗi của Knight Capital (2012)
Bối cảnh: Knight Capital Group là một nhà tạo lập thị trường lớn trên thị trường chứng khoán Mỹ, xử lý hơn 17% khối lượng giao dịch trên NYSE. Vào tháng 8/2012, một đợt triển khai vận hành đã cập nhật phần mềm định tuyến lệnh SMARS trên bảy trong tám máy chủ sản xuất, nhưng bỏ sót máy thứ tám (U.S. Securities and Exchange Commission 2013).
Cơ chế: Đợt triển khai này tái sử dụng một cờ đặc trưng nhị phân, vô tình kích hoạt mã Power Peg cũ trên máy chủ thứ tám chưa được cập nhật. Máy chủ lỗi thời này rơi vào một vòng lặp không bị hạn chế tốc độ, liên tục gửi các yêu cầu lệnh gốc với tốc độ khoảng \(\sim 1,400\text{ orders/sec}\).
Tác động: Trong 45 phút, bộ định tuyến đã thực hiện hơn 4 triệu giao dịch trái phép, bao phủ hơn 397 triệu cổ phiếu, gây thiệt hại $460 triệu. Công ty chỉ trụ được nhờ khoản cứu trợ khẩn cấp huy động vài ngày sau đó, và mất độc lập khi bị mua lại chỉ trong vài tháng.
Phản ứng: Sự cố này thúc đẩy việc xác minh triển khai theo kiểu nguyên tử trên toàn bộ các nút sản xuất, kiểm soát rõ ràng vòng đời của các cờ đặc trưng, và bổ sung các cầu dao (circuit breaker) để giới hạn thiệt hại mà một bản phát hành lỗi có thể gây ra.
Bài học hệ thống: Triển khai tự động là một bài toán điều khiển ở tầng vật lý, nơi trôi cấu hình giữa các nút không đồng nhất có thể dẫn tới lỗi thảm khốc. Các triển khai ML có đúng lỗ hổng này: không khớp phiên bản trong kho lưu trữ mô hình, lược đồ đặc trưng không đồng bộ, hoặc định tuyến canary một phần có thể làm tràn ngập môi trường sản xuất bằng các yêu cầu suy luận hỏng trước khi cảnh báo đo từ xa kịp phát ra.
U.S. Securities and Exchange Commission. 2013. “Securities Exchange Act of 1934, Release No. 70694: Knight Capital Americas LLC.”
Tránh lặp lại kiểu sự cố như Knight Capital chính là lý do các triển khai ML thường rollout theo từng giai đoạn thay vì bật công tắc một cái. Nhưng rollout theo giai đoạn lại nảy sinh vấn đề riêng. Khi canary deployments cho thấy lỗi ở mức lưu lượng một phần (ví dụ: xuất hiện ở 30% lưu lượng nhưng không ở 5%), các nhóm cần những chiến lược gỡ lỗi có hệ thống. Chẩn đoán hiệu quả đòi hỏi phải liên hệ nhiều tín hiệu: các chỉ số hiệu suất từ Benchmarking, phân tích phân phối dữ liệu để phát hiện drift, và các thay đổi trong mức độ quan trọng của các đặc trưng có thể lý giải sự suy giảm. Các nhóm duy trì bộ công cụ gỡ lỗi gồm các framework phân tích thử nghiệm A/B, công cụ quy gán đặc trưng (feature attribution tools), và bộ phân tích lát cắt dữ liệu (data slice analyzers) để xác định những phân nhóm nào đang bị giảm hiệu suất.
Vòng lặp chẩn đoán này phải được nối trực tiếp với release pipeline. Tích hợp CI/CD tự động hóa triển khai và rollback, nhưng chỉ hiệu quả khi rollback được thiết kế như một phần của cơ chế rollout thay vì bị xem như một script khẩn cấp.
Chiến lược rollback và cơ chế an toàn
Rollback17 là lưới an toàn giúp triển khai một cách tự tin. Nếu không có rollback đáng tin cậy, các nhóm sẽ ngại triển khai và làm chậm tốc độ lặp. Để rollback hiệu quả, cần lên kế hoạch cho ba tình huống khác nhau:
17 Rollback (from database transaction management): Hành động “hoàn tác” cho triển khai trong ML trở nên phức tạp vì trạng thái phụ thuộc mô hình (ví dụ: các embedding được cache) có thể không tương thích giữa các phiên bản mô hình. Sự không khớp này có thể kéo dài thời gian phục hồi, góp phần khiến các nhóm ngại triển khai và làm chậm tốc độ lặp.
Tầng nhanh nhất, rollback tức thì, dùng để xử lý các lỗi nghiêm trọng được phát hiện ngay sau khi triển khai: lỗi khi phục vụ (serving), độ trễ tăng đột biến, hoặc lỗi dự đoán rõ ràng. Để làm được điều này, cần giữ phiên bản mô hình trước đó luôn được tải và “ấm” để có thể chuyển lưu lượng ngay lập tức mà không bị độ trễ khởi động lạnh (cold-start delay). Rollback nhanh xử lý sự suy giảm hiệu suất được phát hiện qua các chỉ số canary ngay sau khi triển khai. Việc này đòi hỏi tích hợp với registry mô hình để các phiên bản trước đó có thể được triển khai lại với thay đổi cấu hình tối thiểu. Rollback chậm giải quyết các vấn đề tinh tế hơn, được phát hiện thông qua các chỉ số kinh doanh hoặc phản hồi người dùng sau khi đã triển khai đầy đủ; khi đó rollback phải tính đến các dữ liệu phụ thuộc vào mô hình, chẳng hạn như trạng thái cá nhân hóa hoặc các embedding đã được cache tích lũy trong thời gian mô hình mới hoạt động.
Table 11 tóm tắt các mẫu triển khai cho từng loại rollback:
| Loại hoàn tác | Kích hoạt | Triển khai | Xử lý trạng thái |
|---|---|---|---|
| Ngay lập tức | Lỗi phục vụ (serving), sự cố | Dự phòng nóng với chuyển đổi tức thì | Không trạng thái—không xử lý đặc biệt |
| Nhanh chóng | Suy giảm chỉ số Canary | Triển khai lại dựa trên Registry | Xóa cache, khởi động lại phiên |
| Trì hoãn | Các chỉ số kinh doanh suy giảm | Triển khai lại hoàn toàn kèm di chuyển | Di chuyển trạng thái, phát lại nếu cần |
Kiểm thử rollback
Các quy trình rollback chưa từng được kiểm thử có thể thất bại khi cần, và khoảng trống này thường chỉ lộ ra trong lúc sự cố đang diễn ra, khi gánh nặng nhận thức và áp lực thời gian là cao nhất. Thất bại có thể xuất phát từ phụ thuộc cấu hình, trạng thái không tương thích, hoặc quyền sở hữu không rõ ràng. Các bài tập rollback định kỳ sẽ phơi bày những khoảng trống này trước khi chúng gây hậu quả. Tiêu chí rollback tự động có thể rút ngắn thời gian phản ứng, nhưng các ngưỡng phải được hiệu chỉnh phù hợp với dịch vụ và có cơ chế bảo vệ để tránh tình trạng dao động (flapping). Mô hình được khôi phục cũng phải cho hành vi nhất quán, không bị dự đoán sai lệch do cache lỗi thời hoặc trạng thái đặc trưng không tương thích. Các runbook hướng dẫn từng bước đảm bảo người xử lý sự cố không nhất thiết phải là người đã thiết kế quy trình triển khai.
Rollback có trạng thái và không trạng thái
Các hệ thống ML có tính trạng thái khác nhau, điều này ảnh hưởng đến độ phức tạp của quá trình rollback:
- Các mô hình không trạng thái: Với phân loại và hồi quy, rollback chỉ là chuyển đổi các trọng số của mô hình, vì mỗi dự đoán là độc lập.
- Các mô hình có trạng thái: Hệ thống khuyến nghị tuần tự và hệ thống hội thoại phải tính đến trạng thái người dùng đã tích lũy; việc rollback có thể đòi hỏi đặt lại phiên, các lớp tương thích hoặc di chuyển trạng thái. Một số hệ thống có thể lưu các checkpoint trạng thái theo phiên bản tại các ranh giới triển khai, nhưng khả năng khôi phục sạch là một thuộc tính kiến trúc cần được kiểm thử, không nên mặc định là nó sẽ hoạt động.
- Các mô hình có vòng lặp phản hồi: Các mô hình dựa trên phản hồi có thể không khôi phục được hành vi trước đó nếu dữ liệu huấn luyện bị nhiễm bẩn trong khoảng thời gian triển khai gặp sự cố.
Kiểm thử A/B để xác thực mô hình
Kiểm thử A/B cung cấp nền tảng thống kê cho các quyết định triển khai bằng cách so sánh các phiên bản mô hình trong điều kiện được kiểm soát. Khác với triển khai canary (dùng để xác thực ổn định vận hành), kiểm thử A/B đo lường xem mô hình mới có cải thiện các mục tiêu kinh doanh với độ tin cậy thống kê hay không.
Thiết lập thử nghiệm và quy tắc quyết định
Một thử nghiệm A/B hợp lệ bắt đầu với bốn yếu tố kiểm soát khiến quyết định triển khai sau này có ý nghĩa thống kê. Đơn vị ngẫu nhiên hóa xác định đối tượng nào sẽ được gán ngẫu nhiên vào nhóm thử nghiệm (treatment) so với nhóm đối chứng (control). Ngẫu nhiên hóa ở cấp người dùng đảm bảo trải nghiệm nhất quán nhưng đòi hỏi kích thước mẫu lớn hơn. Ngẫu nhiên hóa ở cấp yêu cầu cho phép chạy thử nghiệm nhanh hơn nhưng có thể khiến người dùng bối rối khi thấy các kết quả khác nhau.
Theo xấp xỉ phân phối Chuẩn với phương sai chung, gọi \(n\) là số người dùng cần cho mỗi biến thể, \(\delta\) là hiệu ứng tối thiểu có thể phát hiện, \(\sigma\) là độ lệch chuẩn của kết quả, và \(z_{\alpha/2}\) cùng \(z_{\beta}\) là các giá trị tới hạn dương của phân phối Chuẩn chuẩn hóa cho mức tin cậy hai phía và công suất đã chọn. Kịch bản minh họa này sử dụng mức tin cậy 95 percent và công suất 80 percent. Equation 9 chuyển các mục tiêu thiết kế đó thành lưu lượng cần có trước khi triển khai. \[n = \frac{2(z_{\alpha/2} + z_{\beta})^2 \sigma^2}{\delta^2} \tag{9}\] Với mức tăng tương đối 2 percent trên tỷ lệ chuyển đổi cơ sở 5 percent (từ 5 percent lên 5.1 percent) và công suất 80 percent, chúng ta cần khoảng 745,644 người dùng cho mỗi biến thể; nếu chỉ có 25,000 người dùng cho mỗi biến thể, ta chỉ có thể phát hiện được một mức tăng lớn hơn nhiều, khoảng 0.5 percentage points điểm phần trăm tuyệt đối.
Các chỉ số bảo vệ là các chỉ số bắt buộc không được suy giảm, kể cả khi chỉ số chính được cải thiện. Một mô hình khuyến nghị nâng tỷ lệ nhấp 10% nhưng làm thời gian tải trang tăng 500 ms có thể không vượt qua các kiểm tra chỉ số bảo vệ.
Với thử nghiệm có thời hạn cố định, hãy chạy cho đến khi đạt kích thước mẫu và thời lượng tối thiểu đã đăng ký trước, đồng thời có đủ thời gian theo lịch để bao quát các mẫu hình theo tuần có liên quan. Đừng dừng lại khi lần đầu thấy có ý nghĩa thống kê, vì việc xem kết quả lặp lại sẽ làm tăng tỷ lệ dương tính giả. Dừng sớm chỉ hợp lệ khi dùng thiết kế tuần tự đã quy định trước với các ngưỡng quyết định hợp lệ.
Những kiểm soát đó thiết lập khung thống kê, nhưng các hệ thống ML lại có thêm những kiểu lỗi mà thử nghiệm web thông thường có thể che khuất. Các sự kiện chuyển đổi có thể xảy ra nhiều ngày sau khi dự đoán, tạo ra phản hồi trễ: chẳng hạn, một khuyến nghị hiển thị vào thứ Hai có thể dẫn đến giao dịch mua vào thứ Sáu, vì vậy cửa sổ quy gán (attribution window) phải là một phần của thiết kế thử nghiệm. Các hiệu ứng mới lạ cũng có thể làm “đẹp” hiệu suất ban đầu khi người dùng tương tác với các khuyến nghị mới, nên các thử nghiệm ở giai đoạn ổn định thường có một giai đoạn khởi động (burn-in period) trước khi đo lường.
Các hệ thống khuyến nghị và xếp hạng xuất hiện hiệu ứng can thiệp: hiển thị một mục cho người dùng này có thể làm thay đổi những gì còn lại để hiển thị hoặc trở nên nổi bật với người dùng khác, từ đó vi phạm giả định độc lập trong phân tích A/B tiêu chuẩn. Sự khác biệt giữa các phân khúc còn tạo ra một vấn đề thứ hai: một kết quả tổng thể có vẻ trung tính có thể che đi tác động dương mạnh ở một nhóm và tác động âm ở nhóm khác. Những phức tạp này không làm mất giá trị của kiểm thử A/B, nhưng chúng khiến các chỉ số bảo vệ (guardrails), phân tích theo phân khúc và các quyết định đã đăng ký trước phải là một phần của thí nghiệm, thay vì chỉ diễn giải sau khi mọi việc đã rồi.
Table 12 chuyển những ràng buộc đó thành một quyết định triển khai:
| Chỉ số chính | Rào chắn bảo vệ | Quyết định |
|---|---|---|
| Cải thiện đáng kể | Tất cả đều đạt | Triển khai mô hình mới |
| Cải thiện đáng kể | Một số thất bại | Điều tra các đánh đổi, có thể cần lặp lại mô hình |
| Không có thay đổi đáng kể | Tất cả đều đạt | Bằng chứng không thuyết phục; giữ lại mô hình hiện tại trừ khi một thử nghiệm tương đương hoặc không kém hơn được chỉ định trước hỗ trợ thay đổi |
| Suy giảm đáng kể | N/A | Không triển khai; điều tra nguyên nhân gốc rễ |
Bảng này chỉ đáng tin cậy khi quy trình phân tích được chuẩn bị một cách kỷ luật trước khi bắt đầu. Các nhóm nên đăng ký trước các tác động kỳ vọng trước khi thử nghiệm bắt đầu, và chọn đơn vị ngẫu nhiên hóa, cửa sổ quy gán, các chỉ số bảo vệ (guardrails), và runtime tối thiểu trước khi quan sát kết quả.
Kỷ luật đó cũng phải được duy trì trong quá trình phân tích. Kiểm thử tuần tự hỗ trợ các quyết định tạm thời hợp lệ bằng cách xác định trước khi nào được phép dừng sớm về mặt thống kê, và các kỹ thuật giảm phương sai như CUPED (Controlled-experiment Using Pre-Experiment Data) giúp giảm nhiễu chỉ số bằng cách điều chỉnh kết quả theo các biến đồng biến trước thử nghiệm. Các thử nghiệm thất bại nên được lưu trữ vì chúng chứa đựng bằng chứng phủ định, và pipeline phân tích nên được tự động hóa để công việc bảng tính thủ công không trở thành một nguồn lỗi triển khai mới.
Một quyết định A/B chỉ có giá trị nếu hệ thống phát hành/triển khai có thể đưa lên, giữ lại hoặc hoàn tác đúng tạo phẩm đã được thử nghiệm. Các kho lưu trữ mô hình, như kho lưu trữ mô hình của Vertex AI (Google Cloud 2024d), là các kho tập trung để lưu trữ và quản lý các mô hình đã huấn luyện và các phiên bản của chúng. Danh mục mô hình thì đóng vai trò khác. Vertex AI Model Garden giúp các nhóm khám phá, thử nghiệm, tùy chỉnh và triển khai các mô hình của Google, đối tác và một số mô hình mã nguồn mở được chọn (Google Cloud 2026a). Llama thuộc về ngữ cảnh họ mô hình và danh mục mô hình đó, chứ không phải trong phạm vi quản lý vòng đời của kho lưu trữ (Touvron et al. 2023).
Google Cloud. 2024d. Vertex AI Model Registry.
Google Cloud. 2026a. Explore Models in Model Garden.
18 Suy luận ML serverless: Tùy chọn này hiệu quả về chi phí vì chỉ cấp phát tài nguyên tính toán khi có yêu cầu và tự động thu về 0 khi không hoạt động, loại bỏ chi phí cho một điểm cuối luôn bật. Tuy nhiên, điều này tạo ra một sự đánh đổi trực tiếp với các mục tiêu hiệu suất, bởi yêu cầu đầu tiên sau một khoảng thời gian không hoạt động sẽ gặp độ trễ “khởi động nguội” (cold start) trong lúc mô hình được tải vào bộ nhớ. Với các mô hình lớn, độ trễ đó có thể đủ dài để vượt quá ngân sách độ trễ thời gian thực, trừ khi dịch vụ duy trì dung lượng “ấm” (warm capacity) hoặc sử dụng một runtime được thiết kế để tải nhanh.
Các điểm cuối suy luận đưa tạo phẩm đã được kiểm thử ra môi trường lưu lượng thực tế. Chúng thường cung cấp mô hình đã triển khai qua các API REST để dự đoán theo thời gian thực. Tùy yêu cầu hiệu suất, các nhóm có thể cấu hình tài nguyên, chẳng hạn như các bộ tăng tốc GPU, để đáp ứng mục tiêu về độ trễ và thông lượng. Một số nhà cung cấp cũng cung cấp các tùy chọn linh hoạt như suy luận serverless18 hoặc batch, giúp loại bỏ nhu cầu về các điểm cuối luôn bật và cho phép triển khai tiết kiệm chi phí, có khả năng mở rộng.
Để duy trì nguồn gốc và khả năng kiểm toán, các nhóm theo dõi các tạo phẩm mô hình, gồm script, trọng số, nhật ký và chỉ số, bằng các công cụ như MLflow19 (Databricks 2024). Khi kết hợp lại, các kho lưu trữ, điểm cuối, tính năng theo dõi nguồn gốc và các framework điều phối phân tán như Ray20 sẽ biến kết quả A/B thành các thay đổi sản xuất có kiểm soát: mô hình đã được kiểm thử có thể được đưa lên, quan sát và hoàn tác mà không làm mất nguồn gốc của nó.
19 MLflow: Một framework MLOps mã nguồn mở, kết hợp kho lưu trữ tạo phẩm (S3/GCS) với cơ sở dữ liệu metadata (PostgreSQL) để ghi lại các lượt chạy siêu tham số, mã băm nhị phân của mô hình và các chuyển trạng thái trong quá trình triển khai. Điểm đánh đổi của hệ thống là: một mặt, tập trung hóa việc theo dõi nguồn gốc; mặt khác, có thể gây nghẽn kết nối cơ sở dữ liệu khi quét siêu tham số song song ở quy mô lớn.
Databricks. 2024. MLflow: An Open Source Platform for the Machine Learning Lifecycle.
20 Ray: Một framework tính toán phân tán từ UC Berkeley (Moritz et al. 2018), cung cấp giao diện tác vụ và tác nhân thống nhất, được hỗ trợ bởi trình lập lịch phân tán và kho lưu trữ chịu lỗi. Bài học lớn hơn trong MLOps là: cơ sở hạ tầng bị phân mảnh tạo ra các điểm chuyển đổi, nơi logic tiền xử lý, hằng số chuẩn hóa, phiên bản tokenizer hoặc định dạng tạo phẩm có thể âm thầm lệch nhau. Các trừu tượng thực thi dùng chung có thể giảm bớt sự phân mảnh này. Tuy nhiên, sự sai lệch giữa huấn luyện và phục vụ (serving) vẫn đòi hỏi phải kiểm tra tính nhất quán rõ ràng trên dữ liệu, đặc trưng và mã phục vụ.
Moritz, Philipp, Robert Nishihara, Stephanie Wang, Alexey Tumanov, Richard Liaw, Eric Liang, Melih Elibol, et al. 2018. “Ray: A Distributed Framework for Emerging AI Applications.” Proceedings of the 13th USENIX Symposium on Operating Systems Design and Implementation (OSDI), 561–77.
Tối ưu hóa định dạng mô hình
Một mô hình PyTorch với độ chính xác benchmark hàng đầu có thể phục vụ dự đoán với độ trễ 200 ms trong môi trường sản xuất, chậm hơn mười lần so với mục tiêu mức dịch vụ (SLO). Khoảng cách giữa các framework dùng trong nghiên cứu và việc phục vụ trong môi trường sản xuất thường rất lớn, và tối ưu hóa định dạng giúp thu hẹp khoảng cách này. Các định dạng được tối ưu hóa có thể cải thiện độ trễ bằng cách chuyển đổi mô hình sang các biểu diễn được tùy chỉnh cho phần cứng cụ thể, nhưng mức cải thiện còn phụ thuộc vào khối lượng công việc (workload) và runtime. Các runtime suy luận và chiến lược độ chính xác được trình bày chi tiết trong Lựa chọn inference runtime và Lựa chọn độ chính xác cho *phục vụ (serving)* cung cấp nền tảng kỹ thuật; phần này tập trung vào quy trình vận hành.
Giới hạn vận hành đầu tiên là cách biểu diễn. Open Neural Network Exchange (ONNX) là một định dạng trao đổi phổ biến giúp mô hình dễ dàng di chuyển giữa các hệ thống. Tuy nhiên, việc lựa chọn runtime và bộ thực thi sẽ quyết định phần cứng mục tiêu, các toán tử được hỗ trợ và những tối ưu hoá có sẵn. ONNX Runtime nhấn mạnh một API chung cho nhiều backend, còn TensorRT thì chuyên biệt hoá việc thực thi cho các GPU NVIDIA; hiệu suất thực tế cần được đo trên đúng mô hình và phần cứng mục tiêu. Quy trình điển hình gồm: xuất mô hình PyTorch sang ONNX, dọn dẹp đồ thị (gộp hằng số và loại bỏ phần không dùng), hợp nhất các toán tử tương thích, chọn độ chính xác số học, và xác thực kết quả số học cũng như hành vi ở mức tác vụ so với mô hình gốc tại mỗi bước. Các lựa chọn framework đại diện trong table 13 khác nhau về tính di động, phạm vi phần cứng và cơ chế tối ưu hoá.
| Framework | Định dạng nguồn | Phần cứng mục tiêu | Các tối ưu hóa chính |
|---|---|---|---|
| ONNX Runtime | PyTorch, TF, Keras, scikit | CPU, GPU, NPU | Tối ưu hóa đồ thị, hợp nhất toán tử, lượng tử hoá |
| TensorRT | ONNX, TF, PyTorch | Chỉ GPU NVIDIA | Tự động điều chỉnh kernel, hiệu chuẩn độ chính xác, hợp nhất lớp |
| OpenVINO | ONNX, TensorFlow/TFLite, PyTorch, PaddlePaddle | Intel CPU, GPU, NPU | Nén mô hình, thực thi bất đồng bộ, caching |
| TF-TRT | TensorFlow | NVIDIA GPU | Tích hợp TensorRT trong đồ thị TensorFlow |
| Core ML | TensorFlow, PyTorch | Apple Neural Engine, GPU, CPU | Định dạng thống nhất cho thiết bị Apple, suy luận trên thiết bị |
| TFLite | TensorFlow, Keras | Mobile CPU, GPU, Edge TPU | Lượng tử hoá, delegate support, nén mô hình |
Điều cốt lõi không phải là danh sách sản phẩm, mà là sự đánh đổi mà chúng cho thấy: mọi mức tăng thông lượng tối đa đều phải trả giá bằng một mức độ gắn chặt với phần cứng hoặc runtime. Vì vậy, chọn framework trước hết là quyết định giữa tính di động và hiệu năng đỉnh, rồi mới đến so sánh tính năng. Yếu tố giới hạn thứ hai là độ chính xác. Lượng tử hoá giúp giảm kích thước mô hình và tăng thông lượng nhờ dùng số học độ chính xác thấp hơn, nhưng từ góc độ vận hành, câu hỏi triển khai quan trọng không phải là INT8 có nhanh hơn hay không. Cốt lõi là mô hình đã lượng tử hoá có duy trì độ chính xác dưới phân phối lưu lượng sản xuất hay không, chứ không chỉ trên các tập dữ liệu hiệu chuẩn. Cơ chế PTQ, QAT và các chiến lược độ chính xác hỗn hợp được trình bày trong Nén mô hình, còn việc chọn độ chính xác cho phục vụ (serving) — bao gồm độ chính xác động theo từng yêu cầu — được trình bày chi tiết trong Lựa chọn độ chính xác cho *phục vụ (serving)*.
Do đó, khi đưa các mô hình đã tối ưu vào sản xuất, cần có bước xác thực nhắm đúng các kiểu lỗi mà quá trình tối ưu hoá có thể âm thầm tạo ra. Hãy hình dung một nhóm triển khai một mô hình đã lượng tử hoá INT8 nhưng chỉ kiểm tra xem thông lượng có tăng không: độ chính xác phân loại giảm trên các trường hợp biên hiếm nhưng giá trị cao, và sự suy giảm này không bị phát hiện trong nhiều tuần vì các chỉ số tổng hợp vẫn nằm trong ngưỡng SLO. Lớp xác thực đầu tiên là kiểm tra tương đương số học, so sánh đầu ra của mô hình đã tối ưu với mô hình gốc trên một tập kiểm thử đại diện, với các ngưỡng sai lệch theo ứng dụng. Kiểm tra đó cần thiết nhưng chưa đủ, vì các đầu vào hiếm, các ví dụ ngoài phân phối (out-of-distribution) và các trường hợp đặc thù theo nhóm con có thể làm lộ các artefact do lượng tử hoá mà các chỉ số kiểm thử tổng hợp che khuất.
Lớp xác thực thứ hai là xác thực vận hành. Cần đo dấu chân bộ nhớ (memory footprint) tại thời điểm runtime đạt mức sử dụng cực đại, bao gồm cả cấp phát động trong quá trình suy luận, vì một số tối ưu hoá đánh đổi việc tăng bộ nhớ runtime để lấy tốc độ tính toán. Hành vi khởi động (warm-up) cũng khác nhau theo runtime: Accelerated Linear Algebra có thể JIT biên dịch các kernel trong lần chạy đầu tiên, trong khi TensorRT chọn tactics và xây dựng engine trước khi triển khai; ngay cả việc tải engine cũng có thể làm tăng độ trễ khởi động. Tiếp đến là khả năng tương thích phiên bản runtime: cấu hình triển khai cần ghim (pin) phiên bản runtime một cách rõ ràng, vì ngay cả thay đổi nhỏ trong runtime cũng có thể ảnh hưởng đến cả đặc tính hiệu năng và tính đúng đắn số học.
Phục vụ (serving) suy luận
Một mô hình đã tối ưu hóa nhưng chỉ nằm trên đĩa thì không tạo ra giá trị. Nó cần hạ tầng để tiếp nhận yêu cầu, chạy suy luận và trả về dự đoán ở quy mô lớn. Các thỏa thuận mức dịch vụ (SLA), SLO và các kiến trúc phục vụ (serving) được trình bày trong Phục vụ mô hình cung cấp nền tảng kỹ thuật; phần này tập trung vào các khía cạnh vận hành khi lựa chọn và quản lý hạ tầng đó. Ở quy mô mà Facebook báo cáo, các hệ thống phục vụ đã thực hiện hàng chục nghìn tỷ lượt suy luận mỗi ngày với các mục tiêu độ trễ nghiêm ngặt (Hazelwood et al. 2018), và khoảng cách giữa một hệ thống phục vụ chạy được và một hệ thống được vận hành tốt quyết định việc các SLO có được đáp ứng ổn định trong nhiều tháng, nhiều năm hay không.
Hazelwood, Kim, Sarah Bird, David Brooks, Soumith Chintala, Utku Diril, Dmytro Dzhulgakov, Mohamed Fawzy, et al. 2018. “Applied Machine Learning at Facebook: A Datacenter Infrastructure Perspective.” 2018 IEEE International Symposium on High Performance Computer Architecture (HPCA), 620–29. https://doi.org/10.1109/hpca.2018.00059.
Olston, Christopher, Noah Fiedel, Kiril Gorovoy, Jeremiah Harmsen, Li Lao, Fangwei Li, Vinu Rajashekhar, Sukriti Ramesh, and Jordan Soyke. 2017. “TensorFlow-Serving: Flexible, High-Performance ML Serving.” CoRR abs/1712.06139. https://doi.org/10.48550/arXiv.1712.06139.
NVIDIA. 2024. NVIDIA Triton Inference Server.
KServe Community. 2024. KServe: Highly Scalable and Standards-Based Model Inference Platform on Kubernetes.
Các framework phục vụ (serving) đạt chuẩn sản xuất như TensorFlow Serving (Olston et al. 2017), NVIDIA Triton Inference Server (NVIDIA 2024) và KServe (KServe Community 2024) cung cấp cơ chế chuẩn hóa để triển khai, quản lý phiên bản và mở rộng quy mô mô hình. Ở góc độ vận hành, quyết định then chốt là chọn framework phù hợp nhất với bối cảnh triển khai: TensorFlow Serving cho workflow thuần TensorFlow, Triton cho phục vụ (serving) GPU đa framework, và KServe cho môi trường Kubernetes cần scale-to-zero.
Bất kể chọn kiểu phục vụ (serving) nào (trực tuyến, ngoại tuyến hoặc gần trực tuyến, như trình bày trong Phổ kiến trúc phục vụ (serving)), phần suy luận của mô hình chỉ là một phần của tổng độ trễ đầu cuối. Phân tích ngân sách độ trễ sẽ cho thấy nút thắt cổ chai nằm ở mô hình hay ở các bước khác trên đường đi của yêu cầu.
Systems Perspective 1.1: Ngân sách độ trễ
Một dịch vụ có SLO p99 là 100 ms, và ngân sách dành cho suy luận của mô hình là 45 ms; phần còn lại 55 ms phải bao phủ mọi công đoạn khác trên đường đi của yêu cầu. Table 14 phân bổ ngân sách này cho toàn bộ vòng đời của một yêu cầu.
| Thành phần | Phần ngân sách | Ngân sách p99 | Đòn bẩy tối ưu hóa |
|---|---|---|---|
| Network RTT | 15% | 15 ms | Triển khai edge, connection pooling |
| Truy xuất đặc trưng | 25% | 25 ms | Lưu trữ đặc trưng vào cache, tính toán trước |
| Phân tích cú pháp yêu cầu | 5% | 5 ms | Giao thức nhị phân (gRPC), tối ưu hóa lược đồ |
| Suy luận mô hình | 45% | 45 ms | Lượng tử hoá, batching, chưng cất mô hình |
| Hậu xử lý | 5% | 5 ms | Xử lý bất đồng bộ, lưu trữ kết quả vào cache |
| Tuần tự hóa phản hồi | 5% | 5 ms | Định dạng hiệu quả (Protobuf, MessagePack) |
Góc nhìn hệ thống: Việc chỉ tối ưu hóa mô hình thường chỉ khai thác được dưới 50% cơ hội giảm độ trễ. Nếu một mô hình chạy nhanh hơn 2× lần, độ trễ trong ví dụ này sẽ giảm từ 100 ms xuống 77.5 ms, tức chỉ cải thiện tổng thể 1.3× lần, vì suy luận chỉ chiếm 45 percent tổng độ trễ.
Tư duy hệ thống đòi hỏi phân tích end-to-end. Hãy áp dụng khung phân loại D·A·M để chẩn đoán nguyên nhân gốc ở các khía cạnh: Dữ liệu (chi phí trích xuất đặc trưng, chi phí tuần tự hóa), Thuật toán (quá nhiều lớp, đồ thị chưa tối ưu) và Máy (bão hòa băng thông bộ nhớ, giới hạn do nhiệt). Hãy đo lường hiệu suất end-to-end và tối ưu hóa nút thắt cổ chai đang ràng buộc. Nếu truy xuất đặc trưng vượt quá ngân sách của nó, thì tối ưu mô hình cũng không thể đạt SLO.
Ngoài ngân sách độ trễ, đưa hệ thống phục vụ (serving) vào vận hành đòi hỏi chọn các kỹ thuật hạ tầng phù hợp với các ràng buộc mà ngân sách phơi bày. Table 15 tóm tắt các chiến lược tiêu biểu cho hạ tầng ML-as-a-service; câu hỏi trọng tâm là nút thắt cổ chai nằm ở độ trễ xếp hàng, dung lượng, định tuyến, chi phí điều phối hay dự đoán độ trễ.
| Kỹ thuật | Mô tả | Hệ thống ví dụ |
|---|---|---|
| Lập lịch yêu cầu & batching | Nhóm các yêu cầu suy luận để cải thiện thông lượng và giảm chi phí chung | Clipper (Crankshaw et al. 2017) |
| Chọn và định tuyến Instance | Gán động các yêu cầu cho các biến thể mô hình dựa trên các ràng buộc | INFaaS (Romero et al. 2021) |
| Tự động điều chỉnh quy mô dự đoán | Thêm dung lượng trước các đợt tăng đột biến nhu cầu để đáp ứng các SLO về độ trễ | MArk (Zhang et al. 2019) |
| Tự động điều chỉnh quy mô | Điều chỉnh các instance mô hình để phù hợp với nhu cầu khối lượng công việc (workload) | INFaaS |
| Điều phối mô hình | Điều phối việc thực thi trên các thành phần mô hình hoặc các pipeline | AlpaServe (Li et al. 2023) |
| Dự đoán thời gian thực thi | Dự báo độ trễ để tối ưu hóa việc lập lịch yêu cầu | Clockwork (Gujarati et al. 2020) |
Crankshaw, Daniel, Xin Wang, Guilio Zhou, Michael J. Franklin, Joseph E. Gonzalez, and Ion Stoica. 2017. “Clipper: A Low-Latency Online Prediction Serving System.” 14th USENIX Symposium on Networked Systems Design and Implementation (NSDI 17), 613–27.
Romero, Francisco, Qian Li, Neeraja J. Yadwadkar, and Christos Kozyrakis. 2021. “INFaaS: Automated Model-Less Inference Serving.” 2021 USENIX Annual Technical Conference (USENIX ATC 21), 397–411.
Zhang, Chengliang, Minchen Yu, Wei Wang, and Feng Yan. 2019. “MArk: Exploiting Cloud Services for Cost-Effective, SLO-Aware Machine Learning Inference Serving.” 2019 USENIX Annual Technical Conference (USENIX ATC 19), 1049–62.
Li, Zhuohan, Lianmin Zheng, Yinmin Zhong, Vincent Liu, Ying Sheng, Xin Jin, Yanping Huang, et al. 2023. “\(\{\)AlpaServe\(\}\): Statistical Multiplexing with Model Parallelism for Deep Learning Serving.” 17th USENIX Symposium on Operating Systems Design and Implementation (OSDI 23), 663–79.
Gujarati, Arpan, Reza Karimi, Safya Alzayat, Wei Hao, Antoine Kaufmann, Ymir Vigfusson, and Jonathan Mace. 2020. “Clockwork: Predictable and Scalable DNN Inference in the Cloud.” USENIX Symposium on Operating Systems Design and Implementation (OSDI), 443–62.
Các chiến lược này tạo thành nền tảng phục vụ (serving) trên đám mây. Triển khai edge vẫn giữ nguyên mục tiêu vận hành nhưng ràng buộc thay đổi: rollback, đo từ xa và kiểm soát cập nhật phải hoạt động trên các thiết bị có công suất, bộ nhớ và kết nối hạn chế.
Triển khai AI trên edge
Hãy hình dung một máy báo khói dùng mô hình machine learning để phân biệt khói nấu ăn và khói cháy. Khi mô hình xuống cấp, kỹ sư không thể đơn giản SSH vào thiết bị, khôi phục về phiên bản trước rồi khởi động lại. Thiết bị đó gắn trên trần nhà của ai đó, Wi-Fi chập chờn, dùng pin cúc áo và chỉ có 256 KB bộ nhớ. Mọi giả định về vận hành trong MLOps trên đám mây (hoàn tác tức thì, ghi nhật ký tập trung, giám sát thời gian thực) đều phải được nghĩ lại.
Edge AI đại diện cho sự chuyển dịch này: suy luận machine learning diễn ra tại hoặc gần nguồn dữ liệu, thay vì trong hạ tầng đám mây tập trung (Reddi et al. 2019). Các khối lượng công việc (workload) đòi hỏi độ trễ thấp, xử lý cục bộ bảo vệ quyền riêng tư, kết nối không liên tục hoặc ngân sách năng lượng eo hẹp khiến các kiểu triển khai edge trở thành kiến thức thiết yếu cho người làm MLOps. Sự chuyển dịch này đưa ra ba nhóm thách thức vận hành liên quan chặt chẽ: ràng buộc tài nguyên, phân cấp triển khai và cơ chế cập nhật.
Reddi, Vijay Janapa, Christine Cheng, David Kanter, Peter Mattson, Guenther Schmuelling, Carole-Jean Wu, Brian Anderson, et al. 2019. “MLPerf Inference Benchmark.” 2020 ACM/IEEE 47th Annual International Symposium on Computer Architecture (ISCA), 446–59. https://doi.org/10.1109/isca45697.2020.00045.
Warden, Pete, and Daniel Situnayake. 2020. TinyML: Machine Learning with TensorFlow Lite on Arduino and Ultra-Low-Power Microcontrollers. O’Reilly Media.
Các ràng buộc tài nguyên là yếu tố chi phối quyết định triển khai trên edge. Thiết bị edge cần áp dụng các kỹ thuật tối ưu hoá mô hình mạnh mẽ đã nêu ở Nén mô hình (lượng tử hoá, tỉa (pruning), chưng cất tri thức) để đáp ứng các giới hạn về bộ nhớ và công suất của các triển khai cấp vi điều khiển (Warden and Situnayake 2020; David et al. 2021). Ngân sách công suất trải dài qua bốn bậc độ lớn, từ miliwatt cho cảm biến IoT đến hàng chục watt trong các hệ thống ô tô, đòi hỏi lập lịch suy luận có tính đến công suất và quản lý nhiệt. Một số ứng dụng thời gian thực cứng, trọng yếu về an toàn áp đặt mục tiêu thời gian xác định, cần phân tích thời gian thực thi trong trường hợp xấu nhất (WCET) ngay cả dưới các điều kiện bất lợi như giảm tốc do nhiệt và tranh chấp bộ nhớ.
Ngân sách công suất tại edge trải dài từ cảm biến, gateway đến phương tiện, khác nhau nhiều bậc độ lớn.
Các ràng buộc này định hình nên một phân cấp triển khai tự nhiên gồm ba tầng. Ở tầng cảm biến, xử lý đảm nhiệm lọc dữ liệu tức thời và trích xuất đặc trưng trên các thiết bị vi điều khiển, tiêu thụ 1–100 mW. Tầng edge gateway thực hiện suy luận trung gian trên các bộ xử lý ứng dụng với ngân sách công suất 1–10 W. Tầng đám mây đảm nhận phân phối mô hình, học tổng hợp và lập luận phức tạp, những việc cần tài nguyên cấp GPU. Phân cấp này cho phép tối ưu hoá toàn hệ thống: các phép tính tốn kém được đẩy lên tầng cao hơn, còn các quyết định nhạy cảm với độ trễ được giữ lại tại chỗ.
Có hai bối cảnh triển khai cần đặc biệt lưu ý. TinyML nhắm tới suy luận trên vi điều khiển với các ràng buộc chặt về bộ nhớ và công suất mức miliwatt, đòi hỏi các engine chuyên biệt như TensorFlow Lite Micro và CMSIS-NN (David et al. 2021; Lai et al. 2018). Kiến trúc mô hình phải đồng thiết kế với ràng buộc phần cứng, ưu tiên toán tử gọn nhẹ, lượng tử hoá và các chiến lược tỉa (pruning) với mức độ áp dụng tuỳ thiết bị và mục tiêu độ chính xác. AI di động mở rộng việc triển khai trên edge sang điện thoại thông minh có khả năng tính toán vừa phải, dùng NPU và GPU compute shader để đáp ứng yêu cầu về độ trễ tương tác và thời lượng pin thông qua lập lịch tối ưu theo công suất.
David, Robert, Jared Duke, Advait Jain, Vijay Janapa Reddi, Nat Jeffries, Jian Li, Nick Kreeger, et al. 2021. “TensorFlow Lite Micro: Embedded Machine Learning for TinyML Systems.” Proceedings of Machine Learning and Systems 3: 800–811.
Lai, Liangzhen, Naveen Suda, and Vikas Chandra. 2018. “CMSIS-NN: Efficient Neural Network Kernels for Arm Cortex-M CPUs.” ArXiv Preprint abs/1801.06601.
Các bản cập nhật và giám sát hoàn thiện bức tranh vận hành ở edge. Cập nhật mô hình qua OTA (Over-the-air) cho phép bảo trì các hệ thống không thể tiếp cận trực tiếp. Các pipeline OTA cần đảm bảo phân phối mô hình an toàn, xác minh gói mô hình và có cơ chế khôi phục; các bản cập nhật delta hoặc khác biệt có thể giảm dung lượng truyền khi thiết bị không cần nhận toàn bộ gói mô hình. Lịch cập nhật phải tính đến kiểu kết nối của thiết bị, nguồn công suất sẵn có và mức độ quan trọng của hoạt động.
Việc giám sát cần thích ứng với môi trường bị giới hạn tài nguyên: các hệ thống đo từ xa gọn nhẹ thu thập các chỉ số thiết yếu (độ trễ suy luận, mức tiêu thụ công suất, các chỉ báo độ chính xác) đồng thời giảm tối đa tải bổ sung. Giám sát “sức khỏe” thiết bị theo dõi các điều kiện ở mức thiết bị (trạng thái nhiệt, mức pin, chất lượng kết nối) để dự đoán nhu cầu bảo trì. Các mẫu điều phối giữa edge và đám mây cho phép offload linh hoạt giữa các tầng dựa trên tải hiện tại, điều kiện mạng và yêu cầu về độ trễ. Việc lưu đệm đặc trưng tại các cổng edge giúp giảm tính toán lặp lại, trong khi học liên bang (federated learning) cho phép các thiết bị edge gửi các bản cập nhật mô hình thay vì các bản ghi huấn luyện thô. Tuy vậy, chỉ riêng lựa chọn giao thức này không đảm bảo quyền riêng tư, vì các bản cập nhật vẫn có thể làm lộ thông tin nếu thiếu các biện pháp bảo vệ bổ sung.
Suy giảm có kiểm soát (graceful degradation) là mô hình vận hành đặc trưng của AI trên edge. Khi tài nguyên bị hạn chế, hệ thống phải duy trì các chức năng thiết yếu bằng cách giảm độ phức tạp của mô hình, giảm tần suất suy luận hoặc giảm mức độ đầy đủ của đặc trưng. Triết lý thiết kế này cần được xây dựng ngay từ đầu, không phải bổ sung sau cùng.
Đưa các mô hình vào sản xuất chỉ là một nửa thách thức. Một mô hình đã triển khai thành công vẫn có thể suy giảm do drift (trôi dạt) hoặc do chất lượng dữ liệu, mà không kích hoạt bất kỳ cảnh báo nào — chính là những chế độ lỗi âm thầm đã thúc đẩy cả chương này. Các thực hành giám sát, ứng phó sự cố và trực ban dưới đây sẽ khép kín vòng lặp đó.
Quản lý tài nguyên và giám sát
Việc triển khai và phục vụ (serving) giúp đưa các mô hình vào môi trường sản xuất. Để giữ cho chúng “khỏe mạnh”, cần hai lĩnh vực bổ trợ: quản lý tài nguyên (cấp phát và mở rộng tài nguyên tính toán, lưu trữ, mạng) và giám sát (quan sát hành vi hệ thống và phát hiện suy giảm trước khi người dùng nhận ra).
Quản lý hạ tầng
Ba lỗi sau minh họa rõ vấn đề. Một mô hình chạy tốt ở môi trường thử nghiệm nhưng hỏng khi vào sản xuất vì ai đó đã cấp phát thủ công loại GPU khác. Một tác vụ huấn luyện bị sập vì thử nghiệm của đồng nghiệp đã dùng hết bộ nhớ. Một dịch vụ suy luận không thể mở rộng vì hạn mức tài nguyên được đặt qua một tin nhắn không chính thức từ sáu tháng trước. Gốc rễ chung: hạ tầng được quản lý bằng quy trình thủ công thay vì bằng mã.
Hạ tầng có khả năng mở rộng và chịu lỗi tốt là nền tảng để vận hành các hệ thống ML, và hạ tầng dưới dạng mã (IaC) là thực hành giúp nó trở nên đáng tin cậy. IaC xem cấu hình hạ tầng như phần mềm (được kiểm soát phiên bản, rà soát, kiểm thử và tự động thực thi) thay vì cấu hình thủ công qua giao diện đồ họa hay công cụ dòng lệnh. Cách tiếp cận này đưa kỷ luật của kỹ thuật phần mềm vào quản lý tài nguyên: mọi thay đổi đều được theo dõi, cấu hình có thể được kiểm thử trước khi triển khai, và môi trường có thể được tái tạo một cách đáng tin cậy.
Công cụ hạ tầng cụ thể không quan trọng bằng các ràng buộc mà nó áp đặt. Terraform (HashiCorp 2014), AWS CloudFormation (Amazon Web Services 2024d), và Ansible (Hatcher 2024) là những cách phổ biến để quản lý phiên bản các định nghĩa hạ tầng song song với mã ứng dụng. Trong bối cảnh MLOps, chính các định nghĩa được quản lý phiên bản này cho phép nhóm tái tạo loại GPU, chính sách mạng, quyền lưu trữ và giới hạn mở rộng quy mô đã dùng cho môi trường huấn luyện hoặc phục vụ (serving), dù trên AWS (Amazon Web Services 2024b), Google Cloud Platform (Google Cloud 2024a), Microsoft Azure (Microsoft 2024), hay hạ tầng tại chỗ.
HashiCorp. 2014. Terraform: Infrastructure as Code. Software available from https://www.terraform.io/.
Amazon Web Services. 2024d. AWS CloudFormation.
Hatcher, Blake Douglas. 2024. “Automating Server Deployments with Ansible: Utilizing Automation in DevOps.” Journal of Computing Sciences in Colleges 40 (3): 42–43.
Amazon Web Services. 2024b. Amazon Web Services (AWS).
Google Cloud. 2024a. Google Cloud Platform Documentation. Https://cloud.google.com/docs.
Microsoft. 2024. Microsoft Azure.
Quản lý hạ tầng bao trùm toàn bộ vòng đời ML. Trong giai đoạn huấn luyện, các script IaC sẽ cấp phát các instance tính toán với GPU hoặc TPU, cấu hình lưu trữ phân tán, và triển khai các cụm container. Vì các định nghĩa hạ tầng được lưu dưới dạng mã, chúng có thể được kiểm tra, tái sử dụng và tích hợp vào các pipeline CI/CD, đảm bảo tính nhất quán giữa các môi trường.
Containerization mang lại tính tái lập cho các phụ thuộc ở runtime. Docker (Merkel 2014) đóng gói mô hình, thư viện và mã phục vụ (serving) thành một đơn vị cách ly, trong khi các hệ thống điều phối như Kubernetes (Cloud Native Computing Foundation 2024a) quản lý các đơn vị này trên các cụm. Giá trị vận hành không nằm ở tên container; mà ở khả năng triển khai lặp lại cùng một artifact, trong khi việc cấp phát tài nguyên, mở rộng quy mô và quản lý tình trạng hoạt động vẫn được xác định rõ ràng.
Cloud Native Computing Foundation. 2024a. Kubernetes: Production-Grade Container Orchestration.
21 ML autoscaling: Autoscaling điều chỉnh năng lực dựa trên tín hiệu nhu cầu (Amazon Web Services 2024c), nhưng việc phục vụ (serving) ML có thêm những ràng buộc mà các dịch vụ web phi trạng thái không gặp. Các quyết định autoscaling cần tính đến thời gian tải mô hình (chi phí khởi động nguội), phân mảnh bộ nhớ GPU và hành vi batching, bên cạnh mức sử dụng CPU. Mở rộng quá chậm sẽ vi phạm SLO về độ trễ; thu hẹp quá mạnh sẽ gây ra khởi động nguội lặp lại, làm xấu đi độ trễ p99.
Amazon Web Services. 2024c. AWS Auto Scaling.
Để ứng phó với biến động cường độ khối lượng công việc (workload) – như các đợt tăng đột biến khi tinh chỉnh siêu tham số hoặc khi lưu lượng dự đoán tăng mạnh – các nhóm dựa vào tính đàn hồi của đám mây và cơ chế autoscaling.21 Các nền tảng đám mây hỗ trợ cấp phát tài nguyên hạ tầng theo yêu cầu và mở rộng theo chiều ngang. Cơ chế autoscaling (Amazon Web Services 2024c) tự động điều chỉnh năng lực tính toán dựa trên các chỉ số sử dụng, giúp tối ưu cả hiệu suất lẫn chi phí.
Hạ tầng trong MLOps không chỉ nằm ở đám mây. Nhiều hệ thống được triển khai trên on-premises, đám mây và edge, tùy theo các ràng buộc về độ trễ, quyền riêng tư hoặc quy định. Vì vậy, một chiến lược quản lý hạ tầng vững chắc cần đáp ứng được sự đa dạng này bằng cách cung cấp các đích triển khai linh hoạt và quản lý cấu hình nhất quán trên mọi môi trường.
Để minh họa, hãy xét một kịch bản: một nhóm dùng Terraform để cấp phát một node GPU phục vụ (serving) trên Google Cloud Platform. Node này chạy một mô hình TensorFlow đóng gói dưới dạng container, phục vụ dự đoán qua API HTTP, và một autoscaling group sẽ thêm hoặc bớt các bản sao giống hệt nhau tùy theo tải yêu cầu. Đồng thời, các pipeline CI/CD cập nhật container mô hình theo các chu kỳ huấn luyện lại, và công cụ giám sát theo dõi độ trễ cùng mức sử dụng tài nguyên. Toàn bộ thành phần hạ tầng, từ cấu hình mạng đến hạn mức tài nguyên tính toán, đều được quản lý dưới dạng mã có kiểm soát phiên bản, đảm bảo khả năng tái lập và kiểm toán. Bằng cách áp dụng Hạ tầng dưới dạng mã, điều phối cloud-native và tự động mở rộng, các nhóm MLOps có thể cấp phát và duy trì các tài nguyên cần thiết cho machine learning ở quy mô sản xuất.
Hạ tầng dưới dạng mã giải quyết cách cấp phát tài nguyên; bài toán còn lại là quyết định khi nào cấp phát và cấp phát bao nhiêu. Các khối lượng công việc (workload) trong machine learning có kiểu tiêu thụ tài nguyên khác hẳn so với ứng dụng web phi trạng thái: tác vụ huấn luyện có thể bùng lên từ 0 lên hàng chục GPU rồi trở lại mức tiêu thụ tối thiểu, trong khi tác vụ suy luận duy trì mức sử dụng ổn định dưới lưu lượng biến động. Khối lượng công việc huấn luyện có nhu cầu bùng nổ, tạo ra căng thẳng giữa hiệu quả sử dụng tài nguyên và thời gian thu được insight (time-to-insight). Ngược lại, khối lượng công việc suy luận có mẫu tiêu thụ ổn định hơn nhưng kèm yêu cầu độ trễ nghiêm ngặt khi lưu lượng thay đổi.
Các mô hình sử dụng phần cứng
Cấp phát tài nguyên mới chỉ là nửa bài toán; sử dụng hiệu quả đòi hỏi đặt mục tiêu sử dụng cân bằng giữa chi phí và độ tin cậy, và các mục tiêu đó phụ thuộc vào việc đọc đúng các chỉ số phần cứng thay vì chỉ nhìn bề ngoài. Hiểu các mô hình sử dụng phần cứng là yếu tố then chốt để vận hành ML tiết kiệm chi phí. Mức sử dụng GPU, tương tự CPU, có thể gây hiểu lầm vì thông lượng còn phụ thuộc vào bộ nhớ, I/O, mức độ đồng thời và cơ chế xếp hàng.
Các chỉ số sử dụng GPU có thể gây hiểu lầm cho người vận hành. Một số liệu sử dụng cao có thể là do bị giới hạn bởi tính toán (GPU đang tích cực thực hiện các phép toán tensor, đây là trường hợp lý tưởng), bị giới hạn bởi bộ nhớ (chờ truyền dữ liệu từ bộ nhớ GPU), hoặc bị giới hạn bởi I/O (bị chặn do chờ dữ liệu đầu vào từ CPU hoặc mạng).
Table 16 phân biệt các mô hình này và các chiến lược tối ưu hóa tương ứng:
| Mẫu | Mức sử dụng GPU | Mức sử dụng băng thông bộ nhớ | Chiến lược tối ưu hóa |
|---|---|---|---|
| Giới hạn bởi tính toán | >85% | <70% | Kích thước batch lớn hơn, tensor parallelism trong một node |
| Giới hạn bởi bộ nhớ | 50–85% | >85% | Giảm kích thước mô hình, lượng tử hoá, tối ưu hóa truy cập bộ nhớ |
| Giới hạn bởi I/O | <50% | <50% | Cải thiện pipeline dữ liệu, tìm nạp trước đầu vào, sử dụng SSD |
| Thiếu batch | Thay đổi (có gai) | Thay đổi | Batching động, xếp hàng đợi yêu cầu trên một máy chủ |
Mục tiêu sử dụng theo khối lượng công việc (workload)
Các mục tiêu sử dụng điển hình thay đổi theo đặc điểm của từng khối lượng công việc (workload), phản ánh mức chịu đựng độ trễ và độ nhạy chi phí khác nhau của mỗi chế độ vận hành:
- Huấn luyện theo batch: Mục tiêu là đạt >80% mức sử dụng GPU. Nếu thấp hơn, có thể do tắc nghẽn ở pipeline dữ liệu hoặc kích thước batch chưa tối ưu. Theo dõi
gpu_util,memory_bandwidth_utilvàdata_load_time. - Suy luận trực tuyến: Đặt mục tiêu sử dụng GPU 50–70% ở tải p50. Dành 30–50% dư địa để xử lý các đợt tăng đột biến lưu lượng. Nếu duy trì mức sử dụng cao hơn, hệ thống có nguy cơ vi phạm SLO về độ trễ khi có lưu lượng tăng đột biến.
- Suy luận theo batch: Mục tiêu là sử dụng trên 85%. Khác với phục vụ (serving) trực tuyến, các tác vụ batch có thể chấp nhận độ trễ do xếp hàng, nhờ đó tối đa hóa hiệu quả phần cứng.
Các mục tiêu sử dụng này là điểm khởi đầu để chẩn đoán, không phải ngưỡng chung cho mọi trường hợp. Cùng một mức sử dụng có thể phản ánh các nút thắt khác nhau, tùy thuộc khối lượng công việc (workload) là phục vụ (serving) nhạy cảm với độ trễ, suy luận theo batch ưu tiên thông lượng, hay huấn luyện.
Ảnh hưởng của hệ thống phân cấp bộ nhớ
Hiệu năng phục vụ mô hình phụ thuộc rất lớn vào cách tận dụng hệ thống phân cấp bộ nhớ GPU. Dữ liệu phải luân chuyển qua nhiều cấp bộ nhớ với băng thông rất khác nhau (Hệ thống phân cấp bộ nhớ mô tả chi tiết toàn bộ hệ thống phân cấp độ trễ trên phổ lưu trữ), và table 17 định lượng điều này. L2 là cache do phần cứng quản lý, dành cho một tập làm việc nhỏ đang hoạt động; không phải nơi để đặt các trọng số đã chọn. Toàn bộ tham số của mô hình thường nằm trong bộ nhớ băng thông cao (HBM); các mô hình lớn hơn có thể offload tham số hoặc trạng thái sang bộ nhớ máy chủ hoặc lưu trữ, và độ trễ truyền thường chi phối thời gian suy luận. Các con số cần biết tổng hợp các thông số kỹ thuật hiện tại của bộ tăng tốc và băng thông HBM mà các số liệu phục vụ này dựa trên, nên dung lượng và băng thông giao diện trong table 17 truy ngược về các số liệu đã được ghi nhận theo từng thế hệ, còn băng thông cache L2 trên chip là giá trị ước tính, vì nhà cung cấp không công bố trực tiếp:
| Cấp độ bộ nhớ | Băng thông | Nội dung điển hình |
|---|---|---|
| L2 Cache (40 MB trên A100) | ~3 TB/s | Tập làm việc được lưu vào cache |
| Bộ nhớ GPU HBM2e (80 GB) | ~2 TB/s | Mô hình |
| PCIe Gen4 x16 đến CPU | ~32 GB/s | Activations |
| RAM hệ thống (512 GB) | ~200 GB/s | Đầu vào theo batch |
| NVMe SSD | ~7 GB/s | Hoán đổi mô hình |
Đối với việc phục vụ (serving) LLM trên một GPU hoặc một máy chủ, KV-cache (lưu trữ các khóa và giá trị attention cho mỗi token) thường trở thành nút thắt bộ nhớ. Thiết kế PagedAttention của vLLM ra đời để giải tỏa áp lực phục vụ (serving) này (Kwon et al. 2023). Với một mô hình grouped-query attention kiểu Llama 2 70 tỷ tham số (Touvron et al. 2023) có 80 lớp, 8 KV head, ngữ cảnh dài 4,096 token và mục cache định dạng FP16, mỗi chuỗi đang hoạt động lưu khoảng 1.3 GB KV cache. Tám chuỗi đồng thời vì thế tiêu tốn khoảng 10.7 GB trước khi tính phần dự phòng của bộ lập lịch, phân mảnh, hoặc activations, qua đó giới hạn số yêu cầu mà một nút có thể ghép trong cùng một batch. Giám sát mức sử dụng KV-cache trên mỗi nút phục vụ (serving) giúp lập kế hoạch dung lượng. Khi tiến gần giới hạn bộ nhớ, bộ lập lịch có thể xếp hàng hoặc từ chối yêu cầu, giảm kích thước batch, hoặc rút ngắn ngữ cảnh cho phép; mỗi lựa chọn đều có đánh đổi khác nhau về độ trễ hoặc chất lượng dịch vụ.
Kwon, Woosuk, Zhuohan Li, Siyuan Zhuang, Ying Sheng, Lianmin Zheng, Cody Hao Yu, Joseph Gonzalez, Hao Zhang, and Ion Stoica. 2023. “Efficient Memory Management for Large Language Model Serving with PagedAttention.” Proceedings of the 29th Symposium on Operating Systems Principles, 611–26. https://doi.org/10.1145/3600006.3613165.
Touvron, Hugo, Louis Martin, Kevin Stone, Peter Albert, Amjad Almahairi, Yasmine Babaei, Nikolay Bashlykov, et al. 2023. “Llama 2: Open Foundation and Fine-Tuned Chat Models.” arXiv Preprint arXiv:2307.09288.
Theo dõi chi phí trên mỗi suy luận
Giả sử \(\text{Hourly GPU cost}\) là chi phí tính tiền của GPU phục vụ (serving) trong một giờ và \(\text{Inferences per hour}\) là thông lượng suy luận duy trì trong cùng khoảng thời gian. Equation 10 chuyển các chỉ số phần cứng này thành chi phí trên mỗi suy luận có ý nghĩa kinh doanh: \[\text{Cost per 1K inferences} = \frac{\text{Hourly GPU cost} \times 1000}{\text{Inferences per hour}} \tag{10}\]
Ví dụ, với một GPU có chi phí $3/hour mỗi giờ và xử lý 50,000 inferences/hour suy luận mỗi giờ, chi phí là $0.06/1K inferences. Hãy theo dõi chỉ số này theo thời gian; những thay đổi có thể phản ánh giá cả, cơ cấu khối lượng công việc (workload), hoặc hiệu quả.
Giám sát mô hình và hạ tầng
Quản lý hạ tầng cung cấp tài nguyên; giám sát quan sát hành vi của chúng. Kiểm thử đơn vị có thể xác minh các thành phần có tính xác định, nhưng tự bản thân chúng không thể thiết lập được hiệu suất dự đoán ở mức tổng thể; điều đó phải được ước tính bằng phương pháp thống kê. Giám sát triển khai việc phát hiện các suy giảm có thể quan sát được (section 1.2.1), biến hạn chế lý thuyết này thành thực tiễn vận hành. Khi giám sát phát hiện một triệu chứng—vi phạm SLA về độ trễ, thông lượng dưới mục tiêu, hoặc bộ nhớ tăng dần—Chẩn đoán nút thắt cổ chai ánh xạ triệu chứng đó tới thành phần D·A·M chiếm ưu thế của nó và cho người vận hành biết tối ưu hóa nào sẽ dịch chuyển ràng buộc then chốt và tối ưu hóa nào sẽ chỉ lãng phí trên hạ tầng phục vụ (serving). Nếu không có giám sát liên tục và khả năng quan sát sâu hơn mà nó mang lại (khả năng suy luận trạng thái bên trong từ các đầu ra), một mô hình đã triển khai chỉ là một hộp đen dần dần trở nên không còn phù hợp.
Giám sát hiệu quả bao phủ cả hành vi mô hình và hiệu suất hạ tầng. Về phía mô hình, các nhóm theo dõi các số liệu như độ chính xác (accuracy), độ đúng (precision), độ phủ (recall) và ma trận nhầm lẫn (confusion matrix) (scikit-learn developers 2024b), dùng các dự đoán trực tiếp hoặc được lấy mẫu để xem hiệu suất có ổn định hay bắt đầu trôi dạt. Một ràng buộc quan trọng là độ trễ phát hiện trôi dạt, yếu tố quyết định tốc độ giám sát thống kê có thể xác nhận rằng sự suy giảm đã xảy ra. Tốc độ phát hiện phụ thuộc vào lưu lượng. Một phép tính ngắn về tốc độ lấy mẫu giúp thấy rõ ràng ràng buộc đó.
scikit-learn developers. 2024b. Sklearn.metrics.confusion_matrix — Scikit-Learn Documentation. Scikit-learn Documentation.
Phép tính tốc độ lấy mẫu cho độ trễ phát hiện trôi dạt làm lộ ra một bất đối xứng cơ bản: các kiểm định thống kê cần đủ mẫu có nhãn để đạt được công suất, và các hệ thống lưu lượng thấp có thể phải chờ vài ngày hoặc vài tuần mới tích lũy đủ bằng chứng. Khoảng trễ này không phải chuyện có thể khép lại bằng các lối tắt kỹ thuật hay công cụ tốt hơn; nó là hệ quả của tốc độ lấy mẫu hữu hạn va vào yêu cầu về công suất thống kê của kiểm định giả thuyết. Hệ quả thực tế là hệ thống giám sát phải phân biệt giữa trôi dạt làm thay đổi phân phối đầu vào (có thể phát hiện không cần nhãn) và trôi dạt làm thay đổi chính ranh giới quyết định (chỉ phát hiện được sau khi có ground truth).
Tốc độ phát hiện trôi dạt bị giới hạn bởi tốc độ lấy mẫu.
Napkin Math 1.4: Độ trễ phát hiện trôi dạt
Vấn đề: Một mô hình có độ chính xác 95 percent có thể bị suy giảm 5 percentage-point. Chính sách giám sát cần 1,000 mẫu có nhãn; số lượng chính xác phụ thuộc vào phép kiểm định, công suất, nhiễu nhãn và sự phụ thuộc. Vậy việc thu thập mất bao lâu?
Toán học:
- Ngân sách bằng chứng: 1,000 mẫu có nhãn.
- Trường hợp tốc độ cao: Với 1 kết quả có nhãn mỗi giây, việc thu thập sẽ mất 1,000 seconds ≈ 16.7 minutes.
- Trường hợp tốc độ thấp: Với 100 kết quả có nhãn mỗi ngày, việc thu thập sẽ mất 10 days.
Thông tin chuyên sâu về hệ thống: Tốc độ phát hiện bị giới hạn bởi thời điểm các kết quả có nhãn đến, và điều này có thể chậm hơn nhiều so với lưu lượng. Miền có lưu lượng thấp hoặc nhãn đến trễ có thể cần vài ngày hoặc vài tuần, nên các hệ thống rủi ro cao thường bổ sung giám sát thống kê bằng các cuộc kiểm tra mô hình chủ động.
Các hệ thống ML trong môi trường sản xuất cần theo dõi nguồn gốc nghiêm ngặt trong một kho mô hình. Khi có thể, mỗi phiên bản mô hình đã đăng ký nên liên kết các định danh hoặc mã băm bất biến của mã, dữ liệu huấn luyện, cấu hình và tệp trọng số đã tạo ra nó. Chuỗi này hỗ trợ kiểm tra và khôi phục về phiên bản trước, nhưng không đảm bảo tái lập chính xác nếu còn tồn tại tính không xác định, dịch vụ bên ngoài, trình điều khiển hoặc phần cứng nằm ngoài môi trường đã được ghi lại. Các hệ thống sản xuất phải đối mặt với hai dạng trôi dạt mô hình22 mà hệ thống giám sát cần phân biệt, dù chúng có thể xảy ra đồng thời. Trôi dạt khái niệm xảy ra khi mối quan hệ giữa các đặc trưng và biến mục tiêu thay đổi, tức là \(p(y \mid x)\) dịch chuyển. Trôi dạt dữ liệu23 là sự thay đổi trong phân phối đầu vào \(p(x)\). Trong các ứng dụng như xe tự lái, điều này có thể do biến động theo mùa của thời tiết, ánh sáng hoặc điều kiện đường xá.
22 Độ trễ phát hiện trôi dạt: Ta có thể ước tính sự thay đổi trong \(p(x)\) từ đủ số lượng mẫu đầu vào mà không cần nhãn, dù việc phát hiện không diễn ra ngay. Sự thay đổi trong \(p(y \mid x)\) thường đòi hỏi kết quả có nhãn; trong các lĩnh vực rủi ro cao (như chẩn đoán y tế, phát hiện gian lận, quyết định pháp lý), việc có được nhãn có thể mất hàng ngày, hàng tuần hoặc thậm chí hàng tháng. Các chỉ số gián tiếp (proxy) như phân phối độ tin cậy của dự đoán và entropy đầu ra có thể đưa ra cảnh báo sớm, dù không hoàn hảo, đánh đổi giữa tỉ lệ báo động sai và tốc độ phát hiện.
23 Dịch chuyển covariate: Các phương pháp hiệu chỉnh bằng trọng số cho dịch chuyển covariate giả định rằng miền hỗ trợ của phân phối huấn luyện bao trùm phân phối triển khai: mọi đầu vào khi triển khai đều có thể đã xuất hiện trong huấn luyện, chỉ khác về xác suất. Khi triển khai có các đầu vào thực sự nằm ngoài phân phối (như danh mục sản phẩm mới, nhân khẩu học mới, hoặc các đầu vào đối kháng), việc hiệu chỉnh có thể thất bại và mô hình có thể tự tin đưa ra kết quả sai mà không có tín hiệu cảnh báo. Vì vậy, phạm vi bao phủ của miền hỗ trợ là giả định ngầm then chốt quyết định liệu nên hiệu chỉnh trôi dạt hay phải huấn luyện lại hoàn toàn mô hình.
Cả hai dạng trôi dạt này dẫn tới một định nghĩa chính thức:
Definition 1.3: Trôi dạt dữ liệu
Trôi dạt dữ liệu là sự thay đổi trong phân phối đầu vào \(p(x)\). Dịch chuyển covariate là một trường hợp đặc biệt, khi \(p(x)\) thay đổi còn \(p(y \mid x)\) vẫn ổn định. Phân loại trôi dạt rộng hơn trong Phát hiện và phản ứng với trôi dữ liệu còn bao gồm trôi dạt khái niệm (concept drift), tức là khi \(p(y \mid x)\) thay đổi; hai dạng này cũng có thể xảy ra đồng thời.
- Ý nghĩa: Trôi dạt dữ liệu vi phạm giả định phân phối đồng nhất (identical-distribution assumption) và có thể làm độ chính xác giảm dần khi độ phân kỳ phân phối \((\mathcal{D}(P_t \lVert P_0))\) tăng lên. Khi có số đo trôi dạt và kết quả đi kèm hỗ trợ ở phạm vi cục bộ, các nhóm có thể khớp \(\text{Accuracy}(t) \approx \text{Accuracy}_0 - \lambda \cdot \mathcal{D}(P_t \lVert P_0)\), với \(\lambda\) được khớp cho từng lần triển khai; đây là một heuristic, không phải quy luật chung. Dưới các giả định về dịch chuyển covariate và miền hỗ trợ, áp dụng trọng số theo tầm quan trọng (importance weighting) hoặc huấn luyện lại bằng dữ liệu có nhãn hiện tại có thể khôi phục hiệu suất.
- Phân biệt: Suy giảm mô hình mô tả việc chất lượng mô hình giảm dần theo thời gian, dù mã mô hình không thay đổi. Trôi dạt dữ liệu là một nguyên nhân bên ngoài có thể dẫn đến hiện tượng này, bên cạnh trôi dạt khái niệm và những thay đổi trong pipeline xung quanh.
- Cạm bẫy thường gặp: Chỉ giám sát đầu ra của mô hình có thể bỏ sót trôi dạt đầu vào, hoặc nhầm lẫn những thay đổi đầu ra vô hại với suy giảm chất lượng. Các thống kê về đặc trưng đầu vào (\(\mathcal{D}(P_t \lVert P_0)\) qua PSI, kiểm định KS, hoặc khoảng cách Wasserstein/Earth Mover’s Distance (EMD)) có thể cảnh báo sớm hơn so với hiệu suất dựa trên nhãn, vì phản hồi ground-truth thường đến muộn.
Do trôi dạt, một mô hình đã triển khai có thể hành xử như hàng tồn kho đang suy giảm hơn là phần mềm tĩnh. Rủi ro trôi dạt thống kê được mô hình hóa cục bộ bằng \((\text{Accuracy}(t) \approx \text{Accuracy}_0 - \lambda \cdot \mathcal{D}(P_t \lVert P_0))\), với \(\lambda\) được ước lượng từ các cặp độ phân kỳ và kết quả; đây không phải là quy luật đơn điệu phổ quát. Cần giám sát cả hai yếu tố này trước khi sự suy giảm tích lũy thành tác động kinh doanh.
Biểu đồ Đường cong Tài sản Hư hỏng (figure 8) giúp đặt sự suy giảm này vào bối cảnh bằng cách so sánh hai chiến lược bảo trì. Đường răng cưa màu cam biểu diễn huấn luyện lại theo lịch: độ chính xác được đặt lại theo chu kỳ cố định, dù mô hình còn khỏe hay đã xuống dưới ngưỡng trôi dạt. Cách làm này đơn giản nhưng có thể vừa lãng phí vừa chậm, vì lịch là yếu tố quyết định thay vì dựa trên mức suy giảm quan sát được. Đường màu xanh lá cây biểu diễn phản ứng theo ngưỡng: khi chất lượng được giám sát vượt ngưỡng, hệ thống kích hoạt chẩn đoán; huấn luyện lại diễn ra khi có đủ bằng chứng đã gán nhãn và nguyên nhân đã được chẩn đoán ủng hộ quyết định đó. Tốc độ suy giảm và các khoảng thời gian chỉ mang tính minh họa.
Hai đường cong này biến hiện tượng trôi dạt từ một vấn đề thống kê trừu tượng thành một lựa chọn chính sách vận hành. Huấn luyện lại theo lịch trình dễ lên kế hoạch nhưng có thể quá sớm hoặc quá muộn; còn huấn luyện lại dựa trên kích hoạt đòi hỏi hệ thống giám sát (telemetry) mạnh hơn, nhưng giúp việc can thiệp bám sát mức suy giảm quan sát được.
Giám sát theo lớp và định lượng sự trôi dạt
Rủi ro trôi dạt thống kê đã nêu trước đó cho thấy phân phối lệch đi có thể đi kèm với suy giảm độ chính xác, nhưng cần kết quả có nhãn để xác định hướng và mức độ. Để định lượng mối quan hệ này, cần hai lớp telemetry: lớp chỉ số hạ tầng để xem hệ thống phục vụ (serving) có phải nút thắt cổ chai không, và lớp chỉ số về phân phối và kết quả để nối thay đổi dữ liệu với hiệu suất mô hình. Sự suy giảm dần dần trong dài hạn đặc biệt khó nhận ra vì có thể lọt qua các ngưỡng phát hiện thô: những thay đổi nhỏ theo ngày trong một chỉ số chất lượng có thể cộng dồn thành suy giảm đáng kể sau một năm mà không kích hoạt cảnh báo theo tháng. Tính mùa vụ còn làm mọi thứ phức tạp hơn. Một mô hình huấn luyện vào mùa hè có thể chạy tốt suốt mùa thu nhưng lại thất bại trước điều kiện mùa đông mà nó chưa từng thấy. Để phát hiện loại suy giảm từ từ này, cần giám sát đa thang thời gian: đường chuẩn hiệu suất theo nhiều chân trời thời gian (hàng ngày, hàng tuần, hàng quý), so sánh cửa sổ trượt để bắt xu hướng chậm, và hồ sơ hiệu suất theo mùa để tính đến các chu kỳ lặp lại.
Systems Perspective 1.2: Quy luật sắt trong giám sát vận hành
Các kiểu sử dụng tài nguyên này ánh xạ trực tiếp đến quy luật sắt của hệ thống ML (Định luật sắt của hệ thống ML). Việc giám sát sẽ cho biết yếu tố nào đang chiếm ưu thế:
- Giới hạn bởi tính toán (mức sử dụng GPU cao, mức sử dụng băng thông bộ nhớ thấp): Bị giới hạn bởi \(O/(R_{\text{peak}} \cdot \eta_{\text{hw}})\). Tối ưu kernel, dùng Tensor Cores, hoặc nâng cấp phần cứng.
- Giới hạn bởi bộ nhớ (mức sử dụng GPU vừa phải, mức sử dụng băng thông bộ nhớ cao): Bị giới hạn bởi \(D_{\text{vol}}/\text{BW}\). Tối ưu bằng lượng tử hoá, tỉa (pruning), hoặc batching.
- Giới hạn bởi I/O (mức sử dụng GPU thấp, mức sử dụng băng thông bộ nhớ thấp): Bị giới hạn bởi độ trễ của pipeline dữ liệu. Sửa DataLoader, không phải mô hình.
Quy luật sắt cũng đồng thời là một framework chẩn đoán cho hệ thống vận hành. Khi SLO về độ trễ bị vi phạm, bảng điều khiển giám sát sẽ cho biết nên kiểm tra yếu tố nào.
Lớp đầu tiên là giám sát ở cấp hạ tầng, theo dõi các chỉ số như mức sử dụng CPU và GPU, mức dùng bộ nhớ và đĩa, độ trễ mạng, và khả năng sẵn sàng của dịch vụ. Chỉ nhìn mỗi mức sử dụng GPU là chưa đủ; hãy đối chiếu với các chỉ số về băng thông bộ nhớ và pipeline để phân biệt hệ thống đang bị giới hạn bởi tính toán, bộ nhớ hay I/O. Các chỉ số về hiệu quả công suất (ví dụ: số suy luận trên mỗi joule hoặc FLOP/s/W, tùy theo khối lượng công việc (workload)) đưa thêm góc nhìn chuẩn hóa theo chi phí, cho phép lập lịch các khối lượng công việc (workload) hỗn hợp để tối ưu cả chi phí kinh tế lẫn tác động môi trường.
Napkin Math 1.5: Kinh tế học của khả năng quan sát
Đánh đổi: Ở quy mô lớn, việc “đo lường mọi thứ” là bất khả thi về mặt vật lý. Gọi \(N_{\text{series}}\) là tổng số chuỗi, \(f_{\text{sample}}\) là tần số lấy mẫu cho mỗi chuỗi, \(B_{\text{sample}}\) là số byte mỗi mẫu, và \(T_{\text{retention}}\) là thời gian lưu trữ; \(C_{\text{ingest/sample}}\) và \(C_{\text{storage/byte-time}}\) là giá nhập liệu và lưu trữ do nhà cung cấp quy định. Equation 11 kết hợp các đại lượng này thành tỷ lệ chi phí vận hành: \[ \text{Cost rate} \approx N_{\text{series}} f_{\text{sample}} \left(C_{\text{ingest/sample}} + B_{\text{sample}} T_{\text{retention}} C_{\text{storage/byte-time}}\right) \tag{11}\]
Table 18: Lấy mẫu dấu vết so với Chi phí khả năng quan sát: Việc chỉ giữ lại một trong 60 dấu vết yêu cầu sẽ tạo ra khác biệt về khối lượng dữ liệu là 60× khi tốc độ yêu cầu là 1M req/s, giả sử mỗi yêu cầu có 1 KB. Khoảng thời gian batch không phải là nguyên nhân gây ra mức giảm đó.
Kết quả là một tỷ lệ chi phí vận hành, không phải chi phí thiết lập một lần.
Cả hai khối lượng dữ liệu này đều được tính theo cùng một quy trình hai bước. Khi thu thập đầy đủ, dữ liệu đo từ xa của mỗi yêu cầu sẽ đi vào luồng: 1M req/s \(\times\) 1 KB cho mỗi yêu cầu = 1 GB/s. Nếu chỉ giữ lại một trong 60 dấu vết yêu cầu, lượng dữ liệu nhập trung bình sẽ giảm xuống còn 16.7 MB/s. Việc gom batch các dấu vết đã lấy mẫu sau mỗi 60 s chỉ thay đổi thời gian phân phối, không làm thay đổi tốc độ byte trung bình. Table 18 đặt hai chế độ này cạnh nhau cùng với tác động chi phí của chúng.
| Sampling | Mức độ chi tiết | Khối lượng dữ liệu (1M req/s) | Tác động chi phí |
|---|---|---|---|
| Tất cả traces | Micro-bursts | ~1 GB/s | Cao (Yêu cầu cụm chuyên dụng) |
| 1 trên 60 traces | Xu hướng | ~16.7 MB/s | Thấp hơn (Phụ thuộc vào chính sách) |
Systems insight: Giữ lại 1 percent các yêu cầu thành công và 100 percent các lỗi. Giám sát các bộ đếm tổng hợp mỗi 1 s và các bản tóm lược (sketch) cho tập chỉ số có số lượng giá trị phân biệt cao mỗi 60 s; section 1.5.3.1 cho thấy cách lập ngân sách hạ tầng.
Giám sát nhiệt độ được tích hợp vào các quyết định lập lịch vận hành, đặc biệt với các hệ thống được triển khai liên tục ở mức sử dụng cao, nơi việc điều tiết nhiệt (thermal throttling) có thể làm hiệu suất suy giảm khó lường. Một bảng điều khiển giám sát MLOps có thể tích hợp các chỉ số về khoảng nhiệt dự phòng (thermal headroom) để định hướng phân phối khối lượng công việc (workload) lên phần cứng sẵn có, từ đó giảm suy giảm hiệu suất do nhiệt gây ra, vốn có thể dẫn đến vi phạm SLA về độ trễ suy luận. Các công cụ như Prometheus24 (Cloud Native Computing Foundation 2024b), Grafana (Labs 2024) và Elastic (Elastic NV 2024) được dùng rộng rãi để thu thập, tổng hợp và trực quan hóa các chỉ số vận hành này. Các công cụ này thường được tích hợp vào bảng điều khiển, cung cấp góc nhìn thời gian thực và lịch sử về hành vi hệ thống.
24 Prometheus: Prometheus định kỳ thu thập dữ liệu từ các mục tiêu (scrape targets) và lưu chuỗi thời gian để tổng hợp. Khoảng thời gian thu thập và đánh giá quy tắc cùng ảnh hưởng đến độ trễ cảnh báo và có thể bỏ lỡ các biến động ngắn. Giám sát nhiệt độ theo từng bộ tăng tốc cho phép định tuyến khối lượng công việc (workload) chính xác hơn, nhưng với chi phí dữ liệu cao hơn; trong khi đó, các tổng hợp ở cấp máy chủ có thể che khuất hiện tượng throttling ở cấp thành phần.
Cloud Native Computing Foundation. 2024b. Prometheus: Monitoring System and Time Series Database.
Labs, Grafana. 2024. Grafana.
Elastic NV. 2024. Elasticsearch: Distributed Search and Analytics Engine.
Việc thu thập tất cả các tín hiệu này ở quy mô sản xuất kéo theo các ràng buộc chi phí riêng. Những ràng buộc đó buộc các nhóm kỹ thuật phải cân nhắc và chấp nhận các đánh đổi có chủ đích giữa độ chi tiết của giám sát và chi phí hạ tầng.
Vấn đề còn lại là làm sao các cơ chế cảnh báo chuyển tín hiệu thống kê thành hành động kịp thời, trước khi thiệt hại do lỗi âm thầm gây ra vượt quá chi phí can thiệp. Các cơ chế cảnh báo chủ động sẽ thông báo cho đội ngũ khi phát hiện bất thường hoặc vi phạm ngưỡng. Ví dụ, việc độ chính xác của mô hình giảm liên tục có thể kích hoạt điều tra hiện tượng drift; còn các cảnh báo về hạ tầng có thể báo hiệu bộ nhớ bão hòa hoặc hiệu suất mạng suy giảm. Cách thiết kế các cảnh báo này quyết định khoảng thời gian từ lúc suy giảm bắt đầu đến khi kỹ sư hành động, và khoảng thời gian đó sẽ chuyển thẳng thành tác động kinh doanh ở quy mô lớn. Các cảnh báo cần lưu giữ thông tin về phiên bản mô hình, phân đoạn bị ảnh hưởng và cửa sổ kích hoạt, để đội ngũ xử lý có thể tái tạo trạng thái lỗi.
Example 1.3: Giám sát khuyến nghị ở quy mô lớn
Tình huống: Hãy xem xét một dịch vụ khuyến nghị dạng luồng với thông lượng cao, có độ trễ vẫn nằm trong giới hạn SLO, nhưng chất lượng khuyến nghị lại giảm sút khi hành vi người dùng thay đổi.
Chẩn đoán: Các chỉ số hạ tầng truyền thống (mức sử dụng CPU, tỷ lệ lỗi HTTP) vẫn bình thường, trong khi CTR của mô hình giảm vì các chỉ số tổng thể đã che lấp sự suy giảm ở các phân nhóm cục bộ.
Bài học về hệ thống: Chỉ dữ liệu đo từ xa của hạ tầng thôi thì không thể phát hiện lỗi mô hình thống kê. Các hệ thống khuyến nghị có thông lượng cao cần theo dõi các phân nhóm theo cohort và đánh giá counterfactual để phát hiện trôi dạt độ chính xác ở những phân nhóm cụ thể.
Giám sát chất lượng dữ liệu
Giám sát mô hình và hạ tầng thường theo dõi các đầu ra. Tuy nhiên, đến khi các chỉ số đầu ra bắt đầu suy giảm, vấn đề gốc rễ có thể đã tồn tại từ vài ngày hoặc vài tuần. Giám sát chất lượng dữ liệu có thể giúp lộ diện sớm các nguyên nhân ở phía đầu vào, trong khi giám sát đầu ra và kết quả cho biết những thay đổi đó có ảnh hưởng đến người dùng hay không. Hai cách nhìn này bổ sung cho nhau, không thể thay thế lẫn nhau. Hàng rào đầu tiên cho dữ liệu đầu vào là xác thực có thể thực thi, như minh họa trong listing 4: các kỳ vọng về lược đồ sẽ từ chối các batch dữ liệu bị định dạng sai trước khi suy luận, biến một giả định về chất lượng dữ liệu thành một ràng buộc có thể kiểm chứng.
schema.require_column("user_id")
schema.require_type("timestamp", "datetime")
schema.require_non_null("feature_a")

schema.require_range("age", min_value=0, max_value=120)
schema.require_mean_between(
    "purchase_amount", min_value=10, max_value=1000
)
Xác thực dữ liệu đầu vào
Xác thực lược đồ25 giúp phát hiện các vấn đề cấu trúc trước khi chúng chạm tới mô hình. Các nhóm quy tắc phổ biến gồm kiểm tra sự tồn tại của cột, ràng buộc kiểu, phát hiện giá trị null, và đặt giới hạn thống kê.
25 Xác thực lược đồ: Các quy tắc trong listing 4 giúp ngăn những vi phạm ngầm đối với hợp đồng dữ liệu, ví dụ một cột đặc trưng đổi từ số nguyên sang số thực. Nếu thiếu hàng rào bảo vệ ở tầng đầu vào này, khâu giám sát mô hình phía sau sẽ không phân biệt được lỗi chất lượng dữ liệu với suy giảm hiệu suất thực sự, khiến nguyên nhân gốc bị che mờ. Lệch lược đồ ở một đặc trưng quan trọng có thể khiến một batch dự đoán vốn định dạng đúng trở nên không hợp lệ.
Giám sát phân phối đặc trưng
Xác thực lược đồ phát hiện các lỗi cấu trúc (thiếu cột, sai kiểu dữ liệu, giá trị null) nhưng không thể nhận ra kiểu lỗi tinh vi hơn khi dữ liệu vẫn đúng định dạng nhưng đến từ một phân phối đã bị dịch chuyển. Ví dụ, một đặc trưng đại diện cho tuổi người dùng có thể vượt qua mọi kiểm tra lược đồ trong khi giá trị trung bình của nó âm thầm tăng từ 32 lên 45 trong ba tháng, do một chiến dịch tiếp thị thu hút nhóm khách hàng lớn tuổi hơn. Sự dịch chuyển phân phối này làm suy giảm dự đoán của mô hình rất lâu trước khi xuất hiện bất thường về cấu trúc. Các thước đo khoảng cách thống kê giúp định lượng khác biệt này bằng cách so sánh các phân phối đặc trưng hiện tại với đường cơ sở từ dữ liệu huấn luyện. Table 19 nêu các ngưỡng cảnh báo tiêu biểu cho ba chỉ số phổ biến: chỉ số ổn định dân số (PSI) phù hợp cho đặc trưng phân loại, thống kê KS cho phân phối liên tục, và độ phân kỳ Jensen-Shannon để so sánh các phân phối xác suất đầy đủ bằng một thước đo đối xứng, có giới hạn, dẫn xuất từ KL.
| Chỉ số | Ngưỡng cảnh báo | Trường hợp sử dụng |
|---|---|---|
| PSI | PSI > 0.25 | Các đặc trưng phân loại và được phân nhóm |
| Thống kê Kolmogorov-Smirnov | KS > 0.1 | Các phân phối đặc trưng liên tục |
| Độ phân kỳ Jensen-Shannon | JS > 0.1 | Các phân phối xác suất |
Để hiểu các ngưỡng này, chúng ta cần nhìn vào toán học. PSI26 định lượng sự dịch chuyển của phân phối bằng cách so sánh tần suất dự kiến (trong huấn luyện) với tần suất thực tế (khi phục vụ (serving)) trên các bin (Đo lường sự trôi dạt (phân kỳ) phát triển nền tảng toán học của độ phân kỳ KL, PSI và lý thuyết thông tin cho giám sát hệ thống). Ở đây, \(n\) là số bin cố định, còn \(\text{expected}_i\) và \(\text{actual}_i\) là các tỷ lệ bin đã được căn chỉnh, dương nghiêm ngặt và có tổng bằng một trong mỗi phân phối. Equation 12 định nghĩa điều này dưới dạng công thức: \[ \text{PSI} = \sum_{i=1}^{n} (\text{actual}_i - \text{expected}_i) \times \ln\left(\frac{\text{actual}_i}{\text{expected}_i}\right) \tag{12}\]
26 PSI (chỉ số ổn định dân số): PSI được dùng rộng rãi trong giám sát bảng điểm rủi ro tín dụng để so sánh các quần thể đã được phân bin giữa giá trị dự kiến và giá trị quan sát; Yurdakul và Naranjo phân tích các đặc tính thống kê của chỉ số này (Yurdakul and Naranjo 2020). Các dải 0.1 và 0.25 phổ biến là những quy ước vận hành hữu ích, không phải các định luật thống kê phổ quát. Vận hành ML đã áp dụng PSI vì chỉ số này hoạt động trên các đặc trưng phân loại hoặc liên tục đã được phân bin và cung cấp một điểm số dịch chuyển dễ hiểu mà cả người không chuyên cũng có thể xem xét.
Yurdakul, Bilal, and Joshua Naranjo. 2020. “Statistical Properties of the Population Stability Index.” The Journal of Risk Model Validation 52. https://doi.org/10.21314/jrmv.2020.227.
Vì vậy, các hệ thống giám sát trong môi trường sản xuất cần có một zero-bin policy được ghi nhận rõ ràng, chẳng hạn như làm mịn, và phải giữ nguyên ranh giới các bin qua các giai đoạn so sánh; PSI là một tín hiệu dịch chuyển, không phải cơ chế tự động kích hoạt huấn luyện lại.
Với các phân phối rời rạc hoặc đã phân bin, độ phân kỳ KL là một cách so sánh khác. Gọi \(p\) là phân phối phục vụ (serving) đang được giám sát và \(q\) là phân phối tham chiếu từ huấn luyện. Equation 13 định nghĩa ký hiệu riêng cho độ phân kỳ KL là \(\mathcal{D}_{\text{KL}}\); ở những chỗ khác trong sách này, \(\mathcal{D}(P_t \lVert P_0)\) biểu thị một độ phân kỳ thống kê chung trong phương trình suy giảm: \[ \mathcal{D}_{\text{KL}}(p \lVert q) = \sum_{x} p(x) \log\left(\frac{p(x)}{q(x)}\right) \tag{13}\]
Vì độ phân kỳ KL là bất đối xứng và trở thành vô hạn khi \(p(x)>0\) còn \(q(x)=0\), các hệ thống giám sát vận hành phải giữ đúng hướng và áp dụng một chính sách về miền hỗ trợ rõ ràng, chẳng hạn làm mịn các bin chưa từng xuất hiện. Để thấy điều này trong thực tế, hãy xem một hệ thống khuyến nghị giám sát tuổi người dùng: sự dịch chuyển từ nhóm nhân khẩu học “trẻ hơn” sang “lớn tuổi hơn” có thể trông tinh tế trên biểu đồ tần suất, nhưng lại tạo ra một tín hiệu PSI rõ ràng, được phân rã theo từng bin trong table 20:
| Nhóm tuổi | Huấn luyện | Phục vụ (serving) | Chênh lệch | ln(Serving/Training) | Đóng góp |
|---|---|---|---|---|---|
| 18–25 | 15% | 12% | -0.03 | -0.223 | 0.0067 |
| 26–35 | 25% | 22% | -0.03 | -0.128 | 0.0038 |
| 36–45 | 20% | 18% | -0.02 | -0.105 | 0.0021 |
| 46–55 | 18% | 20% | +0.02 | +0.105 | 0.0021 |
| 56–65 | 12% | 15% | +0.03 | +0.223 | 0.0067 |
| 66+ | 10% | 13% | +0.03 | +0.262 | 0.0079 |
Cộng đóng góp của sáu bin cho ta tổng PSI là 0.029 (Stable). Các cột huấn luyện và phục vụ (serving) được hiển thị dưới dạng phần trăm, trong khi cột chênh lệch được biểu diễn dưới dạng tỷ lệ; do đó, một dịch chuyển 3 điểm phần trăm sẽ hiện là \(\pm 0.03\). Dù một số bin đã dịch chuyển 3 điểm phần trăm, độ trôi tổng hợp vẫn thấp hơn nhiều so với ngưỡng cảnh báo 0.1. Hành động vận hành phụ thuộc vào ngưỡng đã hiệu chỉnh, kích thước mẫu và chi phí kinh doanh.
Giám sát độ tươi mới của dữ liệu
Các kho đặc trưng và pipeline dữ liệu có thể bị cũ (stale) mà không gây ra lỗi rõ ràng. Giám sát độ tươi mới của dữ liệu giúp bắt được dạng lỗi này, và listing 5 minh họa một cấu hình giám sát độ tươi mới của đặc trưng và kích hoạt cơ chế dự phòng khi dữ liệu bị cũ.
user_purchase_history feature for staleness, alerting operations teams via PagerDuty and Slack and falling back to default values when the feature exceeds the maximum allowed age.
# Example freshness alert configuration
feature: user_purchase_history
max_staleness: 6h
alert_channels: [pagerduty, slack]
on_stale:
  action: fallback_to_default
  default_value: []
Một chính sách độ tươi biến dữ liệu bị cũ từ một lỗi âm thầm thành một cơ chế dự phòng rõ ràng; cùng một cơ chế phát hiện và phản hồi phải bao trùm mọi lớp của ngăn xếp giám sát.
Checkpoint 1.2: Ngăn xếp giám sát
Giám sát ML được phân lớp, không phải nguyên khối. Các câu hỏi trong danh sách kiểm tra này kiểm tra xem mỗi triệu chứng có thể được truy về đúng lớp chịu trách nhiệm hay không.
Cùng một stack cũng phải giám sát các nguồn dữ liệu cấp cho hệ thống ML: độ trễ sao chép cơ sở dữ liệu, tình trạng sẵn sàng của điểm cuối API, và trạng thái hoàn thành của các job extract, transform, load (ETL). Trong một mẫu sự cố tiêu biểu, một hệ thống đề xuất phát hiện sự dịch chuyển đáng kể trong phân phối user_lifetime_value trong vòng hai ngày và lần ra nguyên nhân là một đợt di chuyển cơ sở dữ liệu đã thay đổi logic tổng hợp. Nếu không có giám sát chất lượng dữ liệu, kiểu sự cố này có thể làm chất lượng đề xuất suy giảm suốt nhiều tuần trước khi các chỉ số độ chính xác phát hiện ra vấn đề.
Mô hình chi phí giám sát
Cơ sở hạ tầng khả năng quan sát phát sinh chi phí tỉ lệ với mức độ chi tiết giám sát. Hiểu rõ các chi phí này giúp đưa ra quyết định hợp lý về mức độ giám sát, cân bằng với các ràng buộc về ngân sách.
Các thành phần chi phí
Chi phí giám sát được chia thành bốn loại, như equation 14 phân tách: \[\text{Monitoring Cost} = C_{\text{ingest}} + C_{\text{storage}} + C_{\text{compute}} + C_{\text{alert}} \tag{14}\]
Bốn thuật ngữ \(C_*\) là các thành phần chi phí trong cùng một khoảng thời gian kế toán: thu nạp dữ liệu, lưu trữ dữ liệu, tính toán cho truy vấn hoặc bảng điều khiển, và đánh giá quy tắc cảnh báo. Việc tách biệt chúng rất quan trọng vì mỗi thành phần tỉ lệ theo một tham số điều khiển khác nhau.
Table 21 cung cấp các giả định về chi phí đơn vị đại diện cho từng thành phần. Việc chuyển các chi phí đơn vị này thành một ước tính ngân sách cụ thể giúp làm rõ chi phí thực tế của việc giám sát ngay cả một mô hình sản xuất duy nhất:
| Thành phần | Chi phí đơn vị minh họa | Hệ số tỷ lệ |
|---|---|---|
| Thu nạp chỉ số | $0.10–0.50 mỗi triệu điểm dữ liệu | \(\text{Number of metrics} \times \text{sample rate}\) |
| Lưu trữ nhật ký | $0.50–2.00 mỗi GB/tháng | \(\text{Log verbosity} \times \text{retention period}\) |
| Tính toán truy vấn | $0.01–0.05 mỗi truy vấn | \(\text{Dashboard refresh rate} \times \text{users}\) |
| Đánh giá cảnh báo | $0.001–0.01 mỗi lần đánh giá | \(\text{Number of alert rules} \times \text{check frequency}\) |
Napkin Math 1.6: Ngân sách giám sát cho một mô hình
Bài toán: Với các giả định này, chi phí thu nạp, lưu trữ và truy vấn hàng tháng khi giám sát một nút ML duy nhất là bao nhiêu?
Biến:
- một mô hình với 3 biến thể triển khai (production, canary, staging), mỗi biến thể phát ra 50 chỉ số
- Các chỉ số được lấy mẫu mỗi 15 seconds
- Yêu cầu lưu giữ: 30 days
- 2 bảng điều khiển (tình trạng mô hình, cơ sở hạ tầng), 3 thành viên nhóm, làm mới mỗi 5 phút
Thu nạp chỉ số:
- Điểm dữ liệu mỗi tháng: 3 \(\times\) 50 \(\times\) (4 samples/min \(\times\) 60 \(\times\) 24 \(\times\) 30 days) = 25.9M
- Chi phí với $0.30/million: $7.8/month
Lưu trữ:
- Với 8 byte/điểm (đã nén): 25.9M \(\times\) 8 byte = 0.2 GB
- Chi phí với $1/GB: $0.21/month
Tính toán truy vấn:
- Truy vấn mỗi tháng: 2 bảng điều khiển \(\times\) 3 người dùng \(\times\) (12 queries/hour \(\times\) 8 hours/day \(\times\) 22 days) = 12,672 queries/month
- Chi phí với $0.02/query: $253.4/month
Tổng cộng: ~$261.4/month cho một nút ML duy nhất. Không bao gồm đánh giá cảnh báo và chi phí nền tảng.
Góc nhìn hệ thống: Với các giả định này, chi phí tăng tuyến tính theo số nút giống hệt nhau; ở quy mô nền tảng, tối ưu hóa chi phí truy vấn ngày càng quan trọng.
Chiến lược tối ưu hóa chi phí
Chi phí lớn nhất trong hạ tầng giám sát thường đến từ cardinality của các chỉ số: các nhãn có cardinality cao như user_id hoặc request_id gây ra “bùng nổ” tổ hợp về nhu cầu lưu trữ, đến mức áp đảo chi phí tính toán. Xử lý cardinality bằng cách lấy mẫu hoặc tổng hợp dữ liệu cho các chiều có cardinality cao thường mang lại khoản tiết kiệm tức thì và đáng kể nhất. Yếu tố chi phí lớn thứ hai là độ phân giải theo thời gian: hiếm khi cần lưu tất cả chỉ số ở mức 15 giây trong 30 ngày, nhưng đây lại là mặc định ở nhiều hệ thống giám sát. Một chính sách lưu trữ theo tầng (độ phân giải cao cho các sự cố gần đây, còn dữ liệu đã được giảm mẫu cho lịch sử dài hơn) giúp giữ được độ chi tiết khi gỡ lỗi, đồng thời giảm chi phí lưu trữ. Chi phí truy vấn dashboard tích lũy một cách khó nhận ra: mỗi lần refresh (làm mới) sẽ kích hoạt truy vấn vào hệ thống backend quản lý chỉ số, và các khoảng refresh tự động mặc định trên hàng chục dashboard và người dùng tạo ra tải truy vấn liên tục ngay cả khi không ai đang xem. Đặt khoảng refresh chậm hơn cho các dashboard không quan trọng và tự động tạm dừng các tab không hoạt động có thể giảm chi phí truy vấn. Cuối cùng, cấu hình cảnh báo ảnh hưởng đến cả chi phí tính toán lẫn hiệu quả vận hành: gộp các cảnh báo liên quan vào các quy tắc đa điều kiện giúp giảm chi phí đánh giá đồng thời giảm “mệt mỏi do cảnh báo” (alert fatigue), qua đó gắn tối ưu chi phí với chất lượng vận hành.
Framework lợi ích-chi phí
Hãy biện minh cho các khoản đầu tư vào giám sát so với chi phí sự cố bằng cách sử dụng tỷ lệ lợi ích-chi phí giám sát trong equation 15: \[\text{Monitoring Benefit/Cost} = \frac{\text{Incidents Prevented} \times \text{Avg Incident Cost}}{\text{Annual Monitoring Cost}} \tag{15}\]
Nếu chi phí sự cố trung bình là $50,000 (bao gồm thời gian ngừng hoạt động + thời gian của kỹ sư + tổn hại danh tiếng) và giám sát giúp ngăn chặn 5 sự cố mỗi năm, với chi phí giám sát hằng năm là $50,000:
\[ \text{Benefit/Cost} = \frac{5 \times \$50,000}{\$50,000} = 5× \]
framework này giúp chúng ta biện minh cho các khoản đầu tư vào giám sát và ưu tiên chỉ số nào cần theo dõi chi tiết so với chỉ lấy mẫu thưa. Bản thân các hệ thống giám sát cần có kế hoạch tăng khả năng chống chịu để tránh các điểm mù trong vận hành. Khi hạ tầng giám sát chính gặp sự cố (ví dụ: Prometheus ngừng hoạt động hoặc Grafana không khả dụng), các nhóm có nguy cơ phải vận hành trong tình trạng mù thông tin ở những giai đoạn quan trọng. Vì vậy, các triển khai MLOps đạt chuẩn sản xuất duy trì các đường giám sát dự phòng: bộ thu thập chỉ số phụ tự động kích hoạt khi hệ thống chính hỏng, ghi log cục bộ vẫn được duy trì khi các hệ thống tập trung gặp lỗi, và kiểm tra heartbeat để phát hiện khi hệ thống giám sát bị ngừng.
Một số tổ chức triển khai giám sát chéo, tức là dùng một hạ tầng riêng để giám sát chính các hệ thống giám sát. Điều này đảm bảo rằng khi quá trình quan sát gặp lỗi, cảnh báo sẽ được gửi ngay qua các kênh thay thế như PagerDuty hoặc thông báo trực tiếp. Cách tiếp cận phòng thủ nhiều lớp này giúp ngăn chặn kịch bản thảm họa khi cả mô hình và hệ thống giám sát đồng thời gặp sự cố mà không ai phát hiện. Một circuit breaker27 bổ sung thêm một lớp bảo vệ, tự động chuyển hướng lưu lượng khỏi dịch vụ đang lỗi khi tỷ lệ lỗi vượt quá ngưỡng đặt trước. Việc phối hợp các lớp bảo vệ này trên nhiều dịch vụ được nhân rộng, cùng với cảnh báo dựa trên đồng thuận và tổng hợp chỉ số xuyên vùng, là mối quan tâm ở quy mô toàn đội dịch vụ khi một mô hình được nhân rộng đa vùng, vượt ra ngoài phạm vi một nút đơn như trường hợp chúng ta đang xét ở đây.
27 Circuit breaker pattern: Cơ chế phát hiện lỗi tự động sẽ “ngắt mạch” (mở) khi tỷ lệ lỗi vượt ngưỡng cấu hình, từ đó chuyển hướng lưu lượng khỏi các dịch vụ đang gặp sự cố. Trong các hệ thống ML, mẫu thiết kế này cần một điều chỉnh quan trọng: sự suy giảm độ chính xác dự đoán đòi hỏi các ngưỡng khác so với lỗi về tính sẵn sàng của dịch vụ, vì một mô hình đưa ra dự đoán có vẻ hợp lý nhưng sai sẽ không phát ra tín hiệu lỗi, khiến circuit breaker mù trước chế độ lỗi nguy hiểm nhất này.
Ứng phó sự cố và thực hành vận hành
Giám sát và phát hiện trôi dạt giúp nhận diện vấn đề; các thực hành trong phần này giúp giải quyết chúng và duy trì sức khỏe vận hành theo thời gian. Phản ứng sự cố, gỡ lỗi và lịch trực tạo thành khía cạnh con người của giao diện giám sát sản xuất, bảo đảm các tín hiệu thống kê được chuyển thành hành động kỹ thuật kịp thời.
Phản ứng sự cố cho các hệ thống ML
Vào 2 giờ sáng, một kỹ sư trực nhận được cảnh báo: tỷ lệ nhấp (click-through rate) của các đề xuất đã giảm 12% trong giờ qua. Không có stack trace, không có nhật ký lỗi, không có tiến trình nào bị dừng đột ngột, chỉ có một tín hiệu thống kê cho thấy có điều gì đó đã thay đổi. Người xử lý sự cố phải phân biệt giữa bốn nguyên nhân gốc có thể xảy ra: lỗi ở pipeline dữ liệu đầu vào, trôi dạt mô hình, lưu lượng truy cập theo mùa, hoặc nhiễu thống kê. Tình trạng mơ hồ này thường gặp trong các sự cố ML: các triệu chứng có thể xuất hiện dưới dạng suy giảm về kết quả hoặc các chỉ số chất lượng dự đoán, thay vì lỗi rõ ràng, nên phản ứng sự cố cần tính đến bất định thống kê.
Việc phân loại mức độ nghiêm trọng là cơ sở để ưu tiên xử lý trong bối cảnh mơ hồ này. Table 22 xác định bốn mức độ ưu tiên, kèm theo thời gian phản hồi tương ứng, từ P0 (gián đoạn hoàn toàn) yêu cầu phản hồi trong 15 phút, cho đến P3 (các bất thường nhỏ) cho phép điều tra trong 24 giờ.
Sau khi mức độ nghiêm trọng được xác định, quy trình phản ứng sự cố sẽ tuân theo một checklist có cấu trúc, với các bước được sắp xếp để thu hẹp dần phạm vi tìm kiếm ở mỗi giai đoạn:
- Bước phát hiện xác định tín hiệu giám sát nào đã kích hoạt cảnh báo.
- Đánh giá tác động định lượng tỷ lệ phần trăm lưu lượng truy cập bị ảnh hưởng.
- Người xử lý sự cố xem xét các thay đổi gần đây để xác định liệu có mô hình, đặc trưng hay pipeline dữ liệu nào mới được triển khai hay không.
- Các lựa chọn giảm thiểu được đánh giá, bao gồm quay lại phiên bản trước (rollback), kích hoạt cơ chế dự phòng (fallback), hoặc giảm lưu lượng truy cập.
- Phân tích nguyên nhân gốc xác định xem vấn đề bắt nguồn từ mô hình, dữ liệu hay cơ sở hạ tầng.
| Mức độ | Tiêu chí | Thời gian phản hồi | Ví dụ |
|---|---|---|---|
| P0 | Lỗi mô hình hoàn toàn, lỗi phục vụ (serving) | 15 phút | Mô hình trả về dự đoán rỗng |
| P1 | Suy giảm độ chính xác đáng kể (>10%) | 1 giờ | CTR đề xuất giảm 15% |
| P2 | Độ lệch vừa phải, tác động cục bộ | 4 giờ | Một đặc trưng cho thấy PSI > 0.3 |
| P3 | Bất thường nhỏ, không ảnh hưởng đến người dùng | 24 giờ | Độ trễ pipeline huấn luyện |
Đối với các sự cố P0 và P1, tài liệu hậu sự cố (postmortem) là bắt buộc. Các tài liệu này phải bao gồm dòng thời gian, nguyên nhân gốc rễ, tác động đến người dùng và các biện pháp phòng ngừa. Các yếu tố đặc thù của ML gồm xác định lỗ hổng giám sát nào đã khiến vấn đề lọt vào môi trường sản xuất, và những bước kiểm tra xác thực nào đáng lẽ đã phát hiện sớm hơn.
Gỡ lỗi mô hình: Từ phát hiện đến chẩn đoán
Quy trình xử lý sự cố sẽ phân loại và giảm nhẹ tác động; còn gỡ lỗi mô hình giúp xác định nguyên nhân gốc rễ. Việc giám sát phát hiện ra vấn đề, còn gỡ lỗi sẽ tìm hiểu tại sao. Gỡ lỗi ML cần xét đến các lỗi mang tính xác suất và phụ thuộc vào dữ liệu, bên cạnh các lỗi phần mềm thông thường. Một dự đoán không chính xác sẽ không gây ra ngoại lệ hay tạo ra stack trace, vì vậy gỡ lỗi có hệ thống là rất cần thiết để xử lý sự cố ML một cách hiệu quả.
Cây quyết định gỡ lỗi
Khi hiệu suất mô hình suy giảm, hãy lần lượt trả lời các câu hỏi chẩn đoán theo thứ tự. Khắc phục sự cố sản xuất cung cấp một ma trận chẩn đoán có hệ thống, ánh xạ các triệu chứng lên các trục D·A·M (Dữ liệu · Thuật toán · Máy).

Gỡ lỗi trong môi trường sản xuất bắt đầu từ trục dữ liệu của D·A·M.
- Vấn đề có phải do dữ liệu không? Hãy kiểm tra xem có lỗi ở các pipeline dữ liệu thượng nguồn, thay đổi schema, giá trị bị thiếu hay sự dịch chuyển phân phối nào không. Dữ liệu thường là nơi cần kiểm tra đầu tiên, vì nhiều lỗi ML trong môi trường sản xuất bắt nguồn từ thay đổi trong đầu vào, nhãn hoặc các pipeline đặc trưng.
- Có phải là độ lệch huấn luyện-phục vụ (training-serving skew) không? Hãy so sánh các giá trị đặc trưng hoặc kết quả tiền xử lý của các ví dụ tương ứng giữa giai đoạn huấn luyện và phục vụ (serving). Các phương pháp như KS hoặc PSI có thể giúp sàng lọc chênh lệch phân phối, nhưng không thể xác định nguyên nhân của nó.
- Vấn đề có nằm ở một nhóm cụ thể không? Hãy phân tích hiệu suất bằng cách chia nhỏ theo các chiều chính (ví dụ: địa lý, loại thiết bị, phân khúc người dùng). Nếu suy giảm chỉ xảy ra ở một lát cắt cụ thể, điều đó gợi ý vấn đề về độ phủ dữ liệu hoặc nhãn.
- Vấn đề có liên quan đến yếu tố thời gian không? Hãy vẽ biểu đồ hiệu suất theo thời gian. Nếu có sụt giảm đột ngột, ưu tiên kiểm tra các lần triển khai gần đây và lỗi dữ liệu; suy giảm dần dần có thể phù hợp với drift, nhưng chỉ dựa vào thời điểm thì chưa đủ để xác định nguyên nhân.
- Vấn đề có phải do mô hình không? Sau khi đã loại trừ các nguyên nhân từ dữ liệu và pipeline, hãy xem xét hành vi của mô hình thông qua phân tích dự đoán và xác định mức độ đóng góp của đặc trưng (feature attribution).
Phân tích lát cắt
Trình tự này khiến phân tích lát cắt trở thành bước đào sâu đầu tiên khi phát hiện suy giảm hiệu suất toàn cục, vì nó kiểm tra liệu vấn đề tưởng như trên toàn hệ thống có thực ra tập trung trong một nhóm con hay không. Các chỉ số hiệu suất gộp cho toàn bộ lưu lượng có thể che mờ những vấn đề nghiêm trọng trong các nhóm con: Phân tích lát cắt sẽ lật mở lớp che này, và table 23 minh họa cách độ chính xác tổng thể có thể che giấu suy giảm nghiêm trọng ở các phân khúc cụ thể.
| Phân khúc người dùng | Lưu lượng truy cập % | Độ chính xác | Tác động |
|---|---|---|---|
| Người dùng máy tính để bàn | 45% | 94% | Bình thường |
| Di động (iOS) | 30% | 92% | Bình thường |
| Di động (Android) | 20% | 88% | Suy giảm nhỏ |
| Người dùng máy tính bảng | 5% | 62% | Nghiêm trọng—cần điều tra |
| Tổng thể | 100% | 91% | Che giấu vấn đề máy tính bảng |
Xác định đóng góp của đặc trưng để gỡ lỗi
Khi phân tích lát cắt chỉ ra một phân khúc có vấn đề, các kỹ thuật xác định đóng góp của đặc trưng giúp nhận diện những đặc trưng mà mô hình dựa vào trong các dự đoán sai. Listing 6 minh họa một quy trình dùng giá trị SHAP — các điểm số ước lượng mức đóng góp của từng đặc trưng đầu vào vào một dự đoán cụ thể — để phân tích các dự đoán sai trong một lát cắt nhất định.
# SHAP-based debugging workflow
import shap

# Select mispredicted examples from problematic slice
errors = predictions[
    (predictions.actual != predictions.predicted)
    & (predictions.device_type == "tablet")
]

# Compute SHAP values for error cases
explainer = shap.Explainer(model)
shap_values = explainer(errors[feature_columns])

# Plot feature attributions for the selected errors
shap.summary_plot(shap_values, errors[feature_columns])
Biểu đồ đóng góp đặc trưng cho biết mô hình đã dựa vào những đặc trưng nào trong lát cắt lỗi; nó không khẳng định các đặc trưng đó là nguyên nhân gây lỗi. Để chẩn đoán đặc trưng lỗi thời (stale features), thiếu độ phủ (missing coverage) hoặc dịch chuyển ngữ nghĩa (semantic shift), cần kiểm tra nguồn gốc đặc trưng (feature lineage) và phân phối của chúng trong môi trường sản xuất.
Systems Perspective 1.3: Đặc trưng zombie
Các mô hình sản xuất chạy dài hạn thường tích lũy những đặc trưng mà chủ sở hữu ban đầu, ý nghĩa hay mục đích sử dụng của chúng đã bị quên lãng. Một đặc trưng có thể bị loại bỏ trong mã ứng dụng nhưng vẫn đi qua kho đặc trưng (feature store), tập dữ liệu huấn luyện hoặc hợp đồng giao diện đầu vào của mô hình đã được tuần tự hóa. Mô hình có thể học cách bỏ qua đặc trưng đó, chia tín hiệu cho một bản sao trùng lặp, hoặc phụ thuộc vào một thành phần tiền xử lý mà không còn ai quản lý. Vì vậy, việc loại bỏ đặc trưng như vậy không còn là dọn dẹp cục bộ: nó trở thành một thay đổi về khả năng tương thích, có thể ảnh hưởng đến huấn luyện lại, phục vụ (serving), giám sát và các phân tích tiếp theo.
Các đặc trưng trong hệ thống ML không tự biến mất chỉ vì những người phụ trách mã không còn nghĩ về chúng. Lượng dữ liệu đặc trưng không dùng đến (\(D_{\text{vol}}\)) làm tăng chi phí tuần tự hóa và tiêu tốn băng thông bộ nhớ (\(\text{BW}\)) mà không cải thiện độ chính xác. Nếu không có chính sách loại bỏ rõ ràng và quản trị kho đặc trưng, các mô hình sẽ tích tụ “mã chết”, làm giảm tỷ lệ \(D_{\text{vol}}/\text{BW}\) và khiến việc gỡ lỗi trở nên phức tạp hơn (Sculley et al. 2015).
Các đặc trưng zombie cho thấy việc phân bổ đóng góp có thể chỉ ra những gì mô hình không nên còn phụ thuộc vào. Với các dự đoán sai ở từng trường hợp, phân tích phản thực tế bổ sung một góc nhìn bổ trợ: thay đổi nhỏ nhất có thể đảo ngược một quyết định đơn lẻ.
Phân tích phản thực tế
Đối với những dự đoán sai của từng trường hợp cụ thể, phân tích phản thực tế xác định thay đổi nhỏ nhất có thể đảo ngược dự đoán: nếu session_duration là 45 giây thay vì 12 giây, mô hình sẽ dự đoán “engaged” thay vì “churned.” Điều này cho thấy ranh giới của đặc trưng nào đang chi phối quyết định và liệu những ranh giới đó có hợp lý về mặt ngữ nghĩa hay không. Các phản thực tế đòi hỏi những thay đổi phi lý (“tuổi người dùng cần phải là -5 tuổi”) thường báo hiệu vấn đề trong kỹ thuật đặc trưng.
Những kỹ thuật này (cây quyết định, phân tích lát cắt, phân bổ đóng góp của đặc trưng và phản thực tế) tạo thành một bộ công cụ gỡ lỗi. Để áp dụng chúng nhất quán, các nhóm cần chuẩn hóa quy trình.
Danh sách kiểm tra gỡ lỗi
Quá trình gỡ lỗi có hệ thống tuân theo danh sách kiểm tra sáu giai đoạn: tái tạo, cô lập, chia đôi, quy nguyên nhân, xác thực và phòng ngừa. Thứ tự này được sắp xếp có chủ đích vì mỗi giai đoạn thu hẹp không gian tìm kiếm cho giai đoạn tiếp theo. Tái tạo đứng đầu, vì một lỗi ML không thể tái tạo trên dữ liệu giữ lại thường phụ thuộc vào dữ liệu, một nhận định hướng việc điều tra về lớp dữ liệu trong phân loại D·A·M. Khi đã tái tạo được, bước cô lập xác định tập đầu vào nhỏ nhất kích hoạt lỗi, biến một lời phàn nàn mơ hồ kiểu “mô hình sai” thành một điều kiện cụ thể, có thể kiểm tra.
Kỹ thuật chia đôi (bisection) sau đó tận dụng lịch sử phiên bản: nếu lỗi trùng với một lần triển khai gần đây, việc so sánh các phiên bản mô hình sẽ chỉ ra chính xác thay đổi nào đã đưa lỗi hồi quy vào. Phân bổ đặc trưng (feature attribution) áp dụng các kỹ thuật diễn giải để xác định những yếu tố đầu vào nào dẫn đến hành vi sai lệch. Việc xác thực khép kín vòng lặp nhân quả bằng cách xác nhận rằng khi nguyên nhân gốc rễ được giả định được khắc phục thì lỗi thực sự biến mất, từ đó phân biệt rõ giữa bản sửa lỗi thực sự và những cải tiến chỉ tình cờ.
Giai đoạn cuối cùng, phòng ngừa, chuyển mỗi sự cố đã được giải quyết thành một quy tắc giám sát hoặc một bước kiểm tra xác thực, qua đó thu hẹp có hệ thống khoảng cách giữa phát hiện và tái diễn. Việc củng cố dần dần này có thể làm giảm các kiểu lỗi lặp lại theo thời gian vì mỗi sự cố được xử lý đều giúp tăng cường hạ tầng quan sát.
Gỡ lỗi hệ thống ML đòi hỏi cả phương pháp có hệ thống lẫn chuyên môn lĩnh vực. Những ca gỡ lỗi hiệu quả nhất thường đến từ các kỹ sư hiểu rõ cả kiến trúc mô hình và bối cảnh kinh doanh của các dự đoán.
Thực hành trực ban cho hệ thống ML
Các kỹ thuật gỡ lỗi trong section 1.5.4.2 phát huy hiệu quả khi kỹ sư chủ động điều tra sự cố trong giờ làm việc. Nhưng hệ thống sản xuất thường “đổ bệnh” lúc 3 giờ sáng cuối tuần, và người trực ban khi phản hồi có thể không phải là người đã xây dựng mô hình. Gỡ lỗi xử lý từng sự cố; còn thực hành trực ban duy trì sức khỏe vận hành theo thời gian bằng cách bảo đảm luôn có người có chuyên môn phù hợp sẵn sàng và đủ công cụ để ứng phó. Luân phiên trực ban cho hệ thống ML cần các thực hành chuyên biệt hơn so với vận hành phần mềm truyền thống, vì sự cố ML thường biểu hiện thành suy giảm dần dần, không phải là những lỗi hỏng hẳn (hard failure) rõ ràng. Một kỹ sư phần mềm truyền thống khi nhận cảnh báo thường có thể lần theo stack trace để tìm nguyên nhân gốc trong vài phút. Ngược lại, một kỹ sư ML khi thấy độ chính xác giảm 3% phải xác định xem đó là nhiễu thống kê, trôi khái niệm hợp lệ, hay một lỗi nghiêm trọng cần rollback ngay. Phân biệt được điều này đòi hỏi ngữ cảnh thống kê chứ không chỉ phân tích nhật ký.
Sự mơ hồ này càng nặng vì tác động xuất hiện trễ. Không như các đợt tăng đột biến độ trễ hiện ngay trên bảng điều khiển, sự suy giảm của mô hình ML có thể mất hàng giờ hoặc vài ngày mới phản ánh vào chỉ số kinh doanh. Một mô hình đề xuất bắt đầu phục vụ (serving) gợi ý kém đi một chút từ thứ Hai có thể đến tận thứ Sáu mới thấy tác động doanh thu có thể đo được, lúc đó cửa sổ chẩn đoán dễ dàng đã khép lại. Phụ thuộc chéo hệ thống còn làm ứng phó phức tạp hơn: vấn đề ML thường bắt nguồn từ các hệ thống dữ liệu ngược dòng (upstream) do các nhóm khác quản lý, nên phải phối hợp xuyên ranh giới tổ chức khi xử lý sự cố. Thách thức sâu nhất là ứng phó hiệu quả đòi hỏi hiểu hành vi mô hình, không chỉ tình trạng hạ tầng. Quản trị viên cơ sở dữ liệu có thể khởi động lại một dịch vụ bị sập mà không cần hiểu logic nghiệp vụ của nó, nhưng kỹ sư ML không thể gỡ lỗi suy giảm độ chính xác một cách có ý nghĩa nếu không hiểu các phụ thuộc đặc trưng và các mẫu hành vi kỳ vọng của mô hình.
Những thách thức này dẫn tới nhu cầu về cấu trúc leo thang phân cấp để ghép đúng mức chuyên môn với độ phức tạp của sự cố. Table 24 minh họa một cấu trúc khả thi: người trực ban cấp đầu xử lý các vấn đề thường nhật bằng sổ tay vận hành tiêu chuẩn, còn các luồng leo thang nối tới chuyên gia có thể điều tra sâu hơn. Một vai trò trực ban dữ liệu song song giúp rút ngắn thời gian khắc phục khi nguyên nhân gốc nằm ở hệ thống dữ liệu phía trước (upstream).
| Cấp độ | Người phản hồi | Trách nhiệm |
|---|---|---|
| Cấp độ 1 (Chính) | Kỹ sư ML | Phân loại ban đầu, runbook tiêu chuẩn, quyết định leo thang |
| Cấp độ 2 (Leo thang) | Kỹ sư ML cấp cao/Nhà khoa học dữ liệu | Gỡ lỗi phức tạp, điều tra liên hệ thống, các vấn đề cụ thể của mô hình |
| Cấp độ 3 (Nghiêm trọng) | Trưởng nhóm nền tảng ML | Quyết định kiến trúc, sự cố lớn, leo thang nhà cung cấp |
| Trực dữ liệu (Song song) | Kỹ sư dữ liệu | Các vấn đề về data pipeline, các vấn đề về feature store, các phụ thuộc upstream |
Hiệu quả trực ban phụ thuộc lớn vào chất lượng sổ tay vận hành. Mọi mô hình ML chạy sản xuất cần có tài liệu nêu rõ mục đích, chủ sở hữu, mức độ quan trọng với kinh doanh, cùng các tham số vận hành bình thường: độ trễ, thông lượng và khoảng độ chính xác kỳ vọng để xác định trạng thái khỏe mạnh. Các sự cố trước đây và cách khắc phục của chúng cung cấp khuôn mẫu cho những lỗi phổ biến, còn các lệnh chẩn đoán giúp đánh giá nhanh tình trạng: cách kiểm tra các dự đoán gần đây, phân phối đặc trưng và điểm tin cậy của mô hình. Quan trọng là sổ tay phải chỉ rõ tiêu chí leo thang (khi nào cần gọi Cấp 2 và khi nào có thể rollback mà không cần phê duyệt) và quy trình rollback với hướng dẫn từng bước cùng thời gian phục hồi dự kiến. Viết sẵn sổ tay trong lúc mọi thứ bình ổn sẽ tiết kiệm những phút quý giá khi sự cố xảy ra lúc 3:00 sáng.
Ngay cả hệ thống giám sát được thiết kế tốt cũng có thể tạo ra quá nhiều cảnh báo, làm giảm hiệu quả trực ban. Hội chứng mệt mỏi vì cảnh báo — xu hướng bỏ qua hoặc phớt lờ cảnh báo sau khi gặp quá nhiều báo động nhầm — là một rủi ro vận hành đáng kể. Các đội ngũ đối phó bằng cách gộp các cảnh báo liên quan: khi nhiều đặc trưng cùng trôi lệch đồng thời, chỉ phát một thông báo thay vì hàng chục. Các ngưỡng cảnh báo thích ứng, có tính đến các mẫu biến động theo tuần và theo mùa, sẽ ngăn những dao động có thể dự đoán kích hoạt cảnh báo không cần thiết. Những cảnh báo hiếm khi có hành động xử lý nên được loại bỏ hoặc hiệu chỉnh lại. Khi cần tạm thời tắt cảnh báo, các cơ chế bảo đảm trách nhiệm (ví dụ: yêu cầu tạo một phiếu theo dõi trước khi tạm dừng) giúp ngăn cảnh báo bị bỏ qua vĩnh viễn.
Việc bàn giao ca là một thực hành quan trọng khác, phản ánh mức độ trưởng thành của vận hành. Các kỹ sư trực ban nhận ca cần nắm rõ bối cảnh về các sự cố đang diễn ra và trạng thái hiện tại của chúng, các đợt triển khai gần đây có thể gây ra vấn đề về sau, các thay đổi theo lịch trình sắp tới như di chuyển dữ liệu hoặc cập nhật mô hình, và bất kỳ cảnh báo nào đã bị tạm dừng cùng với lý do. Nếu không có quy trình bàn giao rõ ràng, thông tin sẽ bị thất lạc giữa các ca, khiến kỹ sư nhận ca phải tốn thời gian tìm lại những gì đồng nghiệp trước đã thu thập.
Để việc trực ban bền vững, cũng phải giải quyết nguy cơ kiệt sức. Trực ban ML đặc biệt căng thẳng vì sự mơ hồ của sự cố: không chắc một cảnh báo có thật sự là vấn đề hay không khiến người trực phải luôn cảnh giác. Tổ chức giảm kiệt sức bằng cách giới hạn số ngày trực ban liên tiếp, cho nghỉ bù sau các sự cố nghiêm trọng, đánh giá định kỳ lịch luân phiên để cân bằng tải giữa các thành viên, và đầu tư tự động hóa để giảm việc lặp lại tốn sức. Mục tiêu là duy trì ca trực ban bền vững qua nhiều năm vận hành, chứ không phải bố trí nhân sự trực một cách đối phó.
Chỉ riêng khả năng giám sát kỹ thuật thôi thì chưa đủ để đảm bảo vận hành thành công. Ngay cả những bảng điều khiển tinh vi nhất cũng sẽ vô dụng nếu không có ai chịu trách nhiệm xử lý cảnh báo, và các tài liệu hướng dẫn vận hành chi tiết đến mấy cũng sẽ bị bỏ quên nếu cấu trúc nhóm không hỗ trợ việc sử dụng. Để vận hành ML trong môi trường sản xuất, chúng ta cần một hạ tầng tổ chức song song với hạ tầng kỹ thuật, gồm quản trị rõ ràng, vai trò được phân định, và các hình thức giao tiếp giúp phối hợp đa chức năng.
Quản trị và phối hợp nhóm
Việc trực ban giúp xử lý các trường hợp khẩn cấp trong vận hành. Tuy nhiên, ML trong môi trường sản xuất còn cần có sự quản trị chủ động và sự phối hợp đa chức năng. Quản trị bao gồm các chính sách và quy trình để đảm bảo các mô hình ML hoạt động minh bạch, công bằng, và tuân thủ các tiêu chuẩn đạo đức cũng như quy định. Nếu không có quản trị, các mô hình đã triển khai có thể đưa ra các quyết định có độ chệch (bias) hoặc không rõ ràng, gây ra rủi ro về pháp lý, danh tiếng và xã hội. Quản trị tập trung vào ba mục tiêu chính: minh bạch (các mô hình dễ giải thích, có thể kiểm toán), công bằng (đối xử công bằng giữa các nhóm người dùng), và tuân thủ (phù hợp với các chính sách pháp lý và tổ chức). Các phương pháp giải thích, các chỉ số công bằng và kỹ thuật phát hiện độ chệch (bias) cụ thể để hiện thực hóa các mục tiêu này sẽ được xem xét trong Kỹ thuật có trách nhiệm; MLOps cung cấp hạ tầng để thực hiện các kiểm tra này liên tục trong suốt vòng đời triển khai.
Tương tự như tuân thủ phần mềm truyền thống, quản trị ML phải bao trùm các giai đoạn phát triển, triển khai và vận hành. Trong quá trình phát triển, các nhóm phải ghi lại các giả định của mô hình và nguồn gốc dữ liệu huấn luyện. Khi triển khai, các kiểm tra trước khi phát hành sẽ đánh giá tính công bằng và tính vững. Sau khi triển khai, các hệ thống giám sát đã nêu ở phần trước không chỉ phải theo dõi sự suy giảm hiệu suất mà còn cả hiện tượng fairness drift, tức là khi chênh lệch về hiệu suất hoặc kết quả giữa các nhóm người dùng thay đổi. Các chính sách quản trị được mã hóa vào các pipeline tự động sẽ đảm bảo những kiểm tra này được áp dụng nhất quán, thay vì dựa vào các lần rà soát thủ công mang tính tùy hứng.
Cụ thể, một cổng thăng hạng trong model registry có thể yêu cầu: một hợp đồng đặc trưng đã ký, một mã băm ghi lại nguồn gốc dữ liệu huấn luyện, các chỉ số của nhóm con vượt ngưỡng chính sách, một SLO canary kèm tiêu chí rollback, và một chủ sở hữu artifact được nêu rõ. Chỉ khi đáp ứng đủ các điều kiện này, mô hình mới được chuyển từ môi trường thử nghiệm (staging) sang môi trường sản xuất (production). Cổng này biến việc quản trị từ một cuộc họp thành một bất biến của bản phát hành, được thực thi bởi chính hệ thống CI/CD dùng để triển khai mô hình.
Quản trị đặt ra các chính sách, nhưng chính sự hợp tác liên chức năng mới triển khai được chúng. Các hệ thống machine learning được phát triển và duy trì bởi các nhóm đa ngành, và ranh giới giữa các vai trò chính là những điểm dễ phát sinh lỗi nhất trong toàn bộ vòng đời. Việc theo dõi thí nghiệm chung, các kho lưu trữ mô hình và tài liệu chuẩn hóa tạo nên lớp kết nối giúp tái lập kết quả và bàn giao giữa các chuyên gia được thuận lợi. Quan trọng không kém là sự hiểu biết chung về ngữ nghĩa dữ liệu: các bảng thuật ngữ, tài liệu tham chiếu lược đồ và tài liệu về nguồn gốc đảm bảo mọi bên liên quan diễn giải các đặc trưng, nhãn và số liệu thống kê một cách nhất quán.
Chức danh và ranh giới công việc có thể khác nhau giữa các tổ chức, nhưng một cách phân chia phổ biến sử dụng năm vai trò trong table 25. Bảng này ánh xạ mỗi vai trò với một trách nhiệm chính, nhưng không ngụ ý rằng mọi tổ chức đều cần đủ năm vị trí riêng biệt:
| Vai trò | Trọng tâm chính | Kết quả chính | Điểm hợp tác |
|---|---|---|---|
| Nhà khoa học dữ liệu | Phát triển mô hình, thử nghiệm, lựa chọn thuật toán | Các mô hình đã huấn luyện, kết quả thử nghiệm, benchmark hiệu suất | Bàn giao cho Kỹ sư ML để đưa vào sản xuất |
| Kỹ sư ML | Hệ thống ML sản xuất, các pipeline huấn luyện, cơ sở hạ tầng phục vụ (serving) | Các mô hình đã triển khai, các pipeline huấn luyện, hệ thống phục vụ (serving) | Nhận từ Data Scientist; làm việc với Platform Engineer về cơ sở hạ tầng |
| Kỹ sư dữ liệu | Các pipeline dữ liệu, kỹ thuật đặc trưng, chất lượng dữ liệu | Các pipeline đặc trưng, hệ thống chất lượng dữ liệu, kho đặc trưng | Cung cấp dữ liệu cho Data Scientist; duy trì kho đặc trưng cho ML Engineer |
| Platform Engineer | Cơ sở hạ tầng MLOps, công cụ, tự động hóa | Các pipeline CI/CD, hệ thống giám sát, cơ sở hạ tầng tính toán | Hỗ trợ ML Engineer; duy trì cơ sở hạ tầng dùng chung |
| DevOps/SRE | Độ tin cậy, ứng phó sự cố, tình trạng hệ thống | SLOs/SLAs, quy trình trực ban, runbook | Hỗ trợ tất cả các vai trò; chịu trách nhiệm về tình trạng sản phẩm |
Việc phân định rõ vai trò quan trọng nhất tại các điểm bàn giao, nơi công việc chuyển giữa các chuyên môn. Điểm bàn giao dễ phát sinh lỗi nhất thường là giữa Data Scientists và ML Engineers: một mô hình chạy tốt trong Jupyter notebook có thể thất bại khi lên môi trường sản xuất vì các bước tiền xử lý không được ghi chép, đường dẫn tệp cố định (hardcode), hoặc phụ thuộc môi trường. Tương tự, việc bàn giao từ ML Engineers sang SREs (Beyer et al. 2016) đòi hỏi các dashboard giám sát đã được kiểm chứng, các quy tắc cảnh báo được cấu hình sẵn, runbook có tài liệu và các quy trình rollback đã được thử nghiệm. Data Engineers bàn giao cho nhóm ML rộng hơn thông qua các hợp đồng đặc trưng — tức là các đặc tả chính thức về schema, SLO về độ tươi và các cam kết chất lượng — giúp ngăn những thay đổi pipeline âm thầm bộc lộ thành suy giảm mô hình khó giải thích vài tuần sau đó. Các tổ chức giảm thiểu rủi ro bàn giao bằng các giao diện mô hình tiêu chuẩn, tài liệu bắt buộc và yêu cầu về khả năng tái lập, tất cả đều phải được xác minh trước mỗi lần chuyển giao.
Beyer, Betsy, Chris Jones, Jennifer Petoff, and Niall Richard Murphy. 2016. Site Reliability Engineering: How Google Runs Production Systems. O’Reilly Media.
Giao tiếp với các bên liên quan
MLOps hiệu quả không chỉ là phối hợp trong nội bộ nhóm mà còn phải xử lý các thách thức giao tiếp rộng hơn khi các đội kỹ thuật làm việc với các bên liên quan kinh doanh. Hợp tác liên chức năng giải quyết việc điều phối trong các đội kỹ thuật; giao tiếp với các bên liên quan bắc cầu giữa miền kỹ thuật và kinh doanh. MLOps hiệu quả nối hai miền này bằng cách diễn dịch thực tế của machine learning thành những điều khoản mà các bên liên quan có thể hành động. Các hệ thống machine learning thêm vào tính hiệu năng mang xác suất, phụ thuộc dữ liệu và các kiểu suy giảm mà các bên liên quan thường thấy không trực quan.
Thách thức giao tiếp phổ biến nhất nảy sinh từ các yêu cầu cải tiến bị đơn giản hóa quá mức. Các nhà quản lý sản phẩm thường đề xuất “làm cho mô hình chính xác hơn” mà không hiểu các đánh đổi phía sau. Giao tiếp hiệu quả sẽ định khung lại các yêu cầu như vậy bằng cách đưa ra các lựa chọn cụ thể: cải thiện độ chính xác từ 85% lên 87% có thể đòi hỏi nhiều dữ liệu có nhãn hơn đáng kể và một mô hình chậm hơn, vi phạm ngân sách độ trễ. Việc nêu rõ các ràng buộc cụ thể sẽ biến các yêu cầu mơ hồ thành quyết định kinh doanh có cơ sở.
Để chuyển các chỉ số kỹ thuật thành tác động kinh doanh, chúng ta cần các framework nhất quán liên kết hiệu suất mô hình với kết quả vận hành. Chẳng hạn, cải thiện độ chính xác 5% có thể trông nhỏ nếu nhìn riêng lẻ. Nhưng khi đặt trong bối cảnh “giảm cảnh báo gian lận sai từ 1.000 xuống 800 sự cố gây phiền toái cho khách hàng mỗi ngày”, ta có được ngữ cảnh kinh doanh cụ thể, có thể hành động.
Figure 9 cho thấy rõ mối đánh đổi phi tuyến tính giữa lỗi và chi phí. Trong ví dụ có trọng số lớp bằng nhau này, điểm vận hành tối ưu là ngưỡng phân loại giúp tối thiểu hóa chỉ số chi phí tổng hợp cho dương tính giả (chặn nhầm người dùng hợp pháp) và âm tính giả (bỏ sót gian lận).
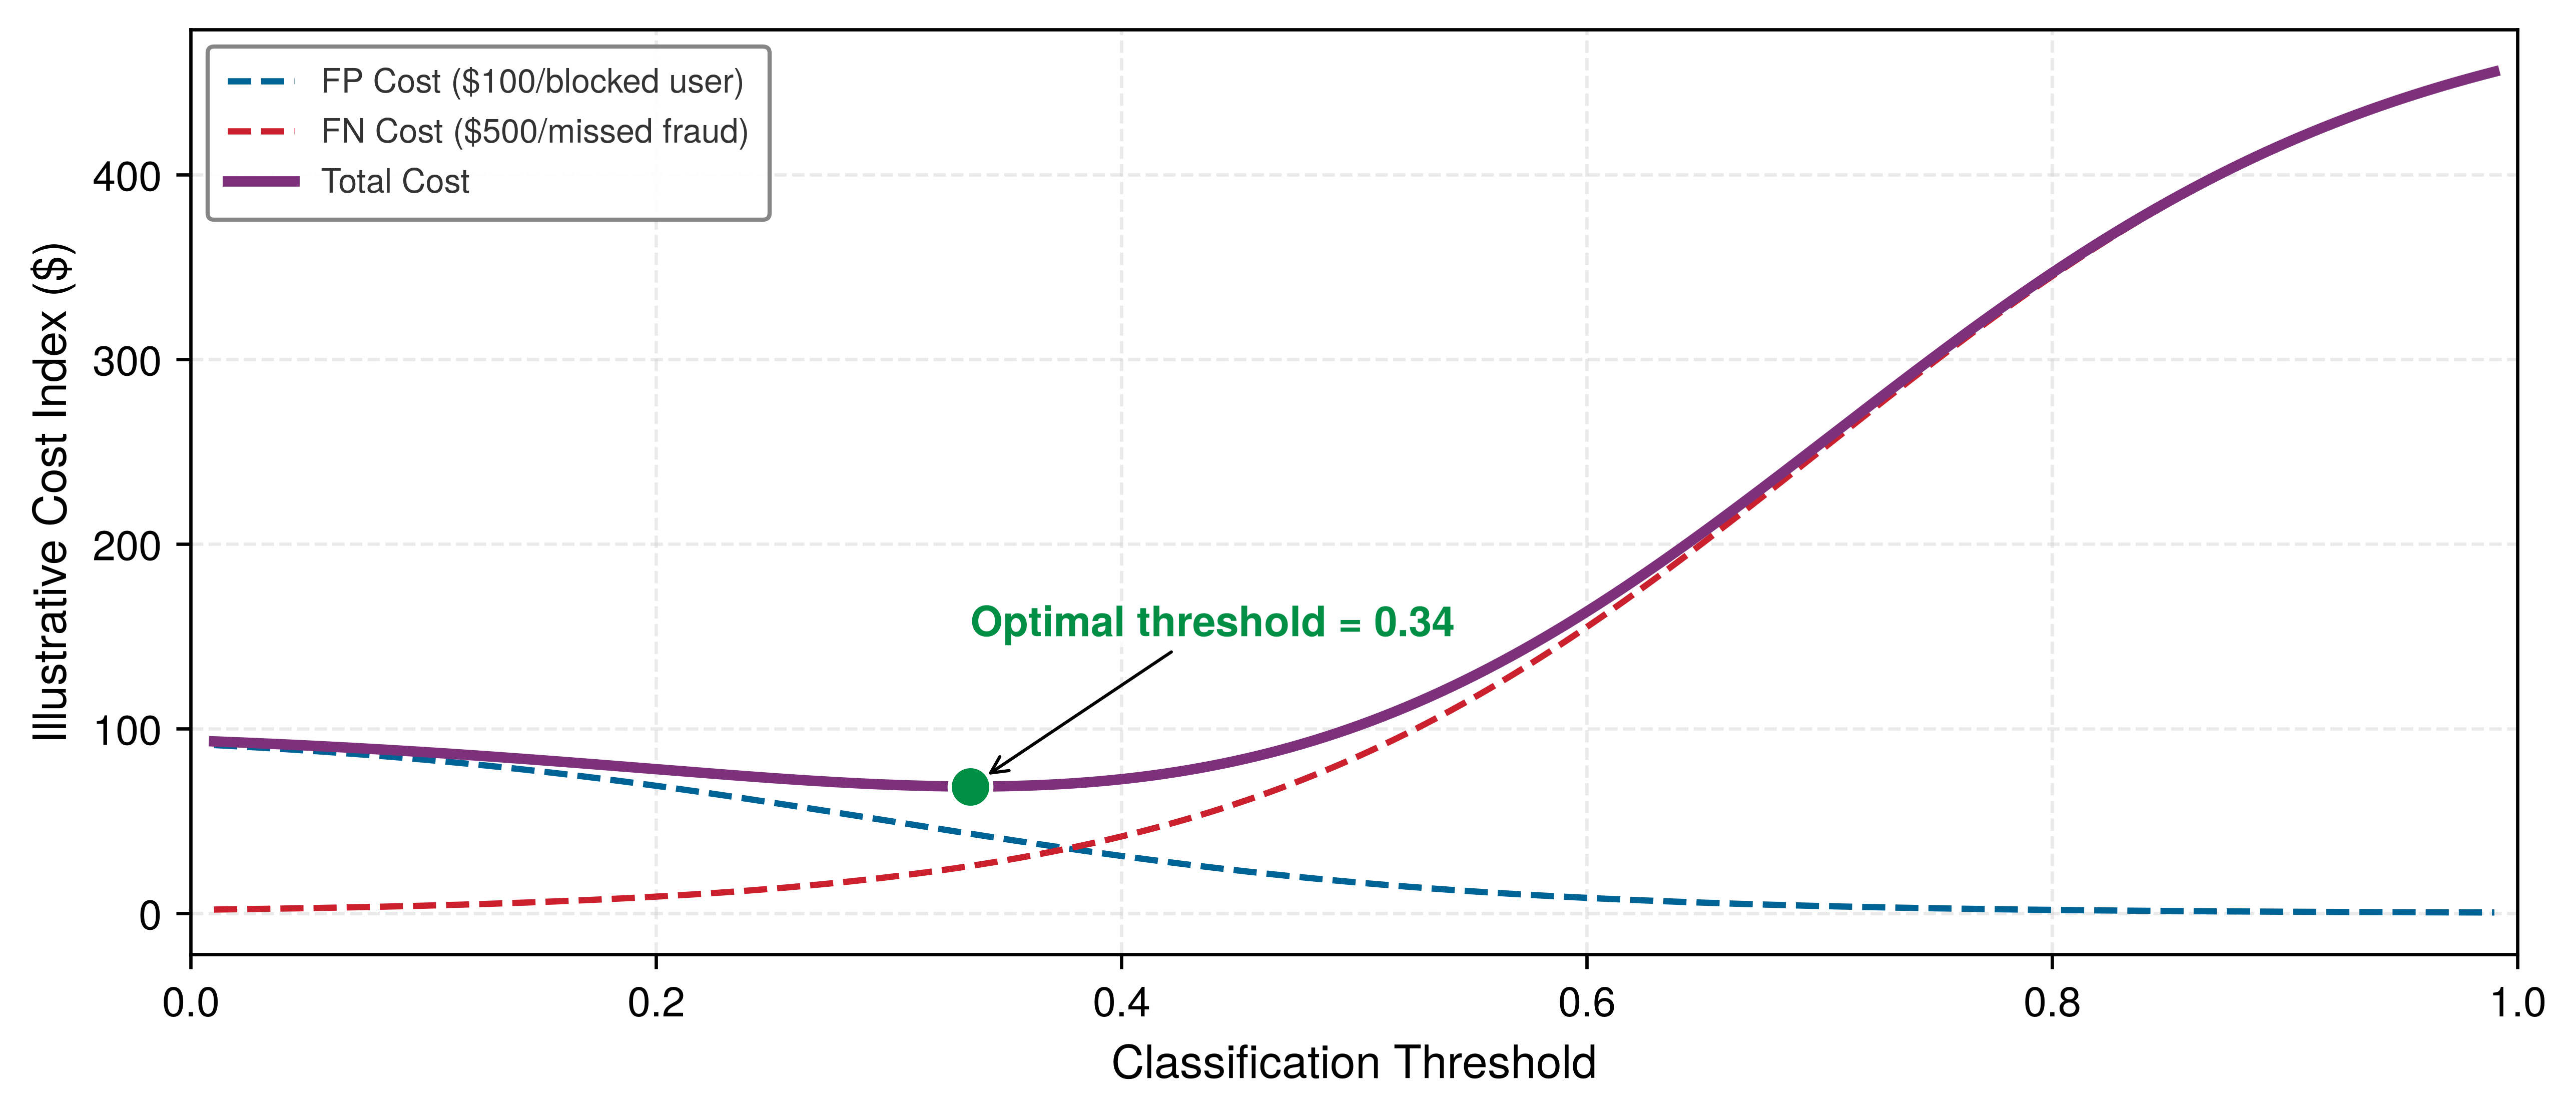
Truyền thông khi có sự cố là một thách thức quan trọng khác. Khi mô hình suy giảm hoặc cần khôi phục về phiên bản trước, các bên liên quan cần được cập nhật về bằng chứng hiện tại, nhóm người dùng bị ảnh hưởng, tác động vận hành, biện pháp giảm thiểu và mức độ bất định còn lại. Không nên vội coi một dao động là biến thiên bình thường trước khi đã kiểm tra, và drift không phải chỉ là bảo trì theo kế hoạch nếu nó đã làm xấu đi kết quả. Báo cáo hiệu suất định kỳ thiết lập đường cơ sở, giúp việc giải thích những hành vi bất thường trở nên dễ dàng hơn.
Để biện minh cho tài nguyên, cần chuyển các yêu cầu kỹ thuật thành giá trị kinh doanh. Thay vì đề nghị “tám GPU A100 để huấn luyện mô hình,” cách truyền đạt hiệu quả là gọi đó là “hạ tầng giúp rút ngắn chu kỳ thử nghiệm từ vài tuần xuống còn vài ngày, cho phép lặp nhanh các đặc trưng.” Ước tính tiến độ phải phản ánh tỷ lệ thực tế: chuẩn bị dữ liệu và tích hợp để triển khai thường chiếm phần lớn lịch trình, còn phát triển mô hình chỉ là một phần của công việc.
Xem xét một nhóm phát hiện gian lận đang triển khai cải tiến mô hình. Khi các bên liên quan yêu cầu tăng khả năng bắt gian lận, nhóm phản hồi bằng một đề xuất có cấu trúc: để tăng tỷ lệ số tiền gian lận bắt được từ 92 percent lên 94 percent, cần tích hợp thêm nguồn dữ liệu bên ngoài, kéo dài thời gian huấn luyện thêm hai tuần và chấp nhận chi phí hạ tầng cao hơn 30 percent; đổi lại, có thể ngăn chặn ước tính $2 million tổn thất gian lận hàng năm và, với một giả định riêng về giảm 20 percent, giảm 50,000 cảnh báo dương tính giả mỗi tháng.
Thông qua giao tiếp với các bên liên quan một cách kỷ luật, các chuyên gia MLOps duy trì được sự ủng hộ của tổ chức đồng thời đặt ra kỳ vọng thực tế về năng lực hệ thống. Năng lực giao tiếp này quan trọng không kém chuyên môn kỹ thuật để duy trì vận hành ML thành công.
Điểm kiểm tra ML
Để đánh giá mức độ sẵn sàng phát hành, cần có một danh mục dùng chung về các dạng nợ kỹ thuật có thể khiến mô hình không an toàn để triển khai, ngay cả khi các chỉ số ngoại tuyến của nó trông có vẻ chấp nhận được. Bảng Table 26 tổng hợp các dạng nợ đã được thảo luận xuyên suốt chương này, làm tài liệu tham chiếu cho bộ tiêu chí đánh giá trong table 27.
| Mô hình nợ | Nguyên nhân chính | Triệu chứng chính | Các chiến lược giảm thiểu |
|---|---|---|---|
| Xói mòn ranh giới | Các thành phần liên kết chặt chẽ, giao diện không rõ ràng | Các thay đổi lan truyền không thể đoán trước, vi phạm nguyên tắc CACE | Thực thi các giao diện mô-đun, thiết kế để đóng gói |
| Thác điều chỉnh | Các phụ thuộc mô hình tuần tự, các giả định kế thừa | Các bản sửa lỗi ở thượng nguồn làm hỏng hệ thống ở hạ nguồn, các bản sửa đổi leo thang | Cân nhắc cẩn thận giữa tái sử dụng và thiết kế lại, quản lý phiên bản rõ ràng |
| Người tiêu dùng không được khai báo | Chia sẻ đầu ra không chính thức, các phụ thuộc không được theo dõi | Lỗi ngầm từ các bản cập nhật mô hình, các vòng lặp phản hồi ẩn | Kiểm soát truy cập chặt chẽ, hợp đồng giao diện chính thức, giám sát việc sử dụng |
| Nợ phụ thuộc dữ liệu | Đầu vào dữ liệu không ổn định hoặc ít được sử dụng | Lỗi mô hình do thay đổi dữ liệu, các pipeline đặc trưng dễ hỏng | Quản lý phiên bản dữ liệu, theo dõi nguồn gốc, phân tích bỏ một phần tử |
| Các vòng lặp phản hồi | Đầu ra của mô hình ảnh hưởng đến dữ liệu huấn luyện trong tương lai | Hành vi tự củng cố, suy giảm hiệu suất ẩn | Giám sát dựa trên nhóm, triển khai canary, cô lập kiến trúc |
| Nợ pipeline | Quy trình làm việc tùy biến, thiếu giao diện tiêu chuẩn | Thực thi dễ hỏng, trùng lặp, gánh nặng bảo trì | Thiết kế module, công cụ điều phối workflow, thư viện dùng chung |
| Nợ cấu hình | Cài đặt phân mảnh, quản lý phiên bản kém | Kết quả không thể tái tạo, lỗi ngầm, sự thiếu minh bạch trong tinh chỉnh | Kiểm soát phiên bản, xác thực, định dạng có cấu trúc, tự động hóa |
| Nợ nguyên mẫu | Các lối tắt tạo nguyên mẫu nhanh, liên kết chặt chẽ giữa mã và logic | Thiếu linh hoạt khi hệ thống mở rộng, cộng tác nhóm khó khăn | Nền tảng linh hoạt, theo dõi nợ có chủ đích, tái cấu trúc có kế hoạch |
Khi đã có đầy đủ các dạng nợ kỹ thuật ở một chỗ, chỉ nhận biết thôi là chưa đủ; các nhóm cần một tiêu chí đánh giá nợ kỹ thuật có hệ thống để chuyển những cuộc thảo luận chủ quan kiểu “hệ thống này đã sẵn sàng chưa?” thành các đánh giá định lượng. ML Test Score (Breck et al. 2017) cung cấp một tiêu chí có hệ thống để đánh giá mức độ sẵn sàng sản xuất trên bốn hạng mục: kiểm thử dữ liệu, kiểm thử mô hình, kiểm thử hạ tầng machine learning và kiểm thử giám sát. Bài báo này định nghĩa tổng cộng 28 kiểm thử, mỗi phần bảy kiểm thử, với điểm số được tính một phần hoặc toàn bộ cho mỗi kiểm thử. Mức độ sẵn sàng được theo dõi theo từng hạng mục thay vì chỉ dựa vào một thang đo mức độ trưởng thành tổng thể: một hệ thống có kiểm thử mô hình tốt nhưng giám sát yếu vẫn tiềm ẩn rủi ro khi đưa vào vận hành. Bảng Table 27 tóm tắt các kiểm thử tiêu biểu mà các chuyên gia nên áp dụng:
- Phần Dữ liệu: Xác thực các kỳ vọng về đặc trưng, kiểm soát quyền riêng tư và đánh giá xem mỗi đặc trưng có mang lại lợi ích tương xứng với chi phí vận hành hay không.
- Phần Mô hình: Xác thực các đặc tả mô hình đã được xem xét, kỷ luật về siêu tham số, giới hạn lỗi thời và sự khớp giữa các chỉ số ngoại tuyến và trực tuyến.
- Phần Hạ tầng: Xác thực quá trình huấn luyện có thể tái lập, khả năng quay lại phiên bản trước (rollback), tính nhất quán giữa giai đoạn huấn luyện và phục vụ (serving), cũng như các chốt kiểm soát triển khai.
- Phần Giám sát: Xác thực các cảnh báo cho thay đổi ở các phụ thuộc, các bất biến dữ liệu, độ lệch và sự lỗi thời của mô hình.
| Danh mục | Kiểm thử | Ví dụ triển khai |
|---|---|---|
| Kiểm thử dữ liệu | Các kỳ vọng về đặc trưng được ghi lại trong schema | Great Expectations, TFX Data Validation |
| Tất cả các đặc trưng đều có lợi (không có đặc trưng không sử dụng) | Phân tích tầm quan trọng của đặc trưng, nghiên cứu loại bỏ (ablation studies) | |
| Chi phí của không đặc trưng nào vượt quá lợi ích của nó | Phân tích đánh đổi độ trễ/độ chính xác | |
| pipeline dữ liệu có các kiểm soát quyền riêng tư phù hợp | Phát hiện PII, ghi nhật ký truy cập | |
| Kiểm thử mô hình | Đặc tả mô hình được xem xét và đưa vào kiểm soát phiên bản | Cấu hình mô hình được theo dõi bằng Git |
| Các chỉ số ngoại tuyến và trực tuyến có tương quan | Xác thực bằng kiểm thử A/B các cải tiến ngoại tuyến | |
| Tất cả các siêu tham số đều được tinh chỉnh | HPO tự động với kết quả được theo dõi | |
| Sự lỗi thời của mô hình được đo lường và giới hạn | Giám sát sự suy giảm hiệu suất | |
| Kiểm thử hạ tầng | Huấn luyện có thể tái tạo | Seed cố định, dữ liệu có phiên bản, các phụ thuộc bị khóa |
| Mô hình có thể được khôi phục về phiên bản trước | Kho lưu trữ mô hình với quản lý phiên bản | |
| Các đường dẫn mã huấn luyện và phục vụ (serving) được kiểm thử về tính nhất quán | Kiểm thử tích hợp Feature store | |
| Chất lượng mô hình được xác thực trước khi phục vụ (serving) | Các cổng xác thực tự động trong CI/CD | |
| Kiểm thử giám sát | Thay đổi phụ thuộc dẫn đến cảnh báo | Giám sát lược đồ dữ liệu |
| Bất biến dữ liệu được duy trì trong huấn luyện và phục vụ (serving) | Kiểm thử so sánh phân phối | |
| Các đặc trưng huấn luyện và phục vụ (serving) không bị lệch | Phát hiện độ lệch giữa huấn luyện và phục vụ (serving) | |
| Mô hình lỗi thời kích hoạt huấn luyện lại | Các retraining pipelines tự động |
Việc kiểm tra hàng quý dựa trên bộ tiêu chí này, ưu tiên các kiểm thử tập trung vào những loại sự cố xảy ra thường xuyên nhất, sẽ chỉ ra khoản đầu tư vận hành nào mang lại mức tăng độ tin cậy cao nhất. Đánh dấu hoàn thành các mục kiểm tra là cần thiết nhưng chưa đủ. Để sẵn sàng đưa vào sản xuất, chúng ta cần hiểu cách các thực hành được ghép lại thành một hệ thống mạch lạc và cách tổ chức phát triển năng lực của mình theo thời gian.
Self-Check: Question
An engineering team needs to evaluate the live inference latency, resource consumption, and numerical output distribution of a new deep recommender against live production traffic without exposing users to potential prediction quality regressions. Which deployment pattern should they select?
- Canary deployment, routing 5% of user-facing production traffic directly to the candidate model
- Blue-green deployment, performing an immediate router-level cutover of 100% of user traffic
- Shadow deployment, asynchronously duplicating live production traffic to the candidate model while returning only the incumbent model’s predictions to users
- In-place deployment, updating the model weights directly on active production inference servers
A real-time inference service has a 100 ms P99 latency SLO partitioned as: Network RTT (15 ms), Feature retrieval (25 ms), Request parsing (5 ms), Model inference (45 ms), Postprocessing (5 ms), and Response serialization (5 ms). If the team applies weight quantization and kernel fusion to achieve a 2x speedup on model inference (reducing it from 45 ms to 22.5 ms), what is the new end-to-end P99 latency and overall system speedup?
- 50.0 ms total latency, resulting in a 2.0x end-to-end speedup
- 22.5 ms total latency, because inference was the sole target of optimization
- 95.0 ms total latency, because non-inference stages expand to consume the budget
- 77.5 ms total latency, resulting in approximately 1.3x end-to-end speedup
Explain why high-stakes production ML systems (such as medical diagnosis or loan underwriting) experience a ‘verification gap’ and describe how leading indicators mitigate this challenge.
A production ML monitoring pipeline processes streaming inference requests. Place the following monitoring checks in the logical order of the monitoring hierarchy, from earliest input validation to downstream business verification:
- Model Output & Confidence Distribution Tracking: Log prediction distributions and softmax confidence scores.
- Business KPI & Outcome Metric Evaluation: Correlate delayed ground-truth labels with conversion or default rates.
- Infrastructure Health & Latency Telemetry: Measure CPU/GPU utilization, memory bandwidth, and P99 latency.
- Input Schema & Null Value Validation: Verify column types, required fields, and physical range bounds.
- Feature Distribution Drift Quantification: Compute PSI, KS statistics, or Wasserstein distance against baseline training distributions.
True or False: An inference server displaying 95% GPU compute utilization and 30% HBM memory bandwidth utilization should be optimized primarily by applying weight quantization to reduce memory bus traffic.
In statistical drift monitoring, a Population Stability Index value of \(\text{PSI} >\) ____ is the standard operational threshold indicating a significant distribution shift that requires investigation.
Design and Maturity Framework
Một tổ chức khi mới triển khai mô hình ML đầu tiên có thể chỉ dựa vào một Jupyter notebook chạy thủ công, một cron job theo lịch và giám sát tối thiểu. Ngược lại, một doanh nghiệp trưởng thành vận hành hàng nghìn mô hình thông qua các pipeline tự động, có phát hiện trôi dạt, triển khai canary và xác thực liên tục. Cả hai đều đang làm “MLOps”, nhưng khoảng cách giữa họ có thể chênh tới nhiều bậc độ lớn về độ tin cậy, hiệu quả chi phí và tốc độ phát triển kỹ thuật. Các nghiên cứu điển hình về triển khai cho thấy những thách thức thực tế xuất hiện trên toàn bộ quy trình triển khai ML (Paleyes et al. 2022). Chương này xem mức độ trưởng thành vận hành như một lăng kính hệ thống cho tiến trình đó: các tổ chức tiến hóa từ thử nghiệm tùy tiện đến vận hành hoàn toàn tự động, và việc hiểu nhóm của mình đang ở đâu trên phổ này cũng quan trọng không kém việc nắm các thành phần kỹ thuật. Xác định khoản đầu tư nào mang lại lợi ích cao nhất ở mỗi giai đoạn sẽ giúp phân bổ nguồn lực hiệu quả hơn so với việc áp dụng công cụ một cách tràn lan.
Paleyes, Andrei, Raoul-Gabriel Urma, and Neil D. Lawrence. 2022. “Challenges in Deploying Machine Learning: A Survey of Case Studies.” ACM Computing Surveys 55 (6): 1–29. https://doi.org/10.1145/3533378.
Các cấp độ trưởng thành
ML Test Score đánh giá các thực hành riêng lẻ. Mức độ trưởng thành vận hành bao quát rộng hơn: đó là sự tích hợp mang tính hệ thống các thực hành này thành một tổng thể thống nhất. Điểm khác biệt chính không phải là đội ngũ dùng công cụ gì mà là độ hiệu quả khi hạ tầng, tự động hóa, giám sát, quản trị và cộng tác vận hành ăn khớp với nhau trong suốt vòng đời machine learning. Các công cụ cho vòng đời như MLflow chỉ đáp ứng từng phần của quy trình đó (Zaharia et al. 2018), còn mức độ trưởng thành là năng lực của tổ chức trong việc làm cho các phần này hoạt động cùng nhau. Mặc dù mức độ trưởng thành vận hành tồn tại trên một phổ liên tục, việc phân tách thành các cấp độ trưởng thành chính giúp minh họa cách các hệ thống machine learning đi từ nguyên mẫu nghiên cứu đến hạ tầng sẵn sàng cho sản xuất.
Zaharia, Matei, Andrew Chen, Aaron Davidson, Ali Ghodsi, Sue Ann Hong, Andy Konwinski, Siddharth Murching, et al. 2018. “Accelerating the Machine Learning Lifecycle with MLflow.” IEEE Data Engineering Bulletin 41 (4): 39–45.
Ở cấp độ thấp nhất, các quy trình làm việc machine learning mang tính tự phát: thử nghiệm chạy thủ công, mô hình được huấn luyện trên máy cục bộ, và triển khai bằng các script viết tay. Khi mức độ trưởng thành tăng, quy trình làm việc trở nên có cấu trúc: đội ngũ áp dụng kiểm soát phiên bản, pipeline huấn luyện tự động và lưu trữ mô hình tập trung. Ở các cấp độ cao nhất, hệ thống được tích hợp hoàn toàn với hạ tầng dưới dạng mã (infrastructure-as-code), pipeline phân phối liên tục và giám sát tự động, hỗ trợ triển khai ở quy mô lớn và thử nghiệm nhanh.
Điểm khác biệt ở mỗi giai đoạn không phải là đội ngũ sử dụng công cụ gì, mà là mức độ tích hợp chặt chẽ giữa hạ tầng, tự động hóa và giám sát trong suốt vòng đời. Table 28 cho thấy bước nhảy từ các quy trình tự phát sang có khả năng mở rộng chủ yếu là một chuyển dịch kiến trúc: từ các script rời rạc sang một hệ thống thống nhất.
| Mức độ trưởng thành | Đặc điểm hệ thống | Kết quả điển hình |
|---|---|---|
| Tùy ý | Xử lý dữ liệu thủ công, huấn luyện cục bộ, không có kiểm soát phiên bản, quyền sở hữu không rõ ràng | Các workflow dễ hỏng, khó tái tạo hoặc gỡ lỗi |
| Có thể lặp lại | Các training pipelines tự động, CI/CD cơ bản, lưu trữ mô hình tập trung, một số giám sát | Khả năng tái tạo được cải thiện, khả năng mở rộng hạn chế |
| Có khả năng mở rộng | Các workflow tự động hoàn toàn, khả năng quan sát tích hợp, infrastructure-as-code, quản trị | Độ tin cậy cao, lặp lại nhanh chóng, ML cấp độ sản xuất |
Hãy xem hệ thống phát hiện gian lận tiến hóa qua các cấp độ trưởng thành này như thế nào:
- Ad hoc: Một nhà khoa học dữ liệu huấn luyện một mô hình trong Jupyter notebook, xuất thành file pickle rồi giao cho một kỹ sư triển khai lên một máy chủ duy nhất. Khi độ chính xác của mô hình giảm, nhà khoa học dữ liệu tự huấn luyện lại bằng cách chạy notebook đó với dữ liệu mới. Việc gỡ lỗi đòi hỏi phải có nhà khoa học dữ liệu ban đầu vì không ai khác hiểu rõ các bước tiền xử lý.
- Repeatable: Script huấn luyện được quản lý bằng hệ thống kiểm soát phiên bản, và có một Jenkins job chạy định kỳ để huấn luyện lại hằng tháng. Các đặc trưng được tính bằng một script SQL do đội kỹ thuật quản lý riêng. Mô hình được triển khai qua container, kèm theo giám sát độ chính xác ở mức cơ bản. Khi script SQL tính đặc trưng thay đổi, nhà khoa học dữ liệu phải tự xác minh thủ công rằng mô hình vẫn hoạt động đúng.
- Scalable: Huấn luyện và phục vụ (serving) dùng chung một kho đặc trưng, giúp giảm sai lệch. Một pipeline CI/CD sẽ điều tra drift khi PSI vượt 0.2, huấn luyện lại khi có bằng chứng ủng hộ, đánh giá mô hình mới so với mô hình cơ sở (baseline), và triển khai theo kiểu canary. Hệ thống giám sát theo dõi độ chính xác theo từng người bán, và kích hoạt điều tra khi một số phân khúc cụ thể suy giảm. Toàn bộ hành trình từ dữ liệu thô đến dự đoán trong sản xuất đều có thể kiểm tra.
Để chuyển đổi giữa các cấp độ này, cần một khoản đầu tư đáng kể và thường tốn hàng tháng công sức của đội ngũ kỹ thuật. Tuy nhiên, việc giảm tần suất sự cố và rút ngắn thời gian gỡ lỗi có thể biện minh cho chi phí bỏ ra, đặc biệt đối với các hệ thống quan trọng trong môi trường sản xuất.
Các cấp độ trưởng thành này giúp chúng ta đánh giá các hoạt động machine learning dưới góc độ hệ thống, không dựa trên các công cụ cụ thể được dùng, mà dựa trên mức độ tin cậy và sự gắn kết của hệ thống trong việc hỗ trợ toàn bộ vòng đời machine learning. Hiểu rõ tiến trình này giúp các chuyên gia nhận diện nút thắt trong thiết kế và ưu tiên các khoản đầu tư để nâng đỡ tính bền vững dài hạn của hệ thống.
Hàm ý thiết kế hệ thống
Các cấp độ trưởng thành mô tả các giai đoạn của tổ chức; hàm ý thiết kế hệ thống mô tả các hệ quả về kiến trúc. Ở mỗi cấp độ, kiến trúc hệ thống tiến hóa để đáp ứng các kỳ vọng mới về tính mô-đun, tự động hóa, giám sát và khả năng chịu lỗi.
Trong các môi trường có độ trưởng thành thấp, hệ thống ML thường là nguyên khối: logic xử lý dữ liệu được nhúng thẳng vào mã mô hình, cấu hình được quản lý không chính thức, và việc triển khai thì dùng các script ad hoc. Những kiến trúc này giúp thử nghiệm nhanh nhưng lại thiếu sự phân tách cần thiết để dễ bảo trì hoặc lặp lại một cách an toàn. Khi độ trưởng thành tăng lên, các trừu tượng theo mô-đun dần hình thành: việc xây dựng đặc trưng tách khỏi logic của mô hình, các pipeline trở nên khai báo, và ranh giới hệ thống được cưỡng chế thông qua API. Ở độ trưởng thành cao, hệ thống ML thể hiện các đặc tính của phần mềm sản xuất (dịch vụ không lưu trạng thái, giao diện theo hợp đồng, cô lập môi trường và thực thi có thể quan sát), nơi dữ liệu, mô hình và cơ sở hạ tầng cùng đồng tiến hóa qua các vòng lặp phản hồi khép kín.
Figure 10 minh họa thực tế kiến trúc này bằng hình ảnh tảng băng trôi. Những gì các bên liên quan thấy (thời gian hoạt động, tức phần nổi) chỉ là một phần rất nhỏ so với những gì phải chạy đúng bên dưới. Khối ẩn dưới mực nước cho thấy những mối đe dọa có thể đánh sập hệ thống, ngay cả khi hệ thống trông có vẻ ổn định: trôi dạt dữ liệu, trôi dạt khái niệm, pipeline bị hỏng, thay đổi lược đồ, độ chệch (bias) mô hình, và các phân khúc hoạt động kém hiệu quả. Mức độ trưởng thành vận hành phải đồng thời bao phủ cả ba miền (tình trạng dữ liệu, tình trạng mô hình, tình trạng dịch vụ).

Ba nhóm mối đe dọa trong mô hình tảng băng này tương ứng với các cơ chế lỗi khác nhau. Các mối đe dọa về tình trạng dữ liệu (trôi lệch, lỗi thời và thay đổi lược đồ) làm xói mòn các giả định thống kê mà mô hình được huấn luyện dựa vào, thường là không cần thay đổi gì ở bản thân mô hình. Các mối đe dọa về tình trạng mô hình (suy giảm độ chính xác, khuếch đại độ chệch (bias) và các vòng lặp phản hồi) âm thầm tích tụ, vì mô hình vẫn tiếp tục tạo ra các đầu ra trông có vẻ đúng đắn dù chất lượng đang suy giảm. Các mối đe dọa về tình trạng dịch vụ (bùng nổ cấu hình, pipeline bị phân mảnh và phụ thuộc lỗi thời) làm suy yếu khả năng tái lập và phục hồi. Một số lỗi như vậy vẫn có thể để dịch vụ hoạt động, nên chỉ giám sát tính sẵn sàng là không đủ để phản ánh đầy đủ trạng thái vận hành.
Các mẫu thiết kế và phản mẫu
Ngay cả cơ sở hạ tầng tinh vi nhất cũng sẽ thất bại nếu thiếu các mẫu tổ chức phù hợp để vận hành hiệu quả. Một kho đặc trưng không thể ngăn hiện tượng lệch giữa huấn luyện và phục vụ (serving) nếu không có ai chịu trách nhiệm về các định nghĩa đặc trưng; giám sát tự động cũng không thể phát hiện trôi lệch nếu các cảnh báo được gửi nhầm nhóm. Khi các hệ thống ML ngày càng phức tạp, các mẫu tổ chức cũng phải phát triển tương ứng.
Trong các môi trường đã phát triển, thiết kế tổ chức nhấn mạnh quyền sở hữu rõ ràng và kỷ luật về giao diện. Các nhóm nền tảng có thể chịu trách nhiệm về cơ sở hạ tầng dùng chung và các pipeline CI/CD, trong khi các nhóm chuyên môn (domain teams) tập trung vào phát triển mô hình và liên kết với mục tiêu kinh doanh. Các giao diện giữa các nhóm (như định nghĩa đặc trưng, lược đồ dữ liệu và mục tiêu triển khai) được xác định rõ ràng và có quản lý phiên bản.
Một mẫu tổ chức hiệu quả là có một nhóm MLOps tập trung cung cấp các dịch vụ dùng chung cho nhiều nhóm phát triển mô hình. Những cấu trúc này giúp tăng cường tính nhất quán và giảm nỗ lực trùng lặp. Ngoài ra, một số tổ chức áp dụng mô hình liên kết (federated model), đặt các kỹ sư MLOps vào các nhóm sản phẩm đồng thời duy trì một chức năng kiến trúc trung tâm để tích hợp toàn hệ thống.
Các phản mẫu thường nảy sinh khi trách nhiệm bị phân mảnh. Cách tiếp cận ưu tiên công cụ (áp dụng các công cụ hạ tầng khi chưa định nghĩa quy trình và vai trò) dẫn đến các pipeline kém ổn định và khâu bàn giao không rõ ràng. Việc thử nghiệm tách biệt, khi các nhà khoa học dữ liệu làm việc độc lập với kỹ sư vận hành môi trường sản xuất, tạo ra các mô hình khó triển khai hoặc khó tái huấn luyện hiệu quả.
Sự xê dịch trong tổ chức cũng là một thách thức. Khi các nhóm mở rộng, các quy trình làm việc không được ghi chép sẽ dần thành nếp và khó thay đổi, kéo theo chi phí phối hợp tăng cao. Mức độ trưởng thành của tổ chức phải cùng tiến hóa với độ phức tạp của hệ thống, thông qua các mô hình giao tiếp, định nghĩa vai trò và cấu trúc trách nhiệm rõ ràng, nhằm củng cố tính mô-đun, tự động hóa và khả năng quan sát.
Những mô hình tổ chức này cần được nâng đỡ bởi các kiến trúc kỹ thuật có thể xử lý các thách thức về độ tin cậy của hệ thống ML. MLOps thừa hưởng các vấn đề của hệ thống phân tán, đồng thời phức tạp hơn do có các thành phần học cần điều chỉnh để ứng xử với hành vi mang tính xác suất. Các dịch vụ thông thường cũng có thể trả về kết quả sai mà không sập; hệ thống ML còn bổ sung các kiểu lỗi phụ thuộc thống kê và dữ liệu mà các kiểm tra tính khả dụng không phát hiện được.
Các mẫu thiết kế ngắt mạch (circuit breaker patterns) cần tính tới các kiểu lỗi đặc thù của mô hình; chẳng hạn, khi độ chính xác dự đoán suy giảm thì ngưỡng cảnh báo phải khác với lỗi về tính khả dụng của dịch vụ. Các mẫu thiết kế vách ngăn (bulkhead patterns)28 trở nên then chốt khi cần cô lập các phiên bản mô hình thử nghiệm khỏi lưu lượng truy cập sản xuất. Những mẫu thiết kế này đòi hỏi các chiến lược phân vùng tài nguyên để ngăn việc cạn kiệt tài nguyên ở một mô hình làm ảnh hưởng tới các mô hình khác. Các lỗi dự đoán thông thường của mô hình là lỗi ngữ nghĩa, không phải lỗi Byzantine; vì vậy, khả năng chịu lỗi Byzantine29 chỉ là phép so sánh hạn chế cho các lỗi thành phần tùy ý.
28 Mẫu vách ngăn: Mẫu này phân chia tài nguyên hệ thống thành các vùng cách ly để khoanh vùng lỗi. Khi cần cô lập các mô hình thử nghiệm, một vách ngăn sẽ cấp cố định ngân sách tính toán và bộ nhớ cho phiên bản mới. Cách chia tài nguyên này đảm bảo rằng ngay cả khi thí nghiệm gặp sự cố nghiêm trọng (ví dụ, rò rỉ bộ nhớ), nó cũng không thể làm cạn kiệt toàn bộ tài nguyên và gây ngừng hoạt động trên toàn hệ thống sản xuất.
29 Khả năng chịu lỗi Byzantine: Mô hình Byzantine cổ điển đề cập đến các nút có thể hành xử tùy ý hoặc gửi thông điệp mâu thuẫn. Trong bối cảnh đồng bộ không xác thực, còn gọi là thiết lập oral-messages, để chịu được \(f\) lỗi Byzantine cần ít nhất \(3f+1\) thành viên (Lamport et al. 1982). Các tập hợp mô hình trong ML chỉ là một phép so sánh, vì lỗi dự đoán có thể tương quan và sự đồng thuận không đảm bảo tính đúng đắn về mặt ngữ nghĩa.
Lamport, Leslie, Robert Shostak, and Marshall Pease. 1982. “The Byzantine Generals Problem.” ACM Transactions on Programming Languages and Systems 4 (3): 382–401. https://doi.org/10.1145/357172.357176.
Các thuật toán đồng thuận giúp các nút đạt được thống nhất; chúng không thể xác định dự đoán của mô hình đúng hay không khi ground truth bị trễ hoặc không có. Dẫu vậy, các mẫu đảm bảo độ tin cậy này vẫn giúp phân biệt các triển khai MLOps vững chắc với các triển khai mong manh, miễn là áp dụng các bảo đảm trong đúng phạm vi.
Đặt MLOps vào ngữ cảnh
Các thực tiễn tốt nhất hiếm khi được áp dụng trong môi trường lý tưởng. Mỗi hệ thống ML hoạt động trong một ngữ cảnh cụ thể, điều này định hình cách triển khai các thực tiễn: các ràng buộc vật lý (edge compute, giới hạn công suất), yêu cầu pháp lý (y tế, tài chính), hoặc thực tế tổ chức (quy mô nhóm, phân bổ kỹ năng). Một pipeline CI/CD chuẩn có thể không khả thi nếu không có quyền truy cập trực tiếp vào host; giám sát có thể phải dựa vào tín hiệu gián tiếp hoặc phát hiện bất thường trên thiết bị; thu thập dữ liệu có thể bị giới hạn bởi quy định về quyền riêng tư. Những điều chỉnh này là biểu hiện của sự trưởng thành trong điều kiện ràng buộc, chứ không phải lệch khỏi các nguyên tắc.
Ở những mức độ trưởng thành vận hành cao nhất, các thực hành cho mô hình đơn lẻ được thiết lập ở đây trở thành nền tảng cho các năng lực ở quy mô tổ chức. Các tổ chức vận hành đồng thời nhiều nút ML thường quy về kiến trúc nền tảng, nơi cung cấp hạ tầng dùng chung, quản trị tập trung và hiệu quả theo quy mô. Việc chuyển từ các nút ML đơn lẻ sang hạ tầng ở quy mô nền tảng đặt ra những thách thức mang tính khác biệt (phân bổ tài nguyên giữa các mô hình, khả năng quan sát ở cấp hệ thống, khả năng chịu lỗi cho các hệ thống AI phụ thuộc lẫn nhau) vượt ngoài phạm vi mô hình đơn của chương này. Các thực hành tốt ở cấp nút ML là điều kiện tiên quyết cho thành công ở cấp nền tảng, vì mọi lỗ hổng trong giám sát, kiểm thử hoặc triển khai cho một mô hình đơn lẻ sẽ bị nhân lên trên toàn bộ danh mục mô hình.
Kinh tế đầu tư cho MLOps
Lợi ích vận hành của MLOps chỉ thực sự thuyết phục khi khoản đầu tư tương xứng với giá trị của mô hình trong sản xuất. Với một nút ML đơn lẻ, câu hỏi là liệu tốc độ triển khai, giảm sự cố và phạm vi giám sát có xứng đáng với chi phí vận hành hay không; còn với một danh mục mô hình, các cân nhắc kinh tế tương tự sẽ cộng gộp thành đầu tư ở cấp nền tảng.
Đầu tư MLOps cho mô hình đơn lẻ
Với một hệ thống ML chạy sản xuất đơn lẻ, ngưỡng đầu tiên là chi phí hàng năm để bảo đảm nút có thể quan sát, có thể triển khai và có thể phục hồi. Table 29 tóm tắt các nhóm chi phí chính:
| Thành phần | Giả định minh họa | Luận cứ |
|---|---|---|
| Thiết lập CI/CD pipeline | $10–30K one-time | Giảm thời gian triển khai từ vài ngày xuống vài giờ |
| Giám sát và cảnh báo | $2–10K/year | Phát hiện sự xuống cấp trước khi ảnh hưởng đến người dùng |
| Feature store (cơ bản) | $5–20K/year | Giảm một nguồn độ lệch giữa huấn luyện và phục vụ (serving) |
| Model registry | $0–5K/year | Cho phép rollback, nhật ký kiểm toán |
| Thời gian kỹ thuật | 1–2 FTE-months setup | Tự động hóa và tích hợp ban đầu |
Tính toán ROI cho mô hình đơn lẻ
Ngưỡng lợi tức sau đó phụ thuộc vào mức độ trọng yếu của mô hình: một mô hình gắn với doanh thu có thể biện minh cho chi phí vận hành cao hơn vì giá trị của việc tránh sự cố và tiết kiệm thời gian triển khai có thể đo lường được. Equation 16 chính thức hóa phép tính cho nút đơn lẻ đó: \[\text{Annual Benefit/Cost} = \frac{\text{Incidents Avoided} \times \text{Avg Incident Cost} + \text{Time Savings} \times \text{Hourly Cost}}{\text{Annual MLOps Investment}} \tag{16}\] trong đó Incidents Avoided là số sự cố sản xuất mà công cụ ngăn được mỗi năm và Avg Incident Cost là tổn thất cho mỗi sự cố; nên tích của chúng là giá trị các sự cố được tránh. Time Savings là số giờ kỹ sư mà tự động hóa thu hồi mỗi năm và Hourly Cost là chi phí lao động theo giờ đã gồm phụ phí; nên tích của chúng là giá trị thời gian lao động thu hồi. Mẫu số là chi phí hằng năm của chính công cụ. Tỷ lệ này biểu thị mỗi đô la đầu tư mang về bao nhiêu đô la.
Với một mô hình tạo ra doanh thu $1M mỗi năm, với:
- 4 sự cố tránh được mỗi năm (với chi phí $25K cho mỗi sự cố) = tiết kiệm được $100K
- 20 hours/tháng thời gian triển khai tiết kiệm được (với chi phí $150/hr mỗi giờ) = tiết kiệm được $36K
- Khoản đầu tư MLOps là $30K/year
\[ \text{Benefit/Cost} = \frac{\$100K + \$36K}{\$30K} = 4.53× \]
Khi nào nên đầu tư thêm
Tỷ lệ lợi ích-chi phí 4.53× cho thấy khoản đầu tư này không được biện minh bởi sự tinh xảo của công cụ; mà bởi vì mô hình đủ tốn kém, nên việc ngăn sự cố và rút ngắn triển khai vượt trội so với chi phí nền tảng hằng năm. Lợi ích từ các thực hành MLOps cho mô hình đơn lẻ sẽ cộng dồn khi các đội thêm nhiều mô hình khác. Việc chuyển từ vận hành vài nút ML độc lập sang xây dựng một nền tảng tập trung là một bài toán kinh tế hoàn toàn khác, gồm khấu hao hạ tầng dùng chung, chi phí đội nền tảng, và chi phí phối hợp giữa các mô hình.
Với vận hành mô hình đơn lẻ, hãy đầu tư vào MLOps tương xứng với mức độ quan trọng của mô hình. Một mô hình mang lại doanh thu 10 triệu đô la mỗi năm đòi hỏi mức độ vận hành chặt chẽ hơn so với một mô hình phân tích nội bộ. Giám sát, truy xuất nguồn gốc (lineage) và khả năng triển khai lặp lại thường là những khoản đầu tư đầu tiên. Thêm kho đặc trưng (feature store) khi các định nghĩa đặc trưng dùng chung và sự đồng nhất giữa môi trường trực tuyến và ngoại tuyến trở thành vấn đề đáng kể, và chỉ tự động hóa huấn luyện lại khi có bằng chứng hỗ trợ tín hiệu kích hoạt và vòng lặp xác thực có thể kiểm soát một bản cập nhật lỗi.
Cơ sở hạ tầng kỹ thuật và framework kinh tế ở phần trước là nền tảng; các nghiên cứu điển hình trong section 1.7 cho thấy các yếu tố này kết hợp như thế nào trong hệ thống vận hành. Mỗi trường hợp làm rõ các cách triển khai cụ thể của năm nguyên tắc nền tảng, chỉ ra nơi đảm bảo tính tái lập, cách quan sát suy giảm, và điều gì kích hoạt tự động hóa.
Self-Check: Question
What fundamental reliability concept is illustrated by the ‘Uptime Iceberg’ metaphor in production machine learning systems?
- Traditional service availability (uptime and low latency) is only the visible tip; hidden failures like feature drift, concept drift, schema corruption, and subpopulation degradation lurk beneath the surface
- Distributed feature retrieval latency over wide-area networks always exceeds local GPU inference execution time
- Data center cooling overhead exceeds the total electrical power consumed by GPU inference accelerators
- Deep neural network weight storage in DRAM requires larger memory allocations than raw training dataset storage
An organization with limited engineering resources is deploying its first production ML model. Based on the chapter’s investment economics framework, which staging sequence provides the most cost-effective path to reliability?
- Construct an enterprise-wide multi-region distributed feature store and autonomous retraining cluster before deploying the initial model
- Invest first in statistical monitoring and basic CI/CD deployment pipelines, then add centralized feature stores and automated retraining as model scale and drift warrant
- Procure an all-in-one commercial MLOps platform suite to eliminate cross-functional on-call rotations
- Defer all monitoring and automation investments until multiple major production outages have occurred
Describe the organizational anti-pattern of ‘tossing models over the wall’ between data scientists and software engineers, and explain how a cross-functional or federated MLOps structure resolves it.
An engineering team is assessing the operational maturity of an ML deployment. Place the three operational maturity stages in order from least mature to most mature:
- Repeatable: Version-controlled training scripts, scheduled batch retraining jobs, centralized model registry, and basic performance monitoring.
- Scalable: Unified feature store enforcing training-serving parity, closed-loop drift detection with automated canary validation, and infrastructure-as-code.
- Ad Hoc: Hand-crafted Jupyter notebooks, local training on developer machines, manual pickle file deployment, and absence of formal versioning.
Các nghiên cứu điển hình
Một chiếc nhẫn theo dõi giấc ngủ dùng pin và phần mềm y tế dựa trên AI/ML (chịu quản lý theo kỳ vọng về vòng đời của FDA (U.S. Food and Drug Administration 2025)) sẽ đối mặt với những ràng buộc vận hành khác nhau. Các nguyên tắc, mẫu hình và hạ tầng được xem xét trong chương này hội tụ theo những cách khác nhau tùy bối cảnh triển khai. Một thiết kế edge lấy cảm hứng từ Oura cho thấy nợ pipeline và quản lý cấu hình thách thức ra sao trong môi trường hạn chế tài nguyên; còn ClinAIOps cho thấy các vòng lặp phản hồi và yêu cầu quản trị định hình lại vận hành y tế như thế nào. Vòng đời Oura trong section 1.7.1 chỉ là giả định; nghiên cứu được trích dẫn chỉ hỗ trợ đánh giá dữ liệu và mô hình ngoại tuyến, chứ không đưa ra tuyên bố nào về OTA trong production hay cách Oura triển khai MLOps. Chúng ta bắt đầu so sánh từ các nguyên tắc chung, vì khác biệt lớn nhất giữa các lĩnh vực nằm ở cách triển khai các nguyên tắc đó.
U.S. Food and Drug Administration. 2025. Marketing Submission Recommendations for a Predetermined Change Control Plan for Artificial Intelligence-Enabled Device Software Functions. Guidance for Industry and Food and Drug Administration Staff. U.S. Department of Health; Human Services.
Table 30 trình bày cách hai môi trường có thể triển khai năm nguyên tắc MLOps nền tảng. Các ràng buộc theo miền (như phần cứng edge hay quy định lâm sàng) sẽ định hình lại cách mỗi nguyên tắc được hiện thực hóa, nhưng không làm thay đổi những nguyên tắc nào là quan trọng. Trong thiết kế lấy cảm hứng từ Oura, polysomnography (PSG) là các phép đo nghiên cứu giấc ngủ lâm sàng được dùng làm nhãn tham chiếu.
Các nguyên tắc vẫn giữ nguyên, nhưng cách triển khai sẽ thay đổi theo chế độ triển khai. Hệ thống edge dành ngân sách tự động hóa cho pin, đo từ xa và các bản cập nhật bị giới hạn; còn hệ thống lâm sàng thì tập trung vào khả năng kiểm toán, các cổng xác thực và sự kiểm soát có trách nhiệm của con người. Hai nghiên cứu điển hình sau đây lần theo cách mỗi môi trường đạt được các hạng mục đó.
| Nguyên tắc | Thiết kế edge lấy cảm hứng từ Oura | ClinAIOps |
|---|---|---|
| Khả năng tái tạo | Các tập dữ liệu thiết bị đeo và PSG được lập phiên bản, đồng bộ hóa | Nhật ký kiểm toán, nguồn gốc quyết định |
| Tách biệt các mối quan tâm | Các lớp dữ liệu, huấn luyện và phục vụ (serving) độc lập với deployment pipeline dành riêng cho edge | Các giai đoạn xác thực lâm sàng và deployment riêng biệt với sự cô lập tuân thủ quy định |
| Tính nhất quán | Tiền xử lý phù hợp với PSG trên toàn bộ quá trình huấn luyện và suy luận trên thiết bị (on-device) | Các data pipeline lâm sàng được tiêu chuẩn hóa đảm bảo sự tương đồng giữa huấn luyện và phục vụ (serving) |
| Suy giảm có thể quan sát được | Phát hiện anomaly detection trên thiết bị (on-device), telemetry hạn chế | Monitoring theo cohort cụ thể, theo dõi kết quả (outcome tracking) |
| Tự động hóa có tính đến chi phí | Các trình kích hoạt huấn luyện lại có nhận biết pin, CI/CD cho edge cân bằng độ chính xác và resource cost | Cập nhật mô hình tự động với các cổng human-in-the-loop cân bằng chi phí cập nhật và rủi ro bệnh nhân |
Thiết kế edge lấy cảm hứng từ Oura
Oura Ring cung cấp bằng chứng nền (offline) cho thiết kế MLOps lấy cảm hứng từ Oura này. Các công bố đã hỗ trợ việc thu thập dữ liệu lâm sàng và đánh giá giai đoạn giấc ngủ sẽ được mô tả sau (Altini and Kinnunen 2021), trong khi quản lý phiên bản, đo từ xa (telemetry), triển khai qua mạng (over-the-air), và chu trình tinh chỉnh lặp là một kiến trúc giả định, không phải mô tả thực tế về vòng đời sản xuất của Oura. Những ràng buộc từ một chiếc vòng chạy pin với khả năng tính toán hạn chế khiến mọi quyết định MLOps trở nên “lộ sáng”, điều mà các hệ thống ở quy mô đám mây thường có thể che mờ.
Bối cảnh và động lực
Oura Ring là một thiết bị đeo dành cho người dùng phổ thông, theo dõi giấc ngủ, hoạt động và phục hồi sinh lý nhờ cảm biến và khả năng tính toán tích hợp. Bằng cách đo chuyển động, nhịp tim và nhiệt độ cơ thể, thiết bị ước tính các giai đoạn giấc ngủ và cung cấp phản hồi cá nhân hóa. Một thiết kế lấy cảm hứng từ Oura có thể đặt một phần tiền xử lý và suy luận ngay trên thiết bị, trong khi các xử lý khác diễn ra trên điện thoại hoặc trên đám mây.
Mục tiêu chính là cải thiện độ chính xác phân loại giai đoạn giấc ngủ, để kết quả gần hơn với đa ký giấc ngủ (PSG),30 tiêu chuẩn vàng trong lâm sàng. Đánh giá ban đầu cho thấy độ chính xác phân loại giấc ngủ bốn giai đoạn của mô hình chỉ dùng gia tốc kế là 57 percent, so với 79 percent ở các mô hình có thêm các đặc trưng từ hệ thần kinh tự chủ và nhịp sinh học. Độ tin cậy giữa những người chấm điểm PSG được công bố vào khoảng 82 percent đến 83 percent, cho thấy khoảng cách còn lại giữa suy luận từ thiết bị đeo và chấm điểm lâm sàng của chuyên gia. Mức tăng 22 percentage-point này giúp thu hẹp khoảng 84.6–88 percent của khoảng cách giữa mức cơ sở và mức đồng thuận của con người, dù sự đồng thuận giữa những người chấm điểm không phải là trần trên cho độ chính xác khi so sánh với một tham chiếu cố định hoặc đã được phân xử. Sự sai khác này đã thúc đẩy việc đánh giá lại quy trình thu thập dữ liệu, tiền xử lý và phát triển mô hình.
30 Đa ký giấc ngủ (PSG): Một nghiên cứu giấc ngủ đa thông số cung cấp dữ liệu chuẩn lâm sàng (ground truth) cho tác vụ phân loại này. Cái “chuẩn” này vốn dĩ có nhiễu; khi diễn giải cùng một bản ghi PSG, các chuyên gia chấm điểm chỉ đạt độ tin cậy khoảng 82 percent–83 percent (Altini and Kinnunen 2021). Mức độ đồng thuận này cho thấy nhãn có độ không chắc chắn, nhưng không tạo ra một trần độ chính xác khi so sánh với một tham chiếu cố định hoặc tham chiếu đã được phân xử.
Altini, Marco, and Hannu Kinnunen. 2021. “The Promise of Sleep: A Multi-Sensor Approach for Accurate Sleep Stage Detection Using the Oura Ring.” Sensors 21 (13): 4302. https://doi.org/10.3390/s21134302.
Để khắc phục các hạn chế về hiệu suất, nhóm Oura đã xây dựng một tập dữ liệu đa dạng dựa trên các tiêu chuẩn lâm sàng thông qua một nghiên cứu với 106 participants đến từ ba châu lục (Altini and Kinnunen 2021). Mỗi người tham gia đeo Vòng Oura đồng thời thực hiện PSG, thu được 440 nights đêm dữ liệu và 3,444 hours giờ bản ghi được đồng bộ thời gian, qua đó ghép dữ liệu cảm biến đeo tay với các chú thích giấc ngủ đã được kiểm chứng. Quy mô và tính đa dạng của bộ sưu tập này giúp nắm bắt được biến thiên sinh lý cùng các yếu tố môi trường và hành vi, những yếu tố then chốt để mô hình có thể tổng quát hóa tốt trên tập người dùng thực tế.
Nghiên cứu này đã hợp nhất các dữ liệu đồng bộ từ gia tốc kế, nhiệt độ, nhịp tim, biến thiên nhịp tim và PSG thu thập bằng các Vòng Oura dành cho nghiên cứu, rồi giải quyết việc căn chỉnh thời gian và các yêu cầu tiền xử lý phục vụ cho các bước phát triển mô hình tiếp theo. Trong một quy trình sản xuất giả định, cần bổ sung quản lý phiên bản vững chắc và theo dõi nguồn gốc dữ liệu để tránh các phụ thuộc không ổn định, vốn thường gây rắc rối cho các hệ thống ML nhúng.
Với dữ liệu chất lượng cao, câu hỏi tiếp theo của nghiên cứu là việc bổ sung thêm cảm biến có giúp cải thiện phân loại giai đoạn giấc ngủ hay không. Họ đánh giá bốn cấu hình ngoại tuyến, lần lượt bổ sung các đặc trưng về nhiệt độ, biến thiên nhịp tim và nhịp sinh học trên nền tảng cơ sở chỉ dùng gia tốc kế. Thông qua 5-fold cross-validation so với các chú thích PSG, các mô hình được tăng cường đạt độ chính xác phân loại bốn giai đoạn là 79 percent, cải thiện so với mức 57 percent của cấu hình chỉ dùng gia tốc kế (Altini and Kinnunen 2021). Những lợi ích ngoại tuyến này là động lực cho một thiết kế sản xuất giả định; tuy vậy, các yêu cầu như huấn luyện có thể tái tạo, quản lý phiên bản, xác thực chuyển đổi và kiểm soát năng lượng là các suy luận, không phải kết quả mà nghiên cứu báo cáo.
31 Cập nhật qua mạng (OTA): Cơ chế dùng để triển khai các mô hình đã tối ưu hoá lên các thiết bị đang hoạt động, mà không cần truy cập vật lý vào thiết bị. Dung lượng nhỏ nhờ lượng tử hoá và tỉa (pruning) rất quan trọng, vì các mạng edge bị hạn chế có thể chỉ truyền các tạo phẩm mô hình đã thay đổi, thay vì toàn bộ gói ứng dụng. Quá trình này khiến tính nhất quán trở thành mối quan tâm then chốt; một bản cập nhật thất bại có thể làm hỏng mô hình trên thiết bị, khiến pipeline ML bị gián đoạn cho đến khi có cửa sổ kết nối trong tương lai để khắc phục.
Sau khi xác thực, việc triển khai chuyển trọng tâm từ chất lượng mô hình sang độ an toàn của cập nhật. Một triển khai edge kiểu Oura phải quyết định phần nào của mô hình chạy liên tục trên thiết bị, những tín hiệu phong phú nào có thể dùng khi ngân sách bộ nhớ và pin dư dả hơn, và cách các bản cập nhật mô hình đến được các thiết bị đã ngoài thực địa. Để việc phân tách đó dễ bảo trì, chuỗi công cụ vận hành cần khả năng chuyển đổi mô hình có thể tái tạo, tạo phẩm có phiên bản, và các quy trình cập nhật OTA31 được xác thực để giữ tính nhất quán trên các thiết bị ngoài thực địa.
Bài học vận hành là MLOps trên edge không chỉ phụ thuộc vào độ chính xác, mà là độ chính xác dưới các ràng buộc về pin, quyền riêng tư, đo từ xa và ground truth yếu. Hãy xem xét kiểu mẫu DS-CNN (Ràng buộc nhỏ) từ table 4, nơi giám sát dựa vào các chỉ số vận hành như chu kỳ hoạt động và tỷ lệ dương tính giả thay vì các nhãn ground truth liên tục, và một nhịp cập nhật OTA minh họa theo quý điều chỉnh việc cập nhật. Đưa vào vận hành việc chuyển đổi từ độ chính xác chỉ dùng gia tốc kế 57 percent sang độ chính xác đa cảm biến 79 percent sẽ đòi hỏi quản lý cấu hình một cách hệ thống trên các khía cạnh thu thập dữ liệu, tập đặc trưng, kiến trúc mô hình và mục tiêu triển khai.
Những ràng buộc đó giải thích cách các nguyên tắc nền tảng được áp dụng mà không cần lặp lại như một danh sách kiểm tra. Các tập dữ liệu đeo được và PSG được quản lý phiên bản giúp mỗi mô hình có thể truy vết được bằng bằng chứng đã dùng để huấn luyện. Các kiến trúc mô-đun phân tầng giữ cho việc thu thập dữ liệu, huấn luyện mô hình và phục vụ (serving) trên thiết bị tách biệt đủ để các chính sách lượng tử hoá, tỉa (pruning) và dự phòng có thể thay đổi mà không làm mất ổn định toàn bộ pipeline. Tiền xử lý căn chỉnh với PSG đảm bảo tính nhất quán giữa huấn luyện và suy luận trên thiết bị, trong khi đo từ xa bảo vệ quyền riêng tư giúp quan sát được sự suy giảm thông qua chu kỳ hoạt động, tác động đến pin, lỗi suy luận, độ tin cậy, tỷ lệ bất thường và các nghiên cứu có nhãn định kỳ. Triển khai OTA khi đó trở thành ranh giới tự động hóa có xét đến chi phí: các bản cập nhật phải chứng minh được lợi ích về độ chính xác so với tác động đến pin, gánh nặng xác thực và rủi ro khi thay đổi phần mềm trên một thiết bị mà người dùng đeo liên tục.
Trường hợp này minh họa cách các nguyên tắc MLOps thích ứng với những ràng buộc đặc thù của từng lĩnh vực. Khi machine learning được đưa vào các ứng dụng lâm sàng, sẽ phát sinh thêm nhiều phức tạp, đòi hỏi các framework phải giải quyết tuân thủ quy định, an toàn bệnh nhân và hỗ trợ ra quyết định lâm sàng.
Nghiên cứu điển hình ClinAIOps
Triển khai ML trong y tế đặt ra những thách thức vượt xa các ràng buộc về tài nguyên. Các framework MLOps tổng quát cần bổ sung cơ chế kiểm soát ở những lĩnh vực có mức độ giám sát của con người cao, yêu cầu đánh giá theo từng chuyên ngành và quản trị đạo đức. Giám sát trị liệu liên tục (CTM)32 là một ví dụ điển hình cho thấy MLOps phải phát triển để đáp ứng nhu cầu tích hợp vào thực hành lâm sàng.
32 Giám sát trị liệu liên tục (CTM): Phương pháp chăm sóc sức khỏe sử dụng cảm biến đeo được để thu thập dữ liệu sinh lý theo thời gian thực và điều chỉnh điều trị cá nhân hóa. CTM buộc MLOps phải đối mặt với những ràng buộc không xuất hiện trong các triển khai điển hình: các vòng lặp phản hồi phải có con người phê duyệt (human-in-the-loop) cho các quyết định liên quan đến an toàn; việc huấn luyện lại cần các nhãn được bác sĩ lâm sàng xác nhận thay vì dựa vào tín hiệu ngầm; và các cập nhật mô hình phải đáp ứng yêu cầu tuân thủ quy định trước khi triển khai. Những ràng buộc này tái định hình mọi nguyên tắc MLOps, biến CTM thành một stress test cho mức độ trưởng thành vận hành.
CTM sử dụng các cảm biến đeo được để thu thập dữ liệu sinh lý và hành vi của bệnh nhân theo thời gian thực. Các hệ thống AI phải được tích hợp vào quy trình lâm sàng, phù hợp với yêu cầu quy định, và được thiết kế để hỗ trợ thay vì thay thế quyết định của con người. Các thực hành MLOps tổng quát cung cấp các kiểm soát kỹ thuật cho vòng đời, nhưng tự chúng không xác lập trách nhiệm lâm sàng, tiêu chuẩn bằng chứng, hay thẩm quyền ra quyết định.
ClinAIOps (Chen et al. 2023), một framework để vận hành AI trong môi trường lâm sàng, cho thấy các nguyên tắc MLOps cần phát triển như thế nào để đáp ứng yêu cầu quy định và lấy con người làm trung tâm. Khác với MLOps thông thường, ClinAIOps trực tiếp giải quyết thách thức của các vòng lặp phản hồi bằng cách thiết kế chúng ngay trong kiến trúc hệ thống. Sự phối hợp có cấu trúc giữa bệnh nhân, bác sĩ lâm sàng và nhà phát triển AI của framework này thể hiện việc hiện thực hóa các nguyên tắc quản trị và hợp tác.
Môi trường lâm sàng vì vậy mở rộng bài toán vận hành thông thường. Chăm sóc sức khỏe đòi hỏi sự phối hợp giữa nhiều chủ thể, các quyết định lâm sàng dựa trên chăm sóc cá thể hóa và trách nhiệm chung, và dữ liệu sức khỏe phải tuân thủ các yêu cầu nghiêm ngặt về quyền riêng tư và quản trị. ClinAIOps đề xuất một framework cân bằng giữa tính chặt chẽ kỹ thuật với giá trị lâm sàng, và giữa độ tin cậy vận hành với trách nhiệm đạo đức.
Các vòng lặp phản hồi
Ba vòng lặp phản hồi lồng vào nhau giúp tích hợp machine learning một cách an toàn và linh hoạt vào thực hành lâm sàng. Figure 11 minh họa các vòng lặp này như một luồng tuần hoàn giữa ba bên liên quan. Bệnh nhân cung cấp dữ liệu giám sát liên tục từ các cảm biến đeo được và nhận được hướng dẫn có giới hạn do AI hỗ trợ. Bác sĩ lâm sàng nhận các bản tóm tắt, cảnh báo và khuyến nghị do AI tạo ra, rồi áp dụng phán đoán lâm sàng bằng cách thiết lập phác đồ điều trị và giới hạn phê duyệt. Các nhà phát triển AI nhận phản hồi liên tục từ bệnh nhân và bác sĩ lâm sàng, sử dụng hiệu suất thực tế và các tín hiệu từ quy trình làm việc để cải thiện các mô hình và quy trình triển khai. Vòng lặp ngoài cùng, kết nối cả ba bên liên quan, đại diện cho chu trình quản trị đầy đủ.

Mỗi vòng lặp phản hồi đóng một vai trò riêng nhưng có liên kết với nhau; khi kết hợp, chúng cho phép cá nhân hóa thích ứng, duy trì quyền kiểm soát của bác sĩ lâm sàng và thúc đẩy cải tiến mô hình liên tục dựa trên phản hồi thực tế:
- Vòng lặp điều trị bệnh nhân thu thập dữ liệu sinh lý theo thời gian thực và sử dụng các kết quả đầu ra có giới hạn của AI để hỗ trợ bệnh nhân tự quản lý.
- Vòng lặp giám sát của bác sĩ lâm sàng đảm bảo các khuyến nghị do AI hỗ trợ được xem xét, giới hạn phạm vi và tinh chỉnh dưới sự giám sát chuyên môn.
- Vòng lặp phản hồi của nhà phát triển cung cấp phản hồi liên tục từ bệnh nhân và bác sĩ lâm sàng cho các nhà phát triển AI, để cải thiện mô hình, giao diện và quy trình giám sát.
Vòng lặp điều trị bệnh nhân
Vòng lặp điều trị bệnh nhân giúp tối ưu hóa liệu pháp cá nhân hóa nhờ dữ liệu sinh lý liên tục từ các thiết bị đeo. Bệnh nhân đeo các cảm biến như máy đo đường huyết liên tục hoặc thiết bị đeo có chức năng đo điện tâm đồ (ECG) để thụ động thu thập các tín hiệu sức khỏe.
Hệ thống AI phân tích các luồng dữ liệu này cùng với ngữ cảnh lâm sàng từ hồ sơ y tế điện tử, từ đó đưa ra các khuyến nghị điều chỉnh liệu pháp cá nhân hóa. Các đề xuất điều trị được phân tầng: những điều chỉnh nhỏ trong ngưỡng an toàn do bác sĩ lâm sàng đặt ra có thể được bệnh nhân thực hiện trực tiếp; còn những thay đổi đáng kể cần có sự chấp thuận của bác sĩ lâm sàng. Cấu trúc này vừa duy trì sự giám sát của con người, vừa cho phép thích ứng với tần suất cao và dựa trên dữ liệu.
Vòng lặp giám sát của bác sĩ lâm sàng
Vòng lặp giám sát của bác sĩ lâm sàng đưa sự giám sát của con người vào quá trình ra quyết định có AI hỗ trợ. AI đưa ra các khuyến nghị điều trị kèm theo bản tóm tắt dễ hiểu về dữ liệu bệnh nhân, bao gồm các xu hướng theo thời gian và các chỉ số suy ra từ cảm biến.
Ví dụ, một mô hình AI có thể đề xuất giảm thuốc điều trị tăng huyết áp cho bệnh nhân có huyết áp liên tục dưới mức mục tiêu. Bác sĩ lâm sàng xem xét khuyến nghị trong ngữ cảnh rồi có thể chấp nhận, từ chối hoặc điều chỉnh. Phản hồi này giúp tinh chỉnh để mô hình phù hợp hơn với thực hành lâm sàng. Bác sĩ lâm sàng cũng đặt ra các giới hạn vận hành, đảm bảo chỉ những điều chỉnh ít rủi ro mới được tự động hóa, qua đó duy trì trách nhiệm lâm sàng trong khi vẫn tích hợp được trí tuệ máy.
Phản hồi của nhà phát triển và sự phối hợp giữa bệnh nhân - bác sĩ lâm sàng
Phản hồi của nhà phát triển và sự phối hợp giữa bệnh nhân - bác sĩ lâm sàng chuyển các tương tác lâm sàng từ thu thập dữ liệu thường quy sang diễn giải ở mức cao hơn, ra quyết định chung và cải thiện mô hình. Khi AI đảm nhiệm việc tổng hợp dữ liệu và phân tích xu hướng, bác sĩ lâm sàng có thể tham gia ý nghĩa hơn: xem xét các mẫu, đặt các nhận định vào bối cảnh và thiết lập mục tiêu sức khỏe cá nhân hóa.
Ví dụ, trong quản lý bệnh tiểu đường, bác sĩ có thể dùng dữ liệu do AI tóm tắt để dẫn dắt cuộc trao đổi về thói quen ăn uống và hoạt động thể chất. Tần suất thăm khám được điều chỉnh linh hoạt theo tiến độ của bệnh nhân, thay vì theo lịch cố định. Nhờ đó, bác sĩ đóng vai trò như một huấn luyện viên và cố vấn, diễn giải dữ liệu dựa trên sở thích của bệnh nhân và phán đoán lâm sàng của mình. Phản hồi từ những tương tác này cung cấp bằng chứng cho các nhà phát triển AI về cách mô hình vận hành, mức độ dễ dùng của giao diện và độ phù hợp với quy trình công việc.
Ví dụ về tăng huyết áp
Quản lý tăng huyết áp minh họa cách ba vòng lặp của ClinAIOps vận hành trong thực tế. Vì bệnh này ảnh hưởng đến một tỷ lệ lớn người trưởng thành và đòi hỏi điều chỉnh điều trị liên tục, cá nhân hóa, nên đây là ứng viên lý tưởng cho theo dõi điều trị liên tục.
Hạ tầng dữ liệu
Các hệ thống nghiên cứu ước tính huyết áp tâm thu gián tiếp từ ECG, quang phổ xung (PPG),33 thời gian truyền xung và các đặc trưng nhịp tim (Zhang et al. 2017). Trong một quy trình công việc về tăng huyết áp đã triển khai, các tín hiệu đó có thể được bổ sung bằng dữ liệu từ gia tốc kế để có ngữ cảnh về mức độ hoạt động và nhật ký tự báo cáo việc tuân thủ thuốc. Độ chính xác phụ thuộc vào xác thực, hiệu chuẩn và sự cho phép của cơ quan quản lý; những tuyên bố về thiết bị đeo tay hoặc nhẫn cho người tiêu dùng không nên được coi là đáng tin cậy về mặt lâm sàng nếu thiếu bằng chứng. Khi đã được xác thực cho đúng đối tượng và bối cảnh, luồng dữ liệu đa phương thức này, khi tích hợp với hồ sơ sức khỏe điện tử, có thể làm nền tảng cho các khuyến nghị AI cá nhân hóa.
33 Quang phổ xung (PPG): Kỹ thuật quang học suy ra biến đổi thể tích máu dựa trên sự thay đổi ánh sáng thu được sau khi chiếu sáng mô. Trong vận hành ML, PPG đặt ra một thách thức về chất lượng dữ liệu mà môi trường kiểm soát không có: nhiễu do cử động cổ tay làm hỏng tín hiệu, tạo ra hiện tượng trôi dữ liệu, nơi cùng một trạng thái sinh lý lại cho ra các phân phối đầu vào khác nhau tùy hoạt động của người dùng. Mô hình phải hoặc lọc bỏ các đoạn tín hiệu bị hỏng trước khi suy luận, hoặc học cách chịu nhiễu chuyển động; đồng thời hệ thống giám sát cần phân biệt được thay đổi sinh lý thực sự với dịch chuyển phân phối do nhiễu gây ra.
Zhang, Qingxue, Dian Zhou, and Xuan Zeng. 2017. “Highly Wearable Cuff-Less Blood Pressure and Heart Rate Monitoring with Single-Arm Electrocardiogram and Photoplethysmogram Signals.” BioMedical Engineering OnLine 16 (1): 23. https://doi.org/10.1186/s12938-017-0317-z.
Triển khai vòng lặp
Figure 12 cho thấy hai trong ba vòng lặp phản hồi ở phía trên và cơ chế phối hợp bệnh nhân - bác sĩ lâm sàng ở phía dưới. Khung trên bên trái minh họa vòng lặp điều trị bệnh nhân: bệnh nhân theo dõi huyết áp và nhận các khuyến nghị điều chỉnh liều trong giới hạn an toàn do bác sĩ lâm sàng đặt; những thay đổi lớn cần được phê duyệt rõ ràng. Khung trên bên phải mô tả vòng lặp giám sát của bác sĩ lâm sàng: các bản tóm tắt xu hướng theo thời gian được hệ thống AI gửi cho bác sĩ; bác sĩ đặt giới hạn phê duyệt và nhận cảnh báo về các rủi ro lâm sàng như hạ huyết áp kéo dài hoặc cơn tăng huyết áp. Khung phía dưới thể hiện sự phối hợp bệnh nhân - bác sĩ lâm sàng hình thành khi việc thu thập dữ liệu thường quy được đưa vào vòng lặp AI: các cuộc hẹn chuyển sang thảo luận ở mức độ cao hơn về lối sống và cùng ra quyết định. Vòng lặp thứ ba (phản hồi từ nhà phát triển) không được thể hiện trong hình; nó được trình bày trong section 1.7.2.1 như kênh để các tín hiệu quy trình làm việc thực tế từ cả bệnh nhân và bác sĩ lâm sàng cung cấp thông tin cho việc cải thiện mô hình và giao diện.

Chen, Emma, Shvetank Prakash, Vijay Janapa Reddi, David Kim, and Pranav Rajpurkar. 2023. “A Framework for Integrating Artificial Intelligence for Clinical Care with Continuous Therapeutic Monitoring.” Nature Biomedical Engineering 9 (4): 445–54. https://doi.org/10.1038/s41551-023-01115-0.
Ba bảng này làm rõ ranh giới trách nhiệm: theo dõi thường quy chỉ có thể tự động hóa trong các giới hạn do bác sĩ lâm sàng xác định, còn việc chuyển cấp, xem xét sự kiện bất lợi và cân nhắc đánh đổi trong điều trị vẫn do con người phụ trách. Chính ranh giới đó là điểm mà các thực hành MLOps thông thường cần thêm sự phối hợp lâm sàng, sẽ được tóm tắt ngay sau đây.
So sánh MLOps và ClinAIOps
Trường hợp tăng huyết áp minh họa sự so sánh giữa ClinAIOps và MLOps. MLOps đa dụng cung cấp nền tảng cho vòng đời kỹ thuật; còn triển khai trong môi trường lâm sàng có rủi ro cao cần bổ sung các cấu phần rõ ràng cho việc ra quyết định của con người, bằng chứng và trách nhiệm giải trình.
ClinAIOps vượt ra ngoài hạ tầng kỹ thuật để hỗ trợ các hệ thống kỹ thuật - xã hội phức tạp, đưa machine learning vào những bối cảnh nơi bác sĩ lâm sàng, bệnh nhân và các bên liên quan cùng nhau định hình quyết định điều trị. Table 31 đối chiếu các cách tiếp cận này trên tám khía cạnh.
| Nhấn mạnh MLOps đa năng | Mở rộng ClinAIOps | |
|---|---|---|
| Trọng tâm | Vòng đời mô hình kỹ thuật | Ra quyết định của con người và AI |
| Các bên liên quan | Các nhóm ML, dữ liệu, platform và operations | Bổ sung bệnh nhân, bác sĩ lâm sàng và clinical governance |
| Vòng lặp phản hồi | Monitoring, huấn luyện lại và phát hành | Bổ sung phản hồi từ điều trị, bác sĩ lâm sàng và nhà phát triển |
| Mục tiêu | Các ML operations đáng tin cậy, được quản lý | Hỗ trợ chăm sóc an toàn, hiệu quả và có trách nhiệm |
| Quy trình | Các pipelines tự động và operational controls | Tích hợp clinical workflows và human gates |
| Các cân nhắc về dữ liệu | Nguồn gốc, chất lượng, độ mới và access control | Bổ sung sự đồng ý, clinical provenance và dữ liệu được bảo vệ |
| Xác thực mô hình | Các chỉ số dự đoán, operational và slice-level metrics | Bổ sung clinical utility, an toàn và cohort outcomes |
| Triển khai | Tích hợp kỹ thuật và operational ownership | Bổ sung clinical accountability và stakeholder incentives |
Khác biệt trọng tâm của bảng là: triển khai lâm sàng làm thay đổi ai là người gánh rủi ro. Hiệu suất kỹ thuật vẫn cần, nhưng không đủ khi một khuyến nghị ảnh hưởng đến quyết định chăm sóc. Vì vậy, framework ClinAIOps chuyển ràng buộc chi phối từ hiệu quả thiết bị sang trách nhiệm giải trình lâm sàng. Mô hình tham gia vào quá trình chăm sóc, nhưng không thể nắm quyền quyết định lâm sàng. Mỗi khuyến nghị và hành động tiếp theo của bác sĩ lâm sàng phải truy nguyên được đến các đầu vào liên quan, phiên bản mô hình và phần mềm, cùng siêu dữ liệu đầu ra; nếu không, hệ thống sẽ không thể hỗ trợ kiểm toán, rà soát hoặc phân tích kết quả. Việc tách bạch trách nhiệm trở thành một cơ chế an toàn thay vì chỉ là một lựa chọn thiết kế phần mềm: thu thập dữ liệu tự động từ thiết bị đeo, khuyến nghị của AI, chẩn đoán của bác sĩ lâm sàng, quyết định điều trị và cải tiến quy trình làm việc của nhà phát triển đều cần ranh giới rõ ràng và các điểm phê duyệt của con người tại các thời điểm quyết định then chốt.
Yêu cầu trách nhiệm giải trình tương tự cũng làm thay đổi cách giám sát. Các pipeline dữ liệu lâm sàng được tiêu chuẩn hóa giúp đảm bảo tính nhất quán giữa quá trình huấn luyện và phục vụ (serving). Tuy nhiên, xác thực lâm sàng còn phải so sánh các khuyến nghị với kết quả theo chuẩn chăm sóc, bằng chứng từ các nghiên cứu tiến cứu, và các hiệu ứng đặc thù theo từng nhóm bệnh nhân. Người ta đánh giá mức suy giảm quan sát được thông qua kiểm soát huyết áp, các biến cố bất lợi, các trường hợp bác sĩ ghi đè, và kết quả của các nhóm phụ, chứ không chỉ dựa vào chỉ số của mô hình. Do đó, các vòng lặp phản hồi không phải là nợ kỹ thuật trong bối cảnh này; điều trị bệnh nhân, giám sát của bác sĩ lâm sàng, và các vòng lặp phản hồi của nhà phát triển là những cơ chế có chủ đích nhằm cải thiện chăm sóc, đồng thời vẫn giữ quyền quyết định ở con người. Tự động hóa có cân nhắc chi phí hoạt động trong các “cổng” đó: các bản cập nhật chỉ có thể được tự động hóa khi lợi ích kỳ vọng đủ lớn để bù chi phí xác thực và rủi ro cho bệnh nhân, và các khuyến nghị thận trọng hoặc cờ cảnh báo độ không chắc chắn phải chuyển các trường hợp có độ tin cậy thấp về lại khâu đánh giá lâm sàng.
Tổng hợp nghiên cứu điển hình
Thiết kế lấy cảm hứng từ Oura và các trường hợp ClinAIOps giúp tách bạch các nguyên tắc MLOps ổn định khỏi những ràng buộc khi triển khai, vốn làm thay đổi cách chúng được áp dụng. Vòng đời của chiếc nhẫn giả định là một trường hợp bị giới hạn tài nguyên: hệ thống vận hành phải đảm bảo tính tái tạo, tính nhất quán và khả năng quan sát được suy giảm, trong khi pin, đo từ xa và ground truth kém tin cậy lại hạn chế những gì có thể đo lường và cập nhật ngay trên thiết bị. ClinAIOps là một trường hợp bị giới hạn bởi trách nhiệm giải trình: các nguyên tắc tương tự vẫn áp dụng, nhưng việc xác thực, dấu vết kiểm toán và các bước phê duyệt của con người chi phối vì mô hình ảnh hưởng trực tiếp đến hành động lâm sàng.
Bài học kỹ thuật chung là mức độ trưởng thành trong MLOps không phải nằm ở việc tích lũy công cụ, mà ở khả năng nhận diện ràng buộc chi phối, lựa chọn các kiểm soát vận hành phù hợp, và lưu giữ bằng chứng khi mô hình thay đổi. Các hệ thống ML trong sản xuất có thể thất bại khi các nhóm áp dụng trực giác vận hành tập trung vào mã nguồn mà không tính đến hành vi thống kê và dữ liệu luôn thay đổi; đó là lý do chương này kết lại bằng cách chỉ ra những ngụy biện và cạm bẫy mà hai nghiên cứu điển hình vừa nêu giúp phơi bày.
Self-Check: Question
In the Oura-inspired wearable sleep-tracking case study, how do edge hardware constraints (microcontroller RAM, battery capacity, intermittent Bluetooth connectivity) reshape the implementation of foundational MLOps principles?
- They eliminate the requirement for artifact versioning because firmware cannot be updated over the air
- They require continuous on-device distributed backpropagation to retrain neural networks nightly
- They require lightweight on-device feature extraction, OTA deployment with rollback safety, and batched event telemetry rather than continuous cloud streaming
- They allow the system to bypass training-serving consistency because raw sensor data is processed without filtering
Why does the ClinAIOps clinical AI framework intentionally incorporate clinician-in-the-loop override gates as a core architectural feature rather than viewing human review as a failure of automation?
- Because FDA regulations strictly forbid machine learning algorithms from executing in clinical settings
- Because clinical patient distributions never experience covariate shift or demographic drift
- Because human review eliminates the need for regulatory audit trails or data provenance tracking
- Because in healthcare, the asymmetric cost of diagnostic error involves patient harm, making expert oversight an essential risk-mitigation control in cost-aware automation
In the Oura sleep-stage study, multi-sensor enhancement increased four-stage sleep classification accuracy from \(57\%\) (accelerometer baseline) to \(79\%\), while human polysomnography (PSG) inter-scorer agreement is \(82\%\text{--}83\%\). Calculate the fraction of the addressable gap closed by the enhanced model and explain the systems lesson of comparing model accuracy against human agreement.
True or False: When transitioning an MLOps architecture from a cloud environment to a battery-constrained edge wearable, the foundational principles of reproducibility and consistency are discarded in favor of battery life.
Các ngụy biện và cạm bẫy
Những ngụy biện và cạm bẫy này tóm lược các lỗi phổ biến, làm lãng phí nguồn lực kỹ thuật, gây sự cố sản xuất và khiến độ chính xác suy giảm âm thầm. Mỗi mục được liên kết với các phần cụ thể, nơi giải thích cơ chế gốc rễ và các giải pháp.
Ngụy biện: MLOps chỉ là việc áp dụng các thực hành DevOps truyền thống cho các mô hình machine learning.
Không ít kỹ sư cho rằng các pipeline CI/CD tiêu chuẩn có thể áp dụng trực tiếp cho machine learning, nhưng ML trong môi trường sản xuất cần hạ tầng chuyên biệt. Như section 1.4.2.1 đã chỉ ra, pipeline ML bổ sung các bước như xác thực dữ liệu, huấn luyện mô hình, đánh giá hiệu suất, đăng ký artifact và các cổng triển khai, nên chậm hơn và có trạng thái (stateful) hơn so với các pipeline phần mềm thông thường. DevOps truyền thống có thể phát hành các dịch vụ có tính xác định với tần suất cao; còn các hệ thống ML thiếu công cụ chuyên biệt thường chậm lại vì việc huấn luyện lại và validation đều có trạng thái. Bản thân các công cụ CI/CD tiêu chuẩn không xử lý được feature store, model registry hay phát hiện trôi dạt (drift detection). Một hệ thống khuyến nghị được triển khai chỉ bằng DevOps thông thường có thể mất dần độ chính xác vì pipeline thiếu các kiểm tra tính nhất quán giữa huấn luyện và phục vụ (serving). Các tổ chức áp dụng DevOps mà không điều chỉnh cho ML sẽ tối ưu hóa độ tin cậy của hạ tầng tính toán nhưng bỏ qua các đặc tính thống kê của mô hình, dẫn đến suy giảm mô hình âm thầm, training-serving skew và các lỗi chất lượng dữ liệu vốn vượt qua được các bài kiểm thử thông thường.
Cạm bẫy: Coi việc triển khai mô hình là một sự kiện một lần thay vì một quá trình liên tục.
Các nhóm thường xem việc triển khai là một cột mốc cuối cùng, tương tự như phát hành phần mềm. Nhưng chất lượng mô hình có thể thay đổi khi dữ liệu bị trôi và phân phối dịch chuyển. Section 1.5.3.1 xác lập PSI là một tín hiệu hữu ích để phát hiện dịch chuyển phân phối, với ngưỡng cần được hiệu chỉnh theo đặc trưng và rủi ro kinh doanh; vượt ngưỡng nên kích hoạt điều tra, không phải tự động huấn luyện lại. Một mô hình phát hiện gian lận có thể từ dưới ngưỡng cảnh báo tăng lên trên ngưỡng cần rà soát chỉ trong vài tháng, trong khi các chỉ số kết quả sẽ cho biết liệu độ chính xác ban đầu còn chấp nhận được hay đã suy giảm. Mô hình chi phí được khớp cục bộ trong section 1.4.2.2 đưa ra \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\) theo các giả định của nó. ML trong môi trường sản xuất yêu cầu giám sát liên tục các phân phối đặc trưng và các chỉ số hiệu suất, với việc huấn luyện lại chỉ diễn ra sau khi đã chẩn đoán và xác thực.
Ngụy biện: Huấn luyện lại tự động đảm bảo hiệu suất mô hình tối ưu mà không cần giám sát của con người.
Các kỹ sư thường cho rằng các pipeline tự động có thể xử lý mọi tình huống bảo trì, nhưng tự động hóa không thể phát hiện hết mọi kiểu lỗi. Huấn luyện lại tự động có thể duy trì hoặc khuếch đại độ chệch (bias) trong dữ liệu huấn luyện bị lỗi, kích hoạt cập nhật vào giờ lưu lượng cao điểm, hoặc triển khai mô hình vượt qua kiểm định tổng thể nhưng lại làm giảm chất lượng ở các edge case. Chẳng hạn, một hệ thống khuyến nghị tin tức được huấn luyện lại bằng dữ liệu cuối tuần có thể có mức độ tương tác thấp hơn vào các ngày trong tuần vì hành vi người dùng khác biệt rõ giữa ngày thường và cuối tuần. MLOps hiệu quả cần có quy trình leo thang cho các kết quả kiểm định bất thường, phê duyệt thủ công khi xuất hiện mẫu số liệu lạ, và khả năng ghi đè khi tự động hóa tạo ra kết quả đáng ngờ.
Cạm bẫy: Chỉ tập trung vào cơ sở hạ tầng kỹ thuật mà bỏ qua sự phối hợp về tổ chức và quy trình.
Các tổ chức đầu tư vào các nền tảng MLOps với kỳ vọng công cụ sẽ giải quyết bài toán triển khai, nhưng hạ tầng dù hiện đại đến đâu cũng sẽ thất bại nếu thiếu chuyển đổi văn hóa. MLOps đòi hỏi sự phối hợp chặt chẽ giữa các nhà khoa học dữ liệu (tối ưu độ chính xác), các kỹ sư (ưu tiên độ trễ), và các bên kinh doanh (tập trung vào tác động). Một công ty bán lẻ có thể triển khai kho đặc trưng và kho lưu trữ mô hình nhưng nhịp triển khai vẫn chậm vì các nhà khoa học dữ liệu và kỹ sư làm việc tách rời. Thành công trong MLOps cần các nhóm đa chức năng với mục tiêu chung, luân phiên trực on-call để xây dựng sự thấu hiểu giữa các vai trò, và cơ chế khuyến khích ghi nhận cả độ tin cậy vận hành lẫn hiệu suất mô hình.
Ngụy biện: Môi trường huấn luyện và phục vụ (serving) tự động duy trì tính nhất quán sau khi các pipeline được thiết lập.
Các nhóm thường cho rằng việc tính toán đặc trưng sẽ tạo ra các giá trị giống nhau giữa huấn luyện và phục vụ (serving) sau khi đã thiết lập pipeline ban đầu, nhưng sai lệch giữa huấn luyện và phục vụ lại nảy sinh từ những khác biệt nhỏ trong logic tiền xử lý, cách xử lý múi giờ, hoặc phiên bản phụ thuộc. Section 1.4.1.2 minh họa cách một kho đặc trưng giúp giảm rủi ro này bằng cách tập trung hóa định nghĩa đặc trưng và so sánh phân phối đặc trưng giữa các môi trường. Ví dụ, một mô hình xếp hạng thương mại điện tử tính session_length theo thời gian thực (wall-clock time) khi huấn luyện nhưng lại dùng thời gian xử lý khi phục vụ (serving) có thể bị giảm đáng kể độ chính xác; tình trạng này kéo dài cho đến khi có người trực tiếp so sánh phân phối đặc trưng. Nếu thiếu kho đặc trưng tập trung và cơ chế tự động kiểm tra tính nhất quán, việc phát hiện sai lệch có thể mất hàng tuần, vì sự suy giảm chỉ dần dần hiện ra trong các số liệu tổng hợp.
Cạm bẫy: Cho rằng giám sát toàn diện ngăn chặn mọi sự cố sản xuất.
Nhiều kỹ sư tin rằng có đủ chỉ số và bảng điều khiển là có thể loại bỏ các sự cố bất ngờ. Nhưng giám sát lại tạo ra điểm mù khi các nhóm chỉ theo dõi đầu ra mà không xác thực đầu vào. Section 1.5.3.1 khẳng định rằng xác thực đầu vào có thể phát hiện vấn đề trước khi chúng làm suy giảm dự đoán, thế nhưng trong thực tế nhiều hệ thống ML chỉ giám sát độ chính xác và độ trễ. Một hệ thống khuyến nghị có thể theo dõi tỷ lệ nhấp (click-through rate) nhưng bỏ qua tình trạng đặc trưng bị cũ, và bỏ sót embedding đã lỗi thời hàng giờ do độ trễ sao chép cơ sở dữ liệu. Điều này có thể làm giảm mức độ tương tác trước khi giám sát kết quả kịp phát cảnh báo. Chỉ giám sát đầu ra khiến phát hiện lỗi chậm; bổ sung giám sát chất lượng dữ liệu giúp rút ngắn thời gian phát hiện. ML trong môi trường sản xuất cần giám sát nhiều lớp với các SLO (Service Level Objectives) rõ ràng cho độ tươi dữ liệu, xác thực lược đồ, phân phối đặc trưng, đầu ra mô hình và chỉ số kinh doanh. Bản thân hạ tầng giám sát cũng cần dự phòng để tránh vận hành mù khi nền tảng gặp sự cố.
Ngụy biện: Độ chính xác là tín hiệu trong sản xuất đầu tiên cần giám sát.
Các nhóm thường lắp các bảng điều khiển độ chính xác cho hệ thống sản xuất và cho rằng sự suy giảm sẽ xuất hiện ở đó trước. Tuy nhiên, độ chính xác thường là một chỉ báo trễ. Độ chính xác tổng thể của một mô hình có thể vẫn ổn định ngay cả khi phân phối đầu vào trôi lệch hoặc hành vi của các nhóm con thay đổi. Đến khi độ chính xác suy giảm rõ rệt, sự trôi lệch có thể đã tích lũy trong nhiều tuần. Giám sát phân phối đầu vào bằng PSI hoặc độ phân kỳ KL (section 1.5.3.1) có thể báo hiệu thay đổi sớm hơn và cho phép điều tra; tuy nhiên, kết quả có nhãn và chẩn đoán mới quyết định liệu huấn luyện lại có phù hợp hay không.
Cạm bẫy: Chuyển hướng cảnh báo chỉ báo sớm đến một kênh khác với cảnh báo độ chính xác.
Các nhóm khi gắn các tín hiệu theo dõi drift và độ tươi của dữ liệu thường nối chúng vào một dashboard hoặc một hàng đợi ưu tiên thấp, tách khỏi đường trực xử lý các trường hợp suy giảm độ chính xác. Kết quả là cảnh báo sớm có phát ra nhưng không ai bị gọi. Một chỉ báo sớm chỉ thật sự mua thêm thời gian nếu nó đi vào một đường phản hồi có người chịu trách nhiệm, với mức độ ưu tiên và runbook được hiệu chỉnh theo tác động vận hành của nó; không nhất thiết phải gọi trực với mức khẩn cấp như khi đã xác nhận mất độ chính xác. Mục tiêu vận hành là biến độ chính xác thành tín hiệu xác nhận, chứ không phải dấu hiệu đầu tiên của sự cố — điều này chỉ đúng khi các tín hiệu sớm hơn được xử lý đúng cách.
Tổng hợp lại, những thất bại này cho thấy khả năng quan sát không chỉ là chuyện của dashboard. Các tín hiệu phải bao phủ dữ liệu, mô hình và dịch vụ, rồi đến được những người chịu trách nhiệm phản hồi; kỷ luật vận hành là cầu nối giữa pipeline kỹ thuật và đường phản hồi của con người.
Self-Check: Question
Why is ‘Accuracy is the first production signal to monitor’ classified as a dangerous operational fallacy in ML systems?
- Because neural network accuracy cannot be mathematically computed after model weights are converted to ONNX format
- Because accuracy is a lagging indicator that requires delayed ground-truth labels, whereas input feature drift (e.g., PSI) is a leading indicator that detects distribution shifts before prediction errors occur
- Because traditional infrastructure availability (HTTP 200 responses and uptime) guarantees that model accuracy remains static
- Because input feature distributions never change unless model source code is redeployed
Explain why routing leading-indicator alerts (such as feature drift or data freshness violations) to a low-priority chat channel while paging on-call engineers only for HTTP 500 errors is a critical operational pitfall.
True or False: Unconstrained automated retraining without validation gates or human oversight is guaranteed to maintain optimal model performance in production.
Tóm tắt
MLOps tồn tại vì các hệ thống machine learning tạo thêm những chế độ lỗi vượt ra ngoài phần mềm thông thường. Một máy chủ bị sập sẽ làm bảng điều khiển khả dụng chuyển sang đỏ, nhưng một dịch vụ vẫn khả dụng cũng có thể trả về kết quả sai. Khi mô hình xuống cấp, xuất hiện một chế độ lỗi mang tính thống kê: dự đoán vẫn tiếp tục trong khi độ chính xác dần suy giảm mà không có tín hiệu về khả dụng. Sự khác biệt này giải thích vì sao các thực tiễn vận hành thông thường cần bổ sung kiểm soát cho machine learning và vì sao vận hành machine learning ra đời để lấp khoảng trống về khả năng quan sát đó.
Năm nguyên tắc nền tảng được giới thiệu ở đầu chương (section 1.2.1) cung cấp một framework đánh giá áp dụng cho mọi quy mô và lĩnh vực. Tính tái lập (reproducibility) thông qua versioning giải quyết nguyên nhân gốc của nhiều sự cố sản xuất: các thành phần không được theo dõi như phiên bản dữ liệu, thay đổi cấu hình và sự thay đổi môi trường, khiến việc gỡ lỗi bất khả thi và việc khôi phục không đáng tin cậy. Nguyên tắc tách biệt mối quan tâm (separation of concerns) giúp giới hạn phạm vi ảnh hưởng khi cần thay đổi, ngăn xói mòn ranh giới và chuỗi sửa lỗi có thể biến một vá lỗi cục bộ thành hồi quy trên toàn hệ thống. Nguyên tắc nhất quán (consistency imperative) nhắm vào độ lệch huấn luyện-phục vụ (training-serving skew), một tác nhân âm thầm làm giảm độ chính xác khi cách tính đặc trưng khác nhau giữa các pipeline; các kho đặc trưng (feature stores) tập trung hóa định nghĩa đặc trưng và các đường dẫn phục vụ (serving), dù vậy để đảm bảo đồng nhất vẫn cần kiểm chứng. Khả năng quan sát suy giảm (observable degradation) biến vấn đề trừu tượng về “lỗi âm thầm” thành các cảnh báo có thể hành động thông qua giám sát nhiều lớp, theo dõi độ tươi của dữ liệu, phân phối đặc trưng, đầu ra mô hình và các chỉ số kinh doanh. Tự động hóa có ý thức chi phí (cost-aware automation) thay thế các lịch huấn luyện lại tùy tiện bằng một mô hình chi phí lỗi thời (staleness cost model) được hiệu chỉnh \((T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}})\); việc sử dụng mô hình này phụ thuộc vào các giả định của nó.
Các thành phần hạ tầng được phân tích trong chương này triển khai trực tiếp các nguyên tắc đã nêu ở phần mở đầu, thông qua ba giao diện then chốt. Feature stores và phiên bản hóa dữ liệu xử lý Giao diện Dữ liệu-Mô hình bằng cách giảm bất nhất giữa huấn luyện và phục vụ (serving). Các CI/CD pipelines và registry mô hình xử lý Giao diện Mô hình-Hạ tầng bằng cách đảm bảo tính tái lập và cho phép quay lui. Hệ thống giám sát, incident response frameworks và thực hành trực ban xử lý Giao diện Sản xuất-Giám sát bằng cách khiến các suy giảm trở nên quan sát được và có thể hành động. Framework ra quyết định huấn luyện lại cho phép tự động hóa có cân nhắc chi phí bằng cách nối mức suy giảm đo được với các ngưỡng kinh tế. Các nghiên cứu điển hình cho thấy ràng buộc miền sẽ định hình lại cách triển khai các nguyên tắc mà không thay đổi những nguyên tắc quan trọng: thiết kế lấy cảm hứng từ Oura dùng mức cải thiện độ chính xác ngoại tuyến từ 57 percent lên 79 percent của nghiên cứu để thúc đẩy xác thực và kiểm soát cập nhật có cân nhắc tài nguyên, thay vì tuyên bố một vòng đời sản xuất đã báo cáo. ClinAIOps cho thấy vì sao trong các ứng dụng lâm sàng rủi ro cao, kiểm soát suy giảm mượt mà và giám sát của con người là rất quan trọng; ở đây, ba vòng lặp phản hồi hoạt động như các mẫu kiến trúc thay vì là chi phí vận hành.
Key Takeaways: Sẵn sàng hoàn hảo, sai hoàn toàn
- Hệ thống ML có thể thất bại âm thầm, và các chỉ số drift báo hiệu sự thay đổi: Chất lượng ML có thể suy giảm khi độ phân kỳ phân phối \(\mathcal{D}(P_t \lVert P_0)\) tăng lên, mặc dù chỉ riêng độ phân kỳ không quyết định độ chính xác. Một mô hình có thể duy trì thời gian hoạt động hoàn hảo trong khi độ chính xác giảm. Cần giám sát kết quả, không chỉ theo dõi thời gian hoạt động.
- Sự sai lệch giữa huấn luyện và phục vụ (serving) có thể âm thầm làm thay đổi độ chính xác: Kho đặc trưng giảm sai lệch bằng cách tập trung hóa các định nghĩa đặc trưng và đường dẫn phục vụ (serving), dù vậy để đảm bảo tương đương vẫn cần xác thực.
- Huấn luyện lại là một tối ưu hóa kỹ thuật, không phải phỏng đoán: Hàm chi phí lỗi thời đã được hiệu chỉnh \((T^* \approx \sqrt{2C/(Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma)})\) liên kết tần suất huấn luyện lại với các yếu tố kinh tế định lượng, dựa trên các giả định đã nêu.
- Hãy triển khai theo từng giai đoạn (graduated rollout) và đảm bảo có cơ chế khôi phục (rollback) đã được kiểm thử trước: Các phương pháp triển khai như Canary, blue-green và shadow cần được lựa chọn sao cho phù hợp với mức độ rủi ro của hệ thống. Đồng thời, các chiến lược khôi phục theo tầng (tiered rollback) phải được kiểm thử định kỳ thông qua các buổi diễn tập ứng phó sự cố.
- Đầu tư theo từng giai đoạn: Giám sát và tích hợp/triển khai liên tục thường là những khoản đầu tư ban đầu. Các hệ thống có giá trị cao hoặc rủi ro lớn cần quy trình nghiêm ngặt hơn so với các hệ thống phân tích nội bộ ít ảnh hưởng. Hãy bổ sung kho đặc trưng khi đo lường được độ lệch huấn luyện-phục vụ; và thêm cơ chế huấn luyện lại tự động khi mô hình đã trưởng thành.
- Năm nguyên tắc áp dụng được trên nhiều lĩnh vực: Khả năng tái tạo, phân tách trách nhiệm, tính nhất quán, suy giảm có thể quan sát và tự động hóa có cân nhắc chi phí vẫn không thay đổi; tuy nhiên, các ràng buộc của từng lĩnh vực sẽ làm thay đổi cách chúng được triển khai và hạ tầng hỗ trợ.
- Mức độ trưởng thành trong vận hành cần có lộ trình và mang tính tổ chức: Việc quản lý một mô hình khác hẳn về bản chất so với quản lý nhiều mô hình. Các nguyên tắc vẫn có thể mở rộng, nhưng độ phức tạp tăng lên theo số lượng mô hình. Khi đó, lịch trực chung và các chính sách khuyến khích đồng bộ cũng quan trọng không kém các công cụ hỗ trợ.
Kỷ luật vận hành được trình bày trong chương này giúp phân biệt hệ thống ML trong môi trường sản xuất với các nguyên mẫu trong giai đoạn phát triển. Các nguyên tắc này giúp các chuyên gia chẩn đoán xem liệu sự suy giảm hiệu suất có phải do trôi dữ liệu (kiểm tra phân phối đặc trưng), độ lệch huấn luyện-phục vụ (so sánh các đường dẫn tiền xử lý), nợ cấu hình (kiểm tra lại các thay đổi gần đây) hay vòng lặp phản hồi bị nhiễu (phân tích các mẫu theo thời gian). Các nhóm coi ML sản xuất là “triển khai rồi quên” có thể để mô hình sai trong nhiều tháng trong khi các bảng điều khiển khả dụng vẫn xanh. Khi các hệ thống ML hỗ trợ các quyết định từ phê duyệt khoản vay đến chẩn đoán y tế, kỷ luật vận hành này giúp các tổ chức triển khai chúng một cách có trách nhiệm ở quy mô lớn.
Một hệ thống thông thường có thể đạt trạng thái sẵn sàng hoàn hảo nhưng vẫn trả về kết quả sai. Với mô hình, còn một con đường khác dẫn đến tình trạng đó: mã có thể giữ nguyên từng byte trong khi phân phối dữ liệu ở môi trường triển khai hoặc quan hệ với mục tiêu lại thay đổi, khiến một hệ thống dù có thời gian hoạt động tối đa vẫn sai một cách đầy tự tin nhưng lặng lẽ. Đó là lý do vận hành ML mở rộng phạm vi của vận hành phần mềm. Sự khớp giữa mô hình và thế giới không phải đạt một lần là xong, mà là một chi phí phải trả liên tục, vì trục dữ liệu của D·A·M có thể tiếp tục dịch chuyển. Độ tin cậy phải bao hàm kết quả, không chỉ riêng thời gian hoạt động, và trạng thái nguy hiểm nhất của một hệ thống ML là khi bảng điều khiển vẫn xanh trong khi mô hình đang bị trôi (drift).
What’s Next: Từ độ tin cậy đến trách nhiệm
Một hệ thống ML có thể hiệu quả, có khả năng mở rộng và đáng tin cậy nhưng vẫn có thể gây hại nếu nó khuếch đại độ chệch (bias) hoặc làm rò rỉ dữ liệu. Ngay cả khi đạt thời gian hoạt động 99.9% và độ trễ dưới 10 ms, điều đó cũng không thể khẳng định các quyết định của hệ thống là có trách nhiệm. Kỹ thuật có trách nhiệm đề cập đến ràng buộc cuối cùng: căn chỉnh tối ưu hóa kỹ thuật với các giá trị của con người để những hệ thống được triển khai phục vụ đúng những người chịu tác động từ chúng.
Self-Check: Question
Which architectural pairing correctly matches an MLOps infrastructure component to the critical system interface it primarily safeguards?
- Feature Store -> Data-Model Interface (ensures feature computation parity between offline training and online serving)
- Model Registry -> Production-Monitoring Interface (monitors live concept drift across incoming user traffic)
- Canary Deployment -> Data-Model Interface (tracks historical dataset lineage in cloud object storage)
- Statistical Drift Alerting -> Model-Infrastructure Interface (compiles computational graphs for GPU acceleration)
Synthesize the core message of the chapter captured by the phrase ‘perfectly available, perfectly wrong,’ and explain why MLOps is an essential extension of traditional software reliability.
In the quantitative retraining economics formula \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\), if daily query volume \(Q\) increases by \(4\times\) and daily drift rate \(\gamma\) increases by \(4\times\), the optimal retraining interval \(T^*\) shrinks by a factor of ____.
Self-Check Answers
Self-Check: Answer
A fraud detection service maintains a 12 ms P99 latency, 99.99% server availability, and zero HTTP error responses. However, over six weeks, the true positive rate drops from 96% to 78% due to evolving fraudster tactics. Which operational challenge does this scenario illustrate?
- The hardware compute capacity ceiling between GPU memory and host memory
- The protocol communication overhead between REST endpoints and gRPC streaming
- The operational mismatch between traditional infrastructure availability and statistical predictive correctness
- The serialization throughput bottleneck between CPU preprocessing and accelerator execution
Answer: The correct answer is C. The operational mismatch between traditional infrastructure availability and statistical predictive correctness. Traditional infrastructure monitoring tracks server uptime, request latency, and HTTP status codes, none of which detect statistical decay in model predictions. When fraud patterns evolved, the model failed silently while all infrastructure dashboards remained green. The choices concerning hardware memory capacity ceilings, serialization bottlenecks, and network communication protocols describe systems and computational constraints rather than the statistical observability gap that motivates MLOps.
Learning Objective: Explain how the operational mismatch between infrastructure availability and statistical predictive correctness motivates MLOps
Which scenario represents a direct failure of the Data-Model Interface in a production ML system?
- An inference container crashes upon startup because the host system has an incompatible CUDA driver
- A candidate model deployment is delayed because previous model weights were not cached in warm standby
- A statistical drift alert is routed to an unmonitored ticketing queue instead of the on-call engineer
- An online inference service computes user_session_duration in seconds while the offline training pipeline calculated it in minutes
Answer: The correct answer is D. An online inference service computes user_session_duration in seconds while the offline training pipeline calculated it in minutes. The Data-Model Interface governs feature consistency and transformation alignment between data pipelines and model training/serving; diverging feature definitions between offline and online systems is a textbook failure of this interface. A container crashing due to CUDA driver incompatibilities or delayed deployments due to lack of warm standby are Model-Infrastructure Interface failures. A misrouted drift alert represents a Production-Monitoring Interface failure.
Learning Objective: Classify operational system failures according to the three critical MLOps interfaces
Explain why MLOps treats a deployed model as a closed-loop control system rather than a terminal release pipeline.
Answer: MLOps treats deployment as a closed-loop control system because real-world data distributions drift continuously after launch, causing silent accuracy degradation. A closed-loop system continuously measures model outputs and incoming data distributions via statistical telemetry (sensors), evaluates the economic trade-off of retraining, and triggers automated pipeline execution, validation, and staged rollout (actuators) to maintain predictive quality over time.
Learning Objective: Analyze MLOps as a closed-loop control system that continuously detects degradation and triggers corrective updates
True or False: An ML Node is defined solely as the trained neural network weight file packaged inside a container runtime.
Answer: False. An ML Node is the complete, self-contained operational unit for a single machine learning application, encompassing data ingestion pipelines, feature computation, model training, serving infrastructure, and monitoring/telemetry systems. Packaging weights in a container is only a single component of the Model-Infrastructure layer.
Learning Objective: Define the operational scope and architectural components comprising a single ML Node
Self-Check: Answer
A production recommendation service processes \(Q = 2 \times 10^6\) queries per day. Due to a feature encoding discrepancy between offline training and online serving, \(\text{Rate}_{\text{skew}} = 0.005\) (\(0.5\%\) of queries) receive incorrect predictions, each causing an estimated business loss of \(C_{\text{error}} = \$0.20\). Using the chapter’s skew-cost equation, what is the annual financial impact of this inconsistency over a 365-day year?
- \(\$730,000\) per year
- \(\$73,000\) per year
- \(\$200,000\) per year
- \(\$36,500\) per year
Answer: The correct answer is A. \(\$730,000\) per year. The skew cost equation is \(\text{Skew Cost} = \text{Rate}_{\text{skew}} \times Q \times C_{\text{error}} \times \text{Days}\). Substituting the parameters: \(\text{Daily Cost} = 0.005 \times (2 \times 10^6) \times \$0.20 = 10,000 \times \$0.20 = \$2,000/\text{day}\). Multiplying across 365 days yields \(\$2,000 \times 365 = \$730,000/\text{year}\). The choice of \(\$73,000\) underestimates the daily volume by a factor of 10, while \(\$36,500\) and \(\$200,000\) fail to reflect the compound product of daily query volume, skew error rate, error cost, and days in a year.
Learning Objective: Calculate the annualized financial impact of training-serving skew using the skew cost equation
A team versions its model training code in Git, but datasets are pulled dynamically from unversioned live database queries and training hyperparameters are passed via ad hoc shell flags. Which foundational MLOps principle is violated, and what formal dependency does this break?
- Observable degradation; it prevents inference proxies from logging P99 latency percentiles
- Reproducibility; it breaks the requirement that Model Output is a deterministic function of versioned Code, Data, Config, and Environment artifacts
- Separation of concerns; it couples feature transformation code with neural loss calculation
- Cost-aware automation; it prevents the workload scheduler from executing batch inference
Answer: The correct answer is B. Reproducibility; it breaks the requirement that Model Output is a deterministic function of versioned Code, Data, Config, and Environment artifacts. Reproducibility formalizes model behavior as \(\text{Model Output} = f(\text{Code}_v, \text{Data}_v, \text{Config}_v, \text{Environment}_v; \xi)\). When dataset snapshots and configurations are unversioned, the model cannot be audited, reproduced, or safely rolled back. Observable degradation addresses runtime telemetry rather than artifact provenance. Separation of concerns manages functional layer boundaries. Cost-aware automation optimizes economic retraining decisions.
Learning Objective: Apply the formal model reproducibility dependency to identify artifact versioning violations
Explain how the principle of ‘Separation of Concerns’ across the four MLOps functional layers (Data, Training, Serving, Monitoring) limits the blast radius of operational updates.
Answer: Separation of concerns isolates the Data Layer (feature storage and transformation), Training Layer (model architecture and hyperparameter optimization), Serving Layer (low-latency inference and scaling), and Monitoring Layer (drift detection and alerting) behind modular interfaces. This allows each layer to evolve at its own natural cadence without breaking adjacent layers: serving infrastructure can scale or update runtimes without model retraining, and drift thresholds can be calibrated without redeploying serving containers.
Learning Objective: Analyze how the separation of concerns across MLOps functional layers isolates faults and enables independent component evolution
**An engineering team is designing a triage sequence to respond to an unexpected drop in business conversion for a production ML model. Place the five foundational MLOps principles in the operational sequence in which the team should apply them during the incident investigation:
- Consistency: Verify whether feature computation logic and schemas match between training and serving.
- Cost-aware automation: Evaluate whether expected accuracy gains justify the compute cost and deployment risk of retraining.
- Observable degradation: Analyze real-time statistical telemetry and drift metrics to identify the failure signature.
- Separation of concerns: Isolate the fault to a specific functional layer (Data, Training, Serving, or Monitoring).
- Reproducibility: Reconstruct the exact model, data snapshot, configuration, and environment of the running deployment.**
Answer: The correct sequence is: (5) Reproducibility -> (4) Separation of concerns -> (1) Consistency -> (3) Observable degradation -> (2) Cost-aware automation. The team must first reconstruct the deployed artifact state via (5) Reproducibility, then isolate which layer failed via (4) Separation of concerns. Next, they verify training-serving feature alignment via (1) Consistency, inspect drift and telemetry signatures via (3) Observable degradation, and finally decide if intervention is economically justified via (2) Cost-aware automation.
Learning Objective: Apply the five foundational MLOps principles in a structured incident response sequence
The formal decision gate governing whether a degraded model should be retrained balances expected accuracy improvement against training compute costs and deployment risk under the principle of ____.
Answer: Cost-aware automation (or Cost-Aware Automation). Cost-aware automation states that retraining should only be triggered when the expected accuracy gain multiplied by the value per point exceeds the sum of training compute costs and deployment risk.
Learning Objective: Identify the principle of cost-aware automation as the decision framework for model retraining
Self-Check: Answer
According to Sculley et al. (2015), why is technical debt in machine learning systems fundamentally more challenging to detect and manage than conventional software debt?
- Because ML frameworks prevent developers from running unit tests or continuous integration jobs
- Because ML algorithms require more lines of raw mathematical code than supporting infrastructure software
- Because ML debt accumulates through implicit statistical relationships, data dependencies, and feedback loops that degrade predictive accuracy silently without throwing runtime exceptions
- Because neural network parameters cannot be serialized to disk or stored in artifact registries
Answer: The correct answer is C. Because ML debt accumulates through implicit statistical relationships, data dependencies, and feedback loops that degrade predictive accuracy silently without throwing runtime exceptions. In ML systems, ML code is only a tiny fraction (often under 5%) of the overall system, which is dominated by data collection, verification, feature extraction, and monitoring infrastructure. Debt in ML lives primarily in data distributions, undeclared consumers, and statistical entanglement, causing predictive failure while systems remain available and pass standard code-level tests. The assertions that ML code dominates codebase volume, that unit tests are unsupported, or that weights cannot be serialized are factually incorrect.
Learning Objective: Distinguish ML-specific technical debt from traditional software technical debt
A data engineering team spends 6 hours per week manually extracting features, executing training runs, and validating a customer churn model. Building an automated CI/CD retraining pipeline requires a one-time upfront investment of 120 engineering hours. What is the breakeven time for this automation investment, and what long-term capacity risk arises if the team remains manual?
- Breakeven is 6 weeks; manual processes remain more cost-effective for multi-model deployments
- Breakeven is 10 weeks; automated pipelines eliminate the need for future model monitoring
- Breakeven is 40 weeks; manual maintenance has zero ongoing engineering cost after the first year
- Breakeven is 20 weeks; manual maintenance scales linearly with the number of deployed models until engineering capacity is fully consumed by routine operations
Answer: The correct answer is D. Breakeven is 20 weeks; manual maintenance scales linearly with the number of deployed models until engineering capacity is fully consumed by routine operations. The breakeven period is calculated as \(\text{Upfront Investment} / \text{Weekly Manual Work} = 120\text{ hours} / 6\text{ hours/week} = 20\text{ weeks}\). Beyond 20 weeks, manual operations incur over 300 hours of recurring maintenance annually per model. In expanding fleets, manual maintenance hits a capacity ceiling where engineers spend all their time maintaining legacy models and cannot build new capabilities. The calculation of 6, 10, or 40 weeks incorrectly divides the investment hours or makes invalid claims about eliminating monitoring or recurring costs.
Learning Objective: Calculate the breakeven time for pipeline automation and evaluate the engineering capacity ceiling of manual ML operations
Explain why ‘correction cascades’ create a severe maintenance trap in production ML architectures, and state the primary architectural remedy.
Answer: A correction cascade occurs when auxiliary models are trained sequentially to correct the residual errors of an upstream base model (e.g., Model B corrects Model A, and Model C corrects Model B). Because each downstream model relies on the exact error distribution of its predecessor, updating or fixing the upstream model invalidates all downstream models simultaneously, forcing an expensive, coordinated retraining of the entire chain. The architectural remedy is to eliminate corrective patching chains, retrain the foundational base model directly on a unified objective, and maintain clean modular version boundaries.
Learning Objective: Analyze how correction cascades create fragile dependency chains and explain architectural methods to eliminate them
True or False: In production ML systems, ‘glue code’ refers to the core machine learning algorithm, which typically comprises over 90% of the total system codebase.
Answer: False. Glue code refers to the integration code required to connect general-purpose ML libraries with data pipelines and serving infrastructure. In production ML systems, glue code and supporting infrastructure typically comprise up to 95% of the codebase, while the actual ML algorithmic code accounts for only about 5%.
Learning Objective: Evaluate the role and proportion of glue code versus core algorithmic code in production ML systems
The systemic vulnerability where modifying a single input feature’s distribution or encoding alters the learned weights and contributions of all other features across an ML pipeline is known as the ____ principle.
Answer: CACE (or Change Anything Changes Everything). The CACE principle captures boundary erosion and statistical entanglement in ML systems, where local changes propagate globally through learned feature correlations.
Learning Objective: Identify the CACE principle as the governing dynamic of boundary erosion and feature entanglement
Self-Check: Answer
A fraud detection system serves \(Q = 10^6\) queries/day with baseline accuracy \(\text{Accuracy}_0 = 0.95\), daily accuracy decay rate \(\gamma = 0.02\) (\(2\%\) decay per day), value per query for unit accuracy fraction \(V = \$0.50\), and fixed retraining cost \(C = \$5,000\). Using the square-root optimal retraining approximation \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\), what is the economically optimal retraining interval \(T^*\)?
- Approximately \(1.0\) day
- Approximately \(5.2\) days
- Approximately \(14.5\) days
- Approximately \(30.0\) days
Answer: The correct answer is A. Approximately \(1.0\) day. Using the formula \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\): Numerator \(= 2 \times 5,000 = 10,000\). Denominator \(= 10^6 \times 0.50 \times 0.95 \times 0.02 = 500,000 \times 0.019 = 9,500\). Ratio \(= 10,000 / 9,500 \approx 1.0526\). Taking the square root: \(T^* \approx \sqrt{1.0526} \approx 1.026\text{ days} \approx 1.0\text{ day}\). Given the high daily query volume and rapid drift penalty, the economic cost of prediction staleness compounds so rapidly that daily automated retraining is justified. Choices of 5.2, 14.5, or 30.0 days fail to balance the quadratic growth of staleness losses against fixed retraining costs.
Learning Objective: Compute the economically optimal retraining interval using the quantitative retraining economics formula
In the optimal retraining formula \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\), how does the optimal interval \(T^*\) change if the fixed retraining compute and validation cost \(C\) increases by a factor of 4 while all other parameters remain constant?
- \(T^*\) increases by a factor of 4 (\(4\times\) longer interval), scaling linearly with cost
- \(T^*\) increases by a factor of 2 (\(2\times\) longer interval), because \(T^*\) scales with the square root of retraining cost \(\sqrt{C}\)
- \(T^*\) decreases by a factor of 2 (\(0.5\times\) shorter interval), forcing more frequent retraining
- \(T^*\) remains unchanged, because optimal retraining cadence is governed solely by query traffic and drift rate
Answer: The correct answer is B. \(T^*\) increases by a factor of 2 (\(2\times\) longer interval), because \(T^*\) scales with the square root of retraining cost \(\sqrt{C}\). In the formula, the retraining cost \(C\) appears under the radical in the numerator: \(\sqrt{4C} = 2\sqrt{C}\). A fourfold increase in retraining cost makes frequent retraining economically prohibitive, doubling the optimal time interval between retraining runs. The option claiming a \(4\times\) increase ignores the square-root dependency, while decreasing the interval or asserting no change violates the mathematical structure of the cost optimization.
Learning Objective: Perform sensitivity analysis on the optimal retraining interval with respect to retraining costs
Explain how a centralized feature store’s point-in-time (time-travel) query capability prevents data leakage during model training.
Answer: Point-in-time queries join feature values as of the exact historical timestamp of each training event rather than using current feature values. This prevents future information (data leakage) from contaminating training datasets, ensuring that the model is trained only on the feature state that was realistically available at the moment the prediction would have been made.
Learning Objective: Explain how feature store point-in-time correctness prevents data leakage in offline model training
**An automated MLOps continuous training and delivery pipeline executes upon receiving a drift alert. Place the following pipeline stages in their correct execution order:
- Data Validation Gate: Run schema and statistical boundary checks on newly ingested data.
- Staged Rollout / Canary Deployment: Route a small percentage of live production traffic to the new model.
- Model Training & Hyperparameter Optimization: Train candidate model weights on the validated dataset.
- Model Evaluation & Guardrail Gate: Evaluate candidate model against golden test slices and latency SLOs.
- Model Registry Registration: Tag and store the validated model binary, metadata, and container hash.**
Answer: The correct sequence is: (1) Data Validation Gate -> (3) Model Training & Hyperparameter Optimization -> (4) Model Evaluation & Guardrail Gate -> (5) Model Registry Registration -> (2) Staged Rollout / Canary Deployment. The pipeline must first validate input data via (1), train candidate weights via (3), verify accuracy and guardrails via (4), register the approved artifact via (5), and finally deploy via staged canary release via (2).
Learning Objective: Design the end-to-end execution sequence of an automated continuous ML training and deployment pipeline
True or False: In automated ML pipelines, a ‘reproducibility failure’ and an ‘operational idempotence failure’ describe the exact same defect.
Answer: False. A reproducibility failure occurs when identical code, data, and configuration produce divergent model weights or metrics due to unpinned random seeds or non-deterministic GPU kernels. An operational idempotence failure occurs when retrying a pipeline run produces unintended duplicate side effects (such as creating duplicate model registry versions or appending duplicate database entries).
Learning Objective: Differentiate reproducibility failures from operational idempotence failures in automated ML workflows
Self-Check: Answer
An engineering team needs to evaluate the live inference latency, resource consumption, and numerical output distribution of a new deep recommender against live production traffic without exposing users to potential prediction quality regressions. Which deployment pattern should they select?
- Canary deployment, routing 5% of user-facing production traffic directly to the candidate model
- Blue-green deployment, performing an immediate router-level cutover of 100% of user traffic
- Shadow deployment, asynchronously duplicating live production traffic to the candidate model while returning only the incumbent model’s predictions to users
- In-place deployment, updating the model weights directly on active production inference servers
Answer: The correct answer is C. Shadow deployment, asynchronously duplicating live production traffic to the candidate model while returning only the incumbent model’s predictions to users. Shadow deployment mirrors real-world traffic to the candidate model in the background, logging predictions and measuring latency without ever exposing users to candidate outputs, achieving zero operational and business risk. Canary deployment routes live users directly to the candidate model, exposing a subpopulation to potential regressions. Blue-green deployment flips all live traffic at once. In-place deployment lacks safety isolation and instant rollback capability.
Learning Objective: Select appropriate model deployment patterns based on risk tolerance and operational verification requirements
A real-time inference service has a 100 ms P99 latency SLO partitioned as: Network RTT (15 ms), Feature retrieval (25 ms), Request parsing (5 ms), Model inference (45 ms), Postprocessing (5 ms), and Response serialization (5 ms). If the team applies weight quantization and kernel fusion to achieve a 2x speedup on model inference (reducing it from 45 ms to 22.5 ms), what is the new end-to-end P99 latency and overall system speedup?
- 50.0 ms total latency, resulting in a 2.0x end-to-end speedup
- 22.5 ms total latency, because inference was the sole target of optimization
- 95.0 ms total latency, because non-inference stages expand to consume the budget
- 77.5 ms total latency, resulting in approximately 1.3x end-to-end speedup
Answer: The correct answer is D. 77.5 ms total latency, resulting in approximately 1.3x end-to-end speedup. Model inference represents 45% of the 100 ms budget (45 ms / 100 ms). A 2x model speedup reduces inference execution time to \(45 / 2 = 22.5\text{ ms}\). Non-inference stages remain unchanged at \(15 + 25 + 5 + 5 + 5 = 55\text{ ms}\). The new end-to-end latency is \(55 + 22.5 = 77.5\text{ ms}\). The end-to-end speedup is \(100\text{ ms} / 77.5\text{ ms} \approx 1.29\times \approx 1.3\times\), as governed by Amdahl’s Law. Optimizing the model in isolation cannot overcome bottlenecks in feature retrieval or networking. The option claiming a 2.0x overall speedup ignores Amdahl’s Law, while 22.5 ms ignores non-inference stages and 95.0 ms miscalculates the savings.
Learning Objective: Apply latency budget decomposition and Amdahl’s Law to calculate end-to-end serving speedups
Explain why high-stakes production ML systems (such as medical diagnosis or loan underwriting) experience a ‘verification gap’ and describe how leading indicators mitigate this challenge.
Answer: A verification gap occurs when ground-truth labels arrive with substantial real-world delay (e.g., loan defaults take months or years to materialize), preventing immediate calculation of true accuracy metrics. Leading indicators—such as feature distribution drift (PSI, KS test, Wasserstein distance), prediction confidence distributions, and schema validation—provide real-time statistical signals of distribution shifts without waiting for delayed labels, enabling proactive investigation before business harm occurs.
Learning Objective: Analyze the verification gap caused by label delay and explain the role of leading indicators in drift monitoring
**A production ML monitoring pipeline processes streaming inference requests. Place the following monitoring checks in the logical order of the monitoring hierarchy, from earliest input validation to downstream business verification:
- Model Output & Confidence Distribution Tracking: Log prediction distributions and softmax confidence scores.
- Business KPI & Outcome Metric Evaluation: Correlate delayed ground-truth labels with conversion or default rates.
- Infrastructure Health & Latency Telemetry: Measure CPU/GPU utilization, memory bandwidth, and P99 latency.
- Input Schema & Null Value Validation: Verify column types, required fields, and physical range bounds.
- Feature Distribution Drift Quantification: Compute PSI, KS statistics, or Wasserstein distance against baseline training distributions.**
Answer: The correct sequence is: (4) Input Schema & Null Value Validation -> (5) Feature Distribution Drift Quantification -> (3) Infrastructure Health & Latency Telemetry -> (1) Model Output & Confidence Distribution Tracking -> (2) Business KPI & Outcome Metric Evaluation. Requests are first verified for structural schema correctness via (4), then statistical feature drift via (5). System runtime latency and utilization are tracked during execution via (3), followed by model output/confidence logging via (1), and finally downstream business outcome and label evaluation via (2).
Learning Objective: Organize layered ML monitoring checks across input data, infrastructure, model outputs, and delayed business outcomes
True or False: An inference server displaying 95% GPU compute utilization and 30% HBM memory bandwidth utilization should be optimized primarily by applying weight quantization to reduce memory bus traffic.
Answer: False. High GPU compute utilization (95%) with low memory bandwidth utilization (30%) indicates a compute-bound workload governed by arithmetic processing limits (\(O / (R_{\text{peak}} \cdot \eta_{\text{hw}})\)). It should be optimized via kernel fusion, Tensor Core utilization, or faster compute hardware, whereas quantization primarily alleviates memory-bandwidth bottlenecks.
Learning Objective: Analyze compute versus memory-bandwidth bottlenecks from GPU telemetry using the Iron Law of ML Systems
In statistical drift monitoring, a Population Stability Index value of \(\text{PSI} >\) ____ is the standard operational threshold indicating a significant distribution shift that requires investigation.
Answer: 0.25 (or 0.25 threshold). PSI conventions classify \(\text{PSI} < 0.10\) as stable, \(0.10 \le \text{PSI} \le 0.25\) as moderate shift, and \(\text{PSI} > 0.25\) as significant distribution shift requiring root-cause investigation.
Learning Objective: Identify standard Population Stability Index (PSI) operational thresholds for feature drift alerting
Self-Check: Answer
What fundamental reliability concept is illustrated by the ‘Uptime Iceberg’ metaphor in production machine learning systems?
- Traditional service availability (uptime and low latency) is only the visible tip; hidden failures like feature drift, concept drift, schema corruption, and subpopulation degradation lurk beneath the surface
- Distributed feature retrieval latency over wide-area networks always exceeds local GPU inference execution time
- Data center cooling overhead exceeds the total electrical power consumed by GPU inference accelerators
- Deep neural network weight storage in DRAM requires larger memory allocations than raw training dataset storage
Answer: The correct answer is A. Traditional service availability (uptime and low latency) is only the visible tip; hidden failures like feature drift, concept drift, schema corruption, and subpopulation degradation lurk beneath the surface. The Uptime Iceberg illustrates that an ML service can maintain 99.99% uptime and green infrastructure dashboards while serving completely invalid or degraded predictions due to data outages, schema changes, or drift. Comprehensive MLOps must monitor all three tiers: Service Health, Data Health, and Model Health. The alternative choices introduce unrelated network latency, thermodynamic cooling, or memory storage claims.
Learning Objective: Explain why service uptime is an insufficient measure of ML system health using the Uptime Iceberg model
An organization with limited engineering resources is deploying its first production ML model. Based on the chapter’s investment economics framework, which staging sequence provides the most cost-effective path to reliability?
- Construct an enterprise-wide multi-region distributed feature store and autonomous retraining cluster before deploying the initial model
- Invest first in statistical monitoring and basic CI/CD deployment pipelines, then add centralized feature stores and automated retraining as model scale and drift warrant
- Procure an all-in-one commercial MLOps platform suite to eliminate cross-functional on-call rotations
- Defer all monitoring and automation investments until multiple major production outages have occurred
Answer: The correct answer is B. Invest first in statistical monitoring and basic CI/CD deployment pipelines, then add centralized feature stores and automated retraining as model scale and drift warrant. Monitoring provides immediate visibility into silent statistical failure, and CI/CD ensures safe, reproducible releases. Complex infrastructure like enterprise feature stores and closed-loop continuous retraining should be added incrementally as traffic volume, training-serving skew, and model criticality justify the capital investment. Building heavy enterprise infrastructure upfront over-engineers before validating value, while purchasing platforms to avoid on-call rotations represents a tool-first anti-pattern.
Learning Objective: Prioritize staged MLOps infrastructure investments based on ROI and operational risk
Describe the organizational anti-pattern of ‘tossing models over the wall’ between data scientists and software engineers, and explain how a cross-functional or federated MLOps structure resolves it.
Answer: ‘Tossing models over the wall’ occurs when data scientists build models in isolation and hand unoptimized code or raw weights to software engineers to deploy. Data scientists lack visibility into production latency budgets, memory limits, and runtime dependencies, while software engineers lack the statistical context to diagnose data drift or training-serving skew. A federated MLOps structure resolves this by embedding MLOps engineers within cross-functional product squads, establishing shared ownership of the entire lifecycle (from feature design and training to deployment, monitoring, and on-call response).
Learning Objective: Analyze organizational anti-patterns in MLOps and evaluate cross-functional ownership structures
**An engineering team is assessing the operational maturity of an ML deployment. Place the three operational maturity stages in order from least mature to most mature:
- Repeatable: Version-controlled training scripts, scheduled batch retraining jobs, centralized model registry, and basic performance monitoring.
- Scalable: Unified feature store enforcing training-serving parity, closed-loop drift detection with automated canary validation, and infrastructure-as-code.
- Ad Hoc: Hand-crafted Jupyter notebooks, local training on developer machines, manual pickle file deployment, and absence of formal versioning.**
Answer: The correct sequence is: (3) Ad Hoc -> (1) Repeatable -> (2) Scalable. An organization begins with (3) Ad Hoc manual workflows, matures into (1) Repeatable structured pipelines with centralized storage, and reaches (2) Scalable operations with automated closed-loop validation and unified feature management.
Learning Objective: Classify organizational ML system practices across the three levels of operational maturity
Self-Check: Answer
In the Oura-inspired wearable sleep-tracking case study, how do edge hardware constraints (microcontroller RAM, battery capacity, intermittent Bluetooth connectivity) reshape the implementation of foundational MLOps principles?
- They eliminate the requirement for artifact versioning because firmware cannot be updated over the air
- They require continuous on-device distributed backpropagation to retrain neural networks nightly
- They require lightweight on-device feature extraction, OTA deployment with rollback safety, and batched event telemetry rather than continuous cloud streaming
- They allow the system to bypass training-serving consistency because raw sensor data is processed without filtering
Answer: The correct answer is C. They require lightweight on-device feature extraction, OTA deployment with rollback safety, and batched event telemetry rather than continuous cloud streaming. Extreme edge constraints mean continuous high-frequency telemetry upload would exhaust battery life in hours, and microcontroller memory limits prohibit complex on-device training. MLOps adapts by running lightweight quantized models on-device, batching telemetry syncs, and ensuring robust Over-The-Air (OTA) firmware release validation. The claims that OTA eliminates versioning, that on-device backpropagation is used on microcontrollers, or that training-serving consistency can be ignored are false.
Learning Objective: Analyze how edge hardware constraints reshape the implementation of foundational MLOps principles
Why does the ClinAIOps clinical AI framework intentionally incorporate clinician-in-the-loop override gates as a core architectural feature rather than viewing human review as a failure of automation?
- Because FDA regulations strictly forbid machine learning algorithms from executing in clinical settings
- Because clinical patient distributions never experience covariate shift or demographic drift
- Because human review eliminates the need for regulatory audit trails or data provenance tracking
- Because in healthcare, the asymmetric cost of diagnostic error involves patient harm, making expert oversight an essential risk-mitigation control in cost-aware automation
Answer: The correct answer is D. Because in healthcare, the asymmetric cost of diagnostic error involves patient harm, making expert oversight an essential risk-mitigation control in cost-aware automation. In clinical systems, catastrophic failure costs mean cost-aware automation balances operational efficiency against patient safety. Clinician override gates allow AI to automate routine triage while ensuring that ambiguous, anomalous, or high-risk cases receive expert medical review. Regulations do not forbid ML, clinical distributions drift frequently, and audit trails remain strictly mandatory.
Learning Objective: Evaluate the role of human-in-the-loop oversight in cost-aware automation for safety-critical domains
In the Oura sleep-stage study, multi-sensor enhancement increased four-stage sleep classification accuracy from \(57\%\) (accelerometer baseline) to \(79\%\), while human polysomnography (PSG) inter-scorer agreement is \(82\%\text{--}83\%\). Calculate the fraction of the addressable gap closed by the enhanced model and explain the systems lesson of comparing model accuracy against human agreement.
Answer: The addressable gap between the \(57\%\) baseline and human agreement (\(82\%\text{--}83\%\)) is \(82 - 57 = 25\text{ percentage points}\) (low ceiling) to \(83 - 57 = 26\text{ percentage points}\) (high ceiling). The enhanced model achieved a \(79 - 57 = 22\text{ percentage point}\) gain, closing \(22 / 26 \approx 84.6\%\) to \(22 / 25 = 88.0\%\) of the addressable gap. The systems lesson is that ground-truth labels derived from human expert consensus carry inherent variance; recognizing the \(82\%\text{--}83\%\) human agreement ceiling establishes rational stopping criteria for retraining and prevents teams from overfitting to noisy reference labels.
Learning Objective: Calculate validation gap closure against human agreement baselines and apply label uncertainty to retraining decisions
True or False: When transitioning an MLOps architecture from a cloud environment to a battery-constrained edge wearable, the foundational principles of reproducibility and consistency are discarded in favor of battery life.
Answer: False. The five foundational MLOps principles (reproducibility, separation of concerns, consistency, observable degradation, cost-aware automation) remain universal across domains; edge constraints reshape how they are implemented (e.g., using OTA firmware versioning and quantized preprocessing parity) without discarding the principles themselves.
Learning Objective: Compare how domain constraints alter the technical implementation of universal MLOps principles
Self-Check: Answer
Why is ‘Accuracy is the first production signal to monitor’ classified as a dangerous operational fallacy in ML systems?
- Because neural network accuracy cannot be mathematically computed after model weights are converted to ONNX format
- Because accuracy is a lagging indicator that requires delayed ground-truth labels, whereas input feature drift (e.g., PSI) is a leading indicator that detects distribution shifts before prediction errors occur
- Because traditional infrastructure availability (HTTP 200 responses and uptime) guarantees that model accuracy remains static
- Because input feature distributions never change unless model source code is redeployed
Answer: The correct answer is B. Because accuracy is a lagging indicator that requires delayed ground-truth labels, whereas input feature drift (e.g., PSI) is a leading indicator that detects distribution shifts before prediction errors occur. Measuring accuracy requires ground truth, which often arrives with days, weeks, or months of delay (the verification gap). Monitoring input distributions, feature freshness, and prediction confidence acts as a leading indicator, detecting distribution shifts in real time before customer-facing accuracy degrades. The assertions regarding ONNX conversion, uptime guaranteeing accuracy, or static input distributions are common misconceptions.
Learning Objective: Differentiate leading indicators (input drift) from lagging indicators (accuracy) in production ML monitoring
Explain why routing leading-indicator alerts (such as feature drift or data freshness violations) to a low-priority chat channel while paging on-call engineers only for HTTP 500 errors is a critical operational pitfall.
Answer: Routing leading-indicator alerts to low-priority, unowned channels ensures they will be ignored, allowing data corruption, schema changes, and statistical drift to accumulate silently. By the time customer complaints or business KPI drops trigger urgent investigation, the model has been serving corrupted predictions for weeks. Leading indicators must be connected to defined operational owners, calibrated severity tiers, and actionable response runbooks.
Learning Objective: Analyze the operational pitfall of routing leading-indicator alerts to unowned communication channels
True or False: Unconstrained automated retraining without validation gates or human oversight is guaranteed to maintain optimal model performance in production.
Answer: False. Unconstrained automated retraining can perpetuate self-reinforcing feedback loops and entrench bias, or retrain on corrupted data during transient data pipeline glitches, deploying degraded models that pass naive aggregate loss checks.
Learning Objective: Identify failure modes of unconstrained automated retraining and explain the necessity of validation gates
Self-Check: Answer
Which architectural pairing correctly matches an MLOps infrastructure component to the critical system interface it primarily safeguards?
- Feature Store -> Data-Model Interface (ensures feature computation parity between offline training and online serving)
- Model Registry -> Production-Monitoring Interface (monitors live concept drift across incoming user traffic)
- Canary Deployment -> Data-Model Interface (tracks historical dataset lineage in cloud object storage)
- Statistical Drift Alerting -> Model-Infrastructure Interface (compiles computational graphs for GPU acceleration)
Answer: The correct answer is A. Feature Store -> Data-Model Interface (ensures feature computation parity between offline training and online serving). The Data-Model Interface governs feature consistency and transformation alignment between data pipelines and model training/serving, which feature stores directly address. Model registries and canary deployment pipelines safeguard the Model-Infrastructure Interface. Drift monitors, telemetry, and on-call alerting safeguard the Production-Monitoring Interface. The other pairings misalign the infrastructure components with their corresponding interfaces.
Learning Objective: Map core MLOps infrastructure components to the three critical system interfaces
Synthesize the core message of the chapter captured by the phrase ‘perfectly available, perfectly wrong,’ and explain why MLOps is an essential extension of traditional software reliability.
Answer: Traditional software reliability defines health through deterministic availability: servers respond with HTTP 200s, uptime reaches 99.99%, and latency stays within SLO bounds. However, an ML system can be 100% available while producing completely wrong or harmful predictions because real-world data distributions drift away from the training baseline. MLOps extends software engineering by closing this verification gap—introducing statistical telemetry, feature consistency enforcement, drift detection, and economic retraining loops to ensure that production systems remain not only available, but predictively correct over time.
Learning Objective: Synthesize the core thesis of MLOps as closing the verification gap between service availability and predictive correctness
In the quantitative retraining economics formula \(T^* \approx \sqrt{\frac{2C}{Q \cdot V \cdot \text{Accuracy}_0 \cdot \gamma}}\), if daily query volume \(Q\) increases by \(4\times\) and daily drift rate \(\gamma\) increases by \(4\times\), the optimal retraining interval \(T^*\) shrinks by a factor of ____.
Answer: 4 (or four, or 0.25x). In the denominator under the square root, the product \(Q \cdot \gamma\) increases by \(4 \times 4 = 16\). Taking the square root gives \(\sqrt{16} = 4\). Because this term is in the denominator, the optimal retraining interval \(T^*\) becomes \(1/4\) of its original length, requiring four times more frequent retraining.
Learning Objective: Apply the retraining economics scaling formula to calculate compound changes in traffic and drift rates